이 글에서 다루는 것
"Apache httpd 소스 파헤치기" 연재의 여덟 번째 글입니다. 5편에서는 main() 이 설정을 읽고 나서 ap_run_mpm() 을 부르면, 그 안에서 MPM 이 자식 프로세스를 띄우고 신호를 기다린다는 데까지 봤습니다. 이번 글은 그 ap_run_mpm() 의 안쪽, 접속을 받아 누구에게 맡길지 정하는 부품을 엽니다.
답하려는 질문은 네 가지입니다.
- MPM 은 무엇이고, 왜
LoadModule한 줄로 갈아 끼울 수 있는가 - prefork, worker, event 는 접속 하나를 받아 처리하는 방식이 어떻게 다른가 — 특히 event 는 놀고 있는 keep-alive 연결을 어떻게 다루는가
- 부모 프로세스는 자식을 언제 늘리고 언제 줄이며, 그 판단의 근거인 스코어보드는 무엇인가
StartServers,MaxRequestWorkers,ThreadsPerChild같은 디렉티브는 코드의 어떤 변수가 되는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache httpd |
| 버전 | 2.5.1-dev (trunk) |
| 커밋 | e4af30fe6d (2026-10-24) |
| 주로 읽는 파일 | include/ap_mpm.h, server/mpm_common.c, server/mpm/prefork/prefork.c, server/mpm/worker/worker.c, server/mpm/event/event.c, server/mpm_fdqueue.c, server/scoreboard.c, include/scoreboard.h, server/listen.c |
글에 나오는 줄 번호와 세부 동작은 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제 환경을 만드는 방법은 1편에 있습니다. MPM 파일들은 하나에 1,600~4,500줄이나 되고 신호 처리·재시작·오류 대응이 대부분을 차지합니다. 이 글은 처음 소스를 여는 분이 따라올 수 있게 "접속이 어디로 흘러가는가"라는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름만 적어 두었습니다.
먼저 알아 둘 말
프로세스와 스레드: 프로세스는 실행 중인 프로그램 하나로, 자기만의 메모리를 가집니다. fork() 로 자기를 복사해 자식 프로세스를 만들 수 있고, 복사된 뒤에는 서로의 메모리를 보지 못합니다. 스레드는 한 프로세스 안에서 동시에 도는 실행 흐름으로, 같은 메모리를 함께 씁니다. 프로세스는 서로 격리되어 하나가 죽어도 다른 것은 멀쩡하지만 무겁고, 스레드는 가볍지만 하나가 메모리를 망가뜨리면 프로세스 전체가 죽습니다. httpd 의 "부모 프로세스 하나 + 자식 여럿" 구조는 5편에서 봤습니다.
MPM(Multi-Processing Module): 듣기 소켓에서 접속을 받아(accept) 어느 프로세스·스레드가 처리할지 정하는 모듈입니다. 받은 접속을 실제로 읽고 응답하는 것은 코어와 다른 모듈이고, MPM 은 "누가 맡을지"와 "일꾼을 몇이나 둘지"만 정합니다.
듣기 소켓(listening socket)과 accept: Listen 80 은 80번 포트에 "접속을 받겠다"고 열어 두는 소켓을 만듭니다. 손님이 접속하면 운영체제가 그 소켓에 줄을 세워 두고, 서버가 accept() 를 부르면 그 손님 전용의 새 소켓(연결 소켓)을 하나 내줍니다. 이후의 대화는 이 새 소켓으로 합니다.
keep-alive: HTTP/1.1 에서는 응답을 보낸 뒤에도 연결을 끊지 않고 같은 연결로 다음 요청을 받을 수 있습니다. 다음 요청이 언제 올지는 모르므로 서버는 KeepAliveTimeout(기본 5초) 동안 기다립니다. 이 "기다리는 동안 누가 연결을 붙잡고 있나"가 이 글의 핵심 질문입니다.
poll / epoll: 소켓 여러 개를 한꺼번에 등록해 두고 "이 가운데 읽을 것이 생긴 소켓을 알려 달라"고 운영체제에 묻는 기능입니다. Linux 에서는 epoll 이고, APR(3편에서 본 운영체제 추상화 층)은 이것을 apr_pollset_* 함수로 감싸 둡니다. 스레드 하나가 소켓 수천 개를 지켜볼 수 있게 해 줍니다.
훅: 코어가 정해 둔 자리에 모듈이 함수를 걸어 두면 코어가 그 자리에서 불러 주는 방식입니다. 훅을 부르는 방식에는 "누가 처리하면 거기서 멈추는" RUN_FIRST 와 "모두 부르는" RUN_ALL 이 있습니다. 자세한 것은 6편에 있습니다.
1. MPM 은 왜 갈아 끼우는 부품인가
운영체제마다, 쓰임마다 정답이 다르다
접속을 나눠 맡기는 방법에는 정답이 하나가 아닙니다. 스레드가 없거나 믿을 수 없는 운영체제도 있었고, 스레드에 안전하지 않은 라이브러리를 쓰는 모듈(예전의 PHP 모듈이 대표적입니다)은 프로세스 하나에 요청 하나가 안전합니다. Windows 는 fork() 가 없어 전혀 다른 방식이 필요합니다. 실제로 server/mpm/ 폴더에는 이 커밋에서 여덟 가지 MPM 이 있습니다 — prefork, worker, event, winnt(Windows), mpmt_os2(OS/2), netware, 그리고 trunk 에만 있는 실험적인 motorz, simple. 2.4.x 브랜치에는 motorz 와 simple 폴더가 없습니다.
그래서 httpd 는 이 결정을 코어에 박아 두지 않고 모듈 하나로 떼어 냈습니다. httpd.conf 의 이 줄이 그것입니다.
LoadModule mpm_event_module modules/mod_mpm_event.so
이 줄을 mod_mpm_prefork.so 로 바꾸면 같은 httpd 실행 파일이 전혀 다른 방식으로 접속을 받습니다. (이 예제 환경은 --enable-mpms-shared=all 로 빌드해서 MPM 이 .so 로 따로 있습니다. 빌드할 때 MPM 하나를 실행 파일에 넣어 버리는 방법도 있습니다.)
코어와 MPM 사이의 약속: mpm 훅 하나
코어가 MPM 에게 바라는 것은 include/ap_mpm.h 의 훅 선언 한 줄로 요약됩니다.
AP_DECLARE_HOOK(int, mpm, (apr_pool_t *pconf, apr_pool_t *plog, server_rec *server_conf))
바로 위의 설명 주석은 "MPM 은 재시작이나 종료가 지시될 때까지 돌면서 부모와 자식 프로세스를 다스린다"고 적고 있고(83–92행), 파일 머리의 긴 주석은 접속이 오면 MPM 이 ap_process_connection() 으로 코어를 부른다고 약속합니다(37–81행). 이 훅은 RUN_FIRST 로 구현되어 있어서(server/mpm_common.c 103–105행) 걸린 함수 하나가 일을 맡으면 끝납니다. main() 은 설정을 다 읽은 뒤 이것을 부를 뿐입니다(server/main.c 882행).
각 MPM 은 6편에서 본 보통 모듈과 똑같이 register_hooks 함수에서 자기 함수를 겁니다. prefork 의 경우입니다.
    ap_hook_pre_config(prefork_pre_config, NULL, NULL, APR_HOOK_REALLY_FIRST);
    ap_hook_check_config(prefork_check_config, NULL, NULL, APR_HOOK_MIDDLE);
    ap_hook_mpm(prefork_run, NULL, NULL, APR_HOOK_MIDDLE);
    ap_hook_mpm_query(prefork_query, NULL, NULL, APR_HOOK_MIDDLE);
    ap_hook_mpm_get_name(prefork_get_name, NULL, NULL, APR_HOOK_MIDDLE);
server/mpm/prefork/prefork.c 1517–1521행
worker 는 worker_run 을(worker.c 2402행), event 는 event_run 을(event.c 4381행) 같은 자리에 겁니다. prefork_run 같은 함수들은 모두 static 입니다. C 에서 static 함수는 그 파일 밖에서 이름으로 부를 수 없다는 뜻이라(2편), 코어는 MPM 의 함수 이름을 하나도 모릅니다. 오직 훅에 걸린 함수 포인터로만 부릅니다. 이것이 "갈아 끼울 수 있다"의 정체입니다.
정확히 하나만 — ap_check_mpm()
MPM 은 하나만 있어야 합니다. 설정을 읽는 ap_read_config() 는 파일을 다 처리한 뒤 이 함수로 확인합니다(server/config.c 2355행).
AP_DECLARE(const char *)ap_check_mpm(void)
{
    static const char *last_mpm_name = NULL;

    if (!_hooks.link_mpm || _hooks.link_mpm->nelts == 0)
        return "No MPM loaded.";
    else if (_hooks.link_mpm->nelts > 1)
        return "More than one MPM loaded.";

    if (last_mpm_name) {
        if (strcmp(last_mpm_name, ap_show_mpm())) {
            return "The MPM cannot be changed during restart.";
        }
    }
    else {
        last_mpm_name = apr_pstrdup(ap_pglobal, ap_show_mpm());
    }

    return NULL;
}
_hooks.link_mpm 은 mpm 훅에 걸린 함수들의 배열이고 nelts 는 그 개수입니다. 0개면 "No MPM loaded.", 2개 이상이면 "More than one MPM loaded." 입니다. static 지역 변수 last_mpm_name 은 함수가 끝나도 값이 남아 있으므로, 처음 읽은 MPM 이름을 기억해 두었다가 재시작(5편)에서 다른 MPM 으로 바뀌면 거절합니다.
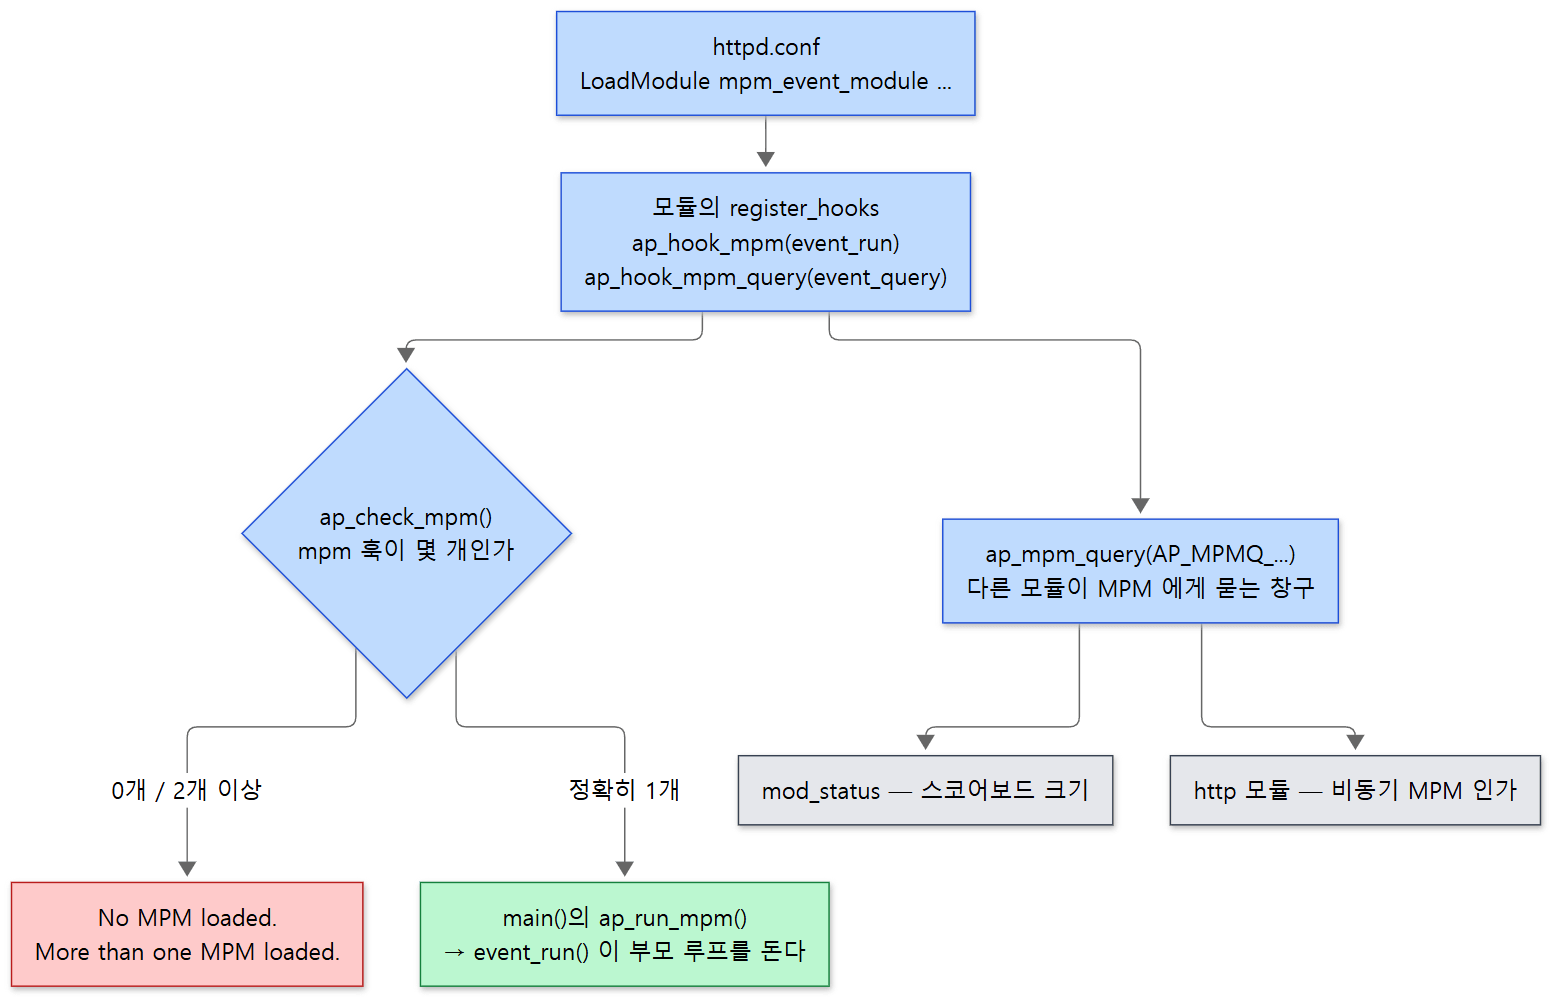 MPM 은 훅 두 개(실행과 질의)로 코어에 붙습니다. 파란색은 절차, 빨간색은 오류, 회색은 MPM 에게 묻는 쪽입니다.
다른 모듈은 MPM 에게 묻는다 — ap_mpm_query()
MPM 이 갈아 끼워지면 다른 모듈은 "지금 MPM 이 스레드를 쓰나? 프로세스는 최대 몇 개인가?"를 알 길이 필요합니다. 그 창구가 ap_mpm_query() 입니다. 질문 번호는 AP_MPMQ_* 상수로 정해져 있고(include/ap_mpm.h 149–186행), 함수 자체는 mpm_query 훅을 부르는 것이 전부입니다.
AP_DECLARE(apr_status_t) ap_mpm_query(int query_code, int *result)
{
    apr_status_t rv;

    if (ap_run_mpm_query(query_code, result, &rv) == DECLINED) {
        rv = APR_EGENERAL;
    }

    return rv;
}
대답은 각 MPM 의 switch 문이 합니다. prefork 는 "스레드를 쓰나?"에 AP_MPMQ_NOT_SUPPORTED, "자식당 스레드 수"에 1 이라고 답하고(prefork.c 316–367행), event 는 "비동기(async) MPM 인가?"(AP_MPMQ_IS_ASYNC)에 1 이라고 답합니다(event.c 697–699행).
이 대답을 실제로 쓰는 곳이 HTTP 를 처리하는 http 모듈입니다. 시작할 때 MPM 이 비동기인지 물어 두고(modules/http/http_core.c 346–348행), 연결을 처리할 때 길을 나눕니다.
static int ap_process_http_connection(conn_rec *c)
{
    if (async_mpm && !c->clogging_input_filters) {
        return ap_process_http_async_connection(c);
    }
    else {
        return ap_process_http_sync_connection(c);
    }
}
modules/http/http_core.c 247–255행
sync 쪽은 한 연결의 요청들을 while 루프로 계속 읽고, async 쪽은 요청 하나만 처리하고 돌아갑니다. 이 두 함수의 속은 9편에서 봅니다. 이 글은 그 차이가 MPM 쪽에서 어떤 모양이 되는지를 4절에서 봅니다.
예제 1: MPM 을 빼거나 둘 넣어 보기, 그리고 httpd -V
이 글의 예제는 기준 커밋(e4af30fe6d)을 그대로 빌드한 httpd 2.5.1-dev 로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 예제 폴더는 ex/u08-mpm/ 이고 run.sh 하나로 이 글의 예제를 모두 돌립니다. 설정 파일은 MPM 을 싣는 LoadModule 줄만 바꿔 끼우고 나머지(Listen 8080, mod_status, LogLevel debug)는 같게 두었습니다. 아래 명령들은 run.sh 에서 해당 부분만 줄여 옮긴 것입니다.
# 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다)
httpd -t -f /tmp/none.conf     # MPM 을 싣지 않은 설정
httpd -t -f /tmp/two.conf      # mod_mpm_event 와 mod_mpm_worker 를 둘 다 실은 설정
for m in prefork worker event; do
  httpd -V -f /tmp/$m.conf | grep -A2 "Server MPM"
done
=== 1. exactly one MPM ===
  AH00534: httpd: Configuration error: No MPM loaded.
  AH00534: httpd: Configuration error: More than one MPM loaded.

=== 2. same httpd, different MPM: the MPM lines of httpd -V (ap_mpm_query answers) ===
--- prefork
  Server MPM:     prefork
    threaded:     no
      forked:     yes (variable process count)
--- worker
  Server MPM:     worker
    threaded:     yes (fixed thread count)
      forked:     yes (variable process count)
--- event
  Server MPM:     event
    threaded:     yes (fixed thread count)
      forked:     yes (variable process count)
위의 두 줄은 ap_check_mpm() 이 돌려준 문자열 그대로입니다. 아래의 threaded:·forked: 줄은 httpd -V 를 처리하는 show_mpm_settings() 가 ap_mpm_query(AP_MPMQ_IS_THREADED, …) 와 AP_MPMQ_IS_FORKED 로 물어 받은 대답을 글로 바꾼 것입니다(server/main.c 64–100행). 실행 파일은 같은데 대답이 달라집니다.
헷갈리기 쉬운 곳: Listen 은 MPM 의 디렉티브다
Listen 80 은 코어의 설정처럼 보이지만, 소스에서 이 디렉티브를 등록하는 것은 MPM 입니다. include/ap_listen.h 에 Listen, ListenBacklog, SendBufferSize 등을 묶은 LISTEN_COMMANDS 매크로가 있고(176–190행), 각 MPM 의 디렉티브 표가 이것으로 시작합니다(예: prefork.c 1584행, event.c 4510행). 듣기 소켓을 여는 ap_setup_listeners() 도 각 MPM 의 open_logs 훅에서 부릅니다(prefork.c 1315행). 그러면 예제 1의 none.conf 처럼 MPM 을 싣지 않은 설정에서는 Listen 8080 이 "모르는 디렉티브" 오류를 낼 것 같지만, 실제로 httpd -t 는 "No MPM loaded." 로 멈췄습니다. ap_check_mpm() 은 설정 파일을 트리로 다 읽어 LoadModule 을 처리한 직후, 나머지 디렉티브를 실행하기 전에 불리기 때문입니다(server/config.c 2348–2362행). 설정이 두 단계로 처리되는 이야기는 7편에 있습니다.
2. prefork — 프로세스 하나에 연결 하나
prefork 는 가장 오래되고 가장 단순한 방식입니다. 이름 그대로 접속이 오기 전에(pre) 미리 fork 해 둔 자식 프로세스들이, 각자 스레드 하나로 접속을 하나씩 받아 처리합니다.
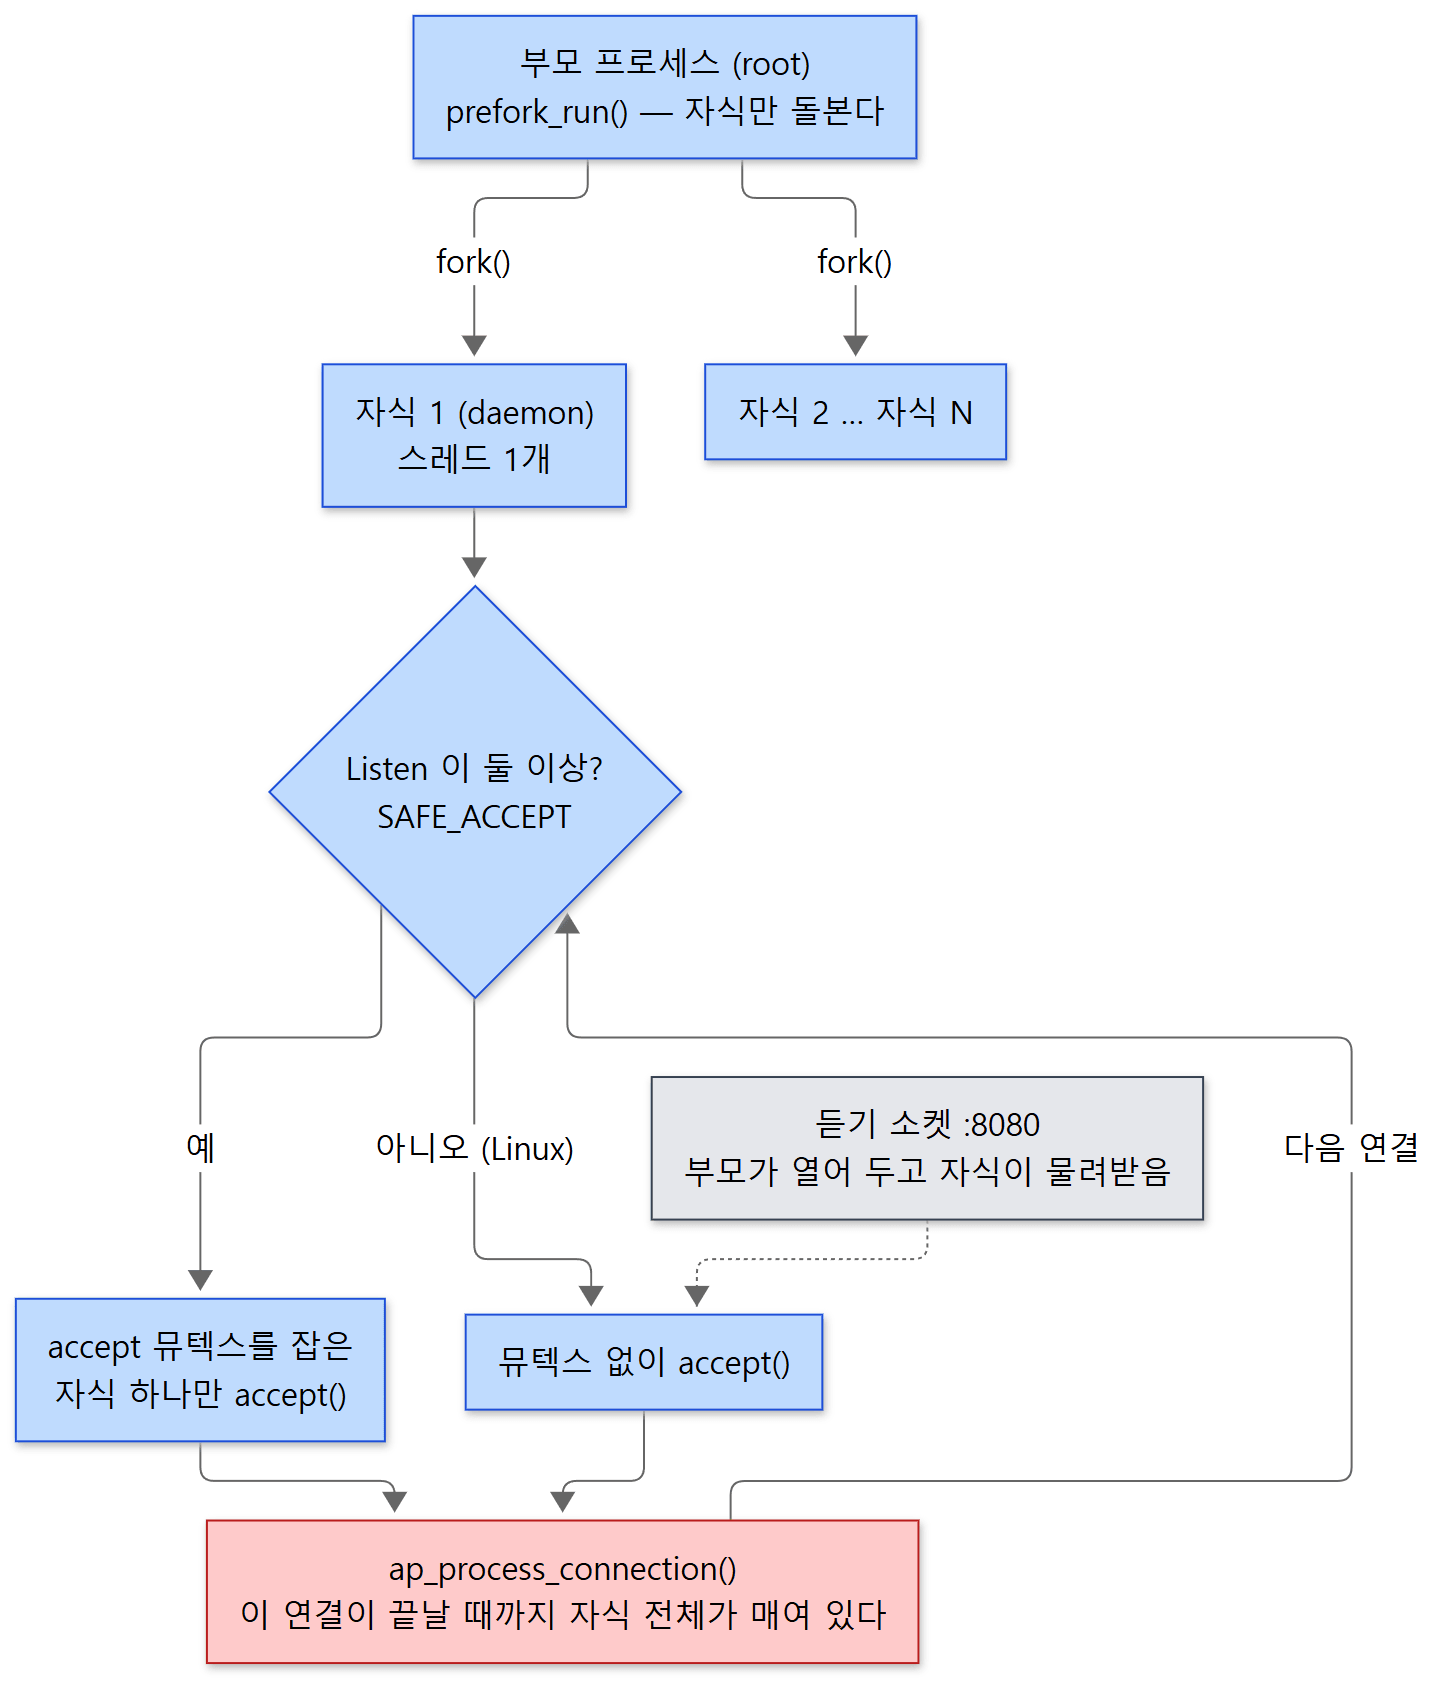 빨간 상자가 prefork 의 약점입니다. 연결 하나가 자식 프로세스 하나를 통째로 차지합니다.
자식의 하루: child_main() 의 루프
자식 프로세스는 make_child() 에서 fork() 로 태어나(prefork.c 745행) 곧바로 child_main() 에 들어가 평생 이 루프를 돕니다. (/* ... */ 는 이 글에서 줄인 곳입니다.)
        apr_pool_clear(ptrans);

        if ((ap_max_requests_per_child > 0
             && requests_this_child++ >= ap_max_requests_per_child)) {
            clean_child_exit(0);
        }

        (void) ap_update_child_status(sbh, SERVER_READY, (request_rec *) NULL);

        /*
         * Wait for an acceptable connection to arrive.
         */

        /* Lock around "accept", if necessary */
        SAFE_ACCEPT(accept_mutex_on());
        /* ... Listen 이 여럿이면 poll 로 읽을 수 있는 듣기 소켓을 고른다 ... */
        status = lr->accept_func(&csd, lr, ptrans);

        SAFE_ACCEPT(accept_mutex_off());      /* unlock after "accept" */
        /* ... 오류 처리 ... */
        current_conn = ap_run_create_connection(ptrans, ap_server_conf, csd, my_child_num, sbh, bucket_alloc);
        if (current_conn) {
#if APR_HAS_THREADS
            current_conn->current_thread = thd;
#endif
            ap_process_connection(current_conn, csd);
            ap_lingering_close(current_conn);
        }
server/mpm/prefork/prefork.c 580–695행
- 풀을 비웁니다.
ptrans는 연결 하나 동안 쓰는 메모리 풀이고, 접속을 받기 전마다 비워 다시 씁니다(4편). - 은퇴할 때인지 봅니다.
MaxConnectionsPerChild를 넘게 연결을 처리했으면 스스로 끝냅니다. 이 디렉티브는 MPM 이 아니라 코어에 등록되어 있고(server/core.c4994행) 공용 변수ap_max_requests_per_child에 들어갑니다(server/mpm_common.c411행). - 스코어보드에 "놀고 있음"(
SERVER_READY)을 적습니다. 스코어보드는 6절에서 봅니다. - accept 합니다.
lr->accept_func는 듣기 소켓 구조체ap_listen_rec에 들어 있는 함수 포인터입니다(include/ap_listen.h40행, 55–87행). Unix 에서는ap_unixd_accept()가 들어가고(prefork.c559행), 그 안에서 APR 의apr_socket_accept()를 부릅니다(os/unix/unixd.c303행). 함수 포인터가 무엇인지는 2편에 있습니다. - 연결을 처리합니다.
ap_process_connection()은 이 연결의 요청을 읽고 응답하는 코어의 입구입니다(9편). 이 함수가 돌아올 때까지 — keep-alive 로 다음 요청을 기다리는 시간까지 포함해서 — 이 자식 프로세스는 다른 일을 할 수 없습니다.
accept 뮤텍스와 SAFE_ACCEPT
여러 자식이 같은 듣기 소켓에서 동시에 accept() 를 부르면 어떻게 될까요? Listen 이 하나이고 운영체제가 잘 처리해 주면 문제가 없지만, Listen 이 여럿이면 자식들은 먼저 poll 로 "어느 소켓에 손님이 왔나"를 본 뒤 accept 해야 하고, 그 사이에 다른 자식이 손님을 채 가면 엉뚱한 소켓에서 기다리게 될 수 있습니다. 그래서 prefork 는 프로세스 사이의 잠금(accept 뮤텍스)을 잡은 자식 하나만 accept 하게 합니다. 이 잠금을 할지 말지는 매크로 하나가 정합니다.
#ifdef SINGLE_LISTEN_UNSERIALIZED_ACCEPT
#define SAFE_ACCEPT(stmt) (ap_listeners->next ? (stmt) : APR_SUCCESS)
#else
#define SAFE_ACCEPT(stmt) (stmt)
#endif
server/mpm/prefork/prefork.c 310–314행
SINGLE_LISTEN_UNSERIALIZED_ACCEPT 는 "듣기 소켓이 하나면 잠그지 않아도 안전한 운영체제"라는 표시이고, configure 가 Linux(2.2 이후) 등에서 켭니다(configure.in 348–356행). 켜져 있으면 SAFE_ACCEPT(x) 는 듣기 소켓 목록에 다음 것(ap_listeners->next)이 있을 때만 x 를 실행합니다. 뮤텍스를 만드는 코드도 SAFE_ACCEPT 로 감싸여 있어서(prefork.c 1031–1035행) Listen 이 하나면 뮤텍스가 아예 없습니다. 매크로가 C 에서 어떻게 펼쳐지는지는 2편에 있습니다.
예제 2: prefork 를 기본값으로 띄우기
=== 3. start with defaults, count processes and threads ===
--- prefork
  PID / PPID / threads(NLWP) / user
  27 1 1 root
  28 27 1 daemon
  30 27 1 daemon
  31 27 1 daemon
  32 27 1 daemon
  33 27 1 daemon
  httpd processes: 6, threads in total: 6
  scoreboard, first 80 slots: W____...........................................................................
  scoreboard, all 256 slots = '_' 4  'W' 1  '.' 251
  BusyWorkers: 1
  IdleWorkers: 4
  log: prefork.c(1087): AH00165: Accept mutex: none (default: pthread)

=== 4. prefork accept mutex: one Listen vs two ===
  two Listens: prefork.c(1087): AH00165: Accept mutex: pthread (default: pthread)
PID 는 실행마다 다릅니다. ps -eo pid,ppid,nlwp,user 로 본 결과, root 인 부모 하나(PPID 1) 아래에 daemon 사용자의 자식이 다섯이고 모두 스레드가 하나(NLWP 1)입니다. 다섯은 StartServers 의 기본값입니다(server/mpm/prefork/mpm_default.h 33행). 스코어보드 줄은 mod_status 의 /server-status?auto 에서 가져왔고 6절에서 읽습니다. log: 줄은 prefork_run() 이 LogLevel debug 에서 남기는 로그입니다(prefork.c 1087–1092행). Listen 8080 하나일 때는 뮤텍스가 none, Listen 8081 을 더하자 pthread 방식의 뮤텍스가 생겼습니다. 앞에서 읽은 SAFE_ACCEPT 그대로입니다.
3. worker — 리스너 스레드 하나와 작업 스레드 여럿
prefork 는 동시에 처리할 연결 수만큼 프로세스가 필요합니다. 프로세스는 메모리를 따로 쓰므로 연결이 수백 개면 무겁습니다. worker 는 자식 프로세스 하나 안에 스레드를 여럿 두어 이 문제를 풉니다. 자식마다 ThreadsPerChild(기본 25, server/mpm/worker/mpm_default.h 51행)개의 작업 스레드와, accept 만 하는 리스너 스레드 하나가 있습니다.
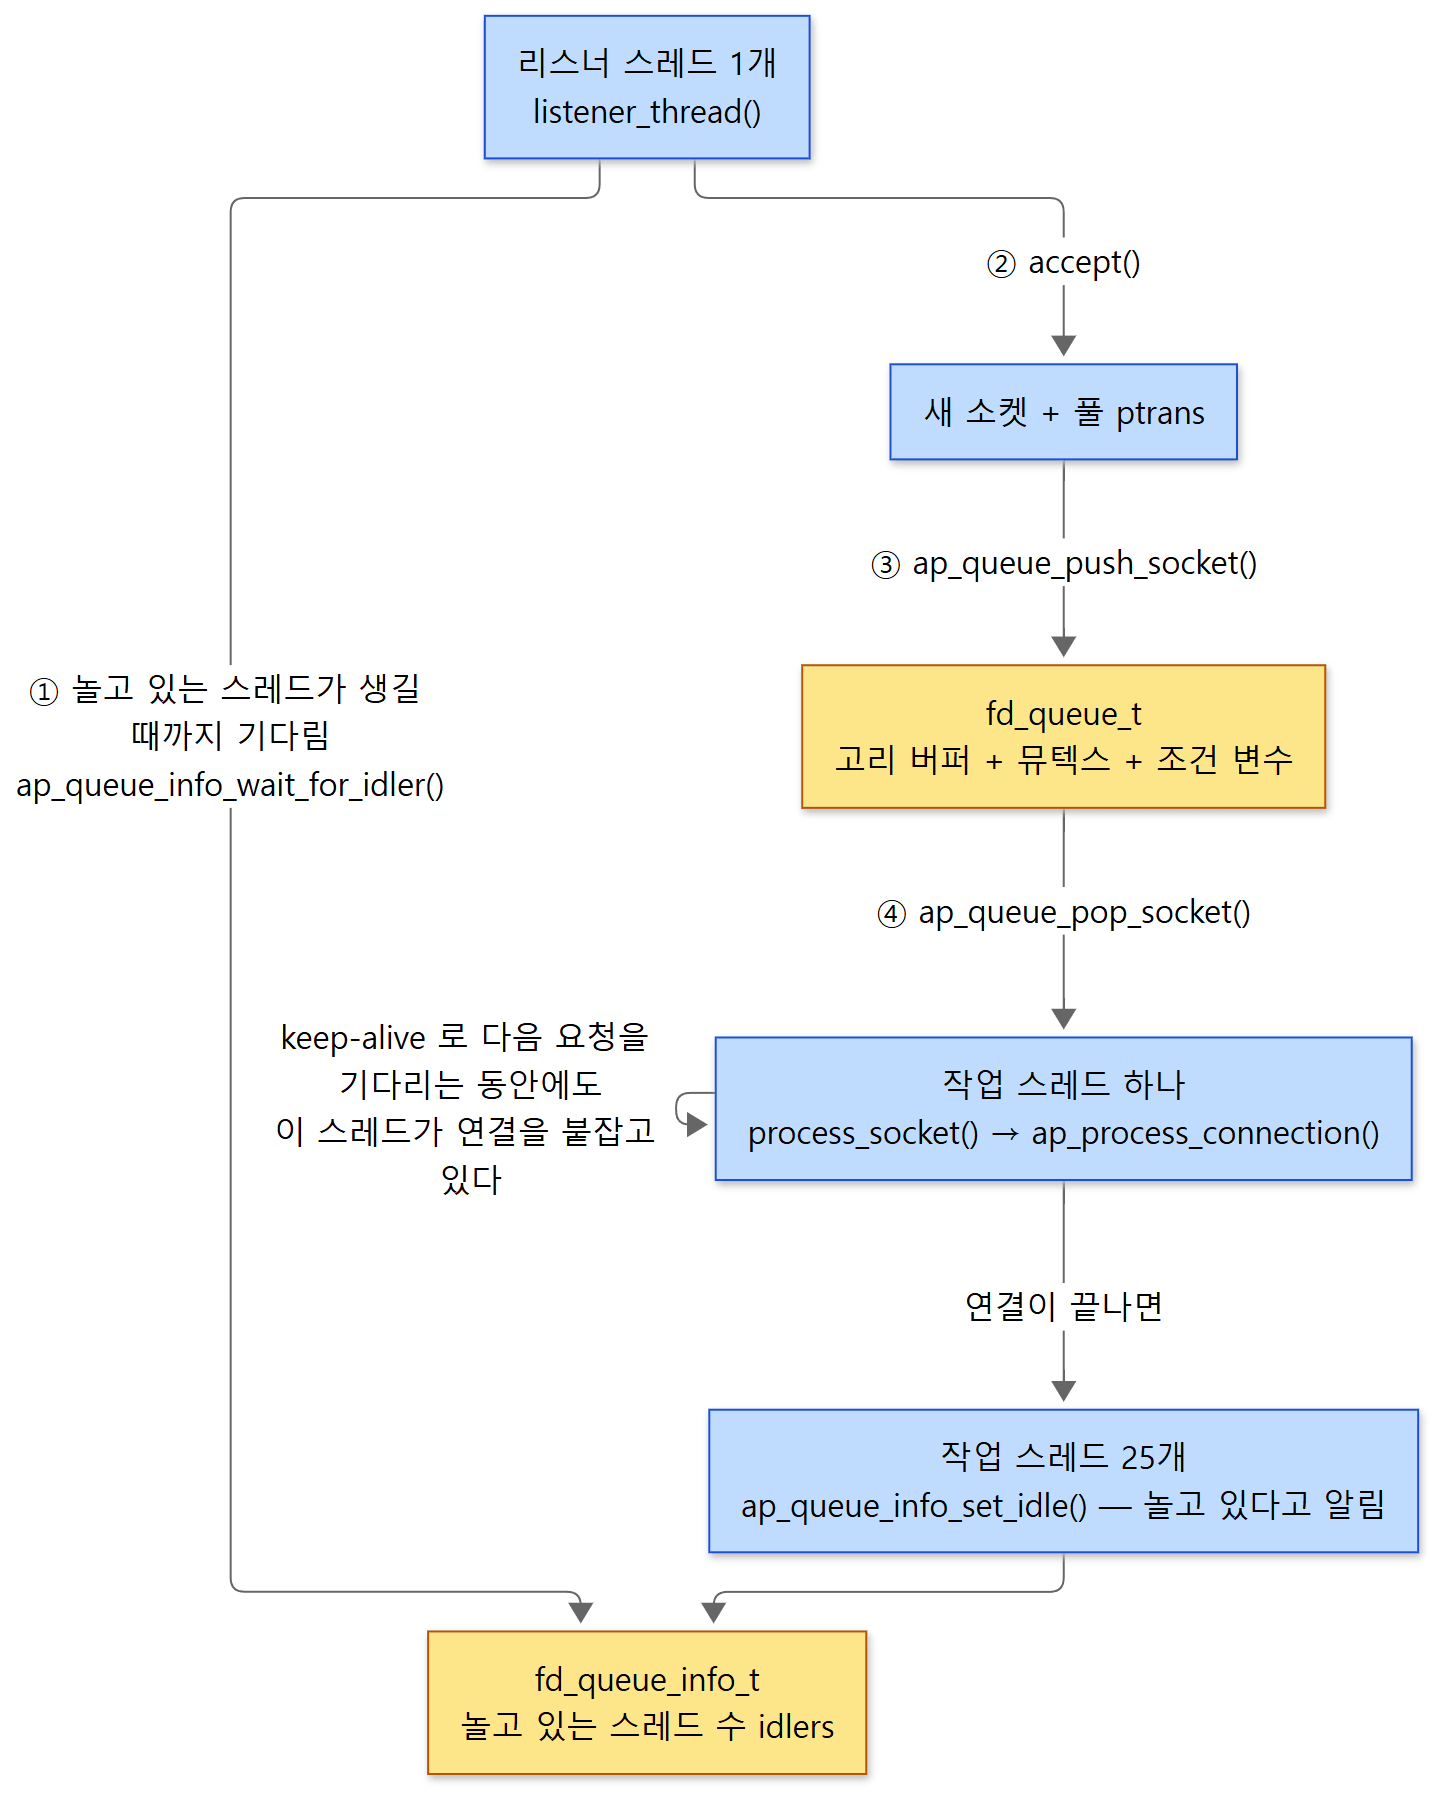 노란 상자 둘이 스레드 사이에 공유하는 자료 구조입니다. ①~④ 순서로 소켓이 리스너에서 작업 스레드로 건너갑니다.
리스너: 놀고 있는 일꾼부터 확보하고 accept
리스너 스레드의 루프에서 줄기만 뽑으면 이렇습니다.
        if (!have_idle_worker) {
            rv = ap_queue_info_wait_for_idler(worker_queue_info, NULL);
            /* ... */
            have_idle_worker = 1;
        }
        /* ... accept 뮤텍스, Listen 이 여럿이면 poll ... */
            rv = lr->accept_func(&csd, lr, ptrans);
        /* ... */
            if (csd != NULL) {
                rv = ap_queue_push_socket(worker_queue, csd, NULL, ptrans);
server/mpm/worker/worker.c 585–699행
순서가 중요합니다. 리스너는 놀고 있는 작업 스레드가 있다는 것을 확인한 다음에야 accept 합니다(586행). 일꾼이 모두 바쁘면 accept 하지 않고 기다리므로, 새 손님은 운영체제의 대기 줄(backlog)에 남아 있습니다. 받아 놓고 아무도 처리하지 못하는 일은 생기지 않지만, 대신 손님은 그만큼 기다립니다. 4절의 예제에서 이것이 눈에 보입니다.
작업 스레드: 큐에서 꺼내 처리
        rv = ap_queue_pop_socket(worker_queue, &csd, &ptrans);
        /* ... */
        process_socket(thd, ptrans, csd, process_slot, thread_slot, bucket_alloc);
server/mpm/worker/worker.c 796–829행
process_socket() 은 prefork 와 똑같이 ap_run_create_connection() 과 ap_process_connection() 을 부릅니다(482–499행). 연결 하나를 맡는 단위가 프로세스에서 스레드로 바뀌었을 뿐, 연결이 끝날 때까지 그 일꾼이 매여 있다는 점은 prefork 와 같습니다.
둘 사이의 다리: server/mpm_fdqueue.c
리스너와 작업 스레드는 server/mpm_fdqueue.c 의 두 자료 구조로 이어집니다. worker 와 event 가 함께 씁니다.
fd_queue_t— 소켓을 담는 고리 버퍼(ring buffer, 끝에 닿으면 처음으로 돌아가는 배열)와 뮤텍스, 조건 변수(스레드를 재워 두었다가 깨우는 장치)입니다(server/mpm_fdqueue.h76–87행). 크기는ThreadsPerChild입니다(worker.c897행).fd_queue_info_t— 지금 놀고 있는 작업 스레드 수(idlers)와, 다 쓴 풀을 모아 두는 목록입니다(server/mpm_fdqueue.c31–45행).
넣는 쪽은 짧습니다.
apr_status_t ap_queue_push_socket(fd_queue_t *queue,
                                  apr_socket_t *sd, void *sd_baton,
                                  apr_pool_t *p)
{
    fd_queue_elem_t *elem;
    apr_status_t rv;

    if ((rv = apr_thread_mutex_lock(queue->one_big_mutex)) != APR_SUCCESS) {
        return rv;
    }

    AP_DEBUG_ASSERT(!queue->terminated);
    AP_DEBUG_ASSERT(!ap_queue_full(queue));

    elem = &queue->data[queue->in++];
    if (queue->in >= queue->bounds)
        queue->in -= queue->bounds;
    elem->sd = sd;
    elem->sd_baton = sd_baton;
    elem->p = p;
    queue->nelts++;

    apr_thread_cond_signal(queue->not_empty);

    return apr_thread_mutex_unlock(queue->one_big_mutex);
}
in 자리에 소켓과 풀을 적고, bounds(크기)에 닿으면 0으로 돌립니다. 그리고 not_empty 조건 변수로 기다리던 작업 스레드 하나를 깨웁니다. 꺼내는 ap_queue_pop_something() 은 큐가 비어 있으면 그 조건 변수에서 잠듭니다(432–490행). 위 함수의 설명 주석에 "ap_queue_info_wait_for_idler 가 먼저 불려 놀고 있는 스레드를 확보해 두었다"는 전제가 적혀 있는데(376–381행), 이 전제 덕분에 큐가 넘치는지(ap_queue_full)는 디버그 빌드에서 확인만 하고 넘어갑니다.
헷갈리기 쉬운 곳: 스레드가 25개가 아니라 27개
예제를 돌려 보면 worker 의 자식 하나에 스레드가 27개입니다.
--- worker
  PID / PPID / threads(NLWP) / user
  64 1 1 root
  66 64 27 daemon
  67 64 27 daemon
  69 64 27 daemon
  httpd processes: 4, threads in total: 82
작업 스레드 25개 + 리스너 1개 + 프로세스가 처음부터 가진 메인 스레드 1개입니다. 메인 스레드는 child_main() 에서 부모의 신호(5절의 "죽음의 파이프")를 기다리는 일을 합니다(worker.c 1298–1300행). 스레드들을 만드는 start_threads 라는 스레드가 하나 더 있지만, 다 만들고 나면 스스로 끝납니다(worker.c 1058행). 자식 셋은 worker 의 StartServers 기본값 3입니다(mpm_default.h 33행). event 도 같은 모양이라, gdb 로 확인한 결과는 4절에 싣습니다.
4. event — keep-alive 연결을 스레드에서 떼어 내기
worker 의 남은 문제
worker 에서 keep-alive 연결은 다음 요청이 올 때까지 최대 KeepAliveTimeout 동안 작업 스레드를 붙잡습니다. 그 스레드는 실제로는 아무것도 하지 않고 소켓 하나를 바라보고 있을 뿐입니다. 브라우저는 페이지를 받은 뒤에도 연결을 열어 두는 일이 흔하므로, 스레드 대부분이 "놀면서 바쁜" 상태가 됩니다. event.c 머리의 주석이 바로 이 문제를 적고 있습니다 — 전통적으로 Apache 는 클라이언트의 데이터를 기다리는 동안 프로세스나 스레드 하나를 통째로 붙잡아 두었고, 이 MPM 은 듣기 소켓과 keep-alive 상태인 모든 소켓을 맡는 전용 스레드를 두어 이것을 푼다(server/mpm/event/event.c 17–39행).
작업 스레드는 요청 하나만 처리하고 상태를 남긴다
event 는 worker 와 같은 큐(fd_queue_t)와 작업 스레드 구조를 씁니다. 다른 점은 작업 스레드가 부르는 process_socket() 이 ap_process_connection() 대신 ap_run_process_connection() 을 직접 부르고, 돌아온 뒤 연결의 상태를 보고 다음 일을 정한다는 것입니다. 1절에서 본 대로 event 는 "비동기 MPM 이다"라고 답하므로 http 모듈은 async 쪽 함수를 써서, 요청 하나를 처리한 뒤 c->cs->state 에 상태를 적어 두고 돌아옵니다(9편).
상태 목록은 include/httpd.h 에 있습니다(1328–1348행).
| 상태 | 뜻 (소스 주석) | event 가 하는 일 |
|---|---|---|
CONN_STATE_PROCESSING |
process_connection 훅이 처리 중 | 작업 스레드가 훅을 부른다 |
CONN_STATE_WRITE_COMPLETION |
keep-alive 로 가기 전에 MPM 이 남은 출력을 내보냄 | 다 못 보냈으면 쓰기 가능을 기다리는 큐(wc_q)로 |
CONN_STATE_KEEPALIVE |
MPM 안에서 keep-alive 로 대기 (KeepAliveTimeout) |
keep-alive 큐(ka_q)로, 스레드는 풀려난다 |
CONN_STATE_ASYNC_WAITIO |
소켓이 읽기/쓰기 가능해질 때까지 MPM 이 대기 (Timeout) |
io_q 로 |
CONN_STATE_LINGER 등 |
출력을 마저 내보내고 천천히 닫음 | 닫기 대기 큐(linger_q, short_linger_q)로 |
CONN_STATE_SUSPENDED |
모듈이 연결을 잠시 맡아 둠 | MPM 은 손을 뗀다 |
keep-alive 로 넘어가는 부분입니다.
    if (cs->pub.state == CONN_STATE_KEEPALIVE) {
        ap_update_child_status(cs->sbh, SERVER_BUSY_KEEPALIVE, NULL);
        /* ... 주석 ... */
        cs->queue_timestamp = apr_time_now();
        notify_suspend(cs);

        /* Add work to pollset. */
        cs->pub.sense = CONN_SENSE_DEFAULT;
        update_reqevents_from_sense(cs, CONN_SENSE_WANT_READ);
        apr_thread_mutex_lock(timeout_mutex);
        TO_QUEUE_APPEND(cs->sc->ka_q, cs);
        rv = apr_pollset_add(event_pollset, &cs->pfd);
        /* ... 실패 처리 ... */
        return;
    }
server/mpm/event/event.c 1305–1339행
연결을 keep-alive 큐 뒤에 붙이고(TO_QUEUE_APPEND), 소켓을 pollset 에 넣고, return 합니다. 함수가 돌아가면 작업 스레드는 다시 큐에서 다음 일을 꺼내러 갑니다. 이 연결은 이제 어느 스레드의 것도 아닙니다. 큐에 시간 순서대로 붙이기만 하면 되는 이유는 큐마다 기다리는 시간이 하나로 정해져 있기 때문입니다 — 위에서 줄인 주석과 큐 선언부의 주석(273–286행)이 그렇게 설명합니다.
리스너 스레드: 듣기 소켓과 기다리는 연결을 함께 poll
event 의 리스너는 worker 의 리스너보다 훨씬 많은 일을 합니다. 듣기 소켓과, 위에서 맡겨진 연결 소켓들이 모두 같은 pollset 에 들어 있습니다(듣기 소켓은 2763–2772행에서 PT_ACCEPT 로 등록). 리스너는 apr_pollset_poll() 하나로 둘 다 기다리고(2112행), 깨어나면 무엇이 준비됐는지 봅니다. 연결 소켓(PT_CSD)이면 그 연결이 어떤 상태로 기다리고 있었는지에 따라 큐에서 뺍니다.
                switch (cs->pub.state) {
                case CONN_STATE_WRITE_COMPLETION:
                    remove_from_q = cs->sc->wc_q;
                    blocking = 1;
                    break;

                case CONN_STATE_ASYNC_WAITIO:
                    cs->pub.state = CONN_STATE_PROCESSING;
                    remove_from_q = cs->sc->io_q;
                    blocking = 1;
                    break;

                case CONN_STATE_KEEPALIVE:
                    cs->pub.state = CONN_STATE_PROCESSING;
                    remove_from_q = cs->sc->ka_q;
                    break;

                case CONN_STATE_LINGER_NORMAL:
                    remove_from_q = linger_q;
                    break;

                case CONN_STATE_LINGER_SHORT:
                    remove_from_q = short_linger_q;
                    break;
server/mpm/event/event.c 2149–2172행
keep-alive 연결에 다음 요청이 도착하면 상태를 PROCESSING 으로 바꾸고 큐와 pollset 에서 뺀 뒤, 놀고 있는 작업 스레드에게 넘깁니다(push2worker(), 2208–2215행). 받는 작업 스레드는 처음 그 연결을 맡았던 스레드가 아니어도 됩니다. ap_mpm.h 의 머리 주석이 "앞으로는 ap_process_connection 이 연결을 다 끝내기 전에 MPM 으로 돌아오고, 같은 스레드에서 다시 불린다는 보장이 없다"고 예고한 것이 바로 이 모습입니다(49–53행). 듣기 소켓(PT_ACCEPT)이면 accept 해서 같은 방법으로 넘깁니다(2218–2297행).
시간이 다 된 연결도 리스너가 정리합니다. 큐 맨 앞의 만료 시각이 지나면 keep-alive 큐에서 시간이 다 된 연결을 닫고, 쓰기 대기·닫기 대기 큐도 차례로 처리합니다(2352–2399행).
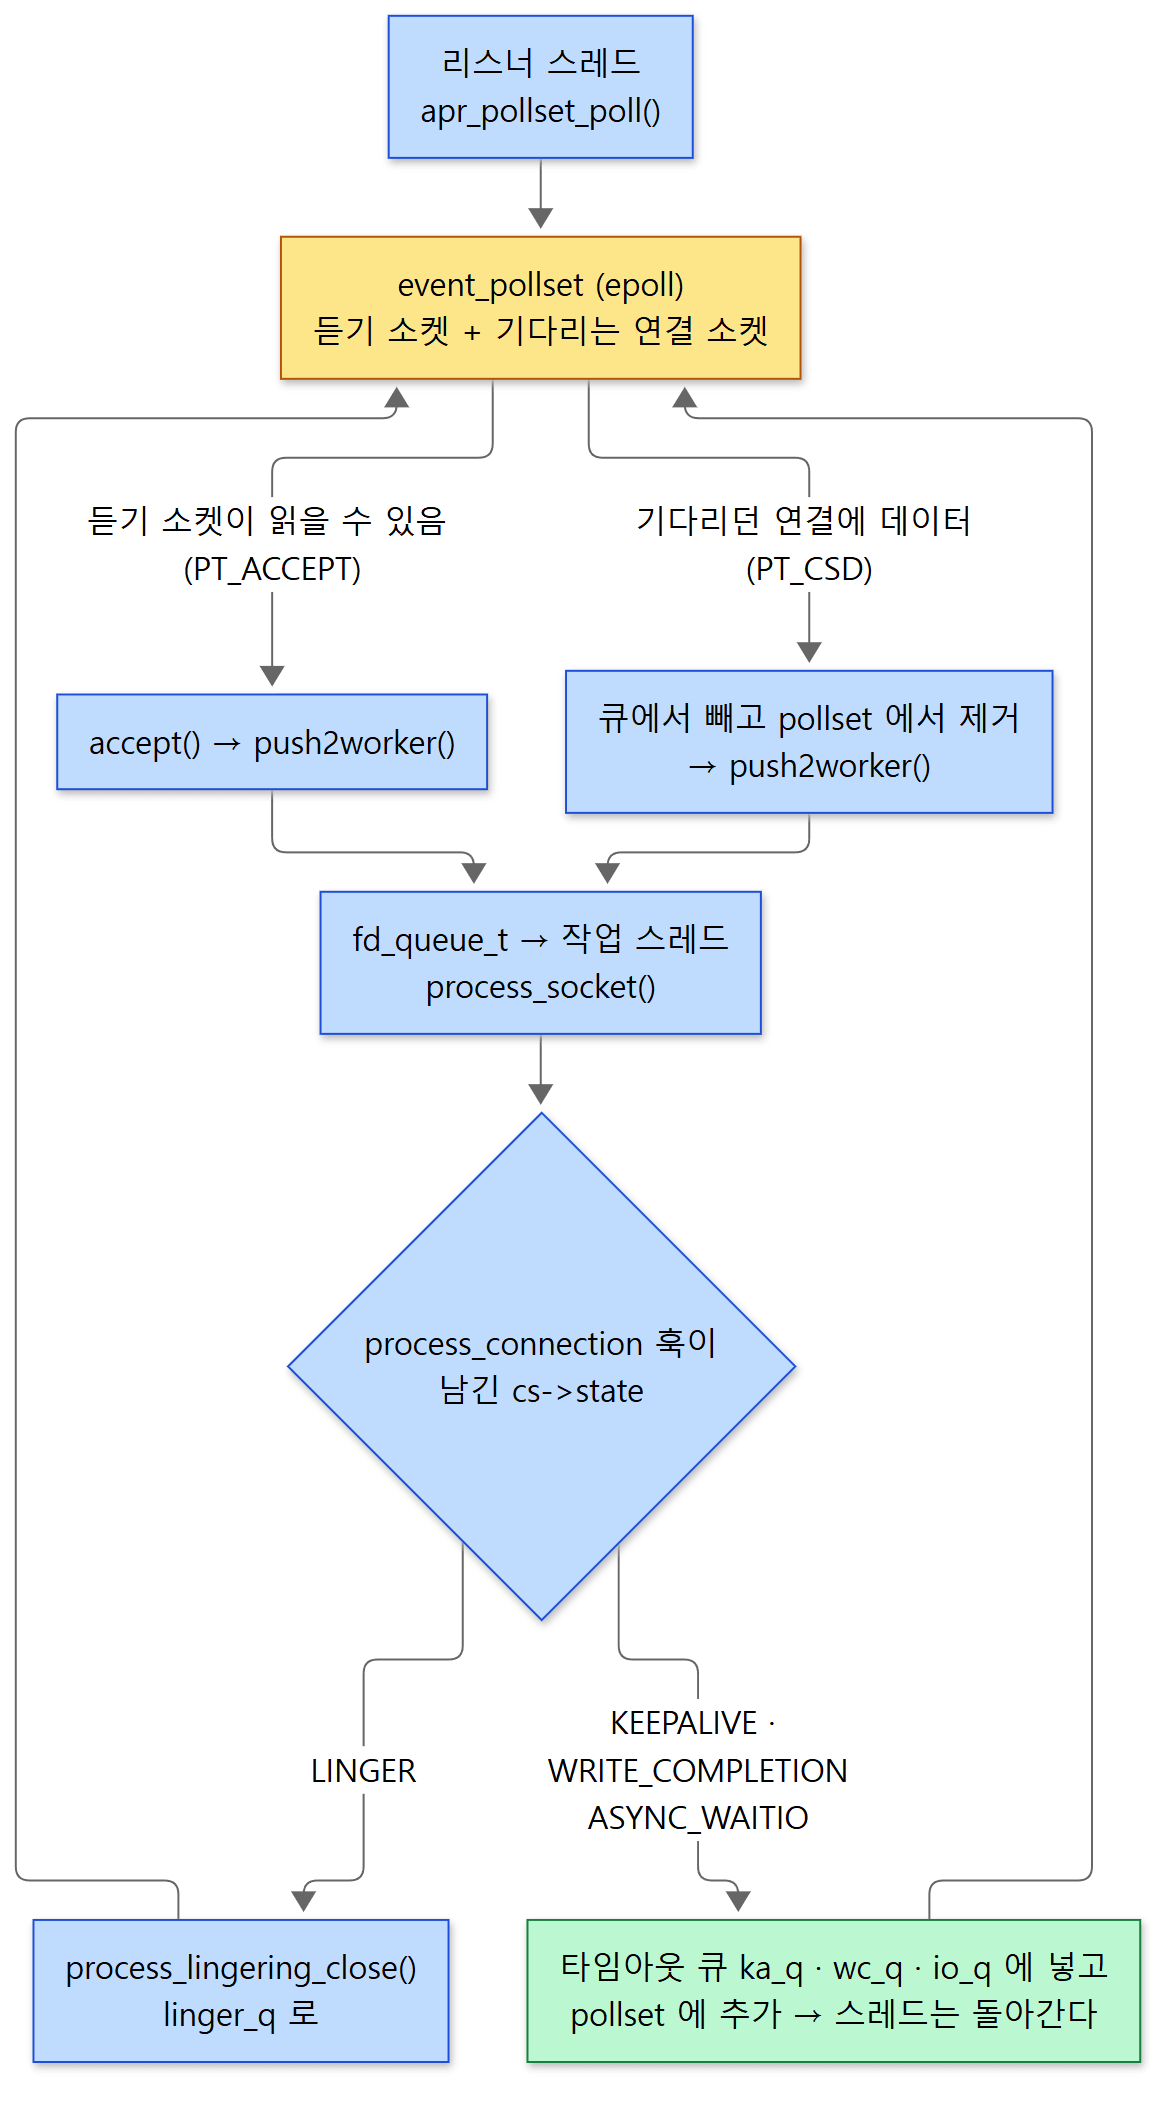 노란 상자(pollset)가 "기다리는 연결"을 맡습니다. 초록 상자에서 작업 스레드가 풀려나는 것이 worker 와의 차이입니다.
예제 3: 작업 스레드 4개에 keep-alive 연결 6개
차이를 눈으로 보려고 작업 스레드를 4개로 줄였습니다(StartServers 1, ServerLimit 1, ThreadsPerChild 4, MaxRequestWorkers 4). 그리고 bash 의 /dev/tcp 로 연결 6개를 열어 각각 요청을 하나씩 보내고 닫지 않고 둡니다. 응답을 받은 뒤 다음 요청을 보내지 않는 브라우저 흉내입니다. 1초 뒤 curl 로 새 요청을 하나 보내 걸린 시간을 잽니다. (아래는 run.sh 의 해당 부분을 줄여 옮긴 것입니다.)
# 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다)
for i in 3 4 5 6 7 8; do
  eval "exec $i<>/dev/tcp/127.0.0.1/8080"            # 연결을 열고
  printf 'GET /index.html HTTP/1.1\r\nHost: localhost\r\n\r\n' >&$i   # 요청 하나, 닫지 않는다
done
sleep 1
curl -s -o /dev/null -w "  time for a new request: %{time_total}s (HTTP %{http_code})\n" http://127.0.0.1:8080/index.html
=== 5. six idle keep-alive connections against 4 worker threads ===
--- worker (KeepAliveTimeout 5)
  time for a new request: 5.669387s (HTTP 200)
  BusyWorkers: 4
  IdleWorkers: 0
  Scoreboard: CKWK
--- event (KeepAliveTimeout 5)
  time for a new request: 0.001105s (HTTP 200)
  BusyWorkers: 1
  IdleWorkers: 3
  ConnsTotal: 0
  ConnsAsyncKeepAlive: 0
  Scoreboard: W___
  log: event.c(2015): connections: 6 (waitio:0 write-completion:0keep-alive:6 lingering:0 suspended:0 clogged:0), workers: 0/4 shutdown
--- worker (KeepAliveTimeout 2)
  time for a new request: 2.766733s (HTTP 200)
  BusyWorkers: 4
  IdleWorkers: 0
  Scoreboard: WKKC
시간과 스코어보드의 글자 순서는 실행마다 조금씩 다릅니다.
- worker 에서는 새 요청이 5.7초 걸렸습니다. 앞의 연결 넷이 작업 스레드 넷을 keep-alive 로 붙잡고 있어서, 리스너는 놀고 있는 스레드가 생길 때까지 accept 조차 하지 않았습니다(3절).
KeepAliveTimeout을 2초로 줄이자 2.8초로 줄었으니, 기다린 시간이 keep-alive 시간에 따라 움직입니다. 스코어보드의K가 keep-alive 로 다음 요청을 기다리는 스레드,C가 연결을 닫는 중인 스레드입니다. (기다린 시간이KeepAliveTimeout보다 1초 가까이(실행에 따라 0.6~0.9초쯤) 더 긴 까닭은 이 글에서 따로 확인하지 않았습니다.) - event 에서는 0.001초였습니다. 스코어보드를 보면 스레드 넷 가운데 셋이 놀고(
_) 하나가 이 status 요청을 처리 중(W)입니다. 그런데도 연결 여섯은 끊기지 않았습니다. 마지막 줄은 event 의 리스너가LogLevel trace6에서 1초마다 남기는 로그인데(2011–2030행), 연결 6개가 모두 keep-alive 큐에 있고 작업 스레드는 4개입니다. 스레드보다 연결이 많아도 되는 것입니다.
헷갈리기 쉬운 곳
ConnsAsyncKeepAlive: 0은 "keep-alive 연결이 없다"는 뜻이 아닙니다. 같은 순간 리스너 로그에는keep-alive:6이 찍혔습니다.mod_status가 읽는 스코어보드의 연결 수(ps->keep_alive,ps->connections)는 리스너가 타임아웃 큐를 정리할 때만 갱신됩니다(2393–2398행). 이 예제에서는 가장 이른 만료가 5초 뒤라 아직 한 번도 정리가 돌지 않았습니다. 로그가 보여 준 값은 리스너가 들고 있는 원자 변수(여러 스레드가 동시에 고쳐도 안전한 변수)를 그 자리에서 읽은 것입니다.- 로그의
write-completion:0keep-alive:6에 띄어쓰기가 없는 것은 출력이 깨진 것이 아니라 소스의 문자열이 그렇습니다. C 에서는 나란히 쓴 문자열 두 개가 하나로 붙는데, 앞 문자열 끝에 공백이 없습니다(2016–2017행). 2.4.x 브랜치의 event.c 도 같은 문자열입니다. - event 도 일꾼이 모자라면 keep-alive 연결을 끊습니다. 리스너가 일을 넘기려는데 놀고 있는 작업 스레드가 없었으면(
workers_were_busy) keep-alive 큐를 만료 시각과 상관없이 통째로 닫습니다(process_keepalive_queue(0), 2364–2366행, 2400–2406행). 함수의 주석은 "다른 프로세스로 다시 접속하게" 하려는 것이라고 적고 있습니다(1946–1957행). 또 열린 연결 수(닫는 중인 연결은 빼고)가 대략ThreadsPerChild + 놀고 있는 스레드 수 × AsyncRequestWorkerFactor에 이르면 이 자식은 듣기 소켓을 잠시 꺼서 새 접속을 받지 않습니다(connections_above_limit(), 552–570행). 연결을 무한정 받는 것은 아닙니다. - event 에는 accept 뮤텍스가 없습니다. worker.c 에는 prefork 와 같은
SAFE_ACCEPT와 뮤텍스가 있지만(worker.c603행), event.c 에서는SAFE_ACCEPT·AP_ACCEPT_MUTEX_TYPE이 한 번도 나오지 않습니다. 2.4.x 브랜치의 event.c 도 같습니다. - trunk 와 2.4.x: 위 상태 목록(
CONN_STATE_ASYNC_WAITIO포함)과ka_q·wc_q·io_q큐 구조는 2.4.x 브랜치의include/httpd.h·event.c 에도 있습니다. 다만 우리가 흔히 설치하는 2.4 의 릴리스 버전마다 어디까지 들어 있는지는 확인하지 않았습니다.
예제 4: event 자식의 스레드 27개는 무엇을 하나
컨테이너 안에서는 실행 중인 프로세스에 gdb 를 붙이는 권한(ptrace)이 없어서, gdb 아래에서 httpd -X(자식을 만들지 않고 한 프로세스로 도는 디버그 모드)로 event 를 띄우고 3초 뒤 멈춰 모든 스레드의 호출 스택을 찍었습니다. 처음에는 실행 중인 자식에 gdb -p 로 붙으려다 "Could not attach to process" 로 막혀서 이렇게 바꿨습니다.
# 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다)
(sleep 3; kill -TRAP $(pgrep -x httpd)) &
timeout 30 gdb -batch -ex "handle SIGPIPE nostop noprint" -ex run -ex "thread apply all bt" -ex kill \
    --args /opt/httpd/bin/httpd -X -f /tmp/event.conf > /tmp/gdb.txt 2>&1 || true
=== 6. what are the 27 threads of one event child doing (gdb, -X single-process mode) ===
  27 threads; functions seen in their call stacks:
        1  in child_main
        1  in listener_thread
       25  in worker_thread
child_main() 의 메인 스레드 하나, listener_thread() 하나, worker_thread() 25개입니다. 기본 설정의 event 자식이 ps 에서 스레드 27개로 보인 것(6절 예제 5의 출력)과 맞습니다. 스레드를 만드는 start_threads() 는 작업 스레드를 만든 뒤 리스너를 만들고 끝납니다(2855–2891행).
5. 부모 프로세스: 1초마다 자식을 세고 늘리고 줄인다
세 MPM 모두 부모 프로세스는 요청을 처리하지 않습니다. 부모가 하는 일은 자식을 돌보는 것뿐이고, 그 루프는 세 MPM 이 거의 같은 모양입니다. prefork 를 보면 prefork_run() 의 끝부분이 이 루프입니다(prefork.c 1104–1196행).
ap_wait_or_timeout()— 끝난 자식이 있는지 기다리지 않고 확인하고(APR_NOWAIT), 없으면 1초 잡니다(server/mpm_common.c268행, 280행).- 자식이 끝났으면 그 자식의 스코어보드 칸을
SERVER_DEAD로 적고, 이번 바퀴의 유지 보수는 건너뜁니다. - 1초가 그냥 지났으면
perform_idle_server_maintenance()를 부릅니다(1195행).
worker 와 event 도 server_main_loop() 에서 같은 일을 합니다(event 는 3496–3607행).
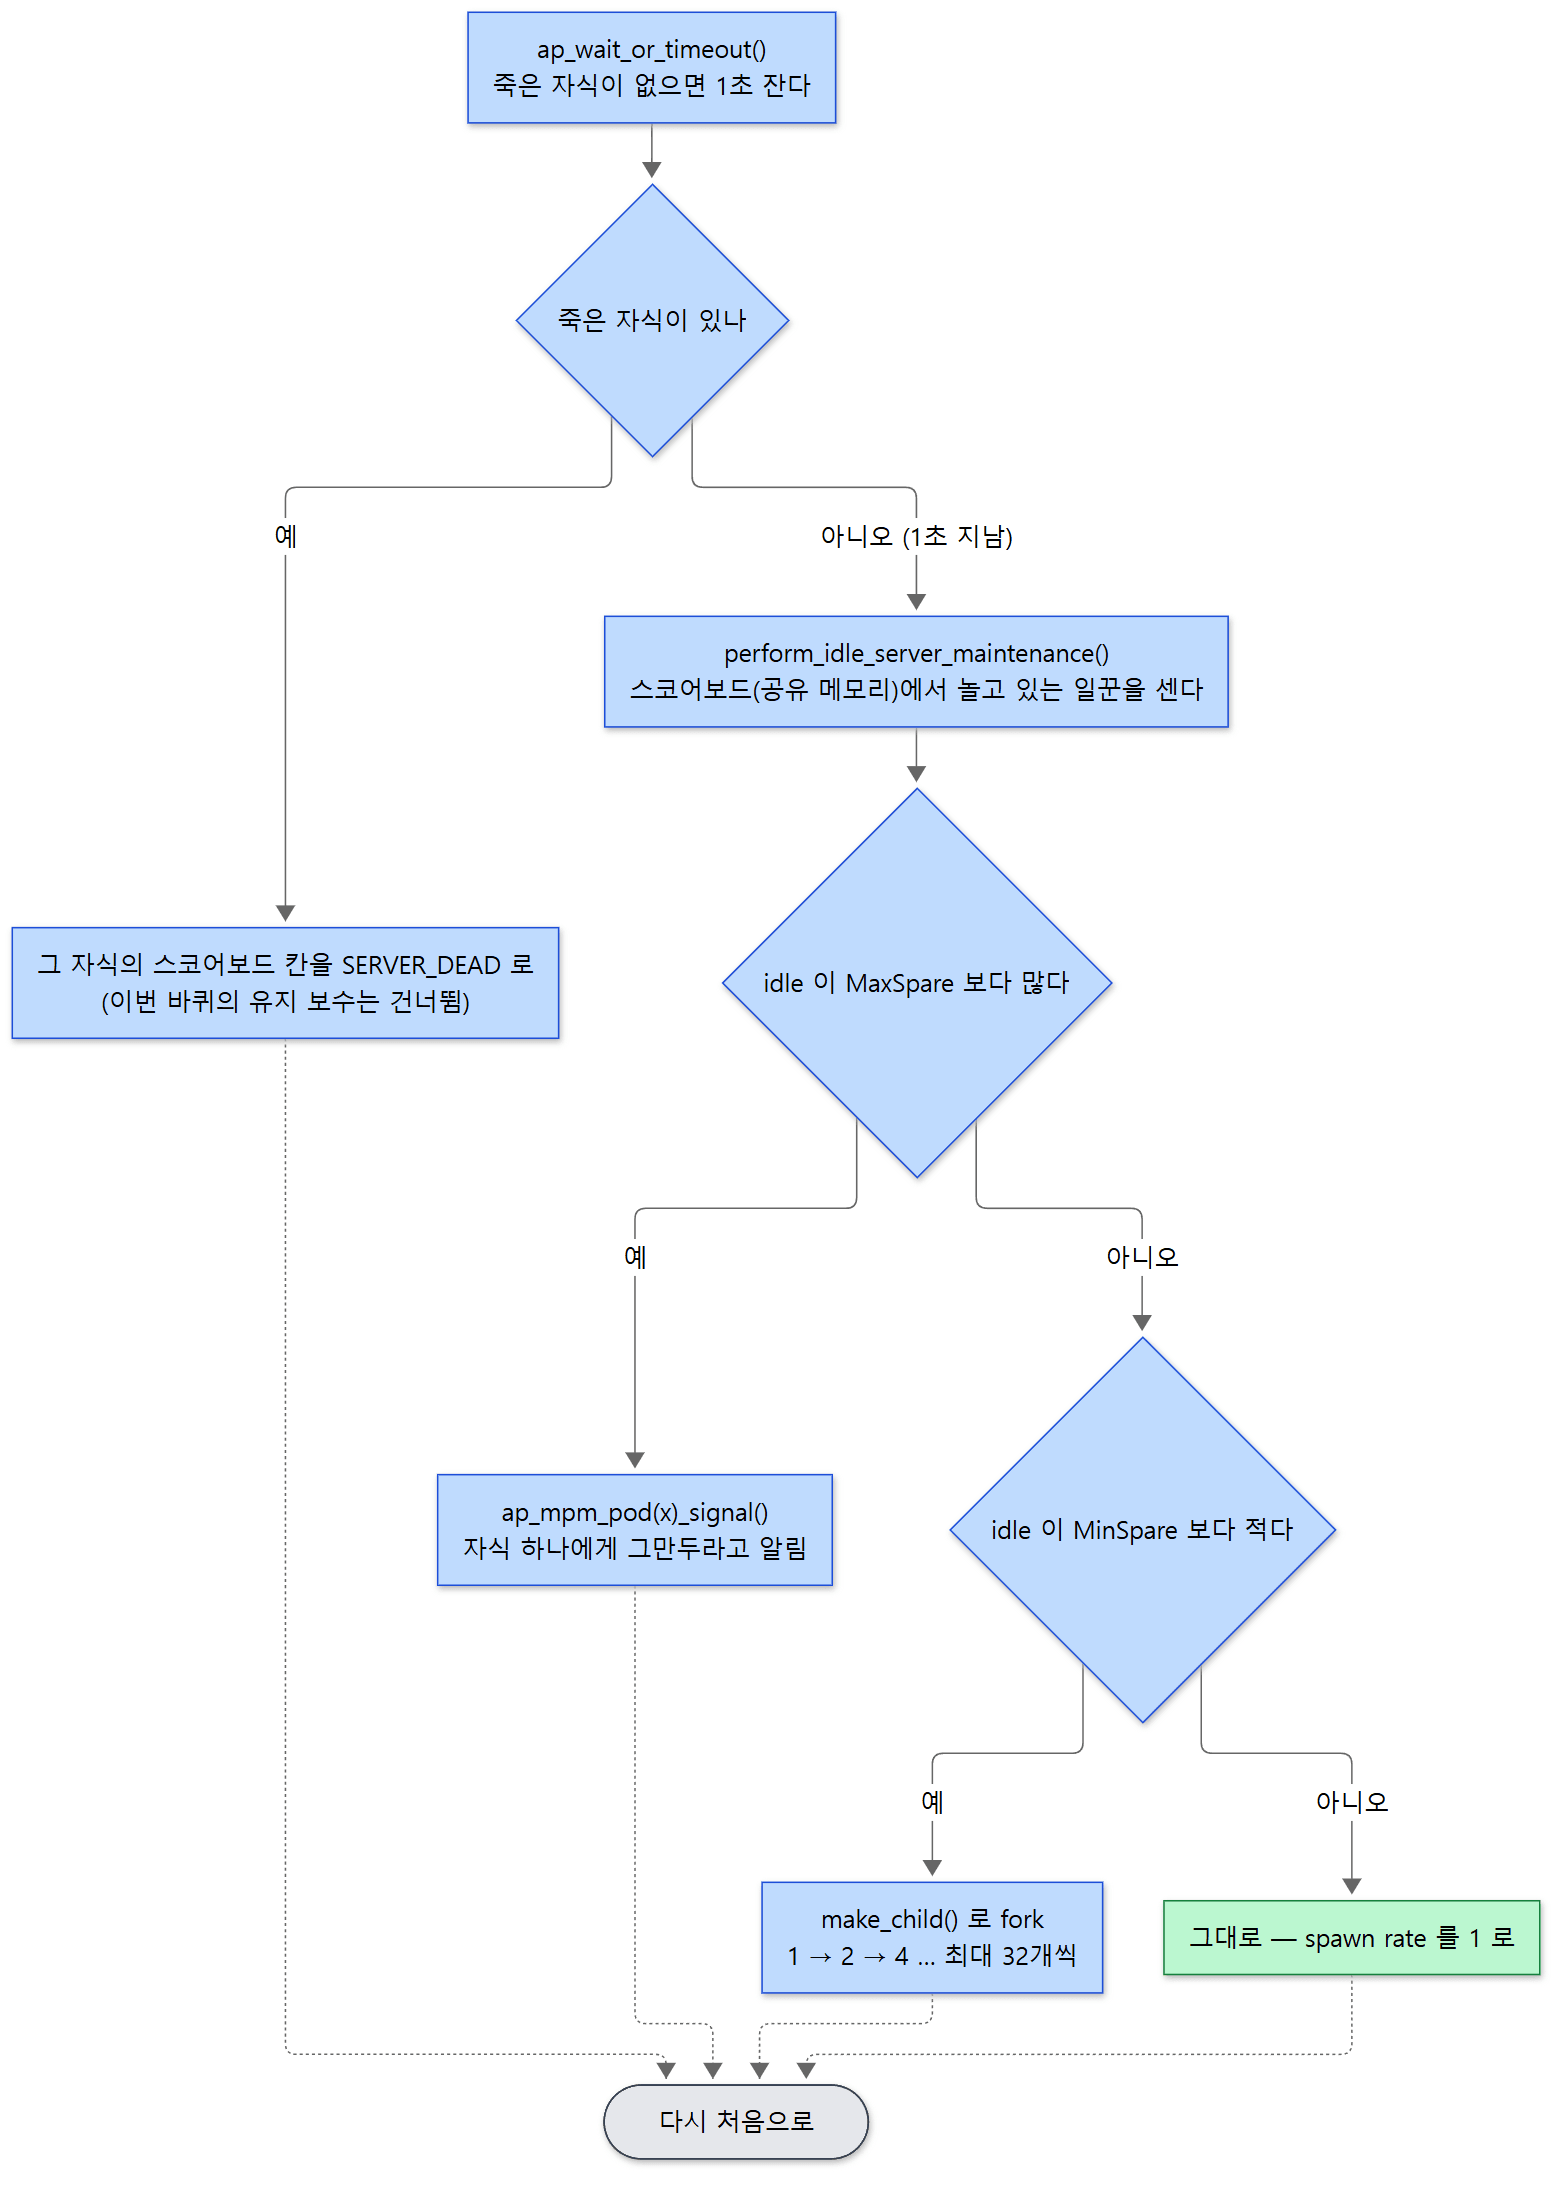 부모는 1초마다 스코어보드를 보고 판단합니다. 자식에게 직접 묻지 않습니다.
perform_idle_server_maintenance()
prefork 판을 보면, 먼저 스코어보드의 칸을 훑어 상태가 SERVER_READY 이하인 자식(놀고 있거나 막 시작하는 중)을 셉니다(prefork.c 863행). 그다음 판단입니다.
    if (idle_count > ap_daemons_max_free) {
        static int bucket_kill_child_record = -1;
        /* kill off one child... we use the pod because that'll cause it to
         * shut down gracefully, in case it happened to pick up a request
         * while we were counting
         */
        bucket_kill_child_record = (bucket_kill_child_record + 1) % retained->mpm->num_buckets;
        ap_mpm_pod_signal(retained->buckets[bucket_kill_child_record].pod);
        retained->idle_spawn_rate = 1;
    }
    else if (idle_count < ap_daemons_min_free) {
        /* ... 빈 칸이 없으면 "server reached MaxRequestWorkers setting" 을 한 번 기록 ... */
        else {
            /* ... */
            for (i = 0; i < free_length; ++i) {
                make_child(ap_server_conf, free_slots[i]);
            }
            /* the next time around we want to spawn twice as many if this
             * wasn't good enough, but not if we've just done a graceful
             */
            if (retained->hold_off_on_exponential_spawning) {
                --retained->hold_off_on_exponential_spawning;
            }
            else if (retained->idle_spawn_rate < MAX_SPAWN_RATE) {
                retained->idle_spawn_rate *= 2;
                if (retained->idle_spawn_rate > MAX_SPAWN_RATE) {
                    retained->idle_spawn_rate = MAX_SPAWN_RATE;
                }
            }
        }
    }
server/mpm/prefork/prefork.c 872–919행
- 놀고 있는 자식이
MaxSpareServers보다 많으면 한 바퀴에 하나만 줄입니다. 그 방법이ap_mpm_pod_signal()입니다. POD(pipe of death, 죽음의 파이프)는 부모와 자식이 공유하는 파이프로, 부모가 여기에 한 글자를 쓰면 그것을 먼저 읽은 자식이 "내가 그만둘 차례"로 받아들입니다(server/mpm_unix.c447–466행, 759행). 특정 자식을 신호로 죽이지 않는 이유는 주석에 있습니다 — 세는 사이에 그 자식이 요청을 받았을 수도 있으니, 하던 일을 마치고 우아하게 끝나게 하려는 것입니다. 2절의child_main()은 연결 하나를 처리할 때마다 이 파이프를 확인합니다(prefork.c702–704행). MinSpareServers보다 적으면 빈 칸에 자식을 만듭니다. 한 번에 만드는 수(idle_spawn_rate)는 1에서 시작해 부족할 때마다 두 배로 늘어MAX_SPAWN_RATE(32, 131행)까지 갑니다. 갑자기 손님이 몰렸을 때 1초에 하나씩 만들면 늦고, 처음부터 많이 만들면 낭비이기 때문입니다. 8 이상이 되면 "server seems busy" 를info수준으로 기록합니다(895–902행).- 사이에 있으면 아무것도 하지 않고 늘리는 속도를 1로 되돌립니다.
worker 와 event 도 같은 틀이지만 세는 단위가 자식이 아니라 스레드이고(MinSpareThreads/MaxSpareThreads), 자식 하나를 줄일 때 스레드 ThreadsPerChild 개가 한꺼번에 사라집니다(worker.c 1565–1569행, event.c 3357–3394행). event 판은 그만두는 중인 자식이 이미 있고 스코어보드에 여유가 없으면 줄이기를 미루는 조건이 더 붙어 있습니다(3374–3376행).
헷갈리기 쉬운 곳: StartServers 는 시작할 때만 쓰인다
StartServers 는 기동할 때 startup_children() 에 넘겨지는 수일 뿐입니다(prefork.c 1070행)(graceful 재시작 때는 같은 수가 죽은 자식을 하나씩 바로 채우는 데 쓰입니다, 1065–1068행·1151–1158행). 그 뒤로는 1초마다 Min/MaxSpare 로 맞추므로, StartServers 50 으로 띄워도 손님이 없으면 자식은 1초에 하나씩 줄어 MaxSpareServers 까지 내려갑니다. 위 코드가 한 바퀴에 하나만 줄이기 때문입니다.
6. 스코어보드 — 부모와 자식이 함께 보는 공유 메모리
부모는 어떻게 자식들이 놀고 있는지 알까요? 프로세스는 서로의 메모리를 볼 수 없으므로(먼저 알아 둘 말), 모두가 볼 수 있는 공유 메모리에 상태판을 하나 두고 각자 자기 칸에 상태를 적습니다. 이것이 스코어보드입니다.
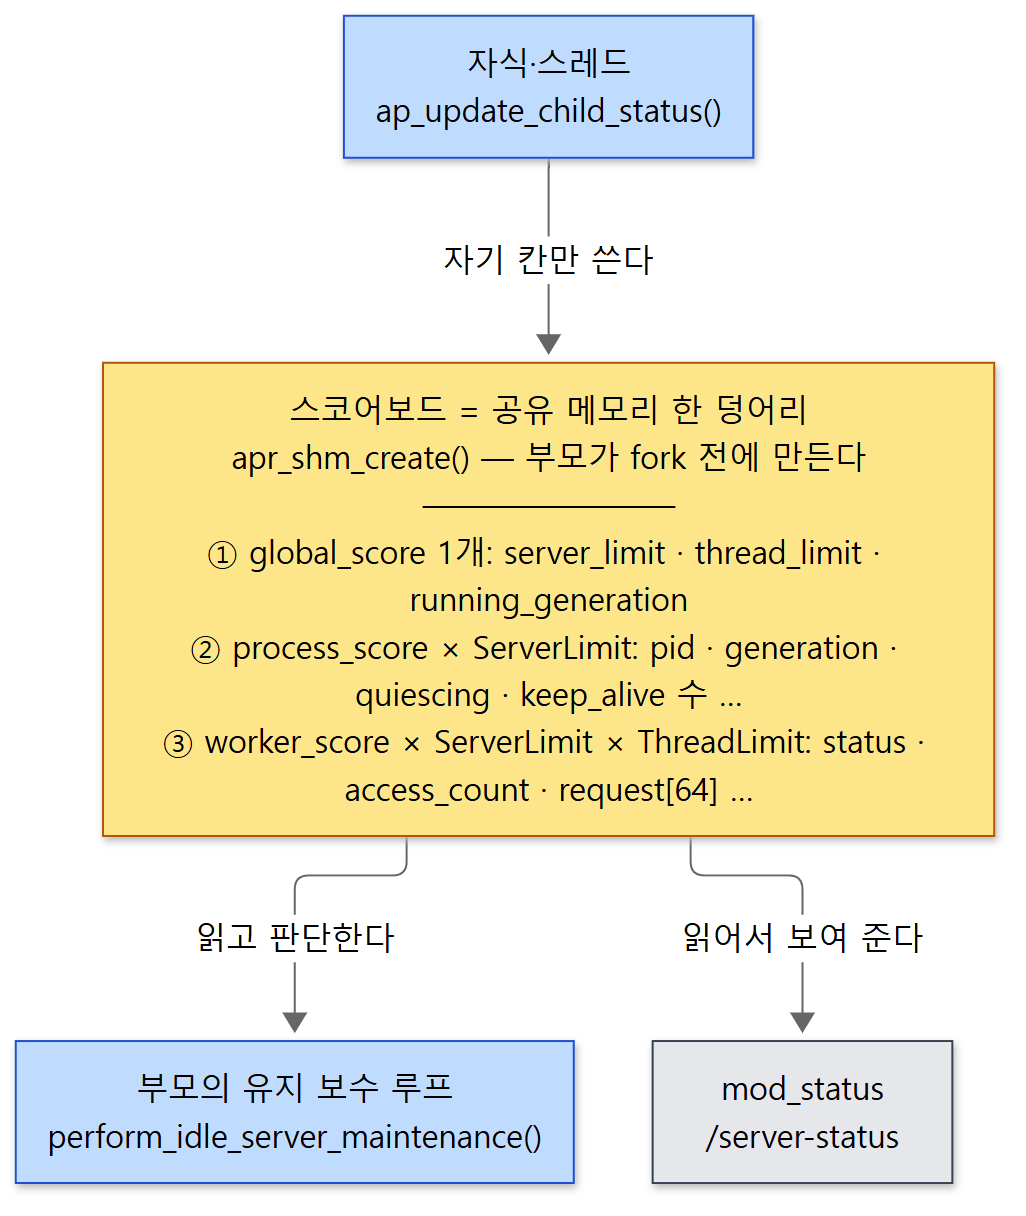 노란 상자 하나가 공유 메모리 전체입니다. 쓰는 쪽은 자기 칸만 쓰므로 잠금이 필요 없습니다.
세 가지 구조체
include/scoreboard.h 에 세 층이 있습니다.
global_score— 하나뿐입니다. 한계값과 지금 살아 있어야 할 세대 번호(running_generation)를 담습니다(123–133행). 세대는 재시작할 때마다 하나씩 늘어나는 번호이고(5편), 자식은 자기 세대와 이 값이 다르면 그만둡니다(예:prefork.c706–712행).process_score— 자식 프로세스마다 하나. PID, 세대, 그만두는 중인지(quiescing), 그리고 event 같은 비동기 MPM 용 연결 수들입니다(137–152행). 2.4.x 브랜치에는 여기에 이제 쓰지 않는bucket필드가 하나 더 있습니다.worker_score— 일꾼(prefork 는 자식, worker·event 는 스레드)마다 하나. 상태(status), 처리한 요청 수, 지금 처리 중인 요청 줄 앞부분(request[64]) 등입니다(90–121행).
status 값은 SERVER_DEAD(0)부터 SERVER_IDLE_KILL(10)까지입니다(56–67행). mod_status 는 이것을 한 글자씩으로 바꿔 보여 줍니다(modules/generators/mod_status.c 1006–1017행).
| 값 | 상수 | mod_status 글자 |
|---|---|---|
| 0 | SERVER_DEAD |
. |
| 1 | SERVER_STARTING |
S |
| 2 | SERVER_READY |
_ |
| 3 | SERVER_BUSY_READ |
R |
| 4 | SERVER_BUSY_WRITE |
W |
| 5 | SERVER_BUSY_KEEPALIVE |
K |
| 8 | SERVER_CLOSING |
C |
| 9 | SERVER_GRACEFUL |
G |
(6 L, 7 D, 10 I 는 표에서 뺐습니다.) 5절의 유지 보수 코드가 "SERVER_READY 이하"를 놀고 있다고 센 것은 STARTING(1)과 READY(2)를 함께 세려는 것이고, 주석은 이것이 상수의 순서에 기대고 있다고 적어 둡니다(prefork.c 857–862행).
크기는 ServerLimit × ThreadLimit, 만드는 것은 부모
AP_DECLARE(int) ap_calc_scoreboard_size(void)
{
    ap_mpm_query(AP_MPMQ_HARD_LIMIT_THREADS, &thread_limit);
    ap_mpm_query(AP_MPMQ_HARD_LIMIT_DAEMONS, &server_limit);

    scoreboard_size  = SIZE_OF_global_score;
    scoreboard_size += SIZE_OF_process_score * server_limit;
    scoreboard_size += SIZE_OF_worker_score * server_limit * thread_limit;

    return scoreboard_size;
}
여기서도 ap_mpm_query() 가 쓰입니다. 코어의 스코어보드 코드는 MPM 이 무엇인지 모르고, 한계값만 물어 크기를 정합니다. prefork 는 스레드 한계로 HARD_THREAD_LIMIT(1)을 답하므로(prefork.c 86–88행) worker_score 가 자식당 하나입니다. 이것이 ServerLimit·ThreadLimit 를 재시작으로 바꿀 수 없는 이유이기도 합니다. 공유 메모리의 크기가 처음에 정해지기 때문입니다(각 MPM 의 check_config 가 처음 값으로 되돌리고 경고합니다, 예: event.c 4190–4198행).
만드는 쪽은 ap_create_scoreboard() 이고, 코어가 이것을 pre_mpm 훅에 걸어 둡니다(server/core.c 6178행). MPM 은 자식을 fork 하기 전, graceful 이 아닌 시작·재시작에서 이 훅을 부릅니다(prefork.c 998–1002행). ScoreBoardFile 을 지정하지 않으면 이름 없는(anonymous) 공유 메모리를 apr_shm_create() 로 만듭니다(server/scoreboard.c 232행). fork 로 태어난 자식은 이 메모리를 그대로 물려받아 같은 곳을 봅니다.
잠금 없이 쓰는 이유
여러 프로세스가 한 메모리에 쓰는데 잠금이 없습니다. 소스 주석이 이유를 적고 있습니다 — 상태를 갱신하는 함수는 칸 하나만 고치고, 한 칸에는 한 번에 한 쪽만 쓴다(그 칸의 주인인 자식, 또는 자식이 죽었음을 적는 부모)(server/scoreboard.c 344–353행). 부모와 mod_status 는 읽기만 하므로 가끔 약간 낡은 값을 볼 수는 있지만, 1초마다 다시 보는 유지 보수에는 그것으로 충분합니다.
예제 5: 스코어보드 읽기
2절 예제와 같은 실행에서 mod_status 의 ?auto 출력을 봤습니다.
--- prefork
  scoreboard, first 80 slots: W____...........................................................................
  scoreboard, all 256 slots = '_' 4  'W' 1  '.' 251
--- worker
  scoreboard, first 80 slots: _________________________W_________________________________________________.....
  scoreboard, all 400 slots = '_' 74  'W' 1  '.' 325
  BusyWorkers: 1
  IdleWorkers: 74
--- event
  PID / PPID / threads(NLWP) / user
  180 1 1 root
  182 180 27 daemon
  183 180 27 daemon
  185 180 27 daemon
  httpd processes: 4, threads in total: 82
  scoreboard, first 80 slots: __________________________________________________W________________________.....
  scoreboard, all 400 slots = '_' 74  'W' 1  '.' 325
- prefork 는 256칸입니다. prefork 의
ServerLimit기본값 256(prefork.c76행) × 자식당 1칸. 다섯 자식 가운데 하나가 이 status 요청을 처리 중(W)이고 넷이 놀고 있으며(_), 나머지 251칸은 비어 있습니다(.). - worker 와 event 는 400칸입니다.
ServerLimit기본 16 ×ThreadsPerChild25. 공유 메모리에는 16 ×ThreadLimit(기본 64) 칸이 있지만,mod_status는ThreadsPerChild를 넘는 칸을 출력에서 뺍니다(mod_status.c334–338행, 656–668행). 자식 셋 × 25 = 75칸이 살아 있고, 그 가운데 1칸이W입니다.
7. 디렉티브는 코드의 어디로 가나
숫자를 받는 MPM 디렉티브는 모두 7편에서 본 AP_INIT_TAKE1 로 등록되고, 처리 함수는 대개 atoi() 로 숫자를 읽어(AsyncRequestWorkerFactor 만 소수를 받으려고 strtod()) 파일 안의 static 변수에 넣을 뿐입니다(예: event 의 표, event.c 4509–4532행). 값들이 서로 맞는지는 check_config 훅에서 한꺼번에 맞춥니다.
| 디렉티브 | 들어가는 변수 | 쓰이는 곳 |
|---|---|---|
StartServers |
ap_daemons_to_start |
기동할 때 startup_children() 에 한 번 (prefork.c 1070행) |
MinSpareServers / MaxSpareServers (prefork) |
ap_daemons_min_free / ap_daemons_max_free |
유지 보수의 판단 (872행, 882행) |
MinSpareThreads / MaxSpareThreads (worker·event) |
min_spare_threads / max_spare_threads |
유지 보수의 판단 (event.c 3357행, 3394행) |
MaxRequestWorkers (prefork) |
ap_daemons_limit |
자식 수의 상한 그 자체 (prefork.c 1568행) |
MaxRequestWorkers (worker·event) |
max_workers |
÷ ThreadsPerChild 로 자식 수 상한을 계산 (worker.c 2311행, event.c 4288행) |
ThreadsPerChild |
threads_per_child |
만들 작업 스레드 수, 큐의 크기 (event.c 2677행, 2807행) |
ServerLimit / ThreadLimit |
server_limit / thread_limit |
ap_mpm_query 를 거쳐 스코어보드 크기 (6절) |
AsyncRequestWorkerFactor (event) |
worker_factor |
새 접속을 멈추는 기준 (connections_above_limit()) |
MaxConnectionsPerChild (코어) |
ap_max_requests_per_child |
자식·스레드가 은퇴할 때 (2절) |
Listen 등 (LISTEN_COMMANDS) |
ap_listeners 목록 |
부모가 소켓을 열고 자식이 물려받음 (8절) |
헷갈리기 쉬운 곳: 같은 MaxRequestWorkers, 다른 뜻
prefork 의 디렉티브 설명은 "Maximum number of children alive at the same time"(prefork.c 1593–1594행), event 의 설명은 "Maximum number of threads alive at the same time"(event.c 4521–4522행)입니다. 이름은 같지만 prefork 에서는 프로세스 수, worker·event 에서는 스레드 수입니다. 그래서 worker·event 에서 MaxRequestWorkers 가 ThreadsPerChild 의 배수가 아니면 check_config 가 배수로 내려 맞추고 경고합니다(worker.c 2313–2330행). 또 event 에서는 이 값이 "동시에 처리할 수 있는 연결 수"가 아닙니다. 4절 예제처럼 keep-alive 연결은 스레드를 차지하지 않으므로, 열려 있는 연결은 이보다 많을 수 있습니다.
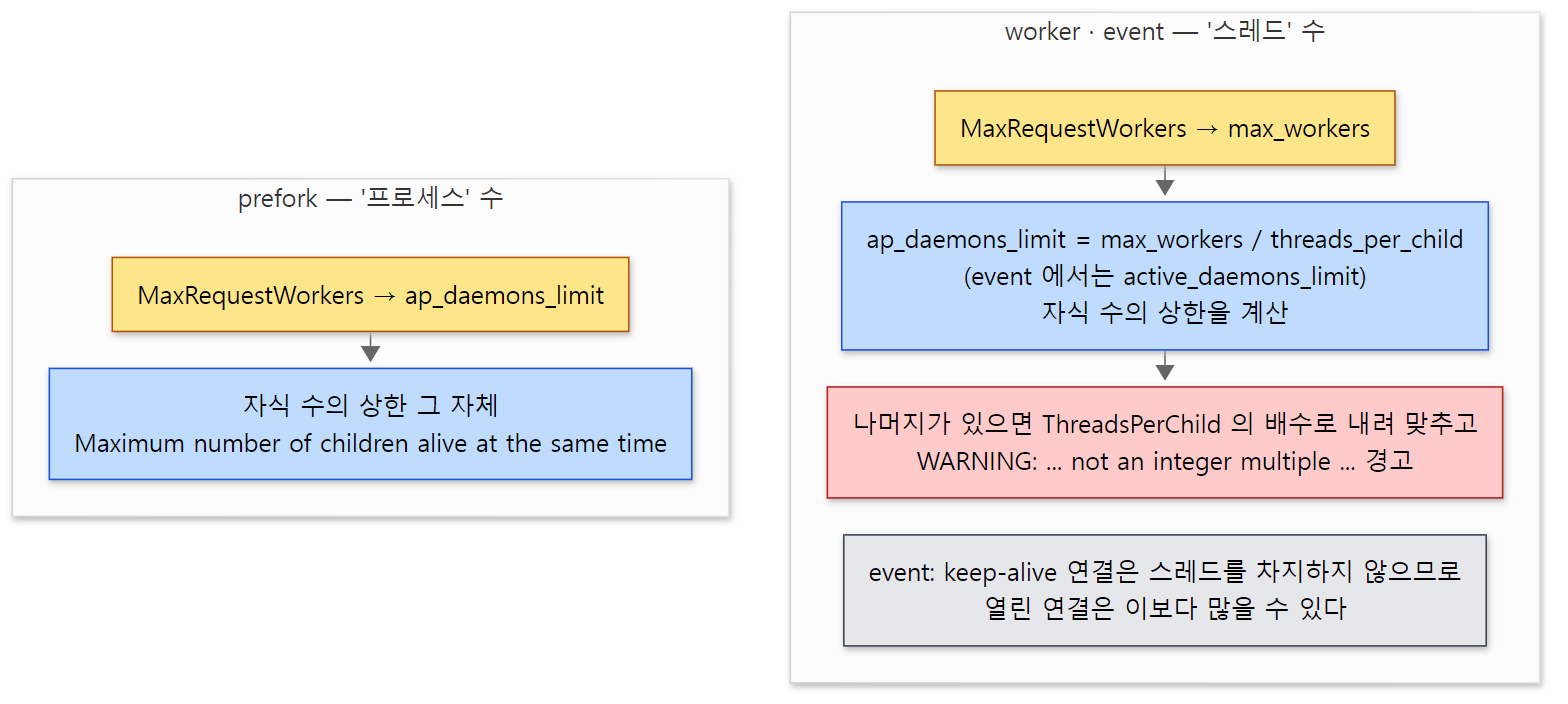 이름은 같아도 prefork 는 프로세스 수, worker·event 는 스레드 수입니다. 계산은 worker.c 2311–2330행과 event.c 4288–4306행에서 확인했습니다.
8. 듣기 소켓은 부모가 열고, 재시작을 넘어 살아남는다
Listen 디렉티브를 처리하는 ap_set_listener() 는 ap_listen_rec 를 목록 ap_listeners 에 더하기만 하고(server/listen.c 1074행), 실제로 소켓을 여는 것은 MPM 의 open_logs 훅이 부르는 ap_setup_listeners() 입니다(1절). 이 훅은 부모에서 fork 전에 돌므로, 자식들은 열린 소켓을 그대로 물려받아 같은 소켓에서 accept 합니다. 80번처럼 1024 미만의 포트는 root 만 열 수 있는데, 자식이 daemon 사용자로 내려간 뒤에도(5편) 80번에서 받을 수 있는 이유가 이것입니다.
재시작할 때도 소켓을 닫았다 다시 열지 않습니다.
- 각 MPM 의
pre_config가 부르는ap_listen_pre_config()가 지금의 목록을old_listeners로 옮겨 둡니다(server/listen.c986–988행). - 설정을 다시 읽으며
Listen을 만날 때마다, 주소와 포트가 같은 옛 항목이 있으면 그 항목(열린 소켓 포함)을 새 목록으로 그대로 옮깁니다(find_listeners()424–456행, 472–478행). - 소켓을 여는 단계에서 새 설정에 없는 옛 소켓만 닫습니다(699–701행).
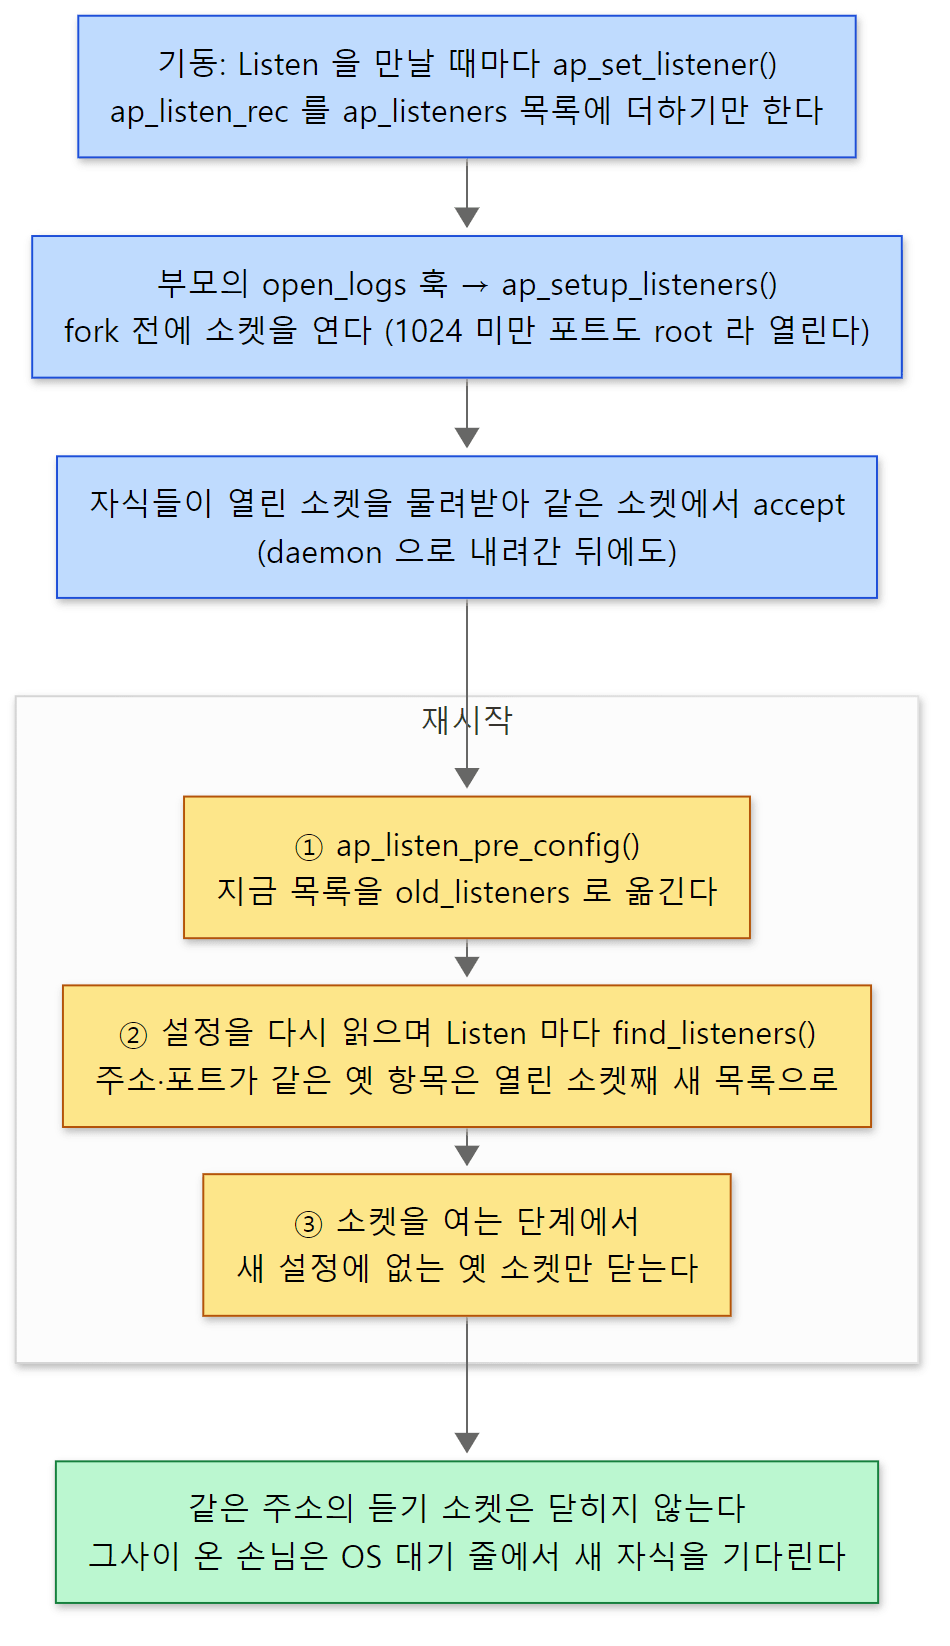 위 세 단계를 기동 때의 흐름에 이어 붙였습니다. 노란 칸이 재시작 때만 하는 일입니다.
그래서 재시작 중에도 같은 주소의 듣기 소켓은 닫히지 않고, 그사이 들어온 손님은 운영체제의 대기 줄에서 새 자식을 기다립니다.
헷갈리기 쉬운 곳: 리스너 "버킷"
소스에서 my_bucket, num_buckets 라는 이름이 자주 보입니다. ListenCoresBucketsRatio 를 설정하고 운영체제가 SO_REUSEPORT 를 지원하면, 듣기 소켓을 CPU 코어 수에 비례해 여러 벌 복제하고 자식들을 그 묶음(버킷)에 나눠 배정합니다(server/listen.c 823–870행). 기본값은 0이라(994행) 버킷은 하나이고, 이 글의 예제도 모두 버킷 하나로 돌았습니다. 코드에서 % num_buckets 같은 계산을 만나면 "기본 설정에서는 1로 나누는 것"이라고 읽으면 됩니다.
이 글에서 뺀 것
- graceful 재시작·종료에서 자식과 스레드를 거두는 과정 —
ap_reclaim_child_processes()(server/mpm_unix.c), worker·event 의signal_threads()·join_workers(),GracefulShutdownTimeout. - event 의 타이머와 콜백 —
ap_mpm_register_timed_callback(),ap_mpm_register_poll_callback()(include/ap_mpm.h204–254행,event.c1581–1776행).mod_proxy_wstunnel같은 모듈이 이것으로 연결을 MPM 에 맡깁니다. - 연결을 천천히 닫는 lingering close —
ap_lingering_close()(server/connection.c), event 의process_lingering_close()(event.c1778행). CONN_STATE_SUSPENDED와 suspend/resume 훅(event.c874–893행, 1354행).- 자식이 잇따라 죽을 때 서버를 멈추는 판단 —
sick_child_detected,APEXIT_CHILDSICK·APEXIT_CHILDFATAL. mod_unixd의 신호 설정ap_unixd_mpm_set_signals()(os/unix/unixd.c).- Windows 의
winntMPM(server/mpm/winnt/)과 trunk 에만 있는motorz·simple.
정리
| 개념 | 한 줄 요약 |
|---|---|
| MPM | 접속을 받아 어느 프로세스·스레드가 처리할지 정하는 모듈. LoadModule 로 정확히 하나를 싣는다 |
| mpm 훅 | 코어와 MPM 의 가장 큰 약속. main() 이 ap_run_mpm() 으로 부르면 MPM 이 부모 루프를 돈다 |
ap_mpm_query() |
다른 모듈이 MPM 의 성질과 한계를 묻는 창구. 스코어보드 크기, http 모듈의 sync/async 선택이 이것으로 정해진다 |
| prefork | 스레드 하나짜리 자식이 연결 하나씩. 듣기 소켓이 여럿이면 accept 뮤텍스로 줄을 세운다 |
| worker | 자식마다 리스너 1 + 작업 스레드 N. 놀고 있는 스레드를 먼저 확보하고 accept 해 fd_queue_t 로 넘긴다 |
| event | worker 구조에 더해, keep-alive·쓰기 대기·닫기 대기 연결을 리스너의 pollset 에 맡겨 작업 스레드를 풀어 준다 |
연결 상태 cs->state |
작업 스레드가 요청 하나를 처리하고 남기는 다음 할 일. event 는 이것으로 큐를 고른다 |
| 부모의 유지 보수 | 1초마다 스코어보드를 세어 Min/MaxSpare 에 맞춘다. 늘릴 때는 두 배씩, 줄일 때는 하나씩 |
| POD | 부모가 "누구든 하나 그만두라"고 알리는 파이프. 자식은 일을 마친 뒤 읽는다 |
| 스코어보드 | 부모가 fork 전에 만드는 공유 메모리. 각자 자기 칸만 써서 잠금이 없다. mod_status 가 이것을 보여 준다 |
| 듣기 소켓 | 부모가 열고 자식이 물려받는다. 재시작해도 같은 주소의 소켓은 닫지 않고 넘긴다 |
다음에 볼 것
MPM 이 소켓 하나를 일꾼에게 넘기는 데까지 봤습니다. 일꾼이 그 소켓으로 ap_process_connection() 을 부른 뒤, 연결이 conn_rec 가 되고 요청 줄과 헤더를 읽어 request_rec 가 되는 과정은 9편: 연결과 요청 읽기 — 소켓 하나가 request_rec가 되기까지에서 이어집니다. 4절에서 event 가 상태만 보고 넘긴 sync/async 두 함수의 속도 그 글에 있습니다.
Spring 연재와 견주어 보면, worker 의 "연결 하나 = 스레드 하나"는 서블릿 컨테이너의 스레드 하나가 요청 하나를 맡아 DispatcherServlet 을 끝까지 따라가는 모습(Spring 21편)과 닮았고, event 가 기다리는 연결을 스레드에서 떼어 소수의 스레드가 poll 로 지켜보게 한 것은 WebFlux 가 "본문이 다 도착할 때까지 스레드를 붙잡고 기다리지 않으려는" 설계(Spring 24편)와 같은 문제를 겨냥합니다. 다만 event 는 요청을 처리하는 동안에는 여전히 작업 스레드 하나를 쓰고, 요청과 요청 사이에 기다리는 시간만 스레드에서 떼어 낸다는 점이 다릅니다.
- 1편: AI와 함께 소스를 읽는 방법과 분석 지도
- 3편: 전체 지도 — 코어, APR, MPM, 모듈과 세 개의 큰 구조체
- 5편: main()과 기동 — 설정을 두 번 읽는 이유와 재시작
- 6편: 모듈과 훅 — 모듈 하나가 서버에 끼어드는 방법
- 같은 문제를 Java 서버는 어떻게 푸나: Tomcat 소스 파헤치기 5: 커넥터와 NIO 엔드포인트 — 연결은 어떤 스레드가 받나
- 워커 스레드 하나가 연결을 지켜보고 처리까지 하고, 새 연결은 기본으로 accept 뮤텍스 대신
EPOLLEXCLUSIVE로 나누는 C 서버: nginx 소스 파헤치기 7: 이벤트 루프 — epoll, 타이머, posted 이벤트, accept