이 글에서 다루는 것
"Apache httpd 소스 파헤치기" 연재의 네 번째 글입니다. 3편에서 httpd 가 OS ↔ APR ↔ 코어 ↔ MPM ↔ 모듈의 층으로 이루어져 있고, server_rec·conn_rec·request_rec 세 구조체가 저마다 pool 이라는 필드를 가진다는 것까지 봤습니다. 이번에는 그 pool, 곧 APR 메모리 풀을 엽니다.
httpd 소스를 처음 열면 이상한 점이 하나 있습니다. C 프로그램인데 malloc() 과 free() 가 거의 보이지 않습니다. 대신 apr_palloc(r->pool, …) 같은 호출이 곳곳에 있고, 그렇게 받은 메모리를 돌려주는 코드는 어디에도 없습니다. 이 글은 그 이유를 따라갑니다.
답하려는 질문은 네 가지입니다.
- 메모리를 받기만 하고 돌려주지 않는데 왜 메모리가 새지 않는가
apr_palloc()은 왜malloc()보다 빠른가 — 안에서 실제로 무슨 일을 하는가- 파일이나 소켓처럼 메모리가 아닌 것은 언제, 어떤 순서로 닫히는가
- httpd 는 어떤 풀을 언제 만들고 언제 버리며, 모듈을 짤 때 무엇을 조심해야 하는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache httpd |
| 버전 | 2.5.1-dev (trunk) |
| 커밋 | e4af30fe6d (2026-10-24) |
| APR | APR 1.7.2 (태그 1.7.2, 커밋 e905526629) |
| 주로 읽는 파일 | APR memory/unix/apr_pools.c, include/apr_pools.h, include/apr_allocator.h / httpd server/main.c, server/core.c, server/protocol.c, server/eor_bucket.c, server/mpm/event/event.c |
글에 나오는 줄 번호는 모두 위 두 커밋 기준입니다. httpd 소스를 같은 커밋으로 받는 방법과 예제를 돌리는 도커 환경은 1편에 있습니다.
풀 코드는 디버깅용 분기까지 합치면 3,000줄 가까이 되지만, 이 글은 소스를 처음 보는 분이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름만 적어 두었습니다.
먼저 알아 둘 말
malloc() 과 free() 는 C 표준 라이브러리의 메모리 함수입니다. malloc(100) 은 100바이트를 빌려 주고 그 주소를 돌려줍니다. 다 쓰면 그 주소로 free() 를 불러 돌려줘야 합니다. 돌려주지 않으면 프로그램이 끝날 때까지 그 메모리는 다시 쓸 수 없습니다. 이것을 메모리 누수(leak)라고 합니다. 반대로 돌려준 뒤에 그 주소를 또 쓰면 이미 다른 데 쓰이고 있을지 모르는 메모리를 건드리게 됩니다(use-after-free).
풀(pool)은 메모리를 빌려 주는 "통"입니다. 풀에서 받은 메모리는 하나씩 돌려주지 않고, 풀을 비우거나(apr_pool_clear()) 없앨 때(apr_pool_destroy()) 한꺼번에 돌아갑니다. APR 의 자료형 이름은 apr_pool_t 입니다.
수명(lifetime)은 어떤 데이터가 쓰이는 기간입니다. 요청 헤더는 요청 하나가 끝나면 필요 없고, 설정은 서버를 재시작할 때까지 필요합니다. 풀은 수명이 같은 데이터를 한 통에 담는 방법이라고 보면 됩니다.
노드(node)는 풀이 실제로 메모리를 담아 두는 큰 덩어리입니다. 풀은 4KB 단위의 덩어리를 받아 와서 그 안을 잘게 나눠 줍니다. 소스에서는 apr_memnode_t 입니다.
allocator 는 노드를 만들어 주고 돌려받는 관리자입니다. 다 쓴 노드를 운영체제에 바로 돌려주지 않고 크기별 목록에 모아 두었다가 다음에 다시 내줍니다. 소스에서는 apr_allocator_t 입니다.
cleanup 은 풀이 비워지거나 없어질 때 불러 달라고 풀에 맡겨 두는 함수입니다. 파일을 닫거나 소켓을 닫는 일처럼 "메모리를 돌려주는 것 말고 해야 할 뒷정리"를 여기에 둡니다. 함수를 값처럼 넘기는 함수 포인터와, 어떤 자료형이든 가리킬 수 있는 void * 가 여기서 쓰입니다. 둘 다 2편에서 풀어 두었습니다.
1. 왜 free 가 없나 — 서버의 메모리는 묶음으로 죽는다
웹 서버가 요청 하나를 처리하는 동안 만드는 데이터를 떠올려 봅니다. 요청 줄과 헤더를 담을 문자열, URL 을 파일 경로로 바꾼 문자열, 응답 헤더 표, 모듈마다 요청별로 쓰는 설정 조각… 수십에서 수백 개의 작은 메모리 조각이 생깁니다. 그리고 이것들은 거의 모두 요청이 끝나는 순간 함께 필요 없어집니다.
malloc()/free() 로 이것을 관리하면 조각 하나하나에 대해 "누가 언제 free() 하나"를 정해야 합니다. 모듈이 수십 개 끼어드는 httpd 에서 이것을 틀리지 않기는 어렵습니다. 한 군데만 빠뜨려도 요청마다 메모리가 새고, 서버는 몇 주씩 켜져 있으니 결국 메모리를 다 먹습니다.
APR 풀은 질문을 바꿉니다. "이 조각을 언제 버리나" 대신 "이 조각은 무엇과 같이 죽나" 만 정합니다.
- 요청과 같이 죽는 것 → 요청 풀
r->pool에서 받는다 - 연결과 같이 죽는 것 → 연결 풀
c->pool에서 받는다 - 설정과 같이 죽는 것 → 설정 풀
pconf에서 받는다
그러면 httpd 코어가 요청이 끝날 때 r->pool 을 한 번 없애는 것으로 그 요청에서 받은 메모리가 전부 돌아갑니다. 모듈은 free() 를 부를 필요가 없고, 부를 방법도 없습니다. APR 에는 풀에서 받은 조각 하나를 돌려주는 함수가 없습니다. apr_pools.h 에 있는 할당 함수는 apr_palloc()·apr_pcalloc() 뿐이고, 돌려주는 쪽은 풀 전체를 대상으로 하는 apr_pool_clear()·apr_pool_destroy() 뿐입니다(include/apr_pools.h 357–483행).
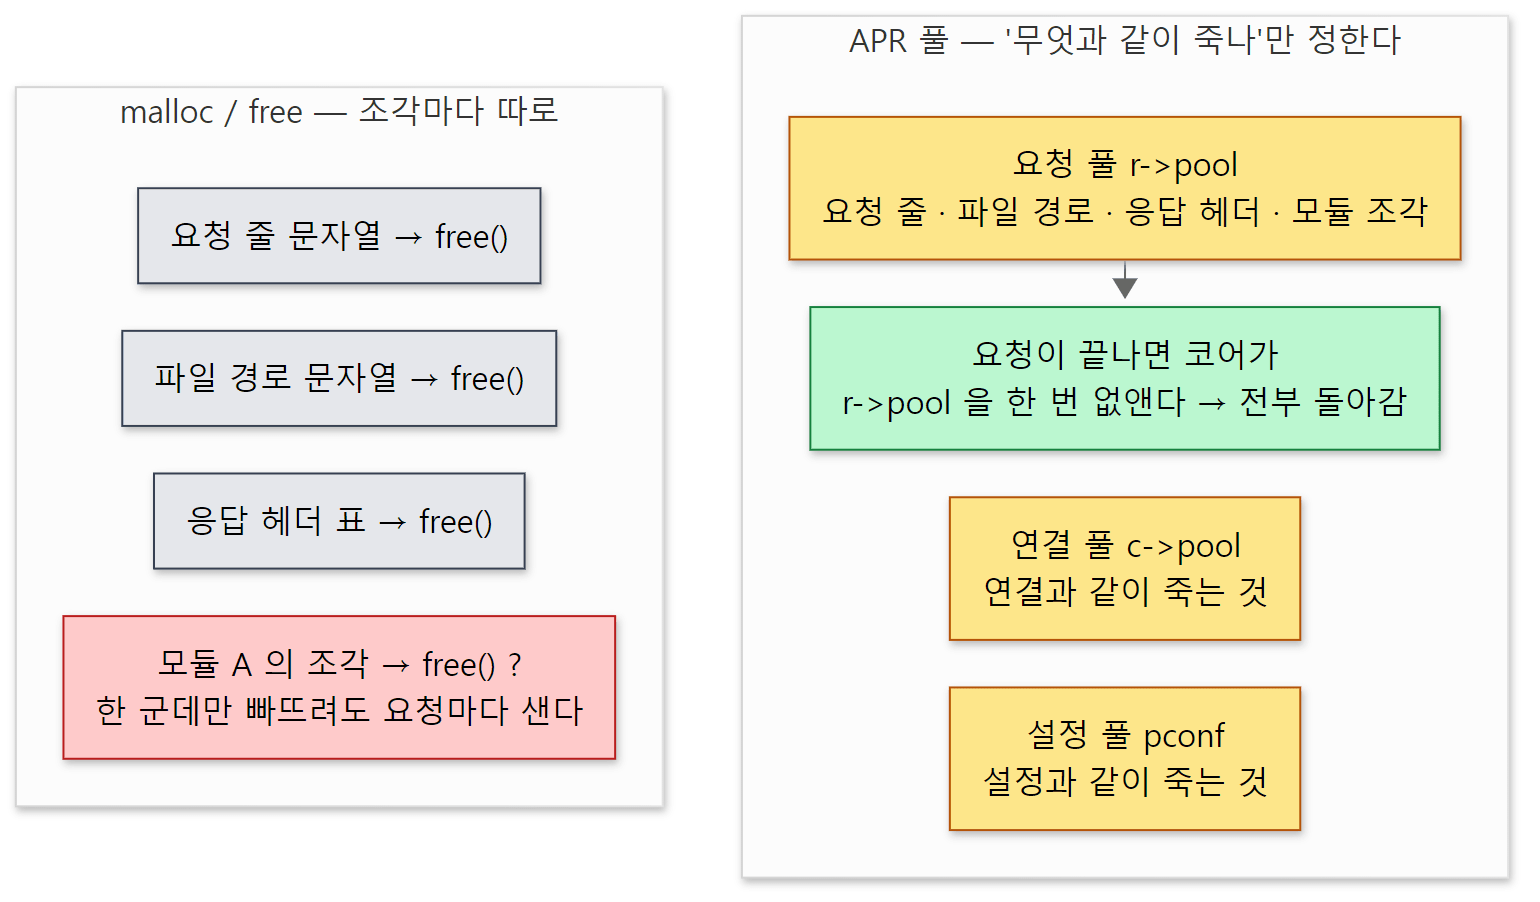 질문이 "언제 버리나"에서 "무엇과 같이 죽나"로 바뀝니다. 빨간 칸이 malloc/free 에서 생기기 쉬운 누수입니다.
설정 파일에서도 이 설계의 흔적을 볼 수 있습니다. MaxMemFree 디렉티브는 "풀이 다 쓴 메모리를 운영체제에 돌려주지 않고 쥐고 있을 수 있는 양"을 정합니다. 2절의 allocator 가 바로 그 메모리를 쥐고 있는 곳입니다.
2. 풀의 생김새 — 노드와 allocator
풀 구조체
apr_pool_t 의 앞부분입니다. (/* ... */ 는 이 글에서 줄인 곳이고, 나머지는 소스 그대로입니다.)
struct apr_pool_t {
    apr_pool_t           *parent;
    apr_pool_t           *child;
    apr_pool_t           *sibling;
    apr_pool_t          **ref;
    cleanup_t            *cleanups;
    cleanup_t            *free_cleanups;
    apr_allocator_t      *allocator;
    struct process_chain *subprocesses;
    apr_abortfunc_t       abort_fn;
    apr_hash_t           *user_data;
    const char           *tag;

#if !APR_POOL_DEBUG
    apr_memnode_t        *active;
    apr_memnode_t        *self; /* The node containing the pool itself */
    char                 *self_first_avail;
    /* ... */
memory/unix/apr_pools.c 562–578행
세 무리로 나눠 읽으면 됩니다.
parent·child·sibling— 풀은 나무 모양을 이룹니다. 풀을 만들 때 부모를 정하면(apr_pool_create(&새풀, 부모)) 새 풀이 부모의 자식 목록 맨 앞에 붙습니다(1106–1116행). 부모가 비워지거나 없어지면 자식은 먼저 없어집니다. 이것이 4절의 핵심입니다.cleanups— 1절에서 말한 뒷정리 함수의 목록입니다. 4절에서 봅니다.active·self— 실제 메모리가 들어 있는 노드입니다.self는 풀 구조체 자신이 들어 있는 노드,active는 지금 메모리를 나눠 주고 있는 노드입니다.
#if !APR_POOL_DEBUG 는 "APR 을 풀 디버깅 모드로 빌드하지 않았을 때만 이 필드들을 넣으라"는 전처리 지시입니다. 디버깅 모드에서는 풀이 완전히 다른 방식으로 동작하는데, 그 이야기는 3절 끝에 있습니다.
self 의 주석이 말하듯 풀 구조체는 자기 첫 노드 안에 들어 있습니다. 풀을 만들 때 노드를 먼저 하나 받고, 그 노드의 맨 앞자리에 apr_pool_t 를 놓은 다음, 나머지 자리를 나눠 줄 메모리로 씁니다(1086–1092행). 그래서 풀을 하나 만드는 데에도 노드 하나가 듭니다. 이 노드의 최소 크기 MIN_ALLOC 은 2 * BOUNDARY_SIZE, 기본 빌드에서 BOUNDARY_SIZE 는 1 << 12 = 4096 이므로 8KB 입니다(85행, 94–95행). APR 을 mmap 으로 노드를 받게 빌드하면 이 값이 페이지 크기를 따르게 되는데(88–92행), 흔한 x86-64 리눅스의 페이지 크기가 4KB 라 결과는 같습니다.
노드
노드의 머리에 붙는 구조체는 여섯 필드가 전부입니다.
struct apr_memnode_t {
    apr_memnode_t *next;            /**< next memnode */
    apr_memnode_t **ref;            /**< reference to self */
    apr_uint32_t   index;           /**< size */
    apr_uint32_t   free_index;      /**< how much free */
    char          *first_avail;     /**< pointer to first free memory */
    char          *endp;            /**< pointer to end of free memory */
};
include/apr_allocator.h 54–61행
중요한 것은 아래 두 줄입니다. first_avail 은 아직 아무에게도 주지 않은 첫 바이트, endp 는 노드의 끝입니다. 그 사이가 남은 곳입니다. 노드 안에서 이미 나눠 준 조각들이 어디서 어디까지인지는 어디에도 적혀 있지 않습니다. 적어 둘 필요가 없기 때문입니다 — 조각을 하나씩 돌려받는 일이 없으니까요.
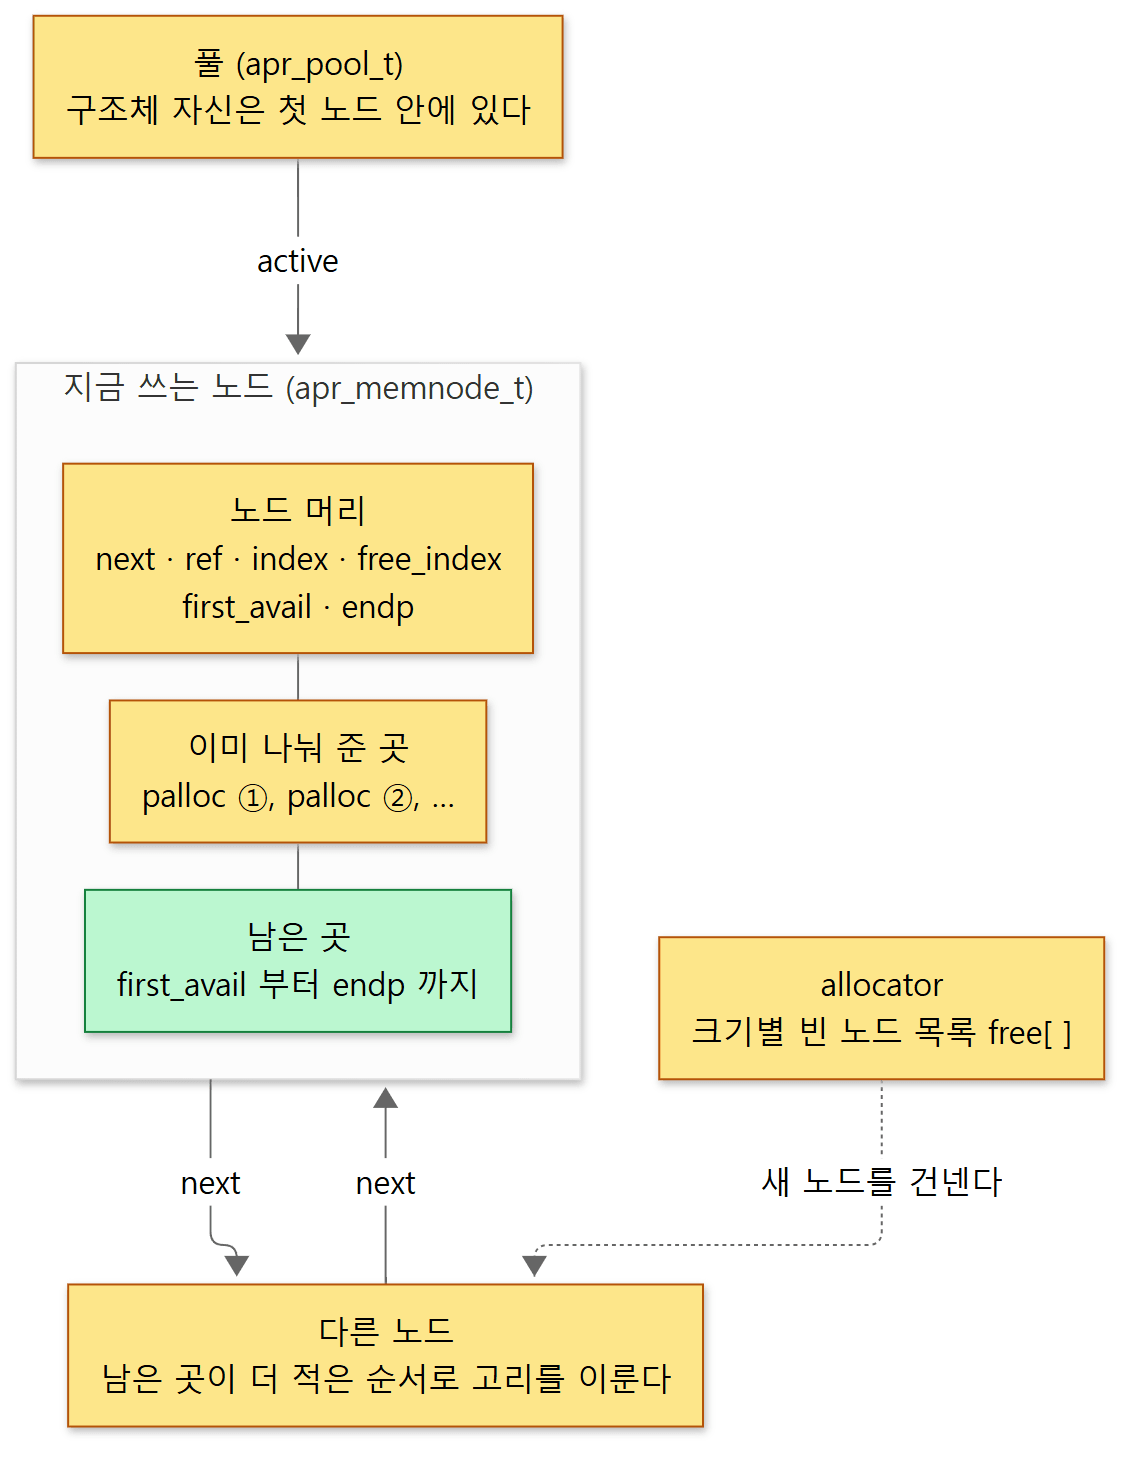 노란색은 메모리, 초록색이 다음
apr_palloc() 이 떼어 갈 남은 곳입니다.
풀이 가진 노드들은 next 로 이어진 고리(원형 목록)를 이룹니다. apr_palloc() 은 새 노드를 끼울 때마다 고리를 남은 곳이 많은 순서로 정리해 둡니다(861–875행).
allocator — 다 쓴 노드를 모아 두는 곳
풀이 비워지면 노드는 free() 되지 않고 allocator 에게 돌아갑니다. allocator 는 노드를 크기별 목록 free[] 에 모아 둡니다.
struct apr_allocator_t {
    /* ... */
    /**
     * Lists of free nodes. Slot 0 is used for oversized nodes,
     * and the slots 1..MAX_INDEX-1 contain nodes of sizes
     * (i+1) * BOUNDARY_SIZE. Example for BOUNDARY_INDEX == 12:
     * slot  0: nodes larger than 81920
     * slot  1: size  8192
     * slot  2: size 12288
     * ...
     * slot 19: size 81920
     */
    apr_memnode_t      *free[MAX_INDEX];
};
memory/unix/apr_pools.c 125–154행
다음에 어느 풀이 노드를 달라고 하면 allocator 는 먼저 이 목록에서 맞는 크기를 찾고, 없을 때만 malloc() 을 부릅니다(allocator_alloc() 289–424행, malloc 은 402행). 요청을 처리할 때마다 같은 크기의 노드가 필요해지는 서버에서는 대부분 목록에서 꺼내는 것으로 끝납니다.
그런데 이렇게 모아 두기만 하면, 한 번 큰 요청이 지나간 뒤에 그 메모리를 영영 쥐고 있게 됩니다. 그래서 allocator 에는 "모아 둘 수 있는 최대량" max_free_index 가 있고, 그것을 넘는 노드는 돌려받는 즉시 free() 합니다(448–452행, free() 는 485–494행). 기본값은 APR_ALLOCATOR_MAX_FREE_UNLIMITED(0), 곧 "한없이 모아 둔다"입니다(apr_allocator_create() 191행).
httpd 는 이 값을 MaxMemFree 디렉티브로 정합니다. 디렉티브가 읽히면 ap_max_mem_free 에 KB × 1024 가 들어가고(server/mpm_common.c 471행), 따로 적지 않았을 때의 기본값은 2048*1024, 곧 2MB 입니다(186–187행). MPM 은 연결마다, 또는 자식 프로세스마다 allocator 를 따로 만들면서 이 값을 넣습니다(5절).
헷갈리기 쉬운 곳
- 풀이 비워져도 프로세스의 메모리 사용량이 줄지 않을 수 있습니다. 노드는 allocator 로 돌아갈 뿐이고,
max_free_index안쪽이면free()되지 않습니다.top으로 보이는 메모리가 요청이 끝나도 그대로인 것은 대개 누수가 아니라 이것입니다. 다만 다음 요청이 그 노드를 다시 쓰므로 계속 늘어나지는 않습니다. free()된다고 해서 운영체제에 바로 돌아가는 것도 아닙니다. 그다음은 C 라이브러리의malloc구현이 정할 일이고, APR 소스의 범위 밖입니다.
3. apr_palloc — 할당은 포인터를 미는 것
이제 풀에서 메모리를 받는 함수를 봅니다. apr_palloc() 의 앞부분입니다. Valgrind(메모리 검사 도구)용 분기와 크기가 넘칠 때의 오류 처리는 줄였습니다.
APR_DECLARE(void *) apr_palloc(apr_pool_t *pool, apr_size_t in_size)
{
    apr_memnode_t *active, *node;
    void *mem;
    apr_size_t size, free_index;

    pool_concurrency_set_used(pool);
    size = APR_ALIGN_DEFAULT(in_size);
    /* ... */
    active = pool->active;

    /* If the active node has enough bytes left, use it. */
    if (size <= node_free_space(active)) {
        mem = active->first_avail;
        active->first_avail += size;
        goto have_mem;
    }
    /* ... */
memory/unix/apr_pools.c 810–836행
- 크기를 8의 배수로 올립니다.
APR_ALIGN_DEFAULT(size)는APR_ALIGN(size, 8)이고,APR_ALIGN은 비트 연산으로 다음 8의 배수를 만드는 매크로입니다(include/apr_general.h136–140행). 13바이트를 달라고 하면 16바이트를 씁니다. 다음 조각의 주소도 8의 배수가 되어, 그 자리에 어떤 자료형을 두어도 CPU 가 읽기 좋은 위치(정렬)가 됩니다. - 지금 노드에 남은 곳이 충분하면 —
node_free_space()는endp - first_avail을 계산하는 매크로입니다(742행). first_avail을 돌려주고,first_avail을 크기만큼 앞으로 밉니다. 끝입니다.
함수 이름 앞의 APR_DECLARE(void *) 는 "이 함수를 라이브러리 밖에 공개하고 void * 를 돌려준다"는 뜻의 매크로이고, goto have_mem 은 함수 끝의 have_mem: 표시로 바로 건너뛰는 것입니다.
덧셈 한 번, 비교 한 번으로 할당이 끝납니다. malloc() 은 빈 곳을 찾고, 나중에 free() 할 때를 대비해 조각의 크기를 적어 두고, 여러 스레드가 동시에 부를 때를 대비한 처리도 해야 합니다. 풀은 그 일을 전부 하지 않습니다. 조각을 하나씩 돌려받지 않으니 크기를 적어 둘 필요도, 돌려받은 빈 곳을 찾아 다시 쓸 필요도 없습니다. 이런 방식을 흔히 bump pointer(포인터 밀기) 할당이라고 부릅니다(소스에 이 낱말이 있는 것은 아닙니다).
지금 노드가 가득 찼을 때만 일이 조금 늘어납니다.
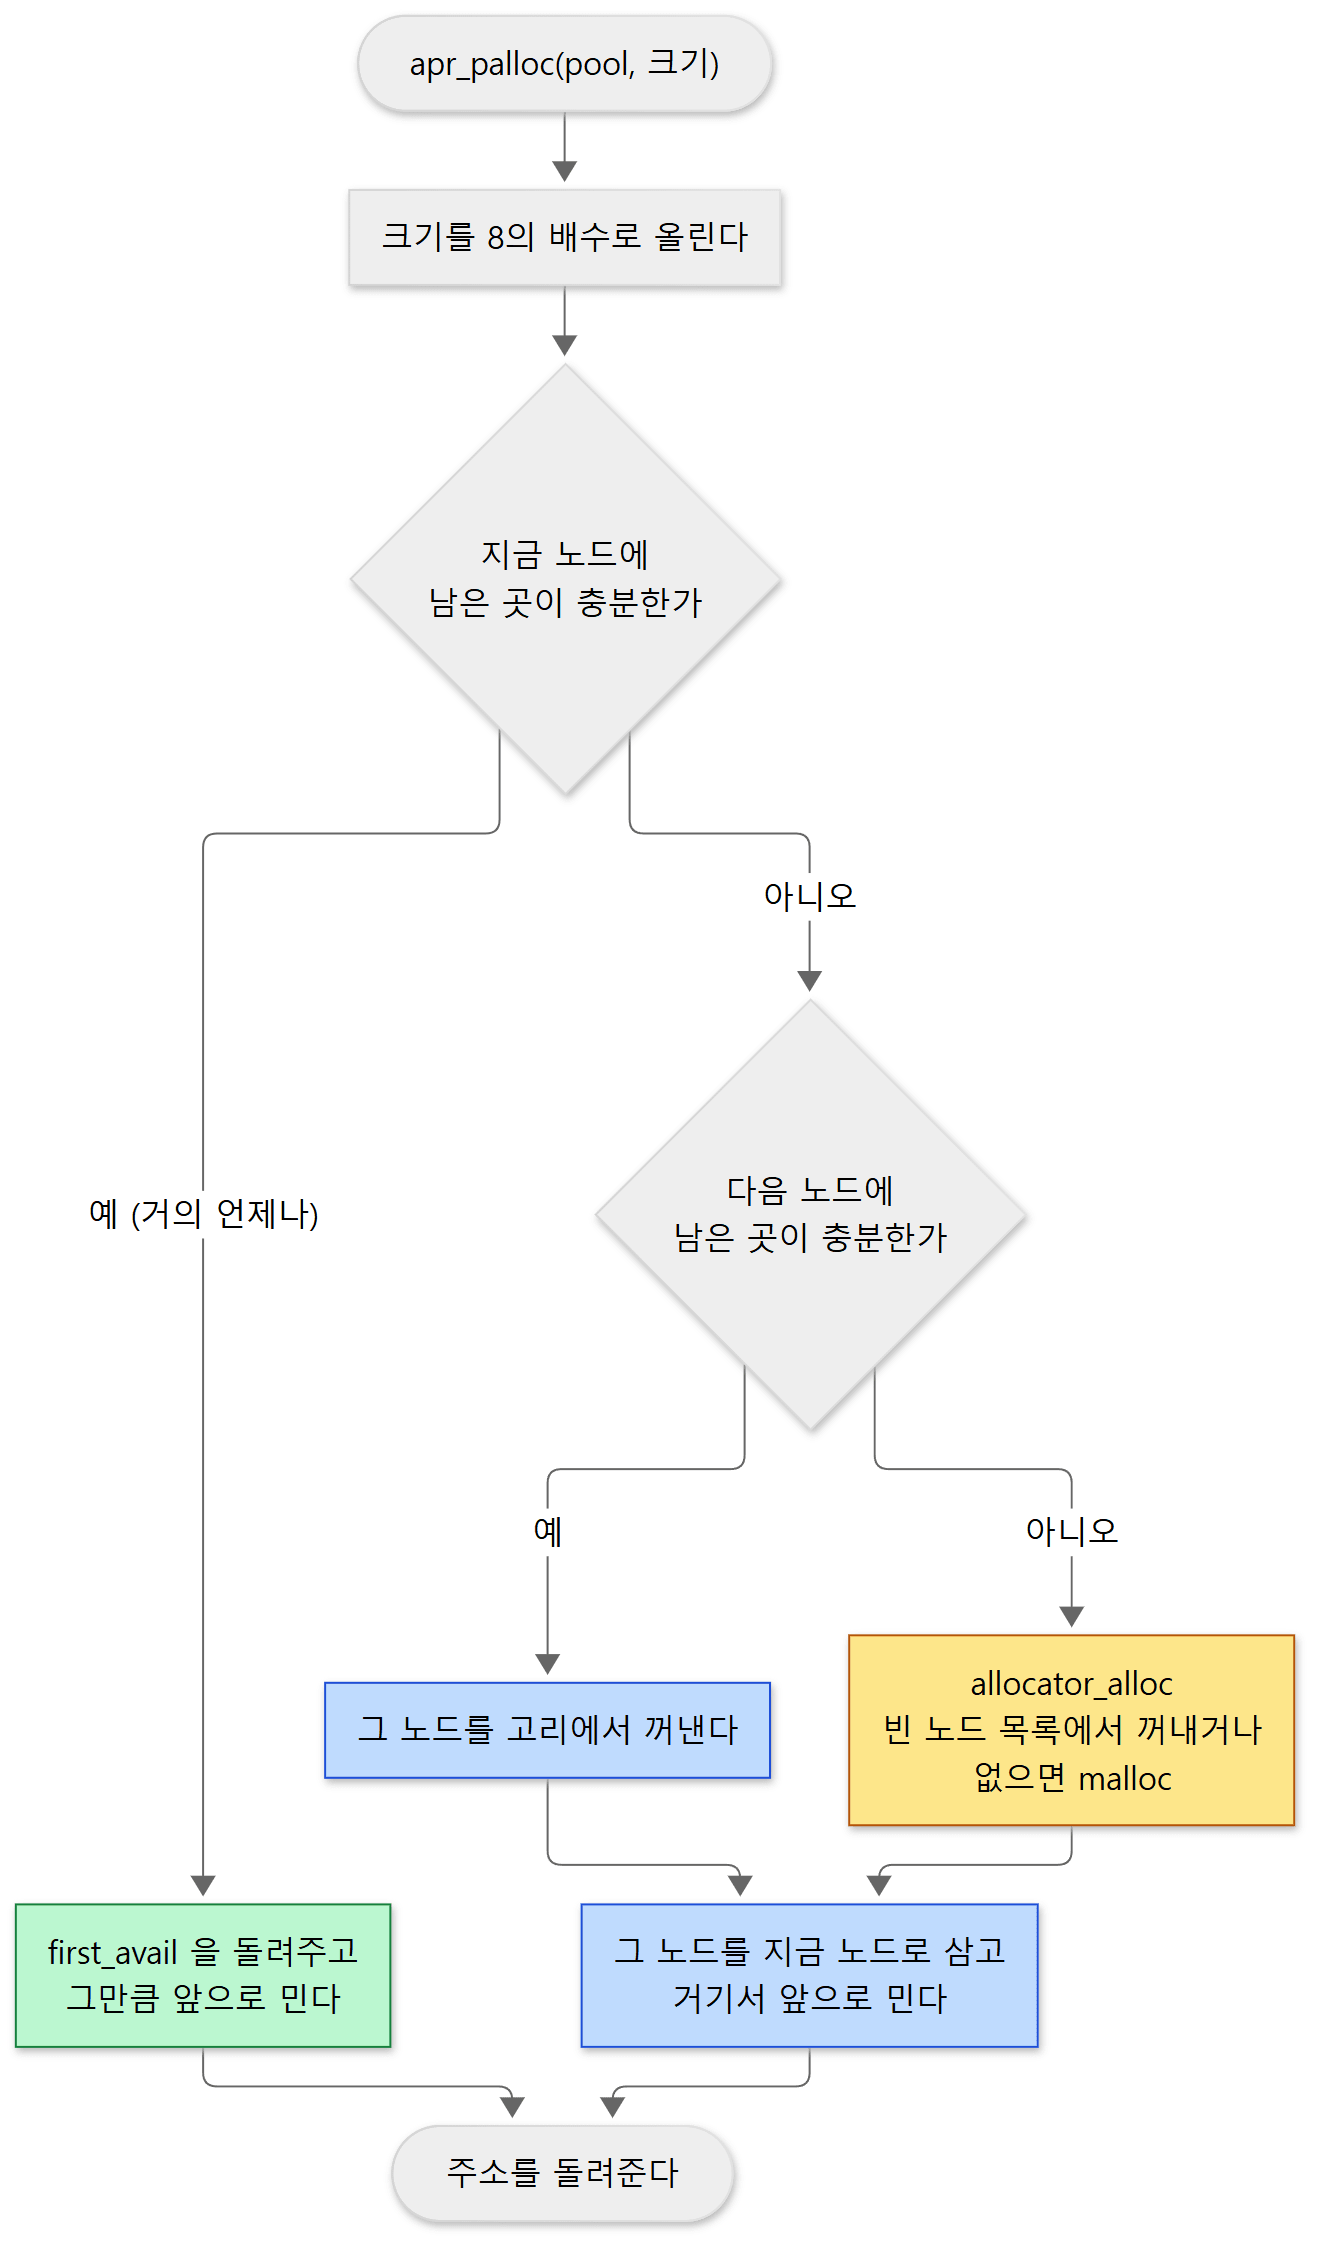 초록색 길이 거의 언제나 지나는 길입니다. 노란색 상자에서만
malloc() 이 불릴 수 있습니다.
고리에서 바로 다음 노드(남은 곳이 가장 많은 노드)를 보고, 거기도 모자라면 allocator 에게 새 노드를 받습니다(838–850행). 어느 쪽이든 그 노드를 active 로 삼고 똑같이 포인터를 밉니다(852–859행). 노드는 4KB 단위로 만들어지므로(allocator_align() 263–279행) 100KB 를 한 번에 달라고 해도 그만큼 큰 노드가 하나 생길 뿐 방식은 같습니다.
예제 1: 정말 포인터만 미는지
풀을 직접 써 보는 작은 C 프로그램입니다. httpd 없이 APR 라이브러리(libapr-1)만 링크합니다. 이 글의 예제는 모두 기준 커밋(e4af30fe6d)을 그대로 빌드한 httpd 2.5.1-dev 와 같은 컨테이너(Ubuntu 24.04, 패키지 APR 1.7.2)에서 실행했습니다. 프로그램 전체는 예제 폴더의 pooldemo.c 이고, 여기서는 1번 부분만 싣습니다.
/* 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다) */
    apr_initialize();
    apr_pool_create(&pool, NULL);

    /* 1. 할당은 포인터를 앞으로 미는 것 */
    a = apr_palloc(pool, 13);
    b = apr_palloc(pool, 13);
    c = apr_palloc(pool, 100);
    printf("[1] palloc(13), palloc(13), palloc(100)\n");
    printf("  b - a = %ld bytes, c - b = %ld bytes\n", (long)(b - a), (long)(c - b));
컴파일과 실행은 컨테이너 안에서 이렇게 했습니다.
gcc $(apr-1-config --cflags --cppflags --includes) -o /tmp/pooldemo pooldemo.c $(apr-1-config --link-ld)
/tmp/pooldemo
[1] palloc(13), palloc(13), palloc(100)
  b - a = 16 bytes, c - b = 16 bytes
13바이트짜리 두 조각이 16바이트 간격으로 바로 붙어서 나왔습니다. 8의 배수로 올린 크기만큼만 포인터가 움직였다는 뜻입니다. malloc() 이었다면 조각마다 크기 정보 같은 머리가 붙어 간격이 더 벌어지는 것이 보통입니다.
헷갈리기 쉬운 곳
apr_palloc()이 준 메모리는 비어 있지 않습니다. 노드를 재활용하므로 이전 요청이 남긴 내용이 그대로 있을 수 있습니다. 0으로 채워진 메모리가 필요하면apr_pcalloc()을 씁니다. 풀 디버깅을 끈 빌드에서apr_pcalloc은memset(apr_palloc(p, size), 0, size)로 바뀌는 매크로입니다(include/apr_pools.h464–465행).ap_create_request()가request_rec을apr_pcalloc()으로 받는 것도 이 때문입니다(5절).apr_palloc()에는 잠금이 없습니다. 위 코드의 빠른 길에는 뮤텍스가 없고, 잠금은 allocator 에서 노드를 꺼낼 때만 잡습니다(allocator_alloc()316행). 첫 줄의pool_concurrency_set_used()는 APR 을APR_POOL_CONCURRENCY_CHECK로 빌드했을 때만 "다른 스레드가 같은 풀을 동시에 쓰고 있으면 멈춘다"는 검사를 하는 함수이고, 평소에는 빈 함수입니다(744–804행). 그래서 한 풀은 한 스레드가 쓰는 것이 원칙입니다. 부모 풀에 자식 풀을 만드는 것만은 여러 스레드가 동시에 해도 된다고 헤더에 적혀 있습니다(include/apr_pools.h191–194행).- 풀 디버깅 모드에서는 이 설명이 맞지 않습니다.
APR_POOL_DEBUG로 빌드한 APR 에서apr_palloc은apr_palloc_debug로 바뀌고(include/apr_pools.h451–454행), 조각마다malloc()을 따로 부릅니다(pool_alloc()1754–1791행). 풀을 비울 때는 그 조각들을'A'로 덮어쓴 뒤free()합니다(1831행, 1872–1882행). 이미 비운 풀의 메모리를 쓰는 실수를 드러내기 위한 장치입니다. 위 예제에서 두 조각이 16바이트 간격으로 붙어 나온 것을 보면 이 컨테이너의 APR 은 디버깅 모드가 아닙니다.
4. 비우기와 없애기 — clear, destroy, 그리고 cleanup 의 순서
apr_pool_clear()
풀을 비우는 함수입니다. 동시성 검사 줄과 Valgrind 줄은 줄였습니다.
APR_DECLARE(void) apr_pool_clear(apr_pool_t *pool)
{
    apr_memnode_t *active;

    /* Run pre destroy cleanups */
    run_cleanups(&pool->pre_cleanups);
    /* ... */
    pool->pre_cleanups = NULL;
    /* ... */

    /* Destroy the subpools.  The subpools will detach themselves from
     * this pool thus this loop is safe and easy.
     */
    while (pool->child)
        apr_pool_destroy(pool->child);

    /* Run cleanups */
    run_cleanups(&pool->cleanups);
    /* ... */
    pool->cleanups = NULL;
    pool->free_cleanups = NULL;

    /* Free subprocesses */
    free_proc_chain(pool->subprocesses);
    pool->subprocesses = NULL;

    /* Clear the user data. */
    pool->user_data = NULL;

    /* Find the node attached to the pool structure, reset it, make
     * it the active node and free the rest of the nodes.
     */
    active = pool->active = pool->self;
    active->first_avail = pool->self_first_avail;
    /* ... */
    if (active->next == active) {
        /* ... */
        return;
    }

    *active->ref = NULL;
    allocator_free(pool->allocator, active->next);
    active->next = active;
    active->ref = &active->next;
    /* ... */
}
memory/unix/apr_pools.c 920–970행
순서가 곧 규칙입니다.
- pre_cleanup 을 부릅니다.
apr_pool_pre_cleanup_register()로 건, "자식 풀보다도 먼저" 불려야 하는 뒷정리입니다. - 자식 풀을 모두 없앱니다. 자식은
apr_pool_destroy()로 없어지고, 그 안에서도 1~4가 똑같이 일어납니다. 손주 풀까지 아래에서부터 차례로 정리되는 셈입니다. - cleanup 을 부릅니다.
- 하위 프로세스를 정리하고
user_data를 비웁니다(user_data비우기는 clear 에만 있습니다). - 마지막으로 메모리를 되감습니다. 풀 구조체가 든 첫 노드(
self)의first_avail을 처음 자리로 돌려놓고, 나머지 노드는 고리째 allocator 에게 돌려줍니다.
5번에 free() 가 없다는 것을 눈여겨보세요. 첫 노드는 포인터 하나를 되돌리는 것으로 비워지고, 나머지 노드는 allocator 의 목록으로 갑니다. 할당이 포인터 밀기였듯이 해제도 포인터 되감기입니다.
apr_pool_destroy() 도 1~3과 하위 프로세스 정리는 같고(user_data 는 따로 비우지 않습니다 — 풀의 메모리째 돌아가기 때문입니다, 972–1037행), 마지막에 부모의 자식 목록에서 자기를 빼고 첫 노드까지 allocator 에 돌려준다는 점만 다릅니다. 그 풀이 allocator 의 주인(owner)이면 allocator 자체도 없앱니다(1033–1035행). 이때 비로소 모아 둔 노드가 모두 free() 됩니다(apr_allocator_destroy() 198–217행).
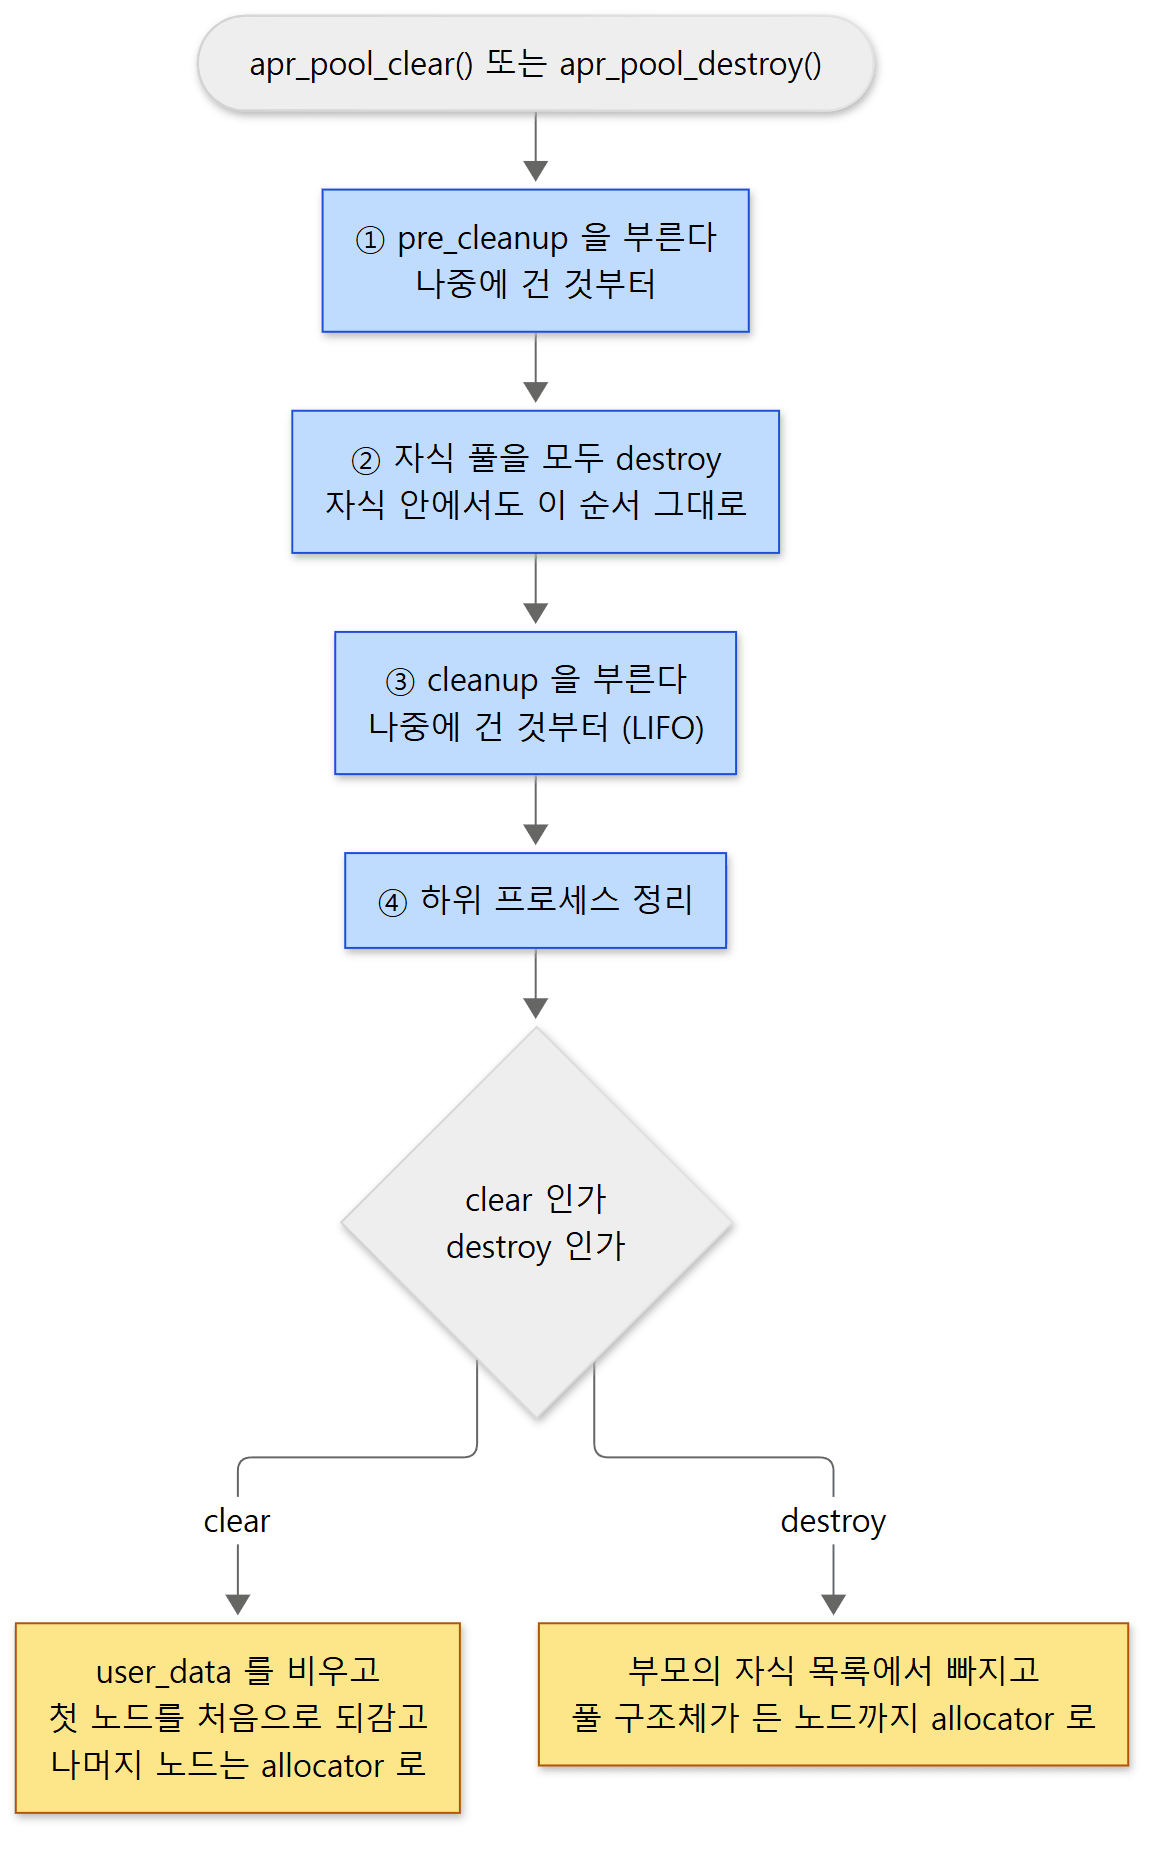 파란 상자 넷은 clear 와 destroy 가 같고, 노란 상자만 다릅니다.
cleanup 은 왜 "나중에 건 것부터"인가
cleanup 을 거는 함수와 부르는 함수입니다.
    if (p != NULL) {
        if (p->free_cleanups) {
            /* reuse a cleanup structure */
            c = p->free_cleanups;
            p->free_cleanups = c->next;
        } else {
            c = apr_palloc(p, sizeof(cleanup_t));
        }
        c->data = data;
        c->plain_cleanup_fn = plain_cleanup_fn;
        c->child_cleanup_fn = child_cleanup_fn;
        c->next = p->cleanups;
        p->cleanups = c;
    }
apr_pool_cleanup_register() — memory/unix/apr_pools.c 2514–2527행
static void run_cleanups(cleanup_t **cref)
{
    cleanup_t *c = *cref;

    while (c) {
        *cref = c->next;
        (*c->plain_cleanup_fn)((void *)c->data);
        c = *cref;
    }
}
memory/unix/apr_pools.c 2660–2669행
새 cleanup 은 목록의 맨 앞에 끼워지고(c->next = p->cleanups; p->cleanups = c;), 부를 때는 맨 앞부터 차례로 부릅니다. 그러니 마지막에 건 것이 맨 먼저 불립니다(LIFO, Last In First Out). 헤더의 설명도 "Cleanups are performed in the reverse order they were registered"라고 못 박아 둡니다(include/apr_pools.h 608–609행).
왜 역순일까요. 나중에 만든 것은 대개 먼저 만든 것에 기대어 만들어지기 때문입니다. 파일을 열고 그 파일 위에 버퍼를 만들었다면, 버퍼를 먼저 비우고(flush) 파일을 닫아야 합니다. 만든 순서의 반대로 정리하면 이 의존 관계가 저절로 지켜집니다.
(*c->plain_cleanup_fn)((void *)c->data) 는 함수 포인터로 함수를 부르는 C 문법입니다. 등록할 때 건넨 data 를 그대로 돌려받습니다. cleanup_t 구조체 자체도 apr_palloc() 으로 그 풀에서 받는다는 점도 보세요. cleanup 목록 역시 풀이 비워질 때 함께 사라집니다.
등록 함수의 네 번째 인자 child_cleanup_fn 은 fork() 로 만든 자식 프로세스가 다른 프로그램을 exec 하기 직전에 불리는 쪽입니다. APR 이 프로세스를 띄울 때 apr_pool_cleanup_for_exec() 를 불러(threadproc/unix/proc.c 425행) 모든 풀의 child_cleanup_fn 을 돌립니다(2673–2695행). 할 일이 없으면 아무것도 하지 않는 apr_pool_cleanup_null 을 넘깁니다.
APR 자신도 이 장치를 씁니다. 예를 들어 apr_socket_accept() 는 받아들인 소켓에 socket_cleanup 을 걸어 두어(network_io/unix/sockets.c 383–384행), 그 소켓을 만든 풀이 비워지면 소켓이 닫히게 합니다. apr_file_open() 도 같은 식으로 파일에 cleanup 을 겁니다(file_io/unix/open.c 245–249행). 풀이 메모리뿐 아니라 자원 전체의 수명을 묶는 장치가 되는 이유입니다.
예제 2: 순서를 눈으로 보기
pooldemo.c 의 2번 부분입니다. 한 풀에 A, B, C 를 차례로 걸고, 자식 풀에 S 를, pre_cleanup 으로 P 를 겁니다. 그리고 풀을 비웁니다.
/* 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다) */
static apr_status_t say(void *data)
{
    printf("  cleanup: %s\n", (const char *)data);
    return APR_SUCCESS;
}
    /* ... main() 안 ... */
    /* 2. cleanup 의 실행 순서 */
    printf("[2] register A, B, C on pool; S on a subpool; P as a pre-cleanup\n");
    apr_pool_cleanup_register(pool, "A", say, apr_pool_cleanup_null);
    apr_pool_cleanup_register(pool, "B", say, apr_pool_cleanup_null);
    apr_pool_cleanup_register(pool, "C", say, apr_pool_cleanup_null);
    apr_pool_create(&sub, pool);
    apr_pool_cleanup_register(sub, "S (subpool)", say, apr_pool_cleanup_null);
    apr_pool_pre_cleanup_register(pool, "P (pre-cleanup)", say);
    printf("  apr_pool_clear(pool):\n");
    apr_pool_clear(pool);

    /* clear 뒤에는 같은 메모리를 처음부터 다시 쓴다 */
    first = apr_palloc(pool, 13);
    printf("  first palloc after clear returns the old address: %s\n",
           first == a ? "yes" : "no");
[2] register A, B, C on pool; S on a subpool; P as a pre-cleanup
  apr_pool_clear(pool):
  cleanup: P (pre-cleanup)
  cleanup: S (subpool)
  cleanup: C
  cleanup: B
  cleanup: A
  first palloc after clear returns the old address: yes
pre_cleanup → 자식 풀 → 나중에 건 cleanup 부터. 위에서 읽은 apr_pool_clear() 의 순서 그대로입니다. 마지막 줄은 비운 뒤 처음 받은 메모리가 비우기 전에 처음 받았던 주소 a 와 같다는 것입니다. 첫 노드의 first_avail 이 처음 자리로 되감겼기 때문입니다.
헷갈리기 쉬운 곳
- cleanup 은 "등록 순서의 역순"이지 "풀 나무의 순서"만으로 정해지지 않습니다. 위 결과에서 자식 풀의 S 는 부모의 A, B, C 보다 먼저 불렸습니다. 부모의 cleanup 이 불릴 때는 자식 풀이 이미 없습니다. 그래서 부모 풀의 cleanup 에서 자식 풀의 메모리를 건드리면 안 됩니다.
- cleanup 안에서 그 풀의 메모리를 써도 됩니다. 메모리를 되감는 5번이 cleanup 을 모두 부른 뒤이기 때문입니다. 헤더에도 cleanup 이 그 풀에서 메모리를 받아도 안전하다고 적혀 있습니다. 다만 cleanup 안에서 자식 풀을 만들면 그 풀은 자동으로 정리되지 않는다는 경고도 함께 있습니다(
include/apr_pools.h609–614행). - cleanup 을 미리 지우려면
apr_pool_cleanup_kill()입니다. 파일을 일찍 닫았다면 풀이 비워질 때 또 닫지 않도록 등록을 지웁니다.data와 함수가 둘 다 같은 항목을 찾아 지웁니다(2566–2627행).
5. httpd 의 풀 나무 — 누가 언제 만들고 언제 버리나
이제 httpd 쪽으로 넘어갑니다. httpd 의 풀은 수명별로 층을 이룹니다.
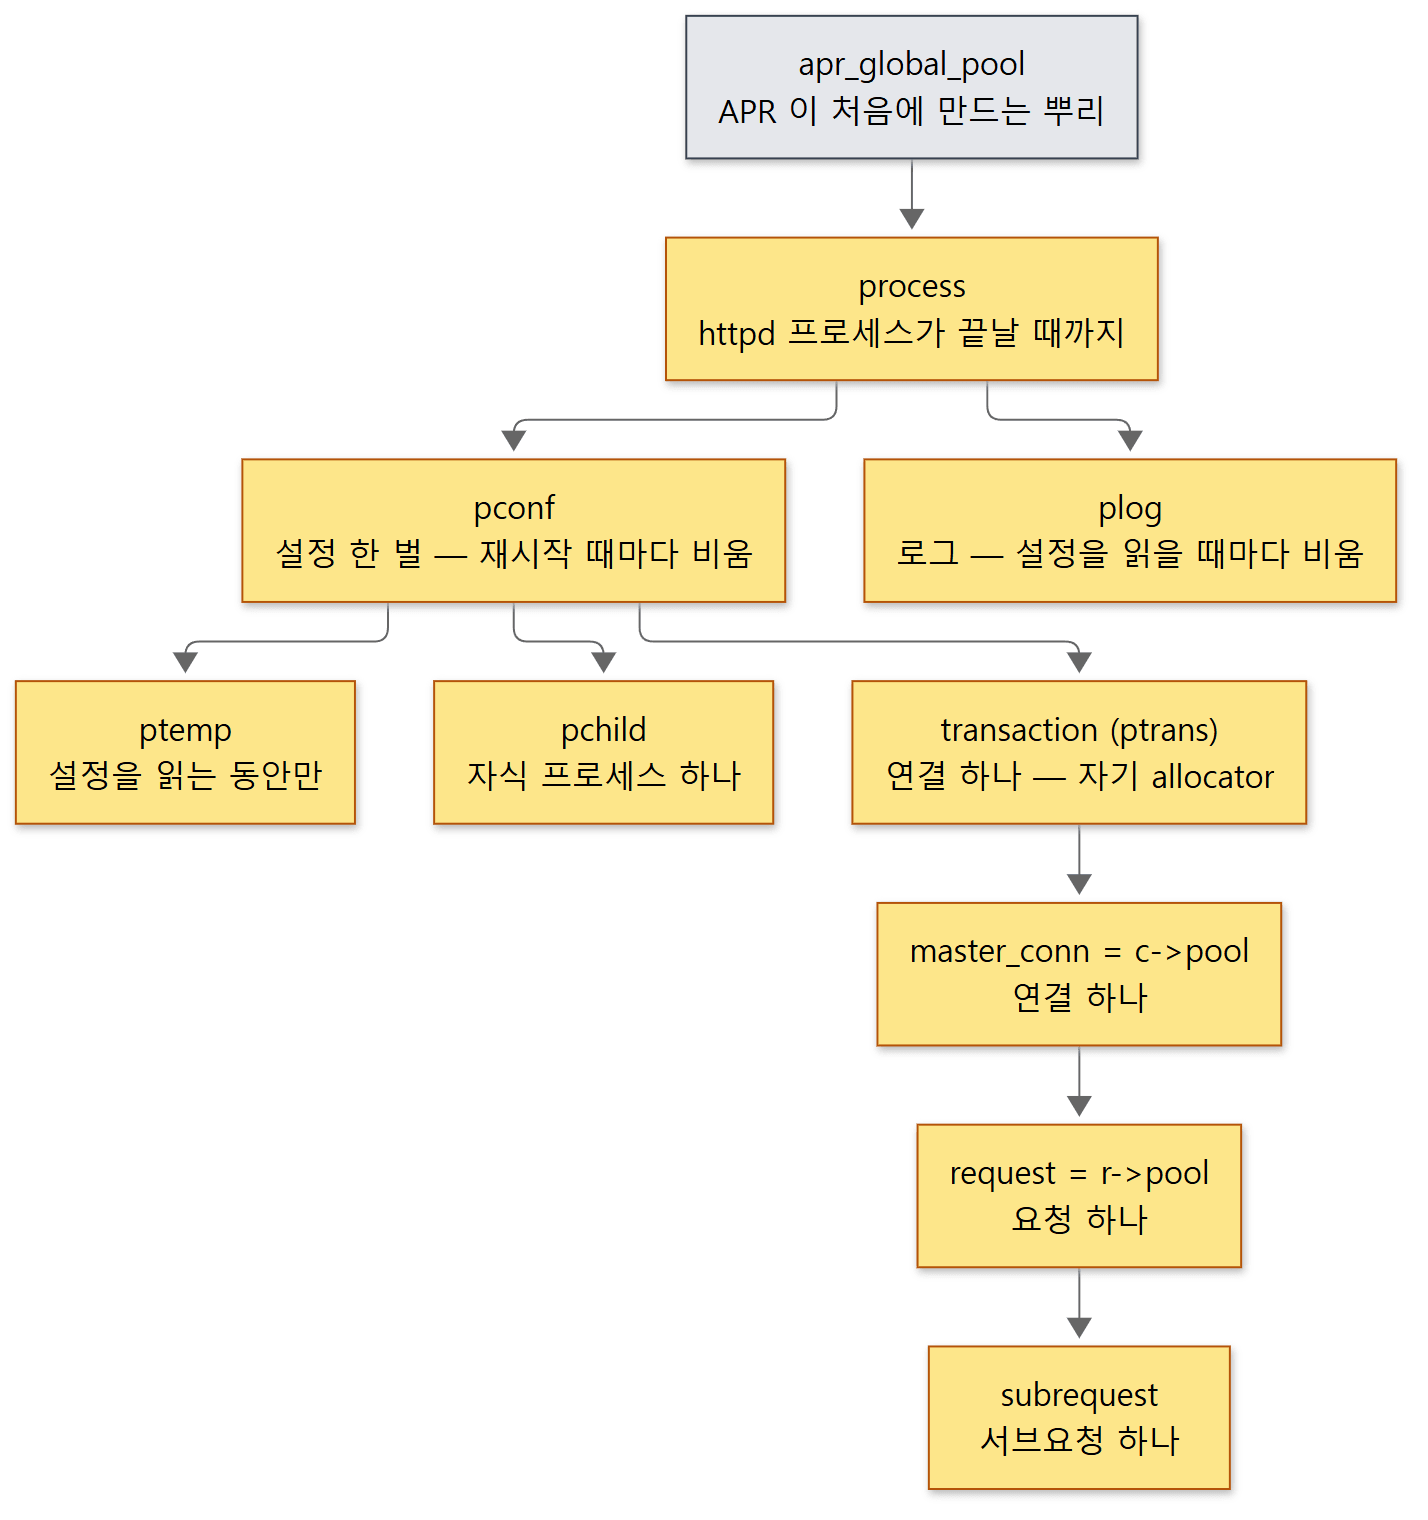 event MPM 기준입니다. 아래로 갈수록 수명이 짧습니다. 화살표는 부모 → 자식입니다.
프로세스와 설정 — process, pconf, ptemp, plog
main() 이 가장 먼저 부르는 init_process() 는 부모 없는 풀을 하나 만들어 "process" 라는 이름표를 붙입니다(server/main.c 352행, 375행). 부모를 NULL 로 주면 APR 은 자기가 처음에 만든 apr_global_pool 을 부모로 삼습니다(apr_pools.c 1049–1050행, 이름표는 680행). 이 풀은 httpd 가 끝날 때 한 번 없어지며, 그 아래의 모든 풀이 함께 없어집니다(server/main.c 302행).
그 아래에서 설정을 담는 풀이 pconf 입니다.
static void reset_process_pconf(process_rec *process)
{
    if (process->pconf) {
        apr_pool_clear(process->pconf);
        ap_server_conf = NULL;
    }
    else {
        apr_pool_create(&process->pconf, process->pool);
        apr_pool_tag(process->pconf, "pconf");
    }
    apr_pool_pre_cleanup_register(process->pconf, NULL, deregister_all_hooks);
}
처음에는 만들고, 그다음부터는 비웁니다. apachectl restart·graceful 로 재시작할 때마다 main() 의 do { … } while 고리가 이 함수를 불러(첫 기동 때도 고리의 첫 바퀴에서 한 번 부릅니다, 811–812행) 이전 설정을 담았던 메모리를 한 번에 버리고 설정을 새로 읽습니다. 모듈이 pconf 에 건 cleanup 도 이때 불립니다. pre_cleanup 으로 건 deregister_all_hooks 는 등록된 훅을 모두 지웁니다 — 설정을 다시 읽으면 훅도 다시 등록되기 때문입니다. 설정을 왜 다시 읽는지는 5편에서 봅니다.
main() 에는 풀이 두 개 더 있습니다. 변수 선언의 주석이 용도를 말해 줍니다.
    apr_pool_t *pconf;
    apr_pool_t *plog; /* Pool of log streams, reset _after_ each read of conf */
    apr_pool_t *ptemp; /* Pool for temporary config stuff, reset often */
ptemp는pconf의 자식으로 만들어져(707–708행) 설정 파일을 읽는 동안 쓰고,post_config단계가 끝나면 바로 없어집니다(808행, 876행). 설정 파일을 파싱하며 만든 중간 결과가 서버가 도는 내내 남지 않게 하는 것입니다.plog는process풀의 자식이고(705–706행), 로그 파일을 여는open_logs단계 직전마다 비워집니다(794행, 863행).
pre_config, post_config 같은 훅이 (pconf, plog, ptemp) 세 풀을 인자로 받는 것은 이 때문입니다(742행, 802행). 모듈은 "이 데이터는 얼마나 살아야 하나"를 보고 풀을 고릅니다.
연결 — ptrans 와 c->pool
event MPM 의 리스너 스레드는 연결을 받을 때마다 연결용 풀 ptrans 를 준비합니다. 재활용 목록에서 꺼내고, 비어 있으면 새로 만듭니다.
                    if (ptrans == NULL) {
                        /* create a new transaction pool for each accepted socket */
                        apr_allocator_t *allocator = NULL;

                        rc = apr_allocator_create(&allocator);
                        if (rc == APR_SUCCESS) {
                            apr_allocator_max_free_set(allocator,
                                                       ap_max_mem_free);
                            rc = apr_pool_create_ex(&ptrans, pconf, NULL,
                                                    allocator);
                            if (rc == APR_SUCCESS) {
                                apr_pool_tag(ptrans, "transaction");
                                apr_allocator_owner_set(allocator, ptrans);
                            }
                        }
server/mpm/event/event.c 2242–2256행
연결 풀마다 allocator 를 따로 만들고, 2절의 MaxMemFree 값을 넣고, 그 풀을 allocator 의 주인으로 삼습니다. 연결은 여러 워커 스레드를 오가며 처리되지만, 노드를 주고받는 allocator 가 연결마다 따로 있으니 다른 연결과 잠금을 다툴 일이 없습니다.
연결이 끝나면 ptrans 는 없어지지 않고 비워져서 재활용 목록으로 갑니다. 목록이 이미 가득 찼을 때만 없앱니다.
    if (queue_info->max_recycled_pools >= 0) {
        apr_uint32_t n = apr_atomic_read32(&queue_info->recycled_pools_count);
        if (n >= queue_info->max_recycled_pools) {
            apr_pool_destroy(pool_to_recycle);
            return;
        }
        apr_atomic_inc32(&queue_info->recycled_pools_count);
    }

    apr_pool_clear(pool_to_recycle);
ap_queue_info_push_pool() — server/mpm_fdqueue.c 227–236행
event MPM 이 연결을 닫는 close_connection() 은 소켓을 닫은 뒤 이 함수를 부릅니다(event.c 924–931행). 재활용 목록의 크기는 MaxMemFree 가 무제한이 아니면 ThreadsPerChild 의 3/4 로 정해집니다(2684–2690행).
prefork MPM 은 더 단순합니다. 자식 프로세스 하나가 연결 하나씩만 처리하므로, 자식 풀 pchild 아래에 ptrans 를 한 번 만들어 두고(server/mpm/prefork/prefork.c 469–470행) 연결을 받기 전마다 apr_pool_clear(ptrans) 로 비워 다시 씁니다(580행). 자식 프로세스의 allocator 에 MaxMemFree 를 넣는 곳은 444–447행입니다. MPM 마다 연결을 나누는 방식은 8편에서 봅니다.
ptrans 를 받은 코어는 conn_rec 을 만듭니다. 그런데 trunk 에서는 c->pool 이 ptrans 자체가 아닙니다.
    conn_rec *c = (conn_rec *) apr_pcalloc(ptrans, sizeof(conn_rec));
    /* ... */
    apr_pool_create(&pool, ptrans);
    apr_pool_tag(pool, "master_conn");
    c->pool = pool;
conn_rec 구조체는 ptrans 에, 연결에서 쓰는 데이터는 그 자식 풀 master_conn 에 둡니다. 2.4.x 브랜치에서는 같은 함수가 c->pool = ptrans; 로 ptrans 를 그대로 씁니다. trunk 가 한 겹을 더 둔 것은 연결 하나 위에 여러 개의 "보조 연결"을 두는 구조(같은 함수 근처의 "secondary_conn", 5610–5611행)를 위한 것으로 보이지만, 그 의도까지 소스로 확인하지는 않았습니다. 어느 쪽이든 ptrans 가 비워지면 c->pool 도 함께 정리된다는 점은 같습니다 — 2.4.x 에서는 같은 풀이고, trunk 에서는 자식 풀이기 때문입니다.
요청 — r->pool 은 언제 없어지나
요청 하나가 들어오면 ap_create_request() 가 c->pool 의 자식으로 요청 풀을 만듭니다.
AP_DECLARE(request_rec *) ap_create_request(conn_rec *conn)
{
    request_rec *r;
    apr_pool_t *p;

    apr_pool_create(&p, conn->pool);
    apr_pool_tag(p, "request");
    r = apr_pcalloc(p, sizeof(request_rec));
    AP_READ_REQUEST_ENTRY((intptr_t)r, (uintptr_t)conn);
    r->pool            = p;
    r->connection      = conn;
request_rec 구조체 자신부터가 요청 풀 안에 있습니다. 요청 풀이 없어지면 r 이 가리키는 메모리도 사라집니다.
그러면 요청 풀은 언제 없어질까요. "핸들러가 응답을 다 만들었을 때"가 아닙니다. 응답이 아직 소켓으로 다 나가지 않았을 수 있기 때문입니다. httpd 는 응답 데이터 뒤에 EOR(End Of Request) 라는 특별한 버킷을 하나 붙여 출력 필터로 내려보냅니다(modules/http/http_request.c 343–362행). 버킷과 출력 필터는 11편에서 자세히 보지만, 여기서는 "응답 데이터 조각들이 줄지어 흘러가는 줄의 맨 끝 표시"라고 보면 됩니다. 그 표시가 다 처리되어 없어질 때 요청 풀이 없어집니다.
static void eor_bucket_destroy(void *data)
{
    ap_bucket_eor *h = data;

    if (apr_bucket_shared_destroy(h)) {
        request_rec *r = h->r;
        if (r) {
            /* eor_bucket_cleanup will be called when the pool gets destroyed */
            apr_pool_destroy(r->pool);
        }
        apr_bucket_free(h);
    }
}
주석이 말하는 eor_bucket_cleanup 은 EOR 버킷을 만들 때 요청 풀에 pre_cleanup 으로 걸어 둔 함수이고(88행), 그 안에서 접근 로그를 쓰는 log_transaction 훅을 부릅니다(40행). 왜 일반 cleanup 이 아니라 pre_cleanup 인지도 주석에 있습니다 — "모듈이 만든 자식 풀이 log_transaction 동안 아직 필요할 수 있기 때문"입니다(85–86행). 4절의 순서에서 pre_cleanup 만이 자식 풀이 없어지기 전에 불리기 때문입니다.
헷갈리기 쉬운 곳
- "요청이 끝났다"의 시점은 핸들러가 돌아온 때가 아닙니다. 요청 풀은 EOR 버킷이 출력 필터를 다 지나 없어질 때 없어집니다. 출력 필터가 응답을 소켓에 다 쓰지 못해 나머지를 따로 맡겨 두면, EOR 버킷도 그 뒤에 남아 있다가 나중에 없어집니다.
http_request.c의 주석도 EOR 버킷은 출력 필터가 처리했거나(지웠거나buffered_bb로 옮겼거나) 그 전에 오류가 났거나 둘 중 하나라고 적습니다(365–370행). - 서브요청은 요청 풀의 자식입니다.
ap_sub_req_lookup_uri()같은 함수가 만드는 서브요청은r->pool아래에"subrequest"풀을 만들고(server/request.c2056–2057행),ap_destroy_sub_req()로 그 풀만 따로 없앨 수 있습니다(2596–2600행). 잊어도 부모 요청이 끝날 때 함께 정리됩니다. 서브요청은 10편에서 봅니다.
6. 예제 3: keep-alive 연결 하나에 요청 둘
5절의 내용을 직접 확인해 봅니다. 핸들러가 불릴 때마다 요청 풀에 cleanup 두 개를, 연결마다 한 번 연결 풀에 cleanup 하나를 거는 모듈입니다. cleanup 이 불리면 오류 로그에 한 줄을 씁니다. 접근 로그를 쓰는 log_transaction 훅에도 한 줄을 남겨, 그것이 요청 풀의 cleanup 과 어느 쪽이 먼저인지 봅니다.
/* 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다) */
#include "httpd.h"
#include "http_config.h"
#include "http_protocol.h"
#include "http_log.h"
#include "apr_strings.h"

APLOG_USE_MODULE(poolwatch);

/* 풀이 정리될 때 불릴 함수. data 에는 등록할 때 건넨 문자열이 온다. */
static apr_status_t say_bye(void *data)
{
    ap_log_error(APLOG_MARK, APLOG_NOTICE, 0, NULL, "cleanup: %s",
                 (const char *)data);
    return APR_SUCCESS;
}

static int poolwatch_handler(request_rec *r)
{
    conn_rec *c = r->connection;

    if (strcmp(r->handler, "poolwatch")) {
        return DECLINED;
    }

    /* 연결 풀에는 연결마다 한 번만 건다 (c->notes 에 표시를 남긴다) */
    if (!apr_table_get(c->notes, "poolwatch")) {
        apr_table_setn(c->notes, "poolwatch", "1");
        apr_pool_cleanup_register(c->pool,
                                  apr_psprintf(c->pool, "c->pool (connection %ld)", c->id),
                                  say_bye, apr_pool_cleanup_null);
    }

    /* 요청 풀에는 요청마다 두 개를 건다 — 등록 순서와 실행 순서를 비교하려고 */
    apr_pool_cleanup_register(r->pool,
                              apr_pstrcat(r->pool, "r->pool ", r->uri, " #1 (registered first)", NULL),
                              say_bye, apr_pool_cleanup_null);
    apr_pool_cleanup_register(r->pool,
                              apr_pstrcat(r->pool, "r->pool ", r->uri, " #2 (registered second)", NULL),
                              say_bye, apr_pool_cleanup_null);

    ap_log_rerror(APLOG_MARK, APLOG_NOTICE, 0, r,
                  "handler: %s (r->pool's parent is c->pool: %s)", r->uri,
                  apr_pool_parent_get(r->pool) == c->pool ? "yes" : "no");

    ap_set_content_type(r, "text/plain");
    ap_rprintf(r, "hello from %s\n", r->uri);
    return OK;
}

/* 접근 로그를 쓰는 단계 — 요청 풀의 cleanup 과 어느 쪽이 먼저인지 보려고 */
static int poolwatch_log(request_rec *r)
{
    ap_log_rerror(APLOG_MARK, APLOG_NOTICE, 0, r, "log_transaction: %s", r->uri);
    return DECLINED;
}

static void register_hooks(apr_pool_t *p)
{
    ap_hook_handler(poolwatch_handler, NULL, NULL, APR_HOOK_MIDDLE);
    ap_hook_log_transaction(poolwatch_log, NULL, NULL, APR_HOOK_MIDDLE);
}

/* 맨 위에서 APLOG_USE_MODULE 을 썼으므로 AP_DECLARE_MODULE 대신 이렇게 정의한다 */
module AP_MODULE_DECLARE_DATA poolwatch_module = {
    STANDARD20_MODULE_STUFF, NULL, NULL, NULL, NULL, NULL, register_hooks
};
cleanup 에 넘기는 문자열을 그 풀에서 만든다는 점(apr_pstrcat(r->pool, …))을 보세요. 4절에서 봤듯이 cleanup 이 불릴 때 그 풀의 메모리는 아직 살아 있으므로 안전합니다. 문자열을 이어 붙이는 apr_pstrcat(), printf 처럼 문자열을 만드는 apr_psprintf() 도 모두 풀에서 메모리를 받습니다.
apxs -c 로 컴파일하고, <Location /pw> 에 SetHandler poolwatch 를 건 설정으로 httpd 를 띄운 뒤, curl 한 번으로 두 URL 을 차례로 요청합니다. curl 은 같은 서버에 대한 두 번째 요청에 첫 연결을 다시 씁니다(keep-alive). 설정과 실행 명령 전체는 예제 폴더의 run.sh 에 있고, 오류 로그 형식은 ErrorLogFormat "[%l] %M" 으로 줄였습니다.
curl -sv http://127.0.0.1:8080/pw/a http://127.0.0.1:8080/pw/b
* Connected to 127.0.0.1 (127.0.0.1) port 8080
* Connection #0 to host 127.0.0.1 left intact
hello from /pw/a
* Re-using existing connection with host 127.0.0.1
* Connection #0 to host 127.0.0.1 left intact
hello from /pw/b
curl 이 끝난 뒤, httpd 를 멈추기 전에 본 오류 로그입니다.
[notice] AH00489: Apache/2.5.1-dev (Unix) configured -- resuming normal operations
[notice] AH00094: Command line: 'httpd -f /tmp/u04.conf'
[notice] handler: /pw/a (r->pool's parent is c->pool: yes)
[notice] log_transaction: /pw/a
[notice] cleanup: r->pool /pw/a #2 (registered second)
[notice] cleanup: r->pool /pw/a #1 (registered first)
[notice] handler: /pw/b (r->pool's parent is c->pool: yes)
[notice] log_transaction: /pw/b
[notice] cleanup: r->pool /pw/b #2 (registered second)
[notice] cleanup: r->pool /pw/b #1 (registered first)
[notice] cleanup: c->pool (connection 128)
(connection 128 의 번호는 연결을 맡은 자식 프로세스와 스레드의 자리에서 계산되는 값이라 실행마다 다를 수 있습니다. 다시 돌렸을 때는 connection 64 가 나왔습니다.)
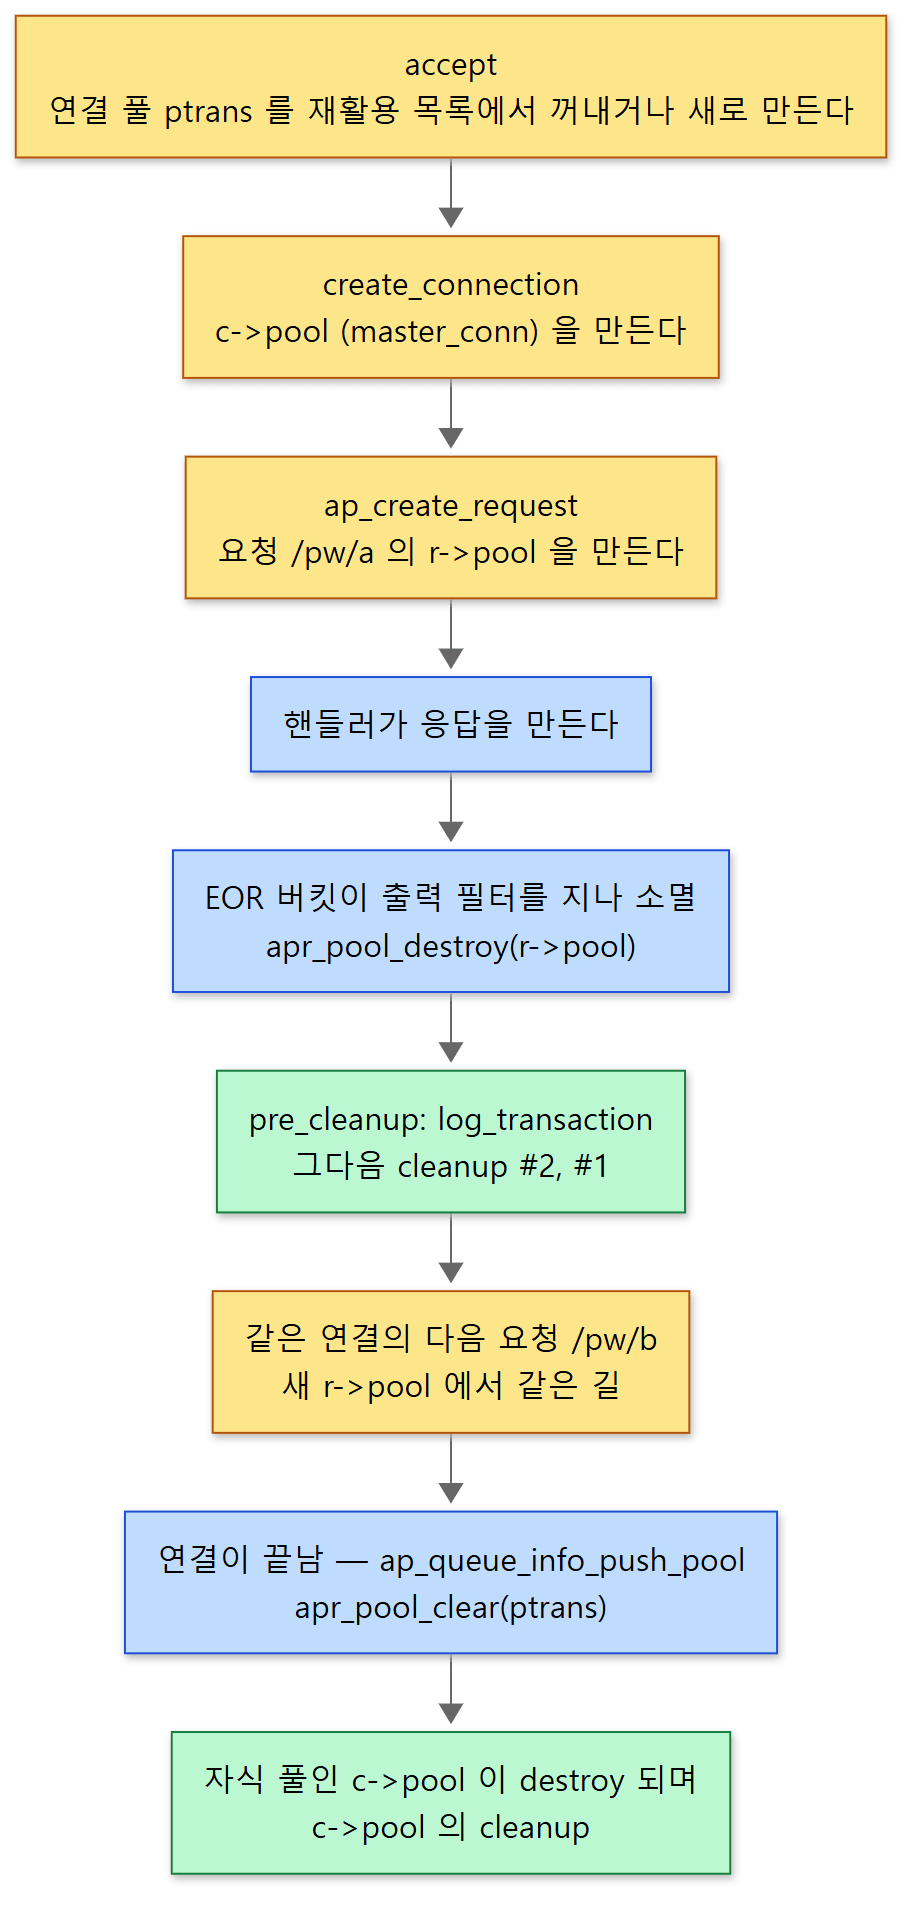 노란색은 풀이 만들어지는 곳, 파란색은 정리를 시작하는 곳, 초록색은 cleanup 이 실제로 불리는 곳입니다.
로그에서 읽을 수 있는 것은 넷입니다.
r->pool의 부모는c->pool입니다 (yes). 5절의ap_create_request()그대로입니다.- 요청마다 요청 풀이 따로 만들어지고 따로 없어집니다.
/pw/a의 cleanup 은/pw/b의 핸들러가 불리기 전에 이미 끝났습니다. 같은 연결 위에서도 요청이 끝날 때마다 그 요청의 메모리가 돌아간 것입니다. log_transaction이 요청 풀의 cleanup 보다 먼저입니다.eor_bucket_cleanup이 pre_cleanup 이기 때문입니다. 그리고 요청 풀의 cleanup 은#2→#1, 등록의 역순입니다.- 연결 풀의 cleanup 은 두 요청이 모두 끝난 뒤, 연결이 닫힐 때 한 번 불립니다. httpd 를 멈추기 전에 이미 찍혀 있으니 서버 종료가 아니라 연결 종료 때 불린 것입니다.
이 예제를 만들며 실제로 막혔던 곳이 하나 있습니다. 처음에는 파일 맨 위의 APLOG_USE_MODULE(poolwatch); 와 맨 아래의 AP_DECLARE_MODULE(poolwatch) 를 함께 썼는데, aplog_module_index 를 두 번 정의했다는 컴파일 오류가 났습니다. AP_DECLARE_MODULE 이 안에서 APLOG_USE_MODULE 을 한 번 더 부르는 매크로이기 때문입니다(include/http_config.h 456–469행). 로그 함수를 모듈 정의보다 위에서 쓰려면 위처럼 APLOG_USE_MODULE 을 위에 두고 아래에서는 module AP_MODULE_DECLARE_DATA … 로 직접 정의하면 됩니다. 모듈 구조체는 6편에서 봅니다.
7. 흔한 실수 두 가지
풀은 "언제 버리나"를 잊게 해 주는 대신 "어느 풀에서 받나" 를 틀리면 안 되게 만듭니다. 틀리는 방향은 둘입니다.
실수 1: 너무 오래 사는 풀에서 받기 — 누수
요청마다 쓰는 데이터를 c->pool 이나 pconf 처럼 오래 사는 풀에서 받으면, 그 메모리는 그 풀이 비워질 때까지 돌아가지 않습니다. 풀에는 조각 하나를 돌려주는 함수가 없으니 도중에 돌려줄 방법도 없습니다. keep-alive 연결 하나로 요청을 수천 개 보내면 c->pool 이 요청 수만큼 커지고, pconf 에서 받았다면 재시작할 때까지 커집니다.
pooldemo.c 의 3번 부분이 이것을 보여 줍니다. 1,000바이트를 1만 번 받는데, 한 번은 오래 사는 풀에서, 한 번은 "요청 하나 분량"마다 비우는 자식 풀에서 받습니다.
/* 이 글을 위해 쓴 예제입니다 (httpd 의 소스가 아닙니다) */
    /* 3. 오래 사는 풀에 요청마다 할당하면 */
    apr_pool_create(&longlived, NULL);
    apr_pool_create(&perreq, longlived);
    before = rss_kb();
    for (i = 0; i < 10000; i++) {
        memset(apr_palloc(longlived, 1000), 'x', 1000);  /* 실수: 오래 사는 풀에 */
    }
    printf("[3] 10000 x palloc(1000) from a long-lived pool: RSS +%ld KB\n",
           rss_kb() - before);

    before = rss_kb();
    for (i = 0; i < 10000; i++) {
        memset(apr_palloc(perreq, 1000), 'x', 1000);     /* 요청 하나 분량 */
        apr_pool_clear(perreq);               /* 요청이 끝나면 비운다 */
    }
    printf("    same, but from a subpool cleared each time: RSS +%ld KB\n",
           rss_kb() - before);
rss_kb() 는 /proc/self/statm 을 읽어 이 프로세스가 실제로 쓰고 있는 메모리(RSS)를 KB 로 돌려주는, 예제에서 직접 쓴 함수입니다.
[3] 10000 x palloc(1000) from a long-lived pool: RSS +10664 KB
    same, but from a subpool cleared each time: RSS +0 KB
(첫 줄의 숫자는 실행마다 조금씩 다릅니다. 세 번 돌려 10664, 10772, 10732 가 나왔습니다.)
오래 사는 풀은 1만 번 × 1,000바이트 ≈ 10MB 를 고스란히 쥐고 있고, 매번 비운 자식 풀은 같은 노드를 계속 되감아 쓰므로 늘지 않습니다.
httpd 안에서 이 문제를 푸는 방법도 같습니다. 오래 사는 풀에 붙은 일을 반복해야 한다면 자식 풀을 하나 만들어 그 안에서 일하고, 한 바퀴마다 비우거나 없앱니다. httpd 코어도 그렇게 합니다. 디렉터리 설정을 찾는 ap_directory_walk() 는 정규식으로 경로를 맞춰 볼 때 r->pool 아래에 임시 풀 "directory_walk_rxpool" 을 만들어 쓰고 다 쓰면 없앱니다(server/request.c 1351–1352행, 1412행). 설정을 읽는 동안만 ptemp 를 쓰는 것(5절)도 같은 생각입니다.
실수 2: 너무 짧게 사는 풀에서 받기 — 사라진 메모리 쓰기
반대 방향은 더 위험합니다. 요청 풀에서 받은 메모리의 주소를 요청보다 오래 사는 곳 — 연결 풀에 둔 구조체, 모듈의 전역 변수, 다른 스레드 — 에 넣어 두면, 요청이 끝나는 순간 그 주소는 이미 돌려준 메모리를 가리킵니다. 그 노드는 다음 요청이 다시 쓰므로 글자가 바뀌어 있거나, 전혀 다른 데이터가 들어 있습니다. 4절 예제의 마지막 줄 — 비운 뒤 처음 받은 주소가 예전 주소와 같다 — 이 바로 그 재사용입니다. 오류가 바로 나지 않고 가끔, 엉뚱한 곳에서 나기 때문에 찾기 어렵습니다.
httpd 코어도 이 경계를 주석으로 못 박아 둡니다. 5절의 EOR 버킷을 출력 필터로 보낸 직후입니다.
    apr_brigade_cleanup(bb);

    /* From here onward, it is no longer safe to reference r
     * or r->pool, because r->pool may have been destroyed
     * already by the EOR bucket's cleanup function.
modules/http/http_request.c 371–375행
"여기서부터는 r 도 r->pool 도 건드리면 안 된다"는 뜻입니다. 함수 이름이 ap_process_request_after_handler() 인데, 이 함수 안에서조차 중간부터는 자기가 처리하던 요청을 건드릴 수 없습니다.
APR 헤더는 이 규칙을 일반화해서 적어 둡니다. 풀 B 가 풀 A 의 자식일 때, B 에 만든 표에 A 의 데이터를 넣는 것은 안전하지만 A 에 만든 표에 B 의 데이터를 넣는 것은 안전하지 않다 — "B can be cleared/destroyed before A is (which would leave dangling pointers …)"(include/apr_pools.h 730–737행). 한 줄로 줄이면 "가리키는 쪽은 가리켜지는 쪽보다 오래 살면 안 된다" 입니다.
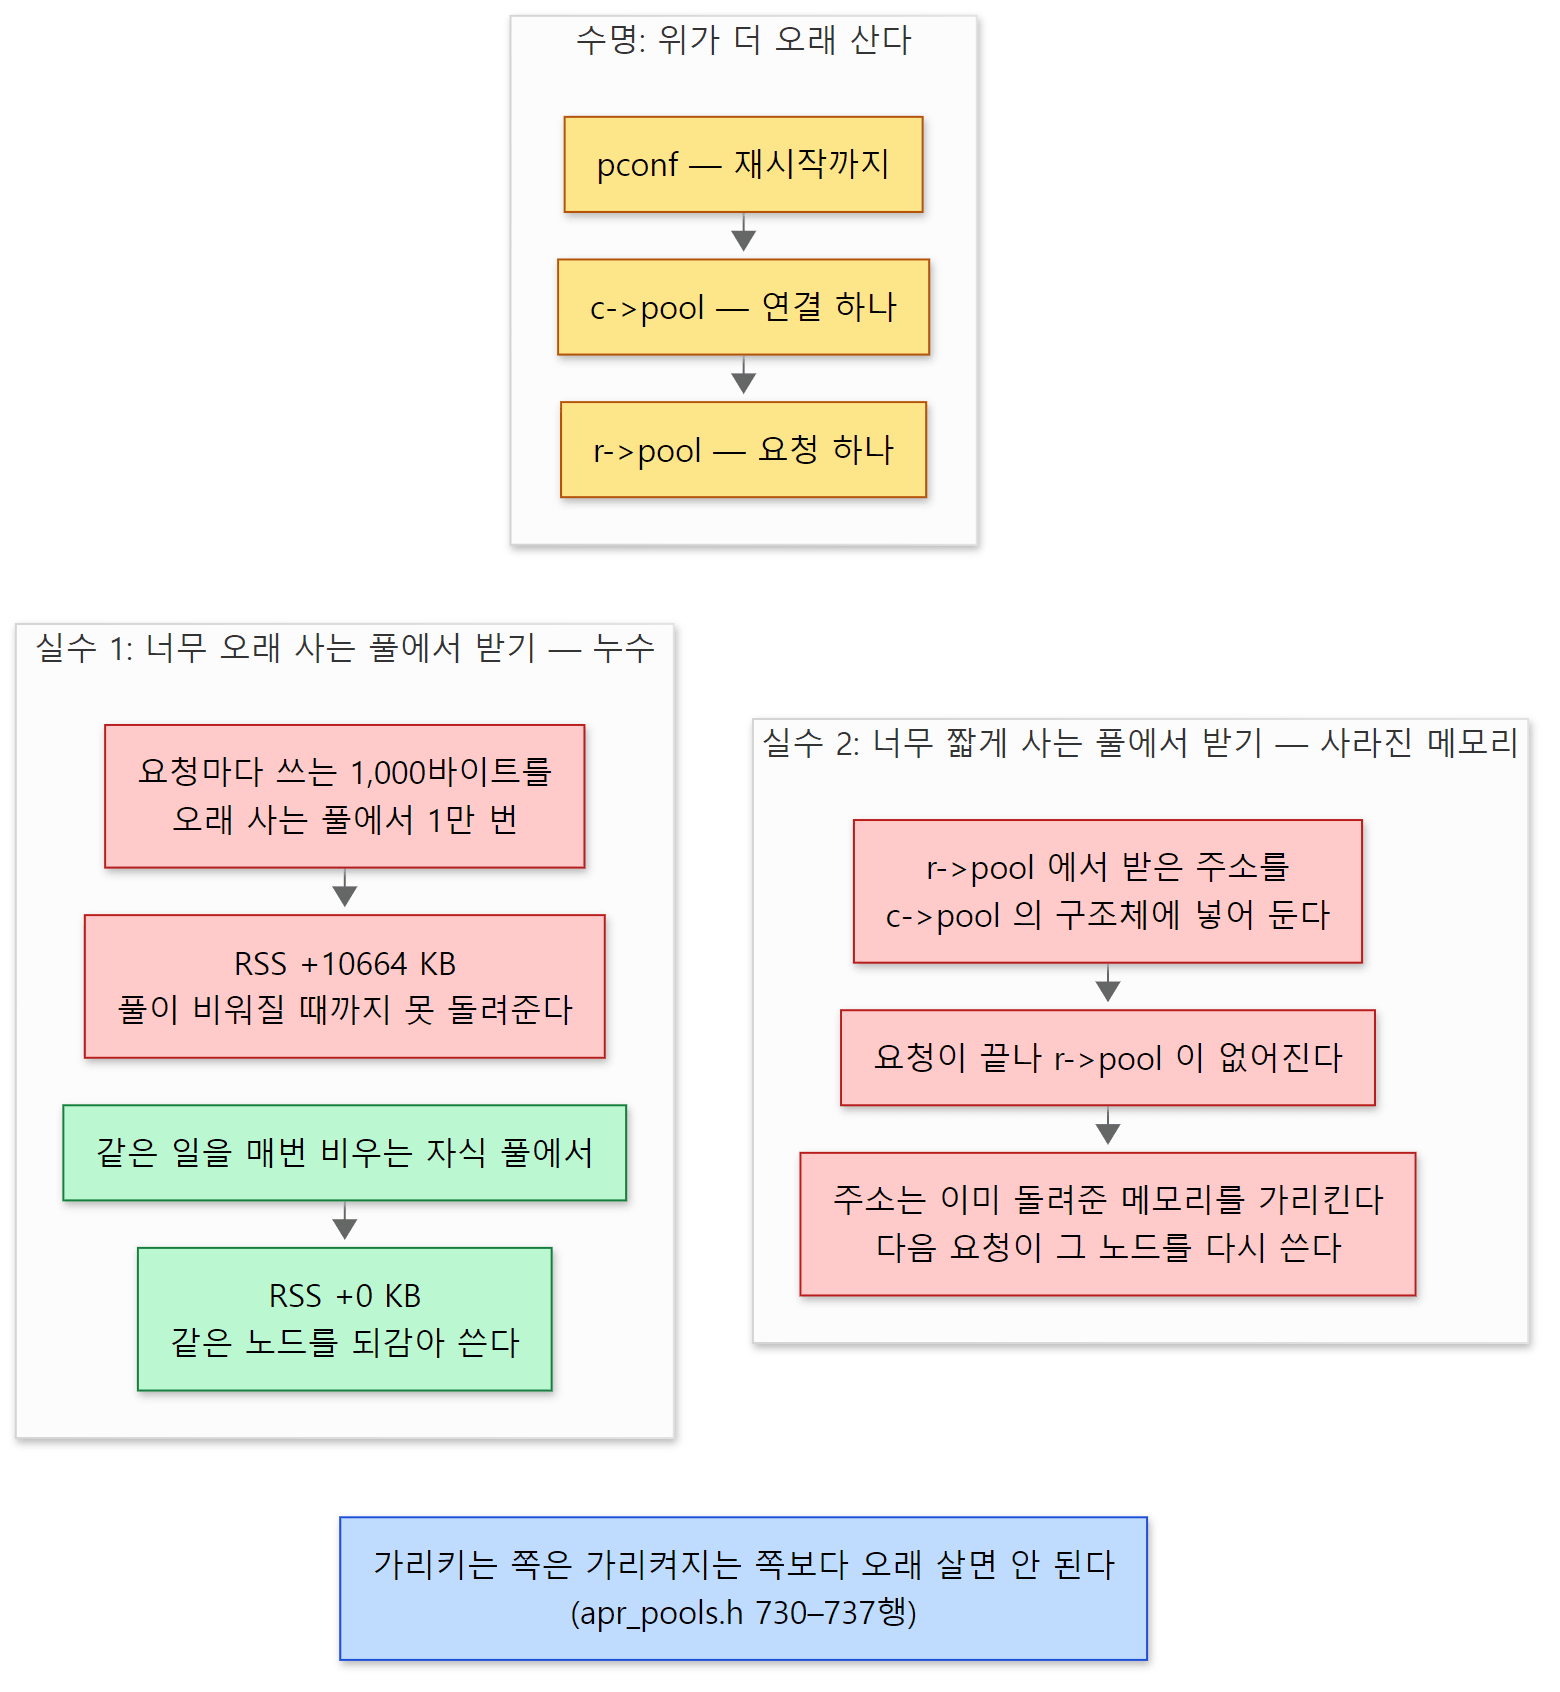 실수 1의 숫자는 위 pooldemo 3번 부분의 실제 출력입니다(첫 줄은 실행마다 조금씩 다릅니다).
헷갈리기 쉬운 곳
- 요청보다 오래 남겨야 하는 것은 복사합니다. 요청에서 얻은 값을 연결 단위로 기억해야 한다면
apr_pstrdup(c->pool, 값)처럼 오래 사는 풀에 복사본을 만듭니다. 다만 이것을 요청마다 하면 실수 1이 됩니다. 연결 하나에 한 번만 필요한 것인지 따져 봐야 합니다. ptemp에서 받은 것을pconf의 설정 구조체에 넣는 것도 같은 실수입니다. 설정을 읽는 동안에는 멀쩡하다가post_config뒤ptemp가 없어지는 순간 깨집니다.
8. Java 의 GC 와 비교하면
Spring 연재를 읽어 오신 분은 Java 에서는 이런 고민을 하지 않았다는 것을 떠올리실 겁니다. Java 는 가비지 컬렉터(GC)가 "더 이상 아무도 가리키지 않는 객체"를 찾아 대신 거둬 갑니다. 아래 표의 Java 쪽은 일반적인 JVM 의 동작으로, 이 글에서 소스로 확인한 내용은 아닙니다.
| APR 풀 | Java GC | |
|---|---|---|
| 메모리를 버리는 때 | 풀을 비우거나 없앨 때, 한꺼번에 | GC 가 "아무도 안 가리킨다"고 판단할 때, 하나씩 |
| 누가 수명을 정하나 | 프로그래머가 풀을 고르는 순간 | 런타임이 참조를 따라가 판단 |
| 할당 비용 | 포인터 밀기 (3절) | 대부분의 JVM 도 새 객체 영역에서 포인터 밀기 |
| 해제 비용 | 노드 몇 개를 목록에 돌려놓기 | 살아 있는 객체를 찾아 표시·이동하는 일 |
| 메모리가 아닌 자원 | cleanup 으로 같은 풀에 묶는다 | try-with-resources, 컨테이너의 소멸 콜백 |
| 틀렸을 때 | 누수, 또는 이미 돌려준 메모리 쓰기 | 누수(참조를 쥐고 있을 때). 이미 거둔 객체를 쓰는 일은 없다 |
풀의 강점은 예측할 수 있다는 것입니다. 요청 풀은 언제나 요청이 끝날 때 정리되고, 그 비용은 노드 몇 개를 돌려놓는 것뿐입니다. 대가는 수명을 프로그래머가 정확히 알아야 한다는 것입니다. 7절의 두 실수는 모두 "이 데이터가 얼마나 살아야 하는지"를 틀린 것입니다. GC 는 그 판단을 대신해 주는 대신, 언제 얼마나 일할지를 런타임에 맡깁니다.
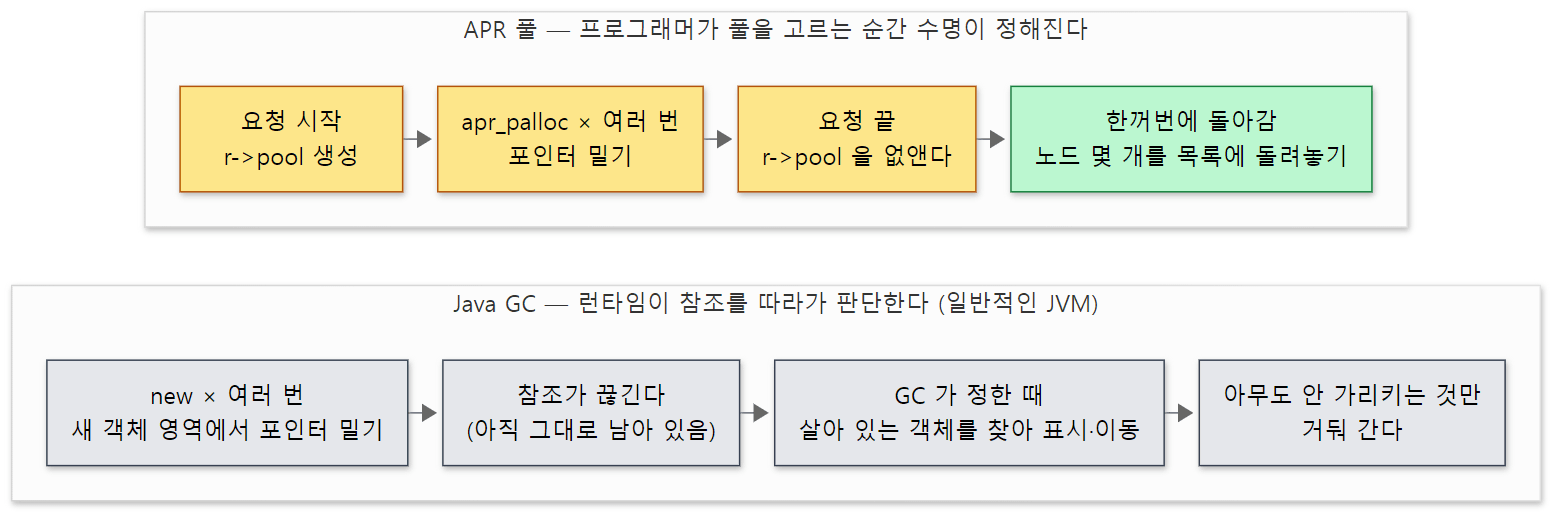 표의 "메모리를 버리는 때"와 "누가 수명을 정하나"를 시간 순서로 옮겼습니다. 아래 줄(Java)은 일반적인 JVM 의 동작이고 이 글에서 소스로 확인한 것은 아닙니다.
cleanup 이 등록의 역순으로 불리는 것은 Spring 에도 같은 생각이 있습니다. Spring 컨테이너가 닫힐 때 싱글톤 빈을 등록된 역순으로 버리고, 한 빈을 버리기 전에 그 빈에 기대는 빈부터 버린다는 것을 Spring 6편에서 봤습니다. "나중에 만든 것이 먼저 만든 것에 기댄다"는 같은 이유입니다. 그리고 pconf 를 비우고 설정을 새로 읽는 httpd 의 재시작은, 컨테이너 하나를 닫고 새로 여는 것과 닮았습니다.
이 글에서 뺀 것
큰 줄기를 위해 다음은 이름과 위치만 적어 둡니다.
- 풀에 키로 데이터를 달아 두는
apr_pool_userdata_set()/get()— 모듈이 재시작 사이에 값을 기억할 때 씁니다(apr_pools.c2430행부터). - 부모 없는 풀
apr_pool_create_unmanaged_ex()— 나무에 매달리지 않고 allocator 도 따로 갖는 풀입니다(1138–1198행). apr_psprintf()의 구현 — 출력 길이를 미리 모르므로 지금 노드에 바로 써 나가다가 모자라면 새 노드로 옮기는 특별한 길이 있습니다(1204–1216행의 설명 주석과 그 아래).- 하위 프로세스 정리
free_proc_chain()— 풀에 등록된 자식 프로세스를 신호로 끝내는 부분입니다(clear/destroy 의 4단계). - 풀 디버깅 모드 전체 —
APR_POOL_DEBUG의 단계별 기능(소유 스레드 검사, 수명 검사, 풀 찾기apr_pool_find())은include/apr_pools.h95–131행의 설명과apr_pools.c의#else /* APR_POOL_DEBUG */아래(1453행부터)에 있습니다. - event MPM 의
pskip·pruntime풀 — 연결 풀보다 오래 살아야 하는 것들을 어디에 둘지에 대한 긴 주석이event.c2647–2673행에 있습니다. - 버킷용 메모리
apr_bucket_alloc— 버킷은 풀이 아니라 allocator 에서 따로 메모리를 받습니다. 11편에서 봅니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
| 풀 | 수명이 같은 메모리를 담는 통. 조각 하나를 돌려주는 함수는 없고 통째로 비우거나 없앤다 |
노드 (apr_memnode_t) |
풀이 받아 오는 4KB 단위 덩어리. first_avail 부터 endp 까지가 남은 곳 |
| allocator | 다 쓴 노드를 크기별 목록에 모아 두었다가 다시 내준다. MaxMemFree 를 넘는 것만 free() |
apr_palloc() |
크기를 8의 배수로 올리고 first_avail 을 그만큼 민다. 노드가 찼을 때만 allocator 에 간다 |
apr_pool_clear() |
pre_cleanup → 자식 풀 destroy → cleanup(역순) → 첫 노드 되감기, 나머지 노드는 allocator 로 |
apr_pool_destroy() |
clear 와 같은 순서 뒤에 풀 자신까지 돌려준다. allocator 의 주인이면 allocator 도 없앤다 |
| cleanup | 풀이 정리될 때 부를 함수. 등록의 역순(LIFO). 소켓·파일 닫기가 여기에 걸린다 |
| pconf / ptemp / plog | 설정(재시작 때 비움) / 설정 읽는 동안만 / 로그(설정 읽을 때마다 비움) |
ptrans, c->pool |
연결 하나. event 는 연결 풀마다 allocator 를 따로 두고 다 쓰면 비워 재활용. trunk 의 c->pool 은 ptrans 의 자식 |
r->pool |
요청 하나. c->pool 의 자식. EOR 버킷이 없어질 때 destroy, 그 직전 pre_cleanup 에서 접근 로그 |
| 흔한 실수 | 오래 사는 풀에 요청마다 받기(누수), 짧게 사는 풀의 주소를 오래 두기(사라진 메모리 쓰기) |
다음에 볼 것
풀이 수명을 묶는 방법을 봤으니, 이제 그 나무의 뿌리를 심는 곳으로 갑니다. 이 글에서 pconf 를 "재시작 때마다 비운다"고만 하고 넘어간 main() 의 do { … } while 고리, 그리고 httpd 가 설정 파일을 두 번 읽는 이유가 5편: main()과 기동 — 설정을 두 번 읽는 이유와 재시작에서 이어집니다. pre_config·post_config 가 몇 번 불리는지 직접 세어 봅니다.
- 1편: AI와 함께 소스를 읽는 방법과 분석 지도
- 2편: C로 짠 서버를 읽기 전에 — 구조체, 함수 포인터, 매크로
- 3편: 전체 지도 — 코어, APR, MPM, 모듈과 세 개의 큰 구조체
- Spring 연재에서 수명과 정리 순서를 다룬 글: Spring 6편: 생명주기 콜백과 PostProcessor
- 같은 생각을 다르게 만든 풀: nginx 3편의
ngx_pool_t, MariaDB 2편의MEM_ROOT