이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 두 번째 글입니다. 1편에서 소스를 받아 Debug 빌드를 하고, 폴더 지도와 쿼리 하나가 지나는 큰 길을 한 줄로 그려 보았습니다. 이번 글은 그 길을 칸으로 나눈 지도입니다. 3편부터 12편까지는 모두 이 지도의 한 칸을 확대해서 읽고, 글 머리에서 "2편 지도의 ④ 준비 칸" 처럼 이 글의 번호로 자기 자리를 밝힙니다.
MariaDB 를 써 본 사람이라면 CREATE TABLE … ENGINE=InnoDB 를 적어 본 적이 있을 것입니다. 같은 자리에 ENGINE=Aria 나 ENGINE=MEMORY 를 적어도 SELECT 문은 한 글자도 바뀌지 않습니다. 그 "한 단어만 바꾸면 되는" 성질이 소스에서는 어떤 모양일까요. 이 글은 그 한 단어를 다리 삼아 다음 질문에 답합니다.
- MariaDB 는 왜 서버 계층(
sql/)과 스토리지 엔진(storage/)으로 나뉘어 있고, 그 경계는 소스에서 무엇인가 handler와handlerton은 무엇이 다르고,ENGINE=InnoDB한 단어는 어떻게ha_innobase객체가 되는가SELECT하나는 연결에서 엔진까지, 다시 클라이언트까지 어떤 칸을 지나는가 — 3~12편은 그 가운데 어디인가- 그 길에서 만들어지는 수많은 객체의 메모리는 누가 언제 치우는가
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | sql/handler.h·handler.cc, sql/sql_class.h, sql/sql_parse.cc, sql/sql_select.cc, sql/table.h·table.cc, sql/sql_plugin.cc, include/my_alloc.h, storage/example/ha_example.cc, storage/innobase/handler/ha_innodb.cc |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 경로는 저장소 루트에서 시작합니다.
지도를 그리는 글이라 이 글은 큰 줄기만 따라갑니다. 각 칸을 자세히 읽는 글은 절마다 "N편에서 봅니다" 로 이어 두었습니다.
먼저 알아 둘 말
서버 계층과 스토리지 엔진. MariaDB 서버(mariadbd) 안은 두 층입니다. 위층인 서버 계층은 SQL 을 다루는 모든 일 — 연결 받기, 권한 확인, 파싱, 실행 계획 고르기, 결과 보내기, 복제용 binlog — 을 맡고, 소스는 거의 다 sql/ 에 있습니다. 아래층인 스토리지 엔진은 행을 실제로 디스크나 메모리에 두고 꺼내는 일을 맡습니다. InnoDB, Aria, MyISAM, MEMORY 가 각각 엔진 하나이고, 소스는 storage/innobase/, storage/maria/, storage/myisam/, storage/heap/ 처럼 엔진마다 폴더가 따로 있습니다.
handler(핸들러)는 두 층의 경계에 놓인 C++ 클래스입니다(sql/handler.h 의 class handler). 정확히는 "열린 테이블 하나"를 나타내는 객체입니다. 서버 계층은 "다음 행 줘", "이 키로 찾아 줘", "이 행 써 줘" 를 늘 이 클래스의 메서드로 말하고, 엔진은 이 클래스를 상속해 그 메서드를 채웁니다. InnoDB 의 것은 ha_innobase, Aria 는 ha_maria, MyISAM 은 ha_myisam, MEMORY 는 ha_heap 입니다. 앞에 붙은 ha_ 는 handler 의 줄임입니다.
handlerton(핸들러톤)은 엔진 하나에 하나 있는 구조체입니다(struct handlerton). 소스의 설명이 "싱글턴(singleton) 구조체 — 엔진마다 하나" 라고 부르는 것으로(3절), 테이블과 상관없는 엔진 전체의 일 — handler 객체 만들기, 트랜잭션 커밋·롤백, DROP DATABASE 때 파일 지우기 — 을 함수 포인터로 들고 있습니다.
THD(이름의 TH 는 thread 에서 왔습니다)는 연결 하나의 모든 상태를 담은 클래스입니다(sql/sql_class.h 의 class THD). 소켓, 지금 실행 중인 문장, 로그인한 사용자, 열어 둔 테이블, 진행 중인 트랜잭션, 세션 변수가 전부 여기 있습니다. 서버 함수 대부분이 첫 인자로 THD *thd 를 받는 이유입니다.
LEX · SELECT_LEX · Item. 파서가 SQL 문장을 읽고 나면 결과가 LEX 라는 구조체 하나에 담깁니다. 문장의 종류(SQLCOM_SELECT, SQLCOM_INSERT …)와 함께, SELECT 하나하나는 SELECT_LEX(정식 이름 st_select_lex) 객체가 되고, 그 안의 열 이름·상수·연산식(a + 1, note LIKE 'row%')은 Item 이라는 클래스의 나무가 됩니다. 6편에서 자세히 봅니다.
TABLE 과 TABLE_SHARE. 테이블 하나에는 정의(열, 키, 엔진 — .frm 파일에서 읽은 것)가 하나 있고, 그 테이블을 여는 연결마다 열린 인스턴스가 하나씩 생깁니다. 앞의 것이 TABLE_SHARE, 뒤의 것이 TABLE 입니다. handler 객체는 TABLE 에 하나씩 붙습니다. 7편에서 자세히 봅니다.
MEM_ROOT(멤 루트)는 MariaDB 의 메모리 풀입니다. 작은 할당을 큰 블록에서 잘라 주고, 하나씩 free 하지 않고 나중에 한꺼번에 버립니다. 문장 하나를 처리하며 만든 객체는 대부분 연결의 MEM_ROOT 에서 나오고, 문장이 끝나면 통째로 비워집니다(7절).
1. 지도 한 장 — 서버 계층과 스토리지 엔진
연재의 지도
먼저 지도부터 펴 둡니다. SELECT 하나가 서버에 들어와 결과가 되어 나가기까지 지나는 칸에 번호를 붙였습니다. 이 연재는 이 번호로 칸을 부릅니다.
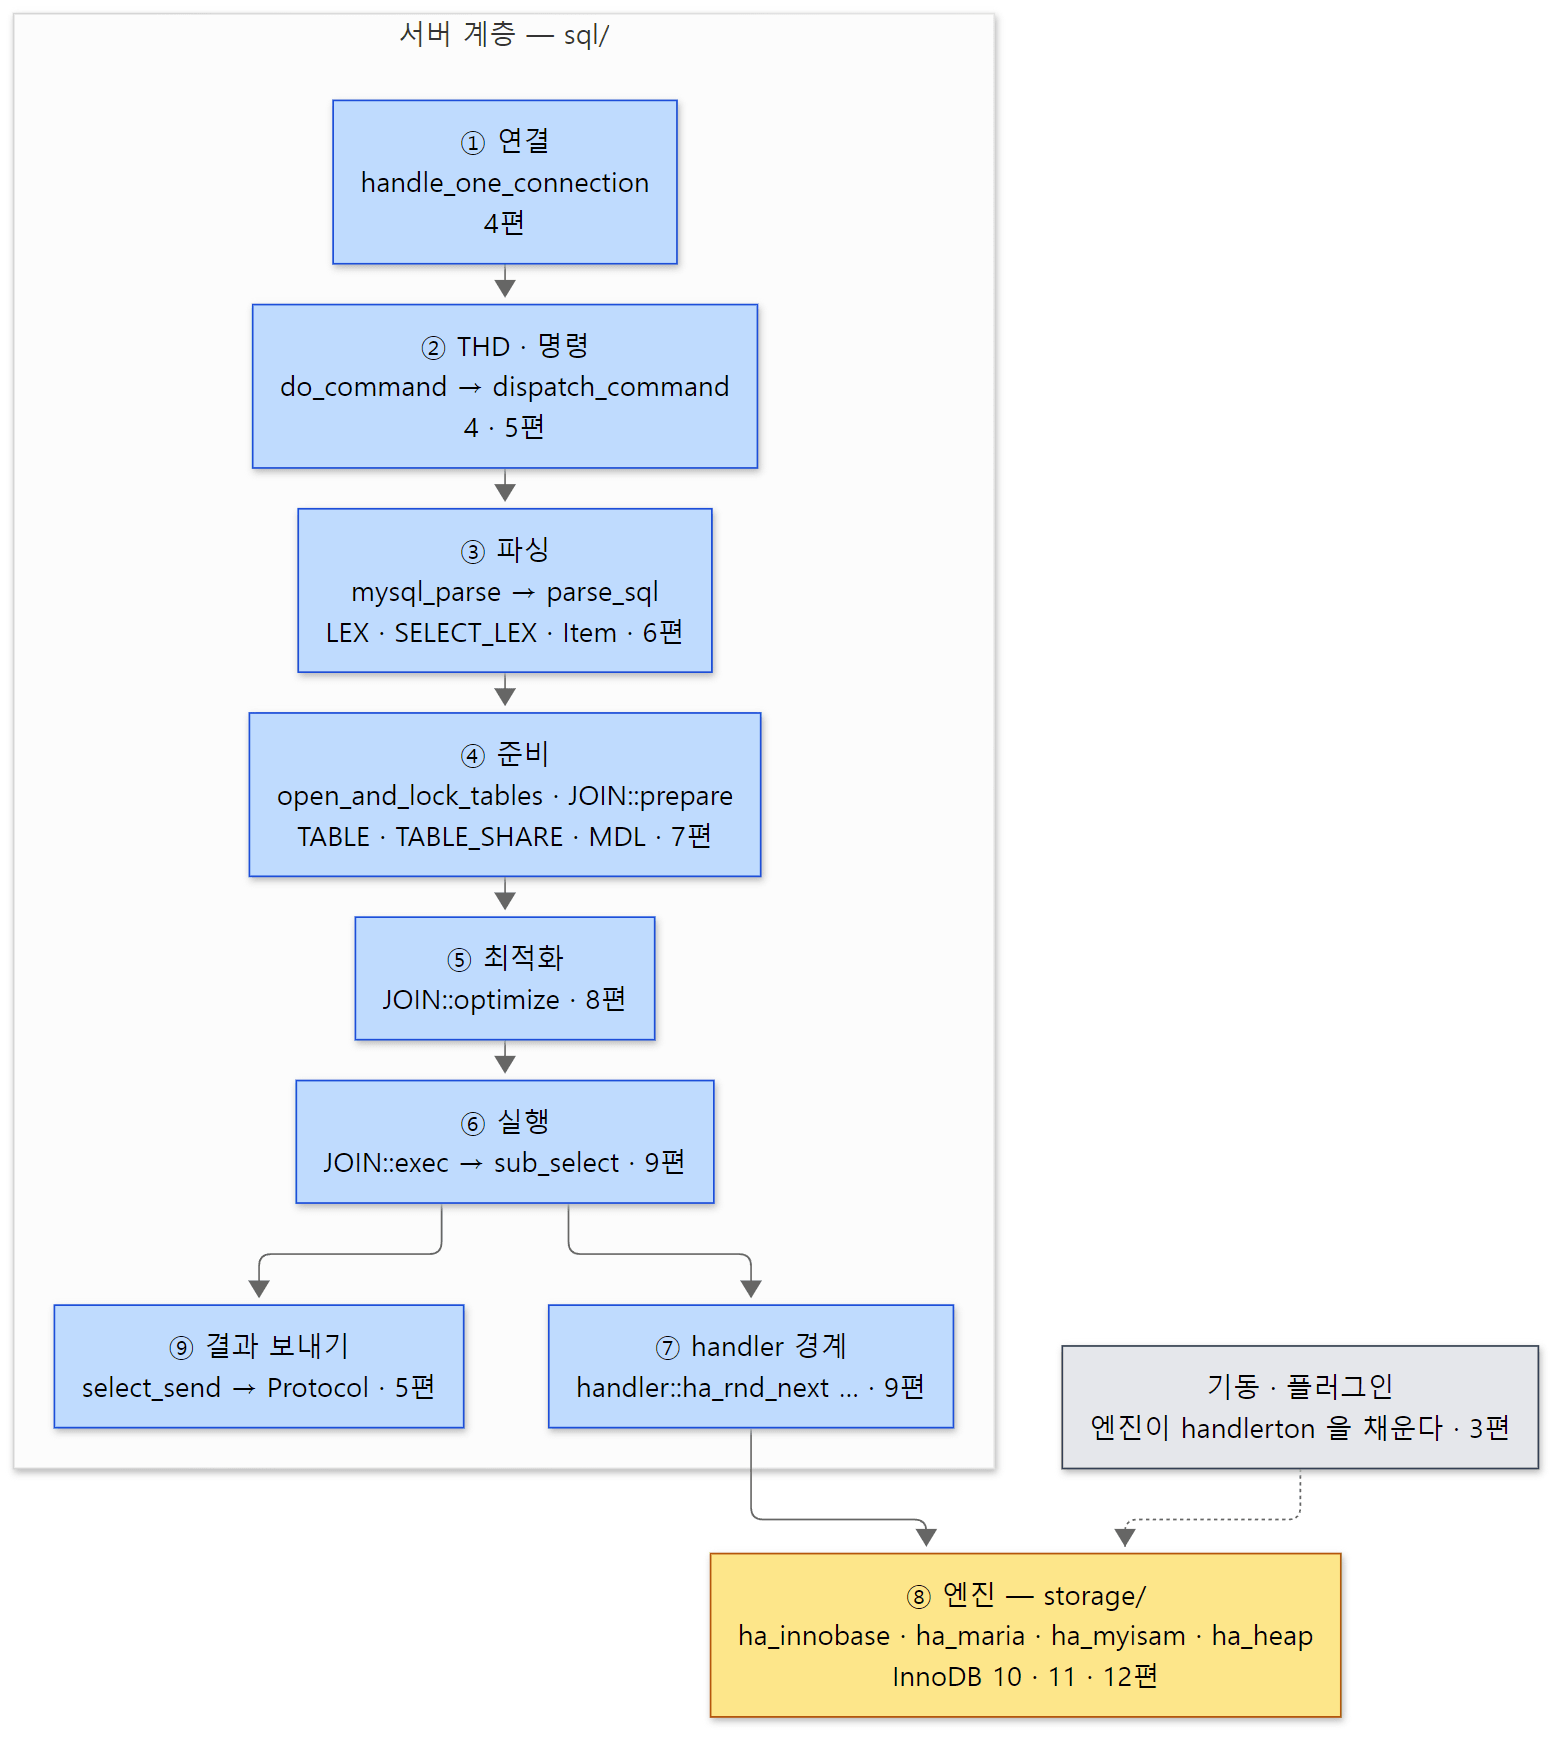 파란 칸이 서버 계층, 노란 칸이 스토리지 엔진입니다. 칸마다 그 칸을 자세히 읽는 편을 적었습니다.
| 칸 | 하는 일 | 대표 함수·자료구조 | 주로 있는 파일 | 자세히 |
|---|---|---|---|---|
| ① 연결 | 연결을 받아 스레드에 맡기고, 끊길 때까지 명령을 기다린다 | handle_one_connection(), do_handle_one_connection() |
sql/sql_connect.cc, sql/mysqld.cc |
4편 |
| ② THD·명령 | 패킷 하나를 읽어 명령 종류(COM_QUERY …)로 가른다 |
THD, do_command(), dispatch_command() |
sql/sql_class.h, sql/sql_parse.cc |
4편·5편 |
| ③ 파싱 | SQL 문자열을 LEX 와 Item 나무로 |
mysql_parse(), parse_sql(), LEX, SELECT_LEX, Item |
sql/sql_parse.cc, sql/sql_yacc.yy, sql/sql_lex.h, sql/item.h |
6편 |
| ④ 준비 | 권한 확인, 테이블 열기, 열 이름 찾기 | mysql_execute_command(), open_and_lock_tables(), JOIN::prepare(), TABLE, TABLE_SHARE, MDL(메타데이터 잠금 — 테이블 정의를 쓰는 동안 ALTER·DROP 을 막는 잠금) |
sql/sql_parse.cc, sql/sql_base.cc, sql/table.cc, sql/mdl.cc |
7편 |
| ⑤ 최적화 | 조인 순서와 접근 방법(풀 스캔·인덱스) 고르기 | JOIN::optimize() |
sql/sql_select.cc, sql/opt_range.cc |
8편 |
| ⑥ 실행 | 고른 계획대로 중첩 루프를 돈다 | JOIN::exec(), do_select(), sub_select() |
sql/sql_select.cc, sql/records.cc |
9편 |
| ⑦ handler 경계 | 엔진에게 행을 달라고 하는 공통 입구 | handler::ha_rnd_next(), ha_index_read_map(), ha_write_row() |
sql/handler.h, sql/handler.cc |
9편 |
| ⑧ 엔진 | 행을 실제로 저장하고 꺼낸다. 트랜잭션·잠금·로그도 엔진 몫 | ha_innobase, ha_maria, ha_myisam, ha_heap |
storage/*/ |
10·11·12편 |
| ⑨ 결과 보내기 | 결과 행을 패킷으로 만들어 보낸다 | select_send::send_data(), Protocol |
sql/sql_class.cc, sql/protocol.cc |
5편 |
| 기동·플러그인 | 서버가 뜰 때 엔진을 플러그인으로 올리고 handlerton 을 채운다 | mysqld_main(), plugin_init(), ha_initialize_handlerton() |
sql/mysqld.cc, sql/sql_plugin.cc, sql/handler.cc |
3편 |
①~⑦과 ⑨는 엔진이 무엇이든 한 벌뿐인 코드이고, ⑧만 엔진마다 따로 있습니다. 이 글의 나머지는 이 지도를 세 방향에서 다시 봅니다. 2~4절은 ⑦·⑧ 사이의 경계(handler, handlerton, 플러그인), 5절은 ①에서 ⑨까지의 길, 6·7절은 모든 칸이 함께 쓰는 THD 와 MEM_ROOT 입니다.
폴더로 보면
같은 지도를 저장소의 폴더로 바꾸면 이렇습니다. 폴더 하나하나의 크기와 내용은 1편의 폴더 지도에 있습니다.
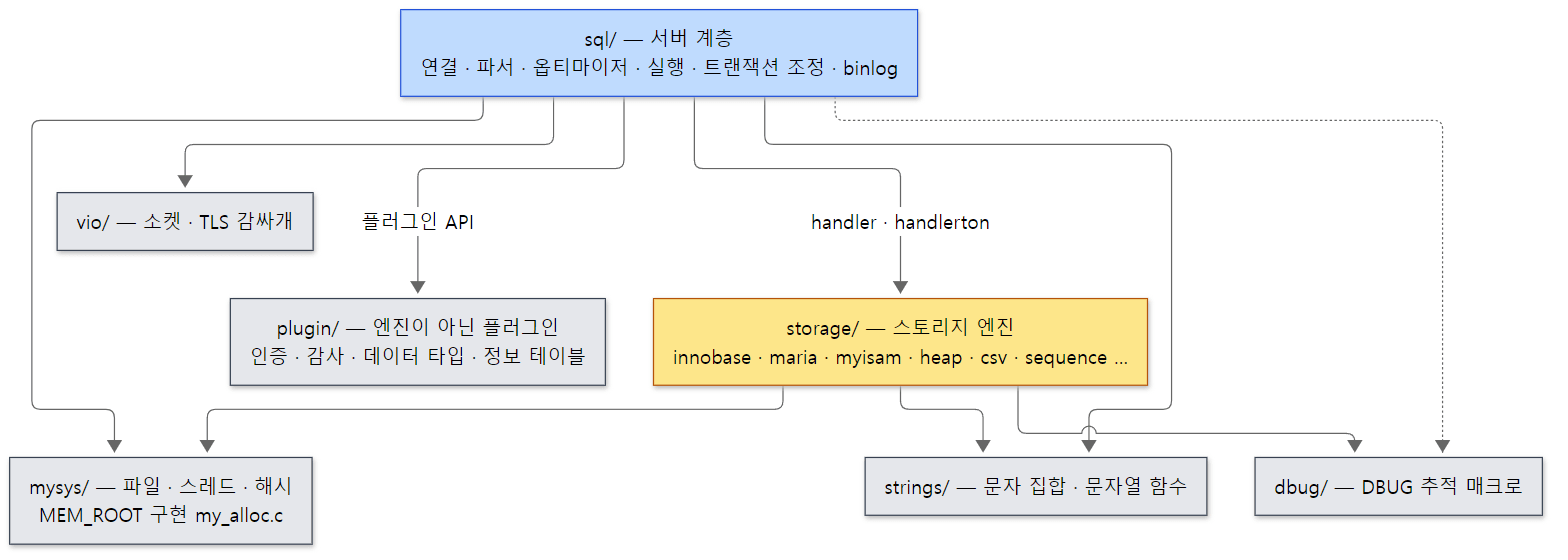 파란 상자가 서버 계층, 노란 상자가 엔진들, 회색 상자는 둘이 함께 쓰는 공통 라이브러리입니다.
mysys/ 와 strings/ 는 서버 계층과 엔진이 함께 쓰는 C 라이브러리입니다. 파일 열기(my_open), 메모리(my_malloc, 7절의 MEM_ROOT), 해시, 문자 집합 변환이 여기 있습니다. InnoDB 도 이 라이브러리를 씁니다. 기준 커밋의 storage/innobase/ 에서 my_sys.h 나 mysys_err.h 를 include 하는 파일은 14개, DBUG_ 매크로를 쓰는 파일은 77개였습니다.
왜 나눴나 — SQL 은 한 벌, 저장 방법은 여러 벌
class handler 바로 위의 설명이 이 클래스를 한 문장으로 정의합니다.
The handler class is the interface for dynamically loadable storage engines.
(sql/handler.h 3405–3406행) "동적으로 올릴 수 있는 스토리지 엔진을 위한 인터페이스". SQL 문법, 옵티마이저, 권한, 복제는 한 벌만 만들고, "행을 어디에 어떻게 둘까" 만 엔진마다 다르게 만들 수 있게 경계를 그었다는 뜻입니다. 엔진 쪽에서 보면 handler 의 메서드 몇 개만 채우면 SQL 을 공짜로 얻습니다(2·4절의 ha_example). 서버 쪽에서 보면 엔진이 몇 개든 실행기는 하나입니다(5절의 백트레이스).
예제 1: 엔진만 바꾼 테이블 네 개
정말 "한 단어만" 다른지, 같은 모양의 테이블을 엔진만 바꿔 네 개 만들어 보았습니다.
이 글의 예제는 모두 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 실행 스크립트는 ex/u02-architecture/run.sh 이고, 출력의 --- 줄은 스크립트가 찍은 제목입니다(맨 앞의 SELECT VERSION() 결과와 첫 제목을 담은 표는 빼고 실었습니다).
-- 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
-- 같은 모양의 테이블을 엔진만 바꿔 네 개 만들고, 같은 행 5개를 넣는다.
-- 행은 SEQUENCE 엔진의 seq_1_to_5 테이블에서 가져온다 (이것도 엔진 하나다).
CREATE DATABASE lab;
USE lab;
CREATE TABLE t_innodb (id INT PRIMARY KEY, note VARCHAR(20)) ENGINE=InnoDB;
CREATE TABLE t_aria   (id INT PRIMARY KEY, note VARCHAR(20)) ENGINE=Aria;
CREATE TABLE t_myisam (id INT PRIMARY KEY, note VARCHAR(20)) ENGINE=MyISAM;
CREATE TABLE t_memory (id INT PRIMARY KEY, note VARCHAR(20)) ENGINE=MEMORY;
INSERT INTO t_innodb SELECT seq, CONCAT('row ', seq) FROM seq_1_to_5;
INSERT INTO t_aria   SELECT * FROM t_innodb;
INSERT INTO t_myisam SELECT * FROM t_innodb;
INSERT INTO t_memory SELECT * FROM t_innodb;

SELECT '--- 1. information_schema.TABLES' AS step;
SELECT TABLE_NAME, ENGINE, TABLE_ROWS, ROW_FORMAT
  FROM information_schema.TABLES
 WHERE TABLE_SCHEMA = 'lab' ORDER BY TABLE_NAME;
그다음 run.sh 가 ls -1 /var/lib/mariadb-lab/lab | sort 로 데이터 디렉터리를 찍습니다.
+------------+--------+------------+------------+
 TABLE_NAME | ENGINE | TABLE_ROWS | ROW_FORMAT |
+------------+--------+------------+------------+
 t_aria     | Aria   |          5 | Page       |
 t_innodb   | InnoDB |          5 | Dynamic    |
 t_memory   | MEMORY |          5 | Fixed      |
 t_myisam   | MyISAM |          5 | Dynamic    |
+------------+--------+------------+------------+
--- 2. files in the data directory (datadir/lab)
db.opt
t_aria.MAD
t_aria.MAI
t_aria.frm
t_innodb.frm
t_innodb.ibd
t_memory.frm
t_myisam.MYD
t_myisam.MYI
t_myisam.frm
INSERT … SELECT는 네 테이블에 똑같이 통했습니다. 엔진이 넷이어도 SQL 은 하나입니다.ROW_FORMAT이 엔진마다 다릅니다(Page,Dynamic,Fixed). 행을 디스크에 어떤 모양으로 둘지는 엔진이 정합니다.- 데이터 디렉터리를 보면 모든 테이블에
.frm이 있고, 그 밖의 파일은 엔진마다 다릅니다. InnoDB 는.ibd하나, Aria 는.MAI(인덱스)·.MAD(데이터), MyISAM 은.MYI·.MYD, MEMORY 는 데이터를 메모리에만 두므로.frm뿐입니다.
.frm 은 서버 계층의 파일입니다. 서버는 기동할 때 정의 파일의 확장자를 .frm 으로 정해 두고(sql/init.cc 43행), 테이블 정의(TABLE_SHARE)를 이 파일에서 읽습니다. 반면 엔진의 파일 확장자는 엔진이 자기 handlerton 에 적어 둡니다. MyISAM 은 ha_myisam_exts[] 배열에 ".MYI", ".MYD" 를 적어 두었고(ha_myisam.cc 747–751행), InnoDB 는 .ibd·.isl, Aria 는 .MAI·.MAD 를 적습니다. handler 의 기본 delete_table()·rename_table() 은 이 목록을 보고 지우거나 이름을 바꿀 파일을 압니다(handler.h 1535–1539행의 설명). 이 목록이 담기는 tablefile_extensions 가 handlerton 의 필드라는 점은 3절에서 다시 봅니다.
헷갈리기 쉬운 곳: "엔진이 하는 일" 이 전부 storage/ 에 있지는 않다
트랜잭션은 엔진의 일이지만, 여러 엔진에 걸친 커밋을 조정하는 코드(ha_commit_trans())는 서버 계층의 sql/handler.cc 에 있습니다. 복제에 쓰는 binlog 도 서버 계층(sql/log.cc)의 것입니다(기준 커밋에는 binlog 를 InnoDB 안에 두는 최근 기능 binlog_storage_engine 도 들어와 있습니다 — 12편). 엔진은 자기 테이블의 행과 자기 로그(InnoDB 라면 redo·undo)를 책임지고, 그 위의 조정은 서버 계층이 합니다. 이 경계는 11편과 12편에서 다시 만납니다.
2. 경계 하나: handler — 열린 테이블 하나
handler 가 들고 있는 것
class handler 의 앞부분입니다. 테이블 정의, 열린 테이블, 그리고 자기 엔진의 handlerton 을 가리킵니다.
class handler :public Sql_alloc
{
// ...
protected:
  TABLE_SHARE *table_share;   /* The table definition */
  TABLE *table;               /* The current open table */
// ...
public:
  handlerton *ht;               /* storage engine of this handler */
  // ...
  uchar *ref;			/* Pointer to current row */
| 필드 | 무엇 |
|---|---|
table_share |
이 테이블의 정의(TABLE_SHARE). 테이블마다 하나 |
table |
이 handler 가 붙은 열린 인스턴스(TABLE). 연결마다 하나 |
ht |
이 handler 를 만든 엔진의 handlerton (3절) |
ref |
"지금 행" 의 위치. 엔진마다 뜻이 다르다(InnoDB 는 기본 키 값 — 기본 키가 없으면 내부 행 ID, MyISAM 은 데이터 파일 안의 위치. ha_innobase::position(), ha_myisam::position()) — 9편 |
handler 가 Sql_alloc 을 상속한다는 점도 기억해 둡니다. 이 클래스의 new 는 malloc 이 아니라 MEM_ROOT 에서 메모리를 받습니다(7절).
엔진이 채우는 것: 낮은 층의 가상 함수
class handler 안에는 엔진이 덮어쓰라고 둔 가상 함수가 많습니다. 그 가운데 한 묶음 위에 이런 설명이 붙어 있습니다.
private:
  /*
    Low-level primitives for storage engines.  These should be
    overridden by the storage engine class. To call these methods, use
    the corresponding 'ha_*' method above.
  */

  virtual int open(const char *name, int mode, uint test_if_locked)=0;
  // ...
  virtual int rnd_init(bool scan)= 0;
  // ...
  virtual int write_row(const uchar *buf __attribute__((unused)))
  {
    return HA_ERR_WRONG_COMMAND;
  }
"엔진의 낮은 층 기본 동작(primitive). 엔진 클래스가 덮어써야 하고, 부를 때는 위의 ha_* 메서드를 쓰라". open()·rnd_init()·write_row() 는 private 이라서 서버 계층의 다른 코드가 직접 부를 수도 없습니다. 반드시 ha_open()·ha_rnd_init()·ha_write_row() 를 거칩니다.
= 0 으로 끝나는, 곧 엔진이 반드시 채워야 하는 순수 가상 함수를 기준 커밋의 class handler(3452–5782행)에서 세어 보면 11개입니다.
| 묶음 | 순수 가상 함수 |
|---|---|
| 열고 닫기, 만들기 | open(), close(), create() |
| 풀 스캔 | rnd_init(), rnd_next(), rnd_pos(), position() |
| 정보 | info(), table_flags(), index_flags() |
| 잠금 | store_lock() |
write_row() 는 위 발췌처럼 기본 구현이 HA_ERR_WRONG_COMMAND 를 돌려줍니다. 그래서 이 11개만 채운 엔진은 "읽기만 되는 엔진" 이 됩니다. 인덱스 읽기(index_read_map() …)도 같은 식으로 기본 구현이 있습니다.
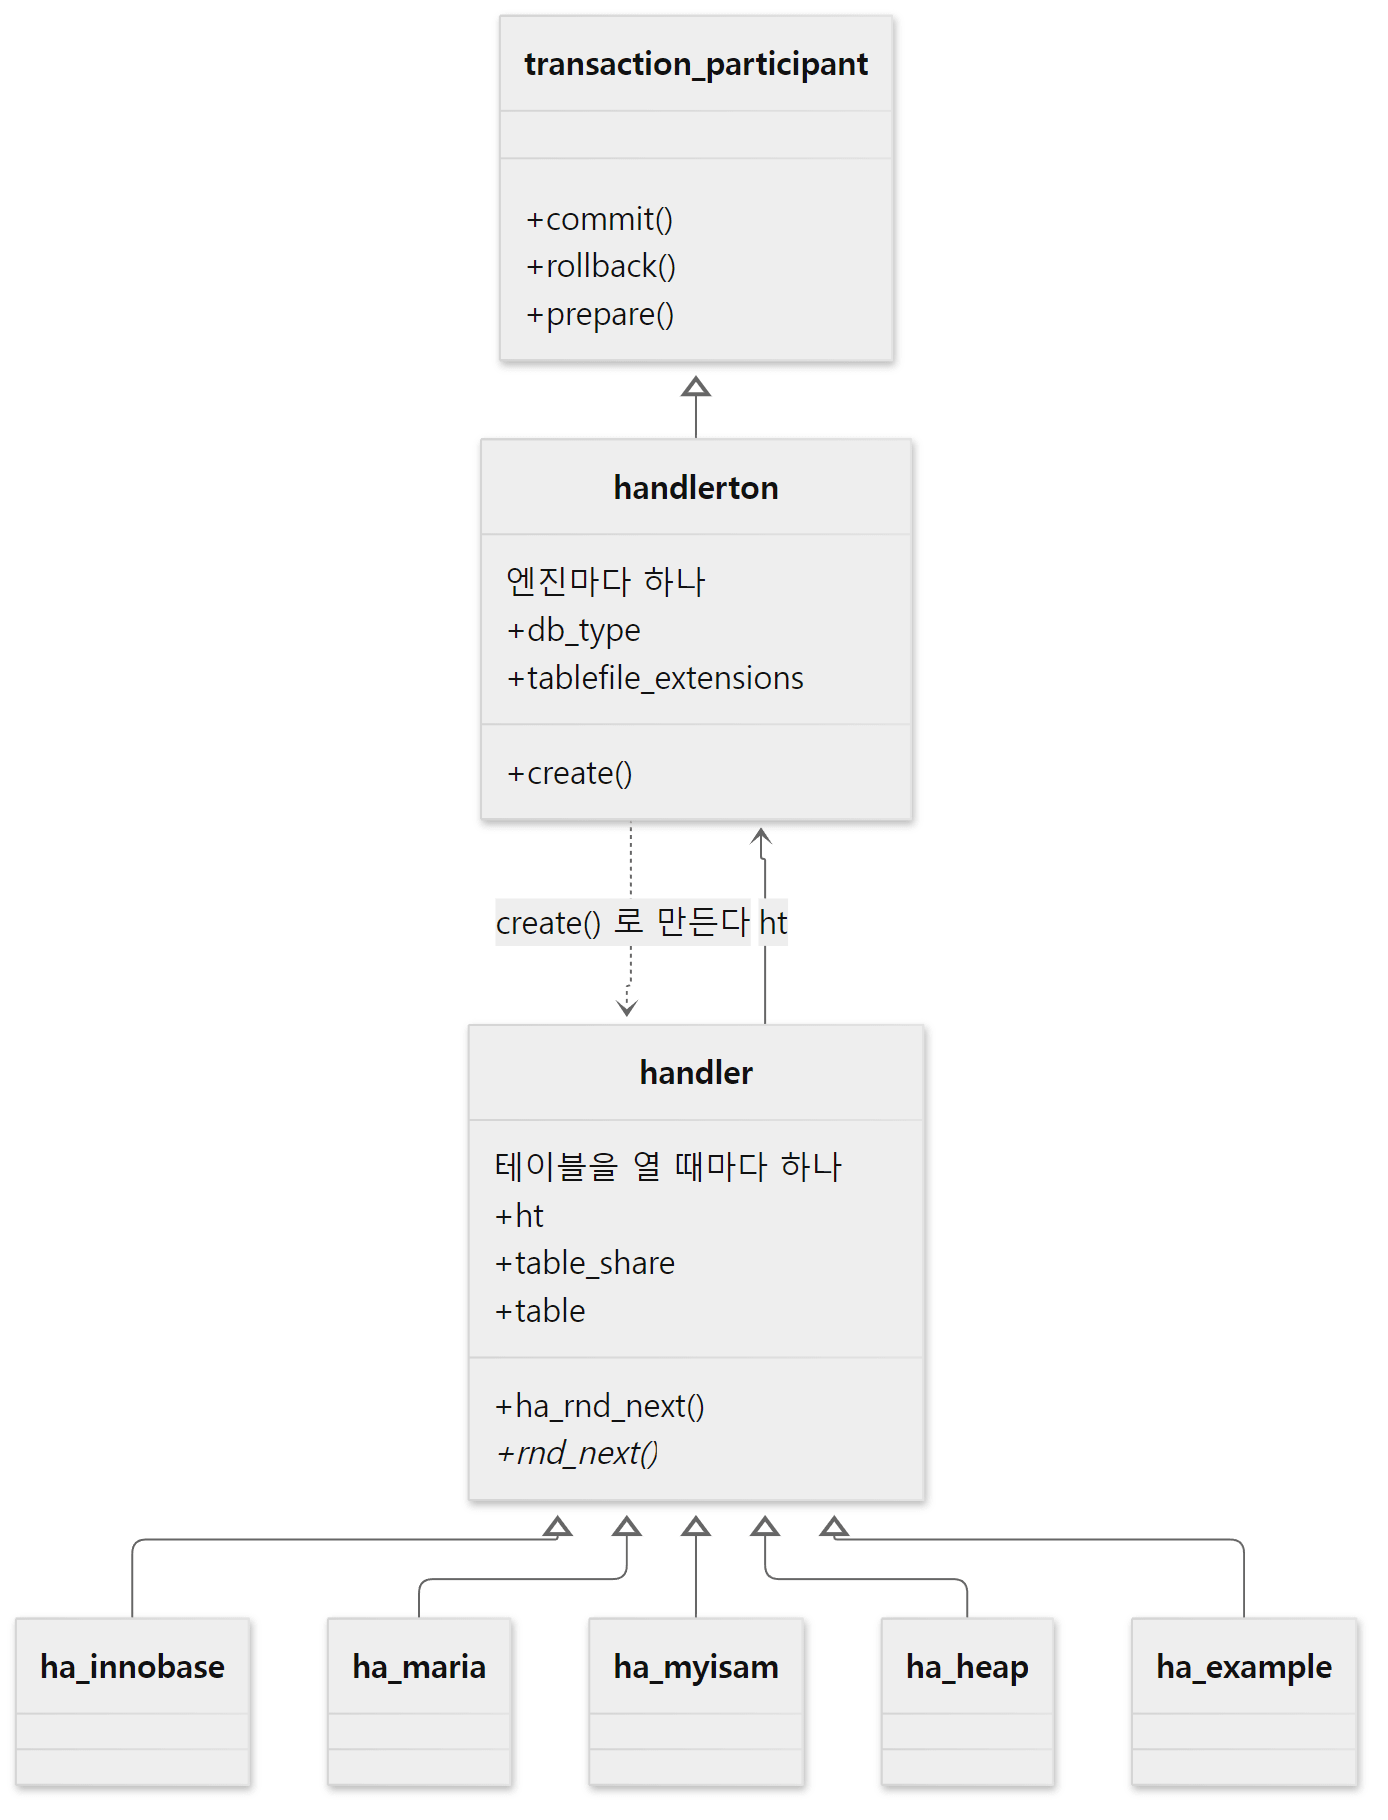 위의 둘은 엔진마다 하나, 아래는 열린 테이블마다 하나입니다. 기울어진
rnd_next() 는 엔진이 채우는 가상 함수입니다.
다섯 엔진 클래스의 선언은 모두 한 줄로 handler 를 상속합니다. class ha_innobase final : public handler(ha_innodb.h 63행), class __attribute__((visibility("default"))) ha_maria :public handler(ha_maria.h 43행), class ha_myisam final : public handler(ha_myisam.h 39행), class ha_heap final : public handler(ha_heap.h 23행), class ha_example: public handler(ha_example.h 59행)입니다.
서버가 부르는 것: ha_ 감싸개
그러면 서버 계층이 부르는 ha_rnd_next() 는 무엇을 할까요. 엔진의 rnd_next() 를 부르는 앞뒤에 서버 계층의 일을 끼워 넣습니다.
int handler::ha_rnd_next(uchar *buf)
{
  int result;
  // ...
  do
  {
    TABLE_IO_WAIT(tracker, PSI_TABLE_FETCH_ROW, MAX_KEY, result,
      { result= rnd_next(buf); })
    if (result != HA_ERR_RECORD_DELETED)
      break;
    status_var_increment(table->in_use->status_var.ha_read_rnd_deleted_count);
  } while (!table->in_use->check_killed(1));

  if (result == HA_ERR_RECORD_DELETED)
    result= HA_ERR_ABORTED_BY_USER;
  else
  {
    if (!result)
    {
      update_rows_read();
      if (table->vfield && buf == table->record[0])
        table->update_virtual_fields(this, VCOL_UPDATE_FOR_READ);
    }
    increment_statistics(&SSV::ha_read_rnd_next_count);
TABLE_IO_WAIT매크로 안에서 엔진의rnd_next(buf)를 부릅니다. 이 매크로는ANALYZE문의 시간 재기와 performance_schema 의 테이블 입출력 계측으로 엔진 호출을 감쌉니다(handler.h 6031–6041행).- 엔진이 "지워진 행" 을 돌려주면(
HA_ERR_RECORD_DELETED) 다음 행을 다시 달라고 하고, 그동안 연결이KILL되었는지 봅니다. - 마지막 줄의
increment_statistics(&SSV::ha_read_rnd_next_count)가 우리가SHOW STATUS에서 보는Handler_read_rnd_next를 하나 올립니다.
곧 Handler_read_* 상태 변수는 엔진이 아니라 서버 계층의 감싸개가 세는 숫자입니다. 그렇다면 엔진을 바꿔도 같은 일을 하면 같은 숫자가 나와야 합니다.
예제 2: 엔진이 달라도 Handler_read_rnd_next 는 같다
예제 1의 네 테이블을 하나씩 풀 스캔하고 Handler_read_rnd_next 를 찍었습니다. note 에는 인덱스가 없으므로 WHERE note LIKE 'row%' 는 풀 스캔이 됩니다. 연결을 새로 열 때마다 세션 상태 변수는 0에서 시작합니다.
for t in t_innodb t_aria t_myisam t_memory; do
  out=$(mariadb -N -e "SELECT COUNT(*) FROM lab.$t WHERE note LIKE 'row%';
                       SHOW SESSION STATUS LIKE 'Handler_read_rnd_next';")
  rows=$(echo "$out" | head -1)
  calls=$(echo "$out" | tail -1 | awk '{print $2}')
  printf '%-9s rows=%s  Handler_read_rnd_next=%s\n' "$t" "$rows" "$calls"
done
--- 3. one full scan per engine: rows found / Handler_read_rnd_next
t_innodb  rows=5  Handler_read_rnd_next=6
t_aria    rows=5  Handler_read_rnd_next=6
t_myisam  rows=5  Handler_read_rnd_next=6
t_memory  rows=5  Handler_read_rnd_next=6
네 엔진 모두 6입니다. 행은 5개인데 6인 이유도 위 감싸개에 있습니다. 다섯 번은 행을 받았고, 여섯 번째 호출에서 엔진이 HA_ERR_END_OF_FILE(끝)을 돌려주었습니다. 감싸개는 결과가 HA_ERR_RECORD_DELETED 만 아니면 else 쪽으로 가서 끝을 알린 호출도 셉니다.
헷갈리기 쉬운 곳: 서버와 엔진은 행을 "MySQL 형식" 바이트로 주고받는다
rnd_next(uchar *buf) 의 buf 는 보통 table->record[0] 이라는 바이트 버퍼입니다. 서버 계층이 정한 고정된 배치(NULL 비트들, 그다음 열마다 고정 위치)로 행 하나를 담습니다(class handler 위 설명의 "TableRecordFormat", handler.h 3417–3426행). InnoDB 소스의 주석이 이것을 "MySQL format" 이라고 부릅니다(ha_innobase::rnd_next() 의 buf 인자 설명, ha_innodb.cc 9664–9665행). 엔진은 자기 디스크 형식의 행을 이 형식으로 바꿔 채워야 합니다. InnoDB 가 그 변환을 하는 곳은 10편과 11편에서 지나갑니다.
3. 엔진 하나에 하나: handlerton
구조체의 설명
handler 가 "테이블마다" 라면, 엔진 전체의 일은 누가 맡을까요. struct handlerton 바로 위의 설명이 둘을 대비해 줍니다.
/*
  handlerton is a singleton structure - one instance per storage engine -
  to provide access to storage engine functionality that works on the
  "global" level (unlike handler class that works on a per-table basis)
*/
struct handlerton : public transaction_participant
{
  // ...
  enum legacy_db_type db_type;
  // ...
  const char **tablefile_extensions; // by default - empty list
  // ...
  handler *(*create)(handlerton *hton, TABLE_SHARE *table, MEM_ROOT *mem_root);
"handlerton 은 싱글턴 구조체다 — 엔진마다 하나 — 엔진의 '전역' 수준 기능에 닿게 해 준다(테이블 단위로 일하는 handler 클래스와 달리)". 필드는 거의 전부 함수 포인터입니다. 발췌의 create 가 가장 중요한 하나로, 이 엔진의 handler 객체를 만들어 돌려줍니다. 이 밖에 drop_database, show_status(SHOW ENGINE … STATUS), flush_logs, binlog 를 엔진 안에 두는 최근 기능용 binlog_* 들이 줄지어 있습니다.
handler 는 C++ 가상 함수로, handlerton 은 C 식의 함수 포인터 구조체로 만들어져 있다는 점이 눈에 띕니다. 함수 포인터 구조체로 "인터페이스" 를 손으로 만드는 방법은 httpd 2편에서 자세히 보았습니다. 엔진은 이 구조체의 칸을 채워 넣는 식으로 자기 기능을 서버에 알립니다.
부모: transaction_participant
handlerton 은 transaction_participant 라는 구조체를 상속합니다. 트랜잭션에 참여하는 쪽이 채워야 할 함수 포인터들입니다.
struct transaction_participant
{
  // ...
  uint slot;
  // ...
  int (*commit)(THD *thd, bool all);
  int  (*rollback)(THD *thd, bool all);
  int  (*prepare)(THD *thd, bool all);
slot 은 연결(THD)마다 엔진이 자기 데이터를 걸어 둘 칸의 번호입니다(6절의 ha_data). commit·rollback·prepare 가 사용자가 COMMIT 을 쳤을 때 결국 불리는 엔진 쪽 함수입니다. 서버 계층의 ha_commit_trans() 가 이 트랜잭션에 참여한 엔진들의 commit 을 차례로 부르는 과정은 11편에서 봅니다.
헷갈리기 쉬운 곳: 트랜잭션 참여자가 엔진만은 아니다
transaction_participant 를 따로 떼어 둔 이유가 소스에 보입니다. 엔진이 아닌데 커밋·롤백에는 끼어야 하는 것들이 이 구조체를 handlerton 없이 씁니다. binlog 가 그렇고(transaction_participant binlog_tp;, sql/log.cc 2031행), 온라인 ALTER TABLE 도 그렇습니다(static transaction_participant online_alter_tp=, sql/online_alter.cc 35행). 커밋을 조정하는 sql/handler.cc 의 함수들이 handlerton * 이 아니라 transaction_participant * 를 받는 것도 이 때문입니다(예: trans_register_ha(), handler.cc 1473행).
엔진이 handlerton 을 채우는 곳
엔진은 서버가 뜰 때(동적 플러그인이면 INSTALL SONAME 때) 자기 초기화 함수에서 handlerton 의 칸을 채웁니다. 가장 작은 엔진 EXAMPLE 의 것은 이것이 전부입니다.
static int example_init_func(void *p)
{
  // ...
  example_hton= (handlerton *)p;
  example_hton->create=  example_create_handler;
  example_hton->flags=   HTON_CAN_RECREATE;
  // ...
  example_hton->tablefile_extensions= ha_example_exts;
// ...
static handler* example_create_handler(handlerton *hton,
                                       TABLE_SHARE *table,
                                       MEM_ROOT *mem_root)
{
  return new (mem_root) ha_example(hton, table);
}
storage/example/ha_example.cc 245–296행
- 서버가 넘겨준
p가 이 엔진의 handlerton 입니다. 엔진이 만드는 것이 아니라 서버가 만들어 넘겨줍니다(아래). create칸에example_create_handler를 넣습니다. 이 함수는new (mem_root) ha_example(hton, table)한 줄, 곧 handler 객체 하나를MEM_ROOT위에 만들어 돌려줍니다.- 파일 확장자 목록(
tablefile_extensions), 테이블 옵션 같은 것도 여기서 채웁니다.
InnoDB 도 모양은 같고 칸이 많을 뿐입니다.
static int innodb_init(void* p)
{
	DBUG_ENTER("innodb_init");
	handlerton* innobase_hton= static_cast<handlerton*>(p);
	// ...
	innobase_hton->commit = innobase_commit;
	innobase_hton->rollback = innobase_rollback;
	// ...
	innobase_hton->create = innobase_create_handler;
storage/innobase/handler/ha_innodb.cc 4295–4326행
commit·rollback 칸에 innobase_commit·innobase_rollback 이, create 칸에 innobase_create_handler 가 들어갑니다. innobase_create_handler() 의 몸통도 return(new (mem_root) ha_innobase(hton, table)); 한 줄입니다(ha_innodb.cc 1717–1726행).
handlerton 을 만들어 엔진의 초기화 함수에 넘기는 쪽은 서버의 ha_initialize_handlerton() 입니다.
int ha_initialize_handlerton(void *plugin_)
{
  // ...
  hton= (handlerton *)my_malloc(key_memory_handlerton, sizeof(handlerton),
                                MYF(MY_WME | MY_ZEROFILL));
  // ...
  hton->tablefile_extensions= hton_no_exts;
  // ...
  plugin->data= hton; // shortcut for the future
  if (plugin->plugin->init && (ret= plugin->plugin->init(hton)))
    goto err;
my_malloc 으로 0으로 채운 handlerton 을 하나 만들고, 몇 칸에 기본값을 넣은 뒤, 플러그인의 init 함수(example_init_func, innodb_init)에 넘깁니다. 엔진 하나당 이 함수가 한 번 불리므로 handlerton 도 엔진당 하나입니다. 서버 기동 중 언제 이 함수가 불리는지는 3편에서 봅니다.
ENGINE=InnoDB 가 ha_innobase 객체가 되기까지
이제 테이블을 열 때 handler 가 생기는 자리를 봅니다. 테이블 정의(TABLE_SHARE)로 열린 인스턴스(TABLE)를 만드는 open_table_from_share() 안입니다.
    if (!(outparam->file= get_new_handler(share, &outparam->mem_root,
                                          share->db_type())))
share->db_type() 은 정의에 기록된 엔진 플러그인(db_plugin)의 handlerton 을 돌려줍니다(table.h 848–849행). CREATE TABLE … ENGINE=InnoDB 로 만든 테이블이라면 InnoDB 의 handlerton 이 나옵니다. 그것을 받은 get_new_handler() 는 handlerton 의 create 칸을 부릅니다.
handler *get_new_handler(TABLE_SHARE *share, MEM_ROOT *alloc,
                         handlerton *db_type)
{
  // ...
  if (ha_storage_engine_is_enabled(db_type))
  {
    if ((file= db_type->create(db_type, share, alloc)))
      file->init();
    DBUG_RETURN(file);
  }
  // ...
  file= get_new_handler(share, alloc, ha_default_handlerton(current_thd));
  DBUG_RETURN(file);
}
엔진이 켜져 있으면 db_type->create(…), 곧 InnoDB 라면 innobase_create_handler() 가 불려 ha_innobase 객체가 나옵니다. 엔진이 꺼져 있으면 기본 엔진으로 다시 시도합니다. 셋째 인자 &outparam->mem_root 는 그 TABLE 의 MEM_ROOT 이므로, handler 객체는 열린 테이블과 수명을 같이합니다(7절).
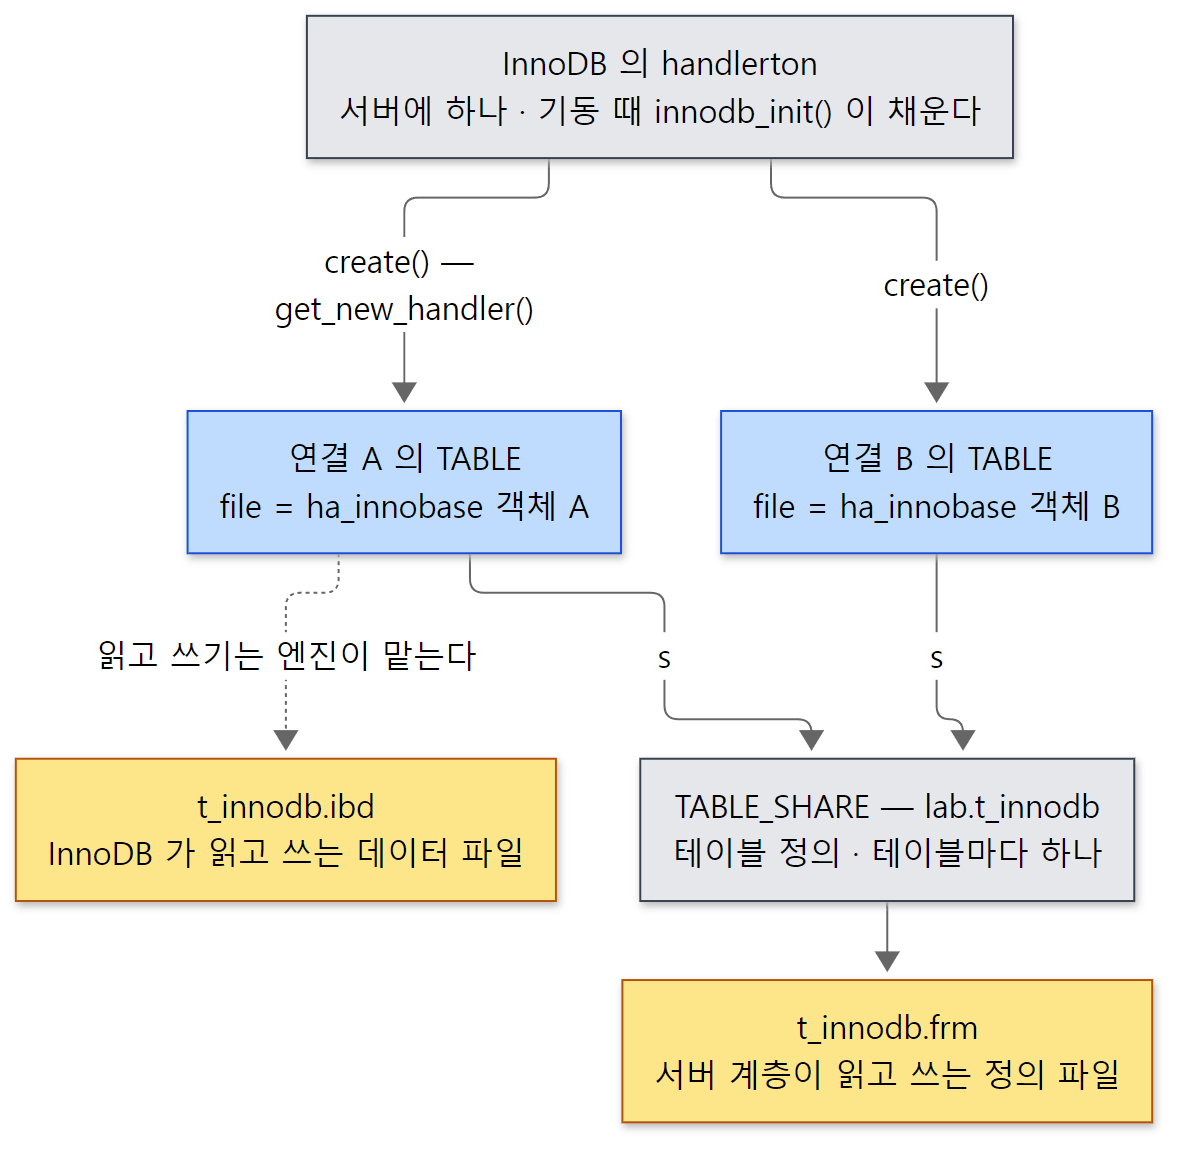 handlerton 은 엔진당 하나,
TABLE_SHARE 는 테이블당 하나, handler 는 열린 TABLE 당 하나입니다. 같은 테이블을 두 연결이 열면 handler 도 둘입니다.
예제 4(5절)에서 gdb 로 ha_innobase::rnd_next() 에 멈춘 김에 handler 객체 안을 찍어 보았습니다. 같은 실행의 출력 가운데 이 부분입니다.
$1 = DB_TYPE_INNODB
$2 = 0x772c8404c074 "t_innodb"
$3 = true
this->ht->db_type 이 DB_TYPE_INNODB — 이 handler 를 만든 handlerton 이 InnoDB 의 것이고, this->table_share->table_name.str 이 t_innodb, 그리고 this->table->s == this->table_share 가 참입니다. 열린 TABLE 의 정의 포인터(s)와 handler 가 들고 있는 정의 포인터가 같은 TABLE_SHARE 를 가리킵니다. 주소(0x772c…)는 실행마다 다릅니다.
4. 엔진도 플러그인이다
플러그인 선언 하나
ha_example.cc 의 끝에는 이 파일이 서버에 무엇을 내놓는지 적은 선언이 있습니다.
maria_declare_plugin(example)
{
  MYSQL_STORAGE_ENGINE_PLUGIN,
  &example_storage_engine,
  "EXAMPLE",
  "Brian Aker, MySQL AB",
  "Example storage engine",
  PLUGIN_LICENSE_GPL,
  example_init_func,                            /* Plugin Init */
storage/example/ha_example.cc 1085–1093행
첫 칸 MYSQL_STORAGE_ENGINE_PLUGIN 이 "이 플러그인은 스토리지 엔진이다", 일곱째 칸의 example_init_func 가 3절에서 본 초기화 함수입니다. InnoDB 도 maria_declare_plugin(innobase)(ha_innodb.cc 20762행), Aria 는 maria_declare_plugin(aria)(ha_maria.cc 4436행)로 같은 선언을 합니다. 스토리지 엔진은 플러그인의 한 종류입니다.
플러그인 종류와, 종류마다 초기화를 맡는 함수는 sql/sql_plugin.cc 의 두 표에 나란히 있습니다.
const LEX_CSTRING plugin_type_names[MYSQL_MAX_PLUGIN_TYPE_NUM]=
{
  { STRING_WITH_LEN("UDF") },
  { STRING_WITH_LEN("STORAGE ENGINE") },
// ...
plugin_type_init plugin_type_initialize[MYSQL_MAX_PLUGIN_TYPE_NUM]=
{
  0, ha_initialize_handlerton, 0, 0,initialize_schema_table,
  initialize_audit_plugin, 0, 0, 0, initialize_encryption_plugin,
  initialize_data_type_plugin, 0
};
첫 표의 둘째 칸이 "STORAGE ENGINE", 둘째 표의 둘째 칸이 ha_initialize_handlerton 입니다. 플러그인 종류 번호 1(MYSQL_STORAGE_ENGINE_PLUGIN, include/mysql/plugin.h 93행)로 들어온 플러그인은 3절의 ha_initialize_handlerton() 으로 초기화된다는 뜻입니다. 기준 커밋의 플러그인 종류는 이 밖에 인증, 감사(audit), 정보 테이블(information schema), 암호화, 데이터 타입 등 모두 12가지입니다.
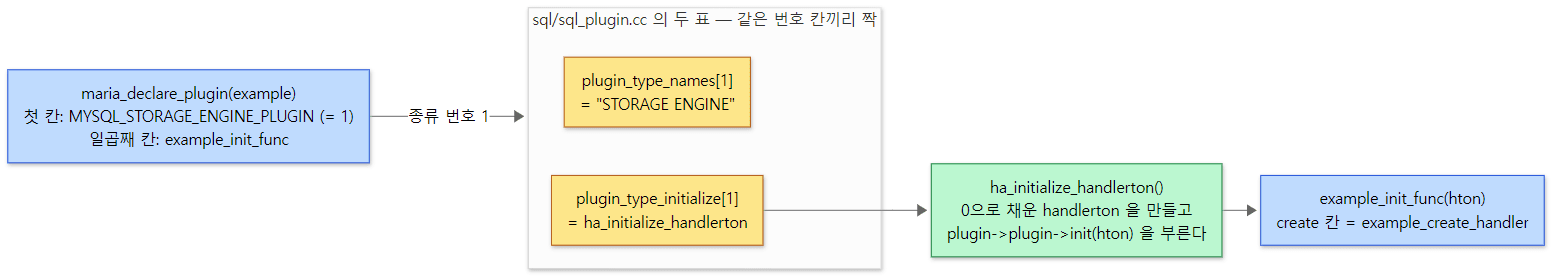 플러그인 선언의 종류 번호 하나가 두 표의 같은 칸을 고르고, 그 칸의 함수가 엔진의 초기화 함수를 부릅니다. 값은 위 두 인용과 3절의 인용에서 가져왔습니다.
예제 3: 가장 작은 엔진을 실행 중에 올리기
예제 이미지에는 InnoDB·Aria·MyISAM·MEMORY 같은 엔진이 서버 실행 파일에 정적으로 들어 있고, EXAMPLE 은 따로 빌드된 ha_example.so 입니다. 먼저 엔진 목록을 보고, INSTALL SONAME 으로 EXAMPLE 을 올려 테이블을 만들어 보았습니다.
mariadb -t -e "SELECT PLUGIN_NAME, PLUGIN_STATUS, IFNULL(PLUGIN_LIBRARY,'(built in)') AS LIBRARY
                 FROM information_schema.PLUGINS
                WHERE PLUGIN_TYPE = 'STORAGE ENGINE' ORDER BY PLUGIN_NAME"
mariadb -t -e "INSTALL SONAME 'ha_example';
               SELECT PLUGIN_NAME, PLUGIN_STATUS, PLUGIN_LIBRARY
                 FROM information_schema.PLUGINS WHERE PLUGIN_NAME = 'EXAMPLE';
               CREATE TABLE lab.t_example (id INT, note VARCHAR(20)) ENGINE=EXAMPLE;
               INSERT INTO lab.t_example SELECT * FROM lab.t_innodb;
               SELECT ROW_COUNT() AS rows_inserted;"
# 세션 상태 변수가 0 에서 시작하도록 연결을 새로 연다.
mariadb -t -e "SELECT COUNT(*) AS rows_in_example FROM lab.t_example WHERE note LIKE 'row%';
               SHOW SESSION STATUS LIKE 'Handler_read_rnd_next';"
ls -1 /var/lib/mariadb-lab/lab | grep example
--- 4. storage engines are plugins
+--------------------+---------------+------------+
 PLUGIN_NAME        | PLUGIN_STATUS | LIBRARY    |
+--------------------+---------------+------------+
 Aria               | ACTIVE        | (built in) |
 CSV                | ACTIVE        | (built in) |
 InnoDB             | ACTIVE        | (built in) |
 MEMORY             | ACTIVE        | (built in) |
 MRG_MyISAM         | ACTIVE        | (built in) |
 MyISAM             | ACTIVE        | (built in) |
 partition          | ACTIVE        | (built in) |
 PERFORMANCE_SCHEMA | ACTIVE        | (built in) |
 SEQUENCE           | ACTIVE        | (built in) |
 SQL_SEQUENCE       | ACTIVE        | (built in) |
+--------------------+---------------+------------+
+-------------+---------------+----------------+
 PLUGIN_NAME | PLUGIN_STATUS | PLUGIN_LIBRARY |
+-------------+---------------+----------------+
 EXAMPLE     | ACTIVE        | ha_example.so  |
+-------------+---------------+----------------+
+---------------+
 rows_inserted |
+---------------+
             5 |
+---------------+
+-----------------+
 rows_in_example |
+-----------------+
               0 |
+-----------------+
+-----------------------+-------+
 Variable_name         | Value |
+-----------------------+-------+
 Handler_read_rnd_next | 1     |
+-----------------------+-------+
t_example.frm
- 정적으로 들어 있는 엔진은
PLUGIN_LIBRARY가 비어((built in)) 있고, 올린 EXAMPLE 은ha_example.so입니다.PERFORMANCE_SCHEMA도 엔진 목록에 있습니다 —performance_schema데이터베이스의 테이블도class ha_perfschema final : public handler(ha_perfschema.h 44행)를 거쳐 읽힙니다. INSERT는 "5행" 을 넣었다고 답했는데COUNT(*)는 0입니다.ha_example의 두 함수가 그대로 드러난 것입니다.
int ha_example::write_row(const uchar *buf)
{
  DBUG_ENTER("ha_example::write_row");
  // ...
  DBUG_RETURN(0);
}
// ...
int ha_example::rnd_next(uchar *buf)
{
  int rc;
  DBUG_ENTER("ha_example::rnd_next");
  rc= HA_ERR_END_OF_FILE;
  DBUG_RETURN(rc);
}
storage/example/ha_example.cc 389–588행
write_row() 는 행을 버리고 성공(0)을 돌려주고, rnd_next() 는 첫 호출부터 HA_ERR_END_OF_FILE 을 돌려줍니다. 그래서 Handler_read_rnd_next 는 "끝" 을 알린 한 번만 세어 1입니다. 데이터 파일 없이 .frm 하나만 생긴 것도 이 엔진이 아무것도 저장하지 않기 때문입니다. 1,116줄짜리 ha_example.cc 는 절반가량이 주석이고, 이 정도만으로 CREATE TABLE·INSERT·SELECT 가 되는 것 — 파싱도, 실행 계획도, 결과 보내기도 서버 계층이 해 주기 때문입니다.
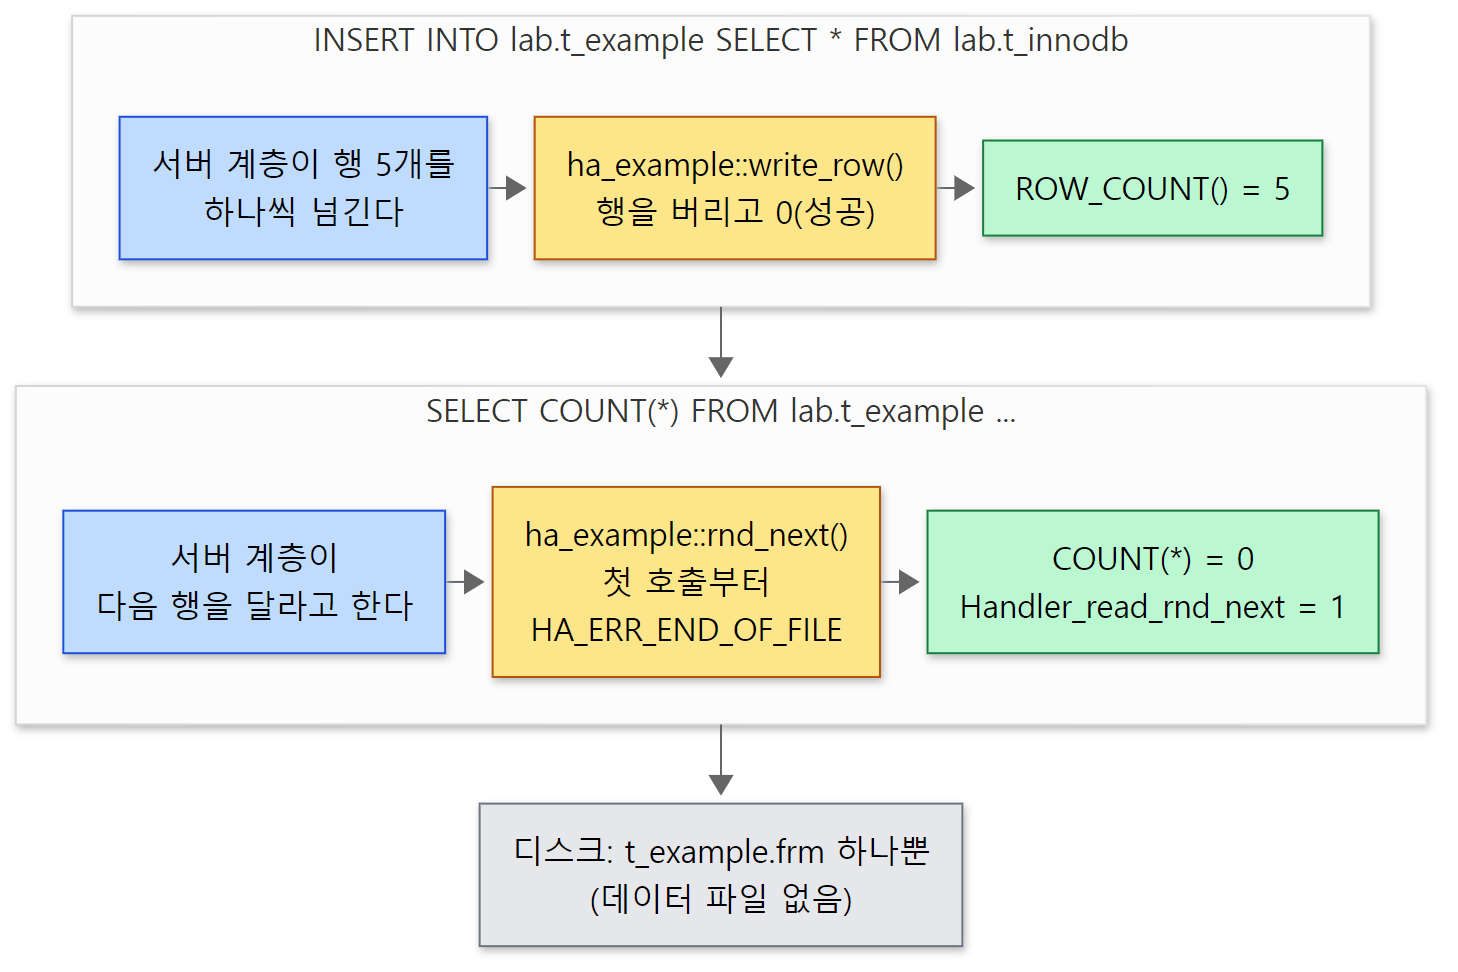 파란 칸은 서버 계층, 노란 칸은 엔진의 함수입니다. 숫자는 예제 3의 실제 출력입니다.
헷갈리기 쉬운 곳: 플러그인이 전부 엔진은 아니다
plugin/ 폴더에는 엔진이 아닌 플러그인이 모여 있습니다. 인증(auth_ed25519, auth_socket …), 감사(server_audit), 데이터 타입(type_inet, type_uuid), 정보 테이블(metadata_lock_info, query_response_time) 같은 것들입니다. 반대로 엔진은 storage/ 에 있습니다. 둘 다 같은 플러그인 장치(sql/sql_plugin.cc)로 올라가지만, 엔진만 handlerton 을 갖고 handler 를 만듭니다. 플러그인 장치 전체는 3편에서 봅니다.
5. 쿼리 하나의 일생
한 장으로
이제 지도의 ①에서 ⑨까지를 한 번에 지나갑니다. 클라이언트가 SELECT 를 보내면 일어나는 일입니다.
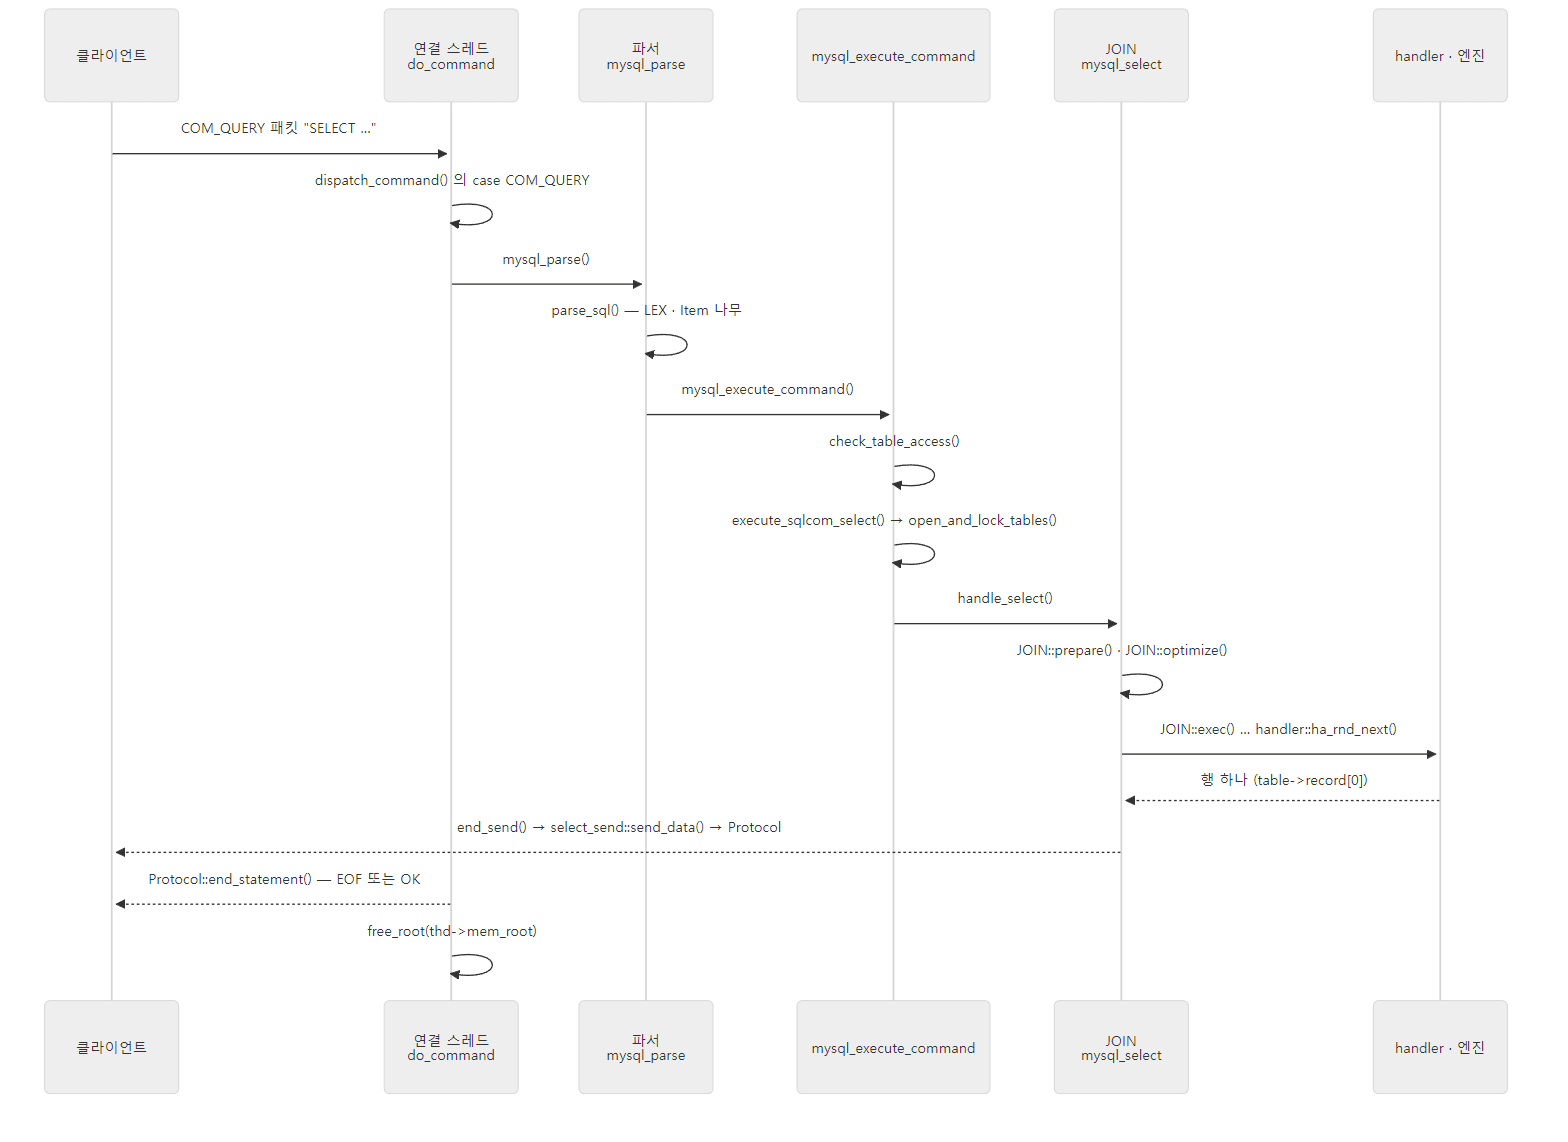 실선은 부르는 쪽, 점선은 돌려주거나 보내는 쪽입니다. 행이 여럿이면
ha_rnd_next() 부터 send_data() 까지가 행마다 되풀이됩니다.
칸마다 소스의 한 자리씩만 짚어 봅니다.
① 연결. 연결 하나를 맡은 스레드는 do_handle_one_connection() 의 이 반복문을 연결이 끊길 때까지 돕니다. do_command() 한 번이 명령 하나입니다.
    while (thd_is_connection_alive(thd))
    {
      if (mysql_audit_release_required(thd))
        mysql_audit_release(thd);
      if (do_command(thd))
	break;
    }
    end_connection(thd);
연결마다 스레드 하나인 이 방식과, 스레드 몇 개가 연결 여럿을 나눠 맡는 스레드 풀은 4편에서 봅니다.
② 명령. do_command() 는 패킷 하나를 읽고 첫 바이트(명령 종류)를 떼어 dispatch_command() 에 넘깁니다(sql_parse.cc 1437–1438행). dispatch_command() 는 switch (command)(1713행)로 갈라지고, 텍스트 SQL 을 보내는 COM_QUERY(1862행)는 결국 mysql_parse() 를 부릅니다(1903행). 패킷의 생김새와 다른 명령들은 5편에서 봅니다.
③ 파싱. mysql_parse() 는 쿼리 캐시를 먼저 들여다보고, 없으면 파서를 돌린 뒤 실행으로 넘깁니다.
void mysql_parse(THD *thd, char *rawbuf, uint length,
                 Parser_state *parser_state)
  // ...
  lex_start(thd);
  thd->reset_for_next_command();

  if (query_cache_send_result_to_client(thd, rawbuf, length) <= 0)
    // ...
    bool err= parse_sql(thd, parser_state, NULL, true);
          // ...
          error= mysql_execute_command(thd);
parse_sql() 이 끝나면 thd->lex 에 문장 전체가 들어 있습니다. LEX 는 맨 바깥 SELECT_LEX_UNIT unit;(sql_lex.h 3407행)에서 시작해 SELECT_LEX 들을 품습니다. SELECT_LEX 를 잠깐 보면 이렇습니다.
class st_select_lex: public st_select_lex_node
{
  // ...
  Item *where, *having;                         /* WHERE & HAVING clauses */
  // ...
  SQL_I_List<TABLE_LIST>  table_list;
  // ...
  List<Item>          item_list;  /* list of fields & expressions */
SELECT a, b FROM t WHERE c > 1 이라면 item_list 에 a·b 를 뜻하는 Item 둘이, table_list 에 t 가, where 에 c > 1 을 뜻하는 Item 나무의 뿌리가 들어갑니다. 문장 종류는 LEX 가 상속하는 Query_tables_list 의 sql_command 에 있습니다(sql_lex.h 1864행). 렉서와 Bison 문법이 이것을 만드는 과정은 6편에서 봅니다.
④ 준비. mysql_execute_command() 는 switch (lex->sql_command)(3946행)로 문장 종류마다 갈라집니다. SELECT 는 권한을 확인한 뒤 execute_sqlcom_select() 로 갑니다.
    if (all_tables)
      res= check_table_access(thd, SELECT_ACL, all_tables, 0, UINT_MAX, 0);
    else
      res= check_access(thd, SELECT_ACL, any_db.str, NULL,NULL, 0, 0);

    if (!res)
      res= execute_sqlcom_select(thd, all_tables);
execute_sqlcom_select() 는 open_and_lock_tables() 로 문장에 나온 테이블을 모두 엽니다(6186행). 3절에서 본 open_table_from_share() 와 get_new_handler() 가 불려 handler 가 생기는 것이 이 안입니다. 그다음 handle_select() 를 부릅니다(6266행). 권한 확인, 테이블 열기, 메타데이터 잠금(MDL), 열 이름 찾기는 7편에서 봅니다.
④⑤⑥ 준비 · 최적화 · 실행. handle_select() 가 부르는 mysql_select() 에 세 단계가 한 화면에 모여 있습니다.
    if (!(join= new (thd->mem_root) JOIN(thd, fields, select_options, result)))
	DBUG_RETURN(TRUE);
    // ...
    if (!join->prepared &&
        (err= join->prepare(tables, conds, og_num, order, false, group, having,
                            proc_param, select_lex, unit)))
    {
      goto err;
    }
  }
  // ...
  if ((err= join->optimize()))
  {
    goto err;					// 1
  }
  // ...
  exec_error= join->exec();
JOIN 은 SELECT 하나를 실행하기 위한 객체입니다. prepare() 가 열 이름을 실제 테이블의 열에 잇고(④의 뒷부분), optimize() 가 조인 순서와 접근 방법을 고르고(⑤, 8편), exec() 가 그 계획을 실행합니다(⑥, 9편). JOIN 객체도 new (thd->mem_root) 로 만들어진다는 점을 7절에서 다시 봅니다.
⑦⑧ handler 와 엔진. exec() 는 테이블마다 "다음 행" 을 엔진에 달라고 합니다. 풀 스캔이라면 2절에서 본 handler::ha_rnd_next() → 엔진의 rnd_next() 입니다. InnoDB 의 rnd_next() 는 처음이면 index_first()(클러스터드 인덱스의 첫 레코드), 아니면 general_fetch(buf, ROW_SEL_NEXT, 0) 을 부릅니다(ha_innodb.cc 9661–9683행). 그 안쪽은 10편과 11편의 몫입니다.
⑨ 결과 보내기. 조건을 통과한 행은 select_send 객체를 거쳐 Protocol 로 나갑니다.
int select_send::send_data(List<Item> &items)
{
  Protocol *protocol= thd->protocol;
  // ...
  protocol->prepare_for_resend();
  if (protocol->send_result_set_row(&items))
  // ...
  thd->inc_sent_row_count(1);
  // ...
  if (likely(thd->vio_ok()))
    DBUG_RETURN(protocol->write());
thd->protocol 은 텍스트 프로토콜(Protocol_text)이나 준비된 문장용 이진 프로토콜(Protocol_binary)입니다. send_result_set_row() 가 행을 패킷으로 만들고 write() 가 보냅니다. 슬로 쿼리 로그의 Rows_sent(sql/log.cc 4170–4175행)가 세는 것이 inc_sent_row_count(1) 입니다. 패킷의 모양은 5편에서 봅니다.
예제 4: gdb 로 지도 위의 자리 확인하기
이 길이 정말 맞는지, 실행 중인 mariadbd 에 gdb 를 붙이고 ha_innobase::rnd_next 에 중단점을 건 뒤 다른 연결에서 SELECT COUNT(*) FROM lab.t_innodb WHERE note LIKE 'row%' 를 보냈습니다. gdb 에 준 명령 파일(gdb-innodb.cmd)에서 set 몇 줄과 주석을 뺀 나머지입니다.
break ha_innobase::rnd_next
continue
bt
print this->ht->db_type
print this->table_share->table_name.str
print this->table->s == this->table_share
frame function mysql_execute_command
print thd->thread_id
print thd->lex->sql_command
print thd->query_string.string.str
detach
quit
빼낸 set print frame-arguments none 이 인자 값을 ... 로 줄여 줍니다. 백트레이스 부분입니다(0x… 주소는 실행마다 다릅니다).
#0  ha_innobase::rnd_next (this=..., buf=...) at /usr/src/mariadb/storage/innobase/handler/ha_innodb.cc:9668
#1  0x0000557d5689f504 in handler::ha_rnd_next (this=..., buf=...) at /usr/src/mariadb/sql/handler.cc:4129
#2  0x0000557d56278f03 in rr_sequential (info=...) at /usr/src/mariadb/sql/records.cc:517
#3  0x0000557d5625f09b in READ_RECORD::read_record (this=...) at /usr/src/mariadb/sql/records.h:77
#4  0x0000557d564b97ba in join_init_read_record (tab=...) at /usr/src/mariadb/sql/sql_select.cc:26694
#5  0x0000557d564b6b39 in sub_select (join=..., join_tab=..., end_of_records=...) at /usr/src/mariadb/sql/sql_select.cc:25572
#6  0x0000557d564b5c49 in do_select (join=..., procedure=...) at /usr/src/mariadb/sql/sql_select.cc:25086
#7  0x0000557d5647ba92 in JOIN::exec_inner (this=...) at /usr/src/mariadb/sql/sql_select.cc:5147
#8  0x0000557d5647ab0a in JOIN::exec (this=...) at /usr/src/mariadb/sql/sql_select.cc:4935
#9  0x0000557d5647c4f7 in mysql_select (thd=..., tables=..., fields=..., conds=..., og_num=..., order=..., group=..., having=..., proc_param=..., select_options=..., result=..., unit=..., select_lex=...) at /usr/src/mariadb/sql/sql_select.cc:5461
#10 0x0000557d56469eb2 in handle_select (thd=..., lex=..., result=..., setup_tables_done_option=...) at /usr/src/mariadb/sql/sql_select.cc:652
#11 0x0000557d563ffe1f in execute_sqlcom_select (thd=..., all_tables=...) at /usr/src/mariadb/sql/sql_parse.cc:6266
#12 0x0000557d563f93a1 in mysql_execute_command (thd=..., is_called_from_prepared_stmt=...) at /usr/src/mariadb/sql/sql_parse.cc:4038
#13 0x0000557d5640481e in mysql_parse (thd=..., rawbuf=..., length=..., parser_state=...) at /usr/src/mariadb/sql/sql_parse.cc:8005
#14 0x0000557d563f3338 in dispatch_command (command=..., thd=..., packet=..., packet_length=..., blocking=...) at /usr/src/mariadb/sql/sql_parse.cc:1903
#15 0x0000557d563f207f in do_command (thd=..., blocking=...) at /usr/src/mariadb/sql/sql_parse.cc:1437
#16 0x0000557d56622c14 in do_handle_one_connection (connect=..., put_in_cache=...) at /usr/src/mariadb/sql/sql_connect.cc:1514
#17 0x0000557d566229a0 in handle_one_connection (arg=...) at /usr/src/mariadb/sql/sql_connect.cc:1426
#18 0x0000557d56c35f50 in pfs_spawn_thread (arg=...) at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#19 0x00007f2cd9918b84 in ?? () from /lib/x86_64-linux-gnu/libc.so.6
#20 0x00007f2cd99a5ecc in ?? () from /lib/x86_64-linux-gnu/libc.so.6
아래에서 위로 읽으면 지도의 칸이 그대로 겹칩니다. 프레임에 찍힌 줄 번호도 위에서 인용한 줄(sql_connect.cc:1514, sql_parse.cc:1903·8005·4038·6266, sql_select.cc:5461, handler.cc:4129)과 같습니다.
| 프레임 | 지도의 칸 | 자세히 |
|---|---|---|
| #16–#18 | ① 연결 — 연결마다 스레드 하나(pfs_spawn_thread 는 performance_schema 가 스레드 시작을 감싼 것) |
4편 |
| #14–#15 | ② 명령 — do_command → dispatch_command |
5편 |
| #13 | ③ 파싱 — mysql_parse(파서는 이미 끝나고 실행으로 넘어간 자리) |
6편 |
| #10–#12 | ④ 준비 — mysql_execute_command → execute_sqlcom_select → handle_select |
7편 |
| #9 | ④⑤⑥ — mysql_select 의 5461행, 곧 join->exec() |
8편 |
| #2–#8 | ⑥ 실행 — JOIN::exec → do_select → sub_select → 풀 스캔용 읽기 함수 rr_sequential |
9편 |
| #1 | ⑦ handler 경계 — handler::ha_rnd_next |
9편 |
| #0 | ⑧ 엔진 — ha_innobase::rnd_next |
10편 |
같은 실행에서 Aria·MyISAM·MEMORY 테이블에 대해서도 각 엔진의 rnd_next 에 멈춰 맨 아래 세 칸만 찍었습니다.
--- 6. gdb: bottom 3 frames for other engines
[t_aria]
#0  ha_maria::rnd_next (this=..., buf=...) at /usr/src/mariadb/storage/maria/ha_maria.cc:2646
#1  0x0000557d5689f504 in handler::ha_rnd_next (this=..., buf=...) at /usr/src/mariadb/sql/handler.cc:4129
#2  0x0000557d56278f03 in rr_sequential (info=...) at /usr/src/mariadb/sql/records.cc:517
[t_myisam]
#0  ha_myisam::rnd_next (this=..., buf=...) at /usr/src/mariadb/storage/myisam/ha_myisam.cc:2060
#1  0x0000557d5689f504 in handler::ha_rnd_next (this=..., buf=...) at /usr/src/mariadb/sql/handler.cc:4129
#2  0x0000557d56278f03 in rr_sequential (info=...) at /usr/src/mariadb/sql/records.cc:517
[t_memory]
#0  ha_heap::rnd_next (this=..., buf=...) at /usr/src/mariadb/storage/heap/ha_heap.cc:425
#1  0x0000557d5689f504 in handler::ha_rnd_next (this=..., buf=...) at /usr/src/mariadb/sql/handler.cc:4129
#2  0x0000557d56278f03 in rr_sequential (info=...) at /usr/src/mariadb/sql/records.cc:517
#1 의 주소(0x0000557d5689f504)까지 네 엔진이 똑같습니다. 같은 기계어의 같은 자리에서 가상 함수 호출 하나로 네 갈래로 나뉜다는 뜻입니다. ⑦ 위쪽은 엔진을 모릅니다.
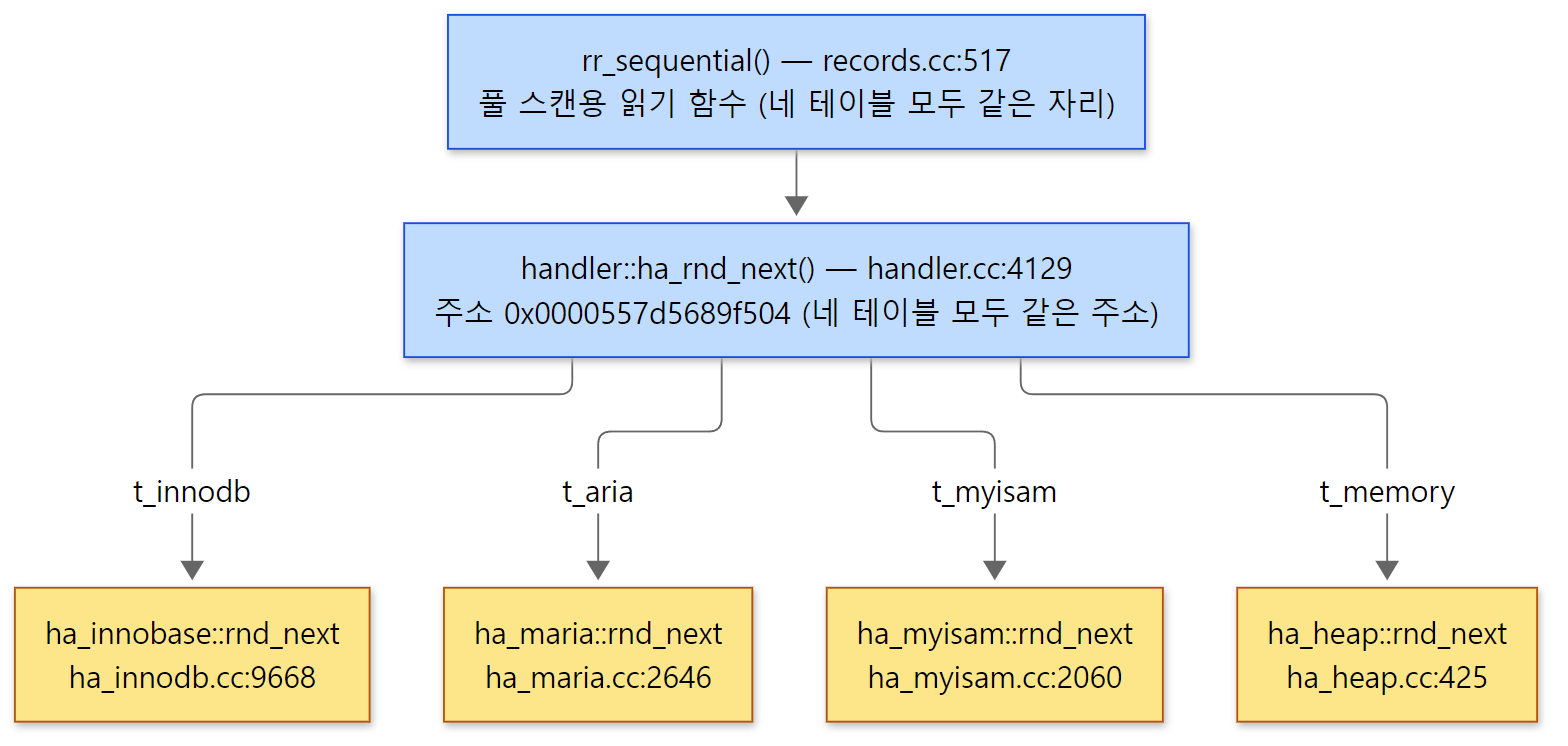 위쪽 두 칸(파랑)은 네 테이블이 같은 기계어 자리를 지나고, 아래 노란 칸에서만 엔진이 갈립니다. 줄 번호와 주소는 예제 4의 실제 출력입니다.
예제 5: 결과 한 행이 나가는 자리
COUNT(*) 는 행을 하나씩 보내지 않으므로, 이번에는 행을 그대로 돌려주는 SELECT id, note FROM lab.t_innodb WHERE note = 'row 3' 을 보내고 Protocol::send_result_set_row 에 멈춰 맨 아래 여섯 칸을 찍었습니다.
--- 7. gdb: bottom 6 frames at Protocol::send_result_set_row
#0  Protocol::send_result_set_row (this=..., row_items=...) at /usr/src/mariadb/sql/protocol.cc:1350
#1  0x0000557d56356b21 in select_send::send_data (this=..., items=...) at /usr/src/mariadb/sql/sql_class.cc:3483
#2  0x0000557d56356808 in select_result_sink::send_data_with_check (this=..., items=..., u=..., sent=...) at /usr/src/mariadb/sql/sql_class.cc:3381
#3  0x0000557d564baa44 in end_send (join=..., join_tab=..., end_of_records=...) at /usr/src/mariadb/sql/sql_select.cc:26975
#4  0x0000557d564b7421 in evaluate_join_record (join=..., join_tab=..., error=...) at /usr/src/mariadb/sql/sql_select.cc:25808
#5  0x0000557d564b6dbb in sub_select (join=..., join_tab=..., end_of_records=...) at /usr/src/mariadb/sql/sql_select.cc:25612
⑥ 실행의 sub_select 가 행 하나를 읽고, evaluate_join_record 가 WHERE 를 확인한 뒤, 맨 끝 단계인 end_send 가 ⑨의 select_send::send_data() 를 부릅니다. #1 의 sql_class.cc:3483 은 위에서 인용한 protocol->send_result_set_row(&items) 줄입니다. 지도에서 ⑥이 ⑦과 ⑨ 두 갈래로 나뉜 것이 이 모양입니다. 행을 읽으러 내려가는 길(⑦)과 결과를 내보내는 길(⑨)이 둘 다 sub_select 에서 갈라집니다.
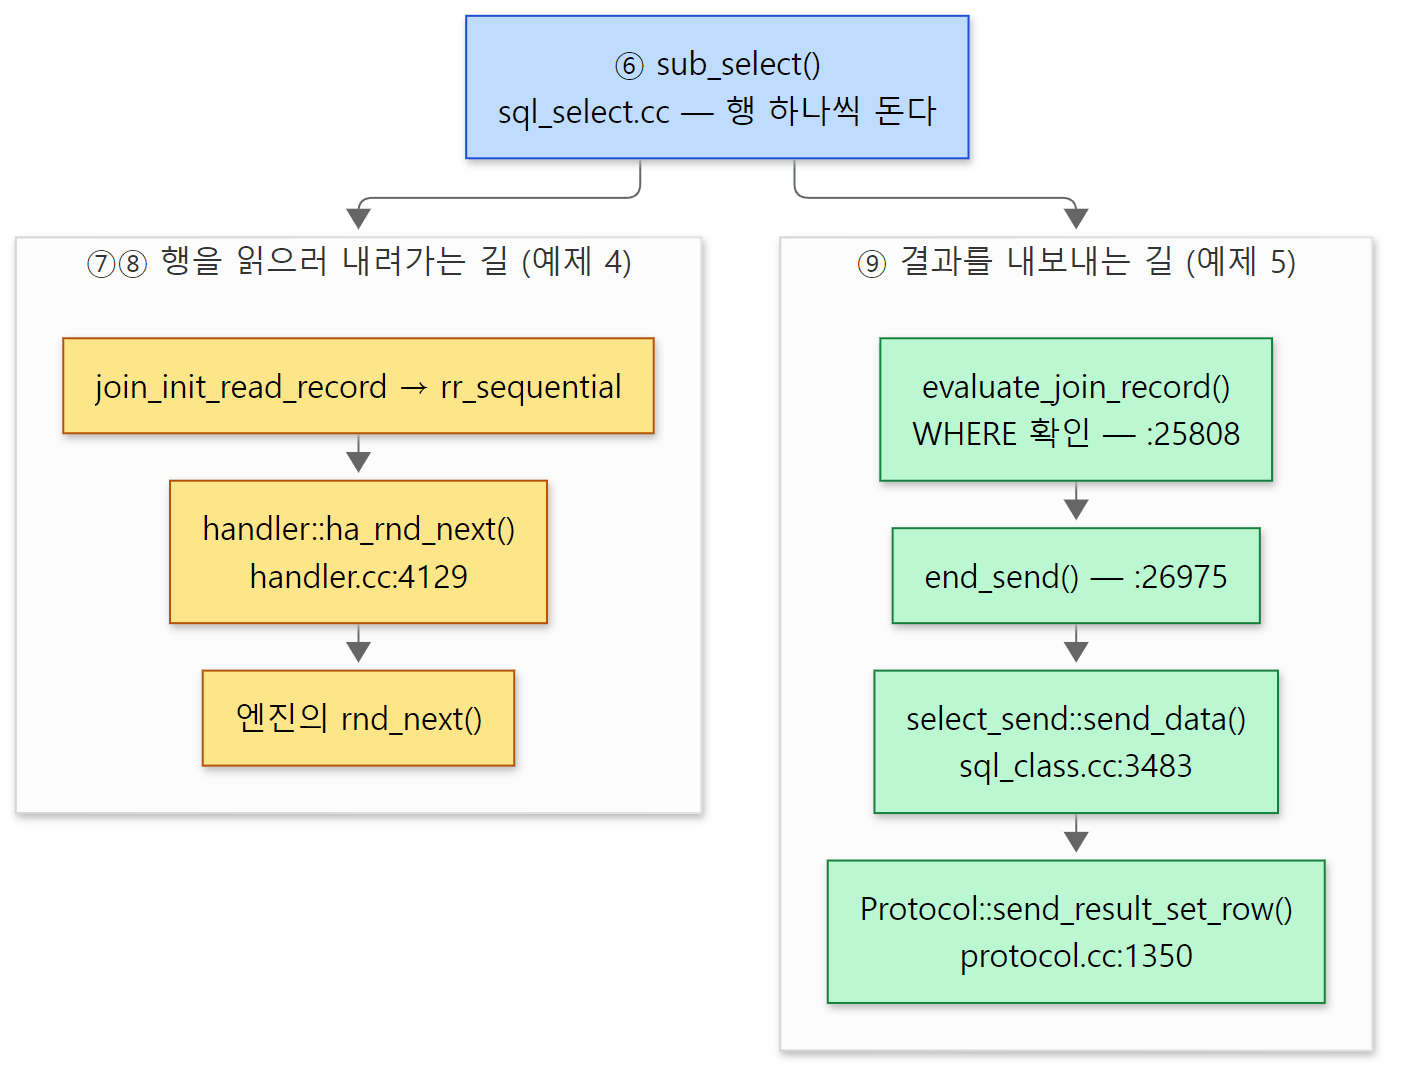 예제 4와 예제 5의 백트레이스를 sub_select 에서 이어 붙인 그림입니다. 줄 번호는 두 예제의 실제 출력입니다.
헷갈리기 쉬운 곳: 백트레이스에 JOIN::prepare 와 JOIN::optimize 가 없다
예제 4의 스택에는 ④의 open_and_lock_tables(), ⑤의 JOIN::optimize() 가 보이지 않습니다. 빠진 것이 아니라 이미 끝나고 돌아온 함수들입니다. 호출 스택은 "지금 이 순간 아직 돌아오지 않은 함수" 만 보여 줍니다. 엔진에 닿은 순간에는 mysql_select() 가 prepare() 와 optimize() 를 마치고 exec() 안에 들어와 있으므로(#9 의 5461행), 앞의 두 단계는 스택에서 사라졌습니다. 앞 단계를 보려면 그 함수에 중단점을 따로 걸어야 합니다. 7편과 8편이 그렇게 합니다.
헷갈리기 쉬운 곳: SHOW 도 같은 길로 간다
위 ④에서 인용한 case SQLCOM_SELECT: 바로 위에는 case SQLCOM_SHOW_PLUGINS:, case SQLCOM_SHOW_STORAGE_ENGINES: 처럼 SHOW 문들이 줄지어 같은 블록에 들어옵니다(sql_parse.cc 3995–4006행). 이 SHOW 들도 execute_sqlcom_select() 로, 곧 SELECT 와 같은 길로 실행된다는 뜻입니다. SHOW 가 어떻게 information_schema 테이블 읽기로 바뀌는지는 이 연재에서 따로 다루지 않습니다.
6. THD — 연결 하나의 모든 것
5절의 거의 모든 함수가 첫 인자로 THD *thd 를 받았습니다. THD 는 연결 하나가 서버 안에서 가진 모든 것입니다. 선언부터 봅니다.
class THD: public THD_count, /* this must be first */
           public Sql_used,
           public Statement,
           // ... (주석 7줄 생략)
           public Item_change_list,
           public Open_tables_state,
           public Sp_caches,
           public Statement_rcontext
{
부모가 일곱입니다. 이름을 보면 THD 를 역할별로 쪼개 둔 것을 알 수 있습니다. Statement 는 "지금 실행 중인 문장", Open_tables_state 는 "이 연결이 열어 둔 테이블들" 입니다. 클래스 본문은 3346행에서 6671행까지, 3,300줄이 넘습니다.
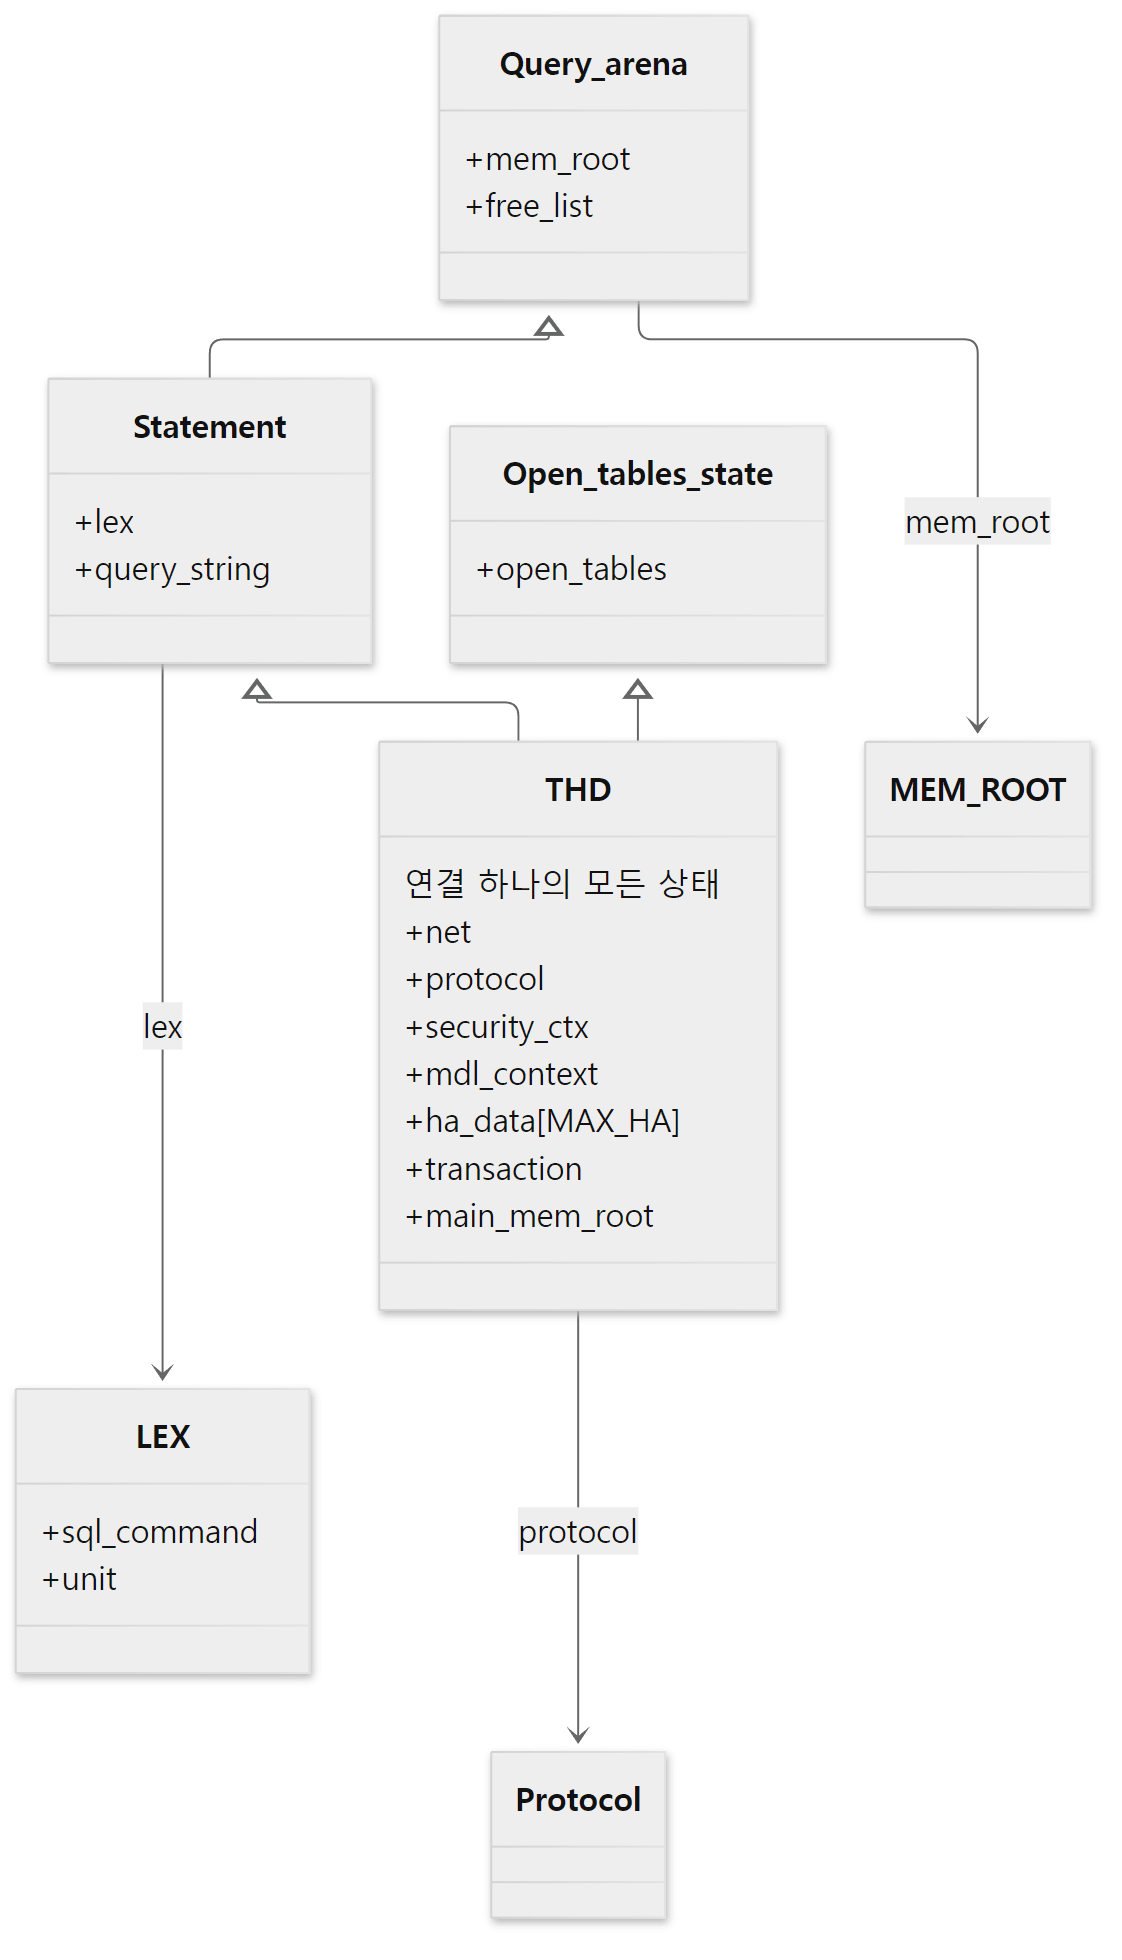 지도의 어느 칸에서든
thd 하나만 있으면 이 모든 것에 닿습니다. 부모 일곱 가운데 이 글에 나오는 둘만 그렸습니다.
부모에서 오는 필드와 THD 자신의 필드 몇 개를 표로 모았습니다(선언 위치: Query_arena::mem_root 1277행, Statement::lex 1867행, Open_tables_state::open_tables 2289행, THD::net·protocol 3401–3407행).
| 필드 | 무엇 | 지도의 칸 |
|---|---|---|
mem_root |
이 문장의 객체를 받는 메모리 풀(Query_arena 에서) |
모든 칸, 7절 |
lex |
파서가 만든 문장 전체(Statement 에서) |
③ ④ |
open_tables |
이 연결이 연 TABLE 들의 목록(Open_tables_state 에서) |
④ |
net |
소켓과 패킷 버퍼 | ② ⑨ |
protocol |
결과를 보내는 방식(텍스트·이진) | ⑨ |
security_ctx |
로그인한 사용자와 권한 | ④ |
mdl_context |
이 연결이 가진 메타데이터 잠금 | ④ |
ha_data[MAX_HA] |
엔진마다 하나씩, 연결별로 쓰는 칸 | ⑧ |
transaction |
이 연결의 트랜잭션에 참여한 엔진 목록 | ⑧, 11편 |
ha_data: 엔진이 연결마다 걸어 두는 칸
3절에서 transaction_participant::slot 을 "연결마다 엔진이 자기 데이터를 걸어 둘 칸의 번호" 라고 했습니다. 그 칸이 THD::ha_data 입니다.
  /* container for handler's private per-connection data */
  Ha_data ha_data[MAX_HA];
MAX_HA 는 64입니다(handler.h 498행). InnoDB 는 이 칸에 자기 트랜잭션 객체(trx_t)를 걸어 두고 필요할 때 꺼냅니다.
trx_t *thd_to_trx(const THD *thd) noexcept
{
  return static_cast<trx_t*>(thd_get_ha_data(thd, innodb_hton_ptr));
}
storage/innobase/handler/ha_innodb.cc 1808–1811행
thd_get_ha_data() 는 thd->ha_data[hton->slot].ha_ptr 을 돌려주는 한 줄짜리 함수입니다(sql_class.cc 457–461행). 서버 계층은 trx_t 가 무엇인지 모르고 void * 하나를 보관해 줄 뿐입니다. 엔진은 THD 의 구조를 몰라도 자기 칸만 찾으면 됩니다. trx_t 는 11편에서 봅니다.
SHOW PROCESSLIST 가 보여 주는 것
예제 4의 gdb 가 mysql_execute_command 프레임으로 올라가 thd 를 찍은 결과입니다.
#12 0x0000557d563f93a1 in mysql_execute_command (thd=..., is_called_from_prepared_stmt=...) at /usr/src/mariadb/sql/sql_parse.cc:4038
$4 = 12
$5 = SQLCOM_SELECT
$6 = 0x772c84038cd0 "SELECT COUNT(*) FROM lab.t_innodb WHERE note LIKE 'row%'"
thd->thread_id 가 12 — SHOW PROCESSLIST 의 Id 열에 나오는 연결 번호입니다(실행마다 다를 수 있습니다). thd->lex->sql_command 가 SQLCOM_SELECT, thd->query_string 이 Info 열에 보이는 문장입니다. SHOW PROCESSLIST 는 서버의 THD 들을 돌며 이 필드들을 베껴 표로 만듭니다(thd_info->thread_id=tmp->thread_id;, sql/sql_show.cc 2993행, 문장은 3025–3031행).
헷갈리기 쉬운 곳: THD 는 "스레드" 가 아니라 "연결" 이다
이름은 thread 에서 왔지만, 스레드 풀(thread_handling=pool-of-threads)에서는 스레드 하나가 여러 연결의 THD 를 번갈아 맡습니다. 연결마다 스레드 하나인 기본 방식에서도, 연결이 끊긴 스레드는 스레드 캐시에 남았다가 다음 연결의 새 THD 를 맡습니다(①의 반복문 뒤 thread_cache.park(), sql_connect.cc 1527행). 그러니 THD 는 "연결 하나" 로 읽는 편이 맞습니다. 4편에서 자세히 봅니다.
7. 메모리 — MEM_ROOT 와 문장마다 비우기
MEM_ROOT 의 생김새
5절의 길에서 LEX 의 조각, Item 나무, JOIN, select_send, handler 같은 객체가 쏟아져 나왔습니다. 이것들을 하나하나 delete 하는 코드는 거의 보이지 않습니다. 비결은 MEM_ROOT 입니다.
typedef struct st_mem_root
{
  USED_MEM *free;                  /* blocks with free memory in it */
  USED_MEM *used;                  /* blocks almost without free memory */
  USED_MEM *pre_alloc;             /* preallocated block */
  /* if block have less memory it will be put in 'used' list */
  size_t min_malloc;
  size_t block_size;               /* initial block size */
// ...
} MEM_ROOT;
큰 블록(USED_MEM) 몇 개를 목록으로 들고 있다가, alloc_root() 가 불리면 블록의 남은 자리에서 잘라 줍니다(mysys/my_alloc.c 266행부터). 하나씩 돌려주는 함수는 없고, free_root() 가 블록을 한꺼번에 버립니다(같은 파일 485행).
C++ 객체를 MEM_ROOT 위에 만드는 법
C++ 의 new 를 MEM_ROOT 로 보내는 장치가 Sql_alloc 입니다. 2절에서 본 class handler :public Sql_alloc 의 그것입니다.
class Sql_alloc
{
public:
  static void *operator new(size_t size) throw ()
  {
    return thd_alloc(_current_thd(), size);
  }
  // ...
  static void *operator new(size_t size, MEM_ROOT *mem_root) throw()
  { return alloc_root(mem_root, size); }
  static void operator delete(void *ptr, size_t size) { TRASH_FREE(ptr, size); }
  static void operator delete(void *, MEM_ROOT *){}
// ...
};
new Foo처럼 쓰면 지금 스레드의 THD 의mem_root에서 받습니다(thd_alloc()은thd->alloc(size), 곧alloc_root(thd->mem_root, …)).new (mem_root) Foo처럼 쓰면 그MEM_ROOT에서 받습니다.delete는 메모리를 돌려주지 않습니다.TRASH_FREE는 그 자리를0x8F로 채우고(TRASH_FREED_MEMORY가 켜진 빌드에서만) valgrind·ASAN 같은 검사 도구에 "접근 금지" 로 알려, 지운 뒤에 쓰는 실수를 드러내는 매크로입니다(include/my_valgrind.h 82–98행).
5절에서 이미 이 모양을 여러 번 보았습니다. new (thd->mem_root) JOIN(…)(mysql_select()), new (thd->mem_root) select_send(thd)(execute_sqlcom_select(), sql_parse.cc 6262행), 3절의 new (mem_root) ha_innobase(hton, table). Item 은 한 걸음 더 나갑니다.
class Item :public Value_source,
            public Type_all_attributes
{
  static void *operator new(size_t size);

public:
  static void *operator new(size_t size, MEM_ROOT *mem_root) throw ()
  { return alloc_root(mem_root, size); }
  static void operator delete(void *ptr,size_t size) { TRASH_FREE(ptr, size); }
인자 없는 operator new(size_t) 를 private 에 선언만 해 두고, 공개된 것은 MEM_ROOT * 를 받는 것뿐입니다. 그래서 Item 은 new (thd->mem_root) Item_int(…) 처럼 반드시 어느 MEM_ROOT 에 둘지 적어야 만들 수 있습니다(예: sql_parse.cc 6182–6183행).
문장이 끝나면 한꺼번에
그 thd->mem_root 를 비우는 곳이 dispatch_command() 의 끝입니다. 명령 하나를 다 처리하고 결과(end_statement(), 2448행)까지 보낸 뒤입니다.
  thd->reset_kill_query();  /* Ensure that killed_errmsg is released */
  /*
    LEX::m_sql_cmd can point to Sql_cmd allocated on thd->mem_root.
    Unlink it now, before freeing the root.
  */
  thd->lex->m_sql_cmd= NULL;
  free_root(thd->mem_root,MYF(MY_KEEP_PREALLOC));
MY_KEEP_PREALLOC 은 "미리 잡아 둔 첫 블록은 남겨 두라" 는 뜻입니다(include/my_sys.h 137행, free_root() 위의 설명). 다음 문장은 남겨 둔 그 블록부터 다시 씁니다. 바로 앞 줄의 주석도 눈여겨볼 만합니다. LEX::m_sql_cmd 가 이 루트 위의 객체를 가리킬 수 있으니 비우기 전에 포인터를 끊어 둔다 — 한꺼번에 비우는 방식에서는 "비운 뒤에도 남은 포인터" 가 가장 흔한 함정입니다.
thd->mem_root 는 보통 THD 가 품은 main_mem_root 를 가리킵니다. THD 생성자가 부모 Statement 를 Statement(&main_lex, &main_mem_root, …) 로 초기화하기 때문입니다(sql_class.cc 721–723행).
수명이 다른 루트 셋
모든 것이 문장 하나의 수명은 아닙니다. 이 글에 나온 객체만 놓고 보면 루트가 셋입니다.
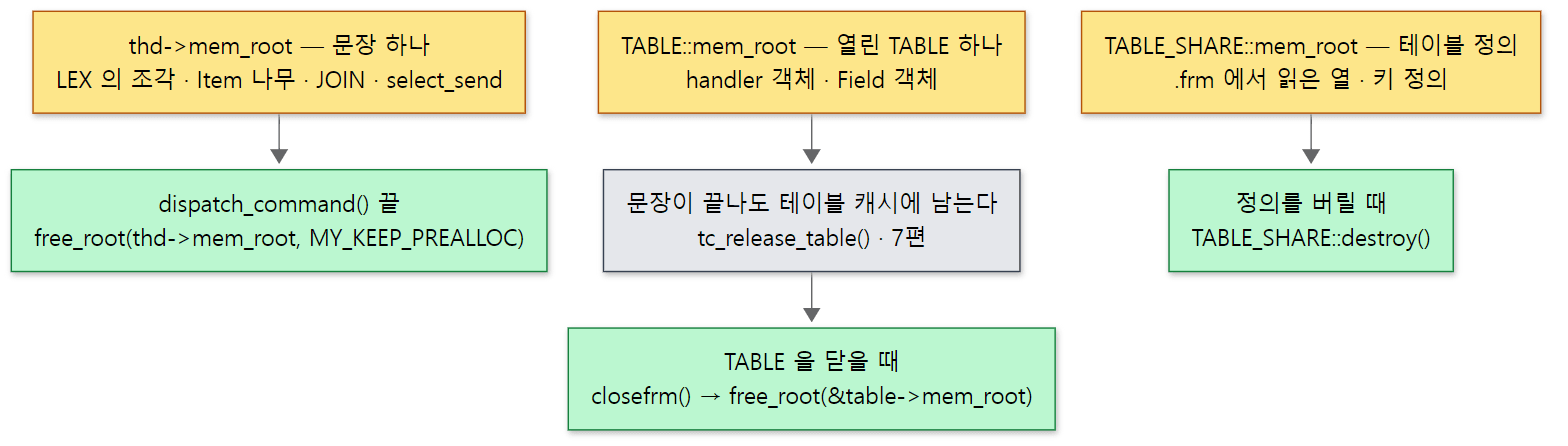 노란 상자가 루트, 초록 상자가 비우는 자리입니다. handler 가 문장보다 오래 사는 이유가 가운데 줄입니다.
handler 객체는 3절에서 본 대로 TABLE 의 mem_root 에 만들어집니다. TABLE 은 문장이 끝나도 닫히지 않고 테이블 캐시(table_open_cache)로 돌아가 다음 문장이 다시 씁니다(7편). 그래서 handler 는 문장마다 새로 만들어지지 않습니다. TABLE 을 정말 닫을 때 closefrm() 이 handler 를 지우고 루트를 비웁니다.
int closefrm(TABLE *table)
{
  // ...
  if (table->db_stat)
    error=table->file->ha_close();
  // ...
  delete table->file;
  // ...
  free_root(&table->mem_root, MYF(0));
  DBUG_RETURN(error);
}
table->file->ha_close() 로 엔진에 닫으라고 한 뒤 delete table->file 로 handler 의 소멸자를 부르고, 메모리는 마지막 free_root(&table->mem_root, …) 가 돌려줍니다. 위의 Sql_alloc::operator delete 가 메모리를 돌려주지 않던 것과 짝이 맞습니다.
httpd 의 APR 풀과 비교하면
같은 생각을 httpd 4편에서 보았습니다. httpd 는 "요청 하나", "연결 하나" 처럼 수명이 같은 것끼리 APR 풀에 묶어 두었다가 한꺼번에 버렸습니다. MariaDB 의 MEM_ROOT 도 "문장 하나"(thd->mem_root), "열린 테이블 하나"(TABLE::mem_root), "테이블 정의 하나"(TABLE_SHARE::mem_root)처럼 수명으로 나눕니다. 다른 점도 있습니다. APR 풀은 부모·자식 나무를 이루고 정리 함수(cleanup)를 걸 수 있었지만, 이 글에서 본 MEM_ROOT 구조체(st_mem_root)에는 부모를 가리키는 필드도, cleanup 목록도 없습니다. 그래서 C++ 소멸자가 꼭 불려야 하는 객체(handler 처럼 파일을 쥔 것)는 closefrm() 처럼 코드가 직접 delete 를 부릅니다.
이 글에서 뺀 것
지도를 한 장으로 유지하려고 뺀 것들입니다.
- 파티션 테이블.
ha_partition은 그 자체가 handler 이면서 파티션마다 다른 handler 를 품습니다 —sql/ha_partition.cc,get_ha_partition()(sql/handler.cc406행) - 엔진에 쿼리를 통째로 넘기는 장치:
handlerton의create_group_by·create_derived·create_select·create_unit(sql/handler.h1766–1789행),mysql_select()의find_single_select_handler() - 테이블 발견(discovery):
.frm없이 엔진이 테이블 정의를 알려 주는discover_table(sql/handler.h1809행) SEQUENCE와CREATE SEQUENCE의SQL_SEQUENCE엔진(ha_sequence) — 예제 3의 엔진 목록에 보인 둘- 쿼리 캐시(
mysql_parse()의query_cache_send_result_to_client()) — 5편 UNION과 서브쿼리가 가는mysql_union()·SELECT_LEX_UNIT(handle_select()의 첫 갈래)- Galera 복제(
WITH_WSREP블록). 예제 이미지는 Galera 를 빼고 빌드했습니다
정리
| 개념 | 한 줄 요약 |
|---|---|
| 서버 계층 / 스토리지 엔진 | SQL 을 다루는 일은 sql/ 에 한 벌, 행을 저장하는 일은 storage/ 에 엔진마다 한 벌 |
handler |
열린 테이블 하나. 서버는 ha_* 감싸개를 부르고, 엔진은 가상 함수(rnd_next() …)를 채운다. 순수 가상 함수 11개 |
ha_* 감싸개 |
엔진 호출 앞뒤로 통계(Handler_read_*), performance_schema, KILL 확인을 한다 — 그래서 엔진이 달라도 숫자가 같다 |
handlerton |
엔진마다 하나인 함수 포인터 구조체. create() 로 handler 를 만든다. transaction_participant 를 상속 |
| handler 가 생기는 길 | open_table_from_share() → get_new_handler(share, &table->mem_root, share->db_type()) → hton->create() |
| 엔진 = 플러그인 | maria_declare_plugin + MYSQL_STORAGE_ENGINE_PLUGIN. 서버가 handlerton 을 만들어 엔진의 init 에 넘긴다 |
| 쿼리 하나의 일생 | ① 연결 → ② dispatch_command → ③ parse_sql → ④ open_and_lock_tables·JOIN::prepare → ⑤ JOIN::optimize → ⑥ JOIN::exec → ⑦ ha_rnd_next → ⑧ 엔진, 그리고 ⑥ → ⑨ Protocol |
THD |
연결 하나의 모든 상태. lex, mem_root, open_tables, net, protocol, ha_data[] … |
MEM_ROOT |
블록에서 잘라 주고 한꺼번에 버리는 풀. thd->mem_root 는 dispatch_command() 끝에서 문장마다 비운다 |
| 루트의 수명 | 문장(thd->mem_root), 열린 테이블(TABLE::mem_root, handler 가 여기), 테이블 정의(TABLE_SHARE::mem_root) |
다음에 볼 것
지도를 접고, 지도의 칸들이 생겨나는 순간부터 읽습니다. 다음 글은 mariadbd 를 실행한 뒤 첫 연결을 받기까지입니다. main() → mysqld_main() 의 순서, my.cnf 를 읽는 자리, 이 글에서 결과만 본 ha_initialize_handlerton() 이 플러그인 초기화 과정의 어디에서 불려 InnoDB 의 innodb_init() 까지 이어지는지, 그리고 INSTALL SONAME 이 실행 중에 플러그인을 올리는 길을 오류 로그와 gdb 로 확인합니다.
MariaDB 소스 파헤치기 3: 기동과 플러그인 — mariadbd가 첫 연결을 받기까지
앞서 끝낸 연재들에서도 두 번째 무렵에 같은 지도를 폈습니다. httpd 3편에서 httpd 는 코어가 훅을 정의하고 모듈이 거기에 함수를 거는 구조였습니다. MariaDB 의 서버 계층과 엔진의 관계도 비슷하지만, 엔진은 훅 여러 개에 흩어져 걸리는 대신 handler 라는 클래스 하나를 통째로 구현합니다. Tomcat 2편에서 Coyote 와 Catalina 가 Adapter 인터페이스 하나로만 이어졌던 것처럼, 두 층 사이를 인터페이스 하나로 좁혀 둔 점이 닮았습니다. 방향은 반대입니다. Tomcat 에서는 아래쪽 Coyote 가 위쪽 Catalina 를 Adapter 로 불렀고, MariaDB 에서는 위쪽 서버 계층이 아래쪽 엔진을 handler 로 부릅니다. 애플리케이션 쪽에서 보던 풍경과도 이어 볼 수 있습니다. Spring 18편의 JdbcTemplate 이 JDBC 드라이버를 거쳐 보낸 SQL 한 줄은, 서버에 닿으면 이 글의 지도에서 ① 칸으로 들어와 ⑨ 칸에서 결과가 되어 돌아갑니다.