이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 열 번째 글입니다. 9편에서는 서버 계층의 실행기가 handler::ha_rnd_next()·ha_index_read_map()·ha_write_row() 같은 감싸개를 거쳐 엔진의 가상 함수 ha_innobase::rnd_next()·index_read()·write_row()를 부르는 데까지 봤습니다. 서버 계층은 거기서 멈춥니다. 그 아래에서 InnoDB가 행을 어디에, 어떤 모양으로 두고, 어떻게 찾아오는지는 서버 계층이 모르는 일입니다.
이번 글은 2편 지도의 ⑦ handler 경계 아래, ⑧ 엔진 구역을 확대합니다. InnoDB를 다루는 세 편(10~12편) 가운데 첫 편으로, 데이터를 담는 그릇 — 페이지, 버퍼 풀, B-트리 — 을 봅니다. 트랜잭션과 잠금은 11편, redo 로그와 복구는 12편에서 봅니다.
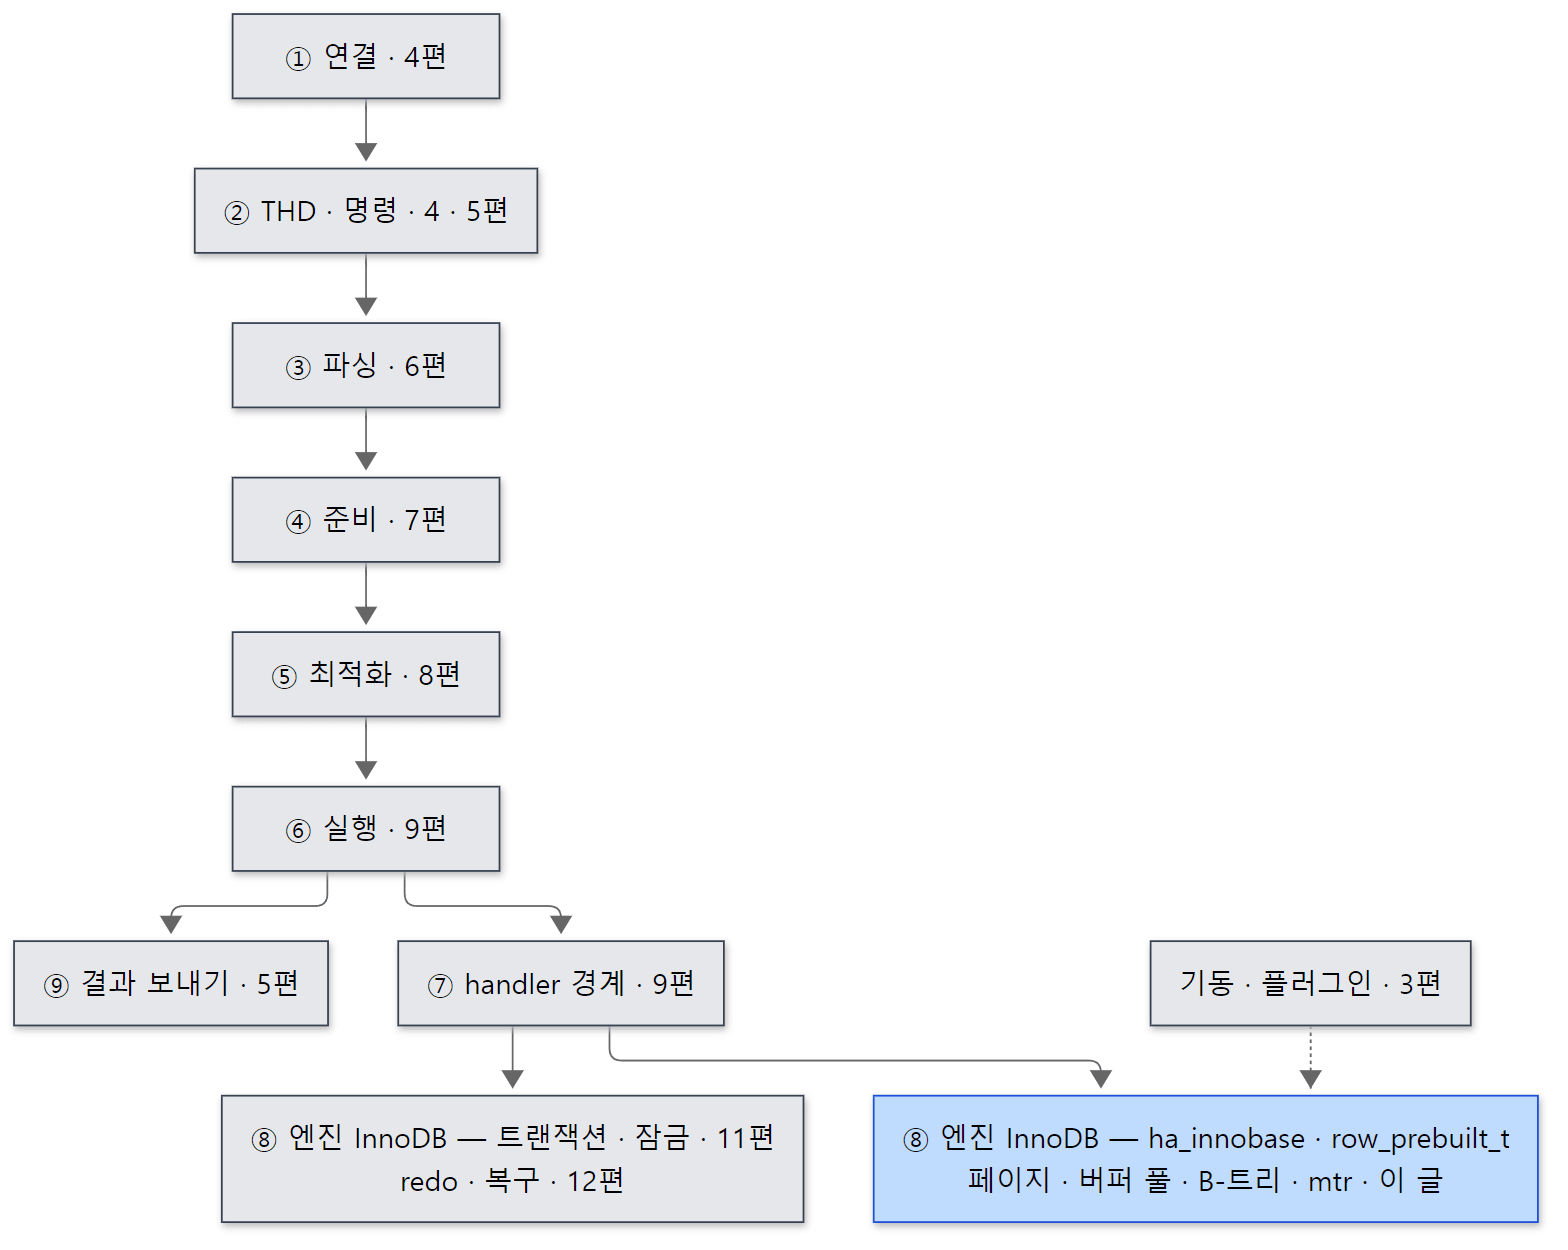 파란 칸이 이 글에서 읽는 곳, 회색 칸은 앞뒤 글에서 보는 곳입니다.
답하려는 질문은 네 가지입니다.
- InnoDB 소스는 어떻게 나뉘어 있고,
ha_innobase에서 디스크까지 어떤 층을 지나나 innodb_page_size=16384의 "페이지" 하나에는 무엇이 어떤 순서로 들어 있나 —.ibd파일을 직접 열어 읽을 수 있나innodb_buffer_pool_size로 잡은 메모리는 어떻게 쓰이나. 어떤 페이지가 남고 어떤 페이지가 밀려나며, 고친 페이지는 언제 디스크에 쓰이나- "InnoDB 테이블은 기본 키로 정렬된 B-트리다"는 말은 소스의 어디에 있나. 페이지가 꽉 차면 무슨 일이 일어나나
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | storage/innobase/ 의 include/fil0fil.h, include/page0page.h, include/rem0rec.inl, include/buf0buf.h, buf/buf0buf.cc, buf/buf0lru.cc, buf/buf0flu.cc, btr/btr0cur.cc, btr/btr0btr.cc, page/page0cur.cc, mtr/mtr0mtr.cc |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
storage/innobase/는 C++ 소스만 30만 줄이 넘고, 이 글이 읽는 buf0buf.cc·btr0cur.cc만 해도 각각 수천 줄입니다. 이 글은 SELECT와 INSERT 한 번이 지나는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
페이지(page). InnoDB가 디스크와 메모리 사이에서 주고받는 가장 작은 단위입니다. 기본 크기는 16KB(innodb_page_size, UNIV_PAGE_SIZE_DEF = 1 << 14, univ.i 211행)이고, 행 하나를 읽고 싶어도 그 행이 든 페이지 16KB를 통째로 읽습니다. 페이지는 테이블스페이스(테이블마다 하나인 .ibd 파일, 또는 시스템 테이블스페이스 ibdata1) 안에서 0번부터 번호가 매겨지고, (테이블스페이스 id, 페이지 번호) 한 쌍이 페이지의 주소 page_id_t입니다.
버퍼 풀(buffer pool). 디스크에서 읽은 페이지를 메모리에 붙잡아 두는 캐시입니다. innodb_buffer_pool_size(기본 128MB)가 그 크기입니다. InnoDB는 행을 읽든 쓰든 버퍼 풀 안의 페이지를 다룹니다. 보통의 읽기·쓰기에서 디스크의 페이지를 직접 고치는 일은 없습니다(테이블스페이스 가져오기 ALTER TABLE … IMPORT TABLESPACE처럼 파일을 직접 고치는 예외는 이 글에서 다루지 않습니다).
더티 페이지(dirty page). 버퍼 풀에서 고쳤지만 아직 디스크에 쓰지 않은 페이지입니다. 커밋해도 바로 디스크에 쓰지 않습니다 — 그래도 안전한 이유가 redo 로그이고, 그것은 12편에서 봅니다.
B-트리와 클러스터드 인덱스. InnoDB의 인덱스는 모두 B-트리(정확히는 잎끼리 이어진 B+트리)이고, 트리의 마디 하나가 페이지 하나입니다. 그 가운데 클러스터드 인덱스(보통 PRIMARY KEY)의 잎에는 행의 모든 열이 들어 있습니다. 그래서 InnoDB에서는 "테이블 = 클러스터드 인덱스"입니다. 보조 인덱스의 잎에는 인덱스 열과 기본 키가 들어 있습니다.
래치(latch)와 미니 트랜잭션(mtr). 래치는 페이지 하나를 여러 스레드가 동시에 만지지 못하게 하는 짧은 잠금입니다. 사용자가 거는 행 잠금(SELECT … FOR UPDATE, 11편)과는 다른 것으로, 페이지를 읽거나 고치는 몇 마이크로초 동안만 잡습니다. 미니 트랜잭션 mtr_t는 "페이지 몇 개의 래치를 잡고, 고치고, 그 변경을 redo 기록으로 남기고, 래치를 푼다"를 한 묶음으로 처리하는 객체입니다. 사용자 트랜잭션(BEGIN … COMMIT) 하나 안에서 mtr은 수없이 시작하고 끝납니다.
LSN(Log Sequence Number). redo 로그 안의 위치를 바이트 단위로 센 값으로, 계속 늘어나기만 하는 64비트 수입니다. 페이지마다 "이 페이지를 마지막으로 고친 변경의 LSN"을 머리에 적어 둡니다. 이 글에서는 페이지 머리의 숫자로만 만나고, 자세한 것은 12편에서 봅니다.
1. InnoDB 폴더 지도 — handler 아래의 층
InnoDB 소스는 storage/innobase/ 아래 폴더 30여 개에 나뉘어 있습니다. 파일 이름에 규칙이 있어서, 이름만 보고도 어디에 무엇이 있는지 짐작할 수 있습니다.
<모듈>0<이름>.cc— 숫자0앞이 모듈(폴더) 이름입니다.buf0buf.cc는buf모듈의 본체,buf0lru.cc는buf모듈의 LRU 부분,buf0flu.cc는 flush(디스크에 쓰기) 부분입니다.- 선언은
include/에 모여 있습니다 —include/buf0buf.h, 작은 인라인 함수는include/btr0cur.inl처럼.inl에. - 함수 이름도 모듈 이름으로 시작합니다 —
buf_page_get_gen(),btr_cur_t::search_leaf(),page_cur_search_with_match(),mtr_t::commit().
이 글에서 만나는 폴더를 위에서 아래로, 즉 서버 계층에 가까운 쪽에서 디스크 쪽으로 늘어놓으면 이렇습니다.
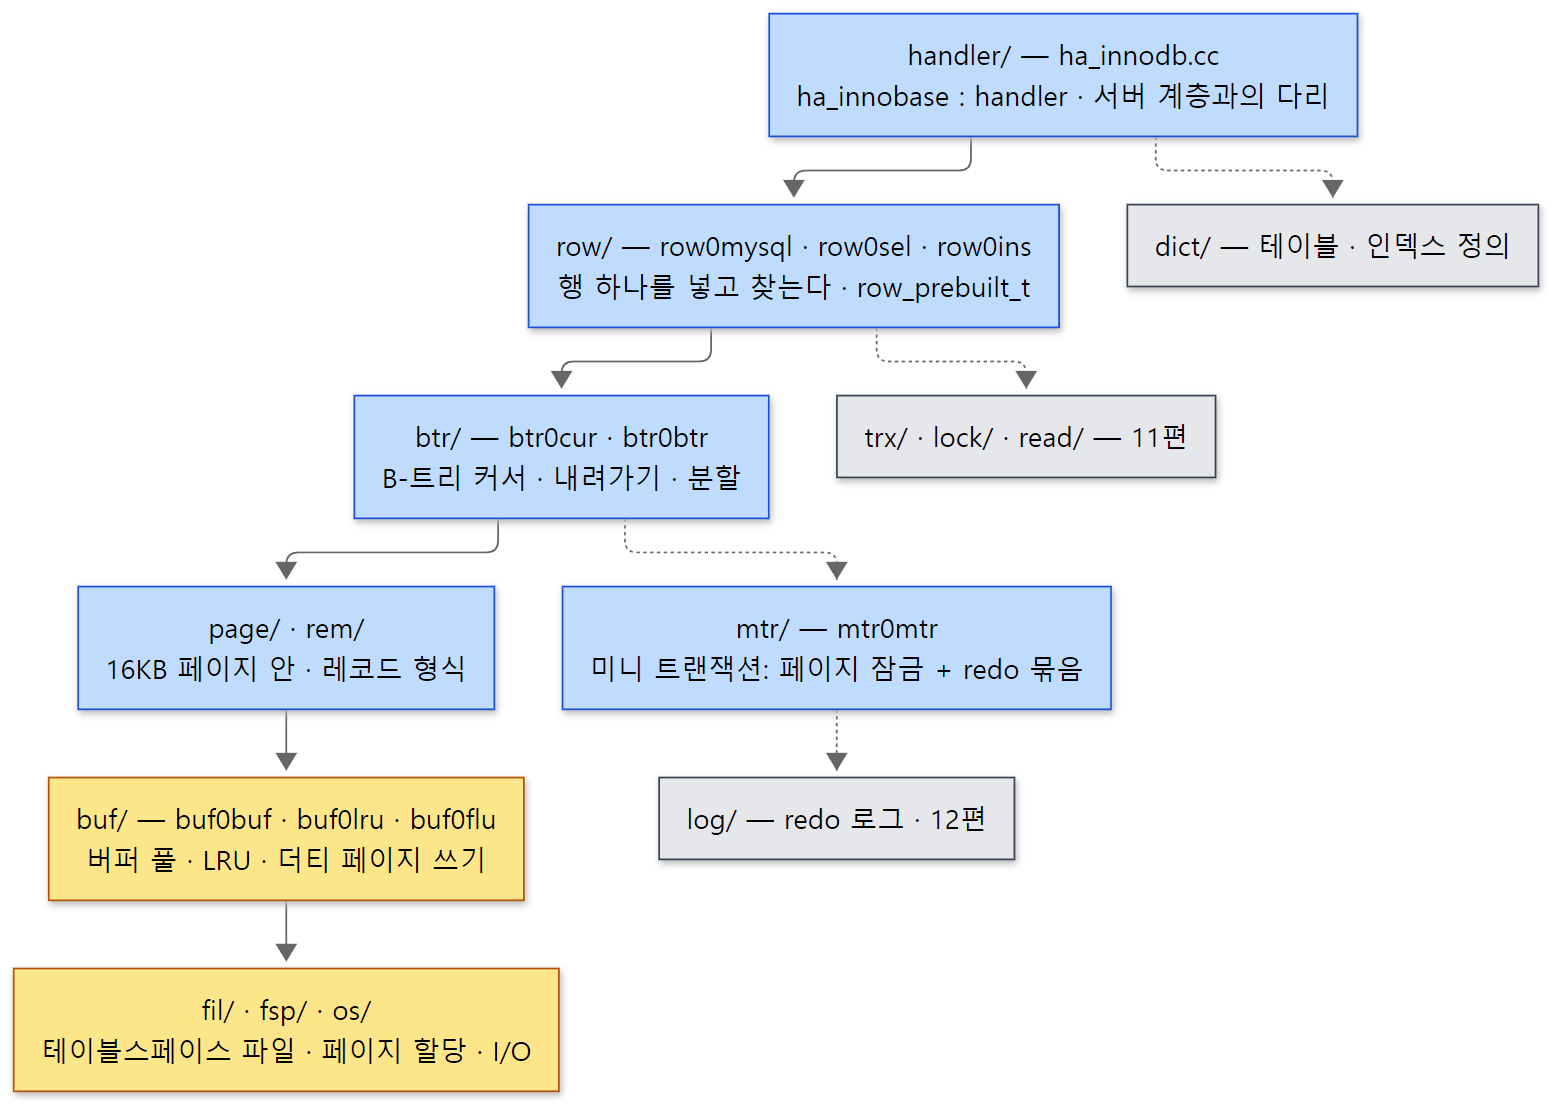 노란 칸은 메모리와 파일, 회색 칸은 이 글에서 다루지 않는 곳입니다.
| 폴더 | 파일 수 | 맡은 일 | 이 글 |
|---|---|---|---|
handler/ |
6 | ha_innobase — 서버 계층의 handler를 구현 |
1절 |
row/ |
17 | 행 하나 넣기·찾기·고치기 (row_insert_for_mysql(), row_search_mvcc()) |
1절 |
btr/ |
5 | B-트리 커서, 트리를 내려가기, 페이지 분할 | 5절 |
page/, rem/ |
3, 2 | 페이지 안의 레코드 배치, 레코드 형식, 비교 | 2절 |
buf/ |
8 | 버퍼 풀, LRU, 더티 페이지 쓰기, 미리 읽기 | 3·4절 |
mtr/ |
1 | 미니 트랜잭션 | 6절 |
fil/, fsp/, os/ |
3, 5, 1 | 테이블스페이스 파일, 페이지 할당, 파일 I/O | 이름만 |
trx/, lock/, read/ |
8, 3, 1 | 트랜잭션, 행 잠금, 읽기 뷰 | 11편 |
log/ |
5 | redo 로그와 복구 | 12편 |
(파일 수는 기준 커밋에서 ls로 센 .cc·.h 수입니다.)
다리: ha_innobase와 row_prebuilt_t
서버 계층이 테이블 하나를 열면 handler 객체가 하나 생깁니다(2편). InnoDB 테이블이면 그것이 class ha_innobase final : public handler(handler/ha_innodb.h 63행)이고, 이 객체는 InnoDB 쪽 짝인 row_prebuilt_t를 하나 들고 있습니다(m_prebuilt, 518행).
struct row_prebuilt_t {
	ulint		magic_n;	/*!< this magic number is set to
					ROW_PREBUILT_ALLOCATED when created,
					or ROW_PREBUILT_FREED when the
					struct has been freed */
	dict_table_t*	table;		/*!< Innobase table handle */
	dict_index_t*	index;		/*!< current index for a search, if
					any */
	trx_t*		trx;		/*!< current transaction handle */
// ...
	btr_pcur_t*	pcur;		/*!< persistent cursor used in selects
					and updates */
	btr_pcur_t*	clust_pcur;	/*!< persistent cursor used in
					some selects and updates */
storage/innobase/include/row0mysql.h 463–559행
이름 그대로 "미리 만들어 둔(prebuilt)" 것들의 묶음입니다. 서버 계층의 handler가 "열린 테이블 하나"이듯, row_prebuilt_t는 InnoDB 쪽에서 본 "열린 테이블 하나"입니다. InnoDB의 테이블 정의(dict_table_t), 지금 검색에 쓰는 인덱스(dict_index_t), 지금 트랜잭션(trx_t, 11편), 그리고 B-트리 위의 위치를 기억하는 영속 커서 btr_pcur_t를 가집니다. ha_innobase::index_read()가 받은 키를 들고 row_search_mvcc()로 내려가고, ha_innobase::write_row()가 row_insert_for_mysql()로 내려가는 길에 이 구조체가 계속 따라갑니다. 서버 계층의 행 형식(TABLE::record[0])과 InnoDB의 레코드 형식을 오가는 변환표(mysql_template)도 여기 있습니다.
실제 호출 순서는 5절의 예제 4에서 gdb로 확인합니다.
2. 16KB 페이지 하나
FIL 헤더와 트레일러 — 모든 페이지에 공통
InnoDB 파일의 페이지는 종류(인덱스, undo, 할당 정보 …)가 무엇이든 맨 앞 38바이트가 FIL 헤더, 맨 끝 8바이트가 FIL 트레일러입니다. include/fil0fil.h가 바이트 위치를 #define으로 적어 두었습니다(1234–1292행).
| 위치 | 이름 | 크기 | 뜻 |
|---|---|---|---|
| 0 | FIL_PAGE_SPACE_OR_CHKSUM |
4 | 옛 형식의 체크섬 자리 (full_crc32에서는 암호화 키 판, 암호화 안 하면 0) |
| 4 | FIL_PAGE_OFFSET |
4 | 이 페이지의 번호 |
| 8 / 12 | FIL_PAGE_PREV / FIL_PAGE_NEXT |
4 / 4 | 같은 높이의 이웃 페이지 번호 (B-트리 잎끼리 잇는 끈) |
| 16 | FIL_PAGE_LSN |
8 | 이 페이지를 마지막으로 고친 변경의 LSN |
| 24 | FIL_PAGE_TYPE |
2 | 페이지 종류 — 인덱스 페이지는 FIL_PAGE_INDEX = 17855 |
| 26 | FIL_PAGE_FILE_FLUSH_LSN_OR_KEY_VERSION |
8 | 시스템 테이블스페이스 첫 페이지에서만 쓰는 값 등 |
| 34 | FIL_PAGE_SPACE_ID |
4 | 테이블스페이스 id |
| 38 | FIL_PAGE_DATA |
— | 여기서부터 페이지 종류별 내용 |
| 끝-8 | 트레일러 | 8 | full_crc32 형식: LSN의 아래 4바이트 + CRC-32C 체크섬 4바이트 |
페이지 종류 값도 같은 파일에 있습니다. 새 .ibd 파일의 앞 네 페이지에서 만나는 것은 FIL_PAGE_TYPE_FSP_HDR = 8(0번, 테이블스페이스 머리), FIL_PAGE_IBUF_BITMAP = 5(1번, 지금은 쓰지 않는 옛 change buffer 비트맵), FIL_PAGE_INODE = 3(2번, 파일 세그먼트 정보), FIL_PAGE_INDEX = 17855(3번, 첫 인덱스의 루트)입니다(1329–1364행).
트레일러에 LSN의 일부를 한 번 더 적는 이유는, 페이지를 쓰다가 전원이 나가 앞부분만 새 내용이고 뒷부분은 옛 내용인 "찢어진 페이지"를 알아내기 위해서입니다. 기준 커밋의 기본 체크섬 방식 full_crc32에서는 페이지 끝 4바이트에 앞쪽 전체의 CRC-32C를 적습니다(buf_flush_assign_full_crc32_checksum(), buf/buf0flu.cc 428–439행).
인덱스 페이지 — 헤더, 레코드, 디렉터리
B-트리의 마디인 인덱스 페이지는 FIL 헤더 바로 뒤(38바이트)에 인덱스 페이지 헤더를 둡니다.
#define	PAGE_HEADER	FSEG_PAGE_DATA	/* index page header starts at this
				offset */
/*-----------------------------*/
#define PAGE_N_DIR_SLOTS 0	/* number of slots in page directory */
#define	PAGE_HEAP_TOP	 2	/* pointer to record heap top */
#define	PAGE_N_HEAP	 4	/* number of records in the heap,
				bit 15=flag: new-style compact page format */
#define	PAGE_FREE	 6	/* pointer to start of page free record list */
#define	PAGE_GARBAGE	 8	/* number of bytes in deleted records */
#define	PAGE_LAST_INSERT 10	/* pointer to the last inserted record, or
				0 if this info has been reset by a delete,
				for example */
// ...
#define	PAGE_N_RECS	 16	/* number of user records on the page */
// ...
#define	PAGE_LEVEL	 26	/* level of the node in an index tree; the
				leaf level is the level 0.  This field should
				not be written to after page creation. */
#define	PAGE_INDEX_ID	 28	/* index id where the page belongs.
				This field should not be written to after
				page creation. */
storage/innobase/include/page0page.h 48–111행
헤더 다음, 94바이트(PAGE_DATA)부터 레코드가 옵니다. 그 첫머리에는 늘 infimum과 supremum이라는 가짜 레코드 두 개가 있습니다. infimum은 어떤 키보다 작고 supremum은 어떤 키보다 큰, 경계 표시용 레코드입니다. 덕분에 "첫 레코드 앞"이나 "마지막 레코드 뒤"를 특별한 경우로 따로 다루지 않아도 됩니다. 새 형식(COMPACT·DYNAMIC) 페이지에서 infimum은 99바이트, supremum은 112바이트에 놓입니다(PAGE_NEW_INFIMUM·PAGE_NEW_SUPREMUM, 141–146행).
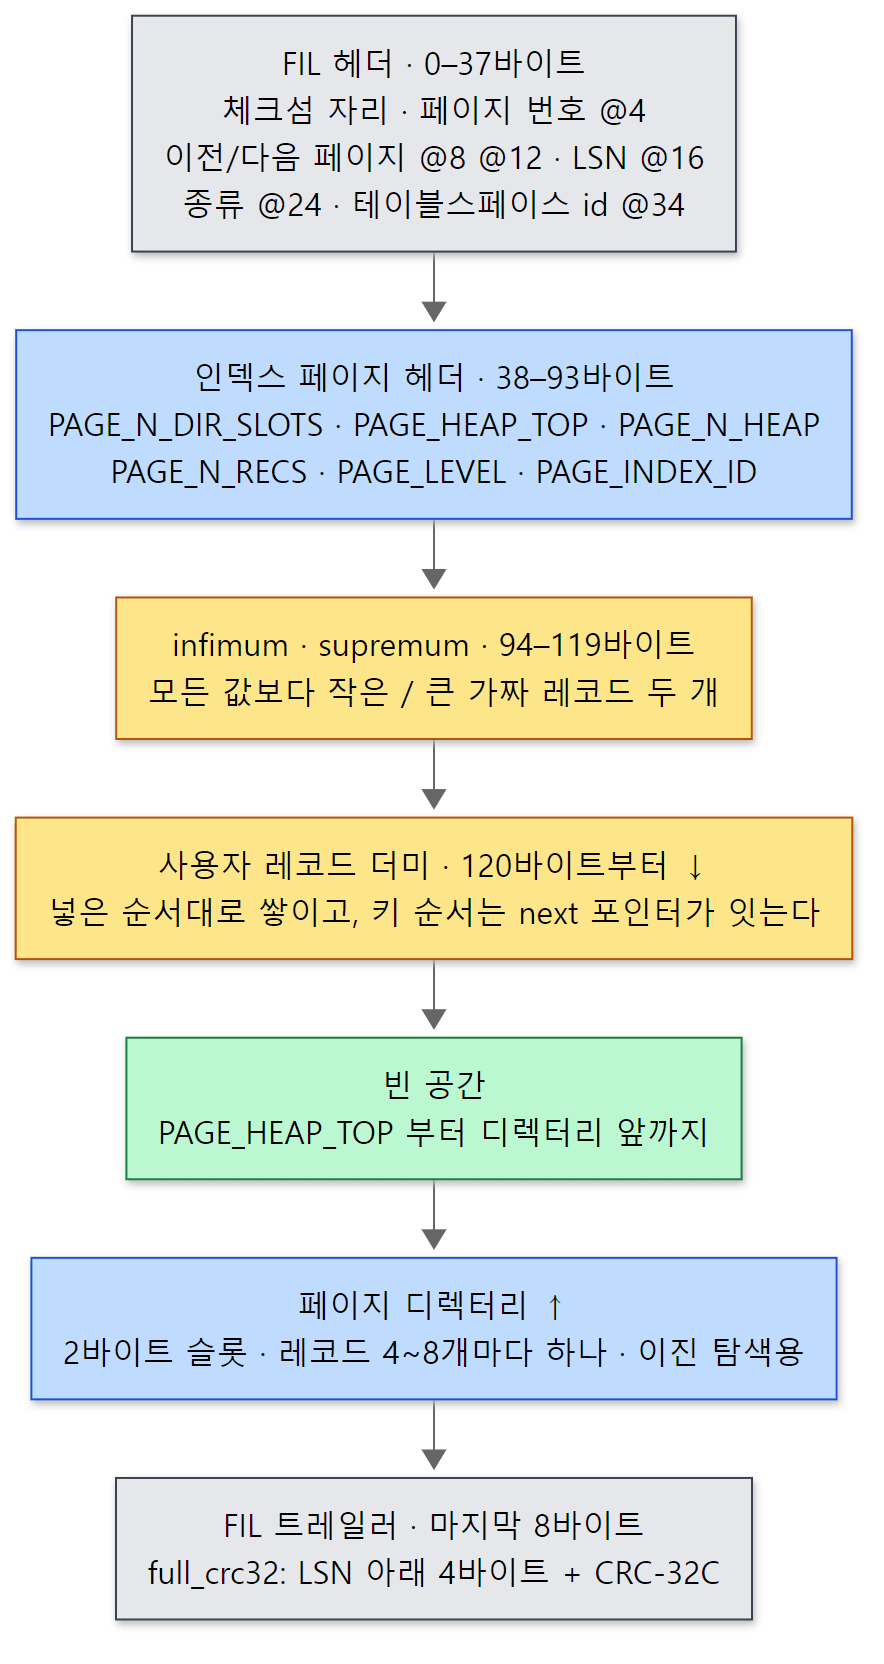 레코드 더미는 앞에서 뒤로, 디렉터리는 뒤에서 앞으로 자라고, 둘 사이가 빈 공간입니다.
레코드는 넣은 순서대로 더미(heap)에 쌓입니다. 키 순서는 레코드마다 머리에 든 "다음 레코드" 포인터가 잇습니다. 정렬을 유지하려고 페이지 안의 바이트를 매번 옮기지 않아도 되도록, 정렬은 연결 리스트로 하고 저장은 쌓기만 하는 것입니다. 새 형식 레코드의 머리 5바이트(REC_N_NEW_EXTRA_BYTES = 5)는 이렇게 생겼습니다.
/* Offsets of the bit-fields in a new-style record. NOTE! In the table the
most significant bytes and bits are written below less significant.

	(1) byte offset		(2) bit usage within byte
	downward from
	origin ->	1	8 bits relative offset of next record
			2	8 bits relative offset of next record
				  the relative offset is an unsigned 16-bit
				  integer:
				  (offset_of_next_record
				   - offset_of_this_record) mod 64Ki,
				  where mod is the modulo as a non-negative
				  number;
				  we can calculate the offset of the next
				  record with the formula:
				  relative_offset + offset_of_this_record
				  mod srv_page_size
			3	3 bits status:
					000=REC_STATUS_ORDINARY
					001=REC_STATUS_NODE_PTR
					010=REC_STATUS_INFIMUM
					011=REC_STATUS_SUPREMUM
					100=REC_STATUS_INSTANT
					1xx=reserved
				5 bits heap number
			4	8 bits heap number
			5	4 bits n_owned
				4 bits info bits
*/
storage/innobase/include/rem0rec.inl 48–76행
- next: 다음 레코드까지의 상대 거리(2바이트)입니다. 절대 위치가 아니라 거리라서 페이지를 통째로 다른 곳에 옮겨도 고칠 필요가 없습니다.
- status: 보통 레코드(000), B-트리 가운데 마디의 노드 포인터(001), infimum(010), supremum(011).
- heap number: 더미 안에서 몇 번째로 만들어진 레코드인가. infimum이 0, supremum이 1, 사용자 레코드는 2부터입니다(page0page.h 153–158행). 행 잠금이 레코드를 가리킬 때 이 번호를 씁니다(11편).
- n_owned: 아래의 페이지 디렉터리와 관계된 값입니다.
연결 리스트만 있으면 레코드 하나를 찾을 때 처음부터 끝까지 따라가야 합니다. 그래서 페이지 끝에 페이지 디렉터리를 둡니다. 레코드 4~8개마다 하나씩(PAGE_DIR_SLOT_MIN_N_OWNED = 4, PAGE_DIR_SLOT_MAX_N_OWNED = 8. 첫 슬롯과 마지막 슬롯은 4개보다 적을 수 있습니다 — 187–191행) 그 무리의 마지막 레코드 위치를 2바이트 슬롯에 적어 두고, 그 레코드의 n_owned에 "내가 몇 개를 대표하나"를 적습니다. 슬롯은 키 순서로 늘어서 있으므로 이진 탐색을 할 수 있습니다(5절).
예제 1: .ibd 파일을 od로 열어 보기
행 세 개짜리 테이블을 만들고, FLUSH TABLES … FOR EXPORT(이 테이블의 더티 페이지를 디스크에 다 쓰고 돌아오는 문장)를 건 뒤 .ibd 파일을 od로 읽습니다. 이 글의 예제는 모두 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
mariadb -e "CREATE DATABASE lab;
  CREATE TABLE lab.t (id INT PRIMARY KEY, name VARCHAR(20)) ENGINE=InnoDB;
  INSERT INTO lab.t VALUES (1,'one'),(2,'two'),(3,'three');"
# ... (설정값과 INNODB_SYS_INDEXES 의 루트 페이지 번호를 찍는 SELECT 생략)
F=/var/lib/mariadb-lab/lab/t.ibd
# FLUSH TABLES ... FOR EXPORT 는 이 테이블의 더티 페이지를 디스크에 다 쓰고 나서 돌아온다.
# 그동안 연결을 열어 두어야 하므로 SLEEP 으로 붙들고, 그 사이에 파일을 읽는다.
mariadb -e "FLUSH TABLES lab.t FOR EXPORT; SELECT SLEEP(4)" > /dev/null &
sleep 2
# ... (파일 크기를 찍는 부분 생략)
# u16·u32·u64: od 로 2·4·8바이트 큰 끝(big-endian) 정수를 읽는 작은 함수 (생략)
for p in 0 1 2 3; do
  b=$(( p * 16384 ))
  printf "%-5s %-12s %-10s %-6s\n" $p $(u32 $F $b+4) $(u64 $F $b+16) $(u16 $F $b+24)
done
# ... (페이지 헤더·레코드·디렉터리를 읽는 부분은 아래 출력과 함께)
전체 스크립트는 예제 폴더 ex/u10-page-header/run.sh에 있습니다. 출력의 앞부분입니다.
+--------------------+-----------------------------+-----------------------------+
 @@innodb_page_size | @@innodb_default_row_format | @@innodb_checksum_algorithm |
+--------------------+-----------------------------+-----------------------------+
              16384 | dynamic                     | full_crc32                  |
+--------------------+-----------------------------+-----------------------------+
+------------+-----------+-------+
 index_name | root_page | SPACE |
+------------+-----------+-------+
 PRIMARY    |         3 |     8 |
+------------+-----------+-------+
--- 1. file size and number of 16KB pages
65536 bytes
4 pages
--- 2. FIL header of each page (FIL_PAGE_OFFSET @4, FIL_PAGE_LSN @16, FIL_PAGE_TYPE @24)
page  offset_field lsn        type
0     0            53441      8
1     1            53120      5
2     2            53441      3
3     3            54811      17855
--- 3. first 38 bytes of page 3 (the FIL header)
0049152 00 00 00 00 00 00 00 03 ff ff ff ff ff ff ff ff
0049168 00 00 00 00 00 00 d6 1b 45 bf 00 00 00 00 00 00
0049184 00 00 00 00 00 08
0049190
- 파일은 16KB 페이지 네 장이고, 종류는 앞에서 본 대로 8(FSP 머리) → 5(옛 비트맵) → 3(INODE) → 17855(인덱스) 입니다.
INNODB_SYS_INDEXES가 알려 준PRIMARY의 루트 페이지 번호 3과 맞습니다. - 3번 페이지의 FIL 헤더를 바이트로 보면: 4번째 바이트부터
00 00 00 03(페이지 번호 3),ff ff ff ff두 번(이전·다음 페이지 없음 —FIL_NULL), 16번째 바이트부터 8바이트 LSN…d6 1b(=54811), 24번째에45 bf(=17855), 34번째에00 00 00 08(테이블스페이스 id 8)입니다. - LSN 값은 빈 데이터 디렉터리에서 같은 순서로 실행한 이 예제를 다시 돌렸을 때는 같게 나왔지만, 서버 설정이나 그 전에 한 일이 다르면 달라집니다.
이어서 인덱스 페이지 헤더와 레코드입니다.
--- 4. index page header of page 3 (starts at byte 38)
PAGE_N_DIR_SLOTS = 2
PAGE_HEAP_TOP    = 203
PAGE_N_HEAP      = 32773  (bit 15 = compact format)
PAGE_N_RECS      = 3
PAGE_LEVEL       = 0
PAGE_INDEX_ID    = 23
--- 5. bytes 94..157 of page 3: infimum, supremum, first user record
0049246 01 00 02 00 1c 69 6e 66 69 6d 75 6d 00 04 00 0b  >.....infimum....<
0049262 00 00 73 75 70 72 65 6d 75 6d 03 00 00 00 10 00  >..supremum......<
0049278 1b 80 00 00 01 00 00 00 00 00 13 84 00 00 00 2e  >................<
0049294 01 10 6f 6e 65 03 00 00 00 18 00 1b 80 00 00 02  >..one...........<
0049310
--- 6. page directory: last bytes of page 3 (slots, then 8-byte FIL trailer)
0065520 00 00 00 00 00 70 00 63 00 00 d6 1b 51 90 4b 4c
0065536
한 바이트씩 소스의 정의에 대어 보면 페이지가 그대로 읽힙니다.
- 헤더: 레코드 3개(
PAGE_N_RECS), 잎(PAGE_LEVEL = 0— 행이 셋뿐이라 루트가 곧 잎입니다), 더미 안의 레코드는 5개(PAGE_N_HEAP = 0x8005의 아래 비트 — infimum·supremum·사용자 3개, 맨 위 비트는 새 형식 표시). - infimum(94~106바이트): 머리 5바이트
01 00 02 00 1c다음에 글자 그대로infimum\0. 머리를 풀면 n_owned=1, heap number 0과 status 010(infimum), next=0x1c=28 — 99+28=127바이트에 첫 사용자 레코드가 있다는 뜻입니다. - supremum(107~119바이트): 머리
04 00 0b 00 00(n_owned=4 — 자기 자신과 사용자 레코드 3개를 대표, heap number 1과 status 011, next=0 — 끝), 그리고supremum. - 첫 사용자 레코드: 120바이트의
03은name열의 길이(3바이트), 121바이트의00은 NULL 표시 비트(아무 열도 NULL이 아님) — 가변 길이 열의 길이와 NULL 비트는 레코드 머리 앞쪽에 거꾸로 붙습니다. 122~126바이트가 머리00 00 10 00 1b(heap number 2, next=27 → 154바이트), 127바이트부터 데이터입니다.80 00 00 01은id = 1(정수는 정렬이 되도록 부호 비트를 뒤집어 큰 끝으로 저장합니다), 그 뒤 6바이트00 00 00 00 00 13은 숨은 열DB_TRX_ID(이 행을 넣은 트랜잭션 id), 7바이트84 00 00 00 2e 01 10은DB_ROLL_PTR(undo 기록을 가리키는 포인터, 11편), 그리고one. 바로 이어 다음 레코드(030000 00 18 00 1b80 00 00 02…)가 시작합니다. - 디렉터리와 트레일러: 마지막 8바이트
00 00 d6 1b | 51 90 4b 4c가 트레일러(LSN 아래 4바이트d6 1b가 헤더의 LSN과 같고, 뒤 4바이트가 CRC-32C), 그 바로 앞00 63(=99, infimum)과00 70(=112, supremum)이 디렉터리 슬롯 두 개입니다(PAGE_N_DIR_SLOTS = 2). 디렉터리가 페이지 끝에서 앞쪽으로 자란다는 것이 보입니다.
DB_TRX_ID(6바이트)와 DB_ROLL_PTR(7바이트)의 길이는 include/data0type.h의 DATA_TRX_ID_LEN·DATA_ROLL_PTR_LEN(156–159행)과 맞습니다. 이 두 숨은 열은 클러스터드 인덱스의 모든 레코드에 붙는데, 그것을 붙이는 곳은 5절에서 봅니다. 서버를 내린 뒤 같은 파일을 InnoDB에 들어 있는 도구 innochecksum -S로 요약하면 인덱스 페이지 1장, INODE 1장, 비트맵 1장, FSP 머리 1장으로 위와 같은 결과가 나옵니다(예제 스크립트의 7번 단계가 찍습니다. 여기에는 싣지 않았습니다).
헷갈리기 쉬운 곳: 서버가 도는 동안의 .ibd는 옛날 것일 수 있습니다
처음에 FLUSH TABLES … FOR EXPORT 없이 INSERT 직후 파일을 읽으면 레코드가 보이지 않을 수 있습니다. 커밋은 redo 로그만 디스크에 쓰고 페이지는 버퍼 풀에 더티로 남겨 두기 때문입니다(4절). 예제가 FOR EXPORT로 이 테이블의 페이지를 다 쓰게 한 다음 읽는 이유입니다.
3. 버퍼 풀 — 페이지를 메모리에 붙잡아 두기
buf_pool_t, buf_block_t, buf_page_t
버퍼 풀은 서버에 하나(extern buf_pool_t buf_pool;, include/buf0buf.h 1964행)입니다. 그 안에 페이지 한 장을 담는 칸이 수천~수백만 개 있고, 칸 하나가 buf_block_t, 그 첫 멤버가 페이지 하나의 설명자 buf_page_t입니다.
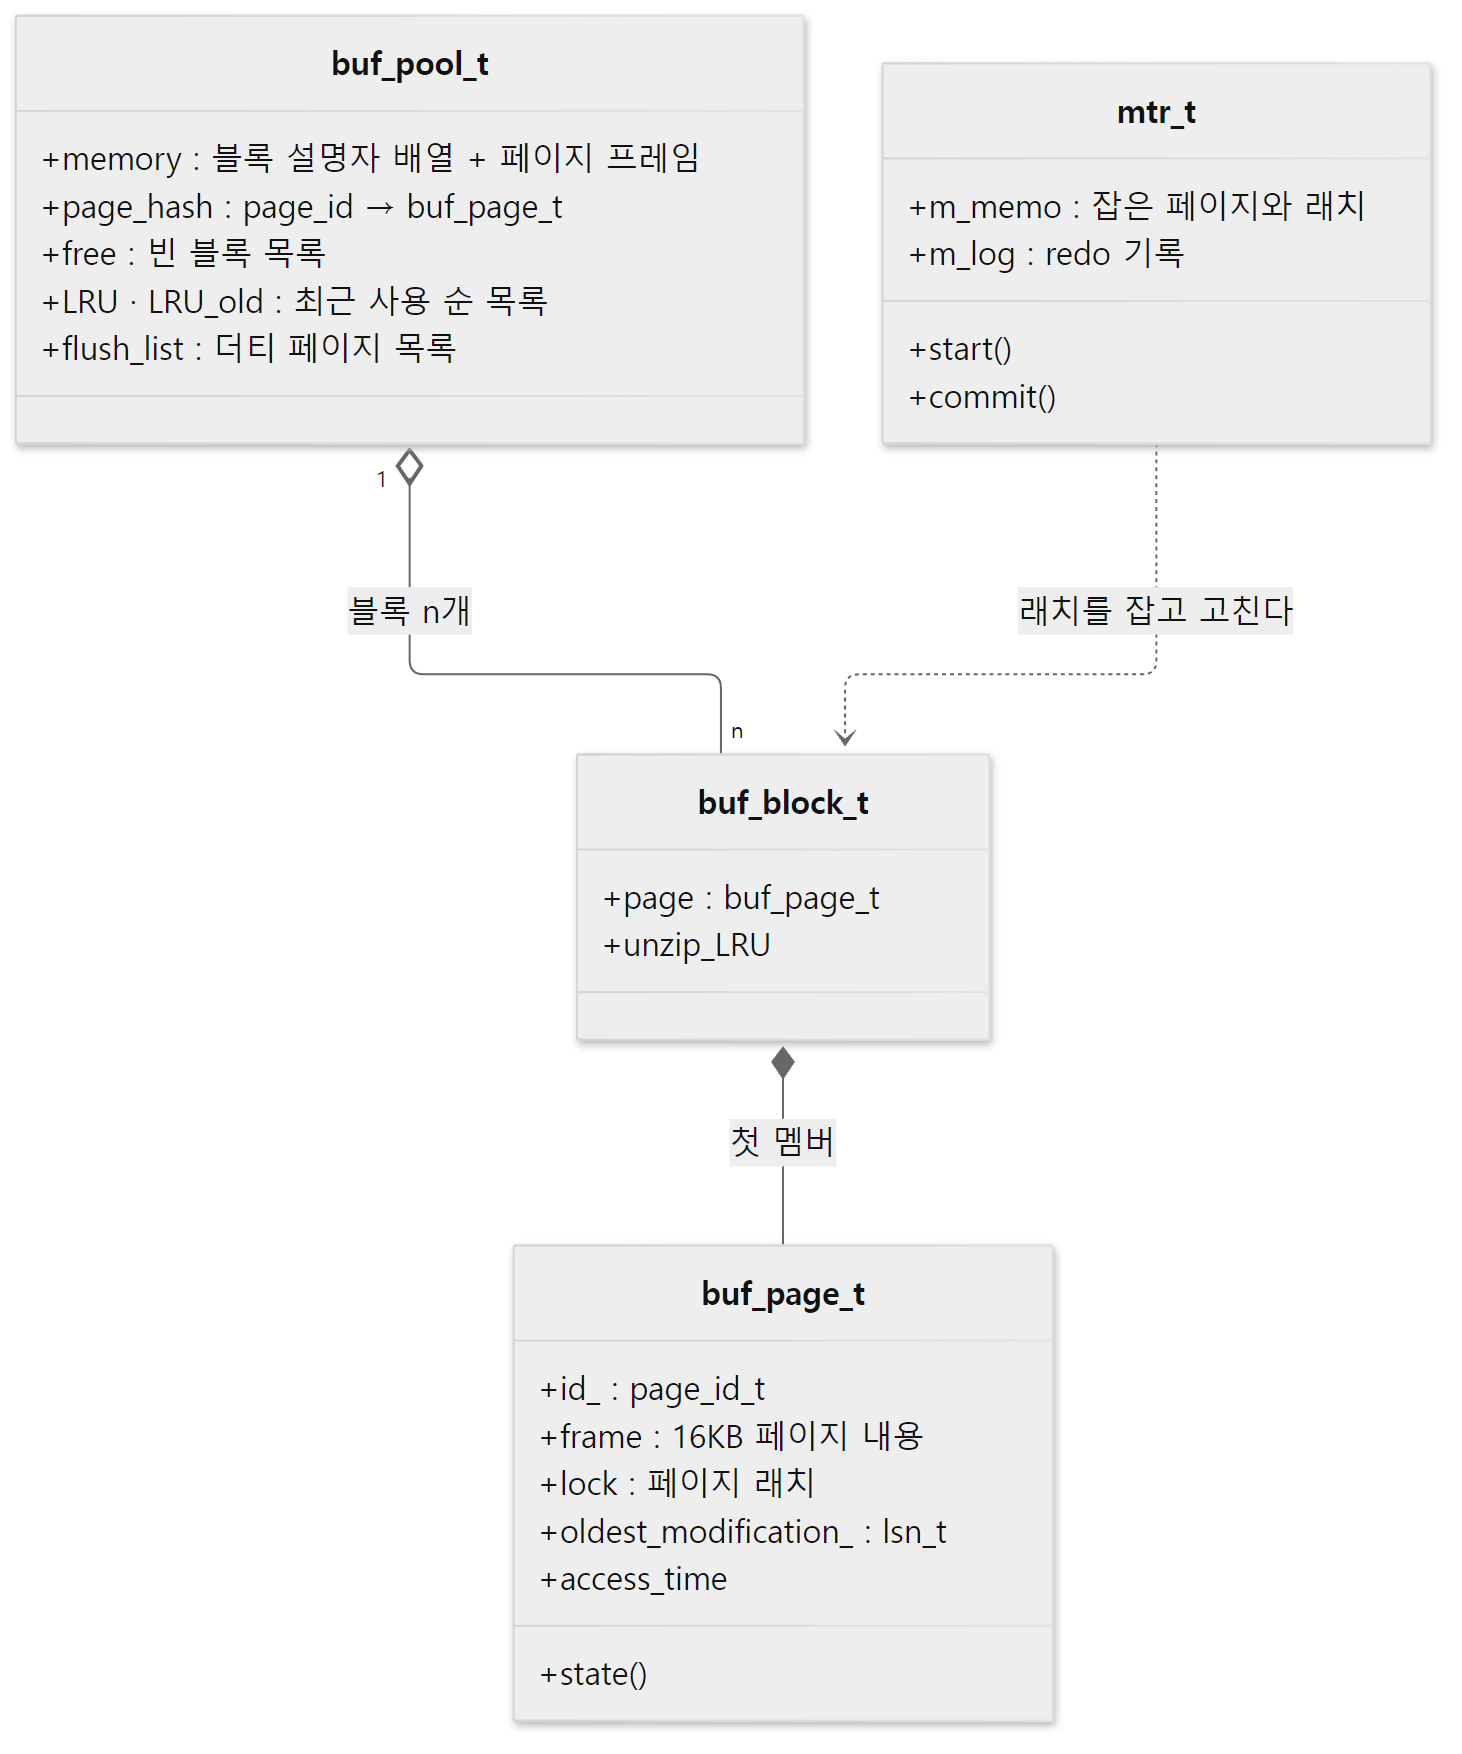 멤버는 이 글에 나오는 것만 적었습니다.
buf_page_t에서 이 글이 쓰는 멤버는 이렇습니다(include/buf0buf.h 484–591행).
id_— 어느 테이블스페이스의 몇 번 페이지인가(page_id_t).frame— 16KB 페이지 내용이 있는 메모리 주소. 2절에서od로 읽은 바이트가 메모리에서는 여기 있습니다.lock— 이 페이지의 래치.oldest_modification_— 이 페이지를 더럽힌 변경 가운데 가장 오래된 것의 LSN. 0이면 깨끗한 페이지입니다.access_time— 첫 접근(또는 마지막 승격) 시각. LRU가 씁니다(4절).list,LRU— 아래 세 목록 가운데 어디에 걸려 있는지를 잇는 고리.
buf_pool_t는 페이지들을 해시 표 하나와 목록 세 개로 관리합니다.
| 목록 | 무엇 | 쓰는 곳 |
|---|---|---|
page_hash |
page_id → 버퍼 풀 안의 블록. "이 페이지가 메모리에 있나"를 찾는 해시 표 |
buf_page_get_gen() |
free |
아직 아무 페이지도 담지 않은 빈 블록 | 디스크에서 새로 읽을 때 |
LRU |
페이지를 담은 블록 전부, 최근에 쓴 순서 | 빈 블록이 모자랄 때 꼬리부터 비운다 |
flush_list |
더티 페이지만, oldest_modification 순서 |
page cleaner가 디스크에 쓴다 |
기동할 때 buf_pool_t::create()가 innodb_buffer_pool_size만큼 메모리를 잡고, 칸을 나눠 전부 free 목록에 넣습니다.
  for (char *extent= memory,
         *end= memory + block_descriptors_in_bytes(n_blocks);
       extent < end; extent+= innodb_buffer_pool_extent_size)
  {
    buf_block_t *block= reinterpret_cast<buf_block_t*>(extent);
    const buf_block_t *extent_end= block + pages_in_extent[ssize];
    if (reinterpret_cast<const char*>(extent_end) > end)
      extent_end= reinterpret_cast<buf_block_t*>(end);
    MEM_MAKE_DEFINED(block, (extent_end - block) * sizeof *block);
    for (byte *frame= reinterpret_cast<byte*>(extent) +
           first_frame_in_extent[ssize];
         block < extent_end; block++, frame+= srv_page_size)
    {
      ut_ad(!memcmp(block, field_ref_zero, sizeof *block));
      block->page.frame= frame;
      block->page.lock.init();
      UT_LIST_ADD_LAST(free, &block->page);
      ut_d(block->page.in_free_list= true);
    }
storage/innobase/buf/buf0buf.cc 1475–1493행
같은 메모리 덩어리 안에 블록 설명자(buf_block_t) 배열이 앞에, 16KB 프레임들이 뒤에 놓입니다(innodb_buffer_pool_extent_size = 64비트에서 8MB 단위로 되풀이 — buf0buf.h 1161–1164행의 주석). 그래서 128MB를 줘도 페이지 칸은 128MB ÷ 16KB = 8192개보다 조금 적습니다 — 예제 2에서 POOL_SIZE가 8096으로 나옵니다. 기준 커밋에서는 실제 크기보다 큰 주소 공간(innodb_buffer_pool_size_max, 64비트 기본 8TB)을 먼저 예약해 두고 요청한 크기만큼만 실제 메모리로 채웁니다(my_virtual_mem_reserve()·my_virtual_mem_commit(), 1373–1453행). 서버가 도는 중에 SET GLOBAL innodb_buffer_pool_size로 크기를 바꿀 수 있게 하려는 구조입니다.
buf_page_get_gen() — 모든 페이지 접근의 입구
InnoDB의 거의 모든 코드는 페이지가 필요하면 buf_page_get_gen()(또는 그것을 감싼 함수)을 부릅니다. 5절의 B-트리 탐색도 마찬가지입니다. 인자는 페이지 주소, 원하는 래치 종류(RW_S_LATCH 읽기, RW_X_LATCH 쓰기 …), 그리고 이 접근이 속한 미니 트랜잭션입니다.
	/* A memory transaction would frequently be aborted here. */
	hash_lock.lock_shared();
	block = reinterpret_cast<buf_block_t*>(
		buf_pool.page_hash.get(page_id, chain));
	if (UNIV_LIKELY(block != nullptr)) {
		state = block->page.fix();
		hash_lock.unlock_shared();
		goto got_block;
	}
	hash_lock.unlock_shared();
// ...
	/* Page not in buf_pool: needs to be read from file */
	switch (mode) {
	case BUF_GET_IF_IN_POOL:
	case BUF_PEEK_IF_IN_POOL:
		break;
	default:
		block = buf_read_page(page_id, err, chain);
storage/innobase/buf/buf0buf.cc 2906–2923행
page_hash에서 찾습니다. 있으면(적중)fix()로 블록을 고정합니다. 고정(buffer-fix)은 "누가 쓰고 있으니 이 칸을 다른 페이지에게 내주지 말라"는 표시입니다.- 없으면(빗나감)
buf_read_page()가 디스크에서 읽어 옵니다. - 마지막으로 원하는 래치를 잡고, 그 블록을 미니 트랜잭션의 메모(
mtr->memo_push())에 적은 뒤 돌려줍니다(3075–3110행). 래치를 푸는 것은 이 함수가 아니라 나중에mtr_t::commit()입니다(6절).
빗나갔을 때 buf_read_page()(buf/buf0rea.cc 510–550행)는 buf_LRU_get_free_block()으로 빈 블록을 하나 얻고, buf_page_init_for_read()에서 그 블록을 page_hash와 LRU에 먼저 등록한 뒤 파일을 읽습니다.
    block= nullptr;
    reinterpret_cast<buf_block_t*>(bpage)->
      initialise(page_id, ssize, READ_BUF_FIX);
    /* x_unlock() will be invoked
    in buf_page_t::read_complete() by the io-handler thread. */
    bpage->lock.x_lock(true);
    /* Insert into the hash table of file pages */
    buf_pool.page_hash.append(chain, bpage);
    hash_lock.unlock();

    /* The block must be put to the LRU list, to the old blocks */
    buf_LRU_add_block(bpage, true/* to old blocks */);
storage/innobase/buf/buf0rea.cc 113–124행
읽기가 끝나기 전에 page_hash에 넣는 까닭은, 같은 페이지를 동시에 원하는 다른 스레드가 디스크를 한 번 더 읽지 않고 이 블록에서 기다리게 하기 위해서입니다(블록은 읽는 동안 READ_FIX 상태와 X 래치로 잠겨 있습니다). 그리고 주석대로 새로 읽은 페이지는 LRU의 old 구역에 붙습니다. 이것이 다음 절의 주제입니다. 읽기가 끝나면 buf_page_t::read_complete()가 체크섬을 확인하고(buf_page_check_corrupt()), 깨진 페이지면 버퍼 풀에서 내쫓고 오류를 돌려줍니다(3718행부터).
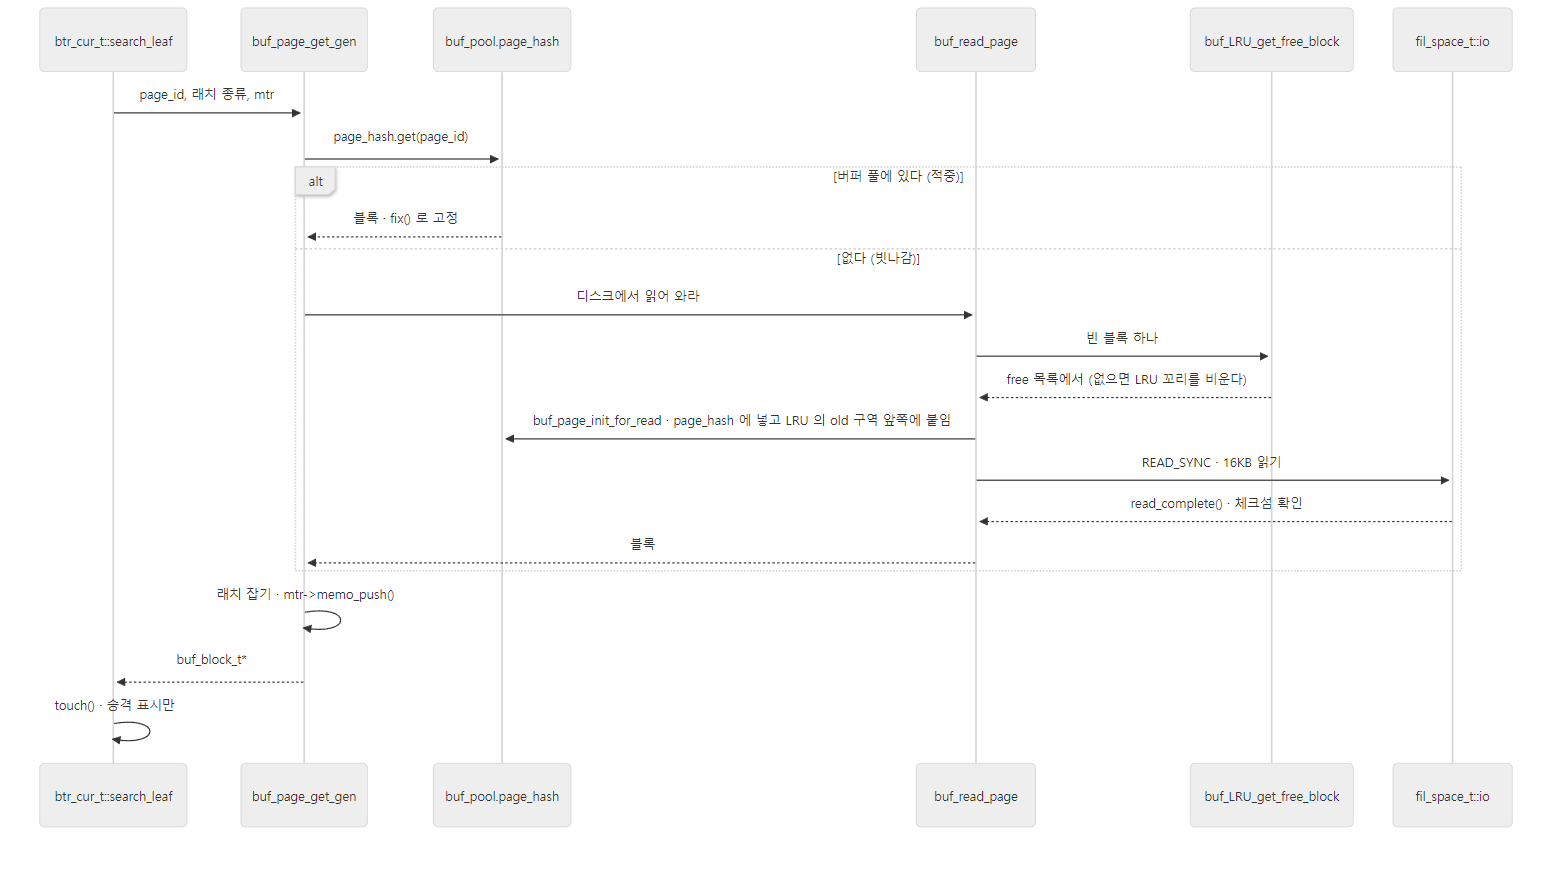 위쪽 칸이 적중, 아래쪽 칸이 빗나감입니다. 어느 쪽이든 끝은 "래치를 잡고 mtr에 적는다"입니다.
SHOW GLOBAL STATUS의 Innodb_buffer_pool_read_requests가 페이지 요청 수, Innodb_buffer_pool_reads가 그 가운데 디스크까지 간 수입니다. 예제 2에서 두 숫자를 봅니다.
헷갈리기 쉬운 곳: 버퍼 풀은 하나입니다
옛 판 설명이나 블로그에서 innodb_buffer_pool_instances(버퍼 풀을 여러 조각으로 나누기)를 보았다면, 기준 커밋에는 그런 구조가 없습니다. buf_pool은 전역 객체 하나이고, 경쟁을 줄이는 일은 page_hash를 여러 래치로 나누는 식(page_hash_latch, 1494행부터)으로 합니다. 언제부터 이렇게 바뀌었는지는 이 글에서 소스로 따라가지 않았습니다.
4. LRU와 더티 페이지 — 무엇을 남기고 언제 쓰나
old 구역: 한 번 훑고 지나간 페이지가 캐시를 밀어내지 않게
빈 블록이 모자라면 LRU의 꼬리(가장 오래 안 쓴 쪽)부터 비웁니다. 그런데 큰 테이블을 한 번 풀 스캔하면, 다시는 안 볼 페이지 수천 장이 "최근에 쓴 페이지"가 되어 정말 자주 쓰는 페이지를 밀어낼 수 있습니다. InnoDB의 답은 LRU를 두 구역으로 나누는 것입니다.
- young 구역(머리 쪽 약 63%)과 old 구역(꼬리 쪽 약 37%). 경계를
buf_pool.LRU_old가 가리키고, 비율은innodb_old_blocks_pct(기본100 * 3 / 8= 37, handler/ha_innodb.cc 20194–20197행)입니다. - 디스크에서 새로 읽은 페이지는 old 구역의 앞쪽에 들어갑니다(
buf_LRU_add_block(bpage, true)). 새로 만든 페이지(INSERT로 생긴 새 페이지)와 승격된 페이지는 머리에 들어갑니다(false). - old 구역의 페이지는 첫 접근에서
innodb_old_blocks_time(기본 1000밀리초, 20199–20204행)이 지난 뒤 다시 접근되어야 young으로 올라갈 자격이 생깁니다. 풀 스캔은 한 페이지를 몇 밀리초 안에 몰아서 읽고 떠나므로 자격을 얻지 못하고, old 구역에 머물다 꼬리에서 밀려납니다.
buf_LRU_add_block(
	buf_page_t*	bpage,	/*!< in: control block */
	bool		old)	/*!< in: true if should be put to the old blocks
				in the LRU list, else put to the start; if the
				LRU list is very short, the block is added to
				the start, regardless of this parameter */
{
	mysql_mutex_assert_owner(&buf_pool.mutex);
	ut_ad(!bpage->in_LRU_list);

	if (!old || (UT_LIST_GET_LEN(buf_pool.LRU) < BUF_LRU_OLD_MIN_LEN)) {
		UT_LIST_ADD_FIRST(buf_pool.LRU, bpage);
	} else {
// ... (UNIV_LRU_DEBUG 검사 생략)
		UT_LIST_INSERT_AFTER(buf_pool.LRU, buf_pool.LRU_old,
			bpage);

		buf_pool.LRU_old_len++;
	}
storage/innobase/buf/buf0lru.cc 644–670행
LRU가 아직 짧으면(BUF_LRU_OLD_MIN_LEN = 512장 미만, include/buf0lru.h 41행) old 구역 자체가 없고 모두 머리에 들어갑니다.
승격은 "표시"와 "옮기기"로 나뉘어 있다 — 최근 판에 들어온 것
기준 커밋에서 주의할 점이 있습니다. 페이지를 다시 접근했을 때 그 자리에서 LRU 머리로 옮기지 않습니다. LRU 목록은 buf_pool.mutex 하나가 지키므로, 페이지에 손댈 때마다 이 뮤텍스를 잡는 것이 병목이었기 때문입니다. 대신 접근하는 쪽은 touch()(buf/buf0buf.cc 3239–3254행)로 승격 표시만 남깁니다. touch()는 첫 접근이면 시각(access_time)을 찍고, 이어서 아래 함수를 부릅니다.
inline void buf_page_t::touch_no_stamp() noexcept
{
  if (zip.is_promote())
    return;
  const uint16_t threshold= buf_pool.LRU_old_threshold;
  if (threshold)
  {
    const uint16_t t= access_time;
    /* access_clock advances once per refresh_clock(), so a difference
    of threshold ticks can span less than threshold seconds. One more
    tick ensures that at least threshold seconds have elapsed. */
    if (!t || uint16_t(buf_pool.access_clock - t) <= threshold)
      return;
  }
  zip.set_promote();
}
storage/innobase/include/buf0buf.h 2141–2156행
첫 접근에서는 막 찍은 시각과의 차이가 0이라 그냥 돌아가고(innodb_old_blocks_time이 0이면 threshold가 0이라 첫 접근부터 표시합니다), 나중 접근이면 첫 접근에서 LRU_old_threshold초(innodb_old_blocks_time을 초로 올림한 값)보다 많이 지났을 때만 승격 표시(set_promote())를 합니다. 실제로 블록을 머리로 옮기는 일은 어차피 buf_pool.mutex를 잡고 LRU나 flush_list를 훑는 쪽 — page cleaner의 LRU·flush_list 훑기, 빈 블록을 찾는 LRU 훑기 — 이 지나가다가 make_young_if_needed()로 합니다(buf/buf0flu.cc 1324행, 1519행, buf/buf0lru.cc 233행). 표시가 있으면 make_young()이 표시를 지우고 시각을 새로 찍은 뒤 블록을 LRU에서 뺐다가 머리에 다시 넣습니다(buf_LRU_add_block(this, false), buf/buf0lru.cc 710–719행).
이 구조는 기준 커밋의 git 기록으로 보면 2025년 11월 커밋 db94f391be4("MDEV-33966: buf_page_make_young() is a contention point")에서 들어왔습니다. 그 커밋 설명에는 "전에는 접근할 때 블록을 옮겼다"고 적혀 있습니다. 흔히 쓰는 LTS 판(11.4, 11.8)의 소스와는 비교하지 않았으므로, 이 절의 동작은 "기준 커밋에서는 이렇다"까지만 말할 수 있습니다.
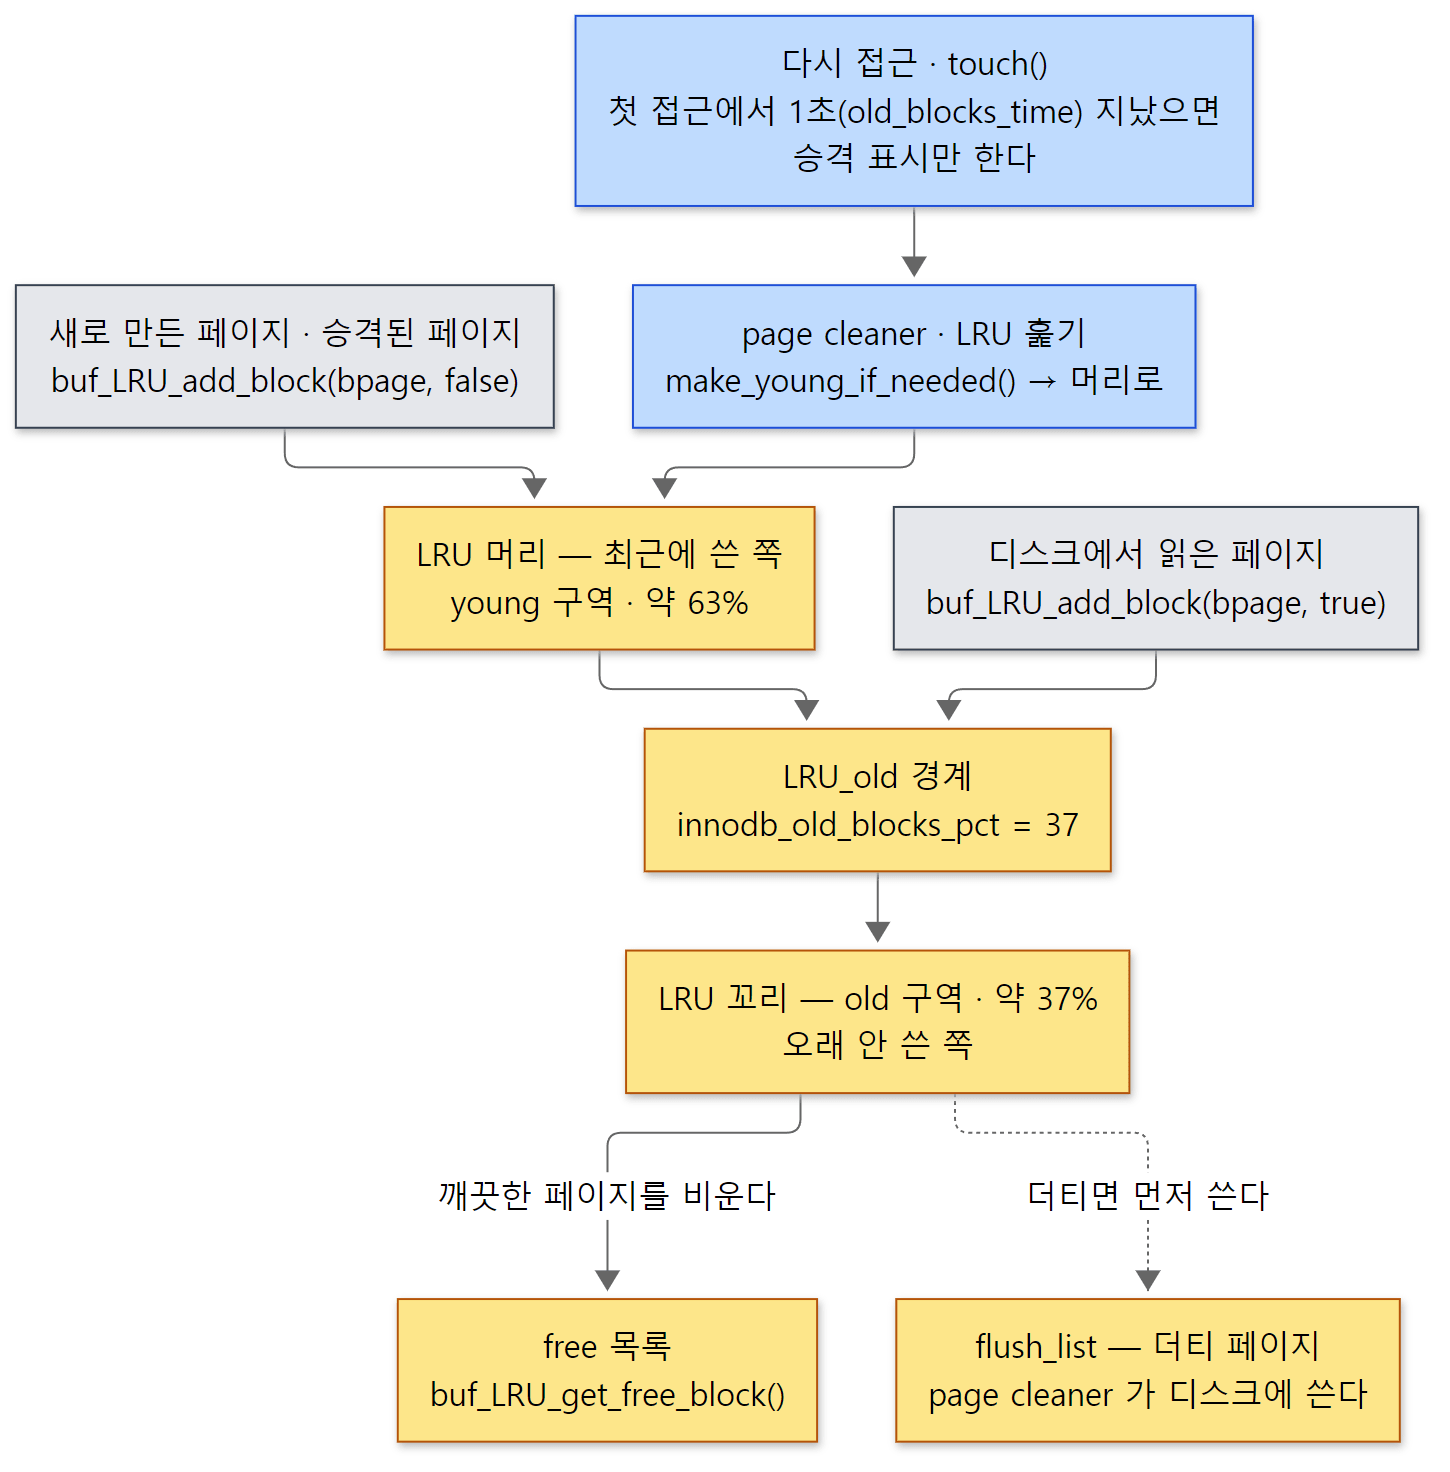 파란 칸이 기준 커밋에서 승격이 일어나는 두 단계입니다.
빈 블록 얻기: buf_LRU_get_free_block()
디스크에서 페이지를 읽으려면 빈 블록이 있어야 합니다. buf_LRU_get_free_block()의 머리 주석이 순서를 요약해 둡니다(buf/buf0lru.cc 326–346행). 사용자 스레드는 free 목록에서만 블록을 가져갑니다. free 목록이 비면 LRU 꼬리를 100장까지 훑어 깨끗한 페이지를 비우고, 그래도 없으면 page cleaner를 깨우고 기다립니다. 꼬리에 있어도 더티 페이지는 바로 비울 수 없습니다 — 디스크에 쓰기 전에 버리면 변경이 사라지기 때문입니다. 이 기다림이 생기면 buf_pool.stat.LRU_waits가 늘고, 오래 이어지면 오류 로그에 경고가 찍힙니다(buf_pool_t::LRU_warn()).
더티 페이지와 page cleaner
페이지를 고치면(6절의 mtr_t::commit()) 그 페이지는 flush_list에 올라갑니다. 디스크에 쓰는 일은 page cleaner라는 백그라운드 스레드 하나가 맡습니다(buf_flush_page_cleaner(), buf/buf0flu.cc 2804–3105행). 일하는 동안은 1초마다(또는 누가 깨우면) 일어나 무엇을 얼마나 쓸지 정하고, 할 일이 없어 쉬는 상태(idle)가 되면 누가 깨울 때까지(page_cleaner_wakeup()) 잠들어 있습니다(2851–2865행). 큰 갈래만 보면 이렇습니다.
- 빈 블록이 급하면(
buf_pool.need_LRU_eviction()) LRU 꼬리부터 쓰고 비웁니다(buf_flush_LRU()). - 아니면 더티 페이지 비율을 계산합니다.
    const ulint dirty_blocks= UT_LIST_GET_LEN(buf_pool.flush_list);
    /* We perform dirty reads of the LRU+free list lengths here.
    Division by zero is not possible, because buf_pool.flush_list is
    guaranteed to be nonempty, and it is a subset of buf_pool.LRU. */
    const double dirty_pct= double(dirty_blocks) * 100.0 /
      double(UT_LIST_GET_LEN(buf_pool.LRU) + UT_LIST_GET_LEN(buf_pool.free));
    pct_lwm= srv_max_dirty_pages_pct_lwm;
// ...
    else if (dirty_pct < srv_max_buf_pool_modified_pct)
    possibly_unemployed:
// ...
      if (!soft_lsn_limit && !af_needed_for_redo(oldest_lsn))
        goto set_idle;
storage/innobase/buf/buf0flu.cc 2975–3023행
- 비율이
innodb_max_dirty_pages_pct(기본 90, ha_innodb.cc 19710–19713행) 아래이고,innodb_max_dirty_pages_pct_lwm(기본 0)도 꺼져 있고, redo 로그 공간 때문에 서둘러야 할 사정(af_needed_for_redo())도 없으면 — 아무것도 쓰지 않고 쉽니다(goto set_idle). - 그렇지 않으면
flush_list의 꼬리(가장 오래된 변경)부터buf_flush_list_holding_mutex()로 씁니다. 몇 장을 쓸지는innodb_adaptive_flushing(적응형 플러시)과innodb_io_capacity가 정합니다.
3번이 중요합니다. 예제 2에서 보듯, 한가한 서버에서는 더티 페이지가 디스크에 안 쓰인 채 그대로 남아 있습니다. 같은 페이지를 또 고치면 디스크 쓰기 한 번으로 여러 변경을 함께 내보낼 수 있으니 미루는 편이 이득이고, 그 사이에 서버가 죽어도 redo 로그로 되살릴 수 있기 때문입니다(12편). redo 로그가 차서 체크포인트를 밀어야 할 때가 그 미룸의 한계입니다(af_needed_for_redo()와 buf_flush_sync_lsn, 12편).
예제 2: 버퍼 풀 안을 information_schema로 보기
INNODB_BUFFER_PAGE는 버퍼 풀의 페이지를 한 장씩 보여 주는 표이고(handler/i_s.cc), INNODB_BUFFER_POOL_STATS는 위의 목록 길이를 보여 줍니다. 4만 행짜리 테이블(행마다 200바이트)을 넣고 들여다봅니다. pages.sql은 INNODB_BUFFER_PAGE에서 TABLE_NAME = '`lab`.`big`'인 페이지를 세는 쿼리입니다 — 페이지 수, 그 가운데 더티(OLDEST_MODIFICATION > 0), old 구역(IS_OLD), 페이지당 평균 행 수.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
mariadb -e "CREATE DATABASE lab;
  CREATE TABLE lab.big (id INT PRIMARY KEY, pad CHAR(200)) ENGINE=InnoDB;
  INSERT INTO lab.big SELECT seq, REPEAT('x',200) FROM lab.seq_1_to_40000;"
# ... (설정값을 찍는 SELECT @@… 와 단계 제목을 찍는 echo 는 생략)
mariadb -t < pages.sql                 # 1. INSERT 직후
# ... (INNODB_BUFFER_POOL_STATS 를 찍는 SELECT 생략)
sleep 5; mariadb -t < pages.sql        # 2. 5초 뒤
mariadb -e "SET GLOBAL innodb_max_dirty_pages_pct=0"
sleep 3; mariadb -t < pages.sql        # 3. 더티 비율 기준을 0으로 내린 뒤
# 버퍼 풀을 비우고 다시 띄운다. 끌 때 페이지 목록을 저장했다가 켤 때 다시 읽는 기능을 꺼서 빈 상태로 시작한다.
lab-stop
lab-start --innodb-buffer-pool-load-at-startup=0
mariadb -t < pages.sql                 # 4. 다시 띄운 직후 (lab.big 의 페이지가 없어 빈 결과)
mariadb -t lab < scan.sql              # 5~7. 풀 스캔 두 번, 그리고 UPDATE
(seq_1_to_40000은 1부터 40000까지의 수를 행으로 돌려주는 SEQUENCE 엔진의 가상 테이블입니다.) 이 서버의 설정은 기본값 그대로 innodb_buffer_pool_size 128MB, innodb_old_blocks_pct 37, innodb_old_blocks_time 1000, innodb_max_dirty_pages_pct 90, innodb_max_dirty_pages_pct_lwm 0입니다(예제에서 SELECT @@…로 찍어 확인). 앞부분의 출력입니다(일부만 실었습니다).
--- 1. right after INSERT: pages of lab.big in the buffer pool
+------------+-----------+-------+-------+------+----------+
 INDEX_NAME | PAGE_TYPE | pages | dirty | old  | avg_recs |
+------------+-----------+-------+-------+------+----------+
 PRIMARY    | INDEX     |   599 |   599 |   17 |       68 |
+------------+-----------+-------+-------+------+----------+
+-----------+--------------+----------------+--------------------+-------------------------+
 POOL_SIZE | FREE_BUFFERS | DATABASE_PAGES | OLD_DATABASE_PAGES | MODIFIED_DATABASE_PAGES |
+-----------+--------------+----------------+--------------------+-------------------------+
      8096 |         7153 |            943 |                328 |                     657 |
+-----------+--------------+----------------+--------------------+-------------------------+
--- 2. 5 seconds later: still dirty
(1번과 같은 표 — 599장 모두 dirty)
--- 3. SET GLOBAL innodb_max_dirty_pages_pct=0, 3 seconds later
+------------+-----------+-------+-------+------+----------+
 INDEX_NAME | PAGE_TYPE | pages | dirty | old  | avg_recs |
+------------+-----------+-------+-------+------+----------+
 PRIMARY    | INDEX     |   599 |     0 |   27 |       68 |
+------------+-----------+-------+-------+------+----------+
- 4만 행이 페이지 599장(평균 68행)을 차지합니다. 599장 모두 더티입니다. 커밋은 끝났지만 페이지는 하나도 디스크에 쓰이지 않았습니다.
POOL_SIZE8096 =FREE_BUFFERS7153 +DATABASE_PAGES943(LRU에 있는 페이지, 시스템 테이블 등 포함). 앞에서 본 대로 8192보다 조금 적습니다.- INSERT가 새로 만든 페이지라서 old는 17장뿐입니다 — 새 페이지는 머리에 들어간다(
buf_LRU_add_block(bpage, false))는 것과 맞습니다. - 5초가 지나도 599장이 그대로 더티입니다. 더티 비율이 657 ÷ 8096 ≈ 8%로 90%에 한참 못 미치고, 막 기동한 서버라 redo 공간도 넉넉하니 page cleaner가 3번 갈래에서 쉰 것입니다.
innodb_max_dirty_pages_pct를 0으로 내리자 3초 안에 0장이 됩니다. 비교식dirty_pct < srv_max_buf_pool_modified_pct가 거짓이 되어 4번 갈래로 간 것입니다.
이어서 버퍼 풀을 비우고 다시 띄운 뒤의 출력입니다(scan.sql은 상태 변수를 스냅숏해 두었다가 차이를 찍는 저장 프로시저를 씁니다. 전체는 예제 폴더에 있습니다).
| --- 5. 1st full scan (cold) |
 INNODB_BUFFER_POOL_PAGES_MADE_YOUNG |     0 |
 INNODB_BUFFER_POOL_READ_REQUESTS    |   624 |
 INNODB_BUFFER_POOL_READS            |   609 |
 DATABASE_PAGES | OLD_DATABASE_PAGES | MODIFIED_DATABASE_PAGES |
            880 |                344 |                       1 |
 PRIMARY    | INDEX     |   599 |     0 |  136 |       68 |

 --- 6. 2nd full scan, 3 seconds later (warm) |
 INNODB_BUFFER_POOL_PAGES_MADE_YOUNG |     0 |
 INNODB_BUFFER_POOL_READ_REQUESTS    |   614 |
 INNODB_BUFFER_POOL_READS            |     0 |
 DATABASE_PAGES | OLD_DATABASE_PAGES | MODIFIED_DATABASE_PAGES |
            880 |                344 |                       1 |
 PRIMARY    | INDEX     |   599 |     0 |  136 |       68 |

 --- 7. UPDATE every row, then let the page cleaner flush |
 INNODB_BUFFER_POOL_PAGES_MADE_YOUNG |    302 |
 INNODB_BUFFER_POOL_READ_REQUESTS    | 124024 |
 INNODB_BUFFER_POOL_READS            |      1 |
 DATABASE_PAGES | OLD_DATABASE_PAGES | MODIFIED_DATABASE_PAGES |
            881 |                345 |                       0 |
 PRIMARY    | INDEX     |   599 |     0 |   67 |       68 |
(표의 테두리 줄은 지웠습니다. 7번의 숫자는 page cleaner가 언제 훑느냐에 따라 실행마다 조금씩 다릅니다 — 다시 돌렸을 때는 PAGES_MADE_YOUNG 331, old 64장이었습니다.)
- 처음 스캔: 페이지 요청 624번 가운데 609번이 디스크까지 갔습니다(
buf_page_get_gen()의 빗나감 →buf_read_page()). 두 번째 스캔: 요청 614번, 디스크 읽기 0번 — 전부 적중입니다. - 버퍼 풀 전체로 보면 LRU 880장 가운데 old가 344장, 39%로
innodb_old_blocks_pct = 37에 가깝습니다. lab.big의 페이지는 old 구역 앞쪽으로 들어갔지만, 경계(LRU_old)가 비율을 지키려고 꼬리 쪽으로 밀리면서 먼저 읽힌 페이지 일부가 경계 앞(young)으로 넘어가 136장만 old로 남았습니다(buf_LRU_old_adjust_len(), buf0lru.cc 446행부터). - 두 번째 스캔은 3초 뒤였는데도
PAGES_MADE_YOUNG가 0입니다. 접근이 승격 표시를 남겼더라도 아직 아무도 LRU를 훑지 않았으므로 옮겨진 페이지가 없습니다. - 모든 행을
UPDATE하고 page cleaner가 flush_list를 훑게 하자 그제야PAGES_MADE_YOUNG가 302 늘고 lab.big의 old 페이지가 136장에서 67장으로 줄었습니다. flush_list 훑기에서 부르는make_young_if_needed<false, true>()는 old 구역에 있는 표시된 블록만 옮깁니다(buf0flu.cc 1516–1519행). 이 302장이 2번째 스캔의 접근으로 표시된 것인지UPDATE의 접근으로 표시된 것인지는 이 예제로 가를 수 없습니다. 이 예제가 보여 주는 것은 "옮기는 일은 접근할 때가 아니라 누군가 목록을 훑을 때 일어난다"까지입니다.
5. B-트리 — 테이블은 클러스터드 인덱스다
클러스터드 인덱스와 보조 인덱스
InnoDB 테이블의 행은 클러스터드 인덱스의 잎에 삽니다. 테이블을 만들 때 기본 키가 있으면 그 인덱스를 먼저 만들어 클러스터드 인덱스로 삼고, 없으면 InnoDB가 숨은 6바이트 행 번호 DB_ROW_ID로 정렬하는 GEN_CLUST_INDEX를 만듭니다.
	if (m_form->s->keys == 0 || primary_key_no == -1) {
		/* Create an index which is used as the clustered index;
		order the rows by their row id which is internally generated
		by InnoDB */
		ulint flags = m_table->flags;
		dict_index_t* index = dict_mem_index_create(
			m_table, GEN_CLUST_INDEX.str,
			DICT_CLUSTERED, 0);
// ...
	if (primary_key_no != -1) {
		/* In InnoDB the clustered index must always be created
		first */
		if ((error = create_index(m_trx, m_form, o, m_table,
					  (uint) primary_key_no))) {
storage/innobase/handler/ha_innodb.cc 13079–13102행
InnoDB 안에서 쓰는 인덱스 정의를 만들 때, 클러스터드 인덱스에는 키 열 뒤에 숨은 열 DB_TRX_ID·DB_ROLL_PTR(기본 키가 없으면 그 앞에 DB_ROW_ID도)를 붙입니다(dict_index_build_internal_clust(), dict/dict0dict.cc 2315–2374행) — 예제 1에서 id 뒤에 본 6바이트와 7바이트가 그것입니다. 보조 인덱스에는 인덱스 열 뒤에 클러스터드 인덱스의 키 열을 붙입니다.
	/* Add to new_index the columns necessary to determine the clustered
	index entry uniquely */

	for (i = 0; i < clust_index->n_uniq; i++) {
		field = dict_index_get_nth_field(clust_index, i);

		if (!indexed[field->col->ind] || index->is_spatial()) {
			dict_index_add_col(new_index, table, field->col,
					   field->prefix_len,
					   field->descending);
		}
	}
storage/innobase/dict/dict0dict.cc 2482–2493행
그래서 보조 인덱스의 잎에서 찾은 것은 행의 위치(페이지 번호)가 아니라 기본 키 값이고, 나머지 열이 필요하면 그 기본 키로 클러스터드 인덱스를 한 번 더 내려가야 합니다. 행이 페이지 분할로 다른 페이지로 옮겨 가도 보조 인덱스를 고칠 필요가 없게 하는 설계입니다. 대신 기본 키가 길면 모든 보조 인덱스가 같이 커집니다.
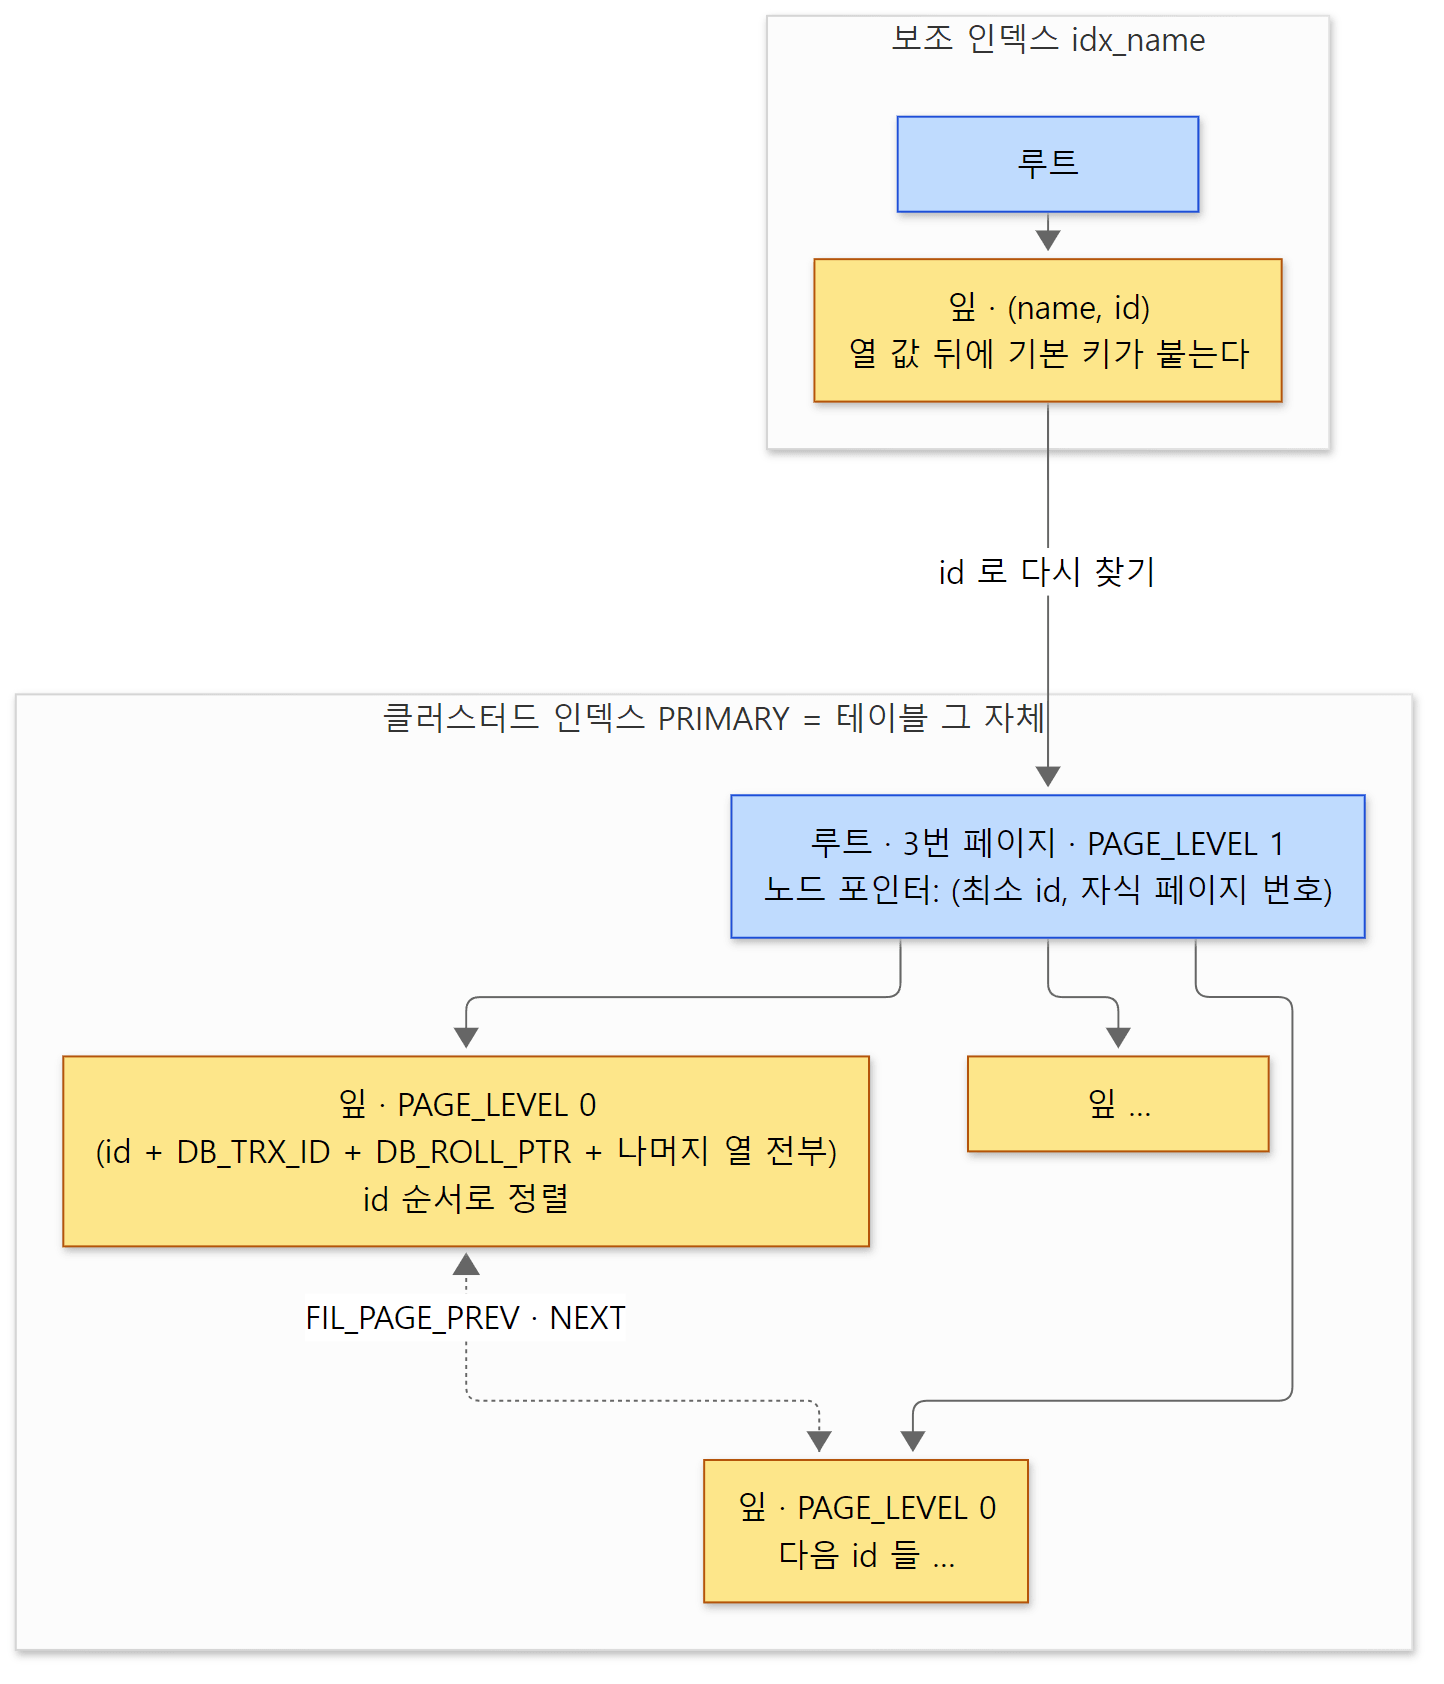 높이 2인 트리입니다. 페이지 하나가 마디 하나이고, 루트 페이지 번호는 바뀌지 않습니다.
트리의 가운데 마디에 든 레코드는 노드 포인터입니다. 자식 페이지에 든 가장 작은 키와 그 자식의 페이지 번호(REC_NODE_PTR_SIZE = 4바이트) 한 쌍이고, 레코드 머리의 status가 001입니다(2절). 잎은 PAGE_LEVEL = 0, 그 위가 1, 2 … 이고, 같은 높이의 페이지끼리는 FIL 헤더의 FIL_PAGE_PREV/FIL_PAGE_NEXT로 양쪽으로 이어져 있어 범위 검색(WHERE id BETWEEN …)이나 풀 스캔이 잎만 따라 옆으로 갈 수 있습니다.
btr_cur_t::search_leaf() — 루트에서 잎까지
키 하나로 잎을 찾는 함수가 btr_cur_t::search_leaf()입니다(1095–1606행). 500줄이 넘지만 대부분은 래치를 어떻게 잡고 놓을지에 관한 것이고, 뼈대는 루프 하나입니다.
  /* Start with the root page. */
  page_id_t page_id(index()->table->space_id, index()->page);
// ...
 search_loop:
  auto block_savepoint= mtr->get_savepoint();
  buf_block_t *block=
    buf_page_get_gen(page_id, zip_size, rw_latch, guess, BUF_GET, mtr, &err);
  if (!block)
  {
    btr_read_failed(err, *index());
    goto func_exit;
  }
// ...
  const bool not_first_access{block->page.touch()};
// ...
  uint32_t page_level= btr_page_get_level(block->page.frame);
// ...
  if (!height)
  {
    /* We reached the leaf level. */
// ...
  reached_latched_leaf:
    if (!(tuple->info_bits & REC_INFO_MIN_REC_FLAG))
    {
      if (page_cur_search_with_match_bytes(*tuple, mode, &up_match, &low_match,
                                           &page_cur, &up_bytes, &low_bytes))
        goto corrupted;
    }
    else if (page_cur_search_with_match(tuple, mode, &up_match, &low_match,
                                        &page_cur, nullptr))
      goto corrupted;
// ...
  guess= nullptr;
  if (page_cur_search_with_match(tuple, page_mode, &up_match, &low_match,
                                 &page_cur, nullptr))
    goto corrupted;
  offsets= rec_get_offsets(page_cur.rec, index(), offsets, 0, ULINT_UNDEFINED,
                           &heap);
// ...
  /* Go to the child node */
  page_id.set_page_no(btr_node_ptr_get_child_page_no(page_cur.rec, offsets));

  if (!--height)
// ...
  goto search_loop;
storage/innobase/btr/btr0cur.cc 1234–1605행
- 루트에서 시작합니다. 인덱스의 루트 페이지 번호는 인덱스 정의(
dict_index_t::page)에 있습니다. 예제 1의INNODB_SYS_INDEXES.PAGE_NO가 이 값입니다. buf_page_get_gen()으로 페이지를 얻고(3절),touch()로 접근을 기록합니다(4절).- 잎이 아니면 그 페이지 안에서
page_cur_search_with_match()로 키가 들어갈 노드 포인터를 찾고, 거기 적힌 자식 페이지 번호로page_id를 바꿔search_loop로 돌아갑니다. - 잎(
height == 0)이면 잎 안에서 위치를 찾고 끝냅니다. 잎에서는 (가장 작은 레코드를 찾는 특별한 경우REC_INFO_MIN_REC_FLAG를 빼면) 바이트 단위까지 비교하는page_cur_search_with_match_bytes()를 쓰고(적응형 해시 인덱스가 쓸 정보up_bytes·low_bytes를 함께 남기려고), 가운데 마디에서는page_cur_search_with_match()를 씁니다. 두 함수의 탐색 방법은 같습니다.
내려가는 동안 래치는 위에서 아래로 갈아 잡습니다. 자식의 래치를 잡은 다음 부모의 래치를 놓는 식이라(mtr->rollback_to_savepoint()로 부모 블록을 메모에서 빼고 래치를 푼다, 1349–1352행), 읽기 검색은 한 번에 페이지 한두 장의 래치만 들고 있습니다. 인덱스 전체의 래치(index()->lock)는 보통 S로 잡고, 트리 모양을 바꿀 수 있는 쓰기(BTR_MODIFY_TREE)일 때만 SX/X로 잡습니다(1183–1217행).
함수 머리에는 적응형 해시 인덱스(AHI)로 트리를 건너뛰는 지름길(btr_search_guess_on_hash())도 있지만, 기준 커밋의 기본값은 innodb_adaptive_hash_index=OFF입니다(ha_innodb.cc 19848–19855행).
페이지 안에서 찾기 — 디렉터리 이진 탐색 + 짧은 선형 탐색
  size_t low= 0, up= ulint{page_dir_get_n_slots(page)} - 1;
  const rec_t *mid_rec;

  /* Perform binary search until the lower and upper limit directory
  slots come to the distance 1 of each other */
  while (up - low > 1)
  {
    const size_t mid= (low + up) / 2;
    mid_rec=
      page_dir_slot_get_rec_validate(page, page_dir_get_nth_slot(page, mid));
    if (UNIV_UNLIKELY(!mid_rec))
      return true;
    uint16_t cur= std::min(low_fields, up_fields);
    int cmp= page_cur_dtuple_cmp(*tuple, mid_rec, index, &cur, comp, leaf);
    if (cmp > 0)
    low_slot_match:
      low= mid, low_fields= cur;
    else if (cmp)
    up_slot_match:
      up= mid, up_fields= cur;
    else if (mode == PAGE_CUR_G || mode == PAGE_CUR_LE)
      goto low_slot_match;
    else
      goto up_slot_match;
  }
storage/innobase/page/page0cur.cc 870–894행
2절의 페이지 디렉터리가 여기서 쓰입니다. 슬롯은 키 순서로 늘어서 있으니 이진 탐색으로 low와 up 슬롯을 하나 차이까지 좁히고, 그 사이의 레코드 4~8개는 next 포인터를 따라 선형으로 비교합니다(903–938행). 비교할 때 앞쪽에서 이미 같다고 확인한 열 수(low_fields·up_fields)를 들고 다니며 그 다음 열부터 비교하는 것도 눈여겨볼 만합니다. 그 앞의 "마지막 삽입 위치 지름길"(PAGE_LAST_INSERT와 PAGE_N_DIRECTION을 보는 page_cur_try_search_shortcut(), 845–857행)은 순차 삽입이 이어질 때 이진 탐색마저 건너뜁니다.
16KB 페이지 하나에 노드 포인터가 수백 개 들어가므로 트리는 아주 낮습니다. 예제 3에서 보듯 200바이트 행 15만 개도 높이 3입니다. 기본 키 조회 한 번은 페이지 세 장을 읽는 일이고, 위쪽 페이지일수록 모든 조회가 함께 지나가므로 버퍼 풀에 남아 있기 쉽습니다.
페이지가 꽉 차면: 분할
row_ins_clust_index_entry()는 먼저 잎 페이지만 래치하는 낙관적 하강(BTR_MODIFY_LEAF)으로 내려가 btr_cur_optimistic_insert()로 그냥 넣어 봅니다. 자리가 없으면(DB_FAIL) 인덱스 트리 래치까지 잡는 비관적 하강(BTR_MODIFY_TREE)으로 다시 내려가고(row/row0ins.cc 3324–3346행), 이번에도 자리가 없으면 btr_cur_pessimistic_insert()가, 그 페이지가 루트면 btr_root_raise_and_insert(), 아니면 btr_page_split_and_insert()를 부릅니다(btr/btr0cur.cc 2651–2665행).
루트는 쪼개지 않고 한 층 올립니다. 루트의 레코드를 새 페이지로 다 옮기고, 루트에는 새 페이지를 가리키는 노드 포인터 하나만 남긴 뒤, 새 페이지를 쪼갭니다(btr/btr0btr.cc 1832–1834행). 그래서 루트 페이지 번호(새 .ibd의 3번)는 트리가 아무리 자라도 그대로이고, 트리는 위로 자랍니다.
btr_page_split_and_insert()는 단계에 번호를 매겨 두었습니다 — 1. 어디서 자를지 정하기, 2. 새 페이지 할당, 3. 위쪽 반의 첫 레코드 계산, 4. 트리 구조(부모의 노드 포인터, 이웃 끈) 먼저 고치기, 5. 레코드 옮기기, 6~8. 삽입 재시도(2819행부터). 흥미로운 것은 1단계입니다.
	/* 1. Decide the split record; split_rec == NULL means that the
	tuple to be inserted should be the first record on the upper
	half-page */
	bool insert_left = false;
	uint32_t hint_page_no = block->page.id().page_no() + 1;
	byte direction = FSP_UP;

// ...
	} else if (btr_page_get_split_rec_to_right(cursor, &split_rec)) {
	} else if ((split_rec = btr_page_get_split_rec_to_left(cursor))) {
		direction = FSP_DOWN;
		hint_page_no -= 2;
	} else {
		/* If there is only one record in the index page, we
		can't split the node in the middle by default. We need
		to determine whether the new record will be inserted
		to the left or right. */

		if (page_get_n_recs(page) > 1) {
			split_rec = page_get_middle_rec(page);
storage/innobase/btr/btr0btr.cc 2884–2909행
어디서 자를지를 삽입 패턴을 보고 정합니다.
- 이번 삽입 위치가 바로 직전 삽입(
PAGE_LAST_INSERT) 바로 뒤라면 오른쪽으로 순차 삽입 중이라고 보고(btr_page_get_split_rec_to_right(), 2066행부터), 기존 레코드는 거의 다 왼쪽 페이지에 남기고 새 레코드부터 오른쪽 새 페이지로 보냅니다.AUTO_INCREMENT기본 키처럼 늘 끝에 붙는 삽입이면 왼쪽 페이지는 꽉 찬 채로 남고 더는 새 행이 들어오지 않습니다. - 반대 방향 순차 삽입이면 왼쪽으로(
btr_page_get_split_rec_to_left()). - 그 밖에는 가운데(
page_get_middle_rec())에서 자릅니다. 두 페이지가 반씩 찬 채로 남습니다.
분할 전에 오른쪽 이웃 페이지에 자리가 있으면 그쪽에 넣고 끝내는 시도(btr_insert_into_right_sibling())도 먼저 합니다. 분할 횟수는 buf_pool.pages_split로 세고, SHOW GLOBAL STATUS의 Innodb_buffer_pool_pages_split로 보입니다. 다만 이 수는 btr_page_split_and_insert()의 맨 앞(오른쪽 이웃에 넣어 보기 전, 2853행)에서 늘리므로, 오른쪽 이웃에 넣고 끝나 실제로는 쪼개지 않은 경우도 셉니다.
예제 3: 행을 늘리며 높이와 분할 세기
같은 모양의 행(id INT PRIMARY KEY, pad CHAR(200))을 순서대로 늘려 가며, 매번 루트 페이지(3번)의 PAGE_LEVEL을 od로 읽고 분할 수를 셉니다. 그리고 같은 4만 행을 순서대로 넣은 테이블과 뒤섞어 넣은 테이블의 잎 페이지를 비교합니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ... (seq_ins·seq40·rnd40 테이블을 만들고 u16 함수를 정의하는 부분 생략)
# 테이블 $1 의 루트 페이지(3번)에서 PAGE_LEVEL·PAGE_N_RECS 를 읽는다. FOR EXPORT 로 더티 페이지를 디스크에 쓰게 한 뒤 읽는다.
tree() {
  mariadb -e "FLUSH TABLES lab.$1 FOR EXPORT; SELECT SLEEP(2)" > /dev/null &
  sleep 1
  b=$(( 3*16384 + 38 ))     # 3번 페이지의 인덱스 페이지 헤더
  echo "$1: rows=$2 ... PAGE_LEVEL=$(u16 /var/lib/mariadb-lab/lab/$1.ibd $b+26) ..."   # (줄임)
  wait
}

done_rows=0
for n in 1 60 70 1000 40000 150000; do
  mariadb -e "INSERT INTO lab.seq_ins SELECT seq, REPEAT('x',200) FROM lab.seq_$((done_rows+1))_to_$n"
  tree seq_ins $n            # 분할 수는 앞뒤의 Innodb_buffer_pool_pages_split 차이로 센다 (생략)
  done_rows=$n
done
# 같은 4만 행을 순서대로(seq40) / 뒤섞어서(rnd40) 넣는다: (seq*7919) % 40000 + 1 은 1..40000 을 한 번씩 섞어 낸다
mariadb -e "INSERT INTO lab.seq40 SELECT seq, REPEAT('x',200) FROM lab.seq_1_to_40000"
mariadb -e "INSERT INTO lab.rnd40 SELECT (seq*7919) % 40000 + 1, REPEAT('x',200) FROM lab.seq_0_to_39999"
# ... (두 테이블의 tree 출력과, INNODB_BUFFER_PAGE 로 잎 페이지를 세는 SELECT 생략)
--- 1. sequential inserts: height grows as rows grow
    page splits during this batch: 0
seq_ins: rows=1 root_page=3 PAGE_LEVEL=0 (height 1) root_PAGE_N_RECS=1 file_pages=4
    page splits during this batch: 0
seq_ins: rows=60 root_page=3 PAGE_LEVEL=0 (height 1) root_PAGE_N_RECS=60 file_pages=4
    page splits during this batch: 1
seq_ins: rows=70 root_page=3 PAGE_LEVEL=1 (height 2) root_PAGE_N_RECS=2 file_pages=6
    page splits during this batch: 14
seq_ins: rows=1000 root_page=3 PAGE_LEVEL=1 (height 2) root_PAGE_N_RECS=16 file_pages=21
    page splits during this batch: 582
seq_ins: rows=40000 root_page=3 PAGE_LEVEL=1 (height 2) root_PAGE_N_RECS=598 file_pages=1088
    page splits during this batch: 1644
seq_ins: rows=150000 root_page=3 PAGE_LEVEL=2 (height 3) root_PAGE_N_RECS=3 file_pages=2816
--- 2. 40000 rows in order vs. the same 40000 rows shuffled
    seq40 page splits: 597
    rnd40 page splits: 966
seq40: rows=40000 root_page=3 PAGE_LEVEL=1 (height 2) root_PAGE_N_RECS=598 file_pages=1088
rnd40: rows=40000 root_page=3 PAGE_LEVEL=1 (height 2) root_PAGE_N_RECS=953 file_pages=1600
--- 3. leaf pages (every page except the root 3, since the height is 2) and how full they are
+---------------+------------+----------+----------------+------------+
 TABLE_NAME    | leaf_pages | avg_recs | avg_data_bytes | pct_of_16k |
+---------------+------------+----------+----------------+------------+
 `lab`.`seq40` |        598 |       67 |          15050 |         92 |
 `lab`.`rnd40` |        953 |       42 |           9444 |         58 |
+---------------+------------+----------+----------------+------------+
- 60행까지는 루트가 곧 잎입니다(높이 1, 루트에 레코드 60개). 61~70행을 넣는 사이 루트가 한 층 올라가 높이 2가 되고, 루트에는 잎 두 장을 가리키는 노드 포인터 2개만 남습니다. 루트 번호는 그대로 3입니다.
- 4만 행이면 잎 598장, 루트에 노드 포인터 598개. 이때까지 높이 2입니다. 15만 행에서 루트가 다시 올라가 높이 3이 됩니다(루트에는 가운데 마디 3장을 가리키는 포인터 3개).
- 같은 4만 행인데 순서대로 넣으면 잎 598장이 92% 차고, 뒤섞어 넣으면 953장이 58%만 찹니다. 분할 수도 597번 대 966번입니다(seq40은 잎 598장 = 분할 597번 + 1로 딱 맞고, rnd40은 966 + 1보다 잎이 14장 적습니다 — 앞에서 본 대로 이 수가 오른쪽 이웃에 넣고 끝난 경우까지 세기 때문으로 보입니다). 순차 삽입에서는 "오른쪽으로 순차 삽입 중" 판단으로 왼쪽 페이지를 꽉 채운 채 두고, 뒤섞인 삽입에서는 가운데서 잘라 반쯤 찬 페이지가 생기기 때문입니다. UUID처럼 무작위인 값을 기본 키로 쓰면 테이블이 더 커지고 버퍼 풀에 덜 들어가는 이유가 여기 있습니다.
file_pages(파일 크기 ÷ 16KB)가 실제 인덱스 페이지 수보다 큰 것은 테이블스페이스 파일을 페이지 할당 모듈(fsp/)이 여러 페이지씩 늘리기 때문으로 보이는데, 이 글에서는 그 코드를 따라가지 않았습니다.
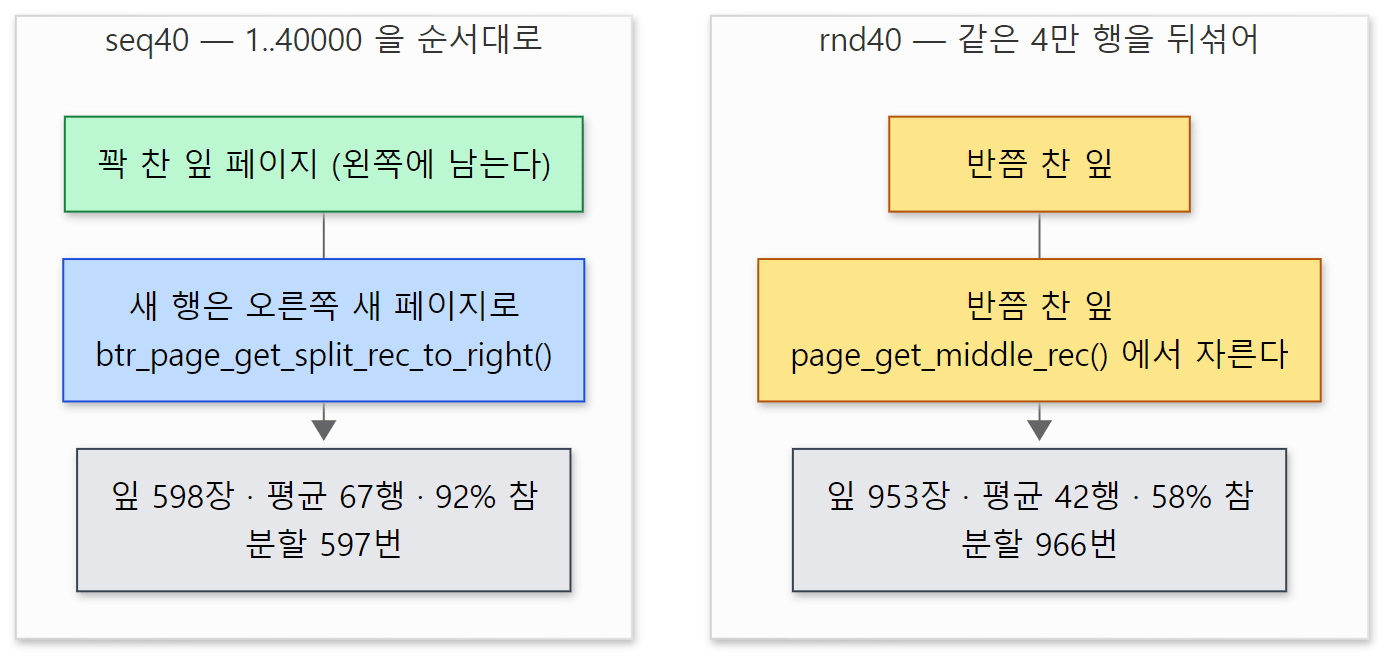 자르는 자리가 달라서 같은 행 수에 잎 페이지 수가 1.6배가 됩니다. 숫자는 예제 3의 실제 출력(2·3번)입니다.
예제 4: SELECT와 INSERT가 B-트리에 닿는 길 (gdb)
실행 중인 mariadbd에 gdb를 붙여, (1) 기본 키 조회가 btr_cur_t::search_leaf()에 닿는 순간과 (2) 61번째 행부터 넣는 INSERT가 페이지를 쪼개는 순간의 호출 스택을 찍습니다. 백그라운드 스레드(더는 필요 없는 옛 판과 지운 행을 치우는 purge 등, 11편)도 B-트리를 읽으므로, 먼저 ha_innobase::index_read에 멈춘 뒤 그 스레드에서만 search_leaf에 멈추게 했습니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# 먼저 index_read 에 멈춘 뒤, 같은 스레드에서만 search_leaf 에 멈추게 한다 (백그라운드 스레드를 피하려고)
gdb -p "$(cat /tmp/mariadbd.pid)" -batch \
    -ex 'break ha_innobase::index_read' -ex 'continue' \
    -ex 'break btr_cur_t::search_leaf thread $_thread' -ex 'continue' -ex 'bt' \
    -ex 'print index()->name.m_name' -ex 'print index()->page' \
    -ex 'delete' -ex 'detach' > /tmp/g1.txt 2>/dev/null &
sleep 5
mariadb -e "SELECT id FROM lab.t WHERE id = 42" > /dev/null
# ... (60행짜리 lab.t 를 만드는 앞부분, 백트레이스를 다듬는 부분,
#      btr_page_split_and_insert 에 멈추고 61~70번째 행을 넣는 2번 gdb 는 생략)
=== 1. SELECT ... WHERE id = 42 : ha_innobase::index_read -> btr_cur_t::search_leaf
#0  btr_cur_t::search_leaf at storage/innobase/btr/btr0cur.cc:1098
#1  btr_pcur_open_with_no_init at storage/innobase/include/btr0pcur.inl:322
#2  row_search_mvcc<InnoDBPolicy<true, true> > at storage/innobase/row/row0sel.cc:4909
#3  ha_innobase::index_read at storage/innobase/handler/ha_innodb.cc:9220
#4  handler::index_read_map at sql/handler.h:4443
#5  handler::index_read_idx_map at sql/handler.cc:7862
#6  handler::ha_index_read_idx_map at sql/handler.cc:4249
#7  join_read_const at sql/sql_select.cc:26187
#8  join_read_const_table at sql/sql_select.cc:26037
#9  make_join_statistics at sql/sql_select.cc:6084
#10 JOIN::optimize_inner at sql/sql_select.cc:2779
#11 JOIN::optimize at sql/sql_select.cc:2032
#12 mysql_select at sql/sql_select.cc:5447
...
#17 dispatch_command at sql/sql_parse.cc:1903
#18 do_command at sql/sql_parse.cc:1437
$1 = 0x7711fc043e48 "PRIMARY"
$2 = 3
(인자와 주소는 지웠고, #13~#16은 handle_select → execute_sqlcom_select → mysql_execute_command → mysql_parse라 줄였습니다. $1의 주소는 실행마다 다릅니다.)
ha_innobase::index_read()→row_search_mvcc()(9220행) → 영속 커서를 여는btr_pcur_open_with_no_init()→search_leaf(). 1절의row_prebuilt_t가 들고 있던pcur가 이 커서입니다.- 찾는 인덱스는
PRIMARY, 시작하는 루트 페이지 번호(index()->page)는 3입니다. 예제 1·3에서 파일로 읽은 번호와 같습니다. - 이 조회는 실행이 아니라 최적화 중에 일어났습니다(#9
make_join_statistics→join_read_const_table).WHERE id = 42처럼 기본 키 등호 조건이면 행이 많아야 하나이므로 옵티마이저가 미리 읽어 상수로 바꿔 둡니다 — 8편의 "상수 테이블"입니다.
=== 2. INSERT of the 61st..70th row: btr_page_split_and_insert
#0  btr_page_split_and_insert at storage/innobase/btr/btr0btr.cc:2844
#1  btr_root_raise_and_insert at storage/innobase/btr/btr0btr.cc:2005
#2  btr_cur_pessimistic_insert at storage/innobase/btr/btr0cur.cc:2656
#3  row_ins_clust_index_entry_low at storage/innobase/row/row0ins.cc:2958
...
#9  row_insert_for_mysql at storage/innobase/row/row0mysql.cc:1311
#10 ha_innobase::write_row at storage/innobase/handler/ha_innodb.cc:7970
#11 handler::ha_write_row at sql/handler.cc:8666
#12 Write_record::single_insert at sql/sql_insert.cc:2396
#13 Write_record::write_record at sql/sql_insert.cc:2438
#14 select_insert::send_data at sql/sql_insert.cc:4564
...
#27 do_command at sql/sql_parse.cc:1437
$1 = 0x7711fc043e48 "PRIMARY"
$2 = 0
$3 = 4
(#4~#8은 row_ins_clust_index_entry → row_ins_index_entry → row_ins_index_entry_step → row_ins → row_ins_step, #15~#26은 select_result_sink::send_data_with_check 다음으로 9편에서 본 end_send → evaluate_join_record → sub_select → do_select → JOIN::exec … dispatch_command라 줄였습니다.)
- 9편의 쓰기 경로
Write_record::single_insert()→handler::ha_write_row()→ha_innobase::write_row()가 그대로 이어져,row_insert_for_mysql()→ 클러스터드 인덱스에 넣는row_ins_clust_index_entry_low()→ 비관적 삽입 → 루트 올리기 → 분할로 내려갑니다. - 쪼개지는 페이지는 높이 0(잎)의 4번 페이지입니다. 루트(3번)의 레코드가 막 옮겨 간 새 페이지 — 위에서 본 "루트를 비우고 새 페이지로 옮긴 뒤 새 페이지를 쪼갠다"가 그대로 보입니다.
6. 미니 트랜잭션 mtr_t — 페이지 래치와 redo를 한 묶음으로
지금까지 본 코드 곳곳에 mtr이 따라다녔습니다. buf_page_get_gen()은 잡은 래치를 mtr->memo_push()로 적었고, search_leaf()는 부모의 래치를 mtr->rollback_to_savepoint()로 놓았고, 분할은 페이지 여러 장을 한 mtr 안에서 고쳤습니다.
미니 트랜잭션은 "페이지를 일관되게 바꾸는 가장 작은 단위"입니다. 페이지 분할은 새 페이지 할당, 레코드 옮기기, 부모의 노드 포인터 추가, 이웃 끈 고치기를 모두 해야 B-트리가 다시 올바른 모양이 됩니다. 그 도중의 반쯤 고친 모습을 다른 스레드가 보거나, 그 도중에 서버가 죽은 상태로 복구되면 안 됩니다. mtr은 이를 위해 두 가지를 모읍니다.
m_memo— 이 mtr이 잡은 래치(페이지, 인덱스 트리)의 목록. 래치는commit()때 한꺼번에 풉니다. 그래서 고치는 동안 다른 스레드는 반쯤 고친 페이지를 보지 못합니다.m_log— 이 mtr이 페이지에 한 변경의 redo 기록.commit()때 한꺼번에 redo 로그 버퍼에 붙입니다. 복구할 때는 mtr 하나의 기록이 통째로 있거나 통째로 없습니다(12편).
mtr_t::start()(mtr/mtr0mtr.cc 189–219행)는 이 둘을 비우고 시작할 뿐이고, 일은 commit()에 있습니다.
void mtr_t::commit()
// ...
  if (m_modifications && (m_log_mode == MTR_LOG_NO_REDO || !m_log.empty()))
// ...
    std::pair<lsn_t,lsn_t> lsns{do_write()};
    process_freed_pages();
storage/innobase/mtr/mtr0mtr.cc 534–554행
변경이 있으면 do_write()가 m_log를 redo 로그에 붙이고 이 mtr의 LSN을 받아 옵니다(12편에서 자세히 봅니다). 그 다음 commit_log()가 고친 페이지마다 두 가지를 합니다.
    while (it != mtr->m_memo.rend())
    {
      const mtr_memo_slot_t &slot= *it++;
      if (slot.type & MTR_MEMO_MODIFY)
      {
// ...
        modified++;
        buf_block_t *b= static_cast<buf_block_t*>(slot.object);
// ...
        mach_write_to_8(b->page.frame + FIL_PAGE_LSN, mtr->m_commit_lsn);
        if (UNIV_LIKELY_NULL(b->page.zip.data))
          memcpy_aligned<8>(FIL_PAGE_LSN + b->page.zip.data,
                            FIL_PAGE_LSN + b->page.frame, 8);
        buf_pool.insert_into_flush_list(prev, b, lsns.first);
      }
    }
storage/innobase/mtr/mtr0mtr.cc 431–452행
- 페이지의 FIL 헤더
FIL_PAGE_LSN에 이 mtr의 LSN을 적습니다(mach_write_to_8(b->page.frame + FIL_PAGE_LSN, …)). 예제 1에서od로 읽은 LSN이 여기서 적힌 것입니다. - 깨끗했던 페이지를 처음 더럽혔다면(
m_made_dirty)flush_list에 올립니다(insert_into_flush_list()— 이미 더티인 페이지는 그대로 둡니다, 154–183행). 그리고 page cleaner를 깨울지 봅니다(page_cleaner_wakeup()).
그 뒤 release()가 m_memo의 래치를 풀고 고정을 해제합니다. 순서가 중요합니다 — redo 기록을 먼저 로그에 넣고, 그 다음 페이지를 더티로 표시하고, 마지막에 래치를 풉니다. 페이지가 디스크에 쓰이는 것은 언제나 그 페이지를 고친 redo가 로그에 들어간 뒤라는 약속(WAL, write-ahead logging)이 이 순서에서 시작합니다. 4절의 page cleaner가 더티 페이지를 마음 놓고 미룰 수 있었던 것도 이 약속 덕분입니다.
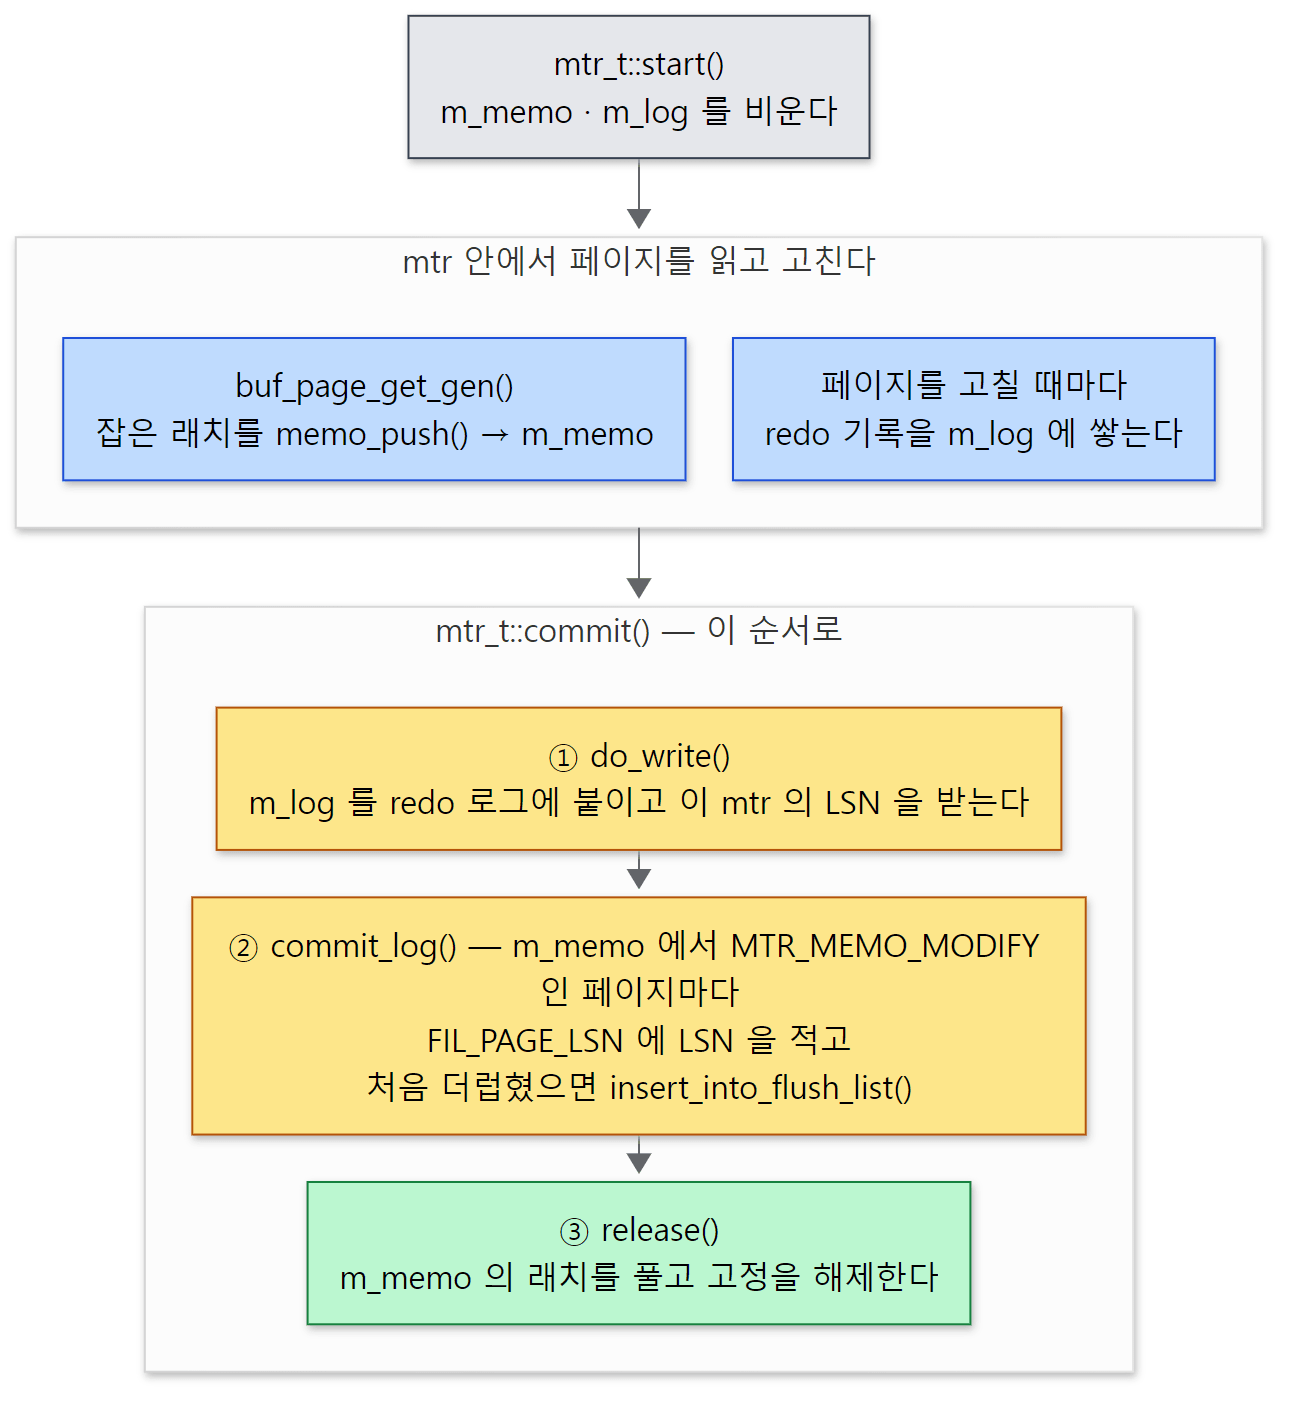 redo 를 먼저 로그에 넣고, 페이지를 더티로 표시하고, 마지막에 래치를 풉니다. 순서는 위에 인용한 mtr0mtr.cc 431–452행과 534–554행에서 가져왔습니다.
헷갈리기 쉬운 곳: mtr은 트랜잭션이 아닙니다
이름에 "트랜잭션"이 들어 있지만 mtr_t에는 고친 내용을 되돌리는 롤백이 없습니다. 이름이 비슷한 mtr_t::rollback_to_savepoint()는 고치지 않은 페이지의 래치를 놓는 함수일 뿐이고, 고친 페이지가 끼어 있으면 안 된다고 단언합니다(ut_ad(!(slot.type & MTR_MEMO_MODIFY)), mtr/mtr0mtr.cc 581–596행). 페이지를 고치기 시작한 mtr은 끝까지 가서 commit()해야 합니다 — 분할 함수 주석의 "the operation of this function must always succeed, we cannot reverse it"도 같은 말입니다. 사용자가 ROLLBACK하면 InnoDB는 새 mtr들을 열어 undo 기록대로 반대 변경을 가합니다(11편). 사용자 트랜잭션 하나 안에서 mtr은 여러 번 열리고 닫힙니다.
이 글에서 뺀 것
- 테이블스페이스와 페이지 할당(익스텐트, 파일 세그먼트,
FSP_HDR·XDES·INODE페이지):storage/innobase/fsp/fsp0fsp.cc,btr_page_alloc() - 파일과 I/O(
fil_space_t,fil_node_t, 비동기 I/O,tpool/):storage/innobase/fil/fil0fil.cc,storage/innobase/os/os0file.cc - doublewrite 버퍼(찢어진 페이지에서 되살리기):
storage/innobase/buf/buf0dblwr.cc - 미리 읽기:
buf_read_ahead_random()·buf_read_ahead_linear() - 버퍼 풀 덤프와 로드(
innodb_buffer_pool_dump_at_shutdown, 예제 2에서 끈 것):storage/innobase/buf/buf0dump.cc - 버퍼 풀 크기 바꾸기:
buf_pool_t::resize() - 적응형 해시 인덱스:
storage/innobase/btr/btr0sea.cc - 압축 테이블(
ROW_FORMAT=COMPRESSED,unzip_LRU, buddy 할당기):storage/innobase/page/page0zip.cc,buf/buf0buddy.cc - 페이지 병합과 레코드 삭제(
btr_compress(),btr_cur_pessimistic_delete()):storage/innobase/btr/btr0btr.cc,btr0cur.cc - 큰 열을 페이지 밖에 두기(BLOB 페이지,
dtuple_convert_big_rec()):storage/innobase/btr/btr0cur.cc - 대량 적재(
btr_bulk,ALTER TABLE·CREATE INDEX의 정렬 후 적재):storage/innobase/btr/btr0bulk.cc - 공간 인덱스 R-트리:
storage/innobase/gis/ - 페이지 상태(
buf_page_t::state()의NOT_USED·MEMORY·UNFIXED·READ_FIX·WRITE_FIX…)와 전이 규칙: include/buf0buf.h 2173–2196행의 주석
정리
| 개념 | 한 줄 요약 |
|---|---|
| 폴더 이름 규칙 | buf0lru.cc = buf 모듈의 LRU 부분. 선언은 include/, 함수 이름도 모듈 이름으로 시작 |
row_prebuilt_t |
InnoDB 쪽에서 본 "열린 테이블 하나". 테이블·인덱스·트랜잭션·영속 커서를 들고 handler 호출마다 따라간다 |
| 페이지 | 16KB. FIL 헤더 38바이트(번호·LSN·종류) + 종류별 내용 + 트레일러 8바이트(체크섬) |
| 인덱스 페이지 | 페이지 헤더, infimum·supremum, 넣은 순서로 쌓인 레코드(키 순서는 next 포인터), 끝에서 자라는 디렉터리 |
| 버퍼 풀 | 서버에 하나. page_hash로 찾고, free·LRU·flush_list 세 목록으로 관리 |
buf_page_get_gen() |
모든 페이지 접근의 입구. 적중이면 고정, 빗나가면 빈 블록을 얻어 읽고, 래치를 잡아 mtr에 적는다 |
| LRU old 구역 | 읽어 온 페이지는 꼬리 쪽 37%에 들어가고, 1초 넘게 지나 다시 써야 올라갈 자격. 기준 커밋에서는 표시만 하고 옮기는 것은 훑는 쪽 |
| page cleaner | 더티 페이지를 쓰는 스레드. 더티 비율이 기준 아래면 쉰다 — 커밋이 페이지 쓰기를 뜻하지 않는다 |
| 클러스터드 인덱스 | 테이블 그 자체. 잎에 모든 열 + DB_TRX_ID·DB_ROLL_PTR. 보조 인덱스 잎은 기본 키를 가리킨다 |
search_leaf() |
루트부터 페이지마다 디렉터리 이진 탐색으로 자식을 골라 잎까지. 래치는 위에서 아래로 갈아 잡는다 |
| 분할 | 루트는 한 층 올리고(번호 그대로), 나머지는 순차 삽입이면 끝에서, 아니면 가운데서 자른다 |
mtr_t |
래치 목록과 redo 기록을 모았다가 commit()에서 redo → 페이지 LSN·flush_list → 래치 풀기 순으로 |
다음에 볼 것
이 글은 행이 어디에 있는지를 봤습니다. 예제 1에서 지나쳐 온 숨은 열 DB_TRX_ID·DB_ROLL_PTR이 다음 글의 출발점입니다. 두 세션이 같은 행을 동시에 읽고 쓸 때 InnoDB가 어떤 판을 보여 주는지(읽기 뷰와 MVCC), 옛 판을 어떻게 만들어 내는지(undo), 언제 기다리게 하는지(행 잠금과 교착 탐지)를 11편: InnoDB 2 — 트랜잭션, MVCC, undo, 잠금에서 봅니다. 6절에서 "12편에서"로 넘긴 do_write()와 LSN, 그리고 page cleaner가 더티 페이지를 미뤄도 되는 이유인 redo 로그와 크래시 복구는 12편: 로그 두 개 — redo 로그와 binlog, 크래시 복구에서 봅니다.
- 2편: 전체 지도 — 서버 계층과 스토리지 엔진, 그리고 쿼리 하나의 일생
- 8편: 옵티마이저 — JOIN::optimize와 실행 계획 고르기 — 예제 4의 상수 테이블 읽기
- 9편: 실행과 handler API — 중첩 루프 조인이 엔진을 부르는 법 — 이 글이 이어받은
ha_innobase::write_row()·index_read()