이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 여덟 번째 글입니다. 7편에서는 권한을 확인하고, 테이블을 열고, JOIN::prepare()가 SQL 속 이름을 실제 테이블과 열에 이어 붙이는 데까지 봤습니다. 이제 서버는 "무엇을 읽어야 하는지"는 압니다. 남은 질문은 "어떻게 읽을 것인가"입니다. 어느 테이블부터 읽을지, 인덱스를 탈지 테이블을 처음부터 끝까지 훑을지 — 이것을 고르는 부품이 옵티마이저입니다.
2편 지도로 말하면 쿼리 하나의 일생 가운데 ⑤ 최적화 칸을 확대합니다.
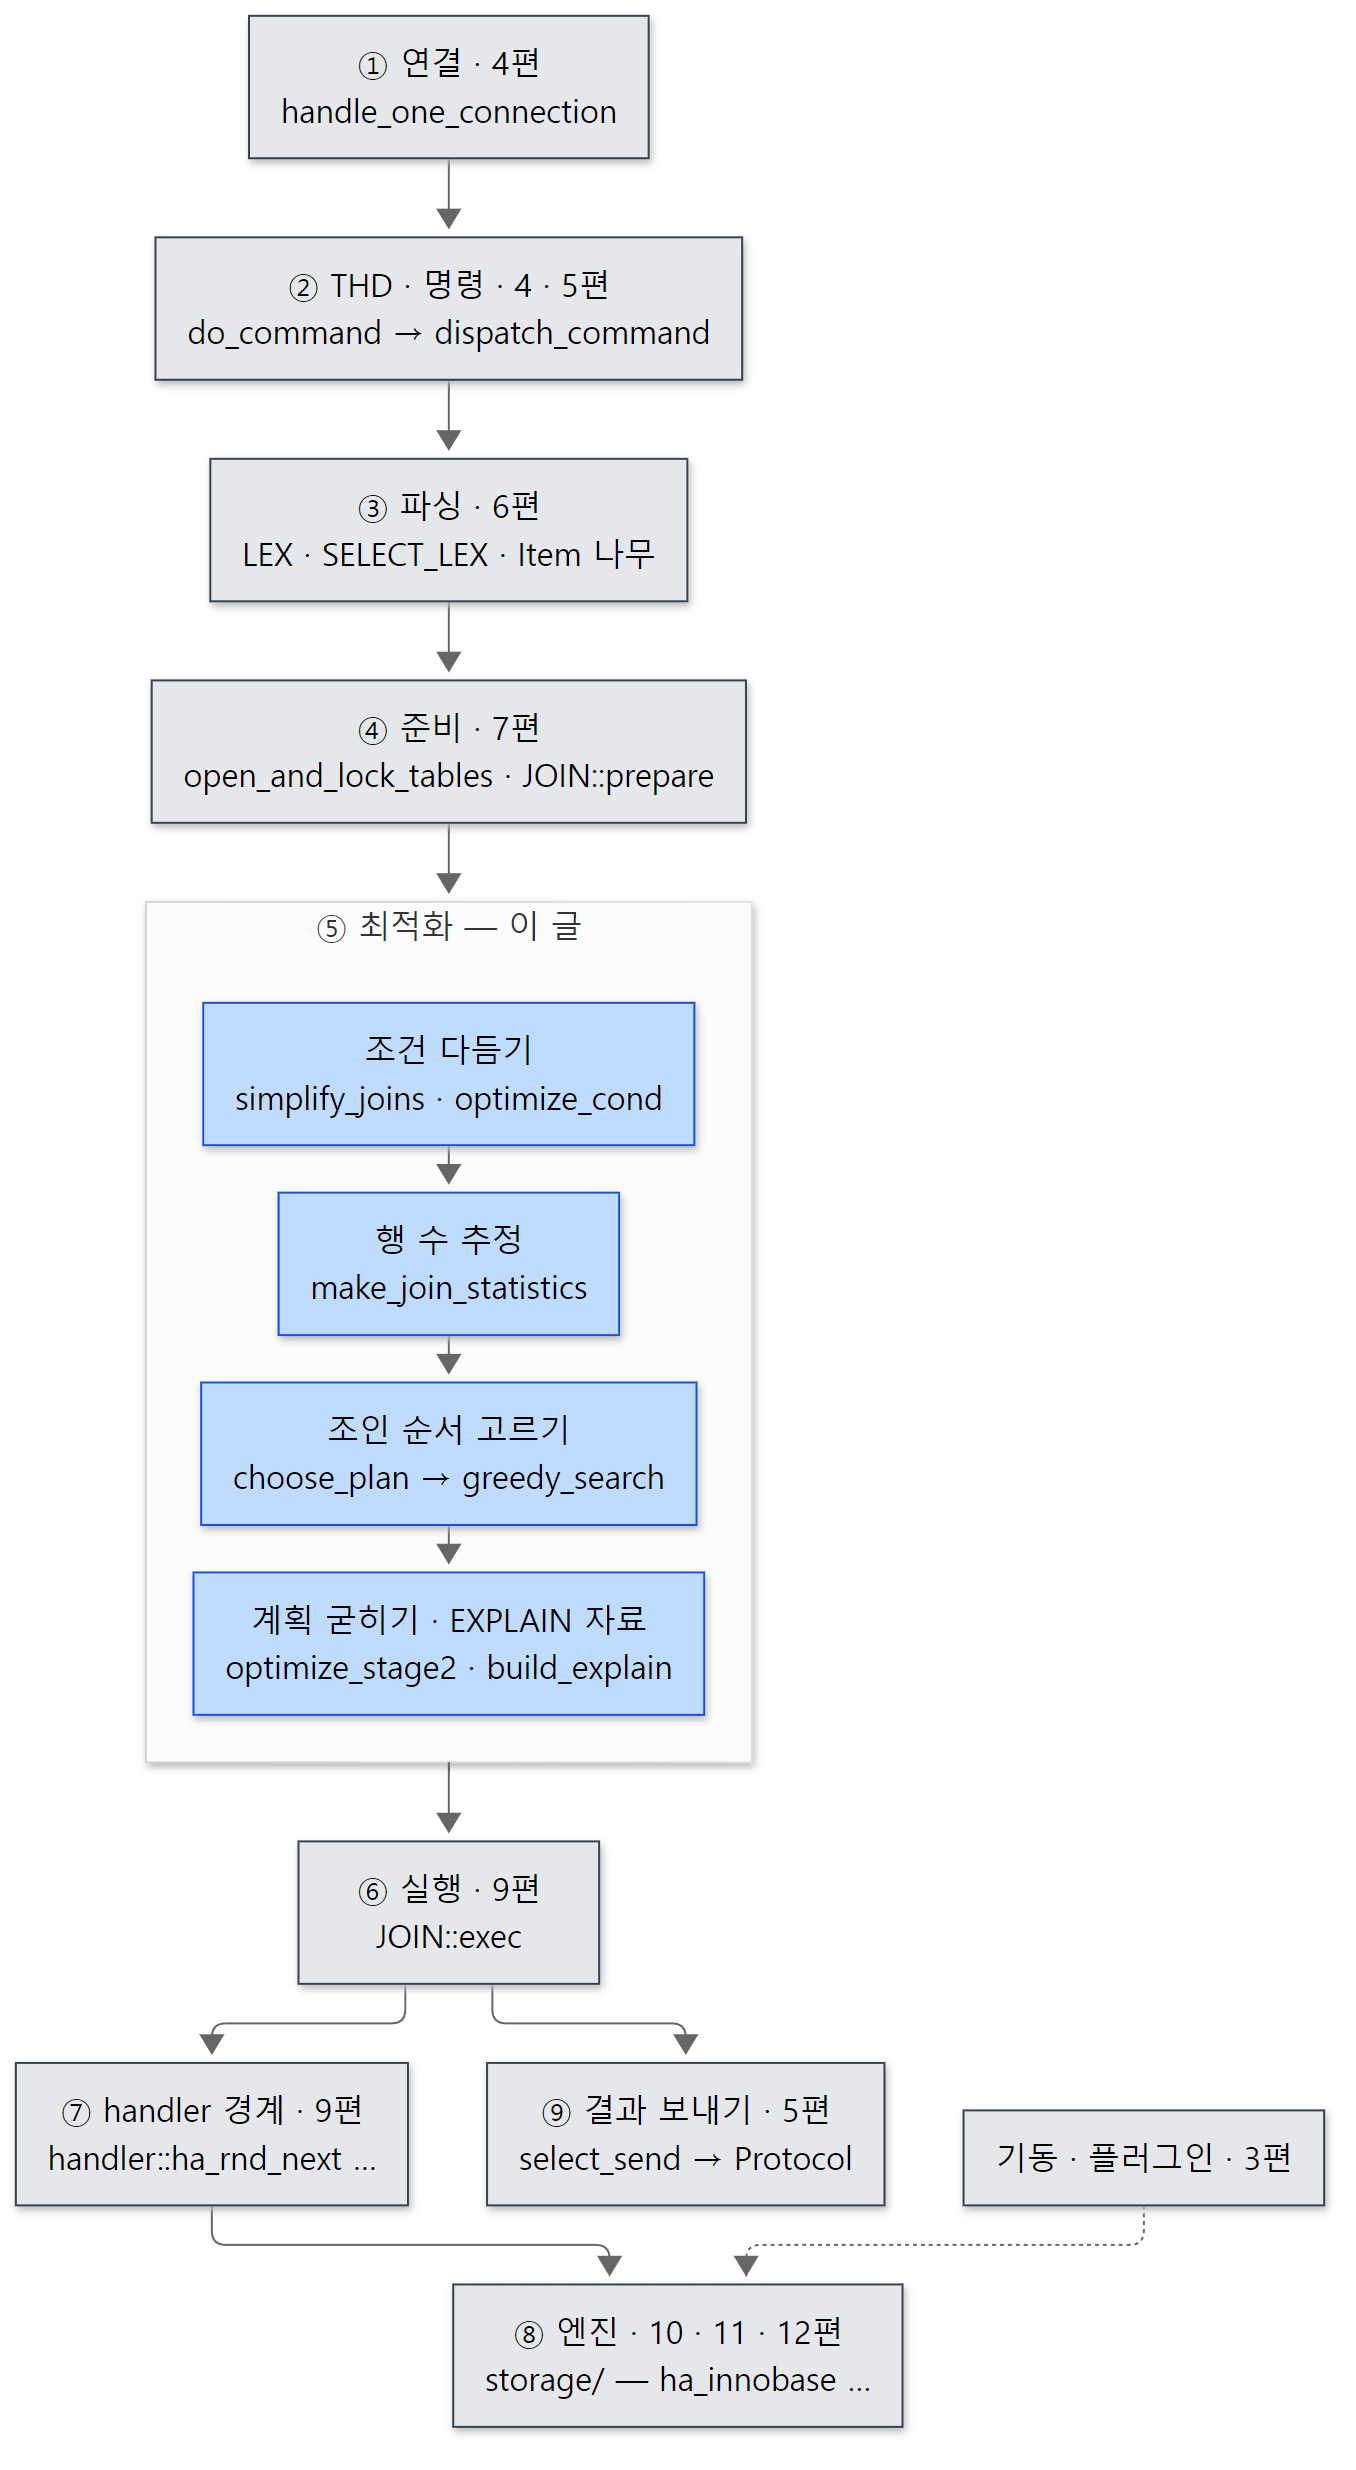 파란 칸이 이 글에서 읽는 곳입니다. 회색 칸은 앞뒤 글에서 봅니다.
답하려는 질문은 네 가지입니다.
EXPLAIN을 치면 서버 안에서 무엇이 돌고, 그 표의type·rows·filtered는 어디서 나오는가- 옵티마이저는 아직 읽지도 않은 테이블의 행 수를 어떻게 아는가 — 엔진 통계, 범위 분석, 히스토그램
- 테이블이 여럿일 때 조인 순서는 어떻게 고르고, 고르지 않은 순서는 어떻게 버리는가
Last_query_cost에 찍히는 "비용"이라는 숫자의 정체는 무엇인가
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | sql/sql_select.cc, sql/opt_range.cc, sql/optimizer_costs.h·optimizer_defaults.h, sql/handler.h, sql/sql_explain.cc, sql/opt_trace.cc |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
sql/sql_select.cc는 36,086줄, 범위 옵티마이저 sql/opt_range.cc는 17,993줄입니다. 서브쿼리 최적화(opt_subselect.cc)만 해도 7,548줄입니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
JOIN (sql/sql_select.h 1478행의 class JOIN)은 SELECT 블록 하나를 실행하는 데 필요한 모든 것을 들고 있는 객체입니다. 이름은 JOIN이지만 테이블이 하나뿐인 SELECT도 JOIN 객체로 돌아갑니다. 7편의 JOIN::prepare()가 준비하고, 이 글의 JOIN::optimize()가 계획을 세우고, 9편의 JOIN::exec()가 실행합니다. 세 단계가 한 객체의 메서드 세 개입니다.
JOIN_TAB (struct st_join_table)은 조인에 참여하는 테이블 하나와 "그 테이블을 어떻게 읽을지"를 묶은 것입니다. EXPLAIN의 한 줄이 JOIN_TAB 하나라고 생각하면 됩니다. EXPLAIN의 type 열(ALL, ref, eq_ref, const …)은 JOIN_TAB::type에 든 enum join_type 값을 글자로 바꾼 것입니다(sql/sql_select.cc 122행의 join_type_str[]).
POSITION (sql/sql_select.h 1248행)은 "조인 순서의 N번째 자리에 이 테이블을 이 방법으로 놓으면" 하는 후보 하나입니다. 읽을 행 수(records_read), WHERE를 거친 뒤 남는 행 수(records_out), 비용(read_time)을 담습니다. JOIN::positions[]가 지금 따져 보는 순서, JOIN::best_positions[]가 지금까지 찾은 가장 좋은 순서입니다.
KEYUSE 는 "t.col = 무엇처럼 인덱스로 찾아갈 수 있는 같음 조건" 하나입니다. WHERE와 ON을 훑어 이것들을 모아 두면(update_ref_and_keys()), 나중에 "이 테이블을 인덱스로 찾아가려면 무엇이 먼저 읽혀 있어야 하나"를 바로 알 수 있습니다.
SEL_TREE와 SEL_ARG 는 범위 옵티마이저가 WHERE를 "인덱스 위의 구간"으로 바꿔 담는 그릇입니다. country = 'KR'은 idx_country 위의 구간 [KR, KR]이 됩니다. 4절에서 봅니다.
비용(cost) 은 옵티마이저가 계획끼리 비교하려고 매기는 점수입니다. 세션 상태 변수 Last_query_cost로 볼 수 있습니다. 이 커밋의 비용은 단위가 정해져 있습니다 — 1이 1밀리초입니다(5절).
const 테이블 은 많아야 한 행만 나오는 것이 확실한 테이블입니다. 옵티마이저는 이런 테이블을 계획을 세우는 도중에 미리 읽어 상수처럼 씁니다(3절).
1. JOIN::optimize() — 큰 줄기
SELECT 하나가 실행되는 길은 2편에서 봤습니다. mysql_select()가 JOIN::prepare()(5432행) → JOIN::optimize()(5447행) → JOIN::exec()(5461행)를 차례로 부릅니다.
EXPLAIN도 같은 길을 갑니다. execute_sqlcom_select()가 lex->describe(EXPLAIN 이면 켜지는 표시)를 보고 mysql_explain_union()을 부르는데, 이 함수가 결국 같은 mysql_select()를 부릅니다(아래 예제 4의 백트레이스에서 확인합니다). 그러니 EXPLAIN이 보여 주는 계획은 실제로 실행할 때와 같은 함수가 세운 계획입니다. 다른 점은 JOIN::exec()에 들어가서 행을 읽는 대신 계획을 찍고 돌아온다는 것뿐입니다(exec_inner()의 SELECT_DESCRIBE 분기, 5114–5120행).
JOIN::optimize() 자체는 짧습니다.
int JOIN::optimize()
{
  int res= 0;
  if (select_lex->pushdown_select)
  // ... (엔진이 SELECT 를 통째로 맡는 select_handler 경우 — 생략)
  else
  {
    // ...
    if (optimization_state != JOIN::NOT_OPTIMIZED)
      return FALSE;
    optimization_state= JOIN::OPTIMIZATION_IN_PROGRESS;
    res= optimize_inner();
  }
  if (!with_two_phase_optimization)
  {
    if (!res && have_query_plan != QEP_DELETED)
      res= build_explain();
    optimization_state= JOIN::OPTIMIZATION_DONE;
  }

  // ...
  if (select_lex->select_number == 1)
    thd->status_var.last_query_cost= best_read;
  return res;
}
세 가지를 읽을 수 있습니다.
- 한 번만 돕니다.
optimization_state가NOT_OPTIMIZED가 아니면 바로 돌아갑니다. 서브쿼리처럼 같은JOIN이 여러 번 불릴 수 있어서 둔 문입니다. - 진짜 일은
optimize_inner()가 합니다. 끝나면build_explain()이 EXPLAIN이 찍을 자료를 따로 만들어 둡니다(8절). Last_query_cost의 정체가 여기 있습니다. 가장 바깥SELECT(select_number == 1)의best_read— 고른 계획의 비용 — 를 세션 상태 변수에 적습니다.
optimize_inner()는 600줄쯤 되는 함수입니다(2230–2809행). 큰 덩어리만 순서대로 적으면 이렇습니다.
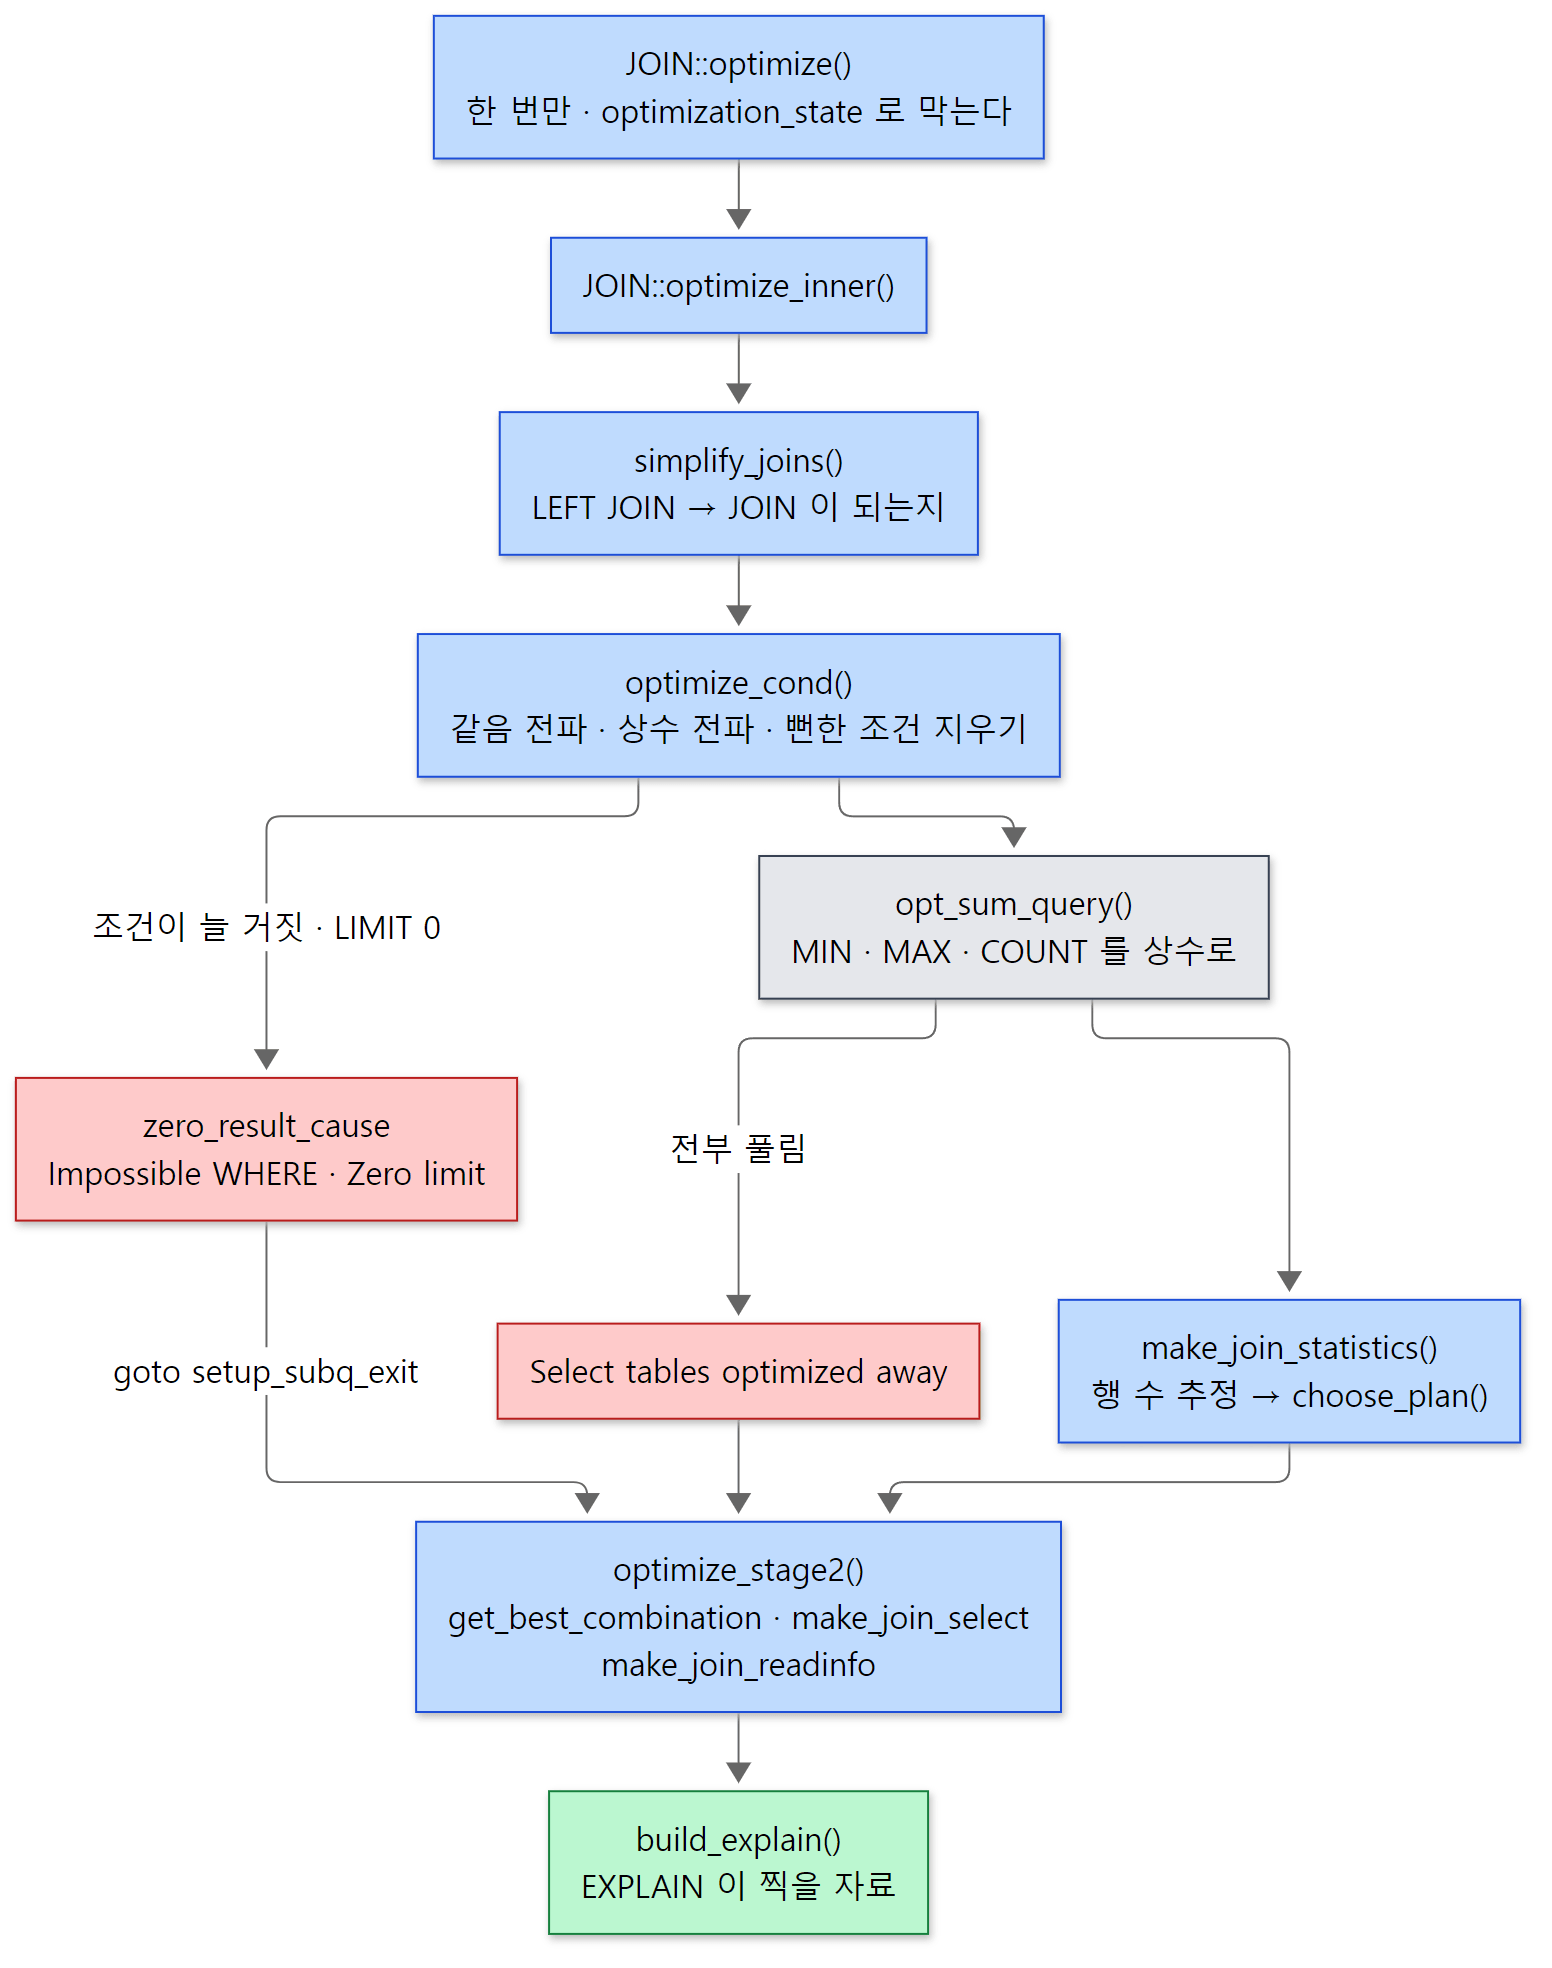 빨간 상자는 테이블을 읽어 볼 필요도 없이 답이 정해지는 지름길입니다.
| 순서 | 하는 일 | 위치 |
|---|---|---|
| 1 | 외부 조인을 내부 조인으로 바꿀 수 있으면 바꾼다 simplify_joins() |
2378행 |
| 2 | WHERE를 다듬는다 optimize_cond() |
2494행 |
| 3 | 조건이 늘 거짓이면 여기서 끝(Impossible WHERE) |
2619–2640행 |
| 4 | 파티션 가지치기 prune_partitions() |
2643–2654행 |
| 5 | MIN()·MAX()·COUNT(*)를 인덱스 끝값이나 통계로 바로 구한다 opt_sum_query() |
2662–2739행 |
| 6 | 행 수를 추정하고 조인 순서를 고른다 make_join_statistics() |
2779행 |
| 7 | 고른 순서대로 JOIN_TAB을 만들고 조건을 테이블마다 나눠 붙인다 optimize_stage2() |
2805행 |
7번 optimize_stage2() 안에서는 get_best_combination()(2839행)이 best_positions[]대로 JOIN_TAB 배열을 만들고, make_join_select()(3091행)가 WHERE를 쪼개 "이 조건은 이 테이블을 읽을 때 검사한다"고 테이블마다 붙이고, make_join_readinfo()(3385행)가 테이블마다 읽기 함수를 정합니다. 읽기 함수가 실제로 불리는 모습은 9편에서 봅니다.
예제 1: EXPLAIN과 Last_query_cost
예제는 고객 1,000명과 주문 20,000건짜리 작은 쇼핑몰 테이블로 합니다. 주문의 약 1%만 status = 'cancelled'입니다. 이 글의 모든 예제가 같은 setup.sql을 씁니다.
-- 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
-- 고객 1,000명과 주문 20,000건. 주문의 약 1%만 'cancelled' 다.
CREATE DATABASE shop;
USE shop;
CREATE TABLE customers (
  id INT PRIMARY KEY,
  name VARCHAR(30),
  country CHAR(2),
  KEY idx_country (country)
) ENGINE=InnoDB;
CREATE TABLE orders (
  id INT PRIMARY KEY,
  customer_id INT NOT NULL,
  status VARCHAR(10) NOT NULL,
  amount INT NOT NULL
) ENGINE=InnoDB;
-- seq_1_to_N 은 SEQUENCE 엔진이 만들어 주는 가상 테이블이다
INSERT INTO customers
  SELECT seq, CONCAT('customer-', seq),
         ELT(1 + seq % 10, 'KR','US','JP','DE','FR','GB','CN','IN','BR','CA')
  FROM seq_1_to_1000;
INSERT INTO orders
  SELECT seq, 1 + seq % 1000, IF(seq % 97 = 0, 'cancelled', 'done'), seq % 500
  FROM seq_1_to_20000;
-- 엔진 통계(InnoDB 의 행 수·인덱스 카디널리티)를 새로 고친다
ANALYZE TABLE customers, orders;
[예제 ex/u08-explain-basics/setup.sql — 네 예제 폴더에 같은 파일이 있습니다]
이 예제와 이 글의 다른 예제는 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 첫 예제는 "한국 고객의 취소된 주문"을 찾는 조인입니다. orders.customer_id에는 아직 인덱스가 없습니다.
EXPLAIN SELECT c.name, o.amount
  FROM customers c JOIN orders o ON o.customer_id = c.id
  WHERE c.country = 'KR' AND o.status = 'cancelled';
-- JOIN::optimize() 가 best_read 를 여기에 남긴다
SHOW SESSION STATUS LIKE 'Last_query_cost';
+------+-------------+-------+--------+---------------------+---------+---------+--------------------+-------+-------------+
 id   | select_type | table | type   | possible_keys       | key     | key_len | ref                | rows  | Extra       |
+------+-------------+-------+--------+---------------------+---------+---------+--------------------+-------+-------------+
    1 | SIMPLE      | o     | ALL    | NULL                | NULL    | NULL    | NULL               | 19982 | Using where |
    1 | SIMPLE      | c     | eq_ref | PRIMARY,idx_country | PRIMARY | 4       | shop.o.customer_id | 1     | Using where |
+------+-------------+-------+--------+---------------------+---------+---------+--------------------+-------+-------------+
+-----------------+-----------+
 Variable_name   | Value     |
+-----------------+-----------+
 Last_query_cost | 21.226778 |
+-----------------+-----------+
SQL에는 customers를 먼저 적었지만 옵티마이저는 orders를 먼저 훑고(ALL), 주문마다 customers를 기본 키로 한 번씩 찾아가는(eq_ref) 순서를 골랐습니다. orders.customer_id에 인덱스가 없으니 orders는 어느 순서든 통째로 훑어야 하고, 그렇다면 orders를 먼저 훑으며 customers를 기본 키로 찾아가는 쪽이 싸다고 계산한 것입니다(계산은 5·6절에서 따라갑니다). rows의 19982는 InnoDB가 추정한 행 수입니다(실제는 20,000 — 3절).
같은 계획을 EXPLAIN FORMAT=JSON으로 보면 테이블마다의 비용이 나옵니다(같은 예제의 6번 출력, c의 키 정보 몇 줄을 ...로 줄였습니다).
{
  "query_block": {
    "select_id": 1,
    "cost": 21.22677768,
    "nested_loop": [
      {
        "table": {
          "table_name": "o",
          "access_type": "ALL",
          "loops": 1,
          "rows": 19982,
          "cost": 3.3499816,
          "filtered": 100,
          "attached_condition": "o.`status` = 'cancelled'"
        }
      },
      {
        "table": {
          "table_name": "c",
          "access_type": "eq_ref",
          ...
          "loops": 19982,
          "rows": 1,
          "cost": 17.87679608,
          "filtered": 10,
          "attached_condition": "c.country = 'KR'"
        }
      }
    ]
  }
}
o를 훑는 데 3.35, c를 19,982번(loops) 찾아가는 데 17.88, 더하면 query_block의 21.23이고 이것이 Last_query_cost입니다. 비용의 대부분이 "찾아가는 횟수"에서 나온다는 점을 기억해 두세요. 7절에서 계획이 바뀌는 이유가 바로 이것입니다. 그리고 o의 "filtered": 100 — 옵티마이저는 status = 'cancelled'가 행을 하나도 거르지 못한다고 보고 있습니다. 이것도 7절에서 다시 봅니다.
"attached_condition"이 테이블마다 따로 붙어 있는 것이 위에서 말한 make_join_select()의 결과입니다. c.country = 'KR'은 c를 읽을 때, o.status = 'cancelled'는 o를 읽을 때 검사합니다.
헷갈리기 쉬운 곳: EXPLAIN의 rows는 "결과 행 수"가 아닙니다
rows는 그 테이블을 그 접근 방법으로 한 번 읽을 때 읽게 될 행 수의 추정치입니다. 앞 테이블의 행마다 되풀이되므로 실제로 읽는 양은 앞 테이블의 행 수를 곱해야 합니다(JSON의 loops). 그리고 WHERE에 걸러지기 전 숫자입니다. 걸러진 뒤 남는 비율은 filtered가 따로 보여 줍니다. 소스에서 best_access_path()가 고른 방법을 적을 때 주석이 이것을 분명히 합니다 — "EXPLAIN 이 키 접근으로 찾은 행 수를 찍게 하려고 records_after_filter가 아니라 records를 쓴다"(9786–9790행).
2. 조건 다듬기 — optimize_cond()와 simplify_joins()
행 수를 세기 전에 옵티마이저는 WHERE부터 다듬습니다. 같은 뜻이면 더 다루기 쉬운 모양으로, 늘 참이거나 늘 거짓인 조각은 지워서. 이 일을 optimize_cond()가 합니다.
    conds= build_equal_items(join, conds, NULL, join_list,
                             ignore_on_conds, cond_equal,
                             MY_TEST(flags & OPT_LINK_EQUAL_FIELDS));
    // ... (추적에 equality_propagation 을 남긴다)
    /* change field = field to field = const for each found field = const */
    propagate_cond_constants(thd, (I_List<COND_CMP> *) 0, conds, conds);
    /*
      Remove all instances of item == item
      Remove all and-levels where CONST item != CONST item
    */
    // ... (추적에 constant_propagation 을 남긴다)
    conds= conds->remove_eq_conds(thd, cond_value, true);
    if (conds && conds->type() == Item::COND_ITEM &&
        ((Item_cond*) conds)->functype() == Item_func::COND_AND_FUNC)
      *cond_equal= &((Item_cond_and*) conds)->m_cond_equal;
sql/sql_select.cc 21080–21110행
세 단계이고, 각 단계가 끝날 때마다 optimizer_trace에 이름을 남깁니다(6절의 예제 3에서 그대로 보입니다).
- 같음 전파 (
build_equal_items()).o.customer_id = c.id AND c.id = 5처럼 같음으로 이어진 열과 상수를Item_equal하나로 묶습니다. 추적에는multiple equal(o.customer_id, c.id)처럼 찍힙니다. 이렇게 묶어 두면 "o.customer_id도 5다"를 따로 적지 않아도 압니다.Item은 6편에서 본 조건 나무의 마디입니다. - 상수 전파 (
propagate_cond_constants()).열 = 상수를 알면 그 열이 나오는 다른 곳에 상수를 넣습니다. - 뻔한 조건 지우기 (
remove_eq_conds()).1 = 1처럼 늘 참인 조각은 지우고, 늘 거짓이면 결과를cond_value에COND_FALSE로 알려 줍니다.
COND_FALSE가 나오면 optimize_inner()는 테이블을 하나도 읽지 않고 끝냅니다(2619–2640행). 이때 zero_result_cause에 "Impossible WHERE"를, LIMIT 0이면 "Zero limit"을 적는데, 이 글자가 그대로 EXPLAIN의 Extra에 나옵니다. 같은 함수에서 opt_sum_query()가 MIN()·MAX()·COUNT(*)를 테이블 없이 풀어 버리면 "Select tables optimized away"가 적힙니다(2710행).
예제 1(이어서): 테이블을 읽기도 전에 답이 나오는 쿼리
EXPLAIN SELECT * FROM customers WHERE id = 5 AND id = 6;
EXPLAIN SELECT MIN(id), MAX(id) FROM orders;
EXPLAIN SELECT * FROM customers WHERE country = 'KR' LIMIT 0;
+------+-------------+-------+------+---------------+------+---------+------+------+------------------+
 id   | select_type | table | type | possible_keys | key  | key_len | ref  | rows | Extra            |
+------+-------------+-------+------+---------------+------+---------+------+------+------------------+
    1 | SIMPLE      | NULL  | NULL | NULL          | NULL | NULL    | NULL | NULL | Impossible WHERE |
+------+-------------+-------+------+---------------+------+---------+------+------+------------------+
+------+-------------+-------+------+---------------+------+---------+------+------+------------------------------+
 id   | select_type | table | type | possible_keys | key  | key_len | ref  | rows | Extra                        |
+------+-------------+-------+------+---------------+------+---------+------+------+------------------------------+
    1 | SIMPLE      | NULL  | NULL | NULL          | NULL | NULL    | NULL | NULL | Select tables optimized away |
+------+-------------+-------+------+---------------+------+---------+------+------+------------------------------+
+------+-------------+-------+------+---------------+------+---------+------+------+------------+
 id   | select_type | table | type | possible_keys | key  | key_len | ref  | rows | Extra      |
+------+-------------+-------+------+---------------+------+---------+------+------+------------+
    1 | SIMPLE      | NULL  | NULL | NULL          | NULL | NULL    | NULL | NULL | Zero limit |
+------+-------------+-------+------+---------------+------+---------+------+------+------------+
id = 5 AND id = 6은 같음 전파에서 id가 5이면서 6이어야 하는 Item_equal이 되어 늘 거짓으로 판정됩니다. table이 NULL — 계획에 테이블이 하나도 없습니다. MIN(id)·MAX(id)는 기본 키 B-트리의 양 끝을 한 번씩 보면 되므로 옵티마이저 단계에서 값까지 구해 둡니다.
LEFT JOIN이 JOIN이 되는 곳
simplify_joins()는 외부 조인을 내부 조인으로 바꿀 수 있는지 봅니다. 핵심은 이 조건문입니다.
    if (!(table->outer_join & (JOIN_TYPE_LEFT | JOIN_TYPE_RIGHT)) ||
        (used_tables & not_null_tables))
    {
      /*
        For some of the inner tables there are conjunctive predicates
        that reject nulls => the outer join can be replaced by an inner join.
      */
      if (table->outer_join && !table->embedding && table->table)
        table->table->maybe_null= FALSE;
      table->outer_join= 0;
sql/sql_select.cc 20248–20257행
not_null_tables는 "이 WHERE가 참이 되려면 NULL이면 안 되는 테이블들"입니다. LEFT JOIN orders o … WHERE o.status = 'cancelled'라면, o가 짝을 못 찾아 NULL로 채워진 행은 o.status = 'cancelled'가 참일 수 없으므로 어차피 버려집니다. 그러면 LEFT JOIN으로 남겨 둘 이유가 없습니다. outer_join= 0으로 내부 조인이 되고, 바로 아래에서 ON 조건을 WHERE에 and_conds()로 합칩니다(20273–20287행).
EXPLAIN EXTENDED SELECT c.name, o.amount
  FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
  WHERE o.status = 'cancelled';
SHOW WARNINGS;
+------+-------------+-------+--------+---------------+---------+---------+--------------------+-------+----------+-------------+
 id   | select_type | table | type   | possible_keys | key     | key_len | ref                | rows  | filtered | Extra       |
+------+-------------+-------+--------+---------------+---------+---------+--------------------+-------+----------+-------------+
    1 | SIMPLE      | o     | ALL    | NULL          | NULL    | NULL    | NULL               | 19982 |   100.00 | Using where |
    1 | SIMPLE      | c     | eq_ref | PRIMARY       | PRIMARY | 4       | shop.o.customer_id | 1     |   100.00 |             |
+------+-------------+-------+--------+---------------+---------+---------+--------------------+-------+----------+-------------+
+-------+------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
 Level | Code | Message                                                                                                                                                                                                        |
+-------+------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
 Note  | 1003 | select `shop`.`c`.`name` AS `name`,`shop`.`o`.`amount` AS `amount` from `shop`.`customers` `c` join `shop`.`orders` `o` where `shop`.`c`.`id` = `shop`.`o`.`customer_id` and `shop`.`o`.`status` = 'cancelled' |
+-------+------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
SHOW WARNINGS의 Note는 옵티마이저가 다듬은 뒤의 쿼리를 다시 찍은 것입니다(6편). left join이 join으로, ON 조건이 where로 옮겨 갔습니다. 그리고 계획에서 o가 앞에 왔습니다. LEFT JOIN이었다면 o는 c에 매달린 테이블이라 c보다 먼저 읽을 수 없습니다(dep_tables). 내부 조인이 되면서 그 제약이 풀려 1절의 첫 예제와 같은 순서를 고를 수 있게 된 것입니다.
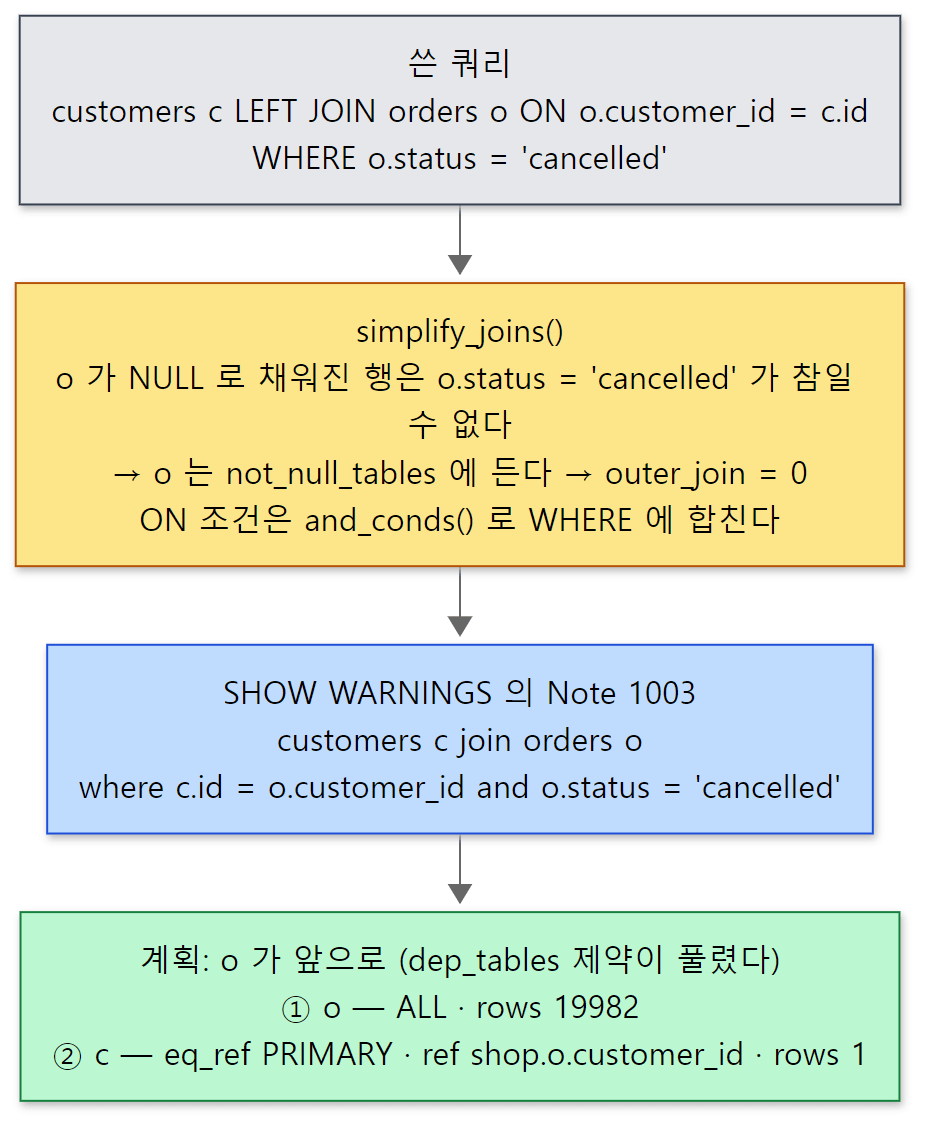 WHERE 에 쓴 오른쪽 테이블 조건 하나가 LEFT JOIN 을 JOIN 으로 바꾸고, 그 덕분에 조인 순서도 바뀝니다. 쿼리와 계획은 위 예제의 실제 출력입니다.
헷갈리기 쉬운 곳: WHERE에 쓴 오른쪽 테이블 조건
애플리케이션 코드에서 흔한 실수가 이 모양입니다. "취소 주문이 없는 고객도 보여 주려고" LEFT JOIN을 썼는데 필터를 WHERE에 걸면, 위처럼 서버가 조용히 내부 조인으로 바꿉니다. 결과가 틀린 게 아니라 SQL이 원래 그런 뜻이기 때문입니다. 짝 없는 고객까지 남기려면 조건을 ON o.customer_id = c.id AND o.status = 'cancelled'처럼 ON에 넣어야 합니다. EXPLAIN EXTENDED + SHOW WARNINGS로 left join이 살아 있는지 확인하는 습관이 도움이 됩니다.
3. 행 수 세기 — make_join_statistics()
조건이 정리되면 make_join_statistics()(5670행부터 약 800줄)가 테이블마다 "몇 행을 읽게 될까"를 추정하고, 마지막에 조인 순서 탐색(choose_plan())을 부릅니다.
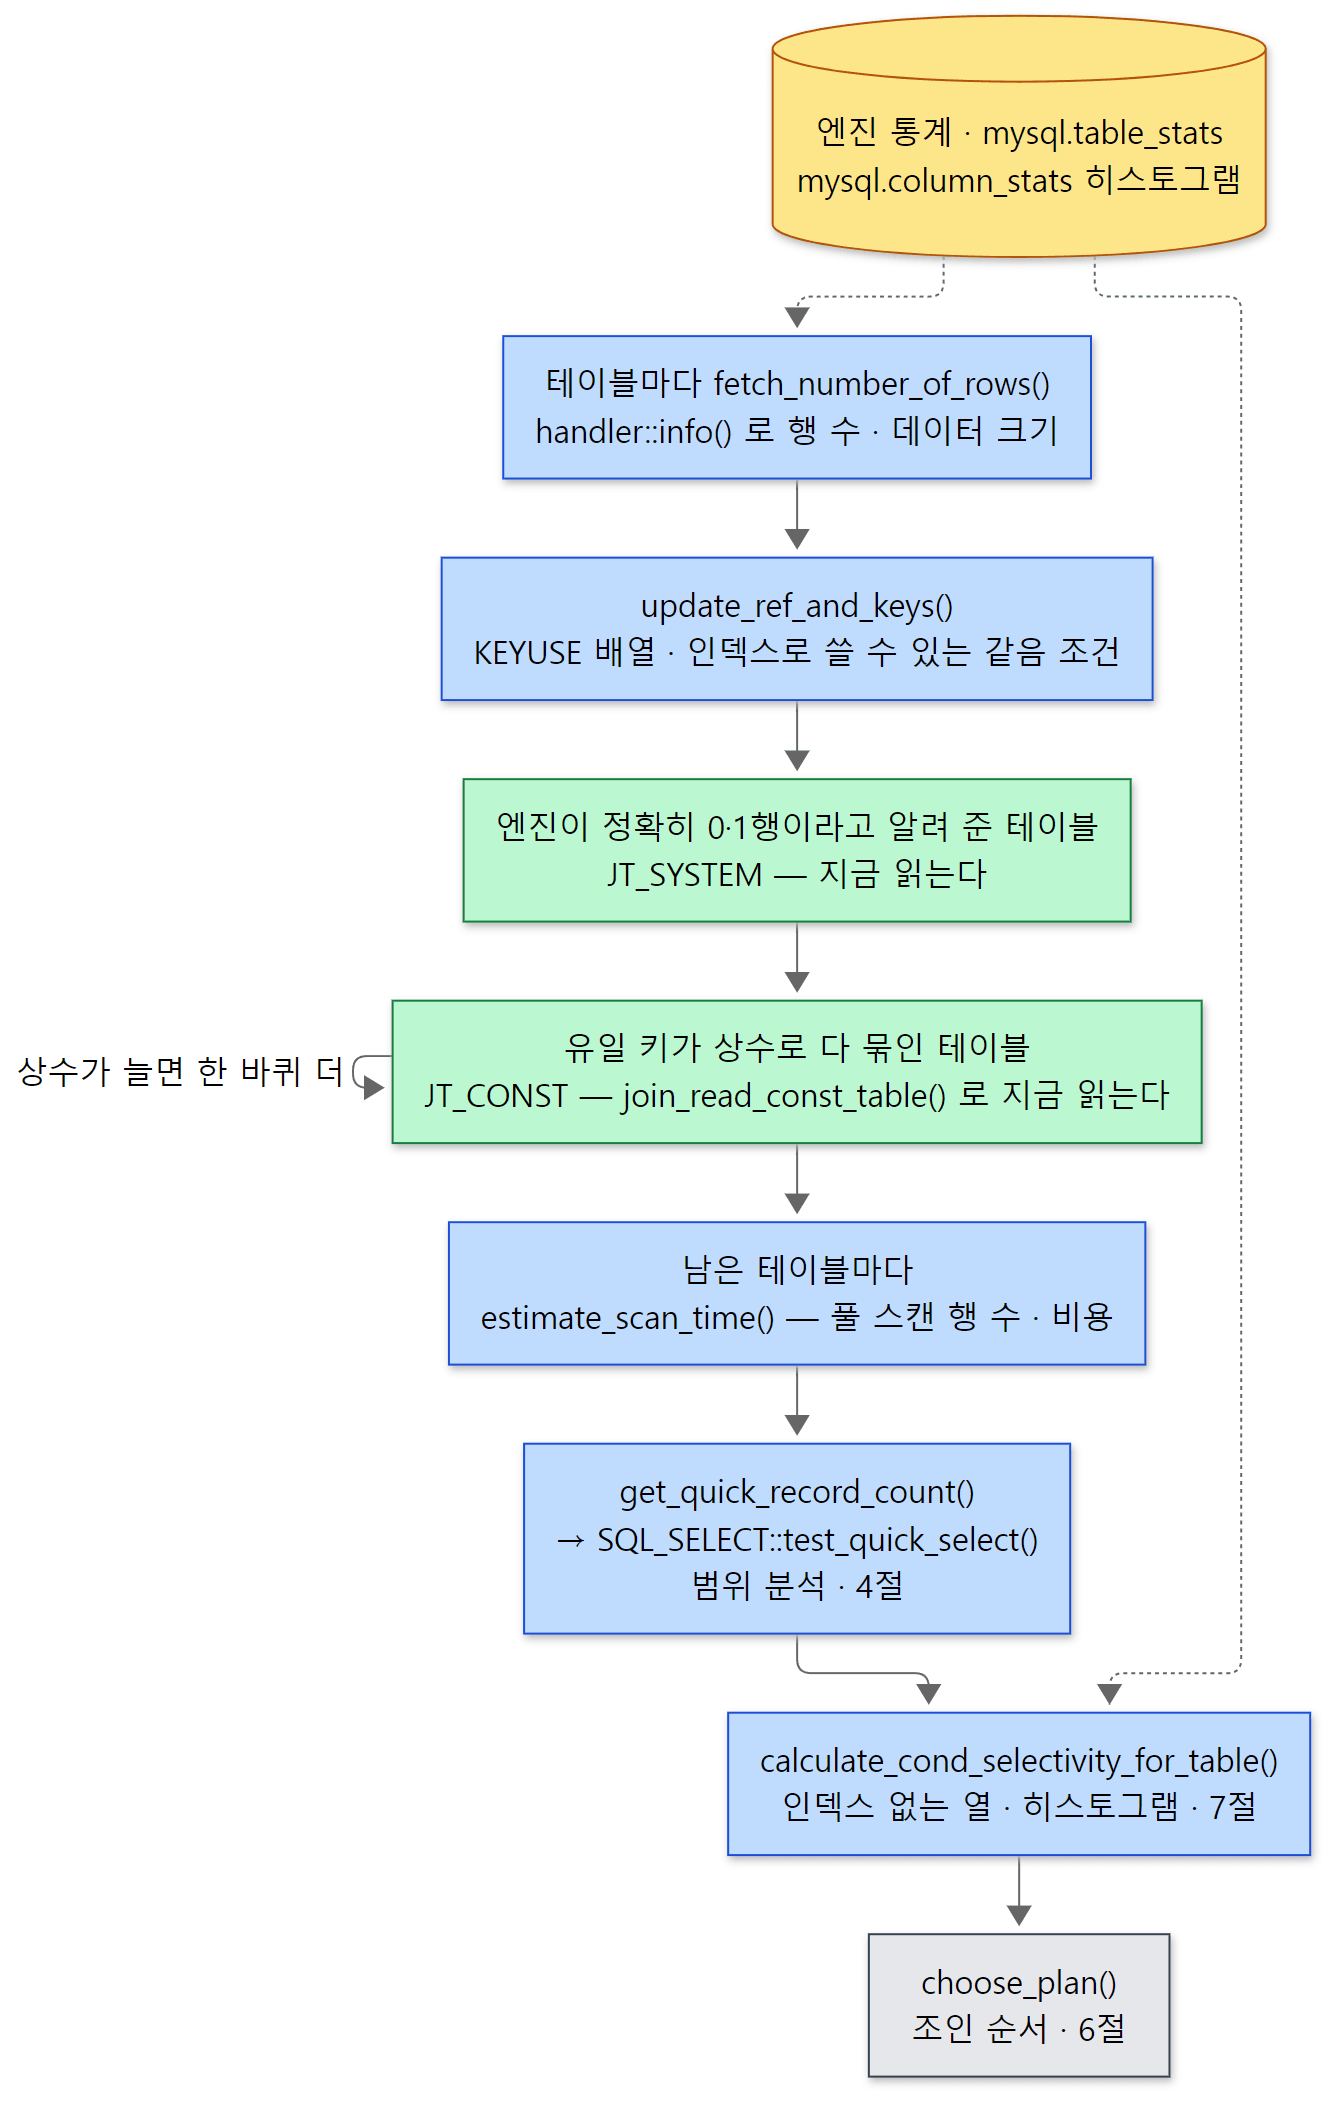 초록 상자 둘은 계획을 세우는 도중에 테이블을 실제로 읽는 곳입니다.
엔진에게 묻는 행 수
첫 단계는 엔진에게 테이블 크기를 묻는 것입니다. TABLE_LIST::fetch_number_of_rows()는 보통의 테이블이면 handler::info()를 부릅니다.
  if (is_materialized_derived() && !fill_me)
  {
    table->file->stats.records= get_unit()->result->est_records;
    set_if_bigger(table->file->stats.records, 2);
    table->used_stat_records= table->file->stats.records;
  }
  else
    error= table->file->info(HA_STATUS_VARIABLE | HA_STATUS_NO_LOCK);
  return error;
handler::info()는 엔진마다 구현하는 가상 함수입니다(2편의 handler). HA_STATUS_VARIABLE은 "행 수·데이터 크기처럼 자주 바뀌는 값"을 채워 달라는 뜻이고, InnoDB는 ha_innobase::info()(ha_innodb.cc 15508행)에서 자기 통계로 stats.records를 채웁니다. information_schema.TABLES의 TABLE_ROWS도 같은 값을 보여 줍니다(예제 2의 0번에서 orders가 19982로 나옵니다). InnoDB의 행 수는 통계로 어림한 추정치라서 실제 20,000과 조금 다릅니다.
const 테이블 — 계획을 세우다가 읽어 버린다
다음은 const 테이블 찾기입니다. 유일 인덱스(기본 키나 UNIQUE)의 모든 열이 상수와 같다고 묶여 있으면 결과는 많아야 한 행입니다. 옵티마이저는 이 테이블을 JT_CONST로 정하고 그 자리에서 읽습니다.
              if (base_const_ref == base_eq_part &&
                  !has_expensive_keyparts &&
                  !((outer_join & table->map) &&
                    (*s->on_expr_ref)->is_expensive()))
              {                                 // Found everything for ref.
                int tmp;
                ref_changed = 1;
                s->type= JT_CONST;
                join->const_table_map|=table->map;
                set_position(join,const_count++,s,start_keyuse);
                // ... (create_ref_for_key() — 찾아갈 키 값을 준비한다)
                if ((tmp=join_read_const_table(join->thd, s,
                                               join->positions+const_count-1)))
                {
                  if (tmp > 0)
                    goto error;                 // Fatal error
                }
                else
                  found_const_table_map|= table->map;
join_read_const_table()이 실제로 엔진에서 한 행을 읽는 함수입니다(25986행). 읽은 행의 값은 그 뒤로 상수처럼 쓰이므로, 이 테이블과 이어진 다른 테이블의 조건이 다시 "열 = 상수"가 될 수 있습니다. 그래서 const 찾기는 새 const 테이블이 더 나오지 않을 때까지 되풀이됩니다(5927–6101행의 do { … } while (ref_changed)). enum join_type의 JT_CONST 주석도 "최적화하는 동안 정확한 키 조회 한 번으로 그 행을 가져온다"고 적어 두었습니다(sql/sql_select.h 223–236행).
예제 1(이어서): EXPLAIN만 했는데 엔진을 읽었다
FLUSH STATUS;
EXPLAIN SELECT * FROM customers WHERE id = 5;
-- EXPLAIN 만 했는데 엔진에서 한 번 읽었다
SHOW SESSION STATUS LIKE 'Handler_read_key';
+------+-------------+-----------+-------+---------------+---------+---------+-------+------+-------+
 id   | select_type | table     | type  | possible_keys | key     | key_len | ref   | rows | Extra |
+------+-------------+-----------+-------+---------------+---------+---------+-------+------+-------+
    1 | SIMPLE      | customers | const | PRIMARY       | PRIMARY | 4       | const | 1    |       |
+------+-------------+-----------+-------+---------------+---------+---------+-------+------+-------+
+------------------+-------+
 Variable_name    | Value |
+------------------+-------+
 Handler_read_key | 1     |
+------------------+-------+
Handler_read_key는 handler가 인덱스로 한 행을 찾을 때마다 1씩 늘어나는 상태 변수입니다(9편). FLUSH STATUS로 0으로 만든 뒤 EXPLAIN만 했는데 1이 되었습니다. const 테이블은 실행이 아니라 최적화 단계에서 이미 읽혔다는 뜻입니다.
헷갈리기 쉬운 곳: "system"은 InnoDB에서 거의 안 보입니다
EXPLAIN의 type에는 const보다 더 강한 system(행이 0개나 1개뿐인 테이블)도 있습니다. 그런데 보통의 테이블이라면 이것은 엔진이 정확한 행 수를 알려 줄 때만 고릅니다 — 조건이 table->file->stats.records <= 1 && (ha_table_flags() & HA_STATS_RECORDS_IS_EXACT)입니다(5828–5832행. 같은 조건에 파티션이 모두 잘려 나간 경우 같은 드문 예외도 함께 있습니다). 이 깃발은 MyISAM(ha_myisam.cc 731행)과 Aria(ha_maria.cc 1003행)에는 있고 InnoDB에는 없습니다. 예제 1의 2b번에서 행이 하나뿐인 테이블을 엔진만 바꿔 EXPLAIN하면 그대로 갈립니다.
|    1 | SIMPLE      | one_innodb | ALL  | NULL          | NULL | NULL    | NULL | 1    |       |
    1 | SIMPLE      | one_myisam | system | NULL          | NULL | NULL    | NULL | 1    |       |
(두 EXPLAIN 표의 데이터 줄만 옮겼습니다.)
남은 테이블마다: 풀 스캔, 범위, 선택도
const가 아닌 테이블마다 세 가지를 구합니다.
      if ((!s->const_keys.is_clear_all() ||                            // (1)
           !bitmap_is_clear_all(&s->table->cond_set) ||                // (2)
           thd->variables.optimizer_use_condition_selectivity >= 5) && // (3)
          !s->table->is_filled_at_execution() &&                       // (4)
          !(s->table->pos_in_table_list->derived &&                    // (5)
            s->table->pos_in_table_list->is_materialized_derived()))   // (5)
      // ... (WHERE 로 SQL_SELECT 를 만든다)
          if (get_quick_record_count(join->thd, select, s->table,
                                     &s->const_keys, join->row_limit, &records))
- 풀 스캔의 행 수와 비용 — 위 발췌 바로 앞의
s->estimate_scan_time()(6216행, 정의는 17123행). 어떤 계획이든 "처음부터 끝까지 훑기"는 늘 할 수 있으므로 이것이 기준점입니다. - 범위 분석 — WHERE에 인덱스 열의 조건이 있으면(
const_keys)get_quick_record_count()→SQL_SELECT::test_quick_select()로 "인덱스로 좁히면 몇 행인가"를 구합니다. 4절의 주제입니다. - 조건 선택도 —
optimizer_use_condition_selectivity가 1보다 크면calculate_cond_selectivity_for_table()(6294행)이 인덱스가 없는 열의 조건까지 "몇 %가 남을까"를 셉니다. 히스토그램은 여기서 쓰입니다(7절).
update_ref_and_keys()(7756행)가 만든 KEYUSE 배열은 이 단계에서는 const 찾기에만 쓰이고, 진짜 쓰임새는 다음 단계의 조인 순서 탐색입니다. "앞 테이블이 읽혀 있으면 이 인덱스로 찾아갈 수 있다"는 정보가 ref·eq_ref 후보가 됩니다.
4. 범위 옵티마이저 — WHERE를 인덱스 위의 구간으로
sql/opt_range.cc의 SQL_SELECT::test_quick_select()는 테이블 하나에 대해 "인덱스 위의 구간으로 읽으면 얼마나 싼가"를 계산합니다. 먼저 하는 일은 넘어야 할 기준선을 정하는 것입니다.
  if (head->force_index || force_quick_range)
  {
    DEBUG_SYNC(thd, "in_forced_range_optimize");
    read_time= DBL_MAX;
  }
  else
  {
    read_time= file->cost(file->ha_scan_and_compare_time(records));
    if (limit < records)
      notnull_cond= nullptr;
  }
풀 스캔 비용이 read_time이 되고, 이 아래로 내려오는 범위 계획만 채택됩니다. FORCE INDEX를 썼다면 기준선을 무한대(DBL_MAX)로 둬서 어떤 범위 계획이든 이기게 만듭니다. 기준선을 정한 다음 WHERE를 구간으로 바꿉니다.
if (cond)
tree= cond->get_mm_tree(¶m, &cond);
if (notnull_cond_tree)
tree= tree_and(¶m, tree, notnull_cond_tree);
// ... (SEL_ARG 개수 한도 추적 등)
if (tree->type == SEL_TREE::IMPOSSIBLE)
{
records=0L;
returnval= IMPOSSIBLE_RANGE;
get_mm_tree()는 Item 나무의 가상 함수입니다. 마디의 종류마다 따로 구현되어 있고, 나무를 따라 내려가며 SEL_TREE를 짜 맞춥니다. AND 마디는 자식들의 결과를 tree_and()로 겹칩니다.
SEL_TREE *Item_cond_and::get_mm_tree(RANGE_OPT_PARAM *param, Item **cond_ptr)
{
  DBUG_ENTER("Item_cond_and::get_mm_tree");
  SEL_TREE *tree= NULL;
  List_iterator<Item> li(*argument_list());
  Item *item;
  while ((item= li++))
  {
    SEL_TREE *new_tree= li.ref()[0]->get_mm_tree(param,li.ref());
    if (param->statement_should_be_aborted())
      DBUG_RETURN(NULL);
    tree= tree_and(param, tree, new_tree);
    if (tree && tree->type == SEL_TREE::IMPOSSIBLE)
    {
      // ... (IMPOSSIBLE 이면 그대로 돌려준다)
      break;
    }
  }
  DBUG_RETURN(tree);
OR 마디(Item_cond::get_mm_tree(), 8935행)는 tree_or()로 합칩니다. 맨 아래의 country = 'KR' 같은 비교(Item_bool_func2 계열, sql/item_cmpfunc.h)가 실제 구간 하나, 곧 SEL_ARG를 만듭니다. 결과물 SEL_TREE(247행)는 type(IMPOSSIBLE, ALWAYS, MAYBE, KEY, KEY_SMALLER)과 인덱스마다의 구간 배열 keys를 가집니다. keys[i]가 인덱스 i 위의 구간들(SEL_ARG의 그래프)입니다. 구간이 서로 겹치지 않게 정렬해 두려고 SEL_ARG는 레드-블랙 트리의 마디이기도 하고(left, right, color), 여러 열짜리 인덱스의 다음 열 구간은 next_key_part로 이어집니다(sql/opt_range.h 323행부터). type이 IMPOSSIBLE이면 "이 조건을 만족하는 행은 없다"는 뜻이고, 그러면 test_quick_select()는 행 수 0과 IMPOSSIBLE_RANGE를 돌려줍니다(2993–2997행). WHERE id > 10 AND id < 5 같은 쿼리가 테이블을 읽지 않고 끝나는 길입니다.
구간이 생기면 인덱스마다 비용을 따집니다. get_key_scans_params()(3036행에서 부른다)가 인덱스마다 check_quick_select()를 부르고, 그 안에서 엔진에게 "이 구간에 몇 행이 있나"를 묻습니다. 결과가 기준선보다 싸면 best_read_time이 그 값으로 내려갑니다(3040–3043행).
엔진에게 묻는 곳은 handler::multi_range_read_info_const()입니다. 구간 하나마다 경우를 셋으로 나눕니다.
    if ((range.range_flag & UNIQUE_RANGE) && !(range.range_flag & NULL_RANGE))
    {
      rows= 1;
      // ...
      single_point_ranges++;
    }
    else if (use_statistics_for_eq_range &&
             // ... (rec_per_key 로 어림)
    }
    else
    {
      page_range pages= unused_page_range;
      if ((rows= this->records_in_range(keyno, min_endp, max_endp, &pages)) ==
sql/multi_range_read.cc 219–247행
- 유일 인덱스의 한 점(
id = 5)이면 묻지 않고 1행입니다. - 같음 구간이 아주 많으면(
IN (…)에 값이eq_range_index_dive_limit개, 기본 200개 이상이면 — 186–189행과opt_range.cc17273행의eq_ranges_exceeds_limit()) 인덱스 통계의 "키 값 하나당 평균 행 수"(rec_per_key)로 대신합니다. - 나머지는 엔진의
records_in_range()를 부릅니다. InnoDB는btr_estimate_n_rows_in_range()(ha_innodb.cc14716행)로 B-트리를 실제로 내려가 구간의 양 끝 사이에 행이 몇 개쯤 있는지 셉니다.
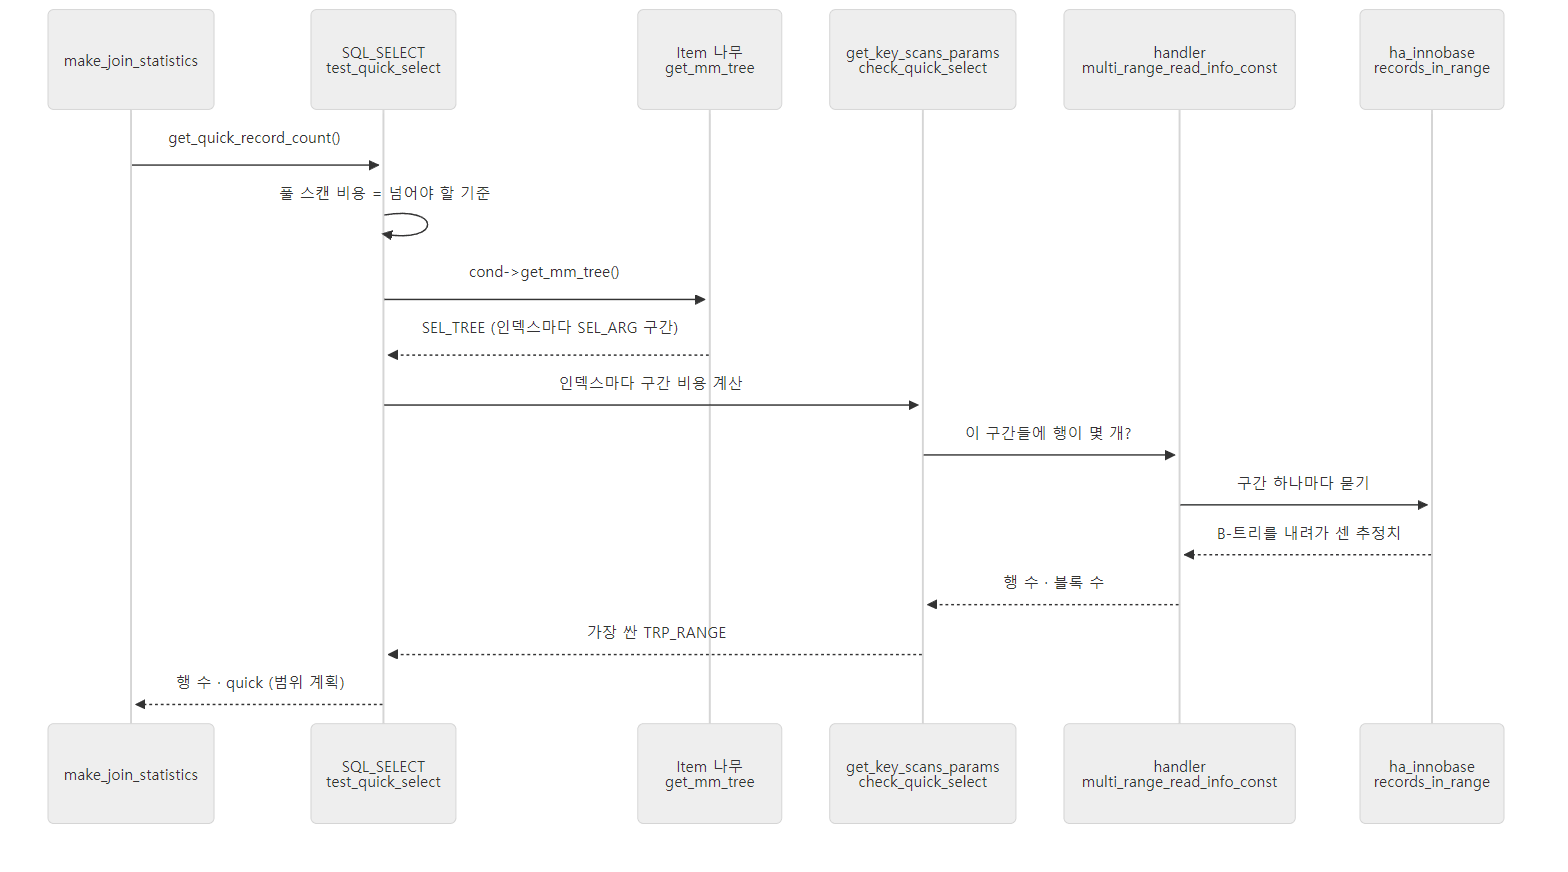 왼쪽 셋은 서버 계층, 오른쪽 둘이 엔진 쪽입니다. EXPLAIN 하나가 엔진의 B-트리까지 내려갑니다.
예제 4: EXPLAIN이 InnoDB의 B-트리까지 내려가는 길
정말 이 길로 가는지 gdb로 확인했습니다. 예제 ex/u08-gdb-range는 실행 중인 mariadbd에 gdb -p로 붙어 break ha_innobase::records_in_range를 걸어 두고, 다른 쪽에서 EXPLAIN SELECT * FROM customers WHERE country = 'KR'를 보낸 뒤 멈춘 자리의 백트레이스(bt)를 찍고 떨어집니다(detach).
#0  ha_innobase::records_in_range (...) at /usr/src/mariadb/storage/innobase/handler/ha_innodb.cc:14632
#1  0x000055aaf6fcb9e8 in handler::multi_range_read_info_const (...) at /usr/src/mariadb/sql/multi_range_read.cc:247
#2  0x000055aaf6fcf969 in DsMrr_impl::dsmrr_info_const (...) at /usr/src/mariadb/sql/multi_range_read.cc:1791
#3  0x000055aaf7640a8d in ha_innobase::multi_range_read_info_const (...) at /usr/src/mariadb/storage/innobase/handler/ha_innodb.cc:20880
#4  0x000055aaf6b82e90 in check_quick_select (...) at /usr/src/mariadb/sql/opt_range.cc:12543
#5  0x000055aaf6b76a89 in get_key_scans_params (...) at /usr/src/mariadb/sql/opt_range.cc:7996
#6  0x000055aaf6b6966e in SQL_SELECT::test_quick_select (...) at /usr/src/mariadb/sql/opt_range.cc:3036
#7  0x000055aaf6db57f0 in get_quick_record_count (...) at /usr/src/mariadb/sql/sql_select.cc:5525
#8  0x000055aaf6db82f4 in make_join_statistics (...) at /usr/src/mariadb/sql/sql_select.cc:6265
#9  0x000055aaf6dab8a2 in JOIN::optimize_inner (...) at /usr/src/mariadb/sql/sql_select.cc:2779
#10 0x000055aaf6da8bca in JOIN::optimize (...) at /usr/src/mariadb/sql/sql_select.cc:2032
#11 0x000055aaf6db545e in mysql_select (...) at /usr/src/mariadb/sql/sql_select.cc:5447
#12 0x000055aaf6e04c2f in mysql_explain_union (...) at /usr/src/mariadb/sql/sql_select.cc:32912
#13 0x000055aaf6d389d4 in execute_sqlcom_select (...) at /usr/src/mariadb/sql/sql_parse.cc:6205
#14 0x000055aaf6d323a1 in mysql_execute_command (...) at /usr/src/mariadb/sql/sql_parse.cc:4038
#15 0x000055aaf6d3d81e in mysql_parse (...) at /usr/src/mariadb/sql/sql_parse.cc:8005
#16 0x000055aaf6d2c338 in dispatch_command (...) at /usr/src/mariadb/sql/sql_parse.cc:1903
...
(인자 목록은 sed로 (...)로 줄였고, #17 아래 연결 스레드 쪽 프레임은 뺐습니다. 주소는 실행마다 다릅니다.) 아래에서 위로 읽으면 dispatch_command()(5편) → mysql_execute_command() → execute_sqlcom_select()의 EXPLAIN 분기 → mysql_explain_union() → 실행과 같은 mysql_select() → JOIN::optimize() → make_join_statistics() 6265행(get_quick_record_count() 부르기) → 범위 옵티마이저 → handler의 MRR(Multi-Range Read, 여러 구간을 한꺼번에 다루는 인터페이스) → InnoDB입니다. 그림의 순서와 같습니다. #3에서 InnoDB가 MRR 함수를 덮어써(ha_innobase::multi_range_read_info_const) 서버 쪽 DS-MRR 구현(DsMrr_impl, sql/multi_range_read.cc)에 맡기고, 그것이 다시 handler의 기본 함수를 부르는 것도 보입니다.
헷갈리기 쉬운 곳: EXPLAIN은 공짜가 아닙니다
위 백트레이스가 보여 주듯 EXPLAIN도 엔진의 인덱스 페이지를 읽습니다(이런 추정을 흔히 "인덱스 다이브"라고 부릅니다). 보통은 한 구간에 페이지 몇 장이지만, IN (…)에 값이 수천 개면 구간도 수천 개입니다. eq_range_index_dive_limit가 있는 이유가 이것입니다 — 같음 구간이 그 수에 이르면 B-트리를 내려가는 대신 통계로 어림합니다. 3절에서 본 const 테이블 읽기까지 합치면, EXPLAIN은 "실행하지 않는다"이지 "아무것도 읽지 않는다"가 아닙니다.
5. 비용 — "1은 1밀리초"인 새 비용 모델
지금까지 "비용"이라는 말을 여러 번 썼습니다. 이 커밋의 비용 정의는 sql/optimizer_defaults.h 머리에 한 줄로 적혀 있습니다.
/*
  This file contains costs constants used by the optimizer
  All costs should be based on milliseconds (1 cost = 1 ms)
*/
sql/optimizer_defaults.h 21–24행
그러니 Last_query_cost의 21.23은 "이 계획은 21밀리초쯤 걸릴 것"이라는 옵티마이저의 어림입니다(실제 시간이 아니라 상수들로 계산한 값입니다). 이 비용 모델은 최근 판에 들어온 것입니다 — sql/optimizer_costs.h의 저작권 표시가 2022년이고, 비용 상수를 엔진마다 따로 두는 구조가 이 파일에 있습니다. 어느 판부터인지는 소스로 확인하지 않았습니다.
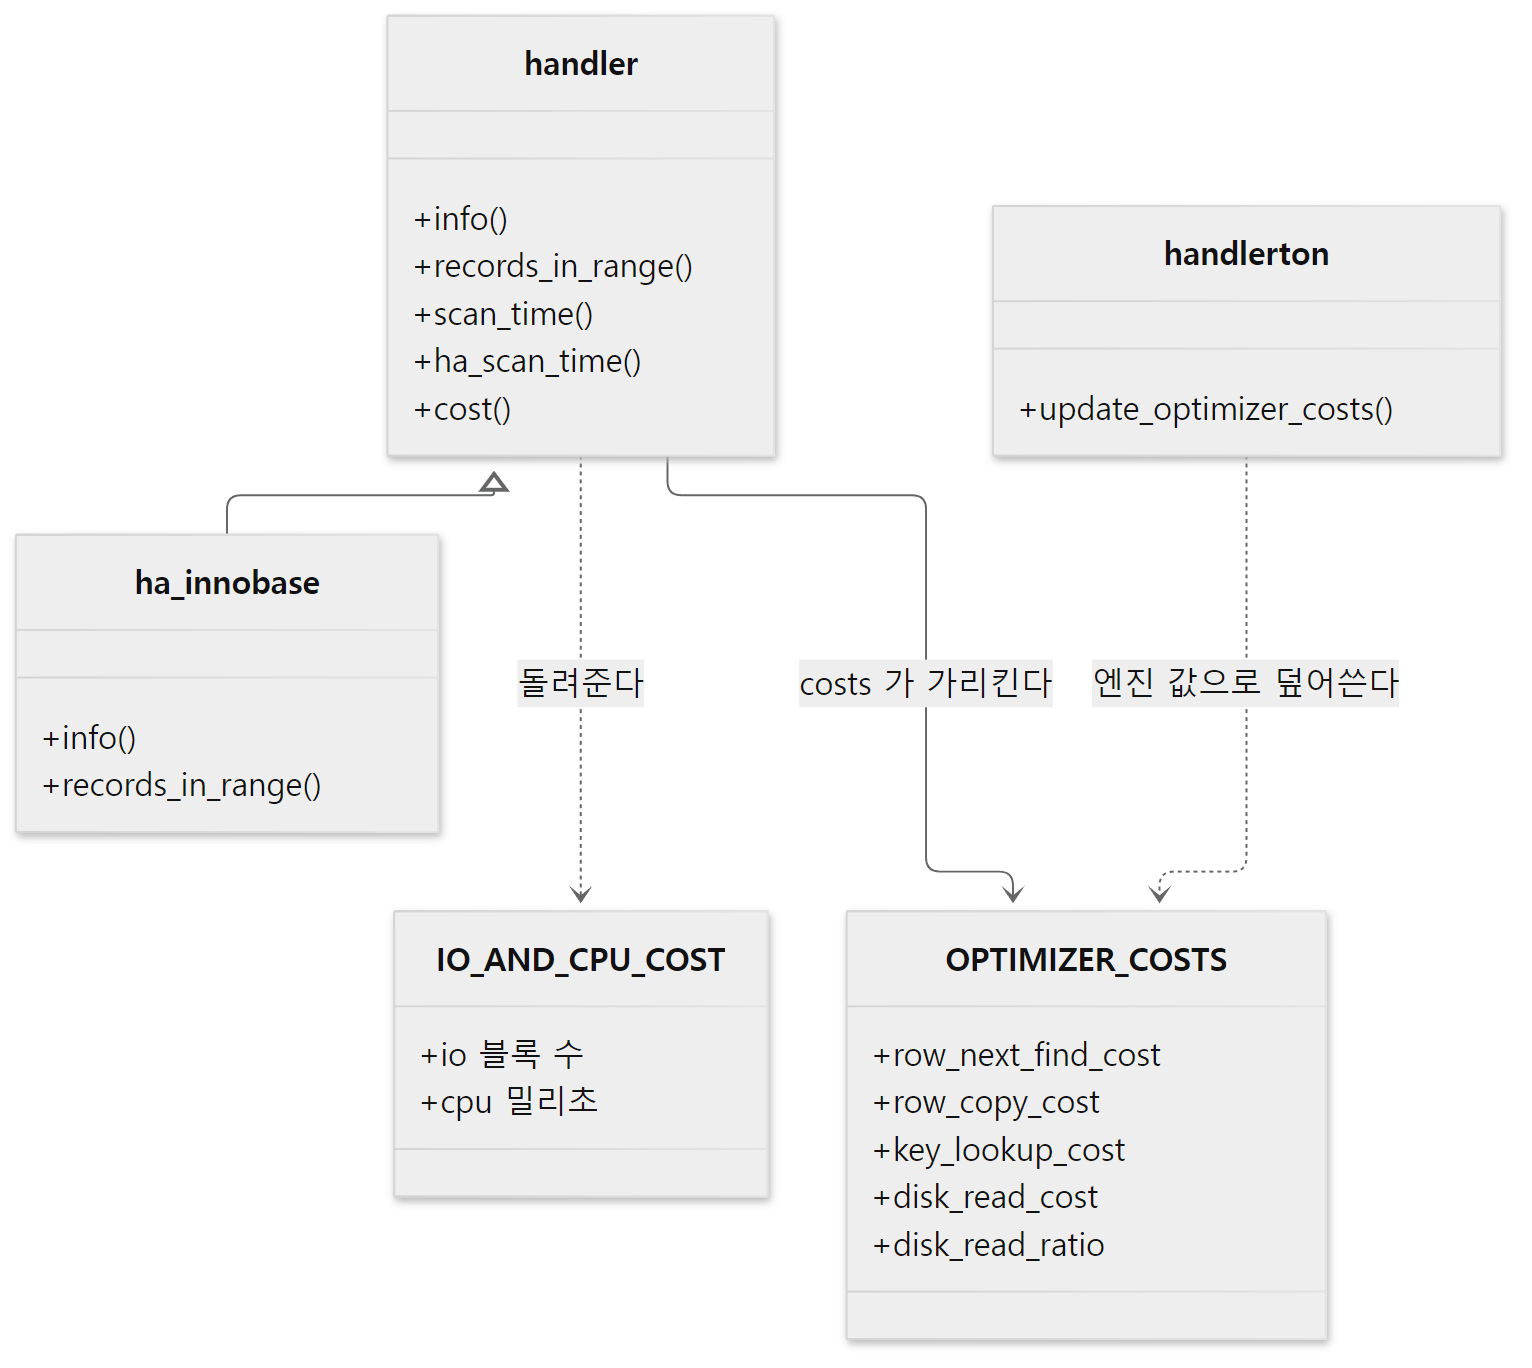 비용 상수는 엔진마다 한 벌씩이고,
handler의 비용 함수가 그 상수로 계산합니다.
상수는 엔진마다 한 벌
비용 상수는 struct OPTIMIZER_COSTS(sql/optimizer_costs.h 32–47행) 하나에 모여 있습니다 — 키 하나 찾기(key_lookup_cost), 다음 행으로 넘어가기(row_next_find_cost), 행 복사(row_copy_cost), 블록 하나 읽기(disk_read_cost) 같은 비용 상수 열두 개(double)와, 값이 채워졌는지 표시하는 initialized입니다. 기본값은 optimizer_defaults.h의 DEFAULT_* 매크로이고(DEFAULT_ROW_NEXT_FIND_COST 0.000045916 등), 엔진은 handlerton(3편에서 본 엔진 하나당 하나인 구조체)의 update_optimizer_costs 함수 포인터로 자기 값을 덮어씁니다. InnoDB는 이렇습니다.
static void innobase_update_optimizer_costs(OPTIMIZER_COSTS *costs)
{
  /*
    The following number was found by check_costs.pl when using 1M rows
    and all rows are cached. See optimizer_costs.txt for details
  */
  costs->row_next_find_cost= 0.00007013;
  costs->row_lookup_cost=    0.00076597;
  costs->key_next_find_cost= 0.00009900;
  costs->key_lookup_cost=    0.00079112;
  costs->row_copy_cost=      0.00006087;
}
storage/innobase/handler/ha_innodb.cc 4242–4253행
주석대로 check_costs.pl이라는 측정 스크립트로 잰 숫자입니다. handler::costs가 이 값을 가리키고(sql/handler.h 3486행 — "Points to table->share->costs"), 비용 함수들이 이 매크로들(ROW_NEXT_FIND_COST 등은 costs->row_next_find_cost의 별명)을 씁니다.
비용 = 디스크 몫 + CPU 몫
비용 함수는 결과를 IO_AND_CPU_COST — 읽을 블록 수(io)와 CPU 시간(cpu, 밀리초) — 로 돌려주고, handler::cost()가 둘을 하나의 숫자로 합칩니다.
  inline double io_cost(IO_AND_CPU_COST cost)
  {
    return cost.io * DISK_READ_COST * DISK_READ_RATIO;
  }

  inline double cost(IO_AND_CPU_COST cost)
  {
    return io_cost(cost) + cost.cpu;
  }
블록 수에 "블록 하나 읽는 시간(DISK_READ_COST)"과 "그 블록이 캐시에 없을 확률(DISK_READ_RATIO)"을 곱합니다. 기본 disk_read_ratio는 0.02, 곧 50번에 한 번만 실제 디스크를 읽는다고 봅니다(optimizer_defaults.h 118행부터의 주석이 그 이유를 길게 설명합니다). 풀 스캔의 비용은 이렇게 계산됩니다.
IO_AND_CPU_COST handler::ha_scan_time(ha_rows rows)
{
  IO_AND_CPU_COST cost;
  bool rc= (table && table->in_use && table->in_use->opt_ctx_replay)
               ? table->in_use->opt_ctx_replay->infuse_ha_scan_time(table, &cost)
               : true;
  if (rc)
  {
    cost= scan_time();
    cost.cpu+= (TABLE_SCAN_SETUP_COST +
                (double) rows * (ROW_NEXT_FIND_COST + ROW_COPY_COST));
  }
  return cost;
}
여기에 행마다 WHERE 검사 비용(rows * WHERE_COST)을 더한 것이 ha_scan_and_compare_time()(sql/handler.h 4044–4049행)이고, 4절의 test_quick_select()가 기준선으로 쓰는 값입니다.
엔진이 scan_time()을 덮어쓰지 않으면 기본 구현(handler.h 4026–4035행)이 쓰입니다 — io는 데이터 크기를 IO_SIZE(4096바이트)로 나눈 값, cpu는 페이지 수 × INDEX_BLOCK_COPY_COST입니다. InnoDB의 ha_innobase::scan_time()은 #ifdef NOT_USED로 막혀 있어서(ha_innodb.cc 14798행) 기본 구현을 씁니다.
예제 2(일부): 손으로 맞춰 보는 풀 스캔 비용
예제 2의 0번은 옵티마이저가 출발하는 숫자들 — information_schema.TABLES의 행 수와 데이터 크기, information_schema.OPTIMIZER_COSTS의 비용 상수(default와 InnoDB 두 줄), 비용 관련 시스템 변수 — 을 찍습니다(SQL은 ex/u08-plan-change/demo.sql).
+------------+------------+-------------+
 TABLE_NAME | TABLE_ROWS | DATA_LENGTH |
+------------+------------+-------------+
 customers  |       1000 |       81920 |
 orders     |      19982 |     1589248 |
+------------+------------+-------------+
+---------+---------------+----------+------------+------------+-----------+-----------------+
 ENGINE  | row_next_find | row_copy | key_lookup | row_lookup | disk_read | disk_read_ratio |
+---------+---------------+----------+------------+------------+-----------+-----------------+
 default |      0.045916 | 0.060866 |   0.435777 |   0.130839 | 10.240000 |        0.020000 |
 InnoDB  |      0.070130 | 0.060870 |   0.791120 |   0.765970 | 10.240000 |        0.020000 |
+---------+---------------+----------+------------+------------+-----------+-----------------+
+------------------------+-----------------------------+--------------------------+
 @@optimizer_where_cost | @@optimizer_scan_setup_cost | @@optimizer_search_depth |
+------------------------+-----------------------------+--------------------------+
               0.032000 |                   10.000000 |                       62 |
+------------------------+-----------------------------+--------------------------+
information_schema.OPTIMIZER_COSTS는 값에 1000을 곱해 보여 줍니다(sql/sql_show.cc 10502–10513행의 *1000.0). 소스의 0.00007013밀리초가 화면에는 0.070130(마이크로초)으로 나오는 것입니다. 시스템 변수 optimizer_where_cost·optimizer_scan_setup_cost도 같은 규칙입니다(sys_vars.cc의 COST_ADJUST(1000)). 비율인 disk_read_ratio만 그대로입니다.
이제 6절의 예제 3이 추적에서 보여 줄 customers 풀 스캔 비용 0.177274를 손으로 맞춰 봅니다(밀리초).
| 몫 | 계산 | 값 |
|---|---|---|
| 디스크 | 81920 / 4096 = 20블록 × 0.01024 × 0.02 | 0.004096 |
| 페이지 복사 | 81920 / 16384 = 5페이지 × 0.0000356 | 0.000178 |
| 스캔 준비 | optimizer_scan_setup_cost |
0.01 |
| 행 1,000개 꺼내기 | 1000 × (0.00007013 + 0.00006087) | 0.131 |
| WHERE 검사 | 1000 × 0.000032 | 0.032 |
| 합계 | 0.177274 |
16384는 InnoDB 페이지 크기(stats.block_size)이고, 행을 꺼내는 두 상수는 위 InnoDB 값입니다. 소스의 식과 상수만으로 추적의 숫자가 소수점 여섯째 자리까지 맞습니다. 옵티마이저의 "비용"이 어디서 오는지 감이 잡혔다면, 1절의 21.23 가운데 17.88이 왜 c의 eq_ref였는지도 보입니다 — 17.88 ÷ 19,982번 ≈ 0.0009밀리초, 곧 한 번에는 1마이크로초도 안 되는 키 조회가 2만 번 곱해진 것입니다.
6. 조인 순서 — choose_plan(), greedy_search(), best_access_path()
테이블이 N개면 조인 순서는 N!가지입니다. 3개면 6가지, 10개면 3,628,800가지입니다. 이 가운데 하나를 고르는 것이 choose_plan()(10519행)입니다. STRAIGHT_JOIN을 쓰면 optimize_straight_join()이 FROM에 적힌 순서 그대로 비용만 계산하고(10577–10580행), 아니면 greedy_search()로 순서를 찾습니다. optimizer_search_depth가 0이면 determine_search_depth()가 정하는데(테이블이 7개 이하면 테이블 수 + 1, 10852–10869행), 기본값은 0이 아니라 MAX_TABLES + 1(= 62)입니다(sys_vars.cc 3067–3076행, 예제 2의 출력에서도 62). MAX_TABLES는 table_map(테이블 하나당 비트 하나인 64비트 정수)의 비트 수에서 3을 뺀 61입니다(sql/sql_const.h 87행).
greedy_search와 best_extension_by_limited_search
greedy_search()는 이름처럼 "한 자리씩 탐욕스럽게" 채웁니다. 매번 best_extension_by_limited_search()로 앞으로 search_depth개 자리까지 깊이 우선으로 따져 보고, 그 가운데 가장 좋은 확장의 첫 테이블 하나만 확정한 뒤 다음 자리로 넘어갑니다. 남은 테이블 수가 search_depth 이하이면 한 번의 탐색으로 끝납니다(11140행의 if (size_remain <= search_depth)). 기본값 62는 한 SELECT에 넣을 수 있는 테이블 수(MAX_TABLES)보다 크므로, 기본 설정에서는 가지치기를 빼면 모든 순서를 따져 보는 셈입니다.
best_extension_by_limited_search()의 핵심은 두 군데입니다. 먼저 후보 테이블 하나를 계획 끝에 붙여 보고 비용을 더합니다.
      /* Compute the cost of the new plan extended with 's' */
      current_record_count= COST_MULT(record_count, position->records_out);
      current_read_time= COST_ADD(read_time, position->read_time);
sql/sql_select.cc 12533–12535행
record_count(앞 테이블들까지 읽었을 때 나오는 행 조합 수)에 이 테이블의 records_out(앞 행 하나당 이 테이블에서 WHERE를 통과해 남는 행 수)을 곱하고, 비용은 더합니다. 그리고 바로 가지치기입니다.
      /* Expand only partial plans with lower cost than the best QEP so far */
      if (current_read_time + COST_EPS >= join->best_read)
      {
        // ... (DBUG 출력)
        trace_one_table
          .add("pruned_by_cost", true)
          .add("current_cost", current_read_time)
          .add("best_cost",    join->best_read);

        restore_prev_nj_state(s);
        restore_prev_sj_state(remaining_tables, s, idx);
        continue;
      }
sql/sql_select.cc 12561–12577행
지금까지 찾은 완성된 계획(best_read)보다 이미 비싸면, 그 뒤에 무엇을 붙여도 더 싸질 수 없으므로 더 내려가지 않습니다. 비용은 더하기만 하니까 맞는 판단입니다. optimizer_prune_level(기본 2)이 1 이상이면 이보다 공격적인 어림 가지치기(pruned_by_heuristic, 12583–12668행)도 합니다 — "행 수도 비용도 이 자리의 최선보다 나쁘면 버린다"는 것이라 최적의 계획을 놓칠 수도 있다고 주석이 밝혀 둡니다. 끝까지 내려가 완성된 계획이 지금까지의 최선보다 싸면 best_positions[]에 복사합니다.
        if (current_read_time < join->best_read)
        {
          memcpy((uchar*) join->best_positions, (uchar*) join->positions,
                 sizeof(POSITION) * (idx + 1));
          join->join_record_count= partial_join_cardinality;
          join->best_read= current_read_time;
        }
sql/sql_select.cc 12759–12765행
best_access_path — 한 자리에 한 테이블을 놓는 가장 싼 방법
"후보 테이블 하나를 계획 끝에 붙여 본다"에서, 그 테이블을 어떻게 읽을지 정하는 함수가 best_access_path()(9023행)입니다. 앞에 놓인 테이블들(remaining_tables의 여집합)이 무엇이냐에 따라 쓸 수 있는 방법이 달라집니다.
KEYUSE를 하나씩 보며 인덱스로 찾아가기(ref,eq_ref)의 비용을 계산합니다(9104행의if (s->keyuse)블록). 찾아가는 데 필요한 값이 앞 테이블에 있어야 후보가 됩니다.c다음의o라면o.customer_id = c.id로idx_customer를 쓸 수 있지만,o가 맨 앞이면 못 씁니다.- 그다음 훑기(풀 스캔, 3절에서 구한 범위 스캔, 인덱스 풀 스캔)의 비용을 계산합니다(9955행부터).
- 더 싼 쪽을 고릅니다. 비교는 늘 같은 모양입니다.
      if (cur_cost + COST_EPS < best.cost)
      {
        trace_access_idx.add("chosen", true);
        best.cost= cur_cost;
COST_EPS(0.0000001, optimizer_costs.h)는 비용이 같은 두 인덱스가 있을 때 먼저 본 것을 고르게 하는 작은 여유입니다. 주석에 따르면 부동소수점 계산 경로에 따라 테스트 결과가 흔들리지 않게 하려는 것입니다.
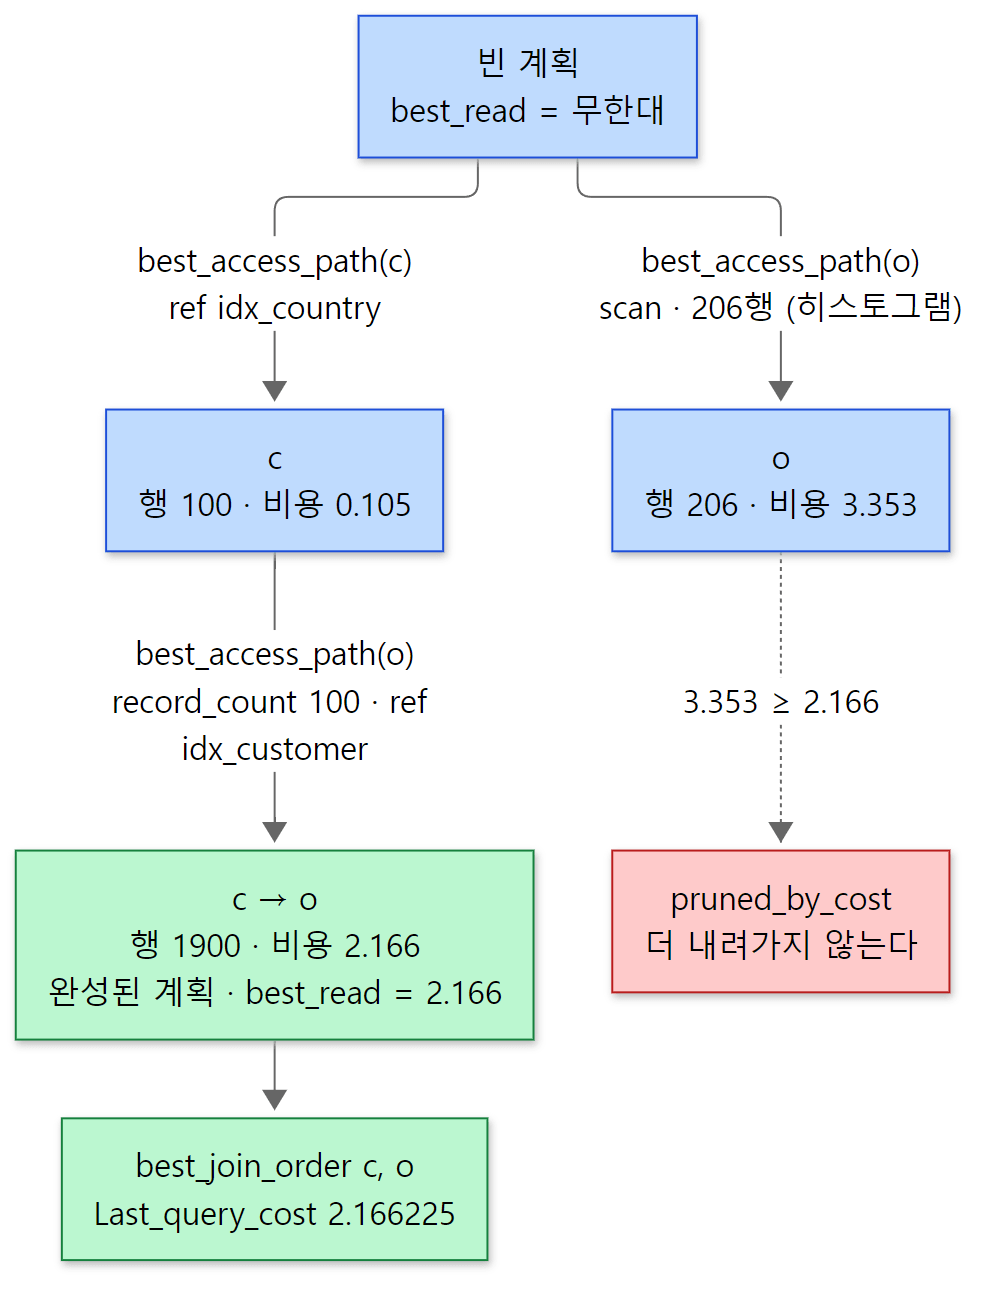 숫자는 아래 예제 3의 추적에서 가져왔습니다.
o로 시작하는 가지는 첫 자리에서 이미 잘립니다.
예제 3: optimizer_trace로 탐색 과정 보기
옵티마이저 추적(optimizer_trace)을 켜면 위의 과정이 JSON으로 남습니다. 이번에는 orders.customer_id에 인덱스를 걸고, status 열의 히스토그램(7절)도 모아 둔 상태에서 1절과 같은 쿼리를 EXPLAIN합니다. 추적 전체는 350줄쯤이라 SQL의 JSON 함수로 필요한 부분만 뽑았습니다.
-- 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
USE shop;
ALTER TABLE orders ADD KEY idx_customer (customer_id);
ANALYZE TABLE orders PERSISTENT FOR COLUMNS (status) INDEXES ();

SET optimizer_trace = 'enabled=on';
-- EXPLAIN 도 옵티마이저를 끝까지 돌리므로 추적이 남는다
EXPLAIN SELECT c.name, o.amount
  FROM customers c JOIN orders o ON o.customer_id = c.id
  WHERE c.country = 'KR' AND o.status = 'cancelled';
-- SHOW STATUS 는 추적 대상이 아니라 추적을 건드리지 않는다
SHOW SESSION STATUS LIKE 'Last_query_cost';
-- 다음 SELECT 가 추적을 덮어쓰므로 먼저 변수에 옮겨 둔다
-- (OPTIMIZER_TRACE 를 읽는 문장 자신은 추적되지 않는다)
SELECT trace INTO @t FROM information_schema.OPTIMIZER_TRACE;
-- ... (@t 에서 단계별로 뽑아내는 SELECT 들은 생략)
[예제 ex/u08-optimizer-trace/demo.sql에서 줄임 — 뽑아내는 SQL은 예제 폴더에 있습니다]
+------+-------------+-------+------+---------------------+--------------+---------+-----------+------+-----------------------+
 id   | select_type | table | type | possible_keys       | key          | key_len | ref       | rows | Extra                 |
+------+-------------+-------+------+---------------------+--------------+---------+-----------+------+-----------------------+
    1 | SIMPLE      | c     | ref  | PRIMARY,idx_country | idx_country  | 9       | const     | 100  | Using index condition |
    1 | SIMPLE      | o     | ref  | idx_customer        | idx_customer | 4       | shop.c.id | 19   | Using where           |
+------+-------------+-------+------+---------------------+--------------+---------+-----------+------+-----------------------+
+-----------------+----------+
 Variable_name   | Value    |
+-----------------+----------+
 Last_query_cost | 2.166225 |
+-----------------+----------+
인덱스가 생기자 순서가 뒤집혔습니다. 한국 고객 100명을 idx_country로 찾고, 고객마다 주문을 idx_customer로 찾아갑니다. 추적에서 단계별로 뽑은 것은 이렇습니다(표 머리의 step 줄은 뺐습니다).
| transformations                                                             |
 ["equality_propagation","constant_propagation","trivial_condition_removal"] |
 rows_estimation                                                                                                                                                                                                  |
 {"c: table_scan":[{"rows":1000,"cost":0.177274}],"c: range on idx_country":[0.10587704],"o: status histogram":[0.0103],"o: table_scan":[{"rows":20000,"read_cost":2.7129156,"read_and_compare_cost":3.3529156}]} |
(두 결과의 머리와 칸 테두리만 남기고 줄였습니다.) 1번은 2절의 optimize_cond() 세 단계 이름 그대로입니다. 2번은 3·4절의 행 수 추정입니다.
c의 풀 스캔 0.177274는 5절에서 손으로 맞춘 그 숫자이고, test_quick_select()가 기준선으로 삼은 값입니다. idx_country 범위(0.106)가 그보다 싸서 채택되었습니다. o는 status에 인덱스가 없어 범위 분석은 없지만 히스토그램이 "1.03%만 남는다"(0.0103)고 알려 줍니다. 3번과 4번이 이 절의 탐색입니다.
+------+--------------+--------+------+--------------+----------+------------+--------+
 tbl  | record_count | access | type | idx          | rows_est | cost       | chosen |
+------+--------------+--------+------+--------------+----------+------------+--------+
 c    |            1 | ref    | NULL | idx_country  |      100 | 0.10508592 | true   |
 c    |            1 | NULL   | scan | NULL         |     NULL |       NULL | false  |
 o    |            1 | scan   | NULL | NULL         |    20000 |  3.3529156 | true   |
 o    |          100 | ref    | NULL | idx_customer |       19 |  2.0611392 | true   |
 o    |          100 | NULL   | scan | NULL         |     NULL |       NULL | false  |
+------+--------------+--------+------+--------------+----------+------------+--------+
+--------+------+---------------+---------------+--------+----------+-----------+------------+
 prefix | tbl  | rows_for_plan | cost_for_plan | pruned | next_tbl | next_rows | next_cost  |
+--------+------+---------------+---------------+--------+----------+-----------+------------+
        | c    |           100 |    0.10508592 | NULL   | o        |      1900 | 2.16622512 |
        | o    |           206 |     3.3529156 | true   | NULL     |      NULL |       NULL |
+--------+------+---------------+---------------+--------+----------+-----------+------------+
+-----------------+----------+------------+
 best_join_order | est_rows | plan_cost  |
+-----------------+----------+------------+
 ["c", "o"]      |    19.57 | 2.16622512 |
+-----------------+----------+------------+
- 3번 표의 한 줄이
best_access_path()가 따져 본 후보 하나입니다.o는 두 번 불렸습니다. 맨 앞 자리(record_count1)에서는ref를 쓸 수 없어scan만 후보이고,c다음 자리(record_count100)에서는idx_customer로 찾아가는ref가 생겨 이겼습니다. 같은 테이블이라도 앞에 무엇이 있느냐에 따라 접근 방법이 달라진다는 것이 이 표에 그대로 보입니다. - 4번 표가 위 그림입니다.
c → o가 비용 2.166으로 먼저 완성되었고,o로 시작하는 계획은 첫 자리 비용 3.353이 이미 그보다 커서pruned(pruned_by_cost)되었습니다. - 마지막 2.16622512가 이 쿼리의
Last_query_cost입니다. 예제는 EXPLAIN 바로 뒤에SHOW SESSION STATUS LIKE 'Last_query_cost'도 찍는데, 2.166225가 나옵니다.
헷갈리기 쉬운 곳: 추적은 바로 다음 문장에 덮어써집니다
처음에 이 예제를 짤 때는 EXPLAIN 다음에 SELECT '--- 1. …' AS step;처럼 단계 이름을 찍는 줄을 넣고 그 뒤에서 OPTIMIZER_TRACE를 읽었습니다. 결과는 전부 NULL이었습니다. 단계 이름을 찍는 그 SELECT도 추적 대상이라 EXPLAIN의 추적을 덮어썼기 때문입니다. 소스를 보면 이유가 분명합니다. 추적은 문장마다 새로 시작하고, 끝날 때 마지막 하나만 남깁니다.
void Opt_trace_context::end()
{
  if (current_trace)
    traces.push(current_trace);

  if (!traces.elements())
    return;
  if (traces.elements() > 1)
  {
    Opt_trace_stmt *prev= traces.at(0);
    delete prev;
    traces.del(0);
  }
  current_trace= NULL;
}
추적 대상은 SELECT·UPDATE·DELETE·다중 테이블 UPDATE/DELETE·INSERT … SELECT입니다(sql_command_can_be_traced(), 110–122행). SHOW STATUS나 SET은 대상이 아니라서 덮어쓰지 않고, OPTIMIZER_TRACE 테이블을 읽는 문장도 빼 줍니다(list_has_optimizer_trace_table()). 그래서 예제는 EXPLAIN 바로 뒤에서 추적을 @t에 옮겨 두고, 그 뒤로는 @t만 읽습니다.
7. 통계가 계획을 바꾼다 — 히스토그램
1절의 JSON에서 o의 "filtered": 100이 걸렸습니다. 옵티마이저가 status = 'cancelled'를 "아무것도 거르지 못하는 조건"으로 본 것입니다. 실제로는 1%만 남습니다. ANALYZE 문(EXPLAIN과 달리 쿼리를 실제로 실행하고 추정과 실제를 나란히 보여 줍니다)으로 확인하면 차이가 보입니다(예제 1의 5번).
ANALYZE SELECT c.name, o.amount
  FROM customers c JOIN orders o ON o.customer_id = c.id
  WHERE c.country = 'KR' AND o.status = 'cancelled';
+------+-------------+-------+--------+---------------------+---------+---------+--------------------+-------+----------+----------+------------+-------------+
 id   | select_type | table | type   | possible_keys       | key     | key_len | ref                | rows  | r_rows   | filtered | r_filtered | Extra       |
+------+-------------+-------+--------+---------------------+---------+---------+--------------------+-------+----------+----------+------------+-------------+
    1 | SIMPLE      | o     | ALL    | NULL                | NULL    | NULL    | NULL               | 19982 | 20000.00 |   100.00 |       1.03 | Using where |
    1 | SIMPLE      | c     | eq_ref | PRIMARY,idx_country | PRIMARY | 4       | shop.o.customer_id | 1     | 1.00     |    10.00 |       9.71 | Using where |
+------+-------------+-------+--------+---------------------+---------+---------+--------------------+-------+----------+----------+------------+-------------+
r_로 시작하는 열이 실제 값입니다. o의 filtered 100 대 r_filtered 1.03 — 추정이 100배 빗나갔습니다. c의 filtered 10은 맞았습니다. country에는 인덱스가 있어서 범위 분석이 "1,000명 가운데 100명"을 알려 주었기 때문입니다. status에는 인덱스도 통계도 없으니 옵티마이저로서는 알 길이 없습니다.
이것을 알려 주는 것이 엔진과 상관없는 통계(Engine-Independent Table Statistics)입니다. ANALYZE TABLE … PERSISTENT FOR …로 모으면 서버가 테이블을 훑어 mysql.table_stats·mysql.column_stats·mysql.index_stats에 저장하고(sql/sql_statistics.cc의 collect_statistics_for_table(), 2753행), 열의 값 분포는 히스토그램으로 남깁니다. 기본 histogram_type은 JSON_HB(높이 균형 히스토그램을 JSON으로 저장)이고 읽는 쪽은 sql/opt_histogram_json.cc의 Histogram_json_hb입니다 — 값 하나의 선택도는 point_selectivity()(821행), 구간은 range_selectivity()(888행)가 계산합니다.
옵티마이저가 이 통계를 쓰는지는 두 변수가 정합니다. use_stat_tables(기본 PREFERABLY_FOR_QUERIES — sys_vars.cc 7372–7376행)는 "통계 테이블이 있으면 엔진 통계보다 먼저 쓴다"이고(sql/sql_statistics.h 118–123행의 check_eits_preferred()), optimizer_use_condition_selectivity(기본 4)는 선택도를 어디까지 따질지입니다. 소스에서 문턱은 셋입니다.
| 값 | 하는 일 | 위치 |
|---|---|---|
| 2 이상 | calculate_cond_selectivity_for_table()을 부른다 |
sql_select.cc 6294행 |
| 3 이상 | 인덱스 없는 열마다 가짜 인덱스를 만들어 4절의 범위 분석(get_mm_tree())을 그대로 돌린다 |
opt_range.cc 3738행 |
| 4 이상 | 그 열의 히스토그램을 읽어 구간의 선택도를 구한다 | sql_statistics.cc 3264행 |
3 이상에서 쓰는 방법이 재미있습니다. 인덱스가 없는 열도 "인덱스가 있다고 치고" 범위 옵티마이저에 넣어 구간을 얻은 뒤, 그 구간을 B-트리 대신 히스토그램에 물어봅니다(3773–3785행의 주석). 같은 부품을 두 번 쓰는 셈입니다.
예제 2: 같은 쿼리, 다섯 번의 EXPLAIN
이번에는 국가 조건을 빼고 "취소된 주문과 그 고객 이름"만 찾습니다. 인덱스와 통계를 하나씩 더하며 EXPLAIN했습니다(각 단계에 같은 쿼리를 썼고, 계획 표와 Last_query_cost만 실었습니다).
--- 1. no index on orders.customer_id
    1 | SIMPLE      | o     | ALL    | NULL          | NULL    | NULL    | NULL               | 19982 | Using where |
    1 | SIMPLE      | c     | eq_ref | PRIMARY       | PRIMARY | 4       | shop.o.customer_id | 1     |             |
 Last_query_cost | 21.226778 |
--- 2. add an index
    1 | SIMPLE      | c     | ALL  | PRIMARY       | NULL         | NULL    | NULL      | 1000 |             |
    1 | SIMPLE      | o     | ref  | idx_customer  | idx_customer | 4       | shop.c.id | 19   | Using where |
 Last_query_cost | 19.970285 |
--- 3. collect a histogram on orders.status
 orders     | status      | JSON_HB   | [{"start": "cancelled", "size": 0.0103, "ndv": 1}, {"start": "done", "end": "done", "size": 0.9897, "ndv": 1}] |
    1 | SIMPLE      | o     | ALL    | idx_customer  | NULL    | NULL    | NULL               | 20000 |     1.03 | Using where |
    1 | SIMPLE      | c     | eq_ref | PRIMARY       | PRIMARY | 4       | shop.o.customer_id | 1     |   100.00 |             |
 Last_query_cost | 3.541266 |
--- 4. same statistics, histogram ignored
    1 | SIMPLE      | c     | ALL  | PRIMARY       | NULL         | NULL    | NULL      | 1000 |   100.00 |             |
    1 | SIMPLE      | o     | ref  | idx_customer  | idx_customer | 4       | shop.c.id | 19   |   100.00 | Using where |
 Last_query_cost | 19.970285 |
--- 5. STRAIGHT_JOIN keeps the FROM order
    1 | SIMPLE      | c     | ALL  | PRIMARY       | NULL         | NULL    | NULL      | 1000 |             |
    1 | SIMPLE      | o     | ref  | idx_customer  | idx_customer | 4       | shop.c.id | 19   | Using where |
 Last_query_cost | 19.970285 |
[예제 ex/u08-plan-change의 출력에서 표의 머리·테두리를 빼고 데이터 줄만 모았습니다. 3·4번은 filtered 열을 보려고 EXPLAIN EXTENDED로 찍었습니다]
- 인덱스가 없을 때:
o를 훑고c를 2만 번 찾아갑니다(21.23). - 인덱스를 걸면:
c를 훑고 고객마다idx_customer로 주문을 찾아가는 쪽(19.97)이 조금 더 싸져서 순서가 뒤집혔습니다. 이번에는 국가 조건이 없어서c가ALL입니다. - 히스토그램을 모으면: 다시
o가 앞으로 왔고 비용이 3.54로 뚝 떨어졌습니다.filtered1.03이 이유입니다.o를 훑는 비용(3.35)은 거의 그대로지만 WHERE를 통과해 다음 테이블로 넘어가는 행이 2만 개가 아니라 206개라고 알게 되었으니,c를 찾아가는 횟수도 206번으로 줄어듭니다. 6절의current_record_count= COST_MULT(record_count, position->records_out)가 바로 이 곱셈입니다. 그리고rows가 19982에서 20000으로 바뀐 것도 보입니다.ANALYZE TABLE … PERSISTENT가mysql.table_stats에 정확한 행 수를 남겼고,use_stat_tables기본값대로 그것이 엔진의 추정보다 먼저 쓰였습니다. - 같은 통계에서
optimizer_use_condition_selectivity = 1로 낮추면: 히스토그램이 있어도 쓰지 않으니(위 표의 문턱 2 아래) 2번 계획으로 돌아갑니다. STRAIGHT_JOIN: FROM 순서(c먼저)를 강제하면optimize_straight_join()이 비용만 계산합니다. 2번과 같은 계획이 같은 비용으로 나옵니다.
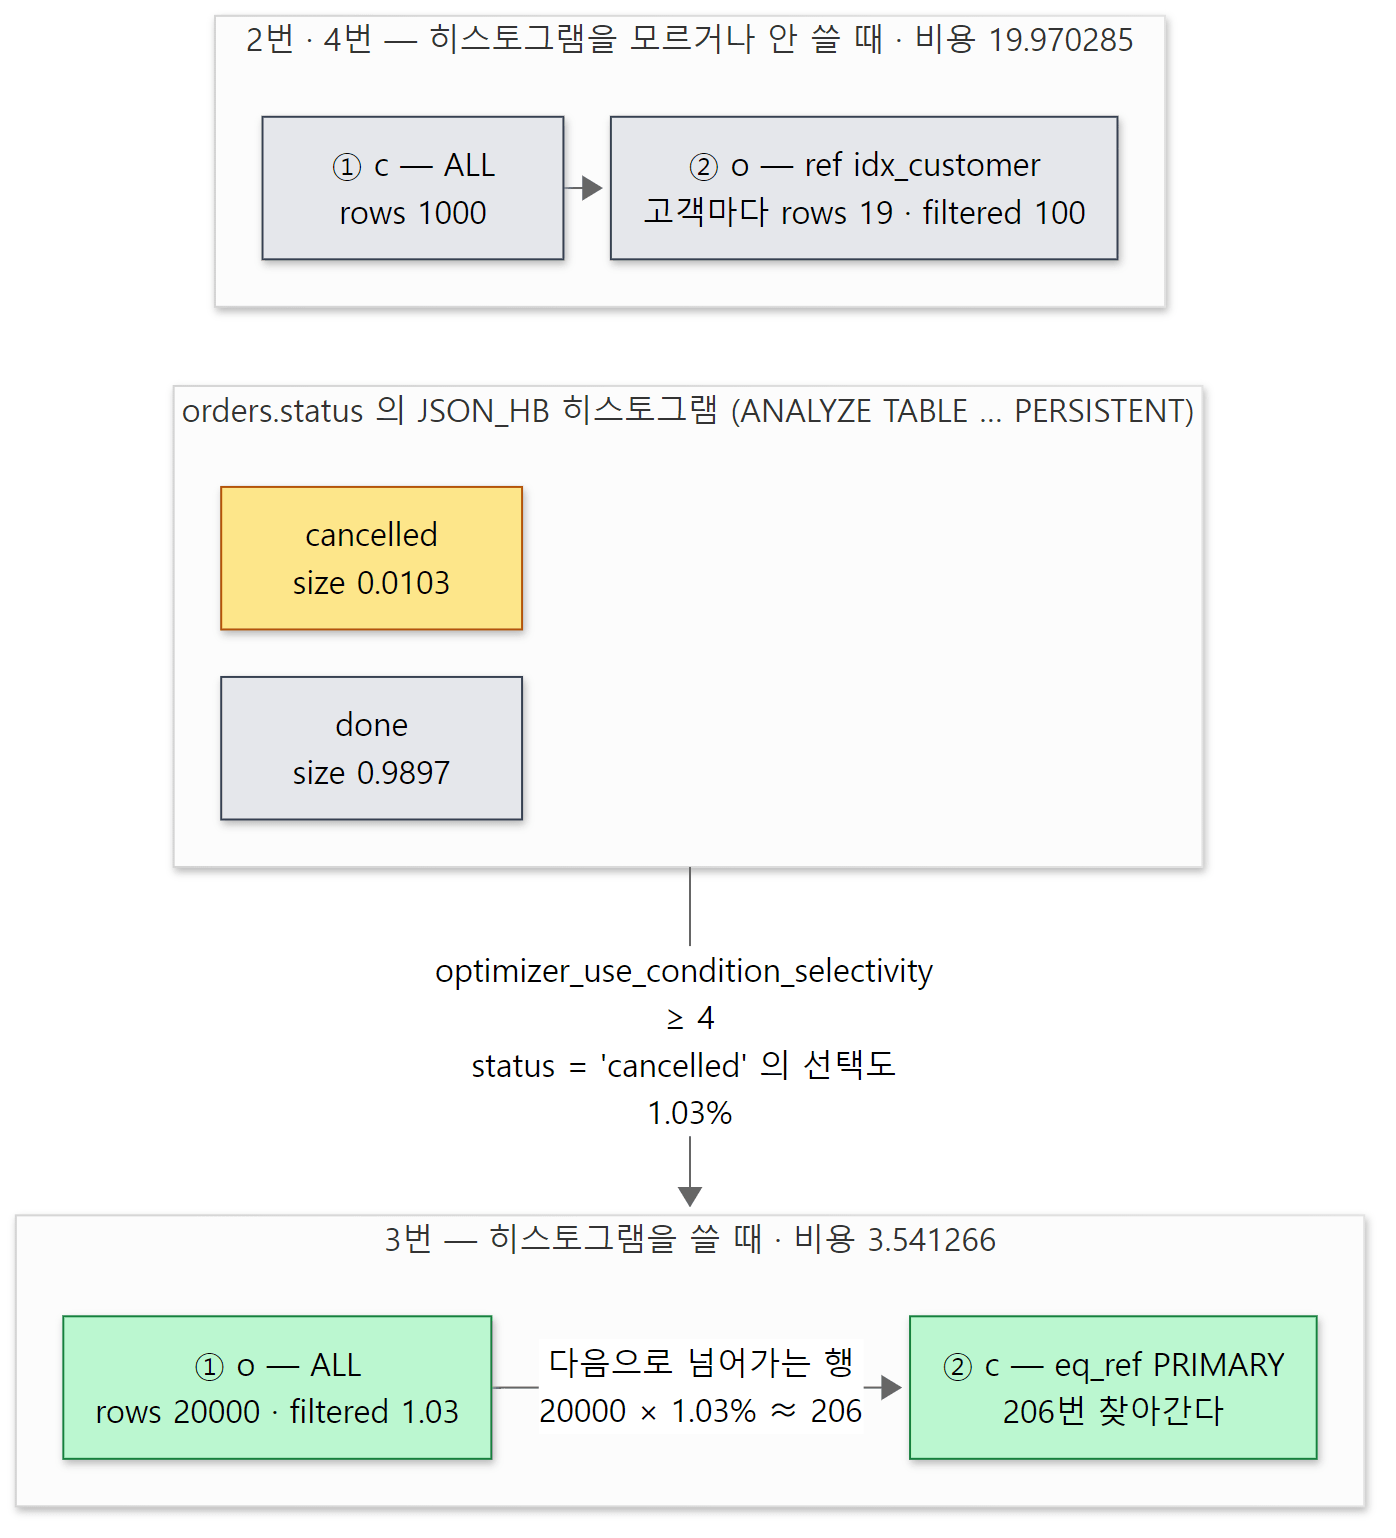 filtered 하나가 바뀌자 순서와 비용이 함께 바뀌었습니다. 숫자는 예제 2(ex/u08-plan-change)의 실제 출력입니다.
헷갈리기 쉬운 곳: ANALYZE TABLE이 두 가지입니다
예제의 setup.sql 끝에 있는 ANALYZE TABLE customers, orders;는 엔진 통계만 새로 고칩니다(InnoDB가 자기 통계를 다시 계산합니다). 히스토그램은 생기지 않습니다. 3번 단계의 ANALYZE TABLE orders PERSISTENT FOR COLUMNS (status) INDEXES ()처럼 PERSISTENT FOR를 붙여야 서버가 테이블을 훑어 mysql.column_stats에 통계와 히스토그램을 씁니다. 출력의 Engine-independent statistics collected 줄이 그 표시입니다. use_stat_tables가 …_FOR_QUERIES일 때 그냥 ANALYZE TABLE로는 이 통계를 모으지 않는다는 것이 sql/sql_statistics.h 22–31행의 주석에 그대로 적혀 있습니다. 이름이 같아서 하나만 하고 둘 다 했다고 착각하기 쉽습니다.
8. EXPLAIN과 optimizer_trace는 어디서 만들어지나
EXPLAIN — 계획을 따로 베껴 둔다
JOIN::optimize() 끝의 build_explain()은 EXPLAIN이 찍을 자료를 따로 만듭니다.
  MEM_ROOT *old_mem_root= thd->mem_root;
  // ...
  thd->mem_root= thd->lex->explain->mem_root;
  bool res= save_explain_data(thd->lex->explain, false /* can overwrite */,
                        need_tmp,
                        !skip_sort_order && !no_order && (order || group_list),
                        select_distinct);
  thd->mem_root= old_mem_root;
  DBUG_ASSERT(thd->free_list == old_free_list); // no Items were created
thd->mem_root를 잠시 Explain_query의 메모리 영역으로 바꿔 놓고 save_explain_data()를 부릅니다. 주석대로 이 자료에는 Item이 들어가면 안 됩니다. JOIN과 Item 나무는 실행이 끝나면 정리되지만, EXPLAIN 자료는 그 뒤에도 남아 있어야 하기 때문입니다 — SHOW EXPLAIN FOR <연결 ID>로 다른 연결이 실행 중인 쿼리의 계획을 볼 때나 ANALYZE가 실행이 끝난 뒤 계획을 찍을 때입니다. 그래서 글자와 숫자로 베껴 둡니다(MEM_ROOT는 2편에서 본 서버의 메모리 풀입니다).
자료는 Explain_query → Explain_select(SELECT 하나) → Explain_table_access(EXPLAIN의 한 줄) 나무입니다(sql/sql_explain.h). Explain_table_access에 type, rows, filtered, cost 같은 필드가 있고, 출력 형식마다 함수가 따로 있습니다 — 표는 Explain_table_access::print_explain()(sql_explain.cc 1533행), JSON은 print_explain_json()(2001행).
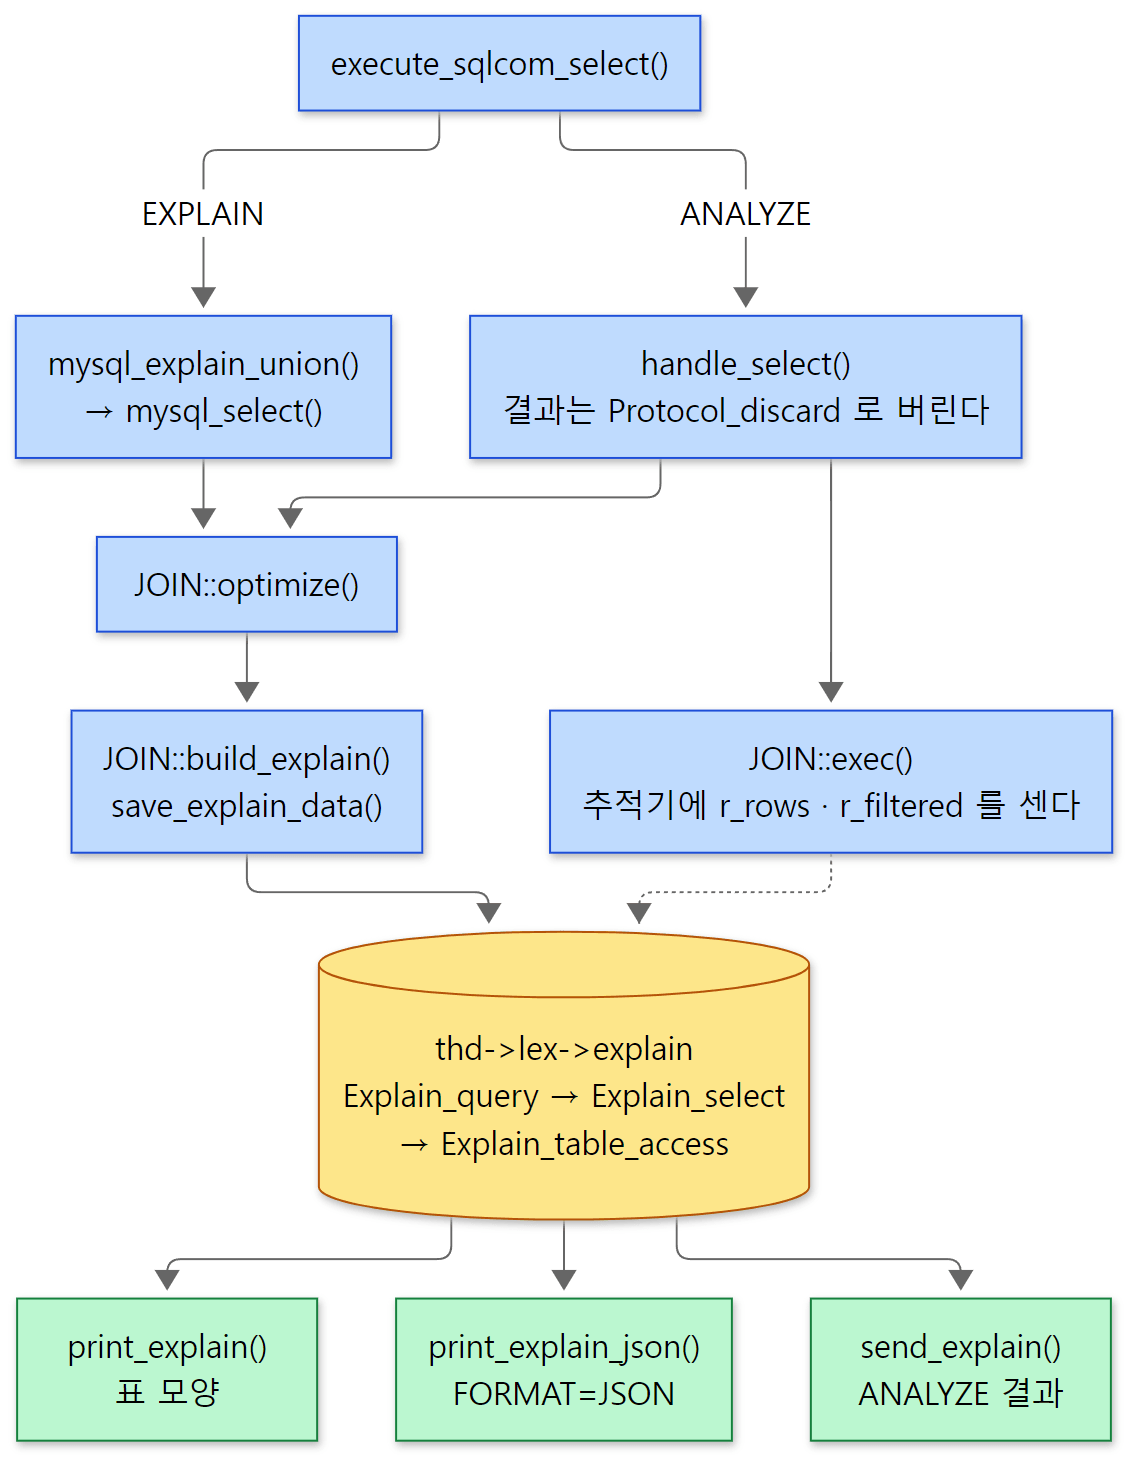 노란 원통이 따로 베껴 둔 EXPLAIN 자료입니다. EXPLAIN과 ANALYZE는 같은 자료를 쓰고, ANALYZE만 실행하며 실제 값을 채웁니다.
execute_sqlcom_select()에서 두 길이 갈립니다. EXPLAIN은 mysql_explain_union()으로 최적화만 하고 lex->explain_json이면 print_explain_json(), 아니면 print_explain()을 부릅니다(6189–6222행). ANALYZE는 쿼리를 정말 실행하되 결과 행을 클라이언트에 보내지 않습니다.
      if (lex->analyze_stmt)
      {
        // ... (결과를 가로채는 객체가 없는 보통의 경우)
          result= new (thd->mem_root) select_send_analyze(thd);
          save_protocol= thd->protocol;
          thd->protocol= new Protocol_discard(thd);
        // ...
      res= handle_select(thd, lex, result, 0);
      // ... (프로토콜을 되돌린다)
        if (!res)
        {
          bool extended= thd->lex->describe & DESCRIBE_EXTENDED;
          res= thd->lex->explain->send_explain(thd, extended);
        }
Protocol_discard(행을 받아서 버리는 Protocol)로 바꿔 끼우고 보통의 handle_select()로 실행한 뒤, 같은 EXPLAIN 자료를 send_explain()으로 보냅니다. 실행하는 동안 Explain_table_access의 추적기(Table_access_tracker tracker 등)가 실제로 읽은 행 수를 세고, 그것이 r_rows·r_filtered가 됩니다. 결과 행 전송(5편의 Protocol)만 빼고 다 실제로 하는 셈입니다.
optimizer_trace — 옵티마이저 곳곳에 박힌 JSON 기록기
추적은 별도의 단계가 아니라 옵티마이저 코드 곳곳에 박혀 있습니다. 위에서 본 optimize_cond()의 Json_writer_object equal_prop_wrapper(thd), test_quick_select()의 Json_writer_object table_rec(thd, "table_scan"), best_extension_by_limited_search()의 trace_one_table.add("pruned_by_cost", true)가 모두 추적 기록입니다. 추적이 꺼져 있으면 이 객체들은 아무것도 쓰지 않고, 비싼 기록은 if (unlikely(thd->trace_started()))로 아예 건너뜁니다.
문장마다 추적을 여닫는 곳은 mysql_execute_command()의 Opt_trace_start ots(thd);(sql_parse.cc 3735행)입니다. Opt_trace_start::init()이 추적이 꺼져 있으면 깃발 하나만 보고 돌아가도록 인라인 함수로 되어 있다는 주석이 sql/opt_trace.h 80–101행에 있습니다. 소멸자가 JSON을 닫고 6절에서 본 Opt_trace_context::end()를 부릅니다. 추적 크기는 optimizer_trace_max_mem_size(기본 1MB — sys_vars.cc 3152–3156행)를 넘으면 잘립니다.
이 글에서 뺀 것
- 서브쿼리 최적화 — 세미조인 변환
convert_join_subqueries_to_semijoins()(sql/opt_subselect.cc1181행), 세미조인 전략 고르기optimize_semijoin_nests()(2548행),IN→EXISTS, 구체화 - 파생 테이블·뷰 합치기와 조건 밀어 넣기 —
handle_derived(…, DT_MERGE),pushdown_cond_for_derived()(sql_select.cc2567–2605행) - 인덱스 병합(
index_merge)과 ROR 교집합 —get_best_ror_intersect()(opt_range.cc7462행), 루스 인덱스 스캔get_best_group_min_max()(14748행) ORDER BY … LIMIT을 정렬 없이 끝내는 계획 —join_limit_shortcut_finalize_plan()(sql_select.cc12189행),test_if_skip_sort_order()- rowid 필터 —
JOIN::make_range_rowid_filters()(2091행) - 테이블 제거(쓰이지 않는 외부 조인 테이블 빼기) —
eliminate_tables()(sql/opt_table_elimination.cc739행) - 파티션 가지치기 —
prune_partitions()(opt_range.cc4188행) - 조인 버퍼와 해시 조인(
hash_ALL등) — 9편 - 옵티마이저 힌트 —
sql/opt_hints.cc,sql/opt_hints_parser.cc - 옵티마이저 맥락을 저장하고 재현하는 기능(
optimizer_record_context) —sql/opt_context_store_replay.cc - 2단계 최적화(분할 구체화, split-materialized) —
check_two_phase_optimization(),JOIN::optimize_stage2_and_finish()(2056행)
정리
| 개념 | 한 줄 요약 |
|---|---|
JOIN::optimize() |
한 번만 돈다. optimize_inner() 후 build_explain(), 고른 비용을 Last_query_cost에 |
optimize_cond() |
같음 전파 → 상수 전파 → 뻔한 조건 지우기. 늘 거짓이면 Impossible WHERE |
simplify_joins() |
WHERE가 오른쪽 테이블의 NULL을 거부하면 LEFT JOIN을 JOIN으로 |
make_join_statistics() |
handler::info()로 행 수, const 테이블은 그 자리에서 읽고, 범위·선택도를 구한 뒤 choose_plan() |
| const 테이블 | 유일 키가 상수로 묶이면 최적화 중에 읽는다. EXPLAIN만 해도 Handler_read_key가 는다 |
test_quick_select() |
풀 스캔 비용을 기준선으로, get_mm_tree()로 만든 구간을 인덱스마다 따진다 |
SEL_TREE/SEL_ARG |
WHERE를 인덱스 위의 구간으로 바꾼 것. AND는 tree_and(), OR는 tree_or() |
records_in_range() |
엔진이 구간의 행 수를 어림한다. InnoDB는 B-트리를 내려가 센다 |
| 비용 모델 | 1 = 1밀리초. 블록 수 × 디스크 읽기 × 캐시 미스 비율 + CPU. 상수는 엔진마다 |
greedy_search() |
깊이 search_depth까지 따져 한 자리씩 확정. 기본 62라 사실상 전수 탐색 |
best_extension_by_limited_search() |
행 수는 곱하고 비용은 더하며, 최선보다 비싸지면 가지를 자른다 |
best_access_path() |
앞 테이블에 따라 ref/eq_ref, 범위, 풀 스캔 가운데 가장 싼 것 |
| 히스토그램 | ANALYZE TABLE … PERSISTENT FOR로 모은다. filtered가 바뀌면 조인 순서가 바뀐다 |
| EXPLAIN 자료 | Item 없이 따로 베껴 둔 Explain_* 나무. ANALYZE는 실행하며 r_*를 채운다 |
| optimizer_trace | 옵티마이저 곳곳의 Json_writer. 문장마다 새로 쓰고 마지막 하나만 남는다 |
다음에 볼 것
계획이 정해졌습니다. best_positions[]대로 JOIN_TAB 배열이 만들어졌고, 테이블마다 붙일 조건과 읽기 함수도 정해졌습니다. 이제 JOIN::exec()가 이 배열을 중첩 루프로 돌며 handler를 부릅니다. 예제 1의 계획 "o를 훑으며 행마다 c를 eq_ref로" 가 실제로 rr_sequential()과 join_read_key(), 그리고 ha_innobase::rnd_next()·index_read() 호출이 되는 모습을 9편: 실행과 handler API — 중첩 루프 조인이 엔진을 부르는 법에서 봅니다. 이 글에서 숫자로만 본 Handler_read_key가 어디서 1씩 느는지도 거기서 나옵니다.
앞 연재에서 "여러 후보 가운데 하나를 고르는" 코드를 두 번 만났습니다. Tomcat 7편의 Mapper는 서블릿 스펙이 정한 고정된 규칙 순서(정확히 → 가장 긴 접두사 → 확장자 → 기본)로 고르고, Spring 22편의 RequestMappingHandlerMapping은 후보를 모은 뒤 비교기로 "가장 구체적인 것"을 고릅니다. 옵티마이저는 같은 일을 추정한 숫자로 합니다. 그래서 같은 SQL이라도 인덱스와 통계가 바뀌면 다른 답을 내고, 예제 2가 그것을 보여 줍니다.
애플리케이션 쪽에서 이 글을 쓸 일은 대개 "느린 쿼리"를 만났을 때입니다. Spring 18편의 JdbcTemplate이나 Spring 19편의 JPA가 보낸 SQL을 그대로 EXPLAIN·ANALYZE에 넣어 보고, filtered와 r_filtered가 크게 다르면 히스토그램을, 기대한 인덱스가 possible_keys에도 없으면 2절의 조건 모양(LEFT JOIN, 함수로 감싼 열)을 먼저 의심해 보세요.
- 2편: 전체 지도 — 서버 계층과 스토리지 엔진, 그리고 쿼리 하나의 일생
- 6편: 파서 — SQL 문장이 LEX와 Item 나무가 되기까지
- 7편: 준비 단계 — 권한 확인, 테이블 열기, 이름 찾기
- 10편: InnoDB 1 — 페이지, 버퍼 풀, B-트리 —
records_in_range()가 내려가는 B-트리의 생김새