이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 여섯 번째 글입니다. 5편에서는 클라이언트가 보낸 패킷 하나가 dispatch_command()의 case COM_QUERY에 닿는 데까지 봤습니다. 그 자리에서 서버가 손에 쥔 것은 "SELECT name FROM t WHERE id = 1" 같은 문자열 하나뿐입니다. 이번 글은 그 문자열이 서버가 다룰 수 있는 자료 구조로 바뀌는 과정, 곧 파싱을 따라갑니다.
2편 지도의 ③ 파싱 구역을 확대합니다.
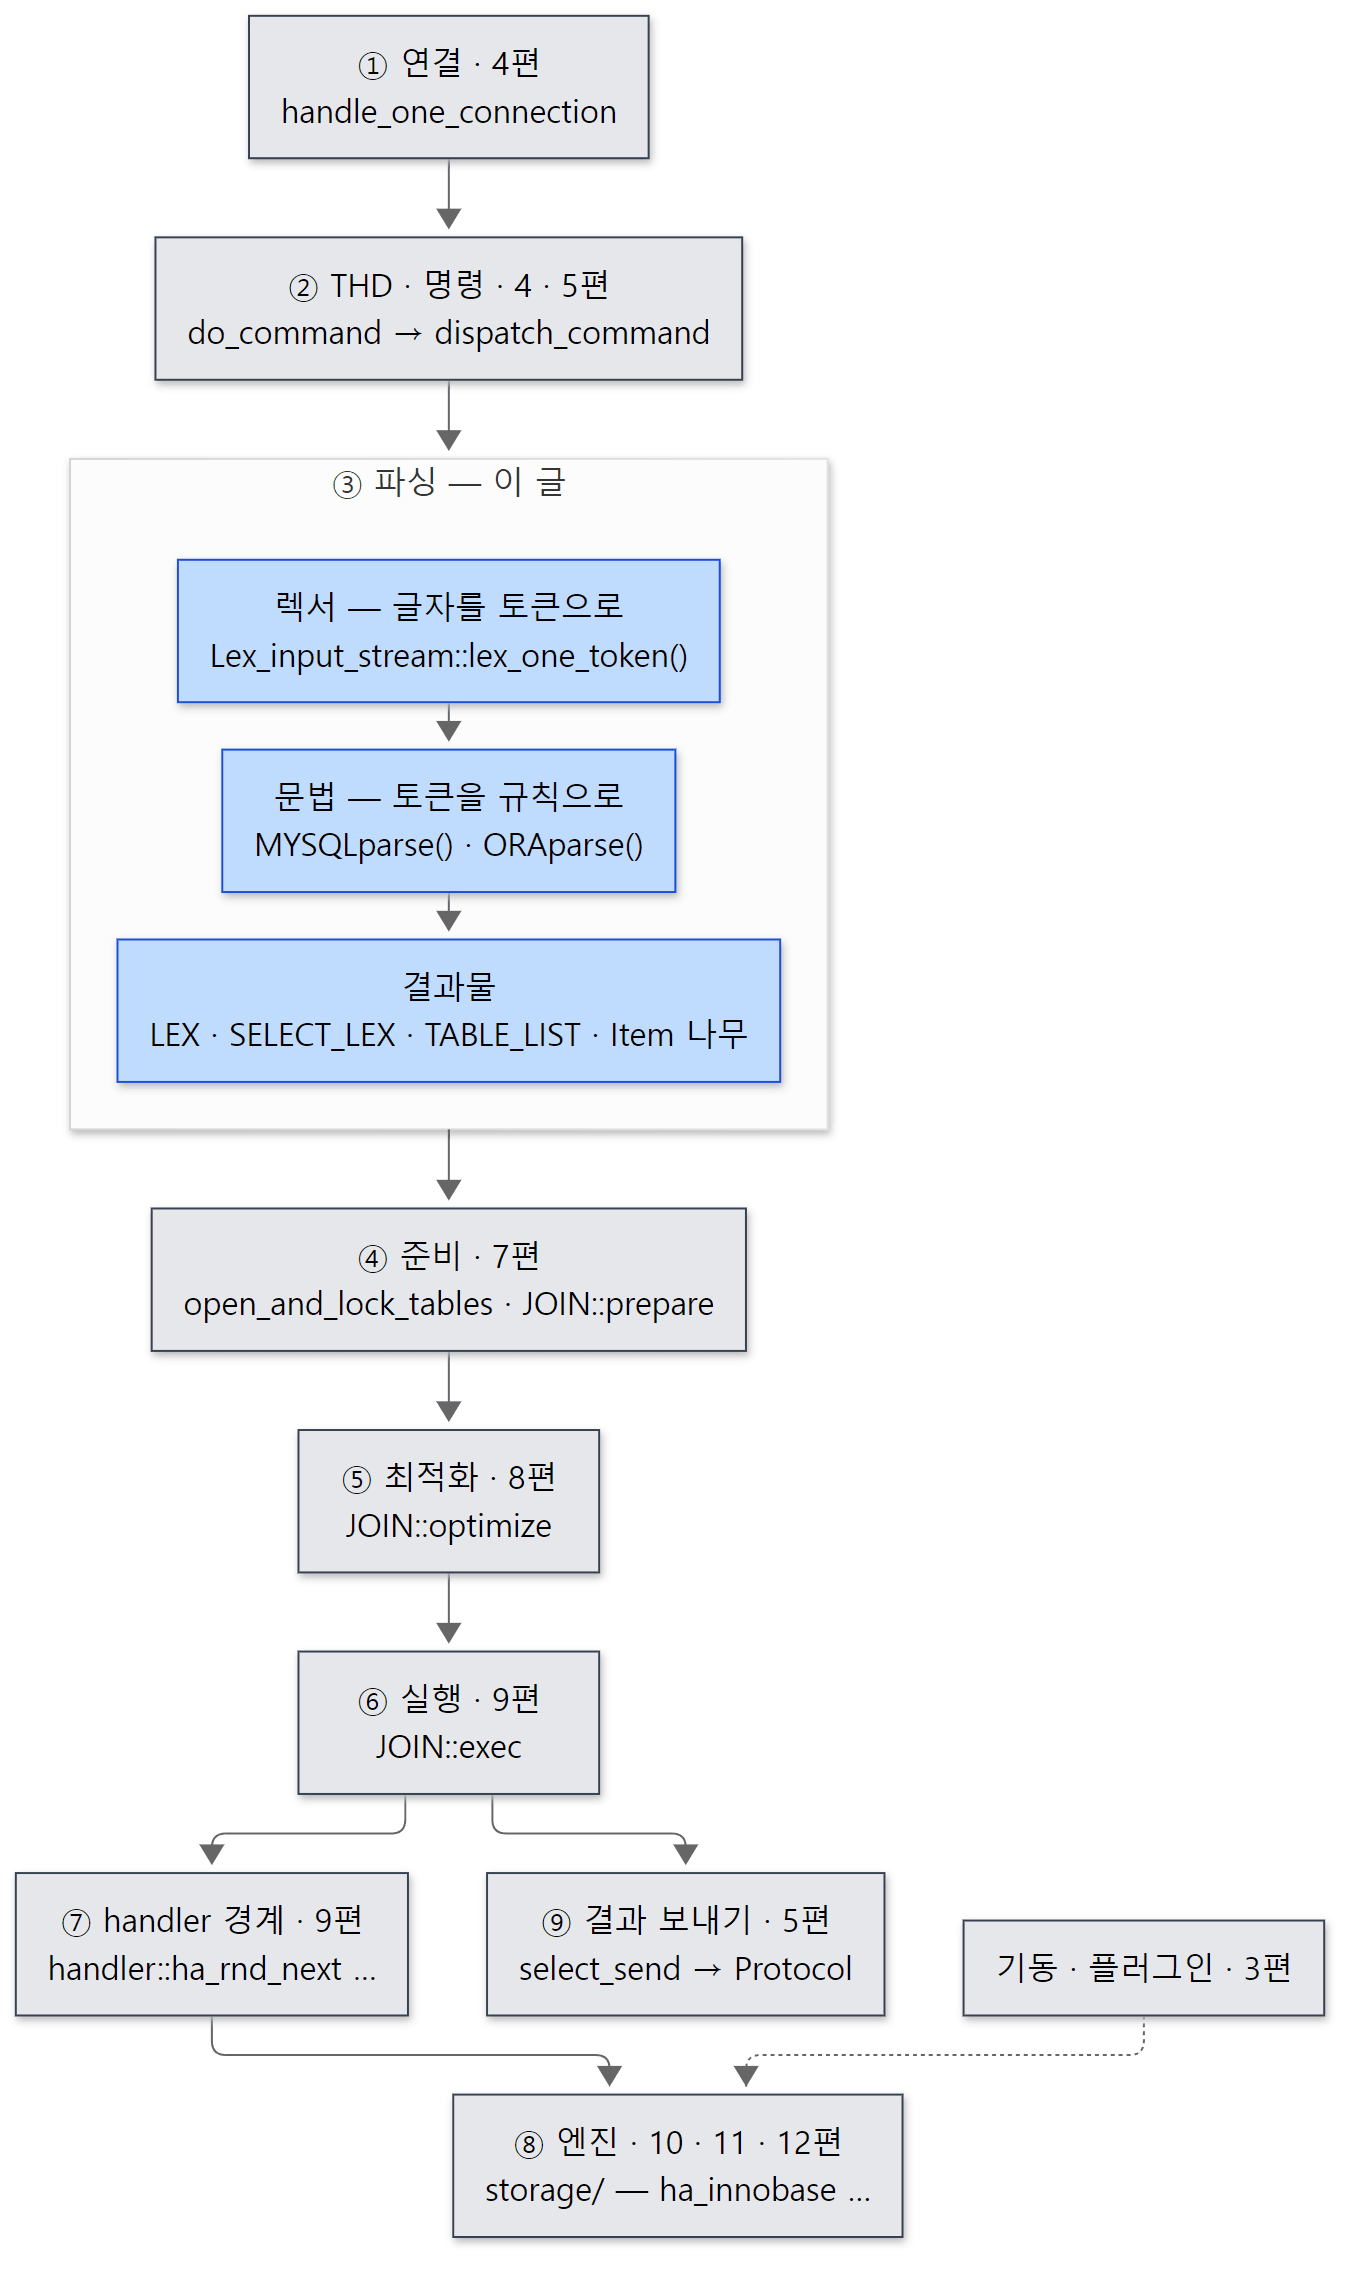 파란 칸이 이 글에서 읽는 곳, 회색 칸은 앞뒤 글에서 보는 곳입니다.
답하려는 질문은 네 가지입니다.
- 문자열
SELECT …는 누구의 손을 거쳐 어떤 구조체가 되는가. 파서는 손으로 짠 코드인가, 생성된 코드인가 sql_mode=ORACLE로 바꾸면 같은 문장이 다르게 읽히는 이유는 무엇인가- 파서가 끝났을 때
thd->lex안에는 무엇이 들어 있고, 무엇은 아직 비어 있는가 You have an error in your SQL syntax … near '...' at line 1메시지의near뒤에는 왜 그 글자가 붙는가
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | sql/sql_parse.cc, sql/sql_yacc.yy, sql/sql_lex.cc·sql_lex.h, sql/lex.h, sql/item.h, sql/sql_cmd.h, sql/CMakeLists.txt |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
문법 파일 sql_yacc.yy는 21,251줄, 렉서가 든 sql_lex.cc는 14,404줄입니다. 이 글은 SELECT 한 문장이 지나는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
렉서와 토큰. 렉서(lexer, 어휘 분석기)는 글자의 줄을 토큰(token)의 줄로 자르는 코드입니다. SELECT id FROM t는 렉서를 지나면 SELECT_SYM, ID_SYM, FROM, IDENT 네 토큰이 됩니다. 토큰은 정수 번호 하나와, 필요하면 원래 글자(t)를 함께 들고 다닙니다. MariaDB의 렉서는 sql/sql_lex.cc의 Lex_input_stream 클래스입니다.
파서, 문법, Bison. 파서(parser, 구문 분석기)는 토큰의 줄이 문법에 맞는지 보고, 맞으면 구조를 만들어 내는 코드입니다. MariaDB는 파서를 손으로 짜지 않고, 문법 규칙을 적은 파일(sql/sql_yacc.yy)을 Bison이라는 파서 생성기에 넣어 C++ 코드를 만들어 냅니다. Bison이 만드는 파서는 LALR(1) 방식입니다. 토큰을 하나씩 스택에 쌓다가(shift), 스택 꼭대기가 어떤 규칙의 오른쪽과 같아지면 그것을 규칙 이름 하나로 줄입니다(reduce). 다음 토큰을 하나만 미리 보고(1) 이 결정을 합니다.
규칙과 액션. 문법 파일의 규칙에는 { … }로 C++ 코드를 붙일 수 있고, 이것을 액션(action)이라고 합니다. 규칙이 하나 완성될 때(reduce할 때) 그 액션이 실행됩니다. $1, $2는 규칙 오른쪽 조각들의 값, $$는 이 규칙이 만들어 위로 올려 보내는 값입니다. MariaDB의 파서는 이 액션들이 자료 구조를 만드는 것이 전부라고 해도 됩니다.
LEX. 파서가 문장 하나를 읽고 남기는 결과 전체입니다. 연결마다 하나 있는 THD(2편)의 thd->lex가 가리킵니다. 문장의 종류(sql_command — SQLCOM_SELECT, SQLCOM_UPDATE …), 문장에 나온 모든 테이블, 그리고 아래의 SELECT_LEX 나무를 가집니다.
SELECT_LEX와 SELECT_LEX_UNIT. SELECT_LEX(클래스 이름은 st_select_lex)는 SELECT … FROM … WHERE … 하나입니다. 고른 열 목록(item_list), FROM의 테이블들(table_list), WHERE 조건(where)을 가집니다. SELECT_LEX_UNIT(st_select_lex_unit)은 UNION으로 묶인 SELECT 여러 개, 또는 서브쿼리 하나를 묶는 단위입니다. 서브쿼리가 있으면 이 둘이 번갈아 쌓인 나무가 됩니다.
TABLE_LIST 는 FROM 절의 테이블 하나를 가리키는 칸입니다. 파서가 만드는 시점에는 데이터베이스 이름, 테이블 이름, 별칭 같은 이름만 들어 있습니다. 실제 테이블을 여는 것은 7편의 일입니다.
Item 은 식(expression) 하나를 나타내는 객체입니다. 열 이름 id는 Item_field, 상수 1은 Item_int, id = 1은 Item_func_eq, … AND …는 Item_cond_and입니다. 식은 식을 품으므로 Item들은 나무를 이룹니다. 모든 Item은 연결의 메모리 풀 thd->mem_root(2편에서 본 MEM_ROOT)에서 만들어지고, 문장이 끝나면 한꺼번에 버려집니다(COM_QUERY로 온 보통 문장의 경우입니다. 준비된 문장은 자기 메모리 풀 Prepared_statement::main_mem_root를 따로 가지고 그 문장이 해제될 때 버립니다).
1. 파서로 들어가는 문 — mysql_parse()와 parse_sql()
5편에서 본 dispatch_command()의 case COM_QUERY는 파서 상태를 담을 Parser_state를 스택에 하나 만들고, 받은 문자열로 초기화한 다음 mysql_parse()를 부릅니다.
    Parser_state parser_state;
    if (unlikely(parser_state.init(thd, thd->query(), thd->query_length())))
      break;
    // ... (WSREP 블록 생략)
      mysql_parse(thd, thd->query(), thd->query_length(), &parser_state);
Parser_state 안에는 렉서(Lex_input_stream m_lip)와 Bison의 스택 상태(Yacc_state m_yacc)가 들어 있습니다(sql/sql_lex.h 5572–5573행). 문장 하나를 읽는 동안만 쓰고 버리는 것이라 스택 변수로 충분합니다.
mysql_parse()의 앞부분은 이렇습니다.
void mysql_parse(THD *thd, char *rawbuf, uint length,
                 Parser_state *parser_state)
{
  DBUG_ENTER("mysql_parse");
  DBUG_EXECUTE_IF("parser_debug", turn_parser_debug_on_MYSQLparse(););
  DBUG_EXECUTE_IF("parser_debug", turn_parser_debug_on_ORAparse(););
  // ... (쿼리 캐시와 초기화 순서에 대한 긴 주석)
  lex_start(thd);
  thd->reset_for_next_command();

  if (query_cache_send_result_to_client(thd, rawbuf, length) <= 0)
  {
    LEX *lex= thd->lex;

    bool err= parse_sql(thd, parser_state, NULL, true);
lex_start()가thd->lex를 이번 문장용으로 비웁니다.LEX객체를 문장마다 새로 만들지 않고, 연결이 가진 것을 다시 씁니다.- 쿼리 캐시를 먼저 봅니다. 같은 문자열의 결과가 캐시에 있으면 파싱을 아예 하지 않습니다. 캐시가 문자열로 찾는 이유와 기본값이 꺼져 있다는 것은 5편에서 봤습니다.
parse_sql()이 실제 파싱을 합니다. 성공하면(err가 거짓) 같은 함수 안에서 조금 아래의mysql_execute_command(thd)(8005행)로 넘어갑니다.
parse_sql()의 핵심은 두 줄입니다.
  /* Parse the query. */

  bool mysql_parse_status= thd->variables.sql_mode & MODE_ORACLE
                           ? ORAparse(thd) : MYSQLparse(thd);
파서 함수가 두 개입니다. sql_mode에 ORACLE이 있으면 ORAparse(), 없으면 MYSQLparse()를 부릅니다. 두 함수 모두 손으로 짠 것이 아니라 Bison이 만든 것이고, 인자는 THD 하나뿐입니다. 읽을 문자열과 결과를 놓을 곳이 모두 thd 안(thd->m_parser_state, thd->lex)에 있기 때문입니다. 돌려주는 값은 성공이면 0입니다.
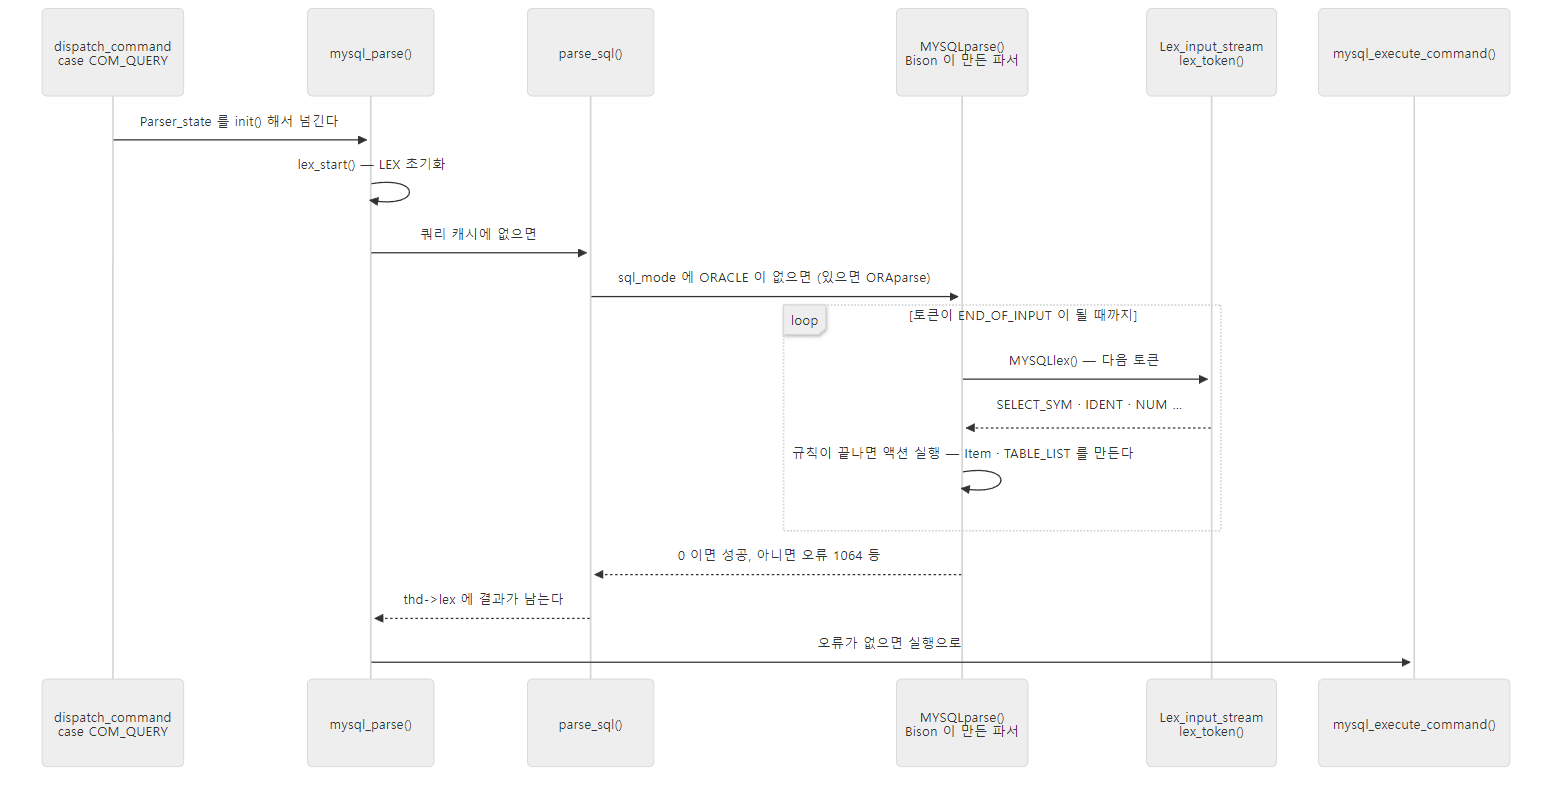 파서는 렉서를 부르는 쪽입니다. 렉서가 문자열을 한꺼번에 토큰 배열로 바꿔 두는 것이 아니라, 파서가 토큰이 필요할 때마다 하나씩 달라고 합니다.
파서가 성공했다는 것은 문법에 맞는다는 뜻일 뿐입니다. 테이블이 있는지, 열 이름이 맞는지, 권한이 있는지는 보지 않습니다(5절 끝의 예제에서 확인합니다).
헷갈리기 쉬운 곳: 한 패킷에 문장이 여럿이면
클라이언트가 CLIENT_MULTI_QUERIES를 켜고 SELECT 1; SELECT 2를 한 패킷에 보내면, 파서는 첫 문장의 ;에서 멈추고 다음 문장이 시작하는 자리를 found_semicolon에 적어 둡니다(query 규칙, sql_yacc.yy 2165–2177행). dispatch_command()는 첫 문장을 실행한 뒤 while (… parser_state.m_lip.found_semicolon != NULL …) 루프(1905행)에서 그 자리부터 다시 mysql_parse()를 부릅니다. 파서 한 번은 언제나 문장 하나만 읽습니다.
2. 문법 원본 하나, 파서 둘 — sql_yacc.yy와 sql_mode=ORACLE
MYSQLparse()와 ORAparse()는 저장소 어디에도 없습니다. 빌드할 때 생깁니다. sql/CMakeLists.txt가 그 순서를 적어 둡니다. 먼저 ADD_CUSTOM_COMMAND가 gen_yy_files.cmake 스크립트로 sql_yacc.yy를 빌드 폴더의 yy_oracle.yy와 yy_mariadb.yy 둘로 나눕니다(sql/CMakeLists.txt 77–89행). 그다음 나뉜 두 파일을 각각 Bison에 넣습니다.
  BISON_TARGET(gen_mariadb_cc_hh ${CMAKE_CURRENT_BINARY_DIR}/yy_mariadb.yy
                                 ${CMAKE_CURRENT_BINARY_DIR}/yy_mariadb.cc
               COMPILE_FLAGS "-p MYSQL -S ${CMAKE_CURRENT_BINARY_DIR}/myskel.m4")
  BISON_TARGET(gen_oracle_cc_hh ${CMAKE_CURRENT_BINARY_DIR}/yy_oracle.yy
                                ${CMAKE_CURRENT_BINARY_DIR}/yy_oracle.cc
               COMPILE_FLAGS "-p ORA -S ${CMAKE_CURRENT_BINARY_DIR}/myskel.m4")
Bison의 -p 옵션은 생성되는 함수 이름의 머리를 바꿉니다. 기본 이름 yyparse·yylex·yyerror가 -p MYSQL이면 MYSQLparse·MYSQLlex·MYSQLerror, -p ORA면 ORAparse·ORAlex가 됩니다. 같은 프로그램 안에 파서 두 개가 이름이 부딪치지 않고 들어가는 방법입니다. 예제 이미지의 mariadbd에서 nm -C로 심볼 표를 찍어 보면 MYSQLparse(THD*), ORAparse(THD*), MYSQLlex(YYSTYPE*, THD*), MYSQLerror(THD*, char const*)가 따로따로 들어 있고, 추적 스위치인 전역 변수도 MYSQLdebug와 ORAdebug 두 개입니다.
나누는 일은 gen_yy_files.cmake가 합니다. sql_yacc.yy 안에는 C 전처리기를 흉내 낸 %ifdef MARIADB 또는 %ifdef ORACLE로 시작해 %endif로 끝나는 구역이 25개 있고, 이 스크립트가 파일을 위에서부터 읽어 내려가며 지시어 줄을 만날 때마다 이후의 줄을 어느 쪽 파일로 보낼지 정합니다. 눈여겨볼 것은 한쪽 파일에 줄을 쓸 때 다른 쪽 파일에는 글자를 다 지운 빈 줄을 쓴다는 것입니다(string(REGEX REPLACE "[^\n]+" "" line "${line}"), sql/gen_yy_files.cmake 30–37행). 그래서 yy_mariadb.yy와 yy_oracle.yy는 줄 번호가 원본 sql_yacc.yy와 똑같습니다. 컴파일 오류나 Bison 추적에 찍히는 줄 번호를 원본에서 그대로 찾을 수 있다는 뜻이고, 4절의 예제가 이 덕을 봅니다.
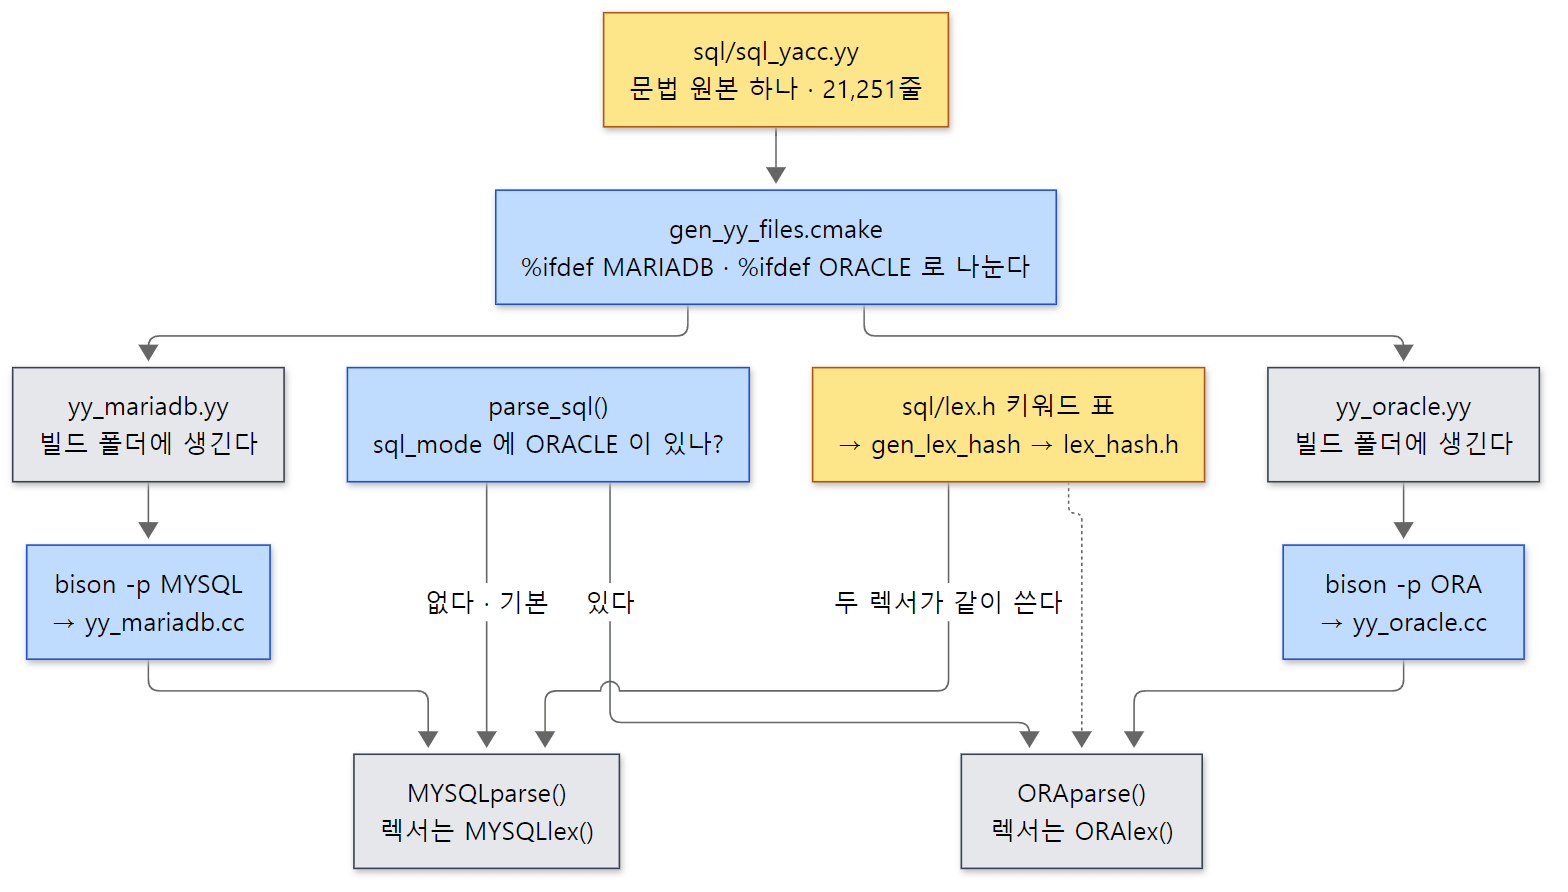 노란 상자가 저장소에 있는 원본, 회색 상자는 빌드할 때 생기는 것입니다.
문법 파일의 머리에는 이 파서가 어떤 모양으로 만들어질지가 적혀 있습니다.
%define api.pure                                    /* We have threads */
%parse-param { THD *thd }
%lex-param { THD *thd }
/*
  We should not introduce any further shift/reduce conflicts.
*/

%ifdef MARIADB
%expect 72
%else
%expect 73
%endif
%define api.pure는 "전역 변수를 쓰지 않는 파서"를 만들라는 뜻입니다. 기본 Bison 파서는 현재 토큰 값(yylval) 같은 것을 전역 변수에 둡니다. 연결마다 스레드가 따로 도는 서버(4편)에서 그러면 두 연결의 파싱이 서로를 덮어씁니다. 주석 그대로 "스레드가 있으니까"입니다.%parse-param·%lex-param은 파서 함수와 렉서 함수에THD *thd인자를 하나씩 더합니다.MYSQLparse(THD *thd)라는 모양이 여기서 나옵니다. 액션 안에서thd를 쓸 수 있는 것도 이 덕입니다.%expect 72는 "이 문법에는 shift/reduce 충돌이 정확히 72개 있고, 알고 있다"는 선언입니다. 실제 충돌 수가 이 숫자와 다르면 Bison은 오류를 내고 멈춥니다(예제 이미지에 든 Bison 3.8.2로 작은 문법을 만들어 확인했습니다). 위 주석은 "충돌을 더 늘리지 말라"고 적어 두었습니다. Oracle 문법 쪽은 하나 더 많은 73입니다.
예제 1: 같은 문장, 다른 문법
sql_mode를 바꿔 같은 문장을 보내 봤습니다. 이 예제와 이 글의 다른 예제는 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 예제 폴더는 ex/u06-two-grammars입니다.
-- 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
-- 같은 문장이 sql_mode 에 따라 다른 파서(MYSQLparse / ORAparse)로 읽힌다.
-- ... (테이블 lab.t 를 만들고 id 1, 2, 3 을 넣는 부분 생략)
SELECT '--- 1. default sql_mode';
SELECT 'a' || 'b' AS concat_or_or;
SHOW WARNINGS;

SELECT '--- 2. sql_mode=ORACLE';
SET sql_mode = ORACLE;
SELECT @@sql_mode;
SELECT 'a' || 'b' AS concat_or_or;
SELECT id FROM t MINUS SELECT id FROM t WHERE id = 2;
SET sql_mode = DEFAULT;
run.sh는 이 파일을 mariadb -N -B(표 테두리와 열 이름 없이 값만)로 보낸 뒤, 기본 sql_mode에서 MINUS가 든 문장 두 개를 더 보냅니다. 첫째는 SELECT MINUS.id FROM lab.t MINUS WHERE MINUS.id = 1, 둘째는 위와 같은 MINUS 문장입니다.
--- 1. default sql_mode
0
Warning	1292	Truncated incorrect DOUBLE value: 'a'
Warning	1292	Truncated incorrect DOUBLE value: 'b'
--- 2. sql_mode=ORACLE
PIPES_AS_CONCAT,ANSI_QUOTES,IGNORE_SPACE,ORACLE,NO_KEY_OPTIONS,NO_TABLE_OPTIONS,NO_FIELD_OPTIONS,NO_AUTO_CREATE_USER,SIMULTANEOUS_ASSIGNMENT
ab
1
3
--- 3. MINUS in default sql_mode
1
--------------
SELECT id FROM lab.t MINUS SELECT id FROM lab.t WHERE id = 2
--------------

ERROR 1064 (42000) at line 1: You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near 'SELECT id FROM lab.t WHERE id = 2' at line 1
||. 기본 모드에서'a' || 'b'는 논리합(OR)이라 두 문자열을 숫자로 바꾸려다 경고 두 개와 함께 0이 됩니다.ORACLE모드에서는 문자열 이어 붙이기라ab입니다.MINUS.ORACLE모드에서는EXCEPT와 같은 뜻이라 1, 2, 3에서 2를 뺀 1, 3이 나옵니다. 기본 모드에서는 문법 오류가 나는데, 오류 위치가MINUS가 아니라 그다음의SELECT입니다. 바로 앞의SELECT MINUS.id FROM lab.t MINUS WHERE MINUS.id = 1이 성공해 1을 돌려준 것을 보면 까닭을 알 수 있습니다. 기본 문법에서MINUS는 테이블 별칭으로 쓸 수 있는 낱말입니다.
이 차이는 렉서와 문법 두 곳에서 만들어집니다. ||는 렉서가 키워드 표에서 OR2_SYM을 찾은 뒤 sql_mode를 보고 토큰을 바꿉니다. ORACLE 모드에는 PIPES_AS_CONCAT이 들어 있으므로(위 출력) 이어 붙이기 토큰이 됩니다.
    if ((symbol->tok == OR2_SYM) &&
        (m_thd->variables.sql_mode & MODE_PIPES_AS_CONCAT))
    {
      return (m_thd->variables.sql_mode & MODE_ORACLE) ?
             ORACLE_CONCAT_SYM : MYSQL_CONCAT_SYM;
    }
MINUS는 같은 함수의 조금 위에서, ORACLE 모드일 때 MINUS_ORACLE_SYM 토큰을 EXCEPT_SYM으로 바꿔 돌려줍니다(1434행). 기본 모드에서는 바뀌지 않은 MINUS_ORACLE_SYM이 파서에 가는데, 문법 파일에서 이 토큰은 %ifdef MARIADB 아래 keyword_func_sp_var_and_label 목록에 들어 있습니다(sql_yacc.yy 17267–17269행). 이름 자리에 써도 되는 키워드 목록입니다. 그래서 FROM lab.t MINUS가 "별칭이 MINUS인 테이블"로 읽히고, 그 뒤의 SELECT에서 막힙니다.
헷갈리기 쉬운 곳: ORACLE 모드는 "다른 파서"이지 "옵션 하나"가 아닙니다
SET sql_mode=ORACLE은 렉서의 토큰 몇 개만 바꾸는 것이 아니라 parse_sql()이 부르는 함수 자체를 바꿉니다. 그래서 렉서가 손댈 수 없는 문법 규칙까지 달라집니다. 예를 들어 저장 프로그램의 레코드 타입을 읽는 rec_field_definition 규칙은 %ifdef ORACLE 안에만 있습니다(sql_yacc.yy 3688행). 반대로 PIPES_AS_CONCAT이나 IGNORE_SPACE 같은 플래그는 기본 파서에서도 따로 켤 수 있고, 그때는 렉서만 달라집니다.
3. 렉서 — 글자를 토큰으로
파서가 토큰을 달라고 부르는 MYSQLlex()와 ORAlex()는 둘 다 몸통이 return thd->m_parser_state->m_lip.lex_token(yylval, thd); 한 줄입니다(sql/sql_lex.cc 1879–1888행). 렉서는 하나입니다. 두 이름은 Bison의 -p 때문에 생긴 껍데기이고, sql_mode에 따른 차이는 렉서 안에서 m_thd->variables.sql_mode를 보고 냅니다(앞 절의 find_keyword()).
첫 글자로 갈래를 고른다 — state_map
실제로 글자를 읽는 것은 lex_one_token()입니다. 공백을 건너뛰고, 토큰의 첫 글자 하나로 무엇을 읽을지 정합니다.
int Lex_input_stream::lex_one_token(YYSTYPE *yylval, THD *thd)
{
  // ...
  const uchar *const state_map= cs->state_map;
  // ...
  for (;;)
  {
    switch (state) {
    case MY_LEX_OPERATOR_OR_IDENT:        // Next is operator or keyword
    case MY_LEX_START:                    // Start of token
      // Skip starting whitespace
      while(state_map[c= yyPeek()] == MY_LEX_SKIP)
      {
        if (c == '\n')
          yylineno++;

        yySkip();
      }

      /* Start of real token */
      restart_token();
      c= yyGet();
      state= (enum my_lex_states) state_map[c];
      break;
state_map은 글자 값(0–255)을 칸 번호로 하는 256칸짜리 표이고, 칸마다 "이 글자로 시작하면 어떤 상태로 가라"가 적혀 있습니다. 표는 문자 집합(charset)마다 하나씩, 문자 집합들을 처음 준비할 때(mysys/charset.c의 init_available_charsets()) 만들어 둡니다(cs->state_map). 글자마다 if를 줄줄이 늘어놓는 대신 표 한 번 보고 switch로 뛰는 구조입니다. 표를 채우는 코드를 보면 갈래가 한눈에 보입니다.
  for (i=0; i < 256 ; i++)
  {
    if (my_isalpha(cs,i))
      state_map[i]=(uchar) MY_LEX_IDENT;
    else if (my_isdigit(cs,i))
      state_map[i]=(uchar) MY_LEX_NUMBER_IDENT;
    // ...
    else if (my_isspace(cs,i))
      state_map[i]=(uchar) MY_LEX_SKIP;
    else
      state_map[i]=(uchar) MY_LEX_CHAR;
  }
  state_map[(uchar)'_']=state_map[(uchar)'$']=(uchar) MY_LEX_IDENT;
  state_map[(uchar)'\'']=(uchar) MY_LEX_STRING;
  // ...
  state_map[(uchar)'>']=state_map[(uchar)'=']=state_map[(uchar)'!']= (uchar) MY_LEX_CMP_OP;
  // ...
  state_map[(uchar)'-']= (uchar) MY_LEX_MINUS_OR_COMMENT;
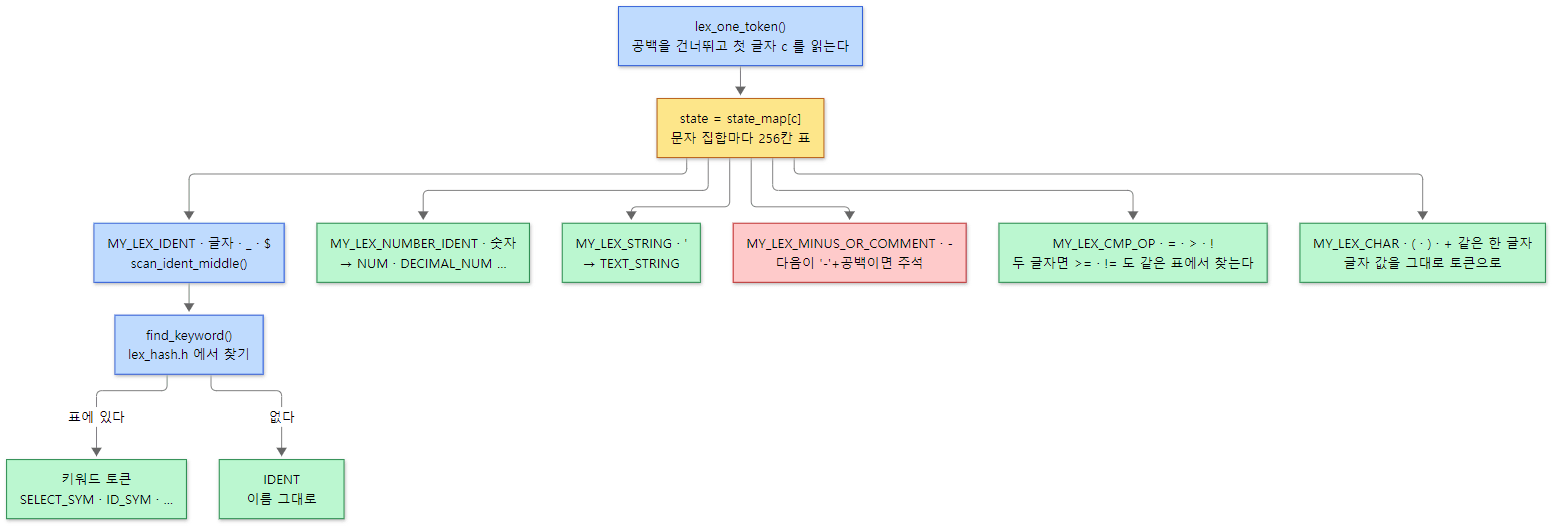 빨간 칸이 아래 예제에서 실제로 사람을 헷갈리게 만드는 갈래입니다.
키워드인가, 이름인가 — lex.h와 find_keyword()
글자로 시작하는 낱말을 다 읽으면, 그것이 키워드인지 그냥 이름(IDENT)인지를 표에서 찾습니다. 표의 원본은 sql/lex.h입니다.
SYMBOL symbols[] = {
  { "&&",		SYM(AND_AND_SYM)},
  { "<=",		SYM(LE)},
표는 둘입니다. symbols[](49–751행)에 700개, sql_functions[](754–804행)에 49개가 있습니다. symbols[]의 맨 앞이 &&, <= 같은 연산자인 것도 눈에 띕니다. 두 글자 연산자도 같은 표로 찾습니다. 이 배열을 빌드 때 gen_lex_hash라는 작은 프로그램이 읽어 빠른 검색표 lex_hash.h를 만들고(sql/CMakeLists.txt 447행과 450–454행), sql_lex.cc가 그것을 #include합니다(685행).
sql_functions[]가 따로 있는 까닭은 scan_ident_middle()의 이 부분에서 보입니다.
  {                                    // '(' must follow directly if function
    int tokval;
    yyUnget();
    if ((tokval= find_keyword(str, length, c == '(')))
    {
      next_state= MY_LEX_START;        // Allow signed numbers
      return(tokval);                  // Was keyword
    }
    yySkip();                  // next state does a unget
  }
find_keyword()의 세 번째 인자는 "낱말 바로 뒤가 (인가"입니다. lex_hash.h의 get_hash_symbol()은 이 값이 참일 때만 sql_functions[]까지 찾습니다. NOW, COUNT, MAX, SUBSTR 같은 49개는 바로 뒤에 괄호가 붙을 때만 키워드이고, 그렇지 않으면 평범한 이름입니다. 그래서 now나 count라는 열을 만들 수 있습니다.
두 토큰을 미리 본다 — lex_token()
Bison 파서는 토큰을 하나만 미리 봅니다(LALR(1)). 그런데 SQL에는 두 개를 봐야 정해지는 곳이 있습니다. GROUP BY a WITH ROLLUP의 WITH는 WITH 하나만 봐서는 WITH 절(CTE)의 시작인지 ROLLUP의 앞인지 알 수 없습니다. MariaDB는 이것을 문법이 아니라 렉서에서 풉니다.
  switch(token) {
  case WITH:
    /*
      Parsing 'WITH' 'ROLLUP' or 'WITH' 'CUBE' requires 2 look ups,
      which makes the grammar LALR(2).
      Replace by a single 'WITH_ROLLUP' or 'WITH_CUBE' token,
      to transform the grammar into a LALR(1) grammar,
      which sql_yacc.yy can process.
    */
    token= lex_one_token(yylval, thd);
    add_digest_token(token, yylval);
    switch(token) {
    // ...
    case ROLLUP_SYM:
      return WITH_ROLLUP_SYM;
    // ...
    default:
      // ...
      lookahead_yylval= yylval;
      lookahead_token= token;
      return WITH;
lex_token()은 lex_one_token()을 감싼 함수입니다. WITH 다음 토큰을 하나 더 읽어 보고 ROLLUP이면 둘을 합친 WITH_ROLLUP_SYM 하나를 돌려줍니다. 아니면 읽은 토큰을 lookahead_token에 맡겨 두고 WITH만 돌려주고, 다음 호출 때 맡겨 둔 것을 먼저 내줍니다(1896–1907행). FOR SYSTEM_TIME, VALUES LESS, VALUES IN도 같은 식으로 합칩니다. 파서 입장에서는 두 낱말짜리 토큰이 하나 있는 것처럼 보입니다.
예제 2: 렉서가 낱말을 자르는 법
ex/u06-lexer-errors의 run.sh에서 렉서와 관련된 네 문장입니다. 작은 함수 q는 제목을 찍고 mariadb -N -B -e(표 테두리와 열 이름 없이 값만)로 문장 하나를 보내며, 오류가 나면 ERROR 줄만 남깁니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ... (설명 주석, lab-start, 함수 q 의 정의 생략)
mariadb -e "CREATE DATABASE lab; CREATE TABLE lab.t (id INT PRIMARY KEY, \`select\` INT, now INT, count INT);
            INSERT INTO lab.t VALUES (1, 10, 100, 1000);"
# ... (1-4 번 문장은 7절에서)
q "5. -- needs a space"    "SELECT 1--1 AS a, 1 -- 1 AS b
"
q "6. reserved word"       "SELECT select FROM lab.t"
q "7. quoted with backticks" "SELECT \`select\` FROM lab.t"
q "8. function names are keywords only before '('" "SELECT now, count, NOW() > '2000-01-01' AS f FROM lab.t"
--- 5. -- needs a space
2	1
--- 6. reserved word
ERROR 1064 (42000) at line 1: You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near 'select FROM lab.t' at line 1
--- 7. quoted with backticks
10
--- 8. function names are keywords only before '('
100	1000	1
1--1은 2입니다.-다음 글자가-이고 그다음이 공백이나 제어 문자일 때만 주석입니다(MY_LEX_MINUS_OR_COMMENT, 2104–2110행).1--1은1 - (-1)로 읽혀 2가 됩니다. 반면1 -- 1 AS b는--뒤가 줄 끝까지 주석이 되어 둘째 열은 그냥1입니다(주석이 아니었다면 이것도 2였을 것입니다).select는 이름 자리에 못 씁니다.SELECT_SYM은 예약어라 문법의 어느 "이름" 규칙에도 들어 있지 않습니다. 역따옴표로 감싸면(MY_LEX_USER_VARIABLE_DELIMITER갈래) 키워드 표를 보지 않고 바로IDENT_QUOTED가 되므로 통과합니다.now와count는 이름,NOW()는 함수입니다. 바로 뒤에(가 있느냐 없느냐로 갈립니다.
헷갈리기 쉬운 곳: id와 name도 키워드입니다
4절의 Bison 추적에서 보겠지만, SELECT id FROM t의 id는 IDENT가 아니라 ID_SYM이라는 키워드 토큰으로 나옵니다(lex.h 290행의 "ID" 항목). name도 NAME_SYM입니다. 그런데도 열 이름으로 잘 쓰이는 까닭은, 문법 파일에 "이름 자리에 써도 되는 키워드" 목록(keyword_ident, keyword_sp_var_and_label …)이 따로 있고 ID_SYM이 거기 들어 있기 때문입니다. 키워드는 "예약어"와 "예약되지 않은 키워드"로 나뉘고, 그 구분은 렉서가 아니라 문법 규칙이 합니다. 예제 1의 MINUS가 별칭이 된 것도 같은 이야기입니다.
4. 문법 규칙과 액션 — 토큰이 Item 나무가 되는 곳
이제 파서 쪽입니다. 문법 파일의 맨 위 규칙은 query입니다(sql_yacc.yy 2151–2191행). 빈 입력(END_OF_INPUT)이면 SQLCOM_EMPTY_QUERY, 아니면 directly_executable_statement 하나와 그 뒤의 ; 또는 입력 끝입니다. 그 directly_executable_statement → statement → verb_clause로 내려가면 alter, delete, insert, select, update … 같은 문장 종류가 한 줄씩 나열되어 있습니다(2205행부터). SELECT 쪽을 따라가면 SELECT 하나를 나타내는 query_specification에 닿습니다.
query_specification_start:
          SELECT_SYM opt_optimizer_hint
          {
            SELECT_LEX *sel;
            LEX *lex= Lex;
            if (!(sel= lex->alloc_select(TRUE)) || lex->push_select(sel))
              MYSQL_YYABORT;
            // ...
          }
          select_options
          {
            Select->parsing_place= SELECT_LIST;
          }
          select_item_list
          // ...
          ;

query_specification:
          query_specification_start
          opt_from_clause
          opt_where_clause
          opt_group_clause
          opt_having_clause
          opt_window_clause
          {
            Lex->handle_parsed_optimizer_hints_in_last_select();
            $$= Lex->pop_select();
          }
        ;
Lex와 Select는 문법 파일 머리에 정의된 매크로로, 각각 thd->lex와 thd->lex->current_select입니다(33–35행). 읽는 법은 이렇습니다.
SELECT토큰을 읽자마자 액션이alloc_select()로SELECT_LEX를 하나 만들고push_select()로 "지금 만드는 중인SELECT"(current_select) 스택에 올립니다. 규칙 가운데에 낀{ … }는 규칙이 끝나기 전, 그 자리까지 읽었을 때 실행됩니다.- 열 목록을 읽는 동안
parsing_place를SELECT_LIST로 둡니다. 식을 만드는 코드가 "지금SELECT목록 안인지,WHERE안인지,HAVING안인지"를 이 값으로 압니다. FROM,WHERE,GROUP BY,HAVING,WINDOW까지 다 읽으면pop_select()로 스택에서 내리고, 완성된SELECT_LEX를$$로 위에 올립니다.
서브쿼리를 만나면 이 스택에 SELECT_LEX가 하나 더 올라가고, 서브쿼리가 끝나면 내려옵니다. 스택 깊이에는 한계가 있어서 MAX_SELECT_NESTING을 넘으면 ER_TOO_HIGH_LEVEL_OF_NESTING_FOR_SELECT가 납니다(sql_lex.h 3996–4000행).
WHERE는 이렇게 생겼습니다.
opt_where_clause:
          /* empty */  { Select->where= 0; }
 WHERE
          {
            Select->parsing_place= IN_WHERE;
          }
          search_condition
          {
            $3->top_level_item();
            Select->where= normalize_cond(thd, $3);
            Select->parsing_place= NO_MATTER;
          }
        ;
search_condition이 만들어 올린 Item 하나($3)가 그대로 SELECT_LEX::where에 들어갑니다. 그 Item은 어디서 만들어지나 — 식 규칙들의 액션입니다. id = 1 AND name = 'one'에 쓰이는 것만 골랐습니다.
열 이름 id는 simple_ident 규칙에서 Item이 됩니다.
simple_ident:
          ident_cli
          {
            if (unlikely(!($$= Lex->create_item_ident(thd, &$1))))
              MYSQL_YYABORT;
          }
create_item_ident()는 저장 프로시저 안이 아니면 create_item_ident_field()로 가고, 거기서 Item_field를 만듭니다.
Item *LEX::create_item_ident_field(THD *thd,
                                   const Lex_ident_sys_st &db,
                                   const Lex_ident_sys_st &table,
                                   const Lex_ident_sys_st &name)
{
  if (check_expr_allows_fields_or_error(thd, name.str))
    return NULL;

  if (current_select->parsing_place != IN_HAVING ||
      current_select->get_in_sum_expr() > 0)
    return new (thd->mem_root) Item_field(thd, current_context(),
                                          db, table, name);

  return new (thd->mem_root) Item_ref(thd, current_context(),
                                      db, table, name);
}
Item_field에 넘기는 것은 이름(db, table, name)과 "이 이름을 어디서 찾을지"(current_context())뿐입니다. 이 열이 어느 테이블의 몇 번째 열인지는 아직 모릅니다. 앞에서 본 parsing_place가 여기서 쓰입니다. HAVING 안에서 집계 함수 밖에 있는 열은 Item_field가 아니라 Item_ref(다른 Item을 가리키는 Item)가 됩니다.
상수 1은 NUM_literal 규칙에서 new (thd->mem_root) Item_int(thd, $1.str, (longlong) my_strtoll10($1.str, NULL, &error), $1.length)가 됩니다(sql_yacc.yy 16328–16338행). 렉서가 넘긴 글자($1.str)를 여기서 정수로 바꾸고, 원래 글자도 같이 넘겨 둡니다. 문자열 상수 'one'은 text_literal 규칙에서 Item_string이 됩니다.
비교 id = 1은 비교 연산자 규칙 comp_op이 "만드는 쪽"을 고르고('='면 $$ = &comp_eq_creator;, sql_yacc.yy 10434–10441행), 비교식 규칙이 그것으로 Item을 만듭니다.
        | boolean_test comp_op predicate %prec '='
          {
            $$= (*$2)(0)->create(thd, $1, $3);
            if (unlikely($$ == NULL))
              MYSQL_YYABORT;
          }
comp_eq_creator(false)는 Eq_creator 객체를 돌려주고(sql_parse.cc 9448–9451행), 그 create()가 new(thd->mem_root) Item_func_eq(thd, a, b)를 합니다(item_cmpfunc.cc 7885–7888행). 연산자 여섯 개마다 규칙을 따로 쓰는 대신 "만드는 객체"를 값으로 올려 보내 규칙 하나로 처리하는 구조입니다. 인자 invert에 참을 주면 반대 연산자(= → <>)를 만드는 쪽이 나오는데, 이것은 > ALL (서브쿼리) 같은 비교를 만드는 Item_allany_subselect가 씁니다(item_subselect.cc 1761행).
AND 는 expr 규칙에서 Item_cond_and가 됩니다.
        | expr and expr %prec AND_SYM
          {
            /* See comments in rule expr: expr or expr */
            Item_cond_and *item1;
            Item_cond_and *item3;
            if (is_cond_and($1))
            {
              item1= (Item_cond_and*) $1;
              // ... ($3 도 AND 면 목록을 합치고, 아니면 $3 을 목록에 더한다)
                /*
                  (X1 AND X2) AND Y ==> AND (X1, X2, Y)
                */
                item1->add($3, thd->mem_root);
                $$ = $1;
              }
            }
            // ... (X AND (Y1 AND Y2) 도 같은 식으로 편다)
            else
            {
              /* X AND Y */
              $$= new (thd->mem_root) Item_cond_and(thd, $1, $3);
              if (unlikely($$ == NULL))
                MYSQL_YYABORT;
            }
          }
a AND b AND c를 문법대로 지으면 AND(AND(a, b), c)처럼 두 갈래짜리 나무가 겹겹이 쌓입니다. 이 액션은 양쪽이 이미 AND이면 새 Item_cond_and를 만들지 않고 목록에 더해 AND(a, b, c) 하나로 폅니다. 괄호로 묶은 X AND (Y1 AND Y2)도 폅니다. 옵티마이저가 받는 조건이 처음부터 평평한 목록이라는 뜻입니다. OR도 같은 방식입니다(9946행부터).
예제 3: Bison 추적으로 본 규칙의 순서
Debug 빌드에서는 Bison의 추적 기능이 켜져 있습니다(문법 파일 124행 #define YYDEBUG 1). debug_dbug에 parser_debug를 넣으면, 1절에서 본 mysql_parse() 첫머리의 DBUG_EXECUTE_IF("parser_debug", …)가 Bison의 전역 변수 yydebug를 1로 만들고, 파서가 하는 일을 모두 표준 오류(이 컨테이너에서는 오류 로그 /tmp/mariadbd.err)에 적습니다. ex/u06-parser-trace의 run.sh입니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ... (서버를 띄우고 lab.t (id, name) 를 만든 뒤)
mariadb -e "SET SESSION debug_dbug='+d,parser_debug'; SELECT id FROM lab.t WHERE id = 1 AND name = 'a'"
# ... (오류 로그에서 첫 번째 파싱만 잘라 토큰 줄과 규칙 줄을 골라 찍는 grep·awk 생략)
--- trace lines: 785
--- 1. tokens the parser asked for (one per 'Reading a token')
SELECT_SYM ID_SYM FROM IDENT '.' IDENT WHERE ID_SYM '=' NUM AND_SYM NAME_SYM '=' TEXT_STRING END_OF_INPUT
--- 2. reductions that build something (sql_yacc.yy line: rule)
16565: simple_ident
9847: select_item
12909: table_primary_ident
16565: simple_ident
10435: comp_op
16329: NUM_literal
10147: boolean_test
16565: simple_ident
10435: comp_op
16158: text_literal
10147: boolean_test
10005: expr
9942: search_condition
9339: query_specification
9181: select_no_with_clause_no_parens
2186: query
--- total reductions: 126
문장 하나에 추적이 785줄 나왔고, 그 가운데 규칙을 줄인(reduce) 것이 126번입니다. 2번 목록은 그 가운데 무언가를 만드는 규칙만 남긴 것입니다(expr → boolean_test처럼 값만 넘기는 통과 규칙은 뺐습니다). 세 가지를 읽을 수 있습니다.
- 토큰은 15개입니다. 파서가 렉서를 15번 불렀습니다. 3절의 이야기대로
id와name은ID_SYM,NAME_SYM이고,lab.t는IDENT '.' IDENT세 토큰입니다. - 줄 번호가 원본과 같습니다.
16565: simple_ident의 16565는sql_yacc.yy에서simple_ident:바로 아래ident_cli줄이고,10147은 위에서 본boolean_test comp_op predicate줄,10005는expr and expr줄입니다. 2절에서 본 "빈 줄을 쓰는" 분할 덕분입니다. - 아래에서 위로 만들어집니다. 잎(
simple_ident=Item_field,NUM_literal=Item_int)이 먼저, 그것을 품는 비교식(boolean_test)이 다음,AND(expr)가 그다음, 맨 마지막에 문장 전체(query)입니다. LR 파서는 오른쪽 조각을 다 모은 뒤에야 규칙을 줄이므로, 액션이 만드는 나무도 언제나 잎부터 지어집니다.
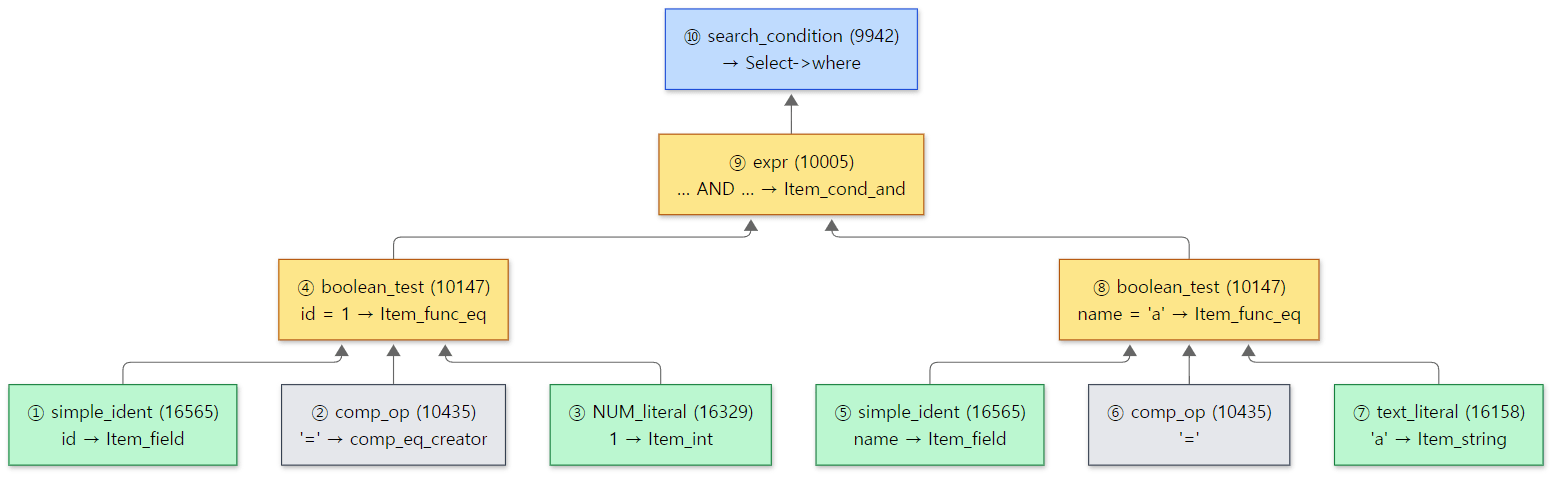 번호는 줄이는 순서입니다. 잎(초록)이 먼저, 뿌리(파랑)가 맨 나중입니다. 규칙 이름·줄 번호·순서는 예제 3의 실제 출력 2번 목록에서 WHERE 부분만 가져왔습니다.
헷갈리기 쉬운 곳: 추적이 다른 연결까지 찍힙니다
처음 돌렸을 때는 SELECT 다음에 SHOW VARIABLES LIKE …의 추적까지 이어서 찍혀 나왔습니다. 그 문장은 lab-stop이 쓰는 mariadb-admin shutdown이 보낸 것이었습니다. debug_dbug는 세션 변수로 켰지만, 그것이 켜는 yydebug는 생성된 파서의 전역 변수(실제 이름은 MYSQLdebug)라서(문법 파일 195–217행) 한 번 켜지면 서버 전체의 파싱이 다 찍힙니다. 그래서 run.sh는 첫 파싱이 끝나는 Cleanup: popping nterm query 줄에서 잘라 냅니다.
5. 결과물 — LEX, SELECT_LEX, TABLE_LIST, Item
파서가 끝나면 thd->lex에 무엇이 남는지 구조체부터 봅니다.
struct LEX: public Query_tables_list
{
  SELECT_LEX_UNIT unit;                         /* most upper unit */
  SELECT_LEX *first_select_lex() { return unit.first_select(); }
  const SELECT_LEX *first_select_lex() const { return unit.first_select(); }

private:
  SELECT_LEX builtin_select;

public:
  /* current SELECT_LEX in parsing */
  SELECT_LEX *current_select;
맨 위 단위 unit은 포인터가 아니라 LEX 안에 박힌 객체입니다. first_select_lex()는 그 단위의 첫 SELECT_LEX이고, current_select는 4절에서 본 "지금 만드는 중인 SELECT"입니다(parse_sql()이 끝날 때 첫 SELECT_LEX로 되돌려 둡니다, 10413행).
문장의 종류 sql_command는 LEX가 아니라 부모 클래스 Query_tables_list에 있습니다(sql/sql_lex.h 1855–1866행). 주석이 이유를 말합니다 — 테이블을 열고 잠글 때 "이 문장이 무엇인지"를 알아야 어떤 잠금을 걸지 정할 수 있어서, 문장에 나온 모든 테이블의 목록(query_tables)과 같은 곳에 두었습니다. enum_sql_command의 값은 sql/sql_command.h에 SQLCOM_SELECT부터 SQLCOM_END 앞까지 162개가 있습니다. SELECT 문장이면 4절의 select_no_with_clause_no_parens 액션이 부르는 LEX::select_finalize()가 sql_command= SQLCOM_SELECT를 넣습니다(sql_lex.cc 12193–12200행).
SELECT_LEX 하나가 가진 것 가운데 이 글에 나오는 것만 추렸습니다.
class st_select_lex: public st_select_lex_node
{
public:
  Name_resolution_context context;
  // ...
  Item *where, *having;                         /* WHERE & HAVING clauses */
  // ...
  SQL_I_List<TABLE_LIST>  table_list;
  // ...
  List<Item>          item_list;  /* list of fields & expressions */
  // ...
  enum_parsing_place parsing_place; /* where we are parsing expression */
  // ...
  uint select_number; /* number of select (used for EXPLAIN) */
TABLE_LIST — 이름과 "잠금 신청서"만
FROM lab.t의 table_primary_ident 규칙(12908행)은 SELECT_LEX::add_table_to_list()를 부릅니다. 이 함수의 끝부분입니다.
  if (likely(!ptr->sequence))
    table_list.insert(ptr, &ptr->next_local);
  // ...
  /* Link table in global list (all used tables) */
  lex->add_to_query_tables(ptr);

  // Pure table aliases do not need to be locked:
  if (!ptr->is_pure_alias())
  {
    MDL_REQUEST_INIT(&ptr->mdl_request, MDL_key::TABLE, ptr->db.str,
                     ptr->table_name.str, mdl_type, MDL_TRANSACTION);
  }
TABLE_LIST 하나는 사슬 두 개에 동시에 걸립니다. next_local은 이 SELECT 안의 테이블들(SELECT_LEX::table_list), next_global은 문장 전체의 테이블들(LEX::query_tables, 서브쿼리 안의 것까지)입니다. 그리고 메타데이터 잠금 요청(mdl_request)을 채워 두기만 합니다. 실제로 잠금을 얻는 것은 7편의 open_and_lock_tables()입니다. 이 칸들(next_local, next_global, db, table_name, alias)과 그 아래 "열린 테이블"이라는 주석이 붙은 TABLE *table이 sql/table.h 2666–2746행에 있습니다. 파서가 끝난 시점에는 아무도 테이블을 열지 않았으므로 table은 NULL입니다. 예제 4에서 확인합니다.
Item 나무와 메모리
예로 든 문장 SELECT name, qty * 2 FROM lab.t WHERE id = 1 AND name = 'one'의 파싱 결과를 그리면 이렇습니다.
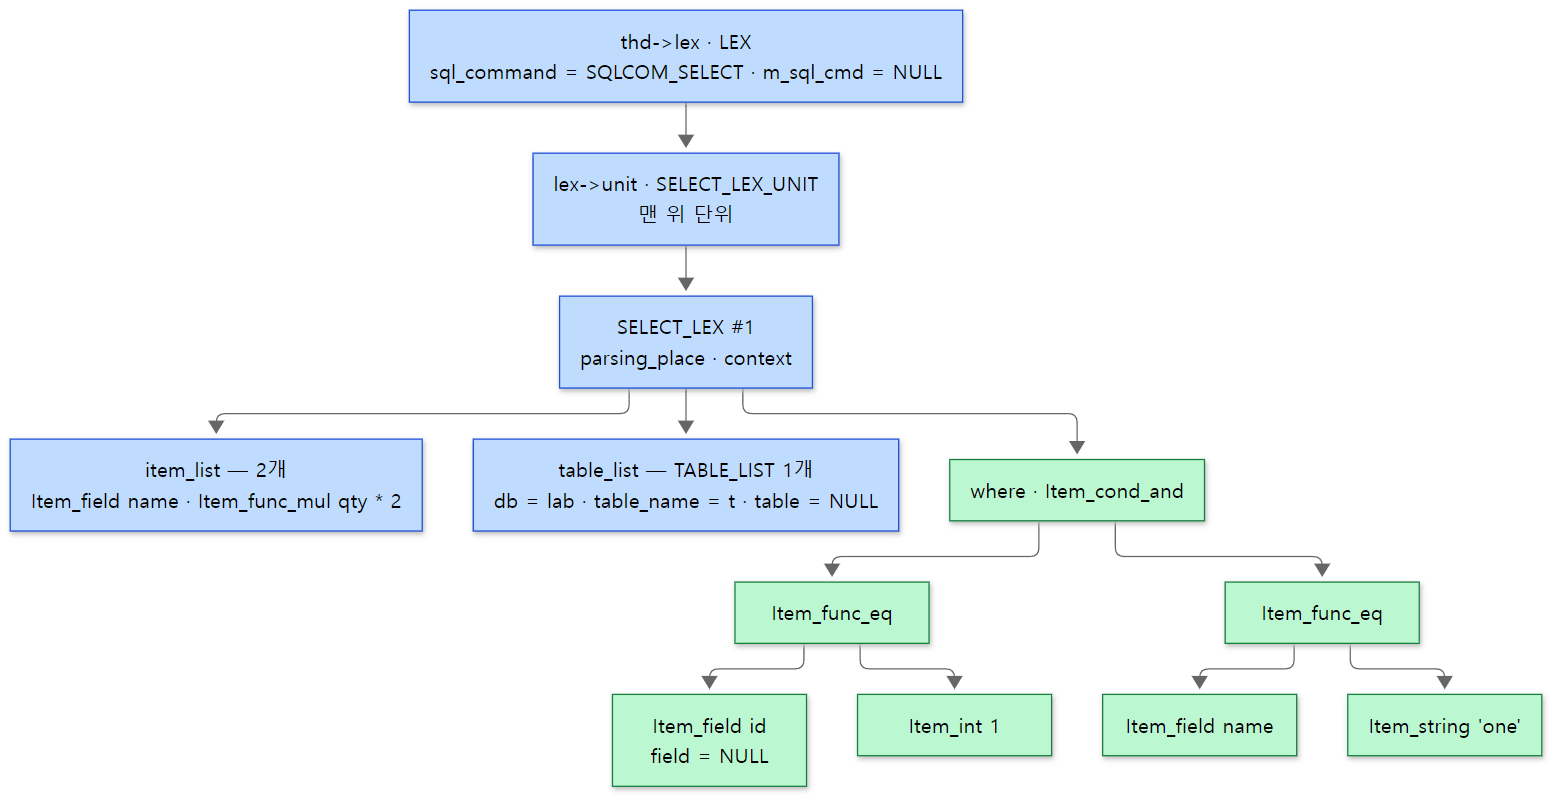 파란 칸은 문장의 뼈대, 초록 칸은
WHERE의 Item 나무입니다. NULL인 칸은 7편에서 채워집니다.
이 그림의 Item들이 어떤 클래스인지 상속 관계로 보면 이렇습니다.
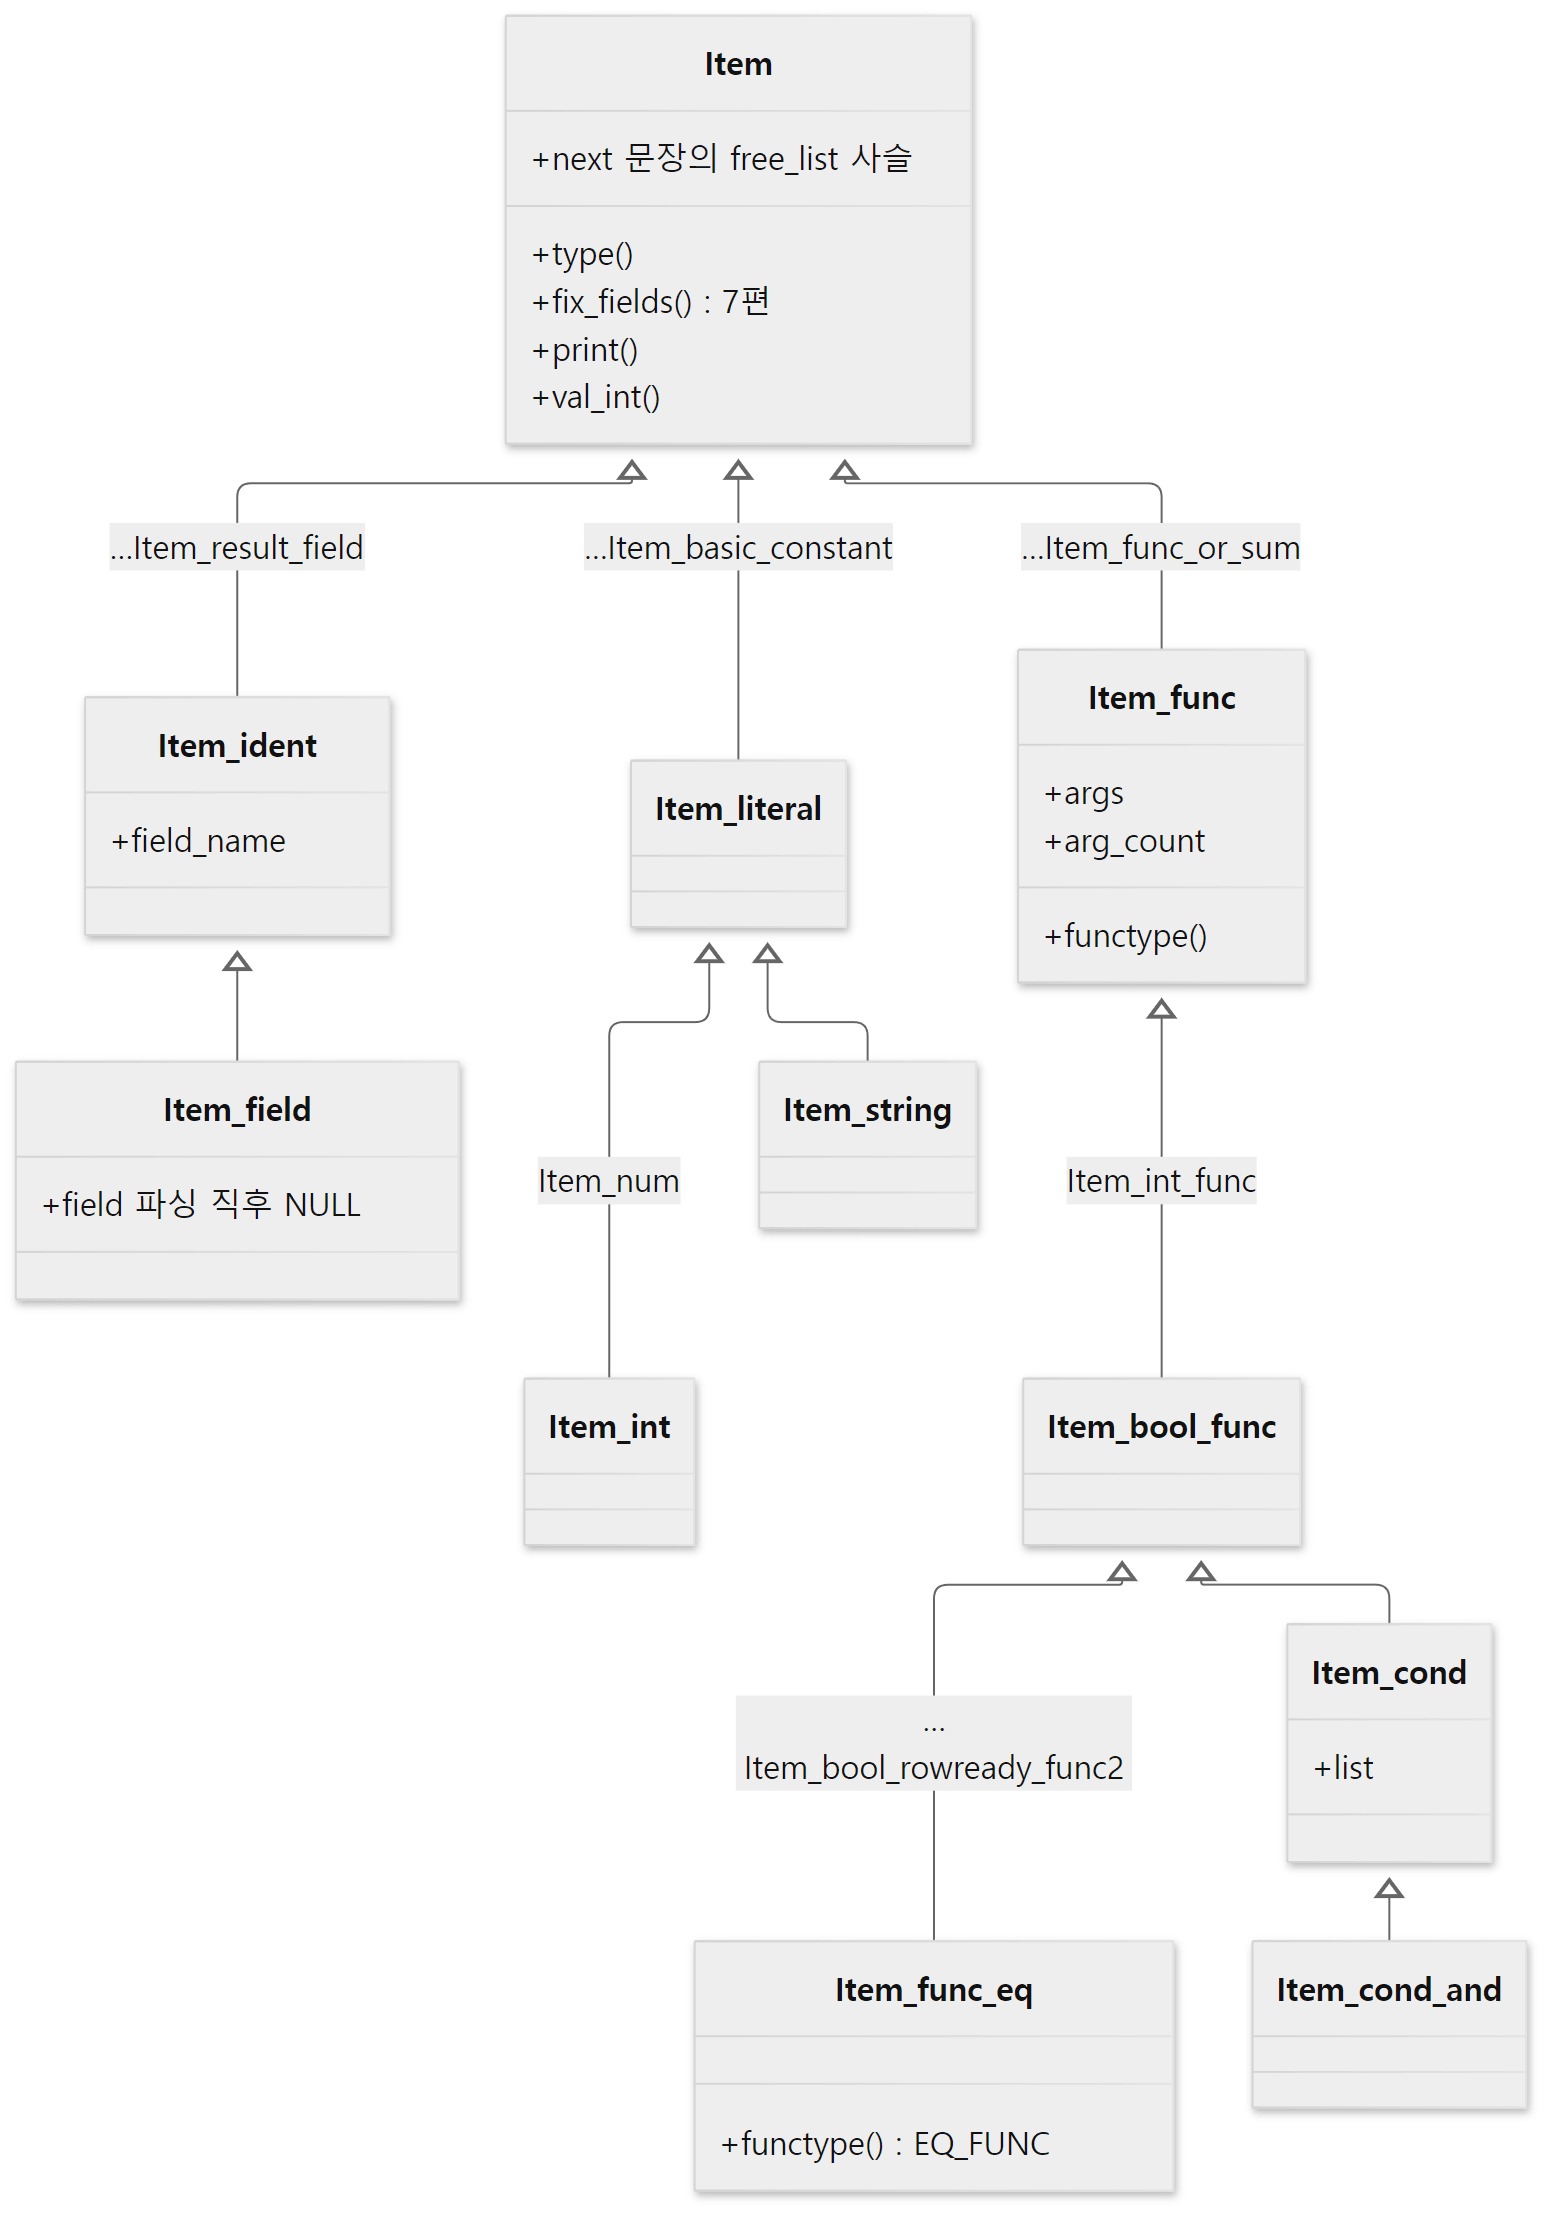 선 위의 이름은 그 사이에서 건너뛴 클래스입니다(
…는 더 있다는 뜻). 실제 상속 단계는 item.h·item_func.h·item_cmpfunc.h에서 셀 수 있습니다.
두 가지가 보입니다. 하나는 함수 쪽과 조건 쪽이 같은 뿌리라는 것입니다. id = 1도 … AND …도 결국 Item_func이고, 인자를 args(Item_func) 또는 list(Item_cond)에 품습니다. 다른 하나는 값을 묻는 가상 함수(val_int() 등)가 맨 위 Item에 있다는 것입니다. 실행 단계는 where->val_int() 하나를 부르고, 그 호출이 나무를 따라 아래로 내려갑니다(실행은 9편).
Item의 생성자는 만들어질 때마다 자신을 THD의 사슬에 겁니다.
Item::Item(THD *thd):
  name(null_clex_str), orig_name(null_clex_str), is_expensive_cache(-1)
{
  // ...
  /* Put item in free list so that we can free all items at end */
  next= thd->free_list;
  thd->free_list= this;
메모리는 new (thd->mem_root)로 연결의 메모리 풀에서 받고, 객체는 thd->free_list에 줄줄이 걸립니다. 문장이 끝나면 THD::cleanup_after_query()의 free_items()가 이 사슬을 따라 delete_self()(정리 뒤 delete this)를 부릅니다(sql_class.cc 2638–2639행). 그런데 Item의 operator delete는 메모리를 돌려주지 않고 TRASH_FREE()만 합니다(item.h 841행) — 소멸자를 부르는 것이 목적입니다. 메모리는 dispatch_command() 끝의 free_root(thd->mem_root, …)가 한꺼번에 돌려받습니다(sql_parse.cc 2494행). httpd 4편의 요청 풀처럼 "문장 하나가 끝나면 통째로 버린다"는 수명입니다.
예제 4: gdb로 파서가 남긴 나무 찍기
파서가 끝난 바로 그 순간 — mysql_execute_command()의 첫 줄 — 에 gdb를 세우고 thd->lex를 들여다봤습니다. ex/u06-item-tree의 gdb 명령 파일 앞부분입니다.
set pagination off
set print object on
set print pretty off
break mysql_execute_command if thd->lex->sql_command == SQLCOM_UPDATE || (thd->lex->sql_command == SQLCOM_SELECT && thd->lex->current_select->where != 0)
continue
echo --- A. SELECT: what the parser left in thd->lex

p thd->lex->sql_command
p thd->lex->m_sql_cmd
# ... (item_list·table_list 의 개수와 첫 칸들)
p thd->lex->current_select->table_list.first->table
set $w = thd->lex->current_select->where
p $w
p dbug_print_item($w)
# ... (WHERE 의 두 자식과 그 인자를 차례로 찍는 줄들)
set print object on을 켜 두면 gdb가 가상 함수 표를 보고 포인터의 실제 클래스를 찍어 줍니다. dbug_print_item()은 Debug 빌드에만 있는 도우미 함수로, Item::print()로 나무를 SQL 글자로 되돌려 줍니다(item.cc 12000행). run.sh는 gdb를 서버에 붙여 둔 뒤 SELECT name, qty * 2 FROM lab.t WHERE id = 1 AND name = 'one'을 보냅니다. 주소는 실행마다 다릅니다.
--- A. SELECT: what the parser left in thd->lex
$1 = SQLCOM_SELECT
$2 = (Sql_cmd *) 0x0
$3 = 2
$4 = 1
$5 = (Item_field *) 0x77ec840392b0
$6 = (Item_func_mul *) 0x77ec840395d0
$7 = 0x77ec840396e0 "lab"
$8 = 0x77ec840396f0 "t"
$9 = (TABLE *) 0x0
$10 = (Item_cond_and *) 0x77ec8403a700
$11 = 0x55efb12e70a0 <dbug_item_print_buf> "`id` = 1 and `name` = 'one'"
$12 = 2
$13 = (Item_func_eq *) 0x77ec8403a090
$14 = 0x55efb12e70a0 <dbug_item_print_buf> "`id` = 1"
$15 = (Item_field *) 0x77ec84039ec0
$16 = (Item_int *) 0x77ec8403a000
$17 = (Item_func_eq *) 0x77ec8403a4c0
$18 = (Item_field *) 0x77ec8403a2e0
$19 = (Item_string *) 0x77ec8403a420
$20 = (Field *) 0x0
#0  mysql_execute_command (...) at /usr/src/mariadb/sql/sql_parse.cc:3541
#1  0x000055efaf37081e in mysql_parse (...) at /usr/src/mariadb/sql/sql_parse.cc:8005
#2  0x000055efaf35f338 in dispatch_command (...) at /usr/src/mariadb/sql/sql_parse.cc:1903
#3  0x000055efaf35e07f in do_command (...) at /usr/src/mariadb/sql/sql_parse.cc:1437
#4  0x000055efaf58ec14 in do_handle_one_connection (...) at /usr/src/mariadb/sql/sql_connect.cc:1514
#5  0x000055efaf58e9a0 in handle_one_connection (...) at /usr/src/mariadb/sql/sql_connect.cc:1426
$1,$2— 문장의 종류는SQLCOM_SELECT,Sql_cmd객체는 없습니다(6절).$3–$6— 열 목록 2개는Item_field(name)와Item_func_mul(qty * 2), 테이블 1개.$7–$9—TABLE_LIST에는lab,t라는 이름만 있고table은NULL입니다.$10–$19—WHERE는Item_cond_and하나에 자식 2개, 각각Item_func_eq이고 그 인자가Item_field·Item_int,Item_field·Item_string입니다. 위 그림과 같습니다.$20—id라는Item_field의field(테이블의 실제 열을 가리킬 포인터)도NULL입니다. 이 칸을 채우는 것이 7편의fix_fields()입니다.- 백트레이스 —
dispatch_command()(1903행, 1절에서 본mysql_parse()호출) →mysql_parse()(8005행,mysql_execute_command()호출) → 여기. 파서 함수들은 이미 다 끝나서 스택에 없습니다. 파서의 결과는 스택이 아니라thd->lex에 남습니다.
이번 실행에서는 WHERE의 Item 주소가 Item_field id(…39ec0) → Item_int(…3a000) → Item_func_eq(…3a090) → … → Item_cond_and(…3a700) 순으로 커졌습니다. MEM_ROOT는 한 덩어리 안에서 앞에서부터 차례로 잘라 주므로, 4절에서 본 "잎부터 만든다"는 순서가 주소에도 남은 것입니다.
SELECT_LEX_UNIT — UNION과 서브쿼리의 나무
서브쿼리와 UNION이 함께 있는 문장을 같은 방법으로 찍었습니다. 문장은 SELECT name FROM lab.t WHERE qty = (SELECT MAX(qty) FROM lab.t) UNION SELECT 'none'이고, gdb 명령은 thd->lex->unit에서 시작해 slave(아래)와 next(옆)를 따라갑니다.
--- C. UNION with a subquery: the SELECT_LEX tree
$25 = SQLCOM_SELECT
$26 = 1
$27 = 3
$28 = (st_select_lex_node *) 0x0
$29 = true
$30 = true
$31 = 2
$32 = 0x55efb12e70a0 <dbug_item_print_buf> "qty = (subquery#2)"
$33 = (Item_singlerow_subselect *) 0x77ec8403b590
차례로 첫 SELECT_LEX의 번호 1($26), 그 옆 SELECT_LEX의 번호 3($27), 그 옆은 없음($28), 맨 위 단위에 fake_select_lex가 있음($29), 첫 SELECT_LEX 아래 단위의 위(master)가 첫 SELECT_LEX임($30), 그 단위 안 SELECT_LEX의 번호 2($31), 그리고 첫 SELECT_LEX의 WHERE가 qty = (subquery#2)이고 오른쪽 인자가 Item_singlerow_subselect($32, $33)입니다.
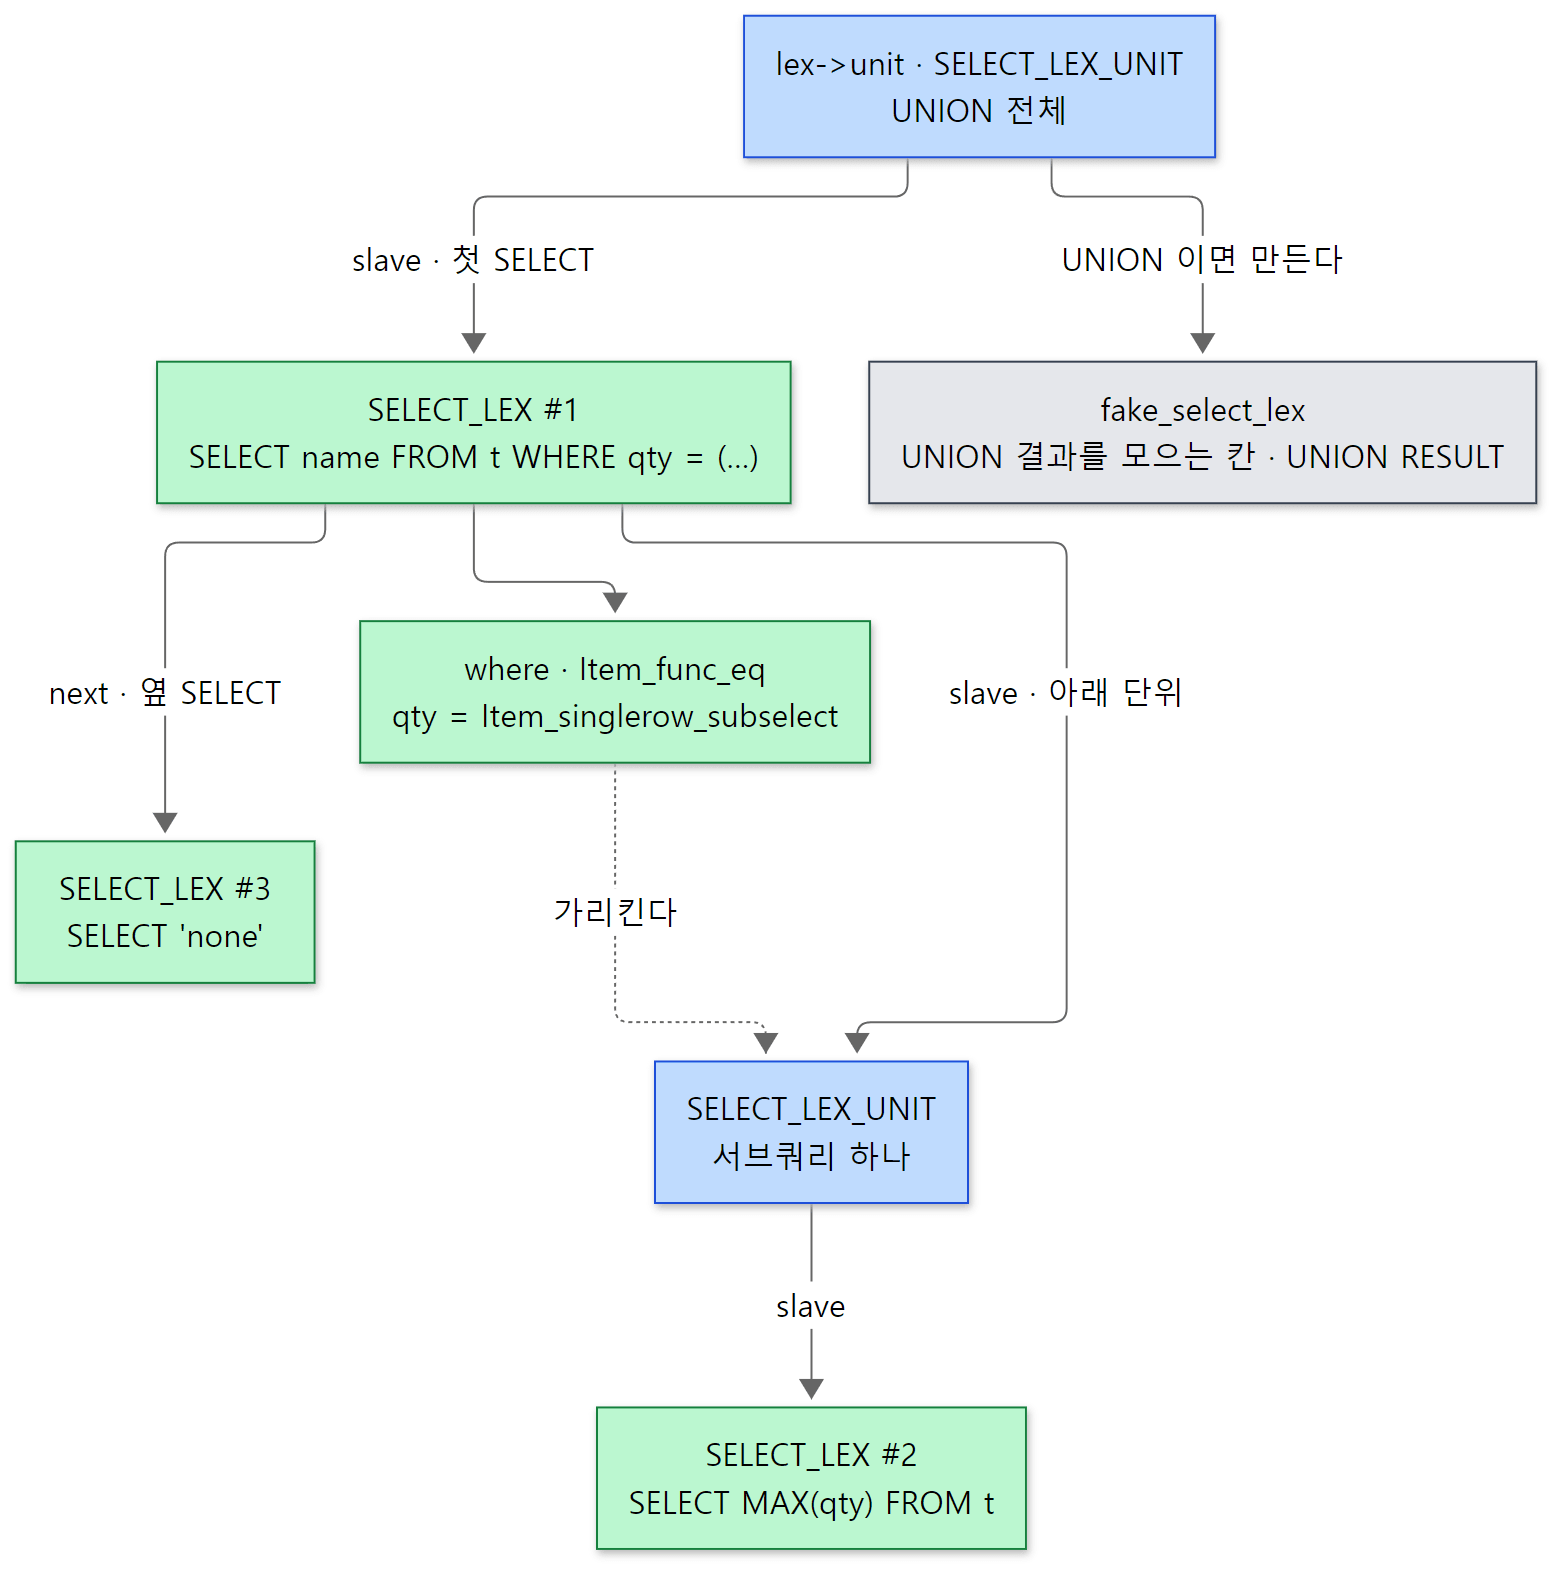 파란 칸이 단위(
SELECT_LEX_UNIT), 초록 칸이 SELECT 하나(SELECT_LEX)입니다. 단위와 SELECT가 번갈아 쌓입니다.
SELECT_LEX의 번호는 alloc_select()가 만들 때 문장 단위의 계수기를 하나씩 올려 매깁니다.
select_lex->select_number= ++thd->lex->stmt_lex->current_select_number;
파서는 왼쪽에서 오른쪽으로 읽으므로 UNION 뒤의 SELECT 'none'보다 괄호 안 서브쿼리를 먼저 만납니다. 그래서 서브쿼리가 2번, UNION의 둘째 SELECT가 3번입니다. EXPLAIN의 id 열이 바로 이 번호입니다(예제 5에서 /* select#2 */로 다시 봅니다). fake_select_lex는 UNION처럼 한 단위에 SELECT가 둘 이상일 때 LEX::create_unit()이 만들어 붙이는 것으로(sql_lex.cc 6586–6592행), EXPLAIN의 UNION RESULT 줄이 이것입니다.
헷갈리기 쉬운 곳: 파서도 의미 오류를 하나쯤은 잡습니다
1절에서 "파서는 확인하지 않는다"고 했지만, 이름만 보고 알 수 있는 오류는 파서 단계에서 잡기도 합니다. add_table_to_list()는 같은 SELECT 안에 같은 별칭이 두 번 나오면 바로 ER_NONUNIQ_TABLE을 냅니다(sql_parse.cc 8253–8265행). 예제 폴더 ex/u06-lexer-errors의 9·10번 문장으로 확인했습니다.
--- 9. same alias twice (tables do not exist)
ERROR 1066 (42000) at line 1: Not unique table/alias: 'a'
--- 10. table does not exist
ERROR 1146 (42S02) at line 1: Table 'lab.nosuch' doesn't exist
9번의 두 테이블은 둘 다 없는 테이블인데도 "테이블이 없다"(1146)가 아니라 "별칭이 겹친다"(1066)가 납니다. 파서가 먼저 별칭을 보고 멈췄기 때문에, 테이블이 있는지 알아보는 단계(7편)까지 가지 못한 것입니다.
6. 파서가 미리 해 두는 일, 그리고 Sql_cmd
NOT을 없애고 AND를 편다
4절의 AND 펴기처럼, 파서의 액션은 나무를 그대로 받아 적기만 하지 않고 조금 다듬습니다. NOT이 그런 예입니다.
Item *negate_expression(THD *thd, Item *expr)
{
  Item *negated;
  // ... (NOT(NOT(x)) 처리)
  if ((negated= expr->neg_transformer(thd)) != 0)
    return negated;
  return new (thd->mem_root) Item_func_not(thd, expr);
}
NOT_SYM expr 규칙(10048–10053행)이 이 함수를 부릅니다. 안쪽 식이 스스로를 뒤집을 줄 알면(neg_transformer()) 뒤집은 식을 쓰고, 모를 때만 Item_func_not으로 감쌉니다. 비교식은 뒤집을 줄 압니다 — NOT (qty > 10)은 Item_func_not(Item_func_gt)가 아니라 Item_func_le, 곧 qty <= 10 하나가 됩니다(Item_func_gt::negated_item(), item_cmpfunc.cc 6987–6990행). NOT (a AND b)는 NOT a OR NOT b로 바뀝니다(item_cmpfunc.cc 6908–6914행).
예제 4의 gdb로 SELECT id FROM lab.t WHERE NOT (qty > 10) AND (id > 0 AND name <> 'x')도 찍었습니다.
--- B. SELECT with NOT and nested AND
$21 = (Item_cond_and *) 0x77ec8403aa90
$22 = 0x55efb12e70a0 <dbug_item_print_buf> "qty <= 10 and `id` > 0 and `name` <> 'x'"
$23 = 3
$24 = (Item_func_le *) 0x77ec8403a000
최적화 전, 파싱 직후인데 이미 NOT은 사라져 Item_func_le가 되어 있고, 괄호로 묶었던 안쪽 AND는 펴져서 Item_cond_and 하나에 자식이 3개입니다.
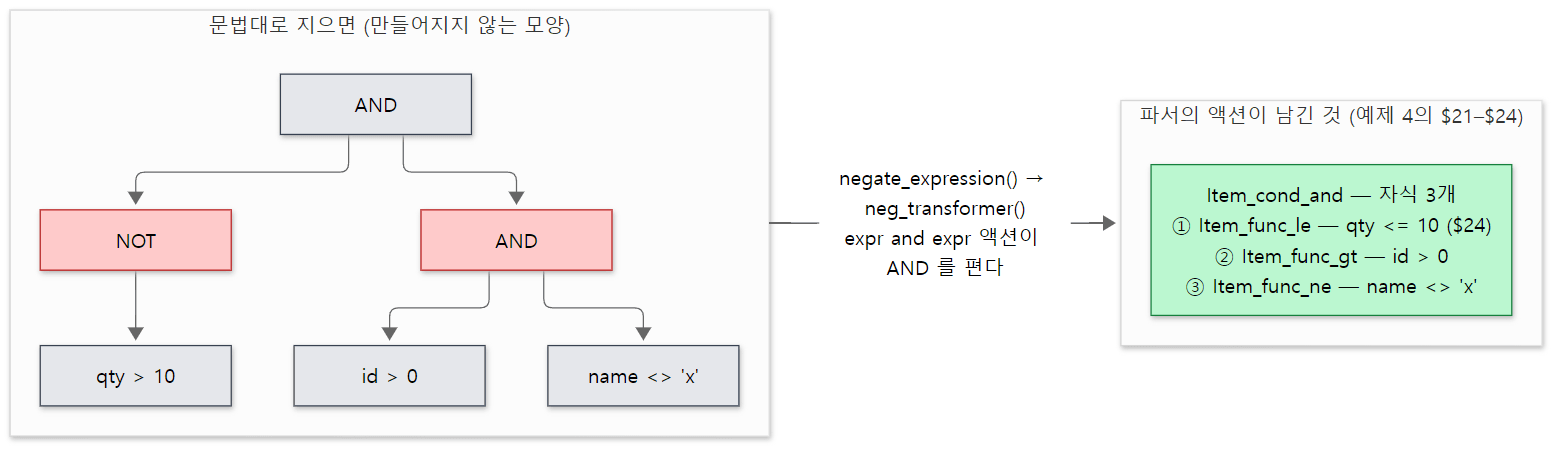 빨간 칸(NOT, 안쪽 AND)이 파싱하는 동안 없어집니다. 자식 수 3, 첫 자식 Item_func_le, 순서는 예제 4의 $21–$24 출력에서 가져왔습니다.
예제 5: 서버가 다시 찍은 문장 — EXPLAIN EXTENDED
Item 나무는 언제든 SQL 글자로 되돌릴 수 있습니다(Item::print(), st_select_lex::print()). 사용자 쪽에서 이것을 보는 가장 쉬운 방법이 EXPLAIN EXTENDED 뒤의 SHOW WARNINGS입니다. ex/u06-print-back의 demo.sql은 예제 4와 같은 테이블에 대고 EXPLAIN EXTENDED SELECT * FROM t WHERE NOT (qty > 10) AND (id > 0 AND name <> 'x')와 EXPLAIN EXTENDED SELECT name FROM t WHERE qty = (SELECT MAX(qty) FROM t) UNION SELECT 'none'을 보내고, 각각 SHOW WARNINGS를 합니다.
SHOW WARNINGS의 Message 열만 옮깁니다(EXPLAIN 표와 step 표는 뺐습니다).
select `lab`.`t`.`id` AS `id`,`lab`.`t`.`name` AS `name`,`lab`.`t`.`qty` AS `qty` from `lab`.`t` where `lab`.`t`.`qty` <= 10 and `lab`.`t`.`id` > 0 and `lab`.`t`.`name` <> 'x'
/* select#1 */ select `lab`.`t`.`name` AS `name` from `lab`.`t` where `lab`.`t`.`qty` = (/* select#2 */ select max(`lab`.`t`.`qty`) from `lab`.`t`) union /* select#3 */ select 'none' AS `none`
첫째 문장에서 NOT (qty > 10)이 qty <= 10으로, 안쪽 괄호가 없어진 것은 위에서 본 대로 파서가 한 일입니다. 둘째 문장의 select#1·select#2·select#3은 select_number입니다.
헷갈리기 쉬운 곳: EXPLAIN EXTENDED의 문장은 "파서가 본 문장"이 아닙니다
*가 id, name, qty 세 열로 펼쳐졌고, 모든 열 앞에 `lab`.`t`.가 붙었습니다. 이것은 파서가 아니라 7편의 이름 찾기(setup_wild(), fix_fields())가 한 일입니다. EXPLAIN EXTENDED가 찍는 것은 준비와 최적화까지 다 끝난 뒤의 나무라서, 파서가 한 일과 그 뒤의 단계가 한 일이 섞여 있습니다. 파서만의 결과를 보려면 예제 4처럼 mysql_execute_command() 첫 줄에서 봐야 합니다. 이 글이 "NOT을 없앤 것은 파서"라고 말할 수 있는 근거도 예제 4의 $22입니다.
Sql_cmd — 문장을 객체로
thd->lex->m_sql_cmd는 SELECT에서 NULL이었습니다. UPDATE를 보내면 다릅니다.
--- D. UPDATE: a Sql_cmd object
$34 = SQLCOM_UPDATE
$35 = (Sql_cmd_update *) 0x77ec84039980
update 규칙의 액션이 Sql_cmd_update 객체를 만들어 둡니다.
            if (!(lex->m_sql_cmd=
                  new (thd->mem_root) Sql_cmd_update(is_multiupdate)))
              MYSQL_YYABORT;
Sql_cmd는 "실행할 줄 아는 문장" 객체의 부모 클래스로, 핵심은 순수 가상 함수 virtual bool execute(THD *thd) = 0;과 문장 종류를 돌려주는 sql_command_code()입니다(sql/sql_cmd.h 74–110행).
MariaDB에는 문장을 실행하는 방식이 두 가지 섞여 있습니다. 오래된 방식은 파서가 sql_command와 LEX의 여러 칸만 채워 두고, mysql_execute_command()의 거대한 switch (lex->sql_command) 안에 문장마다 실행 코드를 두는 것입니다. 새 방식은 파서가 Sql_cmd를 상속한 객체를 만들어 두고, switch는 lex->m_sql_cmd->execute(thd) 한 줄만 부르는 것입니다(UPDATE·DELETE는 4485–4496행). 기준 커밋에서 SELECT는 여전히 앞의 방식입니다. 이 switch의 모양은 7편에서 자세히 봅니다.
7. "near '...' at line N"은 어디서 오나
문법에 맞지 않는 토큰을 만나면 Bison이 만든 파서는 yyerror()를 부르고 멈춥니다. -p MYSQL 때문에 실제 이름은 MYSQLerror지만, 정의는 문법 파일 안에 있습니다.
static void yyerror(THD *thd, const char *s)
{
  /* "parse error" changed into "syntax error" between bison 1.75 and 1.875 */
  if (strcmp(s,"parse error") == 0 || strcmp(s,"syntax error") == 0)
    s= ER_THD(thd, ER_SYNTAX_ERROR);
  thd->parse_error(s, 0);
}
Bison이 넘기는 영어 문구 "syntax error"를 MariaDB의 오류 문구(ER_SYNTAX_ERROR, "You have an error in your SQL syntax; check the manual …")로 바꿔 THD::parse_error()에 넘깁니다.
  void parse_error(const char *err_text, const char *yytext)
  {
    Lex_input_stream *lip= &m_parser_state->m_lip;
    if (!yytext && !(yytext= lip->get_tok_start()))
        yytext= "";
    /* Push an error into the error stack */
    ErrConvString err(yytext, strlen(yytext), variables.character_set_client);
    my_printf_error(ER_PARSE_ERROR,  ER_THD(this, ER_PARSE_ERROR), MYF(0),
                    err_text, err.ptr(), lip->yylineno);
  }
yytext가 없으면 렉서의 get_tok_start(), 곧 방금 읽다가 막힌 토큰이 시작하는 자리를 씁니다. 이것은 문자열 안의 포인터이므로, 거기서부터 문장 끝까지가 통째로 들어갑니다. 줄 번호는 렉서가 공백을 건너뛰며 \n을 셀 때 올린 yylineno입니다(3절의 lex_one_token() 첫머리). 문구의 틀은 오류 메시지 파일의 ER_PARSE_ERROR 항목(1707행부터, 언어마다 한 줄)에 있습니다.
eng "%s near '%-.80sT' at line %d"
sql/share/errmsg-utf8.txt 1711행
%-.80sT는 "문자열을 80자까지만, 넘치면 잘랐다는 표시를 붙여서"라는 MariaDB 고유의 서식입니다(T 접미사, strings/my_vsnprintf.c 709–711행). 이 오류의 번호가 1064, SQLSTATE가 42000입니다.
예제 6: near 뒤의 글자 읽기
ex/u06-lexer-errors의 1–4번 문장입니다.
q "1. typo in FROM"        "SELECT id FORM lab.t WHERE id = 1"
q "2. error on line 3"     "SELECT id
FROM lab.t
WHERE id = = 1"
q "3. long tail is cut"    "SELECT id FROM lab.t WHERE id = 1 ORDER BY BY id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id"
q "4. missing at the end"  "SELECT id FROM lab.t WHERE"
--- 1. typo in FROM
ERROR 1064 (42000) at line 1: You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near 'lab.t WHERE id = 1' at line 1
--- 2. error on line 3
ERROR 1064 (42000) at line 1: You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near '= 1' at line 3
--- 3. long tail is cut
ERROR 1064 (42000) at line 1: You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near 'BY id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id, id...' at line 1
--- 4. missing at the end
ERROR 1064 (42000) at line 1: You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near '' at line 1
- 오타
FORM인데near 'lab.t …'입니다.FORM은 키워드가 아니므로IDENT이고,SELECT id FORM은 "id에FORM이라는 별칭을 붙인 것"(AS를 뺀 별칭)으로 문법에 맞습니다. 파서가 막힌 것은 그 뒤의lab입니다.near뒤의 글자는 "틀린 곳"이 아니라 "파서가 더 갈 수 없게 된 곳"입니다. 진짜 실수는 대개 그보다 조금 앞에 있습니다. - 줄 번호.
= =의 두 번째=에서 막혔고, 그 앞에서 줄 바꿈을 두 번 지났으므로at line 3입니다. 클라이언트가 붙인at line 1은 클라이언트가 보낸 입력의 줄 번호라서 서버의 것과 다릅니다. - 80자에서 자릅니다. 끝에
...가 붙었습니다. 긴 쿼리에서near뒤가 잘려 있으면 이 때문입니다. - 빈
near ''. 문장이 덜 끝났는데 입력이 끝나면, 막힌 토큰이END_OF_INPUT이라 그 뒤의 글자가 없습니다.near ''는 "끝까지 읽었는데 모자란다"는 뜻입니다.
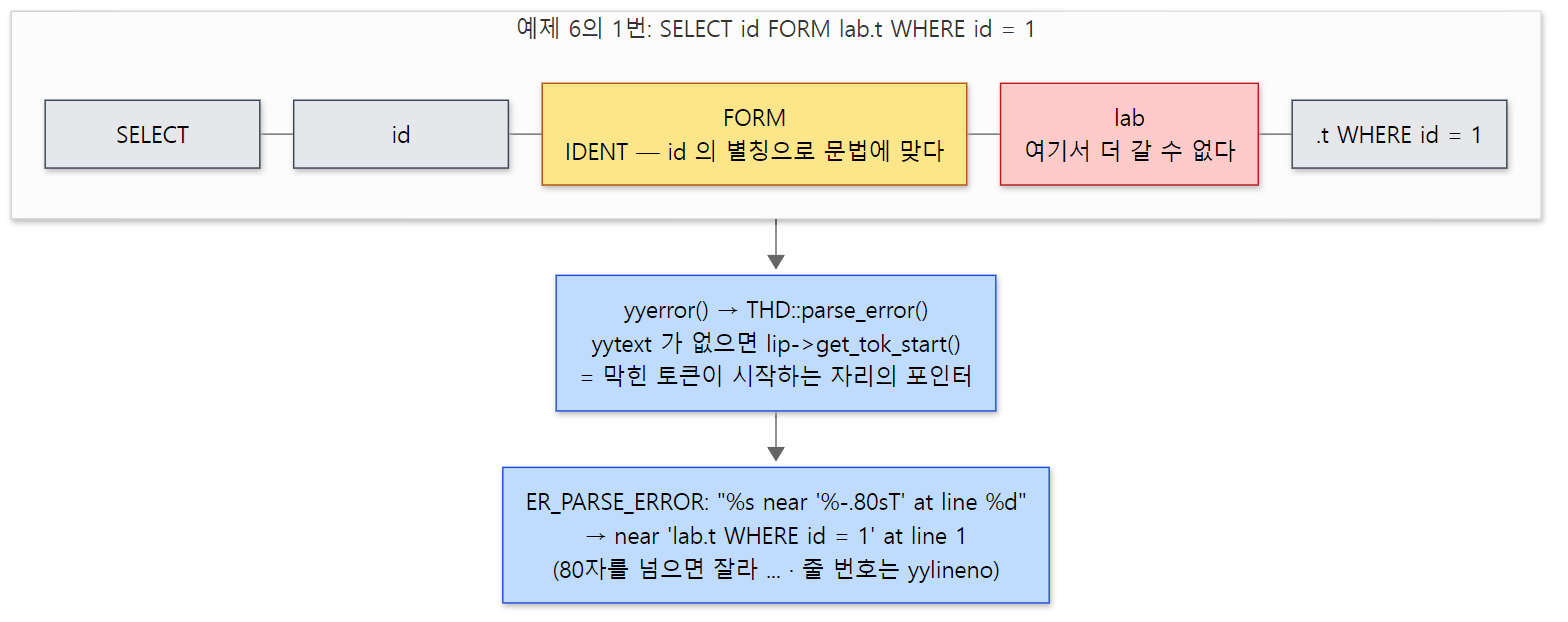 near 뒤에는 틀린 곳이 아니라 파서가 막힌 토큰부터 문장 끝까지가 들어갑니다. 메시지는 예제 6의 1번 실제 출력입니다.
이 글에서 뺀 것
- 옵티마이저 힌트(
/*+ … */)의 별도 파서:sql/opt_hints_parser.cc, 문법 쪽opt_optimizer_hint규칙(sql_yacc.yy 9305행) - 문장 다이제스트(performance_schema가 상수를
?로 바꿔 묶는 것): 렉서의add_digest_token(),sql/sql_digest.cc, 토큰 이름표를 만드는sql/gen_lex_token.cc - 저장 프로시저·트리거 본문의 파싱:
LEX::sphead,sql/sp_head.cc, 지역 변수 찾기LEX::create_item_ident_sp()(sql_lex.cc 9719행) - 준비된 문장의
?: 렉서의MY_LEX_PLACEHOLDER와PARAM_MARKER(sql_lex.cc 2114–2124행),sql/sql_prepare.cc WHERE f를f IS TRUE로 바꾸는normalize_cond(): sql_parse.cc 9033행- Bison 스택이 모자랄 때 늘리는
my_yyoverflow()와YYMAXDEPTH 3200: sql_yacc.yy 32행, sql_parse.cc 7449행 - 뷰·저장 프로그램 본문을 UTF-8로 다시 적어 두는
Lex_input_stream::body_utf8_* MSSQL모드의[이름]따옴표: sql_lex.cc 2084–2085행- 생성 열·
CHECK제약의 식만 따로 파싱하는parse_vcol_expr규칙과sql/table.cc의unpack_vcol_info_from_frm()
정리
| 개념 | 한 줄 요약 |
|---|---|
mysql_parse() |
lex_start() → 쿼리 캐시 → parse_sql() → 성공하면 mysql_execute_command() |
parse_sql() |
sql_mode에 ORACLE이 있으면 ORAparse(), 없으면 MYSQLparse() |
sql_yacc.yy |
문법 원본 하나. gen_yy_files.cmake가 둘로 나누고 Bison -p MYSQL/-p ORA가 파서 둘을 만든다 |
%define api.pure, %parse-param |
전역 변수 없는 파서, 함수 인자는 THD *thd 하나 — 스레드마다 따로 파싱 |
Lex_input_stream |
렉서. state_map[첫 글자]로 갈래를 고르고, 낱말은 lex.h의 표(700 + 49개)에서 찾는다 |
sql_functions[] |
NOW·COUNT 같은 49개는 바로 뒤에 (가 있을 때만 키워드 |
lex_token() |
WITH ROLLUP처럼 두 토큰을 봐야 하는 곳을 토큰 하나로 합쳐 LALR(1)로 만든다 |
| 규칙 액션 | 잎부터 위로 Item·TABLE_LIST·SELECT_LEX를 만든다. AND는 펴고 NOT은 없앤다 |
LEX |
문장 하나의 결과. sql_command(162가지), unit, query_tables, m_sql_cmd |
SELECT_LEX / SELECT_LEX_UNIT |
SELECT 하나 / 그것들을 묶는 단위. 번갈아 쌓여 서브쿼리·UNION 나무가 된다 |
TABLE_LIST |
이름과 잠금 신청서만. table은 NULL — 여는 것은 7편 |
Item |
식 하나. thd->mem_root에서 만들고 free_list에 걸어 문장 끝에 한꺼번에 버린다 |
| 오류 1064 | yyerror() → THD::parse_error(). near 뒤는 막힌 토큰부터 80자, 줄 번호는 렉서가 센 것 |
다음에 볼 것
파서가 남긴 나무에는 NULL인 칸이 셋 있었습니다. TABLE_LIST::table, Item_field::field, 그리고 "이 사용자가 이것을 읽어도 되는가"라는 답입니다. 7편: 준비 단계 — 권한 확인, 테이블 열기, 이름 찾기에서 mysql_execute_command()의 큰 switch가 이 칸들을 어떤 순서로 채우는지, 메타데이터 잠금이 왜 ALTER TABLE을 기다리게 하는지, "Unknown column" 오류가 어디서 나는지를 봅니다.
앞 연재와 비교하면, httpd 9편과 Tomcat 6편은 HTTP 요청 줄과 헤더를 손으로 짠 코드로 한 줄씩 잘랐습니다. HTTP 요청은 모양이 단순해서 그것으로 충분합니다. SQL은 식이 식을 품고 문장 종류만 160가지가 넘어서, 문법을 따로 적고 파서를 생성합니다. 다만 "먼저 통째로 구조로 바꿔 두고, 실행은 그 구조를 걸으며 한다"는 두 단계는 httpd 7편에서 httpd.conf를 트리로 읽은 뒤 걸으며 실행하던 것과 같은 모양입니다.
애플리케이션 쪽에서 보면, Spring 18편의 JdbcTemplate이 보낸 SQL 문자열이 도착하는 곳이 이 글의 mysql_parse()입니다. 문법이 틀리면 여기서 1064 / 42000이 나갑니다. JDBC 드라이버가 이것을 SQLSyntaxErrorException으로 던지면 Spring 18편에서 본 기본 변환기가 BadSqlGrammarException으로 바꿉니다(드라이버가 어떤 예외로 던지는지는 이 연재에서 소스로 확인하지 않았습니다).