이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 네 번째 글입니다. 3편에서 mysqld_main() 이 플러그인과 엔진을 모두 초기화한 뒤 마지막으로 handle_connections_sockets() 의 poll() 루프에 들어가는 데까지 봤습니다. 이번 글은 그 루프에서 시작합니다. 2편 지도의 ① 연결 구역과, ② THD · 명령 구역 가운데 THD 를 만드는 앞부분을 확대합니다.
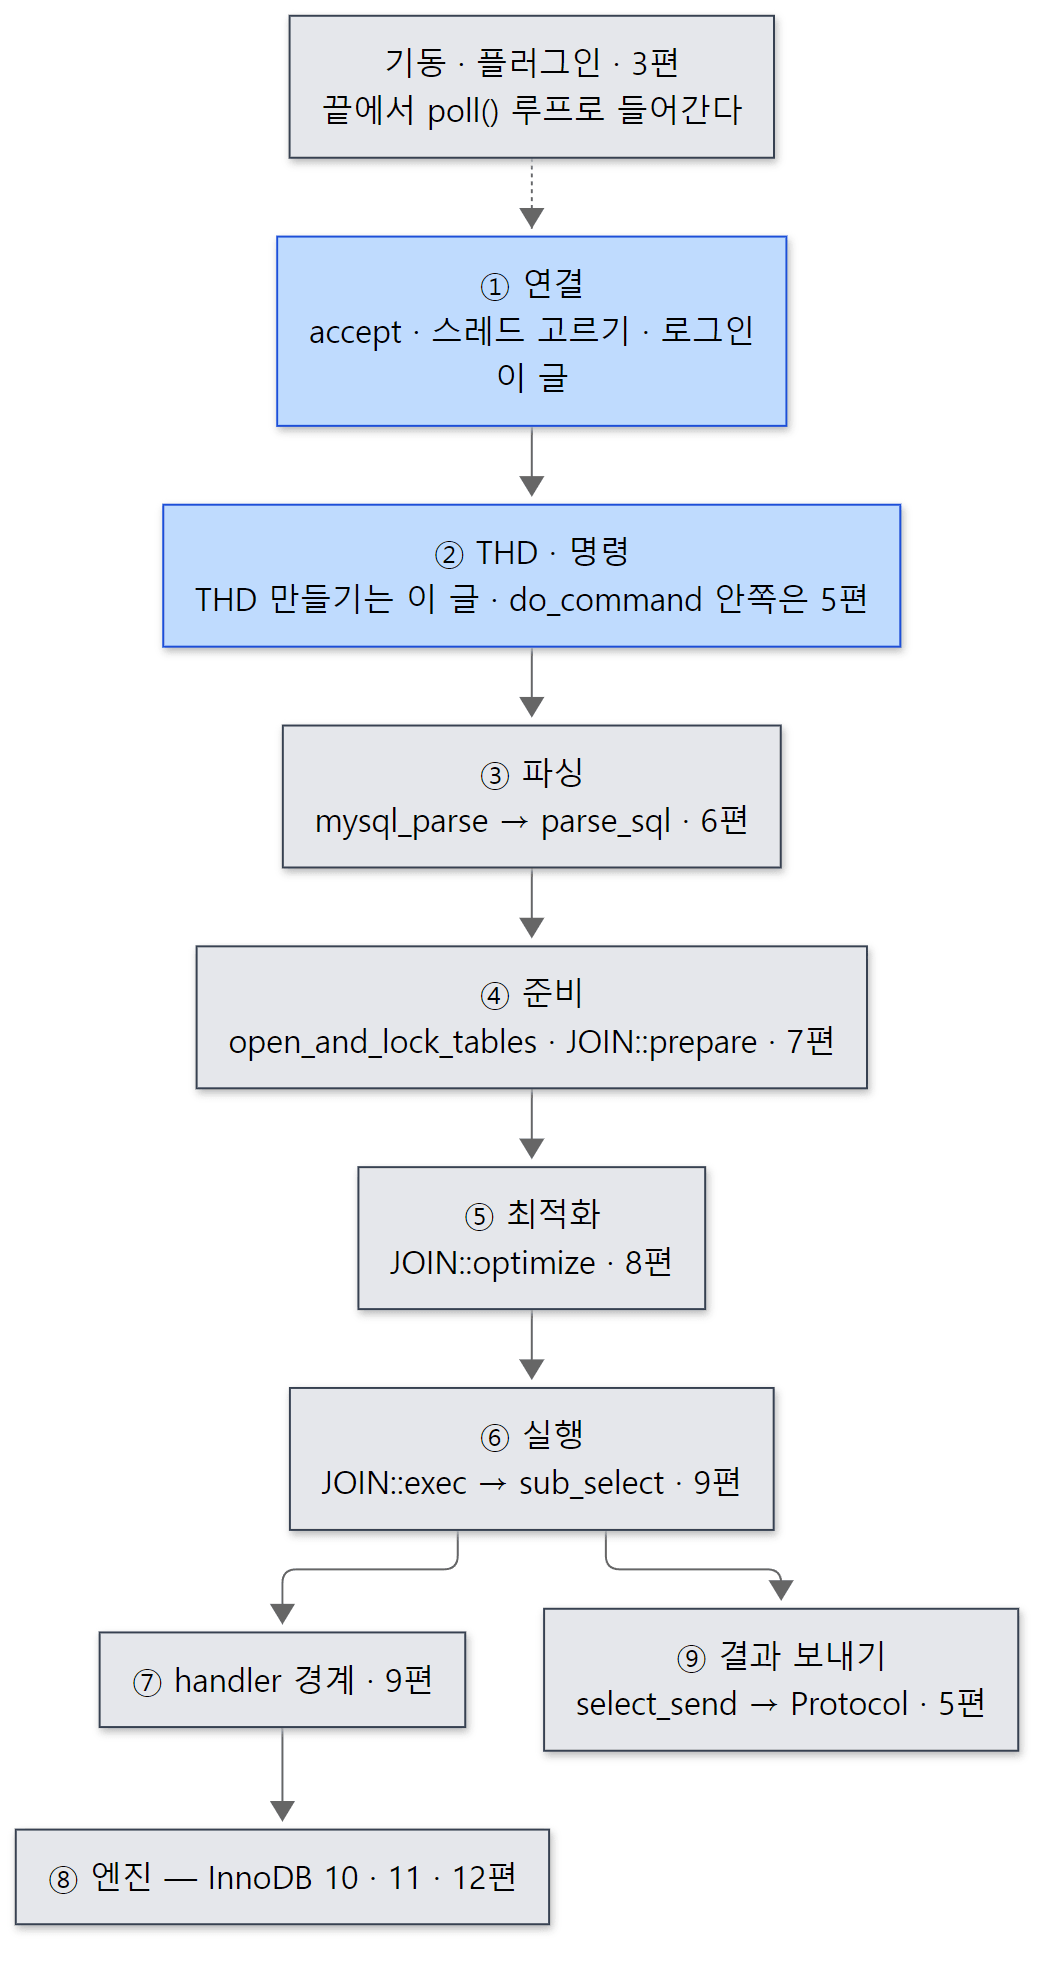 파란 칸이 이 글이 다루는 곳입니다. 회색 칸은 뒤 글에서 봅니다.
답하려는 질문은 네 가지입니다.
- 클라이언트가 3306 번 포트에 접속한 순간부터 첫 SQL 을 받을 준비가 되기까지, 어떤 스레드가 어떤 함수를 지나가는가
SHOW GLOBAL STATUS의Threads_connected·Threads_created·Threads_cached와thread_cache_size,max_connections는 코드의 어디서 세고 어디서 막는가thread_handling=pool-of-threads로 바꾸면 무엇이 달라지고, 놀고 있는 연결은 그동안 어디서 기다리는가- 스레드 풀에서 긴 질의 하나가 다른 연결을 막을 수 있는가 —
thread_pool_stall_limit은 무엇을 재는가
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | sql/mysqld.cc, sql/sql_connect.cc, sql/sql_connect.h, sql/scheduler.h·scheduler.cc, sql/thread_cache.h, sql/sql_acl.cc, sql/threadpool.h·threadpool_common.cc·threadpool_generic.h·threadpool_generic.cc, sql/thread_pool_info.cc |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
threadpool_generic.cc 하나가 1,770줄이고, 그 안에는 Linux 의 epoll 말고도 BSD 의 kqueue, Solaris 의 이벤트 포트, Windows 의 IOCP 판이 함께 들어 있습니다. 인증(sql_acl.cc)은 17,000줄이 넘습니다. 이 글은 처음 서버 소스를 여는 분이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
CONNECT: 메인 스레드가 accept() 로 소켓 하나를 받자마자 만드는 작은 객체입니다(sql/sql_connect.h 32행). 소켓, 소켓 종류(TCP 인지 유닉스 소켓인지), 이 연결을 맡을 스케줄러, 그리고 곧 붙을 연결 번호(thread_id)만 들고 있습니다. "아직 THD 가 없는 연결"이라고 보면 됩니다. 연결을 맡은 스레드가 THD 를 만들고 나면 지웁니다.
THD(thread descriptor): 연결 하나의 모든 상태를 담는 서버의 가장 큰 객체입니다(sql/sql_class.h 의 class THD). 세션 변수, 현재 문장의 LEX, 열어 둔 테이블, 트랜잭션, 네트워크 버퍼(NET)가 다 여기 있습니다. 이름에 "thread" 가 들어 있지만 스레드가 아니라 연결에 붙은 객체라는 것이 이 글의 중요한 대목입니다. 스레드 풀에서는 THD 하나가 여러 스레드를 옮겨 다닙니다. THD 의 전체 모양은 2편에서 봤습니다.
스케줄러(scheduler_functions): "새 연결이 오면 어느 스레드에 맡길까", "연결이 무언가를 기다리기 시작하면 누구에게 알릴까"를 정하는 함수 포인터 묶음입니다. C++ 로 쓰였지만 가상 함수가 아니라 C 식의 구조체 + 함수 포인터입니다. httpd 의 MPM 이 하는 일을 이 구조체 하나가 맡습니다(httpd 8편).
thread_handling: 어떤 스케줄러를 쓸지 고르는 시스템 변수입니다. 값은 one-thread-per-connection(연결마다 스레드 하나), no-threads(메인 스레드가 직접 처리), pool-of-threads(스레드 풀) 셋이고, 기동할 때만 정할 수 있습니다(읽기 전용).
스레드 캐시: 연결이 끊긴 뒤 스레드를 바로 없애지 않고 잠시 재워 두었다가 다음 연결에 다시 쓰는 장치입니다(sql/thread_cache.h 의 class Thread_cache). 크기는 thread_cache_size 입니다.
스레드 풀의 그룹·리스너·워커: 스레드 풀은 연결들을 몇 개의 그룹으로 나눕니다(thread_pool_size 개). 그룹마다 epoll 하나와 작업 큐가 있고, 그룹의 스레드(워커) 가운데 하나가 리스너가 되어 그룹의 모든 연결 소켓을 epoll 로 지켜봅니다. 6절에서 자세히 봅니다.
epoll: 소켓 여러 개를 등록해 두고 "읽을 것이 생긴 소켓을 알려 달라"고 Linux 커널에 묻는 기능입니다. 스레드 하나가 소켓 수천 개를 지켜볼 수 있습니다. httpd 의 event MPM, Tomcat 의 Poller 가 쓰는 것과 같은 운영체제 기능입니다.
1. 메인 스레드 — poll() 하고, accept() 하고, CONNECT 를 만든다
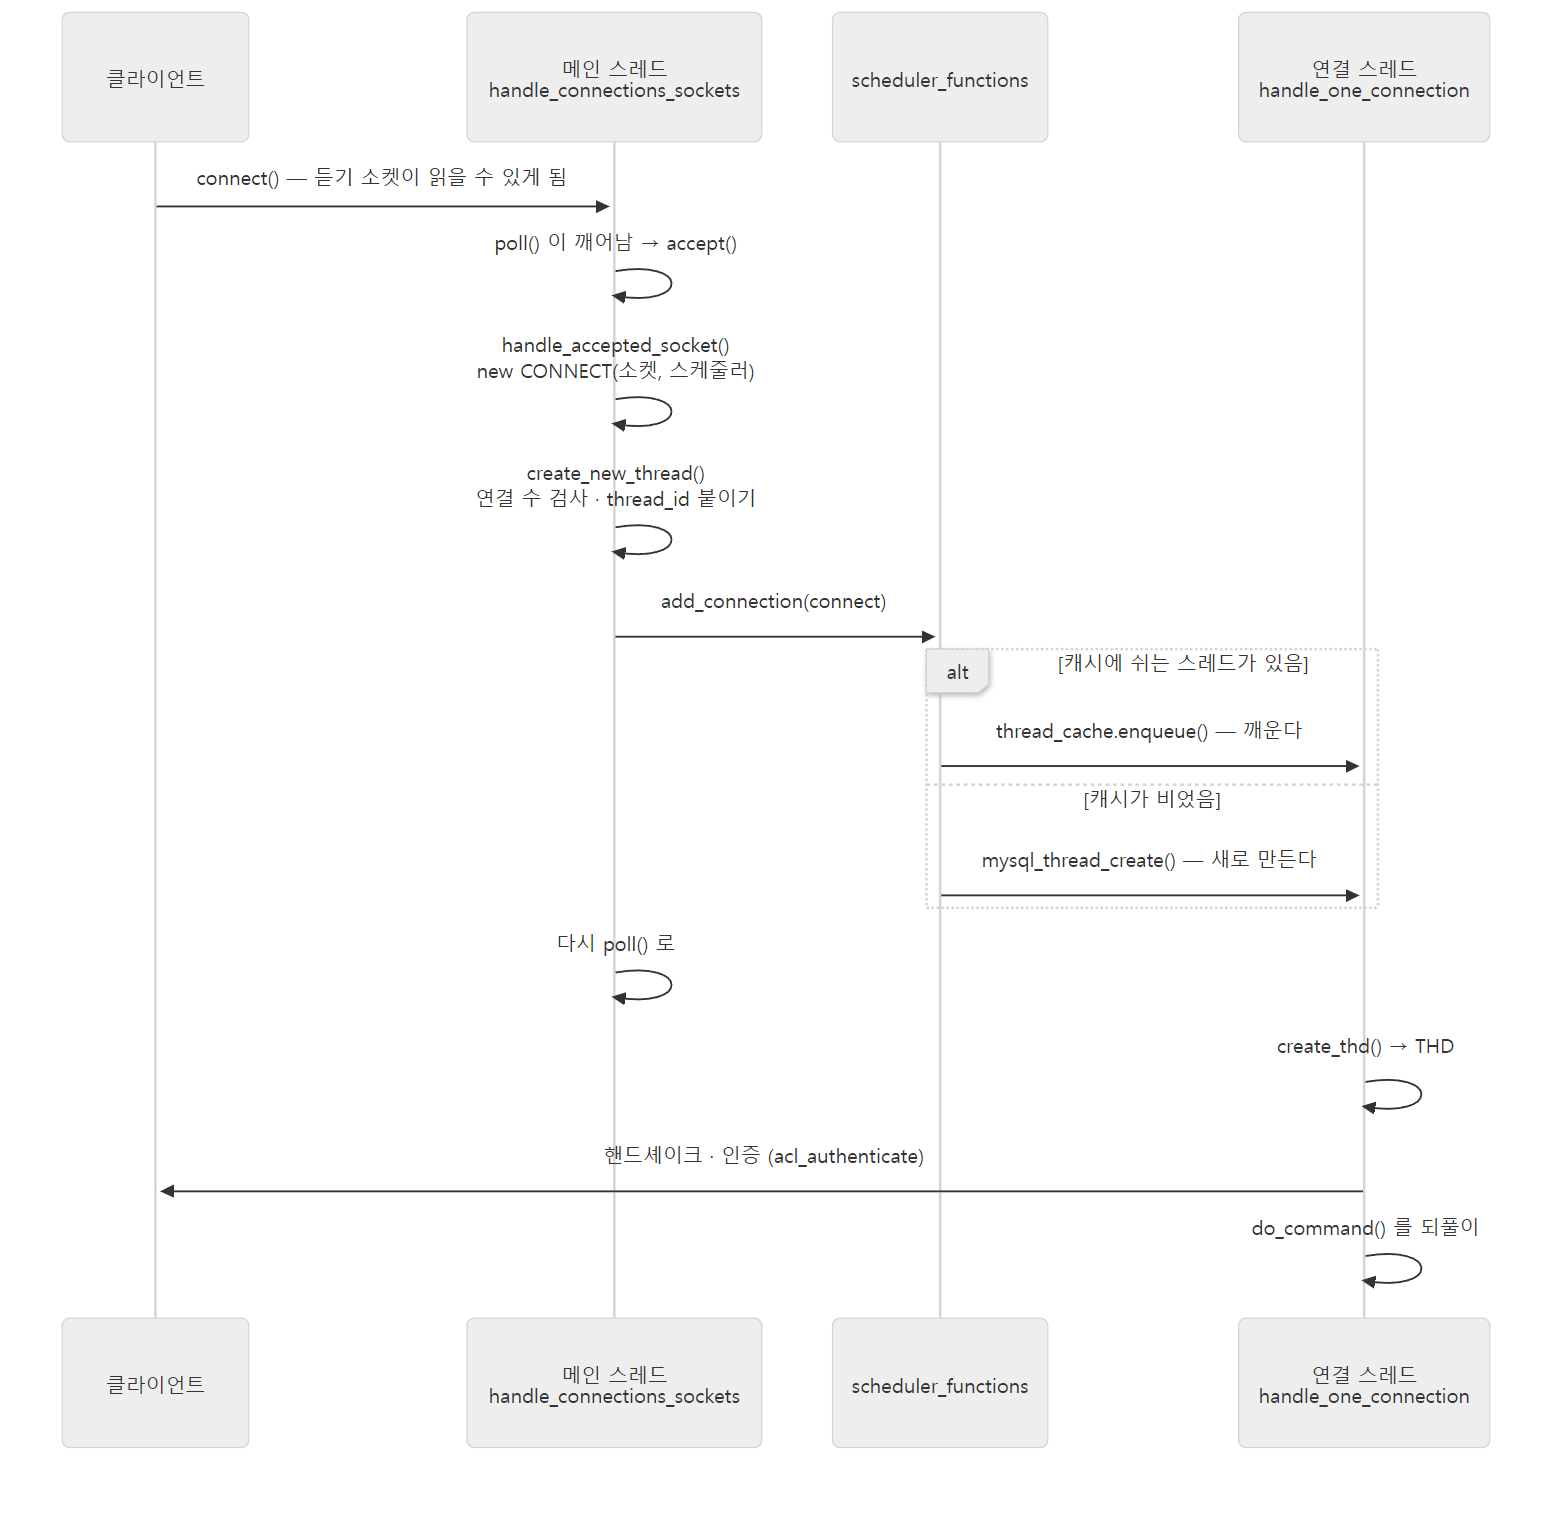 메인 스레드는 소켓을 받아
CONNECT 로 감싸 넘길 뿐, 클라이언트와 대화하지 않습니다(연결 수가 넘쳐 오류 패킷 하나를 보내고 닫는 경우만 예외입니다 — 예제 2). 핸드셰이크부터는 연결 스레드의 일입니다.
poll() 루프
3편에서 본 mysqld_main() 의 끝은 run_main_loop() 이고, 그 안이 handle_connections_sockets() 하나입니다. 듣기 소켓(TCP 3306, 유닉스 소켓, 설정했다면 extra_port)을 모두 pollfd 배열에 넣고, 종료를 알리는 파이프 하나를 더 넣은 뒤 이렇게 돕니다.
  while (!abort_loop)
  {
    retval= poll(fds.get_pos(0), fds.size(), -1);
    // ...
    for (uint retry=0; retry < MAX_ACCEPT_RETRY && !abort_loop; retry++)
    {
      size_socket length= sizeof(struct sockaddr_storage);
      MYSQL_SOCKET new_sock;

      new_sock= mysql_socket_accept(key_socket_client_connection, sock,
                                    (struct sockaddr *)(&cAddr),
                                    &length);
      if (mysql_socket_getfd(new_sock) != INVALID_SOCKET)
        handle_accepted_socket(new_sock, sock);
      else if (socket_errno == SOCKET_EAGAIN || socket_errno == SOCKET_EWOULDBLOCK)
        break;
poll() 의 마지막 인자 -1 은 "무한히 기다린다"입니다. 깨어나면 어느 듣기 소켓이 읽을 수 있게 됐는지 찾고(생략한 6911–6919행), accept() 를 EAGAIN 이 날 때까지 되풀이합니다. 듣기 소켓은 루프에 들어오기 전에 논블로킹으로 바꿔 두었기 때문에(set_non_blocking_if_supported(), 6863행) 줄 선 접속을 다 받고 나면 accept() 가 기다리지 않고 EAGAIN 을 돌려줍니다. 한 번 깨어날 때 몰려온 접속을 한꺼번에 받는 구조입니다.
handle_accepted_socket() — CONNECT 만들기
받은 소켓은 handle_accepted_socket() 로 갑니다. TCP wrapper(HAVE_LIBWRAP) 검사를 빼면 하는 일은 한 문장입니다.
  if (auto connect= new CONNECT(new_sock,
                                sock.is_unix_domain_socket ?
                                VIO_TYPE_SOCKET : VIO_TYPE_TCPIP,
                                sock.is_extra_port ?
                                extra_thread_scheduler : thread_scheduler))
    create_new_thread(connect);
여기서 스케줄러가 연결마다 정해진다는 것을 눈여겨봅니다. 보통 포트로 들어온 연결은 thread_scheduler, extra_port 로 들어온 연결은 extra_thread_scheduler 를 받습니다. 2절에서 보듯 둘은 서로 다른 모드일 수 있습니다.
create_new_thread() — 연결 수 검사와 연결 번호
  if ((*connect->scheduler->connection_count)++ >=
      *connect->scheduler->max_connections + 1)
  {
    DBUG_PRINT("error",("Too many connections"));
    connect->close_with_error(0, NullS, ER_CON_COUNT_ERROR);
    DBUG_VOID_RETURN;
  }

  uint sum= connection_count + extra_connection_count;
  if (sum > max_used_connections)
  {
    max_used_connections= sum;
    max_used_connections_time= time(nullptr);
  }

  // ... (임베디드 라이브러리에 대한 주석 생략)
  connect->thread_id= next_thread_id();
  connect->scheduler->add_connection(connect);
세 가지가 일어납니다.
- 연결 수를 하나 올리면서 검사합니다. 올리기 전 값이
max_connections + 1이상이면 거절합니다. 곧 이 자리에서는max_connections보다 하나 더 들어올 수 있습니다. 이 한 자리가 누구 몫인지는 4절의 인증에서 정해집니다. Max_used_connections상태 변수를 갱신합니다.- 연결 번호를 붙입니다.
next_thread_id()가 주는 이 값이SHOW PROCESSLIST의Id,CONNECTION_ID(),KILL <id>의 그 번호입니다. 이름은 thread_id 이지만 실제로는 연결 번호입니다.
그리고 마지막 줄에서 연결을 스케줄러의 함수 포인터 add_connection 에 넘깁니다. 메인 스레드의 일은 여기까지이고, 곧바로 poll() 로 돌아갑니다. 연결 수는 연결이 끝날 때 unlink_thd() 가 되돌려 놓습니다(--*thd->scheduler->connection_count;, 3096행). SHOW STATUS 의 Threads_connected 는 이 connection_count 를 그대로 보여 줍니다(8218행). 이름과 달리 스레드가 아니라 연결의 수입니다.
예제 1: 접속을 받는 길과 로그인하는 길을 gdb 로
정말 이 순서인지 실행 중인 서버에 gdb 를 붙여 확인했습니다. 이 예제는 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 예제 폴더는 ex/u04-gdb 이고, 이 부분의 핵심은 이렇습니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ...
lab-start > /dev/null
gdb -p "$(cat /tmp/mariadbd.pid)" -batch \
    -ex 'break create_thread_to_handle_connection' -ex 'break acl_authenticate' \
    -ex 'continue' -ex 'bt' -ex 'continue' -ex 'bt' -ex 'detach' > /tmp/bp.txt 2>/dev/null & GDB=$!
sleep 5
mariadb -e "SELECT 'hello' AS greeting" > /dev/null
# ...
[예제 ex/u04-gdb/run.sh 에서 줄임]
중단점 두 곳에서 찍힌 백트레이스입니다(인자 값과 주소는 지웠습니다).
=== 0. breakpoints: who accepts, who logs in
#0  create_thread_to_handle_connection at /usr/src/mariadb/sql/mysqld.cc:6682
#1  create_new_thread at /usr/src/mariadb/sql/mysqld.cc:6756
#2  handle_accepted_socket at /usr/src/mariadb/sql/mysqld.cc:6818
#3  handle_connections_sockets at /usr/src/mariadb/sql/mysqld.cc:6930
#4  run_main_loop at /usr/src/mariadb/sql/mysqld.cc:6171
#5  mysqld_main at /usr/src/mariadb/sql/mysqld.cc:6590
#6  main at /usr/src/mariadb/sql/main.cc:34

#0  acl_authenticate at /usr/src/mariadb/sql/sql_acl.cc:17039
#1  check_connection at /usr/src/mariadb/sql/sql_connect.cc:1184
#2  login_connection at /usr/src/mariadb/sql/sql_connect.cc:1252
#3  thd_prepare_connection at /usr/src/mariadb/sql/sql_connect.cc:1440
#4  do_handle_one_connection at /usr/src/mariadb/sql/sql_connect.cc:1504
#5  handle_one_connection at /usr/src/mariadb/sql/sql_connect.cc:1426
#6  pfs_spawn_thread at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#7  ?? () from /lib/x86_64-linux-gnu/libc.so.6
#8  ?? () from /lib/x86_64-linux-gnu/libc.so.6
두 백트레이스의 바닥이 다릅니다. 첫째는 main() 에서 올라온 메인 스레드이고, 둘째는 handle_one_connection() 에서 시작하는 새 스레드입니다. 접속을 받는 일과 로그인하는 일이 서로 다른 스레드에서 일어난다는 것이 그대로 보입니다. pfs_spawn_thread 는 performance_schema 가 스레드를 만들 때 끼워 넣는 감싸개입니다(이 빌드는 performance_schema 를 넣어 빌드했으므로, 실행 중에 꺼져 있어도 이 프레임이 보입니다). 줄 번호는 모두 기준 커밋의 소스와 맞는 것을 확인했습니다.
예제 2: "Too many connections" 는 두 곳에서 난다
max_connections + 1 의 한 자리를 확인하려고 --max-connections=10 으로 서버를 띄우고, 권한이 없는 사용자 app 으로 연결 10개를 열어 둔 채 다음을 시도했습니다(ex/u04-max-connections).
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ...
lab-start --max-connections=10 > /dev/null
mariadb -e "CREATE USER app@localhost; SELECT @@max_connections"

echo "--- 1. ten idle 'app' clients"
for i in $(seq 1 10); do (sleep 8 | mariadb -u app) & done
sleep 3

echo "--- 2. 11th client as 'app'"
mariadb -u app -e "SELECT 'app got in' AS result" 2>&1 || true

echo "--- 3. 11th client as root (admin)"
# 관리자 연결 하나를 SLEEP(4) 로 열어 둔 채 다음 단계를 본다 (-n: 문장마다 바로 출력)
mariadb -n -N -e "SELECT 'root got in'; SELECT SLEEP(4)" > /tmp/root.out 2>&1 &
sleep 1.5
cat /tmp/root.out

echo "--- 4. 12th client as root"
mariadb -e "SELECT 'second root got in' AS result" 2>&1 || true
# ...
[예제 ex/u04-max-connections/run.sh 에서 줄임]
@@max_connections
10
--- 1. ten idle 'app' clients
--- 2. 11th client as 'app'
ERROR 1040 (08004): Too many connections
--- 3. 11th client as root (admin)
root got in
--- 4. 12th client as root
ERROR 2002 (HY000): Received error packet before completion of TLS handshake. The authenticity of the following error cannot be verified: 1040 - Too many connections
--- 5. status after everyone left
+-----------------------------------+-------+
 Variable_name                     | Value |
+-----------------------------------+-------+
 Aborted_connects                  | 2     |
 Connection_errors_max_connections | 1     |
 Max_used_connections              | 11    |
+-----------------------------------+-------+
같은 1040 번 오류인데 모양이 다릅니다.
- 11번째
app은create_new_thread()를 통과했습니다(올리기 전 값 10 은10 + 1보다 작습니다). 연결 스레드가 생기고 인증까지 끝난 뒤, 4절에서 볼acl_authenticate()의 검사에서 막혔습니다. 핸드셰이크를 마친 뒤라 클라이언트는 평범한ERROR 1040을 받습니다. - 11번째
root는 같은 검사를 관리자 권한으로 건너뛰어 들어왔습니다. 이것이 "하나 더"의 자리입니다. - 12번째
root는create_new_thread()에서 막혔습니다(올리기 전 값 11 ≥ 11). 이때는 연결 스레드도 핸드셰이크도 없이, 메인 스레드에서close_with_error()가 오류를 보내려고 잠깐 쓸 THD 를 만들고close_connection()으로 오류 패킷 하나를 보낸 뒤 소켓을 닫습니다(sql_connect.cc1600–1613행,mysqld.cc3037–3041행). 클라이언트는 서버 인사(핸드셰이크) 대신 오류 패킷을 받았으므로 "TLS 핸드셰이크를 마치기 전에 오류 패킷을 받았다"는 2002 번 오류로 감싸서 보여 줍니다. 기준 커밋의mariadb클라이언트가 기본으로 TLS 를 시도하기 때문에 이런 문구가 나옵니다.
상태 변수도 이 차이를 그대로 셉니다. Connection_errors_max_connections 는 CONNECT::close_and_delete() 가 ER_CON_COUNT_ERROR 일 때만 올리므로(1585–1586행) 12번째 root 하나만 세었고, Aborted_connects 는 두 번 모두 세었습니다.
헷갈리기 쉬운 곳: 관리자 몫의 한 자리는 SUPER 가 아니라 CONNECTION ADMIN
예전 MySQL 문서에서 "SUPER 권한을 가진 사용자를 위해 한 자리를 남겨 둔다"는 설명을 본 분이 많을 것입니다. 기준 커밋에서 이 검사가 보는 권한은 PRIV_IGNORE_MAX_CONNECTIONS 이고, 이것은 CONNECTION_ADMIN_ACL 과 같습니다(sql/privilege.h 428행). 권한이 잘게 나뉜 뒤의 이름입니다. 그리고 이 자리는 "관리자가 몇 명이든 하나"입니다. 예제의 12번째 root 처럼 관리자도 두 번째부터는 막힙니다.
2. 스케줄러 — thread_handling 이 고르는 함수 포인터 묶음
add_connection 이 무엇을 가리키는지는 기동할 때 정해집니다. 먼저 구조체를 봅니다.
struct scheduler_functions
{
  uint max_threads;
  Atomic_counter<uint> *connection_count;
  ulong *max_connections;
  bool (*init)(void);
  void (*add_connection)(CONNECT *connect);
  void (*thd_wait_begin)(THD *thd, int wait_type);
  void (*thd_wait_end)(THD *thd);
  void (*post_kill_notification)(THD *thd);
  void (*end)(void);
  /** resume previous unfinished command (threadpool only)*/
  void (*thd_resume)(THD* thd);
};
함수 포인터는 일곱 개이고, 스레드 풀에서만 쓰는 thd_resume 을 빼면 이것이 스케줄러의 약속입니다.
| 함수 포인터 | 언제 불리나 |
|---|---|
add_connection |
메인 스레드가 새 연결을 넘길 때 (1절) |
thd_wait_begin / thd_wait_end |
연결이 잠금·디스크·SLEEP() 같은 것을 기다리기 시작할 때와 끝날 때 (7절) |
post_kill_notification |
다른 연결이 KILL 했을 때, 기다리는 연결을 깨우려고 (8절) |
init / end |
서버가 시작할 때와 끝날 때 |
비어 있는 포인터도 됩니다. 부르는 쪽은 MYSQL_CALLBACK(obj, func, params) 매크로로 "객체와 함수가 있으면 부른다"를 한 줄로 씁니다(sql/sql_callback.h 33–37행). 연결마다 스레드를 두는 모드는 thd_wait_begin 을 채우지 않으므로, 기다림 알림은 그 모드에서 아무 일도 하지 않습니다.
세 가지 값과 기본값
static const char *thread_handling_names[]=
{
  "one-thread-per-connection", "no-threads",
#ifdef HAVE_POOL_OF_THREADS
  "pool-of-threads",
#endif
  0
};

#if defined (_WIN32) && defined (HAVE_POOL_OF_THREADS)
/* Windows is using OS threadpool, so we're pretty sure it works well */
#define DEFAULT_THREAD_HANDLING 2
#else
#define DEFAULT_THREAD_HANDLING 0
#endif
기본값이 운영체제마다 다릅니다. Linux 에서는 0번 one-thread-per-connection, Windows 에서는 2번 pool-of-threads 입니다(주석: Windows 는 운영체제의 스레드 풀을 쓰니 잘 동작한다고 확신한다). HAVE_POOL_OF_THREADS 는 sql/CMakeLists.txt 가 Linux·Solaris·Windows·kqueue 가 있는 시스템에서 켭니다(229–234행). 변수는 READ_ONLY 로 선언되어 있어(3497행) SET GLOBAL 로 바꿀 수 없고 my.cnf 나 기동 옵션으로만 정합니다.
값에 따라 구조체를 채우는 곳은 get_options() 입니다.
  if (thread_handling <= SCHEDULER_ONE_THREAD_PER_CONNECTION)
    one_thread_per_connection_scheduler(thread_scheduler, &max_connections,
                                        &connection_count);
  else if (thread_handling == SCHEDULER_NO_THREADS)
    one_thread_scheduler(thread_scheduler, &connection_count);
  else
    pool_of_threads_scheduler(thread_scheduler,  &max_connections,
                                        &connection_count);

  one_thread_per_connection_scheduler(extra_thread_scheduler,
                                      &extra_max_connections,
                                      &extra_connection_count);
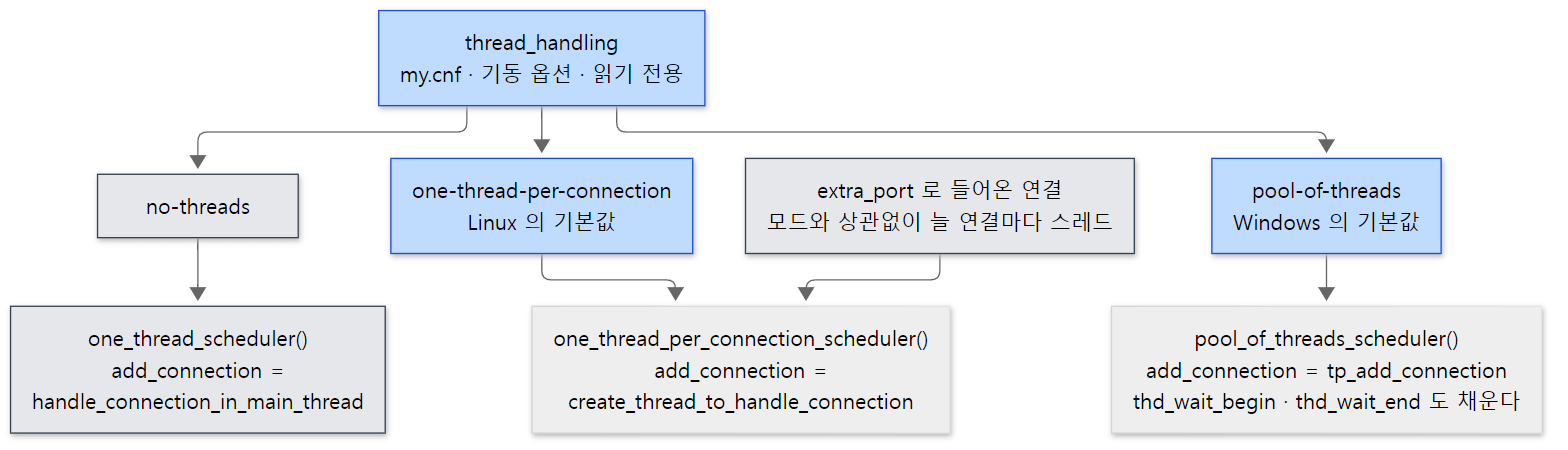
extra_port 의 스케줄러는 thread_handling 과 상관없이 늘 "연결마다 스레드"입니다.
마지막 세 줄이 중요합니다. extra_port 는 언제나 연결마다 스레드 하나입니다. 스레드 풀이 막혔을 때 관리자가 들어와 상황을 볼 수 있게 남겨 둔 비상구입니다. 스레드 풀이 워커를 더 만들지 못할 때 오류 로그에 남기는 메시지도 "extra_port 로 관리자 계정으로 들어와 문제를 살펴볼 수 있다"고 안내합니다(threadpool_generic.cc 1724–1732행). extra_max_connections 의 기본값은 1입니다(sys_vars.cc 7145행).
no-threads 를 고르면 add_connection 이 handle_connection_in_main_thread() 가 되고, 이 함수는 do_handle_one_connection(connect, false) 한 줄입니다(6671–6674행). 메인 스레드가 그 연결이 끝날 때까지 직접 처리하므로 그동안 다른 접속은 받지 못합니다.
헷갈리기 쉬운 곳: enum 에는 pool-of-threads 가 없다
scheduler.h 의 enum scheduler_types 에는 SCHEDULER_ONE_THREAD_PER_CONNECTION=0, SCHEDULER_NO_THREADS, SCHEDULER_TYPES_COUNT 셋뿐입니다(57–69행). 2번(pool-of-threads)에 해당하는 이름이 따로 없고, 위 코드처럼 "둘 다 아니면(else)" 스레드 풀로 갑니다. 그래서 다른 곳에서 "스레드 풀인가"를 물을 때는 thread_handling == SCHEDULER_TYPES_COUNT 라고 씁니다(예: sql/wsrep_thd.cc 509행). 처음 읽으면 "개수와 같은지 비교한다"는 코드가 버그처럼 보이지만 의도된 것입니다. enum 위의 주석도 "마지막 값은 동적인 스레드 처리를 표시하는 데도 쓰인다"고 적어 두었습니다(53–55행).
3. 연결마다 스레드 하나 — handle_one_connection() 과 스레드 캐시
기본 모드에서 add_connection 은 create_thread_to_handle_connection() 입니다(scheduler.cc 117행).
void create_thread_to_handle_connection(CONNECT *connect)
{
  DBUG_ENTER("create_thread_to_handle_connection");

  if (thread_cache.enqueue(connect))
    DBUG_VOID_RETURN;

  /* Create new thread to handle connection */
  inc_thread_created();
  DBUG_PRINT("info",(("creating thread %lu"), (ulong) connect->thread_id));
  connect->prior_thr_create_utime= microsecond_interval_timer();

  pthread_t tmp;
  if (auto error= mysql_thread_create(key_thread_one_connection,
                                      &tmp, &connection_attrib,
                                      handle_one_connection, (void*) connect))
  {
    // ... (ER_CANT_CREATE_THREAD 를 보내고 연결을 닫는다)
  }
  DBUG_PRINT("info",("Thread created"));
  DBUG_VOID_RETURN;
}
먼저 캐시에 재워 둔 스레드가 있으면 그 스레드에게 맡기고(enqueue()), 없을 때만 새 스레드를 만듭니다. 새로 만들 때만 inc_thread_created() 로 Threads_created 상태 변수를 올립니다. 그래서 Threads_created 가 계속 늘어난다면 캐시가 모자라다는 뜻입니다.
연결 스레드의 일생
새 스레드는 handle_one_connection() 에서 시작합니다. 스레드 이름을 one_connection 으로 붙이고(1421행, Linux 에서는 pthread_setname_np() 로 운영체제 스레드 이름이 됩니다) do_handle_one_connection(connect, true) 를 부릅니다. 핵심은 이 함수의 바깥 for 루프입니다.
  for (;;)
  {
    bool create_user= TRUE;

    mysql_socket_set_thread_owner(thd->net.vio->mysql_socket);
    if (thd_prepare_connection(thd))
    {
      create_user= FALSE;
      goto end_thread;
    }

    while (thd_is_connection_alive(thd))
    {
      if (mysql_audit_release_required(thd))
        mysql_audit_release(thd);
      if (do_command(thd))
	break;
    }
    end_connection(thd);

end_thread:
    close_connection(thd);

    if (thd->userstat_running)
      update_global_user_stats(thd, create_user, time(NULL));

    unlink_thd(thd);
    if (IF_WSREP(thd->wsrep_applier, false) || !put_in_cache ||
        !(connect= thread_cache.park()))
      break;
    // ... (새 연결을 위한 performance_schema 계측 생략)
    if (!(connect->create_thd(thd)))
    {
      // ... (자원이 모자라면 연결을 닫고 스레드를 끝낸다)
    }
    delete connect;
    // ... (store_globals() 로 스레드 전역을 새 연결 것으로)
    server_threads.insert(thd);
  }
  delete thd;
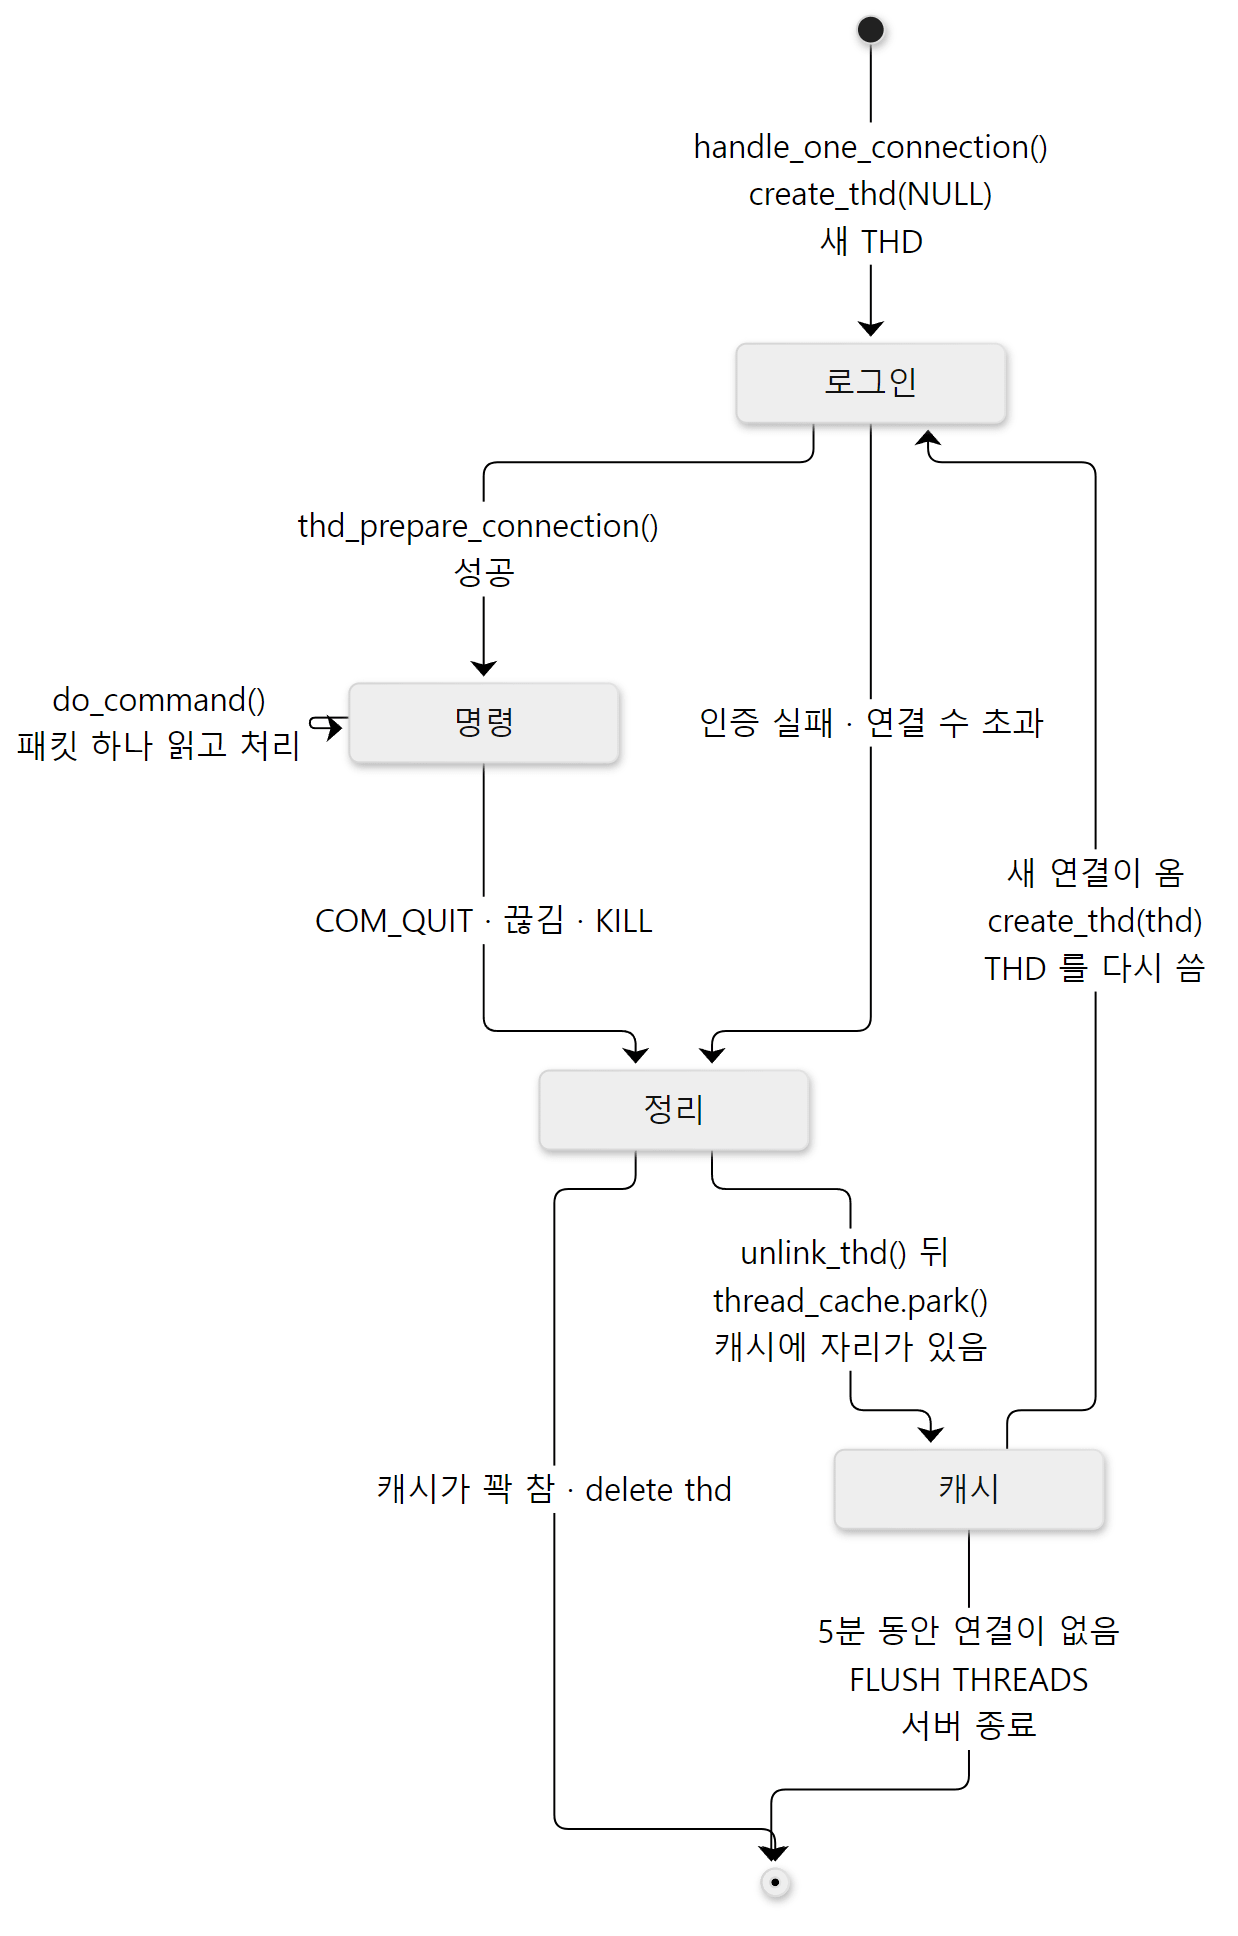 스레드 하나가 여러 연결을 차례로 맡습니다. 캐시에서 깨어난 스레드는 THD 객체까지 다시 씁니다.
읽을 것이 셋입니다.
- 안쪽
while이 연결의 일생입니다.do_command()가 패킷 하나를 읽어 처리하고 돌아오기를 연결이 살아 있는 동안 되풀이합니다.do_command()안쪽(패킷 읽기와dispatch_command())은 5편에서 봅니다. 이 모드에서는 연결이 놀고 있는 동안에도 이 스레드가do_command()안에서 다음 패킷을 기다립니다(5절에서 gdb 로 봅니다). - 바깥
for가 스레드의 일생입니다. 연결이 끝나면thread_cache.park()로 캐시에 들어가 기다리고, 새 연결을 받으면 처음으로 돌아갑니다.park()가NULL을 돌려주면(캐시가 꽉 찼거나 시간이 다 됐으면) 루프를 빠져나와delete thd후 스레드가 끝납니다. - THD 를 다시 씁니다. 처음에는
connect->create_thd(NULL)(1470행)로 새 THD 를 만들지만, 캐시에서 깨어난 뒤에는connect->create_thd(thd)로 쓰던 THD 를 넘깁니다.create_thd()는 이때thd->reset_for_reuse()로 THD 를 비우고 연결 번호만 새것으로 바꿉니다(1626–1636행). 큰 객체를 다시 할당하지 않으려는 것입니다.
Thread_cache::park() — 캐시는 큐 하나와 조건 변수
    mysql_mutex_lock(&LOCK_thread_cache);
    if ((connect= list.get()))
      cached_thread_count++;
    else if (cached_thread_count < thread_cache_size && !kill_cached_threads)
    {
      /* Don't kill the thread, just put it in cache for reuse */
      DBUG_PRINT("info", ("Adding thread to cache"));
      cached_thread_count++;
      for (;;)
      {
        int error= mysql_cond_timedwait(&COND_thread_cache, &LOCK_thread_cache,
                                         &abstime);
        flushed= kill_cached_threads;
        if ((connect= list.get()))
          break;
        else if (flushed || error == ETIMEDOUT || error == ETIME)
        {
          /*
            If timeout, end thread.
            If a new thread is requested, we will handle the call, even if we
            got a timeout (as we are already awake and free)
          */
          cached_thread_count--;
          break;
        }
      }
    }
    mysql_mutex_unlock(&LOCK_thread_cache);
캐시는 CONNECT 의 대기 줄(list) 하나와 조건 변수 COND_thread_cache 하나입니다. 재워 둔 스레드는 조건 변수에서 기다리다가, 메인 스레드의 enqueue() 가 줄에 CONNECT 를 넣고 mysql_cond_signal() 을 보내면(119–132행) 깨어나 꺼내 갑니다. cached_thread_count 가 Threads_cached 상태 변수입니다(show_cached_thread_count(), mysqld.cc 7973–7980행). 기다리는 시간 abstime 은 THREAD_CACHE_TIMEOUT, 곧 5*60 초입니다(sql/sql_const.h 262행). 5분 동안 새 연결이 없으면 스레드는 스스로 끝납니다. thread_cache_size 의 설명 문구도 "5분 동안 놀면 풀린다"입니다(sys_vars.cc 4493행). FLUSH THREADS 는 thread_cache.flush() 로 재워 둔 스레드를 모두 깨워 끝냅니다(sql_reload.cc 398–399행).
예제 3: 연결 수와 스레드 수가 같이 움직인다
기본 모드로 띄운 서버에 놀고 있는 클라이언트 5개를 붙였다가 떼고, 다시 3개를 붙이며 상태 변수와 ps -L 로 센 one_connection 스레드 수를 찍었습니다(ex/u04-one-thread). 놀고 있는 클라이언트는 (sleep 6 | mariadb) & 처럼 표준 입력이 비어 있는 mariadb 로 만들었습니다. 접속만 해 두고 아무것도 보내지 않습니다.
--- 0. settings
@@thread_handling	@@thread_cache_size	@@max_connections
one-thread-per-connection	151	151
--- 1. before
connected=1 created=1 cached=0
one_connection threads (ps -L): 1
--- 2. five idle clients connected
connected=6 created=6 cached=0
one_connection threads (ps -L): 6
+---------------------------+------+-------+
 NAME                      | ID   | CMD   |
+---------------------------+------+-------+
 thread/sql/one_connection |    6 | Sleep |
 thread/sql/one_connection |    7 | Sleep |
 thread/sql/one_connection |    8 | Sleep |
 thread/sql/one_connection |    9 | Sleep |
 thread/sql/one_connection |   10 | Sleep |
 thread/sql/one_connection |   12 | Query |
+---------------------------+------+-------+
--- 3. the five clients disconnected
connected=1 created=6 cached=5
one_connection threads (ps -L): 6
--- 4. three new idle clients
connected=4 created=6 cached=2
one_connection threads (ps -L): 6
상태 변수를 묻는 mariadb -e 도 연결 하나이므로 connected 에는 늘 자기 자신이 1 들어 있습니다. 표는 performance_schema.threads 에서 thread/sql/one_connection 인 스레드를 고른 것입니다(이 표를 찍으려고 이 예제의 서버는 --performance-schema=ON 으로 띄웠습니다). 연결 번호는 실행마다 다릅니다.
- 2단계: 연결이 6이면 스레드도 6입니다. 놀고 있는(
Sleep) 연결 다섯도 스레드를 하나씩 붙잡고 있습니다. - 3단계: 클라이언트가 떠나도 스레드 6개는 그대로이고
cached=5입니다. 5개는park()안에서 자고, 하나는 지금 상태를 묻고 있는 연결을 처리하고 있습니다. - 4단계: 새 클라이언트 3개와 상태를 묻는 연결 1개가 들어왔지만
created는 6에서 늘지 않았습니다. 넷 모두 캐시의 스레드를 깨워 썼고, 캐시에는 2개가 남았습니다.
헷갈리기 쉬운 곳: thread_cache_size 의 기본값 256 이 151 로 보인다
Sys_thread_cache_size 의 DEFAULT 는 256 입니다(sys_vars.cc 4495행). 그런데 예제 0단계에서는 151 이 나왔습니다. get_options() 의 끝에서 "캐시가 max_connections 보다 클 필요는 없다"며 줄이기 때문입니다.
  /* Ensure that some variables are not set higher than needed */
  if (thread_cache_size > max_connections)
    SYSVAR_AUTOSIZE(thread_cache_size, max_connections);
max_connections 의 기본값이 151(MAX_CONNECTIONS_DEFAULT, sql_const.h 168행)이므로 기본 설정에서는 캐시도 151 이 됩니다. 문서의 기본값과 SELECT @@thread_cache_size 가 다르다면 이 때문입니다.
4. 로그인 — THD 를 만들고 인증한다
연결 스레드가 맨 처음 하는 일은 create_thd() 와 thd_prepare_connection() 입니다.
create_thd() — THD 와 Vio, NET
  if (thd)
  {
    /* reuse old thd */
    thd->reset_for_reuse();
    /*
      reset tread_id's, but not thread_dbug_id's as the later isn't allowed
      to change as there is already structures in thd marked with the old
      value.
    */
    thd->thread_id= thd->variables.pseudo_thread_id= thread_id;
  }
  else if (!(thd= new THD(thread_id)))
    DBUG_RETURN(0);
새 THD 는 new THD(thread_id) 로 만듭니다. 생성자(sql_class.cc 721행~)는 끝에서 init() 을 부르고(960행), THD::init() 은 plugin_thdvar_init() 으로 전역 시스템 변수를 세션 변수로 복사합니다(1388–1399행). SET GLOBAL 로 바꾼 값이 새 연결부터 적용되는 이유가 이것입니다. 이미 열려 있는 연결의 THD 는 그때 복사한 값을 계속 씁니다.
그다음 create_thd() 는 소켓을 Vio(MariaDB 의 소켓 추상화)로 감싸고 my_net_init() 으로 THD 의 NET(패킷 읽기·쓰기 버퍼)에 붙입니다(1645–1655행). 유닉스 소켓으로 들어온 연결이면 이 자리에서 호스트를 localhost 로 정해 둡니다(1668–1670행). Vio 와 NET 의 안쪽은 5편의 주제입니다. THD 가 준비되면 do_handle_one_connection() 은 server_threads.insert(thd) 로 THD 를 서버의 연결 목록에 넣습니다(1490행). SHOW PROCESSLIST 에 연결이 보이기 시작하는 것이 이 순간입니다(주석: "Make THD visible in show processlist"). 아직 인증 전이므로 이때 PROCESSLIST 의 User 는 unauthenticated user 로 보입니다.
thd_prepare_connection() → acl_authenticate()
bool thd_prepare_connection(THD *thd)
{
  bool rc;
  lex_start(thd);
  rc= login_connection(thd);
  if (rc)
    return rc;

  MYSQL_CONNECTION_START(thd->thread_id, &thd->security_ctx->priv_user[0],
                         (char *) thd->security_ctx->host_or_ip);

  prepare_new_connection_state(thd);
#ifdef WITH_WSREP
  thd->wsrep_client_thread= true;
  wsrep_open(thd);
#endif /* WITH_WSREP */
  return FALSE;
}
예제 1의 두 번째 백트레이스가 이 길이었습니다. 단계별로 하는 일은 이렇습니다.
| 함수 | 하는 일 |
|---|---|
login_connection() |
핸드셰이크 동안은 읽기·쓰기 제한 시간을 connect_timeout 으로 둔다(1249–1250행). 성공하면 net_read_timeout·net_write_timeout 으로 되돌린다 |
check_connection() |
TCP 면 상대 주소를 얻어 호스트 캐시를 확인한다(thd_set_peer_addr()). TCP keep-alive 를 켜고 acl_authenticate(thd, 0) 을 부른다(1184행) |
acl_authenticate() |
서버 인사 패킷을 보내고, 사용자 이름을 받아, 그 계정의 인증 플러그인으로 비밀번호를 확인한다. 계정 잠금·비밀번호 만료·max_user_connections·max_connections 를 검사하고, 처음 쓸 데이터베이스로 바꾼 뒤 OK 패킷을 보낸다 |
prepare_new_connection_state() |
init_for_queries() 로 질의를 받을 준비를 하고, init_connect 가 설정돼 있으면 실행한다(CONNECTION ADMIN 권한이 있으면 건너뛴다, 1354–1357행) |
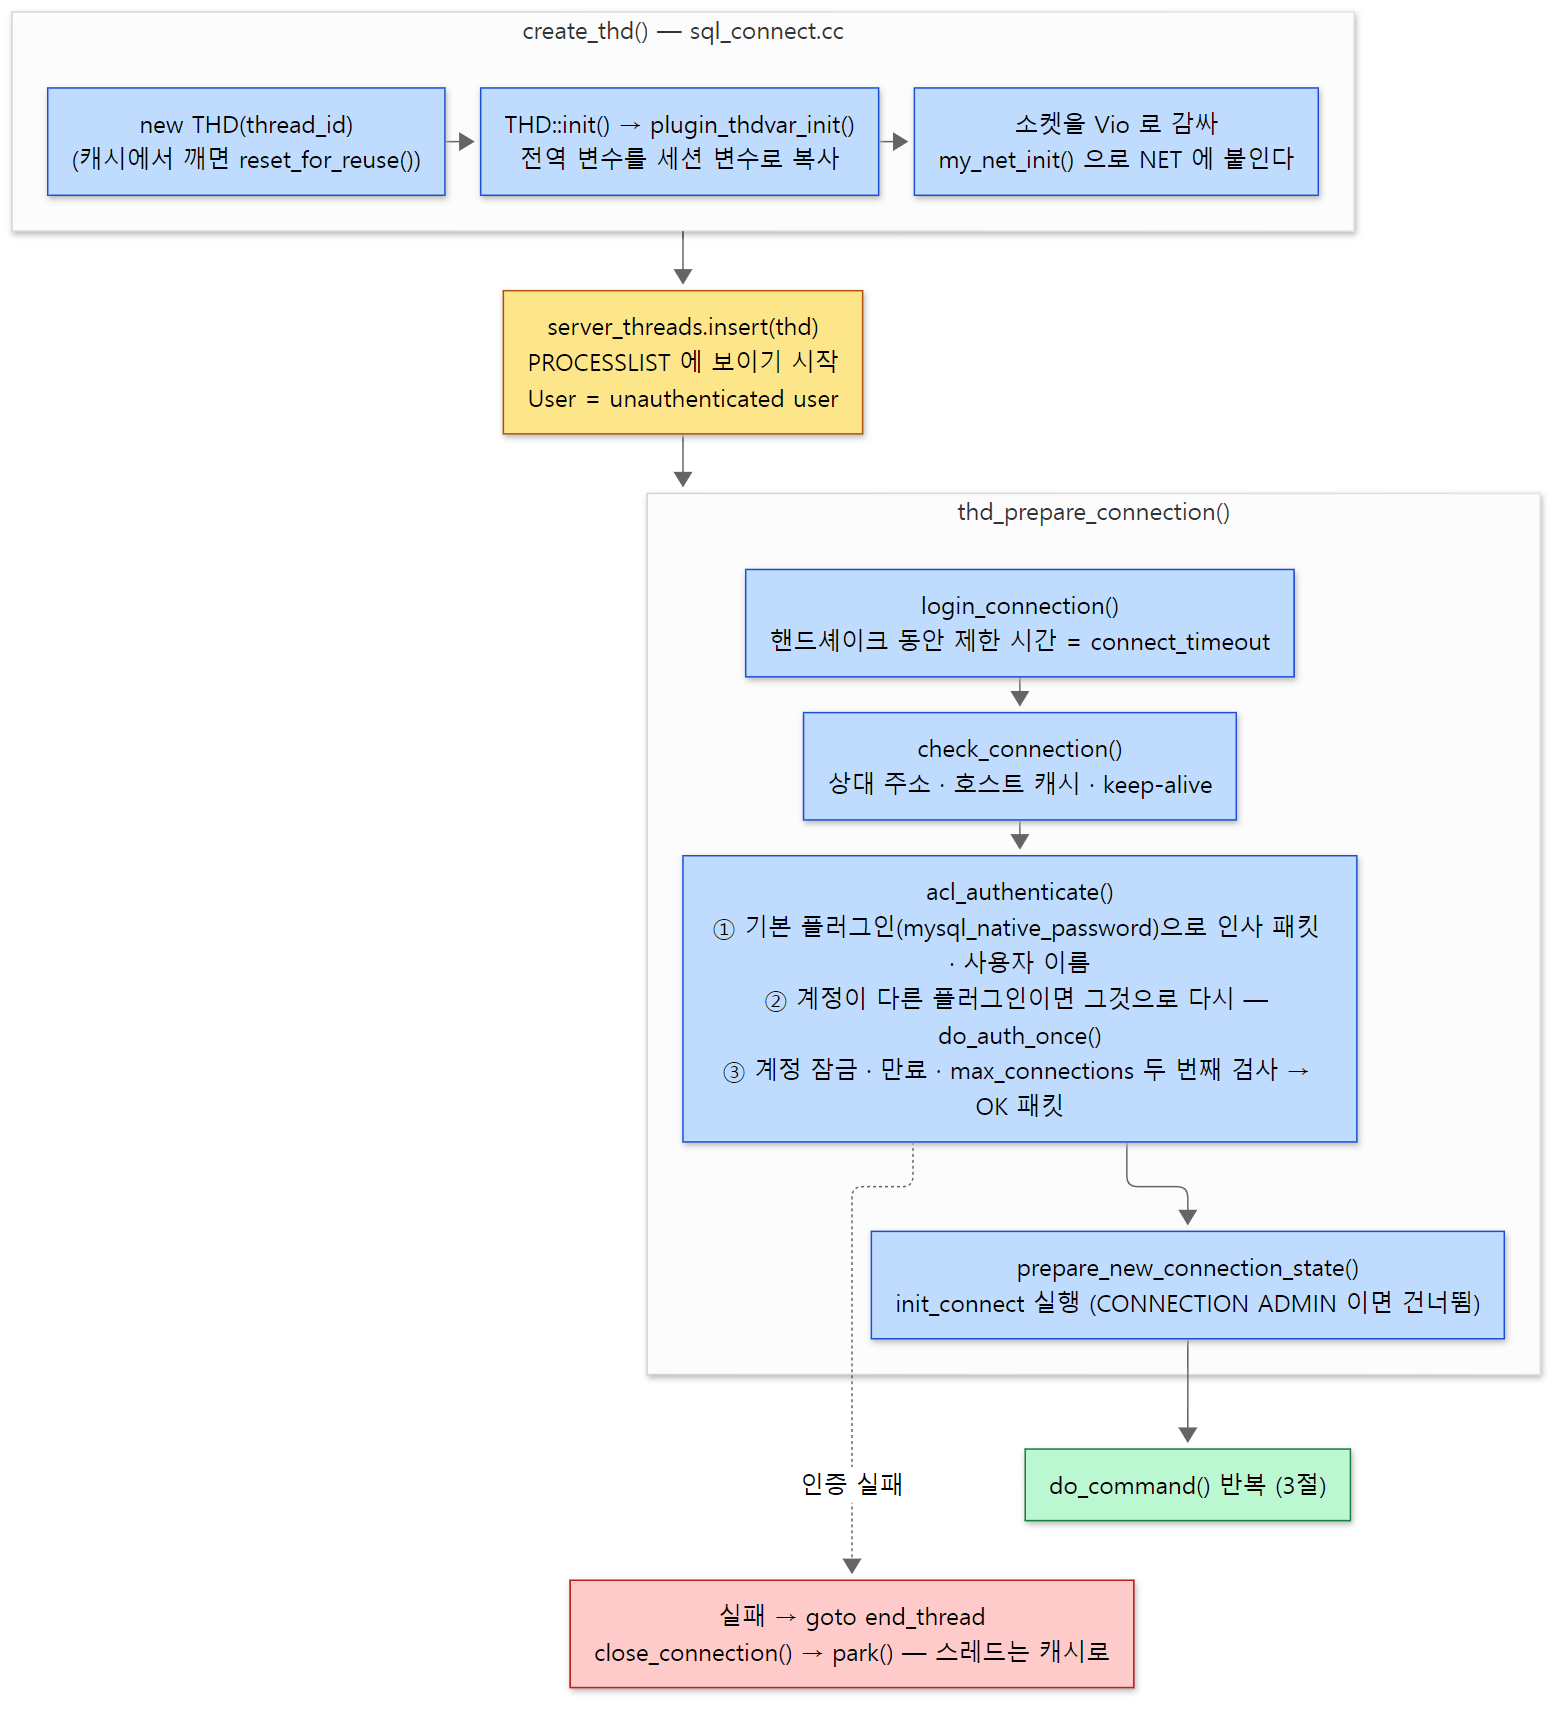 위의 표와 앞뒤 인용을 한 줄로 이은 그림입니다. 노란 칸부터 연결이 PROCESSLIST 에 보입니다.
인증은 플러그인이 합니다. acl_authenticate() 는 먼저 기본 플러그인(default_auth_plugin_name, 기준 커밋에서는 mysql_native_password, 93행)으로 한 번 시도해 서버 인사 패킷을 보내고 사용자 이름을 받은 뒤, 그 계정이 다른 플러그인을 쓰면 그 플러그인으로 다시 시도합니다(17085행, 17101–17108행). 플러그인 하나를 부르는 곳은 do_auth_once() 입니다.
  if (plugin)
  {
    st_mysql_auth *info= (st_mysql_auth *) plugin_decl(plugin)->info;
    switch (info->interface_version >> 8) {
    case 0x02:
      res= info->authenticate_user(mpvio, &mpvio->auth_info);
      break;
authenticate_user 도 함수 포인터입니다. mysql_native_password 플러그인은 같은 파일 끝에서 maria_declare_plugin(mysql_password) 로 선언되어 이 자리에 native_password_authenticate() 를 넣습니다(17579–17612행). 엔진이 handlerton 을 채우듯 인증 방법도 플러그인이 구조체를 채우는 방식입니다(3편). 인증 플러그인과 권한 표의 자세한 내용은 이 연재에서 따로 다루지 않습니다. 권한 확인은 7편에서 봅니다.
1절에서 미뤄 둔 max_connections 의 두 번째 검사도 acl_authenticate() 안에 있습니다.
  if (command == COM_CONNECT &&
      !(thd->main_security_ctx.master_access & PRIV_IGNORE_MAX_CONNECTIONS))
  {
    if (*thd->scheduler->connection_count > *thd->scheduler->max_connections)
    {                                         // too many connections
      my_error(ER_CON_COUNT_ERROR, MYF(0));
      DBUG_RETURN(1);
    }
  }
인증이 끝나 누구인지 안 다음에야 권한을 보고 "한 자리 더"를 허락할 수 있기 때문에, 검사가 두 번으로 나뉜 것입니다. create_new_thread() 는 권한을 모르는 메인 스레드에서 "적어도 max_connections + 1 은 넘지 말자"는 대강의 검사(주석: "We roughly check here")만 하고, 정확한 검사는 연결 스레드가 인증 뒤에 합니다.
헷갈리기 쉬운 곳: 로그인에 실패해도 스레드는 캐시로 간다
3절의 루프를 다시 보면 thd_prepare_connection() 이 실패했을 때 goto end_thread 로 뛰어 close_connection(), unlink_thd() 를 하고 똑같이 park() 에 들어갑니다. 비밀번호를 틀린 연결도 스레드를 하나 만들거나 캐시에서 깨우고, 끝나면 그 스레드를 캐시에 돌려줍니다. 잘못된 접속이 쏟아지면 그만큼 스레드가 바쁘게 깨어난다는 뜻입니다.
5. 놀고 있는 연결은 어디서 기다리나
연결은 대부분의 시간을 놀면서 보냅니다. 애플리케이션의 커넥션 풀은 연결을 미리 열어 두고 필요할 때만 질의를 보내기 때문입니다(Spring 18편에서 본 DataSource 뒤의 커넥션 풀). 그동안 서버의 스레드는 무엇을 하고 있을까요?
예제 4: gdb 로 본 놀고 있는 연결
놀고 있는 클라이언트 하나를 붙여 두고 gdb -batch -ex 'thread apply all bt' 로 모든 스레드의 백트레이스를 찍은 뒤, 필요한 스레드만 골랐습니다(ex/u04-gdb 의 1부).
=== 1. one-thread-per-connection: an idle client
      1 checkpoint_bg
      6 ib_tpool_worker
      1 io_uring_wait
      1 manager
      3 mariadbd
      1 one_connection
      1 page_cleaner
      1 signal_handler
      1 statement_timer
Thread ... "one_connection"
#0  poll () from /lib/x86_64-linux-gnu/libc.so.6
#1  vio_io_wait at /usr/src/mariadb/vio/viosocket.c:960
#2  vio_socket_io_wait at /usr/src/mariadb/vio/viosocket.c:116
#3  handle_ssl_io_error at /usr/src/mariadb/vio/viossl.c:163
#4  vio_ssl_read at /usr/src/mariadb/vio/viossl.c:179
#5  my_real_read at /usr/src/mariadb/sql/net_serv.cc:847
#6  my_net_read_packet_reallen at /usr/src/mariadb/sql/net_serv.cc:1084
#7  my_net_read_packet at /usr/src/mariadb/sql/net_serv.cc:1067
#8  do_command at /usr/src/mariadb/sql/sql_parse.cc:1293
#9  do_handle_one_connection at /usr/src/mariadb/sql/sql_connect.cc:1514
#10 handle_one_connection at /usr/src/mariadb/sql/sql_connect.cc:1426
#11 pfs_spawn_thread at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#12 ?? () from /lib/x86_64-linux-gnu/libc.so.6
#13 ?? () from /lib/x86_64-linux-gnu/libc.so.6

Thread ... "mariadbd"
#0  poll () from /lib/x86_64-linux-gnu/libc.so.6
#1  handle_connections_sockets at /usr/src/mariadb/sql/mysqld.cc:6890
#2  run_main_loop at /usr/src/mariadb/sql/mysqld.cc:6171
#3  mysqld_main at /usr/src/mariadb/sql/mysqld.cc:6590
#4  main at /usr/src/mariadb/sql/main.cc:34
맨 위의 목록은 스레드 이름별 개수입니다(ib_tpool_worker 는 InnoDB 의 내부 스레드 풀 tpool 의 스레드입니다. 두 번 돌려 두 번 다 6개였지만, tpool 은 일감에 따라 스레드를 늘리고 줄이므로 늘 6개라는 보장은 없습니다). 놀고 있는 연결 하나에 one_connection 스레드 하나가 있고, 그 스레드는 do_command() 의 1293행 my_net_read_packet(net, 1) 에서 다음 패킷을 기다리며 poll() 에 멈춰 있습니다. 소켓 하나를 바라보는 poll() 입니다. 메인 스레드(mariadbd 라는 이름의 셋 가운데 하나)는 1절의 poll() 에서 새 접속을 기다리고 있습니다.
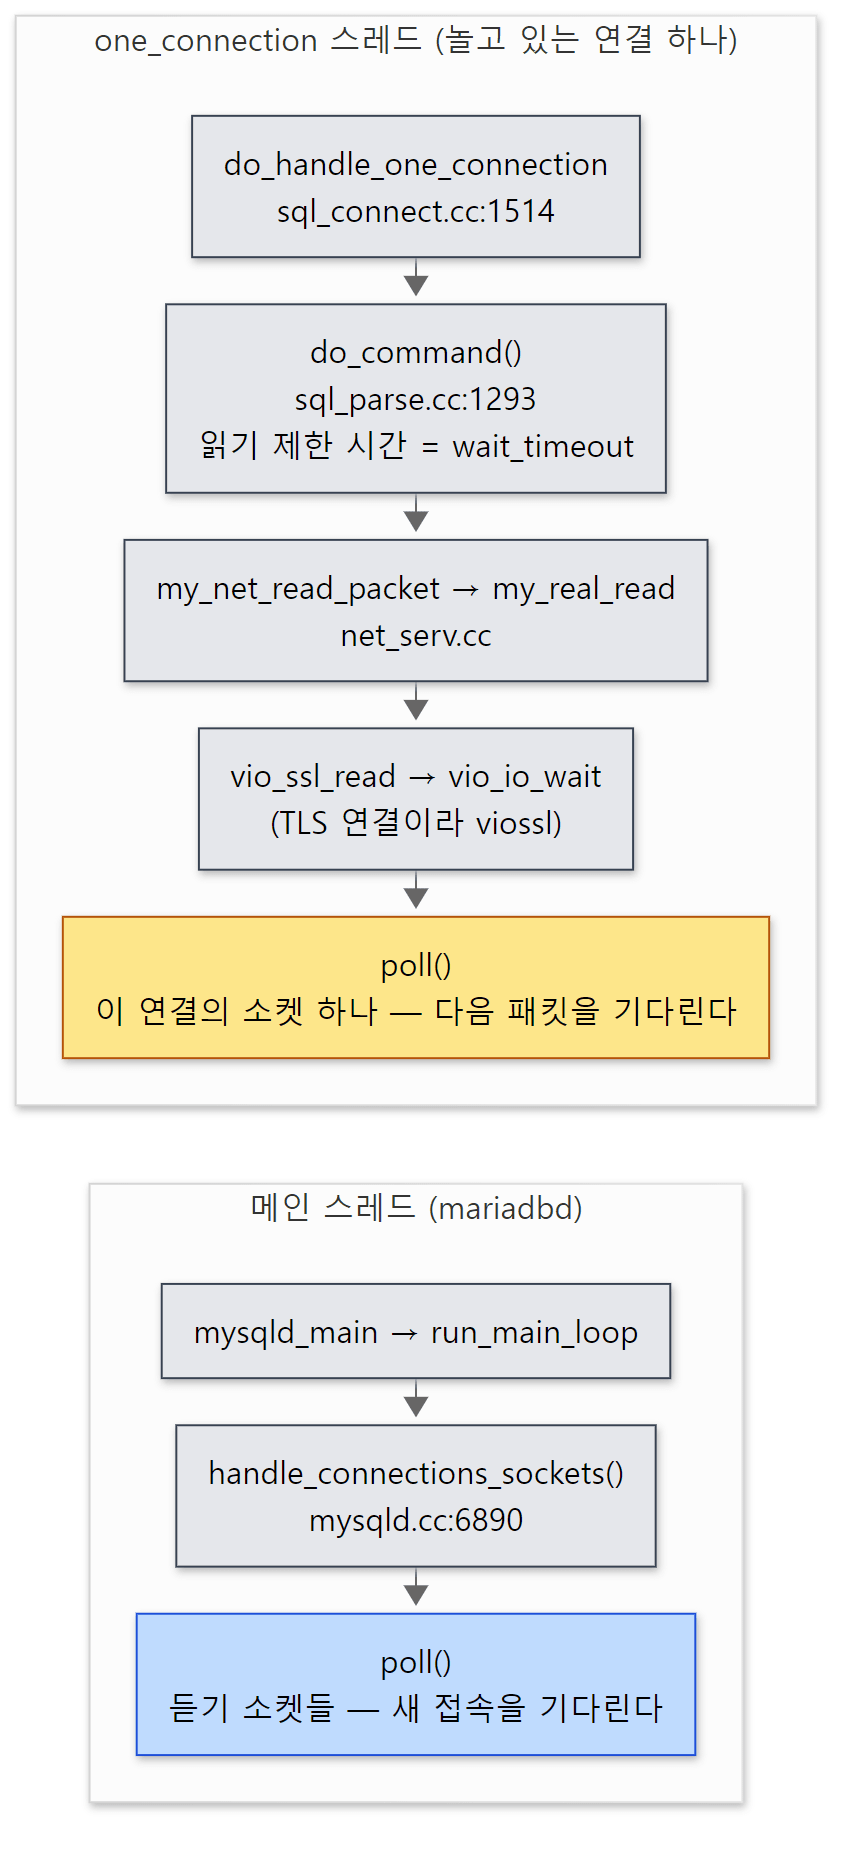 놀고 있는 연결 하나마다 이런 스레드가 하나씩 poll() 에 멈춰 있습니다. 함수와 줄 번호는 예제 4의 실제 출력에서 가져왔습니다.
#3·#4 에 viossl 이 보이는 것은 이 연결이 TLS 로 암호화되어 있기 때문입니다. 유닉스 소켓으로 붙었는데도 기준 커밋의 클라이언트와 서버는 TLS 를 썼습니다(예제 2의 2002 번 오류 문구와 같은 사정입니다).
얼마나 오래 기다리는지는 do_command() 가 읽기 전에 정합니다.
  if (!thd->skip_wait_timeout)
    my_net_set_read_timeout(net, thd->get_net_wait_timeout());
이 모드에서 wait_timeout 은 곧 "소켓 읽기의 제한 시간"입니다. 시간이 지나면 읽기가 실패하고 연결이 닫힙니다. skip_wait_timeout 이 참이면 건너뛰는데, 이것을 켜는 쪽이 스레드 풀입니다(6절).
이 모델의 장단점이 여기서 드러납니다. 코드가 단순하고(읽고, 처리하고, 다시 읽는다), 한 연결의 질의가 오래 걸려도 다른 연결과 상관이 없습니다. 대신 놀고 있는 연결 수만큼 스레드가 있습니다. 연결이 수천 개면 스레드도 수천 개이고, 각 스레드의 스택 메모리와 운영체제의 스케줄링 부담이 따라옵니다. 그 연결들이 한꺼번에 질의를 보내면 CPU 수보다 훨씬 많은 스레드가 동시에 돌며 서로를 밀어냅니다. httpd 의 worker MPM 이 keep-alive 연결 때문에 겪는 문제와 같습니다(httpd 8편의 4절).
6. 스레드 풀 — 그룹, 리스너, 워커
--thread-handling=pool-of-threads 로 띄우면 pool_of_threads_scheduler() 가 구조체를 통째로 바꿔 끼웁니다.
static scheduler_functions tp_scheduler_functions=
{
  0,                                  // max_threads
  NULL,
  NULL,
  tp_init,                            // init
  tp_add_connection,                  // add_connection
  tp_wait_begin,                      // thd_wait_begin
  tp_wait_end,                        // thd_wait_end
  tp_post_kill_notification,          // post kill notification
  tp_end,                              // end
  tp_resume
};
sql/threadpool_common.cc 616–628행
연결마다 스레드를 두는 모드와 달리 함수 포인터가 모두 채워져 있습니다. 특히 thd_wait_begin·thd_wait_end 가 7절의 핵심입니다. 파일은 둘로 나뉩니다. threadpool_common.cc 는 플랫폼과 상관없는 부분(로그인, 질의 하나 처리)이고, threadpool_generic.cc 는 epoll·kqueue 같은 운영체제 기능 위에 그룹과 워커를 만드는 부분입니다. Windows 에는 운영체제의 스레드 풀을 쓰는 threadpool_win.cc 가 따로 있고, Linux 빌드는 TP_pool_generic 만 씁니다(tp_init(), 471–494행).
연결은 그룹 하나에 묶인다
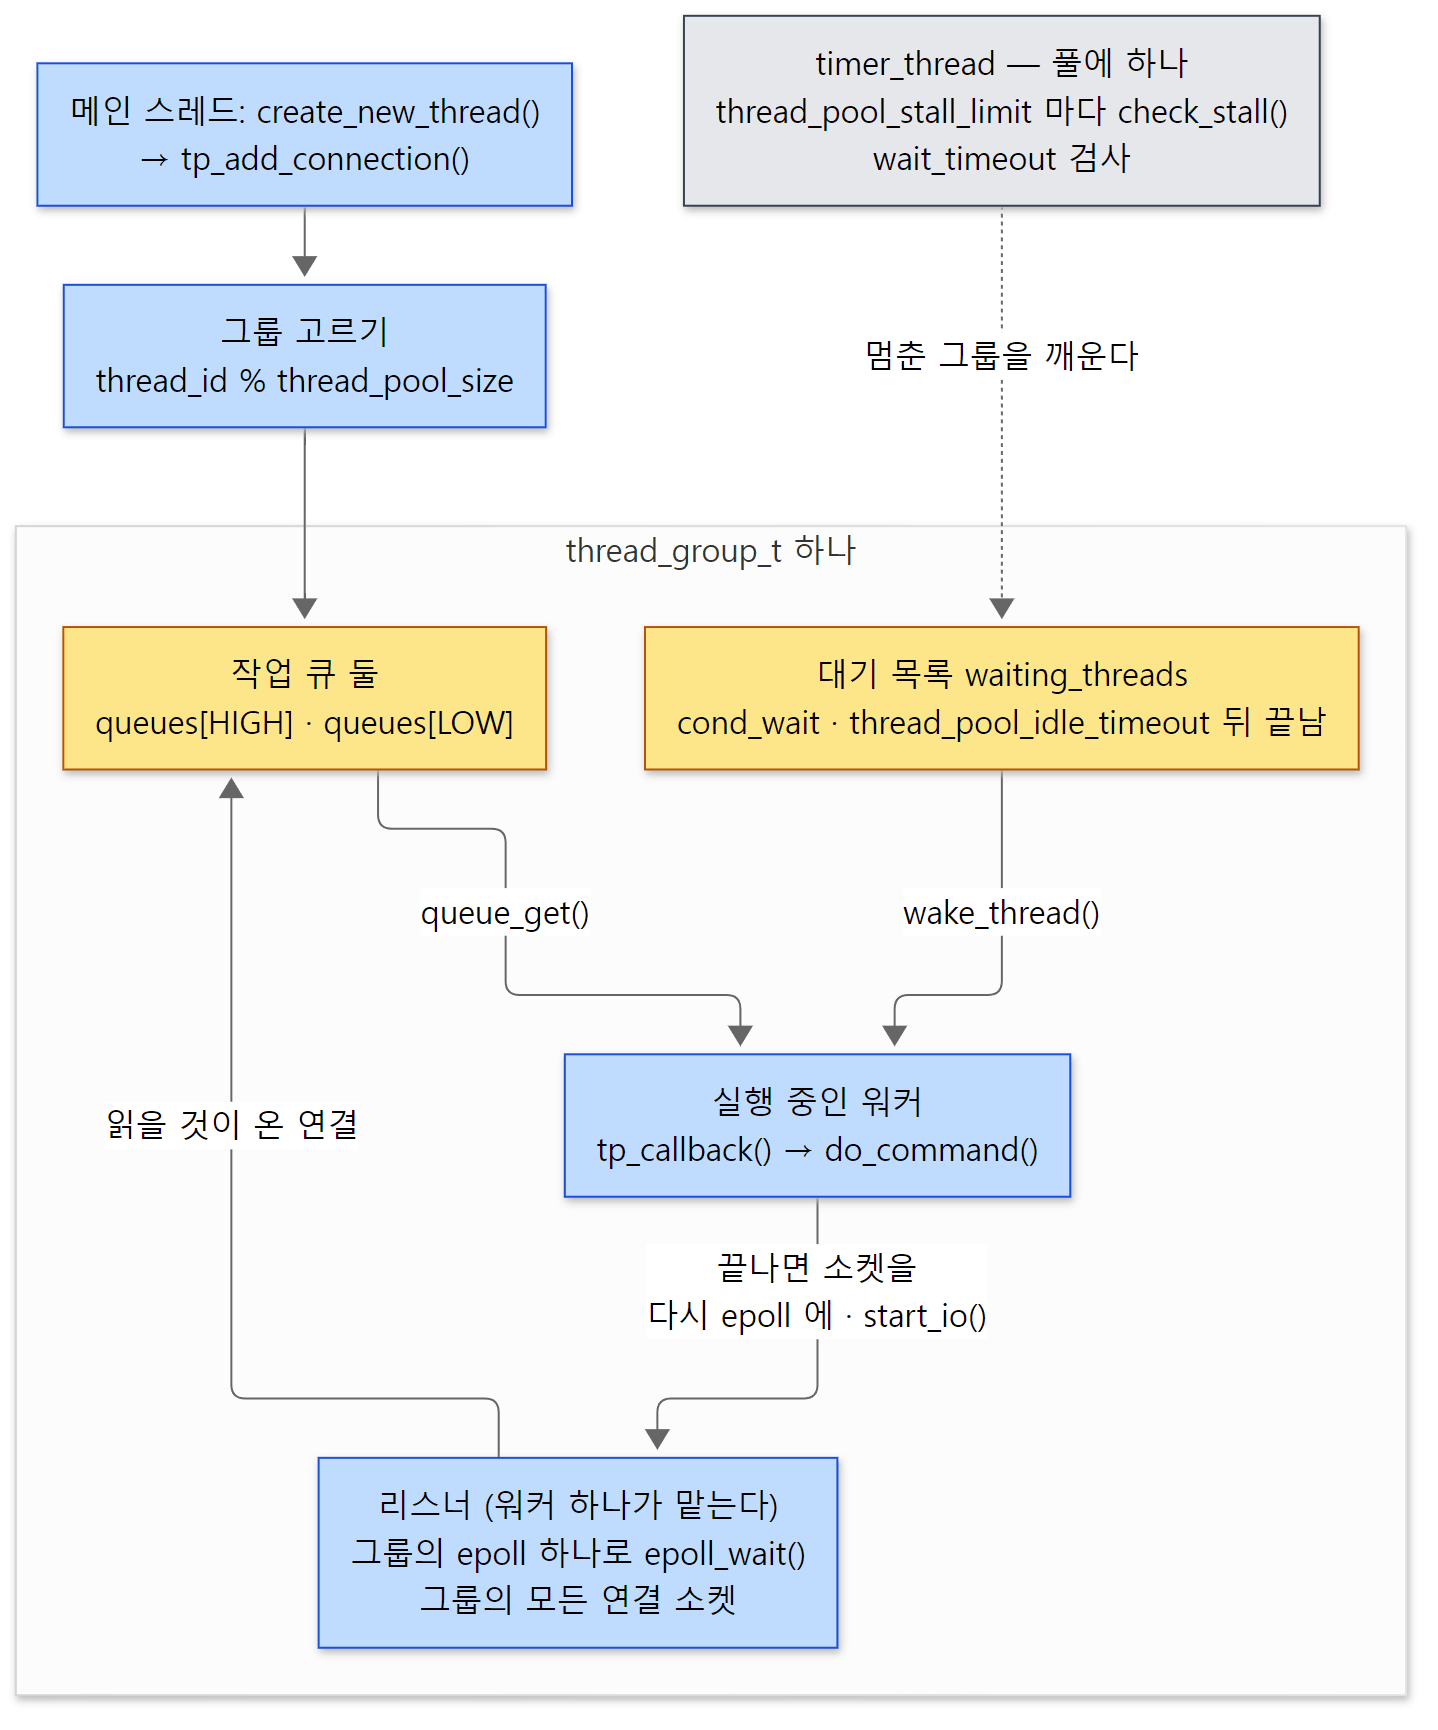 노란 상자는 기다리는 곳(큐와 대기 목록), 파란 상자는 일하는 코드입니다. 그룹마다 epoll 이 하나씩 있습니다.
새 연결은 tp_add_connection() 에서 TP_connection_generic 객체가 되고(1320–1323행), 생성자에서 그룹이 정해집니다.
static size_t get_group_id(my_thread_id tid)
{
  return size_t(tid % group_count);
}
sql/threadpool_generic.cc 1396–1399행
연결 번호를 그룹 수로 나눈 나머지입니다(1422–1424행). group_count 는 thread_pool_size 와 같게 맞춰집니다(set_pool_size(), 1683행). 연결은 끝날 때까지 이 그룹에 묶입니다(thread_pool_size 를 실행 중에 바꾼 드문 경우만 change_group() 으로 옮깁니다). 그룹 하나의 구조체 thread_group_t(sql/threadpool_generic.h 131–151행)에서 이 글에 나오는 필드는 이렇습니다.
| 필드 | 뜻 |
|---|---|
queues[NQUEUES] |
할 일이 있는 연결의 큐 둘(NQUEUES = 2, 높은·낮은 우선순위) |
waiting_threads |
할 일이 없어 잠든 워커들 |
listener |
지금 epoll 을 지켜보는 워커(없으면 NULL) |
pollfd |
그룹의 epoll 파일 디스크립터 |
thread_count / active_thread_count |
그룹의 워커 수 / 그 가운데 "실제로 CPU 를 쓰는" 워커 수 |
io_event_count / queue_event_count |
정체 감지용 카운터 (7절) |
워커의 루프: get_event()
워커 스레드(worker_main())는 get_event() 로 할 일 하나를 얻어 tp_callback() 을 부르기를 되풀이합니다(1558–1568행). get_event() 가 할 일을 찾는 순서가 스레드 풀의 성격을 정합니다.
    /* Check if queue is not empty */
    if (!oversubscribed)
    {
      connection = queue_get(thread_group, operation_origin::WORKER);
      if(connection)
      {
        break;
      }
    }

    /* If there is  currently no listener in the group, become one. */
    if(!thread_group->listener)
    {
      thread_group->listener= current_thread;
      thread_group->active_thread_count--;
      mysql_mutex_unlock(&thread_group->mutex);

      connection = listener(current_thread, thread_group);

      mysql_mutex_lock(&thread_group->mutex);
      thread_group->active_thread_count++;
      /* There is no listener anymore, it just returned. */
      thread_group->listener= NULL;
      break;
    }
sql/threadpool_generic.cc 1186–1210행
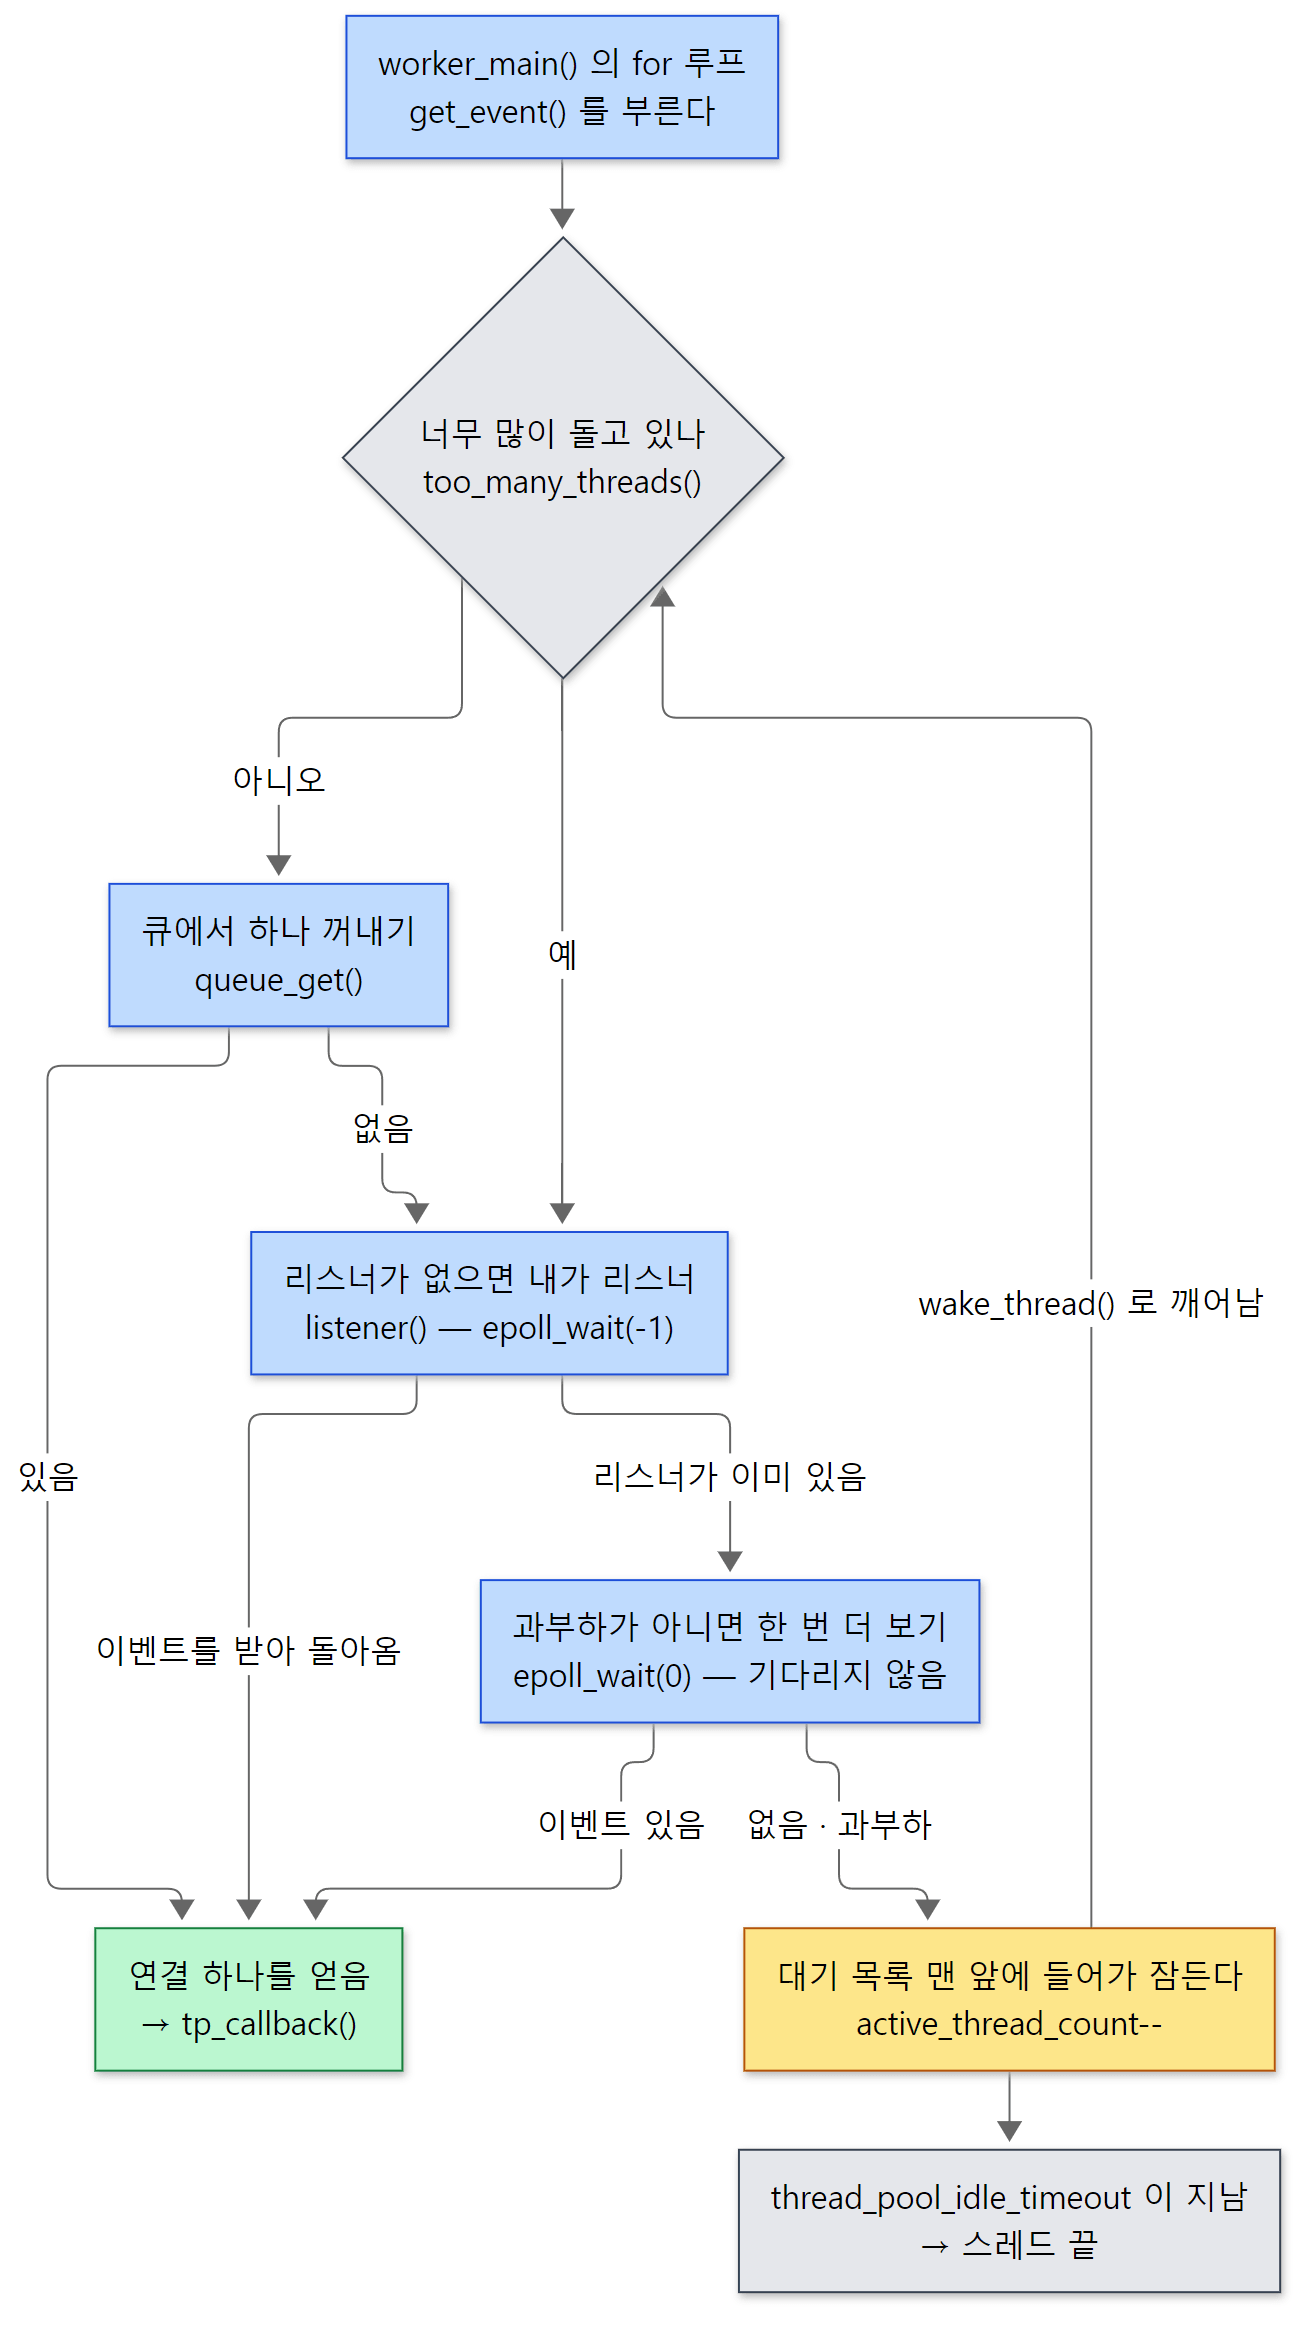 리스너는 따로 있는 스레드가 아니라 워커들이 돌아가며 맡는 역할입니다.
- 큐부터 봅니다. 할 일이 쌓여 있으면 꺼내 처리합니다. 다만 그룹에서 이미 너무 많은 워커가 돌고 있으면(
too_many_threads(): 활동 중인 워커가1 + thread_pool_oversubscribe를 넘고 정체 상태가 아니면, 1141–1145행) 큐를 건너뜁니다. 기본값thread_pool_oversubscribe=3(sys_vars.cc4595행) 이면 그룹마다 동시에 CPU 를 쓰는 워커를 대략 4개로 묶어 두는 셈입니다. - 리스너가 없으면 스스로 리스너가 됩니다.
listener()안에서epoll_wait(-1)로 그룹의 모든 연결을 지켜봅니다. 리스너가 되는 동안은active_thread_count에서 빠집니다. 기다리는 스레드는 "활동 중"으로 세지 않는다는 원칙입니다. - 리스너가 이미 있으면 기다리지 않는
epoll_wait(0)으로 한 번 더 보고(1218–1229행), 그래도 없으면 대기 목록의 맨 앞에 들어가 잠듭니다(1240행). 맨 앞에 넣는 이유는 주석에 있습니다. 가장 최근에 일한 스레드부터 깨워(LIFO) CPU 캐시를 살리고, 오래 논 스레드는 계속 놀다가thread_pool_idle_timeout(기본 60초, 4587행)이 지나면 끝나게 하려는 것입니다.
리스너가 이벤트를 받았을 때 직접 처리할지 큐에 넣을지는 listener() 가 정합니다.
    bool listener_picks_event=is_queue_empty(thread_group) && !threadpool_dedicated_listener;
    queue_put(thread_group, ev, cnt);
    if (listener_picks_event)
    {
      /* Handle the first event. */
      retval= queue_get(thread_group, operation_origin::LISTENER);
      mysql_mutex_unlock(&thread_group->mutex);
      break;
    }
sql/threadpool_generic.cc 798–806행
큐가 비어 있었으면 리스너가 첫 이벤트를 직접 맡아 리스너 자리를 떠납니다. 방금 깨어난 스레드가 다른 스레드를 깨우는 비용을 아끼려는 선택이라고 바로 위의 긴 주석(755–796행)이 설명합니다. 대가는 "그동안 그룹에 리스너가 없다"는 것이고, 그 빈틈은 7절의 timer_thread 가 메웁니다. thread_pool_dedicated_listener=1 로 두면 리스너는 질의를 맡지 않고 지켜보기만 합니다.
질의 하나를 처리하고 소켓을 다시 건다: tp_callback()
워커가 연결 하나를 얻으면 tp_callback() 을 부릅니다. 아직 THD 가 없는 연결이면 threadpool_add_connection() 으로 로그인부터 합니다(237–248행). 이 함수는 create_thd() 와 thd_prepare_connection() 을 부르므로 4절의 로그인이 워커 위에서 그대로 일어납니다. 로그인한 연결이면 threadpool_process_request() 가 do_command(thd, false) 로 명령 하나를 처리합니다(438행). 처리가 끝나면 이렇게 마무리합니다.
  /* Set priority */
  c->priority= get_priority(c);

  /* Read next command from client. */
  c->set_io_timeout(thd->get_net_wait_timeout());
  c->state= TP_STATE_IDLE;
  if (c->start_io())
    goto error;
  return;
sql/threadpool_common.cc 274–282행
- 우선순위:
thread_pool_priority의 기본값auto에서는 트랜잭션이 열려 있는 연결을 높은 우선순위 큐에 넣습니다(get_priority(), 220–221행). 잠금을 쥔 트랜잭션을 빨리 끝내게 하려는 것입니다. 낮은 우선순위 큐에서thread_pool_prio_kickup_timer(기본 1000ms) 넘게 기다린 연결은 높은 쪽으로 올라갑니다(check_stall(), 621–631행). wait_timeout: 스레드가 소켓 읽기에서 기다리지 않으므로 제한 시간을 연결 객체에 적어 두고(set_io_timeout()), timer_thread 가 검사합니다. 로그인할 때thd->skip_wait_timeout= true로 둔 것(344행)이 5절의do_command()에서 읽기 제한 시간을 건너뛰게 합니다.start_io(): 소켓을 다시 epoll 에 겁니다. 그리고tp_callback()은 그냥 돌아갑니다. 워커는 이 연결을 놓고get_event()로 돌아가 다음 일을 찾습니다.
epoll 에 거는 방식이 이 구조를 안전하게 합니다.
int io_poll_associate_fd(TP_file_handle pollfd, TP_file_handle fd, void *data, void*)
{
  struct epoll_event ev;
  ev.data.u64= 0; /* Keep valgrind happy */
  ev.data.ptr= data;
  ev.events=  EPOLLIN|EPOLLET|EPOLLERR|EPOLLRDHUP|EPOLLONESHOT;
  return epoll_ctl(pollfd, EPOLL_CTL_ADD,  fd, &ev);
}
sql/threadpool_generic.cc 184–191행
EPOLLONESHOT 은 "한 번 알리면 그 소켓을 지켜보기 목록에서 잠시 뺀다"는 뜻입니다. 질의를 처리하는 동안 같은 연결에 데이터가 더 와도 다른 워커가 그 연결을 집어 가지 않습니다. 처리가 끝나면 start_io() 가 EPOLL_CTL_MOD 로 다시 겁니다(io_poll_start_read(), 195–202행). 파일 머리의 주석(127–171행)도 지원하는 모든 플랫폼에서 이 "한 번만" 방식을 쓴다고 적어 두었습니다.
예제 5: 연결 20개, 워커 몇 개?
--thread-handling=pool-of-threads --thread-pool-size=2 로 띄우고 놀고 있는 클라이언트 20개를 붙였습니다(ex/u04-thread-pool). 놀고 있는 워커가 빨리 사라지는 것을 보려고 --thread-pool-idle-timeout=3 으로 줄였습니다(기본 60초).
--- 0. settings
+-------------------+--------------------+----------------------------+---------------------------+-----------------------------+
 @@thread_handling | @@thread_pool_size | @@thread_pool_idle_timeout | @@thread_pool_stall_limit | @@thread_pool_oversubscribe |
+-------------------+--------------------+----------------------------+---------------------------+-----------------------------+
 pool-of-threads   |                  2 |                          3 |                       500 |                           3 |
+-------------------+--------------------+----------------------------+---------------------------+-----------------------------+
--- 1. twenty idle clients, right after they logged in
Threads_connected=21
      1 timer_thread
     17 worker_thread
--- 2. the same twenty clients, 6 seconds later
Threads_connected=21
      1 timer_thread
      3 worker_thread
+----------+-------------+---------+----------------+-----------------+--------------+--------------+
 GROUP_ID | CONNECTIONS | THREADS | ACTIVE_THREADS | STANDBY_THREADS | QUEUE_LENGTH | HAS_LISTENER |
+----------+-------------+---------+----------------+-----------------+--------------+--------------+
        0 |          10 |       2 |              0 |               1 |            0 |            1 |
        1 |          11 |       2 |              1 |               1 |            0 |            0 |
+----------+-------------+---------+----------------+-----------------+--------------+--------------+
스레드 수는 ps -L 로 센 운영체제 스레드 이름입니다(one_connection 은 하나도 없습니다). 표는 information_schema.THREAD_POOL_GROUPS 로, sql/thread_pool_info.cc 가 thread_group_t 의 필드를 그대로 옮겨 보여 줍니다(STANDBY_THREADS 는 waiting_threads 의 길이, 44–76행). 이 정보 스키마 플러그인은 스레드 풀과 함께 서버에 정적으로 들어 있습니다(sql/CMakeLists.txt 240행).
- 1단계: 20명이 동시에 로그인한 직후에는 워커가 17개입니다(다시 돌렸을 때는 15개, 16개였습니다). 로그인은 핸드셰이크 패킷을 주고받느라 네트워크를 기다리는데, 이 기다림도 7절의
thd_wait_begin()으로 풀에 알려지므로 그동안 다른 워커가 깨어나거나 만들어졌습니다. - 2단계: 6초 뒤, 연결은 여전히 21개인데 워커는 3개입니다(표를 찍는 연결이 로그인하며 하나를 더 깨워 표에서는 2+2 입니다). 나머지는 3초 동안 할 일이 없어 끝났습니다. 놀고 있는 연결 20개를 그룹마다 리스너 하나가 epoll 로 지켜보고 있을 뿐입니다. 숫자는 실행마다 조금씩 다릅니다.
같은 예제의 2부에서 놀고 있는 연결의 백트레이스를 다시 찍었습니다(ex/u04-gdb, --thread-pool-size=1).
=== 2. pool-of-threads: login on a worker, then an idle client
#0  thd_prepare_connection at /usr/src/mariadb/sql/sql_connect.cc:1439
#1  threadpool_add_connection at /usr/src/mariadb/sql/threadpool_common.cc:332
#2  tp_callback at /usr/src/mariadb/sql/threadpool_common.cc:241
#3  worker_main at /usr/src/mariadb/sql/threadpool_generic.cc:1567
#4  pfs_spawn_thread at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#5  ?? () from /lib/x86_64-linux-gnu/libc.so.6
#6  ?? () from /lib/x86_64-linux-gnu/libc.so.6

Thread ... "worker_thread"
#0  epoll_wait () from /lib/x86_64-linux-gnu/libc.so.6
#1  io_poll_wait at /usr/src/mariadb/sql/threadpool_generic.cc:222
#2  listener at /usr/src/mariadb/sql/threadpool_generic.cc:737
#3  get_event at /usr/src/mariadb/sql/threadpool_generic.cc:1203
#4  worker_main at /usr/src/mariadb/sql/threadpool_generic.cc:1563
#5  pfs_spawn_thread at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#6  ?? () from /lib/x86_64-linux-gnu/libc.so.6
#7  ?? () from /lib/x86_64-linux-gnu/libc.so.6

Thread ... "worker_thread"
#0  ?? () from /lib/x86_64-linux-gnu/libc.so.6
#1  pthread_cond_timedwait () from /lib/x86_64-linux-gnu/libc.so.6
#2  safe_cond_timedwait at /usr/src/mariadb/mysys/thr_mutex.c:544
#3  inline_mysql_cond_timedwait at /usr/src/mariadb/include/mysql/psi/mysql_thread.h:1088
#4  get_event at /usr/src/mariadb/sql/threadpool_generic.cc:1245
#5  worker_main at /usr/src/mariadb/sql/threadpool_generic.cc:1563
#6  pfs_spawn_thread at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#7  ?? () from /lib/x86_64-linux-gnu/libc.so.6
#8  ?? () from /lib/x86_64-linux-gnu/libc.so.6
스레드 이름 목록과 timer_thread 의 백트레이스(timer_thread() 575행의 cond_timedwait)는 빼고 실었습니다.
- 맨 위는
thd_prepare_connection에 건 중단점입니다. 예제 1과 같은 로그인이지만 바닥이worker_main→tp_callback입니다. 로그인도 풀의 워커가 합니다. - 놀고 있는 연결을 붙잡고 있는 스레드가 없습니다. 워커 하나는 리스너로서
listener()의 737행epoll_wait()에, 다른 하나는 대기 목록에서get_event()의 1245행cond_timedwait에 있습니다. 5절의 기본 모드에서do_command()안에서 기다리던 것과 비교해 보면 차이가 분명합니다.
7. 기다림 알리기와 정체 감지 — thd_wait_begin() 과 timer_thread
스레드 풀은 그룹마다 "실제로 CPU 를 쓰는 워커"를 적게 유지하려 합니다. 그러면 질문이 생깁니다. 돌고 있는 워커가 행 잠금을 기다리거나 디스크를 읽느라 멈춰 버리면, 그룹의 다른 연결은 누가 처리할까요? 답은 두 겹입니다.
첫째 겹: 기다리는 쪽이 알린다
서버와 엔진은 오래 기다릴 만한 곳 앞뒤에 thd_wait_begin()·thd_wait_end() 를 부릅니다. 이 함수는 MYSQL_CALLBACK(thd->scheduler, thd_wait_begin, (thd, wait_type)) 한 줄로 스케줄러에 전달합니다(sql_class.cc 6221–6230행). 예를 들어 SLEEP() 은 이렇습니다.
  thd_wait_begin(thd, THD_WAIT_SLEEP);
  while (!thd->killed)
  {
    error= timed_cond->wait(cond, &LOCK_item_func_sleep);
    if (error == ETIMEDOUT || error == ETIME)
      break;
    error= 0;
  }
  thd_wait_end(thd);
InnoDB 도 행 잠금 대기(lock/lock0lock.cc 2324행), 페이지 읽기(buf/buf0rea.cc 211행, 325행), redo 로그 쓰기를 다른 스레드가 끝내 주기를 기다리는 곳(log_write_up_to() 가 쓰는 group_commit_lock::acquire(), log/log0sync.cc 273행) 앞에서 같은 함수를 부릅니다. 네트워크 대기는 scheduler_init() 이 vio_set_wait_callback() 으로 걸어 둡니다(scheduler.cc 78–79행). 기다림의 종류는 THD_WAIT_SLEEP, THD_WAIT_DISKIO, THD_WAIT_ROW_LOCK 처럼 11가지로 나뉩니다(include/mysql/service_thd_wait.h 67–77행).
스레드 풀에서 이 알림은 결국 wait_begin() 에 닿습니다.
void wait_begin(thread_group_t *thread_group)
{
  DBUG_ENTER("wait_begin");
  mysql_mutex_lock(&thread_group->mutex);
  thread_group->active_thread_count--;

  DBUG_ASSERT(thread_group->active_thread_count >=0);
  DBUG_ASSERT(thread_group->connection_count > 0);

  if ((thread_group->active_thread_count == 0) &&
     (!is_queue_empty(thread_group) || !thread_group->listener))
  {
    /*
      Group might stall while this thread waits, thus wake
      or create a worker to prevent stall.
    */
    wake_or_create_thread(thread_group);
  }

  mysql_mutex_unlock(&thread_group->mutex);
  DBUG_VOID_RETURN;
}
sql/threadpool_generic.cc 1283–1304행
기다리기 시작한 워커는 "활동 중"에서 빠지고, 그 결과 그룹에 활동 중인 워커가 하나도 없는데 큐에 일이 있거나 리스너가 없으면 즉시 다른 워커를 깨우거나 만듭니다(wake_or_create_thread(), 946–986행 — 대기 목록에서 깨울 수 있으면 깨우고, 없으면 새로 만들되 그룹의 스레드가 많을수록 만드는 간격을 늘립니다). 6절의 예제 5에서 로그인 20개가 워커 17개를 만든 것도 이 길입니다. 같은 예제의 3단계에서는 SELECT SLEEP(4) 6개를 동시에 보냈고, THREAD_POOL_WAITS 에 SLEEP 6번이 기록되며 워커가 다시 8개로 늘었습니다.
--- 3. six clients running SELECT SLEEP(4) at the same time
      1 timer_thread
      8 worker_thread
...
+--------+-------+
 REASON | COUNT |
+--------+-------+
 SLEEP  |     6 |
 NET    |    92 |
+--------+-------+
(가운데의 그룹 표와 THREAD_POOL_STATS 는 일부만 실었습니다. NET 은 서버가 뜬 뒤 쌓인 네트워크 대기 수로, 실행마다 다릅니다.)
둘째 겹: 알리지 않는 쪽은 timer_thread 가 잡는다
CPU 만 쓰는 긴 질의는 아무것도 기다리지 않으므로 알림도 없습니다. 이때를 위해 풀에는 timer_thread 가 하나 있고, thread_pool_stall_limit(기본 500ms, DEFAULT_THREADPOOL_STALL_LIMIT)마다 깨어나 연결이 있는 모든 그룹에 check_stall() 을 부릅니다(573–590행). 검사는 두 가지입니다.
  if (!thread_group->listener && !thread_group->io_event_count)
  {
    wake_or_create_thread(thread_group, true);
    mysql_mutex_unlock(&thread_group->mutex);
    return;
  }
  // ...
  if (!is_queue_empty(thread_group) && !thread_group->queue_event_count)
  {
    thread_group->stalled= true;
    TP_INCREMENT_GROUP_COUNTER(thread_group,stalls);
    wake_or_create_thread(thread_group,true);
  }
sql/threadpool_generic.cc 639–680행
- 리스너가 없고, 지난 틱 이후 받은 네트워크 이벤트도 없으면 워커를 깨웁니다. 6절에서 본 "리스너가 이벤트를 직접 맡아 자리를 비운" 경우가 이것입니다.
- 큐에 일이 있는데 지난 틱 이후 아무도 큐에서 꺼내지 않았으면 그룹을 "멈췄다(
stalled)"고 표시하고 워커를 깨웁니다.stalled인 동안에는too_many_threads()의 제한도 풀립니다.
두 카운터(io_event_count, queue_event_count)는 틱마다 0으로 되돌려 "이번 틱 사이에 움직임이 있었나"를 봅니다. 그래서 thread_pool_stall_limit 은 "이 시간 동안 아무 진전이 없으면 멈춘 것으로 본다"는 간격입니다. 같은 timer_thread 가 wait_timeout 이 지난 놀고 있는 연결도 찾아 KILL_WAIT_TIMEOUT 으로 끊습니다(timeout_check() → tp_timeout_handler(), 508–536행, threadpool_common.cc 543–567행).
예제 6: BENCHMARK 와 SLEEP 은 다르게 대접받는다
그룹을 하나로(--thread-pool-size=1), 틱을 3초로(--thread-pool-stall-limit=3000) 두고, 한 연결이 약 8초 걸리는 문장을 도는 동안 다른 클라이언트가 SELECT 1 을 보내는 데 걸리는 시간(접속 포함)을 쟀습니다(ex/u04-pool-stall). 긴 문장은 CPU 만 쓰는 BENCHMARK(6000000, MD5('namalzi')) 와, 기다림을 알리는 SLEEP(8) 두 가지입니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ...
lab-start --thread-handling=pool-of-threads --thread-pool-size=1 --thread-pool-stall-limit=3000 > /dev/null
# ...
mariadb -e "FLUSH THREAD_POOL_STATS"
mariadb -N -e "SELECT BENCHMARK(6000000, MD5('namalzi'))" > /dev/null &
sleep 1
timed "SELECT 1"
# ...
[예제 ex/u04-pool-stall/run.sh 에서 줄임 — timed 는 date +%s.%N 으로 앞뒤 시각을 재는 셸 함수]
--- 1. while another client runs BENCHMARK (CPU only, about 8 s)
SELECT 1   took 2.8 s
+----------+------------------+-------------------------------+-------+--------------------+--------+
 GROUP_ID | THREAD_CREATIONS | THREAD_CREATIONS_DUE_TO_STALL | WAKES | WAKES_DUE_TO_STALL | STALLS |
+----------+------------------+-------------------------------+-------+--------------------+--------+
        0 |                0 |                             0 |     2 |                  1 |      0 |
+----------+------------------+-------------------------------+-------+--------------------+--------+
--- 2. while another client runs SLEEP(8)
SELECT 1   took 0.2 s
+----------+------------------+-------------------------------+-------+--------------------+--------+
 GROUP_ID | THREAD_CREATIONS | THREAD_CREATIONS_DUE_TO_STALL | WAKES | WAKES_DUE_TO_STALL | STALLS |
+----------+------------------+-------------------------------+-------+--------------------+--------+
        0 |                1 |                             0 |     3 |                  0 |      0 |
+----------+------------------+-------------------------------+-------+--------------------+--------+
BENCHMARK 옆의 SELECT 1 은 2.8초, SLEEP 옆에서는 0.2초였습니다(시간은 실행마다 다르고 — 다시 돌렸을 때는 3.5초와 0.1초 — Debug 빌드라 느립니다). FLUSH THREAD_POOL_STATS 는 thread_pool_info.cc 의 stats_reset_table() 로 카운터를 0 으로 되돌립니다(212–225행).
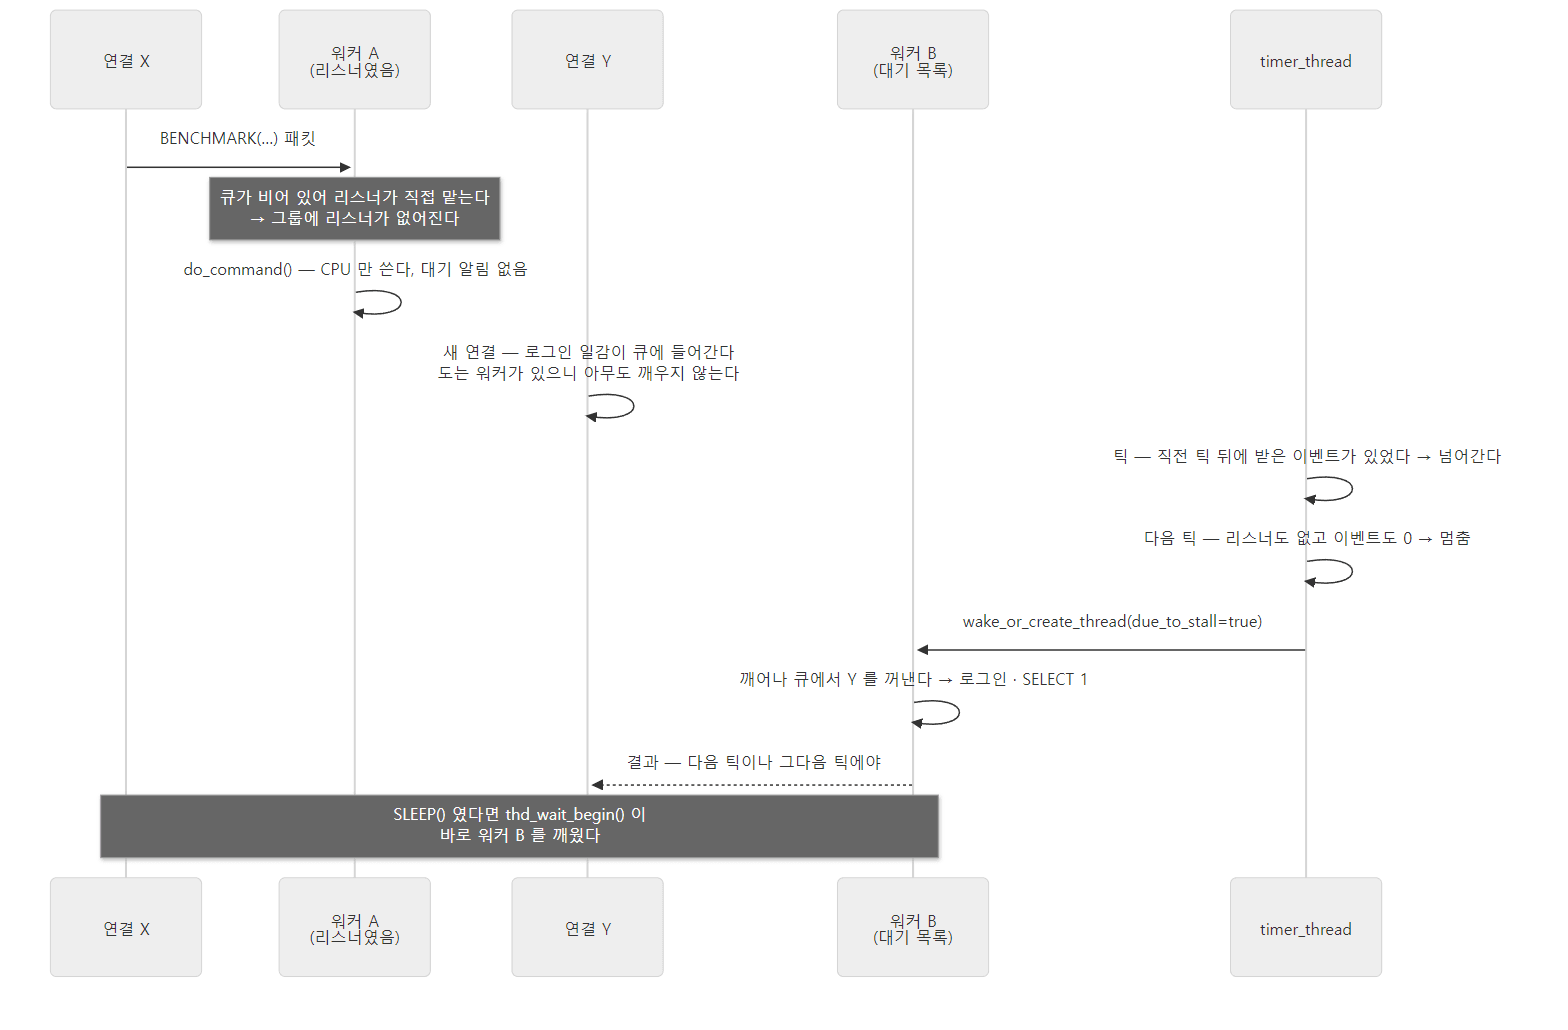
BENCHMARK 쪽에서 WAKES_DUE_TO_STALL 이 1, STALLS 가 0 인 것이 이 그림의 경로(check_stall 의 첫째 검사)를 탔다는 표시입니다.
헷갈리기 쉬운 곳: STALLS 가 0 인데 멈췄던 것이다
예제 6의 첫 표에서 STALLS 는 0입니다. 그래서 "멈춘 적이 없다"고 읽기 쉽지만, WAKES_DUE_TO_STALL 은 1입니다. check_stall() 의 첫째 검사(리스너 없음)는 wake_or_create_thread(thread_group, true) 를 부르고 stalls 카운터를 올리기 전에 return 합니다. stalls 는 둘째 검사(큐가 움직이지 않음)에서만 올라갑니다. 새 연결 Y 의 로그인 일감은 큐에 들어가 있었지만, 첫째 검사가 먼저 걸려 깨운 워커가 그것을 꺼내 갔습니다. 정체 여부를 모니터링할 때는 STALLS 하나만 보지 말고 WAKES_DUE_TO_STALL·THREAD_CREATIONS_DUE_TO_STALL 을 같이 봐야 하는 이유입니다.
정리하면 스레드 풀에서 알림 없이 CPU 를 오래 쓰는 질의는 같은 그룹의 다른 연결을 최대 틱 한두 번만큼 늦출 수 있습니다. thread_pool_stall_limit 을 너무 크게 잡으면 이 지연이 커지고, 너무 작게 잡으면 워커가 쉽게 늘어납니다. check_stall() 위의 주석도 긴 질의가 계속 쏟아지면 스레드 풀이 "천천히 연결마다 스레드 쪽에 가까워진다"고 적어 두었습니다(662–668행).
8. KILL 은 기다리는 연결을 어떻게 깨우나
KILL <id> 는 대상 THD 의 awake_no_mutex() 를 부릅니다(sql_parse.cc 9229행). 이 함수는 killed 표시를 세운 뒤 연결을 끊는 종류의 KILL 이면 스케줄러에 알립니다.
    /* Send an event to the scheduler that a thread should be killed. */
    if (!slave_thread)
      MYSQL_CALLBACK(scheduler, post_kill_notification, (this));
두 모드 모두 결국 같은 함수에 닿습니다.
void post_kill_notification(THD *thd)
{
  DBUG_ENTER("post_kill_notification");
  if (current_thd == thd || thd->system_thread)
    DBUG_VOID_RETURN;

  if (thd->net.vio)
    vio_shutdown(thd->net.vio, SHUT_RD);
  DBUG_VOID_RETURN;
}
소켓의 읽기 쪽을 닫습니다(SHUT_RD). 사실 Linux 빌드에서는 그 전에 한 번 더 닫힙니다. SIGNAL_WITH_VIO_CLOSE 가 켜져 있어서(configure.cmake 844행) awake_no_mutex() 가 위 인용 바로 앞에서 로그인 때 기억해 둔 active_vio 를 vio_shutdown(active_vio, SHUT_RDWR) 로 먼저 닫기 때문입니다(sql_class.cc 2152–2158행, active_vio 는 check_connection() 이 1063행에서 정해 둡니다). 어느 쪽이 먼저든 결과는 같습니다. 기본 모드에서는 5절에서 본 poll() 이 바로 깨어나 읽기가 실패하고, do_command() 가 끝나며 연결이 정리됩니다. 스레드 풀에서는 소켓이 epoll 에서 읽을 수 있는 상태(끝)로 바뀌어 리스너가 그 연결을 큐에 넣고, 워커가 threadpool_process_request() 에서 thd->killed >= KILL_CONNECTION 을 보고 연결을 닫습니다(408–418행). 스레드 풀의 tp_post_kill_notification() 은 그 전에 연결의 우선순위를 높음으로 올려(599–605행) 죽일 연결이 큐에서 오래 기다리지 않게 합니다. 엔진 안에서 기다리는 경우(예: 행 잠금)는 awake_no_mutex() 가 이어서 ha_kill_query() 로 엔진에게 따로 알립니다(2166–2169행).
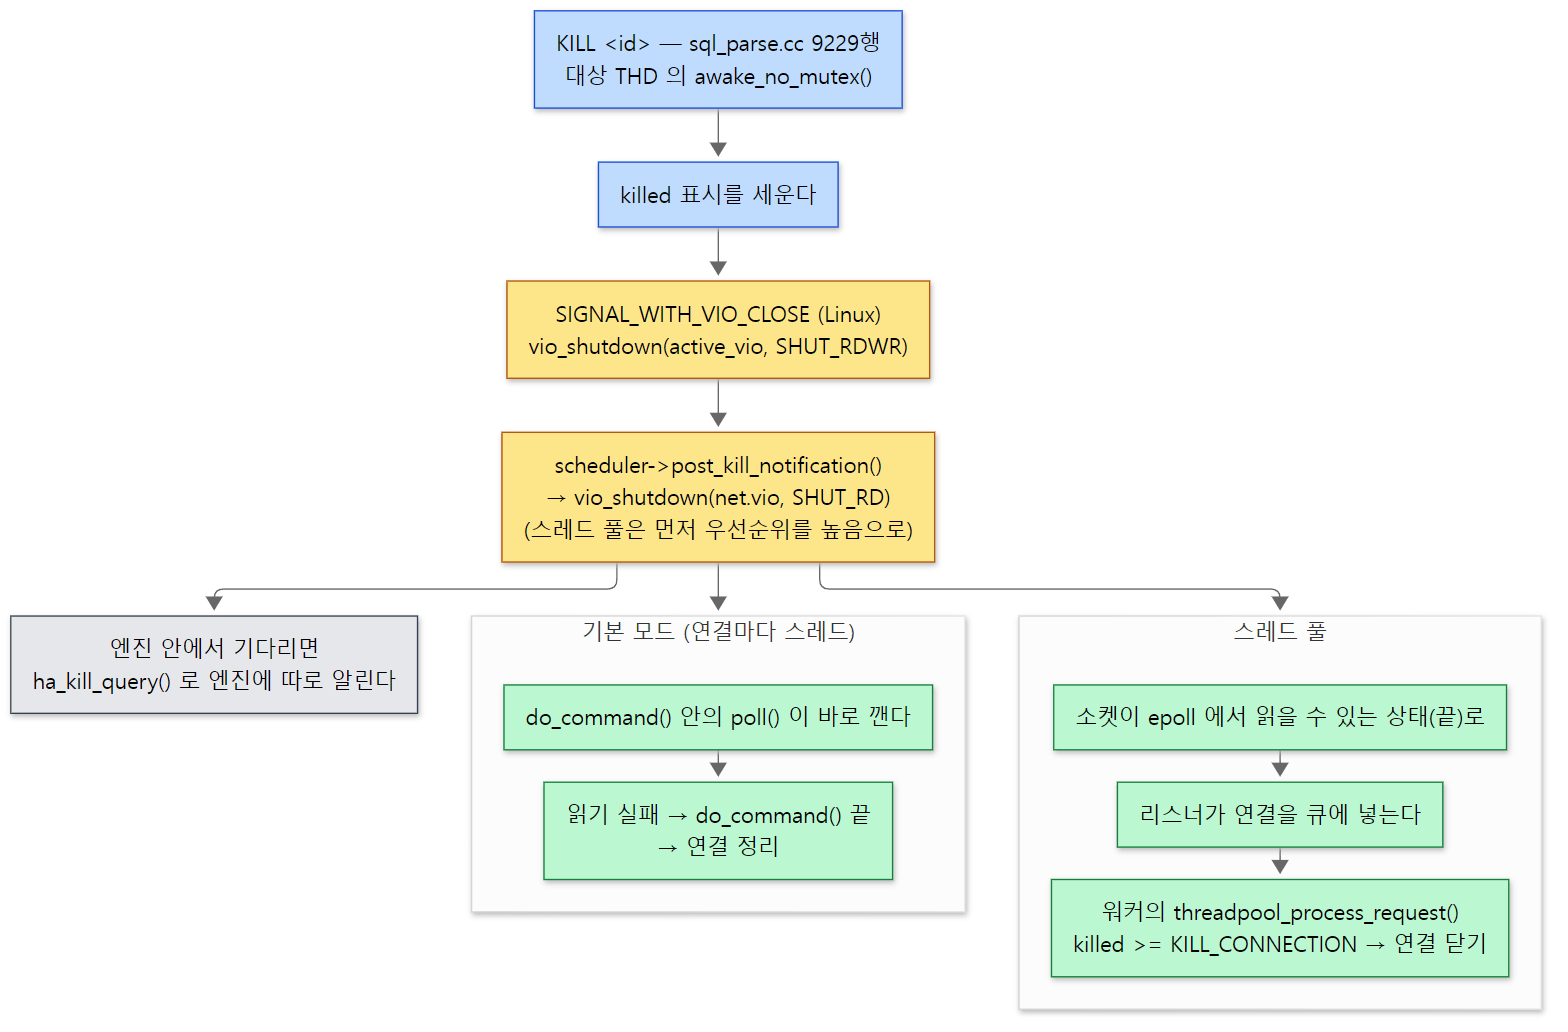 KILL 은 상대 스레드를 직접 멈추지 않고, 표시를 세운 뒤 그 스레드가 기다리는 소켓을 닫아 스스로 깨게 합니다. 줄 번호는 위 문단과 sql_class.cc 2148–2169행에서 확인했습니다.
앞 연재와 견주어 보기
같은 질문 — "연결은 어떤 스레드가 받고, 놀고 있는 연결은 누가 붙잡나" — 에 세 서버가 낸 답을 나란히 놓으면 이렇습니다.
| httpd (8편) | Tomcat (5편) | MariaDB (이 글) | |
|---|---|---|---|
| 갈아 끼우는 단위 | MPM 모듈 (LoadModule 로 하나) |
main 에서는 NIO 하나 | 스케줄러 구조체 (thread_handling) |
| 접속을 받는 스레드 | 자식의 리스너 스레드 | Acceptor 1개 | 메인 스레드 1개 (handle_connections_sockets) |
| "연결마다 스레드" 방식 | worker (keep-alive 동안 스레드를 붙잡음) | — | one-thread-per-connection (Linux 기본) |
| 놀고 있는 연결을 지켜보는 것 | event 의 리스너 (pollset) | Poller 1개 (Selector) | 그룹마다 리스너 1개 (epoll), 워커가 돌아가며 맡음 |
| 일하는 스레드 | 작업 스레드 (fd_queue_t 에서 꺼냄) |
작업 스레드 풀 (TaskQueue) |
워커 (그룹의 큐 둘에서 꺼냄) |
| 일꾼 수 조절 | 부모가 1초마다 스코어보드를 센다 | ThreadPoolExecutor |
thd_wait_begin() 알림 + timer_thread 의 정체 감지 |
MariaDB 의 스레드 풀은 event MPM 이나 Tomcat 의 Poller 와 같은 생각 — 요청과 요청 사이에 기다리는 연결을 스레드에서 떼어 소수의 스레드가 epoll 로 지켜보게 한다 — 을 데이터베이스에 맞게 바꾼 것입니다. 다른 점도 분명합니다. HTTP 서버의 요청은 대개 짧지만 SQL 문장은 몇 분씩 걸리고 잠금을 기다리기도 합니다. 그래서 MariaDB 는 "기다리기 시작한다"는 알림(thd_wait_begin())을 엔진 깊숙한 곳까지 심어 두고, 알림이 없는 긴 질의는 timer_thread 가 잡아내는 두 겹의 장치를 두었습니다. 또 리스너가 따로 있는 스레드가 아니라 워커가 돌아가며 맡는 역할이라는 점, 연결이 처음부터 끝까지 한 그룹에 묶인다는 점이 Tomcat 과 다릅니다.
이 글에서 뺀 것
- Windows 판:
sql/handle_connections_win.cc(이름 있는 파이프와 IOCP 로 접속 받기),sql/threadpool_win.cc(운영체제 스레드 풀),threadpool_winsockets.cc.thread_pool_mode변수는 Windows 에만 있습니다(sys_vars.cc4556–4565행). - kqueue·이벤트 포트·IOCP 판의
io_poll_*:threadpool_generic.cc234–443행. - 비동기 커밋 재개:
DISPATCH_COMMAND_WOULDBLOCK과thd_async_state,tp_resume(). 그룹 커밋을 기다리는 동안 워커를 놓아주는 장치입니다(threadpool_common.cc252–264행, 607–614행,sql_parse.cc1242–1252행). - PROXY 프로토콜과 호스트 캐시:
thd_set_peer_addr()(sql_connect.cc942행~),sql/hostname.cc,max_connect_errors. - 사용자별 자원 제한:
max_user_connections,max_connections_per_hour(check_for_max_user_connections(),sql_connect.cc131행~). - 핸드셰이크 패킷의 모양과 인증 플러그인 대화:
send_server_handshake_packet()(sql_acl.cc15761행),server_mpvio_read_packet()(16703행). 패킷의 틀은 5편에서 봅니다. COM_CHANGE_USER:acl_authenticate(thd, pkt_len)의 다른 길(17060–17072행).- 서버 종료 때 연결 닫기:
close_connections()(mysqld.cc1918행~)와thread_cache.final_flush(). - Galera(wsrep): 이 빌드에는 들어 있지 않아
WITH_WSREP블록은 모두 건너뛰었습니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
| 메인 스레드 | handle_connections_sockets() 에서 poll() → accept() → CONNECT → create_new_thread(). 클라이언트와 대화하지 않는다 |
CONNECT |
소켓·스케줄러·연결 번호만 든 "THD 가 생기기 전의 연결" |
max_connections |
메인 스레드가 +1 까지 대강 막고, 인증 뒤 CONNECTION ADMIN 이 없으면 정확히 막는다. 오류 모양이 다르다 |
scheduler_functions |
add_connection·thd_wait_begin·post_kill_notification 등 함수 포인터 묶음. thread_handling 이 채울 함수를 고른다 |
thread_handling |
Linux 기본 one-thread-per-connection, Windows 기본 pool-of-threads. 읽기 전용. extra_port 는 늘 연결마다 스레드 |
handle_one_connection() |
로그인 → do_command() 반복 → 정리 → thread_cache.park(). THD 까지 다시 쓴다 |
| 스레드 캐시 | 대기 줄 + 조건 변수. 5분 놀면 끝. thread_cache_size 는 max_connections 를 넘지 않게 줄어든다 |
| 로그인 | create_thd() → thd_prepare_connection() → check_connection() → acl_authenticate() → 인증 플러그인 |
| 스레드 풀 | 연결 번호 % 그룹 수로 그룹에 묶고, 그룹마다 epoll·큐 둘·리스너 하나·워커 여럿 |
get_event() |
큐 → 리스너 되기 → epoll_wait(0) → 대기 목록 맨 앞에서 잠들기 |
EPOLLONESHOT |
처리 중인 연결을 다른 워커가 집지 않게 하고, 끝나면 start_io() 로 다시 건다 |
thd_wait_begin() |
잠금·디스크·SLEEP()·네트워크 대기를 풀에 알려 바로 다른 워커를 깨운다 |
| timer_thread | thread_pool_stall_limit 마다 리스너 없음·큐 정체를 검사하고 wait_timeout 도 처리한다 |
KILL |
post_kill_notification() 이 소켓 읽기 쪽을 닫아 기다리는 곳을 깨운다 |
다음에 볼 것
연결 스레드(또는 풀의 워커)가 do_command() 에 들어서는 데까지 왔습니다. 다음 글은 그 안으로 들어갑니다. 5절의 백트레이스에서 이름만 지나간 my_net_read_packet() 이 3바이트 길이와 1바이트 순번으로 패킷을 자르는 방법, 명령 바이트 하나로 COM_QUERY·COM_PING·COM_QUIT 을 가르는 dispatch_command() 의 큰 switch, 그리고 결과를 돌려보내는 Protocol 이 주인공입니다. 5편: 프로토콜과 명령 처리 — 패킷 하나가 dispatch_command에 닿기까지에서 이어집니다.
httpd 연재의 8편: MPM과 Tomcat 연재의 5편: 커넥터와 NIO 엔드포인트는 같은 질문에 대한 웹 서버의 답입니다. 위의 비교 표를 들고 두 글을 읽어 보면, "놀고 있는 연결을 스레드에서 떼어 낸다"는 같은 생각이 세 서버에서 어떻게 다른 모양이 되었는지 보입니다. 애플리케이션 쪽에서 이 연결들을 미리 열어 두고 빌려 쓰는 쪽은 Spring 18편: JdbcTemplate의 DataSource 입니다.