이 글에서 다루는 것
"Spring 소스 파헤치기" 시리즈의 열여덟 번째 글입니다. 17편에서는 @Transactional이 붙은 메서드 앞뒤에서 누가 트랜잭션을 열고 닫는지, 그리고 연 커넥션을 스레드에 묶어 두는 TransactionSynchronizationManager를 봤습니다. 이번에는 그 커넥션으로 실제 SQL을 실행하는 쪽, JdbcTemplate을 읽습니다. 1편의 지도에서는 Phase 4(트랜잭션과 데이터 접근)의 U16입니다.
답하려는 질문은 네 가지입니다.
- 왜 템플릿인가. 날 JDBC 코드가 매번 되풀이하는 일은 무엇이고,
JdbcTemplate.execute(...)는 그것을 어떻게 감싸는가. 결과를 받는 콜백RowMapper·RowCallbackHandler·ResultSetExtractor는 무엇이 다른가 - 커넥션은 어디서 오는가.
@Transactional안에서JdbcTemplate을 세 번 불러도 커넥션은 왜 하나인가 - 예외는 어떻게 바뀌는가. 체크 예외
SQLException이DuplicateKeyException같은 Spring의 예외가 되는 길과, 7.x에서 기본 변환기가 무엇인지 - 그 위에 무엇이 얹혀 있는가.
NamedParameterJdbcTemplate과 6.1에 들어온JdbcClient는 결국 어디에 위임하는가
| 항목 | 내용 |
|---|---|
| 기준 소스 | Spring Framework 7.1.0-SNAPSHOT |
| 커밋 | f447f3c310 (2026-10-01, main 브랜치) |
| 주로 읽는 모듈 | spring-jdbc(jdbc.core, jdbc.datasource, jdbc.support, jdbc.core.namedparam, jdbc.core.simple), 예외 계층은 spring-tx(dao) |
| 주로 읽는 클래스 | JdbcTemplate, JdbcAccessor, DataSourceUtils, SQLExceptionSubclassTranslator, SQLStateSQLExceptionTranslator, SQLErrorCodeSQLExceptionTranslator, NamedParameterJdbcTemplate, DefaultJdbcClient |
글에 나오는 줄 번호와 세부 동작은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고 세부 내용도 달라질 수 있습니다. 같은 커밋의 소스를 받는 방법은 1편에 있습니다.
원래 공부 노트는 줄 단위로 훨씬 깊이 들어가지만, 이 글은 Spring을 처음 보는 분이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "더 깊이 들어가면"에 이름만 적어 두었습니다.
먼저 알아 둘 말
JDBC(Java Database Connectivity)는 Java에서 관계형 데이터베이스에 SQL을 보내는 표준 API입니다. java.sql 패키지에 있고, 데이터베이스마다 제공하는 드라이버가 그 인터페이스를 구현합니다. 핵심 객체는 셋입니다. **Connection**은 데이터베이스와의 연결 하나, Statement(값을 끼워 넣을 수 있는 PreparedStatement 포함)는 그 연결로 보내는 SQL 문 하나, **ResultSet**은 조회 결과를 한 행씩 읽는 커서입니다.
**DataSource**는 "커넥션을 달라고 하면 주는 것"을 나타내는 javax.sql의 인터페이스입니다. 드라이버에 직접 연결하는 단순한 구현도 있고, 미리 열어 둔 커넥션을 빌려주는 커넥션 풀도 같은 인터페이스를 구현합니다. Spring의 JDBC 코드는 드라이버가 아니라 이 DataSource만 봅니다.
체크 예외(checked exception)는 메서드가 throws로 선언하고 호출하는 쪽이 반드시 catch하거나 다시 throws해야 하는 예외입니다. JDBC의 거의 모든 메서드가 체크 예외 SQLException을 던집니다. 반대로 RuntimeException의 자식은 선언하지 않아도 되는 언체크 예외입니다.
템플릿-콜백 패턴은 "매번 같은 뼈대"를 템플릿 메서드 하나에 두고, "매번 다른 부분"만 호출하는 쪽이 콜백(람다나 작은 객체)으로 건네는 방식입니다. 템플릿이 뼈대를 돌다가 정해진 자리에서 콜백을 부릅니다. 이 글의 주인공입니다.
스레드에 묶인 커넥션. 17편에서 본 것처럼, 트랜잭션 매니저는 트랜잭션을 열 때 커넥션을 ConnectionHolder에 담아 TransactionSynchronizationManager의 ThreadLocal 맵에 DataSource를 열쇠로 묶어 둡니다. 이 글의 4절에서 그 맵을 읽는 쪽을 봅니다.
1. 날 JDBC가 되풀이하는 것, 템플릿이 감싸는 것
JDBC만으로 사용자 한 명의 이름을 읽어 오는 코드입니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
static String findNamePlainJdbc(DataSource ds, int id) {
    String sql = "select name from users where id = ?";
    try (Connection con = ds.getConnection();
            PreparedStatement ps = con.prepareStatement(sql)) {
        ps.setInt(1, id);
        try (ResultSet rs = ps.executeQuery()) {
            if (!rs.next()) {
                throw new IllegalStateException("no row");
            }
            return rs.getString("name");
        }
    }
    catch (SQLException ex) {
        throw new IllegalStateException("query failed: " + sql, ex);   // 체크 예외를 직접 감싼다
    }
}
이 가운데 "이 질의만의 것"은 SQL 한 줄, 인자 하나, 결과에서 name을 읽는 한 줄뿐입니다. 나머지, 곧 커넥션 얻기·PreparedStatement 만들기·ResultSet 닫기·SQLException 처리·커넥션 닫기는 어떤 질의를 쓰든 똑같이 되풀이됩니다. JdbcTemplate으로 같은 일을 하면 이렇습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
static String findNameTemplate(JdbcTemplate jdbc, int id) {
    return jdbc.queryForObject("select name from users where id = ?", String.class, id);
}
두 메서드를 H2 인메모리 데이터베이스로 돌리면 둘 다 kim을 돌려줍니다. 이 예제는 릴리스 버전인 Spring Framework 7.0.9로 실행해 결과를 확인했습니다(이 시리즈가 읽는 7.1.0-SNAPSHOT을 직접 빌드해 돌린 것은 아닙니다).
plain JDBC   : kim
JdbcTemplate : kim
템플릿 한 개: execute(StatementCallback)
JdbcTemplate은 2001년 5월부터 있던 클래스이고(JdbcTemplate 105행), JdbcAccessor를 상속하고 JdbcOperations 인터페이스를 구현합니다(118행). 1,800줄이 넘지만 뼈대는 execute라는 이름의 템플릿 메서드 몇 개이고, 나머지 query·update는 전부 그 위에 얹힌 편의 메서드입니다. 값을 끼워 넣지 않는 SQL용 템플릿이 이것입니다. (// ... 줄은 이 글에서 줄인 곳이고, 나머지는 소스 그대로입니다.)
	private <T extends @Nullable Object> T execute(StatementCallback<T> action, boolean closeResources) throws DataAccessException {
		Assert.notNull(action, "Callback object must not be null");

		Connection con = DataSourceUtils.getConnection(obtainDataSource());
		Statement stmt = null;
		try {
			stmt = con.createStatement();
			applyStatementSettings(stmt);
			T result = action.doInStatement(stmt);
			handleWarnings(stmt);
			return result;
		}
		catch (SQLException ex) {
			// Release Connection early, to avoid potential connection pool deadlock
			// in the case when the exception translator hasn't been initialized yet.
			if (stmt != null) {
				handleWarnings(stmt, ex);
			}
			String sql = getSql(action);
			JdbcUtils.closeStatement(stmt);
			stmt = null;
			DataSourceUtils.releaseConnection(con, getDataSource());
			con = null;
			throw translateException("StatementCallback", sql, ex);
		}
		finally {
			if (closeResources) {
				JdbcUtils.closeStatement(stmt);
				DataSourceUtils.releaseConnection(con, getDataSource());
			}
		}
	}
spring-jdbc/src/main/java/org/springframework/jdbc/core/JdbcTemplate.java 404–435행
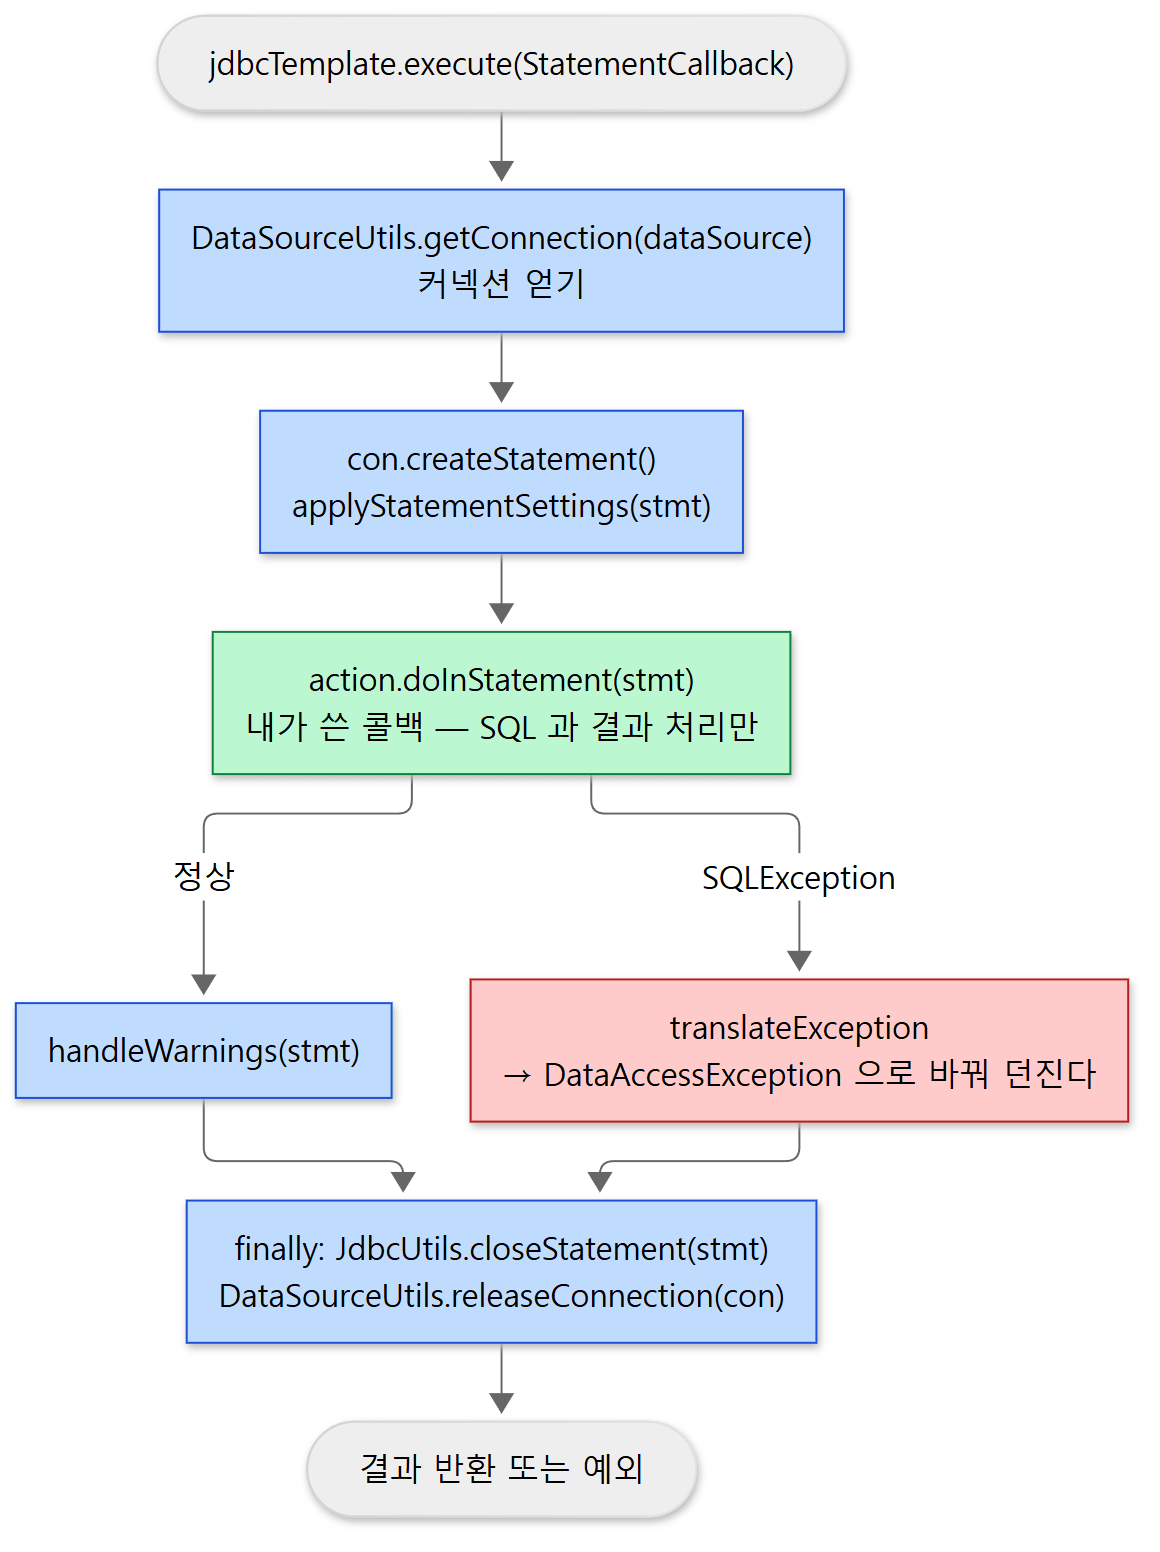 템플릿 한 번의 흐름. 초록 상자 하나만 내가 쓰고, 파란 상자와 빨간 상자는 템플릿이 합니다.
위에서부터 읽으면 날 JDBC 코드에서 되풀이되던 것이 그대로 보입니다.
- 커넥션을 얻습니다.
ds.getConnection()이 아니라DataSourceUtils.getConnection()입니다. 이 차이가 4절의 주제입니다. Statement를 만들고 설정을 입힙니다.applyStatementSettings가fetchSize·maxRows·질의 타임아웃을 적용합니다(1439–1449행).- 콜백을 부릅니다.
action.doInStatement(stmt). 여기가 호출하는 쪽이 채우는 유일한 자리입니다. SQLException을 잡아 바꿔 던집니다.translateException이 Spring의DataAccessException으로 바꿉니다(5절). 그 전에 커넥션을 먼저 돌려주는 이유가 주석에 적혀 있습니다. 변환기를 처음 만들 때 메타데이터를 읽으려고 커넥션을 하나 더 얻을 수 있어서, 풀이 작으면 교착이 날 수 있기 때문입니다.finally에서 닫습니다.Statement를 닫고 커넥션을 돌려줍니다(closeResources가true일 때 — 거의 모든 호출이 그렇습니다).
값을 끼워 넣는 SQL용 템플릿 execute(PreparedStatementCreator, PreparedStatementCallback, boolean)도 모양이 같습니다(655–700행). 다른 점은 con.createStatement() 대신 psc.createPreparedStatement(con)을 불러 PreparedStatement를 만드는 일도 콜백에 맡긴다는 것뿐입니다. 커넥션 자체를 통째로 내주는 가장 낮은 템플릿 execute(ConnectionCallback)도 있습니다(359–379행).
콜백 인터페이스는 "템플릿이 무엇을 내주는가"로 나뉩니다
| 콜백 | 메서드 | 템플릿이 내주는 것 | 어디서 쓰나 |
|---|---|---|---|
ConnectionCallback<T> |
doInConnection(Connection) |
커넥션 | execute(ConnectionCallback) 43–68행 |
StatementCallback<T> |
doInStatement(Statement) |
Statement |
execute(StatementCallback) 39–71행 |
PreparedStatementCreator |
createPreparedStatement(Connection) |
커넥션을 받아 PreparedStatement를 만들어 돌려준다 |
execute(psc, …) 43–55행 |
PreparedStatementSetter |
setValues(PreparedStatement) |
? 자리에 값을 넣는다 |
query(sql, pss, rse) 43–52행 |
PreparedStatementCallback<T> |
doInPreparedStatement(PreparedStatement) |
PreparedStatement |
execute(psc, PreparedStatementCallback) 46–78행 |
모두 @FunctionalInterface라 람다로 쓸 수 있습니다. StatementCallback의 설명 주석은 역할을 한 문장으로 적어 둡니다. "Statement나 Connection을 닫는 일, 트랜잭션을 다루는 일은 신경 쓰지 않아도 된다. 전부 JdbcTemplate이 한다"(42–46행). 결과를 읽는 콜백 셋(RowMapper·RowCallbackHandler·ResultSetExtractor)은 다음 절에서 따로 봅니다.
헷갈리기 쉬운 곳
- 콜백 안에서 커넥션을 닫아도 닫히지 않습니다.
execute(ConnectionCallback)은 커넥션을 그대로 주지 않고createConnectionProxy로 감싼 프록시를 줍니다(365–366행, 392–397행). 그 프록시의close()는 아무 일도 하지 않고null을 돌려주며,isClosed()는 늘false입니다(1667–1668행). 닫는 일은 템플릿의finally가 합니다. execute(String)은Statement, 인자가 있는update(String, Object...)는PreparedStatement입니다.execute(String)은stmt.execute(sql)을 부르는StatementCallback을 만들어 위 템플릿에 넘기고(443–462행),update(String, Object...)는 인자를ArgumentPreparedStatementSetter에 담아PreparedStatement템플릿으로 갑니다(1019–1021행, 1458–1460행). 문자열을 이어 붙여execute(String)에 넣으면 값이?로 바인딩되지 않습니다.
2. 결과를 받는 세 가지 콜백
조회는 ResultSet을 어떻게 읽을지도 콜백으로 받습니다. 셋이 있고, 역할이 다릅니다.
| 콜백 | 메서드 | 커서(rs.next())는 누가 돌리나 |
돌려주는 것 | 상태 |
|---|---|---|---|---|
RowMapper<T> |
mapRow(ResultSet, int rowNum) |
템플릿 | 행 하나당 객체 하나. 템플릿이 List<T>로 모은다 |
없음 (재사용) |
RowCallbackHandler |
processRow(ResultSet) |
템플릿 | 없음(void). 합계·문자열 등 상태를 객체 안에 모은다 |
있음 |
ResultSetExtractor<T> |
extractData(ResultSet) |
콜백 자신 | ResultSet 전체를 보고 만든 값 하나 |
보통 없음 |
RowMapper의 설명 주석은 "이 메서드는 ResultSet의 next()를 부르면 안 된다. 현재 행의 값만 매핑한다"고 못 박습니다(RowMapper 54–57행). RowCallbackHandler도 같습니다(51–55행). 반대로 ResultSetExtractor는 "ResultSet 전체를 처리하라"는 계약이고, 닫는 것만 하지 말라고 합니다(ResultSetExtractor 55–60행).
query 오버로드는 전부 ResultSetExtractor로 모입니다
JdbcTemplate에는 query라는 이름의 메서드가 아주 많지만, 실제로 ResultSet을 받는 템플릿은 ResultSetExtractor를 받는 것 하나입니다. 값을 끼워 넣지 않는 쪽을 보면 이렇습니다.
	@Override
	public <T extends @Nullable Object> T query(String sql, ResultSetExtractor<T> rse) throws DataAccessException {
		// ...
		class QueryStatementCallback implements StatementCallback<T>, SqlProvider {
			@Override
			public T doInStatement(Statement stmt) throws SQLException {
				ResultSet rs = null;
				try {
					rs = stmt.executeQuery(sql);
					return rse.extractData(rs);
				}
				finally {
					JdbcUtils.closeResultSet(rs);
				}
			}
			// ...
		}

		return execute(new QueryStatementCallback(), true);
	}

	@Override
	public void query(String sql, RowCallbackHandler rch) throws DataAccessException {
		query(sql, new RowCallbackHandlerResultSetExtractor(rch, this.maxRows));
	}

	@Override
	public <T extends @Nullable Object> List<T> query(String sql, RowMapper<T> rowMapper) throws DataAccessException {
		return result(query(sql, new RowMapperResultSetExtractor<>(rowMapper, 0, this.maxRows)));
	}
spring-jdbc/src/main/java/org/springframework/jdbc/core/JdbcTemplate.java 464–502행
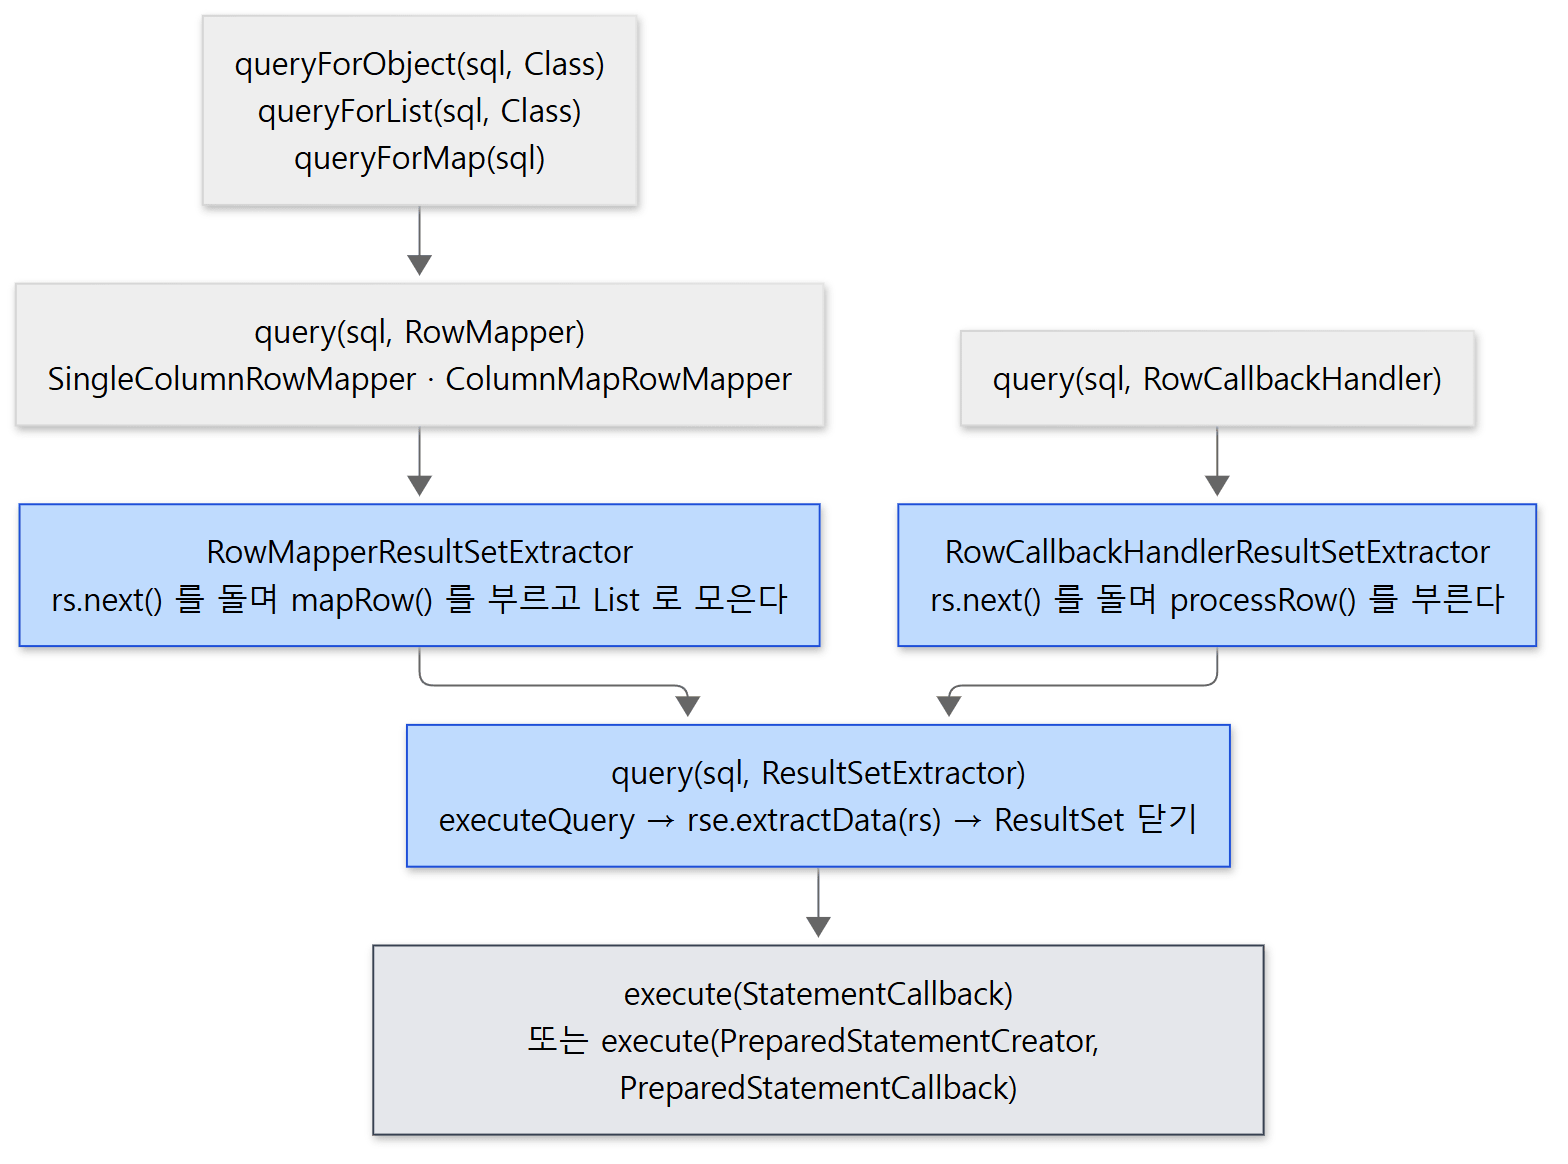 위의 편의 메서드가 아래의 템플릿으로 좁아집니다. 파란 상자가 커서를 돌리는 어댑터입니다.
RowMapper를 ResultSetExtractor로 바꿔 주는 어댑터가 RowMapperResultSetExtractor입니다. 커서를 돌리는 while이 여기 있습니다.
	@Override
	public List<T> extractData(ResultSet rs) throws SQLException {
		List<T> results = (this.rowsExpected > 0 ? new ArrayList<>(this.rowsExpected) : new ArrayList<>());
		int rowNum = 0;
		while (rs.next() && (this.maxRows == -1 || rowNum < this.maxRows)) {
			results.add(this.rowMapper.mapRow(rs, rowNum++));
		}
		return results;
	}
spring-jdbc/src/main/java/org/springframework/jdbc/core/RowMapperResultSetExtractor.java 105–113행
RowCallbackHandler 쪽 어댑터는 JdbcTemplate 안의 private 클래스이고, 같은 while을 돌며 processRow를 부른 뒤 null을 돌려줍니다(1750–1769행). 값을 끼워 넣는 query(String, RowMapper, Object...)도 마찬가지로 RowMapperResultSetExtractor를 만들어 PreparedStatement 쪽 템플릿 query(psc, pss, rse)로 갑니다(824–826행, 725–748행).
예제: 세 콜백으로 같은 표 읽기
users(id, user_name, age)에 세 행을 넣고 세 콜백으로 읽었습니다. Spring Framework 7.0.9로 실행했습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
// ① RowMapper 람다 — 행 하나를 객체 하나로. 반복과 List 만들기는 JdbcTemplate 이 한다
List<User> users = jdbc.query("select * from users order by id",
        (rs, rowNum) -> new User(rs.getInt("id"), rs.getString("user_name"), rs.getInt("age")));
System.out.println("RowMapper lambda      : " + users);

// ② ResultSetExtractor — ResultSet 전체를 받아 내가 돌린다. 합계 하나를 돌려준다
Integer ageSum = jdbc.query("select age from users", rs -> {
    int sum = 0;
    while (rs.next()) {
        sum += rs.getInt("age");
    }
    return sum;
});
System.out.println("ResultSetExtractor    : age sum = " + ageSum);

// ③ RowCallbackHandler — 행마다 불리고 아무것도 돌려주지 않는다
StringBuilder names = new StringBuilder();
jdbc.query("select user_name from users order by id", rs -> {
    names.append(rs.getString("user_name")).append(' ');
});
System.out.println("RowCallbackHandler    : " + names.toString().trim());
RowMapper lambda      : [User[id=1, userName=kim, age=30], User[id=2, userName=lee, age=25], User[id=3, userName=park, age=41]]
ResultSetExtractor    : age sum = 96
RowCallbackHandler    : kim lee park
DataClassRowMapper    : [User[id=1, userName=kim, age=30], User[id=2, userName=lee, age=25], User[id=3, userName=park, age=41]]
BeanPropertyRowMapper : [UserBean[1, kim, 30], UserBean[2, lee, 25], UserBean[3, park, 41]]
JdbcClient            : User[id=2, userName=lee, age=25]
아래 세 줄은 열 이름 user_name을 속성 userName에 자동으로 맞춰 주는 RowMapper 구현들과 6절의 JdbcClient입니다. 자동 매핑의 차이는 "더 깊이 들어가면"에 적어 두었습니다.
헷갈리기 쉬운 곳
- 람다 하나가 두 오버로드에 걸릴 수 있습니다.
rs -> ...꼴 람다는 인자가 하나이므로RowCallbackHandler(반환 없음)와ResultSetExtractor(반환 있음) 둘 다 될 수 있습니다. 위 예제처럼 값을return하면ResultSetExtractor,return이 없으면RowCallbackHandler로 풀립니다. 인자가 둘((rs, rowNum))이면RowMapper입니다. queryForStream은 템플릿이 닫아 주지 않습니다. 이 메서드만execute(..., false)로 불러finally에서 닫지 않고, 돌려주는Stream의onClose에 닫는 코드를 걸어 둡니다(505–524행). 받은Stream을try-with-resources로 닫지 않으면 커넥션이 돌아가지 않습니다.
3. queryForObject는 "정확히 한 행"을 기대합니다
queryForObject(String sql, Class<T> requiredType)는 두 단계입니다. 열 하나만 읽는 SingleColumnRowMapper를 만들어 query(sql, rowMapper)로 리스트를 받고, 그 리스트에서 하나를 꺼냅니다.
	@Override
	public <T extends @Nullable Object> T queryForObject(String sql, RowMapper<T> rowMapper) throws DataAccessException {
		List<T> results = query(sql, rowMapper);
		return DataAccessUtils.nullableSingleResult(results);
	}

	@Override
	public <T> @Nullable T queryForObject(String sql, Class<T> requiredType) throws DataAccessException {
		return queryForObject(sql, getSingleColumnRowMapper(requiredType));
	}
spring-jdbc/src/main/java/org/springframework/jdbc/core/JdbcTemplate.java 531–540행
"하나를 꺼내는" DataAccessUtils.nullableSingleResult는 spring-tx 모듈의 dao.support 패키지에 있습니다.
	public static <T extends @Nullable Object> T nullableSingleResult(@Nullable Collection<T> results)
			throws IncorrectResultSizeDataAccessException {

		// This is identical to the requiredSingleResult implementation but differs in the
		// semantics of the incoming Collection (which we currently can't formally express)
		if (CollectionUtils.isEmpty(results)) {
			throw new EmptyResultDataAccessException(1);
		}
		if (results.size() > 1) {
			throw new IncorrectResultSizeDataAccessException(1, results.size());
		}
		return results.iterator().next();
	}
spring-tx/src/main/java/org/springframework/dao/support/DataAccessUtils.java 192–204행
0건이면 EmptyResultDataAccessException, 2건 이상이면 IncorrectResultSizeDataAccessException입니다. 앞의 것은 뒤의 것의 자식입니다(EmptyResultDataAccessException 30행). 이름의 nullable은 "행이 없어도 null을 준다"는 뜻이 아니라, 한 행의 값이 null이어도 그대로 돌려준다는 뜻입니다. requiredSingleResult는 그 경우에도 예외를 던집니다(164–178행). 열이 둘 이상이면 SingleColumnRowMapper가 그보다 먼저 IncorrectResultSetColumnCountException을 던집니다(118–124행).
예제: 1건, 0건, 2건
users에 이름이 같은 두 행(kim)을 넣고 세 가지 질의를 queryForObject(sql, String.class)로 돌렸습니다. Spring Framework 7.0.9로 실행했습니다.
ok        : kim
exception : EmptyResultDataAccessException (extends IncorrectResultSizeDataAccessException)
  message : Incorrect result size: expected 1, actual 0
exception : IncorrectResultSizeDataAccessException (extends DataRetrievalFailureException)
  message : Incorrect result size: expected 1, actual 2
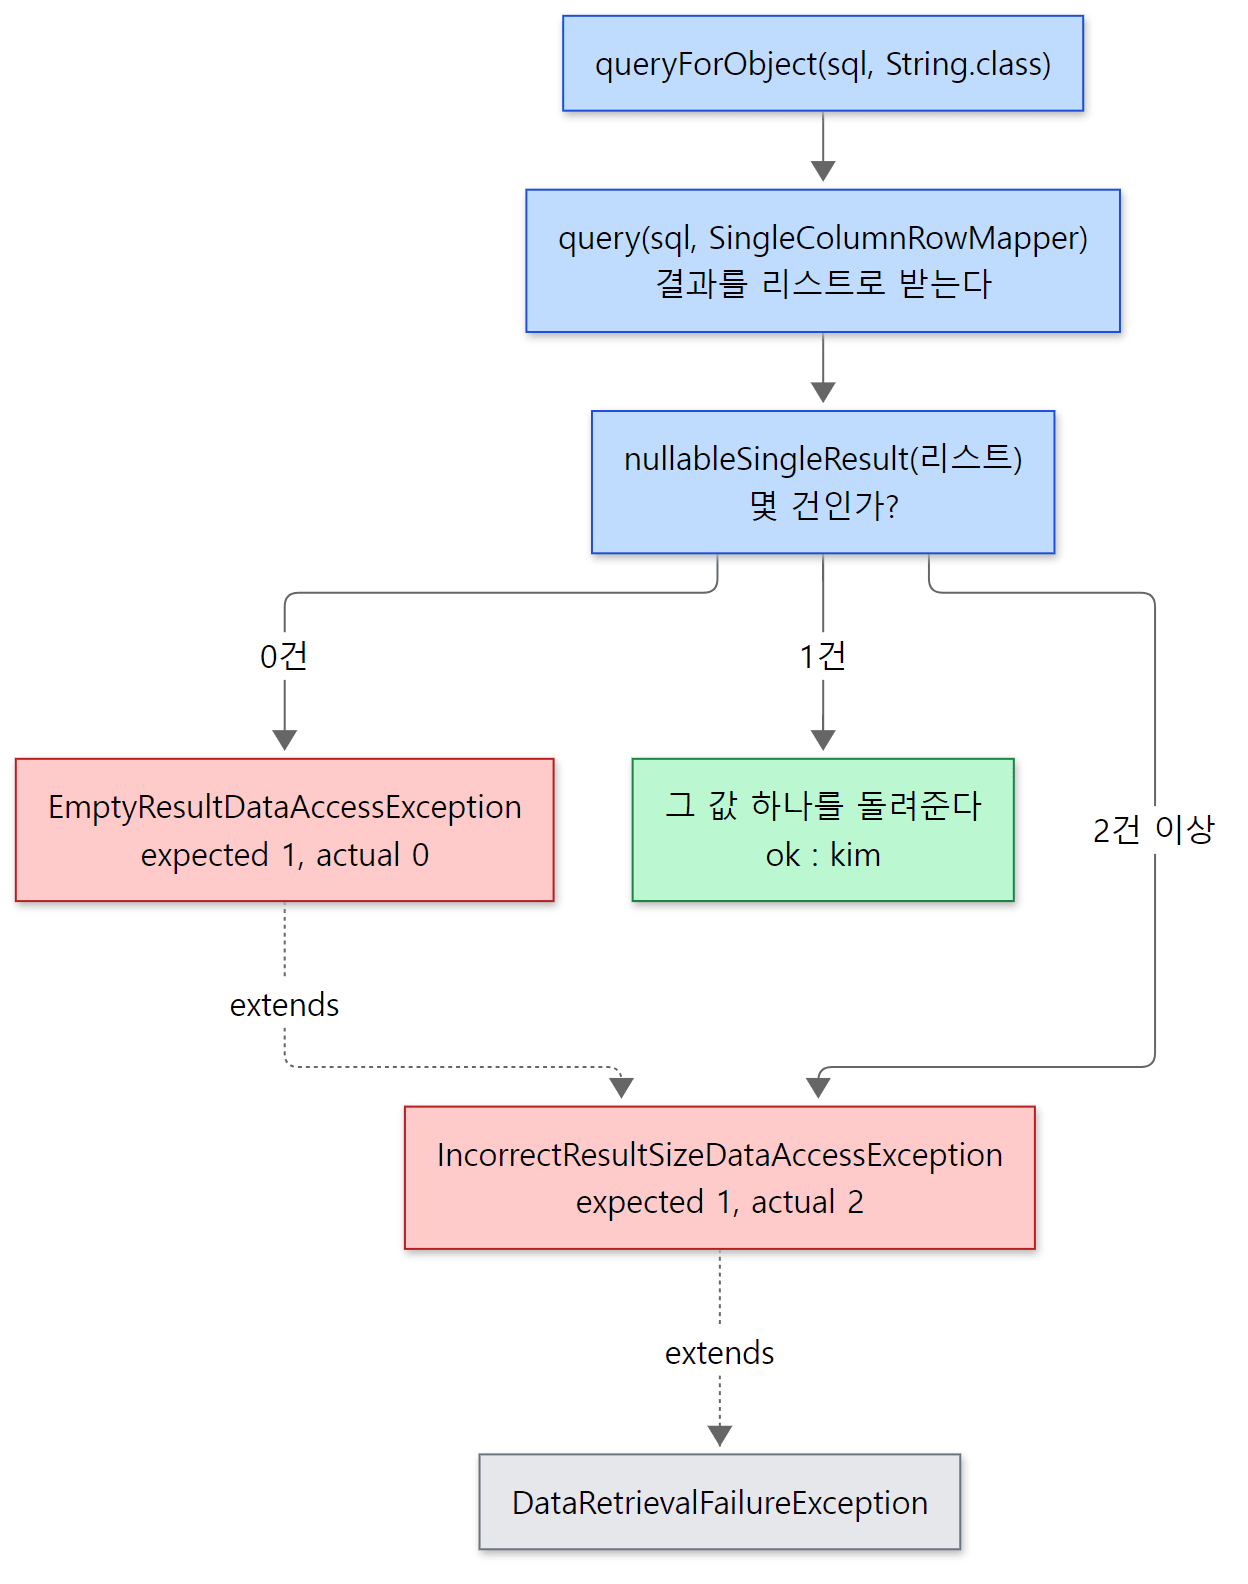 "한 행"은 리스트를 다 받은 뒤에 따집니다. 메시지와 상속 관계는 위 예제의 실제 출력 그대로입니다.
update와 batchUpdate
변경 쪽도 같은 템플릿 위에 있습니다. update(PreparedStatementCreator, PreparedStatementSetter)는 PreparedStatement 템플릿에 "값을 넣고 executeUpdate()를 불러 영향받은 행 수를 돌려주는" 콜백을 넘깁니다(961–983행). batchUpdate(String, BatchPreparedStatementSetter)의 콜백은 드라이버가 배치를 지원하면(JdbcUtils.supportsBatchUpdates) addBatch()를 모아 executeBatch() 한 번으로, 지원하지 않으면 행마다 executeUpdate()로 돕니다(1034–1046행, 1592–1641행).
헷갈리기 쉬운 곳
queryForObject는 0건이면null이 아니라 예외입니다. "없으면null"을 원하면query(sql, rowMapper, args)로 리스트를 받아DataAccessUtils.singleResult를 쓰거나(55–63행), 6절의JdbcClient에서.optional()을 씁니다.- 인자 배열을 받는 오래된 오버로드는
@Deprecated입니다.query(String, Object[], RowMapper)처럼Object[]가 가운데 오는 꼴은 5.3부터 사용 중단이고(817–821행), 가변 인자가 맨 뒤에 오는query(String, RowMapper, Object...)가 현재의 모양입니다.
4. 커넥션은 어디서 오나 — DataSourceUtils
1절 템플릿의 첫 줄 DataSourceUtils.getConnection(obtainDataSource())을 따라갑니다. getConnection은 doGetConnection을 부르고 SQLException을 CannotGetJdbcConnectionException으로 감싸기만 합니다(79–89행). 본론은 이것입니다.
	public static Connection doGetConnection(DataSource dataSource) throws SQLException {
		Assert.notNull(dataSource, "No DataSource specified");

		ConnectionHolder conHolder = (ConnectionHolder) TransactionSynchronizationManager.getResource(dataSource);
		if (conHolder != null && (conHolder.hasConnection() || conHolder.isSynchronizedWithTransaction())) {
			conHolder.requested();
			if (!conHolder.hasConnection()) {
				logger.debug("Fetching resumed JDBC Connection from DataSource");
				conHolder.setConnection(fetchConnection(dataSource));
			}
			return conHolder.getConnection();
		}
		// Else we either got no holder or an empty thread-bound holder here.

		logger.debug("Fetching JDBC Connection from DataSource");
		Connection con = fetchConnection(dataSource);

		if (TransactionSynchronizationManager.isSynchronizationActive()) {
			// ...
		}

		return con;
	}
spring-jdbc/src/main/java/org/springframework/jdbc/datasource/DataSourceUtils.java 103–147행
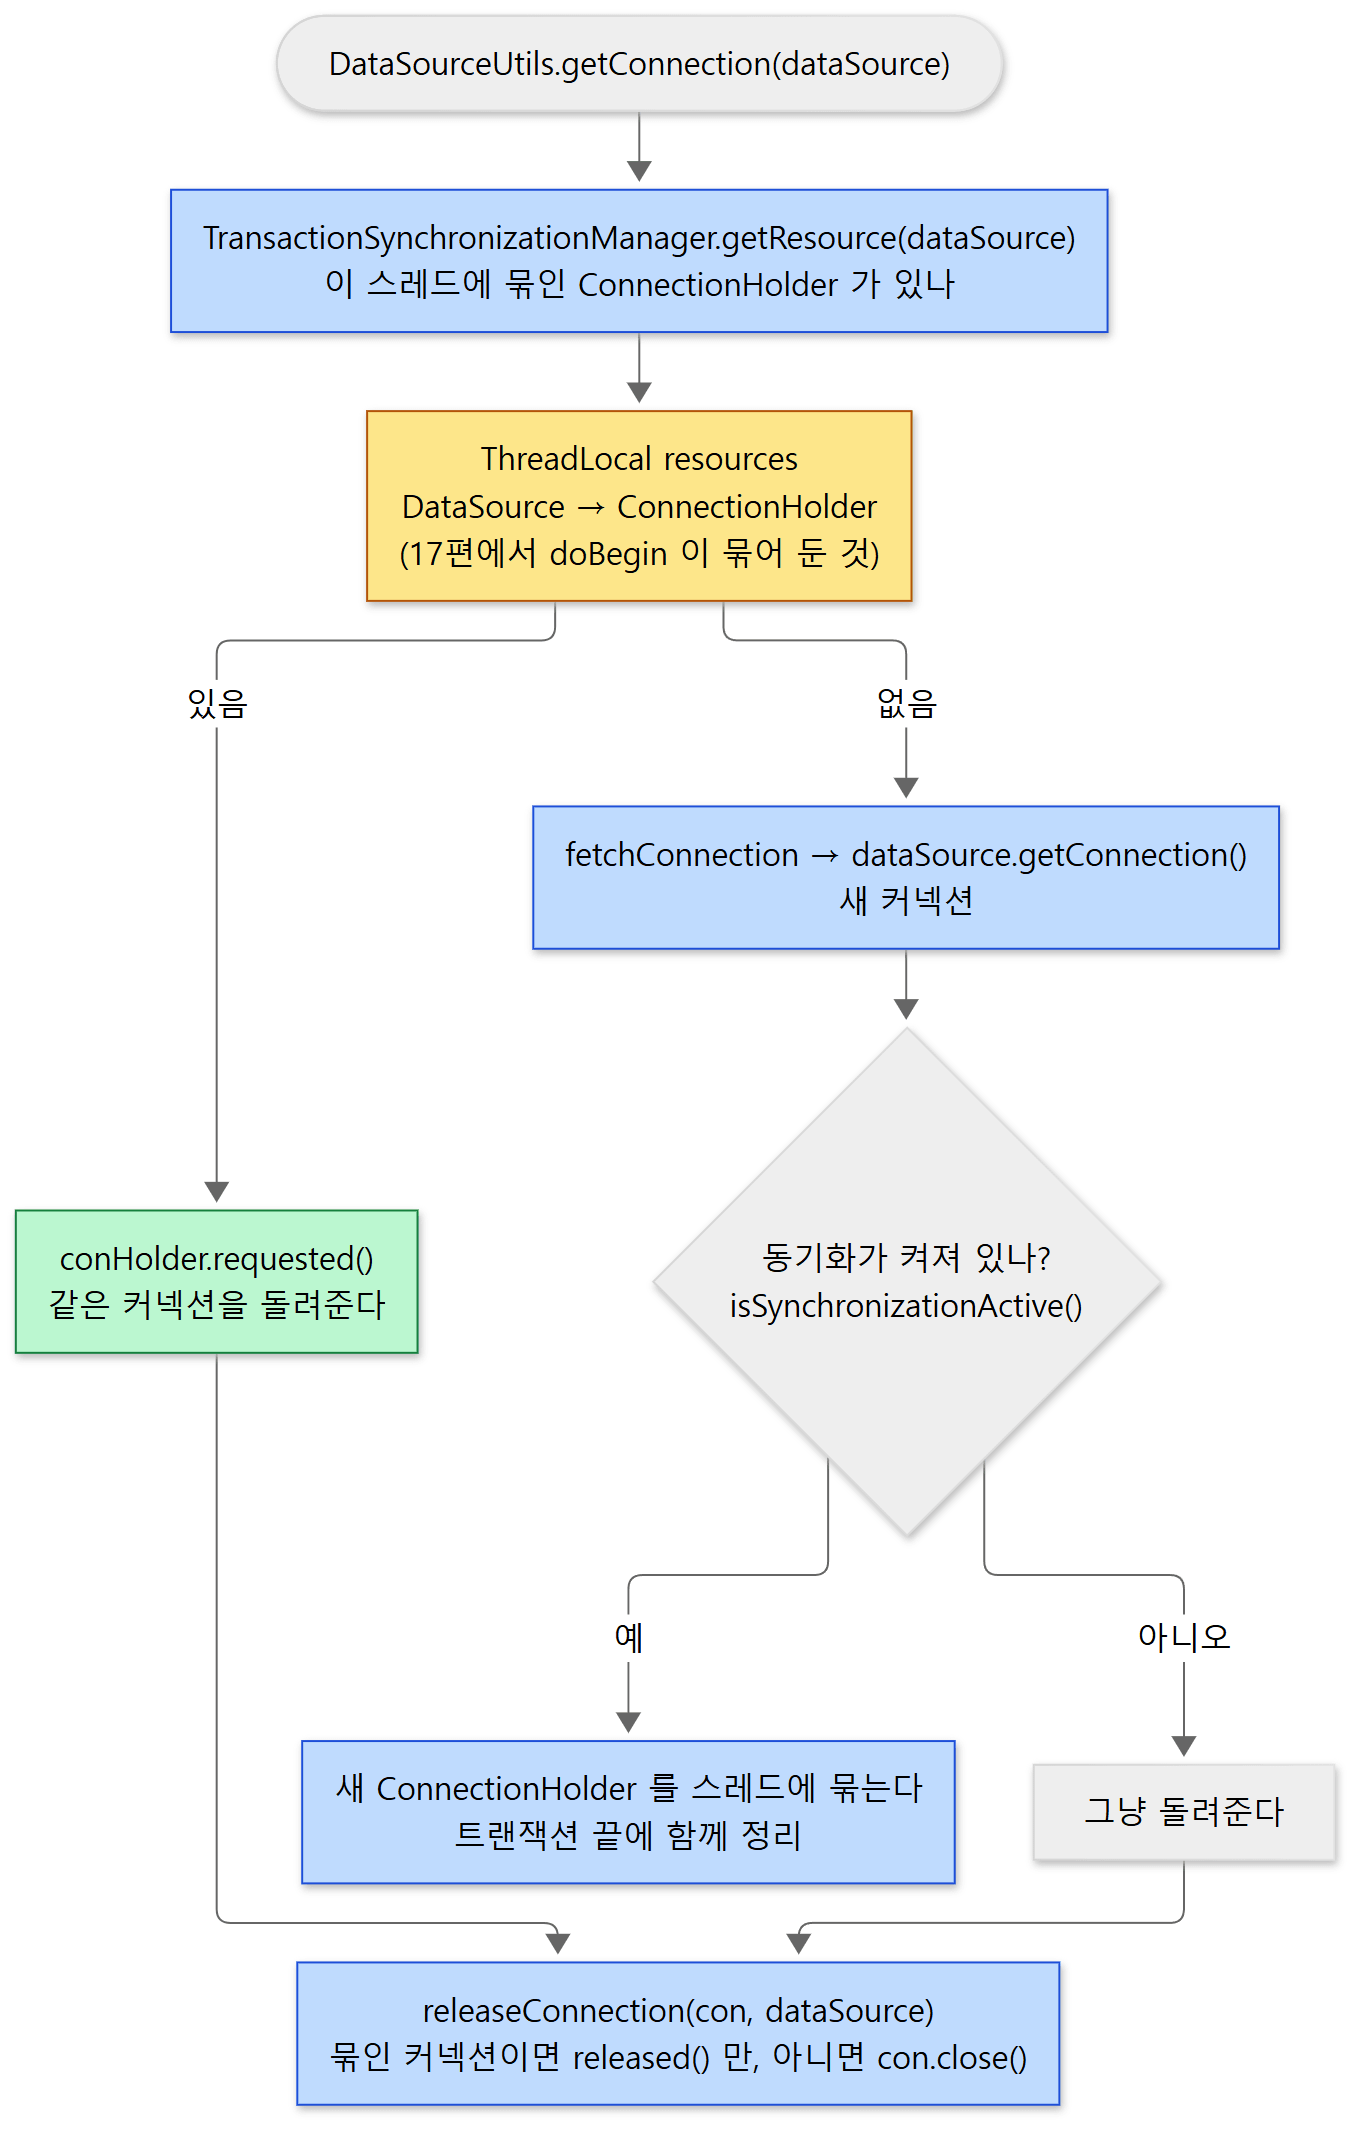 노란 상자가 17편에서 트랜잭션 매니저가 커넥션을 묶어 둔 그 ThreadLocal 맵입니다.
첫 줄이 핵심입니다. TransactionSynchronizationManager.getResource(dataSource)는 17편에서 본 ThreadLocal<Map<Object, Object>> resources에서 이 DataSource를 열쇠로 값을 꺼냅니다(TransactionSynchronizationManager 77행, 133행). 거기에 ConnectionHolder를 넣은 쪽은 DataSourceTransactionManager.doBegin입니다(310행). 그래서 두 경우로 갈립니다.
- 트랜잭션 안 — 묶인 홀더가 있으면
requested()로 참조 수를 하나 올리고(ResourceHolderSupport162–163행) 같은 커넥션을 돌려줍니다.@Transactional메서드 안에서JdbcTemplate을 몇 번 부르든 커넥션이 하나인 이유입니다. 트랜잭션 매니저와JdbcTemplate이 직접 아는 사이가 아니라 같은DataSource객체를 열쇠로 같은 맵을 보기 때문에, 두 쪽에 반드시 같은DataSource를 넣어야 합니다. - 트랜잭션 밖 — 홀더가 없으니
fetchConnection, 곧dataSource.getConnection()으로 새로 얻습니다(159행). 줄인if안은 "트랜잭션은 없지만 동기화는 켜져 있는" 경우(예: JTA)에 새 홀더를 묶는 코드입니다.
돌려주는 쪽도 대칭입니다.
	public static void doReleaseConnection(@Nullable Connection con, @Nullable DataSource dataSource) throws SQLException {
		if (con == null) {
			return;
		}
		if (dataSource != null) {
			ConnectionHolder conHolder = (ConnectionHolder) TransactionSynchronizationManager.getResource(dataSource);
			if (conHolder != null && connectionEquals(conHolder, con)) {
				// It's the transactional Connection: Don't close it.
				conHolder.released();
				return;
			}
		}
		doCloseConnection(con, dataSource);
	}
spring-jdbc/src/main/java/org/springframework/jdbc/datasource/DataSourceUtils.java 407–420행
묶인 커넥션이면 참조 수만 내리고(released()) 닫지 않습니다. 닫는 일은 17편의 커밋·롤백 뒤 정리 단계가 합니다. 묶이지 않은 커넥션이면 con.close()입니다(430–434행). 커넥션 풀이면 close()가 풀에 돌려주는 동작입니다.
예제: 트랜잭션 밖과 안에서 커넥션을 몇 번 얻나
DataSource.getConnection() 호출 횟수를 세는 DelegatingDataSource 포장을 만들고, JdbcTemplate을 세 번 부르는 같은 코드를 트랜잭션 밖과 TransactionTemplate 안에서 돌렸습니다. Spring Framework 7.0.9로 실행했습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
jdbc.update("insert into users values (1, 'a')");
jdbc.update("insert into users values (2, 'b')");
jdbc.queryForObject("select count(*) from users", Integer.class);
System.out.println("outside transaction : 3 calls -> getConnection() x " + ds.count.get());

ds.count.set(0);
TransactionTemplate tx = new TransactionTemplate(new DataSourceTransactionManager(ds));
tx.executeWithoutResult(status -> {
    jdbc.update("insert into users values (3, 'c')");
    jdbc.update("insert into users values (4, 'd')");
    jdbc.queryForObject("select count(*) from users", Integer.class);
});
System.out.println("inside transaction  : 3 calls -> getConnection() x " + ds.count.get());
outside transaction : 3 calls -> getConnection() x 3
inside transaction  : 3 calls -> getConnection() x 1
트랜잭션 안의 한 번은 JdbcTemplate이 아니라 doBegin이 얻은 것이고, 세 번의 JdbcTemplate 호출은 전부 그것을 돌려썼습니다.
헷갈리기 쉬운 곳
- 트랜잭션 밖에서는 호출마다 커넥션을 새로 얻고 닫습니다. 위 출력의 첫 줄이 그것입니다. 풀이 없는
DriverManagerDataSource라면 호출마다 물리 연결을 새로 엽니다. 묶어서 돌리고 싶으면 트랜잭션 안에 넣습니다. - 날 JDBC 코드도 트랜잭션에 끼워 넣을 수 있습니다.
TransactionAwareDataSourceProxy는getConnection()에서DataSourceUtils를 거치는 프록시 커넥션을 내주고(TransactionAwareDataSourceProxy135–143행), 그 커넥션의close()는 묶인 커넥션이면released()만 부릅니다(216–231행). 단, 트랜잭션 매니저에는 이 프록시가 아니라 **원래DataSource**를 줘야 한다고 설명 주석이 못 박습니다(40–41행).
5. 예외 변환 — SQLException이 DataAccessException이 되기까지
왜 바꾸나 — dao 패키지의 계층
SQLException은 체크 예외인 데다, 무엇이 잘못됐는지가 벤더별 숫자 코드(getErrorCode())와 다섯 글자 문자열(getSQLState())에 숨어 있습니다. Spring은 이것을 spring-tx 모듈의 org.springframework.dao 패키지에 있는 언체크 예외 계층으로 바꿉니다. 뿌리 DataAccessException의 설명 주석은 목적을 이렇게 적습니다. "사용하는 데이터 접근 API(예: JDBC)의 세부를 몰라도 어떤 종류의 오류인지 알고 처리할 수 있게 한다"(DataAccessException 29–32행). 그래서 이 패키지는 JDBC 모듈이 아니라 spring-tx에 있고, JPA나 R2DBC도 같은 계층으로 바꿉니다.
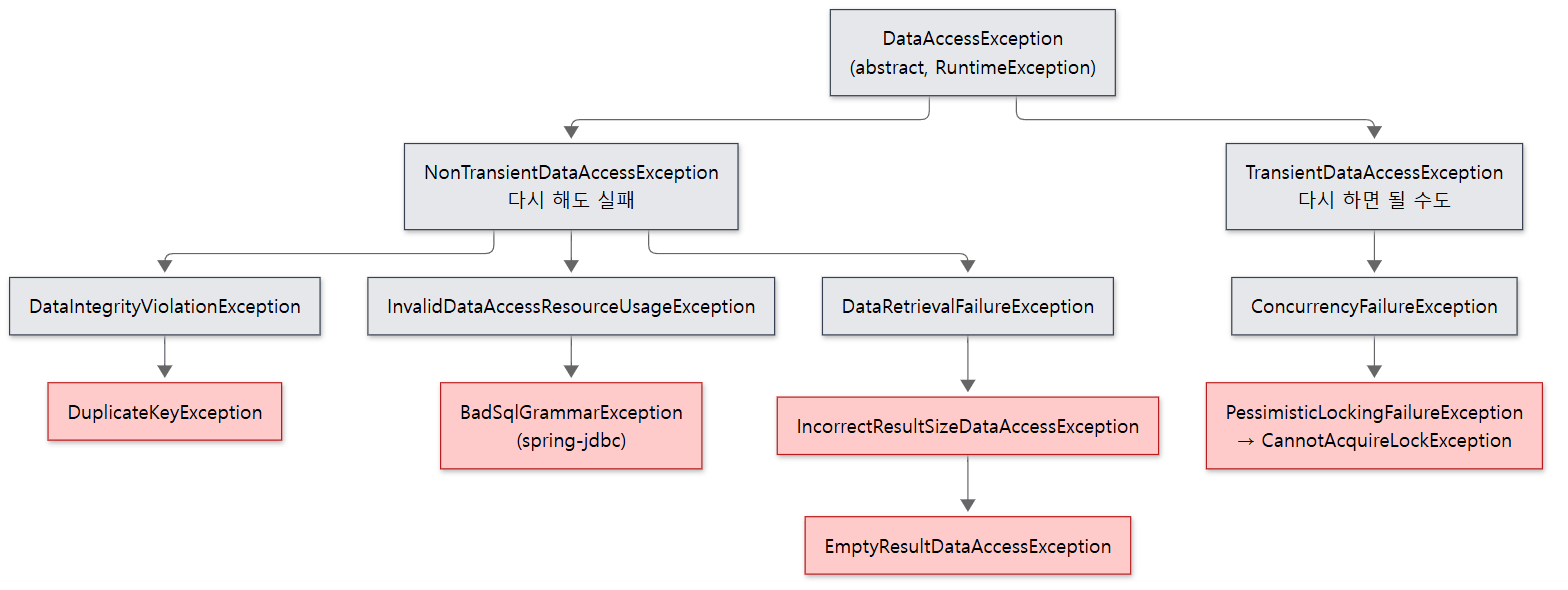 이 글에 나오는 예외만 골라 그렸습니다. 회색은 분류용 부모, 빨강은 실제로 던져지는 것입니다.
| 예외 | 부모 | 뜻 |
|---|---|---|
DataAccessException |
NestedRuntimeException |
뿌리. 추상 클래스 41행 |
NonTransientDataAccessException / TransientDataAccessException |
DataAccessException |
다시 시도해도 실패 / 다시 시도하면 될 수도 31행, 31행 |
DataIntegrityViolationException |
NonTransient… |
제약 조건 위반 36행 |
DuplicateKeyException |
DataIntegrityViolationException |
유니크 키 중복 33행 |
BadSqlGrammarException |
InvalidDataAccessResourceUsageException |
SQL 문법 오류. 이것과 아래 UncategorizedSQLException은 spring-jdbc에 있다 37행 |
CannotAcquireLockException |
PessimisticLockingFailureException |
락을 얻지 못함 31행 |
UncategorizedSQLException |
UncategorizedDataAccessException |
분류하지 못한 SQLException 33행 |
변환기는 누가 고르나 — JdbcAccessor.getExceptionTranslator
1절 템플릿의 catch에서 부른 translateException은 두 줄입니다. 변환기에게 맡기고, null이 돌아오면 UncategorizedSQLException으로 감쌉니다(1549–1552행). 변환기는 부모 클래스 JdbcAccessor가 고릅니다.
	public SQLExceptionTranslator getExceptionTranslator() {
		SQLExceptionTranslator exceptionTranslator = this.exceptionTranslator;
		if (exceptionTranslator != null) {
			return exceptionTranslator;
		}
		synchronized (this) {
			exceptionTranslator = this.exceptionTranslator;
			if (exceptionTranslator == null) {
				if (SQLErrorCodeSQLExceptionTranslator.hasUserProvidedErrorCodesFile()) {
					exceptionTranslator = new SQLErrorCodeSQLExceptionTranslator(obtainDataSource());
				}
				else {
					exceptionTranslator = new SQLExceptionSubclassTranslator();
				}
				this.exceptionTranslator = exceptionTranslator;
			}
			return exceptionTranslator;
		}
	}
spring-jdbc/src/main/java/org/springframework/jdbc/support/JdbcAccessor.java 114–132행
기본값은 SQLExceptionSubclassTranslator입니다. SQLErrorCodeSQLExceptionTranslator가 기본이 되는 경우는 하나, 사용자가 클래스패스 루트에 sql-error-codes.xml을 둔 경우뿐입니다. hasUserProvidedErrorCodesFile()은 그 파일이 있는지를 클래스 로딩 때 한 번 확인한 static final 값을 돌려줍니다(84–86행, 429–431행). setExceptionTranslator의 설명 주석도 "6.0부터 SQLExceptionSubclassTranslator가 기본"이라고 적습니다(99–101행). 변환기는 처음 SQLException이 날 때 게으르게 만들어집니다(lazyInit 기본 true, 50행, 158–166행).
변환기 셋과 그 순서
세 변환기는 모두 AbstractFallbackSQLExceptionTranslator를 상속합니다. 이 부모의 translate가 순서를 정합니다. 먼저 사용자가 끼운 customTranslator(6.1부터)에게 묻고, 자기 doTranslate를 부르고, null이면 fallbackTranslator에게 넘깁니다(89–115행). 각 변환기가 생성자에서 자기 fallback을 정해 두기 때문에 사슬이 생깁니다.
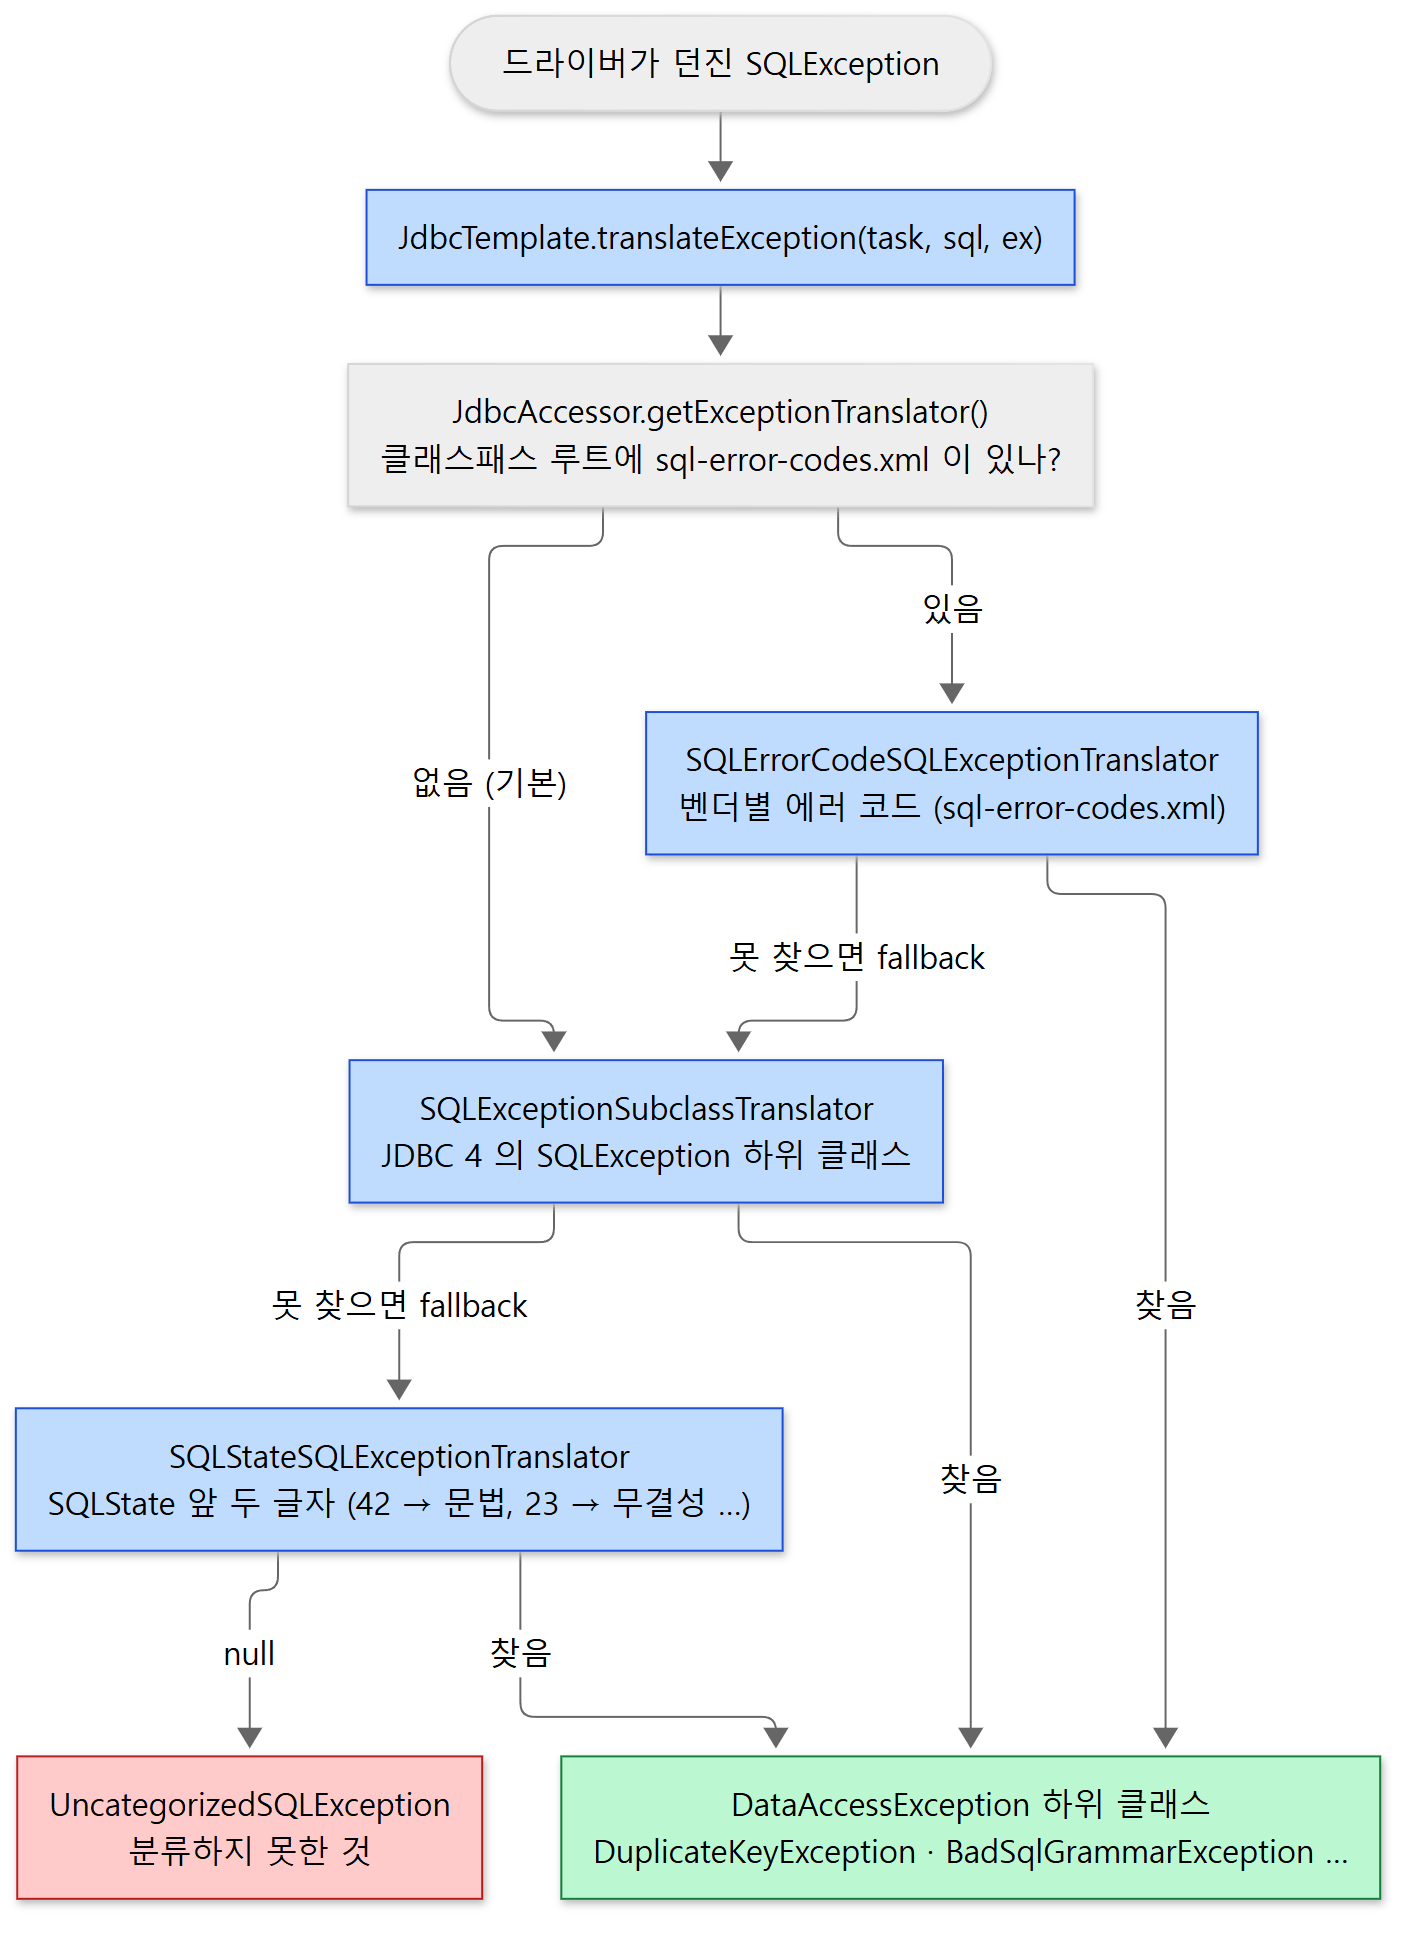 기본 경로는 왼쪽 아래로 내려가는 두 단계입니다. 벤더 코드 변환기는 사용자가 파일을 둘 때만 맨 앞에 끼어듭니다.
| 변환기 | 무엇을 보나 | fallback |
|---|---|---|
SQLExceptionSubclassTranslator (68행) |
JDBC 4가 정한 SQLException의 하위 클래스(SQLIntegrityConstraintViolationException, SQLSyntaxErrorException 등) |
SQLStateSQLExceptionTranslator (70–72행) |
SQLStateSQLExceptionTranslator (57행) |
SQLState 앞 두 글자. 42·07·21·2A·37·65면 문법 오류, 23·22·01·02·27·44면 무결성 위반 등 (59–104행) |
없음 → null (165–166행) |
SQLErrorCodeSQLExceptionTranslator (76행) |
벤더별 에러 코드. sql-error-codes.xml에서 데이터베이스 제품 이름으로 찾은 코드 묶음과 대조 (242–281행) |
SQLExceptionSubclassTranslator (95–97행) |
기본 변환기의 doTranslate는 instanceof 사다리입니다. 일부만 옮깁니다.
	@Override
	protected @Nullable DataAccessException doTranslate(String task, @Nullable String sql, SQLException ex) {
		// ...
		else if (sqlEx instanceof SQLNonTransientException) {
			// ...
			if (sqlEx instanceof SQLIntegrityConstraintViolationException) {
				if (SQLStateSQLExceptionTranslator.indicatesDuplicateKey(sqlEx.getSQLState(), sqlEx.getErrorCode())) {
					return new DuplicateKeyException(buildMessage(task, sql, sqlEx), ex);
				}
				return new DataIntegrityViolationException(buildMessage(task, sql, sqlEx), ex);
			}
			// ...
			if (sqlEx instanceof SQLSyntaxErrorException) {
				return new BadSqlGrammarException(task, (sql != null ? sql : ""), ex);
			}
			// ...
		}
		// ...

		// Fallback to Spring's own SQL state translation...
		return null;
	}
제약 위반이 중복 키인지는 SQLState가 23505이거나, 범용 23000에 잘 알려진 벤더 코드(Oracle 1, MySQL 1062 등)가 붙어 있을 때로 판단합니다(SQLStateSQLExceptionTranslator 197–200행). 벤더 코드 변환기가 읽는 sql-error-codes.xml은 spring-jdbc jar 안에 들어 있고(SQLErrorCodesFactory 64행, 108–131행), 예를 들어 H2 항목은 23001,23505를 중복 키로, 42000,42001,42101,…을 문법 오류로 분류합니다(sql-error-codes.xml 69–85행). 이 파일은 Spring의 XML 빈 설정 형식 그대로라서, 팩토리가 DefaultListableBeanFactory와 XmlBeanDefinitionReader로 읽습니다. 3편에서 본 컨테이너를 설정 파일 파서로 쓰는 셈입니다.
예제: 같은 SQLException을 세 변환기에 넣어 보기
H2에서 같은 기본 키를 두 번 넣고, 없는 표를 조회했습니다. 그다음 중복 키 때의 SQLException을 변환기 셋에 각각 넣어 봤습니다. Spring Framework 7.0.9로 실행했습니다.
translator in use : SQLExceptionSubclassTranslator
sql      : insert into users values (1, 'kim')
  thrown : org.springframework.dao.DuplicateKeyException
  cause  : org.h2.jdbc.JdbcSQLIntegrityConstraintViolationException (SQLState=23505, errorCode=23505)
  message: StatementCallback; SQL [insert into users values (1, 'kim')]; Unique index or primary key violation: "PRIMARY KEY ON PUBLIC.USERS(ID) ( /* key:1 */ 1, 'kim')"; SQL statement:
insert into users values (1, 'kim') [23505-232]
sql      : select * from no_such_table
  thrown : org.springframework.jdbc.BadSqlGrammarException
  cause  : org.h2.jdbc.JdbcSQLSyntaxErrorException (SQLState=42S02, errorCode=42102)
  message: StatementCallback; bad SQL grammar [select * from no_such_table]
SQLExceptionSubclassTranslator       -> DuplicateKeyException
SQLStateSQLExceptionTranslator       -> DuplicateKeyException
SQLErrorCodeSQLExceptionTranslator   -> DuplicateKeyException
첫 줄이 기본 변환기를 보여 줍니다. H2 드라이버는 JDBC 4 하위 클래스(JdbcSQLIntegrityConstraintViolationException, JdbcSQLSyntaxErrorException)를 던지므로 기본 변환기가 첫 단계에서 바로 맞춥니다. 메시지 앞의 StatementCallback; SQL [...]은 템플릿이 translateException("StatementCallback", sql, ex)로 넘긴 작업 이름과 SQL을 buildMessage가 붙인 것입니다(AbstractFallbackSQLExceptionTranslator 140–142행). 이 경우 세 변환기가 같은 답을 내지만, 하위 클래스를 쓰지 않는 드라이버나 SQLState가 표준과 다른 벤더에서는 결과가 갈릴 수 있습니다.
헷갈리기 쉬운 곳
- "기본은 벤더 코드 변환기"라는 설명은 옛날 것입니다. 6.0 전의 이야기이고, 이 커밋에서는 위 코드대로
SQLExceptionSubclassTranslator가 기본입니다. 벤더 코드 변환을 다시 켜려면 클래스패스 루트에sql-error-codes.xml을 두거나setExceptionTranslator로 직접 끼웁니다. - 변환은
JdbcTemplate안에서만 일어납니다.@Repository가 붙은 빈이 다른 데이터 접근 API(JPA 등)에서 던진 예외를 같은 계층으로 바꾸는PersistenceExceptionTranslationPostProcessor는 다른 장치이고, 19편에서 다룹니다.
6. 위에 얹힌 것들 — NamedParameterJdbcTemplate과 JdbcClient
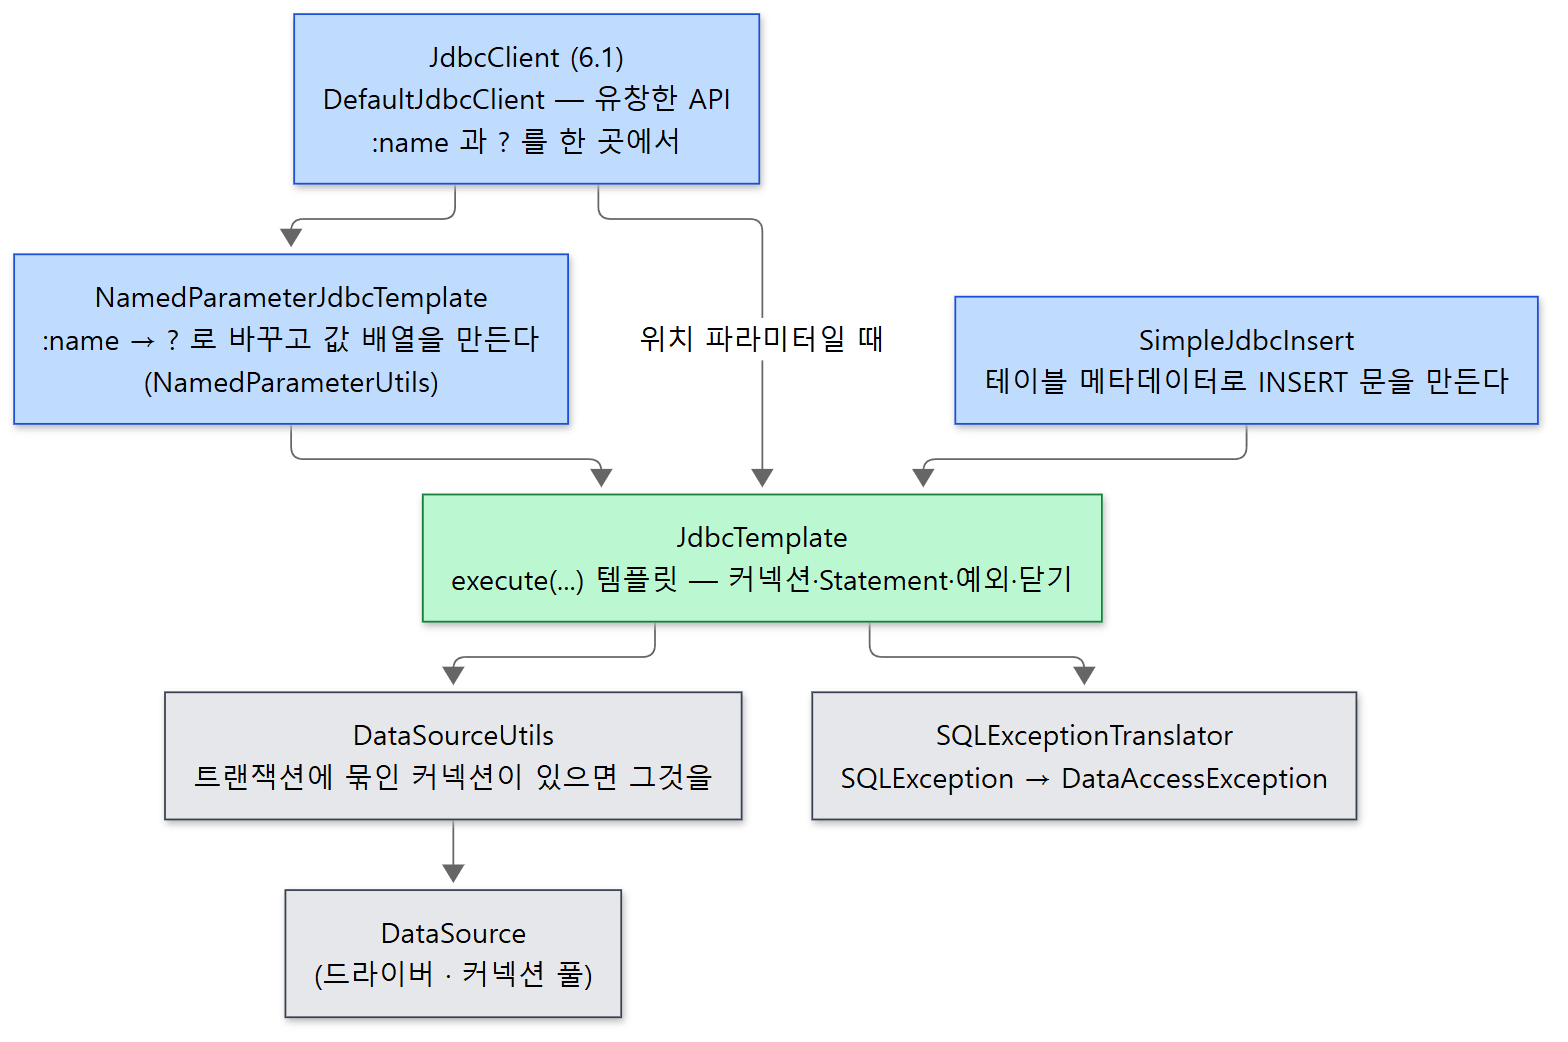 초록이 이 글의 템플릿입니다. 위의 셋은 SQL을 다듬어 템플릿에 넘길 뿐, 커넥션과 예외는 건드리지 않습니다.
**NamedParameterJdbcTemplate**은 ? 대신 :id 같은 이름을 쓰게 해 줍니다. JdbcTemplate을 상속하지 않고 감쌉니다. 필드 하나에 JdbcOperations를 들고(NamedParameterJdbcTemplate 81행, 88행), query·update·execute는 SQL을 PreparedStatementCreator로 바꿔 거기에 넘깁니다(batchUpdate(String, SqlParameterSource[])만은 ?로 바꾼 SQL 문자열과 BatchPreparedStatementSetter를 넘깁니다).
	protected PreparedStatementCreator getPreparedStatementCreator(String sql, SqlParameterSource paramSource,
			@Nullable Consumer<PreparedStatementCreatorFactory> customizer) {

		ParsedSql parsedSql = getParsedSql(sql);
		PreparedStatementCreatorFactory pscf = getPreparedStatementCreatorFactory(parsedSql, paramSource);
		if (customizer != null) {
			customizer.accept(pscf);
		}
		@Nullable Object[] params = NamedParameterUtils.buildValueArray(parsedSql, paramSource, null);
		return pscf.newPreparedStatementCreator(params);
	}
getParsedSql은 NamedParameterUtils.parseSqlStatement로 SQL을 한 글자씩 훑어 :이름의 위치를 찾고(따옴표와 주석 안은 건너뛰고, PostgreSQL의 :: 캐스트는 무시합니다, NamedParameterUtils 83행, 114–118행), 결과를 256개짜리 LRU 캐시에 둡니다(489–492행). substituteNamedParameters가 그 자리를 ?로 바꾸고, 값이 Iterable이면 원소 수만큼 ?, ?, ?로 펼칩니다(287–340행). in (:ids)에 리스트를 넣을 수 있는 이유입니다.
**JdbcClient**는 6.1에 들어온 인터페이스입니다(JdbcClient 69행, 78행). 구현 DefaultJdbcClient는 NamedParameterJdbcTemplate 하나를 들고(71–73행), DataSource로 만들면 JdbcTemplate → NamedParameterJdbcTemplate을 차례로 새로 만들어 감쌉니다(80–86행). 실행은 useNamedParams()로 갈라서 이름 파라미터면 namedParamOps에, 위치 파라미터면 classicOps(안의 JdbcTemplate)에 넘기는 것이 전부입니다(264–268행). .query(User.class)처럼 타입을 주면 단순 타입에는 SingleColumnRowMapper, 아니면 SimplePropertyRowMapper를 만들어 캐시합니다(229–235행).
예제: :name이 ?가 되는 것과 위임
Spring Framework 7.0.9로 실행했습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
// ① 파싱만 — :id 와 :name 이 ? 로 바뀐 SQL 을 돌려준다
String named = "select name from users where id = :id or name = :name";
System.out.println("parsed SQL : " + NamedParameterUtils.parseSqlStatementIntoString(named));

// ② NamedParameterJdbcTemplate — 안에 JdbcTemplate 을 감싼다
NamedParameterJdbcTemplate namedJdbc = new NamedParameterJdbcTemplate(jdbc);
System.out.println("wraps same JdbcTemplate : " + (namedJdbc.getJdbcOperations() == jdbc));
System.out.println("named query : " + namedJdbc.queryForList(named, Map.of("id", 1, "name", "lee"), String.class));

// ③ JdbcClient — 이름 있는 파라미터와 위치 파라미터를 한 API 로. 역시 위임한다
JdbcClient client = JdbcClient.create(jdbc);
System.out.println("JdbcClient named   : " + client.sql("select name from users where id = :id").param("id", 2).query(String.class).single());
System.out.println("JdbcClient indexed : " + client.sql("select name from users where id = ?").param(1).query(String.class).single());
parsed SQL : select name from users where id = ? or name = ?
wraps same JdbcTemplate : true
named query : [kim, lee]
JdbcClient named   : lee
JdbcClient indexed : kim
헷갈리기 쉬운 곳
NamedParameterJdbcTemplate은JdbcOperations가 아닙니다.NamedParameterJdbcOperations만 구현하므로(81행)?방식 메서드를 쓰려면getJdbcOperations()로 안의 것을 꺼냅니다.JdbcClient에 이름과 위치 파라미터를 섞으면 예외입니다.useNamedParams()가 둘 다 있으면IllegalStateException을 던집니다(289–293행).
더 깊이 들어가면
이 글은 큰 줄기를 위해 많은 것을 뺐습니다. 이름과 위치만 적어 둡니다. 열 이름을 속성에 자동으로 맞춰 주는 RowMapper 세 가지 — setter로 넣는 BeanPropertyRowMapper(속성 이름의 소문자형과 언더스코어형(userName → user_name) 둘 다 열 이름 후보로 등록해 두고 맞춥니다, 242–256행, 313–315행, 324–338행), 레코드처럼 생성자 인자 이름으로 넣는 DataClassRowMapper(DataClassRowMapper 90–135행), 생성자·setter·필드 순으로 아무거나 맞춰 주는 6.1의 SimplePropertyRowMapper(77행). 테이블 메타데이터를 읽어 INSERT 문을 만들어 주는 SimpleJdbcInsert(AbstractJdbcInsert 299–309행). 자동 생성 키를 받는 update(psc, KeyHolder)(991–1006행). 저장 프로시저를 부르는 call과 CallableStatementCallback(1151행부터). 커밋·롤백 중의 SQLException도 같은 계층으로 바꾸는 JdbcTransactionManager(5.3부터, JdbcTransactionManager 54행, 178–183행). 변환기 앞에 끼우는 setCustomTranslator(AbstractFallbackSQLExceptionTranslator 71–73행). 그리고 값을 ?에 넣을 때 타입을 고르는 StatementCreatorUtils(ArgumentPreparedStatementSetter 64–73행).
정리
| 개념 | 한 줄 요약 |
|---|---|
| 템플릿-콜백 | 커넥션 얻기·Statement·예외 변환·닫기는 execute(...)가, SQL과 결과 처리만 콜백이 |
StatementCallback / PreparedStatementCallback / ConnectionCallback |
템플릿이 내주는 것이 Statement인가 PreparedStatement인가 Connection인가 |
RowMapper |
행 하나 → 객체 하나. 커서는 템플릿이 돌린다. next()를 부르지 말 것 |
RowCallbackHandler |
행마다 불리고 반환 없음. 상태를 객체 안에 모은다 |
ResultSetExtractor |
ResultSet 전체를 받아 커서를 직접 돌린다. 모든 query가 결국 여기로 모인다 |
queryForObject |
리스트를 받아 nullableSingleResult. 0건은 EmptyResult…, 2건 이상은 IncorrectResultSize… |
DataSourceUtils.getConnection |
스레드에 묶인 ConnectionHolder가 있으면 그 커넥션, 없으면 dataSource.getConnection() |
releaseConnection |
묶인 커넥션이면 released()만, 아니면 close() |
DataAccessException |
spring-tx의 dao 패키지. 언체크. 데이터 접근 API와 무관한 분류 |
| 기본 변환기 | SQLExceptionSubclassTranslator → fallback SQLStateSQLExceptionTranslator → null이면 UncategorizedSQLException |
SQLErrorCodeSQLExceptionTranslator |
클래스패스 루트에 sql-error-codes.xml을 둘 때만 기본. 못 찾으면 위 사슬로 |
NamedParameterJdbcTemplate |
:name을 ?로 바꾸고 값 배열을 만들어 안의 JdbcTemplate에 위임 |
JdbcClient |
6.1의 유창한 API. NamedParameterJdbcTemplate/JdbcTemplate에 위임 |
다음에 볼 것
17편이 트랜잭션을 열고 닫는 쪽, 이 글이 그 커넥션으로 SQL을 보내는 쪽이었습니다. 다음 글은 JDBC 대신 JPA 같은 ORM을 쓸 때 Spring이 어디에 끼어드는지(EntityManager를 트랜잭션에 묶는 법, @Repository가 붙은 빈의 예외를 이 글의 DataAccessException 계층으로 바꾸는 PersistenceExceptionTranslationPostProcessor), 그리고 블로킹 JDBC가 아닌 R2DBC에서는 ThreadLocal에 커넥션을 묶을 수 없으니 어떻게 하는지를 봅니다.
- 다음 글: 19편: ORM과 R2DBC 연동 — JPA 통합과 리액티브 트랜잭션
- 앞 글: 17편: @Transactional — 트랜잭션은 누가 열고 누가 닫나
- 이 SQL이 데이터베이스 서버에 닿은 뒤: MariaDB 소스 파헤치기 5: 프로토콜과 명령 처리 — 패킷 하나가 dispatch_command에 닿기까지
- 시리즈의 지도: 1편: AI와 함께 소스를 읽는 방법과 분석 지도
- 모듈이 어떻게 나뉘는지: 2편: 전체 지도 — 모듈과 패키지는 어떻게 나뉘어 있나
sql-error-codes.xml을 읽는 그 컨테이너: 3편: BeanFactory 계층 구조와 BeanDefinition