이 글에서 다루는 것
"Spring 소스 파헤치기"는 Spring Framework의 소스 코드를 AI의 도움을 받아 조금씩 읽고 정리하는 시리즈입니다. 이 글은 그 첫 번째 글이고, 코드를 깊이 읽기 전에 준비를 합니다.
- Spring은 무엇이고, 어떻게 동작하고, 어디에 쓰는지 봅니다 (처음 보는 분을 위한 절). 가장 작은 예제와 그림 세 장, 3분 실습으로 보고, 이 연재가 풀어 갈 질문을 훑습니다.
- 사용법이 아니라 소스를 읽는 이유를 이야기합니다.
- 이 시리즈가 읽는 것과 똑같은 소스를 받는 방법을 적습니다.
- 그 큰 소스를 어떻게 나눠 읽는지, 그 과정에서 AI를 어디에 쓰는지 설명합니다.
- 앞으로 읽을 순서(분석 지도)와 지금까지 읽은 곳을 보여 줍니다.
Spring을 처음 듣는 분은 아래 "먼저 알아 둘 말"과 "Spring은 무엇인가" 절부터 차례로 읽으면 됩니다. 낱말 다섯 개를 잡은 뒤 예제와 그림, 실습으로 Spring이 하는 일을 먼저 눈으로 보고, 이 연재가 어떤 궁금증을 풀어 가는지 훑어본 다음 본론으로 들어갑니다. Java의 기본(클래스, 인터페이스, 상속, 어노테이션이라는 것이 있다는 정도)은 알지만 Spring은 써 본 적이 없는 분을 독자로 생각하고 씁니다. Spring 용어는 처음 나올 때마다 풀어서 설명합니다.
이 시리즈가 읽는 소스는 다음과 같습니다.
| 항목 | 내용 |
|---|---|
| 대상 | Spring Framework (spring-projects/spring-framework) |
| 버전 | 7.1.0-SNAPSHOT |
| 커밋 | f447f3c310 (2026-10-01) |
| 언어 | Java |
글에 나오는 줄 번호와 세부 내용은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고, 내용이 달라진 곳도 있을 수 있습니다.
연재는 모두 27편입니다.
- AI와 함께 소스를 읽는 방법과 분석 지도 (이 글)
- 전체 지도 — 모듈과 패키지는 어떻게 나뉘어 있나
- BeanFactory 계층 구조와 BeanDefinition
- Bean은 어떻게 만들어지나 — 생성 흐름과 3단계 캐시
- @Autowired는 넣을 빈을 어떻게 고르나 — 의존성 주입 해석
- 생명주기 콜백과 PostProcessor — 컨테이너에 끼어드는 자리
- refresh() 12단계 — 컨테이너가 켜지는 순서
- @Configuration과 @ComponentScan은 어떻게 설계도가 되나
- @Conditional, @Profile, @Import — 조건에 따라 빈을 고르는 법
- AOP 프록시는 어떻게 만들어지나 — JDK 방식과 CGLIB 방식
- @Aspect는 어떻게 발견되고 어드바이스 체인은 어떻게 돌아가나
- 이벤트, Environment, Resource — 컨테이너 주변의 세 추상화
- ResolvableType과 MergedAnnotations — 타입과 어노테이션을 읽는 법
- 타입 변환과 BeanWrapper — 문자열이 객체의 속성이 되기까지
- SpEL — 표현식은 어떻게 파싱되고 계산되나
- 유틸리티와 AOT — 모두가 쓰는 도구 상자와 미리 계산해 두기
- @Transactional — 트랜잭션은 누가 열고 누가 닫나
- JdbcTemplate — 템플릿-콜백 패턴과 예외 변환
- ORM과 R2DBC 연동 — JPA 통합과 리액티브 트랜잭션
- spring-web 기반 — HttpMessageConverter, WebApplicationContext, 필터
- DispatcherServlet — 요청 하나가 응답이 되기까지
- 핸들러 매핑과 어댑터 — @RequestMapping은 어떻게 찾고 어떻게 부르나
- 예외 처리, 인터셉터, 뷰 — 요청 처리의 앞뒤와 끝
- WebFlux — DispatcherHandler, 함수형 엔드포인트, WebClient
- WebSocket과 메시징 — STOMP 메시지는 어떻게 흐르나
- spring-test — SpringExtension, TestContext, MockMvc
- 캐시, 스케줄링, 검증, 리질리언스 — 컨테이너 위에 얹힌 기능들
먼저 알아 둘 말 다섯 가지
Spring 자료에는 같은 낱말이 계속 나옵니다. 이 다섯 가지만 먼저 잡아 두면 나머지가 훨씬 쉽게 읽힙니다.
Spring Framework는 Java로 프로그램을 만들 때 쓰는 프레임워크입니다. 프레임워크는 프로그램의 뼈대를 미리 만들어 둔 것으로, 우리는 그 뼈대에 끼울 코드만 씁니다. 흔히 그냥 "Spring"이라고 부릅니다.
의존성(dependency)은 어떤 객체가 일을 하려면 필요한 다른 객체입니다. 자동차(Car)가 달리려면 엔진(Engine)이 있어야 한다면, Engine이 Car의 의존성입니다.
빈(Bean)은 Spring이 만들어서 관리하는 객체입니다. 특별한 종류의 객체가 아니라 평범한 Java 객체이고, 내 코드가 직접 만들어 들고 있는 것이 아니라 Spring이 만들어 보관하고 있다는 점만 다릅니다.
컨테이너(Container)는 빈을 만들고, 서로 이어 주고, 보관하는 주체입니다. Spring의 중심이 바로 이 컨테이너입니다. 소스에서는 BeanFactory와 ApplicationContext라는 이름으로 나옵니다.
DI와 IoC. DI(Dependency Injection, 의존성 주입)는 필요한 객체를 스스로 만들지 않고 밖에서 넣어 받는 것입니다. IoC(Inversion of Control, 제어의 역전)는 객체를 만들고 이어 주는 주도권이 내 코드에서 컨테이너로 넘어갔다는 뜻입니다. 둘은 같은 이야기의 두 면이라서, "컨테이너가 주도권을 쥐고(IoC) 의존성을 넣어 준다(DI)"로 기억하면 됩니다. 그래서 Spring의 컨테이너를 IoC 컨테이너라고도 부릅니다.
말로만 보면 잘 잡히지 않으니, 다음 절에서 비유와 그림, 예제로 봅니다.
Spring은 무엇인가 — 어떻게 동작하고, 어디에 쓰나
소스를 열기 전에, Spring이 하는 일부터 예제와 그림, 짧은 실습으로 봅니다. 이미 Spring으로 프로그램을 만들어 봤다면 이 절 끝의 "이 연재가 풀어 갈 질문"만 보고 넘어가도 됩니다.
한 문장으로 — 부품을 받아 조립해 주는 공장
Spring의 중심은 객체를 대신 만들고 서로 끼워 맞춰 주는 조립 공장입니다. 우리는 부품(클래스)과 조립 설명서(설정)만 건넵니다. 설명서에 "자동차에는 엔진이 들어간다"라고 적어 두면, 공장이 엔진을 만들고, 그 엔진을 끼워 자동차를 완성하고, 창고에 넣어 두었다가 달라고 할 때 내줍니다. 자동차는 자기 엔진을 누가 만들었는지 모릅니다.
이 공장이 바로 위에서 말한 컨테이너이고, 공장이 만든 완성품 하나하나가 빈입니다. 웹 요청 처리, 트랜잭션, 테스트 지원 같은 Spring의 다른 기능은 모두 이 공장 위에 얹혀 있습니다. 이 연재 전체가 결국 "이 공장이 설명서를 어떻게 읽고, 부품을 어떤 순서로 만들어 끼우고, 그 위에 기능을 어떻게 얹는가"를 소스로 따라가는 이야기입니다.
왜 이런 것이 필요한가
자동차와 엔진을 Java로만 쓰면 이렇습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
class Engine {
}

class Car {
    private final Engine engine = new Engine();   // Car가 Engine을 직접 만든다
}
동작에는 문제가 없습니다. 다만 Car가 어떤 Engine을 쓸지를 스스로 정해 버렸습니다. 다른 엔진으로 바꾸려면 Car의 코드를 고쳐야 합니다. 그리고 객체가 두 개가 아니라 수백 개가 되면, 누가 누구를 필요로 하고 어떤 순서로 만들어야 하는지를 전부 내 코드가 챙겨야 합니다.
객체가 많아지면 구체적으로 이런 일이 생깁니다.
- 바꾸기 어렵습니다. 엔진을 전기 엔진으로 바꾸려면
Car를 열어 고쳐야 합니다.new Engine()을 직접 부르는 클래스가 열 개면 열 곳을 고쳐야 합니다. - 떼어 내서 시험하기 어렵습니다.
Car만 따로 시험하고 싶어도Car가 진짜Engine을 스스로 만들어 버리니, 시험용 가짜 엔진을 끼울 틈이 없습니다. - 만드는 순서를 사람이 챙겨야 합니다. A를 만들려면 B가, B를 만들려면 C가 있어야 한다면
main에 C → B → A 순서로new를 늘어놓아야 합니다. 한 객체를 여러 곳에서 같이 쓰려면 그것을 들고 다니며 건네는 코드도 필요합니다.
컨테이너를 가운데 두면 각 클래스는 "나는 무엇이 필요하다"를 생성자로 밝히기만 하고, 무엇을 끼울지는 설정 한 곳에 적습니다. 만드는 순서는 컨테이너가 필요 관계를 보고 정하고, 만든 객체는 컨테이너가 들고 있다가 필요한 곳에 넣어 줍니다. 엔진을 바꿀 때는 설정만 고칩니다. 아래 "3분 실습"의 4단계에서 실제로 해 봅니다.
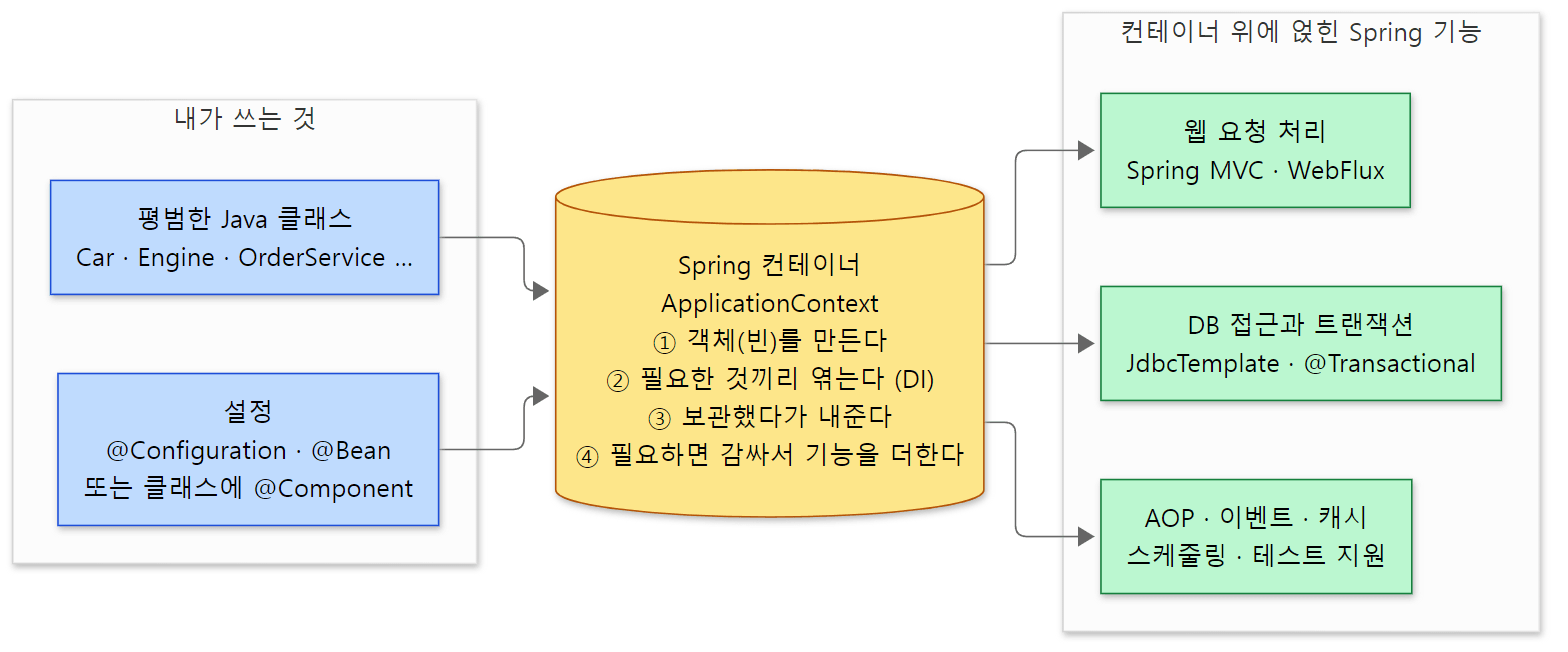 Spring을 가운데 둔 모습. 파란 칸이 우리가 쓰는 것, 노란 칸이 컨테이너, 초록 칸이 컨테이너 위에 얹힌 기능입니다. ④의 "감싸서 기능을 더한다"는 진짜 객체 대신 대리 객체(프록시)를 넣어 주는 일로, 10편에서 봅니다.
Spring에게 맡기면 — 가장 작은 예제
같은 것을 Spring에게 맡기면 이렇게 됩니다. 파일 하나(example/Main.java)에 다 넣은 가장 작은 모양입니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
package example;

import org.springframework.context.annotation.AnnotationConfigApplicationContext;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

class Engine {
}

class Car {
    private final Engine engine;

    Car(Engine engine) {          // 필요한 Engine을 밖에서 받는다
        this.engine = engine;
    }
}

@Configuration
class AppConfig {

    @Bean
    Engine engine() {
        return new Engine();
    }

    @Bean
    Car car(Engine engine) {      // 컨테이너가 Engine 빈을 찾아서 넣어 준다
        return new Car(engine);
    }
}

public class Main {
    public static void main(String[] args) {
        var context = new AnnotationConfigApplicationContext(AppConfig.class);
        Car car = context.getBean(Car.class);
        System.out.println(car == context.getBean(Car.class));   // true
        context.close();
    }
}
새로 나온 것은 네 가지입니다.
| 코드 | 뜻 |
|---|---|
@Configuration |
이 클래스는 "무엇을 빈으로 만들지"를 적어 둔 설정이라는 표시 |
@Bean |
이 메서드가 돌려주는 객체를 빈으로 삼으라는 표시 |
AnnotationConfigApplicationContext |
컨테이너. 어노테이션으로 쓴 설정을 읽는 종류다 |
getBean(Car.class) |
컨테이너에게 Car 타입의 빈을 달라고 한다 |
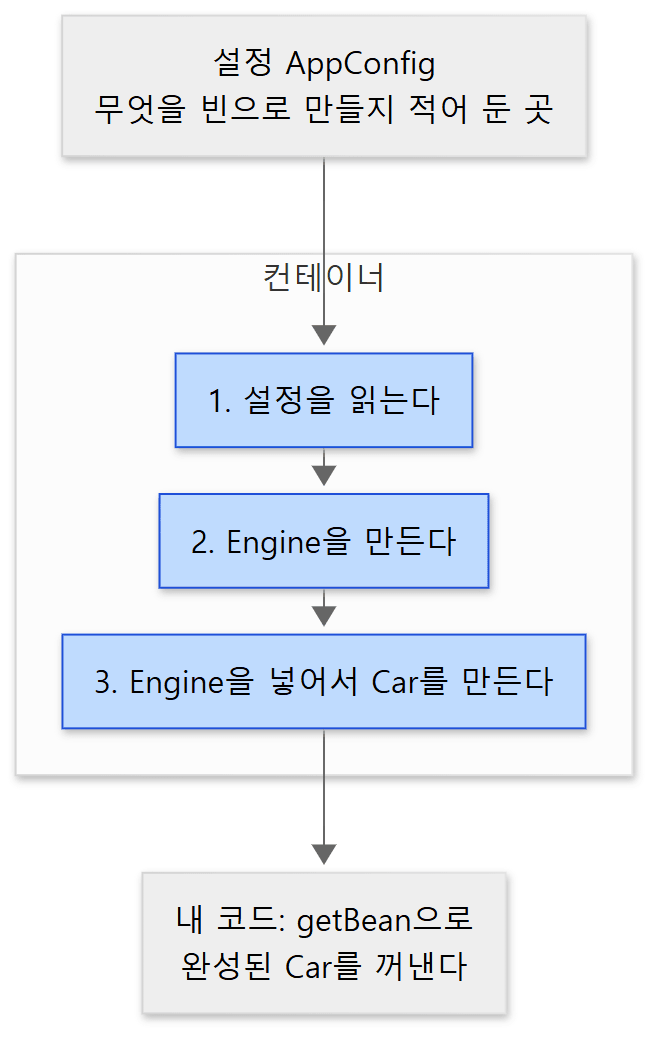 컨테이너가 하는 일. 파란 칸이 컨테이너가 알아서 하는 절차이고, 내 코드는 설정을 적어 두고 마지막에 꺼내 쓰기만 합니다.
이 예제에서 눈여겨볼 곳은 세 군데입니다.
engine()과car()를 부르는 코드가Main에 없습니다. 두 메서드는 컨테이너가 부릅니다. 객체를 언제 어떤 순서로 만들지를 내 코드가 아니라 컨테이너가 정합니다. 이것이 IoC입니다.car(Engine engine)의 인자를 내가 넘긴 적이 없습니다. 컨테이너가Engine타입의 빈을 찾아서 넣어 줍니다. 이것이 DI입니다.Car는 엔진이 어디서 왔는지 모르고 받아 쓰기만 합니다.getBean(Car.class)를 두 번 불러도 같은 객체가 나옵니다. 컨테이너는 따로 말하지 않으면 빈을 하나만 만들어 두고 같은 것을 돌려줍니다. 이런 빈을 싱글톤(singleton)이라고 하고, 4편에서 자세히 다룹니다.
이 예제는 릴리스 버전인 Spring Framework 7.0.9로 컴파일하고 실행해서 true가 출력되는 것을 확인했습니다(이 시리즈가 읽는 7.1.0-SNAPSHOT을 직접 빌드해서 돌린 것은 아닙니다). @Bean 메서드를 쓰는 대신 클래스에 @Component를 붙여서 컨테이너가 찾아내게 하는 방식도 많이 쓰는데, 컨테이너가 하는 일은 같습니다.
3분 실습 — 컨테이너가 언제 무엇을 하는지 찍어 보기
위 예제는 true 한 줄만 찍어서, 컨테이너가 언제 무엇을 했는지는 보이지 않습니다. 그래서 생성자마다 한 줄씩 찍게 하고 몇 가지를 더해 돌려 봅니다. 위 예제와 달라진 곳은 셋입니다.
Engine을 인터페이스로 바꾸고 구현을 둘(GasEngine,ElectricEngine) 둡니다. 생성자가 불리면 한 줄씩 찍습니다.Car의 생성자도 자기가 받은 엔진의 종류를 찍습니다.Car의 코드에는 어느 엔진이 올지 적혀 있지 않습니다.- 설정 클래스를 둘 둡니다.
GasConfig와ElectricConfig는engine()이 돌려주는 객체만 다르고,ElectricConfig에는 일부러car()를engine()보다 먼저 적었습니다.
main은 네 단계를 차례로 밟습니다.
- 컨테이너를 켭니다.
- 켜진 직후 컨테이너가 들고 있는 빈 이름을 모두 찍습니다.
getBean으로Car를 꺼내 쓰고, 한 번 더 꺼내 같은 객체인지 봅니다.- 설정만
ElectricConfig로 바꿔 새 컨테이너를 켭니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다). package와 import 세 줄은 위 예제와 같아서 뺐고, 줄인 곳은 // ... 로 표시했습니다
interface Engine {
    String sound();
}

class GasEngine implements Engine {
    GasEngine() {
        System.out.println("   [컨테이너가 부름] GasEngine 생성자");
    }

    public String sound() {
        return "부릉부릉";
    }
}

// ... ElectricEngine도 같은 꼴입니다 (생성자에서 한 줄 찍고, sound()는 "위잉"을 돌려줍니다)

class Car {
    private final Engine engine;

    Car(Engine engine) {          // 어떤 Engine 이 올지 Car 는 모른다
        System.out.println("   [컨테이너가 부름] Car 생성자 — 받은 엔진: " + engine.getClass().getSimpleName());
        this.engine = engine;
    }

    String drive() {
        return engine.sound();
    }
}

@Configuration
class GasConfig {
    @Bean
    Engine engine() {
        return new GasEngine();
    }

    @Bean
    Car car(Engine engine) {
        return new Car(engine);
    }
}

@Configuration
class ElectricConfig {             // 일부러 car() 를 engine() 보다 먼저 적었다
    @Bean
    Car car(Engine engine) {
        return new Car(engine);
    }

    @Bean
    Engine engine() {
        return new ElectricEngine();   // GasConfig 와 다른 곳은 이 한 줄뿐. Car 는 그대로다
    }
}

public class FirstLook {
    public static void main(String[] args) {
        System.out.println("1. 컨테이너를 켠다: new AnnotationConfigApplicationContext(GasConfig.class)");
        var context = new AnnotationConfigApplicationContext(GasConfig.class);

        System.out.println("2. 켜진 직후 컨테이너가 들고 있는 빈 이름");
        for (String name : context.getBeanDefinitionNames()) {
            System.out.println("   " + name);
        }

        System.out.println("3. getBean 으로 꺼내 쓴다");
        Car car = context.getBean(Car.class);
        System.out.println("   car.drive() → " + car.drive());
        System.out.println("   한 번 더 꺼내면 같은 객체인가? " + (car == context.getBean(Car.class)));
        context.close();

        System.out.println("4. 설정만 ElectricConfig 로 바꿔 새 컨테이너를 켠다 (Car 코드는 그대로)");
        try (var electric = new AnnotationConfigApplicationContext(ElectricConfig.class)) {
            System.out.print("   내가 만든 빈 이름(등록 순서):");
            for (String name : electric.getBeanDefinitionNames()) {
                if (!name.startsWith("org.springframework")) {
                    System.out.print(" " + name);
                }
            }
            System.out.println();
            System.out.println("   car.drive() → " + electric.getBean(Car.class).drive());
        }
    }
}
예제 프로젝트에서 이렇게 돌렸습니다(Gradle의 application 플러그인으로 main을 실행하는 명령입니다).
./gradlew run -q -PmainClass=ex.u01.FirstLook
출력입니다. 여러 번 돌려도 같은 출력이 나왔습니다.
1. 컨테이너를 켠다: new AnnotationConfigApplicationContext(GasConfig.class)
   [컨테이너가 부름] GasEngine 생성자
   [컨테이너가 부름] Car 생성자 — 받은 엔진: GasEngine
2. 켜진 직후 컨테이너가 들고 있는 빈 이름
   org.springframework.context.annotation.internalConfigurationAnnotationProcessor
   org.springframework.context.annotation.internalAutowiredAnnotationProcessor
   org.springframework.context.annotation.internalCommonAnnotationProcessor
   org.springframework.context.annotation.internalPersistenceAnnotationProcessor
   org.springframework.context.event.internalEventListenerProcessor
   org.springframework.context.event.internalEventListenerFactory
   gasConfig
   engine
   car
3. getBean 으로 꺼내 쓴다
   car.drive() → 부릉부릉
   한 번 더 꺼내면 같은 객체인가? true
4. 설정만 ElectricConfig 로 바꿔 새 컨테이너를 켠다 (Car 코드는 그대로)
   [컨테이너가 부름] ElectricEngine 생성자
   [컨테이너가 부름] Car 생성자 — 받은 엔진: ElectricEngine
   내가 만든 빈 이름(등록 순서): electricConfig car engine
   car.drive() → 위잉
위의 가장 작은 예제와 마찬가지로 릴리스 버전인 Spring Framework 7.0.9(Java 21)로 돌린 결과입니다. 이 시리즈가 읽는 7.1.0-SNAPSHOT으로 돌린 것은 아니고, 아래에 단 소스 링크는 모두 기준 커밋 f447f3c310의 줄입니다.
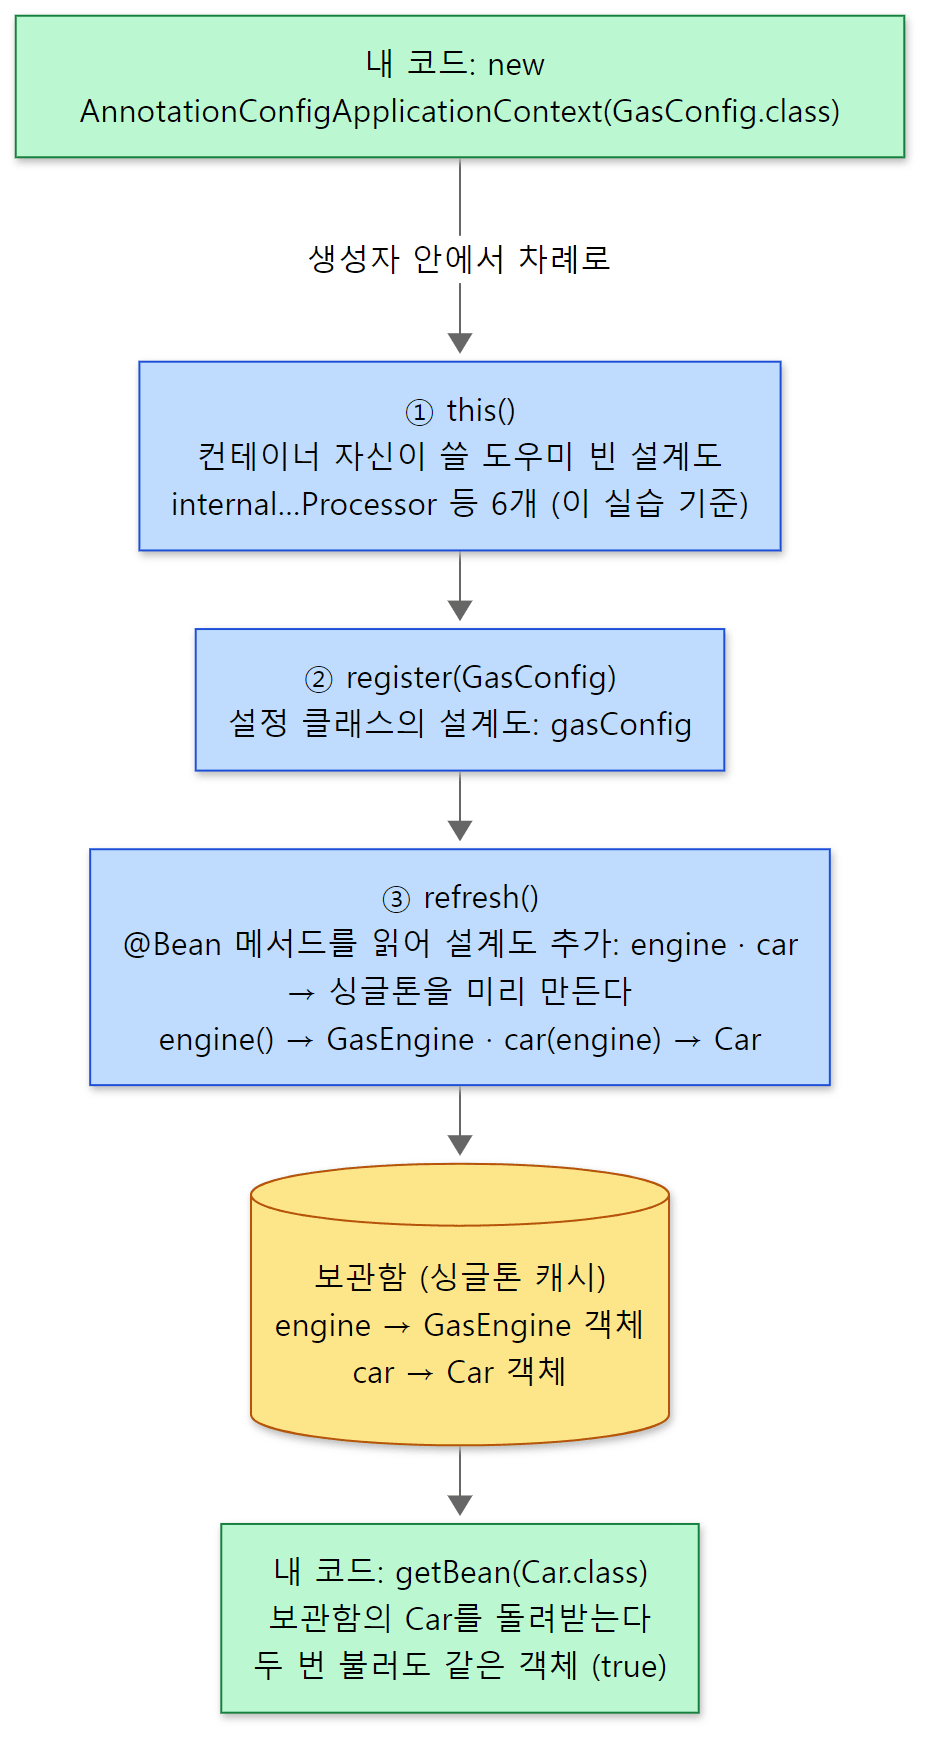 실습 1~3단계를 그린 것. 파란 칸이
new AnnotationConfigApplicationContext(...) 한 줄 안에서 차례로 일어나는 일입니다. 설계도(BeanDefinition, 빈을 어떻게 만들지 적어 둔 정보)를 먼저 모은 뒤에 객체를 만듭니다. 노란 칸이 만든 빈을 넣어 두는 보관함, 초록 칸이 내 코드입니다.
출력에서 볼 것은 다섯 가지입니다.
- 객체는
getBean보다 먼저, 컨테이너를 켜는 줄에서 만들어집니다. "1." 바로 다음 줄에GasEngine과Car의 생성자가 찍혔고, 3단계에서getBean을 부를 때는 아무것도 새로 만들어지지 않았습니다.refresh()는 끝 무렵의finishBeanFactoryInitialization에서(AbstractApplicationContext.java 622행) 지연 생성(lazy)으로 표시되지 않은 싱글톤을 모두 미리 만듭니다(같은 파일 995행, DefaultListableBeanFactory.java 1117–1125행). 그래서 빈을 만들다 실패할 설정이라면getBean까지 가지 않고 컨테이너를 켜는 줄에서 실패합니다.refresh()의 열두 단계는 7편에서 봅니다. - 만드는 순서는 컨테이너가 정합니다. 4단계의
ElectricConfig에서는car가engine보다 먼저 등록됐지만(출력의 "등록 순서"), 생성자는ElectricEngine이 먼저 찍혔습니다. 컨테이너가car를 만들려다 인자로Engine이 필요하다는 것을 보고engine부터 만든 것입니다. 우리 코드는 순서를 적은 적이 없습니다. 인자에 넣을 빈을 찾는 과정은 5편, 빈 하나를 만드는 흐름은 4편에서 봅니다. - 빈 이름은 저절로 붙고, 컨테이너가 스스로 넣은 빈도 있습니다. 설정 클래스
GasConfig는 첫 글자를 소문자로 바꾼gasConfig가 되고(AnnotationBeanNameGenerator.java 244–249행),@Bean메서드는 따로 이름을 주지 않으면 메서드 이름인engine,car가 됩니다(ConfigurationClassBeanDefinitionReader.java 317–319행). 그 위의org.springframework…internal…여섯 개는 우리가 등록하지 않은 도우미입니다. 생성자의this()가 만드는AnnotatedBeanDefinitionReader가 이것들을 등록합니다(AnnotationConfigApplicationContext.java 68–71행, AnnotatedBeanDefinitionReader.java 90행, AnnotationConfigUtils.java 156–204행). 맨 위의internalConfigurationAnnotationProcessor가@Bean메서드를 읽어engine,car의 설계도를 더하는 주인공이고(ConfigurationClassPostProcessor.java 464행, 8편),internalAutowiredAnnotationProcessor는@Autowired를 처리합니다(5편). 이런 도우미가 컨테이너에 끼어드는 자리는 6편에서 봅니다. - 도우미의 개수는 환경에 따라 다릅니다.
internalCommonAnnotationProcessor는jakarta.annotation.PostConstruct가,internalPersistenceAnnotationProcessor는 JPA가 클래스패스(프로그램이 쓸 수 있게 올라와 있는 라이브러리 목록)에 있을 때만 등록됩니다(AnnotationConfigUtils.java 119–124행, 171행, 178행). 이 예제 프로젝트에는 다른 편의 예제 때문에 둘 다 들어 있어서 여섯 개가 나왔습니다. 소스대로라면 둘 다 없는 프로젝트에서는 네 개입니다(그렇게 돌려 보지는 않았습니다). - 다시 꺼내면 같은 객체이고, 엔진을 바꿔도
Car는 그대로입니다. 만든 싱글톤은 이름 → 객체 맵인 보관함에 들어가고(DefaultSingletonBeanRegistry.java 85–86행),getBean은 먼저 이 보관함을 봅니다(AbstractBeanFactory.java 257행). 범위(scope)를 따로 정하지 않은 빈은 싱글톤으로 취급됩니다(AbstractBeanDefinition.java 532–534행). 그리고 4단계에서 설정만 바꿨더니Car가ElectricEngine을 받았습니다. "왜 이런 것이 필요한가"에서 말한 "설정만 고친다"가 이것입니다.
그 한 줄 뒤에 있는 코드
위 예제에서 일은 전부 new AnnotationConfigApplicationContext(AppConfig.class) 한 줄에서 일어났습니다. 그 생성자를 Spring 소스에서 찾아보면 이렇습니다.
	public AnnotationConfigApplicationContext(Class<?>... componentClasses) {
		this();
		register(componentClasses);
		refresh();
	}
세 줄뿐입니다. register는 넘겨받은 클래스(AppConfig)를 컨테이너에 등록하고, refresh는 컨테이너를 실제로 켭니다. 설정을 해석하고 빈을 만드는 일이 전부 이 refresh() 한 줄 안에서 일어납니다. refresh()의 본문은 AbstractApplicationContext.java 582행에 있고, 그 안에서 열두 단계를 차례로 밟습니다.
이 시리즈가 하려는 일이 이것입니다. 한 줄짜리 호출 뒤에서 실제로 무슨 코드가 도는지를 따라가 보는 것입니다. 컨테이너가 켜지는 과정의 큰 그림은 2편에 있습니다.
어디에 쓰나
Spring Framework는 컨테이너 위에 여러 모듈을 얹어, Java로 서버 프로그램을 만들 때 필요한 일을 넓게 덮습니다. 이 연재가 읽는 모듈로 정리하면 이렇습니다.
| 쓰임 | 하는 일 | 이 연재에서 |
|---|---|---|
| 웹 애플리케이션과 REST API | HTTP 요청을 받아 알맞은 메서드(@RequestMapping)를 부르고, 돌려준 값을 JSON이나 화면으로 바꿔 응답한다 |
spring-web, spring-webmvc (20~23편) |
| 리액티브 웹 | 기다리는 동안 스레드를 붙잡아 두지 않는 방식으로 요청을 처리하고, 다른 서버를 부른다 | spring-webflux (24편) |
| DB 다루기 | SQL을 실행할 때마다 되풀이되는 코드(연결 열고 닫기, 예외 바꾸기)를 대신 해 주고, JPA 같은 ORM을 컨테이너에 붙인다 | spring-jdbc, spring-orm, spring-r2dbc (18, 19편) |
| 트랜잭션 | 메서드에 @Transactional을 붙이면 시작·커밋·롤백을 대신 한다 |
spring-tx (17편) |
| 실시간 메시지 | 브라우저와 연결을 열어 두고 메시지를 주고받는다(WebSocket, STOMP) | spring-websocket, spring-messaging (25편) |
| 공통 기능 끼워 넣기 | 로그, 캐시, 트랜잭션처럼 여러 메서드에 똑같이 들어가는 일을 한 곳에 모아 끼운다. 정해진 시각에 메서드를 돌리기도 한다 | spring-aop (10, 11편), 캐시·스케줄링 (27편) |
| 테스트 | 테스트에 컨테이너를 띄워 빈을 넣어 주고, 서버를 띄우지 않고도 웹 요청을 흉내 낸다 | spring-test (26편) |
흔히 듣는 Spring Boot는 이 Framework 위에 얹힌 별도 프로젝트로, 설정과 서버 띄우기를 자동으로 해 줍니다. Boot로 만든 프로그램도 안에서는 이 연재가 읽는 컨테이너가 돕니다(둘의 관계는 아래 "헷갈리기 쉬운 곳").
반대로 맞지 않는 곳도 있습니다. 객체가 몇 개뿐인 작은 명령줄 도구나 스크립트라면 new로 직접 엮는 편이 단순합니다. 컨테이너는 켜질 때 설정을 해석하고 객체를 미리 만드는 준비를 하므로, 아주 짧게 돌고 끝나는 프로그램에서는 그 준비가 일의 큰 몫이 될 수 있습니다(Spring은 이 준비의 일부를 빌드할 때 미리 해 두는 AOT를 갖추고 있습니다 — 16편). 또 Spring Framework는 Java 가상 머신(JVM) 위의 언어(Java, Kotlin 등)를 위한 것이라 다른 언어의 프로그램에는 쓰지 않습니다.
이 연재가 풀어 갈 질문
실습을 돌려 보면 궁금한 것이 생깁니다. 이 연재는 그 궁금증을 소스로 하나씩 풉니다. 끌리는 질문이 있으면 그 편부터 읽어도 됩니다.
| 궁금한 것 | 답이 있는 곳 |
|---|---|
| 22개나 되는 모듈은 서로 어떻게 기대고 있을까? 컨테이너가 켜지는 큰 흐름은? | 2편: 전체 지도 |
실습에서 본 "설계도"(BeanDefinition)는 어떻게 생겼고, BeanFactory와 ApplicationContext는 무엇이 다를까? |
3편: BeanFactory 계층 구조와 BeanDefinition |
getBean() 한 번에 무슨 일이 일어날까? A가 B를, B가 A를 필요로 하면 어떻게 만들까? |
4편: Bean은 어떻게 만들어지나 |
Engine 빈이 둘이면 car(Engine engine)에는 무엇이 들어갈까? |
5편: 의존성 주입 해석 |
실습 2단계의 internal…Processor들은 언제, 어떤 순서로 끼어들까? |
6편: 생명주기 콜백과 PostProcessor |
refresh() 한 줄 안의 열두 단계는 무엇일까? |
7편: refresh() 12단계 |
@Configuration과 @Bean은 어떻게 설계도가 될까? @Bean 메서드를 직접 두 번 부르면 엔진이 둘 생길까? |
8편: 어노테이션 설정 처리 |
실습의 GasConfig·ElectricConfig처럼 상황에 따라 다른 빈을 고르려면? |
9편: @Conditional, @Profile, @Import |
| 그림의 ④ "감싸서 기능을 더한다"는 어떻게 할까? 같은 클래스 안에서 부르면 왜 안 걸릴까? | 10편: AOP 프록시, 11편: 어드바이스 체인 |
| 이벤트, 설정값, 파일 읽기는 컨테이너와 어떻게 이어질까? | 12편: 이벤트, Environment, Resource |
| 컨테이너는 제네릭 타입과 어노테이션을 어떻게 읽고, 문자열 설정값을 어떻게 객체로 바꿀까? | 13편, 14편, 15편: SpEL, 16편: 유틸리티와 AOT |
@Transactional 하나로 트랜잭션은 누가 열고 닫을까? SQL 실행은 무엇을 대신해 줄까? |
17편: @Transactional, 18편: JdbcTemplate, 19편: ORM과 R2DBC |
| HTTP 요청 하나는 어떤 길을 지나 내 메서드에 닿고 응답이 될까? | 20편, 21편: DispatcherServlet, 22편, 23편 |
| 리액티브 웹과 WebSocket 메시지는 안에서 어떻게 흐를까? | 24편: WebFlux, 25편: WebSocket과 메시징 |
테스트마다 컨테이너를 새로 띄울까? @Cacheable, @Scheduled는 어떻게 돌까? |
26편: spring-test, 27편: 캐시, 스케줄링, 검증, 리질리언스 |
이 글의 나머지는 이 질문들을 소스로 따라가기 위한 준비입니다. 왜 소스까지 읽는지, 같은 소스를 받는 법, 큰 소스를 나눠 읽는 방법과 AI를 쓰는 자리, 그리고 읽는 순서(분석 지도)를 봅니다. 소스를 직접 내려받을 생각이 없다면 "같은 소스 받기" 절은 건너뛰어도 됩니다. 글의 코드 링크는 모두 GitHub의 같은 커밋으로 열립니다.
왜 소스까지 읽나
Spring은 눈에 보이지 않는 곳에서 많은 일을 합니다. 위 예제만 해도 어노테이션 두 개와 생성자 한 줄이 전부인데, 그 뒤에서 객체가 만들어지고 이어집니다. 사용법만 알아도 프로그램은 만들 수 있습니다. 소스를 읽으면 그 위에 세 가지가 더해집니다.
- 오류 메시지가 읽힙니다. 빈을 만들다가 문제가 생기면 화면에 찍히는 호출 기록(스택 트레이스)은 대부분
AbstractAutowireCapableBeanFactory,DefaultSingletonBeanRegistry같은 Spring 내부 클래스 이름으로 채워집니다. 이 이름들이 무엇을 하는 곳인지 알면 어디서 무엇이 잘못됐는지 짐작할 수 있습니다. - "왜 이렇게 써야 하는지"를 알게 됩니다. 문서는 무엇을 하면 되는지를 알려 주고, 소스는 왜 그렇게 되어 있는지를 알려 줍니다. 원본 노트가 답하려는 질문도 "내부적으로 왜 이렇게 구현했고, 어디가 함정이며, 확장하려면 어디를 건드리는가"입니다.
- 오래 다듬은 설계를 구경할 수 있습니다. 컨테이너의 가장 기본이 되는 인터페이스
BeanFactory의 소스에는@since 13 April 2001이라고 적혀 있습니다. 20년 넘게 고쳐 온 코드입니다.
소스는 누구나 볼 수 있습니다. Spring Framework는 Apache License 2.0으로 공개되어 있고 GitHub에 전부 올라와 있습니다.
문제는 크기입니다. 이 커밋에서 직접 세어 보면, 테스트를 뺀 본 코드(src/main/java)만 모듈 22개, Java 파일 5,223개, 약 84만 줄(빈 줄과 주석 포함)입니다. 첫 파일부터 차례로 읽어서는 끝나지 않습니다. 그래서 읽는 방법부터 정해야 합니다.
한 가지 미리 말해 둡니다. 이 시리즈는 Spring 사용법 강좌가 아닙니다. 사용법을 배우려면 공식 문서의 Overview와 가이드 모음을 함께 보는 것이 좋습니다.
같은 소스 받기
이 절은 글에 나오는 줄 번호를 내 컴퓨터에서 직접 열어 보고 싶은 분을 위한 것입니다. 읽기만 할 거라면 글의 GitHub 링크로 충분하니 "어떻게 읽나" 절로 넘어가도 됩니다.
글에 나오는 줄 번호를 직접 열어 보려면 같은 커밋의 소스가 있어야 합니다. Git이 설치되어 있다면 명령 세 줄이면 됩니다.
- 저장소를 내려받습니다. 이력이 긴 저장소라 시간이 조금 걸립니다.
- 받은 폴더로 들어갑니다.
- 이 시리즈가 기준으로 삼는 커밋으로 맞춥니다.
git clone https://github.com/spring-projects/spring-framework.git
cd spring-framework
git checkout f447f3c310009f5dc083306d25d12f13a1380dc4
세 번째 명령을 실행하면 "detached HEAD" 상태라는 안내가 나옵니다. 브랜치가 아니라 특정 커밋을 직접 꺼냈다는 뜻이고, 읽기만 할 때는 문제가 없습니다. 제대로 맞춰졌는지는 다음 명령으로 확인합니다. 위의 긴 커밋 번호가 그대로 출력되면 됩니다.
git rev-parse HEAD
버전은 저장소 맨 위 폴더의 gradle.properties 첫 줄에 적혀 있습니다.
version=7.1.0-SNAPSHOT
SNAPSHOT은 아직 정식으로 내놓지 않은, 개발 중인 버전이라는 표시입니다. 즉 이 시리즈는 7.1이 만들어지고 있는 도중의 코드를 읽습니다.
내려받지 않고 웹에서만 봐도 됩니다. GitHub에서 이 커밋의 폴더를 여는 주소로 들어가면 같은 파일이 보이고, 이 시리즈의 코드 링크도 전부 이 커밋을 가리킵니다.
폴더는 이렇게 생겼습니다
맨 위 폴더에서 spring-으로 시작하는 폴더 22개가 각각 하나의 모듈입니다. 모듈은 관련된 코드를 묶어 따로 배포하는 단위입니다. 어떤 모듈이 있는지는 settings.gradle 5–26행에 나열되어 있습니다.
| 위치 | 들어 있는 것 |
|---|---|
spring-beans, spring-context, spring-core 등 22개 |
모듈. 이 시리즈가 읽는 대상 |
<모듈>/src/main/java |
그 모듈의 본 코드 |
<모듈>/src/test/java |
그 모듈의 테스트 (거의 모든 모듈에 있다) |
framework-docs |
공식 참고 문서의 원본 |
gradle.properties, settings.gradle, build.gradle |
빌드 설정 |
읽기만 한다면 빌드하지 않고 폴더를 편집기로 열어도 됩니다. 디버거로 한 줄씩 따라가 보려면 프로젝트를 빌드해야 하는데, 그 방법은 저장소 README가 안내하는 Build from Source 문서와 맨 위 폴더의 import-into-intellij-idea.md를 따르면 됩니다.
어떻게 읽나 — 지도 먼저, 그다음 작은 단위
이 시리즈의 바탕은 따로 써 둔 공부 노트입니다. 그 노트를 쓰는 방법이 곧 이 시리즈의 읽는 방법이라, 노트에 적혀 있는 규칙을 그대로 소개합니다.
원칙은 한 문장입니다. 전체를 한 번에 읽지 않고, 지도에서 작은 단위를 하나 골라 그것만 깊게 읽는다.
단위(Unit)가 무엇인가요
단위는 "질문 하나에 답하는 데 필요한 만큼의 코드 묶음"입니다. 예를 들어 U02라는 단위의 질문은 "getBean()을 한 번 부르면 무슨 일이 일어나는가"입니다. 단위마다 U01, U02처럼 번호가 붙어 있고, 모두 25개입니다.
단위의 크기에는 규칙이 있습니다. 한 단위는 핵심 클래스 10~25개까지이고, 넘치면 단위를 쪼갭니다. 한 번에 머리에 담을 수 있는 크기로 자르는 것입니다.
단위 하나의 노트는 이렇게 생겼습니다
단위 노트는 모두 같은 틀로 씁니다.
| 순서 | 절 | 내용 |
|---|---|---|
| 1 | 한 줄 요약 | 이 단위가 답하는 질문 |
| 2 | 한눈에 보기 | 그림 여러 장과 짧은 설명. 여기만 읽어도 윤곽이 잡히게 쓴다 |
| 3 | 자세히 | 등장하는 클래스, 호출 흐름, 설계 이유를 줄 단위 근거와 함께 |
| 4 | 직접 확인하기 | 브레이크포인트를 걸 위치와 돌려 볼 작은 실험 |
| 5 | 학습 체크 | 스스로 답해 볼 질문 |
그리고 내용에 관한 규칙이 몇 가지 있습니다.
- 코드 위치는
모듈/경로/파일.java:줄꼴로 적고, 줄 번호는 커밋f447f3c310기준입니다. 이렇게 적어 두면 누구든 같은 줄을 열어서 맞는지 확인할 수 있습니다. 위에서refresh()를 "AbstractApplicationContext.java582행"이라고 적은 것이 이 방식입니다. - "어떻게 쓰는가"보다 "왜 이렇게 만들었는가"를 적습니다. 설계를 그렇게 한 이유와, 다른 방법으로는 왜 안 되는지를 함께 적습니다.
- 잘못 쓰기 쉬운 곳이 코드의 어디에서 비롯되는지 짚습니다.
- 버전에 따라 달라진 곳은 해당 코드와 함께 적습니다.
- 그림은 뜻이 있을 때만 색을 씁니다. 한 장에 칸은 12개 이하로 둡니다.
원본 노트는 Spring을 오래 써 온 개발자를 독자로 삼아서, 기초 개념과 사용 예제는 일부러 적지 않습니다. 이 블로그 시리즈는 반대로 Spring이 처음인 독자를 위해 노트의 줄기만 골라 처음부터 다시 설명합니다.
AI는 어디에 쓰나요
노트에 기록되어 있는 것만 적습니다.
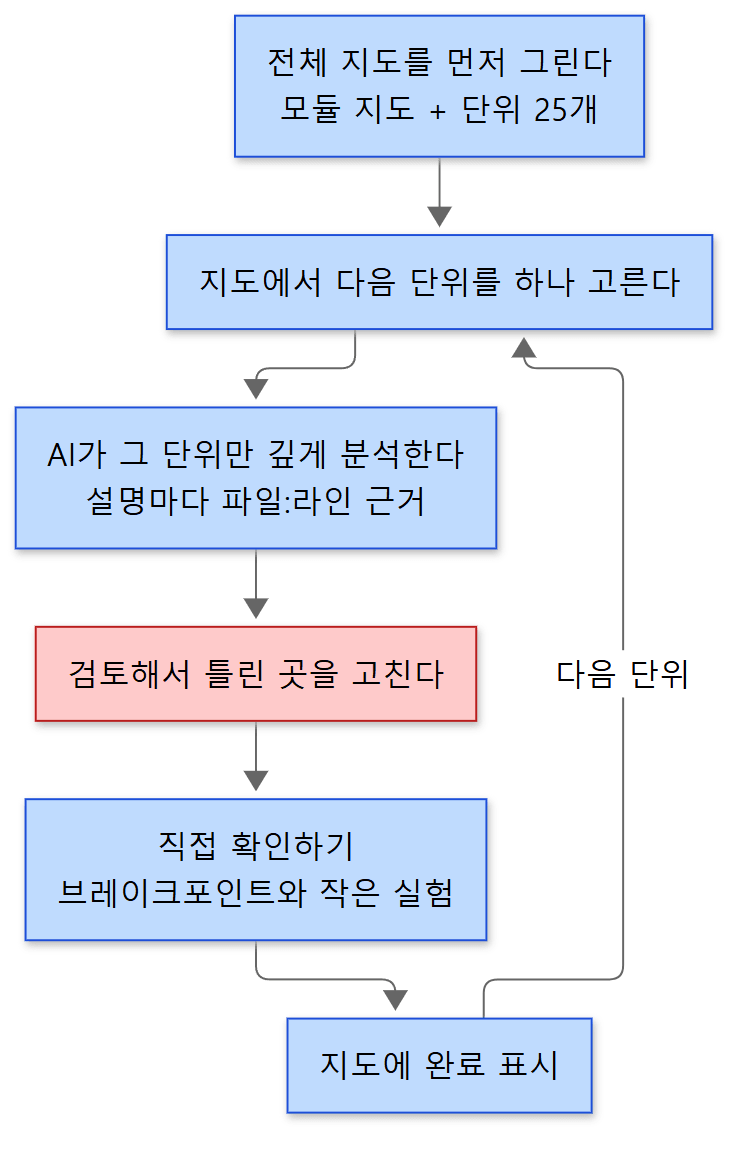 단위 하나를 읽는 순서. 파란 칸은 절차이고, 빨간 칸은 AI의 분석에서 틀린 곳을 걸러 내는 단계입니다.
- 지도를 먼저 만듭니다. 모듈과 패키지가 어떻게 나뉘어 있는지를 정리한 전체 지도(2편의 바탕)와, 단위 25개를 늘어놓은 분석 지도(이 글의 바탕)입니다.
- 단위 하나의 분석을 AI 작업 하나에 맡깁니다. 노트는 이것을 "서브에이전트"라고 부릅니다. 한 가지 일만 맡아서 따로 도는 AI 작업이라는 뜻입니다.
- AI가 쓴 분석을 검토하고 고칩니다. 진행 기록에는 U01과 U02를 분석한 뒤 검토해서 U01의 실험 하나에서 예상 결과를 바로잡고, U02에서 확신이 낮았던 두 곳을 보강했다고 적혀 있습니다.
- 직접 확인할 수 있는 길을 남깁니다. 단위 노트 끝의 "직접 확인하기"는 디버거로 따라가며 검증하라고 둔 절입니다.
분량에 관한 기록도 있습니다. AI가 읽고 쓰는 글의 양은 토큰이라는 단위로 셉니다. 노트에 따르면 단위 하나를 분석하는 데 대략 15만~35만 토큰이 들고, 큰 클래스가 들어 있는 단위일수록 많이 듭니다. 예를 들어 U02에 들어 있는 AbstractAutowireCapableBeanFactory는 파일 하나가 2,072줄입니다. U01과 U02는 서브에이전트 두 개를 동시에 돌려 분석했고 합쳐서 약 42만 토큰이 들었다고 기록되어 있습니다. 노트는 한 번에 2~3단위씩 진행하기를 권합니다.
여기서 가장 중요한 것은 3번과 4번입니다. AI의 분석은 틀릴 수 있습니다. 줄 번호를 커밋에 묶어 두는 규칙과 "직접 확인하기" 절이 있는 까닭이 그것입니다. 근거가 "어느 파일 몇 번째 줄"로 적혀 있으면, 맞는지 틀린지를 그 줄을 열어 보고 가릴 수 있습니다.
노트를 블로그 글로 옮길 때
이 시리즈의 글은 노트를 그대로 옮긴 것이 아닙니다. 글로 옮기면서 노트의 내용을 같은 커밋의 소스와 다시 대조하고, 노트와 소스가 다르면 소스를 따릅니다. 글에 싣는 Spring 코드는 소스에서 그대로 가져오고, 줄인 곳은 // ...로 표시하며, 코드마다 GitHub의 해당 줄로 가는 링크를 붙입니다.
분석 지도
큰 구분: Phase 여섯 개
단위 25개는 주제에 따라 여섯 묶음(Phase)으로 나뉩니다.
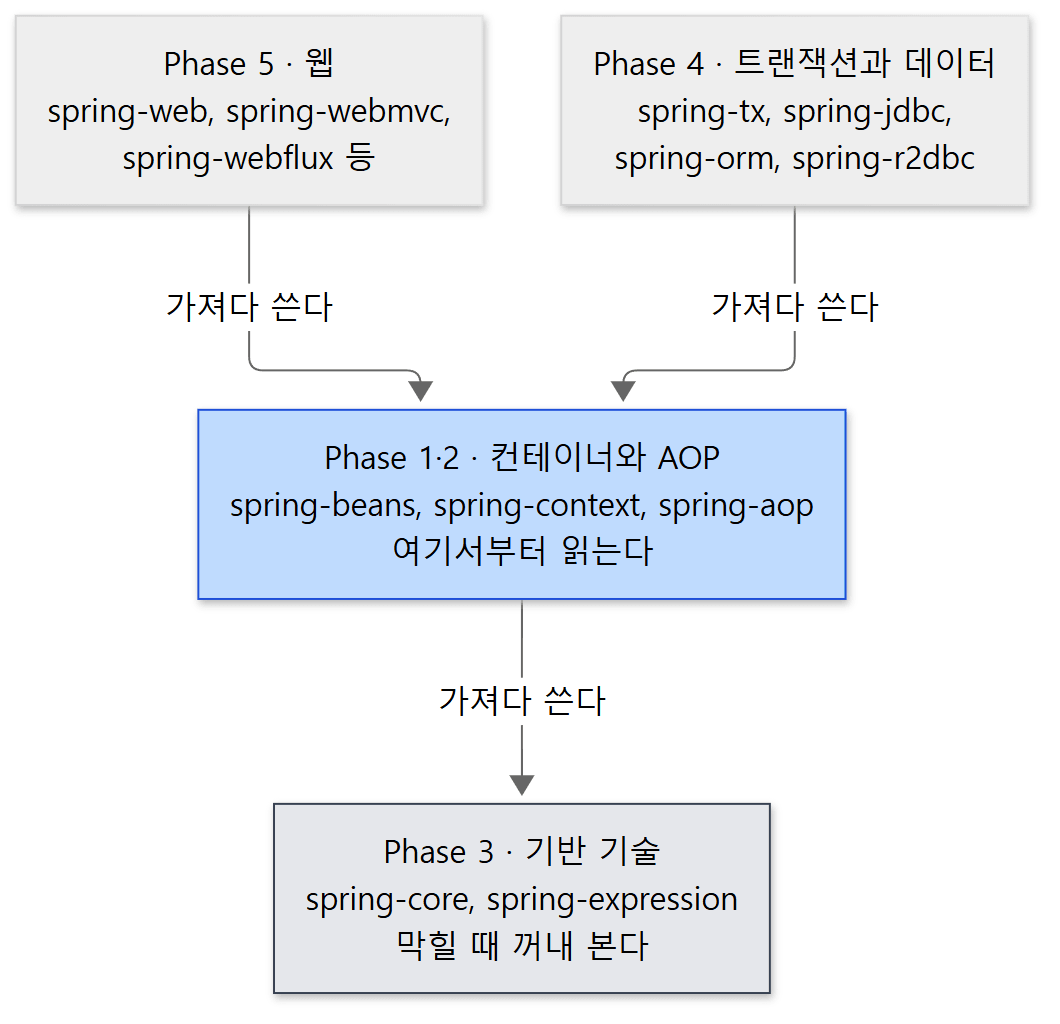 Phase와 모듈의 층. 화살표는 "위가 아래의 코드를 가져다 쓴다"는 뜻입니다. 파란 칸에서 읽기 시작하고, 회색 칸은 따로 진도를 나가지 않고 필요할 때 찾아봅니다.
| Phase | 주제 | 주로 읽는 모듈 | 단위 | 상태 |
|---|---|---|---|---|
| 1 | IoC 컨테이너 | spring-beans, spring-context |
U01–U08 | 완료 (3~9편, 12편) |
| 2 | AOP | spring-aop |
U09–U10 | 완료 (10, 11편) |
| 3 | 기반 기술 | spring-core, spring-expression |
U11–U14 | 완료 (13~16편) |
| 4 | 트랜잭션과 데이터 접근 | spring-tx, spring-jdbc, spring-orm, spring-r2dbc |
U15–U17 | 완료 (17~19편) |
| 5 | 웹 | spring-web, spring-webmvc, spring-webflux, spring-websocket, spring-messaging |
U18–U23 | 완료 (20~25편) |
| 6 | 나머지 | spring-test, 그리고 spring-context 안의 캐시·스케줄링·검증 등 |
U24–U25 | 완료 (26, 27편) |
Phase와 모듈이 꼭 일대일로 맞지는 않습니다. 예를 들어 Phase 1의 U08은 spring-core에 있는 core.env, core.io 패키지도 읽게 되어 있습니다. 또 22개 모듈 가운데 spring-jms, spring-oxm처럼 따로 단위를 두지 않은 모듈도 있습니다.
표에 나온 낯선 말만 짧게 풀어 둡니다. 지금 몰라도 괜찮고, 그 단위를 읽을 때 다시 설명합니다.
- AOP(관점 지향 프로그래밍): 로그 남기기처럼 여러 곳에 똑같이 끼어드는 코드를 한 곳에 모아 쓰는 방법입니다. Spring은 이것을 프록시, 곧 진짜 객체를 감싸서 호출을 대신 받는 대리 객체로 구현합니다.
- 트랜잭션: 여러 데이터 작업을 "전부 되거나 전부 안 되거나"로 묶는 것입니다.
- SpEL: Spring이 가진 작은 표현식 언어입니다.
spring-expression모듈이 이것입니다.
Phase 1을 자세히
가장 먼저, 가장 꼼꼼히 읽는 곳이 Phase 1입니다. 컨테이너가 Spring의 중심이기 때문입니다.
| 단위 | 제목 | 답하려는 질문 | 상태 |
|---|---|---|---|
| U01 | BeanFactory 계층과 BeanDefinition | 컨테이너는 어떤 인터페이스들로 이루어져 있고, 빈의 "설계도"는 무엇인가 | 완료 → 3편 |
| U02 | Bean 생성 흐름과 3단계 캐시 | getBean() 한 번에 무슨 일이 일어나는가. 서로를 필요로 하는 두 빈은 어떻게 만드는가 |
완료 → 4편 |
| U03 | 의존성 주입(DI) 해석 | @Autowired는 넣어 줄 후보를 어떻게 찾고 고르는가 |
완료 → 5편 |
| U04 | 생명주기 콜백과 PostProcessor | 컨테이너가 일하는 중간에 끼어들 수 있는 확장 지점(BeanPostProcessor 등)은 언제, 어떤 순서로 불리는가 |
완료 → 6편 |
| U05 | refresh() 12단계 |
컨테이너가 켜질 때 어떤 순서로 진행되는가 | 완료 → 7편 |
| U06 | 어노테이션 설정 처리 | @Configuration, @Bean, @ComponentScan은 어떻게 빈의 설계도가 되는가 |
완료 → 8편 |
| U07 | @Conditional, @Profile, @Import |
조건에 따라 빈을 등록하거나 다른 설정을 가져오는 일은 어떻게 처리되는가 | 완료 → 9편 |
| U08 | 이벤트, Environment, Resource | 이벤트를 보내고 받는 일, 설정값과 파일을 읽는 일은 어떻게 추상화되어 있는가 | 완료 → 12편 |
위 예제와 이어 보면 이렇습니다. @Bean이 붙은 메서드가 빈의 설계도가 되는 과정이 U06, 그 설계도가 어떻게 생겼는지가 U01, getBean(Car.class)이 U02, car(Engine engine)의 인자를 찾아 넣는 일이 U03, refresh()가 U05입니다.
나머지 Phase의 단위
| Phase | 단위 |
|---|---|
| 2 · AOP | U09 프록시 생성(JDK 방식과 CGLIB 방식) (10편) · U10 자동 프록시와 어드바이스 체인 (11편) |
| 3 · 기반 기술 | U11 타입과 어노테이션 메타데이터 (13편) · U12 타입 변환과 BeanWrapper (14편) · U13 SpEL (15편) · U14 유틸리티와 AOT (16편) |
| 4 · 트랜잭션과 데이터 접근 | U15 트랜잭션 추상화와 @Transactional (17편) · U16 JdbcTemplate (18편) · U17 ORM과 R2DBC 연동 (19편) |
| 5 · 웹 | U18 spring-web 기반 (20편) · U19 DispatcherServlet의 요청 처리 (21편) · U20 핸들러 매핑과 어댑터 (22편) · U21 예외 처리, 인터셉터, 뷰 (23편) · U22 WebFlux (24편) · U23 WebSocket과 메시징 (25편) |
| 6 · 나머지 | U24 spring-test (26편) · U25 캐시, 스케줄링, 검증, 리질리언스 (27편) |
읽는 순서: 주 경로 아홉 개
25개를 번호 순서대로 읽지는 않습니다. 뼈대가 되는 아홉 단위를 주 경로라고 부르고, 이것을 먼저 읽습니다.
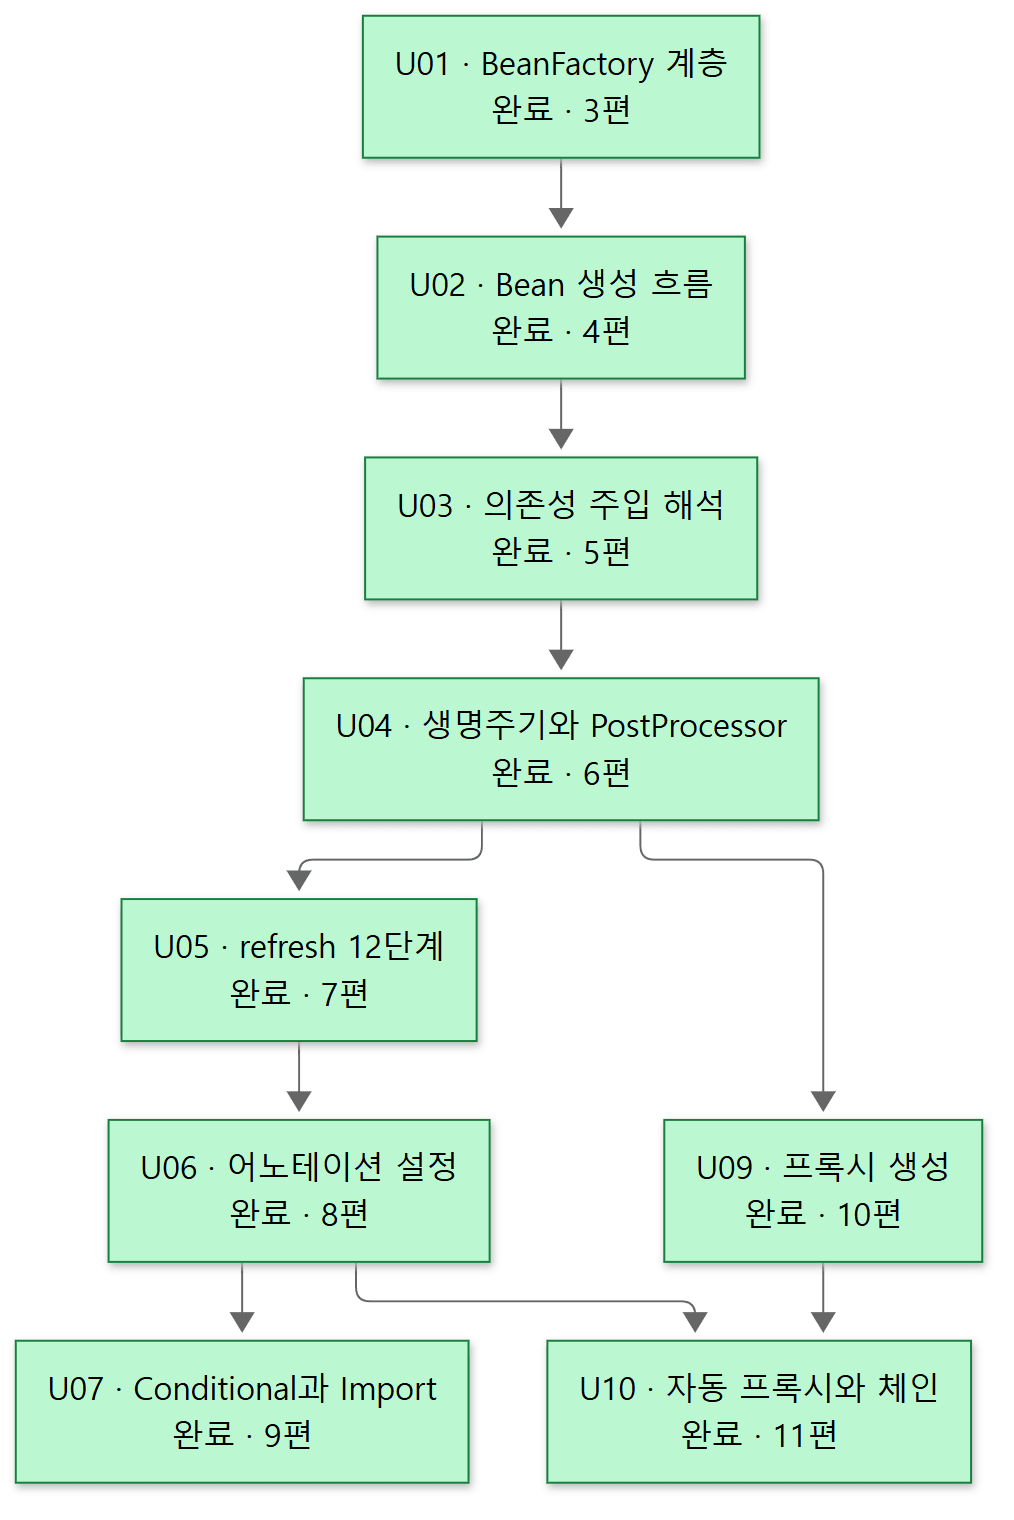 주 경로. 화살표는 "앞의 것을 알아야 뒤의 것이 빨리 이해된다"는 뜻입니다. 초록 칸은 다 읽은 단위이고, 칸에 적힌 번호가 그 단위를 다룬 글입니다.
순서를 이렇게 잡은 이유는 세 가지입니다.
- 컨테이너부터 읽습니다. 위의 층 그림처럼 웹과 데이터 쪽 모듈은 컨테이너 위에 얹혀 있습니다. 컨테이너를 모르면 위층의 코드는 읽히지 않습니다.
- Phase 3(기반 기술)은 따로 진도를 나가지 않습니다. 가장 아래층이지만 먼저 읽지 않고, 주 경로를 가다가 막히는 곳에서 꺼내 봅니다. 노트의 예를 들면, U03을 읽다가
ResolvableType이라는 클래스 때문에 막히면 그때 U11을 끼워 넣습니다. - Phase 4와 5는 U10까지 읽은 뒤에 들어갑니다. 둘 다 주 경로의 지식을 전제로 하기 때문입니다. 주 경로가 끝나면 데이터 쪽과 웹 쪽 가운데 관심 있는 것부터 읽어도 됩니다.
다음에 읽을 단위는 정해 둔 규칙으로 고릅니다.
- 지도에서 완료된 단위를 확인합니다.
- 먼저 읽어야 하는 단위가 모두 완료된 것 가운데 번호가 가장 낮은 것을 고릅니다.
- 후보가 여럿이면 주 경로에 있는 것을 먼저 읽습니다.
- 주 경로가 끝났으면 관심사에 따라 Phase 4나 Phase 5의 첫 단위를 고릅니다.
실제로 읽은 순서도 이 규칙을 따랐습니다. 주 경로 아홉 단위를 먼저 읽었고(3~11편), 이어서 Phase 1에 남아 있던 U08(12편)과 U11부터 U25까지를 번호 순서대로 읽었습니다(13~27편).
이 글에서는 지도를 줄여서 실었습니다. 원본 노트에는 단위마다 읽을 클래스 목록과, 단위별로 무엇을 먼저 읽어야 하는지를 적은 표가 더 있습니다. 그 내용은 각 단위를 다루는 글에서 필요한 만큼 꺼내겠습니다.
헷갈리기 쉬운 곳
Spring Framework와 Spring Boot는 다른 프로젝트입니다. 저장소의 README는 Spring Framework를 모든 Spring 프로젝트의 토대라고 소개하고, 이 프레임워크와 그 위의 여러 프로젝트를 묶어서 흔히 "Spring"이라고 부른다고 적고 있습니다. Spring Boot는 그 위에 얹힌 프로젝트 가운데 하나입니다. 이 시리즈가 읽는 것은 토대인 Spring Framework입니다.
Phase 번호는 읽는 순서가 아닙니다. Phase는 주제로 나눈 묶음입니다. Phase 3은 필요할 때만 꺼내 보고, Phase 1에 속한 U08은 주 경로에 들어 있지 않습니다. 읽는 순서는 주 경로 그림과 고르는 규칙이 정합니다.
컨테이너의 이름이 둘입니다. BeanFactory와 ApplicationContext가 둘 다 컨테이너로 불립니다. 소스를 보면 ApplicationContext는 BeanFactory 계열 인터페이스를 물려받고 거기에 기능을 더한 것입니다(ApplicationContext.java 59–60행). 둘의 관계는 3편에서 다룹니다.
줄 번호는 커밋이 바뀌면 달라집니다. 최신 소스를 받아서 열면 이 시리즈의 줄 번호와 어긋납니다. 줄 번호를 따라가려면 위에서 적은 커밋으로 맞추거나 글의 GitHub 링크를 누르세요.
"완료"는 그 단위의 노트가 쓰였다는 뜻입니다. 그 모듈의 모든 코드를 읽었다는 뜻이 아닙니다. 예를 들어 spring-beans에는 Java 파일이 338개 있지만 U01과 U02가 다루는 것은 그 가운데 질문에 답하는 데 필요한 클래스들입니다.
지금까지 한 것
노트의 진행 기록을 블로그 글과 짝지으면 이렇습니다.
| 날짜 | 한 일 | 블로그 글 |
|---|---|---|
| 2026-10-02 | 분석 지도와 전체 지도(모듈, 패키지) 작성 | 1편(이 글), 2편 |
| 2026-10-02 | U01, U02 분석과 검토 | 3편, 4편 |
| 2026-10-02 | 노트를 그림 중심으로 다시 구성 | — |
| 2026-10-10 | U03~U25를 기준 커밋의 소스로 다시 확인하며 글로 정리 | 5편부터 27편까지 |
단위 25개를 모두 한 번씩 읽었습니다. 다만 위에 적은 대로 "완료"는 그 모듈의 모든 코드를 읽었다는 뜻이 아닙니다.
정리
| 항목 | 한 줄 요약 |
|---|---|
| 빈 | Spring이 만들어서 관리하는 객체 |
| 컨테이너 | 빈을 만들고, 이어 주고, 보관하는 주체. BeanFactory, ApplicationContext |
| DI | 필요한 객체를 스스로 만들지 않고 밖에서 넣어 받는 것 |
| IoC | 객체를 만들고 잇는 주도권이 컨테이너에 있는 것 |
| 읽는 소스 | Spring Framework 7.1.0-SNAPSHOT, 커밋 f447f3c310. 본 코드만 약 84만 줄 |
| 읽는 방법 | 지도 먼저 → 단위 하나 선택 → AI 분석 → 검토와 정정 → 직접 확인 |
| 단위 | 질문 하나에 답하는 코드 묶음. 핵심 클래스 10~25개, 모두 25개 |
| 근거 | 파일:줄로 적고 커밋에 묶는다. AI의 분석은 틀릴 수 있으므로 |
| 순서 | 컨테이너(Phase 1) → AOP(Phase 2) → 데이터나 웹. 기반 기술은 막힐 때 |
| 진행 | 지도 두 장과 단위 25개(U01~U25) 완료. 글 27편 |
다음에 볼 것
다음 글은 지도입니다. 모듈 22개가 서로 어떻게 기대고 있는지, 무엇이 어느 폴더에 있는지, 컨테이너가 켜질 때의 큰 흐름을 봅니다.
- 다음 글: Spring 소스 파헤치기 2: 전체 지도 — 모듈과 패키지는 어떻게 나뉘어 있나
- 컨테이너의 뼈대로 바로 가려면: 3편: BeanFactory 계층 구조와 BeanDefinition
getBean()안쪽이 궁금하면: 4편: Bean은 어떻게 만들어지나- 같은 방법으로 C 로 짠 웹 서버를 읽은 연재: Apache httpd 소스 파헤치기 1: AI와 함께 소스를 읽는 방법과 분석 지도
- 같은 방법으로 Spring 이 올라가는 서블릿 컨테이너를 읽은 연재: Tomcat 소스 파헤치기 1: AI와 함께 소스를 읽는 방법과 분석 지도
- 이 저장소를 빌드하는 도구(위의
settings.gradle·build.gradle)를 같은 방법으로 읽은 연재: Gradle 소스 파헤치기 1: AI와 함께 소스를 읽는 방법과 분석 지도