이 글에서 다루는 것
"Tomcat 소스 파헤치기"는 Apache Tomcat(자바 웹 애플리케이션을 돌리는 서버)의 소스 코드를 AI의 도움을 받아 조금씩 읽고 정리하는 연재입니다. 앞서 끝낸 Spring 소스 파헤치기(27편), Apache httpd 소스 파헤치기(16편)와 같은 방식으로 읽습니다. 두 연재 사이에 Tomcat이 있습니다. Spring MVC는 Tomcat 같은 서블릿 컨테이너 위에서 도는 프레임워크이고, httpd는 Tomcat과 같은 일(HTTP 요청을 받아 응답하기)을 C로 하는 웹 서버입니다.
이 글은 그 첫 번째 글이고, 코드를 깊이 읽기 전에 준비를 합니다. 답하려는 질문은 다섯 가지입니다.
- Tomcat은 무엇이고, 어떻게 동작하고, 어디에 쓰는가 (처음 보는 분을 위한 절)
- 어떤 판의 소스를 읽는가. 흔히 쓰는 안정판 11.0과는 무엇이 다르고, 서블릿 스펙은 몇 판인가
- 이 연재와 똑같은 소스를 어떻게 받고, 어떻게 빌드해서 돌려 보는가
- 74만 줄쯤 되는 소스는 어떤 폴더로 나뉘어 있고, 어디서부터 읽어야 하는가
- 요청 하나는 소스의 어떤 클래스들을 지나 내 서블릿에 닿는가
Tomcat을 처음 듣는 분은 바로 아래 "Tomcat은 무엇인가" 절부터 읽으면 됩니다. 그림 두 장과 3분짜리 실습으로 Tomcat이 하는 일을 먼저 눈으로 보고, 이 연재가 어떤 궁금증을 풀어 가는지 훑어본 뒤 본론으로 들어갑니다. 그다음부터는 Tomcat을 내려받아 실행해 본 적은 있지만(WAR를 webapps/에 넣어 보고, server.xml의 포트를 바꿔 보고, Spring Boot로 내장 Tomcat을 써 본 정도) 소스는 처음 여는 사람을 기준으로 씁니다. Java의 클래스·인터페이스·상속, 스레드가 있다는 것, 서블릿을 하나쯤 써 본 경험이면 충분합니다.
| 항목 | 내용 |
|---|---|
| 대상 | Apache Tomcat (apache/tomcat) |
| 버전 | 12.0.0-M1 (main), 빌드하면 12.0.0-M1-dev |
| 커밋 | 17aa1769b0 (2026-10-23) |
| 언어 | Java (Java 21 이상) |
| 구현하는 스펙 | Servlet 6.2, JSP 4.1, EL 6.1, WebSocket 2.3 (모두 초안 — 1절 참고) |
| 이 글에서 주로 읽는 파일 | build.properties.default, build.xml, catalina/core/Constants.java, conf/server.xml, catalina/connector/CoyoteAdapter.java, tomcat/util/net/AbstractEndpoint.java |
글에 나오는 줄 번호와 세부 내용은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고, 내용이 달라진 곳도 있을 수 있습니다. 이 글은 연재 전체의 지도이므로 큰 줄기만 다루고, 깊은 내용은 각 편으로 넘깁니다.
연재는 모두 16편입니다.
- AI와 함께 소스를 읽는 방법과 분석 지도 (이 글)
- 전체 지도 — Server, Service, Connector, 그리고 컨테이너 넷
- Lifecycle과 기동 — catalina.sh start 뒤에 일어나는 일
- 클래스로더 — 웹앱마다 따로 보는 클래스
- 커넥터와 NIO 엔드포인트 — 연결은 어떤 스레드가 받나
- HTTP/1.1 요청 읽기 — 바이트가 coyote Request가 되기까지
- CoyoteAdapter와 Mapper — 요청은 어느 서블릿으로 가나
- 파이프라인과 밸브 — 컨테이너마다 걸린 처리 사슬
- 필터 체인과 서블릿 호출 — service()가 불리기까지
- 웹앱 배포와 Context 설정 — WAR 하나가 서비스되기까지
- 세션 — JSESSIONID는 어떻게 만들고 지우나
- 비동기 서블릿과 논블로킹 I/O — 스레드를 놓아주는 법
- Jasper — JSP가 서블릿이 되기까지
- 인증과 Realm — security-constraint는 어떻게 지켜지나
- HTTP/2와 WebSocket — 업그레이드로 갈아타는 프로토콜
- 내장 Tomcat, JMX, 로깅 — 그리고 연재를 마치며
Tomcat은 무엇인가 — 어떻게 동작하고, 어디에 쓰나
소스를 열기 전에, Tomcat이 하는 일부터 그림과 실습으로 봅니다. 이미 Tomcat에 웹앱을 올려 봤다면 이 절 끝의 "이 연재가 풀어 갈 질문"만 보고 넘어가도 됩니다.
한 문장으로 — HTTP와 내 자바 코드 사이의 "통역사 겸 관리인"
Tomcat은 HTTP로 들어온 요청을 자바 객체로 바꿔 내 코드를 불러 주는 서버입니다. 브라우저가 보내는 것은 GET /shop/hello?name=alice HTTP/1.1 같은 글자 몇 줄인데, 우리가 짜는 자바 코드는 그런 글자를 직접 읽지 않습니다. Tomcat이 연결을 받고, 글자를 읽어 HttpServletRequest라는 객체로 만들고, 어느 코드가 이 요청을 맡을지 골라 그 메서드를 부릅니다. 우리 코드가 응답 객체에 쓴 내용은 Tomcat이 다시 HTTP 글자로 바꿔 돌려보냅니다. 통역사이자, 손님(요청)을 알맞은 담당자(코드)에게 안내하는 관리인입니다.
이렇게 Tomcat이 불러 주는 자바 클래스를 서블릿(servlet)이라고 하고, 서블릿을 맡아 돌리는 서버를 서블릿 컨테이너라고 부릅니다. 이 연재 전체가 결국 "요청 하나가 연결에서 시작해 내 서블릿의 메서드에 닿기까지, Tomcat 안에서 무슨 일이 일어나나"를 따라가는 이야기입니다.
왜 이런 것이 필요한가
자바로 웹 서비스를 직접 만든다고 해 봅시다. Tomcat 같은 것이 없으면 이 일을 모두 손으로 해야 합니다.
- 포트를 열고 연결을 받고, 동시에 들어오는 수백 개의 연결을 스레드에 나눠 맡깁니다.
- 바이트를 읽어 요청 줄과 헤더, 쿼리 문자열(
?name=alice)을 해석하고, 응답을 HTTP 형식으로 씁니다. /shop으로 온 요청과/blog로 온 요청을 서로 다른 코드로 보냅니다.- HTTP는 요청끼리 서로를 기억하지 못하므로, "아까 그 손님"을 알아보는 장치(세션)를 만듭니다.
Tomcat을 쓰면 이 일은 모두 Tomcat이 하고, 우리는 "이 경로로 요청이 오면 이렇게 답한다"는 서블릿만 씁니다. 서블릿이 지켜야 할 약속(인터페이스)은 Jakarta Servlet이라는 표준 규격으로 정해져 있어서, 같은 웹앱을 규격을 지키는 다른 서블릿 컨테이너에서도 돌릴 수 있습니다. Spring MVC도 이 위에서 돕니다. Spring MVC의 중심인 DispatcherServlet은 FrameworkServlet → HttpServletBean을 거쳐 HttpServlet을 상속한 서블릿 하나입니다(HttpServletBean.java 82행, Spring Framework 커밋 f447f3c310 — Spring 연재의 기준 커밋). 이 블로그의 Spring 연재도 웹 예제를 Tomcat을 프로그램 안에 넣어(내장 Tomcat) 돌렸습니다(Spring 20편). Spring Boot로 만든 앱이 java -jar 하나로 뜨는 것도 Tomcat을 안에 품고 있기 때문이라고 알려져 있는데, 이 연재에서 Spring Boot의 소스로 확인하지는 않았습니다(16편).
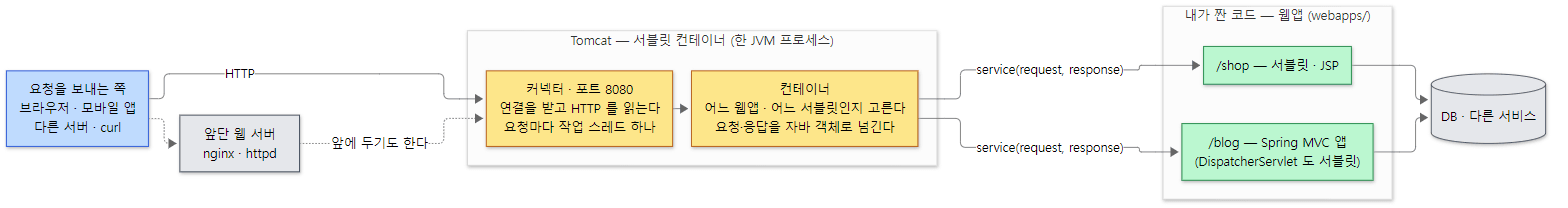 Tomcat이 놓이는 자리. 노란 칸이 Tomcat, 초록 칸이 우리가 짜는 코드입니다. 앞단 웹 서버는 이 블로그의 nginx·httpd 연재에서 읽은 그 서버들입니다.
어떻게 동작하나 — 다섯 가지 말로
Tomcat을 움직이는 말은 다섯 개면 충분합니다. 아래 실습과 그림이 이 다섯 개를 그대로 보여 줍니다.
- 서블릿(servlet) — 요청을 받아 응답을 만드는 자바 클래스입니다. 보통
HttpServlet을 상속하고doGet()같은 메서드를 채웁니다. 객체는 Tomcat이 만들고 Tomcat이 부릅니다. - 웹앱(web application, Tomcat 안에서는 Context) — 서블릿과 설정, 정적 파일을 묶은 한 덩어리입니다. 주소의 앞부분(컨텍스트 경로, 예:
/shop)으로 구분하고, Tomcat 하나에 여러 개를 올릴 수 있습니다.webapps/폴더에 폴더나 WAR 파일(웹앱을 묶은 압축 파일)을 넣으면 그 이름이 경로가 됩니다. - 커넥터(connector) — 포트를 열고 연결을 받아 HTTP를 읽고 쓰는 부분입니다. 요청마다 스레드 풀(미리 만들어 둔 작업 스레드 묶음)의 스레드 하나에 일을 맡깁니다.
- 요청·응답 객체 — 커넥터가 읽은 HTTP를
HttpServletRequest·HttpServletResponse객체로 바꾼 것입니다. 서블릿은req.getParameter("name")처럼 객체의 메서드로 요청을 읽고, 응답 객체에 씁니다. - 세션(session) — 같은 손님의 여러 요청을 이어 주는 서버 쪽 저장소입니다. Tomcat은 손님마다 무작위 ID를 만들어
JSESSIONID라는 쿠키로 보내고, 다음 요청에 그 쿠키가 돌아오면 같은 세션을 꺼내 줍니다.
3분 실습 — 서블릿 하나를 두 웹앱으로 올리고 불러 보기
말로만 보면 감이 오지 않으니 직접 돌려 봅니다. 이 연재가 빌드한 Tomcat(2절에서 만드는 도커 이미지)으로 돌렸지만, javac와 catalina.sh, curl만 쓰므로 내려받은 공식 배포판으로도 같은 순서로 해 볼 수 있습니다(공식 배포판으로는 돌려 보지 않았습니다). 예제 폴더는 ex/u01-first-look이고, 서블릿은 이것 하나입니다.
// 1편 "Tomcat은 무엇인가" 실습용 서블릿 (Tomcat 의 소스가 아닙니다)
import jakarta.servlet.annotation.WebServlet;
import jakarta.servlet.http.*;
import java.io.IOException;
import java.io.PrintWriter;

@WebServlet("/hello")
public class Hello extends HttpServlet {
    @Override
    protected void doGet(HttpServletRequest req, HttpServletResponse resp) throws IOException {
        HttpSession session = req.getSession();          // 이 손님의 세션 (없으면 새로 만든다)
        Integer n = (Integer) session.getAttribute("visits");
        n = (n == null) ? 1 : n + 1;
        session.setAttribute("visits", n);

        resp.setContentType("text/plain");
        PrintWriter out = resp.getWriter();
        out.println("app     : " + req.getContextPath());
        out.println("request : " + req.getMethod() + " " + req.getRequestURI()
                + "  name=" + req.getParameter("name"));
        out.println("thread  : " + Thread.currentThread().getName());
        out.println("session : " + session.getId() + "  visit #" + n);
    }
}
@WebServlet("/hello") 한 줄이 "웹앱 안의 /hello로 오는 요청은 이 클래스가 맡는다"는 표시입니다(web.xml 설정 파일 없이 이 어노테이션만으로 등록됩니다. Tomcat이 어노테이션을 찾는 곳은 10편). run.sh가 하는 일은 이렇습니다.
Hello.java를javac로 컴파일합니다. 클래스패스에는 Tomcat의lib/servlet-api.jar하나만 둡니다.- 컴파일된
Hello.class를webapps/shop/WEB-INF/classes/와webapps/blog/WEB-INF/classes/두 곳에 넣습니다. 같은 클래스로 웹앱 두 개를 만드는 셈입니다. catalina.sh start로 Tomcat을 띄우고, 로그에서 Tomcat이 찾은 웹앱을 봅니다./shop/hello를 처음 부릅니다.curl -i로 응답 헤더까지 봅니다.- 받은 쿠키를 돌려보내며 두 번 더 부릅니다.
- 같은 쿠키 상자로
/blog/hello를 부릅니다. - 요청 다섯 개를 동시에 보내고, 어느 스레드가 맡았는지 봅니다.
- 어느 웹앱도 맡지 않은 경로(
/nothing/hello)를 부릅니다.
핵심 명령만 옮기면 이렇습니다.
javac -d /tmp/build -cp $CATALINA_HOME/lib/servlet-api.jar Hello.java
for app in shop blog; do                      # 같은 클래스를 웹앱 두 개에 넣는다
  mkdir -p /tmp/base/webapps/$app/WEB-INF/classes
  cp /tmp/build/Hello.class /tmp/base/webapps/$app/WEB-INF/classes/
done
catalina.sh start

curl -si -c /tmp/jar 'http://127.0.0.1:8080/shop/hello?name=alice'   # 받은 쿠키를 /tmp/jar 에 담는다
curl -s  -b /tmp/jar 'http://127.0.0.1:8080/shop/hello?name=alice'   # 담아 둔 쿠키를 보낸다
출력입니다.
=== 1. what Tomcat found in webapps/ (from logs/catalina.out)
Deploying web application directory [/tmp/base/webapps/blog]
Deploying web application directory [/tmp/base/webapps/shop]
=== 2. first visit to /shop/hello  (curl -i: response headers too)
HTTP/1.1 200
Set-Cookie: JSESSIONID=B1BF925D8048991331B2018E2B4FEA2D; Path=/shop; HttpOnly
Content-Type: text/plain;charset=UTF-8

app     : /shop
request : GET /shop/hello  name=alice
thread  : http-nio-8080-exec-2
session : B1BF925D8048991331B2018E2B4FEA2D  visit #1
=== 3. two more visits, sending the cookie back
app     : /shop
request : GET /shop/hello  name=alice
thread  : http-nio-8080-exec-4
session : B1BF925D8048991331B2018E2B4FEA2D  visit #2
app     : /shop
request : GET /shop/hello  name=alice
thread  : http-nio-8080-exec-5
session : B1BF925D8048991331B2018E2B4FEA2D  visit #3
=== 4. same class, other app: /blog/hello with the same cookie jar
app     : /blog
request : GET /blog/hello  name=alice
thread  : http-nio-8080-exec-6
session : 935E2B4A4886E2C0D1A180E81849687E  visit #1
=== 5. five requests at the same time: which threads ran them?
thread  : http-nio-8080-exec-1
thread  : http-nio-8080-exec-7
thread  : http-nio-8080-exec-8
thread  : http-nio-8080-exec-9
thread  : http-nio-8080-exec-10
=== 6. a path no app owns
404
(2단계의 응답 헤더에서 Date·Keep-Alive·Connection·Content-Length 줄은 뺐습니다. 세션 ID와 exec- 뒤의 번호는 실행할 때마다 다릅니다. 7단계는 보기 쉽게 정렬했습니다. 출력의 번호 === 1.~6.은 위 목록의 3~8단계입니다.)
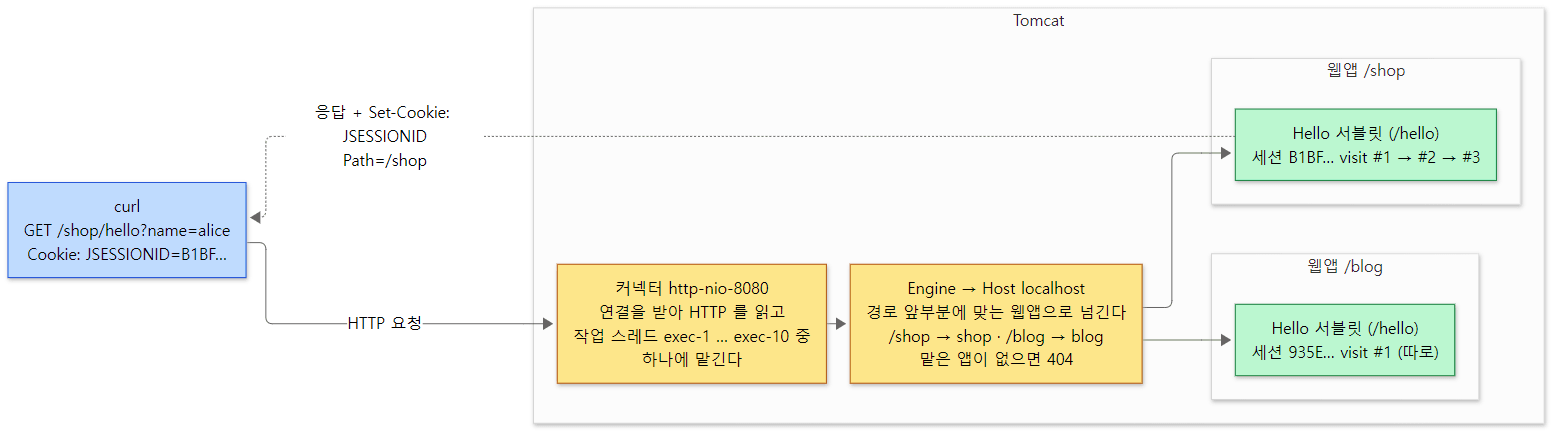 실습에서 본 것을 그대로 그린 모습. 노란 칸이 Tomcat이 하는 일, 초록 칸이 우리가 짠 서블릿입니다. 경로로 웹앱을 고르는 일의 안쪽은 7편에서 봅니다.
출력에서 볼 것은 다섯 가지입니다.
- 폴더 이름이 곧 주소가 됩니다. 1번 출력에서 Tomcat은
webapps/아래 폴더 둘을 찾아 각각 웹앱으로 올렸고,shop폴더는/shop,blog폴더는/blog가 되었습니다. Host가 웹앱을 찾는 폴더의 기본값이webapps이고(StandardHost.java 85행), 폴더마다 그 이름으로 Context를 만들며 이 로그를 찍습니다(HostConfig.java 984–986행, 1037행). 폴더를 넣기만 했는데 앱이 되는 과정은 10편에서 봅니다. - HTTP 글자가 자바 객체가 되어 내 메서드에 옵니다. 서블릿은 소켓도 바이트도 만지지 않았는데
req.getContextPath()가/shop을,req.getParameter("name")이alice를 돌려주었습니다. 서블릿이println()으로 쓴 글자에는 Tomcat이HTTP/1.1 200상태 줄과 헤더를 붙여 보냈습니다. 상태 줄 끝에 흔히 보던OK가 없는 것은 Tomcat이 이유 문구(reason phrase)를 일부러 보내지 않기 때문입니다(Http11OutputBuffer.java 372–374행). 바이트가 요청 객체가 되는 과정은 6편에서 봅니다. - 요청마다 작업 스레드 하나가 맡습니다. 같은 손님(같은 쿠키)이 연달아 보낸 요청도
exec-2,exec-4,exec-5로 스레드가 달랐고, 7번에서 동시에 보낸 다섯 요청은 다섯 스레드가 나눠 맡았습니다. 스레드 이름은 커넥터 이름(http-nio+ 포트, Http11NioProtocol.java 97–103행, AbstractProtocol.java 659–685행) 뒤에-exec-와 번호를 붙인 것이고(AbstractEndpoint.java 1967행), 처음에는 10개를 준비해 두었다가(1459행) 요청이 몰리면 기본 200개까지 늘립니다(1499행). 그래서 서블릿 객체 하나를 여러 스레드가 동시에 부를 수 있고, 서블릿의 필드에 요청별 값을 담으면 안 됩니다. 연결과 스레드는 5편에서 봅니다. - 세션은 쿠키
JSESSIONID로 이어집니다. 첫 응답의Set-Cookie: JSESSIONID=B1BF…; Path=/shop; HttpOnly가 Tomcat이 만든 세션 ID입니다. 쿠키를 돌려보낸 두 번째·세 번째 요청은 같은 ID로visit #2,#3이 되었습니다. 쿠키 이름의 기본값이JSESSIONID이고(SessionConfig.java 28행), ID는 무작위 16바이트를 16진수 32글자로 쓴 것입니다(SessionIdGeneratorBase.java 91–92행, StandardSessionIdGenerator.java 44–61행). 쿠키의Path는 따로 정하지 않으면 웹앱의 경로이고(SessionConfig.java 89–95행),HttpOnly(브라우저의 자바스크립트가 이 쿠키를 읽지 못하게 하는 표시)는 기본으로 켜져 있습니다(StandardContext.java 649행). 세션을 만들고 지우는 안쪽은 11편에서 봅니다. - 웹앱 둘은 서로 섞이지 않습니다. 6번에서 같은 쿠키 상자로
/blog/hello를 불렀지만 쿠키의Path가/shop이라 curl은 쿠키를 보내지 않았고,blog는 새 세션(935E…,visit #1)을 만들었습니다. 쿠키뿐 아니라 세션을 담아 두는 저장소(Manager)도 웹앱마다 따로입니다. 웹앱(Context)이 켜질 때 따로 정한 것이 없으면 자기 몫의StandardManager를 하나씩 만듭니다(StandardContext.java 4542–4566행). 같은Hello.class를 두 웹앱이 각자 따로 싣는 이유는 4편의 클래스로더에서 봅니다. 8번처럼 어느 웹앱도 맡지 않은 경로는 Host 단계에서 404가 됩니다(StandardHostValve.java 80–87행).
어디에 쓰나
| 쓰임 | 하는 일 | 예 |
|---|---|---|
| 자바 웹앱 서버 | 서블릿·JSP로 만든 웹앱을 WAR로 묶어 webapps/에 올려 돌린다. 서버 하나에 앱 여럿을 경로로 나눠 올릴 수 있다 |
위 실습의 /shop, /blog |
| Spring MVC 앱 실행 | DispatcherServlet이라는 서블릿 하나가 요청을 받아 컨트롤러로 나눠 준다. Tomcat은 그 서블릿을 부를 뿐이다 |
Spring 연재의 웹 예제 |
| 프로그램 안에 넣는 서버(내장 Tomcat) | 따로 설치하지 않고 main() 안에서 new Tomcat()으로 띄운다 |
16편 |
| REST API 서버 | 화면 없이 JSON을 주고받는 API도 서블릿 위에서 돈다 | 모바일 앱이 부르는 백엔드 |
| 실시간 연결 | WebSocket으로 연결을 열어 둔 채 메시지를 주고받고, HTTP/2로 연결 하나에 요청 여럿을 실어 보낸다 | 15편 |
반대로 맞지 않는 곳도 있습니다. HTML·그림 같은 정적 파일만 내주는 사이트라면 Tomcat도 할 수는 있지만(conf/web.xml에 정적 파일을 내주는 DefaultServlet이 등록되어 있습니다) 자바가 필요 없으니 nginx나 httpd 쪽이 단순합니다. 또 Tomcat은 Jakarta EE 가운데 서블릿·JSP·EL·WebSocket·인증(Jakarta Authentication) 같은 웹 쪽 규격만 구현합니다. 2절의 lib/ jar 목록에 든 *-api.jar(annotations, el, jaspic, jsp, servlet, websocket)가 그 규격들의 API입니다. EJB나 메시징(JMS)처럼 다른 Jakarta EE 규격이 필요한 앱은 그것까지 구현한 애플리케이션 서버가 필요합니다.
이 연재가 풀어 갈 질문
실습을 돌려 보면 궁금한 것이 생깁니다. 이 연재는 그 궁금증을 소스로 하나씩 풉니다. 끌리는 질문이 있으면 그 편부터 읽어도 됩니다.
| 궁금한 것 | 답이 있는 곳 |
|---|---|
| Tomcat 안에는 무엇이 몇 겹으로 들어 있을까? 커넥터와 컨테이너는 왜 나뉘어 있을까? | 2편: 전체 지도 |
catalina.sh start를 치면 무엇부터 만들어지고, 어떤 순서로 켜질까? |
3편: Lifecycle과 기동 |
같은 Hello.class를 두 앱에 넣었는데 왜 서로 섞이지 않을까? |
4편: 클래스로더 |
http-nio-8080-exec-N 스레드는 누가 만들고, 연결은 누가 받을까? |
5편: 커넥터와 NIO 엔드포인트 |
GET /shop/hello?name=alice 글자는 어떻게 요청 객체가 될까? |
6편: HTTP/1.1 요청 읽기 |
/shop/hello는 어떻게 shop 앱의 Hello로 찾아갈까? |
7편: CoyoteAdapter와 Mapper |
| 접근 로그와 회색 오류 페이지는 요청 사이 어디에 끼어들까? | 8편: 파이프라인과 밸브 |
필터는 어떻게 서블릿 앞에 줄을 서고, doGet()은 누가 부를까? |
9편: 필터 체인과 서블릿 호출 |
폴더를 webapps/에 넣기만 했는데 어떻게 앱이 됐을까? @WebServlet은 누가 읽을까? |
10편: 웹앱 배포와 Context 설정 |
JSESSIONID는 어떻게 만들고, 언제 지울까? |
11편: 세션 |
| 오래 걸리는 요청이 작업 스레드를 붙잡고 있지 않게 하려면? | 12편: 비동기 서블릿과 논블로킹 I/O |
.jsp 파일은 어떻게 서블릿이 될까? |
13편: Jasper |
| 로그인해야 볼 수 있는 페이지는 어떻게 지킬까? | 14편: 인증과 Realm |
| HTTP/1.1 연결이 어떻게 HTTP/2나 WebSocket으로 갈아탈까? | 15편: HTTP/2와 WebSocket |
따로 설치하지 않고 main() 안에서 Tomcat을 띄우려면? |
16편: 내장 Tomcat, JMX, 로깅 |
이 글의 나머지는 이 질문들을 소스로 따라가기 위한 준비입니다. 어떤 판을 읽는지(1절), 소스를 받아 빌드하는 법(2절), 폴더 지도(3절), 그리고 위 실습의 요청 하나가 실제로 어떤 클래스들을 지나가는지(4절)를 보고, 읽는 방법(5절)과 연재 지도(6절)로 마칩니다. 직접 빌드해 볼 생각이 없다면 2절은 건너뛰어도 뒤의 내용을 읽는 데 지장이 없습니다.
먼저 알아 둘 말
Tomcat 자료에는 처음 보면 낯선 이름이 계속 나옵니다. 이 여섯 가지만 먼저 잡아 두면 나머지가 훨씬 쉽게 읽힙니다.
서블릿 컨테이너(servlet container)는 네트워크에서 HTTP 요청을 받아, 우리가 짠 서블릿 객체의 service() 메서드를 불러 주는 서버 프로그램입니다. Tomcat이 바로 서블릿 컨테이너입니다. 서블릿을 만들고(init()), 요청마다 부르고, 내릴 때 정리(destroy())하는 일을 모두 컨테이너가 맡습니다.
**Jakarta EE와 jakarta.***는 서블릿·JSP 같은 자바 웹 표준의 이름입니다. 예전에는 Java EE라고 부르고 패키지 이름이 javax.servlet이었는데, 표준을 Eclipse 재단으로 옮기면서 jakarta.servlet으로 바뀌었습니다. 이 연재가 읽는 Tomcat은 jakarta.*만 씁니다. 표준은 스펙(specification, 규격 문서)이고, Tomcat은 그 스펙을 구현한 것입니다.
Catalina(카탈리나)는 Tomcat 안에서 서블릿 컨테이너 역할을 하는 부분의 이름입니다. server.xml의 <Engine>, <Host>, <Context>가 이 부분의 클래스로 만들어집니다. 소스로는 org.apache.catalina 패키지이고, 실행 스크립트 이름(catalina.sh)에도 남아 있습니다.
Coyote(코요테)는 네트워크 쪽, 곧 커넥터(connector)의 이름입니다. 소켓에서 바이트를 읽어 HTTP 요청으로 만들고, 응답을 다시 바이트로 씁니다. server.xml의 <Connector port="8080" …>이 Coyote를 띄우는 줄입니다. Catalina와 Coyote가 왜 나뉘어 있는지는 2편에서 봅니다.
Jasper(재스퍼)는 JSP 파일을 자바 서블릿 소스로 바꾸고 컴파일하는 엔진입니다. org.apache.jasper 패키지이고, 13편에서 봅니다.
main과 11.0.x는 Tomcat 저장소의 브랜치 이름입니다. main은 다음 판(12.x)을 만드는 개발 줄기이고, 우리가 내려받아 쓰는 안정판은 11.0.x 같은 브랜치에서 나옵니다. 이 연재가 읽는 것이 main입니다. 이 차이는 바로 다음 절에서 봅니다.
1. 어떤 판을 읽나 — main과 11.0.x
버전은 빌드 설정 파일에 적혀 있습니다
Tomcat의 버전은 저장소 맨 위의 build.properties.default에 적혀 있습니다. Tomcat은 Ant(자바 프로젝트를 빌드하는 오래된 도구, build.xml에 할 일을 적습니다)로 빌드하는데, Ant가 이 파일의 값을 읽어 버전 문자열을 만듭니다.
version.major=12
version.minor=0
version.build=0
version.patch=0
version.suffix=-M1
version.dev=-dev
build.properties.default 31–36행
12.0.0에 -M1(Milestone 1, 정식판 전에 내는 시험판)을 붙이고, 아직 개발 중이라 -dev를 붙입니다. 그래서 기준 커밋을 빌드한 Tomcat의 이름이 12.0.0-M1-dev입니다. 아래 "예제"에서 version.sh로 직접 확인합니다.
main과 11.0.x는 무엇이 다른가
이 저장소에서 직접 확인하면 이렇습니다.
| 브랜치 / 태그 | 버전 | 무엇인가 |
|---|---|---|
main (커밋 17aa1769b0, 2026-10-23) |
12.0.0-M1-dev | 다음 메이저 판을 만드는 개발 줄기. 이 연재가 읽는 것 |
11.0.x 브랜치 (커밋 62983467e4, 2026-10-23) |
11.0.28-dev | 안정판을 고쳐 나가는 줄기 |
태그 11.0.27 (2026-10-06) |
— | 이 저장소에서 가장 최근의 11.0 안정판 태그 |
git tag -l '11.0.*' | sort -V로 태그를 늘어놓으면 11.0.27이 마지막이고, 12.* 태그는 아직 하나도 없습니다. 즉 12.0은 아직 한 번도 정식으로 나온 적이 없는 판입니다. 저장소에는 10.1.x, 9.0.x 같은 더 오래된 안정판 브랜치도 함께 있습니다.
왜 굳이 main을 읽느냐 하면, httpd 연재에서 trunk를 읽은 것과 같은 이유입니다. 고친 것과 새 기능은 개발 줄기에 먼저 들어가고, 큰 줄기(커넥터·컨테이너·밸브·필터 체인)는 두 브랜치가 같습니다. 대신 이 연재는 글이 단정하는 내용이 11.0.x에서 다르면 그렇다고 밝힙니다. 두 브랜치의 java/ 아래 .java 파일 목록을 비교해 보면, 이번 글에 닿는 것만 해도 이런 차이가 있습니다.
- NIO2 커넥터가 없습니다. 11.0.x에는
Nio2Endpoint,Http11Nio2Protocol,AjpNio2Protocol이 있지만 main에는 NIO 엔드포인트(NioEndpoint) 하나만 남았습니다. 커밋21f0936fe3(2025-05-15)의 메시지가 "Drop NIO2 connector from Tomcat 12"입니다. 커넥터는 5편에서 봅니다. - 사라진 클래스가 더 있습니다.
RemoteAddrValve·RemoteAddrFilter(커밋6eda98540a, "Remove the deprecated …"),JAASRealm(커밋e12e023930),JDBCAccessLogValve가 main에는 없습니다.RemoteAddrValve로 IP를 막던 설정은RemoteCIDRValve로 바꿔야 합니다. 11.0.x의RemoteAddrValve에는 "Tomcat 12부터 없어지니RemoteCIDRValve를 쓰라"는@deprecated주석이 붙어 있고,RemoteCIDRValve는 main에 그대로 있습니다. - EL에 연산자가 늘었습니다.
org/apache/el/parser/AstElvis.java와AstNullCoalescing.java가 main에만 있습니다. EL에?:(Elvis) 연산자를 더한 것이 커밋1242677516("Add support for the Elvis operator"), 그것을 고치면서??(null 병합) 연산자를 더한 것이 커밋b037fcfec5입니다. .java파일 수는 main 2,984개, 11.0.x 2,986개입니다(저장소 전체, 아래 3절과 같은 방법으로 셈). 빠진 것과 더한 것이 거의 맞먹습니다.
Java 21이 필요합니다
어떤 Java로 빌드하고 돌려야 하는지는 build.xml에 있습니다.
  <!-- Jakarta EE 12 platform requires Java 21+ -->
  <!-- Keep in sync with webapps/docs/tomcat-docs.xsl -->
  <property name="compile.release" value="21"/>
  <property name="min.java.version" value="21"/>
  <property name="build.java.version" value="21"/>
  <property name="release.java.version" value="25"/>
주석 그대로 "Jakarta EE 12 플랫폼이 Java 21 이상을 요구"하므로, 소스를 Java 21 문법·API 기준으로 컴파일(compile.release)하고, 돌리는 데도 Java 21 이상(min.java.version)이 필요합니다. 바로 아래 115–122행은 빌드하는 JDK가 21보다 낮으면 "Java version 21 or newer is required"라는 메시지로 빌드를 멈춥니다. 11.0.x 브랜치의 같은 자리는 세 값이 모두 17입니다. 즉 11.0은 Java 17, 12.0은 Java 21부터입니다. (release.java.version의 25는 정식판을 만들 때 쓰는 JDK 버전입니다. 이 연재의 예제는 JDK 21로 빌드했습니다.)
서블릿 스펙은 몇 판인가 — 두 군데의 숫자가 다릅니다
Tomcat의 판마다 구현하는 서블릿 스펙 판이 정해져 있습니다. 이것도 build.xml에 있습니다.
  <!-- Exact spec versions (for the manifests etc.) -->
  <property name="servlet.spec.version"    value="6.2" />
  <property name="servlet.revision"        value="DRAFT" />
  <property name="jsp.spec.version"        value="4.1" />
  <property name="jsp.revision"            value="DRAFT" />
  <property name="el.spec.version"         value="6.1" />
  <property name="el.revision"             value="DRAFT" />
  <property name="websocket.spec.version"  value="2.3" />
  <property name="websocket.revision"      value="DRAFT" />
  <property name="jaspic.spec.version"     value="3.2" />
  <property name="jaspic.revision"         value="DRAFT" />
  <property name="annotation.spec.version" value="3.1" />
  <property name="annotation.revision"     value="DRAFT" />
Servlet 6.2, JSP 4.1, EL 6.1, WebSocket 2.3이고, 모두 DRAFT(초안)라고 적혀 있습니다. Jakarta EE 12 스펙이 아직 확정되지 않았다는 뜻입니다. 11.0.x 브랜치의 같은 자리는 Servlet 6.1, JSP 4.0, EL 6.0, WebSocket 2.2이고 revision은 비어 있습니다(확정판).
실제로 서블릿 API 소스에도 6.2에서 새로 생긴 메서드가 있습니다. HttpServlet에 HTTP의 새 QUERY 메서드를 처리하는 doQuery()가 생겼고(HttpServlet.java 294행), HttpServletResponse에 103 응답을 보내는 sendEarlyHints()가 생겼습니다(HttpServletResponse.java 224행). 둘 다 javadoc에 @since Servlet 6.2가 붙어 있고, 11.0.x 브랜치의 같은 파일에는 없습니다.
그런데 실행 중인 웹앱이 컨테이너에게 "서블릿 스펙 몇 판이냐"고 물으면(ServletContext.getMajorVersion()·getMinorVersion()) 다른 답이 나옵니다. 그 두 메서드는 ApplicationContext에 이렇게 구현되어 있습니다.
    @Override
    public int getMajorVersion() {
        return Constants.MAJOR_VERSION;
    }


    @Override
    public int getMinorVersion() {
        return Constants.MINOR_VERSION;
    }
java/org/apache/catalina/core/ApplicationContext.java 290–299행
가리키는 상수는 같은 패키지의 Constants입니다.
    /**
     * The major version of the Servlet specification implemented by this container.
     */
    public static final int MAJOR_VERSION = 6;

    /**
     * The minor version of the Servlet specification implemented by this container.
     */
    public static final int MINOR_VERSION = 1;
java/org/apache/catalina/core/Constants.java 30–38행
6.1입니다. 이 파일을 마지막으로 바꾼 버전 관련 커밋은 9609c385cd("Update version constant for Servlet 6.1")이고, 그 뒤로 6.2로 올리는 커밋은 아직 없습니다. 아래 예제에서 실제로 물어보면 servlet spec: 6.1이 찍힙니다.
헷갈리기 쉬운 곳
"Tomcat 12는 Servlet 몇 판인가"에 답이 둘입니다. 빌드 설정(build.xml)과 API 소스(jakarta.servlet의 @since Servlet 6.2 메서드, conf/web.xml의 version="6.2")는 6.2를 향해 가고 있는데, 실행 중에 컨테이너가 스스로 밝히는 번호(Constants.MINOR_VERSION)는 아직 6.1입니다. 스펙이 초안인 개발판에서 생기는 어긋남이라고 보이고, 정식판 전에 맞춰질 것으로 짐작합니다(소스로 확인할 수 있는 것은 "지금은 다르다"까지입니다). 이 연재는 **"Servlet 6.2(초안)를 구현하는 중인 판"**이라고 부르겠습니다.
12.0.0-M1은 정식판이 아닙니다. "M1"은 첫 번째 마일스톤(시험판)이라는 뜻이고, 이 저장소에는 아직 12.0.0-M1 태그조차 없습니다. 실제 서비스에 쓰는 것은 11.0.x(또는 그 이전) 안정판입니다. Spring 연재의 20편 예제도 내장 Tomcat 안정판(tomcat-embed-core 11.0.15)으로 돌렸습니다.
2. 같은 소스 받기
이 절은 글의 예제를 직접 돌려 보고 싶은 분을 위한 것입니다. 읽기만 할 거라면 3절(폴더 지도)로 넘어가도 됩니다.
소스 받고 커밋 고정하기
글의 줄 번호를 직접 열어 보려면 같은 커밋의 소스가 있어야 합니다. Git이 있으면 다음 순서로 합니다.
- 저장소를 받습니다. 이력이 길어서 시간이 조금 걸립니다.
- 기준 커밋을 따로 꺼내 둡니다. 저는 받은 폴더(
tomcat)는 그대로 두고 git worktree로 기준 커밋만 다른 폴더(tomcat-17aa1769b0)에 꺼냈습니다. worktree는 저장소 하나에서 다른 커밋을 다른 폴더로 동시에 꺼내 두는 기능입니다. 이렇게 하면 원래 폴더에서git pull로 최신 소스를 받아도 기준 커밋 폴더의 줄 번호는 바뀌지 않습니다. - 제대로 맞춰졌는지 확인합니다. 긴 커밋 번호가 그대로 나오면 됩니다.
git clone https://github.com/apache/tomcat.git
cd tomcat
git worktree add --detach ../tomcat-17aa1769b0 17aa1769b0fa32713b7b36b10a33155b63a40bbc
git -C ../tomcat-17aa1769b0 rev-parse HEAD
worktree가 번거로우면 git checkout 17aa1769b0fa32713b7b36b10a33155b63a40bbc로 받은 폴더 자체를 그 커밋에 맞춰도 됩니다. "detached HEAD"라는 안내가 나오는데, 브랜치가 아니라 특정 커밋을 꺼냈다는 뜻이고 읽기만 할 때는 문제없습니다. 11.0.x와 비교하고 싶을 때는 git show origin/11.0.x:<경로>로 파일을 꺼내 보면 체크아웃을 바꾸지 않아도 됩니다.
내려받지 않고 웹에서만 봐도 됩니다. GitHub에서 이 커밋을 여는 주소로 들어가면 같은 파일이 보이고, 이 연재의 코드 링크도 전부 이 커밋을 가리킵니다.
도커에서 빌드하기
읽기만 할 거면 빌드는 필요 없습니다. 하지만 이 연재는 글에 싣는 예제를 전부 실제로 돌려 보기 때문에, 기준 커밋을 빌드한 Tomcat이 필요합니다. 내려받은 정식판(11.0.x)으로 돌리면 줄 번호도, 있는 클래스도 다르기 때문입니다. 그래서 도커 컨테이너 안에서 기준 커밋을 그대로 빌드했습니다. 실제로 쓰는 Dockerfile입니다.
# "Tomcat 소스 파헤치기" 예제용 이미지.
# 기준 커밋 17aa1769b0 (main, 12.0.0-M1) 의 소스를 그대로 Ant 로 빌드한다.
# 소스는 git archive 로 뽑은 tomcat-17aa1769b0.tar.gz (LF 줄 끝, 손대지 않은 원본).
FROM eclipse-temurin:21-jdk

RUN apt-get update && DEBIAN_FRONTEND=noninteractive apt-get install -y --no-install-recommends \
      ant curl procps unzip \
    && rm -rf /var/lib/apt/lists/*

COPY tomcat-17aa1769b0.tar.gz /usr/src/
WORKDIR /usr/src
# base.path: 빌드가 내려받는 의존 라이브러리(ecj, bnd 등)를 둘 곳
RUN tar xzf tomcat-17aa1769b0.tar.gz && cd tomcat \
    && echo "base.path=/usr/src/tomcat-deps" > build.properties \
    && ant -q deploy \
    && cp -r output/build /opt/tomcat

ENV CATALINA_HOME=/opt/tomcat PATH=/opt/tomcat/bin:$PATH
WORKDIR /work
CMD ["version.sh"]
하는 일을 순서대로 풀면 이렇습니다.
- JDK 21이 든 이미지에서 시작합니다.
eclipse-temurin:21-jdk는 Eclipse Adoptium이 만든 OpenJDK 21 이미지입니다. 위에서 본 대로 main은 Java 21이 있어야 빌드됩니다. - Ant와 도구를 설치합니다.
ant가 빌드 도구이고,curl·ps(procps)는 예제에서 서버를 들여다보려고 넣었습니다.jstack·jcmd(스레드 덤프 도구)는 JDK에 이미 들어 있습니다. - 기준 커밋의 소스를 압축 파일로 넣습니다. 저장소에서
git archive로 뽑은 원본입니다. 주석에 "LF 줄 끝"이라고 적은 까닭은 httpd 연재에서 겪은 일 때문입니다. Windows의 Git(core.autocrlf=true)으로 꺼낸 파일은 줄 끝이 CRLF가 되어, 리눅스에서 셸 스크립트가 "없는 파일"이라며 실행되지 않았습니다(httpd 1편의 "막혔던 곳"). 그래서 이번에는 처음부터 변환 없이 뽑았습니다. build.properties에base.path를 적습니다. Tomcat의 빌드는 JSP 컴파일러 ecj(Eclipse의 자바 컴파일러) 같은 의존 라이브러리를 빌드하면서 인터넷에서 내려받습니다.base.path는 그것을 둘 폴더입니다. 저장소의BUILDING.txt도 기본값이 마땅치 않으니 이 파일을 늘 만들라고 권합니다(BUILDING.txt 126–148행).ant deploy로 빌드합니다.deploy는build.xml의 기본 대상(target)이고, 끝나면output/build에 바로 실행할 수 있는 Tomcat이 생깁니다(BUILDING.txt 164–173행). 이것을/opt/tomcat으로 복사하고CATALINA_HOME(Tomcat이 설치된 폴더를 가리키는 환경 변수)으로 둡니다.
이렇게 만든 이미지 이름이 tomcat-lab:17aa1769b0입니다. 내려받은 정식판 압축 파일을 풀었을 때와 같은 모양(bin/, conf/, lib/, webapps/ …)이 /opt/tomcat에 생깁니다.
예제를 돌리는 방법
예제는 편마다 폴더 하나(ex/u01-reading-plan처럼)에 run.sh를 두고, 이것을 컨테이너 안에서 실행하는 작은 스크립트(run-example.sh)로 돌립니다. 핵심은 한 줄입니다.
MSYS_NO_PATHCONV=1 docker run --rm -v "$(pwd -W 2>/dev/null || pwd)/$dir:/work" -w /work \
  tomcat-lab:17aa1769b0 bash ./run.sh
예제 폴더를 컨테이너의 /work에 붙이고 run.sh를 실행한 뒤, 컨테이너는 바로 지웁니다(--rm). 매번 깨끗한 서버에서 시작하므로 앞 예제가 남긴 웹앱이나 로그에 영향을 받지 않습니다. pwd -W는 Git Bash에서 Windows 경로(D:/…)를 얻는 방법이고, MSYS_NO_PATHCONV=1은 Git Bash가 /work 같은 인자를 Windows 경로로 멋대로 바꾸지 못하게 막는 설정입니다(httpd 연재와 같은 방식입니다).
run.sh 안에서는 설치 폴더(CATALINA_HOME=/opt/tomcat)를 건드리지 않고, /tmp/base에 conf/·logs/·webapps/를 따로 만든 뒤 CATALINA_BASE=/tmp/base로 띄웁니다. CATALINA_HOME은 프로그램(jar·스크립트)이 있는 곳, CATALINA_BASE는 설정·웹앱·로그가 있는 곳입니다. 둘을 나눠 두면 설치본 하나로 여러 인스턴스를 띄울 수 있습니다. 두 값이 어떻게 쓰이는지는 3편에서 봅니다.
예제: 빌드한 서버에게 직접 물어보기
이 연재의 예제는 모두 기준 커밋(17aa1769b0)을 그대로 빌드한 Tomcat 12.0.0-M1-dev로 도커 컨테이너(Eclipse Temurin JDK 21)에서 실행했습니다. 예제 폴더는 ex/u01-reading-plan입니다. 먼저 version.sh입니다(Server built 시각은 빌드마다, OS Version은 실행하는 PC마다 다릅니다).
Server version: Apache Tomcat/12.0.0-M1-dev
Server built:   Oct 24 2026 13:31:50 UTC
Server number:  12.0.0.0
OS Name:        Linux
OS Version:     5.15.146.1-microsoft-standard-WSL2
Architecture:   amd64
JVM Version:    21.0.12.1+1-LTS
JVM Vendor:     Eclipse Adoptium
APR loaded:     false

Third-party libraries:
  ecj-4.41.jar:                          3.46.100.v20260826-1225
  jakartaee-migration-1.0.13-shaded.jar: 1.0.13
build.properties.default에서 읽은 숫자가 그대로 나옵니다. APR loaded: false는 Tomcat Native(OpenSSL을 쓰는 C 라이브러리)를 싣지 않았다는 뜻이고, 이 연재의 예제는 모두 순수 자바로 돕니다. 아래 두 줄은 빌드가 내려받아 함께 넣은 라이브러리입니다. ecj는 JSP를 컴파일하는 데(13편), jakartaee-migration은 "Apache Tomcat Migration Tool for Jakarta EE"(bin/migrate.sh가 부르는 도구)로, javax.*로 짠 옛 Java EE 웹앱을 jakarta.*로 바꿔 줍니다.
다음은 lib/ 폴더의 jar 목록입니다. 크기(바이트)와 이름입니다.
35
    13731  annotations-api.jar
    60127  catalina-ant.jar
   132150  catalina-ha.jar
    67464  catalina-ssi.jar
    97889  catalina-storeconfig.jar
   368904  catalina-tribes.jar
  1769887  catalina.jar
  3384534  ecj-4.41.jar
    97854  el-api.jar
  1466818  jakartaee-migration-1.0.13-shaded.jar
   184793  jasper-el.jar
   551772  jasper.jar
    27816  jaspic-api.jar
    72851  jsp-api.jar
   445522  servlet-api.jar
    12039  tomcat-api.jar
     9200  tomcat-coyote-ffm.jar
   900823  tomcat-coyote.jar
   344745  tomcat-dbcp.jar
    70245  tomcat-i18n-cs.jar
    77508  tomcat-i18n-de.jar
   106939  tomcat-i18n-es.jar
   186025  tomcat-i18n-fr.jar
   211770  tomcat-i18n-ja.jar
   190389  tomcat-i18n-ko.jar
    52780  tomcat-i18n-pt-BR.jar
    71663  tomcat-i18n-ru.jar
   177889  tomcat-i18n-zh-CN.jar
   154827  tomcat-jdbc.jar
    16750  tomcat-jni.jar
   231698  tomcat-util-scan.jar
   214154  tomcat-util.jar
   260099  tomcat-websocket.jar
    14064  websocket-api.jar
    31767  websocket-client-api.jar
35개입니다. 이름만 봐도 소스 폴더와 이어집니다. *-api.jar는 java/jakarta/ 아래의 표준 API, catalina.jar는 Catalina, tomcat-coyote.jar는 Coyote, jasper.jar는 Jasper입니다. 다만 jar와 패키지가 일대일은 아닙니다. 예를 들어 build.xml의 묶음 규칙을 보면 catalina.jar에는 JNDI(org/apache/naming)도 들어가고 클러스터(ha, tribes)는 빠집니다(build.xml 493–502행). 연결을 받는 NioEndpoint가 든 org/apache/tomcat/util/net은 tomcat-util.jar가 아니라 tomcat-coyote.jar에 들어갑니다(build.xml 767–776행). 스택 트레이스에서 클래스 이름을 보고 "이건 어느 jar에 있나"를 찾을 때 알아 두면 좋습니다.
3. 폴더 지도 — 74만 줄은 어디에 있나
맨 위 폴더
기준 커밋에서 git이 관리하는 파일은 5,036개입니다. 그 가운데 자바 소스(.java)는 2,984개, 합쳐서 741,389줄(빈 줄과 주석 포함)입니다. 맨 위 폴더별로 직접 세면 이렇습니다(git ls-files로 파일을 고르고 wc -l로 셈).
| 폴더 | 들어 있는 것 | .java 파일 |
줄 수 |
|---|---|---|---|
java/ |
서버 본체. 표준 API(jakarta/)와 구현(org/apache/) |
1,779 | 503,838 |
test/ |
단위·통합 테스트 | 1,019 | 192,251 |
modules/ |
따로 빌드하는 부가 모듈(jdbc-pool, manager2, stuffed 등) |
116 | 38,012 |
webapps/ |
같이 배포되는 웹앱(ROOT, docs, examples, manager, host-manager) |
70 | 7,288 |
conf/ |
기본 설정 파일(server.xml, web.xml, context.xml, tomcat-users.xml, catalina.properties, logging.properties 등 9개) |
0 | 0 |
bin/ |
실행 스크립트(catalina.sh, startup.sh, version.sh 등과 .bat 짝) |
0 | 0 |
res/ |
빌드에 쓰는 자원(jar 안에 넣을 META-INF 파일, Windows 설치 프로그램 install-win, 검사 도구 설정 등) |
0 | 0 |
conf/와 bin/은 정식판을 풀었을 때 보던 바로 그 폴더입니다. 빌드는 이것들을 output/build로 복사하고 java/를 컴파일해 lib/의 jar로 묶습니다. 소스를 읽을 때는 java/가 전부라고 생각해도 됩니다. 테스트가 19만 줄이나 되는 것도 눈에 띕니다. 어떤 동작이 헷갈릴 때 test/에서 같은 이름의 테스트(예: TestCoyoteAdapter)를 찾아 보면 의도를 알 수 있는 경우가 많습니다.
java/ 안
java/ 안을 패키지별로 나누면 이렇습니다.
| 패키지 | 들어 있는 것 | .java 파일 |
줄 수 | 다루는 편 |
|---|---|---|---|---|
jakarta/* |
표준 API — servlet(117개, 18,666줄), el, websocket, security, annotation 등 10개 |
262 | 33,109 | 9·12편 |
org/apache/catalina |
Catalina, 서블릿 컨테이너 | 611 | 205,367 | 2–4·7–11·14·16편 |
org/apache/coyote |
Coyote, 커넥터 — http11, http2, ajp |
92 | 30,746 | 5·6·15편 |
org/apache/tomcat |
공통 도구 — util(358개, 107,414줄), dbcp, websocket 등 |
577 | 167,199 | 5·6·15·16편 |
org/apache/jasper |
Jasper, JSP 엔진 | 109 | 42,371 | 13편 |
org/apache/el |
EL(${…} 식) 구현 |
82 | 16,690 | 13편 |
org/apache/naming |
JNDI(java:comp/env 이름 찾기) 구현 |
32 | 4,739 | — |
org/apache/juli |
로깅(JULI, java.util.logging을 웹앱별로 나눠 쓰게 한 것) |
14 | 3,617 | 16편 |
Catalina가 가장 크지만, 그 안의 20만 줄이 전부 요청 처리에 쓰이는 것은 아닙니다. 서버 여러 대를 묶는 클러스터 코드 catalina/tribes(30,578줄)와 catalina/ha(10,651줄)가 4만 줄을 넘습니다. org/apache/tomcat에서도 DB 커넥션 풀 tomcat/dbcp(39,906줄)는 Apache Commons DBCP와 Pool(dbcp2, pool2)을 패키지 이름만 바꿔 넣은 것이라 이 연재에서 읽지 않습니다. 이 연재가 가장 많이 머무를 파일들의 크기도 적어 둡니다.
| 파일 | 줄 수 | 다루는 편 |
|---|---|---|
tomcat/util/net/AbstractEndpoint.java |
2,576 | 5편 |
tomcat/util/net/NioEndpoint.java |
2,274 | 5편 |
coyote/http11/Http11Processor.java |
1,452 | 6편 |
catalina/connector/CoyoteAdapter.java |
1,323 | 7편 |
catalina/mapper/Mapper.java |
1,882 | 7편 |
catalina/core/StandardWrapperValve.java |
337 | 9편 |
catalina/core/ApplicationFilterChain.java |
248 | 9편 |
catalina/startup/ContextConfig.java |
3,032 | 10편 |
catalina/core/StandardContext.java |
6,019 | 2·10편 |
Spring을 읽을 때 본 코드가 테스트를 뺀 본 코드만 약 84만 줄, httpd가 .c·.h 약 35만 줄이었으니 Tomcat은 그 중간입니다. 다만 Tomcat의 74만 줄은 4분의 1이 테스트이고, 테스트를 뺀 본체(java/)는 50만 줄 남짓입니다.
층으로 보면
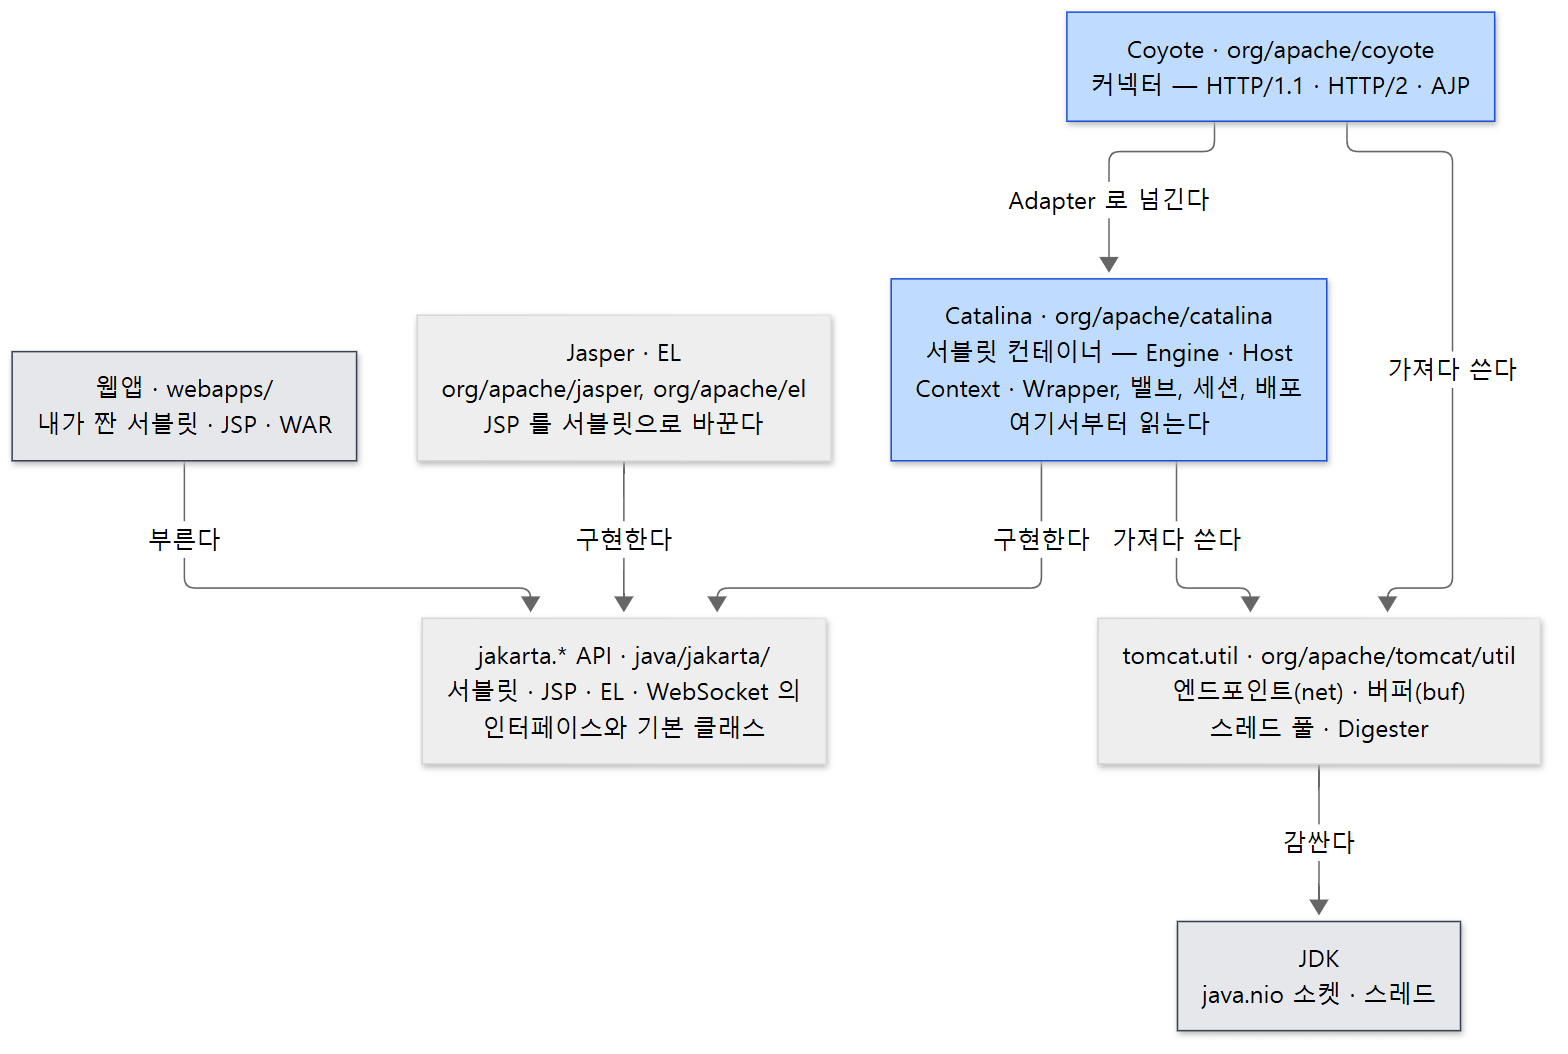 Tomcat의 층. 파란 칸(Catalina, Coyote)에서 읽기 시작하고, 회색 칸(웹앱, JDK)은 바깥입니다.
이 그림에서 두 가지를 기억해 두면 됩니다.
첫째, 웹앱은 Tomcat의 클래스를 모릅니다. 우리가 짠 서블릿은 jakarta.servlet.http.HttpServletRequest 같은 인터페이스만 보고, 그 뒤에 있는 실제 객체(Catalina의 RequestFacade)는 Tomcat이 넣어 줍니다. 그래서 같은 WAR가 Tomcat에서도 Jetty에서도 돕니다. 왜 Request가 아니라 RequestFacade인지는 7편에서 봅니다.
둘째, Coyote와 Catalina는 Adapter 하나로만 이어집니다. Coyote(org.apache.coyote)는 서블릿을 모르고, 자기 패키지의 Adapter 인터페이스에 요청을 넘길 뿐입니다. 그 인터페이스를 구현한 것이 Catalina 쪽의 CoyoteAdapter입니다. 이 설계는 2편에서 자세히 봅니다.
헷갈리기 쉬운 곳
org/apache/tomcat/websocket과 jakarta/websocket은 다릅니다. 앞의 것은 WebSocket의 Tomcat 구현이고, 뒤의 것은 표준 API입니다. 서블릿(jakarta/servlet ↔ org/apache/catalina)도 같은 관계입니다. **"jakarta로 시작하면 표준, org/apache로 시작하면 Tomcat의 구현"**으로 기억하면 됩니다. 다만 표준 API의 소스가 Tomcat 저장소 안에 있는 것은 Tomcat이 servlet-api.jar를 직접 만들어 배포하기 때문입니다.
TOMCAT-NEXT.txt는 비어 있습니다. 저장소 맨 위에 "다음 메이저 판(12.x)에서 고려할 것들의 메모"라는 파일이 있어서 12.0의 계획이 적혀 있을 것 같지만, 기준 커밋에서는 라이선스 머리말과 그 제목 한 줄뿐이고 항목은 하나도 없습니다. main과 11.0.x의 차이는 위처럼 소스와 git 기록으로 직접 봐야 합니다.
4. 요청 하나가 지나는 큰 길
설정 파일에서 보던 것부터
소스로 들어가기 전에 늘 보던 conf/server.xml을 봅니다. 주석을 걷어 내면 뼈대는 이렇습니다.
<Server port="8005" shutdown="SHUTDOWN">
<!-- ... -->
<Service name="Catalina">
<!-- ... -->
<Connector port="8080" protocol="HTTP/1.1"
connectionTimeout="20000"
redirectPort="8443" />
<!-- ... -->
<Engine name="Catalina" defaultHost="localhost">
<!-- ... -->
<Host name="localhost" appBase="webapps"
unpackWARs="true" autoDeploy="true">
<!-- ... -->
<Valve className="org.apache.catalina.valves.AccessLogValve" directory="logs"
prefix="localhost_access_log" suffix=".txt"
pattern="%h %l %u %t "%r" %s %b" />
</Host>
</Engine>
</Service>
</Server>
conf/server.xml 22–154행 (줄인 곳은 <!-- ... -->로 표시)
<Connector>가 Coyote, <Engine>부터 안쪽이 Catalina입니다. Context(웹앱 하나)와 Wrapper(서블릿 하나)는 여기에 적혀 있지 않지만, webapps/ 아래 폴더와 그 안의 서블릿마다 실행 중에 만들어집니다(<Context> 는 따로 적을 수도 있지만, Wrapper 에는 server.xml 요소가 아예 없습니다). 그래서 컨테이너는 Engine → Host → Context → Wrapper 네 겹입니다. 이 네 겹은 2편에서, server.xml이 객체가 되는 과정은 3편에서 봅니다.
한 장으로 보면
연재의 5편부터 9편까지는 요청 하나가 지나가는 길을 순서대로 따라갑니다. 큰 길만 한 장에 그리면 이렇습니다.
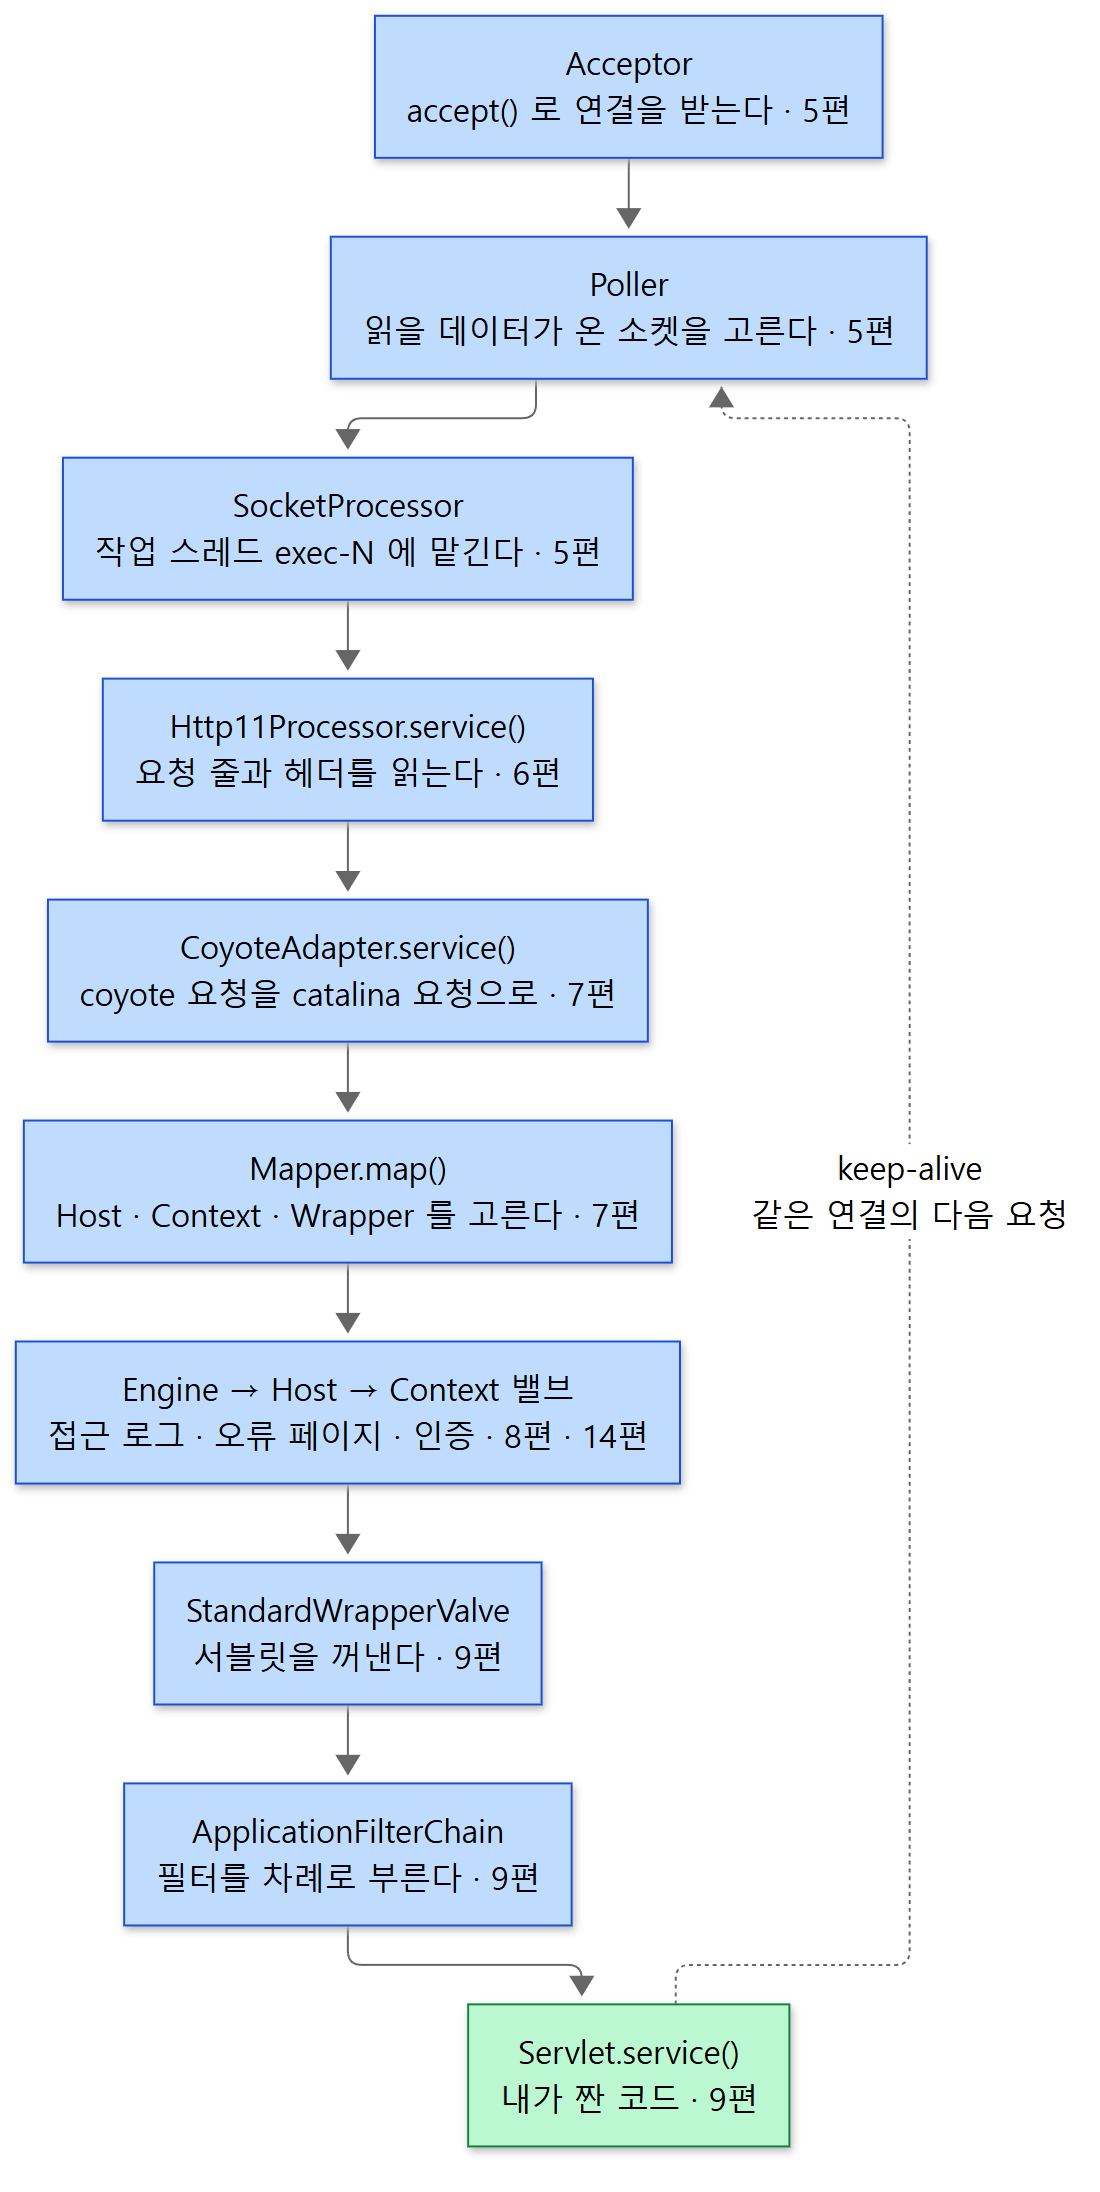 요청 하나의 큰 길. 칸마다 그 단계를 다루는 편이 적혀 있습니다. 점선은 keep-alive 연결에서 다음 요청으로 돌아가는 길입니다.
설정 파일에서 보던 것과 이어 보면 이렇습니다.
| 단계 | 설정 파일에서 보던 것 | 다루는 편 |
|---|---|---|
| Acceptor · Poller · 작업 스레드 | <Connector port maxThreads maxConnections acceptCount>, <Executor> |
5편 |
| HTTP/1.1 읽기 | connectionTimeout, maxHttpHeaderSize, keepAliveTimeout |
6편 |
| CoyoteAdapter · Mapper | <Host name>, <Context path>, web.xml의 <servlet-mapping> |
7편 |
| 밸브 | <Valve className="…AccessLogValve">, <Realm> |
8·14편 |
| 필터 체인 · 서블릿 | web.xml의 <filter>·<servlet>, @WebFilter·@WebServlet |
9편 |
코드에서 두 군데만 미리 보기
하나, 연결을 작업 스레드에 넘기는 곳. Poller가 "이 소켓에 읽을 데이터가 왔다"고 알아차리면 AbstractEndpoint.processSocket()을 부릅니다.
            SocketProcessorBase<S> sc = null;
            if (processorCache != null) {
                sc = processorCache.pop();
            }
            if (sc == null) {
                sc = createSocketProcessor(socketWrapper, event);
            } else {
                sc.reset(socketWrapper, event);
            }
            Executor executor = getExecutor();
            if (dispatch && executor != null) {
                executor.execute(sc);
            } else {
                sc.run();
            }
java/org/apache/tomcat/util/net/AbstractEndpoint.java 2136–2150행
할 일(SocketProcessor)을 하나 만들어(쓰고 남은 것이 캐시에 있으면 다시 쓰고) 스레드 풀(executor)에 넘깁니다. 그 뒤로 응답을 다 쓸 때까지는 풀의 작업 스레드 하나가 이 요청을 맡습니다. Poller 스레드는 곧바로 다른 소켓을 지켜보러 돌아갑니다. 이 구조는 5편에서 봅니다.
둘, Coyote에서 Catalina로 넘어가는 곳. CoyoteAdapter.service()의 가운데입니다.
        try {
            // Parse and set Catalina and configuration specific
            // request parameters
            postParseSuccess = postParseRequest(req, request, res, response);
            if (postParseSuccess) {
                // check valves if we support async
                request.setAsyncSupported(connector.getService().getContainer().getPipeline().isAsyncSupported());
                // Calling the container
                connector.getService().getContainer().getPipeline().getFirst().invoke(request, response);
            }
java/org/apache/catalina/connector/CoyoteAdapter.java 339–348행
req·res는 Coyote가 만든 요청·응답이고, request·response는 Catalina 쪽 객체입니다. 먼저 postParseRequest()가 URI를 정리하고 Mapper로 이 요청이 갈 Host·Context·서블릿을 정합니다(같은 파일 700행의 connector.getService().getMapper().map(…)). 정해지면 347행에서 컨테이너의 맨 위(Engine)의 파이프라인(밸브를 줄 세운 사슬)에서 첫 밸브를 부릅니다. 그다음부터는 밸브가 다음 밸브를, 마지막 밸브가 한 겹 안쪽 컨테이너의 파이프라인을 부르는 식으로 Wrapper까지 내려갑니다(8편).
예제: 정말 이 길로 지나가나
그림이 맞는지 서블릿 안에서 호출 스택(지금 실행 중인 메서드를 누가 불렀는지 거꾸로 늘어놓은 목록)을 찍어 확인했습니다. httpd 연재에서는 gdb를 썼지만, 자바는 new Throwable().getStackTrace() 한 줄이면 됩니다. 예제 서블릿입니다.
// 이 글을 위해 쓴 예제입니다 (Tomcat 의 소스가 아닙니다)
import jakarta.servlet.annotation.WebServlet;
import jakarta.servlet.http.HttpServlet;
import jakarta.servlet.http.HttpServletRequest;
import jakarta.servlet.http.HttpServletResponse;
import java.io.IOException;
import java.io.PrintWriter;

@WebServlet("/where")
public class WhereAmI extends HttpServlet {
    @Override
    protected void doGet(HttpServletRequest req, HttpServletResponse resp) throws IOException {
        resp.setContentType("text/plain");
        PrintWriter out = resp.getWriter();
        // 서버 이름과, 컨테이너가 스스로 밝히는 서블릿 스펙 버전
        out.println("server info : " + getServletContext().getServerInfo());
        out.println("servlet spec: " + getServletContext().getMajorVersion()
                + "." + getServletContext().getMinorVersion());
        // 이 요청을 처리하는 스레드
        out.println("thread      : " + Thread.currentThread().getName());
        // 지금 이 순간의 호출 스택 — 맨 위가 이 메서드, 맨 아래가 스레드의 시작
        out.println("stack (top = this method):");
        for (StackTraceElement e : new Throwable().getStackTrace()) {
            out.println("  at " + e.getClassName() + "." + e.getMethodName()
                    + "(" + e.getFileName() + ":" + e.getLineNumber() + ")");
        }
    }
}
run.sh는 이것을 servlet-api.jar만 클래스패스에 두고 javac로 컴파일해 /tmp/base/webapps/u01/WEB-INF/classes에 넣고, catalina.sh start로 띄운 뒤 curl http://127.0.0.1:8080/u01/where로 부릅니다. web.xml 없이 @WebServlet 어노테이션만으로 등록됩니다(어노테이션을 찾는 곳은 10편). 응답입니다.
server info : Apache Tomcat/12.0.0-M1-dev
servlet spec: 6.1
thread      : http-nio-8080-exec-2
stack (top = this method):
  at WhereAmI.doGet(WhereAmI.java:23)
  at jakarta.servlet.http.HttpServlet.service(HttpServlet.java:673)
  at jakarta.servlet.http.HttpServlet.service(HttpServlet.java:762)
  at org.apache.catalina.core.ApplicationFilterChain.doFilter(ApplicationFilterChain.java:132)
  at org.apache.tomcat.websocket.server.WsFilter.doFilter(WsFilter.java:59)
  at org.apache.catalina.core.ApplicationFilterChain.doFilter(ApplicationFilterChain.java:111)
  at org.apache.catalina.core.StandardWrapperValve.invoke(StandardWrapperValve.java:164)
  at org.apache.catalina.core.StandardContextValve.invoke(StandardContextValve.java:77)
  at org.apache.catalina.authenticator.AuthenticatorBase.invoke(AuthenticatorBase.java:540)
  at org.apache.catalina.core.StandardHostValve.invoke(StandardHostValve.java:115)
  at org.apache.catalina.valves.ErrorReportValve.invoke(ErrorReportValve.java:82)
  at org.apache.catalina.valves.AbstractAccessLogValve.invoke(AbstractAccessLogValve.java:777)
  at org.apache.catalina.core.StandardEngineValve.invoke(StandardEngineValve.java:71)
  at org.apache.catalina.connector.CoyoteAdapter.service(CoyoteAdapter.java:347)
  at org.apache.coyote.http11.Http11Processor.service(Http11Processor.java:404)
  at org.apache.coyote.AbstractProcessorLight.process(AbstractProcessorLight.java:71)
  at org.apache.coyote.AbstractProtocol$ConnectionHandler.process(AbstractProtocol.java:1317)
  at org.apache.tomcat.util.net.NioEndpoint$SocketProcessor.doRun(NioEndpoint.java:2218)
  at org.apache.tomcat.util.net.SocketProcessorBase.run(SocketProcessorBase.java:74)
  at org.apache.tomcat.util.threads.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:968)
  at org.apache.tomcat.util.threads.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:481)
  at org.apache.tomcat.util.threads.TaskThread$WrappingRunnable.run(TaskThread.java:74)
  at java.lang.Thread.run(Thread.java:1583)
(스레드 이름 끝의 번호는 실행마다 다릅니다.) 위 두 줄에서 1절의 버전이 확인됩니다. 서버는 12.0.0-M1-dev, 컨테이너가 밝히는 서블릿 스펙은 6.1입니다.
스택은 아래에서 위로 읽습니다. 괄호 안의 줄 번호는 모두 기준 커밋의 소스와 맞춰 보았습니다. 예를 들어 CoyoteAdapter.java:347은 바로 위에서 본 "Calling the container" 줄입니다.
- 스레드 풀의 작업 스레드(
ThreadPoolExecutor→SocketProcessorBase.run())가 시작점입니다. JDK의 것이 아니라 Tomcat이 따로 가진org.apache.tomcat.util.threads.ThreadPoolExecutor입니다(왜 따로 가졌는지는 5편). - Coyote:
NioEndpoint$SocketProcessor.doRun()→AbstractProtocol$ConnectionHandler.process()→Http11Processor.service(). 여기서 요청 줄과 헤더를 읽습니다(6편). - 경계:
CoyoteAdapter.service()에서 Catalina로 넘어갑니다. - 밸브: Engine의
StandardEngineValve→ Host의AbstractAccessLogValve·ErrorReportValve·StandardHostValve→ Context의AuthenticatorBase·StandardContextValve→ Wrapper의StandardWrapperValve. 네 겹의 컨테이너를 차례로 내려가는 것이 그대로 보입니다. - 필터 체인:
ApplicationFilterChain.doFilter()가 필터(WsFilter)를 부르고, 필터가 다시 체인을 불러 마지막에 서블릿의service()에 닿습니다(9편). - 서블릿:
HttpServlet.service()가 GET이니doGet()을 부릅니다.
run.sh는 마지막으로 jcmd <pid> Thread.print로 스레드 덤프를 떠서 이름이 http-nio-8080으로 시작하는 스레드만 골랐습니다.
"http-nio-8080-Acceptor"
"http-nio-8080-Poller"
"http-nio-8080-exec-1"
"http-nio-8080-exec-2"
"http-nio-8080-exec-3"
"http-nio-8080-exec-4"
"http-nio-8080-exec-5"
"http-nio-8080-exec-6"
"http-nio-8080-exec-7"
"http-nio-8080-exec-8"
"http-nio-8080-exec-9"
"http-nio-8080-exec-10"
그림의 맨 위 세 칸이 스레드로 보입니다. 연결을 받는 Acceptor 하나, 소켓을 지켜보는 Poller 하나, 그리고 작업 스레드 exec-1~exec-10입니다. 이름은 소스에서 이렇게 붙습니다. Acceptor는 getName() + "-Acceptor"(AbstractEndpoint.java 2331행), Poller는 getName() + "-Poller"(NioEndpoint.java 542행), 작업 스레드는 getName() + "-exec-" 뒤에 번호입니다(AbstractEndpoint.java 1967행). 작업 스레드가 10개인 것은 minSpareThreads의 기본값이 10이기 때문입니다(AbstractEndpoint.java 1459행). 요청이 몰리면 maxThreads의 기본값 200까지 늘어납니다(1499행).
헷갈리기 쉬운 곳
Mapper는 스택에 없습니다. 그림에서 Mapper는 CoyoteAdapter와 밸브 사이에 있는데, 위 스택에는 Mapper가 한 줄도 없습니다. 호출 스택은 지금 이 순간 열려 있는 메서드만 보여 주기 때문입니다. Mapper는 postParseRequest() 안에서 불려 "이 요청은 이 Context의 이 서블릿"이라고 적어 두고(request.getMappingData()) 이미 돌아갔습니다. 밸브들은 그 적어 둔 결과를 꺼내 쓸 뿐입니다(StandardEngineValve의 request.getHost()처럼). httpd 1편에서 ap_read_request()가 스택에 없던 것과 같은 이유입니다.
아무것도 걸지 않았는데 필터와 밸브가 끼어 있습니다. 예제 웹앱에는 필터도, 로그인 설정도 없는데 스택에 WsFilter와 AuthenticatorBase가 보입니다. 소스를 따라가면 셋 다 Tomcat이 스스로 끼운 것입니다.
WsFilter:tomcat-websocket.jar가ServletContainerInitializer(웹앱이 시작할 때 컨테이너가 불러 주는 초기화 클래스)로WsSci를 등록해 두었고(res/META-INF/tomcat-websocket.jar/services/jakarta.servlet.ServletContainerInitializer), 그 과정에서WsServerContainer가 모든 웹앱에 이 필터를 더합니다(WsServerContainer.java 98행). WebSocket 업그레이드 요청을 가로채려는 것입니다(15편).AuthenticatorBase: 로그인 설정이 없으면ContextConfig가 인증 방식NONE인 가짜 설정을 넣고(ContextConfig.java 342–345행) 그에 맞는NonLoginAuthenticator(AuthenticatorBase의 하위 클래스) 밸브를 Context에 겁니다. 주석은HttpServletRequest.login()을 쓸 수 있게 하려는 것이라고 적고 있습니다(14편).ErrorReportValve:server.xml에 없는데도StandardHost.startInternal()이 Host의 파이프라인에 더합니다(StandardHost.java 785–801행). 우리가 자주 보는 Tomcat의 회색 오류 페이지를 만드는 밸브입니다(8편). 반면AbstractAccessLogValve는server.xml에 적힌AccessLogValve입니다.
설정 파일만 봐서는 알 수 없는 것이 스택 한 번으로 드러납니다. 이 연재가 편마다 스택이나 스레드 이름을 찍어 보는 까닭입니다.
5. 어떻게 읽나 — AI와 함께, 그러나 소스로 확인하며
읽는 순서
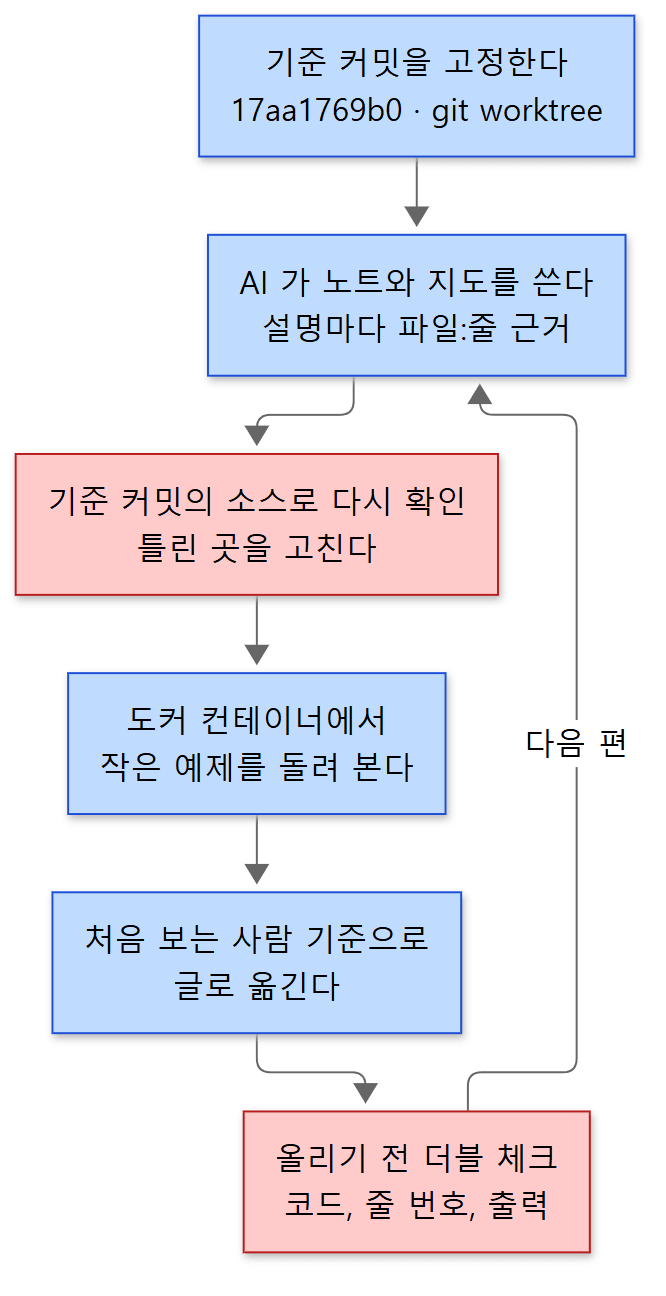 한 편을 읽고 쓰는 순서. 파란 칸은 절차이고, 빨간 칸은 AI가 쓴 내용에서 틀린 곳을 걸러 내는 단계입니다.
Spring·httpd 연재와 원칙은 같습니다. 전체를 한 번에 읽지 않고, 지도에서 질문 하나를 골라 그 질문에 답하는 데 필요한 코드만 깊게 읽습니다. 이 연재에서는 그 질문 하나가 곧 글 한 편입니다.
- 기준 커밋을 고정합니다. 위 2절의 worktree입니다. 줄 번호가 흔들리지 않아야 AI가 쓴 근거를 검증할 수 있습니다.
- AI가 노트와 지도를 씁니다. 연재 16편의 구성, 편마다 출발점이 될 클래스 목록이 이렇게 만들어졌습니다. 편마다 같은 지시서(무엇을 읽고, 어떤 형식으로, 어떤 근거를 달아 쓰는지)를 주고 AI 작업 하나에 한 편씩 맡겼습니다.
- 기준 커밋의 소스로 다시 확인합니다. 지시서에 적은 클래스는 말 그대로 출발점일 뿐이고, 글에 싣는 것은 소스에서 직접 확인한 것만입니다. 코드는 파일에서 그대로 복사하고, 줄 번호는 직접 찾은 것만 적습니다.
- 예제를 실제로 돌립니다. 위 4절처럼 글의 주장 하나를 눈으로 확인하는 작은 예제를 컨테이너에서 돌리고, 출력을 그대로 싣습니다.
- 올리기 전에 한 번 더 확인합니다. 글을 다 쓰면 다른 AI 작업이 소스를 기준으로 코드 블록, 줄 번호, 단정한 사실, 예제 출력을 처음부터 다시 대조합니다. 이 확인을 거치지 않은 글은 올리지 않습니다.
이번 글에서 확인하다 걸린 것
3단계가 왜 필요한지는 이 글을 쓰는 동안에도 드러났습니다. 지시서에는 "1편: 서블릿 스펙 버전을 ServletContext의 major/minor가 가리키는 상수에서 찾아 확인"이라고만 적혀 있었습니다. build.xml만 보고 "Servlet 6.2"라고 쓰거나, 상수만 보고 "Servlet 6.1"이라고 쓰면 둘 다 반만 맞습니다. 두 곳을 다 열고, 실행해서 물어보고 나서야 1절의 "헷갈리기 쉬운 곳"처럼 쓸 수 있었습니다.
WsFilter·AuthenticatorBase도 마찬가지입니다. 요청 경로를 그리면 보통 "밸브 → 필터 → 서블릿"으로 그리고 끝냅니다. 실제 스택을 찍어 보지 않았다면 "필터가 없는 웹앱에도 필터가 하나 끼어 있다"는 것은 글에 들어가지 못했을 것입니다.
저장소 안의 AI 안내문
Tomcat 저장소 맨 위에는 AGENTS.md라는 파일이 있습니다. git 기록을 보면 2026-05-14에 커밋(11043b325a, "Add AGENTS.md + SECURITY.md linking the project's security model")된 파일이고, 첫 문단은 이렇습니다.
This file is read by automated agents (security scanners, code analyzers, AI assistants) operating on this repository. It points them at the human-authored references they should consult before producing output.
"자동 에이전트(보안 스캐너, 코드 분석기, AI 도우미)는 결과를 내기 전에 사람이 쓴 참고 문서를 보라"는 안내이고, 내용은 보안 모델 문서(SECURITY.md)로 가는 링크 하나입니다. AI가 소스를 읽고 "보안 문제를 찾았다"고 보고하는 일이 많아지자, 프로젝트가 무엇을 문제로 보고 무엇을 보지 않는지 먼저 읽으라고 적어 둔 것입니다. 이 연재의 원칙과 같은 말입니다. AI가 쓴 것은 사람이 쓴 기준(여기서는 기준 커밋의 소스)에 대 보고 나서 씁니다.
res/llm/에도 AI와 관련된 것이 있습니다. repomix.config.json5(2025-06-25, 커밋 385b898bff, "Add basic config for building repository data")와 repomix-full.config.json5(이튿날, 커밋 016413da69, "Add a config for java + testsuite") 두 파일로, Repomix라는 도구의 설정입니다. 주석대로 npx repomix를 돌리면 .java 파일(앞의 것은 java/의 일부 패키지를 빼고, 뒤의 것은 테스트까지)을 마크다운 파일 하나(output/repomix/repomix-tomcat.md)로 모아 줍니다. AI에게 소스 전체를 한 번에 건네려는 용도로 보입니다. 그런데 이 설정에는 "removeEmptyLines": true, "showLineNumbers": false가 들어 있습니다. 빈 줄을 지우고 줄 번호를 붙이지 않은 파일을 읽은 AI는 원래 파일의 줄 번호를 알 수 없습니다. AI가 "몇 행"이라고 말하면 그대로 믿지 말고 기준 커밋의 파일에서 다시 찾아야 하는 이유가 하나 더 생기는 셈입니다.
6. 연재 지도
네 묶음
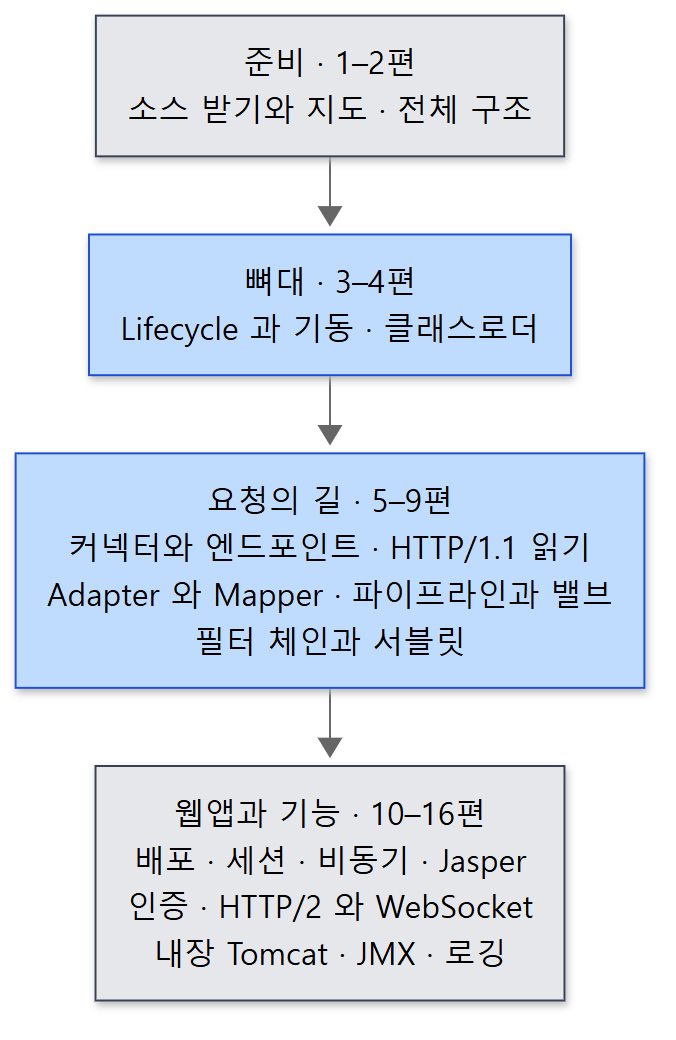 연재의 네 묶음. 파란 칸이 연재의 중심이고, 회색 칸은 그 앞의 준비와 그 위에 얹힌 기능입니다.
| 묶음 | 편 | 답하려는 질문 |
|---|---|---|
| 준비 | 1 | 어떤 소스를 어떻게 읽나 (이 글) |
| 2 | server.xml의 요소는 어떤 클래스가 되고, Catalina와 Coyote는 왜 나뉘었나 |
|
| 뼈대 | 3 | catalina.sh start 뒤에 무엇이 어떤 순서로 켜지나 |
| 4 | 웹앱마다 다른 클래스를 보게 하는 클래스로더는 어떻게 생겼나 | |
| 요청의 길 | 5 | 연결은 어떤 스레드가 받고, 작업 스레드는 어떻게 나뉘나 |
| 6 | 소켓의 바이트는 어떻게 요청 객체가 되나 | |
| 7 | 요청은 어느 Host·Context·서블릿으로 가나 | |
| 8 | 컨테이너마다 걸린 밸브 사슬은 어떻게 돌아가나 | |
| 9 | 필터 체인을 지나 service()가 불리기까지 |
|
| 웹앱과 기능 | 10 | WAR 하나는 어떻게 배포되고 web.xml은 어떻게 읽히나 |
| 11 | 세션 ID는 어떻게 만들고, 세션은 언제 지우나 | |
| 12 | 비동기 서블릿은 어떻게 스레드를 놓아주나 | |
| 13 | JSP는 어떻게 서블릿이 되나 | |
| 14 | security-constraint는 어떻게 지켜지나 |
|
| 15 | HTTP/2와 WebSocket은 어떻게 업그레이드되나 | |
| 16 | 내장 Tomcat, JMX, 로깅은 어떻게 되어 있나 |
읽는 순서
번호 순서대로 읽으면 됩니다. 이 연재도 httpd 연재처럼 처음부터 4절의 큰 길을 따라가도록 번호를 매겼습니다. 이유는 셋입니다.
- 뼈대를 먼저 읽습니다. 요청의 길(5~9편)을 따라가다 보면 컨테이너의 부모·자식 관계,
Lifecycle(켜고 끄는 순서), 웹앱 클래스로더가 계속 나옵니다. 이 셋을 먼저 알아야 그 길이 읽힙니다. - 요청의 길은 바깥에서 안으로 갑니다. 소켓(5편)에서 시작해 서블릿(9편)에서 끝납니다. 위 스택 트레이스를 아래에서 위로 읽는 순서와 같습니다.
- 웹앱과 기능은 마지막에 읽습니다. 배포, 세션, 인증, JSP, WebSocket은 요청의 길 위에 밸브·필터·서블릿으로 얹혀 있습니다. 길을 알고 나면 "이 기능은 길의 어디에 끼어드나"라는 질문 하나로 읽을 수 있습니다.
이 글에서 뺀 것
- 클러스터. 세션을 서버 여러 대에 복제하는
catalina/ha와 그 아래 통신 계층catalina/tribes(합쳐서 4만 줄 남짓)는 이 연재에서 다루지 않습니다. - AJP 커넥터. httpd 같은 앞단 서버와 이어 주는
coyote/ajp(2,683줄)는 다루지 않습니다.server.xml에서도 기본으로 꺼져(주석 처리되어) 있습니다. - Tomcat Native와 FFM. OpenSSL을 쓰는
tomcat/jni(APR loaded: false의 그 APR)와 Java의 FFM(외부 함수 호출) API로 OpenSSL을 부르는tomcat/util/net/openssl/panama는 뺐습니다. 예제는 모두 JDK만으로 돕니다. - DB 커넥션 풀.
tomcat/dbcp와modules/jdbc-pool은 읽지 않습니다. - 관리 웹앱과 부가 모듈.
webapps/manager·host-manager,modules/의manager2·stuffed·cxf·owb는 다루지 않습니다. - 테스트.
test/의 19만 줄은 동작을 확인할 때 참고로만 봅니다. - Windows 서비스.
bin/service.bat과 Commons Daemon(daemon.sh)으로 서비스로 띄우는 방법은 다루지 않습니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
| 읽는 소스 | Apache Tomcat 12.0.0-M1(main), 커밋 17aa1769b0(2026-10-23). .java 2,984개, 약 74만 줄(본체 java/는 약 50만 줄) |
| main과 11.0.x | main은 다음 메이저 판(12)을 만드는 개발 줄기, 안정판은 11.0.x(최신 태그 11.0.27). main에서는 NIO2 커넥터 등이 빠졌다 |
| Java | main은 Java 21 이상(build.xml), 11.0.x는 Java 17 이상 |
| 서블릿 스펙 | build.xml과 API는 Servlet 6.2(초안), 실행 중 getMinorVersion()은 아직 6.1 |
| 같은 소스 받기 | git clone 뒤 git worktree add --detach … 17aa1769b0…로 커밋 고정 |
| 빌드 | 도커(Temurin JDK 21)에서 build.properties에 base.path를 적고 ant deploy → output/build |
| 폴더 | java/jakarta(표준 API) · org/apache/catalina(컨테이너) · coyote(커넥터) · tomcat/util(공통 도구) · jasper·el(JSP) |
| 큰 길 | Acceptor → Poller → 작업 스레드 → Http11Processor → CoyoteAdapter → Mapper → 밸브 → 필터 체인 → 서블릿 |
| 읽는 방법 | 커밋 고정 → AI 노트 → 소스로 확인 → 예제 실행 → 글 → 더블 체크 |
다음에 볼 것
다음 글은 전체 지도입니다. 이 글에서 server.xml의 <Server>, <Service>, <Connector>, <Engine>, <Host>를 잠깐 보고, 스택 트레이스에서 Engine → Host → Context → Wrapper의 밸브가 차례로 불리는 것을 봤습니다. 다음 글에서는 이 요소들이 각각 어떤 클래스(StandardServer, StandardService, Connector, StandardEngine …)가 되는지, 네 겹의 컨테이너가 Container 인터페이스 하나로 어떻게 부모·자식을 이루는지, 그리고 Catalina와 Coyote를 Adapter 하나로 갈라 둔 이유를 봅니다.
- 다음 글: Tomcat 소스 파헤치기 2: 전체 지도 — Server, Service, Connector, 그리고 컨테이너 넷
- 요청의 길로 바로 가려면: 5편: 커넥터와 NIO 엔드포인트 — 연결은 어떤 스레드가 받나
- 내 서블릿이 불리는 곳으로 바로 가려면: 9편: 필터 체인과 서블릿 호출 — service()가 불리기까지
같은 방식으로 읽은 앞 연재도 있습니다. httpd 소스 파헤치기 1편은 C로 짠 웹 서버를 같은 원칙으로 읽기 시작한 글입니다. 연결을 받아 스레드에 나눠 맡기는 일을 httpd는 MPM이라는 모듈이 하고(httpd 8편), Tomcat은 위에서 본 Acceptor·Poller·스레드 풀이 합니다. 둘 다 "연결을 지켜보는 스레드와 요청을 처리하는 스레드를 나눈다"는 같은 답에 이르렀다는 것을 5편에서 비교합니다. Spring 소스 파헤치기 1편은 Tomcat 위에서 도는 프레임워크를 읽은 연재의 첫 글입니다. 위 스택 트레이스의 맨 위 HttpServlet.service() 자리에 Spring MVC에서는 DispatcherServlet이 섭니다(Spring 21편). 이 연재는 그 아래, Spring이 "서블릿 컨테이너가 불러 준다"고만 하고 넘어간 부분을 읽는 셈입니다.