이 글에서 다루는 것
"Tomcat 소스 파헤치기" 연재의 여섯 번째 글입니다. 5편에서는 NIO 엔드포인트의 Acceptor가 연결을 받고, Poller가 "읽을 거리가 생겼다"는 것을 알아채 SocketProcessor를 작업 스레드(http-nio-8080-exec-N)에 넘기는 데까지 봤습니다. 이번에는 그 작업 스레드가 소켓에서 바이트를 읽어 HTTP 요청 하나로 만드는 과정을 따라갑니다. 서블릿의 HttpServletRequest가 getMethod()나 getHeader()로 돌려주는 값은 모두 여기서 만들어집니다.
답하려는 질문은 네 가지입니다.
- 소켓에서 읽은 바이트는 누가, 어떤 순서로 요청 줄과 헤더로 나누는가
- 요청 줄과 헤더를 왜 곧바로
String으로 바꾸지 않는가 (MessageBytes) - 잘못된 요청이나 너무 큰 헤더는 어디서 걸러지고, 왜 400 응답에 HTML 오류 페이지가 붙어 오는가
- 한 연결로 요청이 여러 개 올 때(keep-alive) 루프는 어디에 있고, 응답 길이를 모를 때
chunked는 누가 정하는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Tomcat |
| 버전 | 12.0.0-M1 (main, 개발판 12.0.0-M1-dev) |
| 커밋 | 17aa1769b0 (2026-10-23) |
| 주로 읽는 클래스 | coyote/http11/Http11Processor, Http11InputBuffer, Http11OutputBuffer, tomcat/util/http/parser/HttpHeaderParser, coyote/Request, tomcat/util/buf/MessageBytes·ByteChunk, tomcat/util/http/MimeHeaders |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
Http11Processor.java는 1,452줄, Http11InputBuffer.java는 864줄입니다. 업그레이드(HTTP/2·WebSocket), sendfile, 비동기 처리까지 한 파일에 섞여 있어서 처음 열면 길을 잃기 쉽습니다. 이 글은 "요청 하나를 읽고, 컨테이너에 넘기고, 응답을 마무리하고, 다음 요청으로" 라는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
Coyote(코요테)는 Tomcat에서 "네트워크와 프로토콜"을 맡는 부분의 이름입니다. 패키지로는 org.apache.coyote이고, server.xml의 <Connector>가 여기에 해당합니다. 서블릿을 고르고 부르는 쪽은 Catalina(org.apache.catalina)이고, 둘 사이를 CoyoteAdapter가 잇습니다. 이 나눔은 2편에서 봤습니다.
프로세서(processor)는 연결 하나에서 오가는 HTTP 메시지를 해석하고 만드는 객체입니다. HTTP/1.1은 Http11Processor, HTTP/2는 StreamProcessor, AJP는 AjpProcessor가 맡습니다. 연결마다 새로 만들지 않고, 쉬는 프로세서를 모아 두었다가 다시 씁니다.
coyote Request와 Catalina Request. 이름이 같은 클래스가 둘 있습니다. org.apache.coyote.Request는 프로토콜에서 읽어 낸 날것의 값(메서드, URI 바이트, 헤더 목록)을 담는 가벼운 객체이고, 서블릿 API(HttpServletRequest)를 구현하지 않습니다. 서블릿이 받는 쪽은 org.apache.catalina.connector.Request로, 이것이 coyote Request를 안에 품고 있습니다. 이 글은 앞쪽, 곧 coyote Request가 채워지는 과정을 봅니다. 뒤쪽은 7편에서 봅니다.
커밋(commit)은 응답의 상태 줄과 헤더를 소켓으로 내보내는 순간입니다. 한 번 커밋되면 상태 코드나 헤더를 바꿀 수 없습니다. 서블릿에서 response.isCommitted()로 확인하는 바로 그 상태입니다.
keep-alive와 파이프라이닝. HTTP/1.1은 기본적으로 응답을 보낸 뒤에도 연결을 닫지 않고 다음 요청을 기다립니다(keep-alive). 클라이언트가 앞 응답을 기다리지 않고 요청 여러 개를 한꺼번에 보내는 것을 파이프라이닝(pipelining)이라고 합니다. 두 경우 모두 서버는 "이 요청이 어디서 끝나는지"를 정확히 알아야 다음 요청을 읽을 수 있습니다.
chunked 전송(Transfer-Encoding: chunked)은 본문 전체 길이를 모를 때 쓰는 방식입니다. 본문을 조각(chunk)으로 나눠 조각마다 "16진수 길이 + CR LF + 데이터 + CR LF"로 보내고, 길이 0인 조각으로 끝을 알립니다. 길이를 알면 Content-Length 헤더를 씁니다.
1. 프로세서는 어디서 불리나
먼저 길을 확인합니다. 서블릿 안에서 new Throwable().getStackTrace()로 호출 스택을 받아, Tomcat의 커넥터 쪽 프레임만 골라 찍는 예제를 만들었습니다.
이 예제는 기준 커밋(17aa1769b0)을 그대로 빌드한 Tomcat 12.0.0-M1-dev 로 도커 컨테이너(Eclipse Temurin JDK 21)에서 실행했습니다. 예제 폴더는 ex/u06-http11-processor이고, 서블릿 Echo는 요청의 메서드·URI·쿼리·프로토콜·헤더 이름과 처리한 스레드 이름을 본문에 씁니다.
        // stack=1 이면 이 서블릿까지 오는 호출 스택 가운데 Tomcat 의 프레임만 골라 찍는다.
        if (req.getParameter("stack") != null) {
            for (StackTraceElement e : new Throwable().getStackTrace()) {
                String c = e.getClassName();
                if (c.startsWith("org.apache.coyote") || c.startsWith("org.apache.tomcat.util.net")
| c.equals("org.apache.catalina.connector.CoyoteAdapter")
| c.equals("org.apache.catalina.core.StandardEngineValve")) {
                    out.println("  at " + c.substring(c.lastIndexOf('.') + 1) + "." + e.getMethodName()
                            + ":" + e.getLineNumber());
                }
            }
        }
[예제 ex/u06-http11-processor/Echo.java에서 줄임]
=== 1. stack: from the servlet back to the processor ===
method=GET uri=/u06/echo query=stack=1 protocol=HTTP/1.1 headers=[Host, User-Agent, Accept] thread=http-nio-8080-exec-2
  at StandardEngineValve.invoke:71
  at CoyoteAdapter.service:347
  at Http11Processor.service:404
  at AbstractProcessorLight.process:71
  at AbstractProtocol$ConnectionHandler.process:1317
  at NioEndpoint$SocketProcessor.doRun:2218
  at SocketProcessorBase.run:74
스레드 이름의 번호(exec-2)는 실행마다 다릅니다. 아래에서 위로 읽으면 이렇습니다.
SocketProcessorBase.run()→NioEndpoint$SocketProcessor.doRun()— 5편에서 본 작업 단위입니다. 2218행에서 프로토콜의 처리기(handler)를 부릅니다.AbstractProtocol$ConnectionHandler.process()— 이 연결을 맡을 프로세서를 고르고 부릅니다(1317행).AbstractProcessorLight.process()— 소켓 이벤트가 "읽기"(OPEN_READ)면service()를 부릅니다(70–71행).Http11Processor.service()— 이 글의 주인공입니다. 404행에서CoyoteAdapter.service()를 부릅니다.CoyoteAdapter.service()→StandardEngineValve— 여기서부터는 Catalina입니다(7편, 8편).
2번의 프로세서 고르기는 이렇습니다.
                if (processor == null) {
                    processor = recycledProcessors.pop();
                    if (getLog().isTraceEnabled()) {
                        getLog().trace(sm.getString("abstractConnectionHandler.processorPop", processor));
                    }
                }
                if (processor == null) {
                    processor = getProtocol().createProcessor();
                    register(processor);
                    if (getLog().isTraceEnabled()) {
                        getLog().trace(sm.getString("abstractConnectionHandler.processorCreate", processor));
                    }
                }
java/org/apache/coyote/AbstractProtocol.java 1299–1311행
쉬는 프로세서 더미(recycledProcessors)에서 하나 꺼내고, 없으면 새로 만듭니다. HTTP/1.1 쪽 createProcessor()는 new Http11Processor(this, adapter) 한 줄입니다(AbstractHttp11Protocol.java 1172–1174행). 생성자는 요청을 읽을 Http11InputBuffer와 응답을 쓸 Http11OutputBuffer를 만들고, 본문을 다룰 필터들을 미리 등록해 둡니다.
        inputBuffer = new Http11InputBuffer(request, protocol.getMaxHttpRequestHeaderSize(), httpParser);
        request.setInputBuffer(inputBuffer);

        outputBuffer = new Http11OutputBuffer(response, protocol.getMaxHttpResponseHeaderSize());
        response.setOutputBuffer(outputBuffer);

        // Create and add the identity filters.
        inputBuffer.addFilter(new IdentityInputFilter(protocol.getMaxSwallowSize()));
        outputBuffer.addFilter(new IdentityOutputFilter());

        // Create and add the chunked filters.
        inputBuffer.addFilter(new ChunkedInputFilter(request, protocol.getMaxTrailerSize(),
                protocol.getAllowedTrailerHeadersInternal(), protocol.getMaxExtensionSize(),
                protocol.getMaxSwallowSize()));
        outputBuffer.addFilter(new ChunkedOutputFilter());
java/org/apache/coyote/http11/Http11Processor.java 171–185행
request와 response는 부모 클래스 AbstractProcessor가 들고 있는 coyote Request·Response입니다. 프로세서 하나에 요청 객체 하나가 붙어 다니고, 요청이 끝날 때마다 비우고(recycle()) 다시 씁니다. 필터는 "등록된 목록"(library)과 "이번 요청에 실제로 쓰는 목록"(active)이 따로 있습니다. 등록은 생성자에서 한 번, 고르기는 요청마다 합니다(4절, 6절).
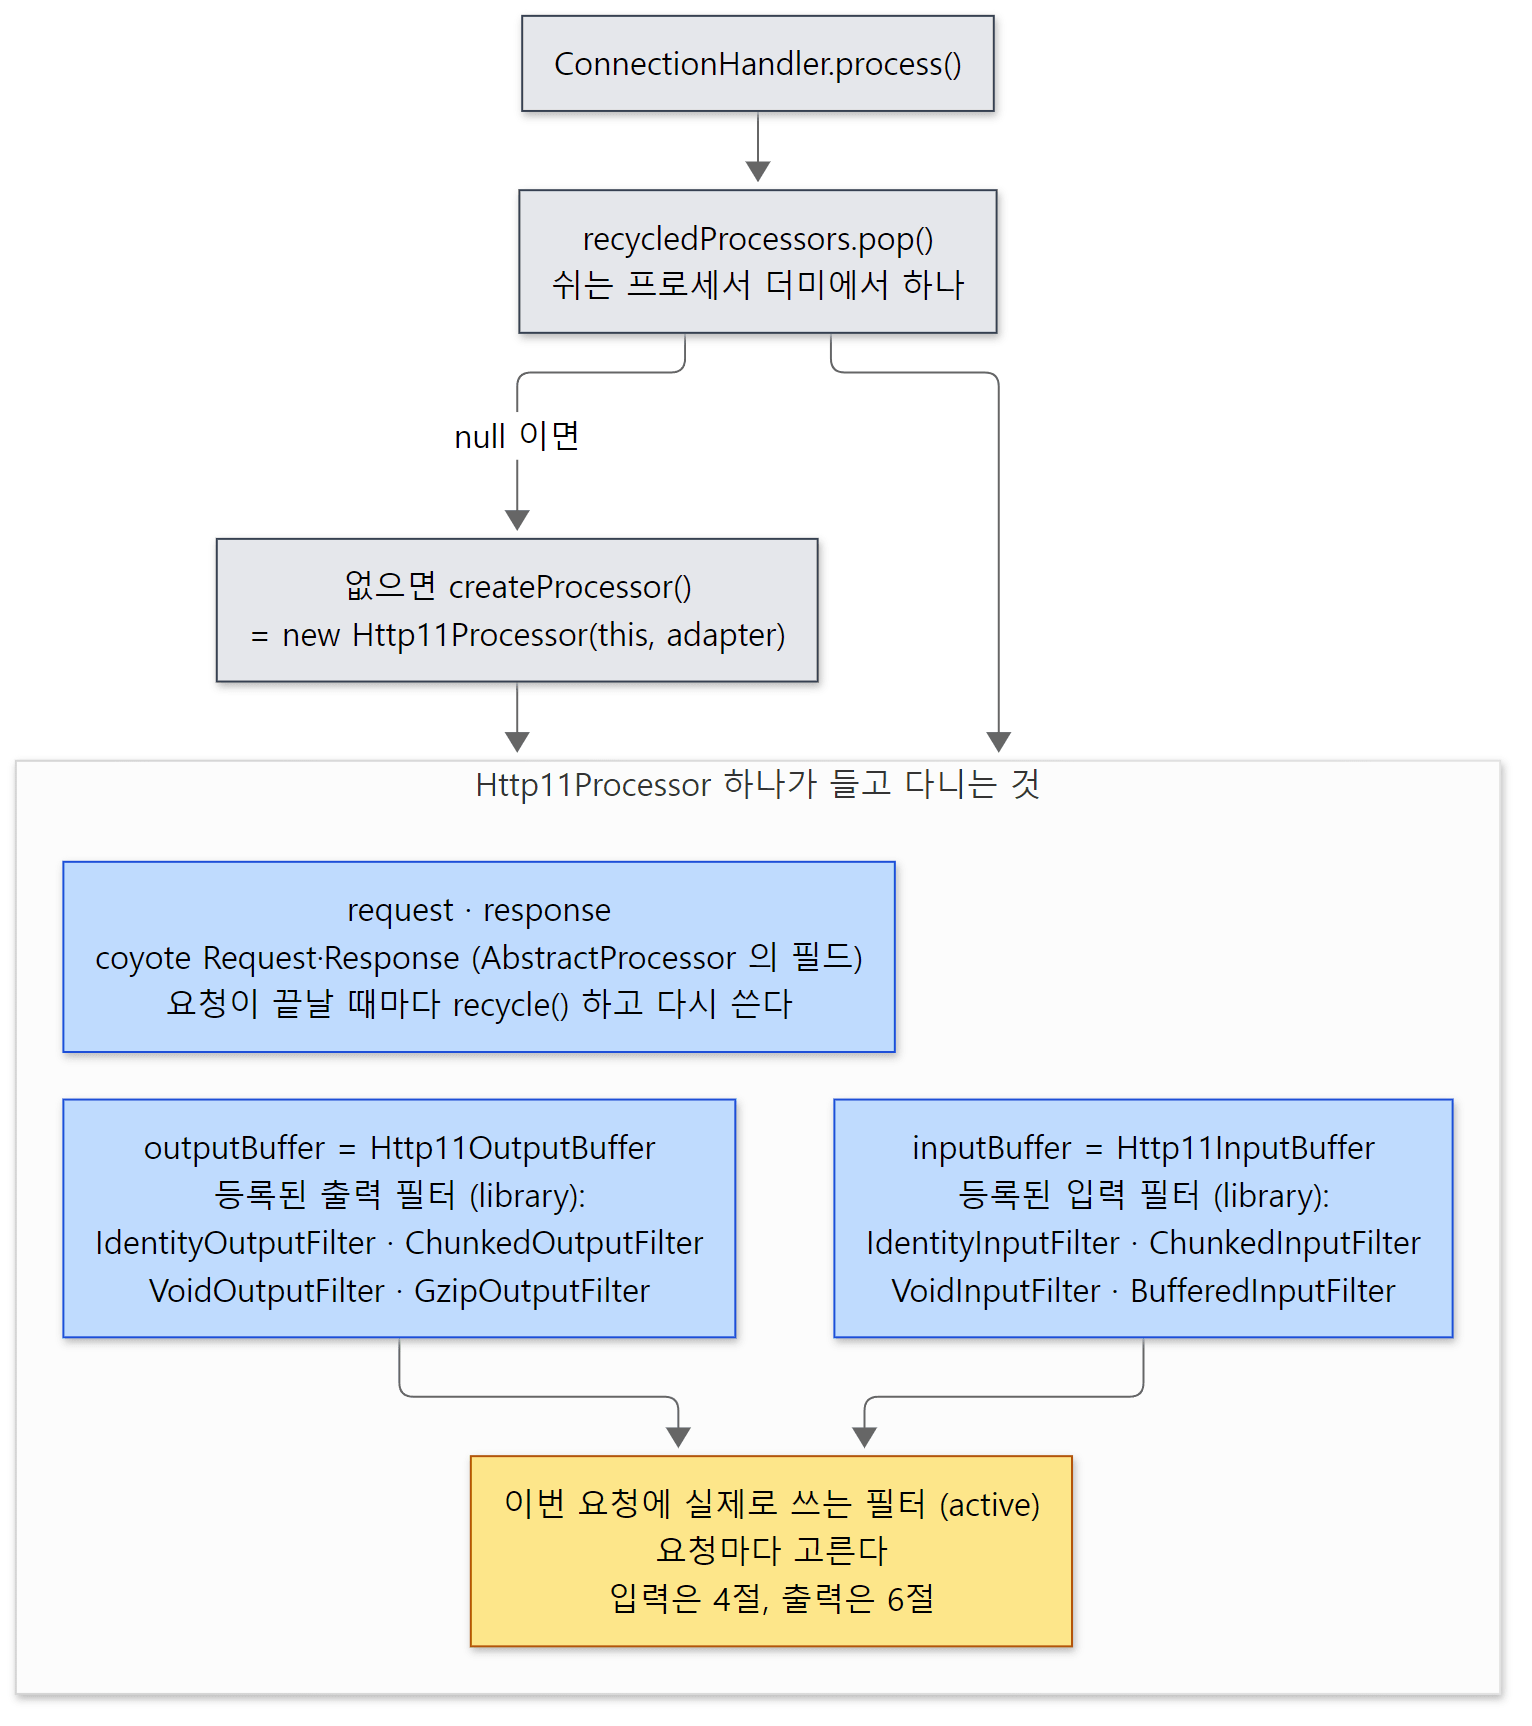 위 코드는 identity·chunked 필터까지만 실었습니다. Void·Buffered·Gzip 필터는 같은 생성자의 바로 뒤(Http11Processor.java 187–196행)에서 등록됩니다.
헷갈리기 쉬운 곳: 연결 하나에 프로세서 하나가 아닙니다
프로세서는 연결이 아니라 "지금 처리 중인 요청" 에 붙습니다. keep-alive로 연결이 열려 있어도, 다음 요청을 기다리는 동안에는 프로세서를 더미에 돌려줍니다(6절). 그래서 연결이 1만 개 열려 있어도 동시에 처리 중인 요청이 10개면 프로세서는 10개 남짓이면 됩니다.
2. service() 루프 — 요청 하나의 일생
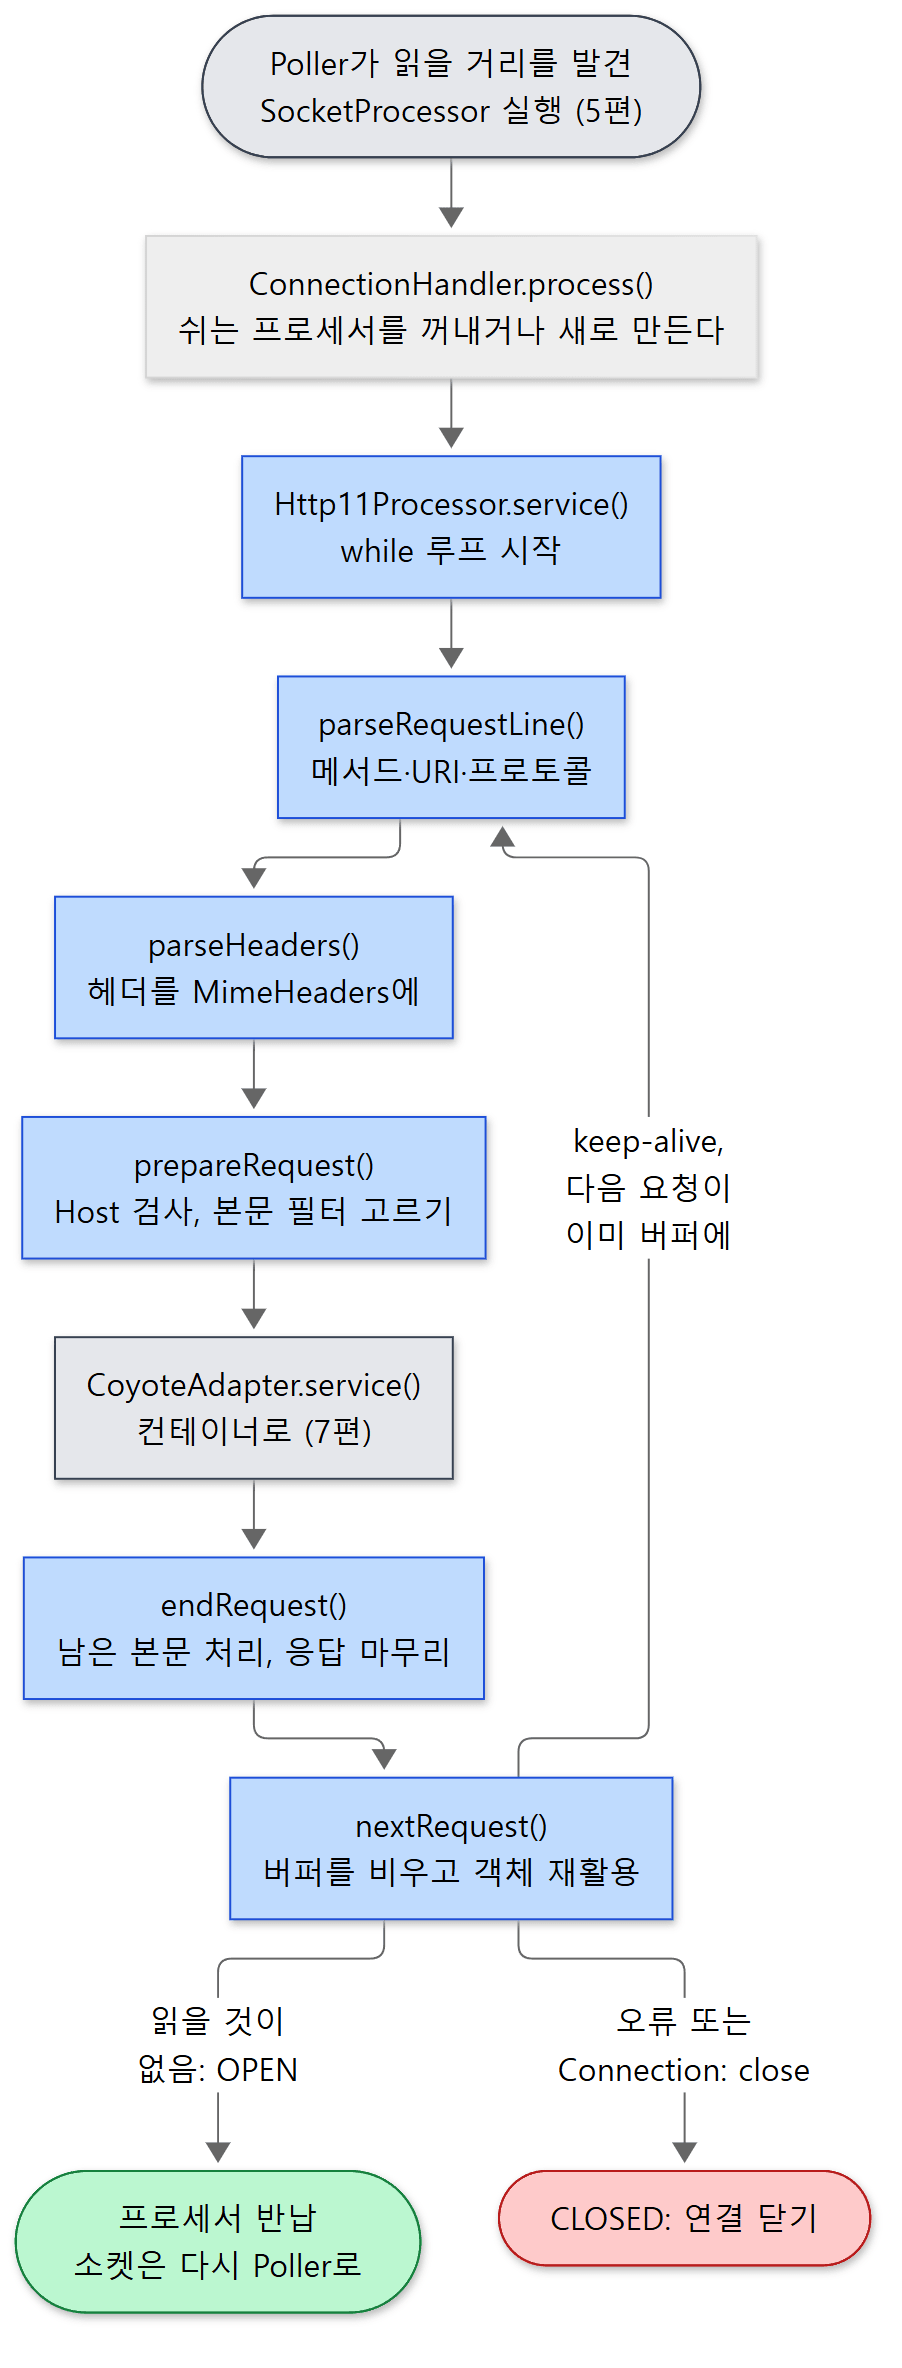 파란 상자가
Http11Processor 안에서 일어나는 일입니다. 회색은 앞뒤 글이 다루는 곳입니다.
service()의 앞부분입니다.
    @Override
    public SocketState service(SocketWrapperBase<?> socketWrapper) throws IOException {
        RequestInfo rp = request.getRequestProcessor();
        rp.setStage(org.apache.coyote.Constants.STAGE_PARSE);

        // Setting up the I/O
        setSocketWrapper(socketWrapper);

        // Flags
        keepAlive = true;
        openSocket = false;
        readComplete = true;
        boolean keptAlive = false;
        SendfileState sendfileState = SendfileState.DONE;

        while (!getErrorState().isError() && keepAlive && !isAsync() && upgradeToken == null &&
                sendfileState == SendfileState.DONE && !protocol.isPaused()) {

            // Parsing the request header
            try {
                if (!inputBuffer.parseRequestLine(keptAlive, protocol.getConnectionTimeout(),
                        protocol.getKeepAliveTimeout())) {
                    if (inputBuffer.getParsingRequestLinePhase() == -1) {
                        return SocketState.UPGRADING;
                    } else if (handleIncompleteRequestLineRead()) {
                        break;
                    }
                }

                // Process the Protocol component of the request line
                // Need to know if this is an HTTP 0.9 request before trying to
                // parse headers.
                prepareRequestProtocol();

                if (protocol.isPaused()) {
                    // 503 - Service unavailable
                    response.setStatus(503);
                    setErrorState(ErrorState.CLOSE_CLEAN, null);
                } else {
                    keptAlive = true;
                    // Set this every time in case limit has been changed via JMX
                    request.getMimeHeaders().setLimit(protocol.getMaxHeaderCount());
                    if (!inputBuffer.parseHeaders()) {
                        // We've read part of the request, don't recycle it
                        // instead associate it with the socket
                        openSocket = true;
                        readComplete = false;
                        break;
                    }
java/org/apache/coyote/http11/Http11Processor.java 253–301행
while의 조건이 이 루프의 성격을 말해 줍니다. 오류가 없고, keep-alive이고, 비동기나 업그레이드로 넘어가지 않았으면 계속 다음 요청을 읽습니다. 루프 한 바퀴가 요청 하나이고, 순서는 위 그림 그대로입니다.
parseRequestLine()—GET /u06/echo?n=1 HTTP/1.1을 메서드·URI·쿼리·프로토콜로 나눕니다(3절). 읽을 바이트가 모자라면false를 돌려줍니다.prepareRequestProtocol()— 프로토콜이HTTP/1.1인지HTTP/1.0인지 봅니다. 둘 다 아니면 505입니다(3절).parseHeaders()— 헤더를 한 줄씩 읽어MimeHeaders에 담습니다(4절).- 업그레이드 확인 —
Connection: upgrade가 있으면 HTTP/2(h2c)나 WebSocket으로 넘어갈 수 있습니다(334–375행, 15편). prepareRequest()—Host헤더 검사,Connection: close확인, 본문을 읽을 입력 필터 고르기(4절).getAdapter().service(request, response)— 다 만든 coyoteRequest를 Catalina로 넘깁니다(404행). 서블릿이 돌고 응답이 쓰입니다.endRequest()— 서블릿이 읽지 않은 본문을 처리하고, 응답을 끝까지 내보냅니다(444행, 1189–1230행).nextRequest()— 입력·출력 버퍼와 요청·응답 객체를 다음 요청을 위해 비웁니다(457–458행).
루프 곳곳의 rp.setStage(...)는 "이 요청이 지금 어느 단계인가"를 기록합니다. 값은 coyote/Constants.java에 STAGE_NEW(0)부터 STAGE_ENDED(7)까지 있습니다(48–83행). manager 앱의 서버 상태 화면에 요청마다 보이는 P(parse·prepare), S(service), F(finishing), K(keep-alive), R(ready) 글자는 이 값을 바꾼 것입니다(StatusTransformer.java 552–588행).
헷갈리기 쉬운 곳: 주석에는 HTTP/0.9가 남아 있지만 main에서는 지원하지 않습니다
282–284행 주석은 "헤더를 읽기 전에 HTTP 0.9 요청인지 알아야 한다"고 말합니다. 그런데 이 커밋의 prepareRequestProtocol()(600–620행)에는 0.9를 다루는 갈래가 없습니다. 11.0.x 브랜치에서는 parseRequestLine()이 프로토콜 없이 줄이 끝나면 빈 프로토콜("HTTP/0.9 style request")로 받아 주고, Http11Processor에 http09 깃발이 있어 헤더 읽기를 건너뛰었습니다. main에서는 그 코드가 지워졌고 주석만 남았습니다. 3절의 예제 2b에서 실제로 400이 나는 것을 봅니다.
3. 요청 줄 읽기 — parseRequestLine()의 단계 번호
Http11InputBuffer.parseRequestLine()은 parsingRequestLinePhase라는 정수 하나로 "어디까지 읽었나"를 기억하며 바이트를 하나씩 봅니다.
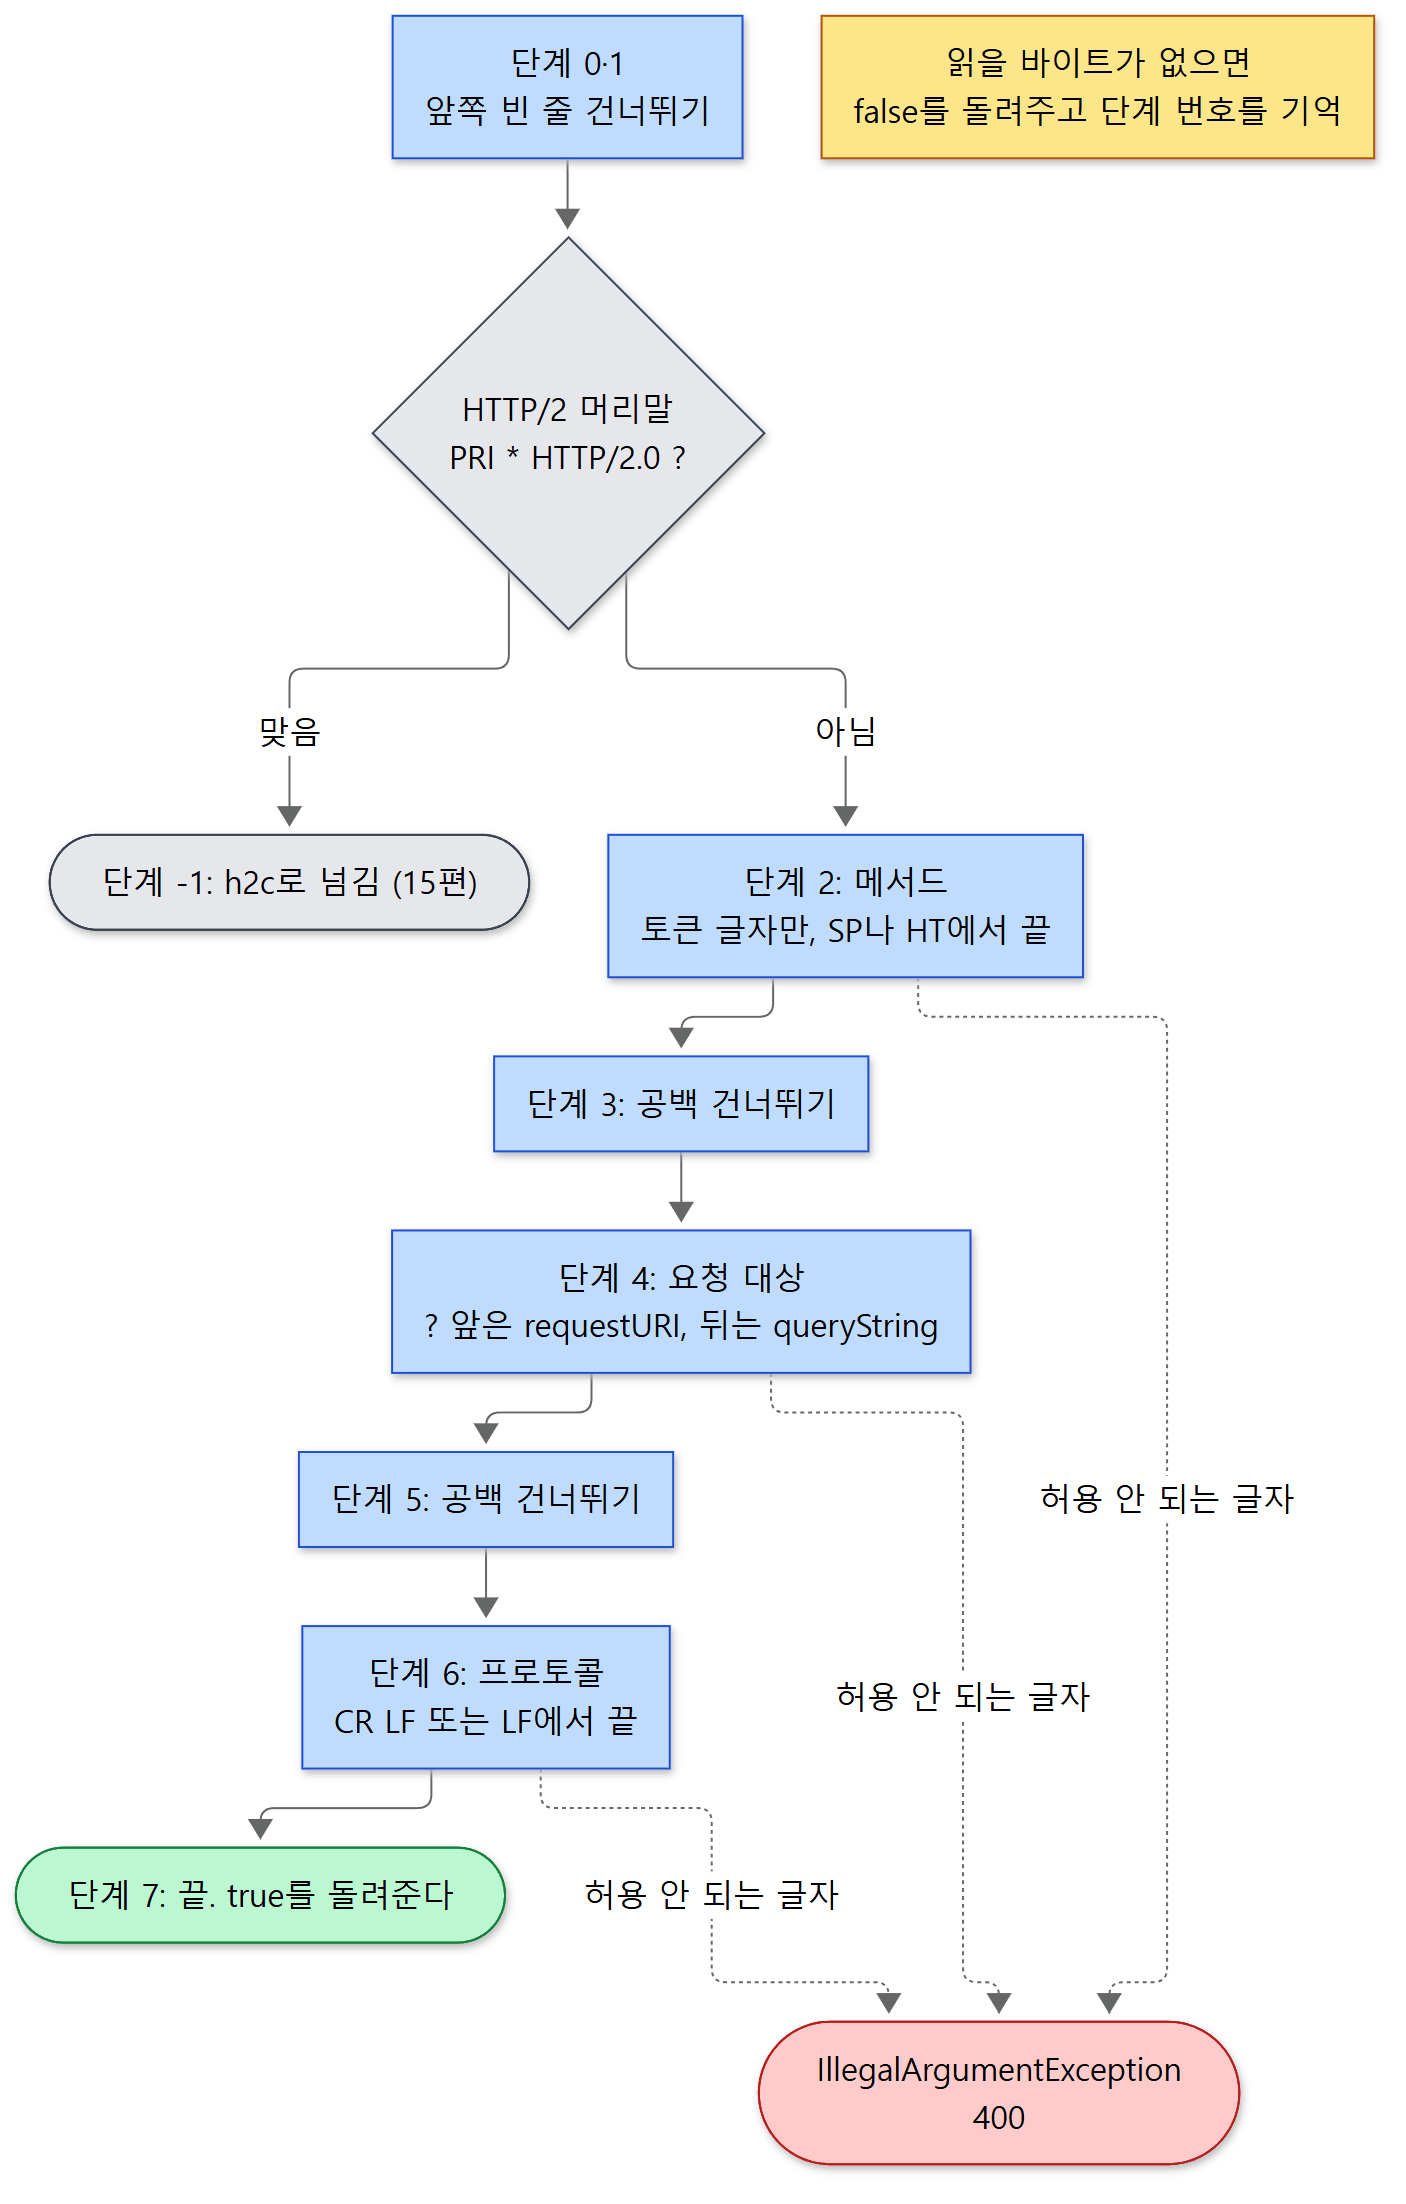 노란 상자의 성질 때문에 단계 번호가 필요합니다. 아래에서 설명합니다.
| 단계 | 하는 일 | 소스 |
|---|---|---|
| 0·1 | 요청 앞의 빈 줄(CR, LF) 건너뛰기. 첫 바이트를 받으면 시작 시각을 적는다 | 332–373행 |
| -1 | 연결 첫머리가 HTTP/2 머리말(PRI * HTTP/2.0)이면 h2c로 넘긴다 |
348–360행 |
| 2 | 메서드. HTTP 토큰 글자만, SP나 HT를 만나면 끝 | 374–402행 |
| 3 | 공백 건너뛰기 | 403–421행 |
| 4 | 요청 대상(URI). 첫 ?에서 경로와 쿼리를 나눈다 |
422–474행 |
| 5 | 공백 건너뛰기 | 475–496행 |
| 6 | 프로토콜. CR LF(또는 LF 하나)에서 끝 | 497–534행 |
| 7 | 정리하고 true |
535–542행 |
단계 4가 끝나는 자리를 보면 값을 담는 방식이 보입니다.
            if (parsingRequestLineQPos >= 0) {
                request.queryString().setBytes(byteBuffer.array(), parsingRequestLineQPos + 1,
                        end - parsingRequestLineQPos - 1);
                request.requestURI().setBytes(byteBuffer.array(), parsingRequestLineStart,
                        parsingRequestLineQPos - parsingRequestLineStart);
            } else {
                request.requestURI().setBytes(byteBuffer.array(), parsingRequestLineStart,
                        end - parsingRequestLineStart);
            }
java/org/apache/coyote/http11/Http11InputBuffer.java 460–468행
URI를 String으로 만들지 않고, 소켓에서 읽어 온 바이트 배열(byteBuffer.array())과 시작 위치, 길이만 requestURI()에 넘깁니다. 이 "위치만 기억하는" 객체가 5절의 MessageBytes입니다.
왜 단계 번호를 들고 다니나 — 기다리지 않는 읽기
각 단계의 반복문은 모두 이 모양으로 시작합니다.
                // Read new bytes if needed
                if (byteBuffer.position() >= byteBuffer.limit()) {
                    if (!fill(false)) {
                        return false;
                    }
                }
java/org/apache/coyote/http11/Http11InputBuffer.java 381–386행
fill(false)의 false는 "기다리지 말라"(non-blocking)는 뜻입니다. 소켓에 지금 읽을 바이트가 없으면 0바이트를 읽고 false를 돌려주고, parseRequestLine()도 곧바로 false로 돌아갑니다. 헤더도 마찬가지입니다. fillHeaderBuffer()에는 "HTTP headers are always read using non-blocking IO"라는 주석이 붙어 있습니다(714–717행).
요청 줄이 반쯤 왔을 때 작업 스레드가 나머지를 기다리며 멈춰 있지 않게 하려는 설계입니다. 대신 돌아갔다가 바이트가 더 오면 Poller가 다시 깨워 줄 것이므로, 다시 들어왔을 때 "메서드는 다 읽었고 URI를 읽는 중이었다"를 알아야 합니다. 그것이 단계 번호이고, 읽던 위치(parsingRequestLineStart 등)도 필드로 들고 있는 이유입니다. 요청 줄을 일부라도 읽은 상태(단계 2 이상)면 handleIncompleteRequestLineRead()가 readComplete = false로 표시하고(544–562행), service()는 SocketState.LONG을 돌려줘 프로세서가 이 소켓에 붙은 채로 남습니다(484–489행). 이 경우에는 프로세서를 더미에 돌려주지 않습니다. 반쯤 읽은 요청이 프로세서 안에 있기 때문입니다.
프로토콜 확인 — 1.1, 1.0, 그 밖에는 505
    private void prepareRequestProtocol() {

        MessageBytes protocolMB = request.protocol();
        if (protocolMB.equals(Constants.HTTP_11)) {
            http11 = true;
            protocolMB.setString(Constants.HTTP_11);
        } else if (protocolMB.equals(Constants.HTTP_10)) {
            http11 = false;
            keepAlive = false;
            protocolMB.setString(Constants.HTTP_10);
        } else {
            // Unsupported protocol
            http11 = false;
            // Send 505; Unsupported HTTP version
            response.setStatus(505);
            setErrorState(ErrorState.CLOSE_CLEAN, null);
            if (log.isDebugEnabled()) {
                log.debug(sm.getString("http11processor.request.unsupportedVersion", protocolMB));
            }
        }
    }
java/org/apache/coyote/http11/Http11Processor.java 600–620행
바이트 그대로 상수 문자열과 비교한 뒤 같으면 setString()으로 상수 String을 넣어 둡니다. 이후 getProtocol()이 몇 번 불려도 새 문자열을 만들 필요가 없습니다. HTTP/1.0이면 이 자리에서 keepAlive = false가 됩니다. HTTP/1.0의 기본은 "응답 하나 보내고 닫기"이기 때문입니다.
예제 2: 잘못된 요청 줄
curl은 잘못된 요청을 만들어 주지 않으므로 bash의 /dev/tcp로 날 요청을 보냅니다(컨테이너에 nc가 없어 이 방법을 썼습니다). 응답 첫 줄과, 400 응답의 HTML 본문 중 "Message" 부분만 뽑는 도우미 함수입니다.
# 상태 줄과 ErrorReportValve 가 만든 본문의 "Message" 부분만 본다
raw_err() {
  exec 3<>/dev/tcp/127.0.0.1/8080
  printf '%b' "$1" >&3
  out=$(timeout 3 cat <&3 | tr -d '\r')
  exec 3>&-
  echo "$out" | head -1
  echo "$out" | grep -o '<b>Message</b> [^<]*' | sed 's/<b>Message<\/b>/  message:/' || true
}

raw_err 'G@T /u06/echo HTTP/1.1\r\nHost: a\r\n\r\n'
raw_err 'GET /u06/echo\r\n\r\n'
raw_err 'GET /u06/echo HTTP/1.2\r\nHost: a\r\n\r\n'
--- 2a. invalid character in method
HTTP/1.1 400
  message: Invalid character found in method name [G@T ]. HTTP method names must be tokens
--- 2b. HTTP/0.9 style request (no protocol)
HTTP/1.1 400
  message: Invalid character found in the request target [/u06/echo0x0d0x0a0x0d0x0a...]. The valid characters are defined in RFC 7230 and RFC 3986
--- 2c. unknown version HTTP/1.2
HTTP/1.1 505
- 2a: 단계 2에서
@가 토큰 글자가 아니라IllegalArgumentException이 났습니다(394–398행). 메시지는LocalStrings.properties의iib.invalidmethod입니다. - 2b: 프로토콜 없이 CR LF로 끝난 요청입니다. 단계 4에서 URI를 읽다가 CR(
0x0d)을 만났고, CR은 요청 대상에 쓸 수 없는 글자라 400입니다(450–457행). 11.0.x였다면 HTTP/0.9 요청으로 받아 줬을 자리입니다./는/를 HTML로 이스케이프한 것입니다. - 2c: 요청 줄 형식은 맞지만
HTTP/1.2라서prepareRequestProtocol()의 마지막 갈래로 505입니다.
상태 줄이 HTTP/1.1 400 처럼 숫자 뒤에서 끝나는 것은 실수가 아닙니다. 6절에서 봅니다.
헷갈리기 쉬운 곳: 공백과 줄 끝에 너그럽습니다
httpd 9편에서 본 httpd의 HttpProtocolOptions Strict는 공백이 둘이거나 줄 끝이 LF 하나면 400이었습니다. Tomcat의 요청 줄 파서는 반대로 너그럽습니다. 단계 3·5의 주석은 "Spec says single SP but also be tolerant of multiple SP and/or HT"(404행, 476행)이고, 단계 6은 LF 하나도 줄 끝으로 받아 줍니다("LF is an optional line terminator", 519–522행). 대신 글자에는 엄격합니다. 메서드는 토큰 글자, URI는 RFC 3986이 허용하는 글자만 받습니다(server.xml의 relaxedPathChars·relaxedQueryChars로 몇 글자를 풀어 줄 수 있습니다).
4. 헤더 읽기 — HttpHeaderParser와 MimeHeaders
parseHeaders()는 헤더 한 줄씩 파서에 맡기며 크기를 확인합니다.
    boolean parseHeaders() throws IOException {
        if (!parsingHeader) {
            throw new IllegalStateException(sm.getString("iib.parseheaders.ise.error"));
        }

        HeaderParseStatus status;

        do {
            status = httpHeaderParser.parseHeader();
            // Checking that headers plus request line size does not exceed its limit
            if (byteBuffer.position() > headerBufferSize) {
                throw new IllegalArgumentException(sm.getString("iib.requestheadertoolarge.error"));
            }
        } while (status == HeaderParseStatus.HAVE_MORE_HEADERS);
        if (status == HeaderParseStatus.DONE) {
            parsingHeader = false;
            end = byteBuffer.position();
            return true;
        } else {
            return false;
        }
    }
java/org/apache/coyote/http11/Http11InputBuffer.java 552–573행
헤더 한 줄의 실제 해석은 HttpHeaderParser(tomcat/util/http/parser)가 합니다. 이 파서도 요청 줄처럼 "어디까지 읽었나"(HEADER_START, HEADER_NAME, HEADER_VALUE …)를 기억하고, 바이트가 모자라면 NEED_MORE_DATA를 돌려줍니다. 결과는 세 가지입니다.
| 돌려주는 값 | 뜻 | parseHeaders()가 하는 일 |
|---|---|---|
HAVE_MORE_HEADERS |
헤더 한 줄을 다 읽었다 | 다음 줄을 또 읽는다 |
DONE |
빈 줄을 만났다. 헤더 끝 | end에 본문 시작 위치를 적고 true |
NEED_MORE_DATA |
바이트가 모자란다 | false. service()는 LONG으로 돌아간다(295–301행) |
헤더 이름을 다 읽으면(콜론을 만나면) 그 자리에서 MimeHeaders에 한 칸을 만듭니다.
            if (chr == COLON) {
                if (headerData.start == pos) {
                    // Zero length header name - not valid.
                    // skipLine() will handle the error
                    return skipLine();
                }
                headerParsePos = HeaderParsePosition.HEADER_VALUE_START;
                headerData.headerValue = headers.addValue(source.getHeaderByteBuffer().array(), headerData.start,
                        pos - headerData.start);
java/org/apache/tomcat/util/http/parser/HttpHeaderParser.java 139–147행
여기서도 이름은 바이트 배열의 위치로만 기억합니다. 값은 줄 끝까지 읽으면서 버퍼 안에서 제자리 정리를 합니다. 앞쪽 공백은 건너뛰고, 여러 줄로 접힌 값(obs-fold)은 공백 하나로 바꾸고, 끝의 공백은 잘라 냅니다(177–197행, 228–239행, 258–263행). 다 되면 headerValue.setBytes(...)로 같은 버퍼의 위치를 기록합니다(268–269행).
이름에 토큰이 아닌 글자가 있거나, 값에 제어 문자가 있거나, 콜론이 없는 줄이면 skipLine()으로 그 줄 끝까지 읽은 뒤 예외를 던집니다. 메시지에 문제의 줄을 넣기 위해서입니다.
        throw new IllegalArgumentException(sm.getString("httpHeaderParser.invalidHeader",
                HeaderUtil.toPrintableString(source.getHeaderByteBuffer().array(), headerData.lineStart,
                        headerData.lastSignificantChar - headerData.lineStart + 1)));
java/org/apache/tomcat/util/http/parser/HttpHeaderParser.java 306–308행
MimeHeaders — 해시 없이 배열 하나
헤더를 담는 MimeHeaders는 HashMap이 아니라 MimeHeaderField의 배열입니다. 클래스 주석이 이유를 적어 두었습니다. 대부분의 서블릿은 헤더를 몇 개만 보고 대부분의 헤더는 값이 하나이므로, 해시를 만드는 비용이 더 크다는 것입니다(58–60행). 찾을 때는 처음부터 이름을 대소문자 구분 없이 비교합니다.
    public MessageBytes getValue(String name) {
        for (int i = 0; i < count; i++) {
            if (headers[i].getName().equalsIgnoreCase(name)) {
                return headers[i].getValue();
            }
        }
        return null;
    }
java/org/apache/tomcat/util/http/MimeHeaders.java 365–372행
배열의 칸(MimeHeaderField)은 recycle()해도 지우지 않고 남겨 두었다가 다음 요청에서 다시 씁니다(113–118행). "가비지가 생기지 않게"(no GC is generated)가 이 클래스의 목표라고 주석 첫 줄에 적혀 있습니다(34–35행).
두 가지 한도 — 크기와 개수
server.xml <Connector> 속성 |
기본값 | 정의된 곳 | 넘으면 |
|---|---|---|---|
maxHttpHeaderSize |
8192바이트 | AbstractHttp11Protocol.java 283행 |
400 "Request header is too large" |
maxHttpRequestHeaderSize |
-1 (= maxHttpHeaderSize를 따름) |
307–316행 | 위와 같음 |
maxHeaderCount |
100개 | AbstractProtocol.java 239행 |
400 "More than the maximum allowed number of headers" |
크기 한도는 요청 줄과 헤더를 합친 바이트 수입니다. parseHeaders()의 검사 주석이 "headers plus request line size"이고, 아예 버퍼를 채우기 전에도 막습니다.
        if (parsingHeader) {
            if (byteBuffer.limit() >= headerBufferSize) {
                if (parsingRequestLine) {
                    // Avoid unknown protocol triggering an additional error
                    request.protocol().setString(Constants.HTTP_11);
                }
                throw new IllegalArgumentException(sm.getString("iib.requestheadertoolarge.error"));
            }
        } else {
            byteBuffer.limit(end).position(end);
        }
java/org/apache/coyote/http11/Http11InputBuffer.java 738–748행
개수 한도는 MimeHeaders가 칸을 만들 때 확인합니다. 루프가 요청마다 setLimit(protocol.getMaxHeaderCount())를 다시 부르는 것은 JMX로 값을 바꿔도 다음 요청부터 바로 적용되게 하려는 것입니다(293–294행 주석).
    private MimeHeaderField createHeader() {
        if (limit > -1 && count >= limit) {
            throw new IllegalStateException(sm.getString("headers.maxCountFail", Integer.valueOf(limit)));
        }
java/org/apache/tomcat/util/http/MimeHeaders.java 280–283행
예제 3: 헤더 한도와 잘못된 헤더
--- 2e. header line without colon
HTTP/1.1 400
  message: The HTTP header line [Broken header] does not conform to RFC 9112. The request has been rejected.
=== 3. limits ===
--- 3a. one 9000-byte header (maxHttpHeaderSize default 8192)
HTTP/1.1 400
  message: Request header is too large
--- 3b. 101 headers + Host (maxHeaderCount default 100)
HTTP/1.1 400
  message: More than the maximum allowed number of headers, [100], were detected.
--- 3c. 98 headers + Host + Connection = 100
HTTP/1.1 200
--- 3d. 9000-byte request target
HTTP/1.1 400
  message: Request header is too large
- 2e: 콜론 없는
Broken header줄 하나로 요청 전체가 400입니다. - 3a·3b: 기본 한도를 넘었습니다.
Host까지 102개인 3b는 101번째 헤더를 만들 때IllegalStateException이 났습니다. 이 예외도 2절 루프의catch (Throwable t)가 받아 400으로 바꿉니다(6절). - 3c: 정확히 100개는 통과합니다.
count >= limit로 비교하므로 100번째 칸까지는 만들 수 있습니다. - 3d: 9000바이트짜리 URI도 같은 메시지의 400입니다.
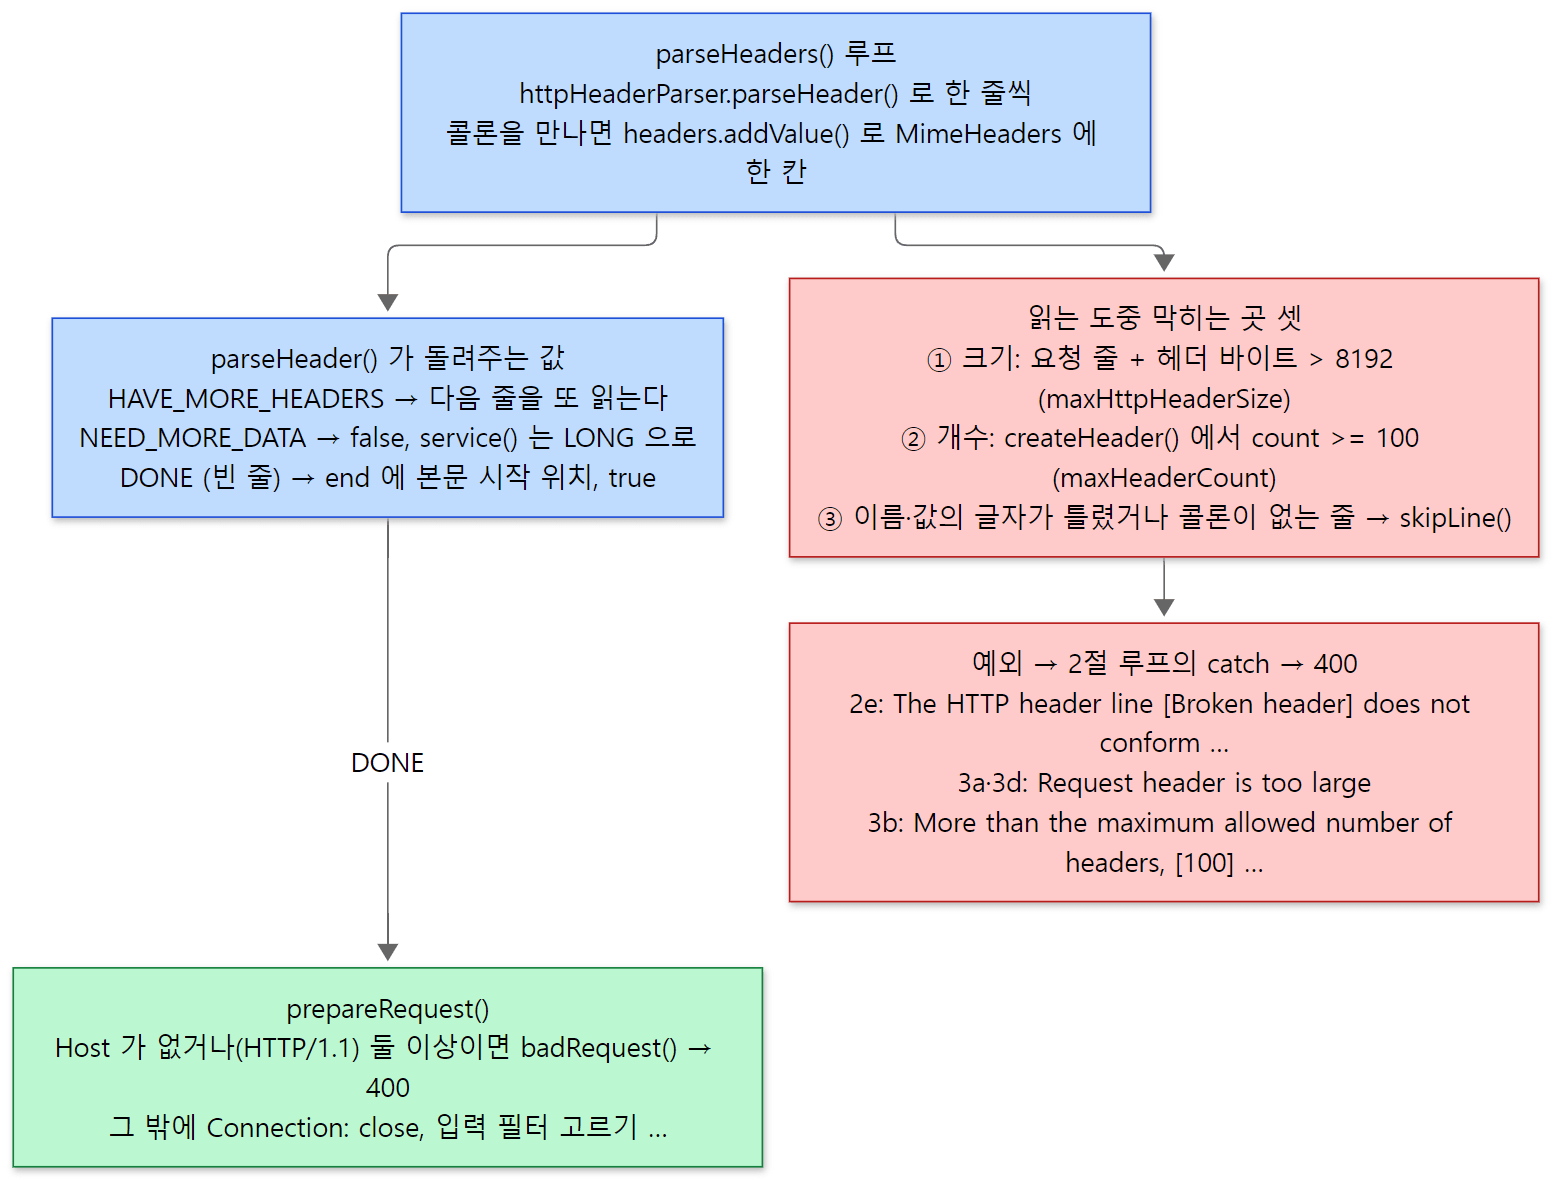 빨간 칸의 메시지는 예제 2e·3a·3b·3d의 실제 출력입니다. 3d는 헤더가 아니라 긴 URI인데도 같은 크기 한도에 걸립니다.
헷갈리기 쉬운 곳: Tomcat에는 414가 없습니다
httpd는 요청 줄 한도(LimitRequestLine, 8190바이트)와 헤더 한 줄 한도(LimitRequestFieldSize)를 따로 두고, 요청 줄이 길면 414(URI Too Long)를 돌려줬습니다(httpd 9편 5절). Tomcat의 HTTP/1.1 커넥터는 요청 줄과 헤더를 하나의 한도로 재고, 넘으면 URI든 헤더든 400입니다. 3d가 그 결과입니다. 그래서 "긴 쿼리 문자열이 400으로 막힌다"는 문의가 오면 maxHttpHeaderSize(또는 maxHttpRequestHeaderSize)를 봐야 합니다. 이름만 보면 헤더 이야기 같지만 요청 줄도 여기에 들어갑니다. 반대로 개수 한도 100은 httpd의 LimitRequestFields 기본값과 같습니다.
prepareRequest() — 헤더를 다 읽은 뒤의 검사
헤더를 다 읽으면 prepareRequest()가 요청을 "쓸 수 있는 상태"로 다듬습니다. 대표적인 것이 Host 검사입니다.
        // Check host header
        MessageBytes hostValueMB = null;
        try {
            hostValueMB = headers.getUniqueValue("host");
        } catch (IllegalArgumentException iae) {
            // Multiple Host headers are not permitted
            badRequest("http11processor.request.multipleHosts");
        }
        if (http11 && hostValueMB == null) {
            badRequest("http11processor.request.noHostHeader");
        }
java/org/apache/coyote/http11/Http11Processor.java 666–676행
HTTP/1.1인데 Host가 없거나 두 개 이상이면 400입니다. 이 밖에 prepareRequest()가 하는 일은 이렇습니다.
Connection헤더에close가 있으면keepAlive = false(634–644행).- 요청 줄에
http://host/path같은 절대 URI가 오면 경로만 남기고, 그 호스트가Host헤더와 같은지 확인(678–760행). - URI 글자를 한 번 더 검사(762–769행).
- 본문을 읽을 입력 필터 고르기(
prepareInputFilters(), 800–858행).Transfer-Encoding: chunked면ChunkedInputFilter,Content-Length가 있으면IdentityInputFilter(그 길이만큼만 읽는 필터), 둘 다 없으면 본문이 없다고 보고VoidInputFilter입니다. 이렇게 "본문이 어디서 끝나는지"를 정해 두어야 서블릿이 본문을 덜 읽어도 다음 요청의 시작을 찾을 수 있습니다. Host값에서 서버 이름과 포트를 꺼내기(parseHost(), 775행).
badRequest()는 상태를 400으로 두고 오류 상태를 기록할 뿐 예외를 던지지 않습니다(861–867행). 그래서 예제 2d(Host 없는 HTTP/1.1)의 400에는 "Message" 줄이 없었습니다.
--- 2d. HTTP/1.1 without Host
HTTP/1.1 400
5. MessageBytes와 ByteChunk — 문자열은 필요할 때 만든다
3·4절에서 URI도, 헤더 이름과 값도 모두 setBytes(배열, 시작, 길이)로 담겼습니다. 그 그릇이 MessageBytes입니다.
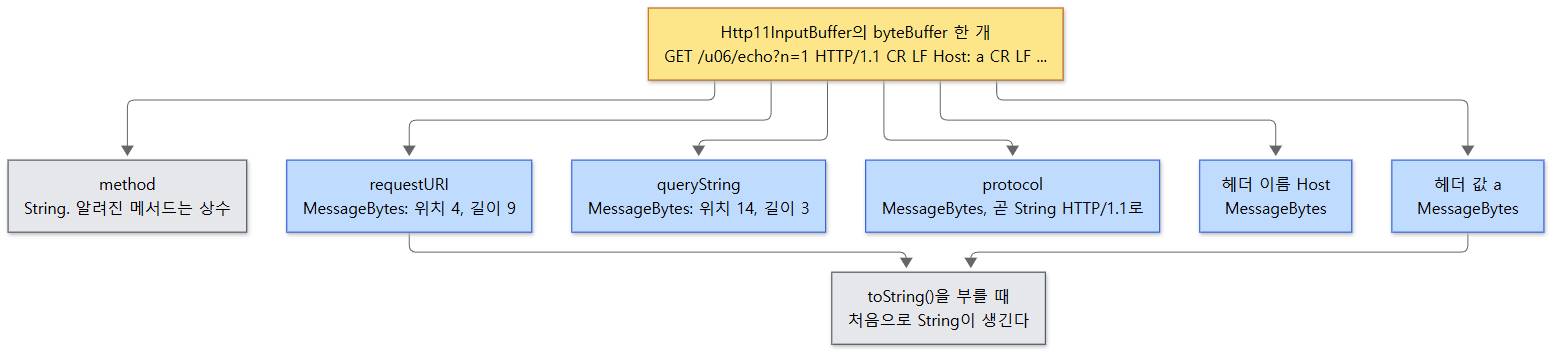 노란 상자 하나를 파란 상자들이 나눠 가리킵니다. 복사본은 없습니다.
클래스 주석이 한 문장으로 요약합니다.
/**
 * This class is used to represent a sub array of bytes in an HTTP message. It represents all request/response elements.
 * The byte/char conversions are delayed and cached. Everything is recyclable.
java/org/apache/tomcat/util/buf/MessageBytes.java 30–32행
MessageBytes는 네 가지 상태 가운데 하나입니다. 비어 있음(T_NULL), String(T_STR), 바이트 배열의 일부(T_BYTES), 문자 배열의 일부(T_CHARS)입니다(51–63행). 바이트를 담을 때는 안에 든 ByteChunk에 위치만 넘깁니다.
    public void setBytes(byte[] b, int off, int len) {
        buff = b;
        start = off;
        end = start + len;
        isSet = true;
        hasHashCode = false;
    }
java/org/apache/tomcat/util/buf/ByteChunk.java 217–223행
배열을 복사하지 않고 참조(buff = b)와 두 숫자만 적습니다. 문자열은 누군가 toString()을 부를 때 만듭니다.
    @Override
    public String toString() {
        switch (type) {
            case T_NULL:
            case T_STR:
                // No conversion required
                break;
            case T_BYTES:
                strValue = byteC.toString();
                break;
            case T_CHARS:
                strValue = charC.toString();
                break;
        }

        return strValue;
    }
java/org/apache/tomcat/util/buf/MessageBytes.java 197–213행
비교도 문자열 없이 합니다. ByteChunk.equals(String)은 바이트와 String의 글자를 하나씩 직접 비교합니다(693–706행). 대소문자를 무시하는 equalsIgnoreCase(String)도 같은 방식입니다(718–732행). 3절의 protocolMB.equals("HTTP/1.1")는 앞의 것을, 4절의 getValue("host")는 뒤의 것을 써서 String을 하나도 만들지 않습니다. 바이트를 글자로 바꿀 때 문자 집합을 따로 정하지 않았으면 ISO-8859-1을 씁니다(ByteChunk.DEFAULT_CHARSET, ByteChunk.java 114행). URI의 %xx를 풀고 UTF-8로 바꾸는 일은 Catalina 쪽 CoyoteAdapter가 원본을 decodedURI로 복사한 다음 합니다(7편).
왜 이렇게까지 하나. 요청 하나에는 메서드, URI, 쿼리, 프로토콜, 헤더 수십 개가 있고, 서버는 초당 수천 개의 요청을 받습니다. 그 값을 전부 String으로 만들면 대부분은 아무도 읽지 않은 채 쓰레기가 됩니다. 서블릿이 실제로 묻는 몇 개만 문자열로 만들면 할당과 GC가 그만큼 줄어듭니다. 메서드만은 예외입니다. 이 커밋의 coyote Request는 메서드를 String 필드로 들고 있고(Request.java 100행), GET·POST처럼 알려진 메서드면 바이트를 보고 미리 만들어 둔 상수를 돌려줍니다(Method.bytesToString(), Request.java 395–403행). 11.0.x 브랜치에서는 메서드도 MessageBytes였고, 그것을 돌려주는 method()에 @Deprecated가 붙어 있었습니다. main에서는 그 메서드가 지워졌습니다.
예제 4: MessageBytes는 복사본이 아니라 창입니다
MessageBytes를 직접 써 보는 작은 프로그램입니다. Tomcat의 lib/*.jar를 클래스패스에 두고 JDK 21의 소스 파일 바로 실행으로 돌렸습니다.
        // 소켓에서 읽어 온 버퍼라고 생각한다
        byte[] buf = "GET /hello HTTP/1.1\r\nHost: a\r\n\r\n".getBytes(StandardCharsets.ISO_8859_1);

        MessageBytes uri = MessageBytes.newInstance();
        uri.setBytes(buf, 4, 6);                 // "/hello" 의 위치만 기억한다
        System.out.println("type=" + uri.getType() + " (T_BYTES=" + MessageBytes.T_BYTES + ")");
        System.out.println("equals(\"/hello\")=" + uri.equals("/hello") + " string=" + uri.getString());

        System.out.println("toString()=" + uri.toString() + " type=" + uri.getType());

        // 원래 버퍼를 바꾸면 MessageBytes 가 보는 값도 바뀐다 — 복사본이 아니라 창(view)이다
        buf[5] = 'j';
        System.out.println("after buf[5]='j': toString()=" + uri.toString());

        // toStringType() 은 String 으로 바꿔 두고 type 도 T_STR 로 바꾼다
        uri.toStringType();
        buf[5] = 'y';
        System.out.println("after toStringType(): type=" + uri.getType() + " toString()=" + uri.toString());
[예제 ex/u06-http11-processor/MbDemo.java에서 줄임]
=== 9. MessageBytes ===
type=2 (T_BYTES=2)
equals("/hello")=true string=null
toString()=/hello type=2
after buf[5]='j': toString()=/jello
after toStringType(): type=1 toString()=/jello
getHeader("host")=a size=1
equals("/hello")가 참인데getString()은null입니다. 비교하는 동안 문자열이 만들어지지 않았습니다.- 원래 배열의 한 바이트를 바꾸자
toString()이/jello를 돌려줬습니다.T_BYTES인 동안은 부를 때마다 버퍼에서 다시 읽기 때문입니다(205행). toStringType()을 부르면String으로 바꿔 두고 상태도T_STR(1)이 됩니다(221–236행). 그 뒤로는 버퍼를 바꿔도 값이 그대로입니다.- 마지막 줄은
MimeHeaders에 바이트 위치로 헤더를 넣고 소문자host로 찾은 결과입니다.
헷갈리기 쉬운 곳: 요청이 끝나면 그 버퍼는 다음 요청이 씁니다
MessageBytes가 가리키는 배열은 프로세서의 입력 버퍼 하나입니다. 요청이 끝나면 nextRequest()가 요청 객체를 비우고, 남은 바이트(파이프라이닝된 다음 요청)를 버퍼 맨 앞으로 당겨 옵니다.
    void nextRequest() {
        request.recycle();

        if (byteBuffer.position() > 0) {
            if (byteBuffer.remaining() > 0) {
                // Copy leftover bytes to the beginning of the buffer
                byteBuffer.compact();
                byteBuffer.flip();
            } else {
                // Reset position and limit to 0
                byteBuffer.position(0).limit(0);
            }
        }
java/org/apache/coyote/http11/Http11InputBuffer.java 281–293행
같은 배열의 같은 자리를 다음 요청의 바이트가 덮어씁니다. 예제 4에서 버퍼를 바꾸자 값이 바뀐 것과 같은 일이 실제로 일어납니다. 요청 객체를 비우는 것은 그래서 꼭 필요한 일이고, 요청 처리가 끝난 뒤까지 요청 객체를 들고 있다가 값을 읽으면 엉뚱한 값을 볼 수 있는 이유이기도 합니다. Catalina 쪽 Request도 요청이 끝나면 recycle()됩니다(CoyoteAdapter.service()의 finally, CoyoteAdapter.java 423–427행).
6. 오류, keep-alive, 그리고 응답의 모양
400은 어떻게 HTML 페이지가 되나
예제 2·3의 400 응답에는 모두 HTML 본문이 붙어 있었습니다. 요청 줄도 제대로 못 읽은 요청인데 누가 그 페이지를 만들었을까요. service()의 catch부터 봅니다.
            } catch (Throwable t) {
                ExceptionUtils.handleThrowable(t);
                UserDataHelper.Mode logMode = userDataHelper.getNextMode();
                if (logMode != null) {
                    String message = sm.getString("http11processor.header.parse");
                    switch (logMode) {
                        case INFO_THEN_DEBUG:
                            message += sm.getString("http11processor.fallToDebug");
                            //$FALL-THROUGH$
                        case INFO:
                            log.info(message, t);
                            break;
                        case DEBUG:
                            log.debug(message, t);
                    }
                }
                // 400 - Bad Request
                response.setStatus(400);
                setErrorState(ErrorState.CLOSE_CLEAN, t);
            }
java/org/apache/coyote/http11/Http11Processor.java 312–331행
요청 줄·헤더를 읽다 난 예외(IOException 제외)는 모두 여기서 400이 됩니다. 핵심은 마지막 줄의 ErrorState.CLOSE_CLEAN입니다.
CLOSE_CLEAN(true, 1, true, true),
java/org/apache/coyote/ErrorState.java 35행
네 인자는 차례로 "오류인가", "심각도", "이 요청에 입출력을 해도 되나"(ioAllowed), "연결에 입출력을 해도 되나"입니다(56–61행). CLOSE_CLEAN은 오류지만 응답은 깨끗하게 보내도 된다, 단 그 뒤에 연결은 닫는다는 뜻입니다(주석 29–34행). 그래서 루프는 catch를 지나서도 if (getErrorState().isIoAllowed())인 prepareRequest()(377–391행)와 getAdapter().service()(401–436행)를 그대로 부릅니다.
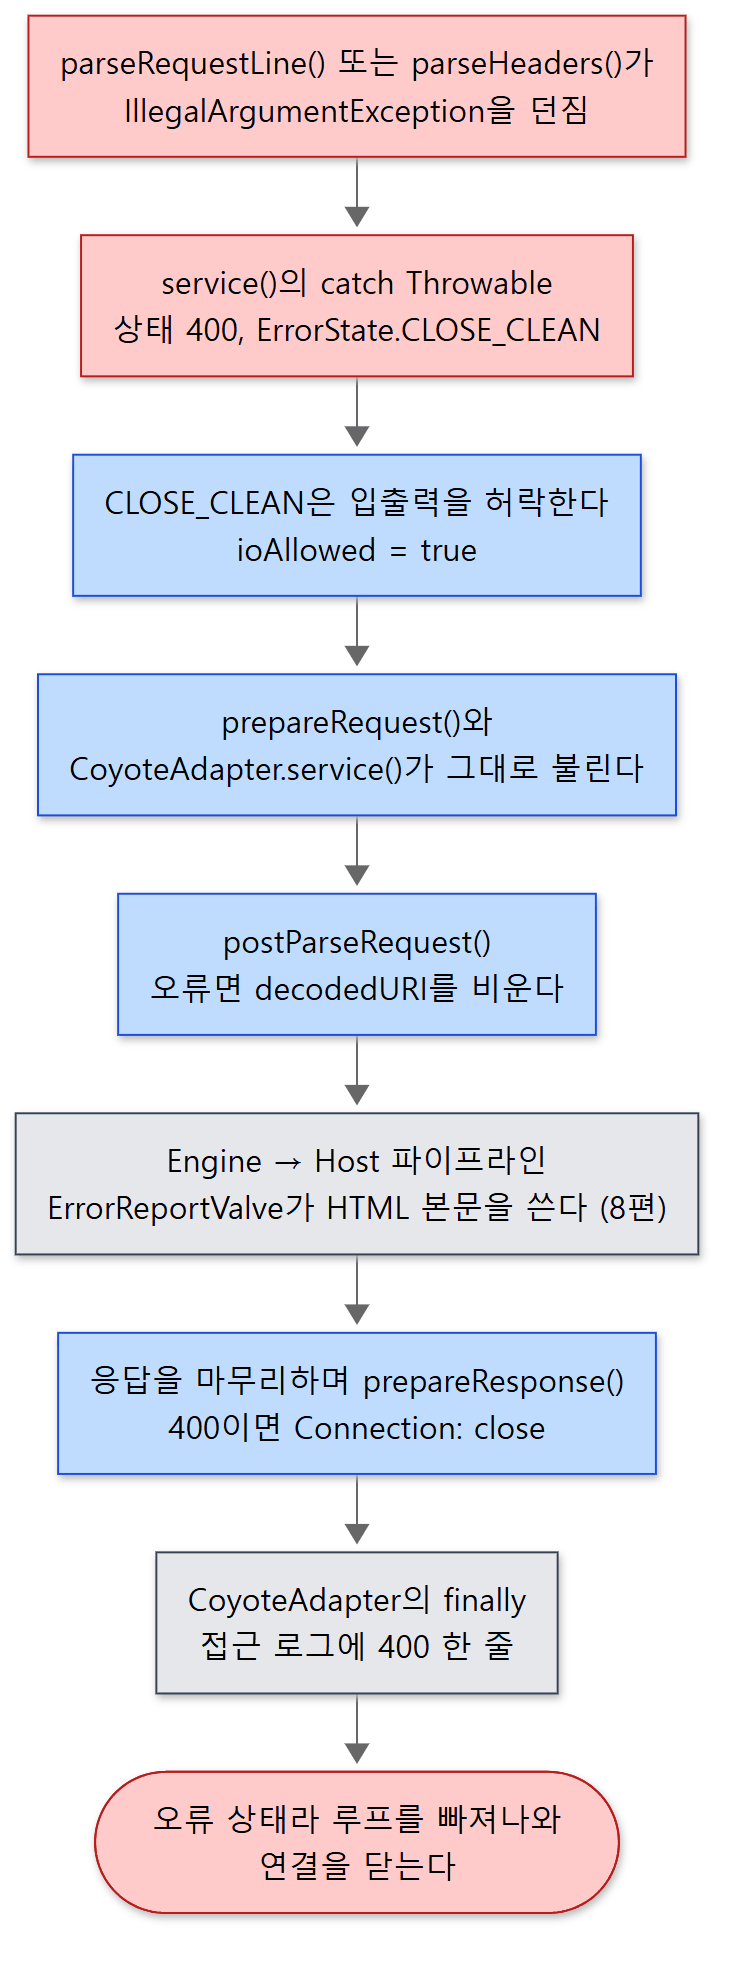 빨간 상자가 오류의 시작과 끝, 회색이 앞뒤 글에서 볼 부분입니다.
CoyoteAdapter.postParseRequest()는 응답이 이미 오류면 "URI가 잘못됐다는 뜻이니 잘못된 데이터를 Mapper에 넘기지 않는다"며 decodedURI를 비우고 매핑을 계속합니다(CoyoteAdapter.java 691–696행). 그래서 요청은 Engine → Host 파이프라인을 지나고, Host에 기본으로 걸리는 ErrorReportValve(StandardHost.java 146행)가 400 페이지를 씁니다. 밸브는 8편에서 봅니다. 이 길 덕분에 잘못된 요청도 접근 로그에 남습니다. 예제의 접근 로그입니다(앞의 주소와 시각은 떼어 냈습니다).
"-" 400 1935
"GET - HTTP/1.1" 400 2063
"GET /u06/echo HTTP/1.2" 505 712
"GET /u06/echo HTTP/1.1" 400 769
"GET /u06/echo HTTP/1.1" 400 2148
"GET /u06/echo HTTP/1.1" 400 2085
"GET /u06/echo HTTP/1.1" 400 2150
"GET /u06/echo HTTP/1.1" 200 786
"GET - HTTP/1.1" 400 1908
위에서부터 2a, 2b, 2c, 2d, 2e, 3a, 3b, 3c, 3d입니다. 요청 줄(%r)이 어디까지 읽혔는지가 그대로 보입니다. 2a는 메서드에서 실패해 아무것도 없어 "-", 2b와 3d는 URI를 읽다 실패해 GET -, 헤더에서 실패한 2e·3a·3b는 요청 줄이 온전합니다. 마지막 숫자는 본문 바이트 수로, 메시지가 길수록 HTML이 큽니다. 200 응답의 바이트 수는 본문에 찍힌 스레드 이름(exec-9, exec-10)의 길이에 따라 실행마다 한두 바이트 달라집니다.
오류 로그(catalina.<날짜>.log)에는 이 여러 400 가운데 처음 하나만 찍혔습니다.
24-Oct-2026 13:42:54.129 INFO [http-nio-8080-exec-4] org.apache.coyote.http11.Http11Processor.service Error parsing HTTP request header
 Note: further occurrences of HTTP request parsing errors will be logged at DEBUG level.
	java.lang.IllegalArgumentException: Invalid character found in method name [G@T ]. HTTP method names must be tokens
시각과 스레드 번호는 실행마다 다릅니다. UserDataHelper의 기본 방식(INFO_THEN_DEBUG)이 처음 한 번은 INFO로, 그 뒤 24시간은 DEBUG로만 남기기 때문입니다(UserDataHelper.java 33행, 61–76행). 밖에서 오는 엉터리 요청이 로그를 채우지 않게 하려는 것입니다. 이 기록은 프로세서 객체마다 따로 합니다(userDataHelper는 AbstractProcessor의 필드, 116행). 이 예제처럼 요청이 하나씩 차례로 오면 같은 프로세서가 다시 쓰여 한 줄만 남지만, 동시에 여러 프로세서가 400을 만나면 INFO 줄이 더 찍힐 수 있습니다.
헷갈리기 쉬운 곳: 어떤 상태 코드는 연결을 닫습니다
서블릿이 sendError(400)이나 500을 돌려줘도 keep-alive는 끝납니다.
    private static boolean statusDropsConnection(int status) {
        return status == 400 /* SC_BAD_REQUEST */ || status == 408 /* SC_REQUEST_TIMEOUT */ ||
                status == 411 /* SC_LENGTH_REQUIRED */ || status == 413 /* SC_REQUEST_ENTITY_TOO_LARGE */ ||
                status == 414 /* SC_REQUEST_URI_TOO_LONG */ || status == 500 /* SC_INTERNAL_SERVER_ERROR */ ||
                status == 503 /* SC_SERVICE_UNAVAILABLE */ || status == 501 /* SC_NOT_IMPLEMENTED */;
    }
java/org/apache/coyote/http11/Http11Processor.java 206–211행
메서드 주석은 "Apache/httpd와 같은 목록을 쓴다"고 적어 두었습니다(202–205행). 응답 헤더를 만들 때 이 목록에 들면 keepAlive = false가 되어 Connection: close가 붙습니다(989–996행). 400이 난 요청 뒤의 바이트는 어디서부터 다음 요청인지 믿을 수 없으니 연결을 끊는 편이 안전합니다.
keep-alive — 루프는 버퍼에 있는 만큼만 돈다
루프 한 바퀴 안에서, 어댑터를 부르기 직전에 요청 수 한도를 셉니다.
            int maxKeepAliveRequests = protocol.getMaxKeepAliveRequests();
            if (maxKeepAliveRequests == 1) {
                keepAlive = false;
            } else if (maxKeepAliveRequests > 0 && socketWrapper.decrementKeepAlive() <= 0) {
                keepAlive = false;
            }
java/org/apache/coyote/http11/Http11Processor.java 393–398행
maxKeepAliveRequests의 기본값은 100이고, 소스 주석이 "as in Apache HTTPD server"입니다(AbstractEndpoint.java 1628행). 연결마다 남은 횟수를 소켓 래퍼가 세고, 0이 되면 이번 응답에 Connection: close를 붙입니다.
keepAlive가 참인 채로 한 바퀴가 끝나면 루프는 다시 parseRequestLine()으로 갑니다. 이번에는 keptAlive가 참이라 소켓 읽기 시간 한도를 keepAliveTimeout(정하지 않으면 connectionTimeout과 같음, AbstractEndpoint.java 1358–1361행)으로 바꾸고 fill(false)를 해 봅니다(336–346행). 여기서 두 갈래로 나뉩니다.
- 다음 요청의 바이트가 이미 와 있으면 그대로 읽어 같은 스레드에서 처리합니다.
- 아직 아무것도 없으면
fill(false)가false이고, 단계가 0·1이므로handleIncompleteRequestLineRead()가true를 돌려 루프를 빠져나옵니다.service()는SocketState.OPEN을 돌려줍니다.
OPEN을 받은 ConnectionHandler는 프로세서를 반납하고 소켓을 다시 Poller에 맡깁니다.
                } else if (state == SocketState.OPEN) {
                    // In keep-alive but between requests. OK to recycle
                    // processor. Continue to poll for the next request.
                    release(processor);
                    processor = null;
                    wrapper.registerReadInterest();
java/org/apache/coyote/AbstractProtocol.java 1386–1391행
"In keep-alive but between requests". 작업 스레드는 다음 요청을 기다리지 않고 풀로 돌아갑니다. 다음 요청이 오면 Poller가 다시 알아채 아무 작업 스레드에게나 맡깁니다.
예제 5: 한꺼번에 보낸 두 요청과 1초 뒤에 보낸 두 요청
같은 연결로 요청 두 개를 보냅니다. 한 번은 두 요청을 printf 한 번에 붙여 보내고(파이프라이닝), 한 번은 첫 요청을 보내고 1초 뒤에 두 번째를 보냈습니다. 두 번째 요청에만 Connection: close를 넣어 응답 뒤에 연결이 닫히게 했고, length=1은 서블릿이 Content-Length를 미리 정하게 하는 예제의 옵션입니다. raw는 raw_err와 같은 방식으로 요청을 보내고 응답의 앞 N줄(Date 줄은 뺌)을 보여 주는 도우미입니다.
raw 'GET /u06/echo?n=1&length=1 HTTP/1.1\r\nHost: a\r\n\r\nGET /u06/echo?n=2&length=1 HTTP/1.1\r\nHost: a\r\nConnection: close\r\n\r\n' 20

exec 3<>/dev/tcp/127.0.0.1/8080
printf 'GET /u06/echo?n=1&length=1 HTTP/1.1\r\nHost: a\r\n\r\n' >&3
sleep 1
printf 'GET /u06/echo?n=2&length=1 HTTP/1.1\r\nHost: a\r\nConnection: close\r\n\r\n' >&3
timeout 3 cat <&3 | tr -d '\r' | grep -E '^(HTTP|method)'
exec 3>&-
=== 4. keep-alive: two requests written at once on one connection ===
HTTP/1.1 200
Content-Type: text/plain;charset=UTF-8
Content-Length: 105

method=GET uri=/u06/echo query=n=1&length=1 protocol=HTTP/1.1 headers=[Host] thread=http-nio-8080-exec-3
HTTP/1.1 200
Content-Type: text/plain;charset=UTF-8
Content-Length: 117
Connection: close

method=GET uri=/u06/echo query=n=2&length=1 protocol=HTTP/1.1 headers=[Host, Connection] thread=http-nio-8080-exec-3
=== 5. keep-alive: second request sent 1s later ===
HTTP/1.1 200
method=GET uri=/u06/echo query=n=1&length=1 protocol=HTTP/1.1 headers=[Host] thread=http-nio-8080-exec-4
HTTP/1.1 200
method=GET uri=/u06/echo query=n=2&length=1 protocol=HTTP/1.1 headers=[Host, Connection] thread=http-nio-8080-exec-6
스레드 번호는 실행마다 다릅니다. 이 실행에서 읽을 것은 이렇습니다.
- 한꺼번에 보낸 두 요청은 같은 스레드(
exec-3) 가 처리했습니다. 첫 요청을 읽을 때 두 번째 요청의 바이트까지 버퍼에 들어왔으므로, 루프의 두 번째 바퀴가 곧바로 읽었습니다. - 1초 뒤에 보낸 요청은 다른 스레드(
exec-6) 가 처리했습니다. 첫 요청 뒤 루프가OPEN으로 빠져나가 스레드가 풀로 돌아갔고, 1초 뒤 Poller가 깨운 다른 스레드가 받았습니다. 풀에서 어느 스레드가 잡힐지는 정해져 있지 않으므로, 같은 번호가 나올 때도 있을 수 있습니다. 확실한 것은 첫 스레드가 1초 동안 이 연결을 붙잡고 있지 않았다는 점입니다. - 첫 응답에는
Connection헤더가 없습니다. HTTP/1.1에서는 연결을 유지하는 것이 기본이므로 따로 알리지 않습니다(997–1000행:Connection: keep-alive는 HTTP/1.0일 때만 붙입니다).
httpd 9편과 비교하면 Tomcat의 NIO 커넥터는 prefork보다 event MPM에 가깝습니다. prefork는 다음 요청이 올 때까지 그 연결에 묶여 기다렸고, event는 요청 하나를 처리하면 스레드를 돌려줬습니다. 다만 event도 입력이 이미 와 있으면(ap_run_input_pending()) 돌려주지 않고 곧바로 다음 요청을 처리합니다(server/mpm/event/event.c 1293–1295행, httpd 9편에서는 다루지 않은 곳입니다). Tomcat도 같은 모양입니다. 버퍼에 이미 있는 요청은 이어서 처리하고, 없으면 돌아갑니다. 비동기 처리가 끝난 뒤처럼 service() 루프 밖에서 요청이 끝났을 때는, 프로세서를 반납하기 전에 남은 데이터를 한 번 더 확인하는 코드도 있습니다(AbstractProcessorLight.checkForPipelinedData(), 119–131행).
응답의 모양 — Content-Length냐 chunked냐
응답 헤더는 커밋되는 순간 prepareResponse()가 만듭니다. 길이를 정하는 갈래입니다.
        long contentLength = response.getContentLengthLong();
        boolean connectionClosePresent = isConnectionToken(headers, Constants.CLOSE);
        if (http11 && response.getTrailerFields() != null) {
            // If trailer fields are set, always use chunking
            outputBuffer.addActiveFilter(outputFilters[Constants.CHUNKED_FILTER]);
            contentDelimitation = true;
            headers.addValue(Constants.TRANSFERENCODING).setString(Constants.CHUNKED);
        } else if (contentLength != -1) {
            headers.setValue("Content-Length").setLong(contentLength);
            outputBuffer.addActiveFilter(outputFilters[Constants.IDENTITY_FILTER]);
            contentDelimitation = true;
        } else if (head) {
            /* ... */
        } else {
            // If the response code supports an entity body and we're on
            // HTTP 1.1 then we chunk unless we have a Connection: close header
            if (http11 && entityBody && !connectionClosePresent) {
                outputBuffer.addActiveFilter(outputFilters[Constants.CHUNKED_FILTER]);
                contentDelimitation = true;
                headers.addValue(Constants.TRANSFERENCODING).setString(Constants.CHUNKED);
            } else {
                outputBuffer.addActiveFilter(outputFilters[Constants.IDENTITY_FILTER]);
            }
        }
java/org/apache/coyote/http11/Http11Processor.java 924–952행
길이를 알면 Content-Length, 모르면 HTTP/1.1에서는 chunked, 그것도 안 되면(HTTP/1.0, 또는 응답에 Connection: close) 길이 없이 보내고 연결을 닫아 끝을 알립니다. 끝을 알릴 방법이 없으면(contentDelimitation이 거짓) keepAlive = false가 됩니다(970–978행).
그런데 서블릿에서 setContentLength()를 부르지 않아도 Content-Length가 붙는 경우가 많습니다. Catalina 쪽 출력 버퍼가 끝날 때 길이를 채워 주기 때문입니다.
        // Content length can be calculated if:
        // - the response has not been committed
        // AND
        // - the content length has not been explicitly set
        // AND
        // - some content has been written OR this is NOT a HEAD request
        if (!coyoteResponse.isCommitted() && coyoteResponse.getContentLengthLong() == -1 &&
                (bb.remaining() > 0 || !Method.HEAD.equals(coyoteResponse.getRequest().getMethod()))) {
            coyoteResponse.setContentLength(bb.remaining());
        }
java/org/apache/catalina/connector/OutputBuffer.java 224–233행
서블릿이 끝났을 때 아직 커밋 전이면, 곧 본문이 전부 응답 버퍼(기본 8KB, OutputBuffer.DEFAULT_BUFFER_SIZE 50행) 안에 들어 있으면, 그 크기가 곧 길이입니다.
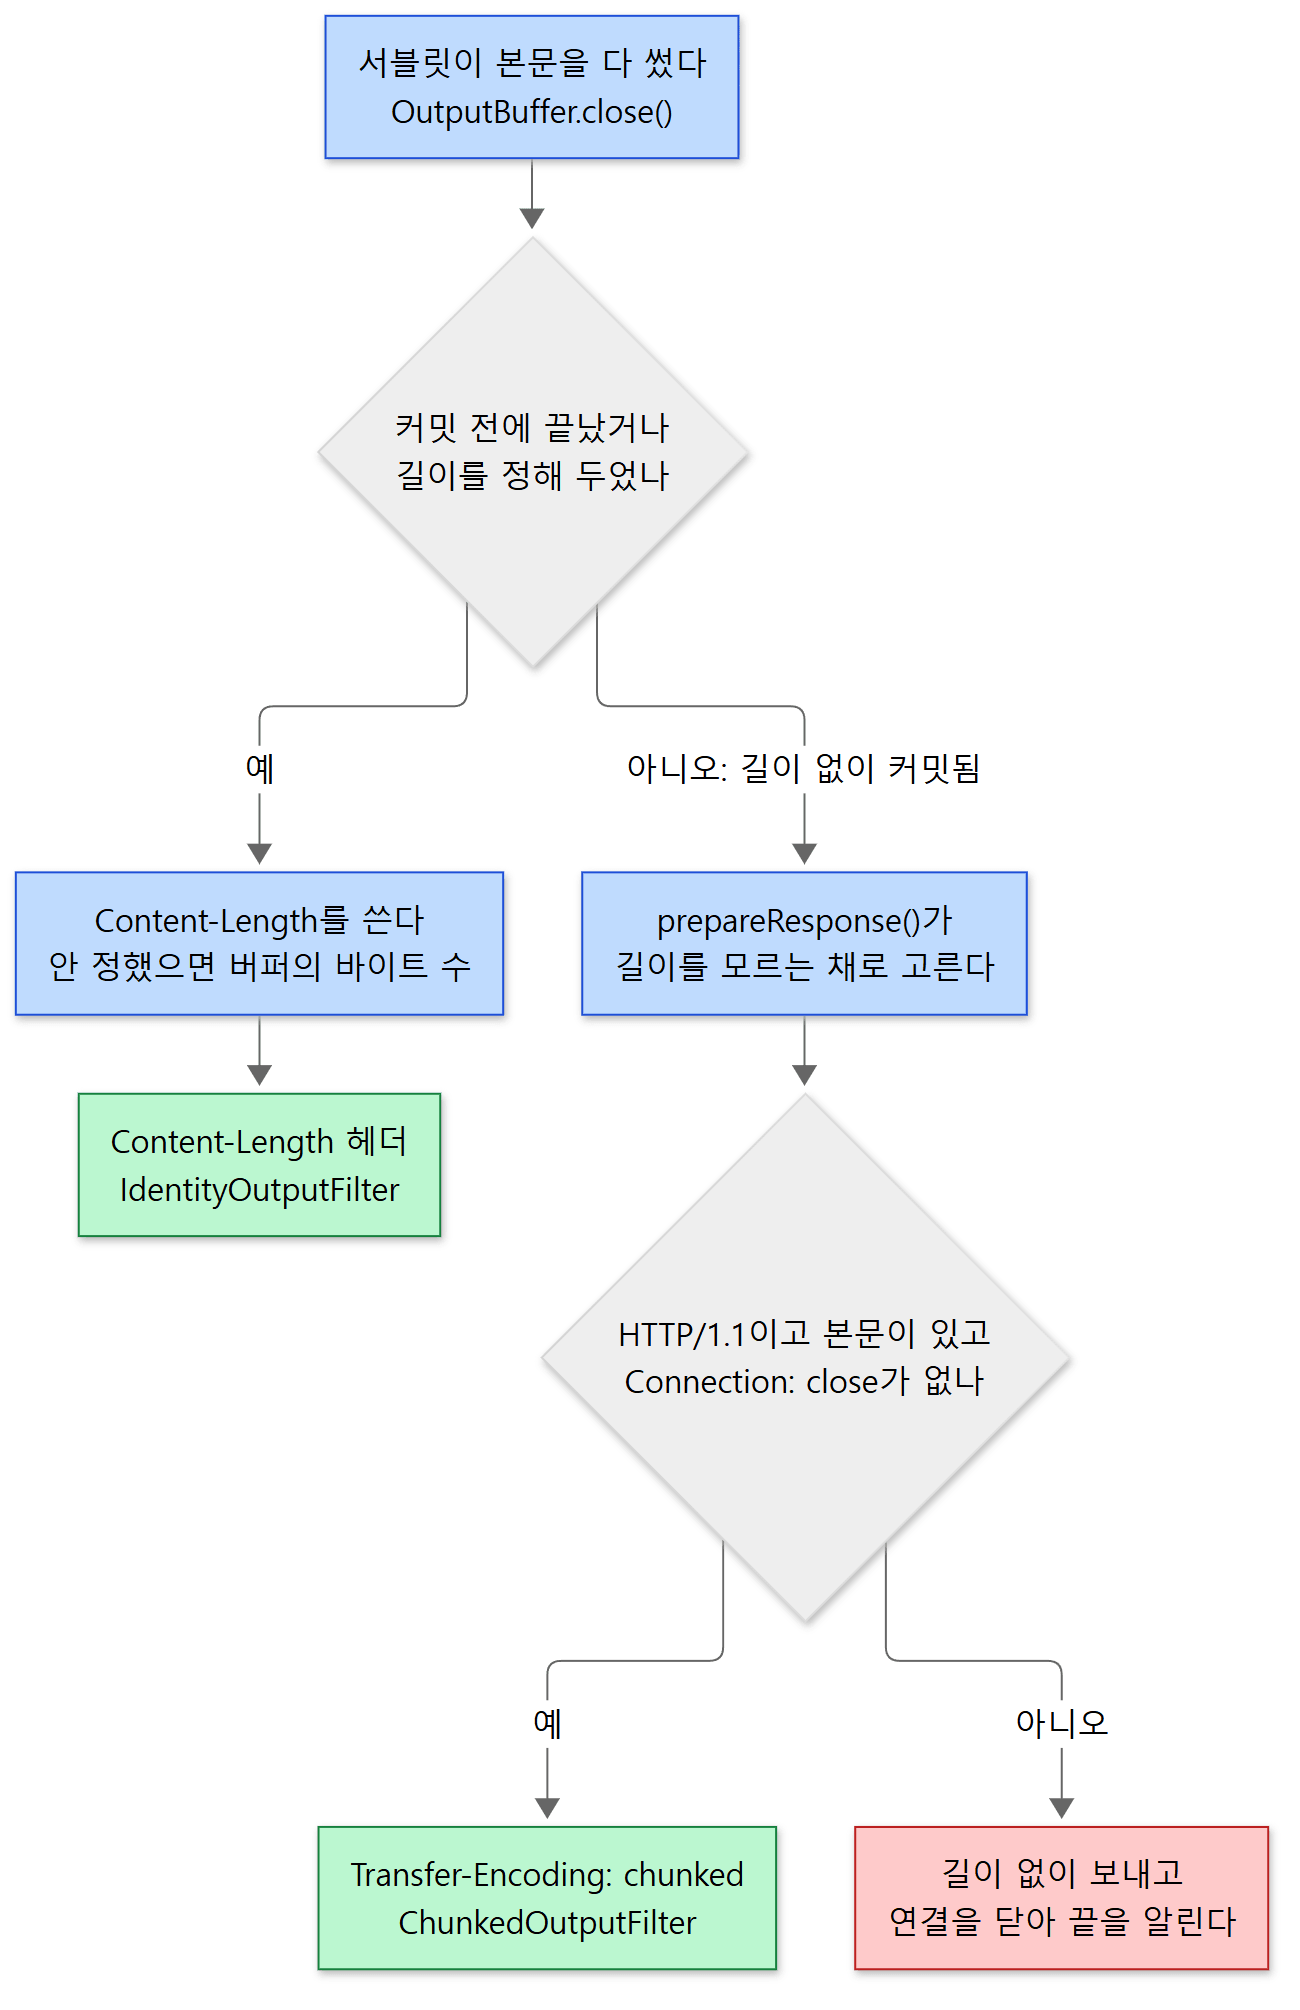 초록 상자는 연결을 유지할 수 있는 끝, 빨간 상자는 연결을 닫아야 하는 끝입니다.
예제 6: 같은 서블릿, 세 가지 응답
예제 서블릿은 flush=1이면 본문의 첫 줄을 쓴 뒤 resp.flushBuffer()로 먼저 커밋하고 after flush를 한 줄 더 씁니다.
--- 6a. GET /u06/echo (no length)
HTTP/1.1 200
Content-Type: text/plain;charset=UTF-8
Content-Length: 109
Connection: close

method=GET uri=/u06/echo query=null protocol=HTTP/1.1 headers=[Host, Connection] thread=http-nio-8080-exec-7
--- 6c. GET /u06/echo?flush=1 (committed before the end)
HTTP/1.1 200
Content-Type: text/plain;charset=UTF-8
Transfer-Encoding: chunked
Connection: close

70
method=GET uri=/u06/echo query=flush=1 protocol=HTTP/1.1 headers=[Host, Connection] thread=http-nio-8080-exec-9

c
after flush

0

--- 6d. HTTP/1.0, flush=1
HTTP/1.1 200
Content-Type: text/plain;charset=UTF-8
Connection: close

method=GET uri=/u06/echo query=flush=1 protocol=HTTP/1.0 headers=[] thread=http-nio-8080-exec-10
after flush
(length=1로 길이를 직접 정한 6b도 Content-Length: 113으로 6a와 같은 모양이라 뺐습니다. 응답의 Date 줄은 예제에서 지웠습니다. 길이 값은 본문의 스레드 이름에 따라 실행마다 조금 다릅니다.)
- 6a: 서블릿은 길이를 정하지 않았지만 본문 109바이트가 버퍼에 다 들어 있어
OutputBuffer.close()가Content-Length: 109를 채웠습니다. 요청에Connection: close를 보냈으므로 응답에도 붙었습니다. - 6c:
flushBuffer()로 길이를 모르는 채 커밋됐습니다. 요청 쪽Connection: close는prepareResponse()가 보는 응답 헤더가 아니므로 chunked가 골라졌고, 커밋 시점에keepAlive가 거짓이라Connection: close도 붙었습니다. 본문은 조각 둘입니다.70(16진수 112바이트)짜리 첫 줄,c(12바이트)짜리after flush줄, 그리고 끝을 알리는0입니다. 조각 머리는ChunkedOutputFilter.doWrite()가 16진수로 계산해 씁니다(ChunkedOutputFilter.java83–115행). - 6d: HTTP/1.0에는 chunked가 없으므로 길이 없이 보내고 연결을 닫았습니다. 3절에서 본 대로 HTTP/1.0 요청은
prepareRequestProtocol()에서 이미keepAlive = false였습니다.
헷갈리기 쉬운 곳: 상태 줄은 언제나 HTTP/1.1이고, 이유 문구가 없습니다
6d는 HTTP/1.0 요청인데 응답 첫 줄이 HTTP/1.1 200 입니다. 그리고 모든 응답에 OK나 Bad Request 같은 이유 문구(reason phrase)가 없습니다. 둘 다 Http11OutputBuffer.sendStatus()에 그대로 적혀 있습니다.
    public void sendStatus(int status) {
        // Write protocol name
        write(Constants.HTTP_11_BYTES);
        headerBuffer.put(Constants.SP);
java/org/apache/coyote/http11/Http11OutputBuffer.java 350–353행
        headerBuffer.put(Constants.SP);

        // The reason phrase is optional but the space before it is not. Skip
        // sending the reason phrase. Clients should ignore it (RFC 7230) and it
        // just wastes bytes.

        headerBuffer.put(Constants.CR).put(Constants.LF);
java/org/apache/coyote/http11/Http11OutputBuffer.java 370–376행
프로토콜 이름은 상수 HTTP/1.1 하나뿐이고, 이유 문구는 "클라이언트가 무시해야 하는 바이트 낭비"라며 보내지 않습니다. 다만 앞의 공백은 문법상 필요해서 남깁니다. 그래서 상태 줄이 HTTP/1.1 400 처럼 공백으로 끝납니다. 자주 쓰는 200·400·404는 숫자를 미리 바이트로 만들어 둔 상수를 씁니다(356–368행). 헤더는 headerBuffer(크기 maxHttpResponseHeaderSize, 기본 8192바이트)에 모았다가 커밋 때 한 번에 보냅니다(317–342행).
이 글에서 뺀 것
- HTTP/1.1 업그레이드(
Connection: upgrade, h2c):Http11Processor.java333–375행 → 15편 - 비동기 요청이 끝날 때의 길(
dispatchEndRequest()): 1154–1170행 → 12편 Expect: 100-continue와100응답: 788–798행, 1239–1256행- 요청 본문 필터의 내부(
ChunkedInputFilter,IdentityInputFilter)와 남은 본문 버리기 한도maxSwallowSize:coyote/http11/filters/, 580–597행 - sendfile(큰 정적 파일을 커널이 직접 보내기): 1102–1114행, 1406–1432행
- gzip 압축(
compression속성,GzipOutputFilter)과restrictedUserAgents: 650–663행, 905–909행 Host값의 해석과 SNI 확인(parseHost(),checkSni()): 774–780행- 글자 검사 표(
HttpParser,relaxedPathChars):java/org/apache/tomcat/util/http/parser/HttpParser.java
정리
| 개념 | 한 줄 요약 |
|---|---|
ConnectionHandler.process() |
쉬는 프로세서를 꺼내거나 만들어 process()를 부른다. 요청 사이에는 프로세서를 반납한다 |
Http11Processor.service() |
요청 줄 → 프로토콜 → 헤더 → prepareRequest() → 어댑터 → endRequest() → nextRequest()를 도는 루프 |
parseRequestLine() |
단계 번호로 위치를 기억하며 기다리지 않고 읽는다. 공백엔 너그럽고 글자엔 엄격하다 |
| HTTP/0.9 | main에서는 지원하지 않는다(11.0.x는 지원). 주석만 남아 있다 |
HttpHeaderParser·MimeHeaders |
헤더 한 줄씩 버퍼 안에서 정리해 배열에 담는다. 찾을 때는 처음부터 대소문자 무시 비교 |
maxHttpHeaderSize·maxHeaderCount |
요청 줄+헤더 8192바이트, 헤더 100개. 넘으면 400(414가 아니다) |
MessageBytes·ByteChunk |
바이트 배열의 위치만 기억하고, toString()할 때 문자열을 만든다. 요청이 끝나면 버퍼는 다음 요청이 쓴다 |
| 400 | CLOSE_CLEAN이라 어댑터까지 가서 ErrorReportValve가 HTML을 쓰고 접근 로그에 남은 뒤 연결을 닫는다 |
| keep-alive | 버퍼에 다음 요청이 있으면 같은 스레드가 이어서, 없으면 OPEN으로 돌아가 Poller가 기다린다 |
| 응답 길이 | 커밋 전에 끝나면 Content-Length, 먼저 커밋되면 HTTP/1.1은 chunked, 아니면 연결을 닫아 끝을 알린다 |
다음에 볼 것
이 글은 getAdapter().service(request, response)에서 멈췄습니다. coyote Request는 아직 URI를 %xx도 풀지 않은 바이트로 들고 있고, 어느 웹앱의 어느 서블릿이 받을지도 모릅니다. 7편: CoyoteAdapter와 Mapper — 요청은 어느 서블릿으로 가나에서는 이 요청을 Catalina의 Request로 감싸고, URI를 디코딩·정규화하고, Host → Context → Wrapper 순서로 서블릿을 찾는 과정을 봅니다. 이 글의 400 예제에서 잠깐 본 postParseRequest()가 그 중심입니다.
같은 일을 C로 하는 httpd와 비교하고 싶다면 httpd 9편이 짝입니다. httpd는 요청 줄과 헤더를 요청 풀에 문자열로 복사해 request_rec에 두고(trunk에서는 HTTP1_REQUEST_IN 필터가 읽은 값을 ap_read_request()가 apr_pstrdup()으로 옮겨 적습니다) 요청이 끝나면 풀째 버립니다. Tomcat은 버퍼 하나를 가리키는 MessageBytes를 두고 객체를 재활용합니다. 메모리를 아끼는 방법이 다를 뿐 "요청마다 생기는 쓰레기를 줄인다"는 목표는 같습니다. 한도 쪽은 httpd가 요청 줄·헤더 한 줄·개수를 따로 재고 414를 쓰는 반면, Tomcat은 요청 줄과 헤더를 한데 잽니다.