이 글에서 다루는 것
"Spring 소스 파헤치기" 시리즈의 스물일곱 번째 글이자 마지막 글입니다. 26편에서 spring-test를 봤고, 이번에는 1편의 지도에서 마지막 단위인 U25, 곧 spring-context 안에 들어 있는 캐시·스케줄링·검증·리질리언스(실패에 버티기)를 읽습니다.
2편 7절에서 "여러 기능이 되풀이하는 세 조각"이라는 말을 했습니다. @EnableXxx가 @Import로 빈 정의를 등록하고, BeanPostProcessor가 빈 생성에 끼어들고, 프록시가 호출을 가로챈다는 것입니다. 그때는 표 하나로 넘어갔습니다. 이 글은 그 표의 줄 하나하나를 소스로 확인하는 글입니다. 답하려는 질문은 네 가지입니다.
@EnableCaching,@EnableScheduling,@EnableAsync,@EnableResilientMethods한 줄은 각각 컨테이너에 무엇을 등록하는가@Cacheable메서드를 부르면 캐시 조회, 본문 호출, 저장, 비우기는 어떤 순서로 일어나는가@Scheduled와@Async는 둘 다 "다른 스레드에서 돈다"인데 왜 하나는 프록시가 없고 하나는 있는가- 7.0에 들어온
@Retryable은 본문을 몇 번 부르고, 한 메서드에 여러 기능을 붙이면 누가 바깥에 서는가
| 항목 | 내용 |
|---|---|
| 기준 소스 | Spring Framework 7.1.0-SNAPSHOT |
| 커밋 | f447f3c310 (2026-10-01, main 브랜치) |
| 주로 읽는 모듈 | spring-context (cache, scheduling, validation, resilience), spring-aop (aop.framework, aop.interceptor), spring-core (core.retry) |
| 주로 읽는 클래스 | CachingConfigurationSelector, ProxyCachingConfiguration, CacheAspectSupport, ScheduledAnnotationBeanPostProcessor, ScheduledTaskRegistrar, AsyncAnnotationBeanPostProcessor, AsyncExecutionInterceptor, AbstractAdvisingBeanPostProcessor, DataBinder, SpringValidatorAdapter, MethodValidationPostProcessor, RetryAnnotationBeanPostProcessor, AbstractRetryInterceptor, RetryTemplate |
글에 나오는 줄 번호와 세부 동작은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고 세부 내용도 달라질 수 있습니다. 같은 커밋의 소스를 받는 방법은 1편에 있습니다.
범위가 넓어서 기능마다 "스위치 → 등록되는 것 → 가로채는 자리"의 뼈대와 핵심 메서드 하나씩만 봅니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치를 적어 두었습니다.
먼저 알아 둘 말
프록시와 어드바이저는 앞 글에서 봤습니다. 프록시는 원래 객체를 감싸 호출을 먼저 받는 객체이고(10편), 어드바이저는 "어디에 끼어들지(포인트컷)"와 "끼어들어 무엇을 할지(어드바이스)"를 묶은 것입니다(11편). 어드바이스 가운데 메서드 호출을 감싸는 종류를 인터셉터(MethodInterceptor)라고 부릅니다.
빈 후처리기(BeanPostProcessor, 줄여서 BPP)는 컨테이너가 빈을 하나 만들 때마다 불러 주는 확장 지점입니다. 받은 빈 대신 다른 객체를 돌려주면 그것이 빈이 됩니다(4편 3절, 6편).
캐시는 한 번 계산한 결과를 열쇠(키)와 함께 적어 두었다가 같은 열쇠로 다시 물으면 계산하지 않고 돌려주는 저장소입니다. Spring에서는 Cache 인터페이스가 저장소 하나, CacheManager가 이름으로 Cache를 찾아 주는 창구입니다.
실행기(Executor)는 "이 일을 실행해 달라"고 맡기면 자기가 가진 스레드에서 실행해 주는 객체입니다. 정해진 시각이나 간격으로 실행해 주는 것은 따로 스케줄러(TaskScheduler)라고 부릅니다.
Bean Validation은 @NotBlank, @Min(1) 같은 제약 어노테이션으로 값의 규칙을 적는 Jakarta의 표준입니다(패키지 jakarta.validation). 표준은 인터페이스만 정하고, 실제 검증은 Hibernate Validator 같은 구현 라이브러리가 합니다. Spring에는 이와 별개로 자기 인터페이스 org.springframework.validation.Validator가 있습니다. 이름이 같은 Validator가 둘이라는 점이 4절에서 중요해집니다.
리질리언스(resilience)는 호출이 실패하거나 몰릴 때 버티는 장치를 묶어 부르는 말입니다. 이 커밋의 org.springframework.resilience 패키지에는 실패하면 다시 부르는 @Retryable과 동시에 들어오는 호출 수를 제한하는 @ConcurrencyLimit 두 가지가 있습니다.
1. 네 기능, 같은 틀
먼저 결론부터 표로 봅니다. 클래스 이름은 모두 이 커밋의 소스에서 확인한 것이고, 근거가 되는 줄은 뒤의 절에서 하나씩 겁니다(기본 모드 PROXY 기준).
| 기능 | 스위치 | @Import가 가져오는 것 |
어노테이션을 읽는 것 | 호출을 가로채는 것 | 프록시를 만드는 후처리기 |
|---|---|---|---|---|---|
@Cacheable 등 |
@EnableCaching |
AutoProxyRegistrar, ProxyCachingConfiguration |
AnnotationCacheOperationSource |
CacheInterceptor |
자동 프록시 생성기 |
@Async |
@EnableAsync |
ProxyAsyncConfiguration |
AsyncAnnotationAdvisor의 포인트컷 |
AnnotationAsyncExecutionInterceptor |
AsyncAnnotationBeanPostProcessor |
@Scheduled |
@EnableScheduling |
SchedulingConfiguration |
ScheduledAnnotationBeanPostProcessor |
없음 | 없음 (프록시를 만들지 않는다) |
@Retryable |
@EnableResilientMethods |
ResilientMethodsConfiguration |
RetryAnnotationBeanPostProcessor |
RetryAnnotationInterceptor |
RetryAnnotationBeanPostProcessor |
@ConcurrencyLimit |
@EnableResilientMethods |
ResilientMethodsConfiguration |
ConcurrencyLimitBeanPostProcessor |
ConcurrencyLimitInterceptor |
ConcurrencyLimitBeanPostProcessor |
메서드 검증 (@Validated) |
없음. 후처리기를 빈으로 직접 등록 | — | MethodValidationPostProcessor |
MethodValidationInterceptor |
MethodValidationPostProcessor |
17편의 @Transactional을 여기에 한 줄 더하면 캐시와 똑같은 모양입니다(@EnableTransactionManagement → AutoProxyRegistrar + ProxyTransactionManagementConfiguration → AnnotationTransactionAttributeSource → TransactionInterceptor).
표를 세로로 읽으면 프록시에 이르는 길이 셋으로 갈립니다.
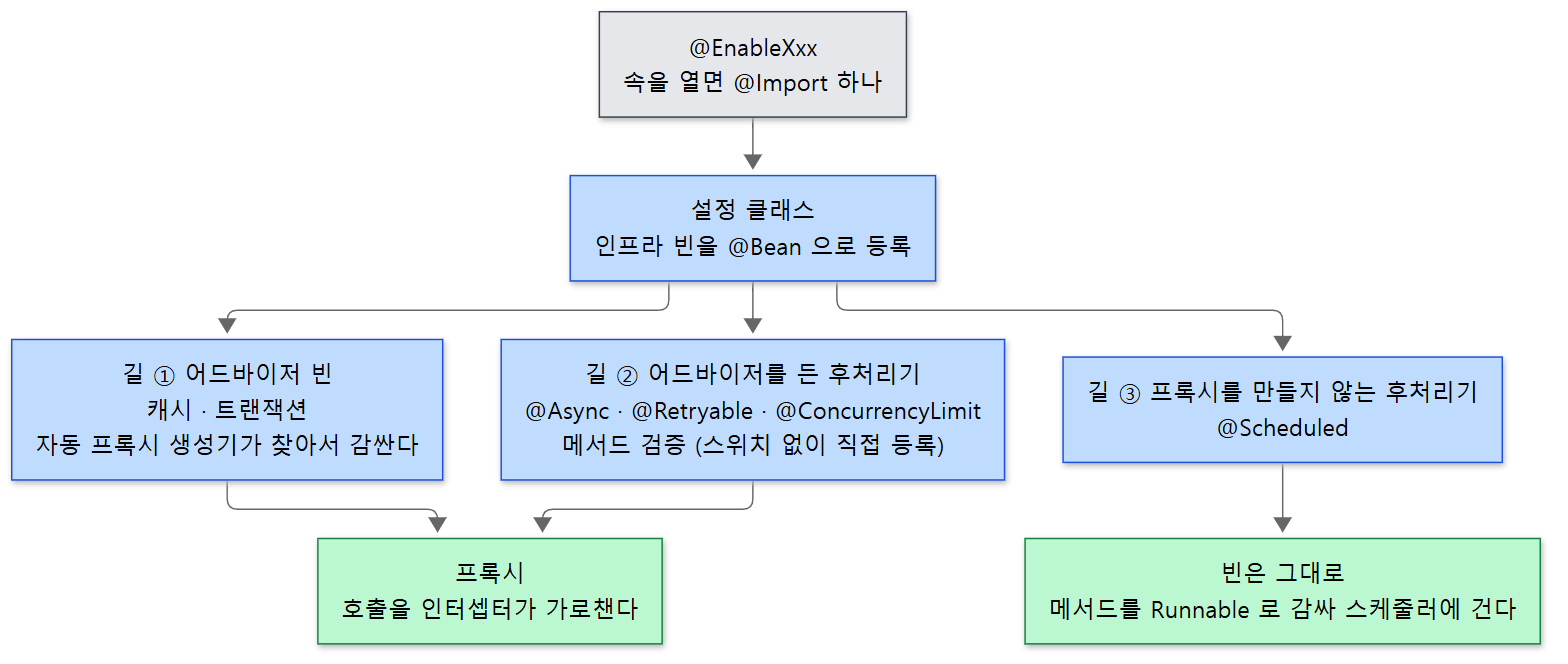 회색이 스위치, 파란색이 등록되는 것, 초록색이 결과입니다. 길 ①과 ②는 프록시로, 길 ③은 프록시 없이 끝납니다.
- 길 ① — 어드바이저를 빈으로 등록한다. 캐시와 트랜잭션이 이 길입니다. 설정 클래스는 어드바이저 빈만 등록하고, 빈을 감싸는 일은 11편의 자동 프록시 생성기(
InfrastructureAdvisorAutoProxyCreator)가 합니다. 이 생성기는 컨테이너에서 어드바이저 빈을 모아 빈마다 맞는지 보고, 맞으면 감쌉니다. - 길 ② — 어드바이저를 든 후처리기를 등록한다.
@Async,@Retryable,@ConcurrencyLimit, 메서드 검증이 이 길입니다. 후처리기가 어드바이저 하나를 필드로 들고 있다가 직접 프록시를 만듭니다. 넷 모두spring-aop의AbstractAdvisingBeanPostProcessor를 상속합니다(3절). - 길 ③ — 프록시를 만들지 않는다.
@Scheduled입니다. 호출을 가로챌 일이 없고, 메서드를 정해진 때에 불러 주기만 하면 되기 때문입니다.
2편의 "세 조각"으로 말하면 길 ①과 ②는 세 조각을 모두 쓰고, 길 ③은 앞의 두 조각만 씁니다.
헷갈리기 쉬운 곳
- 모든 기능에
@EnableXxx가 있는 것은 아닙니다. 이 커밋에서MethodValidationPostProcessor를 가져오는@Import는 없습니다. 각 모듈의src/main에서 이 클래스 이름이 나오는 곳은 자기 자신과MethodValidationInterceptor·@Validated의 설명 주석, 그리고 문서용 예제 코드뿐입니다. 순수한 Spring Framework에서는 이 후처리기를@Bean으로 직접 등록해야 메서드 검증이 켜집니다(4절의 예제가 그렇게 합니다). @EnableResilientMethods하나가 후처리기 둘을 등록합니다. 재시도와 동시성 제한은 스위치가 같고 후처리기가 다릅니다(ResilientMethodsConfiguration63–77행).
2. 캐시 — @EnableCaching에서 CacheAspectSupport.execute까지
스위치가 등록하는 것
@EnableCaching을 열면 @Import(CachingConfigurationSelector.class) 하나가 붙어 있습니다(EnableCaching 164–168행). 9편에서 본 ImportSelector, 곧 "무엇을 더 가져올지 이름으로 돌려주는 클래스"입니다. mode가 기본값 PROXY(198행)일 때 돌려주는 이름은 이렇습니다.
	private String[] getProxyImports() {
		List<String> result = new ArrayList<>(3);
		result.add(AutoProxyRegistrar.class.getName());
		result.add(ProxyCachingConfiguration.class.getName());
		if (JSR_107_PRESENT && JCACHE_IMPL_PRESENT) {
			result.add(PROXY_JCACHE_CONFIGURATION_CLASS);
		}
		return StringUtils.toStringArray(result);
	}
17편의 트랜잭션 선택기도 같은 짝, 곧 AutoProxyRegistrar와 자기 설정 클래스(ProxyTransactionManagementConfiguration)의 이름을 돌려줍니다. AutoProxyRegistrar는 자동 프록시 생성기를 등록하고(AutoProxyRegistrar 72–73행), ProxyCachingConfiguration은 빈 셋을 등록하는 설정 클래스입니다(38–72행).
| 빈 | 타입 | 하는 일 |
|---|---|---|
cacheOperationSource |
AnnotationCacheOperationSource |
메서드와 클래스에서 @Cacheable·@CachePut·@CacheEvict를 읽어 CacheOperation 목록으로 바꾼다 |
cacheInterceptor |
CacheInterceptor |
호출을 가로채 캐시를 조회하고 저장하는 어드바이스 |
cacheAdvisor |
BeanFactoryCacheOperationSourceAdvisor |
위 둘을 묶은 어드바이저. 포인트컷은 "이 메서드에 캐시 동작이 하나라도 있는가"(CacheOperationSourcePointcut 54–57행) |
트랜잭션의 …AttributeSource + 인터셉터 + 어드바이저와 이름만 다르고 구조가 같습니다. 어노테이션을 읽는 쪽과 실행하는 쪽을 나눠 두면, 어노테이션이 아닌 다른 방식으로 캐시 동작을 정해도 인터셉터는 그대로 쓸 수 있습니다.
실제 저장소는 이 설정이 만들지 않습니다. CacheInterceptor는 모든 싱글톤이 만들어진 뒤에 컨테이너에서 CacheManager 타입의 빈을 찾고, 없으면 "CacheManager 빈을 등록하거나 @EnableCaching을 지우라"는 예외를 던집니다(CacheAspectSupport 260–292행). CacheManager는 이름으로 Cache를 찾아 주는 getCache(String name)이 핵심인 인터페이스이고( CacheManager 43행), Cache는 get·put·evict·clear를 가진 저장소입니다(Cache 43행부터). 이 글의 예제가 쓰는 ConcurrentMapCache는 ConcurrentMap 하나를 감싼 가장 단순한 구현입니다(55–59행).
호출 시점: execute가 지키는 순서
프록시의 메서드가 불리면 CacheInterceptor.invoke가 받습니다. 하는 일은 "다음으로 넘어가기"(invocation.proceed())를 람다로 감싸 부모 클래스의 execute에 넘기는 것뿐입니다(48–69행). 부모 CacheAspectSupport는 이 메서드의 캐시 동작 목록을 CacheOperationSource에서 받아(381–396행) 다음 메서드로 들어갑니다.
	private @Nullable Object execute(CacheOperationInvoker invoker, Method method, CacheOperationContexts contexts) {
		if (contexts.isSynchronized()) {
			// Special handling of synchronized invocation
			return executeSynchronized(invoker, method, contexts);
		}

		// Process any early evictions
		processCacheEvicts(contexts.get(CacheEvictOperation.class), true,
				CacheOperationExpressionEvaluator.NO_RESULT);

		// Check if we have a cached value matching the conditions
		Object cacheHit = findCachedValue(invoker, method, contexts);
		if (cacheHit == null || cacheHit instanceof Cache.ValueWrapper) {
			return evaluate(cacheHit, invoker, method, contexts);
		}
		return cacheHit;
	}
spring-context/src/main/java/org/springframework/cache/interceptor/CacheAspectSupport.java 412–428행
이어지는 evaluate가 나머지 순서를 정합니다.
		if (cacheHit != null && !hasCachePut(contexts)) {
			// If there are no put requests, just use the cache hit
			cacheValue = unwrapCacheValue(cacheHit);
			returnValue = wrapCacheValue(method, cacheValue);
		}
		else {
			// Invoke the method if we don't have a cache hit
			returnValue = invokeOperation(invoker);
			cacheValue = unwrapReturnValue(returnValue);
		}

		// Collect puts from any @Cacheable miss, if no cached value is found
		List<CachePutRequest> cachePutRequests = new ArrayList<>(1);
		if (cacheHit == null) {
			collectPutRequests(contexts.get(CacheableOperation.class), cacheValue, cachePutRequests);
		}

		// Collect any explicit @CachePuts
		collectPutRequests(contexts.get(CachePutOperation.class), cacheValue, cachePutRequests);

		// Process any collected put requests, either from @CachePut or a @Cacheable miss
		for (CachePutRequest cachePutRequest : cachePutRequests) {
			Object returnOverride = cachePutRequest.apply(cacheValue);
			// ...
		}

		// Process any late evictions
		Object returnOverride = processCacheEvicts(
				contexts.get(CacheEvictOperation.class), false, returnValue);
spring-context/src/main/java/org/springframework/cache/interceptor/CacheAspectSupport.java 567–597행
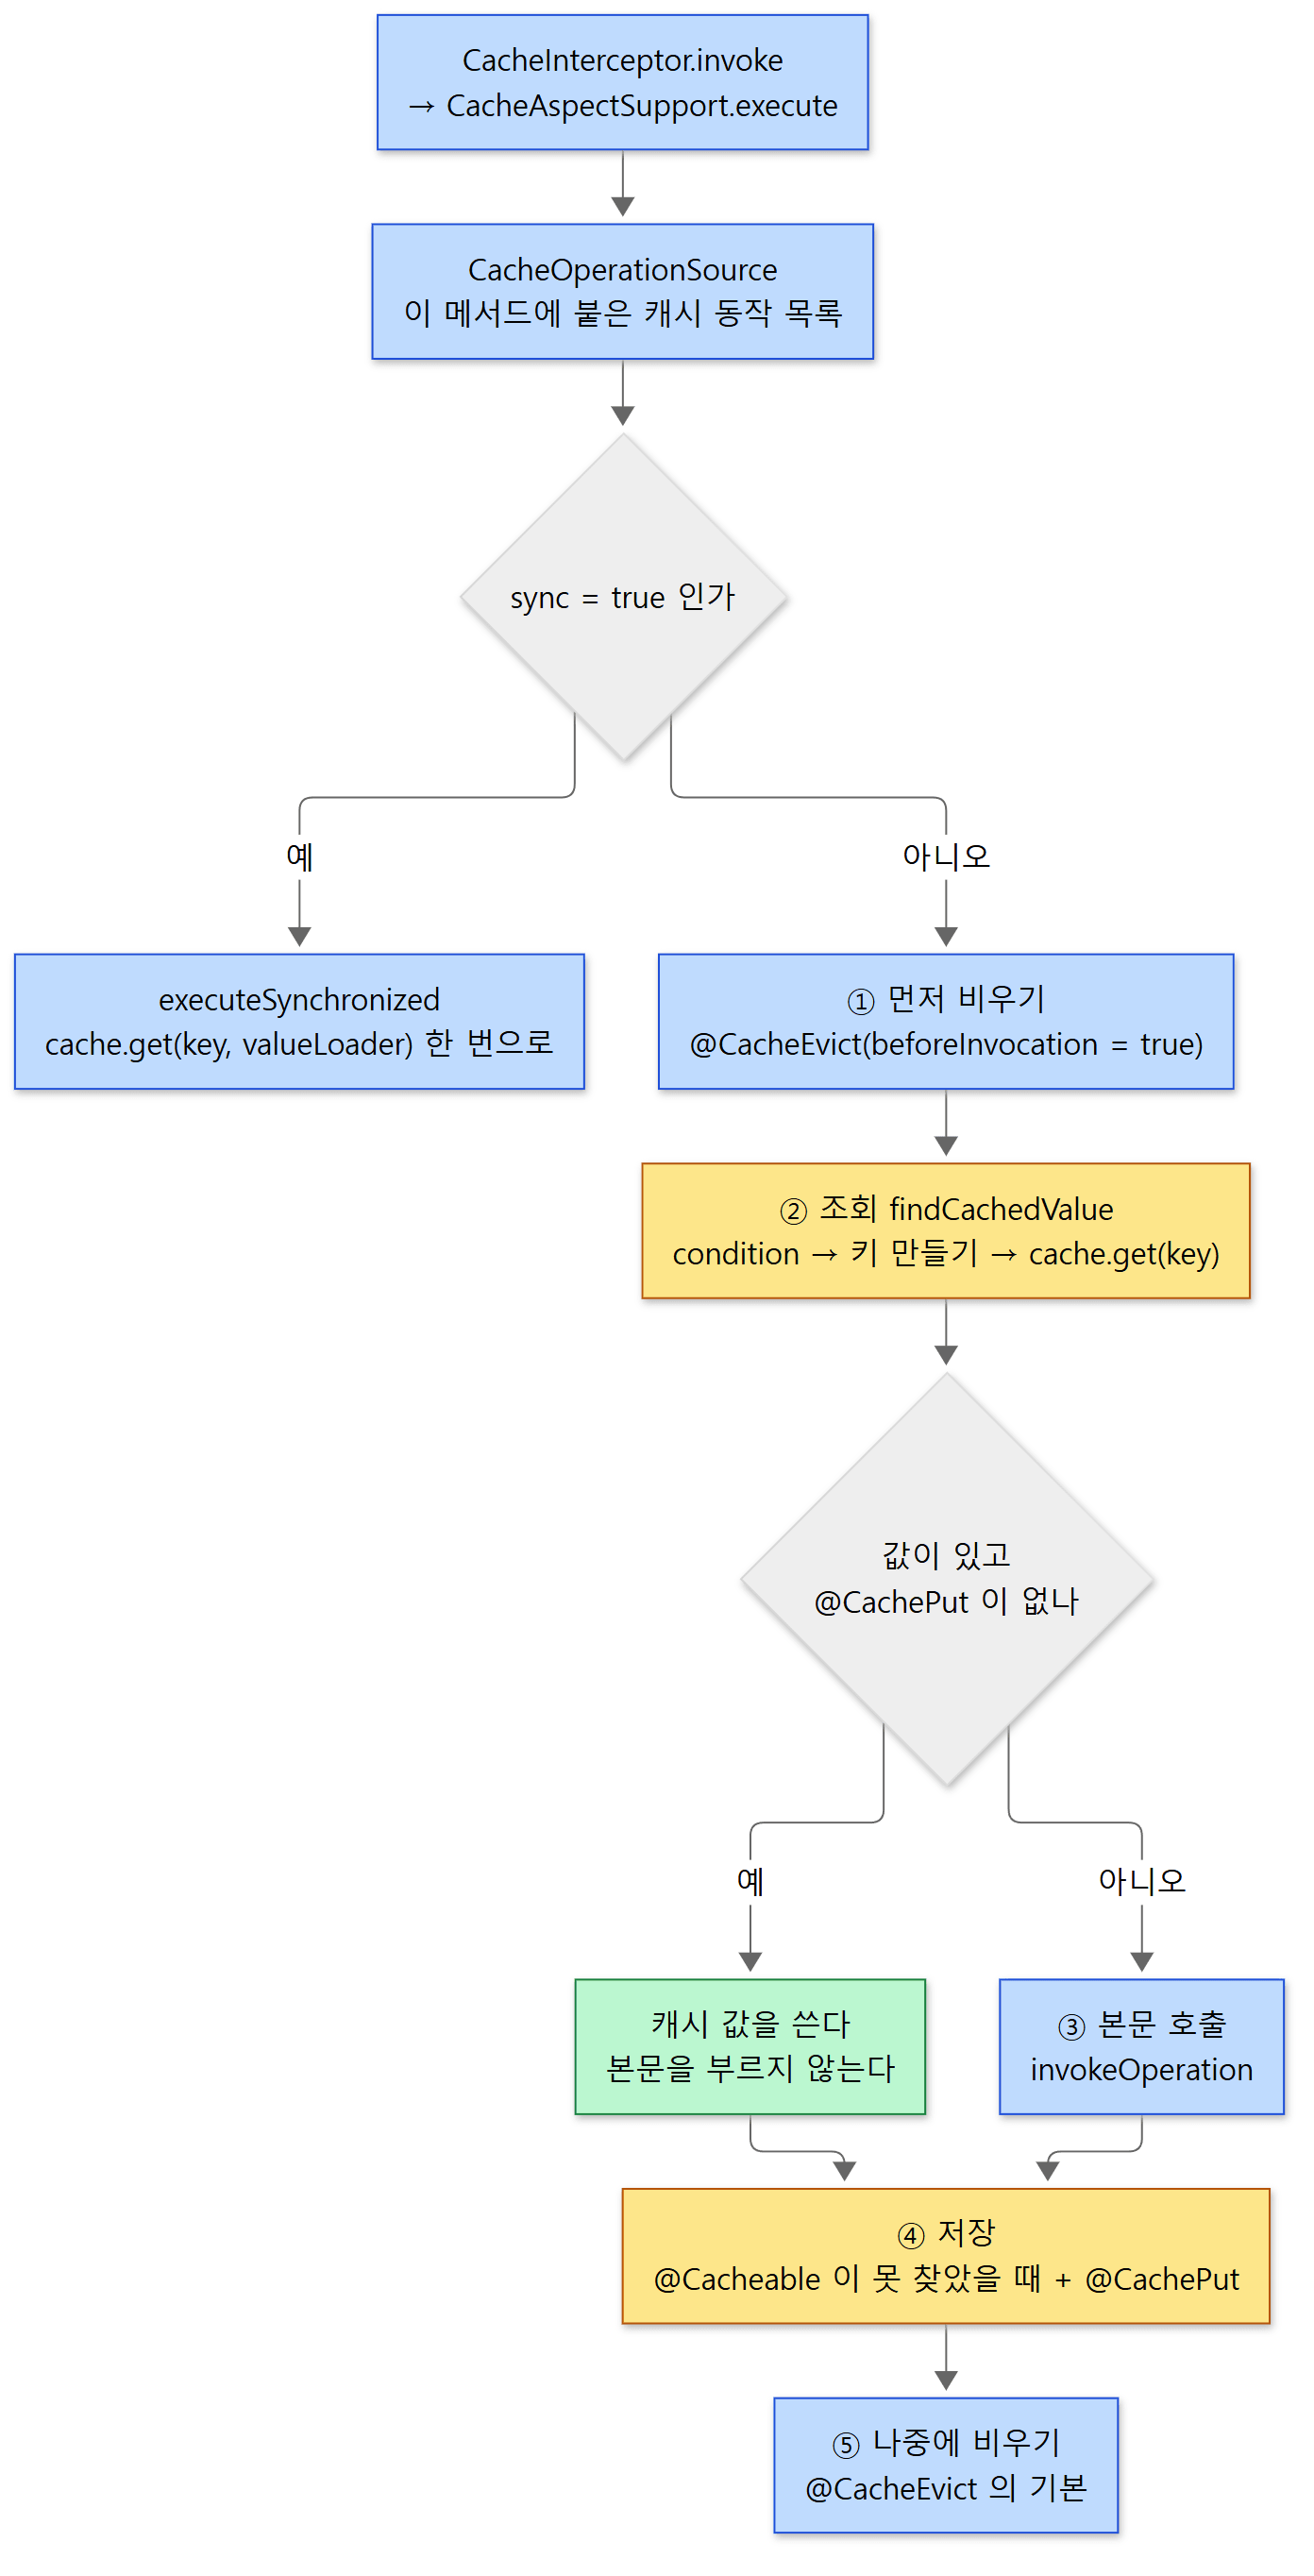 노란색이 캐시를 읽고 쓰는 자리, 초록색이 본문을 건너뛰는 자리입니다.
- 먼저 비우기.
@CacheEvict(beforeInvocation = true)인 것만 지금 비웁니다. 걸러내는 조건은beforeInvocation == evict.isBeforeInvocation()입니다(648–650행). - 조회.
@Cacheable마다condition을 계산하고, 통과하면 키를 만들어 캐시에서 찾습니다(494–513행). - 본문 호출. 찾았고
@CachePut이 없으면 캐시 값을 쓰고 본문은 부르지 않습니다. 아니면invokeOperation(invoker)가 아까의 람다, 곧 체인의 다음(결국 원본 메서드)을 부릅니다. - 저장.
@Cacheable이 못 찾았을 때의 저장과@CachePut의 저장을 한데 모아 실행합니다.unless는 여기서, 결과가 나온 뒤에 계산됩니다(canPutToCache, 914–927행, 부르는 곳은 1041행). - 나중에 비우기.
beforeInvocation의 기본값은false이므로(CacheEvict161행) 보통의@CacheEvict는 본문이 예외 없이 끝난 뒤에 비웁니다. 본문이 예외를 던지면 5번까지 오지 못합니다.
키는 key 속성에 식이 있으면 SpEL로 계산하고, 없으면 KeyGenerator에게 맡깁니다(932–941행). 기본 생성기 SimpleKeyGenerator의 규칙은 짧습니다. 인자가 없으면 SimpleKey.EMPTY, 인자가 하나이고 null도 배열도 아니면 그 인자 자체, 그 밖에는 인자 전부를 담은 SimpleKey입니다(54–65행). 식을 쓰는 쪽은 15편의 SpEL 그대로입니다. 식 안에서 #item처럼 인자를 이름으로 쓸 수 있는 것은 캐시용 컨텍스트 CacheEvaluationContext가 MethodBasedEvaluationContext를 상속하고(46행), 이 부모가 인자마다 a0·p0와 파라미터 이름으로 변수를 넣어 주기 때문입니다(84–111행). 호출마다 식을 다시 파싱하지 않도록 CachedExpressionEvaluator가 "어느 메서드의 어느 식"을 열쇠로 파싱 결과(Expression)를 맵에 넣어 둡니다(CachedExpressionEvaluator 82–87행). 캐시 쪽 자식 클래스는 key, condition, unless마다 맵을 따로 둡니다(CacheOperationExpressionEvaluator 104–116행).
sync = true는 다른 길입니다
위 순서의 2번과 4번 사이에는 틈이 있습니다. 두 스레드가 동시에 같은 키로 들어오면 둘 다 "없다"는 답을 받고 둘 다 본문을 부릅니다. @Cacheable(sync = true)(Cacheable 211행)는 조회와 저장을 Cache.get(key, valueLoader) 한 번에 맡겨서 이 틈을 저장소가 막게 합니다(executeSynchronized, 431–486행, 핵심은 472행). ConcurrentMapCache에서는 그것이 ConcurrentMap.computeIfAbsent입니다(146–155행).
대신 제약이 생깁니다. 다른 캐시 동작과 함께 쓸 수 없고, sync = true인 @Cacheable은 하나뿐이어야 하고, 캐시도 하나여야 하고, unless를 쓸 수 없습니다. 어느 하나라도 어기면 IllegalStateException입니다(determineSyncFlag, 769–803행).
예제 ①: 두 번 부르면 본문은 몇 번 도나
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
@Configuration
@EnableCaching
static class Config {

	@Bean
	CacheManager cacheManager() {
		return new ConcurrentMapCacheManager("prices");
	}

	@Bean
	PriceService priceService() {
		return new PriceService();
	}
}

public static class PriceService {

	@Cacheable("prices")
	public int price(String item) {
		System.out.println("  [본문] price(" + item + ") 계산");
		return item.length() * 1000;
	}

	// 키를 SpEL 로 만들고, 이름이 3글자보다 길 때만 캐시한다
	@Cacheable(cacheNames = "prices", key = "'upper:' + #item.toUpperCase()", condition = "#item.length() > 3")
	public int priceIgnoreCase(String item) {
		System.out.println("  [본문] priceIgnoreCase(" + item + ") 계산");
		return item.length() * 1000;
	}

	@CacheEvict(cacheNames = "prices", key = "#item")
	public void changed(String item) {
		System.out.println("  [본문] changed(" + item + ")");
	}

	public int priceTwice(String item) {
		return price(item) + price(item);   // this.price() — 프록시를 거치지 않는다
	}
}
이 예제는 릴리스 버전인 Spring Framework 7.0.9로 실행해 아래 출력을 확인했습니다(이 시리즈가 읽는 7.1.0-SNAPSHOT을 직접 빌드해 돌린 것은 아닙니다). "저장소"는 ConcurrentMapCache가 감싼 맵을 그대로 찍은 것입니다.
빈의 클래스: CacheExample$PriceService$$SpringCGLIB$$0, 프록시인가: true
== price(apple) 두 번
  [본문] price(apple) 계산
  결과 5000
  결과 5000
  저장소: {apple=5000}
== changed(apple) 뒤에 price(apple)
  [본문] changed(apple)
  저장소: {}
  [본문] price(apple) 계산
  결과 5000
== priceTwice(pear) — 안에서 this.price() 를 두 번
  [본문] price(pear) 계산
  [본문] price(pear) 계산
  결과 8000
  저장소: {apple=5000}
== priceIgnoreCase: kiwi, KIWI, fig, fig
  [본문] priceIgnoreCase(kiwi) 계산
  [본문] priceIgnoreCase(fig) 계산
  [본문] priceIgnoreCase(fig) 계산
  저장소: {upper:KIWI=4000, apple=5000}
price("apple")의 두 번째 호출에는[본문]이 없습니다. 키가 인자apple그 자체인 것도 저장소에 보입니다(SimpleKeyGenerator의 "인자 하나" 규칙).changed("apple")은 본문이 먼저 찍히고 그 뒤에 저장소가 비었습니다. 위 순서의 5번입니다.priceTwice("pear")는 본문이 두 번 돌았고 저장소에pear가 없습니다. 6절에서 다시 봅니다.kiwi와KIWI는 키가 둘 다upper:KIWI라 본문이 한 번만 돌았고,fig는condition이 거짓이라 매번 돌고 저장되지도 않았습니다.
헷갈리기 쉬운 곳
condition과unless는 계산되는 때가 다릅니다.condition은 조회 전에(2번),unless는 본문이 돈 뒤 저장 직전에(4번) 계산됩니다. 그래서 반환값#result는unless에서만 뜻이 있습니다.@CachePut이 같이 붙으면 캐시에 값이 있어도 본문이 돕니다.evaluate의 첫if에!hasCachePut(contexts)가 있습니다(567행).ConcurrentMapCacheManager는 모르는 이름의 캐시를 그 자리에서 만들 수 있습니다. 이름을 주지 않고 만들면 "동적" 모드라getCache가 없는 이름을 받을 때 새 캐시를 만들고, 예제처럼 생성자에 이름을 주면 그 이름들만 있는 고정 모드가 됩니다(169–175행).
3. 스케줄링과 비동기 — 하나는 등록만, 하나는 프록시
두 기능은 같은 패키지(scheduling.annotation)에 있고 둘 다 본문이 다른 스레드에서 돌지만, 붙는 방식은 정반대입니다.
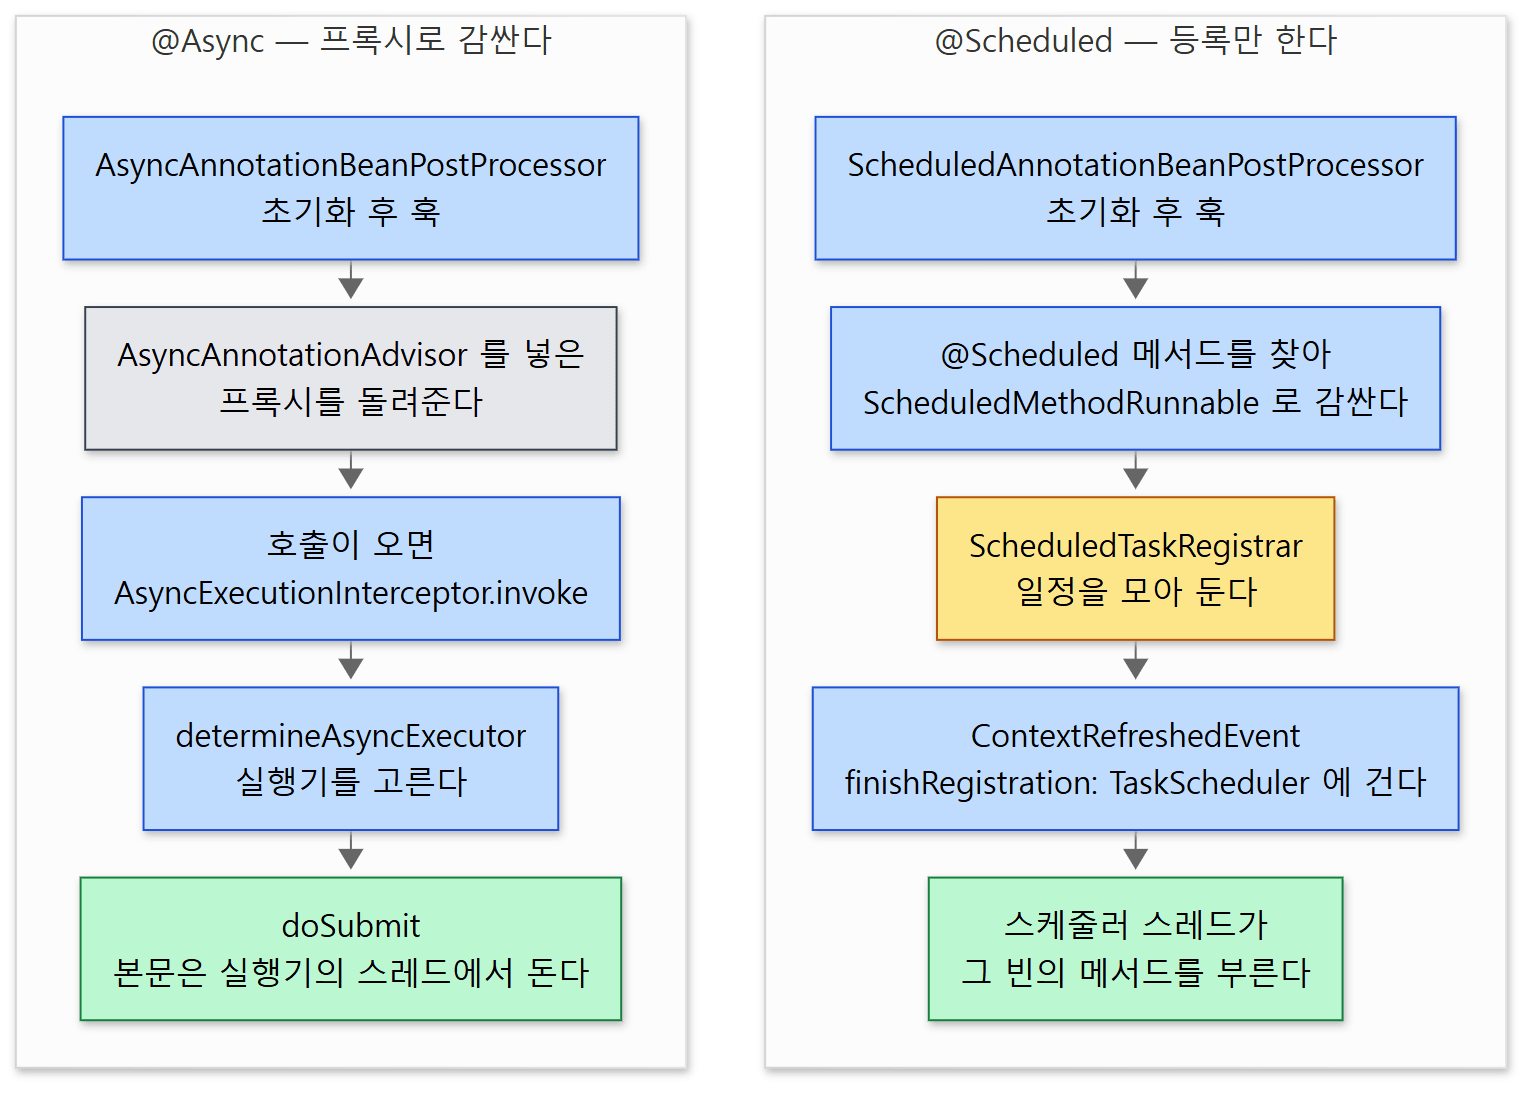 왼쪽이
@Async(프록시), 오른쪽이 @Scheduled(등록만)입니다. 회색 상자가 프록시가 생기는 자리입니다.
@Scheduled: 메서드를 찾아 Runnable로 감싸 건넵니다
@EnableScheduling은 @Import(SchedulingConfiguration.class)이고(203행), 그 설정 클래스는 빈 하나, ScheduledAnnotationBeanPostProcessor만 등록합니다(38–48행). 선택기도 mode도 없습니다. 이 후처리기의 "초기화 후" 훅을 줄이면 이렇습니다.
	public Object postProcessAfterInitialization(Object bean, String beanName) {
		// ...
		Class<?> targetClass = AopProxyUtils.ultimateTargetClass(bean);
		if (!this.nonAnnotatedClasses.contains(targetClass) &&
				AnnotationUtils.isCandidateClass(targetClass, List.of(Scheduled.class, Schedules.class))) {
			Map<Method, Set<Scheduled>> annotatedMethods = MethodIntrospector.selectMethods(targetClass,
					(MethodIntrospector.MetadataLookup<Set<Scheduled>>) method -> {
						Set<Scheduled> scheduledAnnotations = AnnotatedElementUtils.getMergedRepeatableAnnotations(
								method, Scheduled.class, Schedules.class);
						return (!scheduledAnnotations.isEmpty() ? scheduledAnnotations : null);
					});
			if (annotatedMethods.isEmpty()) {
				this.nonAnnotatedClasses.add(targetClass);
				// ...
			}
			else {
				// Non-empty set of methods
				annotatedMethods.forEach((method, scheduledAnnotations) ->
						scheduledAnnotations.forEach(scheduled -> processScheduled(scheduled, method, bean)));
				// ...
			}
		}
		return bean;
	}
마지막 줄이 return bean;입니다. 받은 빈을 그대로 돌려주므로 프록시가 생기지 않습니다. 대신 processScheduled가 메서드마다 세 가지를 합니다.
- 빈과 메서드를
ScheduledMethodRunnable로 감쌉니다. 인자가 있는 메서드면 여기서 "Only no-arg methods may be annotated with @Scheduled"로 거절합니다(542–550행). 이Runnable의 본문은 리플렉션으로method.invoke(target)을 부르는 것이고, 여기서target은 후처리기가 받은 빈입니다(ScheduledMethodRunnable125–128행). - 어노테이션의
cron,fixedDelay,fixedRate가운데 무엇이 적혔는지 보고, 그에 맞는 작업 객체(CronTask,FixedDelayTask,FixedRateTask)를 만들어ScheduledTaskRegistrar에 넘깁니다.fixedRate라면this.registrar.scheduleFixedRateTask(new FixedRateTask(runnable, fixedRate, delayToUse))입니다(486–492행). - 돌려받은
ScheduledTask(취소할 수 있는 손잡이)를 빈별로 적어 둡니다(522–525행). 컨테이너가 닫힐 때destroy()가 이것을 전부cancel합니다(622–645행).
ScheduledTaskRegistrar는 이름 그대로 일정의 등록부입니다. 스케줄러가 아직 정해지지 않았으면 작업을 목록에 넣어만 두고(scheduleFixedRateTask, 544–568행), 나중에 scheduleTasks()가 모아 둔 것을 한꺼번에 TaskScheduler에 겁니다(436–481행). 그 "나중"은 컨테이너가 다 켜졌다는 ContextRefreshedEvent(12편)가 올 때이고, 후처리기가 그 이벤트를 받아 finishRegistration()을 부릅니다(654–661행, 246–267행). 모든 빈이 준비되기 전에 일정이 돌기 시작하면 안 되기 때문입니다.
어느 스케줄러를 쓰나. 따로 정해 주지 않으면 TaskSchedulerRouter가 첫 작업을 걸 때 찾습니다(determineDefaultScheduler, 163–225행). 순서는 ① TaskScheduler 타입의 빈, 여럿이면 이름이 taskScheduler인 것 → ② TaskScheduler 빈이 하나도 없으면 ScheduledExecutorService 타입의 빈, 여럿이면 역시 이름이 taskScheduler인 것 → ③ 그렇게 해서 고르지 못하면 Executors.newSingleThreadScheduledExecutor(), 곧 스레드 하나짜리 실행기입니다.
@Async: 후처리기가 어드바이저를 들고 직접 감쌉니다
@EnableAsync는 @Import(AsyncConfigurationSelector.class)이고(167행), PROXY 모드에서 선택기가 돌려주는 이름은 ProxyAsyncConfiguration 하나입니다(44–50행). 캐시와 달리 AutoProxyRegistrar가 없습니다. 자동 프록시 생성기를 쓰지 않는다는 뜻입니다. 설정 클래스가 등록하는 빈도 어드바이저가 아니라 후처리기 AsyncAnnotationBeanPostProcessor입니다(44–59행).
이 후처리기는 BeanFactory를 받는 순간 AsyncAnnotationAdvisor를 하나 만들어 advisor 필드에 넣습니다(142–151행). 그 어드바이저의 포인트컷은 "클래스나 메서드에 @Async가 있는가"이고 어드바이스는 AnnotationAsyncExecutionInterceptor입니다(AsyncAnnotationAdvisor 98행, 159–165행, 172–186행). 감싸는 코드는 부모의 부모인 AbstractAdvisingBeanPostProcessor에 있습니다.
	public Object postProcessAfterInitialization(Object bean, String beanName) {
		// ...
		if (bean instanceof Advised advised) {
			if (!advised.isFrozen() && isEligible(AopUtils.getTargetClass(bean))) {
				// Add our local Advisor to the existing proxy's Advisor chain.
				if (this.beforeExistingAdvisors) {
					advised.addAdvisor(0, this.advisor);
				}
				// ...
				else {
					advised.addAdvisor(this.advisor);
				}
				return bean;
			}
		}

		if (isEligible(bean, beanName)) {
			ProxyFactory proxyFactory = prepareProxyFactory(bean, beanName);
			// ...
			proxyFactory.addAdvisor(this.advisor);
			// ...
			return proxyFactory.getProxy(classLoader);
		}

		// No proxy needed.
		return bean;
	}
갈래는 둘입니다. 받은 빈이 이미 프록시면(Advised) 새 프록시를 만들지 않고 그 프록시의 어드바이저 목록에 자기 것을 끼워 넣습니다. 프록시가 아니고 포인트컷에 맞으면 10편의 ProxyFactory로 새로 만듭니다. beforeExistingAdvisors가 참이면 목록의 맨 앞(0번)에 넣는데, AsyncAnnotationBeanPostProcessor는 생성자에서 이것을 true로 켭니다(87–89행). 이 한 줄이 6절의 순서를 정합니다.
호출 시점은 AsyncExecutionInterceptor.invoke입니다.
	public @Nullable Object invoke(final MethodInvocation invocation) throws Throwable {
		// ...
		AsyncTaskExecutor executor = determineAsyncExecutor(userMethod);
		// ...

		Callable<Object> task = () -> {
			try {
				Object result = invocation.proceed();
				if (result instanceof Future<?> future) {
					return future.get();
				}
			}
			// ...
			return null;
		};

		return doSubmit(task, executor, userMethod.getReturnType());
	}
spring-aop/src/main/java/org/springframework/aop/interceptor/AsyncExecutionInterceptor.java 100–128행
캐시 인터셉터와 모양이 같습니다. invocation.proceed()를 지금 부르지 않고 Callable에 담아 실행기에 넘깁니다. doSubmit은 반환 타입에 따라 갈립니다. CompletableFuture면 submitCompletable, 그 밖의 Future면 submit, void면 맡기고 null을 돌려주고, 그 밖의 타입이면 IllegalArgumentException입니다(AsyncExecutionAspectSupport 278–293행). 호출한 쪽은 본문이 끝나기를 기다리지 않으므로, 결과를 받으려면 "나중에 채워질 그릇"을 돌려받는 수밖에 없습니다.
어느 실행기를 쓰나. determineAsyncExecutor는 메서드별로 한 번 정해 맵에 적어 둡니다(168–190행).
@Async("이름")처럼 값이 적혀 있으면 그 이름(한정자)의 실행기 빈을 찾습니다. 값은 메서드의 어노테이션, 없으면 클래스의 어노테이션에서 읽습니다(AnnotationAsyncExecutionInterceptor83–91행).- 없으면 기본 실행기입니다.
AsyncConfigurer빈이 있고 그getAsyncExecutor()가 실행기를 주면 그것이 먼저입니다(AbstractAsyncConfiguration71–84행,AsyncExecutionAspectSupport119–124행). 그것이 없을 때 컨테이너에서 찾습니다.TaskExecutor타입의 빈이 하나면 그것, 여럿이거나 없으면 이름이taskExecutor인Executor빈을 찾습니다(232–268행). - 그것도 없으면
new SimpleAsyncTaskExecutor()입니다(AsyncExecutionInterceptor154–158행).
예제 ②: 프록시인가, 어느 스레드인가
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
@Configuration
@EnableScheduling
@EnableAsync
static class Config {
	// Ticker 와 Mailer 를 @Bean 으로 등록 (줄임)
}

public static class Ticker {

	final AtomicInteger count = new AtomicInteger();

	final CountDownLatch firstThree = new CountDownLatch(3);

	@Scheduled(fixedRate = 100)
	public void tick() {
		int n = this.count.incrementAndGet();
		if (n <= 3) {
			System.out.println("  tick " + n + " — 스레드 " + Thread.currentThread().getName());
			this.firstThree.countDown();
		}
	}
}

public static class Mailer {

	@Async
	public CompletableFuture<String> send(String to) {
		return CompletableFuture.completedFuture(to + " 에게 보냄 — 스레드 " + Thread.currentThread().getName());
	}
}
main은 tick이 세 번 돌 때까지 기다렸다가 send를 한 번 부르고, finally에서 컨텍스트를 닫은 뒤 300ms 동안 tick이 더 도는지 셉니다. Spring Framework 7.0.9로 실행한 출력입니다.
main 스레드: main
Ticker 는 프록시인가: false
Mailer 는 프록시인가: true
등록된 일정 수: 1
== @Scheduled(fixedRate = 100)
  tick 1 — 스레드 pool-1-thread-1
  tick 2 — 스레드 pool-1-thread-1
  tick 3 — 스레드 pool-1-thread-1
  세 번 돌았나: true
== @Async
  kim 에게 보냄 — 스레드 SimpleAsyncTaskExecutor-1
== 컨텍스트를 닫은 뒤 300ms 동안 늘어난 tick: 0
Ticker는 프록시가 아니고 Mailer는 프록시입니다. 스케줄러나 실행기 빈을 하나도 등록하지 않았으므로 tick은 위 ③의 스레드 하나짜리 실행기에서(pool-1-thread-1은 JDK가 붙인 이름입니다), send는 SimpleAsyncTaskExecutor의 스레드에서 돌았습니다. 컨텍스트를 닫자 일정이 멈춘 것은 destroy()가 일정을 취소하고 자기가 만든 실행기를 shutdownNow()로 세우기 때문입니다(TaskSchedulerRouter 253–255행).
헷갈리기 쉬운 곳
- 기본 스케줄러는 스레드가 하나입니다. 따로 등록하지 않으면 모든
@Scheduled메서드가 한 스레드를 나눠 씁니다. 하나가 오래 걸리면 나머지가 그만큼 밀립니다. - "
@Scheduled는 프록시를 만들지 않는다"와 "그 빈은 프록시가 아니다"는 다른 말입니다. 같은 클래스에@Cacheable같은 것이 있어 빈이 이미 프록시가 되었다면, 이 후처리기는 순서 값이LOWEST_PRECEDENCE라 뒤에 돌면서(182–184행) 그 프록시를 받고, 받은 객체에서 부를 수 있는 메서드를 골라Runnable을 만듭니다(548행). 이 경우는 소스만 읽었고 예제로 돌려 보지는 않았습니다. - 컨텍스트를 닫지 않으면 JVM이 끝나지 않습니다. 위 예제에서
ctx.close()를 빼면 스케줄러 스레드가 살아 있어main이 끝나도 프로세스가 남습니다. 그래서finally에 넣었습니다. @Async메서드의 반환 타입은void아니면Future계열입니다.String을 돌려주게 쓰면 호출 시점에 "Invalid return type for async method (only Future and void supported)"가 납니다(289–292행).@Async가void면 예외가 호출한 쪽으로 오지 않습니다. 본문은 이미 다른 스레드에 있습니다. 위invoke의Callable은 예외를 잡아handleError로 넘기고null을 돌려줍니다(117–124행).
4. 검증 — Validator, DataBinder, 그리고 메서드 검증
검증은 두 갈래입니다. 코드가 직접 부르는 객체 검증과, 프록시가 대신 부르는 메서드 검증입니다.
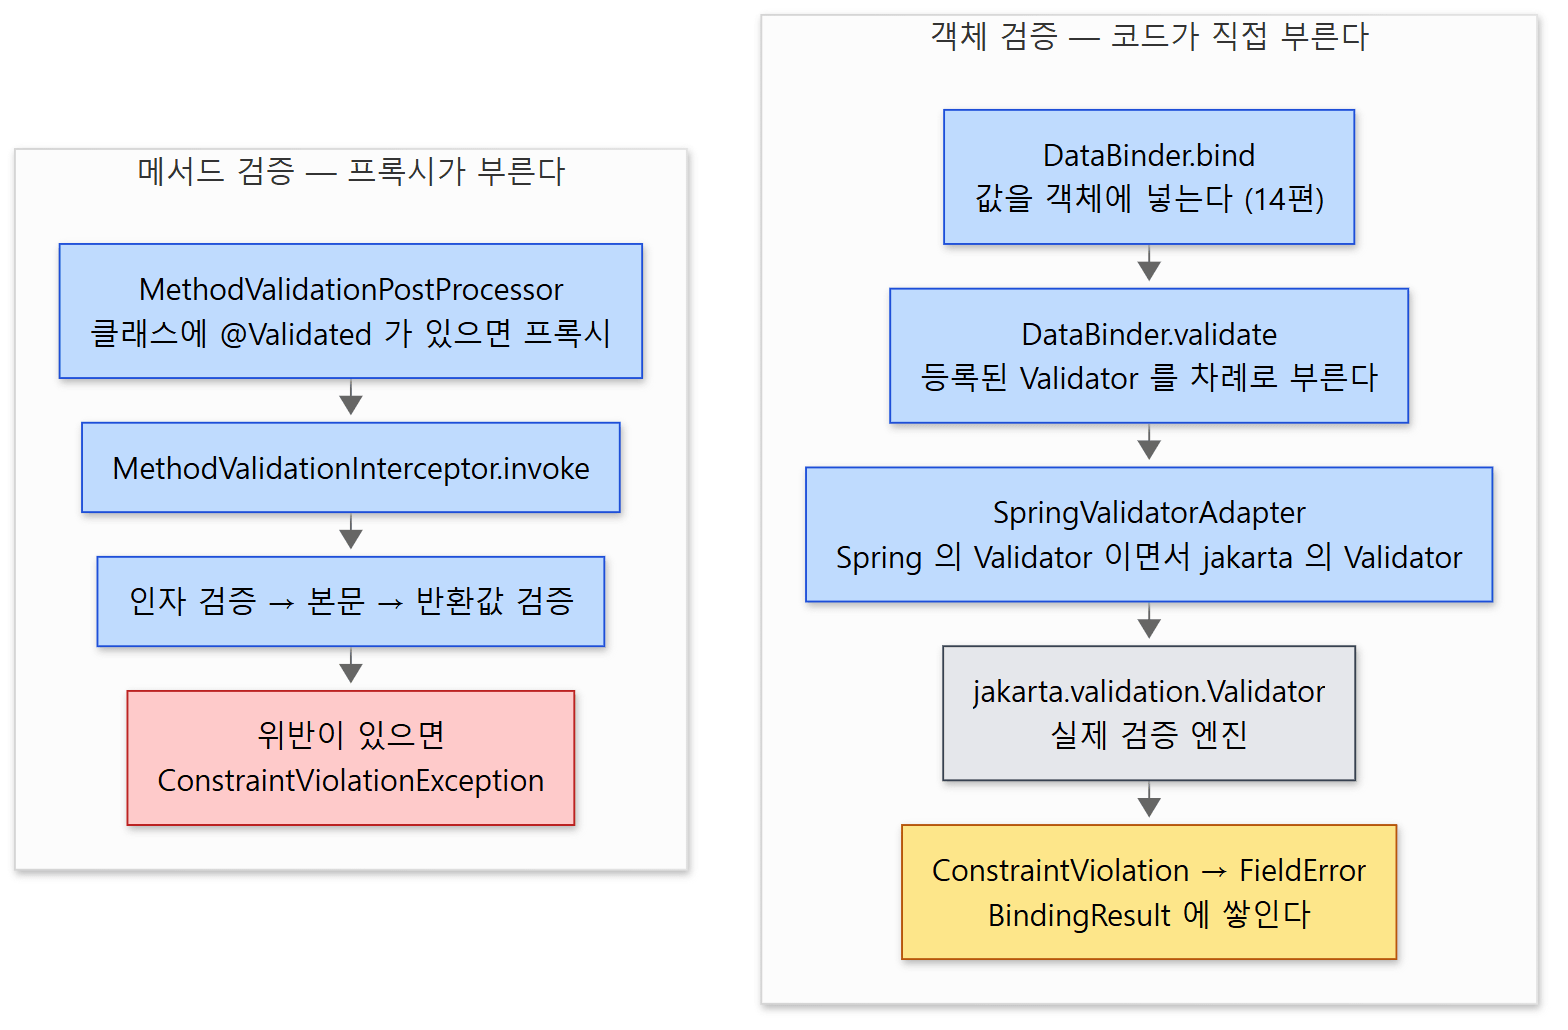 왼쪽이 메서드 검증, 오른쪽이 객체 검증입니다. 노란 상자가 오류가 쌓이는 곳, 빨간 상자가 예외입니다.
객체 검증: Validator와 DataBinder.validate
Spring의 Validator는 구현할 메서드가 둘인 인터페이스입니다. supports(Class)로 "이 타입을 검증할 수 있는가"를 답하고, validate(Object target, Errors errors)로 검증한 결과를 Errors에 적습니다(Validator 63–116행). 예외를 던지지 않고 오류를 모으는 방식입니다. 폼 하나에 틀린 칸이 셋이면 셋을 한꺼번에 알려 줘야 하기 때문입니다.
이것을 부르는 대표가 DataBinder입니다. 14편에서 본 BeanWrapper와 변환기를 써서 "이름 → 값" 묶음을 객체의 속성에 넣고(bind, 1254–1261행), 넣다가 생긴 변환 실패와 그 뒤의 검증 오류를 하나의 BindingResult(Errors를 넓힌 인터페이스)에 모읍니다. 검증하는 메서드는 짧습니다.
	public void validate() {
		Object target = getTarget();
		Assert.state(target != null, "No target to validate");
		BindingResult bindingResult = getBindingResult();
		// Call each validator with the same binding result
		for (Validator validator : getValidatorsToApply()) {
			validator.validate(target, bindingResult);
		}
	}
spring-context/src/main/java/org/springframework/validation/DataBinder.java 1439–1447행
눈여겨볼 것은 bind와 validate가 따로라는 점입니다. DataBinder는 묶기만 하고 스스로 검증하지 않습니다. 부르는 쪽이 bind 다음에 validate를 불러야 합니다. 웹 계층에서는 컨트롤러 메서드의 인자를 만들어 주는 인자 해석기가 그 일을 합니다(ModelAttributeMethodProcessor 154행, 226–230행, 인자 해석기는 22편).
Bean Validation을 잇는 어댑터
@NotBlank 같은 제약 어노테이션은 Spring의 Validator가 아니라 jakarta.validation.Validator가 압니다. 둘을 잇는 것이 SpringValidatorAdapter입니다. 선언이 그 역할을 그대로 보여 줍니다.
public class SpringValidatorAdapter implements SmartValidator, jakarta.validation.Validator {
두 인터페이스를 동시에 구현합니다. Spring 쪽 validate(target, errors)가 불리면 안에 든 jakarta 검증기에게 넘기고(101–105행), 돌아온 위반 목록(ConstraintViolation)을 FieldError로 바꿔 Errors에 넣습니다(processConstraintViolations, 147–198행). 오류 코드는 제약 어노테이션의 짧은 이름(NotBlank, Min)이 됩니다.
LocalValidatorFactoryBean은 이 어댑터를 상속하면서(84–85행) 안에 넣을 jakarta 검증기를 스스로 만드는 클래스입니다. 초기화 때 Validation.byDefaultProvider()로 클래스패스의 구현 라이브러리를 찾아 설정하고(247–257행), 만들어진 검증기를 setTargetValidator로 끼웁니다(325–326행). 이 빈 하나를 등록하면 Spring의 Validator로도 jakarta의 Validator로도 주입받을 수 있습니다.
메서드 검증: 다시 "어드바이저를 든 후처리기"
메서드의 인자와 반환값에 붙은 제약을 호출할 때마다 검증하는 쪽은 1절의 길 ②입니다. MethodValidationPostProcessor는 3절의 AsyncAnnotationBeanPostProcessor와 부모가 같고(69–70행), 어드바이저를 만드는 코드는 두 줄입니다.
	public void afterPropertiesSet() {
		Pointcut pointcut = new AnnotationMatchingPointcut(this.validatedAnnotationType, true);
		this.advisor = new DefaultPointcutAdvisor(pointcut, createMethodValidationAdvice(this.validator));
	}
포인트컷은 "클래스에 @Validated가 붙어 있는가"입니다(validatedAnnotationType의 기본값이 Validated.class, 72행). 어드바이스 MethodValidationInterceptor.invoke는 인자를 검증하고, 위반이 있으면 ConstraintViolationException을 던지고, 없으면 invocation.proceed()로 본문을 부른 뒤 반환값을 같은 식으로 검증합니다(143–185행). 객체 검증과 달리 여기서는 예외입니다. 메서드 호출에는 오류를 적어 돌려줄 Errors가 없기 때문입니다.
예제 ③: 두 갈래를 나란히
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
@Configuration
static class Config {

	@Bean
	static MethodValidationPostProcessor methodValidationPostProcessor() {
		return new MethodValidationPostProcessor();
	}

	@Bean
	LocalValidatorFactoryBean validator() {
		return new LocalValidatorFactoryBean();
	}
	// OrderService 와 PlainService 를 @Bean 으로 등록 (줄임)
}

@Validated
public static class OrderService {

	public String order(@NotBlank String item, @Min(1) int qty) {
		return item + " x " + qty;
	}
}

// 제약 어노테이션은 같지만 클래스에 @Validated 가 없다
public static class PlainService {

	public String order(@NotBlank String item, @Min(1) int qty) {
		return "[" + item + "] x " + qty;
	}
}
객체 검증 쪽은 @NotBlank String item과 @Min(1) int qty 두 필드를 가진 OrderForm을 만들어 DataBinder로 값을 넣고 validate()를 부릅니다. 구현 라이브러리는 Hibernate Validator 9.0.1입니다. Spring Framework 7.0.9로 실행한 출력입니다(맨 앞에 Hibernate Validator가 자기 버전을 알리는 로그 두 줄이 더 나오는데 뺐습니다).
OrderService 는 프록시인가: true
PlainService 는 프록시인가: false
== 메서드 검증: OrderService.order
  order(pen, 2) → pen x 2
  order("", 0) → ConstraintViolationException
    order.item : NotBlank
    order.qty : Min
  PlainService.order("", 0) → [] x 0
== 객체 검증: DataBinder.bind → validate
  item="", qty=0
    item : NotBlank (바인딩 실패인가: false)
    qty : Min (바인딩 실패인가: false)
  item="", qty=abc
    item : NotBlank (바인딩 실패인가: false)
    qty : typeMismatch (바인딩 실패인가: true)
헷갈리기 쉬운 곳
- 메서드 검증은 클래스에
@Validated가 있어야 켜집니다.PlainService는 인자에 같은 제약이 붙어 있어도 프록시가 아니고, 빈 문자열과 0이 그대로 통과했습니다. 제약 어노테이션은 "규칙"일 뿐이고 그것을 검사하러 오는 것은 프록시입니다. - 변환에 실패한 필드는 검증 오류를 덧붙이지 않습니다. 마지막 경우에
qty는"abc"를int로 바꾸지 못해typeMismatch하나만 남았습니다. 값이 들어가지 못한qty는 0이라@Min(1)에도 걸리지만,processConstraintViolations가 바인딩에 실패한 필드를 먼저 모아 두고 그 필드의 위반은 건너뜁니다(148–162행). MethodValidationPostProcessor의@Bean메서드는static으로 썼습니다. 후처리기는 다른 빈보다 먼저 만들어져야 하는데,static이 아니면 그것을 만들려고 설정 클래스부터 일찍 만들어야 합니다. 이 사정은 6편 2절의 "헷갈리기 쉬운 곳"에 있습니다.
5. 리질리언스 — @Retryable과 @ConcurrencyLimit
org.springframework.resilience 패키지는 7.0에 새로 들어왔습니다(두 어노테이션과 스위치, 두 후처리기가 모두 @since 7.0). 틀은 3절의 @Async와 같습니다.
스위치와 후처리기
@EnableResilientMethods는 @Import(ResilientMethodsConfiguration.class)입니다(41–45행). 선택기 없이 설정 클래스를 바로 가져오고, 그 클래스가 후처리기 둘을 등록합니다(63–77행). 재시도 쪽 후처리기의 생성자가 전부를 보여 줍니다.
	public RetryAnnotationBeanPostProcessor() {
		setBeforeExistingAdvisors(true);

		Pointcut cpc = new AnnotationMatchingPointcut(Retryable.class, true);
		Pointcut mpc = new AnnotationMatchingPointcut(null, Retryable.class, true);
		this.advisor = new DefaultPointcutAdvisor(new ComposablePointcut(cpc).union(mpc), this.interceptor);
	}
"클래스에 @Retryable이 있거나(cpc) 메서드에 있거나(mpc)"라는 포인트컷과 인터셉터를 묶어 advisor에 넣습니다. 나머지, 곧 빈을 감싸는 일은 3절에서 본 AbstractAdvisingBeanPostProcessor.postProcessAfterInitialization이 그대로 합니다. ConcurrencyLimitBeanPostProcessor의 생성자도 어노테이션 이름만 다르고 같은 모양입니다(60–68행).
인터셉터는 RetryTemplate을 부릅니다
다시 부르는 로직은 인터셉터에 없습니다. spring-core의 RetryTemplate에 있고, 인터셉터는 어노테이션을 읽어 그것을 부를 뿐입니다.
	public @Nullable Object invoke(MethodInvocation invocation) throws Throwable {
		Method method = invocation.getMethod();
		Object target = invocation.getThis();
		MethodRetrySpec spec = getRetrySpec(method, (target != null ? target.getClass() : method.getDeclaringClass()));

		if (spec == null) {
			return invocation.proceed();
		}

		// ...

		RetryPolicy retryPolicy = RetryPolicy.builder()
				.includes(spec.includes())
				.excludes(spec.excludes())
				.predicate(spec.predicate().forMethod(method))
				.maxRetries(spec.maxRetries())
				// ...
				.build();

		RetryTemplate retryTemplate = new RetryTemplate(retryPolicy);
		// ...

		try {
			return retryTemplate.execute(new Retryable<@Nullable Object>() {
				@Override
				public @Nullable Object execute() throws Throwable {
					return (invocation instanceof ProxyMethodInvocation pmi ?
							pmi.invocableClone().proceed() : invocation.proceed());
				}
				// ...
			});
		}
		catch (RetryException ex) {
			// ...
			throw ex.getCause();
		}
	}
세 군데를 봅니다.
- **
getRetrySpec**은 메서드의@Retryable, 없으면 클래스의@Retryable을 읽어MethodRetrySpec으로 바꾸고 맵에 적어 둡니다(RetryAnnotationBeanPostProcessor89–117행). 캐시의CacheOperationSource가 하던 일입니다. pmi.invocableClone().proceed(). 11편에서 본 대로proceed()는 "체인의 몇 번째까지 왔는지"를 번호 하나로 세므로, 같은invocation의proceed()를 두 번 부르면 두 번째는 번호가 이미 끝에 가 있습니다. 그래서 시도할 때마다 지금 위치를 복사한 사본을 만들어 그 사본을 진행시킵니다. 재시도 인터셉터 안쪽의 체인(캐시, 트랜잭션, 원본 메서드)이 시도마다 처음부터 다시 도는 것은 이 때문입니다.throw ex.getCause().RetryTemplate은 끝내 실패하면RetryException을 던지는데, 인터셉터가 그 안의 원래 예외를 꺼내 던집니다.@Retryable을 붙였다고 호출한 쪽의catch가 바뀌지 않습니다.
RetryTemplate.execute의 뼈대는 그림과 같습니다(126–207행).
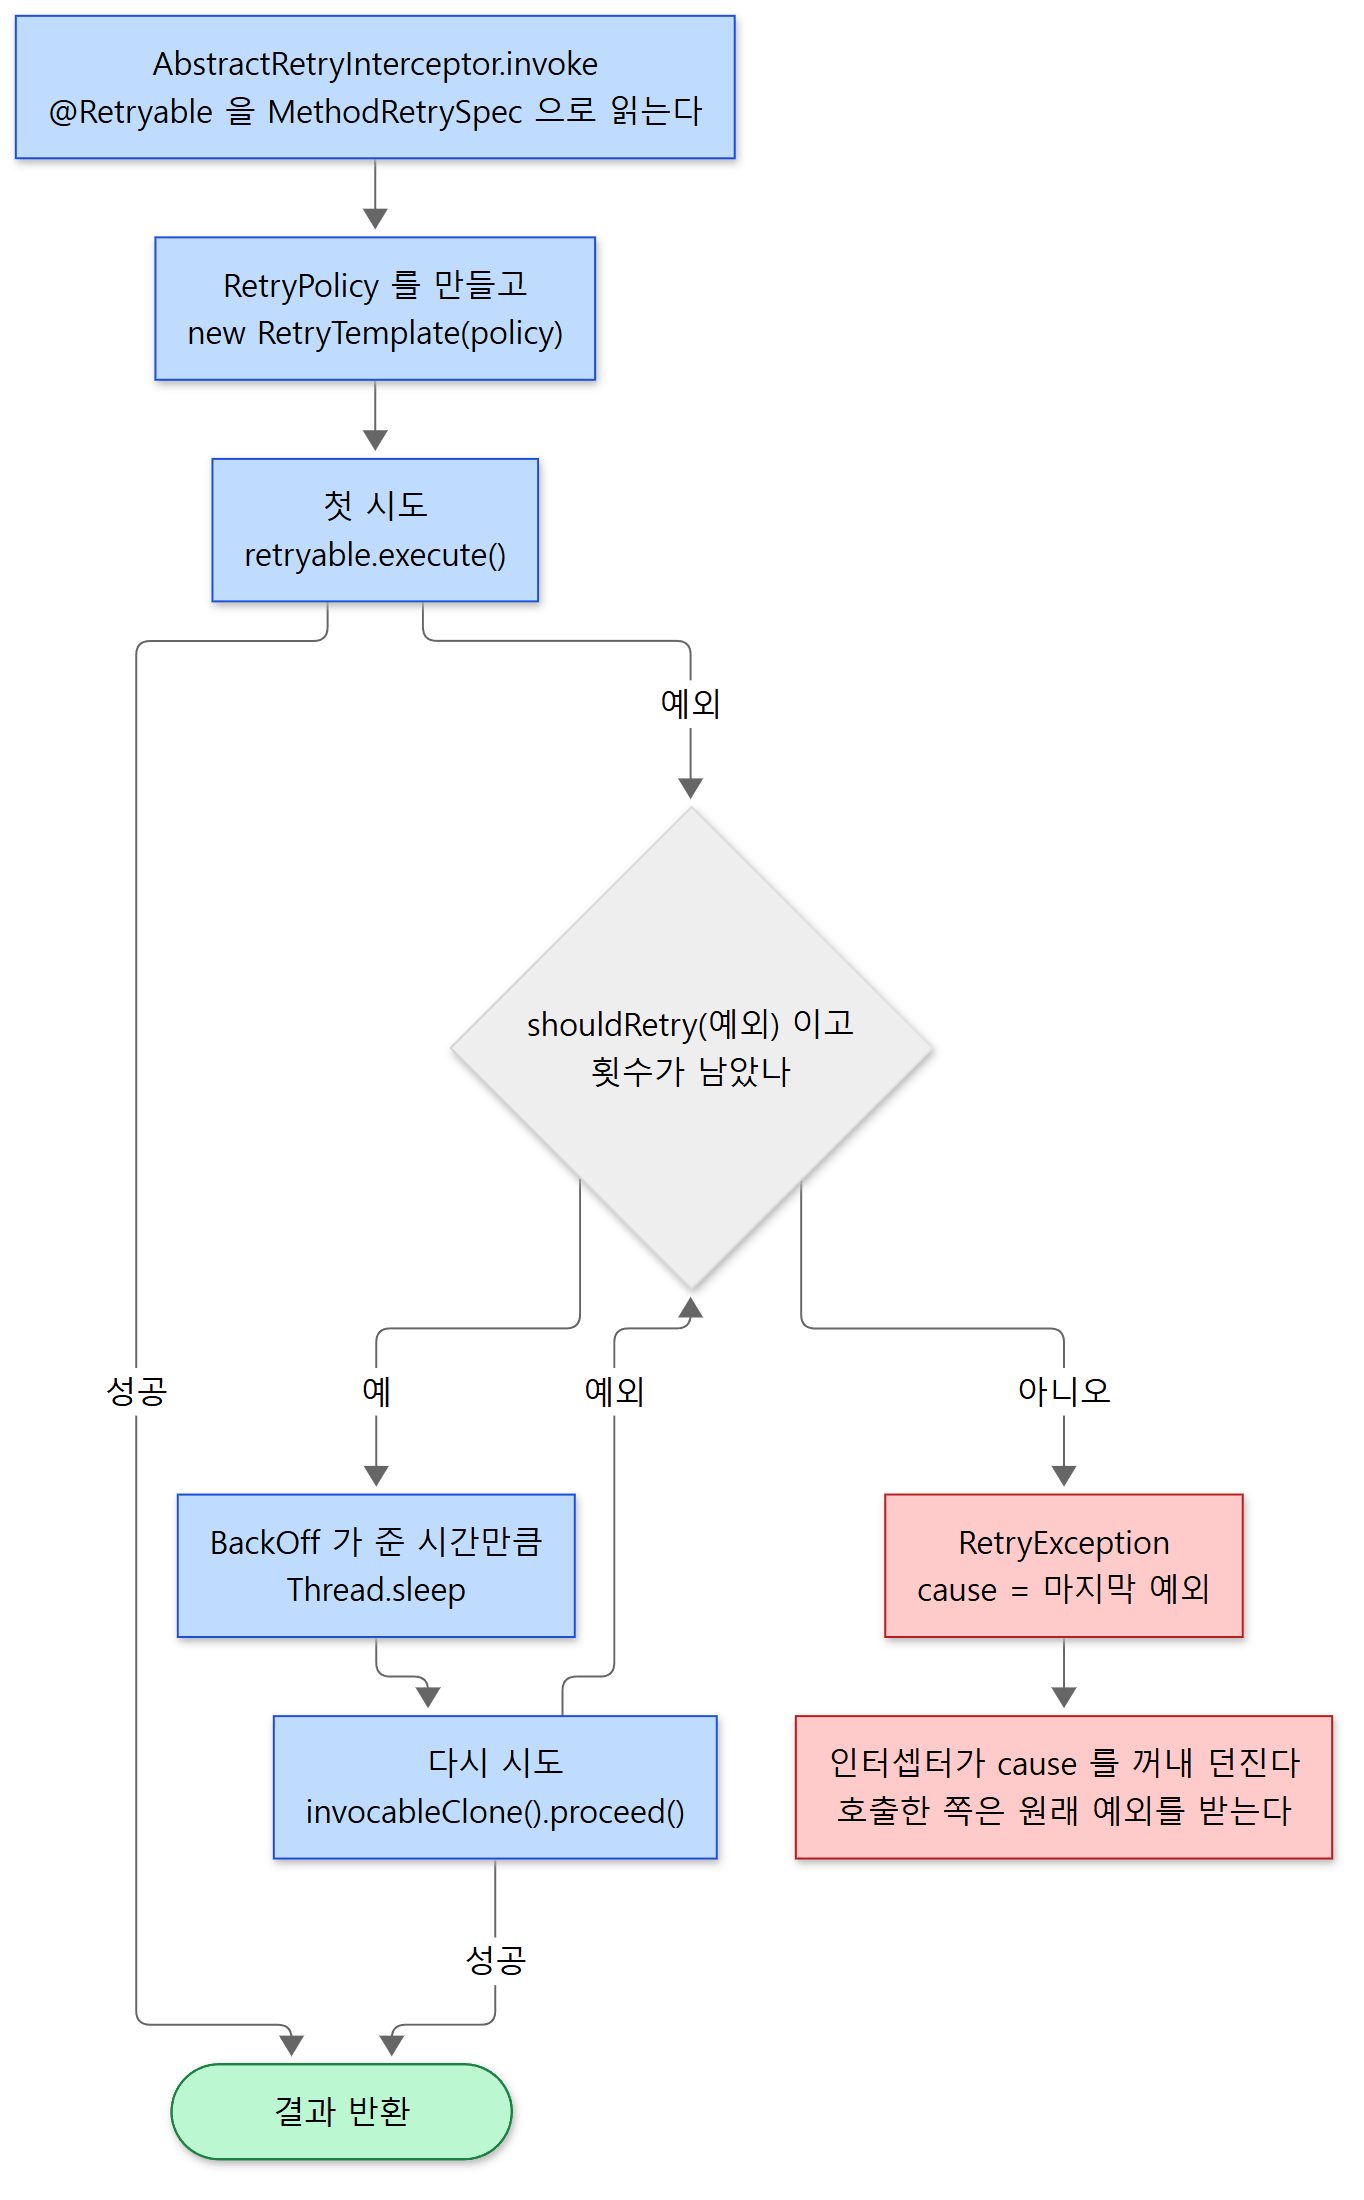 파란색이 한 번의 시도와 그 사이의 기다림, 빨간색이 포기하는 길입니다.
- 먼저 한 번 실행합니다. 성공하면 끝입니다(133–136행).
- 실패하면
while (this.retryPolicy.shouldRetry(lastException) && ...)에 들어갑니다(149행).shouldRetry가includes·excludes·predicate로 "이 예외가 다시 해 볼 만한 예외인가"를 답합니다. backOffExecution.nextBackOff()가 다음까지 기다릴 시간을 주고,STOP을 주면 횟수를 다 쓴 것이라 루프를 나옵니다(153–156행). 아니면Thread.sleep(sleepTime)뒤에 다시 실행합니다(160행, 174행).- 루프를 나오면
RetryException입니다. 마지막 예외가cause, 그 앞의 예외들이suppressed로 붙습니다(196–200행,RetryException63–69행).
기본값은 어노테이션과 정책이 같습니다. maxRetries는 3, delay는 1000ms입니다(Retryable 128행, 181행, RetryPolicy 153행, 158행).
@ConcurrencyLimit
ConcurrencyLimitInterceptor는 ConcurrencyThrottleInterceptor를 프록시 객체마다, 그리고 어노테이션을 메서드에 붙였으면 그 메서드마다(클래스에 붙였으면 그 클래스의 메서드들이 함께 쓰는 것 하나) 만들어 두고 호출을 넘깁니다(82–133행). 한도에 닿았을 때 기본(policy = BLOCK, ConcurrencyLimit 110행)은 자리가 날 때까지 기다리는 것이고, REJECT면 InvocationRejectedException을 던집니다(176–186행).
예제 ④: 본문은 몇 번 불리나
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
public static class Flaky {

	private final AtomicInteger calls = new AtomicInteger();

	@Retryable(maxRetries = 3, delay = 10)
	public String alwaysFails() {
		int n = this.calls.incrementAndGet();
		System.out.println("  [본문] alwaysFails " + n + "번째 호출");
		throw new IllegalStateException("실패 " + n);
	}

	@Retryable(maxRetries = 3, delay = 10)
	public String thirdTimeLucky() {
		int n = this.calls.incrementAndGet();
		System.out.println("  [본문] thirdTimeLucky " + n + "번째 호출");
		if (n < 3) {
			throw new IllegalStateException("실패 " + n);
		}
		return "성공 (" + n + "번째)";
	}

	// IOException 일 때만 다시 부른다
	@Retryable(includes = IOException.class, maxRetries = 3, delay = 10)
	public String otherException() {
		int n = this.calls.incrementAndGet();
		System.out.println("  [본문] otherException " + n + "번째 호출");
		throw new IllegalArgumentException("재시도 대상이 아닌 예외");
	}
	// ...
}
설정 클래스에는 @EnableResilientMethods를 붙였고, 마지막에는 컨테이너 없이 RetryTemplate을 직접 써 봤습니다.
RetryTemplate template = new RetryTemplate(
		RetryPolicy.builder().maxRetries(2).delay(Duration.ofMillis(10)).build());
AtomicInteger calls = new AtomicInteger();
try {
	template.execute(() -> {
		int n = calls.incrementAndGet();
		System.out.println("  [람다] " + n + "번째 호출");
		throw new IllegalStateException("실패 " + n);
	});
}
catch (RetryException ex) {
	// 예외의 종류, retryCount, cause, suppressed 개수를 찍는다
}
Spring Framework 7.0.9로 실행한 출력입니다.
프록시인가: true
== alwaysFails (maxRetries = 3)
  [본문] alwaysFails 1번째 호출
  [본문] alwaysFails 2번째 호출
  [본문] alwaysFails 3번째 호출
  [본문] alwaysFails 4번째 호출
  호출한 쪽이 받은 예외: IllegalStateException / 실패 4
== thirdTimeLucky (maxRetries = 3)
  [본문] thirdTimeLucky 1번째 호출
  [본문] thirdTimeLucky 2번째 호출
  [본문] thirdTimeLucky 3번째 호출
  성공 (3번째)
== otherException (includes = IOException)
  [본문] otherException 1번째 호출
  호출한 쪽이 받은 예외: IllegalArgumentException
== RetryTemplate 을 직접 (maxRetries = 2)
  [람다] 1번째 호출
  [람다] 2번째 호출
  [람다] 3번째 호출
  받은 예외: RetryException
  retryCount = 2, cause = 실패 3, suppressed = 2개
헷갈리기 쉬운 곳
maxRetries = 3이면 본문은 최대 네 번 돕니다. 첫 시도는 "재시도"가 아닙니다. 위 뼈대의 1번이 루프 밖에 있습니다.@Retryable은 원래 예외를,RetryTemplate.execute는RetryException을 줍니다. 같은 로직인데 받는 예외가 다릅니다. 앞의 것은 인터셉터가getCause()를 꺼내 던진 결과입니다.- 기다림은 호출한 스레드를 재웁니다.
Thread.sleep입니다. 기본delay가 1초이므로, 요청을 처리하는 스레드에서 기본값으로 세 번 다시 부르면 그 스레드는 3초 넘게 잡혀 있습니다. - 예제는 7.0.9, 읽은 소스는 7.1.0-SNAPSHOT입니다. 이 커밋의
resilience패키지와core.retry패키지에서@since를 전부 찾아보면 가장 높은 값이7.0.9이고7.1은 없습니다. 이 절에서 본 타입은 모두 7.0.9에도 있는 것들입니다(@ConcurrencyLimit의policy와InvocationRejectedException은@since 7.0.3). 다만 메서드 본문까지 7.0.9와 같은지는 대조하지 않았습니다. 예제의 출력이 위 뼈대와 맞는다는 것까지만 확인했습니다.
6. 공통 함정 — 자기 호출과 순서
자기 호출: 프록시 기반은 전부 해당됩니다
2절의 예제에서 priceTwice("pear")는 본문이 두 번 돌았고 캐시에도 남지 않았습니다. 이유는 10편 6절과 17편의 예제 ②에서 본 것과 같습니다. 인터셉터는 프록시 안에만 있고, 원본 객체가 this.price()로 자기 메서드를 부르면 프록시를 거치지 않습니다. @EnableCaching의 설명 주석에도 같은 클래스 안의 호출은 가로채지 못한다고 적혀 있습니다(190–196행).
이것은 캐시만의 일이 아닙니다. 1절 표에서 프록시를 만드는 줄, 곧 @Cacheable, @Async, @Retryable, @ConcurrencyLimit, 메서드 검증, 그리고 @Transactional이 전부 같습니다. 같은 클래스의 다른 메서드에서 this.sendAsync()를 부르면 그냥 같은 스레드에서 돌고, this.retryable()은 한 번만 돕니다.
@Scheduled는 사정이 다릅니다. 호출을 가로채는 기능이 아니라서 "자기 호출이라 @Scheduled가 안 걸린다"는 문제 자체가 없습니다. 다만 @Scheduled 메서드의 본문이 this.price()를 부르면 그것은 역시 자기 호출입니다. 본문은 원본 객체 안에서 돌기 때문입니다.
순서: 누가 바깥에 서나
한 메서드에 여러 기능을 붙이면 프록시 하나에 어드바이저가 여럿 들어갑니다. 순서는 두 단계로 정해집니다.
- 길 ①이 먼저입니다. 자동 프록시 생성기는
order가 가장 앞선 값(HIGHEST_PRECEDENCE)으로 등록됩니다(AopConfigUtils139행). 이 절에 나오는 다른 후처리기보다 먼저 돌므로, 캐시·트랜잭션 어드바이저가 든 프록시가 먼저 만들어집니다. - 길 ②의 후처리기가 그 프록시에 자기 어드바이저를 끼웁니다. 3절에서 본
advised.addAdvisor(0, this.advisor)입니다. 맨 앞에 끼우므로 나중에 도는 후처리기일수록 바깥에 섭니다. 후처리기의order기본값은@EnableResilientMethods가LOWEST_PRECEDENCE - 1(69행),@EnableAsync가LOWEST_PRECEDENCE(215행)라서 재시도 쪽이 먼저 돌고@Async가 나중에 돕니다.MethodValidationPostProcessor는beforeExistingAdvisors를 켜지 않으므로 맨 뒤(대상에 가장 가까운 쪽)에 붙습니다.
예제 ⑤: 다섯 개를 다 붙여 보기
한 메서드에 @Async, @Retryable, @ConcurrencyLimit(2), @Cacheable을 붙이고 클래스에 @Validated를 붙인 뒤, 프록시가 가진 어드바이저를 차례로 찍었습니다(((Advised) bean).getAdvisors()). Spring Framework 7.0.9로 실행한 출력입니다.
프록시 하나에 어드바이저 5개 (바깥 → 안쪽)
  0: AnnotationAsyncExecutionInterceptor
  1: ConcurrencyLimitInterceptor
  2: RetryAnnotationInterceptor
  3: CacheInterceptor
  4: MethodValidationInterceptor
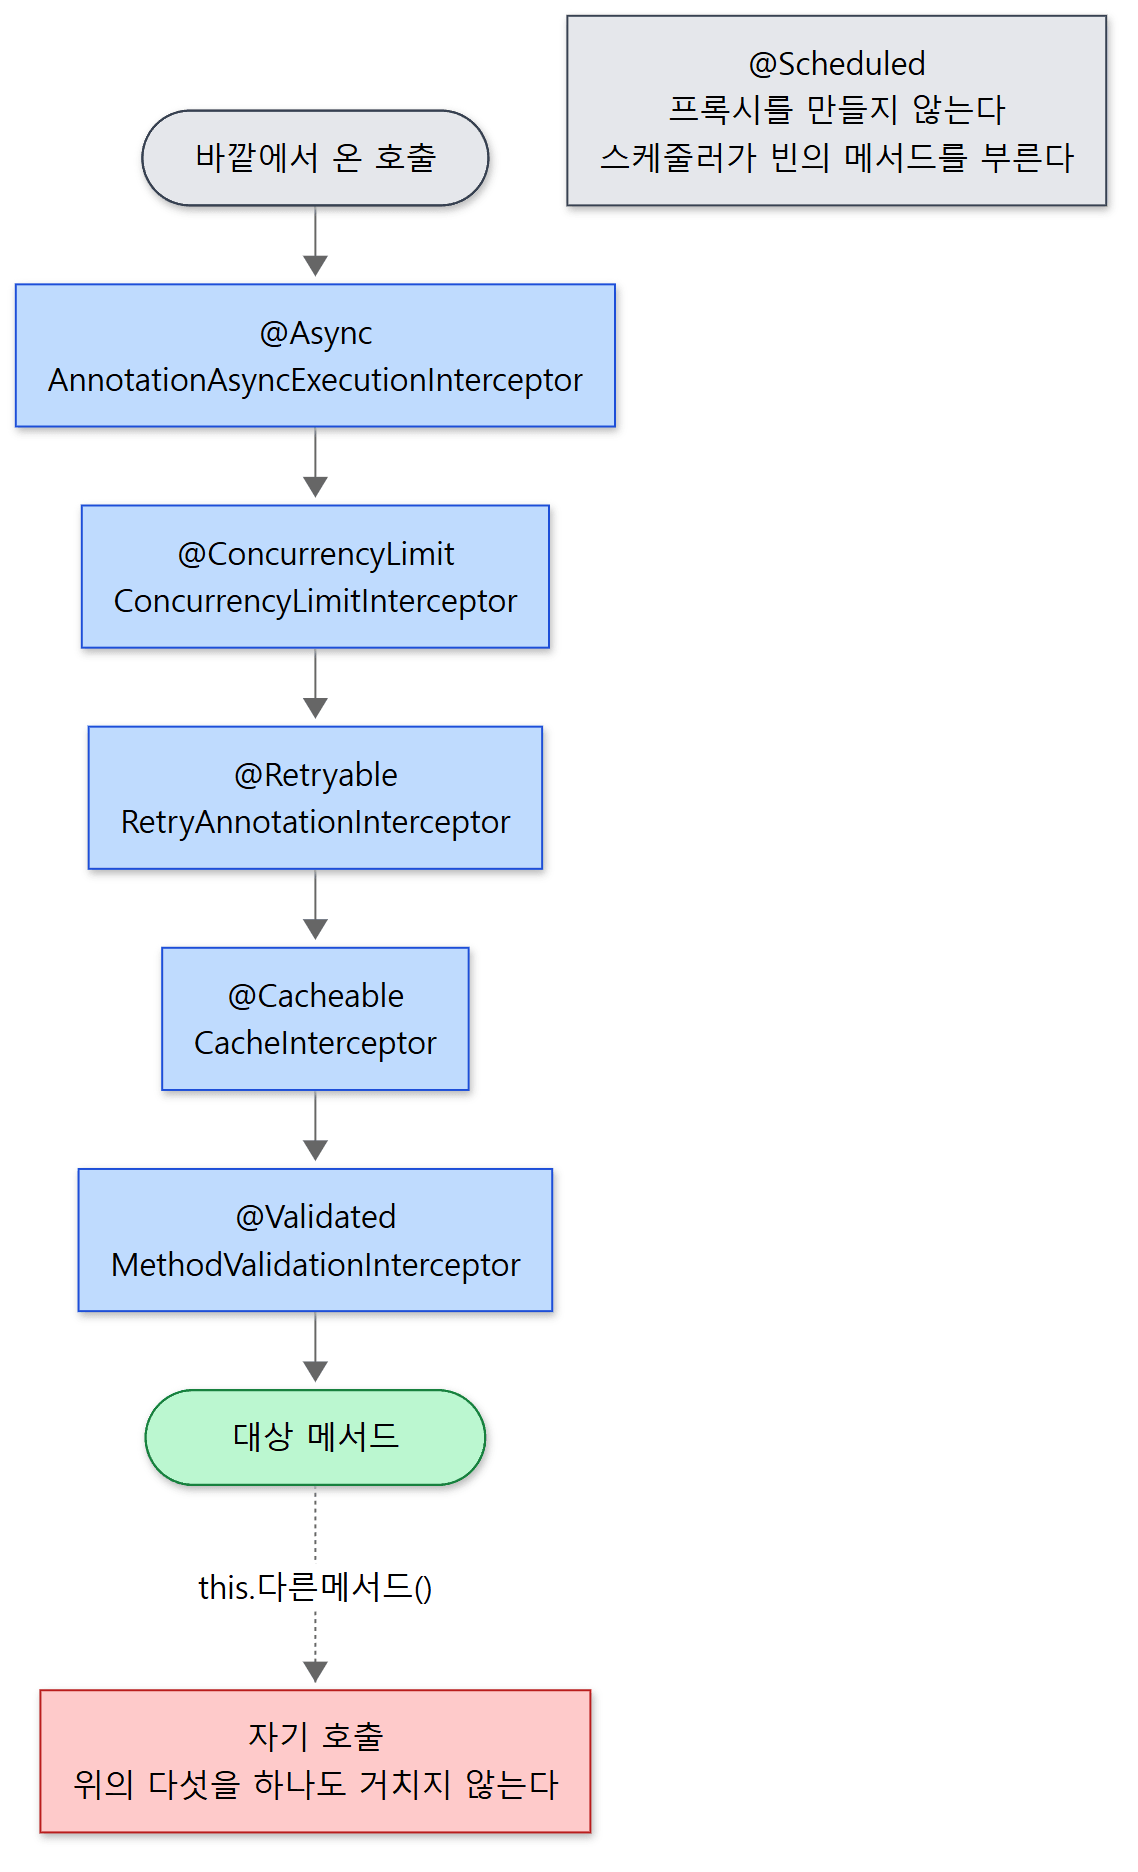 위에서 아래가 바깥에서 안쪽입니다. 빨간 상자가 자기 호출, 회색 상자가 이 줄에 끼지 않는
@Scheduled입니다.
읽으면 이렇습니다. 먼저 다른 스레드로 넘어가고(@Async), 그 스레드에서 동시 호출 수를 세고, 재시도 루프가 돌고, 시도마다 캐시를 다시 확인합니다. @Retryable의 설명 주석도 같은 내용을 적어 두었습니다. 재시도는 @Transactional·@Cacheable의 바깥이라 시도마다 트랜잭션을 새로 열거나 캐시를 다시 확인하고, @Async의 안쪽이라 모든 시도가 비동기 실행기의 스레드에서 돈다는 것입니다(Retryable 45–53행). 같은 주석에 @Async와의 순서는 두 스위치의 order로 바꿀 수 있지만 @Transactional·@Cacheable과의 순서는 고정이라고 되어 있습니다. 위 1번, 곧 길 ①이 항상 먼저 돌기 때문입니다.
헷갈리기 쉬운 곳
- 프록시는 하나입니다. 기능이 다섯이라고 프록시가 다섯 겹으로 싸이지 않습니다. 길 ②의 후처리기는 이미 프록시인 빈을 만나면 어드바이저만 더합니다.
- 위 출력에서는
@ConcurrencyLimit이@Retryable의 바깥이었습니다. 예제로 본 것이고 소스가 보장하는 순서는 아닙니다. 두 후처리기는order가 같고(LOWEST_PRECEDENCE - 1), 설정 클래스에 재시도 쪽이 먼저 적혀 있습니다. 위 출력에서 동시성 제한이 1번, 재시도가 2번인 것은 그 결과로 보입니다. 다시 부르는 동안에도 동시성 자리 하나를 계속 쥐고 있다는 뜻입니다. 이 둘 사이의 순서를 보장한다는 설명은 소스에서 찾지 못했으므로, 여기에 기대는 코드는 쓰지 않는 편이 좋습니다. - 캐시와 트랜잭션 사이의 순서는 이 예제로 확인하지 않았습니다. 둘 다 어드바이저의
order기본값이LOWEST_PRECEDENCE입니다(EnableCaching205행). 순서가 중요하면 두 스위치의order속성으로 정해 주어야 합니다.
이 글에서 뺀 것
범위가 넓어 많은 것을 뺐습니다. 이름과 위치만 적어 둡니다. 캐시에서는 @EnableCaching(mode = ASPECTJ)와 JSR-107(javax.cache) 어노테이션 지원(CachingConfigurationSelector 43–61행), 캐시 장애를 삼킬지 던질지 정하는 CacheErrorHandler(AbstractCacheInvoker 76–83행), 클래스 단위 공통 설정 @CacheConfig, CompletableFuture와 리액티브 반환 타입의 처리(CacheAspectSupport 515–554행), Caffeine 등 다른 저장소 구현(spring-context-support 모듈)을 뺐습니다. 스케줄링에서는 cron 식의 파싱(scheduling.support.CronExpression), 리액티브 반환 타입과 Kotlin suspend 메서드의 일정(ScheduledAnnotationBeanPostProcessor 378–391행), 코드로 일정을 더하는 SchedulingConfigurer, ThreadPoolTaskScheduler·ThreadPoolTaskExecutor 같은 실행기 구현(scheduling.concurrent)을 뺐습니다. 검증에서는 검증 그룹과 SmartValidator, 생성자 바인딩(DataBinder 911행부터), 위반을 MethodValidationResult로 바꿔 주는 adaptConstraintViolations(MethodValidationPostProcessor 120–130행), 제약 검증기에 빈을 주입해 주는 SpringConstraintValidatorFactory를 뺐습니다. 리질리언스에서는 리액티브 반환 타입의 재시도(AbstractRetryInterceptor 173행부터), 재시도마다 발행되는 MethodRetryEvent, jitter·multiplier·maxDelay로 기다림을 늘려 가는 백오프, 전체 제한 시간 timeout(RetryTemplate 209–228행)을 뺐습니다. 이 커밋에서 이 글이 읽은 네 패키지의 @since 7.1은 DataBinder의 setMaxNestedPathDepth(315행)와 ScheduledTaskRegistrar의 시간대를 받는 addCronTask(309행) 등 몇 곳뿐이고, 이 글의 예제는 그것들을 쓰지 않습니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
| 같은 틀 | 스위치(@EnableXxx = @Import) → 설정 클래스가 인프라 빈 등록 → 후처리기가 빈을 감싸거나 살핀다 |
| 길 ① | 어드바이저 빈을 등록하고 자동 프록시 생성기가 감싼다. 캐시, 트랜잭션 |
| 길 ② | 어드바이저를 든 후처리기(AbstractAdvisingBeanPostProcessor)가 직접 감싼다. @Async, @Retryable, @ConcurrencyLimit, 메서드 검증 |
| 길 ③ | 프록시 없이 메서드를 Runnable로 감싸 스케줄러에 건다. @Scheduled |
CacheAspectSupport.execute |
먼저 비우기 → 조회 → (없으면) 본문 → 저장 → 나중에 비우기. sync = true는 Cache.get(key, loader) 한 번 |
| 캐시 키 | key 식이 있으면 SpEL, 없으면 SimpleKeyGenerator. 인자 하나면 그 인자가 키 |
ScheduledAnnotationBeanPostProcessor |
빈을 그대로 돌려주고 일정만 등록한다. 실제로 거는 것은 ContextRefreshedEvent 때 |
| 기본 스케줄러·실행기 | 스케줄러는 스레드 하나짜리, @Async는 SimpleAsyncTaskExecutor. 빈으로 등록하면 그것을 쓴다 |
DataBinder.validate |
등록된 Validator를 차례로 불러 오류를 BindingResult에 모은다. bind와는 따로 불러야 한다 |
SpringValidatorAdapter |
Spring의 Validator이면서 jakarta의 Validator. 위반을 FieldError로 바꾼다 |
| 메서드 검증 | 클래스에 @Validated가 있어야 프록시가 된다. 위반이면 ConstraintViolationException |
@Retryable |
인터셉터가 RetryTemplate을 부른다. maxRetries = 3이면 최대 네 번. 호출한 쪽은 원래 예외를 받는다 |
| 자기 호출 | 프록시 기반 기능은 전부 this.메서드()에 걸리지 않는다. @Scheduled는 프록시가 아니라 해당 없음 |
| 어드바이저 순서 | 기본값으로 @Async → @Retryable → 캐시·트랜잭션 → 메서드 검증 → 대상. @ConcurrencyLimit은 예제에서 @Async와 @Retryable 사이였지만 @Retryable과의 안팎은 보장된 것이 아니다 |
연재를 마치며
이 글로 1편의 지도에 적어 둔 단위 25개를 모두 읽었습니다. 지나온 길을 Phase별로 정리합니다.
**Phase 1(컨테이너)과 Phase 2(AOP)**가 가장 길었습니다. 빈의 설계도 BeanDefinition이 무엇인지(3편), 그 설계도로 객체가 만들어지고 맵 세 개로 순환 참조가 풀리는 과정(4편), @Autowired가 후보를 고르는 규칙(5편), 후처리기와 생명주기 콜백이 끼어드는 자리(6편), refresh()의 열두 단계(7편), 어노테이션 설정이 설계도가 되는 과정(8·9편), 이벤트·Environment·Resource(12편)를 읽었고, 그 위에서 프록시가 만들어지는 두 방식과 어드바이스 체인(10·11편)을 읽었습니다. **Phase 3(기반 기술)**에서는 나머지 모두가 가져다 쓰는 것들, 곧 ResolvableType과 MergedAnnotations(13편), 타입 변환과 BeanWrapper(14편), SpEL(15편), 유틸리티와 AOT(16편)를 봤습니다.
**Phase 4(트랜잭션과 데이터 접근)**에서는 @Transactional을 프록시가 열고 닫는 과정(17편), JdbcTemplate의 템플릿-콜백과 예외 변환(18편), JPA 통합과 리액티브 트랜잭션(19편)을 읽었습니다. **Phase 5(웹)**는 spring-web의 기반(20편)에서 시작해 DispatcherServlet의 요청 처리(21편), 핸들러 매핑과 어댑터(22편), 예외 처리·인터셉터·뷰(23편)를 거쳐 WebFlux(24편)와 WebSocket·메시징(25편)까지 갔습니다. **Phase 6(나머지)**이 spring-test(26편)와 이 글입니다.
이 글의 1절 표는 그 순서로 읽은 이유를 다시 보여 줍니다. 캐시도 비동기도 재시도도, 9편의 @Import와 6편의 후처리기와 10·11편의 프록시를 조합한 것입니다. 2편에서 "가운데 층을 먼저 읽는다"고 한 까닭이 이것이었습니다. 이 블로그는 Spring에 이어 Tomcat·nginx·MariaDB·Gradle의 소스를 같은 방식으로 읽을 예정입니다.
연재의 글 전체입니다.
- 1편: AI와 함께 소스를 읽는 방법과 분석 지도
- 2편: 전체 지도 — 모듈과 패키지는 어떻게 나뉘어 있나
- 3편: BeanFactory 계층 구조와 BeanDefinition
- 4편: Bean은 어떻게 만들어지나 — 생성 흐름과 3단계 캐시
- 5편: @Autowired는 넣을 빈을 어떻게 고르나 — 의존성 주입 해석
- 6편: 생명주기 콜백과 PostProcessor — 컨테이너에 끼어드는 자리
- 7편: refresh() 12단계 — 컨테이너가 켜지는 순서
- 8편: @Configuration과 @ComponentScan은 어떻게 설계도가 되나
- 9편: @Conditional, @Profile, @Import — 조건에 따라 빈을 고르는 법
- 10편: AOP 프록시는 어떻게 만들어지나 — JDK 방식과 CGLIB 방식
- 11편: @Aspect는 어떻게 발견되고 어드바이스 체인은 어떻게 돌아가나
- 12편: 이벤트, Environment, Resource — 컨테이너 주변의 세 추상화
- 13편: ResolvableType과 MergedAnnotations — 타입과 어노테이션을 읽는 법
- 14편: 타입 변환과 BeanWrapper — 문자열이 객체의 속성이 되기까지
- 15편: SpEL — 표현식은 어떻게 파싱되고 계산되나
- 16편: 유틸리티와 AOT — 모두가 쓰는 도구 상자와 미리 계산해 두기
- 17편: @Transactional — 트랜잭션은 누가 열고 누가 닫나
- 18편: JdbcTemplate — 템플릿-콜백 패턴과 예외 변환
- 19편: ORM과 R2DBC 연동 — JPA 통합과 리액티브 트랜잭션
- 20편: spring-web 기반 — HttpMessageConverter, WebApplicationContext, 필터
- 21편: DispatcherServlet — 요청 하나가 응답이 되기까지
- 22편: 핸들러 매핑과 어댑터 — @RequestMapping은 어떻게 찾고 어떻게 부르나
- 23편: 예외 처리, 인터셉터, 뷰 — 요청 처리의 앞뒤와 끝
- 24편: WebFlux — DispatcherHandler, 함수형 엔드포인트, WebClient
- 25편: WebSocket과 메시징 — STOMP 메시지는 어떻게 흐르나
- 26편: spring-test — SpringExtension, TestContext, MockMvc
- 27편: 캐시, 스케줄링, 검증, 리질리언스 — 컨테이너 위에 얹힌 기능들 (이 글)
Spring 다음으로는 같은 방법으로 Apache HTTP Server(httpd)의 소스를 읽었습니다. 자바 객체와 인터페이스 대신 C 구조체와 함수 포인터로 짠 서버가 같은 문제(요청 처리 단계, 끼어드는 자리, 설정 병합)를 어떻게 푸는지 비교해 보고 싶다면 Apache httpd 소스 파헤치기 1편부터 읽어 보세요.