이 글에서 다루는 것
"Spring 소스 파헤치기" 시리즈의 열다섯 번째 글입니다. 14편에서는 설정의 문자열 "8080"이 빈의 int 필드에 들어가기까지 누가 변환하는지를 봤습니다. 그 글의 끝에서 @Value를 처리하는 doResolveDependency가 변환 바로 앞에서 evaluateBeanDefinitionString을 부른다고 했습니다(DefaultListableBeanFactory 1682행). "8080"이면 그냥 지나가지만 "#{…}"로 감싼 값이면 거기서 계산이 일어납니다. 그 계산을 하는 도구가 SpEL(Spring Expression Language)이고, 이번 글은 그 안을 따라갑니다. 1편의 지도에서는 Phase 3(기반 기술)의 U13입니다.
답하려는 질문은 네 가지입니다.
- 문자열은 어떻게 트리가 되는가.
"T(java.lang.Math).max(a, 3) + 1"은 어떤 토큰으로 잘리고, 어떤 노드로 이루어진 트리가 되는가.*가+보다 먼저 묶이는 규칙은 코드의 어디에 있는가 - 트리는 어떻게 값이 되는가.
getValue()를 부르면 노드가 무엇을 누구에게 물어보는가.StandardEvaluationContext와SimpleEvaluationContext는 왜 둘인가 - 컴파일 모드는 무엇인가. 트리를 해석하는 대신 바이트코드로 만들어 두는 길은 어떻게 켜지고, 왜 기본으로는 꺼져 있는가
- 컨테이너와는 어떻게 이어지는가.
@Value("#{…}")는 어느 길로 SpEL에 닿고,systemProperties나otherBean.count같은 이름은 어디서 오는가
| 항목 | 내용 |
|---|---|
| 기준 소스 | Spring Framework 7.1.0-SNAPSHOT |
| 커밋 | f447f3c310 (2026-10-01, main 브랜치) |
| 주로 읽는 모듈 | spring-expression, spring-context(context.expression), spring-beans(AbstractBeanFactory) |
| 주로 읽는 클래스 | Tokenizer, InternalSpelExpressionParser, SpelExpression, ExpressionState, StandardEvaluationContext, SimpleEvaluationContext, SpelCompiler, StandardBeanExpressionResolver |
글에 나오는 줄 번호와 세부 동작은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고 세부 내용도 달라질 수 있습니다. 같은 커밋의 소스를 받는 방법은 1편에 있습니다.
원래 공부 노트는 줄 단위로 훨씬 깊이 들어가지만, 이 글은 Spring을 처음 보는 분이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "더 깊이 들어가면"에 이름만 적어 두었습니다.
먼저 알아 둘 말
표현식 언어(expression language)는 프로그램 안에서 문자열로 적은 작은 식을 실행 시점에 계산해 주는 언어입니다. "a > 5 and a < 10"처럼 Java 코드가 아니라 문자열이므로 설정 파일이나 어노테이션 값에 넣을 수 있습니다. SpEL은 Spring이 가진 표현식 언어이고 spring-expression 모듈 전체가 이것입니다.
토큰(token)은 문자열을 뜻이 있는 조각으로 자른 것입니다. "max(a, 3)"은 글자 9개지만 토큰으로는 max, (, a, ,, 3, ) 여섯 개입니다. 이렇게 자르는 일을 토크나이저(tokenizer) 또는 렉서(lexer)가 합니다.
트리(AST, 추상 구문 트리)는 토큰을 문법에 맞게 묶어 만든 나무 구조입니다. 1 + 2 * 3은 "더하기" 노드 아래에 1과 "곱하기" 노드가 있고, 곱하기 아래에 2와 3이 있는 트리입니다. 이렇게 묶는 일을 파서(parser)가 합니다. SpEL의 파서는 재귀 하강(recursive descent) 방식인데, 문법 규칙 하나가 메서드 하나로 되어 있고 메서드가 메서드를 부르며 내려가는 방식입니다. 이 글의 2절이 이것입니다.
평가(evaluation)는 트리를 따라 실제 값을 계산하는 일입니다. 소스에서는 getValue()입니다. 평가할 때 "이름 a는 어느 객체의 무엇인가", "T(Math)는 어느 클래스인가" 같은 질문에 답해 주는 것이 EvaluationContext(평가 컨텍스트)이고, 식이 기본으로 기대는 객체를 루트 객체(root object)라고 합니다.
컴파일은 여기서는 트리를 해석하는 대신 그 트리와 같은 일을 하는 Java 클래스를 바이트코드로 만들어 두는 것입니다. 5절에서 봅니다.
${…}와 #{…}는 다른 것입니다. ${…}는 12편의 Environment가 푸는 플레이스홀더이고 SpEL이 아닙니다. #{…}가 SpEL입니다. 둘이 어떤 순서로 처리되는지는 6절에서 소스로 확인합니다.
1. 문자열이 토큰이 되기까지 — Tokenizer
입구는 SpelExpressionParser입니다. 설명 주석에 "Instances are reusable and thread-safe"라고 적혀 있고(28행), 하는 일은 파싱 한 번마다 InternalSpelExpressionParser를 새로 만들어 넘기는 것뿐입니다.
	@Override
	protected SpelExpression doParseExpression(String expressionString, @Nullable ParserContext context) throws ParseException {
		return new InternalSpelExpressionParser(this.configuration).doParseExpression(expressionString, context);
	}
안쪽 파서의 주석은 반대로 "reusable but are not thread-safe"입니다(85행). 토큰 목록과 "지금 몇 번째 토큰을 보고 있는가"(tokenStreamPointer)를 필드로 들고 있기 때문입니다(113–119행). 바깥 파서가 매번 새로 만드는 이유가 그것입니다.
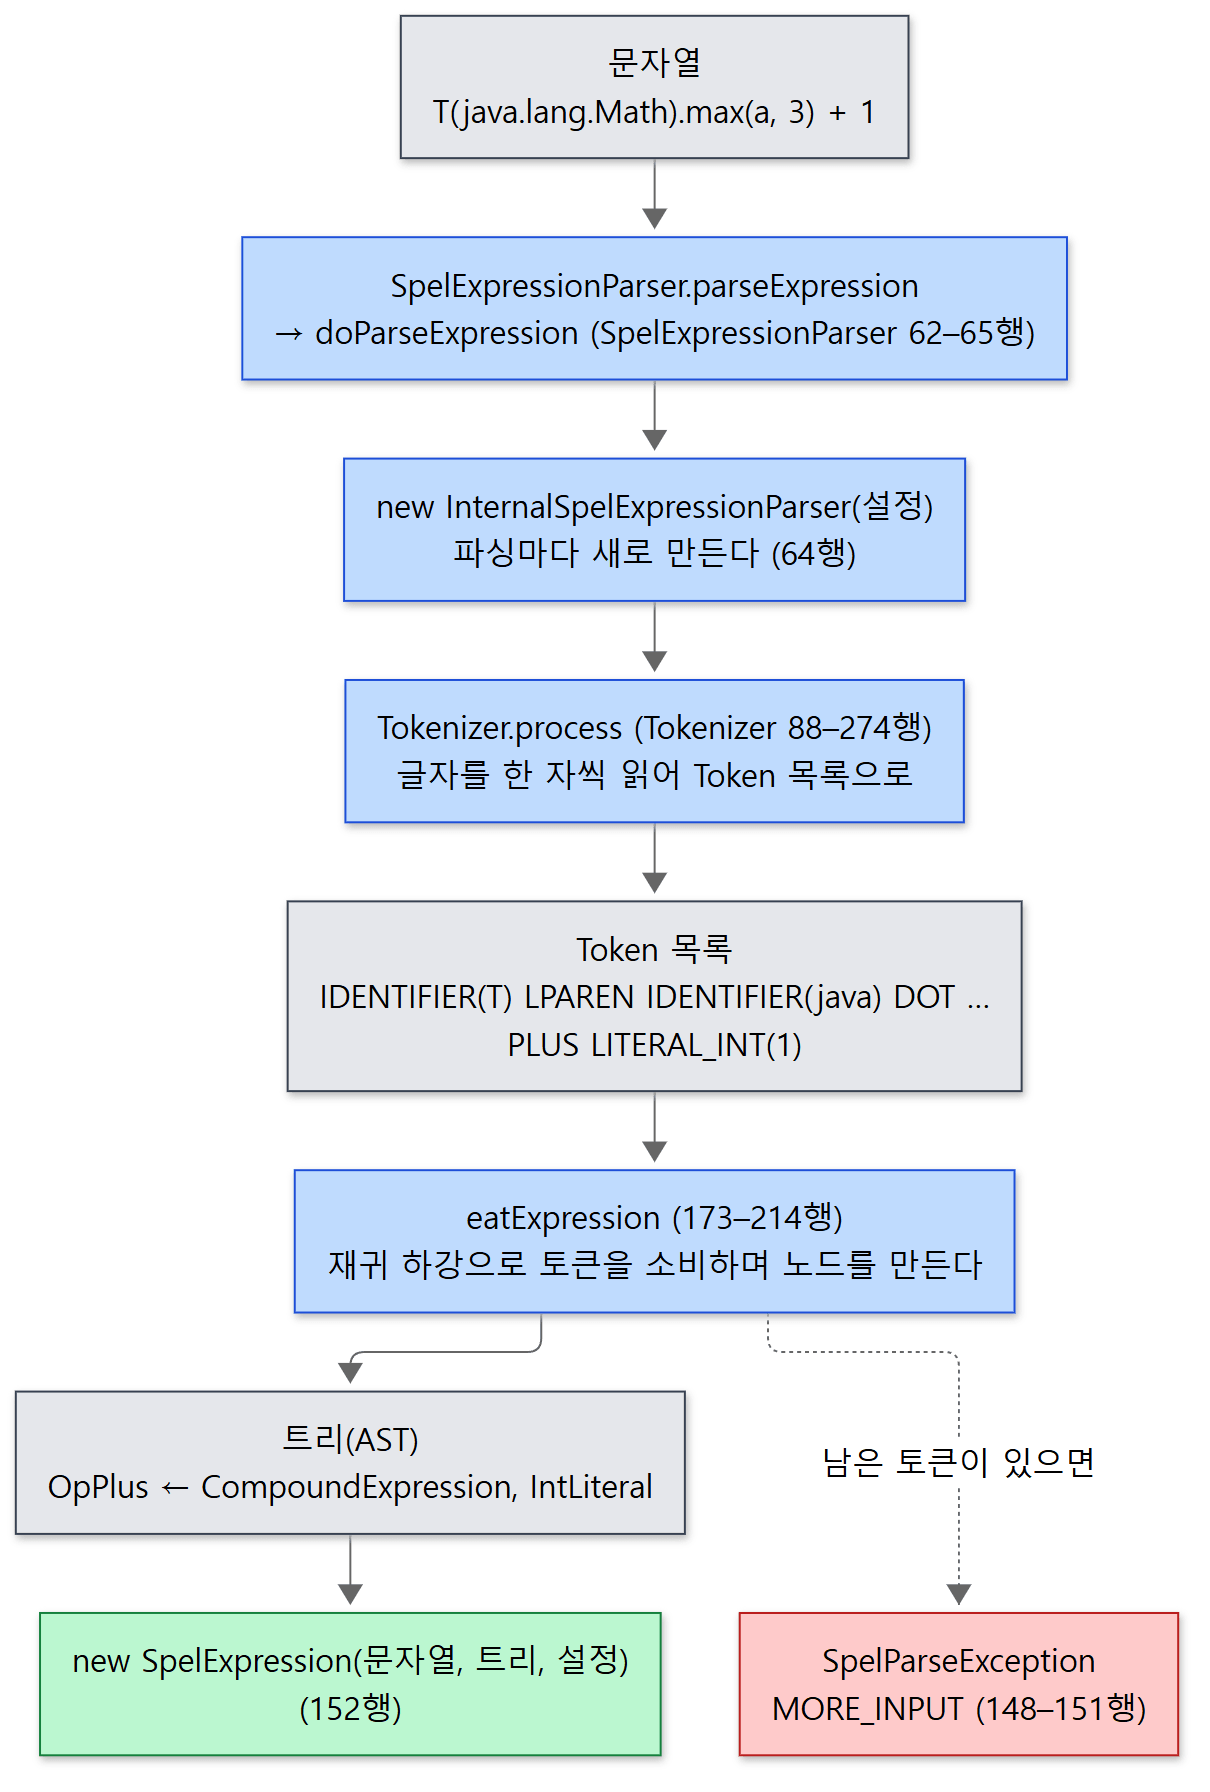 파란 상자가 절차, 회색 상자가 중간 산물입니다. 줄 번호는
InternalSpelExpressionParser 기준입니다.
안쪽 파서의 doParseExpression이 전체 순서를 보여 줍니다.
	@Override
	protected SpelExpression doParseExpression(String expressionString, @Nullable ParserContext context)
			throws ParseException {

		checkExpressionLength(expressionString);

		try {
			this.expressionString = expressionString;
			Tokenizer tokenizer = new Tokenizer(expressionString);
			this.tokenStream = tokenizer.process();
			this.tokenStreamLength = this.tokenStream.size();
			this.tokenStreamPointer = 0;
			this.constructedNodes.clear();
			SpelNodeImpl ast = eatExpression();
			if (ast == null) {
				throw new SpelParseException(this.expressionString, 0, SpelMessage.OOD);
			}
			Token t = peekToken();
			if (t != null) {
				throw new SpelParseException(this.expressionString, t.startPos, SpelMessage.MORE_INPUT, toString(nextToken()));
			}
			return new SpelExpression(expressionString, ast, this.configuration);
		}
		catch (InternalParseException ex) {
			throw ex.getCause();
		}
	}
세 단계입니다. Tokenizer.process()가 토큰 목록을 만들고, eatExpression()이 그 토큰을 먹으며(eat) 트리를 만들고, 다 먹었는데 토큰이 남아 있으면 MORE_INPUT 오류입니다. 결과는 문자열·트리·설정을 묶은 SpelExpression입니다.
토크나이저가 하는 일
Tokenizer.process()는 글자를 한 자씩 보며 switch로 종류를 가립니다. 길지만 모양은 단순합니다.
	public List<Token> process() {
		while (this.pos < this.max) {
			char ch = this.charsToProcess[this.pos];
			if (isAlphabetic(ch)) {
				lexIdentifier();
			}
			else {
				switch (ch) {
					// ...
					case '#':
						pushCharToken(TokenKind.HASH);
						break;
					// ...
					case '@':
						pushCharToken(TokenKind.BEAN_REF);
						break;
					// ...
					case '$':
						if (isTwoCharToken(TokenKind.SELECT_LAST)) {
							pushPairToken(TokenKind.SELECT_LAST);
						}
						else {
							lexIdentifier();  // '$' is another way to start an identifier
						}
						break;
					// ...
				}
			}
		}
		return this.tokens;
	}
spring-expression/src/main/java/org/springframework/expression/spel/standard/Tokenizer.java 88–274행
글자로 시작하면 식별자(lexIdentifier, 448–467행), 숫자로 시작하면 숫자 리터럴(236–247행), 따옴표면 문자열 리터럴(255–260행), 나머지 기호는 한 글자 또는 두 글자 토큰입니다. 예를 들어 +를 만나면 다음 글자까지 보고 ++(INC)인지 +(PLUS)인지 가립니다(96–103행). 토큰의 종류는 TokenKind enum에 모두 있습니다(25–123행). 토큰 하나는 종류, 글자, 시작·끝 위치를 담은 작은 객체입니다(Token 28–37행).
이 규칙대로 T(java.lang.Math).max(a, 3) + 1을 자르면 이렇게 됩니다. Tokenizer는 패키지 밖에서 부를 수 없는 클래스라 프로그램으로 찍은 것이 아니라 위 코드를 따라 손으로 적은 것입니다.
| 글자 | 토큰 | 근거 |
|---|---|---|
T |
IDENTIFIER |
글자로 시작. T가 특별한 것은 토크나이저가 아니라 파서가 안다 |
( ) , |
LPAREN RPAREN COMMA |
한 글자 기호 |
java . lang . Math |
IDENTIFIER DOT IDENTIFIER DOT IDENTIFIER |
식별자에 .은 들어가지 않는다(538–540행) |
max a |
IDENTIFIER |
|
3 1 |
LITERAL_INT |
|
+ |
PLUS |
다음 글자가 +가 아니므로 |
| 공백 | (없음) | 건너뛴다(248–254행) |
헷갈리기 쉬운 곳
$는 식별자의 글자입니다. 위case '$'를 보면$[(마지막 원소 선택)가 아니면lexIdentifier()로 갑니다. 즉 SpEL 안에서${…}는 특별한 문법이 아닙니다.${…}가 풀리는 것은 SpEL에 오기 전의 일이고, 6절에서 그 순서를 봅니다.#{도 토큰이 아닙니다. 위 표에#{가 없는 것은#{…}껍데기를 벗기는 일을 토크나이저가 아니라 그 바깥의 템플릿 층이 하기 때문입니다.#은HASH토큰으로#root,#this같은 변수 참조에 쓰입니다. 역시 6절입니다.- 연산자를 글자로도 쓸 수 있습니다.
lexIdentifier는 식별자가 두세 글자이면DIV,EQ,GE,GT,LE,LT,MOD,NE,NOT목록과 대조해 연산자 토큰으로 바꿉니다(47–48행, 456–465행). XML 안에서<를 쓰기 불편할 때a lt b로 쓸 수 있는 이유입니다.and와or는 이 목록에 없고 파서가 따로 봅니다(주석 42–43행). - 길이 제한이 있습니다.
checkExpressionLength가 설정의 최대 길이를 넘으면 예외를 던지고(159–164행), 기본값은 10,000자입니다(SpelParserConfiguration62행).
2. 토큰이 트리가 되기까지 — 재귀 하강과 우선순위
파서의 메서드는 거의 전부 eatXxx라는 이름이고, 하나가 다음 하나를 부릅니다. 그 호출 순서가 곧 연산자 우선순위입니다.
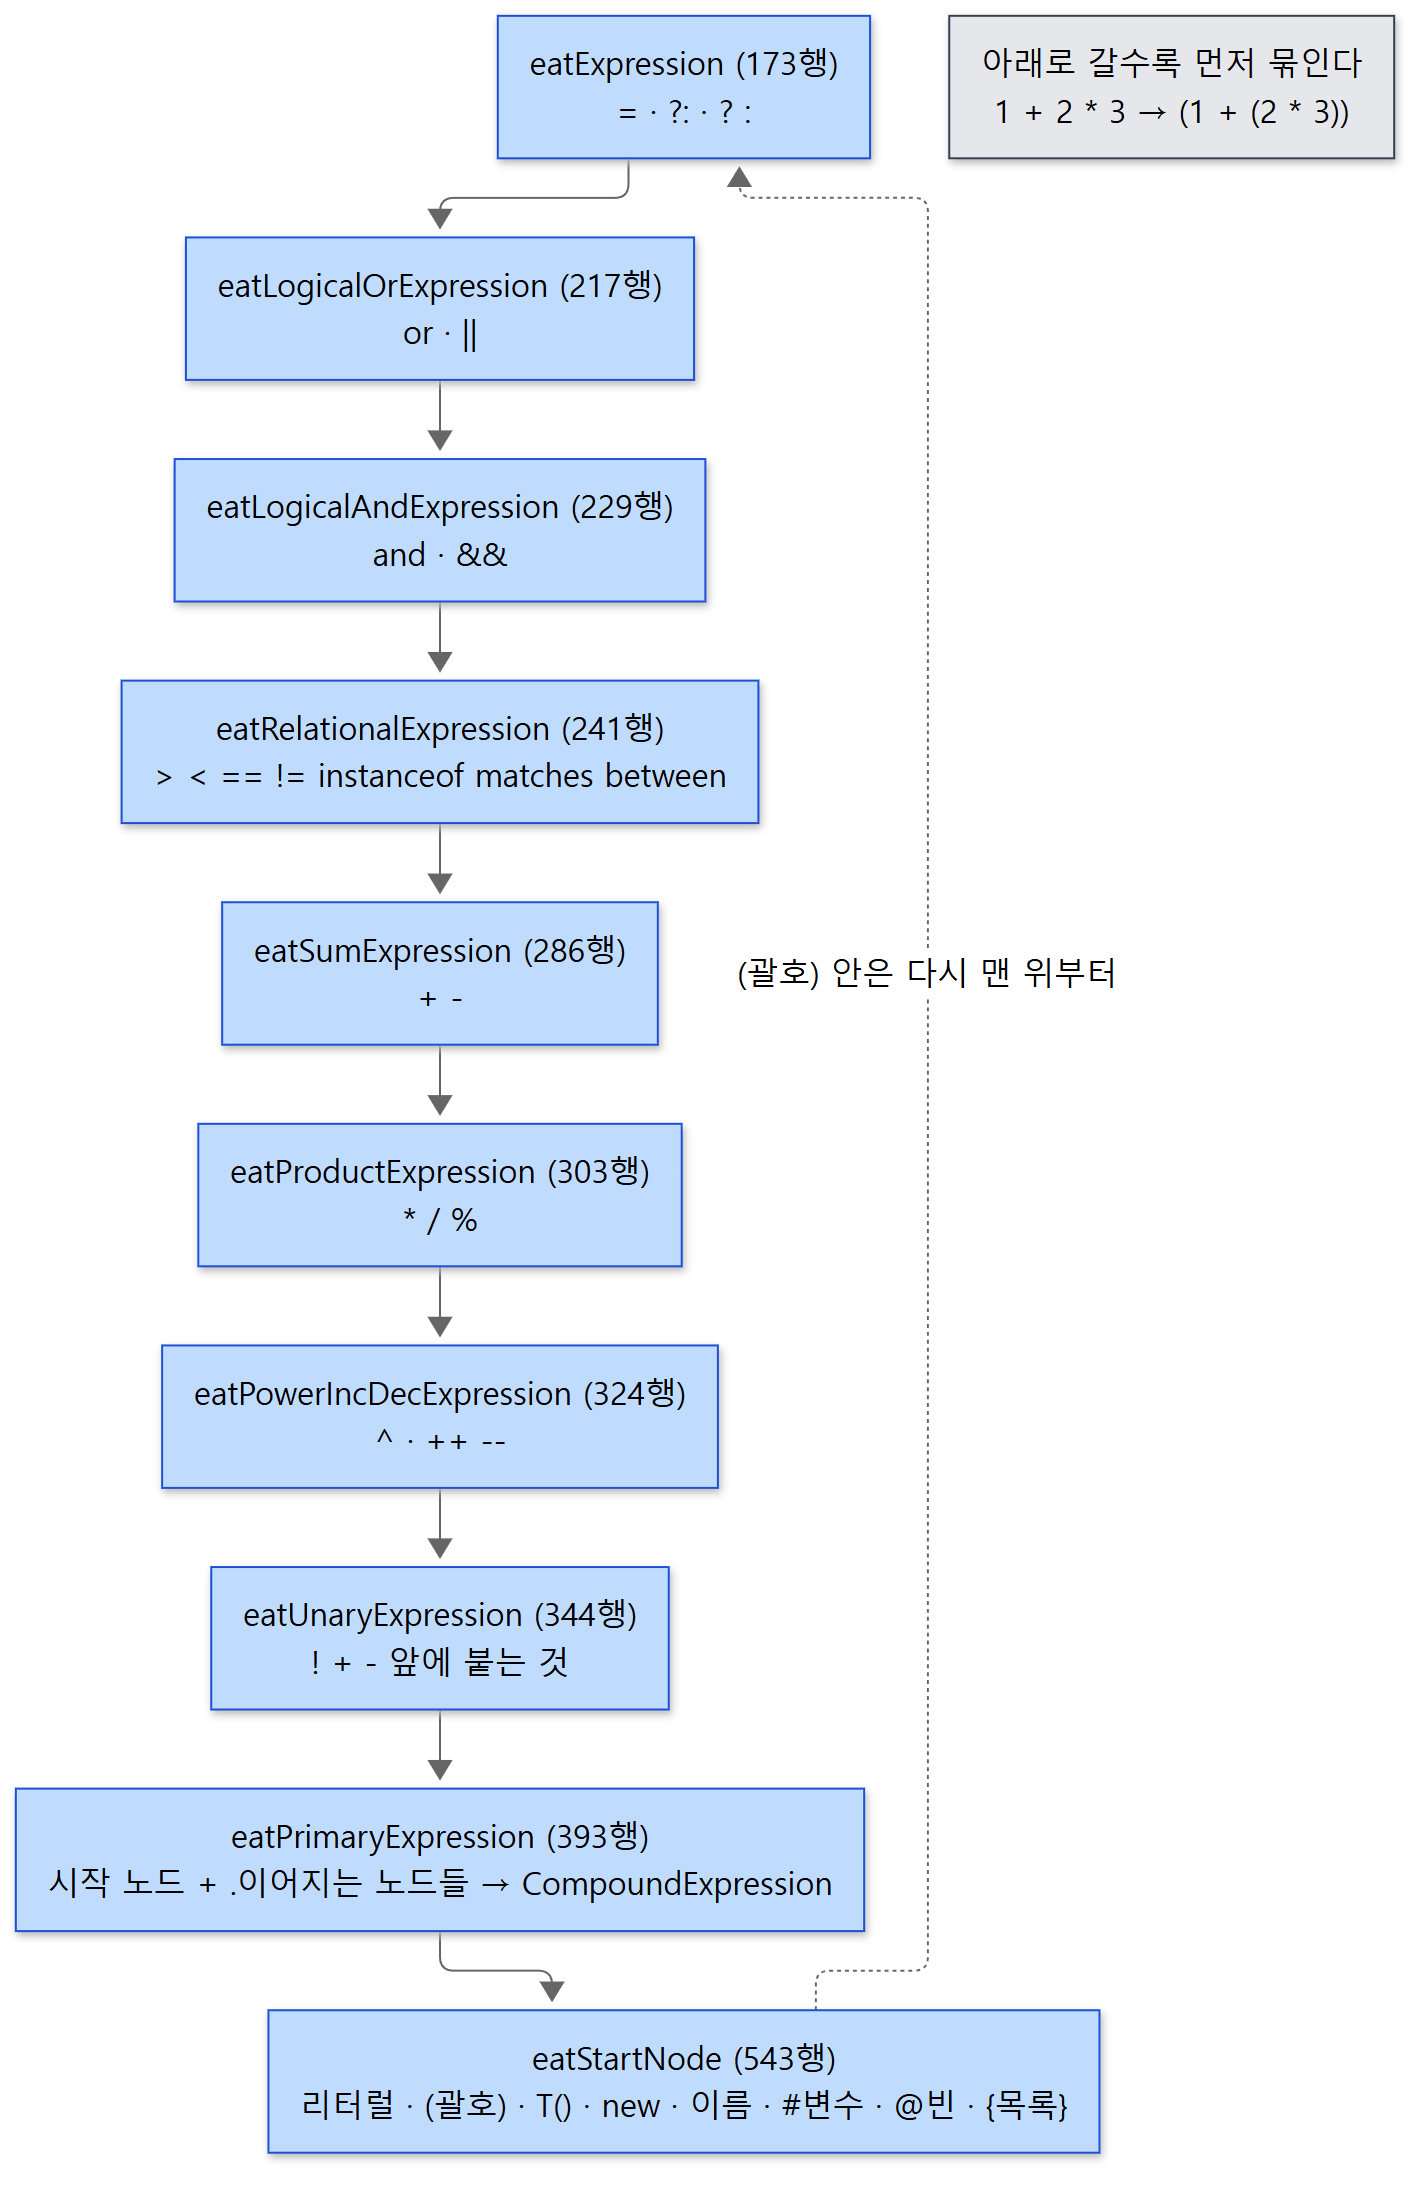 메서드마다 맡은 연산자가 적혀 있습니다. 아래에 있을수록 먼저 묶입니다.
+와 *를 맡은 두 메서드를 보면 규칙이 보입니다.
	//sumExpression: productExpression ( (PLUS^ | MINUS^) productExpression)*;
	@SuppressWarnings("NullAway") // Not null assertion performed in SpelNodeImpl constructor
	private @Nullable SpelNodeImpl eatSumExpression() {
		SpelNodeImpl expr = eatProductExpression();
		while (peekToken(TokenKind.PLUS, TokenKind.MINUS, TokenKind.INC)) {
			Token t = takeToken();  //consume PLUS or MINUS or INC
			SpelNodeImpl rhExpr = eatProductExpression();
			checkRightOperand(t, rhExpr);
			if (t.kind == TokenKind.PLUS) {
				expr = new OpPlus(t.startPos, t.endPos, expr, rhExpr);
			}
			else if (t.kind == TokenKind.MINUS) {
				expr = new OpMinus(t.startPos, t.endPos, expr, rhExpr);
			}
		}
		return expr;
	}

	// productExpression: powerExpr ((STAR^ | DIV^| MOD^) powerExpr)* ;
	private @Nullable SpelNodeImpl eatProductExpression() {
		SpelNodeImpl expr = eatPowerIncDecExpression();
		while (peekToken(TokenKind.STAR, TokenKind.DIV, TokenKind.MOD)) {
			Token t = takeToken();  // consume STAR/DIV/MOD
			SpelNodeImpl rhExpr = eatPowerIncDecExpression();
			checkOperands(t, expr, rhExpr);
			if (t.kind == TokenKind.STAR) {
				expr = new OpMultiply(t.startPos, t.endPos, expr, rhExpr);
			}
			// ...
		}
		return expr;
	}
1 + 2 * 3을 넣으면 이렇게 됩니다. eatSumExpression은 먼저 eatProductExpression을 불러 왼쪽 항을 받습니다. 그 호출은 1만 먹고 돌아옵니다(다음 토큰이 *가 아니라 +이므로 while에 들어가지 않습니다). +를 먹고 다시 eatProductExpression을 부르면, 이번에는 2를 받은 뒤 *를 보고 3까지 먹어 OpMultiply(2, 3)을 만들어 돌려줍니다. 그래서 OpPlus(1, OpMultiply(2, 3))입니다. 더 아래 메서드가 먼저 끝까지 먹기 때문에 더 먼저 묶입니다. 괄호는 eatStartNode에서 (를 만나면 eatExpression()을 다시 부르는 것이라(913–930행) 괄호 안은 맨 위부터 다시 시작합니다.
각 메서드 위의 주석(sumExpression: productExpression ( (PLUS^ | MINUS^) productExpression)*;)은 문법 규칙입니다. 이 파서는 그 규칙을 메서드로 손으로 옮긴 것이라 주석에 "Handwritten SpEL parser"라고 적혀 있습니다(85행).
| 메서드 | 맡는 것 | 위치 |
|---|---|---|
eatExpression |
=, ?:(Elvis), ? :(삼항) |
173–214행 |
eatLogicalOrExpression |
or, || |
217–226행 |
eatLogicalAndExpression |
and, && |
229–238행 |
eatRelationalExpression |
> < >= <= == != instanceof matches between |
241–282행 |
eatSumExpression |
+ - |
위 코드 |
eatProductExpression |
* / % |
위 코드 |
eatPowerIncDecExpression |
^, 뒤에 붙는 ++ -- |
324–340행 |
eatUnaryExpression |
앞에 붙는 ! + - ++ -- |
344–372행 |
eatPrimaryExpression |
시작 노드 + 점으로 이어지는 노드들 → CompoundExpression |
393–410행 |
eatStartNode |
리터럴, 괄호, T(), null, new, 이름, #변수, @빈, 셀렉션·프로젝션·인덱서, {…} |
543–566행 |
이름 하나가 속성인지 메서드인지
eatStartNode와 점(.) 뒤의 노드를 먹는 eatDottedNode(436–450행)가 둘 다 부르는 메서드가 이것입니다.
	private boolean maybeEatMethodOrProperty(boolean nullSafeNavigation) {
		if (peekToken(TokenKind.IDENTIFIER)) {
			Token methodOrPropertyName = takeToken();
			SpelNodeImpl[] args = maybeEatMethodArgs();
			if (args == null) {
				// property
				push(new PropertyOrFieldReference(nullSafeNavigation, methodOrPropertyName.stringValue(),
						methodOrPropertyName.startPos, methodOrPropertyName.endPos));
				return true;
			}
			// method reference
			push(new MethodReference(nullSafeNavigation, methodOrPropertyName.stringValue(),
					methodOrPropertyName.startPos, methodOrPropertyName.endPos, args));
			return true;
		}
		return false;
	}
식별자 다음에 (가 있으면 MethodReference, 없으면 PropertyOrFieldReference입니다. 파서는 그 이름이 실제로 있는지는 보지 않습니다. 그것은 평가 때의 일입니다. T(…)도 비슷합니다. maybeEatTypeReference는 식별자가 정확히 T이고 바로 (가 따라올 때만 TypeReference를 만들고, 괄호 안은 eatPossiblyQualifiedId가 IDENTIFIER와 DOT 토큰을 모아 QualifiedIdentifier 하나로 묶습니다(601–628행, 759–778행).
예제: 트리를 직접 찍어 보기
노드는 전부 SpelNodeImpl의 하위 클래스이고(50행), 자식 배열 children을 가집니다(59행). spel.ast 패키지에 파일이 53개 있습니다(package-info.java 포함). SpelExpression.getAST()로 루트 노드를 받아 자식을 따라 내려가며 찍어 봤습니다. 이 예제는 릴리스 버전인 Spring Framework 7.0.9로 실행해 결과를 확인했습니다(이 시리즈가 읽는 7.1.0-SNAPSHOT을 직접 빌드해 돌린 것은 아닙니다).
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
SpelExpressionParser parser = new SpelExpressionParser();
Scores root = new Scores(7, null);                                 // getA() = 7, getNickname() = null
StandardEvaluationContext ctx = new StandardEvaluationContext(root);  // #root = root

for (String text : List.of("T(java.lang.Math).max(a, 3) + 1", "1 + 2 * 3", "(1 + 2) * 3",
        "a > 5 and a < 10", "'a=' + a", "#root.a == a",
        "nickname ?: '(별명 없음)'", "nickname?.length()", "{1, 2, 3}.?[#this > 1]")) {
    System.out.printf("%-34s → %s%n", text, parser.parseExpression(text).getValue(ctx));
}

System.out.println();
for (String text : List.of("T(java.lang.Math).max(a, 3) + 1", "1 + 2 * 3")) {
    SpelExpression expr = parser.parseRaw(text);
    System.out.println("AST of \"" + text + "\"  (toStringAST = " + expr.toStringAST() + ")");
    printTree(expr.getAST(), 1);      // 노드 클래스 이름과 toStringAST() 를 재귀로 찍는다
}
출력입니다.
T(java.lang.Math).max(a, 3) + 1    → 8
1 + 2 * 3                          → 7
(1 + 2) * 3                        → 9
a > 5 and a < 10                   → true
'a=' + a                           → a=7
#root.a == a                       → true
nickname ?: '(별명 없음)'              → (별명 없음)
nickname?.length()                 → null
{1, 2, 3}.?[#this > 1]             → [2, 3]

AST of "T(java.lang.Math).max(a, 3) + 1"  (toStringAST = (T(java.lang.Math).max(a,3) + 1))
  OpPlus  (T(java.lang.Math).max(a,3) + 1)
    CompoundExpression  T(java.lang.Math).max(a,3)
      TypeReference  T(java.lang.Math)
        QualifiedIdentifier  java.lang.Math
          Identifier  java
          Identifier  lang
          Identifier  Math
      MethodReference  max(a,3)
        PropertyOrFieldReference  a
        IntLiteral  3
    IntLiteral  1
AST of "1 + 2 * 3"  (toStringAST = (1 + (2 * 3)))
  OpPlus  (1 + (2 * 3))
    IntLiteral  1
    OpMultiply  (2 * 3)
      IntLiteral  2
      IntLiteral  3
주인공 식의 트리는 루트가 OpPlus이고, 왼쪽이 T(java.lang.Math)와 max(a,3)을 점으로 이은 CompoundExpression, 오른쪽이 IntLiteral 1입니다. toStringAST()가 괄호를 넣어 돌려주므로 묶인 순서를 눈으로 확인할 수 있습니다.
헷갈리기 쉬운 곳
- 비교 연산자는 이어 쓸 수 없습니다.
eatSumExpression은while이지만eatRelationalExpression은if한 번입니다(243–244행). 주석의 문법도(relationalOperator^ sumExpression)?로 물음표(0 또는 1번)입니다(240행). 그래서a > b > c는 파싱이 안 되고, 위 예제처럼and로 이어야 합니다. ^는 두 뜻입니다. 토크나이저에서^[는 "첫 원소 선택"(SELECT_FIRST), 그냥^는 거듭제곱(POWER)입니다(157–164행).- 파싱은 이름을 검사하지 않습니다.
nickname?.length()가null을 돌려준 것은 파싱 때가 아니라 평가 때?.(안전 내비게이션)이 처리한 결과입니다. 없는 속성 이름도 파싱은 통과하고 평가에서 실패합니다(3절). - 중첩 깊이에도 제한이 있습니다. 괄호나 단항 연산자를 아주 깊이 겹치면 재귀 호출이 스택을 넘칠 수 있어, 이 커밋에서는 깊이를 세어 기본 1,000을 넘으면 예외를 던집니다(
eatUnaryOperand382–390행,SpelParserConfiguration103행). 둘 다@since 7.1이라 7.0.9에는 없습니다.
3. 트리가 값이 되기까지 — getValue, ExpressionState, EvaluationContext
SpelExpression.getValue(EvaluationContext)입니다. 앞부분의 컴파일 분기는 5절로 미루고 뒷부분 세 줄만 보면 됩니다.
	@Override
	public @Nullable Object getValue(EvaluationContext context) throws EvaluationException {
		Assert.notNull(context, "EvaluationContext must not be null");

		CompiledExpression compiledAst = this.compiledAst;
		if (compiledAst != null && context.isCompilationSupported()) {
			// ...
		}

		ExpressionState expressionState = new ExpressionState(context, this.configuration);
		Object result = this.ast.getValue(expressionState);
		checkCompile(expressionState);
		return result;
	}
여기서 객체가 둘 나옵니다. **EvaluationContext**는 여러 평가가 함께 쓰는 것이고, **ExpressionState**는 이번 평가 한 번 동안만 사는 것입니다. ExpressionState의 설명 주석이 둘의 차이를 그대로 적고 있습니다. 이 상태에 생기는 변화는 다른 식에 보이지 않지만, EvaluationContext에 생기는 변화는 다른 식에도 보인다고요(40–45행). ExpressionState가 들고 있는 것은 컨텍스트, 루트 객체, 설정, 그리고 "지금 점 앞에 있는 객체"의 스택(contextObjects)입니다(55–74행).
this.ast.getValue(state)는 루트 노드의 getValueInternal을 부르고, 각 노드는 자식의 getValueInternal을 부릅니다(SpelNodeImpl 113–115행, 205행). 값은 객체와 타입 정보를 묶은 TypedValue로 오갑니다(TypedValue 34–44행).
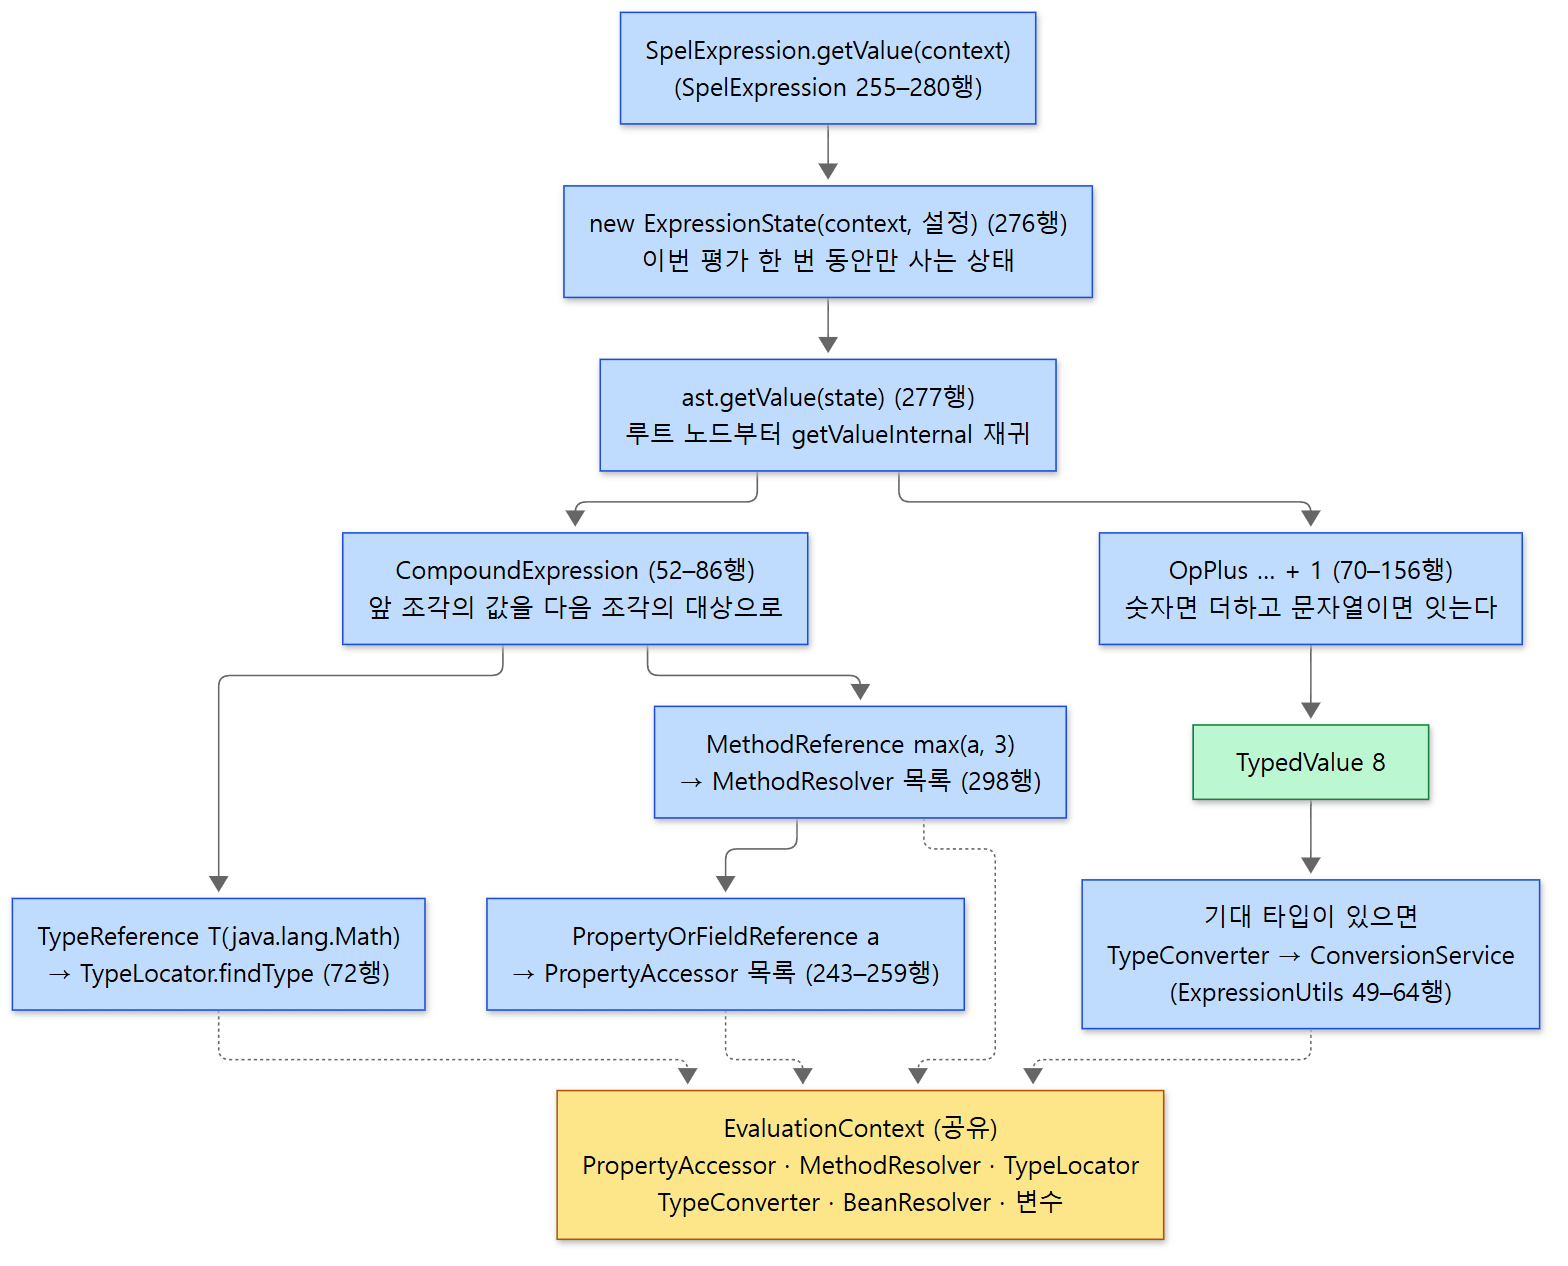 노란 상자가 공유되는 컨텍스트, 파란 상자가 이번 평가의 절차입니다.
노드는 컨텍스트에게 무엇을 묻나
EvaluationContext는 인터페이스이고, 노드가 물어볼 것을 종류별로 돌려줍니다.
| 메서드 | 돌려주는 것 | 어느 노드가 쓰나 |
|---|---|---|
getRootObject() |
루트 객체 | 이름만 쓴 a, #root (73행) |
getPropertyAccessors() |
속성을 읽고 쓰는 접근기 목록 | PropertyOrFieldReference (79–81행) |
getMethodResolvers() |
메서드를 찾아 주는 해석기 목록 | MethodReference (105–107행) |
getConstructorResolvers() |
생성자를 찾아 주는 해석기 목록 | ConstructorReference(new) (97–99행) |
getTypeLocator() |
이름으로 클래스를 찾아 주는 것 | TypeReference(T()) (118행) |
getBeanResolver() |
이름으로 빈을 찾아 주는 것. null일 수 있다 |
BeanReference(@빈) (112행) |
getTypeConverter() |
값의 타입을 바꾸는 것 | 결과 타입 맞추기, 메서드 인자 맞추기 (123행) |
lookupVariable(name) |
#이름 변수 |
VariableReference (172행) |
주인공 식의 트리를 위에서부터 따라가면 이렇습니다.
- **
CompoundExpression**은 조각을 차례로 평가하면서 앞 조각의 값을pushActiveContextObject로 올려 다음 조각의 대상으로 삼습니다(52–86행).T(java.lang.Math)의 값인Class객체가max(a,3)의 대상이 됩니다. - **
TypeReference**는 자식QualifiedIdentifier에서 문자열"java.lang.Math"를 받아state.findType()을 부르고(56–77행), 그것은 컨텍스트의TypeLocator.findType()입니다(ExpressionState179–181행). 기본 구현StandardTypeLocator는 생성자에서java.lang을 import 접두사로 등록해 두므로T(Math)로 줄여 써도 됩니다(76–80행, 117–130행). - **
MethodReference**는 먼저 인자a와3을 평가합니다. 인자를 평가할 때는 대상 객체를 잠시 루트로 되돌립니다(254–260행).max(a, 3)의a가Math의 속성이 아니라 루트 객체의 속성인 이유입니다. 그다음 컨텍스트의MethodResolver목록을 돌며 맞는 메서드를 찾고(298행), 못 찾으면METHOD_NOT_FOUND입니다(220–231행). 기본 해석기ReflectiveMethodResolver는 이름이 같은 메서드를 모아 인자 타입을 맞춰 보는데, 정확히 맞지 않으면 컨텍스트의TypeConverter로 바꿀 수 있는지까지 봅니다(116–123행, 179행). PropertyOrFieldReferencea는PropertyAccessor목록을 돌며canRead를 묻고, 된다는 접근기의read를 부릅니다.
		List<PropertyAccessor> accessorsToTry =
				AccessorUtils.getAccessorsToTry(target, evalContext.getPropertyAccessors());
		// Go through the accessors that may be able to resolve it. If they are a cacheable accessor then
		// get the accessor and use it. If they are not cacheable but report they can read the property
		// then ask them to read it.
		try {
			for (PropertyAccessor accessor : accessorsToTry) {
				// First, attempt to find the property on the target object.
				if (accessor.canRead(evalContext, target, name)) {
					if (accessor instanceof ReflectivePropertyAccessor reflectivePropertyAccessor) {
						accessor = reflectivePropertyAccessor.createOptimalAccessor(
								evalContext, target, name);
					}
					this.cachedReadAccessor = accessor;
					state.trackOperation();
					return accessor.read(evalContext, target, name);
				}
				// ...
			}
		}
		// ...
AccessorUtils.getAccessorsToTry는 대상 타입을 콕 집어 지원한다고 한 접근기를 앞에, 아무 타입이나 받는 접근기를 뒤에 세웁니다(주석 59–66행). 기본 접근기 ReflectivePropertyAccessor는 getter(getA(), isActive(), 레코드식 a())나 public 필드를 리플렉션으로 읽습니다(설명 주석 56–63행). 한 번 찾은 접근기는 노드의 cachedReadAccessor에 넣어 두고 다음 평가부터 바로 씁니다(83행, 228–241행). 끝까지 없으면 PROPERTY_OR_FIELD_NOT_READABLE, 곧 "Property or field 'x' cannot be found on object of type 'y' - maybe not public or not valid?"입니다(289–295행, SpelMessage 63–64행).
- **
OpPlus**는 두 자식의 값을 받아 둘 다 숫자면 더하고(타입은BigDecimal>double>float>BigInteger>long>int순으로 넓은 쪽을 따릅니다), 한쪽이라도 문자열이면 이어 붙이고, 그 밖에는 컨텍스트의OperatorOverloader에 맡깁니다(70–156행). 예제의'a=' + a가a=7이 된 분기가 141–146행입니다.IntLiteral은 만들 때 정해진 값을 그대로 돌려줍니다(Literal50–53행,IntLiteral35–45행).
14편과 이어지는 자리 — TypeConverter
getValue(ctx, Integer.class)처럼 결과 타입을 지정하면 마지막에 ExpressionUtils.convertTypedValue가 컨텍스트의 TypeConverter를 부릅니다(49–64행). SpEL의 TypeConverter는 canConvert와 convertValue 둘뿐인 작은 인터페이스이고(TypeConverter 42행, 58행), 기본 구현 StandardTypeConverter는 그것을 14편의 ConversionService에 그대로 넘깁니다. 따로 주지 않으면 DefaultConversionService.getSharedInstance()이고(50–52행), convertValue는 conversionService.convert(...)를 부르고 ConversionException이 나면 TYPE_CONVERSION_ERROR로 감쌉니다(79–89행). 즉 SpEL은 자기만의 변환 규칙을 갖지 않고, 14편의 컨버터 52종을 그대로 씁니다.
헷갈리기 쉬운 곳
#this와#root는 다릅니다.#root는 루트 객체이고#this는 "지금 점 앞에 있는 객체"입니다(VariableReference72–95행). 예제의{1, 2, 3}.?[#this > 1]에서#this가 원소 하나하나였던 이유입니다. 셀렉션은 원소마다pushActiveContextObject와enterScope로 새 범위를 엽니다(Selection186–187행).Expression하나를 여러 컨텍스트에 돌려 쓸 때 조심할 것이 있습니다. 노드가 접근기와 메서드 실행기를 캐시하기 때문에, 같은Expression을 먼저StandardEvaluationContext로, 나중에 더 제한된SimpleEvaluationContext로 평가하면 느슨한 쪽에서 캐시된 것이 다시 쓰일 수 있습니다.Expression의 설명 주석이 이것을 지원하지 않는다고 적고, 컨텍스트 종류마다 따로 파싱하라고 합니다(30–45행). 4절의 예제가 컨텍스트마다 따로 파싱한 이유입니다.- 연산 횟수에도 상한이 있습니다. 노드가 일을 할 때마다
state.trackOperation()을 부르고, 횟수가 설정의 최대 연산 수(기본 10,000)에 이르면 예외입니다(ExpressionState260–263행,SpelParserConfiguration69행). 주석에@since 6.2.19입니다.
4. StandardEvaluationContext 와 SimpleEvaluationContext — 왜 둘인가
EvaluationContext의 설명 주석이 기본 구현이 둘이라고 적습니다(29–39행). 둘의 차이는 "무엇을 돌려주느냐"입니다.
**StandardEvaluationContext**는 묻는 것마다 리플렉션 기반 기본값을 채워 줍니다. 접근기 목록을 처음 물으면 ReflectivePropertyAccessor를, 생성자 해석기는 ReflectiveConstructorResolver를, 메서드 해석기는 ReflectiveMethodResolver를 하나씩 만들어 넣습니다(568–606행). TypeLocator와 TypeConverter도 처음 물을 때 StandardTypeLocator, StandardTypeConverter를 만듭니다(379–384행, 398–403행). BeanResolver만은 기본값이 없어 setBeanResolver로 넣어야 합니다(112행, 343–353행). 설명 주석은 이 컨텍스트가 "exposes the complete SpEL language, backed by reflection"이라 믿을 수 없는 곳에서 온 식을 평가하는 데 절대 쓰지 말라고 적어 두었습니다(67–73행). T(java.lang.Runtime)처럼 아무 클래스에나 닿을 수 있기 때문입니다.
SimpleEvaluationContext(4.3.15부터, 119행)는 그 반대입니다. 빌더로 만들면서 고른 것만 넣고, 안 고른 것은 비어 있거나 막혀 있습니다. 타입 참조가 막히는 자리가 이것입니다.
	private static final TypeLocator typeNotFoundTypeLocator = typeName -> {
		throw new SpelEvaluationException(SpelMessage.TYPE_NOT_FOUND, typeName);
	};
	// ...
	/**
	 * {@code SimpleEvaluationContext} does not support use of type references.
	 * @return {@code TypeLocator} implementation that raises a
	 * {@link SpelEvaluationException} with {@link SpelMessage#TYPE_NOT_FOUND}
	 */
	@Override
	public TypeLocator getTypeLocator() {
		return typeNotFoundTypeLocator;
	}
T(…)는 파싱은 되지만, 평가에서 TypeReference가 TypeLocator에게 물었을 때 무조건 TYPE_NOT_FOUND를 던지는 로케이터가 대답하는 것입니다. 나머지도 같은 식입니다.
| 묻는 것 | StandardEvaluationContext |
SimpleEvaluationContext |
|---|---|---|
PropertyAccessor |
ReflectivePropertyAccessor |
빌더에 준 것만. forReadOnlyDataBinding()은 DataBindingPropertyAccessor(읽기 전용) 하나 (356–358행) |
MethodResolver |
ReflectiveMethodResolver |
기본 없음. withInstanceMethods()를 부르면 DataBindingMethodResolver (464–467행) |
ConstructorResolver |
ReflectiveConstructorResolver |
없음 (인터페이스 기본값인 빈 목록) |
TypeLocator |
StandardTypeLocator |
항상 TYPE_NOT_FOUND를 던지는 것 |
BeanResolver |
null (넣으면 쓴다) |
항상 null (211–213행) |
TypeConverter |
StandardTypeConverter |
StandardTypeConverter (바꿀 수 있다) (163행) |
대입 = ++ -- |
허용 | forReadOnlyDataBinding()은 막음 (304–306행, Assign 44–45행) |
| 컴파일(5절) | 허용 | 기본 불허 (317–319행) |
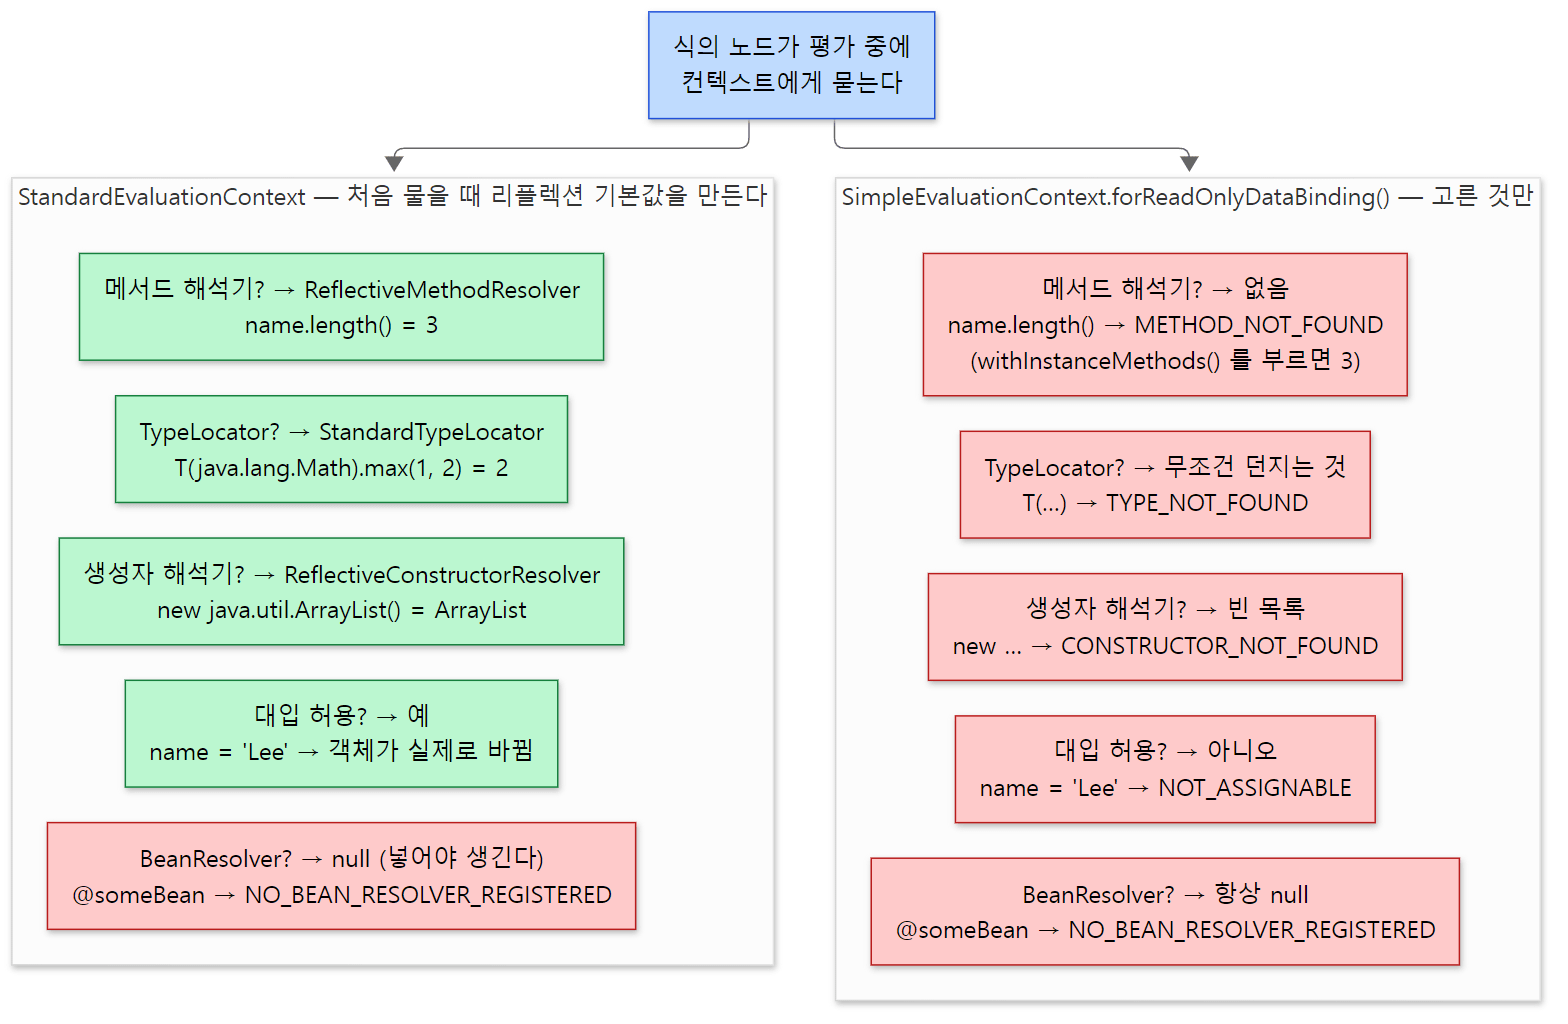 같은 질문에 두 컨텍스트가 다르게 대답합니다. 초록 칸은 식이 계산된 것, 빨간 칸은 막힌 것이고, 결과는 아래 예제의 실제 출력에서 가져왔습니다.
DataBindingPropertyAccessor는 ReflectivePropertyAccessor의 하위 클래스인데, Object와 Class에 선언된 메서드와 ClassLoader 대상은 후보에서 빼서 getClass() 같은 "기술적인" 속성에 닿지 못하게 합니다(50행, 61–65행). DataBindingMethodResolver도 같은 제한에 더해 static 메서드를 뺍니다(59–65행). 빌더는 아예 날것의 ReflectivePropertyAccessor나 ReflectiveMethodResolver를 넣으려 하면 IllegalArgumentException을 던집니다(336–344행, 445–454행).
둘인 이유는 결국 용도입니다. 컨테이너 설정처럼 Spring 자신이 쓰는 곳에서는 T()도 @빈도 new도 필요하니 Standard를, 폼 값이나 필터 조건처럼 사용자가 준 데이터를 다루는 곳에서는 속성 읽기 정도만 열어 둔 Simple을 씁니다. Simple의 설명 주석도 "data binding scenarios"가 목표라고 적습니다(44–46행).
예제: 같은 식을 세 컨텍스트에서
Person(getter·setter name)을 루트로, 식 여섯 개를 StandardEvaluationContext, SimpleEvaluationContext.forReadOnlyDataBinding(), 거기에 withInstanceMethods()를 더한 것에서 돌렸습니다. 실패하면 SpelEvaluationException.getMessageCode()의 상수 이름을 찍었습니다. Spring Framework 7.0.9로 실행했습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
EvaluationContext standard = new StandardEvaluationContext();
EvaluationContext readOnly = SimpleEvaluationContext.forReadOnlyDataBinding().build();
EvaluationContext withMethods = SimpleEvaluationContext.forReadOnlyDataBinding().withInstanceMethods().build();

System.out.printf("%-28s | %-22s | %-30s | %s%n", "식", "Standard", "Simple(readOnly)", "Simple + withInstanceMethods");
for (String text : List.of("name", "name.length()", "T(java.lang.Math).max(1, 2)",
        "new java.util.ArrayList()", "@someBean", "name = 'Lee'")) {
    // 같은 Expression 을 두 종류의 컨텍스트에 번갈아 쓰지 말라고 소스가 경고하므로 컨텍스트마다 따로 파싱한다
    System.out.printf("%-28s | %-22s | %-30s | %s%n", text,
            eval(parser.parseExpression(text), standard, kim),
            eval(parser.parseExpression(text), readOnly, kim),
            eval(parser.parseExpression(text), withMethods, kim));
}
System.out.println("name 은 지금 " + kim.getName());
출력입니다.
식                            | Standard               | Simple(readOnly)               | Simple + withInstanceMethods
name                         | Kim                    | Kim                            | Kim
name.length()                | 3                      | METHOD_NOT_FOUND               | 3
T(java.lang.Math).max(1, 2)  | 2                      | TYPE_NOT_FOUND                 | TYPE_NOT_FOUND
new java.util.ArrayList()    | ArrayList              | CONSTRUCTOR_NOT_FOUND          | CONSTRUCTOR_NOT_FOUND
@someBean                    | NO_BEAN_RESOLVER_REGISTERED | NO_BEAN_RESOLVER_REGISTERED    | NO_BEAN_RESOLVER_REGISTERED
name = 'Lee'                 | Lee                    | NOT_ASSIGNABLE                 | NOT_ASSIGNABLE
name 은 지금 Lee
표와 맞아떨어집니다. 메서드 해석기가 없어 name.length()가 METHOD_NOT_FOUND였다가 withInstanceMethods()로 살아나고, T()·new는 끝까지 막히고, 대입은 NOT_ASSIGNABLE입니다. 마지막 줄은 Standard에서의 name = 'Lee'가 실제로 객체를 바꿨다는 뜻입니다.
헷갈리기 쉬운 곳
@빈은Standard에서도 그냥은 안 됩니다.BeanReference는 컨텍스트의BeanResolver가null이면NO_BEAN_RESOLVER_REGISTERED를 던집니다(60–66행). 컨테이너 안에서@otherBean이 되는 것은 6절에서BeanFactoryResolver를 넣어 주기 때문입니다.Simple이 곧 안전하다는 뜻은 아닙니다. 설명 주석은 제한이 "best-effort"이며, 읽기 전용이라는 것은 대입만 막을 뿐 getter가 부작용이 없다는 보장은 아니라고 적습니다(91–98행).ReflectivePropertyAccessor주석의 예는File.delete()가 getter와 같은 모양이라는 것입니다(65–68행).SpelExpression.getValue()에 컨텍스트를 안 주면Standard입니다.getEvaluationContext()가 없으면new StandardEvaluationContext()를 만들어 둡니다(115–120행).
5. 컴파일 모드 — 트리를 바이트코드로
3절의 방식은 평가할 때마다 트리를 걷고 리플렉션을 부릅니다. 같은 식을 수만 번 평가하는 곳(주석은 Spring Integration을 예로 듭니다)을 위해 4.1부터 컴파일러가 있습니다(SpelCompilerMode 23–38행). 모드는 셋입니다.
| 모드 | 동작 | 위치 |
|---|---|---|
OFF |
컴파일하지 않는다. 기본값 | 46–51행 |
IMMEDIATE |
가능한 한 빨리 컴파일(주석은 "보통 첫 해석 뒤", 코드는 아래에서 보듯 2번째 해석 뒤). 컴파일된 식이 실패하면 예외가 호출자에게 간다 | 53–61행 |
MIXED |
여러 번 해석한 뒤 컴파일. 실패하면 조용히 해석으로 돌아가고 나중에 다시 시도 | 63–78행 |
모드는 SpelParserConfiguration에 들어가고, 지정하지 않으면 시스템 프로퍼티 spring.expression.compiler.mode를 보고, 그것도 없으면 OFF입니다(114행, 147–153행, 566행). 이 커밋(7.1)에서는 생성자들이 @Deprecated가 되고 SpelParserConfiguration.builder()를 쓰라고 합니다(30–36행, 210–213행).
언제 컴파일하나 — checkCompile
3절의 getValue 마지막 줄이 checkCompile이었습니다.
	private void checkCompile(ExpressionState expressionState) {
		this.interpretedCount.incrementAndGet();
		if (!expressionState.getEvaluationContext().isCompilationSupported()) {
			return;
		}
		SpelCompilerMode compilerMode = expressionState.getConfiguration().getCompilerMode();
		if (compilerMode != SpelCompilerMode.OFF) {
			if (compilerMode == SpelCompilerMode.IMMEDIATE) {
				if (this.interpretedCount.get() > 1) {
					compileExpression();
				}
			}
			else {
				// compilerMode = SpelCompilerMode.MIXED
				if (this.interpretedCount.get() > INTERPRETED_COUNT_THRESHOLD) {
					compileExpression();
				}
			}
		}
	}
해석한 횟수를 세어, IMMEDIATE는 2번째 해석이 끝난 뒤, MIXED는 INTERPRETED_COUNT_THRESHOLD = 100번을 넘긴 뒤 컴파일합니다(66행). 그 앞의 isCompilationSupported() 검사는 @since 7.0.9로, 4절의 SimpleEvaluationContext가 false를 돌려주는 자리입니다(EvaluationContext 188–208행).
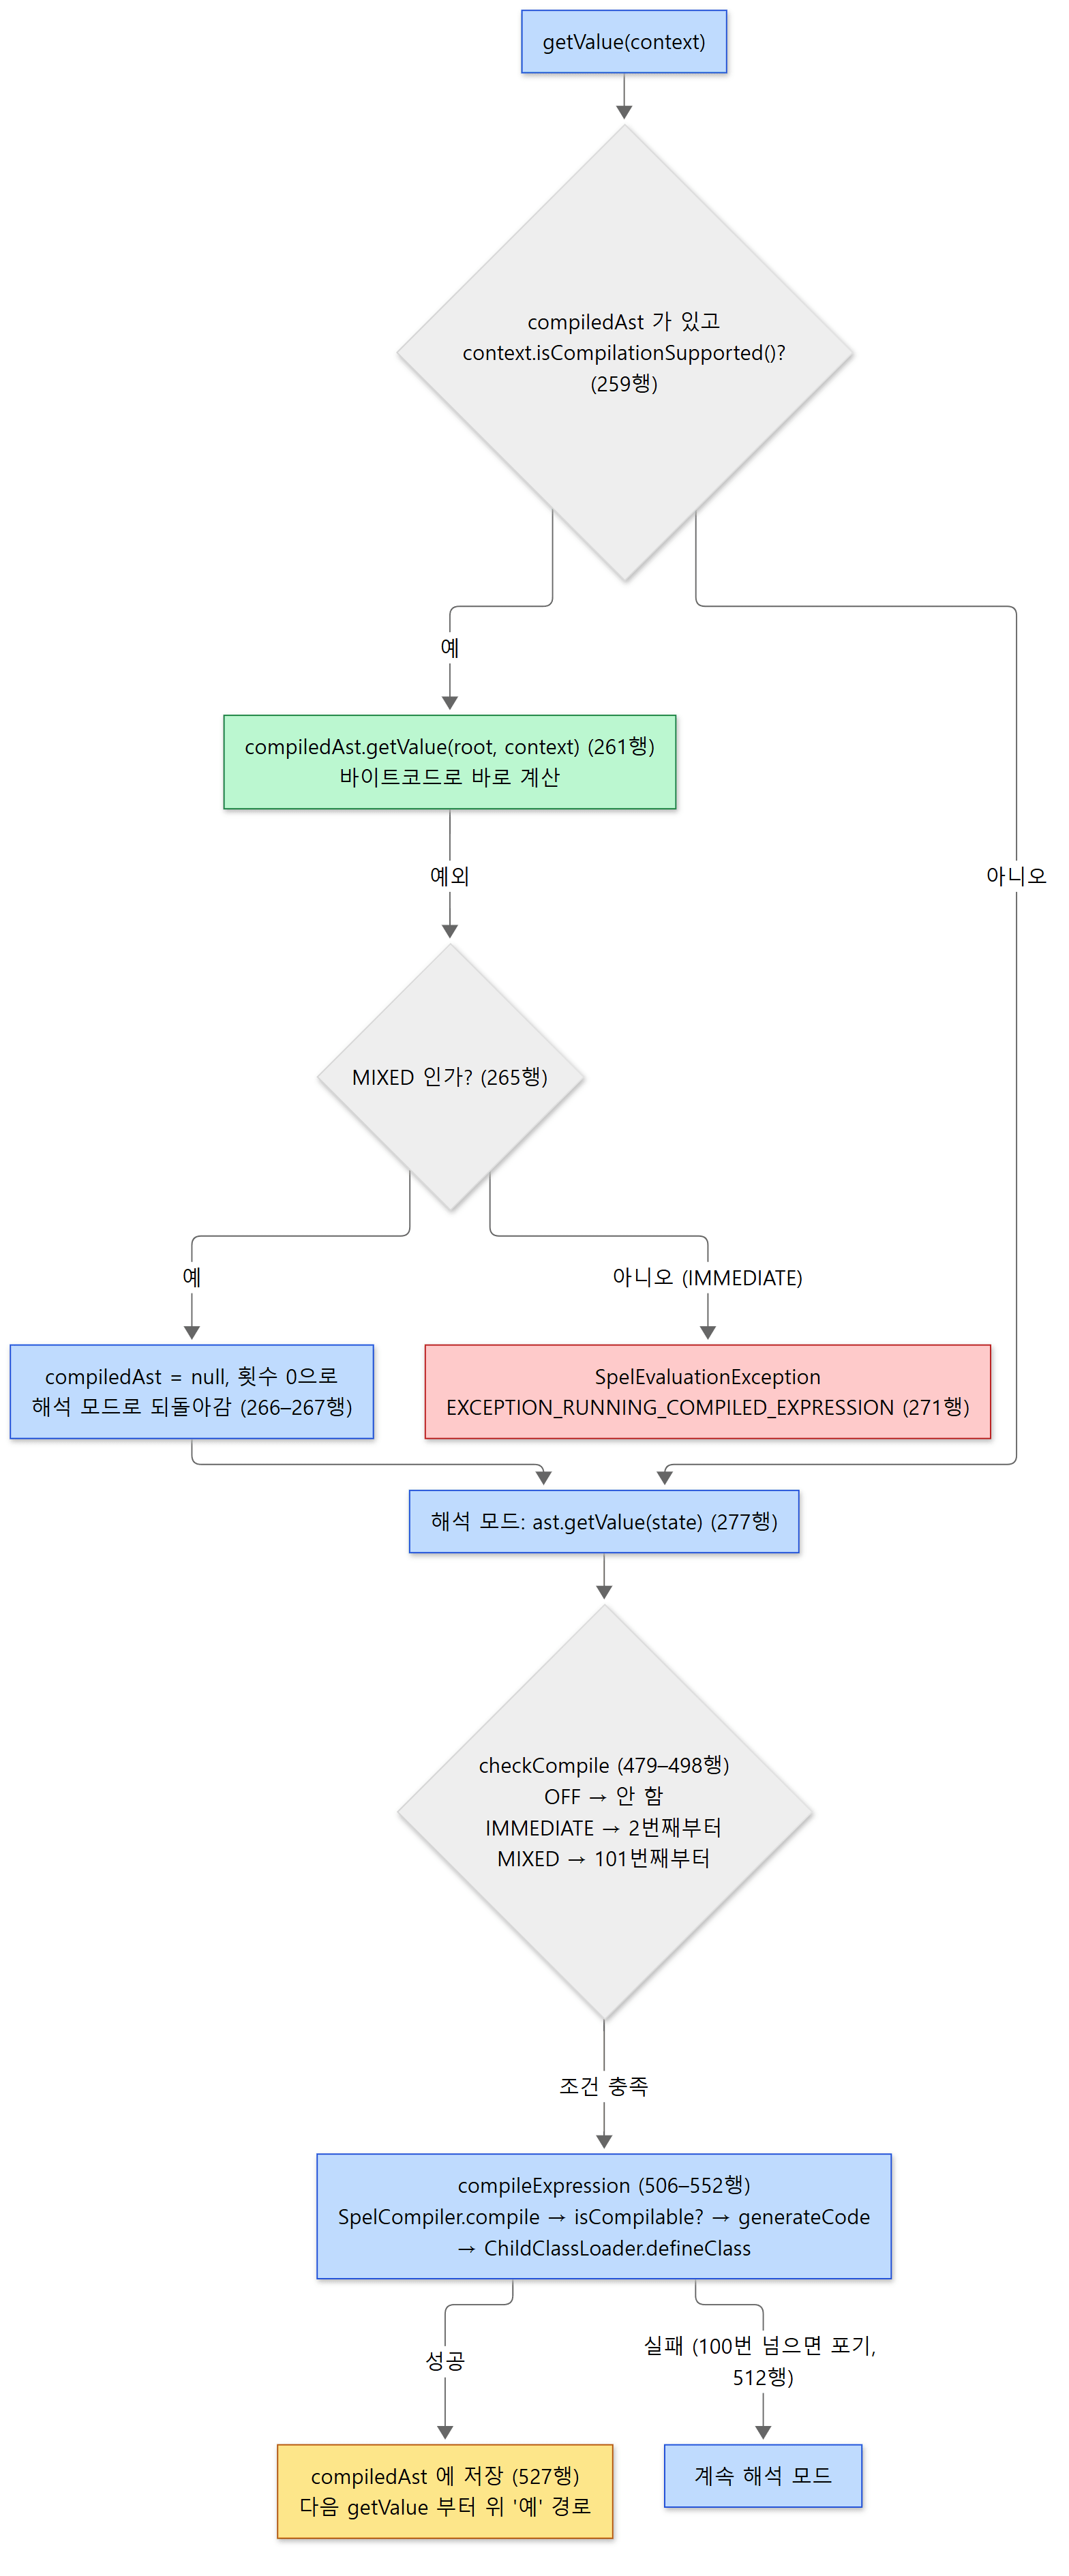 노란 상자가 컴파일 결과를 담는 자리, 빨간 상자가
IMMEDIATE에서 호출자에게 가는 예외입니다. 줄 번호는 SpelExpression 기준입니다.
무엇이 만들어지나 — SpelCompiler
compileExpression()은 클래스 로더마다 하나씩 있는 SpelCompiler를 얻어 compile(ast)를 부릅니다(506–552행, SpelCompiler 248–256행). 컴파일러는 먼저 루트 노드에 isCompilable()을 묻고, 된다면 createExpressionClass로 클래스를 만듭니다(101–122행).
	private @Nullable Class<? extends CompiledExpression> createExpressionClass(SpelNodeImpl expressionToCompile) {
		// Create class outline:
		// org.springframework.expression.spel.generated.CompiledExpression##### extends org.springframework.expression.spel.CompiledExpression
		String className = "org/springframework/expression/spel/generated/CompiledExpression" + getNextSuffix();
		String evaluationContextClass = "org/springframework/expression/EvaluationContext";
		ClassWriter cw = new ExpressionClassWriter();
		cw.visit(V17, ACC_PUBLIC, className, null, "org/springframework/expression/spel/CompiledExpression", null);
		// ...
		// Create getValue() method
		mv = cw.visitMethod(ACC_PUBLIC, "getValue",
				"(Ljava/lang/Object;L" + evaluationContextClass + ";)Ljava/lang/Object;", null,
				new String[] {"org/springframework/expression/EvaluationException"});
		mv.visitCode();

		CodeFlow cf = new CodeFlow(className, cw);

		// Ask the expression AST to generate the body of the method
		try {
			expressionToCompile.generateCode(mv, cf);
		}
		catch (IllegalStateException ex) {
			// ...
			return null;
		}
		// ...
		byte[] data = cw.toByteArray();
		// ...
		return loadClass(StringUtils.replace(className, "/", "."), data);
	}
ASM의 ClassWriter로 CompiledExpression을 상속한 클래스를 하나 만들고(CompiledExpression은 getValue(target, context) 추상 메서드 하나뿐입니다, 32–39행), 그 getValue의 본문을 루트 노드의 generateCode가 채웁니다. 노드는 자기 자식의 generateCode를 부르므로 트리를 걷는 것은 같지만, 이번에는 값을 내는 것이 아니라 값을 내는 바이트코드를 쓰는 것입니다. 예를 들어 OpPlus는 문자열이면 StringBuilder.append를, 숫자면 IADD 같은 명령을 씁니다(241–275행). 만든 바이트 배열은 전용 ChildClassLoader로 정의하는데, 클래스가 쌓여 메모리를 붙잡지 않도록 100개마다 로더를 새로 만듭니다(71행, 221–237행).
왜 먼저 해석해야 하나 — exitTypeDescriptor
SpelNode.isCompilable()의 기본값은 false이고, 노드마다 "결과 타입이 알려졌고 자식도 컴파일 가능하면"으로 덮어씁니다(125–127행). 그 "결과 타입"이 SpelNodeImpl.exitTypeDescriptor인데, 설명 주석대로 리터럴은 만들 때 알지만 속성 접근이나 메서드 호출은 한 번 평가해 봐야 압니다(63–72행). 문자열 name만 보고는 그것이 String인지 int인지 알 수 없기 때문입니다. PropertyOrFieldReference.isCompilable은 3절에서 캐시한 접근기가 CompilablePropertyAccessor이고 그것이 컴파일 가능하다고 할 때만 true이고(369–372행), ReflectivePropertyAccessor가 만드는 최적 접근기는 멤버와 그 선언 클래스가 둘 다 public일 때만 그렇다고 답합니다(698–701행). MethodReference는 거기에 더해 프록시 대상이 아니고, 인자 변환이 일어나지 않았고, 메서드가 public일 것을 요구합니다(360–378행). 컴파일된 코드에는 검사가 없어서, 해석 때 본 타입과 다른 객체가 오면 ClassCastException처럼 실패합니다. SpelCompiler의 설명 주석이 그래서 기본으로 켜지 않는다고 적어 두었습니다(46–61행).
예제: 컴파일되는 순간 보기
compiledAst는 private 필드라 리플렉션으로 들여다봤습니다. Spring Framework 7.0.9로 실행했고, 7.0.9에는 builder()가 아직 없어 생성자를 썼습니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
SpelParserConfiguration config = new SpelParserConfiguration(
        SpelCompilerMode.IMMEDIATE, CompileExample.class.getClassLoader());
SpelExpression expr = new SpelExpressionParser(config).parseRaw("name.length() * 2");
Person kim = new Person("Kim");                              // public static class, public getName()
for (int i = 1; i <= 3; i++) {
    System.out.println("① IMMEDIATE, " + i + "번째 getValue = " + expr.getValue(kim)
            + ", compiledAst = " + compiledClassName(expr));
}

SpelExpression plain = new SpelExpressionParser().parseRaw("name.length() * 2");   // OFF
plain.getValue(kim); plain.getValue(kim);
System.out.println("② OFF, 2번 해석 뒤 compiledAst = " + compiledClassName(plain));
System.out.println("   compileExpression() = " + plain.compileExpression() + ", compiledAst = " + compiledClassName(plain));

SpelExpression fresh = new SpelExpressionParser().parseRaw("name.length() * 2");
System.out.println("③ 해석 전 compileExpression() = " + fresh.compileExpression());

SpelExpression simple = new SpelExpressionParser(config).parseRaw("name.length() * 2");
SimpleEvaluationContext readOnly = SimpleEvaluationContext.forReadOnlyDataBinding().withInstanceMethods().build();
for (int i = 1; i <= 3; i++) { simple.getValue(readOnly, kim); }
System.out.println("④ IMMEDIATE + SimpleEvaluationContext, 3번 뒤 compiledAst = " + compiledClassName(simple));
출력입니다.
① IMMEDIATE, 1번째 getValue = 6, compiledAst = null
① IMMEDIATE, 2번째 getValue = 6, compiledAst = org.springframework.expression.spel.generated.CompiledExpression00001
① IMMEDIATE, 3번째 getValue = 6, compiledAst = org.springframework.expression.spel.generated.CompiledExpression00001
② OFF, 2번 해석 뒤 compiledAst = null
   compileExpression() = true, compiledAst = org.springframework.expression.spel.generated.CompiledExpression00002
③ 해석 전 compileExpression() = false
④ IMMEDIATE + SimpleEvaluationContext, 3번 뒤 compiledAst = null
①은 checkCompile의 > 1 그대로 2번째 해석 뒤에 CompiledExpression00001이 생겼습니다. 클래스 이름의 다섯 자리 번호가 위 코드의 getNextSuffix()입니다(124–126행). ②는 OFF라도 compileExpression()을 직접 부르면 된다는 것, ③은 한 번도 해석하지 않은 식은 exitTypeDescriptor가 없어 컴파일할 수 없다는 것, ④는 SimpleEvaluationContext에서는 IMMEDIATE여도 컴파일되지 않는다는 것입니다.
헷갈리기 쉬운 곳
- 컴파일 모드를 켰는데 안 되는 식이 있습니다. 위에서 본 조건 때문입니다.
public이 아닌 클래스의 getter,#this를 쓰는 셀렉션·프로젝션(VariableReference의 주석이 "not a compilable expression"이라고 적습니다, 77–83행), 인자 변환이 필요한 메서드 호출, 그리고SimpleEvaluationContext입니다. 이때MIXED는 조용히 해석을 계속하고, 100번 넘게 실패하면 더 시도하지 않습니다(69행, 512–515행). - 컨테이너의
#{…}는 컴파일되지 않습니다(기본 설정에서). 6절의StandardBeanExpressionResolver는 설정에 클래스 로더와 최대 길이만 넣고 모드는 건드리지 않으므로(121–124행) 시스템 프로퍼티가 없으면OFF입니다. - 컴파일된 식이 실패하면 모드에 따라 결과가 다릅니다.
getValue앞부분에서MIXED면compiledAst를 지우고 해석으로 돌아가지만,IMMEDIATE면EXCEPTION_RUNNING_COMPILED_EXPRESSION을 던집니다(258–274행).
6. 컨테이너와의 연결 — @Value("#{…}") 가 지나는 길
여기까지는 spring-expression 혼자였습니다. 컨테이너가 이것을 꺼내 쓰는 자리를 봅니다.
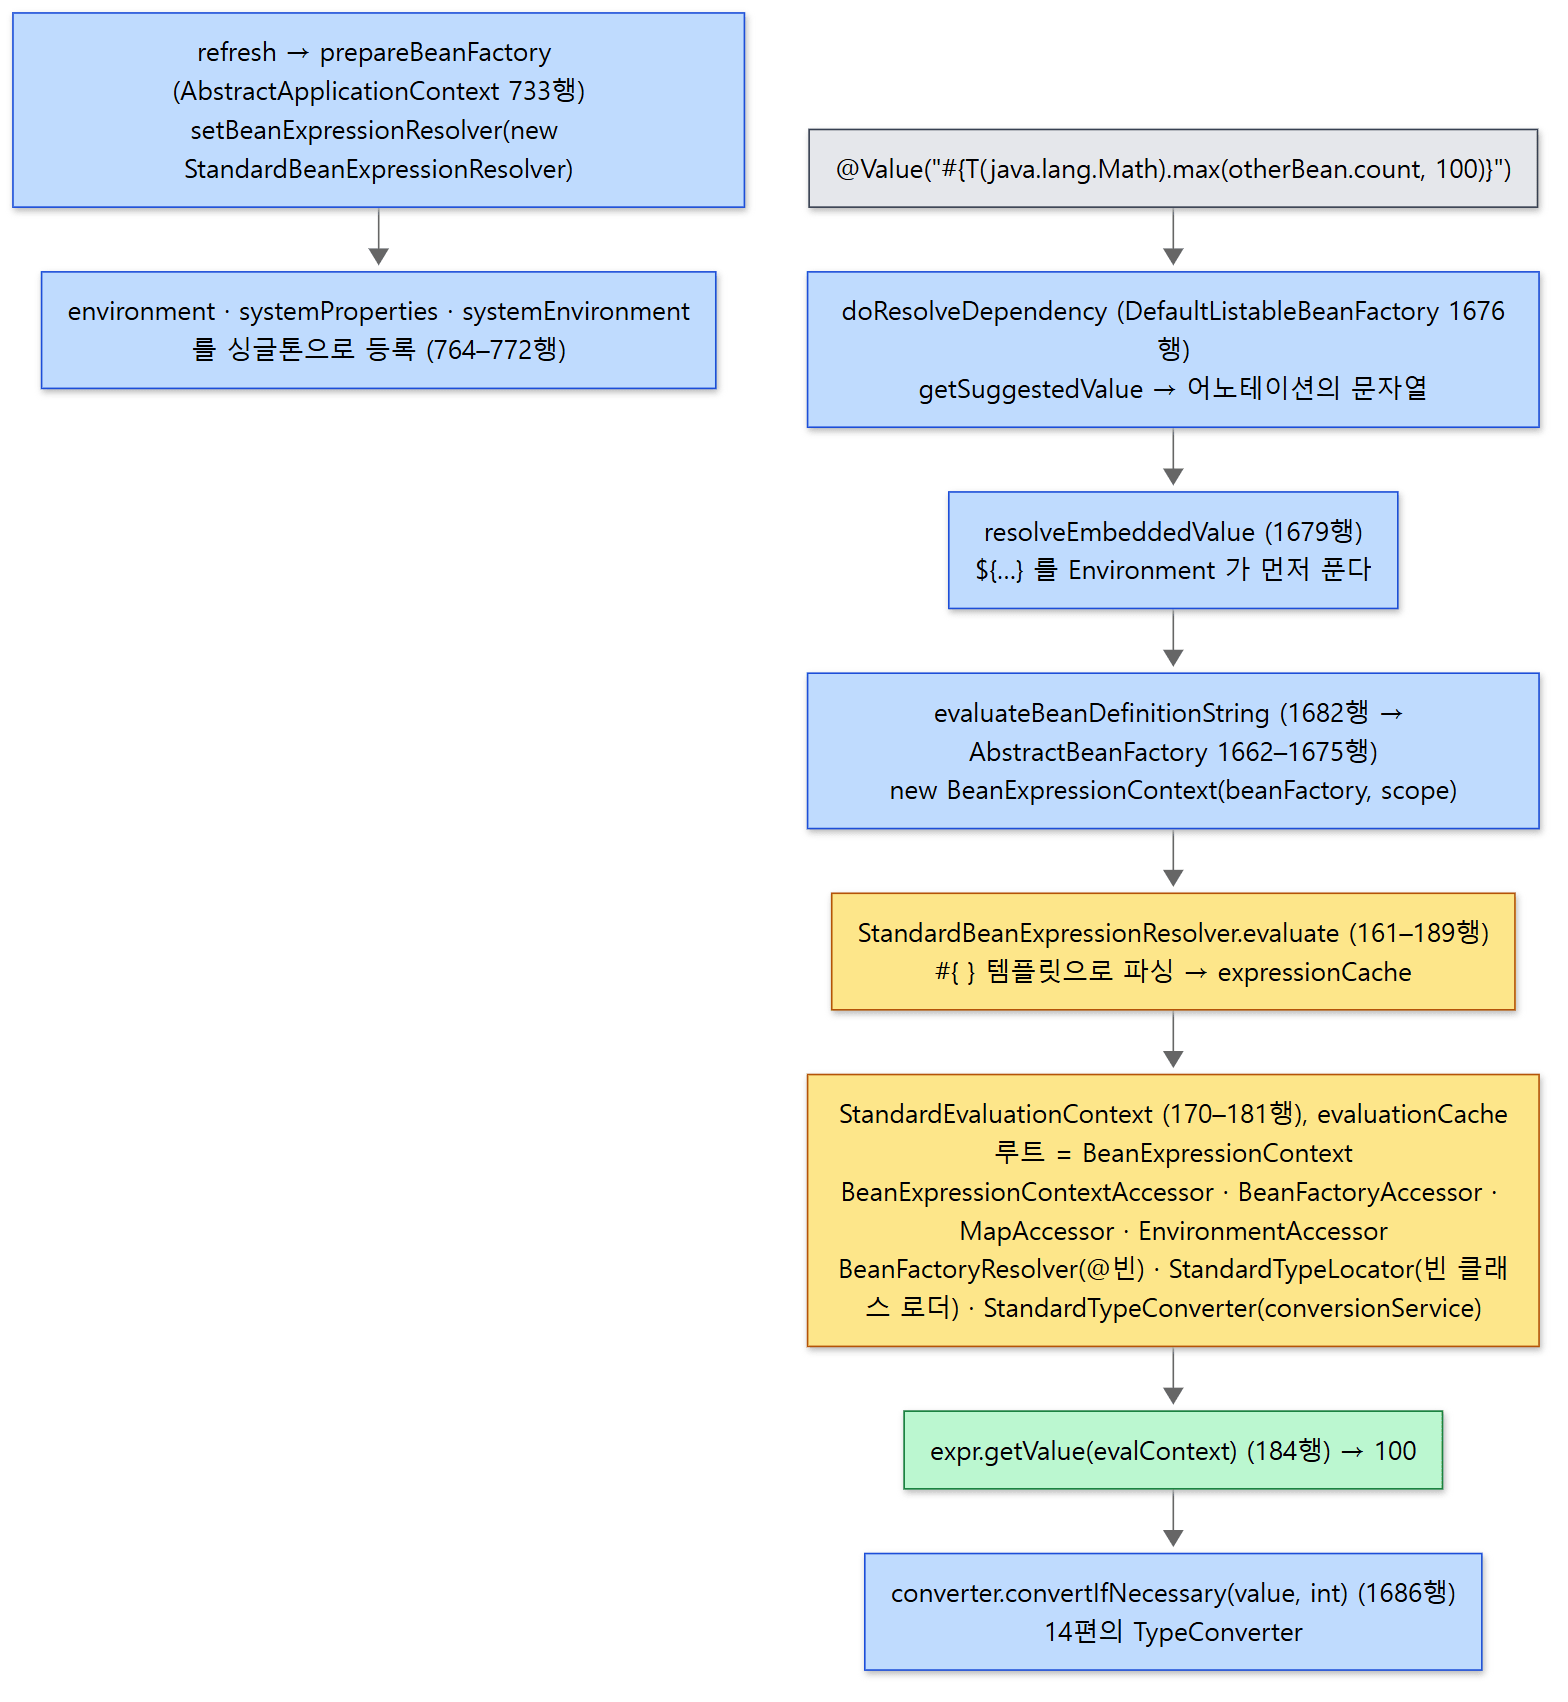 왼쪽이 컨테이너를 켤 때, 오른쪽이
@Value 하나를 넣을 때입니다. 노란 상자가 캐시입니다.
① 켤 때: 해석기를 끼우고 이름 셋을 등록한다
7편의 refresh() 세 번째 단계 prepareBeanFactory의 두 번째 줄입니다.
	protected void prepareBeanFactory(ConfigurableListableBeanFactory beanFactory) {
		// Tell the internal bean factory to use the context's class loader etc.
		beanFactory.setBeanClassLoader(getClassLoader());
		beanFactory.setBeanExpressionResolver(new StandardBeanExpressionResolver(beanFactory.getBeanClassLoader()));
		// ...
		// Register default environment beans.
		if (!beanFactory.containsLocalBean(ENVIRONMENT_BEAN_NAME)) {
			beanFactory.registerSingleton(ENVIRONMENT_BEAN_NAME, getEnvironment());
		}
		if (!beanFactory.containsLocalBean(SYSTEM_PROPERTIES_BEAN_NAME)) {
			beanFactory.registerSingleton(SYSTEM_PROPERTIES_BEAN_NAME, getEnvironment().getSystemProperties());
		}
		if (!beanFactory.containsLocalBean(SYSTEM_ENVIRONMENT_BEAN_NAME)) {
			beanFactory.registerSingleton(SYSTEM_ENVIRONMENT_BEAN_NAME, getEnvironment().getSystemEnvironment());
		}
		// ...
	}
#{systemProperties['os.name']}의 systemProperties는 마법의 이름이 아니라 여기서 등록된 싱글톤 빈의 이름입니다. 상수는 "environment", "systemProperties", "systemEnvironment"입니다(ConfigurableApplicationContext 90행, 96행, 102행). StandardBeanExpressionResolver의 설명 주석도 "All beans in the containing BeanFactory are made available as predefined variables with their common bean name"이라고 적습니다(49–51행). 순수 BeanFactory에는 해석기가 없어서(beanExpressionResolver 필드가 null, AbstractBeanFactory 133행) #{…}가 문자열 그대로 남습니다. ApplicationContext가 끼워 주는 것입니다.
② @Value 하나를 넣을 때: ${} 먼저, #{} 다음
14편에서 본 doResolveDependency의 2단계입니다.
			// Step 2: pre-defined value or expression, for example, from @Value
			Object value = getAutowireCandidateResolver().getSuggestedValue(descriptor);
			if (value != null) {
				if (value instanceof String strValue) {
					String resolvedValue = resolveEmbeddedValue(strValue);
					BeanDefinition bd = (beanName != null && containsBean(beanName) ?
							getMergedBeanDefinition(beanName) : null);
					value = evaluateBeanDefinitionString(resolvedValue, bd);
				}
				TypeConverter converter = (typeConverter != null ? typeConverter : getTypeConverter());
				try {
					return converter.convertIfNecessary(value, type, descriptor.getTypeDescriptor());
				}
순서가 셋입니다. **resolveEmbeddedValue**가 등록된 StringValueResolver들을 차례로 돌려 ${…}를 풉니다(AbstractBeanFactory 966–978행). 아무도 등록하지 않았으면 finishBeanFactoryInitialization이 Environment.resolvePlaceholders를 부르는 기본 해석기를 하나 넣어 둡니다(AbstractApplicationContext 961–966행). 그다음 **evaluateBeanDefinitionString**이 #{…}를 계산하고, 마지막으로 14편의 **convertIfNecessary**가 결과를 필드 타입에 맞춥니다.
	protected @Nullable Object evaluateBeanDefinitionString(@Nullable String value, @Nullable BeanDefinition beanDefinition) {
		if (this.beanExpressionResolver == null) {
			return value;
		}

		Scope scope = null;
		if (beanDefinition != null) {
			String scopeName = beanDefinition.getScope();
			if (scopeName != null) {
				scope = getRegisteredScope(scopeName);
			}
		}
		return this.beanExpressionResolver.evaluate(value, new BeanExpressionContext(this, scope));
	}
BeanExpressionContext는 빈 팩토리와 스코프를 묶은 작은 객체로, containsObject·getObject가 빈 팩토리를 먼저 보고 없으면 스코프의 resolveContextualObject를 봅니다(29–66행). 이것이 식의 루트 객체가 됩니다. XML이나 PropertyValues로 들어온 문자열도 BeanDefinitionValueResolver가 같은 evaluateBeanDefinitionString을 부르고(311–313행), 심지어 빈의 클래스 이름도 식일 수 있습니다(주석에 "supported as of 4.2", 1617–1622행).
③ StandardBeanExpressionResolver.evaluate — 접근기 넷과 캐시 둘
	@Override
	public @Nullable Object evaluate(@Nullable String value, BeanExpressionContext beanExpressionContext) throws BeansException {
		if (!StringUtils.hasLength(value)) {
			return value;
		}
		try {
			Expression expr = this.expressionCache.computeIfAbsent(value, expression ->
					this.expressionParser.parseExpression(expression, this.beanExpressionParserContext));
			EvaluationContext evalContext = this.evaluationCache.computeIfAbsent(beanExpressionContext, bec -> {
					ConfigurableBeanFactory beanFactory = bec.getBeanFactory();
					StandardEvaluationContext sec = new StandardEvaluationContext(bec);
					sec.addPropertyAccessor(new BeanExpressionContextAccessor());
					sec.addPropertyAccessor(new BeanFactoryAccessor());
					sec.addPropertyAccessor(new org.springframework.expression.spel.support.MapAccessor());
					sec.addPropertyAccessor(new EnvironmentAccessor());
					sec.setBeanResolver(new BeanFactoryResolver(beanFactory));
					sec.setTypeLocator(new StandardTypeLocator(beanFactory.getBeanClassLoader()));
					sec.setTypeConverter(new StandardTypeConverter(() -> {
						ConversionService cs = beanFactory.getConversionService();
						return (cs != null ? cs : DefaultConversionService.getSharedInstance());
					}));
					customizeEvaluationContext(sec);
					return sec;
				});
			return expr.getValue(evalContext);
		}
		catch (Throwable ex) {
			throw new BeanExpressionException("Expression parsing failed", ex);
		}
	}
이 메서드가 1~4절을 전부 꿰어 줍니다.
- 파싱은 템플릿 모드입니다.
beanExpressionParserContext는isTemplate()이true이고 접두사#{, 접미사}입니다(72–75행, 88–101행). 템플릿이면TemplateAwareExpressionParser.parseExpression이 1절의doParseExpression대신parseTemplate으로 갑니다(55–65행). 그것은 문자열을#{와}기준으로 잘라, 바깥 글자는LiteralExpression으로, 안쪽만 SpEL로 파싱하고, 조각이 둘 이상이면CompositeStringExpression으로 묶습니다(68–80행, 100–143행). 합쳐진 식의 값은 각 조각을 문자열로 이은 것입니다(CompositeStringExpression70–79행). 1절에서#{가 토큰이 아니라고 한 이유가 이것입니다. 접두사·접미사만 다른 같은 틀이TemplateParserContext입니다(38–50행). #{가 하나도 없으면 문자열 전체가LiteralExpression하나가 되어(136–139행) 값이 그대로 돌아옵니다.@Value("8080")도 이 메서드를 지나가지만 아무 일도 일어나지 않는 것입니다. 이 글 첫머리에서 ""8080"이면 그냥 지나간다"고 한 것의 실체입니다.- 캐시가 둘입니다. 같은 문자열은
expressionCache에서 파싱된Expression을 다시 쓰고(84행), 같은BeanExpressionContext(같은 빈 팩토리·같은 스코프,equals가 그렇게 정의되어 있습니다, 69–73행)는evaluationCache에서 같은StandardEvaluationContext를 다시 씁니다(86행). - 루트는
BeanExpressionContext이고 접근기가 넷 더 붙습니다.otherBean.count의otherBean은 루트의 속성을 읽는 것인데,BeanExpressionContextAccessor가 "대상이BeanExpressionContext이고containsObject(name)이면 읽을 수 있다"고 답해getObject로 빈을 돌려줍니다(36–45행). 빈 이름이 곧 속성 이름이 되는 장치입니다.BeanFactoryAccessor는 대상이BeanFactory일 때 같은 일을 하고(36–45행),MapAccessor는Map의 키를 속성처럼(MapAccessor64–70행),EnvironmentAccessor는Environment.getProperty(name)을 속성처럼 읽게 합니다(35–54행).addPropertyAccessor는 기본ReflectivePropertyAccessor앞에 끼웁니다(193–195행, 608–610행). - **
@otherBean은BeanFactoryResolver**가beanFactory.getBean(beanName)으로 풉니다(48–55행). 4절에서 비어 있던 자리입니다. T()는 빈 클래스 로더로, 변환은 컨테이너의conversionService로 합니다.StandardTypeLocator에beanFactory.getBeanClassLoader()를 주고,StandardTypeConverter에는 14편 6절에서 끼운ConversionService가 있으면 그것을, 없으면 공유DefaultConversionService를 주는Supplier를 넘깁니다.
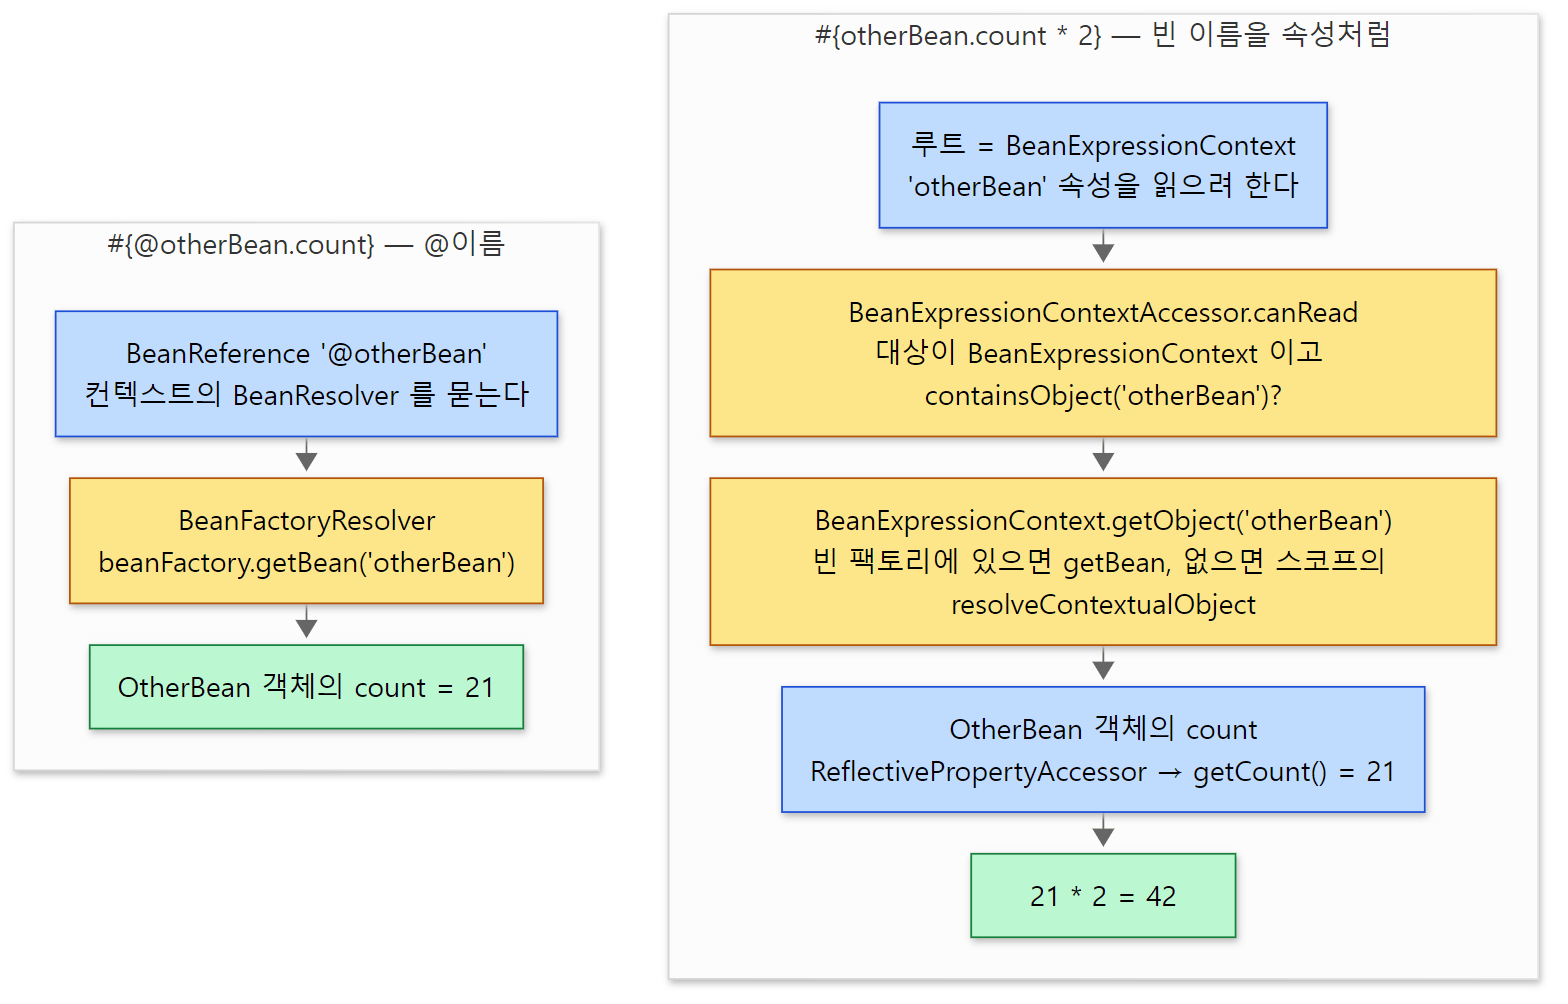
otherBean(이름)과 @otherBean(빈 참조)은 다른 길로 같은 빈에 닿습니다. 노란 칸이 컨테이너가 끼운 접근기·해석기이고, 42와 21은 아래 예제의 실제 출력입니다.
예제: @Value 여덟 개
Spring Framework 7.0.9로 실행했습니다. OtherBean은 getCount()가 21을 돌려주는 빈입니다.
// 이 글을 위해 쓴 예제입니다 (Spring의 소스가 아닙니다)
public static class Holder {
    @Value("${os.name}") String placeholder;                          // ${…}: Environment 가 푼다 (SpEL 아님)
    @Value("#{systemProperties['os.name']}") String spel;             // #{…}: SpEL 이 계산한다
    @Value("#{environment['os.name']}") String viaEnvironment;        // environment 빈 + EnvironmentAccessor
    @Value("#{'${os.name}'.toUpperCase()}") String both;              // ${…} 를 먼저 풀고, 그 결과를 SpEL 이 계산
    @Value("#{otherBean.count * 2}") int viaName;                     // 빈 이름이 곧 속성 이름
    @Value("#{@otherBean.count}") int viaBeanRef;                     // @이름: BeanResolver 를 거친다
    @Value("#{T(java.lang.Math).max(otherBean.count, 100)}") int typeRef;   // 컨테이너의 컨텍스트는 T() 도 허용한다
    @Value("port #{8080 + 1}") String template;                       // 글자와 섞인 템플릿: 결과는 문자열
}
출력입니다.
${os.name}                       = Windows 11
#{systemProperties['os.name']}   = Windows 11
#{environment['os.name']}        = Windows 11
#{'${os.name}'.toUpperCase()}    = WINDOWS 11
#{otherBean.count * 2}           = 42
#{@otherBean.count}              = 21
#{T(java.lang.Math).max(...)}    = 100
port #{8080 + 1}                 = port 8081
BeanExpressionResolver = StandardBeanExpressionResolver
네 번째 줄이 ②의 순서를 보여 줍니다. ${os.name}이 먼저 Windows 11로 바뀌어 #{'Windows 11'.toUpperCase()}가 된 뒤 SpEL이 계산했습니다. otherBean.count * 2와 T(java.lang.Math).max(…)가 되는 것은 4절 표의 Standard 열 그대로이고, 마지막 줄의 port 8081이 템플릿의 CompositeStringExpression입니다. typeRef의 결과 100은 Integer로 나와 14편의 convertIfNecessary를 거쳐 int 필드에 들어갔습니다.
헷갈리기 쉬운 곳
${}안에#{}를 넣는 순서는 소스에 없습니다. 위 코드의 순서는resolveEmbeddedValue→evaluateBeanDefinitionString으로 고정이라,${…}가 먼저 풀리고 그 결과를 SpEL이 받습니다. 반대 순서로 처리하는 코드는 이 경로에 없습니다. (반대 방향을 직접 돌려 보지는 않았습니다.)- 스코프가 있는 빈은 스코프의 객체도 이름으로 닿습니다.
BeanExpressionContext.getObject가 빈 팩토리에 없으면scope.resolveContextualObject(key)를 묻습니다(56–66행). 웹 스코프에서request·session같은 이름이 오는 길인데, 이 글에서 돌려 보지는 않았습니다. - 식의 최대 길이를 컨테이너는 따로 정합니다.
spring.context.expression.maxLength프로퍼티로, 없으면 1절의 10,000입니다(69행, 198–214행). MapAccessor가 둘 있습니다.context.expression.MapAccessor는 7.0부터@Deprecated이고spel.support.MapAccessor를 상속만 합니다(28–31행). 위evaluate코드가 패키지 이름까지 적어 새것을 쓰는 이유입니다.
더 깊이 들어가면
이 글은 큰 줄기를 위해 많은 것을 뺐습니다. 이름과 위치만 적어 둡니다. 셀렉션(?[], ^[], $[])과 프로젝션(![])이 원소마다 범위를 여는 방식(Selection 140–160행). 배열·리스트·맵·문자열·객체를 다 받는 인덱서 […]와 6.2에 들어온 IndexAccessor(Indexer 55–64행). #함수()를 위한 registerFunction(StandardEvaluationContext 493–507행). null 속성을 자동으로 만들어 주는 autoGrowNullReferences와 컬렉션 자동 확장(SpelParserConfiguration 56행, 160–164행). 사용자 타입끼리의 연산을 열어 주는 OperatorOverloader와 비교를 맡는 TypeComparator(EvaluationContext 128–134행). 거듭제곱 결과 크기 제한 같은 안전장치들(79행). 바이트코드 생성의 보조 도구 CodeFlow(47행)와 CompilablePropertyAccessor(31–51행). 그리고 @Cacheable(key = "#id"), @EventListener(condition = "…")처럼 메서드 인자를 #p0·#id로 쓰게 해 주는 MethodBasedEvaluationContext(45행)와 그 식을 캐시하는 CachedExpressionEvaluator(37행)는 27편에서 다룹니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
SpelExpressionParser |
스레드 안전한 입구. 파싱마다 스레드 안전하지 않은 InternalSpelExpressionParser를 새로 만든다 |
Tokenizer |
글자를 한 자씩 보고 Token 목록으로. $는 식별자 글자, #{는 토큰이 아니다 |
| 재귀 하강 파서 | eatExpression → … → eatStartNode. 아래 메서드일수록 먼저 묶인다 = 우선순위 |
| 트리(AST) | spel.ast 패키지의 SpelNodeImpl 하위 노드들. 이름 뒤에 (가 있으면 MethodReference, 없으면 PropertyOrFieldReference |
getValue |
ExpressionState(이번 평가용)를 만들고 루트 노드의 getValueInternal을 재귀로 부른다 |
EvaluationContext |
노드가 묻는 곳. 접근기·메서드 해석기·TypeLocator·BeanResolver·TypeConverter·변수 |
TypeConverter |
14편의 ConversionService를 그대로 감싼 것(StandardTypeConverter) |
StandardEvaluationContext |
리플렉션 기본값을 다 채운다. 믿을 수 없는 식에는 쓰지 말 것 |
SimpleEvaluationContext |
고른 것만 연다. T()는 항상 TYPE_NOT_FOUND, @빈·new는 없음, 읽기 전용이면 대입도 막힘 |
| 컴파일 모드 | OFF(기본)·IMMEDIATE(2번째부터)·MIXED(101번째부터). 해석 때 알아낸 타입으로 CompiledExpression 하위 클래스를 ASM으로 만든다 |
#{…}의 길 |
resolveEmbeddedValue(${}) → evaluateBeanDefinitionString → StandardBeanExpressionResolver.evaluate → convertIfNecessary |
| 컨테이너의 컨텍스트 | 루트 = BeanExpressionContext, 빈 이름이 속성이 되는 접근기 넷, BeanFactoryResolver, 빈 클래스 로더, 컨테이너의 ConversionService |
다음에 볼 것
이 글로 Phase 3(기반 기술)의 네 단위 가운데 셋을 봤습니다. 13편의 타입·어노테이션 읽기, 14편의 타입 변환, 그리고 이 글의 표현식입니다. 남은 하나는 그 세 글에서 이름만 스쳐 간 도구들입니다. ClassUtils, ReflectionUtils, StringUtils, Assert처럼 Spring의 거의 모든 클래스가 가져다 쓰는 유틸리티와, 리플렉션으로 실행 시점에 하던 일을 빌드 시점에 미리 해 두는 AOT입니다. 다음 글 16편: 유틸리티와 AOT — 모두가 쓰는 도구 상자와 미리 계산해 두기에서 봅니다.