이 글에서 다루는 것
"MariaDB 소스 파헤치기"는 관계형 데이터베이스 서버 MariaDB의 소스 코드를 AI의 도움을 받아 조금씩 읽고 정리하는 연재입니다. 앞서 끝낸 Spring 소스 파헤치기(27편), Apache httpd 소스 파헤치기(16편), Tomcat 소스 파헤치기(16편), 그리고 바로 앞 연재인 nginx 소스 파헤치기와 같은 방식으로 읽습니다. 앞의 연재들이 "요청을 받아 응답하는 서버"와 "그 위에서 도는 애플리케이션"을 읽었다면, 이번에는 그 애플리케이션이 JdbcTemplate이나 ORM으로 SQL을 보내던 반대쪽 끝을 읽습니다.
이 글은 첫 번째 글이고, 코드를 깊이 읽기 전에 준비를 합니다. 답하려는 질문은 다섯 가지입니다.
- MariaDB는 무엇이고, 어떻게 동작하고, 어디에 쓰는가 (처음 보는 분을 위한 절)
- 어떤 판의 소스를 읽는가. 흔히 쓰는 LTS 판(11.4, 11.8)과는 무엇이 다르고, 판 번호는 어디에 적혀 있는가
- 이 연재와 똑같은 소스를 서브모듈까지 어떻게 받고, 어떻게 빌드해서 돌려 보는가
- 259만 줄쯤 되는 소스는 어떤 폴더로 나뉘어 있고, 어디서부터 읽어야 하는가
SELECT하나는 소스의 어떤 함수들을 지나 InnoDB에 닿는가
MariaDB를 처음 듣는 분은 바로 아래 "MariaDB는 무엇인가" 절부터 읽으면 됩니다. 그림 두 장과 3분짜리 실습으로 MariaDB가 하는 일을 먼저 눈으로 보고, 이 연재가 어떤 궁금증을 풀어 가는지 훑어본 뒤 본론으로 들어갑니다. 그다음부터는 애플리케이션에서 MariaDB나 MySQL을 써 본 개발자가 서버 소스를 처음 여는 상황을 기준으로 씁니다. SQL을 쓰고, 인덱스를 걸어 보고, BEGIN/COMMIT과 격리 수준이라는 말을 알고, EXPLAIN을 한 번쯤 들여다본 정도면 됩니다. C++는 클래스·상속·가상 함수·포인터가 있다는 것을 알고 읽을 수 있으면 충분합니다. 다만 데이터베이스 서버의 소스는 처음 연다고 생각하고, 서버 안에서만 쓰는 말은 처음 나올 때 풉니다.
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server (MariaDB/server) |
| 버전 | 13.2.0 (main 브랜치, 성숙도 alpha), Debug 빌드하면 13.2.0-MariaDB-debug |
| 커밋 | c894d97781 (2026-10-19) |
| 언어 | C++와 C (빌드는 CMake) |
| 이 글에서 주로 읽는 파일 | VERSION, cmake/mysql_version.cmake, cmake/submodules.cmake, extra/comp_err.c, sql/sql_connect.cc, sql/sql_parse.cc, sql/sql_select.cc, sql/handler.cc, storage/innobase/handler/ha_innodb.cc |
글에 나오는 줄 번호와 세부 내용은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고, 내용이 달라진 곳도 있을 수 있습니다. 이 글은 연재 전체의 지도이므로 큰 줄기만 다루고, 깊은 내용은 각 편으로 넘깁니다.
연재는 모두 12편입니다.
- AI와 함께 소스를 읽는 방법과 분석 지도 (이 글)
- 전체 지도 — 서버 계층과 스토리지 엔진, 그리고 쿼리 하나의 일생
- 기동과 플러그인 — mariadbd가 첫 연결을 받기까지
- 연결과 스레드 — 연결마다 스레드 하나, 그리고 스레드 풀
- 프로토콜과 명령 처리 — 패킷 하나가 dispatch_command에 닿기까지
- 파서 — SQL 문장이 LEX와 Item 나무가 되기까지
- 준비 단계 — 권한 확인, 테이블 열기, 이름 찾기
- 옵티마이저 — JOIN::optimize와 실행 계획 고르기
- 실행과 handler API — 중첩 루프 조인이 엔진을 부르는 법
- InnoDB 1 — 페이지, 버퍼 풀, B-트리
- InnoDB 2 — 트랜잭션, MVCC, undo, 잠금
- 로그 두 개 — redo 로그와 binlog, 크래시 복구, 그리고 연재를 마치며
MariaDB는 무엇인가 — 어떻게 동작하고, 어디에 쓰나
소스를 열기 전에, MariaDB가 하는 일부터 그림과 실습으로 봅니다. 이미 MariaDB나 MySQL을 써 봤다면 이 절 끝의 "이 연재가 풀어 갈 질문"만 보고 넘어가도 됩니다.
한 문장으로 — 여러 프로그램이 함께 쓰는 "표 보관소"
MariaDB는 데이터를 표(테이블)로 맡아 두고, 여러 프로그램이 동시에 꺼내 쓰게 해 주는 서버 프로그램입니다. 엑셀 시트를 닮은 표에 "주문 번호, 손님, 상품, 값" 같은 칸을 정해 두면, 프로그램들은 SQL이라는 질문 언어로 "alice의 주문을 다 보여 줘", "손님마다 합계를 내 줘"처럼 묻고, 서버가 답을 찾아 돌려줍니다. 엑셀 파일과 다른 점은 셋입니다. 수많은 프로그램이 동시에 읽고 써도 서로 엉키지 않고, 행이 수백만 개여도 필요한 행만 빨리 찾고, 쓰다가 전원이 나가도 "저장했다"고 답한 것은 잃지 않습니다.
이런 프로그램을 관계형 데이터베이스 서버(RDBMS)라고 부릅니다. MariaDB는 MySQL에서 갈라져 나온 것이라 지금도 명령과 SQL 문법이 거의 같습니다. 이 연재 전체가 결국 "SQL 문장 하나가 서버 안에서 어떻게 해석되고, 어떤 방법으로 찾을지 정해지고, 디스크의 파일에서 행으로 꺼내지는가"를 따라가는 이야기입니다.
왜 이런 것이 필요한가
쇼핑몰 프로그램이 주문을 파일에 직접 적는다고 해 봅시다. 처음에는 간단하지만 곧 문제가 생깁니다.
- 손님 둘이 동시에 주문하면 두 프로그램이 같은 파일을 한꺼번에 고치다가 한 줄이 사라지거나 섞입니다.
- "alice의 주문"을 찾으려면 파일을 처음부터 끝까지 읽어야 합니다. 주문이 백만 건이면 백만 줄을 읽습니다.
- 주문을 넣고 재고를 빼는 도중에 프로그램이 죽으면, 주문은 들어갔는데 재고는 그대로인 어중간한 상태가 남습니다.
- 통계 프로그램, 관리 화면처럼 같은 데이터를 쓰는 프로그램이 늘 때마다 파일 형식과 잠금 규칙을 서로 맞춰야 합니다.
MariaDB를 가운데 두면 프로그램들은 SQL만 보내면 됩니다. 동시에 들어온 요청은 서버가 차례와 잠금으로 정리하고, 인덱스(책 뒤의 찾아보기 같은 것)로 필요한 행만 찾아가고, 트랜잭션으로 "주문 넣기 + 재고 빼기"를 전부 되거나 전부 안 되게 묶습니다. 파일을 어떻게 적는지는 서버가 알아서 하고, 프로그램은 몰라도 됩니다.
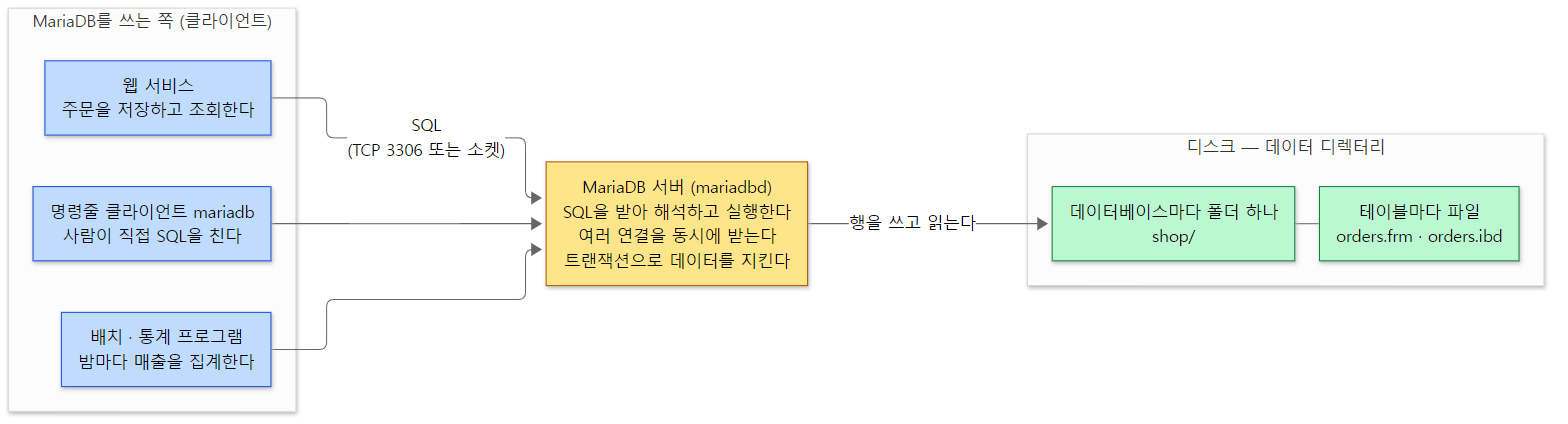 MariaDB를 가운데 둔 모습. 프로그램들은 디스크의 파일을 직접 만지지 않고 서버에게 SQL로 부탁합니다. 3306은 빌드할 때 따로 정하지 않으면 쓰는 기본 TCP 포트입니다(cmake/mysql_version.cmake 83행).
어떻게 동작하나 — 다섯 가지 말로
MariaDB를 움직이는 말은 다섯 개면 충분합니다. 아래 실습과 그림이 이 다섯 개를 그대로 보여 줍니다.
- 데이터베이스·테이블·행 — 테이블은 칸(열, column)이 정해진 표이고, 행(row)은 그 표의 한 줄입니다. 데이터베이스는 테이블 여러 개를 묶는 이름이고, 디스크에서는 폴더 하나입니다.
- SQL — 서버에게 일을 시키는 언어입니다.
CREATE TABLE로 표를 만들고,INSERT로 넣고,SELECT로 묻습니다. 서버는 받은 문장을 먼저 뜯어 읽고(파싱, 6편), 어떻게 찾을지 정한 뒤(최적화, 8편) 실행합니다. - 인덱스(index) — 어떤 칸의 값으로 행을 빨리 찾게 해 주는 찾아보기입니다. 없으면 표를 처음부터 끝까지 훑어야 합니다. 서버가 어떤 방법으로 찾을지는
EXPLAIN을 붙여 물어볼 수 있습니다. - 트랜잭션(transaction) — 여러 문장을 "전부 되거나 전부 안 되게" 묶는 단위입니다.
BEGIN으로 열고COMMIT으로 확정합니다. 확정하기 전의 변경은 다른 연결에게 보이지 않습니다. 따로 묶지 않은 문장은 하나하나가 곧바로 커밋됩니다(autocommit의 기본값이 켜짐, sql/sys_vars.cc 4997–5005행). - 스토리지 엔진(storage engine) — 행을 실제로 디스크에 쓰고 읽는 부품입니다. MariaDB는 "SQL을 이해하는 위층"과 "행을 저장하는 아래층(엔진)"이 나뉘어 있고, 엔진을 테이블마다 고를 수 있습니다. 아무것도 고르지 않으면 InnoDB입니다(sql/mysqld.cc 4285–4289행). 이 나눔은 2편에서 자세히 봅니다.
서버 프로그램의 이름은 mariadbd(끝의 d는 뒤에서 늘 도는 프로그램, 데몬이라는 뜻), 사람이 SQL을 쳐 넣는 명령줄 프로그램은 **mariadb**입니다. 서버에 붙는 쪽을 통틀어 클라이언트라고 부르고, 클라이언트 하나가 서버에 붙어 있는 것을 연결(connection)이라고 합니다.
3분 실습 — 주문 표를 만들고, 두 연결로 보고, 인덱스를 걸어 보기
말로만 보면 감이 오지 않으니 직접 돌려 봅니다. 이 연재가 빌드한 MariaDB(3절에서 만드는 도커 이미지 mariadb-lab:c894d97781)로 돌렸지만, 평범한 SQL과 mariadb 클라이언트만 쓰므로 내려받은 정식판으로도 같은 순서로 해 볼 수 있습니다(정식판으로는 돌려 보지 않았습니다). 예제 폴더는 ex/u01-first-look이고, 하는 일은 이렇습니다.
- 서버를 띄우고 판 번호를 묻습니다.
- 데이터베이스
shop과 주문 표orders를 만들고 6건을 넣습니다. 엔진은 일부러 적지 않습니다. - SQL로 "손님마다 주문 수와 합계"를 묻습니다.
- 연결 두 개(A, B)를 엽니다. A가 트랜잭션 안에서 한 건을 넣고, 커밋 전과 후에 B가 셉니다.
- 다른 손님의 주문 1000건을 더 넣은 뒤,
customer칸에 인덱스가 없을 때와 있을 때EXPLAIN을 비교합니다. - 서버의 데이터 디렉터리에서
shop폴더를 들여다봅니다.
2·4단계의 핵심만 옮기면 이렇습니다(나머지 단계는 mariadb -e "…"로 SQL 한두 문장을 보내는 것이 전부입니다. 전체는 예제 폴더의 run.sh에 있습니다).
-- 2단계: ENGINE= 을 적지 않는다
CREATE DATABASE shop;
CREATE TABLE shop.orders (
  id       INT AUTO_INCREMENT PRIMARY KEY,
  customer VARCHAR(20) NOT NULL,
  item     VARCHAR(20) NOT NULL,
  price    INT NOT NULL);
INSERT INTO shop.orders (customer, item, price) VALUES
  ('alice','coffee',4500), ('dave','bagel',3000), ('carol','tea',4000),
  ('alice','muffin',3500), ('dave','juice',5000), ('alice','cookie',2000);

-- 4단계: 연결 A                         -- 연결 B
BEGIN;
INSERT INTO orders (customer, item, price) VALUES ('bob','cake',6000);
SELECT COUNT(*) FROM orders;              -- (A 에게는 7)
                                          SELECT COUNT(*) FROM orders;  -- 커밋 전
COMMIT;
                                          SELECT COUNT(*) FROM orders;  -- 커밋 후
출력입니다.
=== 1. the server is up and answers
13.2.0-MariaDB-debug
=== 2. create a table (no ENGINE= given) and insert 6 orders
+------------+--------+
 TABLE_NAME | ENGINE |
+------------+--------+
 orders     | InnoDB |
+------------+--------+
=== 3. ask a question in SQL: orders and total per customer
+----------+--------+-------+
 customer | orders | total |
+----------+--------+-------+
 alice    |      3 | 10000 |
 carol    |      1 |  4000 |
 dave     |      2 |  8000 |
+----------+--------+-------+
=== 4. two connections: A inserts inside a transaction, B looks
A: BEGIN;
A: INSERT INTO orders (customer, item, price) VALUES ('bob','cake',6000);
A: SELECT CONCAT('A sees ', COUNT(*), ' orders') FROM orders;
    A> A sees 7 orders
    B> B sees 6 orders (before A commits)
A: COMMIT;
    B> B sees 7 orders (after A commits)
=== 5. EXPLAIN: how will the server find alice's orders?
--- without an index on customer
+------+-------------+--------+------+---------------+------+---------+------+------+-------------+
 id   | select_type | table  | type | possible_keys | key  | key_len | ref  | rows | Extra       |
+------+-------------+--------+------+---------------+------+---------+------+------+-------------+
    1 | SIMPLE      | orders | ALL  | NULL          | NULL | NULL    | NULL | 1007 | Using where |
+------+-------------+--------+------+---------------+------+---------+------+------+-------------+
--- after CREATE INDEX idx_customer ON orders (customer)
+------+-------------+--------+------+---------------+--------------+---------+-------+------+-----------------------+
 id   | select_type | table  | type | possible_keys | key          | key_len | ref   | rows | Extra                 |
+------+-------------+--------+------+---------------+--------------+---------+-------+------+-----------------------+
    1 | SIMPLE      | orders | ref  | idx_customer  | idx_customer | 82      | const | 3    | Using index condition |
+------+-------------+--------+------+---------------+--------------+---------+-------+------+-----------------------+
=== 6. the table on disk
db.opt
orders.frm
orders.ibd
(4단계에서 A:는 연결 A에 보낸 문장, A>는 A가 받은 결과, B>는 B가 받은 결과입니다. 여러 번 돌려도 같은 출력이 나왔습니다.)
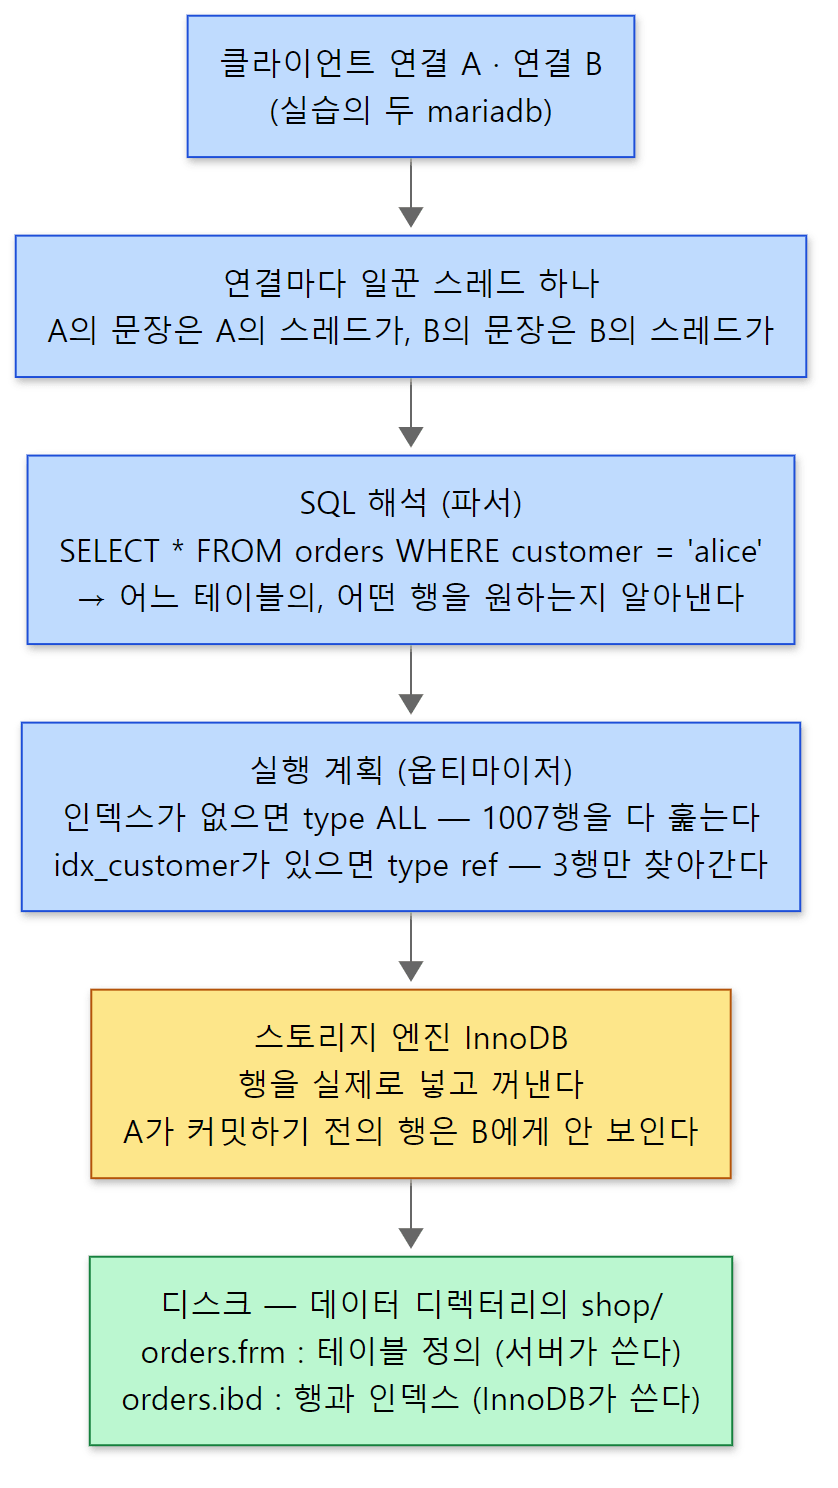 실습에서 본 것을 위에서 아래로 놓은 모습. 파란 칸이 SQL을 이해하는 위층(서버 계층), 노란 칸이 행을 저장하는 아래층(엔진), 초록 칸이 디스크입니다. 같은 길을 함수 이름으로 따라가는 지도는 5절에 있습니다.
출력에서 볼 것은 다섯 가지입니다.
- 엔진을 적지 않았는데 InnoDB가 맡았습니다. 2단계의
information_schema.TABLES가orders의ENGINE을InnoDB로 보여 줍니다. InnoDB가 함께 빌드된 서버에서는default_storage_engine의 기본값이"InnoDB"이기 때문입니다(sql/mysqld.cc 4285–4289행). 서버가 엔진을 플러그인으로 어떻게 붙이는지는 3편에서 봅니다. - SQL은 "무엇을"만 말하고, "어떻게"는 서버가 정합니다. 3단계의 질문에는 어떤 순서로 읽고 어떻게 묶으라는 말이 없는데도 손님별 합계(alice 10000, carol 4000, dave 8000)가 나왔습니다. 문장을 뜯어 읽고 실행 방법을 고르는 일이 서버 안에서 일어났다는 뜻이고, 이 연재의 5편~9편이 그 안을 차례로 따라갑니다.
- 커밋 전의 행은 다른 연결에게 보이지 않습니다. 4단계에서 A는 방금 넣은
bob의 주문까지 7건을 보지만, 같은 순간 B는 6건을 봅니다. A가COMMIT한 뒤에야 B도 7건을 봅니다. 격리 수준의 기본값은REPEATABLE READ이고(sql/sys_vars.cc 4686–4690행), InnoDB는 커밋되지 않은 변경을 다른 트랜잭션에게 감춥니다. 커밋 전의 행을 어떻게 감추고, 옛 값을 어떻게 남겨 두는지는 11편에서 봅니다. 또 A와 B가 동시에 일할 수 있는 것은 서버가 기본으로 연결마다 스레드 하나를 붙이기 때문입니다(thread_handling의 기본값one-thread-per-connection, Windows에서는 스레드 풀, sql/sys_vars.cc 3478–3500행, 4편). - 인덱스가 있으면 찾는 방법이 바뀝니다. 5단계에서 인덱스가 없을 때는
type이ALL(표 전체를 훑기)이고rows(읽을 것으로 어림한 행 수)가 1007입니다.idx_customer를 만든 뒤에는type이ref(인덱스로 같은 값을 찾아가기),key가idx_customer,rows가 3입니다. SQL 문장은 한 글자도 바뀌지 않았고 서버가 고른 길만 바뀌었습니다. 1000건은 Sequence 엔진이 이름만 보고 만들어 주는 가상 표seq_1_to_1000으로 넣었습니다(storage/sequence/sequence.cc 292–294행). 옵티마이저가 이 둘 가운데 하나를 어떻게 고르는지는 8편에서 봅니다. - 테이블 하나가 디스크에서는 파일 두 개입니다. 6단계의
shop/폴더에orders.frm과orders.ibd가 있습니다(db.opt는 데이터베이스의 기본 문자 집합과 정렬 규칙을 적는 파일입니다, sql/sql_db.h 48행, sql/sql_db.cc 506–510행)..frm은 서버 계층이 쓰는 테이블 정의 파일이고(sql/init.cc 43행, sql/table.cc 3907–3914행),.ibd는 InnoDB가 행과 인덱스를 담는 파일입니다. InnoDB는 기본으로 테이블마다.ibd파일을 하나씩 만듭니다(storage/innobase/handler/ha_innodb.cc 19670–19673행). 위층과 아래층이 나뉘어 있다는 것이 파일 이름에서도 보이는 셈입니다..ibd안이 어떻게 생겼는지는 10편에서 열어 봅니다.
어디에 쓰나
| 쓰임 | 하는 일 | 예 |
|---|---|---|
| 웹·앱 서비스의 저장소 | 회원, 주문, 게시글처럼 서비스의 핵심 데이터를 표로 두고 요청마다 읽고 쓴다 | 쇼핑몰의 주문 표, 게시판의 글 표 |
| 돈·재고처럼 어긋나면 안 되는 데이터 | 여러 변경을 트랜잭션으로 묶어 전부 되거나 전부 안 되게 한다 | 주문 넣기와 재고 빼기를 한 번에 |
| 여러 프로그램이 함께 쓰는 데이터 | 서비스, 관리 화면, 배치 프로그램이 같은 표를 동시에 쓴다 | 고객 응대 화면과 정산 배치가 같은 주문 표를 본다 |
| 조회와 집계 | 조건으로 골라내고, 묶고, 합계를 낸다. 인덱스로 필요한 행만 빨리 찾는다 | 손님별 합계, 날짜별 매출 |
| 복제로 나눠 읽기 | 바뀐 내용을 다른 서버에 그대로 따라 쓰게 해서 읽기를 나누거나 예비 서버를 둔다 | 읽기 전용 복제 서버 (binlog, 12편) |
반대로 맞지 않는 곳도 있습니다. 칸이 정해지지 않은 문서나 파일 덩어리를 그대로 쌓아 두는 일, 초당 수많은 이벤트를 흘려보내는 일, 수십억 행을 한꺼번에 훑는 분석은 그 일에 맞춘 다른 저장소가 더 잘합니다. 데이터가 작고 프로그램 하나만 쓴다면 서버를 따로 띄우는 수고가 더 클 수도 있습니다. MariaDB는 "칸이 정해진 데이터를, 여러 프로그램이 동시에, 어긋나지 않게 읽고 쓰는" 모양에 잘 맞습니다.
이 연재가 풀어 갈 질문
실습을 돌려 보면 궁금한 것이 생깁니다. 이 연재는 그 궁금증을 소스로 하나씩 풉니다. 끌리는 질문이 있으면 그 편부터 읽어도 됩니다.
| 궁금한 것 | 답이 있는 곳 |
|---|---|
| 서버 안은 어떤 덩어리로 나뉘어 있고, SQL을 이해하는 쪽과 행을 저장하는 쪽은 왜 따로일까? | 2편: 전체 지도 |
mariadbd를 띄우면 첫 연결을 받기까지 무슨 일이 있을까? InnoDB는 어떻게 "끼워지는" 걸까? |
3편: 기동과 플러그인 |
| 연결 A와 B는 정말 스레드를 하나씩 받을까? 연결이 천 개면 스레드도 천 개일까? | 4편: 연결과 스레드 |
mariadb가 보낸 SQL 한 줄은 네트워크 위에서 어떤 바이트이고, 서버는 그것을 어디서 받을까? |
5편: 프로토콜과 명령 처리 |
| 서버는 SQL 문장을 어떻게 뜯어 읽을까? 문법 오류의 "near '…'"는 어디서 나올까? | 6편: 파서 |
customer라는 이름이 어느 표의 어느 칸인지는 언제 알아낼까? 권한은 언제 볼까? |
7편: 준비 단계 |
EXPLAIN의 ALL과 ref는 누가, 무엇을 보고 골랐을까? |
8편: 옵티마이저 |
| 서버는 InnoDB에게 "다음 행을 달라"고 어떻게 말할까? | 9편: 실행과 handler API |
orders.ibd 안은 어떻게 생겼고, 인덱스로 3행만 찾아가는 길은 무엇일까? |
10편: InnoDB 1 — 페이지, 버퍼 풀, B-트리 |
| A가 커밋하기 전의 행을 B에게 어떻게 감출까? 둘이 같은 행을 고치면? | 11편: InnoDB 2 — 트랜잭션, MVCC, undo, 잠금 |
COMMIT이 끝났는데 전원이 나가면? 커밋한 것은 어떻게 살아남을까? |
12편: redo 로그와 binlog, 크래시 복구 |
이 글의 나머지는 이 질문들을 소스로 따라가기 위한 준비입니다. 어떤 판을 읽는지(1절), 소스를 받아 빌드하는 법(2·3절), 폴더 지도(4절), 그리고 위 실습의 SELECT 하나가 실제로 어떤 함수들을 지나가는지(5절)를 봅니다. 직접 빌드해 볼 생각이 없다면 2·3절은 건너뛰어도 뒤의 내용을 읽는 데 지장이 없습니다.
먼저 알아 둘 말
MariaDB 소스에는 사용자 쪽에서는 볼 일이 없던 이름이 처음부터 나옵니다. 이 여섯 가지만 먼저 잡아 두면 이 글이 쉽게 읽힙니다.
서버 계층과 스토리지 엔진. MariaDB(그리고 갈라져 나오기 전의 MySQL)는 서버를 두 층으로 나눕니다. 위층인 서버 계층(소스의 sql/ 폴더)은 연결을 받고, SQL을 해석하고, 권한을 보고, 실행 계획을 고릅니다. 아래층인 스토리지 엔진(storage/ 폴더)은 행을 실제로 디스크나 메모리에 쓰고 읽습니다. CREATE TABLE … ENGINE=InnoDB의 ENGINE=이 바로 아래층을 고르는 자리입니다. 이 나눔이 왜 있는지는 2편에서 봅니다.
handler와 handlerton. 두 층 사이의 약속(인터페이스)입니다. handler는 sql/handler.h의 C++ 클래스로, 열린 테이블 하나를 다루는 객체입니다. 서버 계층은 "다음 행을 달라"(rnd_next()), "이 키로 찾아 달라"(index_read_map()), "이 행을 넣어 달라"(write_row())를 handler의 가상 함수로 부르고, InnoDB는 이것을 상속한 ha_innobase로 구현합니다. handlerton은 엔진 하나당 하나 있는 구조체로, 커밋·롤백처럼 테이블이 아니라 엔진 전체에 걸린 일을 함수 포인터로 들고 있습니다. 소스의 주석도 "엔진마다 인스턴스가 하나인 싱글턴 구조체로, 테이블 단위로 일하는 handler와 달리 '전역' 수준의 기능을 내준다"고 적습니다(sql/handler.h 1514–1519행).
THD. sql/sql_class.h의 class THD입니다. 클래스 위 주석은 "클라이언트 연결마다 스레드를 따로 만들고, THD가 그 스레드/연결의 descriptor(서술자) 노릇을 한다"고 설명합니다(sql/sql_class.h 3326–3330행). 클라이언트 연결 하나의 모든 상태(지금 실행 중인 문장, 현재 데이터베이스, 세션 변수, 열린 트랜잭션, 오류 정보 …)를 담습니다. 서버 계층의 함수는 거의 다 첫 인자로 THD *thd를 받습니다. Tomcat의 요청 객체나 httpd의 request_rec가 "요청 하나"였다면, THD는 "연결 하나"입니다.
플러그인. MariaDB는 스토리지 엔진, 인증 방식, information_schema의 테이블, 감사 로그 같은 것을 플러그인으로 붙입니다. 서버 실행 파일 mariadbd 안에 처음부터 들어 있는 정적 플러그인과, .so 파일로 따로 있다가 INSTALL SONAME으로 올리는 동적 플러그인이 있습니다. 엔진도 플러그인입니다(3편).
main 브랜치와 LTS. MariaDB 저장소의 main은 다음 판을 만드는 개발 줄기이고, 우리가 운영에 쓰는 판은 11.4, 11.8 같은 판 브랜치에서 나옵니다. 그중 오래 고쳐 주는 판을 LTS(Long Term Support, 장기 지원판)라고 부릅니다. 이 연재가 읽는 것은 main입니다.
Debug 빌드. 컴파일러 최적화를 끄고 디버깅 정보를 넣은 빌드입니다. 느리지만 gdb(리눅스의 디버거)로 멈췄을 때 함수 호출 단계가 빠짐없이 보이고, MariaDB가 소스 곳곳에 심어 둔 추적(DBUG_ENTER, DBUG_PRINT)과 검사(DBUG_ASSERT)가 살아납니다. 이 연재의 예제는 모두 Debug 빌드로 돌립니다.
1. 어떤 판을 읽나 — 13.2.0 alpha와 LTS
판 번호는 VERSION 파일 한 곳에 있습니다
MariaDB의 판 번호는 저장소 맨 위의 VERSION이라는 네 줄짜리 파일에 있습니다.
MYSQL_VERSION_MAJOR=13
MYSQL_VERSION_MINOR=2
MYSQL_VERSION_PATCH=0
SERVER_MATURITY=alpha
13.2.0이고, 성숙도(maturity)가 alpha입니다. MariaDB는 판마다 alpha → beta → gamma → stable 순서로 성숙도를 올려 가며, stable이 되어야 운영에 쓰라고 내놓습니다. 이 커밋의 판은 아직 첫 단계라는 뜻입니다. 이 파일을 git log로 보면 2026-09-09의 커밋 a5525ff5ff("new version of main (3.2)")가 MYSQL_VERSION_MINOR를 1에서 2로 올렸습니다. 13.1을 판 브랜치로 떼어 낸 뒤 main이 다음 판 번호로 넘어간 것입니다.
이 네 줄을 읽는 것은 CMake(빌드 설정 도구)입니다.
MACRO(GET_MYSQL_VERSION)
  MYSQL_GET_CONFIG_VALUE("MYSQL_VERSION_MAJOR" MAJOR_VERSION)
  MYSQL_GET_CONFIG_VALUE("MYSQL_VERSION_MINOR" MINOR_VERSION)
  MYSQL_GET_CONFIG_VALUE("MYSQL_VERSION_PATCH" PATCH_VERSION)
  MYSQL_GET_CONFIG_VALUE("MYSQL_VERSION_EXTRA" EXTRA_VERSION)
  MYSQL_GET_CONFIG_VALUE("SERVER_MATURITY" SERVER_MATURITY)
# ...
  SET(VERSION "${MAJOR_VERSION}.${MINOR_VERSION}.${PATCH_VERSION}${EXTRA_VERSION}")
  SET(SERVER_VERSION ${VERSION})
  MESSAGE(STATUS "MariaDB ${VERSION}")
cmake/mysql_version.cmake 46–65행 (줄인 곳은 # ...로 표시)
VERSION이라는 CMake 변수에 13.2.0이 들어가고, 이것이 헤더 파일 틀 include/mysql_version.h.in의 @VERSION@ 자리에 채워집니다.
#define MYSQL_SERVER_VERSION "@VERSION@-MariaDB"
include/mysql_version.h.in 14행
그래서 빌드된 서버 안에는 "13.2.0-MariaDB"라는 문자열이 박힙니다. 마지막으로 서버가 뜰 때 set_server_version()이 꼬리표를 더 붙입니다.
char *set_server_version(char *buf, size_t size)
{
  bool is_log= opt_log || global_system_variables.sql_log_slow || opt_bin_log;
  bool is_debug= IF_DBUG(!strstr(MYSQL_SERVER_SUFFIX_STR, "-debug"), 0);
  // ... (is_valgrind, is_asan 정하기 생략)

  return strxnmov(buf, size - 1,
                  MYSQL_SERVER_VERSION,
                  MYSQL_SERVER_SUFFIX_STR,
                  IF_EMBEDDED("-embedded", ""),
                  is_valgrind,
                  is_asan,
                  is_debug ? "-debug" : "",
                  is_log ? "-log" : "",
                  NullS);
}
sql/mysqld.cc 9454–9478행 (줄인 곳은 // ...로 표시)
IF_DBUG(a, b)는 Debug 빌드에서는 a, 아니면 b가 되는 매크로입니다. 그래서 Debug 빌드는 -debug가 붙고, 일반 쿼리 로그·슬로 쿼리 로그·binlog 가운데 하나라도 켜고 띄우면 -log까지 붙습니다. 운영 서버에서 SELECT VERSION()이 10.11.6-MariaDB-log처럼 나오는 것을 본 적이 있다면 이 함수가 붙인 꼬리입니다. 이 연재의 서버는 로그를 켜지 않은 Debug 빌드이므로 13.2.0-MariaDB-debug입니다(아래 3절 예제에서 확인).
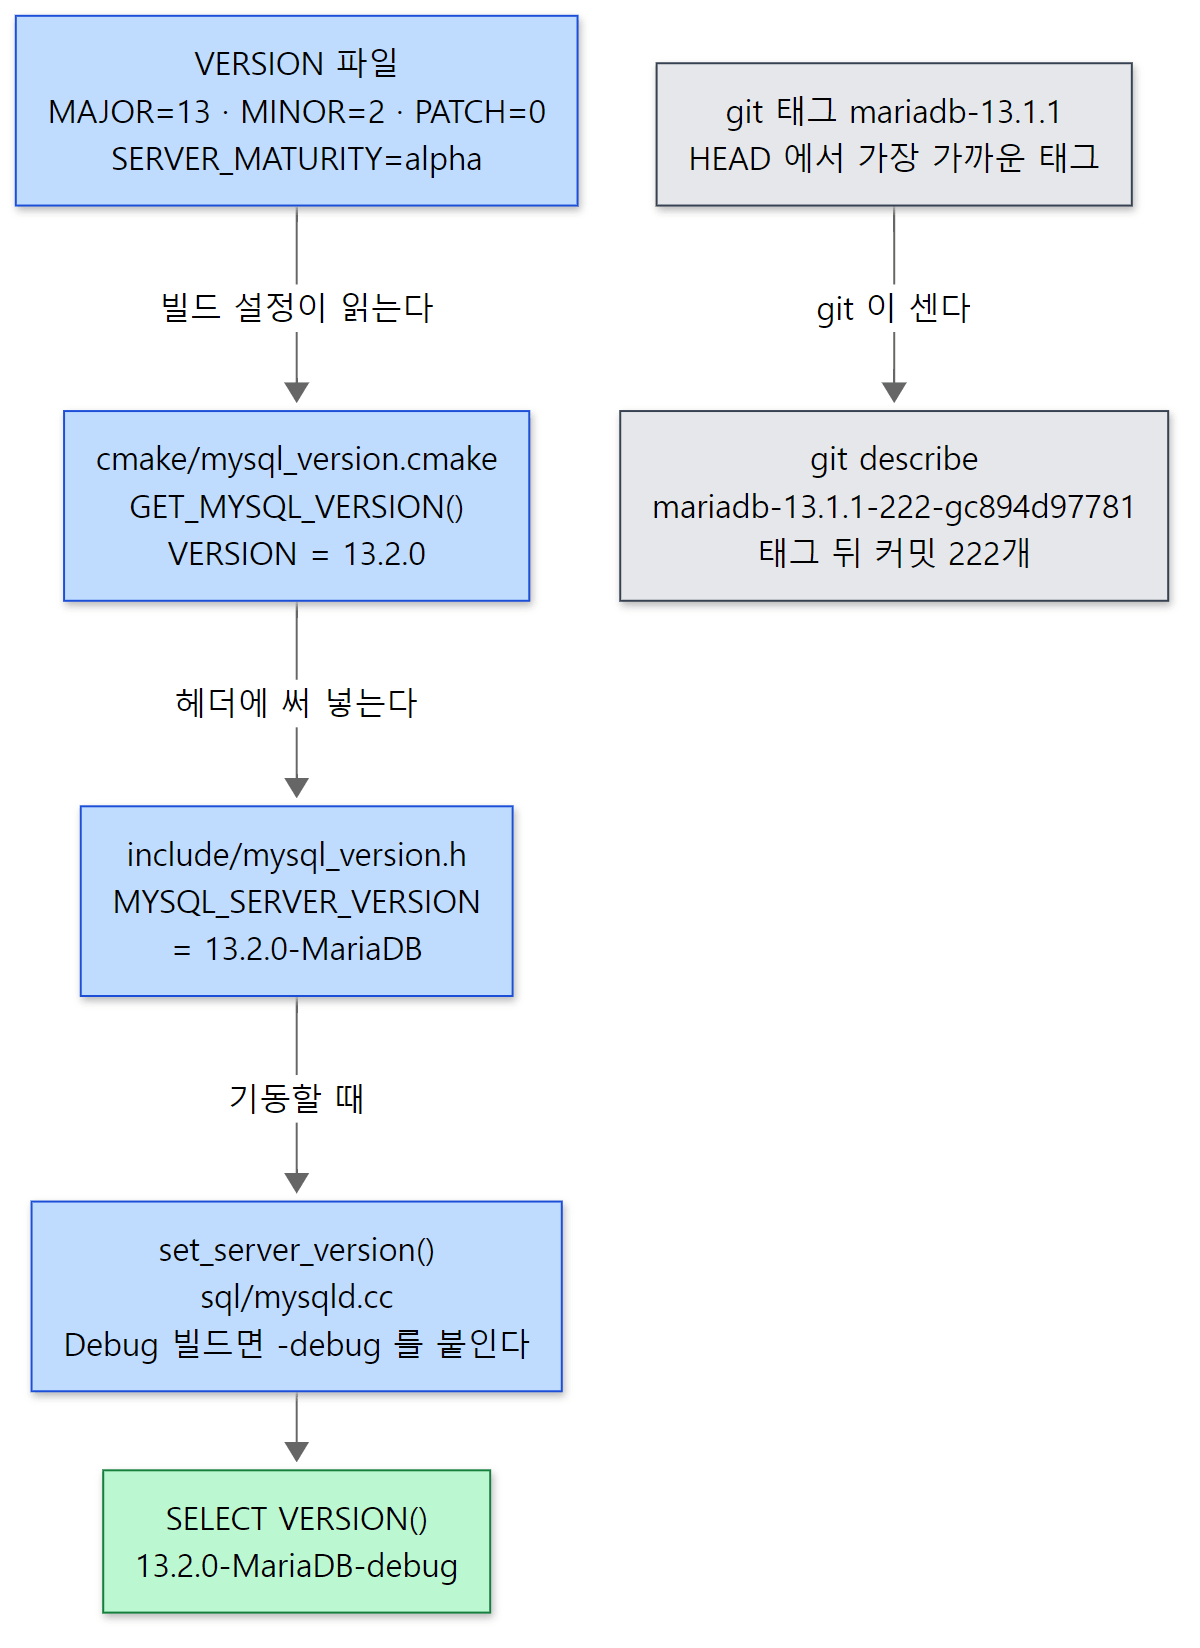 판 번호가 만들어지는 두 갈래. 파란 줄이 서버가 스스로 밝히는 번호이고, 회색 줄은 git이 붙이는 이름입니다.
성숙도는 플러그인을 고를 때도 쓰입니다
SERVER_MATURITY=alpha는 이름표로 끝나지 않습니다. CMake가 이것을 SERVER_MATURITY_LEVEL이라는 숫자로 바꿔 헤더에 넣고, 서버는 그 숫자로 "얼마나 덜 익은 플러그인까지 올려 줄지"의 기본값을 정합니다.
export const char *plugin_maturity_names[]=
{ "unknown", "experimental", "alpha", "beta", "gamma", "stable", 0 };
static Sys_var_enum Sys_plugin_maturity(
       "plugin_maturity",
       "The lowest desirable plugin maturity. "
       "Plugins less mature than that will not be installed or loaded",
       READ_ONLY GLOBAL_VAR(plugin_maturity), CMD_LINE(REQUIRED_ARG),
       plugin_maturity_names,
       DEFAULT(SERVER_MATURITY_LEVEL > 0 ?
               SERVER_MATURITY_LEVEL - 1 : SERVER_MATURITY_LEVEL));
plugin_maturity 시스템 변수의 기본값이 "서버 성숙도보다 한 단계 아래"입니다. alpha(2) 서버라면 experimental(1)까지 올려 줍니다. stable 판이었다면 기본값은 gamma가 되어, 그보다 덜 익은(experimental·alpha·beta) 플러그인은 INSTALL SONAME으로도 올라가지 않습니다(변수 설명 그대로 "will not be installed or loaded"). 아래 예제에서 SELECT @@plugin_maturity가 experimental로 나오는 것으로 확인합니다. 시스템 변수가 my.cnf·SET GLOBAL과 이어지는 방식은 3편에서 봅니다.
main과 판 브랜치
이 커밋을 받은 저장소의 원격 브랜치에서 VERSION 파일만 꺼내 보면(git show origin/11.8:VERSION처럼) 이렇습니다(2026-10-24 무렵 받은 원격 브랜치 기준).
| 브랜치 | VERSION |
성숙도 | 무엇인가 |
|---|---|---|---|
main (커밋 c894d97781) |
13.2.0 | alpha | 다음 판을 만드는 개발 줄기. 이 연재가 읽는 것 |
13.1 |
13.1.2 | gamma | 아직 stable 전인 판 |
13.0 |
13.0.2 | stable | |
12.3 |
12.3.4 | stable | |
11.8 |
11.8.10 | stable | LTS |
11.4 |
11.4.13 | stable | LTS |
VERSION의 숫자는 "다음에 낼 판"을 가리킵니다(예: 11.8 브랜치는 11.8.10을 준비 중). 어느 판이 LTS인지는 저장소 안에 적혀 있지 않습니다. 11.4와 11.8이 LTS라는 것은 MariaDB 재단의 안내에 따른 것이고, 소스로 확인한 것은 아닙니다.
왜 굳이 alpha인 main을 읽느냐 하면, 앞의 연재들에서 개발 줄기(httpd trunk, Tomcat main)를 읽은 것과 같은 이유입니다. 고친 것과 새 기능은 개발 줄기에 먼저 들어가고, 이 연재가 따라갈 큰 줄기(연결 → 파싱 → 최적화 → 실행 → handler → InnoDB)는 판마다 크게 다르지 않습니다. 대신 다른 판과의 차이는 소스로 확인한 것만 적고, 확인하지 않았으면 "기준 커밋에서는 이렇다"까지만 씁니다. 이 커밋에는 최근 판에 들어온 기능도 보입니다. binlog를 InnoDB 안에 두는 새 구현(storage/innobase/fsp/fsp_binlog.cc), 새 비용 모델(sql/optimizer_costs.h) 같은 것인데, 글에서 다룰 때마다 "최근 판에 들어온 것"이라고 밝히겠습니다.
헷갈리기 쉬운 곳
판 번호가 세 가지로 보입니다. VERSION 파일은 13.2.0, 서버가 밝히는 이름은 13.2.0-MariaDB-debug인데, 이 커밋에서 git describe를 돌리면 엉뚱하게 mariadb-13.1.1-222-gc894d97781이 나옵니다. git describe는 판 번호를 읽는 명령이 아니라 HEAD에서 거슬러 올라가 가장 가까운 태그를 찾아 "그 태그 뒤 커밋 몇 개, 지금 커밋 해시"를 붙이는 명령이기 때문입니다. 13.1.1 판 태그(mariadb-13.1.1 — 태그는 2026-09-14에 찍혔고, 가리키는 커밋은 2026-09-10의 것)는 13.1 브랜치의 커밋을 가리키고, 그 커밋이 main으로 다시 합쳐져(merge) main에서도 조상이 됩니다. git rev-list --count mariadb-13.1.1..HEAD로 세면 정말 222개입니다. 13.2라는 태그는 아직 없으니, "13.1.1 다음 222번째 커밋"이라는 이름이 붙은 것입니다(끝의 커밋 해시는 git이 저장소 크기에 맞춰 자릿수를 정하므로, 이 PC에서는 -gc894d97781b처럼 한 자리 더 길게 나왔습니다). 이 연재가 부르는 이름은 VERSION 파일의 13.2.0입니다.
MYSQL_이라는 이름이 곳곳에 남아 있습니다. VERSION 파일의 키부터 MYSQL_VERSION_MAJOR이고, 헤더는 mysql_version.h, 소스 안의 함수는 mysql_parse(), mysql_execute_command()입니다. 저장소의 README.md가 첫머리에 적은 대로 MariaDB는 MySQL의 포크(fork, 갈라져 나온 프로젝트)로 시작했기 때문에 옛 이름을 그대로 쓰는 곳이 많습니다. 설치된 실행 파일도 mysqld -> mariadbd, mysql -> mariadb처럼 옛 이름이 새 이름을 가리키는 심볼릭 링크로 남아 있습니다(예제 이미지의 /opt/mariadb/bin에서 확인). 다만 이름이 같다고 내용이 MySQL과 같지는 않습니다. 갈라진 지 오래되어 옵티마이저·InnoDB·복제 모두 많이 다릅니다. 이 연재는 MySQL에 대한 기억으로 MariaDB를 설명하지 않습니다.
2. 같은 소스 받기 — 서브모듈까지
이 절과 다음 3절은 글의 예제를 직접 돌려 보고 싶은 분을 위한 것입니다. 읽기만 할 거라면 4절(폴더 지도)로 넘어가도 됩니다.
소스 받고 커밋 고정하기
글의 줄 번호를 직접 열어 보려면 같은 커밋의 소스가 있어야 합니다. 순서는 앞 연재와 같습니다.
- 저장소를 받습니다. 이력이 길어서(2000년대 MySQL 시절부터) 시간이 꽤 걸립니다.
- 받은 폴더(
server)는 그대로 두고 git worktree로 기준 커밋만 다른 폴더(mariadb-c894d97781)에 꺼냅니다. worktree는 저장소 하나에서 다른 커밋을 다른 폴더로 동시에 꺼내 두는 기능입니다. 원래 폴더에서git pull로 최신 소스를 받아도 기준 커밋 폴더의 줄 번호는 바뀌지 않습니다. - 긴 커밋 번호가 그대로 나오면 맞춰진 것입니다.
git clone https://github.com/MariaDB/server.git
cd server
git worktree add --detach ../mariadb-c894d97781 c894d97781b54fbf074677c9d67f81cd60a162ac
git -C ../mariadb-c894d97781 rev-parse HEAD
내려받지 않고 웹에서만 봐도 됩니다. GitHub에서 이 커밋을 여는 주소로 들어가면 같은 파일이 보이고, 이 연재의 코드 링크도 전부 이 커밋을 가리킵니다.
서브모듈 일곱 개
MariaDB 저장소에는 다른 저장소를 통째로 끼워 쓰는 서브모듈(git submodule — 폴더 하나를 다른 저장소의 특정 커밋에 묶어 두는 기능)이 있습니다. 목록은 .gitmodules에 있고, 기준 커밋에서 일곱 개입니다.
| 경로 | 무엇인가 |
|---|---|
libmariadb |
MariaDB Connector/C — C로 짠 클라이언트 라이브러리. mariadb 같은 클라이언트 프로그램이 이것으로 서버에 붙는다 |
storage/rocksdb/rocksdb |
Facebook의 RocksDB (MyRocks 엔진의 바닥) |
wsrep-lib |
Galera 클러스터 복제에 쓰는 wsrep API 라이브러리 |
extra/wolfssl/wolfssl |
wolfSSL — OpenSSL 대신 쓸 수 있는 TLS 라이브러리 |
storage/maria/libmarias3 |
Aria 테이블을 S3에 두는 S3 엔진이 쓰는 라이브러리 |
storage/columnstore/columnstore |
ColumnStore(열 지향 분석 엔진) |
storage/duckdb/third_parties/duckdb |
DuckDB(분석용 임베디드 DB) — 최근 판에 들어온 DuckDB 엔진의 바닥 |
git clone만 하면 이 폴더들은 비어 있습니다. 모두 받아야 빌드가 될까요? 소스를 보면 아닙니다. 서브모듈은 CMake 함수 ADD_SUBMODULE()로 쓰고, 이 함수를 부르는 자리가 정해져 있습니다.
  IF(SUBMODULE_UPDATE_CONFIG_MESSAGE)
    IF(NOT EXISTS ${CMAKE_CURRENT_SOURCE_DIR}/${dir}/${file})
      MESSAGE(FATAL_ERROR "Cannot download ${CMAKE_CURRENT_SOURCE_DIR}/${dir} submodule: ${SUBMODULE_UPDATE_CONFIG_MESSAGE}")
    ENDIF()
  ELSE()
    MESSAGE(STATUS "Downloading ${CMAKE_CURRENT_SOURCE_DIR}/${dir} submodule...")
    SET(UPDATE_SUBMODULES_COMMAND
        "${GIT_EXECUTABLE}" submodule update --init --recursive --depth 1)
기본값(UPDATE_SUBMODULES=ON)이고 git 저장소 안이면, CMake가 필요한 서브모듈만 git submodule update --init --depth 1로 그 자리에서 받습니다. 받을 수 없는 상황(-DUPDATE_SUBMODULES=OFF를 줬거나, .git이 없는 압축 파일에서 빌드하거나, git이 없거나)이면 폴더가 이미 차 있는지만 보고, 비어 있으면 "Cannot download … submodule"로 멈춥니다. 그럼 어떤 서브모듈이 "필요"할까요? ADD_SUBMODULE을 부르는 곳을 git grep으로 찾으면 이렇습니다.
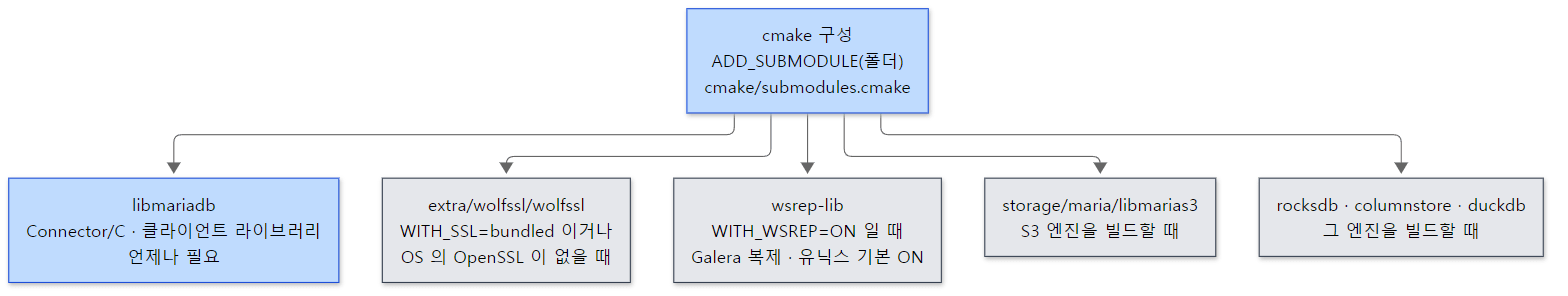 서브모듈이 필요해지는 조건. 파란 칸(libmariadb)만 언제나 필요하고, 회색 칸은 옵션에 따라 끌 수 있습니다.
libmariadb는 언제나 필요합니다. 맨 위CMakeLists.txt493행이 조건 없이INCLUDE(mariadb_connector_c)를 하고, 그 파일 48행이ADD_SUBMODULE_SUBDIRECTORY(libmariadb)입니다(cmake/mariadb_connector_c.cmake 48행). 서버만 빌드하려 해도 이 서브모듈은 빠질 수 없습니다.wsrep-lib는WITH_WSREP가 켜져 있을 때. 그런데 유닉스에서는 기본값이 ON입니다(cmake/wsrep.cmake 23–29행). 그래서 Galera를 쓰지 않으면-DWITH_WSREP=OFF를 직접 줘야 이 서브모듈 없이 빌드됩니다.wolfssl은WITH_SSL=bundled일 때. 기본값yes는 "OS의 OpenSSL이 있으면 쓰고 없으면 번들"이라 OpenSSL 개발 패키지가 있으면 필요 없습니다(cmake/ssl.cmake 33–38행).- 나머지 넷(
libmarias3,rocksdb,columnstore,duckdb)은 그 엔진을 빌드하기로 했을 때만 부릅니다. 예를 들어storage/rocksdb/CMakeLists.txt는PLUGIN_ROCKSDB가NO이면 3–5행에서 바로RETURN()하고, 125행의ADD_SUBMODULE(rocksdb)까지 가지 않습니다.
헷갈리기 쉬운 곳
worktree에는 서브모듈이 따라오지 않습니다. git worktree add로 꺼낸 폴더에서 libmariadb/, wsrep-lib/는 빈 폴더입니다. 이 연재는 서버 쪽 소스만 읽으므로 그대로 두었습니다. 클라이언트 라이브러리 쪽을 볼 일이 있으면 기준 커밋이 가리키는 Connector/C 커밋(8153da40fe)을 따로 받아 봅니다. 서버가 패킷을 읽고 쓰는 쪽은 서버 소스의 sql/net_serv.cc에 있습니다(5편).
3. 도커에서 Debug 빌드하기
실제로 쓰는 Dockerfile
읽기만 할 거면 빌드는 필요 없습니다. 하지만 이 연재는 글에 싣는 예제를 전부 실제로 돌리고, gdb로 서버를 멈춰 함수 호출 단계를 찍습니다. 내려받은 정식판(11.x)으로 돌리면 줄 번호도, 있는 함수도 다르기 때문에 기준 커밋을 그대로 Debug 빌드했습니다. 실제로 쓰는 Dockerfile입니다.
# "MariaDB 소스 파헤치기" 예제용 이미지.
# 기준 커밋 c894d97781 (main, VERSION 13.2.0 alpha, git describe mariadb-13.1.1-222) 의 소스를 그대로 빌드한다.
#   mariadb-c894d97781.tar.gz   : git -c core.autocrlf=false -c core.eol=lf archive 로 뽑은 원본 (LF 줄 끝, 손대지 않음)
#   libmariadb-8153da40fe.tar.gz: 서브모듈 libmariadb (Connector/C) — 기준 커밋이 가리키는 커밋 8153da40fe 의 GitHub 아카이브
# 다른 서브모듈(wsrep-lib, wolfssl, libmarias3, rocksdb, columnstore, duckdb)은 쓰지 않는 기능이라 끄고 빌드한다.
#
# 빌드 종류는 Debug 다: gdb 백트레이스가 인라인으로 뭉개지지 않고, DBUG 추적(--debug=d,...)과
# DBUG_ASSERT 가 살아 있다. 그래서 SELECT VERSION() 은 '13.2.0-MariaDB-debug' 로 나온다.
FROM ubuntu:24.04 AS src

RUN apt-get update && DEBIAN_FRONTEND=noninteractive apt-get install -y --no-install-recommends \
      build-essential cmake ninja-build bison flex pkg-config git ca-certificates \
      libssl-dev zlib1g-dev libncurses-dev libpcre2-dev libxml2-dev liblz4-dev libzstd-dev \
      libaio-dev liburing-dev libsystemd-dev \
      gdb procps psmisc less \
    && rm -rf /var/lib/apt/lists/*

COPY mariadb-c894d97781.tar.gz libmariadb-8153da40fe.tar.gz /usr/src/
WORKDIR /usr/src
RUN tar xzf mariadb-c894d97781.tar.gz \
    && tar xzf libmariadb-8153da40fe.tar.gz \
    && rmdir mariadb/libmariadb \
    && mv mariadb-connector-c-8153da40fe720b1d25db12aa3f993918da15bd3b mariadb/libmariadb \
    && rm -f *.tar.gz

FROM src AS lab
# 소스(/usr/src/mariadb)는 지우지 않는다 — gdb 의 list, 백트레이스의 파일:줄이 이 경로를 가리킨다.
RUN mkdir /usr/src/build && cd /usr/src/build \
    && cmake ../mariadb -G Ninja \
         -DCMAKE_BUILD_TYPE=Debug \
         -DCMAKE_INSTALL_PREFIX=/opt/mariadb \
         -DMYSQL_MAINTAINER_MODE=WARN \
         -DUPDATE_SUBMODULES=OFF \
         -DWITH_WSREP=OFF -DWITH_SSL=system -DWITH_ZLIB=system -DWITH_PCRE=system \
         -DWITH_UNIT_TESTS=OFF -DWITH_EMBEDDED_SERVER=OFF -DWITH_MARIABACKUP=OFF \
         -DPLUGIN_ROCKSDB=NO -DPLUGIN_MROONGA=NO -DPLUGIN_SPIDER=NO -DPLUGIN_COLUMNSTORE=NO \
         -DPLUGIN_CONNECT=NO -DPLUGIN_OQGRAPH=NO -DPLUGIN_SPHINX=NO -DPLUGIN_S3=NO \
         -DPLUGIN_DUCKDB=NO -DPLUGIN_VIDEX=NO -DPLUGIN_FEDERATED=NO \
         -DPLUGIN_AUTH_GSSAPI=NO -DPLUGIN_AUTH_PAM=NO -DPLUGIN_HASHICORP_KEY_MANAGEMENT=NO \
         -DPLUGIN_AWS_KEY_MANAGEMENT=NO \
    && ninja -j"$(nproc)" \
    && ninja install \
    && cd / && rm -rf /usr/src/build

ENV PATH=/opt/mariadb/bin:/opt/mariadb/scripts:$PATH
COPY my.cnf /etc/my.cnf
COPY lab-init lab-start lab-stop /usr/local/bin/
RUN chmod +x /usr/local/bin/lab-*
WORKDIR /work
CMD ["mariadbd", "--version"]
하는 일을 순서대로 풀면 이렇습니다.
- 두 단계로 나눕니다.
src단계는 컴파일러·도구와 소스를 준비하고,lab단계가 빌드합니다. 단계를 나눠 두면 빌드 옵션만 바꿔 다시 빌드할 때 앞 단계를 도커 캐시에서 그대로 씁니다. - 빌드 도구와 라이브러리를 설치합니다.
cmake와ninja-build(빠른 빌드 실행기)가 빌드 도구이고,bison은 SQL 문법 파일sql/sql_yacc.yy를 C++ 파서로 바꾸는 데 씁니다(6편).libssl-dev(OpenSSL),zlib1g-dev(압축),libpcre2-dev(정규식 함수REGEXP) 같은-dev패키지는 서버가 OS 라이브러리를 쓰도록 하려고 넣었습니다.liburing-dev·libaio-dev는 InnoDB의 비동기 디스크 I/O에 씁니다.gdb,procps(ps),psmisc(killall)는 예제에서 서버를 들여다보려고 넣었습니다. - 소스 두 덩이를 넣습니다. 서버 소스는 저장소에서
git archive로 뽑은 원본이고,libmariadb는 서브모듈이 가리키는 커밋을 GitHub에서 받은 압축 파일입니다.git archive는 서브모듈 내용을 담지 않기 때문에 빈libmariadb폴더를 지우고(rmdir) 받은 것을 그 자리에 넣습니다. 앞 절에서 본 대로libmariadb만은 빠질 수 없습니다. - CMake 옵션을 줍니다.
-DCMAKE_BUILD_TYPE=Debug— Debug 빌드.-DUPDATE_SUBMODULES=OFF— 압축 파일에는.git이 없으니 서브모듈을 받으려 하지 말라는 뜻입니다. 대신libmariadb는 직접 넣어 두었으니ADD_SUBMODULE의 "폴더가 차 있나" 검사를 통과합니다.-DWITH_WSREP=OFF,-DWITH_SSL=system— 서브모듈wsrep-lib,wolfssl이 필요 없게 합니다.-DPLUGIN_<이름>=NO— 이 연재에서 읽지 않는 엔진과 플러그인을 끕니다. RocksDB·ColumnStore·DuckDB를 끄면 그 서브모듈도 필요 없어집니다.-DWITH_UNIT_TESTS=OFF -DWITH_EMBEDDED_SERVER=OFF -DWITH_MARIABACKUP=OFF— 단위 테스트, 프로그램 안에 서버를 넣는 임베디드 라이브러리, 백업 도구 mariabackup을 뺍니다.-DMYSQL_MAINTAINER_MODE=WARN— 개발자용 경고는 켜되 오류로 바꾸지는 않습니다. 기본값AUTO는 "Debug 빌드에서만 경고를 오류로" 바꾸므로(CMakeLists.txt 135행), Debug로 빌드하는 이 이미지에서는WARN을 줘서 경고가 빌드를 멈추지 않게 했습니다.
ninja로 빌드하고ninja install로/opt/mariadb에 설치합니다. 이 PC에서 처음부터 끝까지 16분쯤 걸렸습니다. 빌드 폴더는 지우지만 소스(/usr/src/mariadb)는 남겨 둡니다. gdb가 백트레이스에 찍는파일:줄이 이 경로를 가리키고, 줄 번호는 기준 커밋과 같습니다.
이렇게 만든 이미지 이름이 mariadb-lab:c894d97781입니다. 빌드의 흐름을 한 장으로 그리면 이렇습니다.
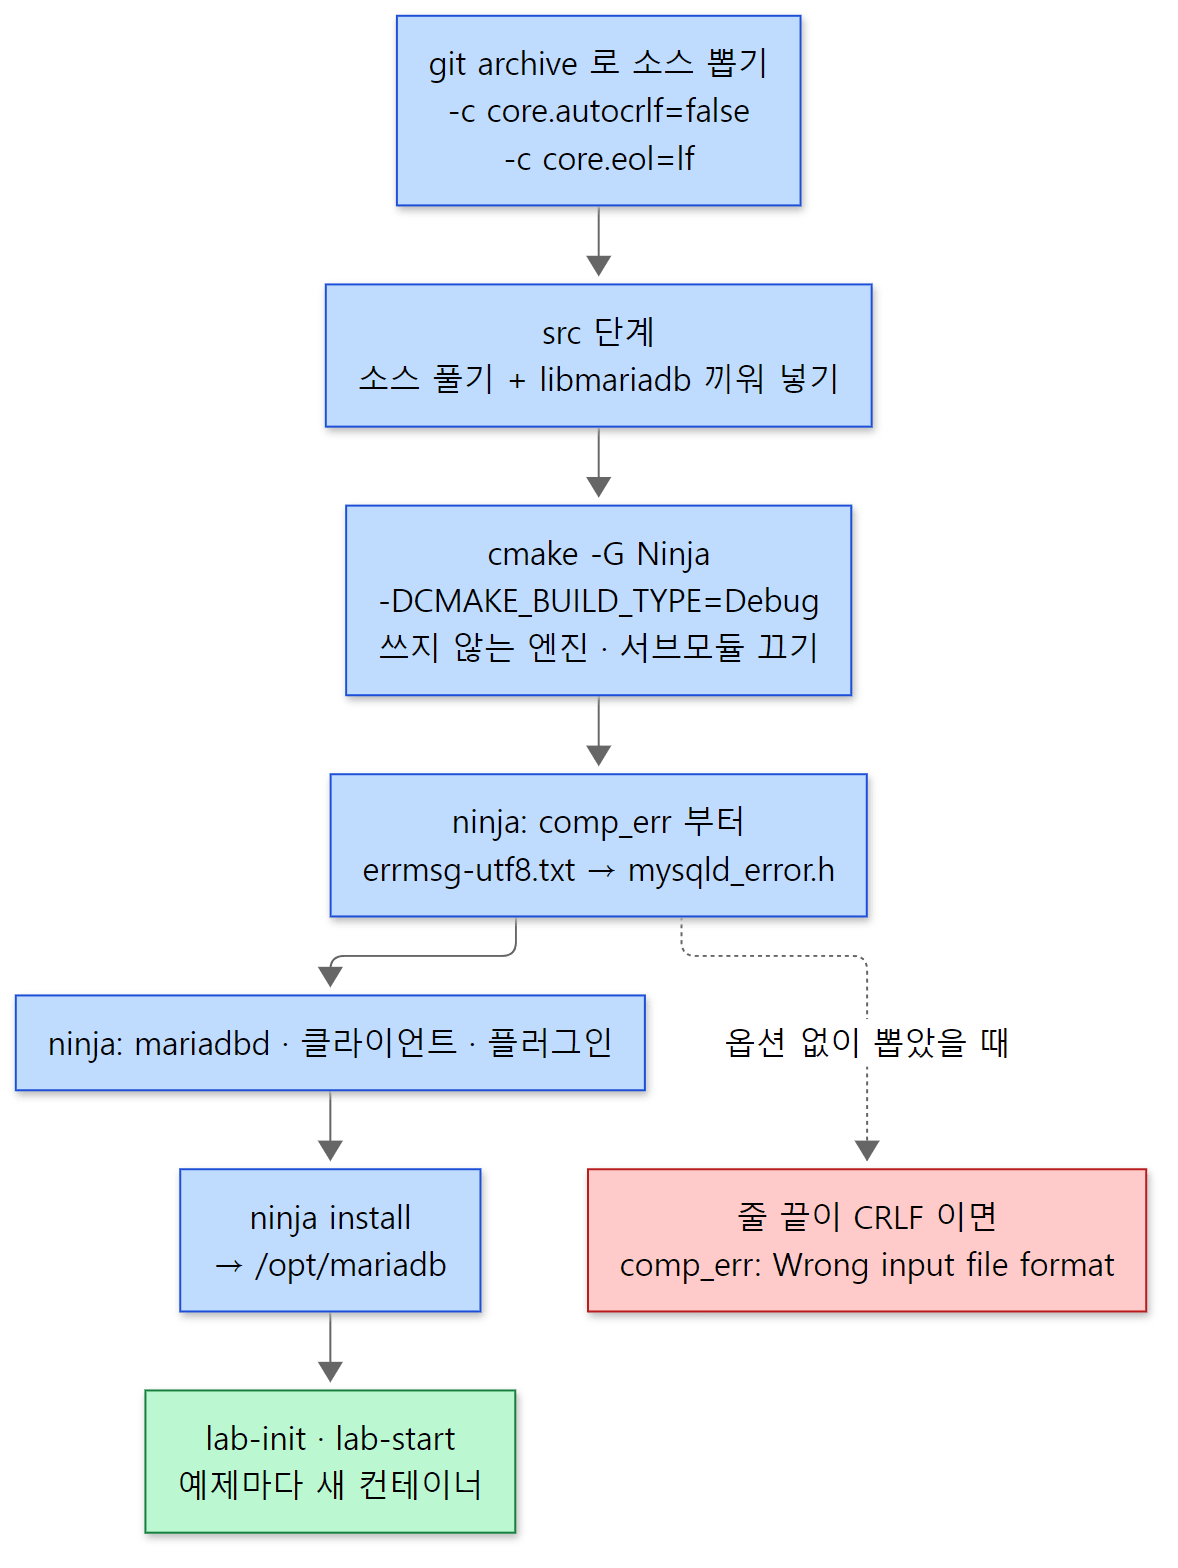 빌드의 흐름. 빨간 칸은 Windows에서 소스를 뽑을 때 실제로 빠졌던 함정입니다(아래 "헷갈리기 쉬운 곳").
예제를 돌리는 방법
예제는 편마다 폴더 하나(ex/u01-reading-plan처럼)에 run.sh를 두고, 이것을 컨테이너 안에서 실행하는 작은 스크립트(run-example.sh)로 돌립니다. 핵심은 한 줄입니다.
MSYS_NO_PATHCONV=1 docker run --rm --cap-add=SYS_PTRACE --security-opt seccomp=unconfined \
  -v "$(pwd -W 2>/dev/null || pwd)/$dir:/work" -w /work \
  mariadb-lab:c894d97781 bash ./run.sh
예제 폴더를 컨테이너의 /work에 붙이고 run.sh를 실행한 뒤 컨테이너를 지웁니다(--rm). 매번 빈 데이터 디렉터리에서 시작하므로 앞 예제가 만든 테이블에 영향을 받지 않습니다. --cap-add=SYS_PTRACE --security-opt seccomp=unconfined는 컨테이너 안에서 gdb가 실행 중인 mariadbd에 붙을 수 있게 하는 권한입니다(도커는 기본으로 다른 프로세스에 붙는 ptrace를 막습니다). pwd -W와 MSYS_NO_PATHCONV=1은 Windows의 Git Bash에서 경로가 멋대로 바뀌지 않게 하는 장치입니다(앞 연재와 같습니다).
컨테이너 안에는 도우미 스크립트 세 개를 넣었습니다. lab-init이 mariadb-install-db로 빈 데이터 디렉터리를 만들고, lab-start가 mariadbd를 뒤에서 띄운 뒤 mariadb-admin ping이 될 때까지 기다리고, lab-stop이 내립니다. 설정 파일 /etc/my.cnf는 소켓을 /tmp/mariadb.sock, 오류 로그를 /tmp/mariadbd.err로 두는 정도입니다.
예제: 빌드한 서버에게 직접 물어보기
이 예제는 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 예제 폴더는 ex/u01-reading-plan이고, 먼저 서버를 띄우고 오류 로그의 첫 줄과 몇 가지 질문을 던집니다.
-- 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
-- 1) 빌드한 서버의 이름표: 버전 문자열과 빌드 정보
SELECT VERSION(), @@version_comment, @@version_compile_os, @@version_compile_machine;
-- 서버가 alpha 라서 플러그인 성숙도 하한이 한 단계 낮다
SELECT @@plugin_maturity;

-- 2) 이 서버가 아는 스토리지 엔진 (SUPPORT: DEFAULT/YES/NO)
SELECT ENGINE, SUPPORT, TRANSACTIONS AS TX, XA, SAVEPOINTS AS SP
  FROM information_schema.ENGINES ORDER BY ENGINE;

-- 3) 플러그인을 종류별로 센다. PLUGIN_LIBRARY 가 NULL 이면 mariadbd 안에 들어 있는(정적) 플러그인
SELECT PLUGIN_TYPE, COUNT(*) AS n,
       SUM(PLUGIN_LIBRARY IS NULL) AS builtin
  FROM information_schema.PLUGINS GROUP BY PLUGIN_TYPE ORDER BY n DESC;

-- 4) 동적 플러그인: 디스크에는 있지만 아직 올리지 않은 것들 (몇 개만)
SELECT PLUGIN_NAME, PLUGIN_TYPE, PLUGIN_MATURITY
  FROM information_schema.ALL_PLUGINS
 WHERE PLUGIN_LIBRARY IN ('ha_blackhole.so','ha_archive.so','metadata_lock_info.so','server_audit.so')
 ORDER BY PLUGIN_NAME;

-- 5) ENGINES 에는 없는데 PLUGINS 에는 있는 스토리지 엔진 플러그인
SELECT PLUGIN_NAME, PLUGIN_STATUS
  FROM information_schema.PLUGINS
 WHERE PLUGIN_TYPE = 'STORAGE ENGINE'
   AND PLUGIN_NAME NOT IN (SELECT ENGINE FROM information_schema.ENGINES);
출력입니다(server_uid는 실행마다 다릅니다).
--- 0. error log at startup
Starting MariaDB 13.2.0-MariaDB-debug source revision  server_uid xj1dJ484WHJjVjINDEeK0lMmhKY= as process 72
--- 1. ask the server
+----------------------+---------------------+----------------------+---------------------------+
 VERSION()            | @@version_comment   | @@version_compile_os | @@version_compile_machine |
+----------------------+---------------------+----------------------+---------------------------+
 13.2.0-MariaDB-debug | Source distribution | Linux                | x86_64                    |
+----------------------+---------------------+----------------------+---------------------------+
+-------------------+
 @@plugin_maturity |
+-------------------+
 experimental      |
+-------------------+
+--------------------+---------+------+------+------+
 ENGINE             | SUPPORT | TX   | XA   | SP   |
+--------------------+---------+------+------+------+
 Aria               | YES     | NO   | NO   | NO   |
 CSV                | YES     | NO   | NO   | NO   |
 InnoDB             | DEFAULT | YES  | YES  | YES  |
 MEMORY             | YES     | NO   | NO   | NO   |
 MRG_MyISAM         | YES     | NO   | NO   | NO   |
 MyISAM             | YES     | NO   | NO   | NO   |
 PERFORMANCE_SCHEMA | YES     | NO   | NO   | NO   |
 SEQUENCE           | YES     | YES  | NO   | YES  |
+--------------------+---------+------+------+------+
+--------------------+----+---------+
 PLUGIN_TYPE        | n  | builtin |
+--------------------+----+---------+
 INFORMATION SCHEMA | 42 |      42 |
 FUNCTION           | 13 |      13 |
 STORAGE ENGINE     | 10 |      10 |
 DATA TYPE          |  6 |       6 |
 DAEMON             |  3 |       3 |
 AUTHENTICATION     |  3 |       3 |
+--------------------+----+---------+
+--------------------+--------------------+-----------------+
 PLUGIN_NAME        | PLUGIN_TYPE        | PLUGIN_MATURITY |
+--------------------+--------------------+-----------------+
 ARCHIVE            | STORAGE ENGINE     | Stable          |
 BLACKHOLE          | STORAGE ENGINE     | Stable          |
 METADATA_LOCK_INFO | INFORMATION SCHEMA | Stable          |
 SERVER_AUDIT       | AUDIT              | Stable          |
+--------------------+--------------------+-----------------+
+--------------+---------------+
 PLUGIN_NAME  | PLUGIN_STATUS |
+--------------+---------------+
 SQL_SEQUENCE | ACTIVE        |
 partition    | ACTIVE        |
+--------------+---------------+
위에서부터 읽으면 이렇습니다.
- 판 번호는 1절의 길을 거쳐
13.2.0-MariaDB-debug로 나오고, 오류 로그 첫 줄에도 같은 이름이 찍힙니다.plugin_maturity는 alpha보다 한 단계 아래인experimental입니다. - 엔진은 여덟 개이고 기본 엔진(
DEFAULT)은 InnoDB입니다. 트랜잭션(TX)·XA(두 단계 커밋)·세이브포인트(SP)를 모두 지원하는 것은 InnoDB 하나입니다. 이 세 열은 사실 엔진의handlerton에 함수가 채워져 있는지를 보여 주는 것입니다.information_schema.ENGINES를 채우는iter_schema_engines()를 보면 그대로 드러납니다.
  if (!(hton->flags & HTON_HIDDEN))
  {
    LEX_CSTRING *name= plugin_name(plugin);
    if (!(wild && wild[0] &&
          wild_case_compare(scs, name->str,wild)))
    {
      const char *option_name= default_type != hton ? "YES"
                                                    : "DEFAULT";
      // ... (ENGINE·SUPPORT·COMMENT 열 채우기 생략)
      table->field[3]->store(
          Show::Yes_or_no::value(hton->commit &&
                                 !(hton->flags & HTON_NO_ROLLBACK)),
          scs);
      table->field[3]->set_notnull();
      table->field[4]->store(Show::Yes_or_no::value(hton->prepare), scs);
      table->field[4]->set_notnull();
      table->field[5]->store(Show::Yes_or_no::value(hton->savepoint_set), scs);
      table->field[5]->set_notnull();
sql/sql_show.cc 7023–7045행 (줄인 곳은 // ...로 표시)
TRANSACTIONS는 "커밋 함수(hton->commit)가 있고 롤백을 못 하는 엔진이 아니다", XA는 "준비 함수(hton->prepare)가 있다", SAVEPOINTS는 "세이브포인트 함수(hton->savepoint_set)가 있다"입니다. 우리가 "InnoDB는 트랜잭션을 지원한다"고 말하는 것은 소스로는 "InnoDB의 handlerton에 commit 함수 포인터가 채워져 있고, '롤백을 못 한다'는 깃발(HTON_NO_ROLLBACK)이 없다"는 뜻입니다. 이 함수들이 실제로 무엇을 하는지는 11편과 12편에서 봅니다.
- 플러그인은 77개이고 전부 정적(
builtin이n과 같음)입니다.ARCHIVE·BLACKHOLE·METADATA_LOCK_INFO·SERVER_AUDIT는/opt/mariadb/lib/plugin에.so로만 있어서,ALL_PLUGINS(디스크의 것까지 보여 주는 테이블)에는 보이지만PLUGINS에는 없습니다.INSTALL SONAME 'ha_blackhole'처럼 올려야 쓸 수 있습니다(3편).
헷갈리기 쉬운 곳
ENGINES는 엔진을 다 보여 주지 않습니다. 위 출력에서 PLUGINS의 스토리지 엔진은 10개인데 ENGINES는 8개입니다. 마지막 질문이 그 차이를 찍었습니다. partition과 SQL_SEQUENCE입니다. 위 코드 첫 줄 if (!(hton->flags & HTON_HIDDEN))가 이유입니다. HTON_HIDDEN은 sql/handler.h 1943행에서 "Engine does not appear in lists"라고 주석이 달린 깃발이고, 파티션 테이블을 맡는 partition(sql/ha_partition.cc 233–235행)과 CREATE SEQUENCE로 만든 시퀀스 객체를 맡는 SQL_SEQUENCE(sql/ha_sequence.cc 552–559행)가 이 깃발을 겁니다. 둘 다 사용자가 ENGINE=으로 직접 고르는 엔진이 아니라 서버가 안에서 쓰는 엔진이라 목록에서 감춘 것입니다. 그리고 ENGINES에 보이는 SEQUENCE는 이름은 비슷하지만 다른 엔진입니다. seq_1_to_10 같은 가상 테이블을 만들어 주는 storage/sequence/sequence.cc의 엔진입니다. 같은 이름을 엔진 목록과 플러그인 목록에서 찾을 때는 이 차이를 알아 두어야 합니다.
Windows에서 뽑은 소스로는 빌드가 깨졌습니다. 예제 환경을 만들 때 실제로 겪은 일입니다. Windows의 Git은 흔히 core.autocrlf=true로 설정되어 있어서, 파일을 꺼낼 때 줄 끝을 리눅스식 LF(\n)에서 Windows식 CRLF(\r\n)로 바꿉니다. 처음에는 그렇게 뽑은 소스로 빌드했는데, 컴파일이 시작되기도 전에 빌드 도구 comp_err가 멈췄습니다. comp_err는 오류 메시지 원본 sql/share/errmsg-utf8.txt(오류 번호마다 여러 언어의 메시지가 적힌 파일)를 읽어, 서버 소스 곳곳이 include하는 헤더 mysqld_error.h(ER_NO_SUCH_TABLE 같은 오류 번호 상수)와 언어별 메시지 파일을 만드는 프로그램입니다(extra/CMakeLists.txt 23–52행). 이 헤더를 직접 include하는 파일만 52개라 이것이 없으면 서버를 빌드할 수 없습니다. 그때의 로그는 남겨 두지 않았기 때문에, 이 글을 쓰면서 같은 상황을 다시 만들었습니다(예제 ex/u01-crlf-comp-err — 이미지 안의 소스로 comp_err 하나만 빌드하고, LF 판과 CRLF로 바꾼 판을 차례로 먹입니다).
--- 1. LF (as in git archive with core.autocrlf=false)
exit=0  1394 ER_ macros
--- 2. CRLF (as checked out on Windows with core.autocrlf=true)
Wrong input file format. Stop!
Line:

Failed to parse input file /tmp/errmsg-crlf.txt
exit=1
(맨 앞에서 두 파일의 줄 끝 바이트를 od -c로 찍은 부분과, Debug 빌드의 메모리 검사가 끝에 덧붙이는 "Memory report from safemalloc" 세 줄은 뺐습니다.) Line: 뒤가 비어 보이는 것이 단서입니다. comp_err의 입력 읽기 루프는 줄 머리 글자만 보고 그 줄이 무엇인지 정하는데, 맨 끝의 검사가 이렇습니다.
    if (*str == '#' || *str == '\n')
      continue;                      	/* skip comment or empty lines */

    fprintf(stderr, "Wrong input file format. Stop!\nLine: %s\n", str);
    DBUG_RETURN(0);
빈 줄은 '\n'으로 시작한다고 가정합니다. CRLF 파일의 빈 줄은 "\r\n"이라 첫 글자가 '\r'이고, 어느 경우에도 걸리지 않아 "형식이 틀렸다"로 멈춥니다. 파일의 2행이 빈 줄이니 거의 첫머리에서 멈춘 셈입니다. Line: 뒤에는 \r이 찍혀 있어 눈에 보이지 않았던 것입니다.
그런데 여기서 한 번 더 걸렸습니다. git -c core.autocrlf=false archive만으로는 고쳐지지 않습니다. 저장소의 .gitattributes 첫 규칙이 * text=auto(모든 텍스트 파일의 줄 끝을 git이 관리한다)이고, 이렇게 표시된 파일을 꺼낼 때 git은 core.eol 설정을 따릅니다. core.eol의 기본값은 "그 OS의 방식"(native)이라 Windows에서는 여전히 CRLF입니다. 기준 커밋에서 git archive로 errmsg-utf8.txt 하나를 뽑아 \r의 개수를 세 보면 분명합니다.
git archive 옵션 |
뽑힌 errmsg-utf8.txt의 \r 개수 |
|---|---|
(없음, core.autocrlf=true) |
12,431 (파일의 줄 수와 같다) |
-c core.autocrlf=false |
12,431 |
-c core.autocrlf=false -c core.eol=lf |
0 |
그래서 Dockerfile 주석에 두 옵션을 함께 적었습니다. httpd 1편에서는 같은 CRLF가 셸 스크립트를 "없는 파일"로 만들었는데, 이번에는 C 프로그램이 읽는 데이터 파일에서 터졌습니다.
오류 로그의 source revision 뒤가 비어 있습니다. 출력 첫 줄의 source revision server_uid는 오타가 아니라 값이 빈 것입니다. CMake는 소스 폴더에 .git이 있을 때만 git rev-parse HEAD로 커밋 해시를 얻어 SOURCE_REVISION에 넣습니다(CMakeLists.txt 580–588행). git archive로 뽑은 압축 파일에는 .git이 없으니 비어 있습니다. 그래서 이 연재는 서버가 밝히는 리비전 대신 이미지 이름(mariadb-lab:c894d97781)으로 커밋을 표시합니다.
4. 폴더 지도 — 259만 줄은 어디에 있나
맨 위 폴더
기준 커밋에서 git이 관리하는 항목은 27,587개(서브모듈 일곱 개는 항목 하나씩으로만 셈)입니다. 그 가운데 64%인 17,745개가 mysql-test/ 아래에 있고, .test 파일만 7,031개, 기대 출력 .result가 6,991개입니다. 서버에 SQL을 보내고 출력을 .result와 비교하는 시험이 7천 개 넘게 있다는 뜻입니다.
C/C++ 소스(.c .cc .h .cpp .ic .inl .yy .hpp)만 세면 3,145개, 합쳐서 2,588,458줄(빈 줄과 주석 포함)입니다. 맨 위 폴더별로 직접 세면 이렇습니다(git ls-files로 파일을 고르고 줄 바꿈 문자를 셈).
| 폴더 | 들어 있는 것 | 파일 | 줄 수 | 다루는 편 |
|---|---|---|---|---|
storage/ |
스토리지 엔진 — 엔진마다 하위 폴더 | 1,629 | 1,112,800 | 2·9–12편 |
sql/ |
서버 계층 — 연결, 파서, 옵티마이저, 실행, 복제, binlog | 559 | 792,070 | 2–9·11–12편 |
strings/ |
문자열·문자 집합(charset)과 정렬 규칙(collation) | 85 | 334,233 | — |
mysys/ |
서버 공통 라이브러리 — 파일·메모리(MEM_ROOT)·스레드·해시 |
153 | 64,751 | 2편 |
extra/ |
빌드 도구(comp_err 등)와 덤으로 딸린 프로그램 |
118 | 62,618 | — |
plugin/ |
엔진이 아닌 플러그인 — 인증, 감사, 자료형, 정보 테이블 | 211 | 47,821 | 3편 |
client/ |
mariadb, mariadb-dump, mariadb-admin, mariadb-binlog 등 |
26 | 46,663 | — |
include/ |
공용 헤더(my_global.h, mysql_com.h, 플러그인 API) |
177 | 36,311 | — |
vio/ |
소켓·TLS를 감싼 입출력 추상화 Vio |
12 | 3,625 | 5편 |
tpool/ |
InnoDB가 쓰는 스레드 풀·비동기 I/O 라이브러리 | 12 | 3,141 | 10편 |
dbug/ |
DBUG_ENTER·DBUG_PRINT 추적 라이브러리 |
9 | 2,658 | — |
이 밖에 tests/(C로 짠 클라이언트 API 시험, 27,938줄), zlib/(번들 압축 라이브러리), unittest/, libmysqld/(임베디드 서버), sql-common/(서버와 클라이언트가 같이 쓰는 코드) 같은 작은 폴더가 있습니다. strings/가 33만 줄이나 되는 것은 대부분 문자 집합 변환 표이기 때문입니다. ctype-eucjpms.c(67,744줄), ctype-ujis.c(67,490줄), ctype-uca.c(39,429줄) 세 파일만으로 17만 줄이 넘습니다. 읽을 코드라기보다 데이터입니다.
storage/ 안
storage/ 안을 엔진별로 나누면 이렇습니다(줄 수가 큰 것부터 열 개, 그리고 견본 엔진 example).
| 폴더 | 엔진 | 파일 | 줄 수 | 이 연재의 빌드 |
|---|---|---|---|---|
storage/innobase |
InnoDB — 기본 엔진, 트랜잭션·MVCC·redo | 303 | 314,449 | 정적 (10–12편) |
storage/mroonga |
Mroonga — 전문 검색 엔진 | 447 | 281,907 | 끔 |
storage/connect |
CONNECT — 외부 데이터(CSV, ODBC …) | 173 | 121,615 | 끔 |
storage/maria |
Aria — MyISAM의 뒤를 잇는 엔진, 시스템 테이블에 쓰임 | 145 | 106,358 | 정적 |
storage/spider |
Spider — 샤딩 | 34 | 75,549 | 끔 |
storage/perfschema |
performance_schema | 255 | 75,470 | 정적 |
storage/myisam |
MyISAM — 트랜잭션 없는 옛 엔진 | 72 | 40,819 | 정적 |
storage/rocksdb |
MyRocks (서브모듈 제외) | 47 | 33,919 | 끔 |
storage/heap |
MEMORY | 41 | 16,030 | 정적 |
storage/duckdb |
DuckDB (서브모듈 제외) | 40 | 13,187 | 끔 |
storage/example |
가장 작은 견본 엔진 ha_example |
2 | 1,385 | 동적 |
InnoDB 하나가 31만 줄로, 서버 계층(sql/)의 40% 정도 크기입니다. 이 연재는 엔진 가운데 InnoDB만 깊게 읽고, 나머지는 handler를 어떻게 구현했는지 비교할 때만 봅니다. 엔진을 처음 만들어 보려는 사람에게는 storage/example/ha_example.cc가 출발점입니다(2편).
이 연재가 오래 머무를 파일
| 파일 | 줄 수 | 다루는 편 |
|---|---|---|
sql/sql_select.cc |
36,086 | 8·9편 (옵티마이저와 실행) |
storage/innobase/handler/ha_innodb.cc |
22,003 | 9–11편 (서버 계층과 InnoDB의 다리) |
sql/sql_yacc.yy |
21,251 | 6편 (SQL 문법) |
sql/opt_range.cc |
17,993 | 8편 (범위 옵티마이저) |
sql/sql_acl.cc |
17,663 | 4·7편 (인증과 권한) |
sql/log.cc |
15,478 | 12편 (binlog) |
sql/mysqld.cc |
10,607 | 3편 (기동) |
sql/sql_base.cc |
10,576 | 7편 (테이블 열기) |
sql/sql_parse.cc |
10,472 | 5–7편 (명령 처리) |
sql/handler.cc |
9,915 | 9·11편 (handler 감싸개, 트랜잭션) |
sql/sql_class.h |
8,857 | 2편 (THD) |
sql/handler.h |
6,210 | 2·9편 (handler, handlerton) |
한 파일이 3만 6천 줄인 것을 보면 겁이 나지만, 한 편에서 읽는 것은 그 가운데 함수 몇 개입니다. 앞 연재와 크기를 대 보면, httpd가 .c·.h 약 35만 줄, Tomcat이 .java 약 74만 줄이었으니 MariaDB는 그 세 배가 넘습니다. 다만 그 3분의 1쯤이 이 연재에서 끄는 엔진(Mroonga, CONNECT, Spider, RocksDB …)과 문자 집합 표입니다.
층으로 보면
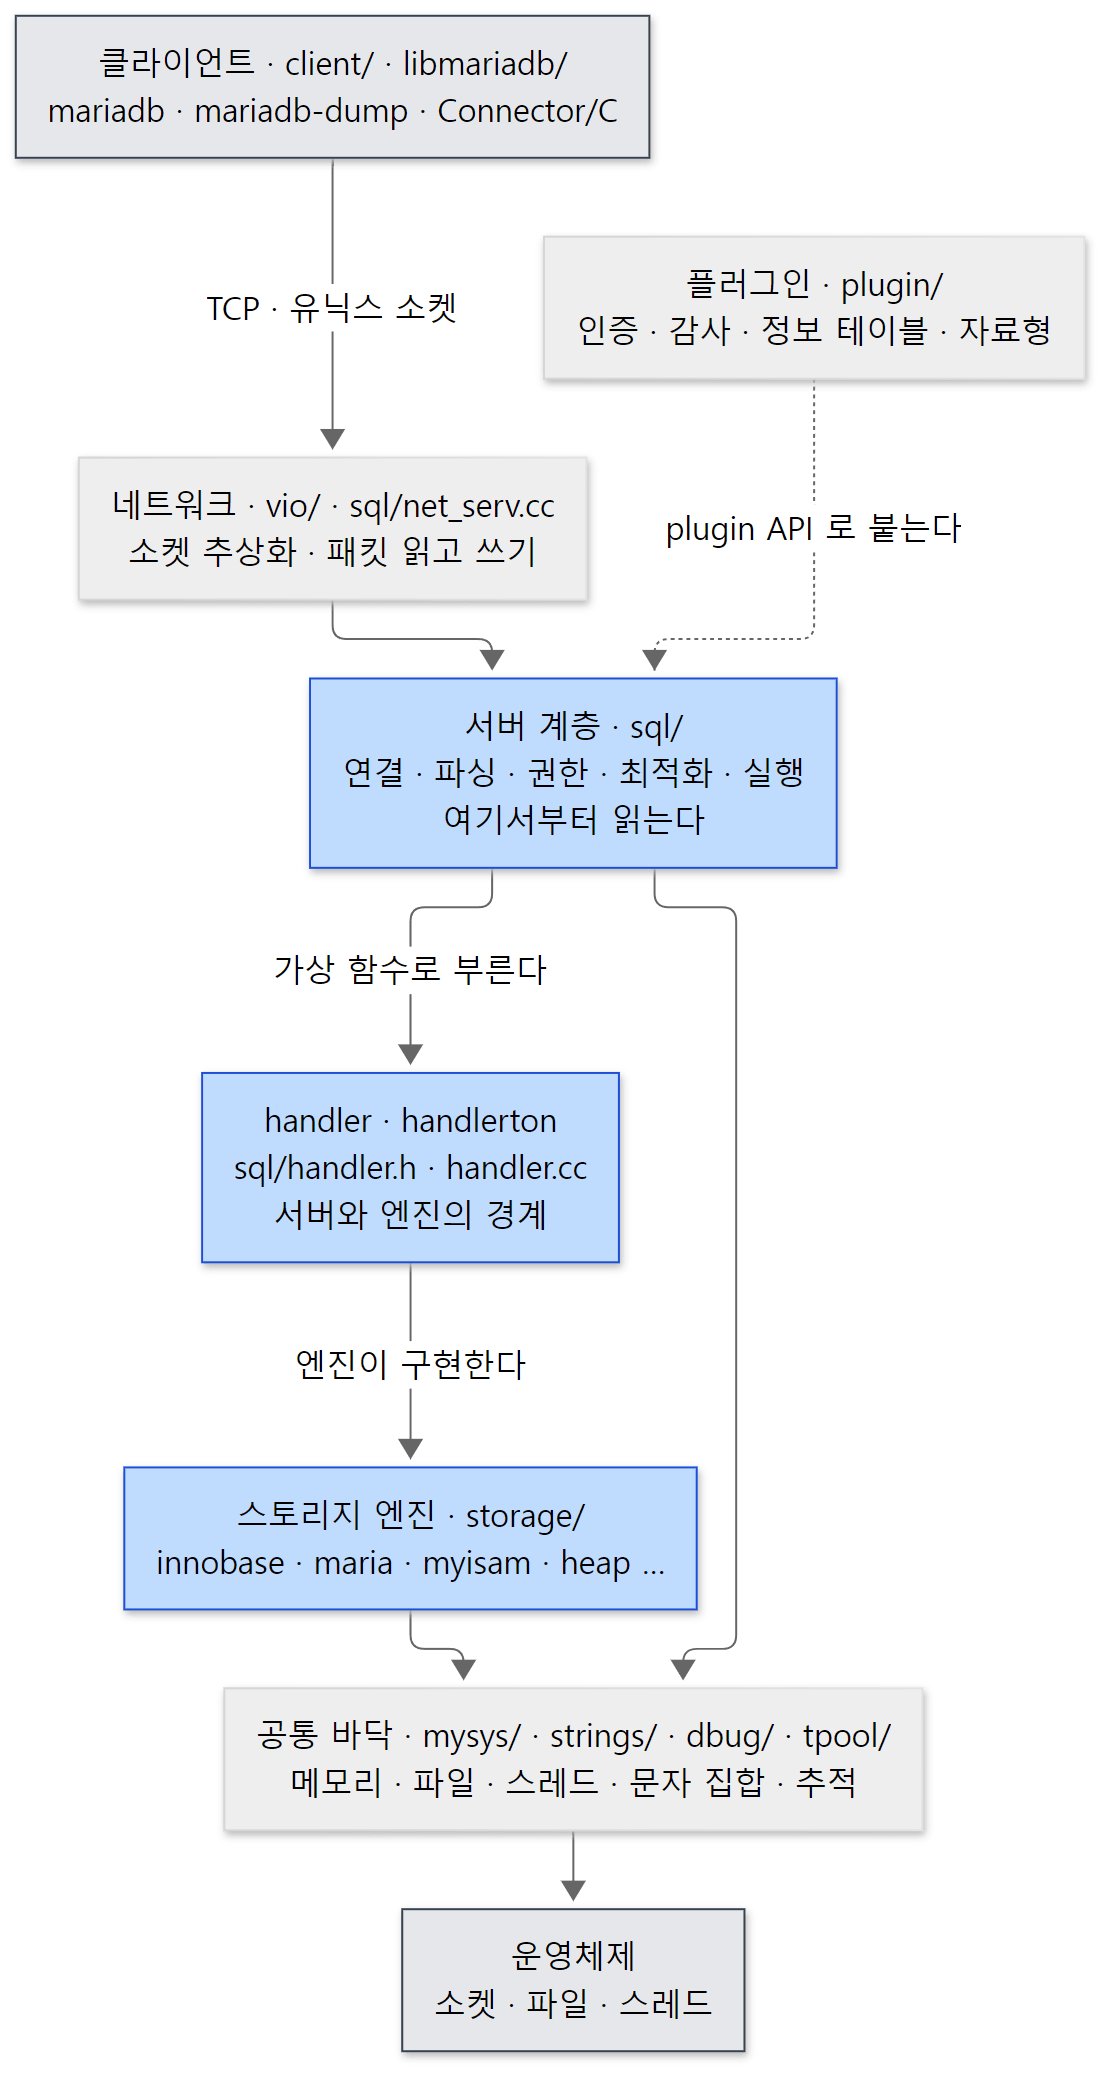 MariaDB 소스의 층. 파란 칸(서버 계층, handler, 엔진)이 이 연재가 읽는 곳이고, 회색 칸은 바깥입니다.
이 그림에서 두 가지를 기억해 두면 됩니다.
첫째, 서버 계층과 엔진은 handler 하나로만 이어집니다. 서버 계층은 InnoDB의 B-트리나 버퍼 풀을 모르고, handler의 가상 함수만 부릅니다. 그래서 같은 SELECT가 엔진만 바꿔도 그대로 돌아갑니다. Tomcat에서 Coyote와 Catalina가 Adapter 하나로만 이어졌던 것과 같은 설계입니다(Tomcat 2편).
둘째, 공통 바닥(mysys/, strings/)은 서버 계층과 엔진이 같이 씁니다. 메모리를 문장 단위로 모아 잡았다가 한 번에 푸는 MEM_ROOT도 mysys/에 있습니다. httpd의 APR 메모리 풀(httpd 4편)과 닮은 장치로, 2편에서 봅니다.
5. 쿼리 하나가 지나는 큰 길
한 장으로 보면
연재의 3편부터 9편까지는 SELECT 하나가 지나가는 길을 순서대로 따라가고, 10~12편은 그 길의 끝인 InnoDB 안으로 들어갑니다. 큰 길만 한 장에 그리면 이렇습니다.
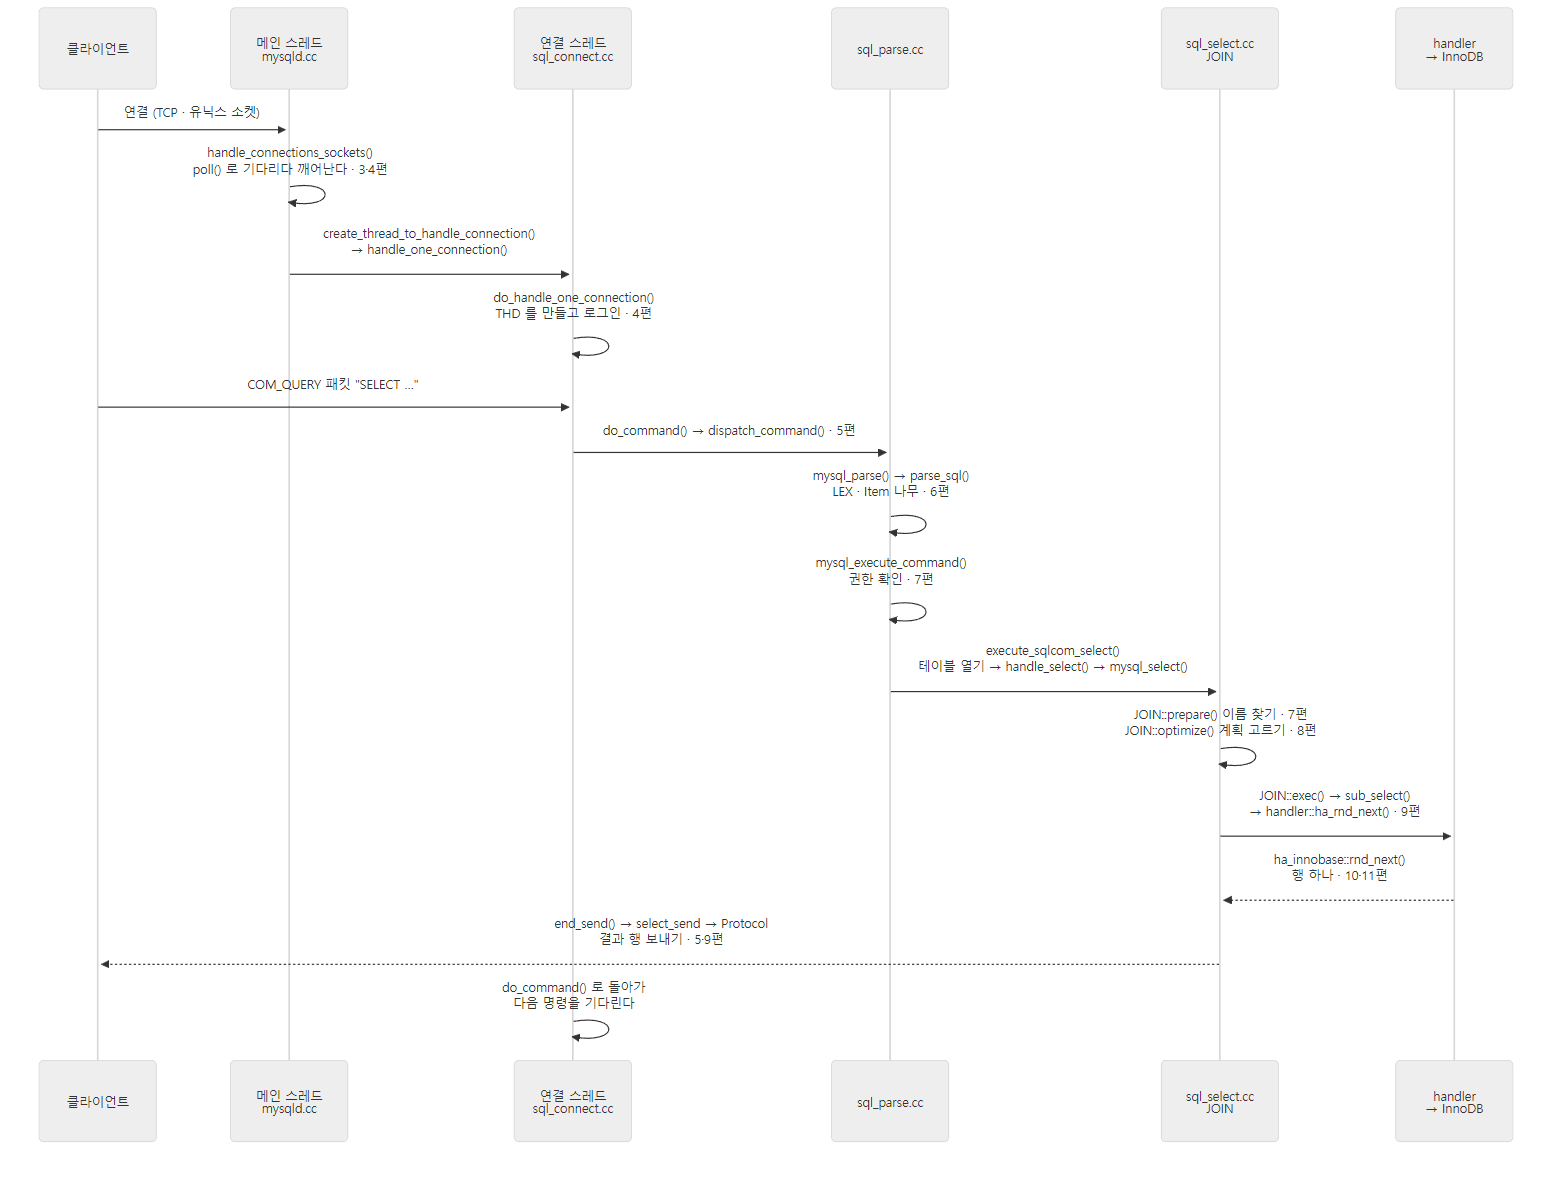
SELECT 하나의 큰 길. 메시지마다 그 단계를 다루는 편이 적혀 있습니다. 연결 스레드가 받은 뒤로는 끝까지 같은 스레드 하나가 일합니다.
사용자 쪽에서 보던 것과 이어 보면 이렇습니다.
| 단계 | 사용자 쪽에서 보던 것 | 다루는 편 |
|---|---|---|
| 기동 · 플러그인 | my.cnf, 오류 로그의 기동 메시지, INSTALL SONAME |
3편 |
| 연결 · 스레드 | SHOW PROCESSLIST, max_connections, thread_handling, thread_cache_size |
4편 |
| 패킷 · 명령 | Com_select 같은 상태 변수, 쿼리 캐시, max_allowed_packet |
5편 |
| 파싱 | "You have an error in your SQL syntax … near '…'" | 6편 |
| 권한 · 테이블 열기 · 이름 찾기 | "Unknown column", Waiting for table metadata lock, table_open_cache |
7편 |
| 최적화 | EXPLAIN, ANALYZE, optimizer_trace |
8편 |
| 실행 · handler | Handler_read_rnd_next 같은 상태 변수 |
9편 |
| InnoDB | innodb_buffer_pool_size, SHOW ENGINE INNODB STATUS, 격리 수준, 교착 |
10–12편 |
코드에서 네 군데만 미리 보기
하나, 연결 스레드의 반복문. 연결 하나를 맡은 스레드는 do_handle_one_connection()에서 로그인을 마친 뒤 명령을 하나씩 처리하는 반복문을 돕니다.
    if (thd_prepare_connection(thd))
    {
      create_user= FALSE;
      goto end_thread;
    }

    while (thd_is_connection_alive(thd))
    {
      if (mysql_audit_release_required(thd))
        mysql_audit_release(thd);
      if (do_command(thd))
	break;
    }
    end_connection(thd);
thd_prepare_connection()이 핸드셰이크와 인증을 하고, 그다음은 연결이 살아 있는 동안 do_command()를 되풀이합니다. do_command() 한 번이 "패킷 하나를 읽고 처리하고 답하기"입니다. 클라이언트가 접속을 끊으면(COM_QUIT) do_command()가 참을 돌려줘 반복이 끝납니다. 이것이 기본 방식인 "연결마다 스레드 하나"(thread_handling=one-thread-per-connection)이고, 스레드 풀 방식은 이 반복문을 다르게 돌립니다(4편).
둘, 명령 종류로 나누는 곳. do_command()가 읽은 패킷의 첫 바이트가 명령 종류이고, dispatch_command()의 큰 switch가 그것으로 나눕니다. SQL 문장을 보내는 COM_QUERY는 이렇습니다.
  case COM_QUERY:
  {
    DBUG_ASSERT(thd->m_digest == NULL);
    thd->m_digest= & thd->m_digest_state;
    thd->m_digest->reset(thd->m_token_array, max_digest_length);

    if (unlikely(alloc_query(thd, packet, packet_length)))
      break;					// fatal error is set
    MYSQL_QUERY_START(thd->query(), thd->thread_id,
                      thd->get_db(),
                      &thd->security_ctx->priv_user[0],
                      (char *) thd->security_ctx->host_or_ip);
    char *packet_end= thd->query() + thd->query_length();
    general_log_write(thd, command, thd->query(), thd->query_length());
    DBUG_PRINT("query",("query_id=%lld, %.*s", thd->query_id, thd->query_length(), thd->query()));
#if defined(ENABLED_PROFILING)
    thd->profiling.set_query_source(thd->query(), thd->query_length());
#endif
    MYSQL_SET_STATEMENT_TEXT(thd->m_statement_psi, thd->query(),
                             thd->query_length());

    Parser_state parser_state;
    if (unlikely(parser_state.init(thd, thd->query(), thd->query_length())))
      break;

// ... (WSREP 블록 생략)
      mysql_parse(thd, thd->query(), thd->query_length(), &parser_state);
alloc_query()가 패킷의 SQL 문자열을 THD 안에 복사하고, general_log_write()가 일반 쿼리 로그(general_log=ON일 때)를 쓰고, 파서 상태를 준비한 뒤 mysql_parse()로 넘깁니다. MYSQL_QUERY_START, MYSQL_SET_STATEMENT_TEXT처럼 대문자로 된 줄은 DTrace·performance_schema에 "문장이 시작됐다"고 알리는 계측 지점이라, 처음 읽을 때는 건너뛰어도 됩니다. 이렇게 본 줄기 사이에 계측·Galera(WITH_WSREP)·프로파일링 블록이 섞여 있는 것이 MariaDB 소스의 특징이고, 이 연재는 인용할 때 그런 블록을 // ...로 줄이고 무엇을 뺐는지 적습니다(5편).
셋, 파싱과 실행이 만나는 곳. mysql_parse()는 쿼리 캐시를 먼저 보고, 없으면 파싱한 뒤 실행합니다.
  lex_start(thd);
  thd->reset_for_next_command();

  if (query_cache_send_result_to_client(thd, rawbuf, length) <= 0)
  {
    LEX *lex= thd->lex;

    bool err= parse_sql(thd, parser_state, NULL, true);
    // ...
          int error __attribute__((unused));
          error= mysql_execute_command(thd);
    // ...
    thd->end_statement();
    thd->Item_change_list::rollback_item_tree_changes();
    thd->cleanup_after_query();
sql/sql_parse.cc 7950–8029행 (줄인 곳은 // ...로 표시)
parse_sql()이 SQL 문자열을 LEX(문장 하나를 해석한 결과 — 어떤 종류의 문장인지, 어떤 테이블과 식이 나오는지)와 Item 나무(WHERE name = 'two' 같은 식을 객체로 만든 나무)로 바꾸고(6편), mysql_execute_command()가 LEX의 문장 종류(SQLCOM_SELECT, SQLCOM_INSERT …)로 다시 switch해서 실행합니다(7편). 끝의 cleanup_after_query()는 이 문장 하나를 위해 잡았던 것을 정리합니다. 쿼리 캐시를 파싱보다 먼저 보는 이유와 그 위 긴 주석의 사연은 5편에서 봅니다.
SELECT이면 execute_sqlcom_select() → handle_select()를 거쳐 mysql_select()에 닿고, 여기서 준비·최적화·실행이 차례로 불립니다.
    if (!(join= new (thd->mem_root) JOIN(thd, fields, select_options, result)))
	DBUG_RETURN(TRUE);
    THD_STAGE_INFO(thd, stage_init);
    thd->lex->used_tables=0;
    if (!join->prepared &&
        (err= join->prepare(tables, conds, og_num, order, false, group, having,
                            proc_param, select_lex, unit)))
    {
      goto err;
    }
  }
  // ...
  if ((err= join->optimize()))
  {
    goto err;					// 1
  }
  // ...
  exec_error= join->exec();
sql/sql_select.cc 5427–5461행 (줄인 곳은 // ...로 표시)
JOIN은 SELECT 하나(서브쿼리가 있으면 그 하나하나)의 실행 계획과 상태를 담는 객체입니다. new (thd->mem_root) JOIN(…)은 C++의 위치 지정 new로, 일반 힙이 아니라 **이 연결의 MEM_ROOT**에 객체를 만듭니다. 문장이 끝나면 MEM_ROOT째로 비우므로 delete를 일일이 하지 않습니다(2편). prepare()가 *를 열 목록으로 펼치고 열 이름을 실제 테이블의 열에 이어 주고(7편), optimize()가 조인 순서와 인덱스를 고르고(8편), exec()가 그 계획대로 엔진을 부릅니다(9편).
넷, 서버 계층이 엔진을 부르는 곳. 실행 단계는 행을 한 줄씩 달라고 handler::ha_rnd_next()를 부릅니다. 이름 앞의 ha_가 붙은 함수는 엔진이 구현한 가상 함수를 감싸는 서버 쪽 함수입니다.
  do
  {
    TABLE_IO_WAIT(tracker, PSI_TABLE_FETCH_ROW, MAX_KEY, result,
      { result= rnd_next(buf); })
    if (result != HA_ERR_RECORD_DELETED)
      break;
    status_var_increment(table->in_use->status_var.ha_read_rnd_deleted_count);
  } while (!table->in_use->check_killed(1));

  if (result == HA_ERR_RECORD_DELETED)
    result= HA_ERR_ABORTED_BY_USER;
  else
  {
    if (!result)
    {
      update_rows_read();
      if (table->vfield && buf == table->record[0])
        table->update_virtual_fields(this, VCOL_UPDATE_FOR_READ);
    }
    increment_statistics(&SSV::ha_read_rnd_next_count);
  }
가운데의 rnd_next(buf)가 엔진의 가상 함수이고, 그 둘레가 서버가 덧붙이는 일입니다. TABLE_IO_WAIT는 performance_schema에 "테이블 I/O를 기다린다"고 기록하는 매크로이고, 마지막의 increment_statistics(&SSV::ha_read_rnd_next_count)가 우리가 SHOW STATUS LIKE 'Handler_read_rnd_next'로 보던 숫자를 하나 올리는 자리입니다. 사용자 쪽 상태 변수가 소스의 어느 한 줄과 바로 이어지는 예입니다. InnoDB 쪽 구현은 이렇습니다.
int
ha_innobase::rnd_next(
/*==================*/
	uchar*	buf)	/*!< in/out: returns the row in this buffer,
			in MySQL format */
{
	int	error;
	DBUG_ENTER("rnd_next");

	if (m_start_of_scan) {
		error = index_first(buf);

		if (error == HA_ERR_KEY_NOT_FOUND) {
			error = HA_ERR_END_OF_FILE;
		}

		m_start_of_scan = false;
	} else {
		error = general_fetch(buf, ROW_SEL_NEXT, 0);
	}

	DBUG_RETURN(error);
}
storage/innobase/handler/ha_innodb.cc 9661–9683행
InnoDB에서 "테이블 처음부터 끝까지 읽기"(풀 스캔)는 별도의 방법이 아니라 클러스터드 인덱스(기본 키 순서로 행이 저장된 B-트리)를 맨 앞부터 따라가기입니다. 첫 호출은 index_first(), 그다음부터는 general_fetch(…, ROW_SEL_NEXT, …)로 다음 행을 가져옵니다. InnoDB에서 테이블이 곧 기본 키 B-트리라는 이야기는 10편에서 봅니다. 들여쓰기도 눈여겨볼 만합니다. 서버 계층(sql/)은 공백 두 칸인데 InnoDB는 탭이고, 함수 이름 아래에 /*===*/ 줄을 긋는 InnoDB만의 양식이 남아 있습니다. 같은 저장소 안에서도 폴더마다 코드 양식이 다르다는 것을 알아 두면, storage/innobase/에 들어갔을 때 덜 낯섭니다.
예제: 정말 이 길로 지나가나
그림이 맞는지 실행 중인 서버를 gdb로 멈춰 확인했습니다. 같은 예제(ex/u01-reading-plan)의 뒷부분입니다. 행 세 개짜리 InnoDB 테이블을 만들고, gdb를 mariadbd에 붙여 ha_innobase::rnd_next에 중단점(breakpoint)을 건 뒤, 다른 쪽에서 SELECT를 보냅니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# (run.sh 의 일부 — 앞부분의 lab-init·lab-start·demo.sql 실행과 끝의 lab-stop 은 생략)
# 테이블 하나를 만들고 행 세 개를 넣는다
mariadb -e "CREATE DATABASE lab;
  CREATE TABLE lab.t (id INT PRIMARY KEY, name VARCHAR(20)) ENGINE=InnoDB;
  INSERT INTO lab.t VALUES (1,'one'),(2,'two'),(3,'three');"

echo "--- 2. EXPLAIN: full table scan"
mariadb -t -e "EXPLAIN SELECT * FROM lab.t WHERE name = 'two'"

echo "--- 3. gdb backtrace at ha_innobase::rnd_next"
# 실행 중인 mariadbd 에 gdb 를 붙여, 첫 rnd_next 호출에서 멈추고 호출 스택을 찍은 뒤 떨어진다
gdb -p "$(cat /tmp/mariadbd.pid)" -batch \
    -ex 'set pagination off' \
    -ex 'break ha_innobase::rnd_next' \
    -ex 'continue' \
    -ex 'bt' \
    -ex 'info threads' \
    -ex 'detach' > /tmp/gdb.out 2>&1 &
gdbpid=$!
# 디버그 빌드라 심볼을 읽는 데 오래 걸린다 — 중단점이 걸릴 때까지 기다린다
until grep -q "^Breakpoint 1 at" /tmp/gdb.out 2>/dev/null; do sleep 1; done
sleep 3
mariadb -e "SELECT * FROM lab.t WHERE name = 'two'"
wait $gdbpid || true
# 함수 이름과 파일:줄만 남긴다 (주소·인자 값은 실행마다 다르다)
grep -E '^#[0-9]+ ' /tmp/gdb.out | sed -E 's/^(#[0-9]+) +(0x[0-9a-f]+ in )?/\1 /; s/ \(.*\) at / at /'
echo "--- threads by name"
grep -E "^[ *] +[0-9]+ +Thread " /tmp/gdb.out | sed -E "s/^[^\"]*\"([^\"]*)\".*/\1/" | sort | uniq -c | sort -rn
name 열에는 인덱스가 없으니 EXPLAIN은 풀 스캔(type이 ALL)을 보여 줍니다. 출력입니다. gdb의 백트레이스는 주소와 인자 값을 지우고 함수 이름과 파일:줄만 남겼습니다.
--- 2. EXPLAIN: full table scan
+------+-------------+-------+------+---------------+------+---------+------+------+-------------+
 id   | select_type | table | type | possible_keys | key  | key_len | ref  | rows | Extra       |
+------+-------------+-------+------+---------------+------+---------+------+------+-------------+
    1 | SIMPLE      | t     | ALL  | NULL          | NULL | NULL    | NULL | 3    | Using where |
+------+-------------+-------+------+---------------+------+---------+------+------+-------------+
--- 3. gdb backtrace at ha_innobase::rnd_next
id	name
2	two
#0 ha_innobase::rnd_next at /usr/src/mariadb/storage/innobase/handler/ha_innodb.cc:9668
#1 handler::ha_rnd_next at /usr/src/mariadb/sql/handler.cc:4129
#2 rr_sequential at /usr/src/mariadb/sql/records.cc:517
#3 READ_RECORD::read_record at /usr/src/mariadb/sql/records.h:77
#4 join_init_read_record at /usr/src/mariadb/sql/sql_select.cc:26694
#5 sub_select at /usr/src/mariadb/sql/sql_select.cc:25572
#6 do_select at /usr/src/mariadb/sql/sql_select.cc:25086
#7 JOIN::exec_inner at /usr/src/mariadb/sql/sql_select.cc:5147
#8 JOIN::exec at /usr/src/mariadb/sql/sql_select.cc:4935
#9 mysql_select at /usr/src/mariadb/sql/sql_select.cc:5461
#10 handle_select at /usr/src/mariadb/sql/sql_select.cc:652
#11 execute_sqlcom_select at /usr/src/mariadb/sql/sql_parse.cc:6266
#12 mysql_execute_command at /usr/src/mariadb/sql/sql_parse.cc:4038
#13 mysql_parse at /usr/src/mariadb/sql/sql_parse.cc:8005
#14 dispatch_command at /usr/src/mariadb/sql/sql_parse.cc:1903
#15 do_command at /usr/src/mariadb/sql/sql_parse.cc:1437
#16 do_handle_one_connection at /usr/src/mariadb/sql/sql_connect.cc:1514
#17 handle_one_connection at /usr/src/mariadb/sql/sql_connect.cc:1426
#18 pfs_spawn_thread at /usr/src/mariadb/storage/perfschema/pfs.cc:2198
#19 ?? () from /lib/x86_64-linux-gnu/libc.so.6
#20 ?? () from /lib/x86_64-linux-gnu/libc.so.6
(id name / 2 two는 gdb가 떨어진 뒤 SELECT가 마저 끝나 돌려준 결과입니다. 셸 스크립트가 백트레이스를 나중에 걸러 찍기 때문에 위에 보입니다.) 스택은 아래에서 위로 읽습니다. 괄호 안의 줄 번호는 모두 기준 커밋의 소스와 맞춰 보았고, 위에서 미리 본 코드가 그대로 나옵니다. sql_connect.cc:1514는 반복문의 if (do_command(thd)), sql_parse.cc:1903은 COM_QUERY의 mysql_parse(…), sql_parse.cc:8005는 error= mysql_execute_command(thd);, sql_select.cc:5461은 exec_error= join->exec();, handler.cc:4129는 TABLE_IO_WAIT로 rnd_next(buf)를 부르는 줄입니다.
- 스레드의 시작(
#19·#20의 libc,#18 pfs_spawn_thread). libc 안쪽은 디버깅 정보가 없어??로 찍힙니다.pfs_spawn_thread는 performance_schema가 스레드를 만들 때 끼워 넣는 감싸개로, 계측 준비를 한 뒤 원래 함수를 부릅니다(pfs.cc 2198행). - 연결 스레드(
#17~#15):handle_one_connection()→do_handle_one_connection()의 반복문 →do_command()(4편, 5편). - 명령과 문장(
#14~#11):dispatch_command()→mysql_parse()→mysql_execute_command()→execute_sqlcom_select()(5–7편). SELECT실행(#10~#4):handle_select()→mysql_select()→JOIN::exec()→do_select()→sub_select()→join_init_read_record(). 테이블 하나를 읽는 첫 함수가join_init_read_record()이고, 이것이READ_RECORD라는 "행을 차례로 읽는 도구"를 준비해 부릅니다(9편).- 경계(
#2~#1):rr_sequential()이handler::ha_rnd_next()를 부릅니다. 여기까지가 서버 계층(sql/)입니다. - 엔진(
#0):ha_innobase::rnd_next(). 여기부터storage/innobase/입니다(10편).
info threads로 서버의 스레드 목록도 찍어 이름별로 셌습니다.
--- threads by name
      6 ib_tpool_worker
      3 mariadbd
      1 statement_timer
      1 signal_handler
      1 page_cleaner
      1 one_connection
      1 manager
      1 io_uring_wait
      1 checkpoint_bg
(스레드 수, 특히 ib_tpool_worker의 수는 실행마다 다릅니다. 이 글을 쓰며 돌린 실행에서 5개일 때도 있었습니다.) 연결이 하나뿐이니 one_connection 스레드도 하나이고, gdb가 멈춘 스레드가 바로 이것입니다. 이 이름은 handle_one_connection() 첫머리의 my_thread_set_name("one_connection")이 붙인 것입니다(sql_connect.cc 1421행). 나머지는 연결과 상관없이 늘 도는 스레드들입니다. signal_handler는 신호를 받아 처리하는 스레드(mysqld.cc 3456행), page_cleaner는 InnoDB의 더티 페이지를 디스크로 내리는 스레드(buf0flu.cc 2810행), ib_tpool_worker는 InnoDB가 tpool/의 스레드 풀로 돌리는 작업 스레드입니다(srv0srv.cc 529행). 이름을 붙이지 않은 스레드는 리눅스가 프로세스 이름(mariadbd)을 그대로 보여 주는데, 연결을 기다리며 poll()에 앉아 있는 메인 스레드도 그 가운데 하나입니다.
헷갈리기 쉬운 곳
파서와 옵티마이저는 스택에 없습니다. 그림에는 parse_sql(), JOIN::prepare(), JOIN::optimize()가 있는데, 위 스택에는 한 줄도 없습니다. 호출 스택은 지금 이 순간 열려 있는 함수만 보여 주기 때문입니다. mysql_parse()는 parse_sql()을 불러 LEX를 다 만든 뒤 돌아온 다음에야 mysql_execute_command()를 부르고, mysql_select()도 prepare()와 optimize()가 끝나고 돌아온 뒤에 exec()를 부릅니다. 엔진이 행을 읽고 있는 순간에는 앞의 둘이 이미 끝나 있는 것입니다. Tomcat 1편에서 Mapper가 스택에 없던 것과 같은 이유입니다. 그 단계들을 보고 싶으면 중단점을 parse_sql이나 JOIN::optimize에 걸어야 합니다(6편과 8편에서 그렇게 합니다).
"풀 스캔"인데 InnoDB 안에서는 인덱스를 읽습니다. EXPLAIN의 type: ALL과 서버 쪽 rnd_next만 보면 인덱스와 상관없는 읽기 같지만, 위에서 본 대로 InnoDB는 클러스터드 인덱스를 처음부터 따라갑니다. InnoDB는 이것을 서버에도 알립니다. ha_innobase가 돌려주는 엔진 성질 깃발에 HA_TABLE_SCAN_ON_INDEX(sql/handler.h의 주석으로는 "데이터 파일과 인덱스 파일이 따로 없다")가 들어 있습니다(ha_innodb.cc 3116행). 서버 계층의 말과 엔진 안의 말이 다를 수 있다는 것, 그래서 handler라는 경계를 사이에 두고 양쪽을 따로 읽어야 한다는 것이 이 연재 내내 나옵니다.
6. 어떻게 읽나 — AI와 함께, 그러나 소스로 확인하며
읽는 순서
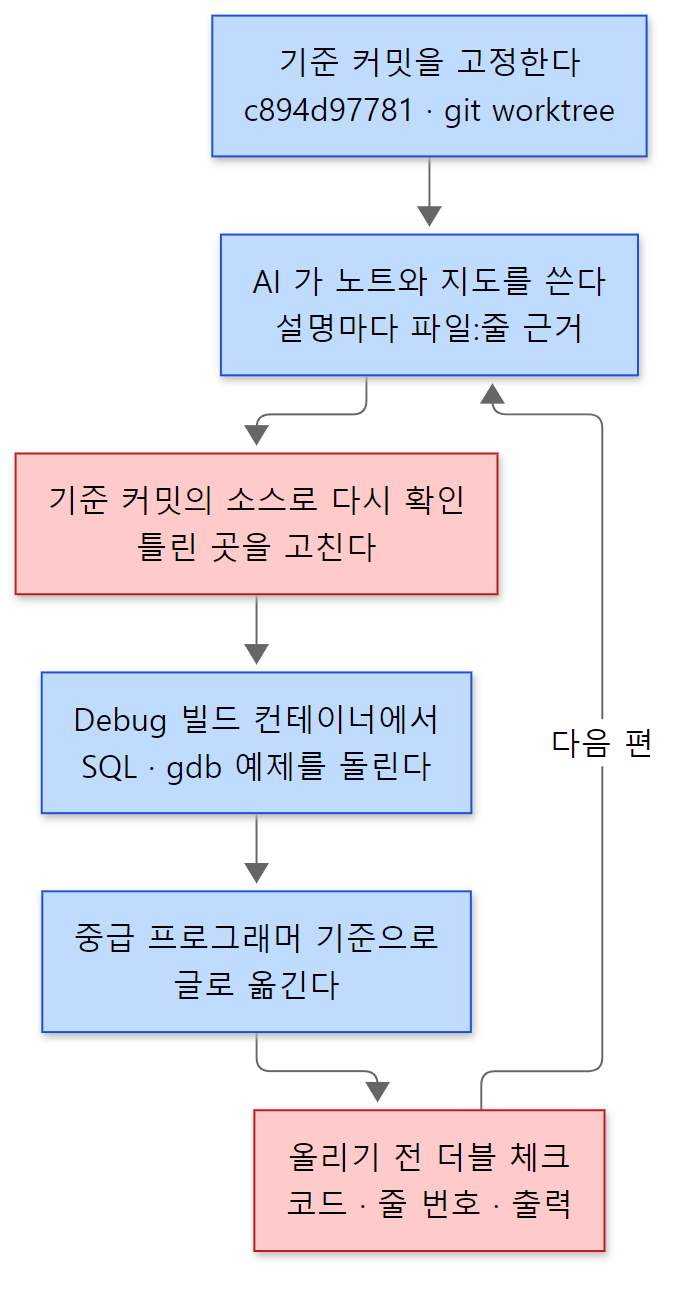 한 편을 읽고 쓰는 순서. 파란 칸은 절차이고, 빨간 칸은 AI가 쓴 내용에서 틀린 곳을 걸러 내는 단계입니다.
원칙은 앞 연재들과 같습니다. 전체를 한 번에 읽지 않고, 지도에서 질문 하나를 골라 그 질문에 답하는 데 필요한 코드만 깊게 읽습니다. 이 연재에서는 그 질문 하나가 곧 글 한 편입니다.
- 기준 커밋을 고정합니다. 2절의 worktree입니다. 줄 번호가 흔들리지 않아야 AI가 쓴 근거를 검증할 수 있습니다.
- AI가 노트와 지도를 씁니다. 12편의 구성과 편마다 출발점이 될 파일·함수 목록이 이렇게 만들어졌습니다. 편마다 같은 지시서(무엇을 읽고, 어떤 형식으로, 어떤 근거를 달아 쓰는지)를 주고 AI 작업 하나에 한 편씩 맡겼습니다.
- 기준 커밋의 소스로 다시 확인합니다. 지시서에 적은 함수는 출발점일 뿐이고, 글에 싣는 것은 소스에서 직접 확인한 것만입니다. 코드는 파일에서 그대로 복사하고, 줄 번호는 직접 찾은 것만 적습니다.
- 예제를 실제로 돌립니다. 5절처럼 글의 주장 하나를 눈으로 확인하는 작은 예제를 컨테이너에서 돌리고, 출력을 그대로 싣습니다. MariaDB는 서버이니 SQL 결과, 상태 변수,
information_schema, gdb 백트레이스가 주로 쓰입니다. - 올리기 전에 한 번 더 확인합니다. 글을 다 쓰면 다른 AI 작업이 소스를 기준으로 코드 블록, 줄 번호, 단정한 사실, 예제 출력을 처음부터 다시 대조합니다. 이 확인을 거치지 않은 글은 올리지 않습니다.
이번 글에서 확인하다 걸린 것
3단계가 왜 필요한지는 이 글을 쓰는 동안에도 드러났습니다.
- 지시서에는 "예제: 엔진 목록(
information_schema.ENGINES)을 묻기"라고만 있었습니다.ENGINES만 찍었다면 "이 서버의 엔진은 8개"라고 썼을 것입니다.PLUGINS와 대 보고 나서야 감춰진 엔진 둘과HTON_HIDDEN을 찾았습니다(3절). - 지시서와 예제 환경의 기록에는 "Windows의
git archive가 CRLF를 내니-c core.autocrlf=false -c core.eol=lf가 필요했다"고만 적혀 있었습니다. 왜 두 옵션이 다 필요한지는.gitattributes를 열고 옵션마다\r을 세어 보고서야 알았고, 왜comp_err가 멈추는지는comp_err.c의 빈 줄 검사를 읽고, 같은 상황을 다시 만들어 보고서야 알았습니다. - 큰 길의 함수 목록에는
parse_sql과JOIN::prepare/optimize가 들어 있었고, 이것은 맞습니다. 다만 "백트레이스 한 번으로 큰 길을 확인한다"고 하면 그 셋이 스택에 보일 것처럼 읽힙니다. 실제로 찍어 보면 없고, 왜 없는지를 글에 적어야 했습니다(5절).
반대로 지시서에 "참고 숫자"로 적힌 파일 수(27,587)와 C/C++ 줄 수(약 259만 줄), 큰 파일의 줄 수는 다시 세어 보니 모두 같았습니다. 확인해서 맞으면 그대로 쓰고, 다르면 소스를 따릅니다.
저장소 안의 AI 안내문
MariaDB 저장소에도 AI를 위한 파일이 있습니다. 맨 위의 CODING_STANDARDS.md는 2026-06-17의 커밋 7fc6fce20d("update CODING_STANDARDS.md for agent era")에서 고쳐졌고, 머리말이 이렇습니다.
This is a concise agent-oriented version, which highlights differences between "default" coding style that an agent would use anyway and MariaDB.
"에이전트(AI)가 어차피 쓸 '기본' 스타일과 MariaDB가 다른 곳을 짚은, 에이전트용 요약판"이라는 뜻이고, 사람용 판은 따로 있다고 적습니다. 첫 규칙은 "주변 코드와 맞춰라"이고, 새 도구 함수를 만들기 전에 mysys/와 include/를 grep하라고 합니다. 읽는 사람에게도 쓸모 있는 규칙이 하나 있습니다. 대입은 a= 1;처럼 = 앞에 공백을 두지 않습니다("non-standard but grep-friendly"). 덕분에 grep -n "thd->lex= " sql/*.cc처럼 찾으면 비교(==)는 빼고 값을 넣는 곳만 걸러 낼 수 있습니다. 이 연재에서 "이 변수는 어디서 정해지나"를 찾을 때 자주 씁니다.
2026-07-01의 커밋 9beedae93c("github copilot review instructions")는 .github/copilot-instructions.md를 더했습니다. GitHub Copilot이 풀 리퀘스트를 검토할 때 읽는 지시서로, MariaDB에서 자주 나는 버그(MEM_ROOT 메모리 수명, 준비된 문장의 재실행, bool 함수는 false가 성공이라는 약속, SQL NULL과 C NULL의 구분 …)를 점검 목록으로 적어 두었습니다. "하지 말 것"에는 이런 줄이 있습니다.
- Assert about code outside the diff — ask a question instead. Do not invent API/symbol names; verify against the code shown.
"보이지 않는 코드에 대해 단정하지 말고 질문하라. API나 이름을 지어내지 말고 보이는 코드로 확인하라." AI가 그럴듯한 함수 이름을 지어내는 일을 프로젝트가 직접 겪었다는 뜻이고, 이 연재의 원칙과 같은 말입니다. AI가 쓴 것은 기준 커밋의 소스에 대 보고 나서 씁니다. 이 점검 목록은 그대로 이 연재의 읽을거리 목록이기도 합니다. MEM_ROOT는 2편, 준비된 문장은 5편, bool 반환의 약속은 거의 모든 편에서 나옵니다.
7. 연재 지도
네 묶음
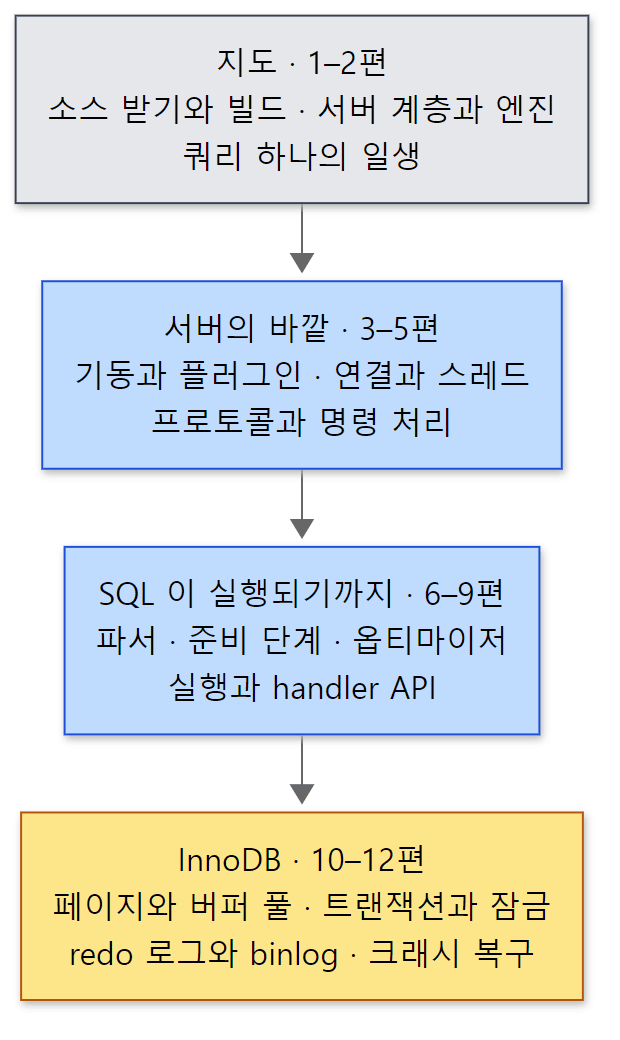 연재의 네 묶음. 파란 칸이 서버 계층의 길이고, 노란 칸은 그 길의 끝에서 데이터를 실제로 저장하는 InnoDB입니다.
| 묶음 | 편 | 답하려는 질문 |
|---|---|---|
| 지도 | 1 | 어떤 소스를 어떻게 읽나 (이 글) |
| 2 | 서버 계층과 엔진은 왜 나뉘었고, 쿼리 하나는 어떤 객체(THD, LEX, JOIN, handler)를 거치나 |
|
| 서버의 바깥 | 3 | mariadbd는 어떤 순서로 뜨고, 엔진과 플러그인은 언제 올라오나 |
| 4 | 연결은 어떤 스레드가 맡고, 스레드 풀은 무엇이 다른가 | |
| 5 | 패킷 하나는 어떻게 읽혀 dispatch_command()에 닿고, 결과는 어떻게 돌아가나 |
|
| SQL이 실행되기까지 | 6 | SQL 문자열은 어떻게 LEX와 Item 나무가 되나 |
| 7 | 권한 확인, 테이블 열기, 메타데이터 잠금, 이름 찾기는 어디서 하나 | |
| 8 | 옵티마이저는 조인 순서와 인덱스를 어떻게 고르고, EXPLAIN은 어디서 만들어지나 |
|
| 9 | 중첩 루프 조인은 handler를 어떻게 부르나 |
|
| InnoDB | 10 | 페이지, 버퍼 풀, B-트리는 어떻게 생겼나 |
| 11 | 트랜잭션, MVCC, undo, 잠금은 어떻게 동작하나 | |
| 12 | redo 로그와 binlog는 무엇이 다르고, 서버가 죽었다 살아나면 무엇을 하나 |
읽는 순서
번호 순서대로 읽으면 됩니다. 1·2편이 지도를 깔고, 3~12편은 2편 지도의 한 구역씩을 확대해 깊게 읽습니다. 이유는 셋입니다.
- 2편을 먼저 읽습니다.
THD,LEX,TABLE,JOIN,handler는 이후 모든 편에 나옵니다. 2편이 이 객체들이 언제 생기고 누가 누구를 가리키는지를 한 장에 모읍니다. - 바깥에서 안으로 갑니다. 기동(3편)에서 시작해 연결(4편), 패킷(5편), 파서(6편)를 거쳐 실행(9편)까지 갑니다. 위 백트레이스를 아래에서 위로 읽는 순서와 같습니다.
- InnoDB는 마지막에 읽습니다. InnoDB는 서버 계층이
handler로 부르는 엔진 하나일 뿐이지만, 가장 크고 가장 많은 것(트랜잭션, 잠금, 복구)을 혼자 해냅니다.handler경계까지 길을 알고 나서 들어가야 "서버가 무엇을 요구하고 InnoDB가 무엇을 약속하나"로 읽을 수 있습니다.
이 글에서 뺀 것
- 꺼 둔 엔진. Mroonga, CONNECT, Spider, RocksDB(MyRocks), ColumnStore, DuckDB, OQGraph, Sphinx, S3, FEDERATED는 이 연재에서 빌드하지도 읽지도 않습니다(
-DPLUGIN_<이름>=NO). - Galera 클러스터.
wsrep-lib과sql/wsrep_*.cc, 본문 곳곳의#ifdef WITH_WSREP블록은 다루지 않습니다. - mariabackup과 임베디드 서버.
extra/mariabackup/,libmysqld/는 뺐습니다. - 클라이언트 프로그램.
client/의mariadb,mariadb-dump등은 예제에서 쓰기만 하고 읽지 않습니다. Connector/C(libmariadb)도 마찬가지입니다. - 문자 집합과 정렬 규칙.
strings/의 33만 줄은 다루지 않습니다. - 시험.
mysql-test/의 7천 개 시험은 동작을 확인할 때 참고로만 봅니다. - Windows 판.
sql/main.cc의mysqld_win_main(),handle_connections_win()같은 Windows 갈래는 읽지 않습니다. 예제는 모두 리눅스 컨테이너에서 돕니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
| 읽는 소스 | MariaDB Server 13.2.0(main, alpha), 커밋 c894d97781(2026-10-19). C/C++ 3,145개 파일, 약 259만 줄 |
| 판 번호 | VERSION 파일 → mysql_version.cmake → MYSQL_SERVER_VERSION → set_server_version()이 -debug·-log를 붙인다 |
git describe |
판 번호가 아니라 가장 가까운 태그(mariadb-13.1.1) 뒤 커밋 수(222). 이 연재는 13.2.0이라 부른다 |
| 성숙도 | alpha 서버라 plugin_maturity 기본값이 한 단계 낮은 experimental |
| 서브모듈 | 일곱 개 가운데 libmariadb만 언제나 필요. 나머지는 옵션(WITH_WSREP, WITH_SSL, PLUGIN_*)으로 끈다 |
| 빌드 | 도커(Ubuntu 24.04)에서 CMake + Ninja로 Debug 빌드 → /opt/mariadb, 이미지 mariadb-lab:c894d97781 |
| CRLF 함정 | * text=auto 때문에 core.autocrlf=false만으로는 부족, core.eol=lf까지. 아니면 comp_err가 빈 줄 "\r\n"에서 멈춘다 |
| 폴더 | sql/(서버 계층) · storage/(엔진, InnoDB는 innobase) · mysys/·strings/(공통 바닥) · plugin/ · vio/ |
| 큰 길 | handle_one_connection → do_command → dispatch_command → mysql_parse → mysql_execute_command → mysql_select → JOIN::exec → handler::ha_rnd_next → ha_innobase::rnd_next |
| 읽는 방법 | 커밋 고정 → AI 노트 → 소스로 확인 → 예제 실행 → 글 → 더블 체크 |
다음에 볼 것
다음 글은 연재의 지도입니다. 이 글에서는 SELECT 하나가 지나는 함수들을 백트레이스로 늘어놓기만 했습니다. 다음 글에서는 그 길 위를 오가는 객체를 봅니다. 연결 하나를 담는 THD, 파서가 만든 LEX와 SELECT_LEX, 테이블 정의 TABLE_SHARE와 연결마다의 TABLE, 실행 계획 JOIN, 그리고 서버 계층과 엔진의 경계인 handler와 handlerton이 언제 생기고 누가 누구를 가리키는지, 서버 계층과 스토리지 엔진을 왜 나눴는지를 한 장의 지도로 모읍니다. 같은 테이블을 엔진만 바꿔 만들어 데이터 디렉터리의 파일이 어떻게 달라지는지도 봅니다.
- 다음 글: MariaDB 소스 파헤치기 2: 전체 지도 — 서버 계층과 스토리지 엔진, 그리고 쿼리 하나의 일생
- 연결과 스레드로 바로 가려면: 4편: 연결과 스레드 — 연결마다 스레드 하나, 그리고 스레드 풀
- InnoDB로 바로 가려면: 10편: InnoDB 1 — 페이지, 버퍼 풀, B-트리
같은 방식으로 읽은 앞 연재들과 이어지는 곳도 많습니다. 바로 앞 연재인 nginx 소스 파헤치기 1편과 httpd 1편, Tomcat 1편은 "연결을 받아 요청을 처리하는 서버"를 같은 원칙으로 읽기 시작한 글입니다. MariaDB도 연결을 받는 서버라서, 기본 방식인 "연결마다 스레드 하나"는 httpd의 prefork·worker MPM(httpd 8편)과, 스레드 풀은 이벤트 루프로 연결을 지켜보다 일이 생기면 작업 스레드에 맡기는 httpd event MPM·Tomcat의 Poller(Tomcat 5편)와 닮았습니다. 이 비교는 4편에서 합니다. 애플리케이션 쪽에서는 Spring 17편의 @Transactional이 결국 이 서버에 COMMIT을 보내고, Spring 18편의 JdbcTemplate이 보낸 SQL이 위 백트레이스의 COM_QUERY로 들어옵니다. 이 연재는 그 SQL이 서버 안에서 무엇이 되는지를 읽는 셈입니다.