이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 아홉 번째 글입니다. 8편에서는 옵티마이저가 JOIN::optimize() 안에서 조인 순서와 테이블마다의 접근 방법(EXPLAIN의 type 열)을 고르는 것을 봤습니다. 그 결과는 아직 "계획"일 뿐입니다. 이번 글은 그 계획이 실제로 행을 읽어 내는 곳, 그리고 서버 계층이 스토리지 엔진에게 "다음 행 주세요"라고 말하는 handler API를 따라갑니다.
2편 지도로 말하면 쿼리 하나의 일생 가운데 ⑥ 실행과 ⑦ handler 경계 구역을 확대하고, ⑧ 엔진은 입구까지만 들어갑니다. 엔진 안쪽(InnoDB가 페이지와 B-트리에서 행을 꺼내는 일)은 10편부터 봅니다.
답하려는 질문은 네 가지입니다.
JOIN::exec()가 불린 뒤 첫 행이 클라이언트로 나가기까지 어떤 함수들을 지나는가- 조인은 정말 "중첩 루프"인가 — 두 테이블, 세 테이블 조인이 소스에서는 어떤 모양인가
EXPLAIN의ALL·ref·eq_ref는 실행 단계에서 무엇이 달라지는가,Handler_read_*숫자는 그 차이를 어떻게 보여 주는가- 서버 계층이 엔진을 부를 때 꼭 지나는
ha_감싸개는 무슨 일을 하고, 엔진을 바꾸면 무엇이 그대로이고 무엇이 달라지는가
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | sql/sql_select.cc(실행 부분), sql/records.cc, sql/handler.cc·handler.h, sql/sql_insert.cc, storage/innobase/handler/ha_innodb.cc |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
sql_select.cc는 3만 6천 줄이 넘고, 그 가운데 실행에 관한 부분만 해도 수천 줄입니다. 서브쿼리, 임시 테이블, GROUP BY, 윈도 함수가 모두 같은 틀 위에 얹혀 있습니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
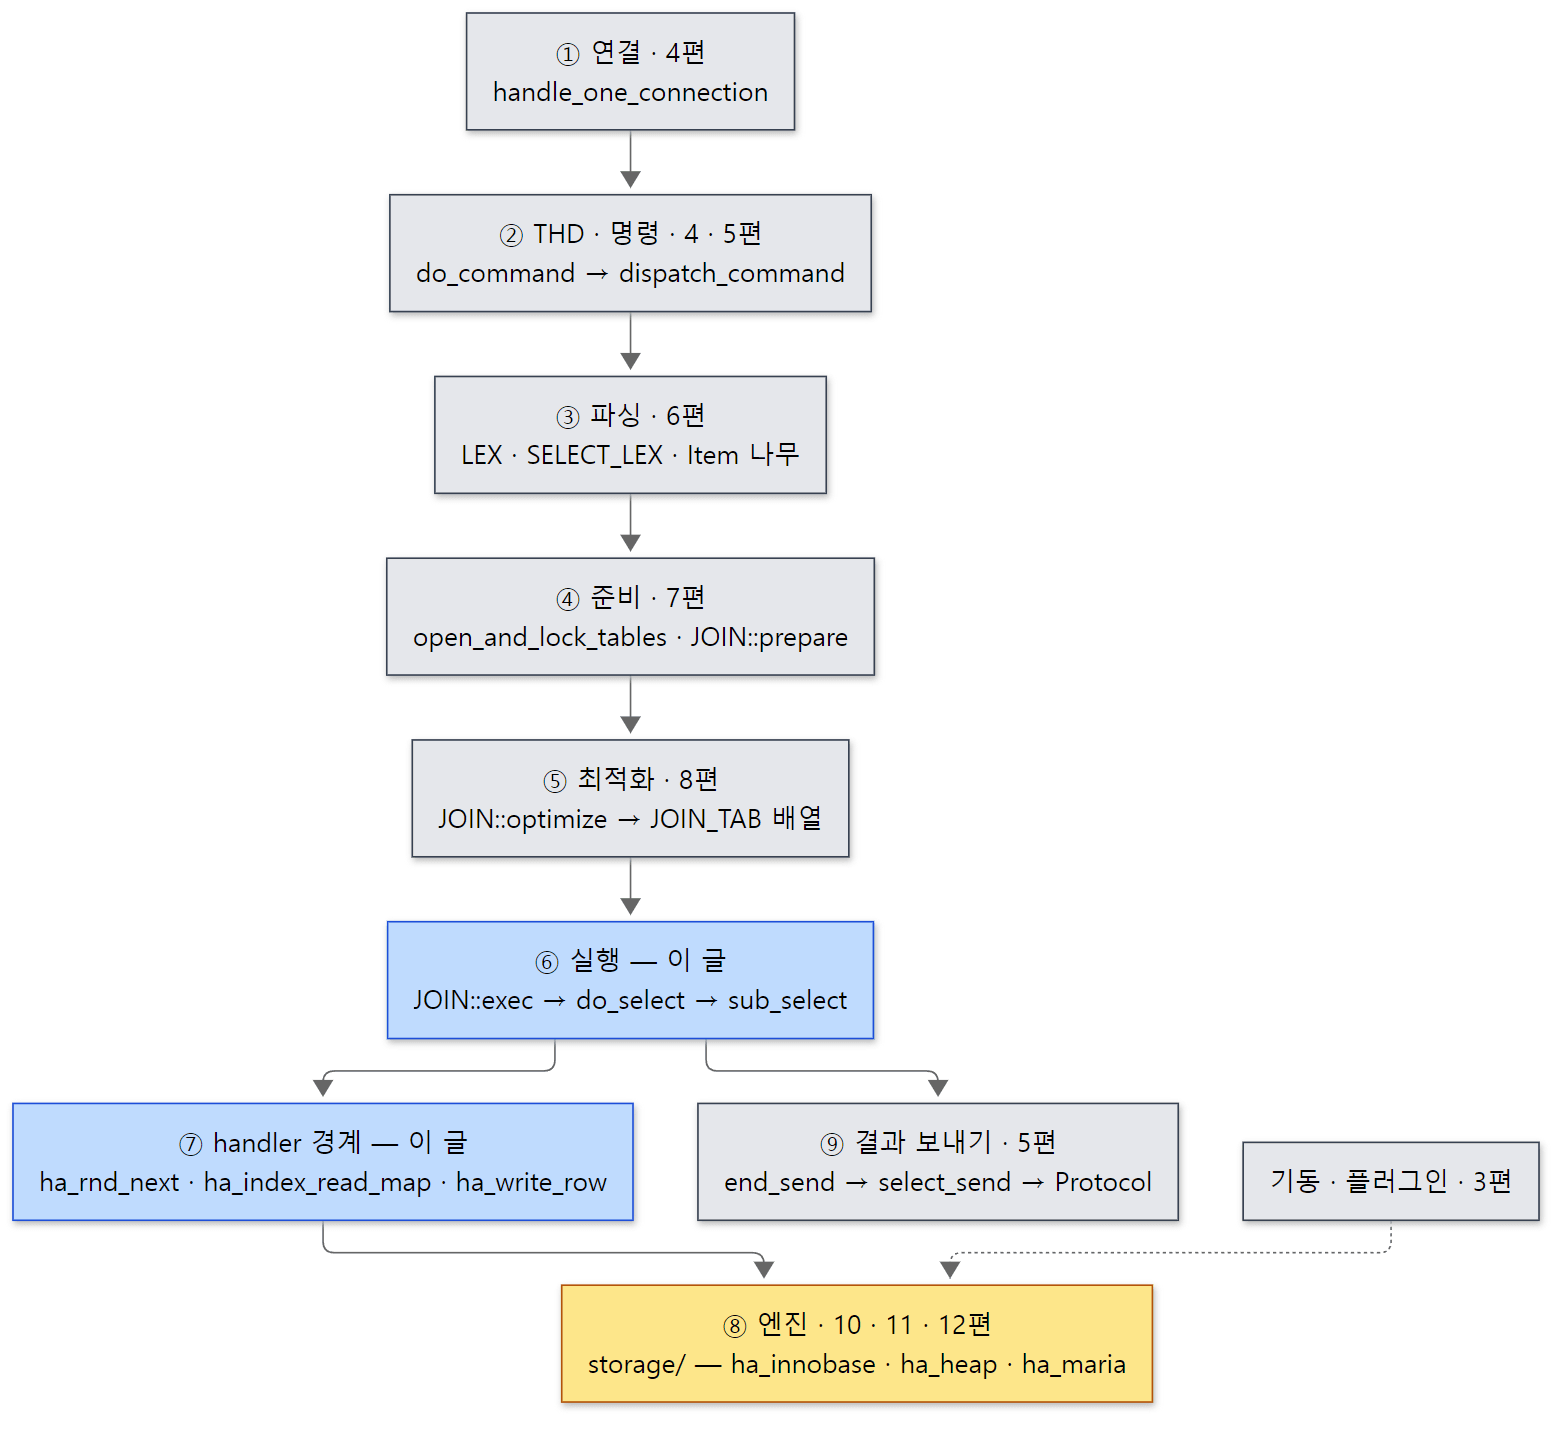 파란 칸이 이 글에서 읽는 곳입니다. 노란 칸(⑧ 엔진)은 handler 경계의 반대편으로, 이 글에서는 입구만 봅니다. ⑨ 결과 보내기는 5편의 몫이지만, ⑥에서 ⑨로 넘어가는 자리(
end_send() → select_send)는 5절에서 봅니다.
먼저 알아 둘 말
JOIN 은 SELECT 하나(정확히는 SELECT_LEX 하나)를 실행하기 위한 객체입니다. 준비(JOIN::prepare(), 7편) → 최적화(JOIN::optimize(), 8편) → 실행(JOIN::exec(), 이 글)의 세 단계가 모두 이 객체의 메서드입니다.
JOIN_TAB 은 조인 순서대로 늘어선 테이블 한 칸입니다(sql/sql_select.h의 typedef struct st_join_table {...} JOIN_TAB). EXPLAIN의 한 줄이 대개 JOIN_TAB 하나에 해당합니다. 옵티마이저가 고른 접근 방법, 그 테이블에 붙은 조건 조각(select_cond), 그리고 이 글의 주인공인 함수 포인터 두 개 — 첫 행을 읽는 read_first_record와, 이 칸에서 행을 하나 찾았을 때 다음에 부를 next_select — 를 가지고 있습니다.
READ_RECORD 는 "이 테이블에서 다음 행 하나를 읽어라"를 담은 작은 구조체입니다(sql/records.h). 핵심 멤버는 read_record_func라는 함수 포인터 하나이고, 풀 스캔이면 rr_sequential, 인덱스로 같은 키를 이어 읽으면 join_read_next_same이 꽂힙니다. JOIN_TAB마다 하나씩 들어 있습니다.
handler 는 2편에서 본, 테이블 하나를 연 엔진 쪽 객체입니다(sql/handler.h의 class handler). TABLE이 열릴 때 엔진이 자기 하위 클래스(ha_innobase, ha_heap, ha_maria …)의 객체를 만들어 TABLE::file에 걸어 둡니다. 서버 계층은 엔진이 무엇인지 모른 채 table->file->...로 이 객체만 부릅니다.
ha_ 감싸개. handler에는 이름이 짝을 이루는 함수가 있습니다. ha_rnd_next()와 rnd_next(), ha_write_row()와 write_row()처럼요. 앞의 것은 서버 계층이 부르는 공통 입구(handler.cc에 한 번만 구현), 뒤의 것은 엔진이 구현하는 가상 함수입니다. 6절에서 자세히 봅니다.
record[0] 은 TABLE이 가진 행 버퍼입니다. 엔진은 읽은 행을 이 버퍼에 서버 형식으로 채워 넣고, 서버 계층의 Item_field(열 하나를 가리키는 Item, 6편)는 이 버퍼에서 값을 읽습니다. 쓰기는 반대로, 서버가 이 버퍼를 채워 ha_write_row(record[0])로 넘깁니다. 엔진과 서버 계층이 주고받는 것은 결국 이 버퍼 하나입니다.
중첩 루프 조인(nested-loop join). t1과 t2를 조인할 때 "t1의 행마다 t2에서 짝을 찾는다"는 가장 단순한 방법입니다. 의사 코드로는 for r1 in t1: for r2 in t2 where 조건(r1,r2): 내보내기(r1,r2)입니다. MariaDB는 이 틀을 기본으로 쓰고, 그 위에 조인 버퍼(4절)나 해시 조인 같은 변형을 얹습니다.
1. 실행의 입구 — JOIN::exec()에서 do_select()까지
6편과 7편에서 본 대로 SELECT는 mysql_execute_command() → execute_sqlcom_select() → handle_select() → mysql_select()로 내려옵니다. mysql_select()는 JOIN을 만들어 prepare(), optimize()를 부른 뒤 마지막으로 이 줄에 닿습니다.
exec_error= join->exec();
JOIN::exec()는 ANALYZE 문장을 위한 시간 측정으로 exec_inner()를 감쌀 뿐이고(4924–4945행), 실제 일은 exec_inner()가 합니다. exec_inner()는 테이블이 없는 SELECT 1 같은 경우, 상수 조건이 거짓인 경우, 외부 엔진으로 통째로 넘기는 경우(pushdown)를 먼저 걸러 내고, 일반적인 경우에는 끝에서 이렇게 합니다.
  THD_STAGE_INFO(thd, stage_sending_data);
  DBUG_PRINT("info", ("%s", thd->proc_info));
  result->send_result_set_metadata(
                 procedure ? procedure_fields_list : *fields,
                 Protocol::SEND_NUM_ROWS | Protocol::SEND_EOF);

  error= result->view_structure_only() ? false : do_select(this, procedure);
두 가지를 읽을 수 있습니다.
THD_STAGE_INFO(thd, stage_sending_data)—SHOW PROCESSLIST의State열에 보이는 "Sending data"가 여기서 정해집니다. 바로 위exec_inner()머리에서는stage_executing("Executing")으로 바꿔 둡니다(4954행). 오래 걸리는 쿼리가 "Sending data"에 머물러 있다면 아래의do_select()안, 곧 행을 읽고 조건을 거르는 중이라는 뜻입니다 — 이름과 달리 "보내는 중"만 뜻하지 않습니다.- 열 정보(메타데이터)를 행보다 먼저 보냅니다.
result는 결과를 받을 객체(select_result의 하위 클래스)이고, 보통의SELECT라면 클라이언트로 보내는select_send입니다. 클라이언트 프로토콜은 "열 정의 패킷들 → 행 패킷들 → EOF"의 순서이므로(5편), 행을 하나도 읽기 전에 열 정의부터 내보냅니다.
do_select()는 "모든 테이블을 조인해 소켓이나 테이블로 쓴다"는 주석이 붙은 함수입니다. 모든 테이블이 상수(const)인 경우를 따로 처리하고, 일반적인 경우에는 이 몇 줄이 전부입니다.
    JOIN_TAB *join_tab= join->join_tab +
                        (join->tables_list ? join->const_tables : 0);
    if (join->outer_ref_cond && !join->outer_ref_cond->val_bool())
      error= NESTED_LOOP_NO_MORE_ROWS;
    else
      error= join->first_select(join,join_tab,0);
    if (error >= NESTED_LOOP_OK && likely(join->thd->killed != ABORT_QUERY))
      error= join->first_select(join,join_tab,1);
sql/sql_select.cc 25081–25088행
first_select는 함수 포인터이고, JOIN을 초기화할 때 first_select= sub_select;로 정해집니다(578행). join_tab은 상수 테이블을 건너뛴 첫 번째 칸입니다. 상수 테이블(EXPLAIN의 const·system)은 옵티마이저가 make_join_statistics() 안에서 이미 한 행을 읽어 두었기 때문에(5912행 등의 join_read_const_table()) 실행 단계에서는 다시 읽지 않습니다.
마지막 인자에 주목합니다. 한 번은 0, 한 번은 1로 부릅니다. 이 셋째 인자 end_of_records가 true이면 "이제 더 들어올 행이 없다"는 신호입니다. 행을 모아 두는 단계(조인 버퍼, GROUP BY)는 이 신호를 받고서야 모아 둔 것을 내보냅니다. 4절의 조인 버퍼에서 다시 나옵니다. do_select()가 끝날 때는 join->join_free()로 테이블들의 커서를 닫고, 오류가 없으면 join->result->send_eof()로 결과의 끝을 알립니다(25133–25142행).
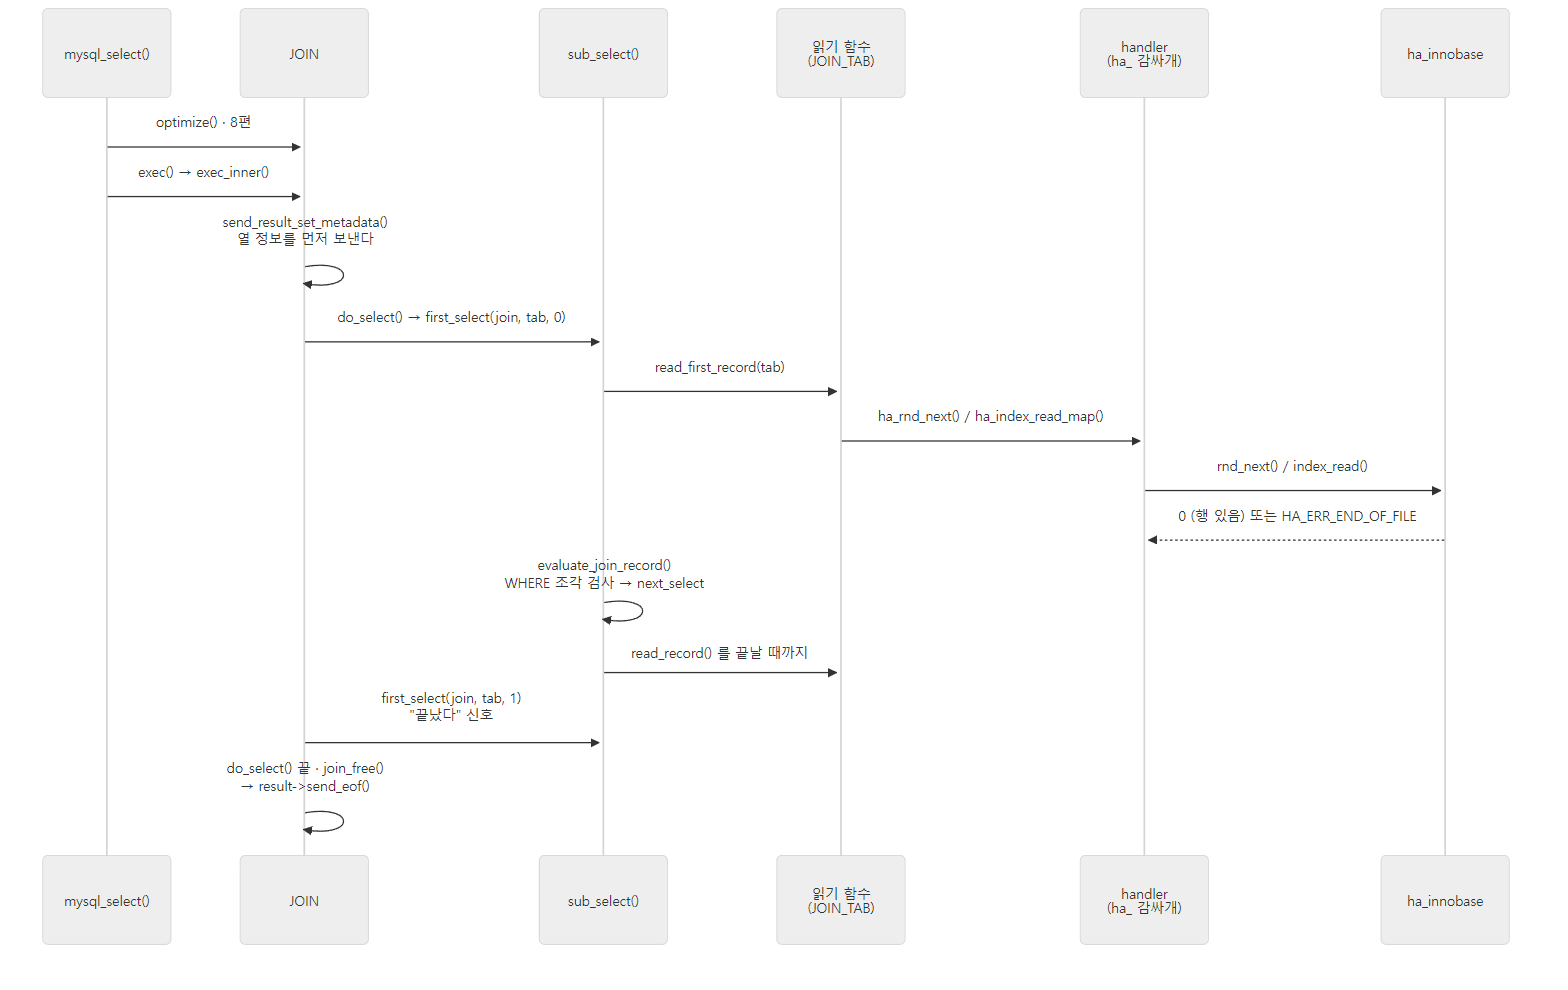 실행 단계의 큰 줄기입니다. 화살표 하나하나를 아래 절에서 소스로 확인합니다.
헷갈리기 쉬운 곳: 계획을 해석하는 실행기는 따로 없습니다
옵티마이저가 "실행 계획"을 만든다고 하면 계획을 해석하는 별도의 실행기가 있을 것 같지만, 이 글이 따라가는 일반적인 실행 경로에는 그런 해석기가 없습니다. 옵티마이저가 끝날 때 남기는 것은 JOIN_TAB 배열과, 각 칸에 꽂힌 함수 포인터들입니다(3절). 실행은 그 포인터를 차례로 부르는 것뿐입니다. "계획"이 곧 "어떤 함수를 어떤 순서로 부를지"입니다.
2. 중첩 루프 — sub_select()와 evaluate_join_record()
sub_select()는 칸 하나를 맡습니다. "이 칸의 테이블에서 행을 하나씩 읽고, 읽을 때마다 evaluate_join_record()에게 넘긴다"가 전부입니다. 주석까지 합치면 길지만 뼈대는 이렇습니다.
  if (rc != NESTED_LOOP_NO_MORE_ROWS)
  {
    error= (*join_tab->read_first_record)(join_tab);
    if (!error && join_tab->keep_current_rowid)
      join_tab->table->file->position(join_tab->table->record[0]);
    rc= evaluate_join_record(join, join_tab, error);
  }

  bool skip_over= FALSE;
  READ_RECORD *info= &join_tab->read_record;

  while (rc == NESTED_LOOP_OK && join->return_tab >= join_tab)
  {
    // ... (LooseScan 반조인 최적화 생략)
    error= info->read_record();
    // ... (LooseScan 생략)
    if (join_tab->keep_current_rowid && likely(!error))
      join_tab->table->file->position(join_tab->table->record[0]);

    rc= evaluate_join_record(join, join_tab, error);
  }
sql/sql_select.cc 25570–25613행
첫 행은 read_first_record로, 둘째 행부터는 read_record()(곧 READ_RECORD::read_record_func)로 읽습니다. 읽기 함수의 반환값 error는 0이면 "행을 읽었다", 음수면 "더 없다", 양수면 "오류"입니다. 그 값을 판정하는 것은 evaluate_join_record()의 첫머리입니다.
  if (error > 0 || unlikely(join->thd->is_error())) // Fatal error
    DBUG_RETURN(NESTED_LOOP_ERROR);
  if (error < 0)
    DBUG_RETURN(NESTED_LOOP_NO_MORE_ROWS);
  if (unlikely(join->thd->check_killed()))       // Aborted by user
  {
    DBUG_RETURN(NESTED_LOOP_KILLED);            /* purecov: inspected */
  }

  join_tab->tracker->r_rows++;

  if (select_cond)
  {
    select_cond_result= MY_TEST(select_cond->val_bool());
    // ... (조건 계산 중 오류 확인)
sql/sql_select.cc 25663–25676행
KILL QUERY가 먹는 자리 하나가 여기입니다. 행 하나를 볼 때마다check_killed()를 확인합니다. 그래서 오래 도는 풀 스캔도KILL QUERY를 보내면 다음 행에서 멈춥니다. (연결 스레드와KILL의 관계는 4편에서 봤습니다.)tracker->r_rows++는ANALYZE SELECT가 보여 주는r_rows(실제로 읽은 행 수)의 출처입니다.select_cond는 옵티마이저가WHERE를 쪼개 이 칸에 붙여 둔 조건 조각입니다(8편의make_join_select()).val_bool()로 평가하는데, 이것이 6편의Item나무를 실제로 계산하는 순간입니다.Item_field는 방금 엔진이 채운record[0]에서 값을 꺼냅니다.
조건을 통과하면(외부 조인과 반조인 처리를 지나서) 다음 칸으로 넘깁니다.
    if (found)
    {
      enum enum_nested_loop_state rc;
      /* A match from join_tab is found for the current partial join. */
      rc= (*join_tab->next_select)(join, join_tab+1, 0);
sql/sql_select.cc 25804–25808행
여기가 "중첩"이 생기는 곳입니다. 앞 칸들의 행이 하나씩 정해진 채로(이것을 부분 행, partial join이라고 부릅니다) next_select가 join_tab+1, 곧 다음 칸을 맡은 sub_select()를 다시 부릅니다. 다음 칸은 처음부터 자기 테이블을 읽기 시작하고, 거기서 행을 찾으면 또 그다음 칸을 부릅니다. 마지막 칸의 next_select는 sub_select가 아니라 결과를 내보내는 end_send()입니다(5절).
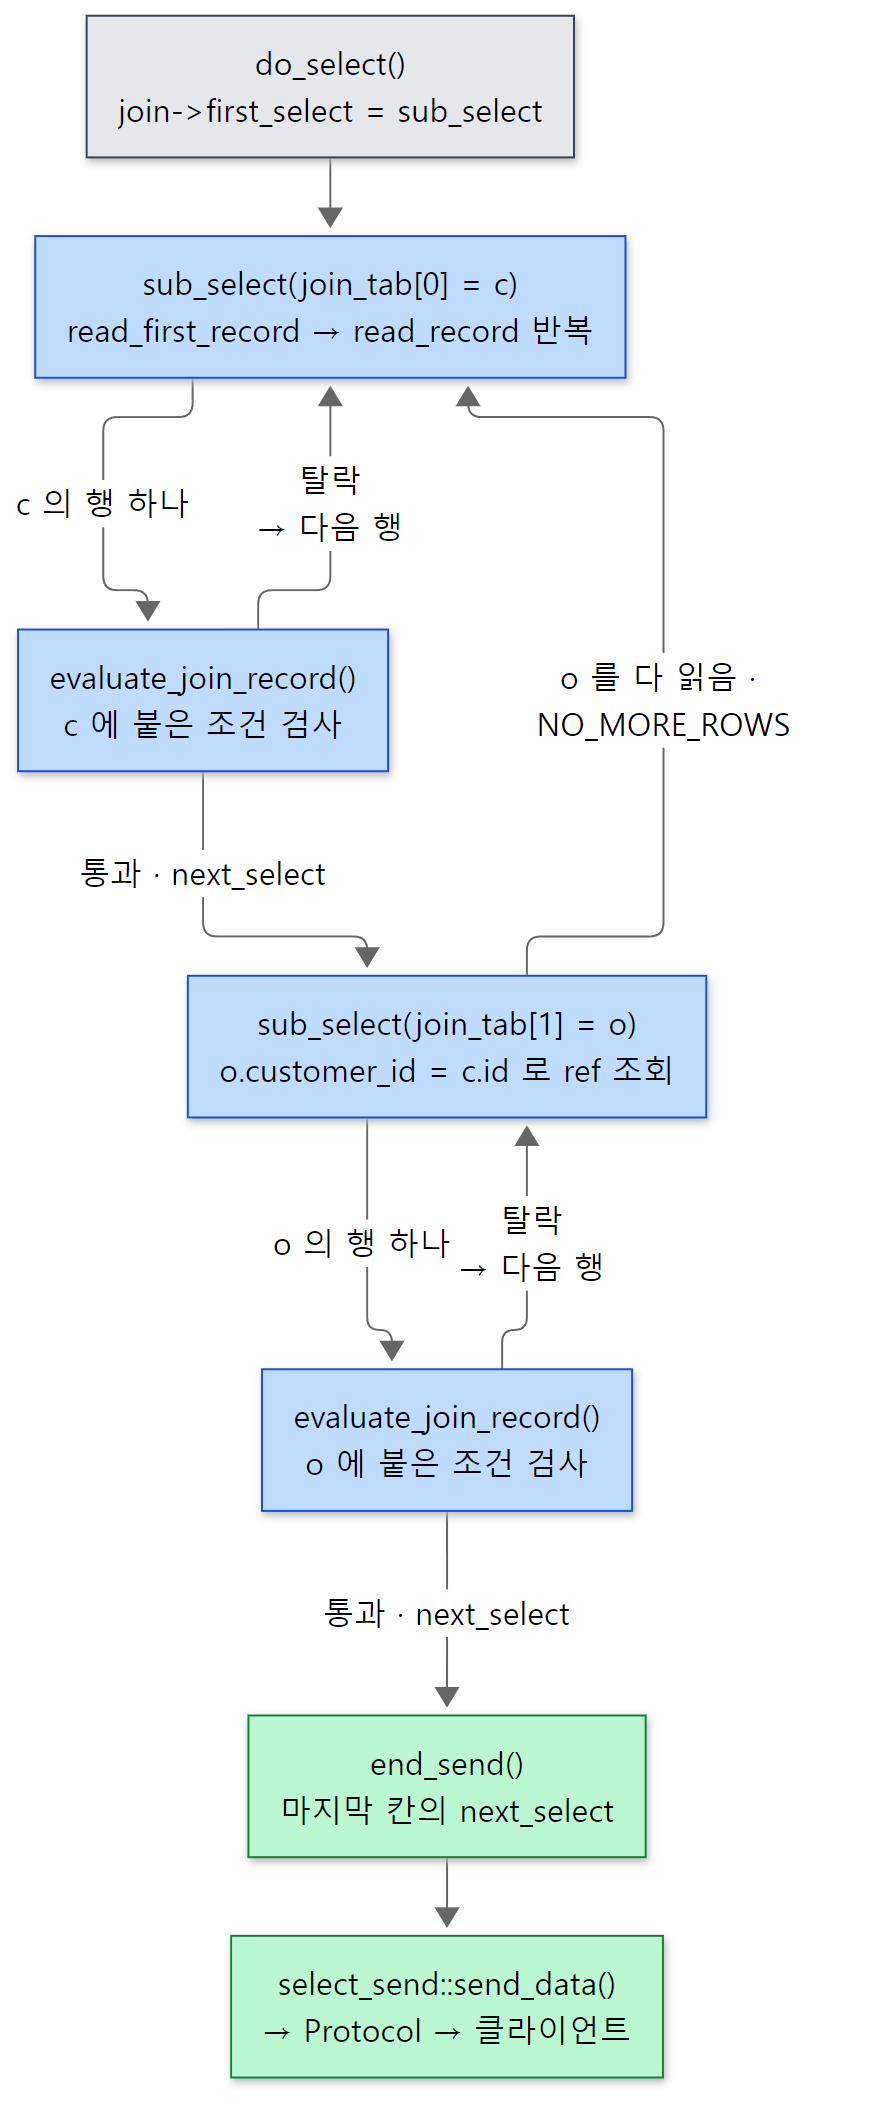
for c in customer: for o in orders where o.customer_id = c.id: send(c, o)가 소스에서는 sub_select() → evaluate_join_record() → sub_select()의 재귀 호출이 됩니다.
루프의 상태는 enum_nested_loop_state 하나로 주고받습니다(sql/sql_select.h 442–447행). 값은 NESTED_LOOP_KILLED(-2), NESTED_LOOP_ERROR(-1), NESTED_LOOP_OK(0), NESTED_LOOP_NO_MORE_ROWS(1), NESTED_LOOP_QUERY_LIMIT(3), NESTED_LOOP_CURSOR_LIMIT(4)입니다. 음수는 멈춰야 하는 경우(오류, KILL), NO_MORE_ROWS는 "이 칸은 다 읽었다", QUERY_LIMIT는 LIMIT을 다 채워 더 읽을 필요가 없다는 뜻입니다. LIMIT 10인 쿼리가 10행을 보내고 곧바로 끝나는 것은 end_send()가 QUERY_LIMIT를 돌려주고 모든 sub_select()가 그 값을 보고 루프를 빠져나오기 때문입니다(end_send()의 주석은 이것을 "Abort nicely"라고 적어 둡니다).
예제 1: 백트레이스에 보이는 재귀
정말 이 모양인지 gdb로 확인했습니다. 이 예제와 이 글의 다른 예제는 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 예제 폴더는 ex/u09-gdb-read입니다.
테이블은 셋입니다. 고객 10명(customer, 기본 키 id), 주문 30건(orders, 고객마다 3건, customer_id에 보조 인덱스), 인덱스 없는 메모 4행(city_note)입니다.
-- 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
-- 고객 10명, 주문 30건(고객마다 3건씩, 같은 고객의 주문이 연달아 놓인다), 인덱스 없는 메모 테이블 4행.
CREATE DATABASE lab;
USE lab;
CREATE TABLE customer (id INT PRIMARY KEY, name VARCHAR(20), city VARCHAR(10)) ENGINE=InnoDB;
CREATE TABLE orders (id INT PRIMARY KEY, customer_id INT, amount INT, KEY (customer_id)) ENGINE=InnoDB;
CREATE TABLE city_note (city VARCHAR(10), note VARCHAR(20)) ENGINE=InnoDB;
INSERT INTO customer SELECT seq, CONCAT('cust', seq), ELT(1 + seq % 4, 'Seoul', 'Busan', 'Daegu', 'Incheon')
  FROM seq_1_to_10;
INSERT INTO orders SELECT seq, (seq + 2) DIV 3, seq * 100 FROM seq_1_to_30;
INSERT INTO city_note VALUES ('Seoul','capital'), ('Busan','port'), ('Daegu','inland'), ('Incheon','airport');
ANALYZE TABLE customer, orders, city_note PERSISTENT FOR ALL;
SELECT STRAIGHT_JOIN SUM(o.amount) FROM customer c JOIN orders o ON o.customer_id = c.id — customer를 먼저 읽고(STRAIGHT_JOIN으로 순서를 고정) orders를 customer_id 인덱스로 찾는 조인입니다. 실행 중인 mariadbd에 gdb를 붙여 break ha_innobase::rnd_next(바깥 테이블)와 break ha_innobase::index_read if key_len > 0(키 값이 있는 호출, 곧 안쪽 테이블의 조회)을 걸고, 멈출 때마다 bt를 찍었습니다. 두 번째로 멈춘 곳의 백트레이스입니다(인자 목록과 주소는 지웠습니다).
=== stop 2: index_read with a key
#0  ha_innobase::index_read at /usr/src/mariadb/storage/innobase/handler/ha_innodb.cc:9144
#1  handler::index_read_map at /usr/src/mariadb/sql/handler.h:4443
#2  handler::ha_index_read_map at /usr/src/mariadb/sql/handler.cc:4215
#3  join_read_always_key at /usr/src/mariadb/sql/sql_select.cc:26392
#4  sub_select at /usr/src/mariadb/sql/sql_select.cc:25572
#5  evaluate_join_record at /usr/src/mariadb/sql/sql_select.cc:25808
#6  sub_select at /usr/src/mariadb/sql/sql_select.cc:25575
#7  do_select at /usr/src/mariadb/sql/sql_select.cc:25086
#8  JOIN::exec_inner at /usr/src/mariadb/sql/sql_select.cc:5147
#9  JOIN::exec at /usr/src/mariadb/sql/sql_select.cc:4935
#10 mysql_select at /usr/src/mariadb/sql/sql_select.cc:5461
#11 handle_select at /usr/src/mariadb/sql/sql_select.cc:652
#12 execute_sqlcom_select at /usr/src/mariadb/sql/sql_parse.cc:6266
#13 mysql_execute_command at /usr/src/mariadb/sql/sql_parse.cc:4038
#14 mysql_parse at /usr/src/mariadb/sql/sql_parse.cc:8005
#15 dispatch_command at /usr/src/mariadb/sql/sql_parse.cc:1903
#16 do_command at /usr/src/mariadb/sql/sql_parse.cc:1437
아래에서 위로 읽으면 이 글 전체의 지도입니다. do_command(5편) → mysql_parse(6편) → mysql_execute_command(7편) → JOIN::exec → do_select의 25086행(first_select(join,join_tab,0)) → sub_select(customer 칸) → evaluate_join_record의 25808행(next_select) → sub_select(orders 칸) → 25572행 read_first_record = join_read_always_key → handler::ha_index_read_map → (handler.h의 기본 구현 index_read_map이 키 길이를 계산해) → ha_innobase::index_read. sub_select가 두 번 보이는 것이 중첩 루프의 증거입니다.
첫 번째로 멈춘 곳(바깥 customer의 풀 스캔)은 ha_innobase::rnd_next ← handler::ha_rnd_next(handler.cc 4129행) ← rr_sequential(records.cc 517행) ← READ_RECORD::read_record ← join_init_read_record(sql_select.cc 26694행) ← sub_select(25572행)이었고, 그 아래는 위와 같습니다.
3. 칸마다 다른 읽기 함수 — EXPLAIN의 type이 함수 포인터가 되는 곳
sub_select()는 테이블을 어떻게 읽는지 모릅니다. read_first_record와 read_record_func를 부를 뿐입니다. 이 두 포인터는 옵티마이저 끝자락의 make_join_readinfo()가 칸마다 꽂아 둡니다.
      tab->next_select= sub_select;		/* normal select */
    // ...
    table->status=STATUS_NO_RECORD;
    pick_table_access_method (tab);

    if (jcl)
       tab[-1].next_select=sub_select_cache;
sql/sql_select.cc 16702–16714행
next_select는 기본이 sub_select이고, 조인 버퍼를 쓰는 칸(jcl, join cache level이 0이 아님)이면 앞 칸의 next_select를 sub_select_cache로 바꿉니다(4절). 마지막 칸의 next_select는 나중에 setup_end_select_func()가 end_send 같은 끝 함수로 덮어씁니다(4389–4390행).
읽기 함수는 pick_table_access_method()가 접근 방법(tab->type)에 따라 고릅니다.
static void
pick_table_access_method(JOIN_TAB *tab)
{
  switch (tab->type)
  {
  case JT_REF:
    tab->read_first_record= join_read_always_key;
    tab->read_record.read_record_func= join_read_next_same;
    break;
  // ...
  case JT_EQ_REF:
    tab->read_first_record= join_read_key;
    tab->read_record.read_record_func= join_no_more_records;
    break;
sql/sql_select.cc 15822–15845행
JT_ALL(풀 스캔)과 JT_RANGE(범위)는 make_join_readinfo()가 직접 read_first_record= join_init_read_record로 정하고, JT_NEXT(인덱스 전체 스캔, EXPLAIN의 index)는 join_read_first로 정합니다(16750–16800행). 정리하면 이렇습니다.
EXPLAIN의 type |
JOIN_TAB::type |
첫 행 (read_first_record) |
다음 행 (read_record_func) |
부르는 handler 함수 |
|---|---|---|---|---|
ALL |
JT_ALL |
join_init_read_record |
rr_sequential |
ha_rnd_init → ha_rnd_next |
range |
JT_RANGE |
join_init_read_record |
rr_quick |
범위 읽기(QUICK_SELECT) |
index |
JT_NEXT |
join_read_first |
join_read_next |
ha_index_first → ha_index_next |
ref |
JT_REF |
join_read_always_key |
join_read_next_same |
ha_index_read_map → ha_index_next_same |
eq_ref |
JT_EQ_REF |
join_read_key |
join_no_more_records |
ha_index_read_map (한 번) |
const |
JT_CONST |
join_read_const |
join_no_more_records |
옵티마이저 단계에서 이미 읽음 |
eq_ref의 다음 행 함수 join_no_more_records는 그냥 -1을 돌려줍니다(26461–26465행). 유일 키로 찾았으니 짝은 많아야 하나이고, 둘째 행은 읽어 볼 필요도 없다는 뜻입니다.
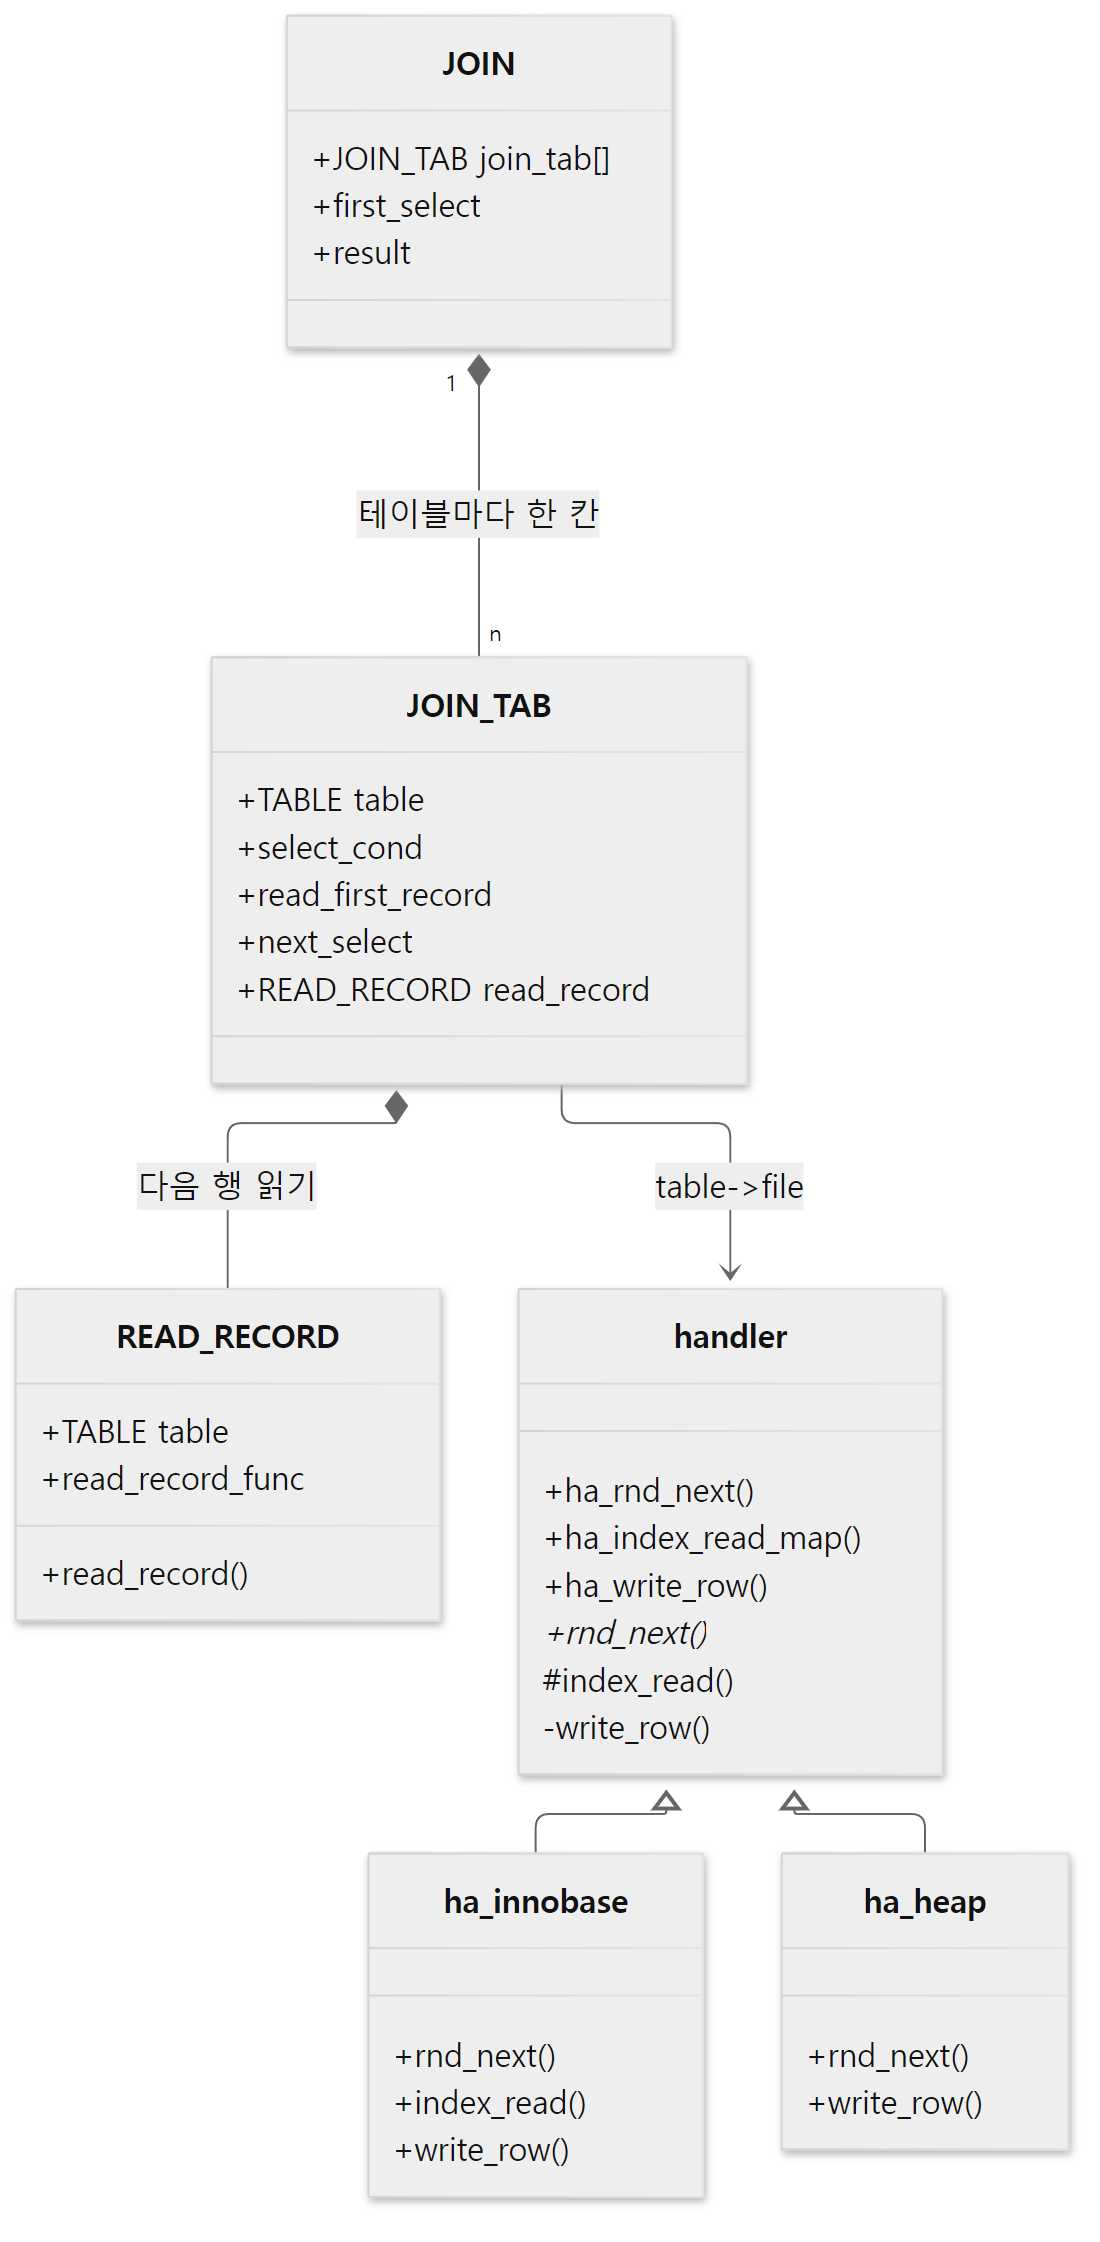
+는 public, #은 protected, -는 private, 기울어진 rnd_next()는 순수 가상 함수입니다. 옵티마이저가 남기는 것은 이 그림의 왼쪽 위 — 함수 포인터가 꽂힌 JOIN_TAB 배열입니다.
풀 스캔: join_init_read_record → rr_sequential
join_init_read_record()는 rowid 필터가 필요하면 먼저 만들고, 정렬(filesort)이 필요하면 정렬하고, 범위 읽기를 준비한 뒤 init_read_record()를 부릅니다. 평범한 풀 스캔이면 거기서 이 갈래로 갑니다.
  else
  {
    DBUG_PRINT("info",("using rr_sequential"));
    info->read_record_func= rr_sequential;
    if (unlikely(table->file->ha_rnd_init_with_error(1)))
      DBUG_RETURN(1);
ha_rnd_init()으로 엔진에게 "처음부터 훑을 준비"를 시키고, 다음 행 함수로 rr_sequential을 꽂습니다. join_init_read_record()는 마지막 줄에서 그 함수를 한 번 불러 첫 행을 읽습니다(return tab->read_record.read_record();, 26694행). rr_sequential은 짧습니다.
int rr_sequential(READ_RECORD *info)
{
  int tmp;
  while ((tmp= info->table->file->ha_rnd_next(info->record())))
  {
    tmp= rr_handle_error(info, tmp);
    break;
  }
  return tmp;
}
info->record()는 table->record[0]입니다(records.h 78행). 엔진이 그 버퍼에 다음 행을 채워 주면 0, 끝이면 HA_ERR_END_OF_FILE이고, rr_handle_error()가 끝을 -1로 바꿔 돌려줍니다.
ref: join_read_always_key → join_read_next_same
ref는 앞 칸의 값으로 키를 만들어 인덱스를 찾습니다.
static int
join_read_always_key(JOIN_TAB *tab)
{
  // ... (처음 한 번 ha_index_init() 으로 인덱스를 여는 부분 생략)
  if (unlikely(cp_buffer_from_ref(tab->join->thd, table, &tab->ref)))
    return -1;
  // ...
  if ((error= table->file->ha_index_read_map(table->record[0],
                                             tab->ref.key_buff,
                                             make_prev_keypart_map(tab->ref.key_parts),
                                             HA_READ_KEY_EXACT)))
  {
    if (error != HA_ERR_KEY_NOT_FOUND && error != HA_ERR_END_OF_FILE)
      return report_error(table, error);
    return -1; /* purecov: inspected */
  }
  return 0;
}
sql/sql_select.cc 26366–26402행
cp_buffer_from_ref()가 앞 칸의 값(c.id)을 키 버퍼 ref.key_buff에 복사하고, ha_index_read_map(..., HA_READ_KEY_EXACT)가 "이 값과 같은 첫 키"로 커서를 놓습니다. 다음 행부터는 join_read_next_same이 ha_index_next_same()으로 "같은 키 값의 다음 행"을 읽다가 값이 바뀌면 HA_ERR_END_OF_FILE을 받아 멈춥니다(26468–26485행).
eq_ref: join_read_key와 한 칸짜리 캐시
eq_ref의 join_read_key()는 join_read_key2()를 부르고, 거기에는 ref에 없는 장치가 하나 있습니다.
  if (cmp_buffer_with_ref(thd, table, table_ref) ||
      (table->status & (STATUS_GARBAGE | STATUS_NO_PARENT | STATUS_NULL_ROW)))
  {
    // ...
    error=table->file->ha_index_read_map(table->record[0],
                                  table_ref->key_buff,
                                  make_prev_keypart_map(table_ref->key_parts),
                                  HA_READ_KEY_EXACT);
sql/sql_select.cc 26276–26296행
cmp_buffer_with_ref()는 이번에 찾을 키를 직전에 찾은 키와 비교해서 다를 때만 참을 돌려줍니다(29707–29726행). 같으면 엔진을 부르지 않고, record[0]에 남아 있는 직전 행을 그대로 씁니다. 함수 주석은 이것을 "one-element lookup cache"라고 부릅니다(26229–26231행). 유일 키라서 같은 키면 같은 행이 나올 것이 확실하기 때문에 가능한 지름길입니다.
예제 2: Handler_read_* 로 호출 수 세기
SHOW STATUS의 Handler_read_*는 handler의 ha_ 감싸개가 부를 때마다 하나씩 올리는 숫자입니다(6절에서 그 줄을 봅니다). 그러니 접근 방법마다 엔진을 몇 번 불렀는지를 셀 수 있습니다. 쿼리마다 EXPLAIN의 주요 열을 한 줄로 찍고, 같은 세션 안에서 FLUSH STATUS; <쿼리>; SHOW SESSION STATUS WHERE Variable_name LIKE 'Handler_read%' AND Value <> '0';을 보내 0이 아닌 값만 남겼습니다(예제 폴더 ex/u09-handler-counts, 데이터는 예제 1과 같습니다). 결과입니다(조인 버퍼 부분은 4절에서 봅니다).
--- 0. no table
SELECT 1
  EXPLAIN: table=NULL type=NULL key=NULL rows=NULL extra=No tables used

--- 1. full scan (ALL)
SELECT SUM(amount) FROM orders WHERE amount > 1000
  EXPLAIN: table=orders type=ALL key=NULL rows=30 extra=Using where
  Handler_read_rnd_next  31

--- 2. primary key (const)
SELECT amount FROM orders WHERE id = 7
  EXPLAIN: table=orders type=const key=PRIMARY rows=1 extra=
  Handler_read_key       1

--- 3. secondary key (ref)
SELECT SUM(amount) FROM orders WHERE customer_id = 4
  EXPLAIN: table=orders type=ref key=customer_id rows=3 extra=
  Handler_read_key       1
  Handler_read_next      3

--- 4. join, eq_ref
SELECT STRAIGHT_JOIN SUM(o.amount), COUNT(c.name) FROM orders o JOIN customer c ON c.id = o.customer_id
  EXPLAIN: table=o type=ALL key=NULL rows=30 extra=Using where
  EXPLAIN: table=c type=eq_ref key=PRIMARY rows=1 extra=
  Handler_read_key       10
  Handler_read_rnd_next  31

--- 5. join, ref
SELECT STRAIGHT_JOIN SUM(o.amount), COUNT(c.name) FROM customer c JOIN orders o ON o.customer_id = c.id
  EXPLAIN: table=c type=ALL key=NULL rows=10 extra=
  EXPLAIN: table=o type=ref key=customer_id rows=3 extra=
  Handler_read_key       10
  Handler_read_next      30
  Handler_read_rnd_next  11
하나씩 소스에 대어 봅니다.
- 0번: 테이블이 없으면 아무것도 오르지 않습니다.
SHOW STATUS자체가 숫자를 흐리지 않는다는 기준선이기도 합니다. - 1번
ALL: 30행 테이블에Handler_read_rnd_next가 31입니다.rr_sequential이 행마다 한 번, 그리고 "끝"을 알아내는 마지막 한 번(HA_ERR_END_OF_FILE)까지ha_rnd_next()를 불렀습니다.WHERE amount > 1000에 걸러진 20행도 엔진은 다 읽어 왔고, 거른 것은 서버 계층의evaluate_join_record()입니다. - 2번
const:Handler_read_key1. 이 한 번은 실행 단계가 아니라 옵티마이저(join_read_const_table())에서 일어났습니다. - 3번
ref:read_key1번(첫 행),read_next3번. 짝은 3행인데next가 3인 것은join_read_next_same이 두 번 행을 얻고 세 번째에 "값이 바뀌었다(끝)"를 받았기 때문입니다.ha_index_next_same()은 결과와 상관없이 숫자를 올립니다(sql/handler.cc 4373–4392행). - 5번
ref조인: 바깥customer풀 스캔이rnd_next11(10행 + 끝), 안쪽orders는 고객마다read_key1 +read_next3이라 10 × (1 + 3) = 10 + 30입니다. 중첩 루프가 숫자로 그대로 보입니다.
헷갈리기 쉬운 곳: eq_ref 조인인데 Handler_read_key가 30이 아니라 10
4번은 orders 30행마다 customer를 기본 키로 찾는 eq_ref입니다. 30번 찾았을 것 같은데 Handler_read_key는 10입니다. 예제 데이터에서 같은 고객의 주문 3건이 연달아 놓여 있어서(customer_id = 1,1,1,2,2,2,…), 30번 가운데 20번은 위에서 본 cmp_buffer_with_ref()가 "직전과 같은 키"라고 판단해 엔진을 부르지 않았기 때문입니다. 주문이 고객 순서와 무관하게 섞여 있었다면 숫자는 30에 가까워졌을 것입니다. Handler_read_key는 "논리적으로 찾은 횟수"가 아니라 엔진을 실제로 부른 횟수입니다.
4. 조인 버퍼 — sub_select_cache()와 JOIN_CACHE
안쪽 테이블에 쓸 인덱스가 없으면 중첩 루프는 비쌉니다. 바깥 행마다 안쪽 테이블을 처음부터 끝까지 다시 읽어야 하니까요. 그래서 MariaDB는 바깥 행들을 조인 버퍼에 모았다가, 안쪽 테이블을 한 번 훑으면서 버퍼의 행 전부와 맞춰 봅니다. 이것이 EXPLAIN의 Using join buffer (flat, BNL join)입니다. BNL은 Block Nested Loop, "덩어리 단위 중첩 루프"입니다.
3절에서 본 대로 조인 버퍼를 쓰는 칸은 앞 칸의 next_select가 sub_select_cache로 바뀌어 있습니다. 그래서 앞 칸에서 행을 하나 찾으면 곧장 다음 칸을 읽는 대신 이 함수로 옵니다.
  join_tab->cache->reset_join(join);

  if (end_of_records)
  {
    rc= cache->join_records(FALSE);
    if (rc == NESTED_LOOP_OK || rc == NESTED_LOOP_NO_MORE_ROWS ||
        rc == NESTED_LOOP_QUERY_LIMIT)
      rc= sub_select(join, join_tab, end_of_records);
    DBUG_RETURN(rc);
  }
  // ...
  if (!(err= test_if_use_dynamic_range_scan(join_tab)))
  {
    if (!cache->put_record())
      DBUG_RETURN(NESTED_LOOP_OK);
    // ... (주석: 버퍼가 찼으니 버퍼의 모든 행에 대해 짝을 찾는다)
    rc= cache->join_records(FALSE);
    DBUG_RETURN(rc);
  }
sql/sql_select.cc 25314–25342행
put_record()가 부분 행을 버퍼에 복사합니다. 버퍼에 아직 자리가 있으면false를 돌려주고,sub_select_cache()는 아무것도 읽지 않고 돌아갑니다 — 앞 칸은 다음 행을 읽으러 갑니다.- 버퍼가 찼으면 그 자리에서
join_records()로 짝을 다 찾고 버퍼를 비웁니다. - 1절의
first_select(join, join_tab, 1)이 여기서 쓰입니다. 앞 칸이 다 끝나end_of_records가 오면, 버퍼에 남은 행들로 마지막join_records()를 합니다. 이 신호가 없으면 버퍼에 남은 행은 영영 처리되지 않습니다.
join_records()가 부르는 JOIN_CACHE::join_matching_records()의 중심은 이 두 겹 루프입니다.
  /* Prepare to retrieve all records of the joined table */
  if (unlikely((error= join_tab_scan->open())))
  // ...
  while (!(error= join_tab_scan->next()))
  {
    // ...
    uchar *rec_ptr;
    /* Read each possible candidate from the buffer and look for matches */
    while ((rec_ptr= get_next_candidate_for_match()))
    {
sql/sql_join_cache.cc 2358–2388행
바깥이 안쪽 테이블의 행(join_tab_scan->next()), 안쪽이 버퍼의 후보 행입니다. 순서가 뒤집혀 있습니다. JOIN_TAB_SCAN::open()은 결국 3절의 join_init_read_record()를 부르고(3497–3503행), next()는 read_record()를 부릅니다. 엔진 쪽에서 보면 버퍼 하나에 풀 스캔 한 번입니다.
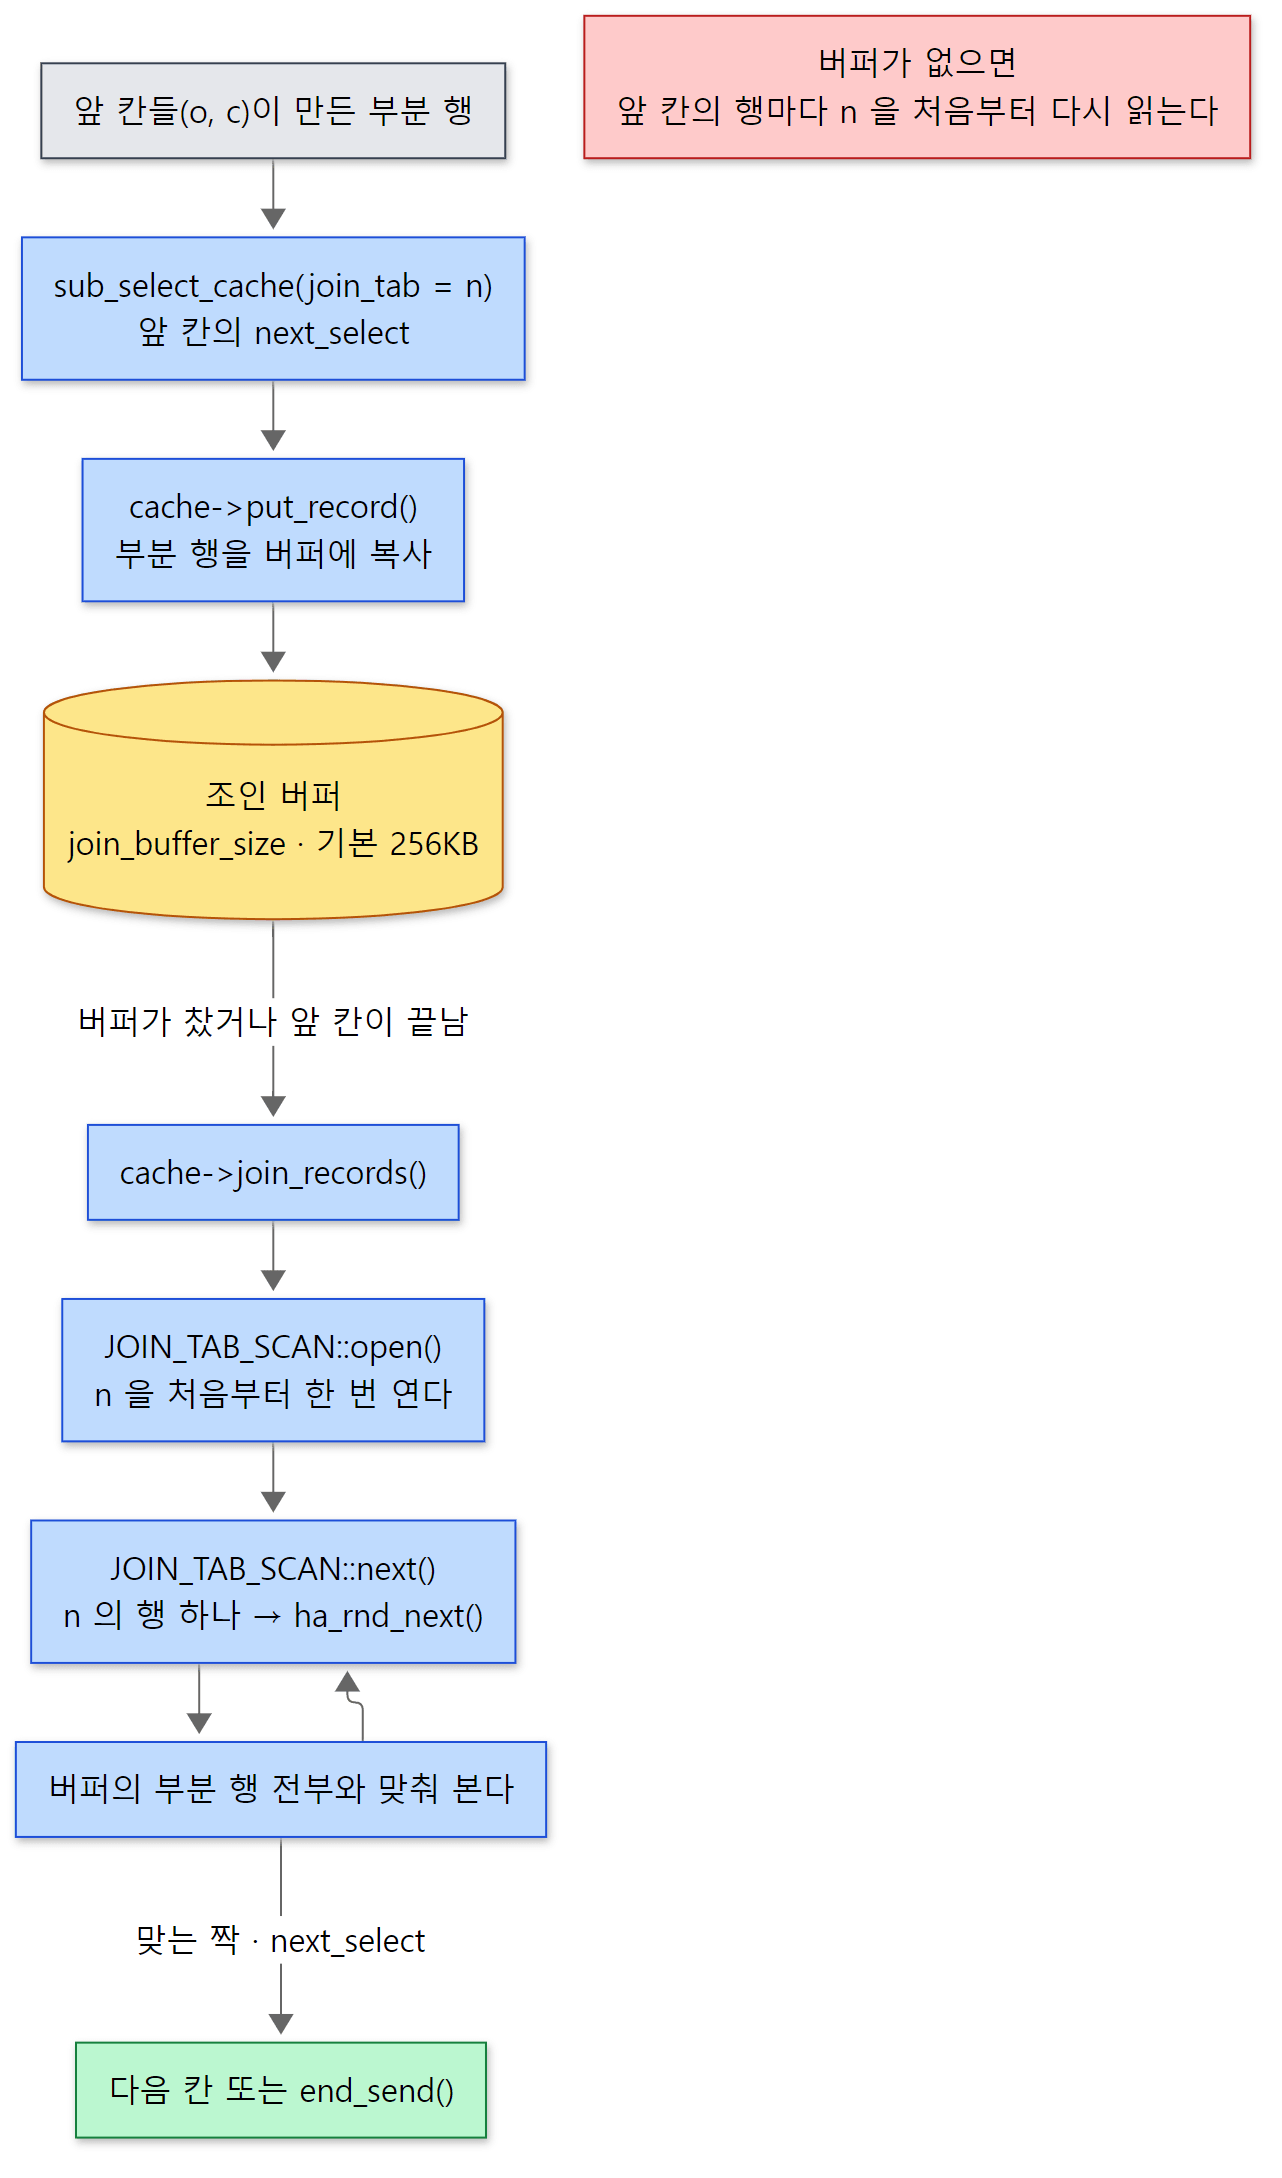 노란 원통이 조인 버퍼입니다. 버퍼 크기는
join_buffer_size(기본 256KB, sys_vars.cc의 Sys_join_buffer_size), 어떤 종류의 버퍼를 쓸 수 있는지는 join_cache_level(기본 2)이 정합니다.
조인 버퍼 종류는 sql/sql_join_cache.h에 클래스로 있습니다. JOIN_CACHE를 바탕으로 JOIN_CACHE_BNL(블록 중첩 루프), JOIN_CACHE_BNLH(버퍼에 해시 표를 세운 해시 조인, JOIN_CACHE_HASHED를 거쳐 상속), JOIN_CACHE_BKA·JOIN_CACHE_BKAH(Batched Key Access — 버퍼에 모은 키로 인덱스를 몰아서 찾는 방식, BKAH는 BNLH를 상속)가 갈라져 나옵니다. 버퍼에 행을 넣는 방식(해시 쪽은 put_record()를 덮어씀), 버퍼에서 짝 후보를 고르는 방식(get_next_candidate_for_match() 등), 안쪽 테이블을 읽는 방식(BKA는 JOIN_TAB_SCAN_MRR)이 다를 뿐, join_records()와 위의 sub_select_cache() 틀은 같습니다.
예제 3: 버퍼가 있을 때와 없을 때
세 테이블 조인의 마지막 칸 city_note(인덱스 없음, 4행)가 조인 버퍼를 씁니다. 같은 쿼리를 join_cache_level=0(조인 버퍼 금지)으로도 돌렸습니다.
--- 6. join buffer (BNL)
SELECT STRAIGHT_JOIN COUNT(*) FROM orders o JOIN customer c JOIN city_note n ON n.city = c.city AND c.id = o.customer_id
  EXPLAIN: table=o type=index key=customer_id rows=30 extra=Using where; Using index
  EXPLAIN: table=c type=eq_ref key=PRIMARY rows=1 extra=
  EXPLAIN: table=n type=ALL key=NULL rows=4 extra=Using where; Using join buffer (flat, BNL join)
  Handler_read_first     1
  Handler_read_key       10
  Handler_read_next      30
  Handler_read_rnd_next  5

=== join_cache_level=0 (no join buffer)
  Handler_read_first     1
  Handler_read_key       10
  Handler_read_next      30
  Handler_read_rnd_next  150
city_note를 읽은 Handler_read_rnd_next가 버퍼가 있을 때는 5(4행 + 끝, 한 번 훑음), 없을 때는 150(앞 칸에서 온 30행 × 5)입니다. 30행이 전부 256KB 버퍼 하나에 들어갔기 때문에 풀 스캔이 한 번으로 끝났습니다.
o의 type=index(Handler_read_first 1 + Handler_read_next 30)는 3절 표의 JT_NEXT → join_read_first → join_read_next 그대로입니다. customer_id 인덱스만으로 o에서 필요한 열(customer_id)이 다 나오므로(Using index) 옵티마이저가 테이블 대신 인덱스를 훑기로 한 경우입니다. 그리고 c의 eq_ref는 여기서도 3절의 한 칸짜리 캐시 덕분에 Handler_read_key 10입니다.
5. 결과 보내기 — end_send() → select_send → Protocol
마지막 칸에서 조건을 통과한 행은 next_select인 end_send()로 갑니다(setup_end_select_func()가 고릅니다. 그룹을 지어 보내야 하면 end_send_group()이고, 임시 테이블에 모으는 단계에는 end_write() 같은 다른 끝 함수가 따로 꽂힙니다). end_send()는 HAVING을 검사하고, LIMIT의 WITH TIES를 처리한 뒤 행을 넘깁니다.
  if (join->do_send_rows)
  {
    int error;
    /* result < 0 if row was not accepted and should not be counted */
    if (unlikely((error= join->result->send_data_with_check(*fields,
                                                            join->unit,
                                                            join->send_records))))
    {
      if (error > 0)
        DBUG_RETURN(NESTED_LOOP_ERROR);
      // error < 0 => duplicate row
      join->duplicate_rows++;
    }
  }
sql/sql_select.cc 26971–26984행
그 바로 뒤에서 send_records를 세어 LIMIT에 닿으면 NESTED_LOOP_QUERY_LIMIT를 돌려줍니다(2절). send_data_with_check()는 LIMIT의 OFFSET만큼은 보내지 않고 건너뛴 뒤 send_data()를 부릅니다(sql/sql_class.cc 3371–3387행). OFFSET 1000이 1000행을 읽고 버린다는 말이 여기서 확인됩니다. 클라이언트로 보내는 select_send::send_data()는 이렇습니다.
int select_send::send_data(List<Item> &items)
{
  Protocol *protocol= thd->protocol;
  DBUG_ENTER("select_send::send_data");

  protocol->prepare_for_resend();
  if (protocol->send_result_set_row(&items))
  {
    // ... (실패하면 만들던 행을 지우고 오류)
  }

  thd->inc_sent_row_count(1);

  /* Don't return error if disconnected, only if write fails */
  if (likely(thd->vio_ok()))
    DBUG_RETURN(protocol->write());
  // ...
}
send_result_set_row()가 SELECT 목록의 Item마다 값을 계산해 패킷에 담고, protocol->write()가 그 패킷을 네트워크 버퍼로 씁니다(패킷의 모양과 텍스트/바이너리 프로토콜의 차이는 5편). 행은 다 모은 뒤가 아니라 찾는 즉시 하나씩 나갑니다. 중첩 루프의 가장 안쪽에서 바로 프로토콜까지 이어지는 것이 이 구조의 특징입니다.
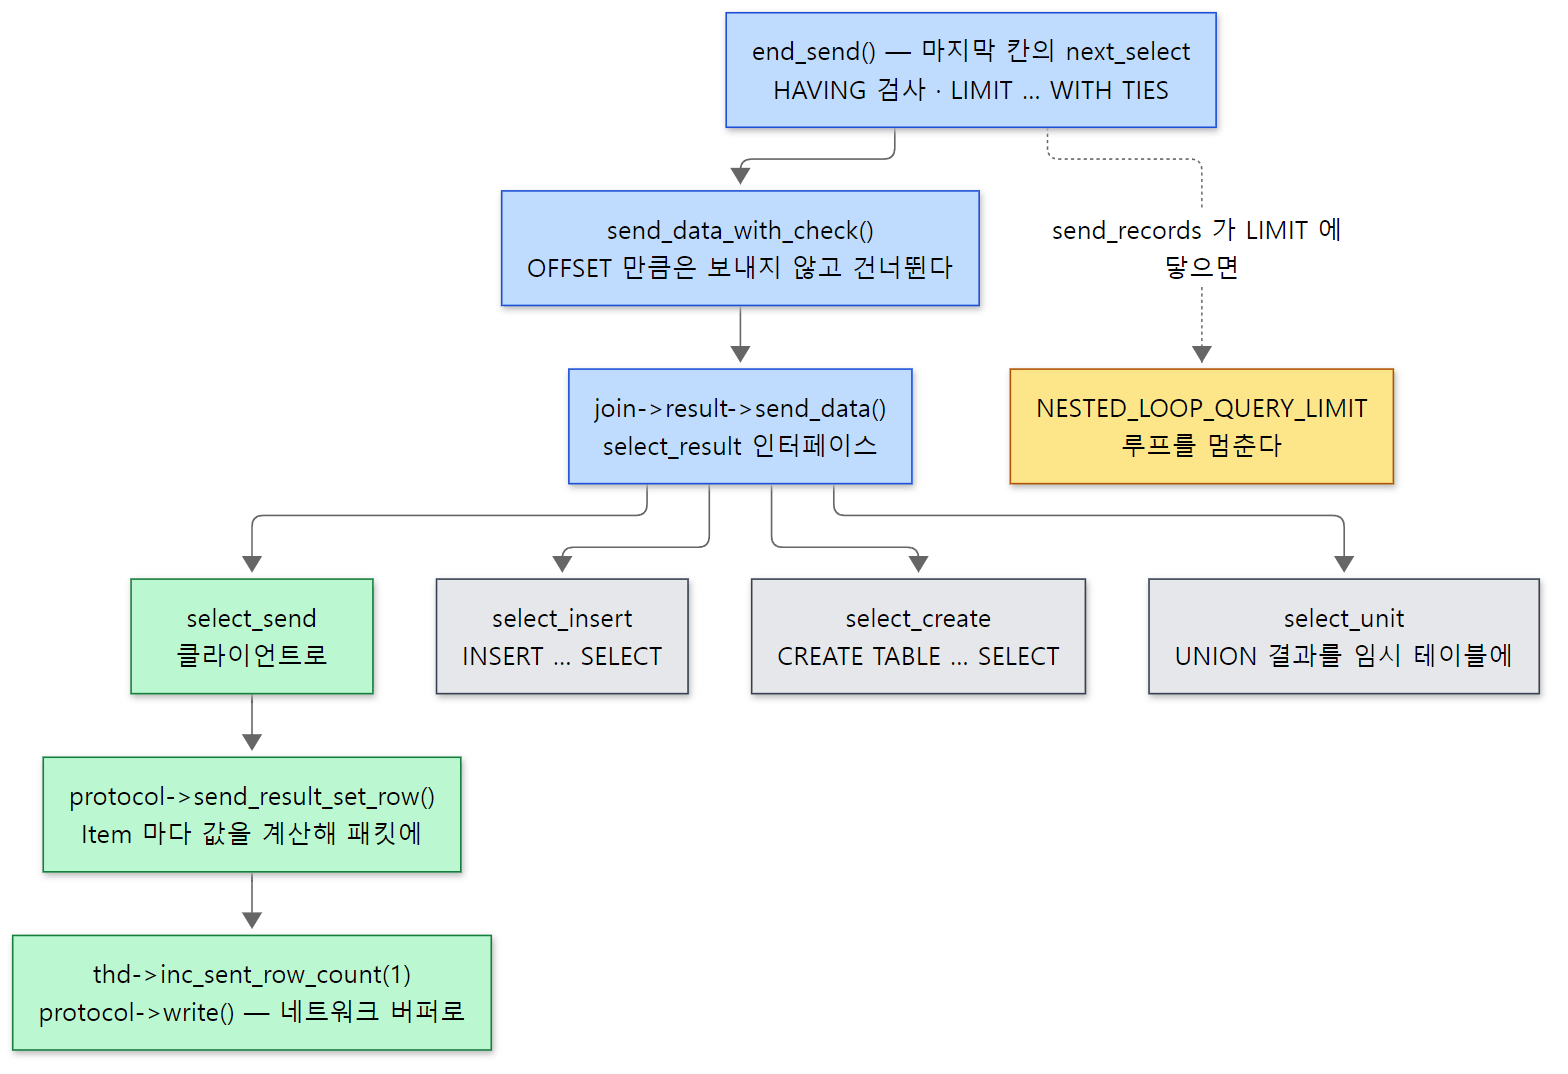 초록 길이 클라이언트로 가는 select_send 이고, 회색 칸은 같은 자리에 들어가는 다른 받는 쪽입니다. 클래스 관계는 sql/sql_class.h(6827·6934·6964·7145행)에서 확인했습니다.
헷갈리기 쉬운 곳: 결과를 받는 쪽이 클라이언트만은 아닙니다
join->result는 select_result 인터페이스이고 select_send는 그 구현 가운데 하나일 뿐입니다. INSERT … SELECT면 행을 테이블에 넣는 select_insert, CREATE TABLE … SELECT면 select_create, UNION의 결과를 임시 테이블에 모을 때는 select_unit 같은 하위 클래스가 같은 자리에 들어갑니다(모두 sql/sql_class.h에 선언). 그래서 같은 do_select()/end_send() 틀이 "클라이언트로 보내기"와 "다른 테이블에 쓰기"를 함께 맡습니다.
6. handler의 ha_ 감싸개 — 서버 계층이 엔진을 부르는 단 하나의 문
이제 반대편, 엔진과의 경계를 봅니다. handler 클래스 안에는 이런 주석이 붙은 private: 구역이 있습니다.
private:
  /*
    Low-level primitives for storage engines.  These should be
    overridden by the storage engine class. To call these methods, use
    the corresponding 'ha_*' method above.
  */
write_row(), update_row(), delete_row(), rnd_init(), index_init(), external_lock() 같은 엔진 쪽 함수가 이 아래에 private으로 선언되어 있습니다. C++에서 private 가상 함수는 하위 클래스가 덮어쓸 수는 있지만, 바깥(서버 계층)에서는 부를 수 없습니다. 그래서 서버 계층은 공개된 ha_write_row() 같은 감싸개를 거칠 수밖에 없습니다. "가상 함수는 숨기고, 공개 함수가 앞뒤 일을 한 뒤 그것을 부른다"는 C++의 흔한 설계(Non-Virtual Interface)입니다.
모든 엔진 함수가 private인 것은 아닙니다. 읽기 쪽 index_read_map()·index_next()·index_read()는 protected(앞의 둘은 4437행, index_read()는 5573행의 protected: 아래), rnd_next()는 public인 순수 가상 함수입니다(4564–4566행). 그래도 SQL 계층의 실행 코드는 이 글에서 본 대로 모두 ha_ 쪽을 부릅니다.
헷갈리기 쉬운 곳: 엔진은 같은 함수를 public으로 선언합니다
ha_innobase는 write_row()를 public: 아래에 override로 선언합니다(ha_innodb.h 120행, 65행의 public: 아래). ha_heap도 마찬가지입니다. C++은 덮어쓴 쪽이 접근 지정을 넓히는 것을 허용합니다. 하지만 서버 계층은 언제나 handler*(TABLE::file)를 통해 부르므로, 접근 검사는 handler의 선언으로 이루어집니다. 엔진 소스만 읽으면 "그냥 공개 함수"로 보이지만, 서버 계층이 직접 부를 수 있는 길은 ha_ 감싸개뿐입니다.
ha_rnd_next()가 하는 일
풀 스캔의 행 하나마다 불리는 ha_rnd_next()의 뼈대입니다.
int handler::ha_rnd_next(uchar *buf)
{
  int result;
  DBUG_ENTER("handler::ha_rnd_next");
  DBUG_ASSERT(table_share->tmp_table != NO_TMP_TABLE ||
              m_lock_type != F_UNLCK);
  DBUG_ASSERT(inited == RND);

  // ... (debug_dbug 로 오류를 흉내 내는 시험용 코드 생략)
  do
  {
    TABLE_IO_WAIT(tracker, PSI_TABLE_FETCH_ROW, MAX_KEY, result,
      { result= rnd_next(buf); })
    if (result != HA_ERR_RECORD_DELETED)
      break;
    status_var_increment(table->in_use->status_var.ha_read_rnd_deleted_count);
  } while (!table->in_use->check_killed(1));

  if (result == HA_ERR_RECORD_DELETED)
    result= HA_ERR_ABORTED_BY_USER;
  else
  {
    // ... (성공이면 행 통계와 가상 열 계산)
    increment_statistics(&SSV::ha_read_rnd_next_count);
  }

  table->status=result ? STATUS_NOT_FOUND: 0;
  // ... (DEBUG_SYNC 생략)
  DBUG_RETURN(result);
}
감싸개가 엔진 호출 앞뒤로 하는 일은 여섯 가지입니다.
- 사용 규칙 검사. 임시 테이블이 아니면 잠근 테이블이어야 하고(
m_lock_type != F_UNLCK),ha_rnd_init()을 먼저 불렀어야 합니다(inited == RND).DBUG_ASSERT라서 Debug 빌드에서만 검사하지만, 엔진 작성자에게는 "이 순서로 부른다"는 약속입니다. - 계측.
TABLE_IO_WAIT매크로가 엔진 호출을 감쌉니다(handler.h 6031–6041행).ANALYZE문장이나log_slow_verbosity=engine일 때만 켜지는 테이블별 시간 측정(tracker, sql_select.cc 32085–32090행)과, performance_schema의 테이블 I/O 대기 이벤트(MYSQL_TABLE_IO_WAIT)가 여기서 기록됩니다. - 엔진 호출.
rnd_next(buf)— 가상 함수이므로 실제로는ha_innobase::rnd_next()나ha_heap::rnd_next()가 불립니다. - 지워진 행 건너뛰기. 엔진이
HA_ERR_RECORD_DELETED(지워진 자리)를 돌려주면Handler_read_rnd_deleted를 올리고 다시 읽습니다. 그 사이에도check_killed()를 봅니다. - 통계.
increment_statistics(&SSV::ha_read_rnd_next_count)— 이것이Handler_read_rnd_next입니다(mysqld.cc의 상태 변수 표가"Handler_read_rnd_next"를 이 칸에 묶습니다, 8067행). 결과가 성공이든 끝이든 오릅니다. 예제 2에서 30행 스캔이 31로 나온 이유입니다. - 상태 표시.
table->status를 정해 둡니다. 3절의join_read_key2()가 이 값을 봅니다.
5번의 increment_statistics()는 숫자 하나만 올리지 않습니다.
inline void handler::increment_statistics(ulong SSV::*offset) const
{
  status_var_increment(table->in_use->status_var.*offset);
  table->in_use->check_limit_rows_examined();
}
SELECT … LIMIT ROWS EXAMINED n의 "읽은 행 수 한도"를 검사하는 곳이 바로 이 감싸개 안입니다. 1절의 exec_inner() 머리에서 set_limit_rows_examined()로 켜 두었던 것이 여기서 쓰입니다.
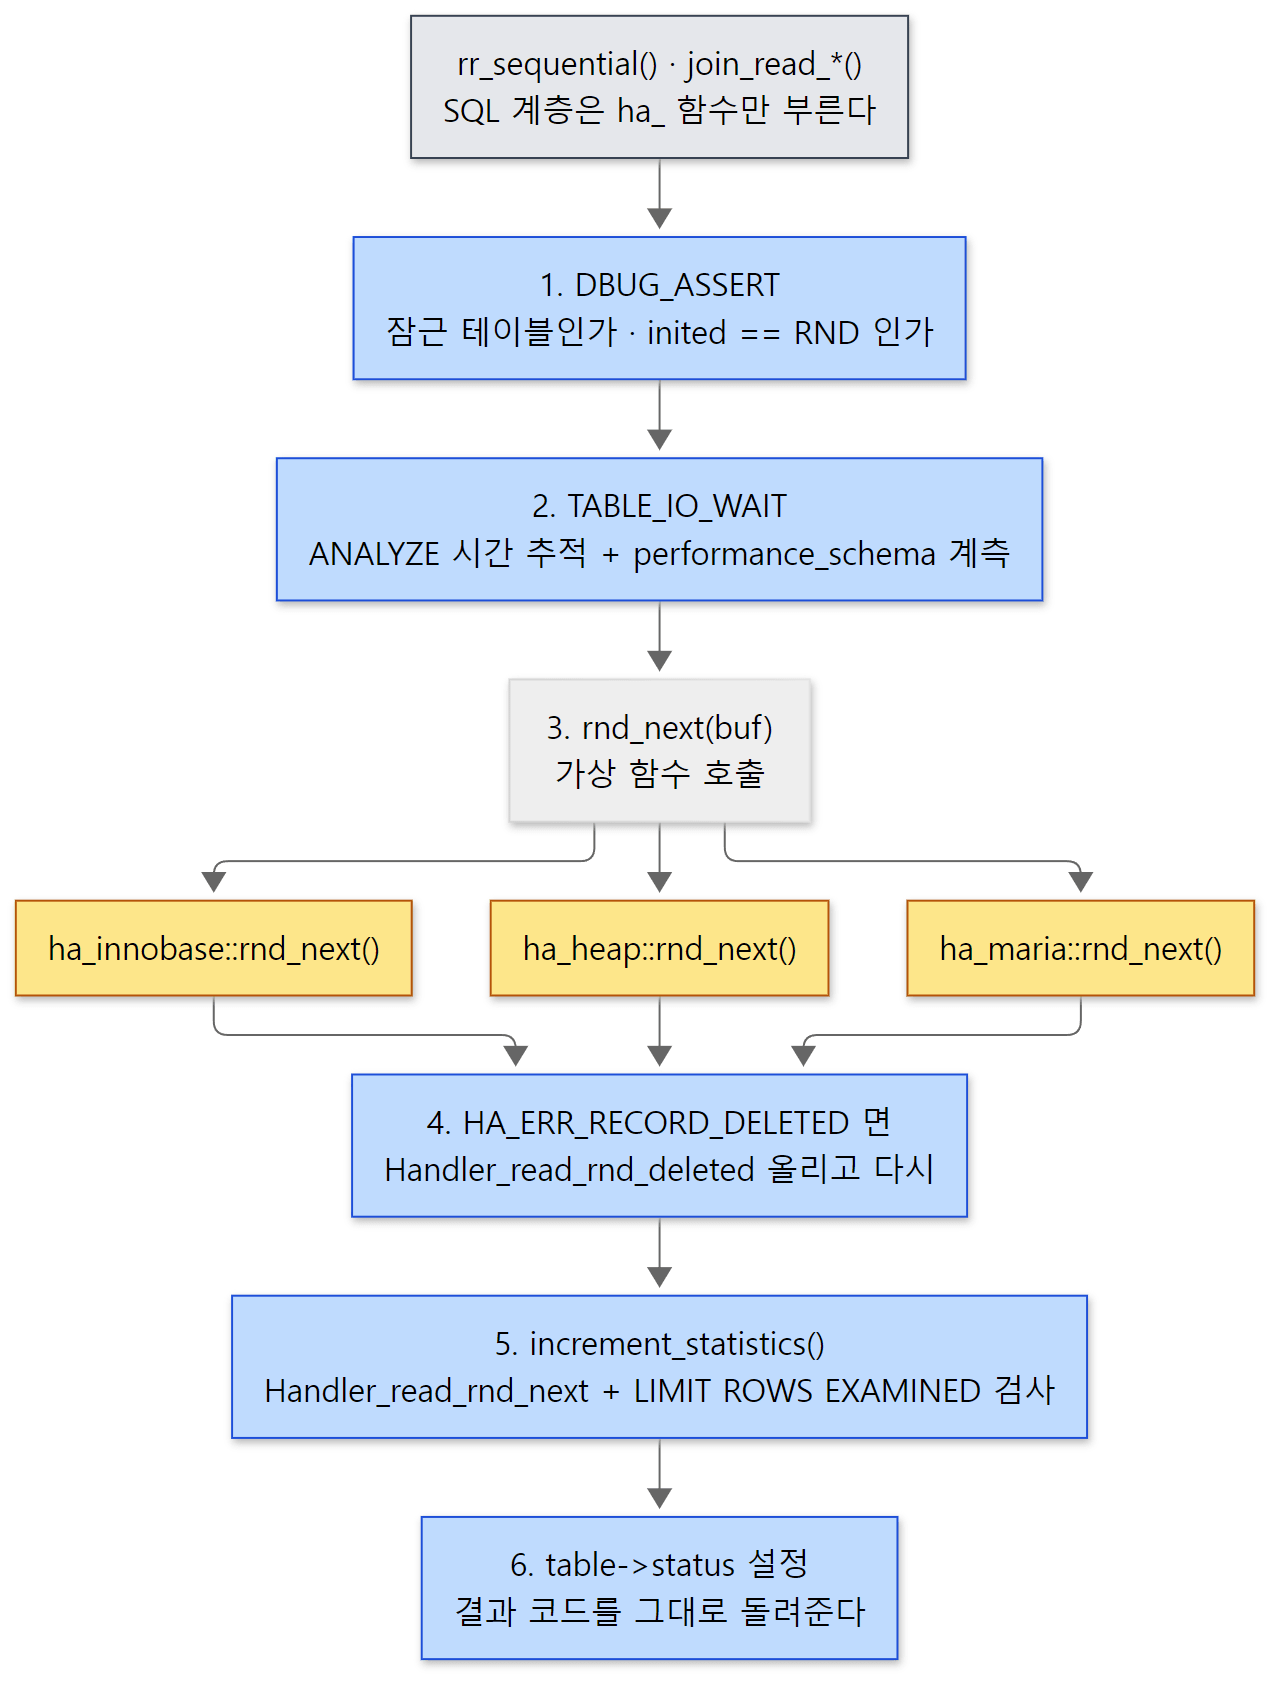 노란 칸만 엔진마다 다르고, 파란 칸은 모든 엔진이 똑같이 지납니다.
인덱스로 찾는 ha_index_read_map()도 같은 모양입니다. TABLE_IO_WAIT로 index_read_map()을 부르고, Handler_read_key를 올리고, 못 찾았으면 사용자 통계용 ha_read_key_miss를 하나 더 올립니다(sql/handler.cc 4204–4231행). 엔진이 index_read_map()을 덮어쓰지 않으면 handler의 기본 구현이 calculate_key_len()으로 키 길이를 계산해 index_read()로 넘기는데(sql/handler.h 4438–4444행), 예제 1의 백트레이스 #1 handler::index_read_map at handler.h:4443이 그 자리입니다. InnoDB는 이 기본 구현을 그대로 씁니다.
엔진 쪽: ha_innobase::rnd_next()
감싸개를 지나면 엔진입니다. InnoDB의 rnd_next() 본문은 if 하나입니다.
        if (m_start_of_scan) {
                error = index_first(buf);

                if (error == HA_ERR_KEY_NOT_FOUND) {
                        error = HA_ERR_END_OF_FILE;
                }

                m_start_of_scan = false;
        } else {
                error = general_fetch(buf, ROW_SEL_NEXT, 0);
        }
storage/innobase/handler/ha_innodb.cc 9670–9680행 (InnoDB 소스는 탭 들여쓰기입니다. 여기서는 8칸 공백으로 바꿔 실었습니다.)
InnoDB에서 "테이블 풀 스캔"은 클러스터드 인덱스(기본 키 B-트리)를 처음부터 끝까지 걷는 것입니다. rnd_init()이 활성 인덱스를 클러스터드 인덱스(기본 키, 기본 키가 없으면 InnoDB가 만든 숨은 행 ID 인덱스)로 바꿔 두고(9605–9642행), 첫 rnd_next()는 index_first() → index_read()로 맨 앞에 커서를 놓고, 그다음부터는 general_fetch()로 다음 레코드를 가져옵니다. index_read()와 general_fetch()는 둘 다 결국 row_search_mvcc()를 부릅니다(9220행, 9471–9472행). 그 안에서 B-트리를 걷고(10편) 트랜잭션에 맞는 판의 행을 고르는 일(11편)이 일어납니다.
예제 1을 처음 돌렸을 때 ha_innobase::index_read에 조건 없이 중단점을 걸었더니, 기대한 안쪽 테이블의 ref 조회가 아니라 바깥 테이블의 풀 스캔에서 먼저 멈췄습니다. 백트레이스는 ha_innobase::index_read ← ha_innobase::index_first ← ha_innobase::rnd_next ← handler::ha_rnd_next …였습니다. 풀 스캔도 InnoDB 안에서는 인덱스 읽기라는 것을 그렇게 알게 되었고, 그래서 if key_len > 0 조건을 붙여(index_first()는 키 없이 index_read(buf, NULL, 0, …)를 부릅니다) 예제를 고쳤습니다.
예제 4: 엔진을 바꿔도 같은 자리
같은 테이블을 엔진만 바꿔 다섯 벌 만들고, 같은 INSERT와 같은 SELECT를 보냈습니다(예제 폴더 ex/u09-engines). BLACKHOLE은 동적 플러그인이라 INSTALL SONAME 'ha_blackhole'로 먼저 올렸습니다(3편). 테이블은 CREATE TABLE t_<엔진> (id INT PRIMARY KEY, v INT) ENGINE=<엔진>, 문장은 INSERT INTO t_<엔진> SELECT seq, seq * 10 FROM seq_1_to_5와 SELECT COUNT(*) FROM t_<엔진> WHERE v > 0입니다(WHERE를 붙여 어느 엔진에서든 행을 하나하나 읽게 했습니다). 마지막 줄은 비교를 위해 SEQUENCE 엔진(seq_1_to_5)에 SUM()을 보낸 것입니다.
=== 1. same statements, different engines
InnoDB     INSERT 5 rows:  Handler_write=5
InnoDB     SELECT      :  result=5  Handler_read_rnd_next=6
Aria       INSERT 5 rows:  Handler_write=5
Aria       SELECT      :  result=5  Handler_read_rnd_next=6
MyISAM     INSERT 5 rows:  Handler_write=5
MyISAM     SELECT      :  result=5  Handler_read_rnd_next=6
MEMORY     INSERT 5 rows:  Handler_write=5
MEMORY     SELECT      :  result=5  Handler_read_rnd_next=6
BLACKHOLE  INSERT 5 rows:  Handler_write=5
BLACKHOLE  SELECT      :  result=0  Handler_read_rnd_next=1
SEQUENCE   SELECT      :  result=15
이어서 gdb로 엔진의 rnd_next에 차례로 중단점을 걸고 bt 3(위 세 프레임만)을 찍었습니다.
=== 2. who answers handler::ha_rnd_next
#0  ha_heap::rnd_next at /usr/src/mariadb/storage/heap/ha_heap.cc:425
#1  handler::ha_rnd_next at /usr/src/mariadb/sql/handler.cc:4129
#2  rr_sequential at /usr/src/mariadb/sql/records.cc:517
#0  ha_maria::rnd_next at /usr/src/mariadb/storage/maria/ha_maria.cc:2646
#1  handler::ha_rnd_next at /usr/src/mariadb/sql/handler.cc:4129
#2  rr_sequential at /usr/src/mariadb/sql/records.cc:517
#0  ha_blackhole::rnd_next at /usr/src/mariadb/storage/blackhole/ha_blackhole.cc:138
#1  handler::ha_rnd_next at /usr/src/mariadb/sql/handler.cc:4129
#2  rr_sequential at /usr/src/mariadb/sql/records.cc:517
- 네 엔진의 숫자가 똑같습니다. 5행 테이블 스캔에
Handler_read_rnd_next6(5행 + 끝). 숫자를 세는 곳이 엔진이 아니라handler::ha_rnd_next()한 곳이기 때문입니다. - gdb의
#1,#2는 엔진과 상관없이 같은 줄(handler.cc 4129행 =TABLE_IO_WAIT안의rnd_next(buf)호출, records.cc 517행)이고#0만 바뀝니다. 서버 계층은 엔진이 무엇인지 모른 채 가상 함수를 부를 뿐입니다. - BLACKHOLE은 쓰면 받아 주고, 읽으면 아무것도 없습니다.
INSERT는 성공하고Handler_write도 5가 오르지만,SELECT는 0행에rnd_next1번(바로 끝)입니다. 소스가 그대로입니다 —ha_blackhole::write_row()는 자동 증가 열 처리만 하고0(성공)을 돌려주고,rnd_next()는 행 기반 복제 적용 중이 아니면 곧바로HA_ERR_END_OF_FILE을 돌려줍니다(storage/blackhole/ha_blackhole.cc 104–145행). handler API를 지키기만 하면 "아무것도 저장하지 않는 엔진"도 엔진입니다.
헷갈리기 쉬운 곳: SEQUENCE 엔진의 SUM()에는 Handler_read_rnd_next가 없습니다
마지막 줄 SELECT SUM(seq) FROM seq_1_to_5 WHERE seq > 0은 15를 돌려주지만 Handler_read_rnd_next가 아예 찍히지 않았습니다(이 예제는 Handler_write와 Handler_read_rnd_next만 골라 찍습니다). 처음에는 gdb 예제에 ha_seq::rnd_next 중단점도 넣었는데, 그 중단점에 영영 닿지 않아 gdb가 멈춘 채 예제가 끝나지 않았습니다. 원인은 SEQUENCE 테이블의 seq 열이 기본 키라는 데 있습니다. 같은 컨테이너에서 이 쿼리를 따로 EXPLAIN해 보면 type=range, key=PRIMARY, Extra=Using where; Using index이고, Handler_read%를 전부 찍으면 Handler_read_key 1, Handler_read_next 5입니다. 옵티마이저가 seq > 0을 기본 키의 범위 조건으로 보고 3절 표의 range를 골랐기 때문에, 풀 스캔용 rnd_next()는 불리지 않습니다. gdb로 ha_seq::index_read_map에 멈춰 보면 handler::ha_index_read_map ← handler::read_range_first ← handler::multi_range_read_next ← QUICK_RANGE_SELECT::get_next ← rr_quick 순서로 올라갑니다. 그래서 gdb 예제에서는 SEQUENCE를 뺐습니다.
WHERE를 떼면 또 다른 길이 열립니다. SEQUENCE 엔진은 집계를 통째로 가져가는 group_by_handler 를 구현해 두었습니다. storage/sequence/sequence.cc의 create_group_by_handler()는 WHERE와 GROUP BY가 없고(408행) SELECT 목록이 기본 키에 대한 SUM()·COUNT()뿐일 때만 ha_seq_group_by_handler를 만들어 돌려줍니다(397–450행). 그러면 do_select()는 1절에서 본 중첩 루프 대신 첫머리의 join->pushdown_query->execute(join) 갈래로 갑니다(24963–24970행). 실제로 SELECT SUM(seq) FROM seq_1_to_5를 EXPLAIN하면 Extra에 Storage engine handles GROUP BY가 보이고, 실행해도 Handler_* 상태 변수가 하나도 오르지 않습니다. 엔진이 1부터 5까지의 합을 행을 읽지 않고 계산해 버리기 때문입니다. handler API 말고도 엔진이 쿼리의 큰 덩어리를 가져가는 길(group by handler, select_lex->pushdown_select)이 있다는 것만 기억해 두면 됩니다.
잠금의 입구: ha_external_lock()
handler API에는 행 함수 말고도 "이 문장에서 이 테이블을 쓰기 시작한다/끝났다"를 알리는 함수가 있습니다. 7편의 open_and_lock_tables()는 테이블을 연 뒤 mysql_lock_tables() → lock_external()에서 테이블마다 이것을 부릅니다.
if (unlikely((error=(*tables)->file->ha_external_lock(thd,lock_type))))
lock_type은 읽기면 F_RDLCK, 쓰기면 F_WRLCK이고, 문장이 끝나 테이블을 닫을 때(close_thread_tables() → mysql_unlock_tables()) F_UNLCK로 한 번 더 부릅니다. 이름은 "외부 잠금"이지만, handler.h의 주석대로 MyISAM이 이 자리에서 fcntl로 데이터 파일에 권고 잠금을 걸던 첫 구현에서 온 이름일 뿐이고(sql/handler.h 5542–5544행), InnoDB에게는 문장의 시작과 끝을 알려 주는 신호입니다.
        switch (lock_type) {
        case F_UNLCK:
                // ...
                if (--trx->n_mysql_tables_in_use) {
                        break;
                }

                /* If the lock count drops to zero we know that the
                current SQL statement has ended */
                // ...
                if (!not_autocommit) {
                        if (!not_started) {
                                innobase_commit(thd, TRUE);
                        }
                } else if (trx->isolation_level <= TRX_ISO_READ_COMMITTED) {
                        trx->read_view.close();
                }
                break;
        case F_WRLCK:
                /* If this is a SELECT, then it is in UPDATE TABLE ...
                or SELECT ... FOR UPDATE */
                m_prebuilt->select_lock_type = LOCK_X;
                m_prebuilt->stored_select_lock_type = LOCK_X;
                goto set_lock;
storage/innobase/handler/ha_innodb.cc 16797–16825행 (탭을 8칸 공백으로 바꿔 실었습니다.)
F_WRLCK이면 이 문장에서 읽는 행에 배타 잠금(LOCK_X)을 걸도록 표시합니다.UPDATE나SELECT … FOR UPDATE가 읽는 행을 잠그는 출발점입니다. 이어지는set_lock:에서innobase_register_trx()로 이 트랜잭션을 서버의 트랜잭션 목록에 등록합니다(16834행).F_UNLCK로 이 문장이 쓰던 마지막 테이블까지 풀리면 "문장이 끝났다"고 봅니다. 자동 커밋 모드인데 InnoDB 트랜잭션이 아직 남아 있으면innobase_commit(thd, TRUE)로 커밋하고, 명시적 트랜잭션(BEGIN또는autocommit=0) 안에서 격리 수준이 READ COMMITTED 이하면 읽기 뷰를 닫습니다(문장마다 새 스냅샷을 쓰는 이유). 이 함수 앞부분에서m_prebuilt->sql_stat_start = TRUE로 "새 문장의 시작"도 표시해 둡니다(16730행). 트랜잭션과 읽기 뷰는 11편에서 봅니다.
헷갈리기 쉬운 곳: Handler_external_lock은 늘 0입니다
SHOW STATUS에는 Handler_external_lock이라는 변수가 있어서 ha_external_lock() 호출 수를 셀 것 같습니다. 그런데 기준 커밋에서 이 숫자를 올리는 코드가 없습니다. 상태 변수 표에 ha_external_lock_count 칸이 묶여 있고(sql/mysqld.cc 8052행) STATUS_VAR에 그 칸이 선언되어 있을 뿐(sql/sql_class.h 1038행), 저장소 전체(.cc·.h·.ic)를 external_lock_count로 찾아도 이 둘 말고는 나오지 않습니다. 위에서 본 ha_external_lock() 본문에도 increment_statistics()가 없습니다. 예제 5의 마지막 줄에서, INSERT·UPDATE·DELETE를 여러 번 보낸 서버에서도 SHOW GLOBAL STATUS LIKE 'Handler_external_lock'은 0이었습니다. (다른 판에서 언제부터 그런지는 확인하지 않았습니다.)
7. 쓰기 경로 — mysql_insert()에서 ha_innobase::write_row()까지
읽기의 반대편, INSERT를 봅니다. 7편에서 본 mysql_execute_command()의 큰 switch가 SQLCOM_INSERT를 mysql_insert()로 보냅니다. mysql_insert()는 테이블을 열고 잠근 뒤(open_and_lock_tables(), 여기서 6절의 ha_external_lock(F_WRLCK)), VALUES의 행마다 값을 table->record[0]에 채우고 Write_record::write_record()를 부릅니다(sql/sql_insert.cc 1232행). write_record()는 중복 처리 방식(DUP_ERROR, ON DUPLICATE KEY UPDATE의 DUP_UPDATE, REPLACE의 DUP_REPLACE)에 따라 갈라지고, 평범한 INSERT면 single_insert()입니다.
int Write_record::single_insert(ha_rows *inserted)
{
  // ... (복제 시험용 DBUG_EXECUTE_IF 생략)
  int error= table->file->ha_write_row(table->record[0]);
ha_write_row()는 읽기 감싸개와 같은 틀에 쓰기에 필요한 일이 더해져 있습니다.
int handler::ha_write_row(const uchar *buf)
{
  int error;
  DBUG_ENTER("handler::ha_write_row");
  // ... (DEBUG_SYNC, WSREP 시험용 코드 생략)
  DBUG_ASSERT(table_share->tmp_table || m_lock_type == F_WRLCK);
  DBUG_ASSERT(buf == table->record[0]);

  if (!(ha_table_flags() & HA_CHECK_UNIQUE_AFTER_WRITE) &&
      (error= ha_check_inserver_constraints(NULL, buf)))
    goto err;

  MYSQL_INSERT_ROW_START(table_share->db.str, table_share->table_name.str);
  mark_trx_read_write();
  increment_statistics(&SSV::ha_write_count);

  TABLE_IO_WAIT(tracker, PSI_TABLE_WRITE_ROW, MAX_KEY, error,
                      { error= write_row(buf); })
  // ...
  rows_stats.inserted++;
  error= binlog_log_row(0, buf,
                        Write_rows_log_event::binlog_row_logging_function);
F_WRLCK로 잠근 테이블에만 쓸 수 있다는 약속을 확인합니다.ha_check_inserver_constraints()— 서버 계층이 맡는 제약 두 가지, 기간 키의WITHOUT OVERLAPS(ha_check_overlaps())와 엔진 인덱스로는 못 거는 긴 열의UNIQUE(ha_check_long_uniques())를 검사합니다.mark_trx_read_write()— "이 트랜잭션에서 이 엔진은 쓰기를 했다"고 표시합니다(문장마다 처음 한 번만 실제 일을 하는mark_trx_read_write_internal(), handler.cc 5807–5831행). 커밋할 때 읽기만 한 엔진은 2단계 커밋에서 뺄 수 있게 하는 표시로, 12편의 2단계 커밋에서 다시 나옵니다.Handler_write를 엔진 호출보다 먼저 올립니다. 그래서 실패한INSERT도 하나로 셉니다(예제 5).binlog_log_row()— 행 기반 binlog(binlog_format=ROW)의 행 이벤트를 만드는 곳이 엔진 호출 뒤(쓰기가 성공했을 때), 감싸개 안입니다. 그래서 어느 엔진에 쓰든 binlog 쪽 처리는 같습니다. binlog는 12편에서 봅니다.ha_update_row()와ha_delete_row()도 같은 순서입니다.mark_trx_read_write()→Handler_update/Handler_delete증가 →TABLE_IO_WAIT안의update_row()/delete_row()→binlog_log_row()(8725–8798행, 8828–8877행).
엔진 쪽 ha_innobase::write_row()는 트랜잭션 상태를 확인하고, 자동 증가 열이면 update_auto_increment()로 값을 받고, 서버 형식과 InnoDB 형식을 오가는 "템플릿"을 준비한 뒤 InnoDB의 삽입 함수로 넘깁니다.
        vers_set_fields = table->versioned_write(VERS_TRX_ID) ?
                ROW_INS_VERSIONED : ROW_INS_NORMAL;

        /* Execute insert graph that will result in actual insert. */
        error = row_insert_for_mysql((byte*) record, m_prebuilt, vers_set_fields);
storage/innobase/handler/ha_innodb.cc 7966–7970행 (탭을 8칸 공백으로 바꿔 실었습니다.)
row_insert_for_mysql()부터는 InnoDB 안쪽입니다. 클러스터드 인덱스와 보조 인덱스에 레코드를 넣는 일은 10편, undo 기록과 잠금은 11편, redo 로그는 12편에서 봅니다.
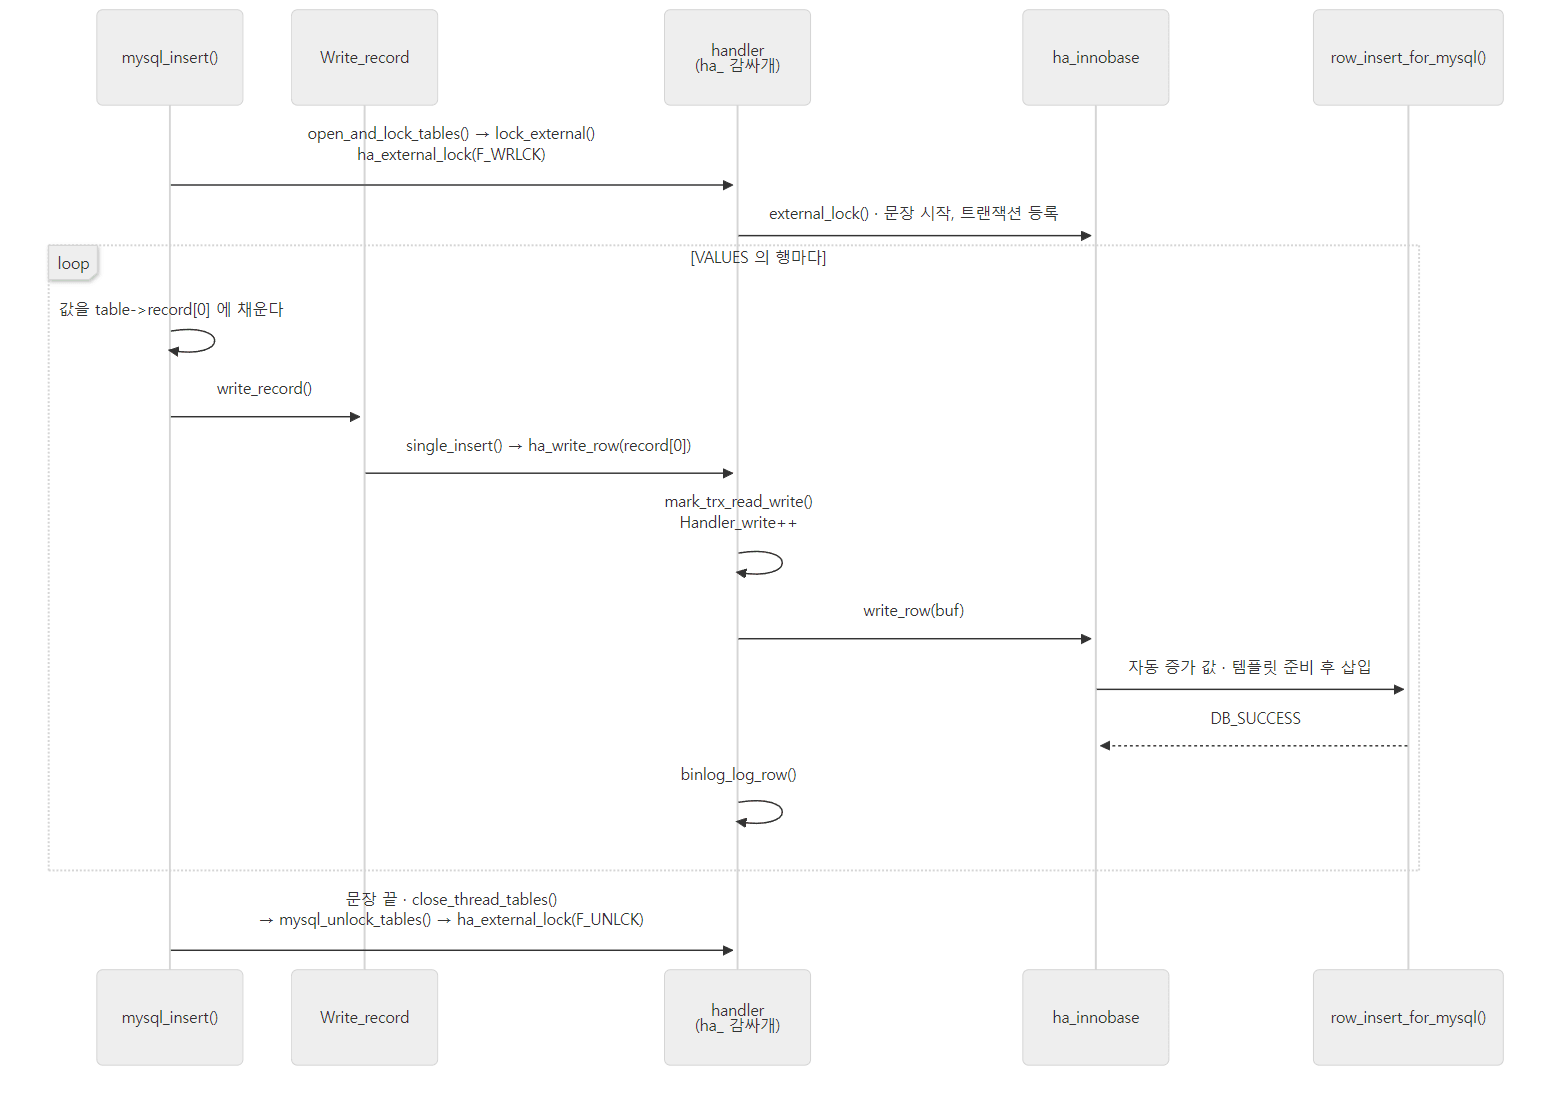 읽기와 마찬가지로 쓰기도
ha_ 감싸개 하나를 지나 엔진으로 들어갑니다.
예제 5: INSERT의 백트레이스와 DML의 Handler_* 숫자
ha_innobase::write_row에 중단점을 걸고 INSERT INTO t VALUES (1,10)을 보냈습니다(예제 폴더 ex/u09-gdb-write).
=== 1. INSERT INTO t VALUES (1,10)
#0  ha_innobase::write_row at /usr/src/mariadb/storage/innobase/handler/ha_innodb.cc:7919
#1  handler::ha_write_row at /usr/src/mariadb/sql/handler.cc:8666
#2  Write_record::single_insert at /usr/src/mariadb/sql/sql_insert.cc:2396
#3  Write_record::write_record at /usr/src/mariadb/sql/sql_insert.cc:2438
#4  mysql_insert at /usr/src/mariadb/sql/sql_insert.cc:1232
#5  mysql_execute_command at /usr/src/mariadb/sql/sql_parse.cc:4549
#6  mysql_parse at /usr/src/mariadb/sql/sql_parse.cc:8005
#7  dispatch_command at /usr/src/mariadb/sql/sql_parse.cc:1903
#8  do_command at /usr/src/mariadb/sql/sql_parse.cc:1437
SELECT와 달리 JOIN도 sub_select도 없습니다. VALUES로 행을 받는 INSERT는 테이블을 읽을 필요가 없어서 실행 단계가 훨씬 짧습니다. handler.cc 8666행은 TABLE_IO_WAIT 안의 write_row(buf) 호출입니다.
이어서 같은 세션에서 FLUSH STATUS → DML → SHOW SESSION STATUS로 0이 아닌 Handler_*를 찍었습니다. 마지막 INSERT는 일부러 이미 있는 기본 키를 넣었습니다.
=== 2. Handler_* for DML
--- INSERT INTO t VALUES (2,20),(3,30),(4,40)
  Handler_commit         1
  Handler_write          3
--- UPDATE t SET v = v + 1 WHERE id >= 3
  Handler_commit         1
  Handler_read_key       1
  Handler_read_next      2
  Handler_update         2
--- DELETE FROM t WHERE id = 2
  Handler_commit         1
  Handler_delete         1
  Handler_read_key       1
--- INSERT INTO t VALUES (1,99)
  ERROR 1062 (23000) at line 1: Duplicate entry '1' for key 'PRIMARY'
  Handler_rollback       1
  Handler_write          1
Handler_external_lock	0
- 세 행
INSERT는Handler_write3 —ha_write_row()세 번입니다. UPDATE … WHERE id >= 3은 기본 키 범위로id=3을 찾고(read_key1) 다음 행4와 끝을 읽은 뒤(read_next2), 두 행을 고쳤습니다(Handler_update2).UPDATE도 앞부분은 이 글의 읽기 경로를 그대로 탑니다.- 중복 키로 실패한
INSERT도Handler_write1입니다. 위에서 본 대로ha_write_row()가write_row()를 부르기 전에 숫자를 올리기 때문입니다. 실패한 문장은 되돌려져Handler_rollback1이 함께 찍힙니다.Handler_write는 "쓴 행 수"가 아니라 "쓰기를 시도한 횟수"입니다. - 마지막 줄이 6절에서 말한
Handler_external_lock0입니다.
이 글에서 뺀 것
GROUP BY·집계와 임시 테이블 — 끝 함수end_send_group()·end_write()·end_write_group(), 집계를 위한 임시 테이블 단계sub_select_postjoin_aggr()(sql/sql_select.cc)와AGGR_OP(sql/sql_select.h), 내부 임시 테이블create_tmp_table().- 정렬 —
JOIN_TAB::sort_table()→create_sort_index()→filesort()(sql/filesort.cc), 정렬 결과를 읽는rr_from_pointers·rr_unpack_from_buffer(sql/records.cc). - 범위 읽기와 MRR —
rr_quick,QUICK_RANGE_SELECT::get_next()(sql/opt_range.cc), Multi-Range Readhandler::multi_range_read_*(sql/multi_range_read.cc)와Handler_mrr_*상태 변수. - 조인 버퍼의 나머지 — BNLH·BKA·BKAH가 덮어쓰는
put_record()·get_next_candidate_for_match()같은 함수와join_cache_level1~8의 뜻(sql/sql_join_cache.cc), 버퍼 크기를 정하는JOIN_CACHE::set_constants(). - 조건을 엔진으로 내려보내기 — Index Condition Pushdown
push_index_cond()(sql/opt_index_cond_pushdown.cc,Handler_icp_*), rowid 필터Range_rowid_filter(sql/rowid_filter.cc), 엔진 조건 푸시다운handler::cond_push(). - 외부 조인·반조인 실행과 통째로 넘기는 길 —
evaluate_null_complemented_join_record(), FirstMatch·LooseScan·DuplicateWeedout(sql/opt_subselect.cc),group_by_handler·select_handler·derived_handler(sql/group_by_handler.h,sql/select_handler.h,sql/derived_handler.h). - handler의 나머지 계약 —
handler::info()(옵티마이저가 행 수·통계를 묻는 함수, 8편),table_flags()(엔진이 할 수 있는 일을 비트로 알리는 함수,ha_external_lock()이cached_table_flags에 캐시한다),ha_innobase::table_flags()(ha_innodb.cc 5201행), 대량 삽입ha_start_bulk_insert(). - UPDATE·DELETE의 실행 함수 —
Sql_cmd_update::update_single_table()(sql/sql_update.cc),Sql_cmd_delete::delete_from_single_table()(sql/sql_delete.cc). 기준 커밋에는 예전 이름mysql_update()·mysql_delete()라는 함수가 없습니다(몇몇 엔진 소스의 오래된 주석에만 이름이 남아 있습니다).
정리
| 개념 | 한 줄 요약 |
|---|---|
JOIN::exec() / exec_inner() |
열 정보를 먼저 보내고(send_result_set_metadata) do_select()를 부른다. "Sending data" 단계가 여기서 시작된다 |
do_select() |
상수 테이블을 건너뛴 첫 칸에 first_select(= sub_select)를 두 번 부른다 — 한 번은 행을 위해, 한 번은 "끝" 신호(end_of_records)를 위해 |
sub_select() |
칸 하나의 루프. read_first_record 한 번, read_record() 반복, 행마다 evaluate_join_record() |
evaluate_join_record() |
KILL 확인, 칸에 붙은 조건(select_cond) 평가, 통과하면 next_select로 다음 칸 — 여기서 중첩이 생긴다 |
JOIN_TAB의 함수 포인터 |
pick_table_access_method()·make_join_readinfo()가 EXPLAIN의 type에 맞는 읽기 함수를 꽂는다. 계획 = 부를 함수의 목록 |
eq_ref의 한 칸짜리 캐시 |
cmp_buffer_with_ref()가 직전과 같은 키면 엔진을 부르지 않는다 |
| 조인 버퍼 | 앞 칸의 next_select가 sub_select_cache가 되어 부분 행을 모으고, 안쪽 테이블을 버퍼마다 한 번만 훑는다 |
end_send() → select_send |
HAVING·LIMIT을 처리하고 행을 찾는 즉시 Protocol로 보낸다 |
ha_ 감싸개 |
엔진 함수는 대부분 private/protected 가상 함수, 서버 계층은 공개 감싸개만 부른다. 사용 규칙 검사·계측·Handler_* 통계·LIMIT ROWS EXAMINED·binlog가 여기서 일어난다 |
Handler_read_* |
엔진을 부른 횟수. 결과(성공/끝)와 무관하게 오르므로 n행 스캔은 n+1이 된다 |
ha_external_lock() |
InnoDB에게는 문장의 시작(F_RDLCK/F_WRLCK)과 끝(F_UNLCK) 신호. Handler_external_lock은 기준 커밋에서 늘 0 |
| 쓰기 경로 | mysql_insert() → Write_record::write_record() → single_insert() → ha_write_row() → ha_innobase::write_row() → row_insert_for_mysql() |
다음에 볼 것
다음 글 10편 InnoDB 1 — 페이지, 버퍼 풀, B-트리는 이 글이 멈춘 곳, row_search_mvcc()와 row_insert_for_mysql()의 안쪽으로 들어갑니다. ha_innobase::rnd_next()가 "클러스터드 인덱스를 걷는다"고 했는데, 그 인덱스가 16KB 페이지로 이루어진 B-트리이고 그 페이지들이 버퍼 풀에 올라와 있다는 것을, ha_innodb.cc와 row0mysql.cc의 row_prebuilt_t(서버 계층과 InnoDB 사이의 다리)부터 따라갑니다.
handler API는 앞 연재에서 본 확장 구조와 닮았습니다. httpd 6편의 모듈은 훅에 함수 포인터를 등록해 요청 처리에 끼어들고, MariaDB의 엔진은 handler의 가상 함수를 구현해 행 읽기·쓰기를 맡습니다. 둘 다 "코어는 상대가 누구인지 모른 채 정해진 입구만 부른다"는 점이 같고, 다른 점은 httpd 훅이 여러 모듈을 차례로 부르는 사슬인 반면 MariaDB는 테이블 하나에 엔진 하나가 정해져 있다는 것입니다. 애플리케이션 쪽에서 보면, Spring 18편의 JdbcTemplate이 ResultSet.next()로 한 행씩 꺼내던 그 행들이 이 글의 end_send() → select_send::send_data()가 찾는 즉시 하나씩 보낸 패킷입니다.