이 글에서 다루는 것
"MariaDB 소스 파헤치기" 연재의 열두 번째이자 마지막 글입니다. 11편에서는 InnoDB가 트랜잭션을 trx_t로 들고 다니며 undo로 옛 판을 만들고(MVCC), 잠금으로 서로를 막는 것을 봤습니다. 거기까지는 전부 메모리 안의 이야기였습니다. 이번 글은 2편 지도에서 ⑥ 실행 끝의 COMMIT과, ⑧ 엔진 칸 맨 아래에 있는 디스크에 남기는 일을 확대합니다. 서버가 갑자기 죽어도 커밋한 것은 남고 커밋하지 않은 것은 사라지게 만드는 장치입니다.
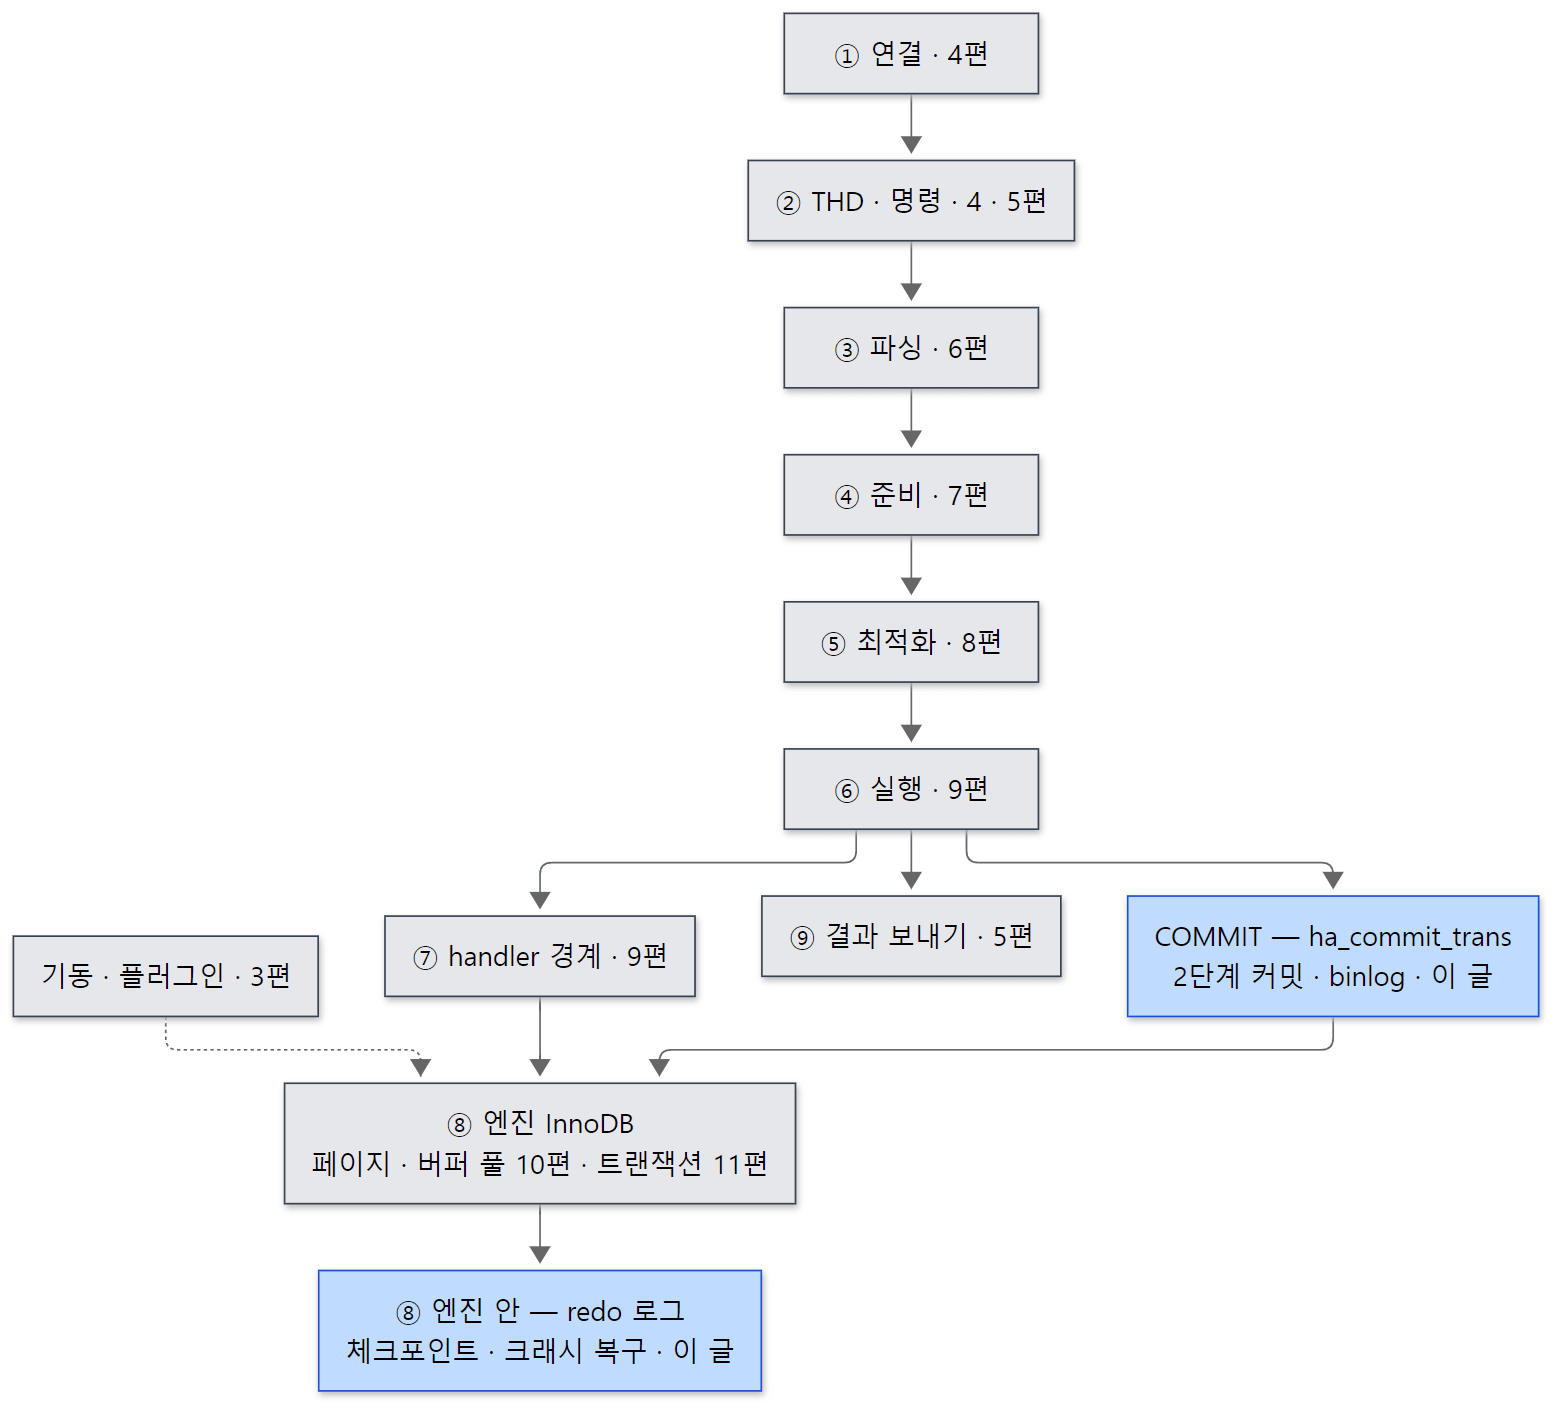 파란 칸이 이 글에서 읽는 곳입니다.
답하려는 질문은 세 가지입니다.
COMMIT이 "OK"를 돌려줬을 때 디스크에는 무엇이 있는가.innodb_flush_log_at_trx_commit의 0·1·2는 소스의 어디서 갈리는가- 서버가
kill -9로 죽으면 다시 뜰 때 무엇을 하는가. 커밋하지 않은 행은 누가 지우는가 - InnoDB에 redo 로그가 있는데 binlog는 왜 또 있고, 두 로그는 어떻게 어긋나지 않게 맞추는가
| 항목 | 내용 |
|---|---|
| 대상 | MariaDB Server |
| 버전 | 13.2.0 (main, alpha) |
| 커밋 | c894d97781 (2026-10-19) |
| 주로 읽는 파일 | storage/innobase/include/log0log.h, log/log0log.cc, mtr/mtr0mtr.cc, log/log0recv.cc, trx/trx0trx.cc, sql/handler.cc, sql/log.h·log.cc, sql/log_event.h |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
sql/log.cc는 15,000줄이 넘고 InnoDB의 로그와 복구 코드(log0log.cc, log0recv.cc)도 합치면 9,000줄 가까이 됩니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
redo 로그. InnoDB가 페이지를 고칠 때마다 "어느 페이지의 몇 번째 바이트를 이렇게 바꿨다"를 따로 적어 두는 파일(ib_logfile0)입니다. 고친 페이지는 메모리(버퍼 풀, 10편)에 둔 채 나중에 쓰고, 로그만 먼저 디스크에 씁니다. 이 방식을 흔히 WAL(write-ahead logging, 먼저 로그를 쓴다)이라고 부릅니다. 서버가 죽으면 이 로그를 다시 읽어 페이지를 고쳐 놓습니다. "다시 한다"는 뜻으로 redo라고 합니다.
LSN(log sequence number). redo 로그 안의 위치를 나타내는 64비트 숫자입니다. 로그를 몇 바이트 썼는지를 세는 시계라고 생각하면 됩니다. 로그에 레코드를 붙일 때마다 그 길이만큼 커지고, 페이지마다 "나를 마지막으로 고친 로그의 LSN"이 머리(FIL_PAGE_LSN)에 적혀 있습니다. SHOW ENGINE INNODB STATUS의 Log sequence number가 이것입니다.
mtr(mini-transaction, 미니 트랜잭션). 페이지 몇 장을 원자적으로 고치는 작은 단위입니다. 행 하나를 넣을 때도 B-트리 페이지와 undo 페이지를 같이 고치는데, 이것을 한 mtr_t로 묶어 "전부 아니면 전무"로 로그에 남깁니다. 10편에서 페이지 잠금과 함께 봤습니다. SQL 트랜잭션 하나는 mtr 여러 개로 이뤄집니다.
체크포인트. "이 LSN 앞의 로그로 고친 페이지는 전부 데이터 파일에 써 두었다"는 표시입니다. 복구는 체크포인트부터만 로그를 읽으면 되고, 체크포인트 앞의 로그 자리는 다시 써도 됩니다.
undo. 행을 바꾸기 전의 값을 적어 둔 기록입니다. 11편에서 MVCC와 롤백에 쓰이는 것을 봤습니다. undo도 페이지에 들어 있으므로, undo 페이지를 고친 일도 redo 로그에 남습니다. 이 글에서 중요해지는 사실입니다.
binlog(binary log)와 이벤트. 서버 계층(sql/)이 쓰는 로그입니다. 엔진과 상관없이 "어떤 SQL을 실행했나, 어떤 행이 어떻게 바뀌었나"를 이벤트(Log_event)로 남깁니다. 복제(replica가 받아 다시 실행)와 시점 복구에 씁니다. --log-bin을 줘야 켜집니다.
XA, 2단계 커밋, XID. 참여자가 둘 이상인 트랜잭션을 함께 커밋하는 방법입니다. 먼저 모두에게 "커밋할 준비를 해 둬라(prepare)"라고 하고, 모두 준비되면 "커밋해라"라고 합니다. 이때 트랜잭션을 가리키는 번호가 XID입니다. MariaDB 안에서는 InnoDB와 binlog가 두 참여자가 됩니다.
handlerton과 transaction_participant. 엔진 하나를 대표하는 함수 표가 handlerton이고(2편), 그중 commit·rollback·prepare 같은 트랜잭션 함수만 모은 부모 구조체가 transaction_participant입니다. binlog는 엔진이 아니지만 이 transaction_participant로 트랜잭션에 참여합니다(5절).
1. 왜 로그가 따로 있나 — 페이지는 나중에, 로그는 먼저
행 하나를 바꾸면 InnoDB는 버퍼 풀에 있는 16KB 페이지를 고칩니다(10편). 커밋할 때마다 고친 페이지를 전부 데이터 파일에 쓴다면, 행 몇 개를 바꾸려고 흩어진 페이지 여러 장을 디스크의 여기저기에 써야 합니다. 대신 InnoDB는 고친 바이트만 한 파일의 끝에 이어 붙입니다. 이어 쓰기는 빠르고, 붙인 양도 페이지보다 훨씬 적습니다. 페이지는 "더티(dirty)" 표시를 단 채 메모리에 남아 있다가 나중에 따로 쓰입니다.
이 로그의 모든 것이 전역 객체 log_sys 하나에 있습니다(log0log.h 760–761행). 이 글에서 따라다닐 칸만 골랐습니다.
  /** The current log sequence number, relative to base_lsn, and flags;
  may be modified while latch_have_any() */
  alignas(CPU_LEVEL1_DCACHE_LINESIZE)
  Atomic_relaxed<uint64_t> write_lsn_offset;
  /** the LSN of the last write_buf() or persist(); protected by latch */
  std::atomic<lsn_t> base_lsn;
  /** the first guaranteed-durable log sequence number */
  std::atomic<lsn_t> flushed_to_disk_lsn;
  // ...
  /** log record buffer, written to by mtr_t::commit() */
  alignas(CPU_LEVEL1_DCACHE_LINESIZE) byte *buf;
  // ...
  /** Last written LSN; protected by latch */
  lsn_t write_lsn;
  // ...
  /** latest completed checkpoint (protected by latch.wr_lock()) */
  Atomic_relaxed<lsn_t> last_checkpoint_lsn;
storage/innobase/include/log0log.h 172–288행
LSN이 네 가지 나옵니다. 크기 순서로 놓으면 이렇습니다.
| 이름 | 뜻 | 상태 변수 |
|---|---|---|
get_lsn() = base_lsn + write_lsn_offset |
지금까지 로그 버퍼에 붙인 끝 | Innodb_lsn_current |
write_lsn |
파일에 write()까지 한 끝 |
— |
flushed_to_disk_lsn |
fsync까지 끝나 정전에도 남는 끝 |
Innodb_lsn_flushed |
last_checkpoint_lsn |
여기 앞은 페이지까지 데이터 파일에 있다 | Innodb_lsn_last_checkpoint |
last_checkpoint_lsn ≤ flushed_to_disk_lsn ≤ write_lsn ≤ get_lsn(). 이 글은 이 네 숫자가 각각 언제 앞으로 가는지를 보는 글이라고 해도 됩니다. 상태 변수 이름은 ha_innodb.cc 1050–1053행에 있습니다.
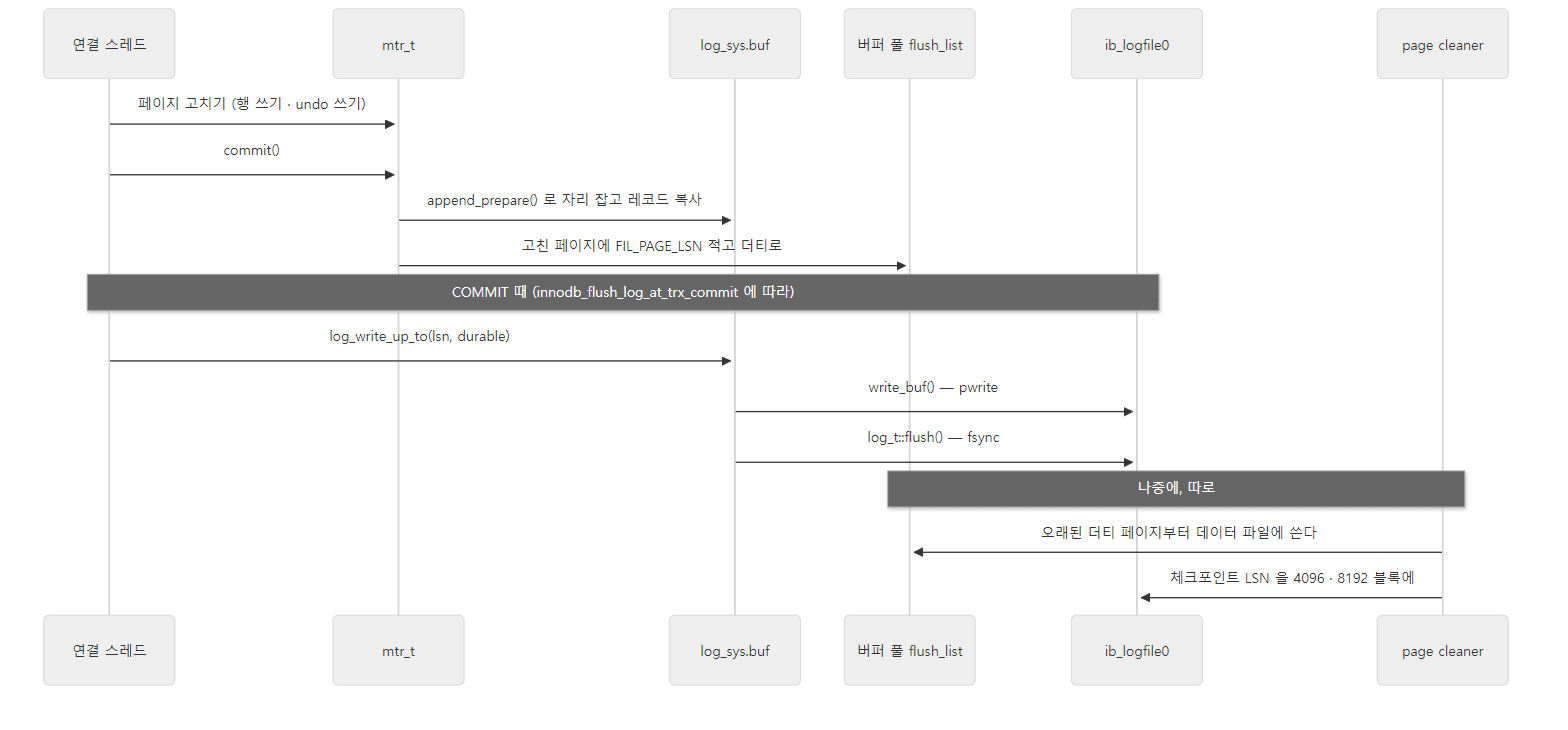 위 절반은 연결 스레드가 하는 일, 아래 절반은 page cleaner 스레드가 따로 하는 일입니다.
mtr_t::commit() — 로그 버퍼에 붙이기
로그 레코드는 mtr이 끝날 때 한꺼번에 로그 버퍼로 갑니다.
void mtr_t::commit()
{
  // ...
  if (m_modifications && (m_log_mode == MTR_LOG_NO_REDO || !m_log.empty()))
  {
    if (UNIV_UNLIKELY(!is_logged()))
    {
      release_unlogged();
      goto func_exit;
    }

    ut_ad(!srv_read_only_mode);
    ut_ad(!recv_sys.rpo);
    std::pair<lsn_t,lsn_t> lsns{do_write()};
    process_freed_pages();
#ifdef HAVE_PMEM
    commit_logger(this, lsns);
#else
    commit_log<false>(this, lsns);
#endif
  }
storage/innobase/mtr/mtr0mtr.cc 534–560행
do_write()가 mtr 안에 모아 둔 레코드(m_log)를 로그 버퍼에 복사하고(돌려주는 쌍의 첫째가 이 mtr의 시작 LSN, 둘째는 3절에서 볼 log_close()의 결과입니다), commit_log()가 페이지 쪽을 정리합니다. 복사할 자리를 잡는 함수가 log_t::append_prepare()입니다.
template<log_t::write mode>
inline
std::pair<lsn_t,byte*> log_t::append_prepare(size_t size, bool ex) noexcept
{
  // ...
  uint64_t l;
  static_assert(WRITE_TO_BUF == WRITE_BACKOFF << 1, "");
  while (UNIV_UNLIKELY((l= write_lsn_offset.fetch_add(size + WRITE_TO_BUF) &
                        (WRITE_TO_BUF - 1)) >=
                       (mode ? capacity() : buf_size) - size))
  {
    // ...
    bool late(write_lsn_offset.fetch_or(WRITE_BACKOFF) & WRITE_BACKOFF);
    /* Subtract our LSN overshoot. */
    write_lsn_offset.fetch_sub(size);
    append_prepare_wait(late, ex);
  }

  const lsn_t lsn{l + base_lsn.load(std::memory_order_relaxed)};
  return {lsn,
          buf + size_t(mode ? FIRST_LSN + (lsn - first_lsn) % capacity() : l)};
}
storage/innobase/mtr/mtr0mtr.cc 1060–1088행
두 가지가 보입니다.
- LSN은 바이트 수입니다.
fetch_add(size + …)로 레코드 길이만큼write_lsn_offset을 늘리고, 그 앞 값l에base_lsn을 더한 것이 이 mtr의 시작 LSN입니다. 여러 스레드가 동시에 와도 원자적 덧셈 한 번으로 서로 다른 자리를 받으므로, 버퍼에 자리 잡는 동안 서로를 오래 기다리지 않습니다. - 버퍼가 차면 기다립니다. 붙일 자리가
buf_size(=innodb_log_buffer_size, 기본 16MB — 예제 1의 출력)를 넘으면append_prepare_wait()로 갑니다. 한 스레드가log_write_up_to(lsn, false)로 버퍼를 파일에 써서 비우고, 나머지는 그동안 기다립니다(984–1053행). 상태 변수Innodb_log_waits가 이 기다림의 횟수입니다(ha_innodb.cc1047행).
복사가 끝나면 commit_log()가 고친 페이지마다 이 mtr의 끝 LSN을 페이지 머리에 적고, 버퍼 풀의 flush list(쓸 차례를 기다리는 더티 페이지 목록)에 넣습니다(mtr0mtr.cc 446–450행). 페이지 머리의 FIL_PAGE_LSN은 10편에서 .ibd 파일을 od로 열어 읽었던 그 8바이트입니다. 복구할 때 이 값을 보고 "이 페이지에는 이 LSN까지의 로그가 이미 들어 있다"를 판단합니다.
헷갈리기 쉬운 곳: mtr 커밋은 트랜잭션 커밋이 아닙니다
이름이 같아서 헷갈리지만 mtr_t::commit()은 디스크에 아무것도 쓰지 않습니다. 레코드를 메모리의 로그 버퍼에 복사하고 페이지를 더티로 걸 뿐입니다. INSERT 한 문장 동안에도 mtr 커밋은 여러 번 일어나고, 그 로그는 아직 메모리에만 있습니다. 로그를 파일에 쓰라고 요청하는 것은 SQL 트랜잭션의 COMMIT 쪽입니다(2절). 거꾸로, 커밋하지 않은 트랜잭션의 변경도 mtr 단위로는 이미 로그 버퍼에 들어가 있으므로, 다른 트랜잭션의 커밋이 버퍼를 파일로 쓰면 함께 디스크에 갑니다. 4절의 크래시 예제가 이 사실 위에 서 있습니다.
2. COMMIT이 디스크에 닿는 곳 — log_write_up_to와 innodb_flush_log_at_trx_commit
트랜잭션이 커밋되면 InnoDB는 그 트랜잭션의 커밋 레코드까지 로그가 파일에 있도록 요청합니다. binlog가 꺼져 있을 때의 길은 이렇습니다. 서버 계층의 ha_commit_trans()가 InnoDB의 innobase_commit()을 부르고(11편), 거기서 트랜잭션을 메모리에서 커밋한 뒤 마지막에 trx_commit_complete_for_mysql()을 부릅니다(ha_innodb.cc 4816행).
void trx_commit_complete_for_mysql(trx_t *trx)
{
  const lsn_t lsn= trx->commit_lsn;
  if (!lsn)
    return;
  switch (srv_flush_log_at_trx_commit) {
  case 0:
    goto func_exit;
  case 1:
    if (trx->active_commit_ordered && trx->active_prepare)
      return;
  }
  trx_flush_log_if_needed(lsn, trx);
 func_exit:
  trx->commit_lsn= 0;
}
storage/innobase/trx/trx0trx.cc 1776–1791행
srv_flush_log_at_trx_commit이 my.cnf의 innodb_flush_log_at_trx_commit입니다. 0이면 아무것도 하지 않고 돌아갑니다. 1일 때 active_commit_ordered && active_prepare면 돌아가는 줄은 binlog가 켜졌을 때의 이야기라 6절에서 다시 봅니다. 나머지는 trx_flush_log_if_needed()로 갑니다.
static void trx_flush_log_if_needed(lsn_t lsn, trx_t *trx)
{
  // ...
  if (log_sys.get_flushed_lsn(std::memory_order_relaxed) >= lsn)
    return;

  ut_ad(!trx->read_only);

  const bool flush= srv_flush_log_at_trx_commit & 1;
  if (!log_sys.is_mmap())
  {
    completion_callback cb;

    if ((cb.m_param= thd_increment_pending_ops(trx->mysql_thd)))
    {
      cb.m_callback= thd_decrement_pending_ops;
      log_write_up_to(lsn, flush, &cb);
      return;
    }
  }
  trx->op_info= "flushing log";
  log_write_up_to(lsn, flush);
  trx->op_info= "";
}
storage/innobase/trx/trx0trx.cc 1284–1309행
flush = srv_flush_log_at_trx_commit & 1 한 줄이 1·3(홀수)과 2(짝수)를 가릅니다. 홀수면 durable=true로 "fsync까지", 2면 durable=false로 "파일에 write만" 합니다. 이미 그 LSN까지 fsync되어 있으면(get_flushed_lsn() >= lsn) 아무것도 하지 않습니다. cb(콜백)가 붙는 길은 스레드 풀(4편)에서 연결 스레드가 fsync를 붙잡고 기다리지 않게 하는 장치입니다. 기다리는 동안 information_schema.INNODB_TRX의 trx_operation_state가 flushing log로 보이는 것은 op_info를 바꾸는 이 두 줄 때문입니다(trx0i_s.cc 446행).
log_write_up_to — 쓰는 사람은 한 명, 나머지는 얹혀 간다
void log_write_up_to(lsn_t lsn, bool durable,
                     const completion_callback *callback) noexcept
{
  // ...
repeat:
  if (durable)
  {
    if (flush_lock.acquire(lsn, callback) != group_commit_lock::ACQUIRED)
      return;
    /* Promise to other concurrent flush_lock.acquire() that we
    will be durable at least up to the current LSN. The LSN may still
    advance when we acquire log_sys.latch below. */
    if (lsn > log_sys.get_flushed_lsn())
      flush_lock.set_pending(lsn);
  }

  lsn_t pending_write_lsn= 0, pending_flush_lsn= 0, flush_ahead= 0;

  if (write_lock.acquire(lsn, durable ? nullptr : callback) ==
      group_commit_lock::ACQUIRED)
  {
    ut_ad(!recv_no_log_write || srv_operation != SRV_OPERATION_NORMAL);
    log_sys.latch.wr_lock();
    // ...
    pending_write_lsn= write_lock.release(log_sys.writer());
  }

  if (durable)
    pending_flush_lsn= log_flush(write_lock.value());
  // ...
}
storage/innobase/log/log0log.cc 1837–1899행
write_lock과 flush_lock은 보통의 뮤텍스가 아니라 group_commit_lock이라는 특별한 잠금입니다(log0sync.h). acquire(lsn)은 "이미 누가 그 LSN까지 써 줬으면 EXPIRED(할 일 없음), 아니면 잠금을 받아 ACQUIRED"입니다. 다른 스레드가 잠금을 쥐고 쓰는 중이면 그 일이 끝날 때까지 기다렸다가 다시 판단하고, 콜백을 넘긴 경우에는 기다리는 대신 콜백을 맡겨 두고 CALLBACK_QUEUED로 돌아오기도 합니다. 그래서 동시에 커밋하는 스레드 열 개가 몰려도 실제로 write()와 fsync()를 하는 것은 잠금을 받은 한 스레드이고, 그 스레드가 그때까지 쌓인 로그를 한꺼번에 쓰면 나머지는 자기 LSN이 이미 지나갔으니 그냥 돌아갑니다. InnoDB 쪽의 그룹 커밋입니다. binlog에도 같은 생각의 그룹 커밋이 따로 있습니다(6절).
log_sys.writer()는 log_t::write_buf()로 이어져 버퍼를 ib_logfile0에 pwrite하고, log_flush()는 log_t::flush()(1802–1813행)를 불러 fsync합니다. fsync가 끝나야 flushed_to_disk_lsn이 앞으로 갑니다. 다만 log_write_through가 참이면(파일을 O_DSYNC로 열어 write() 자체가 디스크까지 가는 경우) fsync를 건너뜁니다. 기준 커밋에서 이 값은 innodb_flush_method=O_DSYNC일 때 참이 됩니다(ha_innodb.cc 4174–4176행).
0과 2는 누가 대신 쓰나 — 1초마다 도는 마스터 콜백
0이면 커밋 때 아무것도 쓰지 않고, 2면 fsync를 하지 않습니다. 그 몫은 1초마다 도는 백그라운드 작업이 맡습니다.
static void srv_sync_log_buffer_in_background()
{
	time_t	current_time = time(NULL);

	srv_main_thread_op_info = "flushing log";
	if (difftime(current_time, srv_last_log_flush_time)
	    >= srv_flush_log_at_timeout) {
		log_buffer_flush_to_disk();
		srv_last_log_flush_time = current_time;
		srv_log_writes_and_flush++;
	}
}
storage/innobase/srv/srv0srv.cc 1236–1247행
1000ms마다 도는 타이머 작업 srv_master_callback()(srv0start.cc 2002–2003행)이 이 함수를 부르고(1334행), innodb_flush_log_at_timeout(기본 1초)이 지났으면 log_buffer_flush_to_disk() — log_write_up_to(현재 LSN, durable=true) — 로 쓰고 fsync합니다. 설정 변수의 설명문(ha_innodb.cc 19687–19699행)이 네 값의 뜻을 요약해 두었습니다. 표로 옮기면 이렇습니다(기본값은 1).
| 값 | 커밋 때 | 1초마다 | mariadbd만 죽으면 |
OS·전원이 죽으면 |
|---|---|---|---|---|
| 0 | 아무것도 안 함 | write + fsync | 마지막 1초쯤 잃을 수 있음 | 마지막 1초쯤 잃을 수 있음 |
| 1 | write + fsync | (돌지만 커밋분은 이미 디스크에) | 잃지 않음 | 잃지 않음 |
| 2 | write만 (OS 캐시까지) | fsync | 잃지 않음 | 마지막 1초쯤 잃을 수 있음 |
| 3 | prepare와 commit 때 모두 fsync (binlog가 꺼져 prepare가 없으면 1과 같음) | (돌지만 커밋분은 이미 디스크에) | 잃지 않음 | 잃지 않음 |
2가 "mariadbd만 죽으면 잃지 않는" 까닭은, write()가 끝난 데이터는 프로세스가 죽어도 운영체제의 페이지 캐시에 남아 결국 디스크에 쓰이기 때문입니다. 운영체제나 전원이 함께 죽으면 그 캐시가 사라집니다. 그래서 기동할 때 2로 주면 InnoDB는 로그 파일의 운영체제 캐시를 일부러 켜 둡니다(log_sys.log_buffered= true, ha_innodb.cc 4204–4207행). 실행 중에 SET GLOBAL로 바꿀 때는 이 손질이 다시 일어나지 않습니다(이 설정 변수에는 값이 바뀔 때 부르는 함수가 없습니다, 19699행의 NULL, NULL).
예제 1: 설정마다 로그를 몇 번 쓰나
innodb_flush_log_at_trx_commit을 1 → 2 → 0으로 바꾸며, 한 줄짜리 autocommit INSERT 200개를 보낼 때 상태 변수가 얼마나 늘어나는지 셌습니다. 이 예제와 이 글의 다른 예제는 기준 커밋(c894d97781)을 그대로 Debug 빌드한 MariaDB 13.2.0(13.2.0-MariaDB-debug)으로 도커 컨테이너(Ubuntu 24.04)에서 실행했습니다. 예제 폴더는 ex/u12-flush-log입니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ... (서버를 띄우고 테이블을 만든 뒤 설정 값 다섯 개를 찍는 부분 생략)
for v in 1 2 0; do
  mariadb -e "SET GLOBAL innodb_flush_log_at_trx_commit=$v"
  # ... (앞뒤로 상태 변수 세 개를 읽어 차이를 찍는다)
  # 문장마다 자기 트랜잭션(autocommit)이 되도록 INSERT 200개를 한 연결로 보낸다
  for i in $(seq 1 200); do echo "INSERT INTO lab.t VALUES ($((base+i)), 'row');"; done | mariadb
done
# ... (LSN 을 두 번 찍고, 정상 종료한 뒤 ib_logfile0 을 od 로 여는 부분 생략)
innodb_flush_method	O_DIRECT
innodb_log_buffer_size	16777216
innodb_log_file_size	100663296
innodb_flush_log_at_trx_commit	1
innodb_flush_log_at_timeout	1
--- 200 autocommit INSERTs per setting
setting    log_writes  data_fsyncs   os_log_written
=1                201          201            66797
=2                200            0            51573
=0                  1            3            88511
--- right after the =0 run, and 2 seconds later
VARIABLE_NAME	VARIABLE_VALUE
INNODB_LSN_CURRENT	276616
INNODB_LSN_FLUSHED	261471
VARIABLE_NAME	VARIABLE_VALUE
INNODB_LSN_CURRENT	276616
INNODB_LSN_FLUSHED	276616
Innodb_log_writes는 log_sys.write_to_log, 곧 write_buf()가 파일에 쓴 횟수입니다(ha_innodb.cc 1049행).
- =1: 커밋 200번에 쓰기 약 200번, fsync 약 200번. 커밋마다
log_write_up_to(lsn, true)가 write와 fsync를 했습니다(한 연결이 차례로 보냈으므로 그룹으로 묶일 동료가 없습니다). - =2: 쓰기는 200번 그대로인데 fsync는 0번.
flush & 1이 0이라 write만 했습니다. - =0: 200번 커밋하는 동안 쓰기가 1번뿐입니다. 커밋은 로그를 쓰지 않았고, 그 1번은 1초 주기 작업입니다(실행에 따라 0이나 1이 나옵니다). 끝난 직후에는
Innodb_lsn_flushed가Innodb_lsn_current보다 15,000바이트쯤 뒤처져 있다가, 2초 뒤에는 같아졌습니다. 그 사이에kill -9가 왔다면 그 15,000바이트 안의 커밋을 잃었을 것입니다. 뒤처진 양은 1초 주기 작업이 언제 돌았느냐에 따라 실행마다 다르고(다시 돌렸을 때는 73,000바이트쯤이었습니다), 그 사이 백그라운드 작업이 로그를 더 남기면 2초 뒤에도flushed가current에 한 발 못 미친 채 찍히기도 했습니다.
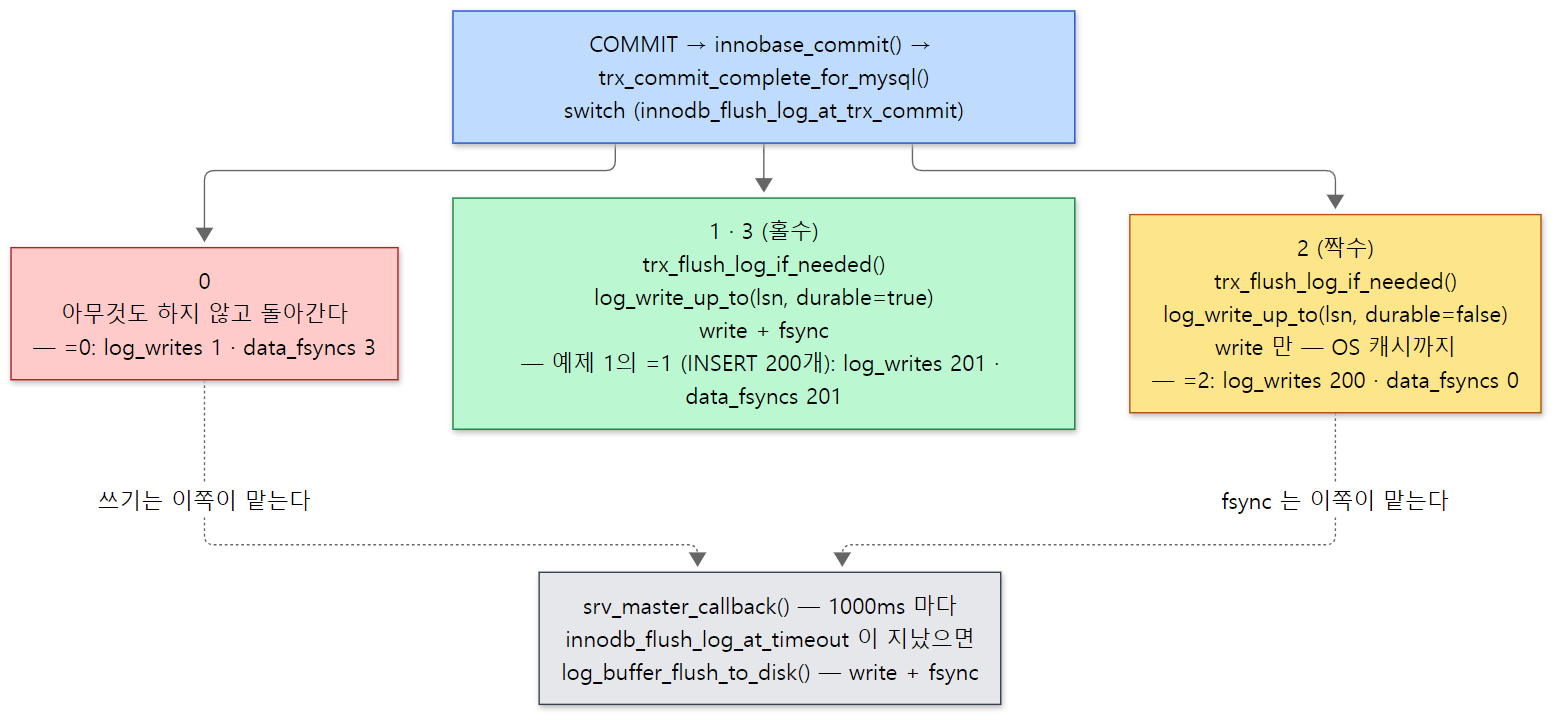 홀짝 한 비트(flush & 1)가 fsync 를 정하고, 남은 일은 1초 주기 작업이 맡습니다. 숫자는 예제 1의 실제 출력이고, data_fsyncs 에는 데이터 파일의 fsync 도 섞여 있습니다(아래 헷갈리기 쉬운 곳).
LSN·바이트 수는 실행마다 다릅니다.
헷갈리기 쉬운 곳: 숫자가 뜻하는 것
Innodb_data_fsyncs는 redo 로그만 세지 않습니다.os_file_flush_func()·os_file_sync_posix()가 부를 때마다 하나씩 늘어나는os_n_fsyncs라(os0file.cc835행,ha_innodb.cc1034행) 데이터 파일의 fsync도 들어갑니다. =0에서 로그 쓰기는 1번인데 fsync가 3번인 것은 그래서입니다(다시 돌렸을 때는 쓰기 0번, fsync 2번이었습니다 — 이 열의 숫자도 실행마다 조금씩 다릅니다).Innodb_os_log_written은 이름과 달리 "파일에 쓴 바이트"가 아니라lsn_current - recv_sys.lsn, 곧 기동 뒤 LSN이 늘어난 양입니다(srv0srv.cc961–962행). 그래서 파일에 1번밖에 안 쓴 =0에서도 커집니다. 세 줄의 크기가 서로 다른 것은 같은 시간 동안 백그라운드 작업도 로그를 남기기 때문이라, 설정끼리 크기를 비교하는 데 쓰면 안 됩니다.
3. ib_logfile0과 체크포인트 — 원형 파일을 다시 쓰려면
redo 로그 파일은 ib_logfile0 하나이고, 크기는 innodb_log_file_size(이 빌드의 기본값 96MB, 예제 1의 100663296)로 정해져 있습니다. 끝까지 쓰면 앞으로 돌아가 다시 씁니다. write_buf()가 파일 안 위치를 정하는 두 줄입니다.
    lsn_t offset{write_lsn - first_lsn};
    if (resizing == RESIZING || !archive)
      offset%= capacity();
    offset+= START_OFFSET;
storage/innobase/log/log0log.cc 1696–1699행
capacity()는 file_size - START_OFFSET입니다(log0log.h 696행). 파일 앞 12KB(START_OFFSET = 12288)를 빼고 나머지를 원형으로 돕니다. 앞 12KB에는 파일 머리와 체크포인트 블록 두 개(CHECKPOINT_1 = 4096, CHECKPOINT_2 = 8192)가 있습니다(log0log.h 153–158행).
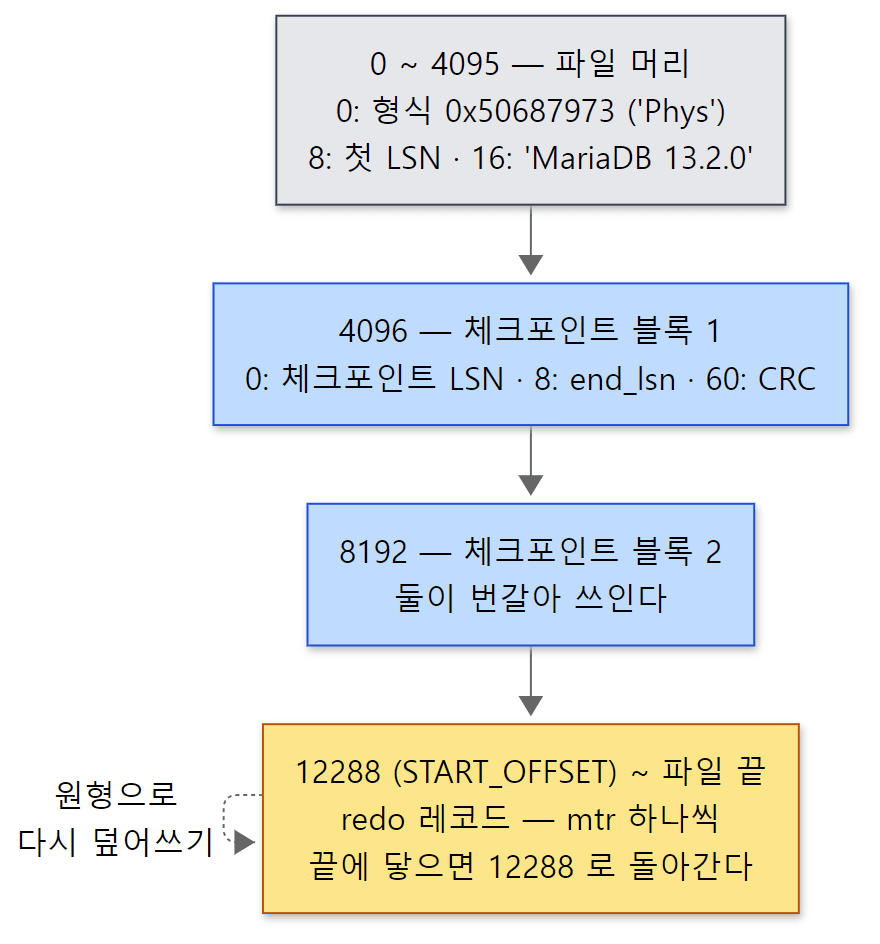 머리의 칸 위치는
log_t::header_write(), 체크포인트 블록의 칸은 log_t::write_checkpoint()에서 읽었습니다.
머리는 log_t::header_write()가 씁니다(log0log.cc 448–468행). 체크포인트 블록은 이렇게 씁니다.
  static_assert(CHECKPOINT_1 << 1 == CHECKPOINT_2, "");
  offset= CHECKPOINT_1 << (next_checkpoint_no & 1);
  c= is_mmap() ? buf + offset : checkpoint_buf;
  circular_recovery_from_sequence_bit_0= !get_sequence_bit(checkpoint);
  memset_aligned<CPU_LEVEL1_DCACHE_LINESIZE>(c, 0,
                                             CPU_LEVEL1_DCACHE_LINESIZE);
  mach_write_to_8(my_assume_aligned<8>(c), checkpoint);
  mach_write_to_8(my_assume_aligned<8>(c + 8), end_lsn);
  mach_write_to_4(my_assume_aligned<4>(c + 60), my_crc32c(0, c, 60));
storage/innobase/buf/buf0flu.cc 2030–2038행
체크포인트 번호의 마지막 비트에 따라 4096과 8192에 번갈아 씁니다. 체크포인트를 쓰는 도중에 전원이 나가 한 블록이 깨져도 다른 블록에 직전 체크포인트가 남아 있게 하려는 것입니다(CRC로 깨졌는지 압니다).
예제 1(이어서): 파일을 직접 열어 보기
예제 1의 끝에서 서버를 정상 종료한 뒤 ib_logfile0의 세 자리를 od로 열었습니다.
f=/var/lib/mariadb-lab/ib_logfile0
od -A d -t x1z -N 48 $f
od -A d -t x1 -j 4096 -N 16 $f
od -A d -t x1 -j 8192 -N 16 $f
0000000 50 68 79 73 00 00 00 00 00 00 00 00 00 00 30 00  >Phys..........0.<
0000016 4d 61 72 69 61 44 42 20 31 33 2e 32 2e 30 00 00  >MariaDB 13.2.0..<
0000032 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00  >................<
0000048
0004096 00 00 00 00 00 04 38 ea 00 00 00 00 00 04 38 ea
0004112
0008192 00 00 00 00 00 04 38 88 00 00 00 00 00 04 38 88
0008208
- 0번 바이트의
50 68 79 73("Phys")은log_t::FORMAT_10_8 = 0x50687973입니다(log0log.h147행). 8번 바이트의00 … 30 00= 12288은 이 파일의 첫 LSN이고, 처음 만들 때의FIRST_LSN과 같습니다. 16번부터 만든 서버의 이름이 문자열로 들어 있습니다. - 4096의 체크포인트 LSN은
0x438ea= 276,714, 8192는0x43888= 276,616입니다. 두 블록이 서로 다른 체크포인트를 들고 있고, 큰 쪽(4096)이 종료하며 남긴 마지막 것입니다. 정상 종료는 더티 페이지를 모두 쓰고 체크포인트를 끝까지 당겨 두므로, 이 상태로 다시 띄우면 복구할 로그가 없습니다.
LSN 값은 실행마다 다릅니다.
체크포인트는 누가, 언제 당기나
체크포인트를 당기려면 그 앞의 로그로 고친 페이지가 모두 데이터 파일에 쓰여 있어야 합니다. 그래서 체크포인트 LSN은 "버퍼 풀에 남은 더티 페이지 가운데 가장 오래된 것의 LSN"이 됩니다.
/** Make a checkpoint. Note that this function does not flush dirty
blocks from the buffer pool: it only checks what is lsn of the oldest
modification in the pool, and writes information about the lsn in
log file. Use log_make_checkpoint() to flush also the pool.
@return the lsn to invoke log_sys.archive_create(lsn, false) on
@retval 0 if log_sys.archive_create() should not be called */
static lsn_t log_checkpoint() noexcept
{
  // ...
  log_sys.latch.wr_lock();
  const lsn_t end_lsn= log_sys.get_lsn();
  mysql_mutex_lock(&buf_pool.flush_list_mutex);
  const lsn_t oldest_lsn= buf_pool.get_oldest_modification(end_lsn);
  // FIXME: limit oldest_lsn below binlog split write LSN
  mysql_mutex_unlock(&buf_pool.flush_list_mutex);
  return log_checkpoint_low(oldest_lsn, end_lsn);
}
storage/innobase/buf/buf0flu.cc 2311–2342행
주석이 말하듯 log_checkpoint()는 페이지를 쓰지 않습니다. 페이지를 쓰는 것은 page cleaner 스레드(buf_flush_page_cleaner(), 10편)이고, 그 스레드가 일하는 틈틈이 log_checkpoint()를 불러 가장 오래된 더티 페이지의 LSN까지 체크포인트를 당깁니다(buf0flu.cc 2904행). 페이지까지 다 쓰고 체크포인트를 끝까지 당기는 것은 log_make_checkpoint()(→ buf_flush_sync_batch(0, true), 3134–3137행)입니다.
원형 파일이라 위험이 하나 있습니다. 체크포인트가 너무 오래 제자리에 있으면 새 로그가 아직 필요한 옛 로그를 덮어쓰게 됩니다. mtr이 로그를 붙일 때마다 부르는 log_close()가 이것을 지켜봅니다. "현재 LSN − 마지막 체크포인트"(체크포인트 나이, Innodb_checkpoint_age)가 정해 둔 선을 넘으면 page cleaner에게 페이지를 더 빨리 쓰라고 요청하고(buf_flush_ahead()), 더 넘으면 furious(맹렬한) 표시를 달아 쓰는 스레드들이 기다리게 합니다(mtr0mtr.cc 1094–1130행). innodb_log_file_size를 너무 작게 잡으면 쓰기가 몰릴 때 갑자기 느려지는 까닭입니다.
헷갈리기 쉬운 곳: log_sys에는 낯선 이름이 많습니다
log0log.h를 열면 archive, resize_log, is_mmap(), HAVE_PMEM 같은 이름이 곳곳에 있습니다. 최근 판에 들어온 기능들입니다 — innodb_log_archive(원형으로 덮어쓰지 않고 로그 파일을 이어 만드는 모드, log_t::set_archive()), 실행 중 로그 크기 바꾸기(resize_start()), 영구 메모리(PMEM)와 메모리 매핑으로 로그 쓰기. 이 빌드는 WITH_INNODB_PMEM을 켜지 않았고(CMakeLists.txt 431–434행), 아카이브도 켜지 않았으므로 이 글은 write_buf()로 pwrite하는 보통 길만 따라갑니다.
4. 크래시 복구 — redo로 앞으로, undo로 뒤로
kill -9나 정전 뒤에 다시 띄우면 InnoDB는 이렇게 합니다.
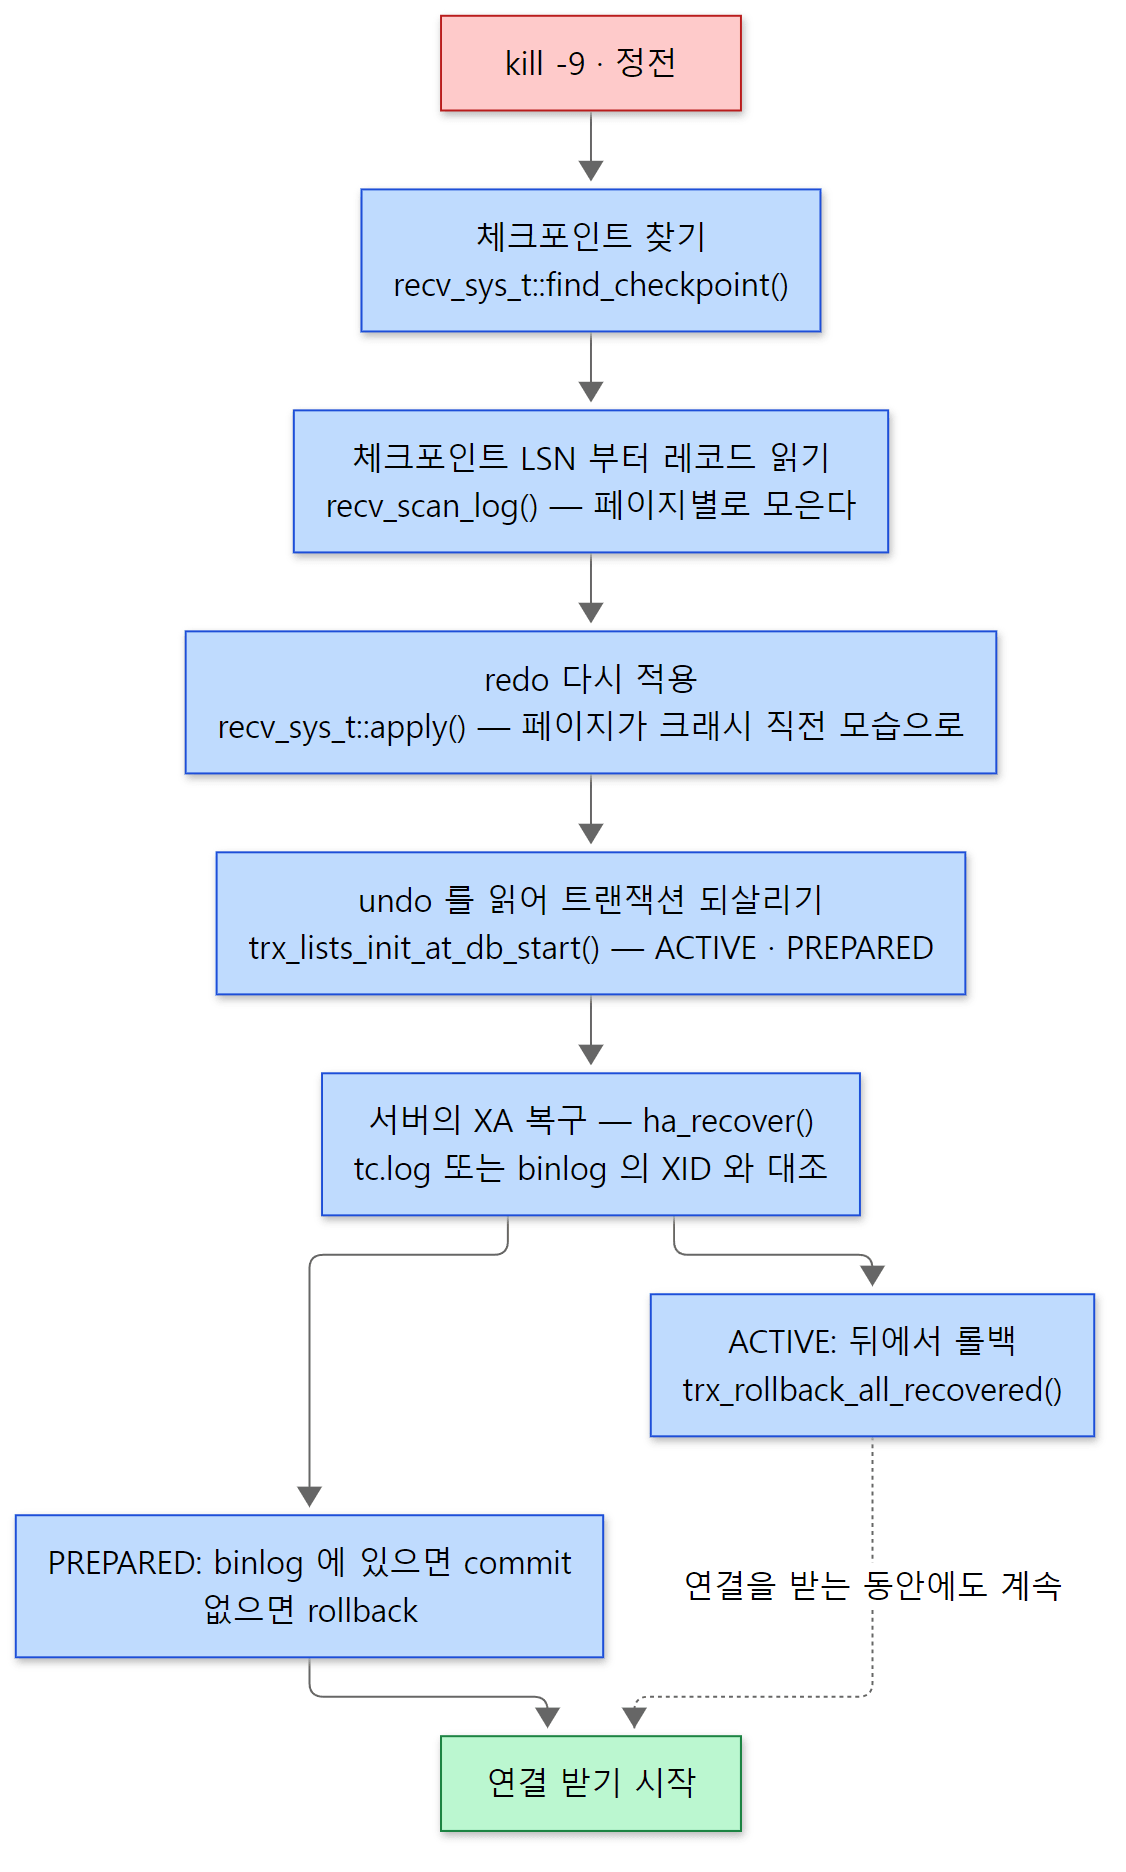 빨간 칸 아래 네 칸은 InnoDB가 기동하는 동안(
srv_start()), 그 아래는 서버가 엔진을 다 올린 뒤의 일입니다.
- 체크포인트를 찾습니다.
srv_start()가recv_sys.find_checkpoint()로 두 체크포인트 블록 가운데 성한 것 중 최신을 고릅니다(srv0start.cc1425행). - 로그를 읽습니다.
recv_recovery_from_checkpoint_start()(1570행, 정의는log0recv.cc5869행)가recv_scan_log()로 체크포인트 LSN부터 레코드를 읽어 페이지별로 모아 둡니다. 체크포인트 뒤에 레코드가 있으면 오류 로그에Starting crash recovery from checkpoint LSN=…을 찍습니다(5241–5243행). 레코드의 끝은 mtr마다 붙은 CRC와 sequence bit(파일을 한 바퀴 돌았는지 알아보는 비트)로 알아봅니다 — 반쯤 쓰다 만 mtr은 CRC가 맞지 않아 거기서 읽기를 멈추고, 그 mtr은 없었던 것이 됩니다(log_parse_start(), 2923–3005행). - redo를 다시 적용합니다.
recv_sys.apply(true)(1623행, 정의log0recv.cc4788행)가 모은 레코드를 페이지에 덮어씁니다. 레코드의 시작 LSN이 페이지의FIL_PAGE_LSN보다 작으면 이미 들어간 것으로 보고 건너뜁니다(recv_recover_page()4086–4096행). 이 단계가 끝나면 모든 페이지가 크래시 직전 모습 — 커밋하지 않은 변경까지 포함한 모습 — 이 됩니다. - 트랜잭션을 되살립니다.
trx_lists_init_at_db_start()(1645행)가 undo 로그 헤더를 읽어, 끝나지 않은 트랜잭션을trx_t로 다시 만듭니다. 3에서 undo 페이지도 되살아났기 때문에 할 수 있는 일입니다. 오류 로그의… transaction(s) which must be rolled back or cleaned up in total … row operations to undo가 여기서 나옵니다(trx0trx.cc807–811행). - 되돌립니다. 끝나지 않은 트랜잭션은 undo로 롤백합니다(11편의
trx_t::rollback()과 같은 일). 다만 바로 하지 않습니다. 데이터 사전(과 통계 테이블)을 고치던 트랜잭션만 기동 중에 되돌리고(trx_rollback_recovered(false), 1924행), 나머지는 서버가 6절의 XA 복구를 마친 다음에 시작합니다.
static void innobase_tc_log_recovery_done() noexcept
{
  if (high_level_read_only || recv_sys.rpo)
    return;

  /* Make durable any innobase_recover_rollback_by_xid(). */
  log_buffer_flush_to_disk(true);

  if (srv_force_recovery < SRV_FORCE_NO_TRX_UNDO)
  {
    /* Rollback incomplete non-DDL transactions */
    trx_rollback_is_active= true;
    srv_thread_pool->submit_task(&rollback_all_recovered_task);
  }
}
storage/innobase/handler/ha_innodb.cc 17849–17863행
handlerton의 signal_tc_log_recovery_done 칸에 걸린 함수입니다(4323행). 서버는 조정자를 열고(tc_log->open(), binlog가 켜졌으면 여기서 binlog를 읽어 복구합니다) ha_recover()를 부른 뒤 이 칸을 부르고(mysqld.cc 5993–6004행), InnoDB는 롤백을 스레드 풀 작업으로 넘깁니다. 그 작업 trx_rollback_all_recovered()(trx0roll.cc 491–505행)가 Starting in background the rollback of recovered transactions를 찍고 trx_rollback_recovered(true)로 모두 되돌린 뒤 Rollback of non-prepared transactions completed를 찍습니다. "in background"라는 말대로, 서버는 이 롤백이 끝나기를 기다리지 않고 연결을 받기 시작합니다. 되살린 트랜잭션은 고치던 테이블의 잠금도 되살려(trx_resurrect_table_locks(), trx0trx.cc 584행) 롤백이 끝날 때까지 들고 있습니다.
예제 2: 커밋한 것과 안 한 것을 남기고 kill -9
예제 폴더 ex/u12-crash-recovery입니다. 커밋한 이체 하나와, 다른 세션에서 열어 둔 채 커밋하지 않은 큰 트랜잭션(1,001행 변경)을 만들고, 작은 커밋을 하나 더 한 뒤 서버를 죽였습니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
# ... (테이블을 만들고 1. 이체 하나를 커밋하는 부분 생략)
echo "--- 2. not committed: big transaction left open in another session"
# 이 세션은 BEGIN 뒤 행을 바꾸고 커밋하지 않은 채 SLEEP 으로 기다린다
mariadb -e "BEGIN;
  UPDATE lab.acct SET balance=0 WHERE id=3;
  INSERT INTO lab.acct SELECT seq, 'tmp', 1 FROM lab.seq_100_to_1099;
  SELECT SLEEP(60);" > /tmp/open-trx.out 2>&1 &
sleep 3
mariadb -e "SELECT trx_id, trx_state, trx_rows_modified FROM information_schema.INNODB_TRX"

echo "--- 3. one more small commit (its log write also carries the open trx's redo)"
mariadb -e "INSERT INTO lab.acct VALUES (4,'dave',100)"
# ...
kill -9 $(cat /tmp/mariadbd.pid)
# ... (다시 띄워 오류 로그를 grep 하고 남은 행과 데이터 디렉터리를 보는 부분 생략)
--- 1. committed: alice -> bob 30
--- 2. not committed: big transaction left open in another session
trx_id	trx_state	trx_rows_modified
25	RUNNING	1001
--- 3. one more small commit (its log write also carries the open trx's redo)
VARIABLE_NAME	VARIABLE_VALUE
INNODB_LSN_CURRENT	150791
INNODB_LSN_FLUSHED	150791
INNODB_LSN_LAST_CHECKPOINT	52245
--- 4. kill -9
--- 5. restart
[Note] InnoDB: Starting crash recovery from checkpoint LSN=52245
[Note] InnoDB: To recover: 32 pages
[Note] InnoDB: 1 transaction(s) which must be rolled back or cleaned up in total 1001 row operations to undo
[Note] InnoDB: Trx id counter is 28
[Note] Recovering after a crash using tc.log
[Note] Crash table recovery finished.
[Note] InnoDB: Starting in background the rollback of recovered transactions
[Note] InnoDB: Rolled back recovered transaction 25
[Note] InnoDB: Rollback of non-prepared transactions completed
--- 6. what survived
+----+-------+---------+
 id | owner | balance |
+----+-------+---------+
  1 | alice |      70 |
  2 | bob   |     130 |
  3 | carol |     100 |
  4 | dave  |     100 |
+----+-------+---------+
+----------+
 tmp_rows |
+----------+
        0 |
+----------+
ib_logfile0
ibdata1
tc.log
undo001
undo002
undo003
오류 로그는 시각과 스레드 번호를 떼고 복구에 관한 줄만 골랐고, 마지막 여섯 줄은 데이터 디렉터리의 ls입니다. LSN·trx id는 실행 환경에 따라 달라질 수 있습니다(검토하며 다시 돌렸을 때는 같게 나왔습니다). 고친 페이지 수(To recover: … pages)는 다시 돌렸을 때 30페이지로 달랐습니다.
- 죽기 직전
Innodb_lsn_flushed가Innodb_lsn_current와 같습니다. 3번의 작은 커밋이log_write_up_to()로 버퍼를 통째로 써서, 커밋하지 않은 트랜잭션 25의 로그까지 디스크에 갔습니다. 반면 체크포인트는 52245에 머물러 있어 그 뒤 약 98KB의 로그가 복구 대상이 됐습니다. - 다시 띄우자 체크포인트 LSN부터 읽어 32페이지를 고쳤고(
To recover: 32 pages), 이어서 undo에서 "롤백할 트랜잭션 1개, 되돌릴 행 작업 1001개"를 찾았습니다. redo가 트랜잭션 25의 변경도 되살렸다는 뜻입니다. Recovering after a crash using tc.log— binlog를 켜지 않았는데 서버의 XA 복구가 돌았습니다(아래 "헷갈리기 쉬운 곳").- 그다음에야
Starting in background the rollback이 나오고 트랜잭션 25가 롤백됐습니다. 결과는 커밋한 이체(alice 70, bob 130)와 dave는 남고, 커밋하지 않은 carol의 0과tmp1,000행은 사라졌습니다.
헷갈리기 쉬운 곳: binlog가 없는데 tc.log가 있습니다
데이터 디렉터리를 보면 tc.log라는 파일이 있고(예제 2의 마지막 ls), 복구 때 Recovering after a crash using tc.log가 찍힙니다. 서버가 쓸 트랜잭션 조정자(TC, transaction coordinator)를 고르는 함수가 답입니다.
static inline TC_LOG *get_tc_log_implementation()
{
  if (total_ha_2pc <= 2) // online_alter_tp and MHNSW_Trx::tp
    return &tc_log_dummy;
  if (opt_bin_log)
    return &mysql_bin_log;
  return &tc_log_mmap;
}
total_ha_2pc는 2단계 커밋을 할 줄 아는 참여자의 수입니다. 주석에 적힌 내부 참여자 두 개(온라인 ALTER의 online_alter_tp, 벡터 인덱스의 MHNSW_Trx::tp)가 이 수에 들어 있어서 2와 비교합니다. InnoDB 같은 엔진이 더해져 2를 넘으면, binlog가 꺼져 있으면 tc_log_mmap(TC_LOG_MMAP, 메모리 매핑한 tc.log 파일에 XID를 적는 구현)이 뽑힙니다. 이 파일은 한 트랜잭션이 2단계 커밋을 하는 엔진 둘 이상을 함께 고칠 때만 쓰입니다. InnoDB 하나만 고치는 보통 트랜잭션은 6절의 rw_ha_count <= 1 길로 한 단계 커밋을 하므로 tc.log를 건드리지 않습니다. 그래서 예제 2의 Crash table recovery finished.는 할 일 없이 끝난 것입니다.
5. binlog — 서버 계층의 로그
redo 로그가 있는데 왜 binlog가 또 있을까요. 둘은 적는 내용과 쓰는 사람이 다릅니다.
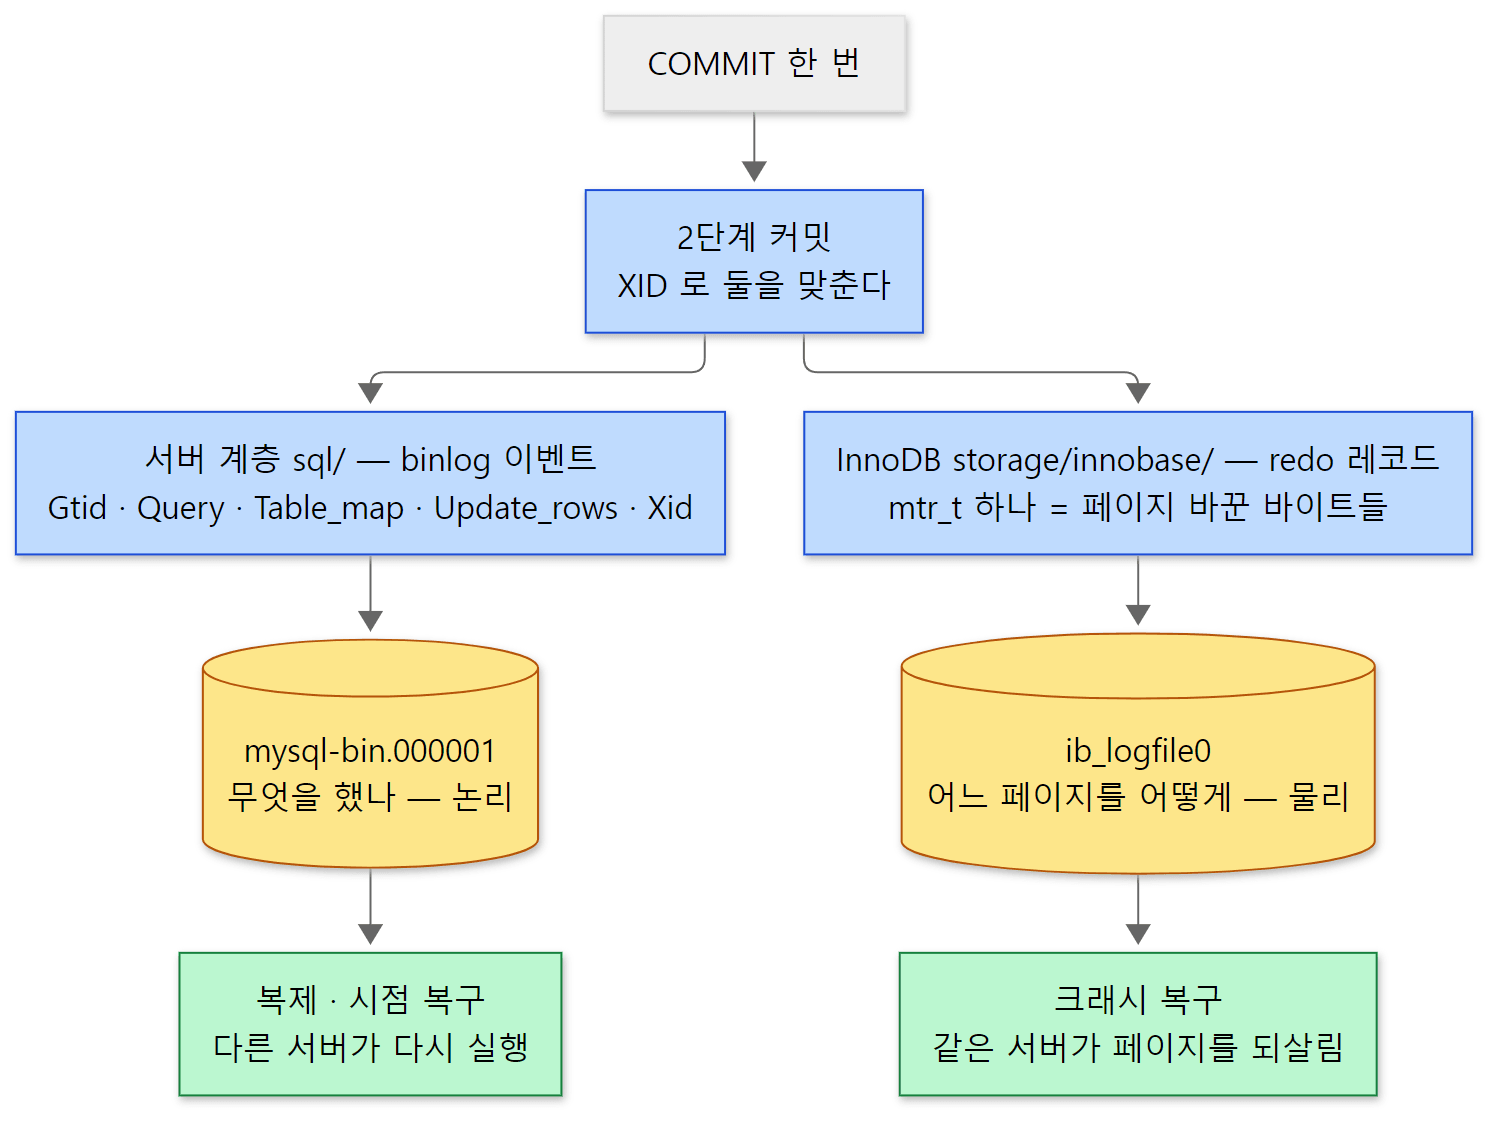 노란 원통이 디스크의 파일입니다.
- redo는 물리 로그, InnoDB 전용입니다. "스페이스 5의 페이지 3, 오프셋 120에 이 바이트들"처럼 적습니다. 같은 서버의 같은 파일에만 의미가 있고, Aria·MyISAM의 변경은 들어 있지 않습니다. 체크포인트가 지나면 덮어씁니다.
- binlog는 논리 로그, 서버 계층의 것입니다. "이 SQL을 실행했다" 또는 "이 테이블의 이 행이 이 값에서 저 값으로 바뀌었다"를 적습니다. 엔진과 상관없고, 다른 서버가 받아 다시 실행할 수 있습니다. 지우라고 할 때까지(
expire_logs_days,PURGE BINARY LOGS) 남습니다.
binlog를 쓰는 클래스가 MYSQL_BIN_LOG입니다.
class MYSQL_BIN_LOG: public TC_LOG, public Event_log
Event_log(이벤트를 파일에 쓰는 쪽)와 함께 TC_LOG를 상속합니다. binlog가 켜지면 binlog 자신이 트랜잭션 조정자가 된다는 뜻이고, 이것이 6절의 열쇠입니다. 트랜잭션에 참여하는 쪽의 얼굴은 binlog_tp입니다.
transaction_participant binlog_tp;

int binlog_init(void *p)
{
  bzero(&binlog_tp, sizeof(binlog_tp));
  // ... (세이브포인트 칸들)
  binlog_tp.commit= [](THD *thd, bool all) { return 0; };
  binlog_tp.rollback= binlog_rollback;
  if (WSREP_ON || opt_bin_log)
  {
    binlog_tp.prepare= binlog_prepare;
    binlog_tp.start_consistent_snapshot= binlog_start_consistent_snapshot;
  }
  binlog_tp.flags= HTON_NO_ROLLBACK;
  // ...
  return setup_transaction_participant(plugin);
}
binlog는 handlerton이 아니라 그 부모인 transaction_participant로 등록됩니다. 테이블이 없으니 handler를 만들 일이 없고, 트랜잭션에 끼는 데 필요한 칸만 채웁니다. 눈여겨볼 곳은 commit이 아무것도 하지 않는 람다라는 점입니다. binlog에 실제로 쓰는 일은 참여자의 commit이 아니라 조정자의 log_and_order()에서 합니다(6절). prepare(binlog_prepare(), 2662–2674행)도 주석에 "아무것도 하지 않는다, 2단계 커밋 대상인지 판단하는 코드가 prepare 칸이 있는지를 보기 때문에 있을 뿐"이라고 적혀 있습니다.
이벤트 — binlog의 한 줄
binlog 파일은 이벤트의 연속입니다. 이벤트 종류 번호는 enum Log_event_type(log_event.h 669행부터)에 있고, 종류마다 Log_event(1322행)를 상속한 클래스가 하나씩 있습니다. 예제 3에 나오는 것만 추리면 이렇습니다.
이벤트 (SHOW BINLOG EVENTS의 이름) |
클래스 | 하는 일 |
|---|---|---|
Format_desc |
Format_description_log_event (2619행) |
파일 맨 앞. 서버 판과 이벤트 형식. "아직 쓰는 중" 표시도 여기 |
Gtid_list |
Gtid_list_log_event (3700행) |
이 파일 앞까지의 GTID 상태 |
Binlog_checkpoint |
Binlog_checkpoint_log_event (3365행) |
XA 복구를 어느 파일부터 하면 되는지 |
Gtid |
Gtid_log_event (3497행) |
트랜잭션 하나의 시작과 그 GTID(도메인-서버-순번) |
Query |
Query_log_event (2271행) |
SQL 문장 그대로(문장 형식, DDL) |
Annotate_rows |
Annotate_rows_log_event (3984행) |
행 이벤트를 만든 원래 SQL(참고용) |
Table_map |
Table_map_log_event (4512행) |
뒤따르는 행 이벤트가 쓸 테이블 번호와 열 정의 |
Update_rows_v1 |
Update_rows_log_event ← Rows_log_event (4836행) |
바뀐 행의 앞 값과 뒤 값(행 형식) |
Xid |
Xid_log_event ← Xid_apply_log_event (2953행) |
트랜잭션의 끝(COMMIT)과 그 XID |
예제 3: binlog에 남은 이벤트 보기
예제 폴더 ex/u12-binlog-events입니다. --log-bin으로 띄워 트랜잭션 두 개를 커밋했습니다. 첫째는 기본 형식(MIXED)으로, 둘째는 세션에서 binlog_format=ROW로 바꿔서 했습니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
lab-start --log-bin=mysql-bin --server-id=1
# ...
mariadb -e "BEGIN; INSERT INTO lab.acct VALUES (1,'alice',100),(2,'bob',100); COMMIT;"
mariadb -e "SET SESSION binlog_format=ROW;
            BEGIN; UPDATE lab.acct SET balance=balance-30 WHERE id=1;
                   UPDATE lab.acct SET balance=balance+30 WHERE id=2; COMMIT;"
log_bin	1
binlog_format	MIXED
sync_binlog	0
gtid_domain_id	0
--- 1. SHOW BINARY LOGS / SHOW BINLOG EVENTS
+------------------+------+-------------------+-----------+-------------+-----------------------------------------------------------------------------
 Log_name         | Pos  | Event_type        | Server_id | End_log_pos | Info
+------------------+------+-------------------+-----------+-------------+-----------------------------------------------------------------------------
 mysql-bin.000001 |    4 | Format_desc       |         1 |         257 | Server ver: 13.2.0-MariaDB-debug-log, Binlog ver: 4
 mysql-bin.000001 |  257 | Gtid_list         |         1 |         286 | []
 mysql-bin.000001 |  286 | Binlog_checkpoint |         1 |         329 | mysql-bin.000001
 mysql-bin.000001 |  329 | Gtid              |         1 |         371 | GTID 0-1-1
 mysql-bin.000001 |  371 | Query             |         1 |         456 | CREATE DATABASE lab
 mysql-bin.000001 |  456 | Gtid              |         1 |         498 | GTID 0-1-2
 mysql-bin.000001 |  498 | Query             |         1 |         658 | CREATE TABLE lab.acct (id INT PRIMARY KEY, owner VARCHAR(20), balance INT) E
 mysql-bin.000001 |  658 | Gtid              |         1 |         700 | BEGIN GTID 0-1-3
 mysql-bin.000001 |  700 | Query             |         1 |           0 | INSERT INTO lab.acct VALUES (1,'alice',100),(2,'bob',100)
 mysql-bin.000001 |  820 | Xid               |         1 |         851 | COMMIT /* xid=8 */
 mysql-bin.000001 |  851 | Gtid              |         1 |         893 | BEGIN GTID 0-1-4
 mysql-bin.000001 |  893 | Annotate_rows     |         1 |           0 | UPDATE lab.acct SET balance=balance-30 WHERE id=1
 mysql-bin.000001 |  965 | Table_map         |         1 |           0 | table_id: 18 (lab.acct)
 mysql-bin.000001 | 1015 | Update_rows_v1    |         1 |           0 | table_id: 18 flags: STMT_END_F
 mysql-bin.000001 | 1079 | Annotate_rows     |         1 |           0 | UPDATE lab.acct SET balance=balance+30 WHERE id=2
 mysql-bin.000001 | 1151 | Table_map         |         1 |           0 | table_id: 18 (lab.acct)
 mysql-bin.000001 | 1201 | Update_rows_v1    |         1 |           0 | table_id: 18 flags: STMT_END_F
 mysql-bin.000001 | 1261 | Xid               |         1 |        1292 | COMMIT /* xid=13 */
+------------------+------+-------------------+-----------+-------------+-----------------------------------------------------------------------------
출력이 넓어 SHOW BINARY LOGS 표와 뒤따르는 mariadb-binlog 출력을 빼고, 표의 줄 끝을 잘랐습니다. 같은 파일을 mariadb-binlog --base64-output=decode-rows -v로 풀면, 첫 Update_rows 이벤트 아래에 ### UPDATE → ### WHERE … @3=100 → ### SET … @3=70처럼 행의 앞 값과 뒤 값이 열 번호(@1, @2, @3)로 찍힙니다.
- 트랜잭션은
Gtid(BEGIN GTID 0-1-3)로 시작해Xid(COMMIT /* xid=8 */)로 끝납니다. DDL은Gtid+Query한 쌍이고Xid가 없습니다. MIXED에서INSERT … VALUES는 안전한 문장이라 SQL 그대로(Query) 남았고,ROW로 바꾼 두UPDATE는Table_map+Update_rows로 바뀐 행의 앞뒤 값이 남았습니다.Annotate_rows는 그 행 이벤트를 만든 원래 문장입니다.- 파일 맨 앞의 세 이벤트(
Format_desc,Gtid_list,Binlog_checkpoint)는 트랜잭션과 상관없이 파일을 열 때 씁니다.Binlog_checkpoint는 6절의 XA 복구가 쓰는 표시입니다.
xid 번호와 table_id는 실행마다 다를 수 있습니다.
헷갈리기 쉬운 곳: End_log_pos가 0인 이벤트
출력에서 트랜잭션 안쪽 이벤트(Query, Annotate_rows, Table_map, Update_rows)의 End_log_pos가 0입니다. 파일이 깨진 것이 아닙니다.
  if (is_artificial_event() ||
      cache_type == Log_event::EVENT_STMT_CACHE ||
      cache_type == Log_event::EVENT_TRANSACTIONAL_CACHE)
  {
    /*
      Artificial events are automatically generated and do not exist
      in master's binary log, so log_pos should be set to 0.

      Events written through transaction or statement cache have log_pos set
      to 0 so that they can be copied directly to the binlog without having
      to compute the real end_log_pos.
    */
    log_pos= 0;
  }
sql/log_event_server.cc 888–901행
트랜잭션이 도는 동안 이벤트는 파일이 아니라 연결마다 있는 binlog 캐시(binlog_cache_mngr의 트랜잭션 캐시)에 먼저 쌓입니다. 커밋할 때 그 캐시를 binlog 파일에 통째로 복사하는데, 그때 이벤트마다 파일 안 위치를 다시 계산하지 않으려고 0으로 둔다는 주석입니다. Gtid와 Xid는 커밋 때 직접 쓰는 이벤트라 진짜 위치가 들어 있습니다. InnoDB 같은 트랜잭션 엔진의 테이블만 고친 트랜잭션은 롤백할 때 캐시만 버리면 되므로 binlog에 아무것도 남지 않습니다.
6. 두 로그를 맞추기 — 2단계 커밋과 그룹 커밋
binlog가 켜지면 커밋 하나가 두 파일에 흔적을 남겨야 합니다. 그 사이에서 서버가 죽으면 어떻게 될까요.
- InnoDB는 커밋했는데 binlog에는 아직 없을 때 죽으면: 이 서버에는 행이 있는데, binlog를 받아 가는 replica에는 영영 없습니다.
- binlog에는 썼는데 InnoDB가 커밋하기 전에 죽으면: replica에는 행이 있는데 이 서버에는 없습니다.
어느 쪽이든 두 서버가 갈라집니다. 그래서 MariaDB는 InnoDB와 binlog를 2단계 커밋으로 묶고, binlog를 판정 기준으로 삼습니다. 서버 쪽 커밋의 중심인 ha_commit_trans()를 보면 됩니다. 먼저 참여자가 하나뿐이면 2단계를 건너뜁니다.
  if (trans->no_2pc || (rw_ha_count <= 1))
  {
rw_ha_count는 이 트랜잭션에서 실제로 무언가를 쓴 참여자의 수입니다. binlog가 꺼져 있고 InnoDB만 고쳤으면 1이라 ha_commit_one_phase()로 바로 갑니다(4절의 tc.log가 쓰이지 않은 까닭). binlog가 켜져 있으면 binlog_tp도 참여자로 등록되므로 2가 되고, 아래로 내려갑니다.
  for (Ha_trx_info *hi= ha_info; hi; hi= hi->next())
  {
    transaction_participant *ht= hi->ht();
    // ...
    if (! hi->is_trx_read_write())
      continue;
    /* We do not need to 2pc the binlog with the engine that implements it. */
    if (ht == opt_binlog_engine_hton)
      continue;
    // ...
    if (unlikely(prepare_or_error(ht, thd, all)))
      goto err;

    need_prepare_ordered|= (ht->prepare_ordered != NULL);
    need_commit_ordered|= (ht->commit_ordered != NULL);
  }
  DEBUG_SYNC(thd, "ha_commit_trans_after_prepare");
  DBUG_EXECUTE_IF("crash_commit_after_prepare", DBUG_SUICIDE(););
  // ...
  cookie= tc_log->log_and_order(thd, xid, all, need_prepare_ordered,
                                need_commit_ordered);
  // ...
  DBUG_EXECUTE_IF("crash_commit_after_log", DBUG_SUICIDE(););

  error= commit_one_phase_2(thd, all, trans, is_real_trans) ? 2 : 0;
  // ... (WSREP 블록 생략)
  DBUG_EXECUTE_IF("crash_commit_before_unlog", DBUG_SUICIDE(););
  if (tc_log->unlog(thd, cookie, xid))
    error= 2;                                /* Error during commit */
세 단계입니다.
- prepare. 쓰기를 한 참여자마다
prepare를 부릅니다. InnoDB의innobase_xa_prepare()(ha_innodb.cc17721행)는trx_prepare()로 undo 로그 헤더의 상태를PREPARED로 바꾸고 XID를 적은 뒤(trx_undo_set_state_at_prepare(), 이 변경도 mtr이라 redo에 남습니다),innodb_flush_log_at_trx_commit이 0이 아니면 그 LSN까지 로그를 씁니다(1·3이면 fsync까지, 2면 write만 — 2절의& 1과 같은 판단,trx0trx.cc1990–1992행). 이제 InnoDB는 "커밋할 수도, 되돌릴 수도 있는" 상태를 디스크에 들고 있습니다. - log_and_order. 조정자(binlog가 켜졌으면
MYSQL_BIN_LOG)가 binlog에 트랜잭션을 쓰고, 참여자들의commit_ordered를 binlog와 같은 순서로 부릅니다. binlog에Xid이벤트가 써지는 순간이 이 트랜잭션의 커밋 시점입니다. - commit.
commit_one_phase_2()가 참여자마다commit을 부릅니다. InnoDB는innobase_commit(), binlog는 앞에서 본 빈 람다입니다. 끝으로unlog()가 조정자에게 "이 XID는 끝났다"고 알립니다.
DBUG_EXECUTE_IF("crash_commit_after_prepare", DBUG_SUICIDE();); 같은 줄이 단계 사이사이에 박혀 있습니다. Debug 빌드에서 debug_dbug로 이름을 켜면 그 자리에서 서버가 스스로 죽습니다. MariaDB의 테스트가 바로 이 틈을 시험하려고 둔 장치이고(예: mysql-test/suite/innodb/t/group_commit_crash.test), 예제 4가 이것을 씁니다.
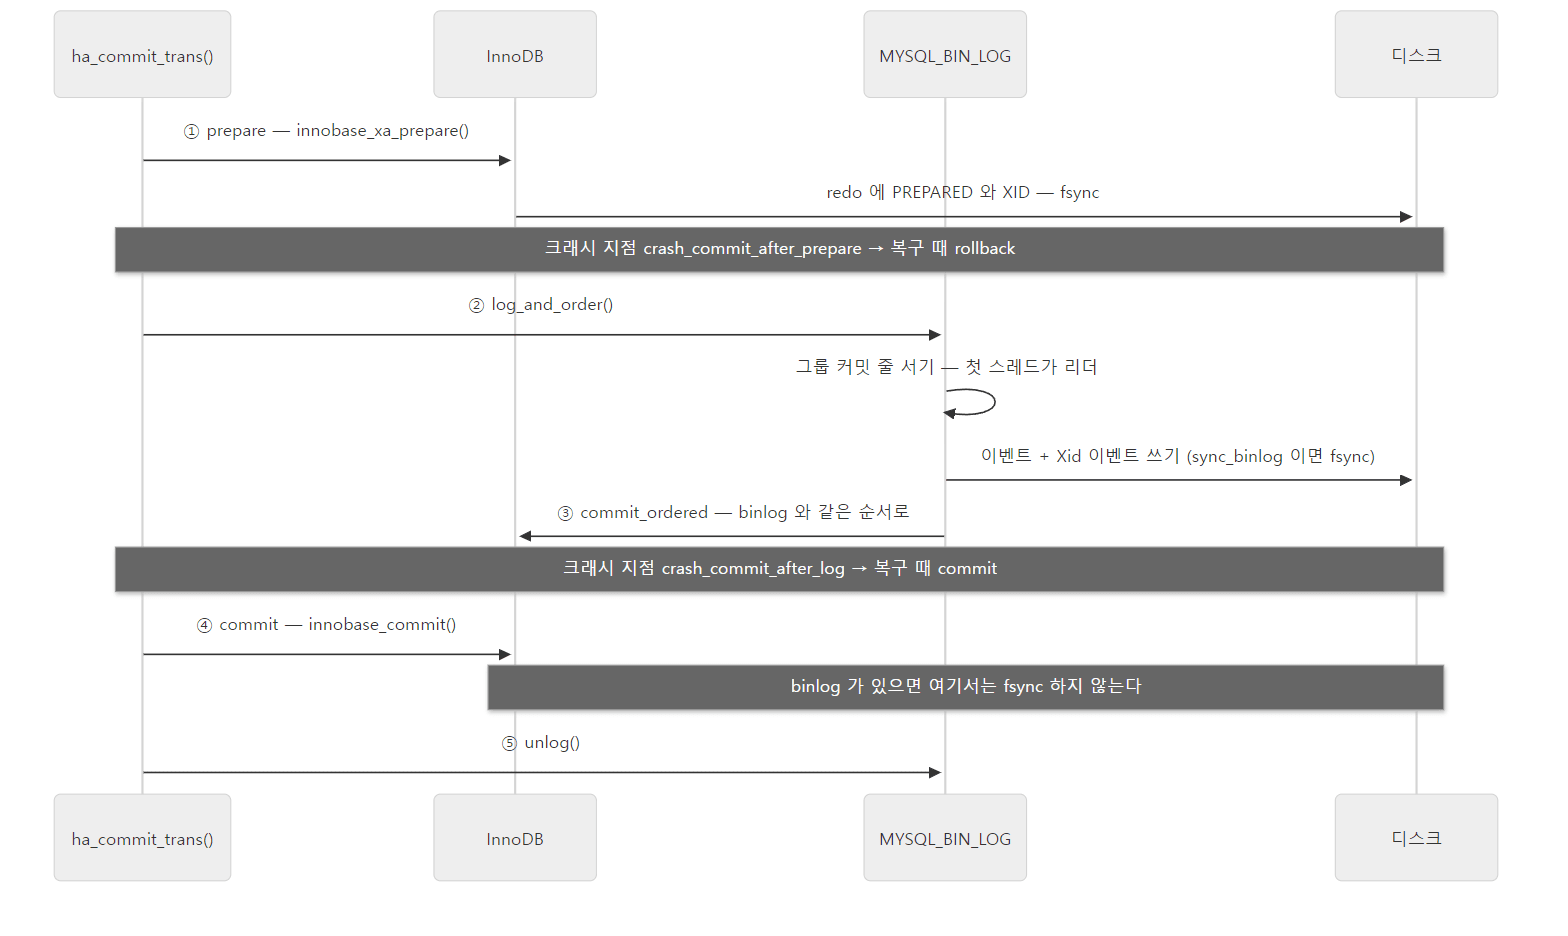 "크래시 지점"이라고 적힌 회색 띠 두 개가 예제 4에서 서버를 죽인 자리입니다. fsync 표시는 기본값
innodb_flush_log_at_trx_commit=1 기준입니다.
예제 4: 커밋 하나가 지나는 순서, 그리고 두 틈에서 죽이기
예제 폴더 ex/u12-two-phase-commit입니다. --log-bin으로 띄운 서버에 gdb를 붙여, autocommit INSERT 하나가 지나는 함수에 멈출 때마다 이름만 찍고 계속 가게 했습니다(order.gdb, 마지막 unlog()에서 떨어집니다). 중단점마다 commands … printf … continue … end를 붙였고, log_write_up_to에는 if $_caller_is("trx_prepare") 조건을 달아 prepare에서 부른 것만 찍게 했습니다. 결과입니다.
--- 1. call order of one autocommit INSERT (gdb)
>> ha_commit_trans(all=0)  thread_id=6  sql_command=5
>> ha_commit_trans(all=1)  thread_id=6  sql_command=5
>> ha_commit_trans(all=0)  thread_id=6  sql_command=5
>>   innobase_xa_prepare            InnoDB PREPARE
>>     log_write_up_to(durable=1)   called from trx_prepare
>>   MYSQL_BIN_LOG::log_and_order
>>     trx_group_commit_leader
>>     write_transaction_or_stmt      events -> binlog file
>>     flush_and_sync
>>     innobase_commit_ordered        InnoDB commit, in binlog order
>>   innobase_commit(commit_trx=0)
>>   MYSQL_BIN_LOG::unlog
- prepare에서
log_write_up_to(durable=1)— InnoDB가 prepare 상태를 fsync했습니다. log_and_order안에서 이 스레드가 그룹 커밋의 리더가 되어(trx_group_commit_leader) 이벤트를 binlog 파일에 쓰고(write_transaction_or_stmt),flush_and_sync를 지나, InnoDB의commit_ordered를 불렀습니다.- 그다음
innobase_commit이 불렸지만 그 안에서trx_flush_log_if_needed()가 불리지 않았습니다(중단점을 걸어 두었는데 찍히지 않았습니다). 2절의case 1: if (trx->active_commit_ordered && trx->active_prepare) return;줄이 이것입니다.
이어서 같은 서버에서 debug_dbug로 크래시 지점을 켜고 INSERT를 보낸 뒤, 다시 띄워 오류 로그와 행을 봤습니다.
# 이 글을 위해 쓴 예제입니다 (MariaDB 의 소스가 아닙니다)
mariadb -e "SET SESSION debug_dbug='+d,crash_commit_after_prepare';
            INSERT INTO lab.t VALUES (2, 'crash after prepare')" 2>&1 || true
--- 2. crash after InnoDB PREPARE, before the binlog write
ERROR 2013 (HY000) at line 2: Lost connection to server during query
[Note] InnoDB: Starting crash recovery from checkpoint LSN=52245
[Note] InnoDB: Transaction 21 was in the XA prepared state.
[Note] InnoDB: 1 transaction(s) which must be rolled back or cleaned up in total 0 row operations to undo
[Note] Recovering after a crash using mysql-bin
[Note] Starting table crash recovery...
[Note] InnoDB: Transaction 21 in prepared state after recovery
[Note] InnoDB: 1 transactions in prepared state after recovery
[Note] Crash table recovery finished.
[Note] InnoDB: Starting in background the rollback of recovered transactions
[Note] InnoDB: Rolled back recovered transaction 21
[Note] InnoDB: Rollback of non-prepared transactions completed
+----+--------+
 id | note   |
+----+--------+
  1 | traced |
+----+--------+
--- 3. crash after the binlog write, before InnoDB commit
ERROR 2013 (HY000) at line 2: Lost connection to server during query
[Note] InnoDB: Starting crash recovery from checkpoint LSN=52261
[Note] InnoDB: Transaction 27 was in the XA prepared state.
...
[Note] Recovering after a crash using mysql-bin
...
[Note] Crash table recovery finished.
+----+--------------------+
 id | note               |
+----+--------------------+
  1 | traced             |
  3 | crash after binlog |
+----+--------------------+
--- 4. which INSERTs are in the binlog
# mysql-bin.000001
INSERT INTO lab.t VALUES (1, 'traced')
Xid = 5
COMMIT/*!*/;
# mysql-bin.000002
INSERT INTO lab.t VALUES (3, 'crash after binlog')
Xid = 5
COMMIT/*!*/;
# mysql-bin.000003
클라이언트가 되풀이해 찍는 문장 줄과 오류 로그의 시각을 뺐고, 3번에서 2번과 같은 줄은 ...로 줄였습니다. trx id와 LSN은 실행 환경에 따라 달라질 수 있습니다(다시 돌렸을 때는 같게 나왔습니다).
- 두 경우 모두 InnoDB는 트랜잭션을
XA prepared state로 되살렸습니다. InnoDB만 보면 둘은 똑같습니다. - 갈린 것은 binlog입니다. 서버가 binlog를 열다가 마지막 파일이 깨끗이 닫히지 않은 것을 보고
Recovering after a crash using mysql-bin, 그 파일의Xid이벤트를 모아 InnoDB의 prepared XID와 대조했습니다.- 2번(prepare 직후): binlog에 그 XID가 없으므로 롤백. 행 2는 없고, binlog에도 없습니다.
- 3번(binlog 쓴 직후): binlog에 그 XID가 있으므로 커밋. 행 3이 있고, binlog에도 있습니다.
- 어느 쪽이든 InnoDB와 binlog가 같은 말을 합니다. 이것이 2단계 커밋이 지키는 약속입니다.
binlog를 기준으로 판정하는 코드
서버가 binlog를 열 때 첫 이벤트(Format_description)에 "쓰는 중" 표시(LOG_EVENT_BINLOG_IN_USE_F)가 남아 있으면 크래시 뒤라고 보고 recover()를 부릅니다(log.cc 14792–14796행). recover()는 먼저 ha_recover()로 엔진들의 prepared XID를 모으고, binlog를 읽으며 Xid 이벤트를 만날 때마다 그 XID에 "커밋하기로" 표시를 합니다.
      case XID_EVENT:
      if (do_xa)
      {
        Xid_log_event *xid_ev= (Xid_log_event*) ev;

        xid_recovery_member *member= (xid_recovery_member *)
          my_hash_search(&xids, (uchar*) &xid_ev->xid, sizeof(my_xid));
#ifndef HAVE_REPLICATION
        {
          if (member)
            member->decided_to_commit= true;
        }
복제가 들어간 보통의 빌드에서는 #else 쪽의 Recovery_context::decide_or_assess()(14336행)가 semi-sync replica 같은 경우까지 따집니다(그 세부는 따라가지 않았습니다). 다 읽고 나면 표시에 따라 엔진마다 commit_by_xid 또는 recover_rollback_by_xid(없으면 rollback_by_xid)를 부릅니다(xarecover_do_commit_or_rollback(), handler.cc 2992–2998행). InnoDB의 recover_rollback_by_xid(innobase_recover_rollback_by_xid())는 그 자리에서 되돌리지 않고 트랜잭션을 ACTIVE로 바꿔만 둡니다. 실제 롤백은 4절의 백그라운드 롤백이 함께 처리합니다 — 예제의 2번에서 Rolled back recovered transaction 21이 Crash table recovery finished. 뒤에 나온 까닭입니다(ha_innodb.cc 17842–17845행의 주석).
그룹 커밋 — 줄을 세워 한 번에 쓴다
커밋마다 binlog에 따로 쓰고 fsync하면 느립니다. log_and_order()는 binlog 캐시를 파일에 쓰는 길에서 queue_for_group_commit()으로 줄을 세웁니다.
/*
  Put a transaction that is ready to commit in the group commit queue.
  The transaction is identified by the ENTRY object passed into this function.

  To facilitate group commit for the binlog, we first queue up ourselves in
  this function. Then later the first thread to enter the queue waits for
  the LOCK_log mutex, and commits for everyone in the queue once it gets the
  lock. Any other threads in the queue just wait for the first one to finish
  the commit and wake them up. This way, all transactions in the queue get
  committed in a single disk operation.
줄의 첫 스레드(리더)가 trx_group_commit_leader()(10777행)에서 LOCK_log를 잡고, 기다리는 동안 늘어난 줄까지 통째로 가져가 차례로 파일에 쓴 뒤(write_transaction_or_stmt()) flush_and_sync()를 한 번 부릅니다. 이어서 LOCK_commit_ordered를 잡고 줄의 순서대로 각 트랜잭션의 run_commit_ordered()를 불러 InnoDB에서도 같은 순서로 커밋되게 하고, 나머지 스레드를 깨웁니다. InnoDB의 log_write_up_to()가 "쓰는 사람은 한 명"이었던 것과 같은 생각입니다.
flush_and_sync()는 캐시를 파일에 쓴 뒤(flush_io_cache()) sync_binlog가 정한 주기에만 mysql_file_sync()로 fsync합니다(7206–7212행). 예제 3의 출력대로 기본값은 sync_binlog=0이라, binlog는 write()만 하고 fsync는 운영체제에 맡깁니다. sync_binlog=1이면 그룹마다 fsync합니다.
헷갈리기 쉬운 곳: binlog가 켜지면 InnoDB 커밋은 fsync하지 않습니다(설정값 1일 때)
예제 4의 3번이 보여 준 것을 다시 봅시다. innodb_flush_log_at_trx_commit=1인데 InnoDB의 commit 단계에서 fsync가 없었습니다. 그래도 되는 까닭이 handlerton의 commit_checkpoint_request 칸 설명에 있습니다.
    An engine that does implement commit_checkpoint_request() is also
    expected to implement commit_ordered(), so that ordering of commits is
    consistent between 2pc participants. Such engine is no longer required to
    durably flush to disk transactions in commit(), provided that the
    transaction has been successfully prepare()d and commit_ordered(); thus
    potentially saving one fsync() call. (Engine must still durably flush
    to disk in commit() when no prepare()/commit_ordered() steps took place,
    at least if durable commits are wanted; this happens eg. if binlog is
    disabled).
prepare가 이미 fsync됐고 binlog에 Xid가 있으면, commit 레코드가 사라져도 복구 때 binlog를 보고 다시 커밋할 수 있습니다(예제 4의 3번이 정확히 그 경우였습니다). 그래서 fsync 하나를 아낍니다. 대신 binlog 파일을 지우려면 그 안의 트랜잭션이 InnoDB에서 정말 디스크까지 커밋됐는지 확인해야 하므로, 서버는 binlog를 돌릴 때(rotation) commit_checkpoint_request를 불러 InnoDB에게 "여기까지 fsync했으면 알려 달라"고 합니다(InnoDB 쪽은 innodb_log_flush_request(), ha_innodb.cc 4983행). innodb_flush_log_at_trx_commit=3은 이 지름길을 쓰지 않고 commit에서도 fsync하는 설정입니다(case 1:에만 지름길이 있으므로).
헷갈리기 쉬운 곳: INSERT 하나에 ha_commit_trans()가 세 번
예제 4의 출력에서 ha_commit_trans가 세 번 찍혔고, 2단계 커밋은 세 번째에서만 일어났습니다. ex/u12-commit-callers에서 세 번 모두 백트레이스를 찍어 보면 앞의 둘은 INSERT가 테이블을 열면서 엔진 독립 통계 테이블(mysql.table_stats 등)을 읽고 닫는 read_statistics_for_tables() → THD::commit_whole_transaction_and_close_tables()(sql_class.cc 6852·6860행)가 부른 것이었고, 참여자 목록(ha_list)이 비어 있어 바로 끝났습니다. 세 번째가 문장 끝의 trans_commit_stmt()(transaction.cc 499행)입니다.
==== call 3 all=0 ha_list=0x779e6c003bc0
#0  ha_commit_trans at /usr/src/mariadb/sql/handler.cc:1788
#1  trans_commit_stmt at /usr/src/mariadb/sql/transaction.cc:499
#2  mysql_execute_command at /usr/src/mariadb/sql/sql_parse.cc:6039
...
all=0(문장 커밋)인데 진짜 커밋이 된 것은 이 줄 때문입니다.
  bool is_real_trans= ((all || thd->transaction->all.ha_list == 0) &&
                       !(thd->variables.option_bits & OPTION_GTID_BEGIN));
autocommit이면 트랜잭션 전체의 참여자 목록(all.ha_list)이 비어 있으므로, 문장 커밋이 곧 트랜잭션 커밋입니다. BEGIN … COMMIT으로 묶으면 문장 끝마다 all=0이 불리지만 is_real_trans가 거짓이라 2단계 커밋은 COMMIT 때의 all=1에서만 합니다. 주소(ha_list=…)는 실행마다 다릅니다.
7. 최근 판의 binlog_storage_engine, 그리고 복제 맛보기
binlog를 InnoDB 안에 두기
기준 커밋에는 최근 판에 들어온 --binlog-storage-engine 옵션이 있습니다(Sys_binlog_storage_engine, sys_vars.cc 2741–2746행, 설명은 "저장 엔진과 합친 더 효율적인 binlog 구현"). innodb를 주면 binlog를 InnoDB가 관리하는 파일(binlog-000000.ibb …)에 쓰고, binlog에 쓰는 일 자체가 InnoDB의 mtr이 되어 redo로 보호됩니다(fsp_binlog.cc가 부르는 mtr_t::write_binlog(), buf0flu.cc 2290행). 구현은 storage/innobase/handler/innodb_binlog.cc(약 5,000줄)와 storage/innobase/fsp/fsp_binlog.cc에 있습니다. 그러면 InnoDB와 binlog를 맞출 2단계 커밋이 필요 없어집니다. 6절에서 본 ha_commit_trans()의 한 줄 — if (ht == opt_binlog_engine_hton) continue;("binlog를 구현한 엔진과는 2PC를 할 필요가 없다") — 이 그것입니다. ex/u12-binlog-in-innodb에서 예제 4와 같은 gdb 스크립트를 돌려 봤습니다.
--- 1. call order of one autocommit INSERT (gdb)
>> ha_commit_trans(all=0)  thread_id=5  sql_command=5
>> ha_commit_trans(all=1)  thread_id=5  sql_command=5
>> ha_commit_trans(all=0)  thread_id=5  sql_command=5
>>   MYSQL_BIN_LOG::log_and_order
>>     trx_group_commit_leader
>>     write_transaction_or_stmt      events -> binlog file
>>     innobase_commit_ordered        InnoDB commit, in binlog order
>>   innobase_commit(commit_trx=0)
>>     trx_flush_log_if_needed
>>   MYSQL_BIN_LOG::unlog
--- 2. binlog files and events
...
+-------------------+------------+
 Log_name          | File_size  |
+-------------------+------------+
 binlog-000000.ibb | 1073741824 |
 binlog-000001.ibb | 1073741824 |
+-------------------+------------+
...
innobase_xa_prepare와 flush_and_sync가 사라졌고, 대신 InnoDB commit 단계의 trx_flush_log_if_needed가 돌아왔습니다. prepare의 fsync와 (sync_binlog=1이면) binlog 파일의 fsync 대신, binlog까지 담긴 InnoDB redo를 한 번 fsync하는 셈입니다. binlog 파일은 처음부터 max_binlog_size(기본 1GB) 크기로 두 개를 만들어 둡니다(크기를 정하는 곳은 ibb_set_max_size(), innodb_binlog.cc 1619–1634행). 출력의 ... 두 곳은 @@binlog_storage_engine(innodb)을 찍은 표와, 뒤따르는 SHOW BINLOG EVENTS 표·파일 크기 줄을 줄인 자리입니다. SHOW BINLOG EVENTS로 이벤트도 볼 수 있지만 Pos가 모두 0으로 나왔습니다(새 구현에서 파일 위치가 무엇을 뜻하는지까지는 확인하지 못했습니다). 이 기능은 최근 판에 들어온 것이라, 다른 판에 있는지는 확인하지 않았습니다.
복제 맛보기
binlog의 첫째 쓰임은 복제입니다. 이 연재에서는 이름과 자리만 적어 둡니다.
- 보내는 쪽(primary): replica가
COM_BINLOG_DUMP를 보내면 그 연결 스레드가mysql_binlog_send()(sql_repl.cc3735행)로 binlog 파일을 읽어 이벤트를 차례로 보냅니다. 새 이벤트가 없으면 binlog가 늘어나기를 기다립니다. - 받는 쪽(replica): IO 스레드
handle_slave_io()(slave.cc4536행)가 이벤트를 받아 relay log(replica가 받아 둔 binlog 사본 파일)에 쓰고, SQL 스레드handle_slave_sql()(5200행)이 relay log를 읽어 이벤트마다do_apply_event()(log_event.h1855행)를 부릅니다.Query_log_event는 SQL을 다시 실행하고,Rows_log_event는 행을 찾아handler로 바로 고칩니다(9편의ha_write_row()·ha_update_row()). - 병렬 적용: SQL 스레드가 이벤트 그룹을 여러 워커에 나눠 주는 것이
sql/rpl_parallel.cc입니다. 6절의 그룹 커밋에서 여러 트랜잭션이 한 그룹으로 묶이면 리더가 commit id를 하나 정해(trx_group_commit_with_engines(),log.cc10845행) 각Gtid이벤트에 적고("같은 commit_id면 같은 그룹 커밋",log_event.h3536–3539행), 병렬 복제가 이 값을 씁니다. 어떻게 쓰는지는 이 글에서 따라가지 않았습니다.
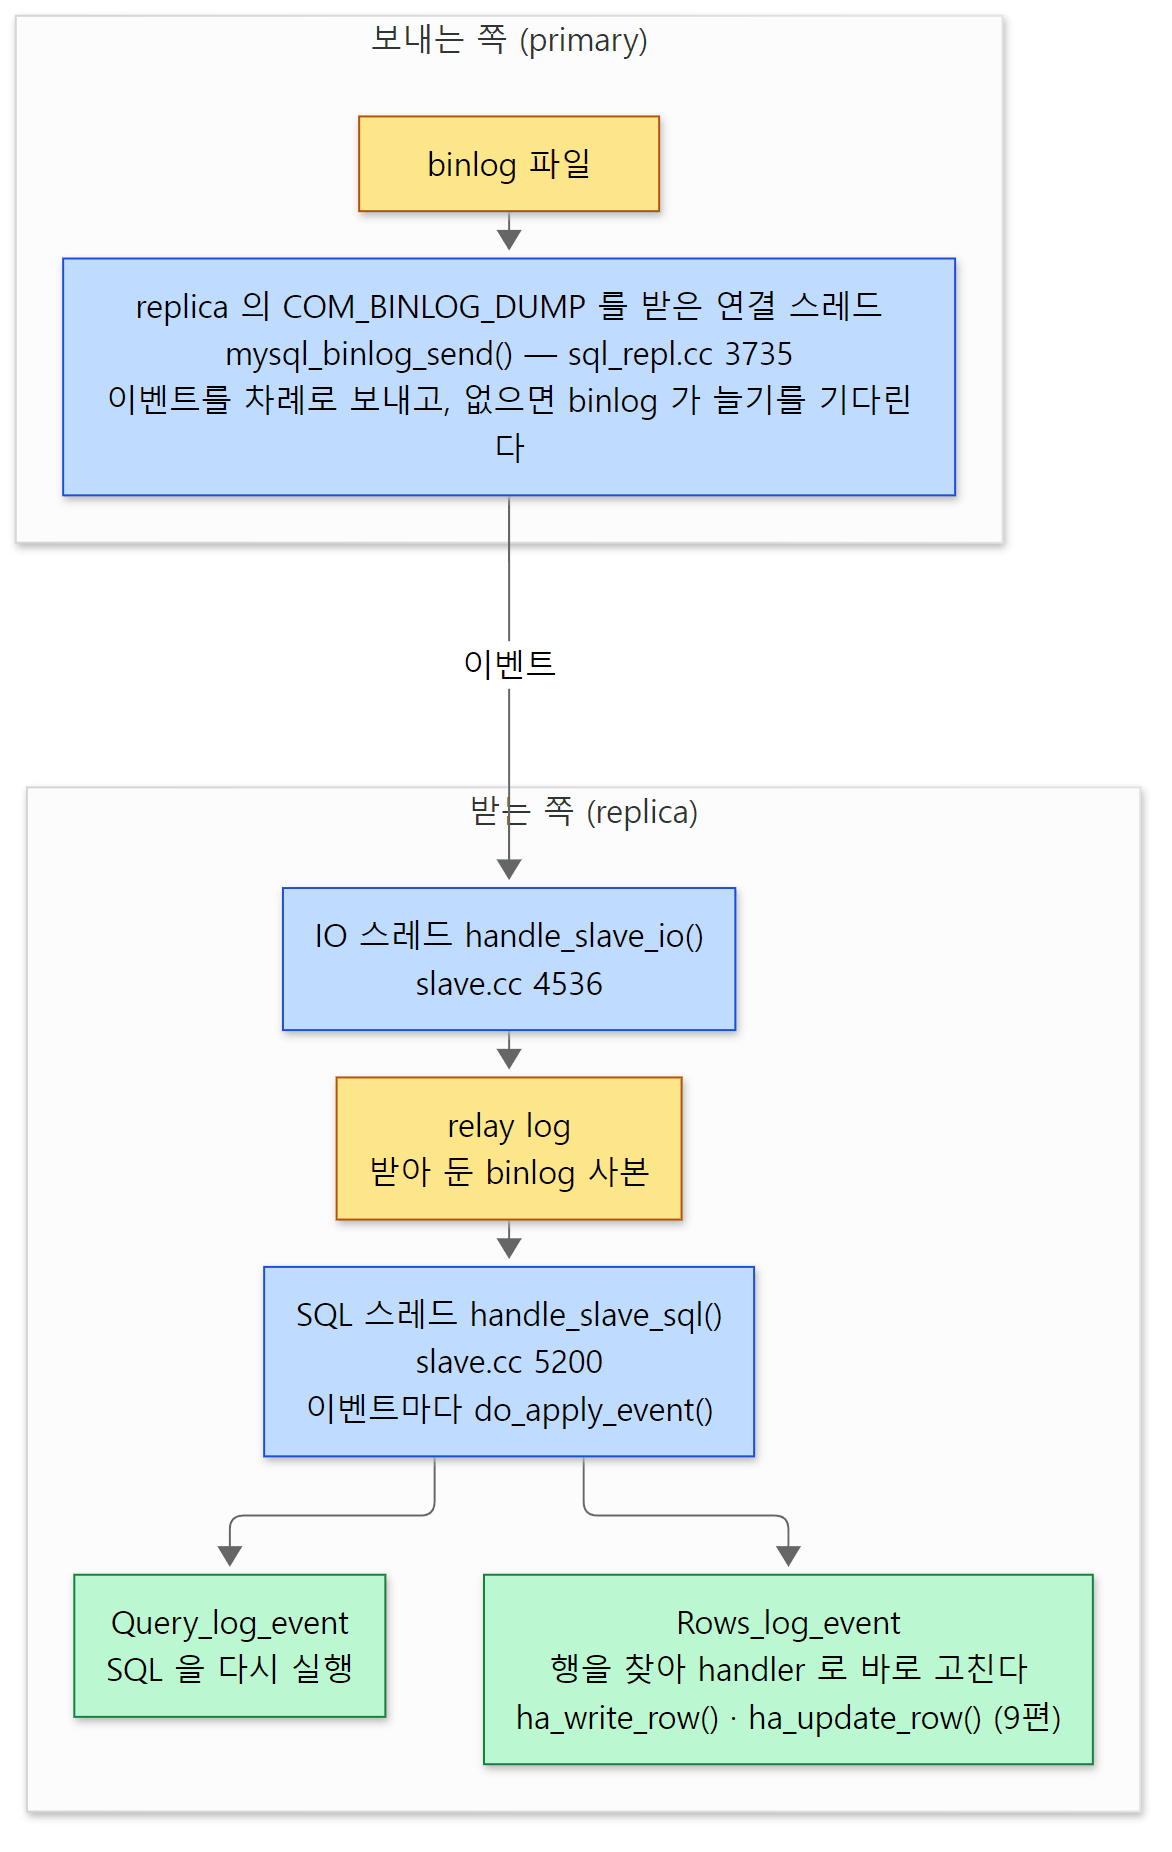 위 목록의 함수들을 이벤트가 흐르는 순서로 늘어놓은 그림입니다. 병렬 적용(rpl_parallel.cc)은 그리지 않았습니다.
이 글에서 뺀 것
- redo 레코드의 형식(레코드 종류
WRITE,MEMSET,MEMMOVE,INIT_PAGE,FREE_PAGE,EXTENDED…와 길이 부호화):storage/innobase/include/mtr0types.h, 쓰는 쪽include/mtr0log.h, 읽는 쪽recv_sys_t::parse()log0recv.cc3015행 - 복구할 페이지가 버퍼 풀보다 많을 때의 여러 번 나눠 적용하기(multi-batch):
recv_sys_t::apply_batch()4421행 - 반쯤 쓰인 페이지를 고치는 doublewrite 버퍼:
storage/innobase/buf/buf0dblwr.cc, 복구 중buf_dblwr.recover() - 로그 아카이브(
innodb_log_archive)와 실행 중 크기 바꾸기:log_t::set_archive(),log_t::resize_start()(log0log.cc) innodb_force_recovery단계별로 무엇을 건너뛰나:include/srv0srv.h의SRV_FORCE_*- 사용자 XA(
XA START … XA PREPARE … XA COMMIT)와 binlog의XA_PREPARE_LOG_EVENT:sql/xa.cc,TC_LOG::log_xa_prepare() - binlog 쓰기의 이벤트 직렬화(
Log_event::write(),Log_event_writer)와 체크섬:sql/log_event_server.cc - semi-sync 복제(
repl_semisync_master), GTID 상태(rpl_gtid.cc), 병렬 복제의 세부:sql/semisync_master.cc,sql/rpl_gtid.cc,sql/rpl_parallel.cc - Aria의 자체 트랜잭션 로그(
aria_log.00000001)와 그 복구:storage/maria/ma_loghandler.c,ma_recovery.c
정리
| 개념 | 한 줄 요약 |
|---|---|
| redo 로그 | 페이지를 바꾼 바이트를 먼저 이어 쓰고, 페이지는 나중에 쓴다. 파일은 ib_logfile0 하나, 원형 |
| LSN | 로그를 쓴 바이트 수. current ≥ write ≥ flushed ≥ checkpoint |
mtr_t::commit() |
레코드를 append_prepare()로 잡은 버퍼 자리에 복사하고 페이지에 FIL_PAGE_LSN을 적는다. 디스크에는 안 쓴다 |
log_write_up_to() |
커밋이 부른다. group_commit_lock으로 한 스레드가 모아서 write, fsync |
innodb_flush_log_at_trx_commit |
& 1이면 fsync, 2면 write만, 0이면 아무것도. 나머지는 1초 주기 작업이 |
| 체크포인트 | 가장 오래된 더티 페이지의 LSN. 4096·8192 블록에 번갈아 적고, 그 앞의 로그 자리는 다시 쓴다 |
| 크래시 복구 | 체크포인트부터 redo를 다시 적용(커밋 안 한 것까지) → undo로 트랜잭션을 되살려 → 서버 XA 복구 → 뒤에서 롤백 |
| binlog | 서버 계층의 논리 로그. 연결마다 캐시에 모았다가 커밋 때 통째로. 복제와 시점 복구용 |
MYSQL_BIN_LOG |
binlog이자 트랜잭션 조정자(TC_LOG). 참여자 얼굴 binlog_tp의 commit은 빈 함수 |
| 2단계 커밋 | InnoDB prepare(fsync) → binlog에 Xid → InnoDB commit(fsync 생략). 판정 기준은 binlog |
| 복구 판정 | prepared XID가 binlog에 있으면 commit, 없으면 rollback |
| 그룹 커밋 | 줄의 첫 스레드가 모두의 이벤트를 쓰고 한 번만 sync, 같은 순서로 commit_ordered |
tc.log |
binlog가 꺼졌을 때의 조정자 TC_LOG_MMAP. 2PC 엔진 둘 이상을 함께 고칠 때만 쓰인다 |
binlog_storage_engine |
최근 판. binlog를 InnoDB 안에 두어 2단계 커밋을 없앤다 |
연재를 마치며
이 글로 1편의 지도에 적어 둔 12편을 모두 썼습니다. 연재의 글 전체입니다.
| 편 | 글 | 한 줄 요약 |
|---|---|---|
| 1 | AI와 함께 소스를 읽는 방법과 분석 지도 | 기준 커밋을 정해 도커로 Debug 빌드하고, 폴더 지도와 쿼리 하나의 큰 길을 그렸다 |
| 2 | 전체 지도 — 서버 계층과 스토리지 엔진, 그리고 쿼리 하나의 일생 | sql/과 storage/를 handler·handlerton이 가르고, 쿼리는 THD를 들고 정해진 칸을 지난다 |
| 3 | 기동과 플러그인 — mariadbd가 첫 연결을 받기까지 | mysqld_main()이 옵션과 플러그인을 올리고, 엔진은 초기화 함수에서 handlerton을 채운다 |
| 4 | 연결과 스레드 — 연결마다 스레드 하나, 그리고 스레드 풀 | 연결마다 스레드 하나가 기본이고, 스레드 풀은 그룹마다 리스너와 워커로 연결을 나눠 맡는다 |
| 5 | 프로토콜과 명령 처리 — 패킷 하나가 dispatch_command에 닿기까지 | 4바이트 머리의 패킷을 읽어 명령 바이트로 갈라 보내고, 결과는 Protocol로 돌려준다 |
| 6 | 파서 — SQL 문장이 LEX와 Item 나무가 되기까지 | 렉서와 Bison 문법이 문장을 LEX, SELECT_LEX, Item 나무로 바꾼다 |
| 7 | 준비 단계 — 권한 확인, 테이블 열기, 이름 찾기 | 권한을 보고, TABLE_SHARE·TABLE을 열어 MDL을 잡고, Item의 이름을 열에 잇는다 |
| 8 | 옵티마이저 — JOIN::optimize와 실행 계획 고르기 | 조건을 다듬고, 범위와 비용을 어림해 조인 순서와 접근 방법을 고른다 |
| 9 | 실행과 handler API — 중첩 루프 조인이 엔진을 부르는 법 | 중첩 루프가 handler의 ha_ 감싸개를 거쳐 엔진의 가상 함수를 부른다 |
| 10 | InnoDB 1 — 페이지, 버퍼 풀, B-트리 | 16KB 페이지를 버퍼 풀에 올려 B-트리로 찾고, mtr로 묶어 고친다 |
| 11 | InnoDB 2 — 트랜잭션, MVCC, undo, 잠금 | 읽기 뷰와 undo로 옛 판을 보여 주고, 행 잠금으로 쓰기끼리 막는다 |
| 12 | 로그 두 개 — redo 로그와 binlog, 크래시 복구, 그리고 연재를 마치며 (이 글) | redo는 앞으로, undo는 뒤로 복구하고, binlog와는 XID로 2단계 커밋한다 |
쿼리 하나의 일생, 다시 한 번
2편에서는 쿼리 하나가 연결에서 엔진까지 지나는 칸을 지도로 그렸습니다. 여기서는 그 앞의 기동과 이 글의 커밋·로그까지 넣어 다시 그립니다. 칸마다 그 칸을 다룬 편이 적혀 있습니다.
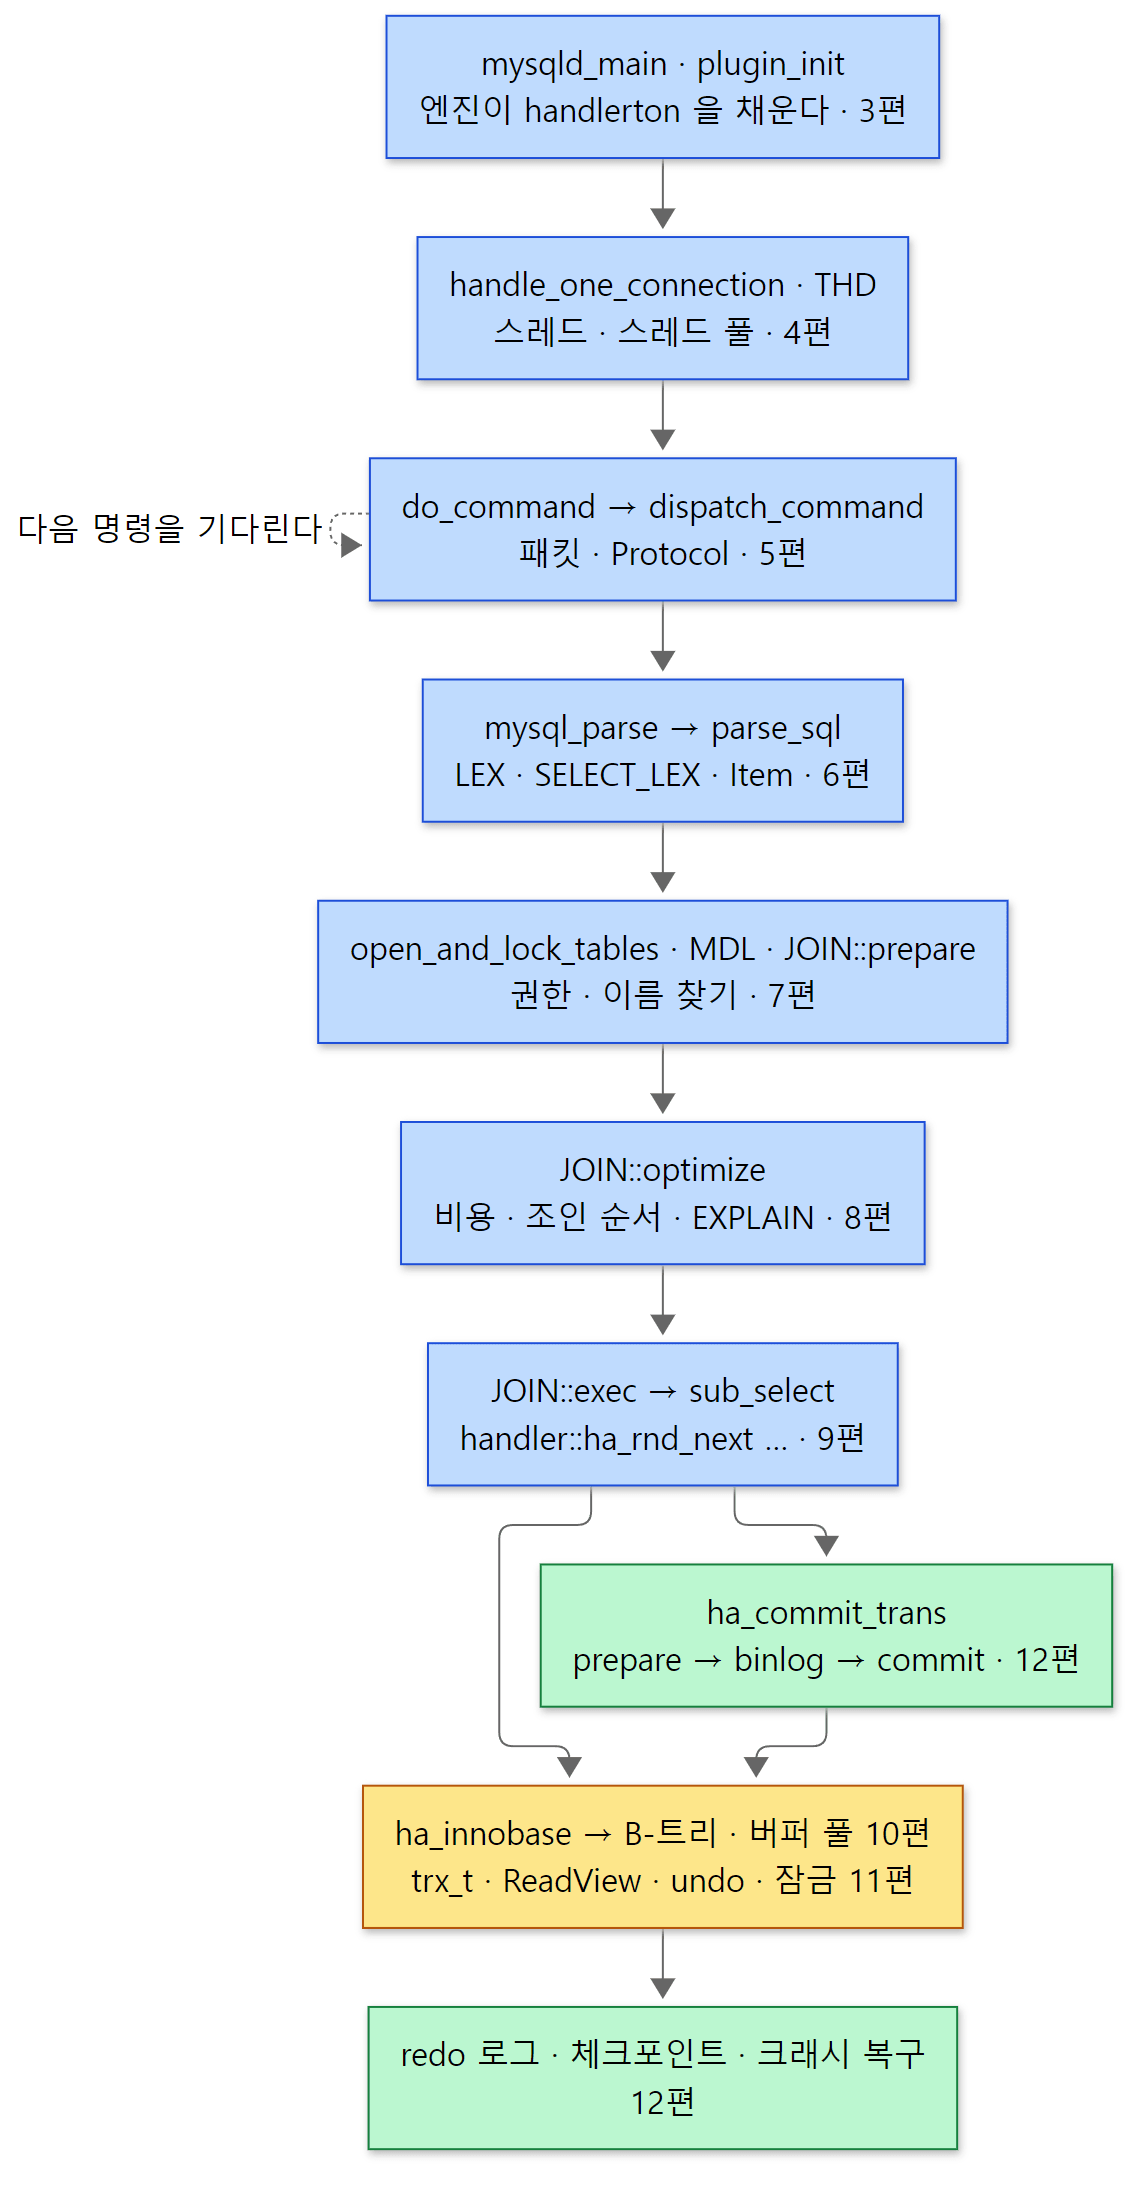 이 글은 초록 두 칸이었습니다.
mariadbd가 뜨면 mysqld_main()이 옵션을 읽고 플러그인을 올리며, InnoDB 같은 엔진은 그때 자기 handlerton을 채웁니다(3편). InnoDB는 이때 이 글의 redo 적용과 트랜잭션 되살리기를 끝내고 나서야 준비됐다고 답합니다. 연결이 오면 스레드 하나(또는 스레드 풀의 워커)가 THD를 들고 그 연결을 맡고(4편), 패킷을 읽어 COM_QUERY면 문장을 파서에 넘깁니다(5편). 파서는 문장을 LEX와 Item 나무로 바꾸고(6편), 준비 단계는 권한을 확인하고 테이블을 열어 MDL을 잡고 이름을 열에 잇습니다(7편). 옵티마이저가 조인 순서와 접근 방법을 고르면(8편), 실행기가 중첩 루프로 handler를 불러 엔진에서 행을 꺼내거나 씁니다(9편). 엔진 안에서는 페이지와 B-트리(10편), 트랜잭션과 잠금(11편)이 일하고, 그동안 고친 것은 mtr마다 redo 로그 버퍼에 쌓입니다. 마지막으로 COMMIT이 오면 ha_commit_trans()가 InnoDB와 binlog를 2단계로 커밋하고, redo 로그가 fsync되는 순간 그 커밋은 서버가 죽어도 남게 됩니다(이 글).
12편을 지나며 되풀이해 나온 것은 세 가지였습니다. handler와 handlerton이라는 경계는 쿼리 실행(9편)뿐 아니라 기동(3편), 트랜잭션(11편), 커밋과 복구(이 글)에서도 서버와 엔진을 가르는 선이었습니다. 이 글의 binlog조차 같은 모양의 transaction_participant로 트랜잭션에 끼었습니다. THD 하나에 연결의 모든 것을 담는 방식은 파서의 LEX, 준비 단계의 열린 테이블, 커밋 때의 참여자 목록(thd->transaction)까지 한 객체에서 꺼내 쓰게 했습니다. 메모리에서 먼저, 디스크는 나중에라는 생각은 버퍼 풀(10편), undo와 읽기 뷰(11편), redo와 binlog 캐시(이 글)에 모두 있었고, 그 "나중"을 안전하게 만드는 것이 로그였습니다. 이 셋을 알면 처음 보는 MariaDB 기능의 소스도 어디부터 볼지 짐작할 수 있습니다.
httpd·Tomcat·Spring 연재와 비교하면
이 블로그는 앞서 Spring 소스 파헤치기(27편), Apache httpd 소스 파헤치기(16편), Tomcat 소스 파헤치기(16편)를 읽었습니다.
- 서버로서는 httpd·Tomcat과 같은 뼈대입니다. 연결을 받아 스레드에 맡기는 일은 httpd 8편의 MPM, Tomcat 5편의 엔드포인트와 같은 문제였고, MariaDB의 스레드 풀은 event MPM과 닮았습니다. 요청(문장)마다 메모리를 한꺼번에 비우는
MEM_ROOT는 httpd 4편의 APR 풀과 같은 생각이고, 엔진을 플러그인으로 갈아 끼우는handlerton은 httpd 6편의 모듈과 훅처럼 함수 포인터 표로 남의 코드를 끼웁니다. - 다른 점은 상태를 디스크에 남긴다는 것입니다. httpd와 Tomcat은 요청이 끝나면 잊어도 되지만, 데이터베이스는 커밋한 것을 서버가 죽어도 기억해야 합니다. 이 글의 redo·undo·binlog·2단계 커밋은 앞의 세 연재에는 없던 종류의 코드였습니다. httpd 16편의 "로그"가 일어난 일을 사람에게 알리는 기록이었다면, 이 글의 로그는 서버 자신이 다시 읽어 상태를 되살리는 기록입니다.
- Spring은 이 연재의 위층입니다. Spring 17편의
@Transactional이 메서드 끝에서 부르는Connection.commit()은 JDBC 드라이버를 거쳐 서버에COMMIT으로 닿고(드라이버 쪽은 이 연재에서 읽지 않았습니다), 5편의dispatch_command()를 지나 이 글의ha_commit_trans()가 됩니다. Spring 18편의JdbcTemplate이 보내는 SQL 한 줄은 6~9편의 길을 따라 실행됩니다. 같은 트랜잭션을 위에서 본 것과 아래에서 본 것입니다.
다음에 읽을 것
이 블로그의 오픈소스 읽기는 nginx, MariaDB에 이어 Gradle로 갑니다. 지금까지는 요청을 받고 데이터를 지키는 서버였다면, 다음은 코드를 빌드하는 도구입니다. Spring 1편에서 버전을 찾아 연 gradle.properties가 바로 Gradle의 설정 파일이었습니다.