이 글에서 다루는 것
"Gradle 소스 파헤치기" 연재의 아홉 번째 글입니다. 8편에서는 태스크가 register()로 등록만 되었다가 필요할 때 만들어지는 것, 그리고 Provider로 이은 입력이 dependsOn 없이도 의존을 만든다는 것을 보았습니다. 설정 단계가 끝나면 Gradle 손에는 태스크들과 그 사이의 관계가 남습니다. 이 글은 그다음, 그 관계를 가지고 "무엇을, 어떤 순서로, 몇 개씩 돌릴지" 정하고 실제로 스레드에 나눠 주는 부분을 읽습니다.
답하려는 질문은 넷입니다.
- 명령줄의
gradle pA는 어떻게packageApp태스크가 되는가 dependsOn·mustRunAfter·shouldRunAfter·finalizedBy는 실행 계획에서 각각 무엇이 되고, 순서는 누가 정하는가- 실행 중에 "다음에 돌릴 태스크"는 누가 어떻게 고르는가. 콘솔에 찍히는 스레드 이름
Execution worker·included builds는 어디서 오는가 --parallel과--max-workers는 정확히 무엇을 제한하는가. Worker API 는 그 안에서 어떤 다른 길인가
| 항목 | 내용 |
|---|---|
| 대상 | Gradle Build Tool |
| 버전 | 9.10.0 개발판 (master) |
| 커밋 | 07ecbf9ead (2026-10-24) |
| 주로 읽는 클래스 | DefaultTaskSelector, DefaultExecutionPlan, DetermineExecutionPlanAction, Node·TaskNode·LocalTaskNode, DefaultFinalizedExecutionPlan, DefaultTaskExecutionGraph, DefaultPlanExecutor, DefaultWorkerLeaseService, DefaultWorkerExecutor |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
2편의 지도에서 이 글은 E 구역(실행 단계)의 첫 칸, "실행 계획·노드(워커 스레드)" 를 확대합니다. 2편의 "실행 쪽 흐름" 그림에서 FinalizedExecutionPlan 이 DefaultPlanExecutor 로 넘어가 Execution worker 스레드들이 노드를 집는 데까지가 이 글의 범위이고, 집은 노드 안에서 UP-TO-DATE 를 따지는 실행 엔진은 10편의 몫입니다.
execution/plan 패키지 하나에 소스 파일이 54개 있고, 실행 중의 노드 고르기(DefaultFinalizedExecutionPlan)만 850줄이 넘습니다. 이 글은 처음 여는 사람이 따라올 수 있는 큰 줄기만 골랐습니다. 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
태스크 그래프(task graph)는 "이번 빌드에서 돌릴 태스크들과 그 사이의 순서"입니다. 빌드 스크립트에서 gradle.taskGraph 로 만지는 것이 이것이고, 소스에서는 DefaultTaskExecutionGraph 가 그 얼굴입니다. 얼굴 뒤에서 실제로 그래프를 들고 있는 것은 실행 계획(execution plan)입니다. 실행 계획은 두 모습이 있습니다. 노드를 모으고 순서를 정하는 동안의 DefaultExecutionPlan 과, 순서가 굳은 뒤 실행 중에 "다음 노드"를 내주는 DefaultFinalizedExecutionPlan 입니다.
노드(node)는 실행 계획의 점 하나입니다. 태스크 하나가 보통 LocalTaskNode 하나가 되지만, 태스크가 아닌 노드도 있습니다(포함된 빌드의 태스크, 아티팩트 변환, 실행 직전에 출력 위치를 계산하는 노드 등, 3절).
후속자(successor)는 이 글에서 가장 헷갈리는 이름입니다. Gradle 소스에서 노드 A 의 "successor" 는 A 보다 먼저 끝나야 하는 노드입니다. b.dependsOn(a) 이면 a 가 b 의 dependency successor 입니다. 그래프에서 화살표가 b → a 로 그려지고, 화살표를 따라가면 "후속"이 나온다는 뜻이지 시간상 뒤라는 뜻이 아닙니다.
워커 리스(worker lease)는 "지금 일해도 된다"는 자리표입니다. 전체 개수가 --max-workers 로 정해지고, 태스크를 돌리는 스레드든 Worker API 의 스레드든 일하는 동안 하나씩 쥡니다(7절).
자원 잠금(resource lock)은 워커 리스와 별개로, 특정 자원을 한 번에 한 스레드만 쓰게 하는 잠금입니다. 이 글에서는 태스크 실행 잠금(task execution lock)과 프로젝트 잠금(project lock)이 중요합니다. --parallel 이 바꾸는 것이 바로 이 잠금의 단위입니다.
Worker API 는 태스크 액션 안의 일을 여러 조각으로 나눠 다른 스레드나 다른 프로세스에서 돌리게 해 주는 공개 API(WorkerExecutor)입니다. 태스크끼리의 병렬과는 다른 길입니다(8절).
1. 큰 그림: 이름 → 노드 → 순서 → 스레드
2편에서 본 빌드 생명주기의 TaskSchedule → ReadyToRun 사이, 빌드 오퍼레이션 이름으로는 Calculate task graph 가 이 글의 앞 절반입니다. 여기서 일을 묶는 클래스는 짧습니다.
    @Override
    public void populateWorkGraph(GradleInternal gradle, ExecutionPlan plan, Consumer<? super ExecutionPlan> action) {
        action.accept(plan);
        plan.determineExecutionPlan();
    }

    @Override
    public FinalizedExecutionPlan finalizeWorkGraph(GradleInternal gradle, ExecutionPlan plan) {
        TaskExecutionGraphInternal taskGraph = gradle.getTaskGraph();
        // ...
        FinalizedExecutionPlan finalizedExecutionPlan = plan.finalizePlan();

        if (LOGGER.isInfoEnabled()) {
            LOGGER.info("Tasks to be executed: {}", plan.getContents().getTasks());
            LOGGER.info("Tasks that were excluded: {}", plan.getContents().getFilteredTasks());
        }

        taskGraph.populate(finalizedExecutionPlan);
        // ...
        return finalizedExecutionPlan;
    }
subprojects/core/src/main/java/org/gradle/internal/build/DefaultBuildWorkPreparer.java 45–68행
populateWorkGraph() 의 action 이 명령줄의 태스크 이름을 골라 계획에 넣고(2·3절), determineExecutionPlan() 이 순서를 정합니다(4절). finalizeWorkGraph() 는 그 계획을 굳히고(finalizePlan()), gradle.taskGraph 에 채워 넣습니다(taskGraph.populate(), 5절). 그다음 빌드 오퍼레이션 Run tasks(DefaultBuildWorkExecutor, 88행) 안에서 DefaultPlanExecutor 가 굳은 계획을 스레드들에 나눠 줍니다(6·7절).
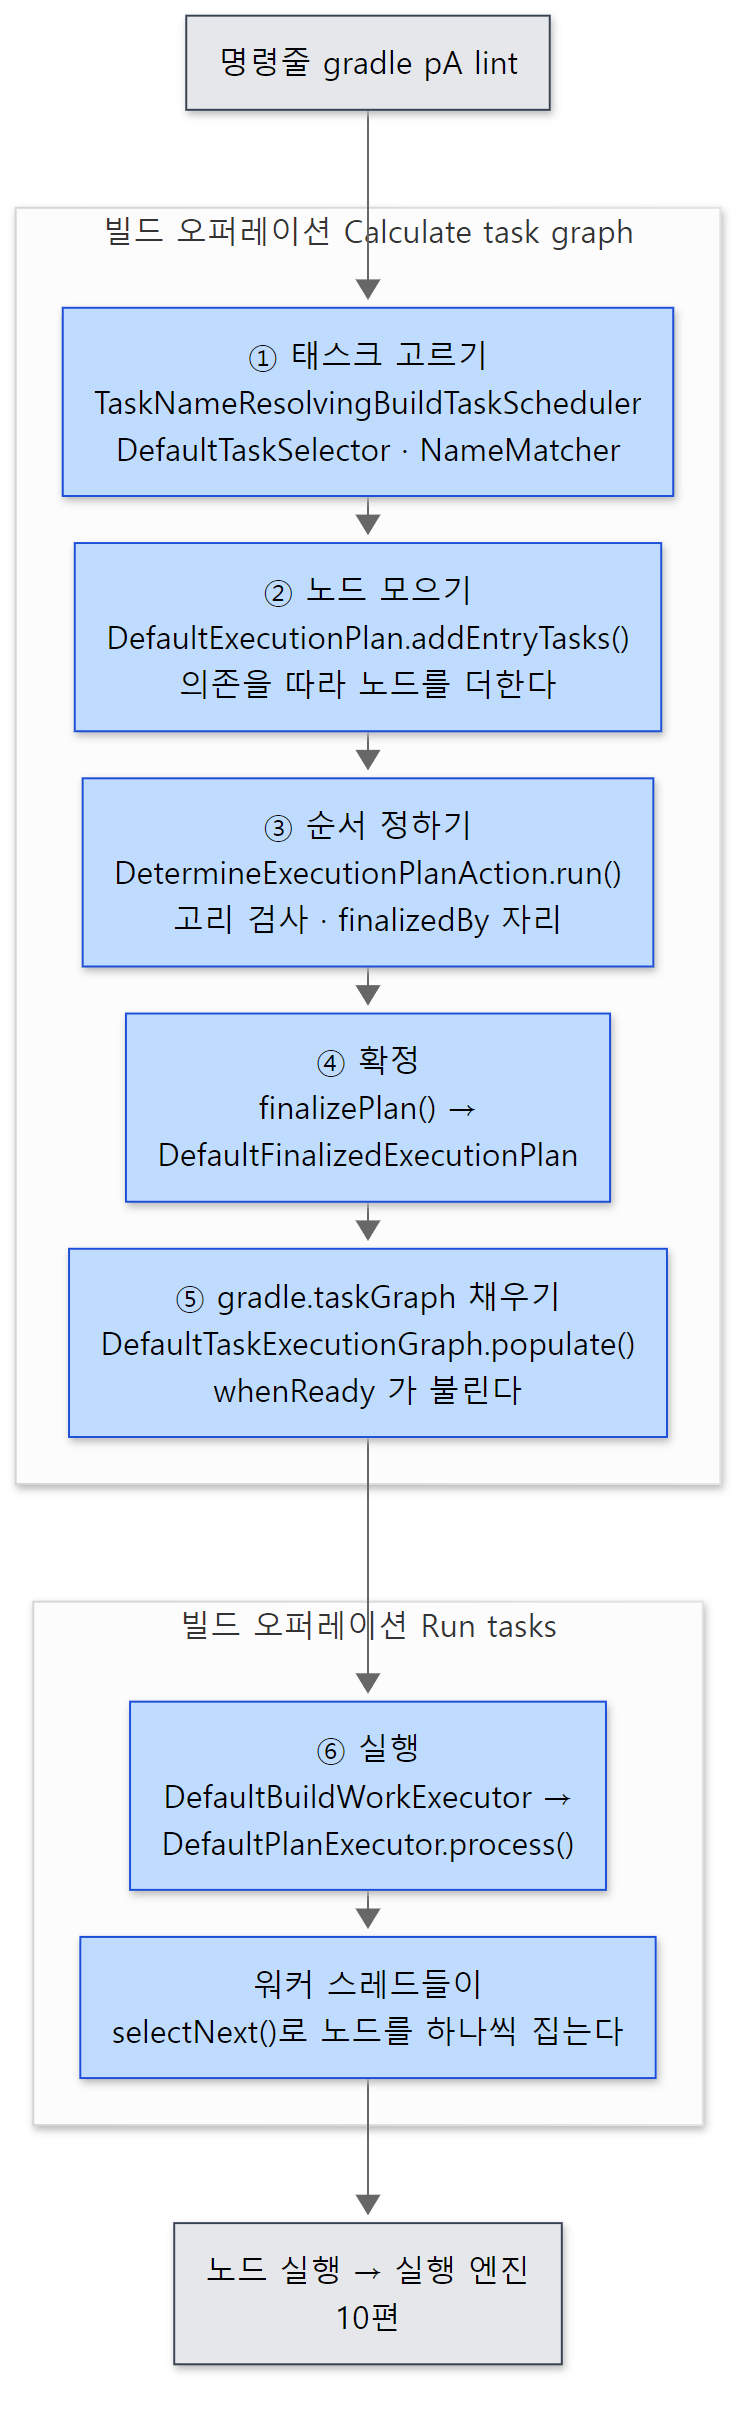 이 글의 절 번호와 그림의 번호가 대략 맞습니다. 파란 칸이 이 글에서 읽는 곳입니다.
예제 1: 확정된 계획을 찍어 보기
이 글의 첫 예제는 태스크 일곱 개짜리 단일 프로젝트입니다. 태스크마다 액션에서 자기 경로와 스레드 이름을 찍고, gradle.taskGraph.whenReady 로 확정된 계획을 한 줄로 찍습니다.
// 이 글을 위해 쓴 예제입니다 (Gradle 의 소스가 아닙니다)

// 태스크 액션이 돌 때 자기 경로와 스레드 이름을 찍는다
fun Task.say() = doLast { println("run ${path} on [${Thread.currentThread().name}]") }

val generate = tasks.register("generate") {
    say()
    // ... -Pstack 이면 스택 일부를 찍는다 (6절) ...
}
val compileApp = tasks.register("compileApp") { dependsOn(generate); say() }
tasks.register("alpha") { say() }
tasks.register("zeta") { say() }
tasks.register("packageApp") {
    // 적은 순서는 compileApp, zeta, alpha
    dependsOn(compileApp, "zeta", "alpha")
    finalizedBy("report")
    say()
    // ... -Pfail 이면 이 태스크가 실패한다 (5절) ...
}
tasks.register("report") { say() }
tasks.register("lint") {
    // 둘 다 그래프에 있을 때만 순서를 정한다 — lint 는 packageApp 을 끌어오지 않는다
    mustRunAfter("packageApp")
    say()
}
// ... -Pcycle, -Pimplicit 일 때만 더하는 설정 (4절, 7절) ...

// 실행 계획이 확정되면 그 안의 태스크를 순서대로 찍는다
gradle.taskGraph.whenReady {
    println("graph ready: " + allTasks.joinToString(" -> ") { it.path })
}
[예제 ex/u09-plan-order/project/build.gradle.kts에서 줄임]
이 글의 예제는 모두 기준 커밋(07ecbf9ead)을 그대로 빌드한 Gradle 9.10.0 개발판으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. gradle pA --info 에서 이 글과 관계있는 줄만 grep 으로 남긴 결과입니다.
=== gradle pA (abbreviated name, --info lines) ===
Abbreviated task name 'pA' matched 'packageApp'
Selected primary task 'pA' from project :
Tasks to be executed: [task ':alpha', task ':generate', task ':compileApp', task ':zeta', task ':packageApp', task ':report']
Tasks that were excluded: []
graph ready: :alpha -> :generate -> :compileApp -> :zeta -> :packageApp -> :report
run :alpha on [Execution worker]
run :generate on [included builds]
run :compileApp on [included builds]
run :zeta on [included builds]
run :packageApp on [Execution worker Thread 10]
run :report on [Execution worker Thread 10]
BUILD SUCCESSFUL in 34s
이 열세 줄에 이 글의 질문이 다 들어 있습니다. pA 가 packageApp 이 된 줄(2절), dependsOn 에 적은 compileApp, zeta, alpha 와 다른 계획 순서(3·4절), 부르지 않았는데 끼어든 report(4절), 그리고 태스크마다 달라지는 스레드 이름(6절)입니다. 스레드 이름 끝의 번호(Thread 10)와 어느 태스크가 어느 스레드에 갔는지는 실행마다 다릅니다. 34s 는 컨테이너의 Gradle 사용자 홈이 매번 새것이라 데몬을 띄우고 스크립트를 컴파일한 시간까지 든 것입니다(빌드 시간도 실행마다 다릅니다. 다시 돌렸을 때는 1m 26s 였고, 그때는 여섯 태스크가 모두 Execution worker 에서 돌았습니다).
2. 태스크 고르기 — gradle pA 가 packageApp 이 되기까지
명령줄의 태스크 이름은 TaskNameResolvingBuildTaskScheduler 가 하나씩 꺼내 계획에 넣습니다.
        List<TaskExecutionRequest> taskParameters = gradle.getStartParameter().getTaskRequests();
        for (TaskExecutionRequest taskParameter : taskParameters) {
            List<TaskSelection> taskSelections = commandLineTaskParser.parseTasks(taskParameter);
            for (TaskSelection taskSelection : taskSelections) {
                LOGGER.info("Selected primary task '{}' from project {}", taskSelection.getTaskName(), taskSelection.getProjectPath());
                plan.addEntryTasks(taskSelection.getTasks());
            }
        }
subprojects/core/src/main/java/org/gradle/execution/TaskNameResolvingBuildTaskScheduler.java 60–67행
예제 출력의 Selected primary task 'pA' from project : 이 64행입니다. 이름 하나가 태스크 집합(getTasks())이 된다는 점을 기억해 둡니다. 다중 프로젝트에서 gradle build 는 루트와 모든 하위 프로젝트의 build 태스크를 한꺼번에 고르기 때문입니다. 그 고르기는 DefaultTaskSelector.getSelection() 이 합니다.
        TaskSelectionResult tasks = taskNameResolver.selectWithName(taskName, targetProject, includeSubprojects);
        if (tasks != null) {
            LOGGER.info("Task name matched '{}'", taskName);
            return new TaskSelection(targetProject.getProjectPath().asString(), taskName, tasks);
        }

        Map<String, TaskSelectionResult> tasksByName = taskNameResolver.selectAll(targetProject, includeSubprojects);
        NameMatcher matcher = new NameMatcher();
        String actualName = matcher.find(taskName, tasksByName.keySet());

        if (actualName == null) {
            throw throwTaskSelectionException(context, targetProject, taskName, includeSubprojects, matcher);
        }
        LOGGER.info("Abbreviated task name '{}' matched '{}'", taskName, actualName);
        return new TaskSelection(targetProject.getProjectPath().asString(), taskName, tasksByName.get(actualName));
subprojects/core/src/main/java/org/gradle/execution/DefaultTaskSelector.java 76–90행
먼저 이름이 정확히 같은 태스크를 찾고(76행), 없으면 모든 태스크 이름을 모아 NameMatcher 에 줄임말을 풀게 합니다(82–84행). 예제의 Abbreviated task name 'pA' matched 'packageApp' 이 89행입니다.
NameMatcher 는 줄임말을 정규식으로 바꿉니다. pA 는 대문자 경계에서 잘려 "p 다음에 소문자 아무거나, A 다음에 소문자 아무거나"가 됩니다(NameMatcher.java 155–166행). 그래서 pA 는 packageApp 에 맞습니다. 같은 식으로 케밥 표기(gBD → gradle-binary-distribution)도 맞춰 봅니다. 후보를 여러 단계로 모은 뒤 앞 단계에 결과가 있으면 그것을 씁니다(132–146행).
| 순서 | 맞추는 방식 | 예 |
|---|---|---|
| 1 | 대소문자만 다른 같은 이름 | PACKAGEAPP → packageApp |
| 2 | 낙타 표기 전체가 맞음(대소문자 구분) | pA → packageApp |
| 3 | 낙타 표기 앞부분이 맞음 | pack → packageApp |
| 4 | 대소문자를 무시한 낙타 표기 앞부분 | PA → packageApp |
| 별도 | 케밥 표기 전체·앞부분 | gBD → gradle-binary-distribution |
마지막에 남은 후보가 정확히 하나일 때만 이름이 정해집니다(148–152행). 둘 이상이면 "ambiguous", 하나도 없으면 "not found" 이고, 아무것도 맞지 않은 이름 가운데 편집 거리(레벤슈타인 거리)가 가까운 것을 "Some candidates are" 로 보여 줍니다(123–129행). 예제에서 없는 이름 pZ 를 주면 이렇습니다.
=== gradle pZ (not found) ===
* What went wrong:
Task not found
  Task 'pZ' not found in root project 'plan-order'.
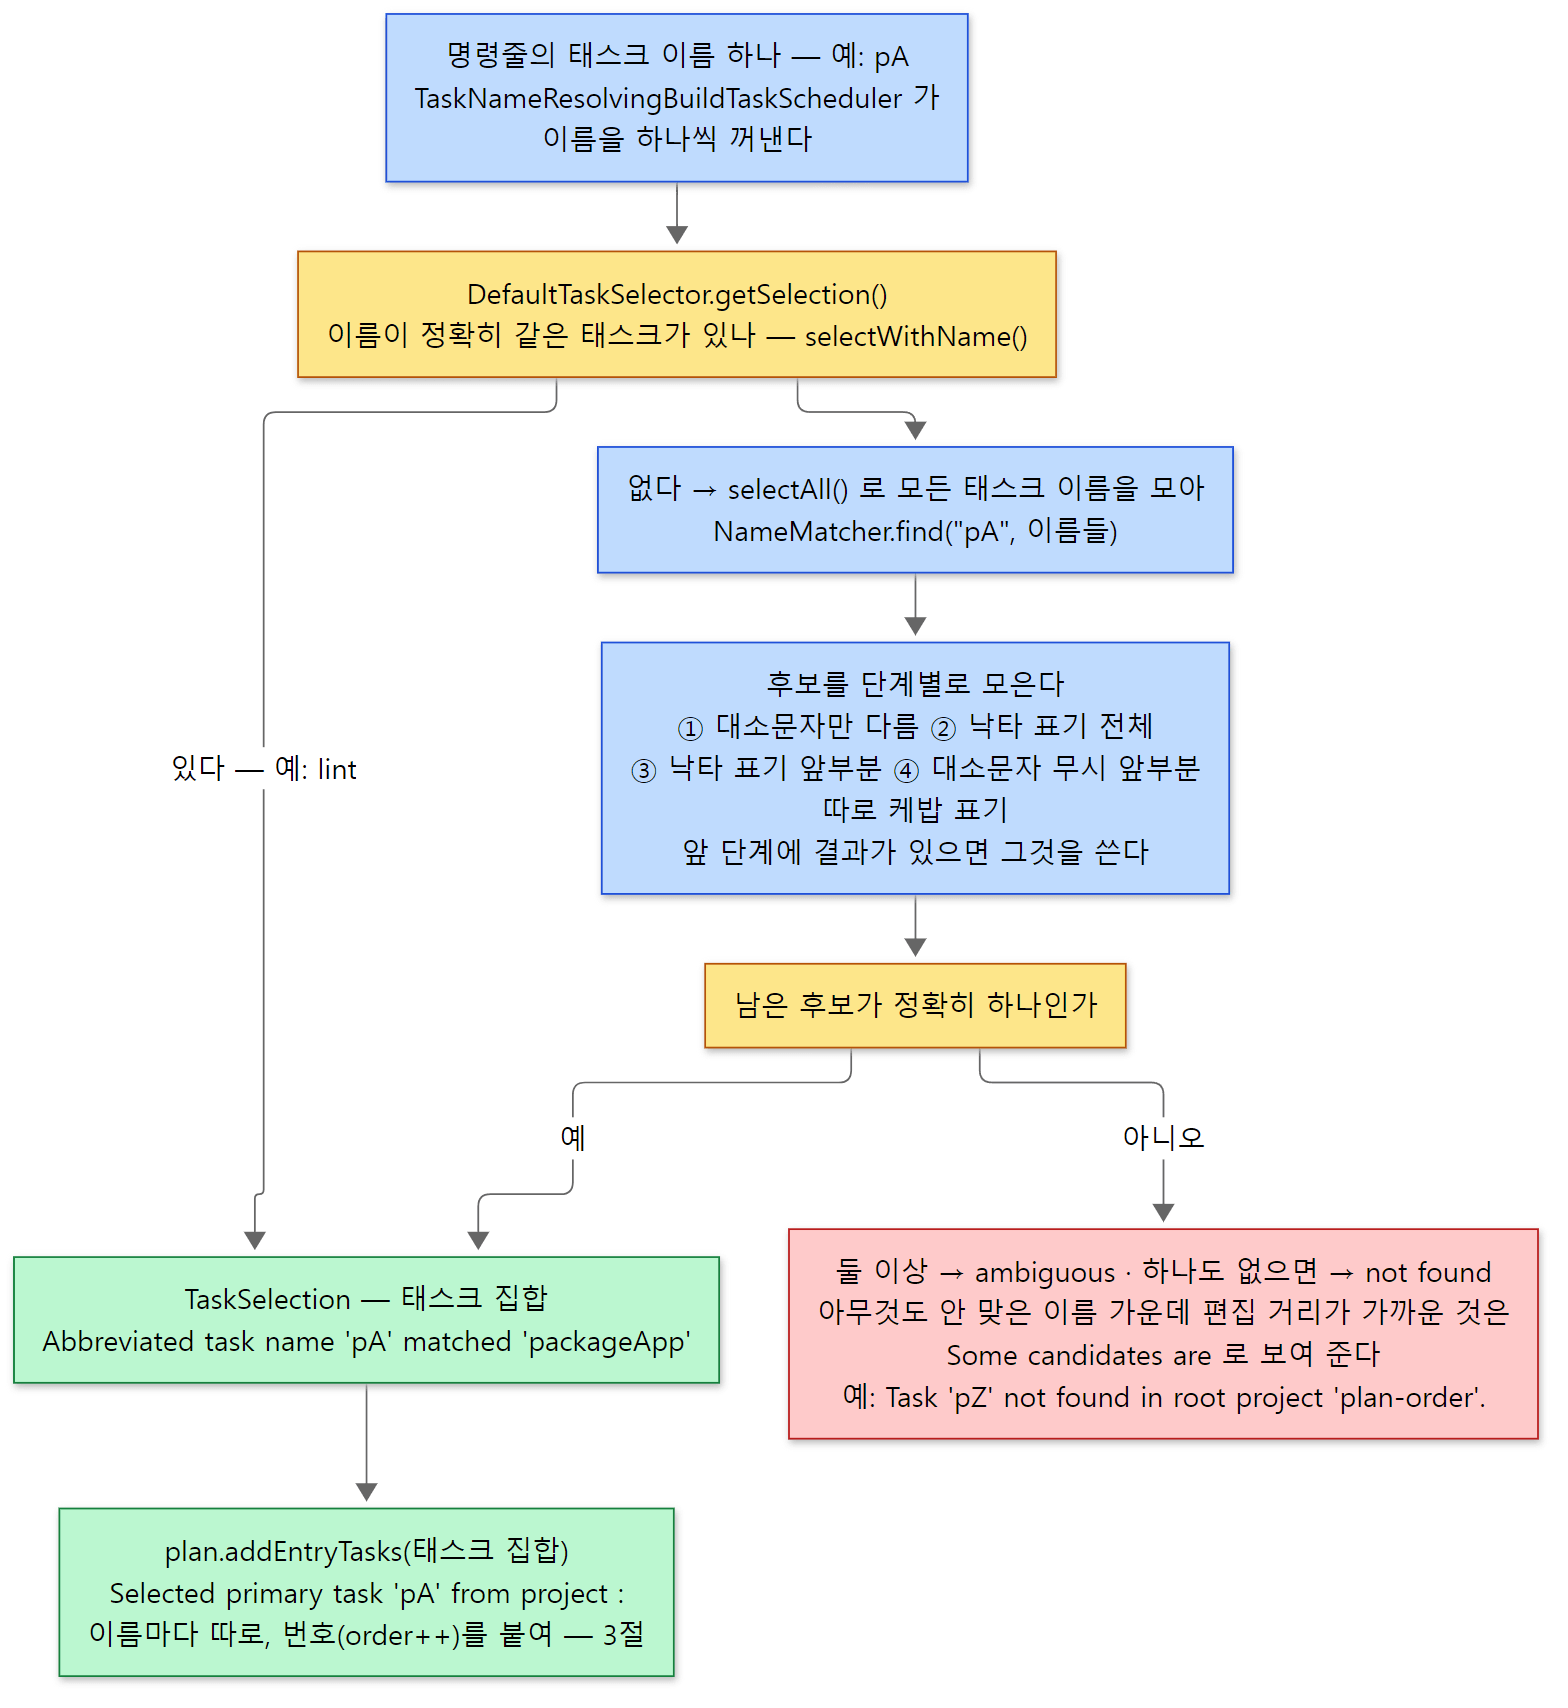 이 절의 코드 세 조각을 한 길로 이었습니다. Abbreviated…·Selected…·Task 'pZ' not found… 줄은 예제의 실제 출력입니다.
헷갈리기 쉬운 곳
- 줄임말은 태스크를 새로 추가하면 깨질 수 있습니다. 정해지는 조건이 "후보가 하나"이므로, 오늘
gradle pA로 되던 것이publishApp이라는 태스크가 생기면 ambiguous 가 됩니다. CI 스크립트에는 줄임말을 쓰지 않는 편이 안전합니다. - 이름은 프로젝트별로 고르고, 계획은 이름별로 쌓습니다.
gradle lint packageApp의 두 이름은 61행의 바깥 반복에서 각각addEntryTasks()로 따로 들어갑니다. 이때 붙는 번호(order++)가 3절과 이 글 끝의 "명령줄 순서"(ordinal) 이야기로 이어집니다.
3. 노드를 모으기 — addEntryTasks() 와 의존 따라가기
고른 태스크는 DefaultExecutionPlan.addEntryTasks() 로 들어갑니다. 여기서 진입 노드(entry node, 명령줄에서 직접 고른 태스크의 노드)가 생기고, 그 노드의 의존을 따라가며 계획에 들어갈 노드를 모두 찾습니다.
진입 노드들을 큐에 넣고(doAddEntryNodes() 153–166행) 부르는 것이 이 메서드입니다.
    private void discoverNodeRelationships(Deque<Node> queue) {
        Set<Node> visiting = new HashSet<>();
        HeadInsertBuffer<Node> successorBuffer = new HeadInsertBuffer<>();
        while (!queue.isEmpty()) {
            Node node = queue.getFirst();
            node.prepareForScheduling();
            if (node.getDependenciesProcessed() || node.isCannotRunInAnyPlan()) {
                // Have already visited this node or have already executed it - skip it
                queue.removeFirst();
                continue;
            }
            // ... -x 로 뺀 태스크(filtered) 처리 ...
            node.require();

            if (visiting.add(node)) {
                // Have not seen this node before - add its dependencies to the head of the queue and leave this
                // node in the queue
                node.resolveDependencies(dependencyResolver);
                // ...
                for (Node successor : node.getDependencySuccessors()) {
                    if (!visiting.contains(successor)) {
                        successorBuffer.add(successor);
                    }
                }
                successorBuffer.drainTo(queue);
            } else {
                // Have visited this node's dependencies - add it to the graph
                queue.removeFirst();
                visiting.remove(node);
                node.dependenciesProcessed();
                // Finalizers run immediately after the node
                for (Node finalizer : node.getFinalizers()) {
                    finalizers.add(finalizer);
                    if (!visiting.contains(finalizer)) {
                        queue.addFirst(finalizer);
                    }
                }
            }
        }
    }
subprojects/core/src/main/java/org/gradle/execution/plan/DefaultExecutionPlan.java 168–218행
큐의 맨 앞 노드를 처음 보면(191행) 의존을 풀고 그 의존들을 큐의 앞에 넣은 채 자기는 남겨 둡니다. 다시 돌아와 두 번째로 보면(204행) 의존을 다 본 것이니 "처리됨"으로 표시하고, 그 노드에 걸린 마무리 태스크(finalizer, finalizedBy 로 건 태스크)를 큐 앞에 넣습니다. 깊이 우선 탐색을 재귀 대신 큐로 한 모양입니다. node.require()(189행)가 노드 상태를 SHOULD_RUN 으로 바꿉니다. 상태는 5절에서 봅니다.
이 단계의 목적은 노드를 빠짐없이 모으는 것이고, 순서는 아직 정하지 않습니다. 순서는 4절의 DetermineExecutionPlanAction 이 처음부터 다시 걸으며 정합니다.
노드 하나가 의존을 푸는 곳
191–194행의 resolveDependencies() 가 태스크에서 실제로 하는 일입니다.
    @Override
    public void resolveDependencies(TaskDependencyResolver dependencyResolver) {
        // Make sure it has been configured
        taskProject.getTasks().prepareForExecution(task);

        for (Node targetNode : getDependencies(dependencyResolver)) {
            addDependencySuccessor(targetNode);
        }

        lifecycleSuccessors = dependencyResolver.resolveDependenciesFor(task, TaskInternalUtil.getLifecycleDependencies(task));

        for (Node targetNode : getFinalizedBy(dependencyResolver)) {
            if (!(targetNode instanceof TaskNode)) {
                throw new IllegalStateException("Only tasks can be finalizers: " + targetNode);
            }
            addFinalizerNode((TaskNode) targetNode);
        }
        for (Node targetNode : getMustRunAfter(dependencyResolver)) {
            addMustSuccessor(targetNode);
        }
        for (Node targetNode : getShouldRunAfter(dependencyResolver)) {
            addShouldSuccessor(targetNode);
        }
    }
subprojects/core/src/main/java/org/gradle/execution/plan/LocalTaskNode.java 122–145행
첫 줄 prepareForExecution(task) 가 8편의 "실현(realize)"과 이어집니다. register() 로 등록만 해 둔 태스크도 이 계획에 들어오는 순간 설정 블록이 돌아 진짜 객체가 됩니다. 그다음 네 가지 관계를 차례로 노드 사이의 관계로 옮깁니다. getDependencies() 가 돌려주는 것에는 dependsOn 으로 적은 것과, 8편에서 본 입력 Provider 가 끌고 오는 생산 태스크가 함께 들어 있습니다(TaskInternalUtil.getTaskDependencies()). lifecycleSuccessors(131행)에는 그 가운데 dependsOn 으로 직접 적은 것만 따로 담아 둡니다. 앞 태스크가 실패했을 때 "결과에 기대는 의존인가, 출력 파일에 기대는 의존인가"를 가르는 데 씁니다(LocalTaskNode.java 216–225행).
네 관계가 노드에서 어떻게 다른지는 TaskNode 의 두 메서드가 보여 줍니다(TaskNode.java 76–93행). getAllSuccessors() 는 shouldSuccessors·finalizingSuccessors·getMustSuccessors() 와 dependency successor 를 모두 잇고, getHardSuccessors() 는 그 가운데 shouldSuccessors 만 뺍니다. 단단한 후속자(hard successor)는 지울 수 없는 관계라는 뜻입니다. Node.getHardSuccessors() 의 주석도 "shouldRunAfter 는 hard successor 가 아니고 mustRunAfter 는 그렇다"고 적어 둡니다(Node.java 532–540행). 정리하면 이렇습니다.
| 빌드 스크립트 | 노드에서 | 단단한가 | 상대를 계획에 끌어오나 |
|---|---|---|---|
dependsOn(a), 입력 Provider |
a 가 dependency successor |
예 | 예 (discoverNodeRelationships 가 따라간다) |
finalizedBy(f) |
f 의 finalizing successor 가 이 태스크 |
예 | 예 (204행 이후 큐에 넣는다) |
mustRunAfter(a) |
a 가 must successor |
예 | 아니요 |
shouldRunAfter(a) |
a 가 should successor |
아니요 — 고리를 만들면 버린다 | 아니요 |
finalizedBy 만 방향이 반대인 것에 주의합니다. packageApp.finalizedBy(report) 를 적으면 report 쪽에 "나는 packageApp 뒤에 돈다"(report 의 finalizing successor = packageApp)가 기록됩니다(LocalTaskNode.java 147–150행, TaskNode.java 62–65행).
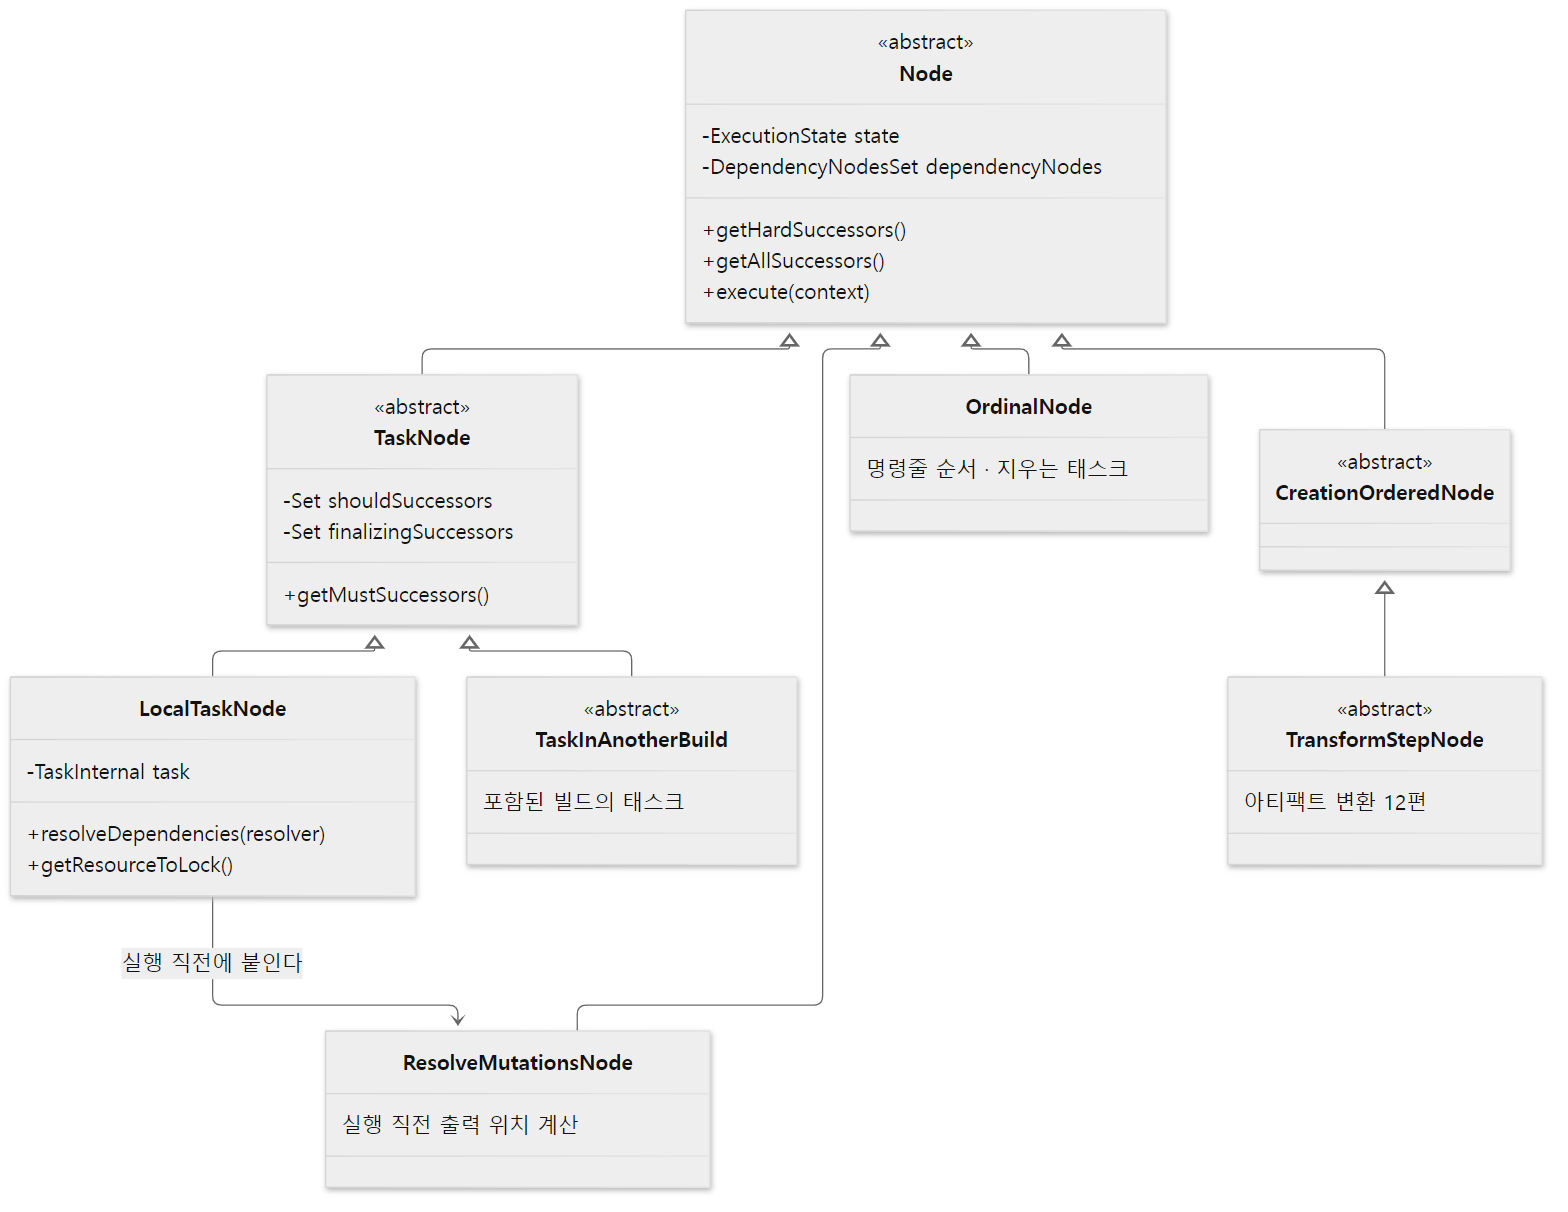 파란 칸이 이 글의 주인공
LocalTaskNode, 회색 칸은 이 글에서 이름만 보고 지나가는 노드입니다.
헷갈리기 쉬운 곳: dependsOn 에 적은 순서는 순서가 아닙니다
예제의 packageApp 은 dependsOn(compileApp, "zeta", "alpha") 로 적었는데, 계획은 alpha → generate → compileApp → zeta 였습니다. 이름 순서입니다. 노드의 후속자 집합이 비교기로 정렬된 집합이기 때문입니다(newSortedNodeSet(), NodeSets.java 35–37행). 태스크 노드끼리는 결국 Task.compareTo() 로 비교하는데, 이것은 프로젝트의 깊이를 먼저 보고 같으면 태스크 경로 문자열을 비교합니다(AbstractTask.java 574–582행). :alpha < :compileApp < :zeta 이니 그 순서로 깊이 우선 탐색을 하고, compileApp 은 자기 의존 generate 를 먼저 데려옵니다. 결과가 예제의 순서입니다. 둘 사이에 순서가 필요하면 dependsOn 의 나열 순서에 기대지 말고 관계를 직접 적어야 합니다. 게다가 이 순서는 "의존이 다 끝난 노드가 여럿일 때 무엇부터 시도하나"일 뿐이고, --parallel 에서는 동시에 돌 수 있습니다(7절).
4. 순서를 정하기 — DetermineExecutionPlanAction
노드를 다 모으면 determineExecutionPlan() 이 DetermineExecutionPlanAction 을 만들어 돌립니다(DefaultExecutionPlan.java 227–239행). 클래스 설명은 "실행 계획을 정하고, 고리를 검사하고, finalizedBy 제약을 지킨다"입니다.
    public ImmutableList<Node> run() {
        updateFinalizerGroups();
        processEntryNodes();
        processNodeQueue();
        return createOrdinalRelationshipsAndCollectNodes();
    }
subprojects/core/src/main/java/org/gradle/execution/plan/DetermineExecutionPlanAction.java 92–97행
핵심은 processNodeQueue() 입니다. 3절의 탐색과 모양이 같지만 두 가지가 다릅니다. 따라가는 관계가 getAllSuccessors() — 곧 mustRunAfter·shouldRunAfter·finalizedBy 까지 — 이고, 노드를 두 번째로 볼 때 계획의 끝에 붙입니다.
            if (visitingNodes.put(node, currentSegment)) {
                // Have not seen this node before - add its dependencies to the head of the queue and leave this
                // node in the queue
                // ...
                // Add any finalizers to the queue just after the current node
                for (Node finalizer : node.getFinalizers()) {
                    addFinalizerToQueue(visitingSegmentCounter++, finalizer);
                }

                for (Node successor : node.getAllSuccessors()) {
                    if (visitingNodes.containsEntry(successor, currentSegment)) {
                        if (!walkedShouldRunAfterEdges.isEmpty()) {
                            //remove the last walked should run after edge and restore state from before walking it
                            // ...
                            break;
                        } else {
                            onOrderingCycle(successor, node);
                        }
                    }
                    successorBuffer.add(new NodeInVisitingSegment(successor, currentSegment));
                }
                successorBuffer.drainTo(nodeQueue);
                path.push(node);
            } else {
                // Have visited this node's dependencies - add it to the end of the plan
                nodeQueue.removeFirst();
                maybeRemoveProcessedShouldRunAfterEdge(node);
                visitingNodes.remove(node, currentSegment);
                path.pop();
                nodeMapping.add(node);
            }
subprojects/core/src/main/java/org/gradle/execution/plan/DetermineExecutionPlanAction.java 160–205행
후속자를 다 계획에 넣은 뒤에야 자기를 넣으니(204행), 계획은 "먼저 끝나야 하는 것이 앞"인 순서, 곧 위상 정렬(topological sort)이 됩니다. 지금 걷고 있는 길 위의 노드를 다시 만나면(176행) 고리입니다. 그때 지금 걷는 길에 shouldRunAfter 관계가 끼어 있으면 가장 최근에 걸은 그 관계를 지우고 그 관계를 걷기 전 상태로 되돌린 뒤 다시 걷고(177–189행), 길에 shouldRunAfter 가 없으면 빌드를 실패시킵니다(191행). shouldRunAfter 는 "되면 지키고 안 되면 버리는" 순서, mustRunAfter 는 어기면 오류인 순서라는 문서의 설명이 이 몇 줄입니다.
그런데 mustRunAfter·shouldRunAfter 의 상대가 계획에 없으면 어떻게 될까요. 큐에서 꺼낸 노드가 isDoNotIncludeInPlan() 이면 버리는데, 그 주석의 예 가운데 하나가 "must-run-after 나 should-run-after 관계로만 닿는 노드"입니다(149–153행). 3절에서 require() 를 받지 못한 노드(NOT_SCHEDULED)는 여기서 버려집니다. 3절은 mustRunAfter 를 따라가지 않았으니, 그 관계로만 닿는 노드는 계획에 들어오지 않습니다. 예제에서 확인합니다.
=== gradle lint (alone) ===
graph ready: :lint
run :lint on [Execution worker]
=== gradle lint packageApp ===
graph ready: :alpha -> :generate -> :compileApp -> :zeta -> :packageApp -> :lint -> :report
...
(두 번째 빌드의 run … 줄 일곱 개는 줄였습니다. 계획과 같은 순서로 찍힙니다.) lint 만 부르면 packageApp 은 끌려오지 않습니다. 둘 다 부르면 명령줄에서 lint 를 먼저 적었는데도 lint 가 packageApp 뒤로 갑니다.
마무리 태스크의 자리
report 는 packageApp 의 마무리 태스크입니다. 계획에서 report 는 packageApp 바로 뒤가 아니라 lint 뒤, 맨 끝에 있습니다. addFinalizerToQueue() 가 마무리 태스크를 큐에 끼울 자리를 고르는 방식 때문입니다(DetermineExecutionPlanAction.java 221–236행). 마무리 태스크는 기본적으로 큐의 두 번째 자리(222행의 insertPosition = 1, 지금 노드 바로 뒤)에 들어가고, 큐의 더 뒤쪽에 자기가 마무리할 노드가 또 있으면 그 자리까지 밀려납니다(230–232행). gradle lint packageApp 을 따라가 보면 이렇습니다.
- 진입 노드 둘이 명령줄 순서대로 큐에 들어갑니다. 큐:
lint,packageApp. lint를 처음 볼 때mustRunAfter상대인packageApp을 큐 앞에 넣습니다. 큐:packageApp,lint,packageApp(진입 노드 몫).- 맨 앞
packageApp을 처음 볼 때 마무리 태스크report를 끼웁니다. 큐 뒤쪽에packageApp이 하나 더 있으니 그 자리(세 번째)로 갑니다. 큐:packageApp,lint,report,packageApp. packageApp이 의존을 다 거쳐 계획에 붙고, 이어서lint,report가 붙습니다. 마지막packageApp은 이미 계획에 있으니 버립니다(149행).
그래서 report 가 lint 뒤에 섰습니다. 다만 실행 중에는 이 자리보다 5절의 규칙(마무리 대상이 끝나야 시작)과 6절의 "준비된 노드" 고르기가 실제 시작 시점을 정합니다.
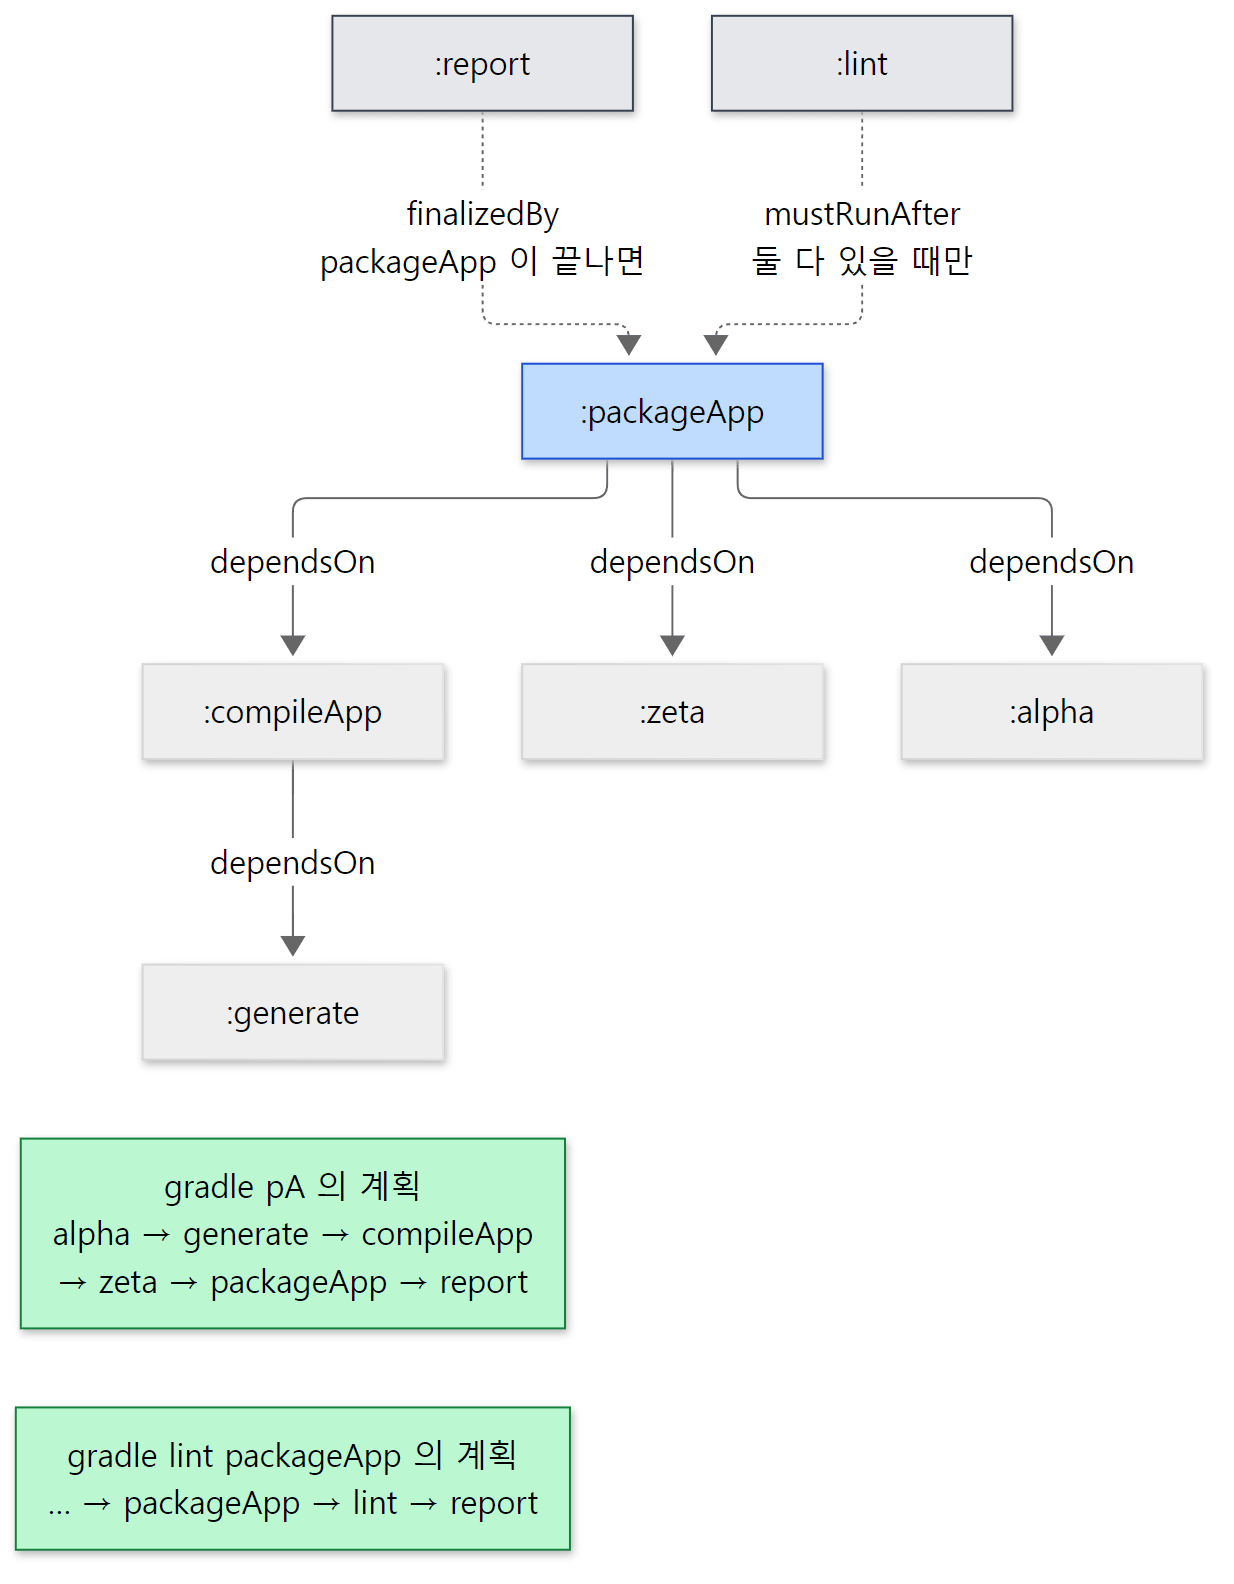 화살표는 소스의 "후속자" 방향입니다. 화살표 끝의 노드가 먼저 끝나야 합니다.
고리가 생기면
-Pcycle 을 주면 예제는 generate.dependsOn("packageApp") 를 더해 generate → packageApp → compileApp → generate 고리를 만듭니다.
=== gradle pA -Pcycle ===
* What went wrong:
Circular dependency between the following tasks:
:compileApp
\--- :generate
     \--- :packageApp
          \--- :compileApp (*)

(*) - details omitted (listed previously)
이 메시지는 onOrderingCycle() 이 CachingDirectedGraphWalker 로 고리를 찾고 DirectedGraphRenderer 로 그린 것입니다(DetermineExecutionPlanAction.java 292–327행). 고리를 찾을 때는 단단한 후속자만 따라갑니다(305행). 그래서 shouldRunAfter 는 이 메시지에 나오지 않습니다.
헷갈리기 쉬운 곳
mustRunAfter는 순서만,dependsOn은 순서와 포함을 함께 정합니다. "lint를 돌릴 때packageApp도 돌았으면 좋겠다"면dependsOn이고, "둘 다 돌 때 순서만 지켜 달라"면mustRunAfter입니다.- 고리 오류의 고리는 그대로 고리입니다. 위 출력의 맨 위
:compileApp은 고리의 시작점을 정렬해서 고른 것일 뿐(sortedListOf, 312행) 원인이 아닙니다. 고리 안의 어느 관계든 하나를 끊어야 합니다.
5. 확정과 gradle.taskGraph — whenReady, --dry-run, 노드의 상태
순서가 정해진 계획은 finalizePlan() 에서 DefaultFinalizedExecutionPlan 이 됩니다(DefaultExecutionPlan.java 291–302행). 생성자는 계획의 노드마다 순번(index)을 매기고, 지금 바로 시작할 수 있는 노드를 "준비된 노드" 큐에 넣습니다(DefaultFinalizedExecutionPlan.java 129–136행). 이 순번이 6절에서 "준비된 노드가 여럿이면 무엇부터"를 정합니다.
그다음 1절의 taskGraph.populate() 가 불립니다.
    @Override
    public void populate(FinalizedExecutionPlan plan) {
        // ...
        executionPlan = plan;
        // Take a snapshot of all tasks, so they remain queryable after the plan is discarded
        // at the end of execution.
        // ...
        tasks = new TasksSnapshot(ImmutableSet.copyOf(executionPlan.getContents().getTasks()));
        if (!hasFiredWhenReady) {
            fireWhenReady();
            hasFiredWhenReady = true;
        } else if (!graphListeners.isEmpty()) {
            LOGGER.info("Ignoring listeners of task graph ready event, as this build ({}) has already executed work.", gradleInternal.getIdentityPath());
        }
    }
subprojects/core/src/main/java/org/gradle/execution/taskgraph/DefaultTaskExecutionGraph.java 88–105행
gradle.taskGraph 는 실행 계획을 잠시 빌려 보여 주는 창입니다. allTasks 는 98행에서 찍어 둔 스냅숏이고, 그 순서는 4절에서 계획에 붙인 순서 그대로입니다(NodeMapping 이 LinkedHashMap, DefaultExecutionPlan.java 395–397행). 예제의 graph ready: 줄과 --info 의 Tasks to be executed: 가 같은 순서인 이유입니다. 그리고 whenReady 는 빌드 하나에 한 번만 불립니다(99–104행). 같은 빌드에 계획이 다시 채워지면 리스너는 부르지 않고 --info 에 그 사실만 남깁니다.
--dry-run 은 계획까지는 다 만듭니다
--dry-run(-m)은 DefaultBuildWorkExecutor 의 실행 직전 갈림길에서 처리됩니다. 계획의 태스크마다 경로와 SKIPPED 를 찍고 성공으로 돌아갈 뿐, PlanExecutor 를 부르지 않습니다(DefaultBuildWorkExecutor.java 106–117행).
=== gradle pA --dry-run ===
graph ready: :alpha -> :generate -> :compileApp -> :zeta -> :packageApp -> :report
:alpha SKIPPED
:generate SKIPPED
:compileApp SKIPPED
:zeta SKIPPED
:packageApp SKIPPED
:report SKIPPED

BUILD SUCCESSFUL in 2s
Consider enabling configuration cache to speed up this build: https://docs.gradle.org/9.10.0-20261107025045+0000/userguide/configuration_cache_enabling.html
whenReady 가 불렸다는 것은 설정 단계와 계획 만들기가 모두 일어났다는 뜻입니다. --dry-run 은 "태스크 액션만 부르지 않는" 모드이고, 줄 순서는 계획 순서입니다. 마지막 줄의 설정 캐시 권유는 11편의 주제입니다.
노드의 상태
계획 안의 노드는 Node.ExecutionState 다섯 상태 가운데 하나입니다(Node.java 40–52행). 상태를 바꾸는 메서드는 같은 파일의 require()·startExecution()·finishExecution()·markFailedDueToDependencies()·cancelExecution() 입니다(288–329행).
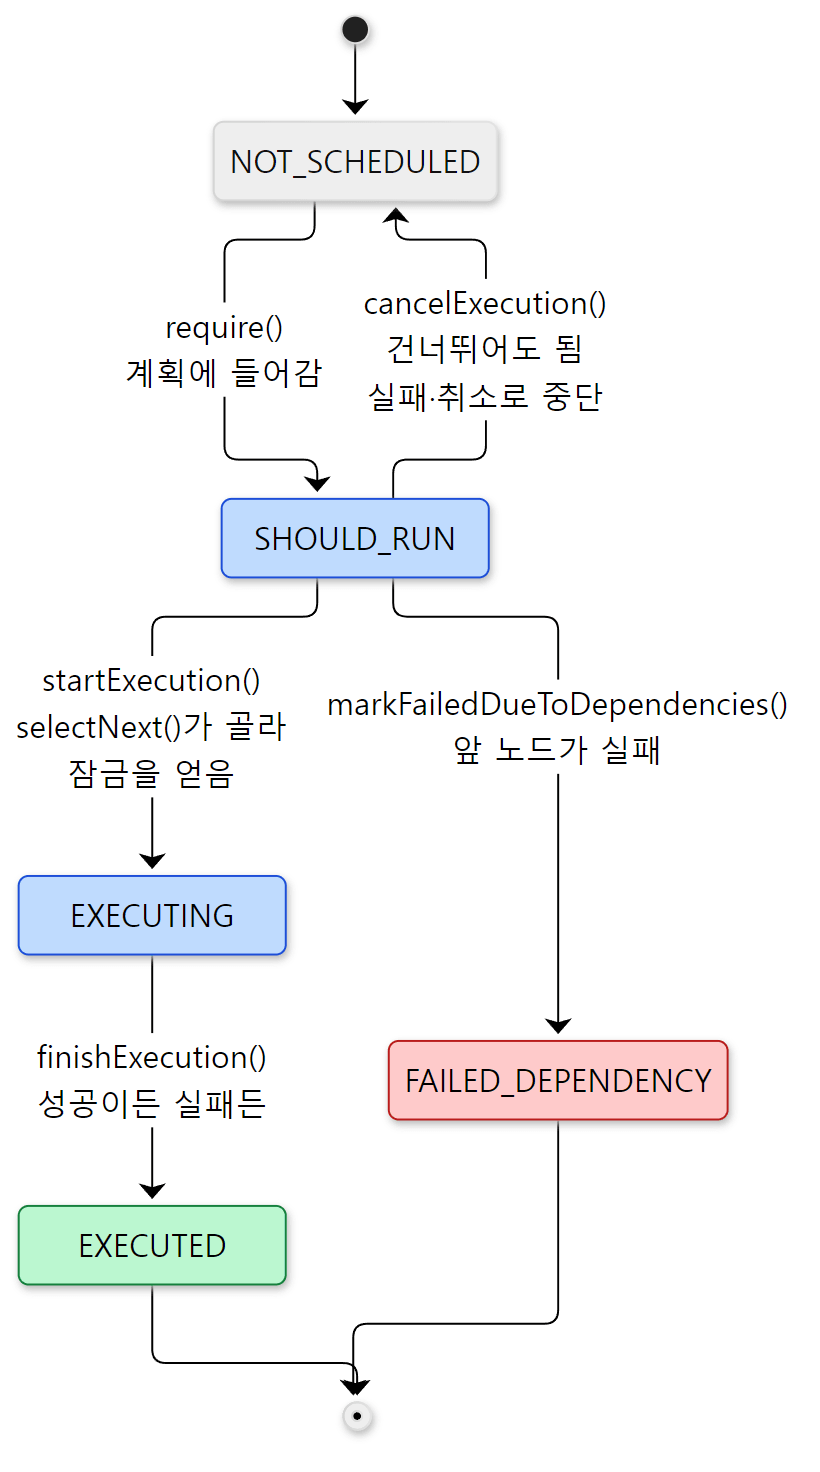
EXECUTED 는 "성공"이 아니라 "실행이 끝났다"입니다. 실패한 태스크도 EXECUTED 입니다.
EXECUTED·FAILED_DEPENDENCY 두 끝 상태는 계획을 닫을 때의 reset() 에서도 지워지지 않습니다(Node.java 349–361행). 그래서 3절 174행이 "이미 실행한 노드"를 건너뛸 수 있습니다.
앞 태스크가 실패해도 마무리 태스크는 돈다
-Pfail 을 주면 packageApp 액션이 예외를 던집니다.
=== gradle packageApp -Pfail ===
graph ready: :alpha -> :generate -> :compileApp -> :zeta -> :packageApp -> :report
> Task :alpha
run :alpha on [Execution worker]
> Task :generate
run :generate on [Execution worker]
> Task :compileApp
run :compileApp on [Execution worker]
> Task :zeta
run :zeta on [Execution worker]
> Task :packageApp FAILED
run :packageApp on [Execution worker]
> Task :report
run :report on [Execution worker]
> packageApp failed on purpose
BUILD FAILED in 1s
report 는 돌았습니다. 두 가지가 맞물린 결과입니다.
첫째, --continue 가 없으면 노드 하나가 실패하는 순간 handleFailure() 가 abortExecution() 을 불러, 아직 시작하지 않은 노드 가운데 취소할 수 있는 것을 모두 취소합니다(cancelExecution() 으로 NOT_SCHEDULED, DefaultFinalizedExecutionPlan.java 685–702행·721–737행). 그런데 마무리 태스크가 속한 그룹(FinalizerGroup)은 마무리할 노드가 하나라도 시작했으면 "취소할 수 없다"고 답합니다(주석 "Don't cancel if any finalized node has started", FinalizerGroup.java 143–157행). packageApp 은 이미 시작했으니 report 는 취소되지 않습니다.
둘째, 마무리 태스크와 마무리 대상의 관계(finalizingSuccessors)는 dependency successor 가 아니어서, "앞 노드가 실패했나"를 따지는 의존 상태 계산에 들어가지 않습니다. 대신 FinalizerGroup 이 "마무리할 노드들이 끝날 때까지 기다린다"를 맡습니다.
    private MemberSuccessors getNodesThatBlock(Node node) {
        if (isFinalizerNode(node)) {
            return new WaitForNodesToComplete(getFinalizedNodes());
        }
subprojects/core/src/main/java/org/gradle/execution/plan/FinalizerGroup.java 262–265행
성공이 아니라 "완료"를 기다리므로, 실패한 뒤에도 정리 작업(서버 끄기, 리포트 만들기)을 돌릴 수 있습니다. 이것이 finalizedBy 가 있는 이유입니다. 반대로 packageApp 에 dependsOn 으로 기대는 태스크가 있었다면 돌지 않습니다. --continue 가 없으면 위의 abortExecution() 이 취소하고, --continue 가 있으면 6절의 selectNext() 가 FAILED_DEPENDENCY 로 만들거나(markFailedDueToDependencies()) 경우에 따라 취소합니다(254–269행). 이 경우는 예제로 돌려 보지 않았고 소스로만 확인했습니다.
6. 실행 — DefaultPlanExecutor 와 세 가지 스레드 이름
이제 Run tasks 입니다. DefaultBuildWorkExecutor 는 굳은 계획을 PlanExecutor.process() 에 넘기며, 노드 하나를 받으면 node.execute() 를 부르라는 람다를 함께 줍니다(DefaultBuildWorkExecutor.java 143–158행). 구현은 DefaultPlanExecutor 하나이고, 빌드 트리 스코프 서비스입니다(ExecutionServices.java 29–32행).
    @Override
    public <T> ExecutionResult<Void> process(WorkSource<T> workSource, Action<T> worker) {
        BuildOperationRef parentOperation = CurrentBuildOperationRef.instance().get();
        if (parentOperation == null) {
            throw new IllegalStateException("No operation is currently running.");
        }

        PlanDetails planDetails = new PlanDetails(Cast.uncheckedCast(workSource), Cast.uncheckedCast(worker), parentOperation);
        queue.add(planDetails);

        maybeStartWorkers(queue, executor);

        // Run the work from the source from this thread as well, given that it will be blocked waiting for that work to complete anyway
        WorkerLease currentWorkerLease = workerLeaseService.getCurrentWorkerLease();
        MergedQueues thisPlanOnly = new MergedQueues(coordinationService, true);
        thisPlanOnly.add(planDetails);
        new ExecutorWorker(thisPlanOnly, currentWorkerLease, cancellationToken, coordinationService, workerLeaseService, stats).run();

        List<Throwable> failures = new ArrayList<>();
        awaitCompletion(workSource, currentWorkerLease, failures);
        return ExecutionResult.maybeFailed(failures);
    }
subprojects/core/src/main/java/org/gradle/execution/plan/DefaultPlanExecutor.java 102–123행
할 일은 셋입니다. 계획을 공용 큐에 넣고(110행), 워커 스레드를 띄우고(112행), process() 를 부른 스레드 자신도 일꾼이 되어(114–118행) 계획이 다 끝날 때까지 노드를 집습니다. 주석대로, 어차피 끝날 때까지 기다려야 하니 노는 대신 돕는 것입니다. 띄우는 워커 수는 이렇습니다.
    private void maybeStartWorkers(MergedQueues queue, Executor executor) {
        int executorCount = workerLimits.getMaxWorkerCount();
        state.maybeStartWorkers(() -> {
            LOGGER.debug("Using {} parallel executor threads", executorCount);
            for (int i = 1; i < executorCount; i++) {
                executor.execute(new ExecutorWorker(queue, null, cancellationToken, coordinationService, workerLeaseService, stats));
            }
        });
    }
subprojects/core/src/main/java/org/gradle/execution/plan/DefaultPlanExecutor.java 183–191행
i = 1 부터이니 max-workers − 1 개입니다. 부른 스레드가 하나를 맡기 때문입니다. maybeStartWorkers() 는 이 DefaultPlanExecutor 에서 처음 한 번만 실행됩니다(547–554행). 이 스레드들의 실행기 이름이 executorFactory.create("Execution worker")(90행)이고, 스레드 이름은 Execution worker, Execution worker Thread 2 … 처럼 붙습니다.
그럼 예제에서 본 included builds 는 무엇일까요. 1편에서 이 112–118행을 처음 보았습니다. 그 "계획을 넘긴 스레드"가 누구인지 따라가면, 빌드 하나의 실행을 맡기는 쪽에 닿습니다.
    private ExecutionResult<Void> doRun() {
        try {
            return workerLeaseService.runAsWorkerThread(workGraph::runWork);
        } catch (Throwable t) {
            return ExecutionResult.failed(t);
        }
    }
DefaultBuildController 는 빌드 트리 안의 빌드마다 하나 있고, startExecution() 에서 이 doRun() 을 실행기에 넘깁니다(127–131행). 그 실행기가 executorFactory.create("included builds") 입니다(DefaultIncludedBuildTaskGraph.java 96행). 포함된 빌드가 없는 평범한 단일 빌드도 루트 빌드 하나를 이 길로 돌립니다. 이름이 included builds 인 것은 컴포지트 빌드를 위해 만든 장치를 모든 빌드가 함께 쓰기 때문입니다. 그동안 Daemon worker 스레드는 모든 빌드가 끝나기를 기다리며 주기적으로 실행기의 건강 상태를 점검합니다(DefaultBuildControllers.java 105–123행).
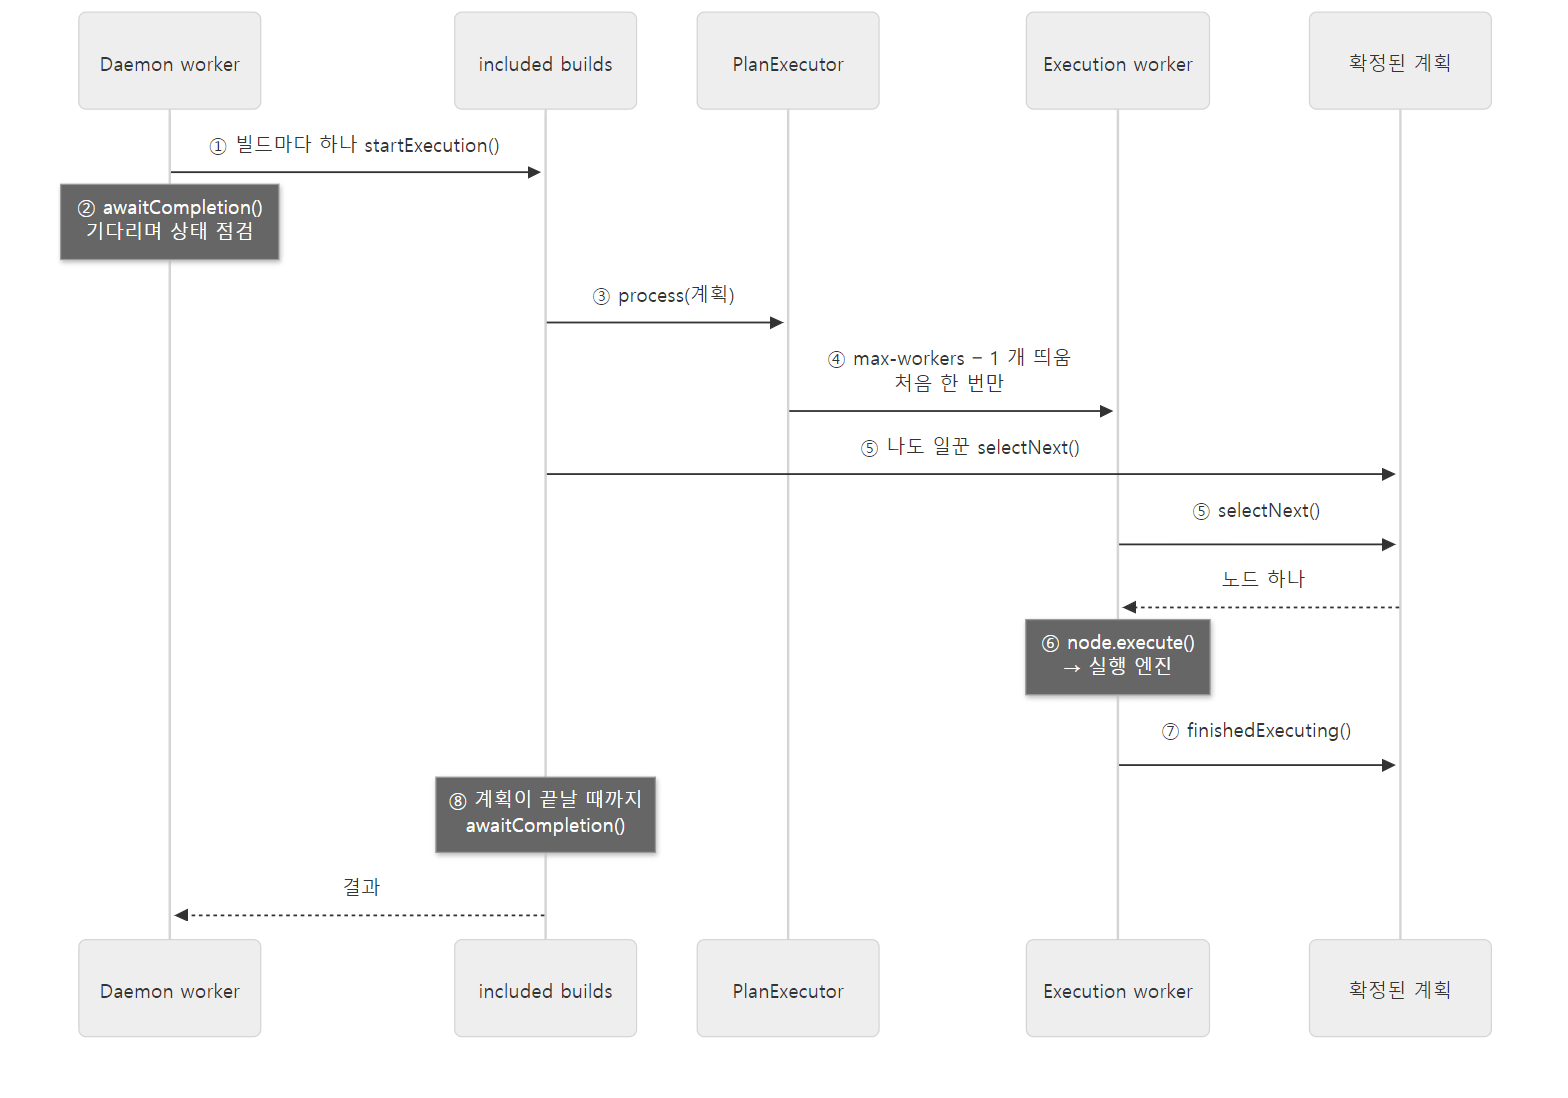 태스크 액션을 돌리는 스레드는
included builds 와 Execution worker 들입니다. Daemon worker 는 기다리기만 합니다.
예제 2: 실행 중에 스레드를 들여다보기
정말 그런지 보려고, 프로젝트 셋(a·b·c)에 4초씩 자는 work 태스크를 두고 --parallel --max-workers=2 로 돌리는 동안 데몬의 스레드 덤프를 떴습니다(jstack). 관심 있는 스레드만 남기고, 스레드마다 Gradle 쪽 프레임 몇 개만 걸렀습니다(줄였습니다).
=== jstack while tasks run (--parallel --max-workers=2) ===
thread: Daemon worker
    at org.gradle.composite.internal.DefaultBuildControllers.awaitCompletion
    at org.gradle.composite.internal.DefaultBuildControllers.execute
thread: included builds
    at Build_gradle.act
    at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.execute
    at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.run
    at org.gradle.execution.plan.DefaultPlanExecutor.process
    at org.gradle.composite.internal.DefaultBuildController.doRun
thread: Execution worker
    at Build_gradle.act
    at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.execute
    at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.run
...
(덤프 뒤에 찍히는 이 빌드의 시작·끝 시각 줄 여섯 개도 줄였습니다. 시각만 4초 단위일 뿐 예제 3의 --max-workers=2 결과와 같은 모양입니다.) 그림 그대로입니다. Daemon worker 는 awaitCompletion 에서 기다리고, included builds 스레드는 doRun → process → ExecutorWorker.run 을 거쳐 우리 태스크 액션(Build_gradle.act, 빌드 스크립트에 쓴 함수)을 돌리고 있습니다. Execution worker 의 스택은 ExecutorWorker.run 에서 시작합니다. 실행기에서 처음부터 그 일만 하도록 만들어진 스레드이기 때문입니다. max-workers=2 이니 Execution worker 는 하나뿐이었습니다.
일꾼의 반복문
두 종류의 스레드가 모두 도는 ExecutorWorker.run() 의 반복문입니다.
                while (true) {
                    WorkItem workItem = getNextItem(workerLease);
                    if (workItem == null) {
                        break;
                    }
                    Object selected = workItem.selection.getItem();
                    LOGGER.info("{} ({}) started.", selected, Thread.currentThread());
                    execute(selected, workItem.plan, workItem.executor, workItem.parentOperation);
                }
subprojects/core/src/main/java/org/gradle/execution/plan/DefaultPlanExecutor.java 385–393행
391행 덕분에 --info 로 "어느 스레드가 어느 노드를 집었나"를 볼 수 있습니다. 예제 2의 --parallel --max-workers=2 에서 그 줄만 뽑았습니다(스레드 번호 #… 는 실행마다 달라 #N 으로 바꿨습니다).
=== --info: who picked which node (--parallel --max-workers=2) ===
Resolve mutations for :a:work (Thread[#N,included builds,5,main]) started.
:a:work (Thread[#N,included builds,5,main]) started.
Resolve mutations for :b:work (Thread[#N,Execution worker,5,main]) started.
:b:work (Thread[#N,Execution worker,5,main]) started.
Resolve mutations for :c:work (Thread[#N,Execution worker,5,main]) started.
:c:work (Thread[#N,Execution worker,5,main]) started.
태스크마다 Resolve mutations for … 라는 노드가 먼저 돕니다. 그림 2의 ResolveMutationsNode 입니다. 태스크가 실행될 차례가 되면 selectNext() 가 이 노드를 그 태스크의 의존으로 끼워 넣고(아래 271–286행), 이 노드가 태스크의 출력·삭제 위치를 계산해 기록합니다(ResolveMutationsNode.java 87–101행). 출력 위치를 실행 직전에 계산하는 것은, 8편에서 본 대로 출력이 Provider 라서 설정이 다 끝나야 값이 정해지기 때문입니다.
selectNext() — 다음 노드 고르기
getNextItem() 은 상태 잠금 아래에서 계획의 selectNext() 를 부릅니다. DefaultFinalizedExecutionPlan.selectNext() 의 골격입니다.
        readyNodes.restart();
        while (readyNodes.hasNext()) {
            Node node = readyNodes.next();
            if (node.allDependenciesComplete()) {
                if (!node.allDependenciesSuccessful()) {
                    // ... 앞 노드가 실패했으면 건너뛰거나 FAILED_DEPENDENCY 로 ...
                }

                if (node.hasPendingPreExecutionNodes()) {
                    // The node is ready to execute and its pre-execution nodes have not been scheduled, so do this now
                    // ... ResolveMutationsNode 를 이 노드의 의존으로 끼워 넣는다 ...
                }

                // Node is ready to execute and all dependencies and pre-execution nodes have completed
                NodeStartResult startResult = attemptToStart(node, resources);
                if (startResult == NodeStartResult.STARTED) {
                    readyNodes.remove();
                    waitingToStartNodes.remove(node);
                    node.getConsumerState().started();
                    return Selection.of(node);
                }
                // ...
            }
            // ...
        }
subprojects/core/src/main/java/org/gradle/execution/plan/DefaultFinalizedExecutionPlan.java 251–305행
준비된 노드 큐(readyNodes)는 5절에서 매긴 순번으로 정렬되어 있습니다(NODE_EXECUTION_ORDER, 52–67행). 앞에서부터 보며 의존이 다 끝났고, 실행 직전 노드도 끝났고, 필요한 잠금을 얻은 첫 노드를 내줍니다. 그 잠금 얻기가 attemptToStart() 이고, 7절의 주제입니다. 노드가 끝나면 markFinished() 가 상태 잠금 아래에서 계획에 알리고 notifyStateChange() 로 기다리던 스레드들을 깨웁니다(488–504행).
예제 1에서 -Pstack 을 주면 generate 액션이 자기를 부른 쪽 가운데 org.gradle.execution·org.gradle.composite 패키지의 프레임만 찍습니다.
=== gradle generate -Pstack ===
run :generate on [Execution worker Thread 5]
  at org.gradle.execution.plan.LocalTaskNode.execute:229
  at org.gradle.execution.DefaultBuildWorkExecutor.lambda$executePlan$0:153
  at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.lambda$execute$0:476
  at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.execute:475
  at org.gradle.execution.plan.DefaultPlanExecutor$ExecutorWorker.run:392
아래에서 위로 392행(위 반복문의 execute(...)) → 476행(worker.execute(selected)) → DefaultBuildWorkExecutor 153행(node.execute(projectContext)) → LocalTaskNode 229행입니다. 229행은 context.getService(TaskNodeExecutor.class).execute(this) 로, 여기서부터가 10편의 DefaultTaskNodeExecutor 와 실행 엔진입니다. 이번에는 Execution worker 가 집어서 composite 프레임이 보이지 않습니다.
헷갈리기 쉬운 곳
- 태스크 액션의 스레드 이름은 정해져 있지 않습니다. 예제 1의 첫 실행에서
alpha는Execution worker, 그다음 셋은included builds, 나머지는Execution worker Thread 10이었습니다.--parallel이 없어도 그렇습니다. 일꾼들이 같은 큐에서 먼저 잡는 쪽이 가져가기 때문입니다.ThreadLocal에 기대는 태스크 코드는 이 점을 알아야 합니다. Daemon worker는 태스크를 돌리지 않습니다(이 길에서는).process()를 부르는 것은included builds스레드이고,Daemon worker는 그 위에서 기다립니다. 이 글의 예제는 모두 설정 캐시 없이 명령줄로 태스크를 돌린 경우입니다.
7. 몇 개씩 — 워커 리스, 태스크 실행 잠금, --parallel
attemptToStart() 앞뒤로 노드 하나가 시작하려면 넘어야 할 문이 넷 있습니다.
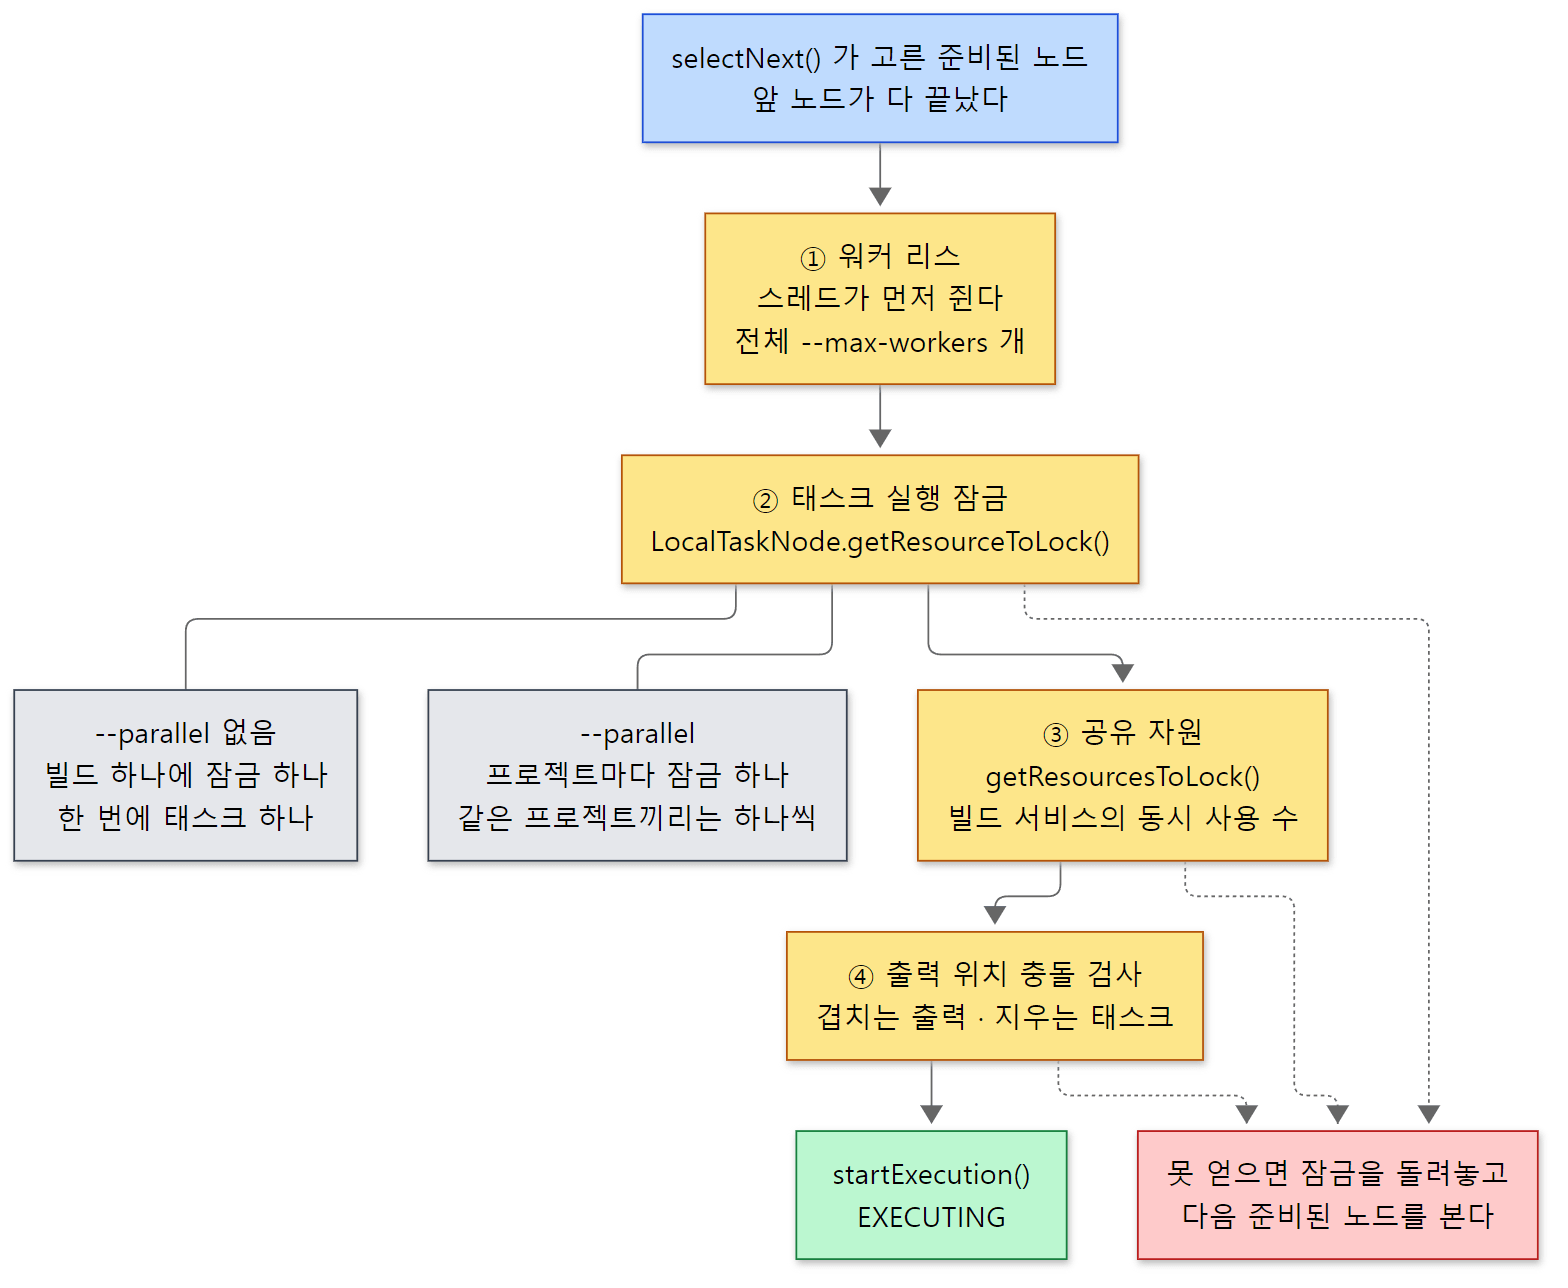 노란 칸은 모두 "잠금"입니다. 하나라도 못 얻으면 그 노드는 건너뛰고 다음 준비된 노드를 봅니다.
① 워커 리스 — --max-workers 개의 자리표
일꾼 스레드는 노드를 고르기 전에 워커 리스부터 쥡니다. getNextItem() 에서 workerLease.tryLock() 이 실패하면 노드를 보지도 않고 RETRY 로 기다립니다(DefaultPlanExecutor.java 426–432행). 리스를 내주는 쪽은 숫자 하나를 세는 것이 전부입니다. LeaseHolder.grantLease() 는 쓰는 중인 리스가 maxWorkerCount 에 닿았으면 false, 아니면 하나 더하고 true 입니다(LeaseHolder.java 27–33행). maxWorkerCount 의 기본값은 Runtime.getRuntime().availableProcessors() 입니다(DefaultParallelismConfiguration.java 85–87행). DefaultWorkerLeaseService 가 만들어질 때 --info 로 그 값을 알립니다(DefaultWorkerLeaseService.java 73행). 예제 2의 컨테이너에서는 CPU 12개가 보였고, Using 12 worker leases. 가 찍혔습니다.
--max-workers 는 스레드 수가 아니라 동시에 일하는 자리 수입니다. 스레드는 Execution worker 말고도 여럿이고(included builds, 8절의 Worker API 스레드), 모두 일하는 동안 이 자리표를 하나씩 쥡니다. 기다리는 동안에는 내려놓습니다(434–438행, 그리고 process() 끝의 awaitCompletion(), 163–181행).
② 태스크 실행 잠금 — --parallel 이 바꾸는 것
태스크 노드가 쥐어야 하는 자원은 이것입니다.
    @Nullable
    @Override
    public ResourceLock getResourceToLock() {
        if (isolated) {
            return null;
        } else {
            // Running the task requires permission to execute against its containing project
            return taskProject.getOwner().getTaskExecutionLock();
        }
    }
subprojects/core/src/main/java/org/gradle/execution/plan/LocalTaskNode.java 70–79행
이름은 "프로젝트의" 태스크 실행 잠금인데, 그 잠금이 실제로 무엇인지는 --parallel 에 따라 다릅니다.
    public ResourceLock getTaskExecutionLock(Path buildIdentityPath, final Path projectIdentityPath) {
        if (projectLockRegistry.getAllowsParallelExecution()) {
            return getTaskExecutionLockForProject(projectIdentityPath, projectIdentityPath, buildIdentityPath);
        } else {
            return getTaskExecutionLockForBuild(buildIdentityPath, projectIdentityPath);
        }
    }
병렬이 꺼져 있으면 잠금의 열쇠가 빌드 경로입니다. 빌드 안의 모든 프로젝트가 잠금 하나를 나눠 씁니다. 프로젝트 잠금(프로젝트 모델을 만질 때 쥐는 잠금)도 똑같이 되어 있고, 주석이 "When not running in parallel, all projects of a build share a single lock." 이라고 그 뜻을 그대로 적어 둡니다(ProjectLockRegistry.java 34–41행). 태스크 실행 잠금은 얻을 때 이 프로젝트 잠금도 함께 얻습니다(TaskExecutionLock.java 28–37행). 그래서 이렇게 정리됩니다.
| 설정 | 태스크 실행 잠금의 단위 | 결과 |
|---|---|---|
--parallel 없음 (기본) |
빌드 하나에 하나 | 한 빌드의 태스크는 한 번에 하나씩. 워커 리스가 12개여도 |
--parallel |
프로젝트마다 하나 | 다른 프로젝트의 태스크는 동시에, 같은 프로젝트의 태스크는 하나씩 |
| (둘 다) | 워커 리스 --max-workers 개 |
동시에 일하는 자리의 상한 |
이 표는 이 글의 예제처럼 설정 캐시 없이 계획을 만든 경우입니다. 설정 캐시에서 읽어 온 계획의 태스크 노드는 isolated() 로 표시되어, 위 getResourceToLock() 이 null 을 돌려주므로 이 잠금을 쥐지 않습니다(이 글에서 뺀 것 참고). 8절의 Worker API 처럼 실행 중에 잠금을 내려놓는 길도 있습니다.
--parallel 여부는 빌드를 시작할 때 startProjectExecution(parallel) 로 정해져 그 빌드 동안 바뀌지 않습니다(RootBuildLifecycleBuildActionExecutor.java 90행, DefaultWorkerLeaseService.java 514–522행).
예제 3: --parallel 과 --max-workers 를 바꿔 가며
예제 2의 빌드에서 work 를 1.5초로 줄이고, a 프로젝트에만 서로 의존하지 않는 extra 태스크를 하나 더 두었습니다. 계획이 확정된 순간(whenReady)을 0초로 삼아 시작·끝 시각을 0.5초 단위로 찍습니다. 처음에는 System.currentTimeMillis() 로 쟀는데, 한 번은 1.5초 자는 태스크가 1.0초 만에 끝난 것으로 찍혔습니다. 원인은 확인하지 못했지만 벽시계(wall clock)는 실행 중에 조정될 수 있으므로, 모든 태스크가 같은 데몬 JVM 에서 돈다는 점을 이용해 단조 시계인 System.nanoTime() 으로 바꿨습니다.
// 이 글을 위해 쓴 예제입니다 (Gradle 의 소스가 아닙니다)

// 실행 계획이 확정된 순간을 0초로 삼는다 (데몬이 재사용되므로 빌드마다 다시 적는다. 벽시계 대신 nanoTime)
gradle.taskGraph.whenReady { System.setProperty("lab.t0", System.nanoTime().toString()) }
// ... slow() 는 "+0.0s start …" 를 찍고, 1.5초(-Phold 면 4초) 자고, "+1.5s end …" 를 찍는 doLast 를 단다 ...

subprojects {
    tasks.register("work") { slow() }
}
// a 프로젝트에만 서로 의존하지 않는 태스크를 하나 더 둔다
project(":a") {
    tasks.register("extra") { slow() }
}
[예제 ex/u09-parallel/project/build.gradle.kts에서 줄임]
세 가지로 돌린 결과입니다. 줄 순서보다 앞의 시각을 보세요. 콘솔 출력이 태스크별로 모여 찍혀서 줄 순서가 시간 순서와 다릅니다.
=== CPUs (nproc): 12 ===
=== gradle work (no --parallel) ===
Using 12 worker leases.
+0.5s start :a:work [Execution worker]
+2.0s end   :a:work
+2.0s start :b:work [Execution worker]
+3.5s end   :b:work
+3.5s start :c:work [Execution worker]
+5.0s end   :c:work
BUILD SUCCESSFUL in 38s
=== gradle work --parallel --max-workers=2 ===
+0.0s start :a:work [included builds]
+1.5s end   :a:work
+0.0s start :b:work [Execution worker]
+1.5s end   :b:work
+1.5s start :c:work [included builds]
+3.0s end   :c:work
BUILD SUCCESSFUL in 5s
=== gradle work extra --parallel --max-workers=4 ===
+0.0s start :c:work [Execution worker Thread 3]
+1.5s end   :c:work
+0.0s start :a:work [Execution worker]
+1.5s end   :a:work
+0.0s start :b:work [included builds]
+1.5s end   :b:work
+1.5s start :a:extra [Execution worker]
+3.0s end   :a:extra
BUILD SUCCESSFUL in 5s
- 병렬 없음: 워커 리스가 12개인데도
a→b→c가 하나씩 돌았습니다. 빌드 하나에 태스크 실행 잠금 하나이기 때문입니다.--max-workers만 올려서는 태스크가 동시에 돌지 않습니다. (시각은 0.5초 단위로 반올림한 것이고 실행마다 조금씩 다릅니다. 이번에는 첫 태스크가 0.5초에 시작했습니다.) --parallel --max-workers=2:a·b가 0초에 함께 시작하고, 리스 두 개가 다 차서c는 1.5초에 시작했습니다. 일한 스레드는included builds와Execution worker하나, 정확히max-workers − 1개의 워커에 부른 스레드를 더한 둘입니다.--parallel --max-workers=4: 세 프로젝트의work가 0초에 함께 시작했지만,a:extra는a:work가 끝난 1.5초에야 시작했습니다. 리스는 남았지만a프로젝트의 태스크 실행 잠금을a:work가 쥐고 있었습니다.
예제 2의 jstack 도 2번과 같은 설정이었습니다. Daemon worker 는 기다리고, 일하는 스레드는 정확히 둘이었습니다.
③·④ 그 밖의 문
tryAcquireLocksForNode() 는 태스크 실행 잠금 다음에 공유 자원(getResourcesToLock() — 태스크가 usesService() 로 쓰겠다고 밝힌 빌드 서비스의 maxParallelUsages 같은 것)을 잠그고(DefaultFinalizedExecutionPlan.java 383–392행), attemptToStart() 는 그 뒤에 출력 위치 충돌을 봅니다. 지금 돌고 있는 노드와 출력 위치가 겹치거나, 지우는 태스크(destroyer)가 아직 누가 읽어야 할 출력을 지우려 하면 시작하지 않습니다(346–375행). 어디서든 막히면 얻은 잠금을 돌려놓고 다음 준비된 노드로 넘어갑니다.
헷갈리기 쉬운 곳: 순서는 정했지만 의존은 안 적은 경우
출력 위치를 기록하는 장부는 실행 중에 하나 더 쓰입니다. 어떤 태스크가 다른 태스크의 출력 파일을 입력으로 읽는데 둘 사이에 아무 관계(dependsOn, 입력 Provider, mustRunAfter)도 없으면, Gradle 은 그 태스크를 실행하려는 순간 막습니다. 예제 1에 -Pimplicit 을 주면, writer 가 outputs.file(shared) 로 build/shared.txt 를 출력으로, reader 가 inputs.file(shared) 로 같은 파일을 입력으로 밝히되 둘 사이의 관계는 적지 않습니다(예제 ex/u09-plan-order/project/build.gradle.kts).
=== gradle writer reader -Pimplicit ===
> Task :writer
> Task :reader FAILED
* What went wrong:
A problem was found with the configuration of task ':reader' (type 'DefaultTask').
Property has implicit dependency
  Gradle detected a problem with the following location: '/tmp/p/build/shared.txt'
    Task ':reader' uses this output of task ':writer' without declaring an explicit or implicit dependency. This can lead to incorrect results being produced, depending on what order the tasks are executed
    For more information, please refer to https://docs.gradle.org/9.10.0-20261107025045+0000/userguide/validation_problems.html#implicit_dependency in the Gradle documentation.
    Possible solutions:
      1. Declare task ':writer' as an input of ':reader'.
      2. Declare an explicit dependency on ':writer' from ':reader' using Task#dependsOn.
      3. Declare an explicit dependency on ':writer' from ':reader' using Task#mustRunAfter.
명령줄 순서 덕분에 이번에는 writer 가 먼저 돌았는데도 실패입니다. "이번에 우연히 맞았다"를 허락하지 않는 것입니다. 이 검사는 계획을 만들 때가 아니라 태스크를 실행할 때, 실행 엔진의 검증 단계에서 TaskExecution 이 MissingTaskDependencyDetector 를 불러 합니다(TaskExecution.java 521–526행). 메시지와 해결책 셋이 그 클래스에 그대로 있습니다(MissingTaskDependencyDetector.java 206–218행). 해결책 3번이 mustRunAfter 인 것은, 관계가 "어떤 순서든 하나라도" 있으면 통과시키기 때문입니다(hasNoSpecifiedOrder(), 138–140행). 같은 빌드 안에서는 이렇게 실패하고, 다른 빌드(포함된 빌드)의 태스크 사이라면 지금은 폐기 예정 경고만 내고 Gradle 10 에서 오류가 된다고 적혀 있습니다(188–204행).
8. Worker API — 태스크 안의 일을 나누는 다른 길
7절의 표대로라면 --parallel 없이는 한 빌드에서 태스크가 하나씩만 돕니다. 그런데 컴파일러나 테스트처럼 한 태스크 안에 나눌 수 있는 일이 많다면 어떨까요. 그 길이 Worker API 입니다. 태스크는 WorkerExecutor 를 주입받고(4편의 @Inject), 격리 수준을 골라 큐를 얻습니다. 구현 DefaultWorkerExecutor 의 noIsolation()·classLoaderIsolation()·processIsolation() 은 모두 DefaultWorkQueue 를 만들고, 다른 것은 큐에 꽂는 WorkerFactory 뿐입니다(DefaultWorkerExecutor.java 118–143행).
| 격리 수준 | 팩토리 | 어디서 도나 |
|---|---|---|
noIsolation() |
NoIsolationWorkerFactory |
데몬 안, 태스크와 같은 클래스로더(제출한 스레드의 컨텍스트 클래스로더) |
classLoaderIsolation() |
IsolatedClassloaderWorkerFactory |
데몬 안, 일마다 따로 만든 클래스로더 |
processIsolation() |
WorkerDaemonFactory |
따로 띄운 워커 데몬 프로세스 |
noIsolation 은 FixedClassLoaderWorkerRequirement 에 Thread.currentThread().getContextClassLoader() 를 담고(234행), classLoaderIsolation 은 일마다 createIsolatedWorkerClassloader() 로 클래스로더를 만들고(IsolatedClassloaderWorkerFactory.java 52–61행), processIsolation 은 쉬고 있는 워커 데몬을 빌리거나 새로 띄웁니다(WorkerDaemonFactory.java 76–83행).
submit() 은 일을 WorkItemExecution 으로 감싸 큐에 넣고(executionQueue.submit(execution)), 지금의 빌드 오퍼레이션(곧 이 태스크 액션)에 "끝나지 않은 일"로 등록한 뒤(asyncWorkTracker.registerWork(...)) 바로 돌아옵니다(DefaultWorkerExecutor.java 163–177행). executionQueue 는 빌드 세션에 하나인 "WorkerExecutor Queue" 입니다(WorkerExecutionQueueFactory.java 32행). 이 큐의 스레드는 일을 돌리는 동안 runAsWorkerThread() 로 워커 리스를 하나 쥡니다(DefaultConditionalExecutionQueue.java 162–163행). 그래서 Worker API 의 일도 --max-workers 안에서 돕니다.
액션이 돌아온 뒤 — 잠금을 놓고 기다린다
submit() 만 하고 await() 를 부르지 않은 액션은 바로 끝납니다. 그 뒤를 TaskExecution 이 받습니다.
                    try {
                        action.execute(task);
                    } catch (Throwable t) {
                        actionFailure = t;
                    } finally {
                        action.clearInputChanges();
                    }

                    try {
                        asyncWorkTracker.waitForCompletion(currentOperation, hasMoreWork ? RELEASE_AND_REACQUIRE_PROJECT_LOCKS : RELEASE_PROJECT_LOCKS);
subprojects/core/src/main/java/org/gradle/api/internal/tasks/execution/TaskExecution.java 267–276행
액션마다, 액션이 제출한 일이 다 끝날 때까지 기다립니다. 마지막 액션 뒤에는 RELEASE_PROJECT_LOCKS, 뒤에 액션이 더 남아 있으면 RELEASE_AND_REACQUIRE_PROJECT_LOCKS(일이 아직 남았으면 잠금을 놓고 기다렸다가 다시 잡는다, DefaultAsyncWorkTracker.java 95–101행)로 기다립니다. 액션이 하나뿐인 이 글의 예제는 앞의 것입니다. RELEASE_PROJECT_LOCKS 는 기다리기 전에 runAsIsolatedTask() 를 부르고(DefaultAsyncWorkTracker.java 91–94행), 그것은 이 스레드가 쥔 프로젝트 잠금과 태스크 실행 잠금을 내려놓습니다.
    @Override
    public void runAsIsolatedTask() {
        Registries registries = getRegistries();
        releaseLocks(registries.getProjectLockRegistry().getResourceLocksByCurrentThread());
        releaseLocks(registries.getTaskExecutionLockRegistry().getResourceLocksByCurrentThread());
    }
7절의 표를 떠올리면 뜻이 분명합니다. --parallel 이 없을 때 빌드에 하나뿐인 태스크 실행 잠금을, Worker API 일이 도는 동안에는 다른 태스크가 쓸 수 있습니다. 기다리는 동안 워커 리스도 내려놓습니다(waitForItemsAndGatherFailures() 의 "Release worker lease while waiting", 125–128행).
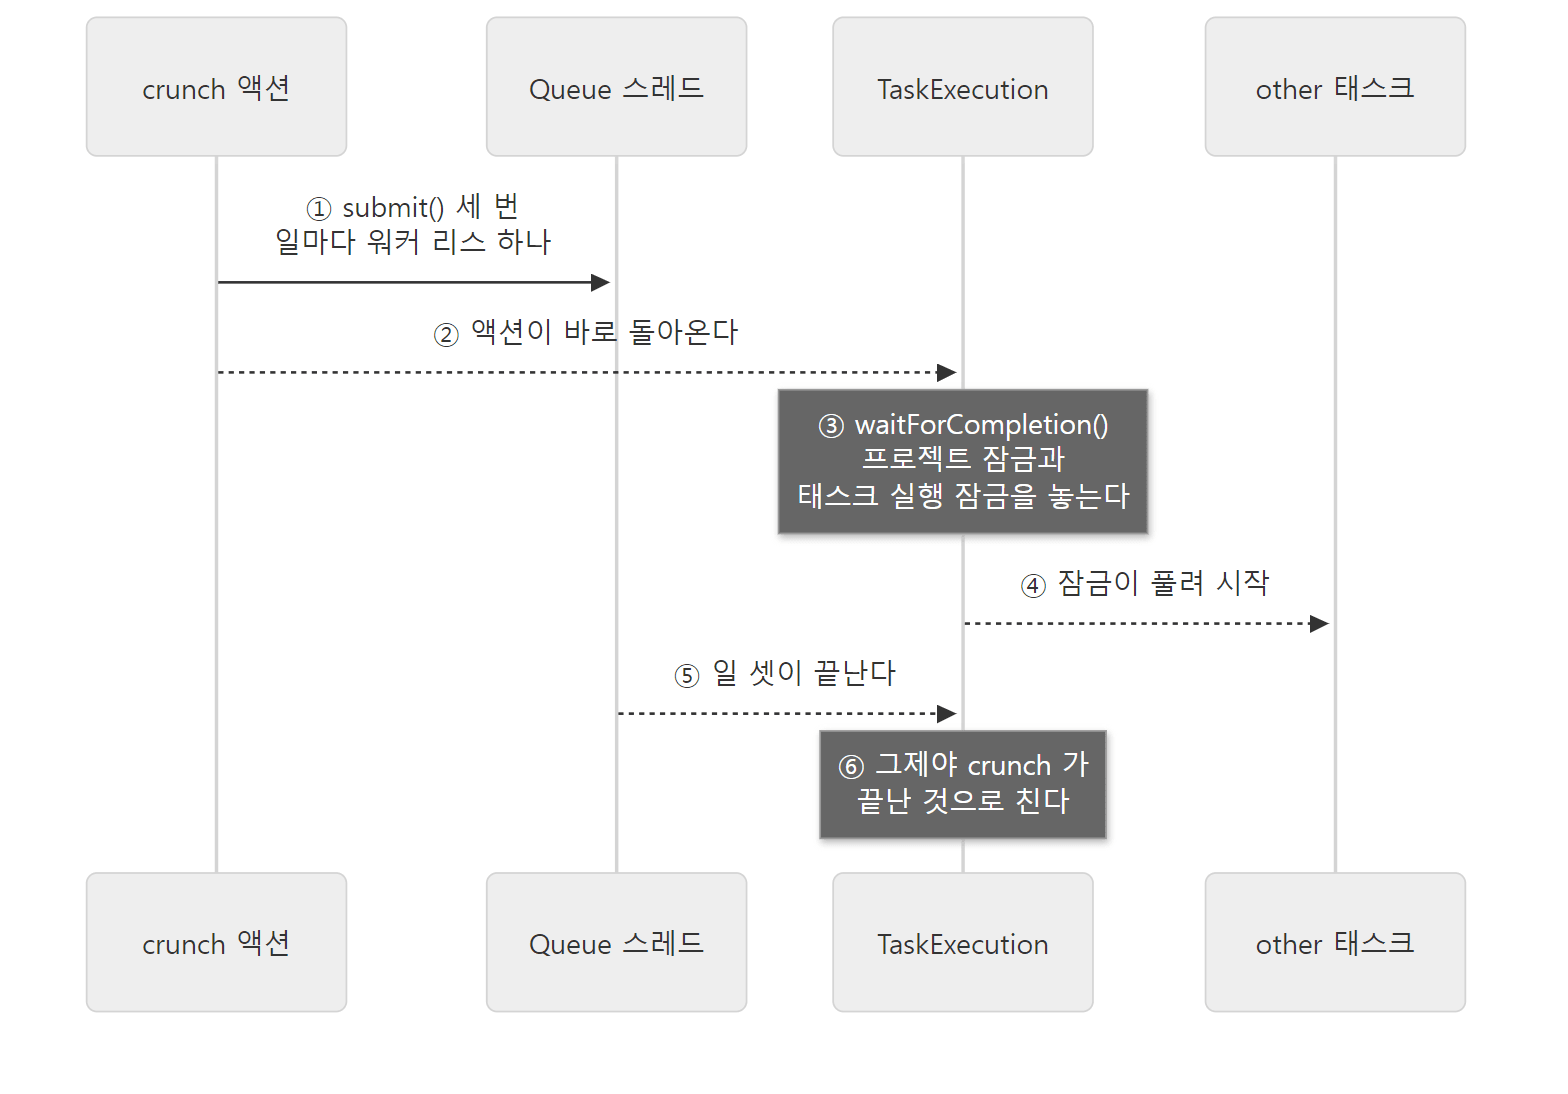 태스크는 끝나지 않았지만 잠금은 놓았습니다. 그 틈에 다른 태스크가 들어옵니다.
예제 4: 일 셋과 다른 태스크 하나
buildSrc 에 Java 로 CrunchTask 와 Crunch(일 하나, 1초 잔다)를 두었습니다.
// 이 글을 위해 쓴 예제입니다 (Gradle 의 소스가 아닙니다)
package lab;
// ... import 생략 ...

// 일 셋을 Worker API 에 넘기고, 기다리지 않고 돌아가는 태스크
public abstract class CrunchTask extends DefaultTask {

    @Input
    public abstract Property<String> getMode(); // none, classloader, process

    @Inject
    public abstract WorkerExecutor getWorkerExecutor(); // 4편의 서비스 주입

    @TaskAction
    public void run() {
        String mode = getMode().get();
        WorkQueue queue;
        // ... mode 에 따라 processIsolation()·classLoaderIsolation()·noIsolation() 가운데 하나 ...
        for (String label : new String[] {"1", "2", "3"}) {
            queue.submit(Crunch.class, p -> p.getLabel().set(getName() + "-" + label));
        }
        // await() 를 부르지 않는다 — 액션은 바로 돌아간다
        System.out.println(Clock.elapsed() + " " + getPath() + " submitted 3 items from [" + Thread.currentThread().getName() + "]"
            + " pid=" + ProcessHandle.current().pid());
    }
}
[예제 ex/u09-worker-api/project/buildSrc/src/main/java/lab/CrunchTask.java에서 줄임]
Crunch.execute() 는 시작할 때 스레드 이름, 프로세스 번호(pid), 자기 클래스를 읽은 클래스로더의 클래스 이름을 찍고 1초 잔 뒤 끝을 찍습니다. 루트 빌드에는 crunch(noIsolation)·crunchLoader·crunchProcess 와, 아무 관계 없는 other 태스크가 있습니다. 시각은 예제 3과 같은 방식입니다.
=== gradle crunch other --max-workers=4 (no --parallel) ===
+0.0s :other runs [included builds]
+0.0s :crunch submitted 3 items from [Execution worker Thread 2] pid=51
+0.0s item crunch-3 start [WorkerExecutor Queue Thread 3] pid=51 loader=InstrumentingVisitableURLClassLoader
+0.0s item crunch-1 start [WorkerExecutor Queue] pid=51 loader=InstrumentingVisitableURLClassLoader
+0.0s item crunch-2 start [WorkerExecutor Queue Thread 2] pid=51 loader=InstrumentingVisitableURLClassLoader
+1.0s item crunch-3 end
+1.0s item crunch-2 end
+1.0s item crunch-1 end
BUILD SUCCESSFUL in 53s
=== gradle crunch other --max-workers=2 ===
+0.0s :other runs [included builds]
+0.0s item crunch-1 start [WorkerExecutor Queue] pid=51 loader=InstrumentingVisitableURLClassLoader
+0.0s :crunch submitted 3 items from [Execution worker] pid=51
+0.0s item crunch-2 start [WorkerExecutor Queue Thread 2] pid=51 loader=InstrumentingVisitableURLClassLoader
+1.0s item crunch-1 end
+1.0s item crunch-3 start [WorkerExecutor Queue] pid=51 loader=InstrumentingVisitableURLClassLoader
+1.0s item crunch-2 end
+2.0s item crunch-3 end
BUILD SUCCESSFUL in 3s
--parallel이 없는데other가crunch의 일과 같은 0초에 돌았습니다. 계획에서 어느 쪽이 먼저든,crunch의 액션이 돌아오면TaskExecution이 태스크 실행 잠금을 놓으므로 일 셋이 도는 동안 다른 태스크가 들어올 수 있습니다. 일 셋은WorkerExecutor Queue스레드 셋에서 동시에 돌았습니다. 첫 실행의53s는 buildSrc 와 Kotlin DSL 스크립트를 처음 컴파일한 시간이 든 것입니다.--max-workers=2로 줄이면 일이 둘씩만 돌았습니다(crunch-3은 앞의 둘이 끝난 1초에 시작). 리스 두 개를 일 둘이 쥐었기 때문입니다. Worker API 의 일과 태스크가 같은 자리표를 나눠 쓴다는 것이 보입니다.other는 이번에는 0초에 돌았지만, 같은 예제를 앞서 돌렸을 때는 일 둘이 리스를 다 쥔 동안 기다렸다가 1초에 돌았습니다(+1.0s :other runs [included builds]). 출력 한 줄만 찍는 태스크라 리스를 언제 잡느냐에 따라 달라집니다.
세 격리 수준을 비교한 결과입니다.
=== gradle crunchLoader crunchProcess ===
+0.0s :crunchLoader submitted 3 items from [Execution worker Thread 8] pid=51
+0.0s item crunchLoader-2 start [WorkerExecutor Queue Thread 2] pid=51 loader=VisitableURLClassLoader
+0.0s item crunchLoader-3 start [WorkerExecutor Queue Thread 3] pid=51 loader=VisitableURLClassLoader
+0.0s item crunchLoader-1 start [WorkerExecutor Queue] pid=51 loader=VisitableURLClassLoader
+1.0s item crunchLoader-3 end
+1.0s item crunchLoader-1 end
+1.0s item crunchLoader-2 end
+0.0s :crunchProcess submitted 3 items from [Execution worker Thread 9] pid=51
+? item crunchProcess-2 start [/127.0.0.1:35702 to /127.0.0.1:39283 workers] pid=311 loader=VisitableURLClassLoader
+? item crunchProcess-1 start [/127.0.0.1:35306 to /127.0.0.1:41447 workers] pid=304 loader=VisitableURLClassLoader
+? item crunchProcess-3 start [/127.0.0.1:60944 to /127.0.0.1:46759 workers] pid=307 loader=VisitableURLClassLoader
+? item crunchProcess-2 end
+? item crunchProcess-1 end
+? item crunchProcess-3 end
BUILD SUCCESSFUL in 3s
=== JVMs left after the build ===
jdk.jcmd/sun.tools.jps.Jps
org.gradle.launcher.daemon.bootstrap.GradleDaemon
noIsolation의 일은 buildSrc 클래스를 읽은 클래스로더(InstrumentingVisitableURLClassLoader)에서,classLoaderIsolation은 따로 만든 클래스로더(VisitableURLClassLoader)에서 돌았습니다. pid 는 둘 다 데몬(51)입니다.processIsolation은 pid 가 304·307·311 로 일마다 다른 프로세스였습니다. 동시에 돈 일 셋에 워커 데몬이 셋 뜬 것입니다. 스레드 이름은 소켓 주소이고(데몬과의 연결), 시각은+?입니다. 다른 프로세스라 데몬의 시스템 속성(lab.t0)이 없기 때문입니다. pid·포트는 실행마다 다릅니다.- 빌드가 끝나자 워커 데몬이 남지 않았습니다.
jps에는 Gradle 데몬과jps자신뿐입니다.
마지막 것은 소스에서 바로 확인됩니다. Worker API 의 프로세스 격리는 워커 데몬을 빌드 세션까지만 살려 둡니다.
        if (configuration instanceof ProcessWorkerSpec) {
            DaemonForkOptionsBuilder builder = new DaemonForkOptionsBuilder(forkOptionsFactory)
                .keepAliveMode(KeepAliveMode.SESSION);
KeepAliveMode 는 SESSION(빌드 세션이 끝날 때까지)과 DAEMON(Gradle 데몬이 멈출 때까지) 둘이고(KeepAliveMode.java 19–28행), 세션이 끝날 때 WorkerDaemonClientsManager 가 SESSION 인 워커를 모두 멈춥니다(246–254행). 빌드가 끝나도 남아 다음 빌드에 다시 쓰이는 워커 데몬은 DAEMON 모드로 만든 것입니다. 예를 들어 포크한 Java 컴파일러 데몬(DaemonJavaCompiler)이 KeepAliveMode.DAEMON 을 씁니다(DaemonJavaCompiler.java 101행). 그 길은 이 글에서 돌려 보지 않았습니다.
헷갈리기 쉬운 곳
- Worker API 는
--parallel의 대체물이 아니라 다른 축입니다.--parallel은 "프로젝트가 다른 태스크끼리", Worker API 는 "한 태스크의 조각끼리"를 동시에 돌립니다. 둘 다 같은 워커 리스를 씁니다. await()를 부르면 잠금을 쥔 채 기다립니다.WorkerExecutor.await()와WorkQueue.await()는RETAIN_PROJECT_LOCKS로 기다립니다(DefaultWorkerExecutor.java188–205행). 액션 안에서 결과를 꼭 써야 할 때만 부르고, 아니면 액션이 그냥 돌아가게 두는 편이 다른 태스크에 자리를 내줍니다. 이 차이는 소스로 확인한 것이고,await()를 부르는 경우는 예제로 돌려 보지 않았습니다.- 일은 Gradle 이 관리하는 스레드에서만 제출할 수 있습니다. 태스크 액션 안에서 직접 만든 스레드에서
submit()하면checkIsManagedThread()(179–183행)가 "Work may only be submitted from a Gradle-managed thread" 로 막습니다.
이 글에서 뺀 것
- 명령줄 순서와 지우는 태스크(
gradle clean build에서clean이build의 출력보다 먼저):OrdinalNode·OrdinalGroup·OrdinalNodeAccess,DetermineExecutionPlanAction.createOrdinalRelationships()329–347행 shouldRunAfter고리를 되돌리는 자세한 과정(restorePath·restoreQueue·restoreExecutionPlan):DetermineExecutionPlanAction.java245–290행- 마무리 태스크의 그룹 계산(
FinalizerGroup,CompositeNodeGroup)과 "마무리 태스크만 필요로 하는 의존은 언제 시작하나":subprojects/core/…/execution/plan/FinalizerGroup.java,DetermineExecutionPlanAction의 클래스 주석 59–65행 -x(태스크 빼기)의 필터와TaskPathSpec:DefaultTaskSelector.getFilter()53–66행- 포함된 빌드의 태스크를 가리키는 노드(
TaskInAnotherBuild)와 빌드 사이의 계획 잇기:subprojects/core/…/execution/plan/TaskInAnotherBuild.java,subprojects/composite-builds/…/DefaultBuildControllers.java - 아티팩트 변환 노드(
TransformStepNode): 12편에서 의존성 해석과 함께 - 설정 캐시에서 읽어 온 계획(노드를 직렬화했다가 되살리고, 태스크를
isolated()로 표시해 태스크 실행 잠금 없이 돌리는 것):platforms/core-configuration/core-serialization-codecs/…/TaskNodeCodec.kt95행 — 11편 - 실행기 건강 검사("Unable to make progress running work"):
DefaultPlanExecutor.assertHealthy()125–158행 --continue(실패해도 다른 태스크를 계속)와 검증 실패(verification failure)의 예외 처리:DefaultFinalizedExecutionPlan.handleFailure()·abortExecution(),Node.shouldContinueExecution()- 내부 옵션
org.gradle.internal.executor.stats(실행기 통계):DefaultPlanExecutor.java65행 - 워커 데몬 프로세스의 안쪽(
GradleWorkerMain, 데몬과의 연결):platforms/core-execution/worker-main/
정리
| 개념 | 한 줄 요약 |
|---|---|
| 태스크 고르기 | 명령줄 이름마다 DefaultTaskSelector 가 정확한 이름 → NameMatcher 줄임말 순으로 찾는다. 후보가 정확히 하나일 때만 |
| 진입 노드 | 명령줄에서 고른 태스크의 노드. 이름마다 addEntryTasks() 한 번, 번호(ordinal)가 붙는다 |
| 노드 모으기 | discoverNodeRelationships() 가 dependsOn·입력 Provider·finalizedBy 를 따라가 require() 한다. mustRunAfter 는 따라가지 않는다 |
| 후속자 | "먼저 끝나야 하는 노드". 단단한 것(dependsOn·finalizedBy·mustRunAfter)과 지울 수 있는 것(shouldRunAfter) |
| 순서 정하기 | DetermineExecutionPlanAction 의 깊이 우선 후위 순회. 고리는 shouldRunAfter 면 버리고 아니면 Circular dependency |
| 후속자의 정렬 | 같은 조건이면 프로젝트 깊이, 그다음 태스크 경로 순. dependsOn 에 적은 순서가 아니다 |
gradle.taskGraph |
DefaultTaskExecutionGraph. 확정된 계획을 빌려 보여 주는 창. whenReady 는 빌드당 한 번 |
--dry-run |
설정과 계획 만들기는 다 하고, 실행 직전에 SKIPPED 만 찍는다 |
| 노드 상태 | NOT_SCHEDULED→SHOULD_RUN→EXECUTING→EXECUTED, 또는 FAILED_DEPENDENCY. 실패한 태스크도 EXECUTED |
| 마무리 태스크 | 마무리 대상이 "끝나기"를 기다리고(성공이 아니라), 대상이 시작했으면 실패로 인한 중단에도 취소되지 않는다 |
DefaultPlanExecutor |
max-workers − 1 개의 Execution worker 를 띄우고, process() 를 부른 스레드도 일꾼이 된다 |
| 스레드 이름 | process() 를 부르는 것은 included builds(빌드마다 하나), Daemon worker 는 기다린다 |
selectNext() |
순번 순으로 준비된 노드를 보며, 실행 직전 노드(Resolve mutations)와 잠금을 갖춘 첫 노드를 내준다 |
| 워커 리스 | --max-workers(기본 CPU 수)개의 자리표. 태스크든 Worker API 일이든 일하는 동안 하나씩 |
| 태스크 실행 잠금 | --parallel 없으면 빌드에 하나, 있으면 프로젝트마다 하나. 같은 프로젝트의 태스크는 하나씩(설정 캐시에서 읽은 계획의 태스크는 이 잠금을 쓰지 않는다) |
| 선언 안 한 의존 | 다른 태스크의 출력을 관계없이 읽으면 실행할 때 implicit dependency 로 실패 |
| Worker API | 한 태스크의 일을 나눈다. 액션이 돌아오면 잠금을 놓고 기다리므로 그 틈에 다른 태스크가 돈다 |
| 프로세스 격리 | 워커 데몬은 KeepAliveMode.SESSION — 빌드 세션이 끝나면 멈춘다 |
다음에 볼 것
이 글은 일꾼이 노드를 집어 LocalTaskNode.execute() 를 부르는 데서 멈췄습니다. 그 한 줄 뒤에서 DefaultTaskNodeExecutor 가 onlyIf 와 "액션 없음"을 따져 건너뛸지 정하고, 태스크를 실행 엔진의 작업 단위로 감싸 IdentifyStep 부터 ExecuteStep 까지 스텝 사슬에 넘깁니다. 이 글 7절의 implicit dependency 검사가 일어난 검증 단계도 그 사슬의 한 칸입니다. 입력과 출력의 핑거프린트를 지난번 실행 기록과 비교해 UP-TO-DATE 를 정하는 과정을 --info 의 이유 줄과 함께 읽습니다.
Gradle 소스 파헤치기 10: 실행 엔진과 증분 빌드 — UP-TO-DATE는 어떻게 정해지나
앞 연재에서 닮은 것을 다뤘습니다. Tomcat 5편의 작업 스레드 풀은 maxThreads 로 스레드 수를 정하지만, Gradle 의 --max-workers 는 스레드 수가 아니라 동시에 일하는 자리표의 수입니다. 스레드는 여러 풀(Execution worker, WorkerExecutor Queue)에 따로 있고 자리표 하나를 함께 나눠 씁니다. httpd 8편의 MPM 이 "프로세스로 나눌까, 스레드로 나눌까"를 고르는 것은 Worker API 의 세 격리 수준과 닮았습니다. 같은 프로세스의 스레드(noIsolation)는 가볍지만 서로 섞이고, 프로세스(processIsolation)는 무겁지만 떨어져 있습니다. Spring 27편의 @Async 가 메서드 호출을 TaskExecutor 에 넘기고 바로 돌아오는 것은 WorkQueue.submit() 과 같은 모양인데, Gradle 은 그 뒤에 "태스크가 끝났다"를 일이 다 끝날 때까지 미루고 그동안 잠금을 내준다는 점이 다릅니다.