이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 네 번째 글입니다. 2편에서 브로커·컨트롤러·파티션의 전체 지도를 그렸고, 3편에서 클라이언트와 브로커가 주고받는 요청·응답의 바이트 모양(4바이트 길이 + 헤더 + 본문)을 봤습니다. 이번에는 그 바이트가 브로커에 도착한 뒤를 따라갑니다. 연결을 받고, 요청을 읽어, 처리할 스레드에 넘기고, 응답을 다시 소켓에 쓰기까지입니다.
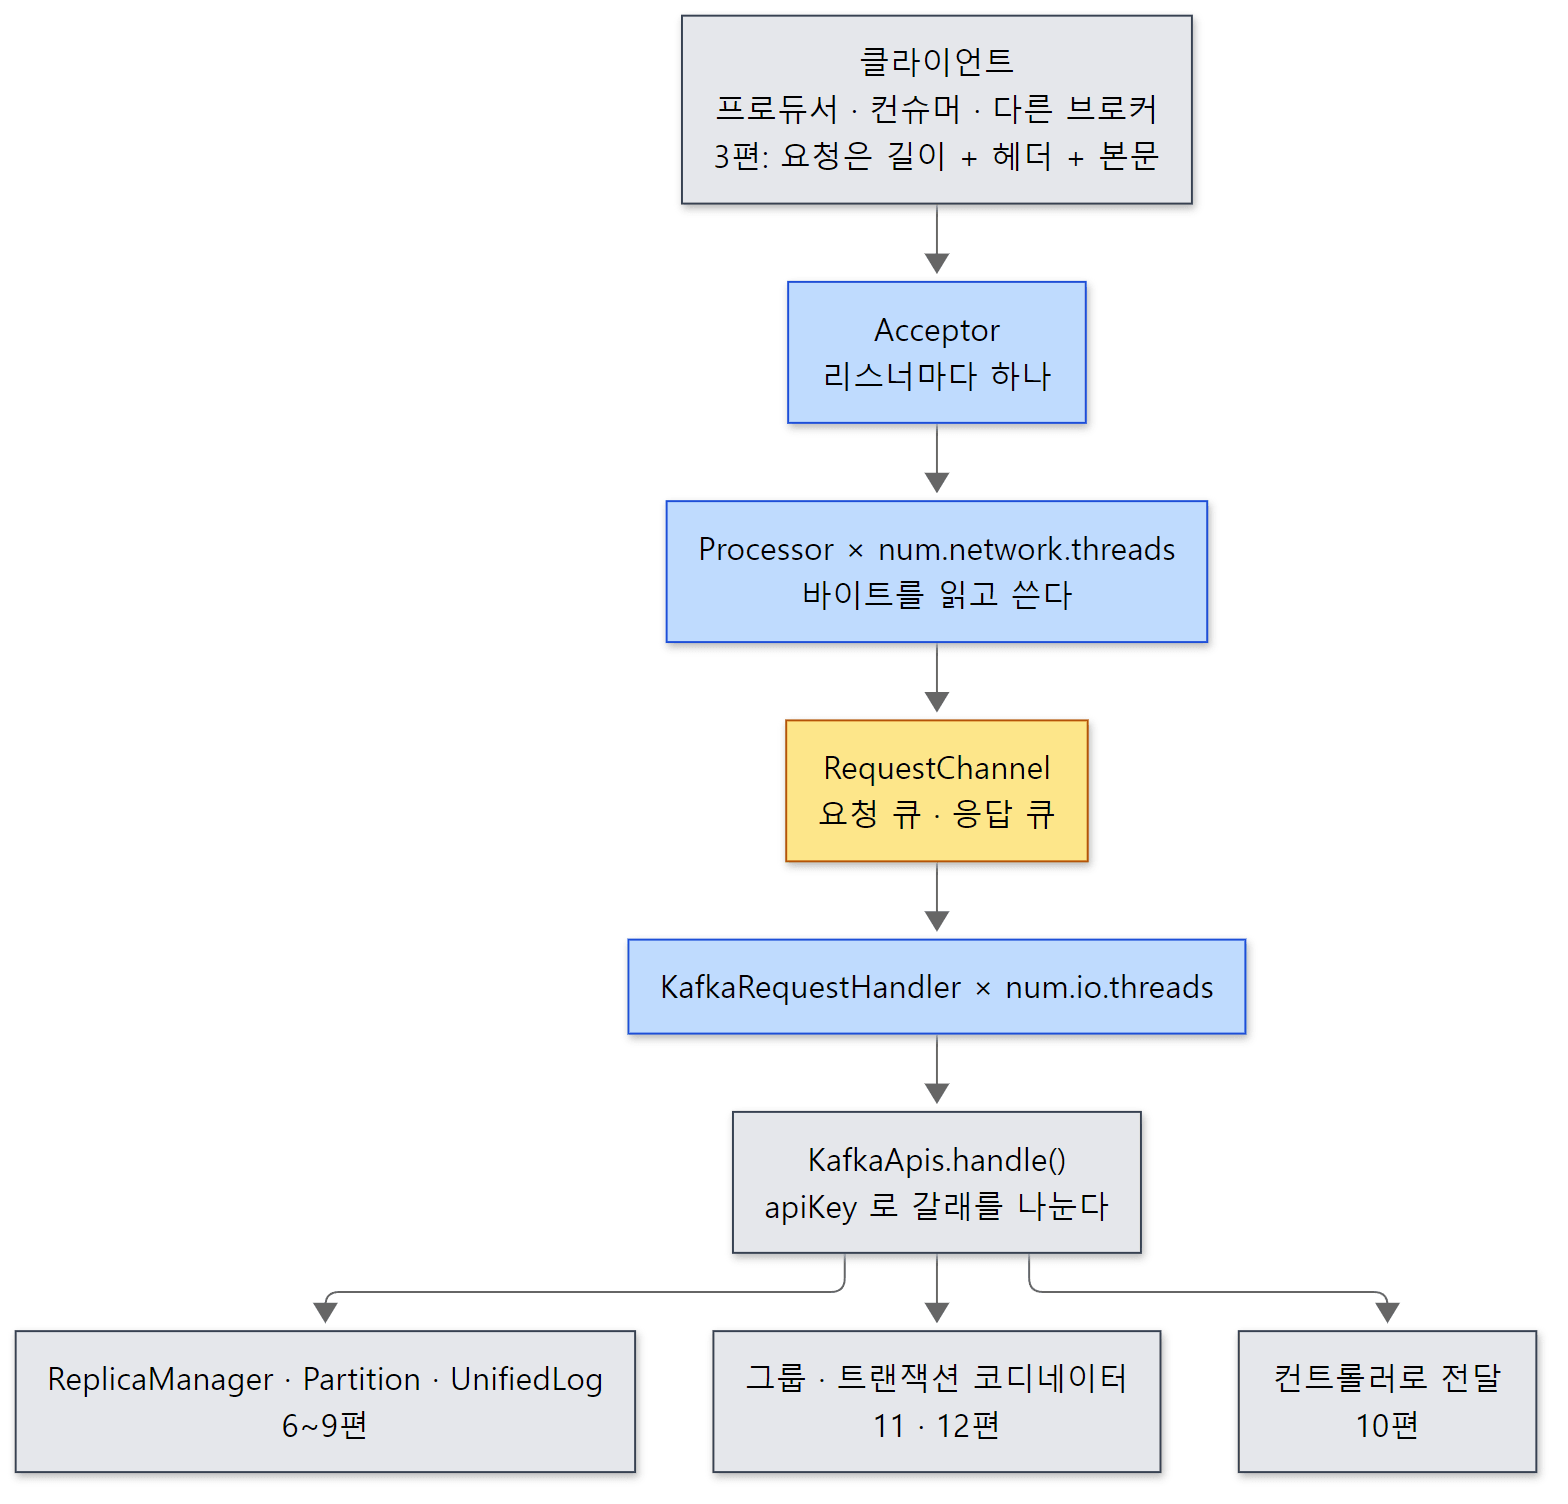 파란·노란 상자가 이 글에서 다루는 브로커 안 네트워크 계층입니다. 회색 상자는 앞뒤 글의 몫입니다.
2편 지도로 말하면 이 글은 B 구역(브로커의 네트워크 계층) 전체와 C 구역(요청 처리) 의 입구 — 요청 처리 스레드와 KafkaApis.handle() 의 갈래 — 까지를 확대합니다.
답하려는 질문은 네 가지입니다.
- 브로커의
jstack에 보이는data-plane-kafka-socket-acceptor-…,…-network-thread-…,…-request-handler-N은 각각 무슨 일을 하고, 몇 개씩 생기는가 - 요청 바이트는 어느 스레드가 읽고, 어느 스레드가 처리하고, 응답은 누가 소켓에 쓰는가
- 처리 스레드가 여러 개인데, 한 연결에서 보낸 요청들의 순서는 어떻게 지켜지는가
num.network.threads,num.io.threads,queued.max.requests는 코드의 어디에서 쓰이고, 넘치면 무엇이 멈추는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | kafka.network.SocketServer·Acceptor·Processor·RequestChannel(Scala), kafka.server.KafkaRequestHandler·KafkaApis(Scala), org.apache.kafka.common.network.Selector·KafkaChannel(Java, clients), org.apache.kafka.network.Request(Java, server) |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 이 글이 읽는 네트워크 계층은 흔히 쓰는 최신 안정판 4.4.0 과 거의 같습니다. SocketServer.scala·RequestChannel.scala·KafkaRequestHandler.scala·Selector.java·KafkaChannel.java·Request.java 를 4.4.0 태그와 비교해 보면 SocketServer.scala 에서 쿼터 설정을 읽는 몇 줄(QuotaConfig 를 만드는 자리)만 다르고 나머지는 같습니다.
SocketServer.scala 하나가 1,695줄이고, 그 안에 Acceptor·Processor 말고도 연결 수 제한(ConnectionQuotas), 연결 생성 속도 쿼터, 리스너를 실행 중에 더하고 빼는 코드가 함께 삽니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
리스너(listener)는 브로커가 연결을 받는 주소 하나입니다. server.properties 의 listeners=PLAINTEXT://:9092,CONTROLLER://:9093 처럼 이름://호스트:포트 를 쉼표로 늘어놓습니다. 이름마다 보안 프로토콜(PLAINTEXT, SSL, SASL_…)이 listener.security.protocol.map 으로 정해집니다. 이 글의 예제는 브로커와 컨트롤러를 한 프로세스로 띄우므로(2편의 combined 모드) 리스너가 둘입니다. 클라이언트가 붙는 PLAINTEXT(9092)와 컨트롤러끼리 쓰는 CONTROLLER(9093)입니다.
NIO Selector: 한 스레드가 여러 소켓을 지켜보는 Java 의 도구입니다. 소켓 채널들을 "읽을 수 있게 되면 알려 달라(OP_READ)", "새 연결이 오면 알려 달라(OP_ACCEPT)" 처럼 관심사를 붙여 등록해 두고 select() 를 부르면, 준비된 채널이 생길 때까지 기다렸다가 그 목록을 돌려줍니다. Linux 에서는 그 밑에 epoll 이 있습니다. Tomcat 5편의 Poller 가 쓰던 바로 그 도구입니다.
Selector(Kafka)와 KafkaChannel: Kafka 는 JDK 의 Selector 를 그대로 쓰지 않고 org.apache.kafka.common.network.Selector 라는 클래스로 한 번 감쌉니다. 이 클래스는 "4바이트 길이를 읽고 그만큼 더 읽어 요청(또는 응답) 하나를 완성하는" 일과 "보낼 바이트를 조금씩 끝까지 쓰는" 일을 해 줍니다. 연결 하나는 KafkaChannel 객체 하나이고, 읽는 중인 수신(NetworkReceive)과 쓰는 중인 송신(NetworkSend)을 하나씩 들고 있습니다. 이 두 클래스는 clients 모듈에 있어서, 프로듀서·컨슈머도 브로커와 같은 클래스로 네트워크를 다룹니다(5편에서 다시 만납니다). 이름이 같아 헷갈리므로 이 글에서는 JDK 의 것을 "NIO Selector", Kafka 의 것을 "Selector" 또는 소스의 별명대로 KSelector 라고 부릅니다.
연결 id: 브로커는 연결마다 127.0.0.1:9092-127.0.0.1:36712-1-1 같은 문자열 id 를 붙입니다. 로컬주소:포트-원격주소:포트-Processor번호-일련번호 입니다(ServerConnectionId.java 122–128행). 마지막 일련번호는 같은 원격 포트가 다시 쓰여도 id 가 겹치지 않게 하려고 붙입니다(SocketServer.scala 866–868행의 주석). 이 id 의 세 번째 칸 덕분에 요청 로그만 보고도 어느 Processor 가 그 연결을 맡았는지 알 수 있습니다(6절의 예제 3).
mute(뮤트, 음소거): 어떤 연결을 "당분간 읽지 않는" 상태로 두는 것입니다. 소스에서는 NIO Selector 에 걸린 그 채널의 관심사에서 OP_READ 를 빼는 것으로 구현됩니다. 그러면 클라이언트가 바이트를 더 보내도 운영체제의 소켓 버퍼에 쌓일 뿐, 브로커는 읽지 않습니다. 이 글의 6절이 mute 가 왜 필요한지를 다룹니다.
요청 큐와 응답 큐: Processor 스레드와 요청 처리 스레드는 직접 부르지 않고 큐로 주고받습니다. 요청은 모든 Processor 가 함께 쓰는 큐 하나(RequestChannel.requestQueue)로, 응답은 Processor 마다 따로 있는 큐(Processor.responseQueue)로 갑니다.
1. SocketServer 를 누가 만들고, 스레드는 몇 개 생기나
브로커가 뜰 때 BrokerServer.startup() 이 new SocketServer(...) 를 부르고(BrokerServer.scala 289–295행), 컨트롤러 역할도 맡은 프로세스라면 ControllerServer.startup() 도 자기 몫의 SocketServer 를 하나 더 만듭니다(ControllerServer.scala 182–187행). BrokerServer·ControllerServer 가 무엇인지는 2편에서 봤습니다. 생성자는 자기가 맡을 리스너마다 Acceptor 를 만듭니다.
  // Create acceptors and processors for the statically configured endpoints when the
  // SocketServer is constructed. Note that this just opens the ports and creates the data
  // structures. It does not start the acceptors and processors or their associated JVM
  // threads.
  if (apiVersionManager.listenerType.equals(ListenerType.CONTROLLER)) {
    config.controllerListeners.foreach(createDataPlaneAcceptorAndProcessors)
  } else {
    config.dataPlaneListeners.foreach(createDataPlaneAcceptorAndProcessors)
  }
core/src/main/scala/kafka/network/SocketServer.scala 142–150행
Scala 읽는 법 — 이 블록은 클래스 본문에 바로 놓인 문장이라 생성자에서 실행됩니다(Scala 에는 따로 생성자 메서드를 쓰지 않고 클래스 본문이 곧 생성자입니다).
xs.foreach(f)는 Java 의xs.forEach(this::f)와 같습니다 — 메서드 이름을 그대로 넘깁니다.
컨트롤러 쪽 SocketServer 는 controller.listener.names 에 적힌 리스너만, 브로커 쪽은 그 나머지만 맡습니다(dataPlaneListeners 는 전체 리스너에서 컨트롤러 리스너를 뺀 것, KafkaConfig.scala 209–219행). 주석대로 이 단계에서는 자료구조만 만들고 스레드는 아직 띄우지 않습니다. 스레드는 나중에 enableRequestProcessing() 이 Acceptor.start() 를 부를 때 시작합니다(173–211행). 인증에 쓸 자격 증명 같은 것이 다 준비된 뒤에 요청을 받기 시작하려는 것입니다(BrokerServer.scala 286–288행의 주석).
Processor 는 리스너마다 num.network.threads 개
createDataPlaneAcceptorAndProcessors() 가 만든 DataPlaneAcceptor 는 설정을 받는 순간 addProcessors(num.network.threads 값) 을 부릅니다(450–452행). addProcessors() 는 이렇습니다.
  def addProcessors(toCreate: Int): Unit = synchronized {
    val listenerName = ListenerName.normalised(endPoint.listener)
    val securityProtocol = endPoint.securityProtocol
    val listenerProcessors = new ArrayBuffer[Processor]()

    for (_ <- 0 until toCreate) {
      val processor = newProcessor(socketServer.nextProcessorId(), listenerName, securityProtocol, socketServer.connectionDisconnectListeners)
      listenerProcessors += processor
      requestChannel.addProcessor(processor)

      if (started.get) {
        processor.start()
      }
    }
    processors ++= listenerProcessors
  }
core/src/main/scala/kafka/network/SocketServer.scala 725–740행
Scala 읽는 법 —
def f(x: Int): Unit = synchronized { … }는 반환값이 없는(Unit) 메서드이고 본문 전체가synchronized블록입니다(Java 의synchronized메서드와 같습니다).val은 다시 대입할 수 없는 변수(final),for (_ <- 0 until n)은 "n 번 되풀이",buf += x는 하나 덧붙이기,buf ++= xs는 여럿 덧붙이기입니다.
눈여겨볼 것이 둘입니다.
- Processor 번호는
SocketServer단위로 매깁니다(socketServer.nextProcessorId(), 154–156행). 브로커 쪽SocketServer의 Processor 는 0, 1, 2 …, 컨트롤러 쪽SocketServer의 Processor 도 따로 0, 1, 2 … 입니다. - 만든 Processor 를
requestChannel.addProcessor()로 등록합니다. 나중에 요청 처리 스레드가 응답을 돌려보낼 때, 요청에 적힌 Processor 번호로 이 표에서 Processor 를 찾습니다(5절).
스레드 이름은 newProcessor() 가 짓습니다.
val name = s"data-plane-kafka-network-thread-$nodeId-${endPoint.listener}-${endPoint.securityProtocol}-$id"
core/src/main/scala/kafka/network/SocketServer.scala 746행
s"…$x…${식}…" 은 Scala 의 문자열 보간(Java 의 "…" + x + "…")입니다. 노드 id, 리스너 이름, 보안 프로토콜, Processor 번호가 차례로 붙습니다. Acceptor 스레드는 리스너마다 하나이고 이름은 s"data-plane-kafka-socket-acceptor-${endPoint.listener}-${endPoint.securityProtocol}-${endPoint.port}" 입니다(506–508행). 끝이 Processor 번호가 아니라 포트입니다.
요청 처리 스레드는 풀마다 num.io.threads 개
요청을 실제로 처리하는 스레드는 SocketServer 바깥에서 만듭니다. BrokerServer 가 KafkaApis 를 만든 뒤 createPool(..., config.numIoThreads, "broker") 를 부르고(BrokerServer.scala 518–525행), ControllerServer 도 ControllerApis 를 넘겨 createPool(..., config.numIoThreads, "controller") 를 부릅니다(ControllerServer.scala 298–305행). 풀은 스레드를 이렇게 띄웁니다.
  private def createHandler(id: Int): Unit = {
    runnables += new KafkaRequestHandler(
      id,
      brokerId,
      aggregateIdleMeter,
      aggregateThreads,
      perPoolIdleMeter,
      threadPoolSize,
      requestChannel,
      apis,
      time,
      nodeName
    )
    aggregateThreads.getAndIncrement()
    KafkaThread.daemon("data-plane-kafka-request-handler-" + id, runnables(id)).start()
  }
core/src/main/scala/kafka/server/KafkaRequestHandler.scala 261–276행
이름에 nodeName("broker"/"controller")이 들어가지 않습니다. 그래서 브로커와 컨트롤러를 한 프로세스로 띄우면 같은 이름의 스레드가 두 벌 생깁니다. 아래 예제에서 그대로 보입니다.
예제 1: 기본 설정으로 띄운 서버의 스레드
이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u04-socket-server 이고, run.sh 가 브로커+컨트롤러 한 프로세스를 기본 설정으로 띄운 뒤 jstack 의 스레드 이름 가운데 네트워크 계층 것만 골라, 끝 번호를 N 으로 바꿔 셉니다. 이 절과 3·6·7절의 출력은 모두 같은 run.sh 를 한 번 돌린 결과입니다.
# 스레드 이름만 뽑아 끝 번호를 N 으로 바꿔 센다 (네트워크 계층 스레드만)
thread_groups() {
  jstack "$1" | grep '^"' | sed 's/^"\([^"]*\)".*/\1/' \
 grep -E 'acceptor|network-thread|request-handler' | sed -E 's/[0-9]+$/N/' | sort | uniq -c
}
[예제 ex/u04-socket-server/run.sh 에서]
=== 1. default settings: network-layer threads (trailing number -> N)
process.roles=broker,controller
listeners=PLAINTEXT://:9092,CONTROLLER://:9093
      3 data-plane-kafka-network-thread-1-CONTROLLER-PLAINTEXT-N
      3 data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-N
     16 data-plane-kafka-request-handler-N
      1 data-plane-kafka-socket-acceptor-CONTROLLER-PLAINTEXT-N
      1 data-plane-kafka-socket-acceptor-PLAINTEXT-PLAINTEXT-N
--- full names of the network threads
"data-plane-kafka-network-thread-1-CONTROLLER-PLAINTEXT-0"
"data-plane-kafka-network-thread-1-CONTROLLER-PLAINTEXT-1"
"data-plane-kafka-network-thread-1-CONTROLLER-PLAINTEXT-2"
"data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-0"
"data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-1"
"data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-2"
읽을 것이 넷입니다.
- Acceptor 는 리스너마다 하나, 둘입니다. 이름 끝의
N은 포트(9092, 9093)를 바꾼 것입니다. - Processor 는 리스너마다 3개입니다.
num.network.threads의 기본값이 3 이기 때문입니다(7절). 이름 가운데1은 노드 id,PLAINTEXT-PLAINTEXT는 "리스너 이름PLAINTEXT, 보안 프로토콜PLAINTEXT" 입니다. 컨트롤러 리스너도 이름은CONTROLLER지만 보안 프로토콜은PLAINTEXT입니다. - 번호가 리스너마다 0 부터 다시 시작합니다. 두 리스너가 서로 다른
SocketServer에 속하기 때문입니다. 브로커 하나에 리스너를 둘 둔다면(예: 내부용·외부용) 같은SocketServer안이므로 0~5 로 이어집니다. request-handler는 16개입니다.num.io.threads의 기본값 8 짜리 풀이 브로커 몫과 컨트롤러 몫으로 하나씩, 같은 이름…-handler-0~…-handler-7로 두 벌 있습니다.
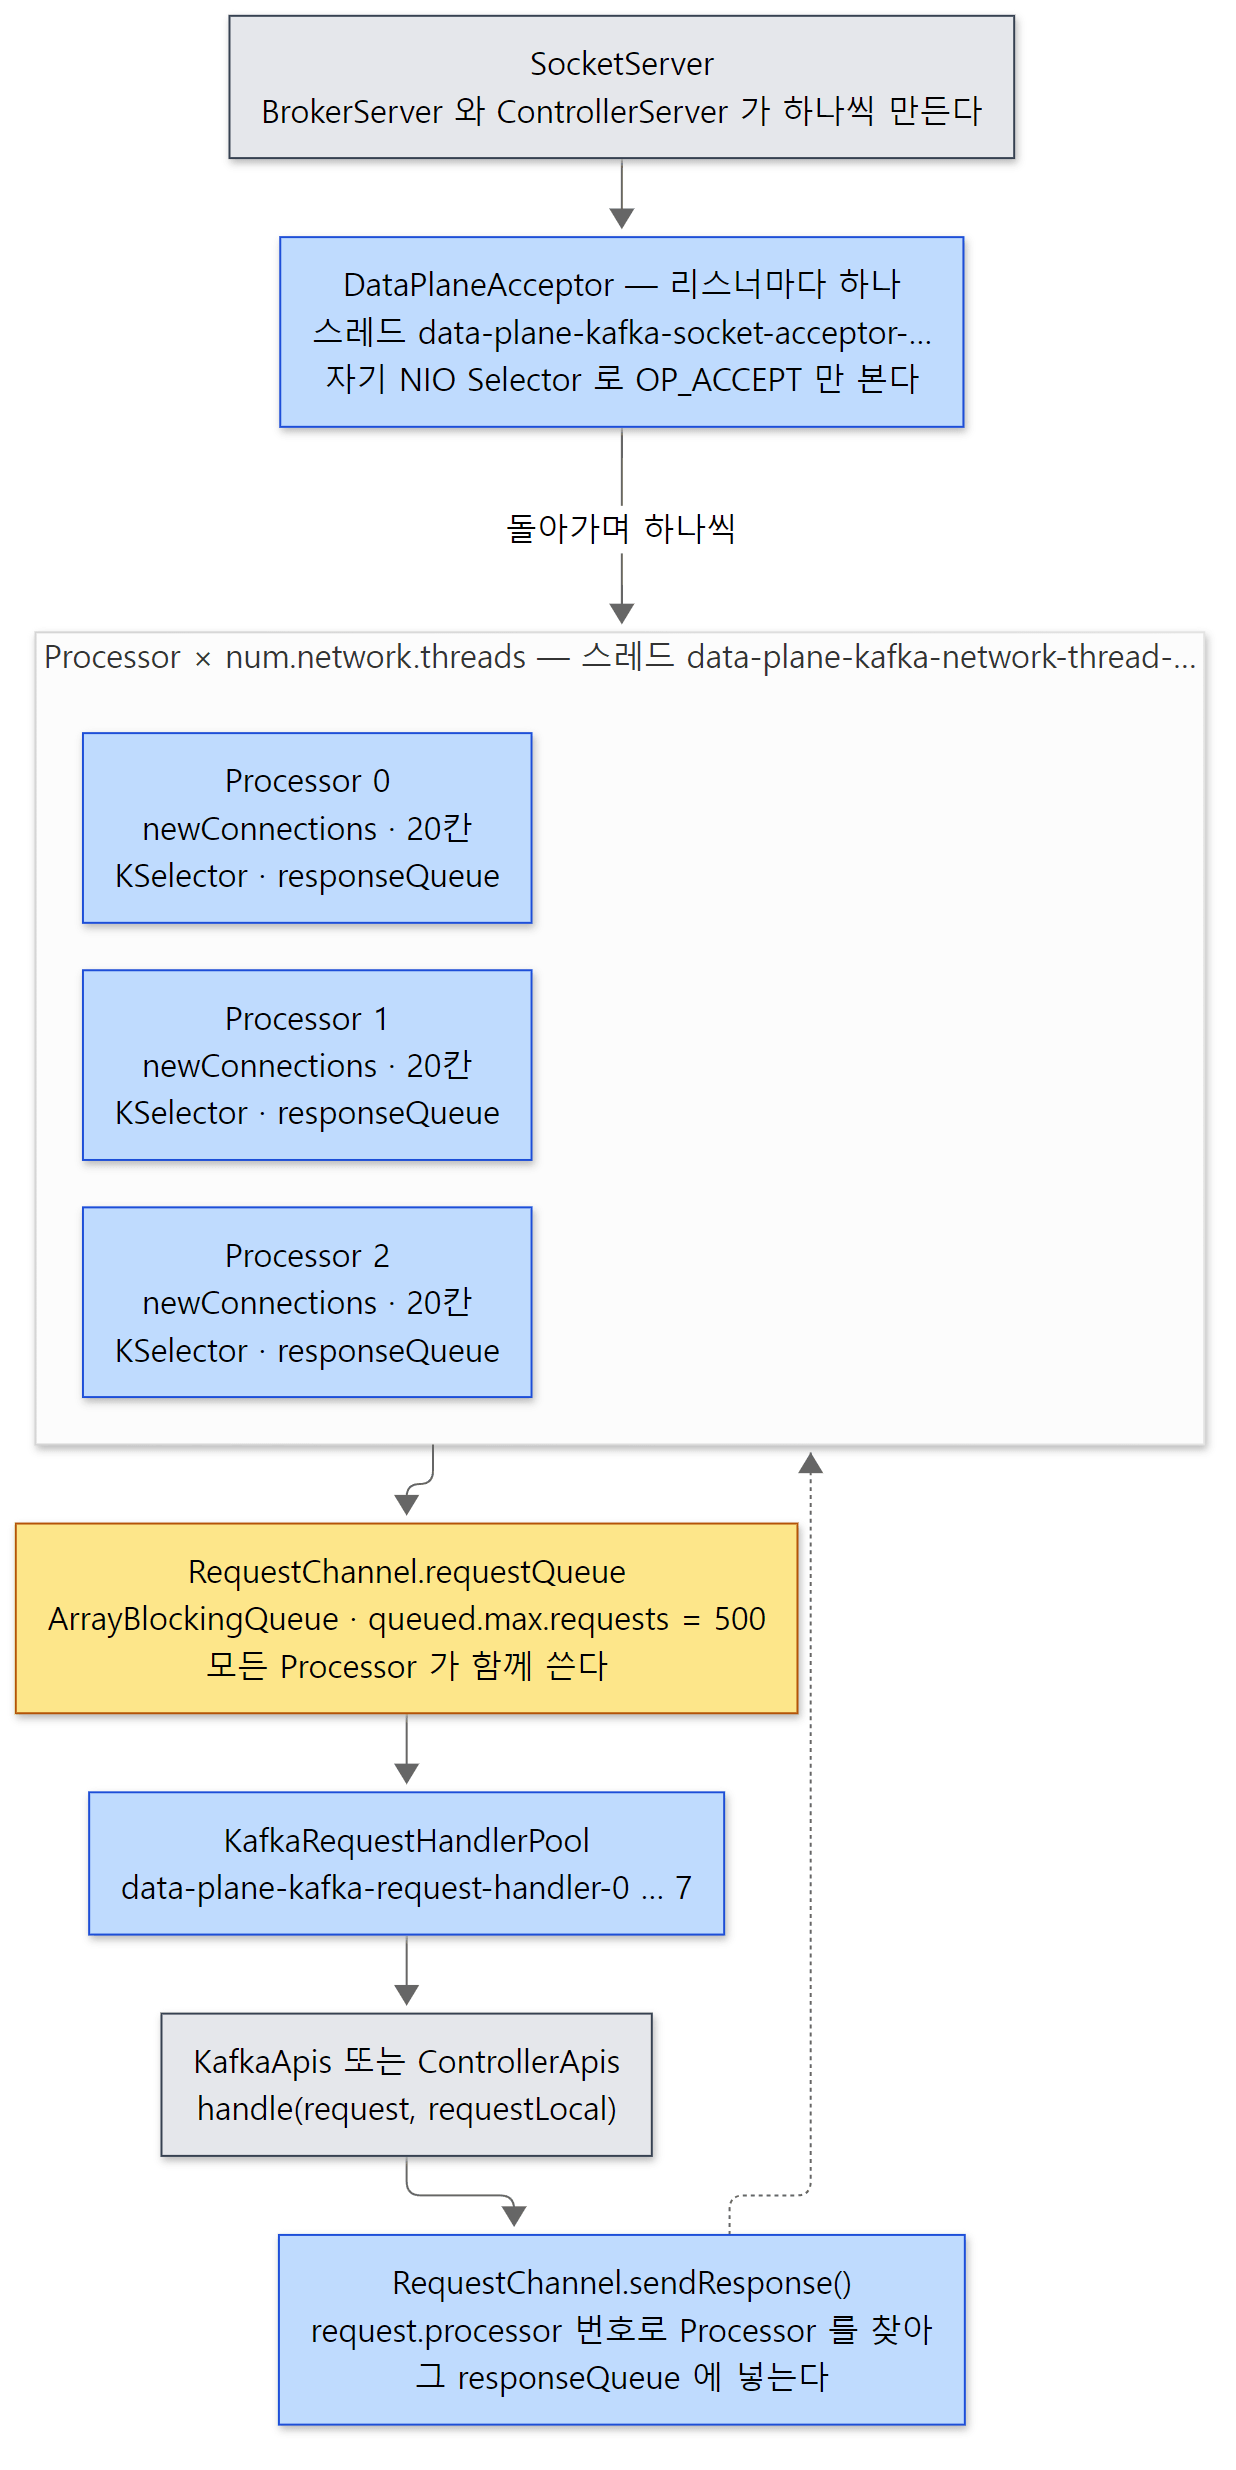 파란 상자가 스레드(맨 아래
sendResponse() 는 요청 처리 스레드가 부르는 단계), 노란 상자가 여러 스레드가 함께 쓰는 큐입니다. 이 그림은 SocketServer 하나와 리스너 하나만 그렸습니다.
헷갈리기 쉬운 곳
- "data-plane" 은 지금은 뜻이 거의 없는 앞말입니다. ZooKeeper 시절에는 컨트롤러가 브로커에 보내는 요청만 따로 받는 리스너(
control.plane.listener.name)를 둘 수 있었고, 그 반대편을 "data plane" 이라 불렀습니다. 그 설정은 커밋0c435e3855(2025-01-08, "KAFKA-18353 Remove zk configcontrol.plane.listener.name")에서 빠졌고 이 커밋에는 control plane 코드가 없습니다. KRaft 의 컨트롤러 리스너(CONTROLLER)도 스레드 이름은data-plane-…입니다. - 설정 설명과 실제가 다른 곳이 있습니다.
num.network.threads의 설명 문구는 "각 리스너(컨트롤러 리스너는 빼고)가 자기 스레드 풀을 만든다" 고 적고 있지만(SocketServerConfigs.java153행), 예제 1 에서 보듯 이 커밋은CONTROLLER리스너에도 같은 수의 Processor 를 만듭니다. 컨트롤러 쪽SocketServer도 같은createDataPlaneAcceptorAndProcessors()→configure()→addProcessors()길을 타기 때문입니다. - 이름이 같은 Java 클래스가 따로 있습니다.
server/src/main/java/org/apache/kafka/network/의SocketServer.java(42줄)와Processor.java(43줄)는 상수와 도우미 메서드만 든 작은 클래스이고, 스레드의 본체는 Scala 의kafka.network.SocketServer·kafka.network.Processor입니다. Scala 쪽에서는import org.apache.kafka.network.{Processor => JProcessor, SocketServer => JSocketServer, …}로 별명을 붙여 구분합니다(43행). 소스에JProcessor.CONNECTION_QUEUE_SIZE가 보이면 Java 쪽 상수입니다.
2. Acceptor: 연결을 받아 Processor 에 돌려 가며 넘긴다
Acceptor 의 run() 은 단순합니다. 듣기 소켓을 자기 NIO Selector 에 OP_ACCEPT 로 등록하고, 멈추라는 신호가 올 때까지 두 일을 되풀이합니다.
  override def run(): Unit = {
    serverChannel.register(nioSelector, SelectionKey.OP_ACCEPT)
    try {
      while (shouldRun.get()) {
        try {
          acceptNewConnections()
          closeThrottledConnections()
        }
        catch {
          // We catch all the throwables to prevent the acceptor thread from exiting on exceptions due
          // to a select operation on a specific channel or a bad request. We don't want
          // the broker to stop responding to requests from other clients in these scenarios.
          case e: ControlThrowable => throw e
          case e: Throwable => error("Error occurred", e)
        }
      }
    } finally {
      closeAll()
    }
  }
core/src/main/scala/kafka/network/SocketServer.scala 572–591행
acceptNewConnections() 가 본체입니다.
  private def acceptNewConnections(): Unit = {
    val ready = nioSelector.select(500)
    if (ready > 0) {
      val keys = nioSelector.selectedKeys()
      val iter = keys.iterator()
      while (iter.hasNext && shouldRun.get()) {
        try {
          val key = iter.next
          iter.remove()

          if (key.isAcceptable) {
            accept(key).foreach { socketChannel =>
              // Assign the channel to the next processor (using round-robin) to which the
              // channel can be added without blocking. If newConnections queue is full on
              // all processors, block until the last one is able to accept a connection.
              var retriesLeft = synchronized(processors.length)
              var processor: Processor = null
              do {
                retriesLeft -= 1
                processor = synchronized {
                  // adjust the index (if necessary) and retrieve the processor atomically for
                  // correct behaviour in case the number of processors is reduced dynamically
                  currentProcessorIndex = currentProcessorIndex % processors.length
                  processors(currentProcessorIndex)
                }
                currentProcessorIndex += 1
              } while (!assignNewConnection(socketChannel, processor, retriesLeft == 0))
            }
          } else
            throw new IllegalStateException("Unrecognized key state for acceptor thread.")
        } catch {
          case e: Throwable => error("Error while accepting connection", e)
        }
      }
    }
  }
core/src/main/scala/kafka/network/SocketServer.scala 623–658행
Scala 읽는 법 —
accept(key)는Option[SocketChannel]을 돌려줍니다.Option은 "값이 있거나(Some(x)) 없거나(None)" 인 상자이고,opt.foreach { x => … }는 값이 있을 때만 블록을 실행합니다(Java 의Optional.ifPresent).var는 다시 대입할 수 있는 변수,synchronized(식)은 그 식을 잠금 안에서 계산한 값입니다.
한 바퀴를 순서대로 읽으면 이렇습니다.
nioSelector.select(500)— 새 연결을 최대 500ms 기다립니다. 영원히 기다리지 않는 이유는 루프 위쪽의shouldRun을 확인하고, 아래의closeThrottledConnections()로 "연결 속도 쿼터에 걸려 일부러 늦게 닫기로 한 연결" 을 정리하기 위해서입니다.accept(key)—serverSocketChannel.accept()로 연결을 받고, 연결 수 제한(ConnectionQuotas.inc())을 통과하면 소켓을 설정해Some(socketChannel)을 돌려줍니다(663–687행). IP 당 연결 수(max.connections.per.ip)를 넘었으면 바로 닫고None입니다.- 돌려 가며(round robin) 고른 Processor 에 넘깁니다.
currentProcessorIndex를 하나씩 올리며 다음 Processor 의accept()를 부릅니다. 그 Processor 의 대기열이 꽉 찼으면 다음 Processor 로 넘어가고, 마지막 시도(retriesLeft == 0)에서만 자리가 날 때까지 기다립니다(mayBlock).
받은 소켓은 이렇게 설정합니다.
  protected def configureAcceptedSocketChannel(socketChannel: SocketChannel): Unit = {
    socketChannel.configureBlocking(false)
    socketChannel.socket().setTcpNoDelay(true)
    socketChannel.socket().setKeepAlive(true)
    if (sendBufferSize != Selectable.USE_DEFAULT_BUFFER_SIZE)
      socketChannel.socket().setSendBufferSize(sendBufferSize)
  }
core/src/main/scala/kafka/network/SocketServer.scala 689–695행
논블로킹으로 바꾸고(이제 이 소켓은 Selector 로 다룹니다), TCP_NODELAY 를 켭니다. TCP_NODELAY 는 작은 패킷을 모아 보내려고 잠깐 기다리는 운영체제의 동작(Nagle 알고리즘)을 끄는 옵션입니다. Kafka 의 배치는 애플리케이션이 이미 모아서 보내므로, 운영체제가 한 번 더 기다릴 이유가 없습니다.
Processor 쪽 accept() 는 큐에 넣고 Processor 를 깨우는 것이 전부입니다.
  def accept(socketChannel: SocketChannel,
             mayBlock: Boolean,
             acceptorBlockedPercentMeter: com.yammer.metrics.core.Meter): Boolean = {
    val accepted = {
      if (newConnections.offer(socketChannel))
        true
      else if (mayBlock) {
        val startNs = time.nanoseconds
        newConnections.put(socketChannel)
        acceptorBlockedPercentMeter.mark(time.nanoseconds() - startNs)
        true
      } else
        false
    }
    if (accepted)
      wakeup()
    accepted
  }
core/src/main/scala/kafka/network/SocketServer.scala 1119–1136행
newConnections 는 크기 20 의 ArrayBlockingQueue 입니다(809행, 크기는 Java 쪽 상수 CONNECTION_QUEUE_SIZE = 20, Processor.java 31행). offer() 는 자리가 없으면 바로 false, put() 은 자리가 날 때까지 기다립니다. Acceptor 는 소켓을 Processor 의 Selector 에 직접 등록하지 않고 큐에 넣기만 합니다. 등록은 그 Selector 의 주인인 Processor 스레드가 다음 바퀴의 configureNewConnections() 에서 직접 합니다(3절). 소스 주석에 이유가 적혀 있지는 않지만, Tomcat 의 Acceptor 가 Poller 의 큐에 넣기만 하던 것과 같은 모양입니다 — NIO Selector 를 한 스레드만 만지게 하는 구조입니다. wakeup() 은 select() 에서 기다리고 있을 Processor 를 깨워 새 연결을 곧바로 등록하게 합니다.
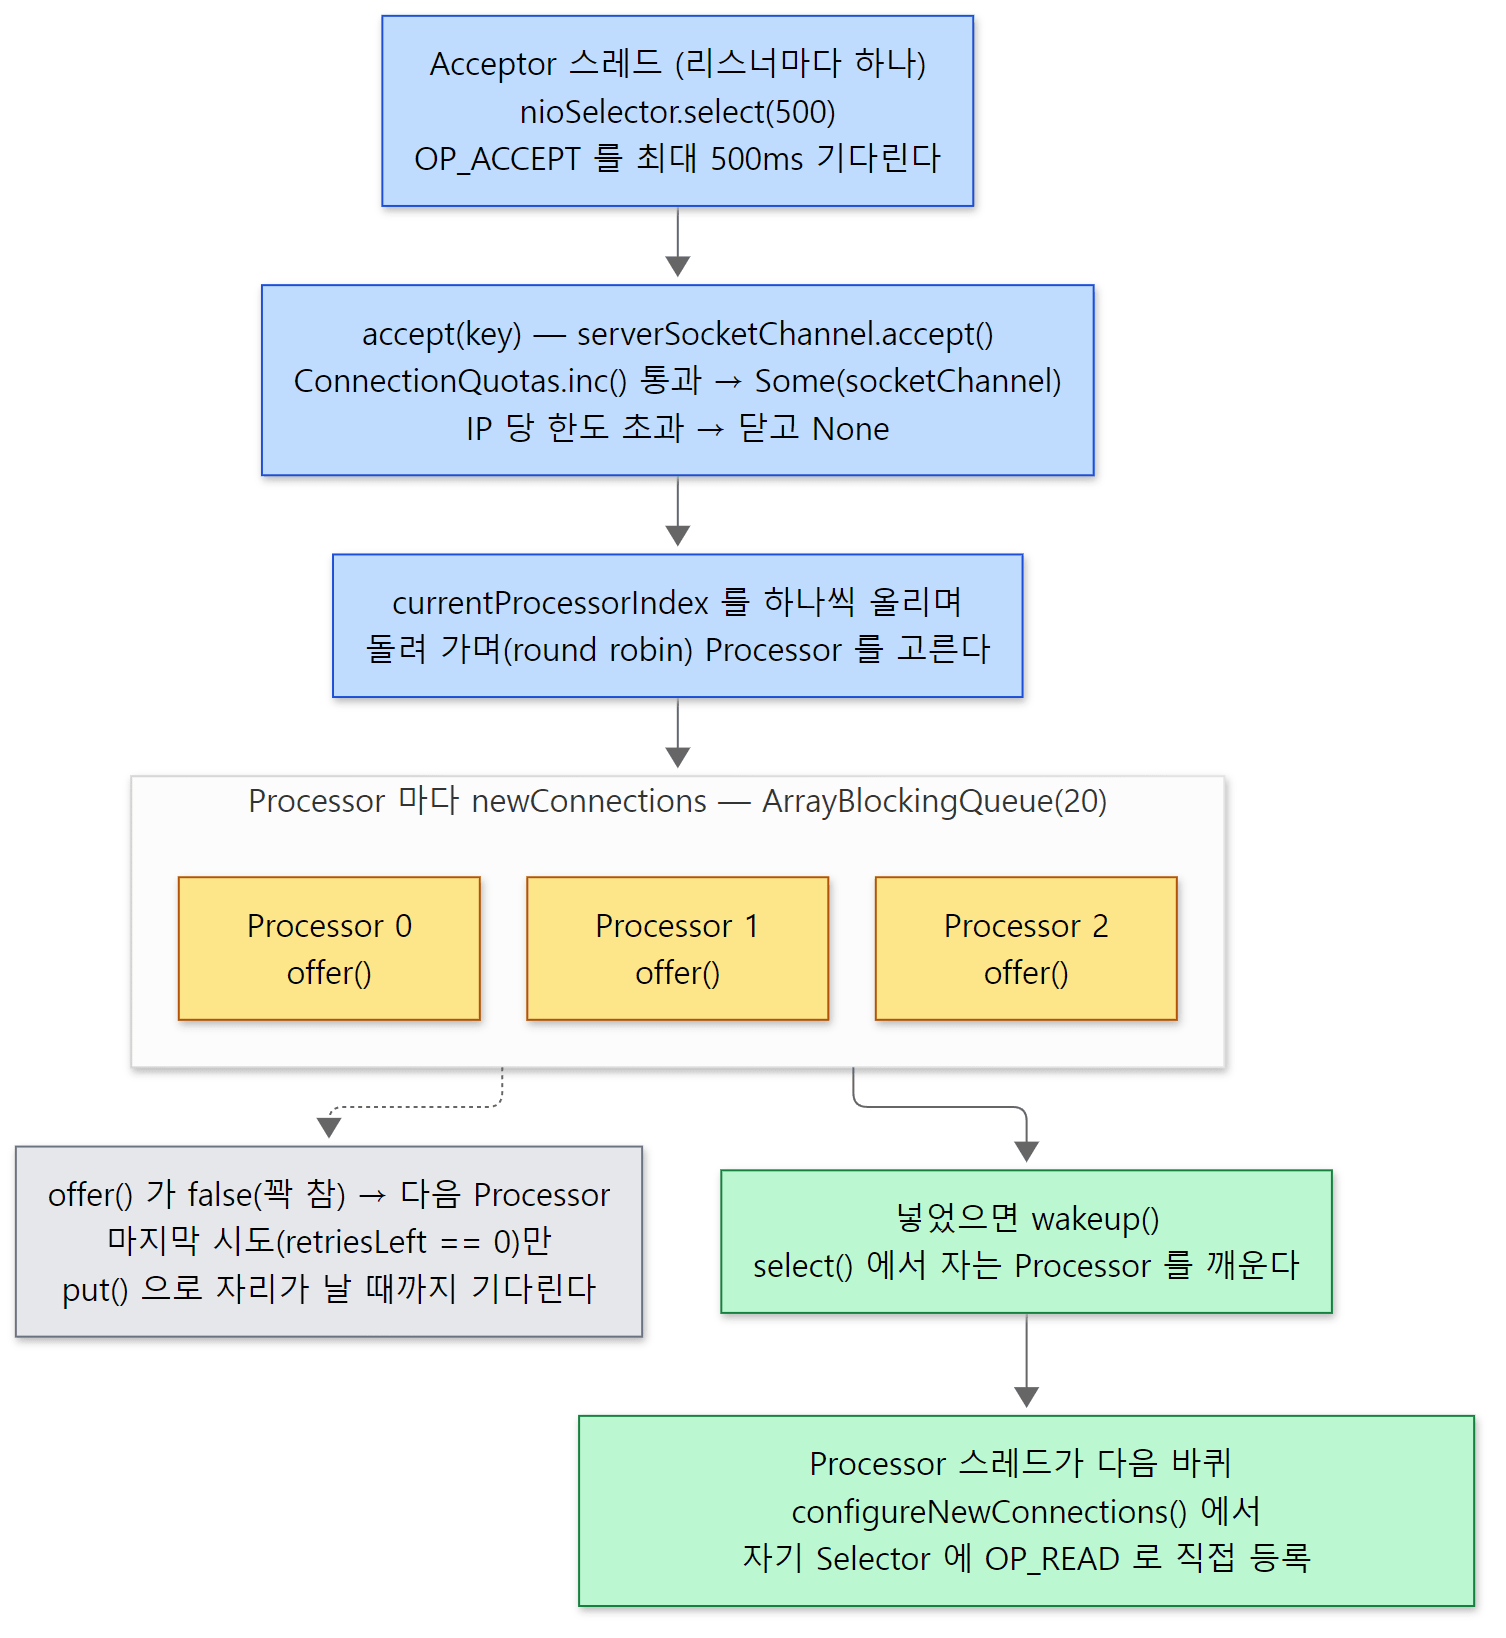 Acceptor 는 소켓을 큐에 넣기만 하고, Selector 등록은 그 Selector 의 주인인 Processor 가 합니다. Processor 셋은 기본값 num.network.threads=3 일 때의 모습입니다.
마지막으로 Scala 읽는 법 하나 — 이 메서드의 마지막 줄 accepted 처럼, Scala 에서는 블록의 마지막 식이 그 블록의 값(반환값) 입니다. val accepted = { … } 도 중괄호 안 if 식의 값이 accepted 가 됩니다.
헷갈리기 쉬운 곳: Tomcat 의 Acceptor 와 다른 점
Tomcat 5편의 Acceptor 는 듣기 소켓을 블로킹으로 열어 두고 accept() 에서 그대로 기다렸습니다. Kafka 의 Acceptor 는 듣기 소켓도 NIO Selector 에 등록해 select(500) 으로 기다립니다. 그래서 jstack 에서 Kafka 의 Acceptor 는 accept 가 아니라 EPoll.wait 에 있습니다(3절의 예제 2). 또 Tomcat 은 커넥터 하나에 Acceptor 하나, Poller 하나였지만 Kafka 는 리스너마다 Acceptor 하나, 리스너마다 Processor 여럿입니다.
연결 수 제한도 자리가 다릅니다. Tomcat 은 maxConnections 를 넘으면 Acceptor 가 accept() 전에 LimitLatch 에서 멈췄습니다. Kafka 는 일단 accept() 로 받은 뒤 ConnectionQuotas.inc() 안의 waitForConnectionSlot() 에서 브로커 전체·리스너별 한도(max.connections)나 연결 생성 속도 한도를 확인하고, 넘었으면 counts.wait() 로 Acceptor 가 멈춥니다(1431–1448행). 기본값은 모두 Integer.MAX_VALUE 라 따로 설정하지 않으면 걸리지 않습니다(7절의 표). 커널 대기열의 크기(Tomcat 의 acceptCount)에 해당하는 것은 socket.listen.backlog.size(기본 50)이고, 듣기 소켓을 bind(socketAddress, listenBacklogSize) 할 때 넘깁니다(ServerSocketFactory.java 53행).
3. Processor: 한 스레드가 읽기와 쓰기를 모두 한다
Processor 스레드의 run() 은 일곱 단계를 한 바퀴로 돕니다.
  override def run(): Unit = {
    try {
      while (shouldRun.get()) {
        try {
          // setup any new connections that have been queued up
          configureNewConnections()
          // register any new responses for writing
          processNewResponses()
          poll()
          processCompletedReceives()
          processCompletedSends()
          processDisconnected()
          closeExcessConnections()
        } catch {
          // ...
core/src/main/scala/kafka/network/SocketServer.scala 871–884행
| 단계 | 하는 일 |
|---|---|
configureNewConnections() |
newConnections 큐에서 소켓을 꺼내 연결 id 를 붙이고 자기 Selector 에 OP_READ 로 등록한다(1143–1160행). 한 바퀴에 최대 20개 |
processNewResponses() |
요청 처리 스레드가 responseQueue 에 넣어 둔 응답을 꺼내 selector.send() 로 "보낼 것" 으로 걸어 둔다(5절) |
poll() |
selector.poll(timeout) — 실제로 소켓에서 읽고 쓰는 곳. 새 연결이 기다리고 있으면 0ms, 아니면 최대 300ms 기다린다(971–980행) |
processCompletedReceives() |
이번 poll() 에서 다 읽힌 요청을 Request 객체로 만들어 요청 큐에 넣고, 그 연결을 mute 한다 |
processCompletedSends() |
다 써진 응답을 정리하고, 그 연결을 unmute 한다(6절) |
processDisconnected() |
끊긴 연결의 연결 수를 내리고, 보내려던 응답을 버린다 |
closeExcessConnections() |
브로커 전체 연결 수가 max.connections 를 넘었으면(브로커 간 리스너는 한도를 넘어서도 받아 주므로 생길 수 있다) 이 리스너에서 연결 하나를 닫는다. 닫히는 중인 연결이 있으면 그것을, 없으면 가장 오래 쓰지 않은 연결을 고른다(유휴 연결 정리가 켜져 있을 때 — 기본값. Selector.java 1026–1036행의 lowestPriorityChannel()) |
Tomcat 과 가장 다른 점이 여기 있습니다. Tomcat 의 Poller 는 "읽을 것이 생겼다" 고 알리기만 하고, 바이트를 읽는 일은 작업 스레드가 했습니다. Kafka 의 Processor 는 요청 하나가 끝까지 다 도착할 때까지 자기가 읽고, 처리 결과인 응답도 자기가 씁니다. 요청 처리 스레드는 소켓을 전혀 만지지 않습니다. 3편에서 본 대로 Kafka 의 요청은 맨 앞 4바이트에 길이가 적혀 있어서, 네트워크 스레드가 "어디까지가 요청 하나인지" 를 내용을 몰라도 알 수 있기 때문에 가능한 나눔입니다. 길이를 읽고 그만큼 읽는 코드는 NetworkReceive.readFrom() 이고, 여기서 socket.request.max.bytes(기본 100MB)보다 큰 길이가 오면 InvalidReceiveException 을 던집니다(NetworkReceive.java 94–95행).
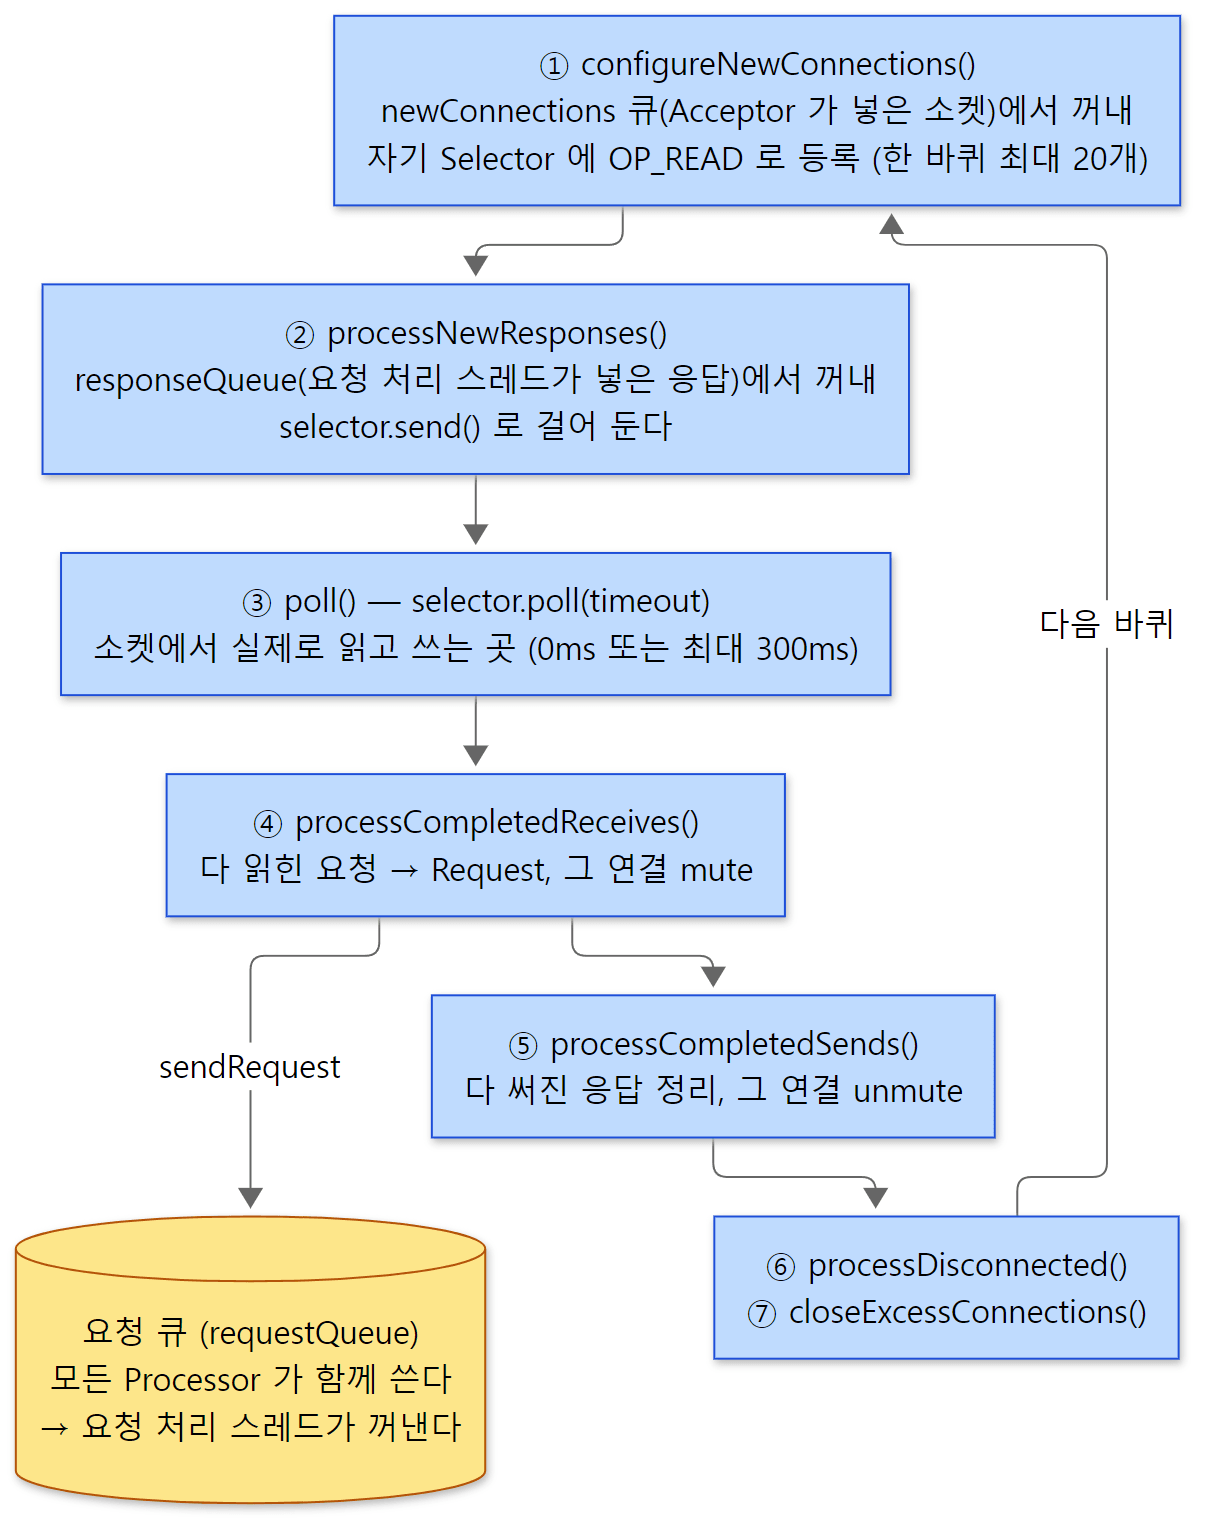 소켓을 읽고 쓰는 일은 처음부터 끝까지 이 한 스레드의 몫이고, 요청 처리 스레드와는 두 큐로만 이어집니다.
요청 하나가 완성되면: Request 를 만들어 큐에 넣고 mute
  private def processCompletedReceives(): Unit = {
    selector.completedReceives.forEach { receive =>
      var header: RequestHeader = null
      var req: Request = null
      try {
        openOrClosingChannel(receive.source) match {
          case Some(channel) =>
            header = JProcessor.parseRequestHeader(apiVersionManager, receive.payload)
            // ...
              val nowNanos = time.nanoseconds()
              // ...
                val connectionId = receive.source
                val context = new RequestContext(header, connectionId, channel.socketAddress, Optional.of(channel.socketPort()),
                  channel.principal, listenerName, securityProtocol, channel.channelMetadataRegistry.clientInformation,
                  isPrivilegedListener, channel.principalSerde)

                req = new Request(id, context, nowNanos, memoryPool, receive.payload, requestChannel.metrics)
                // ...
                requestChannel.sendRequest(req)
                selector.mute(connectionId)
                handleChannelMuteEvent(connectionId, ChannelMuteEvent.REQUEST_RECEIVED)
core/src/main/scala/kafka/network/SocketServer.scala 982–1021행
Scala 읽는 법 —
x match { case Some(channel) => … case None => … }는 Java 의switch를 넓힌 것으로,Option상자를 열어 값이 있으면channel이라는 이름으로 꺼냅니다. 줄인 자리에는 SASL 재인증, 인증 세션이 만료된 연결 닫기, ApiVersions 요청에서 클라이언트 이름·버전 기록하기(KIP-511, 1009–1018행)가 있습니다.
- 헤더만 먼저 풉니다.
parseRequestHeader()는 헤더를 읽고, 이 리스너에서 쓸 수 있는 API·판인지 확인합니다. 쓸 수 없으면 예외(InvalidRequestException또는UnsupportedVersionException,Processor.java33–42행)를 던지고,catch의processChannelException()이 그 연결을 닫습니다. 브로커가 모르는 판의 요청을 보내면 응답 없이 연결이 끊기는 것이 이 자리 때문입니다(ApiVersions 만은 어떤 판이든 통과시킵니다 —ApiKeys.isVersionEnabled()의 247–250행. 그 까닭은 3편의 판 협상에 있습니다). RequestContext와Request를 만듭니다. 컨텍스트는 "누가, 어느 리스너로, 어떤 보안 프로토콜로 보냈나" 를,Request는 그 컨텍스트와 본문, 그리고 도착 시각nowNanos와 Processor 번호id를 들고 있습니다. 도착 시각은 요청 로그의 시간 계산에, Processor 번호는 응답을 돌려보낼 곳을 찾는 데 쓰입니다.Request의 생성자가 본문까지 풀어 둡니다(context.parseRequest(buffer),Request.java101행). 그러니 바이트를 객체로 바꾸는 일까지 네트워크 스레드의 몫입니다.- 요청 큐에 넣고(
sendRequest), 그 연결을 mute 합니다. 이 연결에서는 이 요청의 응답이 나갈 때까지 더 읽지 않겠다는 뜻입니다. 이유는 6절에서 봅니다.
예제 2: 놀고 있을 때 각 스레드가 기다리는 자리
같은 run.sh 가 요청을 보내기 전에 세 종류의 스레드를 하나씩 골라 jstack 을 찍었습니다. 맨 위 프레임과 Kafka 프레임만 남겼습니다(run.sh 의 thread_stack 함수).
=== 2. where each kind of thread waits while idle
"data-plane-kafka-socket-acceptor-PLAINTEXT-PLAINTEXT-9092" #76 [1866] prio=5 os_prio=0 cpu=2.09ms elapsed=2.93s tid=0x00007efdbd3cbb00 nid=1866 runnable  [0x00007efc755d4000]
	at sun.nio.ch.EPoll.wait(java.base@25.0.5/Native Method)
	at kafka.network.Acceptor.acceptNewConnections(SocketServer.scala:624)
	at kafka.network.Acceptor.run(SocketServer.scala:577)
"data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-0" #77 [1863] prio=5 os_prio=0 cpu=18.97ms elapsed=3.14s tid=0x00007efdbd3c30a0 nid=1863 runnable  [0x00007efc758d7000]
	at sun.nio.ch.EPoll.wait(java.base@25.0.5/Native Method)
	at org.apache.kafka.common.network.Selector.select(Selector.java:880)
	at org.apache.kafka.common.network.Selector.poll(Selector.java:470)
	at kafka.network.Processor.poll(SocketServer.scala:973)
	at kafka.network.Processor.run(SocketServer.scala:879)
"data-plane-kafka-request-handler-0" #59 [1544] daemon prio=5 os_prio=0 cpu=13.59ms elapsed=4.23s tid=0x00007efdbd2085d0 nid=1544 waiting on condition  [0x00007efd29bee000]
	at jdk.internal.misc.Unsafe.park(java.base@25.0.5/Native Method)
	at kafka.network.RequestChannel.receiveRequest(RequestChannel.scala:165)
	at kafka.server.KafkaRequestHandler.run(KafkaRequestHandler.scala:117)
#76, nid, tid, cpu, elapsed 같은 값은 실행마다 다릅니다. 줄 번호는 모두 기준 커밋의 소스와 맞는 것을 확인했습니다.
- Acceptor 는
SocketServer.scala:624, 곧nioSelector.select(500)에서EPoll.wait에 있습니다. 새 연결을 기다립니다. - Processor 는
Processor.run의poll()(879행) →Processor.poll의selector.poll(pollTimeout)(973행) →clients모듈의Selector.poll→Selector.select(880행,nioSelector.select(timeoutMs)) 에서 역시EPoll.wait에 있습니다. 브로커의 네트워크 스레드가 클라이언트 라이브러리의org.apache.kafka.common.network.Selector안에서 기다린다는 것이 스택에 그대로 보입니다. - 요청 처리 스레드 는
RequestChannel.scala:165, 곧requestQueue.poll(timeout, …)에서 큐에 일이 들어오기를 기다립니다(JDK 의ArrayBlockingQueue프레임은 걸러 냈습니다). - 머리 줄에
daemon이 붙은 것은 요청 처리 스레드뿐입니다. Acceptor·Processor 는KafkaThread.nonDaemon(…)(506행, 807행), 요청 처리 스레드는KafkaThread.daemon(…)(KafkaRequestHandler.scala275행)으로 만들기 때문입니다.
4. RequestChannel 과 요청 처리 스레드
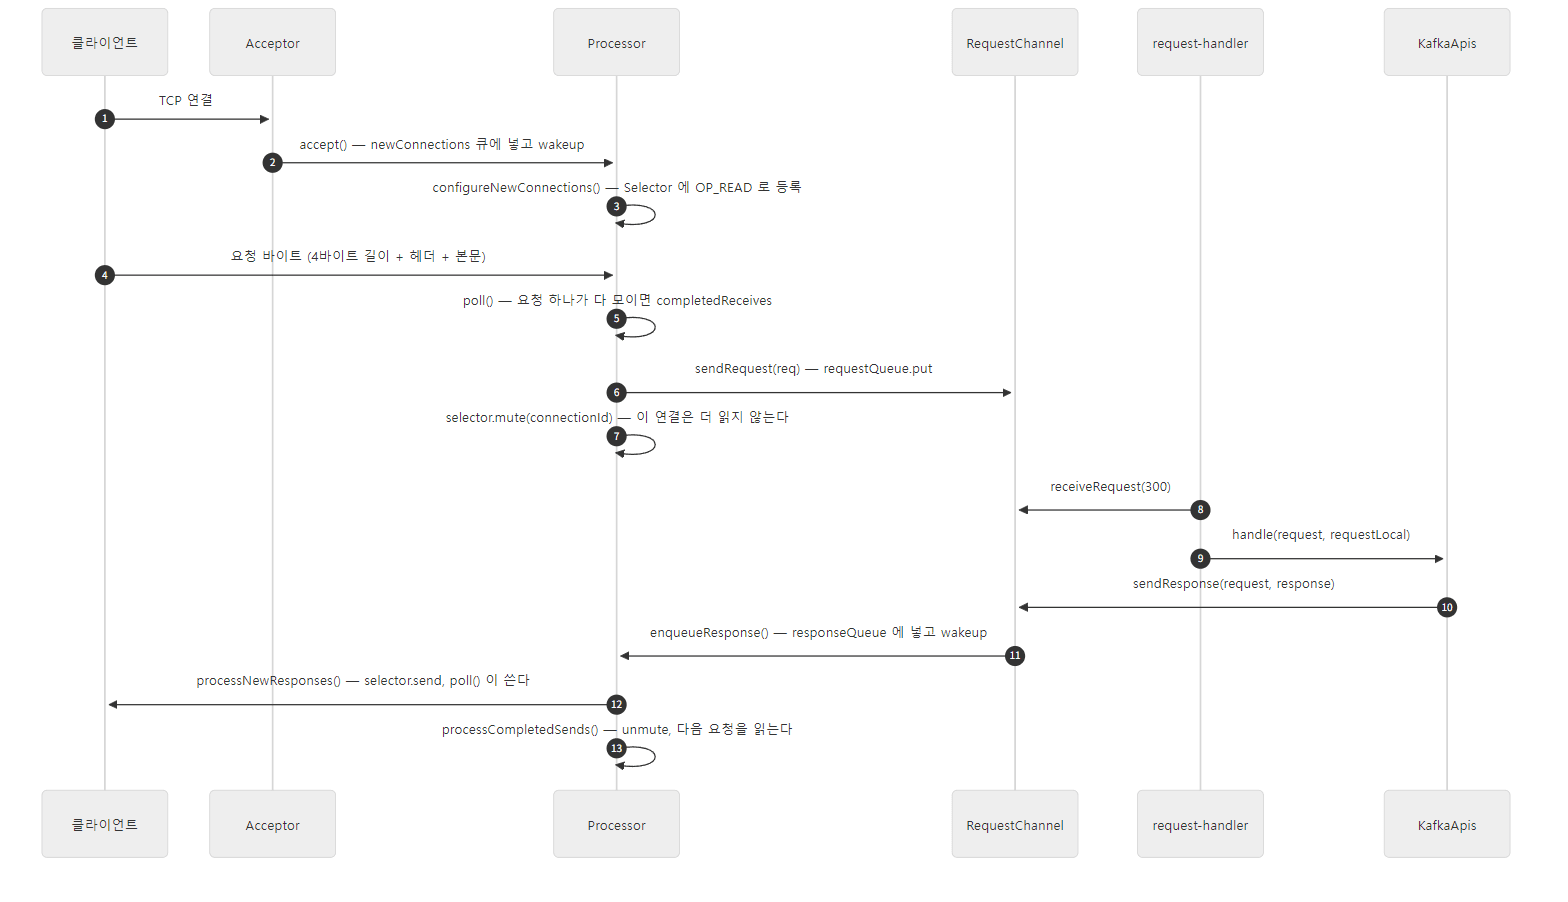 번호는 본문에서 가리키는 순서입니다. 1~7 은 2·3절, 8~9 는 이 절, 10~13 은 5·6절입니다.
요청 큐: 모든 Processor 가 하나를 함께 쓴다
RequestChannel 은 SocketServer 마다 하나이고(100행), 요청 큐는 그 안의 ArrayBlockingQueue 하나입니다.
private val requestQueue = new ArrayBlockingQueue[BaseRequest](queueSize)
core/src/main/scala/kafka/network/RequestChannel.scala 50행
queueSize 는 SocketServer 가 넘긴 config.queuedMaxRequests, 곧 queued.max.requests(기본 500)입니다(SocketServer.scala 85행, 100행). 넣는 쪽과 꺼내는 쪽은 이렇습니다.
  /** Send a request to be handled, potentially blocking until there is room in the queue for the request */
  def sendRequest(request: Request): Unit = {
    requestQueue.put(request)
  }
core/src/main/scala/kafka/network/RequestChannel.scala 76–79행
  def receiveRequest(timeout: Long): BaseRequest = {
    val callbackRequest = callbackQueue.poll()
    if (callbackRequest != null)
      callbackRequest
    else {
      val request = requestQueue.poll(timeout, TimeUnit.MILLISECONDS)
      request match {
        case _: WakeupRequest => callbackQueue.poll()
        case _ => request
      }
    }
  }
core/src/main/scala/kafka/network/RequestChannel.scala 160–171행
sendRequest() 는 put() 입니다. 큐가 500개로 꽉 차 있으면 Processor 스레드가 여기서 멈춥니다. Processor 하나는 많은 연결(수백 개일 수도 있습니다)을 함께 맡으므로, 이것은 그 Processor 의 모든 연결이 잠시 읽기·쓰기를 멈춘다는 뜻입니다. 처리 스레드가 따라오지 못할 때 네트워크에서 더 받아들이지 않는 장치(배압, back pressure)입니다. 설정 설명도 "네트워크 스레드를 막기 전까지 허용하는 대기 요청 수" 라고 적고 있습니다(SocketServerConfigs.java 145행).
receiveRequest() 에는 큐가 하나 더 보입니다. callbackQueue 는 다른 스레드에서 끝난 비동기 작업의 뒷일(콜백)을 요청 처리 스레드에서 이어 하도록 넣어 두는 큐이고, 이미 한 번 줄을 섰던 일이라 먼저 꺼냅니다(157–159행의 주석). WakeupRequest 는 콜백이 들어왔다고 요청 큐 쪽에서 기다리는 스레드를 깨우는 빈 표시입니다(195–199행). 이 글에서는 이름만 알아 둡니다.
요청 처리 스레드의 한 바퀴
  def run(): Unit = {
    threadRequestChannel.set(requestChannel)
    while (!stopped) {
      // ...
      val req = requestChannel.receiveRequest(300)
      // ...
      req match {
        case _: ShutdownRequest =>
          debug(s"Kafka request handler $id on broker $brokerId received shut down command")
          completeShutdown()
          return

        // ...
        case request: Request =>
          try {
            request.requestDequeueTimeNanos(endTime)
            trace(s"Kafka request handler $id on broker $brokerId handling request $request")
            threadCurrentRequest.set(request)
            apis.handle(request, requestLocal)
          } catch {
            case e: FatalExitError =>
              completeShutdown()
              Exit.exit(e.statusCode)
            case e: Throwable => error("Exception when handling request", e)
          } finally {
            threadCurrentRequest.remove()
            request.releaseBuffer()
          }
        // ...
        case null => // continue
      }
    }
core/src/main/scala/kafka/server/KafkaRequestHandler.scala 108–184행
Scala 읽는 법 —
case _: ShutdownRequest =>는 "그 타입이면(값은 쓰지 않음)",case request: Request =>는 "그 타입이면request라는 이름으로 꺼내서" 입니다(Java 21 의switch패턴case Request request ->와 같습니다).case null =>은 300ms 동안 아무것도 오지 않아poll()이null을 돌려준 경우입니다.
하는 일은 셋뿐입니다. 큐에서 꺼낸 시각을 요청에 적고(requestDequeueTimeNanos — 요청 로그의 "큐에서 기다린 시간" 이 여기서 정해집니다), apis.handle() 을 부르고, 끝나면 요청 본문 버퍼를 돌려줍니다. apis 는 브로커 풀이면 KafkaApis, 컨트롤러 풀이면 ControllerApis 입니다. ApiRequestHandler 라는 trait(Java 의 인터페이스) 하나를 둘이 구현합니다(37–40행). ShutdownRequest 는 풀을 내릴 때 스레드 수만큼 큐에 넣는 "그만 하라" 표시입니다(initiateShutdown(), 198행).
KafkaApis.handle(): apiKey 로 갈래를 나눈다
  override def handle(request: Request, requestLocal: RequestLocal): Unit = {
    // ...
      request.header.apiKey match {
        case ApiKeys.PRODUCE => handleProduceRequest(request, requestLocal)
        case ApiKeys.FETCH => handleFetchRequest(request)
        case ApiKeys.LIST_OFFSETS => handleListOffsetRequest(request)
        case ApiKeys.METADATA => handleTopicMetadataRequest(request)
        // ...
        case ApiKeys.CREATE_TOPICS => forwardToController(request)
        // ...
        case _ => throw new IllegalStateException(s"No handler for request api key ${request.header.apiKey}")
      }
core/src/main/scala/kafka/server/KafkaApis.scala 157–257행
Scala 읽는 법 — 여기의
case ApiKeys.PRODUCE =>는 타입이 아니라 값(Java enum 상수)과 같은지 보는 패턴입니다.case _ =>는 Javaswitch의default입니다.
3편에서 본 요청 헤더의 apiKey 로 가르는 큰 match 입니다. 이 커밋에서 case ApiKeys.… 가 79개이고, 그 가운데 16개는 브로커가 직접 처리하지 않고 forwardToController() 로 컨트롤러에 넘깁니다(토픽 만들기·지우기, ACL, 파티션 재배치, 클라이언트 쿼터, 피처 등 — 10편). 이 match 가 이 글과 뒤 글들의 경계입니다. PRODUCE 의 갈래는 6편, FETCH 는 8편에서 따라갑니다.
handle() 의 finally 에서는 replicaManager.tryCompleteActions() 로 미뤄 둔 작업을 마저 시도하고, 처리 스레드에서의 일이 끝난 시각(apiLocalCompleteTimeNanos)을 적습니다(261–270행).
헷갈리기 쉬운 곳: 요청 처리 스레드가 "응답이 나갈 때까지" 붙잡혀 있지는 않습니다
acks=all 인 Produce 나, 데이터가 모이기를 기다리는 Fetch 는 응답이 나가기까지 수백 ms ~ 수 초가 걸릴 수 있습니다. 그동안 요청 처리 스레드가 기다리고 있는 것은 아닙니다. 이런 요청은 handle() 안에서 "조건이 차면 응답을 보내라" 는 지연 작업(퍼거토리, purgatory — 8·9편)으로 걸어 두고 곧바로 돌아옵니다. 응답은 나중에 다른 스레드가 requestChannel.sendResponse() 를 불러 보냅니다. 6절의 예제 3 에서 Fetch 의 시간 대부분이 remoteTimeMs(처리 스레드 밖에서 기다린 시간)로 찍히는 것이 그 흔적입니다.
5. 응답이 돌아가는 길
KafkaApis 가 응답 객체를 만들면 requestChannel.sendResponse(request, response) 를 부릅니다. 이 메서드는 응답을 바이트로 만들 준비(request.buildResponseSend(response))를 한 SendResponse 로 감싸고(91–101행), 시간을 적은 뒤 이렇게 끝납니다.
    val processor = processors.get(response.request.processor)
    // The processor may be null if it was shutdown. In this case, the connections
    // are closed, so the response is dropped.
    if (processor != null) {
      processor.enqueueResponse(response)
    }
core/src/main/scala/kafka/network/RequestChannel.scala 149–154행
요청에 적어 둔 Processor 번호로 Processor 를 찾아 그 Processor 의 응답 큐에 넣습니다. 응답은 반드시 그 요청을 읽은 Processor 로 돌아갑니다. 연결(소켓)은 그 Processor 의 Selector 에만 등록되어 있으니 당연한 일입니다. enqueueResponse() 는 responseQueue.put(response) 다음 wakeup() 으로 poll() 에서 기다리는 Processor 를 깨웁니다(1184–1187행). 응답 큐는 크기 제한이 없는 LinkedBlockingDeque 입니다(811행).
Processor 는 다음 바퀴의 processNewResponses() 에서 응답을 꺼내 종류별로 다룹니다.
  private def processNewResponses(): Unit = {
    var currentResponse: Response = null
    while ({currentResponse = dequeueResponse(); currentResponse != null}) {
      val channelId = currentResponse.request.context.connectionId
      try {
        currentResponse match {
          case response: NoOpResponse =>
            // There is no response to send to the client, we need to read more pipelined requests
            // that are sitting in the server's socket buffer
            updateRequestMetrics(response)
            trace(s"Socket server received empty response to send, registering for read: $response")
            // Try unmuting the channel. If there was no quota violation and the channel has not been throttled,
            // it will be unmuted immediately. If the channel has been throttled, it will be unmuted only if the
            // throttling delay has already passed by now.
            handleChannelMuteEvent(channelId, ChannelMuteEvent.RESPONSE_SENT)
            tryUnmuteChannel(channelId)

          case response: SendResponse =>
            sendResponse(response, response.responseSend)
          case response: CloseConnectionResponse =>
            updateRequestMetrics(response)
            trace("Closing socket connection actively according to the response code.")
            close(channelId)
          // ...
        }
core/src/main/scala/kafka/network/SocketServer.scala 915–945행
| 응답 종류 | 언제 | Processor 가 하는 일 |
|---|---|---|
SendResponse |
보통의 응답 | selector.send() 로 걸어 두고 inflightResponses 에 기록(954–969행). 실제 쓰기는 poll() 이 한다 |
NoOpResponse |
보낼 응답이 없을 때 — acks=0 인 Produce 가 성공했을 때(KafkaApis.scala 529행) |
보낼 것이 없으니 곧바로 unmute 해서 다음 요청을 읽는다 |
CloseConnectionResponse |
응답 없이 연결을 끊어야 할 때 — acks=0 Produce 가 실패했을 때(525행) |
연결을 닫는다. 클라이언트는 연결이 끊긴 것으로 오류를 안다 |
StartThrottlingResponse / EndThrottlingResponse |
쿼터에 걸려 연결을 잠시 묶을 때·풀 때 | mute 상태만 바꾼다(6절의 그림) |
acks=0 의 뜻이 여기서 소스로 보입니다. 프로듀서는 응답을 기다리지 않고, 브로커도 응답을 쓰지 않습니다. 대신 실패하면 연결을 끊는 것이 유일한 신호입니다. KafkaApis.scala 513–515행의 주석이 그렇게 설명합니다.
SendResponse 가 다 써지면 poll() 이 그것을 completedSends 에 넣고, processCompletedSends() 가 마무리합니다.
  private def processCompletedSends(): Unit = {
    selector.completedSends.forEach { send =>
      try {
        val response = inflightResponses.remove(send.destinationId).getOrElse {
          throw new IllegalStateException(s"Send for ${send.destinationId} completed, but not in `inflightResponses`")
        }
        updateRequestMetrics(response)

        // Try unmuting the channel. If there was no quota violation and the channel has not been throttled,
        // it will be unmuted immediately. If the channel has been throttled, it will unmuted only if the throttling
        // delay has already passed by now.
        handleChannelMuteEvent(send.destinationId, ChannelMuteEvent.RESPONSE_SENT)
        tryUnmuteChannel(send.destinationId)
core/src/main/scala/kafka/network/SocketServer.scala 1041–1053행
updateRequestMetrics() 가 요청의 시간 기록을 마무리하고(요청 로그도 여기서 한 줄 남습니다, 6절), 응답을 다 쓴 다음에야 unmute 합니다. 이제 이 연결의 다음 요청을 읽을 수 있습니다.
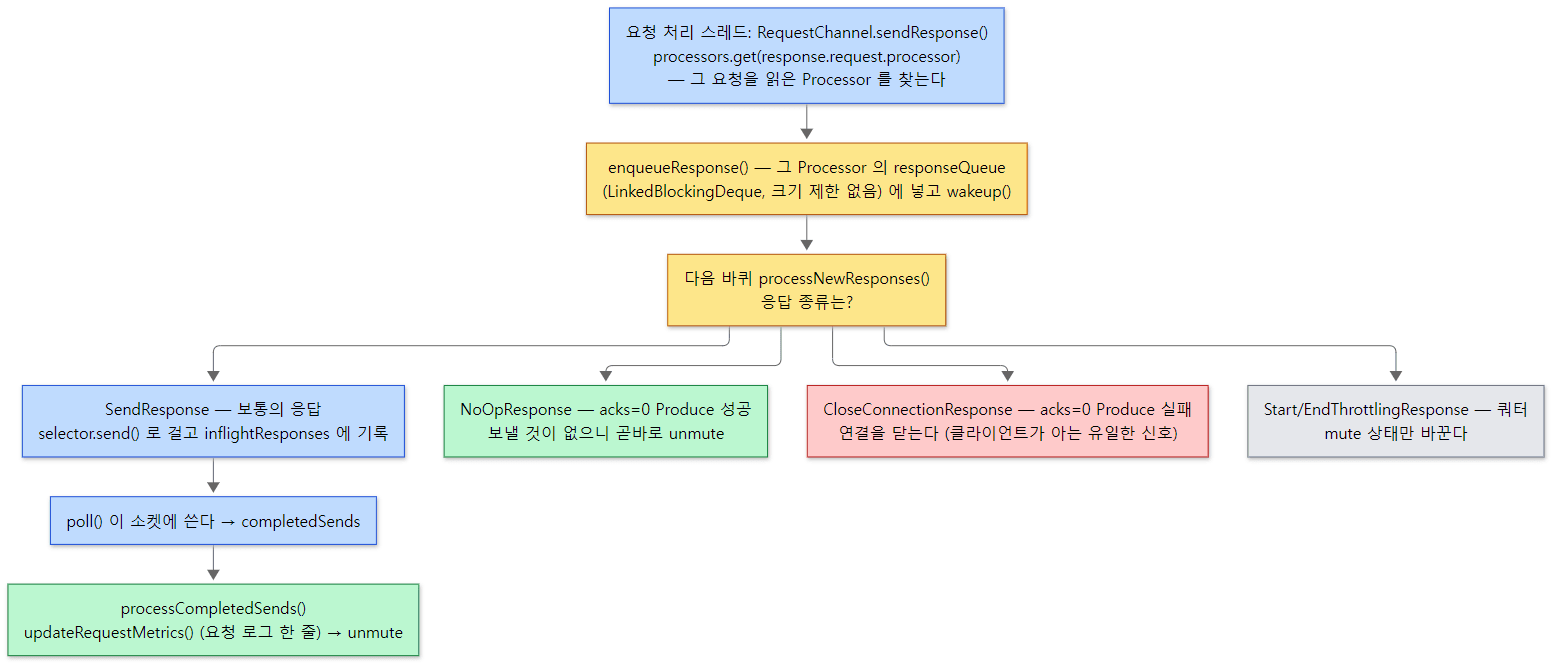 응답은 그 요청을 읽은 Processor 로만 돌아가고, 어느 갈래든 끝에서 연결을 unmute(또는 닫기)해 다음 요청을 읽게 합니다.
6. 연결마다 요청 하나씩 — mute 와 unmute
요청 처리 스레드는 8개이고, 요청 큐는 하나입니다. 한 연결에서 요청 A 와 B 를 잇달아 받아 둘 다 큐에 넣으면, A 는 handler-3 이, B 는 handler-5 가 동시에 꺼내 갈 수 있습니다. 그러면 B 의 응답이 A 보다 먼저 나갈 수도 있고, 같은 파티션에 쓰는 Produce 라면 쓰는 순서가 바뀔 수도 있습니다. Kafka 프로토콜은 한 연결의 응답은 요청을 보낸 순서대로 온다 고 약속하므로(클라이언트의 NetworkClient 는 그 약속을 믿고 응답을 요청과 짝짓습니다 — 3편의 상관 ID), 이래서는 안 됩니다.
Kafka 의 답은 단순합니다. 한 연결에서는 요청을 하나만 꺼내 놓습니다. 그 요청의 응답이 다 나갈 때까지 그 연결은 읽지 않습니다. Selector.poll() 의 설명이 그 이유를 직접 적고 있습니다.
     * At most one entry is added to "completedReceives" for a channel in each poll. This is necessary to guarantee that
     * requests from a channel are processed on the broker in the order they are sent. Since outstanding requests added
     * by SocketServer to the request queue may be processed by different request handler threads, requests on each
     * channel must be processed one-at-a-time to guarantee ordering.
clients/src/main/java/org/apache/kafka/common/network/Selector.java 434–437행
장치는 두 겹입니다.
- 한 번의
poll()에서 연결마다 완성된 요청은 최대 하나.pollSelectionKeys()는 이미 완성된 요청이 있는 연결이나 mute 된 연결은 읽지 않습니다.
                //if channel is ready and has bytes to read from socket or buffer, and has no
                //previous completed receive then read from it
                if (channel.ready() && (key.isReadable() || channel.hasBytesBuffered()) && !hasCompletedReceive(channel)
                        && !explicitlyMutedChannels.contains(channel)) {
                    attemptRead(channel);
                }
clients/src/main/java/org/apache/kafka/common/network/Selector.java 578–583행
- 요청을 큐에 넣는 즉시 그 연결을 mute. 3절의
processCompletedReceives()에서requestChannel.sendRequest(req)바로 다음 줄이selector.mute(connectionId)였습니다. mute 는 결국 NIO Selector 의 관심사에서OP_READ를 빼는 것입니다.
    void mute() {
        if (muteState == ChannelMuteState.NOT_MUTED) {
            if (!disconnected) transportLayer.removeInterestOps(SelectionKey.OP_READ);
            muteState = ChannelMuteState.MUTED;
        }
    }

    /**
     * Unmute the channel. The channel can be unmuted only if it is in the MUTED state. For other muted states
     * (MUTED_AND_*), this is a no-op.
     *
     * @return Whether or not the channel is in the NOT_MUTED state after the call
     */
    boolean maybeUnmute() {
        if (muteState == ChannelMuteState.MUTED) {
            if (!disconnected) transportLayer.addInterestOps(SelectionKey.OP_READ);
            muteState = ChannelMuteState.NOT_MUTED;
        }
        return muteState == ChannelMuteState.NOT_MUTED;
    }
clients/src/main/java/org/apache/kafka/common/network/KafkaChannel.java 252–271행
maybeUnmute() 는 상태가 정확히 MUTED 일 때만 풉니다. 상태가 다섯 가지인 까닭은 "응답이 아직 안 나갔다" 와 "쿼터에 걸려 묶였다" 를 따로 세기 위해서입니다. 응답을 다 써도 쿼터 때문에 묶여 있으면 풀지 않고, 묶임이 끝나도 응답이 아직이면 풀지 않습니다.
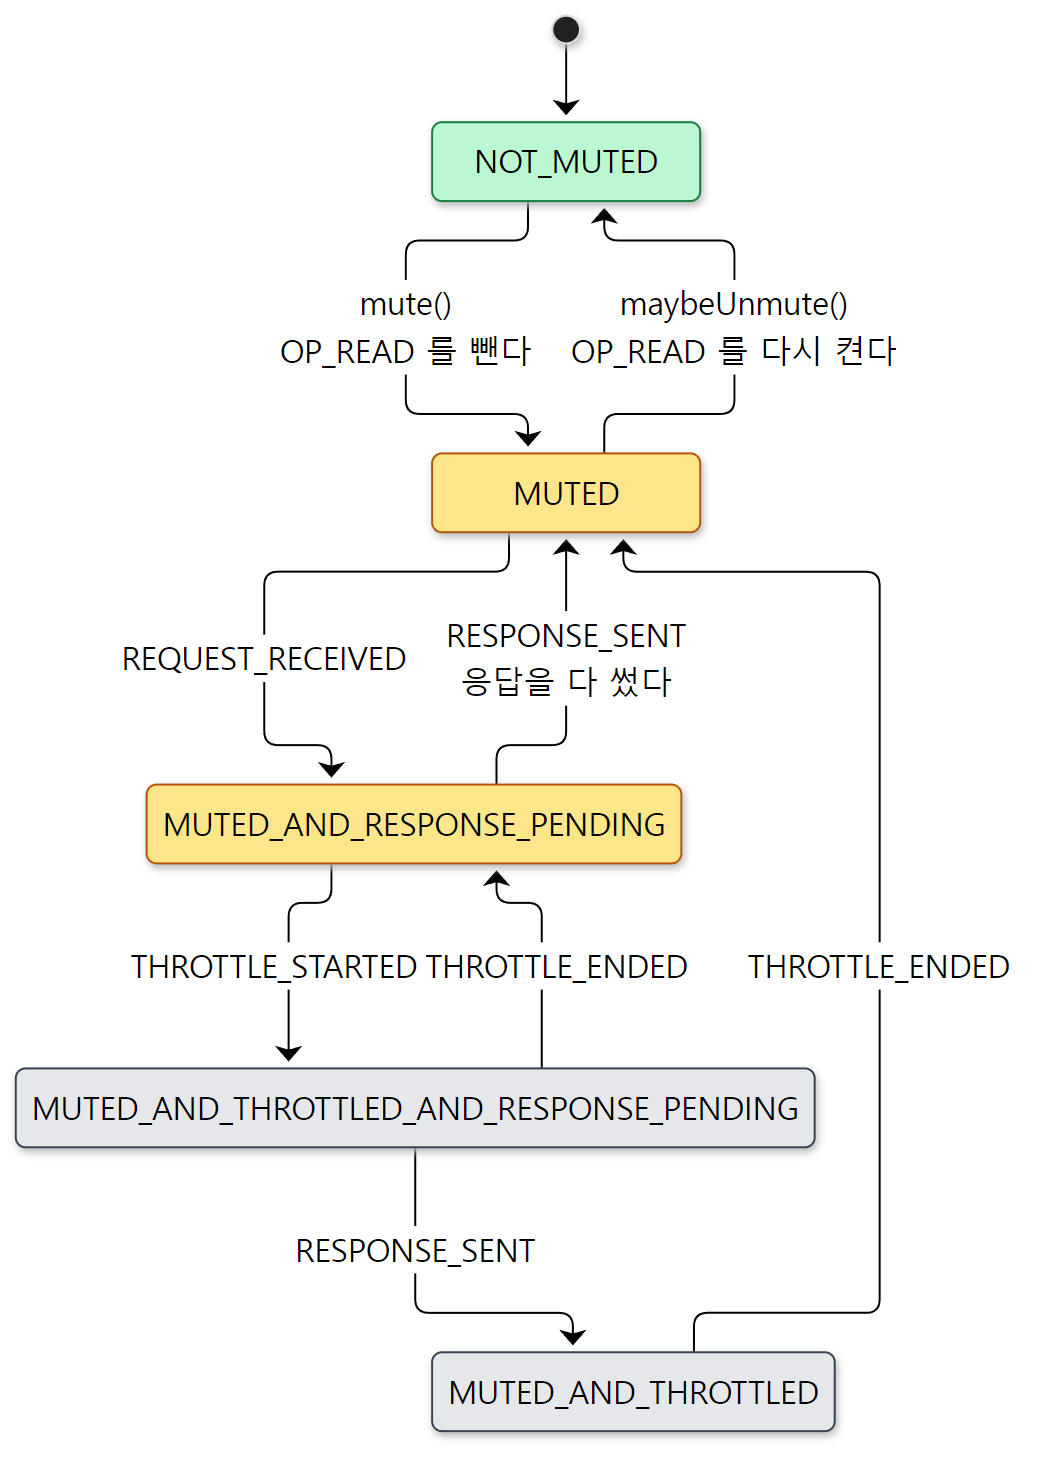 초록·노란 상태가 보통의 요청 한 번이 지나는 길, 회색 상태는 쿼터에 걸렸을 때만 지나는 길입니다. 전이 규칙은
KafkaChannel.java 101–107행의 주석과 274–312행의 handleChannelMuteEvent() 를 옮긴 것입니다.
보통의 요청 한 번은 이렇게 돕니다. NOT_MUTED → (요청을 큐에 넣음) mute() 로 MUTED → REQUEST_RECEIVED 로 MUTED_AND_RESPONSE_PENDING → (응답을 다 씀) RESPONSE_SENT 로 MUTED → maybeUnmute() 로 NOT_MUTED. 규칙에 없는 전이가 오면 handleChannelMuteEvent() 는 IllegalStateException 을 던집니다(309–311행). mute 는 메모리 때문에도 걸립니다. queued.max.request.bytes 로 요청 버퍼의 총량을 제한했는데 버퍼를 못 받으면, KafkaChannel.read() 가 스스로 mute() 합니다(414–417행). 기본값은 -1 이라 이 제한은 꺼져 있습니다(MemoryPool.NONE, SocketServer.scala 97행).
예제 3: 연결 A 의 두 번째 요청은 첫 번째가 끝날 때까지 기다린다
정말 그런지 맨 소켓으로 확인했습니다. 연결 A 로 2초 걸리는 Fetch 와 금방 끝나는 ApiVersions 를 응답을 기다리지 않고 잇달아 보내고, 0.1초 뒤 연결 B 로 ApiVersions 하나를 보냅니다. Fetch 는 빈 파티션에 MinBytes=1, MaxWaitMs=2000 으로 보냈습니다. 브로커는 1바이트라도 모일 때까지 최대 2초를 기다렸다 답합니다(롱 폴링 — 8편). 요청 바이트를 만드는 방법은 3편의 RawWire.java 와 같습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 연결 A 로 "오래 기다리는 Fetch" 와 ApiVersions 를 응답을 기다리지 않고 잇달아 보내고,
// 0.1초 뒤 연결 B 로 ApiVersions 하나를 보낸다. 응답이 각각 언제 오는지 잰다.
// ... (import 줄임)
public class Pipeline {
    static long t0;

    public static void main(String[] args) throws Exception {
        try (Socket a = new Socket("localhost", 9092); Socket b = new Socket("localhost", 9092)) {
            // ...
            // 빈 파티션에 MinBytes=1, MaxWaitMs=2000 — 브로커는 데이터가 없으니 2초까지 기다렸다 답한다
            FetchRequestData fetch = new FetchRequestData()
                .setReplicaId(-1).setMaxWaitMs(2000).setMinBytes(1)
                .setTopics(List.of(new FetchRequestData.FetchTopic().setTopic("u04")
                    .setPartitions(List.of(new FetchRequestData.FetchPartition()
                        .setPartition(0).setFetchOffset(0).setPartitionMaxBytes(1024)))));
            // ...
            // 연결 A: 두 요청을 한 번에 소켓에 쓴다 (파이프라이닝)
            a.getOutputStream().write(frame("u04-a", 1, (short) 12, fetch));
            a.getOutputStream().write(frame("u04-a", 2, (short) 4, apiVersions));
            log("conn A: sent FETCH(corr=1, maxWait=2000ms) and API_VERSIONS(corr=2) back to back");

            Thread.sleep(100);
            b.getOutputStream().write(frame("u04-b", 3, (short) 4, apiVersions));
            log("conn B: sent API_VERSIONS(corr=3)");

            log("conn B: response corr=" + readCorrelationId(inB));
            log("conn A: response corr=" + readCorrelationId(inA));
            log("conn A: response corr=" + readCorrelationId(inA));
        }
    }
    // ... frame(): [4바이트 길이][요청 헤더][요청 본문], readCorrelationId(): 응답 헤더 맨 앞의 int32
}
[예제 ex/u04-socket-server/Pipeline.java 에서 줄임]
Fetch 는 토픽을 이름으로 적는 마지막 판인 v12 로 보냈습니다(v13 부터는 토픽 id 를 씁니다, FetchRequest.json). run.sh 는 이 예제를 돌리기 전에 요청 로거(kafka.request.logger)를 DEBUG 로 켜 두었습니다. 배포판의 config/log4j2.yaml 을 복사해 그 로거의 level: WARN 을 DEBUG 로 바꾸고, KAFKA_LOG4J_OPTS="-Dlog4j2.configurationFile=/tmp/log4j2.yaml" 로 넘깁니다(서버를 띄우는 bin/kafka-server-start.sh 는 이 변수가 비어 있을 때만 기본 설정 파일 config/log4j2.yaml 을 씁니다, 24–25행). 이 로거는 kafka-request.log 에 요청마다 한 줄씩 JSON 을 남기고, run.sh 가 그 가운데 필요한 칸만 뽑았습니다.
=== 3. one request at a time per connection
 0.25s conn A: sent FETCH(corr=1, maxWait=2000ms) and API_VERSIONS(corr=2) back to back
 0.37s conn B: sent API_VERSIONS(corr=3)
 0.38s conn B: response corr=3
 2.31s conn A: response corr=1
 2.31s conn A: response corr=2
--- kafka-request.log for these three requests (fields shortened)
u04-b API_VERSIONS corr=3 conn=127.0.0.1:9092-127.0.0.1:36718-2-1 total=2.939 queue=0.862 local=1.433 remote=0.0 respQueue=0.176 send=0.466
u04-a FETCH corr=1 conn=127.0.0.1:9092-127.0.0.1:36712-1-1 total=2058.32 queue=3.027 local=38.954 remote=2015.709 respQueue=0.129 send=0.499
u04-a API_VERSIONS corr=2 conn=127.0.0.1:9092-127.0.0.1:36712-1-1 total=1.72 queue=0.322 local=0.956 remote=0.0 respQueue=0.102 send=0.339
시각과 포트, 밀리초 값은 실행마다 다릅니다(두 번 돌려 순서와 크기가 같은 것을 확인했습니다). 맨 앞의 0.25s 는 예제 프로그램이 직렬화 클래스를 처음 읽어 들이느라 걸린 시간입니다.
- 연결 B 의 ApiVersions 는 0.01초 만에 답이 왔습니다. 브로커 전체가 Fetch 때문에 멈춘 것이 아닙니다.
- 연결 A 의 ApiVersions(corr=2)는 Fetch(corr=1)와 같은 2.31초에 왔습니다. 요청 자체는 1.72ms 면 끝나는 일인데, 앞의 Fetch 가 2초를 기다리는 동안 처리되지 않았습니다. 연결 A 가 mute 되어 있었기 때문입니다.
- 요청 로그의
conn세 번째 칸을 보면 연결 A 는 Processor 1, 연결 B 는 Processor 2 가 맡았습니다. Acceptor 가 돌려 가며 나눠 준 것입니다(어느 번호에서 시작하는지는 그전에 이 리스너에 붙었던 연결 수 — 앞의kafka-topics.sh등 — 에 따라 정해집니다. 검토 때 세 번 돌려 모두 1·2 였습니다).
요청 로그의 칸은 Request.updateRequestMetrics() 가 계산합니다(Request.java 329–341행). 이 글에서 본 시점들과 맞추면 이렇습니다.
| 칸 | 계산 | 이 글의 어디 |
|---|---|---|
requestQueueTimeMs |
처리 스레드가 꺼낸 시각 − Processor 가 요청을 다 읽은 시각 | 3절의 nowNanos → 4절의 requestDequeueTimeNanos |
localTimeMs |
처리 스레드에서 일이 끝난 시각 − 꺼낸 시각 | handle() 의 finally 가 적는 apiLocalCompleteTimeNanos |
remoteTimeMs |
응답이 준비된 시각 − 처리 스레드의 일이 끝난 시각 | 퍼거토리에서 기다린 시간. Fetch 의 2015ms 가 여기 |
responseQueueTimeMs |
Processor 가 응답을 꺼낸 시각 − 응답이 준비된 시각 | 5절의 responseQueue 에서 기다린 시간 |
sendTimeMs |
응답을 다 쓴 시각 − Processor 가 응답을 꺼낸 시각 | poll() 이 소켓에 쓰는 시간 |
totalTimeMs |
응답을 다 쓴 시각 − Processor 가 요청을 다 읽은 시각 | 위를 모두 더한 것 |
로그 한 줄의 원래 모양은 이렇습니다(응답 본문은 {...} 로 줄였습니다).
--- one raw line (the API_VERSIONS from conn B)
[2026-11-07 03:57:04,426] DEBUG Completed request:{"isForwarded":false,
  "requestHeader":{"requestApiKey":18,"requestApiVersion":4,"correlationId":3,"clientId":"u04-b","requestApiKeyName":"API_VERSIONS"},"request":{"clientSoftwareName":"u04","clientSoftwareVersion":"1.0"},"response":{...},"connection":"127.0.0.1:9092-127.0.0.1:36718-2-1","totalTimeMs":2.939,"requestQueueTimeMs":0.862,"localTimeMs":1.433,"remoteTimeMs":0.0,"throttleTimeMs":0,"responseQueueTimeMs":0.176,"sendTimeMs":0.466,"securityProtocol":"PLAINTEXT","principal":"User:ANONYMOUS","listener":"PLAINTEXT","clientInformation":{"softwareName":"unknown","softwareVersion":"unknown"}} (kafka.request.logger)
헷갈리기 쉬운 곳
- mute 된 동안 기다린 시간은 요청 로그에 남지 않습니다. 연결 A 의 ApiVersions 는 클라이언트 쪽에서 보면 약 2초를 기다렸지만, 요청 로그의
totalTimeMs는 1.72ms 입니다. 시간 계산의 출발점이 "Processor 가 요청을 다 읽은 시각" 인데, mute 된 동안 그 요청은 아직 읽히지 않고 운영체제의 소켓 버퍼에 있었기 때문입니다. 브로커 지표로는 빨라 보이는데 클라이언트에서는 느린 경우, 같은 연결의 앞 요청이 오래 걸렸는지 의심해 볼 자리입니다. - 클라이언트의
max.in.flight.requests.per.connection은 이 규칙을 바꾸지 않습니다. 프로듀서의 기본값은 5 입니다(ProducerConfig.java520–525행의define). 프로듀서는 응답을 기다리지 않고 한 연결에 요청을 다섯 개까지 보내 둘 수 있지만, 브로커는 그것을 여전히 하나씩 처리합니다. 보내 두는 것은 왕복 시간을 줄일 뿐입니다 — 다음 요청이 이미 브로커의 소켓 버퍼에 와 있으므로, unmute 되자마자 곧바로 읽을 수 있습니다. 처리량을 늘리려면 연결(브로커·파티션)을 늘려야 하고, 한 연결 안의 요청은 늘 차례로 처리됩니다. 프로듀서 쪽 이야기는 5편에서 이어집니다. acks=0도 하나씩입니다. 응답을 쓰지 않을 뿐, 요청 처리 스레드가 처리를 마치고NoOpResponse를 보내야 unmute 됩니다(5절의 표). 응답이 없다고 해서 브로커가 요청을 마구 읽어 들이지는 않습니다.
7. 설정 한눈에, 그리고 막히는 자리
지금까지 나온 설정의 이름 → 상수 → 기본값 → 쓰는 곳을 모았습니다. 기본값은 모두 define(…) 에 넘기는 상수에서 확인했습니다.
| 설정 | 상수 (기본값) | 쓰는 곳 | 하는 일 |
|---|---|---|---|
num.network.threads |
SocketServerConfigs.NUM_NETWORK_THREADS_DEFAULT (3) |
DataPlaneAcceptor.configure() → addProcessors() |
리스너마다 Processor 수 |
num.io.threads |
ServerConfigs.NUM_IO_THREADS_DEFAULT (8) |
createPool(…, config.numIoThreads, …) |
풀마다 요청 처리 스레드 수 |
queued.max.requests |
QUEUED_MAX_REQUESTS_DEFAULT (500) |
new RequestChannel(maxQueuedRequests, …) |
요청 큐 크기. 차면 Processor 가 put() 에서 멈춘다 |
queued.max.request.bytes |
QUEUED_MAX_REQUEST_BYTES_DEFAULT (-1) |
SimpleMemoryPool 또는 MemoryPool.NONE |
읽어 둔 요청 바이트의 총량. 넘치면 연결이 스스로 mute |
socket.request.max.bytes |
SOCKET_REQUEST_MAX_BYTES_DEFAULT (100MB) |
NetworkReceive 의 maxSize |
요청 하나의 최대 크기 |
socket.listen.backlog.size |
SOCKET_LISTEN_BACKLOG_SIZE_DEFAULT (50) |
bind(socketAddress, listenBacklogSize) |
커널 대기열 크기 |
connections.max.idle.ms |
CONNECTIONS_MAX_IDLE_MS_DEFAULT (10분) |
KSelector 생성자 |
이 시간 동안 아무것도 안 한 연결을 Processor 가 닫는다 |
max.connections / max.connections.per.ip |
Integer.MAX_VALUE |
ConnectionQuotas.inc() |
넘치면 Acceptor 가 멈추거나(전체·리스너) 연결을 닫는다(IP) |
SocketServerConfigs.java 95–153행, ServerConfigs.java 59–61행
배포판의 config/server.properties 에도 num.network.threads=3, num.io.threads=8 이 적혀 있습니다. 기본값과 같은 값이라 지워도 동작은 같습니다.
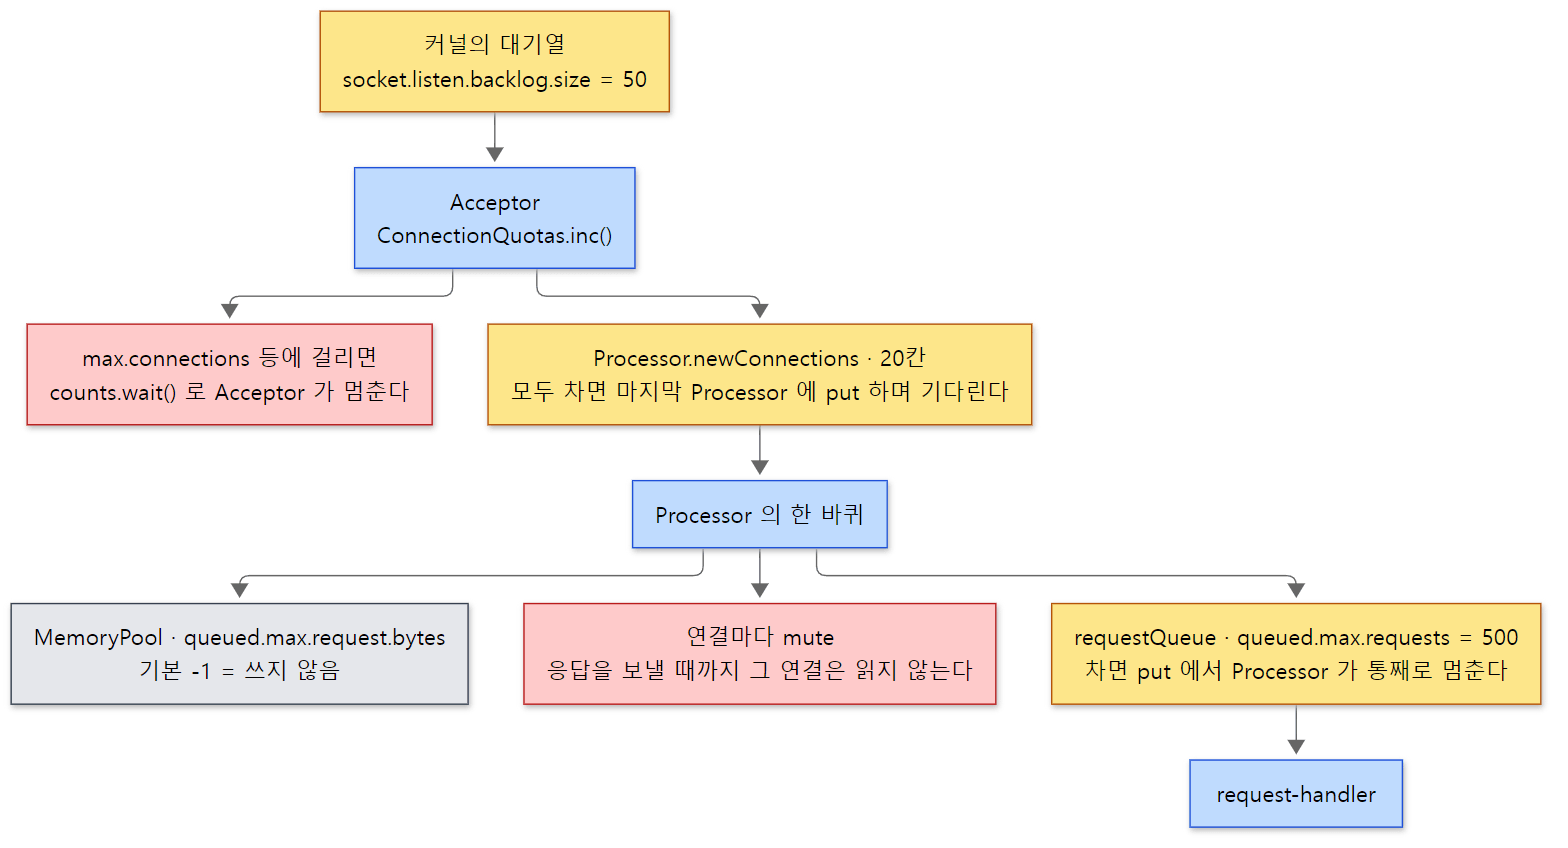 노란 상자는 기다리는 줄, 빨간 상자는 그 자리에서 무엇이 멈추는지입니다. 회색은 기본값으로는 꺼져 있는 장치입니다.
그림을 아래에서 위로 읽으면, 요청 처리 스레드가 느려졌을 때 무엇이 차례로 막히는지가 됩니다. 요청 큐가 차면 Processor 가 멈추고, Processor 가 멈추면 그 Processor 의 newConnections 가 차고, 모두 차면 Acceptor 가 멈추고, Acceptor 가 멈추면 커널 대기열이 찹니다. 큐마다 크기가 정해져 있어서 브로커의 메모리가 끝없이 늘지 않습니다. 응답 큐만 크기 제한이 없는데(5절), 응답은 요청 하나에 하나뿐이고 요청 쪽이 이미 막혀 있으므로 무한히 쌓이지는 않습니다(소스의 주석에서 확인한 설명은 아니고, 구조에서 읽은 것입니다).
예제 4: 스레드 수를 바꾸면
같은 run.sh 의 마지막에서 서버를 지우고 num.network.threads=1, num.io.threads=2 로 다시 띄웠습니다.
=== 4. num.network.threads=1 num.io.threads=2
      1 data-plane-kafka-network-thread-1-CONTROLLER-PLAINTEXT-N
      1 data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-N
      4 data-plane-kafka-request-handler-N
      1 data-plane-kafka-socket-acceptor-CONTROLLER-PLAINTEXT-N
      1 data-plane-kafka-socket-acceptor-PLAINTEXT-PLAINTEXT-N
stopped
Processor 는 리스너마다 1개, 요청 처리 스레드는 2개짜리 풀 두 벌로 4개입니다. Acceptor 수는 설정과 상관없이 리스너 수만큼입니다.
두 값은 서버를 끄지 않고도 바꿀 수 있습니다. num.network.threads 는 리스너마다 다시 설정할 수 있는 값으로 등록되어 있고(DataPlaneAcceptor.ListenerReconfigurableConfigs, 357행), 바꾸면 reconfigure() 가 Processor 를 더하거나 뺍니다(434–445행). 다만 한 번에 지금 값의 절반보다 작게, 두 배보다 크게는 바꿀 수 없습니다(validateReconfiguration(), 418–421행). num.io.threads 는 KafkaRequestHandlerPool.resizeThreadPool() 이 스레드를 더하거나 멈춥니다(283–296행). 이 글의 예제는 실행 중에 바꾸는 것까지는 돌려 보지 않았습니다.
Tomcat 의 NIO 커넥터와 나란히 놓으면
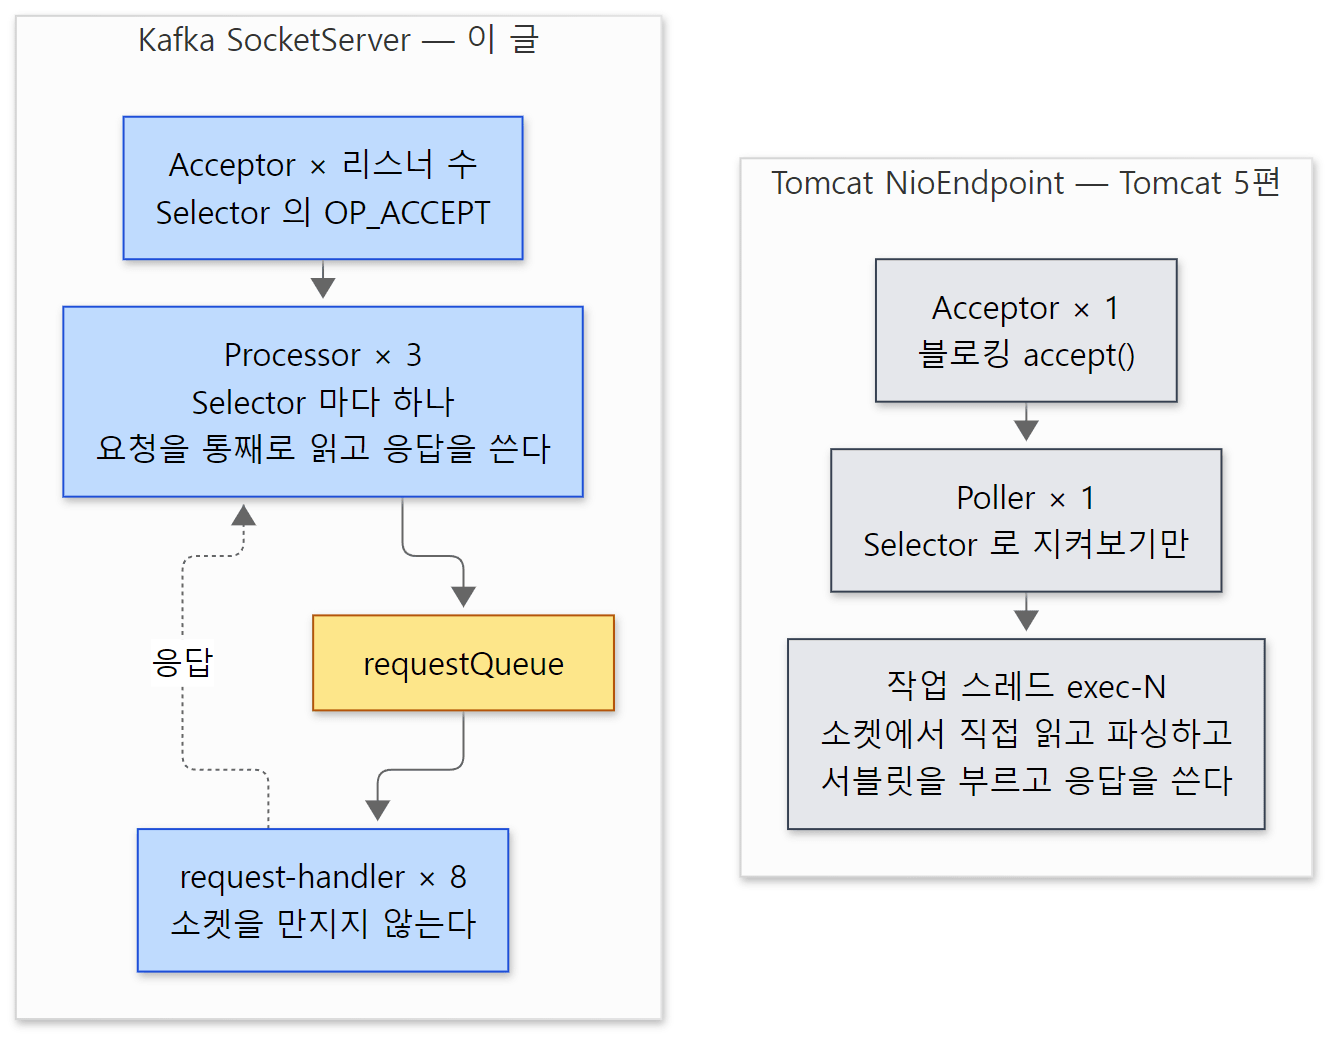 왼쪽이 이 글, 오른쪽이 Tomcat 5편입니다. Kafka 쪽은 기본 설정의 브로커
SocketServer 하나와 리스너 하나만 그렸습니다(combined 모드라면 컨트롤러 쪽에 같은 모양이 한 벌 더 있습니다).
| Tomcat NIO 커넥터 | Kafka SocketServer | |
|---|---|---|
| 연결 받기 | Acceptor 1개, 블로킹 accept() |
리스너마다 Acceptor 1개, NIO Selector 의 OP_ACCEPT |
| 연결 지켜보기 | Poller 1개, Selector 1개 | Processor N개, 각자 Selector 하나 |
| 요청 바이트 읽기 | 작업 스레드 | Processor (요청 하나가 다 올 때까지) |
| 요청 처리 | 작업 스레드 (서블릿까지) | 요청 처리 스레드 (KafkaApis.handle()) |
| 응답 쓰기 | 작업 스레드 | Processor |
| 한 연결 동시 처리 막기 | Poller 가 관심사를 빼고(unreg()), 소켓마다 잠금 |
Processor 가 그 연결을 mute (OP_READ 를 뺀다) |
| 넘치면 | maxConnections 에서 Acceptor 가 멈춤 |
요청 큐(500)에서 Processor 가 멈춤 |
닮은 점은 "Selector 로 많은 연결을 적은 스레드가 지켜보고, 실제 일은 다른 스레드 풀이 한다" 는 큰 틀입니다. 다른 점은 소켓 I/O 를 누가 하느냐 입니다. HTTP 는 요청의 끝을 알려면 헤더를 해석해야 해서 Tomcat 은 읽기를 작업 스레드(프로토콜을 아는 쪽)에 맡겼고, Kafka 는 길이가 앞에 있으니 네트워크 스레드가 끝까지 읽어 줄 수 있어 처리 스레드를 소켓에서 완전히 떼어 냈습니다. 그 대가로 응답을 쓰러 다시 네트워크 스레드로 돌아오는 길(응답 큐와 wakeup())이 하나 더 생겼습니다.
이 글에서 뺀 것
- 연결 수·연결 생성 속도 쿼터의 계산(
ConnectionQuotas,ListenerConnectionQuota, 느리게 닫기DelayedCloseSocket):SocketServer.scala1252행부터. 요청 쿼터와 스로틀링(StartThrottlingResponse)은server/src/main/java/org/apache/kafka/server/quota/ - TLS·SASL(
SslTransportLayer,SaslServerAuthenticator,KafkaChannel.prepare(), 재인증maybeBeginServerReauthentication):clients/src/main/java/org/apache/kafka/common/network/,…/common/security/authenticator/ - 실행 중에 리스너를 더하고 빼기(
addListeners/removeListeners):SocketServer.scala281–311행 - 다른 스레드에서 끝난 비동기 작업을 요청 처리 스레드로 되돌리는
KafkaRequestHandler.wrapAsyncCallback()·CallbackRequest:KafkaRequestHandler.scala65–85행 - 요청을 JSON 으로 바꾸는
RequestConvertToJson(요청 로그의 본문):server/src/main/java/org/apache/kafka/network/RequestConvertToJson.java - 지표(
NetworkProcessorAvgIdlePercent,RequestHandlerAvgIdlePercent,RequestQueueSize등):SocketServer.scala116–141행,RequestChannel.scala54–60행,KafkaRequestHandler.scala243–253행 - 컨트롤러 쪽 처리기
ControllerApis.handle():core/src/main/scala/kafka/server/ControllerApis.scala94행부터(10편) - 메타데이터 로그 복제용 KRaft 네트워크 스레드(
KafkaRaftManager가 따로 만드는Selector):core/src/main/scala/kafka/raft/KafkaRaftManager.scala231행
정리
| 개념 | 한 줄 요약 |
|---|---|
SocketServer |
BrokerServer 와 ControllerServer 가 하나씩. 자기 리스너마다 Acceptor 와 Processor 들을 만든다 |
| Acceptor | 리스너마다 1개. NIO Selector 의 OP_ACCEPT 로 select(500), 받은 소켓을 논블로킹·TCP_NODELAY 로 바꿔 Processor 에 돌려 가며 넘긴다 |
Processor (network-thread) |
리스너마다 num.network.threads(3)개. 자기 Selector 로 요청을 끝까지 읽어 Request 를 만들고, 응답도 자기가 쓴다 |
Selector·KafkaChannel |
clients 모듈의 클래스. 브로커와 클라이언트가 함께 쓴다. 길이 접두로 요청 하나를 완성한다 |
RequestChannel |
요청 큐 하나(queued.max.requests, 500)를 모든 Processor 가 함께 쓰고, 응답은 Processor 마다의 큐로 돌려보낸다 |
request-handler |
풀마다 num.io.threads(8)개. 큐에서 꺼내 KafkaApis.handle()(또는 ControllerApis)을 부를 뿐 소켓을 만지지 않는다 |
KafkaApis.handle() |
apiKey 로 가르는 match(79갈래, 16개는 컨트롤러로 전달). 이 뒤가 6~12편 |
| mute / unmute | 요청을 큐에 넣으면 그 연결의 OP_READ 를 빼고, 응답을 다 쓴 뒤 다시 켠다. 한 연결의 요청은 하나씩, 순서대로 |
| 배압 | 요청 큐가 차면 Processor 가, newConnections 가 차면 Acceptor 가 멈춘다 |
| 요청 로그 | kafka.request.logger 를 DEBUG 로. 큐·처리·대기·응답 큐·전송 시간이 나뉘어 찍힌다. mute 된 시간은 빠진다 |
다음에 볼 것
브로커가 요청을 받아 KafkaApis.handle() 에 넘기는 데까지 왔습니다. 이제 그 요청을 보내는 쪽으로 건너갑니다. KafkaProducer.send() 를 부르면 레코드가 곧바로 나가지 않고 RecordAccumulator 의 배치에 모였다가, 이 글에서 본 것과 같은 Selector 를 쓰는 Sender 스레드가 Produce 요청으로 묶어 보냅니다. linger.ms·batch.size 가 어느 if 에서 쓰이는지, 클라이언트의 max.in.flight.requests.per.connection 이 이 글의 mute 와 어떻게 맞물리는지를 5편: 프로듀서 내부 — send()에서 배치, 그리고 Sender 스레드까지에서 봅니다.
Tomcat 연재의 5편: 커넥터와 NIO 엔드포인트는 같은 질문 — "연결은 어떤 스레드가 받고, 요청은 누가 읽나" — 에 대한 HTTP 서버의 답입니다. 두 글을 나란히 읽으면 프로토콜의 모양(길이 접두냐, 헤더를 해석해야 끝을 아느냐)이 스레드 나눔을 어떻게 바꾸는지가 보입니다. 이벤트 루프 하나로 연결을 다루는 서버는 nginx 연재에서 다룹니다.