이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 세 번째 글입니다. 1편에서 소스를 받아 기준 커밋으로 빌드했고, 2편에서 클라이언트·브로커·컨트롤러가 어떻게 나뉘는지 전체 지도를 그렸습니다. 이번 글부터 연재의 두 번째 묶음 "한 레코드의 길"을 걷습니다. 첫걸음은 길 그 자체, 곧 클라이언트와 브로커가 TCP 위에서 주고받는 바이트의 약속입니다.
답하려는 질문은 네 가지입니다.
- 프로듀서가 보내는 요청은 바이트로 어떤 모양이고, 브로커는 어디서 한 요청이 끝나는지 어떻게 아는가
ProduceRequestData같은 클래스는 왜 저장소에 없고, 어디서 만들어지는가- 클라이언트와 브로커의 Kafka 판이 달라도 통하는 것은 어떤 장치 덕분인가 (
ApiVersions) - "유연한 판", "태그 필드"는 무엇이고 왜 나중에 생겼는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | clients/src/main/resources/common/message/*.json, generator 의 MessageGenerator·MessageDataGenerator·FieldSpec·ApiMessageTypeGenerator, common.protocol 의 ApiKeys·Message·ByteBufferAccessor·SendBuilder, common.requests 의 RequestHeader·AbstractRequest·RequestContext, common.network.NetworkReceive, clients.NetworkClient·NodeApiVersions |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
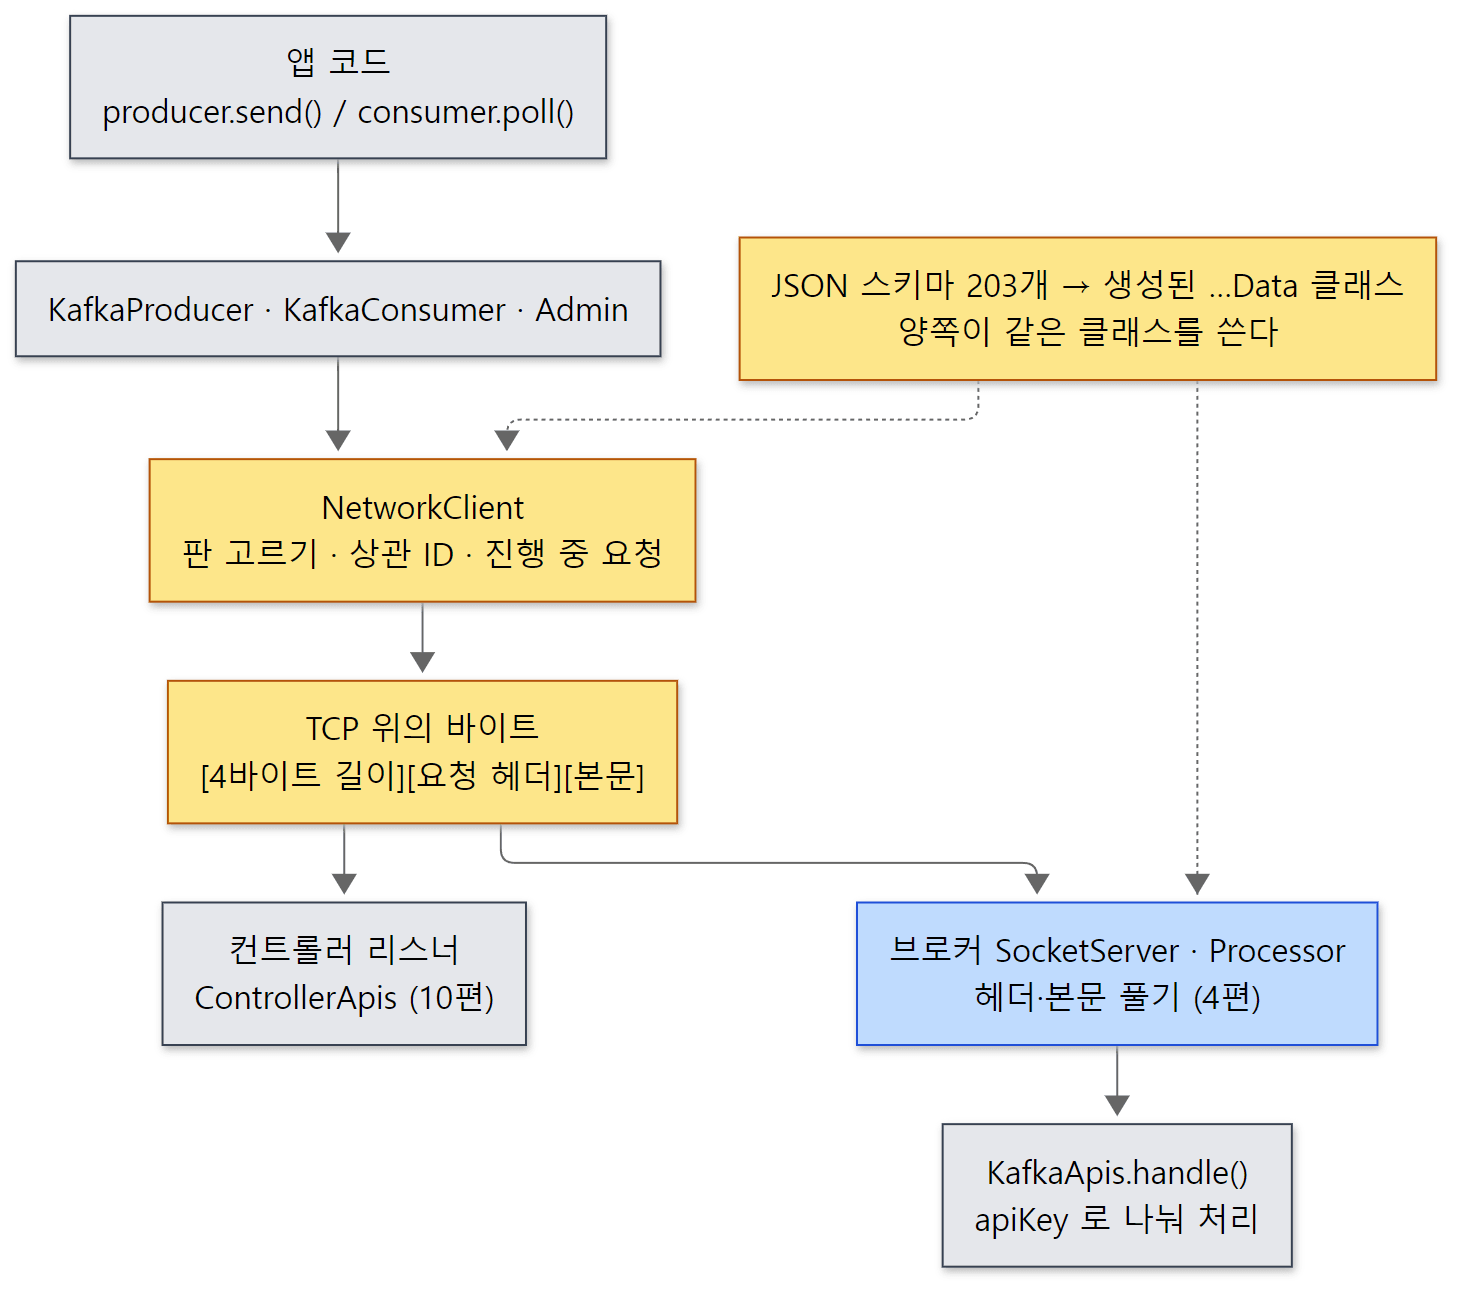 2편 지도의 "클라이언트 ↔ 브로커" 화살표를 확대한 그림입니다. 노란 상자가 이 글의 범위, 파란 상자는 4편, 회색 상자는 다른 편에서 봅니다.
2편 지도에서 A 구역(클라이언트)과 B 구역(브로커 네트워크 계층) 사이에 그은 화살표 한 줄, 곧 "A↔B 사이"를 이 글이 확대합니다. 화살표를 그리는 쪽(NetworkClient)과 받는 쪽(브로커의 Processor)이 같은 생성된 클래스를 쓴다는 점이 이 글의 핵심입니다. 받은 바이트를 브로커의 어느 스레드가 어떻게 넘기는지는 4편에서 봅니다.
프로토콜에 관련된 코드는 clients 모듈 여기저기에 흩어져 있고, 생성된 코드만 18만 줄이 넘습니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
와이어 프로토콜(wire protocol)은 "선(wire) 위로 오가는 바이트의 규칙"입니다. Kafka 클라이언트와 브로커는 HTTP 가 아니라 Kafka 가 직접 정한 이진(binary) 프로토콜로 TCP 위에서 이야기합니다. 브로커끼리(팔로워가 리더에게 복제를 받을 때), 브로커와 컨트롤러 사이도 같은 프로토콜입니다.
API 키(api key)는 요청의 종류를 가리키는 16비트 번호입니다. Produce 는 0, Fetch 는 1, Metadata 는 3, ApiVersions 는 18 입니다. 이 커밋에는 0부터 94까지 95개가 있고, 그중 4개(LeaderAndIsr 등)는 Kafka 4.0 에서 지워 판이 하나도 남지 않은 채("validVersions": "none") 번호만 막아 두었습니다. 응답에는 API 키가 따로 없고 요청과 같은 것으로 봅니다.
판(version)은 API 마다 따로 매기는 16비트 번호입니다. Produce 요청은 v3 부터 v13 까지, Fetch 는 v4 부터 v18 까지를 이 커밋이 압니다. 필드가 늘거나 줄거나 뜻이 바뀌면 판이 오릅니다. 응답의 판은 요청의 판과 같습니다(브로커가 모르는 판으로 온 ApiVersions 요청 하나만 예외입니다 — 5절). 이 글에서는 Kafka 제품의 버전(4.5.0)과 헷갈리지 않게 "판"이라고 부릅니다.
상관 ID(correlation ID)는 클라이언트가 요청마다 붙이는 32비트 번호입니다. 브로커는 응답에 같은 번호를 그대로 돌려줍니다. 한 연결로 요청을 여러 개 보내 두고 응답을 기다릴 수 있으므로, 이 번호로 응답이 어느 요청의 것인지 확인합니다(1절).
요청 헤더와 응답 헤더는 모든 요청·응답 맨 앞에 붙는 작은 머리말입니다. 요청 헤더에는 API 키, 판, 상관 ID, 클라이언트 ID 가, 응답 헤더에는 상관 ID 만 있습니다. 헤더에도 판이 있습니다(4절).
생성된 코드: ProduceRequestData, ApiVersionsResponseData 처럼 이름이 …Data 로 끝나는 클래스는 사람이 쓰지 않았습니다. JSON 으로 적은 메시지 정의(스키마)에서 빌드할 때 만들어지므로 저장소에도 GitHub 에도 없습니다. 이 글에서 생성된 코드를 인용할 때는 기준 커밋으로 직접 생성한 파일에서 옮기고 원본 JSON 스키마에 링크합니다.
varint: 작은 수를 적은 바이트로 적는 정수 표기입니다. 한 바이트에 7비트씩 담고, 맨 위 비트가 1이면 "다음 바이트에 이어진다"는 뜻입니다. 127 이하는 1바이트, 16,383 이하는 2바이트입니다(ByteUtils.writeUnsignedVarint(), ByteUtils.java 408행부터). 6절의 "유연한 판"이 길이를 적을 때 씁니다.
1. 바이트의 모양 — 길이를 먼저 보낸다
Kafka 의 요청과 응답은 하나도 빠짐없이 같은 틀에 담깁니다.
[4바이트 길이 N][N바이트: 헤더 + 본문]
보내는 쪽부터 봅시다. 클라이언트가 요청을 소켓에 쓸 바이트로 바꾸는 곳은 SendBuilder.buildSend() 입니다.
    private static Send buildSend(
        Message header,
        short headerVersion,
        Message apiMessage,
        short apiVersion
    ) {
        ObjectSerializationCache serializationCache = new ObjectSerializationCache();

        MessageSizeAccumulator messageSize = new MessageSizeAccumulator();
        header.addSize(messageSize, serializationCache, headerVersion);
        apiMessage.addSize(messageSize, serializationCache, apiVersion);

        SendBuilder builder = new SendBuilder(messageSize.sizeExcludingZeroCopy() + 4);
        builder.writeInt(messageSize.totalSize());
        header.write(builder, serializationCache, headerVersion);
        apiMessage.write(builder, serializationCache, apiVersion);

        return builder.build();
    }
clients/src/main/java/org/apache/kafka/common/protocol/SendBuilder.java 208–226행
두 번 훑습니다.
- 크기를 먼저 셉니다. 헤더와 본문에
addSize()를 불러 몇 바이트가 될지 더합니다. 이때 문자열을 UTF-8 바이트로 바꾼 결과를serializationCache에 넣어 둡니다. - 버퍼를 한 번에 잡고 씁니다. 맨 앞에 전체 길이(
writeInt)를 쓰고, 이어서 헤더와 본문을 씁니다. 문자열은 1에서 캐시에 넣어 둔 바이트를 꺼내 쓰므로 두 번 바꾸지 않습니다.
버퍼 크기가 totalSize() 가 아니라 sizeExcludingZeroCopy() 인 것이 눈에 띕니다. Produce 요청에 실리는 레코드 묶음처럼 이미 ByteBuffer 로 있는 큰 덩어리는 새 버퍼에 복사하지 않고 따로 붙여 보내기 때문입니다(SendBuilder 의 클래스 주석이 이것을 "zero-copy" 필드라고 부릅니다). 길이에는 들어가지만 버퍼에는 복사되지 않습니다. 레코드 묶음의 안쪽 모양은 6편에서 봅니다.
받는 쪽은 NetworkReceive 입니다. 클래스 주석이 한 줄로 요약합니다. "4바이트 네트워크 바이트 순서 크기 N 뒤에 N바이트 내용이 오는, 크기로 구분된 Receive".
    public long readFrom(ScatteringByteChannel channel) throws IOException {
        int read = 0;
        if (size.hasRemaining()) {
            int bytesRead = channel.read(size);
            if (bytesRead < 0)
                throw new EOFException();
            read += bytesRead;
            if (!size.hasRemaining()) {
                size.rewind();
                int receiveSize = size.getInt();
                if (receiveSize < 0)
                    throw new InvalidReceiveException("Invalid receive (size = " + receiveSize + ")");
                if (maxSize != UNLIMITED && receiveSize > maxSize)
                    throw new InvalidReceiveException("Invalid receive (size = " + receiveSize + " larger than " + maxSize + ")");
                requestedBufferSize = receiveSize; // may be 0 for some payloads (SASL)
                // ...
            }
        }
        if (buffer == null && requestedBufferSize != -1) { // we know the size we want but haven't been able to allocate it yet
            buffer = memoryPool.tryAllocate(requestedBufferSize);
            // ...
        }
        if (buffer != null) {
            int bytesRead = channel.read(buffer);
            // ...
clients/src/main/java/org/apache/kafka/common/network/NetworkReceive.java 82–108행
4바이트짜리 size 버퍼가 다 찰 때까지 읽고, 다 차면 그 값만큼의 버퍼를 잡아 다시 읽습니다. 소켓은 논블로킹이라 한 번에 다 오지 않을 수 있으므로 이 메서드는 여러 번 불립니다. 그때마다 size 와 buffer 에 남은 자리가 "어디까지 읽었는지"를 기억합니다. complete() 는 둘 다 꽉 찼을 때 참입니다(78–80행).
길이를 먼저 보내는 덕분에 받는 쪽은 내용을 하나도 풀지 않고도 한 요청이 어디서 끝나는지 압니다. 그래서 바이트를 받는 일(네트워크 스레드)과 내용을 해석하는 일을 떼어 놓기 쉽고, 크기만 보고 미리 거절할 수도 있습니다. 브로커는 maxSize 자리에 socket.request.max.bytes 를 넘기고, 기본값은 100MB 입니다(SocketServerConfigs.java 96행). Tomcat 6편에서 본 HTTP/1.1 은 글자로 된 요청 줄과 헤더를 한 글자씩 훑어 빈 줄을 찾아야 헤더의 끝을 알았습니다. 이진 프로토콜이 길이 접두(length prefix)를 쓰는 까닭이 여기 있습니다.
응답에는 API 키가 없다 — 그래서 순서가 중요하다
응답 헤더에는 상관 ID 하나뿐입니다. 응답 바이트만 보고는 그것이 무슨 요청의 응답인지, 몇 판으로 풀어야 하는지 알 수 없습니다. 클라이언트는 그 정보를 자기가 보낸 요청 쪽에서 가져옵니다.
    private void handleCompletedReceives(List<ClientResponse> responses, long now) {
        for (NetworkReceive receive : this.selector.completedReceives()) {
            String source = receive.source();
            InFlightRequest req = inFlightRequests.completeNext(source);

            AbstractResponse response = parseResponse(receive.payload(), req.header);
clients/src/main/java/org/apache/kafka/clients/NetworkClient.java 1097–1102행
InFlightRequests 는 노드마다 보낸 요청을 덱(deque)에 쌓아 둡니다. 보낼 때 add() 가 addFirst() 로 넣고(45–50행), 응답이 오면 completeNext() 가 pollLast() 로 가장 오래된 요청을 꺼냅니다(InFlightRequests.java 65–69행). 그 요청의 헤더로 응답을 풀고, AbstractResponse.parseResponse() 가 상관 ID 가 맞는지 확인해 다르면 CorrelationIdMismatchException 을 던집니다(AbstractResponse.java 97–108행).
곧 클라이언트는 **"한 연결의 응답은 요청을 보낸 순서대로 온다"**를 믿고 있습니다. 상관 ID 는 그 믿음이 깨졌을 때 알아채는 안전장치입니다. 브로커가 이 순서를 어떻게 지키는지(연결마다 한 번에 요청 하나만 처리하는 mute/unmute)는 4편에서 봅니다.
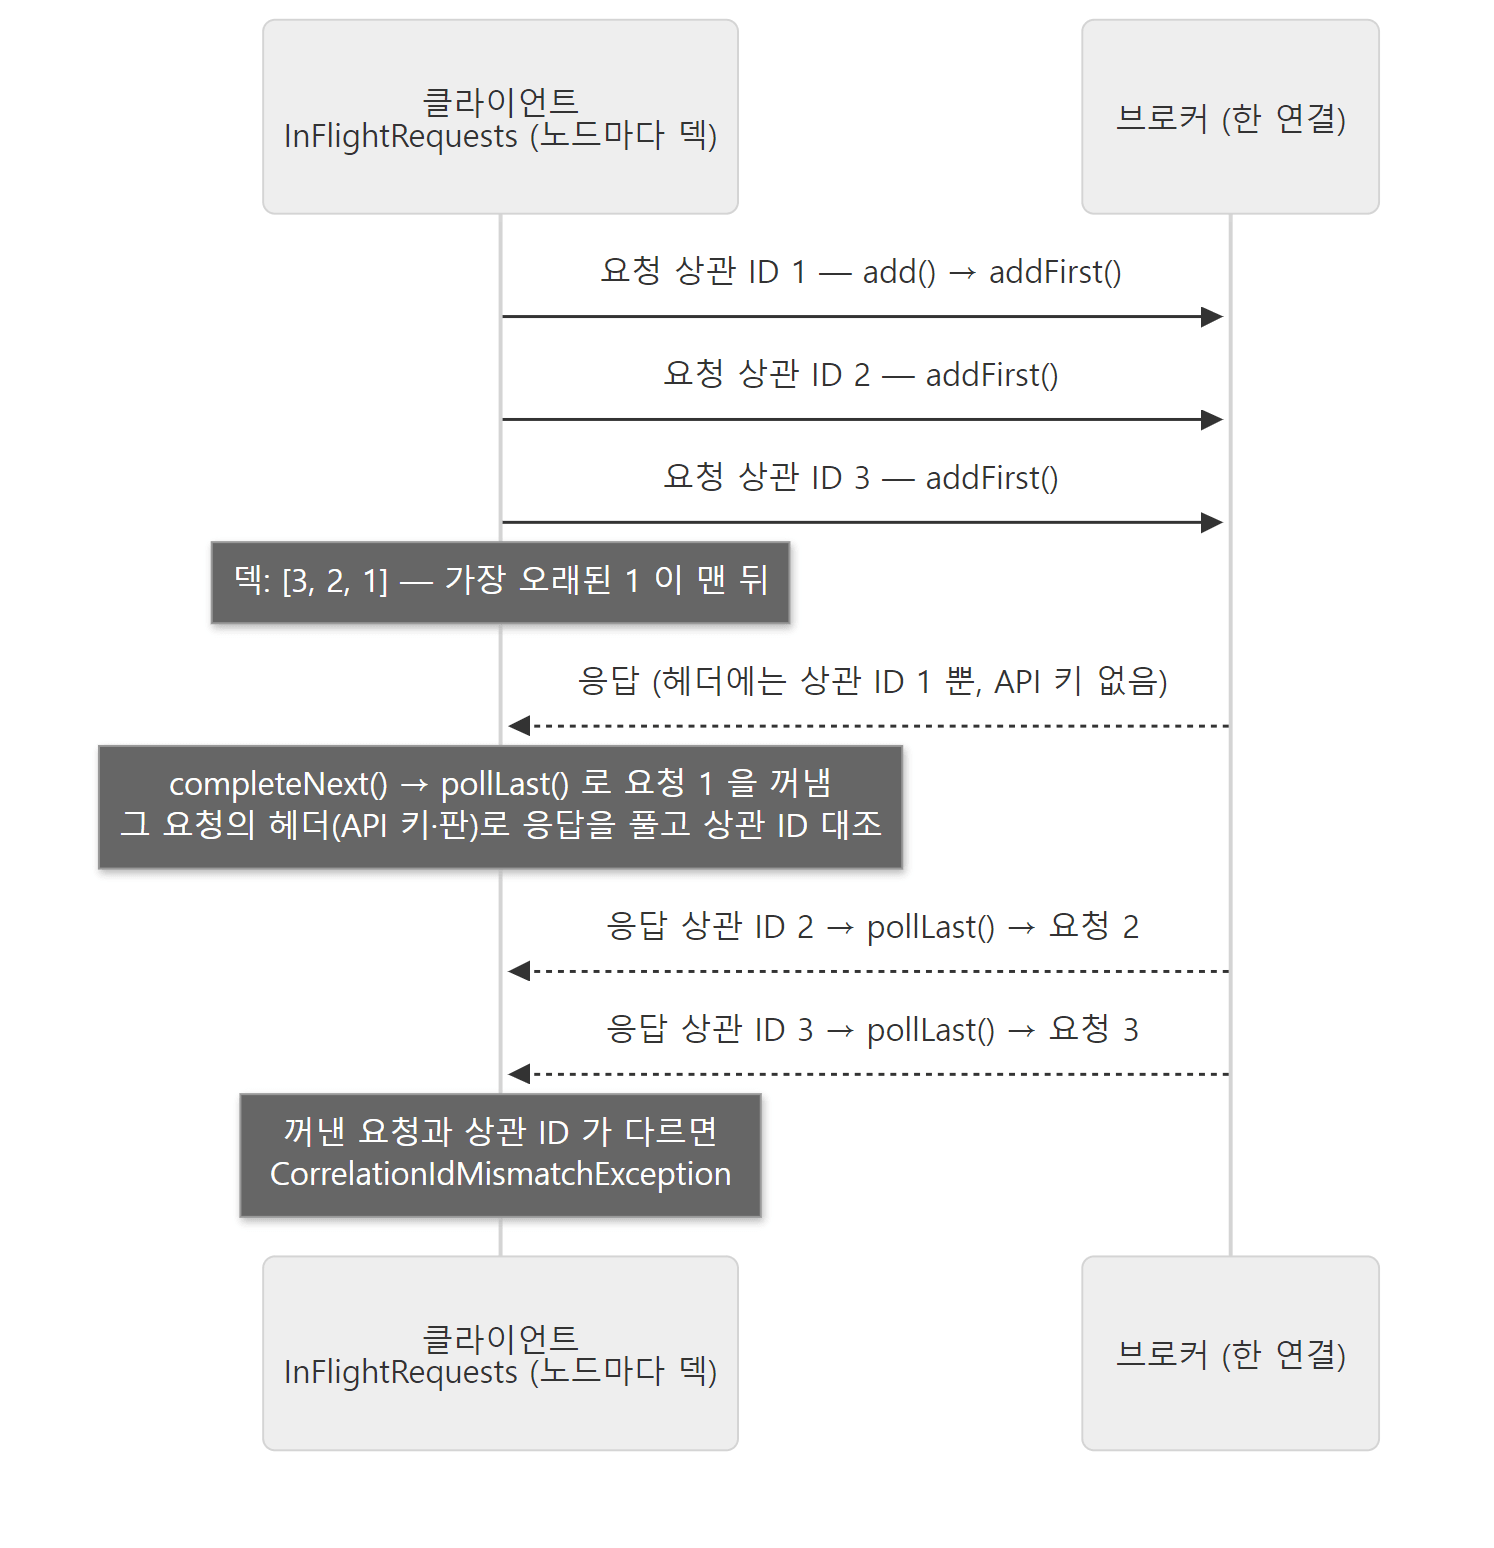 응답은 무슨 요청의 답인지 스스로 말하지 않습니다. 클라이언트는 덱의 가장 오래된 요청을 꺼내 짝을 맞추고, 상관 ID 는 그 짝이 맞는지만 확인합니다.
예제 1: 응답을 기다리지 않고 요청 셋을 보내 보기
이 글의 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u03-wire-protocol 이고, 브로커와 컨트롤러를 한 프로세스로 띄운 서버(브로커 리스너 9092, 컨트롤러 리스너 9093)에 대고 돌렸습니다.
주인공은 RawWire.java 입니다. KafkaProducer 도 NetworkClient 도 쓰지 않고, 생성된 …Data 클래스만으로 요청 바이트를 만들어 java.net.Socket 에 씁니다. 바이트를 만드는 부분은 위의 SendBuilder.buildSend() 를 손으로 따라 한 것입니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
    // [4바이트 길이][요청 헤더][요청 본문] — SendBuilder.buildSend() 가 하는 일을 손으로 따라 한다
    static byte[] frame(short apiVersion, ApiMessage body) {
        ApiKeys apiKey = ApiKeys.forId(body.apiKey());
        short headerVersion = apiKey.requestHeaderVersion(apiVersion);
        RequestHeaderData header = new RequestHeaderData()
            .setRequestApiKey(apiKey.id)
            .setRequestApiVersion(apiVersion)
            .setCorrelationId(nextCorrelationId++)
            .setClientId("u03");
        ObjectSerializationCache cache = new ObjectSerializationCache();
        // 1) 크기를 먼저 센다(이때 문자열의 UTF-8 바이트가 cache 에 들어간다)
        int size = header.size(cache, headerVersion) + body.size(cache, apiVersion);
        ByteBuffer buf = ByteBuffer.allocate(4 + size);
        ByteBufferAccessor w = new ByteBufferAccessor(buf);
        // 2) 길이, 헤더, 본문 순서로 쓴다
        w.writeInt(size);
        header.write(w, cache, headerVersion);
        body.write(w, cache, apiVersion);
        return buf.array();
    }
[예제 ex/u03-wire-protocol/RawWire.java 에서 줄임]
받을 때는 readFrame() 이 readInt() 로 길이를 읽고 그만큼을 readFully() 로 더 읽습니다. NetworkReceive.readFrom() 과 같은 규칙입니다.
pipeline 모드는 ApiVersions 요청(이 요청이 무엇인지는 5절)을 세 번 잇달아 쓰고 나서야 응답 셋을 읽습니다.
=== 8. pipelining: three requests, then three responses
response 1: correlationId=1
response 2: correlationId=2
response 3: correlationId=3
응답이 보낸 순서대로, 보낸 상관 ID 를 달고 돌아왔습니다. Tomcat 6편의 HTTP/1.1 파이프라이닝 예제와 같은 모양입니다.
2. JSON 스키마 한 장 읽기
요청과 응답의 필드는 clients/src/main/resources/common/message/ 의 JSON 파일에 적혀 있습니다. 이 커밋에는 JSON 이 203개 있습니다(같은 폴더에 README.md 가 하나 더 있습니다). 요청 95개, 응답 95개, 그리고 헤더 두 개(RequestHeader, ResponseHeader)와 메시지가 아닌 데이터 구조 11개(ConsumerProtocolSubscription, KRaft 의 VotersRecord 등)입니다.
가장 작은 요청 하나를 봅시다. 5절의 주인공 ApiVersions 입니다.
  "apiKey": 18,
  "type": "request",
  "listeners": ["broker", "controller"],
  "name": "ApiVersionsRequest",
  // Versions 0 through 2 of ApiVersionsRequest are the same.
  //
  // Version 3 is the first flexible version and adds ClientSoftwareName and ClientSoftwareVersion.
  //
  // Version 4 fixes KAFKA-17011, which blocked SupportedFeatures.MinVersion in the response from being 0.
  //
  // Version 5 introduces ClusterId and NodeId checking and REBOOTSTRAP_REQUIRED error (KIP-1242).
  "validVersions": "0-5",
  "flexibleVersions": "3+",
  "headerVersions": {
    "0-2": "1",
    "3+": "2"
  },
  "fields": [
    { "name": "ClientSoftwareName", "type": "string", "versions": "3+",
      "ignorable": true, "about": "The name of the client." },
    { "name": "ClientSoftwareVersion", "type": "string", "versions": "3+",
      "ignorable": true, "about": "The version of the client." },
    { "name": "ClusterId", "type": "string", "versions": "5+", "nullableVersions": "5+", "default": "null",
      "ignorable": true, "about": "The cluster ID the client intends to connect to. Provide both ClusterId and NodeId, if known." },
    { "name": "NodeId", "type": "int32", "versions": "5+", "default": -1,
      "ignorable": true, "about": "The node ID the client intends to connect to. Provide both ClusterId and NodeId, if known." }
  ]
clients/src/main/resources/common/message/ApiVersionsRequest.json 17–43행
표준 JSON 에는 주석이 없지만 이 파일들에는 // 주석이 있습니다. 생성기가 Jackson 의 ALLOW_COMMENTS 를 켜고 읽기 때문입니다(MessageGenerator.java 187행). 주석은 판마다 무엇이 바뀌었는지 적는 변경 기록 노릇을 합니다. 키를 하나씩 읽으면 이렇습니다.
| 키 | 뜻 | 이 파일에서 |
|---|---|---|
apiKey |
API 번호 | 18 |
listeners |
이 요청을 받는 리스너 | 브로커와 컨트롤러 둘 다 |
validVersions |
이 소스가 아는 판의 범위. "0-5", "3+"(3 이상), "none"(없음) |
0~5 |
flexibleVersions |
유연한 판의 범위(6절) | 3 이상 |
headerVersions |
요청 판 → 헤더 판의 대응(4절) | v0~2 는 헤더 v1, v3 부터 헤더 v2 |
fields[].versions |
그 필드가 있는 판 | 이름·판 문자열은 v3 부터, ClusterId·NodeId 는 v5 부터 |
nullableVersions |
null 을 보낼 수 있는 판 | ClusterId 는 v5 부터 null 가능 |
default |
기본값 | ClusterId 는 null, NodeId 는 -1 |
ignorable |
그 필드가 없는 판으로 쓸 때 값을 조용히 버려도 되는가(3절) | 넷 다 버려도 됨 |
README.md 는 규칙 몇 가지를 못 박아 둡니다. "필드의 순서가 곧 네트워크로 보내는 순서이고, 순서를 바꾸는 것은 호환되지 않는 변경이다", "이미 내보낸 판은 끝난 것으로 보고, 실수가 있으면 새 판에서 고친다", "옛 판의 지원을 끊으려면 KIP(Kafka 개선 제안)가 있어야 한다". 필드에 versions 를 다는 방식 덕분에 메시지 하나의 모든 판이 파일 하나에 함께 삽니다.
큰 요청: Produce
프로듀서가 레코드를 보내는 Produce 요청은 이렇게 생겼습니다.
  "fields": [
    { "name": "TransactionalId", "type": "string", "versions": "3+", "nullableVersions": "3+", "default": "null", "entityType": "transactionalId",
      "about": "The transactional ID, or null if the producer is not transactional." },
    { "name": "Acks", "type": "int16", "versions": "0+",
      "about": "The number of acknowledgments the producer requires the leader to have received before considering a request complete. Allowed values: 0 for no acknowledgments, 1 for only the leader and -1 for the full ISR." },
    { "name": "TimeoutMs", "type": "int32", "versions": "0+",
      "about": "The timeout to await a response in milliseconds." },
    { "name": "TopicData", "type": "[]TopicProduceData", "versions": "0+",
      "about": "Each topic to produce to.", "fields": [
      { "name": "Name", "type": "string", "versions": "0-12", "entityType": "topicName", "mapKey": true, "ignorable": true,
        "about": "The topic name." },
      { "name": "TopicId", "type": "uuid", "versions": "13+", "mapKey": true, "ignorable": true, "about": "The unique topic ID" },
      { "name": "PartitionData", "type": "[]PartitionProduceData", "versions": "0+",
        "about": "Each partition to produce to.", "fields": [
        { "name": "Index", "type": "int32", "versions": "0+",
          "about": "The partition index." },
        { "name": "Records", "type": "records", "versions": "0+", "nullableVersions": "0+",
          "about": "The record data to be produced." }
      ]}
    ]}
  ]
clients/src/main/resources/common/message/ProduceRequest.json 56–76행
앱에서 보던 설정이 그대로 보입니다. 프로듀서의 acks 설정은 Acks 필드(0, 1, -1)가 되고, 트랜잭션을 쓰면 TransactionalId 가 채워집니다. 요청 하나에 토픽 여러 개, 토픽마다 파티션 여러 개를 담는 2단 배열([]TopicProduceData 안의 []PartitionProduceData)이고, 맨 안쪽 Records 의 타입 records 가 프로듀서가 모은 레코드 배치 덩어리입니다(5편에서 이 덩어리를 만들고, 6편에서 브로커가 받아 씁니다).
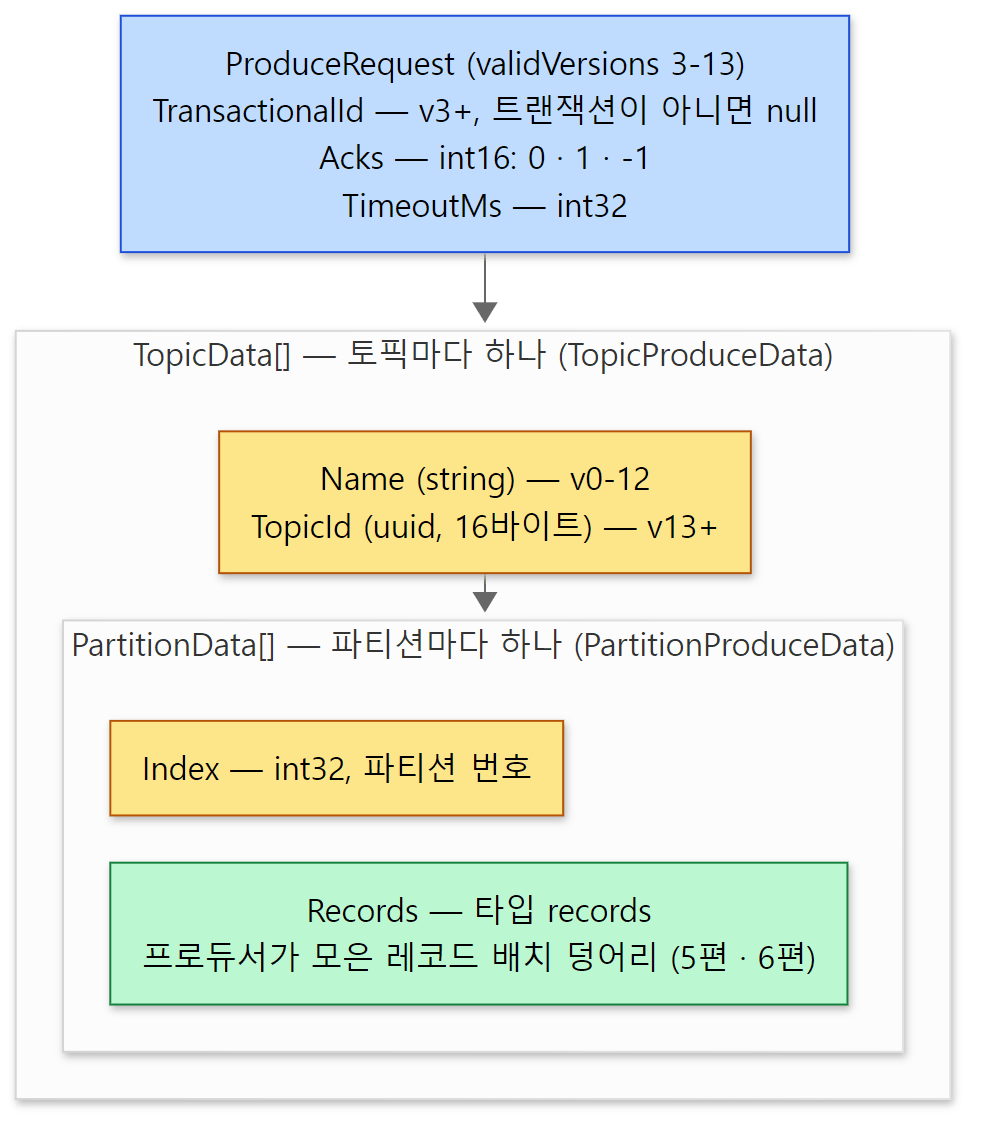 Produce 요청의 2단 배열. 요청 하나 → 토픽 여러 개 → 파티션 여러 개, 맨 안쪽에 레코드 덩어리가 있습니다. 필드와 판은 위 ProduceRequest.json 에서 옮겼습니다.
판의 역사도 보입니다. 토픽 이름(Name)은 v12 까지, v13 부터는 16바이트 토픽 ID(TopicId)로 바뀌었습니다(주석의 KIP-516). 그리고 validVersions 가 "3-13"(50행), 유연한 판은 v9 부터(51행)입니다. 파일 머리 주석대로 v0~2 는 Kafka 4.0 에서 지웠습니다.
헷갈리기 쉬운 곳: mapKey 는 바이트를 바꾸지 않습니다
Name·TopicId 에 붙은 "mapKey": true 는 생성된 자바 코드에서 그 배열을 "이 필드로 찾을 수 있는 집합"으로 만들라는 뜻일 뿐입니다(예제의 resp.apiKeys().find(key) 가 그렇게 생긴 메서드입니다). README 대로 네트워크로 보내는 모양은 그대로라 판을 올리지 않고 넣고 뺄 수 있습니다. JSON 키 가운데 바이트를 바꾸는 것(versions, type, nullableVersions, tag)과 자바 코드만 바꾸는 것(mapKey, about, entityType)을 구분해 읽어야 합니다.
예제 2: 리스너마다 다른 API 목록
listeners 가 정말로 쓰이는지, 같은 서버의 두 포트에 같은 질문(ApiVersions)을 던져 보았습니다. 9092 는 브로커 리스너, 9093 은 컨트롤러 리스너입니다.
=== 4. the same question on each listener
port 9092: apiKeys=77 Produce=true Vote=false
port 9093: apiKeys=42 Produce=false Vote=true
컨트롤러 리스너는 Produce 를 모르고, 대신 KRaft 의 선거 요청인 Vote 를 압니다. JSON 의 listeners 를 세어 보면 "broker" 가 든 요청이 79개, "controller" 가 든 요청이 42개입니다. 컨트롤러 쪽은 42개 그대로이고, 브로커 쪽이 77개인 것은 클라이언트 텔레메트리 API 둘(GetTelemetrySubscriptions, PushTelemetry)을 텔레메트리 수집기가 설정되지 않았을 때 목록에서 빼기 때문입니다(ApiVersionsResponse.java 196–199행). 컨트롤러가 무엇을 하는지는 10편에서 봅니다.
3. 스키마가 자바가 되기까지
JSON 을 자바로 바꾸는 일은 Gradle 빌드가 합니다. clients 프로젝트의 processMessages 작업입니다.
  tasks.register('processMessages', JavaExec) {
    mainClass = "org.apache.kafka.message.MessageGenerator"
    classpath = configurations.generator
    args = [ "-p", "org.apache.kafka.common.message",
             "-o", "${projectDir}/build/generated/main/java/org/apache/kafka/common/message",
             "-i", "src/main/resources/common/message",
             "-t", "ApiMessageTypeGenerator",
             "-m", "MessageDataGenerator", "JsonConverterGenerator"
           ]
generator 모듈의 MessageGenerator 를 자바 프로그램으로 실행(JavaExec)해서, -i 폴더의 JSON 을 읽어 -o 폴더에 자바 파일을 씁니다. 같은 블록 아래에서 compileJava.dependsOn 'processMessages' 로 컴파일보다 먼저 돌게 하고, 생성 폴더를 소스 폴더에 더합니다(2186–2199행). Gradle 의 작업과 의존이 무엇인지는 Gradle 연재에서, Kafka 빌드에 이런 코드 생성 단계가 있다는 것은 1편에서 맛보기로 보았습니다. metadata, raft, group-coordinator 같은 다른 모듈에도 같은 이름의 작업이 있어 각자의 JSON(메타데이터 레코드 등)을 자바로 바꿉니다.
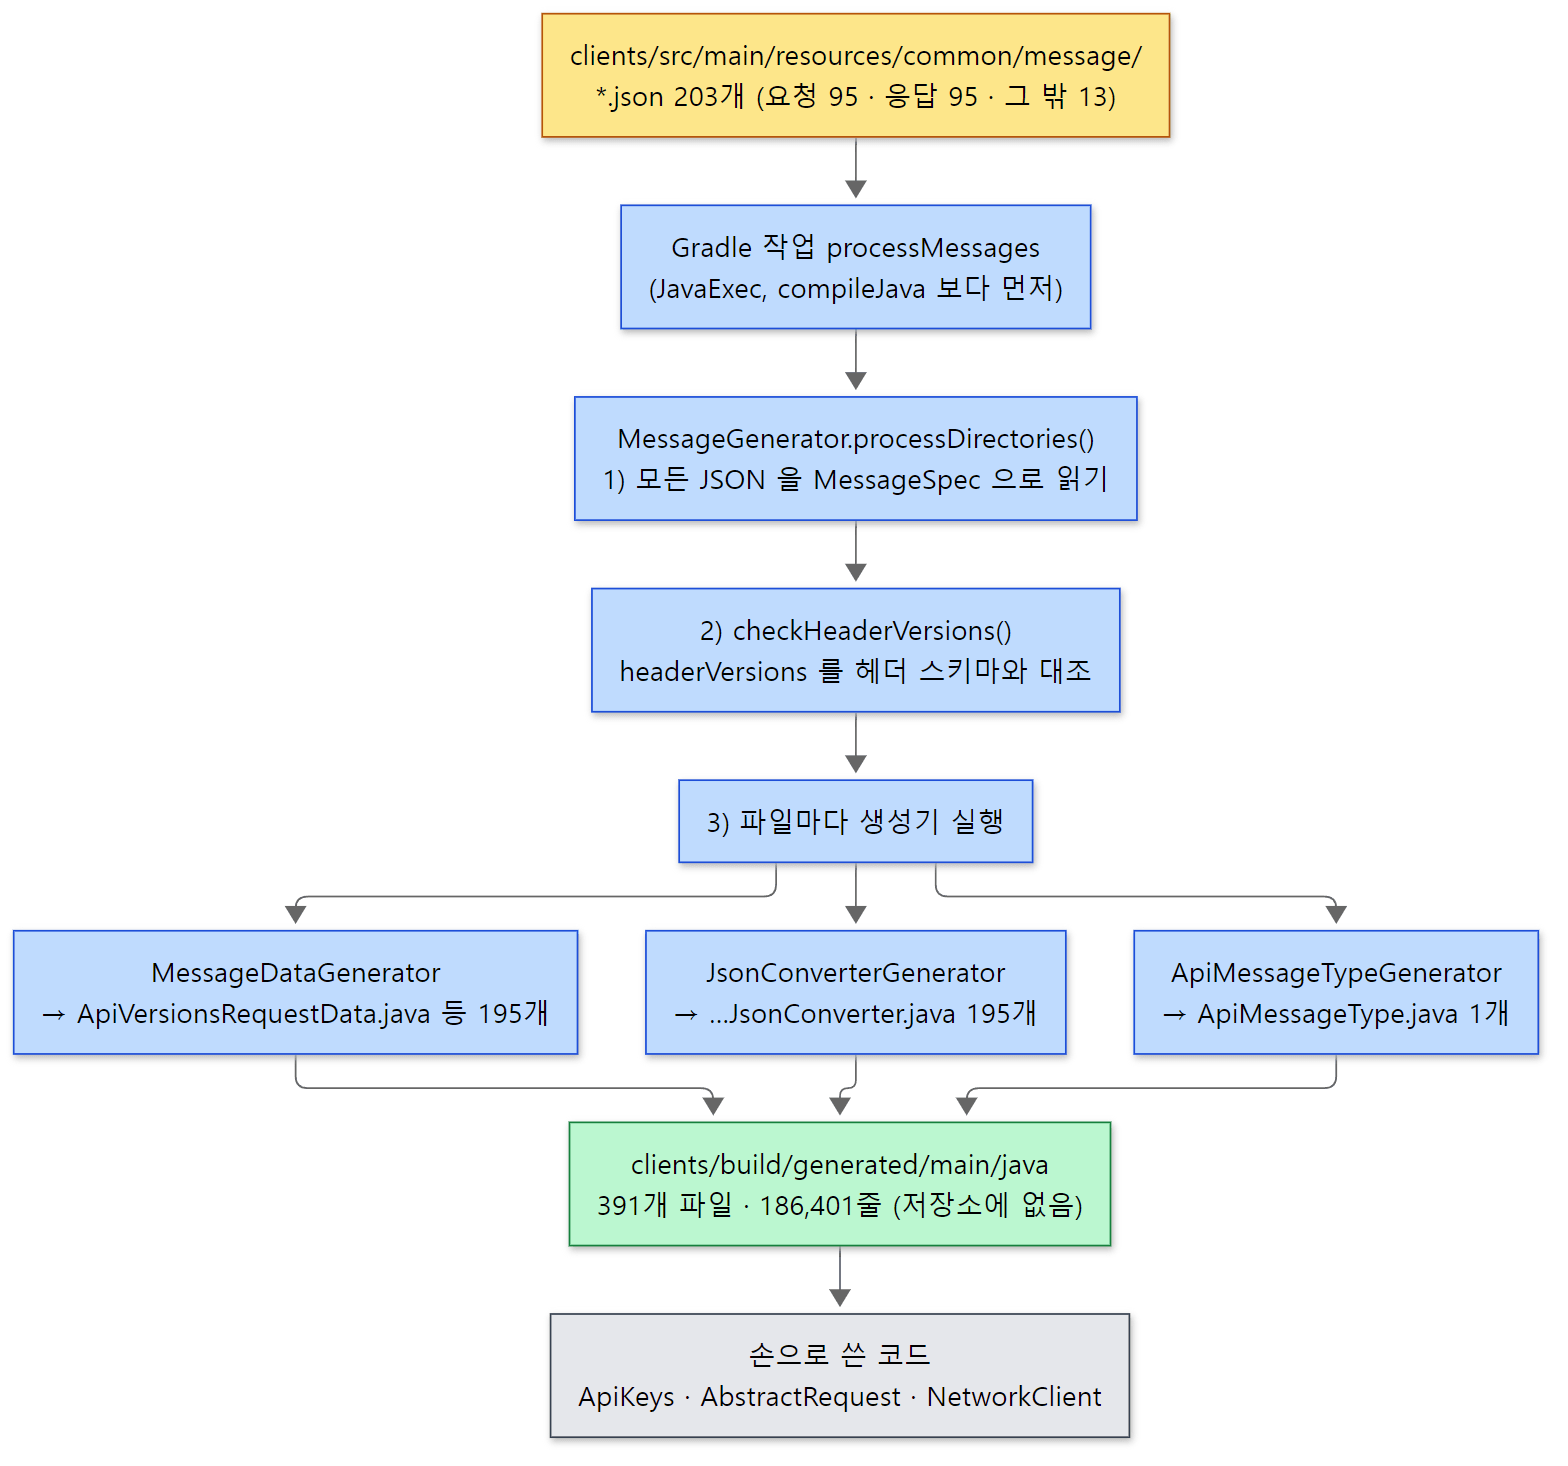 노란 상자가 사람이 쓰는 입력, 초록 상자가 빌드 때마다 새로 만들어지는 출력입니다.
MessageGenerator: 읽고, 대조하고, 만든다
        List<ParsedSpec> parsedSpecs = new ArrayList<>();
        MessageSpec requestHeader = null;
        MessageSpec responseHeader = null;
        try (DirectoryStream<Path> directoryStream = Files.newDirectoryStream(Paths.get(inputDir), JSON_GLOB)) {
            for (Path inputPath : directoryStream) {
                try {
                    MessageSpec spec = JSON_SERDE.readValue(inputPath.toFile(), MessageSpec.class);
                    // ... (헤더 스키마 둘을 따로 챙겨 둔다)
                    parsedSpecs.add(new ParsedSpec(inputPath, spec));
                // ...
        }
        // ...
        checkHeaderVersions(parsedSpecs, requestHeader, responseHeader);

        // Generate pass.
        for (ParsedSpec parsedSpec : parsedSpecs) {
            MessageSpec spec = parsedSpec.spec;
            try {
                outputFileNames.addAll(
                    generateAndWriteMessageClasses(spec, packageName, outputDir, messageClassGeneratorTypes));
                numProcessed++;
                typeClassGenerators.forEach(generator -> generator.registerMessageType(spec));
generator/src/main/java/org/apache/kafka/message/MessageGenerator.java 254–293행
- 읽기: JSON 마다 Jackson 으로
MessageSpec객체를 만듭니다. 이 단계에서 헤더 스키마 둘을 따로 챙겨 둡니다. - 대조: 모든 파일의
headerVersions가 헤더 스키마에 실제로 있는 판을 가리키는지 확인합니다. 줄인 자리의 주석(250–253행, 281–283행)이 이유를 적어 둡니다. 파일 하나만 보고는 헤더 스키마에 닿을 수 없으니 다 읽은 뒤에 하고, 잘못된 스키마가 있으면 아무것도 만들기 전에 빌드를 실패시켜 반쯤 만든 결과가 남지 않게 합니다. - 만들기: 파일마다
-m으로 받은 생성기들(MessageDataGenerator,JsonConverterGenerator)을 돌리고, 모든 메시지를-t의 생성기(ApiMessageTypeGenerator)에 등록해 둡니다. 다 돌면ApiMessageTypeGenerator가 API 목록 전체를 담은ApiMessageType.java하나를 씁니다(298–301행). 이번 실행에서 만들지 않은 옛 파일은 지웁니다(303–312행).
JSON 의 필드 객체 하나는 Jackson 이 FieldSpec 생성자의 인자(@JsonProperty("versions") String versions, @JsonProperty("tag") Integer tag …)로 풀어 넣습니다(FieldSpec.java 62–75행). 판 문자열 "3+", "0-12", "none" 은 Versions.parse() 가 [가장 낮은 판, 가장 높은 판] 한 쌍으로 바꿉니다. "3+" 는 위쪽을 Short.MAX_VALUE 로 둡니다(Versions.java 40–65행).
판의 범위가 if (_version >= 3) 이 된다
생성기의 핵심 생각은 단순합니다. 필드의 판 범위를 if 문으로 바꿔 찍는다. 문자열·배열 같은 길이가 있는 필드를 읽는 코드를 찍는 generateVariableLengthReader() 를 보면 잘 드러납니다.
        String lengthVar = type.isArray() ? "arrayLength" : "length";
        buffer.printf("int %s;%n", lengthVar);
        VersionConditional.forVersions(fieldFlexibleVersions, possibleVersions).
            ifMember(__ -> buffer.printf("%s = _readable.readUnsignedVarint() - 1;%n", lengthVar)).
            ifNotMember(__ -> {
                if (type.isString()) {
                    buffer.printf("%s = _readable.readShort();%n", lengthVar);
                } else if (type.isBytes() || type.isArray() || type.isRecords()) {
                    buffer.printf("%s = _readable.readInt();%n", lengthVar);
                } else {
                    throw new RuntimeException("Can't handle variable length type " + type);
                }
            }).
            generate(buffer);
generator/src/main/java/org/apache/kafka/message/MessageDataGenerator.java 630–643행
VersionConditional 은 "이 판 범위(fieldFlexibleVersions)에 들면 이 코드, 아니면 저 코드"를 if (_version >= N) 꼴로 찍어 주는 도우미입니다. 범위가 지금 다루는 판 전체를 덮으면 if 없이 한쪽만 찍습니다. 그래서 유연한 판에서는 길이를 varint 로(readUnsignedVarint() - 1), 아닌 판에서는 문자열이면 2바이트(readShort()), 배열이면 4바이트(readInt())로 읽는 코드가 나옵니다. 이렇게 찍혀 나온 ApiVersionsRequestData.read() 의 앞부분입니다.
    @Override
    public final void read(Readable _readable, short _version) {
        if (_version >= 3) {
            int length;
            length = _readable.readUnsignedVarint() - 1;
            if (length < 0) {
                throw new RuntimeException("non-nullable field clientSoftwareName was serialized as null");
            } else if (length > 0x7fff) {
                throw new RuntimeException("string field clientSoftwareName had invalid length " + length);
            } else {
                this.clientSoftwareName = _readable.readString(length);
            }
        } else {
            this.clientSoftwareName = "";
        }
[빌드 때 ApiVersionsRequest.json 에서 생성되는 clients/build/generated/main/java/org/apache/kafka/common/message/ApiVersionsRequestData.java 115–129행 (기준 커밋으로 생성) — 원본 스키마: ApiVersionsRequest.json 35–36행]
JSON 의 "versions": "3+" 가 바깥 if (_version >= 3) 이 되고, 그 판에 필드가 없으면 기본값("")을 넣습니다. ClientSoftwareName 의 판 범위가 flexibleVersions(3+)와 겹치므로 안쪽에는 varint 읽기만 남았습니다. null 이 될 수 없는 필드라 길이가 음수면 예외입니다. 사람이 쓰면 판마다 실수하기 쉬운 이런 if 사슬을 생성기가 메시지 수만큼 찍어 냅니다.
Produce 요청의 토픽 항목은 판에 따라 아예 다른 필드를 씁니다.
        public void write(Writable _writable, ObjectSerializationCache _cache, short _version) {
            int _numTaggedFields = 0;
            if (_version <= 12) {
                {
                    byte[] _stringBytes = _cache.getSerializedValue(name);
                    if (_version >= 9) {
                        _writable.writeUnsignedVarint(_stringBytes.length + 1);
                    } else {
                        _writable.writeShort((short) _stringBytes.length);
                    }
                    _writable.writeByteArray(_stringBytes);
                }
            }
            if (_version >= 13) {
                _writable.writeUuid(topicId);
            }
[빌드 때 ProduceRequest.json 에서 생성되는 ProduceRequestData.java 의 TopicProduceData.write() 607–622행 (기준 커밋으로 생성) — 원본 스키마: ProduceRequest.json 65–67행]
"versions": "0-12" 는 if (_version <= 12), "13+" 는 if (_version >= 13) 이 됐습니다. 그 안에서 다시 유연한 판(9+)이냐에 따라 길이를 적는 방식이 갈립니다. 같은 파일의 PartitionProduceData.write() 는 레코드를 _writable.writeRecords(records) 로 넘기고(949행), addSize() 에서는 이 크기를 addZeroCopyBytes() 로 따로 셉니다(977행). 1절에서 본 "레코드는 버퍼에 복사하지 않는다"가 여기서 시작됩니다.
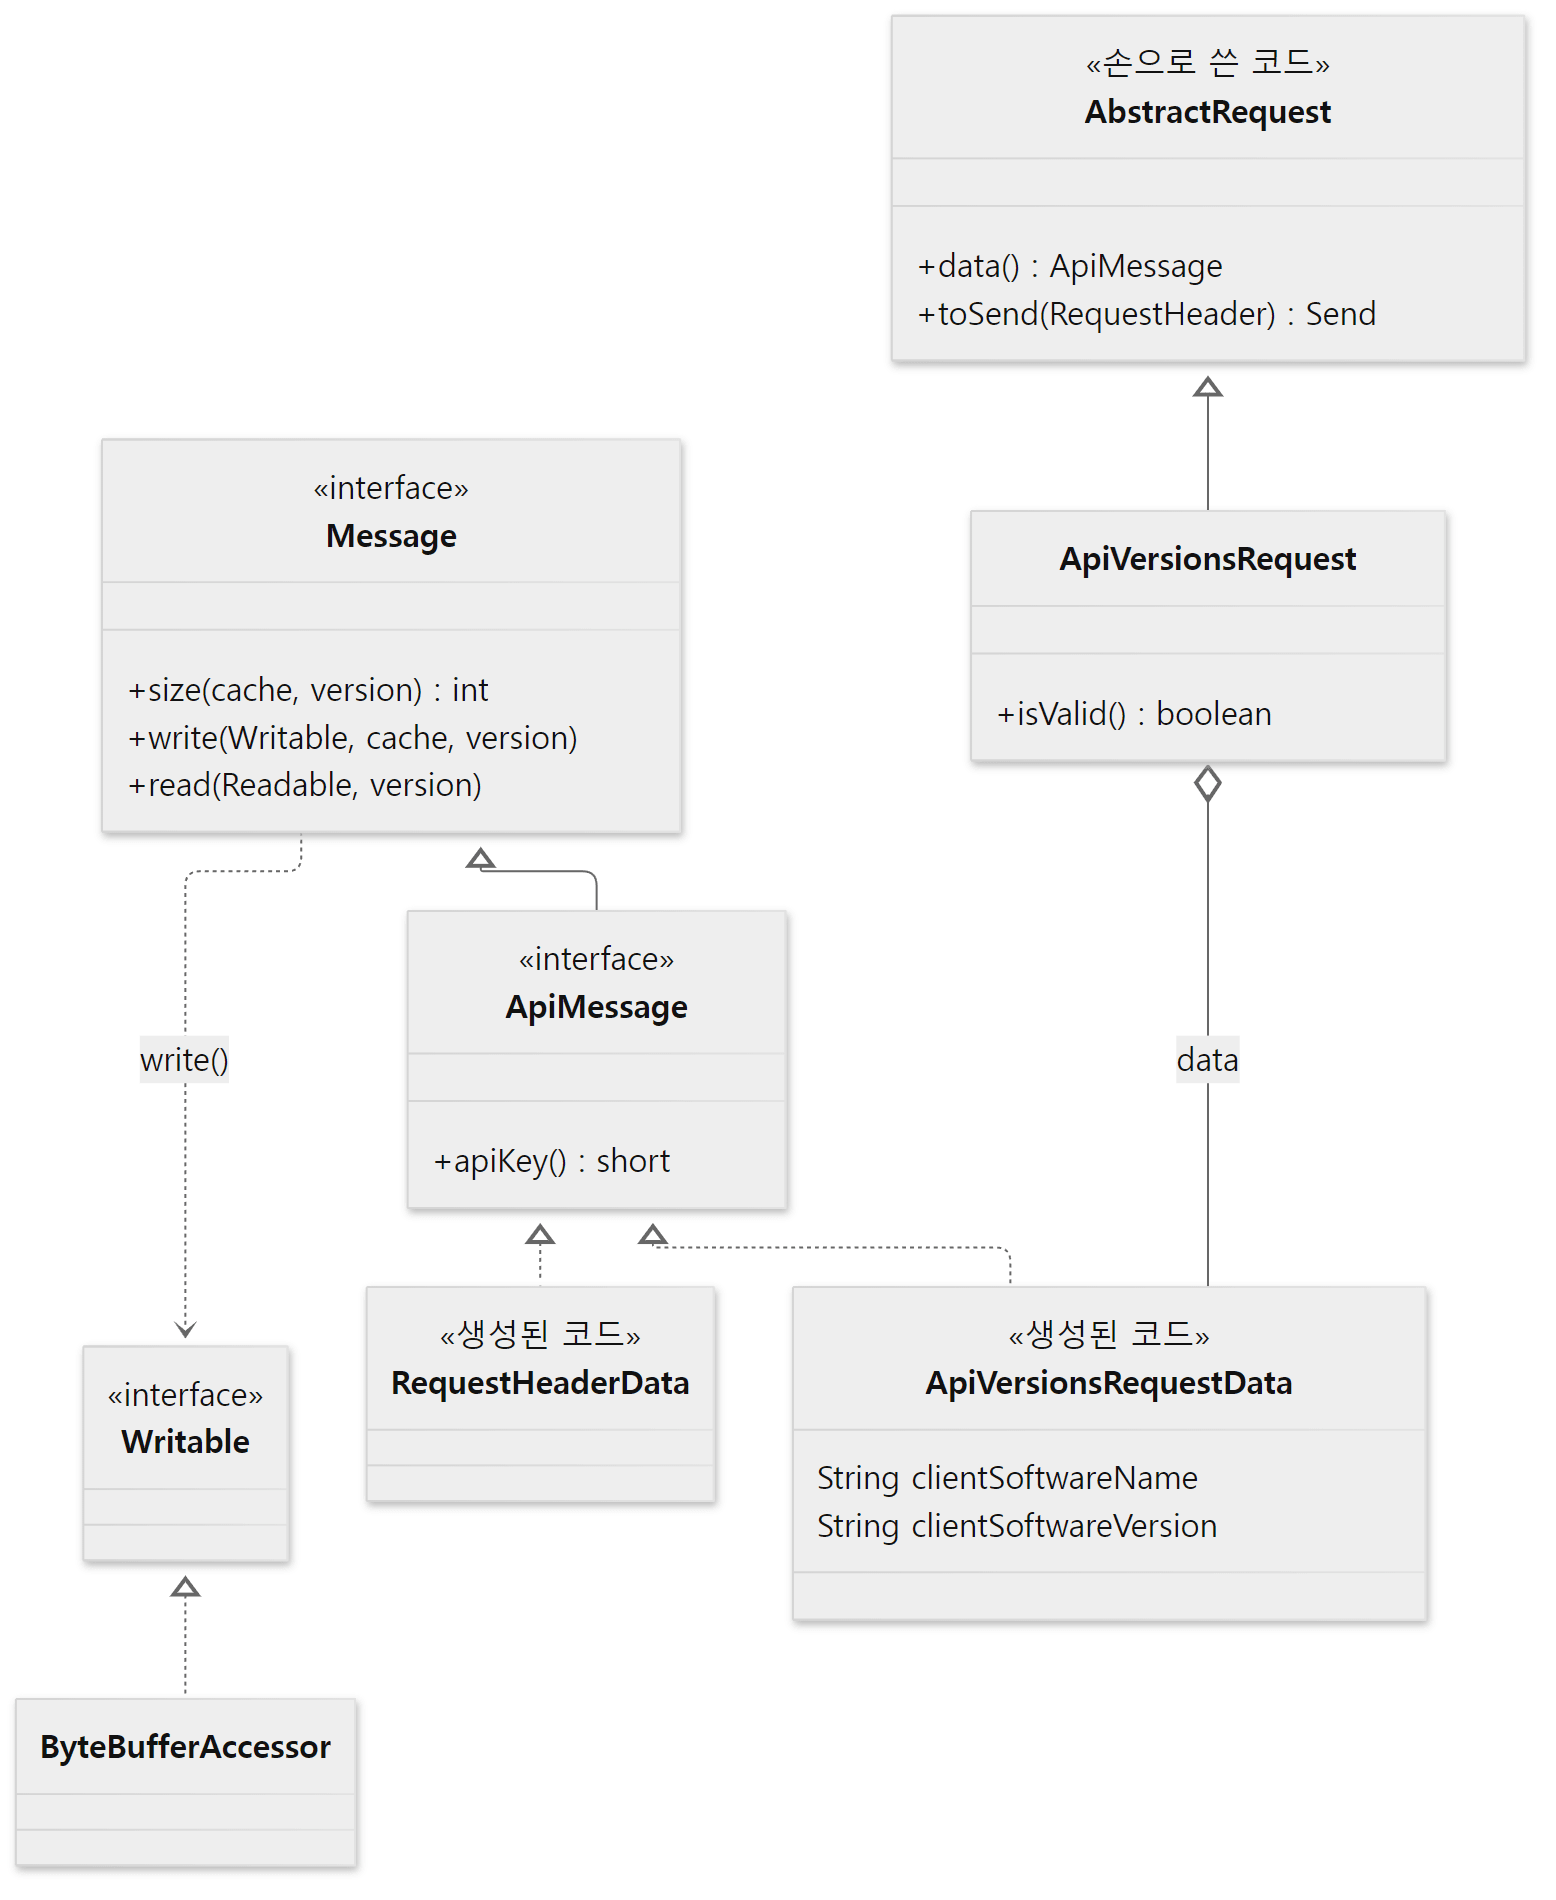 생성된
…Data 는 바이트와 필드 사이를 오가는 일만 하고, 손으로 쓴 ApiVersionsRequest 같은 감싸개가 검사(isValid())와 오류 응답 만들기 같은 일을 맡습니다.
Message인터페이스(size()/addSize(),write(),read(),unknownTaggedFields(),duplicate())를 생성된 클래스가 모두 구현하고, 요청·응답·헤더는apiKey()를 더한ApiMessage를 구현합니다. 헤더의apiKey()는 -1 을 돌려줍니다.- 바이트를 읽고 쓰는 쪽은
Readable/Writable인터페이스이고, 흔히 쓰는 구현이ByteBuffer를 감싼ByteBufferAccessor입니다. 1절의SendBuilder도Writable구현입니다. common.requests패키지의ApiVersionsRequest,ProduceRequest같은 클래스는 손으로 쓴 감싸개로,data()로 생성된 객체를 돌려줍니다(AbstractRequestResponse인터페이스).
clients 의 생성 폴더에는 이 커밋으로 391개 파일, 186,401줄이 나옵니다(ls | wc -l, cat *.java | wc -l 로 셌습니다). 생성된 메시지 클래스 195개, 같은 메시지를 JSON 글로 바꾸는 …JsonConverter 195개, ApiMessageType 1개입니다. JSON 은 203개인데 메시지 클래스가 195개인 것은 판이 남지 않은("validVersions": "none") 옛 API 넷의 요청·응답 8개는 클래스를 만들지 않기 때문입니다(ApiMessageType 에는 빈 스키마로 자리만 남습니다).
헷갈리기 쉬운 곳: 없는 판으로 쓰면 값은 어떻게 되나
필드가 없는 옛 판으로 메시지를 쓰면, 그 필드에 넣어 둔 값은 바이트에 실리지 않습니다. 이때 ignorable 이 갈림길입니다. MessageDataGenerator 는 ignorable 이 아닌 필드에만 "기본값이 아니면 UnsupportedVersionException"을 던지는 검사를 찍습니다(815–818행, FieldSpec.java 649–662행). 생성된 AddPartitionsToTxnRequestData 에는 "Attempted to write a non-default transactions at version " 같은 줄이 그렇게 들어가 있습니다. 반대로 ApiVersions 의 네 필드는 모두 ignorable 이라, 위의 생성된 write() 에는 v5 미만에서 ClusterId 를 검사하는 코드가 없습니다. 클라이언트 이름 같은 값은 옛 브로커에게 못 전해도 그만이지만, 요청의 뜻을 바꾸는 값을 조용히 버리면 안 된다는 구분입니다. README 의 예가 "verify only" 같은 불리언입니다.
예제 3: 같은 요청, 두 판의 바이트
ApiVersions 요청 하나를 v2(유연하지 않은 판)와 v3(유연한 판)로 직렬화해 바이트를 찍었습니다(bytes 모드). 본문에는 클라이언트 이름 u03-app, 판 1.0 을 넣었습니다.
=== 2. request bytes: ApiVersions v2 vs v3
ApiVersions v2 request, header v1, 17 bytes:
  00 00 00 0d 00 12 00 02 00 00 00 01 00 03 75 30 33
ApiVersions v3 request, header v2, 31 bytes:
  00 00 00 1b 00 12 00 03 00 00 00 02 00 03 75 30 33 00 08 75 30 33 2d 61 70 70 04 31 2e 30 00
v2 는 17바이트로, 길이(13) 뒤에 헤더만 있고 본문이 없습니다. JSON 대로 v0~2 에는 필드가 하나도 없기 때문입니다. 클라이언트 이름을 넣어 두었지만 ignorable 이라 조용히 빠졌습니다. v3 은 31바이트이고, 한 바이트씩 나누면 아래 그림과 같습니다.
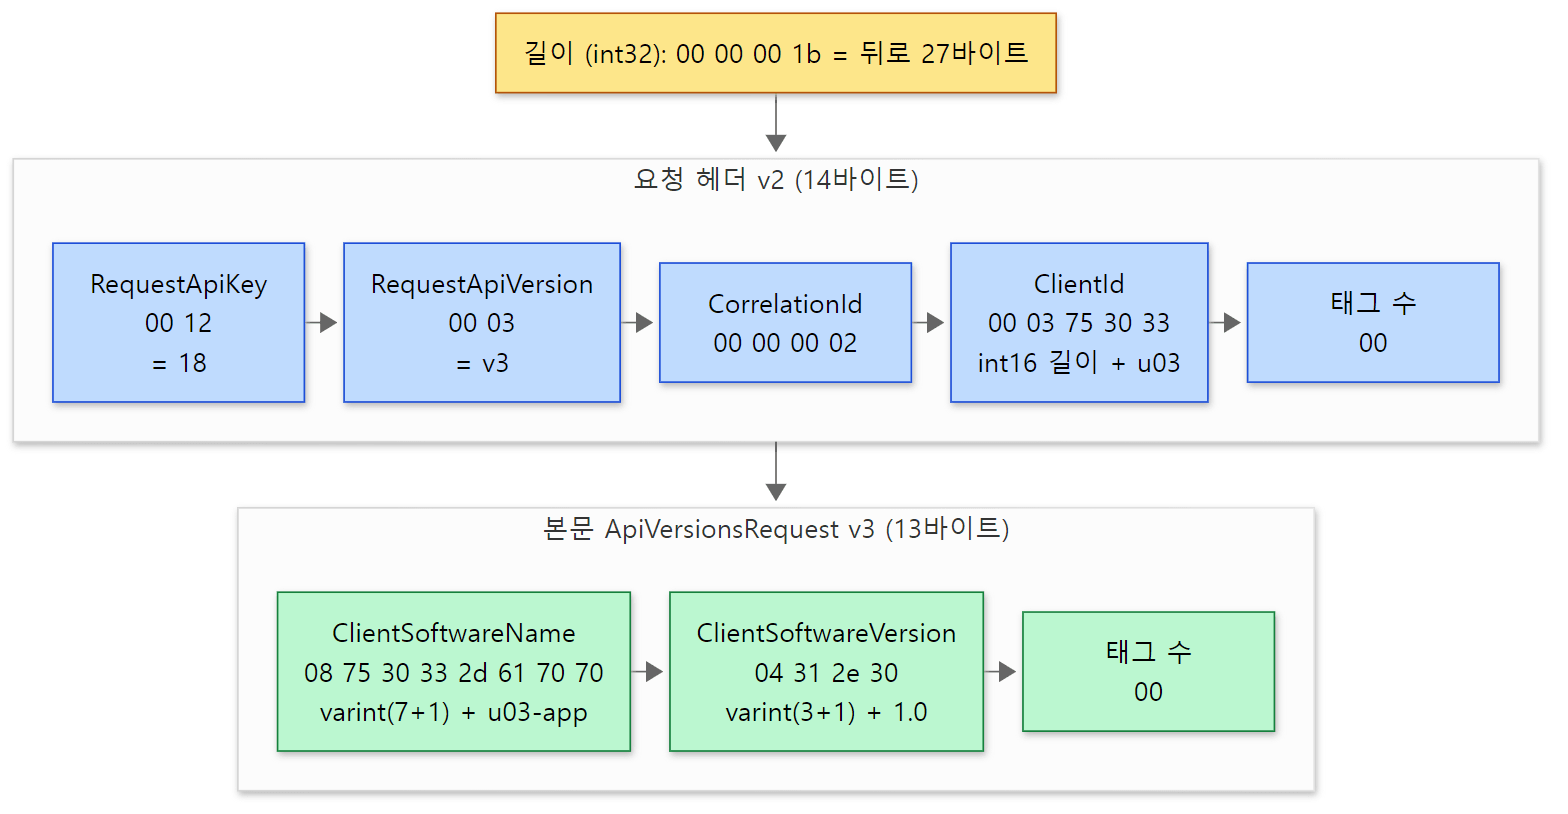 파란 상자가 요청 헤더, 초록 상자가 본문입니다. 헤더의 ClientId 만 옛 방식(2바이트 길이)으로 적힌 것에 눈여겨 보세요(4절).
- 헤더의
ClientId는00 03+u03으로 2바이트 길이, 본문의 문자열은08+u03-app으로 varint(길이+1) 입니다. 같은 요청 안에서 문자열을 적는 방법이 두 가지입니다. 이유는 4절에서 봅니다. - 유연한 판은 헤더 끝과 본문 끝에 태그 필드 개수 바이트(
00)가 하나씩 붙습니다(6절).
4. 요청 헤더와 헤더의 판
요청 헤더도 JSON 으로 정의합니다.
  "validVersions": "1-3",
  "flexibleVersions": "2+",
  "fields": [
    { "name": "RequestApiKey", "type": "int16", "versions": "0+",
      "about": "The API key of this request." },
    { "name": "RequestApiVersion", "type": "int16", "versions": "0+",
      "about": "The API version of this request." },
    { "name": "CorrelationId", "type": "int32", "versions": "0+",
      "about": "The correlation ID of this request." },

    // The ClientId string must be serialized with the old-style two-byte length prefix.
    // The reason is that older brokers must be able to read the request header for any
    // ApiVersionsRequest, even if it is from a newer version.
    // Since the client is sending the ApiVersionsRequest in order to discover what
    // versions are supported, the client does not know the best version to use.
    { "name": "ClientId", "type": "string", "versions": "1+", "nullableVersions": "1+", "flexibleVersions": "none",
      "about": "The client ID, for identifying an application." },
    { "name": "ClientInstanceId", "type": "uuid", "versions": "3+", "taggedVersions": "3+", "tag": 0,
      "about": "The client instance ID, for identifying an instance of an application." }
  ]
clients/src/main/resources/common/message/RequestHeader.json 28–47행
앞의 세 필드(API 키, 판, 상관 ID)는 모든 판에서 같은 자리, 같은 크기입니다. 이것이 프로토콜 전체를 떠받치는 약속입니다. 받는 쪽은 처음 4바이트만 읽으면 무슨 요청의 몇 판인지 알 수 있습니다.
ClientId 에는 필드 단위로 "flexibleVersions": "none" 이 붙어 있습니다. 헤더 v2 가 유연한 판이어도 이 필드만은 옛 방식(2바이트 길이)으로 적으라는 뜻이고, 예제 3의 바이트에서 00 03 75 30 33 으로 본 그것입니다. 주석이 이유를 댑니다. 클라이언트는 브로커가 어느 판을 아는지 모르는 채로 ApiVersions 를 보내므로, 옛 브로커도 그 요청의 헤더만은 읽을 수 있어야 한다는 것입니다.
헤더 판은 요청 판에서 정해진다 — 닭과 달걀
헤더에 판 번호 칸은 따로 없습니다. 헤더의 판은 요청의 API 키와 판에서 정해지는데, 그 둘은 헤더 안에 있습니다. 브로커는 이 문제를 이렇게 풉니다.
    public static RequestHeader parse(ByteBuffer buffer) {
        short apiKeyId = -1;
        try {
            // We derive the header version from the request api version, so we read that first.
            // The request api version is part of `RequestHeaderData`, so we reset the buffer position after the read.
            int bufferStartPositionForHeader = buffer.position();
            apiKeyId = buffer.getShort();
            short apiVersion = buffer.getShort();
            ApiKeys apiKey = ApiKeys.forId(apiKeyId);

            // `apiKey.requestHeaderVersion` will fail if there are no valid versions - we do this check first in order to
            // provide a more helpful message
            if (!apiKey.hasValidVersion())
                throw new InvalidRequestException("Unsupported api with key " + apiKeyId + " (" + apiKey.name + ") and version " + apiVersion);

            short headerVersion = apiKey.requestHeaderVersion(apiVersion);
            buffer.position(bufferStartPositionForHeader);
            final RequestHeaderData headerData = new RequestHeaderData(new ByteBufferAccessor(buffer), headerVersion);
clients/src/main/java/org/apache/kafka/common/requests/RequestHeader.java 140–157행
앞의 2+2바이트를 먼저 엿보고(getShort() 두 번), 헤더 판을 정한 뒤, 위치를 되돌려(buffer.position(...)) 생성된 RequestHeaderData 로 처음부터 다시 읽습니다. 맨 앞 두 필드가 모든 판에서 같은 모양이라서 할 수 있는 일입니다.
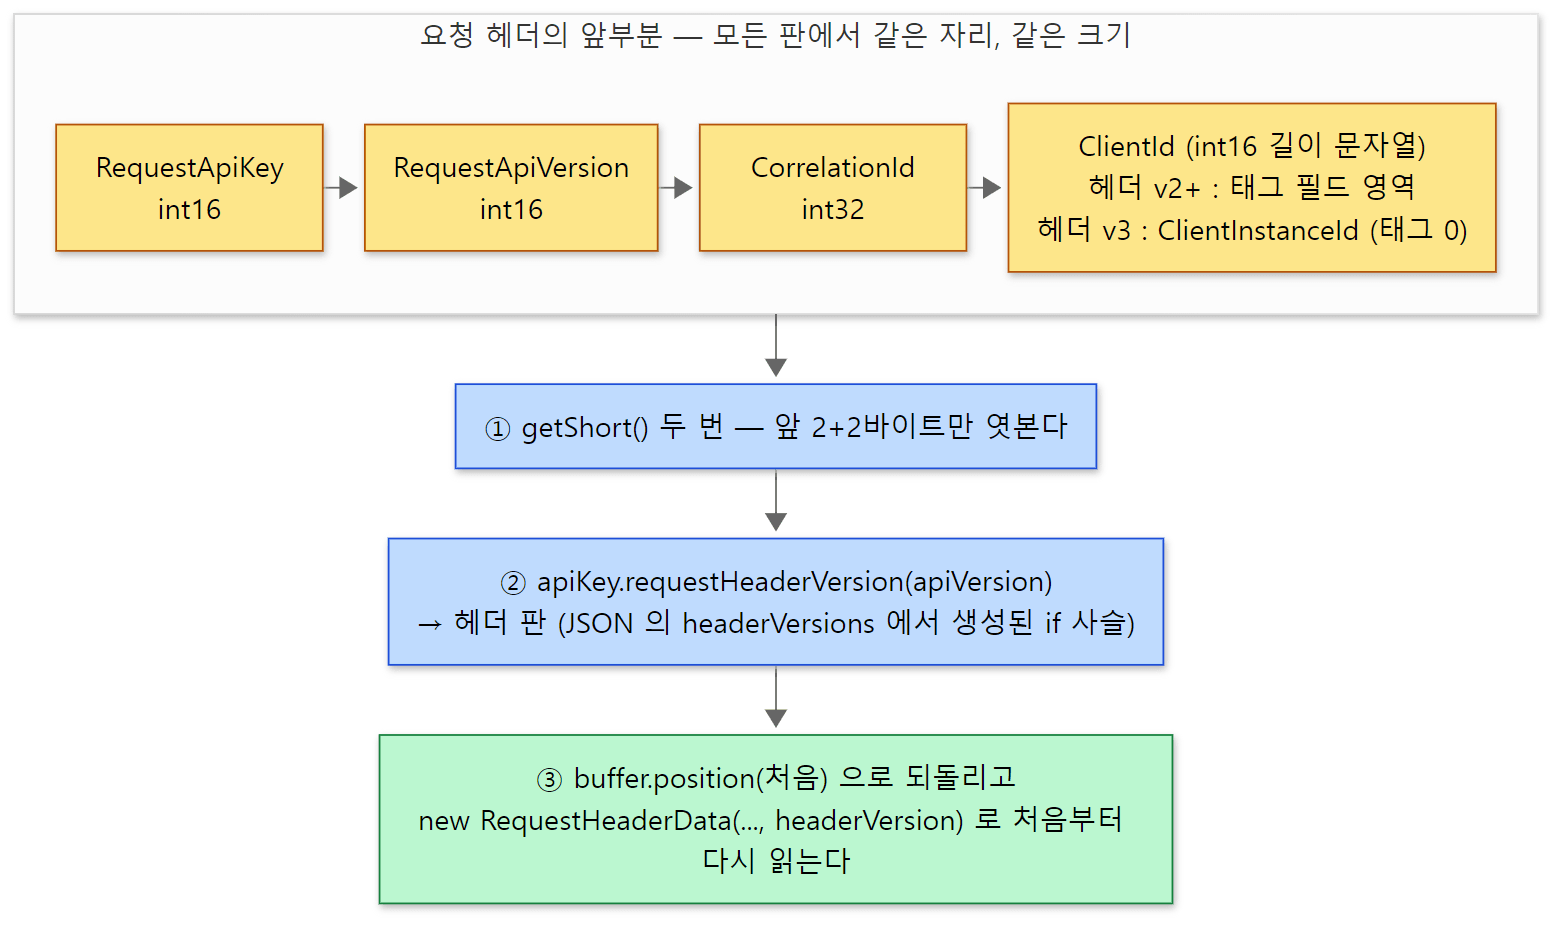 헤더 판을 알려면 헤더 안의 두 칸이 필요합니다. 그 두 칸이 언제나 맨 앞, 같은 크기라서 "엿보고 되돌려 다시 읽기"가 됩니다.
판 대응표: 4.4.0 의 규칙에서 trunk 의 JSON 으로
requestHeaderVersion() 은 생성된 ApiMessageType 의 메서드입니다. 안에는 switch (apiKey) 아래 API 마다 case 0: // Produce → if (_version >= 9) { return (short) 2; } else { return (short) 1; } 같은 if 사슬이 찍혀 있습니다(빌드 때 생성되는 ApiMessageType.java 769행부터, 기준 커밋으로 생성 — 원본은 각 요청 JSON 의 headerVersions, 예: ProduceRequest.json 52–55행).
이 표를 무엇으로 만드는지가 흔히 쓰는 4.4.0 과 이 trunk 커밋이 다른 곳입니다.
- 4.4.0: JSON 에
headerVersions키가 없습니다.ApiMessageTypeGenerator가 "요청 판이 유연한 판이면 헤더 v2, 아니면 v1 / 응답은 v1, v0" 이라는 규칙을 코드에 박아 두고, ApiVersions 응답만apiKey == 18로 따로 처리했습니다(4.4.0 의ApiMessageTypeGenerator.generateHeaderVersion()에서 확인). - trunk(이 커밋): 요청·응답 JSON 마다
headerVersions대응표를 적고, 생성기의generateHeaderVersionFromMap()은 그 표를 유효한 판 범위와 겹쳐 본 뒤 그대로if로 옮길 뿐입니다(ApiMessageTypeGenerator.java384–411행). 3절의 생성기 1·2단계에서 이 표를 헤더 스키마와 대조하는 것도 이 때문입니다.
규칙이 바뀐 까닭으로 보이는 것도 같은 커밋에 있습니다. 요청 헤더에 v3 이 생겼습니다(4.4.0 은 "validVersions": "1-2"). v3 은 ClientInstanceId 라는 태그 필드를 더한 판이고(주석의 KIP-1313), 지금은 GetTelemetrySubscriptions·PushTelemetry·OffsetDelete 요청의 v1 만 헤더 v3 을 씁니다(셋 다 마지막 판을 "아직 불안정"으로 두는 "latestVersionUnstable": true 라서 기본 설정의 브로커는 이 v1 을 알리지 않습니다 — 글 끝 "이 글에서 뺀 것" 참고). "유연하면 v2" 라는 규칙 하나로는 이런 대응을 적을 수 없습니다. 이 변경의 동기를 커밋 기록이나 KIP 문서로 확인하지는 않았습니다. 위는 두 판의 소스를 비교해 본 결과입니다.
헷갈리기 쉬운 곳: ApiVersions 응답의 헤더는 언제나 v0
ApiVersionsResponse.json 의 대응표는 "0+": "0" 하나뿐입니다(38–40행). v3 부터 유연한 판인데도 응답 헤더는 태그 필드 칸이 없는 v0 입니다. 파일 주석은 KIP-511 을 들며 "헤더 길이가 바뀌면 안 된다"고 적습니다. 판을 모르는 클라이언트도 응답의 상관 ID 까지는 읽을 수 있어야 하기 때문입니다. README 도 "응답의 flexible 판은 헤더 v1 이상이어야 한다"는 규칙의 예외로 이 응답을 꼽습니다.
예제 4: v2 와 v4 응답의 첫 12바이트
versions 모드는 같은 연결로 ApiVersions 를 v2 로 한 번, v4 로 한 번 묻고 응답 앞부분을 찍습니다.
=== 3. ApiVersions over a raw socket: v2 vs v4
--- v2: response 476 bytes (after the 4-byte length), first 12: 00 00 00 01 00 00 00 00 00 4d 00 00
correlationId=1 errorCode=0 apiKeys=77 supportedFeatures=0 finalizedFeaturesEpoch=-1
  Produce(0): 0 to 13
  Fetch(1): 4 to 18
  Metadata(3): 0 to 13
  ApiVersions(18): 0 to 5
--- v4: response 895 bytes (after the 4-byte length), first 12: 00 00 00 02 00 00 4e 00 00 00 00 00
correlationId=2 errorCode=0 apiKeys=77 supportedFeatures=7 finalizedFeaturesEpoch=49
  Produce(0): 0 to 13
  Fetch(1): 4 to 18
  Metadata(3): 0 to 13
  ApiVersions(18): 0 to 5
  feature group.version: 0 to 1
  feature kraft.version: 0 to 1
  feature metadata.version: 7 to 33
  feature share.version: 0 to 2
  feature streams.version: 0 to 1
  feature transaction.version: 0 to 2
  feature eligible.leader.replicas.version: 0 to 1
finalizedFeaturesEpoch 값은 실행마다 다릅니다. 첫 12바이트를 나누어 읽습니다.
| 바이트 | v2 응답 | v4 응답 |
|---|---|---|
| 상관 ID (응답 헤더 v0) | 00 00 00 01 |
00 00 00 02 |
ErrorCode |
00 00 |
00 00 |
ApiKeys 배열 길이 |
00 00 00 4d (int32, 77) |
4e (varint, 77+1) |
첫 항목 ApiKey |
00 00 (Produce) |
00 00 (Produce) |
- 두 응답 모두 상관 ID 바로 뒤에
ErrorCode가 옵니다. v4 응답도 헤더에 태그 수 바이트가 없는, 위에서 본 헤더 v0 입니다. - 배열 길이가 v2 는 4바이트(
0x4d= 77), v4 는 varint 1바이트(0x4e= 78 = 77+1)입니다. 3절의generateVariableLengthReader()가 찍는 두 갈래 그대로입니다. - v4 응답에만
SupportedFeatures가 7개 실려 옵니다. JSON 에서 이 필드는"tag": 0, "taggedVersions": "3+"인 태그 필드라 v2 에는 자리가 없습니다(6절). 응답이 476바이트에서 895바이트로 커진 것은 주로 태그 필드로 실린 기능(feature) 목록(SupportedFeatures·FinalizedFeatures) 때문이고, 유연한 판에서는 배열 항목 77개마다 태그 수 바이트가 하나씩 붙는 것도 보탭니다.
5. 판 협상 — ApiVersions
클라이언트와 브로커가 서로 다른 Kafka 판이어도 이야기할 수 있는 것은, 연결하자마자 "너는 어느 API 의 몇 판부터 몇 판까지 아니?" 를 먼저 묻기 때문입니다. 그 질문이 ApiVersions 요청(API 키 18)입니다.
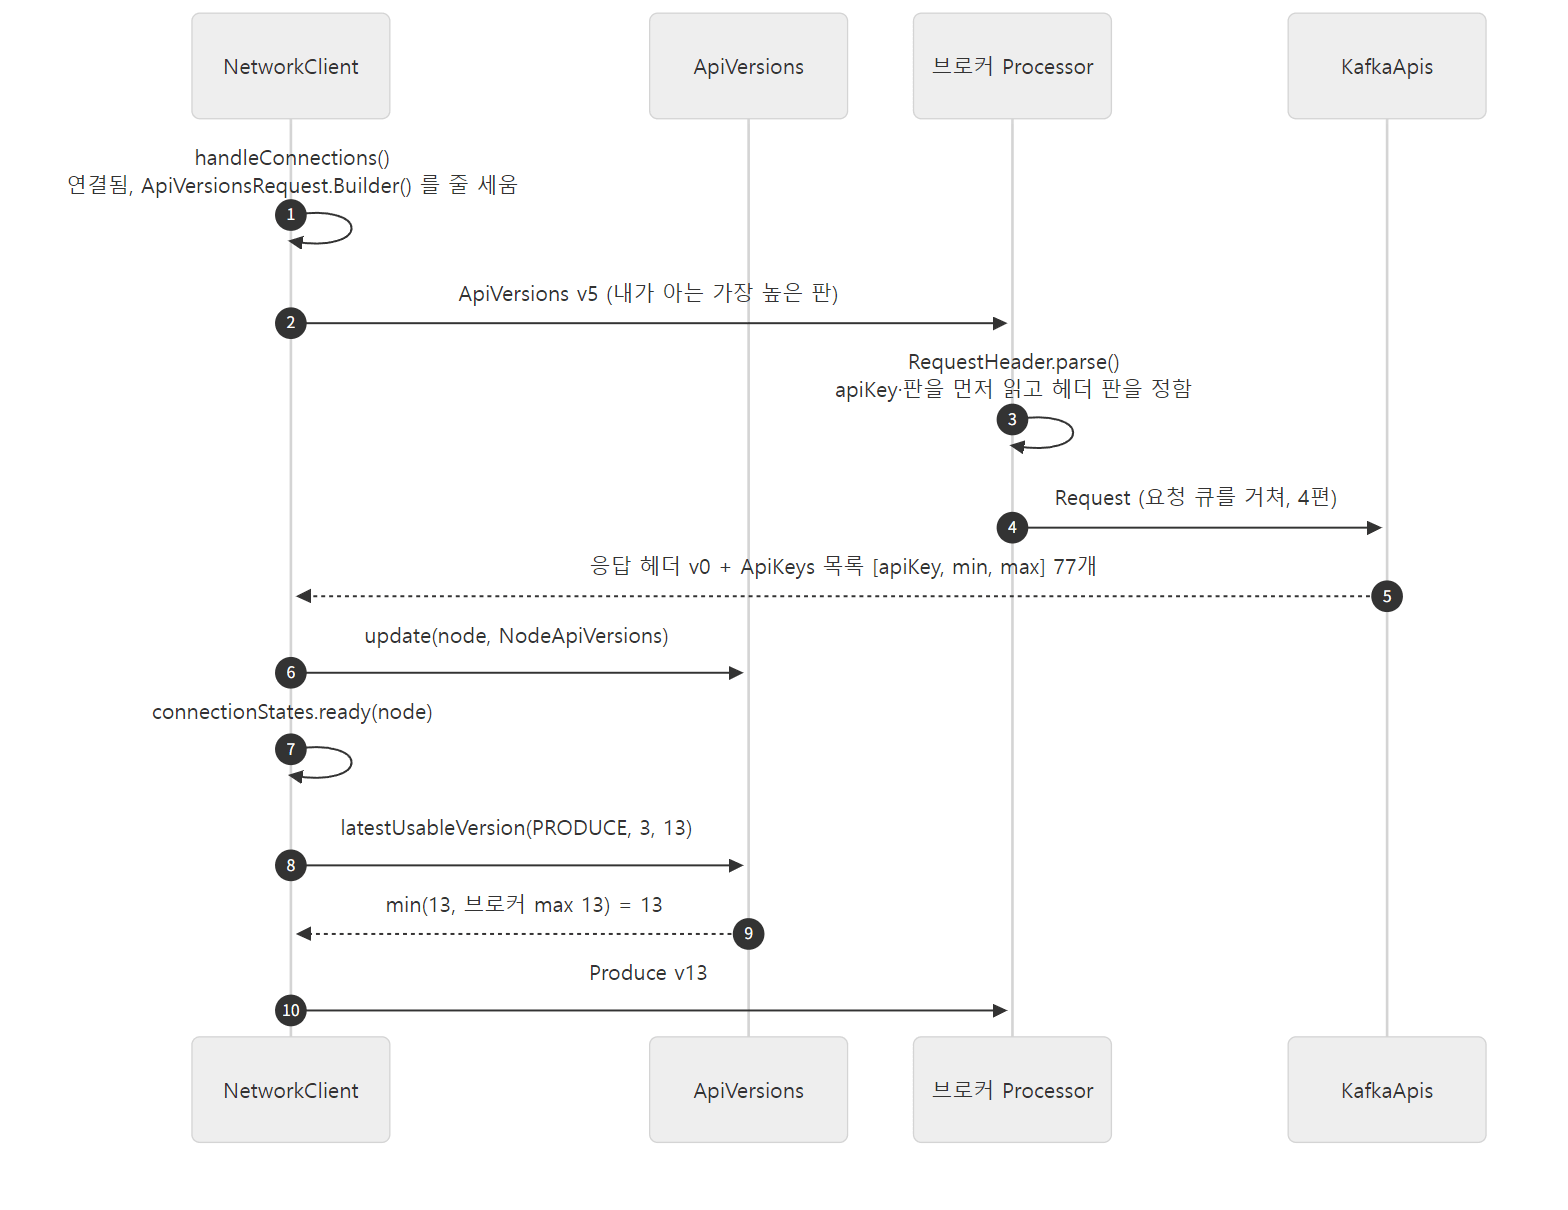 번호는 아래 본문의 설명 순서와 같습니다. 4번에서 요청이 지나는 큐와 스레드는 4편에서 봅니다.
클라이언트: 연결되면 먼저 묻는다
            if (discoverBrokerVersions) {
                nodesNeedingApiVersionsFetch.put(node, new ApiVersionsRequest.Builder());
                log.debug("Completed connection to node {}. Fetching API versions.", node);
            } else {
                this.connectionStates.ready(node);
                log.debug("Completed connection to node {}. Ready.", node);
            }
clients/src/main/java/org/apache/kafka/clients/NetworkClient.java 1201–1207행 (handleConnections())
TCP 연결이 맺어져도 바로 "준비됨"이 되지 않습니다(①). ApiVersions 를 보낼 노드 목록에 넣어 두면, 같은 poll() 의 바로 다음 단계(handleInitiateApiVersionRequests(), 733행)가 채널이 준비됐을 때 연결 상태를 CHECKING_API_VERSIONS 로 바꾸고 요청을 보냅니다(1211–1240행). 빌더 new ApiVersionsRequest.Builder() 의 판 범위는 oldestVersion()~latestVersion(), 곧 0~5 입니다(ApiVersionsRequest.java 40–44행).
이 요청은 몇 판으로 보낼까요? 판을 정하는 곳은 doSend() 입니다.
            NodeApiVersions versionInfo = apiVersions.get(nodeId);
            short version;
            // Note: if versionInfo is null, we have no server version information. This would be
            // the case when sending the initial ApiVersionRequest which fetches the version
            // information itself.  It is also the case when discoverBrokerVersions is set to false.
            if (versionInfo == null) {
                version = builder.latestAllowedVersion();
                // ...
            } else {
                version = versionInfo.latestUsableVersion(clientRequest.apiKey(), builder.oldestAllowedVersion(),
                        builder.latestAllowedVersion());
            }
            // The call to build may also throw UnsupportedVersionException, if there are essential
            // fields that cannot be represented in the chosen version.
            doSend(clientRequest, isInternalRequest, now, builder.build(version));
clients/src/main/java/org/apache/kafka/clients/NetworkClient.java 641–657행
아직 그 노드의 판 정보가 없으면(versionInfo == null) 자기가 아는 가장 높은 판으로 보냅니다(②, ApiVersions 는 v5). 판 정보가 생긴 뒤에는 NodeApiVersions.latestUsableVersion() 이 고릅니다(⑧⑨, NodeApiVersions.java 149–165행). 브로커가 아는 범위 [min, max] 와 클라이언트가 보낼 수 있는 범위의 겹치는 구간(ApiVersionsResponse.intersect() 는 큰 min, 작은 max 를 고릅니다, 306–320행)에서 가장 높은 판(maxVersion())을 씁니다. 겹치는 곳이 없으면 요청을 보내지도 않고 UnsupportedVersionException 으로 끝냅니다. 프로듀서가 쓰는 Produce 빌더의 범위는 ApiKeys.PRODUCE.oldestVersion()~latestVersion(), 곧 3~13 입니다(트랜잭션 v1 프로토콜을 쓸 때만 위를 11로 낮춥니다, ProduceRequest.java 45–51행).
응답을 받으면 handleApiVersionsResponse() 가 NodeApiVersions 를 만들어 ApiVersions(노드 ID → NodeApiVersions 맵)에 넣고 연결을 "준비됨"으로 바꿉니다(⑥⑦, 1161–1167행). 판 정보는 노드마다 따로입니다. 한 클러스터의 브로커들을 하나씩 올려 판을 바꾸는 동안(롤링 업그레이드) 브로커마다 아는 판이 다를 수 있기 때문입니다.
브로커: 모르는 판의 ApiVersions 는 v0 으로 답한다
클라이언트가 브로커보다 새로우면, 첫 ApiVersions 의 판(v5)을 브로커가 모를 수 있습니다. 다른 요청이었다면 모르는 판은 그대로 오류지만(아래 예제 6), ApiVersions 만은 특별 대우를 받습니다.
먼저 ApiKeys.isVersionEnabled() 가 if (this == ApiKeys.API_VERSIONS) return true; 한 줄로 ApiVersions 에 한해 어떤 판이든 통과시킵니다. 주석은 "클라이언트는 언제나 자기가 아는 가장 높은 판을 보내고, 서버는 모르면 v0 으로 물러선다"고 적습니다(ApiKeys.java 246–253행).
그다음 본문을 풀 때 RequestContext.parseRequest() 가 "모르는 판의 ApiVersions" 면(isUnsupportedApiVersionsRequest()) 본문을 아예 읽지 않고 new ApiVersionsRequest(new ApiVersionsRequestData(), (short) 0, header.apiVersion()), 곧 빈 v0 요청으로 바꿔 넣습니다(RequestContext.java 112–117행). 모르는 판의 본문은 어떻게 생겼는지 모르니 풀 수가 없기 때문입니다. 응답도 v0 으로 직렬화합니다(apiVersion() 이 이 경우 0 을 돌려줍니다, 158–163행). 처리는 KafkaApis 가 합니다.
    def createResponseCallback(requestThrottleMs: Int): ApiVersionsResponse = {
      val apiVersionRequest = request.body(classOf[ApiVersionsRequest])
      if (apiVersionRequest.hasUnsupportedRequestVersion) {
        apiVersionRequest.getErrorResponse(requestThrottleMs, Errors.UNSUPPORTED_VERSION.exception)
      } else if (!apiVersionRequest.isValid) {
        apiVersionRequest.getErrorResponse(requestThrottleMs, Errors.INVALID_REQUEST.exception)
      } else if (clusterIdOrNodeIdIsInvalid(apiVersionRequest)) {
        apiVersionRequest.getErrorResponse(requestThrottleMs, Errors.REBOOTSTRAP_REQUIRED.exception)
      } else {
        apiVersionManager.apiVersionResponse(requestThrottleMs, request.header.apiVersion() < 4)
      }
    }
core/src/main/scala/kafka/server/KafkaApis.scala 1551–1562행
Scala 읽는 법:
def f(x: Int): T = { … }는 반환형이T인 메서드이고, 여기처럼 메서드 안에 메서드를 둘 수 있습니다.val은 다시 대입할 수 없는 변수(자바의final)입니다.classOf[ApiVersionsRequest]는 자바의ApiVersionsRequest.class입니다. Scala 의if … else는 값을 내는 식이라, 마지막 줄에return이 없어도 고른 갈래의 값이 메서드의 반환값이 됩니다.
판을 모르면 UNSUPPORTED_VERSION 오류 응답을 만듭니다. 이때 getErrorResponse() 는 오류 코드만 넣지 않고 브로커가 아는 ApiVersions 의 판 범위를 함께 넣습니다(ApiVersionsRequest.java 134–140행, KIP-511). 클라이언트는 그 응답을 받으면 연결을 끊지 않고, 알려 준 최댓값으로 다시 묻습니다.
            } else {
                // Starting from Apache Kafka 2.4, ApiKeys field is populated with the supported versions of
                // the ApiVersionsRequest when an UNSUPPORTED_VERSION error is returned.
                // If not provided, the client falls back to version 0.
                short maxApiVersion = 0;
                if (!apiVersionsResponse.data().apiKeys().isEmpty()) {
                    ApiVersion apiVersion = apiVersionsResponse.data().apiKeys().find(ApiKeys.API_VERSIONS.id);
                    if (apiVersion != null) {
                        maxApiVersion = apiVersion.maxVersion();
                    }
                }
                nodesNeedingApiVersionsFetch.put(node, new ApiVersionsRequest.Builder(maxApiVersion));
            }
clients/src/main/java/org/apache/kafka/clients/NetworkClient.java 1146–1158행
바로 위 갈래(1141–1145행)는 v0 으로 물었는데도 오류이거나 UNSUPPORTED_VERSION 이 아닌 오류일 때 연결을 끊습니다.
이것이 가능한 것은 응답 헤더가 v0 으로 고정이고, v0 응답 본문(ErrorCode, ApiKeys 배열)의 모양이 바뀌지 않았기 때문입니다. 4절의 "ApiVersions 응답 헤더는 언제나 v0" 과 "ClientId 는 옛 방식" 이 모두 이 한 번의 왕복을 위한 장치입니다.
예제 5: 브로커보다 새로운 판으로 묻기
too-new 모드는 ApiVersions 를 v99 로 보냅니다. 응답은 v0 으로 풉니다.
=== 5. ApiVersions v99 (newer than the broker)
errorCode=35 (UNSUPPORTED_VERSION) apiKeys=1
  ApiVersions(18): 0 to 5
오류 코드 35(UNSUPPORTED_VERSION, Errors.java 265행)와 함께, 목록에 ApiVersions 하나만 "0부터 5까지" 로 들어 있습니다. 실제 클라이언트라면 여기서 v5 로 다시 물을 것입니다.
예제 6: 다른 요청을 모르는 판으로 보내면
같은 실험을 Metadata 요청(API 키 3)으로 하면 결과가 다릅니다. metadata-too-new 모드는 Metadata v99 를 보냅니다.
=== 6. Metadata v99 (newer than the broker)
no response: the broker closed the connection
Closing socket for <connection id> because of error
UnsupportedVersionException: Received request for api with key 3 (Metadata) and unsupported version 99
아래 두 줄은 run.sh 가 브로커의 server.log 에서 grep 한 것이고, 연결 ID 는 실행마다 달라 <connection id> 로 바꿨습니다. 응답은 오지 않고 연결이 끊겼습니다. 브로커의 네트워크 스레드가 헤더를 풀자마자 판을 검사하기 때문입니다.
    public static RequestHeader parseRequestHeader(ApiVersionManager apiVersionManager, ByteBuffer buffer) {
        RequestHeader header = RequestHeader.parse(buffer);
        if (apiVersionManager.isApiEnabled(header.apiKey(), header.apiVersion())) {
            return header;
        } else if (header.isApiVersionSupported()) {
            throw new InvalidRequestException("Received request for disabled api with key " + header.apiKey().id + " (" + header.apiKey().name() + ") and version " + header.apiVersion());
        } else {
            throw new UnsupportedVersionException("Received request for api with key " + header.apiKey().id + " (" + header.apiKey().name + ") and unsupported version " + header.apiVersion());
        }
    }
server/src/main/java/org/apache/kafka/network/Processor.java 33–42행
isApiEnabled() 는 "이 리스너가 받는 API 인가"(inScope)와 "아는 판인가"(isVersionEnabled)를 함께 봅니다(ApiVersionManager.java 62–64행). 예외는 SocketServer.scala 의 processCompletedReceives() 에서 잡혀 processChannelException() 이 연결을 닫습니다. 모르는 판의 본문은 모양을 모르므로 오류 응답을 그 판으로 만들 수도 없습니다. 판 협상을 건너뛰고 아무 판이나 보내면 안 되는 이유가 이것입니다.
이름이 헷갈리기 쉬운데, server/.../network/Processor.java 는 이런 도우미 몇 개만 든 작은 자바 클래스이고, 네트워크 스레드 본체 Processor 는 SocketServer.scala 안의 Scala 클래스입니다. 본체의 processCompletedReceives() 가 받은 바이트마다 이 parseRequestHeader() 를 부르고(989행, 자바 클래스를 JProcessor 라는 다른 이름으로 가져와 씁니다), RequestContext 와 Request 를 만든 뒤 요청 큐로 보냅니다(SocketServer.scala 982–1020행). 그리고 Request 의 생성자 안에서 context.parseRequest(buffer) 로 본문까지 풉니다(Request.java 101행). 곧 헤더와 본문을 생성된 클래스로 푸는 일은 브로커의 네트워크 스레드가 하고, 요청 처리 스레드는 이미 풀린 객체를 받습니다. 그 뒤의 sendRequest() 와 mute() 가 4편의 이야기입니다.
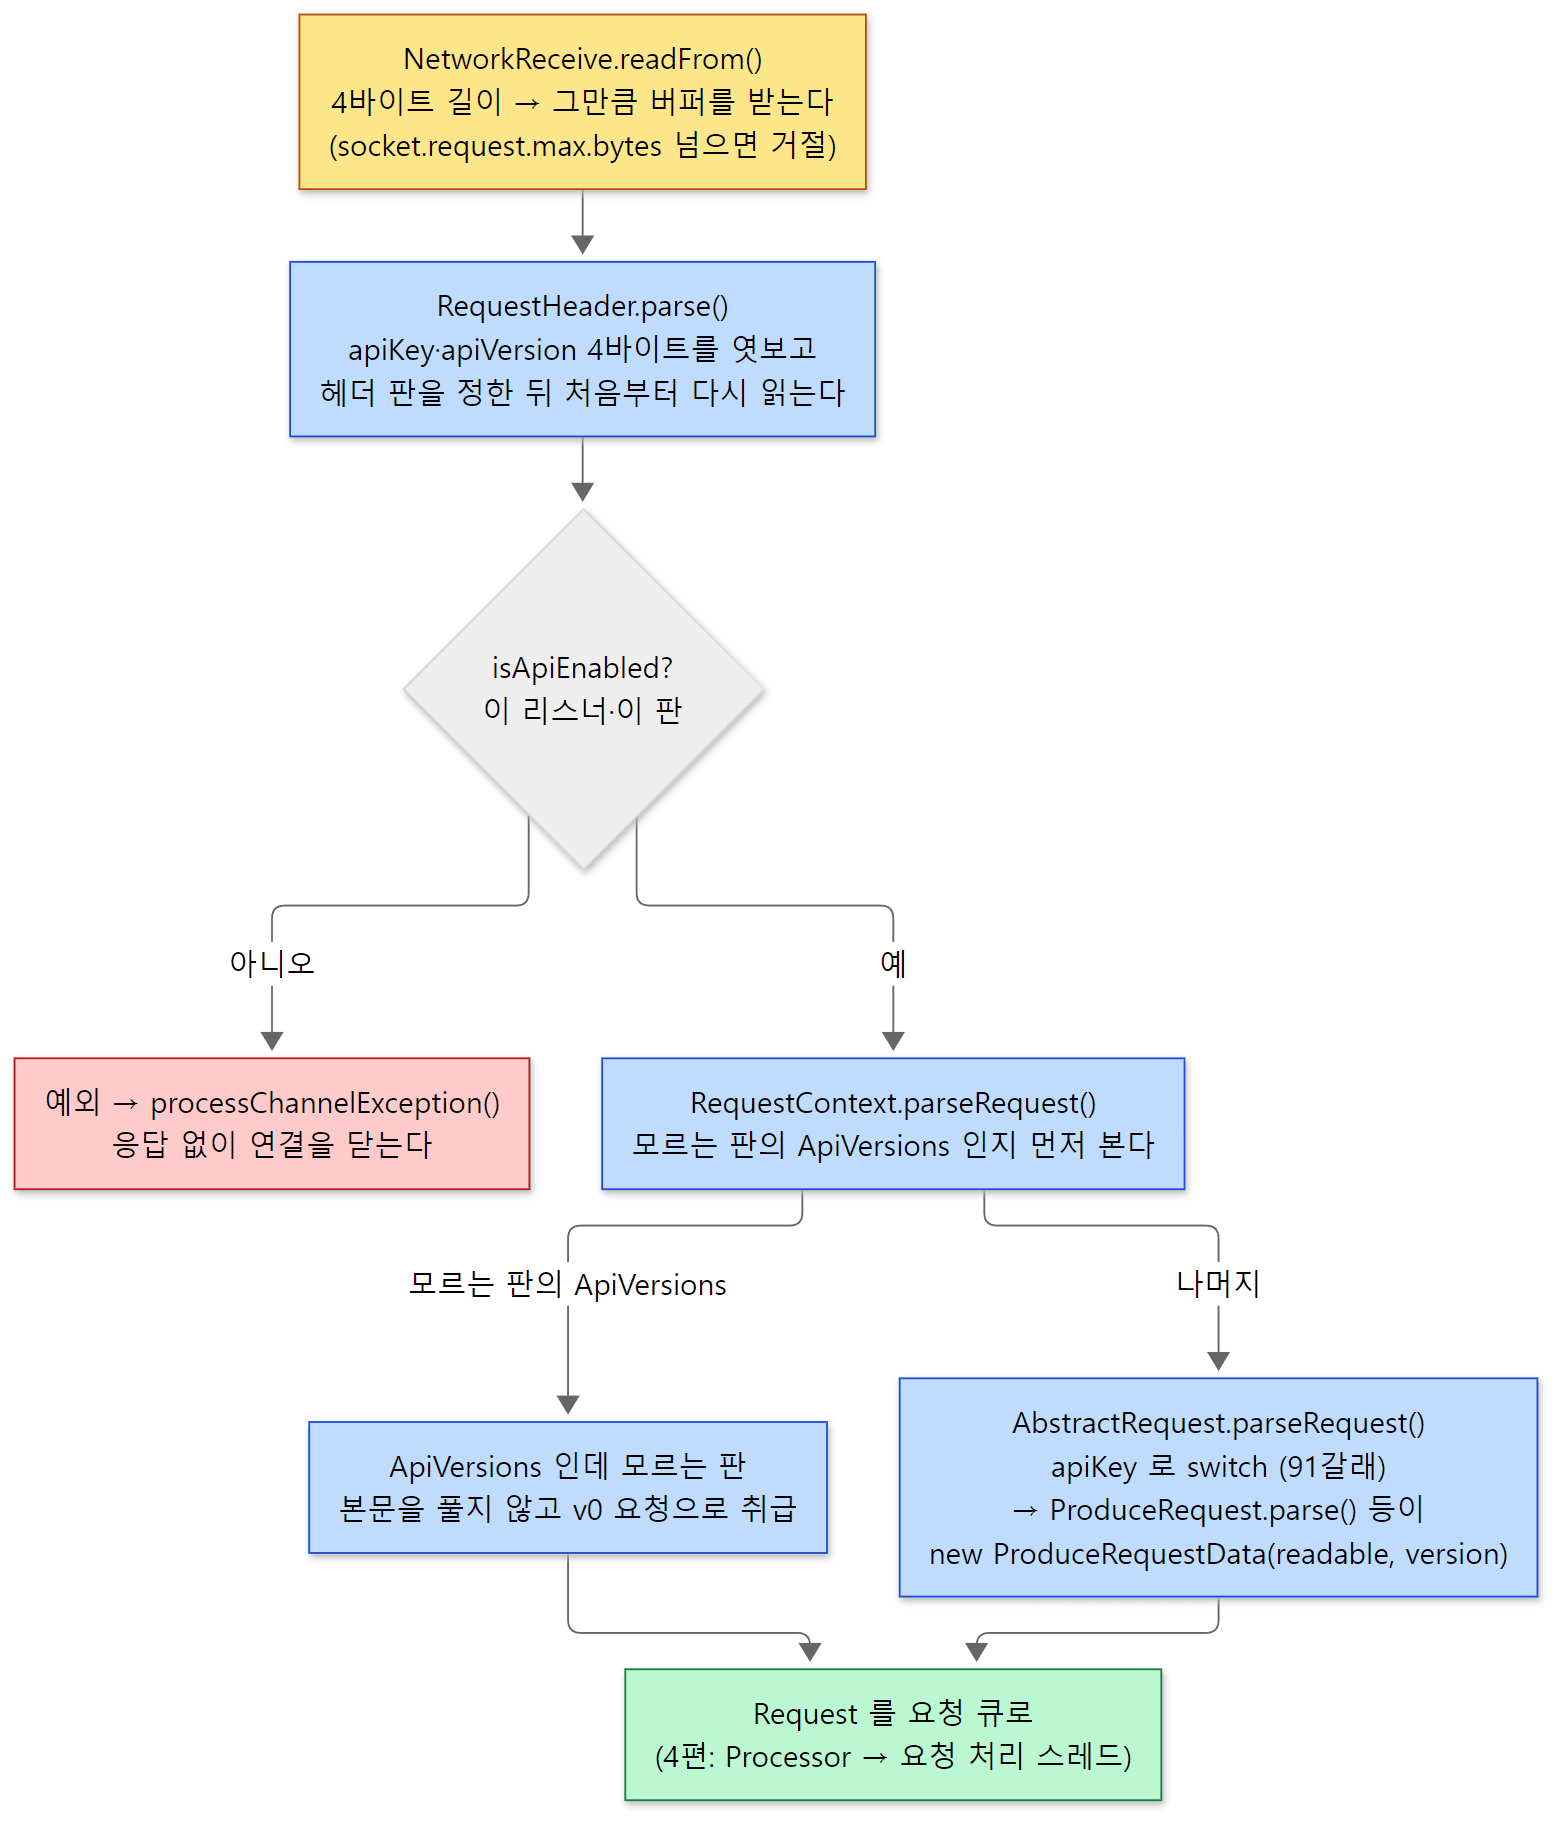 빨간 상자로 가는 길에는 응답이 없습니다. 모르는 판의 요청에 답할 수 있는 것은 ApiVersions 하나뿐입니다.
AbstractRequest.parseRequest() 의 switch 는 판이 남은 API 91개를 하나씩 손으로 적어 두었습니다(case PRODUCE: return ProduceRequest.parse(readable, apiVersion); …, AbstractRequest.java 177행부터). 각 parse() 는 생성된 …Data(readable, version) 생성자를 불러 감싸개에 넣을 뿐입니다(예: ProduceRequest.java 234–236행).
예제 7: 도구로 보기, 그리고 진짜 프로듀서의 대화
Kafka 배포판에는 ApiVersions 를 묻는 도구 kafka-broker-api-versions.sh 가 있습니다.
=== 1. kafka-broker-api-versions.sh (selected lines)
localhost:9092 (id: 1 rack: null isFenced: false) -> (
	Produce(0): 0 to 13 [usable: 13],
	Fetch(1): 4 to 18 [usable: 18],
	Metadata(3): 0 to 13 [usable: 13],
	ApiVersions(18): 0 to 5 [usable: 5],
lines with an api: 80
	GetTelemetrySubscriptions(71): UNSUPPORTED,
	PushTelemetry(72): UNSUPPORTED,
[usable: N] 은 이 도구(같은 커밋의 클라이언트)가 쓸 판, 곧 min(클라이언트의 최댓값, 브로커의 최댓값) 입니다(NodeApiVersions.java 236–237행). 괄호가 든 줄 80개는 첫 줄을 빼면 API 79개로, 브로커가 답한 77개에 클라이언트는 알지만 브로커 응답에 없는 2개(UNSUPPORTED)를 더한 것입니다(toString() 이 ApiKeys.clientApis() 를 돌며 채웁니다, 194–200행). 텔레메트리 API 둘이 빠진 까닭은 예제 2에서 봤습니다.
헷갈리기 쉬운 곳: Produce 는 왜 "0 to 13" 인가
JSON 의 Produce 는 "validVersions": "3-13" 인데, 브로커는 "0부터 13까지" 라고 답했습니다. 일부러 그렇게 합니다.
        // see `PRODUCE_API_VERSIONS_RESPONSE_MIN_VERSION` for details on why we do this
        short oldestVersion = (this == PRODUCE && listenerType.map(l -> l == ApiMessageType.ListenerType.BROKER).orElse(false)) ?
            PRODUCE_API_VERSIONS_RESPONSE_MIN_VERSION : oldestVersion();
clients/src/main/java/org/apache/kafka/common/protocol/ApiKeys.java 289–291행
상수 위의 주석(157–160행)이 사정을 적습니다. v0~2 는 Kafka 4.0 에서 지웠지만, C 클라이언트 라이브러리 librdkafka 의 버그 때문에(KAFKA-18659) ApiVersions 응답에는 최솟값을 0 으로 내보낸다는 것입니다. 실제로 v0~2 Produce 를 보내면 JSON 파일 머리 주석대로 거절됩니다. ApiVersions 응답의 숫자가 브로커가 받는 판과 늘 같지는 않다는 예입니다.
진짜 프로듀서는 이 대화를 어떻게 할까요? Negotiate.java 는 평범한 KafkaProducer 로 레코드 하나를 보내고, 클라이언트 로그 설정(log4j2-client.yaml)으로 NetworkClient 만 DEBUG 로 남겼습니다.
=== 9. a real producer: NetworkClient DEBUG log
sent to u03-0 at offset 0
--- the first request header, as the client logs it
RequestHeader(apiKey=API_VERSIONS, apiVersion=5, clientId=u03-producer, clientInstanceId=AAAAAAAAAAAAAAAAAAAAAA, correlationId=0, headerVersion=2)
--- connections and requests in order (shortened)
Completed connection to node -1. Fetching API versions.
  -> API_VERSIONS v5 (header v2, correlationId=0) to node -1
  <- API_VERSIONS v5 (correlationId=0) from node -1
  -> METADATA v13 (header v2, correlationId=1) to node -1
  -> INIT_PRODUCER_ID v5 (header v2, correlationId=2) to node -1
  <- METADATA v13 (correlationId=1) from node -1
  <- INIT_PRODUCER_ID v5 (correlationId=2) from node -1
Completed connection to node 1. Fetching API versions.
  -> API_VERSIONS v5 (header v2, correlationId=4) to node 1
  <- API_VERSIONS v5 (correlationId=4) from node 1
  -> INIT_PRODUCER_ID v5 (header v2, correlationId=5) to node 1
  <- INIT_PRODUCER_ID v5 (correlationId=5) from node 1
  -> PRODUCE v13 (header v2, correlationId=6) to node 1
  <- PRODUCE v13 (correlationId=6) from node 1
로그 줄이 길어 run.sh 에서 sed 로 줄였습니다(-> 는 Sending … request, <- 는 Received … response 줄입니다).
- 연결마다 ApiVersions 가 먼저입니다. 처음에는 설정의
bootstrap.servers주소로 붙으므로 노드 ID 를 몰라-1이라는 임시 ID 를 씁니다. Metadata 응답으로 그 브로커가 노드 1 인 것을 안 뒤, 같은 주소지만 노드 1 로 새 연결을 맺고 또 ApiVersions 부터 합니다. - 판은 협상 결과대로입니다. ApiVersions 는 v5, Metadata 와 Produce 는 v13 입니다. 이 서버에서 둘 다 클라이언트와 브로커의 최댓값이 같습니다.
- 헤더 v2, 그리고
clientInstanceId. 로그의RequestHeader에는 이 커밋에서 생긴clientInstanceId가 보이지만 값은 0(AAAA…는 0 UUID 의 base64)이고 헤더 판은 2 입니다. 이 필드는 헤더 v3 의 태그 필드라 v2 로는 실리지 않습니다(RequestHeader생성자가headerVersion >= 3일 때만 넣습니다,RequestHeader.java51–54행). - Metadata 요청의 응답이 오기 전에 InitProducerId 를 같은 연결로 또 보냈습니다. 1절에서 본 대로 응답은 보낸 순서대로 돌아왔습니다. 상관 ID 3 은 이 로그에 나오지 않는데, 그 번호를 무엇이 가져갔는지는 따라가지 않았습니다.
InitProducerId 는 멱등 프로듀서(enable.idempotence 의 기본값이 true 입니다, ProducerConfig.java 574–576행)가 producer ID 를 받는 요청입니다. 같은 예제를 따로 한 번 더 돌려 로그 원문을 보니, 첫 번째 InitProducerId 응답이 오류 코드 14(COORDINATOR_LOAD_IN_PROGRESS)여서 두 번째로 다시 보낸 것이었습니다. 이 요청의 뜻은 12편에서 봅니다.
6. 유연한 판과 태그 필드
3·4절에서 "유연한 판(flexible version)"이 계속 나왔습니다. JSON 의 flexibleVersions 범위에 드는 판이고, 생성기 주석은 이것을 "KIP-482 flexible schema" 라고 부릅니다(SchemaGenerator.java 72행). 유연한 판에서 바뀌는 것은 두 가지입니다.
| 유연하지 않은 판 | 유연한 판 | |
|---|---|---|
| 문자열 길이 | int16 (2바이트) | varint(길이+1). 0 이면 null |
| 배열·바이트·레코드 길이 | int32 (4바이트) | varint(길이+1). 0 이면 null |
| 구조체 끝 | 없음 | 태그 필드 영역: varint 개수, 그리고 (태그, 크기, 바이트) 반복 |
첫째는 작게 적기입니다. 짧은 문자열·배열의 길이는 거의 1바이트로 끝납니다. 예제 4에서 ApiKeys 배열 길이가 4바이트에서 1바이트가 된 그것입니다. "+1" 을 하는 것은 0 을 null 에 쓰려고입니다(옛 방식은 -1 이 null).
둘째가 더 중요한 태그 필드(tagged field)입니다. 유연한 판의 모든 구조체 끝에는 "덤 칸"이 붙습니다. 덤 칸에는 (태그 번호, 크기, 바이트) 묶음이 몇 개든 들어갈 수 있고, 받는 쪽은 아는 태그면 풀고 모르는 태그면 크기만큼 건너뜁니다. 그래서 태그 필드는 판을 올리지 않고도 이미 있는 판에 더할 수 있습니다. README 의 표현으로 "옛 서버는 모르는 새 태그 필드를 무시한다" 입니다.
생성된 ApiVersionsRequestData.read() 의 끝부분이 그 "건너뛰기"입니다.
        this._unknownTaggedFields = null;
        if (_version >= 3) {
            int _numTaggedFields = _readable.readUnsignedVarint();
            // ...
            for (int _i = 0; _i < _numTaggedFields; _i++) {
                int _tag = _readable.readUnsignedVarint();
                int _size = _readable.readUnsignedVarint();
                switch (_tag) {
                    default:
                        this._unknownTaggedFields = _readable.readUnknownTaggedField(this._unknownTaggedFields, _tag, _size);
                        break;
                }
            }
        }
[빌드 때 ApiVersionsRequest.json 에서 생성되는 ApiVersionsRequestData.java 161–182행 (기준 커밋으로 생성) — 원본 스키마: ApiVersionsRequest.json 29행]
ApiVersions 요청에는 태그 필드가 하나도 정의돼 있지 않아 switch 에 default 만 있습니다. 모르는 태그는 버리지도 않고 바이트 그대로 _unknownTaggedFields 에 모아 둡니다(Readable.readUnknownTaggedField()). 이 메시지를 다시 쓰면 그 바이트도 다시 실립니다(RawTaggedFieldWriter, 생성된 write() 의 214–218행). 태그 필드가 정의된 메시지라면 case 0: 같은 갈래가 생깁니다. 예제 4에서 본 ApiVersionsResponse 의 SupportedFeatures(태그 0), FinalizedFeaturesEpoch(태그 1), FinalizedFeatures(태그 2)가 그렇게 읽힙니다.
예제 8: 브로커가 모르는 태그를 붙여 보내기
unknown-tag 모드는 ApiVersions v4 요청 본문에 이 브로커가 모르는 태그 99(내용 hello)를 붙여 보냅니다. 그리고 같은 메시지를 유연하지 않은 v2 로 직렬화해 봅니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
                    ApiVersionsRequestData data = body("u03-app", "1.0");
                    data.unknownTaggedFields().add(new RawTaggedField(99, "hello".getBytes(StandardCharsets.UTF_8)));
                    out.write(frame((short) 4, data));
[예제 ex/u03-wire-protocol/RawWire.java 에서 줄임]
=== 7. an unknown tagged field
v4 with tag 99: errorCode=0 apiKeys=77
v2 with tag 99: UnsupportedVersionException: Tagged fields were set, but version 2 of this message does not support them.
- v4 요청은 오류 없이(
errorCode=0) 평소처럼 77개 목록을 받았습니다. 브로커는 태그 99를 건너뛰었습니다. 새 클라이언트가 덤 칸에 새 정보를 실어도 옛 브로커가 깨지지 않는다는 뜻입니다. - v2 로 쓰려 하자 보내기도 전에 클라이언트 쪽에서 예외가 났습니다. 유연하지 않은 판에는 덤 칸이 없기 때문입니다. 생성된
write()의if (_version >= 3) { … } else { if (_numTaggedFields > 0) throw … }갈래입니다(219–223행).
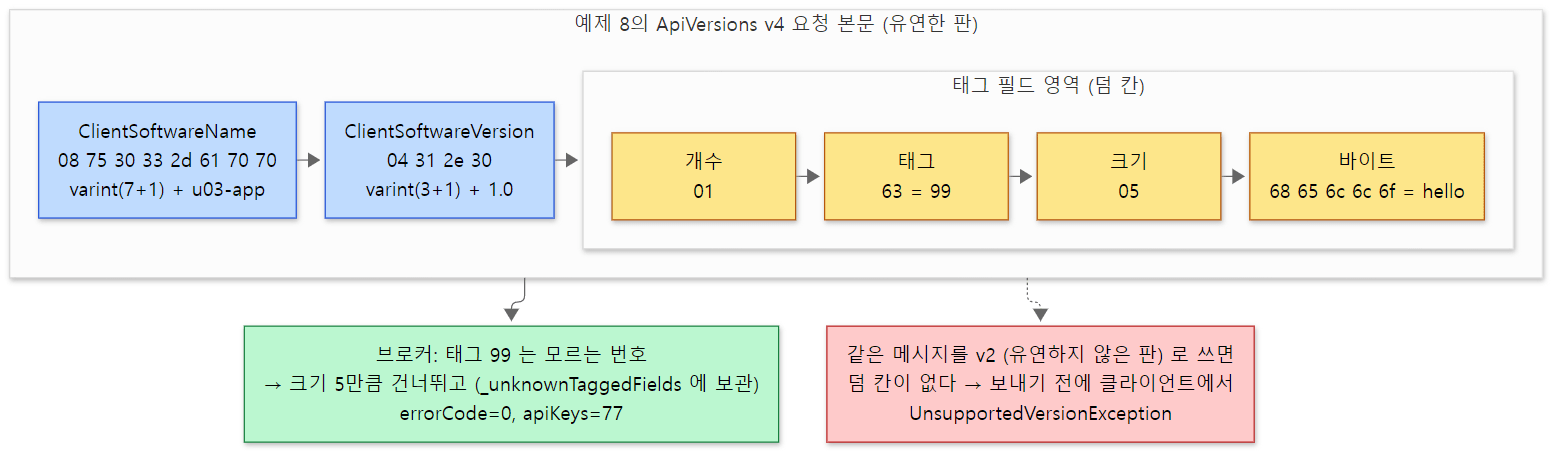 모르는 태그는 크기만 보고 건너뜁니다. 앞 두 필드의 바이트는 3절 그림(v3)과 같고, 태그 영역의 바이트는 RawTaggedFieldWriter 가 쓰는 순서(태그, 크기, 바이트)대로 계산한 것입니다. 결과 두 줄은 예제 8의 실제 출력입니다.
헷갈리기 쉬운 곳: 태그 필드도 아무 판에나 생기지는 않습니다
태그 필드는 판을 올리지 않고 더할 수 있지만, 유연한 판에만 더할 수 있습니다(README: "tagged fields can only be added to "flexible" message versions"). 생성기는 필드의 taggedVersions 가 유연한 판 범위 안에 들지 않으면 빌드를 멈춥니다(MessageDataGenerator.java 436–440행). 그리고 한 번 쓴 태그 번호는 다른 뜻으로 다시 쓸 수 없습니다. 옛 클라이언트가 그 번호를 옛 뜻으로 풀 것이기 때문입니다. 유연한 판이 생기기 전부터 있던 옛 판들은 덤 칸이 없으므로, 거기에 무언가를 더하려면 지금도 판을 올려야 합니다. Produce 가 v9, Fetch 가 v12 부터 유연한 판인 것처럼, API 마다 유연한 판이 시작된 자리가 다릅니다.
이 글에서 뺀 것
- 메시지를 JSON 글로 바꾸는
…JsonConverter(server/src/main/java/org/apache/kafka/network/RequestConvertToJson.java가 씁니다):generator/src/main/java/org/apache/kafka/message/JsonConverterGenerator.java - 옛 방식의 스키마 객체
Schema·Field·Type(생성된 클래스의SCHEMA_0… 상수):clients/src/main/java/org/apache/kafka/common/protocol/types/ - 마지막 판을 "아직 불안정"으로 두는
latestVersionUnstable과 브로커 설정unstable.api.versions.enable(ServerConfigs.java124행). 이 커밋에서는InitProducerIdRequest등 4개 파일이 씁니다. 예제 7의 InitProducerId 가 v6 이 아니라 v5 로 간 것과 관련 있어 보이지만 따라가지 않았습니다 - 다른 브로커로 요청을 넘기는 봉투(envelope) 요청과
forwardable:common/requests/EnvelopeRequest.java,ApiKeys.java의forwardable - 클러스터 기능의 판(
metadata.version등 예제 4의 feature 목록)과 그 협상:server-common/src/main/java/org/apache/kafka/server/common/Feature.java(10편과 이어집니다) - KIP-1242 의
ClusterId·NodeId검사와REBOOTSTRAP_REQUIRED:KafkaApis.scala1567행의clusterIdOrNodeIdIsInvalid(),NetworkClient.java1130–1140행 - SASL 인증 중의 요청(
SaslHandshake,SaslAuthenticate)과 예약된 상관 ID 범위:common/security/authenticator/SaslClientAuthenticator.java - 메타데이터 레코드와 그룹 코디네이터 레코드처럼 요청이 아닌 JSON 스키마(같은 생성기, 다른 모듈):
metadata/src/main/resources/common/metadata/,group-coordinator/src/main/resources/common/message/ - 이 연재 전체에서 뺀 것: Kafka Streams, Kafka Connect, MirrorMaker, 공유 그룹, 계층 저장소, 보안(SASL·TLS·ACL), 쿼터,
Admin클라이언트, JBOD
정리
| 개념 | 한 줄 요약 |
|---|---|
| 프레임 | 모든 요청·응답은 [4바이트 길이][헤더][본문]. 보낼 때 SendBuilder 가 크기를 먼저 세고, 받을 때 NetworkReceive 가 길이만큼 읽는다 |
| 상관 ID | 응답에는 API 키가 없다. 클라이언트는 가장 오래된 진행 중 요청과 짝지어 풀고, 상관 ID 로 확인한다 |
| JSON 스키마 | common/message/ 에 203개. 필드마다 versions, nullableVersions, tag 를 달아 한 파일에 모든 판을 담는다 |
| 생성기 | processMessages 가 MessageGenerator 를 돌려 391개 파일, 186,401줄을 만든다. 판 범위가 if (_version >= N) 이 된다 |
ignorable |
없는 판으로 쓸 때 값을 버려도 되는 필드. 아니면 UnsupportedVersionException |
| 요청 헤더 | API 키·판·상관 ID 는 모든 판에서 같은 자리. 브로커는 앞 4바이트를 엿봐 헤더 판을 정한다. ClientId 는 언제나 2바이트 길이 |
headerVersions |
trunk 에서 JSON 에 적는 요청 판 → 헤더 판 대응표. 4.4.0 은 "유연하면 v2" 규칙이 생성기에 박혀 있었다 |
| ApiVersions | 연결마다 맨 먼저 묻는 질문. 클라이언트는 겹치는 범위의 가장 높은 판을 쓴다. 모르는 판의 ApiVersions 에만 브로커가 v0 으로 답한다 |
| 유연한 판 | 길이를 varint 로 적고, 구조체 끝에 태그 필드 칸을 둔다 |
| 태그 필드 | 판을 올리지 않고 유연한 판에 더하는 필드. 모르는 태그는 건너뛰고 _unknownTaggedFields 에 보관한다 |
다음에 볼 것
바이트가 브로커의 네트워크 스레드에서 Request 객체가 되는 데까지 왔습니다. 이제 그 네트워크 스레드 자체를 봅니다. 연결을 받는 Acceptor, 연결 여러 개를 셀렉터로 지켜보며 이 글의 parseRequestHeader() 를 부르는 Processor, 요청 큐 너머에서 KafkaApis.handle() 을 부르는 요청 처리 스레드, 그리고 "응답은 보낸 순서대로"를 지키는 mute/unmute 가 주인공입니다. 4편: 브로커의 네트워크 계층 — Acceptor, Processor, 요청 처리 스레드에서 이어집니다.
같은 "바이트를 요청 객체로" 문제를 HTTP 서버는 글자를 훑어서 풉니다. Tomcat 6편의 Http11InputBuffer 가 요청 줄과 헤더를 한 글자씩 읽어 가는 모습과, 길이부터 읽는 이 글의 NetworkReceive 를 나란히 놓고 보면 이진 프로토콜이 무엇을 얻고 무엇을 내주는지 보입니다. HTTP 도 HTTP/2 에서는 글자 대신 프레임이라는 이진 덩어리로 주고받습니다(Tomcat 15편). 정의 파일에서 자바 코드를 만들어 내는 또 다른 예로는 JSP 를 서블릿 자바 파일로 바꾸는 Tomcat 13편: Jasper가 있습니다.