이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 여섯 번째 글입니다. 4편에서 요청이 네트워크 스레드(Processor)를 지나 요청 처리 스레드의 KafkaApis.handle() 에 닿는 데까지 봤고, 5편에서 프로듀서가 send() 로 받은 레코드를 배치로 모아 Sender 스레드가 Produce 요청으로 보내는 과정을 봤습니다. 이번에는 그 둘이 만나는 곳, 브로커가 Produce 요청을 받아 디스크의 로그 파일에 쓰기까지입니다.
답하려는 질문은 네 가지입니다.
- 프로듀서가 보낸 "레코드 배치"는 바이트로 어떻게 생겼나. 앱에서 보던 키·값·헤더·타임스탬프는 그 안의 어디에 있나
- Produce 요청 하나는 브로커 안에서 어떤 클래스와 메서드를 거쳐 파일에 닿나
- 오프셋은 누가, 언제 매기나. 그리고 브로커는 왜 받은 배치를 풀어서 다시 만들지 않고 거의 그대로 쓰나
acks=0,acks=1,acks=all은 브로커 코드의 어디에서 응답 시점을 바꾸나
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | common.record.internal.DefaultRecordBatch·DefaultRecord·MemoryRecords(Java, clients), kafka.server.KafkaApis·ReplicaManager, kafka.cluster.Partition(Scala, core), storage.internals.log.UnifiedLog·LogValidator·LocalLog·LogSegment(Java, storage) |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 이 글이 읽는 쓰기 경로는 흔히 쓰는 최신 안정판 4.4.0 과 같은 파일에 같은 모양으로 있습니다. KafkaApis.handleProduceRequest() 가 replicaManager.handleProduceAppend() 를 부르는 것, Partition 의 min.insync.replicas 검사, LogValidator 의 제자리 고치기 조건, "파티션마다 배치는 하나" 검사, 프로듀서의 acks 기본값 all 을 4.4.0 태그에서도 확인했습니다.
UnifiedLog.java 가 2,806줄, ReplicaManager.scala 가 2,577줄입니다. 쓰기 하나에도 멱등 프로듀서·트랜잭션 확인, 쿼터, 세그먼트 롤, 복제 대기가 함께 얽혀 있습니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
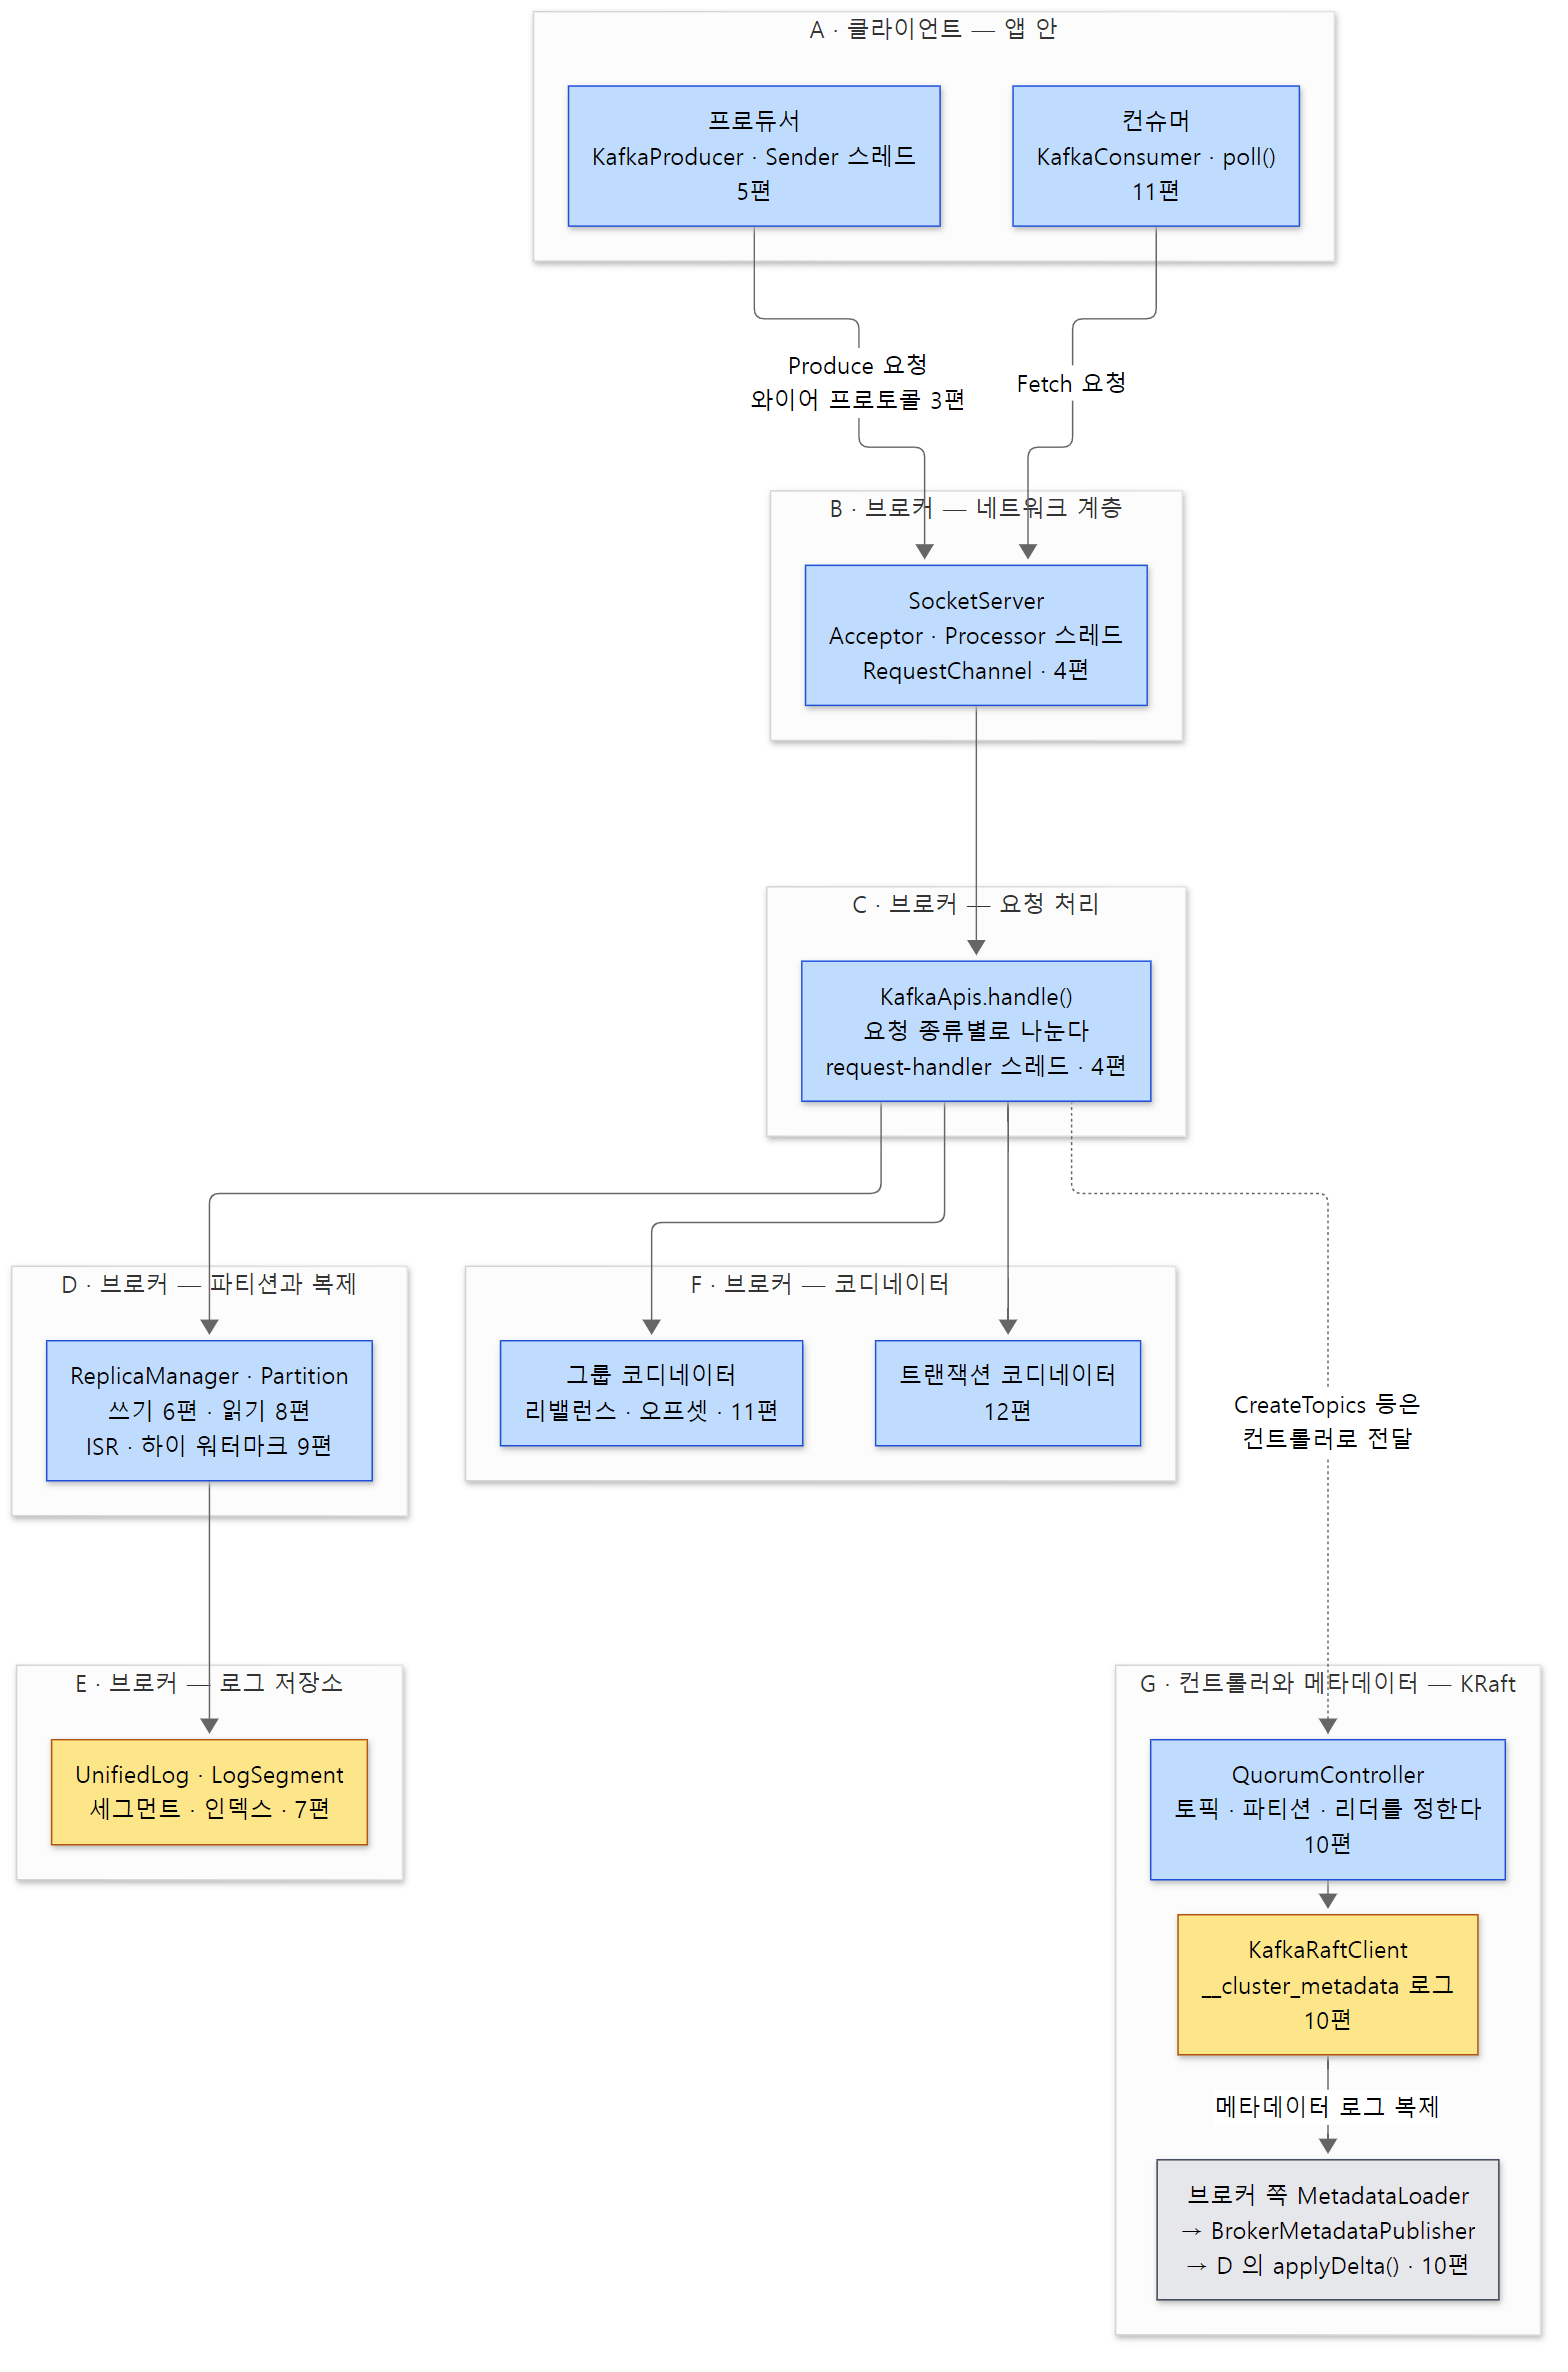 2편의 지도입니다. 이 글은 C(요청 처리)에서 D(파티션)를 지나 E(로그 저장소)로 내려가는 쓰기 쪽 길을 확대합니다. E 안쪽(세그먼트·인덱스)은 7편, D 의 복제는 9편의 몫입니다.
먼저 알아 둘 말
레코드 배치(record batch): 같은 파티션으로 가는 레코드 여러 개를 묶은 덩어리입니다. 프로듀서는 배치 단위로 보내고, 브로커는 배치 단위로 디스크에 쓰며, 컨슈머도 배치 단위로 받습니다. 이 글의 1~2절이 이 덩어리의 바이트 모양입니다. 프로듀서가 배치를 모으는 쪽은 5편에서 봤습니다.
magic: 레코드 형식의 판 번호입니다. 지금 쓰는 형식은 magic 2(이 글에서 "v2")이고, 옛 형식 v0·v1 은 Produce 요청 v3 이상에서 받지 않습니다(3절). Produce 요청의 판(v3~v13)과는 다른 번호이니 헷갈리지 않게 합니다.
오프셋과 로그 끝 오프셋: 오프셋(offset)은 파티션 안에서 레코드가 몇 번째인지를 나타내는 번호입니다. 0 부터 하나씩 늘어나고, 한 번 정해지면 바뀌지 않습니다. 로그 끝 오프셋(log end offset, LEO)은 "다음 레코드가 받을 오프셋", 곧 마지막 레코드의 오프셋 + 1 입니다. 4절에서 보듯 오프셋은 브로커가 이 값에서부터 매깁니다.
리더, ISR, min.insync.replicas: 파티션마다 복제본(레플리카)이 여러 개 있고, 그 가운데 하나가 리더라서 쓰기를 받습니다(2편). ISR(in-sync replicas)은 리더를 잘 따라오고 있는 복제본의 목록(리더 자신 포함)입니다. 토픽 설정 min.insync.replicas 는 "acks=all 쓰기를 받으려면 ISR 이 적어도 몇이어야 하나"입니다(기본값 1, ServerLogConfigs.java 159행).
하이 워터마크(high watermark, HW): ISR 의 모든 복제본이 가진 데까지의 오프셋입니다. 컨슈머는 하이 워터마크 앞까지만 읽을 수 있습니다. 이 글에서는 "acks=all 은 이 값이 올라오기를 기다린다"는 데까지만 쓰고, 어떻게 올라가는지는 9편에서 봅니다.
리더 에포크(leader epoch): 파티션의 리더가 바뀔 때마다 커지는 번호입니다. 브로커는 배치를 쓸 때 "이 배치는 몇 번째 리더 시절에 쓰였나"를 배치 헤더(partitionLeaderEpoch)에 적어 둡니다. 리더가 바뀐 뒤 복제본끼리 로그를 맞출 때 쓰는 값이고, 그 쓰임은 9편에서 봅니다.
varint: 작은 정수를 적은 바이트로 쓰는 가변 길이 정수 형식입니다. 2절에서 자세히 봅니다.
퍼거토리(purgatory): 바로 끝낼 수 없는 요청을 조건이 채워질 때까지 잠시 넣어 두는 대기실입니다. acks=all 의 Produce 요청이 여기서 복제를 기다립니다. 구조는 8편·9편에서 봅니다.
1. 레코드 배치 v2 — 61바이트 헤더
필드 순서
배치의 형식은 DefaultRecordBatch 의 클래스 주석에 그대로 적혀 있습니다.
 * RecordBatch =>
 *  BaseOffset => Int64
 *  Length => Int32
 *  PartitionLeaderEpoch => Int32
 *  Magic => Int8
 *  CRC => Uint32
 *  Attributes => Int16
 *  LastOffsetDelta => Int32 // also serves as LastSequenceDelta
 *  BaseTimestamp => Int64
 *  MaxTimestamp => Int64
 *  ProducerId => Int64
 *  ProducerEpoch => Int16
 *  BaseSequence => Int32
 *  RecordsCount => Int32
 *  Records => [Record]
clients/src/main/java/org/apache/kafka/common/record/internal/DefaultRecordBatch.java 48–62행
그리고 이 순서는 주석에만 있는 것이 아니라, 바로 아래의 상수들이 "앞 필드의 위치 + 앞 필드의 길이"로 하나씩 쌓아 올린 바이트 위치입니다.
    static final int BASE_OFFSET_OFFSET = 0;
    static final int BASE_OFFSET_LENGTH = 8;
    static final int LENGTH_OFFSET = BASE_OFFSET_OFFSET + BASE_OFFSET_LENGTH;
    static final int LENGTH_LENGTH = 4;
    static final int PARTITION_LEADER_EPOCH_OFFSET = LENGTH_OFFSET + LENGTH_LENGTH;
    static final int PARTITION_LEADER_EPOCH_LENGTH = 4;
    static final int MAGIC_OFFSET = PARTITION_LEADER_EPOCH_OFFSET + PARTITION_LEADER_EPOCH_LENGTH;
    static final int MAGIC_LENGTH = 1;
    public static final int CRC_OFFSET = MAGIC_OFFSET + MAGIC_LENGTH;
    // ... (BASE_SEQUENCE 까지 같은 방식)
clients/src/main/java/org/apache/kafka/common/record/internal/DefaultRecordBatch.java 104–112행
이렇게 쌓아 간 끝의 RECORDS_OFFSET(130행), 곧 첫 레코드가 시작하는 자리가 8+4+4+1+4+2+4+8+8+8+2+4+4 = 61 입니다. 그래서 배치 헤더는 61바이트이고, 이 값이 RECORD_BATCH_OVERHEAD 라는 이름으로 곳곳에서 쓰입니다. 앱에서 보던 것과 이어 보면 이렇습니다.
| 필드 | 앱에서 보던 것 | 누가 채우나 |
|---|---|---|
baseOffset |
RecordMetadata.offset() 의 바탕 — 배치 첫 레코드의 오프셋 |
프로듀서는 0 으로 보내고, 브로커가 진짜 값을 채운다 (4절) |
partitionLeaderEpoch |
(앱에서는 안 보임) | 프로듀서는 -1, 브로커가 리더 에포크를 채운다 |
crc |
(앱에서는 안 보임) — 깨진 배치를 걸러 낸다 | 프로듀서 |
attributes |
compression.type, 트랜잭션 여부, 타임스탬프 종류 |
프로듀서 |
lastOffsetDelta |
배치 안 레코드 수 - 1 | 프로듀서 |
baseTimestamp, maxTimestamp |
ProducerRecord 의 타임스탬프 — 첫 레코드와 가장 큰 값 |
프로듀서 (LogAppendTime 토픽이면 브로커가 덮어씀) |
producerId, producerEpoch, baseSequence |
멱등 프로듀서(enable.idempotence)의 번호표 — 12편 |
프로듀서 |
recordsCount |
배치 안 레코드 수 | 프로듀서 |
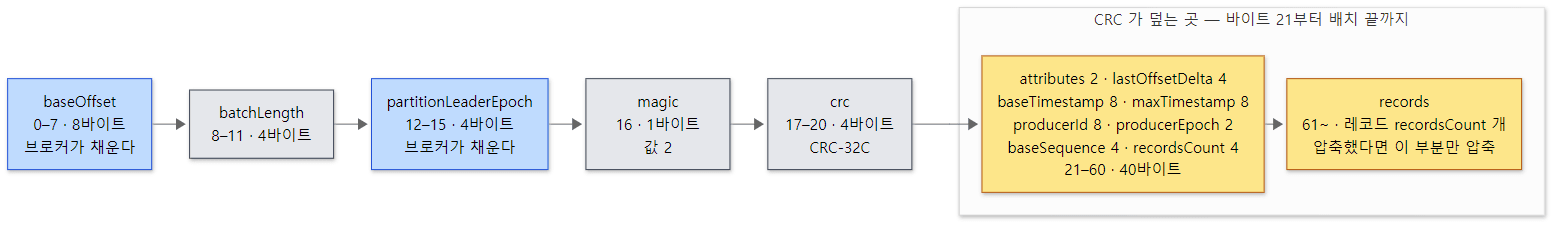 파란 칸 둘은 브로커가 채우는 필드, 노란 칸은 CRC 가 덮는 곳입니다. 브로커가 채우는 두 칸은 모두 CRC 앞에 있습니다.
CRC 가 덮지 않는 두 칸
그림에서 눈여겨볼 곳은 CRC 의 위치입니다. 주석이 이유까지 적어 두었습니다.
 * The CRC covers the data from the attributes to the end of the batch (i.e. all the bytes that follow the CRC). It is
 * located after the magic byte, which means that clients must parse the magic byte before deciding how to interpret
 * the bytes between the batch length and the magic byte. The partition leader epoch field is not included in the CRC
 * computation to avoid the need to recompute the CRC when this field is assigned for every batch that is received by
 * the broker. The CRC-32C (Castagnoli) polynomial is used for the computation.
clients/src/main/java/org/apache/kafka/common/record/internal/DefaultRecordBatch.java 67–71행
CRC 는 attributes 부터 배치 끝까지만 계산합니다. CRC 앞에 있는 baseOffset 과 partitionLeaderEpoch 는 브로커가 받은 모든 배치마다 새로 채우는 칸이라서, 이 두 칸을 CRC 밖에 두면 브로커가 값을 고쳐도 CRC 를 다시 계산할 필요가 없습니다. 계산하는 computeChecksum() 도 Crc32C.compute(buffer, ATTRIBUTES_OFFSET, buffer.limit() - ATTRIBUTES_OFFSET) 한 줄로 그 범위만 봅니다(409–411행).
magic 이 CRC 보다 앞에 있는 것도 이유가 있습니다. 옛 형식(v0·v1)은 같은 자리의 바이트 뜻이 다르므로, 읽는 쪽은 magic 을 먼저 보고 나머지를 어떻게 읽을지 정해야 합니다(주석 67–69행). 이 "브로커가 고치는 칸은 CRC 밖에"라는 배치가 5절의 "거의 그대로 쓴다"를 가능하게 합니다.
예제 1: 디스크에 쓰인 배치를 kafka-dump-log.sh 로 보기
보통의 KafkaProducer 로 레코드 셋을 보내고 flush(), 다시 둘을 보내고 flush() 했습니다. 첫 레코드에는 헤더 trace=abc 를 달았습니다. 그리고 파티션 폴더의 세그먼트 파일(00000000000000000000.log)을 kafka-dump-log.sh --deep-iteration --print-data-log 로 풀었습니다.
이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u06-produce-path 이고, 브로커와 컨트롤러를 한 프로세스로 띄운 노드 하나(kafka_single)에서 돌렸습니다. 보내는 코드의 핵심은 이렇습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 보통의 KafkaProducer 로 레코드를 보낸다. 브로커가 디스크에 쓴 모양은 run.sh 가 kafka-dump-log.sh 로 본다.
// ...
                    for (int i = 0; i < 3; i++) {
                        ProducerRecord<String, String> r = new ProducerRecord<>(topic, 0, "k" + i, "hello-" + i);
                        if (i == 0) r.headers().add("trace", "abc".getBytes(StandardCharsets.UTF_8));
                        fs.add(p.send(r));
                    }
                    p.flush();   // 첫 배치를 보낸다
                    for (int i = 3; i < 5; i++) fs.add(p.send(new ProducerRecord<>(topic, 0, "k" + i, "hello-" + i)));
                    p.flush();   // 둘째 배치
=== 1. a normal producer: 3 records, flush, 2 records, flush
acked: partition 0 offset 0
acked: partition 0 offset 1
acked: partition 0 offset 2
acked: partition 0 offset 3
acked: partition 0 offset 4
--- kafka-dump-log.sh --deep-iteration --print-data-log
baseOffset: 0 lastOffset: 2 count: 3 baseSequence: 0 lastSequence: 2 producerId: 0 producerEpoch: 0 partitionLeaderEpoch: 0 isTransactional: false isControl: false deleteHorizonMs: OptionalLong.empty position: 0 CreateTime: 1794025864682 size: 119 magic: 2 compresscodec: none crc: 199030714 isvalid: true
 offset: 0 CreateTime: 1794025864656 keySize: 2 valueSize: 7 sequence: 0 headerKeys: [trace] key: k0 payload: hello-0
 offset: 1 CreateTime: 1794025864682 keySize: 2 valueSize: 7 sequence: 1 headerKeys: [] key: k1 payload: hello-1
 offset: 2 CreateTime: 1794025864682 keySize: 2 valueSize: 7 sequence: 2 headerKeys: [] key: k2 payload: hello-2
baseOffset: 3 lastOffset: 4 count: 2 baseSequence: 3 lastSequence: 4 producerId: 0 producerEpoch: 0 partitionLeaderEpoch: 0 isTransactional: false isControl: false deleteHorizonMs: OptionalLong.empty position: 119 CreateTime: 1794025864917 size: 93 magic: 2 compresscodec: none crc: 3096572621 isvalid: true
 offset: 3 CreateTime: 1794025864917 keySize: 2 valueSize: 7 sequence: 3 headerKeys: [] key: k3 payload: hello-3
 offset: 4 CreateTime: 1794025864917 keySize: 2 valueSize: 7 sequence: 4 headerKeys: [] key: k4 payload: hello-4
타임스탬프와 CRC 는 실행마다 다릅니다.
- 배치가 둘입니다.
flush()로 끊은 대로 레코드 3개짜리(오프셋 0~2)와 2개짜리(3~4) 배치가 하나씩 생겼습니다. 둘째 배치의position: 119는 첫 배치가 파일의 0~118 바이트를 차지했다는 뜻입니다. partitionLeaderEpoch: 0— 프로듀서는 이 칸을 채우지 않습니다(예제 3에서 보듯 -1 로 보냅니다). 브로커가 리더 에포크 0 을 적었습니다.producerId: 0,baseSequence: 0/3— 아무 설정도 안 했는데 멱등 프로듀서의 번호표가 붙었습니다. 이 커밋의enable.idempotence기본값이true이기 때문입니다(ProducerConfig.java574행부터의define). 둘째 배치의baseSequence가 3 인 것은 시퀀스가 오프셋처럼 레코드마다 하나씩 늘기 때문입니다.- 배치 줄의
CreateTime은 헤더의maxTimestamp이고,|로 시작하는 레코드 줄의CreateTime은 레코드마다의 타임스탬프입니다.
예제 2: 첫 배치를 바이트 그대로 읽기
kafka-dump-log.sh 는 Kafka 의 클래스로 배치를 풀어 줍니다. 정말 위 표의 순서대로 바이트가 놓였는지 보려고, Kafka 클래스를 쓰지 않고 파일을 그대로 읽어 필드마다 위치와 바이트를 찍는 프로그램(BatchHeader.java)을 썼습니다. 필드 순서와 크기는 위 상수를 그대로 따라 했습니다.
=== 2. the first batch, byte by byte
--- batch header (61 bytes)
 0- 7 baseOffset            0               00 00 00 00 00 00 00 00
 8-11 batchLength           107             00 00 00 6b
12-15 partitionLeaderEpoch  0               00 00 00 00
16-16 magic                 2               02
17-20 crc                   199030714       0b dc f7 ba
21-22 attributes            0               00 00
23-26 lastOffsetDelta       2               00 00 00 02
27-34 baseTimestamp         1794025864656   00 00 01 a1 b4 46 3d d0
35-42 maxTimestamp          1794025864682   00 00 01 a1 b4 46 3d ea
43-50 producerId            0               00 00 00 00 00 00 00 00
51-52 producerEpoch         0               00 00
53-56 baseSequence          0               00 00 00 00
57-60 recordsCount          3               00 00 00 03
--- first record (varints)
61-61 length                25              32
62-62 attributes            0               00
63-63 timestampDelta        0               00
64-64 offsetDelta           0               00
65-65 keyLength             2               04
66-67 key                   "k0"            6b 30
68-68 valueLength           7               0e
69-75 value                 "hello-0"       68 65 6c 6c 6f 2d 30
76-76 headersCount          1               02
77-77 headerKeyLength       5               0a
78-82 headerKey             "trace"         74 72 61 63 65
83-83 headerValueLength     3               06
84-86 headerValue           "abc"           61 62 63
next record starts at byte 87
예제 1과 같은 실행의 출력이고, crc 와 타임스탬프 칸의 값·바이트는 실행마다 다릅니다. 헤더 부분만 보면 이렇습니다(레코드 부분은 2절에서 봅니다).
- 0~60 바이트가 61바이트 헤더이고, 바이트 61부터 첫 레코드입니다.
crc의 값이 예제 1의crc: 199030714와 같습니다. baseOffset8바이트가 모두 0 입니다. 이 배치는 파일의 첫 배치라서 0 이 맞습니다. 둘째 배치였다면 이 칸이 3 이었을 것입니다(예제 1의baseOffset: 3).
헷갈리기 쉬운 곳: batchLength 는 배치 크기가 아닙니다
예제 1의 size: 119 와 예제 2의 batchLength 107 이 다릅니다. batchLength 는 자기 뒤의 바이트 수입니다. 앞의 baseOffset(8)과 batchLength(4) 12바이트를 빼고 센 값이라 119 - 12 = 107 입니다. 이 12바이트는 v0 시절부터 모든 형식이 같은 자리에 두는 "오프셋 + 크기" 머리로, Records.LOG_OVERHEAD 라는 이름이 붙어 있습니다(Records.java 49행). 파일을 훑는 쪽은 형식을 몰라도 이 12바이트만 읽으면 다음 배치로 건너뛸 수 있습니다.
2. 레코드 — varint 로 바이트를 아끼기
레코드의 필드
배치 안의 레코드 하나는 DefaultRecord 가 맡습니다. 형식은 역시 클래스 주석에 있습니다.
 * Record =>
 *   Length => Varint
 *   Attributes => Int8
 *   TimestampDelta => Varlong
 *   OffsetDelta => Varint
 *   KeyLength => Varint
 *   Key => Bytes
 *   ValueLength => Varint
 *   Value => Bytes
 *   HeadersCount => Varint
 *   Headers => [HeaderKey HeaderValue]
 *     HeaderKeyLength => Varint
 *     HeaderKey => String
 *     HeaderValueLength => Varint
 *     HeaderValue => Bytes
clients/src/main/java/org/apache/kafka/common/record/internal/DefaultRecord.java 40–54행
배치 헤더와 달리 거의 모든 칸이 Varint/Varlong 입니다. 그리고 오프셋과 타임스탬프를 그대로 적지 않고 배치의 baseOffset·baseTimestamp 와의 차(OffsetDelta, TimestampDelta)로 적습니다. 배치 안 레코드들의 오프셋 차는 0, 1, 2 … 이고 타임스탬프 차도 보통 몇 밀리초라서, 작은 수를 적게 쓰는 varint 와 잘 맞습니다. 쓰는 코드 DefaultRecord.writeTo() 도 이 순서대로 ByteUtils.writeVarint()·writeVarlong() 을 부를 뿐입니다(168–223행). 키가 없으면(null) 길이 자리에 -1 을 씁니다(183–184행). "빈 키"(길이 0)와 "키 없음"(-1)이 구별되는 이유입니다.
지그재그 varint
ByteUtils.writeVarint() 는 주석에 Protocol Buffers 와 같은 방식이라고 적혀 있고, 본문은 writeUnsignedVarint((value << 1) ^ (value >> 31), out) 한 줄입니다(ByteUtils.java 474–476행). 두 단계입니다.
- 지그재그:
(value << 1) ^ (value >> 31)은 0, -1, 1, -2, 2 … 를 0, 1, 2, 3, 4 … 로 바꿉니다. 음수(-1 같은 "없음" 표시)도 작은 양수가 되게 하려는 것입니다. - varint: 그 값을 7비트씩 잘라 바이트마다 담고, 맨 윗비트로 "다음 바이트가 이어진다"를 표시합니다. 0~63 은 지그재그 뒤 0~126 이라 1바이트에 들어갑니다.
예제 2의 레코드 부분이 바로 이것입니다.
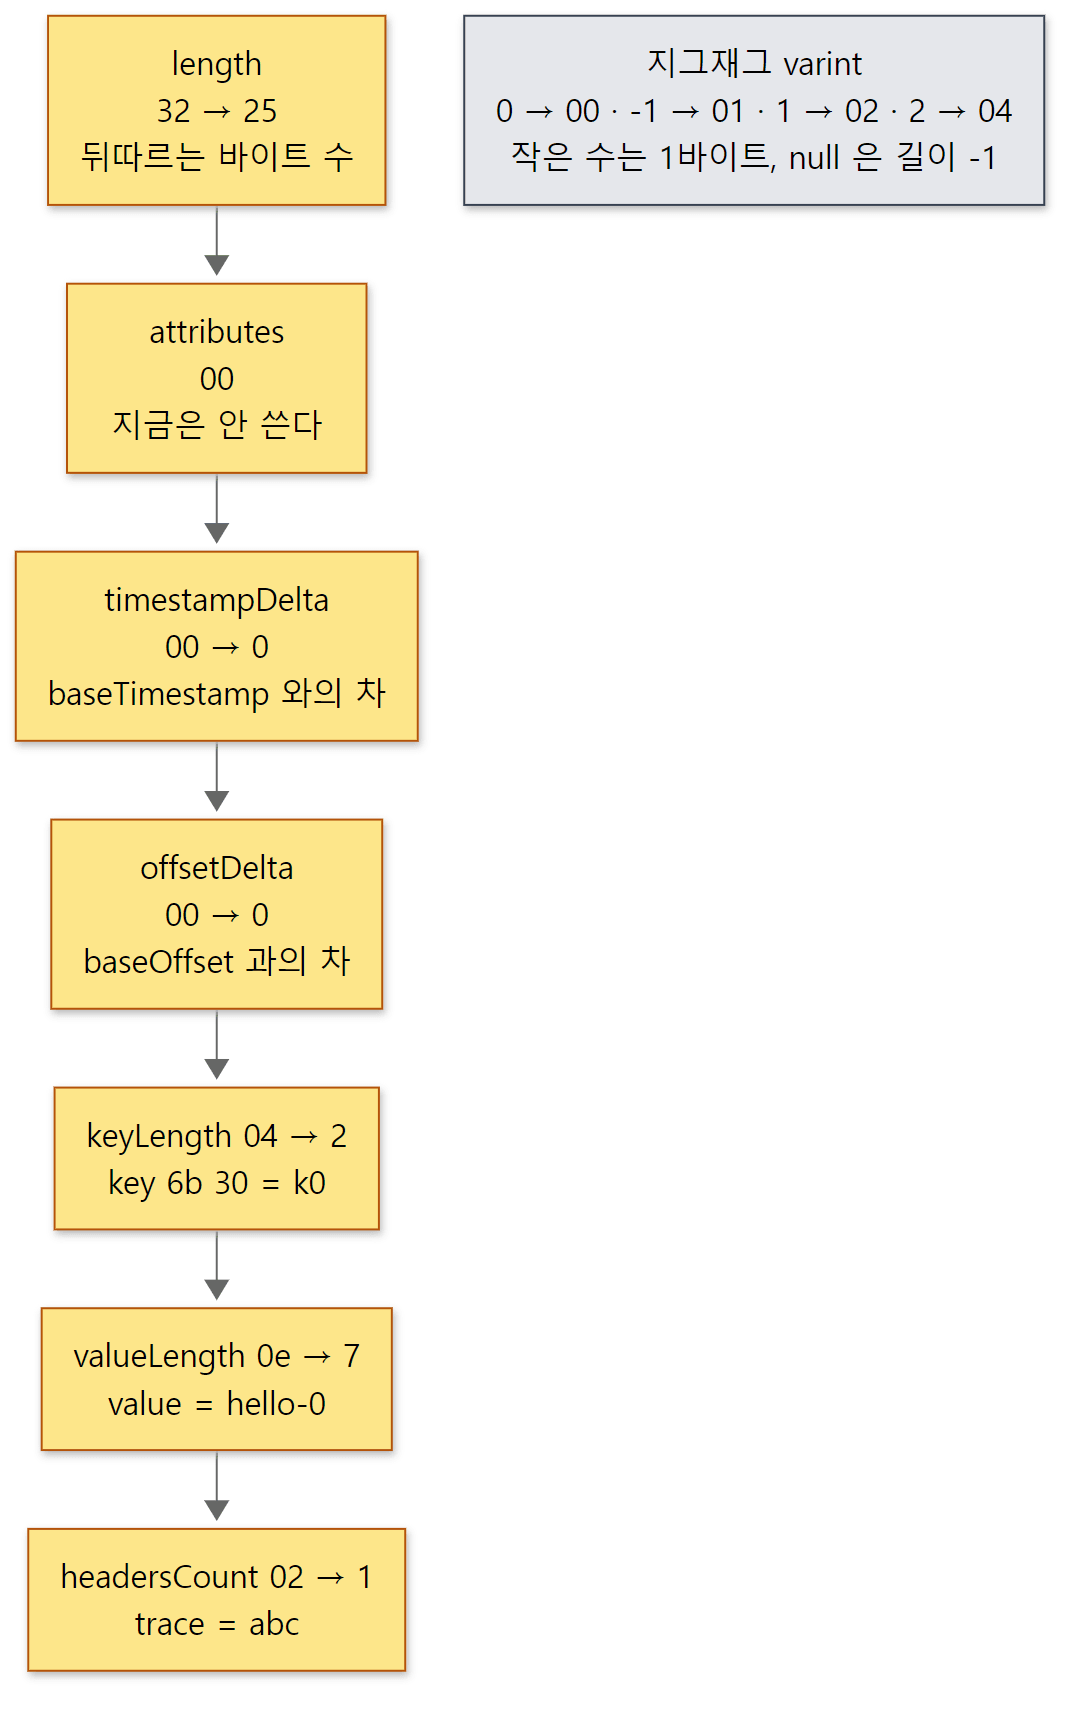 예제 2에서 읽은 첫 레코드입니다. 화살표 왼쪽이 파일의 바이트, 오른쪽이 지그재그를 푼 값입니다.
length바이트32(10진 50)를 지그재그로 풀면 25 이고, 실제로 62~86 번째 바이트 25개가 이 레코드의 나머지입니다.keyLength2 는04,valueLength7 은0e,headersCount1 은02— 모두 "값 × 2" 인 1바이트입니다.- 첫 레코드는 배치의 기준이므로
timestampDelta·offsetDelta가 모두 0 입니다.
레코드 하나의 고정 부담은 키·값·헤더를 빼면 길어야 21바이트입니다(MAX_RECORD_OVERHEAD, DefaultRecord.java 71–72행). 이 예제에서는 키·값 9바이트를 빼면 7바이트였습니다(헤더 10바이트는 따로). 대신 "공통인 것"(오프셋 기준, 타임스탬프 기준, 프로듀서 번호표, CRC)은 배치 헤더에 한 번만 둡니다. 레코드를 많이 모을수록 61바이트가 여럿에게 나뉘므로, 5편의 linger.ms·batch.size 로 배치를 키우면 디스크와 네트워크 모두에서 이득입니다.
헷갈리기 쉬운 곳: 같은 레코드인데 배치 크기가 실행마다 다릅니다
예제 1을 처음 돌렸을 때는 첫 배치가 119바이트였는데, 다른 실행에서는 같은 키·값으로 121바이트가 나왔습니다. 그 실행에서는 첫 레코드와 둘째·셋째 레코드의 타임스탬프 차가 108ms 였습니다. 108 은 지그재그 뒤 216 이라 1바이트(최대 127)를 넘고, 그래서 timestampDelta 가 레코드 둘에서 1바이트씩 늘었습니다. varint 형식에서는 값이 크기를 바꿉니다. 같은 데이터라도 레코드 사이의 시간 간격에 따라 디스크 크기가 몇 바이트씩 달라질 수 있습니다.
3. Produce 요청이 브로커 안에서 지나는 길
레코드는 요청 버퍼의 한 조각으로 온다
3편에서 본 Produce 요청의 JSON 스키마에서, 배치가 실리는 칸은 { "name": "Records", "type": "records", … } 처럼 records 라는 특별한 타입입니다(ProduceRequest.json 72–73행). 이 스키마로 빌드 때 생성되는 ProduceRequestData 는 이 칸을 _readable.readRecords(length) 로 읽습니다(기준 커밋으로 생성한 org/apache/kafka/common/message/ProduceRequestData.java 906행). 그 메서드는 Readable 인터페이스에 있습니다.
    default MemoryRecords readRecords(int length) {
        if (length < 0) {
            // no records
            return null;
        } else {
            ByteBuffer recordsBuffer = readByteBuffer(length);
            return MemoryRecords.readableRecords(recordsBuffer);
        }
clients/src/main/java/org/apache/kafka/common/protocol/Readable.java 65–72행
readByteBuffer() 는 받은 요청 버퍼를 slice() 해서 돌려줍니다(ByteBufferAccessor.java 74–81행). 바이트를 새 배열로 복사하지 않고, 네트워크에서 받은 버퍼의 그 구간을 그대로 가리키는 MemoryRecords 를 만드는 것입니다. 이 해석은 4편에서 본 Processor 가 요청을 다 모은 직후 new Request(...) 로 할 때 일어납니다. 3편에서 본, 프로듀서가 레코드 버퍼를 복사하지 않고 붙여 보내는 것과 짝을 이룹니다. 프로듀서가 만든 바이트가 브로커 메모리에 그대로 앉는 셈입니다.
전체 흐름
요청 처리 스레드가 KafkaApis.handle() 의 case ApiKeys.PRODUCE => handleProduceRequest(request, requestLocal)(KafkaApis.scala 175행)로 들어온 뒤의 길은 이렇습니다.
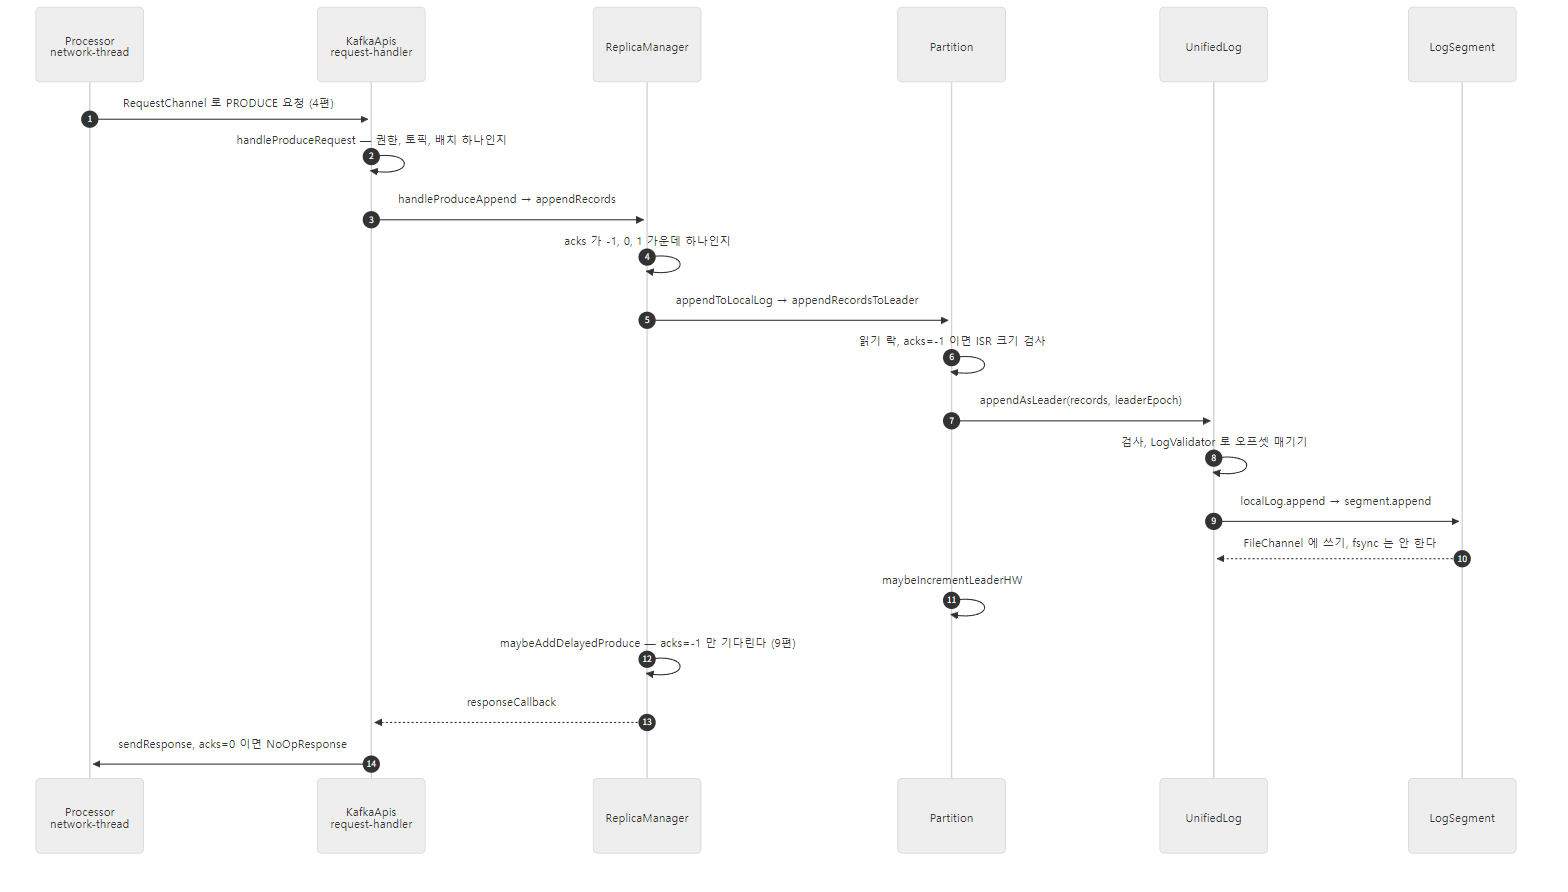 요청 처리 스레드 하나가 1번 다음부터 14번까지를 한 번에 합니다(
acks=all 에서 기다려야 할 때는 12번에서 끊깁니다. 트랜잭션 배치라 코디네이터의 확인을 기다릴 때도 3번의 handleProduceAppend 와 appendRecords 사이에서 끊길 수 있습니다 — 이 절 끝의 "헷갈리기 쉬운 곳").
1~14 가운데 2~6번을 이 절에서, 7~10번을 4·5·6절에서, 11~14번을 6절에서 봅니다.
handleProduceRequest() — 배치를 열어 보지 않는 검사들
KafkaApis.handleProduceRequest() 는 토픽·파티션마다 권한과 토픽이 있는지를 보고, 통과한 것만 모읍니다.
    topicIdToPartitionData.foreach { case (topicIdPartition, partition) =>
      // ... (KAFKA-10698 주석 셋)
      val memoryRecords = partition.records.asInstanceOf[MemoryRecords]
      if (!authorizedTopics.contains(topicIdPartition.topic))
        unauthorizedTopicResponses += topicIdPartition -> new PartitionResponse(Errors.TOPIC_AUTHORIZATION_FAILED)
      else if (!metadataCache.contains(topicIdPartition.topicPartition))
        nonExistingTopicResponses += topicIdPartition -> new PartitionResponse(Errors.UNKNOWN_TOPIC_OR_PARTITION)
      else
        try {
          ProduceRequest.validateRecords(request.header.apiVersion, memoryRecords)
          authorizedRequestInfo += (topicIdPartition -> memoryRecords)
        } catch {
          case e: ApiException =>
            invalidRequestResponses += topicIdPartition -> new PartitionResponse(Errors.forException(e))
        }
    }
core/src/main/scala/kafka/server/KafkaApis.scala 438–455행
Scala 읽는 법 —
xs.foreach { case (a, b) => … }는 짝(튜플)을 받아 두 이름으로 풀어 쓰는 람다입니다.val은 다시 대입하지 않는 변수(Java 의final),x.asInstanceOf[T]는 형변환(T) x입니다.m += (k -> v)는 가변 맵에 넣기,try { … } catch { case e: ApiException => … }는 Java 의catch (ApiException e)와 같습니다.
ProduceRequest.validateRecords() 가 배치의 모양을 처음으로 봅니다.
    public static void validateRecords(short version, BaseRecords baseRecords) {
        if (baseRecords instanceof Records) {
            Records records = (Records) baseRecords;
            Iterator<? extends RecordBatch> iterator = records.batches().iterator();
            if (!iterator.hasNext())
                throw new InvalidRecordException("Produce requests with version " + version + " must have at least " +
                        "one record batch per partition");

            RecordBatch entry = iterator.next();
            if (entry.magic() != RecordBatch.MAGIC_VALUE_V2)
                throw new InvalidRecordException("Produce requests with version " + version + " are only allowed to " +
                        "contain record batches with magic version 2");
            // ... (v7 미만에서 zstd 를 막는 검사)
            if (iterator.hasNext())
                throw new InvalidRecordException("Produce requests with version " + version + " are only allowed to " +
                        "contain exactly one record batch per partition");
        }
    }
clients/src/main/java/org/apache/kafka/common/requests/ProduceRequest.java 211–232행
세 가지를 봅니다. 배치가 적어도 하나 있는가, magic 이 2 인가, 그리고 파티션 하나에 배치가 정확히 하나인가. 프로듀서의 Sender 가 파티션마다 배치를 하나씩만 담아 보내므로(5편) 보통은 걸리지 않는 검사입니다. 여기서 걸린 파티션은 INVALID_RECORD 로 답하고 쓰지 않습니다. 이 단계에서는 배치 헤더만 읽고 레코드는 풀지 않습니다.
그다음 replicaManager.handleProduceAppend(...) 를 부릅니다(548–557행). 이 메서드는 트랜잭션 배치가 있으면 트랜잭션 코디네이터에 "이 파티션이 트랜잭션에 들어 있나"를 먼저 확인하고(12편), 없으면 곧바로 appendRecords() 로 갑니다. appendRecords() 의 첫 검사는 acks 값입니다. isValidRequiredAcks() 는 requiredAcks == -1 || requiredAcks == 1 || requiredAcks == 0 한 줄이고(1369–1371행), -1, 0, 1 이 아니면 아무것도 쓰지 않고 파티션마다 INVALID_REQUIRED_ACKS 를 돌려줍니다(648–651행). 프로듀서의 acks 설정은 all, -1, 0, 1 만 받으므로(ProducerConfig.java 430–435행) 보통의 프로듀서로는 이 오류를 볼 수 없고, 예제 3에서 손으로 만든 요청으로 확인합니다. 통과하면 appendToLocalLog() 가 파티션마다 Partition 객체를 찾아 partition.appendRecordsToLeader(records, origin, requiredAcks, …) 를 부릅니다(1414–1416행).
Partition.appendRecordsToLeader() — 리더인가, ISR 은 충분한가
  def appendRecordsToLeader(
    records: MemoryRecords,
    // ... (origin, requiredAcks, requestLocal 등)
  ): LogAppendInfo = {
    val (info, leaderHWIncremented) = inReadLock(leaderIsrUpdateLock, () => {
      leaderLogIfLocal match {
        case Some(leaderLog) =>
          val minIsr = effectiveMinIsr(leaderLog)
          val inSyncSize = partitionState.isr.size

          // Avoid writing to leader if there are not enough insync replicas to make it safe
          if (inSyncSize < minIsr && requiredAcks == -1) {
            throw new NotEnoughReplicasException(s"The size of the current ISR : $inSyncSize " +
              s"is insufficient to satisfy the min.isr requirement of $minIsr for partition $topicPartition, " +
              s"live replica(s) broker.id are : $inSyncReplicaIds")
          }

          val info = leaderLog.appendAsLeader(records, this.leaderEpoch, origin, requestLocal, verificationGuard, transactionVersion)

          // we may need to increment high watermark since ISR could be down to 1
          (info, maybeIncrementLeaderHW(leaderLog))

        case None =>
          throw new NotLeaderOrFollowerException("Leader not local for partition %s on broker %d"
            .format(topicPartition, localBrokerId))
      }
    })

    info.copy(if (leaderHWIncremented) LeaderHwChange.INCREASED else LeaderHwChange.SAME)
  }
core/src/main/scala/kafka/cluster/Partition.scala 1222–1255행
Scala 읽는 법 —
val (info, leaderHWIncremented) = …는 짝으로 돌아온 값을 두 이름으로 받습니다.leaderLogIfLocal match { case Some(leaderLog) => … case None => … }는 "이 브로커에 리더 로그가 있으면 꺼내 쓰고, 없으면" 의 분기로,Option/Some/None은 Java 의Optional과 같습니다.inReadLock(lock, () => { … })는 읽기 락을 잡은 채 람다를 실행하고 그 값을 돌려줍니다.
여기서 하는 일은 세 가지입니다.
- 이 브로커가 리더인가. 리더 로그가 없으면
NotLeaderOrFollowerException입니다. 프로듀서의Sender는 이 오류(InvalidMetadataException의 하위 클래스)를 받으면 메타데이터를 새로 요청합니다(Sender.java713행부터;KafkaApis는 요청 v10 이상이면 응답에 지금의 리더를 실어 줍니다 — 476–488행). acks=-1이면 ISR 이 충분한가. ISR 크기가min.insync.replicas보다 작으면 쓰기 전에NotEnoughReplicasException을 던집니다. 쓰고 나서 복제를 기다리다 실패하는 것이 아니라, 처음부터 받지 않습니다.- 리더 로그에
appendAsLeader()로 쓰고(4절), 하이 워터마크를 올릴 수 있으면 올립니다(6절).
락이 읽기 락인 것도 볼 만합니다. leaderIsrUpdateLock 은 리더나 ISR 이 바뀔 때 쓰기 락으로 잡히고, 쓰기 요청들은 읽기 락으로 함께 들어옵니다. 같은 파티션에 동시에 들어온 쓰기들의 순서는 그 아래 UnifiedLog 의 락이 정합니다(4절).
예제 7: 쓰기 경로를 브로커 로그로 따라가기
이 경로를 실제로 지나는지, 어느 스레드가 지나는지 보려고 브로커의 로그 설정을 바꿔 ReplicaManager·UnifiedLog·LogSegment 의 TRACE 와 요청 로거(kafka.request.logger, 4편)의 DEBUG 를 스레드 이름(%t)과 함께 한 파일에 남겼습니다. 로그 설정은 config/log4j2.yaml 대신 예제 폴더의 log4j2-broker.yaml 을 KAFKA_LOG4J_OPTS 로 넘겼습니다(bin/kafka-server-start.sh 는 이 변수가 비어 있을 때만 기본 설정을 넣습니다). 아래는 예제 1의 첫 배치에 해당하는 줄만 골라 줄인 것입니다(예제 출력의 번호는 7 이지만 순서상 여기서 봅니다).
=== 7. the append path of the first batch in section 1, from the broker log (shortened)
data-plane-kafka-request-handler-7 | ReplicaManager | Append [u06-0 -> MemoryRecords(size=119, ...)] to local log
data-plane-kafka-request-handler-7 | LogSegment | Inserting 119 bytes at end offset 2 at position 0
data-plane-kafka-request-handler-7 | LogSegment | Appended 119 to /tmp/kafka/1/data/u06-0/00000000000000000000.log at end offset 2
data-plane-kafka-request-handler-7 | UnifiedLog | Appended message set with last offset: 2, first offset: 0, next offset: 3
data-plane-kafka-request-handler-7 | UnifiedLog | Setting high watermark (offset=3, segment=[0:119])
data-plane-kafka-request-handler-7 | ReplicaManager | 119 written to log u06-0 beginning at offset 0 and ending at offset 2
data-plane-kafka-request-handler-7 | ReplicaManager | Produce to local log in 34 ms
data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-2 | logger | Completed request (PRODUCE v13, correlationId=6, acks=-1)
스레드 번호와 걸린 시간은 실행마다 다릅니다.
Append부터Produce to local log까지 모든 줄이data-plane-kafka-request-handler-N한 스레드에서 나왔습니다. 그림의 2~13번이 요청 처리 스레드 하나에서 일어난다는 것입니다. 다른 실행에서는 첫 배치와 둘째 배치를 서로 다른 번호의 처리 스레드가 맡았습니다 — 아무 스레드나 요청 큐에서 꺼내 갑니다(4편).- 순서는
ReplicaManager(Append) →LogSegment(Inserting, Appended) →UnifiedLog(Appended message set) →UnifiedLog(Setting high watermark) →ReplicaManager(written to log) 입니다.UnifiedLog의 "Appended message set" 은 세그먼트에 쓴 뒤에 남기는 줄이라LogSegment보다 늦게 찍혔습니다. - "Setting high watermark (offset=3 …)" — 복제본이 하나뿐인 토픽이라 쓰자마자 하이 워터마크가 로그 끝(3)까지 올라갔습니다(6절).
- 마지막
Completed request는 네트워크 스레드(data-plane-kafka-network-thread-…)가 응답을 다 보낸 뒤 남긴 줄입니다. 프로듀서가 보낸 요청이 Produce v13,acks=-1인 것도 보입니다. 이 커밋의 프로듀서acks기본값은all이고 요청에서는 -1 로 실립니다.
헷갈리기 쉬운 곳
KafkaApis는appendRecords()를 바로 부르지 않습니다.handleProduceRequest()다음은replicaManager.appendRecords()라고 줄여 말하기 쉬운데, 이 커밋(과 4.4.0)에서는 사이에handleProduceAppend()가 있어 트랜잭션 확인을 먼저 합니다. 확인이 비동기로 끝나면appendRecords()는 다른 요청 처리 스레드에서 불릴 수 있습니다(KafkaRequestHandler.wrapAsyncCallback, ReplicaManager.scala 791–794행).min.insync.replicas검사는acks=-1에서만 합니다.acks=1쓰기는 ISR 이 리더 하나뿐이어도 받습니다.
4. UnifiedLog.append() — 오프셋을 매기는 곳
리더와 팔로워가 같은 append() 를 쓴다
appendAsLeader() 는 얇은 입구입니다.
    public LogAppendInfo appendAsLeader(MemoryRecords records,
                                        int leaderEpoch,
                                        AppendOrigin origin,
                                        RequestLocal requestLocal,
                                        VerificationGuard verificationGuard,
                                        short transactionVersion) {
        boolean validateAndAssignOffsets = origin != AppendOrigin.RAFT_LEADER;
        return append(records, origin, validateAndAssignOffsets, leaderEpoch, Optional.of(requestLocal),
            verificationGuard, false, RecordBatch.CURRENT_MAGIC_VALUE, transactionVersion);
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1062–1071행
실제 일은 private 인 append() 가 합니다. 팔로워가 리더에게서 복제해 온 배치를 쓰는 appendAsFollower() 도 같은 append() 를 부르는데, 셋째 인자 validateAndAssignOffsets 를 false 로 넘깁니다(1093–1103행). 리더만 오프셋을 매기고, 팔로워는 리더가 매긴 오프셋을 그대로 받아 씁니다. 그래서 같은 레코드가 모든 복제본에서 같은 오프셋을 가집니다. RAFT_LEADER 는 KRaft 메타데이터 로그(10편)가 이미 오프셋을 정해 쓰는 경우입니다.
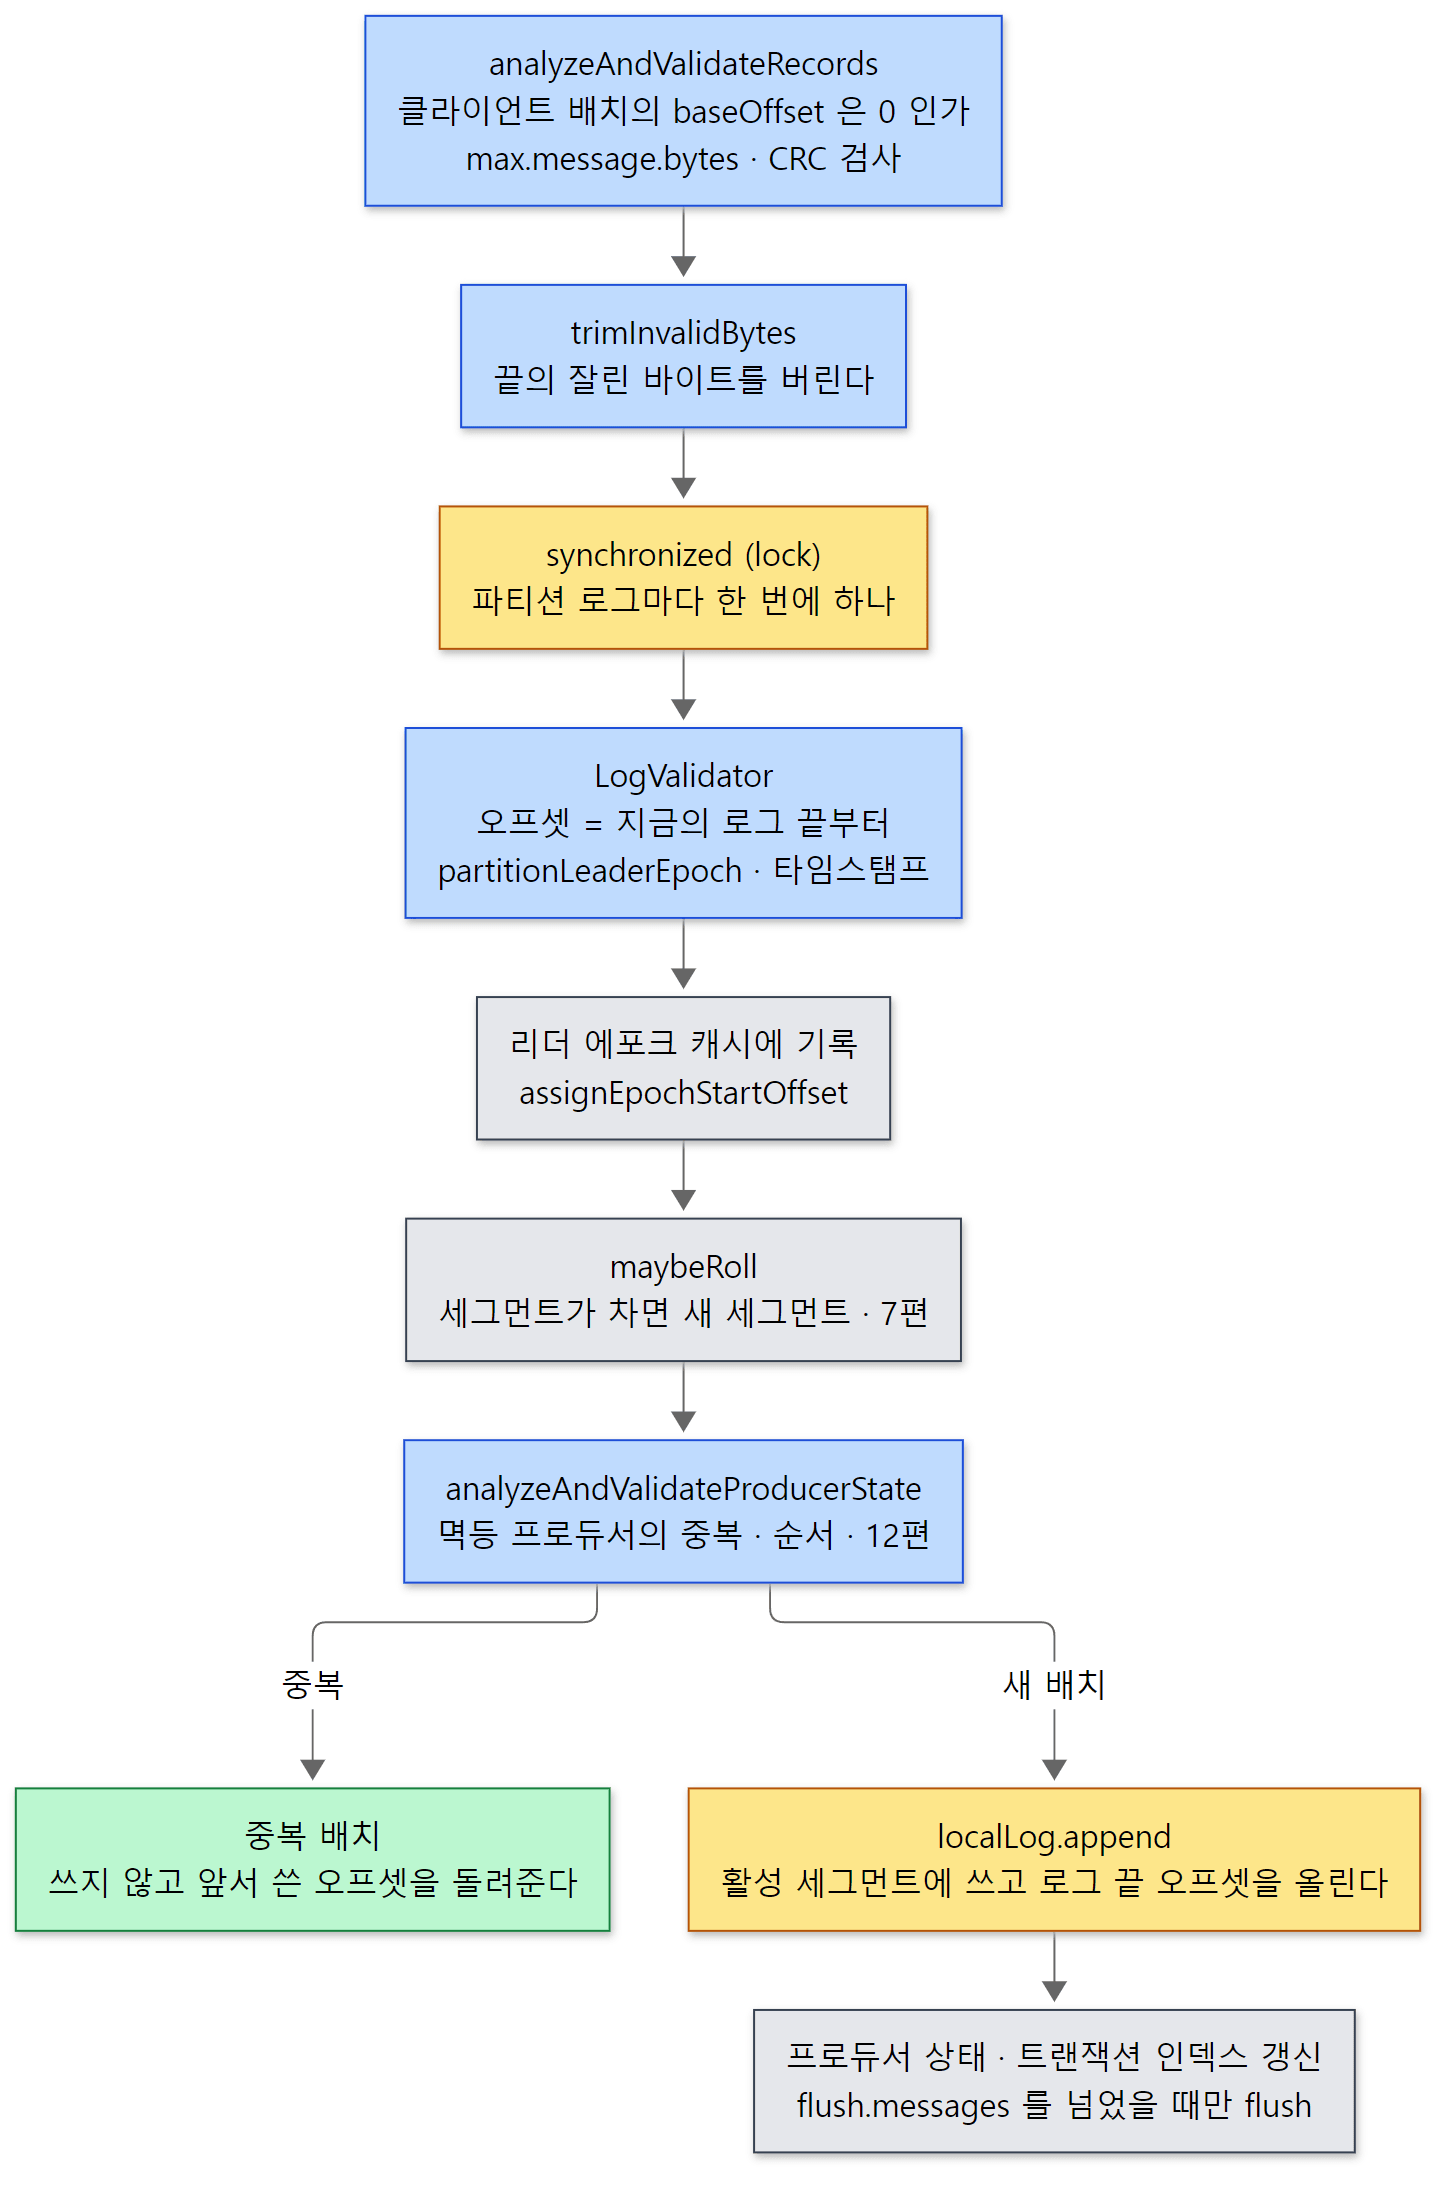 노란
synchronized (lock) 칸부터 그 아래 모든 칸(두 갈래의 끝까지)이 파티션 로그마다 한 번에 하나만 지나는 구간입니다. 회색 칸은 다른 글의 몫입니다.
락 밖: 배치를 열지 않고 하는 검사
append() 는 먼저 락 없이 analyzeAndValidateRecords() 로 배치들을 훑습니다. 배치 헤더만 읽는 검사들입니다.
            if (batch.magic() >= RecordBatch.MAGIC_VALUE_V2 && origin == AppendOrigin.CLIENT && batch.baseOffset() != 0) {
                throw new InvalidRecordException("The baseOffset of the record batch in the append to " + topicPartition() + " should " +
                        "be 0, but it is " + batch.baseOffset());
            }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1525–1528행
클라이언트가 보낸 v2 배치의 baseOffset 은 반드시 0 이어야 합니다. 프로듀서는 오프셋을 모르므로 0 을 넣어 보내고, 다른 값이 오면 무언가 잘못된 것으로 봅니다. 이어서 배치 크기가 토픽의 max.message.bytes 를 넘는지(1564–1570행), CRC 가 맞는지(batch.isValid(), 1573행)를 봅니다. CRC 검사는 앞서 본 computeChecksum() 으로 배치 전체를 한 번 훑는 일입니다.
락 안: 지금의 로그 끝에서부터 오프셋을 센다
검사가 끝나면 파티션 로그의 lock 을 잡고 오프셋을 매깁니다.
            synchronized (lock)  {
                // ...
                            if (validateAndAssignOffsets) {
                                // assign offsets to the message set
                                PrimitiveRef.LongRef offset = PrimitiveRef.ofLong(localLog.logEndOffset());
                                appendInfo.setFirstOffset(offset.value);
                                Compression targetCompression = BrokerCompressionType.targetCompression(config().compression, appendInfo.sourceCompression());
                                LogValidator validator = new LogValidator(validRecords,
                                        // ... (토픽 설정값들)
                                        leaderEpoch,
                                        // ...
                                );
                                LogValidator.ValidationResult validateAndOffsetAssignResult = validator.validateMessagesAndAssignOffsets(offset,
                                        // ...
                                validRecords = validateAndOffsetAssignResult.validatedRecords();
                                appendInfo.setMaxTimestamp(validateAndOffsetAssignResult.maxTimestampMs());
                                appendInfo.setLastOffset(offset.value - 1);
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1150–1182행
offset을 지금의 로그 끝 오프셋(localLog.logEndOffset())으로 시작합니다.PrimitiveRef.LongRef는long하나를 담은 상자로,LogValidator가 레코드를 셀 때마다 이 값을 하나씩 올립니다.- 토픽의
compression.type과 배치의 압축으로 목표 압축(targetCompression)을 정하고(5절),LogValidator를 만들어 검사와 오프셋 매기기를 맡깁니다. 넘기는leaderEpoch가 배치 헤더의partitionLeaderEpoch가 됩니다. - 돌아오면
offset.value - 1이 이 배치의 마지막 오프셋입니다.
오프셋을 읽고(1158행), 매기고, 파일에 쓰고, 로그 끝을 올리는(localLog.append(), 1276행) 일이 모두 같은 synchronized (lock) 안에 있습니다. 같은 파티션에 두 요청 처리 스레드가 동시에 쓰더라도 한쪽이 끝날 때까지 다른 쪽은 기다리므로, 두 배치가 같은 오프셋을 받는 일이 없습니다. 대신 한 파티션에 대한 쓰기는 브로커 안에서 한 줄로 섭니다. 파티션 수가 처리량의 단위가 되는 이유 하나가 여기 있습니다.
그 뒤 리더 에포크 캐시 기록(assignEpochStartOffset, 9편), 세그먼트가 찼으면 새 세그먼트로 넘기기(maybeRoll(), 7편), 멱등·트랜잭션 프로듀서의 중복·순서 검사(analyzeAndValidateProducerState(), 12편)가 이어집니다. 마지막 검사에서 이미 쓴 배치를 다시 보낸 것(재시도로 같은 시퀀스가 다시 온 것)으로 판정되면, 파일에 쓰지 않고 앞서 쓴 오프셋을 그대로 돌려줍니다(1261–1268행). 멱등 프로듀서가 재시도해도 레코드가 두 번 쓰이지 않는 자리입니다.
예제 3: 브로커가 받지 않는 요청들
배치를 손으로 만들어 보내면 보통의 프로듀서로는 볼 수 없는 갈래를 지나 볼 수 있습니다. RawProduce.java 는 KafkaProducer 없이 MemoryRecords.withRecords(...) 로 배치를 만들고, 생성된 ProduceRequestData 에 실어 맨 소켓으로 Produce v12(토픽 이름으로 고르는 마지막 판) 요청을 보냅니다. 요청의 틀(4바이트 길이 + 헤더 + 본문)은 3편의 예제와 같습니다. 핵심은 이렇습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// KafkaProducer 없이 레코드 배치를 손으로 만들어 Produce 요청(v12)에 싣고, 맨 소켓으로 보낸다.
// 보내기 전 배치의 헤더(baseOffset, partitionLeaderEpoch, crc)를 찍어 두면,
// 브로커가 디스크에 쓴 배치(kafka-dump-log.sh)와 무엇이 같고 무엇이 바뀌었는지 비교할 수 있다.
// ...
            // 클라이언트가 baseOffset 을 0 이 아닌 값(5)으로 채워 보낸다
            case "base-offset" -> records = MemoryRecords.withRecords(5L, Compression.NONE, recs("x"));
            case "two-batches" -> {
                // 배치 둘을 한 파티션 자리에 이어 붙인다
                ByteBuffer b1 = MemoryRecords.withRecords(Compression.NONE, recs("x")).buffer();
                ByteBuffer b2 = MemoryRecords.withRecords(Compression.NONE, recs("y")).buffer();
                ByteBuffer both = ByteBuffer.allocate(b1.remaining() + b2.remaining());
                both.put(b1).put(b2).flip();
                records = MemoryRecords.readableRecords(both);
            }
        // ... (보내기 전 배치 헤더를 찍는다)
        ProduceRequestData.TopicProduceDataCollection topics = new ProduceRequestData.TopicProduceDataCollection();
        topics.add(new ProduceRequestData.TopicProduceData()
            .setName(topic)
            .setPartitionData(List.of(new ProduceRequestData.PartitionProduceData().setIndex(0).setRecords(records))));
        ProduceRequestData req = new ProduceRequestData().setAcks(acks).setTimeoutMs(30000).setTopicData(topics);
acks 를 2 로, baseOffset 을 5 로, 한 파티션 자리에 배치 둘을 이어 붙여, 그리고 acks=0 으로 보냈습니다.
=== 5. requests the broker refuses, and acks=0
--- acks2
client batch: baseOffset=0 lastOffset=0 partitionLeaderEpoch=-1 crc=382737714 compression=none size=80
response: acks=2 error=INVALID_REQUIRED_ACKS baseOffset=-1 errorMessage=null
--- base-offset
client batch: baseOffset=5 lastOffset=5 partitionLeaderEpoch=-1 crc=1050192955 compression=none size=80
response: acks=1 error=INVALID_RECORD baseOffset=-1 errorMessage=null
--- two-batches
client batch: baseOffset=0 lastOffset=0 partitionLeaderEpoch=-1 crc=2714997260 compression=none size=80
client batch: baseOffset=0 lastOffset=0 partitionLeaderEpoch=-1 crc=1139444227 compression=none size=80
response: acks=1 error=INVALID_RECORD baseOffset=-1 errorMessage=null
--- acks0
client batch: baseOffset=0 lastOffset=0 partitionLeaderEpoch=-1 crc=4188389087 compression=none size=80
acks=0: no response within 3s
--- broker log: why base-offset was refused
InvalidRecordException: The baseOffset of the record batch in the append to u06-bad-0 should be 0, but it is 5
--- u06-bad on disk (only the acks=0 batch)
baseOffset: 0 lastOffset: 0 count: 1 baseSequence: -1 lastSequence: -1 producerId: -1 producerEpoch: -1 partitionLeaderEpoch: 0 ... position: 0 CreateTime: 1794025933720 size: 80 magic: 2 compresscodec: none crc: 4188389087 isvalid: true
CRC 와 타임스탬프는 실행마다 다릅니다.
acks=2→INVALID_REQUIRED_ACKS.isValidRequiredAcks()에서 걸렸습니다.baseOffset=5→INVALID_RECORD. 응답의errorMessage는 비어 있지만, 브로커 로그에 이유가 남았습니다 — 앞서 본 1526–1527행의 그 문장입니다. 이 예외는UnifiedLog에서 났으므로KafkaApis와Partition의 검사는 지난 뒤입니다.- 배치 둘 →
INVALID_RECORD.KafkaApis의validateRecords()에서 걸렸습니다. 이쪽은 로그를 남기지 않고 오류 코드만 돌려줍니다. acks=0→ 3초 동안 아무 응답도 오지 않았습니다. 그런데 디스크를 보면 그 배치가 오프셋 0 으로 쓰여 있습니다. 앞의 세 요청은 하나도 쓰이지 않았습니다(6절에서 다시 봅니다).
헷갈리기 쉬운 곳: 로그 끝 오프셋은 파일에 쓴 다음에 오릅니다
오프셋을 매기는 순간(1158행)과 로그 끝 오프셋이 오르는 순간(localLog.append() 안, LocalLog.java 577–580행)은 다릅니다. 매긴 직후에 검사(중복 배치, 세그먼트 크기 초과)로 실패하면 로그 끝은 그대로이고, 다음 배치가 같은 오프셋을 다시 받습니다. 그래서 오프셋에는 "구멍"이 생기지 않습니다(트랜잭션 마커나 컴팩션으로 생기는 빈 오프셋은 다른 이야기로, 7·12편에서 봅니다).
5. 거의 그대로 쓴다 — LogValidator 의 제자리 고치기
두 갈래
LogValidator.validateMessagesAndAssignOffsets() 의 입구는 압축 여부로 갈립니다. "보낸 배치의 압축(sourceCompressionType)도 목표 압축도 NONE" 이면 압축 없는 길, 아니면 압축 길입니다(144–157행). Produce 요청 v3 이상은 v2 배치만 받으므로(3절) hasMatchingMagic(toMagic) 은 언제나 참이고, 압축 없는 배치는 assignOffsetsNonCompressed() 로 갑니다. 이 메서드는 레코드를 하나씩 돌며 검사(컴팩션 토픽인데 키가 없는가, 타임스탬프가 허용 범위 안인가)를 하고 오프셋 카운터를 올린 다음, 배치 헤더의 몇 칸만 고칩니다.
            batch.setLastOffset(offsetCounter.value - 1);

            if (batch.magic() >= RecordBatch.MAGIC_VALUE_V2)
                batch.setPartitionLeaderEpoch(partitionLeaderEpoch);

            if (batch.magic() > RecordBatch.MAGIC_VALUE_V0) {
                if (timestampType == TimestampType.LOG_APPEND_TIME)
                    batch.setMaxTimestamp(TimestampType.LOG_APPEND_TIME, now);
                else
                    batch.setMaxTimestamp(timestampType, maxBatchTimestamp);
            }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogValidator.java 264–274행
setLastOffset() 와 setPartitionLeaderEpoch() 가 하는 일은 이렇습니다.
    @Override
    public void setLastOffset(long offset) {
        buffer.putLong(BASE_OFFSET_OFFSET, offset - lastOffsetDelta());
    }

    @Override
    public void setMaxTimestamp(TimestampType timestampType, long maxTimestamp) {
        long currentMaxTimestamp = maxTimestamp();
        // We don't need to recompute crc if the timestamp is not updated.
        if (timestampType() == timestampType && currentMaxTimestamp == maxTimestamp)
            return;

        byte attributes = computeAttributes(compressionType(), timestampType, isTransactional(), isControlBatch(), hasDeleteHorizonMs());
        buffer.putShort(ATTRIBUTES_OFFSET, attributes);
        buffer.putLong(MAX_TIMESTAMP_OFFSET, maxTimestamp);
        long crc = computeChecksum();
        ByteUtils.writeUnsignedInt(buffer, CRC_OFFSET, crc);
    }

    @Override
    public void setPartitionLeaderEpoch(int epoch) {
        buffer.putInt(PARTITION_LEADER_EPOCH_OFFSET, epoch);
    }
clients/src/main/java/org/apache/kafka/common/record/internal/DefaultRecordBatch.java 376–398행
setLastOffset(offset)는baseOffset칸 하나에offset - lastOffsetDelta를 씁니다. 레코드 안의offsetDelta는 기준과의 차이므로 손댈 필요가 없습니다. 2절의 "차로 적기"가 여기서 다시 쓸모가 있습니다 — 오프셋을 절대값으로 적었다면 레코드마다 고쳐야 했을 것입니다.setPartitionLeaderEpoch()도 칸 하나를 덮어씁니다.- 두 칸 모두 CRC 앞이므로 CRC 를 다시 계산하지 않습니다(1절).
setMaxTimestamp()는 CRC 안쪽 칸이라 CRC 를 다시 계산하지만, 값이 그대로면 아무것도 하지 않습니다. 기본CreateTime토픽에서는 프로듀서가 적은 최대 타임스탬프와 레코드에서 다시 센 값이 같으므로 보통 이return에 걸립니다.
이 버퍼는 3절에서 본, 요청 버퍼의 한 조각입니다. 새 버퍼를 만들지도, 레코드를 다시 쓰지도 않고, 받은 바이트의 칸 두어 개만 고쳐서 다음 단계(파일 쓰기)로 넘깁니다. ValidationResult 의 두 번째 인자로 들어온 records 그대로를 돌려줍니다(285–290행).
압축된 배치: 같은 압축이면 제자리, 다르면 다시 만든다
압축된 배치는 validateMessagesAndAssignOffsetsCompressed() 로 갑니다. 레코드를 검사하려면 압축을 풀어 봐야 하지만, 다 본 뒤 결과를 어떻게 쓰느냐는 inPlaceAssignment 하나로 갈립니다.
        // No in place assignment situation 1
        boolean inPlaceAssignment = sourceCompressionType == targetCompression.type();
        // ...
        if (!inPlaceAssignment) {
            return buildRecordsAndAssignOffsets(offsetCounter, now, firstBatch, validatedRecords,
                uncompressedSizeInBytes);
        } else {
            // we can update the batch only and write the compressed payload as is;
            // again we assume only one record batch within the compressed set
            offsetCounter.value += validatedRecords.size();
            // there is only one batch in this path, so last offset can be viewed as shallowOffsetOfMaxTimestamp
            long lastOffset = offsetCounter.value - 1;
            firstBatch.setLastOffset(lastOffset);

            if (timestampType == TimestampType.LOG_APPEND_TIME)
                maxTimestamp = now;

            if (toMagic >= RecordBatch.MAGIC_VALUE_V1)
                firstBatch.setMaxTimestamp(timestampType, maxTimestamp);

            if (toMagic >= RecordBatch.MAGIC_VALUE_V2)
                firstBatch.setPartitionLeaderEpoch(partitionLeaderEpoch);
storage/src/main/java/org/apache/kafka/storage/internals/log/LogValidator.java 303–405행
- 보낸 압축과 목표 압축이 같으면(그리고 형식이 같고 내부 오프셋이 0, 1, 2 … 이면) 압축된 레코드 부분은 손대지 않고 헤더 칸만 고칩니다. 주석이 말하는 그대로 "압축된 내용을 있는 그대로 쓴다(write the compressed payload as is)" 입니다. 이때 레코드를 풀어 보긴 하지만 키·값·헤더를 건너뛰는
skipKeyValueIterator()를 씁니다(334–338행). - 다르면
buildRecordsAndAssignOffsets()가 새 버퍼에MemoryRecordsBuilder로 배치를 처음부터 다시 만들고 목표 압축으로 다시 압축합니다(417–455행). CPU 를 가장 많이 쓰는 갈래입니다.
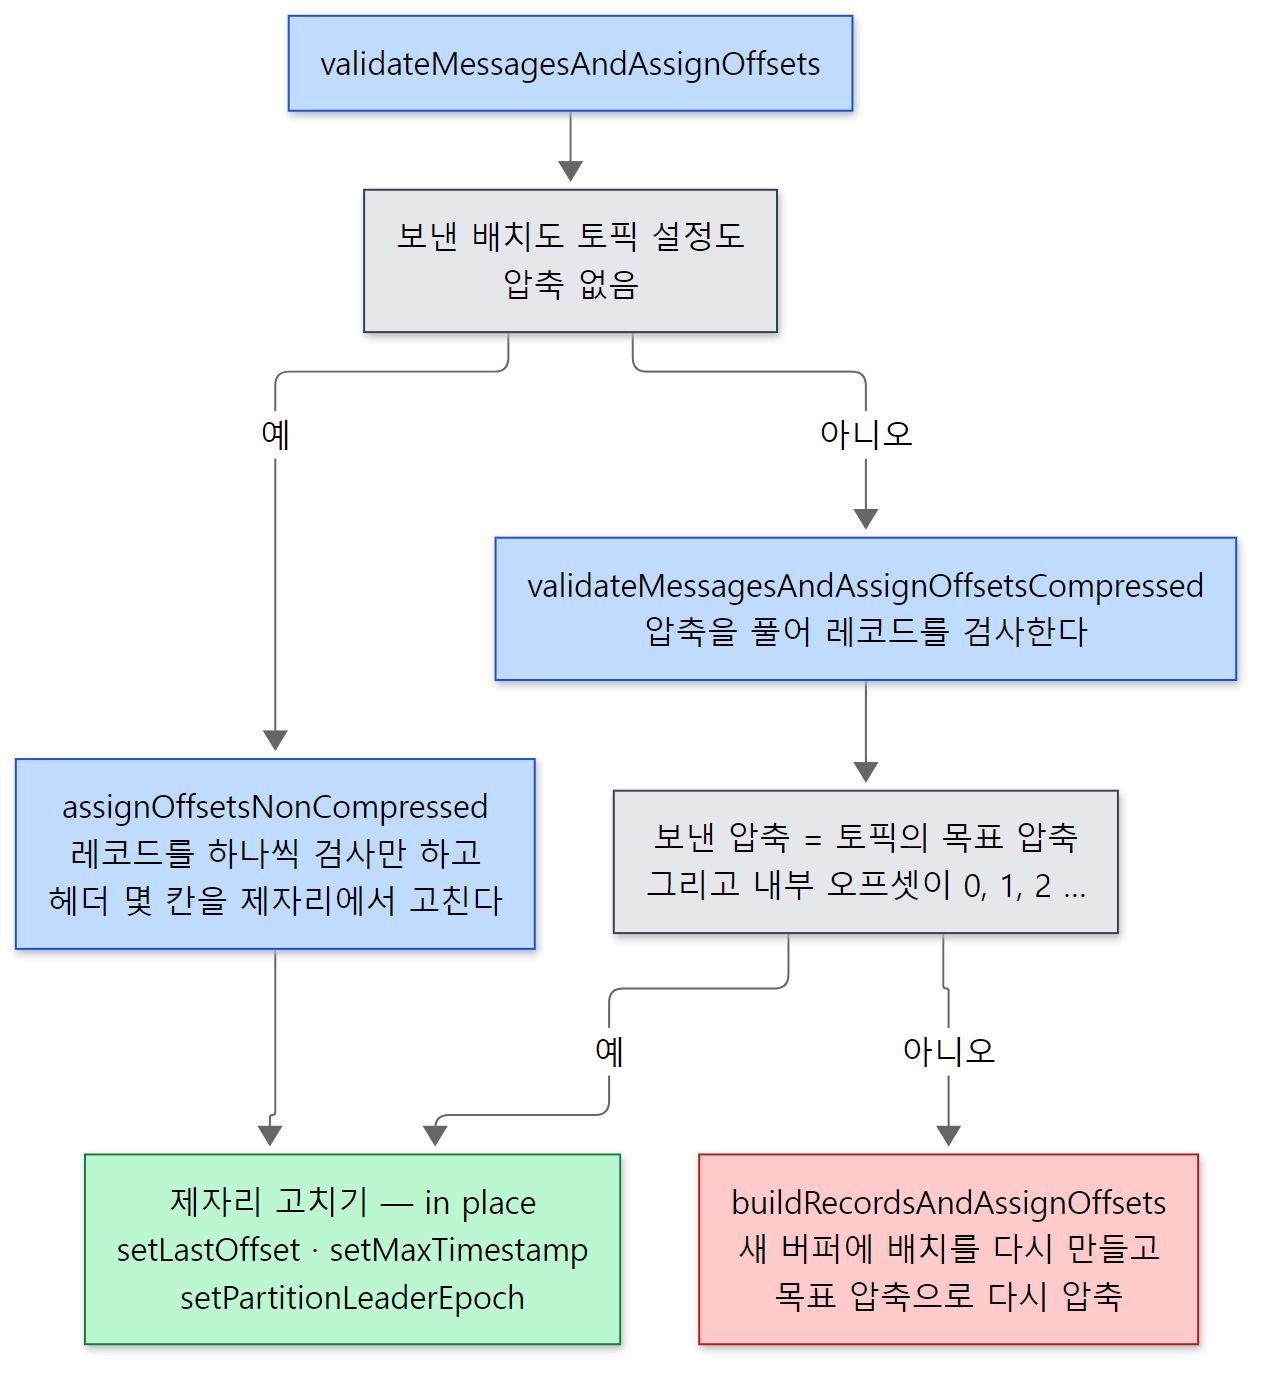 초록 칸이 "거의 그대로 쓰는" 길, 빨간 칸이 배치를 다시 만드는 길입니다.
목표 압축은 BrokerCompressionType.targetCompression(logCompression, producerCompressionType) 이 정합니다. 토픽 설정에 정해진 압축이 있으면 그것, 없으면 프로듀서가 보낸 압축입니다(logCompression.orElseGet(...), BrokerCompressionType.java 43–45행). 토픽의 compression.type 이 producer 이면 LogConfig.getCompression() 이 Optional.empty() 를 돌려주고(LogConfig.java 367–382행), 그러면 프로듀서가 보낸 압축이 곧 목표입니다. 토픽의 compression.type 기본값이 바로 producer 입니다(ServerLogConfigs.java 183행). 그래서 설정을 건드리지 않으면 어떤 압축으로 보내든 제자리 길을 탑니다. 반대로 토픽에 compression.type=lz4 처럼 특정 압축을 정해 두고 프로듀서가 다른 압축(또는 무압축)으로 보내면, 브로커가 모든 배치를 풀어 다시 압축합니다(압축 없이 쓰인 컨트롤 배치 — 트랜잭션 마커 — 만은 예외로 그대로 둡니다, LogValidator.java 325–326행).
"거의 그대로" 의 이유
이 설계가 주는 것을 정리하면 이렇습니다.
- CPU: 무압축 배치는 레코드를 훑기만 하고, 같은 압축의 배치는 풀어서 확인만 하고 다시 압축하지 않습니다. 압축은 보통 프로듀서(여러 대의 앱 서버)가 나눠서 하고, 브로커는 확인만 합니다.
- 메모리 복사: 요청 버퍼의 조각을 고쳐서 그대로 파일 채널에 넘기므로(6절) 브로커 안에서 레코드 바이트를 옮겨 담지 않습니다.
- 읽는 쪽과 같은 모양: 디스크의 바이트가 곧 네트워크로 나갈 바이트입니다. 컨슈머에게 보낼 때 파일에서 소켓으로 바로 보내는 제로 카피가 가능한 것도 이 덕분이고, 그건 8편에서 봅니다.
예제 4: 손으로 만든 배치의 CRC 가 디스크에서도 같은가
RawProduce.java 로 무압축 배치(레코드 3개)를 같은 토픽에 두 번 보냈습니다. 보내기 전 클라이언트 쪽 배치의 헤더를 찍고, 쓰인 뒤 디스크의 배치와 비교합니다.
=== 3. a hand-built batch (no compression), sent with Produce v12, acks=1
client batch: baseOffset=0 lastOffset=2 partitionLeaderEpoch=-1 crc=3388881269 compression=none size=120
response: acks=1 error=NONE baseOffset=0 errorMessage=null
client batch: baseOffset=0 lastOffset=2 partitionLeaderEpoch=-1 crc=839275597 compression=none size=120
response: acks=1 error=NONE baseOffset=3 errorMessage=null
--- on disk
baseOffset: 0 lastOffset: 2 count: 3 baseSequence: -1 lastSequence: -1 producerId: -1 producerEpoch: -1 partitionLeaderEpoch: 0 ... position: 0 CreateTime: 1794025884365 size: 120 magic: 2 compresscodec: none crc: 3388881269 isvalid: true
baseOffset: 3 lastOffset: 5 count: 3 baseSequence: -1 lastSequence: -1 producerId: -1 producerEpoch: -1 partitionLeaderEpoch: 0 ... position: 120 CreateTime: 1794025890717 size: 120 magic: 2 compresscodec: none crc: 839275597 isvalid: true
CRC 와 타임스탬프는 실행마다 다릅니다.
- 둘째 배치: 클라이언트 쪽
baseOffset=0,partitionLeaderEpoch=-1이 디스크에서는baseOffset: 3,partitionLeaderEpoch: 0이 됐습니다. 응답의baseOffset=3도 같습니다. - 그런데
crc는 클라이언트가 계산한 값 그대로입니다(839275597). CRC 가 덮는 바이트(바이트 21부터 끝까지)를 브로커가 하나도 바꾸지 않았다는 뜻입니다.size도 120 그대로입니다. - 클라이언트가 만든 배치의
producerId: -1은 멱등이 아닌 배치라는 표시이고, 그대로 디스크에 남았습니다.
이번에는 gzip 으로 압축한 배치를 토픽 둘에 보냈습니다. 하나는 기본값 compression.type=producer, 다른 하나는 compression.type=lz4 로 만든 토픽입니다.
=== 4. a gzip batch: topic compression.type=producer vs lz4
--- topic compression.type=producer
client batch: baseOffset=0 lastOffset=2 partitionLeaderEpoch=-1 crc=760403212 compression=gzip size=120
response: acks=1 error=NONE baseOffset=0 errorMessage=null
baseOffset: 0 lastOffset: 2 count: 3 baseSequence: -1 lastSequence: -1 producerId: -1 producerEpoch: -1 partitionLeaderEpoch: 0 ... position: 0 CreateTime: 1794025909378 size: 120 magic: 2 compresscodec: gzip crc: 760403212 isvalid: true
--- topic compression.type=lz4
client batch: baseOffset=0 lastOffset=2 partitionLeaderEpoch=-1 crc=3659826953 compression=gzip size=122
response: acks=1 error=NONE baseOffset=0 errorMessage=null
baseOffset: 0 lastOffset: 2 count: 3 baseSequence: -1 lastSequence: -1 producerId: -1 producerEpoch: -1 partitionLeaderEpoch: 0 ... position: 0 CreateTime: 1794025918729 size: 129 magic: 2 compresscodec: lz4 crc: 1373228294 isvalid: true
CRC·타임스탬프와 압축된 배치의 크기는 실행마다 다릅니다(압축되는 레코드 부분에 타임스탬프 차가 들어 있어서, 다른 실행에서는 119 → 127 이었습니다).
producer토픽: 디스크의 배치가compresscodec: gzip,crc도size도 클라이언트 쪽과 같습니다. 압축된 내용을 그대로 썼습니다.lz4토픽: 디스크의 배치는compresscodec: lz4이고 크기(122 → 129)와crc가 모두 바뀌었습니다. 브로커가 gzip 을 풀어 lz4 로 다시 압축한 것입니다. 클라이언트 쪽에서는 아무 차이를 느끼지 못합니다 — 응답은 똑같이NONE입니다.
예제 5: 같은 레코드 2000개, 압축만 바꿔서
compression.type 은 디스크 크기에도 바로 드러납니다. 비슷한 모양의 JSON 문자열 레코드 2000개를 프로듀서의 compression.type 만 바꿔(토픽은 기본값 producer) 각각 다른 토픽에 보냈습니다. batch.size 를 1MB 로 키워 배치 하나에 다 들어가게 했습니다.
=== 6. the same 2000 records with each compression.type (topic: producer)
sent 2000 records with compression.type=none
sent 2000 records with compression.type=gzip
sent 2000 records with compression.type=snappy
sent 2000 records with compression.type=lz4
sent 2000 records with compression.type=zstd
none      169536 bytes, batches: 1, codec on disk: none
gzip       16562 bytes, batches: 1, codec on disk: gzip
snappy     26213 bytes, batches: 1, codec on disk: snappy
lz4        27187 bytes, batches: 1, codec on disk: lz4
zstd       12015 bytes, batches: 1, codec on disk: zstd
정확한 바이트 수는 실행마다 조금씩 다릅니다. 이 예제의 문자열은 거의 같은 내용이 되풀이되므로 압축이 매우 잘 됩니다 — 실제 데이터에서의 비율은 데이터에 따라 다릅니다. 브로커는 다섯 경우 모두 프로듀서가 고른 압축을 그대로 디스크에 썼습니다(codec on disk). 압축을 프로듀서에서 하면 네트워크·브로커 디스크·복제 트래픽·컨슈머로 나가는 트래픽이 모두 이 크기로 줄어듭니다.
헷갈리기 쉬운 곳: "압축 없음"도 다시 압축될 수 있습니다
프로듀서의 compression.type 기본값은 none 입니다(ProducerConfig.java 436행). 토픽에 compression.type=zstd 같은 값을 정해 두면, 압축 없이 보낸 배치도 위 입구에서 targetCompression.type() == NONE 이 아니므로 압축 갈래로 가고, 보낸 것(none)과 목표(zstd)가 달라 브로커가 압축합니다. "토픽에 압축을 걸어 두면 디스크가 줄겠지" 는 맞지만, 그 CPU 를 브로커가 쓴다는 것을 함께 기억해야 합니다. 또 gzip 레벨처럼 같은 종류 안의 설정 차이는 다시 압축하지 않습니다 — inPlaceAssignment 는 압축의 종류(type())만 비교합니다(304행).
6. 파일에 쓰기, 그리고 acks
LogSegment.append() — 파일 채널에 그대로
검사와 오프셋 매기기가 끝난 MemoryRecords 는 localLog.append() 를 거쳐 활성 세그먼트(지금 쓰고 있는 마지막 세그먼트 파일)로 갑니다.
    public void append(long largestOffset,
                       MemoryRecords records) throws IOException {
        if (records.sizeInBytes() > 0) {
            LOGGER.trace("Inserting {} bytes at end offset {} at position {}",
                records.sizeInBytes(), largestOffset, log.sizeInBytes());
            int physicalPosition = log.sizeInBytes();

            ensureOffsetInRange(largestOffset);

            // append the messages
            long appendedBytes = log.append(records);
            LOGGER.trace("Appended {} to {} at end offset {}", appendedBytes, log.file(), largestOffset);
            // ... (배치마다 index.interval.bytes 를 넘으면 인덱스 항목 추가 — 7편)
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 250–261행
log 는 세그먼트의 .log 파일을 감싼 FileRecords 이고, 그 append() 는 records.writeFullyTo(channel) 로 버퍼를 FileChannel 에 씁니다(FileRecords.java 244–252행).
MemoryRecords.writeFullyTo() 는 버퍼가 다 써질 때까지 channel.write(buffer) 를 되풀이할 뿐입니다(MemoryRecords.java 85–92행). 요청 버퍼의 조각이 그대로 파일 채널에 들어갑니다. 예제 7의 Inserting 119 bytes … at position 0 과 Appended 119 to …/00000000000000000000.log 가 이 두 줄의 TRACE 입니다.
여기에 fsync(FileChannel.force())는 없습니다. write() 는 운영체제의 페이지 캐시에 넣는 데까지이고, 디스크에 실제로 내려가는 때는 운영체제가 정합니다. UnifiedLog.append() 끝에서 flush 하는 조건은 if (localLog.unflushedMessages() >= config().flushInterval) flush(false); 한 줄뿐입니다(UnifiedLog.java 1300행). flushInterval 은 토픽 설정 flush.messages 이고, 기본값은 Long.MAX_VALUE 입니다(ServerLogConfigs.java 101행). 기본 설정에서는 쓰기마다 flush 하지 않는다는 뜻입니다. Kafka 는 한 대의 디스크에 확실히 내려 두는 대신 여러 브로커에 복제해 두는 것으로 데이터를 지킵니다 — 그것이 acks=all 이고, 다음 절의 주제입니다. 다른 flush 시점(세그먼트를 넘길 때, 주기적인 flush)은 7편 2절에서 봅니다.
acks 가 응답 시점을 바꾸는 세 자리
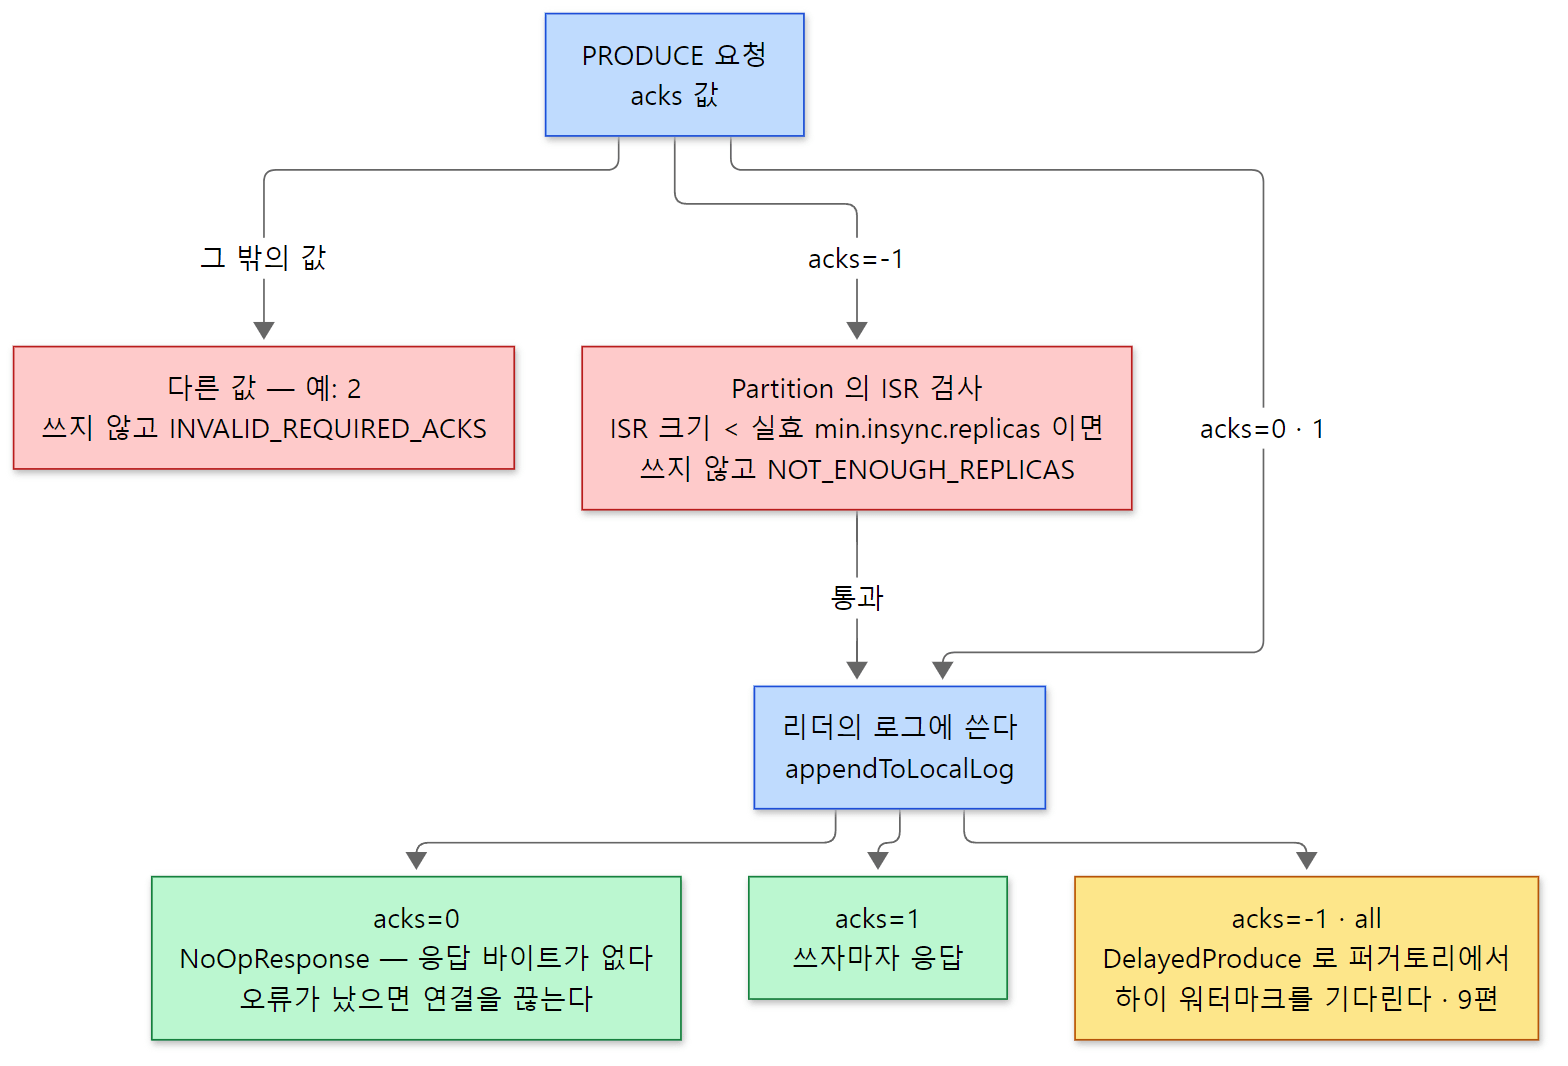 빨간 칸은 쓰기 전에 거절하는 곳, 초록 칸은 쓴 뒤 바로 끝나는 곳, 노란 칸은 기다리는 곳입니다.
acks=-1(all) — 기다릴지 정하는 곳. appendRecords() 는 로컬 로그에 쓴 뒤 maybeAddDelayedProduce() 를 부르고, 그 안에서 이 조건을 봅니다.
  // If all the following conditions are true, we need to put a delayed produce request and wait for replication to complete
  //
  // 1. required acks = -1
  // 2. there is data to append
  // 3. at least one partition append was successful (fewer errors than partitions)
  private def delayedProduceRequestRequired(requiredAcks: Short,
                                            entriesPerPartition: Map[TopicIdPartition, MemoryRecords],
                                            localProduceResults: Map[TopicIdPartition, LogAppendResult]): Boolean = {
    requiredAcks == -1 &&
    entriesPerPartition.nonEmpty &&
    localProduceResults.values.count(_.exception().isPresent) < entriesPerPartition.size
  }
core/src/main/scala/kafka/server/ReplicaManager.scala 1356–1367행
Scala 읽는 법 —
private def f(...): Boolean = { … }는 반환형이Boolean인 메서드이고,return없이 마지막 식의 값이 반환값입니다.localProduceResults.values.count(_.exception().isPresent)의_는 "각 원소" 를 가리키는 짧은 람다(r -> r.exception().isPresent())입니다.
acks=-1 이고, 쓸 데이터가 있고, 적어도 한 파티션은 쓰기에 성공했으면 DelayedProduce 를 만들어 퍼거토리에 넣습니다(903–911행). 이 객체는 "이 파티션의 하이 워터마크가 방금 쓴 배치의 끝까지 올라오면" 응답을 보냅니다. 그 조건을 확인하는 Partition.checkEnoughReplicasReachOffset() 과 하이 워터마크가 오르는 과정은 9편의 주제라 여기서는 이름만 둡니다(server/src/main/java/org/apache/kafka/server/purgatory/DelayedProduce.java). acks=1 이면 이 조건이 거짓이라 else 쪽에서 곧바로 응답 콜백을 부릅니다.
acks=0 — 응답을 보내지 않는 곳. KafkaApis 의 응답 콜백은 acks 가 0 이면 응답 대신 다른 일을 합니다.
      if (produceRequest.acks == 0) {
        // no operation needed if producer request.required.acks = 0; however, if there is any error in handling
        // the request, since no response is expected by the producer, the server will close socket server so that
        // the producer client will know that some error has happened and will refresh its metadata
        if (errorInResponse) {
          // ... (로그 한 줄)
          requestChannel.closeConnection(request, new ProduceResponse(mergedResponseStatus.asJava).errorCounts)
        } else {
          // Note that although request throttling is exempt for acks == 0, the channel may be throttled due to
          // bandwidth quota violation.
          requestHelper.sendNoOpResponseExemptThrottle(request)
        }
      } else {
        requestChannel.sendResponse(request, new ProduceResponse(mergedResponseStatus.asJava, maxThrottleTimeMs, nodeEndpoints.values.toList.asJava))
      }
core/src/main/scala/kafka/server/KafkaApis.scala 512–533행
- 오류가 없으면
NoOpResponse를 보냅니다. 이름과 달리 "아무것도 보내지 말라"는 표시로, Processor 는 소켓에 아무것도 쓰지 않고 그 연결을 다시 읽기 시작합니다(SocketServer.scala921–930행, 4편의unmute). - 오류가 있으면 연결을 끊습니다. 응답을 기다리지 않는 프로듀서에게 오류를 알릴 방법이 그것뿐이기 때문입니다. 주석에 그렇게 적혀 있습니다(513–515행).
프로듀서 쪽도 짝이 맞습니다. Sender 는 Produce 요청을 만들 때 expectResponse 자리에 acks != 0 을 넘깁니다(Sender.java 945행). 예제 3의 "no response within 3s" 와, 그런데도 디스크에 배치가 있었던 것이 이 두 곳의 결과입니다. acks=0 이어도 브로커는 똑같이 검사하고 쓰고, 다만 결과를 알려 주지 않습니다.
실효 min.insync.replicas
3절에서 본 ISR 검사의 minIsr 는 설정값 그대로가 아닙니다.
/**
 * When setting the min ISR, there is no restriction on it. Even if the value does not make sense to be larger than
 * the replication factor. In case there are such setting, the effective min ISR of min(replication factor, min ISR)
 * is returned here.
 */
  private def effectiveMinIsr(leaderLog: UnifiedLog): Int = {
      leaderLog.config.minInSyncReplicas.min(remoteReplicasMap.size + 1)
  }
core/src/main/scala/kafka/cluster/Partition.scala 241–248행
Scala 읽는 법 —
a.min(b)는Math.min(a, b)입니다. Scala 에서는Int같은 기본 타입에도 메서드를 부를 수 있습니다.
설정값과 "복제본 수(다른 복제본 수 + 1)" 가운데 작은 쪽을 씁니다. 주석대로 min.insync.replicas 는 복제 계수보다 크게 정해도 막지 않고, 대신 여기서 잘라 냅니다.
예제 6: 복제본 하나짜리 토픽에 min.insync.replicas=2
복제 계수 1 인 토픽을 min.insync.replicas=2 로 만들고 acks=all 로 보냈습니다.
=== 8. min.insync.replicas=2 on a topic with one replica, acks=all
acks=all ok: offset 0
NotEnoughReplicas 없이 성공했습니다. 실효값이 min(2, 1) = 1 이고 ISR 크기도 1 이기 때문입니다. "설정상 2 를 요구했으니 실패하겠지" 라고 생각하기 쉬운 곳입니다. 브로커가 꺼져 ISR 이 줄어 실제로 NotEnoughReplicas 가 나는 모습은 복제본 셋짜리 클러스터로 9편에서 봅니다.
헷갈리기 쉬운 곳
acks=all이어도 복제본이 하나면 기다리지 않는 것처럼 보입니다. 예제 7의 요청은acks=-1이었으므로DelayedProduce가 만들어졌습니다. 하지만 퍼거토리에 넣는tryCompleteElseWatch()는 넣기 전에 먼저 완료 조건을 확인하고(DelayedOperationPurgatory.java122행부터), 복제본이 하나뿐이라 하이 워터마크가 이미 올라가 있으므로(예제 7의 "Setting high watermark") 곧바로 끝납니다.acks=1의 "성공" 은 리더의 페이지 캐시에 들어갔다는 뜻입니다. 위에서 본 대로 fsync 도, 팔로워 복제도 기다리지 않습니다. 리더가 응답 직후 죽으면 그 레코드는 팔로워에 없을 수 있습니다. 이 차이가acks=all과min.insync.replicas를 함께 쓰는 이유이고, 9편에서 이어집니다.
이 글에서 뺀 것
- 멱등·트랜잭션 프로듀서의 상태 검사(
analyzeAndValidateProducerState(),ProducerStateManager·ProducerAppendInfo):UnifiedLog.java1257–1268행,storage/src/main/java/org/apache/kafka/storage/internals/log/ProducerStateManager.java— 12편 - Produce 요청 안에서 트랜잭션 파티션을 확인하는 길(
handleProduceAppend()의maybeSendPartitionsToTransactionCoordinator,AddPartitionsToTxnManager):ReplicaManager.scala697–833행 — 12편 DelayedProduce와 하이 워터마크가 오르는 과정(Partition.checkEnoughReplicasReachOffset(),maybeIncrementLeaderHW()):server/src/main/java/org/apache/kafka/server/purgatory/DelayedProduce.java,Partition.scala1013행부터 — 9편- 팔로워의 쓰기(
appendAsFollower())와 리더 에포크 캐시:UnifiedLog.java1093–1103행 — 9편 - 세그먼트 롤(
maybeRoll())과 오프셋·타임 인덱스 항목 추가:UnifiedLog.java2166행부터,LogSegment.append()의 나머지 — 7편 LogAppendTime토픽(message.timestamp.type)에서 브로커가 타임스탬프를 덮어쓰는 길과 타임스탬프 허용 범위(message.timestamp.before.max.ms·after.max.ms):LogValidator.java570–598행- 압축을 다시 할 때 크기가
max.message.bytes를 넘는지 다시 보는 검사:UnifiedLog.java1188–1201행 - 쿼터(쓰기 대역폭·요청 쿼터로 응답을 늦추는 throttle):
KafkaApis.scala495–509행,server/src/main/java/org/apache/kafka/server/quota/— 이 연재에서 다루지 않습니다 - KRaft 메타데이터 로그가 같은
UnifiedLog에 쓰는 길(AppendOrigin.RAFT_LEADER):raft/src/main/java/org/apache/kafka/raft/internals/KafkaRaftLog.java— 10편 - 계층 저장소, 디렉터리 여러 개(JBOD), 공유 그룹 — 이 연재에서 다루지 않습니다
정리
| 개념 | 한 줄 요약 |
|---|---|
| 레코드 배치 v2 | 61바이트 헤더 + 레코드들. 필드 위치는 DefaultRecordBatch 의 상수가 하나씩 쌓아 정한다 |
batchLength |
자기 뒤의 바이트 수. 배치 크기 - 12(LOG_OVERHEAD) |
| CRC | CRC-32C, attributes 부터 끝까지. 브로커가 채우는 baseOffset·partitionLeaderEpoch 는 그 앞이라 다시 계산하지 않는다 |
| 레코드 | 거의 모든 칸이 지그재그 varint. 오프셋·타임스탬프는 배치 기준과의 차로 적는다 |
| 요청 속 레코드 | readRecords() 가 요청 버퍼를 slice() 한 MemoryRecords — 복사하지 않는다 |
handleProduceRequest() |
권한·토픽 확인, 파티션마다 v2 배치가 정확히 하나인지. 그다음 handleProduceAppend() → appendRecords() |
appendRecords() |
acks 가 -1·0·1 인지 보고 파티션마다 appendRecordsToLeader() |
Partition.appendRecordsToLeader() |
리더인지, acks=-1 이면 ISR ≥ 실효 min.insync.replicas 인지 보고 쓴다. 실효값 = min(설정, 복제본 수) |
UnifiedLog.append() |
락 밖에서 헤더 검사(baseOffset=0, 크기, CRC), 락 안에서 로그 끝부터 오프셋을 매기고 쓴다. 팔로워는 오프셋을 매기지 않는다 |
LogValidator |
무압축이거나 같은 압축이면 헤더 칸만 제자리에서 고친다. 토픽의 압축과 다르면 배치를 다시 만들고 다시 압축한다 |
토픽 compression.type |
기본 producer — 프로듀서의 압축을 그대로 쓴다 |
LogSegment.append() |
버퍼를 FileChannel 에 쓴다. fsync 는 flush.messages(기본 Long.MAX_VALUE)를 넘을 때만 |
acks=0 |
쓰지만 응답하지 않는다(NoOpResponse). 오류면 연결을 끊는다 |
acks=1 |
리더 로그에 쓰자마자 응답 |
acks=-1(all) |
쓴 뒤 DelayedProduce 로 하이 워터마크를 기다린다(9편) |
다음에 볼 것
배치가 활성 세그먼트의 .log 파일 끝에 붙는 데까지 왔습니다. 그런데 파일은 하나가 아니라 여러 개의 세그먼트로 나뉘어 있고, 옆에는 .index·.timeindex 파일이 따라다니며, 오래된 세그먼트는 보존 설정에 따라 지워지거나 컴팩션으로 줄어듭니다. 4절에서 이름만 본 maybeRoll() 과, LogSegment.append() 에서 줄인 인덱스 항목 추가가 그 시작입니다. 7편: 로그 저장소 — 세그먼트, 인덱스, 보존과 압축에서 이어집니다.
이 글에서 "9편에서" 로 넘긴 것 — acks=all 이 퍼거토리에서 무엇을 기다리고, 하이 워터마크가 팔로워의 Fetch 로 어떻게 올라가는지 — 은 9편: 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림에서 봅니다.