이 글에서 다루는 것
"Kafka 소스 파헤치기"는 Apache Kafka(메시지를 디스크의 로그에 쌓아 두고 여러 소비자가 읽어 가게 하는 분산 이벤트 스트리밍 플랫폼)의 소스 코드를 AI의 도움을 받아 조금씩 읽고 정리하는 연재입니다. 앞서 끝낸 Spring 소스 파헤치기(27편), Apache httpd 소스 파헤치기(16편), Tomcat 소스 파헤치기(16편)와 같은 방식으로 읽습니다. 바로 앞에는 nginx, MariaDB, Gradle 연재가 있습니다. 특히 Gradle 연재는 이 연재와 바로 이어집니다. Kafka가 Gradle로 빌드되기 때문입니다(2절).
이 글은 그 첫 번째 글이고, 코드를 깊이 읽기 전에 준비를 합니다. 답하려는 질문은 다섯 가지입니다.
- Kafka는 무엇이고, 어떻게 동작하고, 어디에 쓰는가 (처음 보는 분을 위한 절)
- 어떤 판의 소스를 읽는가. 흔히 쓰는 안정판 4.4.0과는 어떤 관계인가
- 이 연재와 똑같은 소스를 어떻게 받고, 어떻게 빌드해서 돌려 보는가
- 본체만 72만 줄쯤 되는 소스는 어떤 모듈로 나뉘어 있고, 어디서부터 읽어야 하는가
producer.send()로 보낸 레코드 하나는 어떤 클래스들을 지나 디스크에 쓰이고, 복제되고,consumer.poll()로 돌아오는가
Kafka를 처음 듣는 분은 바로 아래 "Kafka는 무엇인가" 절부터 읽으면 됩니다. 그림 두 장과 3분짜리 실습으로 Kafka가 하는 일을 먼저 눈으로 보고, 이 연재가 어떤 궁금증을 풀어 가는지 훑어본 뒤 본론으로 들어갑니다. 그다음부터는 앱에서 Kafka를 써 본 개발자가 Kafka 소스를 처음 여는 상황을 기준으로 씁니다. 프로듀서로 보내고 컨슈머로 받아 봤고, 토픽·파티션·오프셋·컨슈머 그룹이 무엇인지 알고, acks나 linger.ms 같은 설정을 몇 개 만져 봤고, 어쩌면 Spring Kafka(KafkaTemplate, @KafkaListener)나 kafka-topics.sh를 써 본 정도면 충분합니다. Java의 제네릭·람다·스레드는 읽을 수 있다고 봅니다. 브로커 쪽 코드 일부는 Scala로 되어 있는데, Scala 코드가 나오면 그 자리에서 읽는 법을 한두 줄 붙입니다.
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka (apache/kafka) |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 언어 | Java, 그리고 브로커의 일부(core 모듈)는 Scala 2.13 |
| 빌드 | Gradle 9.8.2 (래퍼 ./gradlew) |
| 이 글에서 주로 읽는 파일 | gradle.properties, build.gradle, settings.gradle, clients/src/main/resources/common/message/ProduceRequest.json, clients/…/producer/KafkaProducer.java, core/…/server/KafkaApis.scala, AGENTS.md |
글에 나오는 줄 번호와 세부 내용은 모두 이 커밋 기준입니다. 다른 버전에서는 줄 번호가 다르고, 내용이 달라진 곳도 있을 수 있습니다. 이 글은 연재 전체의 지도이므로 큰 줄기만 다루고, 깊은 내용은 각 편으로 넘깁니다.
연재는 모두 12편입니다.
- AI와 함께 소스를 읽는 방법과 분석 지도 (이 글)
- 전체 지도 — 클라이언트, 브로커, 컨트롤러, 그리고 파티션
- 와이어 프로토콜 — JSON 스키마에서 만들어지는 요청과 응답
- 브로커의 네트워크 계층 — Acceptor, Processor, 요청 처리 스레드
- 프로듀서 내부 — send()에서 배치, 그리고 Sender 스레드까지
- 브로커가 레코드를 받아 쓰기까지 — 레코드 배치 형식과 Produce 요청 처리
- 로그 저장소 — 세그먼트, 인덱스, 보존과 압축
- 읽기 경로 — Fetch 요청, 롱 폴링, 그리고 제로 카피
- 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림
- KRaft와 메타데이터 — 컨트롤러는 클러스터를 어떻게 기억하나
- 컨슈머와 그룹 코디네이터 — poll()과 리밸런스의 안쪽
- 멱등성과 트랜잭션 — 정확히 한 번은 어떻게 만들어지나, 그리고 연재를 마치며
Kafka는 무엇인가 — 어떻게 동작하고, 어디에 쓰나
소스를 열기 전에, Kafka가 하는 일부터 그림과 실습으로 봅니다. 이미 Kafka를 써 봤다면 이 절 끝의 "이 연재가 풀어 갈 질문"만 보고 넘어가도 됩니다.
한 문장으로 — 모두가 함께 보는 "일어난 일 기록장"
Kafka는 "일어난 일"을 순서대로 적어 두는 기록장입니다. "주문이 들어왔다", "회원이 버튼을 눌렀다", "재고가 바뀌었다" 같은 일이 생길 때마다 한 줄씩 끝에 덧붙여 적습니다. 적힌 줄은 고치지 않습니다. 읽는 쪽은 여럿이고, 저마다 책갈피를 꽂아 두고 자기가 읽은 데까지 기억합니다. 배송 서비스가 바로바로 읽든 통계 서비스가 하루에 한 번 몰아 읽든, 서로 상관이 없습니다.
이런 기록장을 소프트웨어 용어로 로그(log)라고 부릅니다. 여기서 로그는 디버깅용 텍스트 로그가 아니라 "끝에만 덧붙이는, 순서가 있는 레코드 목록"이라는 뜻입니다. 이 연재 전체가 결국 "이 로그를 어떻게 빠르게, 잃어버리지 않게, 여러 서버에 나눠 들고 있나"를 따라가는 이야기입니다.
왜 이런 것이 필요한가
주문 서비스가 주문을 받으면 할 일이 많습니다. 배송을 잡고, 확인 메일을 보내고, 대시보드 숫자를 올리고, 검색 색인과 데이터 웨어하우스(분석용 데이터베이스)에도 넣어야 합니다. 주문 서비스가 이 넷을 직접 하나씩 부르면 문제가 생깁니다.
- 메일 서버가 잠깐 죽으면 주문까지 실패하거나, 실패한 호출을 다시 보내는 장치를 따로 만들어야 합니다.
- 받는 쪽이 하나 늘 때마다 주문 서비스의 코드를 고쳐야 합니다.
- 대시보드처럼 느린 쪽이 빠른 쪽의 발목을 잡습니다.
Kafka를 가운데 두면 주문 서비스는 "주문이 들어왔다"를 Kafka에 한 번만 적고 끝냅니다. 받는 쪽은 각자 Kafka에서 읽어 갑니다. 받는 쪽이 잠깐 죽어도 기록은 Kafka에 남아 있으니, 살아난 뒤 책갈피부터 이어 읽으면 됩니다. 받는 쪽을 새로 붙여도 주문 서비스는 바뀌지 않습니다.
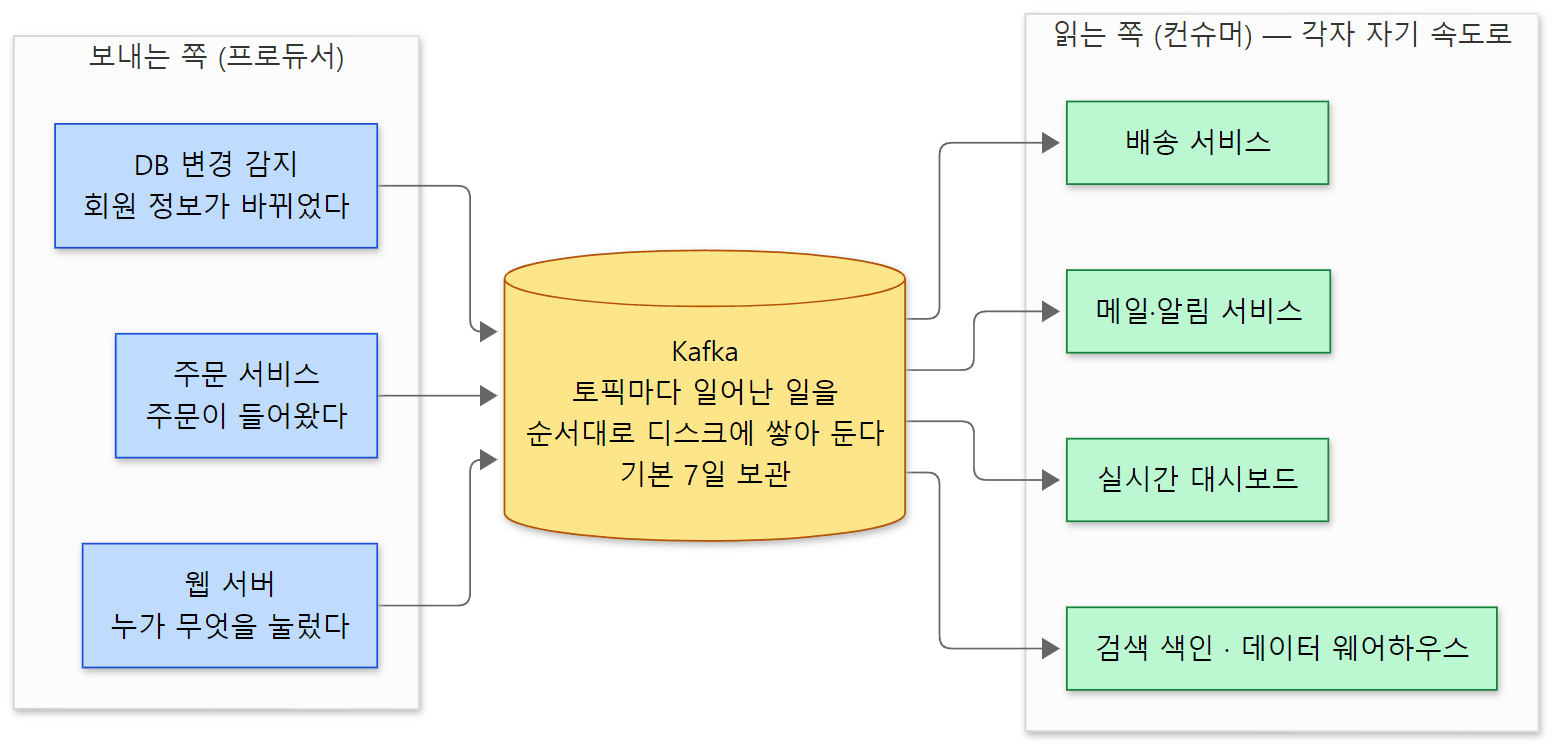 Kafka를 가운데 둔 모습. 보내는 쪽과 읽는 쪽은 서로를 모르고 Kafka만 압니다. "기본 7일"은 브로커 설정
log.retention.hours의 기본값입니다(LogConfig.java 133행).
어떻게 동작하나 — 다섯 가지 말로
Kafka를 움직이는 말은 다섯 개면 충분합니다. 아래 실습과 그림이 이 다섯 개를 그대로 보여 줍니다.
- 레코드(record) — 적어 두는 한 줄입니다. 키(key, 예: 고객 이름)와 값(value, 예: 주문 내용)으로 되어 있습니다.
- 토픽(topic) — 기록장의 이름입니다.
orders,clicks처럼 주제마다 하나씩 만듭니다. - 파티션(partition) — 토픽 하나를 여러 칸으로 나눈 것입니다. 칸마다 따로 순서대로 쌓이므로 여러 서버가 나눠 들고 동시에 받을 수 있습니다. 같은 키의 레코드는 늘 같은 파티션에 들어가서 한 고객의 주문은 순서가 지켜집니다. 대신 파티션이 다르면 순서를 보장하지 않습니다.
- 오프셋(offset) — 파티션 안에서 레코드가 받는 번호(0, 1, 2 …)입니다. 책갈피는 이 번호로 꽂습니다.
- 컨슈머 그룹(consumer group) — 같은 일을 하는 읽는 쪽들의 묶음입니다. 책갈피는 그룹마다 따로 있어서,
shipping그룹과email그룹은 같은 레코드를 각자 처음부터 읽습니다. 한 그룹 안에 컨슈머가 여럿이면 파티션을 나눠 맡아 함께 읽습니다(11편).
보내는 프로그램을 프로듀서(producer), 읽는 프로그램을 컨슈머(consumer), 기록장을 들고 있는 Kafka 서버를 브로커(broker)라고 부릅니다.
3분 실습 — 주문 7건을 보내고 두 그룹이 읽어 보기
말로만 보면 감이 오지 않으니 직접 돌려 봅니다. 이 연재가 빌드한 Kafka(2절에서 만드는 도커 이미지)로 돌렸지만, Kafka 배포판에 들어 있는 명령줄 도구만 쓰므로 공식 배포판으로도 같은 순서로 해 볼 수 있습니다(공식 배포판으로는 돌려 보지 않았습니다). 예제 폴더는 ex/u01-first-look이고, 하는 일은 이렇습니다.
- 파티션 3개짜리 토픽
orders를 만듭니다. 고객:주문꼴의 레코드 6건을 보냅니다.:앞이 키입니다.shipping그룹이 처음부터 읽습니다.email그룹도 처음부터 읽습니다.- 주문이 한 건 더 들어옵니다.
- 두 그룹의 책갈피가 어디 꽂혀 있는지 봅니다.
shipping그룹이 다시 읽으면 어디서부터 읽는지 봅니다.- 새 그룹
analytics가 처음부터 읽어 봅니다. - 브로커의 디스크를 들여다봅니다.
1~3단계의 명령만 옮기면 이렇습니다($B는 브로커 주소 localhost:9092, $FMT는 파티션·오프셋·키를 같이 찍으라는 --formatter-property 옵션 셋입니다. 나머지 단계도 같은 도구에 옵션만 바꿉니다).
kafka-topics.sh --bootstrap-server $B --create --topic orders --partitions 3 --replication-factor 1

printf '%s\n' 'alice:coffee' 'dave:bagel' 'carol:tea' 'alice:muffin' 'dave:juice' 'alice:cookie' \
 kafka-console-producer.sh --bootstrap-server $B --topic orders \
      --reader-property parse.key=true --reader-property key.separator=:

kafka-console-consumer.sh --bootstrap-server $B --topic orders --group shipping --from-beginning \
  $FMT --max-messages 6 2>/dev/null | sort
출력입니다.
=== 1. create topic 'orders' with 3 partitions
Created topic orders.
=== 2. produce 6 orders (key:value)
=== 3. group 'shipping' reads everything
Partition:0	Offset:0	alice	coffee
Partition:0	Offset:1	alice	muffin
Partition:0	Offset:2	alice	cookie
Partition:1	Offset:0	dave	bagel
Partition:1	Offset:1	dave	juice
Partition:2	Offset:0	carol	tea
=== 4. group 'email' reads the same 6 orders, independently
Partition:0	Offset:0	alice	coffee
Partition:0	Offset:1	alice	muffin
Partition:0	Offset:2	alice	cookie
Partition:1	Offset:0	dave	bagel
Partition:1	Offset:1	dave	juice
Partition:2	Offset:0	carol	tea
=== 5. one more order arrives
=== 6. where is each group? (bookmark per partition)
GROUP	TOPIC	PARTITION	CURRENT-OFFSET	LOG-END-OFFSET	LAG
shipping	orders	0	3	3	0
shipping	orders	1	2	2	0
shipping	orders	2	1	2	1
email	orders	0	3	3	0
email	orders	1	2	2	0
email	orders	2	1	2	1
=== 7. 'shipping' continues from its bookmark: only the new order
Partition:2	Offset:1	carol	scone
=== 8. a brand-new group 'analytics' can still read from the start (nothing was deleted)
Partition:0	Offset:0	alice	coffee
Partition:0	Offset:1	alice	muffin
Partition:0	Offset:2	alice	cookie
Partition:1	Offset:0	dave	bagel
Partition:1	Offset:1	dave	juice
Partition:2	Offset:0	carol	tea
Partition:2	Offset:1	carol	scone
=== 9. one folder per partition on the broker's disk
orders-0
orders-1
orders-2
(컨슈머는 여러 파티션의 레코드를 섞인 순서로 받으므로 보기 쉽게 sort로 정렬했습니다. 6단계의 kafka-consumer-groups.sh 출력은 앞 여섯 칸만 남겼습니다.)
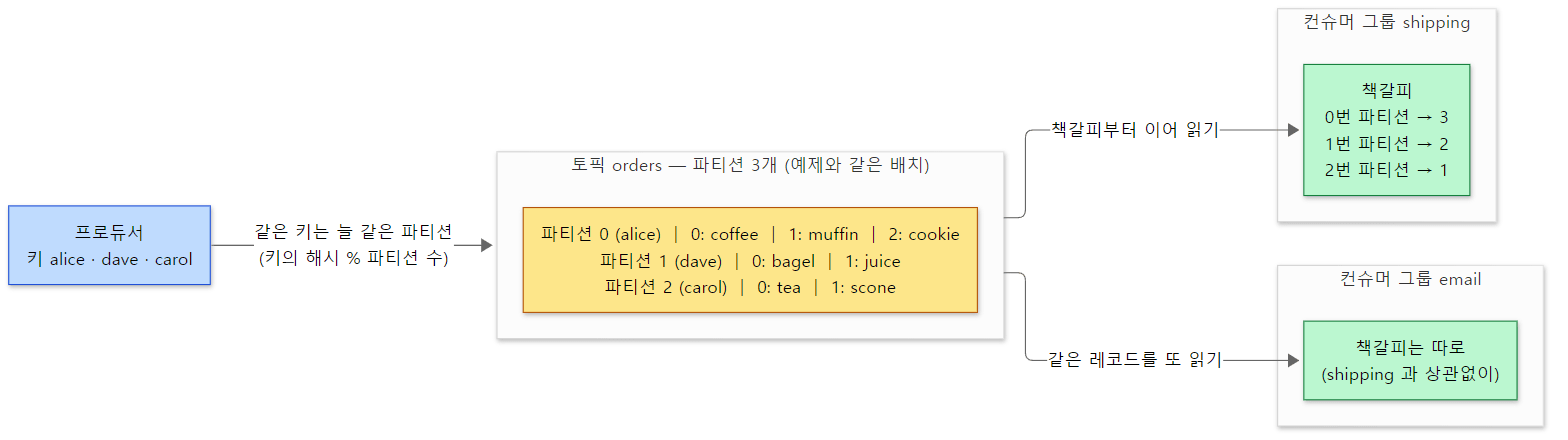 실습 6단계 시점의 모습. 노란 칸이 디스크에 쌓인 로그, 초록 칸이 그룹마다 따로 있는 책갈피입니다.
출력에서 볼 것은 다섯 가지입니다.
- 같은 키는 같은 파티션으로 갑니다.
alice의 주문 셋은 모두 파티션 0에,dave는 1에,carol은 2에 들어갔고, 파티션 안에서는 보낸 순서대로 오프셋 0, 1, 2를 받았습니다. 프로듀서는 키를 해시해서 파티션 수로 나눈 나머지로 파티션을 고릅니다(KafkaProducer.java 1695–1697행, BuiltInPartitioner.java 413–415행). 키가 같으면 해시도 같으니 늘 같은 파티션입니다. 이 세 이름은 세 파티션에 고루 나뉘는 것으로 골랐습니다. 다른 이름을 쓰면 한 파티션에 몰릴 수도 있습니다. - 두 그룹이 같은 레코드를 각자 다 읽습니다. 3단계와 4단계의 출력이 똑같습니다. "누가 한 번 꺼내 가면 사라지는" 우편함이 아니라, 기록은 그대로 두고 읽는 쪽이 각자 읽습니다.
- 책갈피는 그룹마다, 파티션마다 있습니다. 6단계의
CURRENT-OFFSET이 책갈피(다음에 읽을 오프셋),LOG-END-OFFSET이 로그의 끝(다음에 쓸 오프셋)이고, 그 차이가LAG(아직 못 읽은 수)입니다. 5단계에서 들어온carol:scone때문에 파티션 2만LAG이 1입니다. 이 책갈피는 브로커의__consumer_offsets라는 내부 토픽에 저장됩니다(Topic.java 27행). 책갈피조차 Kafka의 로그에 레코드로 적힌다는 것인데, 안쪽은 11편에서 봅니다. - 다시 읽으면 책갈피부터 이어 읽습니다. 7단계에서
shipping은--from-beginning없이 새 주문 한 건만 받았습니다. 컨슈머가 내려갔다 다시 올라와도 처음부터 다시 읽지 않고 이어 갈 수 있는 이유입니다. - 읽어도 지워지지 않습니다. 8단계의 새 그룹
analytics는 일곱 건을 처음부터 다 읽었습니다. 레코드는 읽었는지와 상관없이 보관 기간(기본 7일)이 지나거나, 크기 한도를 정해 두었다면(기본은 한도 없음) 그 한도를 넘을 때까지 디스크에 남습니다. 9단계의orders-0~orders-2가 브로커 디스크의 파티션별 폴더입니다. 이 폴더 안에 무엇이 있는지는 7편에서 열어 봅니다.
어디에 쓰나
| 쓰임 | 하는 일 | 위 그림에서 |
|---|---|---|
| 서비스 사이의 이벤트 전달 | 한 서비스에서 생긴 일을 여러 서비스가 받아 각자 처리한다. 보내는 쪽은 받는 쪽을 몰라도 된다 | 주문 서비스 → 배송·메일 |
| 로그·지표 모으기 | 여러 서버의 접속 기록, 오류, 지표를 한곳에 모아 저장소나 분석 시스템으로 넘긴다 | 웹 서버 → 데이터 웨어하우스 |
| 실시간 분석 | 클릭, 결제 같은 흐름을 들어오는 대로 세고 묶어 대시보드나 이상 탐지에 쓴다 | 웹 서버 → 실시간 대시보드 |
| DB 변경 퍼뜨리기(CDC) | 데이터베이스에서 바뀐 행을 이벤트로 내보내 검색 색인, 캐시, 다른 DB를 맞춘다 | DB 변경 감지 → 검색 색인 |
| 완충기 | 갑자기 몰린 일을 일단 받아 두고, 뒤쪽 시스템이 감당할 수 있는 속도로 꺼내 처리한다 | 보내는 쪽과 읽는 쪽 사이 전부 |
반대로 맞지 않는 곳도 있습니다. 서비스가 두세 개뿐인 작은 앱이라면 Kafka 클러스터를 운영하는 수고가 더 큽니다. 로그인이나 결제 승인처럼 "요청을 보내고 그 자리에서 답을 받아야 하는" 호출은 HTTP 같은 요청-응답 방식이 맞습니다. Kafka는 "일어난 일을 남겨 두고, 받을 쪽이 알아서 가져가는" 모양에 잘 맞습니다.
Kafka 위에는 레코드를 흐르는 대로 가공하는 Kafka Streams, 다른 시스템과 데이터를 주고받는 Kafka Connect 같은 프레임워크도 얹혀 있지만, 이 연재는 그 아래의 Kafka 본체(브로커와 클라이언트)만 읽습니다.
이 연재가 풀어 갈 질문
실습을 돌려 보면 궁금한 것이 생깁니다. 이 연재는 그 궁금증을 소스로 하나씩 풉니다. 끌리는 질문이 있으면 그 편부터 읽어도 됩니다.
| 궁금한 것 | 답이 있는 곳 |
|---|---|
kafka-console-producer.sh가 보낸 한 줄은 네트워크 선 위에서 어떤 바이트일까? |
3편: 와이어 프로토콜 |
| 브로커 하나가 많은 연결을 어떻게 동시에 받을까? | 4편: 브로커의 네트워크 계층 |
send()를 부르면 바로 보내질까? 아니라면 언제 보낼까? |
5편: 프로듀서 내부 |
브로커는 받은 레코드를 어떻게 검사하고 쓸까? orders-0 폴더 안에는 무엇이 있을까? |
6편, 7편: 로그 저장소 |
| 컨슈머는 새 레코드가 올 때까지 어떻게 기다리고, 브로커는 디스크의 바이트를 어떻게 복사 없이 보낼까? | 8편: 읽기 경로와 제로 카피 |
브로커 한 대가 죽어도 레코드가 남으려면? acks=all은 무엇을 기다릴까? |
9편: 복제 |
| 토픽과 파티션 목록은 누가 기억할까? ZooKeeper 없이 어떻게? | 10편: KRaft와 메타데이터 |
| 그룹에 컨슈머가 늘면 파티션은 누가 나눠 줄까? 책갈피는 언제 저장될까? | 11편: 컨슈머와 그룹 코디네이터 |
| 같은 주문이 두 번 들어가지 않게 할 수 있을까? "정확히 한 번"은 어떻게 만들까? | 12편: 멱등성과 트랜잭션 |
이 글의 나머지는 이 질문들을 소스로 따라가기 위한 준비입니다. 어떤 판을 읽는지(1절), 소스를 받아 빌드하는 법(2절), 폴더 지도(3절), 그리고 위 실습의 레코드 하나가 실제로 어떤 클래스들을 지나가는지(4절)를 봅니다. 직접 빌드해 볼 생각이 없다면 2절은 건너뛰어도 뒤의 내용을 읽는 데 지장이 없습니다.
먼저 알아 둘 말
앱을 짤 때는 몰라도 되던 이름이 소스에는 계속 나옵니다. 이 여섯 가지만 먼저 잡아 두면 이 글과 다음 글이 훨씬 쉽게 읽힙니다.
브로커(broker)와 컨트롤러(controller)는 Kafka 서버가 맡는 두 가지 역할입니다. 브로커는 우리가 늘 접속하는 쪽으로, 레코드를 받아 디스크에 쓰고 읽어 줍니다. 컨트롤러는 "어떤 토픽이 있고, 파티션의 리더는 어느 브로커인가" 같은 클러스터의 메타데이터(데이터에 대한 데이터)를 정하고 기억하는 쪽입니다. 한 프로세스가 두 역할을 다 할 수도 있고(이 연재의 예제가 대부분 그렇습니다), 나눠 띄울 수도 있습니다. 설정 파일의 process.roles=broker,controller가 그 선택입니다.
KRaft(크래프트)는 컨트롤러들이 메타데이터를 서로 맞춰 두는 방식의 이름입니다. Kafka에 Raft라는 합의 알고리즘을 붙였다는 뜻입니다. 옛날에는 메타데이터를 ZooKeeper라는 별도 서버가 들고 있었지만, 4.x부터는 KRaft만 남았습니다. 이 커밋의 core/src/main에서 ZooKeeper라는 낱말은 TestRaftServer.scala의 주석 한 줄에만 나옵니다. KRaft는 10편에서 봅니다.
파티션·레플리카·리더는 이미 아는 말이지만 소스에서의 뜻을 짚어 둡니다. 토픽은 파티션 여러 개로 나뉘고, 파티션 하나는 브로커 여러 대에 레플리카(replica, 복제본)로 놓입니다. 그 가운데 하나가 리더(leader)로, 쓰기와 읽기를 받습니다. 나머지 팔로워(follower)는 리더에게서 레코드를 가져다 자기 디스크에 따라 씁니다. 리더를 잘 따라오고 있는 레플리카 묶음을 ISR(In-Sync Replicas)이라고 부릅니다.
오프셋·LEO·하이 워터마크. 오프셋은 파티션 안 레코드의 번호(0, 1, 2 …)입니다. LEO(Log End Offset)는 "다음에 쓸 레코드가 받을 오프셋", 곧 로그의 끝입니다. 하이 워터마크(high watermark, HW)는 "ISR이 모두 받아 간 곳"의 경계입니다. 컨슈머는 하이 워터마크 아래의 레코드만 읽을 수 있습니다. 리더가 방금 쓴 레코드라도 팔로워가 받아 가기 전에는 컨슈머에게 보이지 않는다는 뜻입니다(4절의 그림과 9편).
레코드 배치와 세그먼트. Kafka는 레코드를 하나씩 다루지 않고 레코드 배치(record batch, 같은 파티션으로 가는 레코드 여러 개를 묶은 덩어리)로 보내고 그대로 디스크에 씁니다. 디스크의 로그는 한 파일이 아니라 세그먼트(segment)라는 파일 여러 개로 나뉘고, 세그먼트마다 .log(레코드), .index(오프셋 → 파일 위치), .timeindex(시각 → 오프셋) 파일이 있습니다. 배치는 6편, 세그먼트는 7편에서 봅니다.
trunk와 4.4는 Kafka 저장소의 브랜치 이름입니다. trunk는 다음 판(4.5)을 만드는 개발 줄기이고, 우리가 내려받아 쓰는 안정판은 4.4 같은 브랜치에서 태그(4.4.0)로 나옵니다. 이 연재가 읽는 것은 trunk입니다. 이 차이는 바로 다음 절에서 봅니다.
1. 어떤 판을 읽나 — trunk와 4.4.0
버전은 gradle.properties에 적혀 있습니다
Kafka의 버전은 저장소 맨 위의 gradle.properties에 적혀 있습니다. Gradle(자바 프로젝트 빌드 도구)이 빌드를 시작할 때 이 파일을 읽어 프로젝트 속성으로 씁니다.
group=org.apache.kafka
version=4.5.0-SNAPSHOT
scalaVersion=2.13.18
4.5.0에 -SNAPSHOT이 붙어 있습니다. Maven·Gradle 세계에서 SNAPSHOT은 "아직 나오지 않은, 계속 바뀌는 개발판"이라는 뜻입니다. 그래서 기준 커밋을 빌드한 Kafka는 스스로를 4.5.0-SNAPSHOT이라고 부릅니다. 아래 2절의 예제에서 kafka-topics.sh --version으로 직접 확인합니다.
trunk와 4.4.0은 어떤 관계인가
이 저장소에서 git으로 직접 확인하면 이렇습니다.
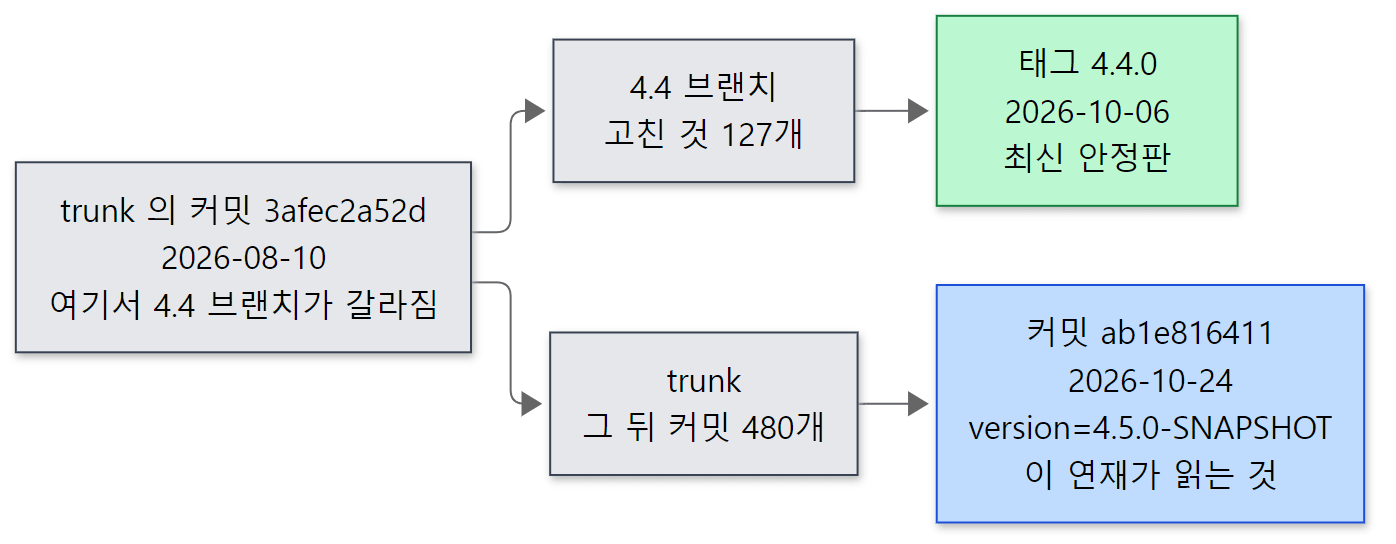 trunk와 4.4 브랜치. 초록 칸이 우리가 내려받아 쓰는 안정판, 파란 칸이 이 연재가 읽는 커밋입니다.
| 브랜치 / 태그 | 버전 | 무엇인가 |
|---|---|---|
trunk (커밋 ab1e816411, 2026-10-24) |
4.5.0-SNAPSHOT | 다음 판을 만드는 개발 줄기. 이 연재가 읽는 것 |
태그 4.4.0 (커밋 1156b2752a, 2026-10-06) |
4.4.0 | 4.4 브랜치에서 나온 최신 안정판 |
두 줄기가 갈라진 곳 (커밋 3afec2a52d, 2026-08-10) |
— | git merge-base 4.4.0 ab1e816411의 결과 |
git rev-list --count로 세면 갈라진 뒤 trunk에는 커밋이 480개, 4.4 브랜치에는 4.4.0까지 127개가 더 있습니다. 4.4.0은 기준 커밋의 조상이 아닙니다(git merge-base --is-ancestor가 거짓). 갈라진 뒤로 두 줄기에는 커밋이 따로 쌓였습니다.
왜 굳이 trunk를 읽느냐 하면, httpd·Tomcat 연재에서 개발 줄기를 읽은 것과 같은 이유입니다. 고친 것과 새 기능은 개발 줄기에 먼저 들어가고, 큰 줄기(프로토콜, 네트워크 계층, 로그, 복제, KRaft)는 두 줄기가 같습니다. 대신 이 연재는 글이 단정하는 내용이 4.4.0에서 다르면 그렇다고 밝힙니다. 이번 글에 닿는 것만 보면 이런 차이가 있습니다.
- Gradle 판이 다릅니다. 기준 커밋의
gradle/wrapper/gradle-wrapper.properties는 Gradle 9.8.2를, 4.4.0의 같은 파일은 9.6.1을 내려받습니다. Scala는 둘 다 2.13.18입니다. mirror-coordinator모듈은 trunk에만 있습니다. 2026-10-12에 커밋f329565593("KAFKA-21222: Add broker-level configs for Cluster Mirroring")으로 생겼고, 지금은 설정 클래스 하나(ClusterMirrorConfigs.java, 110줄)뿐입니다. 4.4.0의 맨 위 폴더 목록에는 없습니다. 아래 예제의 jar 목록에kafka-mirror-coordinator-4.5.0-SNAPSHOT.jar가 보이는 것은 이 때문입니다.- 나머지 맨 위 폴더 구성(
clients,core,server,storage,raft,metadata, 코디네이터들 …)은 같습니다. 3절의 지도는 4.4.0에도 그대로 맞습니다.
클라이언트는 Java 11, 서버는 Java 17
어떤 Java로 컴파일하는지는 build.gradle의 맨 앞에 있습니다.
ext {
  minClientJavaVersion = 11
  minNonClientJavaVersion = 17
  modulesNeedingJava11 = [":clients", ":generator", ":streams", ":streams:test-utils", ":streams:examples", ":streams:streams-scala", ":test-common:test-common-util"]
modulesNeedingJava11에 든 모듈은 --release 11로, 나머지는 --release 17로 컴파일합니다(같은 파일 120행의 def releaseVersion = modulesNeedingJava11.any { … } ? minClientJavaVersion : minNonClientJavaVersion). 앱에 들어가는 clients와 streams는 아직 Java 11에서도 돌아야 하고, 브로커·컨트롤러는 Java 17 이상에서만 돕니다. 빌드하는 JDK 자체는 17과 25를 쓴다고 README.md와 AGENTS.md가 적고 있고, 이 연재의 예제는 JDK 25로 빌드하고 돌렸습니다.
헷갈리기 쉬운 곳
4.5.0-SNAPSHOT인데 메타데이터 판은 4.4입니다. 2절의 예제에서 저장소를 포맷하면 Formatting … with metadata.version 4.4-IV2.라는 줄이 나옵니다. metadata.version은 프로그램의 판이 아니라 클러스터가 메타데이터를 기록하고 노드끼리 주고받을 때 쓰는 형식의 판입니다. 프로그램을 새 판으로 바꿔도 클러스터 전체가 새 형식을 쓰기 시작하는 것은 따로 올려야 합니다. 판의 목록은 MetadataVersion 열거형에 있습니다.
    // Add support for controller unregistration (KIP-1312).
    IBP_4_4_IV2(33, "4.4", "IV2", true),

    //
    // NOTE: MetadataVersions after this point are unstable and may be changed.
    // If users attempt to use an unstable MetadataVersion, they will get an error unless
    // they have set the configuration unstable.feature.versions.enable=true.
    // Please move this comment when updating the LATEST_PRODUCTION constant.
    //

    // New version for the Kafka 4.5.0 release.
    IBP_4_5_IV0(34, "4.5", "IV0", false);
server-common/src/main/java/org/apache/kafka/server/common/MetadataVersion.java 133–144행
4.5용 판(IBP_4_5_IV0, 기능 수준 34)도 이미 있지만 주석대로 "아직 불안정해서 바뀔 수 있는" 판입니다. 같은 파일 163행이 LATEST_PRODUCTION = IBP_4_4_IV2이고, 포맷할 때 판을 따로 고르지 않으면(그리고 unstable.feature.versions.enable을 켜지 않았으면) Formatter가 이 latestProduction()을 씁니다(Formatter.java 277–292행). 그래서 4.5.0-SNAPSHOT 프로그램이 4.4-IV2(기능 수준 33) 형식으로 시작합니다. 이 글에서 "4.5"라고 하면 프로그램 판, "4.4-IV2"라고 하면 메타데이터 형식 판입니다. 메타데이터는 10편에서 봅니다.
4.5.0은 아직 나오지 않았습니다. 저장소의 태그를 git tag -l '4.*'로 늘어놓으면 4.4.0이 마지막이고 4.5로 시작하는 태그는 없습니다. 실제 서비스에 쓰는 것은 4.4.0(또는 그 이전) 안정판입니다.
2. 같은 소스 받고 빌드하기
이 절은 글의 예제를 직접 돌려 보고 싶은 분을 위한 것입니다. 읽기만 할 거라면 3절(폴더 지도)로 넘어가도 됩니다.
소스 받고 커밋 고정하기
글의 줄 번호를 직접 열어 보려면 같은 커밋의 소스가 있어야 합니다. Git이 있으면 다음 순서로 합니다.
- 저장소를 받습니다. 이력이 길어서 시간이 조금 걸립니다.
- 기준 커밋을 따로 꺼내 둡니다. 저는 받은 폴더(
kafka)는 그대로 두고 git worktree로 기준 커밋만 다른 폴더(kafka-ab1e816411)에 꺼냈습니다. worktree는 저장소 하나에서 다른 커밋을 다른 폴더로 동시에 꺼내 두는 기능입니다. 이렇게 하면 원래 폴더에서git pull로 최신 소스를 받아도 기준 커밋 폴더의 줄 번호는 바뀌지 않습니다. - 제대로 맞춰졌는지 확인합니다. 긴 커밋 번호가 그대로 나오면 됩니다.
git clone https://github.com/apache/kafka.git
cd kafka
git worktree add --detach ../kafka-ab1e816411 ab1e8164115dba0a6c5ee39945698cbc4efb6f12
git -C ../kafka-ab1e816411 rev-parse HEAD
worktree가 번거로우면 git checkout ab1e8164115dba0a6c5ee39945698cbc4efb6f12로 받은 폴더 자체를 그 커밋에 맞춰도 됩니다. "detached HEAD"라는 안내가 나오는데, 브랜치가 아니라 특정 커밋을 꺼냈다는 뜻이고 읽기만 할 때는 문제없습니다. 4.4.0과 비교하고 싶을 때는 git show 4.4.0:<경로>로 파일을 꺼내 보면 체크아웃을 바꾸지 않아도 됩니다.
내려받지 않고 웹에서만 봐도 됩니다. GitHub에서 이 커밋을 여는 주소로 들어가면 같은 파일이 보이고, 이 연재의 코드 링크도 전부 이 커밋을 가리킵니다.
Windows에서 받았다면 한 가지를 알아 두세요. Git의 core.autocrlf=true 설정 때문에 꺼낸 파일의 줄 끝이 CRLF가 됩니다. 읽는 데는 문제가 없지만, 이 파일을 그대로 리눅스(도커)로 가져가면 셸 스크립트가 돌지 않습니다(httpd 1편의 "막혔던 곳"). 그래서 아래 도커 빌드에는 git archive로 변환 없이 뽑은 압축 파일을 씁니다.
도커에서 빌드하기
읽기만 할 거면 빌드는 필요 없습니다. 하지만 이 연재는 글에 싣는 예제를 전부 실제로 돌려 보기 때문에, 기준 커밋을 빌드한 Kafka가 필요합니다. 내려받은 정식판(4.4.0)으로 돌리면 줄 번호도, 있는 클래스도 다르기 때문입니다. 그래서 도커 컨테이너 안에서 기준 커밋을 그대로 빌드했습니다. 실제로 쓰는 Dockerfile입니다.
# "Kafka 소스 파헤치기" 예제용 이미지.
# 기준 커밋 ab1e816411 (trunk, 4.5.0-SNAPSHOT, 2026-10-24) 의 소스를 그대로 Gradle 로 빌드한다.
# 소스는 git archive 로 뽑은 kafka-ab1e816411.tar.gz (core.autocrlf=false — LF 줄 끝, 손대지 않은 원본).
#   git -C /d/openSource/kafka-ab1e816411 -c core.autocrlf=false archive --format=tar.gz --prefix=kafka/ \
#       -o kafka-ab1e816411.tar.gz ab1e8164115dba0a6c5ee39945698cbc4efb6f12
# Kafka 는 JDK 17 과 25 로 빌드·테스트한다(README). 여기서는 25 를 쓴다.
#   docker build -t kafka-lab:ab1e816411 .     (처음 한 번 10분쯤, 네트워크 필요)

# ---- 1단계: 소스에서 배포 tar.gz 를 만든다 ----
FROM eclipse-temurin:25-jdk AS build
RUN apt-get update && DEBIAN_FRONTEND=noninteractive apt-get install -y --no-install-recommends curl git \
    && rm -rf /var/lib/apt/lists/*
COPY kafka-ab1e816411.tar.gz /usr/src/
WORKDIR /usr/src
# git archive 에는 .git 이 없으므로 커밋 id 를 직접 넘긴다(서버 로그·--version 에 찍힌다).
# gradlew 는 처음 실행할 때 gradle-wrapper.jar 와 Gradle 9.8.2 배포판을 내려받는다.
# releaseTarGz 는 배포판 tar.gz 를 만드는 태스크다(-x test: 테스트는 돌리지 않는다).
RUN tar xzf kafka-ab1e816411.tar.gz && cd kafka \
    && ./gradlew --no-daemon -PcommitId=ab1e8164115dba0a6c5ee39945698cbc4efb6f12 releaseTarGz -x test

# core/build/distributions 에는 배포판과 문서(…-site-docs.tgz) 두 개가 생긴다 — 배포판만 푼다.
RUN mkdir /opt/kafka \
    && tar xzf /usr/src/kafka/core/build/distributions/kafka_2.13-4.5.0-SNAPSHOT.tgz -C /opt/kafka --strip-components=1

# 빌드 때 JSON 스키마에서 생성된 Java 소스(저장소에는 없다)를 모듈별로 모아 둔다 → /opt/kafka-generated/<모듈>/...
RUN cd /usr/src/kafka && for d in $(find . -path "*/build/generated/main/java" -type d); do \
      m=${d#./}; m=${m%/build/generated/main/java}; \
      mkdir -p /opt/kafka-generated/$m && cp -r $d/. /opt/kafka-generated/$m/; \
    done

# ---- 2단계: 실행 이미지 ----
FROM eclipse-temurin:25-jdk
RUN apt-get update && DEBIAN_FRONTEND=noninteractive apt-get install -y --no-install-recommends \
      curl procps netcat-openbsd less \
    && rm -rf /var/lib/apt/lists/*
COPY --from=build /opt/kafka /opt/kafka
COPY --from=build /opt/kafka-generated /opt/kafka-generated
ENV KAFKA_HOME=/opt/kafka PATH=/opt/kafka/bin:$PATH
WORKDIR /work
CMD ["kafka-topics.sh", "--version"]
하는 일을 순서대로 풀면 이렇습니다.
- JDK 25가 든 이미지에서 시작합니다.
eclipse-temurin:25-jdk는 Eclipse Adoptium이 만든 OpenJDK 25 이미지입니다. 앞에서 본 대로 Kafka는 17과 25로 빌드합니다. - 기준 커밋의 소스를 압축 파일로 넣습니다. 위에서 말한 CRLF 문제를 피하려고
core.autocrlf=false로 뽑은 원본입니다. ./gradlew releaseTarGz로 빌드합니다.gradlew는 Gradle 래퍼(wrapper)입니다. 저장소에 든 작은 스크립트로, 처음 실행할 때gradle-wrapper.properties에 적힌 판(9.8.2)의 Gradle을 내려받아 씁니다. 그래서 PC에 Gradle을 따로 깔지 않아도 모두 같은 판으로 빌드합니다.releaseTarGz는 우리가 Kafka 누리집에서 내려받는 것과 같은 배포판 압축 파일(bin/,config/,libs/)을 만드는 태스크입니다(build.gradle 1395행).-x test는 테스트 태스크를 빼라는 뜻입니다.-PcommitId=…로 커밋 id를 넘깁니다.git archive로 뽑은 소스에는.git폴더가 없어서 빌드가 스스로 커밋을 알아낼 수 없습니다. 빌드 스크립트의determineCommitId()는-PcommitId가 있으면 그것을, git 저장소가 있으면HEAD를, 둘 다 없으면unknown을 씁니다(build.gradle 231–240행). 이 값이 아래 예제의kafka-version.properties와 서버 로그에 찍힙니다.- 배포판을
/opt/kafka에 풉니다.KAFKA_HOME과PATH를 맞춰 두어 컨테이너 안에서kafka-topics.sh를 바로 부를 수 있습니다. - 생성된 소스를 따로 모아 둡니다. 바로 다음에 볼
processMessages가 만든 자바 소스는 저장소에 없으므로, 읽을 수 있게/opt/kafka-generated에 복사해 둡니다.
이 PC(도커 데스크톱, WSL2)에서 빌드 단계는 BUILD SUCCESSFUL in 16m 33s, 이미지까지 17분쯤 걸렸습니다. 빌드 로그 첫머리에는 Starting build with version 4.5.0-SNAPSHOT (commit id ab1e8164) using Gradle 9.8.2, Java 25 and Scala 2.13.18이라는 줄이 찍힙니다(build.gradle 305행이 찍는 줄입니다).
JSON에서 코드를 만드는 단계 — processMessages
Kafka 빌드에는 다른 자바 프로젝트에서 보기 드문 단계가 하나 있습니다. 요청·응답 클래스를 사람이 짜지 않고, JSON 파일에서 생성합니다.
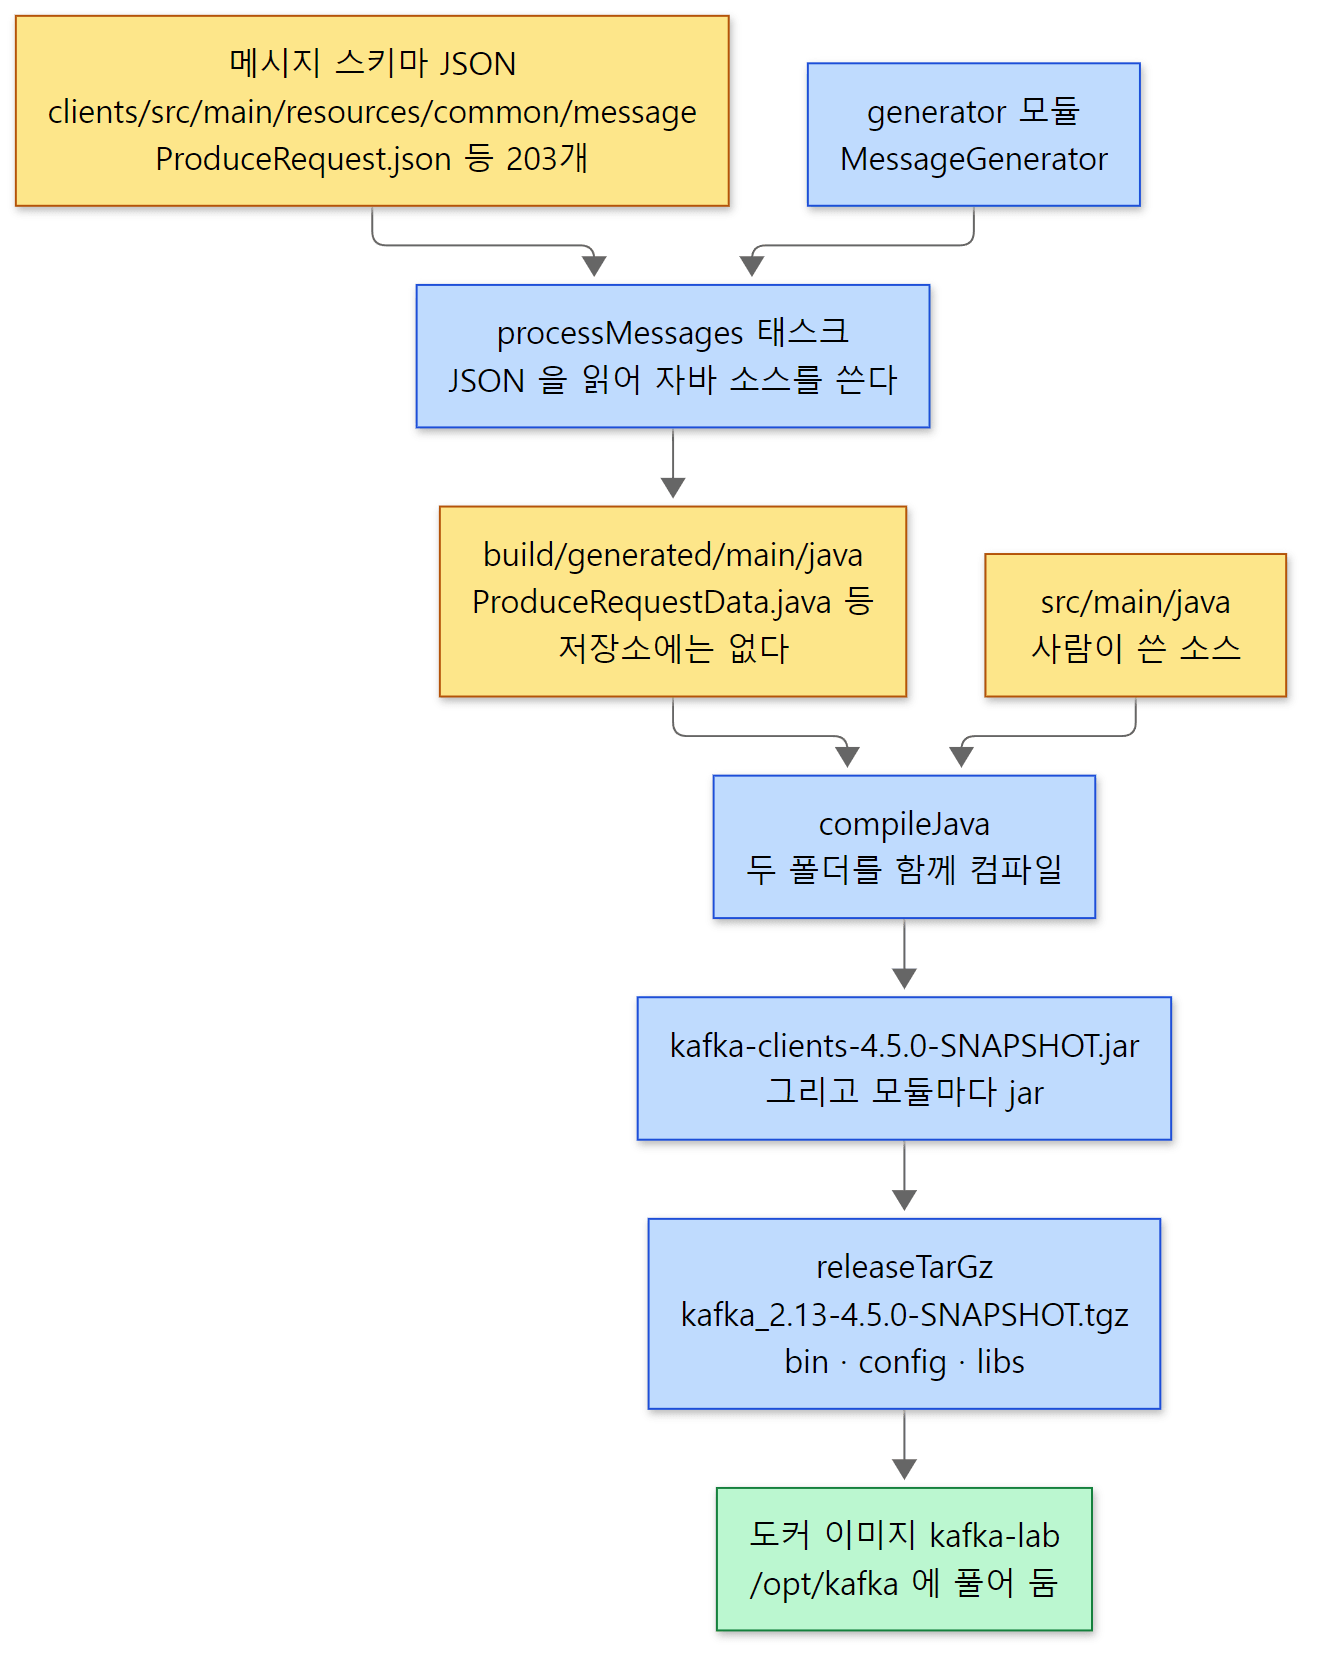 빌드 안에서 코드가 생성되는 자리. 노란 칸이 소스(파일), 파란 칸이 빌드 단계입니다. 생성된 소스는 저장소에 없습니다.
먼저 JSON 쪽입니다. 프로듀서가 보내는 Produce 요청의 모양이 이 파일에 적혀 있습니다.
{
  "apiKey": 0,
  "type": "request",
  "listeners": ["broker"],
  "name": "ProduceRequest",
  // ...
  "validVersions": "3-13",
  "flexibleVersions": "9+",
  // ...
  "fields": [
    { "name": "TransactionalId", "type": "string", "versions": "3+", "nullableVersions": "3+", "default": "null", "entityType": "transactionalId",
      "about": "The transactional ID, or null if the producer is not transactional." },
    { "name": "Acks", "type": "int16", "versions": "0+",
      "about": "The number of acknowledgments the producer requires the leader to have received before considering a request complete. Allowed values: 0 for no acknowledgments, 1 for only the leader and -1 for the full ISR." },
    { "name": "TimeoutMs", "type": "int32", "versions": "0+",
      "about": "The timeout to await a response in milliseconds." },
clients/src/main/resources/common/message/ProduceRequest.json 16–62행 (줄인 곳은 // ...로 표시)
앱에서 쓰던 acks 설정이 여기 Acks 필드(int16, 2바이트 정수)로 보입니다. acks=all은 선에 -1로 실려 갑니다(about의 "-1 for the full ISR"). validVersions: "3-13"은 이 요청의 판이 3부터 13까지 있다는 뜻이고, 필드마다 "versions": "3+"처럼 어느 판부터 있는지가 적혀 있습니다.
이 JSON을 자바로 바꾸는 것이 clients 모듈의 processMessages 태스크입니다.
  tasks.register('processMessages', JavaExec) {
    mainClass = "org.apache.kafka.message.MessageGenerator"
    classpath = configurations.generator
    args = [ "-p", "org.apache.kafka.common.message",
             "-o", "${projectDir}/build/generated/main/java/org/apache/kafka/common/message",
             "-i", "src/main/resources/common/message",
             "-t", "ApiMessageTypeGenerator",
             "-m", "MessageDataGenerator", "JsonConverterGenerator"
           ]
    inputs.dir("src/main/resources/common/message")
        .withPropertyName("messages")
        .withPathSensitivity(PathSensitivity.RELATIVE)
    outputs.cacheIf { true }
    outputs.dir("${projectDir}/build/generated/main/java/org/apache/kafka/common/message")
  }
JavaExec는 "자바 프로그램 하나를 실행하는 태스크"입니다. 실행하는 것은 같은 저장소의 generator 모듈에 있는 MessageGenerator이고, -i의 JSON을 읽어 -o의 폴더(build/generated/main/java/…)에 자바 소스를 씁니다. 같은 clients 프로젝트 설정의 2199행 compileJava.dependsOn 'processMessages' 때문에 컴파일 전에 늘 이 태스크가 먼저 돕니다. inputs·outputs를 적어 둔 것은 Gradle이 "JSON이 안 바뀌었으면 다시 생성하지 않게" 하려는 것입니다. 이런 태스크의 입력·출력과 건너뛰기가 어떻게 돌아가는지는 Gradle 연재에서 다룹니다.
빌드 로그를 보면 > Task :clients:processMessages 아래에 MessageGenerator: processed 203 Kafka message JSON file(s).가 찍힙니다. clients만이 아닙니다. 같은 로그에 metadata(27개), group-coordinator(44개), share-coordinator(4개), storage(5개), transaction-coordinator(2개), raft(1개), streams(1개)의 processMessages도 보입니다. 메타데이터 로그에 쓰는 레코드나 __consumer_offsets에 쓰는 레코드도 같은 방식으로 만든다는 뜻입니다.
생성된 쪽을 보면 이렇습니다. 빌드 때 ProduceRequest.json에서 생성되는 clients/build/generated/main/java/org/apache/kafka/common/message/ProduceRequestData.java(기준 커밋으로 생성, 1,104줄)의 직렬화 메서드 앞부분입니다.
    @Override
    public void write(Writable _writable, ObjectSerializationCache _cache, short _version) {
        int _numTaggedFields = 0;
        if (transactionalId == null) {
            if (_version >= 9) {
                _writable.writeUnsignedVarint(0);
            } else {
                _writable.writeShort((short) -1);
            }
        } else {
            byte[] _stringBytes = _cache.getSerializedValue(transactionalId);
            if (_version >= 9) {
                _writable.writeUnsignedVarint(_stringBytes.length + 1);
            } else {
                _writable.writeShort((short) _stringBytes.length);
            }
            _writable.writeByteArray(_stringBytes);
        }
        _writable.writeShort(acks);
        _writable.writeInt(timeoutMs);
(생성된 파일이라 GitHub 링크가 없습니다. 파일 머리에 // THIS CODE IS AUTOMATICALLY GENERATED. DO NOT EDIT.라고 적혀 있고, 위 인용은 그 파일의 231–250행입니다. 원본은 ProduceRequest.json 57–62행의 세 필드입니다.)
JSON의 필드 순서대로 TransactionalId → Acks → TimeoutMs를 씁니다. 눈여겨볼 것은 _version >= 9 갈림길입니다. JSON의 "flexibleVersions": "9+"가 그대로 코드가 되어, 9판부터는 문자열 길이를 2바이트 고정 길이(writeShort) 대신 가변 길이 정수(writeUnsignedVarint)로 씁니다. 판마다 다른 이런 분기를 200개 넘는 메시지마다 손으로 짜면 틀리기 쉬우니 생성기에 맡긴 것입니다. 이 부분은 3편에서 자세히 봅니다.
Gradle로 보는 Kafka 저장소
Kafka 저장소는 Gradle의 멀티 프로젝트 빌드(한 저장소 안에 하위 프로젝트 여러 개를 두고 함께 빌드하는 구성)입니다. 하위 프로젝트 목록은 settings.gradle의 include에 있습니다(settings.gradle 76–140행). 세어 보면 65개이고, 그 가운데 26개는 Streams의 업그레이드 시험용 프로젝트(streams:upgrade-system-tests-0110 … -43)입니다. 이름과 jar가 거의 일대일입니다. clients 프로젝트가 kafka-clients-….jar, server가 kafka-server-….jar가 되는 식이고, Scala로 된 core만 Scala 판을 붙여 kafka_2.13-….jar가 됩니다. 한 곳은 이름을 바꿉니다. project(":storage:api").name = "storage-api"(142행) 때문에 폴더 storage/api가 kafka-storage-api-….jar가 됩니다.
같은 파일 22행의 includeBuild 'api-checker'도 Gradle다운 장치입니다. api-checker는 별도의 Gradle 빌드인데, Kafka 빌드가 그 빌드의 플러그인을 이름으로 가져다 쓸 수 있게 묶어 둔 것입니다(컴포지트 빌드). 위 주석은 "api-checker의 Maven 의존성이 메인 빌드의 클래스패스에 끼지 않게 하려고 따로 뒀다"고 적고 있습니다. Gradle 자체의 동작(설정 단계, 태스크 그래프, 컴포지트 빌드)은 Gradle 연재의 몫이고, 이 연재는 "Kafka의 빌드가 무엇을 만드는가"까지만 봅니다.
예제를 돌리는 방법
예제는 편마다 폴더 하나(ex/u01-reading-plan처럼)에 run.sh를 두고, 이것을 컨테이너 안에서 실행하는 작은 스크립트(run-example.sh)로 돌립니다. 핵심은 한 줄입니다.
MSYS_NO_PATHCONV=1 docker run --rm -v "$here/$dir:/work" -v "$here/ex/_lib:/examples-lib:ro" -w /work \
  kafka-lab:ab1e816411 bash ./run.sh
예제 폴더를 컨테이너의 /work에 붙이고 run.sh를 실행한 뒤, 컨테이너는 바로 지웁니다(--rm). 매번 저장소를 새로 포맷한 깨끗한 서버에서 시작하므로 앞 예제가 남긴 토픽이나 로그에 영향을 받지 않습니다. 포트를 호스트에 열지 않으므로 여러 예제를 동시에 돌려도 부딪히지 않습니다. MSYS_NO_PATHCONV=1은 Git Bash가 /work 같은 인자를 Windows 경로로 멋대로 바꾸지 못하게 막는 설정입니다(httpd·Tomcat 연재와 같은 방식입니다). 두 번째 -v는 서버를 한 줄로 띄우는 도우미 스크립트를 붙이는 것으로, 뒤 편의 예제에서 씁니다.
예제: 빌드한 Kafka에게 직접 물어보기
이 연재의 예제는 모두 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u01-reading-plan이고, run.sh는 버전을 묻고, 저장소를 포맷하고, 서버(브로커와 컨트롤러를 겸하는 프로세스 하나)를 띄운 뒤 4절의 예제로 이어집니다. 앞부분의 출력입니다.
=== version
4.5.0-SNAPSHOT
=== kafka/kafka-version.properties inside kafka-clients jar
commitId=ab1e8164115dba0a6c5ee39945698cbc4efb6f12
version=4.5.0-SNAPSHOT
=== kafka jars in libs/
kafka-clients-4.5.0-SNAPSHOT.jar
kafka-coordinator-common-4.5.0-SNAPSHOT.jar
kafka-group-coordinator-4.5.0-SNAPSHOT.jar
kafka-group-coordinator-api-4.5.0-SNAPSHOT.jar
kafka-metadata-4.5.0-SNAPSHOT.jar
kafka-mirror-coordinator-4.5.0-SNAPSHOT.jar
kafka-raft-4.5.0-SNAPSHOT.jar
kafka-server-4.5.0-SNAPSHOT.jar
kafka-server-common-4.5.0-SNAPSHOT.jar
kafka-share-coordinator-4.5.0-SNAPSHOT.jar
kafka-shell-4.5.0-SNAPSHOT.jar
kafka-storage-4.5.0-SNAPSHOT.jar
kafka-storage-api-4.5.0-SNAPSHOT.jar
kafka-tools-4.5.0-SNAPSHOT.jar
kafka-tools-api-4.5.0-SNAPSHOT.jar
kafka-transaction-coordinator-4.5.0-SNAPSHOT.jar
kafka_2.13-4.5.0-SNAPSHOT.jar
(all jars: 108)
=== format storage
Bootstrap metadata: BootstrapMetadata(records=[ApiMessageAndVersion(FeatureLevelRecord(name='metadata.version', featureLevel=33) at version 0), ApiMessageAndVersion(FeatureLevelRecord(name='eligible.leader.replicas.version', featureLevel=1) at version 0), ApiMessageAndVersion(FeatureLevelRecord(name='group.version', featureLevel=1) at version 0), ApiMessageAndVersion(FeatureLevelRecord(name='share.version', featureLevel=2) at version 0), ApiMessageAndVersion(FeatureLevelRecord(name='streams.version', featureLevel=1) at version 0), ApiMessageAndVersion(FeatureLevelRecord(name='transaction.version', featureLevel=2) at version 0)], metadataVersionLevel=33, source=format command)
Formatting dynamic metadata voter directory /tmp/kraft-combined-logs with metadata.version 4.4-IV2.
=== start server
INFO [KafkaRaftServer nodeId=1] Kafka Server started (kafka.server.KafkaRaftServer)
INFO Kafka version: 4.5.0-SNAPSHOT (org.apache.kafka.common.utils.internals.AppInfoParser)
INFO Kafka commitId: ab1e8164115dba0a6c5ee39945698cbc4efb6f12 (org.apache.kafka.common.utils.internals.AppInfoParser)
(jar 목록에서 Connect·Streams의 jar는 grep으로 뺐고, 서버 로그 줄은 앞의 시각을 잘라 냈습니다.) 하나씩 보면 이렇습니다.
--version이 찍는 문자열의 출처.kafka-topics.sh는kafka-run-class.sh로org.apache.kafka.tools.TopicCommand를 부르고,--version이 있으면CommandLineUtils.printVersionAndExit()가AppInfoParser.getVersion()을 찍습니다(CommandLineUtils.java 173–174행).AppInfoParser는 클래스패스의/kafka/kafka-version.properties를 읽습니다(AppInfoParser.java 42–51행). 그 파일은 빌드의createVersionFile태스크가version과commitId를 적어 jar에 넣은 것입니다(build.gradle 2096–2113행). 그래서gradle.properties의version과 Dockerfile의-PcommitId가 그대로 나옵니다. 서버도 시작할 때 같은 클래스로 두 값을 로그에 남깁니다.- jar 이름이 곧 모듈 이름. 위에서 본
settings.gradle의 프로젝트들이 jar가 되어libs/에 들어 있습니다.libs/의 jar는 모두 108개이고, 나머지는 Connect·Streams와 바깥 라이브러리(Jackson, Log4j, 압축 라이브러리zstd-jni·lz4-java·snappy-java등)입니다. 3절의 지도에서 이 이름들을 다시 봅니다. - 포맷이 메타데이터를 미리 씁니다.
kafka-storage.sh format은 데이터 폴더를 만들면서 첫 메타데이터 레코드(기능 수준을 정하는FeatureLevelRecord여섯 개)를 준비합니다. 1절의 "헷갈리기 쉬운 곳"에서 본4.4-IV2가 여기서 나옵니다. 왜 서버를 띄우기 전에 포맷이 필요한지는 2편과 10편에서 봅니다. - 서버 이름이
KafkaRaftServer입니다.kafka-server-start.sh는 마지막 줄에서kafka-run-class.sh … kafka.Kafka를 부르고,kafka.Kafka가 만드는 서버는KafkaRaftServer하나뿐입니다(Kafka.scala 65–71행). 이것이process.roles에 따라 브로커·컨트롤러를 켭니다. ZooKeeper 시절에는 다른 서버 클래스도 있었지만, 지금은 고를 것이 없습니다.
헷갈리기 쉬운 곳
커밋 id가 16자리가 아니라 40자리입니다. determineCommitId()는 -PcommitId의 값을 commitId.take(takeFromHash)로 16자리까지 자릅니다. 그런데 위 출력의 kafka-version.properties에는 Dockerfile에서 넘긴 40자리가 그대로 들어 있습니다. 하위 프로젝트(clients)의 createVersionFile이 읽는 commitId가 루트 프로젝트의 ext에 잘라 넣은 값이 아니라 -P로 넘긴 값 그대로라는 뜻입니다. Gradle이 -P 속성을 어떻게 찾는지(하위 프로젝트에서 무엇이 먼저 보이는지)의 문제로 보이지만, Gradle 소스로 확인하지는 않았습니다. 빌드 로그 첫 줄의 commit id ab1e8164는 305행이 commitId.take(8)로 다시 줄여 찍은 것입니다.
AppInfoParser는 internals 패키지에 있습니다. 서버 로그에 찍힌 클래스 이름이 org.apache.kafka.common.utils.internals.AppInfoParser입니다. Kafka는 최근 몇 년 동안 "바깥에 공개하는 API"와 "안쪽 구현"을 패키지 이름으로 가르는 작업을 하고 있어서, 레코드 형식 클래스(MemoryRecords, DefaultRecordBatch …)도 common/record/internal/에 있습니다. 인터넷의 글이나 AI의 기억에 있는 경로가 이 커밋과 다른 경우가 많으니, 이 연재는 클래스 위치를 매번 git ls-files로 확인하고 적습니다.
3. 폴더 지도 — 어디에 무엇이 있나
맨 위 폴더
기준 커밋에서 git이 관리하는 파일은 7,633개입니다. 그 가운데 .java·.scala 소스가 6,529개, 합쳐서 1,734,167줄(빈 줄과 주석 포함)입니다. 이 가운데 테스트가 아닌 본체(src/main)만 세면 3,933개, 719,878줄입니다. 모듈별로 직접 세면 이렇습니다(git ls-files로 src/main 아래 파일을 고르고 wc -l과 같은 방식으로 줄바꿈을 셈, 생성 코드는 저장소에 없으므로 빠짐).
| 폴더 | 들어 있는 것 | src/main 파일 |
줄 수 | 다루는 편 |
|---|---|---|---|---|
clients |
프로듀서·컨슈머·관리 클라이언트, 프로토콜 클래스, 레코드 형식, 네트워크(Selector) |
1,356 | 201,082 | 3·5·6·8·11편 |
core |
브로커 본체에서 Scala가 남은 곳 — KafkaApis, ReplicaManager, Partition, SocketServer, KafkaRaftServer |
Scala 52 + Java 15 | 25,787 + 8,101 | 2·4·6·8·9·12편 |
server |
Java로 옮겨 온 브로커 부품 — 요청 객체(Request), 퍼거토리(DelayedProduce), 소켓 서버 설정 |
172 | 23,510 | 4·6·8·9편 |
server-common |
서버 모듈들이 나눠 쓰는 것 — 설정, 이벤트 큐, 퍼거토리 바탕 | 150 | 19,721 | 8·10편 |
storage (+storage/api) |
로그 저장소 — UnifiedLog, LocalLog, LogSegment, 인덱스, 로그 정리 |
123 + 16 | 27,746 + 1,935 | 6·7·8·9편 |
raft |
KRaft의 Raft 구현 — KafkaRaftClient |
91 | 20,803 | 10편 |
metadata |
컨트롤러(QuorumController)와 메타데이터 이미지 |
179 | 30,651 | 10편 |
group-coordinator (+-api) |
컨슈머 그룹 코디네이터 | 112 + 26 | 49,061 + 1,292 | 11편 |
coordinator-common |
코디네이터들이 같이 쓰는 런타임(CoordinatorRuntime) |
36 | 7,110 | 11편 |
transaction-coordinator |
트랜잭션 상태(TransactionMetadata 등) |
21 | 2,002 | 12편 |
share-coordinator |
공유 그룹(Share groups) | 12 | 3,621 | — |
generator |
JSON → 자바 코드 생성기(MessageGenerator) |
36 | 8,189 | 3편 |
tools (+tools-api) |
명령줄 도구 본체 — TopicCommand, ConsumerGroupCommand … |
81 + 7 | 27,991 + 232 | 예제에서 씀 |
shell |
kafka-metadata-shell.sh |
23 | 2,776 | 10편 |
streams (하위 포함) |
Kafka Streams | Java 795 + Scala 24 | 152,374 + 3,925 | — |
connect (하위 포함) |
Kafka Connect | 368 | 64,928 | — |
bin/, config/ |
실행 스크립트(kafka-server-start.sh …)와 예시 설정(server.properties …) |
— | — | 예제에서 씀 |
bin/과 config/는 배포판을 풀었을 때 보던 바로 그 폴더입니다. releaseTarGz가 이 두 폴더를 그대로 복사해 넣습니다(build.gradle 1399–1400행). 테스트는 본체보다 큽니다. src/test만 Java 878,667줄, Scala 104,397줄입니다. 어떤 동작이 헷갈릴 때 같은 이름의 테스트(예: PartitionTest)를 찾아 보면 의도를 알 수 있는 경우가 많습니다.
Spring을 읽을 때 본 코드가 테스트를 뺀 본 코드만 약 84만 줄, Tomcat이 테스트까지 약 74만 줄이었으니, Kafka의 본체 72만 줄은 Spring에 가깝습니다. 다만 이 연재가 읽는 "레코드의 길과 클러스터"는 그 가운데 Streams·Connect(합쳐서 22만 줄 남짓)와 관리 클라이언트·도구를 뺀 부분입니다.
생성 코드는 셈에 없습니다
위 표의 줄 수에는 2절에서 본 생성 코드가 들어 있지 않습니다. 기준 커밋으로 빌드해 생성된 소스를 세어 보면 clients만 391개 파일, 186,401줄입니다. 사람이 쓴 clients 본체(201,082줄)와 맞먹는 양이 빌드할 때마다 생겨나는 셈입니다. group-coordinator(90개, 21,488줄), metadata(56개, 12,668줄) 등을 합치면 568개 파일, 230,523줄입니다. 소스에서 ProduceRequestData 같은 클래스를 찾다가 "저장소에 없는데?" 하고 멈추게 되면, 이름 끝이 Data이거나 …Record인 메시지 클래스는 생성된 것이라고 기억해 두면 됩니다.
Java와 Scala
Kafka는 원래 브로커를 Scala로 짰습니다. 지금은 본체(src/main)의 Scala가 29,712줄로 전체의 4%쯤이고, 그것도 core(25,787줄)와 streams/streams-scala(3,925줄, Streams의 Scala용 API) 두 곳에만 있습니다. AGENTS.md의 폴더 표는 core를 이렇게 설명합니다.
Broker runtime, log, replication, request handling (gradually being removed along with Scala code)
"Scala 코드와 함께 점점 없어지는 중"이라는 뜻입니다. 실제로 로그(UnifiedLog, LogSegment)는 이미 storage의 Java로 옮겨졌고 core/…/kafka/log/LogManager.scala(72줄)는 껍데기만 남았습니다. 그룹 코디네이터는 group-coordinator의 Java로 다시 짜였습니다. 그래도 요청을 나눠 주는 KafkaApis(4,404줄), 파티션을 관리하는 ReplicaManager(2,577줄)와 Partition(1,856줄), 네트워크의 SocketServer(1,695줄)는 아직 Scala입니다. 레코드의 길 한가운데가 Scala라서, 이 연재에는 Scala 코드가 계속 나옵니다. 반대로 core의 테스트에는 Scala가 102,110줄이나 남아 있어서, 저장소 전체로 보면 Scala의 대부분은 테스트입니다.
의존 방향으로 보면
모듈이 서로 무엇을 가져다 쓰는지를 build.gradle의 implementation project(…)로 따라가면 이렇게 쌓입니다.
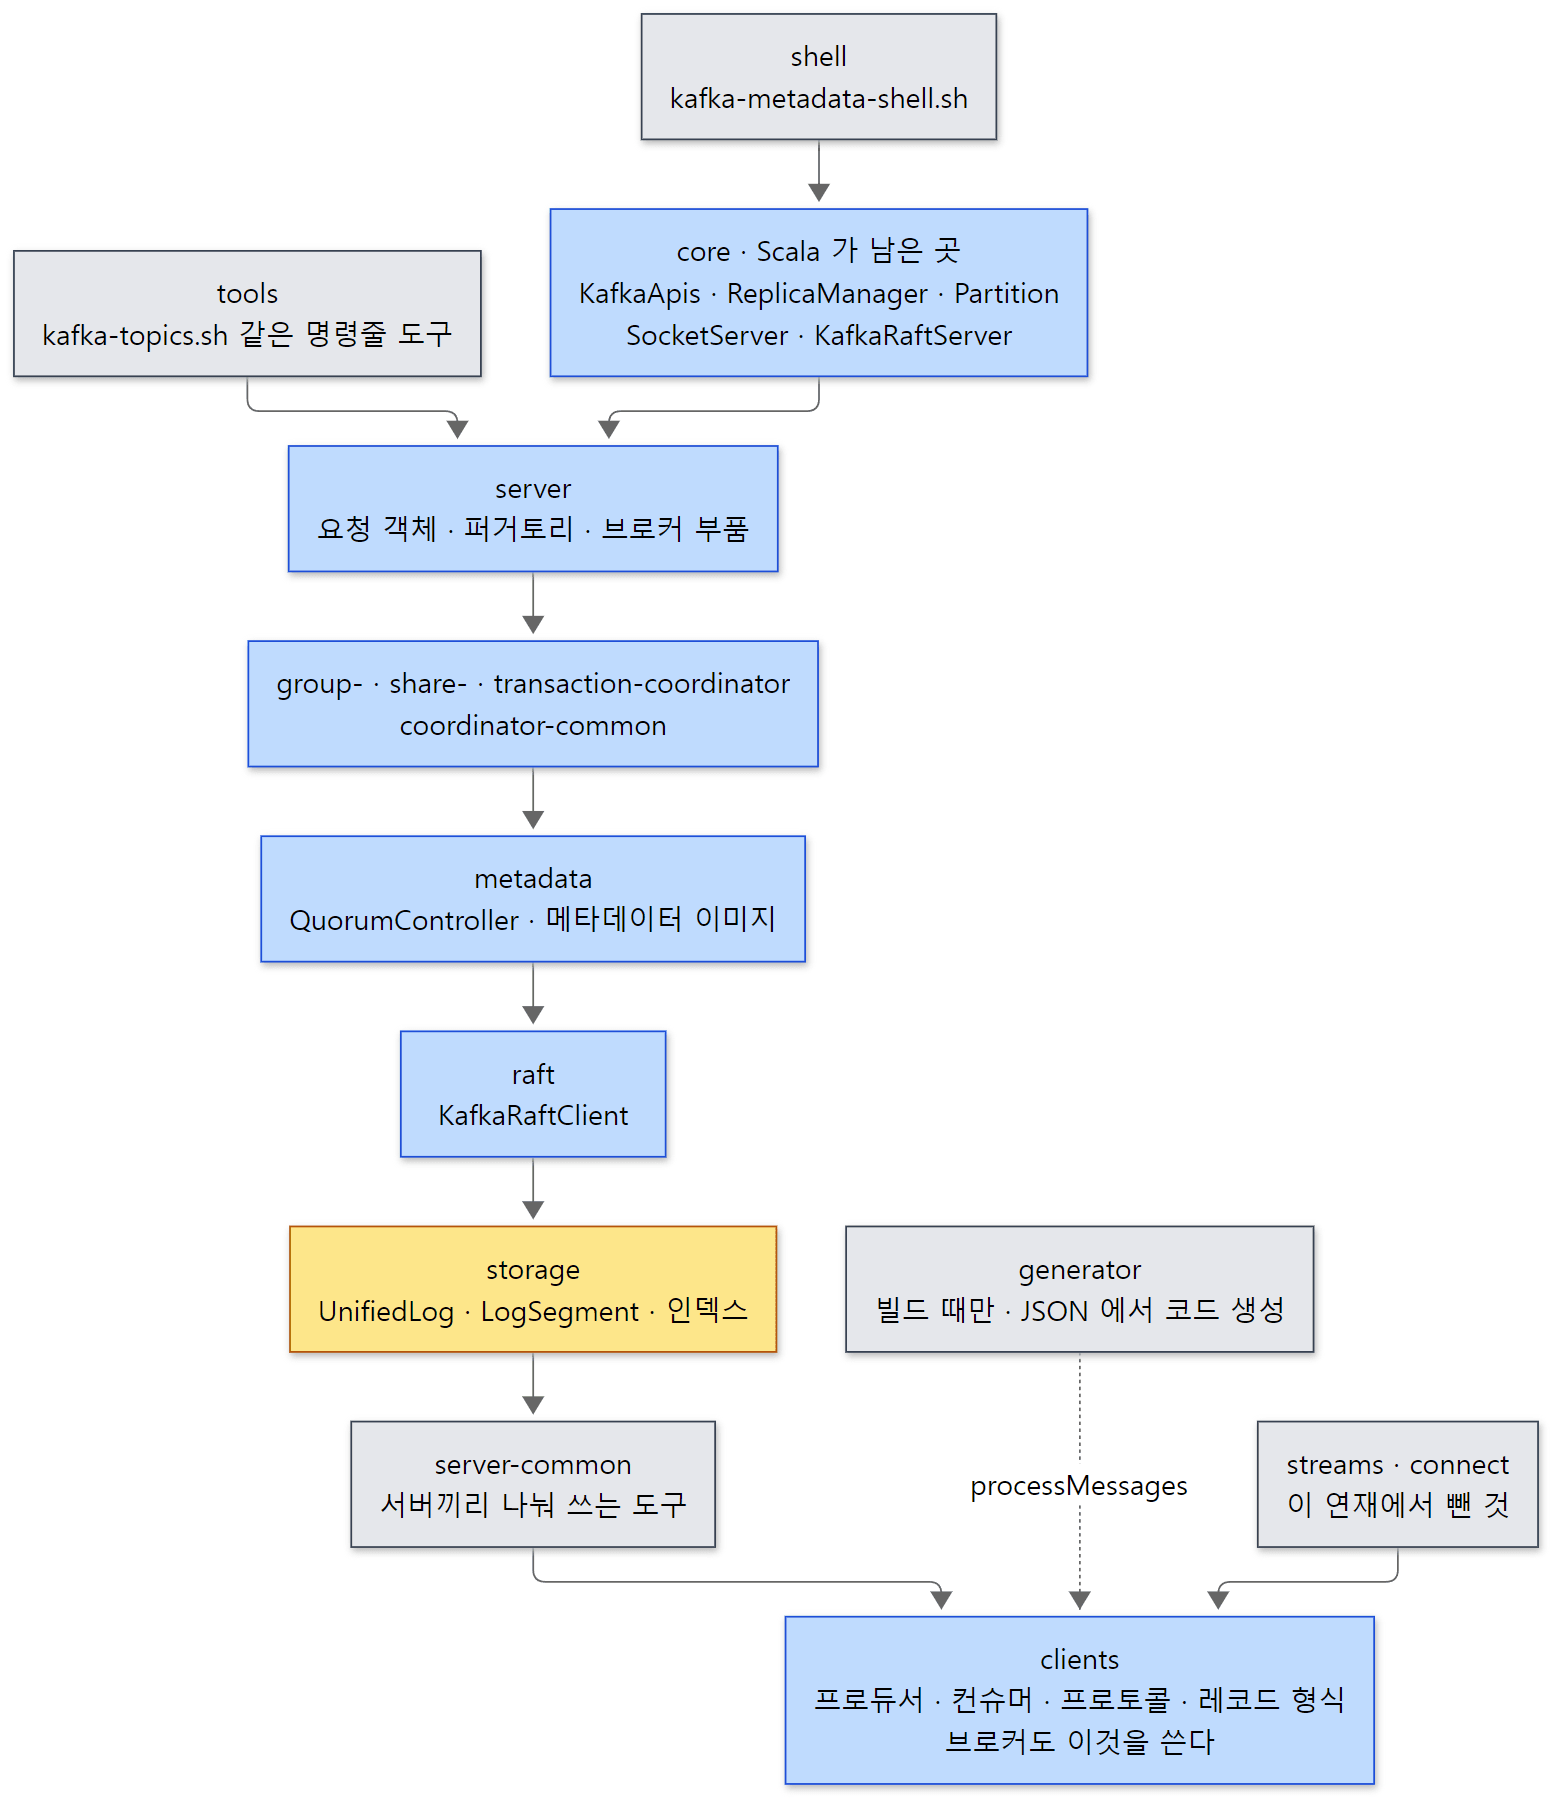 모듈 지도. 화살표는 "가져다 쓴다"(빌드 의존)의 큰 방향입니다. 실제로는 서버 쪽 모듈이 모두
clients를 직접 쓰고, 건너뛰는 의존도 많습니다.
이 그림에서 두 가지를 기억해 두면 됩니다.
첫째, 브로커도 clients를 씁니다. 이름 때문에 "클라이언트 라이브러리"로만 보이지만, 프로토콜 클래스(ApiKeys, 생성된 …Data), 레코드 형식(MemoryRecords), 논블로킹 네트워크(Selector, KafkaChannel)가 모두 여기 있고 브로커가 그대로 가져다 씁니다. 그래서 프로듀서가 만든 배치를 브로커가 같은 클래스로 읽고, 디스크에 거의 그대로 씁니다(6편). 브로커의 네트워크 계층이 클라이언트와 같은 Selector를 쓰는 것은 4편에서 봅니다.
둘째, core가 모든 것을 묶습니다. server, storage, raft, metadata, 코디네이터들은 서로 모르는 부분이 많고, 그것들을 만들어 서로 잇는 일(BrokerServer, ControllerServer)은 core가 합니다. 무엇이 어떤 순서로 만들어지는지는 2편에서 봅니다.
이 연재가 오래 머물 파일
| 파일 | 줄 수 | 다루는 편 |
|---|---|---|
clients/…/producer/KafkaProducer.java |
1,837 | 5편 |
clients/…/producer/internals/RecordAccumulator.java |
1,500 | 5편 |
clients/…/producer/internals/Sender.java |
1,144 | 5편 |
core/…/network/SocketServer.scala |
1,695 | 4편 |
core/…/server/KafkaApis.scala |
4,404 | 4·6·8편 |
core/…/server/ReplicaManager.scala |
2,577 | 6·8·9편 |
core/…/cluster/Partition.scala |
1,856 | 6·9편 |
storage/…/log/UnifiedLog.java |
2,806 | 6·7·9편 |
storage/…/log/LogSegment.java |
902 | 7·8편 |
raft/…/raft/KafkaRaftClient.java |
4,185 | 10편 |
metadata/…/controller/QuorumController.java |
2,245 | 10편 |
group-coordinator/…/group/GroupMetadataManager.java |
10,188 | 11편 |
GroupMetadataManager.java는 한 파일이 1만 줄을 넘습니다. 이런 파일은 처음부터 읽지 않고, 앱에서 보던 동작 하나(예: "컨슈머가 하나 더 붙으면 무슨 일이 생기나")에서 출발해 그 경로만 따라갑니다.
헷갈리기 쉬운 곳
이름이 같은 파일이 두 벌 있습니다. core/src/main/scala/kafka/network/SocketServer.scala가 Acceptor·Processor 스레드의 본체이고, server/src/main/java/org/apache/kafka/network/SocketServer.java는 상수와 도우미 몇 개만 든 작은 Java 클래스입니다. Scala에서 Java로 옮기는 중이라 이런 쌍이 여럿 있습니다. 검색 결과에서 파일 이름만 보고 열면 엉뚱한 쪽을 읽게 됩니다. 경로의 모듈 이름(core인지 server인지)과 확장자를 같이 봐야 합니다.
폴더 이름과 패키지 이름이 다릅니다. server 모듈 안에 org.apache.kafka.network, org.apache.kafka.server 같은 패키지가 있고, storage 모듈의 로그 클래스는 org.apache.kafka.storage.internals.log 패키지입니다. core의 Scala는 kafka.server, kafka.network처럼 org.apache가 없는 짧은 패키지를 씁니다. 스택 트레이스에서 kafka.server.…로 시작하면 core의 Scala, org.apache.kafka.…로 시작하면 Java 모듈이라고 보면 대체로 맞습니다.
4. 레코드 하나가 지나는 큰 길
연재의 3편부터 9편까지는 레코드 하나가 지나가는 길을 순서대로 따라갑니다. 길이 길어서 그림을 둘로 나눴습니다. 먼저 보내서 디스크에 쓰기까지입니다.
쓰는 길 — send()에서 .log 파일까지
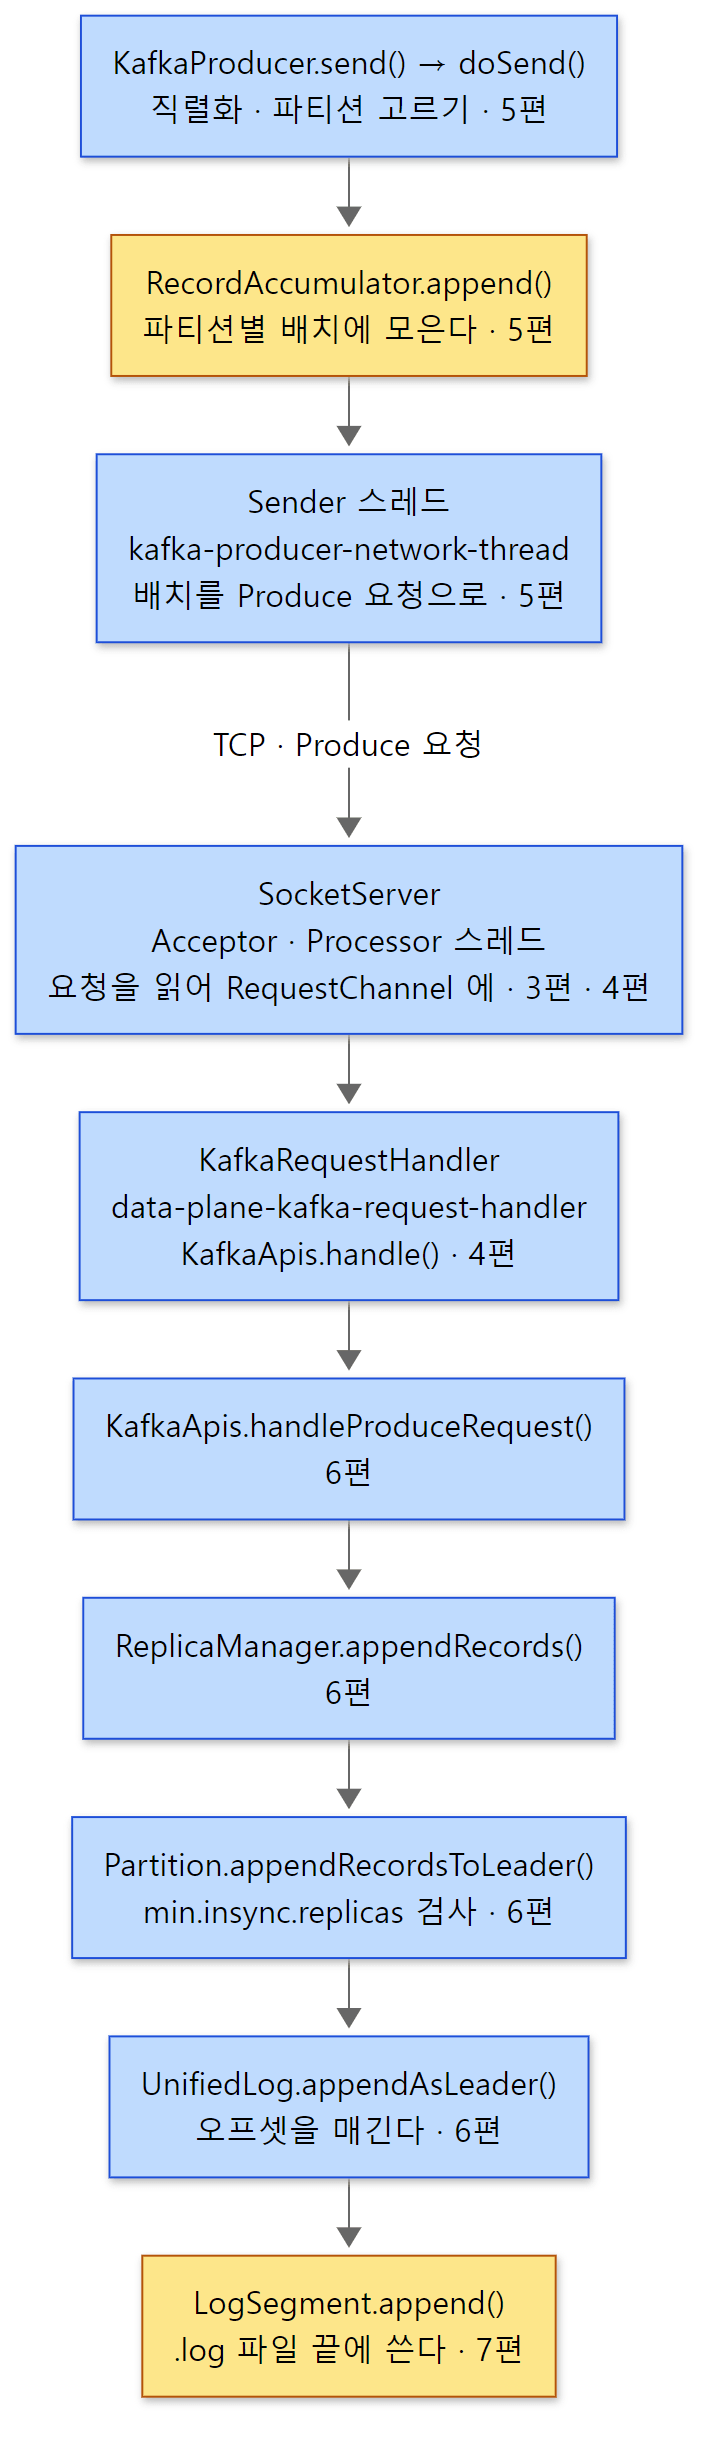 레코드 하나가 디스크에 쓰이기까지. 위 세 칸은 앱 안(클라이언트), 나머지는 브로커입니다. 노란 칸은 레코드가 잠시 머무는 곳(메모리의 배치, 디스크의 파일)입니다.
그림은 큰 칸만 그렸습니다. 실제로는 KafkaApis.handleProduceRequest()와 ReplicaManager.appendRecords() 사이에 ReplicaManager.handleProduceAppend()가, appendRecords()와 Partition 사이에 같은 ReplicaManager의 appendRecordsToLeader()·appendToLocalLog()가 더 있고, UnifiedLog와 LogSegment 사이에는 LocalLog.append()가 있습니다. 앱에서 보던 설정과 이어 보면 이렇습니다.
| 단계 | 앱·설정에서 보던 것 | 다루는 편 |
|---|---|---|
| 요청·응답의 모양 | acks가 선에 -1로 실리는 것, 클라이언트·브로커 판이 달라도 통하는 것 |
3편 |
| 브로커 네트워크·요청 처리 스레드 | num.network.threads, num.io.threads, queued.max.requests |
4편 |
| 프로듀서 | linger.ms, batch.size, buffer.memory, max.in.flight.requests.per.connection, 콜백 |
5편 |
| 브로커가 받아 쓰기 | acks, min.insync.replicas, compression.type |
6편 |
| 디스크 | log.segment.bytes, log.retention.hours, cleanup.policy=compact |
7편 |
복제와 읽기 — 하이 워터마크를 넘어 poll()까지
디스크에 썼다고 끝이 아닙니다. acks=all이면 팔로워가 받아 갈 때까지 응답이 기다리고, 컨슈머는 팔로워가 받아 간 곳까지만 읽습니다.
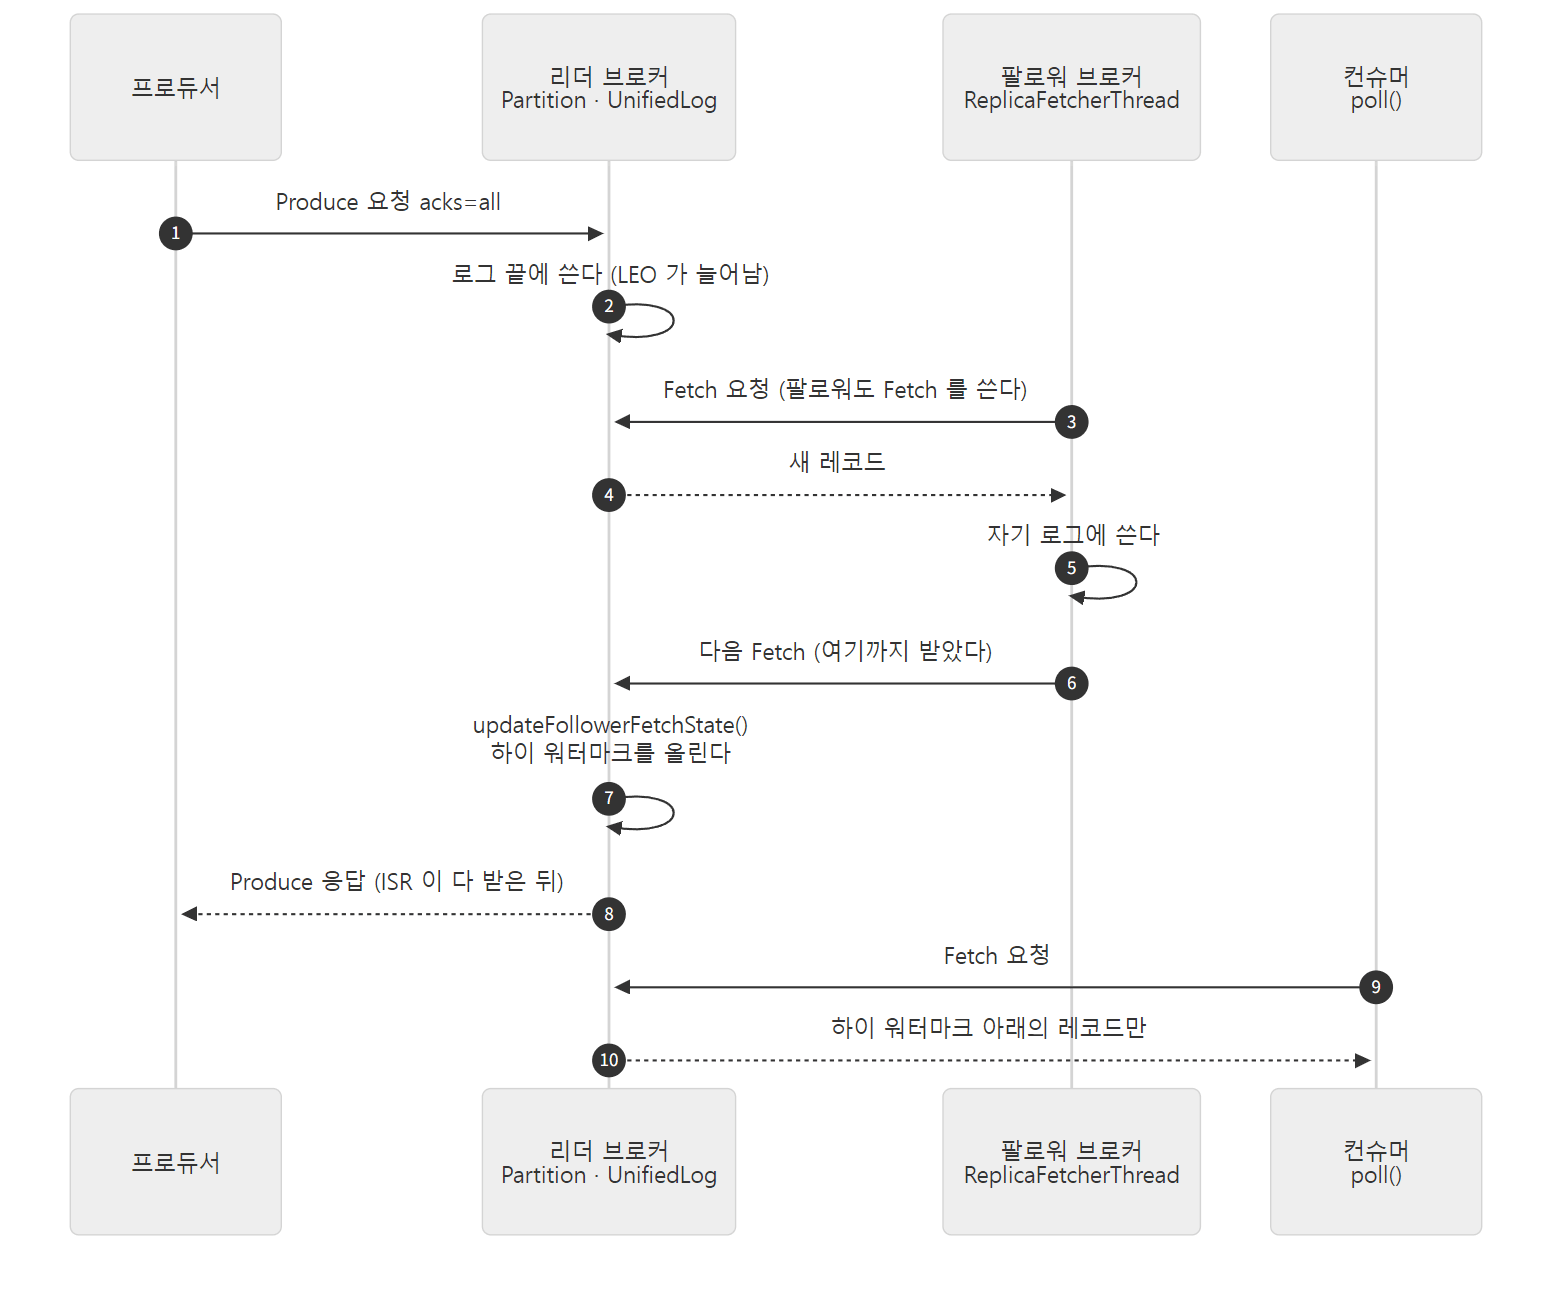 복제와 읽기. 팔로워도 컨슈머와 같은 Fetch 요청으로 레코드를 가져갑니다(3·9).
번호마다 소스의 자리를 짚어 두면 이렇습니다.
- 3·6 팔로워의 Fetch. 팔로워 브로커에는
ReplicaFetcherThread-<번호>-<리더 브로커 id>라는 이름의 스레드가 생깁니다(ReplicaFetcherManager.scala 42행). 이 스레드는 컨슈머와 같은 Fetch 요청을 리더에게 보냅니다. 리더 쪽에서는Partition.fetchRecords()가 "팔로워가 보낸 Fetch"이면 읽은 뒤updateFollowerFetchState()를 부릅니다(Partition.scala 1301–1325행). 팔로워가 "다음엔 오프셋 N부터 달라"고 하는 것 자체가 "N 앞까지는 받았다"는 보고입니다(9편). - 7 하이 워터마크 올리기.
updateFollowerFetchState()안에서 ISR을 넓힐지 보고(maybeExpandIsr) 하이 워터마크를 올릴 수 있는지 봅니다(maybeIncrementLeaderHW)(Partition.scala 769행부터). - 8
acks=all의 기다림. 응답을 보낼 수 있는지는Partition.checkEnoughReplicasReachOffset()이 정하는데, 조건이leaderLog.highWatermark >= requiredOffset입니다(Partition.scala 949행부터). 조건이 채워질 때까지 요청은DelayedProduce라는 객체로 퍼거토리(purgatory, 조건이 채워지거나 시간이 다 될 때까지 요청을 붙잡아 두는 대기실)에 들어가 있습니다(9편). - 10 컨슈머는 하이 워터마크까지. Fetch를 보낸 쪽이 컨슈머이면
FetchIsolation.of()가HIGH_WATERMARK(트랜잭션 격리read_committed이면TXN_COMMITTED)를, 팔로워이면LOG_END를 고릅니다(FetchIsolation.java 31–39행). 같은 Fetch라도 팔로워는 로그 끝까지, 컨슈머는 하이 워터마크까지 읽는 이유입니다. 읽기 경로는 8편, 트랜잭션 격리는 12편에서 봅니다.
그리고 이 모든 일의 바탕에는 "토픽 path의 파티션 0의 리더는 브로커 1이고, ISR은 1·2·3"이라는 메타데이터가 있습니다. 그것을 정하고 퍼뜨리는 것이 컨트롤러와 KRaft이고(10편), 컨슈머 여럿이 파티션을 나눠 맡게 하는 것이 그룹 코디네이터입니다(11편).
코드에서 두 군데만 미리 보기
하나, send()가 레코드를 내려놓는 곳. KafkaProducer.doSend()의 가운데입니다.
            // Append the record to the accumulator.  Note, that the actual partition may be
            // calculated there and can be accessed via appendCallbacks.topicPartition.
            RecordAccumulator.RecordAppendResult result = accumulator.append(record.topic(), partition, timestamp, serializedKey,
                    serializedValue, headers, appendCallbacks, remainingWaitMs, nowMs, cluster);
            assert appendCallbacks.getPartition() != RecordMetadata.UNKNOWN_PARTITION;
            // ...
            if (result.batchIsFull || result.newBatchCreated) {
                log.trace("Waking up the sender since topic {} partition {} is either full or getting a new batch", record.topic(), appendCallbacks.getPartition());
                this.sender.wakeup();
            }
            return result.future;
clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java 1233–1251행 (줄인 곳은 // ...로 표시)
send()는 네트워크로 아무것도 보내지 않습니다. 직렬화한 키·값을 RecordAccumulator(파티션별 배치를 쌓아 두는 메모리 버퍼)에 넣고, 배치가 가득 찼거나 새 배치를 열었으면 Sender 스레드를 깨우고(sender.wakeup()), Future를 돌려줍니다. 실제로 보내는 것은 생성자에서 만든 kafka-producer-network-thread | <client.id> 스레드입니다(KafkaProducer.java 521행). 배치가 꽉 차지 않아도 linger.ms가 지나면 보내는데, 그 판단은 RecordAccumulator.ready()에 있습니다(5편).
둘, 브로커가 요청을 나눠 주는 곳. 요청 처리 스레드는 큐에서 요청을 하나 꺼내 KafkaApis.handle()을 부릅니다(KafkaRequestHandler.scala 167행). 이 연재의 첫 Scala 코드입니다.
  override def handle(request: Request, requestLocal: RequestLocal): Unit = {
    // ...
      request.header.apiKey match {
        case ApiKeys.PRODUCE => handleProduceRequest(request, requestLocal)
        case ApiKeys.FETCH => handleFetchRequest(request)
        case ApiKeys.LIST_OFFSETS => handleListOffsetRequest(request)
        case ApiKeys.METADATA => handleTopicMetadataRequest(request)
        // ...
core/src/main/scala/kafka/server/KafkaApis.scala 157–178행 (줄인 곳은 // ...로 표시)
Scala 읽는 법 —
def handle(request: Request, …): Unit은 메서드 선언으로, 매개변수는이름: 타입순서이고: Unit은 Java의void(돌려주는 값 없음)입니다.override는 Java의@Override와 같습니다.x match { case A => … }는 Java의switch와 비슷한데, 값마다case 값 => 할 일을 적습니다.
요청 머리(header)의 apiKey가 PRODUCE(2절의 JSON에서 본 "apiKey": 0)이면 handleProduceRequest()로, FETCH이면 handleFetchRequest()로 갑니다. Produce와 Fetch, 단 두 가지가 위 두 그림의 거의 전부입니다. 프로듀서도, 팔로워도, 컨슈머도 이 match의 처음 두 줄로 들어옵니다.
예제: 정말 이 길로 지나가나
그림이 맞는지 두 가지로 확인했습니다. 하나는 스레드입니다. 그림의 칸들이 실제로 어떤 이름의 스레드에서 도는지 클라이언트와 서버 양쪽에서 봅니다. 다른 하나는 디스크입니다. 레코드가 정말 세그먼트 파일에 배치로 쓰였는지 봅니다. 예제 클라이언트입니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 레코드 셋을 보내고(프로듀서) 다시 읽어서(컨슈머), 각 단계가 어느 스레드에서 일어나는지 찍는다.
import java.time.Duration;
import java.util.List;
import java.util.Properties;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.serialization.StringDeserializer;
import org.apache.kafka.common.serialization.StringSerializer;

public class Path {
    public static void main(String[] args) throws Exception {
        String topic = "path";

        Properties p = new Properties();
        p.put("bootstrap.servers", "localhost:9092");
        p.put("client.id", "path-demo");
        p.put("key.serializer", StringSerializer.class.getName());
        p.put("value.serializer", StringSerializer.class.getName());
        try (KafkaProducer<String, String> producer = new KafkaProducer<>(p)) {
            for (int i = 1; i <= 3; i++) {
                String value = "record-" + i;
                // send() 는 레코드를 버퍼에 넣고 바로 돌아온다 — 실제 전송은 다른 스레드가 한다
                producer.send(new ProducerRecord<>(topic, value), (md, e) -> {
                    // 콜백: 브로커의 응답이 왔을 때 불린다
                    System.out.printf("ack     %s -> offset %d (callback thread: %s)%n",
                            value, md.offset(), Thread.currentThread().getName());
                });
                System.out.printf("send()  %s returned  (caller thread: %s)%n",
                        value, Thread.currentThread().getName());
            }
            producer.flush(); // 버퍼에 남은 것을 다 보내고 응답을 기다린다
        }

        Properties c = new Properties();
        c.put("bootstrap.servers", "localhost:9092");
        c.put("key.deserializer", StringDeserializer.class.getName());
        c.put("value.deserializer", StringDeserializer.class.getName());
        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(c)) {
            // 그룹 없이 파티션 0 을 직접 맡고 처음부터 읽는다
            TopicPartition tp = new TopicPartition(topic, 0);
            consumer.assign(List.of(tp));
            consumer.seekToBeginning(List.of(tp));
            int got = 0;
            long deadline = System.currentTimeMillis() + 15_000;
            while (got < 3 && System.currentTimeMillis() < deadline) {
                for (ConsumerRecord<String, String> r : consumer.poll(Duration.ofMillis(500))) {
                    System.out.printf("poll()  %s at offset %d (thread: %s)%n",
                            r.value(), r.offset(), Thread.currentThread().getName());
                    got++;
                }
            }
        }
    }
}
run.sh는 파티션 하나짜리 토픽 path를 만들고 이 파일을 java -cp "$KAFKA_HOME/libs/*" Path.java로 돌립니다(JDK 11부터는 .java 파일 하나를 컴파일 없이 바로 실행할 수 있습니다). 그다음 서버 프로세스의 스레드 덤프를 jstack으로 떠서 그림에 나오는 스레드만 골라 이름의 숫자를 N으로 접어 세고, 데이터 폴더의 파일과 kafka-dump-log.sh로 세그먼트 내용을 봅니다. 출력입니다(토픽을 만들 때의 Created topic path.와 마지막에 서버를 끄는 부분은 뺐습니다).
=== java client (Path.java)
send()  record-1 returned  (caller thread: main)
send()  record-2 returned  (caller thread: main)
send()  record-3 returned  (caller thread: main)
ack     record-1 -> offset 0 (callback thread: kafka-producer-network-thread | path-demo)
ack     record-2 -> offset 1 (callback thread: kafka-producer-network-thread | path-demo)
ack     record-3 -> offset 2 (callback thread: kafka-producer-network-thread | path-demo)
poll()  record-1 at offset 0 (thread: main)
poll()  record-2 at offset 1 (thread: main)
poll()  record-3 at offset 2 (thread: main)
=== server threads (jstack, numbers folded to N)
      3 data-plane-kafka-network-thread-N-CONTROLLER-PLAINTEXT-N
      3 data-plane-kafka-network-thread-N-PLAINTEXT-PLAINTEXT-N
     16 data-plane-kafka-request-handler-N
      1 data-plane-kafka-socket-acceptor-CONTROLLER-PLAINTEXT-N
      1 data-plane-kafka-socket-acceptor-PLAINTEXT-PLAINTEXT-N
      1 kafka-N-raft-io-thread
      1 quorum-controller-N-event-handler
threads named exactly data-plane-kafka-request-handler-0: 2
=== segment files
10485760 00000000000000000000.index
106 00000000000000000000.log
10485756 00000000000000000000.timeindex
8 leader-epoch-checkpoint
43 partition.metadata
=== dump the log segment (fields trimmed)
baseOffset: 0 lastOffset: 2 count: 3
offset: 0 payload: record-1
offset: 1 payload: record-2
offset: 2 payload: record-3
(kafka-dump-log.sh의 출력은 필요한 필드만 grep으로 남겼습니다. 이 예제는 여러 번 돌렸는데, .log 파일의 크기만 실행에 따라 106바이트 또는 108바이트로 달랐고 나머지는 매번 같았습니다. 레코드마다 배치 첫 레코드와의 시각 차이(TimestampDelta)를 가변 길이 정수로 적기 때문에(DefaultRecord.java 180행), send() 사이의 간격에 따라 레코드가 1바이트씩 길어질 수 있습니다.) 그림과 맞춰 보면 이렇습니다.
send()는 바로 돌아옵니다. 세 번의send()가 모두main스레드에서 돌아온 뒤에 응답(ack)이 옵니다. 그리고 콜백은main이 아니라kafka-producer-network-thread | path-demo에서 불립니다. 그림의 맨 위 세 칸 가운데send()·RecordAccumulator는 내 스레드, Sender는 다른 스레드라는 것이 그대로 보입니다. 스레드 이름 끝의path-demo는client.id설정값입니다.- 브로커 쪽 스레드. 리스너(
PLAINTEXT9092,CONTROLLER9093)마다 Acceptor(data-plane-kafka-socket-acceptor-…) 하나와 Processor(data-plane-kafka-network-thread-…) 셋이 있습니다. 셋인 것은num.network.threads가 3이기 때문입니다(설정 파일에도 3이 적혀 있고, 기본값도 SocketServerConfigs.java 152행의 3입니다). Processor의 이름은 SocketServer.scala 746행에서 붙습니다. Tomcat의 Acceptor·Poller·작업 스레드(Tomcat 5편)와 닮은 이 구조는 4편에서 봅니다. - KRaft도 스레드로 보입니다.
kafka-1-raft-io-thread(Raft 클라이언트)와quorum-controller-1-event-handler(컨트롤러의 이벤트 처리 스레드)입니다. 컨트롤러가 이벤트 큐 위의 스레드 하나로 돈다는 것은 10편의 주제입니다. - 배치 하나에 세 레코드.
.log파일은 106바이트(위 괄호의 설명대로 108바이트일 때도 있습니다)이고, 그 안에baseOffset: 0 lastOffset: 2 count: 3인 배치 하나가 있습니다. 세 번의send()가 프로듀서 안에서 배치 하나로 묶여 한 번의 Produce 요청으로 갔고, 브로커가 그 배치를 그대로 썼다는 뜻입니다. 이 기준 커밋에서linger.ms의 기본값이 5(밀리초)여서(ProducerConfig.java 445행) 잇달아 부른send()가 한 배치에 모인 것입니다. 이 설정을 바꿔 배치가 어떻게 달라지는지는 5편, 배치의 바이트 모양은 6편에서 봅니다. - 세그먼트 파일 이름은 첫 오프셋.
00000000000000000000은 이 세그먼트의 첫 오프셋 0을 20자리로 적은 것입니다. 세그먼트가 커져서 다음 파일로 넘어가면 그 파일의 이름은 그 파일의 첫 오프셋이 됩니다(7편).
헷갈리기 쉬운 곳
요청 처리 스레드가 8개가 아니라 16개이고, 이름이 겹칩니다. num.io.threads는 8인데(ServerConfigs.java 60행의 기본값도 8) data-plane-kafka-request-handler-N이 16개 보이고, 이름이 정확히 …-handler-0인 스레드가 둘입니다. 이 예제의 서버는 브로커와 컨트롤러를 겸하는데, 브로커는 KafkaApis용 풀을(BrokerServer.scala 518–525행), 컨트롤러는 ControllerApis용 풀을(ControllerServer.scala 298–305행) 각각 config.numIoThreads개씩 만듭니다. 그런데 스레드 이름은 두 풀 모두 "data-plane-kafka-request-handler-" + id로 같습니다(KafkaRequestHandler.scala 275행). 스레드 덤프에서 이 이름만 보고는 어느 쪽 풀인지 알 수 없으니, 스택에 KafkaApis가 있는지 ControllerApis가 있는지로 가려야 합니다.
.index 파일이 10MB인데 비어 있습니다. 레코드 셋을 썼을 뿐인데 .index가 10,485,760바이트, .timeindex가 10,485,756바이트입니다. 인덱스 파일은 처음부터 최대 크기(log.index.size.max.bytes, 기본값 10 * 1024 * 1024 — ServerLogConfigs.java 93행)로 잡아 두고 메모리에 매핑해 씁니다. .timeindex가 4바이트 작은 것은 항목 하나가 12바이트라 크기를 12의 배수로 깎았기 때문입니다(AbstractIndex.java 113행, TimeIndex.java 56행). 세그먼트를 닫을 때 실제 크기로 줄입니다. 이 부분은 7편에서 봅니다.
이 예제에는 팔로워가 없습니다. 서버가 하나라 복제 그림의 3~7번은 일어나지 않습니다. ISR이 자기 하나뿐이라 쓰자마자 하이 워터마크가 올라갑니다. 브로커 셋을 띄워 팔로워와 ISR이 움직이는 것은 2편과 9편에서 봅니다.
5. 어떻게 읽나 — AI와 함께, 그러나 소스로 확인하며
읽는 순서
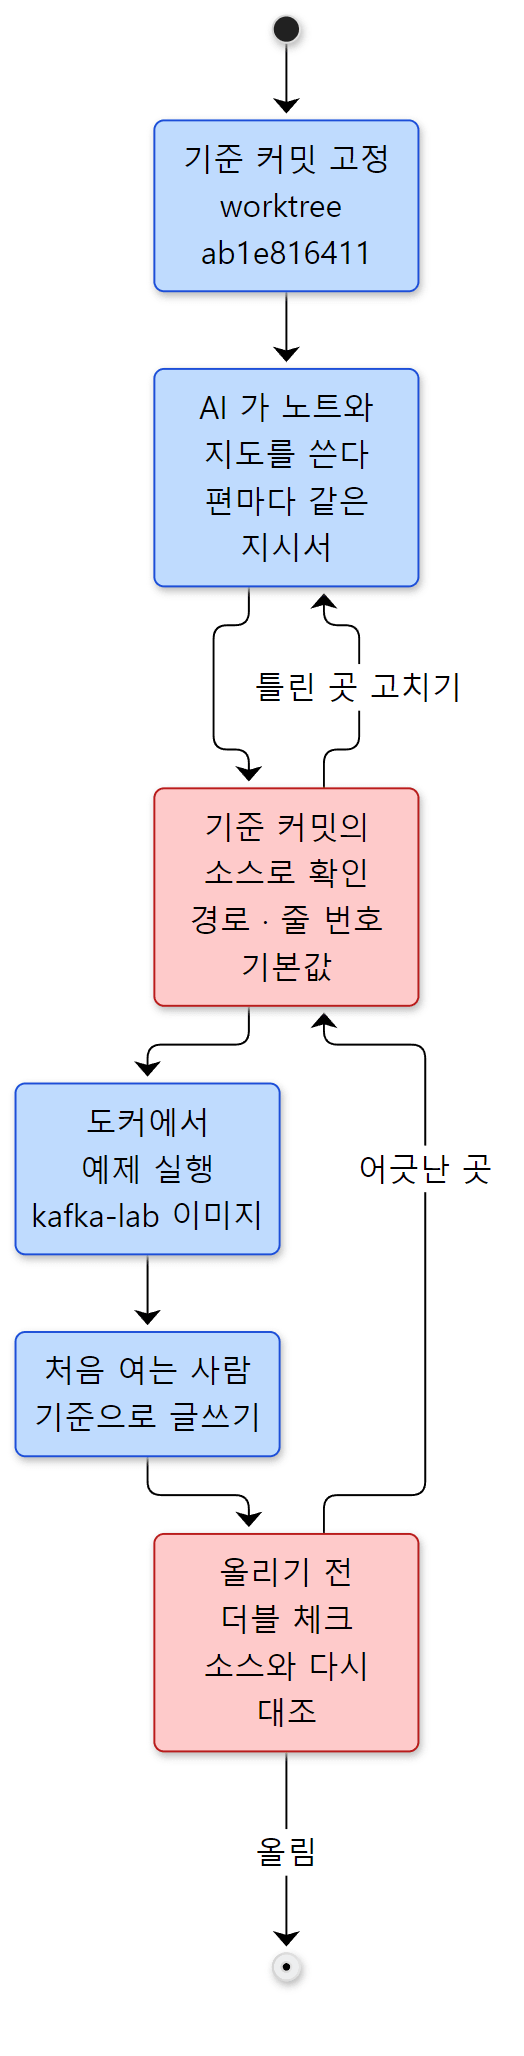 한 편을 읽고 쓰는 순서. 파란 칸은 절차이고, 빨간 칸은 AI가 쓴 내용에서 틀린 곳을 걸러 내는 단계입니다.
Spring·httpd·Tomcat 연재와 원칙은 같습니다. 전체를 한 번에 읽지 않고, 지도에서 질문 하나를 골라 그 질문에 답하는 데 필요한 코드만 깊게 읽습니다. 이 연재에서는 그 질문 하나가 곧 글 한 편입니다.
- 기준 커밋을 고정합니다. 위 2절의 worktree입니다. 줄 번호가 흔들리지 않아야 AI가 쓴 근거를 검증할 수 있습니다.
- AI가 노트와 지도를 씁니다. 연재 12편의 구성, 편마다 출발점이 될 클래스와 예제 제안이 이렇게 만들어졌습니다. 편마다 같은 지시서(무엇을 읽고, 어떤 형식으로, 어떤 근거를 달아 쓰는지)를 주고 AI 작업 하나에 한 편씩 맡겼습니다.
- 기준 커밋의 소스로 다시 확인합니다. 지시서에 적은 클래스는 말 그대로 출발점일 뿐이고, 글에 싣는 것은 소스에서 직접 확인한 것만입니다. Kafka는 클래스가 Scala에서 Java 모듈로 많이 옮겨 다녔기 때문에, 경로는 매번
git ls-files로 찾고 설정 기본값은…Config.java의define(…)에서 읽습니다. - 예제를 실제로 돌립니다. 위 4절처럼 글의 주장 하나를 눈으로 확인하는 작은 예제를 컨테이너에서 돌리고, 출력을 그대로 싣습니다.
- 올리기 전에 한 번 더 확인합니다. 글을 다 쓰면 소스를 기준으로 코드 블록, 줄 번호, 단정한 사실, 예제 출력을 처음부터 다시 대조합니다. 이 확인을 거치지 않은 글은 올리지 않습니다.
이번 글에서 확인하다 걸린 것
3단계가 왜 필요한지는 이 글을 쓰는 동안에도 드러났습니다.
- "메시지 스키마 JSON 204개". 지시서에는 이렇게 적혀 있었는데,
clients/src/main/resources/common/message/에 든 파일 204개 가운데 하나는README.md였습니다. JSON은 203개이고, 빌드 로그의processed 203 Kafka message JSON file(s)와도 맞습니다. 폴더의 파일 수를 그대로 센 것입니다. - "Java 11로 컴파일하는 것은
clients와streams".build.gradle의modulesNeedingJava11을 열어 보면generator와 Streams의 하위 모듈들,test-common:test-common-util도 들어 있습니다.AGENTS.md도 "11+ forclients,generator, andstreams"라고 적고 있습니다. - 크기를 "생성 코드 제외"로만 세면 빠지는 것. 3절의 표는 저장소의 파일만 셌는데, 생성된 소스를 따로 세어 보니
clients에서만 18만 줄이 넘었습니다. 노트의 숫자만 옮겼다면 "clients는 20만 줄"이라고만 쓰고 지나갔을 것입니다. - 요청 처리 스레드 16개. 지시서는 스레드 이름으로 구성요소를 세어 보라고만 했습니다. 실제로 세어 보니
num.io.threads의 두 배였고, 소스를 따라가 보니 브로커와 컨트롤러의 풀이 같은 이름을 쓰고 있었습니다(4절의 "헷갈리기 쉬운 곳"). 숫자를 실제로 세지 않았다면 "요청 처리 스레드는num.io.threads개"라고 쓰고 말았을 것입니다.
저장소 안의 AI 안내문
Kafka 저장소 맨 위에도 Tomcat처럼 AGENTS.md가 있습니다. git 기록을 보면 2026-06-12에 보안 모델 문서로 안내하는 짧은 파일로 처음 생겼고(a5c31c4ac6, "MINOR: A starting point for a formal security model"), 2026-06-18에 폴더 표·빌드 명령·코드 규칙이 크게 더해졌으며(ca0c503be9, "MINOR: adding AGENTS.md"), 2026-10-10에 PR 설명 지침이 더해졌습니다(3de09ca097). 첫 문단은 Tomcat의 것과 거의 같습니다.
This file is read by automated agents (security scanners, code analyzers, AI assistants) operating on this repository.
Tomcat의 AGENTS.md가 보안 모델 문서로 가는 링크 하나였던 것과 달리, Kafka의 것은 꽤 깁니다. 폴더 표(3절에서 인용한 core 설명이 여기 있습니다), 빌드·테스트 명령, 코드 규칙, 보안 안내가 들어 있습니다. 이 연재와 직접 닿는 줄이 둘 있습니다.
- "Generated code: Do not hand-edit generated RPC/message sources. Regenerate with
processMessages/processTestMessages."(136행) 2절에서 본 생성 코드를 고치지 말고 JSON을 고치라는 안내입니다. 거꾸로 말하면, AI가ProduceRequestData.java의 줄 번호를 말하면 그것은 저장소에 없는 파일의 줄 번호이니 어디서 생성한 것인지부터 물어야 합니다. - "AI-Generated Contributions"(132행) AI 도구를 써서 만든 변경에는 커밋 끝에
Co-Authored-By나Generated-by를 달라고,CONTRIBUTING.md의 같은 이름 절로 안내합니다. 그 절은 ASF(아파치 소프트웨어 재단)의 생성 도구 지침을 근거로 듭니다.
AI가 코드를 읽고 쓰는 일이 많아지자 프로젝트가 "무엇이 사람이 정한 기준인가"를 AI에게 먼저 알려 두는 셈입니다. 이 연재의 원칙도 같습니다. AI가 쓴 것은 사람이 쓴 기준(여기서는 기준 커밋의 소스)에 대 보고 나서 씁니다.
6. 연재 지도
세 묶음
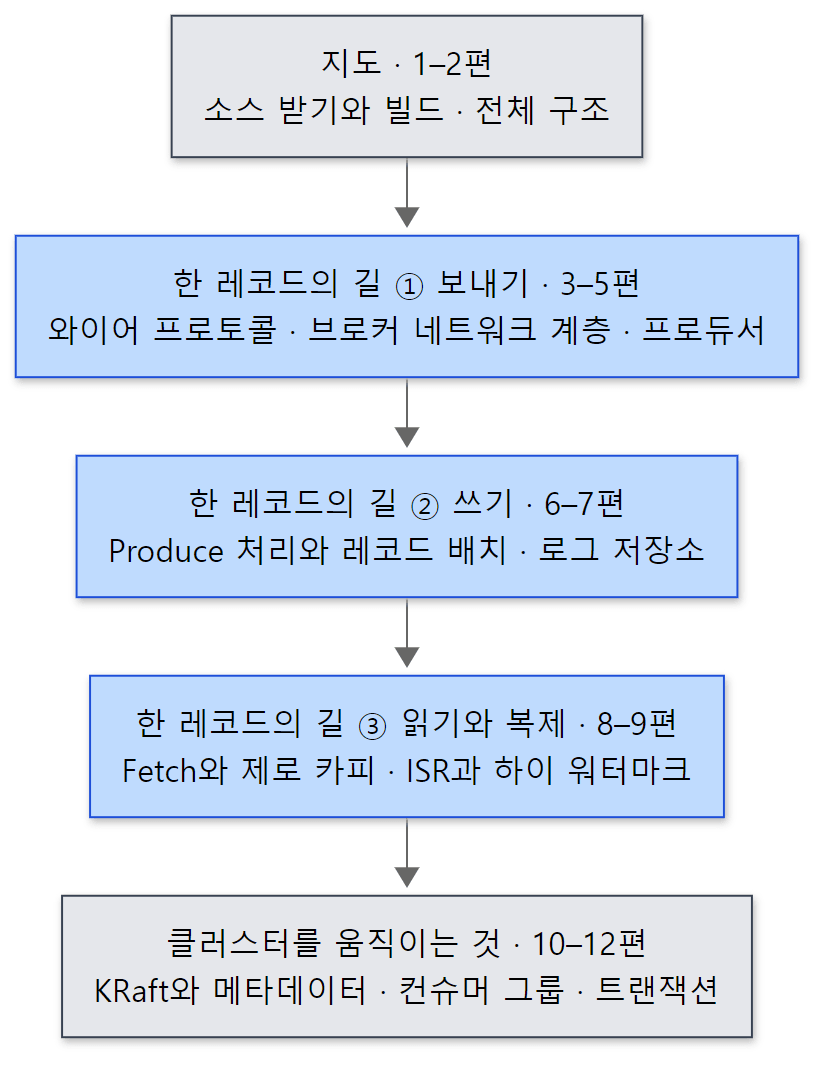 연재의 묶음. 파란 칸이 4절의 큰 길을 따라가는 연재의 중심이고, 회색 칸은 그 앞의 지도와 그 위에서 클러스터를 움직이는 부분입니다.
| 묶음 | 편 | 답하려는 질문 |
|---|---|---|
| 지도 | 1 | 어떤 소스를 어떻게 읽나 (이 글) |
| 2 | 서버 하나는 무엇으로 이루어지고, 브로커·컨트롤러·파티션은 누가 정하나 | |
| 한 레코드의 길 | 3 | 요청과 응답은 선 위에서 어떤 바이트이고, JSON에서 어떻게 만들어지나 |
| 4 | 브로커는 연결과 요청을 어떤 스레드로 나눠 처리하나 | |
| 5 | send()한 레코드는 언제, 어떤 배치로, 어느 스레드가 보내나 |
|
| 6 | 브로커는 받은 배치를 어떻게 검사하고 로그에 쓰나 | |
| 7 | 로그는 디스크에 어떤 파일로 놓이고, 언제 지워지거나 압축되나 | |
| 8 | Fetch는 어떻게 기다리고, 디스크의 바이트를 어떻게 복사 없이 보내나 | |
| 9 | 팔로워는 어떻게 따라오고, acks=all은 무엇을 기다리나 |
|
| 클러스터를 움직이는 것 | 10 | 컨트롤러는 메타데이터를 어떻게 정하고 브로커에 퍼뜨리나 |
| 11 | poll() 안에서 무슨 일이 생기고, 리밸런스는 누가 시작하나 |
|
| 12 | 멱등 프로듀서와 트랜잭션은 "정확히 한 번"을 어떻게 만드나 |
읽는 순서
번호 순서대로 읽으면 됩니다. 이 연재도 앞 연재처럼 4절의 큰 길을 따라가도록 번호를 매겼습니다. 이유는 셋입니다.
- 지도를 먼저 봅니다. 레코드의 길을 따라가다 보면 "이 객체는 누가 만들었나", "리더는 누가 정했나"가 계속 나옵니다. 2편에서 서버의 부품과 역할을 먼저 잡아 둡니다.
- 레코드의 길은 바깥에서 안으로, 그리고 다시 바깥으로 갑니다. 선 위의 바이트(3편)와 브로커의 입구(4편)에서 시작해, 프로듀서(5편)가 만든 배치가 브로커의 디스크(6·7편)에 쓰이고, 다시 읽혀(8편) 팔로워에게 복제되는(9편) 순서입니다. 위 두 그림의 순서와 같습니다.
- 클러스터를 움직이는 것은 마지막에 읽습니다. 메타데이터, 컨슈머 그룹, 트랜잭션은 모두 레코드의 길 위에 얹혀 있습니다. 메타데이터는
__cluster_metadata라는 로그에, 그룹의 오프셋은__consumer_offsets에, 트랜잭션 상태는__transaction_state에 레코드로 쓰입니다. 길을 알고 나면 "이것도 결국 로그에 쓰는 레코드"라는 눈으로 읽을 수 있습니다.
이 글에서 뺀 것
- Kafka Streams와 Kafka Connect.
streams/(Java 15만 줄 남짓)와connect/(6만 5천 줄 가까이)는clients위에 얹힌 별도의 프레임워크라 이 연재에서 다루지 않습니다. MirrorMaker(connect/mirror, 새mirror-coordinator)도 마찬가지입니다. - 공유 그룹(Share groups). 큐처럼 레코드를 나눠 받는 새 기능으로,
share-coordinator/,KafkaShareConsumer,core/src/main/java/kafka/server/share/에 있습니다. - 계층 저장소(tiered storage). 오래된 세그먼트를 원격 저장소로 옮기는 기능입니다.
storage/의Remote*클래스들입니다. - 보안과 쿼터. SASL·TLS 인증, ACL(
Authorizer), 요청량 제한(server/…/quota/)은 다루지 않습니다. 예제는 모두PLAINTEXT로 돕니다. - 관리 클라이언트와 도구.
Admin클라이언트와tools/의 명령줄 도구 본체는 예제에서 쓰기만 합니다. - **디렉터리 여러 개(JBOD)**와 디렉터리 사이 이동(
ReplicaAlterLogDirsThread). - 테스트와 성능 측정.
src/test의 98만 줄,jmh-benchmarks/, 시스템 테스트(tests/)는 동작을 확인할 때 참고로만 봅니다.
정리
| 개념 | 한 줄 요약 |
|---|---|
| 읽는 소스 | Apache Kafka 4.5.0-SNAPSHOT(trunk), 커밋 ab1e816411(2026-10-24). 본체(src/main) 3,933개 파일, 약 72만 줄 |
| trunk와 4.4.0 | trunk는 다음 판(4.5)의 개발 줄기, 안정판은 4.4 브랜치의 태그 4.4.0. 2026-08-10에 갈라졌다 |
| Java | clients·generator·streams는 --release 11, 나머지는 17. 빌드 JDK는 17·25 |
| 같은 소스 받기 | git clone 뒤 git worktree add --detach … ab1e8164…로 커밋 고정 |
| 빌드 | 도커(Temurin JDK 25)에서 ./gradlew -PcommitId=… releaseTarGz -x test → core/build/distributions/kafka_2.13-4.5.0-SNAPSHOT.tgz |
| 코드 생성 | processMessages가 JSON 스키마(clients만 203개)로 …Data 클래스를 만든다. clients의 생성 코드는 약 19만 줄 |
| 모듈 | clients(브로커도 쓴다) · core(Scala, 묶는 곳) · server · storage · raft · metadata · 코디네이터들 |
| Scala | 본체의 4%쯤, core와 streams-scala에만. 레코드의 길 한가운데(KafkaApis, ReplicaManager, Partition, SocketServer)가 아직 Scala |
| 큰 길 | send() → RecordAccumulator → Sender → SocketServer → 요청 처리 스레드 → KafkaApis → ReplicaManager → Partition → UnifiedLog → LogSegment → 팔로워 Fetch·하이 워터마크 → 컨슈머 Fetch → poll() |
| 읽는 방법 | 커밋 고정 → AI 노트 → 소스로 확인 → 예제 실행 → 글 → 더블 체크 |
다음에 볼 것
다음 글은 전체 지도입니다. 이 글에서 서버 하나가 KafkaRaftServer라는 이름으로 뜨고, 그 안에 Acceptor·Processor·요청 처리 스레드, Raft 스레드, 컨트롤러의 이벤트 스레드가 함께 도는 것을 스레드 이름으로 봤습니다. 다음 글에서는 kafka.Kafka의 main()에서 시작해 KafkaRaftServer가 process.roles에 따라 BrokerServer와 ControllerServer를 어떻게 만드는지, BrokerServer.startup()이 무엇을 어떤 순서로 만드는지, 그리고 토픽·파티션·리더·ISR을 누가 정해서 어떻게 브로커에 알리는지를 봅니다.
- 다음 글: Kafka 소스 파헤치기 2: 전체 지도 — 클라이언트, 브로커, 컨트롤러, 그리고 파티션
- 프로듀서 안쪽으로 바로 가려면: 5편: 프로듀서 내부 — send()에서 배치, 그리고 Sender 스레드까지
acks=all이 무엇을 기다리는지 바로 보려면: 9편: 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림
같은 방식으로 읽은 앞 연재도 있습니다. Tomcat 소스 파헤치기 1편은 이 글과 같은 틀로 쓴 첫 글입니다. 연결을 받는 스레드와 요청을 처리하는 스레드를 나누는 Tomcat의 구조(Tomcat 5편)는 Kafka 브로커의 Acceptor·Processor·요청 처리 스레드와 많이 닮았고, 4편에서 둘을 나란히 놓고 봅니다. 이벤트 루프로 연결을 다루는 서버는 nginx 소스 파헤치기에서, 로그(redo 로그)와 복제로 데이터를 지키는 데이터베이스는 MariaDB 소스 파헤치기에서 다룹니다. 그리고 2절에서 본 processMessages 같은 태스크가 Gradle 안에서 어떻게 계획되고 실행되는지는 바로 앞 연재인 Gradle 소스 파헤치기에서 읽을 수 있습니다.