이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 열한 번째 글입니다. 8편에서 브로커가 Fetch 요청에 레코드를 내주는 길을 봤고, 10편에서 컨트롤러가 클러스터의 장부(메타데이터 로그)를 어떻게 지키는지 봤습니다. 이번에는 레코드를 받는 쪽, 컨슈머로 갑니다. 다만 Fetch 로 바이트를 받아 오는 일은 8편에서 이미 봤으니, 이 글은 컨슈머만의 문제 — "여러 컨슈머가 파티션을 어떻게 나눠 갖고, 한 명이 들어오거나 나가면 누가 다시 나누나" — 에 집중합니다.
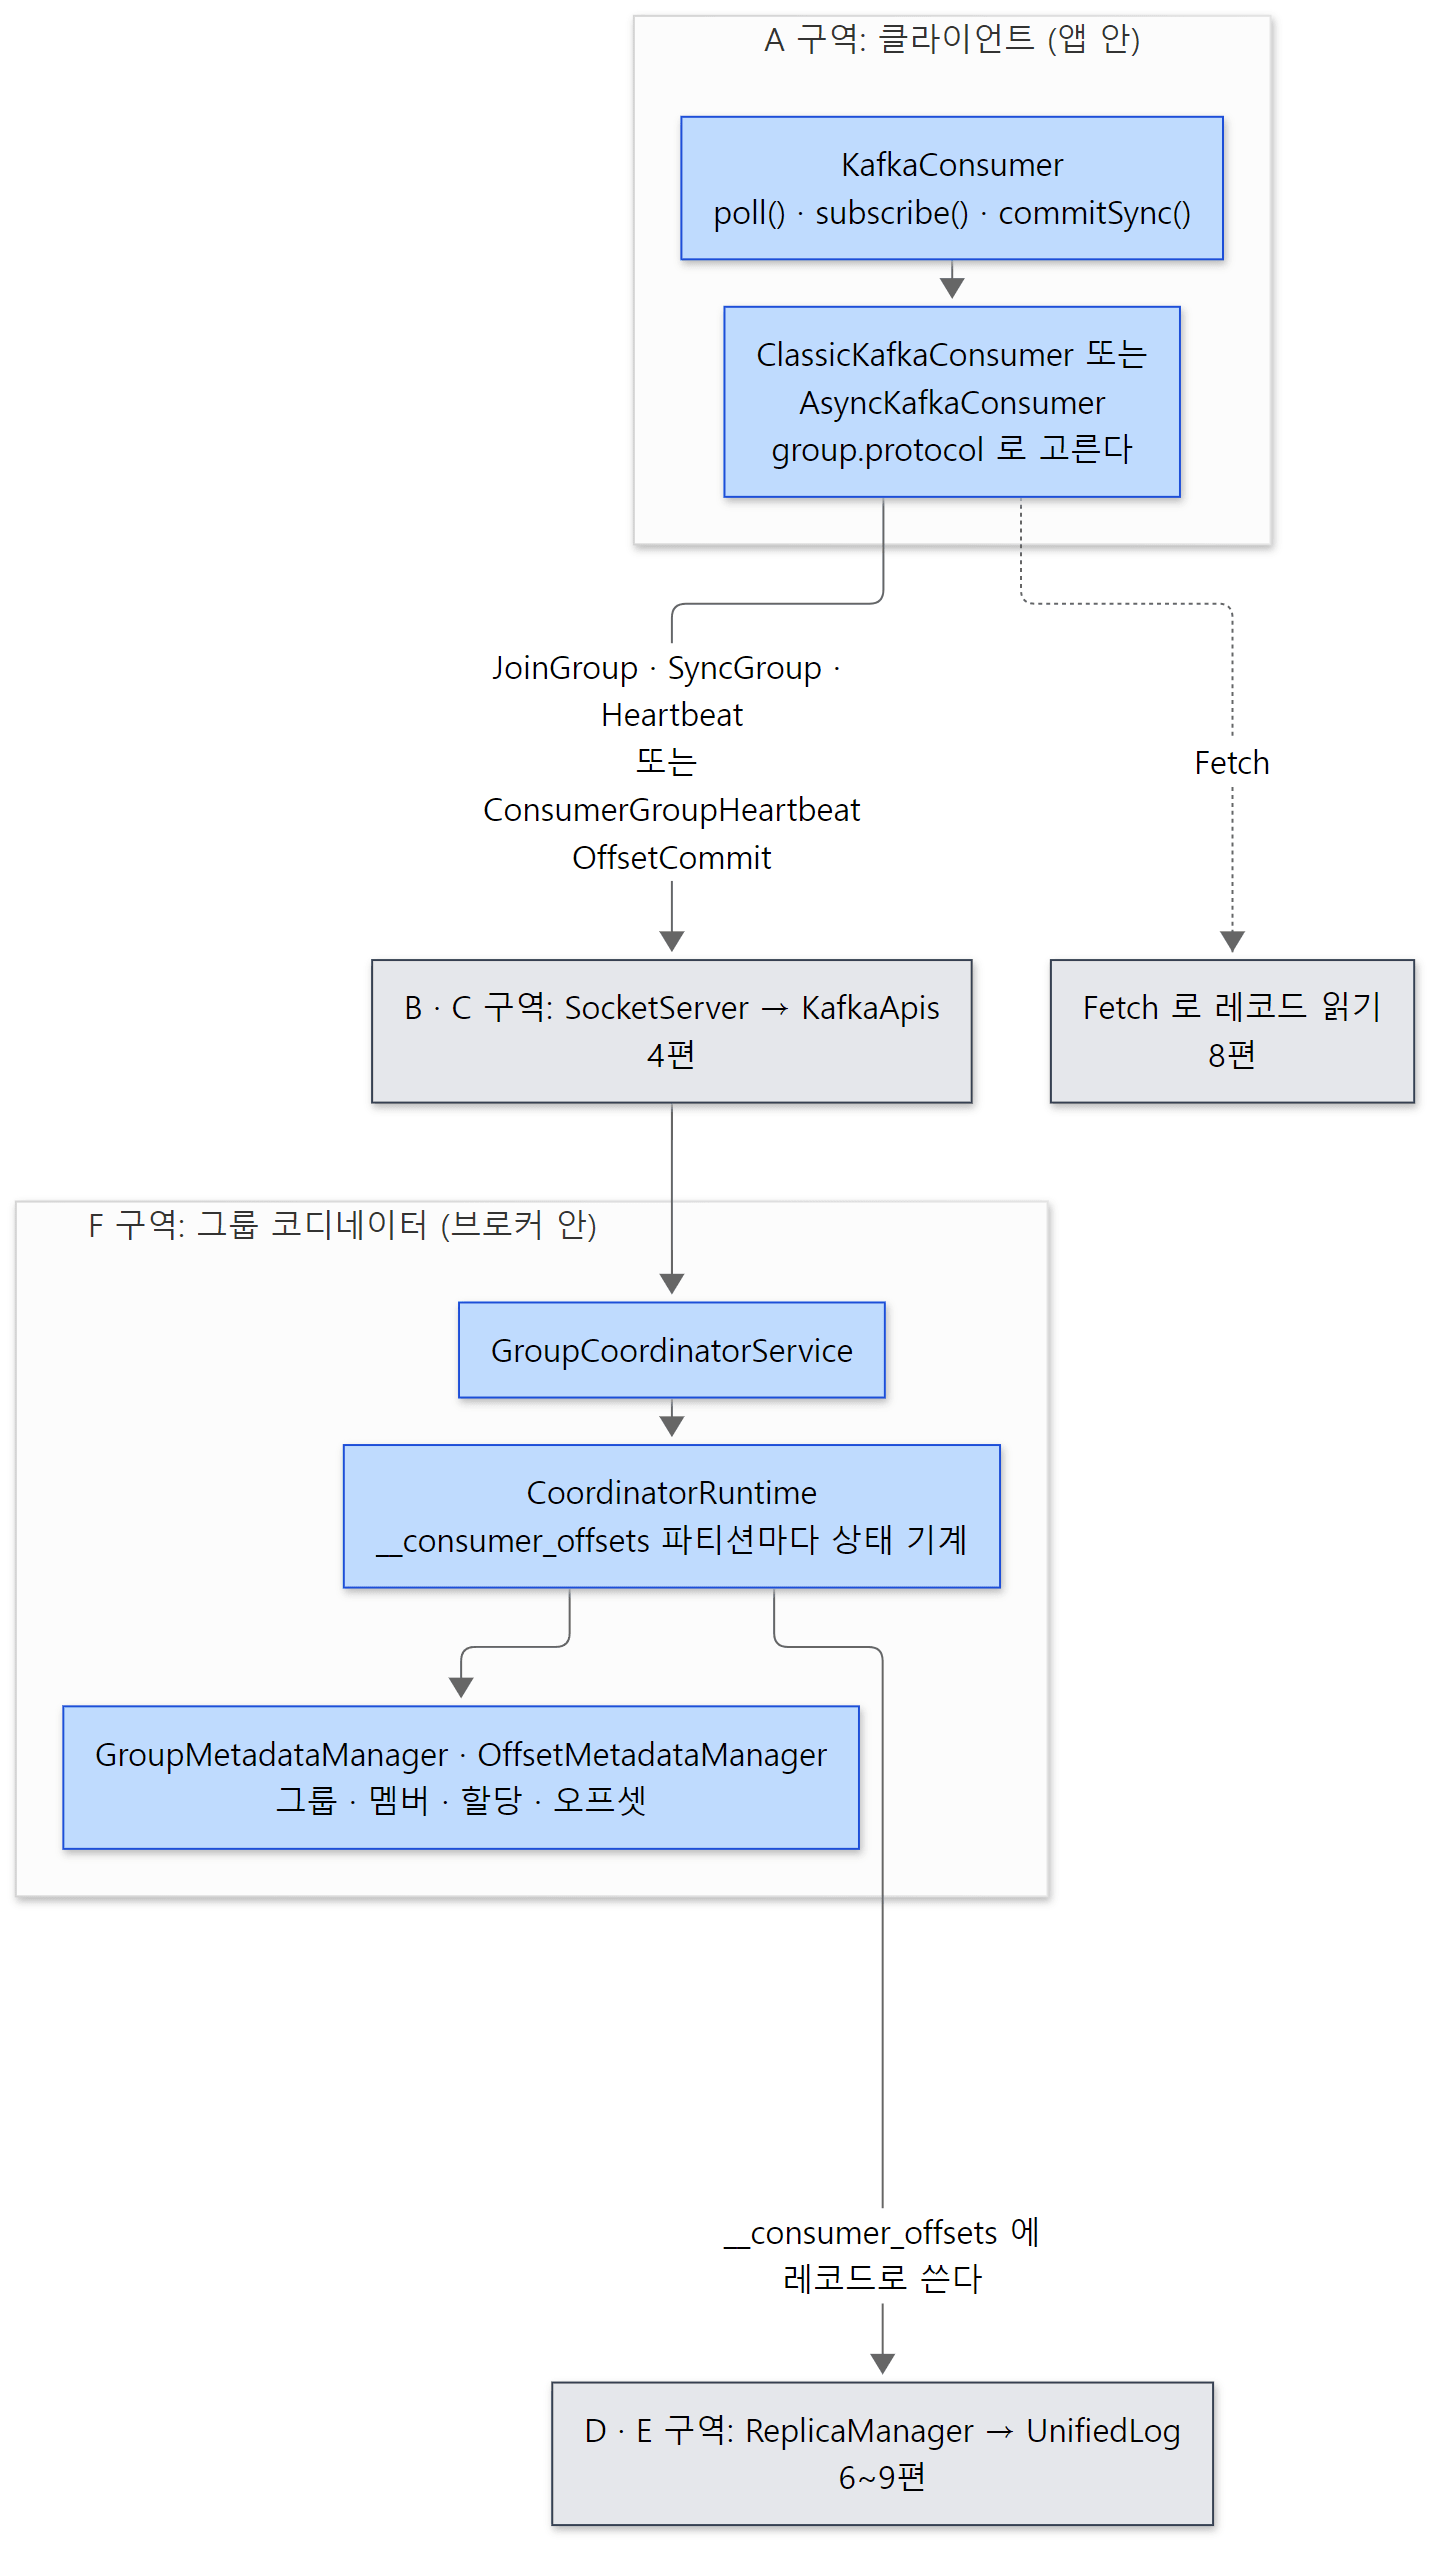 이 글은 2편 지도의 A 구역(클라이언트) 가운데 컨슈머와 F 구역(코디네이터) 가운데 그룹 코디네이터를 확대합니다. 회색 상자는 앞 글들의 몫입니다.
답하려는 질문은 네 가지입니다.
KafkaConsumer를 만들면 실제로 어떤 클래스가 일을 하고,group.protocol설정은 무엇을 바꾸나poll()을 부른 스레드는 그 안에서 무엇을 하고, 하트비트는 누가 보내나- 컨슈머가 하나 더 들어오면 리밸런스는 누가 시작하고, 파티션 할당은 누가 계산하나 — 옛 방식(classic)과 새 방식(consumer)은 어떻게 다른가
- 브로커의 그룹 코디네이터는 그룹 상태를 어디에 두고, 브로커가 다시 켜지면 그 상태를 어떻게 되살리나
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | 클라이언트(clients): KafkaConsumer, internals.ConsumerDelegateCreator·ClassicKafkaConsumer·ConsumerCoordinator·AbstractCoordinator·AsyncKafkaConsumer·ConsumerNetworkThread·ConsumerHeartbeatRequestManager·AbstractMembershipManager / 브로커: kafka.server.KafkaApis(Scala), group-coordinator 의 GroupCoordinatorService·GroupMetadataManager·OffsetMetadataManager·modern.consumer.CurrentAssignmentBuilder, coordinator-common 의 CoordinatorRuntime·CoordinatorLoaderImpl |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 이 글이 읽는 클래스들은 흔히 쓰는 최신 안정판 4.4.0 과 거의 같습니다. 4.4.0 태그와 비교해 눈에 띄게 다른 곳은 두 군데입니다. trunk 에는 새 리밸런스 리스너 API(RebalanceListener, KafkaConsumer.setRebalanceListener())가 들어왔고 4.4.0 에는 없습니다. 그리고 4.4.0 의 SubscriptionState 클래스가 trunk 에서는 ConsumerSubscriptionState 와 공통 인터페이스 AbstractSubscriptionState(공유 컨슈머용 ShareSubscriptionState 도 이것을 구현합니다)로 나뉘었습니다. 나머지 인용 코드는 4.4.0 과 같거나 몇 줄만 다릅니다.
컨슈머 쪽만 해도 AsyncKafkaConsumer.java 2,557줄, ConsumerCoordinator.java 1,763줄이고, 브로커의 GroupMetadataManager.java 는 10,188줄입니다. 이 파일들에는 컨슈머 그룹 말고도 Kafka Streams 그룹과 공유 그룹(share group)의 코드가 함께 삽니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
컨슈머 그룹과 그룹 코디네이터: 같은 group.id 를 쓰는 컨슈머들의 모임이 컨슈머 그룹이고, 한 토픽의 파티션 하나는 그룹 안에서 한 컨슈머에게만 주어집니다. 누가 어느 파티션을 가질지 정하고 기억하는 일은 브로커 가운데 하나가 맡는데, 그 역할(정확히는 브로커 안의 부품)을 그룹 코디네이터라고 합니다. 그룹마다 담당 브로커가 정해져 있고, 그 브로커는 그룹 id 로 고른 __consumer_offsets 파티션의 리더입니다(5절).
리밸런스(rebalance): 그룹의 멤버가 바뀌거나(들어옴·나감·응답 없음) 구독하는 토픽의 파티션 수가 바뀌어 파티션을 다시 나누는 일입니다. 앱에서는 ConsumerRebalanceListener 의 onPartitionsRevoked(내놓기)·onPartitionsAssigned(받기) 콜백으로 보입니다.
group.protocol: 컨슈머 설정으로, 리밸런스를 치르는 방식을 고릅니다. classic 은 오래 써 온 방식으로, JoinGroup·SyncGroup·Heartbeat 요청을 쓰고 컨슈머 가운데 하나(리더)가 할당을 계산합니다. consumer 는 KIP-848 로 들어온 새 방식으로, ConsumerGroupHeartbeat 요청 하나만 쓰고 브로커가 할당을 계산합니다(GroupProtocol.java 의 javadoc 이 두 값을 "pre KIP-848" 과 "KIP-848" 로 부릅니다). 이 커밋의 기본값은 여전히 classic 입니다(1절).
세대와 에포크(generation, epoch): 리밸런스가 한 번 끝날 때마다 올라가는 번호입니다. classic 에서는 그룹 전체에 세대(generation) 하나가 있고, consumer 프로토콜에서는 그룹 에포크(그룹의 구성이 바뀔 때 오름), 목표 할당 에포크, 멤버 에포크(그 멤버가 어느 판의 할당까지 따라왔나)가 따로 있습니다. 옛 번호를 들고 온 요청은 거절됩니다 — 이미 내놓은 파티션의 오프셋을 뒤늦게 커밋하는 "좀비" 컨슈머를 막는 장치입니다.
할당자(assignor): 멤버 목록과 파티션 목록을 받아 "누가 무엇을 가질지" 를 계산하는 클래스입니다. classic 에서는 클라이언트의 partition.assignment.strategy(RangeAssignor, CooperativeStickyAssignor …)가, consumer 프로토콜에서는 브로커의 group.consumer.assignors(uniform, range)가 이 일을 합니다.
eager 와 cooperative: 리밸런스 때 파티션을 내놓는 방식입니다. eager(열심히, 미리)는 리밸런스가 시작되면 모든 멤버가 가진 파티션을 전부 내놓고 새 할당을 받습니다. cooperative(협력)는 실제로 다른 멤버에게 옮겨 갈 파티션만 내놓습니다. 나머지 파티션은 리밸런스 동안에도 계속 읽을 수 있습니다.
__consumer_offsets: 그룹 코디네이터가 쓰는 내부 토픽입니다. 이름은 "오프셋" 이지만, 커밋한 오프셋뿐 아니라 그룹의 멤버·할당 같은 상태도 모두 여기에 레코드로 들어갑니다(6절). 기본 파티션 수는 50 입니다(offsets.topic.num.partitions, GroupCoordinatorConfig.java 120–121행).
앞 글에서 본 말도 몇 개 나옵니다. 하이 워터마크(HW)는 모든 ISR 레플리카에 복제되어 "커밋되었다" 고 볼 수 있는 경계 오프셋입니다(9편). 요청 처리 스레드(data-plane-kafka-request-handler-N)와 KafkaApis.handle() 의 match 는 4편에서 봤습니다.
1. KafkaConsumer 는 껍데기다 — group.protocol 로 갈리는 두 구현
앱에서 new KafkaConsumer<>(props) 를 부르면 무엇이 만들어질까요. KafkaConsumer 를 열어 보면 필드가 사실상 하나뿐입니다.
    private static final ConsumerDelegateCreator CREATOR = new ConsumerDelegateCreator();

    private final ConsumerDelegate<K, V> delegate;
    // ...
    KafkaConsumer(ConsumerConfig config, Deserializer<K> keyDeserializer, Deserializer<V> valueDeserializer) {
        delegate = CREATOR.create(config, keyDeserializer, valueDeserializer);
    }
clients/src/main/java/org/apache/kafka/clients/consumer/KafkaConsumer.java 554–629행
그리고 poll(), subscribe(), commitSync() 같은 공개 메서드는 모두 delegate.poll(timeout) 처럼 한 줄로 넘깁니다(예: poll() 은 986–989행). 2,027줄짜리 파일의 대부분은 javadoc 입니다. 실제 구현을 고르는 곳은 ConsumerDelegateCreator 입니다.
    public <K, V> ConsumerDelegate<K, V> create(ConsumerConfig config,
                                                Deserializer<K> keyDeserializer,
                                                Deserializer<V> valueDeserializer) {
        try {
            GroupProtocol groupProtocol = GroupProtocol.valueOf(config.getString(ConsumerConfig.GROUP_PROTOCOL_CONFIG).toUpperCase(Locale.ROOT));

            if (groupProtocol == GroupProtocol.CONSUMER)
                return new AsyncKafkaConsumer<>(config, keyDeserializer, valueDeserializer, Optional.empty());
            else
                return new ClassicKafkaConsumer<>(config, keyDeserializer, valueDeserializer);
        } catch (KafkaException e) {
            throw e;
        } catch (Throwable t) {
            throw new KafkaException("Failed to construct Kafka consumer", t);
        }
    }
group.protocol=consumer 이면 AsyncKafkaConsumer, 그 밖에는 ClassicKafkaConsumer 입니다. 기본값은 ConsumerConfig 에서 확인합니다.
    public static final String GROUP_PROTOCOL_CONFIG = "group.protocol";
    public static final String DEFAULT_GROUP_PROTOCOL = GroupProtocol.CLASSIC.name().toLowerCase(Locale.ROOT);
    public static final String GROUP_PROTOCOL_DOC = "The group protocol that the consumer uses. The " +
        "supported values are <code>classic</code> or <code>consumer</code>. The default value is <code>classic</code>.";
clients/src/main/java/org/apache/kafka/clients/consumer/ConsumerConfig.java 120–123행
define(GROUP_PROTOCOL_CONFIG, Type.STRING, DEFAULT_GROUP_PROTOCOL, …)(684–689행)이 이 상수를 기본값으로 씁니다. 그러니 설정을 따로 하지 않은 앱은 지금도 ClassicKafkaConsumer 를 씁니다. 4.4.0 도 같습니다.
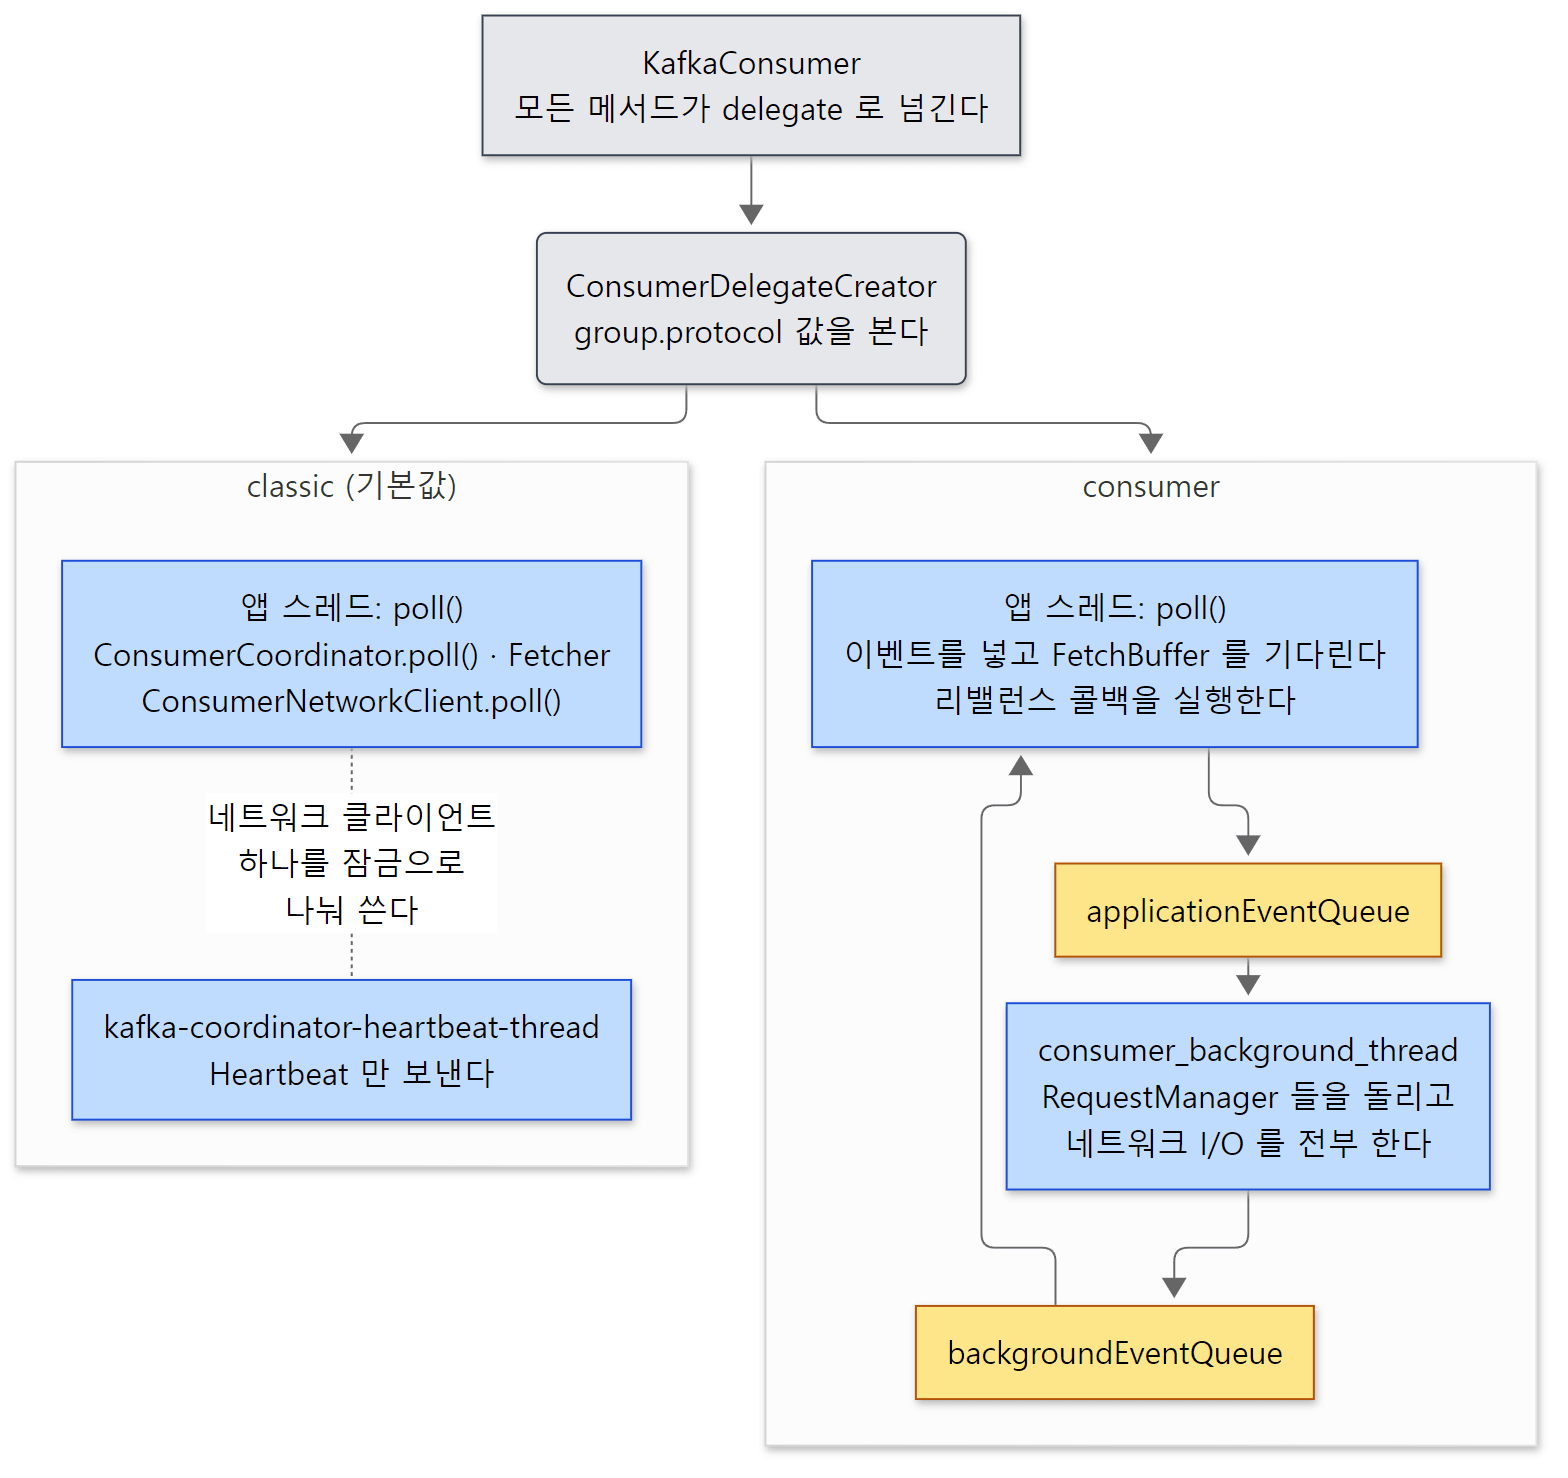 두 구현은 스레드를 나누는 방식부터 다릅니다. 파란 상자가 스레드, 노란 상자가 두 스레드 사이의 큐입니다.
헷갈리기 쉬운 곳: 설정 이름 몇 개는 프로토콜에 따라 금지된다
두 구현은 받는 설정도 조금 다릅니다. ConsumerConfig 는 group.protocol=consumer 일 때 partition.assignment.strategy, heartbeat.interval.ms, session.timeout.ms 를 적으면 예외를 던집니다(423–438행의 두 목록과 819–842행의 checkUnsupportedConfigsPostProcess()). 이 셋은 새 프로토콜에서 브로커 쪽 설정(group.consumer.assignors, group.consumer.heartbeat.interval.ms, group.consumer.session.timeout.ms)으로 옮겨 갔기 때문입니다. 반대로 classic 에서는 group.remote.assignor(브로커 쪽 할당자 이름을 고르는 설정)를 적을 수 없습니다. 기존 앱의 설정 파일에 session.timeout.ms 가 들어 있다면, group.protocol 만 바꿔서는 컨슈머가 만들어지지 않습니다.
2. classic 컨슈머의 poll() — 한 스레드가 거의 다 한다
먼저 기본값인 ClassicKafkaConsumer 부터 봅니다. poll(Duration) 은 타이머를 만들어 아래 루프를 돕니다.
            do {
                client.maybeTriggerWakeup();

                // try to update assignment metadata BUT do not need to block on the timer for join group
                updateAssignmentMetadataIfNeeded(timer, false);

                final Fetch<K, V> fetch = pollForFetches(timer);
                if (!fetch.isEmpty()) {
                    // ...
                    if (sendFetches() > 0 || client.hasPendingRequests()) {
                        client.transmitSends();
                    }
                    // ...
                    return this.interceptors.onConsume(new ConsumerRecords<>(fetch.records(), fetch.nextOffsets()));
                }
            } while (timer.notExpired());
clients/src/main/java/org/apache/kafka/clients/consumer/internals/ClassicKafkaConsumer.java 673–698행
루프 한 바퀴는 두 단계입니다.
updateAssignmentMetadataIfNeeded()— 그룹 일을 합니다. 안에서coordinator.poll()(ConsumerCoordinator)을 부르고, 이어서 아직 읽기 시작할 위치를 모르는 파티션의 위치(커밋된 오프셋 또는auto.offset.reset)를 정합니다(712–718행).pollForFetches()— 레코드를 가져옵니다. 이미 받아 둔 것이 있으면 바로 돌려주고, 없으면 Fetch 요청을 보내고(sendFetches()) 네트워크 클라이언트의poll()에서 응답을 기다립니다(723–756행). Fetch 의 안쪽은 8편의 몫입니다.
레코드를 돌려주기 직전에 다음 Fetch 를 미리 보내 두는 것(681–689행의 주석)도 눈여겨볼 만합니다. 앱이 레코드를 처리하는 동안 다음 묶음이 오고 있게 하려는 것입니다.
그룹 일의 본체 ConsumerCoordinator.poll() 은 이렇습니다.
    public boolean poll(Timer timer, boolean waitForJoinGroup) {
        maybeUpdateSubscriptionMetadata();

        invokeCompletedOffsetCommitCallbacks();

        if (subscriptions.hasAutoAssignedPartitions()) {
            // ...
            pollHeartbeat(timer.currentTimeMs());
            if (coordinatorUnknownAndUnreadySync(timer)) {
                return false;
            }

            if (rejoinNeededOrPending()) {
                // ...
                // if not wait for join group, we would just use a timer of 0
                if (!ensureActiveGroup(waitForJoinGroup ? timer : time.timer(0L))) {
                    // ...
                    return false;
                }
            }
        } else {
            // ...
        }

        maybeAutoCommitOffsetsAsync(timer.currentTimeMs());
        return true;
    }
clients/src/main/java/org/apache/kafka/clients/consumer/internals/ConsumerCoordinator.java 513–579행
subscribe() 로 구독했다면(hasAutoAssignedPartitions()) 차례로 이렇게 합니다.
pollHeartbeat()— "앱이 방금poll()을 불렀다" 는 시각을 적어 둡니다. 아래의 하트비트 스레드가 이 시각으로max.poll.interval.ms를 잽니다.coordinatorUnknownAndUnreadySync()— 그룹 코디네이터가 어느 브로커인지 모르면 FindCoordinator 요청으로 찾습니다(AbstractCoordinator.lookupCoordinator(), 331행).rejoinNeededOrPending()이면ensureActiveGroup()으로 그룹에 (다시) 들어갑니다. 리밸런스는 여기, 앱이 부른poll()안에서 치러집니다. 그래서 리밸런스 콜백도poll()을 부른 스레드에서 불립니다.maybeAutoCommitOffsetsAsync()—enable.auto.commit=true(기본값,ConsumerConfig.java489–493행)이면auto.commit.interval.ms(기본 5000, 494–499행)마다 오프셋을 비동기로 커밋합니다. 자동 커밋은 따로 스레드가 있는 것이 아니라poll()을 부를 때 "시간이 됐나" 를 보는 것입니다.
ensureActiveGroup()(AbstractCoordinator.java 415–424행)은 코디네이터를 확인하고, startHeartbeatThreadIfNeeded() 로 하트비트 스레드를 띄운 뒤, joinGroupIfNeeded() 로 그룹에 들어갑니다. 하트비트 스레드는 처음 그룹에 들어갈 때 한 번 만들어집니다. 이름은 "kafka-coordinator-heartbeat-thread" + " | " + group.id 입니다(124행의 상수와 1467행). 이 스레드는 Heartbeat 요청만 보내고, 리밸런스 자체(JoinGroup·SyncGroup)는 앱 스레드가 joinGroupIfNeeded() 에서 합니다.
하트비트 스레드가 지키는 두 시계
하트비트 스레드의 run() 루프에서 핵심은 이 몇 줄입니다.
                        } else if (heartbeat.sessionTimeoutExpired(now)) {
                            // the session timeout has expired without seeing a successful heartbeat, so we should
                            // probably make sure the coordinator is still healthy.
                            markCoordinatorUnknown("session timed out without receiving a "
                                    + "heartbeat response");
                        } else if (heartbeat.pollTimeoutExpired(now)) {
                            // the poll timeout has expired, which means that the foreground thread has stalled
                            // in between calls to poll().
                            handlePollTimeoutExpiry();
시계는 둘입니다.
- 세션 시계(
session.timeout.ms, 기본 45000): 하트비트 응답을 이 시간 동안 못 받으면 코디네이터가 이상하다고 보고 다시 찾습니다. 브로커 쪽도 같은 시간 동안 하트비트를 못 받으면 이 멤버를 그룹에서 뺍니다. - poll 시계(
max.poll.interval.ms, 기본 300000): 앱이 이 시간 동안poll()을 부르지 않으면, 하트비트 스레드가 스스로 그룹을 떠납니다(handlePollTimeoutExpiry()). 하트비트가 따로 돌기 때문에, 이 시계가 없으면 레코드 처리에 갇힌 앱이 파티션을 영영 붙잡고 있을 수 있습니다.
하트비트 간격은 heartbeat.interval.ms(기본 3000)입니다. 세 기본값은 ConsumerConfig.java 467–476행과 658–663행의 define(…) 에서 확인했습니다. 그리고 max.poll.interval.ms 는 그룹에 들어갈 때 rebalance timeout 으로도 쓰입니다(GroupRebalanceConfig.java 55행). 다음 절에서 이 값이 다시 나옵니다.
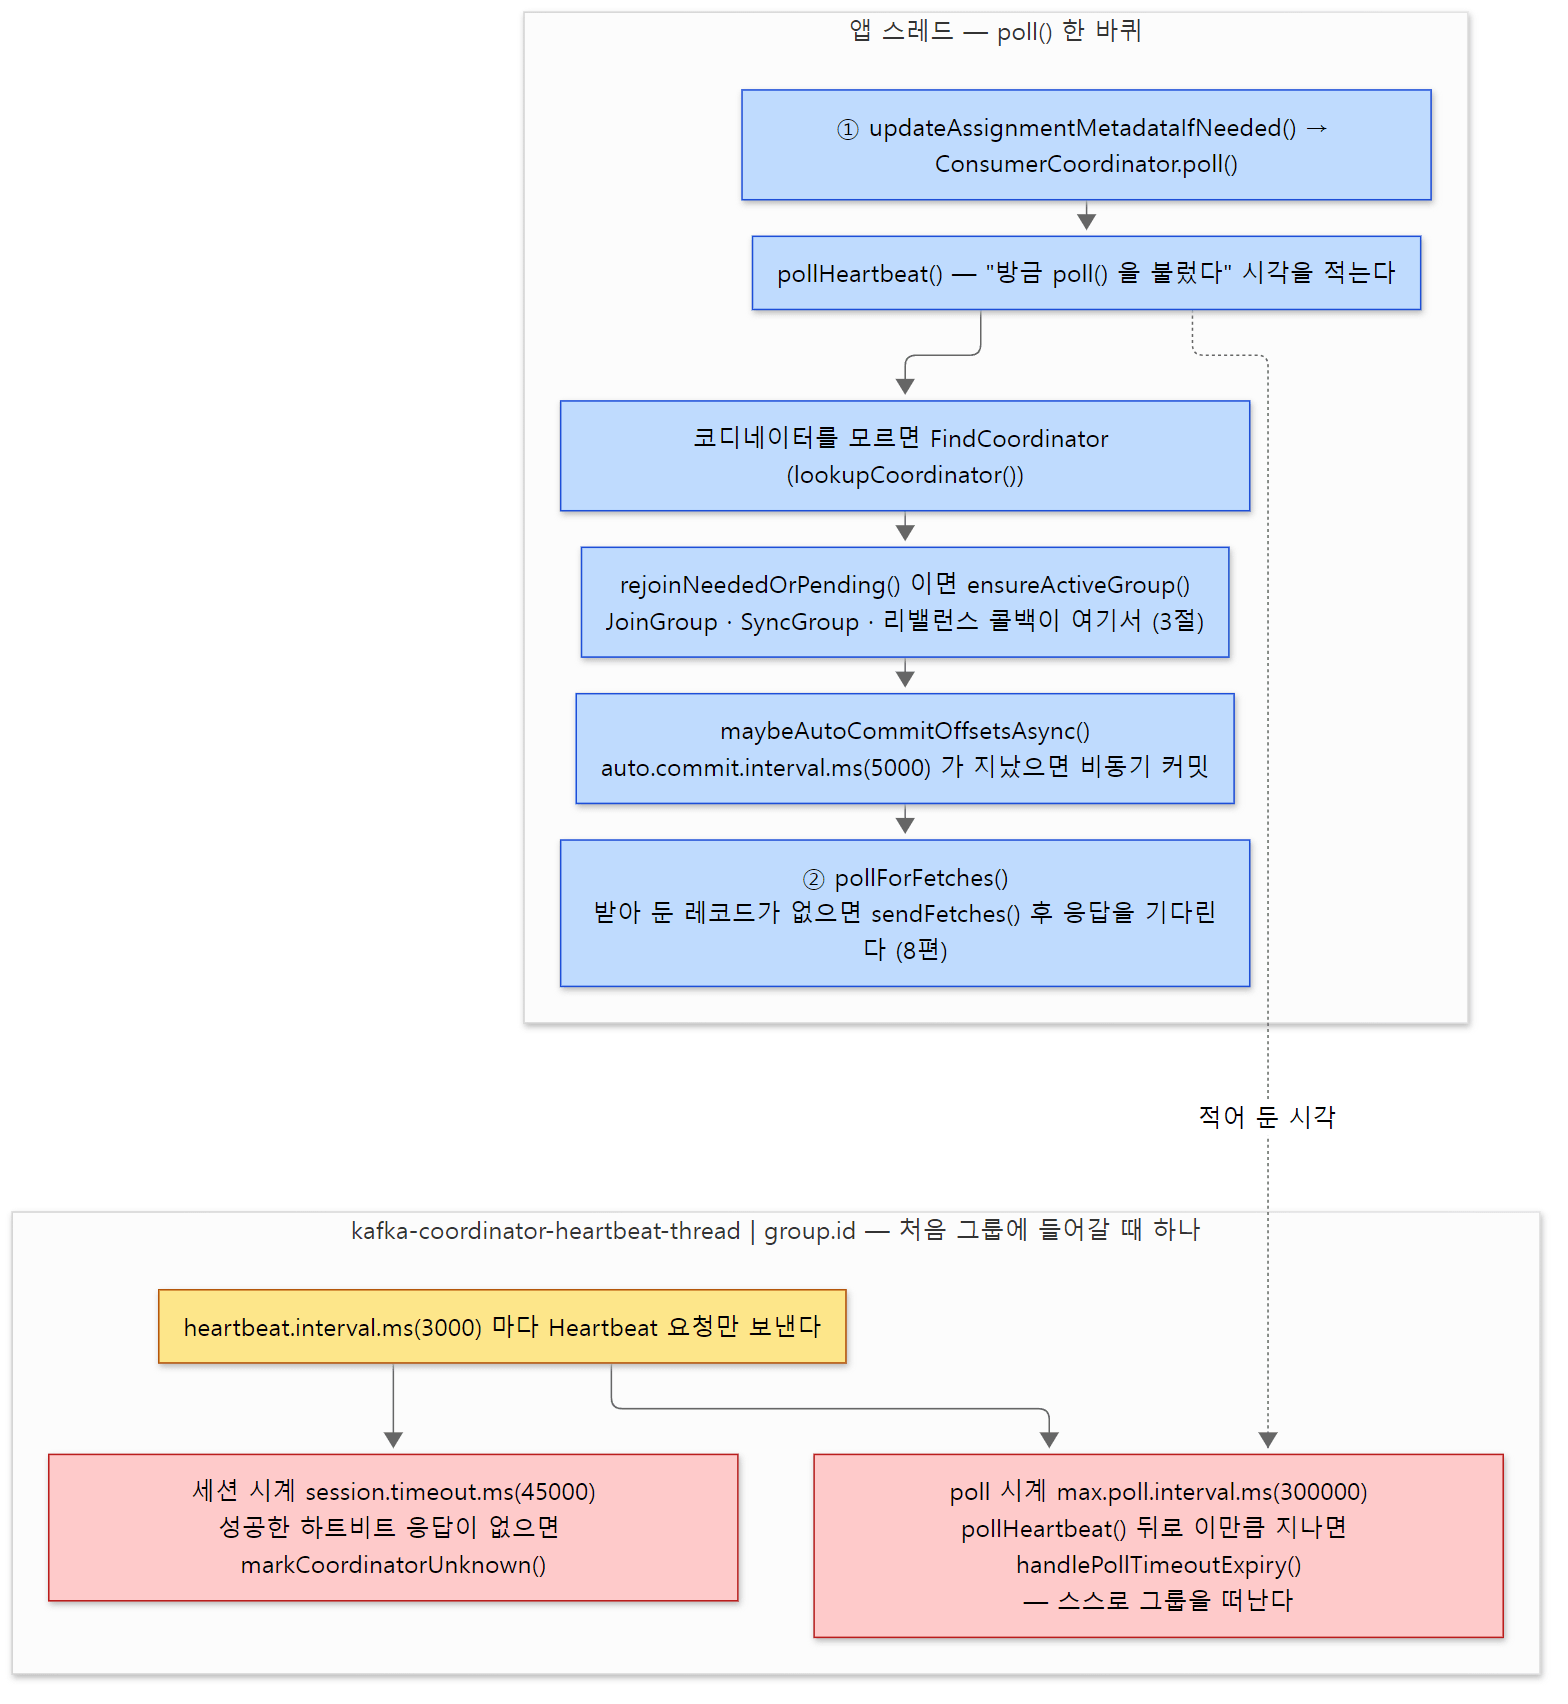 리밸런스와 자동 커밋은 앱이 부른 poll() 안에서, 시계 둘은 하트비트 스레드에서. poll 시계는 앱 스레드가 적어 둔 시각으로 잽니다. 괄호 안 숫자는 기본값입니다.
3. classic 리밸런스 — JoinGroup, SyncGroup, 그리고 리더 컨슈머
classic 리밸런스는 두 번의 왕복입니다.
- JoinGroup: 멤버마다 "나는 이 그룹에 들어가고, 이 토픽을 구독하며, 이 할당자들을 쓸 수 있다" 를 보냅니다(
sendJoinGroupRequest(),AbstractCoordinator.java608–638행). 코디네이터는 멤버들이 다 올 때까지 응답을 붙잡아 두었다가, 한 명을 리더로 정해 리더에게만 멤버 전원의 구독 정보를 줍니다. - SyncGroup: 리더는 받은 구독 정보로 클라이언트 안에서 할당을 계산해 SyncGroup 에 실어 보내고, 나머지 멤버는 빈 SyncGroup 을 보냅니다(
onJoinFollower(), 755–770행). 코디네이터는 리더가 보낸 할당을 멤버마다 나눠 SyncGroup 응답으로 돌려줍니다.
JoinGroup 응답을 받은 JoinGroupResponseHandler 는 joinResponse.isLeader() 로 갈라져 리더면 onLeaderElected(), 아니면 onJoinFollower() 로 갑니다(678–682행). 리더 쪽 ConsumerCoordinator.onLeaderElected() 는 멤버들의 구독을 풀어 모은 뒤 assignor.assign(metadata.fetch(), new GroupSubscription(subscriptions)) 로 할당을 계산합니다(693행). 브로커는 할당 내용을 해석하지 않고 바이트로 전달만 합니다. 그래서 classic 에서는 할당 전략을 바꾸거나 새 할당자를 쓰려면 모든 컨슈머 앱을 바꿔 배포해야 했습니다.
기본 설정은 eager 다
partition.assignment.strategy 의 기본값은 [RangeAssignor, CooperativeStickyAssignor] 두 개입니다(ConsumerConfig.java 477–482행). 그런데 리밸런스 방식은 모든 할당자가 지원하는 것 가운데 가장 앞선 것으로 정해집니다.
        if (!assignors.isEmpty()) {
            List<RebalanceProtocol> supportedProtocols = new ArrayList<>(assignors.get(0).supportedProtocols());

            for (ConsumerPartitionAssignor assignor : assignors) {
                supportedProtocols.retainAll(assignor.supportedProtocols());
            }

            // ...
            Collections.sort(supportedProtocols);

            protocol = supportedProtocols.get(supportedProtocols.size() - 1);
clients/src/main/java/org/apache/kafka/clients/consumer/internals/ConsumerCoordinator.java 256–271행
RangeAssignor 는 EAGER 만 지원하므로(교집합을 구하는 retainAll), 기본 설정의 리밸런스 방식은 EAGER 입니다. 목록에 CooperativeStickyAssignor 가 함께 있는 것은 나중에 Range 를 빼고 cooperative 로 넘어가는 길을 열어 두려는 것이지, 지금 cooperative 로 동작한다는 뜻이 아닙니다. EAGER 에서 리밸런스 직전(onJoinPrepare())에 하는 일은 이렇습니다.
            switch (protocol) {
                case EAGER:
                    // revoke all partitions
                    revokedPartitions.addAll(subscriptions.assignedPartitions());
                    exception = rebalanceListenerInvoker.invokePartitionsRevoked(revokedPartitions);

                    subscriptions.assignFromSubscribed(Collections.emptySet());

                    break;

                case COOPERATIVE:
                    // only revoke those partitions that are not in the subscription anymore.
                    Set<TopicPartition> ownedPartitions = new HashSet<>(subscriptions.assignedPartitions());
                    revokedPartitions.addAll(ownedPartitions.stream()
                        .filter(tp -> !subscriptions.subscription().contains(tp.topic()))
                        .collect(Collectors.toSet()));

                    if (!revokedPartitions.isEmpty()) {
                        exception = rebalanceListenerInvoker.invokePartitionsRevoked(revokedPartitions);

                        ownedPartitions.removeAll(revokedPartitions);
                        subscriptions.assignFromSubscribed(ownedPartitions);
                    }

                    break;
            }
clients/src/main/java/org/apache/kafka/clients/consumer/internals/ConsumerCoordinator.java 828–853행
EAGER 는 가진 파티션을 전부 내놓고(onPartitionsRevoked 에 전부), 할당을 비운 채로 JoinGroup 을 보냅니다. 새 할당을 받을 때까지 이 컨슈머는 아무것도 읽지 않습니다.
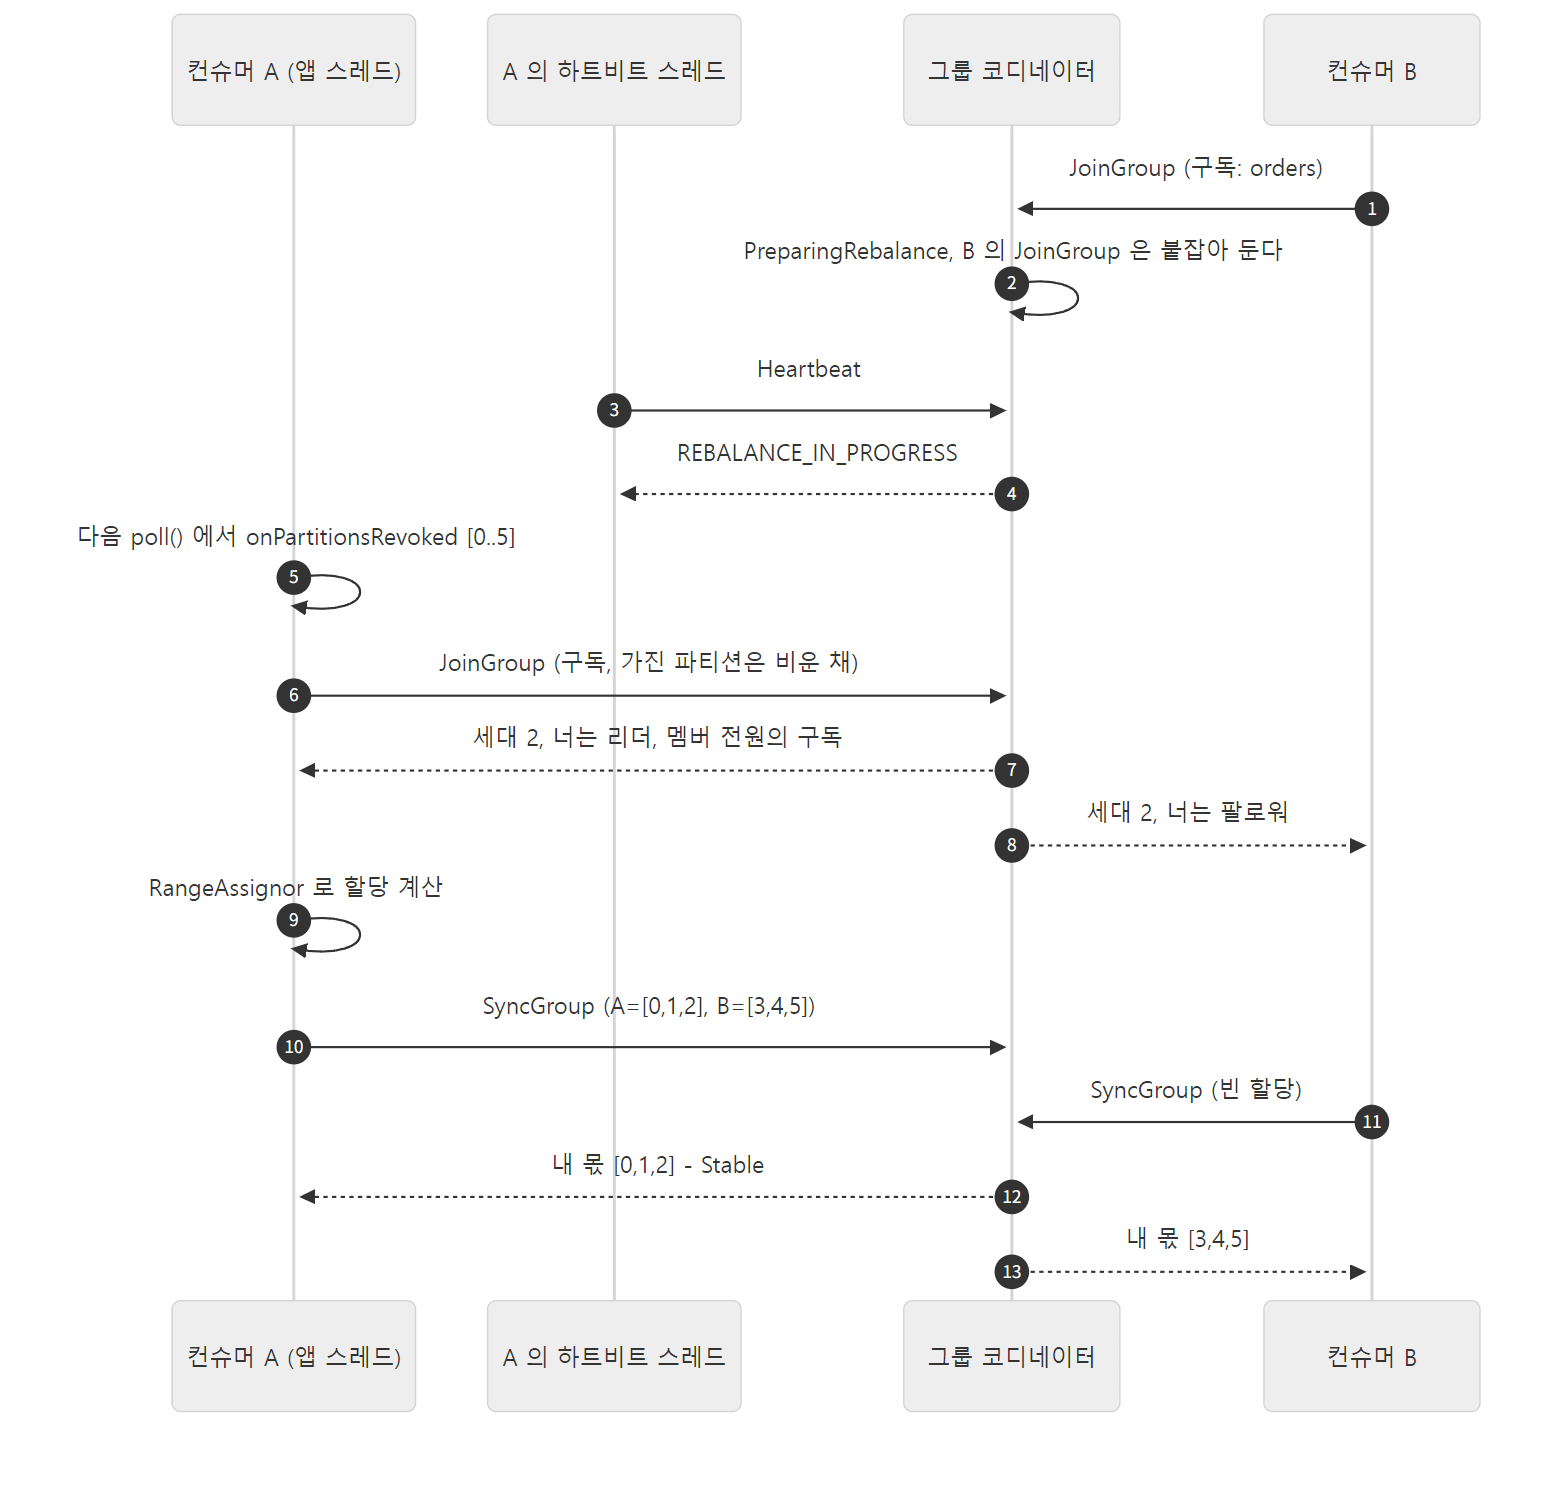 컨슈머 A 혼자 파티션 6개를 갖고 있을 때 B 가 들어오는 경우입니다. 아래 예제 1의 실행 결과와 같은 순서입니다. 새 멤버 B 의 첫 JoinGroup 은 실제로는
MEMBER_ID_REQUIRED 오류와 함께 멤버 id 만 받고 곧바로 그 id 로 다시 보내는데(GroupMetadataManager.classicGroupJoinNewDynamicMember(), 7416–7437행), 그림에서는 이 왕복을 1번 하나로 줄였습니다.
그림의 3~4번이 중요합니다. 코디네이터는 A 에게 "리밸런스하자" 고 먼저 연락할 길이 없습니다. A 의 다음 하트비트 응답에 REBALANCE_IN_PROGRESS 를 실어 보낼 뿐이고(HeartbeatResponseHandler, 1257–1268행에서 requestRejoin()), A 는 그다음 poll() 에서 JoinGroup 을 보냅니다. 그래서 B 가 들어오고 나서 A 가 파티션을 내놓기까지 최대 heartbeat.interval.ms(3초)쯤 걸립니다.
코디네이터 쪽의 그룹 상태
브로커 쪽에서 classic 그룹은 다섯 상태를 오갑니다. 상태마다 어떤 요청에 어떻게 답하는지가 ClassicGroupState 의 javadoc 에 표처럼 적혀 있고, 허용되는 이전 상태는 정적 블록에 있습니다.
    static {
        EMPTY.addValidPreviousStates(PREPARING_REBALANCE);
        PREPARING_REBALANCE.addValidPreviousStates(STABLE, COMPLETING_REBALANCE, EMPTY);
        COMPLETING_REBALANCE.addValidPreviousStates(PREPARING_REBALANCE);
        STABLE.addValidPreviousStates(COMPLETING_REBALANCE);
        DEAD.addValidPreviousStates(STABLE, PREPARING_REBALANCE, COMPLETING_REBALANCE, EMPTY, DEAD);
    }
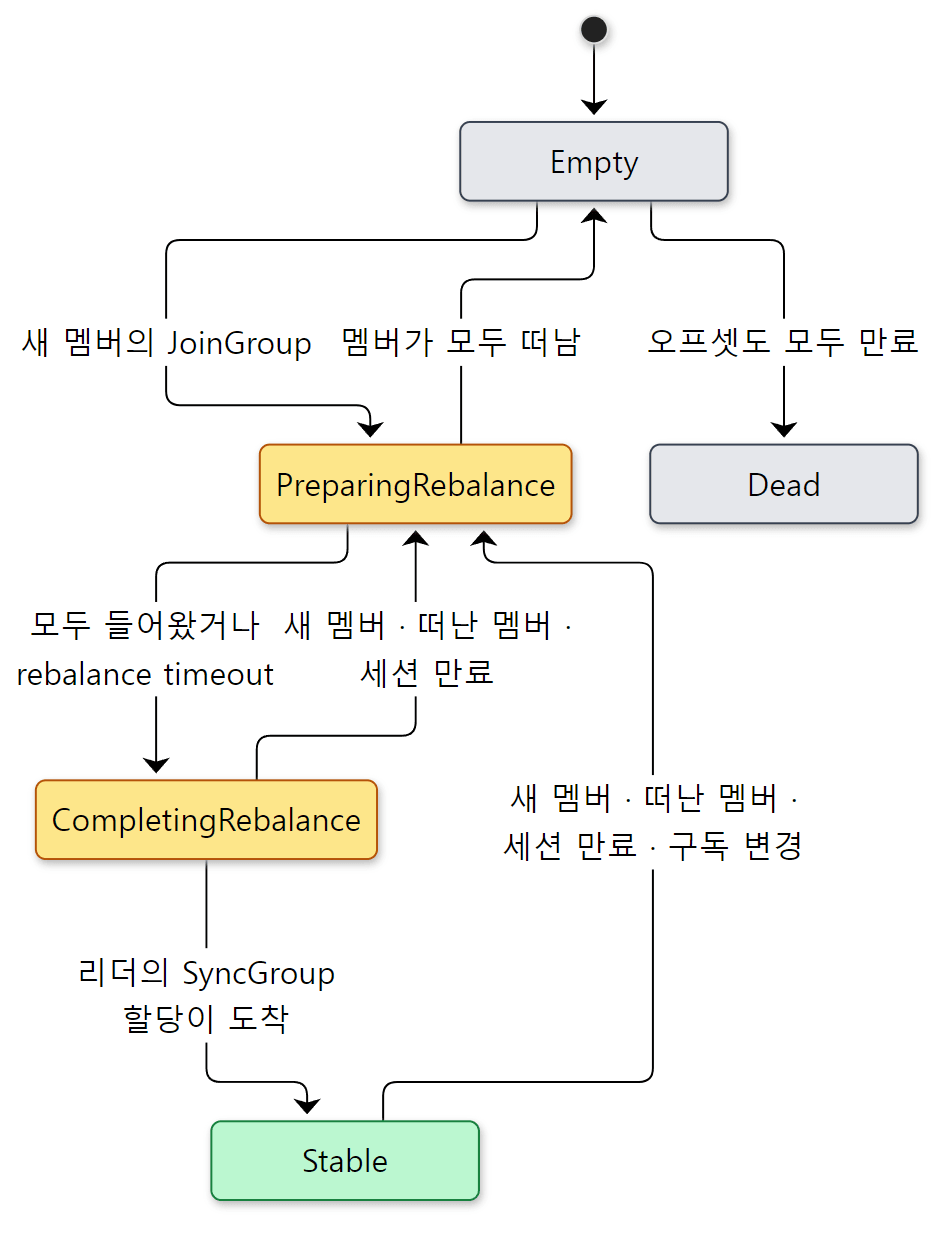 노란 두 상태가 "리밸런스 중" 입니다. Dead 로 가는 길은 그림의 하나 말고도, 그룹을 맡은
__consumer_offsets 파티션이 다른 브로커로 옮겨 갈 때 어느 상태에서든 있습니다.
PreparingRebalance 에서 얼마나 기다리는지는 GroupMetadataManager.prepareRebalance()(7952–7985행)가 정합니다. 빈 그룹에 첫 멤버가 들어오면 group.initial.rebalance.delay.ms(기본 3000, GroupCoordinatorConfig.java 180행) 동안 다른 멤버를 더 기다립니다. 앱 여러 개가 거의 동시에 뜰 때 리밸런스가 연달아 일어나지 않게 하려는 것입니다. 이미 멤버가 있는 그룹은 기존 멤버가 모두 다시 JoinGroup 을 보낼 때까지, 길어야 그룹의 rebalance timeout(멤버들의 max.poll.interval.ms 가운데 가장 큰 값, ClassicGroup.rebalanceTimeoutMs() 767–773행)만큼 기다립니다(maybeCompleteJoinElseSchedule(), 7994–8011행). 이 글의 예제는 도우미 스크립트가 group.initial.rebalance.delay.ms=0 으로 서버를 띄웁니다.
예제 1: 컨슈머 둘을 차례로 붙여 보기 (classic)
이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 파티션 6개짜리 토픽 orders 에 레코드 60개를 넣어 두고, 한 JVM 안에서 컨슈머 A 를 먼저 띄웁니다. A 가 6개를 다 받으면 B 를 띄우고, 둘이 3개씩 나눠 가진 뒤 20초 있다가 B 를 닫습니다. 컨슈머마다 자기 스레드(app-A, app-B)에서 poll(100ms) 를 돌리고, 리밸런스 콜백이 불린 시각과 스레드를 찍습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// ...
                consumer.subscribe(List.of(topic), new ConsumerRebalanceListener() {
                    public void onPartitionsRevoked(Collection<TopicPartition> p) {
                        log(name, "onPartitionsRevoked  " + parts(p) + "  thread=" + Thread.currentThread().getName());
                    }
                    // ...
                });
                while (running.get()) {
                    consumed.addAndGet(consumer.poll(Duration.ofMillis(100)).count());
                }
전체 코드는 Rebalance.java 하나이고, group.protocol 과 그룹 id 를 인자로 받습니다. group.protocol=classic 으로 돌린 결과입니다(시각·멤버 id 는 실행마다 다릅니다).
group.protocol=classic  group.id=g-classic  -> __consumer_offsets-18
  1013 ms [main] start A
  3089 ms [A] onPartitionsAssigned [0, 1, 2, 3, 4, 5]  thread=app-A  now owns [0, 1, 2, 3, 4, 5]
  3118 ms [main] A is stable. client threads:
         thread: app-A
         thread: kafka-coordinator-heartbeat-thread | g-classic
  3121 ms [main] start B
  6116 ms [A] onPartitionsRevoked  [0, 1, 2, 3, 4, 5]  thread=app-A
  6147 ms [A] onPartitionsAssigned [0, 1, 2]  thread=app-A  now owns [0, 1, 2]
  6148 ms [B] onPartitionsAssigned [3, 4, 5]  thread=app-B  now owns [3, 4, 5]
  6167 ms [main] A and B are stable. client threads:
         thread: app-A
         thread: app-B
         thread: kafka-coordinator-heartbeat-thread | g-classic
 24451 ms [main] stop B
 24501 ms [B] close() (consumed 0 records)
 24513 ms [B] onPartitionsRevoked  [3, 4, 5]  thread=app-B
 24706 ms [B] closed
 27154 ms [A] onPartitionsRevoked  [0, 1, 2]  thread=app-A
 27161 ms [A] onPartitionsAssigned [0, 1, 2, 3, 4, 5]  thread=app-A  now owns [0, 1, 2, 3, 4, 5]
 27195 ms [main] stop A
 27288 ms [A] close() (consumed 60 records)
 27289 ms [A] onPartitionsRevoked  [0, 1, 2, 3, 4, 5]  thread=app-A
 27399 ms [A] closed
 27401 ms [main] records consumed: A=60 B=0
읽을 것은 세 가지입니다.
- B 가 들어오자 A 는 6개를 전부 내놓았다가(
onPartitionsRevoked [0, 1, 2, 3, 4, 5]) 3개를 다시 받습니다. 기본 설정이 EAGER 이기 때문입니다. A 가 원래 갖고 있던 0·1·2 도 잠깐 손을 놓습니다. - B 를 띄운 뒤 A 가 내놓기까지 약 3초가 걸렸습니다. 위에서 본 대로 A 는 다음 하트비트 응답(간격 3초)에서야 리밸런스를 알게 됩니다. B 가 닫힐 때도 마찬가지로, B 는 닫으면서 LeaveGroup 을 보내지만 A 는 다음 하트비트에서 알아차리고 다시 전부 내놓았다가 6개를 받습니다.
- 콜백은 늘
app-A·app-B, 곧poll()을 부른 스레드에서 불립니다. JVM 에는 그 밖에kafka-coordinator-heartbeat-thread | g-classic이 보입니다. B 가 들어온 뒤에도 이름이 하나뿐인 것은, A 와 B 의 하트비트 스레드가 같은 그룹 id 로 같은 이름을 쓰고 예제가 이름을TreeSet에 모아 찍기 때문입니다 — 실제로는 컨슈머마다 하나씩, 두 개입니다. (클라이언트 이름으로 거른 목록이라,kafka-producer-network-thread같은 다른 스레드는 없다는 것을 보여 줄 뿐 JVM 의 스레드 전부는 아닙니다.)
A 가 처음 6개를 받기까지 걸린 시간은 예제를 네 번 돌리는 동안 2초에서 8초까지 들쭉날쭉했습니다(위 출력은 약 2초). 이 그룹은 브로커에서 처음 __consumer_offsets 를 쓰는 그룹이라, 첫 FindCoordinator 가 이 내부 토픽(파티션 50개)을 만들게 하고 토픽이 준비될 때까지는 COORDINATOR_NOT_AVAILABLE 을 받습니다(KafkaApis.scala 1292–1295행). 그 기다림이 끼어 있기 때문으로 보지만, 시간을 나눠 재 보지는 않았습니다.
4. consumer 프로토콜 — 백그라운드 스레드와 하트비트 하나
이번에는 group.protocol=consumer 를 고르면 만들어지는 AsyncKafkaConsumer 입니다. 이름의 "Async" 가 말하듯, 앱 스레드는 네트워크를 직접 만지지 않습니다. 생성자에서 ConsumerNetworkThread 를 하나 띄우는데, 이름이 consumer_background_thread 입니다(ConsumerNetworkThread.java 68행). poll() 의 루프는 classic 과 모양이 같지만 하는 일이 다릅니다.
        if (inflightPoll == null) {
            inflightPoll = new AsyncPollEvent(calculateDeadlineMs(timer), time.milliseconds());
            newlySubmittedEvent = true;
            log.trace("Inflight event {} submitted", inflightPoll);
            applicationEventHandler.add(inflightPoll);
        }

        try {
            // Note: this is calling user-supplied code, so make sure that any errors thrown here are caught and
            // the inflight event is cleared.
            offsetCommitCallbackInvoker.executeCallbacks();
            processBackgroundEvents();
clients/src/main/java/org/apache/kafka/clients/consumer/internals/AsyncKafkaConsumer.java 1006–1017행
앱 스레드는 AsyncPollEvent 를 이벤트 큐(applicationEventQueue)에 넣어 "poll 이 불렸다" 고 백그라운드 스레드에 알리고, 백그라운드 스레드가 보낸 이벤트(backgroundEventQueue)를 처리합니다(processBackgroundEvents()). 그다음 pollForFetches() 에서 백그라운드 스레드가 채워 주는 FetchBuffer 를 기다립니다(fetchBuffer.awaitWakeup(pollTimer), 2026행). 받은 바이트를 레코드로 바꾸는 일은 FetchCollector 가 앱 스레드에서 합니다.
백그라운드 스레드의 한 바퀴는 이렇습니다.
        long pollWaitTimeMs = MAX_POLL_TIMEOUT_MS;

        for (RequestManager rm : requestManagers.entries()) {
            NetworkClientDelegate.PollResult pollResult = rm.poll(currentTimeMs);
            long timeoutMs = networkClientDelegate.addAll(pollResult);
            pollWaitTimeMs = Math.min(pollWaitTimeMs, timeoutMs);
        }

        networkClientDelegate.poll(pollWaitTimeMs, currentTimeMs);
runOnce()(210–242행)는 앱 스레드가 넣은 이벤트를 먼저 처리하고(processApplicationEvents()), 요청 관리자(RequestManager) 들에게 차례로 "지금 보낼 요청이 있나" 를 묻고(rm.poll()), 모인 요청을 네트워크 클라이언트로 보내고 응답을 받습니다. 요청 관리자의 목록은 RequestManagers 생성자에 있습니다 — 코디네이터 찾기(CoordinatorRequestManager), 오프셋 커밋(CommitRequestManager), 하트비트(ConsumerHeartbeatRequestManager), 멤버 상태(ConsumerMembershipManager), 오프셋 조회, 토픽 메타데이터, Fetch(FetchRequestManager) 순입니다(RequestManagers.java 94–105행). 요청마다 담당 클래스가 따로 있고, 한 스레드가 그것들을 돌려 가며 부르는 구조입니다. 4편의 브로커 Processor 가 셀렉터 하나로 여러 연결을 돌보던 것처럼, 여기서는 스레드 하나가 여러 종류의 요청을 돌봅니다.
하트비트가 곧 리밸런스다
새 프로토콜에서 그룹과 주고받는 요청은 사실상 ConsumerGroupHeartbeat(API 키 68) 하나입니다. 들어갈 때도, 할당을 받을 때도, 파티션을 내놓았다고 알릴 때도, 나갈 때도 이 요청을 씁니다. 하트비트에 무엇을 싣는지 보면 프로토콜이 보입니다.
            // MemberEpoch - always sent
            data.setMemberEpoch(membershipManager.memberEpoch());

            // ...
            boolean sendAllFields = membershipManager.state() == MemberState.JOINING;

            // RebalanceTimeoutMs - only sent when joining or if it has changed since the last heartbeat
            if (sendAllFields || sentFields.rebalanceTimeoutMs != rebalanceTimeoutMs) {
                data.setRebalanceTimeoutMs(rebalanceTimeoutMs);
                sentFields.rebalanceTimeoutMs = rebalanceTimeoutMs;
            }

            // SubscribedTopicNames - only sent if it has changed since the last heartbeat
            TreeSet<String> subscribedTopicNames = new TreeSet<>(this.subscriptions.subscription());
            if (sendAllFields || !subscribedTopicNames.equals(sentFields.subscribedTopicNames)) {
                data.setSubscribedTopicNames(new ArrayList<>(this.subscriptions.subscription()));
                sentFields.subscribedTopicNames = subscribedTopicNames;
            }
그룹 id·멤버 id·멤버 에포크는 매번 보내고, 구독 토픽·rebalance timeout·지금 가진 파티션(TopicPartitions, 304–314행) 같은 나머지는 바뀌었을 때만 보냅니다(sentFields 에 지난번 값을 기억해 둡니다). 처음 들어갈 때(JOINING)는 전부 보냅니다. 멤버 id 는 classic 과 달리 클라이언트가 처음부터 만들어 둡니다(263행의 주석, AbstractMembershipManager.java 82행의 Uuid.randomUuid()). 하트비트 간격도 클라이언트 설정이 아니라 브로커가 응답에 실어 주는 값(group.consumer.heartbeat.interval.ms, 기본 5000)을 따릅니다.
응답에 새 할당이 오면 AbstractMembershipManager.maybeReconcile() 이 지금 가진 것과 비교합니다.
        // Partitions to assign (not previously owned)
        SortedSet<TopicPartition> addedPartitions = new TreeSet<>(TOPIC_PARTITION_COMPARATOR);
        addedPartitions.addAll(assignedTopicPartitions);
        addedPartitions.removeAll(ownedPartitions);

        // Partitions to revoke
        SortedSet<TopicPartition> revokedPartitions = new TreeSet<>(TOPIC_PARTITION_COMPARATOR);
        revokedPartitions.addAll(ownedPartitions);
        revokedPartitions.removeAll(assignedTopicPartitions);
"받을 것 = 새 할당 − 가진 것", "내놓을 것 = 가진 것 − 새 할당" 입니다. 그다음 (자동 커밋이 켜져 있으면) 커밋 → onPartitionsRevoked → onPartitionsAssigned 순서로 진행하고(956–970행, revokeAndAssign() 994–1036행), 끝나면 상태를 ACKNOWLEDGING 으로 바꿔 다음 하트비트를 기다리지 않고 바로 보내 "다 했다" 고 알립니다(1031행). 내놓을 파티션만 콜백에 넘기므로, 이 프로토콜은 처음부터 cooperative 입니다.
콜백은 백그라운드 스레드가 직접 부르지 않습니다.
    private CompletableFuture<Void> enqueueConsumerRebalanceListenerCallback(ConsumerRebalanceListenerMethodName methodName,
                                                                             Set<TopicPartition> partitions) {
        SortedSet<TopicPartition> sortedPartitions = new TreeSet<>(TOPIC_PARTITION_COMPARATOR);
        sortedPartitions.addAll(partitions);

        CompletableBackgroundEvent<Void> event = new PartitionsRemovedEvent(methodName, sortedPartitions);
        backgroundEventHandler.add(event);
        log.debug("The event to trigger the {} method execution was enqueued successfully", methodName.fullyQualifiedMethodName());
        return event.future();
    }
백그라운드 스레드는 "이 콜백을 불러 달라" 는 이벤트를 앱 쪽 큐에 넣고, 앱 스레드가 다음 poll() 의 processBackgroundEvents() 에서 콜백을 실행한 뒤 future 를 완료합니다. 백그라운드 스레드의 리밸런스 처리는 그 future 가 끝날 때까지 기다립니다. 콜백 안에서 commitSync() 같은 컨슈머 메서드를 부를 수 있어야 하는데, KafkaConsumer 는 한 스레드에서만 쓰게 되어 있으니 콜백을 앱 스레드에서 부르는 것입니다.
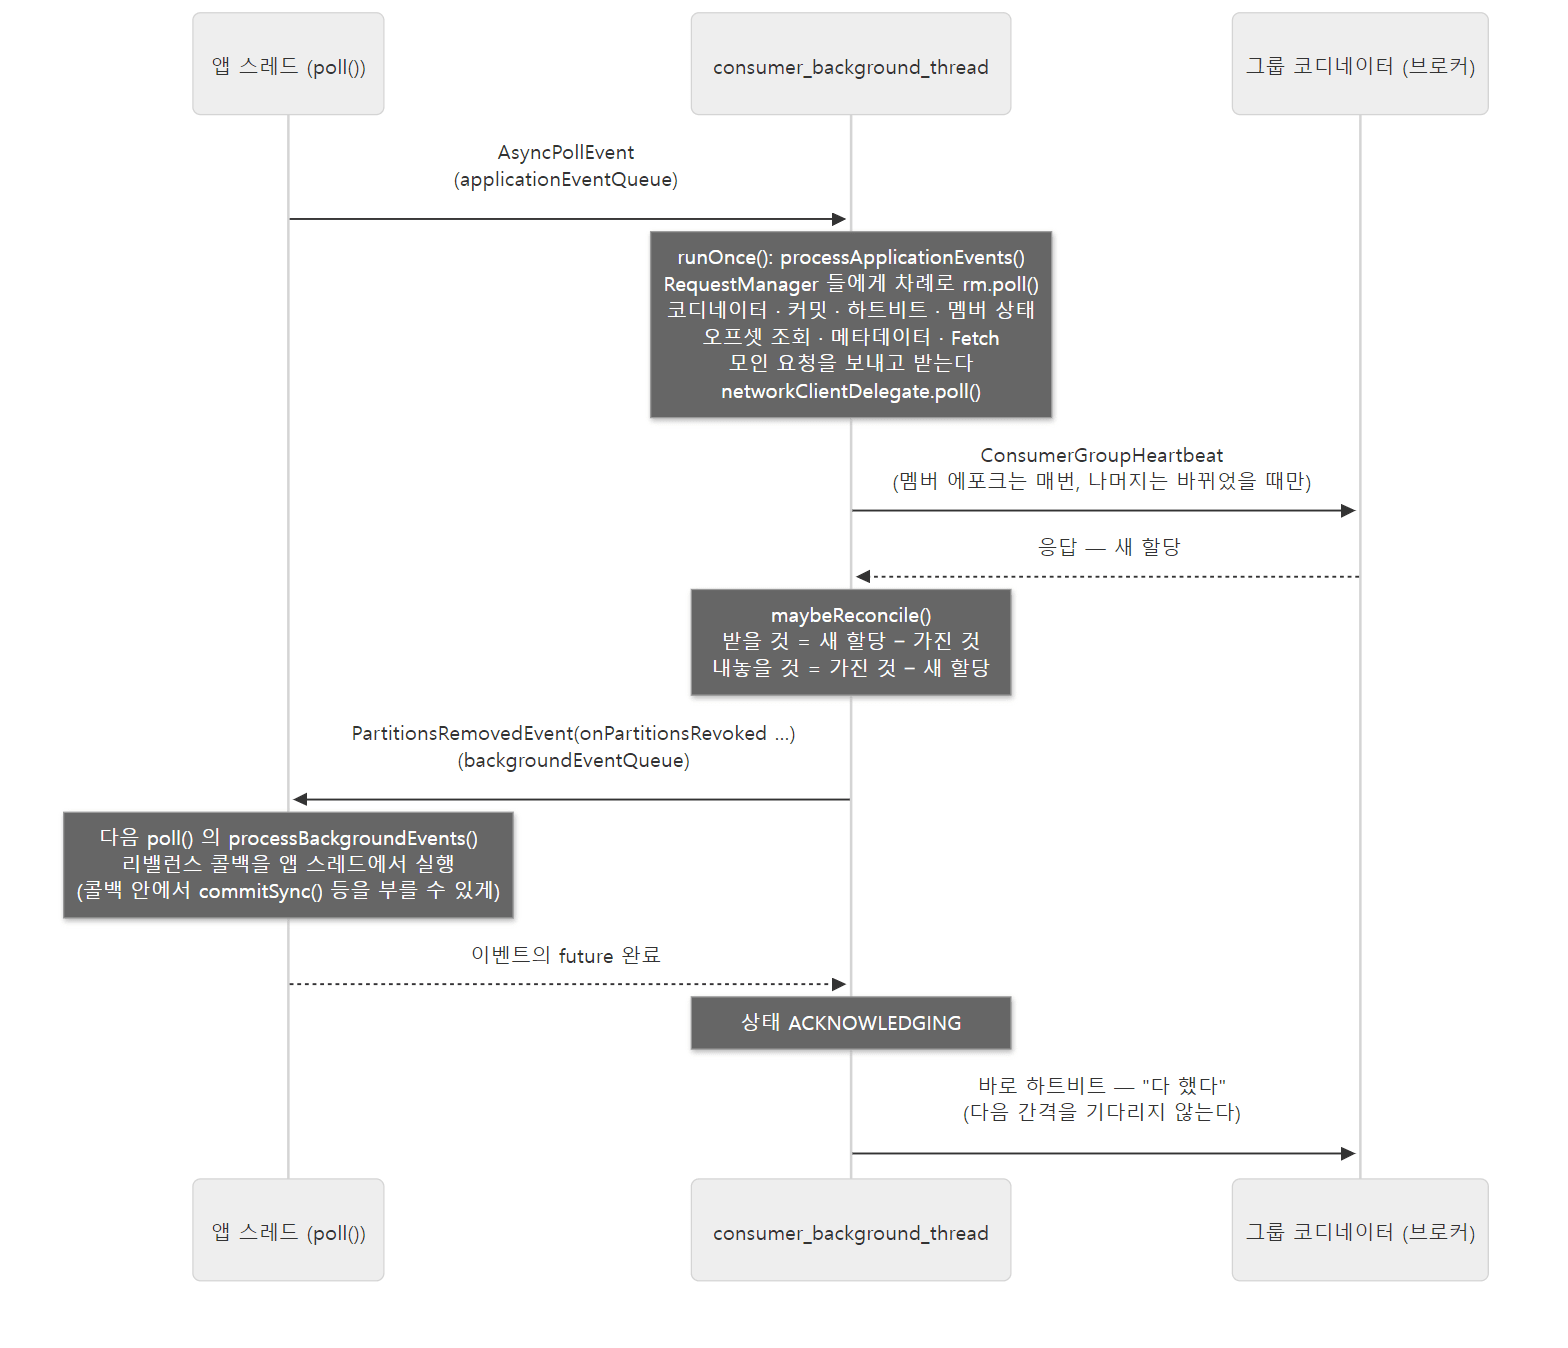 네트워크는 백그라운드 스레드가 전부 맡지만, 사용자 코드인 리밸런스 콜백만은 이벤트로 앱 스레드에 넘겨 실행합니다.
max.poll.interval.ms 는 이제 백그라운드 스레드가 잰다
classic 의 하트비트 스레드가 하던 poll 시계는 여기서는 하트비트 요청 관리자가 잽니다(AbstractHeartbeatRequestManager.poll(), 171–186행). poll() 이 너무 오래 안 불리면 그룹을 떠나는 하트비트를 보냅니다. 앱 로그에서 자주 보는 "Consumer poll timeout has expired" 경고를 남기는 곳이 여기입니다(173행). 클라이언트 쪽 멤버 상태(MemberState — JOINING, RECONCILING, ACKNOWLEDGING, STABLE, FENCED, PREPARE_LEAVING, LEAVING, STALE 등 10개)는 MemberState.java 에 정의되어 있고, 허용되는 전이는 118–142행의 정적 블록에 있습니다. poll 시계가 끝나면 LEAVING 을 거쳐 STALE 로 가고, 다음 poll() 에서 JOINING 으로 다시 들어갑니다.
예제 1 이어서: 같은 일을 consumer 프로토콜로
같은 Rebalance.java 를 group.protocol=consumer 로 돌린 결과입니다.
group.protocol=consumer  group.id=g-consumer  -> __consumer_offsets-32
  1097 ms [main] start A
  2741 ms [A] onPartitionsAssigned [0, 1, 2, 3, 4, 5]  thread=app-A  now owns [0, 1, 2, 3, 4, 5]
  2781 ms [main] A is stable. client threads:
         thread: app-A
         thread: consumer_background_thread
  2784 ms [main] start B
  3037 ms [B] onPartitionsAssigned []  thread=app-B  now owns []
  7957 ms [A] onPartitionsRevoked  [3, 4, 5]  thread=app-A
  8040 ms [A] onPartitionsAssigned []  thread=app-A  now owns [0, 1, 2]
 13102 ms [B] onPartitionsAssigned [3, 4, 5]  thread=app-B  now owns [3, 4, 5]
 13147 ms [main] A and B are stable. client threads:
         thread: app-A
         thread: app-B
         thread: consumer_background_thread
 31443 ms [main] stop B
 31526 ms [B] close() (consumed 0 records)
 31536 ms [B] onPartitionsRevoked  [3, 4, 5]  thread=app-B
 31908 ms [B] closed
 33084 ms [A] onPartitionsAssigned [3, 4, 5]  thread=app-A  now owns [0, 1, 2, 3, 4, 5]
 33093 ms [main] stop A
 33161 ms [A] close() (consumed 60 records)
 33167 ms [A] onPartitionsRevoked  [0, 1, 2, 3, 4, 5]  thread=app-A
 33598 ms [A] closed
 33600 ms [main] records consumed: A=60 B=0
classic 과 견주어 보면 차이가 분명합니다.
- B 가 들어와도 A 는 3·4·5 만 내놓습니다(
onPartitionsRevoked [3, 4, 5]). 0·1·2 는 리밸런스 내내 A 의 것이었습니다. A 의onPartitionsAssigned []는 "새로 받은 것은 없다" 는 뜻으로, 내놓기가 끝난 뒤 늘 한 번 불립니다(revokeAndAssign()의 javadoc, 988–993행). - B 는 들어오자마자 빈 할당(
[])을 먼저 받고,[3, 4, 5]는 한참 뒤에 받습니다. 브로커는 A 가 3·4·5 를 내놓았다고 알릴 때까지 B 에게 그 파티션을 주지 않습니다(5절). - B 를 띄우고 A 가 내놓기까지 약 5초 — 브로커가 준 하트비트 간격(5000ms)만큼입니다. A 는 다음 하트비트에서야 새 할당을 압니다.
- B 가
[3, 4, 5]를 받기까지는 약 10초, 하트비트 간격 두 번이 걸렸습니다. 이 실행에서는 B 의 정기 하트비트가 A 의 "다 내놓았다" 하트비트보다 몇 밀리초 먼저 브로커에 닿아 그때는 받을 것이 없었고, 그다음 하트비트(5초 뒤)에서야 받았습니다. 예제 3의 레코드에 그 순서가 그대로 남아 있습니다. 앞선 실행들에서는 약 5.5초였습니다 — 두 하트비트의 순서에 따라 달라집니다. - B 가 떠날 때 A 는 아무것도 내놓지 않고
[3, 4, 5]를 더 받기만 합니다. - 클라이언트 스레드는
kafka-coordinator-heartbeat-thread대신consumer_background_thread가 있습니다. classic 의 하트비트 스레드처럼, 컨슈머가 둘인데 목록에 이름이 하나뿐인 것은 두 컨슈머의 백그라운드 스레드가 같은 이름을 쓰기 때문입니다(super(BACKGROUND_THREAD_NAME, true), 96행 — 이름에 client id 가 붙지 않습니다). 예제는 이름을TreeSet에 모아 찍으므로 겹친 이름은 한 번만 보입니다.jstack으로 앱을 볼 때 컨슈머마다 이 스레드가 하나씩 있다는 것을 기억해 두면 좋습니다.
헷갈리기 쉬운 곳: 새 리스너 API 와 옛 리스너
예제는 앱 개발자에게 익숙한 subscribe(topics, ConsumerRebalanceListener) 를 썼습니다. 이 커밋(trunk)의 KafkaConsumer javadoc 은 이 메서드를 "deprecated" 라고 적고, 대신 subscribe(topics) 와 setRebalanceListener(RebalanceListener) 를 따로 부르라고 안내합니다(713–715행, 885–915행). 새 RebalanceListener 의 콜백은 두 번째 인자로 RebalanceConsumer(리밸런스 중에 써도 안전한 메서드만 연 컨슈머)를 받습니다. 다만 이 메서드에는 @Deprecated 애너테이션이 붙어 있지 않아 컴파일 경고는 나지 않고, 4.4.0 에는 RebalanceListener 자체가 없습니다. 4.4.0 에서 돌릴 코드라면 지금처럼 ConsumerRebalanceListener 를 쓰면 됩니다.
5. 브로커 쪽: 그룹 코디네이터는 어디에 있고, 할당은 어떻게 정하나
이제 요청을 받는 쪽으로 건너갑니다. 그룹 코디네이터는 따로 떠 있는 서버가 아니라, 모든 브로커 안에 있는 부품입니다. 그룹마다 담당 브로커가 다를 뿐입니다. 클라이언트는 먼저 아무 브로커에게나 FindCoordinator 를 보내 담당을 묻습니다.
      val (partition, internalTopicName) = CoordinatorType.forId(keyType) match {
        case CoordinatorType.GROUP =>
          (groupCoordinator.partitionFor(key), GROUP_METADATA_TOPIC_NAME)

        case CoordinatorType.TRANSACTION =>
          (txnCoordinator.partitionFor(key), TRANSACTION_STATE_TOPIC_NAME)

        case CoordinatorType.SHARE =>
          // We know that shareCoordinator is defined at this stage.
          (shareCoordinator.partitionFor(SharePartitionKey.getInstance(key)), SHARE_GROUP_STATE_TOPIC_NAME)
      }
core/src/main/scala/kafka/server/KafkaApis.scala 1277–1287행
Scala 읽는 법 —
x match { case A => … case B => … }는 Java 의switch식과 같고, 고른 갈래의 마지막 식이 값이 됩니다. 여기서는 갈래마다(파티션 번호, 토픽 이름)이라는 튜플(값 두 개를 묶은 것)을 돌려주고,val (partition, internalTopicName) = …가 그 튜플을 두 변수로 풀어 받습니다.
그룹이면 groupCoordinator.partitionFor(그룹 id) 로 __consumer_offsets 의 파티션 번호를 구하고, 그 파티션의 리더 브로커를 담당 코디네이터로 돌려줍니다(1300–1307행). 계산은 단순합니다.
    public int partitionFor(
        String groupId
    ) {
        throwIfNotActive();
        return Utils.abs(groupId.hashCode()) % numPartitions;
    }
그룹 id 의 hashCode() 를 파티션 수(기본 50)로 나눈 나머지입니다. 예제의 g-classic 은 18번, g-consumer 는 32번 파티션이었습니다(예제가 같은 식으로 계산해 찍었습니다). 이렇게 하면 그룹들이 50개 파티션에, 곧 그 리더들인 여러 브로커에 고르게 흩어집니다. 그리고 그룹의 상태를 그 파티션에 쓰므로, 리더가 바뀌면 코디네이터도 자연히 새 리더로 옮겨 갑니다. 이것은 9편의 복제가 그대로 해 주는 일입니다.
요청 하나가 코디네이터에 닿기까지
ConsumerGroupHeartbeat 를 따라가 봅니다. KafkaApis.handleConsumerGroupHeartbeat()(2680–2718행)는 권한을 확인한 뒤 groupCoordinator.consumerGroupHeartbeat(…) 를 부르고, 돌아온 CompletableFuture 가 끝나면 응답을 보냅니다. GroupCoordinatorService 는 이것을 쓰기 작업으로 예약합니다.
        return runtime.scheduleWriteOperation(
            "consumer-group-heartbeat",
            topicPartitionFor(request.groupId()),
            coordinator -> coordinator.consumerGroupHeartbeat(context, request)
        ).exceptionally(exception -> handleOperationException(
"하트비트" 인데 쓰기 작업인 것이 처음엔 이상해 보입니다. 하트비트가 그룹 상태(멤버, 할당, 에포크)를 바꿀 수 있고, 바뀐 상태는 __consumer_offsets 에 써야 하기 때문입니다. 무엇을 바꿀지는 GroupMetadataManager.consumerGroupHeartbeat() 가 정합니다. 에포크가 -1(또는 고정 멤버의 -2)이면 그룹을 떠나는 요청으로 갈라지고(5729–5737행), 나머지는 세 단계를 거칩니다. 메서드 안의 주석이 단계를 번호로 매겨 둡니다 — 1단계는 멤버를 만들거나 고치고, 구독이 바뀌었으면 그룹 에포크를 올립니다(2635–2703행). 2·3단계는 이렇습니다.
        // 2. Update the target assignment if the group epoch is larger than the target assignment epoch. The delta between
        // the existing and the new target assignment is persisted to the partition.
        UpdateTargetAssignmentResult<Assignment> updateTargetAssignmentResult = maybeUpdateTargetAssignment(
            group,
            groupEpoch,
            member,
            updatedMember,
            subscriptionType,
            records
        );

        // 3. Reconcile the member's assignment with the target assignment if the member is not
        // fully reconciled yet.
        updatedMember = maybeReconcile(
            groupId,
            updatedMember,
            group::currentPartitionEpoch,
            updateTargetAssignmentResult.targetAssignmentEpoch(),
            updateTargetAssignmentResult.targetAssignment(),
            group.resolvedRegularExpressions(),
            // Force consistency with the subscription when the subscription has changed.
            hasSubscriptionChanged,
            ownedTopicPartitions,
            records
        );
- 목표 할당(target assignment): 그룹 에포크가 목표 할당 에포크보다 크면, 브로커의 할당자(기본
uniform,GroupCoordinatorConfig.java221–233행)로 그룹 전체의 새 목표 할당을 계산합니다(maybeUpdateTargetAssignment(), 4346–4429행). 할당을 계산하는 쪽이 클라이언트의 리더에서 브로커로 옮겨 온 것입니다. 단, 직전 계산에서group.consumer.assignment.interval.ms(기본 1000) 가 지나지 않았으면 이번에는 계산하지 않고 다음에 들어오는 하트비트(어느 멤버의 것이든)로 미룹니다(4359–4366행,canComputeNextTargetAssignment()4312–4333행). 멤버가 한꺼번에 들어올 때 할당을 매번 다시 계산하지 않으려는 장치입니다. - 조정(reconcile): 목표는 그룹 전체의 그림이고, 이 멤버가 지금 당장 가질 수 있는 몫은 따로 계산합니다.
maybeReconcile()안의CurrentAssignmentBuilder가 그 일을 합니다.
모든 레코드는 records 목록에 모이고, 마지막에 응답과 함께 CoordinatorResult 로 돌려줍니다(2750행). 할당은 멤버가 처음 들어왔거나, 요청이 전체 필드를 실었거나, 이 멤버의 할당이 바뀌었을 때만 응답에 넣습니다(2739–2748행).
목표와 현재 사이: CurrentAssignmentBuilder
목표 할당이 A=[0,1,2], B=[3,4,5] 로 바뀌어도, B 에게 3·4·5 를 바로 주면 A 와 B 가 같은 파티션을 동시에 읽게 됩니다. A 가 아직 3·4·5 를 내놓았다고 알리지 않았기 때문입니다. CurrentAssignmentBuilder.computeNextAssignment() 가 이 틈을 메웁니다.
            // New Assigned Partitions = Previous Assigned Partitions ∩ Target
            Map<Integer, Integer> assignedPartitions = new HashMap<>(currentAssignedPartitions);
            assignedPartitions.keySet().retainAll(target);

            // Partitions Pending Revocation = Previous Assigned Partitions - New Assigned Partitions
            Map<Integer, Integer> partitionsPendingRevocation = new HashMap<>(currentAssignedPartitions);
            partitionsPendingRevocation.keySet().removeAll(assignedPartitions.keySet());

            // Partitions Pending Assignment = Target - New Assigned Partitions - Unreleased Partitions
            Set<Integer> partitionsPendingAssignment = new HashSet<>(target);
            partitionsPendingAssignment.removeAll(assignedPartitions.keySet());
            hasUnreleasedPartitions = partitionsPendingAssignment.removeIf(partitionId ->
                currentPartitionEpoch.apply(topicId, partitionId) != -1 &&
                // Don't consider a partition unreleased if it is owned by the current member
                // because it is pending revocation. This is safe to do since only a single member
                // can own a partition at a time.
                !member.partitionsPendingRevocation().getOrDefault(topicId, Map.of()).containsKey(partitionId)
            ) || hasUnreleasedPartitions;
주석이 그대로 집합 식입니다.
- 계속 가질 것 = 지금 가진 것 ∩ 목표
- 내놓아야 할 것 = 지금 가진 것 − 계속 가질 것
- 새로 받을 것 = 목표 − 계속 가질 것 − 아직 다른 멤버가 쥐고 있는 것(
currentPartitionEpoch(…) != -1)
내놓아야 할 것이 있으면 멤버는 에포크를 올리지 못하고 UNREVOKED_PARTITIONS 상태가 됩니다(425–435행). 받을 것 가운데 다른 멤버가 쥔 것이 있으면 에포크는 올리되 UNRELEASED_PARTITIONS 상태로 기다립니다(436–465행). 둘 다 없으면 STABLE 입니다. 이 세 상태(와 미래용 UNKNOWN)가 modern/MemberState.java 에 정의된 브로커 쪽 멤버 상태입니다 — 4절의 클라이언트 쪽 MemberState 와 이름이 같은 다른 enum 이니 헷갈리지 않게 조심합니다.
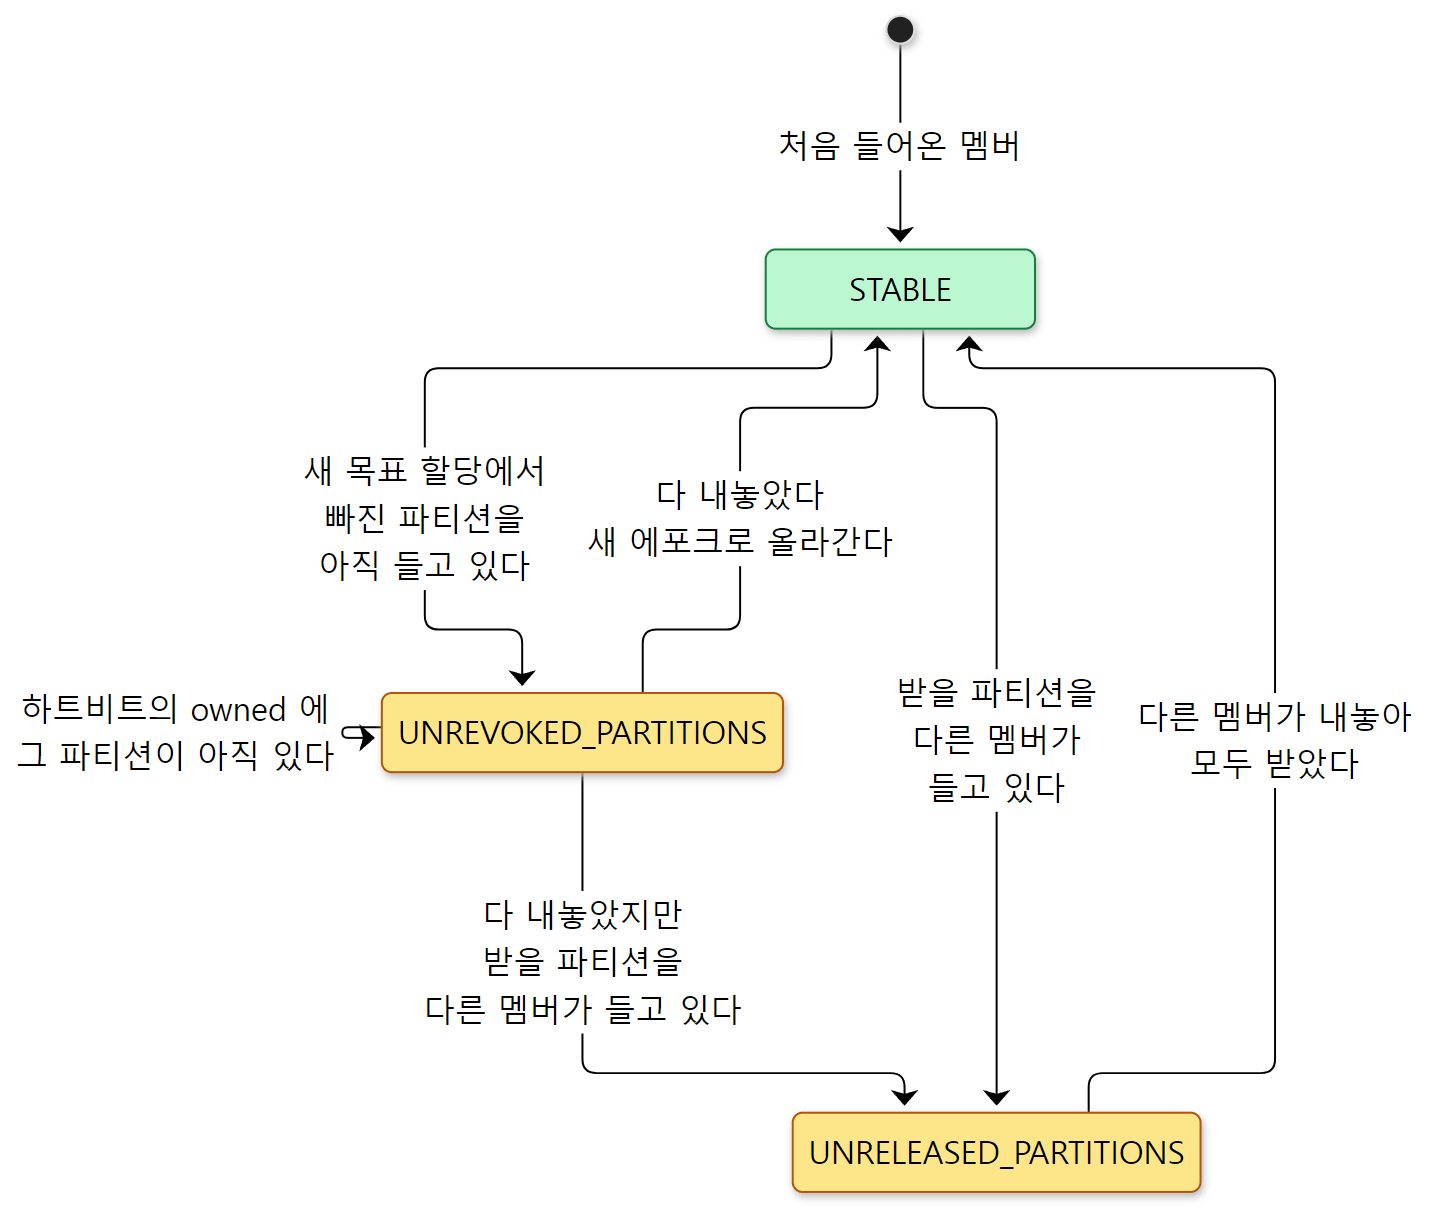
CurrentAssignmentBuilder.build()(187–260행)의 switch 를 그림으로 옮겼습니다. 기다리는 두 상태(노랑)에서 목표가 또 바뀌는 경우 같은 드문 화살표는 뺐습니다.
이 장치 덕분에 한 파티션은 어느 순간에도 한 멤버만 갖게 되고, 그러면서도 옮겨 가지 않는 파티션은 계속 읽힙니다. classic 의 EAGER 가 "모두 내려놓고 다시 받는" 방식으로 얻던 안전을, 파티션 단위로 얻는 것입니다.
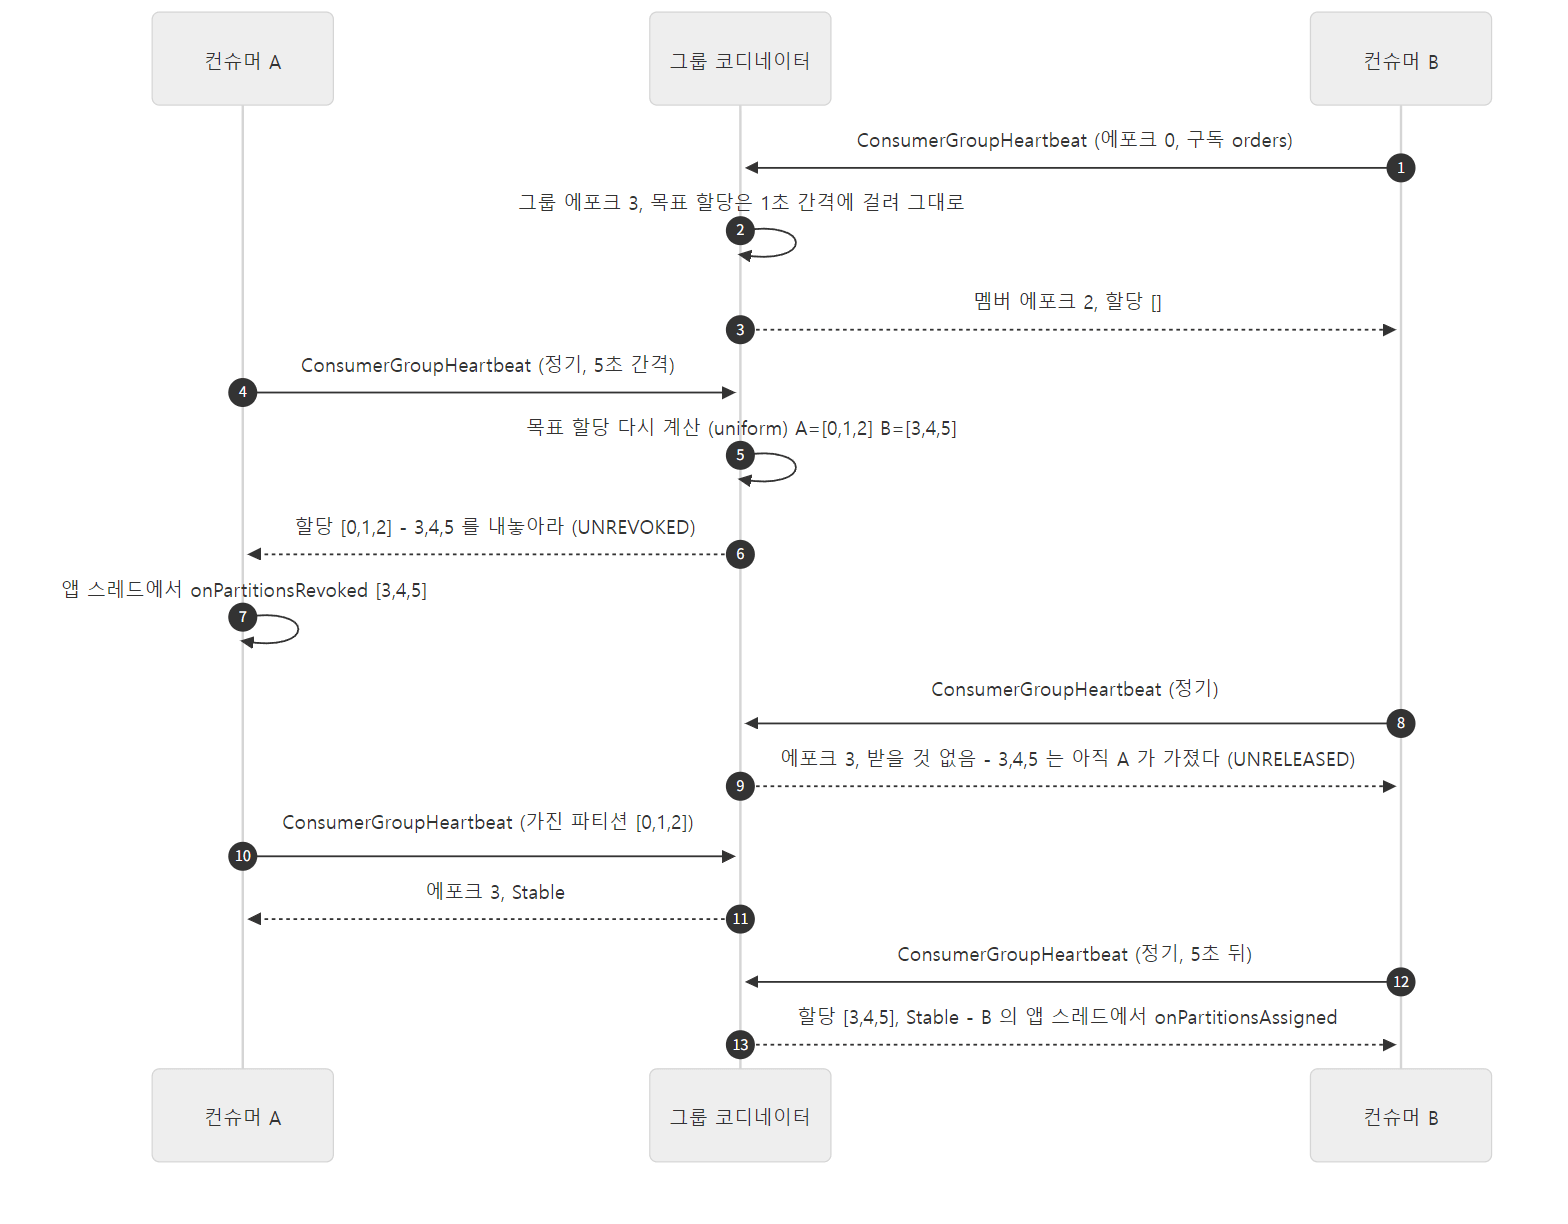 예제 1의 consumer 프로토콜 실행(위 출력)을 예제 3의 레코드와 맞춰 요청 단위로 그렸습니다. 8~11번의 순서는 실행마다 바뀔 수 있습니다. 3번 뒤에 B 의
onPartitionsAssigned [] 가 한 번 불리는 것은 그림에서 뺐습니다.
예제 2: kafka-consumer-groups.sh 로 본 두 그룹
예제 1을 돌리는 동안, A 와 B 가 자리를 잡은 때에 같은 컨테이너에서 kafka-consumer-groups.sh --describe --state 와 --describe --members --verbose 를 불렀습니다.
=== 1. group.protocol=classic
--- kafka-consumer-groups.sh --describe --state (while A and B are stable)

GROUP           COORDINATOR (ID)          ASSIGNMENT-STRATEGY  STATE                #MEMBERS
g-classic       localhost:9092  (1)       range                Stable               2
--- kafka-consumer-groups.sh --describe --members

GROUP           CONSUMER-ID                                      HOST            CLIENT-ID       #PARTITIONS     CURRENT-EPOCH   CURRENT-ASSIGNMENT   TARGET-EPOCH    TARGET-ASSIGNMENT
g-classic       g-classic-A-386cac32-ece8-4c7b-a804-fec4152c1e6e /127.0.0.1      g-classic-A     3               -               orders:0,1,2         -               -
g-classic       g-classic-B-e2fd2ef9-937d-4eb2-8c87-370a1089cb72 /127.0.0.1      g-classic-B     3               -               orders:3,4,5         -               -
=== 2. group.protocol=consumer
--- kafka-consumer-groups.sh --describe --state (while A and B are stable)

GROUP           COORDINATOR (ID)          ASSIGNMENT-STRATEGY  STATE                #MEMBERS
g-consumer      localhost:9092  (1)       uniform              Stable               2
--- kafka-consumer-groups.sh --describe --members

GROUP           CONSUMER-ID            HOST            CLIENT-ID       #PARTITIONS     CURRENT-EPOCH   CURRENT-ASSIGNMENT   TARGET-EPOCH    TARGET-ASSIGNMENT
g-consumer      dHHCFy_6RmWBvpyk1U7leQ /127.0.0.1      g-consumer-A    3               3               orders:0,1,2         3               orders:0,1,2
g-consumer      90SoJ7ajR6eTABfmOMF6Fw /127.0.0.1      g-consumer-B    3               3               orders:3,4,5         3               orders:3,4,5
- classic 그룹의 할당 전략은
range(클라이언트 할당자 이름), consumer 그룹은uniform(브로커 할당자 이름)입니다. - 멤버 id 모양이 다릅니다. classic 은 브로커가
client.id + "-" + UUID로 만들고(ClassicGroup.generateMemberId(), 782–785행), consumer 프로토콜은 클라이언트가 만든 22자짜리 UUID(base64) 입니다. - consumer 그룹에만
CURRENT-EPOCH·TARGET-EPOCH와 목표 할당이 보입니다. 브로커가 멤버마다 "목표"와 "현재"를 따로 들고 있다는 것이 도구 출력에도 드러납니다. classic 그룹은 그 칸이-입니다.
6. CoordinatorRuntime — 상태를 로그에 쓰고, 로그에서 되살린다
5절에서 GroupMetadataManager 는 레코드 목록과 응답을 돌려줄 뿐, 직접 디스크에 쓰지 않았습니다. 쓰는 일은 coordinator-common 모듈의 CoordinatorRuntime 이 합니다. 이 모듈은 그룹 코디네이터와 공유 그룹 코디네이터가 함께 쓰는 공통 런타임입니다(12편의 트랜잭션 코디네이터는 아직 이것을 쓰지 않는 Scala 코드입니다).
런타임은 __consumer_offsets 파티션마다 상태 기계 하나를 둡니다. 브로커가 어떤 파티션의 리더가 되면 그 파티션의 상태 기계를 만들고, 그 그룹들에 대한 모든 요청을 그 상태 기계에서 처리합니다. 작업은 이벤트 큐에 들어가고, group-coordinator-event-processor-N 스레드들이 꺼내 실행합니다. 스레드 수는 group.coordinator.threads(기본 4, GroupCoordinatorConfig.java 103행)이고, 같은 파티션의 이벤트는 한 번에 하나만 실행됩니다(EventAccumulator 의 javadoc, 35–45행). 그래서 GroupMetadataManager 안에는 잠금이 거의 없습니다 — 한 그룹의 상태는 늘 한 스레드만 만지기 때문입니다.
쓰기 작업이 실행되는 곳은 CoordinatorWriteEvent.run() 입니다.
        public void run() {
            try {
                // Get the context of the coordinator or fail if the coordinator is not in active state.
                withActiveContextOrThrow(tp, context -> {
                    // Execute the operation.
                    result = op.generateRecordsAndResult(context.coordinator.coordinator());

                    // Append the records and replay them to the state machine.
                    context.append(
                        producerId,
                        producerEpoch,
                        verificationGuard,
                        result.records(),
                        result.replayRecords(),
                        result.isAtomic(),
                        this
                    );

                    // ...
                });
            } catch (Throwable t) {
                complete(t);
            }
        }
op.generateRecordsAndResult(…) 가 5절의 consumerGroupHeartbeat() 같은 메서드를 부르는 자리이고, context.append(…) 가 그 결과를 처리합니다. append() 의 순서가 이 설계의 핵심입니다.
                    try {
                        if (replay) {
                            coordinator.replay(
                                currentBatch.nextOffset,
                                producerId,
                                producerEpoch,
                                recordToReplay
                            );
                        }

                        currentBatch.builder.append(recordToAppend);
                        currentBatch.nextOffset++;
- 레코드를 먼저 메모리 상태에 적용합니다(
replay()). consumer 프로토콜 그룹이라면GroupMetadataManager는 요청을 처리할 때 상태를 직접 고치지 않고 "이렇게 바꾸겠다" 는 레코드만 만들고, 상태는replay()에서 바뀝니다. (classic 그룹은 예외입니다. 멤버 추가·삭제나PreparingRebalance같은 상태 전이를ClassicGroup객체에 직접 하고 — 예:prepareRebalance()의group.transitionTo(PREPARING_REBALANCE), 7979행 — 세대가 바뀔 때GroupMetadata레코드 하나로 결과를 남깁니다.) - 같은 레코드를 배치(
MemoryRecordsBuilder, 6편의 레코드 배치)에 덧붙입니다. - 배치를 내보낼 때(
flushCurrentBatch())partitionWriter.append(…)로__consumer_offsets-N에 씁니다(712–717행). 이것은 프로듀서의 레코드와 같은 길 —ReplicaManager를 거쳐UnifiedLog로 — 을 탑니다. - 응답은 바로 보내지 않습니다. 이벤트를
deferredEventQueue에 그 배치의 오프셋과 함께 넣어 두고(738행), 그 파티션의 하이 워터마크가 그 오프셋을 넘으면 완료합니다(onHighWatermarkUpdated()→deferredEventQueue.completeUpTo(newHighWatermark), 1810–1831행). 레코드가 ISR 에 다 복제되어 리더가 바뀌어도 잃지 않을 때에야 클라이언트에게 "됐다" 고 답하는 것입니다.
메모리 상태를 먼저 고쳤는데 쓰기가 실패하면 어떻게 될까요. 메모리 상태는 TimelineHashMap 같은 되돌릴 수 있는 자료구조(10편에서 본 SnapshotRegistry 위의 자료구조)로 되어 있습니다. 배치를 로그에 쓸 때마다 그 오프셋에서 스냅숏을 찍어 두고(SnapshottableCoordinator.updateLastWrittenOffset(), 139–148행), 다음 배치가 실패하면 failCurrentBatch() 가 revertLastWrittenOffset(배치 시작 오프셋) 으로 그 스냅숏까지 되돌립니다(CoordinatorRuntime.java 786–792행, SnapshottableCoordinator.java 85–96행). 하이 워터마크가 넘어간 스냅숏은 더 필요 없으니 지웁니다(updateLastCommittedOffset() 의 deleteSnapshotsUpTo(), 158–172행). 컨트롤러도 메타데이터 로그에 대해 같은 SnapshotRegistry 로 같은 일을 합니다(metadata/…/controller/OffsetControlManager.java 271·328행).
오프셋 커밋도 똑같은 길입니다. GroupCoordinatorService.commitOffsets() 는 "commit-offset" 이라는 이름으로 scheduleWriteOperation() 을 부르고(2374–2384행), OffsetMetadataManager.commitOffset() 은 커밋할 파티션마다 GroupCoordinatorRecordHelpers.newOffsetCommitRecord(그룹, 토픽, 파티션, 오프셋) 레코드를 하나씩 만들어 돌려줍니다(665–670행). commitSync() 가 돌아왔다는 것은 이 레코드가 __consumer_offsets 에 쓰이고 하이 워터마크를 넘었다는 뜻입니다.
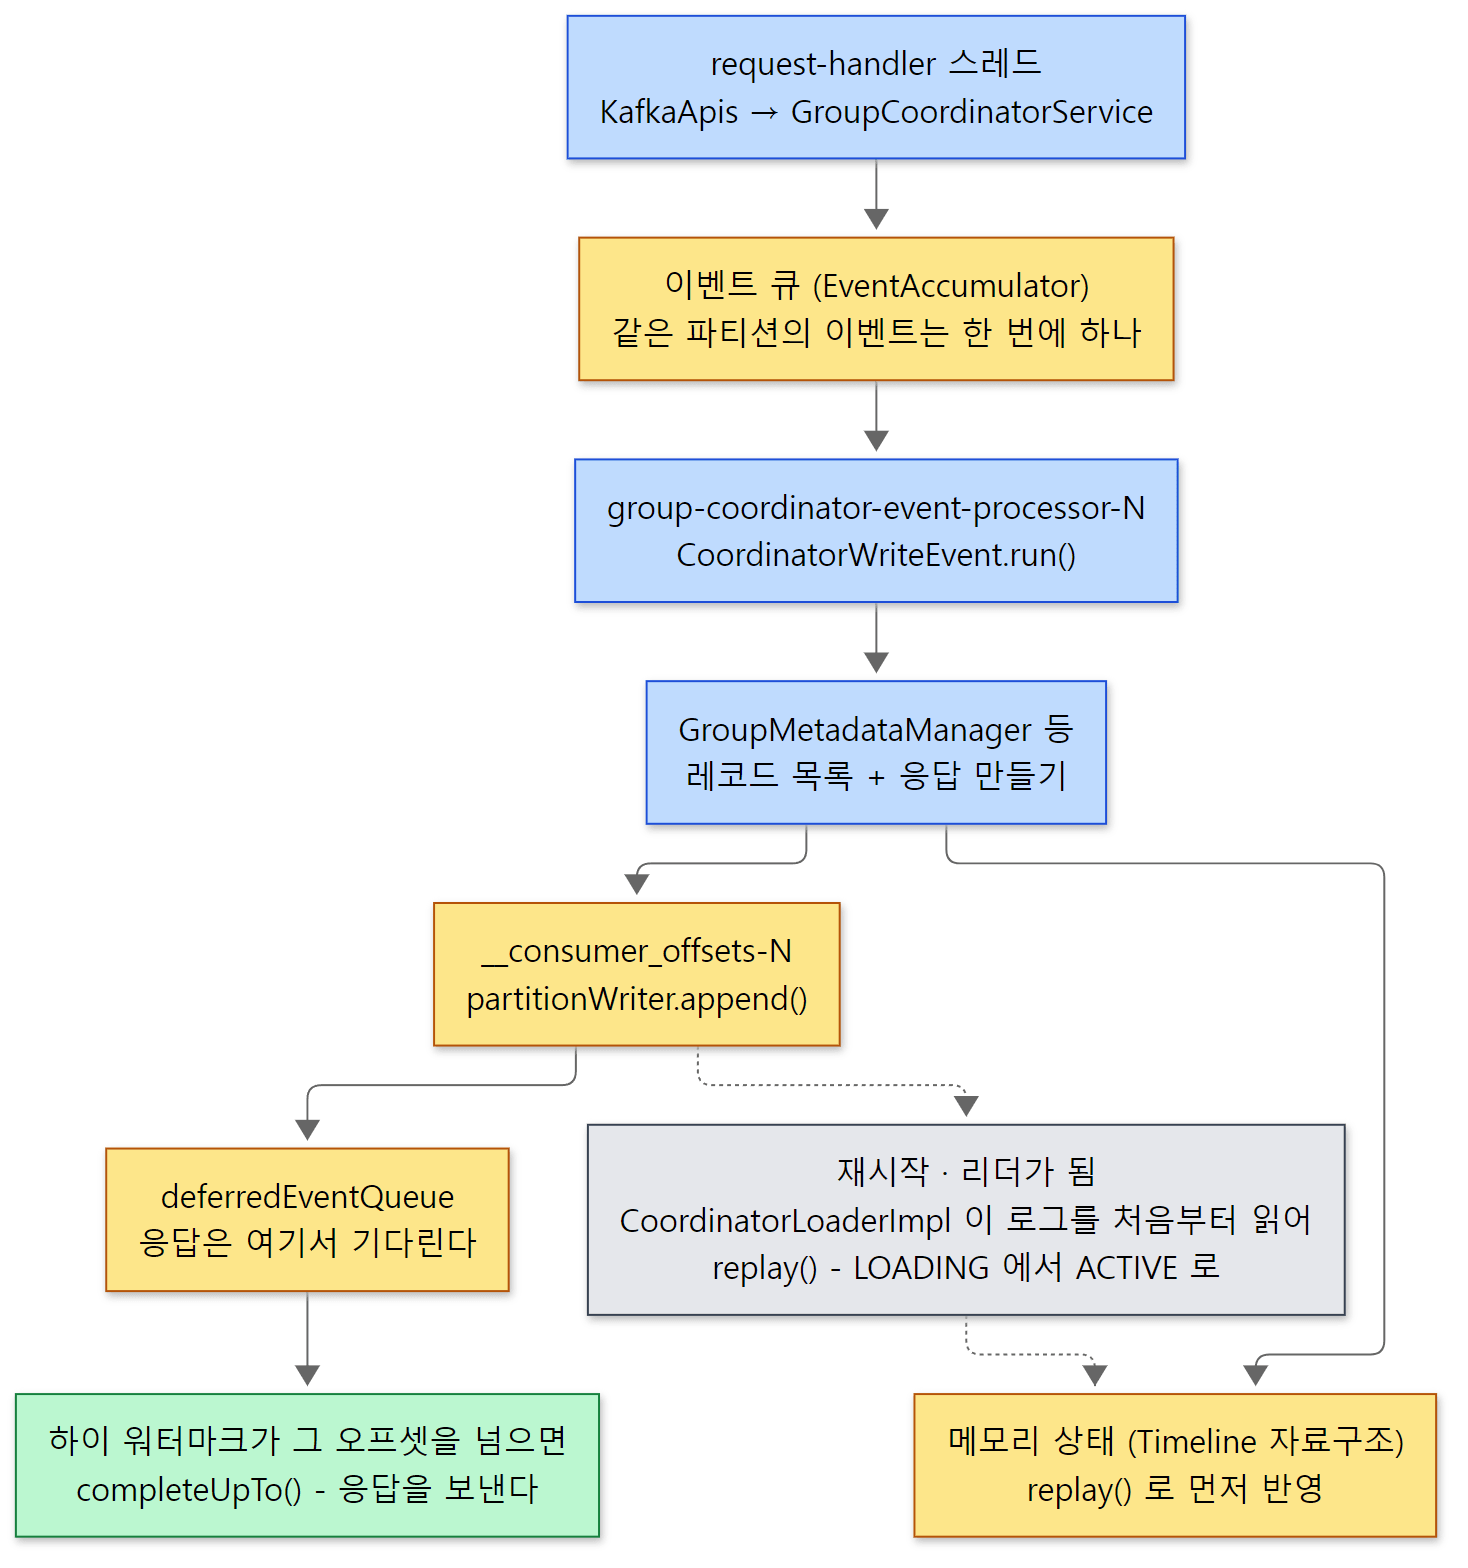 노란 상자가 상태가 머무는 곳입니다. 점선은 브로커가 다시 켜지거나 파티션의 리더가 되었을 때의 복원 경로입니다.
로그에서 되살리기
로그에 남는 것이 상태의 변화 전부라는 것은, 로그를 처음부터 다시 읽어 replay() 하면 같은 상태가 나온다는 뜻이기도 합니다(classic 그룹은 마지막 GroupMetadata 레코드에서 그 세대의 멤버와 함께 Empty 나 Stable 로 되살아납니다 — 리밸런스 도중의 상태는 로그에 없습니다, 7094행). 브로커가 __consumer_offsets 파티션의 리더가 되면(BrokerMetadataPublisher 가 groupCoordinator.onElection 을 부릅니다, 158행) 런타임은 그 파티션의 상태 기계를 LOADING 상태로 만들고 CoordinatorLoaderImpl 에게 읽게 합니다.
            long currentOffset = log.logStartOffset();
            LoadStats stats = new LoadStats();

            long lastCommittedOffset = -1L;
            while (shouldFetchNextBatch(currentOffset, logEndOffset(tp), stats.readAtLeastOneRecord)) {
                FetchDataInfo fetchDataInfo = log.read(currentOffset, loadBufferSize, FetchIsolation.LOG_END, true);

                stats.readAtLeastOneRecord = fetchDataInfo.records.sizeInBytes() > 0;

                // ...
                MemoryRecords memoryRecords = toReadableMemoryRecords(tp, fetchDataInfo.records, buffer);
                // ...

                ReplayResult replayResult = processMemoryRecords(tp, log, memoryRecords, coordinator, stats, currentOffset, lastCommittedOffset);
                currentOffset = replayResult.nextOffset;
                lastCommittedOffset = replayResult.lastCommittedOffset;
            }
로그 시작 오프셋부터 끝까지 UnifiedLog.read()(8편에서 본 그 메서드)로 읽어, 레코드마다 coordinator.replay(…) 를 부릅니다(processMemoryRecords() 안, 281–286행). 다 읽으면 상태 기계가 ACTIVE 가 되고 "Finished loading of metadata from …" 로그를 남깁니다(CoordinatorRuntime.java 594–600행). 그 전까지 이 파티션의 그룹에 오는 요청은 COORDINATOR_LOAD_IN_PROGRESS 오류를 받고(CoordinatorRuntime.java 2096–2097행), 클라이언트는 잠시 뒤 다시 시도합니다(classic 쪽 처리는 AbstractCoordinator.java 686–689행).
로그가 끝없이 길어지지 않는 것은 __consumer_offsets 가 컴팩션(같은 키의 옛 값은 지우고 마지막 값만 남기기, 7편) 토픽이기 때문입니다(토픽 설정은 GroupCoordinatorService.java 2610행). 레코드의 키가 "그룹 + 멤버" 나 "그룹 + 토픽 + 파티션" 이라서, 컴팩션이 끝나면 키마다 마지막 상태만 남습니다. 멤버가 떠나면 그 멤버의 키에 값이 없는 레코드(톰스톤, tombstone)를 써서 컴팩션 때 지워지게 합니다.
예제 3: __consumer_offsets 안의 레코드
예제 1이 끝난 뒤, 두 그룹이 쓴 파티션(18번, 32번)을 kafka-dump-log.sh --offsets-decoder 로 풀었습니다. 이 도구는 키·값을 JSON 으로 보여 주는데, 줄이 길어서 키의 type 번호를 레코드 이름으로 바꾸고 필드 몇 개만 남겨 한 줄씩 줄였습니다(OffsetCommit 레코드는 개수만 셉니다. 줄이는 데 쓴 fmt.awk 는 예제 폴더에 있습니다). 멤버 id 와, 자동 커밋이 끼어드는 자리에 따라 레코드 번호·OffsetCommit 개수는 실행마다 다릅니다.
=== 4. __consumer_offsets records
--- g-classic -> __consumer_offsets-18
  0  GroupMetadata                                       generation=0 protocol=null leader=null members=0
  1  GroupMetadata                                       generation=1 protocol=range leader=g-classic-A-3.. members=1
  8  GroupMetadata                                       generation=2 protocol=range leader=g-classic-A-3.. members=2
 36  GroupMetadata                                       generation=3 protocol=range leader=g-classic-A-3.. members=1
 37  GroupMetadata                                       generation=4 protocol=null leader=null members=0
(+ 33 OffsetCommit records)
--- g-consumer -> __consumer_offsets-32
  0  ConsumerGroupMemberMetadata            member=dHHC  clientId=g-consumer-A
  1  ConsumerGroupMetadata                               groupEpoch=2
  2  ConsumerGroupTargetAssignmentMember    member=dHHC  target=[0,1,2,3,4,5]
  3  ConsumerGroupTargetAssignmentMetadata               assignmentEpoch=2
  4  ConsumerGroupCurrentMemberAssignment   member=dHHC  memberEpoch=2 state=0 assigned=[0,1,2,3,4,5] pending=
  5  ConsumerGroupMemberMetadata            member=90So  clientId=g-consumer-B
  6  ConsumerGroupMetadata                               groupEpoch=3
  7  ConsumerGroupCurrentMemberAssignment   member=90So  memberEpoch=2 state=0 assigned= pending=
  8  ConsumerGroupTargetAssignmentMember    member=dHHC  target=[0,1,2]
  9  ConsumerGroupTargetAssignmentMember    member=90So  target=[3,4,5]
 10  ConsumerGroupTargetAssignmentMetadata               assignmentEpoch=3
 11  ConsumerGroupCurrentMemberAssignment   member=dHHC  memberEpoch=2 state=1 assigned=[0,1,2] pending=[3,4,5]
 24  ConsumerGroupCurrentMemberAssignment   member=90So  memberEpoch=3 state=2 assigned= pending=
 25  ConsumerGroupCurrentMemberAssignment   member=dHHC  memberEpoch=3 state=0 assigned=[0,1,2] pending=
 26  ConsumerGroupCurrentMemberAssignment   member=90So  memberEpoch=3 state=0 assigned=[3,4,5] pending=
 51  ConsumerGroupCurrentMemberAssignment   member=90So  <DELETE>
 52  ConsumerGroupTargetAssignmentMember    member=90So  <DELETE>
 53  ConsumerGroupMemberMetadata            member=90So  <DELETE>
 54  ConsumerGroupMetadata                               groupEpoch=4
 55  ConsumerGroupTargetAssignmentMember    member=dHHC  target=[0,1,2,3,4,5]
 56  ConsumerGroupTargetAssignmentMetadata               assignmentEpoch=4
 57  ConsumerGroupCurrentMemberAssignment   member=dHHC  memberEpoch=4 state=0 assigned=[0,1,2,3,4,5] pending=
 64  ConsumerGroupCurrentMemberAssignment   member=dHHC  <DELETE>
 65  ConsumerGroupTargetAssignmentMember    member=dHHC  <DELETE>
 66  ConsumerGroupMemberMetadata            member=dHHC  <DELETE>
 67  ConsumerGroupMetadata                               groupEpoch=5
 68  ConsumerGroupTargetAssignmentMetadata               assignmentEpoch=5
(+ 42 OffsetCommit records)
키의 type 번호는 레코드 스키마 JSON 의 apiKey 입니다. group-coordinator/src/main/resources/common/message/ 에서 확인했습니다 — OffsetCommitKey(1), GroupMetadataKey(2), ConsumerGroupMetadataKey(3), ConsumerGroupMemberMetadataKey(5), ConsumerGroupTargetAssignmentMetadataKey(6), ConsumerGroupTargetAssignmentMemberKey(7), ConsumerGroupCurrentMemberAssignmentKey(8). 이 스키마들도 3편의 요청·응답처럼 빌드 때 Java 클래스로 생성됩니다.
- classic 그룹은 그룹 하나에
GroupMetadata레코드 하나입니다. 세대가 바뀔 때마다 멤버 전원과 할당을 통째로 담은 값을 다시 씁니다. 리더(g-classic-A…)가 계산한 할당이 바이트로 그대로 들어 있습니다. - consumer 그룹은 상태를 잘게 나눠 씁니다. 그룹 에포크(
ConsumerGroupMetadata), 멤버 정보(MemberMetadata), 멤버마다의 목표(TargetAssignmentMember)와 목표 에포크(TargetAssignmentMetadata), 멤버마다의 현재 할당(CurrentMemberAssignment)이 각각 다른 키입니다. 목표 할당도 이전과 달라진 멤버의 것만 씁니다(2705–2706행의 주석). classic 처럼 세대마다 그룹 전체를 값 하나에 다시 쓰지 않습니다. state숫자는modern/MemberState.java의 값입니다 — 0 =STABLE, 1 =UNREVOKED_PARTITIONS, 2 =UNRELEASED_PARTITIONS(32–45행). 5절의 상태 그림이 레코드로 남은 것입니다.- 0~4번은 A 가 들어온 때, 5~7번은 B 가 들어온 때입니다. B 가 들어와 그룹 에포크는 3 이 됐지만(6번), 목표 할당은 다시 계산되지 않았고 B 의 현재 할당은 에포크 2 의 빈 할당입니다(7번). 덤프의 원래 줄을 보면 A 의 목표를 계산한 시각(3번 레코드의
assignmentTimestamp)과 B 의 레코드가 쓰인 시각(CreateTime)이 344ms 차이였습니다.group.consumer.assignment.interval.ms(1000ms)가 지나지 않아 계산을 미룬 것입니다(5절). - 8~11번은 약 4.9초 뒤 A 의 정기 하트비트 때 쓰였습니다. 새 목표(A=[0,1,2], B=[3,4,5], 에포크 3)를 계산하고, A 는 3·4·5 를 내놓아야 해서 에포크 2 에 머문 채
state=1(UNREVOKED) 이 됩니다. - 24번: B 가 에포크 3 으로 올라갔지만 받을 3·4·5 를 A 가 아직 쥐고 있어
state=2(UNRELEASED), 빈 할당입니다. 25번: 7ms 뒤 A 가 내놓았다고 알려STABLE. 26번: 5초 뒤 B 의 다음 하트비트에서 B 가 3·4·5 를 받습니다. 예제 1에서 B 가[3, 4, 5]를 받기까지 10초가 걸린 까닭이 이것입니다. - 51~53번: B 가 떠나며(에포크 -1 하트비트) B 의 세 키에
<DELETE>(톰스톤)가 쓰이고, 그룹 에포크가 4 로 올라 A 가 6개를 모두 받습니다. 64~68번은 A 가 떠난 때입니다. 멤버는 없어도 그룹과 커밋된 오프셋은 남습니다(예제 4의 출력). - 중간에 빈 번호(12~23 등)는 자동 커밋이 쓴 OffsetCommit 레코드입니다.
예제 4: 브로커를 다시 켜면
마지막으로 서버를 정상 종료하고 다시 띄운 뒤, 두 파티션의 로딩 로그와 g-consumer 의 커밋된 오프셋을 다시 봤습니다. 끝에는 브로커의 jstack 에서 그룹 코디네이터 스레드 이름만 뽑았습니다.
=== 5. restart the server: the coordinator replays its partitions
Finished loading of metadata from __consumer_offsets-18 with epoch 2 in 290ms where 248ms was spent in the scheduler. Loaded 38 records which total to 4268 bytes. (org.apache.kafka.coordinator.common.runtime.CoordinatorRuntime)
Finished loading of metadata from __consumer_offsets-32 with epoch 2 in 246ms where 7ms was spent in the scheduler. Loaded 69 records which total to 6233 bytes. (org.apache.kafka.coordinator.common.runtime.CoordinatorRuntime)

GROUP           TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG             CONSUMER-ID     HOST            CLIENT-ID
g-consumer      orders          0          10              10              0               -               -               -
g-consumer      orders          1          9               9               0               -               -               -
g-consumer      orders          2          13              13              0               -               -               -
g-consumer      orders          3          6               6               0               -               -               -
g-consumer      orders          4          14              14              0               -               -               -
g-consumer      orders          5          8               8               0               -               -               -
--- group coordinator threads in the broker (jstack)
"group-coordinator-event-processor-0"
"group-coordinator-event-processor-1"
"group-coordinator-event-processor-2"
"group-coordinator-event-processor-3"
"group-coordinator-reaper"
stopped
Loaded N records 는 그 파티션의 레코드를 처음부터 다시 읽어 replay() 한 개수입니다. 예제 3에서 센 레코드 수(그룹 레코드 + OffsetCommit)와 같습니다(개수와 걸린 시간·바이트 수는 실행마다 다릅니다). 메모리에 있던 그룹 상태는 서버와 함께 사라졌지만, 로그에서 그대로 다시 만들어져 커밋된 오프셋이 재시작 전과 같습니다. 스레드는 group-coordinator-event-processor-0 ~ -3(기본 4개, GroupCoordinatorService.java 263–269행)과, 세션 만료·rebalance timeout 같은 타이머를 돌리는 group-coordinator-reaper(BrokerServer.scala 695–698행)가 보입니다. 정규식 해석 같은 무거운 일을 맡는 group-coordinator-background-… 풀(271–276행)은 보이지 않는데, 이 풀은 JDK 의 ThreadPoolExecutor 를 이어받은 것이라 일이 처음 들어올 때 스레드를 만들고, 이 예제에는 그런 일이 없었기 때문입니다.
7. 설정 한눈에
지금까지 나온 설정을 모았습니다. 기본값은 모두 define(…) 에 넘기는 상수에서 확인했습니다.
| 설정 | 어디 | 기본값 | 쓰는 곳 · 하는 일 |
|---|---|---|---|
group.protocol |
컨슈머 | classic |
ConsumerDelegateCreator 가 ClassicKafkaConsumer/AsyncKafkaConsumer 를 고른다 |
partition.assignment.strategy |
컨슈머(classic) | [RangeAssignor, CooperativeStickyAssignor] |
리더가 할당을 계산. 공통 프로토콜이 EAGER 라 기본은 eager |
heartbeat.interval.ms |
컨슈머(classic) | 3000 | 하트비트 스레드의 간격. 리밸런스를 알아차리는 데 걸리는 시간 |
session.timeout.ms |
컨슈머(classic) | 45000 | 하트비트가 끊긴 멤버를 빼는 시간 |
max.poll.interval.ms |
컨슈머 | 300000 | poll() 사이의 최대 시간. 넘으면 스스로 떠난다. classic 에서는 rebalance timeout 도 된다 |
enable.auto.commit / auto.commit.interval.ms |
컨슈머 | true / 5000 |
시간마다 비동기 커밋. classic 은 poll() 안에서, consumer 는 poll 이벤트를 받은 백그라운드 스레드가(CommitRequestManager.updateTimerAndMaybeCommit()) |
group.remote.assignor |
컨슈머(consumer) | 없음 | 브로커의 어느 할당자를 쓸지 고른다 |
group.consumer.assignors |
브로커 | uniform, range |
첫 번째가 기본 할당자 |
group.consumer.heartbeat.interval.ms |
브로커 | 5000 | 응답에 실어 클라이언트에 알려 주는 하트비트 간격 |
group.consumer.session.timeout.ms |
브로커 | 45000 | consumer 프로토콜 멤버의 세션 |
group.consumer.assignment.interval.ms |
브로커 | 1000 | 목표 할당을 다시 계산하는 최소 간격 |
group.initial.rebalance.delay.ms |
브로커(classic) | 3000 | 빈 그룹에 첫 멤버가 왔을 때 더 기다리는 시간 |
group.coordinator.threads |
브로커 | 4 | group-coordinator-event-processor-N 스레드 수 |
offsets.topic.num.partitions |
브로커 | 50 | __consumer_offsets 파티션 수. 그룹 → 파티션 계산의 나머지 |
ConsumerConfig.java 460–499행, GroupCoordinatorConfig.java 460–494행
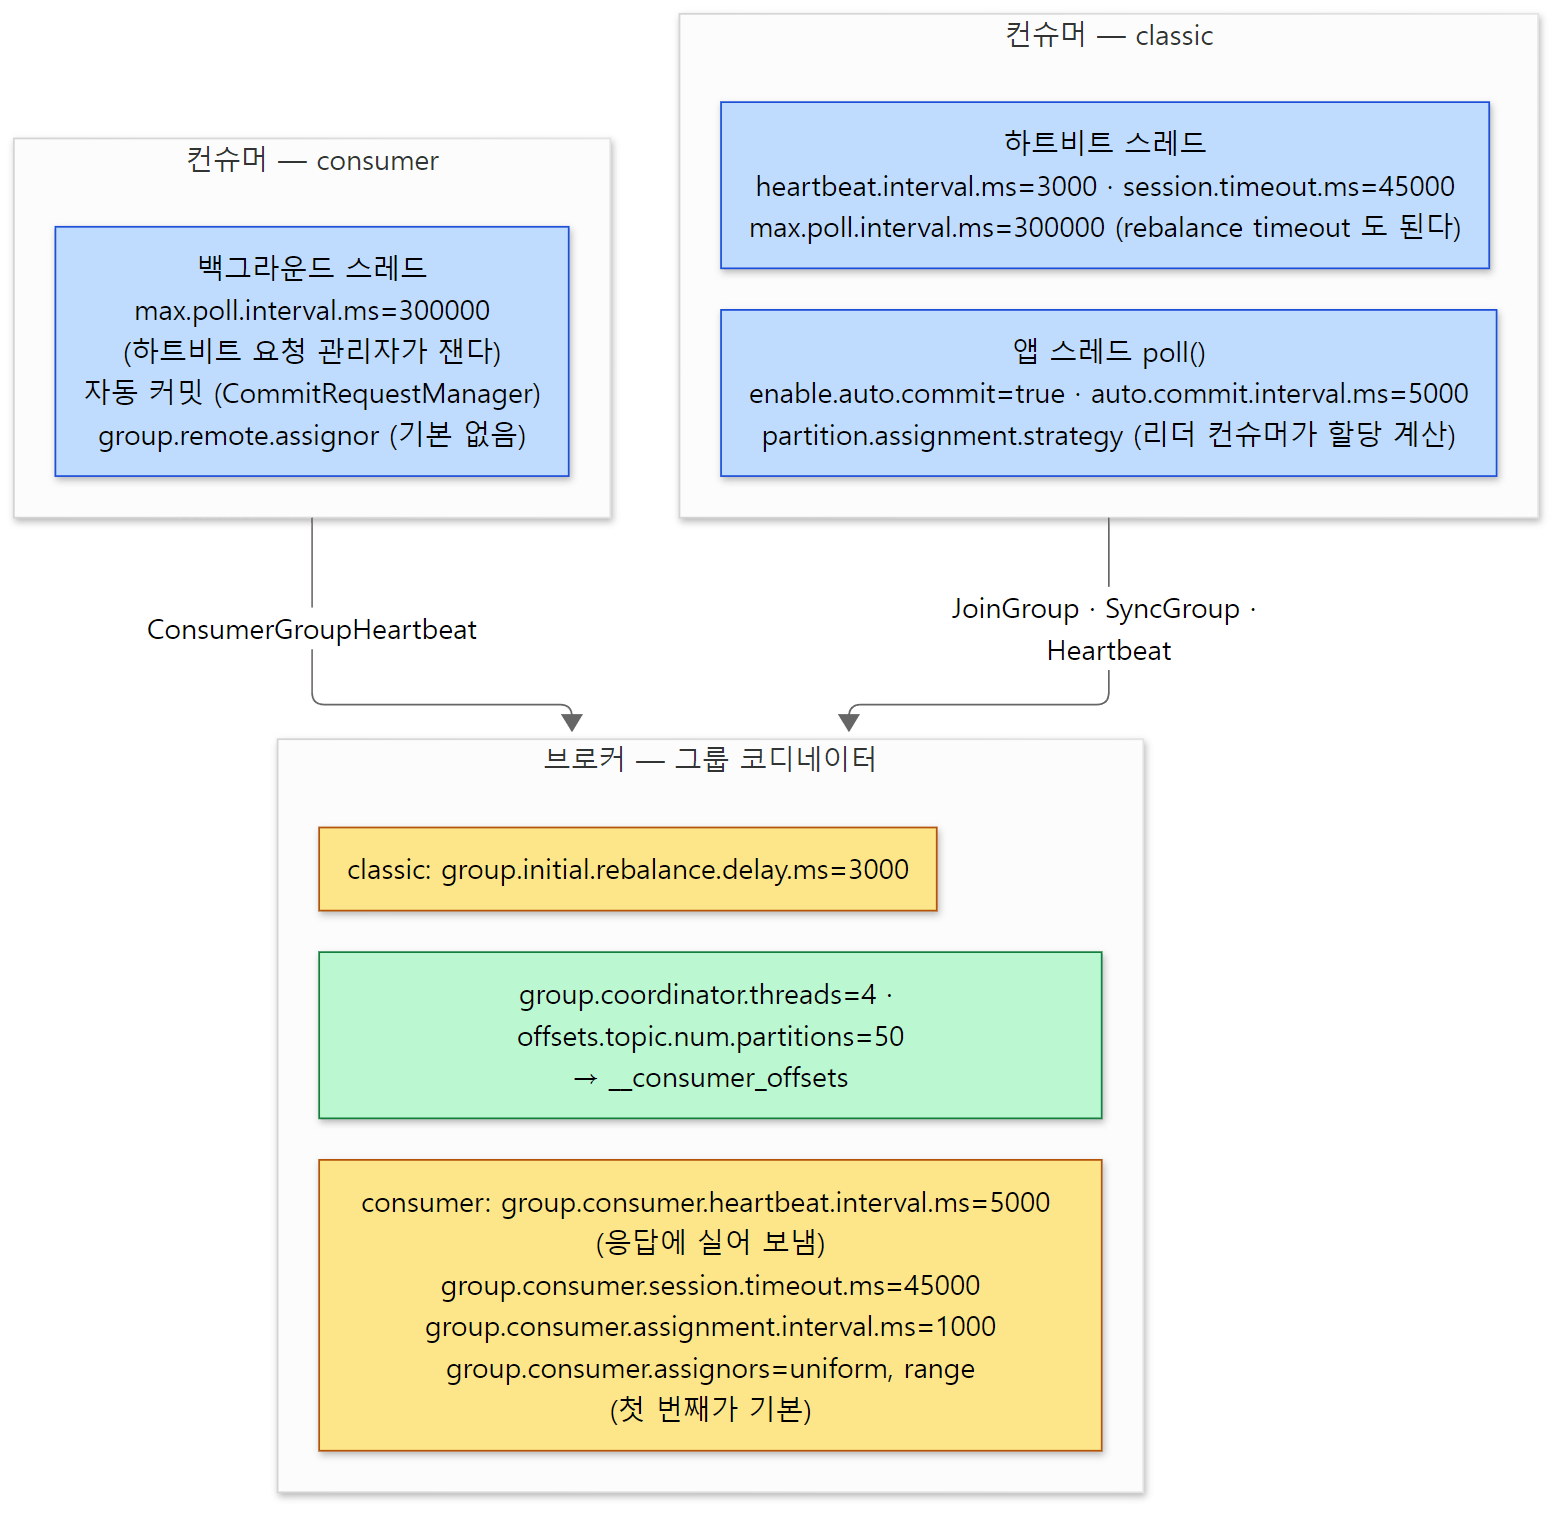 위 표의 설정을 쓰는 자리별로 다시 나눈 그림입니다. 값은 모두 표의 기본값입니다.
브로커 쪽에서 consumer 프로토콜을 쓰려면 기능 플래그 group.version 이 1 이상이고, 브로커 설정 group.coordinator.rebalance.protocols 에 consumer 가 들어 있어야 합니다(KafkaApis.isConsumerGroupProtocolEnabled(), 2675–2678행). 뒤의 설정은 기본값에 classic·consumer·streams 가 모두 들어 있고, 5.0 에서 없앨 예정이라고 deprecated 표시가 붙어 있습니다(GroupCoordinatorConfig.java 82–92행). 예제의 서버는 kafka-storage.sh format 으로 새로 만든 것이고, consumer 프로토콜 실행이 그대로 성공했으니 처음부터 켜져 있었습니다(예제의 kafka-features.sh describe 출력은 run.sh 가 앞 여섯 칸만 잘라 찍어서, 지원 범위 SupportedMaxVersion: 1 까지만 보이고 실제 적용된 레벨 칸은 잘렸습니다). 옛 클러스터를 올린 경우라면 따로 올려야 할 수 있습니다(소스로 확인한 것은 이 조건식까지입니다).
이 글에서 뺀 것
- 클래식 멤버와 새 멤버가 한 그룹에 섞이는 경우(온라인 마이그레이션,
group.consumer.migration.policy):GroupMetadataManager.classicGroupJoinToConsumerGroup()2763행부터,ConsumerGroupMigrationPolicy.java - 고정 멤버(static membership,
group.instance.id):GroupMetadataManager.getOrMaybeSubscribeStaticConsumerGroupMember(),ClassicGroup.java의staticMembers - 정규식 구독(
subscribe(Pattern),SubscriptionPattern)과 브로커의 정규식 해석:modern/consumer/TopicRegexResolver.java,GroupMetadataManager.maybeUpdateRegularExpressions() - 할당자 자체의 알고리즘:
group-coordinator/…/assignor/UniformAssignor.java(와uniform2/),RangeAssignor.java, 클라이언트의CooperativeStickyAssignor.java·AbstractStickyAssignor.java - 오프셋 만료와 그룹 삭제:
OffsetExpirationConditionImpl.java,OffsetMetadataManager.cleanupExpiredOffsets() - 컨슈머의 위치 관리와 Fetch 결과 해석:
ConsumerSubscriptionState.java,FetchCollector.java,OffsetFetcher.java·OffsetsRequestManager.java(8편과 이어짐) - 트랜잭션 오프셋 커밋(
TxnOffsetCommit,OffsetMetadataManager.commitTransactionalOffset()): 12편 - Kafka Streams 그룹(
streams/,StreamsGroupHeartbeat)과 공유 그룹(share-coordinator/,KafkaShareConsumer,ShareGroupHeartbeat) — 이 연재 전체에서 뺍니다
정리
| 개념 | 한 줄 요약 |
|---|---|
KafkaConsumer |
필드 하나(delegate)짜리 껍데기. ConsumerDelegateCreator 가 group.protocol 로 구현을 고른다 |
group.protocol |
classic(기본) = JoinGroup·SyncGroup, 리더 컨슈머가 할당 / consumer = ConsumerGroupHeartbeat, 브로커가 할당 |
ClassicKafkaConsumer |
poll() 안에서 앱 스레드가 리밸런스·자동 커밋·Fetch 를 하고, 하트비트 스레드는 Heartbeat 만 |
| classic 의 기본 리밸런스 | [Range, CooperativeSticky] 의 공통 프로토콜이 EAGER 라 전부 내놓고 다시 받는다 |
AsyncKafkaConsumer |
앱 스레드는 이벤트를 넣고 결과를 기다린다. consumer_background_thread 가 RequestManager 들로 네트워크를 전부 한다 |
| 리밸런스 콜백 | 두 구현 모두 poll() 을 부른 스레드에서. 새 구현은 백그라운드 이벤트로 넘겨 받는다 |
| 그룹 코디네이터의 위치 | abs(groupId.hashCode()) % 50 번 __consumer_offsets 파티션의 리더 브로커 |
| 목표 할당 / 현재 할당 | 브로커가 그룹 전체의 목표를 계산하고, CurrentAssignmentBuilder 가 내놓기 → 받기 순서로 멤버를 한 걸음씩 옮긴다 |
CoordinatorRuntime |
파티션마다 상태 기계. 레코드를 replay() 로 먼저 적용하고 로그에 쓴 뒤, HW 가 넘으면 응답한다 |
__consumer_offsets |
오프셋뿐 아니라 그룹·멤버·할당까지 레코드로. 재시작하면 처음부터 읽어 replay() 로 되살린다 |
다음에 볼 것
컨슈머가 오프셋을 커밋하는 것과 레코드를 처리하는 것은 서로 다른 두 동작입니다. 처리하고 커밋하기 전에 죽으면 같은 레코드를 다시 읽고, 커밋하고 처리하기 전에 죽으면 레코드를 잃습니다. 프로듀서도 재시도하다 같은 레코드를 두 번 쓸 수 있습니다. 마지막 글은 이 틈을 메우는 장치들 — 프로듀서 id·시퀀스로 중복을 막는 멱등 프로듀서, 여러 파티션에 쓰는 것과 오프셋 커밋을 하나로 묶는 트랜잭션(sendOffsetsToTransaction() 이 이 글의 __consumer_offsets 에 쓰는 길), 그리고 컨슈머의 isolation.level=read_committed — 을 12편: 멱등성과 트랜잭션 — 정확히 한 번은 어떻게 만들어지나, 그리고 연재를 마치며에서 봅니다.
이 글에서 본 "상태를 로그에 레코드로 쓰고, 다시 읽어 되살린다" 는 방식은 10편의 컨트롤러가 메타데이터 로그로 하는 일과 같은 생각입니다. 두 글을 나란히 읽으면 Kafka 가 자기 자신의 상태도 Kafka 의 로그에 맡긴다는 것이 보입니다.