이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 여덟 번째 글입니다. 6편에서 프로듀서가 보낸 배치가 브로커의 로그에 쓰이는 길을, 7편에서 그 로그가 세그먼트 파일과 인덱스로 디스크에 놓이는 모양을 봤습니다. 이번에는 반대 방향, 읽는 쪽입니다. 컨슈머가 poll() 을 부르면 그 안에서 브로커로 Fetch 요청이 나가고, 브로커는 디스크의 바이트를 찾아 돌려줍니다. 그 사이에 무슨 일이 있는지가 이 글의 주제입니다.
앱에서 컨슈머를 써 봤다면 fetch.min.bytes, fetch.max.wait.ms, max.partition.fetch.bytes 같은 설정을 본 적이 있을 것이고, "Kafka 는 제로 카피(zero-copy)라서 빠르다"는 말도 들어 봤을 것입니다. 이 글은 그 말들이 소스의 어디에 있는지 찾아갑니다. 답하려는 질문은 네 가지입니다.
- 컨슈머가 보낸 Fetch 는 브로커 안에서 어떤 클래스들을 지나 디스크의 바이트에 닿는가. 팔로워 브로커가 보내는 Fetch 와는 무엇이 같고 무엇이 다른가
- 읽을 것이 모자라면 브로커는 어떻게 "기다렸다가" 답하는가. 기다리는 동안 요청 처리 스레드는 무엇을 하는가
- 같은 파티션들을 몇 백 ms 마다 계속 묻는 요청을 어떻게 작게 만드는가(증분 fetch 세션)
- "제로 카피"는 소스의 어느 줄이고, TLS 를 켜면 왜 사라지는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | KafkaApis.handleFetchRequest(), ReplicaManager.fetchMessages()·readFromLog(), Partition.fetchRecords(), UnifiedLog·LocalLog·LogSegment 의 read(), DelayedFetch·DelayedOperationPurgatory, FetchManager·FetchSession, FileRecords.writeTo(), PlaintextTransportLayer·SslTransportLayer |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
2편의 지도로 보면 이 글은 C 구역(요청 처리)에서 D 구역(파티션)을 지나 E 구역(로그 저장소)까지 내려갔다가, 다시 B 구역(네트워크 계층)으로 올라오는 길입니다. 6편이 같은 구역을 쓰기 방향으로 내려갔다면, 이번에는 읽기 방향으로 내려갔다 올라옵니다. 아래 그림이 이 글에서 볼 부품들입니다.
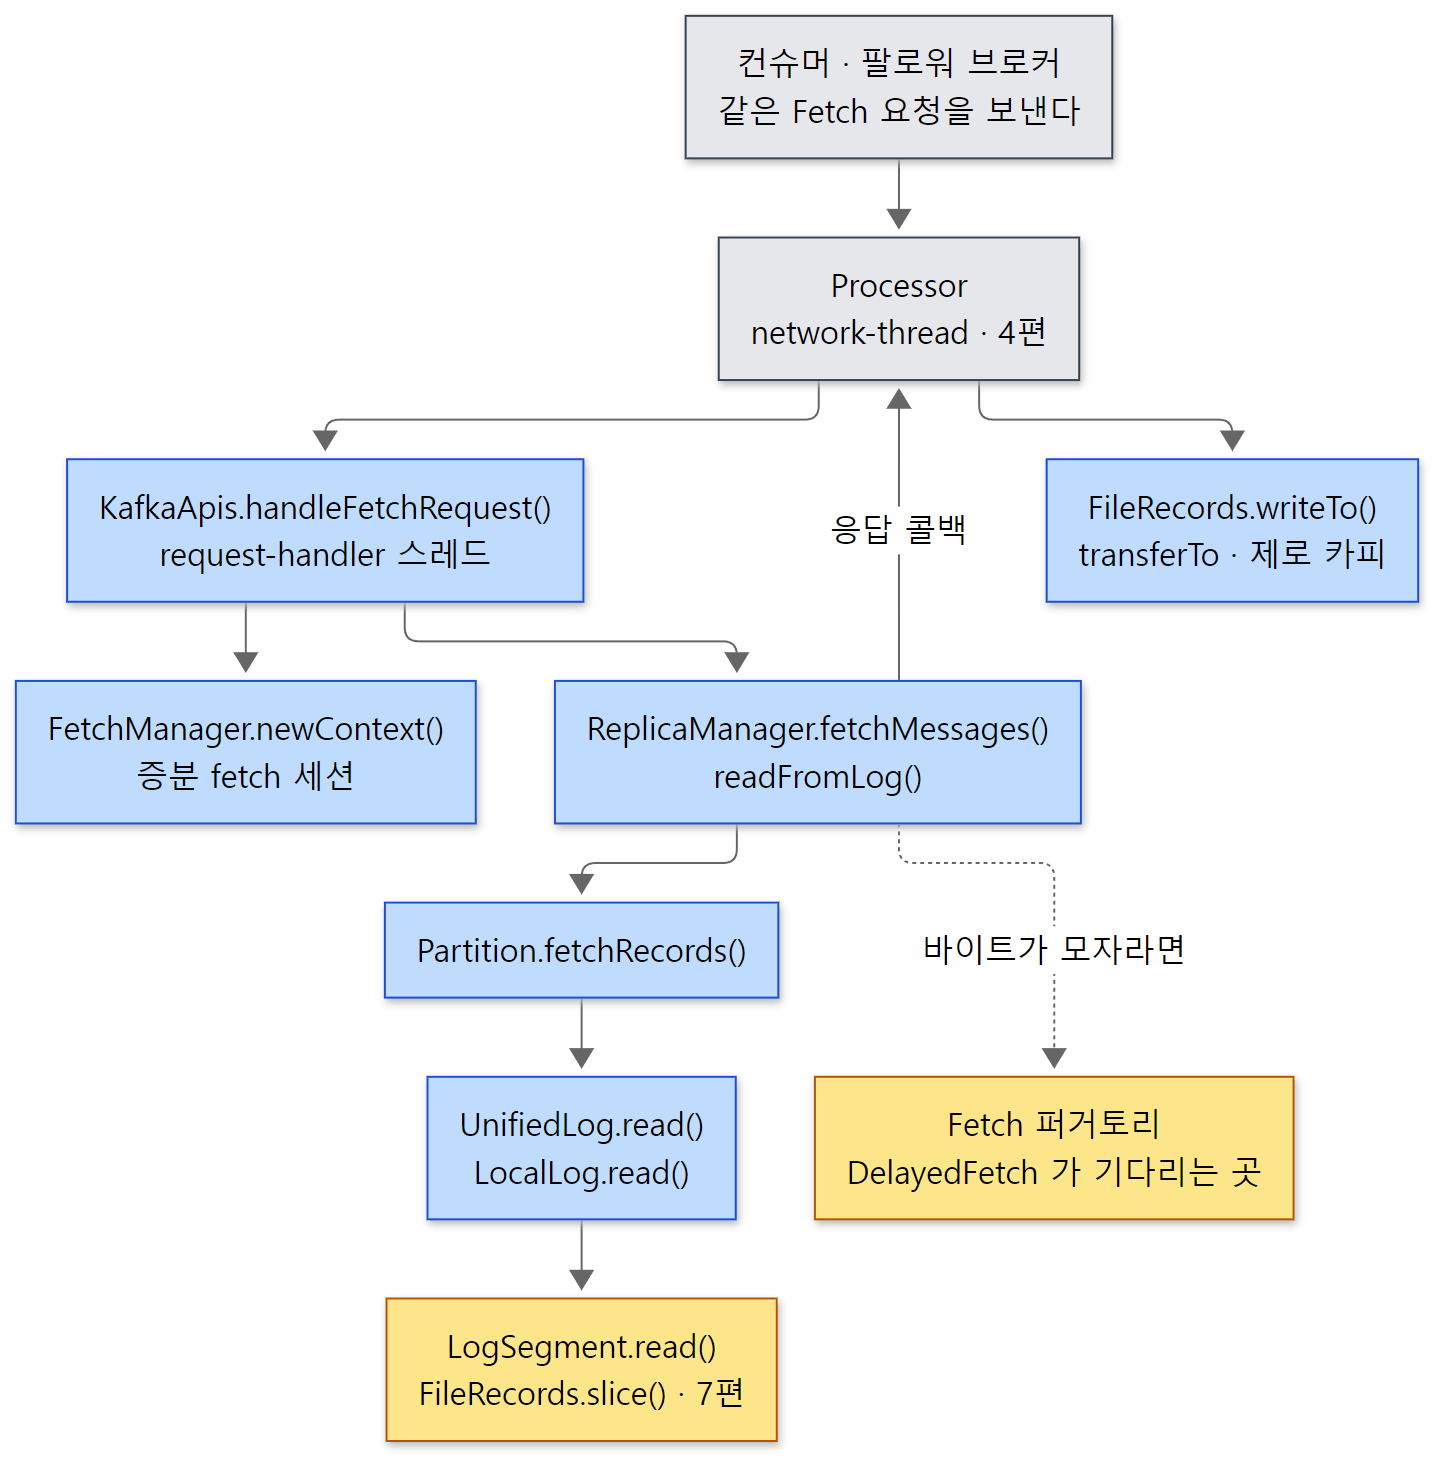 파란 상자는 이 글에서 읽는 메서드, 노란 상자는 데이터가 머무는 곳(퍼거토리, 세그먼트 파일), 회색 상자는 앞 글에서 본 부품입니다.
KafkaApis.scala 는 4,404줄, ReplicaManager.scala 는 2,577줄입니다. 읽기 경로에는 계층 저장소(tiered storage), 가까운 레플리카에서 읽기(rack-aware fetch), 쿼터, 트랜잭션 처리가 함께 얽혀 있습니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
Fetch 요청은 "이 파티션의 이 오프셋부터 데이터를 달라"는 요청입니다. API 키는 1번이고, 요청과 응답의 바이트 모양은 JSON 스키마(FetchRequest.json, FetchResponse.json)에서 만들어집니다(3편). 컨슈머만 쓰는 것이 아니라 팔로워 브로커도 리더에게서 데이터를 복제해 올 때 같은 Fetch 를 보냅니다. 이 글은 두 쪽이 공유하는 브로커 쪽 처리를 보고, 팔로워 쪽 이야기는 9편으로 넘깁니다.
롱 폴링(long polling)은 "물어봤는데 줄 것이 없으면, 빈손으로 바로 돌려보내지 않고 조금 기다렸다가 생기면 그때 답하는" 방식입니다. 컨슈머가 빈 응답을 받고 곧바로 다시 묻기를 수없이 되풀이하지 않게 합니다. Kafka 에서는 요청에 실린 MinBytes(컨슈머 설정 fetch.min.bytes)와 MaxWaitMs(fetch.max.wait.ms)가 "얼마나 모이면 답할지"와 "최대 얼마나 기다릴지"를 정합니다.
퍼거토리(purgatory, 연옥)는 바로 끝낼 수 없는 요청을 조건이 채워질 때까지 넣어 두는 대기실입니다. 6편에서 acks=all 의 Produce 가 여기서 기다린다고 이름만 소개했습니다. 이 글의 4절에서 Fetch 를 예로 구조를 봅니다. 요청 처리 스레드가 기다리는 것이 아니라, "조건이 차면 응답을 보내라"는 작업 객체(DelayedFetch)가 기다립니다.
HW·LEO·LSO: LEO(log end offset, 로그 끝 오프셋)는 로그에 다음으로 쓰일 오프셋, 즉 "로그의 끝"입니다. HW(high watermark, 하이 워터마크)는 ISR(리더를 잘 따라오는 레플리카들) 모두에 복제된 지점으로, 보통 컨슈머는 HW 앞까지만 읽을 수 있습니다. HW 가 어떻게 오르는지는 9편에서 봅니다. LSO(last stable offset, 마지막 안정 오프셋)는 아직 끝나지 않은 트랜잭션 가운데 가장 앞의 오프셋(그런 것이 없거나 HW 보다 뒤면 HW)으로(UnifiedLog.java 678–686행), isolation.level=read_committed 인 컨슈머는 여기 앞까지만 읽습니다(12편).
fetch 세션(fetch session): 컨슈머는 같은 파티션 목록을 수백 ms 마다 묻습니다. 매번 파티션 목록 전체를 보내고 받는 대신, 브로커가 첫 요청의 목록을 기억해 두고(세션) 그다음부터는 바뀐 파티션만 주고받게 하는 장치입니다. 5절에서 봅니다.
페이지 캐시와 제로 카피: 운영체제는 디스크에서 읽은 파일 내용을 메모리(페이지 캐시)에 남겨 둡니다. 보통 프로그램이 파일을 소켓으로 보내려면 파일을 자기 메모리로 읽어 들인 다음(read) 다시 소켓에 써야(write) 합니다. 제로 카피는 이 "프로그램 메모리를 거치는 복사"를 없애고 운영체제에게 "이 파일의 이 구간을 저 소켓으로 보내라"고 맡기는 것입니다. Java 에서는 FileChannel.transferTo() 가 그 문입니다.
FileRecords: 세그먼트 파일(.log) 하나, 또는 그 파일의 한 구간을 가리키는 객체입니다(7편). 이 글에서는 이것이 "아직 읽지 않은 바이트의 위치"로서 응답에 실려 소켓까지 갑니다.
1. Fetch 요청 한 장 — 컨슈머와 팔로워가 같은 요청을 쓴다
먼저 요청에 무엇이 실리는지 봅니다. FetchRequest.json 의 요청 수준 칸들입니다.
    { "name": "ReplicaId", "type": "int32", "versions": "0-14", "default": "-1", "entityType": "brokerId",
      "about": "The broker ID of the follower, of -1 if this request is from a consumer." },
    // ... (15판부터는 태그 필드 ReplicaState 안의 ReplicaId·ReplicaEpoch 로 옮겨졌다) ...
    { "name": "MaxWaitMs", "type": "int32", "versions": "0+",
      "about": "The maximum time in milliseconds to wait for the response." },
    { "name": "MinBytes", "type": "int32", "versions": "0+",
      "about": "The minimum bytes to accumulate in the response." },
    { "name": "MaxBytes", "type": "int32", "versions": "3+", "default": "0x7fffffff", "ignorable": true,
      "about": "The maximum bytes to fetch.  See KIP-74 for cases where this limit may not be honored." },
    // ... (IsolationLevel — read_committed 이면 1) ...
    { "name": "SessionId", "type": "int32", "versions": "7+", "default": "0", "ignorable": true,
      "about": "The fetch session ID." },
    { "name": "SessionEpoch", "type": "int32", "versions": "7+", "default": "-1", "ignorable": true,
      "about": "The fetch session epoch, which is used for ordering requests in a session." },
clients/src/main/resources/common/message/FetchRequest.json 71–91행에서 줄임
그 아래에 토픽·파티션마다 FetchOffset(여기서부터 달라), PartitionMaxBytes(이 파티션에서 최대 몇 바이트), CurrentLeaderEpoch 같은 칸이 붙습니다(97–110행). 요청 하나로 여러 파티션을 한꺼번에 묻습니다.
가장 먼저 볼 칸은 ReplicaId 입니다. 컨슈머는 -1, 팔로워는 자기 브로커 id 를 적습니다(15판부터는 태그 필드 ReplicaState 안으로 옮겨졌습니다. 태그 필드는 3편에서 봤습니다). 브로커는 이 값 하나로 누가 보냈는지 가립니다.
컨슈머 설정이 요청 칸이 되는 곳
컨슈머 쪽에서 요청을 만드는 곳은 AbstractFetch.createFetchRequest() 입니다.
        final FetchRequest.Builder request = FetchRequest.Builder
                .forConsumer(maxVersion, fetchConfig.maxWaitMs, fetchConfig.minBytes, requestData.toSend())
                .isolationLevel(fetchConfig.isolationLevel)
                .setMaxBytes(fetchConfig.maxBytes)
                .metadata(requestData.metadata())
                .removed(requestData.toForget())
                .replaced(requestData.toReplace())
                .rackId(fetchConfig.clientRackId);
clients/src/main/java/org/apache/kafka/clients/consumer/internals/AbstractFetch.java 313–320행
fetchConfig.maxWaitMs·minBytes·maxBytes 는 각각 fetch.max.wait.ms·fetch.min.bytes·fetch.max.bytes 의 값이고, forConsumer() 가 ReplicaId 에 CONSUMER_REPLICA_ID(-1)를 넣습니다(FetchRequest.java 41행, 167행). metadata(...) 가 실어 나르는 것이 5절의 세션 id 와 에포크입니다. 기본값은 ConsumerConfig 의 define(...) 에서 확인했습니다.
| 컨슈머 설정 | 상수 | 기본값 | 요청의 칸 |
|---|---|---|---|
fetch.min.bytes |
DEFAULT_FETCH_MIN_BYTES |
1 | MinBytes |
fetch.max.wait.ms |
DEFAULT_FETCH_MAX_WAIT_MS |
500 | MaxWaitMs |
fetch.max.bytes |
DEFAULT_FETCH_MAX_BYTES |
50 MiB | MaxBytes |
max.partition.fetch.bytes |
DEFAULT_MAX_PARTITION_FETCH_BYTES |
1 MiB | 파티션마다 PartitionMaxBytes |
ConsumerConfig.java 212·225·235·250행의 상수, 510–545행의 define(...)
팔로워는 RemoteLeaderEndPoint 에서 FetchRequest.Builder.forReplica(version, brokerConfig.brokerId, brokerEpochSupplier(), maxWait, minBytes, fetchData.toSend) 로 같은 요청을 만듭니다(RemoteLeaderEndPoint.scala 212–217행). 여기의 maxWait·minBytes 는 브로커 설정 replica.fetch.wait.max.ms(기본 500)와 replica.fetch.min.bytes(기본 1)입니다(ReplicationConfigs.java 75·80행). 이름만 다를 뿐 컨슈머와 같은 롱 폴링 손잡이입니다.
누가 보냈느냐에 따라 "어디까지 읽어도 되나"가 다르다
브로커는 ReplicaId 를 보고 읽어도 되는 끝을 고릅니다.
    public static FetchIsolation of(int replicaId, IsolationLevel isolationLevel) {
        if (!FetchRequest.isConsumer(replicaId)) {
            return LOG_END;
        } else if (isolationLevel == IsolationLevel.READ_COMMITTED) {
            return TXN_COMMITTED;
        } else {
            return HIGH_WATERMARK;
        }
    }
server-common/src/main/java/org/apache/kafka/server/storage/log/FetchIsolation.java 31–39행
isConsumer() 는 replicaId < 0 && replicaId != FUTURE_LOCAL_REPLICA_ID 입니다(FetchRequest.java 463–465행). 그래서 세 갈래가 됩니다.
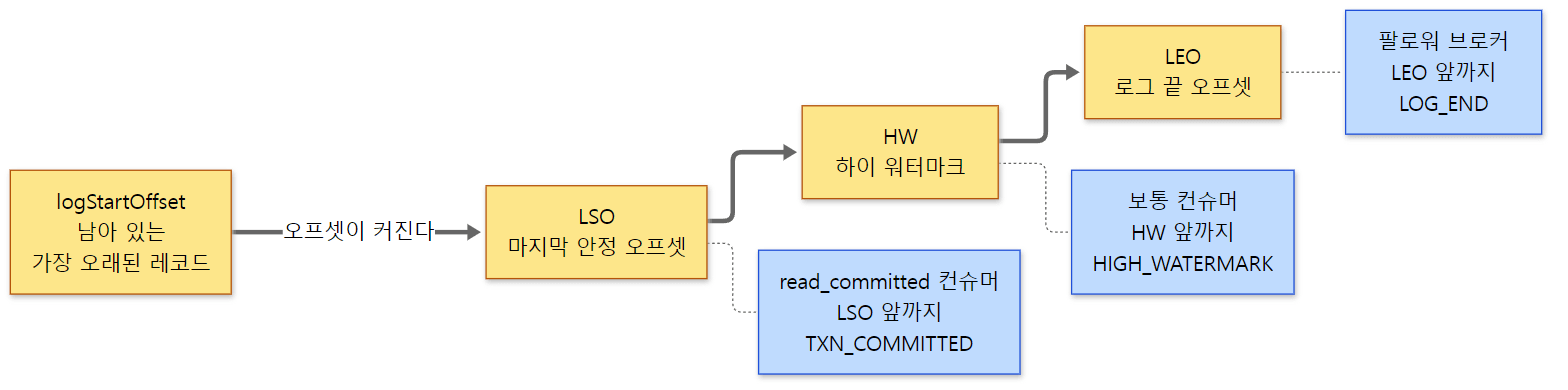 같은 Fetch 라도 보낸 쪽에 따라 읽을 수 있는 끝이 다릅니다. 이 선택이 3절에서 "파일의 어느 위치까지 잘라 줄지"가 됩니다.
팔로워는 아직 커밋되지 않은 레코드까지 가져가야 복제가 진행되므로 로그 끝(LEO)까지 읽고, 컨슈머는 모든 ISR 에 복제가 끝난 HW 앞까지만 읽습니다. 컨슈머가 HW 를 넘어 읽으면, 리더가 바뀌었을 때 사라질 수 있는 레코드를 보게 되기 때문입니다.
헷갈리기 쉬운 곳: 이름이 같은 fetch.max.bytes 가 둘 있습니다
컨슈머 설정 fetch.max.bytes(기본 50 MiB)와 같은 이름의 브로커 설정이 따로 있습니다. 브로커 쪽 기본값은 55 MiB 입니다(ServerConfigs.java 114–115행). 브로커는 둘 가운데 작은 쪽을 씁니다(2절의 KafkaApis 748행). 컨슈머에서 fetch.max.bytes 를 100 MiB 로 올려도 브로커 설정을 그대로 두면 한 응답은 55 MiB 를 넘지 않습니다.
2. 브로커 안의 길 — handleFetchRequest() 에서 fetchMessages() 까지
Fetch 요청이 브로커에 들어오면 4편에서 본 대로 Processor(네트워크 스레드)가 바이트를 읽어 요청 큐에 넣고, 요청 처리 스레드가 꺼내 KafkaApis.handle() 의 case ApiKeys.FETCH => handleFetchRequest(request)(176행)로 갑니다. 거기서부터 응답이 소켓으로 나갈 때까지를 한 장으로 그리면 이렇습니다.
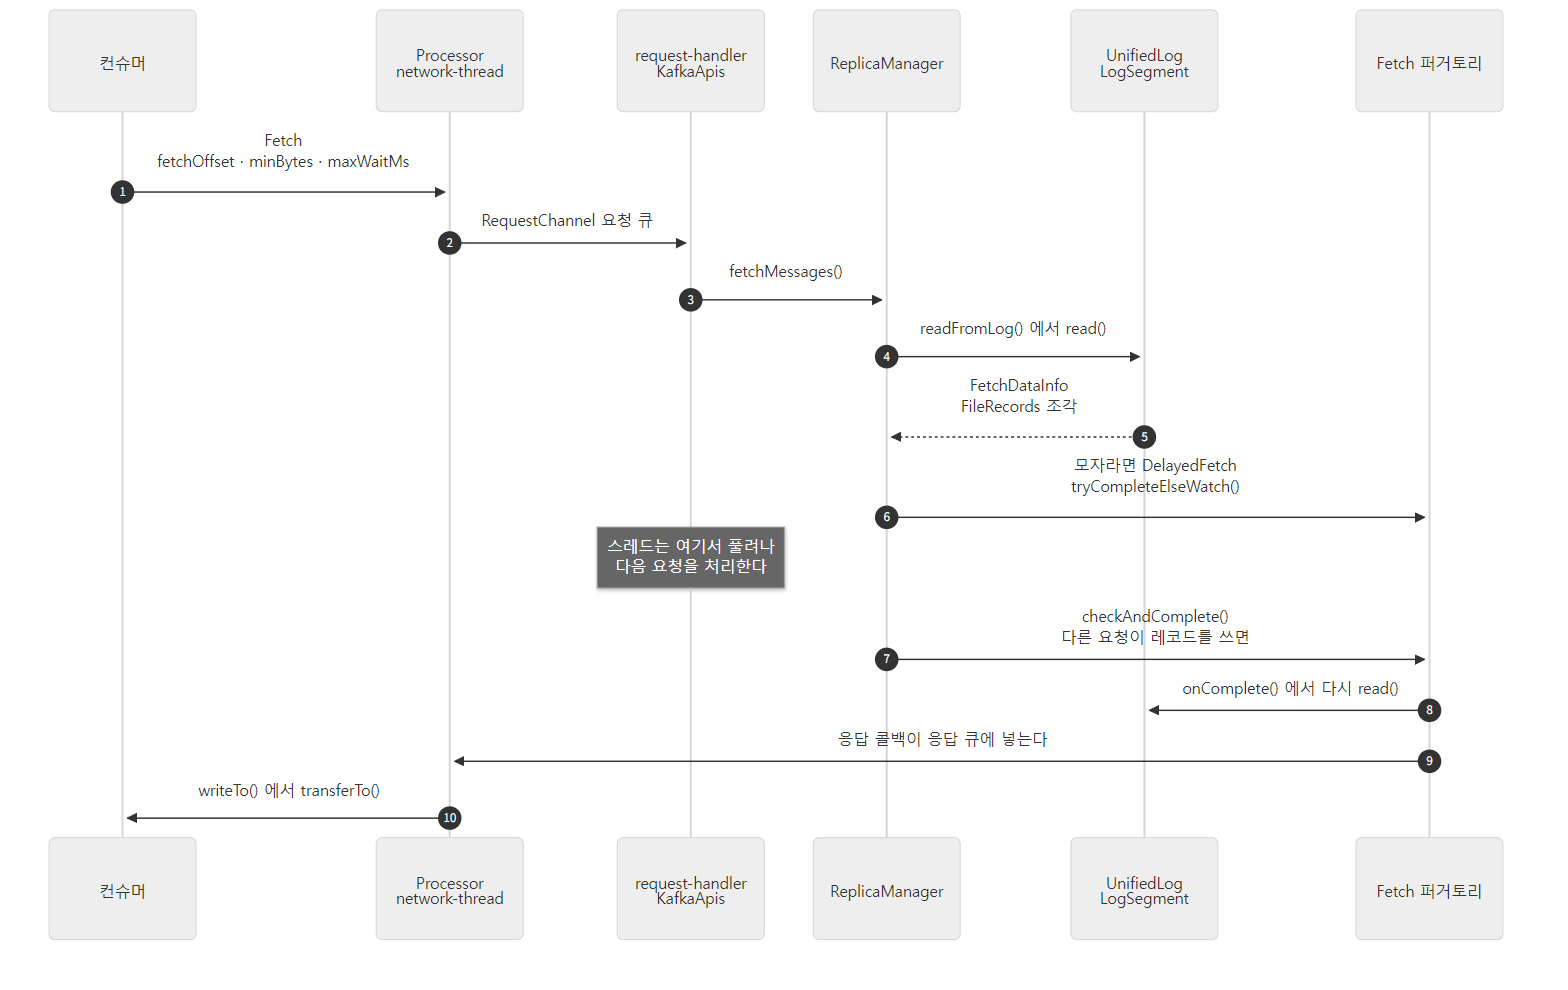 데이터가 처음부터 충분하면 6~8번 없이 5번 다음 바로 9번으로 갑니다. 번호는 아래 본문과 맞춥니다.
handleFetchRequest(): 세션을 풀고, 권한을 보고, 한도를 정한다
handleFetchRequest() 는 먼저 5절에서 볼 fetch 세션으로 "이번에 읽을 파티션 목록"을 얻습니다(fetchManager.newContext(...), 581–587행). 다음으로 팔로워면 클러스터 권한을, 컨슈머면 토픽마다 READ 권한을 보고 걸러 interesting(읽을 파티션)과 erroneous(오류로 답할 파티션)로 나눕니다(591–625행). 그리고 읽기를 ReplicaManager 에 맡깁니다.
      val fetchMaxBytes = Math.min(Math.min(fetchRequest.maxBytes, config.fetchMaxBytes), maxQuotaWindowBytes)
      val fetchMinBytes = Math.min(fetchRequest.minBytes, fetchMaxBytes)

      // ... (11판부터의 clientMetadata — 가까운 레플리카에서 읽기용) ...

      val params = new FetchParams(
        fetchRequest.replicaId,
        fetchRequest.replicaEpoch,
        fetchRequest.maxWait,
        fetchMinBytes,
        fetchMaxBytes,
        FetchIsolation.of(fetchRequest),
        clientMetadata
      )

      // call the replica manager to fetch messages from the local replica
      replicaManager.fetchMessages(
        params = params,
        fetchInfos = interesting,
        quota = replicationQuota(fetchRequest),
        responseCallback = processResponseCallback,
      )
core/src/main/scala/kafka/server/KafkaApis.scala 748–779행에서 줄임
Scala 읽는 법:
val은 다시 대입할 수 없는 변수(Java 의final지역 변수)입니다.fetchMessages(params = params, ...)처럼이름 = 값으로 넘기는 것은 이름 붙은 인자(named argument)로, 순서와 상관없이 매개변수 이름에 값을 넣습니다.
눈여겨볼 것은 마지막 인자 responseCallback = processResponseCallback 입니다. processResponseCallback 은 같은 메서드 안에 정의된 함수로(640–735행), 읽은 결과를 받아 응답(FetchResponse)을 만들고 requestChannel.sendResponse() 로 보냅니다. fetchMessages() 는 결과를 돌려주지 않고 이 콜백을 부릅니다. 지금 바로 부를 수도 있고, 몇 초 뒤 다른 스레드에서 부를 수도 있습니다. 롱 폴링이 이 모양에서 나옵니다.
fetchMessages(): 일단 읽어 보고, 모자라면 기다린다
  def fetchMessages(params: FetchParams,
                    fetchInfos: Seq[(TopicIdPartition, PartitionData)],
                    quota: ReplicaQuota,
                    responseCallback: Seq[(TopicIdPartition, FetchPartitionData)] => Unit): Unit = {

    // check if this fetch request can be satisfied right away
    val logReadResults = readFromLog(params, fetchInfos, quota, readFromPurgatory = false)
    var bytesReadable: Long = 0
    var errorReadingData = false
    // ... (원격 저장소·갈라진 에포크·선호 레플리카 표시용 변수) ...

    logReadResults.foreach { case (topicIdPartition, logReadResult) =>
      // ... (지표 갱신, 오류·원격 저장소·갈라진 에포크 표시) ...
      bytesReadable = bytesReadable + logReadResult.info.records.sizeInBytes
      // ...
    }

    // Respond immediately if no remote fetches are required and any of the below conditions is true
    //                        1) fetch request does not want to wait
    //                        2) fetch request does not require any data
    //                        3) has enough data to respond
    //                        4) some error happens while reading data
    //                        5) we found a diverging epoch
    //                        6) has a preferred read replica
    if (remoteFetchInfos.isEmpty && (params.maxWaitMs <= 0 || fetchInfos.isEmpty || bytesReadable >= params.minBytes || errorReadingData ||
      hasDivergingEpoch || hasPreferredReadReplica)) {
      val fetchPartitionData = logReadResults.map { case (tp, result) =>
        val isReassignmentFetch = params.isFromFollower && isAddingReplica(tp.topicPartition, params.replicaId)
        tp -> result.toFetchPartitionData(isReassignmentFetch)
      }
      responseCallback(fetchPartitionData)
    } else {
core/src/main/scala/kafka/server/ReplicaManager.scala 1665–1712행에서 줄임
Scala 읽는 법:
def f(...): Unit은 반환값이 없는 메서드(Java 의void)입니다.responseCallback: Seq[...] => Unit은 "Seq를 받아 아무것도 돌려주지 않는 함수"라는 타입입니다.var는 다시 대입할 수 있는 변수입니다.foreach { case (a, b) => ... }는 짝(튜플)으로 된 원소를 하나씩 꺼내a,b로 풀어 쓰는 반복입니다.tp -> result는 짝(tp, result)를 만드는 식입니다.
순서가 그대로 롱 폴링의 규칙입니다. 그림의 3~5번에 해당합니다.
- 먼저 한 번 읽어 봅니다(
readFromLog(..., readFromPurgatory = false)). 기다릴지 말지는 읽어 본 뒤에 정합니다. - 읽은 바이트를 모두 더해
bytesReadable을 만듭니다. - 주석의 여섯 조건 가운데 하나라도 맞으면 바로 콜백을 부릅니다. 기본값
fetch.min.bytes=1이면 1바이트라도 읽혔을 때 3)이 참이 되어 바로 답합니다. - 아니면
else로 가서DelayedFetch를 만들고 퍼거토리에 넣습니다(4절, 1728–1745행).
maxWaitMs <= 0 이면 기다리지 않는다는 것(1)도 보아 둡니다. fetch.max.wait.ms=0 으로 두면 롱 폴링이 꺼지고, 데이터가 없을 때 빈 응답을 바로 받습니다.
readFromLog(): 파티션마다 읽되, 한도는 앞에서부터 깎는다
readFromLog() 는 파티션마다 안쪽 함수 read() 를 부릅니다. 핵심은 맨 끝의 반복입니다.
    var limitBytes = params.maxBytes
    val result = new mutable.ArrayBuffer[(TopicIdPartition, LogReadResult)]
    var minOneMessage = true
    readPartitionInfo.foreach { case (tp, fetchInfo) =>
      val readResult = read(tp, fetchInfo, limitBytes, minOneMessage)
      val recordBatchSize = readResult.info.records.sizeInBytes
      // ... (estimatedRecordBatchSize: 원격 저장소에서 읽을 파티션이면 fetchMaxBytes 로 어림, 아니면 recordBatchSize) ...
      // Once we read from a non-empty partition, we stop ignoring request and partition level size limits
      if (estimatedRecordBatchSize > 0)
        minOneMessage = false
      limitBytes = math.max(0, limitBytes - estimatedRecordBatchSize)
      result += (tp -> readResult)
    }
    result
core/src/main/scala/kafka/server/ReplicaManager.scala 1894–1910행에서 줄임
Scala 읽는 법:
mutable.ArrayBuffer는 Java 의ArrayList같은 늘어나는 목록이고,result += (tp -> readResult)는 거기에 짝 하나를 더합니다. Scala 에서는 블록의 마지막 식이 반환값이므로, 맨 끝 줄의result가return result입니다.
limitBytes 는 요청 전체의 한도(fetch.max.bytes 와 브로커 설정 중 작은 쪽)에서 시작해, 파티션 하나를 읽을 때마다 읽은 만큼 줄어듭니다. 각 파티션은 min(PartitionMaxBytes, limitBytes) 만큼만 읽습니다(read() 안의 adjustedMaxBytes, 1796행). 그래서 요청에 적은 파티션 순서가 앞인 쪽이 한도를 먼저 씁니다.
minOneMessage 는 "처음으로 데이터가 나온 파티션 하나는 한도를 넘어도 첫 배치를 통째로 준다"는 표시입니다. 이 값이 LogSegment.read() 까지 내려가(3절) 첫 배치가 max.partition.fetch.bytes 보다 커도 잘라 내지 않게 합니다. 그렇지 않으면 1 MiB 보다 큰 배치 하나가 파티션 맨 앞에 있을 때 컨슈머는 영원히 그 배치를 받지 못하고 같은 오프셋을 다시 묻게 됩니다. 데이터가 하나라도 나오면 minOneMessage = false 가 되어, 그다음 파티션부터는 한도를 그대로 지킵니다.
헷갈리기 쉬운 곳: fetch.min.bytes 를 못 채우면 "안 주는" 것이 아닙니다
fetch.min.bytes 를 크게 잡으면 "그만큼 모일 때까지 응답이 없다"고 생각하기 쉽습니다. 실제로는 fetch.max.wait.ms 가 지나면 있는 만큼 준다입니다. 기다림이 끝났을 때 DelayedFetch.onComplete() 가 로그를 다시 읽어 그 결과로 콜백을 부르기 때문입니다(4절). 아래 예제 1의 b) 에서 212바이트밖에 없는데 fetch.min.bytes=1048576 으로 물으면, 3초를 기다린 뒤 그 212바이트를 받습니다.
3. 디스크에서 읽기 — 오프셋에서 파일 조각까지
read() 는 파티션을 찾아 Partition.fetchRecords() 를 부르고(1838–1844행), 여기서 리더인지, 리더 에포크가 맞는지를 확인한 뒤 readRecords() 로 갑니다. readRecords() 의 시작과 끝은 이렇습니다.
    // Note we use the log end offset prior to the read. This ensures that any appends following
    // the fetch do not prevent a follower from coming into sync.
    val initialHighWatermark = localLog.highWatermark
    // ... (logStartOffset, logEndOffset, lastStableOffset 도 같은 식으로) ...

    // ... (팔로워가 보낸 lastFetchedEpoch 로 갈라진 로그를 찾는 검사 — 9편) ...

    val fetchedData = localLog.read(
      fetchOffset,
      maxBytes,
      fetchIsolation,
      minOneMessage
    )
core/src/main/scala/kafka/cluster/Partition.scala 1379–1424행에서 줄임
읽기 전에 HW·LEO 를 먼저 적어 둡니다. 이 값이 응답의 HighWatermark·LogStartOffset 칸이 됩니다. 주석의 이유는 팔로워 쪽 사정(읽는 사이에 쓰인 레코드 때문에 팔로워가 ISR 에 들어오지 못하는 일을 막기)이고 9편에서 다시 봅니다. 여기서 localLog 는 이름과 달리 UnifiedLog 입니다. 7편에서 본 네 층(UnifiedLog → LocalLog → LogSegments → LogSegment)을 차례로 내려갑니다.
UnifiedLog.read(): 읽어도 되는 끝을 정한다
    public FetchDataInfo read(long startOffset,
                              int maxLength,
                              FetchIsolation isolation,
                              boolean minOneMessage) throws IOException {
        checkLogStartOffset(startOffset);
        LogOffsetMetadata maxOffsetMetadata = switch (isolation) {
            case LOG_END -> localLog.logEndOffsetMetadata();
            case HIGH_WATERMARK -> fetchHighWatermarkMetadata();
            case TXN_COMMITTED -> fetchLastStableOffsetMetadata();
        };
        return localLog.read(startOffset, maxLength, minOneMessage, maxOffsetMetadata, isolation == FetchIsolation.TXN_COMMITTED);
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1663–1674행
1절의 그림이 여기서 코드가 됩니다. FetchIsolation 에 따라 LEO·HW·LSO 가운데 하나를 "끝"으로 고릅니다. 이 끝은 숫자 하나가 아니라 LogOffsetMetadata 입니다. 오프셋, 그 오프셋이 있는 세그먼트의 기준 오프셋, 세그먼트 파일 안의 바이트 위치 세 값을 함께 듭니다(LogOffsetMetadata.java 27–47행). 바이트 위치를 알고 있으니 "HW 앞까지"를 "파일의 몇 번째 바이트까지"로 바로 바꿀 수 있습니다.
LocalLog.read(): 세그먼트를 고르고, 잘라도 되는 위치를 넘긴다
                    LogOffsetMetadata endOffsetMetadata = nextOffsetMetadata;
                    long endOffset = endOffsetMetadata.messageOffset;
                    Optional<LogSegment> segmentOpt = segments.floorSegment(startOffset);
                    // return error on attempt to read beyond the log end offset
                    if (startOffset > endOffset || segmentOpt.isEmpty()) {
                        throw new OffsetOutOfRangeException("Received request for offset " + startOffset + " for partition " + topicPartition + ", " +
                                "but we only have log segments upto " + endOffset + ".");
                    }
                    if (startOffset == maxOffsetMetadata.messageOffset) return emptyFetchDataInfo(maxOffsetMetadata, includeAbortedTxns);
                    if (startOffset > maxOffsetMetadata.messageOffset) return emptyFetchDataInfo(convertToOffsetMetadataOrThrow(startOffset), includeAbortedTxns);

                    // ... (주석 줄임) ...
                    FetchDataInfo fetchDataInfo = null;
                    while (fetchDataInfo == null && segmentOpt.isPresent()) {
                        LogSegment segment = segmentOpt.get();
                        long baseOffset = segment.baseOffset();

                        // ... (주석 줄임) ...
                        Optional<Long> maxPositionOpt;
                        if (segment.baseOffset() < maxOffsetMetadata.segmentBaseOffset)
                            maxPositionOpt = Optional.of((long) segment.size());
                        else if (segment.baseOffset() == maxOffsetMetadata.segmentBaseOffset && !maxOffsetMetadata.messageOffsetOnly())
                            maxPositionOpt = Optional.of((long) maxOffsetMetadata.relativePositionInSegment);
                        else
                            maxPositionOpt = Optional.empty();

                        fetchDataInfo = segment.read(startOffset, maxLength, maxPositionOpt, minOneMessage);
                        if (fetchDataInfo != null) {
                            // ... (read_committed 면 중단된 트랜잭션 목록을 붙인다 — 12편) ...
                        } else {
                            segmentOpt = segments.higherSegment(baseOffset);
                        }
                    }
storage/src/main/java/org/apache/kafka/storage/internals/log/LocalLog.java 479–518행에서 줄임
floorSegment(startOffset)로 기준 오프셋이startOffset이하인 마지막 세그먼트를 고릅니다(7편에서 본ConcurrentSkipListMap찾기).startOffset이 로그 끝보다 뒤면OffsetOutOfRangeException입니다. 컨슈머의auto.offset.reset이 처리하는 그 오류입니다.startOffset이 "끝"(예를 들어 HW)과 같으면 읽지 않고 빈 결과를 돌려줍니다. 컨슈머가 다 따라잡은 상태가 이것이고, 이때 2절의bytesReadable이 0 이 되어 롱 폴링으로 갑니다.- 세그먼트마다
maxPositionOpt, 즉 "이 세그먼트에서 읽어도 되는 마지막 바이트 위치"를 정합니다. "끝"이 더 뒤 세그먼트에 있으면 이 세그먼트는 끝까지(segment.size()), 같은 세그먼트에 있으면 그 바이트 위치까지입니다. - 이 세그먼트에
startOffset이후의 레코드가 없으면(null) 다음 세그먼트(higherSegment)로 넘어갑니다.
LogSegment.read(): 인덱스로 위치를 찾고, 파일의 구간을 잘라 낸다
        LogOffsetPosition startOffsetAndSize = translateOffset(startOffset);

        // if the start position is already off the end of the log, return null
        if (startOffsetAndSize == null)
            return null;

        int startPosition = startOffsetAndSize.position;
        LogOffsetMetadata offsetMetadata = new LogOffsetMetadata(startOffsetAndSize.offset, this.baseOffset, startPosition);

        int adjustedMaxSize = maxSize;
        if (minOneMessage)
            adjustedMaxSize = Math.max(maxSize, startOffsetAndSize.size);

        // return empty records in the fetch-data-info when:
        // 1. adjustedMaxSize is 0 (or)
        // 2. maxPosition to read is unavailable
        if (adjustedMaxSize == 0 || maxPositionOpt.isEmpty())
            return new FetchDataInfo(offsetMetadata, MemoryRecords.EMPTY);

        // calculate the length of the message set to read based on whether or not they gave us a maxOffset
        int fetchSize = Math.min((int) (maxPositionOpt.get() - startPosition), adjustedMaxSize);

        return new FetchDataInfo(offsetMetadata, log.slice(startPosition, fetchSize),
            adjustedMaxSize < startOffsetAndSize.size, Optional.empty());
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 439–462행
translateOffset() 은 7편에서 자세히 본 메서드입니다. 오프셋 인덱스(.index)에서 이진 탐색으로 "찾는 오프셋 이하의 가장 큰 항목"의 파일 위치를 얻고, 거기서부터 배치 머리만 훑어 startOffset 을 담은 배치의 시작 위치와 크기를 찾습니다(398–401행). 인덱스는 4KB 마다 하나씩만 있는 희소 인덱스라서 이 "훑기"가 필요합니다.
그다음이 이 글에서 가장 중요한 한 줄입니다. log.slice(startPosition, fetchSize). log 는 이 세그먼트의 FileRecords 이고, slice() 는 이렇게 생겼습니다.
    @Override
    public FileRecords slice(int position, int size) {
        int availableBytes = availableBytes(position, size);
        int startPosition = this.start + position;

        return new FileRecords(file, channel, startPosition, startPosition + availableBytes, transferFailureHandler);
    }
clients/src/main/java/org/apache/kafka/common/record/internal/FileRecords.java 174–180행
같은 파일, 같은 FileChannel 을 쥐고 시작·끝 위치만 다른 FileRecords 를 새로 만들 뿐입니다. 파일에서 레코드 바이트를 읽어 오지 않습니다. 읽기 경로의 결과물 FetchDataInfo 는 "오프셋 메타데이터 + 파일의 한 구간을 가리키는 객체"입니다. 바이트를 실제로 옮기는 일은 6절에서 네트워크 스레드가 할 때까지 미뤄집니다.
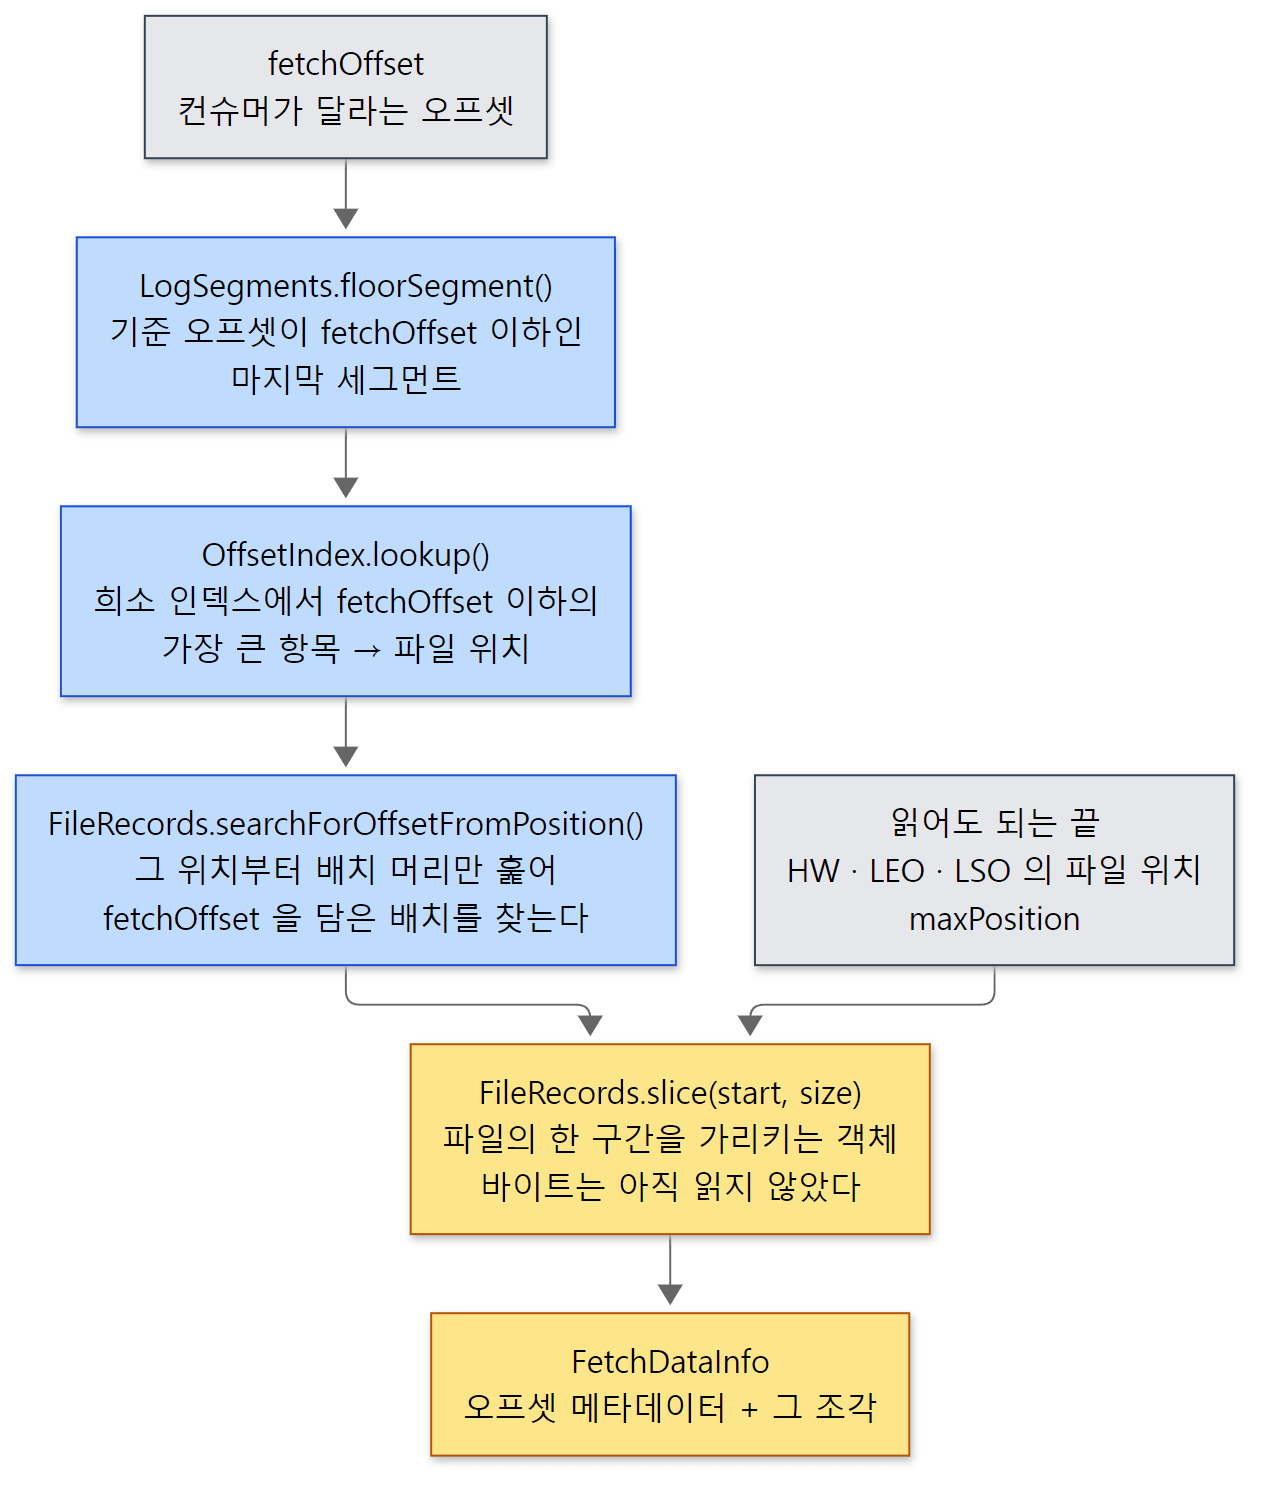 읽기 경로가 브로커 안에서 하는 일은 "어디서부터 어디까지"를 정하는 것까지입니다. 노란 상자는 바이트가 아니라 위치를 들고 있습니다.
nginx 연재 10편에서 정적 파일 핸들러가 파일 내용을 읽지 않고 "파일의 몇 번째부터 몇 번째"만 버퍼에 적어 두는 것을 봤다면, 같은 생각입니다. Kafka 에서는 그 "정적 파일"이 세그먼트이고, 범위를 고르는 기준이 오프셋입니다.
헷갈리기 쉬운 곳: "HW 앞까지"는 레코드 단위가 아니라 바이트 위치로 자릅니다
fetchSize = min(maxPosition - startPosition, adjustedMaxSize) 이므로 잘리는 곳은 바이트 위치입니다. maxPosition 은 HW 가 있는 배치의 시작 위치이므로 HW 앞의 배치들이 온전히 들어갑니다. 그런데 adjustedMaxSize(파티션 한도)로 잘리면 마지막 배치가 중간에서 잘린 채 응답에 들어갈 수 있습니다. 컨슈머는 잘린 끝 배치를 버리고 다음 Fetch 에서 그 배치부터 다시 받습니다(클라이언트의 ByteBufferLogInputStream.nextBatch() 는 남은 바이트가 배치 크기보다 적으면 그 배치를 내놓지 않습니다, 41–46행). 반대로 첫 배치가 한도보다 크면 minOneMessage 덕분에 통째로 들어가고(449–450행), 그마저 꺼져 있는데 첫 배치가 잘리면 firstEntryIncomplete 가 참이 되어 ReplicaManager 가 빈 결과로 바꿉니다(1782–1785행).
또 하나, maxOffsetMetadata 가 오프셋만 알고 바이트 위치를 모르는 상태(messageOffsetOnly())이면 maxPositionOpt 가 비고, 그러면 455–456행에서 빈 결과가 나옵니다. 위치를 모르는 채로 HW 를 넘어 읽지 않으려는 안전장치입니다. 보통은 이렇게 되지 않습니다. UnifiedLog.fetchHighWatermarkMetadata() 가 HW 의 메타데이터가 오프셋만 들고 있으면 먼저 파일 위치로 바꿔 두기 때문이고(UnifiedLog.java 607–619행), 바꾸지 못할 때(그 오프셋이 로컬 세그먼트에 없을 때)만 오프셋만 남습니다.
4. 롱 폴링 — DelayedFetch 와 퍼거토리
2절의 fetchMessages() 에서 데이터가 모자라면 else 쪽으로 갑니다.
        val delayedFetch = new DelayedFetch(
          params,
          fetchPartitionStatus,
          this,
          quota,
          (fetchPartitionData: util.LinkedHashMap[TopicIdPartition, FetchPartitionData]) => responseCallback(fetchPartitionData.asScala.toSeq)
        )

        // create a list of (topic, partition) pairs to use as keys for this delayed fetch operation
        val delayedFetchKeys = fetchPartitionStatus.keySet()
          .stream()
          .map(new TopicPartitionOperationKey(_))
          .toList()

        // try to complete the request immediately, otherwise put it into the purgatory;
        // this is because while the delayed fetch operation is being created, new requests
        // may arrive and hence make this operation completable.
        delayedFetchPurgatory.tryCompleteElseWatch(delayedFetch, delayedFetchKeys)
core/src/main/scala/kafka/server/ReplicaManager.scala 1728–1745행
Scala 읽는 법:
(x: 타입) => 식은 람다입니다.new TopicPartitionOperationKey(_)의_는 "들어오는 인자 자리"로, 람다tp => new TopicPartitionOperationKey(tp)를 줄여 쓴 것입니다.
DelayedFetch 는 "이 요청의 읽기 조건(params), 파티션별 시작 위치(fetchPartitionStatus), 다 되면 부를 콜백"을 든 객체입니다. 이 객체를 파티션마다 하나씩인 키(TopicPartitionOperationKey)로 퍼거토리에 걸어 둡니다. handleFetchRequest() 는 여기서 끝나고, 요청 처리 스레드는 큐로 돌아가 다음 요청을 꺼냅니다. 그림의 6번입니다. 4편의 "요청 처리 스레드가 응답이 나갈 때까지 붙잡혀 있지는 않습니다"가 이 자리입니다.
DelayedFetch: 지금 끝내도 되나?
DelayedFetch 는 DelayedOperation 을 상속하고, 생성자에서 super(params.maxWaitMs) 로 제한 시간을 넘깁니다(DelayedFetch.java 86행). 하위 클래스가 채우는 메서드는 둘, "지금 끝내도 되나"를 보는 tryComplete() 와 "끝낼 때 할 일" onComplete() 입니다. 4.4.0 에서는 이 클래스가 core 의 Scala 파일(kafka/server/DelayedFetch.scala)이었고, trunk 에서 커밋 013710cc3a(2026-09-09, "Move DelayedFetch to server module")로 Java 로 옮겨졌습니다. 끝낼 조건(A~H)은 두 판이 같습니다. tryComplete() 의 핵심 부분입니다.
                    LogOffsetMetadata endOffset = switch (params.isolation) {
                        case LOG_END -> offsetSnapshot.logEndOffset();
                        case HIGH_WATERMARK -> offsetSnapshot.highWatermark();
                        case TXN_COMMITTED -> offsetSnapshot.lastStableOffset();
                    };

                    // ... (주석 3줄 줄임 — 오프셋이 같으면 곧장 Case G 검사로 간다) ...
                    if (fetchOffset.messageOffset > endOffset.messageOffset) {
                        // ... (Case F: 처음 위치가 지금의 끝보다 뒤면 — 잘린 리더 — 바로 끝낸다) ...
                    } else if (fetchOffset.messageOffset < endOffset.messageOffset) {
                        if (fetchOffset.onOlderSegment(endOffset)) {
                            // ... (Case F: 이미 넘어간 옛 세그먼트를 읽는 중이면 바로 끝낸다) ...
                        } else if (fetchOffset.onSameSegment(endOffset)) {
                            // We take the partition fetch size as upper bound when accumulating the bytes
                            // (skip if a throttled partition).
                            int bytesAvailable = Math.min(endOffset.positionDiff(fetchOffset), fetchStatus.fetchInfo().maxBytes);
                            if (!params.isFromFollower() || !ReplicaManagerAdapter.shouldLeaderThrottle(quota, partition, params.replicaId)) {
                                accumulatedSize += bytesAvailable;
                            }
                        }
                    }
                    // ... (Case H: 갈라진 에포크, 그리고 catch 의 Case A~E: 리더가 아니게 됨 등) ...

        // Case G
        if (accumulatedSize >= params.minBytes) {
            return forceComplete();
        }
        return false;
server/src/main/java/org/apache/kafka/server/purgatory/DelayedFetch.java 129–220행에서 줄임
여기서 3절의 LogOffsetMetadata 가 다시 쓰입니다. 파티션마다 "처음 읽었을 때의 위치"(fetchOffset)와 "지금의 끝"(endOffset)이 같은 세그먼트에 있으면 두 바이트 위치의 차이(positionDiff)가 곧 새로 생긴 바이트 수입니다. 로그를 다시 읽지 않고 뺄셈 한 번으로 "얼마나 모였나"를 셉니다. 이 합이 minBytes 이상이 되면(Case G) forceComplete() 를 부릅니다. 파일 머리의 주석은 끝낼 조건을 A~H 여덟 가지로 적어 두었습니다(101–113행). 바이트가 모인 경우 말고도 리더가 아니게 된 경우, 파티션이 사라진 경우 등은 "기다려도 소용없으니" 바로 끝냅니다.
forceComplete() 는 DelayedOperation 에 있고, 락을 잡고 completed 를 한 번만 참으로 바꾼 쪽이 onComplete() 를 부릅니다(DelayedOperation.java 60–81행). 여러 스레드가 동시에 끝내려 해도 응답은 한 번만 나갑니다. DelayedFetch.onComplete() 는 세 줄짜리입니다. 파티션별 요청 정보를 다시 모아 responseCallback.accept(replicaManager.readFromLogByPurgatory(params, fetchInfos, quota)) 를 부릅니다(DelayedFetch.java 235–245행).
처음에 읽은 결과를 들고 있지 않습니다. 끝낼 때 readFromLogByPurgatory() 로 로그를 처음부터 다시 읽고(3절의 길을 한 번 더), 그 결과를 콜백에 넘깁니다. 기다리는 동안 새로 쓰인 레코드까지 담기 위해서입니다. 그림의 8번입니다.
누가 깨우나: checkAndComplete() 와 타이머
퍼거토리의 tryCompleteElseWatch() 는 먼저 tryComplete() 를 한 번 해 보고, 안 되면 키마다 지켜보기 목록(watcher list)에 걸고, 다시 한 번 tryComplete() 를 한 뒤, 그래도 안 되면 타이머에 넣습니다.
        if (operation.safeTryCompleteOrElse(() -> {
            watchKeys.forEach(key -> {
                if (!operation.isCompleted())
                    watchForOperation(key, operation);
            });
            if (!watchKeys.isEmpty())
                estimatedTotalOperations.incrementAndGet();
        })) {
            return true;
        }

        // if it cannot be completed by now and hence is watched, add to the timeout queue also
        if (!operation.isCompleted()) {
            if (timerEnabled)
                timeoutTimer.add(operation);
            // ...
        }
        return false;
목록에 건 다음에 한 번 더 확인하는 이유는 주석(127–131행)에 있습니다. 확인과 걸기 사이에 레코드가 들어오면 그 신호를 놓칠 수 있는데, 건 뒤에 한 번 더 보면 "그 뒤의 신호는 반드시 목록을 거친다"가 보장됩니다.
깨우는 쪽은 둘입니다.
하나, 다른 요청이 그 파티션의 상태를 바꿨을 때. Produce 가 레코드를 쓰면 ReplicaManager 가 끝에 이런 작업을 큐에 넣습니다.
    actionQueue.add {
      () => appendResults.foreach { case (topicIdPartition, result) =>
        val requestKey = new TopicPartitionOperationKey(topicIdPartition.topicPartition)
        result.logAppendSummary.leaderHwChange match {
          case LeaderHwChange.INCREASED =>
            // some delayed operations may be unblocked after HW changed
            delayedProducePurgatory.checkAndComplete(requestKey)
            delayedFetchPurgatory.checkAndComplete(requestKey)
            delayedDeleteRecordsPurgatory.checkAndComplete(requestKey)
            // ... (공유 그룹의 퍼거토리) ...
          case LeaderHwChange.SAME =>
            // probably unblock some follower fetch requests since log end offset has been updated
            delayedFetchPurgatory.checkAndComplete(requestKey)
          case LeaderHwChange.NONE =>
          // nothing
        }
      }
    }
core/src/main/scala/kafka/server/ReplicaManager.scala 857–875행에서 줄임
Scala 읽는 법:
x match { case A => ... case B => ... }는 Java 의switch식과 비슷합니다.actionQueue.add { () => ... }는 인자 없는 람다를 넘기는 것입니다.
HW 가 올랐으면(INCREASED) 컨슈머의 Fetch 까지 깨우고, LEO 만 늘었으면(SAME) 주석대로 팔로워의 Fetch 를 위해 깨웁니다. 둘 다 같은 delayedFetchPurgatory.checkAndComplete(키) 이고, 그 키에 걸린 DelayedFetch 들의 tryComplete() 를 다시 부릅니다. 이 작업은 큐에만 넣어 두고, KafkaApis.handle() 의 finally 에서 replicaManager.tryCompleteActions() 로 실행합니다(262–266행). 주석은 이유를 "락이 서로 얽히지 않게"라고 적습니다. 결국 보통은 Produce 를 처리한 요청 처리 스레드가, 그 요청을 다 처리한 뒤 기다리던 Fetch 의 응답까지 만들어 보내는 셈입니다(이 큐는 요청 처리 스레드들이 함께 쓰므로, 먼저 finally 에 닿은 다른 스레드가 실행할 수도 있습니다). 팔로워가 복제를 받아 HW 를 올렸을 때도 ReplicaFetcherThread 가 같은 checkAndComplete() 를 부릅니다(ReplicaManager.scala 319–321행, 9편).
둘, 시간이 다 됐을 때. 퍼거토리는 만들어질 때 SystemTimer 를 하나 갖고(new SystemTimer(purgatoryName), 70행), 그 타이머는 Executors.newFixedThreadPool(1, …) 로 만든 executor- + 이름의 스레드 하나에서 만료된 작업을 실행합니다(SystemTimer.java 54–55행). 시계를 돌리는 쪽은 ExpirationReaper-<브로커 id>-<이름> 스레드로, advanceClock(200L) 을 되풀이해 부릅니다. 만료된 칸이 있으면 바로, 없으면 최대 200ms 를 기다렸다 돌아옵니다(DelayedOperationPurgatory.java 409–417행). 만료된 작업은 executor-Fetch 스레드에서 DelayedOperation.run() → forceComplete() → onComplete() 로 이어집니다(DelayedOperation.java 145–149행). Fetch 퍼거토리의 이름은 "Fetch" 이므로(ReplicaManager.scala 188–191행) 스레드 이름은 ExpirationReaper-1-Fetch 와 executor-Fetch 가 됩니다. ExpirationReaper-1-Fetch 는 2편의 스레드 표에서 이름만 봤던 스레드입니다.
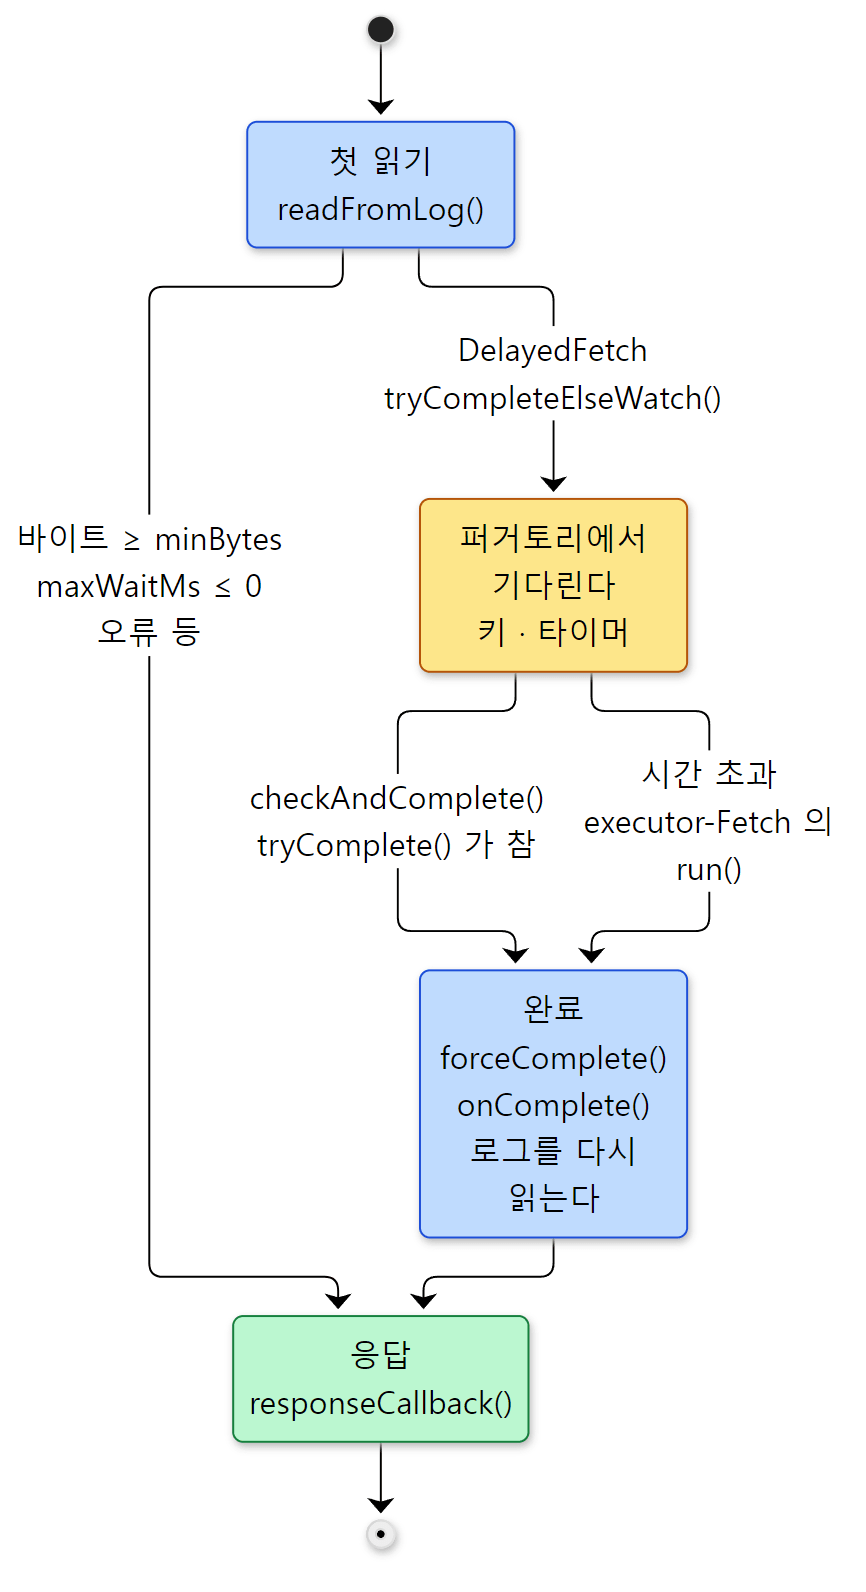 완료로 들어가는 문은 둘이지만, 들어간 뒤 하는 일(로그를 다시 읽고 콜백 부르기)은 같습니다. 그래서 시간이 다 돼도 "있는 만큼" 답합니다.
예제 1: fetch.min.bytes 와 fetch.max.wait.ms 를 바꿔 보면
정말 이렇게 동작하는지 시간으로 확인했습니다. 이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u08-fetch 입니다. 서버 하나(브로커+컨트롤러)를 요청 로거(kafka.request.logger)를 켜서 띄우고, 파티션 하나짜리 토픽 u08 에 레코드 10개(오프셋 0~9)를 넣은 뒤, 설정만 바꾼 컨슈머로 "첫 레코드를 받기까지 걸린 시간"을 잽니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 컨슈머의 fetch.min.bytes / fetch.max.wait.ms 를 바꿔 가며, 첫 레코드가 손에 들어오기까지 걸린 시간을 잰다.
// ... (사용법 주석, import 줄임) ...
public class LongPoll {
    public static void main(String[] args) throws Exception {
        // ... (인자: 토픽, 시작 오프셋, fetch.min.bytes, fetch.max.wait.ms, client.id, [produceAfterMs]) ...
        props.put(ConsumerConfig.FETCH_MIN_BYTES_CONFIG, minBytes);    // "fetch.min.bytes"
        props.put(ConsumerConfig.FETCH_MAX_WAIT_MS_CONFIG, maxWait);   // "fetch.max.wait.ms"

        TopicPartition tp = new TopicPartition(topic, 0);
        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props)) {
            // group.id 없이 assign() — 그룹 코디네이터를 거치지 않고 Fetch 만 보낸다
            consumer.assign(List.of(tp));
            consumer.seek(tp, startOffset);
            consumer.partitionsFor(topic);                             // 메타데이터를 미리 받아 둔다(시간 재기에서 빼려고)

            long start = System.nanoTime();
            // ... (produceAfterMs 가 있으면 그 시간 뒤에 다른 스레드가 레코드 하나를 보낸다) ...
            int got = 0;
            while (got == 0 && (System.nanoTime() - start) < 20_000_000_000L) {
                ConsumerRecords<String, String> recs = consumer.poll(Duration.ofMillis(200));
                got = recs.count();
            }
            // ... (걸린 시간과 받은 레코드 수를 찍는다) ...
        }
    }

    // ... (produceOne(): 레코드 하나를 보내고 응답을 받을 때까지 기다린다) ...
}
[예제 ex/u08-fetch/LongPoll.java 에서 줄임]
세 경우를 돌렸습니다. a) 데이터가 있고 기본값(fetch.min.bytes=1), b) 데이터는 있지만 fetch.min.bytes=1048576(1 MiB)에 못 미치고 fetch.max.wait.ms=3000, c) 로그 끝(오프셋 10)에서 기다리는데, 1.5초 뒤에 다른 스레드가 프로듀서를 만들어 레코드 하나를 보낸다. 요청 로그(kafka-request.log)는 JSON 한 줄이 길어서 필요한 칸만 뽑아 줄였습니다. 시각, 걸린 시간(ms), 세션 id 는 실행마다 다릅니다(두 번 더 돌렸을 때 a) 는 512ms·872ms, b) 는 3153ms·3293ms 였습니다). c) 의 [producer] 줄과 u08-c: 줄은 몇 ms 차이로 찍히므로 실행에 따라 순서가 바뀌기도 합니다.
topic u08: 10 records at offsets 0..9
=== 1. long polling: how long until the first records arrive
--- a) data is there, fetch.min.bytes=1 (default)
u08-a: fetch.min.bytes=1 fetch.max.wait.ms=500 -> 10 records after 263 ms
--- b) data is there but less than fetch.min.bytes=1048576, fetch.max.wait.ms=3000
u08-b: fetch.min.bytes=1048576 fetch.max.wait.ms=3000 -> 10 records after 3235 ms
--- c) at the end of the log (offset 10), fetch.max.wait.ms=10000, a producer sends 1 record after 1500 ms
u08-c: fetch.min.bytes=1 fetch.max.wait.ms=10000 -> 1 records after 2174 ms
  [producer] sent 1 record at 2192 ms
--- kafka-request.log: Fetch requests of b) and c) (fields shortened)
04:43:10,390 u08-b corr=4 req[maxWaitMs=3000 minBytes=1048576 sessionId=0 epoch=0 topics=1 fetchOffset=0] resp[sessionId=371989317 partitions=1 hw=10 bytes=212] total=3005.598 local=1.933 remote=3002.72 send=0.453
04:43:13,486 u08-b corr=6 req[maxWaitMs=3000 minBytes=1048576 sessionId=371989317 epoch=1 topics=1 fetchOffset=10] resp[sessionId=371989317 partitions=0 hw=- bytes=-] total=3004.113 local=1.052 remote=3002.316 send=0.313
04:43:13,488 u08-b corr=7 req[maxWaitMs=3000 minBytes=1048576 sessionId=371989317 epoch=-1 topics=0 fetchOffset=-] resp[sessionId=0 partitions=0 hw=- bytes=-] total=0.992 local=0.543 remote=0.0 send=0.207
04:43:27,920 u08-c corr=4 req[maxWaitMs=10000 minBytes=1 sessionId=0 epoch=0 topics=1 fetchOffset=10] resp[sessionId=545400081 partitions=1 hw=11 bytes=72] total=1856.662 local=1.051 remote=1854.681 send=0.463
04:43:38,045 u08-c corr=6 req[maxWaitMs=10000 minBytes=1 sessionId=545400081 epoch=1 topics=1 fetchOffset=11] resp[sessionId=545400081 partitions=0 hw=- bytes=-] total=10003.258 local=0.969 remote=10001.505 send=0.327
04:43:38,047 u08-c corr=7 req[maxWaitMs=10000 minBytes=1 sessionId=545400081 epoch=-1 topics=0 fetchOffset=-] resp[sessionId=0 partitions=0 hw=- bytes=-] total=1.205 local=0.646 remote=0.0 send=0.306
요청 로그의 시간 칸은 4편에서 봤습니다. local 은 요청 처리 스레드가 붙잡고 있던 시간, remote 는 그 뒤 응답이 만들어질 때까지 기다린 시간입니다(Request.java 336–337행). 읽어 보면 이렇습니다.
- a) 263ms 만에 10개를 받았습니다. 데이터가 있고
minBytes=1이므로fetchMessages()의 조건 3)이 참이 되어 바로 답한 경우입니다. - b) 첫 Fetch(corr=4)는
local=1.9ms동안만 요청 처리 스레드를 썼고,remote=3002ms를 퍼거토리에서 기다렸습니다. 212바이트로는 Case G(1 MiB)를 채우지 못해executor-Fetch가 시간 초과로 끝낸 것입니다. 그래도 응답에는bytes=212가 실려 있습니다. 2절 "헷갈리기 쉬운 곳"의 "있는 만큼 준다"입니다. - c) 첫 Fetch 는 로그 끝에서 기다리다가
remote=1854ms만에 끝났고hw=11,bytes=72(레코드 하나짜리 배치)를 실었습니다. 10초를 다 기다리지 않았습니다. 프로듀서의 Produce 가 HW 를 올리자checkAndComplete()가 이DelayedFetch를 깨운 것입니다. 컨슈머는 2174ms 에 받았고, 프로듀서 스레드가 "보냈다"고 찍은 것은 2192ms 로 오히려 늦습니다. 프로듀서는 Produce 응답을 받고 프로듀서를 닫은 뒤에 찍기 때문입니다(다시 돌렸을 때는 1803ms·1833ms, 그리고 순서가 바뀌어 1996ms·1988ms 였습니다. 어느 쪽이든 두 시각이 수십 ms 안쪽으로 붙어 있습니다). Produce 가 처리되자마자 기다리던 Fetch 의 응답도 나갔다는 뜻입니다(소스대로라면 Produce 를 처리한 요청 처리 스레드가handle()끝에서 깨웁니다).
각 클라이언트의 corr=6, 7 은 5절에서 다시 봅니다.
예제 2: 기다리는 동안 브로커 안에는 무엇이 있나
같은 run.sh 의 두 번째 부분입니다. 로그 끝(오프셋 11)에서 fetch.min.bytes=1048576, fetch.max.wait.ms=15000 으로 기다리는 컨슈머를 뒤에 띄워 둡니다. 그 Fetch 가 퍼거토리에 들어간 것을 확인한 뒤(브로커 JVM 에 jcmd … ManagementAgent.start 로 JMX 를 켜고 kafka-jmx.sh 로 퍼거토리의 게이지를 읽습니다), 그 순간의 요청 처리 스레드 상태와 퍼거토리 스레드를 jstack 으로 봤습니다. 끝의 stopped 줄은 뺐습니다. 시각·걸린 시간·세션 id 는 실행마다 다르고, 게이지 값과 스레드 상태·개수는 세 번 돌려 모두 같았습니다.
=== 2. while a Fetch waits in the purgatory
kafka.server:type=DelayedOperationPurgatory,name=NumDelayedOperations,delayedOperation=Fetch:Value=1
kafka.server:type=DelayedOperationPurgatory,name=PurgatorySize,delayedOperation=Fetch:Value=2
--- request-handler threads right now (state)
     16    java.lang.Thread.State: TIMED_WAITING (parking)
--- threads that belong to the Fetch purgatory
"ExpirationReaper-1-Fetch"
"executor-Fetch"
u08-d: fetch.min.bytes=1048576 fetch.max.wait.ms=15000 -> 0 records after 20053 ms
04:44:16,300 u08-d corr=4 req[maxWaitMs=15000 minBytes=1048576 sessionId=0 epoch=0 topics=1 fetchOffset=11] resp[sessionId=904435016 partitions=1 hw=11 bytes=0] total=15012.666 local=0.923 remote=15010.602 send=0.334
NumDelayedOperations=1: 타이머에 걸린 작업, 즉 지금 기다리는 Fetch 가 하나입니다(numDelayed()는timeoutTimer.size(), 217–219행).- 그 Fetch 가 15초를 기다리는 동안 요청 처리 스레드 16개는 모두
TIMED_WAITING (parking), 즉 요청 큐가 비어 쉬고 있었습니다. 16개인 것은 결합 모드에서 브로커와 컨트롤러가 8개씩 풀을 따로 만들기 때문입니다(2편의 "헷갈리기 쉬운 곳"). 기다리는 것은 스레드가 아니라DelayedFetch객체입니다. - 15초 뒤의 응답은
local=0.9ms,remote=15010ms,bytes=0입니다. 끝내 데이터가 없었으므로 빈 응답입니다.
이 구조 덕분에 컨슈머 수천 개가 fetch.max.wait.ms=500 으로 계속 롱 폴링을 해도 요청 처리 스레드(num.io.threads, 기본 8)는 금방 풀려납니다. 스레드 하나가 요청 하나를 끝까지 붙잡는 모델이었다면, 기다리는 컨슈머 수만큼 스레드가 필요했을 것입니다. Tomcat 5편에서 keep-alive 연결이 요청 사이에 작업 스레드를 놓아주는 것을 봤다면, 같은 생각을 요청 하나의 "응답 대기"에 적용한 것입니다.
헷갈리기 쉬운 곳
PurgatorySize와NumDelayedOperations가 다릅니다. 위에서PurgatorySize=2인데 기다리는 Fetch 는 하나입니다.PurgatorySize는 지켜보기 목록에 걸린 항목 수(watched())이고, 주석대로 "이미 끝난 작업이 목록에 남아 있을 수 있어 실제보다 클 수 있습니다"(DelayedOperationPurgatory.java201–206행). 끝난 항목은 끝난 수가fetch.purgatory.purge.interval.requests(기본 1000)를 넘을 때ExpirationReaper가 한꺼번에 치웁니다(392–403행).checkAndComplete()로 깨워 끝낸 작업은 그 자리에서 목록에서 빠지지만, 시간 초과로 끝난 작업은 그 키에 다음checkAndComplete()가 오거나 한꺼번에 치울 때까지 목록에 남습니다(Watchers.tryCompleteWatched(), 333–352행). 예제 1의 c) 에서 10초를 다 기다리고 시간 초과로 끝난 corr=6 이 아직 남아 있던 것으로 보입니다. "지금 몇 개가 기다리나"를 보려면NumDelayedOperations를 봅니다.- 기다리는 Fetch 는 그 연결의 다음 요청을 막습니다. 예제 1에서 c) 의 corr=6 은 10초를 기다렸고, 컨슈머를 닫으며 보낸 corr=7 은 corr=6 이 끝난 지 2ms 뒤에야 끝났습니다(
04:43:38,045→04:43:38,047). corr=7 자신의total은 1.2ms 이므로, 브로커가 corr=7 을 받은 것 자체가 corr=6 의 응답이 나간 뒤입니다. 4편에서 본 "연결마다 요청 하나씩(mute)" 규칙 때문에, 같은 연결의 요청은 앞 요청이 퍼거토리에서 나올 때까지 줄을 섭니다. 컨슈머를 닫을 때fetch.max.wait.ms만큼 늦어질 수 있는 이유가 여기 있습니다.
5. 증분 fetch 세션 — 바뀐 파티션만 주고받기
컨슈머 하나가 파티션 수백 개를 읽는다고 해 봅시다. Fetch 마다 파티션 수백 개의 이름(또는 토픽 id)·오프셋·한도를 적어 보내고, 응답에도 데이터가 없는 파티션까지 수백 개의 HW·로그 시작 오프셋이 돌아옵니다. 대부분은 지난번과 같은 값입니다. 증분 fetch 세션(KIP-227)은 "지난번과 같은 것은 빼고 보내자"는 장치입니다.
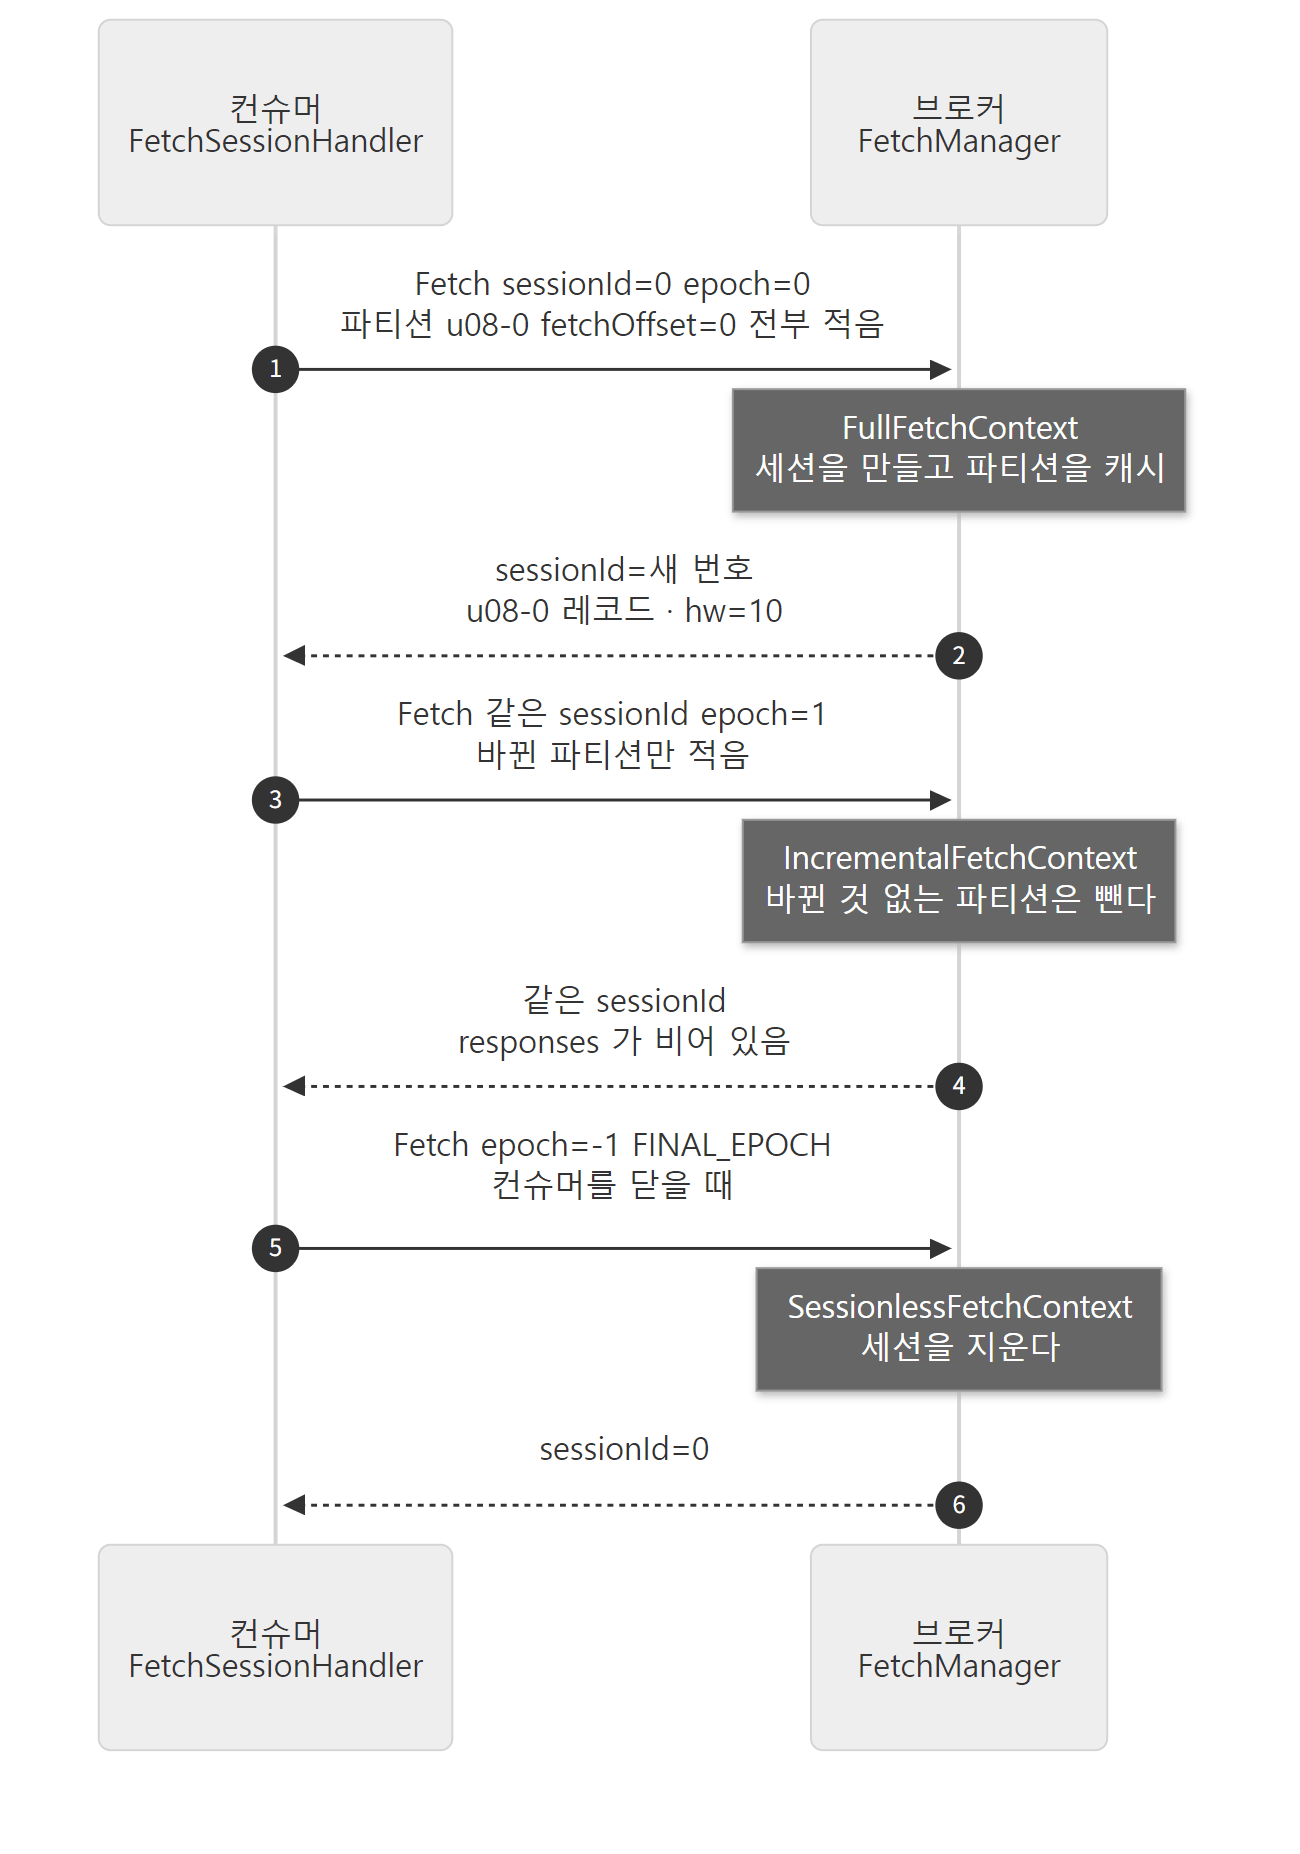 예제 1의 b) 가 이 대화 그대로입니다(corr=4 → 6 → 7).
FetchManager.newContext(): 요청의 세션 칸을 보고 세 갈래로
2절의 handleFetchRequest() 가 맨 먼저 부르는 fetchManager.newContext(...) 가 이 일을 합니다.
        if (reqMetadata.isFull()) {
            // ... (요청에 세션 id 가 있으면 그 세션을 지운다) ...
            FetchContext fetchContext;
            if (reqMetadata.epoch() == FINAL_EPOCH) {
                // If the epoch is FINAL_EPOCH, don't try to create a new session.
                suffix = " Will not try to create a new session.";
                fetchContext = new SessionlessFetchContext(fetchData);
            } else
                fetchContext = new FullFetchContext(time, cache, fetchData, reqVersion >= 13, isFollower);
            // ... (debug 로그) ...
        } else {
            // ... (세션을 찾고, 없으면 FETCH_SESSION_ID_NOT_FOUND, 에포크가 다르면 INVALID_FETCH_SESSION_EPOCH) ...
                            List<List<TopicIdPartition>> lists = session.update(fetchData, toForget);
                            // ... (세션이 비면 지우고 SessionlessFetchContext) ...
                                cacheShard.touch(session, time.milliseconds());
                                session.setEpoch(FetchMetadata.nextEpoch(session.epoch()));
                                // ... (debug 로그) ...
                                return new IncrementalFetchContext(reqMetadata, session, topicNames);
server/src/main/java/org/apache/kafka/server/FetchManager.java 64–125행에서 줄임
isFull() 은 에포크가 0(INITIAL_EPOCH)이거나 -1(FINAL_EPOCH)일 때 참입니다(FetchMetadata.java 91–93행). 그래서 갈래는 셋입니다.
| 요청의 (sessionId, epoch) | 컨텍스트 | 하는 일 |
|---|---|---|
| (0, 0) — 처음 | FullFetchContext |
파티션 목록 전체를 받고, 응답을 만들 때 세션을 새로 만들어 id 를 돌려준다 |
| (N, 1 이상) — 이어서 | IncrementalFetchContext |
세션에 기억해 둔 목록에 이번 요청의 추가·변경·삭제만 반영한다 |
| (N, -1) — 끝 | SessionlessFetchContext |
세션을 지우고 새로 만들지 않는다 |
세션은 session.update(fetchData, toForget) 로 "요청에 적힌 것"만 고칩니다. 요청에 없는 파티션은 지난번 오프셋 그대로 세션에 남아 있다가, foreachPartition() 으로 전부 다시 읽힙니다. 그래서 컨슈머는 오프셋이 바뀐 파티션만 요청에 적으면 됩니다.
응답에서 빼는 기준: maybeUpdateResponseData()
응답 쪽에서는 세션이 파티션마다 지난번에 보낸 HW·로그 시작 오프셋을 기억해 두었다가, 바뀐 것이 없으면 응답에서 뺍니다.
        boolean maybeUpdateResponseData(FetchResponseData.PartitionData respData, boolean updateResponseData) {
            // Check the response data.
            boolean mustRespond = false;
            if (FetchResponse.recordsSize(respData) > 0) {
                // Partitions with new data are always included in the response.
                mustRespond = true;
            }
            if (highWatermark != respData.highWatermark()) {
                mustRespond = true;
                if (updateResponseData)
                    highWatermark = respData.highWatermark();
            }
            if (localLogStartOffset != respData.logStartOffset()) {
                mustRespond = true;
                if (updateResponseData)
                    localLogStartOffset = respData.logStartOffset();
            }
            // ... (선호 레플리카, 오류, 갈라진 에포크가 있으면 언제나 넣는다) ...
            return mustRespond;
        }
server/src/main/java/org/apache/kafka/server/FetchSession.java 336–371행에서 줄임
IncrementalFetchContext.updateAndGenerateResponseData() 가 이 메서드로 파티션을 하나씩 걸러 응답 목록을 줄입니다(FetchContext.java 346–367행).
예제 1의 b) 를 이 표에 맞춰 다시 읽으면 이렇습니다.
- corr=4:
sessionId=0 epoch=0의 전체 요청입니다. 응답에sessionId=371989317이 실려 왔습니다. 세션이 생겼습니다. - corr=6: 같은 세션 id 에
epoch=1입니다.topics=1로 파티션을 적어 보낸 것은 오프셋이 0 → 10 으로 바뀌었기 때문입니다. 3초 기다린 뒤의 응답은partitions=0, 즉responses가 비었습니다. 새 레코드가 없고 HW 도 10 그대로라서maybeUpdateResponseData()가 뺐습니다. - corr=7: 컨슈머를 닫으며 보낸
epoch=-1입니다. 세션을 지우고sessionId=0으로 답했습니다.
헷갈리기 쉬운 곳: 세션 칸 수는 브로커 전체에 1,000개입니다
세션은 공짜가 아닙니다. 브로커는 세션마다 파티션 목록을 메모리에 들고 있어야 합니다. 칸 수는 브로커 설정 max.incremental.fetch.session.cache.slots(기본 1000)이고, 설정 설명에 "캐시는 8조각으로 나뉘고 한도도 똑같이 나눈다"고 적혀 있습니다(ServerConfigs.java 110–112행). 팔로워가 만든 세션은 "특권(privileged)" 세션으로 표시되어(FetchSession.java 66–67행) 컨슈머 세션보다 덜 밀려나게 되어 있습니다. 컨슈머가 이보다 많으면 일부 컨슈머는 세션을 얻지 못하고 매번 전체 요청을 보냅니다. 동작은 그대로이고 요청이 커질 뿐이라 눈에 잘 띄지 않습니다. 밀려남(eviction)의 자세한 규칙은 FetchSessionCacheShard.java 에 있고 이 글에서는 따라가지 않았습니다.
6. 제로 카피 — 파일 조각이 소켓으로 가는 길
3절에서 읽기 경로의 결과는 "파일의 한 구간을 가리키는 FileRecords"였습니다. 이 객체가 어떻게 응답이 되어 소켓까지 가는지 따라갑니다.
응답 객체에 파일 조각을 그대로 싣는다
2절의 processResponseCallback 은 파티션마다 응답 칸(HW, 로그 시작 오프셋 …)을 채우고, 레코드 칸에는 읽은 결과를 그대로 넣습니다(.setRecords(data.records), KafkaApis.scala 655행). data.records 는 3절의 FileRecords 조각입니다. 응답 스키마에서 이 칸의 타입은 "records" 라는 특별한 타입입니다(FetchResponse.json 115행).
이 스키마에서 빌드 때 생성되는 FetchResponseData.java(기준 커밋으로 생성, 저장소에는 없습니다)를 보면, 이 칸은 크기를 셀 때 따로 셉니다.
_size.addZeroCopyBytes(records.sizeInBytes());
생성된 clients/…/common/message/FetchResponseData.java 1327행(기준 커밋으로 생성)
그리고 쓸 때는 _writable.writeRecords(records);(같은 파일 1217행)를 부릅니다. 크기를 "제로 카피 바이트"로 따로 세는 이유는 응답 버퍼를 만들 때 이 바이트만큼은 버퍼를 잡지 않기 위해서입니다. 응답을 바이트로 만드는 SendBuilder 가 그 일을 합니다.
    @Override
    public void writeRecords(BaseRecords records) {
        if (records instanceof MemoryRecords) {
            flushPendingBuffer();
            addBuffer(((MemoryRecords) records).buffer());
        } else if (records instanceof UnalignedMemoryRecords) {
            flushPendingBuffer();
            addBuffer(((UnalignedMemoryRecords) records).buffer());
        } else {
            flushPendingSend();
            addSend(records.toSend());
        }
    }
clients/src/main/java/org/apache/kafka/common/protocol/SendBuilder.java 136–148행
SendBuilder 는 응답 머리와 다른 칸들을 messageSize.sizeExcludingZeroCopy() + 4 크기의 버퍼 하나에 씁니다(220행). 레코드 칸이 메모리에 있는 MemoryRecords 면 그 버퍼를 목록에 붙이고, FileRecords 처럼 그 밖의 것이면 records.toSend() 로 "나중에 보낼 거리"(Send)를 하나 끼워 넣습니다. FileRecords 의 toSend() 는 new DefaultRecordsSend<>(this) 입니다(AbstractRecords.java 68–71행). 그래서 Fetch 응답은 "머리 바이트 버퍼 → 파일 조각 → 다음 파티션의 머리 버퍼 → 파일 조각 …" 이 줄줄이 이어진 MultiRecordsSend 가 됩니다(173–181행).
이 Send 를 만드는 것은 requestChannel.sendResponse() 안의 request.buildResponseSend(response) 이고(RequestChannel.scala 91–100행), 콜백을 부른 스레드(요청 처리 스레드, 또는 4절의 executor-Fetch)에서 일어납니다. 그 스레드는 여전히 파일을 읽지 않습니다. 만든 Send 를 응답 큐에 넣고 끝입니다.
네트워크 스레드: writeTo() 에서 transferTo() 로
응답 큐에서 응답을 꺼낸 Processor 는 selector.send(new NetworkSend(connectionId, responseSend)) 로 그 연결에 쓸 거리를 걸어 두고(SocketServer.scala 966행), 소켓이 쓰기 가능해지면 Selector.write() → KafkaChannel.write() → send.writeTo(transportLayer) 로 씁니다(4편의 "응답이 돌아가는 길"). 파일 조각 차례가 되면 RecordsSend.writeTo() → DefaultRecordsSend.writeTo() → records().writeTo(channel, ...) 로 FileRecords 에 닿습니다(RecordsSend.java 46–61행, DefaultRecordsSend.java 33–35행).
    @Override
    public int writeTo(TransferableChannel destChannel, int offset, int length) throws IOException {
        int oldSize = sizeInBytes();
        long position = start + offset;
        int count = Math.min(length, oldSize - offset);
        try {
            long newSize = Math.min(channel.size(), end) - start;
            if (newSize < oldSize)
                throw new KafkaException(String.format(
                        "Size of FileRecords %s has been truncated during write: old size %d, new size %d",
                        file.getAbsolutePath(), oldSize, newSize));
            // safe to cast to int since `count` is an int
            return (int) destChannel.transferFrom(channel, position, count);
        } catch (IOException e) {
            // ... (주석 줄임) ...
            if (transferFailureHandler != null && !(e instanceof ClosedChannelException))
                transferFailureHandler.onTransferFailure(this, position, count, e);
            throw e;
        }
    }
clients/src/main/java/org/apache/kafka/common/record/internal/FileRecords.java 328–349행에서 줄임
destChannel 은 연결의 전송 계층(TransportLayer)입니다. 전송 계층이 구현하는 TransferableChannel 인터페이스의 설명이 이 설계를 한 문장으로 말합니다. "FileChannel.transferTo 에 위임하되, 제로 카피의 이득을 보려면 목적지 채널을 (Kafka 가 감싼 것이 아니라) 원래 채널로 풀어서 넘겨야 한다. transferTo 의 빠른 길은 목적지가 JDK 내부 클래스일 때만 타기 때문이다"(TransferableChannel.java 37–42행). 평문(PLAINTEXT) 리스너의 구현이 정확히 그렇습니다.
    @Override
    public long transferFrom(FileChannel fileChannel, long position, long count) throws IOException {
        return fileChannel.transferTo(position, count, socketChannel);
    }
clients/src/main/java/org/apache/kafka/common/network/PlaintextTransportLayer.java 212–215행
세그먼트 파일의 FileChannel 에서, 연결의 원래 SocketChannel 로, position 부터 count 바이트. Kafka 의 "제로 카피"는 이 한 줄입니다. 레코드 바이트는 JVM 힙에도, 직접 버퍼에도 올라오지 않고 운영체제 안에서 파일에서 소켓으로 옮겨집니다. Linux 의 JDK 는 이것을 sendfile 시스템 호출로 처리하는 것으로 알려져 있지만, 이 부분은 JDK 쪽 구현이라 이 연재의 소스로 확인한 것은 아닙니다. 아래 예제 3에서는 "JVM 이 파일 바이트를 읽지 않았다"는 것까지 확인합니다.
같은 일을 httpd 는 파일 버킷과 EnableSendfile 로(httpd 12편), nginx 는 sendfile on; 으로(nginx 10편) 합니다. 정적 파일을 내주는 웹 서버와 Kafka 가 같은 도구를 쓰는 이유는 같습니다. 보낼 바이트가 디스크에 있는 모양 그대로라서 고칠 것이 없기 때문입니다. 6편에서 "프로듀서가 만든 배치를 브로커가 거의 그대로 쓴다"고 한 설계가 여기서 값을 합니다. 디스크의 배치 형식과 응답의 레코드 형식이 같으니, 브로커는 배치를 열어 볼 필요 없이 파일 구간을 통째로 넘깁니다.
TLS 에서는 왜 안 되나: SslTransportLayer.transferFrom()
TLS(SSL) 리스너의 전송 계층은 같은 메서드를 전혀 다르게 구현합니다.
    /**
     * Transfers bytes from `fileChannel` by reading them into a buffer and writing them to this channel, since
     * they have to be encrypted.
     * ... (예외 설명 줄임) ...
     */
    @Override
    public long transferFrom(FileChannel fileChannel, long position, long count) throws IOException {
        // ... (상태 검사, 남은 암호문 먼저 비우기) ...
        if (fileChannelBuffer == null) {
            // ... (32k 를 고른 이유 — 디스크 읽기 효율과 연결마다의 메모리) ...
            int transferSize = 32768;
            // Allocate a direct buffer to avoid one heap to heap buffer copy. SSLEngine copies the source
            // buffer (fileChannelBuffer) to the destination buffer (netWriteBuffer) and then encrypts in-place.
            // FileChannel.read() to a heap buffer requires a copy from a direct buffer to a heap buffer, which is not
            // useful here.
            fileChannelBuffer = ByteBuffer.allocateDirect(transferSize);
            // ... (빈 버퍼 상태로 맞추기) ...
        }

        int totalBytesWritten = 0;
        long pos = position;
        while (totalBytesWritten < totalBytesToWrite) {
            if (!fileChannelBuffer.hasRemaining()) {
                // ... (버퍼를 비우고 읽을 크기 정하기) ...
                    bytesRead = fileChannel.read(fileChannelBuffer, pos);
                // ...
            }
            int networkBytesWritten = write(fileChannelBuffer);
            // ... (부분 쓰기 처리) ...
        }
        return totalBytesWritten;
    }
clients/src/main/java/org/apache/kafka/common/network/SslTransportLayer.java 1002–1069행에서 줄임
첫 주석이 이유입니다. "암호화해야 하므로, 버퍼로 읽어 들인 뒤 이 채널에 쓴다." 소켓으로 나가는 바이트는 파일의 바이트가 아니라 그것을 암호화한 바이트여야 합니다. 암호화는 JVM 안의 SSLEngine 이 하므로, 바이트가 JVM 으로 올라와야 합니다. 그래서 32KB 직접 버퍼(direct buffer)로 FileChannel.read() 하고, write() 가 sslEngine.wrap() 으로 암호화해 netWriteBuffer 에 담은 뒤 socketChannel.write() 로 보냅니다(710–742행, flush() 는 247–250행). 직접 버퍼를 쓰는 것은 "힙 버퍼로 읽으면 직접 버퍼 → 힙 버퍼 복사가 한 번 더 생기기 때문"이라는 주석도 보아 둡니다. 제로 카피는 못 해도 복사는 한 번이라도 줄이려는 것입니다.
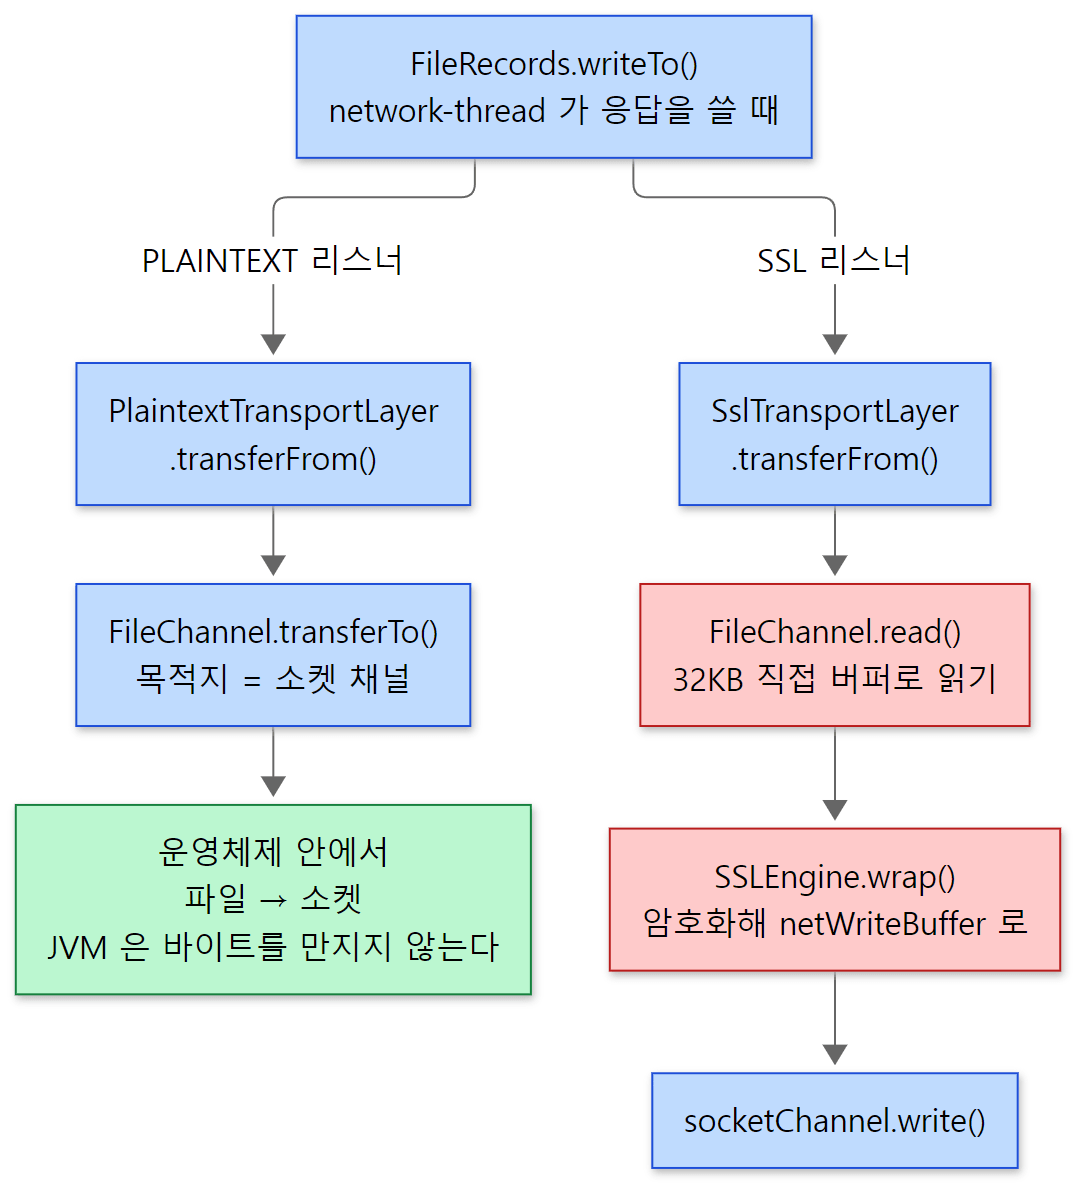 빨간 상자 둘이 TLS 가 더하는 일입니다. 레코드 바이트가 JVM 으로 올라와 읽히고 암호화됩니다.
예제 3: JVM 이 세그먼트 파일을 읽는가 — PLAINTEXT 와 SSL 비교
예제 폴더는 ex/u08-zerocopy 입니다(실행 환경은 예제 1과 같습니다). 자기 서명 인증서로 SSL 리스너(9095)를 하나 더 연 서버에 약 48 MB 짜리 토픽을 만들고, 컨슈머 하나가 PLAINTEXT(9092)로, 또 하나가 SSL 로 처음부터 끝까지 읽게 했습니다. 읽는 동안 브로커 JVM 에 JFR(Java Flight Recorder)을 켜서 파일 읽기 이벤트(jdk.FileRead)와 소켓 쓰기 이벤트(jdk.SocketWrite)를 빠짐없이 기록하고, 네트워크 스레드에서 일어난 것만 셌습니다. 파일 읽기는 토픽 세그먼트(big-0/….log)를 읽은 것만 셉니다. JFR 은 jcmd <pid> JFR.start 'jdk.FileRead#threshold=0ms' 'jdk.FileRead#throttle=off' … 처럼 이벤트 설정을 주어 켰고, 컨슈머는 kafka-consumer-perf-test.sh 를 썼습니다.
=== 1. one topic, about 48 MB of records
50500078 /tmp/kafka/1/data/big-0/00000000000000000000.log
=== 2. PLAINTEXT listener (9092)
consumed 50000 records, 47.6837 MB
plain network threads: segment reads (jdk.FileRead) 0 events, 0.0 MB / socket writes (jdk.SocketWrite) 277 events, 0.0 MB
=== 3. SSL listener (9095)
consumed 50000 records, 47.6837 MB
ssl network threads: segment reads (jdk.FileRead) 1545 events, 48.3 MB / socket writes (jdk.SocketWrite) 4947 events, 48.4 MB
--- one segment read on an SSL network thread (JDK frames removed)
    path = "/tmp/kafka/1/data/big-0/00000000000000000000.log"
    bytesRead = 32.0 kB
    endOfFile = false
    eventThread = "data-plane-kafka-network-thread-1-SSL-SSL-4" (javaThreadId = 82)
    stackTrace = [
      org.apache.kafka.common.network.SslTransportLayer.transferFrom(FileChannel, long, long) line: 1049
      org.apache.kafka.common.record.internal.FileRecords.writeTo(TransferableChannel, int, int) line: 340
      org.apache.kafka.common.record.internal.DefaultRecordsSend.writeTo(TransferableChannel, int, int) line: 34
      org.apache.kafka.common.record.internal.RecordsSend.writeTo(TransferableChannel) line: 50
      org.apache.kafka.common.record.internal.MultiRecordsSend.writeTo(TransferableChannel) line: 89
      org.apache.kafka.common.network.NetworkSend.writeTo(TransferableChannel) line: 45
      org.apache.kafka.common.network.KafkaChannel.write() line: 440
      ... (Selector.write → attemptWrite → pollSelectionKeys → poll → Processor.poll, cut for this post) ...
      kafka.network.Processor.run() line: 879
    ]
  }
스택 가운데의 다섯 프레임과 끝의 stopped 줄은 글에서 줄였습니다. 파일 크기와 이벤트 수는 실행마다 조금씩 다릅니다(다시 돌렸을 때 세그먼트 50,499,505바이트, PLAINTEXT 의 소켓 쓰기 169번, SSL 의 세그먼트 읽기 1,547번·48.3 MB, 소켓 쓰기 4,800번·48.5 MB). "PLAINTEXT 는 세그먼트 읽기 0번, SSL 은 32 kB 씩 약 48 MB" 라는 모양은 같았습니다.
- PLAINTEXT: 47.7 MB 를 내보내는 동안 네트워크 스레드의 세그먼트 읽기는 0번이고, 소켓 쓰기 이벤트 277번의 합도 0.0 MB(소수 첫째 자리에서 0)입니다. 이 277번은 합이 0.05 MB 도 안 되는 작은 쓰기들입니다(응답 머리 버퍼나 다른 요청의 작은 응답으로 보이지만, 하나하나 확인하지는 않았습니다). 레코드 바이트는 JFR 이 볼 수 있는 Java 의 읽기·쓰기를 한 번도 거치지 않았습니다.
transferTo()가 운영체제 안에서 옮겼기 때문입니다. - SSL: 같은 양을 내보내는 데 세그먼트 읽기가 1,545번, 합이 48.3 MB 이고, 한 번에
32.0 kB입니다. 소스의transferSize = 32768그대로입니다. 스택의SslTransportLayer.transferFrom(…) line: 1049는 위 발췌의fileChannel.read(fileChannelBuffer, pos)줄이고,FileRecords.writeTo(…) line: 340은destChannel.transferFrom(...)줄입니다. 맨 아래의kafka.network.Processor.run()은 이 모든 일이 네트워크 스레드에서 일어난다는 것을 보여 줍니다.
두 리스너에서 브로커 JVM 이 레코드 바이트를 다루는 양이 0 과 48 MB 로 갈렸습니다. TLS 를 켜면 CPU 사용량이 늘어나는 이유의 큰 몫이 여기 있습니다(이 예제에서 CPU 시간 자체를 재지는 않았습니다).
헷갈리기 쉬운 곳
- "브로커는 레코드를 전혀 읽지 않는다"는 아닙니다. 3절의
translateOffset()은 오프셋 인덱스 다음에searchForOffsetFromPosition()으로 배치 머리를 훑습니다(FileRecords.java395–425행). 읽지 않는 것은 레코드 본문입니다. 또 6편에서 본 대로 쓰기 경로에서는 브로커가 배치를 검증합니다. 제로 카피는 읽기 경로의 "응답 본문"에 한한 이야기입니다. - 디스크 오류는 네트워크 스레드에서 터집니다. 바이트를 실제로 읽는 순간이
transferTo()안이므로, 디스크가 망가졌다면 그 오류는 요청 처리 스레드가 아니라 네트워크 스레드의writeTo()에서IOException으로 나옵니다. 그런데 소켓이 끊긴 것도 같은IOException입니다. 이 커밋은 그 둘을 가리려고LocalLog.read()가 돌려주는 조각에transferFailureHandler를 달아 둡니다. 주석이 사정을 그대로 적고 있습니다. "fetch 의 레코드는 이 로그가 돌려준 뒤 네트워크에 쓰일 때에야 세그먼트에서 읽히므로, 그 읽기의 IOException 은 여기서 잡을 수 없다"(LocalLog.java531–541행). 전송이 실패하면 처리기가 그 구간을 스케줄러 스레드에서 다시 읽어 보고, 읽기도 실패하면 로그 디렉터리를 오프라인으로 돌립니다. 이 장치는 4.4.0 에는 없습니다. 커밋0d82450b0a(2026-10-20, KAFKA-16304 "Offline the log directory on a disk error in the zero-copy Fetch path")로 trunk 에 들어왔고, 4.4.0 의FileRecords.writeTo()는try/catch없이transferFrom()을 부르기만 합니다(git show 4.4.0:…로 확인). - 파일을 지워도 보내던 응답은 끝까지 갑니다.
FileRecords조각은 세그먼트의FileChannel을 쥐고 있습니다. 보존 정책이 세그먼트를 지울 때 이름만.deleted로 바꾸고file.delete.delay.ms(기본 60초) 뒤에 지우는 것은, 이처럼 이미 세그먼트를 가리키고 있는 읽기가 있기 때문입니다(7편의 "지우는 두 단계").
이 글에서 뺀 것
읽기 경로에 함께 있지만 이 글에서 따라가지 않은 것들입니다.
- 가까운 레플리카에서 읽기(follower fetching): 컨슈머가
client.rack을 주면 리더가 같은 랙의 팔로워를 "선호 레플리카"로 알려 주는 길.ReplicaManager.findPreferredReadReplica(),read()의 1813–1834행, 설정replica.selector.class. - 계층 저장소에서 읽기(tiered storage): 로컬에 없는 오프셋을 원격 저장소에서 읽는
DelayedRemoteFetch·processRemoteFetches()(ReplicaManager.scala1605–1657행),handleOffsetOutOfRangeError()(1913행~). - 쿼터와 스로틀링:
processResponseCallback의 701–721행,quotas.fetch·quotas.leader(팔로워 복제 쿼터). - 트랜잭션 격리:
read_committed에서 중단된 트랜잭션 목록을 붙이는LocalLog.addAbortedTransactions()— 12편. - 팔로워 쪽:
Partition.fetchRecords()의updateFollowerFetchState()(1316–1325행), 갈라진 에포크(divergingEpoch)와 잘라내기 — 9편. - 컨슈머 쪽에서 받는 곳:
AbstractFetch.handleFetchSuccess()(151행),FetchCollector.collectFetch()(91행)가 응답의 배치를 풀어poll()이 돌려줄 레코드로 만드는 길, 컨슈머 쪽 세션 관리FetchSessionHandler— 11편. - 그 밖에: 공유 그룹의
ShareFetch(KafkaApis.handleShareFetchRequest(), 3280행 — 이 연재에서 뺐습니다), 퍼거토리 타이머 아래의TimingWheel(server-common/…/util/timer/TimingWheel.java).
정리
| 개념 | 한 줄 요약 |
|---|---|
| Fetch 요청 | 컨슈머(ReplicaId=-1)와 팔로워(브로커 id)가 같은 요청을 쓴다. 보낸 쪽에 따라 HW·LSO·LEO 가운데 읽을 수 있는 끝이 다르다(FetchIsolation.of()) |
fetchMessages() |
먼저 한 번 읽어 보고, 모인 바이트가 minBytes 이상이면(또는 maxWaitMs ≤ 0, 오류 등) 바로 콜백, 아니면 DelayedFetch 를 퍼거토리에 건다 |
minOneMessage |
처음으로 데이터가 나온 파티션은 첫 배치를 한도를 넘어도 통째로 준다 — 큰 배치에 갇히지 않게 |
| 읽기 경로의 결과 | LogSegment.read() 가 인덱스로 위치를 찾고 FileRecords.slice() 로 파일 구간만 가리킨다. 바이트는 아직 읽지 않는다 |
DelayedFetch |
바이트 위치의 차이로 새로 쌓인 양을 세고, 차면 forceComplete(). 끝날 때 로그를 다시 읽어 "있는 만큼" 답한다 |
| 깨우는 쪽 | 레코드를 쓴 요청이 checkAndComplete()(KafkaApis.handle() 의 finally), 시간이 다 되면 executor-Fetch 스레드 |
| 기다리는 동안 | 요청 처리 스레드는 풀려나 있다. 기다리는 것은 객체다. 단, 같은 연결의 다음 요청은 줄을 선다(mute) |
| 증분 fetch 세션 | (0,0) 전체 → (N,1…) 바뀐 것만 → (N,-1) 닫기. 응답은 레코드·HW·로그 시작 오프셋이 바뀐 파티션만 |
| 제로 카피 | 응답에 FileRecords 를 그대로 싣고, 네트워크 스레드가 PlaintextTransportLayer.transferFrom() → FileChannel.transferTo() 로 보낸다 |
| TLS | SslTransportLayer.transferFrom() 이 32KB 직접 버퍼로 읽고 암호화해 쓴다. 제로 카피가 아니다 |
다음에 볼 것
이 글에서 Fetch 는 주로 컨슈머의 눈으로 봤습니다. 같은 Fetch 를 팔로워 브로커가 보내면 이야기가 하나 더 붙습니다. 리더는 팔로워의 Fetch 오프셋을 보고 "이 팔로워가 어디까지 따라왔나"를 기록하고, 그것으로 ISR 을 늘리고 줄이고, 하이 워터마크를 올립니다. HW 가 오르면 이 글의 4절에서 본 checkAndComplete() 가 기다리던 컨슈머의 Fetch 와 acks=all 의 Produce 를 깨웁니다. 9편: 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림에서 ReplicaFetcherThread 와 Partition.maybeIncrementLeaderHW() 를 따라갑니다.
- 4편: 브로커의 네트워크 계층 — Acceptor, Processor, 요청 처리 스레드 — 응답이 Processor 로 돌아가는 길과 mute
- 6편: 브로커가 레코드를 받아 쓰기까지 — 레코드 배치 형식과 Produce 요청 처리 — 디스크의 배치가 곧 응답의 배치인 이유
- 7편: 로그 저장소 — 세그먼트, 인덱스, 보존과 압축 —
translateOffset()과 희소 인덱스 - 11편: 컨슈머와 그룹 코디네이터 — poll()과 리밸런스의 안쪽 — 컨슈머가 응답을 받아 레코드로 푸는 쪽
- nginx 10편: 필터와 정적 파일 — 응답은 어떻게 흘러 나가나 —
sendfile을 strace 로 확인한 글 - httpd 12편: 핸들러와 정적 파일 — 파일 하나는 어떻게 응답이 되나 — 파일 버킷이 sendfile·mmap·read 로 소켓에 가는 길