이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 아홉 번째 글입니다. 6편에서 리더 브로커가 Produce 요청의 레코드를 자기 로그에 쓰는 길을, 7편에서 그 로그가 디스크에 놓이는 모양을, 8편에서 Fetch 요청으로 로그를 읽어 가는 길을 봤습니다. 8편 끝에서 "컨슈머와 팔로워가 같은 Fetch 를 쓴다" 고 했는데, 이번 글이 그 팔로워 쪽 이야기입니다. 리더에 쓰인 레코드가 다른 브로커로 옮겨 가고, 그 사실이 다시 리더에 알려져 프로듀서의 acks=all 응답과 컨슈머가 읽을 수 있는 범위를 정하기까지입니다.
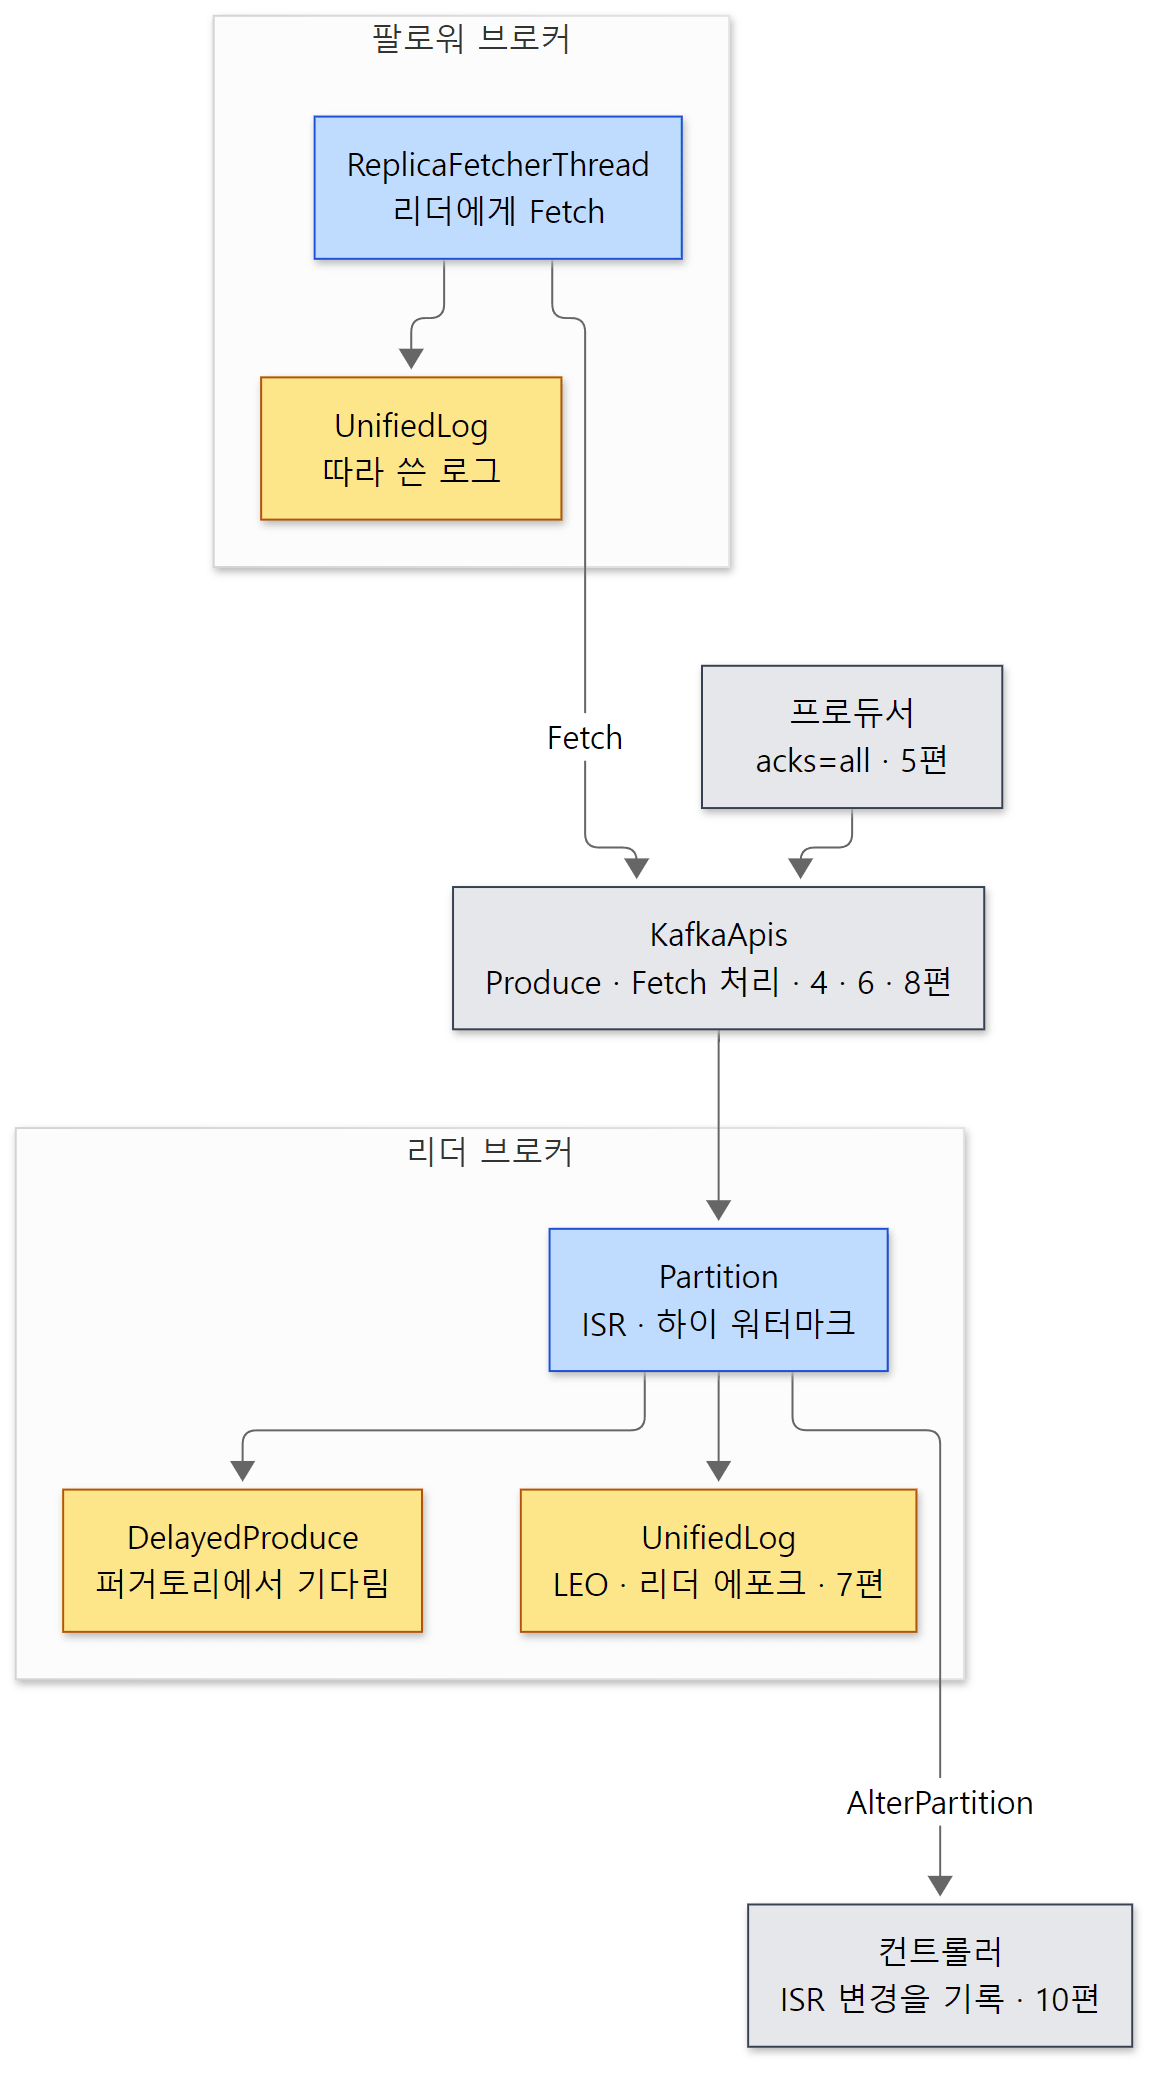 2편 전체 지도의 D 구역(파티션과 복제)을 확대한 그림입니다. 파란 상자가 이 글의 주인공, 노란 상자는 상태를 담는 곳, 회색은 앞뒤 글의 몫입니다.
답하려는 질문은 네 가지입니다.
- 팔로워는 리더에게서 레코드를 어떻게 가져오나 — 어느 스레드가, 어떤 요청으로
- 하이 워터마크는 언제 오르나. 리더가 방금 쓴 레코드를 컨슈머가 바로 못 읽는 이유는 무엇인가
- 팔로워가 ISR 에서 빠지고 돌아오는 기준은 무엇이고, 그 결정은 누가 어떻게 확정하나
acks=all은 정확히 무엇을 기다리고,min.insync.replicas는 어디서 요청을 거절하나
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | kafka.cluster.Partition(Scala), kafka.server.ReplicaFetcherManager·AbstractFetcherThread·ReplicaFetcherThread·RemoteLeaderEndPoint·ReplicaManager(Scala), org.apache.kafka.server.replica.Replica·ReplicaState, org.apache.kafka.server.partition.DefaultAlterPartitionManager, org.apache.kafka.server.purgatory.DelayedProduce, org.apache.kafka.storage.internals.log.UnifiedLog·epoch.LeaderEpochFileCache(Java) |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
복제의 중심인 Partition.scala 가 1,856줄, AbstractFetcherThread.scala 가 873줄, ReplicaManager.scala 가 2,577줄입니다. 디렉터리 옮기기(JBOD), 계층 저장소, 재할당 같은 기능이 같은 파일들에 섞여 삽니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
레플리카·리더·팔로워: 파티션 하나는 여러 브로커에 복제본(레플리카)으로 놓이고, 그 가운데 하나인 리더가 쓰기와 읽기를 받습니다. 나머지 팔로워는 리더의 로그를 가져다 따라 씁니다(1편). 누가 리더인지는 컨트롤러가 정해 메타데이터 로그로 퍼뜨립니다(2편, 10편).
LEO(log end offset, 로그 끝 오프셋): 그 레플리카의 로그에 다음에 쓸 레코드가 받을 오프셋입니다. 오프셋 0~9 를 가진 로그의 LEO 는 10 입니다. 레플리카마다 따로 있습니다.
하이 워터마크(high watermark, HW): "여기 앞까지는 ISR 이 모두 가지고 있다" 는 경계 오프셋입니다. 컨슈머는 HW 앞의 레코드만 읽을 수 있습니다. HW 가 10 이면 오프셋 9 까지만 보입니다. 리더가 계산하고, 팔로워는 리더가 알려 준 값을 받아 적습니다.
ISR(in-sync replicas): 리더를 "충분히 따라오고 있는" 레플리카의 집합입니다. 리더 자신도 들어 있습니다. kafka-topics.sh --describe 의 Isr: 1,2,3 이 그것입니다. 이 글의 4절이 "충분히" 의 정확한 뜻을 소스로 봅니다.
리더 에포크(leader epoch): 파티션의 리더가 바뀔 때마다 하나씩 오르는 세대 번호입니다(재할당으로 레플리카가 빠질 때처럼 리더가 그대로여도 오르는 경우가 있습니다, PartitionChangeBuilder.triggerLeaderEpochBumpForReplicaReassignmentIfNeeded()). 리더는 자기가 쓰는 레코드 배치마다 이 번호를 찍어 둡니다(6편의 배치 헤더 partitionLeaderEpoch). 리더가 바뀐 뒤 "어느 레코드가 어느 리더 시절에 쓰였나" 를 가려 갈라진 로그를 맞추는 데 씁니다(6절). 이와 별도로 ISR 이나 리더처럼 파티션 상태가 바뀔 때마다 오르는 파티션 에포크(partition epoch)도 있습니다.
퍼거토리(purgatory)와 DelayedProduce: 조건이 채워질 때까지 응답을 미뤄 두는 대기실입니다. 8편의 DelayedFetch 가 "데이터가 쌓일 때까지" 기다렸다면, 이 글의 DelayedProduce 는 "복제가 끝날 때까지" 기다립니다.
AlterPartition: 리더 브로커가 컨트롤러에게 "이 파티션의 ISR 을 이렇게 바꿔 달라" 고 보내는 요청입니다. ISR 을 정하는 것은 리더지만, 확정하고 기록하는 것은 컨트롤러입니다.
1. 팔로워 쪽 — ReplicaFetcherThread 가 리더에게 Fetch 를 보낸다
브로커가 "나는 이 파티션의 팔로워다" 라는 메타데이터를 받으면 ReplicaManager.applyLocalFollowersDelta() 가 Partition.makeFollower() 를 부르고, 그 파티션을 fetcher 에 붙입니다(ReplicaManager.scala 2458–2563행). fetcher 스레드를 만드는 곳은 59줄짜리 ReplicaFetcherManager 입니다.
  override def createFetcherThread(fetcherId: Int, sourceBroker: BrokerEndPoint): ReplicaFetcherThread = {
    val threadName = s"ReplicaFetcherThread-$fetcherId-${sourceBroker.id}"
    val logContext = new LogContext(s"[ReplicaFetcher replicaId=${brokerConfig.brokerId}, leaderId=${sourceBroker.id}, " +
      s"fetcherId=$fetcherId] ")
    val endpoint = new BrokerBlockingSender(sourceBroker, brokerConfig, metrics, time, fetcherId,
      s"broker-${brokerConfig.brokerId}-fetcher-$fetcherId", logContext)
    val fetchSessionHandler = new FetchSessionHandler(logContext, sourceBroker.id)
    val leader: LeaderEndPoint = new RemoteLeaderEndPoint(logContext.logPrefix, endpoint, fetchSessionHandler, brokerConfig,
      replicaManager, quotaManager, metadataVersionSupplier, brokerEpochSupplier)
    new ReplicaFetcherThread(threadName, leader, brokerConfig, failedPartitions, replicaManager,
      quotaManager, logContext.logPrefix)
  }
core/src/main/scala/kafka/server/ReplicaFetcherManager.scala 41–52행
Scala 읽는 법 —
override def f(...): T = { ... }는 부모의 메서드를 다시 정의하는 메서드이고, 블록의 마지막 식(new ReplicaFetcherThread(...))이 반환값입니다.s"...$x...${a.b}"는 문자열 안에 값을 끼워 넣는 문법(문자열 보간)입니다.val은 다시 대입할 수 없는 변수입니다.
스레드 이름이 ReplicaFetcherThread-<fetcherId>-<리더 브로커 id> 입니다. 이름에 파티션이 없다는 데 주목하세요. fetcher 스레드는 파티션마다가 아니라 "리더 브로커 × fetcherId" 마다 하나입니다. 어느 스레드에 넣을지는 AbstractFetcherManager.addFetcherForPartitions() 가 파티션들을 (리더 브로커, getFetcherId(파티션)) 으로 묶어 정하고, getFetcherId() 는 abs(31 * 토픽 이름 해시 + 파티션 번호) % num.replica.fetchers 입니다(AbstractFetcherManager.scala 111–115행, 120–150행). num.replica.fetchers 의 기본값은 1 이므로(ReplicationConfigs.java 95–96행), 기본 설정에서는 리더 브로커 하나에 fetcher 스레드 하나가 그 리더에게서 받아 올 파티션 전부를 맡습니다. 리더가 브로커 1 인 파티션 100개를 팔로우하든 1개를 팔로우하든 스레드는 ReplicaFetcherThread-0-1 하나입니다.
BrokerBlockingSender 는 clients 모듈의 NetworkClient 와 Selector 를 하나씩 만들어(최대 동시 요청 1개) 요청을 보내고 응답이 올 때까지 기다리는 얇은 껍데기입니다(BrokerBlockingSender.scala 71–123행). 4편에서 브로커가 받는 쪽으로 쓰던 그 Selector 를, 여기서는 브로커가 보내는 쪽으로 씁니다. 팔로워 브로커는 리더에게 클라이언트처럼 행동합니다.
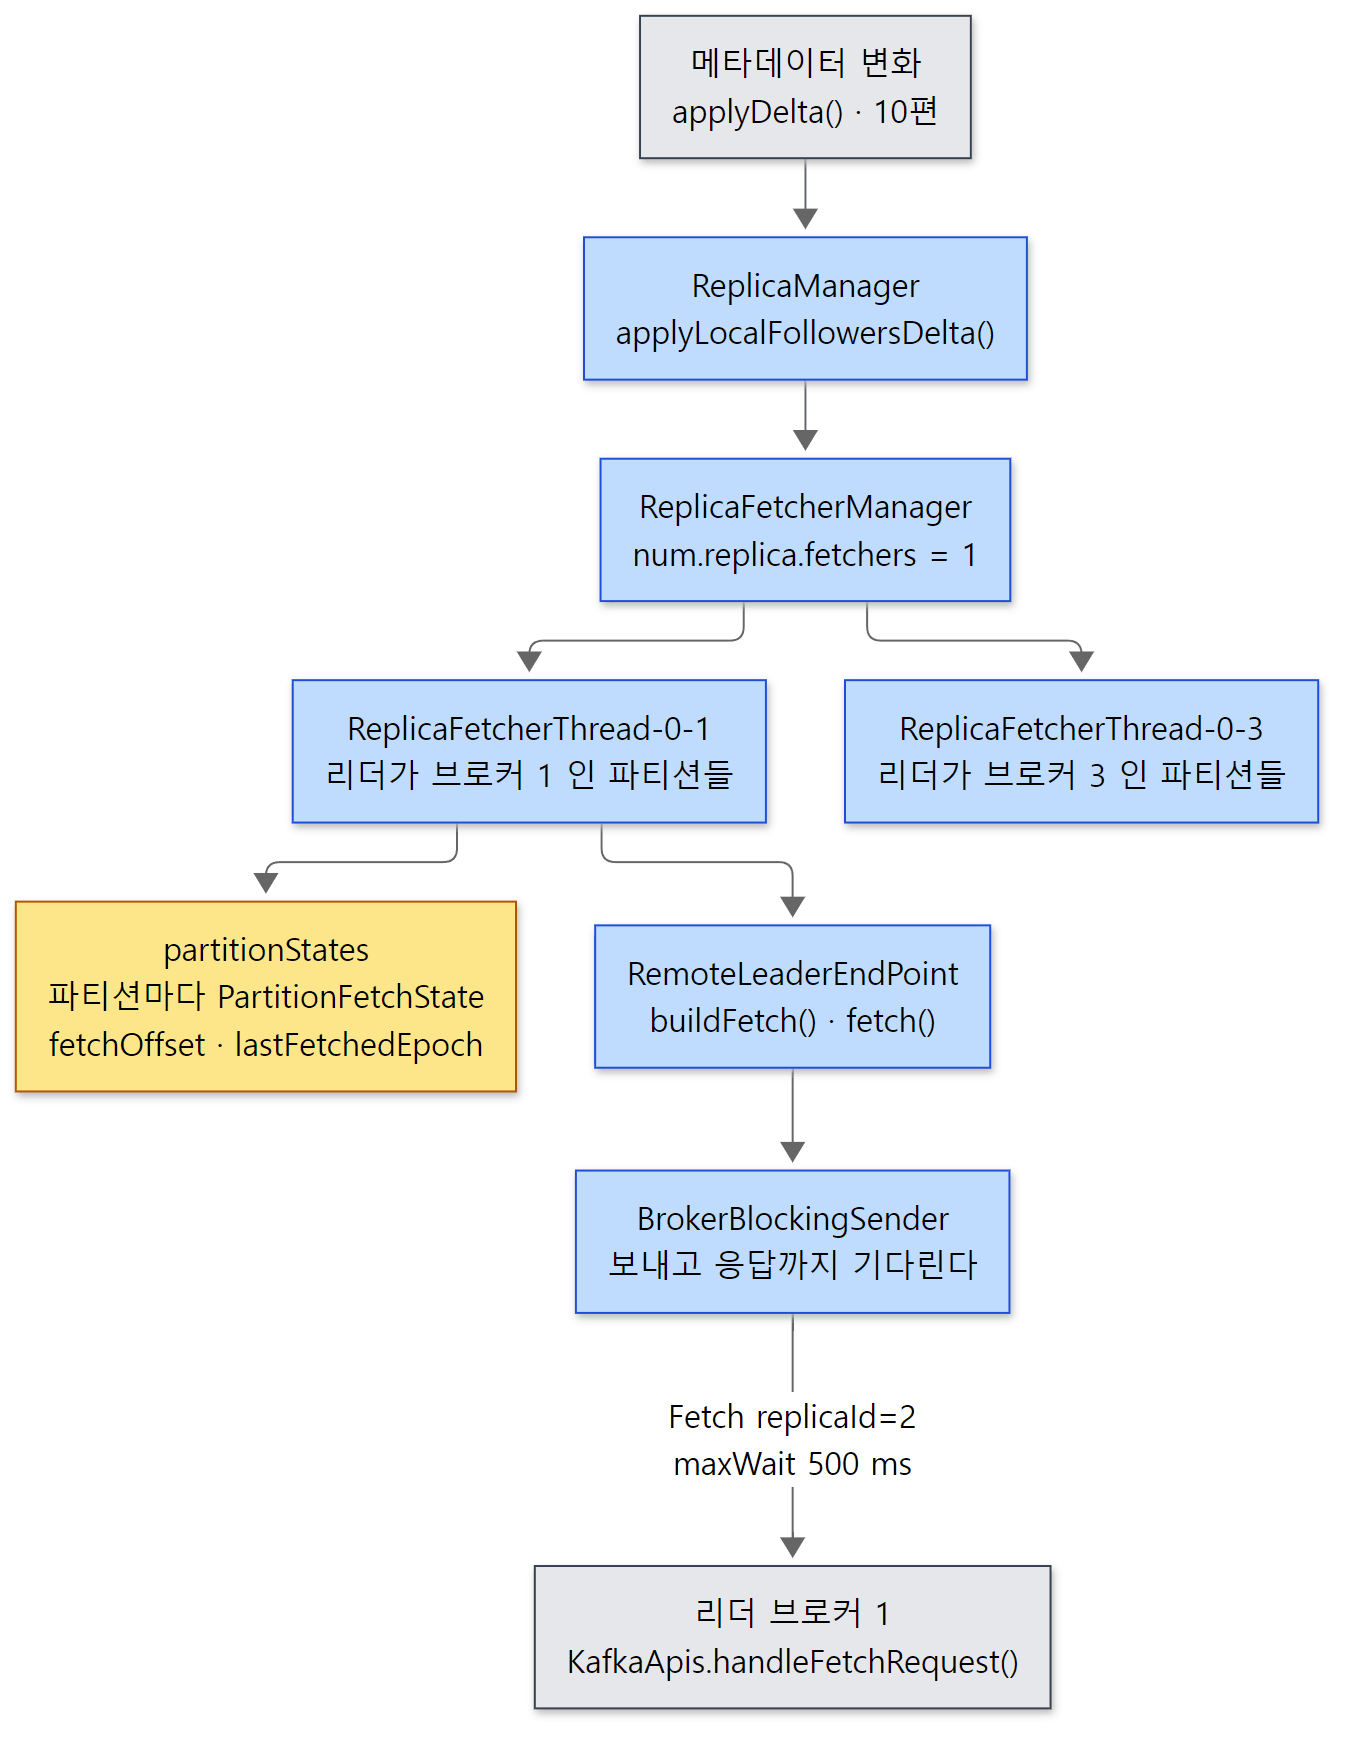 브로커 2 의 입장에서 그린 그림입니다. 파란 상자는 스레드와 그 스레드가 부르는 객체, 노란 상자는 스레드가 들고 있는 파티션별 상태입니다.
한 바퀴: 잘라 낼 것이 있으면 자르고, Fetch 를 보낸다
ReplicaFetcherThread 는 ShutdownableThread 를 이어받아, 멈추라는 말이 있을 때까지 doWork() 를 되풀이해 부릅니다. 부모 클래스의 doWork() 는 두 줄입니다.
  override def doWork(): Unit = {
    maybeTruncate()
    maybeFetch()
  }
core/src/main/scala/kafka/server/AbstractFetcherThread.scala 110–113행
Scala 읽는 법 —
: Unit은 Java 의void입니다. 인자가 없는 메서드는 괄호를 붙여maybeTruncate()처럼 부릅니다.
maybeTruncate() 는 6절에서 볼 "잘라 내기" 가 필요한 파티션만 처리하고, 보통은 아무것도 하지 않습니다. maybeFetch() 는 leader.buildFetch(partitionStates.partitionStateMap) 로 요청을 만들어 processFetchRequest() 로 보냅니다(115–134행). 보낼 파티션이 하나도 없으면 replica.fetch.backoff.ms 만큼 조건 변수에서 기다립니다. 자식 클래스 ReplicaFetcherThread 는 여기에 한 줄을 더해, 한 바퀴가 끝날 때마다 하이 워터마크가 오른 파티션의 DelayedFetch 를 깨웁니다(completeDelayedFetchRequests(), ReplicaFetcherThread.scala 107–110행). 팔로워에서 읽어 가는 컨슈머(이 글에서 뺀 "가까운 레플리카에서 읽기")를 위한 것입니다.
요청에 무엇이 실리는지는 RemoteLeaderEndPoint.buildFetch() 에 있습니다.
          val logStartOffset = replicaManager.localLogOrException(topicPartition).logStartOffset
          val lastFetchedEpoch = fetchState.lastFetchedEpoch()
          builder.add(topicPartition, new FetchRequest.PartitionData(
            fetchState.topicId().orElse(Uuid.ZERO_UUID),
            fetchState.fetchOffset(),
            logStartOffset,
            fetchSize,
            Optional.of(fetchState.currentLeaderEpoch()),
            lastFetchedEpoch))
core/src/main/scala/kafka/server/RemoteLeaderEndPoint.scala 184–192행
파티션마다 다섯 가지를 보냅니다. fetchOffset(여기부터 달라), 자기 로그의 시작 오프셋, 최대 바이트, 지금 알고 있는 리더 에포크(currentLeaderEpoch), 그리고 마지막으로 받은 배치의 리더 에포크(lastFetchedEpoch)입니다. 요청 전체는 FetchRequest.Builder.forReplica(version, brokerId, brokerEpoch, maxWait, minBytes, ...) 로 만듭니다(212–213행). 컨슈머의 Fetch 와 다른 점은 이 forReplica 하나입니다. 요청에 자기 브로커 id 와 브로커 에포크가 실려, 받는 리더가 "이건 팔로워의 Fetch" 임을 압니다. maxWait·minBytes 는 replica.fetch.wait.max.ms(기본 500)·replica.fetch.min.bytes(기본 1)입니다(ReplicationConfigs.java 74–80행). 새 레코드가 없으면 리더가 최대 0.5초 붙잡아 두는 8편의 롱 폴링이 팔로워에게도 그대로 걸립니다.
받은 레코드는 그대로 덧붙이고, 리더가 알려 준 HW 를 적는다
응답이 오면 processFetchRequest() 가 파티션마다 오류 코드를 보고(NONE, OFFSET_OUT_OF_RANGE, FENCED_LEADER_EPOCH …, 279–388행), 정상이면 processPartitionData() 를 부릅니다.
    // Append the leader's messages to the log
    val logAppendInfo = partition.appendRecordsToFollowerOrFutureReplica(records, isFuture = false, partitionLeaderEpoch)

    if (logTrace)
      trace("Follower has replica log end offset %d after appending %d bytes of messages for partition %s"
        .format(log.logEndOffset, records.sizeInBytes, topicPartition))
    val leaderLogStartOffset = partitionData.logStartOffset

    // For the follower replica, we do not need to keep its segment base offset and physical position.
    // These values will be computed upon becoming leader or handling a preferred read replica fetch.
    var maybeUpdateHighWatermarkMessage = s"but did not update replica high watermark"
    log.maybeUpdateHighWatermark(partitionData.highWatermark).ifPresent { newHighWatermark =>
      maybeUpdateHighWatermarkMessage = s"and updated replica high watermark to $newHighWatermark"
      partitionsWithNewHighWatermark += topicPartition
    }
core/src/main/scala/kafka/server/ReplicaFetcherThread.scala 132–146행
Scala 읽는 법 —
var는 다시 대입할 수 있는 변수입니다.opt.ifPresent { x => ... }는 JavaOptional.ifPresent(x -> ...)에 Scala 람다(x => ...)를 넘긴 것입니다.buf += x는 가변 컬렉션에 하나를 더합니다. 인자를isFuture = false처럼 이름으로 넘길 수도 있습니다.
두 가지가 일어납니다. 하나는 덧붙이기입니다. appendRecordsToFollowerOrFutureReplica() 는 결국 UnifiedLog.appendAsFollower() 를 부르는데, 이 메서드는 append(..., AppendOrigin.REPLICATION, false, ...) — 세 번째 인자 assignOffsets 가 false — 로 부릅니다(UnifiedLog.java 1093–1103행). 리더가 6편에서 오프셋과 리더 에포크를 매겨 둔 배치를, 팔로워는 다시 매기지 않고 바이트 그대로 붙입니다. 덧붙이면서 배치에 찍힌 리더 에포크를 자기 에포크 캐시에 적어 두는 것도 이때입니다(assignEpochStartOffset(batch.partitionLeaderEpoch(), batch.baseOffset()), 1226–1229행). 그래서 모든 레플리카의 로그가 오프셋까지 같아집니다.
다른 하나는 HW 입니다. 응답에 리더의 HW 가 실려 오고, 팔로워는 maybeUpdateHighWatermark() 로 그 값을 자기 HW 로 삼습니다. 다만 그 안의 updateHighWatermark() 는 값을 자기 LEO 이하로 깎습니다.
    public long updateHighWatermark(LogOffsetMetadata highWatermarkMetadata) throws IOException {
        LogOffsetMetadata endOffsetMetadata = localLog.logEndOffsetMetadata();
        LogOffsetMetadata newHighWatermarkMetadata = highWatermarkMetadata.messageOffset < logStartOffset
            ? new LogOffsetMetadata(logStartOffset)
            : highWatermarkMetadata.messageOffset >= endOffsetMetadata.messageOffset
                ? endOffsetMetadata
                : highWatermarkMetadata;

        updateHighWatermarkMetadata(newHighWatermarkMetadata);
        return newHighWatermarkMetadata.messageOffset;
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 542–552행
팔로워의 HW 는 min(리더가 알려 준 HW, 내 LEO) 입니다. 리더의 HW 는 "ISR 이 모두 가진 곳" 이므로 대개 팔로워의 LEO 이하이지만, 그렇지 않은 경우에도 자기 로그에 없는 오프셋을 HW 로 삼지 않게 막아 둔 것입니다. 메서드 위 주석도 "upper-bounded by the log end offset" 이라고 적고 있습니다(583–591행).
예제 1-1: fetcher 스레드 이름
이 글의 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 컨트롤러 1개(node 100)와 브로커 3개(node 1·2·3)를 한 컨테이너에 띄우고(ex/u09-isr-hw/run.sh), 레플리카를 1:2:3 으로 못 박은 토픽 rep 를 만들었습니다. --replica-assignment 1:2:3 은 레플리카 목록의 순서까지 정하므로 첫 번째인 브로커 1 이 리더가 됩니다(2편에서 본 "살아 있는 첫 번째 레플리카").
kafka-topics.sh --bootstrap-server $BOOTSTRAP --create --topic rep --replica-assignment 1:2:3
jstack $(kafka_pid 2) | grep -o '^"ReplicaFetcherThread[^"]*"'
위 두 줄은 run.sh 에서 골라 줄인 것입니다(실제 스크립트는 브로커마다 jstack 결과를 한 줄로 이어 찍습니다). 출력에서 스레드 부분만 옮깁니다.
broker 2: "ReplicaFetcherThread-0-1"
broker 3: "ReplicaFetcherThread-0-1"
broker 1: (none: leader of rep-0)
broker 1: "broker-1-to-controller-alter-partition-channel-manager"
팔로워인 브로커 2·3 에는 리더(브로커 1)에게서 받아 오는 ReplicaFetcherThread-0-1 이 하나씩 있고, 리더인 브로커 1 에는 없습니다. 대신 브로커 1 에는 ISR 변경을 컨트롤러에 보낼 broker-1-to-controller-alter-partition-channel-manager 스레드가 있습니다(4절).
2. 리더 쪽 — Fetch 의 오프셋이 곧 "여기까지 받았다" 는 보고
팔로워는 "레코드를 받았다" 는 확인 메시지를 따로 보내지 않습니다. 다음 Fetch 의 fetchOffset 이 그 보고입니다. fetchOffset=11 로 달라는 것은 "10 까지는 내 로그에 있다", 곧 "내 LEO 는 11" 이라는 뜻입니다. 리더 쪽에서 Fetch 를 처리하는 ReplicaManager.readFromLog() 는 파티션마다 Partition.fetchRecords() 를 부르고, 거기서 팔로워의 Fetch 만 갈라집니다.
    if (fetchParams.isFromFollower) {
      // Check that the request is from a valid replica before doing the read
      val (replica, logReadInfo) = inReadLock(leaderIsrUpdateLock, () => {
        val localLog = localLogWithEpochOrThrow(
          fetchPartitionData.currentLeaderEpoch,
          fetchParams.fetchOnlyLeader
        )
        val replica = followerReplicaOrThrow(
          fetchParams.replicaId,
          fetchPartitionData
        )
        val logReadInfo = readFromLocalLog(localLog)
        (replica, logReadInfo)
      })

      if (updateFetchState && !logReadInfo.divergingEpoch.isPresent) {
        updateFollowerFetchState(
          replica,
          followerFetchOffsetMetadata = logReadInfo.fetchedData.fetchOffsetMetadata,
          followerStartOffset = fetchPartitionData.logStartOffset,
          followerFetchTimeMs = fetchTimeMs,
          leaderEndOffset = logReadInfo.logEndOffset,
          fetchParams.replicaEpoch
        )
      }
core/src/main/scala/kafka/cluster/Partition.scala 1301–1325행
Scala 읽는 법 —
val (a, b) = ...는 두 값짜리 튜플을 한 번에 풀어 두 변수에 담습니다. 람다() => { ... }의 마지막 식(replica, logReadInfo)가 그 튜플입니다.
isFromFollower 는 요청의 replicaId 가 올바른 브로커 id(0 이상)인지로 가립니다(FetchParams.java 67–69행). 읽기 자체는 컨슈머와 같은 readFromLocalLog() 이지만, 어디까지 읽어 주느냐가 다릅니다. FetchIsolation.of() 가 팔로워에게는 LOG_END(로그 끝까지), 컨슈머에게는 HIGH_WATERMARK(HW 까지)를 고릅니다(FetchIsolation.java 31–39행, 1편에서 본 그 분기). 팔로워는 아직 복제가 끝나지 않은 레코드를 가져가야 복제가 진행되고, 컨슈머는 복제가 끝난 것만 봐야 하기 때문입니다.
그리고 팔로워의 Fetch 일 때만 updateFollowerFetchState() 로 넘어갑니다. 조건의 updateFetchState 는 ReplicaManager 가 !readFromPurgatory 로 넘기는 값이라(ReplicaManager.scala 1838–1844행), 요청이 처음 도착해 읽을 때 한 번만 상태를 고칩니다. 롱 폴링으로 붙잡혀 있다가 나중에 다시 읽을 때는 고치지 않습니다.
리더가 팔로워마다 들고 있는 것: Replica 와 lastCaughtUpTimeMs
리더의 Partition 은 팔로워마다 Replica 객체를 하나씩 들고(remoteReplicasMap, 181행), 그 안에 불변 레코드 ReplicaState 를 AtomicReference 로 바꿔 끼웁니다. 필드는 팔로워의 로그 시작·끝 오프셋, 마지막 Fetch 시각, 그때의 리더 LEO, lastCaughtUpTimeMs, 그리고 Fetch 에 실려 온 브로커 에포크입니다(ReplicaState.java 32–39행). updateFollowerFetchState() 가 부르는 Replica.updateFetchStateOrThrow() 의 핵심은 lastCaughtUpTimeMs 를 고르는 세 갈래입니다.
            long lastCaughtUpTime;
            if (followerFetchOffsetMetadata.messageOffset >= leaderEndOffset) {
                lastCaughtUpTime = Math.max(currentReplicaState.lastCaughtUpTimeMs(), followerFetchTimeMs);
            } else if (followerFetchOffsetMetadata.messageOffset >= currentReplicaState.lastFetchLeaderLogEndOffset()) {
                lastCaughtUpTime = Math.max(currentReplicaState.lastCaughtUpTimeMs(), currentReplicaState.lastFetchTimeMs());
            } else {
                lastCaughtUpTime = currentReplicaState.lastCaughtUpTimeMs();
            }
server/src/main/java/org/apache/kafka/server/replica/Replica.java 84–91행
lastCaughtUpTimeMs 는 "이 팔로워가 마지막으로 리더를 완전히 따라잡았던 시각" 입니다. 이번 Fetch 의 오프셋이 리더의 지금 LEO 이상이면 지금이 그 시각입니다(첫 갈래). 아니어도, 이번 Fetch 의 오프셋이 지난번 Fetch 때의 리더 LEO 이상이면 "지난번 Fetch 시각에는 그때의 끝까지 따라잡고 있었다" 고 인정해 지난번 시각을 씁니다(둘째 갈래). 메서드 위의 주석이 이 둘째 갈래가 왜 필요한지 설명합니다. 작은 Produce 가 쉴 새 없이 들어오면 팔로워의 Fetch 오프셋은 늘 리더의 LEO 보다 조금 작아서, 첫 갈래만으로는 영영 "따라잡았다" 가 되지 않기 때문입니다(53–68행 주석).
이 값이 4절의 ISR 판정에 쓰이고, updateFollowerFetchState() 는 기록을 마친 뒤 이어서 maybeExpandIsr(replica) 로 ISR 을 넓힐지 보고, 팔로워의 LEO 가 바뀌었으면 maybeIncrementLeaderHW() 로 HW 를 올릴 수 있는지 보고, 무언가 올랐으면 tryCompleteDelayedRequests() 로 기다리는 요청들을 깨웁니다(Partition.scala 798–815행). 이 한 메서드가 복제의 세 가지 결과 — ISR, HW, acks=all 응답 — 를 모두 움직이는 지점입니다.
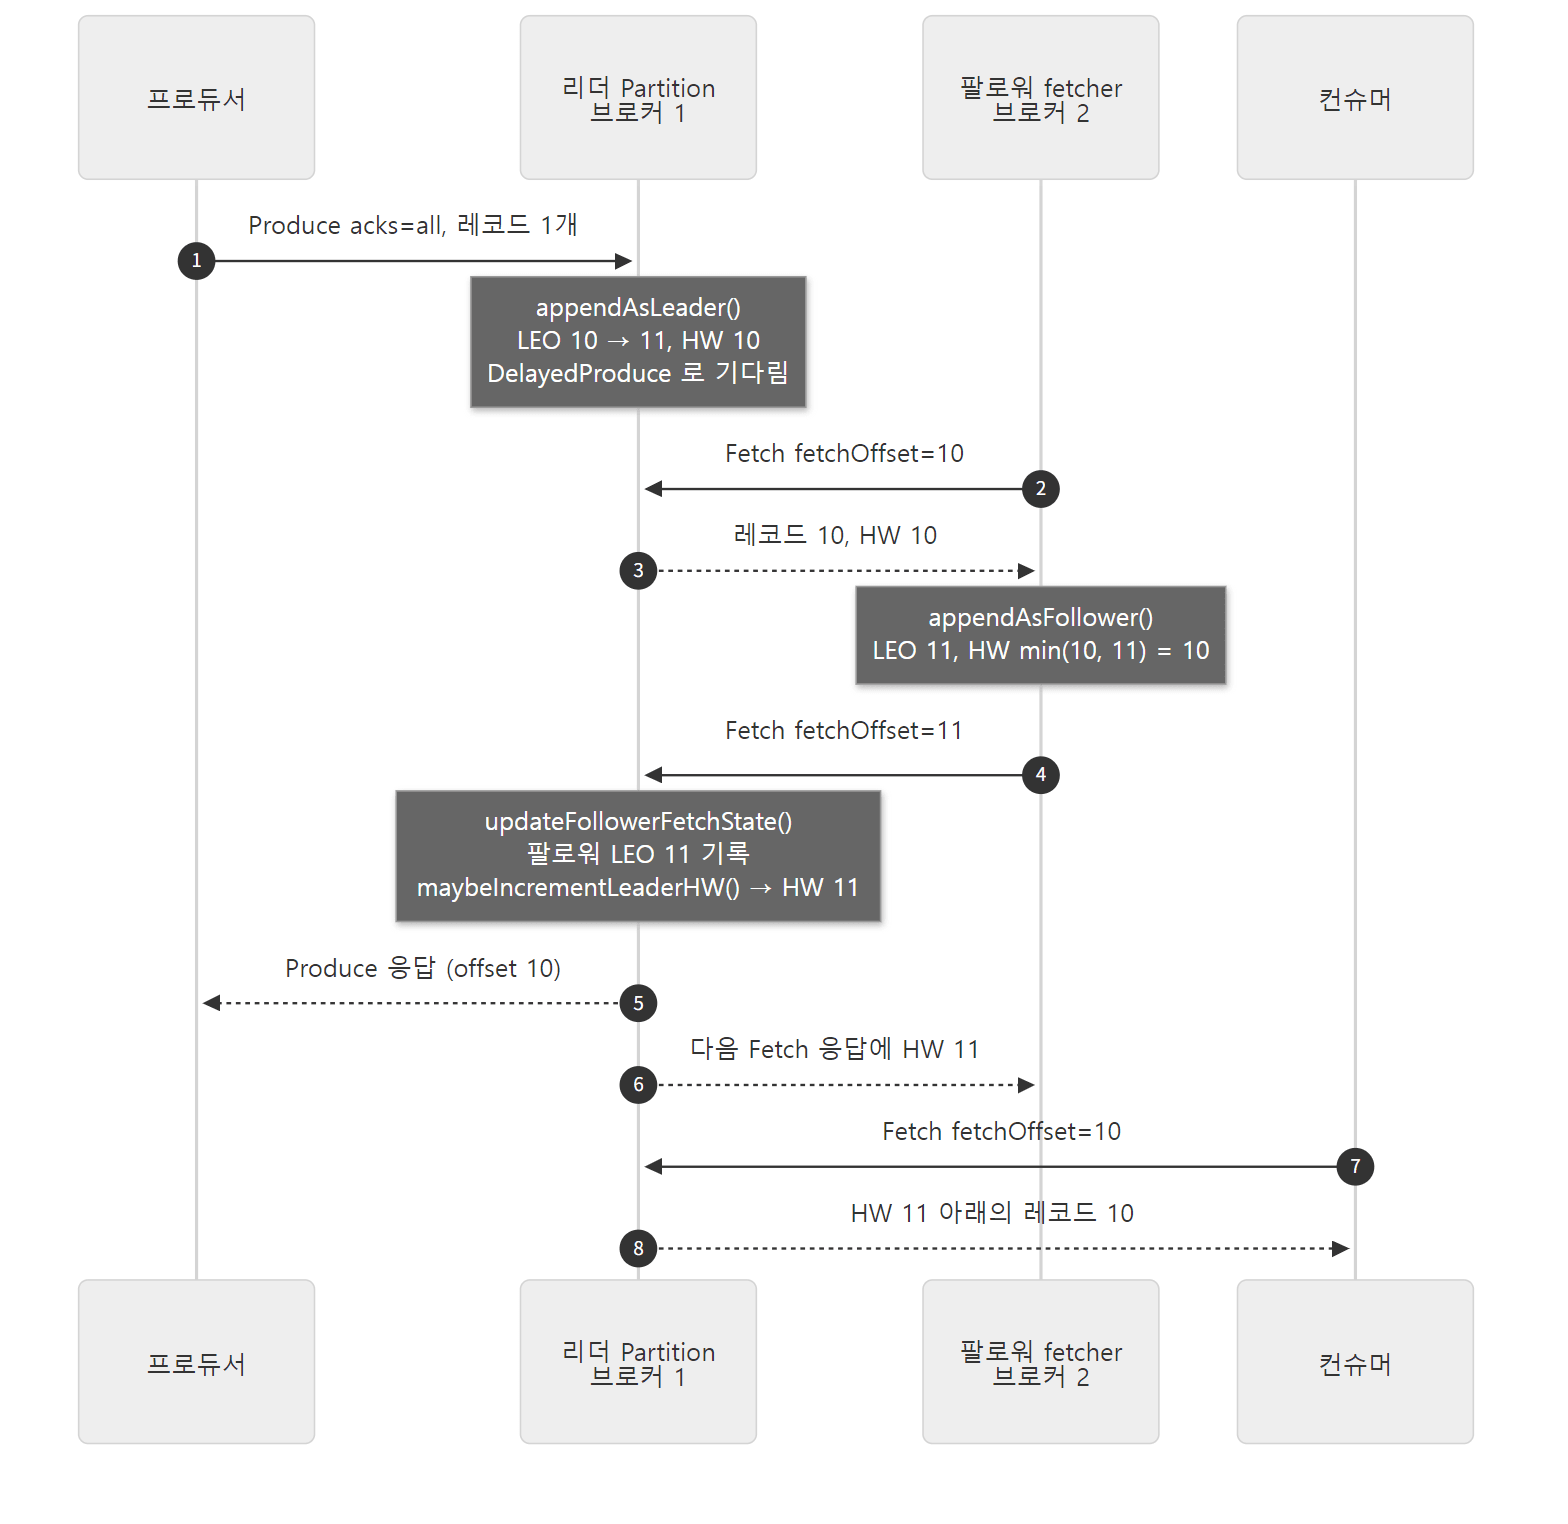 팔로워가 하나뿐인 것처럼 그렸습니다. 팔로워가 둘이면 4번이 둘 다에게서 와야 HW 가 오릅니다(3절).
그림에서 눈여겨볼 것은 2번과 4번, Fetch 가 두 번 필요하다는 점입니다. 2번의 Fetch 로 레코드가 팔로워에게 가지만, 리더는 4번의 Fetch 가 와서야 "팔로워가 받아 적었다" 는 것을 압니다. acks=all 의 응답 시간에는 이 왕복이 들어갑니다. 팔로워 쪽 HW(6번)는 리더보다 한 박자 늦습니다. 새 레코드가 없으면 팔로워의 Fetch 는 리더에서 replica.fetch.wait.max.ms 동안 붙잡혀 있다가 돌아오므로(팔로워의 DelayedFetch 는 LOG_END 기준이라 HW 가 오른 것만으로는 끝나지 않습니다, DelayedFetch.java 129–133행), 팔로워의 HW 는 최대 0.5초쯤 늦게 따라올 수 있습니다.
헷갈리기 쉬운 곳: 팔로워의 LEO 는 리더가 "추측" 한 값입니다
리더가 기록하는 팔로워의 LEO 는 팔로워가 실제로 디스크에 쓴 끝이 아니라 팔로워가 마지막으로 보낸 Fetch 의 오프셋입니다. 팔로워가 레코드를 받아 적은 직후에 멈추면, 리더는 그 레코드가 팔로워에 있다는 것을 모릅니다. 반대로 같은 리더 에포크 안에서는, 리더가 아는 팔로워 LEO 보다 팔로워의 실제 LEO 가 작은 일은 없습니다. Fetch 의 오프셋은 이미 쓴 끝이기 때문입니다(리더가 바뀌어 팔로워가 로그를 잘라 내는 경우는 6절에서 봅니다). HW 계산이 "모자라게" 틀릴 수는 있어도 "넘치게" 틀리지는 않는 이유입니다.
3. 하이 워터마크 — ISR 의 LEO 가운데 가장 작은 값
리더의 HW 를 올리는 곳은 Partition.maybeIncrementLeaderHW() 하나입니다. 메서드 위 주석에 부르는 때가 두 가지로 적혀 있습니다. ISR 이 바뀌었을 때와 어떤 레플리카의 LEO 가 바뀌었을 때입니다(987–1012행).
  private def maybeIncrementLeaderHW(leaderLog: UnifiedLog, currentTimeMs: Long = time.milliseconds): Boolean = {
    if (isUnderMinIsr) {
      trace(s"Not increasing HWM because partition is under min ISR(ISR=${partitionState.isr})")
      return false
    }
    // maybeIncrementLeaderHW is in the hot path, the following code is written to
    // avoid unnecessary collection generation
    val leaderLogEndOffset = leaderLog.logEndOffsetMetadata
    var newHighWatermark = leaderLogEndOffset
    remoteReplicasMap.forEach { (_, replica) =>
      val replicaState = replica.stateSnapshot

      def shouldWaitForReplicaToJoinIsr: Boolean = {
        replicaState.isCaughtUp(leaderLogEndOffset.messageOffset, currentTimeMs, replicaLagTimeMaxMs) &&
        isReplicaIsrEligible(replica.brokerId)
      }

      // Note here we are using the "maximal", see explanation above
      if (replicaState.logEndOffsetMetadata.messageOffset < newHighWatermark.messageOffset &&
          (partitionState.maximalIsr.contains(replica.brokerId) || shouldWaitForReplicaToJoinIsr)
      ) {
        newHighWatermark = replicaState.logEndOffsetMetadata
      }
    }

    leaderLog.maybeIncrementHighWatermark(newHighWatermark).toScala match {
core/src/main/scala/kafka/cluster/Partition.scala 1013–1038행
Scala 읽는 법 —
currentTimeMs: Long = time.milliseconds는 기본값이 있는 인자입니다.return false는 Java 처럼 그 자리에서 메서드를 끝냅니다(Scala 에서는 드물게 씁니다).forEach { (_, replica) => ... }는 JavaMap.forEach((k, v) -> ...)이고_는 "쓰지 않는 인자" 입니다. 메서드 안에def로 작은 메서드를 또 정의할 수 있습니다.
읽는 법은 단순합니다. 리더 자신의 LEO 에서 시작해, 팔로워들을 돌며 LEO 가 더 작은 팔로워가 있으면 그 값으로 끌어내립니다. 끌어내릴 자격이 있는 팔로워는 두 종류입니다. 하나는 ISR 에 든 팔로워(maximalIsr, 아래 4절)이고, 다른 하나는 아직 ISR 은 아니지만 따라잡아서 곧 들어올 팔로워(shouldWaitForReplicaToJoinIsr)입니다. 두 번째가 있는 이유를 주석(994–999행)이 설명합니다. ISR 에 리더 혼자 남았을 때 따라오는 팔로워를 기다려 주지 않으면, HW(= 리더 LEO)가 계속 앞서 달아나 팔로워가 영영 ISR 에 들지 못합니다.
맨 앞의 isUnderMinIsr 도 눈여겨볼 만합니다. ISR 의 수가 min.insync.replicas(레플리카 수보다 크면 레플리카 수, effectiveMinIsr(), 246–248행)보다 작으면 HW 를 아예 올리지 않습니다. acks=1 로 받은 레코드도 컨슈머에게 보이지 않게 됩니다. 5절의 min.insync.replicas 이야기와 이어집니다.
마지막 줄의 UnifiedLog.maybeIncrementHighWatermark() 는 새 값이 옛 값보다 클 때만 바꿉니다(UnifiedLog.java 563–581행). 같은 오프셋이라도 세그먼트가 새로 굴러간 경우만 예외로 바꿉니다(그 오프셋의 파일 위치가 달라지므로). 그래서 리더가 이 길로 고치는 HW 는 줄지 않습니다. (팔로워는 다릅니다. 6절의 잘라 내기로 LEO 가 HW 밑으로 내려가면 HW 도 LEO 로 내립니다, UnifiedLog.java 2391–2392행.) 팔로워 하나가 ISR 에서 빠져 "가장 작은 LEO" 가 커지면 HW 는 그만큼 한 번에 뛰어오릅니다.
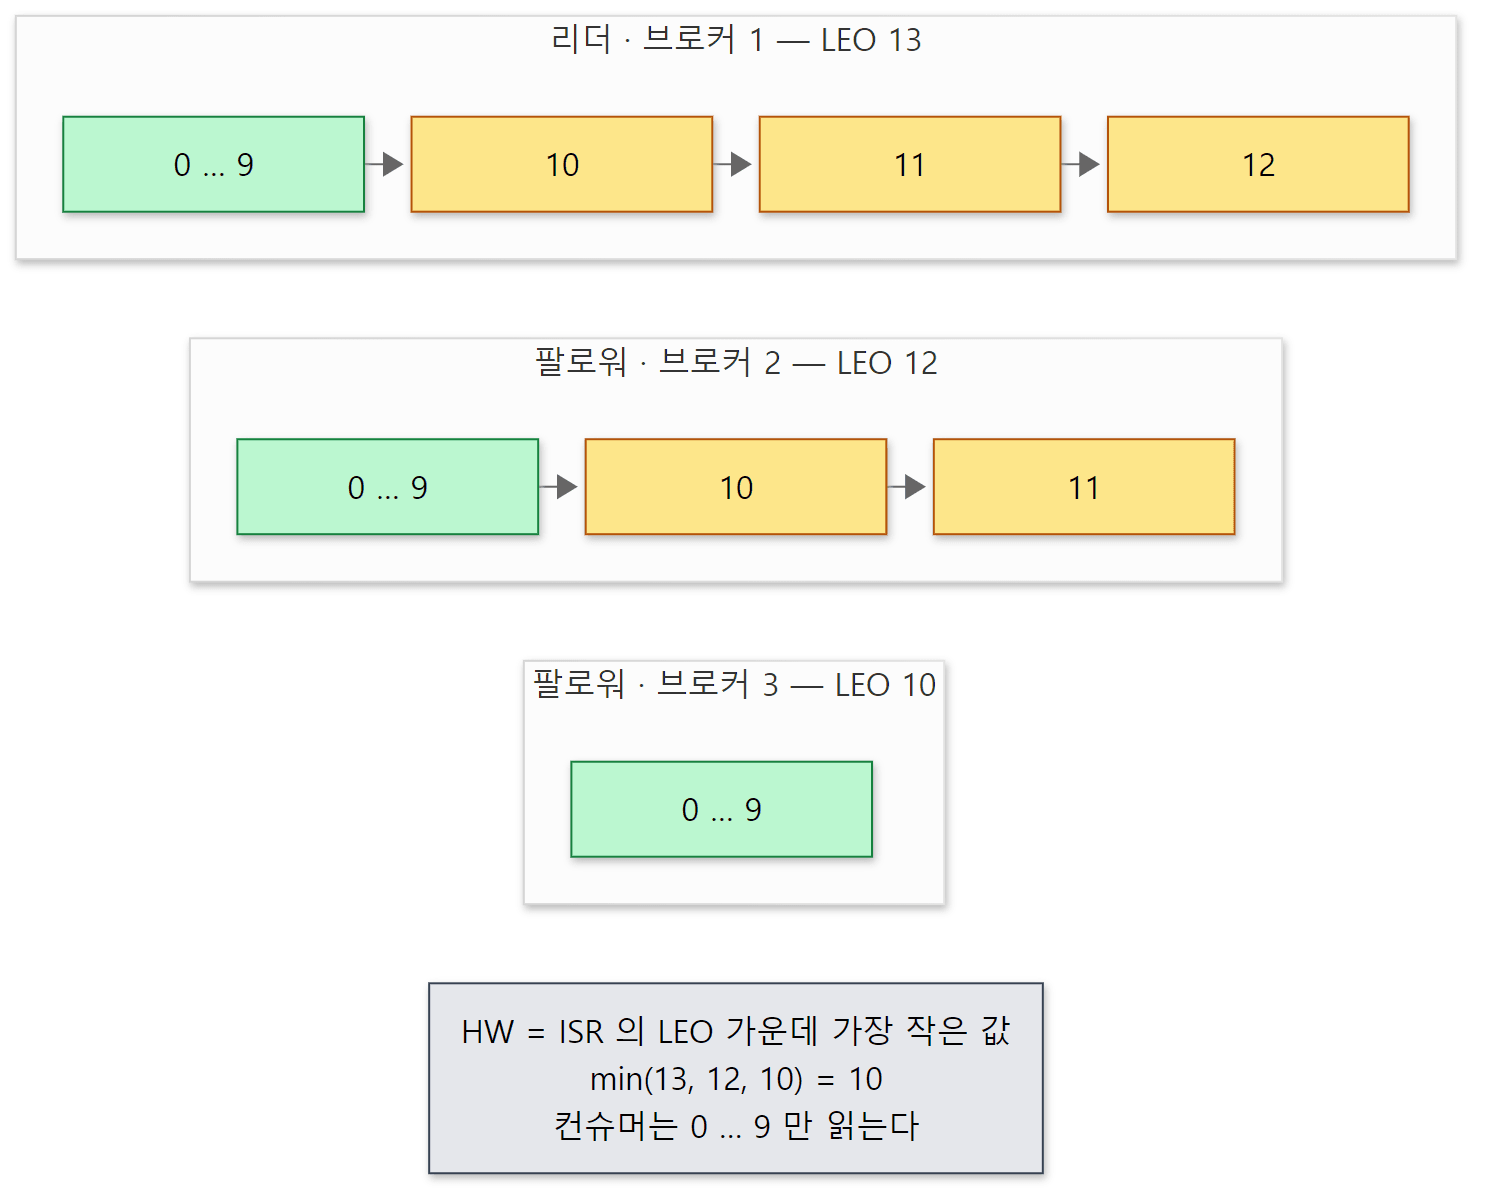 초록이 세 레플리카 모두에 있는 레코드(HW 앞), 노랑이 일부에만 있는 레코드입니다. 브로커 3 이 ISR 에서 빠지면 HW 는 12 로 뛰어오릅니다.
HW 는 디스크에도 적힌다: replication-offset-checkpoint
HW 는 메모리의 값이지만, 브로커가 다시 켜졌을 때 쓰려고 주기적으로 파일에 적습니다. ReplicaManager 가 로그 디렉터리마다 replication-offset-checkpoint 파일을 두고(ReplicaManager.scala 89행, 217–218행), replica.high.watermark.checkpoint.interval.ms(기본 5000)마다 checkpointHighWatermarks() 가 모든 파티션의 HW 를 씁니다(263–266행, 2125–2147행). 파일은 7편의 다른 체크포인트 파일과 같은 형식(판 번호, 줄 수, 그리고 토픽 파티션 값 줄들)입니다. 예제 1의 마지막에서 세 브로커의 이 파일을 봅니다.
4. ISR 에서 빠지고 돌아오기 — 리더가 정하고, 컨트롤러가 확정한다
빠지는 기준: replica.lag.time.max.ms 동안 한 번도 따라잡지 못했다
ISR 을 줄이는 검사는 Fetch 가 올 때가 아니라 타이머로 돕니다.
  def startup(): Unit = {
    // start ISR expiration thread
    // A follower can lag behind leader for up to config.replicaLagTimeMaxMs x 1.5 before it is removed from ISR
    scheduler.schedule("isr-expiration", () => maybeShrinkIsr(), 0L, config.replicaLagTimeMaxMs / 2)
core/src/main/scala/kafka/server/ReplicaManager.scala 282–285행
Scala 읽는 법 —
() => maybeShrinkIsr()는 인자 없는 람다(Java 의() -> maybeShrinkIsr())로, 스케줄러가 주기마다 부를 일을 값으로 넘긴 것입니다.config.replicaLagTimeMaxMs / 2는 정수 나눗셈입니다.
replica.lag.time.max.ms(기본 30000, ReplicationConfigs.java 54–55행)의 절반마다 이 브로커의 모든 파티션에 Partition.maybeShrinkIsr() 를 부릅니다. 주석대로 판정 기준이 30초이고 검사가 15초마다이므로, 뒤처진 팔로워가 빠지기까지는 30초에서 45초가 걸립니다. 누가 뒤처졌는지는 이렇게 고릅니다.
  def getOutOfSyncReplicas(maxLagMs: Long): Set[Int] = {
    val current = partitionState
    if (!current.isInflight) {
      val candidateReplicaIds = (current.isr.asScala.map(_.toInt) - localBrokerId).toSet
      val currentTimeMs = time.milliseconds()
      val leaderEndOffset = localLogOrException.logEndOffset
      candidateReplicaIds.filter(replicaId => isFollowerOutOfSync(replicaId, leaderEndOffset, currentTimeMs, maxLagMs))
    } else {
      Set.empty
    }
  }
core/src/main/scala/kafka/cluster/Partition.scala 1158–1168행
Scala 읽는 법 —
if (...) { a } else { b }는 값을 내는 식이라, 메서드의 마지막에 두면 그대로 반환값이 됩니다.set - x는 x 를 뺀 새 집합,asScala는 Java 컬렉션을 Scala 컬렉션으로 보는 변환,map(_.toInt)는map(x -> x.toInt())의 줄임입니다.
ISR 에서 리더 자신을 뺀 팔로워들 가운데 isFollowerOutOfSync() 인 것을 고르고, 그 판정은 !ReplicaState.isCaughtUp(...) 입니다(1136–1143행).
    public boolean isCaughtUp(
        long leaderEndOffset,
        long currentTimeMs,
        long replicaMaxLagMs) {
        return leaderEndOffset == logEndOffset() || currentTimeMs - lastCaughtUpTimeMs <= replicaMaxLagMs;
    }
server/src/main/java/org/apache/kafka/server/replica/ReplicaState.java 62–67행
"따라잡은 상태" 는 둘 중 하나입니다. 리더와 LEO 가 같거나, 마지막으로 완전히 따라잡았던 때(lastCaughtUpTimeMs)로부터 replica.lag.time.max.ms 가 지나지 않았거나. 몇 개의 레코드가 뒤처졌는지(개수)는 보지 않습니다. 시간만 봅니다. 아주 옛 판의 Kafka 에는 개수 기준 설정(replica.lag.max.messages)도 있었다고 알려져 있습니다(소스로 확인한 것은 아닙니다). 이 커밋의 저장소에는 그 이름이 한 번도 나오지 않습니다.
첫 조건 때문에 생기는 재미있는 결과가 있습니다. 새 레코드가 들어오지 않는 파티션에서는, 팔로워가 멈춰 있어도 ISR 에서 빠지지 않습니다. 리더의 LEO 와 멈춘 팔로워의 (리더가 아는) LEO 가 같으니 "따라잡은 상태" 입니다. 예제 1의 4단계가 이것을 확인합니다.
들어오는 기준: HW 와 이번 리더 에포크의 시작점까지 따라왔다
반대 방향은 Fetch 가 올 때마다 maybeExpandIsr() 가 봅니다. 판정은 두 가지입니다.
  private def isFollowerInSync(followerReplica: Replica): Boolean = {
    leaderLogIfLocal.exists { leaderLog =>
      val followerEndOffset = followerReplica.stateSnapshot.logEndOffset
      followerEndOffset >= leaderLog.highWatermark && leaderEpochStartOffsetOpt.exists(followerEndOffset >= _)
    }
  }
core/src/main/scala/kafka/cluster/Partition.scala 909–914행
Scala 읽는 법 —
Option은 값이 있을 수도(Some) 없을 수도(None) 있는 상자입니다.opt.exists(f)는 "값이 있고 f 가 참이면 참" 입니다.followerEndOffset >= _의_는 상자 안의 값입니다.
팔로워의 LEO 가 리더의 HW 이상이고, 지금 리더 에포크가 시작된 오프셋 이상이어야 합니다. 두 번째 조건의 이유는 메서드 위 주석(864–877행)에 있습니다. 새 리더의 HW 와 LEO 사이에 커밋된 레코드가 있을 수 있는데, 그것을 받기 전의 팔로워가 ISR 에 들어갔다가 리더가 되면 그 레코드를 잃습니다. 여기에 isReplicaIsrEligible() 의 검사 — 그 브로커가 펜싱(fencing, 컨트롤러가 "살아 있지 않다" 고 표시한 상태)되지 않았고, 정상 종료 중이 아니고, Fetch 에 실린 브로커 에포크가 메타데이터의 것과 같을 것 — 가 더해집니다(916–934행). 재시작한 브로커의 옛 Fetch 가 늦게 도착해 ISR 에 잘못 들어가는 것을 막는 장치입니다.
리더는 제안만 한다: PendingShrinkIsr 와 AlterPartition
리더가 "ISR 을 1,2 로 줄이자" 고 정해도 그 자리에서 ISR 을 바꾸지 않습니다. ISR 은 컨트롤러의 메타데이터 로그에 기록되어야 하는 값이고(10편), 리더가 바뀌면 새 리더도 같은 ISR 을 알아야 하기 때문입니다. 그래서 Partition 의 partitionState 는 세 가지 모양 가운데 하나입니다.
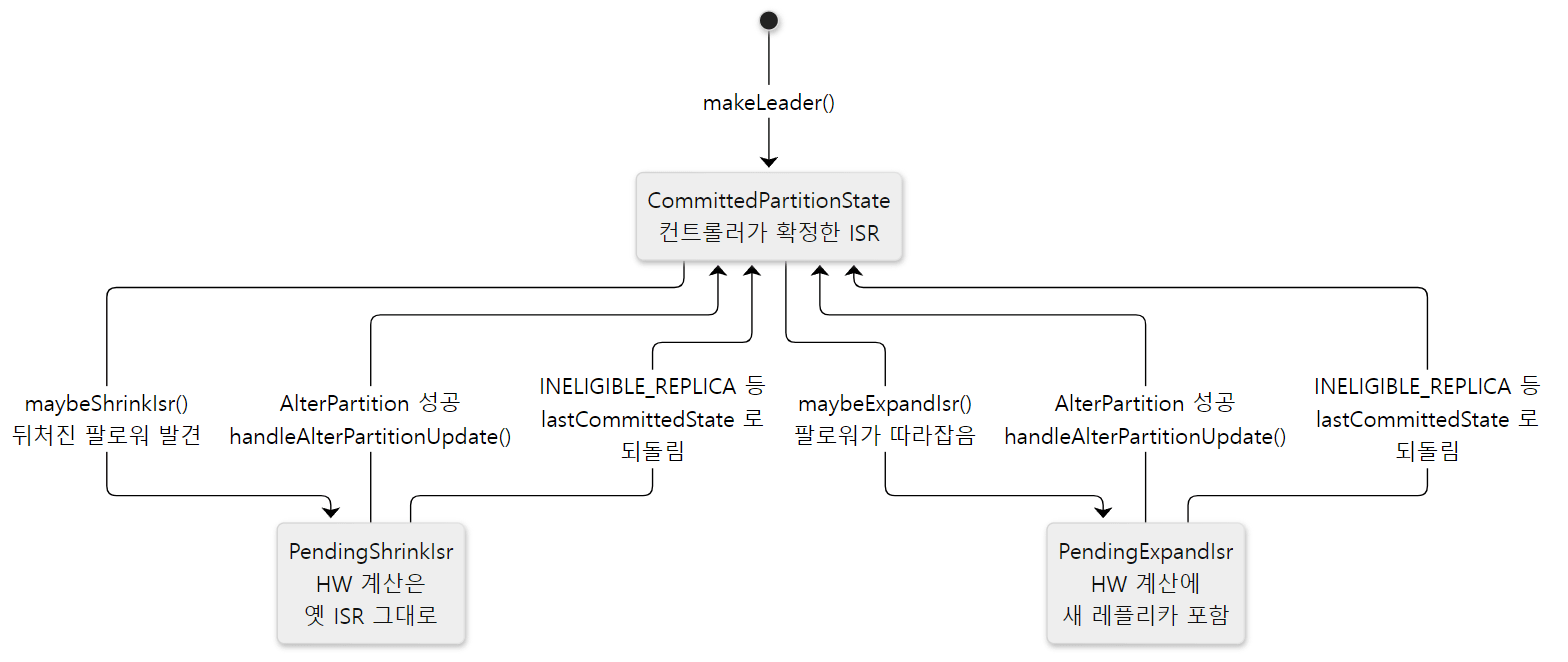 세 상태는 모두
server/.../partition/ 의 Java 레코드(CommittedPartitionState, PendingShrinkIsr, PendingExpandIsr)입니다.
Pending 상태에는 두 가지 뜻이 있습니다. 첫째, 하나의 변경이 진행 중이면(isInflight) 다른 변경을 시작하지 않습니다(getOutOfSyncReplicas() 의 if (!current.isInflight)). 둘째, HW 계산에 쓰는 maximalIsr 가 상태마다 다릅니다. prepareIsrExpand() 와 prepareIsrShrink() 의 주석이 그 이유를 적어 두었습니다.
    // When expanding the ISR, we assume that the new replica will make it into the ISR
    // before we receive confirmation that it has. This ensures that the HW will already
    // reflect the updated ISR even if there is a delay before we receive the confirmation.
    // Alternatively, if the update fails, no harm is done since the expanded ISR puts
    // a stricter requirement for advancement of the HW.
core/src/main/scala/kafka/cluster/Partition.scala 1616–1620행
    // When shrinking the ISR, we cannot assume that the update will succeed as this could
    // erroneously advance the HW if the `AlterPartition` were to fail. Hence the "maximal ISR"
    // for `PendingShrinkIsr` is the current ISR.
core/src/main/scala/kafka/cluster/Partition.scala 1643–1645행
원칙은 하나입니다. HW 는 확정되지 않은 변경 때문에 앞서 나가면 안 된다. ISR 을 넓히는 중에는 새 레플리카도 미리 세어 HW 를 더 보수적으로 잡고, 줄이는 중에는 빠질 레플리카도 계속 세어 컨트롤러가 받아들일 때까지 HW 를 올리지 않습니다. 그래서 줄어드는 팔로워 때문에 기다리던 acks=all 요청은 AlterPartition 응답이 와야 풀립니다(예제 1에서 그 시간을 잽니다).
제안은 alterIsrManager.submit() 으로 넘어갑니다(submitAlterPartition(), 1690–1724행). 받는 쪽 DefaultAlterPartitionManager 는 이렇습니다.
    @Override
    public CompletableFuture<LeaderAndIsr> submit(TopicIdPartition topicIdPartition,
                                                  LeaderAndIsr leaderAndIsr) {
        CompletableFuture<LeaderAndIsr> future = new CompletableFuture<>();
        AlterPartitionItem alterPartitionItem = new AlterPartitionItem(topicIdPartition, leaderAndIsr, future);
        boolean enqueued = unsentIsrUpdates.putIfAbsent(alterPartitionItem.topicIdPartition(), alterPartitionItem) == null;
        if (enqueued) {
            maybePropagateIsrChanges();
        } else {
            future.completeExceptionally(new OperationNotAttemptedException(String.format(
                    "Failed to enqueue ISR change state %s for partition %s", leaderAndIsr, topicIdPartition)));
        }
        return future;
    }

    void maybePropagateIsrChanges() {
        // Send all pending items if there is not already a request in-flight.
        if (!unsentIsrUpdates.isEmpty() && inflightRequest.compareAndSet(false, true)) {
            // Copy current unsent ISRs but don't remove from the map, they get cleared in the response handler
            List<AlterPartitionItem> inflightAlterPartitionItems = new ArrayList<>(unsentIsrUpdates.values());
            sendRequest(inflightAlterPartitionItems);
        }
    }
server/src/main/java/org/apache/kafka/server/partition/DefaultAlterPartitionManager.java 103–125행
파티션마다 보내지 않은 변경은 하나만 둘 수 있고(putIfAbsent), 컨트롤러로 가는 AlterPartition 요청은 브로커 전체에서 한 번에 하나만 날아갑니다(inflightRequest). 그동안 쌓인 다른 파티션의 변경은 다음 요청에 한꺼번에 실립니다. 파티션이 수천 개인 브로커가 컨트롤러를 요청으로 덮지 않게 하려는 것입니다. 요청은 예제 1-1에서 본 broker-1-to-controller-alter-partition-channel-manager 스레드가 보냅니다(DefaultAlterPartitionManager.java 80–88행, 스레드 이름 형식은 NodeToControllerChannelManagerImpl.java 79행).
컨트롤러 쪽 ReplicationControlManager.alterPartition() 은 브로커 에포크와 파티션 에포크를 확인하고, 새 ISR 의 브로커마다 등록되어 있는지·정상 종료 중인지·펜싱됐는지·브로커 에포크가 맞는지를 다시 봅니다(ineligibleReplicasForIsr(), ReplicationControlManager.java 1418–1438행). 통과하면 PartitionChangeRecord 를 메타데이터 로그에 쓰고 파티션 에포크를 올려 응답합니다(1093행부터). 리더는 응답을 받아 handleAlterPartitionUpdate() 에서 CommittedPartitionState 로 돌아가고, 바뀐 ISR 로 maybeIncrementLeaderHW() 를 한 번 더 부릅니다(Partition.scala 1797–1828행). 서버 로그의 ISR updated to ... and version updated to N 이 이 자리에서 찍힙니다.
헷갈리기 쉬운 곳: ISR 을 줄이는 길은 둘입니다
리더가 maybeShrinkIsr() 로 줄이는 길 말고, 컨트롤러가 직접 줄이는 길도 있습니다. 브로커가 정상 종료를 시작하면(handleBrokerInControlledShutdown()) 또는 하트비트가 broker.session.timeout.ms(기본 9000, KRaftConfigs.java 43–44행) 동안 끊겨 펜싱되면(handleBrokerFenced()), 컨트롤러가 그 브로커를 들고 있는 모든 ISR 에서 빼는 레코드를 만듭니다(ReplicationControlManager.java 1449–1460행, 1514–1523행). 브로커를 kafka-server-stop.sh(SIGTERM)로 끄면 이쪽 길이라 ISR 이 거의 곧바로 줄고, 브로커가 살아 있지만 느린 경우에만 리더 쪽 길을 탑니다. 예제 1은 리더 쪽 길만 보려고 broker.session.timeout.ms 를 30초로 늘렸습니다. 그대로 두면 멈춘 브로커가 9초 뒤 펜싱되어 컨트롤러 쪽 길로 빠집니다.
예제 1-2: 멈춘 팔로워, ISR, HW, 그리고 acks=all
같은 run.sh 는 replica.lag.time.max.ms=5000, broker.session.timeout.ms=30000 으로 클러스터를 띄웁니다. 검사 주기는 그 절반인 2.5초입니다. 순서는 이렇습니다.
acks=all로 레코드 10개를 쓴다.- 브로커 3 을
kill -STOP으로 멈추고(프로세스가 얼어붙을 뿐 소켓은 열려 있습니다), 아무것도 쓰지 않고 12초 기다린 뒤 ISR 을 본다. 그리고kill -CONT로 깨운다. - 자바 프로그램(
IsrWait.java)이 프로듀서 둘을 미리 만들어 한 개씩 보내 둔 뒤, 브로커 3 을 다시 멈추고, 곧바로acks=1로 5개를 보내고, HW 를 묻고,acks=all로 1개를 보내 응답까지 걸린 시간을 잰다. - 브로커 3 을 깨우고 ISR 이 돌아오는지 본다.
3단계를 자바 안에서 하는 이유는 JVM 을 띄우는 데 몇 초가 걸려서입니다. 처음에는 셸에서 브로커를 멈춘 뒤 자바를 띄웠는데, 컨테이너가 바쁠 때는 프로그램이 첫 레코드를 보내기까지 17초가 걸려 그사이 판정 기준(5초)이 지나 버렸습니다. HW 는 Admin 클라이언트의 listOffsets(OffsetSpec.latest()) 로 물었습니다. 격리 수준을 정하지 않은 ListOffsets(LATEST) 는 컨슈머가 읽을 수 있는 끝, 곧 HW 를 돌려줍니다.
        try (KafkaProducer<String, String> acks1 = producer("1");
             KafkaProducer<String, String> acksAll = producer("all")) {
            // 준비: 두 프로듀서가 한 번씩 보내 둔다(팔로워가 살아 있으니 둘 다 금방 끝난다)
            acks1.send(new ProducerRecord<>(topic, "warmup-acks1")).get();
            acksAll.send(new ProducerRecord<>(topic, "warmup-acksall")).get();
            System.out.printf("before SIGSTOP: high watermark = %d%n", highWatermark(tp));

            new ProcessBuilder("kill", "-STOP", followerPid).start().waitFor();
            stoppedAt = System.currentTimeMillis();
            System.out.println("SIGSTOP sent to the follower");

            for (int i = 0; i < 5; i++) {
                RecordMetadata md = acks1.send(new ProducerRecord<>(topic, "acks1-" + i)).get();
                System.out.printf("acks=1   offset=%d  (t+%d ms)%n", md.offset(), since());
            }
            System.out.printf("high watermark = %d  (t+%d ms)%n", highWatermark(tp), since());

            long start = System.currentTimeMillis();
            RecordMetadata md = acksAll.send(new ProducerRecord<>(topic, "acksall-0")).get();
            System.out.printf("acks=all offset=%d  waited %d ms  (t+%d ms)%n",
                    md.offset(), System.currentTimeMillis() - start, since());
            System.out.printf("high watermark = %d  (t+%d ms)%n", highWatermark(tp), since());
[ex/u09-isr-hw/IsrWait.java 에서 줄임]
출력입니다. 1·2단계(토픽 만들기, 예제 1-1의 스레드)와 마지막 stopped 줄은 뺐습니다. rep-0 Leader: … 줄은 예제의 Isr.java 가 Admin 클라이언트로 물어 찍은 것입니다. 시각(t+… ms, 멈춘 때부터), waited … ms, lastCaughtUpTimeMs 값, 그리고 서버 로그에 ISR 이 찍히는 순서(2,1,3 또는 3,2,1)는 실행마다 다릅니다. 서버 로그는 줄 앞의 시각을 지웠습니다.
=== 3. write 10 records with acks=all
rep:0:10
=== 4. SIGSTOP broker 3, no new records, wait 12s
rep-0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3
=== 5. Java: warm up, SIGSTOP broker 3 again, then produce
before SIGSTOP: high watermark = 12
SIGSTOP sent to the follower
acks=1   offset=12  (t+23 ms)
acks=1   offset=13  (t+36 ms)
acks=1   offset=14  (t+51 ms)
acks=1   offset=15  (t+66 ms)
acks=1   offset=16  (t+75 ms)
high watermark = 12  (t+160 ms)
acks=all offset=17  waited 4964 ms  (t+5126 ms)
high watermark = 18  (t+5191 ms)
rep-0 Leader: 1 Replicas: 1,2,3 Isr: 1,2
--- leader (broker 1) server.log
INFO [Partition rep-0 broker=1] Shrinking ISR from 2,1,3 to 1,2. Leader: (highWatermark: 12, endOffset: 18). Out of sync replicas: (brokerId: 3, endOffset: 12, lastCaughtUpTimeMs: 1794027649149). (kafka.cluster.Partition)
INFO [Partition rep-0 broker=1] ISR updated to 1,2  and version updated to 1 (kafka.cluster.Partition)
=== 6. SIGCONT broker 3, wait 5s
rep-0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3
--- leader (broker 1) server.log
INFO [Partition rep-0 broker=1] ISR updated to 2,1,3  and version updated to 2 (kafka.cluster.Partition)
=== 7. replication-offset-checkpoint (high watermark on disk)
broker 1: rep 0 18
broker 2: rep 0 18
broker 3: rep 0 18
한 줄씩 소스와 맞춰 봅니다.
- 4단계: 12초(판정 기준 5초의 두 배가 넘는 시간) 동안 브로커 3 이 멈춰 있었는데도 ISR 은
1,2,3그대로입니다. 새 레코드가 없어 리더 LEO(10) 와 브로커 3 의 LEO(10) 가 같으니isCaughtUp()의 첫 조건이 참입니다. - 5단계의 준비: 두 프로듀서가 보낸 준비용 레코드가 offset 10·11 을 차지해, 멈추기 전의 HW 가 12 입니다.
- 5단계의 acks=1: 멈춘 팔로워와 상관없이 리더에 쓰자마자 응답이 옵니다(offset 12~16). 그런데 바로 뒤에 물은 HW 는 여전히 12 로, 방금 쓴 다섯 개가 컨슈머에게는 보이지 않습니다. 브로커 3 이 아직 ISR 에 있고 그 LEO 가 12 에 머물러 있기 때문입니다(3절의 "가장 작은 LEO").
- 5단계의 acks=all: 응답까지 4,964ms 가 걸렸습니다. 브로커를 멈춘 때부터 세면 약 5.1초 입니다(다시 돌렸을 때는 5,093ms, 6,008ms 였습니다. 검사가 2.5초마다 돌므로 대략 5~7.5초 사이에서 달라집니다).
lastCaughtUpTimeMs로부터 5초가 지나고, 2.5초마다 도는 검사가 그것을 발견해Shrinking ISR from 2,1,3 to 1,2를 찍고, AlterPartition 이 받아들여져ISR updated to 1,2가 찍힌 뒤에야 HW 가 오르고DelayedProduce가 풀립니다. 그 직후 물은 HW 는 18 로, 그동안 막혀 있던acks=1레코드까지 한 번에 보이게 되었습니다(3절의 "뛰어오르는 HW"). - Shrinking ISR 줄:
Leader: (highWatermark: …, endOffset: …)와Out of sync replicas: (brokerId: 3, endOffset: …, lastCaughtUpTimeMs: …)는maybeShrinkIsr()의info(...)(1116–1119행)가 그대로 찍은 것입니다. 리더가 아는 브로커 3 의endOffset이 12, 리더의endOffset이 18 입니다. ISR 은 집합이라2,1,3처럼 찍히는 순서에는 뜻이 없습니다.1,2 and의 빈칸 두 개는 ISR 이 하한 밑일 때만(under-min-isr)가 들어가는 자리입니다(1818행). - 6단계: 깨어난 브로커 3 이 Fetch 를 다시 보내 LEO 가 HW 이상이 되자
maybeExpandIsr()가 넓히기를 제안했고,ISR updated to 2,1,3이 찍혔습니다. 파티션 에포크(version)가 줄일 때(0 → 1)와 넓힐 때(1 → 2) 한 번씩 올랐습니다. - 7단계: 세 브로커의
replication-offset-checkpoint에 같은 HW 가 적혀 있습니다. 팔로워도 리더에게서 받은 HW 를 자기 파일에 적습니다.
5. acks=all 은 무엇을 기다리나 — DelayedProduce 와 min.insync.replicas
6편에서 Produce 요청은 ReplicaManager.appendRecords() 에서 리더 로그에 쓰인 뒤 maybeAddDelayedProduce() 로 넘어갔습니다. 응답을 바로 보낼지 기다릴지는 이 조건이 정합니다.
  // If all the following conditions are true, we need to put a delayed produce request and wait for replication to complete
  //
  // 1. required acks = -1
  // 2. there is data to append
  // 3. at least one partition append was successful (fewer errors than partitions)
  private def delayedProduceRequestRequired(requiredAcks: Short,
                                            entriesPerPartition: Map[TopicIdPartition, MemoryRecords],
                                            localProduceResults: Map[TopicIdPartition, LogAppendResult]): Boolean = {
    requiredAcks == -1 &&
    entriesPerPartition.nonEmpty &&
    localProduceResults.values.count(_.exception().isPresent) < entriesPerPartition.size
  }
core/src/main/scala/kafka/server/ReplicaManager.scala 1356–1367행
Scala 읽는 법 — 본문이 식 하나뿐인 메서드는 그 식의 값이 반환값입니다.
count(_.exception().isPresent)는 "예외가 있는 결과의 개수" 입니다.
acks=all 은 선에 -1 로 실려 옵니다(1편). acks=0·1 은 이 조건에서 걸러져 리더에 쓰자마자 응답합니다(acks=0 이면 응답 자체를 보내지 않고, 오류가 있었을 때만 연결을 끊어 알립니다, KafkaApis.scala 512–530행). -1 이면 DelayedProduce 를 만듭니다. 기다리는 목표는 파티션마다 requiredOffset = 이번에 쓴 마지막 오프셋 + 1 입니다(ReplicaManager.scala 838–840행).
      val delayedProduce = new DelayedProduce(timeoutMs, initialProduceStatus.asJava, delegate, responseCallback.asJava)

      // create a list of (topic, partition) pairs to use as keys for this delayed produce operation
      val producerRequestKeys = entriesPerPartition.keys.map(new TopicPartitionOperationKey(_)).toList

      // try to complete the request immediately, otherwise put it into the purgatory
      // this is because while the delayed produce operation is being created, new
      // requests may arrive and hence make this operation completable.
      delayedProducePurgatory.tryCompleteElseWatch(delayedProduce, producerRequestKeys.asJava)
core/src/main/scala/kafka/server/ReplicaManager.scala 903–911행
Scala 읽는 법 —
keys.map(new TopicPartitionOperationKey(_))의_는 각 원소 자리라서keys.map(k -> new TopicPartitionOperationKey(k))와 같습니다..toList는 Scala 리스트로,.asJava는 Scala 컬렉션을 Java 컬렉션으로 바꿔 Java 메서드에 넘깁니다.
tryCompleteElseWatch() 는 8편의 DelayedFetch 와 같은 퍼거토리 장치입니다. 한 번 시도해 보고, 안 되면 파티션을 열쇠로 걸어 둡니다. 시간 제한 timeoutMs 는 Produce 요청의 TimeoutMs 필드이고(KafkaApis.scala 548–549행), 프로듀서의 Sender 가 이 필드에 request.timeout.ms(기본 30000)를 넣습니다(Sender.java 890행, 930–934행). 앱의 request.timeout.ms 가 브로커에서 acks=all 을 기다려 주는 시간이라는 뜻입니다.
DelayedProduce 는 만들어질 때 미리 오류 코드를 REQUEST_TIMED_OUT 으로 적어 둡니다.
        // first update the acks pending variable according to the error code
        produceStatus.forEach((topicPartition, status) -> {
            if (status.responseStatus.error == Errors.NONE) {
                // Timeout error state will be cleared when required acks are received
                status.acksPending = true;
                status.responseStatus.error = Errors.REQUEST_TIMED_OUT;
            } else {
                status.acksPending = false;
            }
server/src/main/java/org/apache/kafka/server/purgatory/DelayedProduce.java 110–118행
조건이 채워지면 tryComplete() 가 그 오류를 지우고(152–155행), 시간이 다 되면 적어 둔 REQUEST_TIMED_OUT 이 그대로 응답에 실립니다. 조건을 판정하는 것은 ReplicaManager 가 넘긴 대리 함수가 부르는 Partition.checkEnoughReplicasReachOffset() 입니다.
        val minIsr = effectiveMinIsr(leaderLog)
        if (leaderLog.highWatermark >= requiredOffset) {
          /*
           * The topic may be configured not to accept messages if there are not enough replicas in ISR
           * in this scenario the request was already appended locally and then added to the purgatory before the ISR was shrunk
           */
          if (minIsr <= curMaximalIsr.size)
            (true, Errors.NONE)
          else
            (true, Errors.NOT_ENOUGH_REPLICAS_AFTER_APPEND)
        } else
          (false, Errors.NONE)
core/src/main/scala/kafka/cluster/Partition.scala 970–981행
Scala 읽는 법 —
(true, Errors.NONE)은 두 값짜리 튜플입니다. 메서드는 "끝났나, 어떤 오류로" 를 한 쌍으로 돌려줍니다.
acks=all 이 기다리는 것은 "ISR 의 모든 레플리카" 가 아니라 "HW 가 내 레코드를 넘는 것" 입니다. 같은 말 같지만 다릅니다. HW 는 3절에서 본 대로 그 순간의 ISR 로 계산되므로, 팔로워 하나가 ISR 에서 빠지면 그 팔로워를 기다리지 않고 HW 가 오릅니다. 예제 1의 acks=all 이 끝난 것도 브로커 3 이 따라잡아서가 아니라 브로커 3 이 ISR 에서 빠져서였습니다. acks=all 의 보장은 "응답 시점의 ISR 이 모두 가지고 있다" 이고, 그 ISR 이 몇 개인지의 하한을 정하는 것이 min.insync.replicas 입니다.
그 하한이 걸리는 자리는 두 곳입니다. 하나는 위 코드의 NOT_ENOUGH_REPLICAS_AFTER_APPEND 로, 기다리는 사이에 ISR 이 줄어 하한 밑으로 내려간 경우입니다. 이때 레코드는 이미 리더 로그에 쓰였습니다(주석: "the request was already appended locally"). 다른 하나는 쓰기 전입니다.
          val minIsr = effectiveMinIsr(leaderLog)
          val inSyncSize = partitionState.isr.size

          // Avoid writing to leader if there are not enough insync replicas to make it safe
          if (inSyncSize < minIsr && requiredAcks == -1) {
            throw new NotEnoughReplicasException(s"The size of the current ISR : $inSyncSize " +
              s"is insufficient to satisfy the min.isr requirement of $minIsr for partition $topicPartition, " +
              s"live replica(s) broker.id are : $inSyncReplicaIds")
          }
core/src/main/scala/kafka/cluster/Partition.scala 1233–1241행
Partition.appendRecordsToLeader() 의 첫머리입니다. acks=all 이고 ISR 이 하한보다 작으면 로그에 쓰지 않고 거절합니다. acks=1 은 이 검사를 받지 않습니다(requiredAcks == -1 조건). min.insync.replicas 의 기본값은 1 이라(ServerLogConfigs.java 158–159행), 기본 설정의 acks=all 은 ISR 이 리더 혼자여도 성공합니다. 프로듀서의 acks 기본값은 "all" 이므로(ProducerConfig.java 430–435행), "기본값으로 쓰면 안전하다" 는 말은 브로커 쪽 min.insync.replicas 를 2 이상으로 올렸을 때에만 맞습니다.
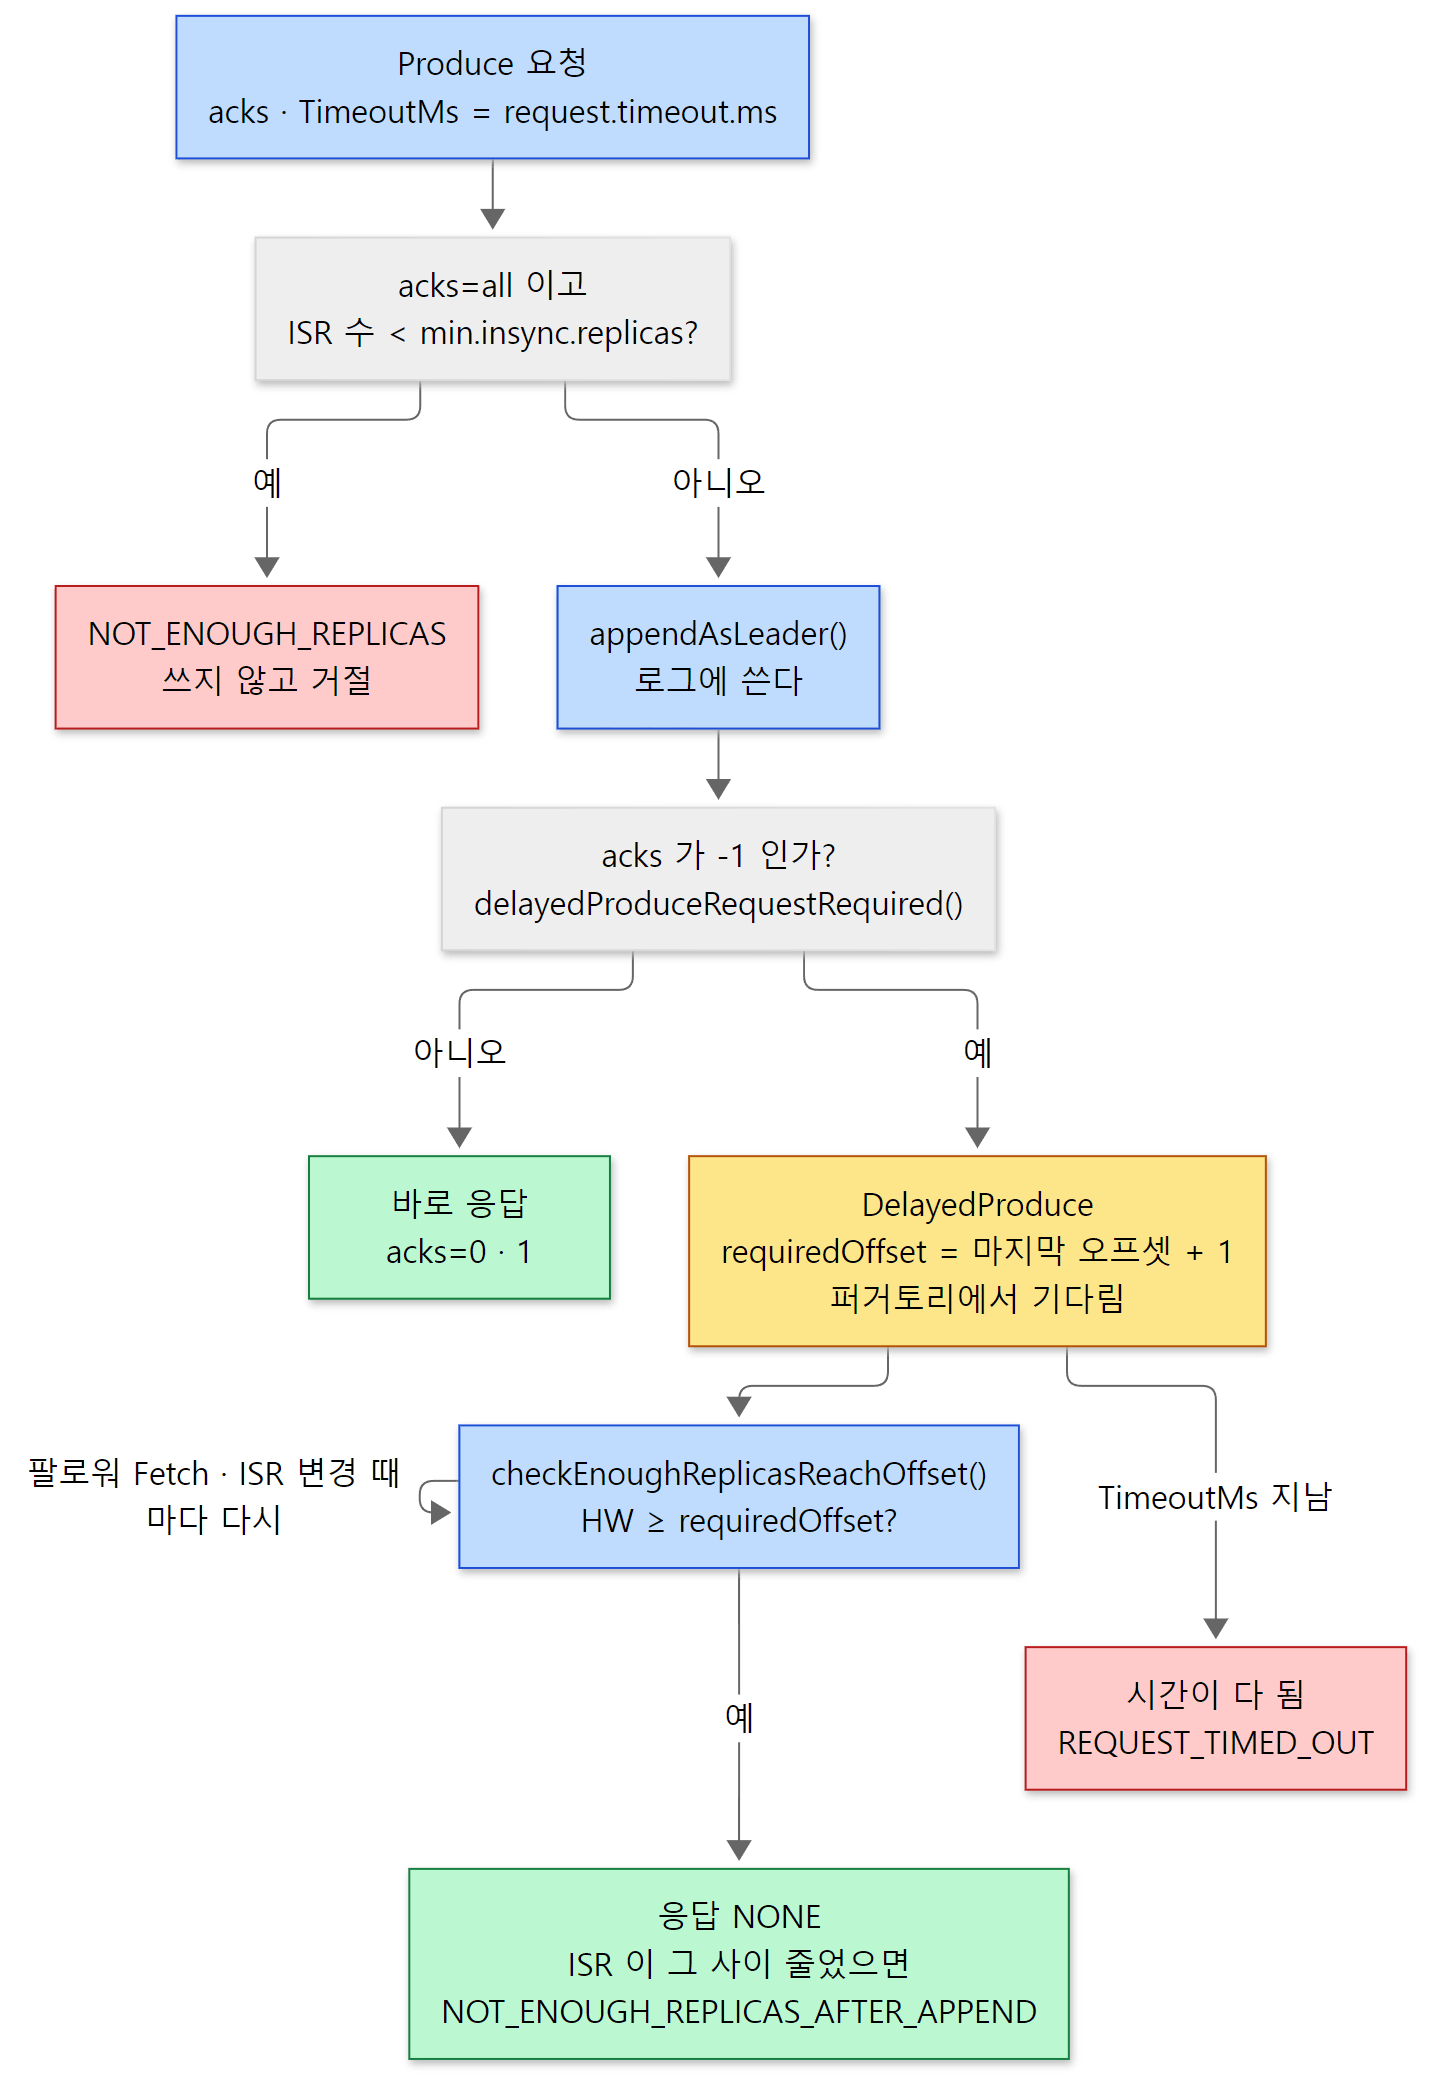 빨간 상자가 프로듀서가 받는 실패, 초록 상자가 응답입니다. 첫 번째 거절만 레코드를 쓰지 않습니다.
누가 DelayedProduce 를 다시 들여다보게 하느냐도 소스에 있습니다. 퍼거토리는 스스로 조건을 살피지 않고, 누군가 checkAndComplete(파티션) 을 불러 줘야 합니다. 그 호출이 2절의 updateFollowerFetchState() 끝의 tryCompleteDelayedRequests()(→ DelayedOperations.checkAndCompleteAll(), Partition.scala 69–76행), 4절의 handleAlterPartitionUpdate() 뒤(1714–1716행), 그리고 리더에 쓴 결과로 HW 가 올랐을 때(addCompletePurgatoryAction(), ReplicaManager.scala 853–876행)입니다. acks=all 을 깨우는 것은 대개 팔로워의 Fetch 라는 뜻입니다(예제 1처럼 ISR 이 줄어서 풀릴 때는 AlterPartition 응답이 깨웁니다). 시간 초과는 2편에서 본 ExpirationReaper-1-Produce 스레드가 거둡니다.
예제 2: min.insync.replicas=3 에서 브로커 하나를 끄면
ex/u09-min-isr/run.sh 는 레플리카 1:2:3, min.insync.replicas=3 인 토픽 strict 를 만들고, acks=all 과 acks=1 로 하나씩 보내는 자바 프로그램(MinIsr.java)을 세 번 돌립니다. 처음, 브로커 3 을 kafka_stop_node 3(SIGTERM, 정상 종료)으로 끈 뒤, 그리고 토픽 설정을 min.insync.replicas=2 로 내린 뒤입니다. 프로듀서는 retries=0 으로 두었습니다. NotEnoughReplicasException 은 재시도할 수 있는 오류라, 그대로 두면 프로듀서가 delivery.timeout.ms(기본 2분) 동안 다시 보내다 시간 초과로 끝납니다.
            props.put(ProducerConfig.ACKS_CONFIG, acks);
            // 재시도하지 않게 한다 — NotEnoughReplicas 는 재시도할 수 있는 오류라서, 그대로 두면 delivery.timeout.ms 동안 다시 보낸다
            props.put(ProducerConfig.RETRIES_CONFIG, "0");
            props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "false");
[ex/u09-min-isr/MinIsr.java 에서 줄임]
=== 1. topic strict, replicas 1,2,3, min.insync.replicas=3
 Topic: strict Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 Elr: LastKnownElr:
acks=all -> ok, offset=0
acks=1   -> ok, offset=1
=== 2. stop broker 3 (SIGTERM, controlled shutdown)
 Topic: strict Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2 Elr: 3 LastKnownElr:
acks=all -> NotEnoughReplicasException: Messages are rejected since there are fewer in-sync replicas than required.
acks=1   -> ok, offset=2
=== 3. min.insync.replicas=2
acks=all -> ok, offset=3
acks=1   -> ok, offset=4
=== 4. offsets on the leader's disk (broker 1)
offset: 0 payload: acks-all
offset: 1 payload: acks-1
offset: 2 payload: acks-1
offset: 3 payload: acks-all
offset: 4 payload: acks-1
- 브로커 3 을 끄자 ISR 이 곧바로
1,2가 되었습니다. 정상 종료라서 4절의 "컨트롤러가 줄이는 길" 입니다. - 그 상태에서
acks=all은NotEnoughReplicasException으로 거절되고,acks=1은 받아들여졌습니다(offset 2). 마지막 덤프에서 보듯 거절된acks=all레코드는 로그에 없습니다(offset 1 다음이 바로acks=1의 offset 2).appendRecordsToLeader()가 쓰기 전에 던졌기 때문입니다. - 하한을 2 로 내리자 같은 ISR(1,2)에서
acks=all이 성공했습니다.min.insync.replicas는 토픽 설정이라 브로커를 다시 켜지 않아도 바로 적용됩니다. - 예외 메시지는
Partition이 만든 긴 문장("The size of the current ISR : 2 is insufficient …")이 아니라Errors.NOT_ENOUGH_REPLICAS에 붙은 기본 문장입니다(Errors.java231행). 프로듀서의Sender는response.error.exception(response.errorMessage)로 예외를 만들고(Sender.java780행), 응답에 오류 문장이 없으면 이 기본 문장을 씁니다(Errors.java484–488행). 이 응답에는 실려 오지 않았습니다. Elr: 3이 보입니다. ELR(eligible leader replicas)은 ISR 에서 빠졌지만 리더가 될 자격은 남은 레플리카의 목록입니다(메타데이터 레코드 스키마PartitionChangeRecord.json의 주석이 KIP-966 이라고 적고 있습니다). 이 실행에서는 ISR 이 하한(3) 밑인 2 로 줄면서 브로커 3 이 그 목록에 올랐습니다. 목록을 채우는 규칙은 컨트롤러의 리더 선출 쪽 이야기라 이 글에서는 따라가지 않았습니다.
6. 리더가 바뀔 때 — 리더 에포크로 갈라진 로그를 잘라 낸다
새 리더는 에포크의 시작점을 적고, 팔로워 상태를 처음부터 다시 잰다
컨트롤러가 새 리더를 고르면(리더 에포크 + 1) 그 메타데이터를 받은 브로커에서 Partition.makeLeader() 가 돕니다. 에포크가 바뀌었을 때 하는 일의 핵심입니다.
      if (isNewLeaderEpoch) {
        val leaderEpochStartOffset = leaderLog.logEndOffset
        // ...
        leaderLog.assignEpochStartOffset(partitionRegistration.leaderEpoch, leaderEpochStartOffset)

        // Initialize lastCaughtUpTime of replicas as well as their lastFetchTimeMs and
        // lastFetchLeaderLogEndOffset.
        remoteReplicas.foreach { replica =>
          replica.resetReplicaState(
            currentTimeMs,
            leaderEpochStartOffset,
            isNewLeader,
            isr.contains(replica.brokerId)
          )
        }
core/src/main/scala/kafka/cluster/Partition.scala 637–662행
Scala 읽는 법 —
remoteReplicas.foreach { replica => ... }는 Java 의forEach(replica -> ...)입니다. 중괄호 안의 람다를 괄호 없이 넘길 수 있습니다.
새 리더는 "에포크 N 은 지금 내 LEO 에서 시작한다" 를 에포크 캐시에 적습니다(assignEpochStartOffset()). 이 캐시가 LeaderEpochFileCache 이고, 파티션 폴더의 leader-epoch-checkpoint 파일에 에포크 시작오프셋 줄로 저장됩니다(LeaderEpochCheckpointFile.java 45행). 그리고 팔로워마다 resetReplicaState() 로 상태를 다시 잡습니다. 새로 리더가 된 경우 팔로워의 LEO 를 "모름" 으로 두고, ISR 에 있던 팔로워의 lastCaughtUpTimeMs 만 지금으로 두어 곧바로 ISR 에서 쫓겨나지 않게 합니다(Replica.java 108–146행).
팔로워가 된 브로커에서는 makeFollower() 가 ISR 정보를 비우고 새 리더와 에포크를 적은 뒤(696–745행), ReplicaManager 가 fetcher 를 떼었다가 새 리더 쪽으로 다시 붙입니다. 어디서부터 받을지는 이렇습니다.
  protected def initialFetchOffset(log: UnifiedLog): Long = {
    if (log.latestEpoch.isPresent)
      log.logEndOffset
    else
      log.highWatermark
  }
core/src/main/scala/kafka/server/ReplicaManager.scala 2102–2107행
에포크 정보가 있으면 자기 LEO 부터 달라고 합니다. 문제는 자기 로그의 끝부분이 새 리더의 로그와 다를 수 있다는 것입니다. 옛 리더가 acks=1 로 받아 혼자만 가진 레코드가 있었다면, 그 오프셋에 새 리더는 다른 레코드를 쓰고 있을 것입니다.
갈라진 곳은 Fetch 응답이 알려 준다
1절에서 팔로워가 Fetch 에 lastFetchedEpoch 를 싣는다고 했습니다. 리더는 읽기 전에 그 값으로 팔로워의 로그가 자기와 같은 길 위에 있는지 확인합니다.
    lastFetchedEpoch.ifPresent { fetchEpoch =>
      val epochEndOffset = lastOffsetForLeaderEpoch(currentLeaderEpoch, fetchEpoch, fetchOnlyFromLeader = false)
      // ...
      if (epochEndOffset.leaderEpoch < fetchEpoch || epochEndOffset.endOffset < fetchOffset) {
        val divergingEpoch = new FetchResponseData.EpochEndOffset()
          .setEpoch(epochEndOffset.leaderEpoch)
          .setEndOffset(epochEndOffset.endOffset)

        return new LogReadInfo(
          FetchDataInfo.empty(fetchOffset),
          Optional.of(divergingEpoch),
          initialHighWatermark,
          initialLogStartOffset,
          initialLogEndOffset,
          initialLastStableOffset)
      }
    }
core/src/main/scala/kafka/cluster/Partition.scala 1386–1417행
lastOffsetForLeaderEpoch() 는 리더의 에포크 캐시에 "에포크 E 는 어디서 끝났나" 를 묻습니다. 끝은 "E 다음 에포크의 시작 오프셋" 입니다(LeaderEpochFileCache.endOffsetFor(), 284–328행). 팔로워가 "에포크 0 의 레코드를 오프셋 15 직전까지 가졌다" 고 하는데 리더가 아는 에포크 0 은 10 에서 끝났다면, 팔로워의 10~14 는 리더에 없는 레코드입니다. 그러면 리더는 레코드 대신 divergingEpoch(에포크 0, 끝 10) 을 실어 돌려줍니다. 이 경우에는 팔로워 상태도 고치지 않습니다(2절 fetchRecords() 의 !logReadInfo.divergingEpoch.isPresent 조건).
팔로워의 processFetchRequest() 는 이 응답을 보면 레코드를 처리하지 않고(282–290행) truncateOnFetchResponse() → truncationOffset() 으로 잘라 낼 오프셋을 정합니다.
    val replicaEndOffset = logEndOffset(tp)

    // get (leader epoch, end offset) pair that corresponds to the largest leader epoch
    // less than or equal to the requested epoch.
    val endOffsetForEpochOpt = endOffsetForEpoch(tp, leaderEpochOffset.leaderEpoch)
    if (endOffsetForEpochOpt.isPresent) {
      val offsetAndEpoch = endOffsetForEpochOpt.get
      val followerEpochEndOffset = offsetAndEpoch.offset
      val followerEpoch = offsetAndEpoch.epoch()
      if (followerEpoch != leaderEpochOffset.leaderEpoch) {
        // ...
      } else {
        val offsetToTruncateTo = min(followerEpochEndOffset, leaderEpochOffset.endOffset)
        min(offsetToTruncateTo, replicaEndOffset)
      }
core/src/main/scala/kafka/server/AbstractFetcherThread.scala 507–529행
Scala 읽는 법 —
min(a, b)는 파일 위에서 가져온scala.math._의 함수입니다.if (...) { ... } else { ... }가 값을 내는 식이라, 마지막 줄min(offsetToTruncateTo, replicaEndOffset)이 그대로 잘라 낼 오프셋이 됩니다.
리더가 말한 끝, 팔로워 자신이 아는 그 에포크의 끝, 팔로워의 LEO 가운데 가장 작은 곳까지 잘라 내고(truncate() → Partition.truncateTo()), 그 오프셋부터 다시 Fetch 합니다. 리더가 말한 에포크를 팔로워가 모르는 경우(생략한 갈래)에는 자기가 아는 더 앞 에포크의 끝까지 자르고, 다음 Fetch 에서 리더가 다시 갈라진 곳을 알려 주면 한 번 더 자릅니다(489–504행 주석). 에포크 정보가 아예 없는 로그(비었거나 아주 옛 형식)는 이 방법을 쓸 수 없어서, partitionFetchState() 가 그 파티션을 TRUNCATING 상태로 두고 1절의 maybeTruncate() 가 HW 까지 잘라 냅니다(144–175행, 427–436행).
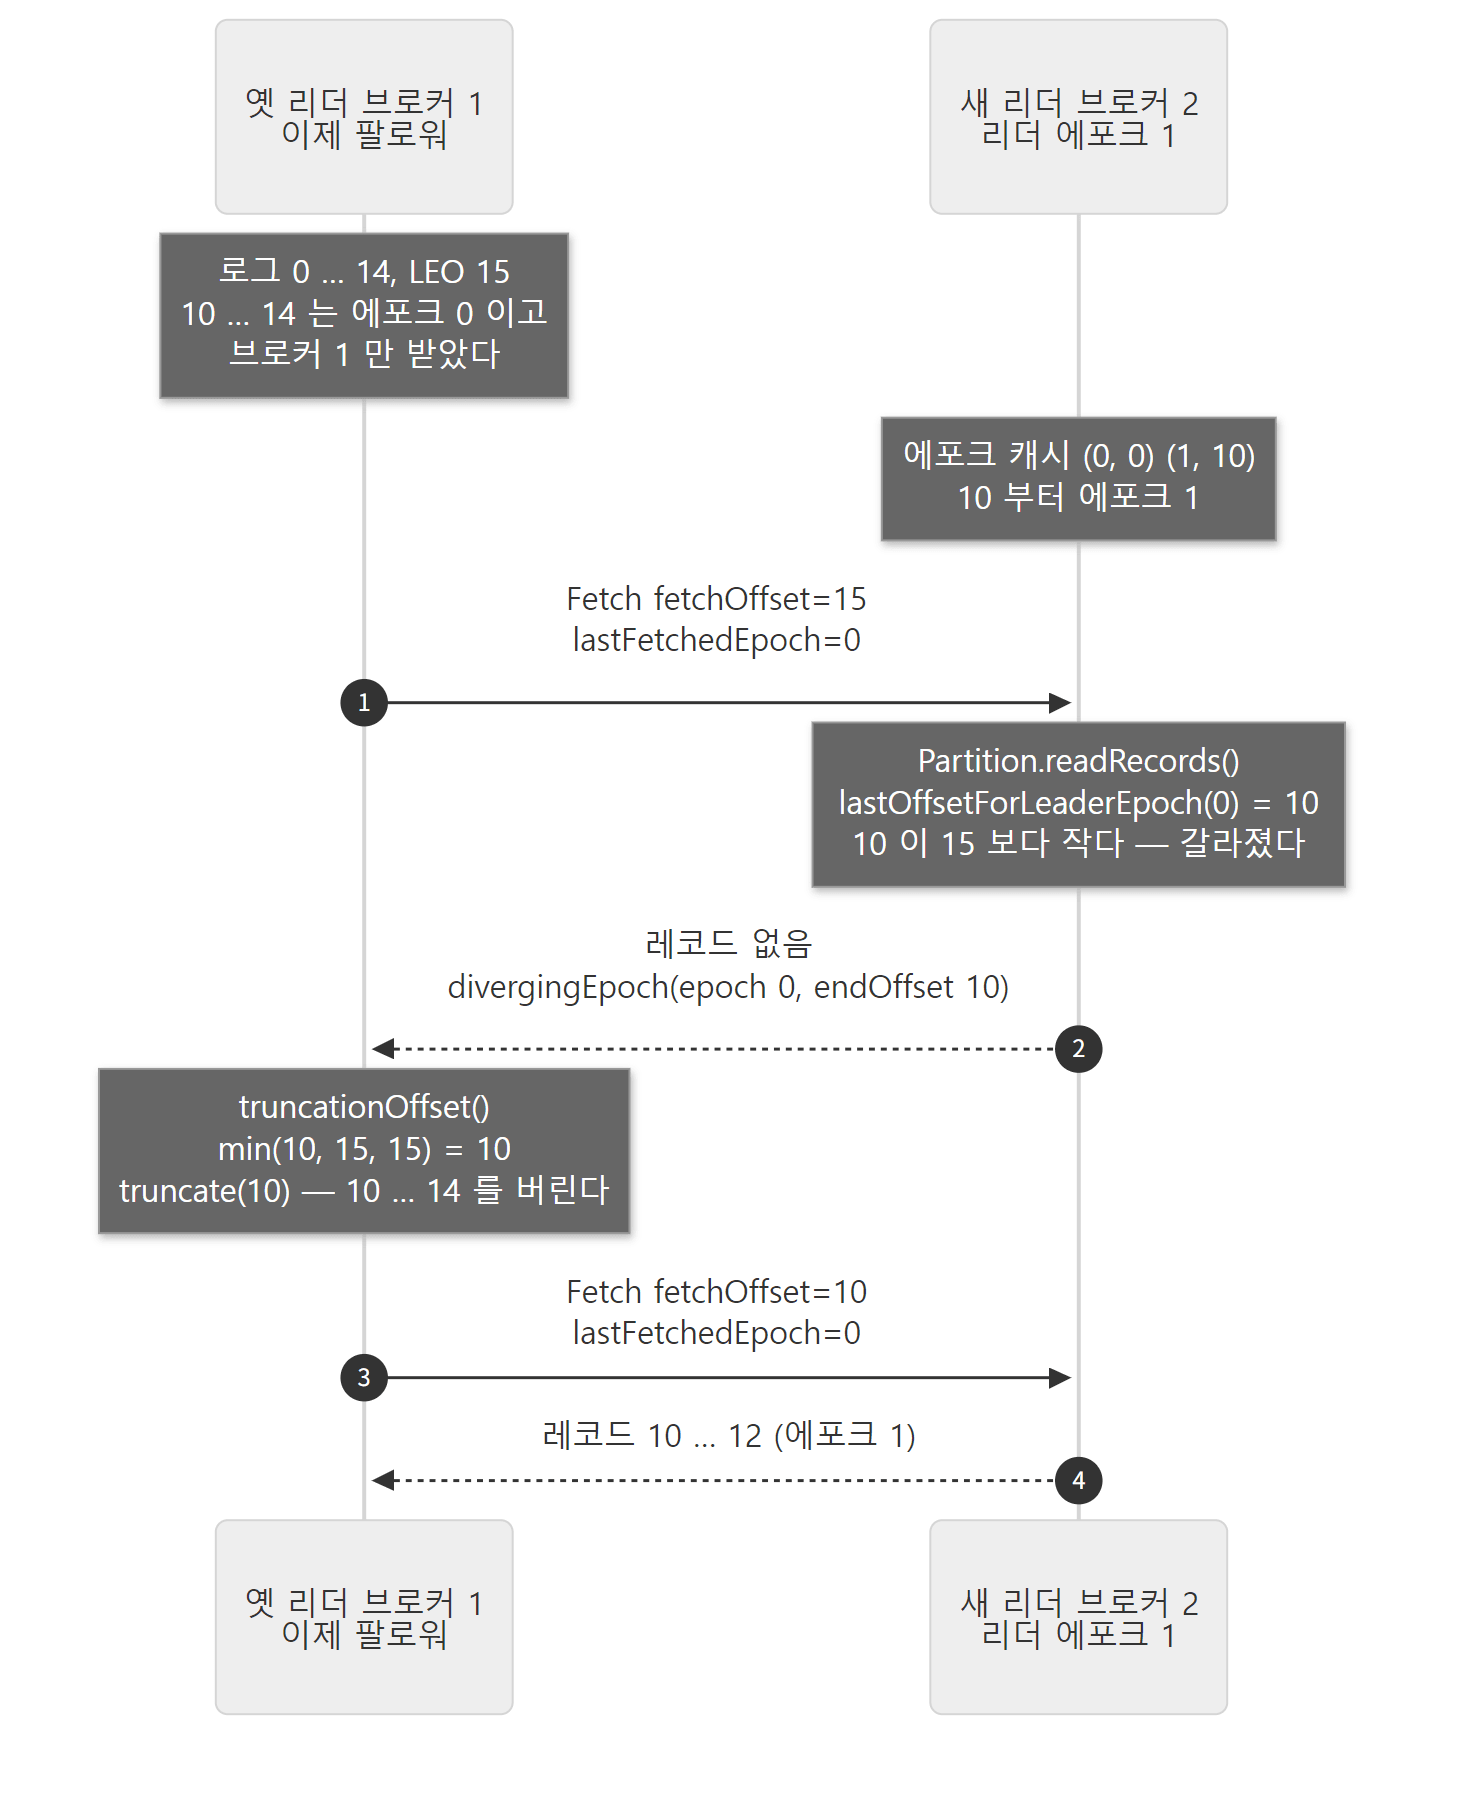 예제 3의 실제 숫자로 그렸습니다. 같은 오프셋 10 에 브로커 1 은
lost-1, 브로커 2 는 new-1 을 가진 상태에서 시작합니다.
4.4.0 과 다른 점: OffsetsForLeaderEpoch 를 묻는 길이 지워졌다
4.4.0 의 AbstractFetcherThread 에는 잘라 낼 곳을 따로 OffsetsForLeaderEpoch 요청으로 리더에게 묻는 길(truncateToEpochEndOffsets())이 있었습니다. 다만 팔로워가 쓰는 RemoteLeaderEndPoint 는 4.4.0 에서도 isTruncationOnFetchSupported = true 여서, 에포크 정보가 있는 파티션은 그때도 이 글에서 본 Fetch 응답의 divergingEpoch 로 잘라 냈습니다. 따로 묻는 길은 그렇지 않은 쪽 — 같은 브로커 안에서 디렉터리를 옮기는 LocalLeaderEndPoint(false) — 을 위해 남아 있었습니다(4.4.0 소스에서 확인). 기준 커밋보다 16일 앞선 2026-10-08 의 커밋 b234a3a667 "KAFKA-18477 Remove usage of OffsetForLeaderEpochRequest in AbstractFetcherThread" 가 그 길을 지웠습니다. 그래서 이 커밋의 maybeTruncate() 에는 HW 까지 자르는 경우만 남았고, LeaderEndPoint.fetchEpochEndOffsets() 는 계층 저장소의 TierStateMachine 만 씁니다. 브로커가 OffsetsForLeaderEpoch 요청을 받아 처리하는 쪽(KafkaApis.handleOffsetForLeaderEpochRequest(), 2196행)은 남아 있습니다. 컨슈머가 리밸런스 뒤 자기 오프셋이 잘리지 않았는지 확인할 때 쓰는 요청이기도 합니다(endOffsetFor() 의 주석, 294–296행).
예제 3: 리더만 받은 acks=1 레코드가 사라지는 것
ex/u09-truncation/run.sh 는 레플리카 1:2:3 인 토픽 div 에 acks=all 로 ok-1~ok-10 을 쓴 뒤, 자바 프로그램 Diverge.java 로 시간에 민감한 부분을 2초 안팎에 끝냅니다. 팔로워 둘(브로커 2·3)을 SIGSTOP → 1초 기다림 → acks=1 로 lost-1~lost-5 → 리더(브로커 1)를 kill -9 → 팔로워 둘을 SIGCONT. 그다음 새 리더가 뽑히기를 기다려 acks=all 로 new-1~new-3 을 쓰고, 브로커 1 을 다시 켭니다. replica.lag.time.max.ms 는 10초로 두어, 리더가 죽기 전에 팔로워들을 ISR 에서 빼지 않게 했습니다.
처음에는 이 순서를 셸에서 콘솔 프로듀서로 했는데, 콘솔 프로듀서가 뜨는 데 10초 넘게 걸리는 사이 리더가 멈춘 팔로워들을 ISR 에서 빼 버렸습니다. 그러자 ISR 이 리더 하나뿐인 채로 리더가 죽어 Leader: none … Isr: Elr: 1 이 되었고, 다시 켠 브로커 1 이 리더로 돌아와 lost-* 레코드가 살아남았습니다. ISR 에 든 레플리카만 리더가 될 수 있다는 규칙이 지킨 결과지만, 이 예제가 보이려던 것은 아니어서 자바 프로그램으로 바꿨습니다.
자바로 바꾼 뒤에도 한 번은 lost-1 하나가 팔로워들에게까지 복제되어 있었습니다. 팔로워가 멈추기 직전에 보내 둔 Fetch 가 리더의 퍼거토리에서 최대 replica.fetch.wait.max.ms(500ms) 기다리는데, 그사이 lost-1 이 쓰이면 그 Fetch 가 lost-1 을 싣고 끝나 응답이 멈춘 팔로워의 소켓 버퍼에 들어가고, 깨어난 팔로워가 그것을 받아 적은 것으로 보입니다(소스의 DelayedFetch 로 설명한 추측이고, 패킷으로 확인하지는 않았습니다). 그래서 멈춘 뒤 1초를 기다렸다가 쓰게 했고, 그 뒤 두 번 돌려 두 번 모두 아래와 같은 결과를 얻었습니다.
배치 줄은 kafka-dump-log.sh --print-data-log 출력을 sed 로 줄였고, leader-epoch-checkpoint 는 파일 내용을 한 줄로 붙인 것입니다(판 번호 0, 줄 수, 그리고 에포크 시작오프셋 쌍). ok-2~ok-9 레코드 줄은 … 으로 줄였습니다. 멈춘 때부터의 시간(ms after SIGSTOP)은 실행마다 다릅니다.
=== 1. topic div, replicas 1,2,3 (leader 1), 10 records with acks=all
 Topic: div Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 Elr: LastKnownElr:
--- leader-epoch-checkpoint (version, count, then 'epoch startOffset')
broker 1: 0 1 0 0
broker 2: 0 1 0 0
broker 3: 0 1 0 0
=== 2. Java: SIGSTOP followers 2,3 -> 5 records with acks=1 -> kill -9 leader 1 -> SIGCONT 2,3
acks=1 offset=10 (only the leader has it)
acks=1 offset=11 (only the leader has it)
acks=1 offset=12 (only the leader has it)
acks=1 offset=13 (only the leader has it)
acks=1 offset=14 (only the leader has it)
leader killed, followers resumed (1171 ms after SIGSTOP)
--- broker 1 log (process is dead, the file is still there)
  batch offsets 0-9 (count 10) partitionLeaderEpoch=0
    offset 0: ok-1
    …
    offset 9: ok-10
  batch offsets 10-10 (count 1) partitionLeaderEpoch=0
    offset 10: lost-1
  batch offsets 11-11 (count 1) partitionLeaderEpoch=0
    offset 11: lost-2
  batch offsets 12-12 (count 1) partitionLeaderEpoch=0
    offset 12: lost-3
  batch offsets 13-13 (count 1) partitionLeaderEpoch=0
    offset 13: lost-4
  batch offsets 14-14 (count 1) partitionLeaderEpoch=0
    offset 14: lost-5
=== 3. wait for a new leader, then 3 records with acks=all
 Topic: div Partition: 0 Leader: 2 Replicas: 1,2,3 Isr: 2,3 Elr: LastKnownElr:
--- broker 2 log (new leader)
  batch offsets 0-9 (count 10) partitionLeaderEpoch=0
    offset 0: ok-1
    …
    offset 9: ok-10
  batch offsets 10-12 (count 3) partitionLeaderEpoch=1
    offset 10: new-1
    offset 11: new-2
    offset 12: new-3
broker 1: 0 1 0 0
broker 2: 0 2 0 0 1 10
broker 3: 0 2 0 0 1 10
=== 4. restart broker 1
 Topic: div Partition: 0 Leader: 2 Replicas: 1,2,3 Isr: 1,2,3 Elr: LastKnownElr:
--- broker 1 server.log
INFO [ReplicaFetcher replicaId=1, leaderId=2, fetcherId=0] Truncating partition div-0 to offset 10 due to leader epoch and offset EpochEndOffset(errorCode=0, partition=0, leaderEpoch=0, endOffset=10) (kafka.server.ReplicaFetcherThread)
INFO [UnifiedLog partition=div-0, dir=/tmp/kafka/1/data] Truncating to offset 10 (org.apache.kafka.storage.internals.log.UnifiedLog)
--- broker 1 log after truncation
  batch offsets 0-9 (count 10) partitionLeaderEpoch=0
    offset 0: ok-1
    …
    offset 9: ok-10
  batch offsets 10-12 (count 3) partitionLeaderEpoch=1
    offset 10: new-1
    offset 11: new-2
    offset 12: new-3
broker 1: 0 2 0 0 1 10
broker 2: 0 2 0 0 1 10
broker 3: 0 2 0 0 1 10
--- console consumer from the beginning
ok-1 ok-2 ok-3 ok-4 ok-5 ok-6 ok-7 ok-8 ok-9 ok-10 new-1 new-2 new-3
- 2단계: 리더 브로커 1 의 로그에만
lost-1~lost-5(offset 10~14, 에포크 0)가 있습니다.acks=1이라 프로듀서는 다섯 개 모두 성공 응답을 받았습니다. - 3단계: 컨트롤러가 브로커 1 을 펜싱한 뒤(하트비트가 끊기고
broker.session.timeout.ms9초 뒤) ISR 에 남은 브로커 2 를 새 리더로 골랐습니다. 브로커 2·3 의 에포크 캐시에1 10— "에포크 1 은 오프셋 10 에서 시작" — 이 더해졌고,new-1~new-3이 offset 10~12 에 에포크 1 로 쓰였습니다. 같은 오프셋 10 에 브로커 1 은lost-1을, 브로커 2 는new-1을 가진 상태입니다. - 4단계: 다시 켠 브로커 1 의 로그에
Truncating partition div-0 to offset 10 due to leader epoch and offset EpochEndOffset(… leaderEpoch=0, endOffset=10)이 찍혔습니다.maybeTruncateToEpochEndOffsets()(208행)의 로그이고, 괄호 안이 새 리더가 Fetch 응답에 실어 보낸divergingEpoch입니다. 이어서UnifiedLog가Truncating to offset 10을 찍었습니다. 잘라 낸 뒤의 로그는 리더와 똑같이new-1~new-3(에포크 1)이고, 에포크 캐시도 같아졌습니다. - 콘솔 컨슈머: 처음부터 읽으면
ok-*10개와new-*3개뿐입니다. 프로듀서가 성공 응답을 받은lost-*다섯 개는 클러스터 어디에도 남지 않았습니다.acks=1의 "리더에 쓰였다" 는 보장이 리더가 죽으면 무엇을 뜻하는지가 이것입니다. 같은 일을acks=all로 했다면, 팔로워가 멈춰 있는 동안 HW 가 오르지 않아 프로듀서는 성공 응답을 받지 못했을 것입니다(예제 1).
이 글에서 뺀 것
- 깨끗하지 않은 리더 선출(unclean leader election,
unclean.leader.election.enable, 기본false)과 ELR(eligible leader replicas)·LastKnownElr: 컨트롤러의metadata/src/main/java/org/apache/kafka/controller/PartitionChangeBuilder.java. 팔로워 쪽fetchOffsetAndTruncate()의 주석(AbstractFetcherThread.scala546–616행)이 그 뒤처리를 설명합니다 - 리더가 아닌 레플리카에서 읽기(
replica.selector.class,findPreferredReadReplica()):ReplicaManager.scala1813–1833행 - 복제 쿼터(
leader.replication.throttled.rate등,shouldFollowerThrottle()):RemoteLeaderEndPoint.scala224–230행,server/src/main/java/org/apache/kafka/server/quota/ - 같은 브로커 안에서 로그 디렉터리를 옮기는
ReplicaAlterLogDirsThread·LocalLeaderEndPoint, 그리고Partition의futureLog:core/src/main/scala/kafka/server/ - 계층 저장소에서 따라잡기(
TierStateMachine,OFFSET_MOVED_TO_TIERED_STORAGE):core/src/main/java/kafka/server/TierStateMachine.java - 파티션 재할당(
AddingReplicas/RemovingReplicas,OngoingReassignmentState):Partition.updateAssignmentAndIsr()(837–862행) - 증분 Fetch 세션(
FetchSessionHandler): 팔로워도 컨슈머와 같은 세션을 씁니다. 8편 - 메타데이터 로그 자체의 복제(KRaft): 같은 "Fetch 로 따라 쓰고 HW 로 커밋" 이지만 다른 구현입니다. 10편
- 지표(
UnderReplicated,UnderMinIsr,IsrShrinksPerSec,MaxLag등):Partition.scala221–226행,AbstractFetcherManager.scala48–65행
정리
| 개념 | 한 줄 요약 |
|---|---|
ReplicaFetcherThread-<fetcherId>-<리더 id> |
팔로워 브로커에서 리더 브로커마다(기본 num.replica.fetchers=1) 하나. 그 리더의 파티션을 모두 맡아 Fetch 를 되풀이한다 |
| 팔로워의 Fetch | 컨슈머와 같은 요청에 replicaId·브로커 에포크·lastFetchedEpoch 가 더 실린다. 리더는 로그 끝(LOG_END)까지 읽어 준다 |
appendAsFollower() |
리더가 매긴 오프셋·에포크를 바꾸지 않고 배치를 그대로 덧붙인다 |
| 팔로워의 LEO | 리더는 팔로워가 보낸 fetchOffset 으로 안다. 확인 메시지는 따로 없다 |
lastCaughtUpTimeMs |
팔로워가 마지막으로 리더 LEO 까지 따라잡았던 시각. ISR 판정의 기준 |
| 하이 워터마크 | ISR(진행 중인 변경을 보수적으로 반영한 maximalIsr)의 LEO 가운데 가장 작은 값. 리더의 계산으로는 줄지 않고, ISR 이 min.insync.replicas 밑이면 오르지 않는다 |
| 팔로워의 HW | min(리더가 알려 준 HW, 내 LEO). 리더보다 한 박자 늦다 |
| ISR 축소 | replica.lag.time.max.ms / 2 마다 검사. 리더와 LEO 가 다르고 따라잡은 지 기준 시간이 지난 팔로워를 뺀다. 새 레코드가 없으면 멈춘 팔로워도 빠지지 않는다 |
| ISR 확장 | 팔로워 LEO ≥ HW 이고 ≥ 이번 리더 에포크의 시작 오프셋, 그리고 펜싱·종료 중이 아닐 때 |
| AlterPartition | 리더의 제안. 브로커당 한 번에 한 요청. 컨트롤러가 확인하고 PartitionChangeRecord 로 기록해야 확정된다. 정상 종료·펜싱 때는 컨트롤러가 직접 줄인다 |
acks=all |
DelayedProduce 로 HW ≥ 마지막 오프셋 + 1 이 될 때까지, 최대 프로듀서의 request.timeout.ms 동안 기다린다. 깨우는 것은 팔로워의 Fetch 와 ISR 변경 |
min.insync.replicas |
acks=all 이고 ISR 이 모자라면 쓰기 전에 NOT_ENOUGH_REPLICAS, 기다리는 사이 모자라지면 NOT_ENOUGH_REPLICAS_AFTER_APPEND. 기본값 1 |
| 리더 에포크 | 리더가 바뀔 때마다 오르는 번호. 배치마다 찍히고 leader-epoch-checkpoint 에 시작 오프셋이 적힌다 |
| 잘라 내기 | 팔로워의 lastFetchedEpoch 로 리더가 갈라진 곳을 찾아 divergingEpoch 로 알려 주고, 팔로워가 그곳까지 자른다. 이 커밋에서 OffsetsForLeaderEpoch 를 묻는 길은 지워졌다 |
다음에 볼 것
이 글 내내 "컨트롤러가 정한다", "메타데이터로 퍼진다" 고 넘긴 것이 있습니다. 리더를 고르고, AlterPartition 을 받아 PartitionChangeRecord 를 쓰고, 브로커를 펜싱하는 쪽입니다. 다음 글은 그 컨트롤러로 갑니다. 재미있게도 컨트롤러의 메타데이터 로그 __cluster_metadata 역시 리더에게 Fetch 를 보내 따라 쓰고, 과반이 받은 곳을 하이 워터마크로 삼아 커밋합니다. 이 글의 ISR 이 아니라 Raft 의 과반입니다. KafkaRaftClient 의 역할 상태 전이, QuorumController 가 한 스레드의 이벤트 큐 위에서 레코드를 만드는 방식, 브로커가 그 레코드를 받아 이 글의 makeLeader()·makeFollower() 까지 이어지는 길을 10편: KRaft와 메타데이터 — 컨트롤러는 클러스터를 어떻게 기억하나에서 봅니다.
복제를 다른 시스템과 견줘 보고 싶다면, 데이터베이스가 변경 기록을 남기고 복구하는 방식은 MariaDB 연재에서 다룹니다.