이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 열 번째 글이고, 셋째 묶음 "클러스터를 움직이는 것"의 첫 글입니다. 3편부터 9편까지는 레코드 하나가 프로듀서에서 브로커의 디스크로, 다시 팔로워와 컨슈머로 가는 데이터의 길을 따라갔습니다. 이번에는 2편에서 이름만 본 장부의 길로 갑니다. "토픽 orders 는 파티션이 3개이고, 0번 파티션의 리더는 브로커 1이며, ISR 은 1·2·3이다" 같은 사실을 누가 정하고, 어디에 적어 두고, 브로커들은 그것을 어떻게 알게 되는지입니다.
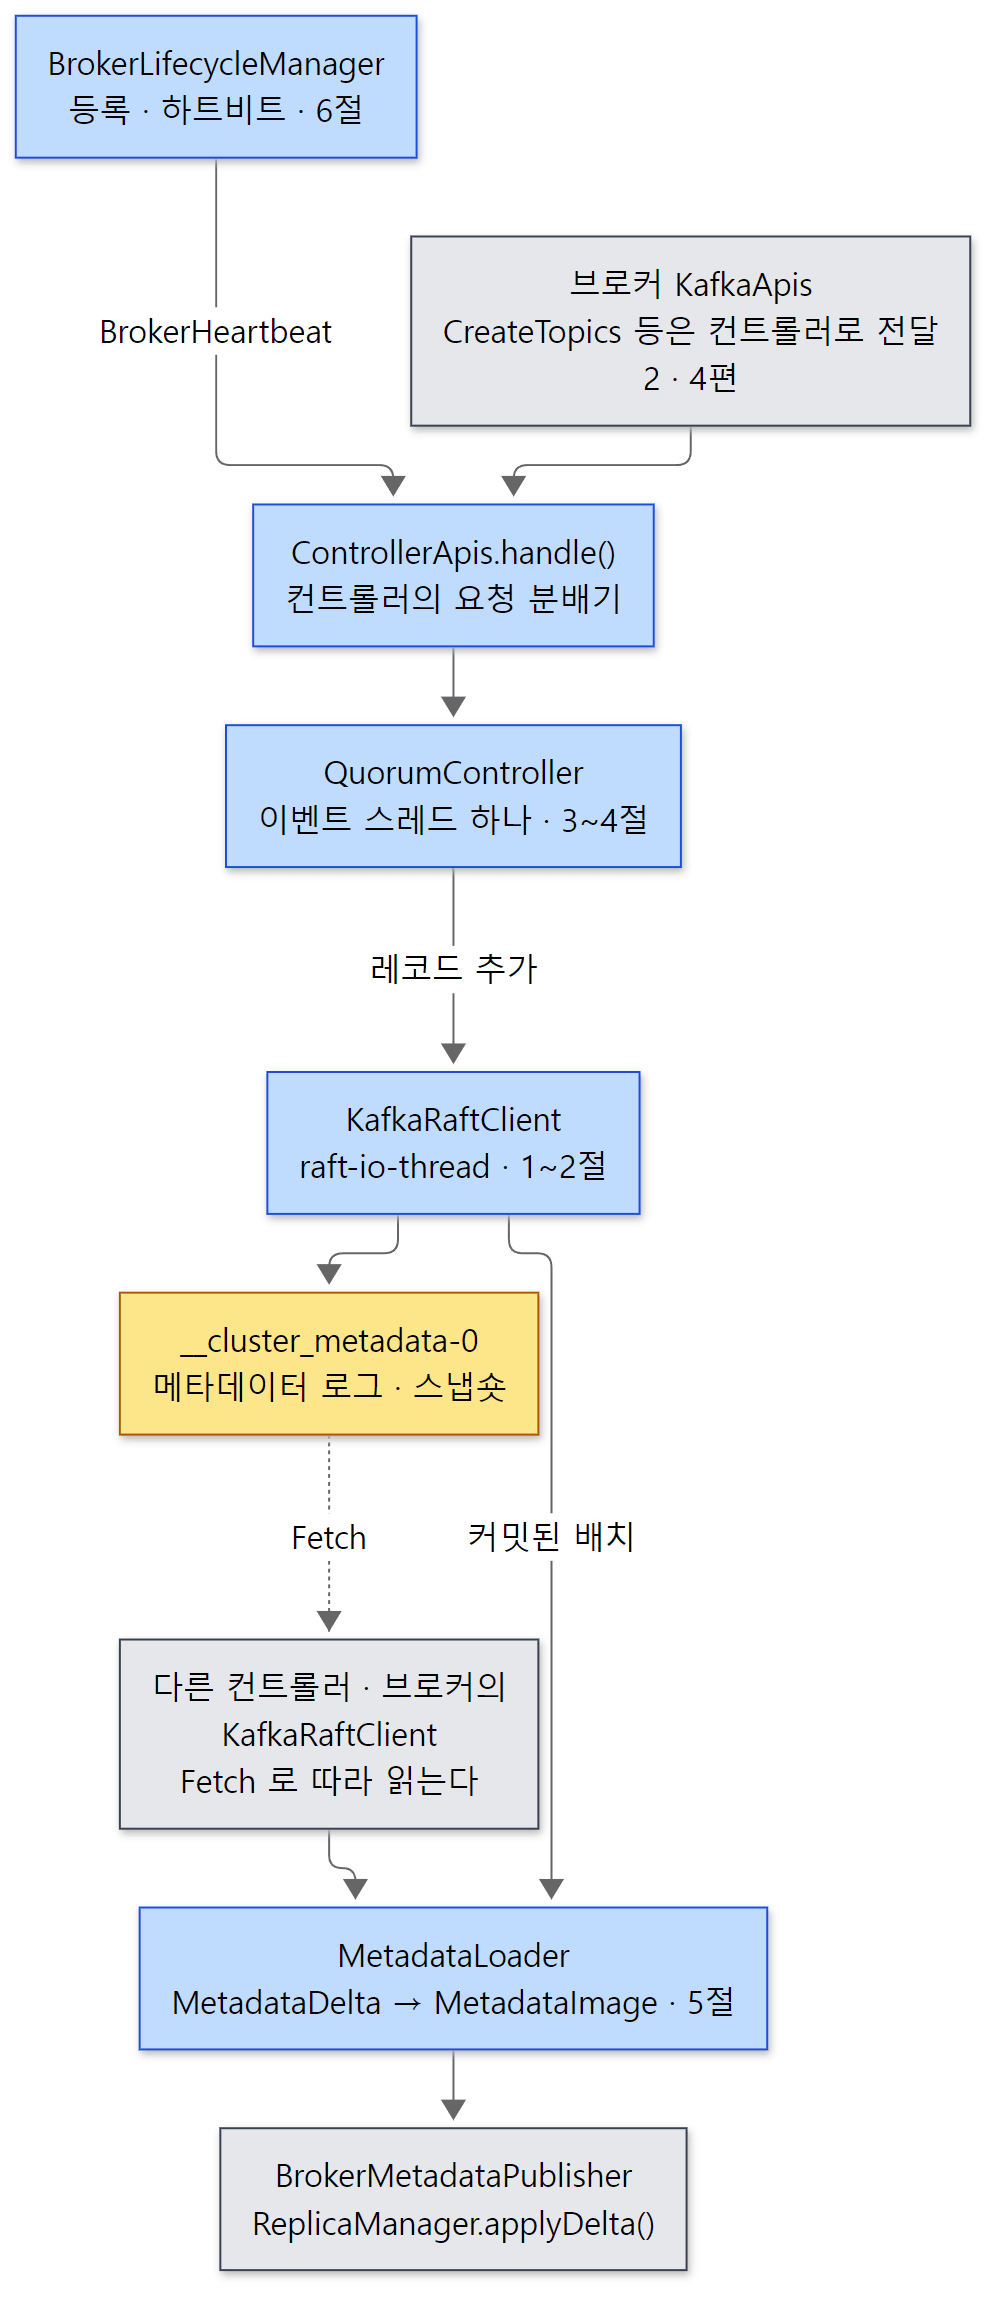 이 글은 2편 지도의 G 구역 "컨트롤러와 메타데이터(KRaft)"를 확대합니다. 파란 상자가 이 글에서 읽는 부품, 노란 상자가 장부가 쌓이는 곳, 회색 상자는 앞 글에서 본 것입니다.
2편에서는 토픽 하나를 만들 때 요청이 브로커에서 컨트롤러로 전달되고, 컨트롤러가 TopicRecord·PartitionRecord 를 메타데이터 로그에 덧붙이면 브로커들이 그 로그를 읽어 폴더를 만든다는 큰 흐름까지 봤습니다. 이 글은 그 흐름의 상자 하나하나를 엽니다. 답하려는 질문은 네 가지입니다.
- 클러스터의 장부(
__cluster_metadata)는 무엇으로 되어 있고, 컨트롤러가 여럿일 때 누가 쓰고 나머지는 어떻게 같은 내용을 갖게 되는가 - 컨트롤러 하나가 죽으면 새 리더는 어떻게 뽑히고, "커밋되었다"는 것은 정확히 언제인가
- 컨트롤러는 락 없이 어떻게 요청을 처리하고, 아직 커밋되지 않은 결정은 어떻게 되돌리는가
- 브로커는 장부의 변화를 어떻게 받아 적용하고, 컨트롤러는 죽은 브로커를 어떻게 알아채는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | org.apache.kafka.raft.KafkaRaftClient·QuorumState·LeaderState, raft.internals.KafkaRaftLog, org.apache.kafka.controller.QuorumController·OffsetControlManager·ReplicationControlManager, org.apache.kafka.timeline.SnapshotRegistry·TimelineHashMap, org.apache.kafka.image.loader.MetadataLoader·MetadataDelta·MetadataImage, org.apache.kafka.server.BrokerLifecycleManager (모두 Java) |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 이 글이 읽는 곳은 흔히 쓰는 최신 안정판 4.4.0 과 거의 같습니다. 위 클래스들을 4.4.0 태그와 비교하면 QuorumState·KafkaRaftLog·MetadataLoader·MetadataDelta·MetadataImage·KafkaEventQueue·OffsetControlManager·SnapshotRegistry·TimelineHashMap·BrokerLifecycleManager 는 한 줄도 다르지 않고, KafkaRaftClient·LeaderState 는 투표자를 바꾸는(add/remove/update voter) 처리 쪽만, QuorumController·ReplicationControlManager 는 요청 하나가 만들 수 있는 레코드 수 상한을 새 설정 controller.max.records.per.batch 로 받게 된 부분(KRaftConfigs.java 72행) 정도만 다릅니다(QuorumController 는 노드 id 를 확인하는 부분도 조금 바뀌었습니다).
이번 글의 코드는 거의 다 Java 입니다. KRaft 는 처음부터 Java 모듈(raft, metadata, server-common)로 쓰였고, Scala 인 core 에는 조립하는 껍데기만 남아 있습니다. 대신 파일이 큽니다(KafkaRaftClient.java 4,185줄, QuorumController.java 2,245줄). 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
메타데이터(metadata): 이 글에서는 데이터(레코드) 말고 클러스터에 대한 사실 전부를 말합니다. 어떤 브로커가 살아 있나, 어떤 토픽이 있고 파티션이 몇 개인가, 파티션마다 레플리카·리더·ISR 은 무엇인가, 토픽 설정·쿼터·ACL 은 무엇인가. 2편에서 "장부"라고 부른 것이 이것입니다.
메타데이터 로그와 메타데이터 레코드: 장부는 표 하나가 아니라, 바뀐 내용을 시간 순서로 적은 로그입니다. "토픽을 만들었다"(TopicRecord), "파티션을 이렇게 만들었다"(PartitionRecord), "파티션의 ISR 이 바뀌었다"(PartitionChangeRecord), "브로커 3을 펜스했다"(BrokerRegistrationChangeRecord) 같은 레코드가 한 줄씩 쌓입니다. 처음부터 끝까지 다시 읽으면(replay) 지금의 장부가 나옵니다. 은행 통장의 거래 내역을 처음부터 더하면 잔액이 나오는 것과 같습니다. 이 로그가 토픽 __cluster_metadata 의 0번 파티션입니다.
쿼럼(quorum), 투표자(voter), 옵서버(observer): 메타데이터 로그를 함께 지키는 컨트롤러들의 모임이 쿼럼이고, 그 구성원이 투표자입니다. 투표자만 리더 선거에 표를 던지고, 레코드가 "커밋"되었는지를 정하는 과반에 들어갑니다. 브로커는 투표권 없이 로그를 따라 읽기만 하는 옵서버입니다(2편 예제의 CurrentObservers).
에포크(epoch): 리더가 바뀔 때마다 하나씩 오르는 세대 번호입니다. 데이터 파티션의 리더 에포크(9편)와 같은 생각입니다. 요청에 에포크를 실어 보내, 옛 리더가 뒤늦게 보낸 요청을 "지난 세대 것"이라고 알아보고 버립니다.
커밋(commit)과 하이 워터마크(high watermark, HW): 리더가 로그에 쓴 레코드가 투표자의 과반에 복제되면 그 레코드는 커밋되었다고 합니다. 과반이 가졌으니 리더가 죽어도 새 리더(역시 과반 가운데 하나에서 나옵니다)가 그 레코드를 갖고 있다는 보장이 생깁니다. 커밋된 레코드와 아닌 레코드의 경계 오프셋이 하이 워터마크입니다. 데이터 파티션의 하이 워터마크는 9편에서 본 대로 ISR 전원이 기준이었는데, 메타데이터 로그는 과반이 기준입니다. 2절에서 그 차이를 소스로 봅니다.
활성 컨트롤러(active controller)와 대기 컨트롤러(standby): 메타데이터 로그의 Raft 리더가 활성 컨트롤러입니다. 결정(새 레코드)을 만드는 것은 활성 컨트롤러뿐이고, 대기 컨트롤러는 그 레코드를 받아 자기 메모리에 다시 적용해 두었다가 리더가 바뀌면 곧바로 이어받습니다. 2편 4절에서 QuorumController 의 javadoc 으로 봤습니다.
펜스(fence, 울타리): 컨트롤러가 "이 브로커는 지금 믿을 수 없다"고 표시해 둔 상태입니다. 펜스된 브로커에는 리더를 맡기지 않고, ISR 에서도 뺍니다. 2편에서 브로커가 뜰 때 "울타리를 걷어 줄 때까지" 기다린다고 했던 그 울타리입니다. 6절에서 컨트롤러가 언제 울타리를 치고 걷는지 봅니다.
1. 장부는 평범한 Kafka 로그다 — __cluster_metadata-0
메타데이터 로그도 UnifiedLog 위에 있다
메타데이터 로그의 이름은 clients 의 상수 하나입니다(CLUSTER_METADATA_TOPIC_NAME = "__cluster_metadata", Topic.java 30행). 이 로그를 들고 있는 것은 SharedServer 가 만드는 KafkaRaftManager 입니다(2편 3절).
  override val raftLog: RaftLog = buildMetadataLog()
  private val netChannel = buildNetworkChannel()
  private val expirationTimer = new SystemTimer("raft-expiration-executor")
  private val expirationService = new TimingWheelExpirationService(expirationTimer)
  override val client: KafkaRaftClient[T] = buildRaftClient()
  private val clientDriver = new KafkaRaftClientDriver[T](client, threadNamePrefix, fatalFaultHandler, logContext)
core/src/main/scala/kafka/raft/KafkaRaftManager.scala 129–134행
Scala 읽는 법 —
val은 다시 대입할 수 없는 필드(Java 의final필드)입니다.override val raftLog: RaftLog = …는 이 클래스가 구현하는RaftManager인터페이스의raftLog멤버를 이 값으로 채운다는 뜻이고,KafkaRaftClient[T]의[T]는 Java 의<T>입니다.
세 부품이 이 글의 1~2절입니다. raftLog 가 디스크의 로그, client(KafkaRaftClient)가 Raft 프로토콜, clientDriver 가 그 프로토콜을 돌리는 스레드입니다. buildMetadataLog() 가 만드는 KafkaRaftLog 를 열어 보면 낯익은 클래스가 나옵니다.
    @Override
    public LogAppendInfo appendAsLeader(Records records, int epoch) {
        if (records.sizeInBytes() == 0) {
            throw new IllegalArgumentException("Attempt to append an empty record set");
        }

        try {
            return handleAndConvertLogAppendInfo(log.appendAsLeader((MemoryRecords) records, epoch, AppendOrigin.RAFT_LEADER));
        } catch (IOException ioe) {
            throw new UncheckedIOException(ioe);
        }
    }
raft/src/main/java/org/apache/kafka/raft/internals/KafkaRaftLog.java 147–158행
여기의 log 는 private final UnifiedLog log;(84행)입니다. 6편·7편에서 본, 데이터 파티션이 쓰는 바로 그 UnifiedLog 입니다. 그래서 메타데이터 로그도 세그먼트 파일(.log), 오프셋 인덱스(.index), 타임 인덱스(.timeindex)를 갖고, 레코드는 데이터와 같은 레코드 배치 v2 형식으로 저장됩니다. 2편의 모듈 그림에서 raft → storage 화살표가 이것이었습니다. 장부도 Kafka 로그로 만든다 — KRaft 의 가장 큰 설계 결정이 이 한 줄에 들어 있습니다. 덕분에 저장·복제·도구(kafka-dump-log.sh)를 데이터와 같이 쓸 수 있습니다.
메타데이터 레코드도 JSON 스키마에서 생성된다
레코드의 모양은 3편에서 본 요청·응답처럼 JSON 스키마로 정의하고 빌드 때 Java 클래스를 생성합니다. 스키마는 metadata/src/main/resources/common/metadata/ 에 27개가 있습니다(TopicRecord.json, PartitionRecord.json, PartitionChangeRecord.json, RegisterBrokerRecord.json, BrokerRegistrationChangeRecord.json, FenceBrokerRecord.json, ConfigRecord.json, FeatureLevelRecord.json, NoOpRecord.json … 그리고 ZooKeeper 에서 옮겨 오던 시절의 ZkMigrationRecord.json 도 이름은 남아 있습니다). 가장 짧은 TopicRecord 입니다.
{
  "apiKey": 2,
  "type": "metadata",
  "name": "TopicRecord",
  "validVersions": "0",
  "flexibleVersions": "0+",
  "fields": [
    { "name": "Name", "type": "string", "versions": "0+", "entityType": "topicName",
      "about": "The topic name." },
    { "name": "TopicId", "type": "uuid", "versions": "0+",
      "about": "The unique ID of this topic." }
  ]
}
metadata/src/main/resources/common/metadata/TopicRecord.json 16–28행
요청 스키마의 "type": "request" 자리에 "type": "metadata" 가 있고, apiKey 는 레코드 종류 번호입니다. 생성기는 이 파일에서 TopicRecord 클래스와, 번호로 종류를 찾는 MetadataRecordType 열거형을 만듭니다(둘 다 빌드 때 생성되므로 저장소에는 없습니다). PartitionRecord.json 에는 파티션 번호·토픽 id·Replicas·Isr·Leader·LeaderEpoch·PartitionEpoch 같은 필드가 있습니다(PartitionRecord.json 24–53행). 2편 5절에서 buildPartitionRegistration() 이 채우던 값이 그대로 이 필드들이 됩니다.
예제 1: 토픽 하나를 만들고 메타데이터 로그를 직접 읽기
이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다(이 글의 다른 예제도 같습니다). 브로커와 컨트롤러를 한 프로세스로 띄우고(node 1), 쿼럼 상태를 본 뒤 토픽 orders(파티션 3개)를 만들고, 메타데이터 로그 폴더와 그 안의 레코드를 봅니다. 스크립트는 kafka-examples/ex/u10-metadata-log/run.sh 이고, 쓰는 도구는 kafka-metadata-quorum.sh … describe --status, ls·cat, 그리고 메타데이터 레코드를 풀어 주는 kafka-dump-log.sh --cluster-metadata-decoder --files …/00000000000000000000.log 입니다. 출력 앞부분입니다(클러스터 id, 디렉터리 id, 토픽 id, 오프셋, 시각 같은 값은 실행마다 다릅니다).
=== quorum status (kafka-metadata-quorum.sh describe --status)
ClusterId:              cTyAk73kQ4CIt8MyqMzHOQ
LeaderId:               1
LeaderEpoch:            1
HighWatermark:          32
MaxFollowerLag:         0
MaxFollowerLagTimeMs:   0
CurrentVoters:          [{"id": 1, "directoryId": "5H7XVkyAS9mZZQhe8CMRaw", "endpoints": ["CONTROLLER://localhost:9093"]}]
CurrentObservers:       []
=== create topic orders (3 partitions)
Created topic orders.
=== files in __cluster_metadata-0
00000000000000000000-0000000000.checkpoint
00000000000000000000.index
00000000000000000000.log
00000000000000000000.timeindex
leader-epoch-checkpoint
partition.metadata
quorum-state
=== quorum-state file
{"leaderId":1,"leaderEpoch":1,"votedId":-1,"votedDirectoryId":"AAAAAAAAAAAAAAAAAAAAAA","data_version":1}
폴더의 모양이 7편에서 본 데이터 파티션 폴더(orders-0)와 똑같습니다. 다른 것은 두 파일입니다. quorum-state 는 Raft 가 "지금 에포크와 리더, 이번 에포크에 누구에게 표를 줬는지"를 적어 두는 파일이고(FileQuorumStateStore.DEFAULT_FILE_NAME = "quorum-state", FileQuorumStateStore.java 80행), 2절의 선거에서 다시 봅니다. …-0000000000.checkpoint 는 스냅숏 파일입니다. 이름이 <끝 오프셋>-<에포크> 이고, 이것은 kafka-storage.sh format 이 써 둔 "부트스트랩" 스냅숏(오프셋 0, 에포크 0)입니다. 스냅숏은 5절에서 봅니다.
로그 안의 레코드는 종류별로 이렇게 쌓여 있었습니다.
=== metadata log: the first batch (control records written by the new leader)
baseOffset: 0 lastOffset: 2 count: 3 ... isControl: true
 offset: 0 LeaderChange: {"version":0,"leaderId":1,"voters":[{"voterId":1}],"grantingVoters":[{"voterId":1}]}
 offset: 1 KRaftVersion {"version":0,"kRaftVersion":1}
 offset: 2 KRaftVoters {"version":0,"voters":[{"voterId":1,"voterDirectoryId":"5H7XVkyAS9mZZQhe8CMRaw","endpoints":[{"name":"CONTROLLER","host":"localhost","po
=== metadata log: record types (count)
     32 "type":"NO_OP_RECORD"
      6 "type":"FEATURE_LEVEL_RECORD"
      3 "type":"PARTITION_RECORD"
      2 "type":"BROKER_REGISTRATION_CHANGE_RECORD"
      1 "type":"TOPIC_RECORD"
      1 "type":"REGISTER_CONTROLLER_RECORD"
      1 "type":"REGISTER_BROKER_RECORD"
      1 "type":"END_TRANSACTION_RECORD"
      1 "type":"CONFIG_RECORD"
      1 "type":"BEGIN_TRANSACTION_RECORD"
=== metadata log: records for topic orders (the batch header, then the records)
baseOffset: 41 lastOffset: 44 count: 4 ... isControl: false
 offset: 41 {"type":"TOPIC_RECORD","version":0,"data":{"name":"orders","topicId":"oerNM_RtQJiR5zDk9XwK7w"}}
 offset: 42 {"type":"PARTITION_RECORD","version":2,"data":{"partitionId":0,"topicId":"oerNM_RtQJiR5zDk9XwK7w","replicas":[1],"isr":[1], ...,"directories":["5H7XVkyAS9mZZ
 offset: 43 {"type":"PARTITION_RECORD","version":2,"data":{"partitionId":1,"topicId":"oerNM_RtQJiR5zDk9XwK7w","replicas":[1],"isr":[1], ...,"directories":["5H7XVkyAS9mZZ
 offset: 44 {"type":"PARTITION_RECORD","version":2,"data":{"partitionId":2,"topicId":"oerNM_RtQJiR5zDk9XwK7w","replicas":[1],"isr":[1], ...,"directories":["5H7XVkyAS9mZZ
=== controller.log: the controller replayed the records
04:55:26,907 INFO [QuorumController id=1] Replayed TopicRecord for topic orders with topic ID oerNM_RtQJiR5zDk9XwK7w. (org.apache.kafka.cont
04:55:26,912 INFO [QuorumController id=1] Replayed PartitionRecord for new partition orders-0 with topic ID oerNM_RtQJiR5zDk9XwK7w and Parti
(긴 줄은 스크립트에서 잘랐습니다. ... 자리는 removingReplicas·addingReplicas·leader·leaderEpoch·partitionEpoch 필드를 줄인 곳입니다. 마지막 두 줄은 controller.log 에서 뽑은 Replayed … 줄로, 3절의 replay() 가 남긴 것입니다. 스크립트가 이어서 찍는 describe --replication 출력(리더 한 줄)은 뺐습니다.)
읽을거리가 세 가지 있습니다.
- 토픽 하나 = 레코드 배치 하나.
TopicRecord1개와PartitionRecord3개가 오프셋 41~44 의 한 배치에 들어 있습니다. 2편 5절에서 본createTopics()가 만든 레코드 목록이 그대로 한 번에 덧붙여진 것입니다. - 맨 앞은 컨트롤 레코드. 오프셋 0~2 는
isControl: true배치입니다. 이 노드가 에포크 1의 리더가 되면서 쓴LeaderChange와 투표자 목록입니다. 이것이 왜 맨 앞에 있는지는 2절에서 봅니다. NO_OP_RECORD가 가장 많다. 아무 일도 없을 때도 활성 컨트롤러는metadata.max.idle.interval.ms(기본 500,MetadataLogConfig.java75–76행)마다 빈 레코드를 하나씩 씁니다(registerWriteNoOpRecord(...),QuorumController.java1634–1636행). 로그가 계속 앞으로 가야 브로커들이 "나는 오프셋 N 까지 따라잡았다"를 계속 보고할 수 있고, 하이 워터마크도 계속 오릅니다. 실행 시간이 길수록 이 줄 수가 늘어납니다.
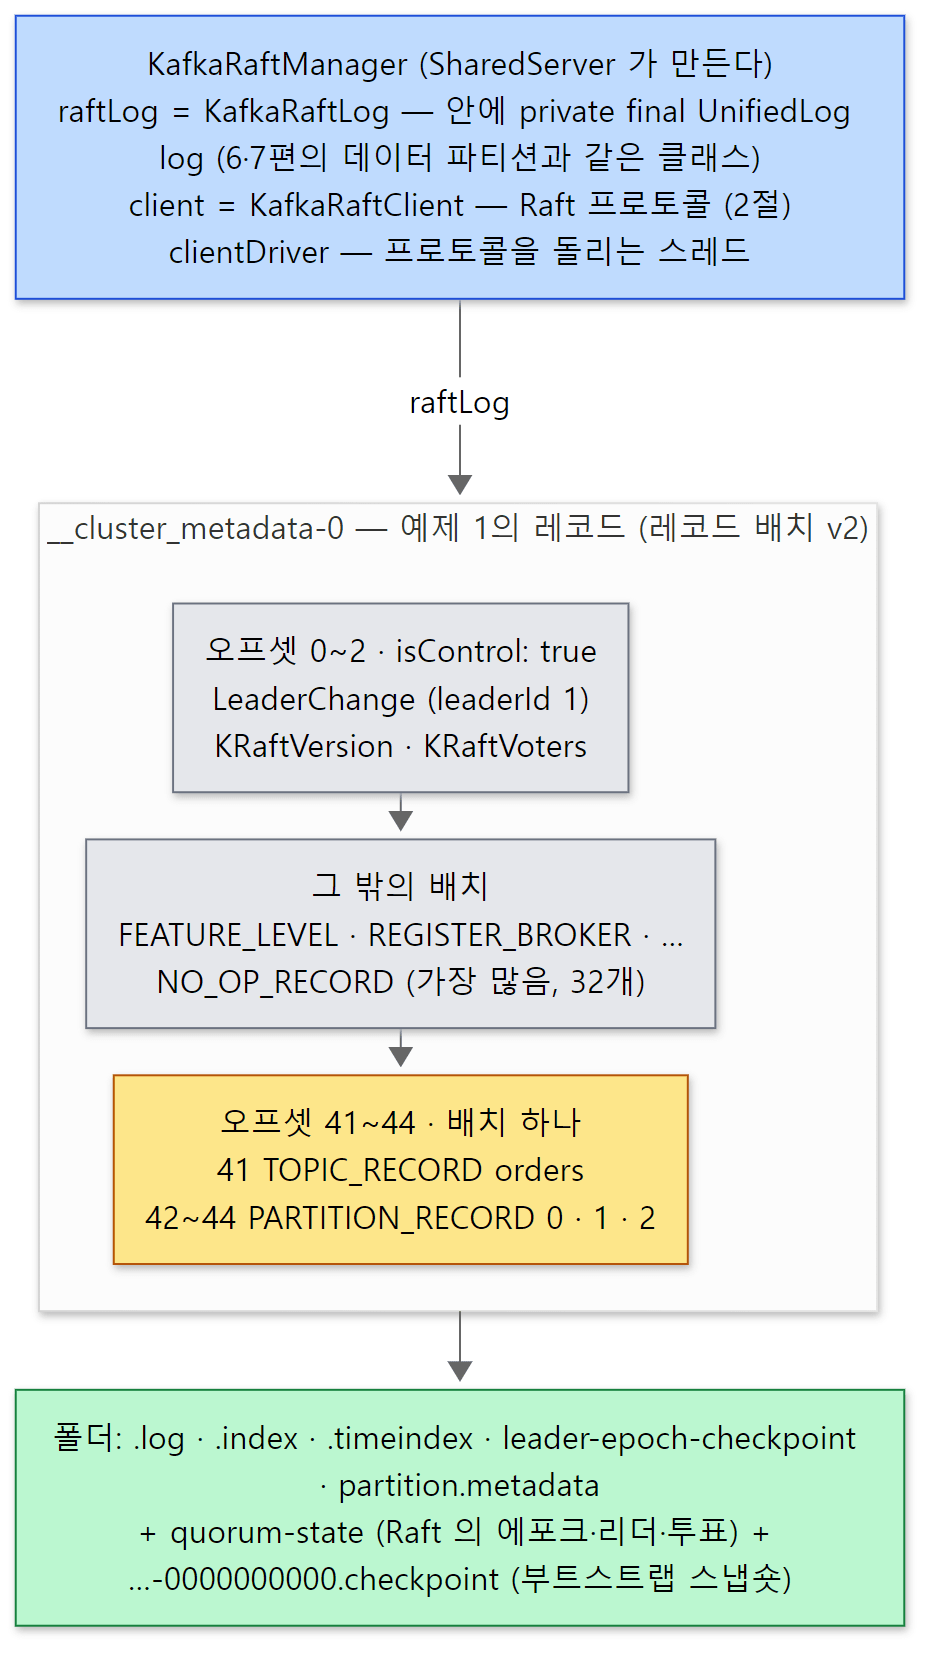 장부도 UnifiedLog 위의 평범한 로그입니다. 오프셋과 레코드 종류·개수는 위 예제 1의 출력에서 가져왔습니다(오프셋은 실행마다 다릅니다).
2. KafkaRaftClient — 리더 뽑기는 Raft, 복제는 Fetch
클래스 설명이 요약하는 것
KafkaRaftClient 의 javadoc 은 이 구현이 교과서 Raft 와 어디가 같고 어디가 다른지를 먼저 밝힙니다.
/**
 * This class implements a Kafkaesque version of the Raft protocol. Leader election
 * is more or less pure Raft, but replication is driven by replica fetching and we use Kafka's
 * log reconciliation protocol to truncate the log to a common point following each leader
 * election.
 *
 * Like Zookeeper, this protocol distinguishes between voters and observers. Voters are
 * the only ones who are eligible to handle protocol requests and they are the only ones
 * who take part in elections.
 *
 * These are the APIs in this protocol:
 * ...
 * 2) {@link BeginQuorumEpochRequestData}: Sent by the leader of an epoch only to valid voters to
 *    assert its leadership of the new epoch. This request will be retried indefinitely for
 *    each voter until it acknowledges the request or a new election occurs.
 *
 *    This is not needed in usual Raft because the leader can use an empty data push
 *    to achieve the same purpose. The Kafka Raft implementation, however, is driven by
 *    fetch requests from followers, so there must be a way to find the new leader after
 *    an election has completed.
 * ...
 */
raft/src/main/java/org/apache/kafka/raft/KafkaRaftClient.java 129–168행
(줄인 자리는 나머지 API — 1) Vote, 3) EndQuorumEpoch, 4) Fetch, 5) FetchSnapshot — 의 설명입니다.)
정리하면 이렇습니다. 교과서 Raft 에서는 리더가 팔로워에게 레코드를 밀어 넣습니다(AppendEntries). Kafka 는 반대로 팔로워가 리더에게 가져갑니다(Fetch). 9편의 팔로워 복제, 8편의 컨슈머와 같은 방식입니다. 대신 리더가 먼저 말을 걸 수단이 없으니, 선거가 끝나면 "내가 새 리더다"를 알리는 BeginQuorumEpoch 를 따로 둡니다. javadoc 이 꼽는 요청은 다섯 가지 — Vote, BeginQuorumEpoch, EndQuorumEpoch, Fetch, FetchSnapshot — 이고(쿼럼 상태를 묻는 DescribeQuorum 과 투표자를 바꾸는 요청도 같은 길로 들어옵니다), 컨트롤러의 요청 분배기 ControllerApis.handle() 의 match 에 case ApiKeys.VOTE => handleVote(request) 처럼 나란히 있습니다(ControllerApis.scala 96–109행, match 는 2편에서 풀었습니다). 이 갈래들은 모두 handleRaftRequest() 로 모여 raftManager.handleRequest(...) 를 부릅니다(707–714행).
스레드 하나가 poll() 을 돈다
KafkaRaftClientDriver 는 스레드 이름 끝에 -io-thread 를 붙여(55행) kafka-1-raft-io-thread 같은 스레드를 만들고, 그 스레드가 하는 일은 이것뿐입니다.
    @Override
    public void doWork() {
        try {
            client.poll();
        } catch (Throwable t) {
            throw fatalFaultHandler.handleFault("Unexpected error in raft IO thread", t);
        }
    }
raft/src/main/java/org/apache/kafka/raft/KafkaRaftClientDriver.java 61–68행
doWork() 는 부모 클래스 ShutdownableThread 가 멈추라는 신호가 올 때까지 되풀이해 부릅니다. poll() 한 번은 "지금 역할에 맞는 일을 하고, 들어온 메시지를 하나 처리하고, 구독자에게 알린다"입니다.
    public void poll() {
        // ...
        long pollStateTimeoutMs = pollCurrentState(startPollTimeMs);
        long cleaningTimeoutMs = snapshotCleaner.maybeClean(startPollTimeMs);
        long pollTimeoutMs = Math.min(pollStateTimeoutMs, cleaningTimeoutMs);

        // ...
        var maybeEntry = messageQueue.poll(pollTimeoutMs);

        long endWaitTimeMs = time.milliseconds();
        // ...
        maybeEntry.ifPresent(entry -> handleInboundMessage(entry.message(), entry.future(), endWaitTimeMs));

        pollListeners();
    }
raft/src/main/java/org/apache/kafka/raft/KafkaRaftClient.java 3687–3712행
pollCurrentState()— 역할에 따라pollLeader(),pollCandidate(),pollProspective(),pollFollower(),pollUnattached(),pollResigned()중 하나를 부릅니다(3540–3556행의if … else if사슬). 리더라면 쌓인 레코드를 로그에 쓰고BeginQuorumEpoch를 보내며, 팔로워라면 리더에게Fetch를 보내고, 후보라면Vote를 보냅니다. 돌려주는 값은 "다음에 할 일이 생기기까지 남은 시간"입니다.messageQueue.poll(pollTimeoutMs)— 그 시간 동안 들어오는 요청·응답을 기다립니다. 컨트롤러의 요청 처리 스레드가 받은 Raft 요청도, 이 노드가 보낸 요청의 응답도 이 큐로 들어옵니다.pollListeners()— 새로 커밋된 배치가 있으면 구독자(활성·대기 컨트롤러의QuorumController, 브로커의MetadataLoader)에게handleCommit()으로 알립니다. 3절과 5절의 출발점이 여기입니다.
Raft 의 모든 상태는 이 스레드 하나만 바꿉니다. 요청을 받는 스레드는 메시지를 큐에 넣고 future 만 받아 갑니다(messageQueue.add(...), KafkaRaftClient.java 3672–3681행). 4편의 요청 처리 스레드 풀과 다르게, Raft 는 순서가 생명이라 한 줄로 세운 것입니다.
역할과 상태 전이
QuorumState 의 javadoc 은 역할이 어떻게 바뀌는지를 표처럼 적어 둡니다(QuorumState.java 35–83행). 그림으로 옮기면 이렇습니다.
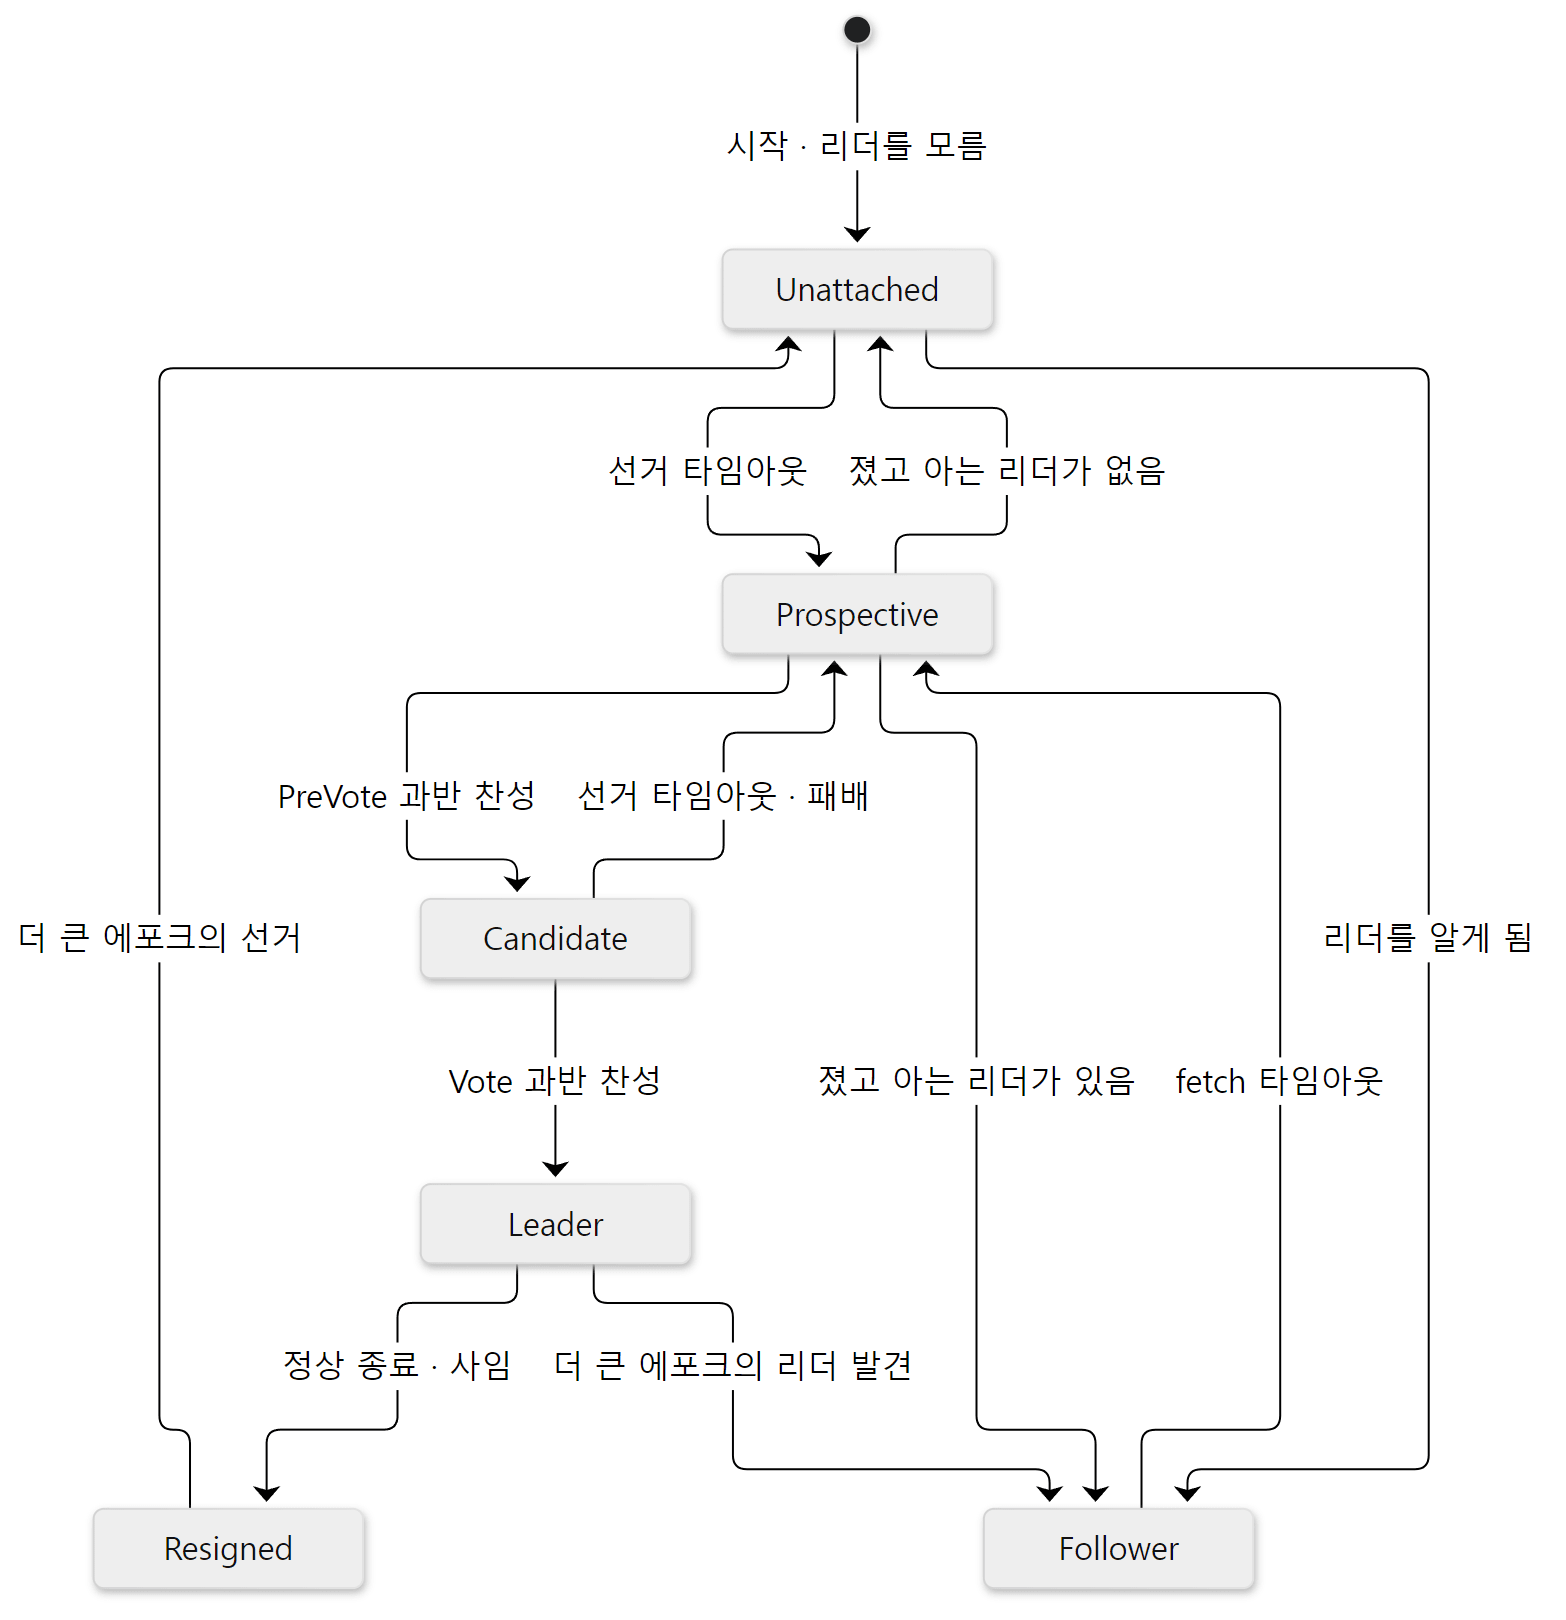 투표자(컨트롤러)의 역할 상태. 그림을 단순하게 하려고 "더 큰 에포크의 선거를 알게 되면 Unattached 로" 같은, 거의 모든 상태에서 나가는 화살표 몇 개는 뺐습니다. 옵서버(브로커)는 Unattached 와 Follower 두 상태만 오갑니다.
상태마다 클래스가 하나씩 있습니다(UnattachedState, ProspectiveState, CandidateState, LeaderState, FollowerState, ResignedState). 교과서 Raft 에 없는 것이 Prospective 입니다. 팔로워가 리더에게서 controller.quorum.fetch.timeout.ms(기본 2,000ms, QuorumConfig.java 79–83행) 동안 소식을 못 들으면 곧바로 후보가 되지 않고, 먼저 PreVote("내가 지금 선거를 하면 나를 뽑아 주겠니?")를 돌립니다. 에포크를 올리지 않는 연습 투표라서, 네트워크가 잠깐 끊겼던 노드 하나가 돌아와 쓸데없이 에포크를 올려 멀쩡한 리더를 끌어내리는 일을 막습니다. 과반이 "그래"라고 해야 Candidate 가 되어 에포크를 하나 올리고(int newEpoch = epoch() + 1;, QuorumState.java 641행) 진짜 Vote 를 보냅니다.
상태를 바꿀 때는 디스크부터 씁니다.
    private void durableTransitionTo(EpochState newState) {
        log.info("Attempting durable transition to {} from {}", newState, state);
        store.writeElectionState(newState.election(), partitionState.lastKraftVersion());
        memoryTransitionTo(newState);
    }
raft/src/main/java/org/apache/kafka/raft/QuorumState.java 729–733행
store.writeElectionState() 가 예제 1에서 본 quorum-state 파일을 씁니다. "에포크 2 에서 102 에게 표를 줬다"를 디스크에 먼저 남겨야, 그 직후에 프로세스가 죽었다 살아나도 같은 에포크에서 다른 후보에게 또 표를 주는(한 에포크에 리더가 둘 생기는) 일이 없습니다. memoryTransitionTo() 가 남기는 Completed transition to … from … 로그 줄(742행)은 예제 2에서 선거를 지켜보는 창이 됩니다.
표를 줄지 정하는 한 줄
Vote 요청을 받은 투표자의 판단은 handleVoteRequest() 에 있습니다.
        if (replicaEpoch > quorum.epoch()) {
            transitionToUnattached(replicaEpoch, OptionalInt.empty());
        }
        // ...
        OffsetAndEpoch lastEpochEndOffsetAndEpoch = new OffsetAndEpoch(lastEpochEndOffset, lastEpoch);
        ReplicaKey replicaKey = ReplicaKey.of(
            replicaId,
            partitionRequest.replicaDirectoryId()
        );
        boolean voteGranted = quorum.canGrantVote(
            replicaKey,
            lastEpochEndOffsetAndEpoch.compareTo(endOffset()) >= 0,
            preVote
        );
raft/src/main/java/org/apache/kafka/raft/KafkaRaftClient.java 896–929행
(줄인 자리는 요청이 이 노드를 겨냥한 것인지 확인하는 코드입니다.)
- 요청의 에포크가 내 에포크보다 크면, 먼저 그 에포크의 Unattached 로 넘어갑니다(새 선거가 시작되었다는 뜻이므로).
lastEpochEndOffsetAndEpoch.compareTo(endOffset()) >= 0— 후보의 로그가 내 로그보다 뒤처지지 않았을 때만 표를 줄 수 있습니다. 비교는 (마지막 에포크, 끝 오프셋) 순서입니다. 커밋된 레코드는 과반이 갖고 있고, 후보는 과반의 표를 받아야 하므로, 이 규칙 하나로 "커밋된 레코드를 모르는 노드는 리더가 될 수 없다"가 보장됩니다.- PreVote 가 아닌 진짜 표를 주면 바로 아래에서 그 사실을 기록합니다(
if (!preVote && voteGranted)안의unattachedAddVotedState(...), 931–937행 → 앞에서 본durableTransitionTo). PreVote 는 기록하지 않습니다.
선거에서 이긴 노드는 onBecomeLeader() 에서 곧바로 컨트롤 레코드를 씁니다(state.appendStartOfEpochControlRecords(currentTimeMs), 주석은 "새 리더의 에포크로 쓴 레코드가 있어야 하이 워터마크를 올릴 수 있으니 곧바로 컨트롤 메시지를 쓴다", KafkaRaftClient.java 670–673행). 예제 1의 오프셋 0 LeaderChange 가 이것이었습니다. 왜 "자기 에포크의 레코드"가 있어야 하이 워터마크를 올릴 수 있는지는 바로 아래에서 봅니다.
Fetch 의 오프셋이 곧 "받았다"는 대답
리더 쪽에서 팔로워의 Fetch 를 처리하는 tryCompleteFetchRequest() 의 핵심입니다.
            final Records records;
            if (validOffsetAndEpoch.kind() == ValidOffsetAndEpoch.Kind.VALID) {
                LogFetchInfo info = log.read(fetchOffset, Isolation.UNCOMMITTED, maxSizeBytes);

                if (state.updateReplicaState(replicaKey, currentTimeMs, info.startOffsetMetadata)) {
                    onUpdateLeaderHighWatermark(state, currentTimeMs);
                }

                records = info.records;
            } else {
                records = MemoryRecords.EMPTY;
            }

            return buildFetchResponse(
                // ...
                state.highWatermark()
            );
raft/src/main/java/org/apache/kafka/raft/KafkaRaftClient.java 1633–1653행
팔로워가 "오프셋 N 부터 주세요"라고 하면, 그것은 "N 앞까지는 다 받았습니다"라는 뜻이기도 합니다. 리더는 updateReplicaState() 로 그 팔로워의 끝 오프셋을 N 으로 기록하고, 그 결과 하이 워터마크가 올랐으면 알립니다. 응답에는 레코드와 함께 지금의 하이 워터마크가 실려 가므로 팔로워도 어디까지 커밋되었는지 압니다. 9편에서 본 데이터 파티션의 팔로워 Fetch 와 같은 설계입니다. 새 데이터가 없으면 응답을 미뤄 두었다가(fetchPurgatory.await(...), 1551행) 데이터가 생기거나 시간이 다 되면 답하는 롱 폴링도 8편의 DelayedFetch 와 같은 생각입니다.
하이 워터마크를 계산하는 곳은 LeaderState.maybeUpdateHighWatermark() 입니다.
    private boolean maybeUpdateHighWatermark() {
        // Find the largest offset which is replicated to a majority of replicas (the leader counts)
        ArrayList<ReplicaState> followersByDescendingFetchOffset = followersByDescendingFetchOffset()
            .collect(Collectors.toCollection(ArrayList::new));

        int indexOfHw = voterStates.size() / 2;
        Optional<LogOffsetMetadata> highWatermarkUpdateOpt = followersByDescendingFetchOffset.get(indexOfHw).endOffset;

        if (highWatermarkUpdateOpt.isPresent()) {

            // The KRaft protocol requires an extra condition on commitment after a leader
            // election. The leader must commit one record from its own epoch before it is
            // allowed to expose records from any previous epoch. This guarantees that its
            // log will contain the largest record (in terms of epoch/offset) in any log
            // which ensures that any future leader will have replicated this record as well
            // as all records from previous epochs that the current leader has committed.

            LogOffsetMetadata highWatermarkUpdateMetadata = highWatermarkUpdateOpt.get();
            long highWatermarkUpdateOffset = highWatermarkUpdateMetadata.offset();

            if (highWatermarkUpdateOffset > epochStartOffset) {
                // ...
raft/src/main/java/org/apache/kafka/raft/LeaderState.java 660–680행
투표자(리더 자신 포함)를 끝 오프셋이 큰 순서로 늘어놓고(ReplicaState.compareTo() 가 내림차순, 1025–1034행) size / 2 번째를 고릅니다. 투표자가 3이면 1번째(0부터 셈) — 두 번째로 앞선 노드의 오프셋, 곧 셋 중 둘이 가진 가장 큰 오프셋입니다. 5면 2번째, 다섯 중 셋이 가진 오프셋입니다. 가장 느린 하나(5대면 둘)를 기다리지 않습니다.
그리고 highWatermarkUpdateOffset > epochStartOffset — 새 리더는 자기 에포크에서 쓴 레코드가 하나 커밋되기 전에는 하이 워터마크를 올리지 않습니다. 앞 에포크에서 남은 레코드가 "과반에 있어 보이는" 것만으로 커밋을 선언하면, 다음 선거에서 그 레코드가 없는 노드가 이길 수 있는 경우가 Raft 논문에 알려져 있습니다(주석이 설명하는 조건이 그것입니다). 그래서 onBecomeLeader() 가 당선 직후 컨트롤 레코드부터 써서, 이 조건이 빨리 채워지게 합니다.
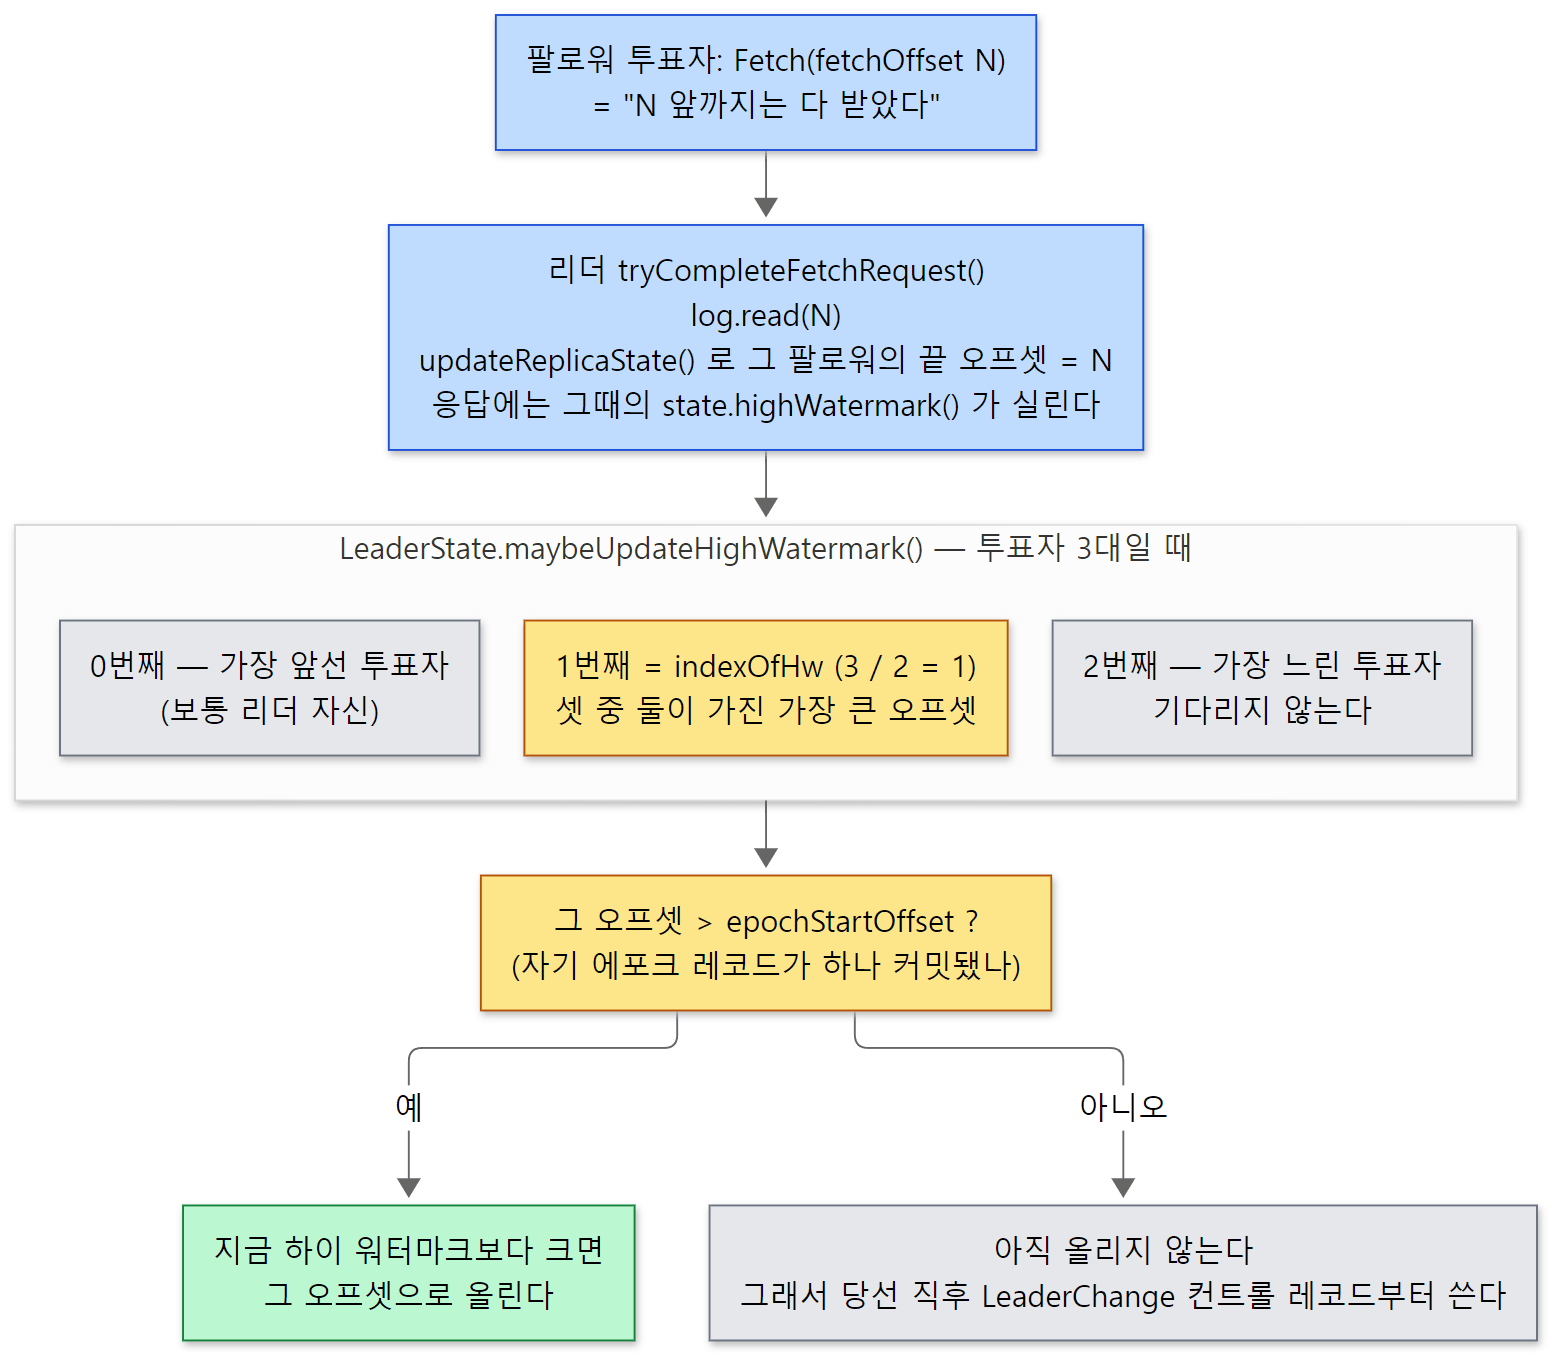 메타데이터 로그의 하이 워터마크는 "과반이 가진 오프셋"이고, 새 리더는 자기 에포크의 레코드가 커밋될 때까지 그것을 올리지 않습니다.
헷갈리기 쉬운 곳: 데이터 파티션의 HW 와 메타데이터 로그의 HW 는 기준이 다르다
| 데이터 파티션 (9편) | 메타데이터 로그 (이 글) | |
|---|---|---|
| 복제 방식 | 팔로워가 리더에게 Fetch | 같다 (팔로워·옵서버가 리더에게 Fetch) |
| 리더를 정하는 것 | 컨트롤러가 정해 메타데이터 레코드로 알림 | 투표자끼리 Vote 로 선거 |
| HW 기준 | ISR 전원의 끝 오프셋 중 가장 작은 값 | 투표자 과반이 가진 오프셋 |
| 느린 복제본 | ISR 에서 빼서 기다리지 않음(AlterPartition) | 과반만 있으면 기다리지 않음 |
같은 Fetch 를 쓰지만 "누가 리더를 정하느냐"가 다릅니다. 데이터 파티션은 바깥(컨트롤러)이 정해 주므로 ISR 이라는 유연한 집합을 쓸 수 있고, 메타데이터 로그는 자기 자신이 클러스터의 맨 밑바닥이라 기댈 바깥이 없으니 과반 투표로 스스로 정합니다. 그래서 컨트롤러는 보통 3대나 5대를 둡니다. 3대면 1대, 5대면 2대가 죽어도 과반이 남습니다.
예제 2: 컨트롤러 3대에서 리더를 죽여 선거를 지켜보기
컨트롤러 3대(node 101·102·103, 포트 9093·9095·9097)와 브로커 1대(node 1)를 띄웁니다. 연재 공용 도우미(kafka_cluster3)는 컨트롤러가 1대뿐이라 설정 파일을 run.sh 에서 직접 쓰고, 세 컨트롤러를 같은 --initial-controllers "101@localhost:9093:<디렉터리id>,102@…,103@…" 로 포맷합니다. 쿼럼을 확인하고 토픽을 하나 만든 뒤, 리더 컨트롤러를 kill -9 로 죽이고 15초 기다립니다. 스크립트는 ex/u10-quorum3/run.sh 입니다.
=== quorum status
LeaderId:               101
LeaderEpoch:            1
HighWatermark:          57
CurrentVoters:          [{"id": 101, "directoryId": "_pdRJ3m8RC2kDhEtIiQPKg", "endpoints": ["CONTROLLER://localhost:9093"]}, {"id": 102, "directoryId": "NAtqshP9S760aRSGrKw9GA", "endpoints": ["CONTROL
CurrentObservers:       [{"id": 1, "directoryId": "OwKvqSLAVEgnDd_0Rh5V3Q"}]
leader controller: 101
=== quorum replication (voters and the observer)
NodeId	LogEndOffset	Lag	Status
101   	86          	0  	Leader
102   	85          	1  	Follower
103   	85          	1  	Follower
1     	86          	0  	Observer
=== create topic orders
Created topic orders.
=== 'Replayed TopicRecord' on every controller (active and standby)
node 101: INFO [QuorumController id=101] Replayed TopicRecord for topic orders with topic ID lVgPP2VQS7uVa6RLnyF7uQ. (or
node 102: INFO [QuorumController id=102] Replayed TopicRecord for topic orders with topic ID lVgPP2VQS7uVa6RLnyF7uQ. (or
node 103: INFO [QuorumController id=103] Replayed TopicRecord for topic orders with topic ID lVgPP2VQS7uVa6RLnyF7uQ. (or
=== elections so far (CandidateState transitions in all controller logs): 1
=== kill -9 the leader controller (101, epoch 1) at 05:03:33
LeaderId:               102
LeaderEpoch:            2
HighWatermark:          146
=== state transitions logged by node 102 after the kill (new leader: 102)
05:03:34,908  FollowerState -> ProspectiveState  epoch=1
05:03:35,022  ProspectiveState -> CandidateState  epoch=2
05:03:35,135  CandidateState -> Leader  epoch=2
=== state transitions logged by node 103 after the kill (new leader: 102)
05:03:34,907  FollowerState -> ProspectiveState  epoch=1
05:03:35,077  ProspectiveState -> UnattachedState  epoch=2
05:03:35,104  UnattachedState -> UnattachedState  epoch=2
05:03:35,227  UnattachedState -> FollowerState  epoch=2
=== quorum-state files of the two survivors
node 102: {"leaderId":102,"leaderEpoch":2,"votedId":-1,"votedDirectoryId":"AAAAAAAAAAAAAAAAAAAAAA","data_version":1}
node 103: {"leaderId":102,"leaderEpoch":2,"votedId":102,"votedDirectoryId":"NAtqshP9S760aRSGrKw9GA","data_version":1}
=== the cluster still works with 2 of 3 controllers
Created topic payments.
(시각·id·오프셋·누가 리더가 되는지는 실행마다 다릅니다. 긴 줄은 스크립트에서 잘랐습니다. 상태 전이 줄은 server.log 의 Completed transition to … 줄에서 시각·상태 이름·에포크만 뽑은 것입니다.)
--replication의Lag은 투표자마다 리더보다 몇 레코드 뒤에 있나입니다. 브로커 1은Observer로 나옵니다.Replayed TopicRecord줄이 세 컨트롤러 모두에 찍혔습니다. 레코드를 만든 것은 활성 컨트롤러 101 뿐이지만, 대기 컨트롤러 102·103 도 커밋된 레코드를 받아 같은 메모리 상태를 만들어 둡니다(3절의handleCommit()).- 101을 죽이고(스크립트는 초 단위로만 찍었습니다) 2초가 되기 전(05:03:34.9) 102와 103이 거의 같은 순간에 fetch 타임아웃으로 Prospective 가 되었습니다. 102가 먼저 Candidate(에포크 2)가 되어
Vote를 보냈고, 103은 더 큰 에포크의 요청을 받아 Unattached(에포크 2)로 넘어간 뒤(앞에서 본 896–897행), 표를 주며 한 번 더 Unattached(투표함)로 바뀌었습니다(931–933행). 102는 자기 표와 103의 표로 셋 중 둘을 얻어 Leader 가 되었고, 103은BeginQuorumEpoch를 받고 Follower 가 되었습니다. Prospective 가 된 때부터 새 리더가 나오기까지 0.23초, 죽인 때부터 따지면 2초 안팎입니다. quorum-state파일에서 103은"votedId":102를 기억하고 있습니다.durableTransitionTo()가 디스크에 남긴 표입니다.- 컨트롤러가 둘만 남아도(셋 중 둘 = 과반) 토픽 만들기가 됩니다.
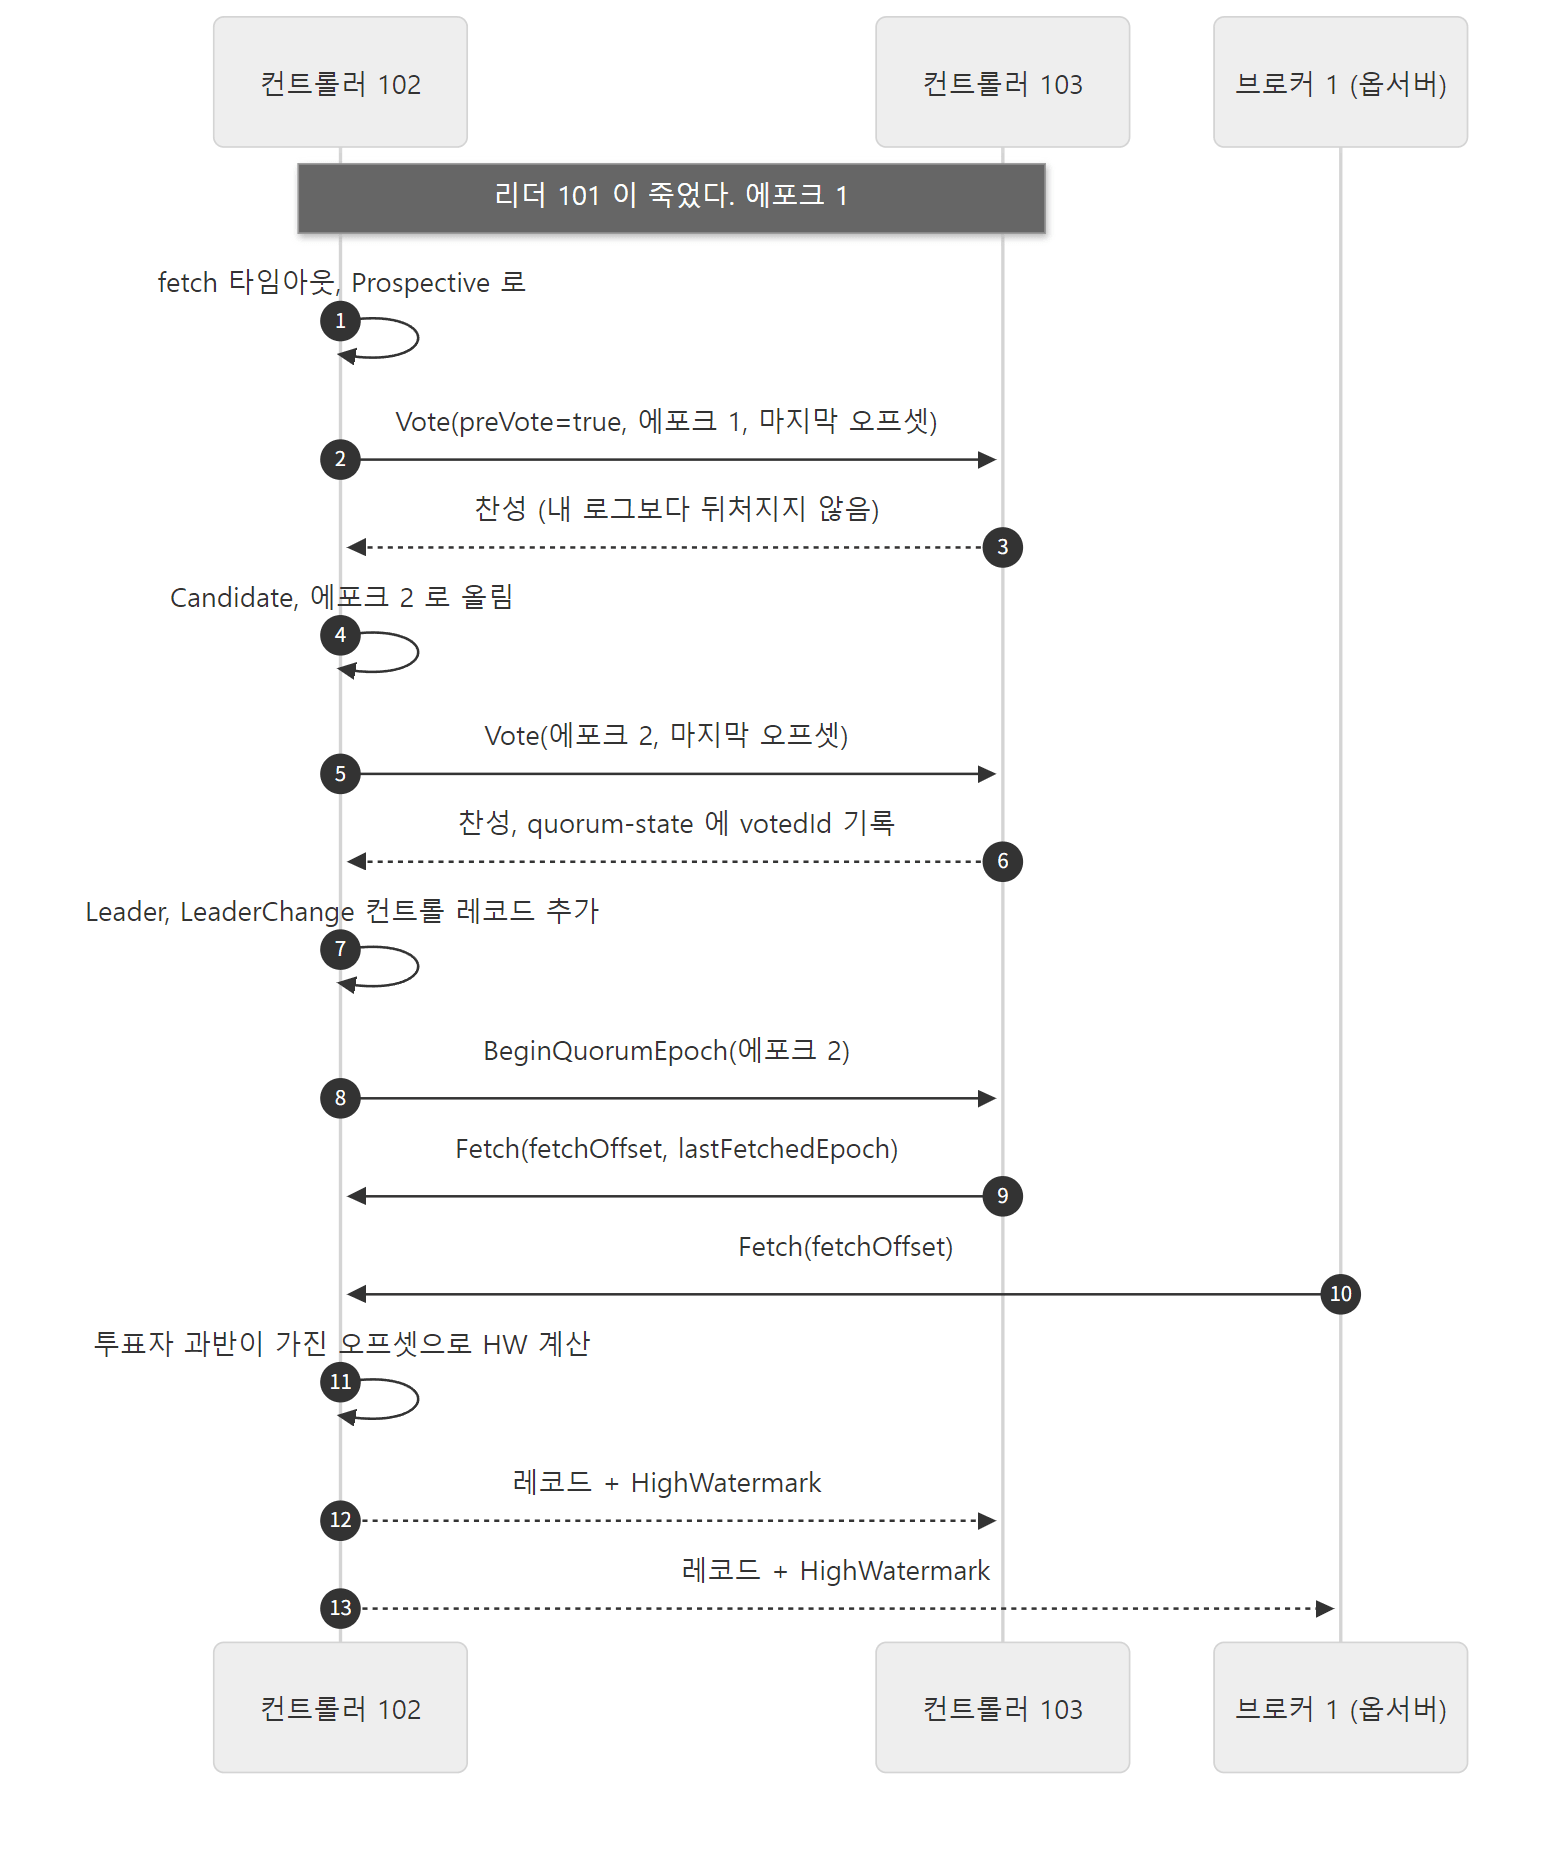 예제 2와 같은 노드 번호로 그린 선거 한 번. 실제 실행에서는 103 도 동시에 Prospective 가 되었는데, 그림에서는 102 가 PreVote 를 보내는 쪽만 그렸습니다.
헷갈리기 쉬운 곳: 선거가 한 번에 끝나지 않을 때가 있다
리더를 에포크 1에서 죽인 실행이 세 번이었는데, 위에 실은 마지막 실행 말고 앞의 두 번은 새 리더가 에포크 3 에서 나왔습니다. 그때 새 리더의 로그는 ProspectiveState -> CandidateState epoch=2 다음에 CandidateState -> ProspectiveState epoch=2 가 있고, 다시 -> CandidateState epoch=3 → -> Leader epoch=3 이었습니다. 에포크 2 선거가 시간 안에 과반을 얻지 못해(그림의 Candidate → Prospective: 선거 타임아웃 · 패배) 한 번 더 한 것입니다. 실패한 이유가 둘이 동시에 후보가 되어 표가 갈렸기 때문인지는 그 실행에서 다른 노드의 로그를 남기지 않아 확인하지 못했습니다(마지막 실행부터 두 노드의 로그를 모두 찍게 고쳤습니다). 선거 타임아웃은 controller.quorum.election.timeout.ms(기본 1,000ms)에 0~그 값 사이의 무작위 시간을 더해 노드마다 다르게 잡으므로(electionTimeoutMs + random.nextInt(electionTimeoutMs), QuorumState.java 745–749행), 다음 판에는 보통 한쪽이 먼저 나서서 끝납니다. 에포크 숫자가 2씩 뛰었다고 이상한 것이 아닙니다.
또 하나, 처음 돌렸을 때는 같은 PC 에서 다른 컨테이너 여러 개가 함께 돌아 기계가 몹시 느렸고, 죽이기도 전에 에포크가 6까지 올라가 있었습니다(describe --replication 은 시간 초과로 실패했습니다). fetch 타임아웃이 2초뿐이라 JVM 이 몇 초 멈추면 멀쩡한 리더도 죽은 것으로 보입니다. 그래서 스크립트가 죽이기 직전에 리더와 에포크를 다시 묻고, 그때까지의 선거 횟수(elections so far)를 찍게 고쳤습니다.
3. QuorumController — 이벤트 큐 위의 스레드 하나
큐 하나, 스레드 하나
2편 4절에서 "QuorumController 는 단일 스레드다"라는 javadoc 을 봤습니다. 그 스레드는 server-common 의 KafkaEventQueue 가 생성자에서 하나 만들어 띄웁니다(new KafkaThread(threadNamePrefix + EVENT_HANDLER_THREAD_SUFFIX, …), KafkaEventQueue.java 483–488행). EVENT_HANDLER_THREAD_SUFFIX 는 "event-handler"(43행)이고, ControllerServer 가 넘기는 접두어가 quorum-controller-<노드 id>- 라서(ControllerServer.scala 242행) 2편 예제의 quorum-controller-1-event-handler 가 됩니다. 이 큐는 컨트롤러 전용이 아닙니다. 브로커의 MetadataLoader(…metadata-loader-event-handler), BrokerLifecycleManager, 스냅숏을 만드는 SnapshotGenerator 도 같은 클래스로 자기 스레드 하나씩을 둡니다. KRaft 쪽 코드는 거의 전부 "상태는 스레드 하나만 만지고, 다른 스레드는 이벤트를 넣는다"는 같은 틀로 짜여 있습니다.
그 스레드가 도는 handleEvents() 의 가운데는 이렇습니다.
                    if (head.next == head) {
                        if (deadlineMap.isEmpty() && (shuttingDown || interrupted)) {
                            // If there are no more entries to process, and the queue is
                            // closing, exit the thread.
                            return;
                        }
                    } else {
                        if (interrupted) {
                            toDeliver = new InterruptedException("The event handler thread is interrupted");
                        } else {
                            toDeliver = null;
                        }
                        toRun = head.next;
                        remove(toRun);
                        continue;
                    }
server-common/src/main/java/org/apache/kafka/queue/KafkaEventQueue.java 266–281행
연결 리스트의 맨 앞(head.next)을 하나 꺼내 toRun 에 두고 다시 돌면, 루프 맨 위(216–218행)에서 락을 놓은 채로 그 이벤트를 실행합니다. 큐에 넣고 빼는 것만 락으로 지키고, 이벤트 자체는 한 번에 하나씩 한 스레드에서 돌기 때문에 컨트롤러의 상태(토픽 목록, 브로커 등록 정보…)에는 락이 하나도 없습니다. 위에서 줄인 부분(231–265행)은 마감 시간이 지난 이벤트에 TimeoutException 을 건네고, 미뤄 둔(deferred) 이벤트를 때가 되면 꺼내는 코드입니다. 스레드 하나가 이벤트를 차례로 처리해 락을 없애는 생각은 nginx 연재의 이벤트 루프와도 닮았습니다.
ControllerResult = 레코드 목록 + 응답
컨트롤러의 쓰기 작업은 모두 같은 모양의 값을 돌려줍니다.
class ControllerResult<T> {
    private final List<ApiMessageAndVersion> records;
    private final T response;
    private final boolean isAtomic;
metadata/src/main/java/org/apache/kafka/controller/ControllerResult.java 27–30행
ReplicationControlManager.createTopics() 는 토픽을 "만들지" 않습니다. 만들려면 로그에 무엇을 써야 하는지(레코드 목록)와 다 되면 클라이언트에게 무엇이라고 답할지(응답)만 계산해 돌려줍니다. 실제로 상태를 바꾸는 것은 따로 있는 replay(레코드) 입니다. 이렇게 "결정"과 "적용"을 나눠 두었기 때문에, 활성 컨트롤러가 결정한 것을 대기 컨트롤러와 브로커가 레코드만 받아 똑같이 적용할 수 있습니다. isAtomic 은 레코드들을 한 배치에 넣어 다 같이 쓰이거나 다 같이 안 쓰이게 하라는 표시입니다.
쓰기 이벤트 하나의 일생
appendWriteEvent() 는 ControllerWriteEvent 를 만들어 큐에 넣고 그 future 를 돌려줄 뿐입니다(952–965행). 큐에서 꺼내진 이벤트의 run() 이 진짜 일을 합니다.
            ControllerResult<T> result = op.generateRecordsAndResult();
            if (result.records().isEmpty()) {
                // ...
            } else {
                // Pass the records to the Raft layer. This will start the process of committing
                // them to the log.
                long offset = appendRecords(log, result, maxRecordsPerBatch,
                    records -> {
                        // Start by trying to apply the record to our in-memory state. This should always
                        // succeed; if it does not, that's a fatal error. It is important to do this before
                        // scheduling the record for Raft replication.
                        int recordIndex = 0;
                        long lastOffset = raftClient.prepareAppend(controllerEpoch, records);
                        long baseOffset = lastOffset - records.size() + 1;
                        for (ApiMessageAndVersion message : records) {
                            long recordOffset = baseOffset + recordIndex;
                            try {
                                replay(message.message(), Optional.empty(), recordOffset);
                            } catch (Throwable e) {
                                // ...
                            }
                            recordIndex++;
                        }
                        raftClient.schedulePreparedAppend();
                        offsetControl.handleScheduleAppend(lastOffset);
                        return lastOffset;
                    }
                );
                op.processBatchEndOffset(offset);
                resultAndOffset = ControllerResultAndOffset.of(offset, result);
                // ...
            }

            // Remember the latest offset and future if it is not already completed
            if (!future.isDone()) {
                deferredEventQueue.add(resultAndOffset.offset(), this);
            }
metadata/src/main/java/org/apache/kafka/controller/QuorumController.java 792–853행
(줄인 자리는 레코드가 없는 읽기 전용 작업의 처리, 적용 실패를 치명적 오류로 다루는 코드, 디버그 로그입니다.)
generateRecordsAndResult()—ControllerResult를 만듭니다(createTopics()라면TopicRecord+PartitionRecord들).raftClient.prepareAppend()— 레코드를 Raft 의 배치 누적기(BatchAccumulator)에 넣고 오프셋을 받습니다. 아직 디스크에 쓴 것도, 복제된 것도 아닙니다.replay()— 주석이 강조하듯 커밋되기 전에 자기 메모리에 먼저 적용합니다. 그래야 바로 다음 이벤트(예: 같은 이름의 토픽을 또 만들기)가 방금 결정을 반영한 상태를 봅니다. 예제 1·2의Replayed TopicRecord로그가 이replay()에서 나왔습니다.schedulePreparedAppend()와handleScheduleAppend(lastOffset)— Raft 에 "이제 써도 된다"고 알리고, 그 오프셋에 메모리 스냅숏을 하나 만듭니다(4절).deferredEventQueue.add(offset, this)— future 는 아직 완료하지 않고 "오프셋offset이 커밋되면 깨워 달라"고 줄을 세웁니다. 2편에서 본 "결과가 메타데이터 로그에 기록된 뒤에야 future 가 완료된다"가 이것입니다.
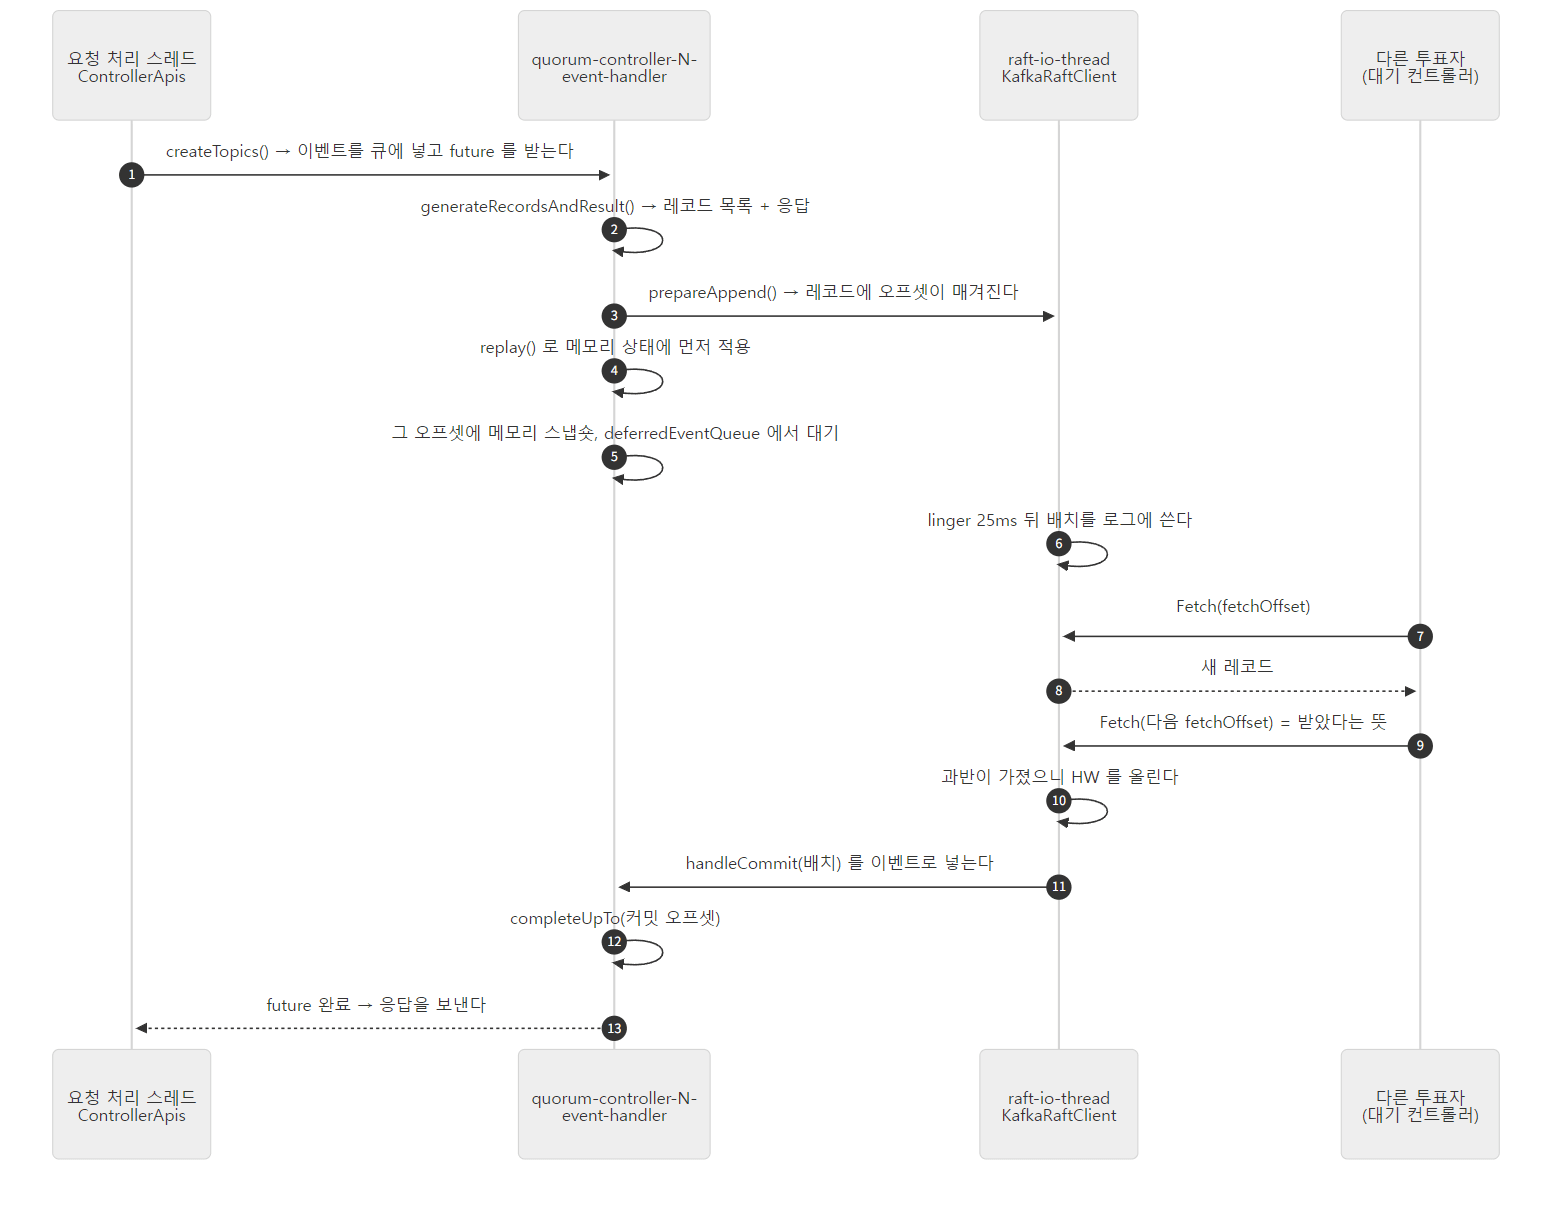 스레드 세 개와 다른 투표자 하나가 쓰기 하나를 나눠 맡습니다. 6의 25ms 는
controller.quorum.append.linger.ms 의 기본값입니다(DEFAULT_QUORUM_LINGER_MS = 25, QuorumConfig.java 94행). 프로듀서의 linger.ms(5편)처럼 조금 모아서 씁니다.
커밋이 오면: 활성은 future 를 깨우고, 대기는 다시 적용한다
KafkaRaftClient 의 pollListeners() 가 부르는 QuorumMetaLogListener.handleCommit() 입니다.
        public void handleCommit(BatchReader<ApiMessageAndVersion> reader) {
            appendRaftEvent("handleCommit[baseOffset=" + reader.baseOffset() + "]", () -> {
                try {
                    boolean isActive = isActiveController();
                    while (reader.hasNext()) {
                        Batch<ApiMessageAndVersion> batch = reader.next();
                        long offset = batch.lastOffset();
                        int epoch = batch.epoch();
                        List<ApiMessageAndVersion> messages = batch.records();

                        if (messages.isEmpty()) {
                            // ...
                        } else if (isActive) {
                            // If the controller is active, the records were already replayed,
                            // so we don't need to do it here.
                            log.debug("Completing purgatory items up to offset {} and epoch {}.", offset, epoch);

                            // Advance the committed and stable offsets then complete any pending purgatory
                            // items that were waiting for these offsets.
                            offsetControl.handleCommitBatch(batch);
                            deferredEventQueue.completeUpTo(offsetControl.lastStableOffset());
                        } else {
                            // If the controller is a standby, replay the records that were
                            // created by the active controller.
                            // ... (레코드마다 replay(message.message(), Optional.empty(), recordOffset))
                            offsetControl.handleCommitBatch(batch);
                        }
                    }
                } finally {
                    reader.close();
                }
            });
        }
metadata/src/main/java/org/apache/kafka/controller/QuorumController.java 969–1020행
appendRaftEvent(...)—handleCommit()은 raft-io-thread 에서 불리지만, 일은 바로 하지 않고 컨트롤러의 이벤트 큐에 넣습니다. 컨트롤러의 상태는 이벤트 스레드만 만지기 때문입니다.- 활성 컨트롤러는 이미
replay()를 했으니 다시 하지 않고, 커밋 오프셋을 올린 뒤completeUpTo()로 그 오프셋까지 기다리던 쓰기 이벤트의 future 를 모두 완료합니다. 이때ControllerApis가 클라이언트에게 응답을 보냅니다. - 대기 컨트롤러는 같은 레코드를 여기서
replay()합니다. 대기 컨트롤러는 커밋된 것만 적용하므로 되돌릴 일이 없습니다. 예제 2에서 102·103 에도Replayed TopicRecord가 찍힌 길입니다.
replay() 는 레코드 종류로 갈래를 나눠 담당 관리자에게 넘기는 switch 입니다(case TOPIC_RECORD: replicationControl.replay((TopicRecord) message); 처럼, QuorumController.java 1240–1262행). 관리자는 영역마다 하나씩 있습니다 — 브로커 등록은 ClusterControlManager, 토픽·파티션은 ReplicationControlManager, 설정은 ConfigurationControlManager, 기능 판(feature level)은 FeatureControlManager …
4. 되돌릴 수 있는 메모리 — SnapshotRegistry 와 TimelineHashMap
먼저 적용했는데 커밋이 안 되면?
3절에서 활성 컨트롤러는 레코드를 커밋 전에 메모리에 적용했습니다. 그런데 커밋되기 전에 이 컨트롤러가 리더 자리를 잃으면(네트워크가 끊겨 다른 노드가 더 큰 에포크로 당선되면) 어떻게 될까요. 그 레코드는 새 리더의 로그에 없을 수 있고, 새 리더를 따라 잘려 나갑니다. 그러면 메모리에 먼저 반영해 둔 것도 없던 일로 해야 합니다.
컨트롤러의 상태 자료구조가 일반 HashMap 이 아니라 TimelineHashMap 인 이유가 이것입니다.
    /**
     * Maps topic names to topic UUIDs.
     */
    private final TimelineHashMap<String, Uuid> topicsByName;
    // ...
    /**
     * Maps topic UUIDs to structures containing topic information, including partitions.
     */
    private final TimelineHashMap<Uuid, TopicControlInfo> topics;
metadata/src/main/java/org/apache/kafka/controller/ReplicationControlManager.java 336–361행
replay(TopicRecord) 는 이 맵들에 put 할 뿐입니다(topicsByName.put(record.name(), record.topicId()), 427행 / topics.put(record.topicId(), new TopicControlInfo(…)), 449–450행). 이 맵들은 생성할 때 공용 SnapshotRegistry 를 받아(416–418행) 거기에 등록됩니다. timeline 패키지의 바탕 클래스 설명(SnapshottableHashTable.java 26–31행)이 방법을 요약합니다. 스냅숏(여기서는 메모리 안의 것)을 찍을 때 맵 전체를 복사하지 않습니다. 스냅숏 뒤에 어떤 항목을 덮어쓰거나 지우면, 그때 옛 값의 참조만 가장 최근 스냅숏 칸에 옮겨 둡니다. 그래서 스냅숏을 자주 찍어도 바뀐 만큼만 메모리를 씁니다. 되돌릴 때는 옮겨 둔 옛 값들을 제자리로 돌려놓습니다. 이 "메모리 스냅숏"은 5절의 디스크 스냅숏(.checkpoint)과 이름만 같고 다른 것입니다.
스냅숏을 찍고 지우고 되돌리는 시점
QuorumController 는 이 스냅숏을 오프셋으로 찍습니다. 시점을 정하는 것은 OffsetControlManager 입니다. 레코드를 적용한 뒤 부르는 handleScheduleAppend(lastOffset) 가 snapshotRegistry.idempotentCreateSnapshot(lastOffset) 으로 그 오프셋에 스냅숏을 찍고(OffsetControlManager.java 302–305행), 커밋이 오면 이렇게 합니다.
    void maybeAdvanceLastStableOffset() {
        long newLastStableOffset;
        if (transactionStartOffset == -1L) {
            newLastStableOffset = lastCommittedOffset;
        } else {
            newLastStableOffset = Math.min(transactionStartOffset - 1, lastCommittedOffset);
        }
        if (lastStableOffset < newLastStableOffset) {
            lastStableOffset = newLastStableOffset;
            snapshotRegistry.deleteSnapshotsUpTo(lastStableOffset);
            if (!active()) {
                snapshotRegistry.idempotentCreateSnapshot(lastStableOffset);
            }
        }
    }
metadata/src/main/java/org/apache/kafka/controller/OffsetControlManager.java 319–333행
- 활성 컨트롤러가 되기 직전(
activate())에 마지막 커밋 오프셋에 스냅숏을 하나 찍어 둡니다(249–252행). - 레코드를 적용할 때마다 그 마지막 오프셋에 스냅숏을 찍습니다(
handleScheduleAppend). - 커밋이 오면 그보다 오래된 스냅숏은 더 쓸 일이 없으니 지웁니다(
deleteSnapshotsUpTo). - 리더 자리를 잃으면(
renounce()→deactivate(), QuorumController.java 1204–1216행) 마지막 커밋 오프셋의 스냅숏으로 되돌립니다(snapshotRegistry.revertToSnapshot(lastStableOffset), OffsetControlManager.java 260–272행). 같은 때deferredEventQueue.failAll(...)로 기다리던 future 들을 "컨트롤러가 아니다" 오류로 끝내므로, 클라이언트는 새 컨트롤러로 다시 보냅니다.
(transactionStartOffset 은 여러 배치에 걸친 레코드 묶음을 위한 메타데이터 트랜잭션입니다. 예제 1의 BEGIN_TRANSACTION_RECORD·END_TRANSACTION_RECORD 는 첫 활성 컨트롤러가 부트스트랩 레코드(기능 판 등)를 한 묶음으로 쓸 때 둘러친 것이고(new BeginTransactionRecord().setName("Bootstrap records"), ActivationRecordsGenerator.java 81행), 12편의 프로듀서 트랜잭션과는 다른 것입니다.)
예제 3: TimelineHashMap 을 직접 써서 되돌리기
서버를 띄우지 않고, 배포판의 libs/kafka-server-common-4.5.0-SNAPSHOT.jar 에 든 SnapshotRegistry·TimelineHashMap 을 그대로 불러 위의 1~4를 같은 순서로 흉내 냅니다(ex/u10-timeline/Timeline.java).
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 활성 컨트롤러가 메타데이터 레코드를 "커밋되기 전에" 메모리에 먼저 적용하고,
// 리더 자리를 잃으면 마지막으로 커밋된 오프셋으로 되돌리는 과정을
// QuorumController·OffsetControlManager 와 같은 순서로 흉내 낸다.
import org.apache.kafka.common.utils.internals.LogContext;
import org.apache.kafka.timeline.SnapshotRegistry;
import org.apache.kafka.timeline.TimelineHashMap;
// ...
public class Timeline {
    static SnapshotRegistry registry = new SnapshotRegistry(new LogContext());
    // ReplicationControlManager.topicsByName 처럼 "토픽 이름 → 토픽 id" 를 든 맵
    static TimelineHashMap<String, String> topicsByName = new TimelineHashMap<>(registry, 0);

    public static void main(String[] args) {
        // 오프셋 10까지는 이미 커밋된 상태라고 하자
        topicsByName.put("orders", "id-A");
        // activate(): 활성 컨트롤러가 되기 전에 마지막 커밋 오프셋(10)에 스냅숏을 만든다
        registry.idempotentCreateSnapshot(10);
        print("committed up to 10");

        // 레코드 11: TopicRecord(payments) 를 적용하고, handleScheduleAppend(11) 처럼 스냅숏 11
        topicsByName.put("payments", "id-B");
        registry.idempotentCreateSnapshot(11);
        // 레코드 12: RemoveTopicRecord(orders) 를 적용하고 스냅숏 12
        topicsByName.remove("orders");
        registry.idempotentCreateSnapshot(12);
        print("applied 11, 12 (not committed)");

        // 지난 시점의 값도 읽을 수 있다 — get(key, epoch)
        System.out.println("  as of 10: orders=" + topicsByName.get("orders", 10)
            + " payments=" + topicsByName.get("payments", 10));
        System.out.println("  as of 11: orders=" + topicsByName.get("orders", 11)
            + " payments=" + topicsByName.get("payments", 11));

        // Raft 가 11까지 커밋했다 → maybeAdvanceLastStableOffset(): 11보다 오래된 스냅숏을 지운다
        registry.deleteSnapshotsUpTo(11);
        print("committed up to 11");

        // 12가 커밋되기 전에 리더 자리를 잃었다 → deactivate(): 마지막 커밋 오프셋(11)으로 되돌린다
        registry.revertToSnapshot(11);
        print("lost leadership, reverted to 11");
    }
    // ... print(): 지금 맵의 내용과 registry.epochsList() 를 한 줄로 찍는다
}
=== jar that holds org.apache.kafka.timeline
kafka-server-common-4.5.0-SNAPSHOT.jar
=== Timeline.java
committed up to 10                 current={orders=id-A} snapshots=[10]
applied 11, 12 (not committed)     current={payments=id-B} snapshots=[10, 11, 12]
  as of 10: orders=id-A payments=null
  as of 11: orders=id-A payments=id-B
committed up to 11                 current={payments=id-B} snapshots=[11, 12]
lost leadership, reverted to 11    current={orders=id-A, payments=id-B} snapshots=[11]
- 레코드 12(
orders지우기)를 적용한 뒤에도get("orders", 11)은id-A를 돌려줍니다. 스냅숏 11 칸에 옛 값의 참조가 옮겨져 있기 때문입니다. 컨트롤러가describeConfigs같은 읽기 요청에 커밋된 시점의 값으로 답할 때 이 기능을 씁니다(configurationControl.describeConfigs(offsetControl.lastStableOffset(), resources), QuorumController.java 1884행). - 11까지 커밋되자 스냅숏 10이 사라졌습니다(
deleteSnapshotsUpTo(11)은 11보다 작은 것만 지웁니다,SnapshotRegistry.java297–305행). - 리더 자리를 잃고 11로 되돌리자, 커밋되지 않은 레코드 12의 효과(
orders삭제)만 사라지고 커밋된 11의 효과(payments)는 남았습니다.
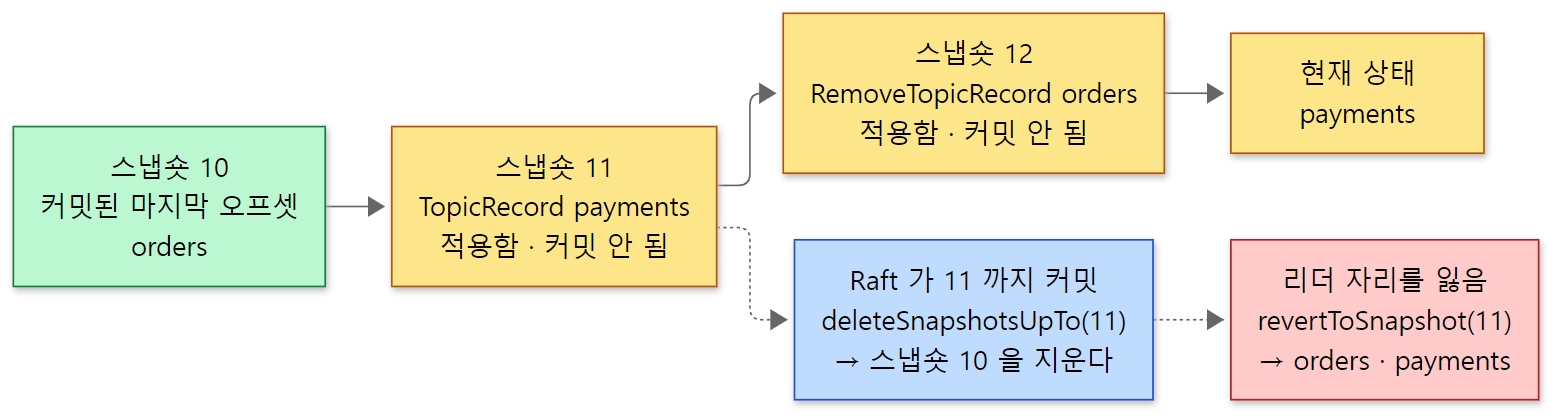 예제 3이 지나간 길. 초록은 커밋된 상태, 노랑은 적용했지만 커밋되지 않은 상태, 파랑은 커밋이 왔을 때 하는 일, 빨강은 리더 자리를 잃었을 때의 되돌리기입니다.
헷갈리기 쉬운 곳: 스냅숏 N 은 "레코드 N 까지 적용한 뒤"의 상태다
handleScheduleAppend(lastOffset) 는 레코드를 replay() 한 다음에 불립니다(3절 발췌의 순서). 그래서 스냅숏 11은 "레코드 11을 적용하기 전"이 아니라 "레코드 11까지 적용한 뒤"의 상태이고, revertToSnapshot(lastStableOffset) 은 "커밋된 마지막 레코드까지 적용한 상태"로 돌아갑니다. 예제 3에서도 put("payments") 를 한 뒤에 idempotentCreateSnapshot(11) 을 불렀습니다. 순서를 거꾸로 하면 되돌릴 때 커밋된 레코드 하나가 함께 사라집니다.
5. 브로커가 장부를 읽는 법 — MetadataLoader, MetadataDelta, MetadataImage
브로커는 레코드를 "이미지"로 바꿔 둔다
SharedServer 가 만드는 MetadataLoader 는 Raft 의 또 다른 구독자입니다. 클래스 설명은 "RaftClient 가 주는 변화를 따라가 구독자(publisher)가 쓸 수 있는 메타데이터 델타와 이미지로 묶는다, 구독자 호출은 로더의 스레드 하나에서 설치된 순서대로 한다, 구독자는 받은 자료구조를 고치면 안 된다"입니다(MetadataLoader.java 63–70행). 새 낱말이 둘입니다.
MetadataImage(메타데이터 이미지): 어느 오프셋까지의 장부 전체를 담은 불변 객체입니다. Java 레코드(record) 클래스로, 기능 판·클러스터(브로커들)·토픽·설정·쿼터·프로듀서 id·ACL·SCRAM·위임 토큰 이미지를 필드로 갖습니다(MetadataImage.java 31–34행). 한 번 만들어지면 바뀌지 않으므로 여러 스레드가 락 없이 읽어도 됩니다. 2편에서 본KRaftMetadataCache가Metadata요청에 답할 때 읽는 것이 이 이미지입니다.MetadataDelta(메타데이터 델타): 이전 이미지에 레코드들을 적용해 생긴 차이입니다.replay(레코드)를 받으면 그 레코드가 건드리는 영역의 델타만 만들어 쌓습니다(case TOPIC_RECORD: replay((TopicRecord) record);→getOrCreateTopicsDelta().replay(record), MetadataDelta.java 195–209행, 287–289행).
커밋된 배치가 오면 로더는 자기 이벤트 스레드에서 이렇게 합니다.
    @Override
    public void handleCommit(BatchReader<ApiMessageAndVersion> reader) {
        eventQueue.append(() -> {
            try (reader) {
                while (reader.hasNext()) {
                    Batch<ApiMessageAndVersion> batch = reader.next();
                    loadControlRecords(batch);
                    long elapsedNs = batchLoader.loadBatch(batch, currentLeaderAndEpoch);
                    // ...
                }
                batchLoader.maybeFlushBatches(currentLeaderAndEpoch, true);
            } catch (Throwable e) {
                // ...
            }
        });
    }
metadata/src/main/java/org/apache/kafka/image/loader/MetadataLoader.java 395–414행
batchLoader.loadBatch() 가 배치 안의 레코드를 델타에 replay() 하고, maybeFlushBatches() 가 모인 델타로 새 이미지를 만들어 구독자에게 넘깁니다(maybePublishMetadata() 의 publisher.onMetadataUpdate(delta, image, manifest), 362–370행). 새 이미지를 만드는 MetadataDelta.apply() 는 영역마다 if (featuresDelta == null) { newFeatures = image.features(); } else { newFeatures = featuresDelta.apply(); } 같은 꼴의 갈래를 늘어놓습니다(MetadataDelta.java 395–413행 이하). 델타가 없는 영역은 이전 이미지의 객체를 그대로 씁니다. 토픽 하나를 만들어도 클러스터·설정·ACL 이미지는 새로 만들지 않고 이전 것을 공유합니다. 불변 객체이기 때문에 이렇게 나눠 써도 안전합니다.
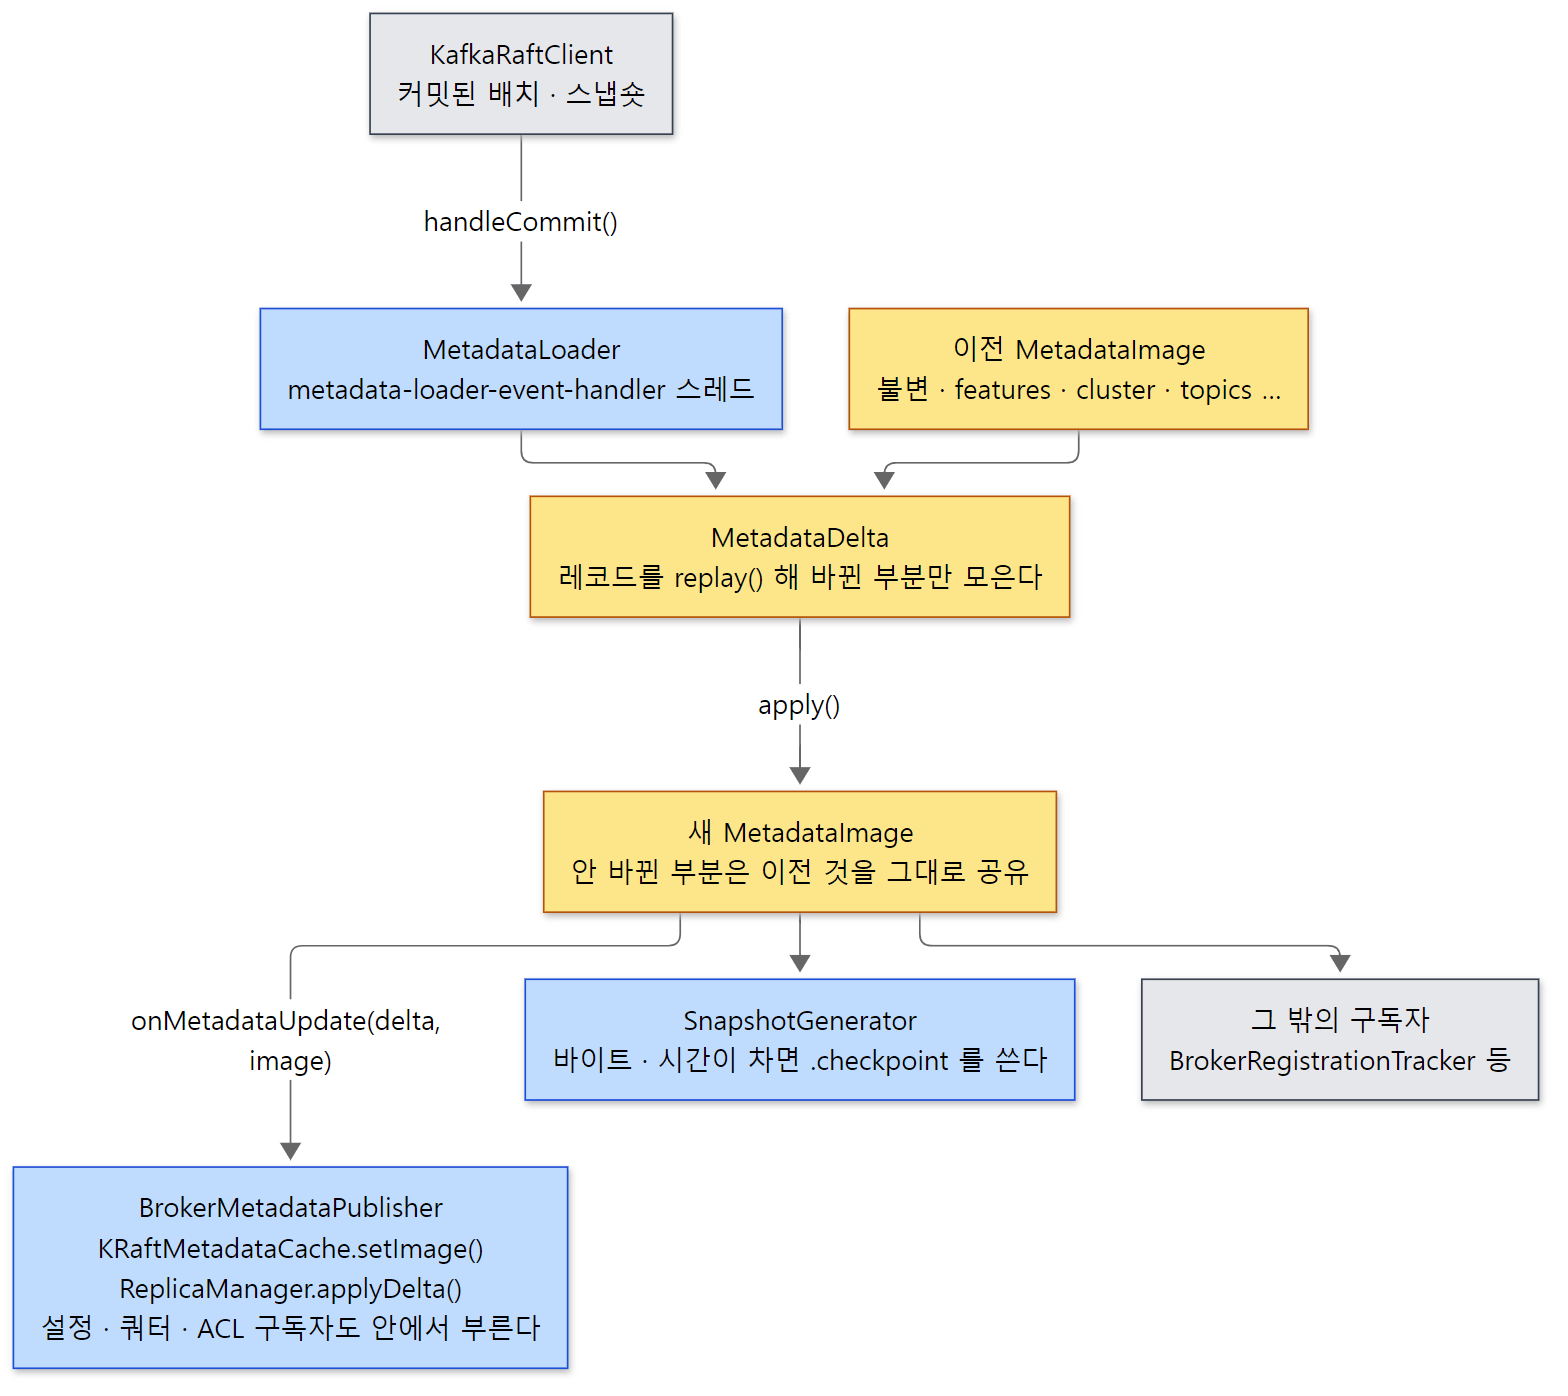 구독자는 델타(무엇이 바뀌었나)와 새 이미지(지금 전체가 어떤가)를 함께 받습니다.
ReplicaManager.applyDelta() 가 델타에서 "내 노드가 들어 있는 파티션의 변화"만 골라 리더·팔로워를 맡는 것은 2편 5절에서 봤습니다.
브로커의 구독자는 BrokerServer 가 설치합니다. 설정(DynamicConfigPublisher), 쿼터(DynamicClientQuotaPublisher), SCRAM, 위임 토큰, ACL(AclPublisher)을 맡는 구독자도 있는데, 이것들은 로더에 따로 설치되지 않고 BrokerMetadataPublisher 를 만들 때 넘겨져(BrokerServer.scala 531–576행) BrokerMetadataPublisher.onMetadataUpdate() 가 차례로 부릅니다(BrokerMetadataPublisher.scala 189–205행). kafka-configs.sh 로 토픽 설정을 바꾸면 ConfigRecord 가 쓰이고, 그것이 브로커마다 DynamicConfigPublisher 에 닿아 실제 설정이 바뀝니다.
다 따라잡기 전에는 알리지 않는다
브로커가 막 떴을 때 로그를 처음부터 읽으며 레코드 하나마다 구독자에게 알리면, ReplicaManager 가 "토픽이 생겼다, 지워졌다, 다시 생겼다"를 일일이 겪습니다. 그래서 로더는 처음에 하이 워터마크까지 따라잡을 때까지 구독자를 부르지 않습니다. stillNeedToCatchUp() 이 "읽은 오프셋이 아직 하이 워터마크 - 1 보다 작으면 따라잡는 중"이라고 판단하고(MetadataLoader.java 260–264행), maybePublishMetadata() 는 이 검사가 참이면 이미지만 바꿔 두고 돌아갑니다(352–357행). 다 따라잡은 뒤에야 그때까지의 모든 변화를 델타 하나로 묶어 한 번에 알립니다.
스냅숏 — 로그를 처음부터 읽지 않으려면
메타데이터 로그가 계속 자라면, 새로 붙는 브로커나 오래 꺼져 있던 컨트롤러가 수백만 개의 레코드를 처음부터 다시 읽어야 합니다. 그래서 어느 오프셋까지의 이미지 전체를 레코드로 써 둔 스냅숏(<끝 오프셋>-<에포크>.checkpoint 파일)을 만들어 둡니다. 스냅숏을 쓰는 것도 MetadataLoader 의 구독자 하나, SnapshotGenerator 입니다(SharedServer 가 설치, SharedServer.scala 346–356행).
publishLogDelta()(SnapshotGenerator.java 232–253행)는 지난 스냅숏 뒤로 적용한 바이트가 metadata.log.max.record.bytes.between.snapshots(기본 20MB, MetadataLogConfig.java 40–41행)를 넘거나, 시간이 metadata.log.max.snapshot.interval.ms(기본 1시간, 38–39행)를 넘으면 지금 이미지를 파일로 씁니다. 스냅숏이 생기면 그보다 앞의 로그 세그먼트는 지울 수 있게 됩니다. 리더는 빈 로그로 Fetch 하는 팔로워(부트스트랩이 아닌 스냅숏이 있을 때, 1625–1628행)나 리더의 로그 시작보다 뒤처진 팔로워에게 레코드 대신 "이 스냅숏을 받아 가라"고 답하고, 팔로워는 FetchSnapshot 으로 받아 갑니다 — 2절 javadoc 의 5번째 API 입니다. 예제 1은 짧게 돌았기 때문에 포맷 때의 부트스트랩 스냅숏 하나만 있었습니다.
예제 1 이어서: kafka-metadata-shell.sh 로 이미지 둘러보기
kafka-metadata-shell.sh 는 메타데이터 로그(또는 스냅숏) 파일을 읽어 이미지를 파일 시스템처럼 보여 줍니다. 서버가 쓰는 폴더를 잠그므로 서버를 끈 뒤에 돌렸습니다.
=== metadata shell over the log file (after stop)
--- ls /image
acls clientQuotas cluster configs delegationToken features producerIds provenance scram topics
--- ls /image/topics/byName/orders
0 1 2 id name
--- cat /image/topics/byName/orders/0
PartitionRegistration(replicas=[1], directories=[5H7XVkyAS9mZZQhe8CMRaw], isr=[], removingReplicas=[], addingReplicas=[], elr=[1], lastKnownElr=[1], leader=-1, leaderRecoveryState=RECOVERED, leaderEpo
--- cat /image/provenance
offset 71, epoch 1, time 2026-11-07T04:55:37.811Z[UTC]
/image 아래의 이름이 MetadataImage 의 필드 이름 그대로입니다. 이 도구는 이미지를 따로 흉내 내지 않고, 브로커와 같은 MetadataLoader 를 만들어 파일을 먹입니다(shell/src/main/java/org/apache/kafka/shell/MetadataShell.java 154–161행). 그러니 여기 보이는 것이 브로커의 메모리에 있던 이미지와 같은 것입니다.
헷갈리기 쉬운 곳: 서버를 끈 뒤의 로그에는 "끄는 과정"까지 적혀 있다
위 출력에서 orders-0 의 isr=[], leader=-1 이 눈에 걸렸습니다. 토픽을 만들 때 레코드는 isr=[1], leader=1 이었습니다. 셸은 서버를 끈 뒤에 로그 끝(오프셋 71)까지 읽었고, 그 사이에 브로커 1이 정상 종료(controlled shutdown)하면서 컨트롤러가 "브로커 1을 ISR 에서 빼라"는 레코드를 써 둔 것입니다(handleBrokerInControlledShutdown() 이 그 브로커가 든 ISR 마다 generateLeaderAndIsrUpdates(...) 를 부릅니다, ReplicationControlManager.java 1514–1523행). 레플리카가 하나뿐이라 ISR 이 비었고, 대신 elr=[1] 에 남았습니다. ELR(Eligible Leader Replicas)은 ISR 에서 빠졌지만 다시 리더가 될 자격이 있는 레플리카 목록으로, PartitionRecord.json 의 주석이 KIP-966 이라고 밝히는 기능입니다(예제 1의 eligible.leader.replicas.version 기능 판이 1로 켜져 있었습니다). ELR 의 규칙은 이 글에서 다루지 않습니다. 메타데이터 로그는 "지금 상태"가 아니라 "일어난 일 전부"이므로, 언제까지 읽었는지(/image/provenance)를 함께 봐야 합니다.
6. 브로커 등록, 하트비트, 펜스
브로커 쪽: BrokerLifecycleManager
2편에서 브로커는 "메타데이터를 따라잡았다고 인정받고, 울타리가 걷힐 때까지" 기다린 뒤에야 클라이언트를 받는다고 했습니다. 그 일을 하는 것이 BrokerLifecycleManager 입니다. 뜰 때 BrokerRegistration 요청으로 자신을 등록하고(컨트롤러가 RegisterBrokerRecord 를 씁니다), 그 뒤로는 하트비트를 보냅니다.
    private void sendBrokerHeartbeat() {
        Long metadataOffset = highestMetadataOffsetProvider.get();
        BrokerHeartbeatRequestData data = new BrokerHeartbeatRequestData()
            .setBrokerEpoch(brokerEpoch)
            .setBrokerId(nodeId)
            .setCurrentMetadataOffset(metadataOffset)
            .setWantFence(!readyToUnfence)
            .setWantShutDown(state == BrokerState.PENDING_CONTROLLED_SHUTDOWN)
            .setOfflineLogDirs(new ArrayList<>(offlineDirs.keySet()));
server/src/main/java/org/apache/kafka/server/BrokerLifecycleManager.java 564–572행
하트비트는 "살아 있다"는 신호이면서 보고서입니다. currentMetadataOffset 은 이 브로커의 MetadataLoader 가 어디까지 읽었나, wantFence 는 아직 준비가 안 됐으니 울타리를 걷지 말라, wantShutDown 은 이제 내려가고 싶다는 뜻입니다. 간격은 broker.heartbeat.interval.ms(기본 2,000ms)입니다(KRaftConfigs.java 39–44행).
컨트롤러 쪽: 따라잡음, 울타리, 세션 만료
컨트롤러는 하트비트를 받아 ReplicationControlManager.processBrokerHeartbeat() 에서 다음 상태를 정합니다. 따라잡았는지는 이 한 줄입니다.
        boolean isCaughtUp = request.currentMetadataOffset() >= registerBrokerRecordOffset;
        BrokerHeartbeatReply reply = new BrokerHeartbeatReply(isCaughtUp,
                states.next().fenced(),
                states.next().inControlledShutdown(),
                states.next().shouldShutDown());
        return ControllerResult.of(records, reply);
metadata/src/main/java/org/apache/kafka/controller/ReplicationControlManager.java 1753–1758행
브로커가 읽은 오프셋이 자기 등록 레코드의 오프셋 이상이면 따라잡은 것으로 칩니다. 적어도 "내가 등록되었다"는 사실까지는 장부에서 읽었다는 뜻이고, 그러면 그 앞의 토픽·파티션도 다 알고 있습니다. 하트비트 처리도 ControllerResult 를 돌려주는 쓰기 이벤트라는 점을 보세요. 상태가 바뀌면(울타리를 걷으면) records 에 레코드가 들어갑니다.
하트비트가 끊긴 브로커는 주기 작업이 찾아냅니다. 컨트롤러는 maybeFenceStaleBroker 라는 작업을 세션 시간의 1/8 마다 돌리고(QuorumController.java 1684–1701행), 그 작업이 부르는 것이 이것입니다.
        // Even though multiple brokers can go stale at a time, we will process
        // fencing one at a time so that the effect of fencing each broker is visible
        // to the system prior to processing the next one.
        log.info("Fencing broker {} at epoch {} because its session has timed out.", id, epoch);
        List<ApiMessageAndVersion> records = new ArrayList<>();
        handleBrokerFenced(id, records);
        heartbeatManager.fence(id);
        return ControllerResult.of(records, true);
metadata/src/main/java/org/apache/kafka/controller/ReplicationControlManager.java 1809–1816행
handleBrokerFenced()(1449–1460행)는 두 종류의 레코드를 만듭니다. 먼저 그 브로커가 ISR 에 든 파티션마다 ISR 에서 빼고 필요하면 리더를 바꾸는 PartitionChangeRecord(generateLeaderAndIsrUpdates(...)), 그다음 그 브로커가 펜스되었다는 BrokerRegistrationChangeRecord(setFenced(BrokerRegistrationFencingChange.FENCE.value()))입니다. 세션 길이는 broker.session.timeout.ms(기본 9,000ms)입니다.
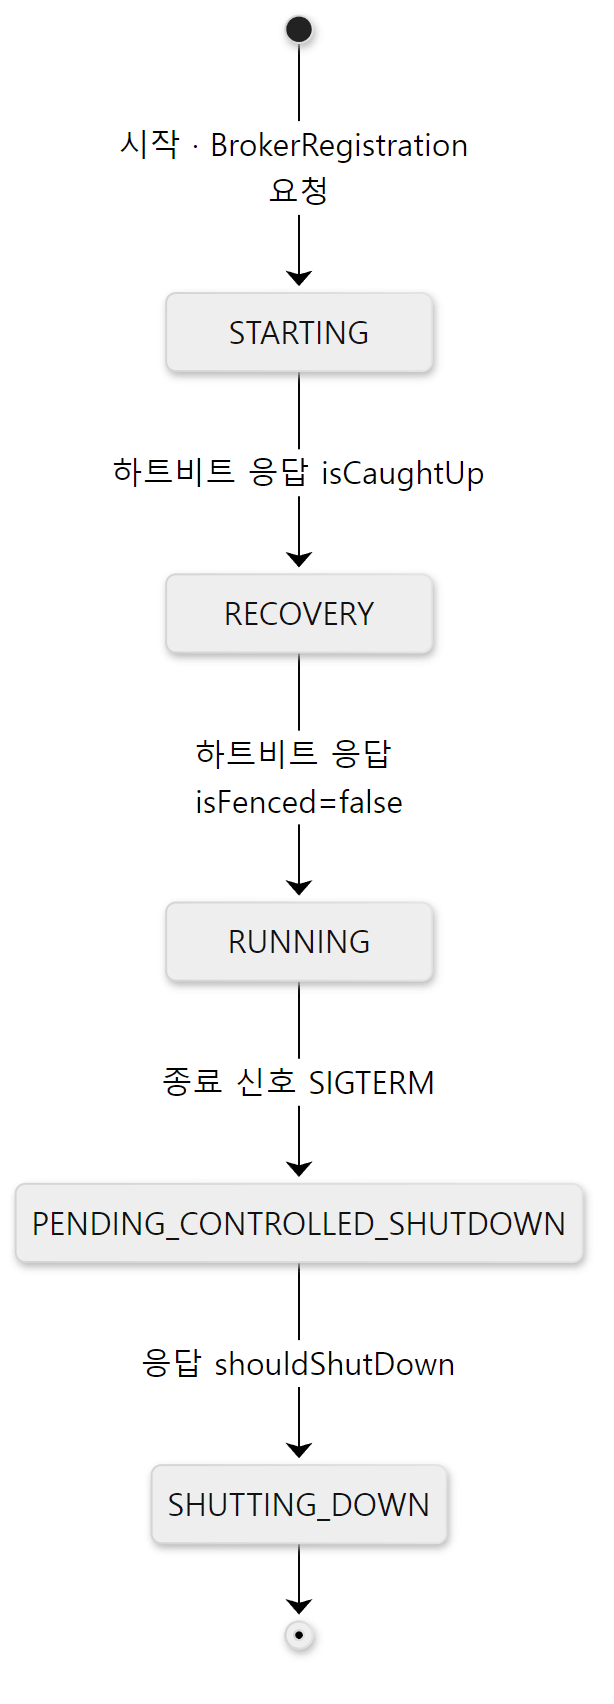 브로커가 스스로 갖는 상태(
BrokerState)입니다. 종료 신호로 PENDING_CONTROLLED_SHUTDOWN 이 되는 것(343행)만 브로커가 스스로 정하고, 나머지 조건은 컨트롤러가 하트비트 응답에 실어 주는 값입니다(BrokerLifecycleManager.java 645–702행의 switch). 반대쪽, 컨트롤러가 브로커를 펜스하는 일은 이 그림 밖에서 따로 일어납니다.
예제 4: 브로커를 얼려 펜스되는 것을 보기
공용 도우미 kafka_cluster3(컨트롤러 node 100 + 브로커 1·2·3)로 띄우고, 복제 계수 3인 토픽을 만든 뒤 브로커 3을 kill -STOP 으로 얼립니다. 프로세스는 살아 있지만 아무 일도 못 하니 하트비트가 끊깁니다. 15초 뒤 컨트롤러의 로그와 메타데이터 로그를 보고, kill -CONT 로 녹인 뒤 다시 봅니다(ex/u10-fence/run.sh).
=== broker lifecycle log of broker 3 (startup)
INFO [BrokerLifecycleManager id=3] The broker has caught up. Transitioning from STARTING to RECOVERY. (org.apache.kafka.
INFO [BrokerLifecycleManager id=3] The broker has been unfenced. Transitioning from RECOVERY to RUNNING. (org.apache.kaf
=== create topic orders (1 partition, RF=3)
 Topic: orders Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 Elr: LastKnownElr:
=== freeze broker 3 (kill -STOP) at 04:58:24
=== controller log
04:58:31 INFO [QuorumController id=100] Fencing broker 3 at epoch 57 because its session has timed out. (org.apache.kafka.controller.Replica
 Topic: orders Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2 Elr: LastKnownElr:
=== new metadata records after offset 113 (NoOp records omitted)
offset 131 {"type":"PARTITION_CHANGE_RECORD","version":2,"data":{"partitionId":0,"topicId":"1YXyxrGoS_uwbCoz0XEUeA","isr":[1,2]}}
offset 132 {"type":"BROKER_REGISTRATION_CHANGE_RECORD","version":0,"data":{"brokerId":3,"brokerEpoch":57,"fenced":1}}
=== thaw broker 3 (kill -CONT)
=== new metadata records after offset 163 (NoOp records omitted)
offset 164 {"type":"BROKER_REGISTRATION_CHANGE_RECORD","version":0,"data":{"brokerId":3,"brokerEpoch":57,"fenced":-1}}
offset 166 {"type":"PARTITION_CHANGE_RECORD","version":2,"data":{"partitionId":0,"topicId":"1YXyxrGoS_uwbCoz0XEUeA","isr":[1,2,3]}}
 Topic: orders Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 Elr: LastKnownElr:
(시각·브로커 에포크·오프셋·토픽 id·처음 리더가 누구인지는 실행마다 다릅니다.)
- 뜰 때의 두 줄이 그림의
STARTING → RECOVERY → RUNNING그대로입니다. 648·666행의logger.info문구가 그대로 찍혔습니다. - 얼린 지 7초 뒤(04:58:24 → 04:58:31) 컨트롤러가 브로커 3을 펜스했습니다. 마지막 하트비트는 얼리기 전 2초 간격 가운데 어딘가에 갔고, 검사 작업은 1.125초(9초의 1/8)마다 돌므로, "마지막 하트비트로부터 9초"는 얼린 때로부터 대략 7~10초가 됩니다(찍힌 시각은 초 아래를 버린 값입니다). 다시 돌렸을 때는 10초, 9초 뒤였습니다. 다른 예제 셋과 동시에 돌려 기계가 바빴을 때는 6초 뒤인 적도 있었는데, 그 까닭은 확인하지 못했습니다.
- 메타데이터 로그에는
handleBrokerFenced()가 만든 순서 그대로, ISR 에서 3을 뺀PARTITION_CHANGE_RECORD다음에fenced: 1이 쌓였습니다. 이 실행에서는 리더가 브로커 1이라isr만 바뀌었고, 다른 실행에서 브로커 3이 리더였을 때는 같은 레코드에"leader":1이 함께 들어 리더가 옮겨 갔습니다. - 녹이자 브로커 3의 하트비트가 다시 닿아
fenced: -1(울타리 걷기,handleBrokerUnfenced()1494–1501행)이 쓰이고, 조금 뒤 ISR 이 1·2·3으로 돌아왔습니다.handleBrokerUnfenced()는 리더가 없는 파티션만 손대므로(brokersToIsrs.partitionsWithNoLeader(), 1499–1500행), 리더가 있던 이 파티션의 ISR 복귀는 울타리 걷기가 아니라 리더(브로커 1)가 "3이 따라잡았다"며 보낸 ISR 변경 요청(AlterPartition, 9편)이 레코드가 된 것입니다.
헷갈리기 쉬운 곳: ISR 에서 빠지는 길은 둘이다
브로커가 응답하지 않을 때 ISR 에서 빠지는 길은 두 가지입니다. 하나는 이 절의 컨트롤러의 펜스(하트비트가 broker.session.timeout.ms 동안 없을 때, 그 브로커가 든 모든 파티션에서 한꺼번에), 다른 하나는 9편의 리더의 ISR 축소(팔로워의 Fetch 가 replica.lag.time.max.ms 동안 따라오지 못할 때, 그 파티션에서만)입니다. 예제 4에서는 9초짜리 펜스가 먼저 일어났고, 로그의 Fencing broker 3 … session has timed out 줄로 어느 길이었는지 알 수 있습니다. ISR 이 왜 줄었는지 궁금할 때는 컨트롤러의 controller.log 와 리더 브로커의 server.log 를 함께 봐야 합니다.
이 글에서 뺀 것
- 투표자를 실행 중에 더하고 빼기(동적 쿼럼,
AddRaftVoter·RemoveRaftVoter·UpdateRaftVoter).raft/src/main/java/org/apache/kafka/raft/internals/AddVoterHandler.java·RemoveVoterHandler.java·UpdateVoterHandler.java,KRaftControlRecordStateMachine.java - 팔로워의 로그 잘라내기(diverging epoch)와 스냅숏 내려받기의 세부.
KafkaRaftClient.handleFetchResponse()·handleFetchSnapshotResponse(),raft/src/main/java/org/apache/kafka/snapshot/ - 리더가 과반의 Fetch 를 못 받으면 스스로 물러나는 check quorum.
LeaderState.timeUntilCheckQuorumExpires() - 레플리카 배치(어느 브로커에 둘지)와 선호 리더 선거·언클린 리더 선거, ELR.
metadata/src/main/java/org/apache/kafka/metadata/placement/,PartitionChangeBuilder.java,ReplicationControlManager의electLeaders - 기능 판(
metadata.version등)과 업그레이드.FeatureControlManager.java,server-common/src/main/java/org/apache/kafka/server/common/MetadataVersion.java - 메타데이터 트랜잭션(
BeginTransactionRecord).OffsetControlManager.replay(BeginTransactionRecord, …),ActivationRecordsGenerator.java - 설정·쿼터·ACL·SCRAM·위임 토큰 관리자와 구독자.
ConfigurationControlManager,ClientQuotaControlManager,AclControlManager,ScramControlManager,DelegationTokenControlManager - 포맷과 부트스트랩 스냅숏.
core/src/main/scala/kafka/tools/StorageTool.scala,metadata/src/main/java/org/apache/kafka/metadata/storage/Formatter.java - 이 연재 전체에서 빼는 것: Kafka Streams, Kafka Connect, MirrorMaker, 공유 그룹(Share groups), 계층 저장소, 보안(SASL·TLS·ACL 의 인가), 쿼터,
Admin클라이언트, JBOD
정리
| 개념 | 한 줄 요약 |
|---|---|
__cluster_metadata-0 |
클러스터의 장부. UnifiedLog 위의 평범한 Kafka 로그이고, 레코드는 JSON 스키마(27개)에서 생성된다 |
| 메타데이터 레코드 | TopicRecord, PartitionRecord, PartitionChangeRecord, BrokerRegistrationChangeRecord … 처음부터 다시 적용하면 지금의 장부가 된다 |
KafkaRaftClient |
raft-io-thread 하나가 poll() 을 돌며 역할에 맞는 일을 한다. 선거는 Raft, 복제는 Fetch |
| 역할 상태 | Unattached → Prospective(PreVote) → Candidate(에포크 +1, Vote) → Leader, 그리고 Follower·Resigned. 옵서버는 Unattached·Follower 만 |
| 표 주기 | 후보의 (마지막 에포크, 끝 오프셋)이 내 것보다 뒤처지지 않을 때만. 준 표는 quorum-state 에 먼저 쓴다 |
| 하이 워터마크 | 투표자 과반이 가진 오프셋. 새 리더는 자기 에포크 레코드가 커밋되어야 올린다 |
QuorumController |
KafkaEventQueue 위의 이벤트 스레드 하나. 락 없이 이벤트를 하나씩 처리한다 |
ControllerResult |
레코드 목록 + 응답. 결정(레코드 만들기)과 적용(replay())을 나눈다 |
| 쓰기 이벤트 | 레코드 → 오프셋 받기 → 메모리에 먼저 적용 → 커밋되면 future 완료 |
| 대기 컨트롤러 | 커밋된 레코드를 handleCommit() 에서 replay() 해 같은 상태를 들고 있다 |
SnapshotRegistry·TimelineHashMap |
오프셋마다 메모리 스냅숏. 커밋되면 지우고, 리더 자리를 잃으면 커밋 오프셋으로 되돌린다 |
MetadataLoader |
커밋된 레코드를 MetadataDelta 로 모아 불변 MetadataImage 를 만들고 구독자에게 알린다 |
스냅숏(.checkpoint) |
이미지 전체를 파일로. 20MB 또는 1시간마다. 새 노드는 스냅숏 + 그 뒤 로그만 읽는다 |
BrokerLifecycleManager |
등록 후 2초마다 하트비트(읽은 오프셋 보고). STARTING → RECOVERY → RUNNING |
| 펜스 | 하트비트가 9초 없으면 컨트롤러가 ISR 에서 빼고 fenced: 1 레코드를 쓴다 |
다음에 볼 것
다음 글 11편: 컨슈머와 그룹 코디네이터 — poll()과 리밸런스의 안쪽에서는 클러스터를 움직이는 또 하나의 상태 기계로 갑니다. 컨슈머 그룹의 멤버와 할당, 커밋된 오프셋을 들고 있는 그룹 코디네이터입니다. 재미있게도 그 구조가 이 글과 닮았습니다. 그룹 코디네이터도 상태를 __consumer_offsets 라는 로그에 레코드로 쓰고, 다시 읽어 메모리 상태를 복원하며, 파티션마다 이벤트를 하나씩 처리하는 런타임(CoordinatorRuntime)과 이 글의 TimelineHashMap 을 씁니다. "로그가 곧 상태"라는 생각이 컨트롤러 밖에서 어떻게 다시 쓰이는지 봅니다.
함께 읽으면 좋은 글:
- 2편: 전체 지도 — 이 글이 확대한 G 구역과, 토픽 만들기 한 번의 전체 흐름
- 9편: 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림 — 같은 Fetch 로 하는 데이터 파티션의 복제와, ISR 기준의 하이 워터마크
- 7편: 로그 저장소 — 메타데이터 로그도 쓰는 세그먼트와 인덱스
- nginx 소스 파헤치기 — 스레드 하나가 이벤트를 차례로 처리하는 또 다른 설계