이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 다섯 번째 글입니다. 3편에서 요청·응답의 바이트 모양을, 4편에서 그 바이트가 브로커에 도착해 KafkaApis.handle() 까지 가는 길을 봤습니다. 이번에는 요청을 보내는 쪽으로 건너갑니다. 앱에서 producer.send(record) 를 부른 순간부터 그 레코드가 Produce 요청에 실려 소켓으로 나가고, 응답이 돌아와 콜백이 불리기까지입니다.
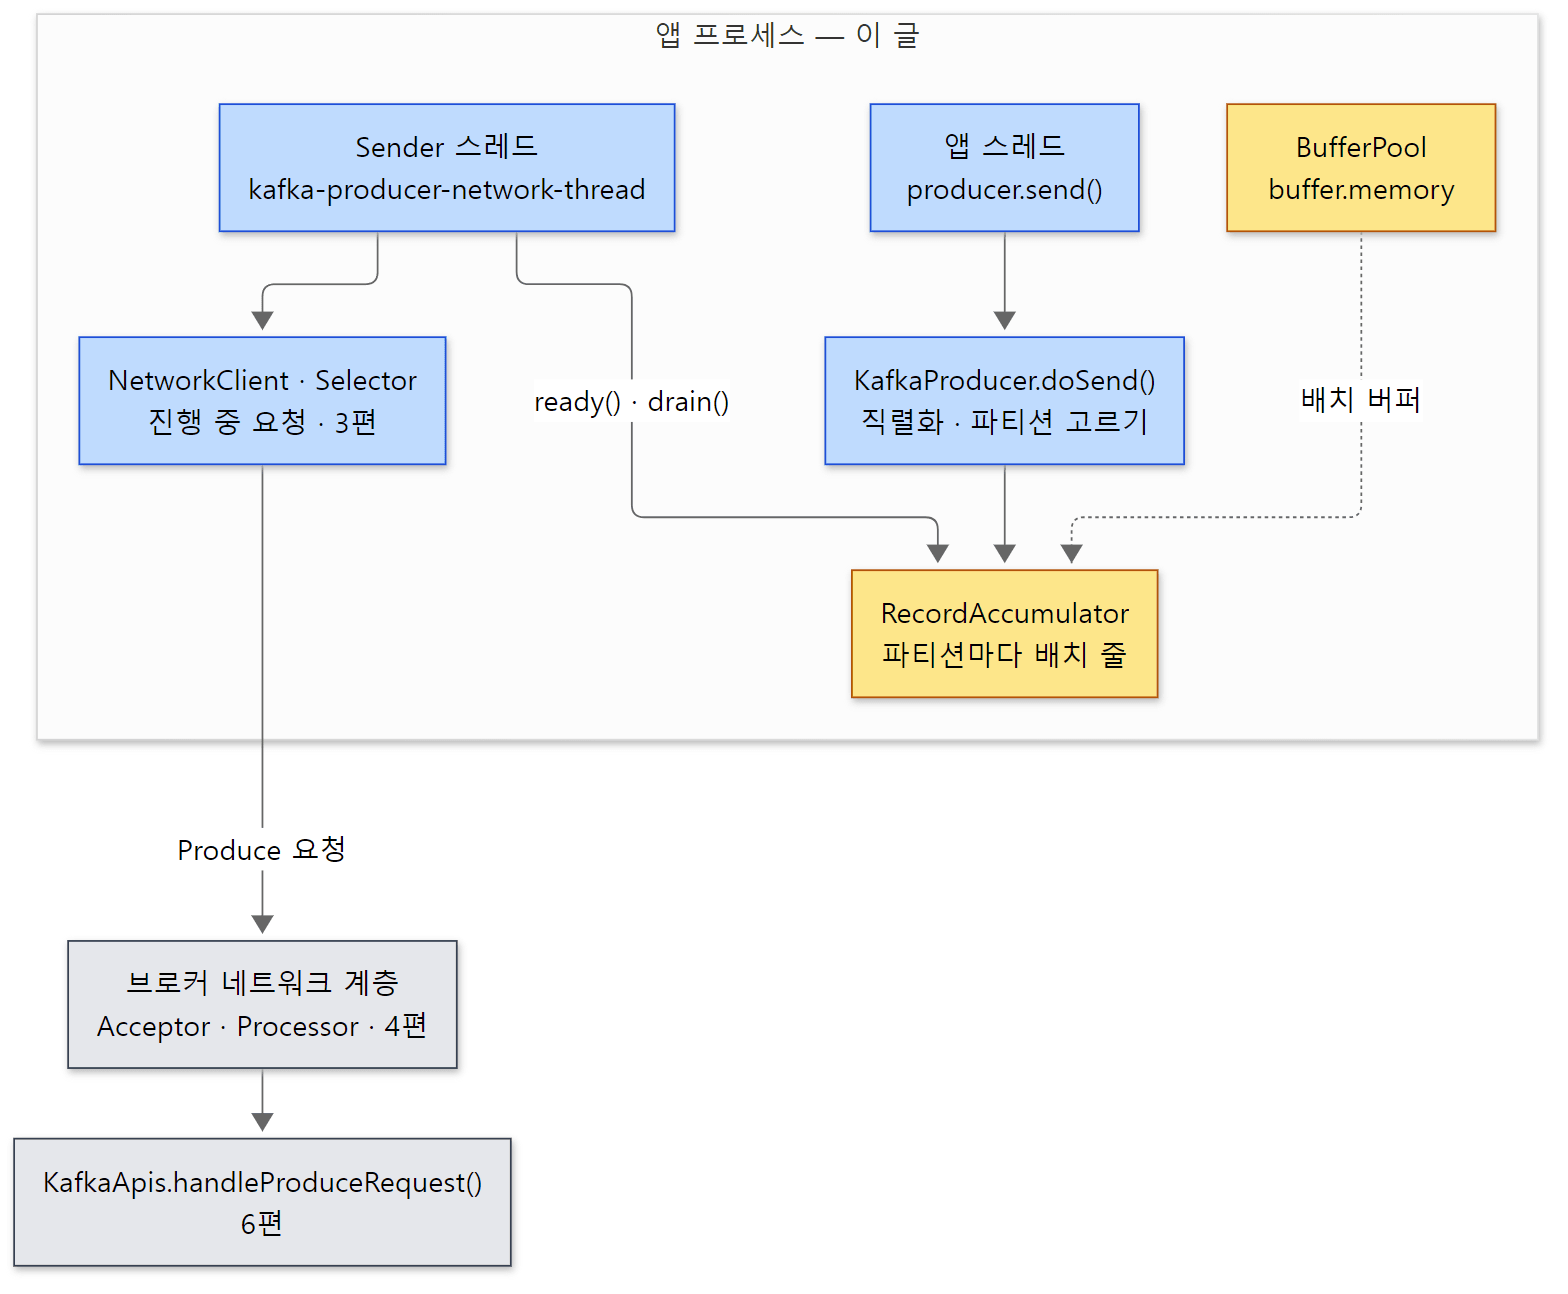 2편 지도의 A 구역(클라이언트) 가운데 프로듀서를 확대한 그림입니다. 파란 상자가 스레드와 처리 단계, 노란 상자가 메모리, 회색 상자는 앞뒤 글의 몫입니다.
답하려는 질문은 네 가지입니다.
send()를 부르면 그 스레드에서 무슨 일이 일어나고, 무엇을 돌려받는가 — 그리고send()는 언제 막히는가- 키가 없는 레코드는 어느 파티션으로 가는가
linger.ms와batch.size는 코드의 어느if에서 쓰이고, 바꾸면 배치가 실제로 어떻게 달라지는가- 레코드를 실제로 보내는 스레드는 누구이고, 콜백은 어느 스레드에서 불리며, 실패하면 몇 번·언제까지 다시 보내는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | clients.producer.KafkaProducer·ProducerConfig, clients.producer.internals.RecordAccumulator·ProducerBatch·BuiltInPartitioner·BufferPool·Sender, common.record.internal.MemoryRecordsBuilder, clients.NetworkClient·InFlightRequests (모두 Java, clients 모듈) |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 이 글이 읽는 프로듀서 코드는 흔히 쓰는 최신 안정판 4.4.0 과 규칙이 같습니다. BufferPool.java·ProducerConfig.java·InFlightRequests.java 는 4.4.0 태그와 글자 하나 다르지 않고, RecordAccumulator.java 는 메서드 인자를 TopicPartition 으로 바꾸고 도우미 메서드를 몇 개 더한 정리가 있을 뿐 이 글이 말하는 조건(ready()·drain()·append())은 같습니다. KafkaProducer.java 의 차이는 주로 트랜잭션의 2단계 커밋 쪽입니다.
프로듀서는 clients 모듈 안에서도 큰 편입니다. KafkaProducer.java 1,837줄, RecordAccumulator.java 1,500줄, Sender.java 1,144줄이고, 그 안에 트랜잭션·멱등성 처리가 함께 삽니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
레코드 배치(record batch): 같은 파티션으로 가는 레코드 여러 개를 하나로 묶은 덩어리입니다. 헤더 하나(기준 오프셋, 레코드 수, 프로듀서 id, CRC …) 뒤에 레코드들이 붙습니다. 프로듀서는 레코드를 하나씩 보내지 않고 이 배치 단위로 보내고, 브로커도 디스크에 이 단위로 씁니다. 그래서 kafka-dump-log.sh 로 세그먼트 파일(브로커가 파티션의 로그를 나눠 담는 디스크 파일, 7편)을 열면 배치가 몇 개인지, 배치마다 레코드가 몇 개인지 보입니다(이 글의 예제가 그렇게 셉니다). 배치의 바이트 모양은 6편에서 봅니다.
RecordAccumulator: 프로듀서 안의 "보낼 레코드 대기실"입니다. 파티션마다 배치의 줄(Deque<ProducerBatch>)을 두고, send() 한 레코드를 그 파티션 줄의 마지막 배치에 덧붙입니다. 이름의 accumulate 는 "쌓아 둔다"는 뜻입니다.
Sender 스레드: 프로듀서를 만들 때 하나 생기는 백그라운드 스레드입니다. 이름은 kafka-producer-network-thread | <client.id> 입니다. 대기실에서 보낼 만한 배치를 꺼내 브로커별 Produce 요청으로 묶어 보내고, 응답을 받아 각 레코드의 Future 를 완료하고 콜백을 부릅니다. 앱 스레드는 소켓을 직접 만지지 않습니다.
linger.ms 와 batch.size: 배치를 언제 보낼지 정하는 두 설정입니다. batch.size 는 배치 하나의 목표 크기(바이트, 기본 16384), linger.ms 는 배치가 다 차지 않았어도 그만큼 기다렸으면 보내라는 시간(기본 5밀리초)입니다. 둘 다 4절의 if 에 그대로 나옵니다.
메타데이터: 토픽마다 파티션이 몇 개이고 각 파티션의 리더가 어느 브로커인지 적은 정보입니다. 프로듀서는 리더에게만 쓸 수 있으므로, 이것을 먼저 알아야 배치를 어느 브로커로 보낼지 정합니다. 메타데이터를 받아 오는 길은 2편에서 봤습니다.
진행 중 요청(in-flight request): 보냈지만 아직 응답을 받지 못한 요청입니다. 프로듀서는 응답을 기다리지 않고 한 연결에 요청을 여러 개 보내 둘 수 있고, 그 한도가 max.in.flight.requests.per.connection(기본 5)입니다. 6절에서 봅니다.
멱등 프로듀서(idempotent producer): 재시도 때문에 같은 배치가 두 번 쓰이지 않게, 프로듀서 id 와 일련번호(sequence)를 배치에 붙여 보내는 방식입니다. 이 커밋에서 enable.idempotence 의 기본값은 true 입니다(ProducerConfig.java 574–578행). 이 글의 예제 출력에 producerId·baseSequence 가 찍히는 이유입니다. 자세한 것은 12편에서 봅니다.
1. send() 가 하는 일 — 보내지 않고 쌓는다
send(record) 는 send(record, null) 을 부르고, send(record, callback) 은 인터셉터(interceptor.classes 로 꽂는 사용자 코드)에 레코드를 한 번 보여 준 뒤 doSend() 로 갑니다(KafkaProducer.java 1147–1151행). 프로듀서의 일 대부분이 doSend() 한 메서드에 순서대로 적혀 있습니다.
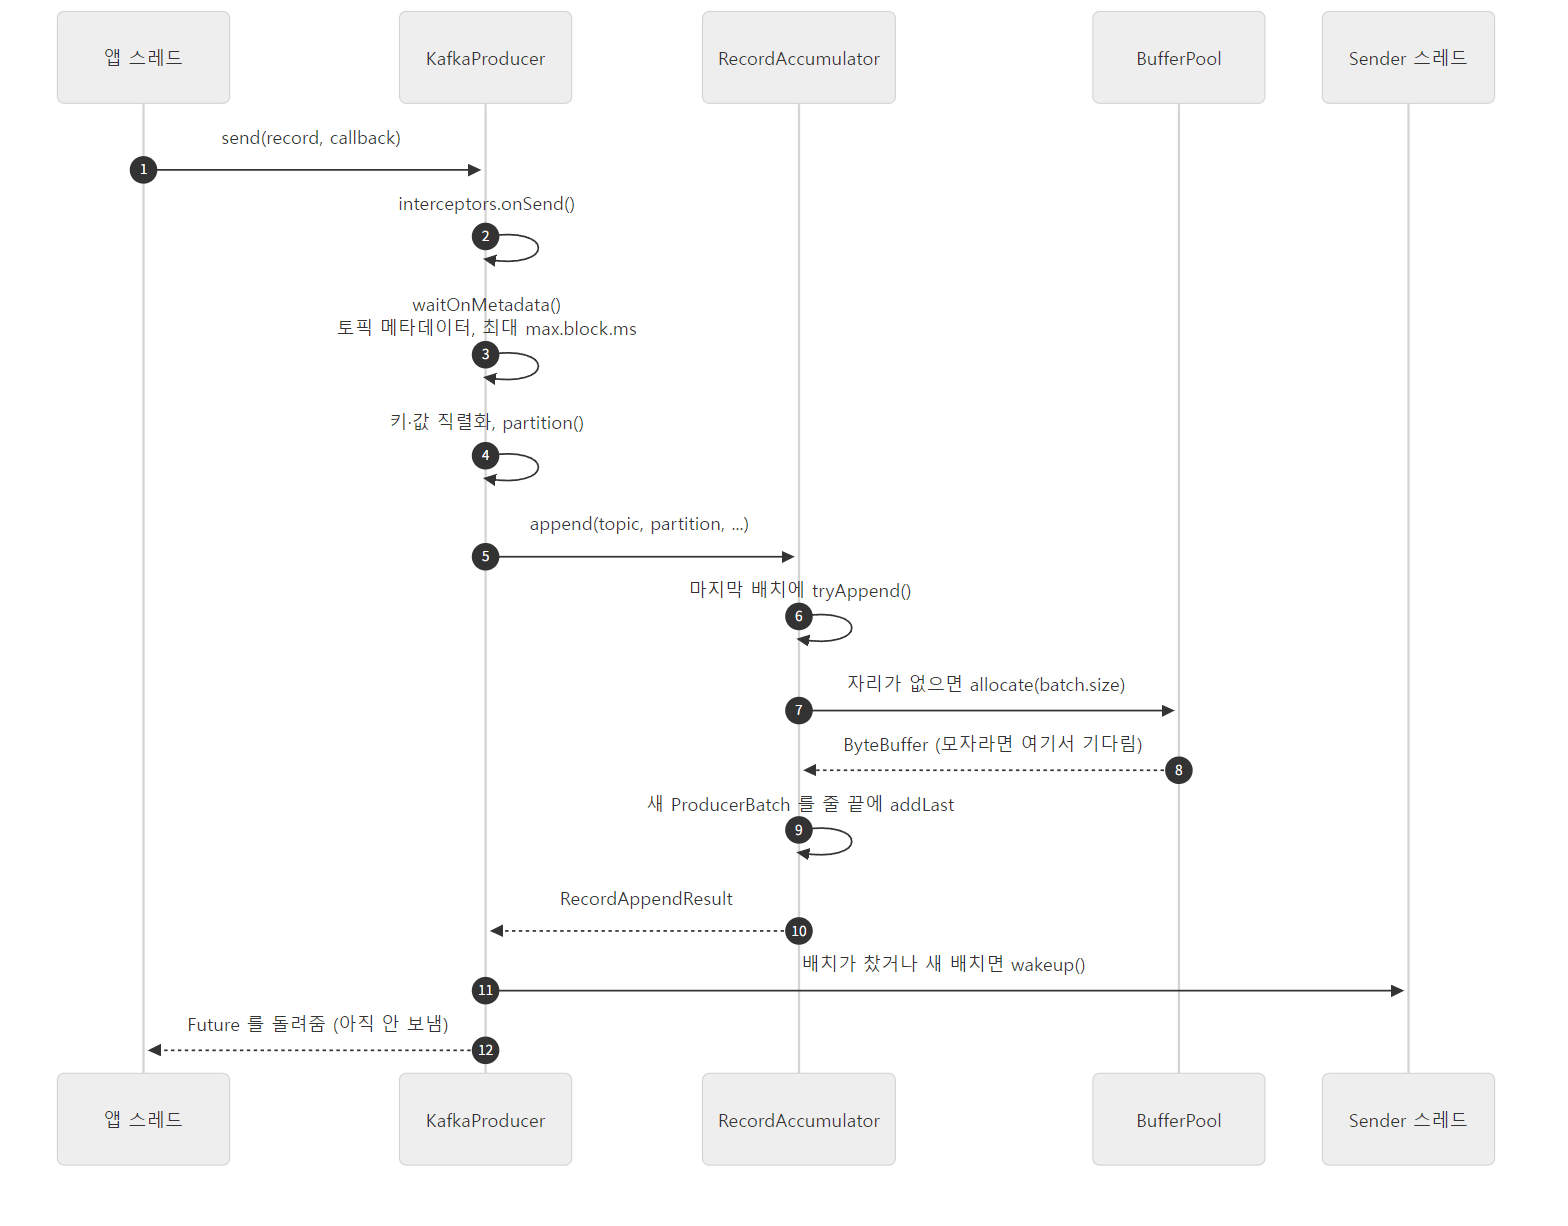 1~12가 모두
send() 를 부른 스레드에서 일어납니다. Sender 스레드는 11번에서 깨워질 뿐이고, 보내는 일은 5절에서 그 스레드가 따로 합니다.
메타데이터를 기다린 뒤(그림의 3번)부터 보겠습니다.
            byte[] serializedKey;
            try {
                serializedKey = keySerializerPlugin.get().serialize(record.topic(), record.headers(), record.key());
            } catch (ClassCastException cce) {
                // ...
            }
            byte[] serializedValue;
            // ... 값도 같은 방식으로 직렬화 ...

            // Try to calculate partition, but note that after this call it can be RecordMetadata.UNKNOWN_PARTITION,
            // which means that the RecordAccumulator would pick a partition using built-in logic (which may
            // take into account broker load, the amount of data produced to each partition, etc.).
            int partition = partition(record, serializedKey, serializedValue, cluster);

            setReadOnly(record.headers());
            Header[] headers = record.headers().toArray();

            int serializedSize = AbstractRecords.estimateSizeInBytesUpperBound(RecordBatch.CURRENT_MAGIC_VALUE,
                    compression.type(), serializedKey, serializedValue, headers);
            ensureValidRecordSize(serializedSize);
            long timestamp = record.timestamp() == null ? nowMs : record.timestamp();

            // Append the record to the accumulator.  Note, that the actual partition may be
            // calculated there and can be accessed via appendCallbacks.topicPartition.
            RecordAccumulator.RecordAppendResult result = accumulator.append(record.topic(), partition, timestamp, serializedKey,
                    serializedValue, headers, appendCallbacks, remainingWaitMs, nowMs, cluster);
            // ...

            if (result.batchIsFull || result.newBatchCreated) {
                log.trace("Waking up the sender since topic {} partition {} is either full or getting a new batch", record.topic(), appendCallbacks.getPartition());
                this.sender.wakeup();
            }
            return result.future;
clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java 1203–1251행
순서대로 읽으면 이렇습니다.
- 직렬화. 앱에서 설정한
key.serializer·value.serializer가 여기서 불립니다. 레코드는 이 순간byte[]가 되고, 그 뒤로 프로듀서는 키·값의 자바 타입을 모릅니다. 타입이 맞지 않으면ClassCastException을SerializationException으로 바꿔 던집니다. - 파티션 고르기.
partition()이 번호를 정하거나, "아직 모름(UNKNOWN_PARTITION)"을 돌려줍니다(2절). - 크기 검사.
ensureValidRecordSize()는 레코드 하나의 최대 크기가max.request.size(기본 1MB)나buffer.memory를 넘으면RecordTooLargeException을 던집니다(1368–1378행). 브로커에 가 보기도 전에 실패하는 경우입니다. - 타임스탬프. 레코드에 시각을 주지 않았으면 지금 시각(
nowMs)을 씁니다. 6편에서 볼 배치 헤더의CreateTime이 이 값입니다. - 대기실에 넣기.
accumulator.append()가 그 파티션 줄의 배치에 레코드를 덧붙입니다(3절). - Sender 깨우기. 배치가 가득 찼거나 새 배치를 열었을 때만
sender.wakeup()을 부릅니다. 레코드를 넣을 때마다 깨우지 않습니다. 이미 있는 배치에 레코드 하나를 더했을 뿐이면 Sender 를 깨울 이유가 없기 때문입니다(그 배치는 어차피linger.ms가 지나야 보냅니다). Future를 돌려줍니다. 이Future는 아직 아무것도 보내지 않은 상태입니다. 레코드가 디스크에 쓰였는지 알려면get()으로 기다리거나 콜백을 받아야 합니다.
waitOnMetadata() 는 이 토픽의 메타데이터가 없으면 갱신을 요청하고 Sender 를 깨운 뒤 기다립니다. 그 길은 2편에서 따라갔습니다. 여기서 볼 것은 기다린 만큼을 시간 예산에서 빼는 두 줄입니다.
            nowMs += clusterAndWaitTime.waitedOnMetadataMs;
            long remainingWaitMs = Math.max(0, maxBlockTimeMs - clusterAndWaitTime.waitedOnMetadataMs);
clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java 1200–1201행
maxBlockTimeMs 는 max.block.ms(기본 60000, ProducerConfig.java 482–487행)입니다. 메타데이터를 기다리고 남은 시간(remainingWaitMs)이 그대로 append() 에 넘어가, 배치 메모리를 기다리는 데 쓰입니다(8절). 즉 max.block.ms 는 "send() 한 번이 앱 스레드를 붙잡을 수 있는 시간 전체" 입니다.
헷갈리기 쉬운 곳: send() 는 "비동기"지만 막힐 수 있습니다
send() 가 Future 를 돌려주니 바로 돌아오는 비동기 메서드로 보입니다. 네트워크 왕복을 기다리지 않는다는 뜻에서는 맞습니다. 하지만 위 코드에서 앱 스레드가 멈출 수 있는 자리가 둘 있습니다. 토픽 메타데이터가 아직 없을 때(waitOnMetadata())와 배치 메모리가 모자랄 때(BufferPool.allocate(), 8절)입니다. 둘 다 합쳐 max.block.ms 까지입니다. 그리고 직렬화도 앱 스레드에서 돌므로, 무거운 직렬화기는 send() 를 그만큼 느리게 합니다.
2. 파티션 고르기 — 키가 있으면 해시, 없으면 "붙어 있기"
partition() 은 네 갈래입니다.
    private int partition(ProducerRecord<K, V> record, byte[] serializedKey, byte[] serializedValue, Cluster cluster) {
        if (record.partition() != null)
            return record.partition();

        if (partitionerPlugin.get() != null) {
            int customPartition = partitionerPlugin.get().partition(
                record.topic(), record.key(), serializedKey, record.value(), serializedValue, cluster);
            // ... 음수면 IllegalArgumentException ...
            return customPartition;
        }

        if (serializedKey != null && !partitionerIgnoreKeys) {
            // hash the keyBytes to choose a partition
            return BuiltInPartitioner.partitionForKey(serializedKey, cluster.partitionsForTopic(record.topic()).size());
        } else {
            return RecordMetadata.UNKNOWN_PARTITION;
        }
    }
clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java 1681–1701행
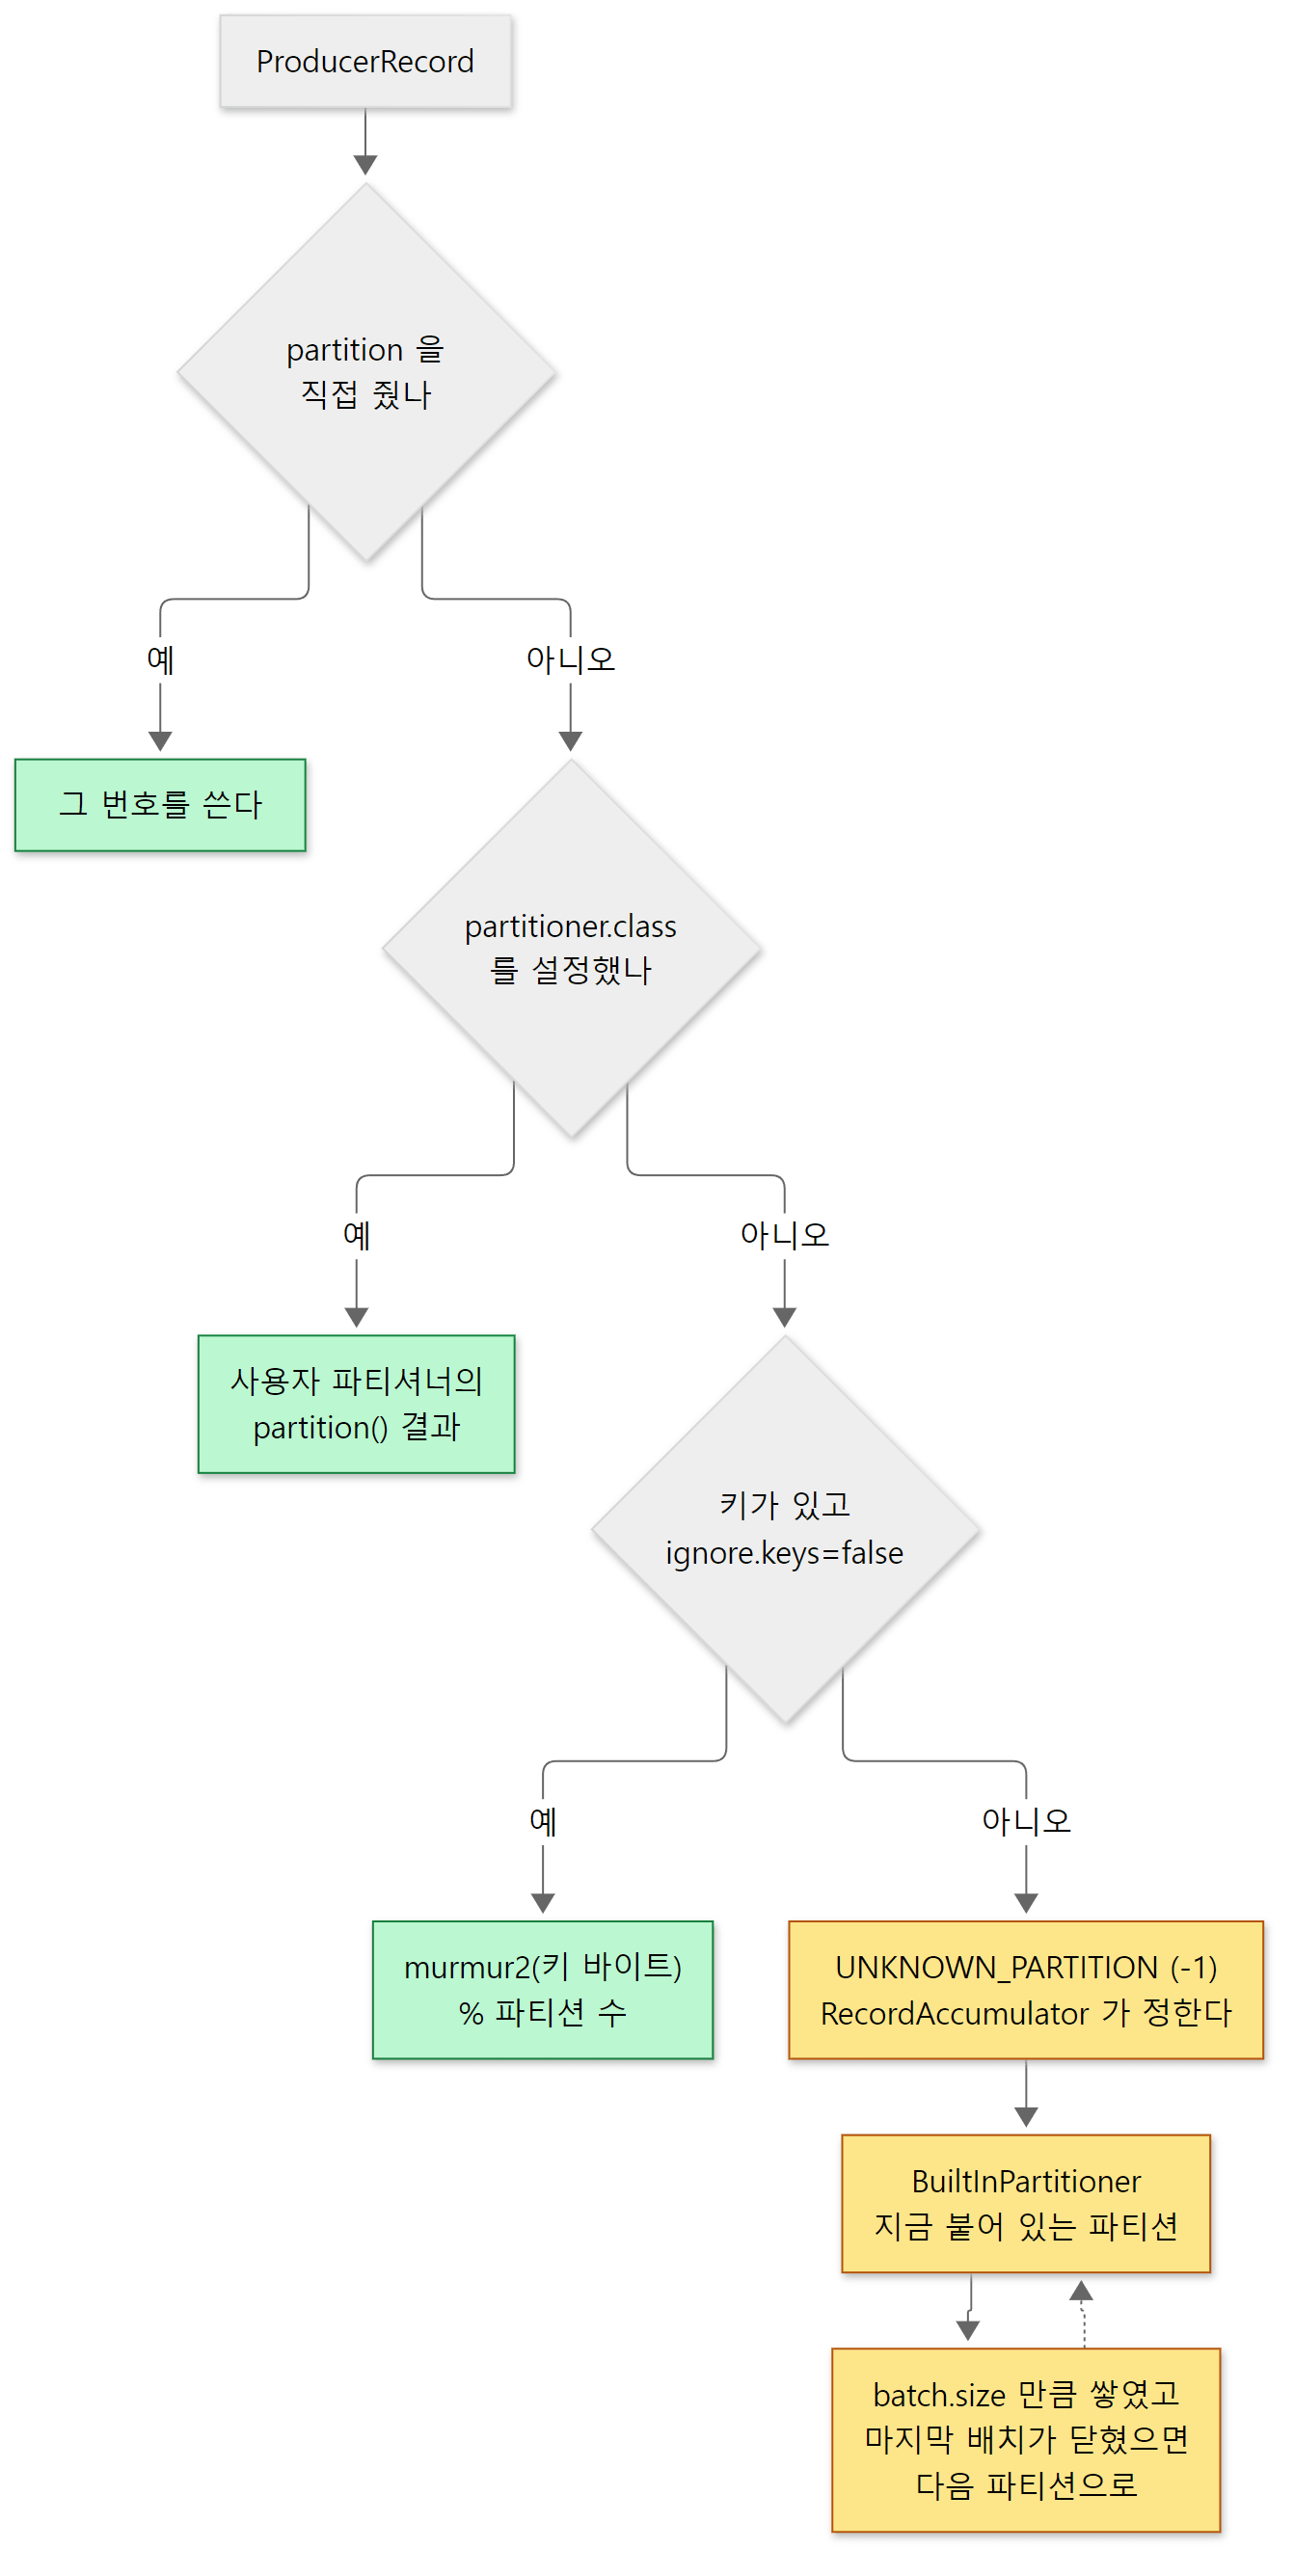 초록 상자는
send() 를 부른 스레드가 partition() 에서 곧바로 번호를 정하는 경우, 노란 상자는 번호를 RecordAccumulator.append() 안에서 정하는 경우입니다.
키가 있으면 partitionForKey() 가 정합니다. 키 바이트의 murmur2 해시를 양수로 만들어 파티션 수로 나눈 나머지입니다.
    public static int partitionForKey(final byte[] serializedKey, final int numPartitions) {
        return Utils.toPositive(Utils.murmur2(serializedKey)) % numPartitions;
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/BuiltInPartitioner.java 413–415행
그래서 같은 키는 파티션 수가 바뀌지 않는 한 늘 같은 파티션으로 갑니다. "같은 키의 순서가 지켜진다"는 Kafka 의 약속이 이 한 줄에서 시작합니다.
키가 없으면: 끈끈한(sticky) 파티셔너
키가 없으면 partition() 은 -1 을 돌려주고, 파티션은 RecordAccumulator.append() 안에서 정해집니다. 토픽마다 하나씩 있는 BuiltInPartitioner 가 "지금 붙어 있는 파티션"을 하나 들고 있다가 그 번호를 줍니다(peekCurrentPartitionInfo(), 174–186행). 레코드마다 파티션을 돌아가며 바꾸지 않고 한 파티션에 붙어서 보내다가, 충분히 보낸 뒤에야 옮깁니다. 옮기는 조건은 레코드를 덧붙인 직후 불리는 updatePartitionInfo() 에 있습니다.
        if (producedBytes >= stickyBatchSize && enableSwitch || producedBytes >= stickyBatchSize * 2) {
            // We've produced enough to this partition, switch to next.
            StickyPartitionInfo newPartitionInfo = new StickyPartitionInfo(nextPartition(cluster));
            stickyPartitionInfo.set(newPartitionInfo);
        }
clients/src/main/java/org/apache/kafka/clients/producer/internals/BuiltInPartitioner.java 254–258행
stickyBatchSize 는 batch.size 입니다(RecordAccumulator 가 topicInfoFor() 에서 batchSize 를 넘겨 만듭니다, RecordAccumulator.java 371–374행). enableSwitch 는 "그 파티션 줄의 마지막 배치가 닫혔는가(allBatchesFull())" 입니다. 정리하면 한 파티션에 batch.size 바이트 이상을 보냈고 그 파티션의 배치가 다 찼으면 옮기고, 배치가 덜 찼더라도 batch.size 의 두 배를 넘으면 옮깁니다. 바로 위 229–248행의 긴 주석이 이유를 설명합니다. 배치가 반쯤 찬 채로 파티션을 옮기면 덜 찬 배치가 늘어나 배치 효율이 떨어지기 때문입니다.
왜 이렇게 할까요? 키 없는 레코드를 파티션마다 하나씩 돌려 보내면 파티션 수만큼 배치가 동시에 열리고, 하나하나가 덜 찬 채로 linger.ms 를 맞아 작게 나갑니다. 한 파티션에 붙어 있으면 배치 하나가 빨리 차서 큰 배치로 나갑니다. 클래스 주석은 이것을 "adaptive sticky partitioning" 이라 부르고 KIP-794 를 가리킵니다(33–39행). 다음 파티션은 nextPartition() 이 무작위로 고르되, 이름의 "adaptive" 대로 브로커별로 쌓인 배치가 적은 파티션에 더 높은 확률을 줍니다(partitioner.adaptive.partitioning.enable, 기본 true). 그 가중치 계산(updatePartitionLoadStats())은 이 글에서 따라가지 않습니다.
예제 1-2: 키 없는 레코드와 키 있는 레코드의 배치
파티션 셋짜리 토픽 두 개에 100바이트짜리 값 600개를 linger.ms=1000, batch.size=1024 로 보냈습니다. 한쪽은 키 없이, 한쪽은 key-0 ~ key-9 열 가지 키를 돌려 가며 붙였습니다. 이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u05-batching 이고, 보내는 코드(Batching.java)와 앞쪽 실험은 4절에 있습니다. 출력의 아랫부분입니다.
=== 2. 3 partitions: records without a key vs with a key (linger.ms=1000 batch.size=1024)
u05-sticky-0: 26 batches, 208 records, records per batch: 8x26
u05-sticky-1: 27 batches, 216 records, records per batch: 8x27
u05-sticky-2: 22 batches, 176 records, records per batch: 8x22
u05-keyed-0: 23 batches, 180 records, records per batch: 8x22 4x1
u05-keyed-1: 23 batches, 180 records, records per batch: 8x22 4x1
u05-keyed-2: 30 batches, 240 records, records per batch: 8x30
8x26 은 "레코드 8개짜리 배치가 26개"라는 뜻입니다(run.sh 가 kafka-dump-log.sh 출력의 count: 를 모아 센 것).
- 키가 있으면 나뉘는 몫이 정해져 있습니다. 열 가지 키가 파티션 0·1·2 에 3·3·4 개씩 해시되어, 600개가 180·180·240 으로 갔습니다. 몇 번을 돌려도 같습니다. 파티션 0·1 은 마지막에 4개짜리 배치가 하나씩 남았습니다.
- 키가 없으면 몫이 실행마다 다릅니다. 이번에는 208·216·176 이었고, 앞서 돌렸을 때는 248·96·256 이었습니다. 다음 파티션을 무작위로 고르기 때문입니다. 대신 모든 배치가 8개짜리였습니다. 붙어 있는 파티션의 배치가 다 찬 뒤에 옮긴다는 위 조건대로입니다.
- 8개가 한계인 이유는 3절에서 봅니다(배치 하나가 1024바이트를 넘지 않게).
헷갈리기 쉬운 곳
- 키가
null이 아니라 빈 문자열이면 키가 있는 것입니다.partition()은serializedKey != null만 봅니다. 빈 문자열을StringSerializer로 직렬화하면 길이 0인 배열이 되고, 모든 레코드가 같은 해시 → 같은 파티션으로 갑니다. partitioner.class로 사용자 파티셔너를 꽂으면 끈끈한 파티셔너와 "adaptive" 계산이 모두 꺼집니다. 생성자는partitionerPlugin.get() == null일 때만 adaptive 를 켭니다(KafkaProducer.java 456–457행). 키가 있어도 해시 대신 무조건 끈끈한 방식을 쓰게 하려면partitioner.ignore.keys=true입니다(기본false, ProducerConfig.java 443행).
3. RecordAccumulator — 파티션마다 배치의 줄
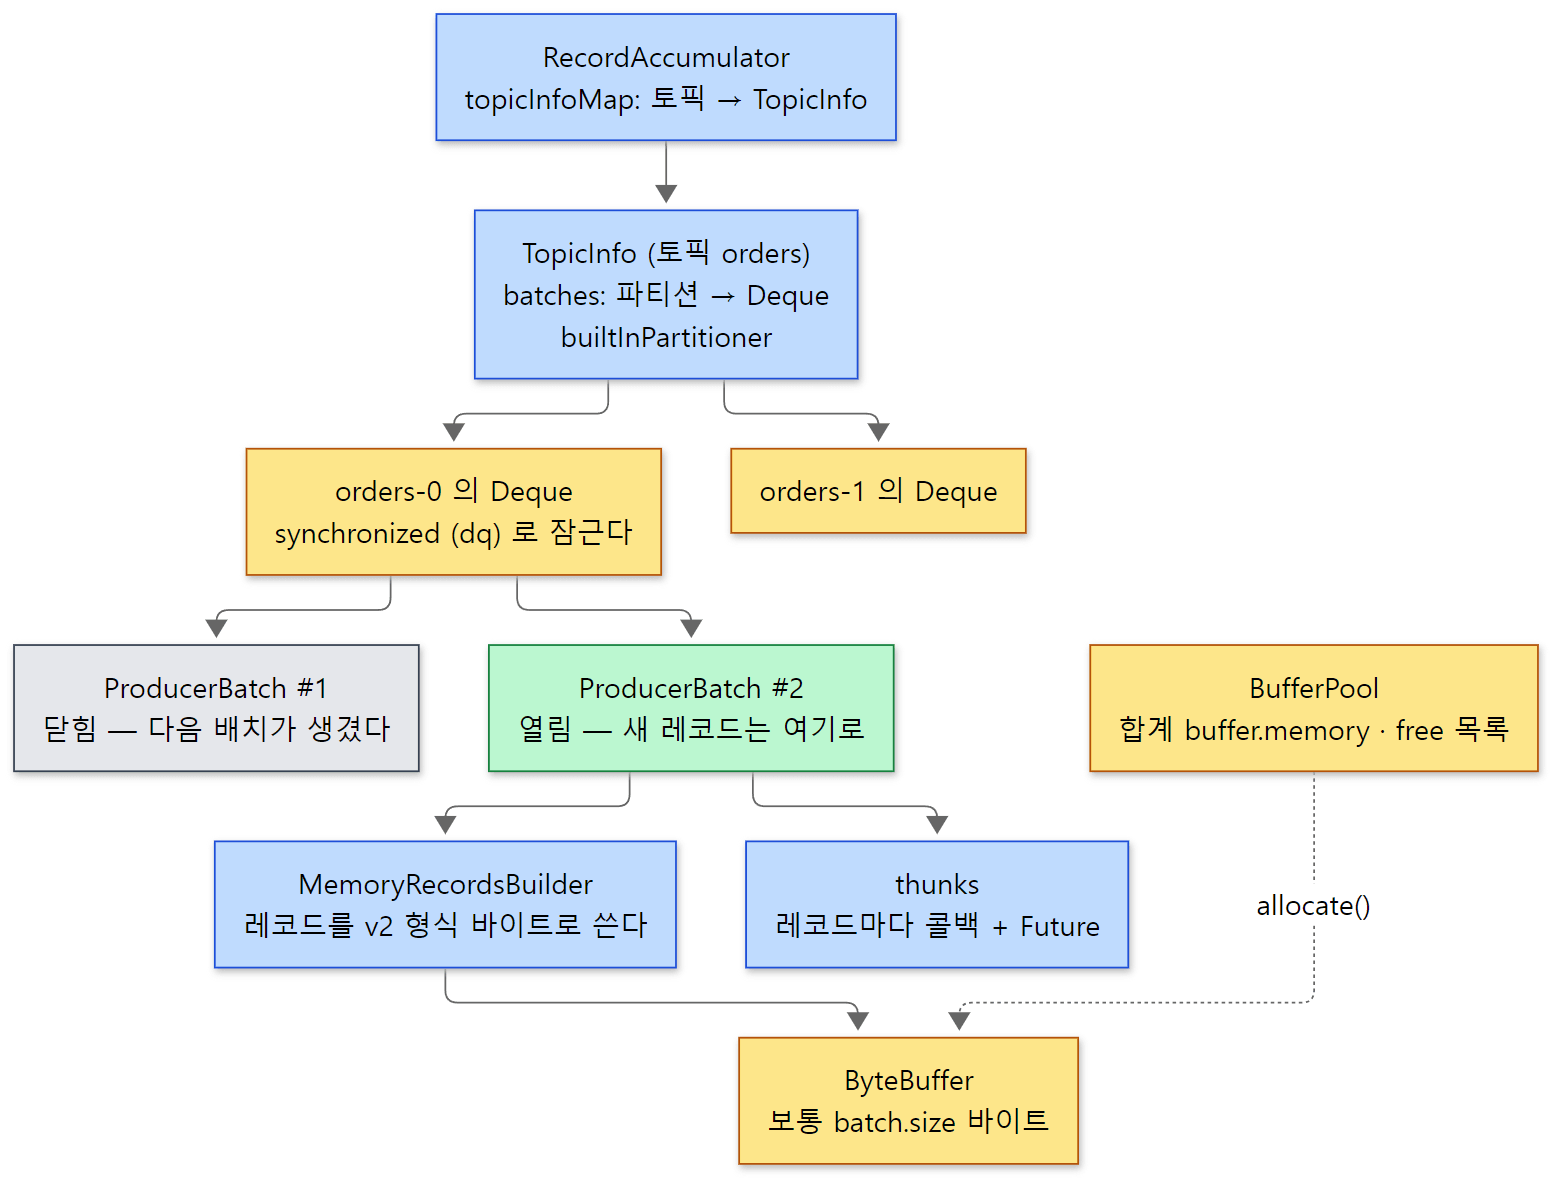 노란 상자가 메모리입니다. 줄의 맨 끝 배치만 열려 있고, 그 앞의 배치들은 모두 닫혀 차례를 기다립니다.
RecordAccumulator 는 토픽 → TopicInfo 맵(topicInfoMap)을 들고, TopicInfo 는 파티션 → Deque<ProducerBatch> 맵과 그 토픽의 BuiltInPartitioner 를 듭니다. 줄 하나를 여러 앱 스레드가 동시에 건드릴 수 있으므로(그리고 Sender 스레드도 꺼내 가므로) 줄마다 synchronized (dq) 로 잠급니다. 잠금이 토픽 전체가 아니라 파티션 줄 하나라서, 서로 다른 파티션에 쓰는 스레드끼리는 기다리지 않습니다. append() 의 핵심입니다.
                // check if we have an in-progress batch
                TopicPartition tp = new TopicPartition(topic, effectivePartition);
                Deque<ProducerBatch> dq = topicInfo.batches.computeIfAbsent(tp, k -> new ArrayDeque<>());
                synchronized (dq) {
                    // After taking the lock, validate that the partition hasn't changed and retry.
                    if (partitionChanged(topic, topicInfo, partitionInfo, dq, nowMs, cluster))
                        continue;

                    RecordAppendResult appendResult = tryAppend(timestamp, key, value, headers, callbacks, dq, nowMs);
                    if (appendResult.appended())
                        return updatePartitionInfoOnAppend(appendResult, topicInfo, partitionInfo, dq, cluster);
                }

                if (buffer == null) {
                    int size = Math.max(this.batchSize, AbstractRecords.estimateSizeInBytesUpperBound(
                            RecordBatch.CURRENT_MAGIC_VALUE, compression.type(), key, value, headers));
                    log.trace("Allocating a new {} byte message buffer for topic {} partition {} with remaining timeout {}ms", size, topic, effectivePartition, maxTimeToBlock);
                    // This call may block if we exhausted buffer space.
                    buffer = free.allocate(size, maxTimeToBlock);
                    // ...
                    nowMs = time.milliseconds();
                }

                synchronized (dq) {
                    // After taking the lock, validate that the partition hasn't changed and retry.
                    if (partitionChanged(topic, topicInfo, partitionInfo, dq, nowMs, cluster))
                        continue;

                    final ByteBuffer batchBuffer = buffer;
                    RecordAppendResult appendResult = appendNewBatch(tp, dq, timestamp, key, value, headers, callbacks,
                            () -> MemoryRecords.builder(batchBuffer, RecordBatch.CURRENT_MAGIC_VALUE, compression, TimestampType.CREATE_TIME, 0L),
                            nowMs);
                    // Set buffer to null, so that deallocate doesn't return it back to free pool, since it's used in the batch.
                    if (appendResult.newBatchCreated)
                        buffer = null;
                    return updatePartitionInfoOnAppend(appendResult, topicInfo, partitionInfo, dq, cluster);
                }
clients/src/main/java/org/apache/kafka/clients/producer/internals/RecordAccumulator.java 322–360행
이 코드 전체가 while (true) 안에 있습니다(304행). 읽는 법은 이렇습니다.
- 잠그고, 마지막 배치에 넣어 봅니다(
tryAppend()). 들어가면 끝입니다. 대부분의send()는 여기서 끝납니다. - 안 들어가면 잠금을 풀고 메모리를 받습니다.
free.allocate()는 메모리가 모자라면 기다리는 메서드라서(8절), 잠금을 쥔 채 부르면 같은 파티션에 쓰려는 다른 스레드와 그 줄에서 배치를 꺼내려는 Sender 까지 모두 멈춥니다. 그래서 잠금 바깥에서 부릅니다. 크기는batch.size와 이 레코드 하나의 최대 크기 가운데 큰 쪽입니다.batch.size보다 큰 레코드도 배치 하나에 혼자 들어갈 수 있다는 뜻입니다. - 다시 잠그고 새 배치를 만듭니다(
appendNewBatch()). 잠금을 풀었던 사이에 다른 스레드가 이미 새 배치를 만들었을 수 있으므로,appendNewBatch()는 먼저tryAppend()를 한 번 더 해 봅니다(481행). 그래도 안 들어가면 받아 온 버퍼로ProducerBatch를 만들어 줄 끝에 붙입니다(dq.addLast(batch), 495행). - 받은 버퍼를 쓰지 않았으면 돌려줍니다. 3번에서 다른 스레드의 배치에 들어갔다면 버퍼가 남습니다.
finally의free.deallocate(buffer)(363행)가 그것을 풀에 돌려줍니다. 새 배치에 썼으면buffer = null로 지워 돌려주지 않습니다. partitionChanged()와continue. 키 없는 레코드는 잠그기 전에 붙어 있는 파티션을 읽어 왔으므로, 잠금을 얻고 보니 다른 스레드가 이미 파티션을 옮겼을 수 있습니다. 그러면 처음부터 다시 합니다.
tryAppend() 는 마지막 배치에 넣어 보고, 안 들어가면 그 배치를 닫습니다.
        ProducerBatch last = deque.peekLast();
        if (last != null) {
            int initialBytes = last.estimatedSizeInBytes();
            FutureRecordMetadata future = last.tryAppend(timestamp, key, value, headers, callback, nowMs);
            if (future == null) {
                last.closeForRecordAppends();
            } else {
                int appendedBytes = last.estimatedSizeInBytes() - initialBytes;
                return RecordAppendResult.appended(future, deque.size() > 1 || last.isFull(), false, appendedBytes);
            }
        }
        return RecordAppendResult.NEEDS_NEW_BATCH;
clients/src/main/java/org/apache/kafka/clients/producer/internals/RecordAccumulator.java 536–547행
ProducerBatch.tryAppend() 는 MemoryRecordsBuilder.hasRoomFor() 가 거짓이면 null 을 돌려주고, 참이면 레코드를 버퍼에 쓰고 그 레코드 몫의 FutureRecordMetadata 와 콜백을 thunks 목록에 넣습니다(ProducerBatch.java 168–187행). 앱이 받은 Future 는 이 배치 하나의 결과(produceFuture)를 같이 바라봅니다. 배치 하나가 완료되면 그 안의 레코드 Future 가 한꺼번에 완료되는 이유입니다(5절).
배치가 "찼다"는 것
자리가 있는지는 MemoryRecordsBuilder 가 판단합니다. 레코드는 이 클래스가 버퍼에 바로 v2 형식 바이트로 씁니다. 배치 헤더 자리를 비워 두고 레코드를 차례로 쓴 뒤, 보내기 직전 close() 에서 헤더를 채웁니다(370–395행).
    public boolean hasRoomFor(long timestamp, ByteBuffer key, ByteBuffer value, Header[] headers) {
        if (isFull())
            return false;

        // We always allow at least one record to be appended (the ByteBufferOutputStream will grow as needed)
        if (numRecords == 0)
            return true;

        final int recordSize;
        if (magic < RecordBatch.MAGIC_VALUE_V2) {
            recordSize = Records.LOG_OVERHEAD + LegacyRecord.recordSize(magic, key, value);
        } else {
            int nextOffsetDelta = lastOffset == null ? 0 : (int) (lastOffset - baseOffset + 1);
            long timestampDelta = baseTimestamp == null ? 0 : timestamp - baseTimestamp;
            recordSize = DefaultRecord.sizeInBytes(nextOffsetDelta, timestampDelta, key, value, headers);
        }

        // Be conservative and not take compression of the new record into consideration.
        return this.writeLimit >= estimatedBytesWritten() + recordSize;
    }
clients/src/main/java/org/apache/kafka/common/record/internal/MemoryRecordsBuilder.java 882–901행
writeLimit 은 받은 버퍼의 남은 크기(보통 batch.size)입니다(MemoryRecords.builder() 가 buffer.remaining() 을 넘깁니다, MemoryRecords.java 584–586행). "지금까지 쓴 바이트 + 이 레코드" 가 그것을 넘으면 자리가 없습니다. 첫 레코드는 크기와 상관없이 언제나 받습니다. 예제 1-2 에서 배치가 8개였던 것을 계산해 보면, 배치 헤더 61바이트에 100바이트 값의 레코드가 약 109바이트씩이라 8개면 933바이트, 9개면 1,042바이트로 1024 를 넘습니다(예제 1-1 의 size: 933 이 그 값입니다).
헷갈리기 쉬운 곳: "가득 찬 배치"는 대개 "다음 배치가 생긴 배치"입니다
batch.size=1024 이고 933바이트까지 찬 배치는 "찼다"고 할 수 있을까요? isFull() 은 이렇습니다.
    public boolean isFull() {
        // note that the write limit is respected only after the first record is added which ensures we can always
        // create non-empty batches (this is used to disable batching when the producer's batch size is set to 0).
        return appendStream == CLOSED_STREAM || (this.numRecords > 0 && this.writeLimit <= estimatedBytesWritten());
    }
clients/src/main/java/org/apache/kafka/common/record/internal/MemoryRecordsBuilder.java 919–923행
933 < 1024 이므로 거짓입니다. 레코드 크기가 batch.size 를 딱 나누어떨어지게 채우는 일은 드물어서, 배치는 보통 다음 레코드가 안 들어가 닫힐 때(closeForRecordAppends() → CLOSED_STREAM) 비로소 "찬" 것이 됩니다. 그래서 4절의 준비 조건도 full = dequeSize > 1 || batch.isFull() — "줄에 다음 배치가 있거나" 를 함께 봅니다(831행). 이것이 4절 예제에서 마지막 배치가 linger.ms 를 다 기다린 이유입니다.
참고로 이 커밋에는 배치 메모리를 처음부터 batch.size 만큼 잡지 않고 레코드가 쌓이는 대로 조각(chunk)씩 늘리는 ChunkedRecordAccumulator 가 들어와 있습니다. buffer.memory.allocation.strategy=incremental 로 켜는데, 이 설정은 defineInternal 로 숨겨져 있고 기본값은 full(지금까지의 방식)이며 압축과 함께 쓸 수 없습니다(KafkaProducer.java 467–517행, ProducerConfig.java 421–428행). 4.4.0 에도 같은 클래스와 설정이 있습니다. 이 글은 기본값인 full 쪽만 봅니다.
4. 언제 보내나 — ready() 의 if 하나
배치를 언제 보낼지는 Sender 스레드가 RecordAccumulator.ready() 로 묻습니다. ready() 는 토픽·파티션을 돌며 줄마다 맨 앞 배치를 보고, 그 배치를 보낼 만하면 그 파티션의 리더 브로커를 "보낼 것이 있는 노드" 집합에 넣습니다. 판단은 batchReady() 에 모여 있습니다.
    private long batchReady(boolean exhausted, Node leader,
                            long waitedTimeMs, boolean backingOff, int backoffAttempts,
                            boolean full, long nextReadyCheckDelayMs, Set<Node> readyNodes) {
        long timeToWaitMs = backingOff ? retryBackoff.backoff(backoffAttempts > 0 ? backoffAttempts - 1 : 0) : lingerMs;
        boolean expired = waitedTimeMs >= timeToWaitMs;
        boolean transactionCompleting = transactionManager != null && transactionManager.isCompleting();
        boolean sendable = full
| expired
| exhausted
| closed
| flushInProgress()
| transactionCompleting;
        if (sendable && !backingOff) {
            readyNodes.add(leader);
        } else {
            long timeLeftMs = Math.max(timeToWaitMs - waitedTimeMs, 0);
            // Note that this results in a conservative estimate since an un-sendable partition may have
            // a leader that will later be found to have sendable data. However, this is good enough
            // since we'll just wake up and then sleep again for the remaining time.
            nextReadyCheckDelayMs = Math.min(timeLeftMs, nextReadyCheckDelayMs);
        }
        return nextReadyCheckDelayMs;
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/RecordAccumulator.java 714–736행
linger.ms 가 쓰이는 if 가 여기입니다. lingerMs 필드가 timeToWaitMs 가 되고, 배치가 기다린 시간(waitedTimeMs, 처음에는 만들어진 뒤 지난 시간)이 그것을 넘으면 expired 입니다. sendable 의 여섯 조건을 표로 정리하면 이렇습니다.
| 조건 | 뜻 | 어디서 오나 |
|---|---|---|
full |
줄에 다음 배치가 있거나 맨 앞 배치가 찼다 | partitionReady() 831행 |
expired |
맨 앞 배치가 linger.ms 이상 기다렸다 |
위 코드 |
exhausted |
BufferPool 에서 메모리를 기다리는 스레드가 있다 |
this.free.queued() > 0, 773행 |
closed |
프로듀서를 닫는 중이다 | close() |
flushInProgress() |
누가 producer.flush() 를 불러 기다리는 중이다 |
beginFlush() |
transactionCompleting |
트랜잭션을 커밋·중단하는 중이다 | 12편 |
보낼 만하지 않은 배치는 "언제 다시 보면 되는지"(timeLeftMs)를 남깁니다. 모든 파티션 가운데 가장 작은 값이 nextReadyCheckDelayMs 가 되어 Sender 가 그만큼만 잠들게 합니다(5절). 재시도 중인 배치(backingOff)는 linger.ms 대신 재시도 대기 시간을 씁니다(7절).
ready() 는 파티션 줄을 잠그는 시간을 줄이려고 잠금 안에서는 맨 앞 배치의 몇 값만 읽어 두고, 판단(batchReady())은 잠금 밖에서 합니다. 주석은 파티션이 많을 때 이 반복이 "특히 뜨겁다(hot)"며 send() 하는 스레드와의 경합을 피하라고 적고 있습니다(801–808행).
예제 1-1: linger.ms 와 batch.size 를 바꾸면
같은 레코드(100바이트 값 200개, 키 없음)를 파티션 하나짜리 토픽에 설정 넷으로 보내고, 디스크에 몇 개의 배치로 들어갔는지 kafka-dump-log.sh 로 셌습니다. 보내는 코드의 핵심입니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 같은 레코드를 설정만 바꿔 보낸다. 배치가 어떻게 묶였는지는 run.sh 가 kafka-dump-log.sh 로 본다.
public class Batching {
    public static void main(String[] args) throws Exception {
        // ... args 에서 토픽, 레코드 수, linger.ms, batch.size, sync/async 를 읽고, bootstrap.servers 와 직렬화기를 설정한다 ...
        props.put(ProducerConfig.LINGER_MS_CONFIG, linger);          // "linger.ms"
        props.put(ProducerConfig.BATCH_SIZE_CONFIG, batchSize);      // "batch.size"

        String value = "v".repeat(100);                               // 값은 100바이트로 고정
        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.partitionsFor(topic);                            // 메타데이터를 미리 받아 둔다(시간 재기에서 빼려고)
            CountDownLatch done = new CountDownLatch(count);
            long start = System.nanoTime();
            for (int i = 0; i < count; i++) {
                String key = withKey ? "key-" + (i % 10) : null;     // 키가 없으면 내장 파티셔너가 고른다
                ProducerRecord<String, String> rec = new ProducerRecord<>(topic, key, value);
                if (sync) {
                    producer.send(rec).get();                         // 응답을 받고 나서야 다음 레코드
                    done.countDown();
                } else {
                    producer.send(rec, (md, e) -> done.countDown());  // 쌓아 두고 바로 다음 레코드
                }
            }
            // ... send() 반복이 끝난 시각과 모든 콜백이 온 시각을 찍는다 ...
        }
    }
}
[예제 ex/u05-batching/Batching.java 에서 줄임]
=== 1. 200 records of 100 bytes, four producer settings
u05-sync: linger.ms=0 batch.size=16384 sync -> send() loop 1790 ms, all acked 1790 ms
u05-small: linger.ms=1000 batch.size=1024 async -> send() loop 110 ms, all acked 1119 ms
u05-large: linger.ms=1000 batch.size=16384 async -> send() loop 157 ms, all acked 1181 ms
u05-default: linger.ms=5 batch.size=16384 async -> send() loop 56 ms, all acked 173 ms
--- batches on disk (kafka-dump-log.sh)
u05-sync-0: 200 batches, 200 records, records per batch: 1x200
u05-small-0: 25 batches, 200 records, records per batch: 8x25
u05-large-0: 2 batches, 200 records, records per batch: 148x1 52x1
u05-default-0: 3 batches, 200 records, records per batch: 148x1 43x1 9x1
--- first two batch headers of u05-small
baseOffset: 0 lastOffset: 7 count: 8 baseSequence: 0 lastSequence: 7 producerId: 1 CreateTime: 1794025632545 size: 940
baseOffset: 8 lastOffset: 15 count: 8 baseSequence: 8 lastSequence: 15 producerId: 1 CreateTime: 1794025632555 size: 933
시간(ms)·CreateTime·producerId 는 실행마다 다릅니다. 배치 헤더 줄은 필요한 칸만 남겼습니다.
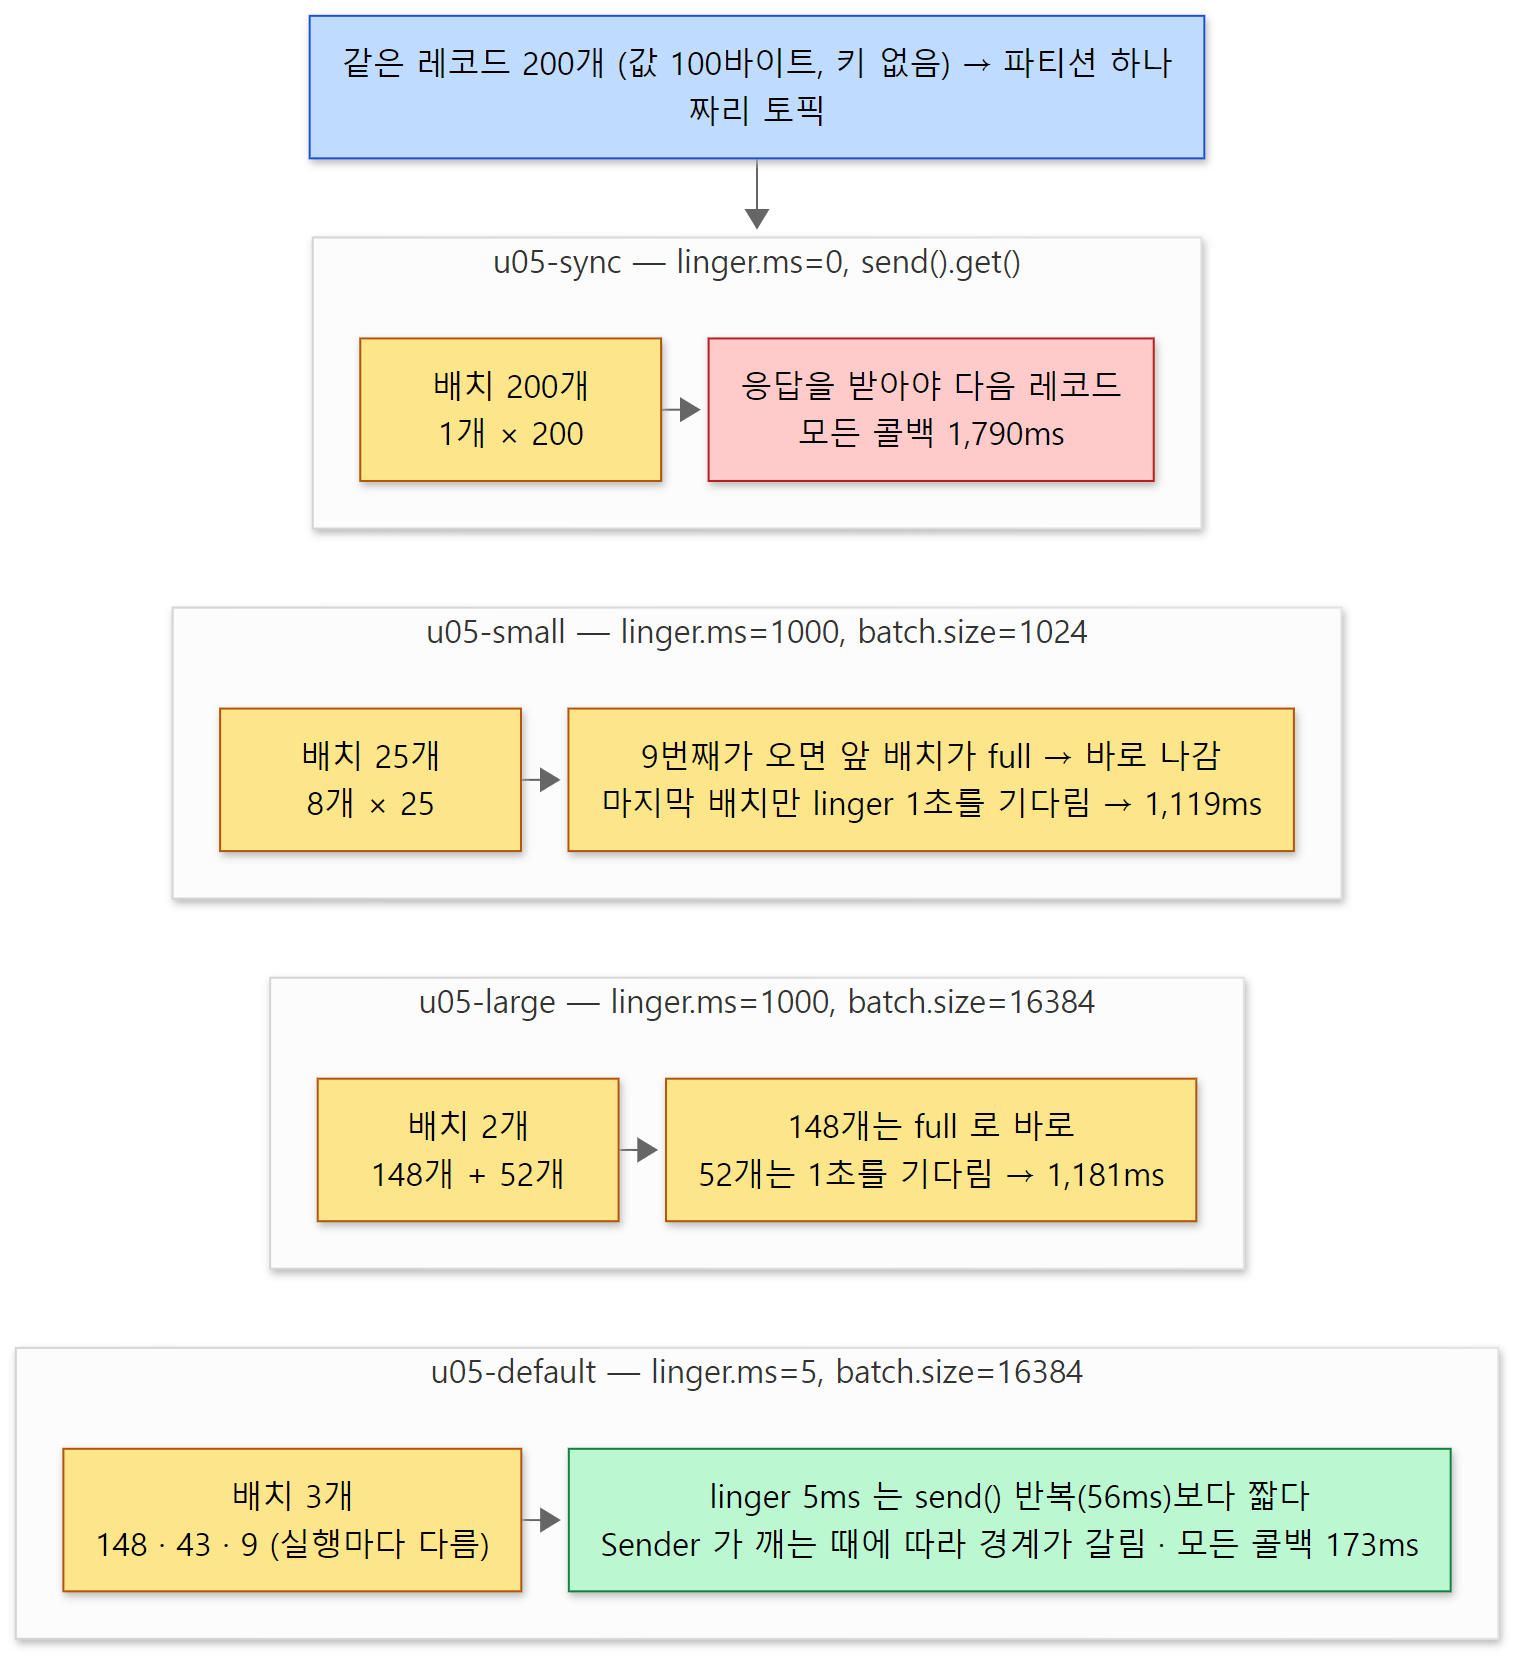 설정 넷이 만든 배치 모양. 숫자는 모두 위 예제 1-1의 실제 출력입니다(시간과 기본값의 배치 경계는 실행마다 다릅니다).
u05-sync: 배치 200개.send().get()으로 응답을 받을 때마다 다음 레코드를 보내니, 대기실에 레코드가 둘 이상 모일 틈이 없습니다. 배치를 만드는 것은 프로듀서의 설정이 아니라send()를 기다리지 않고 잇달아 부르는 앱의 호출 방식이라는 것을 보여 줍니다. 왕복 200번이라 가장 느립니다.u05-small: 8개짜리 배치 25개.batch.size=1024에 8개까지 들어가니(3절의 계산), 9번째 레코드가 올 때마다 앞 배치가 닫히고(full) 곧바로 나갑니다. 그런데 모든 콜백이 온 것은 1,119ms 입니다. 마지막 25번째 배치는 8개가 들어 있지만isFull()이 거짓이고 뒤따르는 배치도 없어서full이 아니고,linger.ms=1000을 다 기다린 뒤에야expired로 나갔습니다.u05-large: 148개와 52개. 16KB 배치에는 148개가 들어갑니다. 첫 배치는 149번째 레코드가 오며 닫혀 바로 나가고, 나머지 52개짜리는 역시 1초를 기다렸습니다. 다시 돌렸을 때는 147개와 53개였습니다. 레코드 안의 타임스탬프 차이(timestampDelta)는 가변 길이 정수로 적히므로(DefaultRecord.java 541행), 첫 레코드들이 느리게 나가 그 차이가 커지면 레코드가 1바이트씩 커져 한 개가 덜 들어갈 수 있습니다(위 헤더의 첫 배치가size: 940으로 둘째 배치보다 7바이트 큰 것도 같은 까닭으로 보입니다).run.sh가 찍는148x1 52x1의 순서는 배치 순서가 아닙니다.u05-default: 기본값(linger.ms=5)은 실행마다 다릅니다. 이번에는 148·43·9 였고, 앞서 돌렸을 때는 148·52 와 83·117 이 나왔습니다. 5밀리초는send()반복 한 번(56ms)보다 짧으므로, Sender 가 언제 깨어ready()를 보느냐에 따라 배치 경계가 달라집니다. 그래도 200번 왕복(1번)보다 훨씬 빠릅니다.- 헤더의
producerId: 1,baseSequence: 0·8은 멱등 프로듀서가 붙인 값입니다(기본값enable.idempotence=true). 일련번호가 배치마다 이어집니다. 이 번호를 붙이는 곳은 6절에서 잠깐 보고, 쓰임새는 12편에서 봅니다.
헷갈리기 쉬운 곳
linger.ms의 기본값은 이 커밋과 4.4.0 모두 5 입니다(ProducerConfig.java 445행). 오래된 글에서 "기본값 0" 을 보았다면 그것은 그 시절 판의 이야기입니다(언제 바뀌었는지는 이 글에서 소스로 확인하지 않았습니다).batch.size=0은 "배치를 쓰지 않음"입니다. 생성자가Math.max(1, …)로 1로 올리고(KafkaProducer.java 466행),hasRoomFor()는 첫 레코드만 받으므로 배치마다 레코드가 하나입니다.linger.ms는 "그만큼 기다린 뒤 보낸다"가 아니라 "늦어도 그만큼 지나면 보낸다"입니다. 배치가 먼저 차면(full) 기다리지 않습니다. 반대로linger.ms=0이어도 Sender 가 다른 일을 하는 동안 쌓인 레코드는 한 배치로 묶입니다.
5. Sender 스레드의 한 바퀴
Sender 스레드는 KafkaProducer 생성자의 끝에서 만들어집니다.
            this.sender = newSender(logContext, kafkaClient, this.metadata, clientInstanceId);
            String ioThreadName = NETWORK_THREAD_PREFIX + " | " + clientId;
            this.ioThread = new Sender.SenderThread(ioThreadName, this.sender, true);
            this.ioThread.start();
clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java 520–523행
NETWORK_THREAD_PREFIX 는 "kafka-producer-network-thread"(255행)이고, 세 번째 인자 true 는 데몬 스레드라는 뜻입니다. 프로듀서 하나에 스레드 하나입니다. 브로커가 몇 대든, 파티션이 몇 개든 이 스레드 하나가 모든 연결을 다룹니다. 그 스레드의 몸통은 Sender.run() 의 반복입니다.
        // main loop, runs until close is called
        while (running) {
            try {
                runOnce();
            } catch (Exception e) {
                log.error("Uncaught error in kafka producer I/O thread: ", e);
            }
        }
clients/src/main/java/org/apache/kafka/clients/producer/internals/Sender.java 244–251행
runOnce() 는 트랜잭션 처리를 빼면 두 줄입니다. 보낼 것을 보내고(sendProducerData()), 네트워크를 돌립니다(client.poll()).
        long currentTimeMs = time.milliseconds();
        long pollTimeout = sendProducerData(currentTimeMs);
        client.poll(pollTimeout, currentTimeMs);
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/Sender.java 343–346행
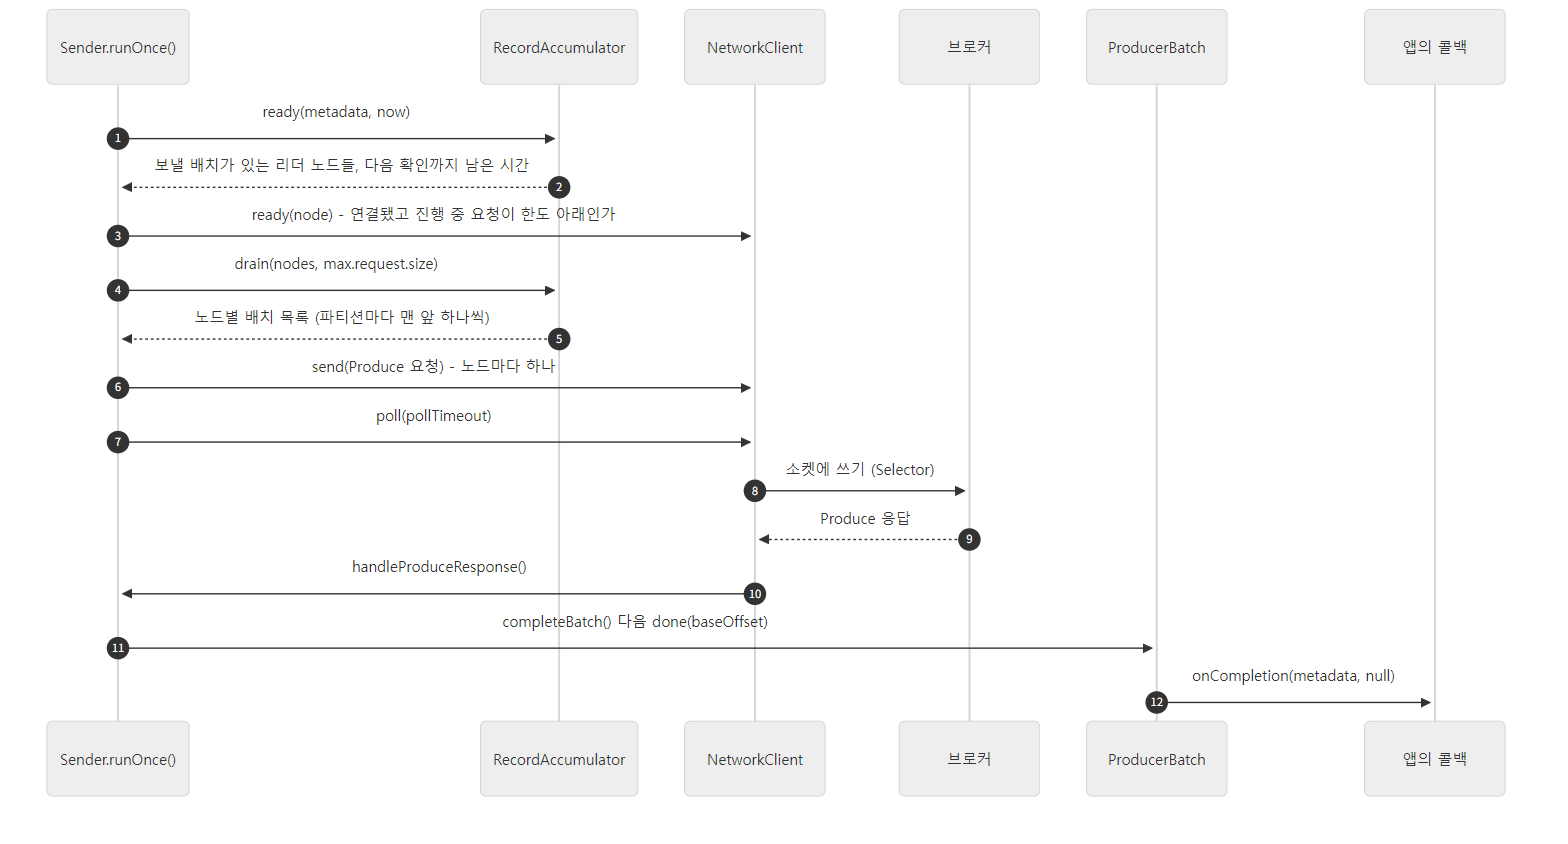 모든 단계가 Sender 스레드 하나에서 일어납니다. 응답(9번)은 보통 같은 바퀴가 아니라 그 뒤 어느 바퀴의
poll() 에서 도착합니다.
sendProducerData() 의 큰 줄기는 그림의 1~6번입니다.
accumulator.ready()— 4절의 판단으로 보낼 것이 있는 리더 노드들을 모읍니다. 리더를 모르는 파티션이 있으면 메타데이터 갱신을 요청합니다.client.ready(node, now)— 그 노드로 지금 보낼 수 있는지 봅니다. 연결이 없으면 이때 연결을 시작하고 이번 바퀴에서는 뺍니다(NetworkClient.java 434–446행). 진행 중 요청이 한도에 닿아도 뺍니다(6절).accumulator.drain()— 남은 노드마다 그 노드가 리더인 파티션들을 돌며 줄 맨 앞 배치를 하나씩 꺼내, 합이max.request.size(기본 1MB)를 넘기 직전까지 모읍니다(976–1060행). 꺼낸 배치는batch.close()로 헤더를 채워 완성합니다. 매번 같은 파티션부터 꺼내면 뒤쪽 파티션이 굶으므로, 노드마다 시작 위치(drainIndex)를 기억해 다음에는 이어서 돕니다(982행의 주석 "to make starvation less likely").- 만료 정리 —
delivery.timeout.ms가 지난 배치를 실패시킵니다(7절). sendProduceRequests()— 노드마다 Produce 요청 하나를 만듭니다. 3편에서 본ProduceRequestData에 토픽·파티션별로 배치의MemoryRecords를 그대로 담습니다(896–949행). 앱 설정acks는 여기서 요청의Acks칸이 됩니다(setAcks(acks)).acks=all은ProducerConfig가 미리-1로 바꿔 둡니다(707행).acks=0이면newClientRequest(…, acks != 0, …)로 "응답을 기다리지 않는 요청"이 되어, 소켓에 다 쓰는 순간 완료됩니다(NetworkClient.java 1061–1070행). 브로커가 각acks에서 언제 응답하는지는 6편과 9편에서 봅니다.pollTimeout— 보낼 노드가 있었으면 0(곧바로 다음 바퀴), 없으면 4절의nextReadyCheckDelayMs(가장 이른linger.ms만료)와 배치 만료 시각 가운데 이른 쪽입니다(2번에서 뺀 노드가 있으면 그 노드에 다시 연결해 볼 수 있을 때까지의 시간도 함께 봅니다)(437–452행).
그다음 client.poll(pollTimeout) 이 Selector 를 돌립니다. 이 Selector 는 4편에서 브로커의 Processor 가 쓰던 바로 그 org.apache.kafka.common.network.Selector 입니다. Sender 는 정확히는 그 안에서 잠듭니다. 앱 스레드가 sender.wakeup() 을 부르면 client.wakeup() → Selector.wakeup() 으로 이 잠을 깨웁니다(Sender.java 963–965행).
        long metadataTimeout = metadataUpdater.maybeUpdate(now);
        long telemetryTimeout = telemetrySender != null ? telemetrySender.maybeUpdate(now) : Integer.MAX_VALUE;
        try {
            this.selector.poll(Utils.min(timeout, metadataTimeout, telemetryTimeout, defaultRequestTimeoutMs));
        } catch (IOException e) {
            log.error("Unexpected error during I/O", e);
        }

        // process completed actions
        long updatedNow = this.time.milliseconds();
        List<ClientResponse> responses = new ArrayList<>();
        handleCompletedSends(responses, updatedNow);
        handleCompletedReceives(responses, updatedNow);
        // ... 끊긴 연결, 새 연결, ApiVersions, 시간 초과 처리 ...
        completeResponses(responses);
clients/src/main/java/org/apache/kafka/clients/NetworkClient.java 718–737행
completeResponses() 가 각 요청에 붙여 둔 완료 처리기를 부릅니다. Produce 요청의 완료 처리기는 Sender.handleProduceResponse() 이고(942행), 거기서 파티션별 결과로 completeBatch() → ProducerBatch.done() → 레코드마다 Future 완료와 콜백 호출로 이어집니다(ProducerBatch.java 318–345행). 즉 콜백은 Sender 스레드에서 불립니다.
예제 2: send() 를 부른 스레드와 콜백이 도는 스레드
client.id=u05-app 으로 프로듀서를 만들고, 레코드 하나를 보낸 뒤 콜백 안에서 스레드 이름과 호출 스택(Kafka 프레임만)을 찍었습니다. 이어서 max.request.size(1MB)보다 큰 2MB 값을 보냈습니다. 예제 폴더는 ex/u05-threads 입니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// send() 를 부른 스레드와 콜백이 도는 스레드를 비교하고, 콜백 안에서 호출 스택을 찍는다.
            // ... 프로듀서를 만들고(client.id=u05-app), 이름이 kafka-producer 로 시작하는 스레드를 찍는다 ...
            System.out.println("send() called on: " + Thread.currentThread().getName());
            CountDownLatch done = new CountDownLatch(1);
            producer.send(new ProducerRecord<>("u05-threads", "k", "hello"), (md, e) -> {
                System.out.println("callback ran on:  " + Thread.currentThread().getName()
                        + " (partition " + md.partition() + ", offset " + md.offset() + ")");
                // ... new Throwable().getStackTrace() 에서 org.apache.kafka 프레임만 아래에서 위로 찍는다 ...
                done.countDown();
            });
            done.await();

            // 3) send() 안에서 바로 실패하는 레코드: max.request.size(기본 1MB)보다 큰 값
            String big = "x".repeat(2 * 1024 * 1024);
            producer.send(new ProducerRecord<>("u05-threads", "k", big), (md, e) ->
                    System.out.println("callback for a too-large record ran on: " + Thread.currentThread().getName()
                            + " -> " + e.getClass().getSimpleName()));
            System.out.println("send() of the too-large record returned");
[예제 ex/u05-threads/Threads.java 에서 줄임]
=== which thread runs what
thread after new KafkaProducer(): kafka-producer-network-thread | u05-app daemon=true
send() called on: main
callback ran on:  kafka-producer-network-thread | u05-app (partition 0, offset 0)
callback stack (bottom = first called, Kafka frames only):
  clients.producer.internals.Sender.run:247
  clients.producer.internals.Sender.runOnce:345
  clients.NetworkClient.poll:737
  clients.NetworkClient.completeResponses:745
  clients.ClientResponse.onComplete:154
  clients.producer.internals.Sender.lambda$sendProduceRequest$0:942
  clients.producer.internals.Sender.handleProduceResponse:609
  clients.producer.internals.Sender.lambda$handleProduceResponse$0:609
  clients.producer.internals.Sender.lambda$handleProduceResponse$1:635
  clients.producer.internals.Sender.completeBatch:733
  clients.producer.internals.Sender.completeBatch:762
  clients.producer.internals.ProducerBatch.complete:243
  clients.producer.internals.ProducerBatch.done:297
  clients.producer.internals.ProducerBatch.completeFutureAndFireCallbacks:333
  clients.producer.KafkaProducer$AppendCallbacks.onCompletion:1807
  (user callback)
callback for a too-large record ran on: main -> RecordTooLargeException
send() of the too-large record returned
- 프로듀서를 만들기만 해도 스레드가 하나 생깁니다. 이름 끝이
client.id이고 데몬 스레드입니다.client.id를 주지 않으면producer-1처럼 번호가 붙은 이름이 됩니다(예제 3의 출력). - 콜백은
main이 아니라 Sender 스레드에서 돕니다. 스택을 아래에서 위로 읽으면 위 그림의 7~12번 그대로입니다.Sender.run→runOnce의client.poll()(345행) →NetworkClient.completeResponses→handleProduceResponse→completeBatch→ProducerBatch.done→completeFutureAndFireCallbacks→ 앱 콜백. - 그런데 너무 큰 레코드의 콜백은
main에서 돌았습니다. 1절의ensureValidRecordSize()가send()안에서RecordTooLargeException을 던지고,doSend()의catch (ApiException e)가 그 자리에서 콜백을 부른 뒤 실패한Future를 돌려주기 때문입니다(1252–1267행).send()는 예외를 던지지 않고 돌아왔습니다.
헷갈리기 쉬운 곳: 콜백 안에서 오래 걸리는 일을 하면 프로듀서 전체가 멈춥니다
콜백이 Sender 스레드에서 돈다는 것은, 콜백이 끝날 때까지 그 프로듀서의 모든 전송과 응답 처리가 멈춘다는 뜻입니다. Sender 는 하나뿐이고, 콜백은 client.poll() 안에서 차례로 불리기 때문입니다. 콜백에서 DB 에 쓰거나 다른 future.get() 을 기다리면 그동안 배치가 나가지 않고, 대기실이 차면 send() 까지 막힙니다(8절). 무거운 일은 다른 스레드(실행기)로 넘겨야 합니다. 그리고 예제 2의 3번처럼 콜백은 send() 를 부른 스레드에서 불릴 수도 있습니다. 콜백이 늘 같은 스레드에서 돈다고 가정한 코드는 틀릴 수 있습니다.
6. 진행 중 요청과 순서 — 두 가지 "mute"
client.ready(node) 가 거짓이 되는 이유 가운데 하나가 진행 중 요청의 한도입니다. NetworkClient 는 노드마다 보낸 요청을 InFlightRequests 에 줄 세워 두고, 응답이 오면 빼냅니다.
    public boolean canSendMore(String node) {
        Deque<NetworkClient.InFlightRequest> queue = requests.get(node);
        return queue == null || queue.isEmpty() ||
               (queue.peekFirst().send.completed() && queue.size() < this.maxInFlightRequestsPerConnection);
    }
clients/src/main/java/org/apache/kafka/clients/InFlightRequests.java 96–100행
조건은 둘입니다. 가장 최근에 보낸 요청을 소켓에 다 썼고(send.completed() — 이 줄에는 새 요청이 앞쪽에 들어갑니다), 진행 중 요청이 max.in.flight.requests.per.connection 보다 적어야 합니다. 기본값 5(ProducerConfig.java 520–525행)면 응답을 기다리지 않고 한 브로커에 Produce 요청을 다섯 개까지 보내 둡니다. 왕복 시간 동안 연결이 놀지 않게 하려는 것입니다.
4편에서 브로커는 연결 하나의 요청을 하나씩만 처리한다고 했습니다(Processor 가 요청을 하나 읽으면 그 연결을 mute). 둘은 부딪히지 않습니다. 프로듀서가 다섯 개를 보내 두어도 브로커는 소켓 버퍼에 쌓인 것을 차례로 하나씩 읽어 처리하고, 응답도 보낸 순서대로 돌아옵니다. 클라이언트의 한도는 "선 위에 몇 개를 띄워 둘까", 브로커의 mute 는 "몇 개를 동시에 처리할까"의 문제입니다.
프로듀서 쪽의 또 다른 mute
max.in.flight.requests.per.connection=1 로 두면 프로듀서는 다른 장치를 하나 더 켭니다. newSender() 가 maxInflightRequests == 1 을 guaranteeMessageOrder 로 넘기고(KafkaProducer.java 599행), Sender 는 꺼낸 배치의 파티션을 mute 합니다.
        Map<Integer, List<ProducerBatch>> batches = this.accumulator.drain(metadataSnapshot, result.readyNodes, this.maxRequestSize, now);
        addToInflightBatches(batches);
        if (guaranteeMessageOrder) {
            // Mute all the partitions drained
            for (List<ProducerBatch> batchList : batches.values()) {
                for (ProducerBatch batch : batchList)
                    this.accumulator.mutePartition(batch.topicPartition);
            }
        }
clients/src/main/java/org/apache/kafka/clients/producer/internals/Sender.java 418–426행
mute 된 파티션은 ready()·drain() 이 건너뛰고(isMuted(tp), 992행), 그 배치의 응답을 처리한 completeBatch() 끝에서 풀립니다(737–738행). 한 파티션의 배치가 한 번에 하나만 선 위에 있게 해서, 앞 배치가 실패해 재시도하는 사이 뒤 배치가 먼저 쓰여 순서가 뒤바뀌는 일을 막습니다. 이름은 같은 "mute" 지만 4편의 것은 브로커가 연결을, 이것은 프로듀서가 파티션을 잠시 멈추는 것입니다.
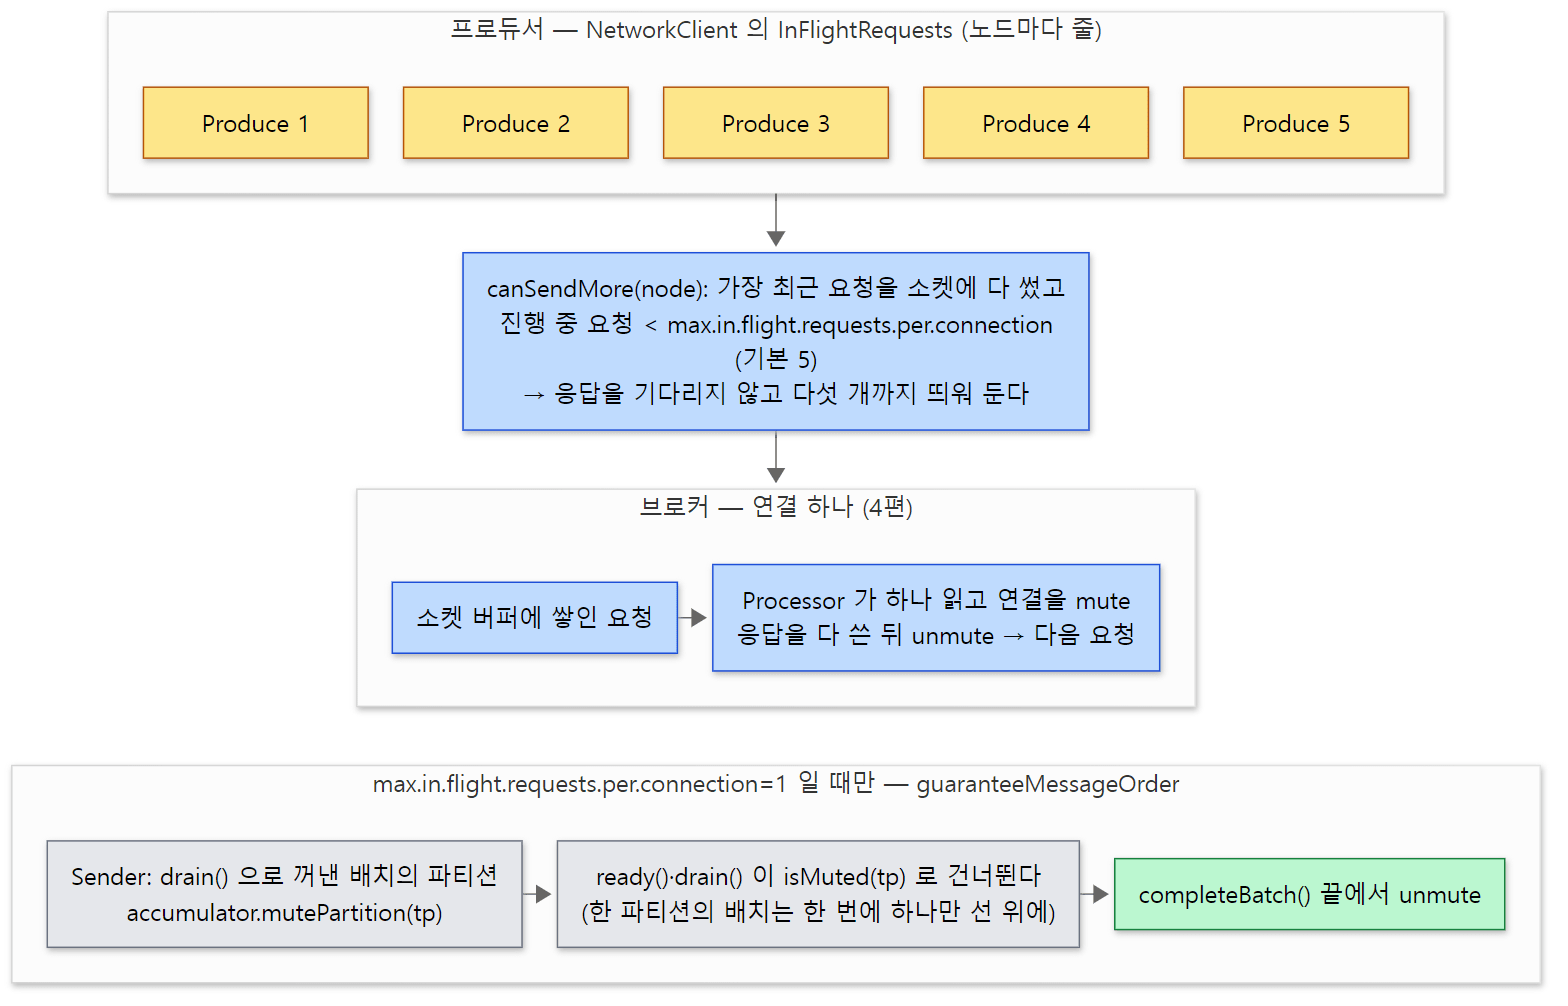 이름이 같은 두 "mute". 브로커는 연결을, 프로듀서(in-flight 1일 때)는 파티션을 멈춥니다. 클라이언트 한도는 "몇 개를 선 위에 띄울까"의 문제입니다.
멱등 프로듀서(기본값)는 이 장치 없이도 순서를 지키는 쪽을 택합니다. drain() 이 배치를 꺼낼 때 프로듀서 id 와 일련번호를 붙이고(batch.setProducerState(…), 1042행), 브로커가 번호로 중복과 빈틈을 검사합니다. 그 대신 ProducerConfig 는 멱등성을 켠 채 max.in.flight.requests.per.connection 을 5보다 크게 주면 설정 오류를 냅니다(672–676행). 일련번호로 순서를 지키는 자세한 규칙은 12편에서 봅니다.
7. 재시도와 delivery.timeout.ms — 배치의 일생
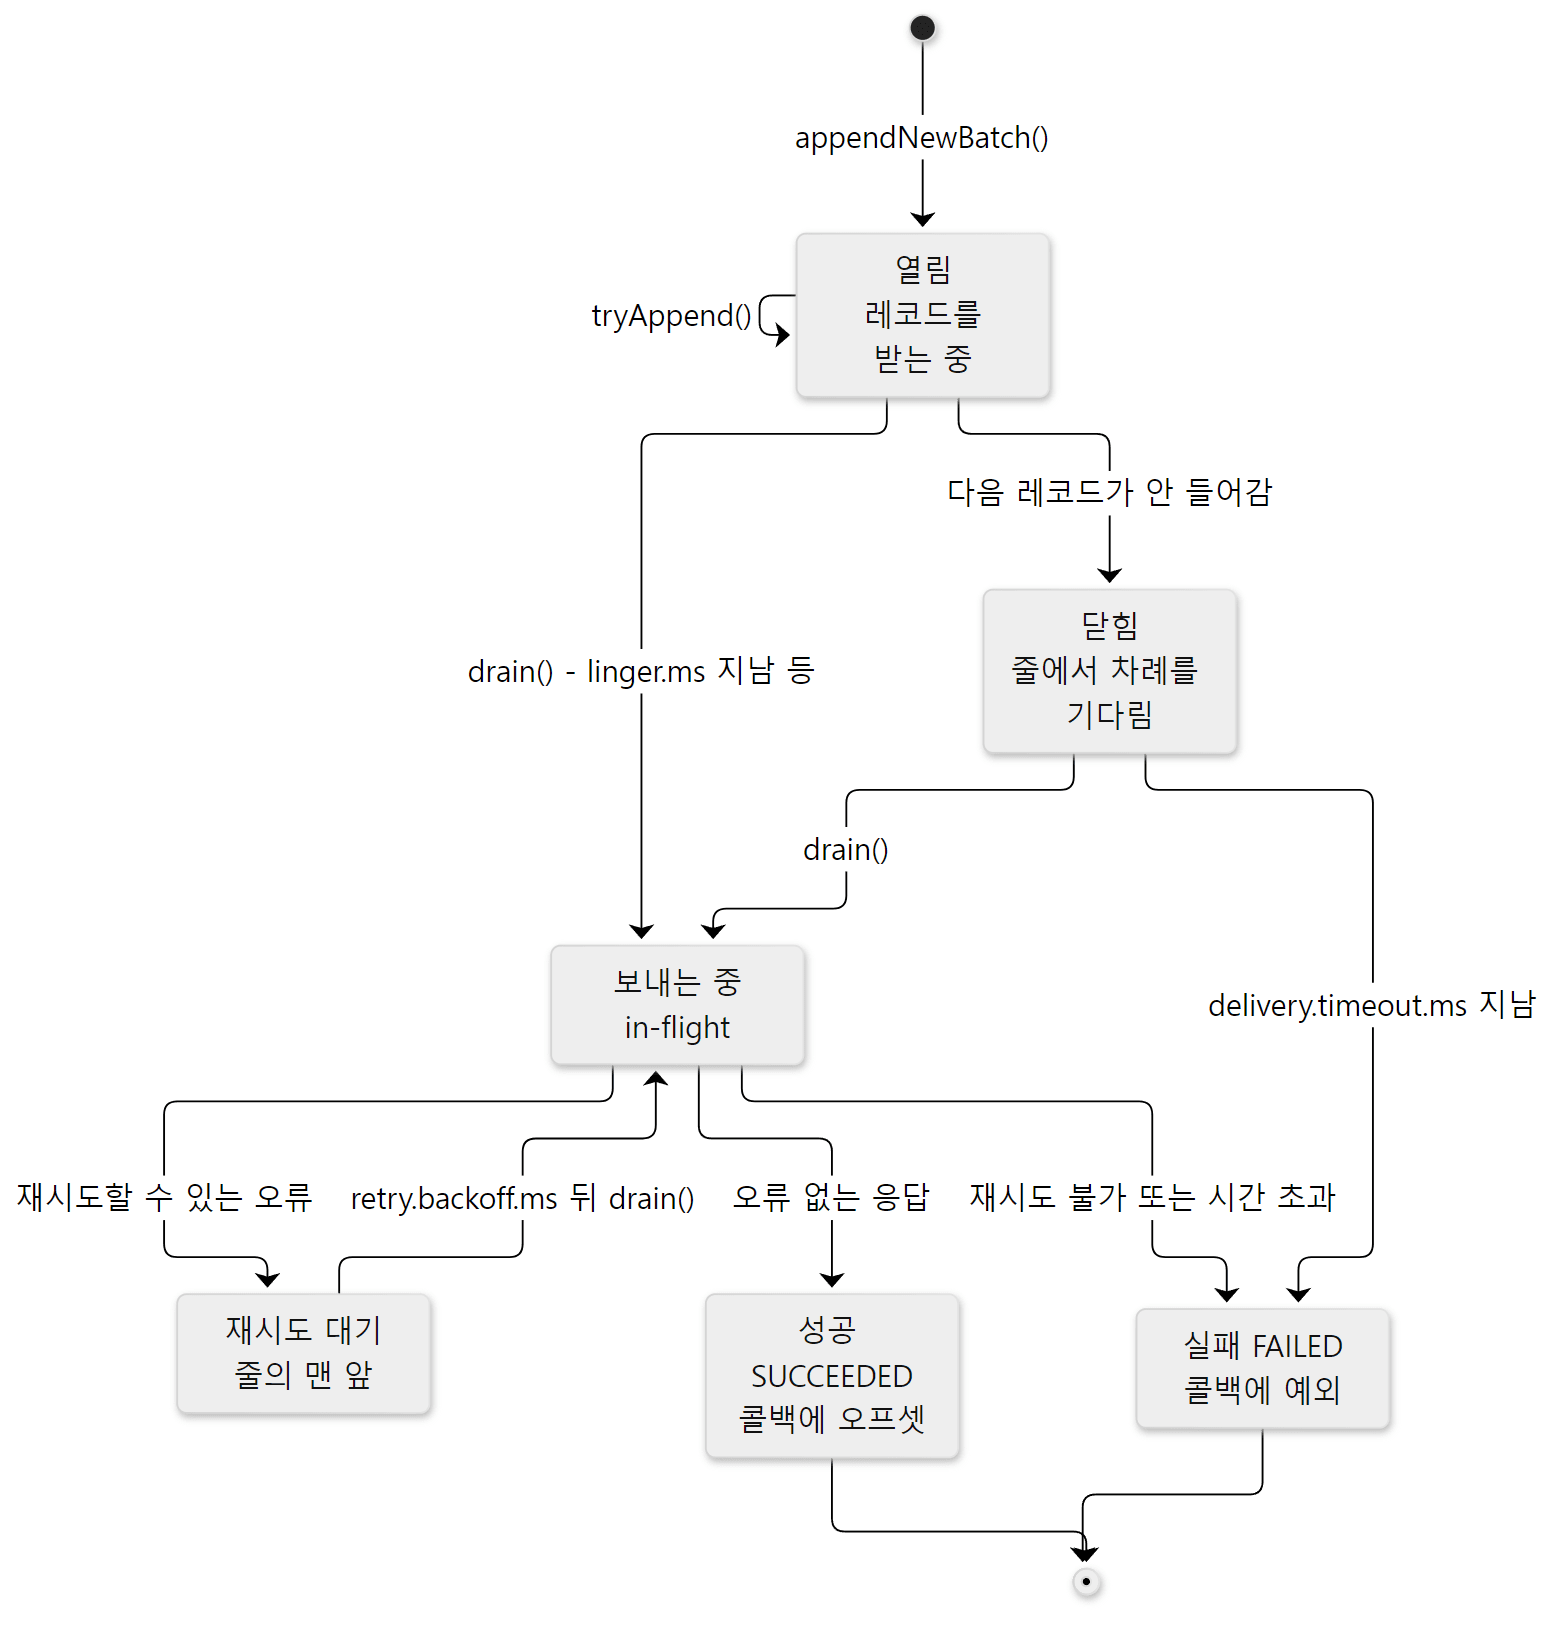 상태 이름은 설명을 위해 붙인 것입니다. 소스의
ProducerBatch.FinalState 에는 끝 상태 셋(ABORTED, FAILED, SUCCEEDED)만 있습니다(64행). ABORTED 는 강제로 닫거나 트랜잭션을 중단할 때의 끝이라 그림에서 뺐습니다.
응답에 오류가 있으면 completeBatch() 가 재시도할지 정합니다.
        } else if (error != Errors.NONE) {
            if (canRetry(batch, response, now)) {
                log.warn(
                    "Got error produce response with correlation id {} on topic-partition {}, retrying ({} attempts left). Error: {}",
                    correlationId,
                    batch.topicPartition,
                    this.retries - batch.attempts() - 1,
                    formatErrMsg(response));
                reenqueueBatch(batch, now);
            } else if (error == Errors.DUPLICATE_SEQUENCE_NUMBER) {
                // ...
                completeBatch(batch, response);
            } else {
                // ...
                failBatch(batch, response, batch.attempts() < this.retries, true);
            }
clients/src/main/java/org/apache/kafka/clients/producer/internals/Sender.java 691–712행
    private boolean canRetry(ProducerBatch batch, ProduceResponse.PartitionResponse response, long now) {
        return !batch.hasReachedDeliveryTimeout(accumulator.getDeliveryTimeoutMs(), now) &&
            batch.attempts() < this.retries &&
            !batch.isDone() &&
            (transactionManager == null ?
                    response.error.exception() instanceof RetriableException :
                    transactionManager.canRetry(response, batch));
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/Sender.java 876–883행
재시도의 조건은 넷입니다. 배치를 만든 뒤 delivery.timeout.ms 가 지나지 않았고, 시도 횟수가 retries 보다 적고, 아직 끝나지 않았고, 오류가 재시도할 수 있는 종류(RetriableException 의 하위 — 리더가 바뀌었다는 NotLeaderOrFollowerException, 9편의 NotEnoughReplicasException 같은 것)여야 합니다. 멱등·트랜잭션 프로듀서에서는 마지막 판단을 TransactionManager 에 맡깁니다.
다시 보낼 배치는 RecordAccumulator.reenqueue() 가 그 파티션 줄의 맨 앞 쪽에 다시 넣습니다(603–612행). 뒤에 쌓인 배치보다 먼저 나가야 하기 때문입니다. 멱등성을 끈 프로듀서는 그냥 deque.addFirst(batch) 이고, 기본값인 멱등 프로듀서(TransactionManager 가 있음)는 insertInSequenceOrder() 로 일련번호 순서가 맞는 자리에 끼워 넣습니다. 보통은 맨 앞이고, 같은 파티션의 배치 여럿이 함께 재시도되면 번호가 앞선 배치 뒤에 들어갑니다(659–699행). 이 배치는 attempts 가 하나 늘어, 4절의 backingOff 가 참이 되고 linger.ms 대신 retry.backoff.ms(기본 100) 부터 retry.backoff.max.ms(기본 1000) 까지 늘어나는 대기 시간을 지킵니다(shouldBackoff(), 920–936행). 단, 리더가 바뀐 것을 알게 된 재시도는 기다리지 않습니다(!hasLeaderChanged).
실제 상한은 retries 가 아니라 delivery.timeout.ms
retries 의 기본값은 Integer.MAX_VALUE 입니다(ProducerConfig.java 429행). 사실상 횟수 제한이 없고, 재시도를 끝내는 것은 시간입니다. delivery.timeout.ms(기본 120000, 446행)는 "send() 가 돌아온 뒤 성공이든 실패든 결과를 알려 줄 때까지"의 상한입니다. 배치를 만든 시각(createdMs)부터 잽니다.
    boolean hasReachedDeliveryTimeout(long deliveryTimeoutMs, long now) {
        return deliveryTimeoutMs <= now - this.createdMs;
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/ProducerBatch.java 462–464행
Sender 는 바퀴마다 두 곳에서 이 시간을 넘긴 배치를 찾습니다. 대기실의 줄 맨 앞부터(accumulator.expiredBatches(), 572–593행), 그리고 보내 놓고 응답을 기다리는 배치에서(getExpiredInflightBatches(), 185–216행). 찾은 배치는 "Expiring N record(s) for … ms has passed since batch creation" 이라는 TimeoutException 으로 실패합니다(368–373행). 브로커가 끝내 응답하지 않아도 앱은 이 시간 안에 결과를 받습니다.
생성자는 이 값이 너무 작지 않은지도 봅니다. delivery.timeout.ms 가 linger.ms + request.timeout.ms 보다 작으면, 직접 설정한 값이면 ConfigException 을 던지고, 기본값이면 그 합으로 올리고 경고만 남깁니다(KafkaProducer.java 637–657행). 한 번은 linger.ms 만큼 기다리고 한 번은 요청을 보내 응답을 기다릴 수 있어야 하기 때문입니다. 예제 3에서 linger.ms 를 60초로 실험할 때 이 검사에 걸려 delivery.timeout.ms=90000 을 함께 주었습니다.
| 시간 설정 | 기본값 | 무엇을 막나 | 걸리는 곳 |
|---|---|---|---|
max.block.ms |
60000 | send() 가 앱 스레드를 붙잡는 시간(메타데이터 + 배치 메모리) |
waitOnMetadata(), BufferPool.allocate() |
linger.ms |
5 | 덜 찬 배치가 대기실에서 기다리는 시간 | batchReady() |
request.timeout.ms |
30000 | 요청 하나의 응답을 기다리는 시간 | NetworkClient |
retry.backoff.ms ~ retry.backoff.max.ms |
100 ~ 1000 | 재시도 사이의 대기 | shouldBackoff() |
delivery.timeout.ms |
120000 | send() 뒤 결과가 나올 때까지 전체 |
expiredBatches(), canRetry() |
헷갈리기 쉬운 곳
request.timeout.ms가 지났다고 레코드가 실패하는 것은 아닙니다. 요청 하나가 시간 초과되면NetworkClient는 그 노드와의 연결을 끊고(handleTimedOutRequests(), NetworkClient.java 1019–1027행),handleProduceResponse()는 그 배치를REQUEST_TIMED_OUT오류로completeBatch()에 넘깁니다(Sender.java 583–588행). 이 오류의 예외(TimeoutException)는 재시도할 수 있는 종류라서,delivery.timeout.ms가 남아 있으면 다시 보냅니다. 앱이 실패를 받는 것은delivery.timeout.ms가 지났거나 재시도할 수 없는 오류일 때입니다.delivery.timeout.ms는send()를 부른 시각이 아니라 배치를 만든 시각부터 잽니다. 이미 열린 배치에 나중에 들어간 레코드는 그만큼 짧은 시간을 받습니다.
8. BufferPool — buffer.memory 와 max.block.ms
배치의 버퍼는 BufferPool 이 나눠 줍니다. 풀의 전체 크기가 buffer.memory(기본 32MB, ProducerConfig.java 420행)이고, batch.size 크기의 버퍼는 쓰고 나서 버리지 않고 free 목록에 모아 다시 씁니다. 매번 16KB 짜리 ByteBuffer 를 새로 만들어 GC 에 맡기지 않으려는 것입니다(클래스 주석, 38–46행).
            // check if we have a free buffer of the right size pooled
            if (size == poolableSize && !this.free.isEmpty())
                return this.free.pollFirst();

            // now check if the request is immediately satisfiable with the
            // memory on hand or if we need to block
            int freeListSize = freeSize() * this.poolableSize;
            if (this.nonPooledAvailableMemory + freeListSize >= size) {
                // we have enough unallocated or pooled memory to immediately
                // satisfy the request, but need to allocate the buffer
                freeUp(size);
                this.nonPooledAvailableMemory -= size;
            } else {
                // we are out of memory and will have to block
                int accumulated = 0;
                Condition moreMemory = this.lock.newCondition();
                // ... waiters 줄 끝에 moreMemory 를 세우고, 모일 때까지 await() 를 되풀이한다 ...
clients/src/main/java/org/apache/kafka/clients/producer/internals/BufferPool.java 155–170행
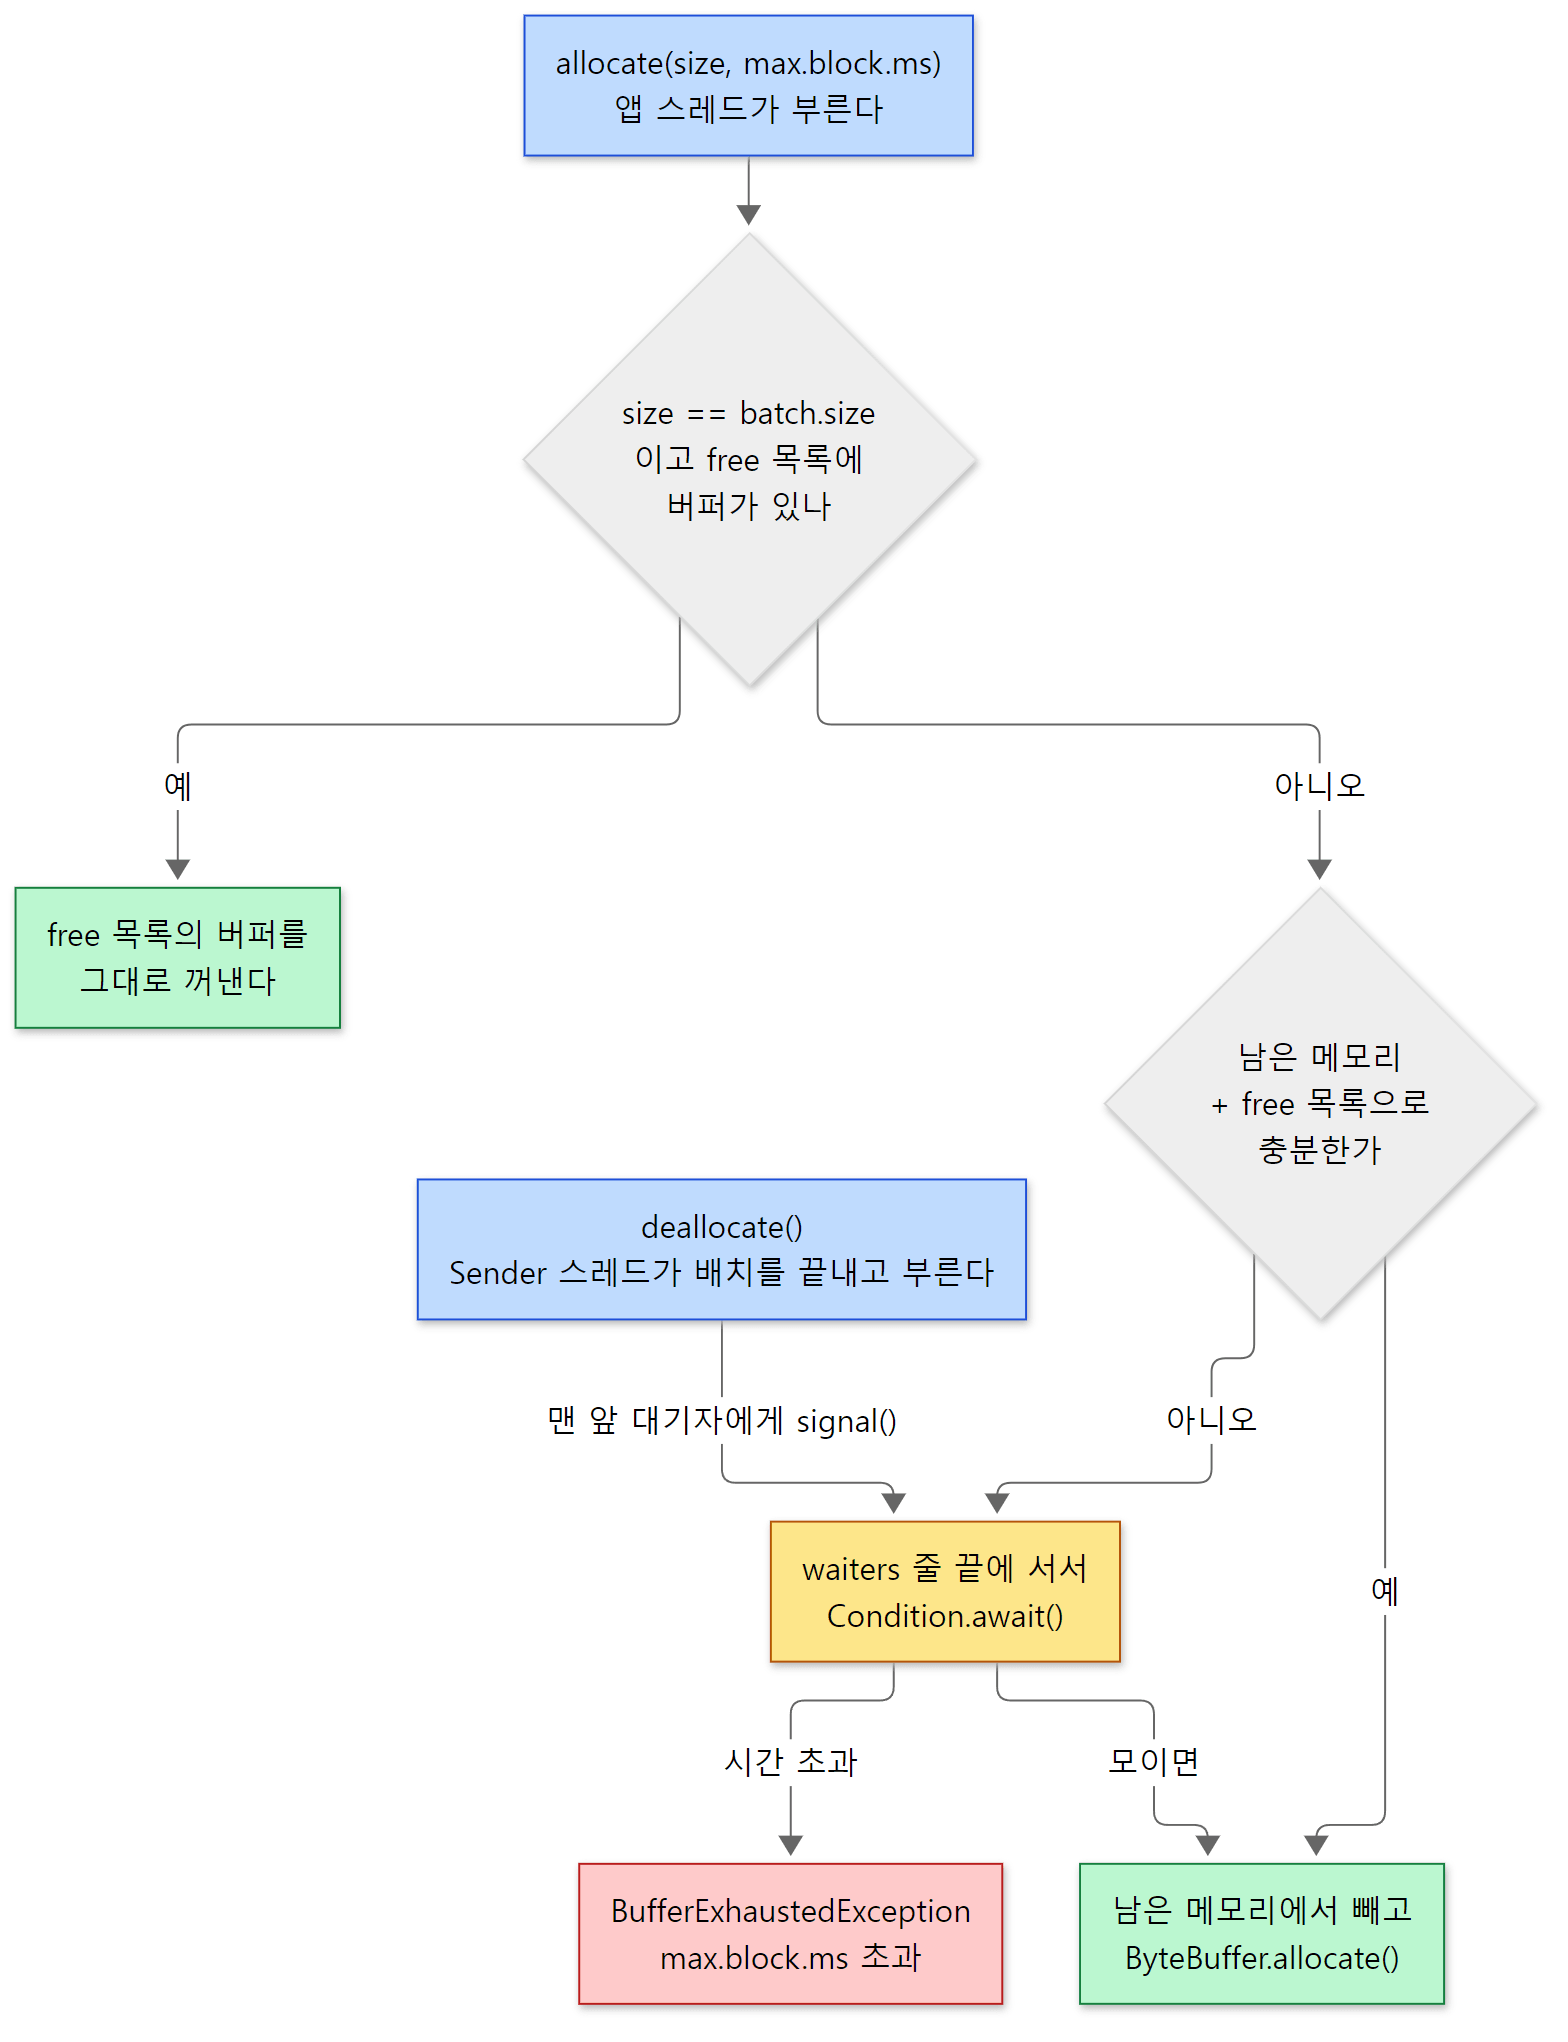
allocate() 는 앱 스레드가, deallocate() 는 주로 Sender 스레드가 부릅니다. 둘 사이를 ReentrantLock 하나와 대기자마다의 Condition 이 잇습니다.
메모리가 모자라면 앱 스레드는 waiters 줄 끝에 자기 Condition 을 세우고 기다립니다. 줄을 세우는 것은 공정성 때문입니다. 클래스 주석은 "가장 오래 기다린 스레드가 충분한 메모리를 얻을 때까지 모든 메모리를 그 스레드에 준다"고 적고 있습니다. 큰 메모리를 기다리는 스레드가 작은 요청들에 밀려 영영 굶지 않게 하려는 것입니다. 기다림의 상한이 1절에서 본 remainingWaitMs(= max.block.ms 에서 메타데이터 기다린 만큼 뺀 것)이고, 넘기면 BufferExhaustedException 입니다.
메모리를 돌려주는 쪽은 deallocate() 입니다. 배치가 성공이든 실패든 끝나면 Sender 가 버퍼를 돌려주고, batch.size 크기면 free 목록으로, 아니면 남은 메모리 숫자로 되돌린 뒤 맨 앞 대기자를 깨웁니다.
    public void deallocate(ByteBuffer buffer, int size) {
        lock.lock();
        try {
            if (size == this.poolableSize && size == buffer.capacity()) {
                buffer.clear();
                this.free.add(buffer);
            } else {
                this.nonPooledAvailableMemory += size;
            }
            Condition moreMem = this.waiters.peekFirst();
            if (moreMem != null)
                moreMem.signal();
        } finally {
            lock.unlock();
        }
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/BufferPool.java 481–496행
그래서 배치 메모리는 응답이 와야 풀립니다. 보냈다고 풀리는 것이 아니라, 브로커가 응답해 배치가 끝나야 돌아옵니다. 브로커가 느리면 대기실과 진행 중 배치가 메모리를 쥔 채로 쌓이고, 결국 send() 가 막힙니다.
예제 3: buffer.memory 를 배치 두 개만큼으로
batch.size=16384, buffer.memory=32768(배치 둘), max.block.ms=3000 으로 두고, 파티션 셋에 레코드를 하나씩 보냈습니다. 파티션마다 배치가 하나씩 필요하므로 세 번째 send() 는 앞의 배치 하나가 끝나 메모리가 돌아오기를 기다려야 합니다. 두 번째 실험에서는 보내기 직전에 브로커 프로세스를 kill -STOP 으로 멈췄습니다(연결은 살아 있지만 응답이 오지 않습니다). 예제 폴더는 ex/u05-buffer-memory 입니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// buffer.memory 를 배치 두 개만큼(32KB)으로 줄이고, 세 파티션에 레코드를 하나씩 보낸다.
        // ... args 에서 토픽을 읽고, bootstrap.servers 와 직렬화기를 설정한다 ...
        props.put(ProducerConfig.BATCH_SIZE_CONFIG, "16384");          // 배치 하나 = 16KB
        props.put(ProducerConfig.BUFFER_MEMORY_CONFIG, "32768");       // 전체 = 배치 두 개
        props.put(ProducerConfig.LINGER_MS_CONFIG, args[1]);
        props.put(ProducerConfig.MAX_BLOCK_MS_CONFIG, "3000");         // send() 가 메모리를 기다리는 한도
        props.put(ProducerConfig.DELIVERY_TIMEOUT_MS_CONFIG, "90000"); // linger.ms + request.timeout.ms 이상이어야 한다

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            // 메타데이터를 받고, 리더 브로커와의 연결도 미리 맺어 둔다(flush() 는 linger 를 기다리지 않고 보낸다)
            producer.send(new ProducerRecord<>(topic, 0, null, "warm-up"));
            producer.flush();
            // ... (두 번째 실험) 여기서 브로커를 kill -STOP ...
            for (int p = 0; p < 3; p++) {
                // ... 파티션 p 에 레코드 하나를 보내고, send() 가 돌아오기까지 걸린 시간과 콜백을 찍는다 ...
            }
            producer.close(Duration.ofSeconds(5));
        }
[예제 ex/u05-buffer-memory/BufferMemory.java 에서 줄임]
=== 1. buffer.memory=32768 batch.size=16384 max.block.ms=3000, linger.ms=5
send() to partition 0 returned after 16 ms
send() to partition 1 returned after 0 ms
  callback p0 at   31 ms on kafka-producer-network-thread | producer-1: offset 1
send() to partition 2 returned after 28 ms
  callback p1 at   50 ms on kafka-producer-network-thread | producer-1: offset 0
  callback p2 at   65 ms on kafka-producer-network-thread | producer-1: offset 0
=== 2. the same, but the broker is paused before sending
broker paused (kill -STOP)
send() to partition 0 returned after 9 ms
send() to partition 1 returned after 0 ms
  callback p2 at 3028 ms on main: BufferExhaustedException: Failed to allocate 16384 bytes within the configured max blocking time 3000 ms. Total memory: 32768 bytes. Available memory: 0 bytes. Poolable size: 16384 bytes
send() to partition 2 returned after 3017 ms
  callback p1 at 8043 ms on kafka-producer-network-thread | producer-1: KafkaException: Producer is closed forcefully.
  callback p0 at 8044 ms on kafka-producer-network-thread | producer-1: KafkaException: Producer is closed forcefully.
시간(ms)은 실행마다 조금씩 다르고, 콜백 p0·p1 이 찍히는 순서도 실행마다 바뀝니다.
- 실험 1: 세 번째
send()가 28ms 걸렸습니다. 앞의 두send()는 곧바로 돌아왔지만 세 번째는 메모리를 기다렸고, 그 사이 앞의 배치들이linger.ms(5ms) 뒤 나가 이 실행에서는 p0 의 응답이 31ms 에 먼저 왔습니다. 그deallocate()가 세 번째send()를 깨웠습니다(콜백 p0 이 세 번째send()보다 먼저 찍힌 순서가 그것입니다). 다시 돌렸을 때는 p1 의 응답이 먼저 와서 같은 자리에 p1 이 찍혔습니다. - 실험 2: 응답이 오지 않으니 메모리도 돌아오지 않습니다. 세 번째
send()는 정확히max.block.ms(3초) 동안 막혔다가BufferExhaustedException으로 끝났습니다. 메시지는 위allocate()인용에서 줄인 대기 반복 안의 문장입니다(BufferPool.java 178–180행). 이 예외도 예제 2의 너무 큰 레코드처럼main에서 콜백으로 전달되고,send()는 예외를 던지지 않고 돌아왔습니다(BufferExhaustedException→TimeoutException→RetriableException→ApiException이라doSend()의catch (ApiException e)에 걸립니다). - p0·p1 은
close(5초)가 시간을 다 쓴 8초쯤 강제로 닫히며 실패했습니다.
헷갈리기 쉬운 곳: 메모리를 기다리는 스레드가 있다고 Sender 가 바로 깨지는 않습니다
4절 표의 exhausted 조건(메모리를 기다리는 스레드가 있으면 덜 찬 배치도 보낸다)을 보면, 메모리가 모자랄 때 프로듀서가 알아서 배치를 밀어내 줄 것 같습니다. 그런데 BufferPool 과 RecordAccumulator 어디에도 Sender 를 깨우는 호출(wakeup)이 없습니다(두 파일에서 wakeup 을 찾아 확인했습니다). exhausted 는 Sender 가 다른 이유로 깨어나 ready() 를 볼 때만 쓰입니다. 실제로 위 실험 1을 linger.ms=60000 으로 돌려 보면 결과가 실행마다 달랐습니다. 세 번째 send() 가 3초 뒤 BufferExhaustedException 으로 실패한 적도 있고(Sender 가 60초짜리 잠을 자는 중), 수십 밀리초 만에 성공한 적도 있습니다(마침 다른 네트워크 일로 Sender 가 깨어 exhausted 를 보고 배치를 보낸 것으로 보입니다 — 무엇이 깨웠는지는 확인하지 못했습니다). 결과가 일정하지 않아 글의 예제에서는 뺐습니다. linger.ms 를 크게 잡을 때는 buffer.memory 를 넉넉히 두는 편이 안전합니다.
설정 한눈에
앱에서 쓰던 설정 이름에서 소스로 가는 길입니다. 상수는 모두 ProducerConfig 에 있고, 기본값은 이 커밋의 define(…) 에서 읽었습니다.
| 설정 | 상수 | 기본값 | 쓰이는 곳 |
|---|---|---|---|
batch.size |
BATCH_SIZE_CONFIG |
16384 (440행) | 배치 버퍼 크기(append()), 끈끈한 파티셔너의 옮김 기준 |
linger.ms |
LINGER_MS_CONFIG |
5 (445행) | batchReady() 의 expired |
buffer.memory |
BUFFER_MEMORY_CONFIG |
33554432 = 32MB (420행) | BufferPool 전체 크기 |
max.block.ms |
MAX_BLOCK_MS_CONFIG |
60000 (482–487행) | waitOnMetadata() + BufferPool.allocate() |
acks |
ACKS_CONFIG |
"all" → -1 (430–435행) |
Produce 요청의 Acks 칸 |
retries |
RETRIES_CONFIG |
Integer.MAX_VALUE (429행) |
canRetry() |
delivery.timeout.ms |
DELIVERY_TIMEOUT_MS_CONFIG |
120000 (446행) | expiredBatches(), canRetry() |
max.in.flight.requests.per.connection |
MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION |
5 (520–525행) | InFlightRequests.canSendMore(), 1이면 파티션 mute |
max.request.size |
MAX_REQUEST_SIZE_CONFIG |
1048576 (451–456행) | 레코드 크기 검사, drain() 의 요청 크기 |
enable.idempotence |
ENABLE_IDEMPOTENCE_CONFIG |
true (574–578행) |
배치에 프로듀서 id·일련번호 |
이 글에서 뺀 것
- 멱등성과 트랜잭션(
TransactionManager,InitProducerId, 일련번호 검사):clients/src/main/java/org/apache/kafka/clients/producer/internals/TransactionManager.java— 12편 - 메타데이터를 받아 오는 길(
waitOnMetadata(),ProducerMetadata): KafkaProducer.java 1299행부터 — 2편 - adaptive 파티셔닝의 가중치 계산(
updatePartitionLoadStats(),partitioner.availability.timeout.ms): BuiltInPartitioner.java 273행부터 - 너무 큰 배치를 나눠 다시 보내기(
MESSAGE_TOO_LARGE→splitAndReenqueue()): RecordAccumulator.java 618행부터 - 압축(
compression.type)과 압축률 추정:MemoryRecordsBuilder의estimatedCompressionRatio, 압축된 배치를 브로커가 다루는 법은 6편 - 조각씩 늘리는 메모리 전략(
ChunkedRecordAccumulator,BufferPool.allocateChunks()):clients/src/main/java/org/apache/kafka/clients/producer/internals/ChunkedRecordAccumulator.java flush()·close()가 남은 배치를 마저 보내는 길: Sender.java 253–262행,RecordAccumulator.beginFlush()·awaitFlushCompletion()- 연결 맺기·ApiVersions 협상·재접속 대기:
NetworkClient— 협상은 3편 - 클라이언트 텔레메트리(
ClientTelemetryReporter), 인터셉터(ProducerInterceptors), 보안(SASL·TLS)
정리
| 개념 | 한 줄 요약 |
|---|---|
send() |
앱 스레드에서 메타데이터 확인 → 직렬화 → 파티션 → 대기실에 넣기 → Future. 네트워크로는 보내지 않는다 |
send() 가 막히는 곳 |
메타데이터 없음, 배치 메모리 모자람. 둘 합쳐 max.block.ms 까지 |
| 파티션 고르기 | 직접 지정 > 사용자 파티셔너 > 키의 murmur2 해시 > 끈끈한 파티셔너 |
| 끈끈한 파티셔너 | 한 파티션에 batch.size 이상 보내고 그 배치가 닫히면(늦어도 두 배에서) 다음 파티션으로 |
RecordAccumulator |
토픽 → 파티션 → Deque<ProducerBatch>. 잠금은 파티션 줄 단위 |
| 배치가 "찼다" | 대개 다음 레코드가 안 들어가 닫히고 뒤에 새 배치가 생겼다는 뜻 |
ready() |
찼거나·linger.ms 지났거나·메모리 대기자·닫는 중·flush()·트랜잭션 완료 중이면 그 리더 노드로 보낸다 |
| Sender 스레드 | 프로듀서마다 하나(kafka-producer-network-thread | client.id). ready() → drain() → 노드마다 Produce 요청 하나 → poll() |
| 콜백 | 보통 Sender 스레드에서. send() 안에서 실패하면 부른 스레드에서 |
max.in.flight.requests.per.connection |
응답 없이 띄워 둘 요청 수(기본 5). 1이면 파티션을 mute 해 순서를 지킨다 |
| 재시도 | 재시도할 수 있는 오류면 줄 맨 앞으로, retry.backoff.ms 부터 늘려 가며. 끝은 delivery.timeout.ms |
BufferPool |
buffer.memory 안에서 batch.size 버퍼를 재사용. 응답이 와야 메모리가 돌아온다 |
다음에 볼 것
Sender 가 배치들을 Produce 요청 하나에 담아 브로커로 보내는 데까지 왔습니다. 그 요청은 4편의 네트워크 계층을 지나 KafkaApis.handleProduceRequest() 에 닿습니다. 다음 글에서는 브로커가 그 배치를 검사하고 오프셋을 매겨 로그에 붙이는 길(ReplicaManager → Partition → UnifiedLog)을 따라가고, 이 글에서 MemoryRecordsBuilder 가 써 둔 레코드 배치의 바이트를 한 칸씩 뜯어봅니다. 프로듀서가 만든 배치를 브로커가 거의 그대로 디스크에 쓴다는 설계가 거기서 드러납니다. 6편: 브로커가 레코드를 받아 쓰기까지 — 레코드 배치 형식과 Produce 요청 처리에서 이어집니다.
acks=all 일 때 브로커가 응답을 미루고 무엇을 기다리는지는 9편에서, 이 글에서 계속 미뤄 둔 프로듀서 id·일련번호의 쓰임새는 12편에서 봅니다. 스레드 하나가 NIO Selector 로 여러 연결을 다루는 모양은 Tomcat 5편의 Poller 와도 닮았습니다.