이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 열두 번째이자 마지막 글입니다. 10편에서 컨트롤러가 메타데이터를 로그에 적어 퍼뜨리는 것을, 11편에서 컨슈머 그룹의 오프셋이 __consumer_offsets 에 레코드로 쓰이는 것을 봤습니다. 이번에는 "클러스터를 움직이는 것" 묶음의 마지막, 멱등 프로듀서와 트랜잭션입니다. 앱에서는 설정 두 줄입니다.
enable.idempotence=true      # 4.x 의 기본값
transactional.id=order-writer
이 두 줄 뒤에서 무슨 일이 생기는지가 이 글의 질문입니다.
- 프로듀서가 재시도하면 같은 레코드가 두 번 쓰이지 않나? 브로커는 중복을 어떻게 알아보나
commitTransaction()을 부르면 누가, 어디에, 무엇을 쓰나. 여러 파티션에 걸친 쓰기가 "한꺼번에" 보이게 되는 원리는 무엇인가isolation.level=read_committed컨슈머는 중단된 트랜잭션의 레코드를 어떻게 걸러 내나. 브로커가 걸러 주나, 컨슈머가 걸러 내나- 같은
transactional.id를 쓰는 프로듀서가 둘 뜨면 어떻게 되나
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | 클라이언트 producer.internals.TransactionManager·RecordAccumulator, consumer.internals.CompletedFetch / 브로커 kafka.coordinator.transaction.TransactionCoordinator·TransactionStateManager·TransactionMarkerChannelManager(Scala), coordinator.transaction.TransactionMetadata·TransactionState(Java), server.transaction.AddPartitionsToTxnManager, storage.internals.log.UnifiedLog·ProducerStateEntry·ProducerAppendInfo·TransactionIndex |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다.
2편의 지도로 말하면 이 글은 F 구역(코디네이터) 가운데 트랜잭션 코디네이터와 A 구역(클라이언트) 가운데 프로듀서의 TransactionManager 를 확대합니다. 다만 트랜잭션은 한 구역에 머물지 않습니다. 프로듀서가 보낸 배치는 D·E 구역(파티션과 로그)에서 검사되고, 코디네이터가 보낸 마커도 같은 로그에 쓰이고, 컨슈머는 그 로그를 읽으며 걸러 냅니다.
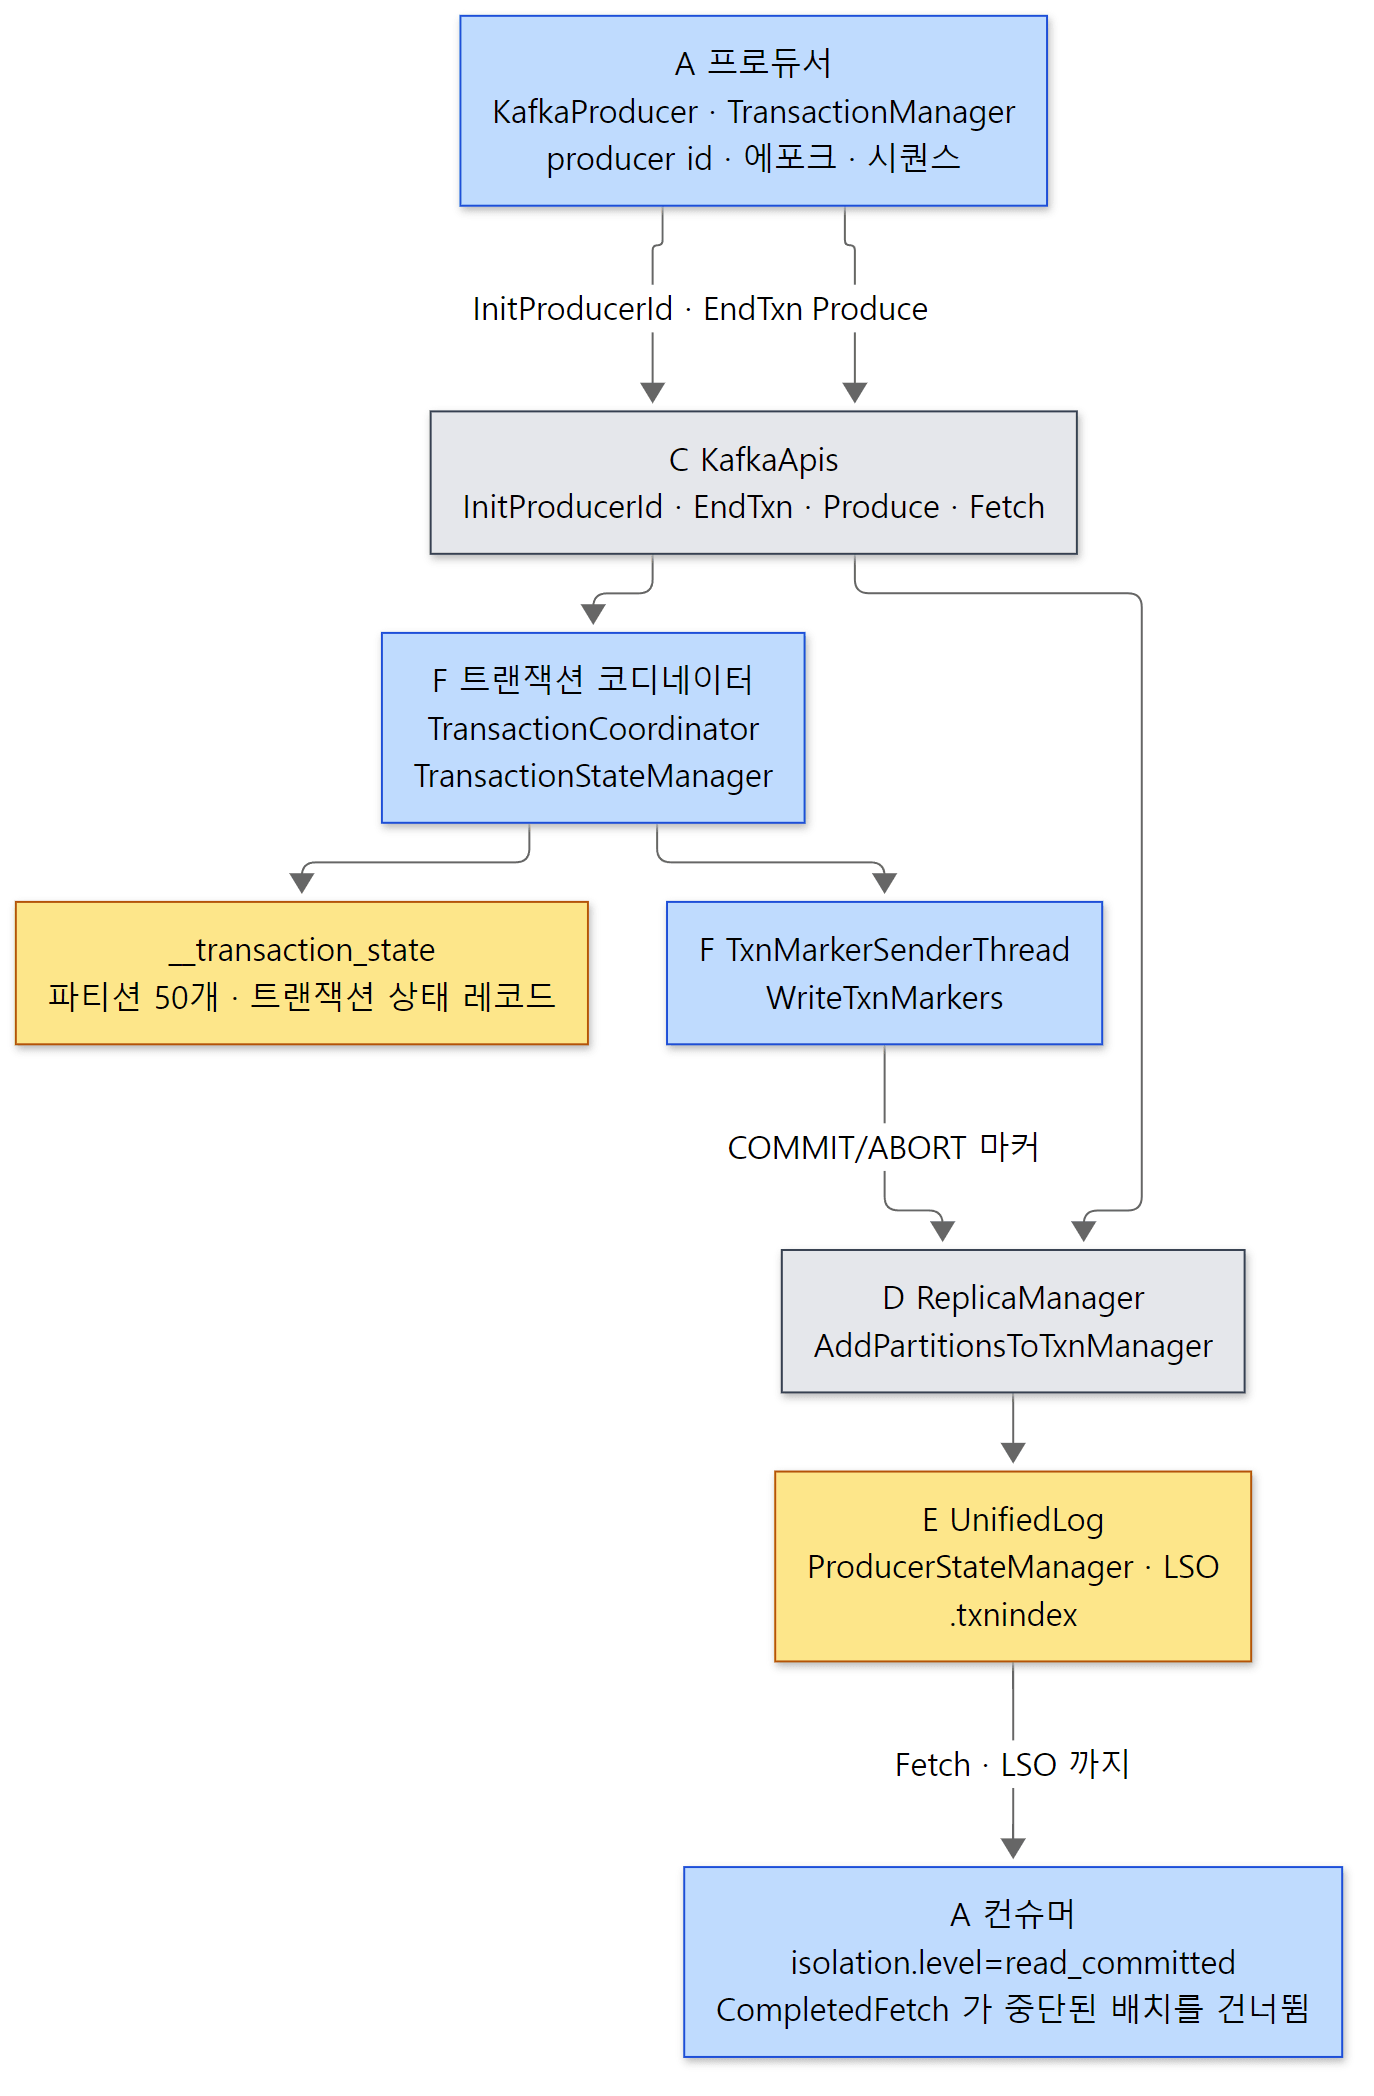 파란 상자가 이 글의 주인공(프로듀서·코디네이터·마커를 보내는 스레드·컨슈머), 노란 상자가 상태가 적히는 곳입니다. 앞의 알파벳은 2편 지도의 구역입니다.
트랜잭션 코드는 크기가 작지 않습니다. TransactionManager.java 가 2,066줄, TransactionCoordinator.scala 가 1,145줄이고, 판(transaction version) 1과 2의 길이 같은 파일에 함께 삽니다. 이 글은 이 커밋의 기본값인 판 2의 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
정확히 한 번(exactly-once): "레코드 하나가 로그에 한 번만 쓰이고, 읽는 쪽도 한 번만 처리한 것처럼 보인다"는 약속입니다. 네트워크는 응답을 잃어버리고, 프로세스는 중간에 죽습니다. 그래서 그냥 두면 "적어도 한 번"(재시도해서 중복이 생길 수 있음)이나 "많아야 한 번"(재시도하지 않아 잃을 수 있음) 가운데 하나가 됩니다. Kafka 는 이것을 두 층으로 만듭니다. 한 파티션 안의 중복을 막는 멱등 프로듀서, 여러 파티션에 걸친 쓰기를 한꺼번에 보이거나 한꺼번에 버리는 트랜잭션입니다.
producer id · 에포크 · 시퀀스: 멱등 프로듀서는 시작할 때 브로커에서 정수 하나(producer id, PID)를 받습니다. 에포크(epoch)는 같은 producer id 의 "세대 번호"(0부터 늘어나는 short)이고, 시퀀스(sequence)는 파티션마다 0부터 레코드 수만큼 늘어나는 번호입니다. 이 셋은 6편에서 본 레코드 배치 헤더의 producerId·producerEpoch·baseSequence 칸에 들어갑니다. 브로커는 이 셋만 보고 중복과 빠짐을 판단합니다.
transactional.id: 앱이 정하는 트랜잭션 프로듀서의 이름입니다. producer id 는 브로커가 나눠 주는 번호라 프로세스를 다시 띄우면 바뀔 수 있지만, transactional.id 는 앱이 고정합니다. 코디네이터는 이 이름을 열쇠로 "이 프로듀서의 producer id 와 에포크, 지금 열린 트랜잭션"을 기억합니다.
트랜잭션 코디네이터와 __transaction_state: 트랜잭션의 상태를 관리하는 브로커 쪽 부품입니다. 따로 떠 있는 서버가 아니라 모든 브로커 안에 하나씩 있고, 내부 토픽 __transaction_state 의 파티션 리더를 맡은 브로커가 그 파티션에 속한 transactional.id 들의 코디네이터가 됩니다. 11편의 그룹 코디네이터가 __consumer_offsets 로 하는 일과 같은 모양입니다.
컨트롤 레코드(트랜잭션 마커): 트랜잭션이 끝났다는 표시로 각 파티션에 쓰는 특별한 레코드입니다. 배치 헤더의 isControl 비트가 켜져 있고, 키가 COMMIT 또는 ABORT 입니다. 오프셋을 하나 차지하지만 컨슈머 앱에는 전달되지 않습니다.
LSO(last stable offset, 마지막 안정 오프셋): "이 오프셋 아래는 모두 결론이 났다"는 경계입니다. 트랜잭션이 아닌 레코드는 쓰자마자 결론이 난 것으로 치고, 트랜잭션 레코드는 마커가 쓰여야 결론이 납니다. 9편의 하이 워터마크(HW, 모든 ISR 이 받은 곳까지)를 넘을 수 없습니다. read_committed 컨슈머는 LSO 까지만 읽습니다.
트랜잭션 판(transaction.version): 클러스터 기능 플래그(feature) 가운데 하나입니다. 2편에서 본 metadata.version 처럼 클러스터 전체가 하나의 값을 쓰고, 값에 따라 트랜잭션 프로토콜이 달라집니다.
    // Version 0 is the original transaction coordinator with no extra features enabled.
    TV_0(0, MetadataVersion.MINIMUM_VERSION, Map.of()),
    // Version 1 enables flexible transactional state records. (KIP-890)
    TV_1(1, MetadataVersion.IBP_4_0_IV2, Map.of()),
    // Version 2 enables epoch bump per transaction and optimizations. (KIP-890)
    TV_2(2, MetadataVersion.IBP_4_0_IV2, Map.of());
server-common/src/main/java/org/apache/kafka/server/common/TransactionVersion.java 26–31행
판 2(TV2)는 "트랜잭션마다 에포크를 하나씩 올린다"와 "파티션을 트랜잭션에 넣는 요청을 클라이언트가 따로 보내지 않는다"는 두 가지가 핵심입니다(3절). 이 연재의 예제 클러스터(metadata.version 4.4-IV2 로 포맷)에서는 TV2 가 켜져 있습니다 — 예제 1의 첫 출력이 그것을 보여 줍니다. 4.4.0 안정판도 같은 TransactionVersion.java 입니다(파일이 같습니다).
1. 멱등 프로듀서 — 재시도가 중복을 만들지 않게
무엇이 문제인가
acks=all 로 보낸 Produce 요청을 리더가 받아 로그에 쓰고 복제까지 마쳤는데, 응답이 돌아오는 길에 연결이 끊겼다고 합시다. 프로듀서는 실패로 보고 같은 배치를 다시 보냅니다(5편에서 본 Sender 의 재시도). 브로커가 아무것도 기억하지 않으면 같은 레코드가 두 번 쓰입니다. 멱등(idempotent, 여러 번 해도 한 번 한 것과 같음) 프로듀서는 이 재시도를 무해하게 만듭니다.
4.x 에서는 따로 켜지 않아도 멱등 프로듀서입니다. 기본값은 ProducerConfig 에 있습니다.
                                .define(ENABLE_IDEMPOTENCE_CONFIG,
                                        Type.BOOLEAN,
                                        true,
                                        Importance.LOW,
                                        ENABLE_IDEMPOTENCE_DOC)
clients/src/main/java/org/apache/kafka/clients/producer/ProducerConfig.java 574–578행
acks 의 기본값도 "all" 입니다(같은 파일 430–435행). 다만 기본값으로 켜졌을 때 사용자가 acks=1 을 주면 INFO 로그 한 줄만 남기고 멱등성을 끄고, 사용자가 enable.idempotence=true 를 직접 적었는데 acks 가 all 이 아니면 ConfigException 을 던집니다(663–669행). max.in.flight.requests.per.connection 이 5보다 크면 역시 거절합니다(672–676행). 이 5라는 숫자가 어디서 오는지는 조금 뒤에 브로커 쪽에서 봅니다.
클라이언트: 시퀀스는 send() 가 아니라 drain 에서 붙는다
producer id 는 Sender 스레드가 처음 돌 때 TransactionManager.bumpIdempotentEpochAndResetIdIfNeeded() 가 InitProducerId 요청(transactionalId 는 null)을 큐에 넣어 받아 옵니다(TransactionManager.java 691–705행). 시퀀스 번호가 붙는 곳은 의외로 send() 가 아닙니다. 5편에서 본 RecordAccumulator.drain() — 배치를 큐에서 꺼내 요청에 담는 순간입니다.
                boolean isTransactional = transactionManager != null && transactionManager.isTransactional();
                ProducerIdAndEpoch producerIdAndEpoch =
                    transactionManager != null ? transactionManager.producerIdAndEpoch() : null;
                if (producerIdAndEpoch != null && !batch.hasSequence()) {
                    // If the producer id/epoch of the partition do not match the latest one
                    // of the producer, we update it and reset the sequence. This should be
                    // only done when all its in-flight batches have completed. This is guarantee
                    // in `shouldStopDrainBatchesForPartition`.
                    transactionManager.maybeUpdateProducerIdAndEpoch(batch.topicPartition);

                    // If the batch already has an assigned sequence, then we should not change the producer id and
                    // sequence number, since this may introduce duplicates. In particular, the previous attempt
                    // may actually have been accepted, and if we change the producer id and sequence here, this
                    // attempt will also be accepted, causing a duplicate.
                    //
                    // Additionally, we update the next sequence number bound for the partition, and also have
                    // the transaction manager track the batch so as to ensure that sequence ordering is maintained
                    // even if we receive out of order responses.
                    batch.setProducerState(producerIdAndEpoch, transactionManager.sequenceNumber(batch.topicPartition), isTransactional);
                    transactionManager.incrementSequenceNumber(batch.topicPartition, batch.recordCount);
                    log.debug("Assigned producerId {} and producerEpoch {} to batch with base sequence " +
                            "{} being sent to partition {}", producerIdAndEpoch.producerId,
                        producerIdAndEpoch.epoch, batch.baseSequence(), tp);

                    transactionManager.addInFlightBatch(batch);
clients/src/main/java/org/apache/kafka/clients/producer/internals/RecordAccumulator.java 1024–1048행
요점은 !batch.hasSequence() 조건입니다. 시퀀스는 배치가 처음 나갈 때 한 번만 붙고, 재시도하는 배치는 처음 받은 producer id·에포크·시퀀스를 그대로 들고 다시 갑니다. 주석이 그 이유를 적어 둡니다 — 앞선 시도가 실제로는 받아들여졌을 수 있으니, 번호를 바꾸면 브로커가 중복을 알아볼 수 없습니다. 다음 배치의 시퀀스는 incrementSequenceNumber() 로 레코드 수만큼 건너뜁니다. 배치 하나가 레코드 3개면 시퀀스 0~2 를 쓰고 다음 배치는 3 부터입니다.
브로커: 최근 배치 5개를 기억한다
브로커는 파티션마다 ProducerStateManager 를 두고, producer id 마다 ProducerStateEntry 하나를 기억합니다. 그 안에 최근 배치의 메타데이터(첫·마지막 시퀀스, 오프셋)를 5개까지 들고 있습니다.
public class ProducerStateEntry {
    public static final int NUM_BATCHES_TO_RETAIN = 5;
storage/src/main/java/org/apache/kafka/storage/internals/log/ProducerStateEntry.java 34–35행
5개가 차면 가장 오래된 것을 버립니다(101–104행의 addBatchMetadata()). 클라이언트 쪽 max.in.flight.requests.per.connection 의 상한 5가 바로 이 숫자에 맞춘 것이라고 ProducerConfig.java 295행의 주석이 밝혀 둡니다("The value 5 is aligned with ProducerStateEntry#NUM_BATCHES_TO_RETAIN"). 한 연결에 응답을 기다리는 요청이 5개까지라면, 재시도로 다시 오는 배치는 반드시 브로커가 기억하는 5개 안에 있습니다.
6편에서 UnifiedLog.append() 가 오프셋을 매긴 뒤 "프로듀서 상태를 검사한다"고만 하고 넘어갔던 곳이 여기입니다.
        for (MutableRecordBatch batch : records.batches()) {
            if (batch.hasProducerId()) {
                // if this is a client produce request, there will be up to 5 batches which could have been duplicated.
                // If we find a duplicate, we return the metadata of the appended batch to the client.
                if (origin == AppendOrigin.CLIENT) {
                    Optional<ProducerStateEntry> maybeLastEntry = producerStateManager.lastEntry(batch.producerId());

                    Optional<BatchMetadata> duplicateBatch = maybeLastEntry.flatMap(e -> e.findDuplicateBatch(batch));
                    if (duplicateBatch.isPresent()) {
                        return new AnalyzeAndValidateProducerStateResult(updatedProducers, completedTxns, duplicateBatch);
                    }
                }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1411–1422행
findDuplicateBatch() 는 "에포크가 같고, 첫 시퀀스와 마지막 시퀀스가 똑같은 배치가 기억 속에 있나"를 봅니다(ProducerStateEntry.java 128–137행). 있으면 append() 는 로그에 쓰지 않고, 그 배치가 처음 쓰였던 오프셋을 응답에 넣어 돌려줍니다(UnifiedLog.java 1261–1268행). 프로듀서 입장에서는 "성공, 오프셋 0" 이라는 처음과 같은 답을 받습니다.
중복이 아니면 ProducerAppendInfo.checkSequence() 가 순서를 봅니다.
        if (producerEpoch != updatedEntry.producerEpoch()) {
            if (appendFirstSeq != 0) {
                if (updatedEntry.producerEpoch() != RecordBatch.NO_PRODUCER_EPOCH) {
                    throw new OutOfOrderSequenceException("Invalid sequence number for new epoch of producer " + producerId +
                            " at offset " + offset + " in partition " + topicPartition + ": " + producerEpoch + " (request epoch), "
                            + appendFirstSeq + " (seq. number), " + updatedEntry.producerEpoch() + " (current producer epoch)");
                }
            }
        } else {
            int currentLastSeq;
            if (!updatedEntry.isEmpty())
                currentLastSeq = updatedEntry.lastSeq();
            else if (producerEpoch == currentEntry.producerEpoch())
                currentLastSeq = currentEntry.lastSeq();
            else
                currentLastSeq = RecordBatch.NO_SEQUENCE;

            // If there is no current producer epoch (possibly because all producer records have been deleted due to
            // retention or the DeleteRecords API) accept writes with any sequence number
            if (!(currentEntry.producerEpoch() == RecordBatch.NO_PRODUCER_EPOCH || inSequence(currentLastSeq, appendFirstSeq))) {
                throw new OutOfOrderSequenceException("Out of order sequence number for producer " + producerId + " at " +
                        "offset " + offset + " in partition " + topicPartition + ": " + appendFirstSeq +
                        " (incoming seq. number), " + currentLastSeq + " (current end sequence number)");
            }
        }
    }

    private boolean inSequence(int lastSeq, int nextSeq) {
        return nextSeq == lastSeq + 1L || (nextSeq == 0 && lastSeq == Integer.MAX_VALUE);
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/ProducerAppendInfo.java 181–210행
규칙은 둘입니다. 에포크가 새로 바뀌었으면 시퀀스는 0부터, 에포크가 같으면 바로 앞 배치의 마지막 시퀀스 + 1부터(Integer.MAX_VALUE 다음은 0으로 돈다). 이보다 앞서 checkProducerEpoch() 가 기억한 것보다 낮은 에포크를 InvalidProducerEpochException 으로 거절합니다(122–159행). 정리하면 이렇습니다.
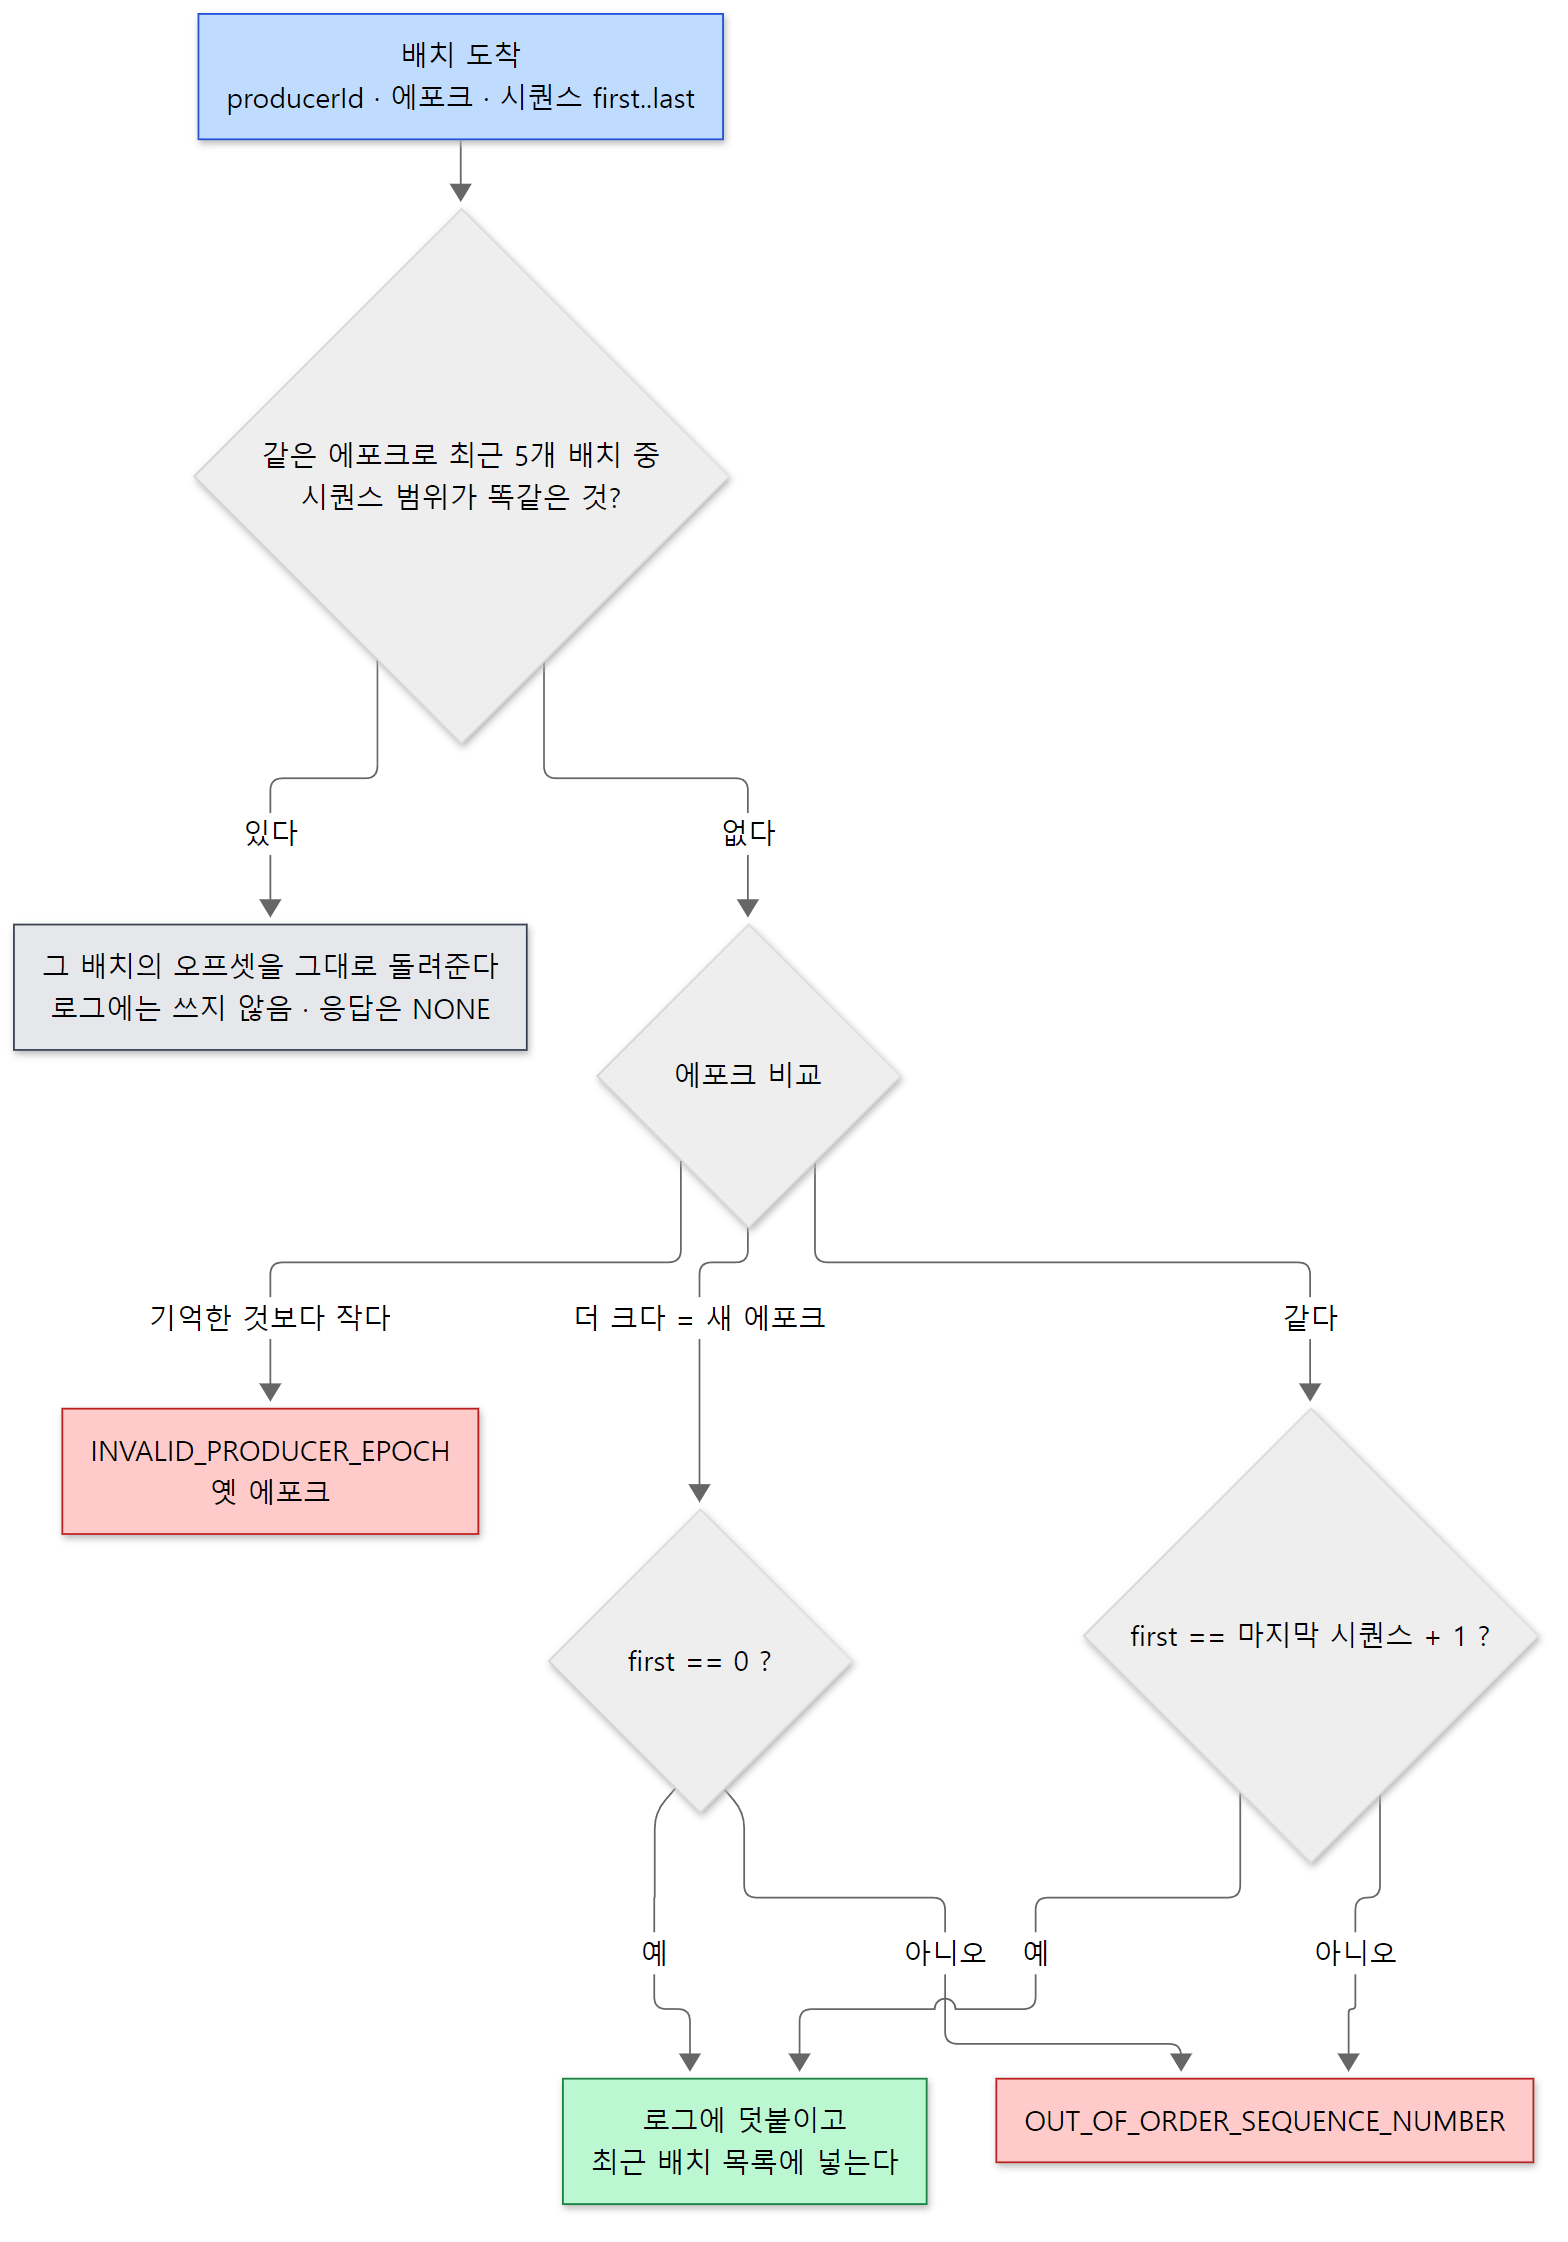 중복 검사는
UnifiedLog.analyzeAndValidateProducerState(), 에포크·순서 검사는 ProducerAppendInfo 가 합니다. 프로듀서 상태가 아예 없는 경우(보존 기간으로 다 지워진 경우 등)의 예외 규칙은 그림에서 뺐습니다.
예제 2: 같은 배치를 두 번, 시퀀스를 건너뛰어 한 번
말로만 보면 잘 와닿지 않으니, KafkaProducer 없이 멱등 프로듀서가 하는 일을 손으로 해 봅니다. 3편의 맨 소켓 예제처럼 생성된 …Data 클래스로 요청을 만들어 보냅니다. 이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 아래 예제들도 모두 같습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// ...
            // 2) 시퀀스 0~2 (레코드 3개) — 처음 보내는 배치
            produce(topic, 0, "first send", "a", "b", "c");
            // 같은 배치를 그대로 다시 — 응답이 사라져 프로듀서가 재시도한 상황
            produce(topic, 0, "same batch again", "a", "b", "c");
            // 다음 시퀀스는 3 이어야 하는데 5 부터 — 중간 배치가 빠진 상황
            produce(topic, 5, "skip seq 3..4", "x");
            // 올바른 다음 시퀀스
            produce(topic, 3, "next seq", "d", "e", "f");
            // 배치 넷을 더 보내 브로커가 기억하는 배치(최근 5개)에서 첫 배치가 밀려나게 한다
            for (int seq = 6; seq <= 15; seq += 3) produce(topic, seq, "more", "g", "h", "i");
            // 이제 첫 배치(시퀀스 0~2)를 다시 보내면?
            produce(topic, 0, "oldest of the 6 batches, again", "a", "b", "c");
// ...
    static void produce(String topic, int baseSequence, String label, String... values) throws Exception {
        // ...
        MemoryRecords records = MemoryRecords.withIdempotentRecords(Compression.NONE, producerId, epoch, baseSequence, recs);
        // ... 이 배치를 Produce v12(acks=-1)에 실어 보내고 응답의 error·baseOffset 을 찍는다
ex/u12-idempotence/RawIdempotent.java 에서 줄였습니다. 앞부분은 InitProducerIdRequestData(transactionalId=null)를 보내 producer id 를 받는 코드입니다. 실행 결과입니다.
=== raw InitProducerId + Produce
InitProducerId: COORDINATOR_LOAD_IN_PROGRESS, retrying in 100 ms
InitProducerId: error=NONE producerId=0 epoch=0
seq  0.. 2 (first send)                       -> error=NONE baseOffset=0
seq  0.. 2 (same batch again)                 -> error=NONE baseOffset=0
seq  5.. 5 (skip seq 3..4)                    -> error=OUT_OF_ORDER_SEQUENCE_NUMBER baseOffset=-1
seq  3.. 5 (next seq)                         -> error=NONE baseOffset=3
seq  6.. 8 (more)                             -> error=NONE baseOffset=6
seq  9..11 (more)                             -> error=NONE baseOffset=9
seq 12..14 (more)                             -> error=NONE baseOffset=12
seq 15..17 (more)                             -> error=NONE baseOffset=15
seq  0.. 2 (oldest of the 6 batches, again)   -> error=OUT_OF_ORDER_SEQUENCE_NUMBER baseOffset=-1
=== kafka-dump-log: u12-idem-0 batches
baseOffset: 0 lastOffset: 2 count: 3 baseSequence: 0 lastSequence: 2 producerId: 0 producerEpoch: 0 magic: 2
baseOffset: 3 lastOffset: 5 count: 3 baseSequence: 3 lastSequence: 5 producerId: 0 producerEpoch: 0 magic: 2
baseOffset: 6 lastOffset: 8 count: 3 baseSequence: 6 lastSequence: 8 producerId: 0 producerEpoch: 0 magic: 2
baseOffset: 9 lastOffset: 11 count: 3 baseSequence: 9 lastSequence: 11 producerId: 0 producerEpoch: 0 magic: 2
baseOffset: 12 lastOffset: 14 count: 3 baseSequence: 12 lastSequence: 14 producerId: 0 producerEpoch: 0 magic: 2
baseOffset: 15 lastOffset: 17 count: 3 baseSequence: 15 lastSequence: 17 producerId: 0 producerEpoch: 0 magic: 2
(kafka-dump-log.sh 출력은 필요한 칸만 남기도록 sed 로 줄였습니다.)
- 두 번째 전송은 오류 없이
baseOffset=0을 받습니다. 그런데 디스크에는 시퀀스 0~2 배치가 하나뿐입니다. 중복을 알아보고 처음 오프셋을 돌려준 것입니다. - 시퀀스 5 로 건너뛴 배치는
OUT_OF_ORDER_SEQUENCE_NUMBER로 거절되고 디스크에 없습니다. 기대한 다음 번호는 3 이었습니다. - 마지막 줄이 5개 기억의 한계를 보여 줍니다. 시퀀스 0~2 배치는 그 뒤에 배치가 5개 더 쓰여 기억에서 밀려났습니다. 그래서 브로커는 이것을 "중복" 으로 알아보지 못하고, 순서 검사(마지막 시퀀스 17 의 다음은 18)에서 거절합니다. 실제
KafkaProducer는 in-flight 요청을 5개 이하로 묶어 두므로 이런 일을 만나지 않습니다.
헷갈리기 쉬운 곳: producer id 는 컨트롤러가 1000개씩 나눠 준다
예제 첫 줄의 COORDINATOR_LOAD_IN_PROGRESS 는 처음 돌렸을 때 실제로 만난 응답입니다. 첫 실행에서는 이 응답을 무시하고 producer id -1 로 배치를 보냈는데, 브로커가 그 배치를 멱등이 아닌 배치로 받아들여 같은 배치가 두 번 쓰였습니다(producerId: -1 인 배치는 위 검사를 건너뜁니다). 재시도 고리를 넣은 것이 위의 코드입니다.
이유는 producer id 를 나눠 주는 방식에 있습니다. 브로커의 RPCProducerIdManager.generateProducerId() 는 자기 손에 든 번호 묶음에서 하나를 꺼내 줍니다. 묶음이 비었으면 컨트롤러에 다음 묶음을 요청하고, 그동안은 COORDINATOR_LOAD_IN_PROGRESS 를 던집니다(RPCProducerIdManager.java 80–109행). 컨트롤러 쪽 ProducerIdControlManager.generateNextProducerId() 는 ProducerIdsBlock.PRODUCER_ID_BLOCK_SIZE(1000)개짜리 묶음을 만들고, 다음 묶음의 시작 번호를 ProducerIdsRecord 로 메타데이터 로그에 적습니다(ProducerIdControlManager.java 84–101행). 10편의 "컨트롤러가 정하고, 로그에 적고, 퍼뜨린다" 와 같은 길이라, 브로커가 막 뜬 직후에는 첫 묶음이 아직 도착하지 않았을 수 있습니다. KafkaProducer 는 이 오류를 재시도할 수 있는 오류로 다루므로 앱에서는 보이지 않습니다.
2. 트랜잭션의 무대 — 코디네이터와 __transaction_state
멱등 프로듀서는 한 파티션 안에서만 중복을 막습니다. 주문 하나를 처리하며 orders 토픽과 payments 토픽에 함께 쓰고, 읽은 위치(컨슈머 오프셋)까지 함께 넘기고 싶다면, 이 셋이 "모두 보이거나 모두 안 보여야" 합니다. 그 결정을 내리고 기억하는 것이 트랜잭션 코디네이터입니다.
누가 내 코디네이터인가
transactional.id 의 해시로 __transaction_state 파티션 하나를 고르고, 그 파티션의 리더가 코디네이터입니다.
def partitionFor(transactionalId: String): Int = Utils.abs(transactionalId.hashCode) % transactionTopicPartitionCount
core/src/main/scala/kafka/coordinator/transaction/TransactionStateManager.scala 451행
Scala 읽는 법 —
def f(x: String): Int = 식은 반환형이Int인 메서드이고,=뒤의 식이 곧 반환값입니다(return을 쓰지 않습니다).
파티션 수(transaction.state.log.num.partitions)의 기본값은 50, 복제 계수는 3, min.insync.replicas 는 2 입니다(TransactionLogConfig.java 32·40·45행). 이 연재의 예제 도우미는 브로커가 하나뿐이라 복제 계수와 min ISR 을 1로 낮춰 둡니다. 클라이언트는 FindCoordinator 요청(키 종류 TRANSACTION)으로 아무 브로커에게 물어 코디네이터를 찾고, 브로커는 txnCoordinator.partitionFor(key) 로 파티션을 골라 그 리더를 알려 줍니다(KafkaApis.scala 1282행). 그룹 코디네이터가 group.id 로 __consumer_offsets 파티션을 고르는 것과 같은 방식입니다.
코디네이터가 기억하는 것: TransactionMetadata 와 여덟 가지 상태
코디네이터는 transactional.id 마다 TransactionMetadata 객체 하나를 메모리에 둡니다. producer id, 에포크, 직전 에포크, 타임아웃, 상태, 이 트랜잭션에 들어온 파티션 목록이 들어 있습니다(TransactionMetadata.java 37–60행). 상태가 바뀔 때마다 그 내용을 __transaction_state 에 레코드로 쓰고, 쓰기가 복제까지 끝난 뒤에야 메모리 상태를 바꿉니다(completeTransitionTo() 의 주석, 357–358행). 코디네이터를 맡은 브로커가 죽으면 새 리더가 이 파티션을 처음부터 읽어 같은 상태를 다시 만듭니다 — 11편의 그룹 코디네이터와 같은 "로그가 곧 상태" 설계입니다.
상태는 Java enum 하나에 모여 있고, 어느 상태에서 어느 상태로 갈 수 있는지가 표 하나로 적혀 있습니다.
    public static final Map<TransactionState, Set<TransactionState>> VALID_PREVIOUS_STATES = Map.of(
        EMPTY, Set.of(EMPTY, COMPLETE_COMMIT, COMPLETE_ABORT),
        ONGOING, Set.of(ONGOING, EMPTY, COMPLETE_COMMIT, COMPLETE_ABORT),
        PREPARE_COMMIT, Set.of(ONGOING, EMPTY, COMPLETE_COMMIT, COMPLETE_ABORT),
        PREPARE_ABORT, Set.of(ONGOING, PREPARE_EPOCH_FENCE, EMPTY, COMPLETE_COMMIT, COMPLETE_ABORT),
        COMPLETE_COMMIT, Set.of(PREPARE_COMMIT),
        COMPLETE_ABORT, Set.of(PREPARE_ABORT),
        DEAD, Set.of(EMPTY, COMPLETE_ABORT, COMPLETE_COMMIT),
        PREPARE_EPOCH_FENCE, Set.of(ONGOING)
    );
키가 "가려는 상태", 값이 "거기로 올 수 있는 앞 상태" 입니다. 그림으로 그리면 이렇습니다.
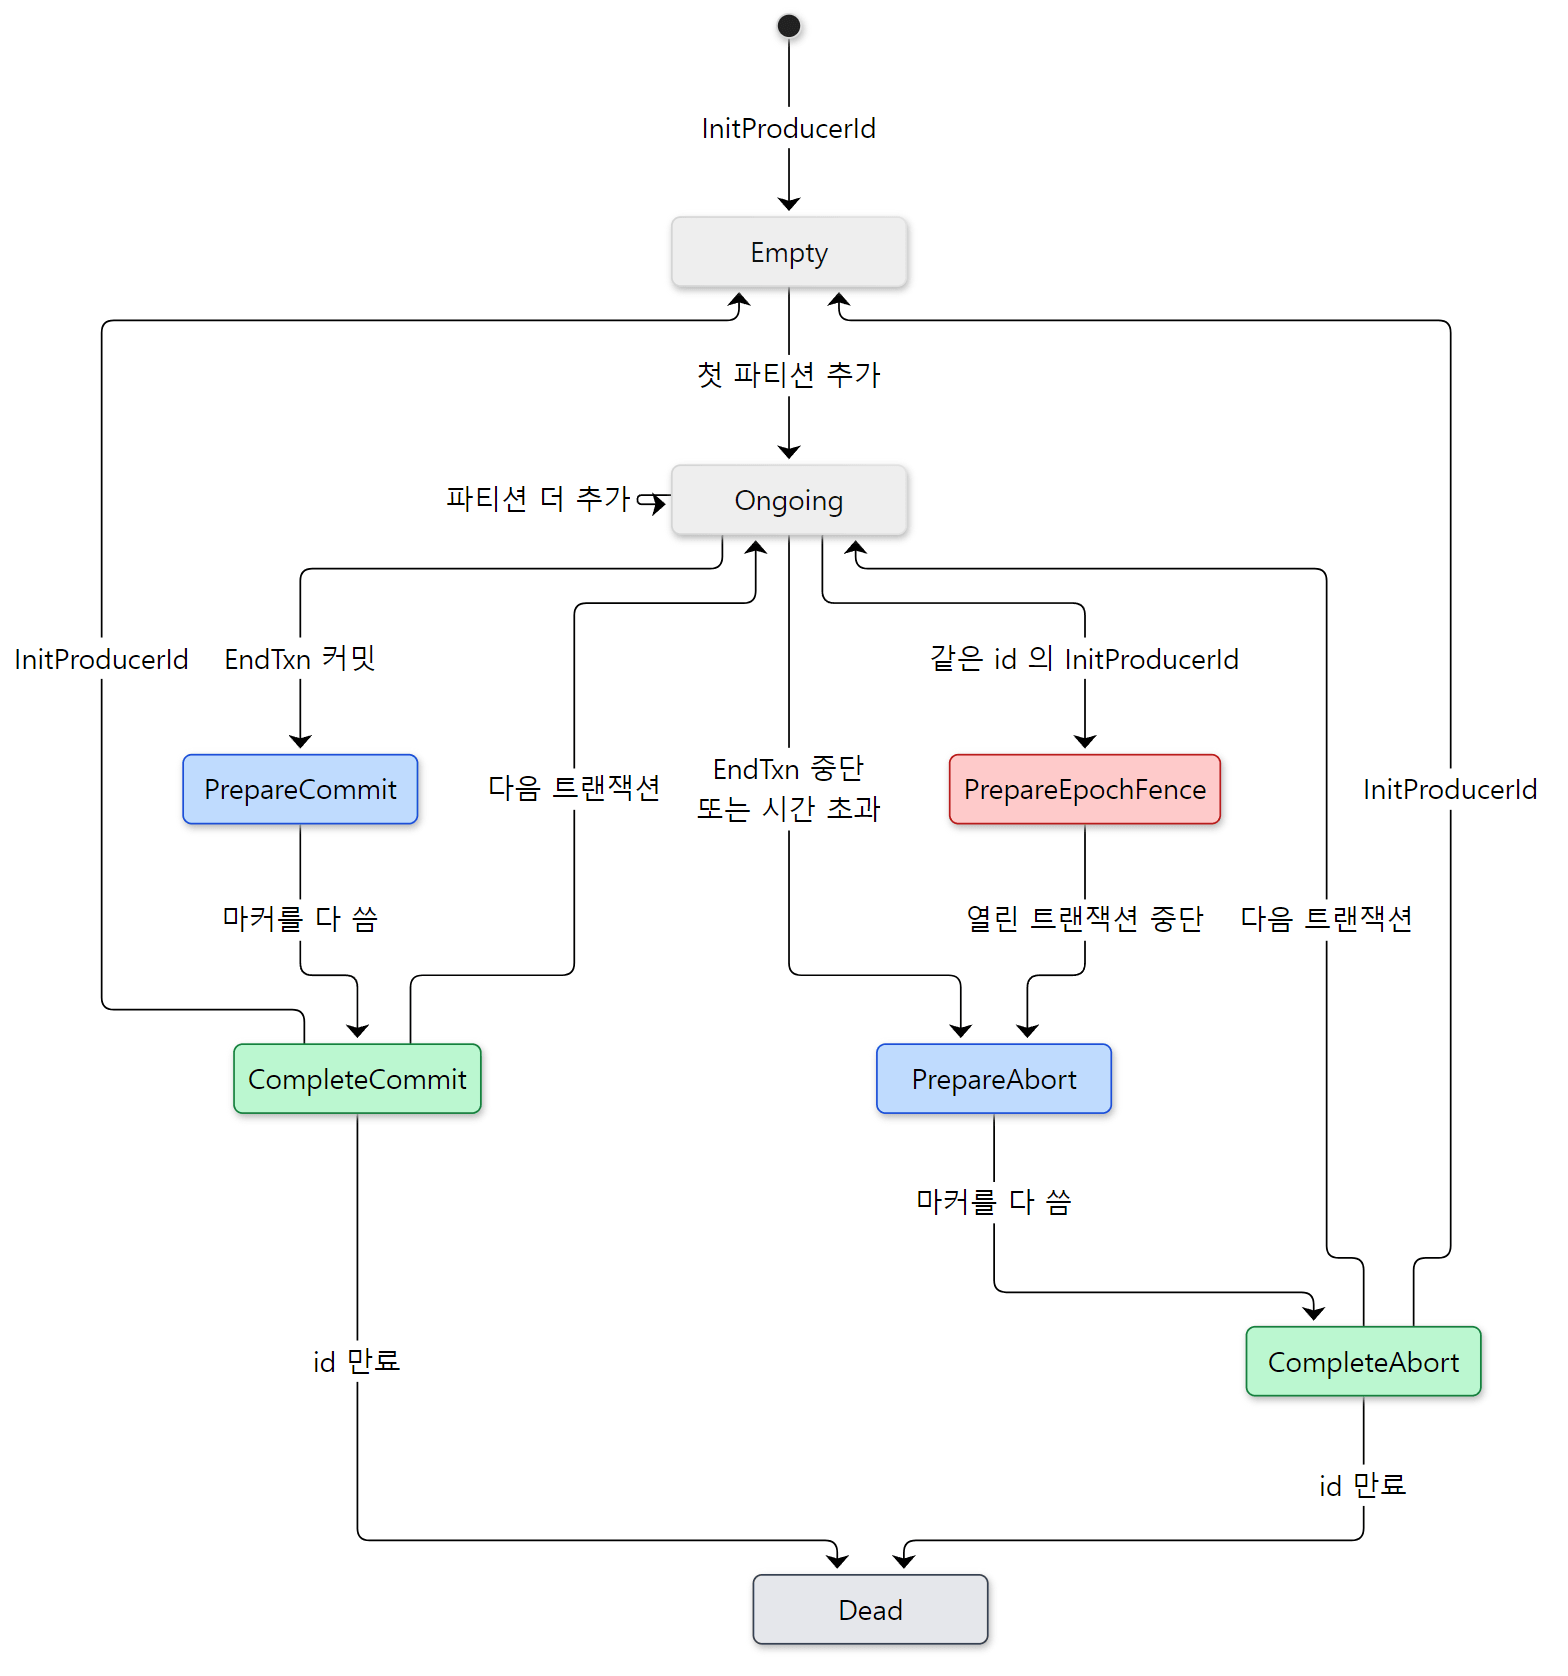 파란 상자가 "결정은 내렸고 마커를 쓰는 중"인 상태, 초록 상자가 끝난 상태입니다. TV2 에서만 쓰는 "빈 트랜잭션의 커밋·중단"(Empty·Complete → Prepare*) 화살표와 Empty → Empty, Empty → Dead 화살표는 그림에서 뺐습니다.*
가장 중요한 경계는 Prepare 상태입니다. PrepareCommit 이 __transaction_state 에 쓰인 순간 "이 트랜잭션은 커밋된다"는 결정이 내구성 있게 남습니다. 그 뒤에 코디네이터가 죽어도, 새 코디네이터가 로그를 읽다가 PrepareCommit 을 만나면 마커 쓰기를 이어서 합니다(TransactionStateManager.loadTransactionsForTxnTopicPartition(), 550행부터). 두 단계 커밋(2PC)의 "준비" 단계와 같은 역할입니다.
헷갈리기 쉬운 곳: 4.4.0 과 다른 곳
PREPARE_COMMIT 줄은 4.4.0 에서는 Set.of(ONGOING) 이었습니다. trunk 에서는 파티션 없이 commitTransaction() 을 불러도(빈 트랜잭션) 중단과 똑같이 에포크를 올리고 PrepareCommit 을 로그에 쓰게 바뀌었습니다. 코디네이터가 리더 자리를 잃었는데 아직 그 사실을 반영하지 못한 순간에, 클라이언트에 치명적인 오류 대신 재시도할 수 있는 오류를 돌려주려는 변경이라고 TransactionCoordinator.scala 의 상태 표 아래 주석이 설명합니다(KAFKA-21181). 앱에서 보이는 차이는 거의 없지만, 4.4.0 소스를 같이 보는 사람은 이 줄이 다르다는 것을 알아 두면 좋습니다.
3. 트랜잭션 한 번의 일생 — initTransactions() 부터 commitTransaction() 까지
앱 코드로는 이렇습니다.
producer.initTransactions();
producer.beginTransaction();
producer.send(new ProducerRecord<>("u12-txn", "c1"));
// ...
producer.commitTransaction();
이 다섯 줄 동안 오가는 요청을 TV2 기준으로 그리면 다음과 같습니다.
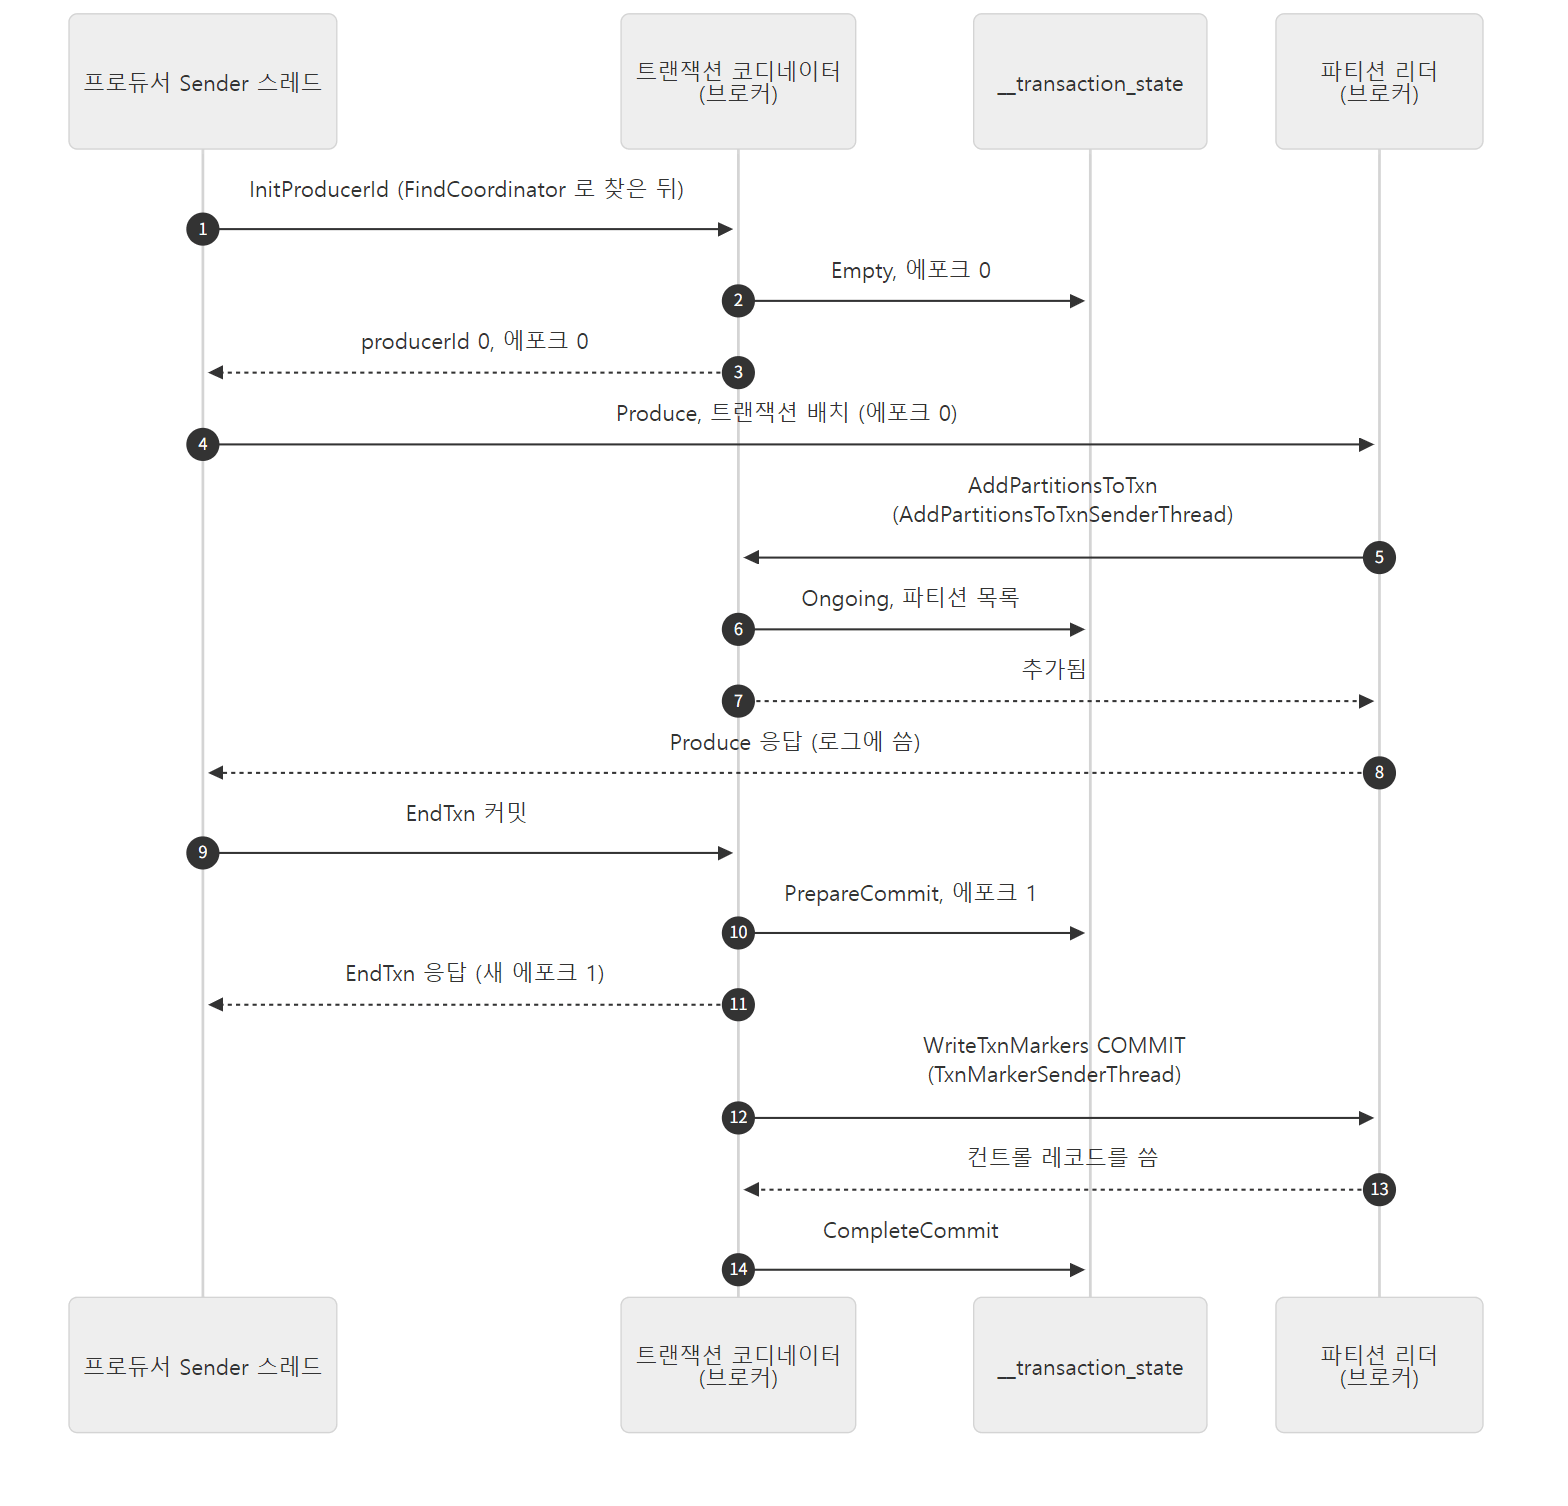 코디네이터와 파티션 리더는 같은 브로커일 수도, 다른 브로커일 수도 있습니다. 5와 12는 브로커가 다른 브로커에게 보내는 요청입니다.
번호를 따라 소스를 봅니다.
1–3: InitProducerId — 에포크를 올려 자리를 잡는다
initTransactions() 는 TransactionManager.initializeTransactions() 를 거쳐 InitProducerId 요청(이번에는 transactionalId 가 채워짐)을 보냅니다(321–356행). 클라이언트의 TransactionManager 는 요청들을 우선순위 큐에 넣는데, 순서가 FIND_COORDINATOR → INIT_PRODUCER_ID → ADD_PARTITIONS_OR_OFFSETS → END_TXN 으로 정해져 있습니다(그 뒤에 트랜잭션을 끝내며 에포크를 올리는 EPOCH_BUMP 가 하나 더 있습니다. enum Priority, 201–213행). 코디네이터를 모르면 찾는 것이 먼저이고, producer id 가 없으면 그것이 먼저입니다.
코디네이터의 handleInitProducerId() 는 처음 보는 transactional.id 면 producer id 를 새로 받아 TransactionMetadata 를 만들고(152–167행), 새것이든 있던 것이든 prepareInitProducerIdTransit() 으로 에포크를 하나 올린 Empty 상태를 준비해 로그에 씁니다(처음이면 에포크 -1 이 0 이 됩니다)(TransactionCoordinator.scala 118–227행). 같은 transactional.id 로 다시 시작한 프로듀서가 새 에포크를 받는 이 동작이 6절의 펜싱입니다.
4–8: 파티션을 트랜잭션에 넣는 것은 이제 브로커가 한다
TV1 까지는 클라이언트가 새 파티션에 쓰기 전에 AddPartitionsToTxn 요청을 코디네이터에 직접 보냈습니다. TV2 에서는 이 요청을 보내지 않습니다. send() 가 부르는 maybeAddPartition() 을 보면 갈래가 나뉩니다.
    public synchronized void maybeAddPartition(TopicPartition topicPartition) {
        maybeFailWithError();
        throwIfPendingState(TransactionOperation.SEND);

        if (isTransactional()) {
            if (!hasProducerId()) {
                throw new IllegalStateException("Cannot add partition " + topicPartition +
                    " to transaction before completing a call to initTransactions");
            } else if (currentState != State.IN_TRANSACTION) {
                throw new IllegalStateException("Cannot add partition " + topicPartition +
                    " to transaction while in state  " + currentState);
            } else if (isTransactionV2Enabled()) {
                txnPartitionMap.getOrCreate(topicPartition);
                partitionsInTransaction.add(topicPartition);
                transactionStarted = true;
            } else if (transactionContainsPartition(topicPartition) || isPartitionPendingAdd(topicPartition)) {
                return;
            } else {
                log.debug("Begin adding new partition {} to transaction", topicPartition);
                txnPartitionMap.getOrCreate(topicPartition);
                newPartitionsInTransaction.add(topicPartition);
            }
        }
    }
clients/src/main/java/org/apache/kafka/clients/producer/internals/TransactionManager.java 465–488행
TV2 갈래는 파티션을 곧바로 "트랜잭션에 들어간 것"(partitionsInTransaction)으로 적고 끝납니다. TV1 갈래는 newPartitionsInTransaction 에 넣어 두었다가 AddPartitionsToTxn 요청을 따로 보냅니다. TV2 를 켤지는 브로커가 ApiVersions 응답에 실어 준 기능 플래그 transaction.version 이 2 이상인지로 정합니다(maybeUpdateTransactionV2Enabled(), 520–532행).
그러면 코디네이터는 이 파티션을 어떻게 알까요. 배치를 받은 파티션 리더가 대신 알려 줍니다. KafkaApis.handleProduceRequest() 는 Produce 요청의 판을 보고 할 일을 정합니다.
    public static TransactionSupportedOperation produceRequestVersionToTransactionSupportedOperation(short version) {
        if (version > 11) {
            return ADD_PARTITION;
        } else if (version > 10) {
            return GENERIC_ERROR_SUPPORTED;
        } else {
            return DEFAULT_ERROR;
        }
    }
server/src/main/java/org/apache/kafka/server/transaction/AddPartitionsToTxnManager.java 98–106행
Produce v12 이상이면 ADD_PARTITION — "검사만 하지 말고 추가까지 하라" 입니다. ReplicaManager.handleProduceAppend() 는 트랜잭션 배치가 있으면 로그에 쓰기 전에 maybeSendPartitionsToTransactionCoordinator() 를 부르고(ReplicaManager.scala 1000–1059행), 이 파티션에 그 프로듀서의 트랜잭션이 아직 열려 있지 않으면 AddPartitionsToTxnManager.addOrVerifyTransaction() 이 코디네이터에 AddPartitionsToTxn 요청을 보냅니다. 이때 setVerifyOnly(!transactionSupportedOperation.supportsEpochBump) 로 TV2 면 "추가", 옛 클라이언트면 "검사만" 을 요청합니다(259행). 이 요청을 보내는 것은 브로커 안의 별도 스레드이고, 이름은 생성자에서 정해집니다.
super("AddPartitionsToTxnSenderThread-" + config.brokerId(), client, config.requestTimeoutMs(), time);
server/src/main/java/org/apache/kafka/server/transaction/AddPartitionsToTxnManager.java 226행
코디네이터 쪽 handleAddPartitionsToTransaction() 은 producer id 와 에포크가 맞는지 보고(producer id 가 다르면 INVALID_PRODUCER_ID_MAPPING, 에포크가 다르면 PRODUCER_FENCED), 파티션을 넣은 Ongoing 상태를 로그에 씁니다(TransactionCoordinator.scala 417–470행). 답이 오면 리더는 그제야 배치를 로그에 씁니다.
왜 이렇게 바꿨을까요. 소스에서 확인할 수 있는 이유는 UnifiedLog.analyzeAndValidateProducerState() 의 긴 주석(1425–1440행)에 있습니다. "트랜잭션 레코드는 코디네이터가 그 파티션에 열린 트랜잭션이 있다는 것을 모르는 채로는 로그에 절대 쓰이지 않는다"를 보장하려는 것입니다. 클라이언트가 AddPartitionsToTxn 을 빠뜨리거나 늦게 보내면, 코디네이터는 마커를 보낼 파티션을 모르고, 그 파티션에는 끝나지 않는 트랜잭션이 남아 LSO 가 영영 멈춥니다. 쓰기를 받는 리더가 직접 확인·추가하면 이 구멍이 닫힙니다(그 주석이 말하는 VerificationGuard 는 확인 응답과 중단 마커가 엇갈리는 경우까지 막는 장치입니다).
9–11: EndTxn — Prepare 를 쓰고, 곧바로 답한다
commitTransaction() 은 beginCommit() → beginCompletingTransaction() 으로 EndTxn 요청을 보냅니다(381–430행). 코디네이터의 endTransaction() 은 Ongoing 이면 PrepareCommit(또는 PrepareAbort)을 준비하는데, TV2 에서는 여기서 에포크를 올립니다.
        TransitionData data = new TransitionData(newState);
        if (clientTransactionVersion.supportsEpochBump()) {
            if (producerEpoch == Short.MAX_VALUE && newState == TransactionState.PREPARE_ABORT) {
                // If we're already in a broken state, we let the abort go through without
                // epoch overflow, so that we can recover and continue.
                LOGGER.error("Aborting producer {} {} with epoch equal to Short.MaxValue, this must not happen unless there is a bug", transactionalId, producerId);
            } else {
                // We already ensured that we do not overflow here. MAX_SHORT is the highest possible value.
                data.producerEpoch = (short) (producerEpoch + 1);
            }
            data.lastProducerEpoch = producerEpoch;
        } else {
            data.producerEpoch = producerEpoch;
            data.lastProducerEpoch = lastProducerEpoch;
        }
이 상태를 appendTransactionToLog() 로 __transaction_state 에 쓰고, 쓰기가 끝나면 콜백에서 이렇게 합니다.
                case Right((txnMetadata, newPreSendMetadata)) =>
                  // we can respond to the client immediately and continue to write the txn markers if
                  // the log append was successful
                  responseCallback(Errors.NONE, newPreSendMetadata.producerId, newPreSendMetadata.producerEpoch)

                  txnMarkerChannelManager.addTxnMarkersToSend(coordinatorEpoch, txnMarkerResult, txnMetadata, newPreSendMetadata)
core/src/main/scala/kafka/coordinator/transaction/TransactionCoordinator.scala 1002–1007행
Scala 읽는 법 —
Right(...)와Left(...)는Either라는 "둘 중 하나" 값입니다. 이 코드베이스는Left에 오류,Right에 성공 값을 담습니다.case Right((a, b)) =>는 성공 값(튜플)을 꺼내a,b라는 이름을 붙이는 패턴 매칭입니다.
마커를 다 쓰기 전에 클라이언트에 답합니다. PrepareCommit 이 로그에 남은 순간 결정은 되돌릴 수 없으니, 나머지는 코디네이터가 책임지고 끝내면 됩니다. 그래서 commitTransaction() 이 돌아온 직후에는 마커가 아직 안 쓰였을 수 있습니다 — 예제 1이 마지막 출력 전에 0.5초 기다리는 이유입니다. 응답에는 올라간 새 에포크가 실려 오고, 클라이언트의 EndTxnHandler 는 그 값을 자기 producer id·에포크로 삼고 시퀀스를 0부터 다시 셉니다(TransactionManager.java 1817–1824행).
12–14: 마커 보내기와 CompleteCommit
addTxnMarkersToSend() 는 트랜잭션에 든 파티션들을 리더 브로커별로 묶어 큐에 넣습니다(addTxnMarkersToBrokerQueue(), TransactionMarkerChannelManager.scala 339–412행). 큐를 비우는 것은 InterBrokerSendThread 를 이어받은 TransactionMarkerChannelManager 자신이고, 스레드 이름은 "TxnMarkerSenderThread-" + config.brokerId 입니다(123행). generateRequests() 가 브로커마다 WriteTxnMarkers 요청 하나를 만듭니다(192–228행). 모든 파티션에서 답이 오면 writeTxnCompletion() 이 CompleteCommit 을 로그에 씁니다(230–269행).
이 WriteTxnMarkers 를 받은 리더는 마커를 파티션에 쓰는데, 그 몸통은 평범한 쓰기입니다.
            controlRecords += replicaManager.topicIdPartition(partition) -> MemoryRecords.withEndTransactionMarker(
              producerId,
              marker.producerEpoch,
              new EndTransactionMarker(controlRecordType, marker.coordinatorEpoch)
            )
core/src/main/scala/kafka/server/KafkaApis.scala 1867–1871행
Scala 읽는 법 —
map += key -> value는 변경 가능한 맵에 항목 하나를 넣는 문장입니다.a -> b는 튜플(a, b)를 만드는 짧은 표기입니다.
마커 레코드 하나짜리 배치를 만들어, 6편에서 본 ReplicaManager.appendRecords() 에 origin = AppendOrigin.COORDINATOR, requiredAcks = -1 로 넘깁니다(1876–1889행). 마커도 복제까지 끝나야 성공입니다. 예외는 __consumer_offsets 파티션입니다. sendOffsetsToTransaction() 으로 트랜잭션에 넣은 컨슈머 오프셋은 그룹 코디네이터가 들고 있으므로, 그 파티션의 마커는 groupCoordinator.completeTransaction() 으로 넘어갑니다(1840–1862행). 이 덕분에 "읽은 위치"도 출력 레코드와 함께 커밋되거나 버려집니다.
헷갈리기 쉬운 곳: TV2 의 sendOffsetsToTransaction()
TV1 은 오프셋을 넣을 때 AddOffsetsToTxn 을 코디네이터에 먼저 보내고 TxnOffsetCommit 을 그룹 코디네이터에 보냈습니다. TV2 에서는 첫 요청을 건너뛰고 TxnOffsetCommit 만 보냅니다(TransactionManager.java 443–449행의 "In transaction V2, the client will skip sending AddOffsetsToTxn" 주석). __consumer_offsets 파티션을 트랜잭션에 넣는 일은 Produce 와 같은 방식으로 받는 쪽 브로커가 맡습니다(txnOffsetCommitRequestVersionToTransactionSupportedOperation(), AddPartitionsToTxnManager.java 108–116행). 클라이언트 로그에서 AddOffsetsToTxn 을 찾다가 없다고 놀랄 필요는 없습니다.
4. 커밋 마커 — 디스크에서 보기
예제 1: 커밋·중단·커밋
트랜잭션 셋을 보내고 디스크를 열어 봅니다. A(c1~c3) 커밋, B(a1~a3) 중단, C(c4~c5) 커밋입니다. B 는 보내고 flush() 한 뒤 중단하기 전에, 끝 오프셋을 두 격리 수준으로 물어 봅니다(5절에서 씁니다).
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// ...
            producer.initTransactions();   // InitProducerId — producer id 와 에포크를 받는다

            // 트랜잭션 A: 커밋
            producer.beginTransaction();
            for (String v : List.of("c1", "c2", "c3")) producer.send(new ProducerRecord<>(TOPIC, v));
            producer.commitTransaction();
            System.out.println("txn A (c1..c3): committed");

            // 트랜잭션 B: 보내고 flush 한 뒤, 중단하기 전에 끝 오프셋을 두 격리 수준으로 묻는다
            producer.beginTransaction();
            for (String v : List.of("a1", "a2", "a3")) producer.send(new ProducerRecord<>(TOPIC, v));
            producer.flush();
            System.out.println("txn B (a1..a3): sent and flushed, still open");
            printEnd(admin, "  while B is open");
            producer.abortTransaction();
            System.out.println("txn B: aborted");
// ...
ex/u12-transactions/Txn.java 에서 줄였습니다(프로듀서 설정은 transactional.id=u12-txn 과 client.id 만 더했고, 토픽 u12-txn 은 파티션 1개입니다). run.sh 는 서버를 띄우고, 이 프로그램을 돌리고, 디스크와 도구 출력을 차례로 찍습니다. 먼저 기능 플래그와 프로그램 출력입니다.
=== finalized features (transaction.version)
Feature: metadata.version                          SupportedMinVersion: 3.3-IV3          SupportedMaxVersion: 4.4-IV2          FinalizedVersionLevel: 4.4-IV2          Epoch: 72
Feature: transaction.version                       SupportedMinVersion: 0                SupportedMaxVersion: 2                FinalizedVersionLevel: 2                Epoch: 72
=== producer and consumers
txn A (c1..c3): committed
txn B (a1..a3): sent and flushed, still open
  while B is open: latest offset read_uncommitted=7 (high watermark), read_committed=4 (LSO)
txn B: aborted
txn C (c4..c5): committed
  after all three: latest offset read_uncommitted=11 (high watermark), read_committed=11 (LSO)
read_uncommitted consumer got 8 records: c1@0 c2@1 c3@2 a1@4 a2@5 a3@6 c4@8 c5@9 (position 11)
read_committed   consumer got 5 records: c1@0 c2@1 c3@2 c4@8 c5@9 (position 11)
=== broker threads that only transactions use
"AddPartitionsToTxnSenderThread-1"
"TxnMarkerSenderThread-1"
transaction.version 이 2 로 확정(Finalized)되어 있습니다(Epoch 값은 실행마다 다릅니다). 브로커의 jstack 에는 3절에서 본 두 스레드가 노드 번호 1 을 달고 보입니다. 다음은 파티션 폴더와 kafka-dump-log.sh 입니다.
=== files of u12-txn-0
00000000000000000000.index
00000000000000000000.log
00000000000000000000.timeindex
00000000000000000000.txnindex
=== kafka-dump-log: u12-txn-0 batches
baseOffset: 0 lastOffset: 0 baseSequence: 0 producerId: 0 producerEpoch: 0 isTransactional: true isControl: false magic: 2
baseOffset: 1 lastOffset: 2 baseSequence: 1 producerId: 0 producerEpoch: 0 isTransactional: true isControl: false magic: 2
baseOffset: 3 lastOffset: 3 baseSequence: -1 producerId: 0 producerEpoch: 1 isTransactional: true isControl: true magic: 2
 offset: 3 keySize: 4 valueSize: 6 sequence: -1 headerKeys: [] endTxnMarker: COMMIT coordinatorEpoch: 0
baseOffset: 4 lastOffset: 6 baseSequence: 0 producerId: 0 producerEpoch: 1 isTransactional: true isControl: false magic: 2
baseOffset: 7 lastOffset: 7 baseSequence: -1 producerId: 0 producerEpoch: 2 isTransactional: true isControl: true magic: 2
 offset: 7 keySize: 4 valueSize: 6 sequence: -1 headerKeys: [] endTxnMarker: ABORT coordinatorEpoch: 0
baseOffset: 8 lastOffset: 9 baseSequence: 0 producerId: 0 producerEpoch: 2 isTransactional: true isControl: false magic: 2
baseOffset: 10 lastOffset: 10 baseSequence: -1 producerId: 0 producerEpoch: 3 isTransactional: true isControl: true magic: 2
 offset: 10 keySize: 4 valueSize: 6 sequence: -1 headerKeys: [] endTxnMarker: COMMIT coordinatorEpoch: 0
=== kafka-dump-log: .txnindex
Dumping /tmp/kafka/1/data/u12-txn-0/00000000000000000000.txnindex
version: 0 producerId: 0 firstOffset: 4 lastOffset: 7 lastStableOffset: 8
(배치 줄은 sed 로 몇 칸을 지웠고, 데이터 레코드 줄은 grep 으로 뺐습니다. 트랜잭션 A 가 배치 둘(0, 1~2)로 나뉜 것은 이번 실행에서 첫 레코드가 먼저 나갔기 때문입니다. 다른 실행에서는 0~2 가 한 배치였습니다 — 배치 경계는 실행마다 다를 수 있습니다.)
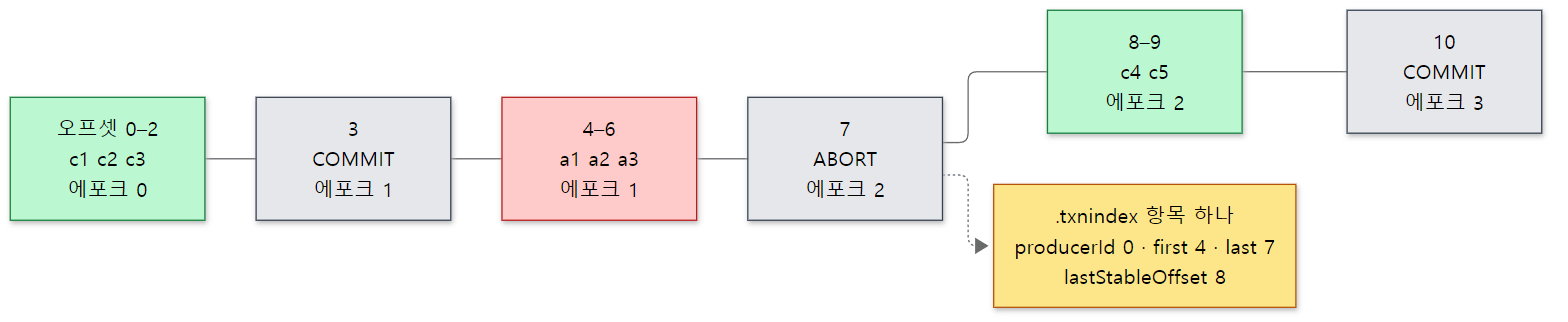 초록은 커밋된 데이터, 빨강은 중단된 데이터, 회색은 컨트롤 레코드(마커)입니다. 마커도 오프셋을 하나씩 차지합니다.
읽을 거리가 셋입니다.
- 에포크가 트랜잭션마다 하나씩 오릅니다. 데이터는 0·1·2, 마커는 1·2·3. TV2 의 코디네이터가
Prepare*에서 에포크를 올리고(3절), 그 올린 에포크로 마커를 쓰기 때문에 마커의 에포크는 언제나 같은 트랜잭션 데이터보다 1 큽니다. 다음 트랜잭션은 그 에포크로 시작하고 시퀀스는 0 부터 다시 셉니다(baseSequence: 0). - 마커는
baseSequence: -1,isControl: true인 배치입니다. 레코드 하나에 키 4바이트·값 6바이트이고, 값에 코디네이터 에포크가 들어 있습니다. .txnindex에는 중단된 트랜잭션만 들어갑니다. 커밋 마커 둘은 항목을 만들지 않았습니다.LogSegment.updateTxnIndex()가completedTxn.isAborted()일 때만 덧붙이기 때문입니다(348–354행). 항목의 모양은 JSON 스키마AbortedTxn.json에서 생성됩니다 —ProducerId·FirstOffset·LastOffset·LastStableOffset네 칸이 모두int64입니다(clients/src/main/resources/common/message/AbortedTxn.json22–33행). 7편에서 이름만 보고 넘어간TransactionIndex가 이 파일입니다.
마커를 받는 쪽의 에포크 검사
브로커는 마커를 쓸 때도 ProducerAppendInfo 로 에포크를 봅니다. TV2 에서는 규칙이 데이터보다 엄격합니다.
    private void checkProducerEpoch(short producerEpoch, long offset, short transactionVersion) {
        short current = updatedEntry.producerEpoch();
        boolean invalidEpoch = (transactionVersion >= 2) ? (producerEpoch <= current) : (producerEpoch < current);
storage/src/main/java/org/apache/kafka/storage/internals/log/ProducerAppendInfo.java 122–124행
데이터 배치는 transactionVersion 을 TV_UNKNOWN(-1)으로 넘기므로 "작으면 거절"이고(97–98행), TV2 마커는 "같거나 작으면 거절" 입니다. 바로 위 예제의 "마커 에포크 = 데이터 에포크 + 1" 이 이 검사의 전제입니다. 메서드 주석(104–121행)은 이 덕분에 늦게 도착한 옛 마커가 다음 트랜잭션을 잘못 끝내는 일을 막는다고 설명합니다. 다만 같은 에포크의 마커가 재시도로 다시 오고 이미 트랜잭션이 끝나 있으면 받아 준다는 예외가 127–144행에 있습니다(KAFKA-19999).
__transaction_state 에 쓰인 것
같은 run.sh 의 마지막 부분은 kafka-dump-log.sh --transaction-log-decoder 로 코디네이터의 로그를 엽니다. 파티션 50개 가운데 비어 있지 않은 것을 찾아 찍게 했습니다.
=== __transaction_state partition that holds u12-txn
__transaction_state-23
{"producerId":0,"previousProducerId":0,"producerEpoch":0,"transactionTimeoutMs":60000,"transactionStatus":"Empty","transactionPartitions":null}
{"producerId":0,"previousProducerId":0,"producerEpoch":0,"transactionTimeoutMs":60000,"transactionStatus":"Ongoing","transactionPartitions":[{"topic":"u12-txn","partitionIds":[0]}],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":0,"producerEpoch":1,"transactionTimeoutMs":60000,"transactionStatus":"PrepareCommit","transactionPartitions":[{"topic":"u12-txn","partitionIds":[0]}],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":0,"producerEpoch":1,"transactionTimeoutMs":60000,"transactionStatus":"CompleteCommit","transactionPartitions":[],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":0,"producerEpoch":1,"transactionTimeoutMs":60000,"transactionStatus":"Ongoing","transactionPartitions":[{"topic":"u12-txn","partitionIds":[0]}],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":1,"producerEpoch":2,"transactionTimeoutMs":60000,"transactionStatus":"PrepareAbort","transactionPartitions":[{"topic":"u12-txn","partitionIds":[0]}],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":1,"producerEpoch":2,"transactionTimeoutMs":60000,"transactionStatus":"CompleteAbort","transactionPartitions":[],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":1,"producerEpoch":2,"transactionTimeoutMs":60000,"transactionStatus":"Ongoing","transactionPartitions":[{"topic":"u12-txn","partitionIds":[0]}],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":2,"producerEpoch":3,"transactionTimeoutMs":60000,"transactionStatus":"PrepareCommit","transactionPartitions":[{"topic":"u12-txn","partitionIds":[0]}],"clientTransactionVersion":2}
{"producerId":0,"previousProducerId":0,"lastProducerEpoch":2,"producerEpoch":3,"transactionTimeoutMs":60000,"transactionStatus":"CompleteCommit","transactionPartitions":[],"clientTransactionVersion":2}
(레코드마다 payload: 의 JSON 만 남기고, 실행마다 바뀌는 두 타임스탬프 칸과 바깥 {"version":"1","data":…} 껍데기는 sed 로 지웠습니다.)
2절의 상태 그림을 그대로 따라갑니다. Empty 한 줄, 그리고 트랜잭션마다 Ongoing → Prepare* → Complete* 세 줄입니다. 에포크는 Prepare* 줄에서 오르고(lastProducerEpoch 에 직전 값이 남습니다), Complete* 에서는 파티션 목록이 비워집니다. 3절 그림의 2·6·10·14번 화살표가 이 레코드들입니다. u12-txn 이 __transaction_state-23 에 간 것은 "u12-txn".hashCode() 의 절댓값을 50 으로 나눈 나머지가 23 이기 때문이고, 이것은 실행마다 같습니다. kafka-transactions.sh 도 같은 상태를 보여 줍니다.
=== kafka-transactions.sh list / describe
TransactionalId	Coordinator	ProducerId	TransactionState
u12-txn        	1          	0         	CompleteCommit
CoordinatorId	TransactionalId	ProducerId	ProducerEpoch	TransactionState	TransactionTimeoutMs	CurrentTransactionStartTimeMs	TransactionDurationMs	TopicPartitions
1            	u12-txn        	0         	3            	CompleteCommit  	60000               	1794026921817                	31955
(시작 시각과 경과 시간은 실행마다 다릅니다.) describe 는 DescribeTransactions 요청으로 코디네이터의 메모리 상태(TransactionMetadata)를 그대로 읽어 옵니다(TransactionCoordinator.handleDescribeTransactions(), 312행부터).
5. 읽는 쪽 — LSO 와 중단된 트랜잭션 목록
브로커는 LSO 까지만 내준다
예제 1의 출력 가운데 이 줄을 다시 봅니다.
while B is open: latest offset read_uncommitted=7 (high watermark), read_committed=4 (LSO)
트랜잭션 B 의 레코드 a1~a3(오프셋 4~6)는 이미 로그에 쓰였고 복제도 끝났습니다(HW 7). 하지만 결론이 나지 않았으므로 LSO 는 B 의 첫 오프셋 4 에 멈춰 있습니다. UnifiedLog 의 정의가 그대로입니다.
    public long lastStableOffset() {
        // cache the first unstable offset metadata to avoid a concurrent update breaking the isPresent check
        Optional<LogOffsetMetadata> firstUnstableOffsetMetadataCopy = firstUnstableOffsetMetadata;
        if (firstUnstableOffsetMetadataCopy.isPresent() && firstUnstableOffsetMetadataCopy.get().messageOffset < highWatermark()) {
            return firstUnstableOffsetMetadataCopy.get().messageOffset;
        } else {
            return highWatermark();
        }
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 678–686행
첫 불안정 오프셋(first unstable offset)은 "아직 열려 있는 트랜잭션 가운데 가장 앞의 첫 오프셋"으로, ProducerStateManager 가 계산합니다. 열린 트랜잭션이 없거나 그 오프셋이 HW 이상이면 LSO 는 HW 와 같습니다. 8편의 UnifiedLog.read() 는 격리 수준에 따라 읽기의 상한을 고릅니다.
        LogOffsetMetadata maxOffsetMetadata = switch (isolation) {
            case LOG_END -> localLog.logEndOffsetMetadata();
            case HIGH_WATERMARK -> fetchHighWatermarkMetadata();
            case TXN_COMMITTED -> fetchLastStableOffsetMetadata();
        };
        return localLog.read(startOffset, maxLength, minOneMessage, maxOffsetMetadata, isolation == FetchIsolation.TXN_COMMITTED);
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1668–1673행
LOG_END 는 팔로워의 Fetch(9편), HIGH_WATERMARK 는 read_uncommitted 컨슈머, TXN_COMMITTED 는 read_committed 컨슈머입니다. 마지막 인자 includeAbortedTxns 가 참이면 LocalLog.read() 가 읽은 범위에 걸친 중단된 트랜잭션 목록을 .txnindex 에서 모아 응답에 붙입니다(addAbortedTransactions(), LocalLog.java 582–603행).
걸러 내는 것은 컨슈머다
여기가 이 글에서 가장 의외였던 곳입니다. 브로커는 중단된 레코드를 빼고 보내지 않습니다. 8편의 제로 카피가 그렇듯 세그먼트의 바이트를 그대로 보내고, 옆에 "producer id 0 의 트랜잭션은 오프셋 4 부터 중단됐다"는 목록(abortedTransactions)만 붙입니다. 실제로 건너뛰는 것은 컨슈머의 CompletedFetch 입니다.
                if (fetchConfig.isolationLevel == IsolationLevel.READ_COMMITTED && currentBatch.hasProducerId()) {
                    // remove from the aborted transaction queue all aborted transactions which have begun
                    // before the current batch's last offset and add the associated producerIds to the
                    // aborted producer set
                    consumeAbortedTransactionsUpTo(currentBatch.lastOffset());

                    long producerId = currentBatch.producerId();
                    if (containsAbortMarker(currentBatch)) {
                        abortedProducerIds.remove(producerId);
                    } else if (isBatchAborted(currentBatch)) {
                        log.debug("Skipping aborted record batch from partition {} with producerId {} and " +
                                        "offsets {} to {}",
                                partition, producerId, currentBatch.baseOffset(), currentBatch.lastOffset());
                        nextFetchOffset = currentBatch.nextOffset();
                        continue;
                    }
                }
clients/src/main/java/org/apache/kafka/clients/consumer/internals/CompletedFetch.java 208–224행
배치를 하나씩 보며, 그 배치의 끝 오프셋까지 시작된 중단 트랜잭션들의 producer id 를 "중단 중" 집합에 넣습니다(consumeAbortedTransactionsUpTo()). 그 producer id 의 트랜잭션 배치는 통째로 건너뛰고(isBatchAborted() = 트랜잭션 배치이고 집합에 있음), 그 producer id 의 ABORT 마커를 만나면 집합에서 뺍니다. 컨트롤 배치 자체는 234–240행에서 레코드를 앱에 주지 않고 오프셋만 넘깁니다. 레코드 하나하나를 보지 않고 배치 단위로 판단할 수 있는 것은, 한 배치가 언제나 한 producer id·한 에포크의 레코드만 담기 때문입니다(6편의 배치 헤더).
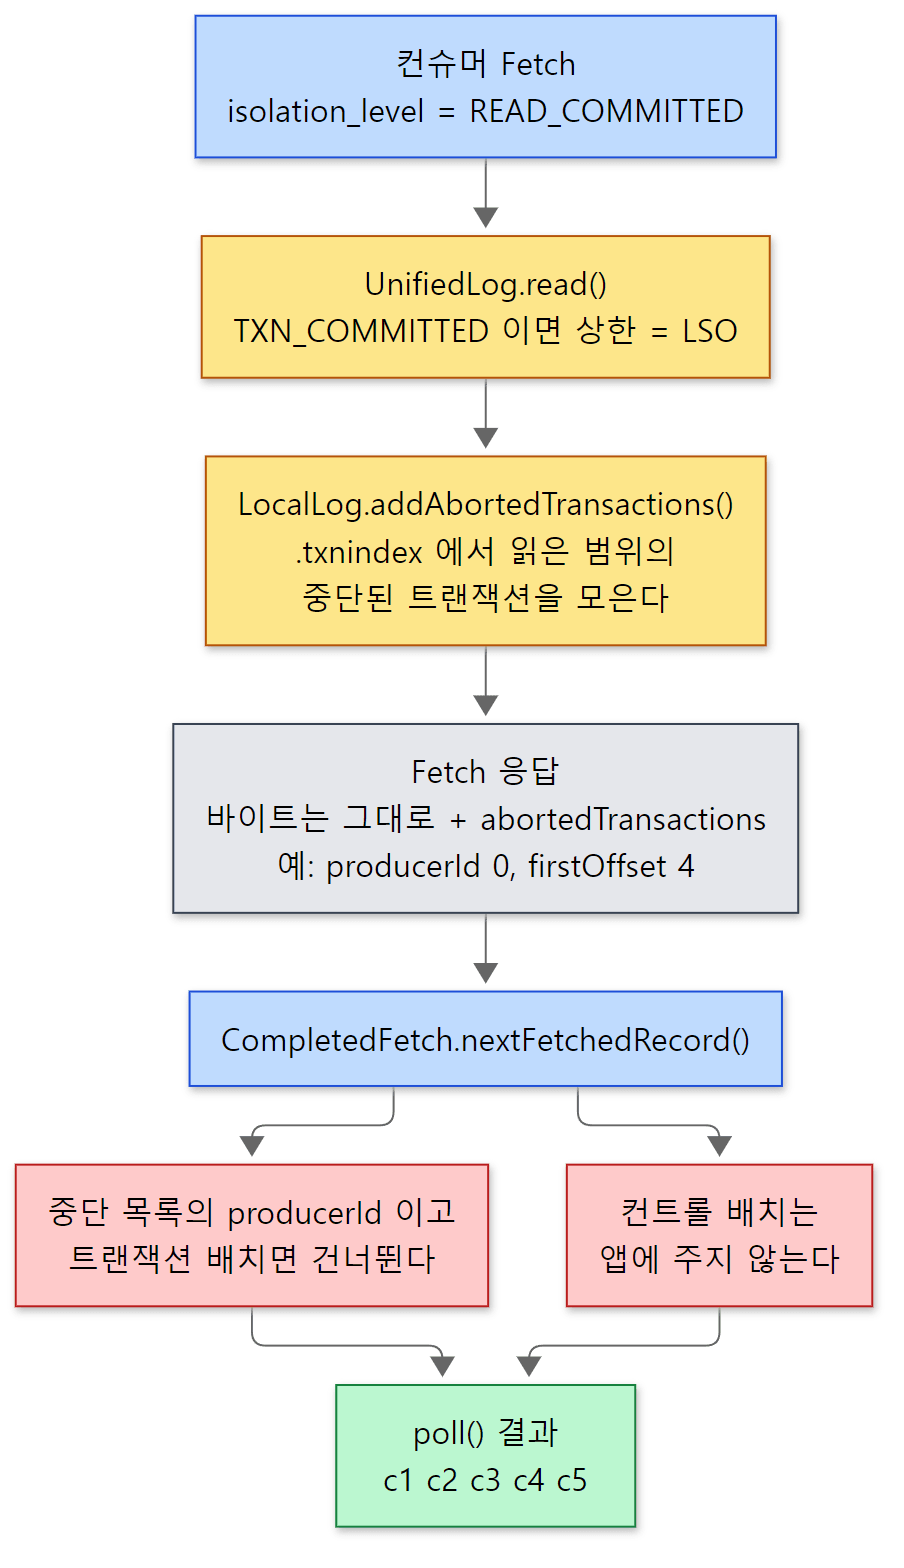 노란 상자까지가 브로커, 파란 상자부터가 컨슈머입니다. 빨간 상자 둘이 "앱에 보이지 않는 것" 입니다.
예제 1의 마지막 두 줄이 그 결과입니다.
read_uncommitted consumer got 8 records: c1@0 c2@1 c3@2 a1@4 a2@5 a3@6 c4@8 c5@9 (position 11)
read_committed   consumer got 5 records: c1@0 c2@1 c3@2 c4@8 c5@9 (position 11)
read_uncommitted 는 중단된 a1~a3 까지 8개를 받고, read_committed 는 5개만 받습니다. 어느 쪽도 마커(3, 7, 10)는 받지 않습니다 — read_uncommitted 라도 컨트롤 배치는 234–240행에서 걸러집니다. 둘 다 다음 읽을 위치(position)는 11 입니다. 오프셋에 구멍(3, 4~7, 10)이 보이는 것이 정상이라는 뜻이기도 합니다.
헷갈리기 쉬운 곳: 기본값은 read_uncommitted
트랜잭션으로 쓰기만 하고 컨슈머 설정을 그대로 두면 중단된 레코드가 그대로 보입니다. isolation.level 의 기본값은 read_uncommitted 입니다.
                                .define(ISOLATION_LEVEL_CONFIG,
                                        Type.STRING,
                                        DEFAULT_ISOLATION_LEVEL,
                                        in(IsolationLevel.READ_COMMITTED.toString(), IsolationLevel.READ_UNCOMMITTED.toString()),
                                        Importance.MEDIUM,
                                        ISOLATION_LEVEL_DOC)
clients/src/main/java/org/apache/kafka/clients/consumer/ConsumerConfig.java 673–678행
DEFAULT_ISOLATION_LEVEL 은 같은 파일 382행에서 IsolationLevel.READ_UNCOMMITTED.toString() 입니다. 또 하나, read_committed 컨슈머는 열린 트랜잭션 하나가 LSO 를 붙잡으면 그 뒤의 커밋된 레코드도 받지 못합니다. 예제에서 B 가 열려 있는 동안 LSO 가 4 였던 것처럼, 오래 열린 트랜잭션은 그 파티션의 모든 read_committed 컨슈머를 멈춰 세웁니다. 프로듀서의 transaction.timeout.ms(기본 60000, ProducerConfig.java 579–583행)가 지나면 코디네이터가 그 트랜잭션을 스스로 중단시키는 것이 이 때문입니다(TransactionStateManager.timedOutTransactions(), 128행부터; 검사 주기는 transaction.abort.timed.out.transaction.cleanup.interval.ms, 기본 10초).
6. 좀비 막기 — 에포크 펜싱
무엇이 좀비인가
트랜잭션 프로듀서를 돌리던 프로세스가 GC 로 한참 멈췄다고 합시다. 운영 도구는 죽은 줄 알고 같은 transactional.id 로 새 프로세스를 띄웁니다. 그런데 옛 프로세스가 깨어나 하던 트랜잭션을 마저 커밋하면 같은 일을 두 번 하게 됩니다. 이런 옛 프로세스를 흔히 좀비라고 부르고, 이를 막는 것을 펜싱(fencing, 울타리 치기)이라고 합니다. Kafka 의 울타리가 에포크입니다.
새 프로세스가 initTransactions() 를 부르면 코디네이터의 prepareInitProducerIdTransit() 이 지금 상태를 봅니다. 트랜잭션이 열려 있으면 이 갈래입니다.
        case TransactionState.ONGOING =>
          // indicate to abort the current ongoing txn first. Note that this epoch is never returned to the
          // user. We will abort the ongoing transaction and return CONCURRENT_TRANSACTIONS to the client.
          // This forces the client to retry, which will ensure that the epoch is bumped a second time. In
          // particular, if fencing the current producer exhausts the available epochs for the current producerId,
          // then when the client retries, we will generate a new producerId.
          Right(coordinatorEpoch, txnMetadata.prepareFenceProducerEpoch())
core/src/main/scala/kafka/coordinator/transaction/TransactionCoordinator.scala 282–288행
Scala 읽는 법 —
x match { case A => … case B => … }는 Java 의switch와 비슷한 패턴 매칭입니다. 여기서는txnMetadata.state값에 따라 갈래를 나눕니다.
PrepareEpochFence 를 준비한 뒤 handleInitProducerId() 는 열린 트랜잭션을 코디네이터 스스로 중단시키고(endTransaction(..., TransactionResult.ABORT, isFromClient = false, ...), 201–208행), 새 프로듀서에게는 CONCURRENT_TRANSACTIONS 를 돌려줍니다. 새 프로듀서는 이 오류를 재시도하고, 다음 InitProducerId 는 CompleteAbort 상태에서 에포크를 한 번 더 올린 Empty 를 받습니다. 그 뒤 옛 프로듀서가 옛 에포크로 무엇을 보내든 거절됩니다.
예제 3: 같은 transactional.id 의 프로듀서 둘
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// ...
        KafkaProducer<String, String> p1 = producer("u12-p1");
        p1.initTransactions();
        System.out.println("producer 1 after initTransactions: " + pidEpoch(p1));
        p1.beginTransaction();
        p1.send(new ProducerRecord<>(TOPIC, "z1"));
        p1.flush();
        System.out.println("producer 1 sent z1, transaction still open");

        KafkaProducer<String, String> p2 = producer("u12-p2");
        long t0 = System.currentTimeMillis();
        p2.initTransactions();   // 같은 transactional.id — 코디네이터가 p1 을 펜싱한다
        System.out.printf("producer 2 after initTransactions: %s (took %d ms)%n", pidEpoch(p2), System.currentTimeMillis() - t0);

        try {
            p1.send(new ProducerRecord<>(TOPIC, "z2"));
            p1.commitTransaction();
            System.out.println("producer 1 commit: succeeded?!");
        } catch (Exception e) {
            System.out.println("producer 1 commit failed: " + e.getClass().getSimpleName());
        }
// ...
ex/u12-fencing/Fence.java 에서 줄였습니다. 두 프로듀서 모두 transactional.id=u12-fence 입니다. pidEpoch() 는 확인용으로 KafkaProducer 안의 TransactionManager 를 리플렉션으로 엿보는 도우미입니다(앱에서 쓸 코드가 아닙니다).
=== two producers, one transactional.id
producer 1 after initTransactions: (producerId=0, epoch=0)
producer 1 sent z1, transaction still open
producer 2 after initTransactions: (producerId=0, epoch=2) (took 552 ms)
producer 1 commit failed: InvalidProducerEpochException
producer 2 committed y1: (producerId=0, epoch=3)
read_uncommitted consumer got: [z1@0, y1@2]
read_committed   consumer got: [y1@2]
=== kafka-dump-log: u12-fence-0 batches
baseOffset: 0 lastOffset: 0 baseSequence: 0 producerId: 0 producerEpoch: 0 isTransactional: true isControl: false
baseOffset: 1 lastOffset: 1 baseSequence: -1 producerId: 0 producerEpoch: 1 isTransactional: true isControl: true
 offset: 1 keySize: 4 valueSize: 6 sequence: -1 headerKeys: [] endTxnMarker: ABORT coordinatorEpoch: 0
baseOffset: 2 lastOffset: 2 baseSequence: 0 producerId: 0 producerEpoch: 2 isTransactional: true isControl: false
baseOffset: 3 lastOffset: 3 baseSequence: -1 producerId: 0 producerEpoch: 3 isTransactional: true isControl: true
 offset: 3 keySize: 4 valueSize: 6 sequence: -1 headerKeys: [] endTxnMarker: COMMIT coordinatorEpoch: 0
(initTransactions() 가 걸린 시간은 실행마다 다릅니다. __transaction_state 디코딩도 같은 run.sh 가 찍지만, 예제 1과 같은 모양이라 상태만 옮기면 Empty(0) → Ongoing(0) → PrepareAbort(1) → CompleteAbort(1) → Empty(2) → Ongoing(2) → PrepareCommit(3) → CompleteCommit(3) 입니다. 괄호 안은 에포크입니다.)
- 프로듀서 2 는 같은 producer id 0 을 받습니다. 바뀌는 것은 에포크입니다(0 → 2). 에포크 1 은 코디네이터가 프로듀서 1 의 트랜잭션을 중단시키며 쓴 ABORT 마커(오프셋 1)의 몫입니다.
- 프로듀서 1 의 z1 은 중단되어
read_committed컨슈머에게 보이지 않습니다. 프로듀서 1 은 자기 트랜잭션이 이미 중단된 줄 모르고 z2 를 보냈다가 실패합니다. - 실패의 이름은
ProducerFencedException이 아니라InvalidProducerEpochException이었습니다. z2 는 디스크에 없습니다.
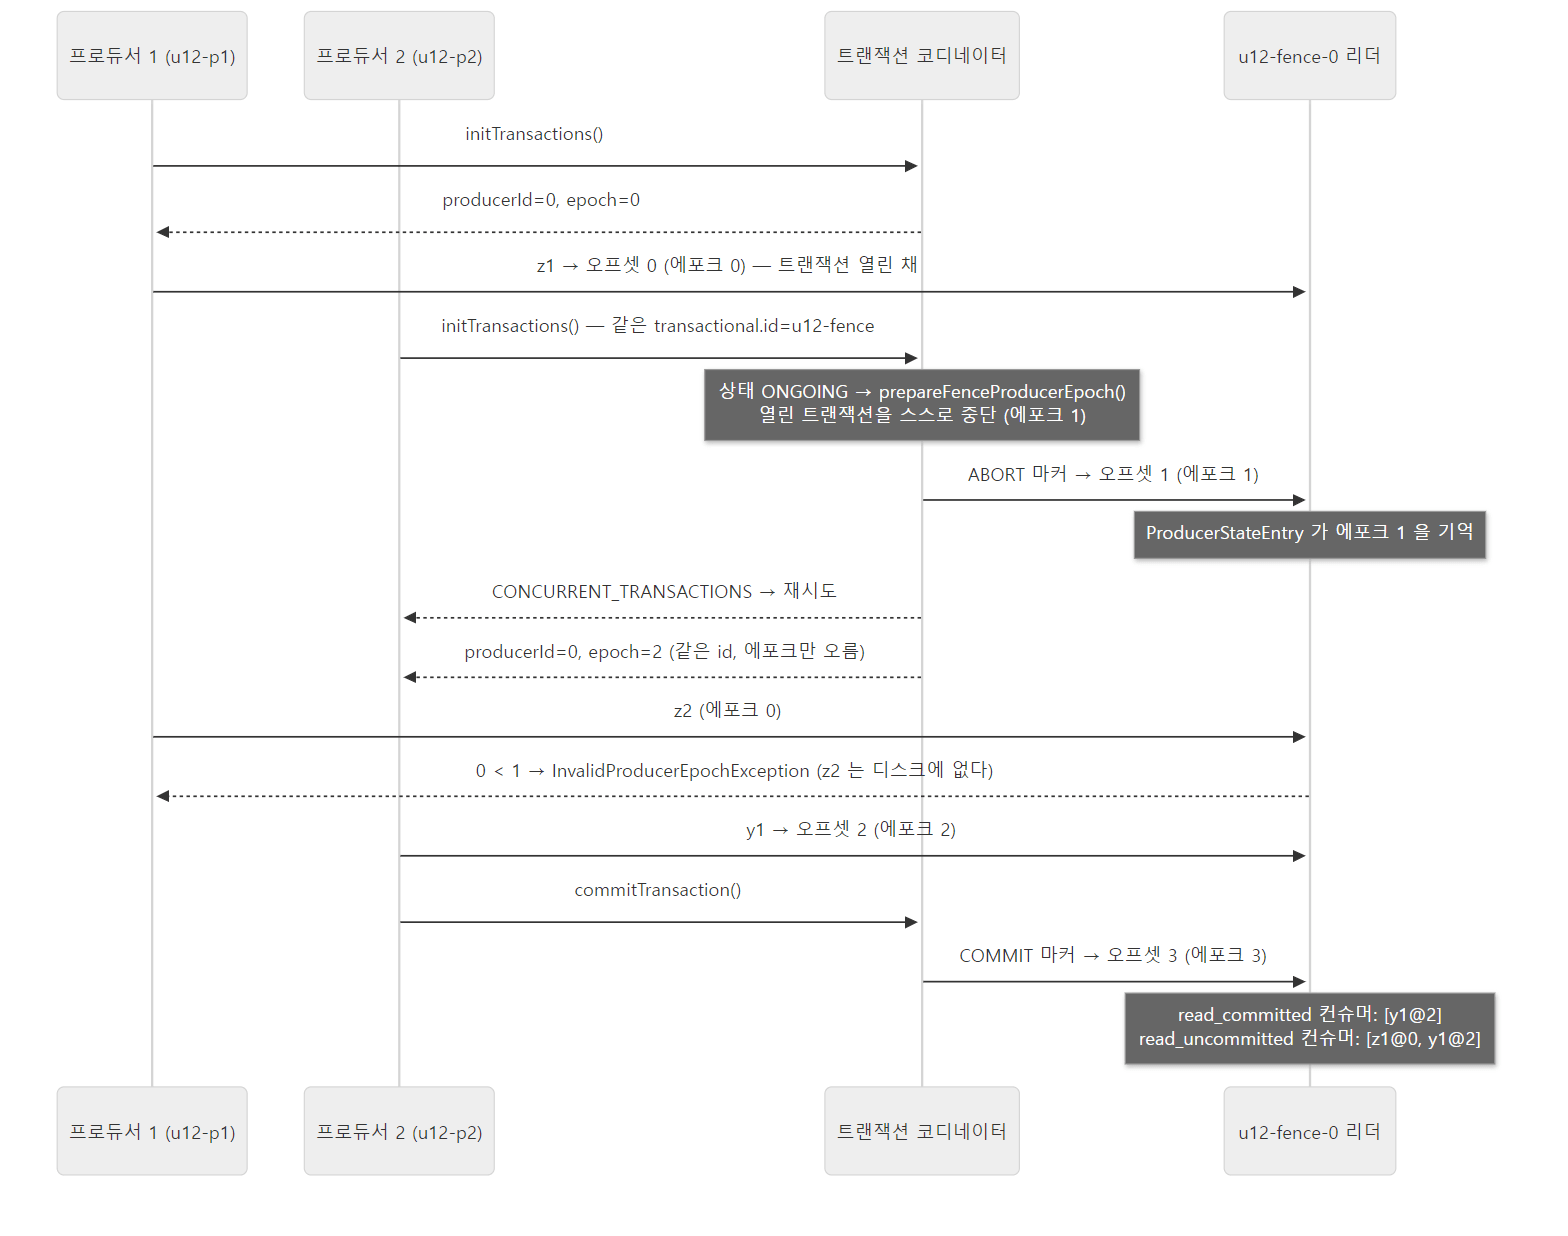 같은 producer id 에 에포크만 올려 옛 프로듀서를 막습니다. 오프셋·에포크·결과는 모두 위 예제 3의 출력에서 가져왔습니다.
헷갈리기 쉬운 곳: 왜 InvalidProducerEpochException 인가
이름만 보면 펜싱에는 ProducerFencedException 이 나올 것 같습니다. z2 가 거절된 곳을 소스로 따라가면, 파티션 리더가 트랜잭션 검증을 시작하는 첫 줄입니다.
    public VerificationGuard maybeStartTransactionVerification(long producerId, int sequence, short epoch, boolean supportsEpochBump) {
        synchronized (lock) {
            // Check if the producer epoch is lower than the stored one, and reject early if it is
            ProducerStateEntry entry = producerStateManager.activeProducers().get(producerId);
            if (entry != null && epoch < entry.producerEpoch()) {
                String message = "Epoch of producer " + producerId + " is " + epoch + ", " +
                        "which is smaller than the last seen epoch " + entry.producerEpoch();
                throw new InvalidProducerEpochException(message);
            }

            if (hasOngoingTransaction(producerId, epoch)) {
                return VerificationGuard.SENTINEL;
            } else {
                return maybeCreateVerificationGuard(producerId, sequence, epoch, supportsEpochBump);
            }
        }
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 887–903행
ABORT 마커(에포크 1)가 쓰이면서 이 파티션의 ProducerStateEntry 는 에포크 1 을 기억합니다. 에포크 0 으로 온 z2 는 여기서 곧바로 거절됩니다. 리더가 코디네이터에 물어보는 길로 갔더라도 결과는 같았을 것입니다. 코디네이터가 PRODUCER_FENCED 로 답하면 AddPartitionsToTxnManager 가 그것을 INVALID_PRODUCER_EPOCH 로 바꿔 돌려주게 되어 있습니다(172–175행, "Producers expect to handle INVALID_PRODUCER_EPOCH in this scenario"). ProducerAppendInfo 의 주석(153–155행)은 2.7 부터 Produce 응답에서 ProducerFenced 대신 InvalidProducerEpoch 를 써서 클라이언트가 트랜잭션을 중단하고 다시 시도할 수 있게 했다고 설명합니다. 앱에서 펜싱을 잡으려면 두 예외를 모두 다뤄야 합니다.
이 글에서 뺀 것
- TV1(판 0·1) 경로 전체 —
TransactionCoordinator.endTransactionWithTV1()(544행부터), 클라이언트가 보내는AddPartitionsToTxn·AddOffsetsToTxn(TransactionManager의AddPartitionsToTxnHandler1599행,AddOffsetsToTxnHandler1854행), TV1 에서 TV2 로 넘어갈 때의 에포크 올리기(clientSideEpochBumpRequired) - 두 단계 커밋(2PC) 지원 —
transaction.two.phase.commit.enable,prepareTransaction(),keepPreparedTxn:TransactionManager.java370–379행,TransactionCoordinator.handleInitProducerId()138–146행 - 코디네이터 이동과 상태 복원 —
TransactionCoordinator.onElection()/onResignation()(478·497행),TransactionStateManager.loadTransactionMetadata()(453행부터), 마커를 보내다 코디네이터가 바뀌었을 때의 처리(TransactionMarkerRequestCompletionHandler.scala) transactional.id만료와 producer id 만료 —TransactionStateManager.removeExpiredTransactionalIds()(151행),transactional.id.expiration.ms(기본 7일),producer.id.expiration.ms(기본 1일,TransactionLogConfig.java57행)- 에포크가
Short.MAX_VALUE에 닿았을 때 producer id 를 바꾸는 길 —TransactionMetadata.prepareProducerIdRotation()(196행),isProducerEpochExhausted()(300행) - 멱등 프로듀서의 오류 복구(시퀀스 다시 매기기, 풀리지 않은 시퀀스) —
TransactionManager의partitionsWithUnresolvedSequences·bumpIdempotentProducerEpoch()(673–689행) - 브로커가 재시작할 때 프로듀서 상태를 되살리는 스냅숏(
.snapshot파일) —ProducerStateManager.takeSnapshot()·readSnapshot(),kafka-dump-log.sh의dumpProducerIdSnapshot() - 매달린 트랜잭션을 찾고 강제로 끝내는 도구 —
kafka-transactions.sh find-hanging/abort(tools/src/main/java/org/apache/kafka/tools/TransactionsCommand.java) - Kafka Streams 의
processing.guarantee=exactly_once_v2(streams/) — 이 글의 트랜잭션 위에 얹혀 있습니다
정리
| 개념 | 한 줄 요약 |
|---|---|
| 멱등 프로듀서 | 4.x 기본값(enable.idempotence=true, acks=all). producer id·에포크·시퀀스를 배치 헤더에 싣는다 |
| 시퀀스 | RecordAccumulator.drain() 에서 배치가 처음 나갈 때 한 번만 붙는다. 재시도는 같은 번호로 간다 |
| 중복 검사 | 브로커가 producer id 마다 최근 배치 5개를 기억(NUM_BATCHES_TO_RETAIN). 같은 범위면 쓰지 않고 처음 오프셋을 돌려준다 |
| 순서 검사 | 같은 에포크면 마지막 시퀀스 + 1, 새 에포크면 0. 어기면 OUT_OF_ORDER_SEQUENCE_NUMBER |
| in-flight 5 | max.in.flight.requests.per.connection ≤ 5 는 브로커가 기억하는 5개에 맞춘 값 |
| producer id 묶음 | 컨트롤러가 1000개씩 나눠 주고 ProducerIdsRecord 로 기억한다. 막 뜬 브로커는 COORDINATOR_LOAD_IN_PROGRESS 를 줄 수 있다 |
| 트랜잭션 코디네이터 | 모든 브로커에 있다. transactional.id 해시 % 50 으로 __transaction_state 파티션을 고르고 그 리더가 맡는다 |
| 상태 | Empty → Ongoing → Prepare* → Complete*. 상태마다 __transaction_state 에 쓰고, 복제된 뒤 메모리를 바꾼다 |
| TV2 | 트랜잭션마다 에포크 + 1. 파티션 추가는 Produce 를 받은 리더가 AddPartitionsToTxnSenderThread 로 대신한다 |
| EndTxn | Prepare* 를 로그에 쓰면 곧바로 답하고, 마커는 TxnMarkerSenderThread 가 따로 보낸다 |
| 마커 | isControl 배치(COMMIT/ABORT). 오프셋을 차지하고, 에포크는 데이터보다 1 크다. 앱에는 안 보인다 |
.txnindex |
중단된 트랜잭션만 적는다(producerId, first, last, LSO) |
| LSO | 열린 트랜잭션의 첫 오프셋과 HW 가운데 작은 쪽. read_committed 의 읽기 상한 |
| read_committed | 브로커는 바이트를 그대로 + 중단 목록을 보내고, 컨슈머의 CompletedFetch 가 배치 단위로 건너뛴다. 기본값은 read_uncommitted |
| 펜싱 | 같은 id 의 InitProducerId 가 에포크를 올리고 열린 트랜잭션을 중단시킨다. 옛 프로듀서는 InvalidProducerEpochException |
연재를 마치며
열두 편 되짚기
| 편 | 제목 | 한 줄 |
|---|---|---|
| 1 | AI와 함께 소스를 읽는 방법과 분석 지도 | 커밋을 고정해 받고, Gradle 로 빌드하고, JSON 에서 코드가 만들어지는 것을 보고, 레코드 하나의 큰 길을 그렸다 |
| 2 | 전체 지도 — 클라이언트, 브로커, 컨트롤러, 그리고 파티션 | process.roles 에 따라 BrokerServer·ControllerServer 가 뜨고, 리더와 ISR 은 컨트롤러가 정해 메타데이터 로그로 퍼뜨린다 |
| 3 | 와이어 프로토콜 — JSON 스키마에서 만들어지는 요청과 응답 | 4바이트 길이 + 헤더 + 본문. 메시지 스키마 JSON 203개에서 …Data 클래스가 생성되고, 판은 ApiVersions 로 맞춘다 |
| 4 | 브로커의 네트워크 계층 — Acceptor, Processor, 요청 처리 스레드 | Processor 가 읽고 쓰며, 요청 처리 스레드는 큐에서 꺼내 KafkaApis.handle() 만 부른다. mute 로 한 연결의 순서를 지킨다 |
| 5 | 프로듀서 내부 — send()에서 배치, 그리고 Sender 스레드까지 | send() 는 RecordAccumulator 에 넣을 뿐, Sender 스레드가 linger.ms·batch.size 에 따라 묶어 보낸다 |
| 6 | 브로커가 레코드를 받아 쓰기까지 — 레코드 배치 형식과 Produce 요청 처리 | 프로듀서가 만든 배치를 브로커가 검사하고 오프셋만 매겨 거의 그대로 쓴다 |
| 7 | 로그 저장소 — 세그먼트, 인덱스, 보존과 압축 | 세그먼트 파일과 희소 인덱스, 오래된 세그먼트는 지우거나 키별로 압축한다 |
| 8 | 읽기 경로 — Fetch 요청, 롱 폴링, 그리고 제로 카피 | 오프셋 → 인덱스 → 파일 위치, 데이터가 모자라면 퍼거토리에서 기다리고, 바이트는 transferTo 로 보낸다 |
| 9 | 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림 | 팔로워도 Fetch 로 따라오고, ISR 모두가 받은 곳이 HW, acks=all 은 HW 를 기다린다 |
| 10 | KRaft와 메타데이터 — 컨트롤러는 클러스터를 어떻게 기억하나 | 컨트롤러는 Raft 로 복제되는 __cluster_metadata 로그에 레코드를 쓰고, 브로커는 그것을 읽어 이미지로 만든다 |
| 11 | 컨슈머와 그룹 코디네이터 — poll()과 리밸런스의 안쪽 | poll() 안의 Fetch 와 하트비트, 그룹 상태와 오프셋은 __consumer_offsets 에 레코드로 쓴다 |
| 12 | 멱등성과 트랜잭션 — 정확히 한 번은 어떻게 만들어지나 (이 글) | producer id·에포크·시퀀스로 중복을 막고, __transaction_state 와 마커와 LSO 로 여러 파티션의 쓰기를 한꺼번에 보이게 한다 |
레코드 하나의 길, 다시
1편에서 그린 큰 길을 이제 소스의 이름으로 다시 걸을 수 있습니다.
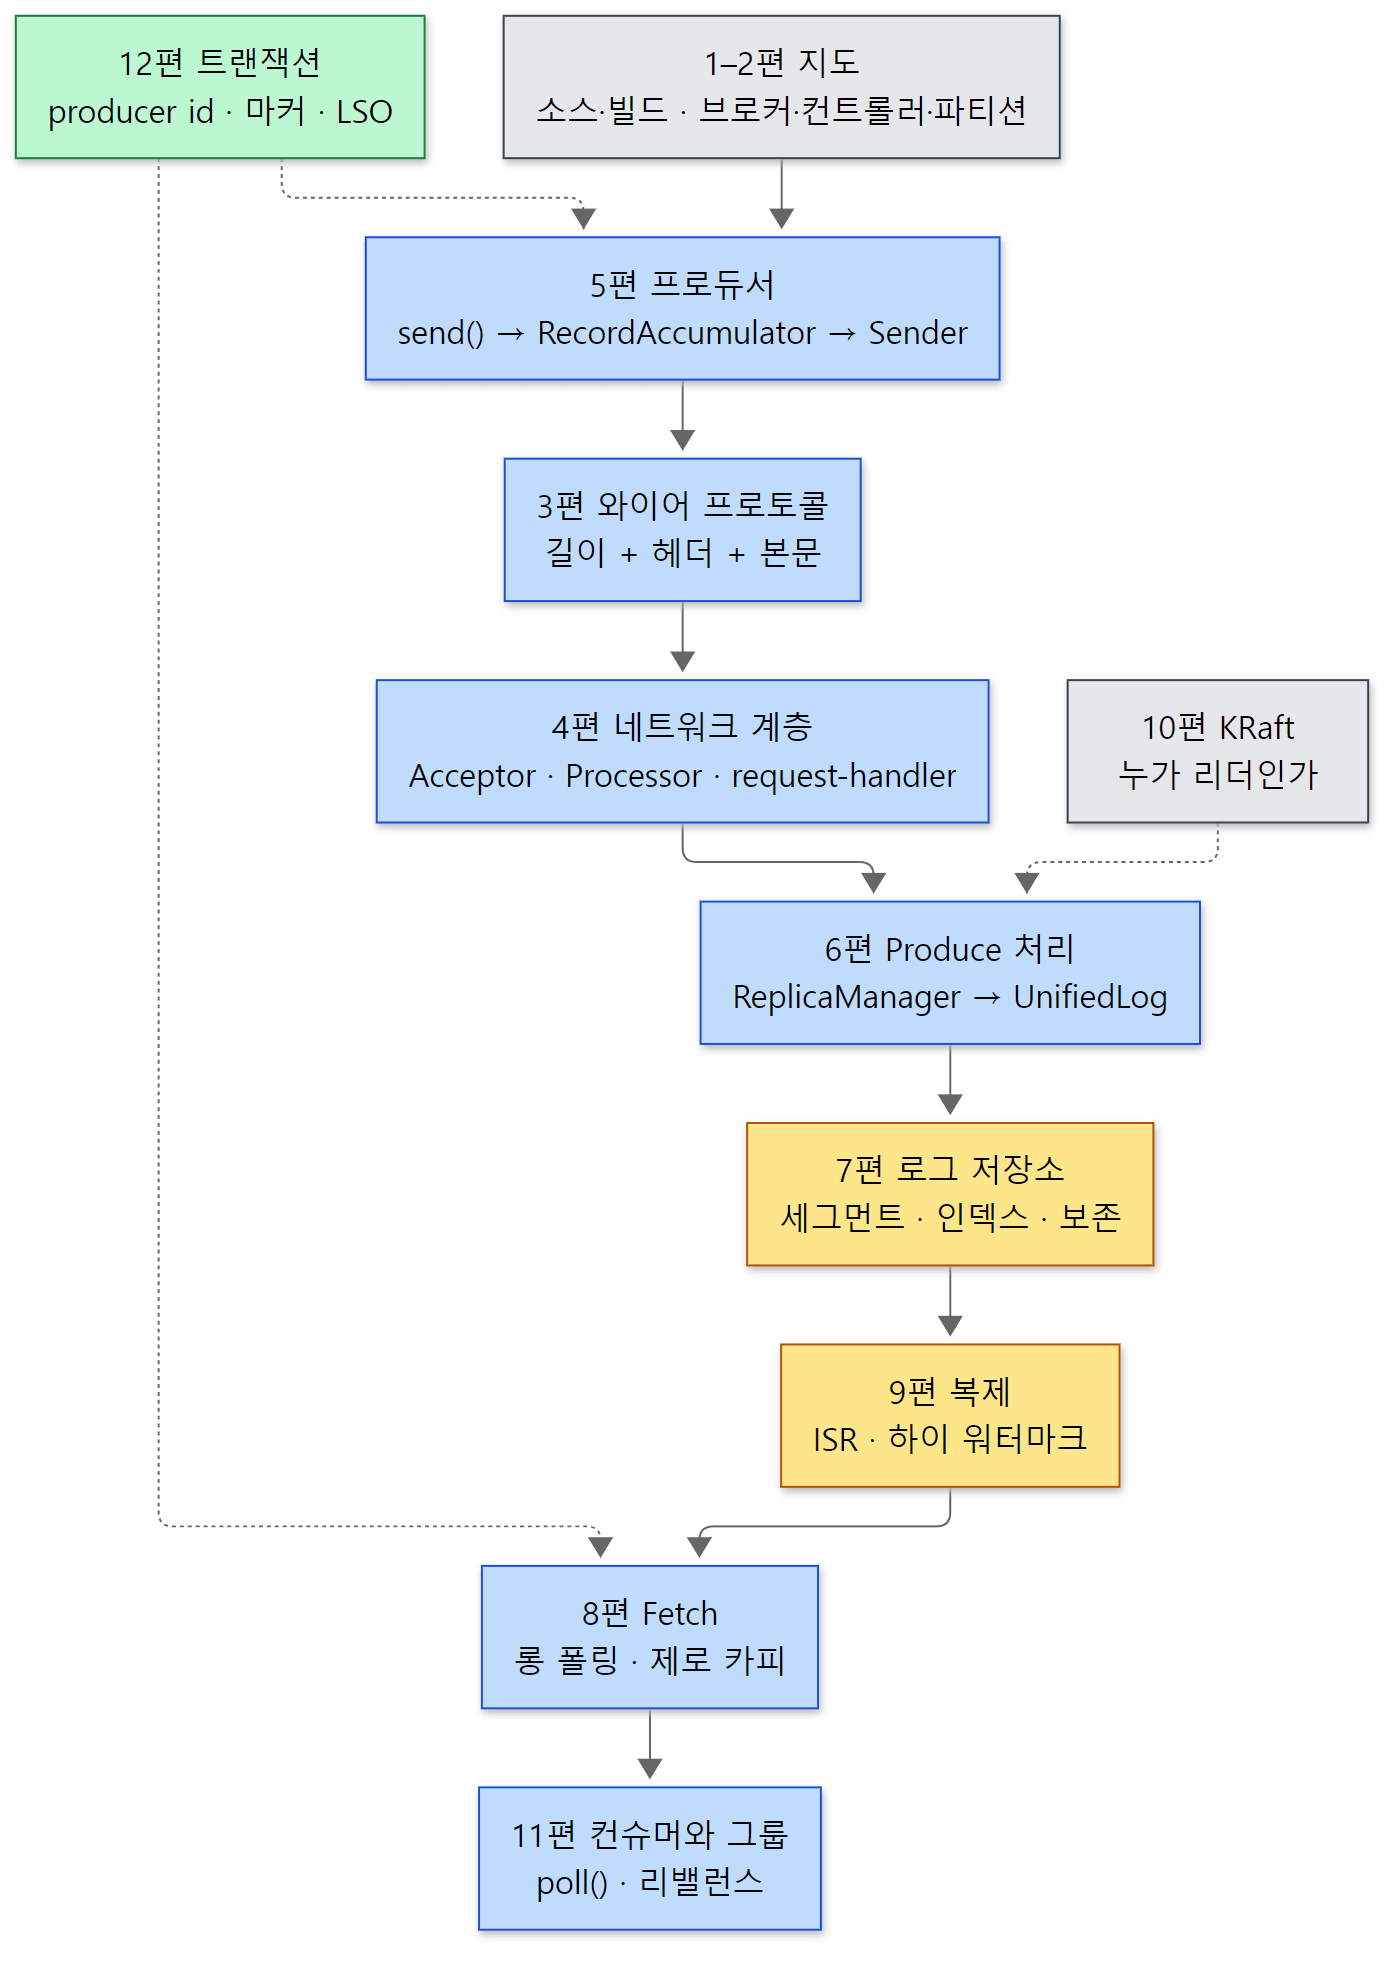 실선이 레코드 하나가 지나는 순서, 점선이 그 길 위에 얹힌 것입니다. 12편은 길의 양 끝 — 보내는 쪽과 읽는 쪽 — 에 규칙을 더합니다.
send() 를 부르면 레코드는 RecordAccumulator 의 배치에 들어가고(5편), drain 될 때 이 글의 producer id·에포크·시퀀스를 받아 Sender 스레드가 Produce 요청의 바이트(3편)로 보냅니다. 브로커의 Processor 가 그 바이트를 읽어 요청 큐에 넣고(4편), 요청 처리 스레드가 ReplicaManager 로 넘기면, 트랜잭션 배치는 여기서 코디네이터의 확인을 받은 뒤(12편) UnifiedLog 에서 오프셋을 받아 세그먼트 끝에 쓰입니다(6·7편). 누가 그 파티션의 리더인지는 컨트롤러가 메타데이터 로그로 정해 두었습니다(10편). 팔로워가 Fetch 로 따라와 HW 가 오르면 acks=all 의 응답이 나가고(9편), 컨슈머의 Fetch 는 HW — read_committed 라면 LSO — 까지의 바이트를 복사 없이 받아 갑니다(8·12편). 그 컨슈머가 어느 파티션을 읽을지, 어디까지 읽었는지는 그룹 코디네이터가 __consumer_offsets 에 적습니다(11편).
돌아보면 이 연재에서 가장 자주 만난 설계는 하나였습니다. "상태를 로그에 레코드로 쓰고, 그 로그를 복제하고, 다시 읽어 상태를 만든다." 사용자 데이터만이 아닙니다. 메타데이터(__cluster_metadata), 그룹과 오프셋(__consumer_offsets), 트랜잭션(__transaction_state)이 모두 같은 로그·같은 복제 위에 있고, 트랜잭션의 결말조차 마커라는 레코드로 파티션에 쓰입니다. Kafka 를 "분산 로그" 라고 부르는 이유를 소스가 여러 번 보여 주었습니다.
앞선 연재와 닮은 곳
이 블로그의 다른 오픈소스 연재와 실제로 닮은 곳만 몇 줄 적습니다.
- 스레드 모델: 4편의 Acceptor·Processor·요청 처리 스레드는 Tomcat 연재의 Acceptor·Poller·작업 스레드와 큰 틀이 같았고, 다른 점은 "소켓을 누가 읽나" 였습니다. 연결을 프로세스마다 하나의 이벤트 루프로 다루는 방식은 nginx 연재에서, 프로세스·스레드를 섞어 연결을 나눠 맡는 MPM 은 httpd 연재에서 다룹니다.
- 로그와 트랜잭션: 먼저 로그에 적고 나중에 반영하는 방식, 그리고 그 로그를 복제하는 방식은 데이터베이스의 redo 로그·복제와 같은 생각에서 나왔습니다. InnoDB 의 트랜잭션과 로그는 MariaDB 연재에서 다룹니다. 이름은 같아도 Spring 연재의
@Transactional은 데이터베이스 연결 하나의 커밋·롤백을 감싸는 추상화이고, Kafka 의 트랜잭션은 여러 파티션(그리고 컨슈머 오프셋)의 쓰기를 코디네이터와 마커로 묶는 별도의 프로토콜입니다. - 빌드: Kafka 는 Gradle 로 빌드되고, 1편에서 본
processMessages처럼 빌드 중에 코드를 만드는 단계가 있습니다. 그 Gradle 의 안쪽은 Gradle 연재에서 다룹니다. 처음 시작한 Spring 연재부터 이 연재까지, 읽는 방법은 같았습니다 — 커밋을 고정하고, 노트를 쓰고, 소스로 확인하고, 예제로 돌려 본다.
이 연재에서 뺀 것
Kafka 저장소에는 이 연재가 들어가지 않은 큰 방이 여럿 남아 있습니다. 이름과 자리만 적어 둡니다.
- Kafka Streams(
streams/) — 토픽 위의 스트림 처리 라이브러리.exactly_once_v2는 이 글의 트랜잭션을 씁니다 - Kafka Connect(
connect/)와 MirrorMaker(connect/mirror/,mirror-coordinator/) — 외부 시스템·다른 클러스터와 데이터를 주고받는 틀 - 공유 그룹(Share groups)(
share-coordinator/,KafkaShareConsumer,core/src/main/java/kafka/server/share/) — 파티션을 나눠 갖지 않고 레코드 단위로 나눠 받는 큐 방식의 소비 - 계층 저장소(tiered storage)(
storage/의Remote*) — 오래된 세그먼트를 원격 저장소로 옮기는 기능 - 보안(SASL·TLS·ACL,
Authorizer), 쿼터(server/…/quota/), 관리 클라이언트Admin, 디렉터리 여러 개(JBOD)와ReplicaAlterLogDirsThread
열두 편 동안 함께 읽어 주셔서 고맙습니다. 소스는 계속 바뀝니다. 이 글들의 줄 번호는 커밋 ab1e816411 에 묶여 있지만, 길을 찾는 방법 — 설정 이름에서 상수로, 상수에서 그 값을 쓰는 if 로 — 은 다음 판에서도 그대로 쓸 수 있을 것입니다.