이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 두 번째 글입니다. 1편에서 소스를 기준 커밋으로 받아 빌드하고, 폴더 지도와 레코드 하나가 지나는 큰 길을 펴 보았습니다. 이번 글은 코드를 한 줄씩 읽기 전에 펴 놓는 전체 지도입니다. 3편부터 12편까지는 모두 이 글의 지도 한 장(1절의 그림)에서 한 구역씩을 골라 확대합니다.
앱에서 Kafka 를 써 봤다면 bootstrap.servers=localhost:9092 를 적고, kafka-topics.sh --describe 로 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 같은 줄을 본 적이 있을 것입니다. 그 줄의 리더는 누가 정했고, 내 프로듀서는 그 리더를 어떻게 알아서 찾아갈까요. 이 글은 서버 설정 한 줄(process.roles)을 다리 삼아 다음 질문에 답합니다.
kafka-server-start.sh server.properties를 치면 어떤 클래스가 어떤 순서로 만들어지고, "브로커"와 "컨트롤러"는 소스에서 각각 무엇인가- 브로커 하나는 무엇을 들고 있나 — 시작할 때 만드는 부품과 스레드
- 토픽·파티션·레플리카·리더·ISR 은 누가 정하고, 그 결정은 어떻게 모든 브로커에 퍼지나
- 클라이언트의 요청은 어느 서버로 가나 —
Metadata응답으로 리더를 찾는 길 - 모듈(
clients,core,storage,raft,metadata…)은 어느 쪽이 어느 쪽에 기대나
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | kafka.Kafka, kafka.server.KafkaRaftServer·SharedServer·BrokerServer·ControllerServer, KafkaApis·ControllerApis, QuorumController·ReplicationControlManager, BrokerMetadataPublisher, 클라이언트의 NetworkClient·RecordAccumulator |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 경로는 저장소 루트에서 시작합니다(core/src/main/scala/kafka/server/BrokerServer.scala).
지도를 그리는 글이라 이 글은 큰 줄기만 따라갑니다. 각 부품을 자세히 읽는 글은 절마다 "N편에서 봅니다"로 이어 두었습니다.
먼저 알아 둘 말
브로커(broker)는 토픽의 데이터를 디스크에 들고 있다가 프로듀서의 쓰기(Produce)와 컨슈머의 읽기(Fetch)에 답하는 서버입니다. 앱이 bootstrap.servers 로 접속하는 상대가 브로커입니다.
컨트롤러(controller)는 클러스터의 "장부"를 맡은 서버입니다. 어떤 토픽이 있고, 파티션이 몇 개이고, 각 파티션의 복사본이 어느 브로커에 있고 누가 리더인지를 정하고 기록합니다. 데이터(레코드)는 들고 있지 않습니다.
KRaft(케이래프트)는 컨트롤러들이 그 장부를 Raft 라는 합의 알고리즘으로 함께 지키는 방식의 이름입니다(Kafka + Raft). 장부는 __cluster_metadata 라는 메타데이터 로그에 레코드로 차곡차곡 쌓입니다. 예전에는 ZooKeeper 라는 바깥 시스템이 이 장부를 들고 있었지만, 4.x 부터는 KRaft 뿐이고 이 커밋의 core/src/main 에는 ZooKeeper 코드가 없습니다. Raft 자체는 10편에서 봅니다.
process.roles 는 서버 설정 파일의 한 줄로, 이 프로세스가 브로커인지(broker), 컨트롤러인지(controller), 둘 다인지(broker,controller)를 정합니다. 둘 다인 것을 결합 모드(combined mode)라고 부릅니다. 배포판의 config/server.properties 가 결합 모드이고(process.roles=broker,controller, 19행), 따로 띄우는 용도로 config/broker.properties 와 config/controller.properties 가 함께 들어 있습니다.
파티션·레플리카·리더·팔로워: 토픽은 파티션 여러 개로 나뉘고, 파티션 하나는 브로커 여러 대에 복사본(레플리카, replica)을 둡니다. 그 수가 복제 계수(replication factor, RF)입니다. 레플리카 가운데 하나가 리더(leader)로 쓰기와 읽기를 받고, 나머지 팔로워(follower)는 리더에게서 데이터를 가져와 따라갑니다.
ISR(in-sync replicas)은 레플리카 가운데 리더를 잘 따라오고 있는 것들의 목록입니다. --describe 의 Isr: 1,2,3 이 그것입니다. 따라오는 기준과 ISR 이 줄고 느는 과정은 9편에서 봅니다.
리스너(listener)는 서버가 연결을 받는 이름 붙은 포트입니다. 예제의 설정은 listeners=PLAINTEXT://:9092,CONTROLLER://:9093 처럼 클라이언트용(PLAINTEXT)과 컨트롤러용(CONTROLLER)을 나눕니다.
1. 지도 한 장 — 이 연재의 일곱 구역
먼저 지도부터 펴 놓습니다. 이 그림이 연재 전체의 지도이고, 3편부터는 글 머리에서 "2편 지도의 C 구역을 확대합니다"처럼 이 그림의 구역 글자로 자리를 짚습니다.
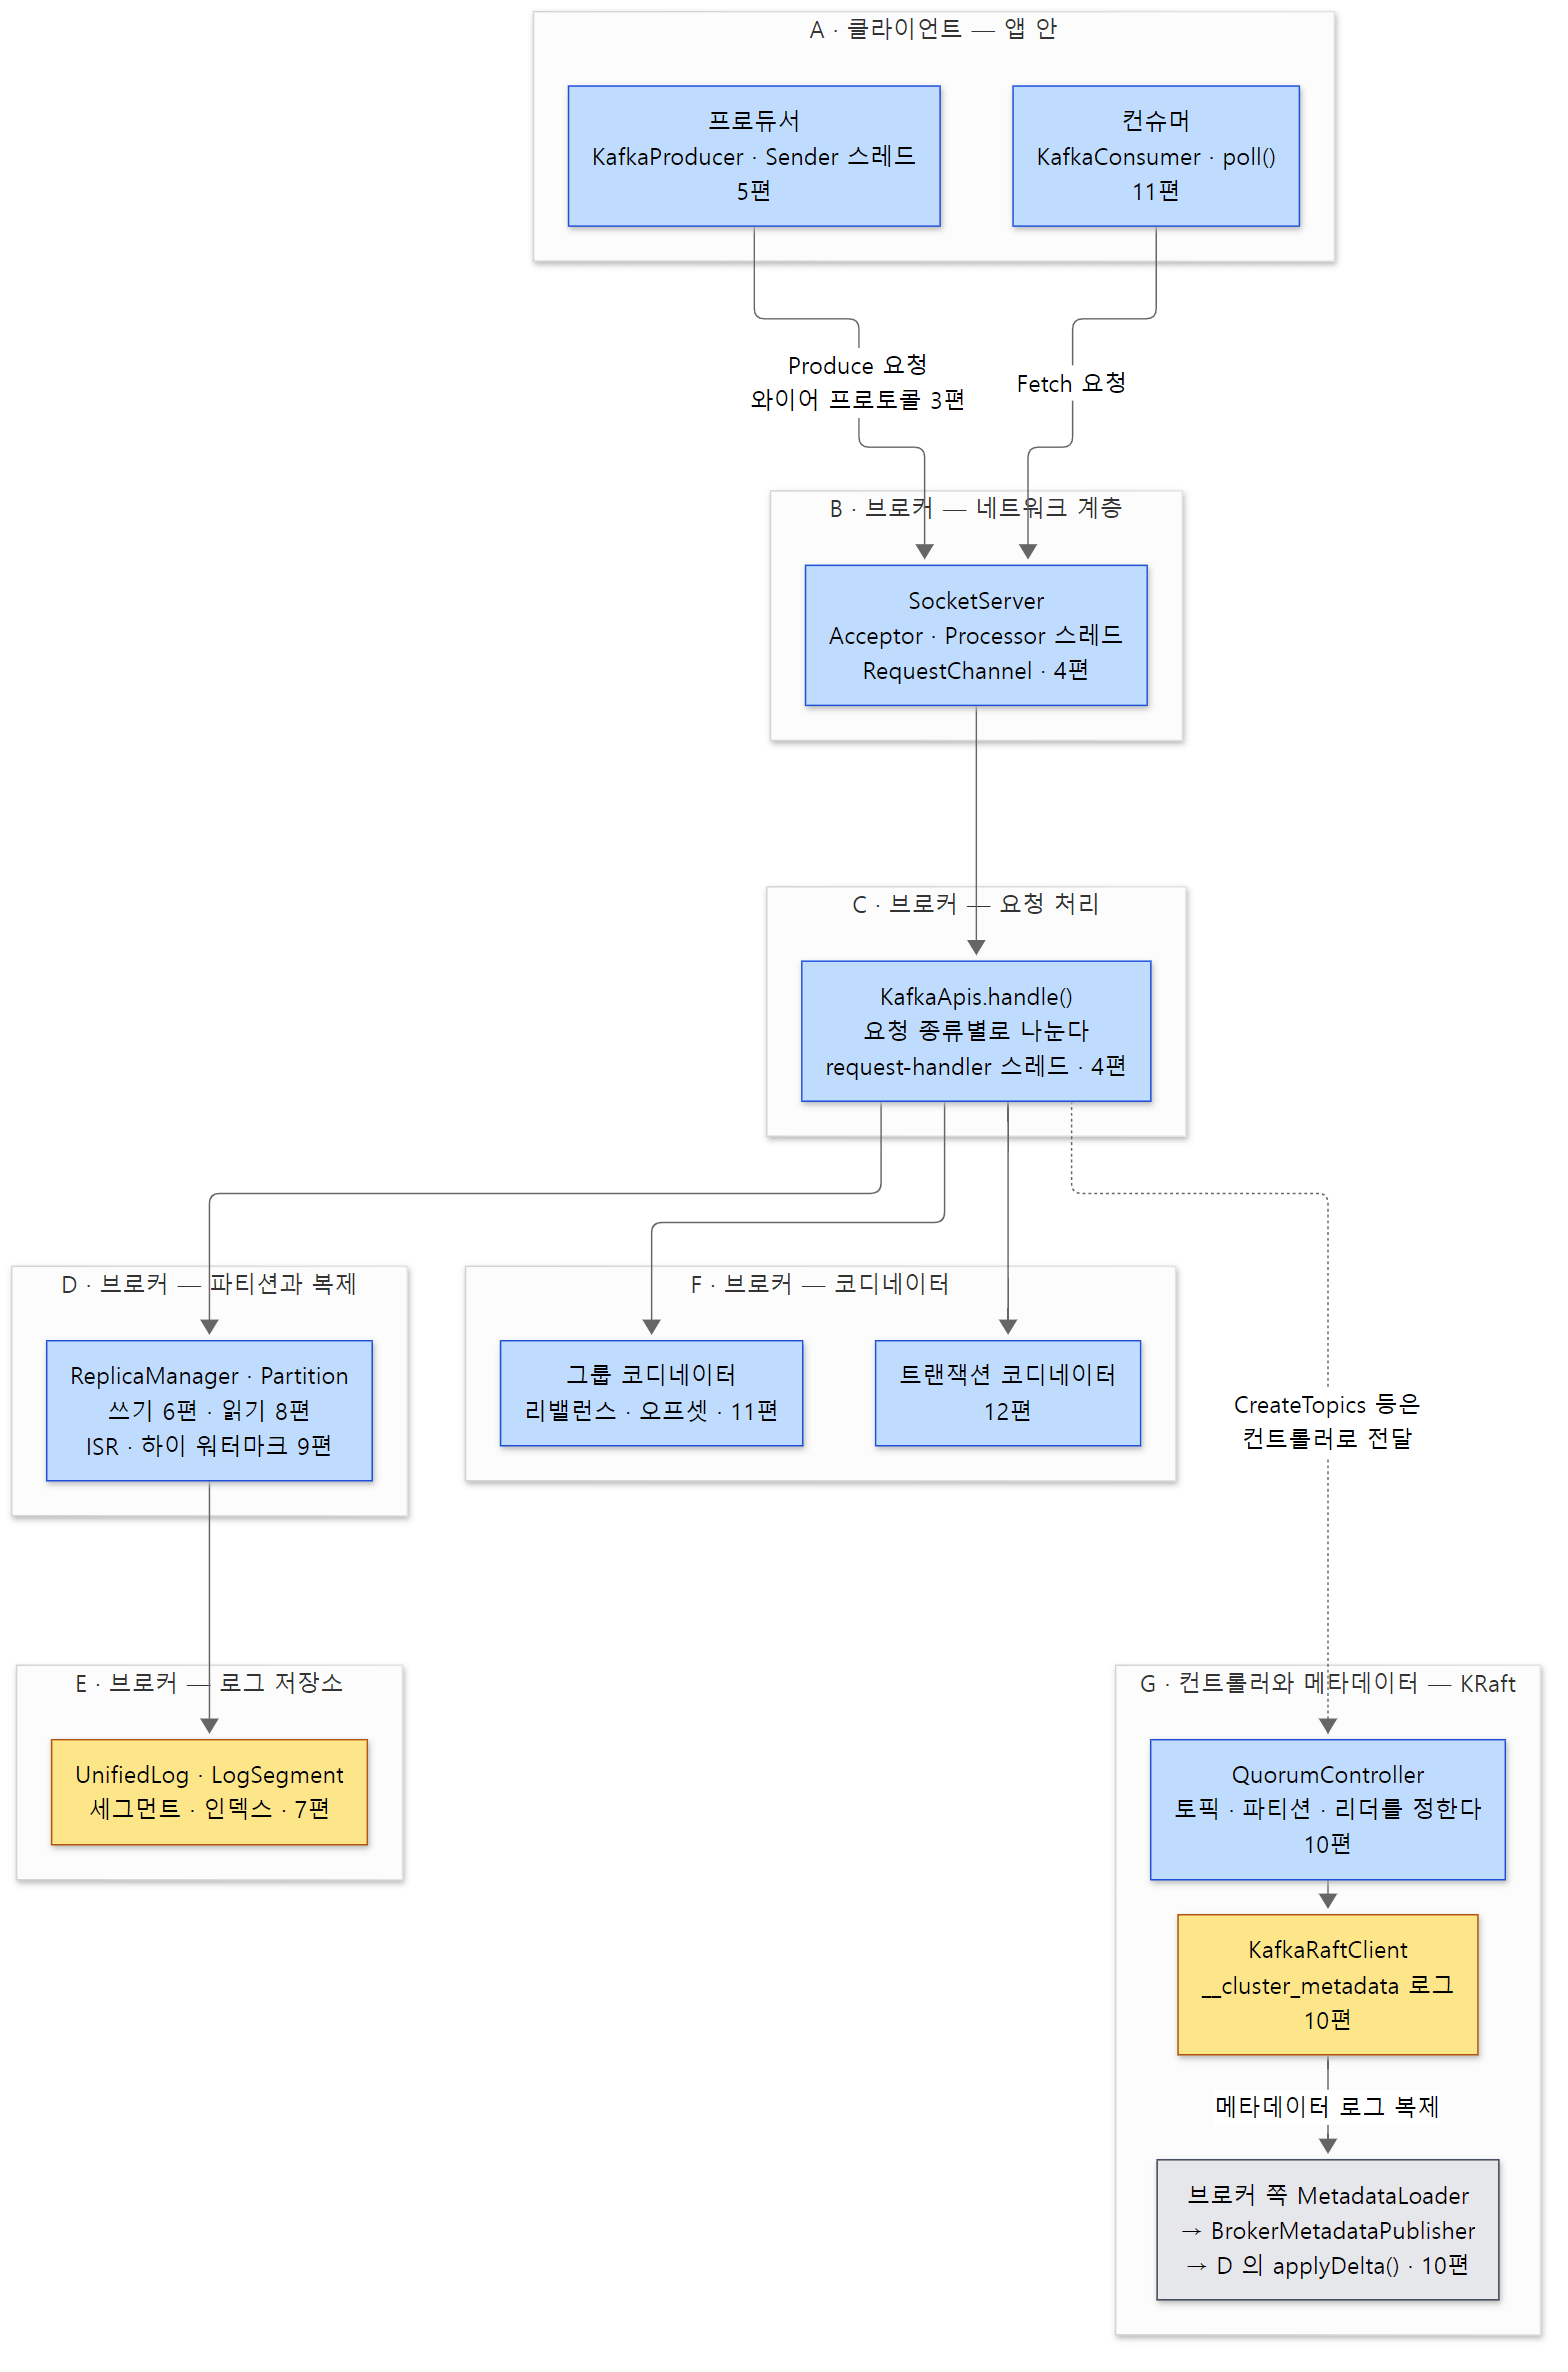 연재의 지도. A~G 일곱 구역과 각 구역을 확대하는 글 번호입니다. 파란 상자는 처리하는 부품, 노란 상자는 데이터가 쌓이는 곳입니다.
| 구역 | 무엇 | 대표 클래스 | 확대하는 글 |
|---|---|---|---|
| A | 클라이언트(앱 안) | KafkaProducer, Sender, KafkaConsumer |
5편, 11편 |
| A↔B 사이 | 와이어 프로토콜 — 요청·응답의 바이트 모양 | ApiKeys, 생성된 …RequestData |
3편 |
| B | 브로커의 네트워크 계층 | SocketServer, Acceptor, Processor, RequestChannel |
4편 |
| C | 요청 처리 — 요청 종류별로 나누기 | KafkaRequestHandler, KafkaApis |
4편, 6편, 8편 |
| D | 파티션과 복제 | ReplicaManager, Partition, 팔로워의 ReplicaFetcherThread |
6편, 8편, 9편 |
| E | 로그 저장소 — 디스크의 파일 | UnifiedLog, LogSegment, 인덱스, LogManager |
7편 |
| F | 코디네이터 — 그룹과 트랜잭션 | GroupCoordinatorService, TransactionCoordinator |
11편, 12편 |
| G | 컨트롤러와 메타데이터(KRaft) | QuorumController, KafkaRaftClient, MetadataLoader |
10편 |
지도에서 눈여겨볼 것은 두 갈래 길입니다. 데이터의 길(A → B → C → D → E)은 레코드가 지나는 길이고, 1편에서 본 "레코드 하나의 큰 길"이 바로 이것입니다. 장부의 길(C ⇢ G → D)은 "토픽을 만들어라" 같은 결정이 컨트롤러에서 정해져 메타데이터 로그를 타고 브로커로 돌아오는 길입니다. 이 글의 나머지는 이 두 길을 받치는 뼈대 — 누가 이 부품들을 만들고, 누가 어디에 사는지 — 를 소스로 확인합니다.
2. 프로세스 하나가 뜨기까지: kafka.Kafka → KafkaRaftServer
시작점: main()
bin/kafka-server-start.sh 의 마지막 줄은 exec $base_dir/kafka-run-class.sh $EXTRA_ARGS kafka.Kafka "$@" 입니다(bin/kafka-server-start.sh 44행). 결국 kafka.Kafka 라는 Scala 객체의 main 이 불립니다.
  private def buildServer(props: Properties): Server = {
    val config = KafkaConfig.fromProps(props, doLog = false)
    new KafkaRaftServer(
      config,
      Time.SYSTEM,
    )
  }

  def main(args: Array[String]): Unit = {
    try {
      val serverProps = getPropsFromArgs(args)
      val server = buildServer(serverProps)
      // ...
      try server.startup()
      // ...
      server.awaitShutdown()
core/src/main/scala/kafka/Kafka.scala 65–106행
Scala 읽는 법 —
object Kafka(29행)는 인스턴스가 하나뿐인 싱글턴이라 Java 의static메서드 모음처럼 읽으면 됩니다.def main(args: Array[String]): Unit은String[]를 받고 아무것도 돌려주지 않는(void) 메서드,val은 다시 대입할 수 없는 변수(Java 의final)입니다.buildServer처럼 중괄호 블록의 마지막 식이 반환값이라return이 없습니다.
buildServer() 는 언제나 KafkaRaftServer 하나를 만듭니다. 서버 종류를 고르는 if 가 없습니다. 예전에는 ZooKeeper 모드의 서버 클래스도 여기서 골랐지만, 이 커밋에는 KRaft 서버 하나뿐입니다. 첫 번째 줄인 자리는 프로세스가 신호로 끝날 때 로그를 남기는 핸들러 등록(78–85행)과 종료 신호를 받으면 server.shutdown() 을 부르는 훅을 거는 코드(87–96행)이고, 두 번째 줄인 자리는 시작에 실패하면 프로세스를 끝내는 catch 블록(99–104행)입니다.
역할에 따라 만들기: KafkaRaftServer
KafkaRaftServer 의 설명이 이 클래스의 일을 한 문장으로 말합니다.
It is responsible for constructing the controller and/or broker based on the
process.rolesconfiguration and for managing their basic lifecycle (startup and shutdown).
(KafkaRaftServer.scala 42–48행) 생성자 본문이 그대로 그 일입니다.
  private val sharedServer = new SharedServer(
    config,
    // ...
  )

  private val broker: Option[BrokerServer] = if (config.processRoles.contains(ProcessRole.BrokerRole)) {
    Some(new BrokerServer(sharedServer))
  } else {
    None
  }

  private val controller: Option[ControllerServer] = if (config.processRoles.contains(ProcessRole.ControllerRole)) {
    Some(new ControllerServer(
      sharedServer,
      KafkaRaftServer.configSchema,
      bootstrapMetadata,
    ))
  } else {
    None
  }

  override def startup(): Unit = {
    Mx4jLoader.maybeLoad()
    // Controller component must be started before the broker component so that
    // the controller endpoints are passed to the KRaft manager
    controller.foreach(_.startup())
    broker.foreach(_.startup())
    AppInfoParser.registerAppInfo(Server.MetricsPrefix, config.brokerId.toString, metrics, time.milliseconds())
    info(KafkaBroker.STARTED_MESSAGE)
  }
core/src/main/scala/kafka/server/KafkaRaftServer.scala 65–100행
Scala 읽는 법 —
Option[BrokerServer]는 "있을 수도 없을 수도 있는 값"으로, 있으면Some(값), 없으면None입니다(Java 의Optional과 같은 생각). Scala 의if … else …는 값을 돌려주는 식이라val broker = if (…) Some(…) else None처럼 바로 대입합니다.controller.foreach(_.startup())는 "값이 있으면 그 값의startup()을 불러라"이고,_는 람다의 인자(c -> c.startup()의c)를 줄여 쓴 것입니다.
세 가지가 보입니다.
- 브로커와 컨트롤러는 같은 프로세스 안의 두 객체입니다.
process.roles에 무엇이 들었느냐에 따라BrokerServer와ControllerServer가 각각Some이 되거나None이 됩니다. 값은"broker","controller"둘뿐입니다(KRaftConfigs의define(PROCESS_ROLES_CONFIG, LIST, …, ValidList.in(false, "broker", "controller"), …), raft/src/main/java/org/apache/kafka/raft/KRaftConfigs.java 79행). SharedServer는 역할과 상관없이 늘 하나 만들어집니다(2절 아래).- 시작은 컨트롤러가 먼저, 끄기는 브로커가 먼저입니다. 시작 순서는 위 주석이 이유를 대고, 끄는 순서(
shutdown(), 102–109행)는 "결합 모드에서 브로커의 정상 종료(controlled shutdown)에 컨트롤러가 필요할 수 있어서" 브로커를 먼저 끈다고 주석이 설명합니다.
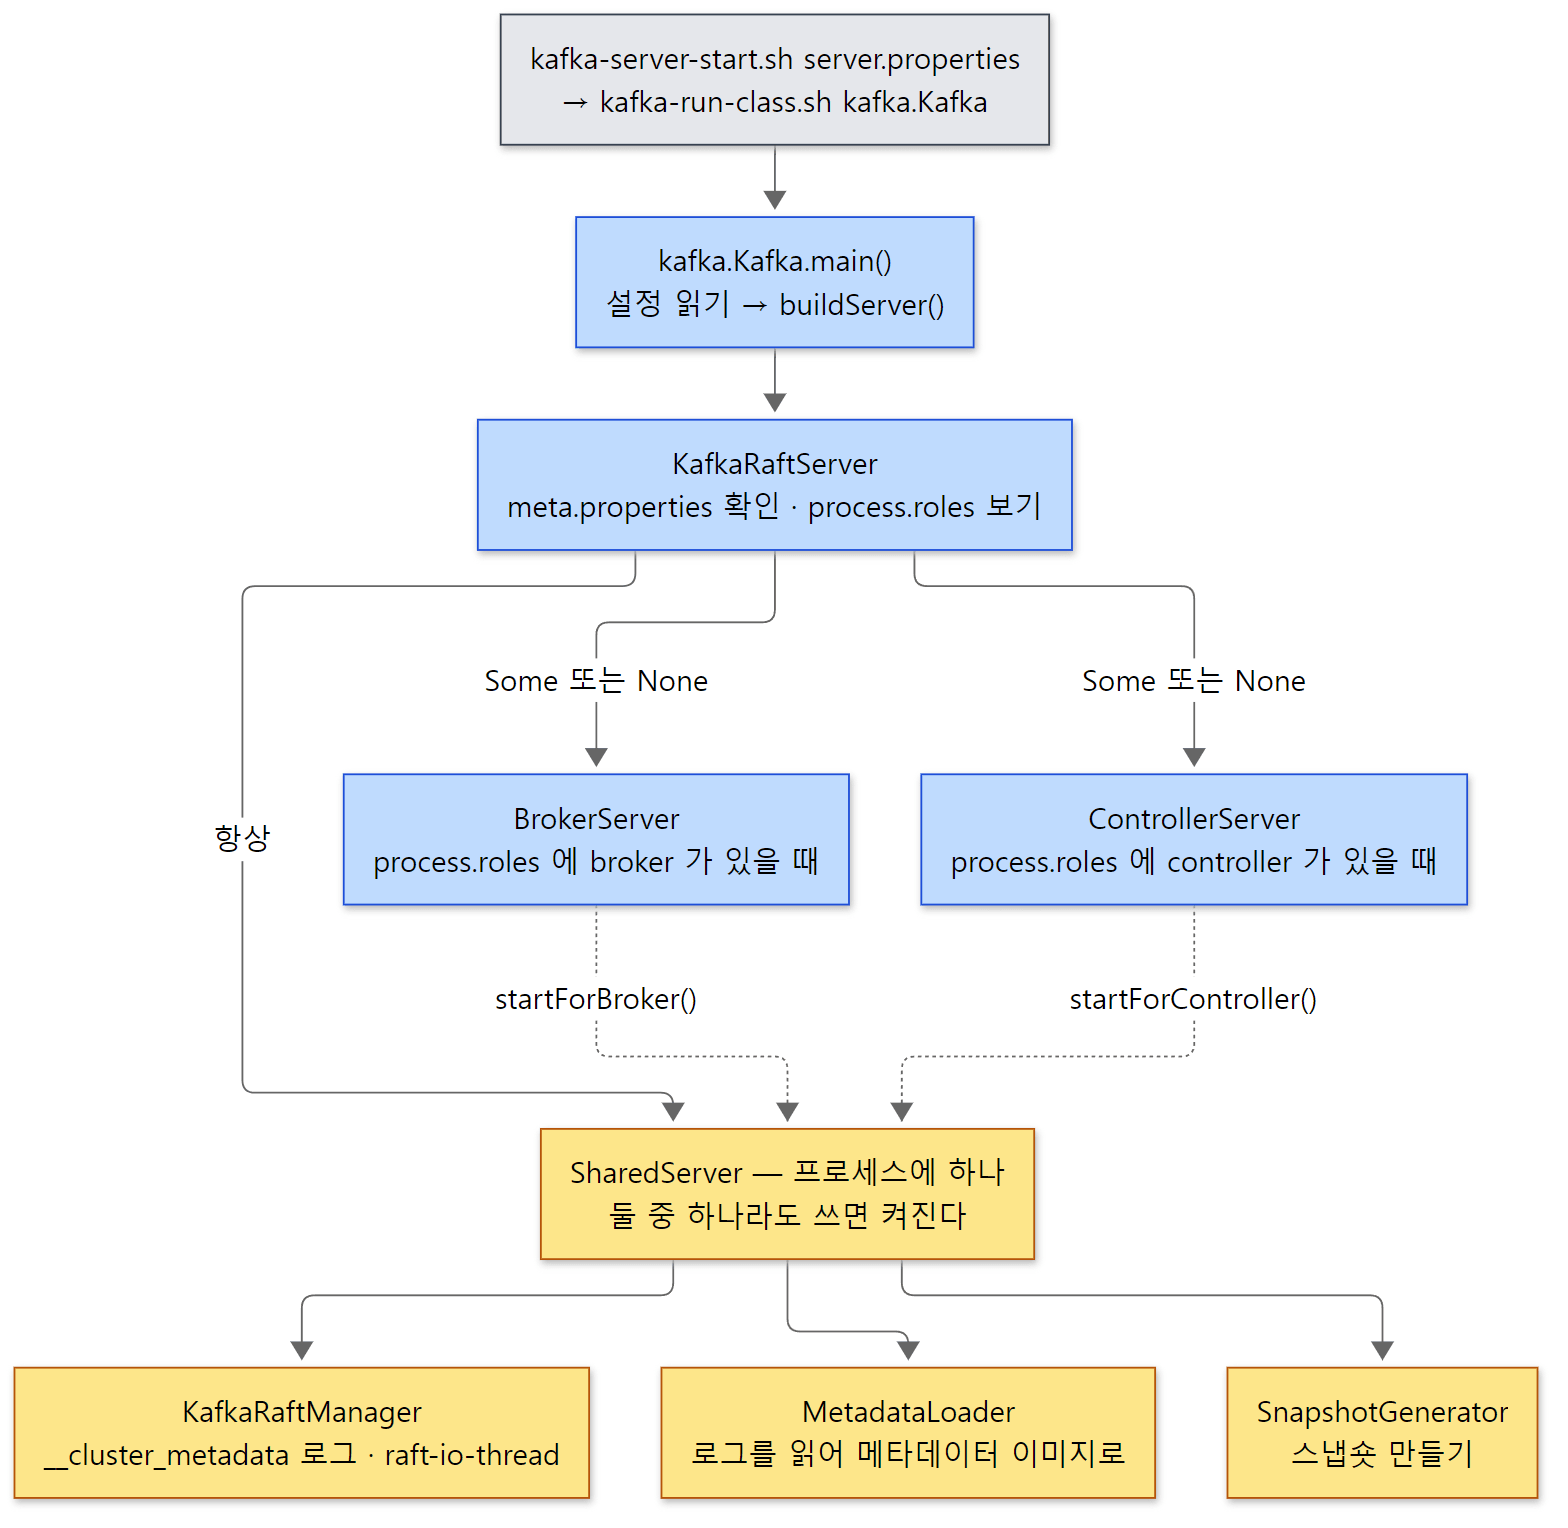 프로세스 하나가 뜨는 길.
SharedServer 와 그 아래 세 부품(노랑)은 역할이 무엇이든 프로세스에 하나씩입니다.
둘이 나눠 쓰는 것: SharedServer
SharedServer 의 설명은 이렇습니다.
The SharedServer manages the components which are shared between the BrokerServer and ControllerServer. These shared components include the Raft manager, snapshot generator, and metadata loader. A KRaft server running in combined mode as both a broker and a controller will still contain only a single SharedServer instance.
(SharedServer.scala 83–96행) 브로커와 컨트롤러가 함께 쓰는 것은 셋입니다.
| 부품 | 하는 일 | 왜 둘 다 필요한가 |
|---|---|---|
KafkaRaftManager |
__cluster_metadata 로그를 Raft 로 복제하는 클라이언트(KafkaRaftClient)와 그 스레드 |
컨트롤러는 이 로그에 쓰고, 브로커는 이 로그를 따라 읽습니다 |
MetadataLoader |
로그의 레코드를 읽어 "지금 클러스터의 모습"(메타데이터 이미지)을 만들고, 등록된 구독자(publisher)에게 알림 | 브로커도 컨트롤러도 최신 메타데이터를 알아야 합니다 |
SnapshotGenerator |
로그가 길어지면 이미지를 스냅숏 파일로 떠 둠 | 로그를 처음부터 다시 읽지 않게 |
결합 모드에서 이것이 둘이면 같은 로그를 두 번 읽고 같은 디렉터리를 두 번 쓰게 되므로 하나로 묶었습니다. 켜고 끄는 방법도 그 설명 그대로입니다.
  def startForBroker(): Unit = synchronized {
    if (!isUsed()) {
      start(Endpoints.empty())
    }
    usedByBroker = true
  }
  // ...
  def stopForBroker(): Unit = synchronized {
    if (usedByBroker) {
      usedByBroker = false
      if (!isUsed()) stop()
    }
  }
core/src/main/scala/kafka/server/SharedServer.scala 144–182행
Scala 읽는 법 —
def f(): Unit = synchronized { … }는 메서드 본문 전체를this로 잠그는 것으로, Java 의synchronized메서드와 같습니다.
먼저 부르는 쪽이 실제로 켜고(start()), 나중에 끄는 쪽이 실제로 끕니다. 설명에 따르면 참조 개수 대신 불린 둘(usedByBroker, usedByController)을 쓴 것은 디버깅을 쉽게 하려는 것입니다(94–95행). 실제로 켜는 start() 의 뼈대는 이렇습니다.
        val _raftManager = new KafkaRaftManager[ApiMessageAndVersion](
          clusterId,
          raftManagerConfig,
          metaPropsEnsemble.logDirProps.get(metaPropsEnsemble.metadataLogDir.get).directoryId.get,
          MetadataRecordSerde.INSTANCE,
          KafkaRaftServer.MetadataPartition,
          KafkaRaftServer.MetadataTopicId,
          time,
          metrics,
          externalKRaftMetrics,
          Some(s"kafka-${sharedServerConfig.nodeId}-raft"), // No dash expected at the end
          // ...
        raftManager = _raftManager
        _raftManager.startup()
        // ...
        loader = loaderBuilder.build()
        // ...
        _raftManager.client.register(loader)
core/src/main/scala/kafka/server/SharedServer.scala 298–363행
Scala 읽는 법 —
KafkaRaftManager[ApiMessageAndVersion]의 대괄호는 Java 의<ApiMessageAndVersion>과 같은 타입 인자입니다.s"kafka-${sharedServerConfig.nodeId}-raft"의s"…"는 문자열 안에${식}을 끼워 넣는 문자열 보간입니다.
KafkaRaftManager 에 넘기는 스레드 이름 접두어 kafka-<노드 id>-raft 가 3절 예제에서 kafka-1-raft-io-thread 라는 이름으로 다시 나옵니다(-io-thread 는 raft/src/main/java/org/apache/kafka/raft/KafkaRaftClientDriver.java 55행이 붙입니다). 마지막 줄 register(loader) 는 "Raft 클라이언트가 새 레코드를 커밋하면 MetadataLoader 에게 알려 달라"는 등록입니다. 이 한 줄이 1절 지도에서 G 구역 안의 KafkaRaftClient → MetadataLoader 화살표입니다.
헷갈리기 쉬운 곳: BrokerServer 와 ControllerServer 는 Server 가 아니다
이름만 보면 셋 다 "서버"지만, main() 이 받는 타입인 trait Server(startup()·shutdown()·awaitShutdown() 세 메서드, Server.scala 27–31행)를 구현하는 것은 KafkaRaftServer 하나뿐입니다(class KafkaRaftServer(…) extends Server with Logging, 49–52행). BrokerServer 는 KafkaBroker 라는 다른 트레이트를 구현하고(class BrokerServer(…) extends KafkaBroker, BrokerServer.scala 83–85행), ControllerServer 는 로깅 트레이트만 섞습니다(extends Logging, ControllerServer.scala 70–74행). 프로세스를 대표하는 것은 KafkaRaftServer 이고, 나머지 둘은 그 안의 부품입니다. (trait 는 Java 의 인터페이스처럼 읽으면 됩니다.)
3. 브로커 하나가 들고 있는 것: BrokerServer.startup()
시작하면서 만드는 부품
BrokerServer.startup() 은 470줄쯤 되는 긴 메서드입니다(201–671행). 하는 일은 단순합니다 — 부품을 하나씩 만들어 서로에게 넘기고, 마지막에 문을 엽니다. 부품을 만드는 줄만 골라 순서대로 보면 이렇습니다.
  override def startup(): Unit = {
    if (!maybeChangeStatus(SHUTDOWN, STARTING)) return
    val startupDeadline = Deadline.fromDelay(time, config.serverMaxStartupTimeMs, TimeUnit.MILLISECONDS)
    try {
      sharedServer.startForBroker()
      // ...
      kafkaScheduler = new KafkaScheduler(config.backgroundThreads)
      // ...
      metadataCache = new KRaftMetadataCache(config.nodeId, () => raftManager.client.kraftVersion())

      // Create log manager, but don't start it because we need to delay any potential unclean shutdown log recovery
      // until we catch up on the metadata log and have up-to-date topic and broker configs.
      logManager = LogManager(config,
      // ...
      lifecycleManager = new BrokerLifecycleManager(
      // ...
      forwardingManager = new ForwardingManagerImpl(clientToControllerChannelManager, metrics)
      // ...
      // Create and start the socket server acceptor threads so that the bound port is known.
      // Delay starting processors until the end of the initialization sequence to ensure
      // that credentials have been loaded before processing authentications.
      socketServer = new SocketServer(config,
      // ...
      this._replicaManager = new ReplicaManager(
      // ...
      groupCoordinator = createGroupCoordinator()
      // ...
      transactionCoordinator = TransactionCoordinator(config, replicaManager,
      // ...
      dataPlaneRequestProcessor = new KafkaApis(
        requestChannel = socketServer.dataPlaneRequestChannel,
        forwardingManager = forwardingManager,
        replicaManager = replicaManager,
        // ...
      dataPlaneRequestHandlerPool = sharedServer.requestHandlerPoolFactory.createPool(
        config.nodeId,
        socketServer.dataPlaneRequestChannel,
        dataPlaneRequestProcessor,
        time,
        config.numIoThreads,
        "broker"
      )
      // ...
      brokerMetadataPublisher = new BrokerMetadataPublisher(config,
core/src/main/scala/kafka/server/BrokerServer.scala 201–531행
Scala 읽는 법 —
new KafkaApis(requestChannel = …, forwardingManager = …)처럼 인자 앞에이름 =을 붙이는 것은 이름 붙인 인자입니다. 인자가 스무 개쯤 되는 생성자를 순서 실수 없이 부르려고 씁니다.() => raftManager.client.kraftVersion()은 인자 없는 람다(Java 의() -> …)입니다.
만든 부품을 1절 지도의 구역과 이어 표로 모으면 이렇습니다.
| 부품 | 무엇 | 지도 | 자세히 |
|---|---|---|---|
KafkaScheduler |
주기 작업용 스레드 풀(kafka-scheduler-N, background.threads 기본 10) |
— | — |
KRaftMetadataCache |
메타데이터 이미지를 들고 있다가 Metadata 요청 등에 답하는 데 쓰는 캐시 |
G | 6절, 10편 |
LogManager |
이 브로커 디스크의 모든 파티션 로그 | E | 7편 |
BrokerLifecycleManager |
컨트롤러에 브로커를 등록하고 하트비트를 보냄 | G | 10편 |
ForwardingManager |
토픽 만들기 같은 요청을 컨트롤러로 넘김 | C ⇢ G | 5절 |
SocketServer |
포트를 열고 연결을 받아 요청을 읽는 계층 | B | 4편 |
ReplicaManager |
이 브로커가 가진 파티션들(리더·팔로워), 쓰기·읽기·복제 | D | 6편, 9편 |
GroupCoordinator, TransactionCoordinator |
컨슈머 그룹과 트랜잭션의 상태 | F | 11편, 12편 |
KafkaApis |
요청 종류에 따라 위 부품을 부르는 분배기 | C | 4편 |
KafkaRequestHandlerPool |
KafkaApis 를 부르는 요청 처리 스레드(num.io.threads 기본 8) |
C | 4편 |
BrokerMetadataPublisher |
새 메타데이터 이미지를 받아 위 부품들에 알림 | G → D | 5절 |
기본값은 설정 클래스의 define() 에서 확인했습니다 — num.io.threads 8(server-common/src/main/java/org/apache/kafka/server/config/ServerConfigs.java 60행, 141행의 define), background.threads 10(같은 파일 64행, 143행), num.network.threads 3(server/src/main/java/org/apache/kafka/network/SocketServerConfigs.java 152행, 171행의 define).
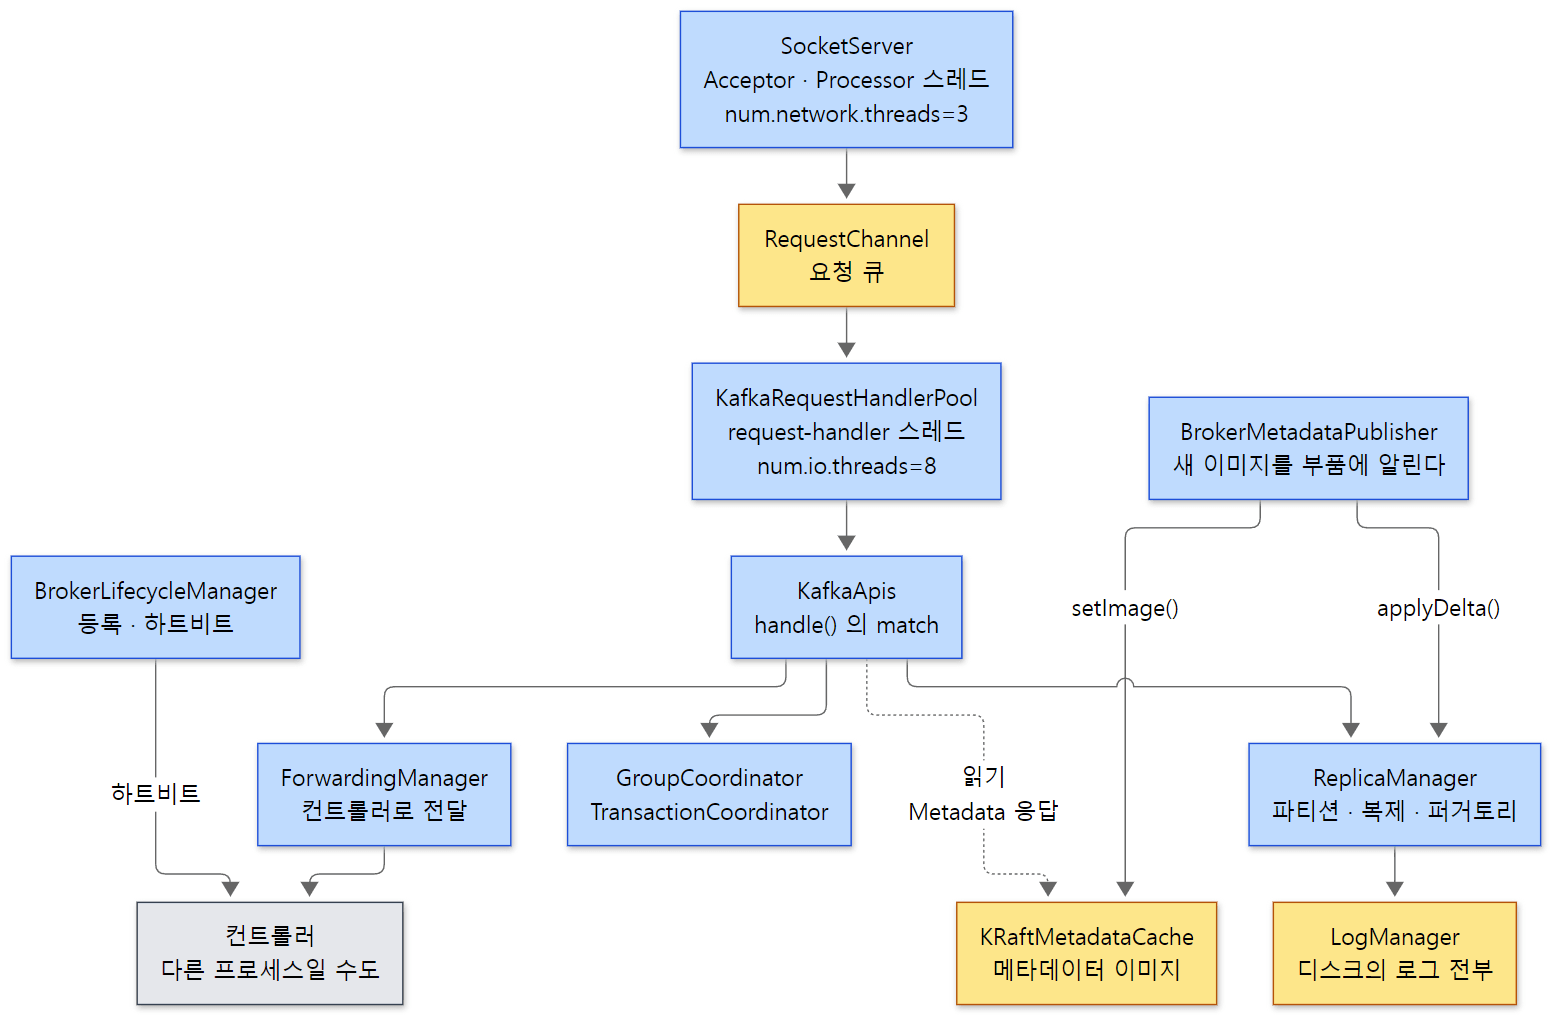 브로커 하나의 부품 지도. 위에서 아래로가 요청이 지나는 길(1절 지도의 B → C → D·F → E), 오른쪽 위의
BrokerMetadataPublisher 가 장부의 길이 들어오는 곳입니다.
SocketServer → RequestChannel → 요청 처리 스레드 의 모양은 Tomcat 5편의 NIO 커넥터(Acceptor → Poller → 작업 스레드 풀)와 닮았습니다. 연결을 받는 스레드, 소켓에서 바이트를 읽고 쓰는 스레드, 실제 일을 하는 스레드를 나눠 둔다는 점이 같습니다. 어디가 같고 다른지는 4편에서 비교합니다.
문은 맨 마지막에 연다
위 코드의 SocketServer 생성 바로 위 주석을 보면, 포트는 일찍 열지만(바인드된 포트 번호를 알아야 다른 부품에 알려 줄 수 있으므로) 요청을 처리하기 시작하는 것은 초기화의 맨 끝으로 미룬다고 적혀 있습니다. 실제로 메서드 끝부분은 기다림의 연속입니다.
      // Wait for this broker to contact the quorum, and for the active controller to acknowledge
      // us as caught up. It will do this by returning a heartbeat response with isCaughtUp set to
      // true. The BrokerLifecycleManager tracks this.
      FutureUtils.waitWithLogging(logger.underlying, logIdent,
        "the controller to acknowledge that we are caught up",
        lifecycleManager.initialCatchUpFuture, startupDeadline, time)
      // ...
      // We're now ready to unfence the broker. This also allows this broker to transition
      // from RECOVERY state to RUNNING state, once the controller unfences the broker.
      FutureUtils.waitWithLogging(logger.underlying, logIdent,
        "the broker to be unfenced",
        lifecycleManager.setReadyToUnfence(), startupDeadline, time)
      // ...
      val enableRequestProcessingFuture = socketServer.enableRequestProcessing(authorizerFutures)
core/src/main/scala/kafka/server/BrokerServer.scala 597–638행
브로커는 (1) 메타데이터 로그를 따라잡았다고 컨트롤러가 인정해 줄 때까지, (2) 컨트롤러가 "울타리를 걷어 줄"(unfence) 때까지 기다린 뒤에야 클라이언트의 요청을 받기 시작합니다. 펜스(fence, 울타리)는 컨트롤러가 "이 브로커는 아직 믿을 수 없다"고 표시해 두는 상태로, 펜스된 브로커에는 리더를 맡기지 않습니다. 이 순서 덕분에 낡은 메타데이터를 든 브로커가 엉뚱한 답을 하는 일이 없습니다. 하트비트와 펜스의 자세한 규칙은 10편에서 봅니다.
예제 1: 스레드 이름으로 부품 세기
부품 목록이 정말 그대로 살아 있는지, 결합 모드 서버 하나를 띄우고 jstack 으로 스레드 이름을 모아 보았습니다. 스레드 이름 끝의 번호는 N 으로 바꿔 같은 종류끼리 셉니다.
이 글의 예제는 모두 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 실행 스크립트는 ex/u02-threads/run.sh 와 ex/u02-cluster/run.sh 이고, 출력의 === 줄은 스크립트가 찍은 제목입니다.
source /examples-lib/kafka.sh
kafka_single      # broker,controller 한 프로세스 (PLAINTEXT 9092 / CONTROLLER 9093)
kafka-topics.sh --bootstrap-server $BOOTSTRAP --create --topic demo --partitions 3 --replication-factor 1 >/dev/null
# ...
jstack $PID > /tmp/jstack.txt
# jstack 의 스레드 머리 줄은 "이름" 으로 시작한다 — 이름만 뽑는다
grep '^"' /tmp/jstack.txt | sed 's/^"\([^"]*\)".*/\1/' > /tmp/names.txt
# ... JVM 자체 스레드(GC, JIT 컴파일러 등)를 빼고, 끝 번호를 N 으로 바꿔 센다
grep -vE "$JVM" /tmp/names.txt | sed -E 's/[0-9]+$/N/' | sort | uniq -c | sort -k2
=== process.roles of node 1
process.roles=broker,controller
=== total threads: 115
=== JVM threads: 30
=== Kafka threads grouped (trailing number -> N)
      1 broker-1-lifecycle-manager-event-handler
      1 broker-1-to-controller-alter-partition-channel-manager
      1 broker-1-to-controller-forwarding-channel-manager
      1 broker-1-to-controller-heartbeat-channel-manager
      3 data-plane-kafka-network-thread-1-CONTROLLER-PLAINTEXT-N
      3 data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-N
     16 data-plane-kafka-request-handler-N
      1 data-plane-kafka-socket-acceptor-CONTROLLER-PLAINTEXT-N
      1 data-plane-kafka-socket-acceptor-PLAINTEXT-PLAINTEXT-N
      1 ExpirationReaper-1-Fetch
      1 ExpirationReaper-1-Produce
      4 group-coordinator-event-processor-N
      1 group-coordinator-reaper
      1 kafka-1-metadata-loader-event-handler
      1 kafka-1-raft-io-thread
      1 kafka-1-raft-outbound-request-thread
      1 kafka-1-raft-schedulerN
      1 kafka-1-snapshot-generator-event-handler
      1 kafka-log-cleaner-thread-N
     10 kafka-scheduler-N
      1 quorum-controller-1-event-handler
      1 transaction-log-manager-N
      1 TxnMarkerSenderThread-N
출력은 줄였습니다. 실제 목록은 52종류이고, 위에서 뺀 29종류는 이 연재에서 다루지 않는 기능(공유 그룹의 share-*·ShareGroupDLQSendThread·PersisterStateManager, 쿼터의 …-ThrottledChannelReaper-*, 계층 저장소의 ExpirationReaper-1-RemoteFetch 등)과 그 밖의 보조 스레드(지표, 컨트롤러 등록, 디렉터리 배정, DeleteRecords·AlterAcls 퍼거토리 등)입니다. 전체 115개 가운데 30개는 JVM 자신의 스레드(GC, JIT 컴파일러 등)이고 나머지 85개가 Kafka 의 것입니다. 이 수는 JVM 과 컨테이너의 CPU 수에 따라 달라질 수 있습니다(GC 스레드 수가 CPU 수를 따릅니다). kafka-1-raft-schedulerN 은 실제 이름 kafka-1-raft-scheduler0 의 끝 숫자를 스크립트가 N 으로 바꾼 것입니다. 이름을 구역별로 묶으면 지도가 그대로 나타납니다.
| 스레드 이름 | 수 | 무엇 | 지도 |
|---|---|---|---|
data-plane-kafka-socket-acceptor-… |
리스너마다 1 | 연결을 받는 Acceptor | B |
data-plane-kafka-network-thread-1-<리스너>-…-N |
리스너마다 3 | 소켓을 읽고 쓰는 Processor(num.network.threads) |
B |
data-plane-kafka-request-handler-N |
16 | KafkaApis·ControllerApis 를 부르는 요청 처리 스레드(아래 "헷갈리기 쉬운 곳") |
C |
ExpirationReaper-1-Produce·-Fetch |
각 1 | 기다리는 요청(퍼거토리)의 시간 초과를 거두는 스레드(DelayedOperationPurgatory) |
D, 8편·9편 |
kafka-log-cleaner-thread-N, kafka-scheduler-N |
1, 10 | 로그 컴팩션(같은 키의 옛 레코드를 지우는 정리), 보존 검사 같은 주기 작업 | E, 7편 |
group-coordinator-event-processor-N |
4 | 그룹 코디네이터(group.coordinator.threads 기본 4) |
F, 11편 |
transaction-log-manager-N, TxnMarkerSenderThread-N |
1, 1 | 트랜잭션 코디네이터 | F, 12편 |
quorum-controller-1-event-handler |
1 | 컨트롤러의 두뇌 — 4절 | G |
kafka-1-raft-io-thread, …-raft-outbound-request-thread, …-raft-scheduler0 |
각 1 | SharedServer 의 KafkaRaftManager |
G |
kafka-1-metadata-loader-event-handler, kafka-1-snapshot-generator-event-handler |
각 1 | SharedServer 의 MetadataLoader, SnapshotGenerator |
G |
broker-1-lifecycle-manager-…, broker-1-to-controller-*-channel-manager |
각 1 | 브로커가 컨트롤러와 말하는 통로(하트비트, 전달, ISR 변경 알림) | G |
스레드 이름을 만드는 곳은 각각 group-coordinator-event-processor-(group-coordinator/src/main/java/org/apache/kafka/coordinator/group/GroupCoordinatorService.java 265행), quorum-controller-<id>-(ControllerServer.scala 242행) + event-handler(server-common/src/main/java/org/apache/kafka/queue/KafkaEventQueue.java 43행), kafka-scheduler-(server-common/src/main/java/org/apache/kafka/server/util/KafkaScheduler.java 95행)처럼 소스에서 확인했습니다.
헷갈리기 쉬운 곳: 결합 모드에서는 요청 처리 스레드 이름이 두 벌 겹친다
num.io.threads 의 기본값은 8인데 data-plane-kafka-request-handler-N 이 16개입니다. 줄이기 전의 이름 목록을 보면 data-plane-kafka-request-handler-0 부터 -7 까지가 두 번씩 나옵니다. 결합 모드에서는 BrokerServer 가 "broker" 풀을, ControllerServer 가 "controller" 풀을 각각 num.io.threads 개씩 만드는데(4절), 스레드 이름을 붙이는 줄은 풀 종류를 넣지 않습니다.
KafkaThread.daemon("data-plane-kafka-request-handler-" + id, runnables(id)).start()
core/src/main/scala/kafka/server/KafkaRequestHandler.scala 275행
그래서 결합 모드 서버의 jstack 에서 request-handler-3 하나를 보고 브로커 쪽인지 컨트롤러 쪽인지는 이름만으로 알 수 없습니다. 스택을 내려가 KafkaApis 인지 ControllerApis 인지를 봐야 합니다. 반면 네트워크 스레드는 이름에 리스너(PLAINTEXT, CONTROLLER)가 들어가 구별됩니다. 같은 이름 짓기는 4.4.0 의 KafkaRequestHandler.scala 에서도 같습니다.
4. 컨트롤러가 들고 있는 것: ControllerServer 와 QuorumController
컨트롤러에도 소켓 서버와 요청 처리 풀이 있다
ControllerServer.startup() 은 브로커보다 짧지만 뼈대가 닮았습니다 — 자기 SocketServer 를 만들고, 요청을 나눠 줄 분배기(ControllerApis)와 요청 처리 풀을 만듭니다. 다른 점은 한가운데 놓인 것이 ReplicaManager 가 아니라 QuorumController 라는 것입니다.
        new QuorumController.Builder(config.nodeId, sharedServer.clusterId).
          setTime(time).
          setThreadNamePrefix(s"quorum-controller-${config.nodeId}-").
          setConfigSchema(configSchema).
          setRaftClient(raftManager.client).
          // ...
      controller = controllerBuilder.build()
      // ...
      controllerApis = new ControllerApis(socketServer.dataPlaneRequestChannel,
        authorizerPlugin,
        quotaManagers,
        time,
        controller,
        raftManager,
        // ...
      controllerApisHandlerPool = sharedServer.requestHandlerPoolFactory.createPool(
        config.nodeId,
        socketServer.dataPlaneRequestChannel,
        controllerApis,
        time,
        config.numIoThreads,
        "controller"
      )
core/src/main/scala/kafka/server/ControllerServer.scala 240–305행
Scala 읽는 법 —
s"quorum-controller-${config.nodeId}-"는 2절에서 본 문자열 보간입니다. 줄 끝의.으로 빌더 메서드를 이어 부르는 것은 Java 와 같습니다.
QuorumController 에 raftManager.client — 곧 SharedServer 가 만든 Raft 클라이언트 — 를 넘기는 줄(setRaftClient)이 핵심입니다. 컨트롤러가 내린 결정은 이 클라이언트를 통해 메타데이터 로그에 쓰입니다.
브로커와 컨트롤러의 SocketServer 는 같은 클래스입니다. 어느 리스너의 포트를 열지는 생성할 때 넘긴 apiVersionManager 의 종류로 갈립니다.
  if (apiVersionManager.listenerType.equals(ListenerType.CONTROLLER)) {
    config.controllerListeners.foreach(createDataPlaneAcceptorAndProcessors)
  } else {
    config.dataPlaneListeners.foreach(createDataPlaneAcceptorAndProcessors)
  }
core/src/main/scala/kafka/network/SocketServer.scala 146–150행
Scala 읽는 법 —
foreach(createDataPlaneAcceptorAndProcessors)는 리스너 하나하나에 대해 그 이름의 메서드(213행의private def)를 부르라는 뜻입니다. 메서드 이름을 그대로 함수처럼 넘기는 것으로, Java 의forEach(this::createDataPlaneAcceptorAndProcessors)와 같습니다.
결합 모드 프로세스가 9092(PLAINTEXT)와 9093(CONTROLLER) 두 포트를 따로 열고, 예제 1에서 acceptor 와 network-thread 가 리스너마다 한 벌씩 나온 이유입니다.
컨트롤러의 두뇌는 스레드 하나
QuorumController 의 설명은 KRaft 컨트롤러의 성격을 짧게 요약합니다.
 * The node which is the leader of the metadata log becomes the active controller.  All
 * other nodes remain in standby mode.  Standby controllers cannot create new metadata log
 * entries.  They just replay the metadata log entries that the current active controller
 * has created.
 *
 * The QuorumController is single-threaded.  A single event handler thread performs most
 * operations.  This avoids the need for complex locking.
 *
 * The controller exposes an asynchronous, futures-based API to the world.  This reflects
 * the fact that the controller may have several operations in progress at any given
 * point.  The future associated with each operation will not be completed until the
 * results of the operation have been made durable to the metadata log.
metadata/src/main/java/org/apache/kafka/controller/QuorumController.java 160–171행
세 문단이 세 가지 사실입니다.
- 컨트롤러가 여럿이어도 일하는 것은 하나입니다. 메타데이터 로그의 Raft 리더가 활성 컨트롤러(active controller)가 되고, 나머지는 로그를 따라 읽기만 하는 대기(standby) 컨트롤러입니다.
- 활성 컨트롤러 안에서도 스레드 하나(예제 1의
quorum-controller-1-event-handler)가 거의 모든 일을 합니다. 요청은 이벤트로 큐에 넣고 그 스레드가 하나씩 꺼내 처리하므로 복잡한 락이 필요 없습니다. - 컨트롤러의 API 는
CompletableFuture를 돌려주고, 그 future 는 결과가 메타데이터 로그에 기록된 뒤에야 완료됩니다.
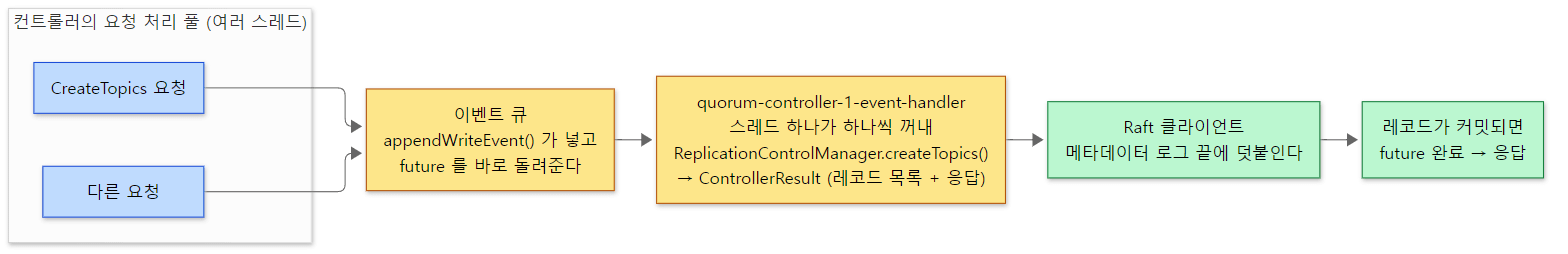 요청을 받는 스레드는 여럿이지만, 결정을 내리는 스레드는 하나입니다. 파란 칸은 여러 스레드, 노란 칸은 한 줄로 서는 곳, 초록 칸은 결과가 로그에 남는 곳입니다.
토픽 만들기가 그 모양 그대로입니다.
    @Override
    public CompletableFuture<CreateTopicsResponseData> createTopics(
        ControllerRequestContext context,
        CreateTopicsRequestData request, Set<String> describable,
        boolean forwarded
    ) {
        if (request.topics().isEmpty()) {
            return CompletableFuture.completedFuture(new CreateTopicsResponseData());
        }
        return appendWriteEvent("createTopics", context.deadlineNs(),
            () -> replicationControl.createTopics(context, request, describable, forwarded));
    }
metadata/src/main/java/org/apache/kafka/controller/QuorumController.java 1813–1824행
appendWriteEvent() 는 "쓰기 이벤트"를 큐에 넣고 future 를 돌려줍니다. 람다 안의 ReplicationControlManager.createTopics() 는 이벤트 스레드에서 돌면서 메타데이터 레코드 목록과 응답을 만들고(ControllerResult), 레코드가 로그에 커밋되면 future 가 완료됩니다. 이벤트 큐와 ControllerResult 의 안쪽은 10편에서 봅니다.
5. 장부의 길: 토픽·파티션·리더는 누가 정하고 어떻게 퍼지나
리더를 정하는 곳
ReplicationControlManager.createTopics() 가 파티션마다 만드는 등록 정보를 보면 "처음 리더는 누구인가"의 답이 있습니다.
    private static PartitionRegistration buildPartitionRegistration(
        PartitionAssignment partitionAssignment,
        List<Integer> isr
    ) {
        return new PartitionRegistration.Builder().
            setReplicas(Replicas.toArray(partitionAssignment.replicas())).
            setDirectories(Uuid.toArray(partitionAssignment.directories())).
            setIsr(Replicas.toArray(isr)).
            setLeader(isr.get(0)).
            setLeaderRecoveryState(LeaderRecoveryState.RECOVERED).
            setLeaderEpoch(0).
            setPartitionEpoch(0).
            build();
    }
metadata/src/main/java/org/apache/kafka/controller/ReplicationControlManager.java 875–888행
여기 넘어오는 isr 은 바로 위에서 레플리카 목록 가운데 지금 살아 있는(active) 브로커만 남긴 것입니다(partitionAssignment.replicas().stream().filter(clusterControl::isActive), 801–802행). 그러니 처음 리더는 레플리카 목록에서 살아 있는 첫 번째 브로커이고, 리더 에포크(leader epoch — 리더가 바뀔 때마다 하나씩 오르는 세대 번호, 9편)는 0에서 시작합니다. 레플리카를 어느 브로커에 둘지(배치) 고르는 규칙은 이 글에서 다루지 않습니다.
결정은 곧바로 레코드가 됩니다.
        records.add(new ApiMessageAndVersion(new TopicRecord().
            setName(topic.name()).
            setTopicId(topicId), (short) 0));
        // ConfigRecords go after TopicRecord but before PartitionRecord(s).
        records.addAll(configRecords);
        for (Entry<Integer, PartitionRegistration> partEntry : newParts.entrySet()) {
            int partitionIndex = partEntry.getKey();
            PartitionRegistration info = partEntry.getValue();
            records.add(info.toRecord(topicId, partitionIndex, new ImageWriterOptions.Builder(featureControl.metadataVersionOrThrow()).
                setEligibleLeaderReplicasEnabled(featureControl.isElrFeatureEnabled()).
                build()));
        }
metadata/src/main/java/org/apache/kafka/controller/ReplicationControlManager.java 860–871행
토픽 하나에 TopicRecord 하나, 그 뒤에 (설정이 있으면 ConfigRecord 들), 파티션마다 PartitionRecord(info.toRecord()) 하나씩. 컨트롤러는 이 레코드 목록을 메타데이터 로그에 덧붙이는 것으로 "토픽을 만든다". 디스크에 orders-0 폴더를 만드는 것은 컨트롤러가 아니라, 이 레코드를 읽은 브로커들입니다.
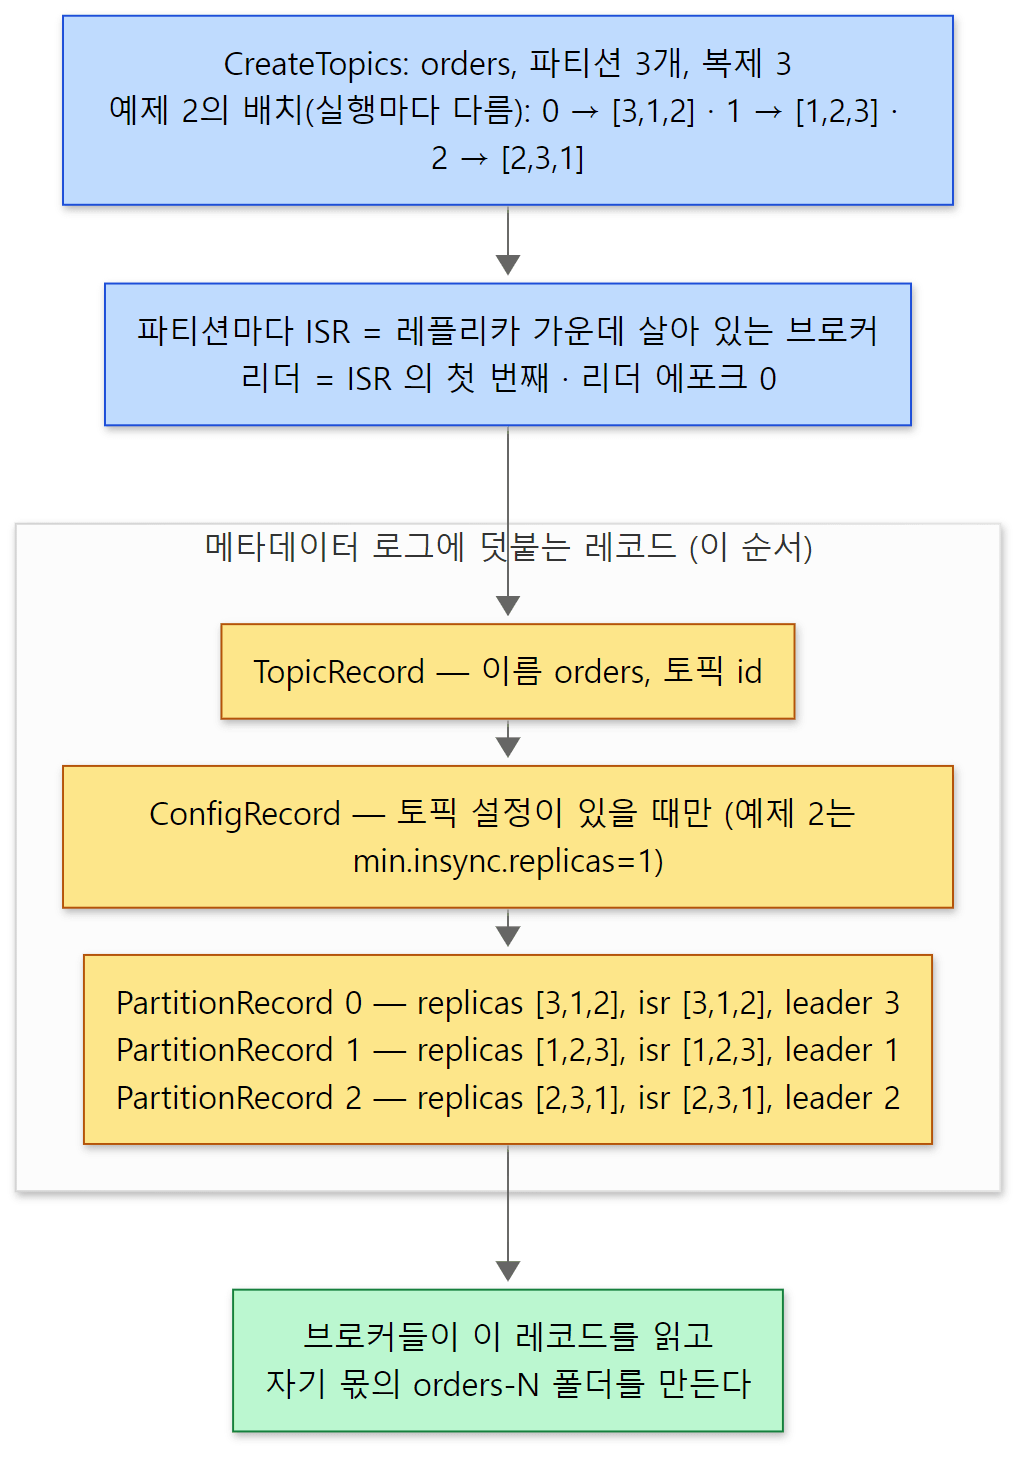 토픽 하나를 만들 때 컨트롤러가 쓰는 레코드. 숫자는 6절 예제 2의 실제 출력에서 가져왔습니다.
브로커가 결정을 받아 적용하는 곳
브로커 쪽에서는 SharedServer 의 MetadataLoader 가 새 레코드를 이미지에 반영하고, 구독자인 BrokerMetadataPublisher.onMetadataUpdate() 를 부릅니다.
      // Apply topic deltas.
      Option(delta.topicsDelta()).foreach { topicsDelta =>
        try {
          // Notify the replica manager about changes to topics.
          replicaManager.applyDelta(topicsDelta, newImage)
core/src/main/scala/kafka/server/metadata/BrokerMetadataPublisher.scala 144–148행
Scala 읽는 법 —
Option(x)는x가null이면None, 아니면Some(x)를 만듭니다. 이어지는.foreach { topicsDelta => … }는 값이 있을 때만 중괄호 안의 람다를 실행합니다(=>는 Java 람다의->).
MetadataDelta 는 "직전 이미지와 새 이미지의 차이"입니다. 같은 메서드 조금 위(130행)에서 먼저 metadataCache.setImage(newImage) 로 캐시를 바꾸고, 여기서 토픽 쪽 차이를 ReplicaManager 에 넘깁니다. ReplicaManager.applyDelta() 는 그 차이 가운데 이 브로커에 해당하는 것만 골라 적용합니다.
  def applyDelta(delta: TopicsDelta, newImage: MetadataImage): Unit = {
    // Before taking the lock, compute the local changes
    val localChanges = delta.localChanges(config.nodeId)
    // ...
      // Handle partitions which we are now the leader or follower for.
      if (!localChanges.leaders.isEmpty || !localChanges.followers.isEmpty) {
        val lazyOffsetCheckpoints = new LazyOffsetCheckpoints(this.highWatermarkCheckpoints.asJava)
        val leaderChangedPartitions = new mutable.HashSet[Partition]
        val followerChangedPartitions = new mutable.HashSet[Partition]
        if (!localChanges.leaders.isEmpty) {
          applyLocalLeadersDelta(leaderChangedPartitions, delta, lazyOffsetCheckpoints, localChanges.leaders.asScala, localChanges.directoryIds.asScala)
        }
        if (!localChanges.followers.isEmpty) {
          applyLocalFollowersDelta(followerChangedPartitions, newImage, delta, lazyOffsetCheckpoints, localChanges.followers.asScala, localChanges.directoryIds.asScala)
        }
core/src/main/scala/kafka/server/ReplicaManager.scala 2369–2409행
Scala 읽는 법 —
new mutable.HashSet[Partition]은 Scala 의 변경 가능한 집합(scala.collection.mutable)이고,.asScala/.asJava는 Java 컬렉션과 Scala 컬렉션을 서로 감싸 바꾸는 변환입니다(scala.jdk.CollectionConverters).
delta.localChanges(config.nodeId) 가 "내 노드 id 가 들어 있는 파티션의 변화"만 뽑고, 그 가운데 내가 리더가 된 것과 팔로워가 된 것을 따로 처리합니다. 리더가 된 파티션은 쓰기를 받을 준비를, 팔로워가 된 파티션은 리더에게서 데이터를 가져오는 fetcher 스레드(예제 2의 ReplicaFetcherThread-…)를 붙입니다. 이 안쪽은 9편에서 봅니다.
토픽 만들기 한 번의 전체 흐름
그러면 kafka-topics.sh --bootstrap-server localhost:9092 --create 는 브로커에 보낸 요청인데 어떻게 컨트롤러까지 갈까요. 브로커의 KafkaApis.handle() 이 요청 종류로 나누는 match 에 답이 있습니다.
      request.header.apiKey match {
        case ApiKeys.PRODUCE => handleProduceRequest(request, requestLocal)
        case ApiKeys.FETCH => handleFetchRequest(request)
        case ApiKeys.LIST_OFFSETS => handleListOffsetRequest(request)
        case ApiKeys.METADATA => handleTopicMetadataRequest(request)
        // ...
        case ApiKeys.CREATE_TOPICS => forwardToController(request)
        case ApiKeys.DELETE_TOPICS => forwardToController(request)
core/src/main/scala/kafka/server/KafkaApis.scala 174–191행
Scala 읽는 법 —
x match { case A => … case B => … }는 Java 의switch와 같은 일을 합니다. 위에서부터 맞는case하나만 실행됩니다.
PRODUCE·FETCH·METADATA 는 브로커가 직접 처리하고, CREATE_TOPICS·DELETE_TOPICS 처럼 메타데이터를 바꾸는 요청은 forwardToController() 로 넘깁니다. 이 함수는 ForwardingManager.forwardRequest() 를 부르고(144행), ForwardingManagerImpl 은 원래 요청을 EnvelopeRequest 에 싸서 컨트롤러로 보냅니다(server/src/main/java/org/apache/kafka/server/ForwardingManagerImpl.java 64행). 컨트롤러 쪽 분배기 ControllerApis.handle() 에는 case ApiKeys.CREATE_TOPICS => handleCreateTopics(request) 가 있고(core/src/main/scala/kafka/server/ControllerApis.scala 99행), 그것이 controller.createTopics()(428행)를 부릅니다. 같은 match 에 VOTE, BEGIN_QUORUM_EPOCH, BROKER_HEARTBEAT, ALTER_PARTITION 처럼 컨트롤러만 받는 요청이 모여 있습니다(96–109행).
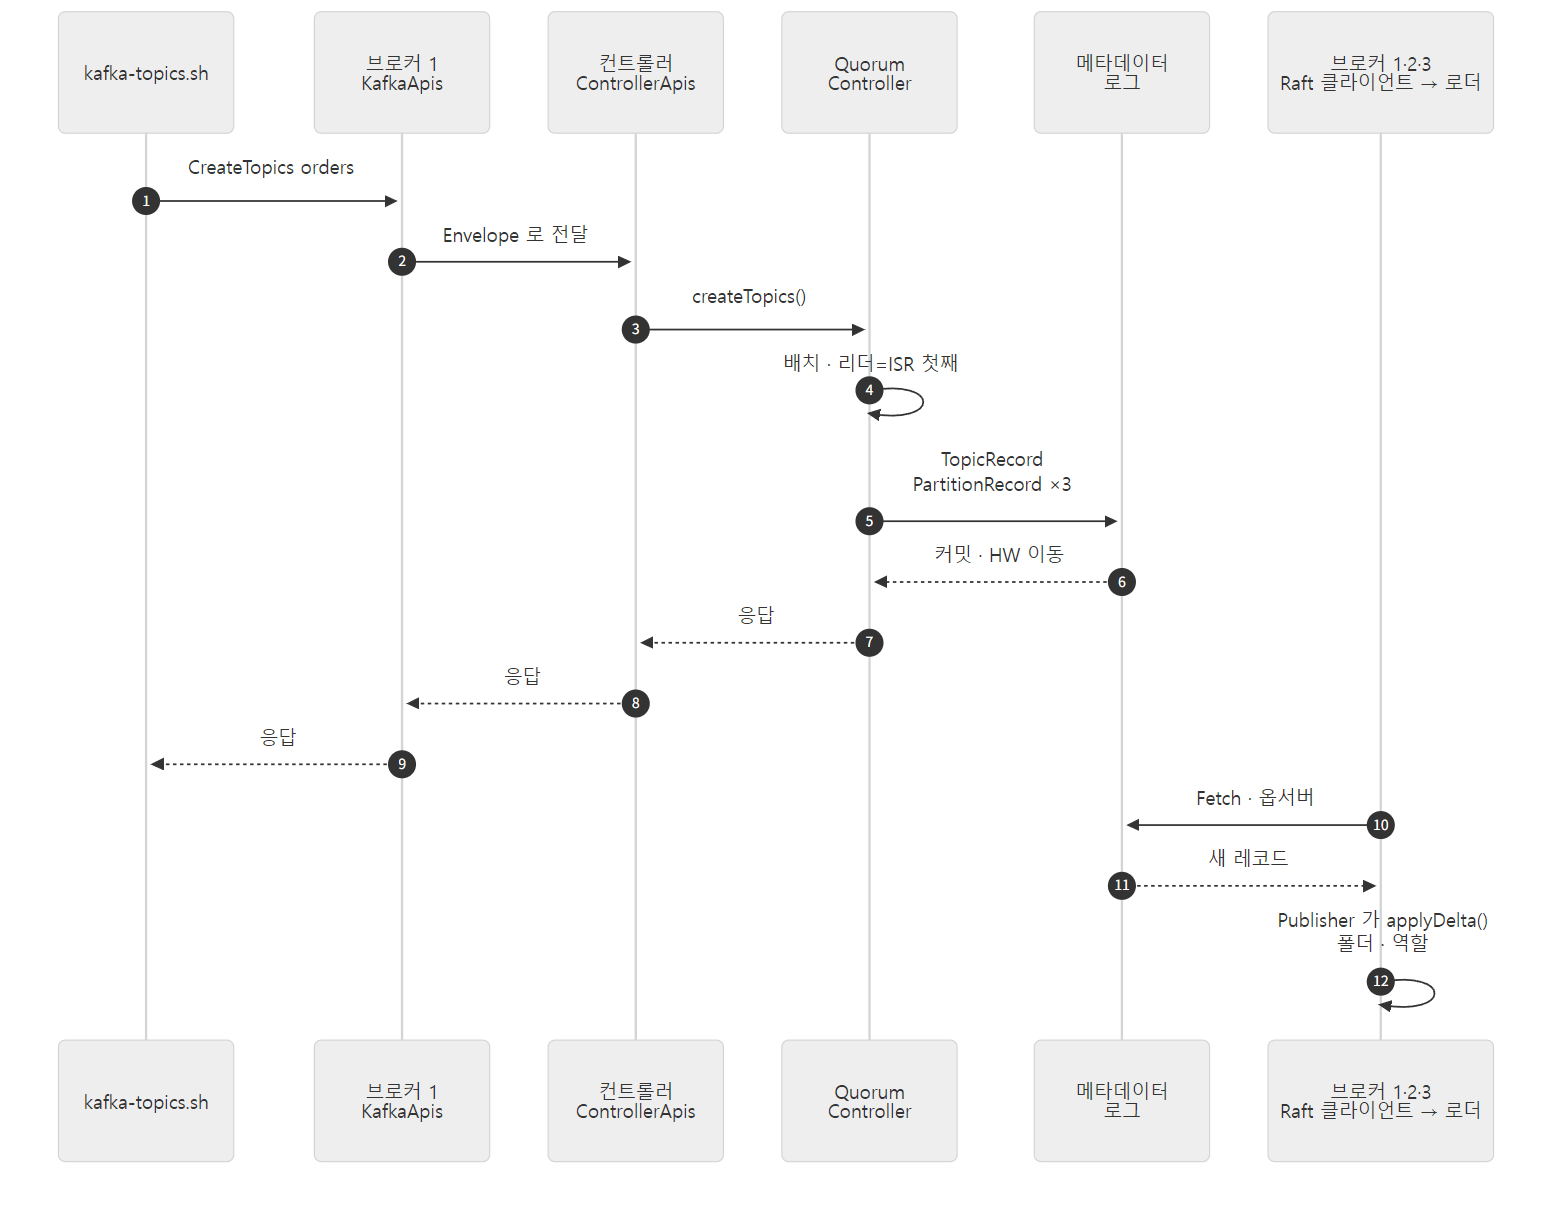 토픽 만들기 한 번. 1~9가 요청과 응답, 10~12는 브로커들이 각자 메타데이터 로그를 따라 읽으며 따로 일어나는 일입니다.
10번의 옵서버(observer)는 Raft 쿼럼에서 투표권 없이 로그만 따라 읽는 참가자입니다. 브로커는 컨트롤러 쿼럼의 투표자(voter)가 아니라 옵서버로 메타데이터 로그를 받습니다(예제 2의 CurrentObservers). 메타데이터 로그도 데이터 파티션처럼 Fetch 요청으로 복제된다는 것, 그리고 6번의 "커밋"과 하이 워터마크(high watermark — 복제가 확정되어 읽어도 되는 경계 오프셋)의 뜻은 10편과 9편에서 봅니다.
헷갈리기 쉬운 곳: 클라이언트가 받는 "컨트롤러"는 진짜 컨트롤러가 아니다
Metadata 응답과 DescribeCluster 응답에는 controllerId 칸이 있습니다. ZooKeeper 시절에는 여기에 진짜 컨트롤러 브로커의 id 가 들어갔지만, 이 커밋의 브로커는 이렇게 채웁니다.
    val brokers = metadataCache.getAliveBrokerNodes(request.context.listenerName)

    trace("Sending topic metadata %s and brokers %s for correlation id %d to client %s".format(completeTopicMetadata.mkString(","),
      brokers.asScala.mkString(","), request.header.correlationId, request.header.clientId))
    val controllerId = metadataCache.getRandomAliveBrokerId.orElse(MetadataResponse.NO_CONTROLLER_ID)
core/src/main/scala/kafka/server/KafkaApis.scala 997–1001행
살아 있는 브로커 하나를 무작위로 골라 "컨트롤러"라고 알려 줍니다(DescribeCluster 도 같은 방식, 2554행). 소스에 이유가 주석으로 적혀 있지는 않지만, KRaft 의 컨트롤러는 클라이언트 리스너를 열지 않는 별도 노드일 수 있고, 메타데이터를 바꾸는 요청은 어느 브로커로 보내든 그 브로커가 컨트롤러로 전달해 주므로 이렇게 해도 문제가 없습니다. 실제로 관리 클라이언트(Admin)는 CreateTopics 를 바로 이 "컨트롤러" 브로커에게 보냅니다(new Call("createTopics", deadline, new ControllerNodeProvider()), clients/src/main/java/org/apache/kafka/clients/admin/KafkaAdminClient.java 1924행). 그래서 위 토픽 만들기 그림의 "브로커 1" 자리에는 부트스트랩 브로커가 아니라 무작위로 뽑힌 브로커가 올 수 있습니다. 예제 2에서 Admin.describeCluster().controller() 가 컨트롤러 노드 100이 아니라 브로커 id 를 돌려주는 것을 직접 봅니다. 진짜 컨트롤러 쿼럼의 상태는 kafka-metadata-quorum.sh 로 컨트롤러에 직접 물어야 합니다.
6. 데이터의 길: 클라이언트는 리더를 어떻게 찾아가나
Metadata 요청 — 아무 브로커에게나 묻는다
프로듀서와 컨슈머는 bootstrap.servers 에 적힌 브로커 몇 개만 압니다. 나머지는 Metadata 요청으로 배웁니다. 클라이언트의 NetworkClient 안 DefaultMetadataUpdater.maybeUpdate() 는 메타데이터를 새로 받을 때가 되면 보낼 브로커를 이렇게 고릅니다.
            // Beware that the behavior of this method and the computation of timeouts for poll() are
            // highly dependent on the behavior of leastLoadedNode.
            LeastLoadedNode leastLoadedNode = leastLoadedNode(now);
            // ...
            return maybeUpdate(now, leastLoadedNode.node());
clients/src/main/java/org/apache/kafka/clients/NetworkClient.java 1473–1493행
leastLoadedNode() 는 이름 그대로 "지금 보내 둔 요청이 가장 적은 브로커"입니다. 메타데이터는 모든 브로커가 같은 것(각자의 KRaftMetadataCache)을 들고 있으므로 아무에게 물어도 됩니다. 응답에는 살아 있는 브로커 목록과 파티션마다 리더·레플리카·ISR 이 들어 있습니다(handleTopicMetadataRequest(), 891–1013행).
KafkaProducer.send() 는 그 토픽의 메타데이터가 아직 없으면 waitOnMetadata() 안에서 metadata.requestUpdateForTopic(topic) 으로 갱신을 청하고 Sender 스레드를 깨운 뒤 기다립니다(clients/src/main/java/org/apache/kafka/clients/producer/KafkaProducer.java 1327–1330행). 앱에서 보던 설정 max.block.ms 가 이 기다림의 상한입니다(5편).
Produce 요청 — 반드시 그 파티션의 리더에게
Sender 스레드가 보낼 배치를 고르는 RecordAccumulator.ready() 는 배치마다 메타데이터에서 리더를 찾습니다.
                // We didn't get leader when queue sizes is null so get it now
                if (queueSizes == null) {
                    leader = cluster.leaderFor(part);
                }
                // Check batch ready as a short-circuit to avoid expensive per-batch computation.
                checkBatchReady = leader != null && !readyNodes.contains(leader) && !isMuted(part);
clients/src/main/java/org/apache/kafka/clients/producer/internals/RecordAccumulator.java 820–825행
리더를 모르면(leader == null) 그 배치는 보낼 준비가 안 된 것입니다. 보낼 배치는 리더 브로커별로 묶여 그 브로커로 가는 Produce 요청 하나가 됩니다(ready()·drain() 의 자세한 규칙과 linger.ms 는 5편).
리더가 그 사이 바뀌었다면 어떻게 될까요. 리더가 아닌 브로커는 NOT_LEADER_OR_FOLLOWER 오류로 답하고, Sender 는 이 오류를 받으면 메타데이터를 새로 청합니다.
            if (error.exception() instanceof InvalidMetadataException) {
                // ...
                metadata.requestUpdate(false);
            }
clients/src/main/java/org/apache/kafka/clients/producer/internals/Sender.java 713–731행
NotLeaderOrFollowerException 은 InvalidMetadataException 의 하위 클래스입니다(public class NotLeaderOrFollowerException extends InvalidMetadataException, NotLeaderOrFollowerException.java 31행). 줄인 자리(722–729행)에서는 응답에 새 리더 정보가 실려 왔으면 그것도 기록해 둡니다. 재시도 횟수·delivery.timeout.ms 와의 관계는 5편에서 봅니다.
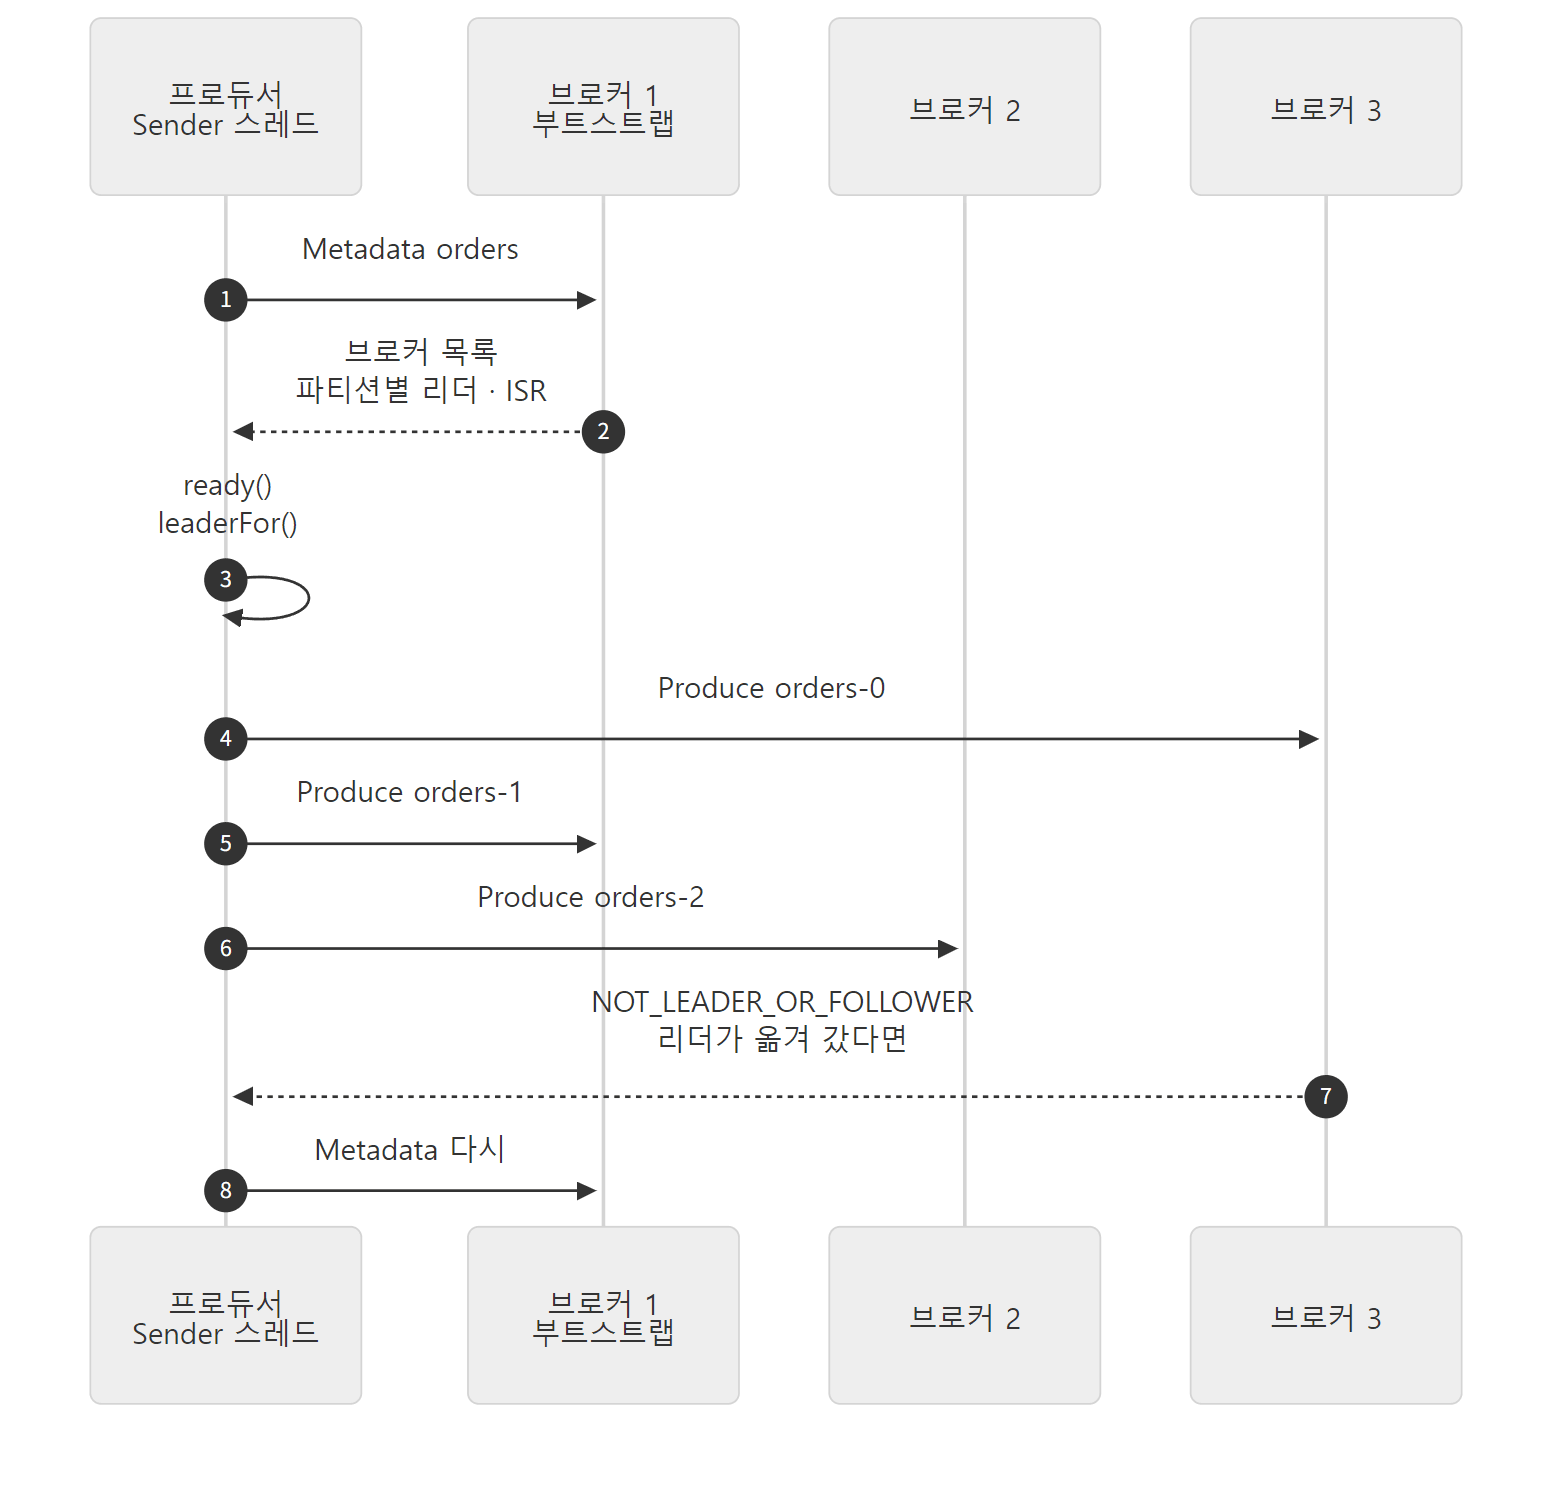 Metadata 는 아무 브로커에게, Produce 는 파티션의 리더에게. 리더 배치(4~6)는 예제 2를 돌렸을 때의 것으로, 실행마다 다릅니다.
예제 2: 컨트롤러 1 + 브로커 3 클러스터에서 지도 확인하기
이번에는 역할을 나눠 컨트롤러 하나(node 100, process.roles=controller)와 브로커 셋(node 1·2·3, process.roles=broker)을 한 컨테이너 안에 띄우고, 파티션 3개·RF 3 인 토픽 orders 를 만들어 다음을 확인했습니다.
- 쿼럼 상태: 누가 투표자이고 누가 옵서버인가
--describe의 Leader/Replicas/Isr 와 디스크의 폴더- 프로듀서가 Metadata 로 받은 지도, 그리고 Produce 요청이 실제로 어느 브로커에 갔는가(요청 로거
kafka.request.logger를 실행 중에 DEBUG 로 켜서kafka-request.log에서 확인) - 컨트롤러 프로세스와 브로커 프로세스가 각각 어떤 스레드를 가졌는가
Java 쪽 예제는 프로듀서의 partitionsFor() 로 Metadata 응답을 찍고, 파티션마다 레코드를 하나씩 보낸 뒤, Admin.describeCluster() 로 브로커가 알려 주는 "컨트롤러"를 찍습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 프로듀서가 Metadata 응답으로 받은 파티션 지도(리더·레플리카·ISR)를 찍고,
// 파티션마다 레코드를 하나씩 보내 실제로 어느 브로커(리더)로 갔는지 확인한다.
// ... (import 생략)
public class Leaders {
    public static void main(String[] args) throws Exception {
        Properties p = new Properties();
        // 부트스트랩 주소는 브로커 1 하나만 준다 — 나머지 브로커는 Metadata 응답으로 알게 된다
        p.put("bootstrap.servers", "localhost:9092");
        p.put("key.serializer", StringSerializer.class.getName());
        p.put("value.serializer", StringSerializer.class.getName());

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(p)) {
            // partitionsFor() 는 Metadata 요청을 보내고 응답이 올 때까지 기다린다
            System.out.println("--- partitionsFor(\"orders\") : from the Metadata response");
            for (PartitionInfo info : producer.partitionsFor("orders")) {
                System.out.printf("partition %d  leader=%s  replicas=%s  isr=%s%n",
                        info.partition(), info.leader().idString(),
                        ids(info.replicas()), ids(info.inSyncReplicas()));
            }
            System.out.println("--- send one record to each partition");
            for (int part = 0; part < 3; part++) {
                RecordMetadata md = producer.send(new ProducerRecord<>("orders", part, "k" + part, "v" + part)).get();
                System.out.printf("partition %d  offset=%d%n", md.partition(), md.offset());
            }
        }

        try (Admin admin = Admin.create(p)) {
            // KRaft 에서 브로커는 진짜 컨트롤러 대신 살아 있는 브로커 하나를 골라 알려 준다
            System.out.println("--- describeCluster() via broker 1");
            System.out.println("nodes      = " + admin.describeCluster().nodes().get().stream().map(Node::idString).sorted().toList());
            System.out.println("controller = " + admin.describeCluster().controller().get().idString());
        }
    }
    // ... ids(): Node[] 를 "[1,2,3]" 모양 문자열로
}
출력은 이렇습니다. 클러스터 id, 디렉터리 id, 토픽 id, 하이 워터마크 값, 리더 배치, 무작위로 고른 "컨트롤러" 값은 실행마다 다릅니다.
=== process.roles
node 100: process.roles=controller
node 1: process.roles=broker
node 2: process.roles=broker
node 3: process.roles=broker
=== quorum (kafka-metadata-quorum.sh describe --status)
ClusterId:              77vznZ5CSbmKGGPryO4TLA
LeaderId:               100
LeaderEpoch:            1
HighWatermark:          60
CurrentVoters:          [{"id": 100, "directoryId": "Kauh39PwTXmTmoIsqH798Q", "endpoints": ["CONTROLLER://localhost:9093"]}]
CurrentObservers:       [{"id": 2, "directoryId": "Ezc48wiVShBbWTUeK_ivag"}, {"id": 3, "directoryId": "0rLPoqAnudMkqyjVp2qgAA"}, {"id": 1, "directoryId": "P6YemdSO2aWPDbGmEWH-wA"}]
=== create topic orders (3 partitions, RF=3)
Topic: orders	TopicId: scuPXA0ORiq9ntTcjVSiUw	PartitionCount: 3	ReplicationFactor: 3	Configs: min.insync.replicas=1
	Topic: orders	Partition: 0	Leader: 3	Replicas: 3,1,2	Isr: 3,1,2	Elr: 	LastKnownElr:
	Topic: orders	Partition: 1	Leader: 1	Replicas: 1,2,3	Isr: 1,2,3	Elr: 	LastKnownElr:
	Topic: orders	Partition: 2	Leader: 2	Replicas: 2,3,1	Isr: 2,3,1	Elr: 	LastKnownElr:
=== partition folders on each node's disk
node 1: __cluster_metadata-0 orders-0 orders-1 orders-2
node 2: __cluster_metadata-0 orders-0 orders-1 orders-2
node 3: __cluster_metadata-0 orders-0 orders-1 orders-2
node 100: __cluster_metadata-0
=== Java client
--- partitionsFor("orders") : from the Metadata response
partition 0  leader=3  replicas=[3,1,2]  isr=[3,1,2]
partition 1  leader=1  replicas=[1,2,3]  isr=[1,2,3]
partition 2  leader=2  replicas=[2,3,1]  isr=[2,3,1]
--- send one record to each partition
partition 0  offset=0
partition 1  offset=0
partition 2  offset=0
--- describeCluster() via broker 1
nodes      = [1, 2, 3]
controller = 2
=== which broker received the PRODUCE requests (kafka-request.log)
node 1 received PRODUCE for orders-1
node 2 received PRODUCE for orders-2
node 3 received PRODUCE for orders-0
--- one PRODUCE line (request part only)
"request":{"transactionalId":null,"acks":-1,"timeoutMs":30000,"topicData":[{"topicId":"scuPXA0ORiq9ntTcjVSiUw","partitionData":[{"index":1,"recordsSizeInBytes":72}]}]},"response"
=== who has which threads (count per process)
thread name pattern                       node100    node1
quorum-controller-                              1        0
-raft-io-thread                                 1        1
metadata-loader-event-handler                   1        1
data-plane-kafka-request-handler-               8        8
data-plane-kafka-network-thread-                3        3
group-coordinator-event-processor-              0        4
TxnMarkerSenderThread                           0        1
ReplicaFetcherThread-                           0        2
kafka-log-cleaner-thread-                       0        1
broker-.*-lifecycle-manager                     0        1
stopped
출력을 이 글의 절과 이어 읽으면 이렇습니다.
- 쿼럼: 투표자(
CurrentVoters)는 컨트롤러 100 하나이고 그것이 리더(LeaderId: 100) — 곧 활성 컨트롤러입니다(4절). 브로커 1·2·3 은 옵서버(CurrentObservers)로 메타데이터 로그를 따라 읽습니다(5절). - 리더 = 레플리카 목록의 첫 번째: 세 파티션 모두
Leader가Replicas의 첫 값과 같습니다. 5절의setLeader(isr.get(0))그대로입니다. 레플리카 목록의 순서가 파티션마다 한 칸씩 밀려 있어서 리더가 세 브로커에 고르게 흩어졌습니다. - 디스크: 데이터 폴더
orders-N은 브로커 셋에만 있고, 컨트롤러 100 에는__cluster_metadata-0하나뿐입니다. 메타데이터 로그 폴더는 브로커에도 있습니다 — 옵서버로 받은 사본입니다. - Produce 는 리더에게: 프로듀서에게 준 부트스트랩 주소는 브로커 1 하나뿐인데,
orders-0의 Produce 는 리더인 브로커 3 에,orders-2는 브로커 2 에 갔습니다(6절). 요청 본문이 토픽 이름이 아니라topicId로 파티션을 가리키는 것, 그리고acks가-1(=all, 이 커밋의 프로듀서 기본값 — ProducerConfig.java 430–433행)인 것도 보입니다. 요청의 바이트 모양은 3편, 요청 로그의 다른 칸(큐 대기·처리 시간)은 4편에서 봅니다. - "컨트롤러"는 브로커 id:
describeCluster().controller()가 100 이 아니라 2 를 돌려줬습니다(5절의 "헷갈리기 쉬운 곳"). 다른 실행에서는 1 과 3 이 나왔습니다. - 누가 무엇을 가졌나:
quorum-controller-스레드는 컨트롤러에만, 그룹 코디네이터·트랜잭션 마커·복제 fetcher·로그 클리너·lifecycle-manager 는 브로커에만 있습니다.raft-io-thread와metadata-loader는 양쪽에 다 있습니다 — 2절의SharedServer가 역할과 상관없이 만드는 부품이기 때문입니다. 브로커 1 의ReplicaFetcherThread-가 2개인 것은 브로커 1 이 팔로워로 따라가는 리더가 브로커 2·3 둘이기 때문입니다(스레드 이름이ReplicaFetcherThread-<fetcherId>-<리더 브로커 id>꼴, ReplicaFetcherManager.scala 42행,num.replica.fetchers기본 1). 컨트롤러도 요청 처리 스레드 8개와 네트워크 스레드 3개를 가집니다(4절).
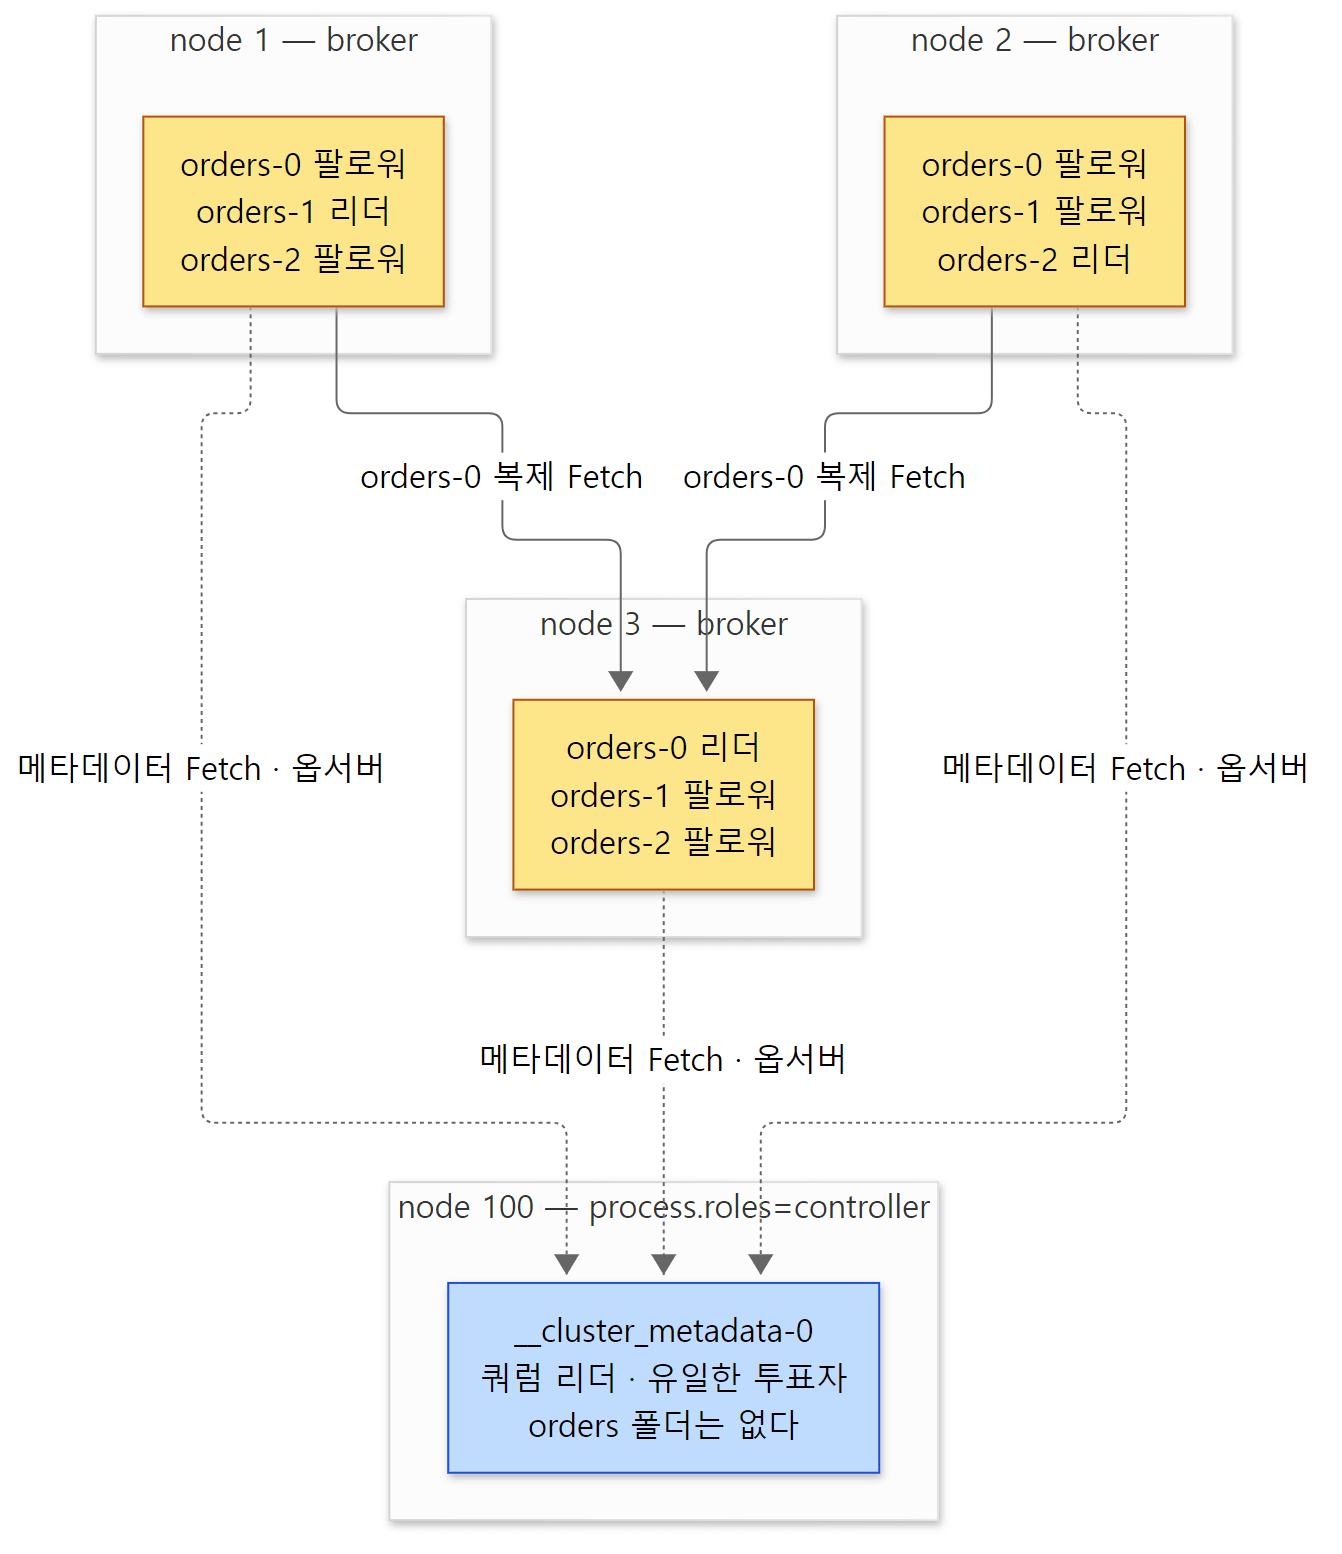 예제 2의 배치. 데이터 복제 화살표는
orders-0 것만 그렸습니다(orders-1·orders-2 도 같은 모양으로 각자의 리더를 향합니다).
헷갈리기 쉬운 곳: 실행할 때마다 리더 배치가 바뀐다
예제 2를 처음 돌렸을 때는 orders-0 의 리더가 브로커 1, 두 번째에는 브로커 2, 세 번째(위 출력)에는 브로커 3 이었습니다. 레플리카 목록이 어느 브로커에서 시작하느냐가 실행마다 달랐기 때문입니다. 그래도 세 번 모두 "리더 = 레플리카 목록의 첫 번째", "Produce 는 그 리더에게"는 같았습니다. 배치 규칙 자체는 이 연재에서 다루지 않습니다.
7. 모듈의 의존 방향: 브로커도 clients 를 쓴다
build.gradle 이 말하는 방향
1편에서 폴더 지도를 보았으니, 이번에는 그 폴더(Gradle 모듈)끼리 누가 누구에게 기대는지를 봅니다. core 의 의존 목록이 맨 위층의 모습입니다.
  dependencies {
    releaseOnly log4jReleaseLibs
    // `core` is often used in users' tests, define the following dependencies as `api` for backwards compatibility
    // even though the `core` module doesn't expose any public API
    api project(':clients')
    api libs.scalaLibrary
    // ...
    implementation project(':server-common')
    implementation project(':group-coordinator:group-coordinator-api')
    implementation project(':group-coordinator')
    implementation project(':transaction-coordinator')
    implementation project(':metadata')
    implementation project(':storage:storage-api')
    // ...
    implementation project(':tools:tools-api')
    implementation project(':raft')
    implementation project(':storage')
    implementation project(':server')
    implementation project(':coordinator-common')
    implementation project(':share-coordinator')
    implementation project(':mirror-coordinator')
core 는 거의 모든 서버 모듈에 기댑니다. 브로커·컨트롤러를 조립하는 BrokerServer·ControllerServer 가 여기 있으니 당연합니다. 다른 모듈의 dependencies 도 같은 식으로 읽어 화살표로 그리면 이렇습니다(테스트용 의존과 *-api 모듈은 뺐습니다).
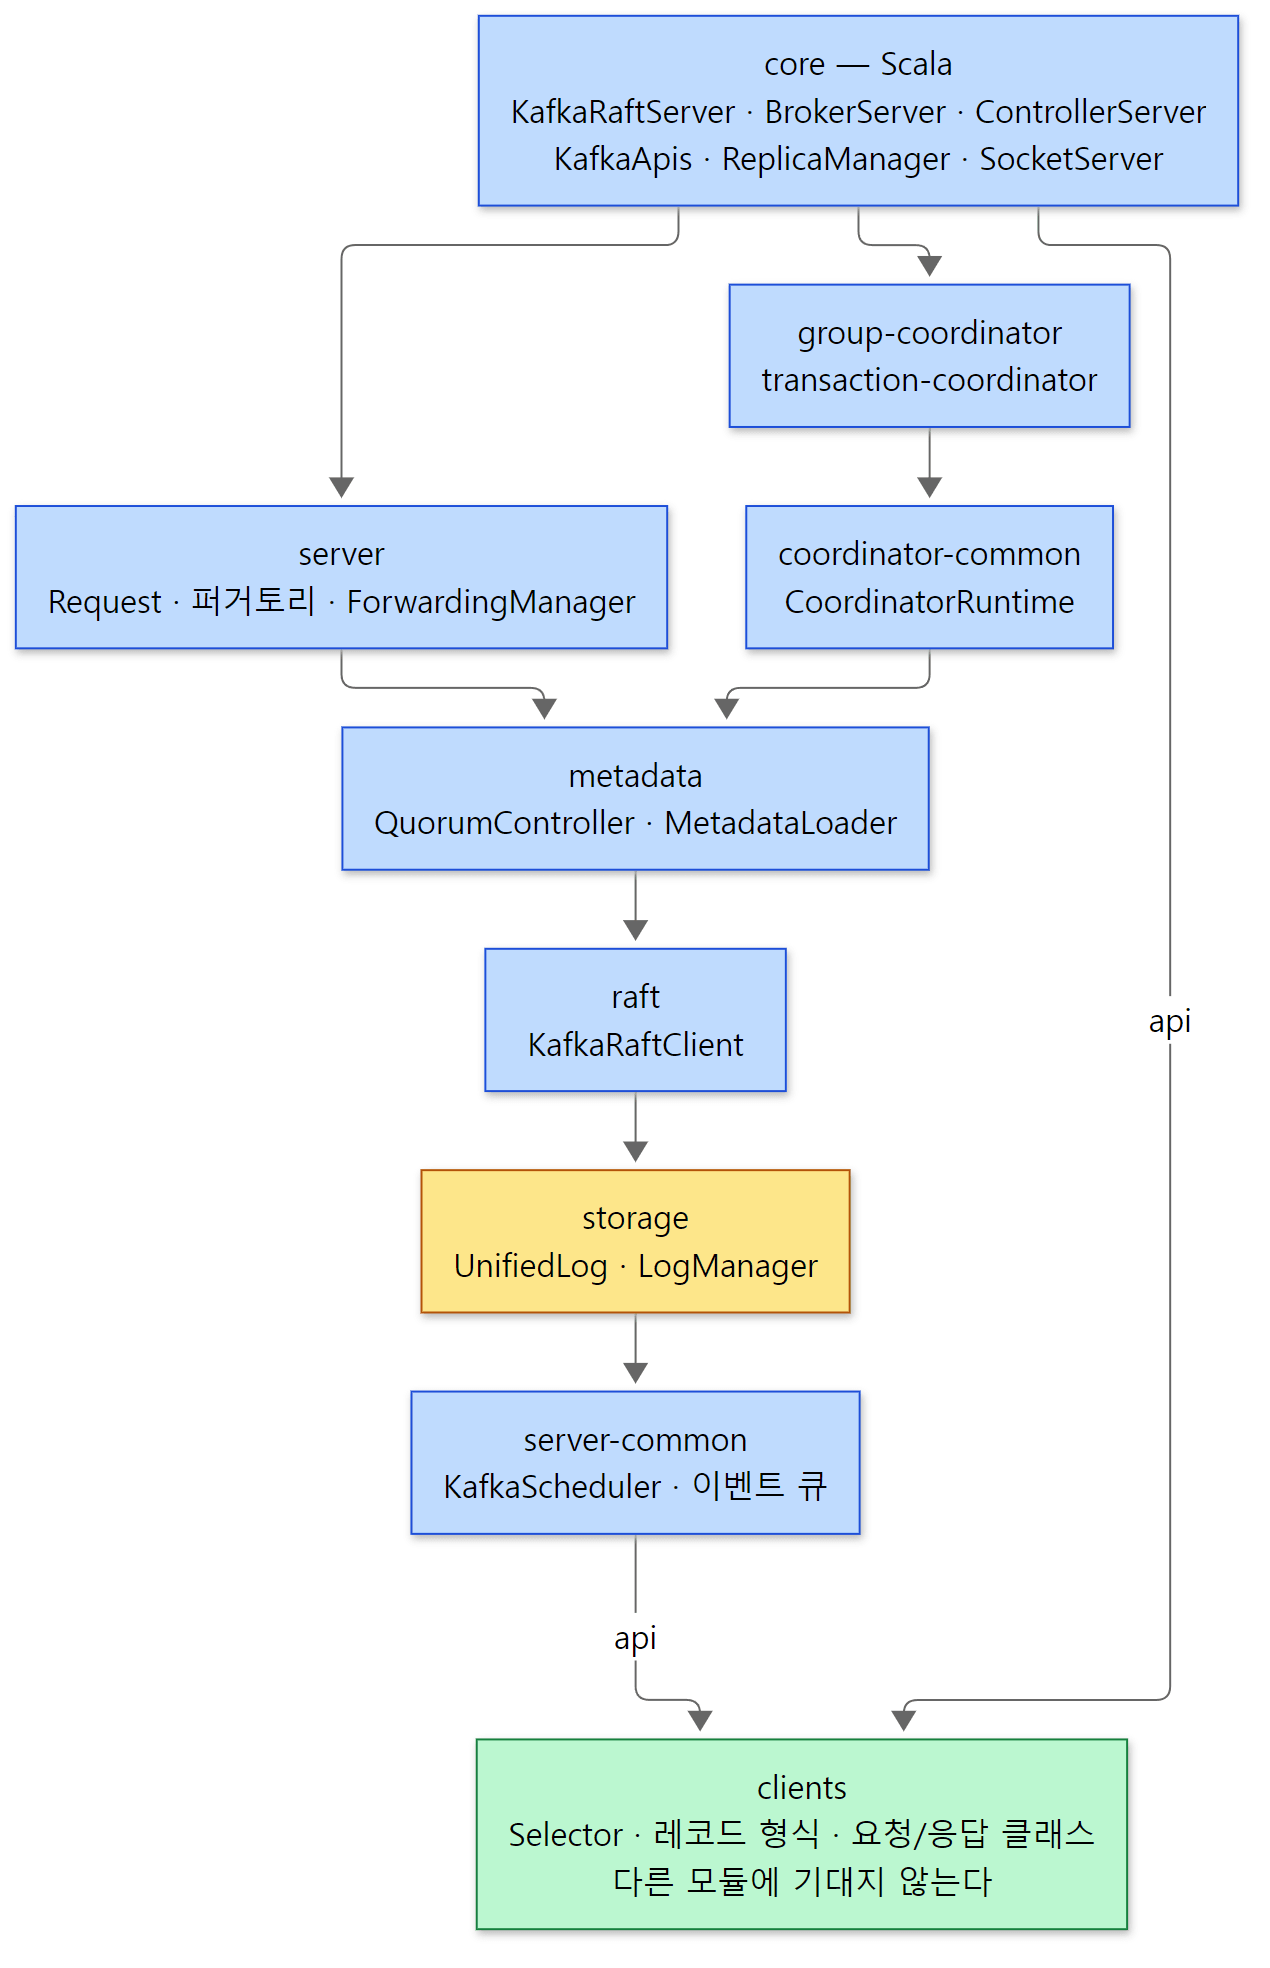 모듈 의존 방향(화살표가 "기댄다"). 그림의 화살표는 모두
build.gradle 에 있는 것이지만, 그림을 단순하게 하려고 건너뛰는 화살표 일부(예: core → storage, metadata → clients)는 생략했습니다.
| 모듈 | build.gradle 의 project(…) 의존(테스트 제외) |
|---|---|
server |
clients, metadata, server-common, storage, group-coordinator, transaction-coordinator, raft, share-coordinator … (1035행~) |
metadata |
server-common, clients, raft (1496행~) |
raft |
server-common, clients, storage (2301행~) |
storage |
storage-api, server-common, clients (2542행~) |
server-common |
api project(':clients') (2418행) |
clients |
없음 — 빌드 때 코드 생성기 generator 만(generator project(':generator')) |
두 가지가 눈에 띕니다. 첫째, clients 는 맨 바닥에 있고 아무 서버 모듈에도 기대지 않습니다. 앱이 kafka-clients.jar 하나만 받아 쓸 수 있는 이유입니다. 둘째, raft → storage 화살표가 보여 주듯 메타데이터 로그도 데이터 로그와 같은 저장 계층 위에 있습니다. Raft 로그 구현(KafkaRaftLog)이 storage 의 UnifiedLog 를 씁니다(10편).
같은 Selector, 같은 레코드 클래스
"브로커도 clients 를 쓴다"는 것이 말로만이 아닙니다. 브로커 네트워크 스레드(Processor)가 소켓을 다루려고 만드는 셀렉터를 보면,
  protected[network] def createSelector(channelBuilder: ChannelBuilder): KSelector = {
    channelBuilder match {
      case reconfigurable: Reconfigurable => config.addReconfigurable(reconfigurable)
      case _ =>
    }
    new KSelector(
      maxRequestSize,
      // ...
      logContext)
  }
core/src/main/scala/kafka/network/SocketServer.scala 846–864행
Scala 읽는 법 —
KSelector는 이 파일 36행의import org.apache.kafka.common.network.{…, Selector => KSelector}로 이름을 바꿔 들여온 것입니다(Java NIO 의java.nio.channels.Selector와 헷갈리지 않게).case _ =>는 "그 밖의 모든 경우, 아무것도 안 함"입니다.protected[network]는network패키지 안에서만 보이는 접근 제한입니다.
org.apache.kafka.common.network.Selector — clients 모듈의 클래스입니다. 프로듀서도 같은 클래스를 씁니다(selector = new Selector(config.getLong(CommonClientConfigs.CONNECTIONS_MAX_IDLE_MS_CONFIG), …, clients/src/main/java/org/apache/kafka/clients/ClientUtils.java 283행). 레코드도 마찬가지로, 브로커의 UnifiedLog 가 clients 의 MemoryRecords·FileRecords·RecordBatch 를 import 합니다(storage/…/UnifiedLog.java 36–43행). 프로듀서가 만든 레코드 배치 형식을 브로커가 같은 클래스로 읽고 거의 그대로 디스크에 쓰는 설계는 6편에서 봅니다.
기준 커밋의 소스에서 import org.apache.kafka.common.…(곧 clients 의 공용 패키지)를 쓰는 src/main 파일 수를 세어 보면 이 방향이 숫자로도 보입니다.
cd /d/openSource/kafka-ab1e816411
for m in core server storage raft metadata group-coordinator; do
  files=$(git ls-files "$m/src/main" | grep -E '\.(java|scala)$')
  echo "$m total=$(echo "$files" | wc -l)" \
       "common=$(echo "$files" | xargs grep -l '^import org\.apache\.kafka\.common\.' | wc -l)" \
       "record=$(echo "$files" | xargs grep -l '^import org\.apache\.kafka\.common\.record\.' | wc -l)" \
       "network=$(echo "$files" | xargs grep -l '^import org\.apache\.kafka\.common\.network\.' | wc -l)"
done
core total=67 common=61 record=11 network=15
server total=172 common=122 record=6 network=13
storage total=123 common=78 record=20 network=0
raft total=91 common=61 record=18 network=14
metadata total=179 common=104 record=4 network=2
group-coordinator total=112 common=69 record=3 network=0
거꾸로 clients/src/main 에서 kafka.·org.apache.kafka.storage.·raft.·metadata.·coordinator.·network. 패키지를 import 하는 파일은 0개였습니다. 레코드 클래스를 가장 많이 쓰는 것이 storage(로그)와 raft(메타데이터 로그)이고, 네트워크 클래스는 소켓을 직접 다루는 core·server·raft 가 씁니다.
헷갈리기 쉬운 곳: 패키지 이름이 모듈을 알려 주지 않는다
org.apache.kafka.server.authorizer.Authorizer 는 이름만 보면 server 모듈의 것 같지만 clients/src/main/java/org/apache/kafka/server/authorizer/ 에 있습니다. clients 안에는 server/authorizer, server/policy, server/quota, server/telemetry 가 있는데, 사용자가 구현해 브로커에 꽂는 플러그인 인터페이스라 공개 API 인 clients jar 에 둔 것입니다. 반대로 core 의 Scala 코드는 kafka.server 패키지, server 모듈의 Java 코드는 org.apache.kafka.server 패키지입니다. 클래스를 찾을 때는 패키지 이름으로 짐작하지 말고 git ls-files | grep '/이름\.\(java\|scala\)$' 로 찾는 것이 빠릅니다.
이 글에서 뺀 것
지도를 한 장으로 유지하려고 뺀 것들입니다.
KafkaRaftServer.initializeLogDirs()가meta.properties를 확인하는 과정과kafka-storage.sh format.core/src/main/scala/kafka/server/KafkaRaftServer.scala131–188행- 레플리카 배치 규칙(어느 브로커에 레플리카를 둘지).
metadata/src/main/java/org/apache/kafka/metadata/placement/ - 브로커 등록·하트비트·펜스 규칙.
server/src/main/java/org/apache/kafka/server/BrokerLifecycleManager.java— 10편 - 컨트롤러 등록(KIP-919,
ControllerRegistrationManager)과 컨트롤러 쿼럼 투표자 추가·제거(ADD_RAFT_VOTER) - 동적 설정(
DynamicBrokerConfig,DynamicConfigPublisher) - 이 연재 전체에서 뺀 것: Kafka Streams(
streams/), Kafka Connect(connect/), MirrorMaker, 공유 그룹(share-coordinator/, 예제 1의share-*스레드), 계층 저장소(RemoteLogManager), 보안(SASL·TLS·ACL,Authorizer), 쿼터(예제 1의ThrottledChannelReaper-*), 관리 클라이언트Admin의 안쪽(예제에서는 도구로만 썼습니다), JBOD 와ReplicaAlterLogDirsThread
정리
| 개념 | 한 줄 요약 |
|---|---|
| 시작점 | kafka-server-start.sh → kafka.Kafka.main() → 언제나 KafkaRaftServer 하나 |
process.roles |
broker·controller 를 보고 BrokerServer·ControllerServer 를 Some/None 으로 만든다. 시작은 컨트롤러 먼저, 끄기는 브로커 먼저 |
SharedServer |
프로세스에 하나. KafkaRaftManager(메타데이터 로그)·MetadataLoader·SnapshotGenerator 를 브로커와 컨트롤러가 함께 쓴다 |
BrokerServer |
SocketServer → RequestChannel → 요청 처리 풀 → KafkaApis → ReplicaManager·코디네이터. 컨트롤러가 펜스를 걷어 준 뒤에야 요청을 받는다 |
ControllerServer |
자기 SocketServer(CONTROLLER 리스너)·ControllerApis·요청 처리 풀 + QuorumController |
QuorumController |
메타데이터 로그의 Raft 리더가 활성 컨트롤러. 스레드 하나가 이벤트를 차례로 처리하고, 결과가 로그에 기록된 뒤 future 를 완료한다 |
| 장부의 길 | 브로커가 CreateTopics 를 컨트롤러로 전달 → 컨트롤러가 TopicRecord·PartitionRecord 를 로그에 → 브로커들이 옵서버로 읽어 applyDelta() |
| 처음 리더 | 레플리카 목록에서 살아 있는 첫 번째 브로커(setLeader(isr.get(0))), 리더 에포크 0 |
| 데이터의 길 | Metadata 는 아무 브로커(leastLoadedNode)에게, Produce 는 파티션의 리더에게. 리더가 바뀌면 NOT_LEADER_OR_FOLLOWER → 메타데이터 갱신 |
응답의 controllerId |
KRaft 에서는 살아 있는 브로커 하나를 무작위로 고른 값. 진짜 쿼럼은 kafka-metadata-quorum.sh 로 |
| 모듈 방향 | core → server·코디네이터 → metadata → raft → storage → server-common → clients. clients 는 아무것에도 기대지 않고, 브로커도 그 Selector·레코드 클래스를 쓴다 |
다음에 볼 것
지도를 접고, 지도의 모든 화살표가 공유하는 말부터 배웁니다. 다음 글은 1절 지도에서 A 와 B 사이의 화살표 — 클라이언트와 브로커가 주고받는 와이어 프로토콜입니다. 예제 2의 요청 로그에 찍힌 "requestApiKeyName":"PRODUCE", "topicData", "partitionData" 같은 이름이 어디서 왔는지, 요청·응답 클래스가 JSON 스키마에서 빌드 때 생성되는 과정, 연결하자마자 ApiVersions 로 판을 맞추는 이유를, 직렬화한 바이트를 소켓으로 직접 보내 보는 예제로 확인합니다.
Kafka 소스 파헤치기 3: 와이어 프로토콜 — JSON 스키마에서 만들어지는 요청과 응답
앞서 끝낸 연재에서도 같은 자리에 전체 지도를 폈습니다. Tomcat 2편에서는 server.xml 한 장이 Server·Service·Engine·Host 객체 나무가 되었고, 연결을 받는 Coyote 와 서블릿을 부르는 Catalina 가 Adapter 하나로 이어졌습니다. Kafka 에서는 설정 한 줄(process.roles)이 브로커와 컨트롤러라는 두 부품을 고르고, 둘은 SharedServer 의 메타데이터 로그로 이어집니다. httpd 3편의 코어·MPM·모듈 지도, Spring 2편의 모듈 지도와 나란히 놓고 보면, 넷 가운데 Kafka 만이 "여러 대의 서버가 하나의 장부를 나눠 지킨다"는 분산 시스템의 모양을 지도 한가운데에 둡니다. 같은 때에 쓰이는 nginx 연재, MariaDB 연재, Gradle 연재도 각자의 1편에서 지도를 펴고 시작합니다.