이 글에서 다루는 것
"Kafka 소스 파헤치기" 연재의 일곱 번째 글입니다. 6편에서 Produce 요청이 KafkaApis → ReplicaManager → Partition → UnifiedLog.append() 를 지나 활성 세그먼트의 .log 파일에 FileChannel.write() 로 쓰이는 데까지 따라갔습니다. 이번에는 그 파일 쪽으로 내려갑니다. 파티션 하나의 로그가 디스크에서 어떤 파일들로 나뉘어 있고, 그 파일들이 언제 생기고 언제 사라지는지입니다.
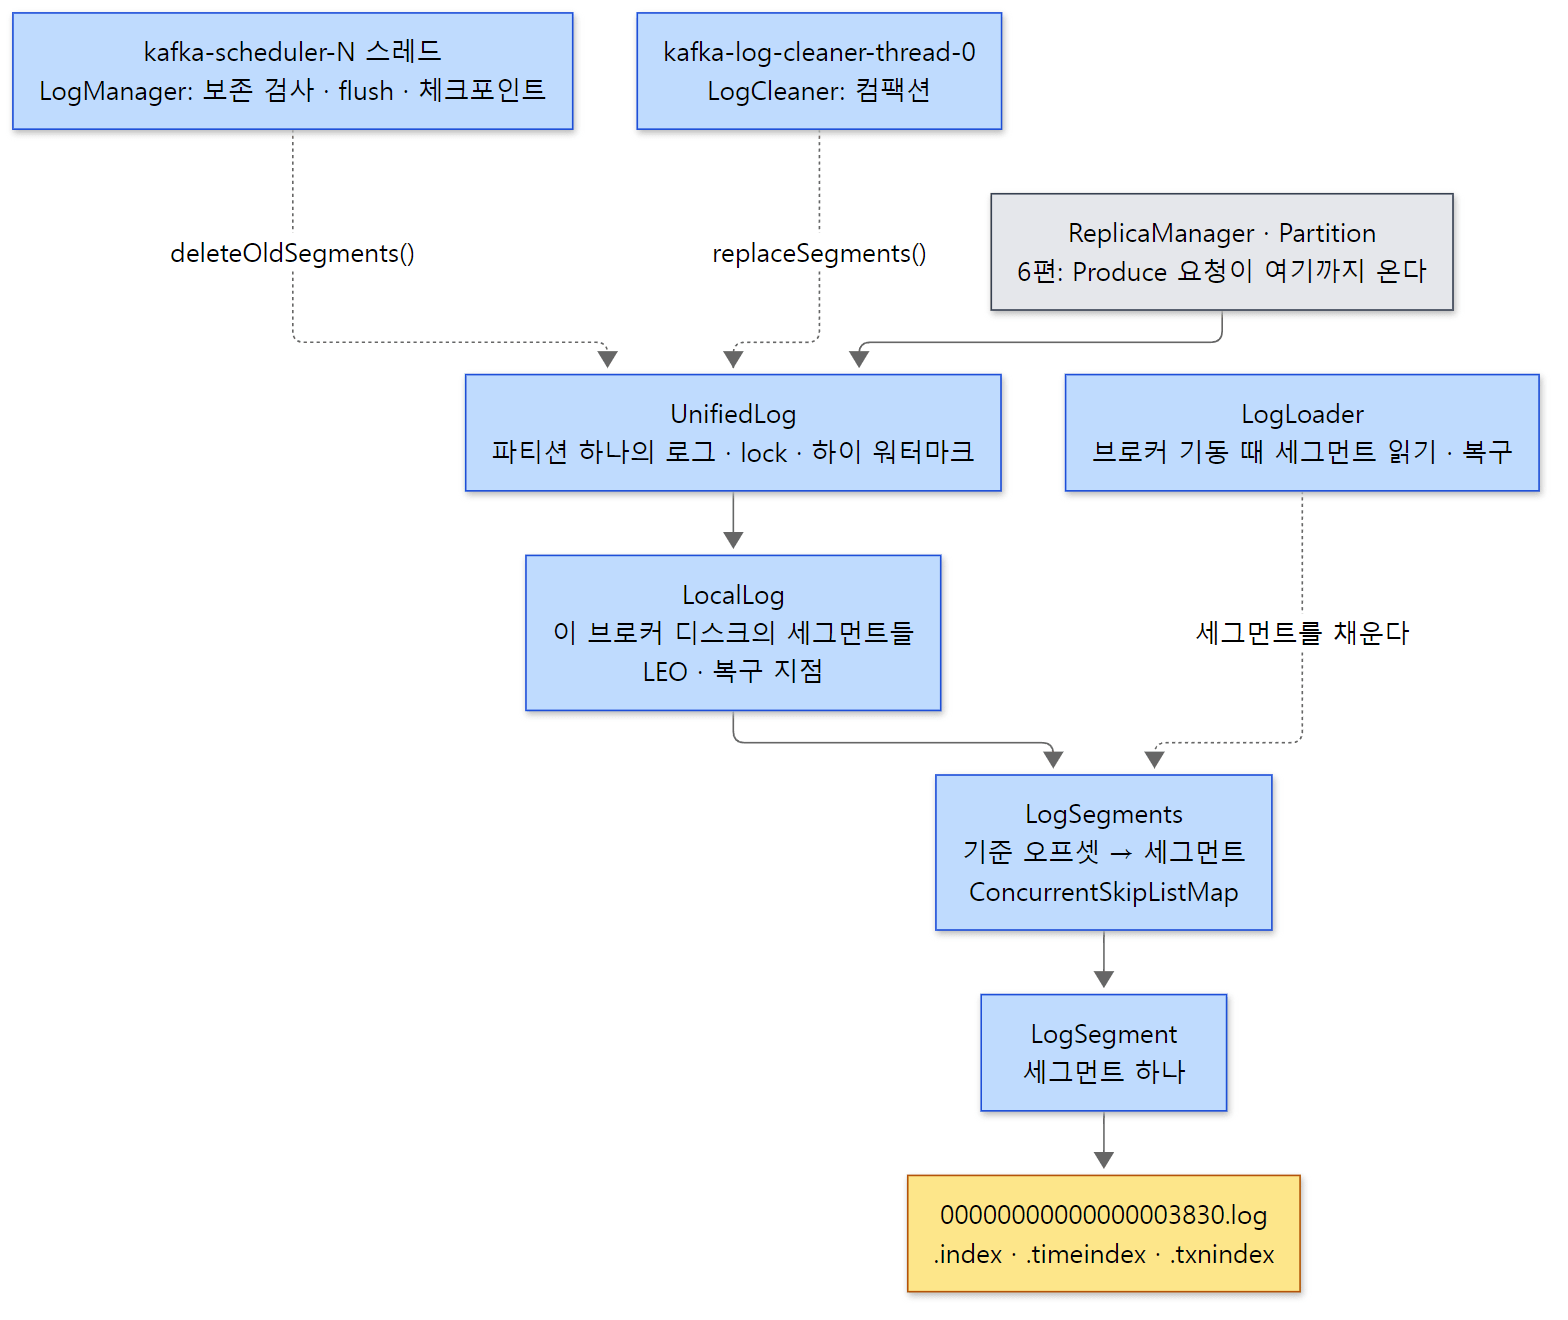 2편 지도의 E 구역(로그 저장소)을 확대한 그림입니다. 가운데 세로줄이 쓰기 요청이 내려가는 길, 위와 옆의 파란 상자가 요청과 상관없이 돌아가는 배경 작업입니다.
답하려는 질문은 네 가지입니다.
- 파티션 폴더의
00000000000000003830.log,.index,.timeindex는 무엇이고, 새 세그먼트는 정확히 언제 생기는가(log.segment.bytes,segment.ms) - 오프셋 35 를 달라는 요청이 오면, 브로커는 그 레코드가 파일의 몇 번째 바이트에 있는지 어떻게 찾는가. 인덱스는 왜 모든 레코드를 적지 않는가
retention.ms,retention.bytes는 누가 언제 검사하고, 세그먼트는 어떤 순서로 지워지는가cleanup.policy=compact는 무엇을 남기고 무엇을 지우는가. 브로커가 갑자기 죽었다 살아나면 무엇을 다시 읽는가
| 항목 | 내용 |
|---|---|
| 대상 | Apache Kafka |
| 버전 | 4.5.0-SNAPSHOT (trunk) |
| 커밋 | ab1e816411 (2026-10-24) |
| 주로 읽는 클래스 | storage/…/log/ 의 UnifiedLog·LocalLog·LogSegments·LogSegment·AbstractIndex·OffsetIndex·TimeIndex·LazyIndex·LogFileUtils·LogManager·LogCleaner·LogCleanerManager·Cleaner·SkimpyOffsetMap·LogLoader (모두 Java), clients/…/record/internal/FileRecords |
글에 나오는 줄 번호는 모두 이 커밋 기준입니다. 같은 커밋의 소스를 받고 예제용 도커 이미지를 만드는 방법은 1편에 있습니다. 이 글의 클래스는 몇 해 전까지 core 모듈의 Scala 코드(kafka.log.LogSegment 같은 이름)였고, 지금은 전부 storage 모듈의 Java 로 옮겨졌습니다. core/src/main/scala/kafka/log/LogManager.scala 는 72줄짜리 껍데기만 남았습니다. 그래서 이 글에는 Scala 코드가 나오지 않습니다.
흔히 쓰는 최신 안정판 4.4.0 과도 비교했습니다. LogSegment·LogSegments·OffsetIndex·TimeIndex·LazyIndex·LogFileUtils·LogLoader·LogCleaner·LogCleanerManager·SkimpyOffsetMap 은 4.4.0 태그와 같은 파일입니다. 다른 곳은 세 군데이고 해당하는 절에서 짚습니다(4절의 미래 타임스탬프, 5절의 청소 중 오버플로, 그리고 이 글에서 다루지 않는 팔로워 append 의 크기 검사).
UnifiedLog.java 하나가 2,806줄이고 LogManager.java 는 1,895줄입니다. 계층 저장소(tiered storage, 오래된 세그먼트를 S3 같은 원격 저장소로 옮기는 기능)와 디렉터리 여러 개(JBOD) 처리가 같은 파일 안에 섞여 있습니다. 이 글은 처음 보는 사람이 따라올 수 있는 큰 줄기만 골랐고, 빼놓은 것은 글 끝의 "이 글에서 뺀 것"에 이름과 위치만 적어 두었습니다.
먼저 알아 둘 말
로그(log)는 Kafka 에서 "끝에만 덧붙이는 레코드의 줄"을 말합니다. 서버가 남기는 server.log 같은 로그 파일과 이름이 같아 헷갈리는데, 이 글에서 "로그"라고 하면 파티션 하나의 데이터입니다. 파티션 하나에 로그 하나이고, 소스에서는 UnifiedLog 객체 하나입니다. 디스크에서는 log.dirs 아래의 <토픽>-<파티션> 폴더 하나(예: seg-0)입니다.
세그먼트(segment)는 로그를 잘라 놓은 파일 묶음 하나입니다. 로그를 파일 하나로 두면 오래된 앞부분만 지우기가 어렵습니다. 그래서 일정 크기나 시간마다 파일을 새로 시작하고, 지울 때는 세그먼트 통째로 지웁니다. 세그먼트마다 .log(레코드 배치 그 자체), .index(오프셋 → 파일 위치), .timeindex(시각 → 오프셋), .txnindex(중단된 트랜잭션 목록, 12편) 파일이 있습니다. 지금 쓰고 있는 마지막 세그먼트를 활성 세그먼트(active segment)라고 부르고, 새 세그먼트로 넘어가는 일을 롤(roll)이라고 합니다.
기준 오프셋(base offset)은 세그먼트에 든 첫 레코드의 오프셋입니다. 세그먼트 파일 이름이 곧 기준 오프셋입니다. 00000000000000003830.log 는 오프셋 3830 부터 담은 세그먼트입니다.
레코드 배치는 6편에서 본 대로 프로듀서가 묶어 보낸 레코드 덩어리이고, 브로커는 그 배치를 거의 그대로 .log 에 씁니다. 이 글에서 중요한 것은 배치 헤더 맨 앞의 두 필드입니다. 첫 8바이트가 배치의 첫 오프셋(baseOffset), 다음 4바이트가 배치의 길이입니다. 이 두 값만 읽으면 배치 안의 레코드를 풀지 않고도 다음 배치로 건너뛸 수 있습니다.
페이지 캐시(page cache)는 운영체제가 디스크 파일의 내용을 메모리에 붙들어 두는 곳입니다. 프로그램이 write() 하면 데이터는 먼저 페이지 캐시에 들어가고, 디스크에는 나중에 운영체제가 내려 씁니다. fsync(Java 에서는 FileChannel.force())를 부르면 그때 디스크까지 내려가기를 기다립니다. 6편에서 본 대로 Kafka 는 기본 설정에서 쓰기마다 fsync 하지 않습니다.
mmap(memory-mapped file, 메모리 매핑)은 파일을 프로세스의 메모리 주소에 그대로 붙이는 운영체제 기능입니다. Java 에서는 FileChannel.map() 이 돌려주는 MappedByteBuffer 로 씁니다. 버퍼의 getInt() 가 곧 파일 읽기이고, 그 밑에서는 페이지 캐시를 직접 보게 됩니다. Kafka 는 .index·.timeindex 를 이렇게 엽니다(2절).
보존(retention)과 컴팩션(compaction)은 오래된 데이터를 치우는 두 방법입니다. 제목의 "압축"은 이 컴팩션을 말합니다. 6편의 compression.type(gzip·zstd 로 바이트를 줄이는 압축)과는 다른 것이어서, 본문에서는 헷갈리지 않게 "컴팩션"이라고 적습니다. 보존(cleanup.policy=delete, 기본값)은 오래되거나 크기를 넘은 세그먼트를 통째로 지우고, 컴팩션(cleanup.policy=compact)은 같은 키의 레코드 가운데 마지막 것만 남기고 나머지를 걷어 냅니다.
1. 로그 하나를 이루는 객체와 파일
네 층: UnifiedLog → LocalLog → LogSegments → LogSegment
위 그림의 가운데 줄이 객체의 층입니다.
| 클래스 | 들고 있는 것 | 한 줄 설명 |
|---|---|---|
UnifiedLog |
LocalLog, 로그 시작 오프셋, 하이 워터마크, 프로듀서 상태, lock |
파티션 하나의 로그. 6편의 append(), 이 글의 롤·보존이 여기서 시작한다 |
LocalLog |
LogSegments, 로그 끝 오프셋(LEO), 복구 지점 |
이 브로커 디스크에 있는 부분. "Unified"는 원격 저장소의 세그먼트까지 합친다는 뜻이고, "Local"은 그 가운데 내 디스크 몫이다 |
LogSegments |
ConcurrentSkipListMap<Long, LogSegment> |
기준 오프셋 → 세그먼트. 맨 마지막 것이 활성 세그먼트 |
LogSegment |
FileRecords(.log), LazyIndex<OffsetIndex>, LazyIndex<TimeIndex>, TransactionIndex |
세그먼트 하나. 파일 넷을 묶는다 |
LogSegment 의 필드가 그대로 파일 넷입니다.
    private final FileRecords log;
    private final LazyIndex<OffsetIndex> lazyOffsetIndex;
    private final LazyIndex<TimeIndex> lazyTimeIndex;
    private final TransactionIndex txnIndex;
    private final long baseOffset;
    private final int indexIntervalBytes;
    private final long rollJitterMs;
    private final Time time;
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 79–86행
LogSegments 가 ConcurrentSkipListMap 인 것은 "오프셋 N 은 어느 세그먼트에 있나"를 빨리 찾기 위해서입니다. floorSegment(offset) 은 기준 오프셋이 offset 이하인 것 가운데 가장 큰 세그먼트를 돌려줍니다(LogSegments.java 220–222행). 오프셋 5000 이면 기준 오프셋 3830 인 세그먼트입니다. 읽기 경로(8편)의 LocalLog.read() 가 맨 먼저 하는 일이 이것입니다(LocalLog.java 481행). 맵이 동시 접근에 안전하므로, 읽는 쪽은 UnifiedLog 의 lock 을 잡지 않고도 세그먼트를 찾습니다. 활성 세그먼트는 그냥 맵의 마지막 항목입니다(activeSegment() 는 lastSegment().get(), 322–324행).
파일 이름은 20자리 기준 오프셋
파일 이름을 만드는 곳은 LogFileUtils 입니다.
    public static String filenamePrefixFromOffset(long offset) {
        NumberFormat nf = NumberFormat.getInstance();
        nf.setMinimumIntegerDigits(20);
        nf.setMaximumFractionDigits(0);
        nf.setGroupingUsed(false);
        return nf.format(offset);
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogFileUtils.java 102–108행
주석은 이유를 한 줄로 적어 둡니다. "0을 채워서 ls 가 숫자 순서대로 정렬하게 한다". long 의 최댓값이 19자리이므로 20자리면 어떤 오프셋이든 들어갑니다. 여기에 .log·.index·.timeindex·.txnindex 를 붙이고, 상황에 따라 .deleted·.cleaned·.swap 을 한 번 더 붙입니다(같은 파일 32–58행의 상수). 거꾸로 파일 이름에서 오프셋을 읽는 offsetFromFileName() 은 첫 . 앞까지를 Long.parseLong() 합니다(79–81행). 브로커가 재시작할 때 폴더의 파일 목록만으로 세그먼트를 다시 세우는 것(6절)이 이 덕분입니다.
예제 1: 1MiB 세그먼트에 레코드 12,000개
정말 이렇게 생기는지 세그먼트 크기를 작게 해서 봤습니다. 이 예제는 기준 커밋(ab1e816411)을 그대로 빌드한 Kafka 4.5.0-SNAPSHOT 으로 도커 컨테이너(Eclipse Temurin JDK 25)에서 실행했습니다. 예제 폴더는 ex/u07-segments 입니다. 브로커를 log.segment.bytes=1048576 으로 띄우고, 레코드를 10개씩 한 배치로 보내는 작은 프로듀서로 250바이트 값을 가진 레코드 12,000개를 보냈습니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// 한 파티션 토픽에 레코드를 10개씩 묶어 보낸다(10개 보내고 flush → 배치 하나가 레코드 10개).
        // ... (bootstrap.servers, 직렬화기) ...
        props.put(ProducerConfig.LINGER_MS_CONFIG, "1000");   // flush() 가 부를 때까지 모아 둔다
        props.put(ProducerConfig.COMPRESSION_TYPE_CONFIG, "none");
        String value = "v".repeat(250);                       // 값은 250바이트로 고정
        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            for (int i = 0; i < count; i++) {
                producer.send(new ProducerRecord<>(topic, 0, String.format("k-%06d", i), value));
                if (i % 10 == 9) producer.flush();             // 10개마다 배치 하나로 내보낸다
            }
            producer.flush();
        }
[예제 ex/u07-segments/Fill.java 에서 줄임]
=== files in the partition directory (size name)
      1528 00000000000000000000.index
   1045973 00000000000000000000.log
      2292 00000000000000000000.timeindex
      1528 00000000000000003830.index
   1045973 00000000000000003830.log
        56 00000000000000003830.snapshot
      2292 00000000000000003830.timeindex
      1528 00000000000000007660.index
   1045973 00000000000000007660.log
        56 00000000000000007660.snapshot
      2292 00000000000000007660.timeindex
  10485760 00000000000000011490.index
    139281 00000000000000011490.log
        56 00000000000000011490.snapshot
  10485756 00000000000000011490.timeindex
         8 leader-epoch-checkpoint
        43 partition.metadata
=== roll lines in server.log
Rolled new log segment at offset 3830 in 9 ms. (org.apache.kafka.storage.internals.log.LocalLog)
Rolled new log segment at offset 7660 in 3 ms. (org.apache.kafka.storage.internals.log.LocalLog)
Rolled new log segment at offset 11490 in 2 ms. (org.apache.kafka.storage.internals.log.LocalLog)
in 9 ms 같은 시간은 실행마다 다릅니다. 배치 하나의 크기도 타임스탬프 차이를 담는 가변 길이 필드 때문에 한두 바이트 달라질 수 있어서, 다른 실행에서는 00000000000000007660.log 가 1,045,982바이트였고, 또 다른 실행에서는 첫 배치가 2,740바이트여서 그 뒤의 위치와 인덱스 항목이 모두 9바이트씩 밀렸습니다(29 → 5471 처럼). 아래 설명의 계산은 이 글에 실은 실행의 값입니다. 읽을 것이 넷입니다.
- 세그먼트가 넷이고 이름이 0, 3830, 7660, 11490 입니다. 세그먼트마다 레코드 3,830개(배치 383개)씩 들어갔습니다.
.log가 1MiB(1,048,576)를 넘지 않습니다. 1,045,973 은 배치 383개 × 2,731바이트입니다. 384번째 배치를 받았다면 1,048,704바이트가 되어 넘치므로, 그 배치는 쓰기 전에 새 세그먼트로 넘어갔습니다. 2절에서 이 판정을 봅니다.- 활성 세그먼트(11490)의
.index는 10MiB, 롤된 세그먼트의.index는 1,528바이트입니다. 인덱스 파일은 처음에 최대 크기로 잡았다가 롤할 때 실제 크기로 줄입니다(2절). 1편의 예제에서 "레코드 셋인데.index가 10MB" 였던 이유가 이것입니다. .snapshot은 롤할 때마다 찍는 프로듀서 상태 스냅숏(멱등 프로듀서의 중복 검사용, 12편),leader-epoch-checkpoint는 리더 에포크(리더가 바뀔 때마다 커지는 번호)와 그 에포크가 시작된 오프셋의 기록(9편),partition.metadata는 토픽 id 입니다. 첫 세그먼트(0)에.snapshot이 없는 것은 스냅숏을 롤할 때 새 세그먼트의 기준 오프셋으로 찍기 때문입니다(UnifiedLog.roll(), 2절).
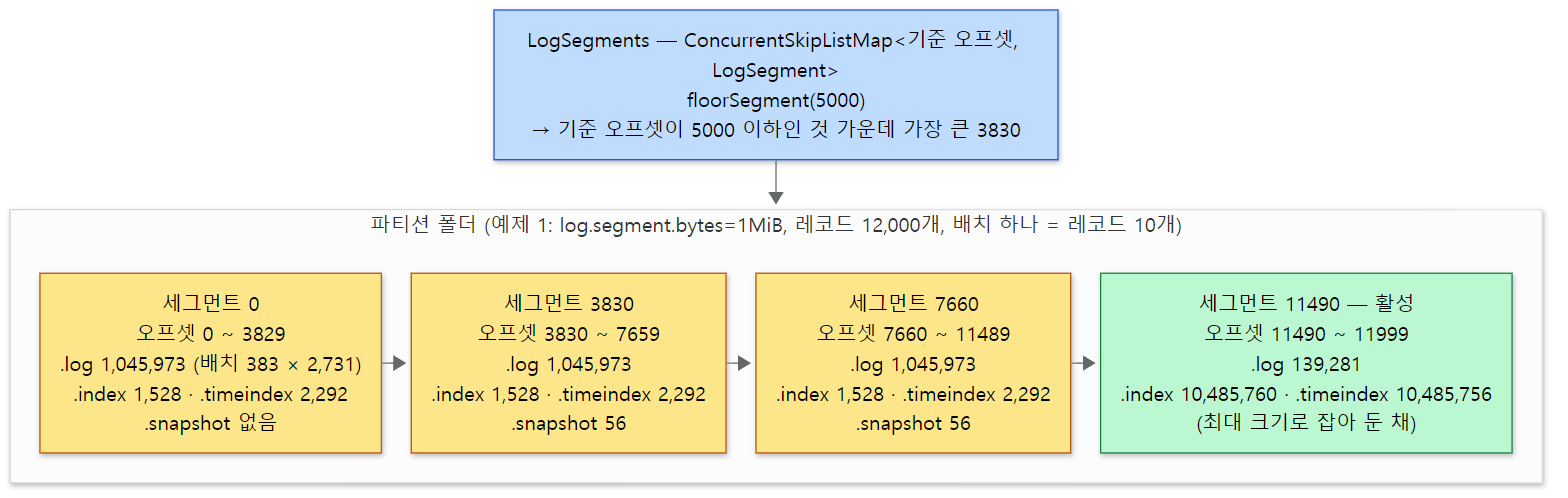 예제 1의 폴더를 세그먼트 단위로 다시 그렸습니다. 파일 크기는 위 출력 그대로이고, 오프셋 범위는 파일 이름(기준 오프셋)과 레코드 수 12,000에서 나옵니다.
헷갈리기 쉬운 곳: log.segment.bytes 는 1MiB 보다 작게 둘 수 없습니다
처음에는 세그먼트를 더 잘게 나눠 보려고 log.segment.bytes=102400 같은 값을 생각했는데, 이 값은 설정 검증에서 막힙니다. 브로커 설정과 토픽 설정 모두 atLeast(1024 * 1024) 로 정의돼 있습니다.
.define(ServerLogConfigs.LOG_SEGMENT_BYTES_CONFIG, INT, DEFAULT_SEGMENT_BYTES, atLeast(1024 * 1024), HIGH, ServerLogConfigs.LOG_SEGMENT_BYTES_DOC)
storage/src/main/java/org/apache/kafka/storage/internals/log/LogConfig.java 160행
토픽 쪽 segment.bytes 도 같은 하한입니다(198행). 기본값 DEFAULT_SEGMENT_BYTES 는 1024 * 1024 * 1024, 곧 1GiB 입니다(130행). 시험 코드가 더 작은 세그먼트를 쓰려고 두는 internal.segment.bytes 라는 내부 설정이 따로 있고(152–153행, 문서에 "testing only"), segmentSize() 는 이 값이 있으면 그쪽을 씁니다(384–387행). 예제는 정식 설정의 최솟값인 1MiB 를 썼습니다.
2. 세그먼트는 언제 넘어가나 — 롤
다섯 가지 조건
롤 판정은 UnifiedLog.append() 안, 오프셋을 매긴 직후에 있습니다. 6편에서 "세그먼트가 찼으면 새 세그먼트로" 라고만 하고 넘어간 maybeRoll() 입니다. lock 을 쥔 채 활성 세그먼트에 shouldRoll(new RollParams(…)) 을 묻고, 참이면 roll() 해서 새 세그먼트를, 거짓이면 지금 세그먼트를 돌려줍니다(UnifiedLog.java 2166–2202행). RollParams 는 판정에 필요한 값 여섯 개를 담는 record 일 뿐입니다(RollParams.java 22–23행). 판정은 LogSegment.shouldRoll() 의 다섯 줄입니다.
    public boolean shouldRoll(RollParams rollParams) throws IOException {
        boolean reachedRollMs = timeWaitedForRoll(rollParams.now(), rollParams.maxTimestampInMessages()) > rollParams.maxSegmentMs() - rollJitterMs;
        int size = size();
        return size > rollParams.maxSegmentBytes() - rollParams.messagesSize() ||
            (size > 0 && reachedRollMs) ||
            offsetIndex().isFull() || timeIndex().isFull() || !canConvertToRelativeOffset(rollParams.maxOffsetInMessages());
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 167–173행
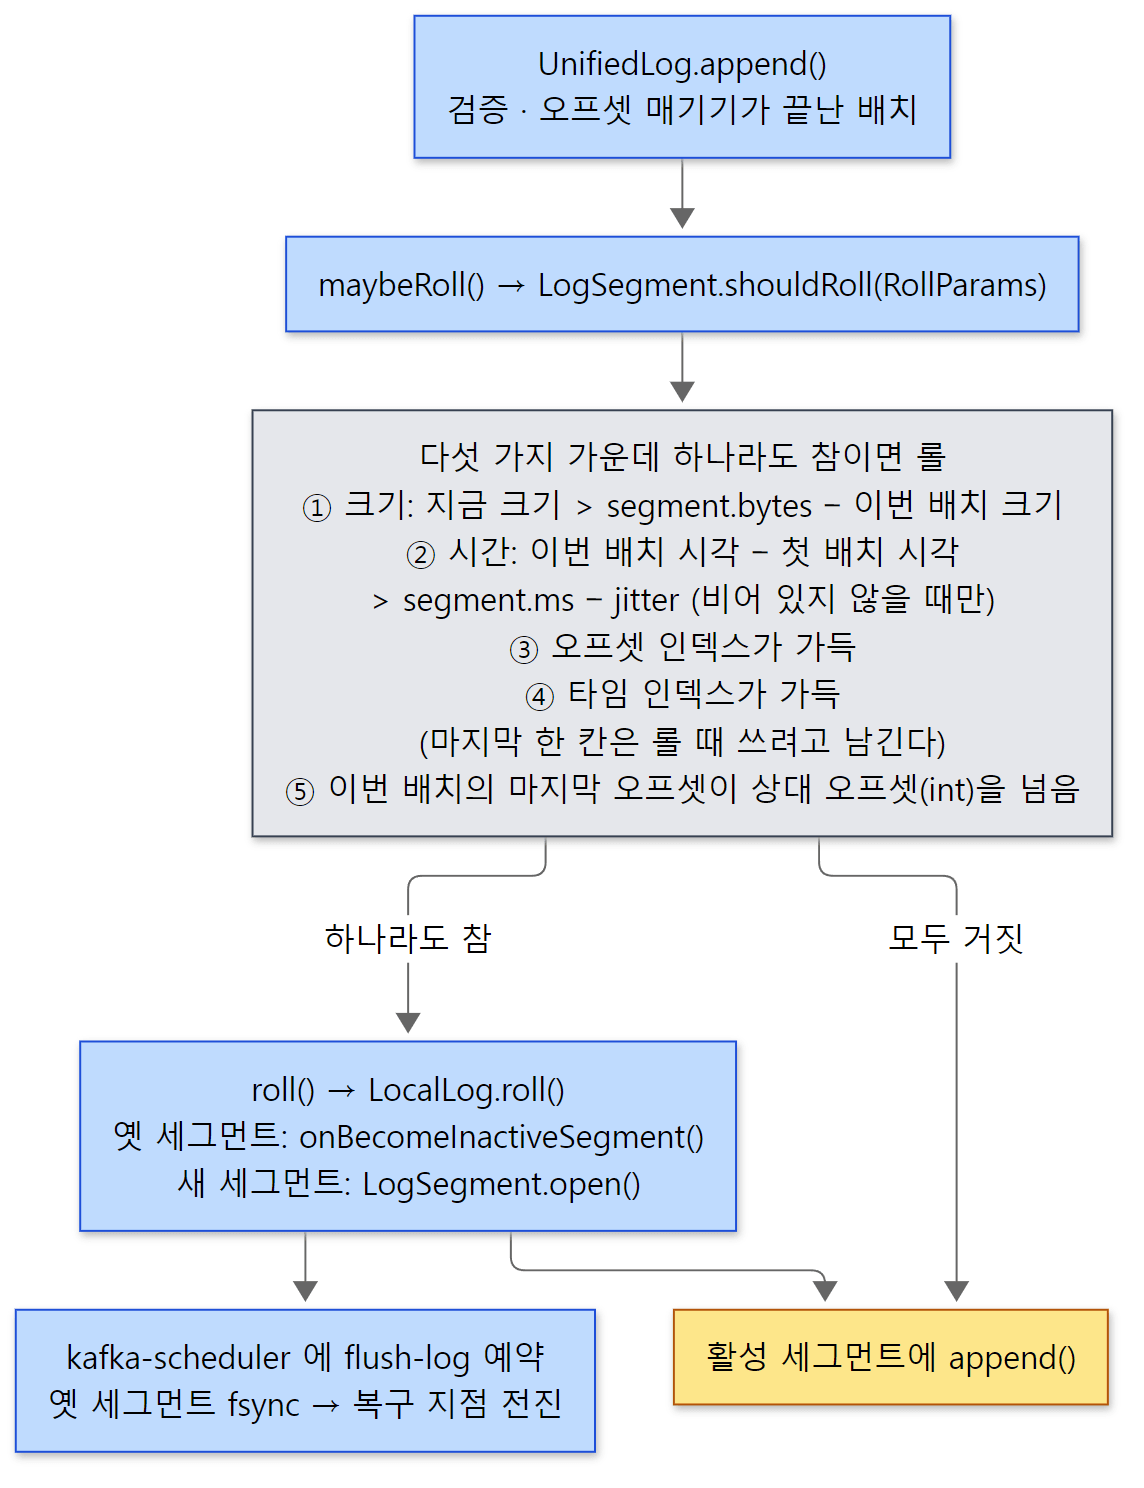 롤 판정은 배치를 쓰기 전에 합니다. 그래서 "넘칠 것 같으면 미리 넘어간다"가 됩니다.
하나씩 보면 이렇습니다.
- 크기 —
지금 크기 > segment.bytes − 이번 배치 크기, 곧 "이번 배치를 쓰면 넘친다". 예제 1에서 1,045,973 > 1,048,576 − 2,731 = 1,045,845 가 참이 되어 384번째 배치가 새 세그먼트로 갔습니다. 그래서 세그먼트는segment.bytes를 넘지 않습니다. 단, 배치 하나가segment.bytes보다 크면 빈 세그먼트에도 들어가지 못하므로,append()가 롤보다 앞에서RecordBatchTooLargeException으로 거절합니다(UnifiedLog.java1242–1245행). 이 검사에서 팔로워의 복제 쓰기(AppendOrigin.REPLICATION)를 빼 주는 것은 4.4.0 에 없던 조건입니다. - 시간 —
segment.ms(브로커 기본값은log.roll.hours=168, 7일 —DEFAULT_SEGMENT_MS,LogConfig.java131행). 기준이 벽시계가 아니라 레코드의 타임스탬프라는 점이 중요합니다.timeWaitedForRoll()은 첫 배치의 타임스탬프가 있으면이번 배치의 최대 타임스탬프 − 첫 배치의 타임스탬프를 돌려주고, 없을 때만지금 − 세그먼트를 만든 시각을 씁니다(709–716행). 빈 세그먼트는 시간으로 롤하지 않습니다(size > 0).rollJitterMs는segment.jitter.ms(기본 0)에서 고른 난수로, 파티션이 많을 때 모두가 같은 순간에 롤하지 않게 흩어 줍니다(LogConfig.randomSegmentJitter(), 399–404행). 컴팩션 토픽에max.compaction.lag.ms를 두면maxSegmentMs()가 둘 가운데 작은 값을 돌려줍니다(406–411행, 5절과 이어짐). - 오프셋 인덱스가 가득 — 아래 3절의
isFull(). - 타임 인덱스가 가득 — 타임 인덱스는 롤할 때 마지막 항목 하나를 꼭 써야 해서 한 칸을 남겨 두고 "가득"이라고 합니다(
TimeIndex.isFull()은entries() >= maxEntries() - 1,TimeIndex.java120–124행). - 상대 오프셋이 넘침 — 인덱스는 오프셋을 기준 오프셋과의 차이(4바이트
int)로 적습니다(3절). 차이가Integer.MAX_VALUE를 넘으면 적을 수 없으니 새 세그먼트로 갑니다(AbstractIndex.toRelative(), 552–558행). 레코드 21억 개를 한 세그먼트에 넣을 일은 드물지만, 컴팩션으로 오프셋 사이에 큰 구멍이 생긴 로그를 복제할 때 걸릴 수 있습니다(maybeRoll()의 2183–2192행 주석).
헷갈리기 쉬운 곳: segment.ms 가 지나도 아무도 쓰지 않으면 롤하지 않습니다
shouldRoll() 은 append() 안에서만 불립니다. 그래서 segment.ms=5000 인 토픽에 레코드를 쓰고 1분을 기다려도, 다음 레코드가 올 때까지 활성 세그먼트는 그대로입니다. 5절의 컴팩션 예제가 6초를 기다린 뒤 레코드 한 건을 더 쓰는 것이 이 때문입니다. (예외로, 보존 검사가 "활성 세그먼트까지 지워야 한다"고 판정하면 그쪽에서 롤합니다 — 4절.)
roll() 이 하는 일
    public LogSegment roll(Optional<Long> expectedNextOffset) throws IOException {
        synchronized (lock) {
            long nextOffset = expectedNextOffset.orElse(0L);

            LogSegment newSegment = localLog.roll(nextOffset);
            // ... (주석: 프로듀서 상태 스냅숏을 새 세그먼트 기준 오프셋에 맞춘다) ...
            producerStateManager.updateMapEndOffset(newSegment.baseOffset());
            // We avoid potentially-costly fsync call, since we acquire UnifiedLog#lock here
            // which could block subsequent produces in the meantime.
            // flush is done in the scheduler thread along with segment flushing below
            Optional<File> maybeSnapshot = producerStateManager.takeSnapshot(false);
            updateHighWatermarkWithLogEndOffset();
            // Schedule an asynchronous flush of the old segment
            scheduler().scheduleOnce("flush-log", () -> {
                maybeSnapshot.ifPresent(f -> flushProducerStateSnapshot(f.toPath()));
                flushUptoOffsetExclusive(newSegment.baseOffset());
            });
            return newSegment;
        }
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 2221–2244행에서 줄임
6편에서 "다른 flush 시점은 7편에서" 라고 넘긴 것이 여기입니다. 롤할 때 옛 세그먼트를 fsync 하지만, lock 을 쥔 채 하지 않고 kafka-scheduler 스레드에 맡깁니다. 주석이 그 이유입니다. fsync 는 느릴 수 있고, lock 을 쥔 동안에는 같은 파티션의 다음 Produce 가 기다려야 하기 때문입니다. flushUptoOffsetExclusive() 는 복구 지점부터 새 세그먼트 앞까지의 세그먼트를 flush()(= .log 의 FileChannel.force(true) + 인덱스의 MappedByteBuffer.force(), LogSegment.java 628–636행)하고, 끝나면 LocalLog.markFlushed() 로 복구 지점을 새 세그먼트의 기준 오프셋까지 올립니다(2274–2291행). 복구 지점이 무엇에 쓰이는지는 6절에서 봅니다.
그 밖의 주기적인 flush 는 LogManager 가 띄우는 kafka-log-flusher 작업(log.flush.scheduler.interval.ms)과 토픽의 flush.ms 인데, 둘 다 기본값이 Long.MAX_VALUE 라서(ServerLogConfigs.java 109행, LogConfig.java 207행) 기본 설정에서는 사실상 돌지 않습니다. 기본 설정의 fsync 는 롤할 때, 그리고 정상 종료할 때 일어난다고 보면 됩니다.
localLog.roll() 쪽은 파일을 다룹니다(LocalLog.java 634–699행). 새 기준 오프셋은 max(기대한 오프셋, LEO) 이고, 옛 활성 세그먼트에 onBecomeInactiveSegment() 를 부른 뒤 LogSegment.open() 으로 새 파일 넷을 엽니다. onBecomeInactiveSegment() 는 네 줄입니다.
    public void onBecomeInactiveSegment() throws IOException {
        timeIndex().maybeAppend(maxTimestampSoFar(), shallowOffsetOfMaxTimestampSoFar(), true);
        offsetIndex().trimToValidSize();
        timeIndex().trimToValidSize();
        log.trim();
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 681–686행
타임 인덱스에 "이 세그먼트의 가장 큰 타임스탬프"를 마지막으로 적고(4절에서 보존 기간을 잴 때 이 값을 씁니다), 10MiB 로 잡아 둔 두 인덱스를 실제 항목 수만큼으로 줄입니다. 예제 1의 1,528바이트(= 191항목 × 8바이트)와 2,292바이트(= 191항목 × 12바이트)가 이 결과입니다. 브로커를 정상 종료할 때도 활성 세그먼트에 같은 일을 합니다(UnifiedLog.prepareActiveSegmentForClose(), 952–959행). 예제 1의 끝에서 종료 뒤 활성 세그먼트의 인덱스를 다시 보면 이렇습니다.
=== after a clean shutdown: the active segment's index files are trimmed
       200 00000000000000011490.index
    139281 00000000000000011490.log
        56 00000000000000011490.snapshot
       300 00000000000000011490.timeindex
25항목 × 8 = 200, 25항목 × 12 = 300 입니다. 다시 기동하면 LogLoader 가 활성 세그먼트의 인덱스를 다시 최대 크기로 늘립니다(resizeIndexes(config.maxIndexSize), LogLoader.java 212행).
3. 오프셋을 파일 위치로 — 희소 인덱스
인덱스 항목은 4KB 마다 하나
6편에서 줄여 놓았던 LogSegment.append() 의 뒷부분입니다.
    public void append(long largestOffset,
                       MemoryRecords records) throws IOException {
        if (records.sizeInBytes() > 0) {
            // ... (trace 로그) ...
            int physicalPosition = log.sizeInBytes();

            ensureOffsetInRange(largestOffset);

            // append the messages
            long appendedBytes = log.append(records);
            // ... (trace 로그) ...

            for (RecordBatch batch : records.batches()) {
                long batchMaxTimestamp = batch.maxTimestamp();
                long batchLastOffset = batch.lastOffset();
                if (batchMaxTimestamp > maxTimestampSoFar()) {
                    maxTimestampAndOffsetSoFar = new TimestampOffset(batchMaxTimestamp, batchLastOffset);
                }

                if (bytesSinceLastIndexEntry > indexIntervalBytes) {
                    offsetIndex().append(batchLastOffset, physicalPosition);
                    timeIndex().maybeAppend(maxTimestampSoFar(), shallowOffsetOfMaxTimestampSoFar());
                    bytesSinceLastIndexEntry = 0;
                }
                var sizeInBytes = batch.sizeInBytes();
                physicalPosition += sizeInBytes;
                bytesSinceLastIndexEntry += sizeInBytes;
            }
        }
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 250–280행에서 줄임
파일에 쓴 뒤 배치를 하나씩 보면서, 마지막 인덱스 항목 뒤로 indexIntervalBytes 를 넘게 쌓였을 때만 항목을 하나 씁니다. indexIntervalBytes 는 토픽 설정 index.interval.bytes(브로커 log.index.interval.bytes)이고 기본값은 4096 입니다(ServerLogConfigs.java 97행). 그래서 오프셋 인덱스는 모든 레코드는커녕 모든 배치도 적지 않습니다. 이런 인덱스를 희소 인덱스(sparse index)라고 합니다. 항목 하나는 (이 배치의 마지막 오프셋, 이 배치가 시작하는 파일 위치) 입니다.
예제 1의 덤프가 그대로 이 계산입니다.
=== first batches of the first segment (baseOffset lastOffset position size)
baseOffset 0 lastOffset 9 position 0 size 2731
baseOffset 10 lastOffset 19 position 2731 size 2731
baseOffset 20 lastOffset 29 position 5462 size 2731
baseOffset 30 lastOffset 39 position 8193 size 2731
baseOffset 40 lastOffset 49 position 10924 size 2731
baseOffset 50 lastOffset 59 position 13655 size 2731
=== first entries of the offset index (.index)
Dumping /tmp/kafka/1/data/seg-0/00000000000000000000.index
offset: 29 position: 5462
offset: 49 position: 10924
offset: 69 position: 16386
offset: 89 position: 21848
=== number of index entries per segment
00000000000000000000.index: 191 offset entries, 191 time entries
00000000000000003830.index: 191 offset entries, 191 time entries
00000000000000007660.index: 191 offset entries, 191 time entries
00000000000000011490.index: 25 offset entries, 25 time entries
kafka-dump-log.sh 출력에서 필요한 칸만 남겼습니다. 첫 배치 앞에서 bytesSinceLastIndexEntry 는 0, 두 번째 앞에서 2,731, 세 번째 앞에서 5,462 입니다. 5,462 > 4,096 이 되는 세 번째 배치(오프셋 20–29, 위치 5462) 에서 첫 항목 29 → 5462 가 생기고 0 으로 돌아갑니다. 그 뒤로는 두 배치마다 한 항목이라, 383개 배치 세그먼트에 191항목입니다. 레코드 3,830개에 인덱스 항목 191개, 1.5KB 입니다.
헷갈리기 쉬운 곳: 항목의 키는 배치의 마지막 오프셋, 값은 배치의 첫 위치
29 → 5462 의 29 는 오프셋 20–29 배치의 마지막 오프셋인데, 5462 는 그 배치의 처음 위치입니다. 처음 보면 짝이 안 맞는 것 같지만, 인덱스가 약속하는 것은 "오프셋 29 이상을 찾으려면 위치 5462 부터 훑으면 된다"뿐이고, 그 배치의 첫 오프셋 20 은 29 보다 작으니 이 약속은 언제나 맞습니다. 4.4.0 의 LogSegment.append() 도 같은 모양입니다.
찾기: 이진 탐색 한 번, 그리고 배치 헤더 훑기
오프셋을 위치로 바꾸는 것은 LogSegment.translateOffset() 의 두 줄입니다.
    LogOffsetPosition translateOffset(long offset, int startingFilePosition) throws IOException {
        OffsetPosition mapping = offsetIndex().lookup(offset);
        return log.searchForOffsetFromPosition(offset, Math.max(mapping.position(), startingFilePosition));
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogSegment.java 398–401행
OffsetIndex.lookup(offset)은 인덱스에서 찾는 오프셋 이하인 항목 가운데 가장 큰 것을 이진 탐색으로 찾습니다. 없으면(기준 오프셋, 0), 곧 파일 처음입니다(OffsetIndex.java97–106행).FileRecords.searchForOffsetFromPosition()은 그 위치부터 배치를 차례로 넘기며, 찾는 오프셋을 담은 배치를 찾습니다(FileRecords.java395–425행). 배치를 넘길 때는 헤더의 앞부분(첫 오프셋, 길이, 매직 바이트 —HEADER_SIZE_UP_TO_MAGIC)만 읽고 길이만큼 건너뜁니다(FileLogInputStream.java64–94행). 레코드를 풀지 않습니다.
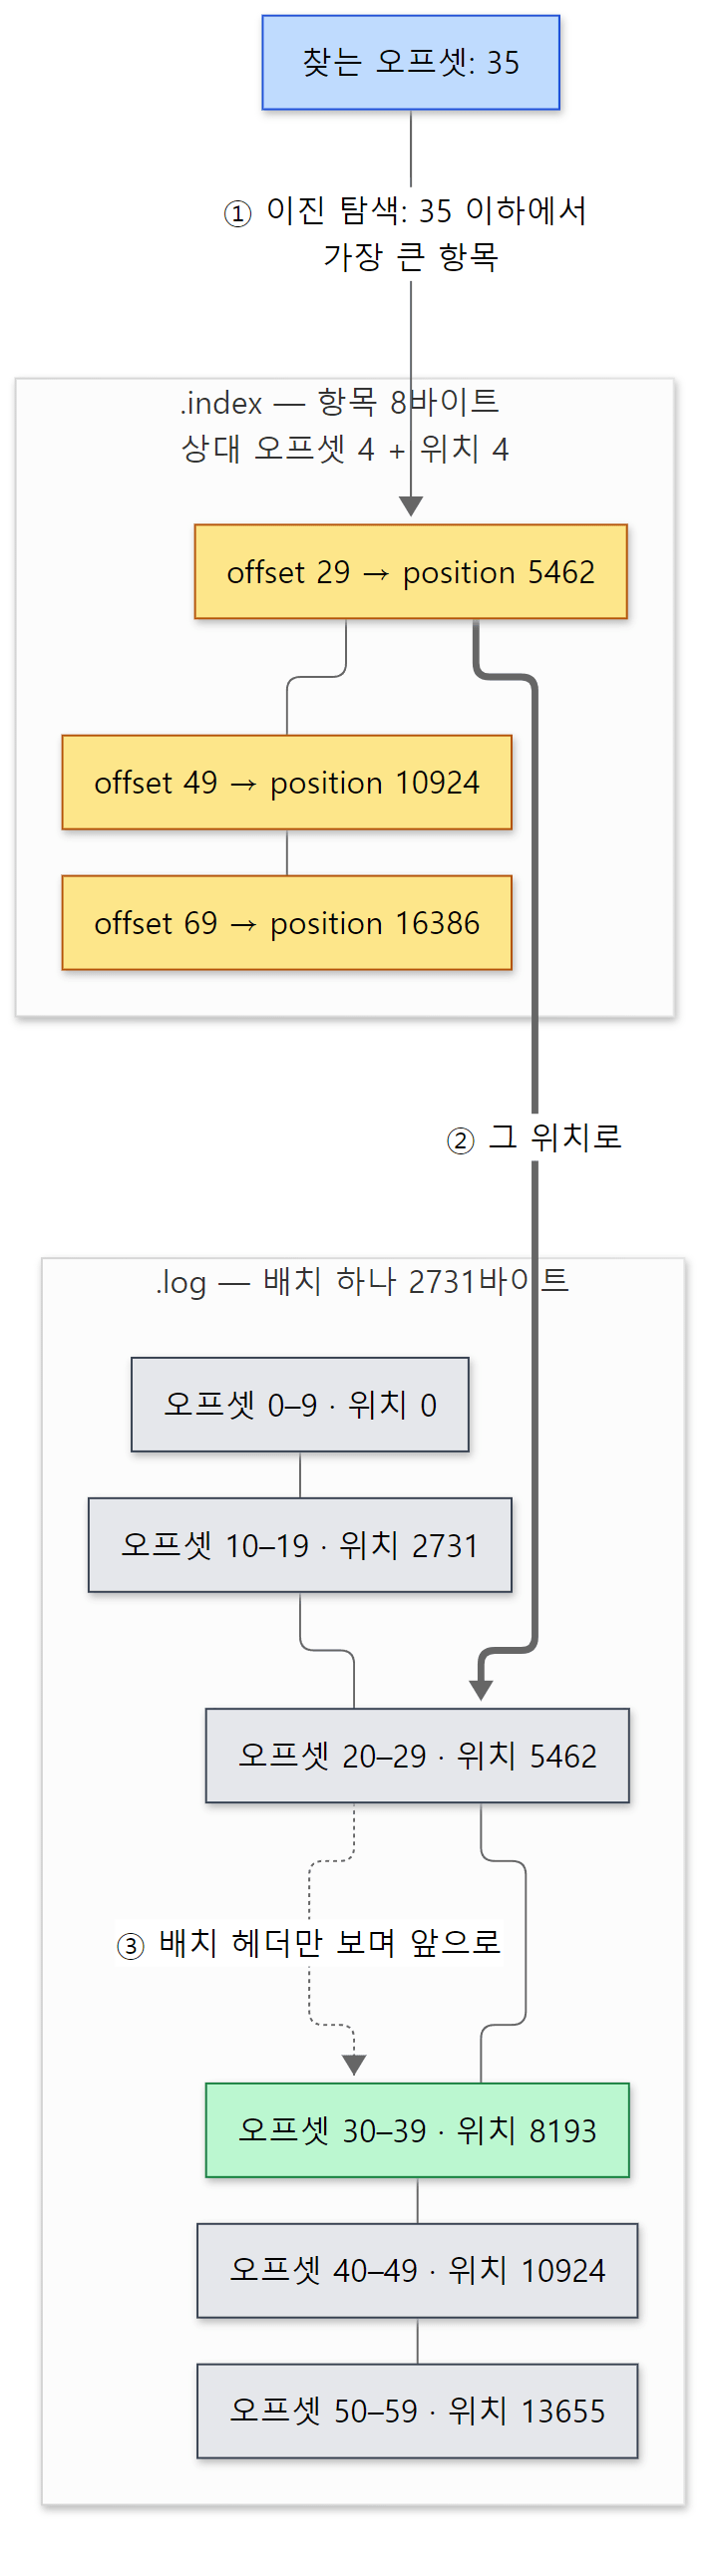 인덱스가 성긴 만큼 ③에서 몇 배치를 더 훑습니다. 기본 설정에서는 많아야 4KB 남짓입니다.
예제 1의 마지막: Kafka 의 클래스로 직접 찾아보기
이 두 단계를 Kafka 의 내부 클래스(OffsetIndex, FileRecords)를 그대로 불러 따라 해 봤습니다. 브로커를 끈 뒤 같은 세그먼트 파일을 읽기 전용으로 엽니다.
// 이 글을 위해 쓴 예제입니다 (Kafka 의 소스가 아닙니다)
// LogSegment.translateOffset() 이 하는 두 단계를 Kafka 의 내부 클래스로 그대로 따라 한다.
        // ... (사용법 주석, import, main 의 시작) ...
        // 파일 이름은 LogFileUtils 가 만든다 — 20자리로 0을 채운 기준 오프셋
        File indexFile = LogFileUtils.offsetIndexFile(dir, baseOffset);
        File logFile = LogFileUtils.logFile(dir, baseOffset);
        // ...
        // 읽기 전용으로 연다(writable=false). maxIndexSize 는 읽기에서는 쓰이지 않는다
        OffsetIndex index = new OffsetIndex(indexFile, baseOffset, -1, false);
        System.out.println("index entries: " + index.entries());
        try (FileRecords records = FileRecords.open(logFile, false)) {
            for (int i = 2; i < args.length; i++) {
                long target = Long.parseLong(args[i]);
                OffsetPosition hint = index.lookup(target);
                FileRecords.LogOffsetPosition found = records.searchForOffsetFromPosition(target, hint.position());
                // ... (target, hint, found 를 한 줄로 찍는다) ...
            }
        }
[예제 ex/u07-segments/Lookup.java 에서 줄임]
=== offset -> file position, the way LogSegment.translateOffset() does it
index file: 00000000000000000000.index, log file: 00000000000000000000.log
index entries: 191
target 0 -> index says (offset 0, position 0) -> batch at position 0 (baseOffset 0, size 2731)
target 35 -> index says (offset 29, position 5462) -> batch at position 8193 (baseOffset 30, size 2731)
target 49 -> index says (offset 49, position 10924) -> batch at position 10924 (baseOffset 40, size 2731)
target 50 -> index says (offset 49, position 10924) -> batch at position 13655 (baseOffset 50, size 2731)
target 3829 -> index says (offset 3829, position 1043242) -> batch at position 1043242 (baseOffset 3820, size 2731)
- 0 은 인덱스의 첫 항목(29)보다 작아서 "파일 처음"이 나왔습니다.
- 35 는 그림 그대로
29 → 5462에서 출발해 한 배치를 넘겨 8193 에 닿았습니다. - 49 는 항목과 정확히 같아서 그 위치(10924, 오프셋 40–49 배치)가 바로 답입니다. 50 은 같은 항목에서 출발해 한 배치 넘깁니다.
- 3829(이 세그먼트의 마지막 오프셋)도 이진 탐색 한 번에 마지막 항목으로 갑니다.
인덱스는 mmap 으로, 그리고 "따뜻한" 끝부분부터
인덱스 파일을 여는 곳은 AbstractIndex 입니다.
        try {
            /* pre-allocate the file if necessary */
            if (newlyCreated) {
                if (maxIndexSize < entrySize())
                    throw new IllegalArgumentException("Invalid max index size: " + maxIndexSize);
                raf.setLength(roundDownToExactMultiple(maxIndexSize, entrySize()));
            }

            long length = raf.length();
            MappedByteBuffer mmap = createMappedBuffer(raf, newlyCreated, length, writable, entrySize());
storage/src/main/java/org/apache/kafka/storage/internals/log/AbstractIndex.java 108–117행
새 인덱스는 파일 길이를 segment.index.bytes(브로커 log.index.size.max.bytes, 기본 10MiB — ServerLogConfigs.java 93행)를 항목 크기의 배수로 깎은 값으로 미리 잡고, 통째로 FileChannel.map() 합니다(471–487행). 항목을 쓸 때는 mmap.putInt() 두 번이면 끝이고(OffsetIndex.append(), 150–151행), 읽을 때는 getInt() 입니다. 오프셋 인덱스 항목은 8바이트(상대 오프셋 4 + 위치 4, OffsetIndex.java 56행), 타임 인덱스 항목은 12바이트(타임스탬프 8 + 상대 오프셋 4)입니다. 기본값으로 계산하면 오프셋 인덱스에는 10,485,760 / 8 = 1,310,720 항목이 들어갑니다. 1GiB 세그먼트를 4KB 마다 한 항목씩 적으면 많아야 26만 개 남짓이므로, 기본 설정에서 인덱스가 먼저 차는 일은 드뭅니다.
오프셋을 4바이트 상대 오프셋(기준 오프셋과의 차이)으로 적는 것도 크기를 줄이는 장치입니다. 기준 오프셋이 50 이면 오프셋 55 를 5 로 적는다는 설명이 OffsetIndex 의 클래스 주석(44–47행)에 있습니다.
이진 탐색에는 작은 꾀가 하나 있습니다. AbstractIndex 의 긴 주석(327–383행)이 그 이유를 적어 둡니다. 요약하면 이렇습니다. 인덱스는 끝에만 덧붙고, 찾는 쪽(따라오는 팔로워, 밀리지 않은 컨슈머)도 거의 끝부분을 찾습니다. 그런데 보통의 이진 탐색은 매번 0번 페이지, 가운데 페이지 … 를 건드리고, 인덱스가 한 페이지 자라면 건드리는 페이지가 바뀌어 오래 안 쓴 페이지를 디스크에서 다시 읽느라(page fault) 지연이 1초까지 튀었다고 합니다. 그래서 끝의 8KB("warm" 구간)를 먼저 봅니다.
        int firstHotEntry = Math.max(0, entries - 1 - warmEntries());
        // check if the target offset is in the warm section of the index
        if (compareIndexEntry(parseEntry(idx, firstHotEntry), target, searchEntity) < 0) {
            return binarySearch(idx, target, searchEntity,
                searchResultType, firstHotEntry, entries - 1);
        }

        // check if the target offset is smaller than the least offset
        if (compareIndexEntry(parseEntry(idx, 0), target, searchEntity) > 0) {
            return switch (searchResultType) {
                case LARGEST_LOWER_BOUND -> -1;
                case SMALLEST_UPPER_BOUND -> 0;
            };
        }

        return binarySearch(idx, target, searchEntity, searchResultType, 0, firstHotEntry);
storage/src/main/java/org/apache/kafka/storage/internals/log/AbstractIndex.java 498–513행
warmEntries() 는 8192 / entrySize(), 오프셋 인덱스로는 1,024 항목입니다(384–386행). 찾는 값이 끝 1,024 항목 안에 있으면 그 안에서만 이진 탐색하므로, 늘 같은 두세 페이지만 건드리고 그 페이지들은 페이지 캐시에 머뭅니다. Kafka 가 디스크를 쓰면서도 빠른 이유가 "페이지 캐시에 맡긴다"인 것은 이 글의 여러 자리에서 보이는데, 이 코드는 그 페이지 캐시가 잘 맞도록 접근 순서까지 맞춘 경우입니다.
LazyIndex: 기동할 때 인덱스를 다 열지 않는다
LogSegment 의 인덱스 필드가 OffsetIndex 가 아니라 LazyIndex<OffsetIndex> 인 이유는 클래스 주석(29–41행)에 있습니다. 세그먼트가 아주 많은 브로커가 기동하거나 종료할 때 인덱스를 모두 mmap 하면 오래 걸리므로, 파일 이름만 들고 있다가 처음 get() 할 때 연다는 것입니다. get() 은 이미 열려 있으면 바로 돌려주고, 아니면 락을 잡고 한 번 더 확인한 뒤 OffsetIndex 나 TimeIndex 를 만듭니다(LazyIndex.java 160–179행). 오래된 세그먼트는 읽히거나 지워질 때까지 인덱스를 열지 않는 셈입니다.
타임 인덱스: 시각 → 오프셋
.timeindex 는 offsetsForTimes()(컨슈머의 "이 시각부터 읽기", kafka-get-offsets.sh --time)에 씁니다. 항목 (T, O) 는 "오프셋 O 까지 본 가장 큰 타임스탬프가 T" 라는 뜻이고, 타임스탬프가 커질 때만 덧붙입니다(TimeIndex.maybeAppend(), 203행). 그래서 항목의 타임스탬프는 늘 증가하고 이진 탐색이 됩니다. 찾을 때는 타임 인덱스로 오프셋을 얻고, 그 오프셋을 다시 오프셋 인덱스로 위치로 바꾼 뒤 파일을 훑습니다(LogSegment.findOffsetByTimestamp(), 752–759행). 예제 1의 타임 인덱스 첫 항목들입니다.
=== first entries of the time index (.timeindex)
Dumping /tmp/kafka/1/data/seg-0/00000000000000000000.timeindex
timestamp: 1794024676890 offset: 29
timestamp: 1794024676913 offset: 49
timestamp: 1794024676935 offset: 69
타임스탬프 값은 실행마다 다릅니다(이 실행에서는 2026-11-07). 오프셋 인덱스와 같은 순간(bytesSinceLastIndexEntry > indexIntervalBytes)에 함께 적으므로 오프셋 칸이 같습니다.
예제: 인덱스를 작게 하면 인덱스 때문에 롤한다
같은 예제에서 segment.index.bytes=400 인 토픽 seg2 에 레코드 2,000개를 보냈습니다.
=== a second topic seg2 with segment.index.bytes=400 (index files hold only a few entries)
Created topic seg2.
sent 2000 records to seg2
00000000000000000000.log 00000000000000000650.log 00000000000000001300.log 00000000000000001950.log
00000000000000000000.index: 32 offset entries, 32 time entries
00000000000000000650.index: 32 offset entries, 32 time entries
00000000000000001300.index: 32 offset entries, 32 time entries
00000000000000001950.index: 2 offset entries, 2 time entries
세그먼트가 고작 177KB 인데 650 레코드마다 롤했습니다. 400바이트면 오프셋 인덱스는 50항목, 타임 인덱스는 400 을 12 의 배수로 깎은 396바이트에 33항목이 들어갑니다. 타임 인덱스는 한 칸을 남기므로 32항목에서 "가득"이 되고, 32번째 항목(오프셋 649)을 쓴 다음 배치에서 롤했습니다. 오프셋 인덱스보다 타임 인덱스가 먼저 찬 것입니다. shouldRoll() 의 세 번째·네 번째 조건이 실제로 걸리는 것을 본 셈입니다.
4. 오래된 세그먼트 지우기 — 보존
누가, 언제: kafka-log-retention 작업
보존 검사는 요청 처리 스레드가 아니라 LogManager 가 기동할 때 예약하는 주기 작업이 합니다. startupWithConfigOverrides() 가 로그를 다 읽은 뒤, cleanupLogs() 를 kafka-log-retention 이라는 이름으로 retentionCheckMs 마다 돌게 예약하는 것을 시작으로 아래 표의 작업들을 예약합니다(LogManager.java 811–834행).
이 작업들이 도는 곳은 KafkaScheduler 의 스레드 풀이고, 스레드 이름이 kafka-scheduler-N 입니다(KafkaScheduler.java 95행). 브로커는 background.threads(기본 10, ServerConfigs.java 64행)개로 이 풀을 만듭니다(BrokerServer.scala 216행). 롤 때의 flush-log, 아래의 delete-file 도 같은 풀에서 돕니다.
| 작업 | 주기 설정 (기본값) | 하는 일 |
|---|---|---|
kafka-log-retention |
log.retention.check.interval.ms (5분) |
컴팩션이 아닌 로그마다 deleteOldSegments() |
kafka-log-flusher |
log.flush.scheduler.interval.ms (Long.MAX_VALUE) |
flush.ms 가 지난 로그를 flush |
kafka-recovery-point-checkpoint |
log.flush.offset.checkpoint.interval.ms (60초) |
복구 지점을 파일에 기록(6절) |
kafka-log-start-offset-checkpoint |
log.flush.start.offset.checkpoint.interval.ms (60초) |
로그 시작 오프셋을 파일에 기록 |
기본값은 ServerLogConfigs.java 85행, 109행, 116행, 120행입니다. 모든 작업의 첫 실행은 log.initial.task.delay.ms(기본 30초, 172행 — 문서에 "testing only") 뒤입니다.
cleanupLogs() 는 cleanup.policy 에 compact 가 없는 로그만 골라 deleteOldSegments() 를 부릅니다(1703–1742행). compact 가 든 로그(compact,delete 포함)의 보존 검사는 5절의 청소 스레드가 대신 합니다(LogCleaner.java 566–579행).
deleteOldSegments(): 세 가지 조건을 차례로
    public int deleteOldSegments() throws IOException {
        int deletedSegments;
        try {
            if (config().delete) {
                deletedSegments = deleteLogStartOffsetBreachedSegments() +
                        deleteRetentionSizeBreachedSegments() +
                        deleteRetentionMsBreachedSegments();
            } else if (config().compact) {
                deletedSegments = deleteLogStartOffsetBreachedSegments();
            } else {
                // ... (cleanup.policy 가 비어 있을 때 — 계층 저장소가 아니면 시작 오프셋만) ...
            }
        } finally {
            // ... (retention-size-in-percent 지표 갱신) ...
        }
        return deletedSegments;
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1981–2010행에서 줄임
delete 정책이면 세 가지를 이 순서로 봅니다.
| 메서드 | 지우는 세그먼트 | 설정 |
|---|---|---|
deleteLogStartOffsetBreachedSegments() |
다음 세그먼트의 기준 오프셋이 로그 시작 오프셋 이하인 것 — 곧 통째로 시작 오프셋 앞에 있는 것 | DeleteRecords 요청(kafka-delete-records.sh)이 시작 오프셋을 올린 경우 |
deleteRetentionSizeBreachedSegments() |
로그 전체 크기가 retention.bytes 를 넘는 만큼, 오래된 쪽부터 |
retention.bytes (기본 -1 = 끔) |
deleteRetentionMsBreachedSegments() |
세그먼트의 가장 큰 타임스탬프가 retention.ms 보다 오래된 것 |
retention.ms (기본 7일 — log.retention.hours=168) |
retention.ms 판정은 이렇습니다.
        DeletionCondition shouldDelete = (segment, nextSegmentOpt) -> {
            long anchorTimestamp = segment.largestTimestamp();
            if (startMs < anchorTimestamp) {
                if (remoteLogEnabledAndRemoteCopyEnabled) {
                    anchorTimestamp = segment.lastModified();
                    futureTimestampLogger.warn("{} contains future timestamp(s), using lastModified time {} as the retention anchor", segment, anchorTimestamp);
                } else {
                    futureTimestampLogger.warn("{} contains future timestamp(s), making it ineligible to be deleted", segment);
                }
            }
            boolean delete = startMs - anchorTimestamp > retentionMs;
            // ... (debug 로그) ...
            return delete;
        };
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 2022–2036행에서 줄임
기준은 segment.largestTimestamp(), 곧 세그먼트에 든 레코드의 가장 큰 타임스탬프입니다(레코드에 타임스탬프가 없을 때만 파일 수정 시각, LogSegment.java 856–861행). 파일을 만든 시각이 아닙니다. 그래서 세그먼트 안의 가장 새 레코드가 retention.ms 보다 오래돼야 그 세그먼트가 지워집니다. 프로듀서가 미래 시각을 찍어 보낸 레코드가 섞이면 startMs < anchorTimestamp 가 되어 그 세그먼트는 지워지지 않고 경고만 남습니다. 계층 저장소를 켰을 때 파일 수정 시각으로 대신 재는 갈래는 4.4.0 에 없고 trunk 에 들어온 것입니다(커밋 f52e331cae, KAFKA-20609). 계층 저장소를 쓰지 않으면 4.4.0 과 같게 동작합니다.
어디까지 지우나: 앞에서부터, 하이 워터마크 아래까지만
세 메서드는 조건(DeletionCondition)만 다르고, 고르는 일은 deletableSegments() 가 합니다.
            while (segmentOpt.isPresent()) {
                LogSegment segment = segmentOpt.get();
                Optional<LogSegment> nextSegmentOpt = nextOption(segmentsIterator);
                boolean isLastSegmentAndEmpty = nextSegmentOpt.isEmpty() && segment.size() == 0;
                long upperBoundOffset = nextSegmentOpt.map(LogSegment::baseOffset).orElseGet(this::logEndOffset);
                // We don't delete segments with offsets at or beyond the high watermark to ensure that the log start
                // offset can never exceed it.
                boolean predicateResult = highWatermark() >= upperBoundOffset && predicate.execute(segment, nextSegmentOpt);

                // ... (계층 저장소: 활성 세그먼트를 롤해 둔다) ...
                if (predicateResult && !isLastSegmentAndEmpty && isSegmentEligibleForDeletion(nextSegmentOpt, upperBoundOffset)) {
                    deletable.add(segment);
                    segmentOpt = nextSegmentOpt;
                } else {
                    segmentOpt = Optional.empty();
                }
            }
storage/src/main/java/org/apache/kafka/storage/internals/log/UnifiedLog.java 1901–1921행에서 줄임
- 가장 오래된 세그먼트부터 보다가 조건이 처음 거짓이 되는 곳에서 멈춥니다. 중간의 세그먼트 하나만 쏙 빼는 일은 없습니다. 로그는 앞에서부터만 줄어듭니다.
- 세그먼트 전체가 하이 워터마크(ISR 이 모두 받아 간 경계, 9편) 아래에 있어야 합니다. 주석대로 로그 시작 오프셋이 하이 워터마크를 앞지르지 않게 하려는 것입니다.
- 마지막 세그먼트가 비어 있으면 고르지 않습니다. 하지만 비어 있지 않은 활성 세그먼트는 고를 수 있습니다. 이때
deleteSegments()는 세그먼트를 모두 지우게 되는 것을 알아채고 빈 세그먼트를 먼저 롤해 둡니다("we must always have at least one segment", 1947–1956행). 로그에는 늘 세그먼트가 하나 이상 있어야 하기 때문입니다.
지우는 두 단계: .deleted, 그리고 file.delete.delay.ms
고른 세그먼트는 deleteSegments() 에서 먼저 로그 시작 오프셋을 남는 첫 세그먼트의 기준 오프셋으로 올린 뒤(1960–1965행), LocalLog.removeAndDeleteSegments() 로 갑니다. 거기서 LogSegments 맵에서 빼고(404행), 파일은 바로 지우지 않습니다.
        for (LogSegment segment : segmentsToDelete) {
            if (!segment.hasSuffix(DELETED_FILE_SUFFIX)) {
                segment.changeFileSuffixes("", DELETED_FILE_SUFFIX);
            }
        }

        Runnable deleteSegments = () -> {
            // ... (로그, 예외 처리) ...
                        for (LogSegment segment : segmentsToDelete) {
                            segment.deleteIfExists();
                        }
            // ...
        };
        if (asyncDelete) {
            scheduler.scheduleOnce("delete-file", deleteSegments, config.fileDeleteDelayMs);
        } else {
            deleteSegments.run();
        }
storage/src/main/java/org/apache/kafka/storage/internals/log/LocalLog.java 904–926행에서 줄임
파일 넷의 이름 뒤에 .deleted 를 붙이고, 실제 삭제는 file.delete.delay.ms(기본 60초, ServerLogConfigs.java 105행) 뒤 delete-file 작업에 맡깁니다. 이유는 removeAndDeleteSegments() 의 주석(385–386행)에 있습니다. 맵에서 빼는 순간 새 읽기는 이 세그먼트를 찾지 못하지만, 이미 이 세그먼트를 읽고 있던 요청(예를 들어 8편의 제로 카피로 파일을 소켓에 보내는 중인 Fetch)이 있을 수 있습니다. 잠시 기다렸다 지우면 그 요청과 동기화하지 않고도 안전합니다. 브로커가 그 사이에 죽으면, 다음 기동 때 LogLoader 가 남은 .deleted 파일을 지웁니다(LogLoader.java 279–281행).
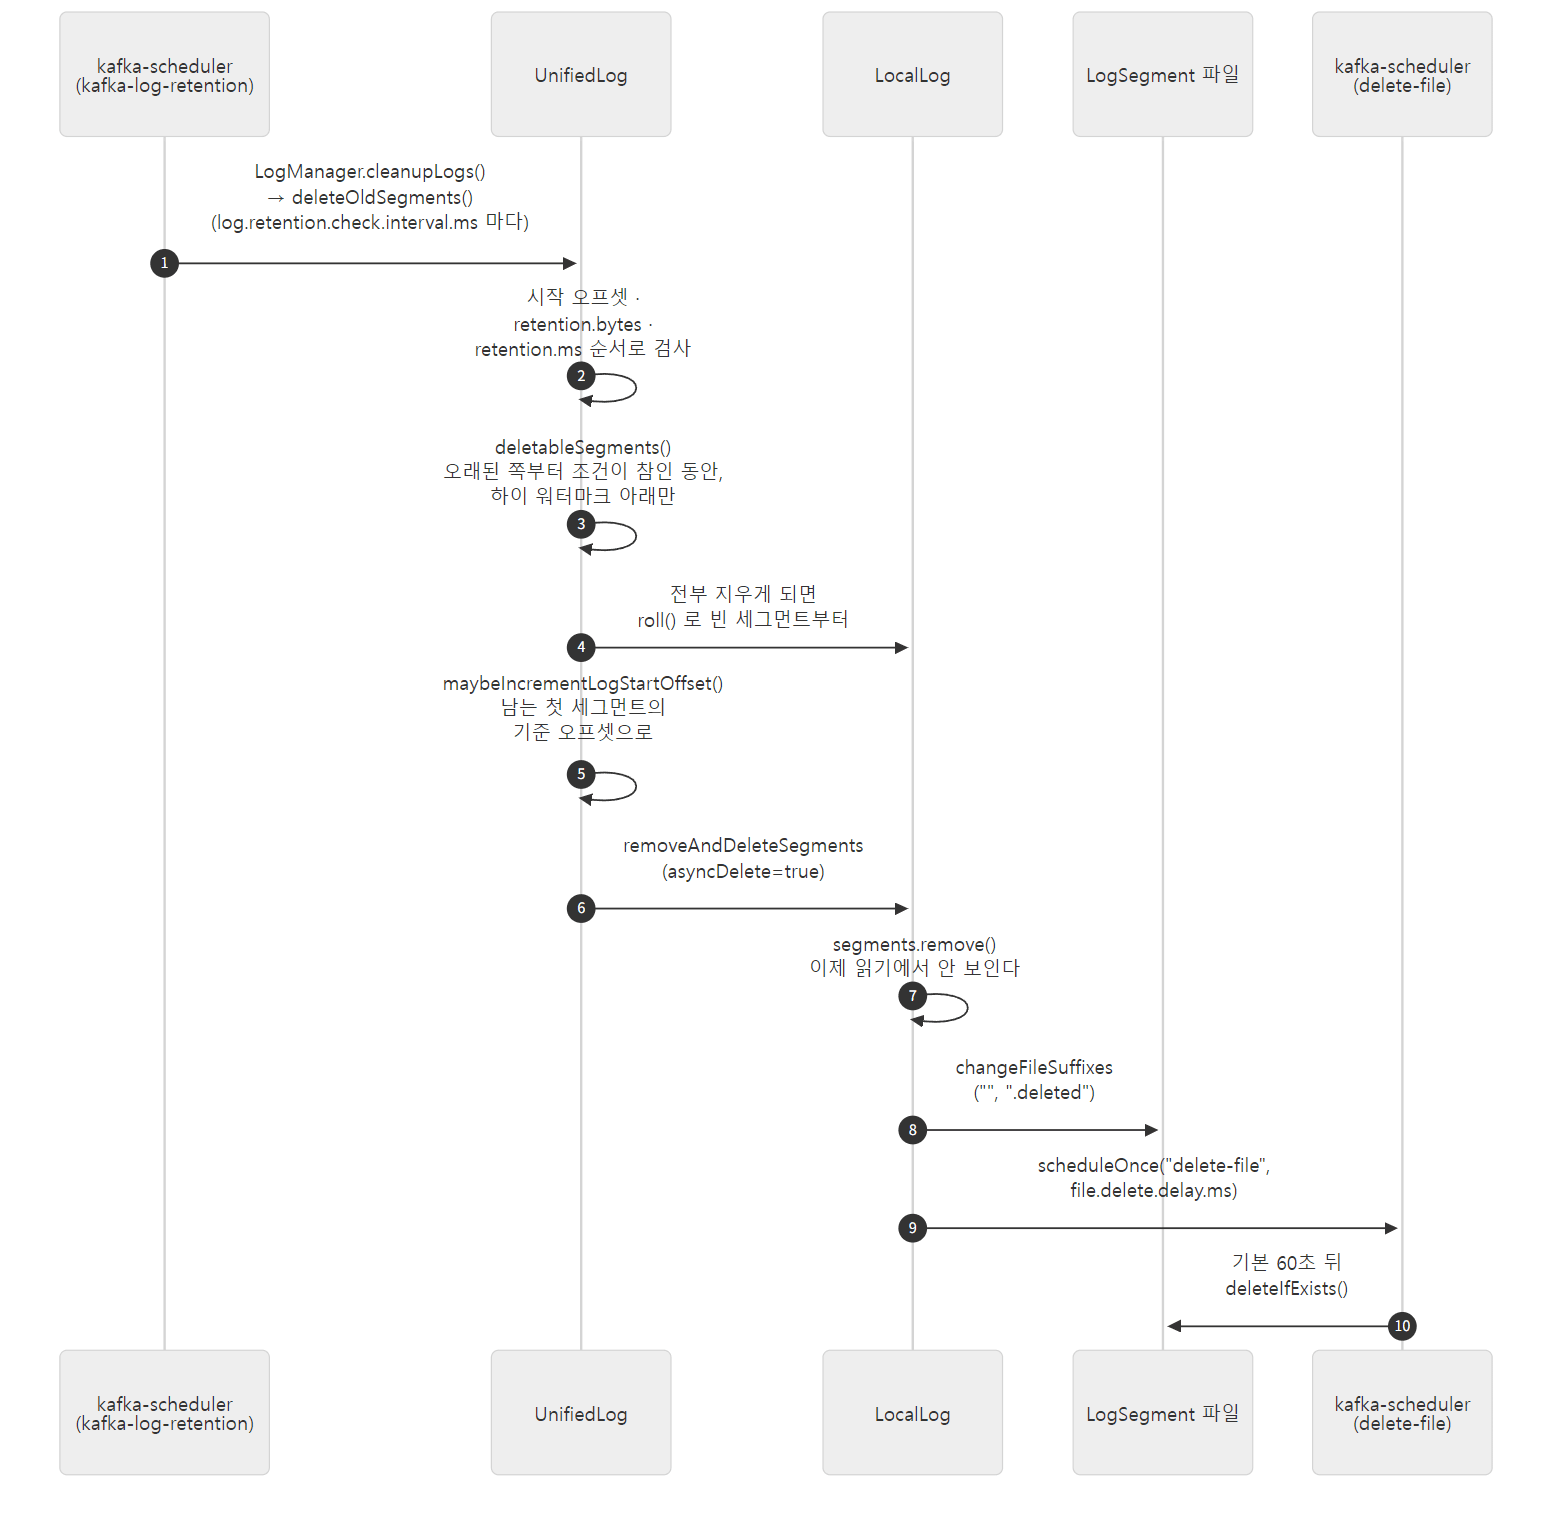 5–7번이 끝나면 세그먼트는 로그에서 사라진 것이고, 8–10번은 디스크를 치우는 뒷정리입니다.
예제 2: retention.ms=20초인 토픽
예제 폴더 ex/u07-retention 입니다. 보존 검사를 2초마다(log.retention.check.interval.ms=2000), 첫 검사도 2초 뒤에(log.initial.task.delay.ms=2000, 시험용 설정) 하도록 브로커를 띄우고, retention.ms=20000, segment.bytes=1048576, file.delete.delay.ms=10000 인 토픽에 예제 1과 같은 레코드 12,000개를 보낸 뒤, .log 파일 목록이 바뀔 때마다 찍었습니다.
=== produce 12000 records
sent 12000 records to ret
earliest offset: ret:0:0
=== watch the .log files (t = seconds after producing)
t=3s: 00000000000000000000.log 00000000000000003830.log 00000000000000007660.log 00000000000000011490.log
t=17s: 00000000000000000000.log.deleted 00000000000000003830.log 00000000000000007660.log 00000000000000011490.log
t=20s: 00000000000000000000.log.deleted 00000000000000003830.log.deleted 00000000000000007660.log 00000000000000011490.log
t=22s: 00000000000000000000.log.deleted 00000000000000003830.log.deleted 00000000000000007660.log.deleted 00000000000000011490.log.deleted 00000000000000012000.log
t=24s: 00000000000000003830.log.deleted 00000000000000007660.log.deleted 00000000000000011490.log.deleted 00000000000000012000.log
t=28s: 00000000000000007660.log.deleted 00000000000000011490.log.deleted 00000000000000012000.log
t=30s: 00000000000000012000.log
earliest offset: ret:0:12000
t 는 프로듀서가 끝난 뒤부터 잰 초이고, 값은 실행마다 조금씩 다릅니다. 아래 로그의 in 8 ms 같은 시간과 lastModifiedTime·largestRecordTimestamp 값도 실행마다 다릅니다. server.log 에서 이 파티션의 줄만 골랐습니다(앞의 시각과 클래스 이름, 파티션 접두어를 지웠습니다).
=== server.log lines about ret-0 (trimmed)
Rolled new log segment at offset 3830 in 8 ms.
Rolled new log segment at offset 7660 in 3 ms.
Rolled new log segment at offset 11490 in 2 ms.
Incremented log start offset to 3830 due to segment deletion
Deleting segment LogSegment(baseOffset=0, size=1045973, lastModifiedTime=1794024815819, largestRecordTimestamp=1794024815939) due to log retention time 20000ms breach based on the largest record timestamp in the segment
Incremented log start offset to 7660 due to segment deletion
Deleting segment LogSegment(baseOffset=3830, size=1045973, lastModifiedTime=1794024818444, largestRecordTimestamp=1794024818462) due to log retention time 20000ms breach based on the largest record timestamp in the segment
Rolled new log segment at offset 12000 in 2 ms.
Incremented log start offset to 12000 due to segment deletion
Deleting segment LogSegment(baseOffset=7660, size=1045973, lastModifiedTime=1794024820273, largestRecordTimestamp=1794024820278) due to log retention time 20000ms breach based on the largest record timestamp in the segment
Deleting segment LogSegment(baseOffset=11490, size=139281, lastModifiedTime=1794024820474, largestRecordTimestamp=1794024820477) due to log retention time 20000ms breach based on the largest record timestamp in the segment
Deleting segment files LogSegment(baseOffset=0, size=1045973, lastModifiedTime=1794024815819, largestRecordTimestamp=1794024815939)
Deleted log 00000000000000000000.log.deleted.
Deleting segment files LogSegment(baseOffset=3830, size=1045973, lastModifiedTime=1794024818444, largestRecordTimestamp=1794024818462)
Deleted log 00000000000000003830.log.deleted.
Deleting segment files LogSegment(baseOffset=7660, size=1045973, lastModifiedTime=1794024820273, largestRecordTimestamp=1794024820278), LogSegment(baseOffset=11490, size=139281, lastModifiedTime=1794024820474, largestRecordTimestamp=1794024820477)
Deleted log 00000000000000007660.log.deleted.
Deleted log 00000000000000011490.log.deleted.
- 세그먼트마다 지워진 시각이 다릅니다. 프로듀서가 12,000개를 보내는 데 몇 초가 걸려서, 세그먼트마다 가장 큰 타임스탬프(
largestRecordTimestamp)가 다르기 때문입니다. 세그먼트 0 의 마지막 레코드가 가장 먼저 20초를 넘었습니다. 로그 줄의 "based on the largest record timestamp" 가 위 코드의 기준 그대로입니다. - "Incremented log start offset" 이 "Deleting segment" 보다 먼저 찍힙니다.
deleteSegments()가 시작 오프셋을 먼저 올리고, 지우는 이유(reason.logReason())는removeAndDeleteSegments()안에서 찍기 때문입니다(LocalLog.java403행).kafka-get-offsets.sh --time -2(가장 이른 오프셋)가 0 에서 12000 으로 바뀐 것이 이 시작 오프셋입니다. - 활성 세그먼트(11490)도 지워졌습니다. 그 직전에
Rolled new log segment at offset 12000이 있습니다. 위에서 본 "모두 지우게 되면 빈 세그먼트를 먼저 롤" 입니다. 그래서 레코드가 하나도 없어도00000000000000012000.log가 남고, 다음 레코드는 오프셋 12000 을 받습니다. .deleted가 붙은 뒤 약 10초 뒤(file.delete.delay.ms=10000)에Deleting segment files와Deleted log가 찍히고 파일이 사라졌습니다.
헷갈리기 쉬운 곳: "보존 기간이 지나면 바로 지워진다"가 아닙니다
retention.ms 를 넘은 레코드가 실제로 디스크에서 사라지기까지는 세 겹의 늦어짐이 있습니다. ① 그 레코드가 든 세그먼트의 가장 새 레코드가 기간을 넘어야 하고(세그먼트는 기본 1GiB·7일 단위입니다), ② 다음 보존 검사(기본 5분마다)를 기다려야 하고, ③ .deleted 로 이름을 바꾼 뒤 file.delete.delay.ms(기본 60초)를 더 기다립니다. 컨슈머에게 안 보이게 되는 것은 ②에서 로그 시작 오프셋이 올라갈 때이고, 디스크 공간이 돌아오는 것은 ③입니다.
5. 키마다 마지막 값만 — 컴팩션
청소 스레드와 "더러운" 구간
cleanup.policy=compact 인 토픽은 LogCleaner 가 맡습니다. log.cleaner.threads(기본 1, CleanerConfig.java 38행)개의 CleanerThread 가 각자 kafka-log-cleaner-thread-<번호> 라는 이름으로 돌고(LogCleaner.java 205–209행, 468행), 한 바퀴마다 이렇게 합니다.
        @Override
        public void doWork() {
            boolean cleaned = tryCleanFilthiestLog();
            if (!cleaned) {
                try {
                    pause(config.backoffMs, TimeUnit.MILLISECONDS);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
            }

            cleanerManager.maintainUncleanablePartitions();
        }
storage/src/main/java/org/apache/kafka/storage/internals/log/LogCleaner.java 503–515행
"가장 더러운 로그를 하나 골라 청소하고, 청소할 것이 없으면 log.cleaner.backoff.ms(기본 15초, CleanerConfig.java 43행) 쉰다"입니다. 로그는 이미 청소한 앞부분(깨끗한 구간)과 아직 안 한 뒷부분(더러운 구간)으로 나뉘고, 그 경계(firstDirtyOffset)를 데이터 폴더의 cleaner-offset-checkpoint 파일에 적어 둡니다(LogCleanerManager.java 66행). "더러운 정도"는 청소할 수 있는 더러운 바이트 ÷ (깨끗한 바이트 + 청소할 수 있는 바이트)이고(LogToClean.java 53–54행), 이것이 min.cleanable.dirty.ratio(기본 0.5, LogConfig.java 137행)를 넘는 로그 가운데 이 비율이 가장 큰 것을 고릅니다(grabFilthiestCompactedLog(), 239–297행). max.compaction.lag.ms 가 지나 당장 청소해야 하는 로그는 비율이 낮아도 후보가 됩니다(282행).
더러운 구간 전부를 청소하지는 않습니다. 청소하면 안 되는 경계가 셋입니다.
        long firstUncleanableDirtyOffset = Stream.of(
                        // we do not clean beyond the last stable offset
                        Optional.of(log.lastStableOffset()),

                        // the active segment is always uncleanable
                        Optional.of(log.activeSegment().baseOffset()),

                        // the first segment whose largest message timestamp is within a minimum time lag from now
                        minCompactionLagMs > 0 ? findFirstUncleanableSegment(log, firstDirtyOffset, now, minCompactionLagMs) : Optional.<Long>empty()
                )
                .flatMap(Optional::stream)
                .min(Long::compare)
                .orElseThrow(() -> new IllegalStateException("No uncleanable offset found"));
storage/src/main/java/org/apache/kafka/storage/internals/log/LogCleanerManager.java 730–742행
활성 세그먼트는 언제나 청소하지 않습니다. 지금 쓰고 있는 파일을 바꿔 끼울 수는 없으니까요. 그 밖에 마지막 안정 오프셋(LSO, 아직 끝나지 않은 트랜잭션의 앞, 12편)과 min.compaction.lag.ms 가 경계입니다. 그래서 "컴팩션이 안 돼요"의 가장 흔한 이유는 활성 세그먼트가 롤되지 않은 것입니다(2절의 헷갈리기 쉬운 곳과 같은 이야기입니다).
청소 한 번: 오프셋 맵을 만들고, 다시 복사한다
Cleaner.doClean() 은 두 단계입니다(Cleaner.java 159–209행).
① 오프셋 맵 만들기(buildOffsetMap()). 더러운 구간을 처음부터 읽으며 "키 → 그 키가 나온 마지막 오프셋"을 맵에 넣습니다.
                        try (CloseableIterator<Record> recordsIterator = batch.streamingIterator(decompressionBufferSupplier, maxRecordBodySize)) {
                            for (Record record : (Iterable<Record>) () -> recordsIterator) {
                                if (record.hasKey() && record.offset() >= startOffset) {
                                    if (map.size() < maxDesiredMapSize) {
                                        map.put(record.key(), record.offset());
                                    } else {
                                        return true;
                                    }
                                }
                                stats.indexMessagesRead(1);
                            }
                        }
storage/src/main/java/org/apache/kafka/storage/internals/log/Cleaner.java 815–826행
같은 키가 다시 나오면 put() 이 값을 덮어쓰므로, 다 읽고 나면 키마다 마지막 오프셋이 남습니다. 맵이 차면(maxDesiredMapSize) 거기서 멈추고, 이번에는 그 앞까지만 청소합니다.
이 맵이 SkimpyOffsetMap 입니다. 이름처럼 "인색한" 해시 테이블로, 키를 그대로 저장하지 않고 키의 MD5 해시(16바이트)와 오프셋(8바이트) 만 저장합니다.
    public SkimpyOffsetMap(int memory, String hashAlgorithm) throws NoSuchAlgorithmException {
        this.bytes = ByteBuffer.allocate(memory);

        this.digest = MessageDigest.getInstance(hashAlgorithm);

        this.hashSize = digest.getDigestLength();
        this.bytesPerEntry = hashSize + 8;
        this.slots = memory / bytesPerEntry;

        this.hash1 = new byte[hashSize];
        this.hash2 = new byte[hashSize];
    }
storage/src/main/java/org/apache/kafka/storage/internals/log/SkimpyOffsetMap.java 77–88행
ByteBuffer 하나를 24바이트짜리 칸으로 나눠 쓰고, 충돌하면 해시에서 4바이트를 읽는 자리를 한 바이트씩 뒤로 옮겨 다른 칸을 시험하고(16바이트 MD5 면 13가지), 그래도 안 되면 한 칸씩 옆으로 가며 빈칸을 찾습니다(positionOf(), 205–209행). 키가 얼마나 길든 한 칸에 24바이트이고, 객체를 만들지 않으니 GC 부담도 없습니다. 메모리는 log.cleaner.dedupe.buffer.size(기본 128MiB, CleanerConfig.java 40행)를 청소 스레드 수로 나눈 만큼입니다(LogCleaner.java 472행). 기본값이면 128MiB ÷ 24 = 5,592,405 칸이고, 부하율 0.9(log.cleaner.io.buffer.load.factor, 42행)까지만 채우므로 한 번에 키 500만 개 남짓을 다룹니다. 서로 다른 키의 MD5 가 같으면 한 키로 취급되는 위험을 받아들이고 공간을 아낀 설계입니다(클래스 주석, 29–30행).
② 다시 복사하기(cleanSegments()). 로그의 처음부터(깨끗한 구간 포함) 청소 경계까지의 세그먼트를 크기에 맞춰 묶고(groupSegmentsBySize()), 묶음마다 새 세그먼트 파일(.cleaned)을 만들어 남길 레코드만 복사합니다. 레코드마다 남길지는 이 메서드가 정합니다.
        boolean pastLatestOffset = record.offset() > map.latestOffset();
        if (pastLatestOffset) {
            return true;
        }

        if (record.hasKey()) {
            ByteBuffer key = record.key();
            long foundOffset = map.get(key);
            /* First,the message must have the latest offset for the key
             * then there are two cases in which we can retain a message:
             *   1) The message has value
             *   2) The message doesn't have value but it can't be deleted now.
             */
            boolean latestOffsetForKey = record.offset() >= foundOffset;
            boolean legacyRecord = batch.magic() < RecordBatch.MAGIC_VALUE_V2;

            boolean shouldRetainDeletes;
            if (!legacyRecord) {
                shouldRetainDeletes = batch.deleteHorizonMs().isEmpty() || currentTime < batch.deleteHorizonMs().getAsLong();
            } else {
                shouldRetainDeletes = retainDeletesForLegacyRecords;
            }

            boolean isRetainedValue = record.hasValue() || shouldRetainDeletes;
            return latestOffsetForKey && isRetainedValue;
        } else {
            stats.invalidMessage();
            return false;
        }
storage/src/main/java/org/apache/kafka/storage/internals/log/Cleaner.java 577–605행
- 맵이 본 범위보다 뒤의 레코드는 그대로 둡니다(이번 청소의 범위 밖).
- 키가 있으면 그 키의 마지막 오프셋 이상인 레코드만 남깁니다. 옛 값이 사라지는 자리입니다.
- 값이
null인 레코드를 톰스톤(tombstone, 묘비)이라고 하고 "이 키를 지워라"는 뜻입니다. 톰스톤은 마지막 값이어도 곧바로 지우지 않고, 배치에 적힌 삭제 기한(deleteHorizonMs)이 지난 뒤의 청소에서 지웁니다. 기한은 처음 청소할 때delete.retention.ms(기본 1일,LogConfig.java134행)를 더해 배치에 적습니다(LogCleaner클래스 주석, 72–77행). 늦게 붙은 컨슈머도 "이 키는 지워졌다"를 볼 시간을 주는 것입니다. - 키가 없는 레코드는 컴팩션 토픽에서는 버려집니다.
복사가 끝나면 log.replaceSegments() 가 옛 세그먼트와 바꿔 끼웁니다(329행). 이름을 .cleaned → .swap 으로 바꿔 맵에 넣고, 옛 세그먼트는 4절의 .deleted 두 단계로 보내고, 마지막으로 .swap 을 떼어 정식 이름으로 만듭니다(LocalLog.java 1079–1109행). 중간에 죽어도 기동할 때 .swap 파일을 보고 바꿔 끼우기를 마저 끝냅니다(LogLoader.java 131–193행).
한 가지 4.4.0 과 다른 곳이 있습니다. 청소 결과를 새 세그먼트 하나에 담다가 상대 오프셋이 넘치는 경우(2절의 다섯 번째 조건, 이 커밋에서는 다시 압축한 결과가 int 크기를 넘는 경우도), 4.4.0 은 원래 세그먼트를 쪼개고 이번 청소를 중단한 뒤 다음에 다시 했습니다. 이 커밋의 cleanSegments() 는 넘치는 자리에서 청소한 세그먼트를 마감하고 새 .cleaned 를 이어 만들어, 바꿔 끼울 때 여러 개를 한꺼번에 넣습니다(289–312행).
여기까지 본 것을 세그먼트 하나의 일생으로 모으면 이렇습니다.
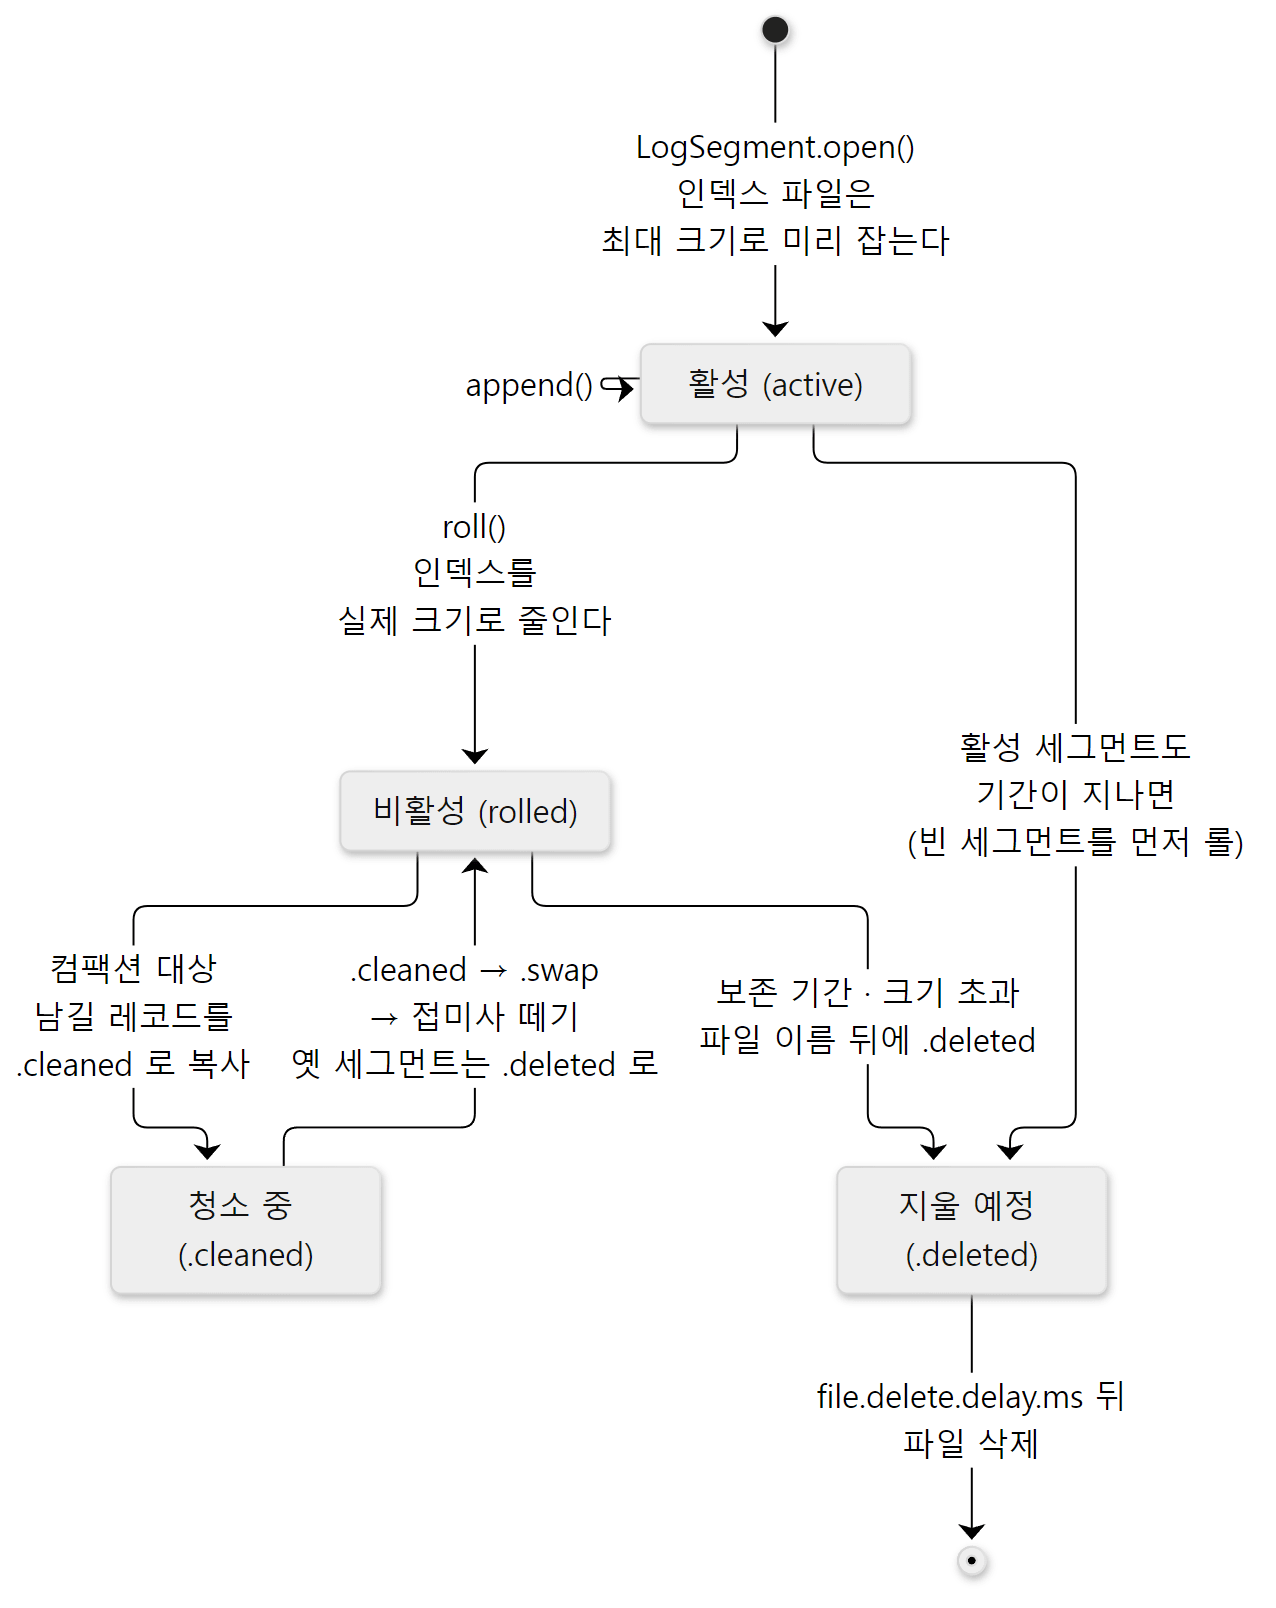 상태 이름 옆의 괄호는 그 상태일 때 파일 이름에 붙는 접미사입니다. 이 접미사들 덕분에 브로커가 어느 단계에서 죽어도 다음 기동 때
LogLoader 가 파일 이름만 보고 지우거나 마저 바꿔 끼울 수 있습니다(LogLoader.java 261–314행).
예제 3: 같은 키를 세 번 쓰고, 하나는 지우기
예제 폴더 ex/u07-compaction 입니다. 청소 스레드가 1초만 쉬게(log.cleaner.backoff.ms=1000) 브로커를 띄우고, cleanup.policy=compact, segment.ms=5000, min.cleanable.dirty.ratio=0.01 인 토픽에 콘솔 프로듀서로 키:값 열 줄을 보냈습니다. 마지막 줄은 null.marker=NULL 로 값을 null 로 바꾼 톰스톤입니다.
=== produce 3 keys x 3 updates, then a tombstone (null value) for user2
=== segment 0 before cleaning (offset key payload)
offset: 0 key: user1 payload: a1
offset: 1 key: user2 payload: b1
offset: 2 key: user3 payload: c1
offset: 3 key: user1 payload: a2
offset: 4 key: user2 payload: b2
offset: 5 key: user3 payload: c2
offset: 6 key: user1 payload: a3
offset: 7 key: user2 payload: b3
offset: 8 key: user3 payload: c3
offset: 9 key: user2
=== wait 6s (> segment.ms), then one more record so that the active segment rolls
00000000000000000000.log
00000000000000000010.log
=== wait for the cleaner thread
Cleaner 0: Beginning cleaning of log cmp-0
Cleaner 0: Building offset map for log cmp-0 for 1 segments in offset range [0, 10).
Cleaner 0: Cleaning log cmp-0 (cleaning prior to Sat Nov 07 04:13:49 UTC 2026, discarding tombstones prior to upper bound deletion horizon Thu Jan 01 00:00:00 UTC 1970)...
Cleaner 0: Swapping in cleaned segment(s) [LogSegment(baseOffset=0, size=110, ...)] for segment(s) [LogSegment(baseOffset=0, size=199, ...)] in log Log(dir=/tmp/kafka/1/data/cmp-0, ...)
=== segment 0 after cleaning (offset key payload)
00000000000000000000.log
00000000000000000010.log
offset: 6 key: user1 payload: a3
offset: 8 key: user3 payload: c3
offset: 9 key: user2
=== consume from the beginning
Offset:6	user1	a3
Offset:8	user3	c3
Offset:9	user2	null
Offset:10	user4	d1
=== cleaner checkpoint (topic partition firstDirtyOffset)
0
1
cmp 0 10
청소 로그(log-cleaner.log)의 마지막 줄은 길어서 ... 로 줄였고, 시각은 실행마다 다릅니다.
- 레코드 열 개(오프셋 0–9)는 콘솔 프로듀서가 한 배치로 보내 세그먼트 0 에 들어갔습니다. 6초를 기다린 뒤
user4:d1을 쓰자 시간 조건으로 롤해 세그먼트 10 이 생겼고, 세그먼트 0 이 활성에서 벗어나 청소 대상이 됐습니다. - 오프셋 맵은
[0, 10)범위, 곧 활성 세그먼트(10) 앞까지로 만들어졌습니다. 경계가 활성 세그먼트의 기준 오프셋인 것이 위firstUncleanableDirtyOffset그대로입니다. - 청소 뒤 남은 것은 6(user1=a3), 8(user3=c3), 9(user2 톰스톤) 입니다. 세그먼트는 199바이트에서 110바이트가 됐습니다(다시 돌린 실행에서는 청소 전이 208바이트였습니다 — 배치 헤더의 가변 길이 필드 때문입니다). 남은 레코드의 오프셋은 바뀌지 않았습니다. 오프셋 0–5, 7 이 빈 구멍으로 남고, 컨슈머는 6, 8, 9, 10 을 받습니다.
- user2 의 톰스톤은 첫 청소에서는 남았습니다(
delete.retention.ms가 지나야 지워짐). user2 의 옛 값 b1·b2·b3 는 톰스톤보다 오프셋이 작으므로 모두 사라졌습니다. cleaner-offset-checkpoint에cmp 0 10이 적혔습니다. 다음 청소는 오프셋 10 부터가 더러운 구간입니다. 파일의 첫 두 줄0,1은 체크포인트 파일 형식의 판 번호와 항목 수입니다(OffsetCheckpointFile의 클래스 주석,OffsetCheckpointFile.java41–50행). 6절의recovery-point-offset-checkpoint도 같은 형식입니다.
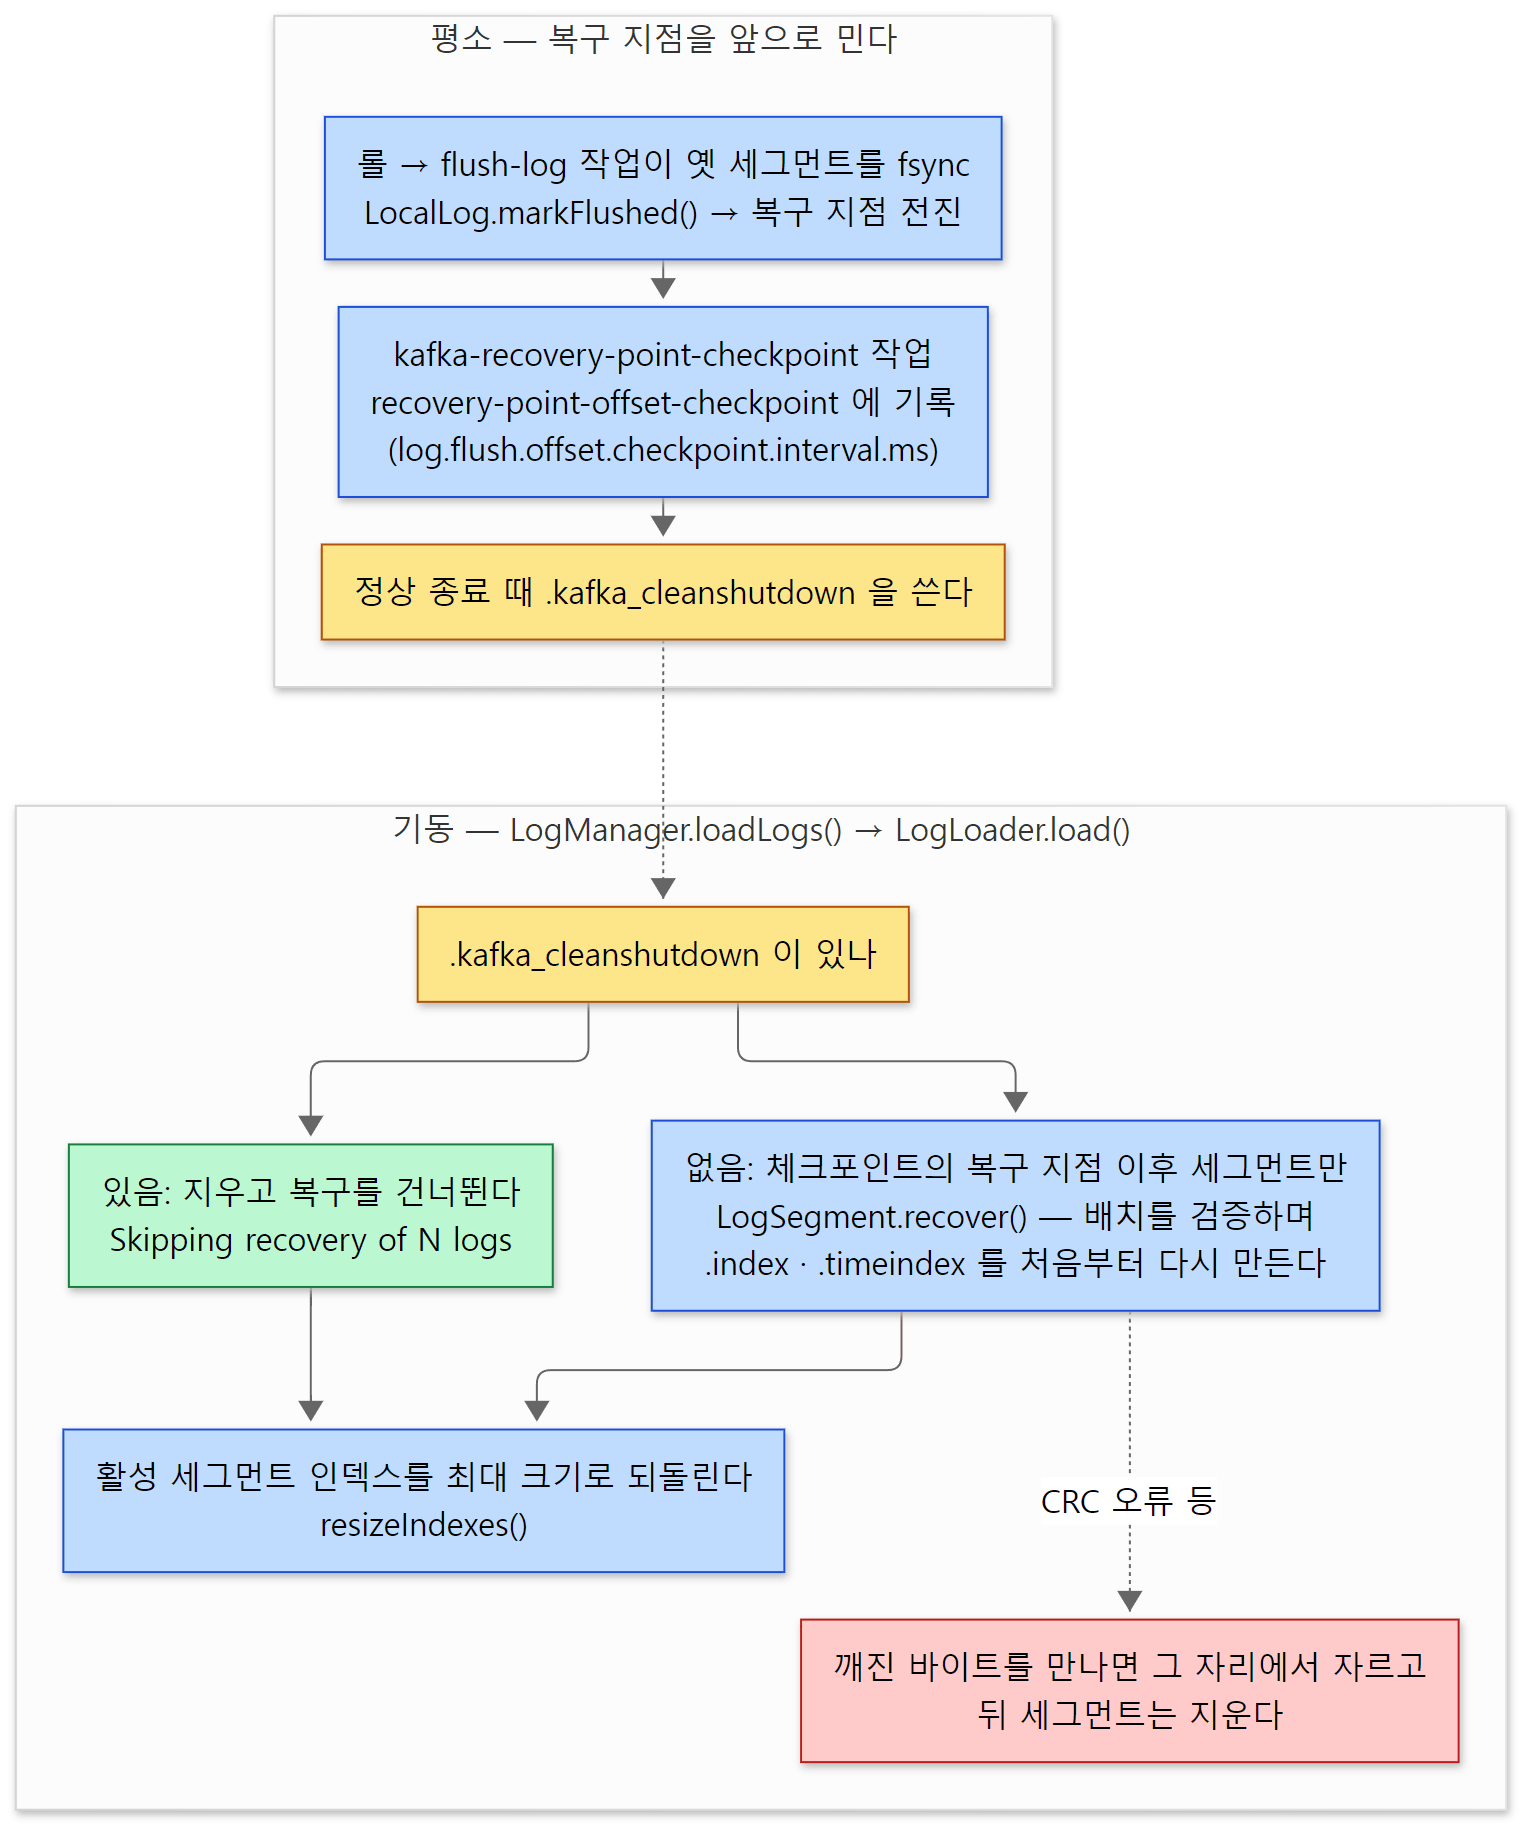 복구 지점이 앞에 있을수록 기동이 빠릅니다. 그래서 롤마다 옛 세그먼트를 fsync 해 복구 지점을 민다는 설계가 됩니다.
예제 4: kill -9 와 정상 종료를 비교하기
예제 폴더 ex/u07-recovery 입니다. 결과가 매번 같도록 복구 지점 체크포인트를 1초마다 쓰게(log.flush.offset.checkpoint.interval.ms=1000, 첫 실행도 1초 뒤 — log.initial.task.delay.ms=1000) 브로커를 띄우고, segment.bytes=1048576 토픽에 레코드 12,000개를 보낸 뒤 3초를 기다렸습니다. 그리고 브로커를 kill -9 로 죽였다가 다시 띄우고, 이번에는 SIGTERM 으로 정상 종료했다가 다시 띄웠습니다.
=== create topic rec (segment.bytes=1048576) and produce 12000 records
Created topic rec.
sent 12000 records to rec
00000000000000000000.log 00000000000000003830.log 00000000000000007660.log 00000000000000011490.log
=== kill -9 the broker
clean shutdown marker: 0
recovery-point-offset-checkpoint for rec-0: rec 0 11490
=== restart #1 (after kill -9)
Recovering 1 logs from /tmp/kafka/1/data since no clean shutdown file was found
Recovering unflushed segment 11490. 0 recovered for rec-0.
Completed load of Log(dir=/tmp/kafka/1/data/rec-0, topicId=kJRxw38gQUKneMDde2_5Ag, topic=rec, partition=0, highWatermark=0, lastStableOffset=0, logStartOffset=0, logEndOffset=12000) with 4 segments, local-log-start-offset 0 and log-end-offset 12000 in 167ms (1/1 completed in /tmp/kafka/1/data)
=== stop with SIGTERM (clean shutdown)
clean shutdown marker: .kafka_cleanshutdown
recovery-point-offset-checkpoint for rec-0: rec 0 12000
=== restart #2 (after clean shutdown)
Skipping recovery of 1 logs from /tmp/kafka/1/data since clean shutdown file was found
Completed load of Log(dir=/tmp/kafka/1/data/rec-0, topicId=kJRxw38gQUKneMDde2_5Ag, topic=rec, partition=0, highWatermark=0, lastStableOffset=0, logStartOffset=0, logEndOffset=12000) with 4 segments, local-log-start-offset 0 and log-end-offset 12000 in 143ms (1/1 completed in /tmp/kafka/1/data)
=== records are all there
rec:0:12000
토픽 id 와 시간(ms)은 실행마다 다릅니다. server.log 에서 해당 줄만 골랐습니다.
kill -9직전의 복구 지점은 11490, 곧 마지막으로 롤한 세그먼트의 기준 오프셋입니다. 세 번의 롤이 각각 옛 세그먼트를fsync하고 복구 지점을 3830 → 7660 → 11490 으로 밀었고, 활성 세그먼트(11490–11999)는 아직fsync하지 않았기 때문입니다.- 다시 띄우자
.kafka_cleanshutdown이 없어 복구가 돌았고,Recovering unflushed segment 11490한 줄만 나왔습니다. 세그먼트 0·3830·7660 은 다시 읽지 않았습니다. (0 recovered는numFlushed / numUnflushed의 정수 나눗셈이라 마지막 세그먼트 전까지 늘 0 으로 찍힙니다.) 컨테이너 안에서 프로세스만 죽였으므로 페이지 캐시는 살아 있어 잘린 바이트 없이 레코드 12,000개가 그대로 있습니다. 서버 전원이 나갔다면 복구 지점 뒤의 일부를 잃을 수 있고, 그 몫은 복제로 다른 브로커에서 되찾습니다(9편). - SIGTERM 정상 종료 뒤에는
.kafka_cleanshutdown이 생겼고 복구 지점이 LEO 와 같은 12000 이 됐습니다. 다음 기동은Skipping recovery로 세그먼트를 하나도 다시 읽지 않았습니다.
헷갈리기 쉬운 곳: 로드 직후의 highWatermark=0
두 번 모두 Completed load of Log(… highWatermark=0 …) 라고 찍힙니다. 정상 종료 뒤인데도 0 입니다. LogLoader 는 세그먼트와 LEO·복구 지점만 되살리고, 하이 워터마크는 그 뒤에 ReplicaManager 가 따로 저장해 둔 replication-offset-checkpoint 파일과 복제 상태로 정합니다. 그 길은 9편에서 봅니다. 이 줄의 highWatermark 를 보고 데이터가 사라졌다고 오해하지 않아도 됩니다. 마지막 kafka-get-offsets.sh 가 12000 을 돌려준 것이 그 증거입니다.
이 글에서 뺀 것
- 계층 저장소(오래된 세그먼트를 원격 저장소로):
UnifiedLog의remoteLogEnabled()·localLogStartOffset갈래,storage/의Remote*클래스,RemoteIndexCache.java— 연재 전체에서 뺍니다 - 트랜잭션 인덱스
.txnindex:TransactionIndex.java,LogSegment.updateTxnIndex()(348–357행) — 12편 - 프로듀서 상태 스냅숏
.snapshot:ProducerStateManager.takeSnapshot()— 12편 - 리더 에포크 캐시와 잘라내기(
truncateTo()):epoch/LeaderEpochFileCache.java,LogSegment.truncateTo()(561–592행) — 9편 - 읽기 경로의 나머지(
UnifiedLog.read()→LocalLog.read()→LogSegment.read(),FetchDataInfo, 제로 카피):LocalLog.java467–529행 — 8편 - 오프셋이 넘친 세그먼트 쪼개기:
LocalLog.splitOverflowedSegment()(LocalLog.java957행),LogLoader.retryOnOffsetOverflow() - 토픽·파티션 폴더 지우기(
-delete접미사,kafka-delete-logs작업):LogManager.deleteLogs()(1413행) - 디렉터리 여러 개(JBOD)와 파티션 옮기기(
-future폴더,ReplicaAlterLogDirsThread) — 연재 전체에서 뺍니다 log.preallocate(세그먼트 파일을 미리 잡기):LogConfig.initFileSize()(413–418행),FileRecords.openChannel()- 청소 속도 제한과 통계:
log.cleaner.io.max.bytes.per.second(Throttler),CleanerStats,kafka.log:type=LogCleaner지표
정리
| 개념 | 한 줄 요약 |
|---|---|
| 로그의 층 | UnifiedLog(lock·HW) → LocalLog(LEO·복구 지점) → LogSegments(기준 오프셋 → 세그먼트, 스킵 리스트) → LogSegment(파일 넷) |
| 파일 이름 | 기준 오프셋을 20자리로 0 채움. ls 순서 = 오프셋 순서, 재시작 때 파일 목록만으로 세그먼트를 세운다 |
| 롤 | append() 가 쓰기 전에 판정. 크기·시간(레코드 타임스탬프 기준)·오프셋 인덱스 가득·타임 인덱스 가득·상대 오프셋 넘침 |
| 롤 때의 fsync | lock 밖, kafka-scheduler 의 flush-log 작업. 끝나면 복구 지점이 새 세그먼트 기준 오프셋으로 |
| 오프셋 인덱스 | index.interval.bytes(4096)마다 한 항목 (배치 마지막 오프셋 → 배치 시작 위치). 8바이트, mmap, 끝 8KB 먼저 이진 탐색 |
| 오프셋 → 위치 | floorSegment() → OffsetIndex.lookup() → 배치 헤더만 읽으며 훑기 |
| 인덱스 파일 크기 | 활성일 때는 segment.index.bytes(10MiB)로 미리 잡고, 롤·종료 때 실제 크기로 |
| 보존 | kafka-log-retention(5분마다)이 시작 오프셋·retention.bytes·retention.ms 순서로, 앞에서부터, HW 아래만. 기준은 세그먼트의 가장 큰 타임스탬프 |
| 지우기 | 맵에서 빼고 .deleted 로 이름 바꾸기 → file.delete.delay.ms(60초) 뒤 삭제. 활성 세그먼트도 지울 수 있고 그때는 먼저 롤 |
| 컴팩션 | kafka-log-cleaner-thread-N 이 가장 더러운 로그를 골라, 키의 MD5 → 마지막 오프셋 맵을 만들고 남길 것만 .cleaned 로 복사해 바꿔 끼운다. 활성 세그먼트는 청소하지 않는다 |
| 톰스톤 | 값이 null 인 레코드. 첫 청소 뒤 delete.retention.ms(1일)가 지나야 지워진다 |
| 복구 | .kafka_cleanshutdown 이 없으면 recovery-point-offset-checkpoint 뒤의 세그먼트만 recover() 로 검증·인덱스 재생성, 깨진 곳에서 자른다 |
다음에 볼 것
이 글에서는 레코드가 파일에 놓이는 모양과, 오프셋 하나를 파일 위치로 바꾸는 translateOffset() 까지 봤습니다. 다음 글은 그 위치를 받아 실제로 읽는 쪽입니다. 컨슈머와 팔로워가 보내는 Fetch 요청이 ReplicaManager.fetchMessages() 를 지나 LogSegment.read() 에 닿고, 읽을 것이 모자라면 fetch.max.wait.ms 만큼 퍼거토리에서 기다리고, 찾은 파일 조각이 FileChannel.transferTo() 로 페이지 캐시에서 소켓으로 바로 나가는 제로 카피까지입니다. 4절에서 "지우기 전에 잠깐 기다린다"고 한 이유가 거기서 한 번 더 보입니다. 8편: 읽기 경로 — Fetch 요청, 롱 폴링, 그리고 제로 카피에서 이어집니다.
- 2편: 전체 지도 — 클라이언트, 브로커, 컨트롤러, 그리고 파티션
- 6편: 브로커가 레코드를 받아 쓰기까지 — 레코드 배치 형식과 Produce 요청 처리
- 9편: 복제 — ISR, 하이 워터마크, 그리고 acks=all의 기다림 — 하이 워터마크, 리더 에포크와 로그 잘라내기
- 12편: 멱등성과 트랜잭션 — 정확히 한 번은 어떻게 만들어지나, 그리고 연재를 마치며 —
.snapshot과.txnindex